Interoperabilidade do Data 360
As empresas muitas vezes armazenam dados no Salesforce e outros data lakes externos (por exemplo, Snowflake, Google BigQuery, Databricks, Redshift ou armazenamento de objetos como o Amazon S3). Siloar dados entre vários sistemas cria um desafio para empresas que querem aproveitar todo o valor de seus dados para impulsionar experiências conduzidas por IA. O Salesforce Data 360 é a camada de inteligência básica que cada Agente de IA do Agentforce usa para acessar o contexto correto no momento certo.
Os arquitetos que trabalham para unir dados entre vários data lakes enfrentam decisões arquitetônicas importantes sobre como integrar melhor esses dados. O Data 360 oferece várias opções para integração de dados, cada uma oferecendo vários prós e contras.
Este guia fornece uma estrutura para avaliar qual padrão atende melhor aos seus requisitos de latência, custo, escalabilidade, governança e complexidade ao integrar dados, ajudando você a escolher quando usar ingestão de dados, federação de dados de Cópia zero ou uma abordagem híbrida. O guia também o ajudará a selecionar entre diferentes métodos de ingestão de dados e federação de dados, cada um dos quais preenche uma necessidade diferente.
Integrar casas de data lake externas ao Data 360 exige que você considere cuidadosamente as compensações entre a atualização dos dados, a governança e a eficiência do pipeline. Por exemplo, usar consultas ativas de federação de dados do Zero Copy maximiza a atualidade dos dados, mas pode reduzir a eficiência do pipeline à medida que mais dados são movidos pela rede. Para a maioria das implementações do mundo real, combinar ingestão e federação em um ecossistema de casa de lago de várias nuvens é o caminho ideal. Essa abordagem híbrida garante uma arquitetura escalonável, governada e interoperável que dá suporte a cargas de trabalho operacionais de baixa latência (por exemplo, personalização em tempo real e detecção de fraudes) e cargas de trabalho analíticas (por exemplo, relatórios regulatórios e análise de tendências históricas). Este guia ajuda a determinar como navegar por essas compensações usando uma estratégia adequada.
- A Ingestão de dados copia dados para o Salesforce Data 360 e cria Modelos de dados canônicos governados. Isso é ideal para quando você precisa:
- Construa um Customer 360 abrangente. Isso permite unificar e transformar origens diferentes em um único perfil confiável.
- Cumpra a rigorosa conformidade regulatória. Isso permite que você crie uma cópia auditável centralizada para que o acesso aos dados e a linhagem possam ser controlados de perto.
- A Federação de cópia zero consulta fontes externas em tempo real sem duplicação, permitindo personalização em tempo real, painéis ativos e integração rápida de origem. Essa abordagem oferece duas opções principais, mas há compensações que precisam ser balanceadas:
- Consulta ao vivo: Use isso para análise interativa e painéis de dados em tempo real que estão em plataformas de dados externas (por exemplo, Snowflake, BigQuery, Redshift ou Databricks). Isso ajuda a evitar duplicação de dados lenta e dispendiosa enviando o processamento de consulta para o sistema de origem e retornando apenas os resultados necessários. Essa abordagem é otimizada para consultas raras ou ad-hoc em que a frescura é crítica. É adequado para cargas de trabalho de baixa consulta por segundo (QPS) (custos de consulta podem aumentar significativamente em QPS alto).
- Cache (consulta acelerada): Use isso para consultas de dados frequentes que não mudam com frequência. Consultas aceleradas mantêm um cache local que é atualizado a intervalos configuráveis (15 minutos a 7 dias), o que reduz os encontros de origem repetidos. Essa abordagem equilibra o desempenho do painel e o custo, a segmentação e as cargas de trabalho de BI em que resultados levemente obsoletos são aceitáveis. Isso não é adequado para tomada de decisão em menos de um segundo.
- Federação de arquivos: Use isso para processamento em lote em grande escala e treinamento de modelo de IA para dados no data lake da sua nuvem (por exemplo, S3 ou ADLS). Essa abordagem evita a ingestão lenta e dispendiosa consultando diretamente arquivos em formatos de tabela abertos, o que desbloqueia conjuntos de dados ETL e cargas de trabalho de ciência de dados em massa.
- Os Modelos híbridos combinam ingestão para Perfis unificados com federação para frescura, que suporta engajamento do Omni-Channel, ações conduzidas pelo Agentforce e treinamento de IA/ML.
- Usar uma arquitetura híbrida. Misturar ingestão de dados e federação costuma ser necessário.
- Use a ingestão de dados em dados críticos para modelos de dados canônicos e governança principal.
- Use Cópia zero para todas as outras federações de dados para manter a atualidade e minimizar a sobrecarga operacional de criar e manter pipelines de ingestão de dados.
- A frequência de ingestão de dados importa. Escolha a frequência com base no valor dos negócios, nas necessidades de latência e na complexidade operacional.
- Use o recurso em tempo real para fluxos de trabalho urgentes (por exemplo, personalização, painéis ativos e ações do Agentforce).
- Use quase em tempo real para processos moderadamente urgentes (por exemplo, campanhas e relatórios operacionais).
- Use lote para conjuntos de dados históricos ou de baixa velocidade.
- Combine padrões de federação com latência e desempenho. Escolha a opção que melhor corresponde aos seus padrões de acesso e requisitos de frescura, desempenho e custo.
- Use a consulta ativa para painéis operacionais e personalização em tempo real quando a baixa latência for crítica.
- Use o cache (consulta acelerada) quando as consultas forem frequentes e os resultados ligeiramente obsoletos forem aceitáveis, o que ajuda a equilibrar o desempenho e o custo.
- Use a Federação de arquivos para análises em grande escala e de alto rendimento ou cargas de trabalho em lote, que são ideais para conjuntos de dados históricos ou menos sensíveis ao tempo.
- Alinhar a governança aos requisitos de residência de dados.
- Use a ingestão quando a governança centralizada for crítica.
- Use a federação quando a governança descentralizada for aceitável, ao mesmo tempo que também imponha uma governança rígida na fonte externa.
- Use Cópia zero em relação a políticas em nível de origem (por exemplo, segurança em nível de linha (RLS) e mascaramento de dados).
- Priorize a ingestão para fluxos de trabalho de alto valor. Aplique a ingestão de modo seletivo a processos críticos (por exemplo, resolução de identidade, relatórios regulatórios e ativação operacional).
- Decisões de custo e complexidade. A ingestão em tempo real pode ser cara e complexa. É por isso que é importante que os arquitetos ponderem o custo de integração, armazenamento e transformação de dados com o custo de consultá-los diretamente por meio da Cópia zero.
Escolher o padrão de integração correto (Ingestão de dados, Cópia zero ou uma abordagem híbrida) afeta diretamente a latência, a governança, a eficiência operacional e o custo em várias plataformas de nuvem. Essa decisão determina como percepções em tempo real, ativação conduzida por IA e engajamento personalizado são entregues de forma confiável e em escala.
Esta tabela compara os padrões de ingestão de dados e cópia zero no Salesforce Data 360, com foco em recursos, compensações e benefícios, bem como casos de uso e resultados corporativos. Use isso como referência para projetar plataformas de dados de várias nuvens híbridas que equilibram desempenho, custo e conformidade.
| Tipo de padrão | Modo/ferramenta | Benefícios | Considerações | Resultados |
|---|---|---|---|---|
| Ingestão de dados |
Em tempo real:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Lote:
|
|
|
Agentforce:
|
|
| Zero Copy |
Consulta ao vivo:
|
|
|
Agentforce:
|
Consulta acelerada (cache):
|
|
|
Agentforce:
|
|
Federação de arquivos:
|
|
|
Agentforce:
|
Há três padrões de integração principais para o Data 360: ingestão de dados, federação de dados de cópia zero e abordagem híbrida.
Com a Ingestão de dados, os dados são copiados fisicamente para o Data 360 e totalmente controlados, ao contrário da Cópia zero, em que os dados permanecem na fonte. Em outras palavras, a computação para transformações ocorre no Data 360, que fornece governança e auditoria centralizadas.
Use a Ingestão de dados para armazenar conjuntos de dados canônicos e controlados no Salesforce Data 360 para conformidade e controle operacional. Use a ingestão quando controle total, auditoria e rastreabilidade forem necessários. A Ingestão de dados é ideal para fluxos de trabalho regulados ou de alto valor em que computação centralizada e governança são essenciais.
A ingestão é adequada para criar uma base confiável para resolução de identidade, relatórios regulatórios e fluxos de trabalho conduzidos por IA críticos para a missão e engajamento do cliente.

Os métodos de ingestão de dados podem variar, dependendo do conector que você usa para ingerir seus dados. Alguns conectores oferecem uma variedade de métodos de ingestão, enquanto outros operam apenas no modo de lote ou streaming. Para obter uma lista completa de conectores e métodos disponíveis do Data 360, consulte Data 360: Integrações e conectores.
- Em tempo real:
- Fornece ingestão de subsegundo usando a captura de dados de alteração (CDC)
- Adequado para fluxos de trabalho urgentes (por exemplo, detecção de fraudes, personalização e painéis operacionais)
- Possui transformações e agregações por push no Data 360, o que ajuda a reduzir as I/O a jusante e otimizar o uso de computação
- Suporta o uso de CDC incremental para minimizar o desvio de dados
- Streaming:
- Fornece ingestão a cada 1 a 3 minutos em pequenos incrementos
- Balança a frescura e o custo
- Adequado para orquestração de campanha, engajamento quase ativo e relatórios operacionais
- Suporta o uso de microlotes para controlar picos de entrada/saída
- Agrega dados na origem (se possível) para reduzir volumes de transferência e otimizar o armazenamento
- Lote (cargas agendadas):
- Fornece ingestão periódica de conjuntos de dados grandes (por exemplo, por hora, diariamente e semanalmente)
- Fornece custo-benefício e confiabilidade para conjuntos de dados históricos, relatórios regulatórios e casos de uso de conformidade
- Garante que a localidade de computação esteja na mesma região que o armazenamento de origem para aprimorar o desempenho e otimizar os custos
- Casos de uso de ingestão de dados:
- Gerar perfis unificados do Customer 360. Crie uma única fonte da verdade para identidades e atributos do cliente.
- Manter conjuntos de dados de conformidade regulatória. Impor governança, lineagem e capacidade de auditoria para dados confidenciais.
- Centralize a orquestração da campanha. Garanta que marketing, vendas e serviço operem com base em conjuntos de dados consistentes e confiáveis.
- Práticas de design:
- Acomode a ingestão em lote para necessidades históricas ou com baixa tolerância a latência (por exemplo, relatórios de arquivo ou instantâneos periódicos).
- Use as APIs de streaming ou CDC para manter a atualidade dos fluxos de trabalho operacionais e de personalização para garantir atualizações quase em tempo real.
- Controle o armazenamento e o crescimento de computação aplicando cargas incrementais para otimizar o custo e a eficiência (em vez de recarregar conjuntos de dados inteiros).
- Alinhe os pipelines de ingestão com localidade de computação e processamento incremental para reduzir as I/O de rede.
- Aplique transformações dentro do Data 360 para evitar mover dados brutos desnecessariamente.
- Considerações de custo:
- A Ingestão em tempo real tem os custos de computação e pipeline mais altos, o que pode ser justificado para fluxos de trabalho de alto valor e sensíveis ao tempo (por exemplo, personalização, painéis operacionais ou ações conduzidas pelo Agentforce).
- A Ingestão de streaming tem custos moderados de computação e armazenamento, o que pode ser adequado para atualizações frequentes que podem tolerar pequenos atrasos (por exemplo, orquestração de campanha ou relatórios operacionais).
- A Ingestão em lote tem custos de computação mais baixos e armazenamento previsível, o que é adequado para conjuntos de dados históricos ou atualizações de baixa frequência. A ingestão de dados em lote de organizações do Salesforce usando determinados conectores é gratuita.
- Modo de atualização Permite que você selecione o modo Atualização incremental, o que reduz os custos totais de ingestão e computação. Na Salesforce, recomendamos usar a atualização incremental sempre que possível para otimizar a eficiência em todos os tipos de ingestão.
- O custo também é afetado pelo volume de I/O da fonte para o Data 360. Otimizar tamanhos de lote, partições e alinhamento regional reduz os custos de transferência e melhora o desempenho.
- Cenários da indústria:
- Finanças: Os conjuntos de dados de ingestão são necessários para conhecer seu cliente (KYC), Anti Money Laundering (AML) e detecção de fraudes quando a capacidade de auditoria e a conformidade não são negociáveis.
- Saúde: Use a ingestão para resolução de identidade do paciente e registros em conformidade com HIPAA, o que habilita visualizações seguras e unificadas.
- Retail: Consolide dados de ponto de venda (POS), comércio eletrônico e programa de fidelidade em perfis unificados para segmentação e personalização.
- Telecom: Dê suporte à prevenção de rotatividade e à análise de uso com dados canônicos de assinante regulamentados.
| Recurso | Ingestão em tempo real | Ingestão de streaming | Ingestão em lote |
|---|---|---|---|
| Latency e frescura | Possui ingestão de latência subsegunda por meio de APIs de ingestão com suporte para captura de dados de alteração (CDC). Fornece pipelines de streaming contínuos. Adequado para casos de uso operacionais de baixa latência. | Apresenta ingestão de microlote a cada 1 a 3 minutos por meio de conectores nativos. Dá suporte a atualizações incrementais. É esperada uma pequena latência. | A latência de dados é esperada. Permite carregamentos de grande volume agendados. Apresenta ingestão periódica (horária, diária e semanal). Não é adequado para operações que exigem tempo. |
| Casos de uso primários | Ideal para casos de uso operacionais e de personalização de baixa latência. Use para fluxos de trabalho urgentes. Dá suporte a fluxos de trabalho conduzidos por evento. Use para alertas de fraude em tempo real e alertas operacionais. | Adequado para processos moderadamente urgentes. Use para orquestração de campanha, engajamento quase ativo e relatórios operacionais. Use para acionadores de campanha oportunos. | Eficiente para conjuntos de dados massivos. Confiável para análise histórica. Use para agregação de histórico ou fluxos de trabalho de relatórios regulados. Adequado para conjuntos de dados históricos ou de baixa velocidade. |
| Complexidade arquitetônica e I/O | Inclui um alto custo e uma arquitetura complexa. Requer sistemas de origem de baixa latência. Intensivo de I/O. Origens de alto volume podem causar pipelines saturados. | Recebe uma arquitetura mais simples do que em tempo real. O I/O é moderado. Adequado para padrões de atualização repetidos e previsíveis. O tamanho do lote afeta a memória e os cálculos. | Fácil de implementar. Intensivo de I/O durante janelas de carregamento. A taxa de transferência de rede pode se tornar um gargalos para lotes grandes. |
| Considerações de custo | Inclui os custos de computação e pipeline mais altos. Justificável apenas para fluxos de trabalho de alto valor e urgentes. | Inclui moderar os custos de computação e armazenamento. Fornece uma abordagem de custo equilibrado versus frescura. Adequado para atualizações frequentes que podem tolerar pequenos atrasos. | Recorre a menores custos de computação e armazenamento previsível. Recomendado para conjuntos de dados históricos ou atualizações de baixa frequência. A ingestão por meio de pipelines internos do Salesforce é gratuita. |
| Práticas de design | Use a CDC incremental para minimizar o desvio de dados. Filtre e use campos seletivos para reduzir a sobrecarga. | Use microlotes para controlar picos de I/O. Considere a agregação com janelas para reduzir a carga de processamento. | Use para relatórios de arquivamento ou instantâneos periódicos. Certifique-se de que a localidade de computação esteja na mesma região que o armazenamento de origem para otimização de custo. |
Use a Cópia zero para consulta em tempo real de sistemas externos sem duplicação de dados para permitir a agilidade, a frescura e o acesso escalonável a conjuntos de dados grandes ou temporários. É adequado para painéis ativos, análise exploratória, treinamento de modelo de IA/ML e engajamento do cliente em tempo real diretamente no Salesforce Data 360.
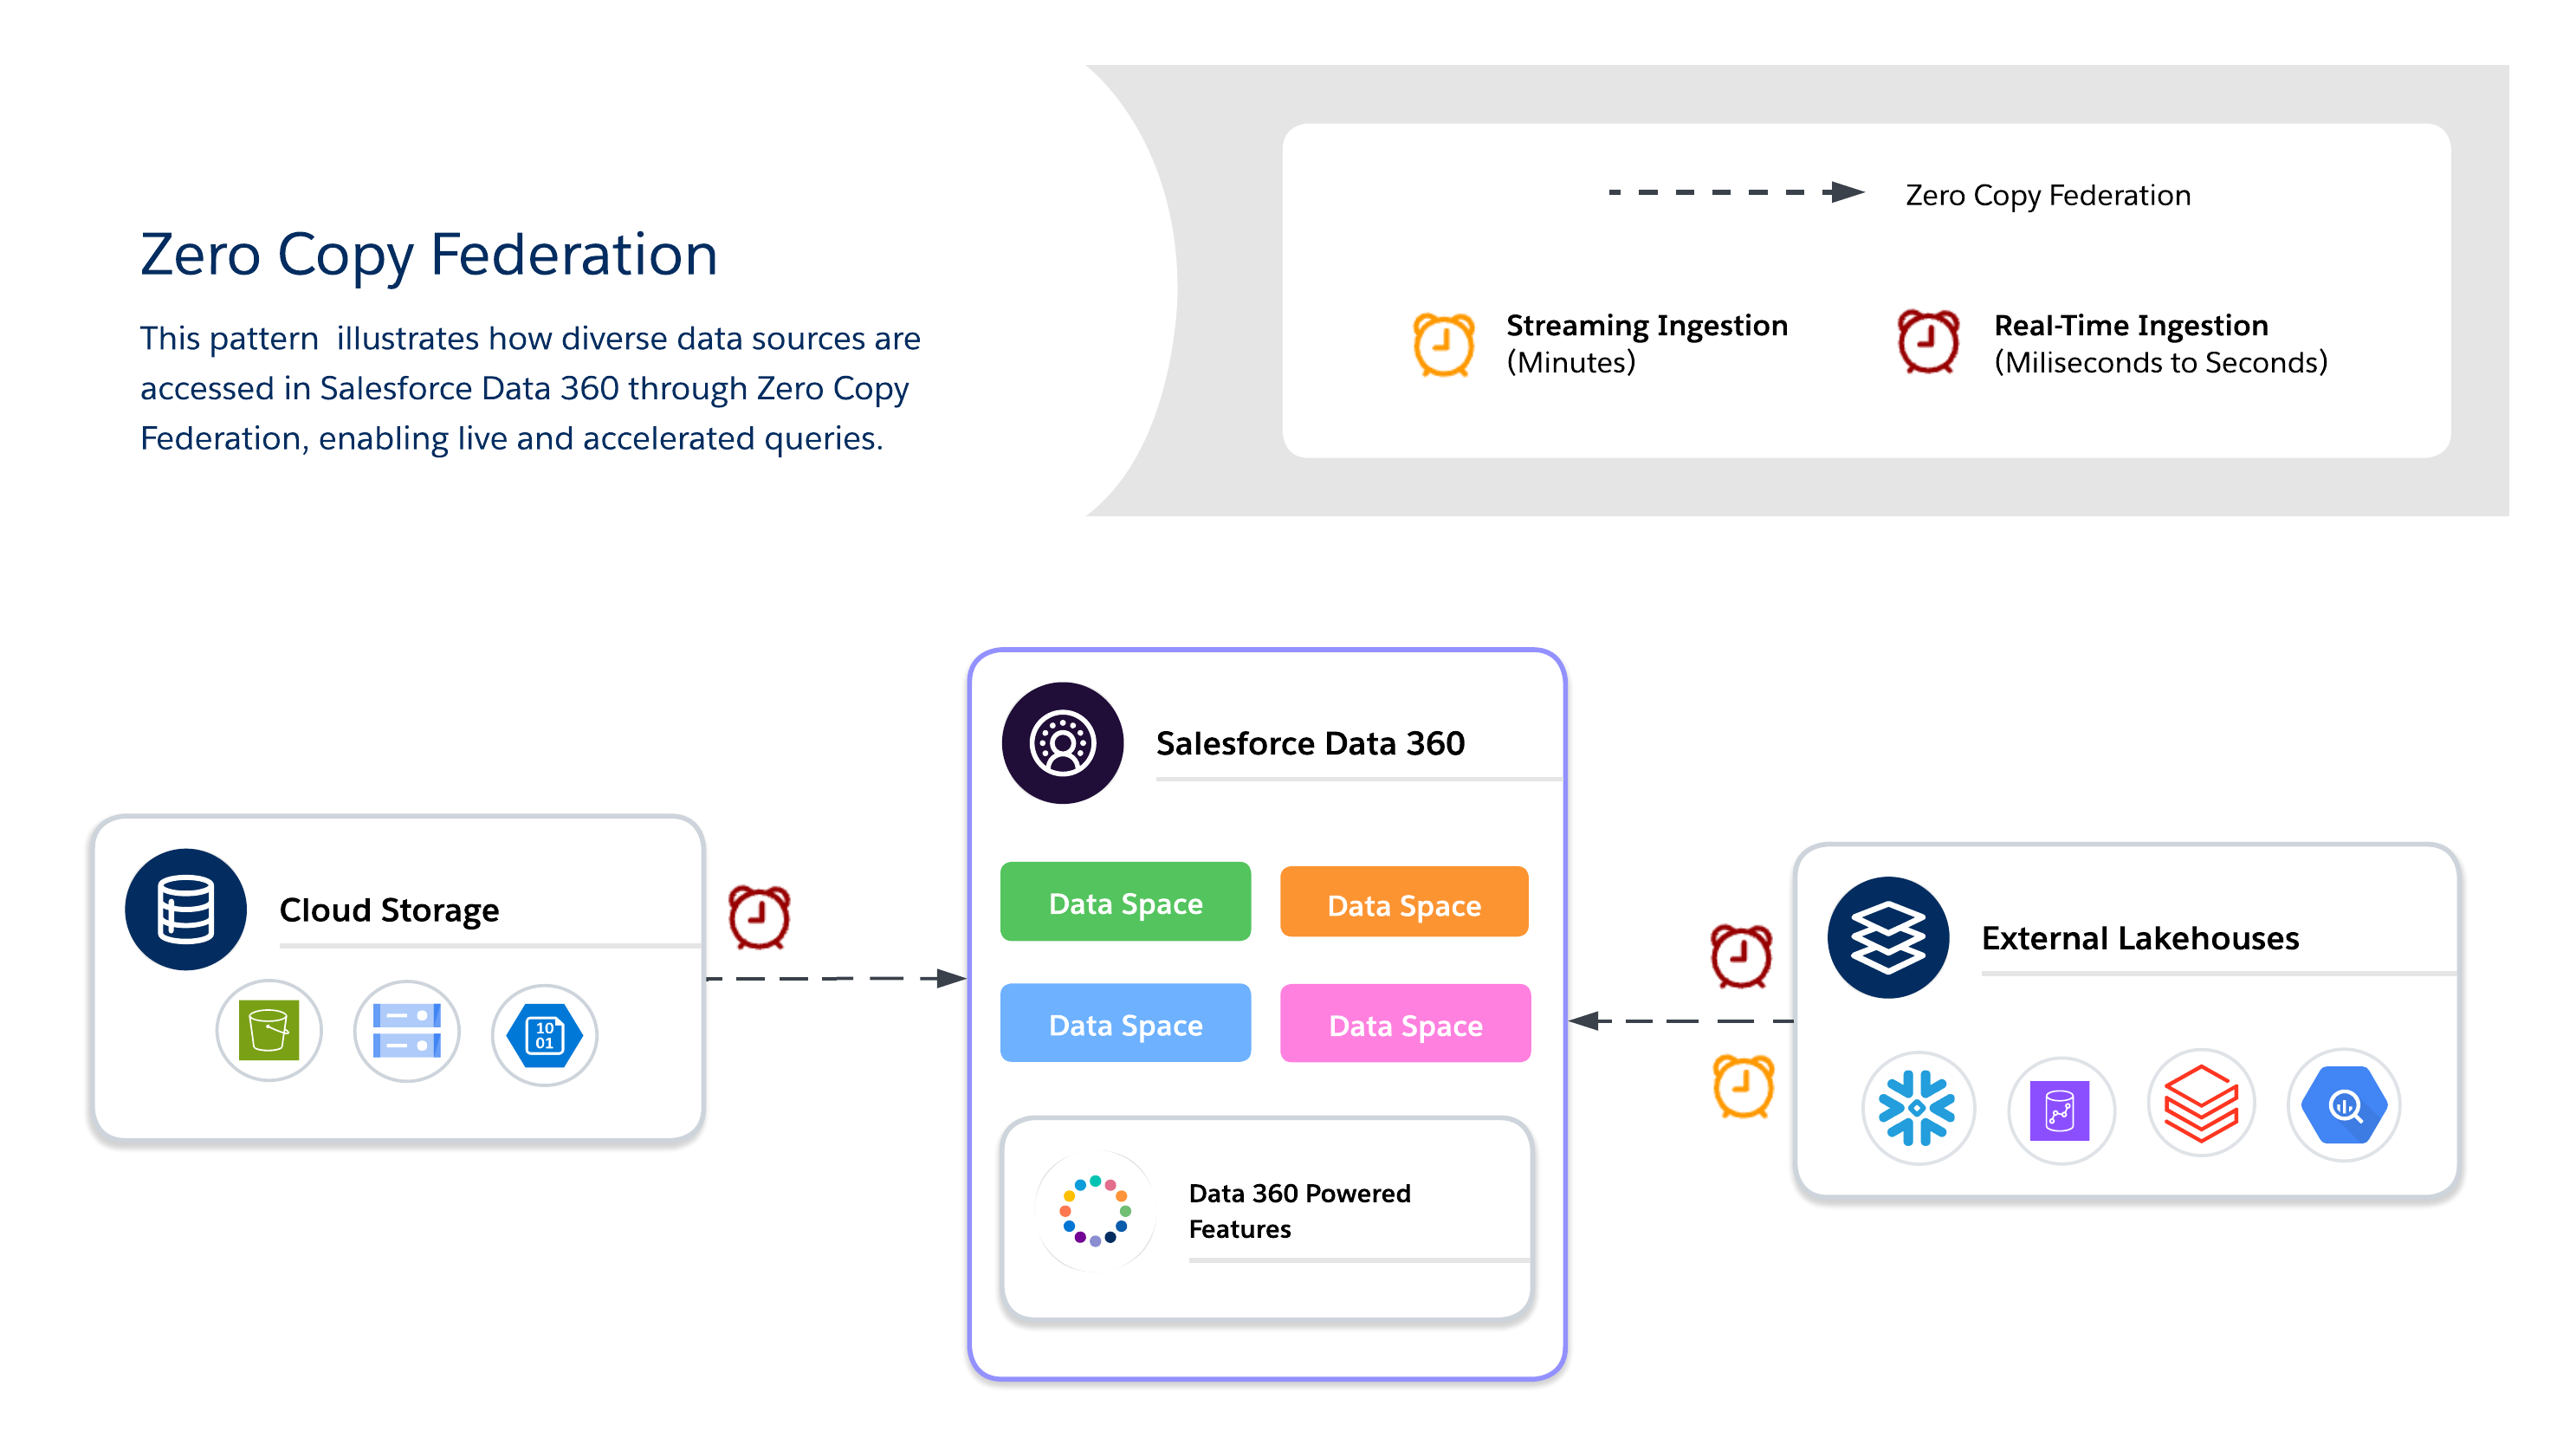
Ao usar o Zero Copy, os arquitetos devem escolher entre três métodos de federação de dados disponíveis, cada um dos quais oferece seus próprios prós e contras entre frescura, desempenho e custo.
- Consulta ativa
- Executa consultas diretamente em sistemas externos (por exemplo, Snowflake, Google BigQuery, Redshift, Databricks, etc.) sem duplicação de dados.
- Minimize a movimentação de dados pela rede e reduza as entradas/saídas no cálculo do Salesforce Data 360, o que é ideal quando os predicados e agregações podem ser reduzidos.
- Adequado para percepções em tempo real e painéis operacionais de baixa latência.
- Dependendo do desempenho do sistema externo.
- Cache (consulta acelerada)
- Armazena temporariamente cópias em cache de dados federados no Salesforce Data 360.
- Reduz os custos de consulta repetida e a latência para conjuntos de dados acessados com frequência com duração configurável (minutos a dias).
- Os dados não são copiados permanentemente nem totalmente controlados, assim, a atualidade é gerenciada por meio de atualizações agendadas da origem.
- A atualização incremental oferece suporte apenas a upserts. Registros excluídos não são removidos do cache.
- Realize uma atualização completa periodicamente para garantir que o cache permaneça sincronizado com a origem.
- Nota: O conector Snowflake suporta a função Descarregar, que aumenta as taxas de aceleração usando um balde de preparação iniciado pelo Snowflake. Isso é ativado por padrão, mas pode ser desativado editando a conexão.
- Federação de arquivos
- Fornece acesso direto e somente leitura a conjuntos de dados em grande escala em repositórios de objetos (por exemplo, S3 e GCS com Iceberg).
- Adequado para cargas de trabalho de IA/ML, análise histórica e relatórios em escala de petabytes sem mover dados.
- O desempenho da consulta depende muito do formato do objeto, do particionamento e das I/O de rede. As verificações grandes podem gerar I/O substanciais se não forem otimizadas.
- Casos de uso
- A personalização em tempo real e os fluxos de trabalho adaptáveis oferecem ofertas dinâmicas, recomendações e as melhores ações conforme o comportamento do cliente muda.
- Painéis ativos e análise operacional alimentam painéis e KPIs críticos para os negócios diretamente de armazéns externos.
- O treinamento de modelo de IA/ML com grandes conjuntos de dados externos aproveita dados em escala de petabytes de data lakes e armazéns sem movê-los via federação de arquivos.
- Cenários da indústria
- Retail/Media: Habilite recomendações personalizadas e engajamento do cliente em tempo real federando dados de interação de conteúdo ou fluxo de cliques.
- Finanças: Execute a detecção de fraudes e a pontuação de risco quase em tempo real consultando armazéns externos sem duplicar dados confidenciais.
- Tech/Enterprise: Dê suporte a relatórios entre nuvens, painéis de serviço de TI e análise operacional quando os conjuntos de dados residem em vários sistemas.
- Práticas de design
- Consulta ativa
- Use para consultas de alta QPS e baixa latência quando a frescura for crítica.
- Envie por push predicados e agregações para o sistema externo para reduzir o desvio de dados na rede.
- Evite consultas que verificam volumes de dados enormes desnecessariamente.
- Considere cortar a partição e filtros em vez disso.
- Federação de arquivos
- Acesse conjuntos de dados em escala de petabytes em lojas de objetos sem ingestão.
- Minimize os custos de latência e saída mantendo o armazenamento de objetos na mesma região de nuvem que o cálculo do Salesforce.
- Use formatos particionados em coluna (Parquet/ORC) e filtros de menu suspenso para reduzir a transferência de I/O e rede.
- Aproveite a consulta e o menu suspenso de predicado para filtrar e agregar dados na origem, o que reduz a movimentação dos dados.
- Evite o acesso a dados entre regiões, a menos que seja absolutamente necessário, pois isso aumenta a entrada/saída, a latência e os custos.
- Cache (consulta acelerada)
- Armazene em cache conjuntos de dados acessados com frequência para equilibrar custo e desempenho.
- Configure intervalos de atualização para equilibrar a frescura versus o custo da consulta.
- Conformidade: Imponha a governança na fonte aproveitando a segurança em nível de linha (RLS) e mascarando políticas diretamente dentro de sistemas federados.
- Aqui estão algumas práticas recomendadas para RLS uniforme e mascaramento entre plataformas:
- Usar um ID corporativo centralizado. Mapeie usuários e entidades no Salesforce Data 360 para um identificador corporativo único e centralizado que corresponde a identidades em sistemas externos.
- Align Políticas de segurança. Garanta que o RLS e as políticas de mascaramento em sistemas federados sejam aplicados com base na identidade mapeada. Isso preserva a conformidade ao consultar dados externos.
- Padronizar esquemas de identidade. Mantenha atributos de identidade consistentes (email, ID do usuário, ID do cliente etc.) em todas as fontes de dados para evitar incompatibilidades e violações de acesso.
- Aqui estão algumas práticas recomendadas para RLS uniforme e mascaramento entre plataformas:
- Consulta ativa
- Considerações de custo
- Consulta ao vivo: No modelo de pagamento por consulta, os custos se acumulam no cálculo externo da residência do lake, o que pode causar picos com QPS alto. Isso é adequado para casos de uso críticos de frescura em que o valor é maior que a variabilidade de custo.
- Consulta acelerada (cache): Esse método reduz o custo de consulta (em comparação com a Questão ativa) reduzindo os encontros no sistema de origem; no entanto, aumenta os custos de ingestão de dados em lote para preenchimento e atualização do cache. Isso é adequado para conjuntos de dados acessados com frequência.
- Federação de arquivos: Essa é a opção de armazenamento mais econômica como dados na Loja de objetos; no entanto, os custos de consulta dependem do tamanho do arquivo, do particionamento e da redução. Isso é adequado para dados históricos ou em massa em escala de petabytes.
| Ponto de decisão | Consulta ativa | Armazenamento em cache (consulta acelerada) | Federação de arquivos |
|---|---|---|---|
| Local da fonte de dados | Casas de data lake externas (por exemplo, Snowflake, Google BigQuery, Redshift e Databricks) | Casas de data lake externas (por exemplo, Snowflake, Google BigQuery, Redshift e Databricks) | Armazéns de objetos ou data lakes de nuvem (por exemplo, S3, ADLS e GCS), que muitas vezes usam formatos de tabela aberta, como Iceberg. |
| Objetivo/Caso de uso | Adequado para análise interativa e painéis em tempo real. Adequado para personalização em tempo real e fluxos de trabalho dinâmicos. | Adequado para quando as consultas são frequentes, mas os resultados levemente obsoletos são aceitáveis. Adequado para painéis de BI e segmentação. | Adequado para processamento em lote em grande escala e treinamento de modelo de IA/ML. Adequado para análise histórica e relatórios em escala de petabytes. |
| Fresqueza/Latency | Fornece máxima atualidade Executa consultas diretamente em tempo real. Dá suporte à tomada de decisão em menos de um segundo quando o sistema de origem é otimizado para consultas de baixa latência com um menu suspenso de predicado eficaz. | Use quando resultados levemente obsoletos forem aceitáveis. A atualidade depende do intervalo de cache, que pode ser configurado de 15 minutos a 7 dias. | Adequado para trabalhos pesados em lote com alta taxa de transferência. Não é adequado para painel em tempo real. |
| Padrão de acesso | Adequado para consultas raras ou ad-hoc em que a atualidade é crítica e o volume de consultas é baixo. Os custos aumentam significativamente em QPS alto, portanto, é importante avaliar o armazenamento em cache (consulta acelerada) quando a frequência de consulta é alta. | Adequado para cenários de leitura de alta frequência. Melhora o desempenho para padrões de acesso frequente. | Fornece acesso somente read. Adequado para conjuntos de dados em escala de petabytes sem ingestão. |
| Drivers de desempenho | Altamente dependente do desempenho do sistema de origem externo. Adequado para quando predicados e agregações podem ser enviados para baixo para a origem. | Reduz a latência em comparação a consultas ativas repetidas. O desempenho depende do gerenciamento de cache e dos intervalos. | O desempenho depende muito do formato do objeto, do particionamento e da taxa de transferência do sistema externo. Use formatos particionados em colunas (Parquet/ORC). |
| Implicações dos custos | Esse é um modelo de pagamento por consulta, portanto, os custos se acumulam nos cálculos externos do Lake House. É econômico para consultas infrequentes, mas as despesas podem aumentar com alto volume de QPS. | O custo é menor que consultas ativas repetidas. Ele reduz a necessidade de consultar repetidamente a origem externa, mas adiciona armazenamento em cache e sobrecarga de atualização. | Esta é a opção de armazenamento mais barata. Para configurações da AWS na mesma região (por exemplo, S3 nos EUA-Leste-1 com um locatário do Data Cloud que também está nos EUA-Leste-1), os créditos não são consumidos para as linhas acessadas. Configurações entre regiões ou entre nuvens (por exemplo, Azure, GCS ou diferentes regiões da AWS) geram consumo de crédito para as linhas acessadas. Os custos de consulta também dependem do tamanho do arquivo, do particionamento e da otimização de menu suspenso de predicado. |
| Consideração principal | Evite consultas não filtradas que verificam volumes de dados enormes desnecessariamente. | Essa abordagem requer gerenciamento de cache. Não é adequado para tomada de decisão em menos de um segundo. | O desempenho da consulta depende fortemente da otimização por meio de particionamento e menu suspenso de predicado. |
As arquiteturas híbridas permitem aos arquitetos ancorar conjuntos de dados críticos no Data 360 para governação centralizada, ao mesmo tempo que aproveitam consultas federadas para atualização, redução de duplicação e acesso escalonável a conjuntos de dados externos grandes. Essa abordagem balanceia os requisitos de I/O, localidade de computação, custo e conformidade.
Use uma abordagem híbrida para uma governança equilibrada, frescura e eficiência operacional combinando ingestão de dados e cópia zero para fornecer percepções acionáveis em tempo real. Use a ingestão para conjuntos de dados regulados de alto valor em que rastreabilidade, RLS e mascaramento são necessários e federação para conjuntos de dados efetivos ou de alto volume em que a atualização e o desempenho são essenciais.
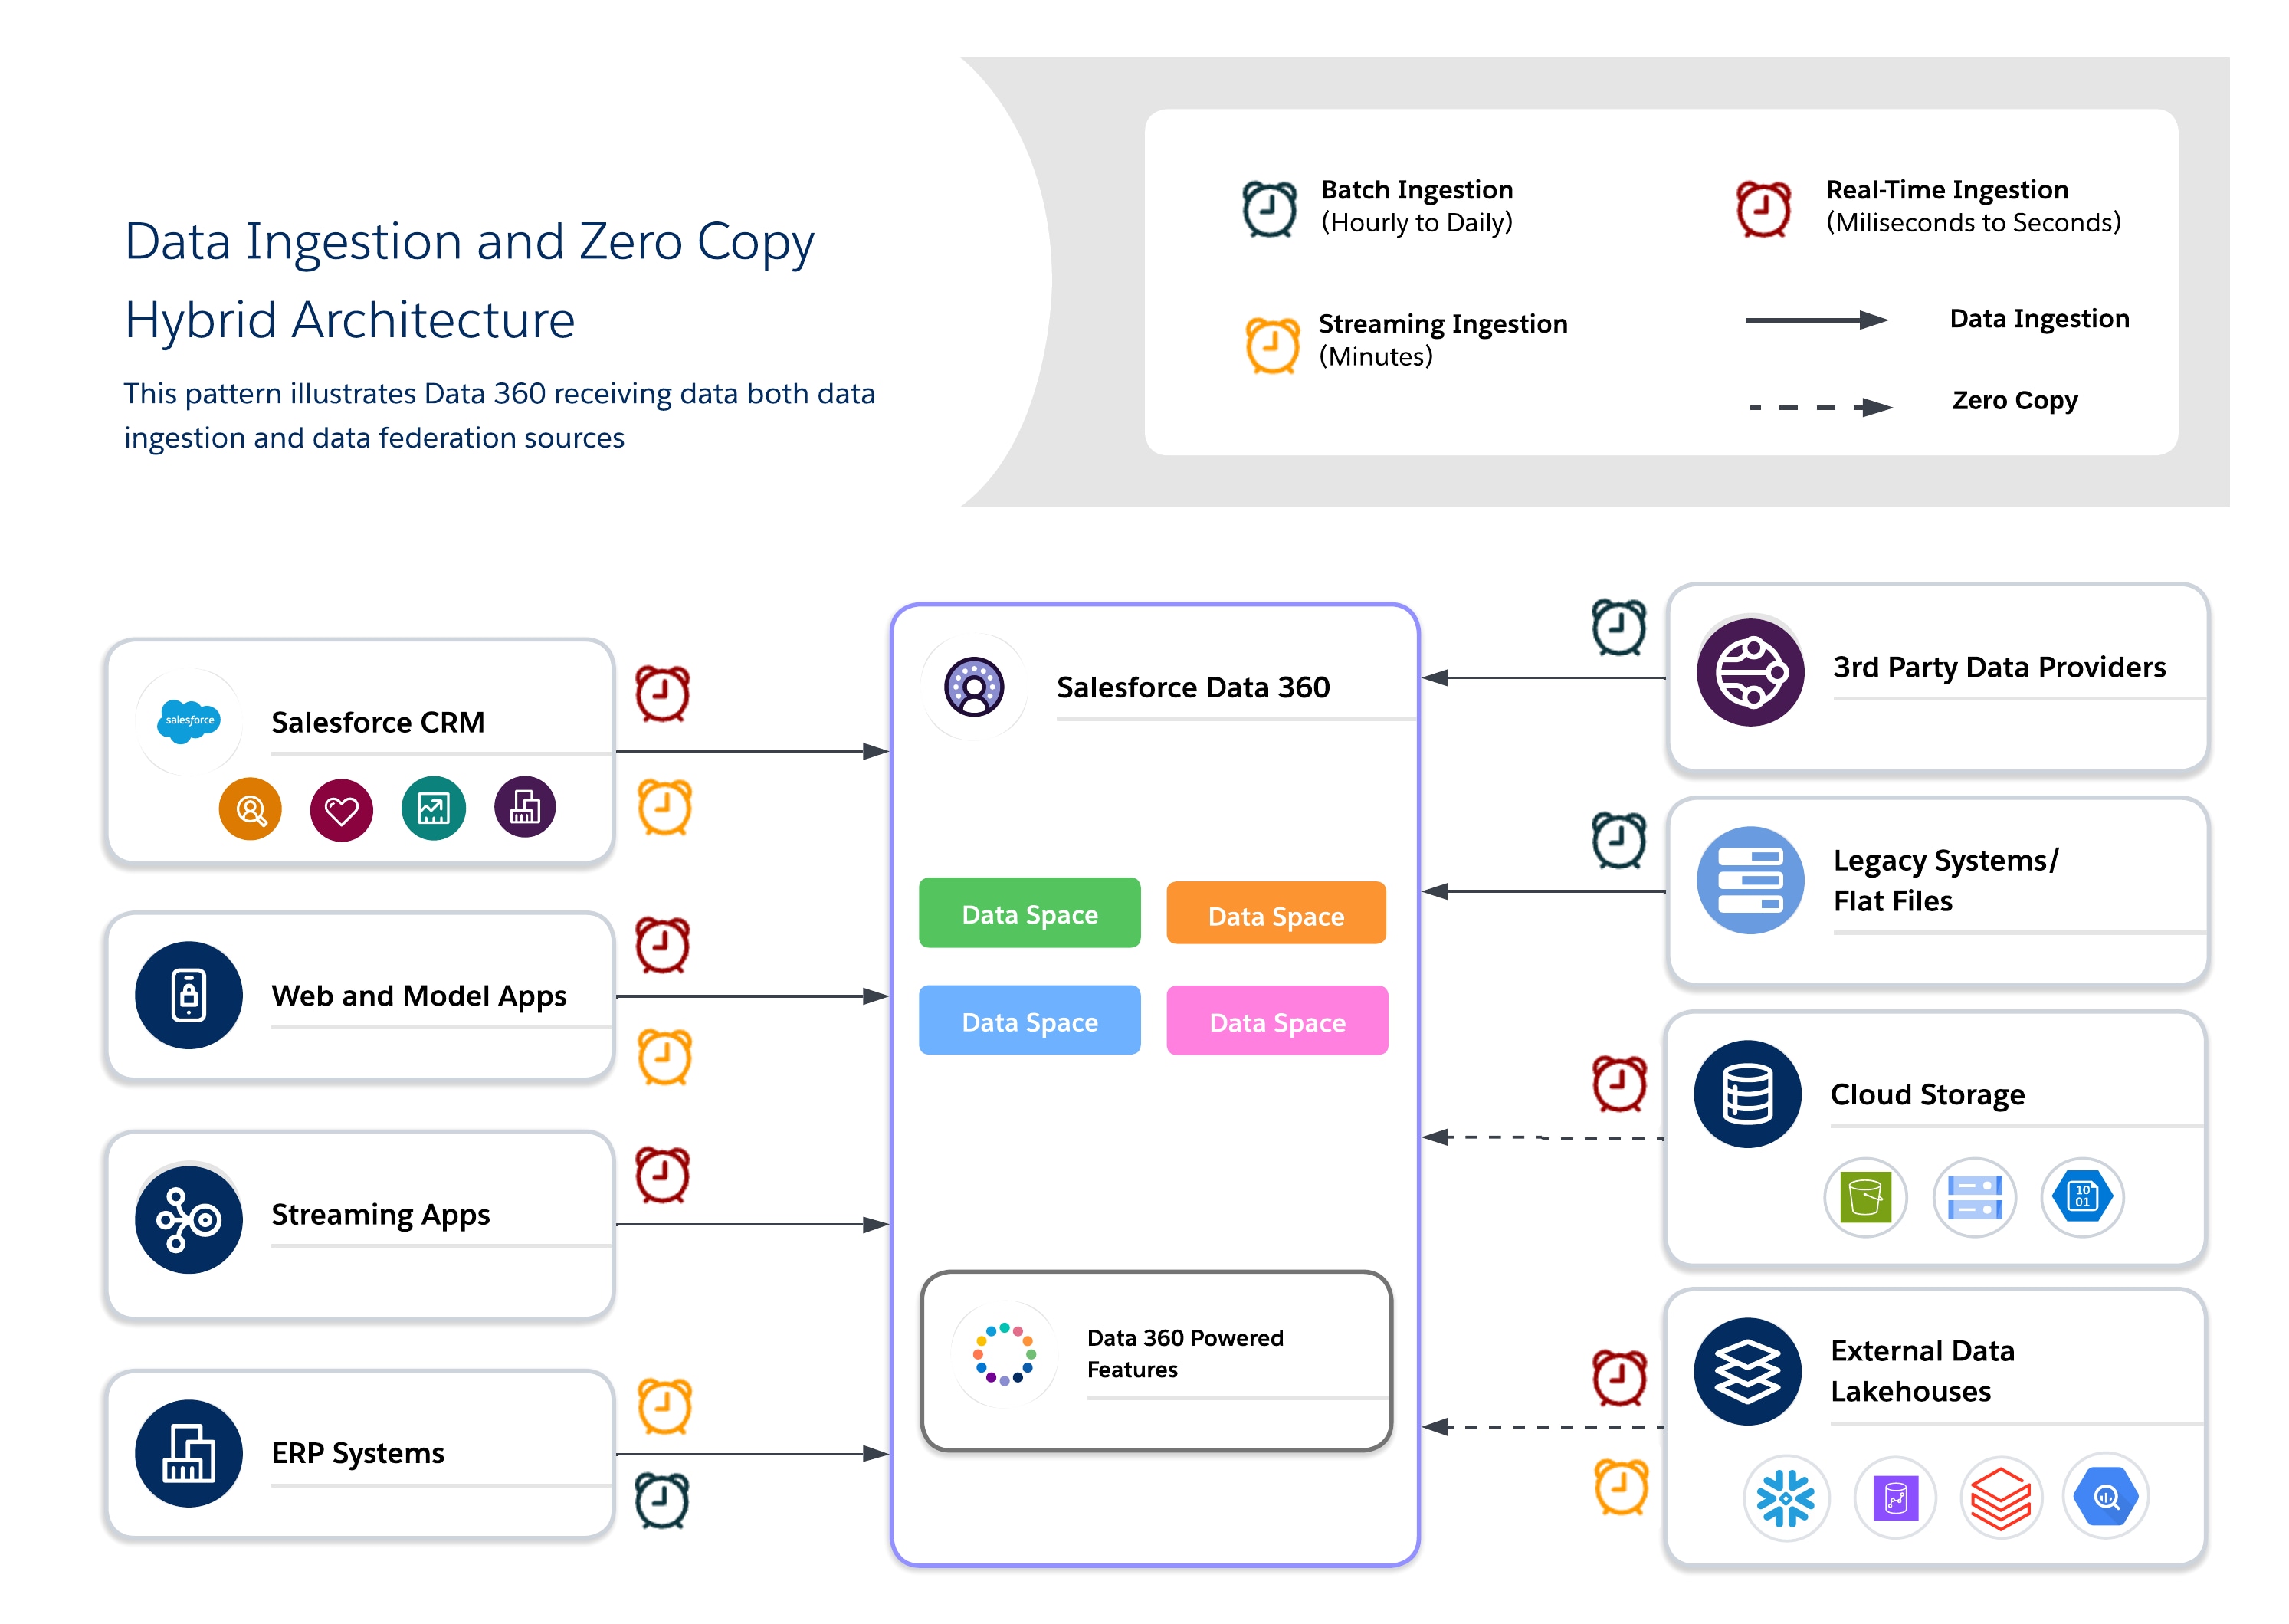
- Casos de uso
- Engajamento do Omni-Channel: Combine dados históricos do cliente com comportamento em tempo real para proporcionar experiências consistentes sensíveis ao contexto.
- Pipelines de IA/ML: Treine modelos em conjuntos de dados canônicos selecionados enquanto os aprimora com sinais brutos ou em tempo real de fontes externas.
- Necessidades de conformidade e agilidade mistas: Aplique governança rígida para dados confidenciais e federação para agilidade operacional.
- Cenários da indústria
- Retail: Use a ingestão para resolução de identidade e unificação de perfil, e a federação para ofertas e personalização em tempo real.
- Saúde: Mantenha registros de pacientes dourados por meio da ingestão enquanto usa a federação em fluxos de dispositivos de IoT e dados de sensor para contexto imediato.
- Serviços financeiros: Ingira dados regulamentados em um lago de conformidade enquanto usa a federação para consultas externas de detecção de fraudes e monitoramento de risco.
- Práticas de design
- Ancora governança com ingestão: Ingira dados de alto valor ou regulados em modelos canônicos para garantir Trust e conformidade.
- Use Federação para frescura: Permite que as casas de lago externas forneçam acesso a dados em tempo real ou em grande escala sem duplicação.
- Custo do saldo vs. desempenho: Analise as cargas de trabalho para determinar quando usar a ingestão vs. a federação, o que minimiza os custos desnecessários de armazenamento e consulta.
- Aplicar governança em camadas: Imponha a governança centralizada para dados ingeridos enquanto aproveita os controles de segurança de sistemas federados (por exemplo, RLS e mascaramento).
- Nota: Ao projetar pipelines híbridos, é importante garantir a ingestão incremental para conjuntos de dados históricos e enviar agregações ou filtros por push a fontes federadas para otimizar o uso de I/O e computação.
- Considerações de custo
- Pesquise o custo total versus o desempenho combinando a ingestão para conformidade ou dados críticos com a federação quando a frescura for necessária.
- Considere a distribuição de I/O e computação ao misturar a ingestão e a federação. Para reduzir o custo de computação de consultas repetidas em sistemas de origem, use o armazenamento em cache (consulta acelerada) para conjuntos de dados federados de alta leitura acessados com frequência.
- Use esta regra para orientar a decisão de ingestão vs. federação: Quando os dados são acessados com frequência, mas mudam com pouca frequência, a consulta acelerada geralmente é mais econômica. No entanto, quando os dados mudam com frequência (em relação à frequência de acesso), a consulta ao vivo ou a ingestão é mais adequada. Aqui estão alguns exemplos de custo:
- Aceleração ganha: Um painel criado com base em 1 milhão de registros e atualizado diariamente com ~10 mil alterações é visualizado 20 vezes por dia. Os custos de aceleração são equivalentes a aproximadamente ~600 créditos/mês vs. ~4.200 créditos/mês para consultas ao vivo.
- Question ao vivo ganha: Segmentos publicados 20 vezes por dia usando dados que mudam a cada 30 minutos. As consultas ao vivo custam aproximadamente ~4.200 créditos/mês vs. ~28.800 créditos/mês para a aceleração nessa frequência de atualização.
Vamos analisar em mais detalhes alguns arquetípicos comuns que ilustram como aplicar essa lógica.
- O Arquétipo da “Fonte Única da Verdade”: Centralizar e governar
- Cenário: Você precisa criar perfis compatíveis e unificados do Customer 360 para toda a sua empresa global. Os dados vêm de uma dúzia de sistemas diferentes, devem cumprir os rigorosos regulamentos GDPR e CCPA, e servirão como fonte de verdade para todas as interações de marketing e serviço.
- Padrão recomendado: Ingestão de dados. A prioridade aqui é governança, Trust e controle. Ingerir os dados no Data 360 é a única maneira de criar um perfil canônico totalmente auditável, isolado dos sistemas de origem.
- O Arquiteto de Insights em tempo real: Analisar sem se mover
- Cenário: Sua equipe de ciência de dados precisa executar consultas exploratórias em uma tabela de transações maciça e constantemente atualizada no Snowflake. Ao mesmo tempo, sua equipe executiva quer um painel BI ativo que seja alimentado pelos mesmos dados. Mover petabytes de dados por dia é lento e caro.
- Padrão recomendado: Federação de cópia zero. A prioridade aqui é velocidade, agilidade e custo-benefício em escala. O Zero Copy permite que você aproveite o poder do seu armazém de dados existente para consultas em tempo real sem sobrecarga e latência de duplicação de dados.
- O Arquétipo de Inteligência Híbrida: Governar o núcleo, Federar a borda
- Cenário: Você deseja aprimorar seus perfis de cliente administrados e ingeridos com sinais comportamentais em tempo real (por exemplo, cliques no site) de um data lake. Você precisa da estabilidade do perfil principal, mas da imediatez dos dados ativos para habilitar a personalização no momento.
- Padrão recomendado: Uma abordagem híbrida. Use a Ingestão de dados para criar um núcleo estável e regulado para seus dados do cliente. Use a Cópia zero para federar os dados de “frente” em tempo real e voláteis e, em seguida, uní-los no momento da consulta para obter uma visualização completa até o segundo.
A estratégia de dados corporativos não é mais focada na escolha de um único padrão de integração, é sobre arquitetar flexibilidade controlada em um ecossistema de dados interoperável. A abordagem correta mapeia cada sistema de origem para o padrão mais adequado aos requisitos de atualidade, governança, custo e acesso:
- Ingira conjuntos de dados regulados essenciais para a missão no Salesforce Data Cloud para conformidade, resolução de identidade e fluxos de trabalho operacionais.
- Federar dados por meio da Cópia zero para análise ativa, exploratória e orientada por IA sem armazenamento duplicado.
- Aplicar cache (consulta acelerada) para reduzir a carga do sistema de origem e o consumo de crédito quando a frequência de consulta é alta e a frequência de alteração de dados é baixa
O Salesforce Data 360 no Hyperforce oferece resiliência e escalabilidade multi-região. Sua casa de lago aberto com mesas Iceberg permite a separação de computação e a interoperabilidade com plataformas como Snowflake, Databricks e S3 Iceberg, que constitui a espinha dorsal de um ecossistema de dados multi-nuvem verdadeiramente interoperável.
Conforme os ecossistemas de dados evoluem, precisamos equilibrar continuamente a atualidade, o custo, o desempenho e a conformidade para manter a agilidade arquitetônica. É por isso que é importante preparar sua plataforma para o futuro unificando dados ingeridos e controlados com acesso federado. Isso habilita a inteligência em tempo real, a ativação de IA e a personalização em escala corporativa em nuvens, regiões e domínios de negócios.
Lembre-se de que soluções unidimensionais para todos não são adequadas à maioria das empresas. A estratégia ideal mapeia o padrão correto para o motor de negócios correto.
Yugandhar Bora é um arquiteto de engenharia de software na Salesforce que é especialista em arquitetura de dados na plataforma de aplicativos de dados e inteligência. Ele lidera iniciativas do Corpo de Revisão de Arquitetura Empresarial (EARB) que se concentram na governança de dados e modelos de dados unificados, além de contribuir para soluções de provisionamento de plataforma automatizadas.
Jan Fernando é um arquiteto principal no Office of Chief Architect (OCA) da Salesforce que entrou para a Salesforce em 2012. Ele traz uma rica experiência de sua época no ecossistema de startups. Antes de ingressar na OCA, ele passou mais de uma década na organização da Plataforma, onde liderou várias transformações tecnológicas importantes.