Interopérabilité de Data 360
Les entreprises stockent souvent des données dans Salesforce et d’autres lacs de données externes (par exemple, Snowflake, Google BigQuery, Databricks, Redshift ou le stockage d’objets tel que Amazon S3). Le cloisonnement des données à travers plusieurs systèmes crée un défi pour les entreprises qui souhaitent exploiter toute la valeur de leurs données afin d’optimiser les expériences pilotées par l’IA. Salesforce Data 360 est la couche d’intelligence fondamentale que chaque agent IA Agentforce utilise pour accéder au contexte approprié au moment opportun.
Les architectes qui travaillent pour regrouper des données à travers plusieurs lacs de données doivent prendre des décisions architecturales importantes sur la meilleure façon d’intégrer ces données. Data 360 fournit plusieurs options d’intégration de données, chacune offrant divers avantages et inconvénients.
Ce guide fournit un cadre qui permet d’évaluer le modèle le plus adapté à vos exigences en matière de latence, de coût, d’évolutivité, de gouvernance et de complexité lors de l’intégration de données, en vous aidant à choisir quand utiliser l’ingestion de données, la fédération de données Zero Copy ou une approche hybride. Le guide vous aidera également à sélectionner entre différentes méthodes d’ingestion de données et de fédération de données, chacune répondant à un besoin différent.
L’intégration de maisons de lac de données externes à Data 360 nécessite d’examiner attentivement les compromis entre l’actualisation des données, la gouvernance et l’efficacité du pipeline. Par exemple, l’utilisation de requêtes live de fédération de données Zero Copy optimise l’actualisation des données, mais peut réduire l’efficacité du pipeline à mesure que de nouvelles données circulent sur le réseau. Pour la plupart des implémentations réelles, la combinaison de l’ingestion et de la fédération dans un écosystème de maison de lac multi-cloud est la voie optimale. Cette approche hybride garantit une architecture évolutive, régie et interopérable qui prend en charge les charges de travail opérationnelles à faible latence (par exemple, la personnalisation en temps réel et la détection des fraudes) et analytiques (par exemple, les rapports réglementaires et l’analyse des tendances historiques). Ce guide vous aide à déterminer comment naviguer ces compromis en utilisant une stratégie appropriée.
- L’ingestion de données copie les données dans Salesforce Data 360 et crée des modèles de données gouvernés et canoniques. C’est idéal lorsque vous devez :
- Élaborez un Customer 360 complet qui permet d’unifier et de transformer des sources différentes en un profil unique et fiable.
- Satisfaire à la conformité réglementaire stricte. Vous pouvez ainsi créer une copie auditable et centralisée afin de contrôler étroitement l’accès aux données et le lignage.
- Zero Copy Federation interroge les sources externes en temps réel sans duplication, ce qui permet la personnalisation en temps réel, des tableaux de bord live et une intégration rapide des sources. Cette approche offre deux options principales, mais il y a des compromis qui doivent être équilibrés :
- Live Query : Utilisez-le pour des analyses interactives et des tableaux de bord de données en temps réel qui vivent sur des plates-formes de données externes (par exemple, Snowflake, BigQuery, Redshift ou Databricks). Cela permet d’éviter les duplications de données lentes et coûteuses en envoyant automatiquement le traitement des requêtes au système source et en renvoyant uniquement les résultats nécessaires. Cette approche est optimisée pour les requêtes peu fréquentes ou ponctuelles dans lesquelles la fraîcheur est essentielle. Il est adapté aux charges de travail à faibles requêtes par seconde (QPS) (les coûts de requête peuvent augmenter considérablement lorsque le QPS est élevé).
- Mise en cache (requête accélérée) : Utilisez-le pour les requêtes de données fréquentes qui ne changent pas souvent. Les requêtes accélérées conservent un cache local qui est mis à jour à intervalles configurables (15 minutes à 7 jours), ce qui réduit les accès sources répétés. Cette approche équilibre les performances et les coûts des tableaux de bord, la segmentation et les charges de travail BI lorsque des résultats légèrement obsolètes sont acceptables. Ce n’est pas adapté à la prise de décision en moins d’une seconde.
- Fédération de fichiers : Utilisez-le pour le traitement par lot à grande échelle et l’entraînement au modèle IA des données du lac de données de votre cloud (par exemple, S3 ou ADLS). Cette approche évite l’ingestion lente et coûteuse en interrogeant directement les fichiers sous des formats de tableau ouvert, ce qui déverrouille les jeux de données ETL massifs et les charges de travail de science des données.
- Les modèles hybrides combinent l’ingestion pour les profils unifiés et la fédération pour la fraîcheur, qui prend en charge l’engagement multicanal, les actions pilotées par Agentforce et la formation IA/ML.
- Employez une architecture hybride. La combinaison de l’ingestion et de la fédération des données est souvent nécessaire.
- Utilisez l’Ingestion de données sur des données critiques pour des modèles de données canoniques et la gouvernance de base.
- Utilisez Zero Copy pour toutes les autres fédérations de données afin de préserver l’actualité et de réduire les coûts opérationnels liés à l’élaboration et à la maintenance de pipelines d’ingestion de données.
- La fréquence d’ingestion de données compte. Choisissez la fréquence en fonction de la valeur métier, des besoins en latence et de la complexité opérationnelle.
- Utilisez le temps réel pour les workflows urgents (par exemple, personnalisation, tableaux de bord live et actions Agentforce).
- Utilisez le temps quasi réel pour des processus modérément urgents (par exemple, campagnes et rapports opérationnels).
- Utilisez le traitement par lot pour des jeux de données historiques ou à faible vitesse.
- Associez les modèles de fédération aux exigences de latence et de performance. Choisissez l’option la plus adaptée à vos modèles d’accès et exigences en matière de fraîcheur, de performance et de coût.
- Utilisez Live Query pour les tableaux de bord opérationnels et la personnalisation en temps réel lorsque la faible latence est critique.
- Utilisez la mise en cache (requête accélérée) lorsque les requêtes sont fréquentes et que les résultats légèrement périmés sont acceptables, ce qui permet d’équilibrer les performances et les coûts.
- Utiliser la Fédération de fichiers pour des analytiques ou des charges de travail par lot à grande échelle et lourdes en débit, ce qui est idéal pour des jeux de données historiques ou moins urgents.
- Alignez la gouvernance sur les exigences de résidence des données.
- Utilisez l’ingestion lorsque la gouvernance centralisée est essentielle.
- Utiliser la fédération lorsque la gouvernance décentralisée est acceptable, tout en appliquant une gouvernance stricte à la source externe.
- Utilisez Zero Copy en ce qui concerne les stratégies au niveau source (par exemple, sécurité au niveau ligne et masquage des données).
- Donnez la priorité à l’ingestion pour les workflows à forte valeur ajoutée. Appliquez l’ingestion de façon sélective à des processus critiques (par exemple, résolution de l’identité, rapports réglementaires et activation opérationnelle).
- Le coût et la complexité déterminent les décisions. L’ingestion en temps réel peut être coûteuse et complexe. Par conséquent, il est important pour les architectes de comparer le coût d’intégration, de stockage et de transformation des données au coût d’interrogation directe via Zero Copy.
Le choix du modèle d’intégration approprié (Ingestion de données, Zéro copie ou approche hybride) impacte directement la latence, la gouvernance, l’efficacité opérationnelle et le coût sur les plates-formes multicloud. Cette décision détermine comment les connaissances en temps réel, l’activation pilotée par l’IA et l’engagement personnalisé sont fournis de façon fiable et à grande échelle.
Le tableau ci-dessous compare les modèles Ingestion de données et Zéro copie dans Salesforce Data 360, en se concentrant sur les capacités, les compromis et les avantages, ainsi que sur les cas d’utilisation et les résultats de l’entreprise. Utilisez-le comme référence pour concevoir des plates-formes de données hybrides et multicloud qui concilient performance, coût et conformité.
| Type de modèle | Mode/Outil | Prestations | Considérations | Résultats |
|---|---|---|---|---|
| Ingestion de données |
En temps réel :
|
|
|
Agentforce :
|
Streaming :
|
|
|
Agentforce :
|
|
Lot :
|
|
|
Agentforce :
|
|
| Zéro copie |
Live Query :
|
|
|
Agentforce :
|
Requête accélérée (mise en cache) :
|
|
|
Agentforce :
|
|
Fédération de fichiers :
|
|
|
Agentforce :
|
Il existe trois principaux modèles d’intégration pour Data 360 : l’ingestion de données, la fédération de données zéro copie et une approche hybride.
Avec l’Ingestion de données, les données sont physiquement copiées dans Data 360 et entièrement régies, contrairement à Zero Copy où les données restent à la source. En d’autres termes, le calcul des transformations est effectué dans Data 360, qui fournit une gouvernance et un audit centralisés.
Utilisez l’Ingestion de données pour stocker des jeux de données canoniques et gouvernés dans Salesforce Data 360 à des fins de conformité et de contrôle opérationnel. Utilisez l’ingestion lorsqu’un contrôle total, un audit et une traçabilité sont requis. L’ingestion de données est idéale pour les workflows réglementés ou à valeur élevée dans lesquels le calcul centralisé et la gouvernance sont essentiels.
L’ingestion est adaptée à l’élaboration d’une base de confiance pour la résolution de l’identité, les rapports réglementaires, et les workflows critiques pilotés par l’IA et l’engagement des clients.

Les méthodes d’ingestion de données peuvent varier selon le connecteur que vous utilisez pour ingérer vos données. Certains connecteurs offrent diverses méthodes d’ingestion, tandis que d’autres fonctionnent uniquement en mode par lot ou streaming. Pour consulter la liste complète des connecteurs Data 360 et des méthodes disponibles, consultez Data 360: Integrations and Connectors.
- En temps réel :
- Fournit une ingestion en moins d’une seconde à l’aide de la Capture de données de modification (CDC)
- Convient aux workflows sensibles au temps (par exemple, détection de fraude, personnalisation et tableaux de bord opérationnels).
- Fonctionne avec des transformations push et des agrégations dans Data 360, ce qui permet de réduire les entrées/sorties en aval et d’optimiser l’utilisation du calcul
- Prend en charge l’utilisation du CDC incrémentiel pour minimiser le mélange de données
- Streaming :
- Ingestion toutes les 1 à 3 minutes par petits incréments
- Équilibre fraîcheur et coût
- Convient pour l’orchestration de campagnes, l’engagement en direct et les rapports opérationnels
- Prend en charge l’utilisation de microbatchs pour contrôler les pics d’E/S
- Agrége les données à la source (si possible) pour réduire les volumes de transfert et optimiser le stockage
- Lot (chargements planifiés) :
- Fournit une ingestion périodique de jeux de données volumineux (par exemple, horaire, quotidien et hebdomadaire)
- Offre une rentabilité et une fiabilité pour les jeux de données historiques, les rapports réglementaires et les cas d’utilisation de conformité
- Garantit que la localisation du calcul se situe dans la même région que le stockage source pour améliorer les performances et optimiser les coûts
- Cas d’utilisation d’ingestion de données :
- Générer des profils unifiés Customer 360. Élaborer une source de vérité unique pour les identités et les attributs des clients.
- Maintenir les jeux de données de conformité réglementaire. Appliquer la gouvernance, la filiation et l’auditabilité des données confidentielles.
- Centraliser l’orchestration des campagnes. Assurer que le marketing, les ventes et le service fonctionnent tous à partir de jeux de données cohérents et fiables.
- Pratiques de conception :
- Adaptez l’ingestion par lot aux besoins historiques ou tolérants à une faible latence (par exemple, rapports d’archives ou clichés instantanés périodiques).
- Utilisez des API CDC ou streaming pour actualiser les workflows opérationnels et de personnalisation afin de garantir des mises à jour en temps quasi réel.
- Contrôlez le stockage et calculez la croissance en appliquant des charges incrémentielles pour optimiser le coût et l’efficacité (au lieu de recharger des jeux de données complets).
- Alignez les pipelines d’ingestion avec la localisation du calcul et le traitement incrémentiel afin de réduire les entrées/sorties réseau.
- Appliquez des transformations dans Data 360 pour éviter de déplacer inutilement des données brutes.
- Considérations relatives aux coûts :
- L ’ ingestion en temps réel entraîne les coûts de calcul et de pipeline les plus élevés, ce qui peut se justifier pour des workflows importants et urgents (par exemple, personnalisation, tableaux de bord opérationnels ou actions pilotées par Agentforce).
- L’ingestion en continu entraîne des coûts de calcul et de stockage modérés, qui peuvent convenir pour des mises à jour fréquentes tolérant de légers retards (par exemple, orchestration de campagne ou rapports opérationnels).
- L’ingestion par lot offre des coûts de calcul réduits et un stockage prévisible, qui convient aux jeux de données historiques ou aux mises à jour à basse fréquence. L’ingestion de données par lot à partir d’organisations Salesforce en utilisant certains connecteurs est gratuite.
- Mode d’actualisation Permet de sélectionner le mode d’actualisation incrémentielle, ce qui réduit les coûts totaux d’ingestion et de calcul. Chez Salesforce, nous recommandons d’utiliser l’actualisation incrémentielle dans la mesure du possible afin d’optimiser l’efficacité dans tous les types d’ingestion.
- Le coût est également impacté par le volume d’E/S depuis la source vers Data 360. L’optimisation de la taille des lots, des partitions et de l’alignement régional réduit les coûts de transfert et améliore les performances.
- Scénarios de l’industrie :
- Finance: Les jeux de données d’ingestion sont requis pour connaître votre client (KYC), Anti Money Laundering (AML) et la détection des fraudes lorsque l’auditabilité et la conformité ne sont pas négociables.
- Santé : Utilisez l’ingestion pour la résolution de l’identité des patients et les enregistrements conformes HIPAA, qui permettent des vues sécurisées et unifiées.
- Retail: Consolidez les données des points de vente, du commerce électronique et du programme de fidélité dans des profils unifiés pour la segmentation et la personnalisation.
- Telecom: Soutenez la prévention du churn et l’analyse de l’utilisation grâce à des données d’abonnés canoniques et gouvernées.
| Fonctionnalité | Ingestion en temps réel | Ingestion en continu | Ingestion par lot |
|---|---|---|---|
| Latence et fraîcheur | Ingestion de latence inférieure à la seconde via des API Ingestion avec prise en charge de la Capture des données modifiées. Fournit des pipelines en continu. Convient aux cas d’utilisation opérationnels à faible latence. | Ingestion par microbatch toutes les 1 à 3 minutes via des connecteurs natifs. Prend en charge les mises à jour incrémentielles. Une légère latence est attendue. | Une latence des données est attendue. Autorise les chargements planifiés à grand volume. Ingestion périodique (horaire, quotidienne et hebdomadaire). Ne convient pas aux opérations temporelles. |
| Cas d’utilisation principaux | Idéal pour les cas d’utilisation opérationnels et de personnalisation à faible latence. Utilisé pour des workflows sensibles au temps. Prend en charge les workflows pilotés par l’événement. Utilisé pour les alertes de fraude et les alertes opérationnelles en temps réel. | Convient aux processus modérément urgents. Utilisé pour l’orchestration de campagnes, l’engagement en direct et les rapports opérationnels. Utilisé pour déclencher des campagnes au moment opportun. | Rentable pour des jeux de données massifs. Fiable pour les analytiques historiques. Utilisé pour les workflows d’agrégation historique ou de rapports réglementés. Convient aux jeux de données historiques ou à faible vitesse. |
| Complexité architecturale et E/S | Inclut un coût élevé et une architecture complexe. Nécessite des systèmes sources à faible latence. E/S intensives. Les sources à haut volume peuvent entraîner la saturation des pipelines. | Présente une architecture plus simple que celle du temps réel. Le volume des E/S est modéré. Convient pour des modèles de mise à jour prévisibles et répétés. La taille du lot impacte la mémoire et le calcul. | Facile à implémenter. Des E/S intensives pendant les fenêtres de chargement. Le débit réseau peut devenir un goulot d’étranglement pour les lots volumineux. |
| Considérations relatives aux coûts | Inclut les coûts de calcul et de pipeline les plus élevés. Justifiable uniquement pour les workflows de grande valeur et sensibles au temps. | Inclut des coûts de calcul et de stockage modérés. Fournit une approche coût/fraîcheur équilibrée. Convient pour les mises à jour fréquentes qui peuvent tolérer de légers retards. | Présente des coûts de calcul réduits et un stockage prévisible. Recommandé pour les jeux de données historiques ou les mises à jour à basse fréquence. L’ingestion via des pipelines internes Salesforce est gratuite. |
| Pratiques de conception | Utilisez le CDC incrémentiel pour limiter le mélange de données. Filtrez et utilisez des champs sélectifs pour réduire les frais généraux. | Utilisez des micro-batchs pour contrôler les pics d’E/S. Envisagez l’agrégation fenêtrée pour réduire la charge de traitement. | Utilisé pour les rapports d’archives ou les clichés instantanés périodiques. Assurez-vous que la localisation du calcul est dans la même région que le stockage source pour optimiser les coûts. |
Utilisez Zero Copy pour interroger en temps réel des systèmes externes sans duplication des données afin de permettre l’agilité, la fraîcheur et l’accès évolutif à des jeux de données volumineux ou transitoires. Il convient aux tableaux de bord live, aux analytiques exploratoires, à l’entraînement au modèle IA/ML et à l’engagement client en temps réel directement via Salesforce Data 360.
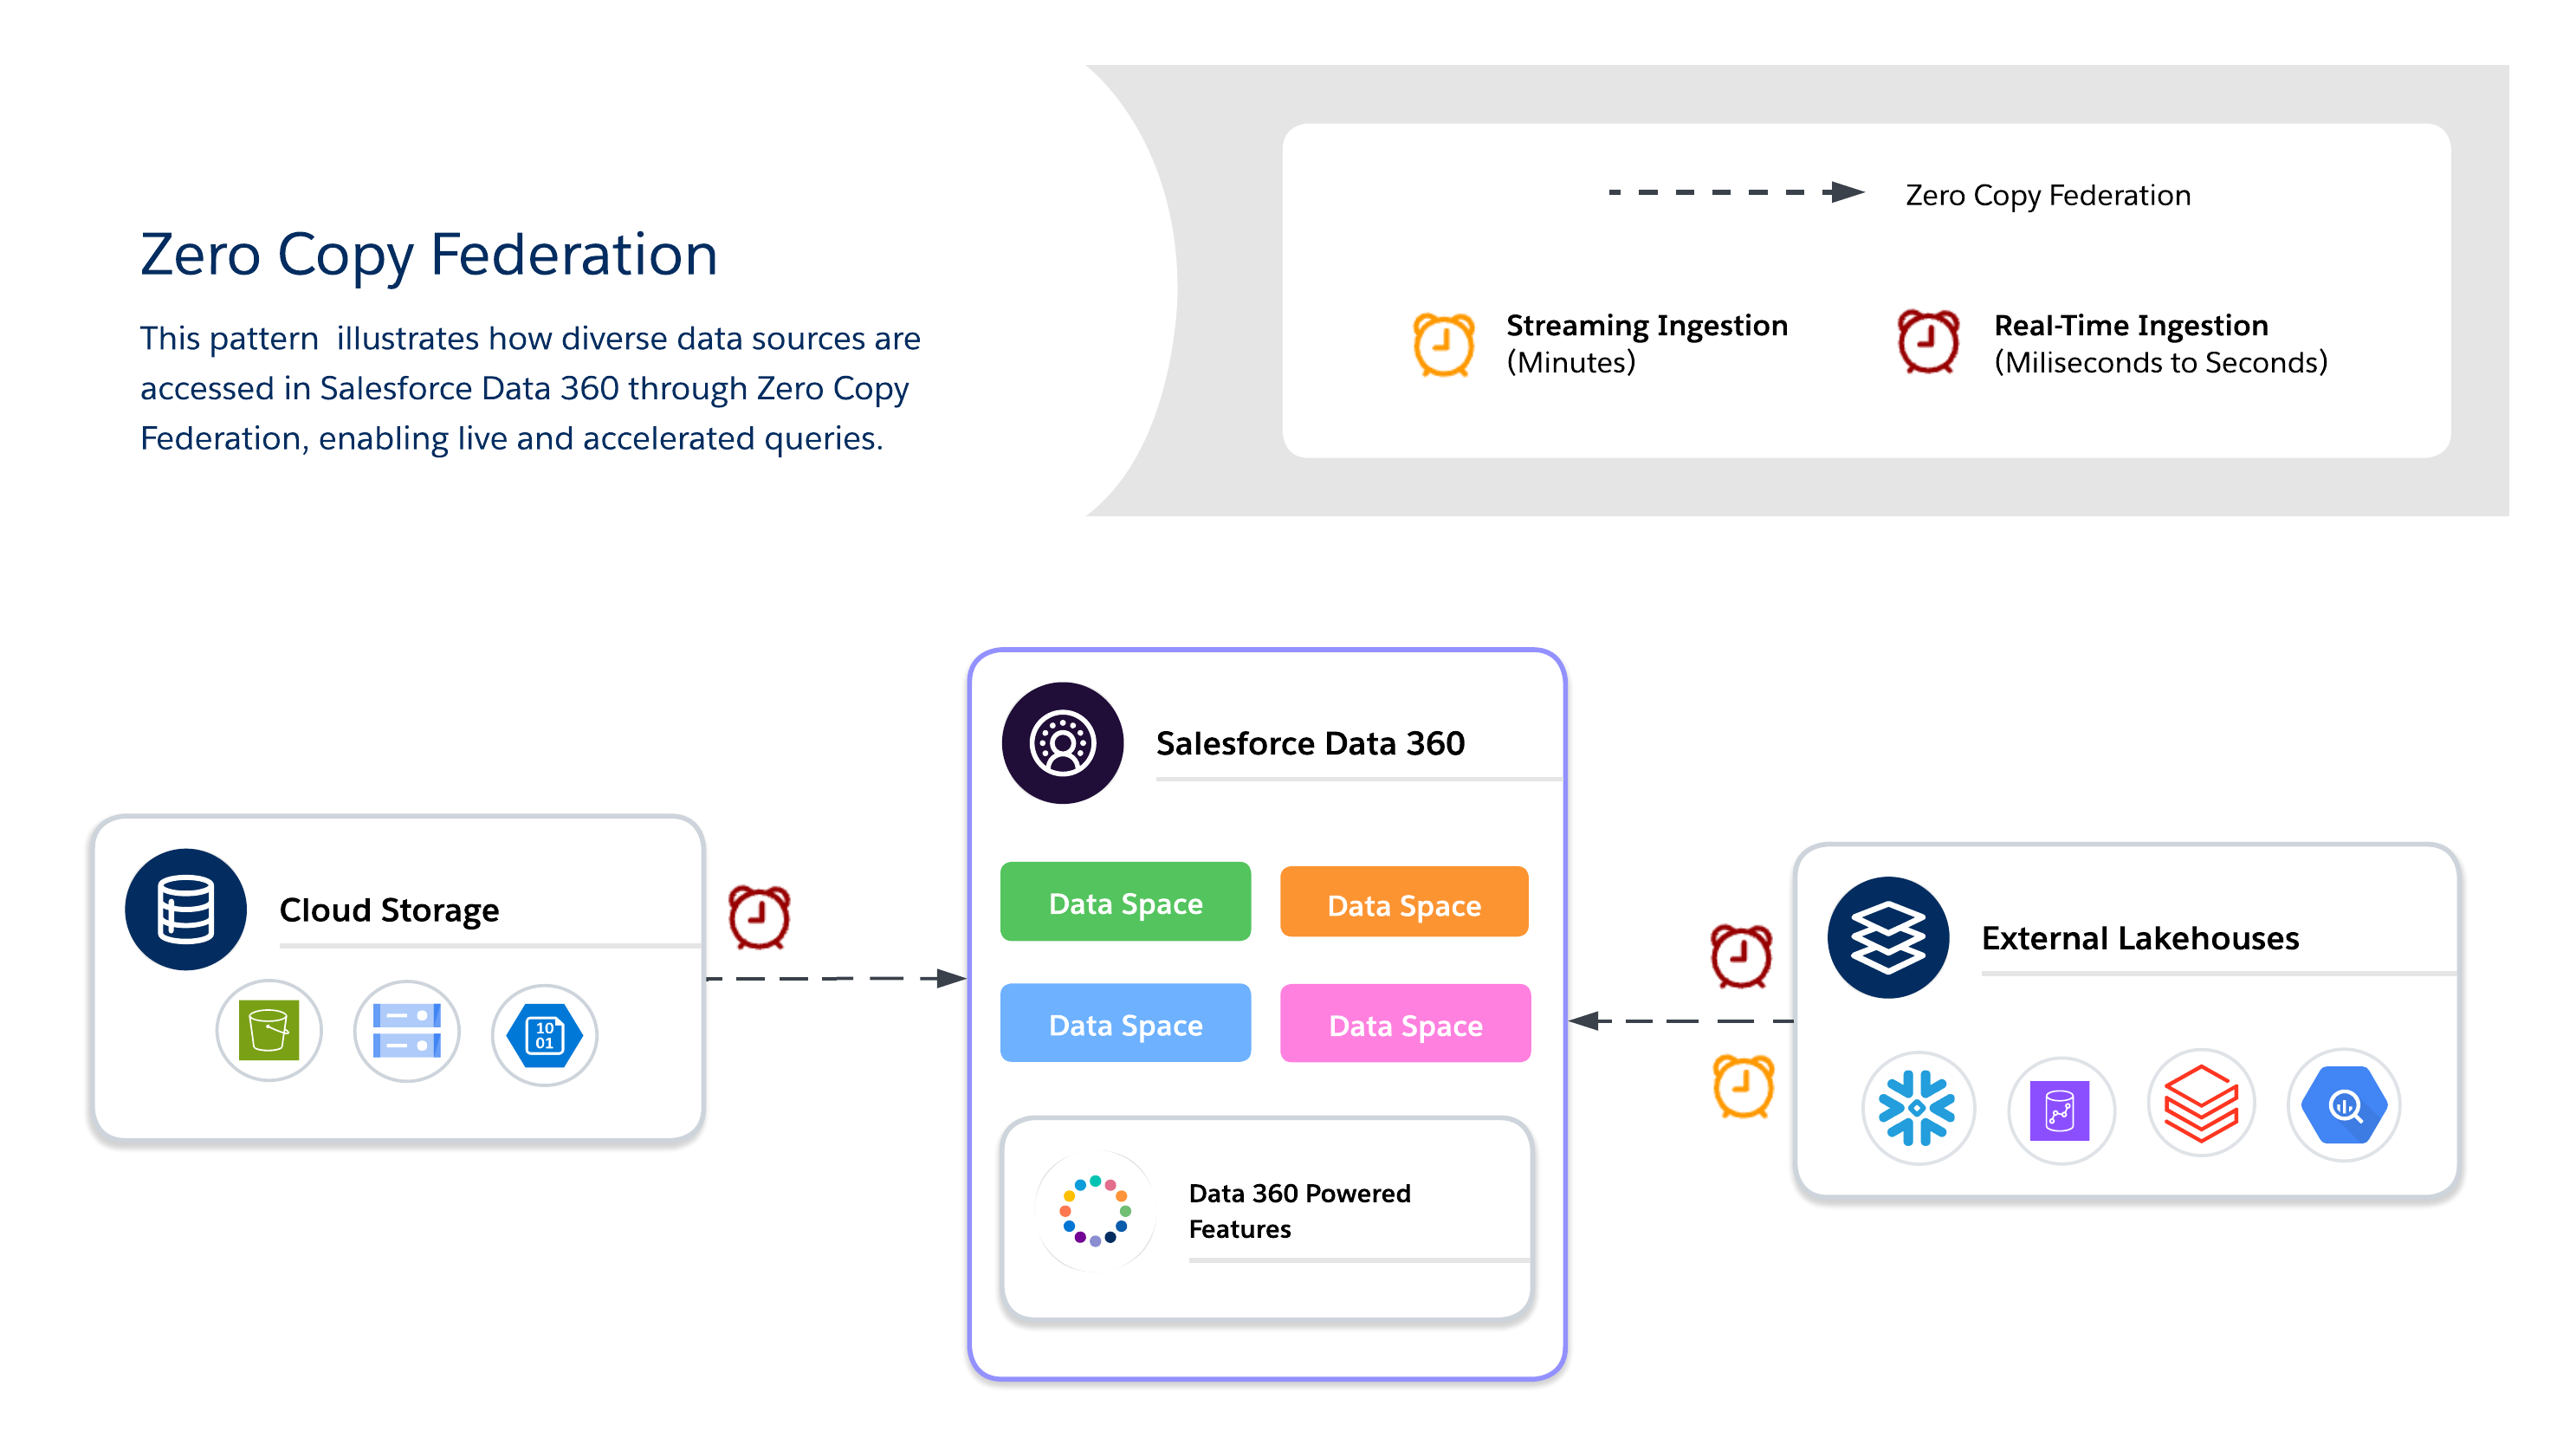
En utilisant Zero Copy, les architectes doivent choisir entre trois méthodes de fédération de données disponibles, chacune offrant ses propres compromis entre fraîcheur, performance et coût.
- Requête en direct
- Exécute des requêtes directement sur des systèmes externes (par exemple, Snowflake, Google BigQuery, Redshift, Databricks, etc.) sans duplication de données.
- Réduit les mouvements de données sur le réseau et les entrées/sorties dans le calcul Salesforce Data 360, ce qui est optimal lorsque les prédicats et les agrégations peuvent être déplacés vers le bas.
- Convient pour les connaissances en temps réel et les tableaux de bord opérationnels à faible latence.
- Selon les performances du système externe.
- Mise en cache (requête accélérée)
- Stocke temporairement des copies mises en cache de données fédérées dans Salesforce Data 360.
- Réduit les coûts des requêtes répétées et la latence des jeux de données fréquemment accédés avec une durée configurable (minutes à jours).
- Les données ne sont pas copiées en permanence ni entièrement régies. Par conséquent, l’actualisation planifiée à partir de la source permet de gérer l’actualisation.
- L’actualisation incrémentielle prend en charge uniquement les mises à jour/insertions. Les enregistrements supprimés ne sont pas retirés du cache.
- Effectuez périodiquement une actualisation complète pour vous assurer que le cache reste synchronisé avec la source.
- Note : Le connecteur Snowflake prend en charge la fonction Unload, qui améliore les taux d’accélération en utilisant un compartiment intermédiaire initié par Snowflake. Elle est activée par défaut, mais peut être désactivée en modifiant la connexion.
- Fédération de fichiers
- Fournit un accès direct en lecture seule aux jeux de données à grande échelle dans les magasins d’objets (par exemple, S3 et GCS avec Iceberg).
- Convient aux charges de travail IA/ML, aux analytiques historiques et aux rapports à l’échelle du pétaoctet sans déplacer les données.
- Les performances des requêtes dépendent fortement du format des objets, du partitionnement et des entrées/sorties réseau. Les analyses volumineuses peuvent générer des entrées/sorties importantes si elles ne sont pas optimisées.
- Cas d’utilisation
- La personnalisation en temps réel et les workflows adaptatifs offrent des offres dynamiques, des recommandations et des actions Next Best à mesure que les comportements des clients changent.
- Les tableaux de bord live et les analytiques opérationnelles pilotent les tableaux de bord et les indicateurs de performance clés critiques de l’entreprise directement depuis des entrepôts externes.
- L ’ entraînement aux modèles IA/ML avec de grands jeux de données externes exploite les données à l ’ échelle du pétaoctet des lacs de données et des entrepôts sans les déplacer par fédération de fichiers.
- Scénarios sectoriels
- Retail/Media : Activez des recommandations personnalisées et l’engagement client en temps réel en fédérant les données de flux de clics ou d’interaction de contenus.
- Finance : Exécutez la détection des fraudes et le score de risque en temps quasi réel en interrogeant des entrepôts externes sans dupliquer les données confidentielles.
- Tech/Entreprise : Prenez en charge les rapports inter-clouds, les tableaux de bord de service TI et les analytiques opérationnelles lorsque les jeux de données résident dans plusieurs systèmes.
- Pratiques de conception
- Requête en direct
- Utilisez pour les requêtes à QPS élevé et à faible latence lorsque la fraîcheur est critique.
- Envoyez automatiquement des prédicats et des agrégations au système externe afin de réduire le transfert de données sur le réseau.
- Évitez les requêtes qui analysent inutilement des volumes de données importants.
- Envisagez plutôt l’élagage des partitions et les filtres.
- Fédération de fichiers
- Accédez aux jeux de données à l’échelle du pétaoctet dans les magasins d’objets sans ingestion.
- Réduisez les coûts de latence et de sortie en gardant le stockage d’objets dans la même région Cloud que le calcul Salesforce.
- Utilisez des formats partitionnés et colonnaires (Parquet/ORC) et des filtres pushdown pour réduire les entrées/sorties et le transfert réseau.
- Exploitez le pushdown des requêtes et des prédicats pour filtrer et agréger les données à la source, ce qui réduit le mouvement des données.
- Évitez l’accès aux données inter-régions, sauf si c’est absolument nécessaire, car cela augmente les entrées/sorties, la latence et les coûts.
- Caching (Accelerated Query)
- Mettez en cache les jeux de données fréquemment accédés pour équilibrer les coûts et les performances.
- Configurez des intervalles d’actualisation pour équilibrer la fraîcheur et le coût des requêtes.
- Conformité : Appliquez la gouvernance à la source en exploitant la sécurité au niveau ligne et en masquant les politiques directement dans les systèmes fédérés.
- Voici quelques pratiques recommandées pour uniformiser le RLS et le masquage entre les plates-formes :
- Utilisez un ID d’entreprise centralisé. Mappez des utilisateurs et des entités dans Salesforce Data 360 avec un identifiant d’entreprise unique et centralisé qui correspond aux identités dans des systèmes externes.
- Alignez les stratégies de sécurité. Assurez-vous que les stratégies RLS et de masquage dans les systèmes fédérés sont appliquées en fonction de l’identité mappée. Cela préserve la conformité lors de l’interrogation de données externes.
- Standardisez les schémas d’identité. Maintenez des attributs d’identité cohérents (e-mail, ID d’utilisateur, ID de client, etc.) entre toutes les sources de données afin d’éviter les incohérences et les violations d’accès.
- Voici quelques pratiques recommandées pour uniformiser le RLS et le masquage entre les plates-formes :
- Requête en direct
- Considérations relatives aux coûts
- Live Query : Dans le modèle de paiement par requête, les coûts augmentent pour le calcul externe du lakehouse, ce qui peut entraîner des pics avec un QPS élevé. Cela convient aux cas d’utilisation critiques pour la fraîcheur où la valeur est supérieure à la variabilité du coût.
- Requête accélérée (mise en cache) : Cette méthode réduit le coût des requêtes (par rapport à Live Query) en réduisant les accès au système source. Cependant, elle augmente les coûts d’ingestion de données par lot pour remplir et actualiser le cache. Convient aux jeux de données fréquemment accédés.
- Fédération de fichiers : Cette option de stockage est la moins chère en tant que données dans Object Store. Cependant, les coûts de requête dépendent de la taille du fichier, du partitionnement et de l’élagage. Convient pour les données historiques ou en masse à l’échelle du pétaoctet.
| Point de décision | Live Query | Mise en cache (requête accélérée) | Fédération de fichiers |
|---|---|---|---|
| Emplacement de la source de données | Maisons de lac de données externes (par exemple, Snowflake, Google BigQuery, Redshift et Databricks) | Maisons de lac de données externes (par exemple, Snowflake, Google BigQuery, Redshift et Databricks) | Les magasins d’objets ou les lacs de données Cloud (par exemple, S3, ADLS et GCS), qui utilisent souvent des formats de tableau ouverts tels que Iceberg. |
| Objectif/cas d’utilisation | Convient pour l’analyse interactive et les tableaux de bord en temps réel. Convient pour la personnalisation en temps réel et les workflows dynamiques. | Convient lorsque les requêtes sont fréquentes, mais que les résultats légèrement périmés sont acceptables. Convient pour les tableaux de bord BI et la segmentation. | Convient pour le traitement par lot à grande échelle et l’entraînement au modèle IA/ML. Convient pour les analytiques historiques et les rapports à l’échelle des pétaoctets. |
| Fraîcheur/Latence | Fournit une fraîcheur maximale en exécutant les requêtes directement en temps réel. Prend en charge la prise de décision en moins d’une seconde lorsque le système source est optimisé pour les requêtes à faible latence avec un pushdown des prédicats efficace. | Utiliser lorsque les résultats légèrement périmés sont acceptables. La fraîcheur dépend de l’intervalle de mise en cache, qui peut être configuré de 15 minutes à 7 jours. | Convient pour les tâches lourdes en lots et exigeantes en débit. Ne convient pas aux tableaux de bord en temps réel. |
| Modèle d’accès | Convient aux requêtes peu fréquentes ou ponctuelles où la fraîcheur est critique et le volume de requête faible. Les coûts augmentent considérablement lorsque le QPS est élevé. Par conséquent, il est important d’évaluer la mise en cache (requête accélérée) lorsque la fréquence des requêtes est élevée. | Convient aux scénarios de lecture à haute fréquence. Améliore les performances des modèles d’accès fréquents. | Fournit un accès en lecture seule. Convient aux jeux de données à l’échelle du pétaoctet sans ingestion. |
| Facteurs de performance | Très dépendant des performances du système source externe. Convient lorsque les prédicats et les agrégations peuvent être poussés vers la source. | Réduit la latence par rapport aux requêtes live répétées. Les performances dépendent de la gestion du cache et des intervalles. | Les performances dépendent fortement du format de l’objet, du partitionnement et du débit système externe. Utilisez des formats partitionnés et colonnaires (Parquet/ORC). |
| Incidences sur les coûts | Il s’agit d’un modèle de paiement par requête. Par conséquent, les coûts s’accumulent dans les calculs lakehouse externes. Il est économique pour les requêtes peu fréquentes, mais les dépenses peuvent augmenter avec un volume de QPS élevé. | Le coût est inférieur aux requêtes en direct répétées. Il réduit la nécessité d’interroger régulièrement la source externe, mais ajoute un espace de stockage cache et une actualisation supplémentaire. | Cette option de stockage est la moins chère. Pour des configurations AWS de même région et de même cloud (par exemple, S3 dans US-East-1 avec un locataire Data Cloud également dans US-East-1), les crédits ne sont pas consommés pour les lignes accédées. Les configurations inter-régions ou inter-clouds (par exemple, Azure, GCS ou différentes régions AWS) entraînent une consommation de crédit pour les lignes accédées. Les coûts de requête dépendent également de la taille du fichier, du partitionnement et de l’optimisation pushdown des prédicats. |
| Considération clé | Évitez les requêtes non filtrées qui analysent inutilement des volumes de données importants. | Cette approche nécessite la gestion du cache. Non adapté à la prise de décision en moins d’une seconde. | Les performances des requêtes dépendent fortement de l’optimisation via le partitionnement et la pushdown des prédicats. |
Les architectures hybrides permettent aux architectes d’ancrer des jeux de données critiques dans Data 360 pour une gouvernance centralisée, tout en exploitant les requêtes fédérées pour l’actualisation, la réduction des duplications et l’accès évolutif à des jeux de données externes volumineux. Cette approche concilie les exigences d’E/S, de localisation du calcul, de coût et de conformité.
Utilisez une approche hybride pour une gouvernance équilibrée, la fraîcheur et l’efficacité opérationnelle en combinant l’ingestion de données et la copie zéro pour fournir des connaissances en temps réel et actionnables. Utilisez l’ingestion pour des jeux de données réglementés de grande valeur où la traçabilité, le RLS et le masquage sont requis, et la fédération pour des jeux de données éphémères ou à haut volume où la fraîcheur et les performances sont essentielles.
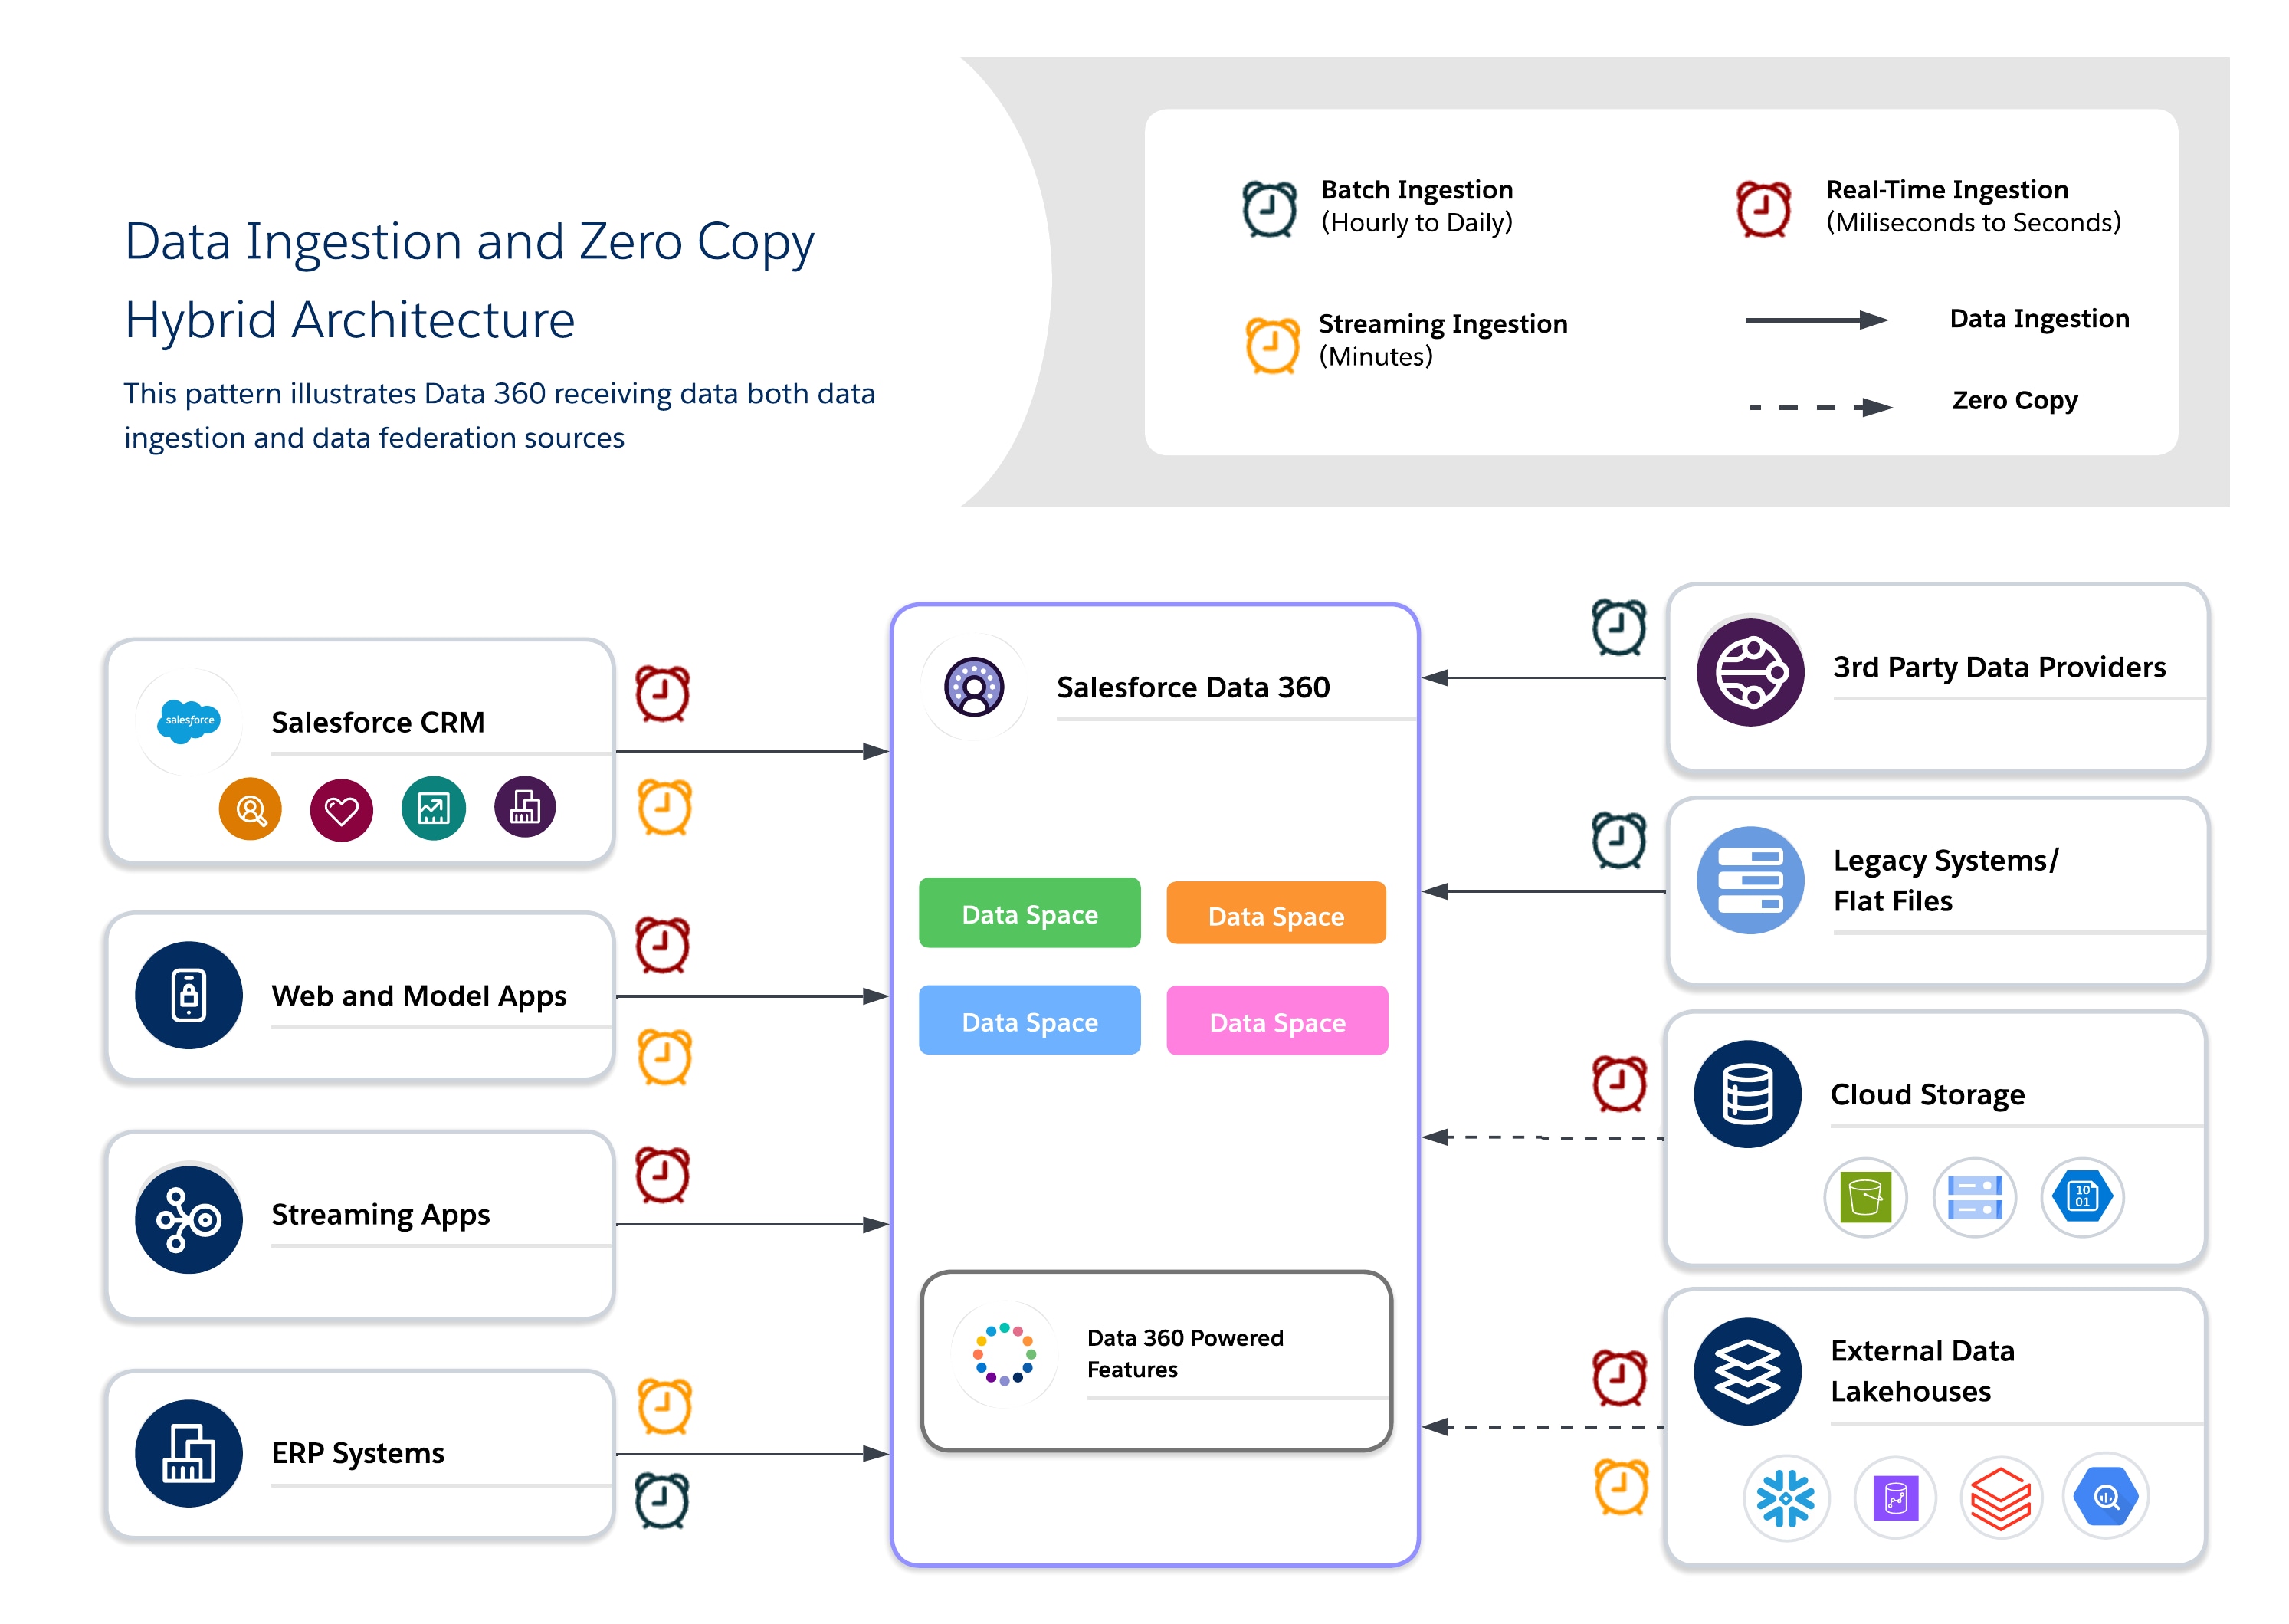
- Cas d’utilisation
- Engagement omnicanal : Combinez les données clients historiques avec un comportement en temps réel pour offrir des expériences cohérentes et sensibles au contexte.
- Pipelines IA/ML : Entraînez les modèles sur des jeux de données organisés et canoniques tout en les enrichissant avec des signaux bruts ou en temps réel provenant de sources externes.
- Besoins mixtes de conformité et d’agilité : Appliquez une gouvernance stricte pour les données confidentielles et une fédération pour l’agilité opérationnelle.
- Scénarios de secteur d’activité
- Commerce de détail : Utilisez l’ingestion pour la résolution de l’identité et l’unification des profils, et la fédération pour les offres en temps réel et la personnalisation.
- Soins de santé : Gérez les enregistrements de patient dorés via l’ingestion tout en utilisant la fédération sur les flux d’appareils Internet des objets et les données des capteurs pour un contexte immédiat.
- Services financiers : Ingérez des données réglementées dans un lac régi par la conformité en utilisant la fédération pour des requêtes externes de détection des fraudes et de surveillance des risques.
- Pratiques de conception
- Ancrage de la gouvernance avec l’ingestion : Ingérez des données de grande valeur ou réglementées dans des modèles canoniques pour garantir Trust et conformité.
- Utilisez la fédération pour la fraîcheur : Permet aux maisons de lac externes de fournir un accès aux données en temps réel ou à grande échelle sans duplication.
- Équilibrer le coût et la performance : Profilez les charges de travail afin de déterminer quand utiliser l’ingestion par rapport à la fédération, ce qui réduit les coûts inutiles de stockage et de requête.
- Appliquer la gouvernance en couches : Appliquer la gouvernance centralisée pour les données ingérées tout en tirant parti des contrôles de sécurité des systèmes fédérés (par exemple, RLS et masquage).
- Note : Lorsque vous concevez des pipelines hybrides, il est important d’assurer l’ingestion incrémentielle pour les jeux de données historiques et d’envoyer automatiquement des agrégations ou des filtres à des sources fédérées afin d’optimiser les entrées/sorties et de calculer l’utilisation.
- Considérations relatives aux coûts
- Évaluez le coût total par rapport aux performances en combinant l’ingestion pour la conformité ou des données critiques avec la fédération lorsque la fraîcheur est nécessaire.
- Tenez compte de la répartition des E/S et du calcul lors du mélange de l’ingestion et de la fédération. Pour réduire les coûts de calcul des requêtes répétées par rapport aux systèmes sources, utilisez la mise en cache (requête accélérée) pour les jeux de données fédérés fréquemment accédés et très lus.
- Utilisez cette règle pour guider la décision d’ingestion par rapport à la fédération : Lorsque les données sont accédées fréquemment, mais changent rarement, la requête accélérée est généralement plus économique. Cependant, lorsque les données changent fréquemment (par rapport à la fréquence d’accès), Live Query ou ingestion est plus approprié. Voici quelques exemples de coûts :
- L’accélération l’emporte : Un tableau de bord élaboré à partir de 1 million d’enregistrements et mis à jour quotidiennement avec environ 10 000 modifications est visualisé 20 fois par jour. Les coûts d’accélération s’élèvent à environ 600 crédits par mois, contre environ 4 200 crédits par mois pour Live Queries.
- Live Query l’emporte : Segments publiés 20 fois par jour en utilisant des données qui changent toutes les 30 minutes. Les requêtes live coûtent environ 4 200 crédits par mois contre 28 800 crédits par mois pour l’accélération à cette fréquence d’actualisation.
Examinons de plus près quelques archétypes courants qui illustrent comment appliquer cette logique.
- L’archétype « Source unique de vérité » : Centraliser et gouverner
- Scénario : Vous devez élaborer des profils Client 360 conformes et unifiés pour l’ensemble de votre entreprise mondiale. Les données proviennent d’une douzaine de systèmes différents, elles doivent respecter des réglementations strictes RGPD et CCPA, et elles serviront de source de vérité pour toutes les interactions marketing et de service.
- Schéma recommandé : Ingestion de données. La priorité ici est la gouvernance, la confiance et le contrôle. L’ingestion des données dans Data 360 est le seul moyen de créer un profil canonique entièrement auditable, isolé des systèmes sources.
- L’archétype « Connaissances en temps réel » : Analyser sans déplacer
- Scénario : Votre équipe de science des données doit exécuter des requêtes exploratoires sur un tableau de transactions massif et constamment mis à jour dans Snowflake. En même temps, votre équipe de direction souhaite un tableau de bord BI live piloté par ces mêmes données. Le déplacement quotidien de pétaoctets de données est lent et coûteux.
- Modèle recommandé : Zero Copy Federation. La priorité ici est la rapidité, l’agilité et la rentabilité à l’échelle. Zero Copy vous permet de tirer parti de la puissance de votre entrepôt de données existant pour les requêtes en temps réel, sans surcharge ni latence de la duplication des données.
- L’archétype « Intelligence hybride » : Gouverner le cœur, fédérer la périphérie
- Scénario : Vous souhaitez enrichir vos profils clients gouvernés et ingérés avec des signaux comportementaux en temps réel (par exemple, des clics sur un site Web) à partir d’un lac de données. Vous avez besoin de la stabilité du profil principal, mais de l’immédiateté des données live pour piloter la personnalisation instantanée.
- Modèle recommandé : A Hybrid Approach. Utilisez l’Ingestion de données afin de créer un noyau stable et gouverné pour vos données clients. Utilisez Zero Copy pour fédérer les données « edge » volatiles en temps réel, puis joignez-les au moment de la requête pour une vue complète et actualisée.
La stratégie de données d’entreprise ne se concentre plus sur le choix d’un modèle d’intégration unique, mais sur l’architecture d’une flexibilité contrôlée dans un écosystème de données interopérable. L’approche correcte associe chaque système source au modèle le plus adapté à ses exigences en matière de fraîcheur, de gouvernance, de coût et d’accès :
- Ingérez des jeux de données réglementés critiques dans Salesforce Data Cloud pour la conformité, la résolution de l’identité et les workflows opérationnels.
- Fédérez des données via Zero Copy pour des analytiques live, exploratoires et pilotées par l’IA sans dupliquer le stockage.
- Appliquer la mise en cache (requête accélérée) pour réduire la charge du système source et la consommation de crédits lorsque la fréquence de requête est élevée et la fréquence de modification des données faible
Salesforce Data 360 sur Hyperforce offre une résilience et une évolutivité multi-régions. Ses portes ouvertes avec des tables Iceberg permettent la séparation des calculs et l’interopérabilité avec des plates-formes telles que Snowflake, Databricks et S3 Iceberg, qui forment l’épine dorsale d’un écosystème de données multicloud véritablement interopérable.
À mesure que les écosystèmes de données évoluent, nous devons constamment équilibrer fraîcheur, coût, performance et conformité pour maintenir l’agilité architecturale. Par conséquent, il est important de pérenniser votre plate-forme en unifiant les données ingérées et régies avec un accès fédéré. Cela permet l’intelligence en temps réel, l’activation de l’IA et la personnalisation à l’échelle de l’entreprise à travers les Clouds, les régions et les domaines métiers.
Notez que les solutions universelles ne conviennent pas à la plupart des entreprises. La stratégie optimale associe le modèle correct au levier métier approprié.
Yugandhar Bora est architecte en génie logiciel chez Salesforce, spécialiste de l’architecture de données sur la plate-forme Data and Intelligence Applications. Il dirige les initiatives du comité d’examen de l’architecture d’entreprise (EARB) qui se concentrent sur la gouvernance des données et les modèles de données unifiés tout en contribuant à des solutions de provisionnement de plate-forme automatisées.
Jan Fernando, architecte principal au bureau de l’architecte en chef (OCA) chez Salesforce, a rejoint Salesforce en 2012 et apporte une riche expérience de son expérience dans l’écosystème des startups. Avant de se joindre à l’OCA, il a passé plus d’une décennie au sein de l’organisation Plate-forme, où il a dirigé plusieurs transformations technologiques clés.