Data 360 の相互運用性
多くの場合、企業はSalesforceやその他の外部データ レイク(Snowflake、Google BigQuery、Databricks、Redshift、_Amazon S3_などのオブジェクト ストレージ)にデータを保存します。複数のシステムでデータをサイロ化すると、AI 主導のエクスペリエンスを強化するためにデータの価値を最大限に活用したいと考えている企業にとって課題が生じます。Salesforce _Data 360_は、すべてのAgentforce AIエージェントが適切なコンテキストに適切なタイミングでアクセスするために使用する基本的なインテリジェンス レイヤーです。
複数のデータレーク間でデータをまとめる作業をしているアーキテクトは、そのデータを統合する最適な方法に関する主要なアーキテクチャ上の意思決定に直面します。Data 360 には、データ統合のための複数のオプションがあり、それぞれにさまざまな長所と短所があります。
このガイドでは、データ統合時の遅延、コスト、拡張性、ガバナンス、複雑さの要件にどのパターンが最適かを評価するフレームワークを提供し、データ取り込み、ゼロコピーデータ統合、またはハイブリッドアプローチを使用するタイミングを選択するのに役立ちます。また、このガイドは、さまざまなニーズに対応するさまざまなデータ取り込み方法とデータ統合方法の選択にも役立ちます。
外部データ レイク ハウスを_Data 360_と統合するには、データの新鮮さ、ガバナンス、パイプラインの効率性のトレードオフを慎重に検討する必要があります。たとえば、ゼロコピーデータ統合ライブクエリを使用すると、データの新鮮度が最大限に高まりますが、ネットワークを介して移動するデータが増えるとパイプラインの効率が低下する可能性があります。ほとんどの実際の実装では、マルチクラウド レイクハウス エコシステムで取り込みと統合を組み合わせることが最適な方法です。このハイブリッド アプローチにより、低レイテンシの運用ワークロード(リアルタイムのパーソナライズや不正行為の検出など)と分析ワークロード(規制レポートや履歴トレンド分析など)をサポートする、拡張性が高く、管理された相互運用性のあるアーキテクチャが実現します。このガイドは、適切な戦略を使用してこれらのトレードオフを解決する方法を判断するのに役立ちます。
- データ取り込みでは、データが Salesforce Data 360 にコピーされ、管理された正規データモデルが作成されます。これは、次のような場合に最適です。
- 包括的なCustomer 360を構築します。 これにより、さまざまなソースを統合し、信頼できる1つのプロファイルに変換できます。
- **厳格な規制コンプライアンスに対応できます。**これにより、監査可能な一元化されたコピーを作成して、データアクセスと系統を厳密に制御できます。
- ゼロコピー統合は、重複なしで外部ソースをリアルタイムに照会し、リアルタイムのパーソナライズ、ライブ ダッシュボード、迅速なソース オンボーディングを可能にします。このアプローチには2つの主なオプションがありますが、バランスを取る必要があるトレードオフがあります。
- **ライブ クエリ:**外部データ プラットフォーム(Snowflake、BigQuery、Redshift、Databricks_など)に存在する対話型分析とリアルタイム データ ダッシュボードに使用します。これにより、クエリ処理をソースシステムに転送し、必要な結果のみを返すことで、低速でコストのかかるデータの重複を回避できます。このアプローチは、新鮮さが重要な頻度の低いクエリやアドホッククエリに最適化されています。低い_QPS(クエリ/秒)ワークロードに適しています(QPSが高いとクエリ コストが大幅に上昇する可能性があります)。
- キャッシング(高速化クエリ): 頻繁に変更されないデータクエリに使用します。高速化されたクエリでは、設定可能な間隔 (15 分~ 7 日) で更新されるローカルキャッシュが維持されるため、ソースヒットの繰り返しが減少します。この方法では、ダッシュボードのパフォーマンスとコスト、セグメント化、BIワークロードのバランスを取ります(若干古い結果が許容される場合)。これは秒未満の意思決定には適していません。
- **ファイルフェデレーション:**クラウドのデータ レイク(_S3_や_ADLS_など)の大規模なバッチ処理とAIモデルのトレーニングに使用します。このアプローチでは、ファイルをオープンテーブル形式で直接照会することで、大量の ETL データセットとデータサイエンスのワークロードを解放し、低速でコストのかかる取り込みを回避します。
- ハイブリッド モデルでは、_統合プロファイル_の取り込みと、オムニチャネル エンゲージメント、Agentforce駆動型アクション、AI/MLトレーニングをサポートする新鮮さのための統合がブレンドされます。
- **ハイブリッドアーキテクチャを採用する。**多くの場合、データの取り込みと統合を組み合わせる必要があります。
- _データ取り込み_は、正規データモデルとコアガバナンスのための重要なデータに使用します。
- 他のすべてのデータ統合で_ゼロ コピーを_使用して、新鮮さを維持し、データ取り込みパイプラインの構築と管理に伴う運用オーバーヘッドを最小限に抑えます。
- **Data Ingestion Frequency Matters (データ取り込み頻度が重要)。**ビジネス価値、遅延のニーズ、運用の複雑さに基づいて頻度を選択します。
- 時間的制約のあるワークフロー(パーソナライズ、ライブ ダッシュボード、Agentforceアクションなど)に_リアルタイムを_使用します。
- 緊急度が中程度のプロセス (キャンペーンや運用レポートなど) には_ほぼリアルタイム_を使用します。
- 履歴データセットまたは低速データセットにはバッチを使用します。
- **統合パターンを遅延とパフォーマンスに合わせます。**新鮮さ、パフォーマンス、コストに対するアクセスパターンと要件に最も適したオプションを選択します。
- _ライブ クエリ_は、低レイテンシが重要となる運用ダッシュボードやリアルタイムのパーソナライズに使用します。
- クエリが頻繁に実行され、若干古い結果が許容される場合に_キャッシュ (クエリ_の高速化) を使用すると、パフォーマンスとコストのバランスを取ることができます。
- _ファイルフェデレーション_は、スループット負荷の高い大規模な分析またはバッチ ワークロードに使用します。これは、履歴データまたは時間的制約の少ないデータセットに最適です。
- ガバナンスをデータレジデンシー要件と整合させましょう。
- 一元化されたガバナンスが重要な場合は、_データ取り込み_を使用します。
- 分散ガバナンスが許容される場合_は統合_を使用し、外部ソースでは厳格なガバナンスを適用します。
- ソースレベルのポリシー (行レベルセキュリティ (RLS) やデータマスキングなど) に関して_ゼロコピー_を使用します。
- **価値の高いワークフローにはデータ取り込みを優先しましょう。**重要なプロセス (ID 解決、規制レポート、運用の有効化など) に取り込みを選択的に適用します。
- **コストと複雑さが意思決定を左右します。**リアルタイム取り込みは、コストがかかり複雑になる可能性があります。そのため、アーキテクトは、データのオンボーディング、保存、変換のコストと、_ゼロ コピー_を使用してデータを直接照会する場合のコストを天秤にかけることが重要です。
適切なインテグレーション パターン(データ取り込み、ゼロ コピー、ハイブリッド アプローチ)を選択することは、マルチクラウド プラットフォーム全体のレイテンシ、ガバナンス、運用効率、コストに直接影響します。この決定により、リアルタイムのインサイト、AI 主導の有効化、パーソナライズされたエンゲージメントが信頼性高く大規模に提供される方法が形成されます。
次の表は、Salesforce Data 360 の_データ取り込み_パターンと_ゼロコピー_パターンを比較し、機能、トレードオフ、メリット、およびエンタープライズの使用事例と結果に焦点を当てています。パフォーマンス、コスト、コンプライアンスのバランスを取るハイブリッドのマルチクラウドデータプラットフォームを設計する際の参考にしてください。
| パターンタイプ | モード/ツール | 利点 | 考慮事項 | 結果 |
|---|---|---|---|---|
| データ取り込み |
リアルタイム:
|
|
|
Agentforce:
|
ストリーミング:
|
|
|
Agentforce:
|
|
バッチ:
|
|
|
Agentforce:
|
|
| Zero Copy |
ライブクエリ:
|
|
|
Agentforce:
|
高速化されたクエリ (キャッシング):
|
|
|
Agentforce:
|
|
ファイル統合:
|
|
|
Agentforce:
|
Data 360 には、データ取り込み、ゼロコピーデータ統合、ハイブリッドアプローチの 3 つの主要なインテグレーションパターンがあります。
_データ取り込み_では、データがソースに残される_ゼロコピー_とは異なり、データが物理的_にData 360_にコピーされ、完全に管理されます。つまり、変換のコンピューティングは_Data 360_内で実行され、一元的なガバナンスと監査が提供されます。
_データ取り込みを_使用して、コンプライアンスと業務管理のために正規の管理データセットをSalesforce _Data 360_に保存します。取り込みは、完全な制御、監査、トレーサビリティが必要な場合に使用します。データ取り込みは、一元的なコンピューティングとガバナンスが重要な、規制対象のワークフローや価値の高いワークフローに最適です。
取り込みは、アイデンティティ解決、規制レポート、ミッションクリティカルなAI駆動型ワークフローおよび顧客エンゲージメントのための信頼できる基盤を構築する場合に適しています。

_データ取り込み_方法は、データの取り込みに使用するコネクタによって異なります。さまざまな取り込み方法を提供するコネクタもあれば、バッチモードまたはストリーミングモードでのみ動作するコネクタもあります。Data 360 コネクタと使用可能なメソッドの完全なリストについては、「Data 360: Integrations and Connectors (Data 360: インテグレーションとコネクタ)」を参照してください。
- リアルタイム:
- 変更データキャプチャ (CDC) を使用して、1秒未満の取り込みを提供します。
- 時間的制約のあるワークフロー (不正行為の検出、パーソナライズ、運用ダッシュボードなど) に適しています。
- _Data 360_内のプッシュ変換と集約により、下流のI/Oを削減し、コンピューティング使用量を最適化
- インクリメンタルなCDCを使用して、データのシャッフルを最小限に抑えることをサポートします。
- ストリーミング:
- 1~3分ごとに小単位で取り込みます。
- 鮮度とコストのバランスをとります。
- キャンペーンオーケストレーション、ニアライブエンゲージメント、運用レポートに最適
- マイクロバッチを使用した I/O スパイクの制御をサポート
- ソースで可能な場合、データを集計して転送量を削減し、ストレージを最適化します。
- バッチ (スケジュール済み読み込み):
- 大規模なデータセットの定期的な取り込み(例:毎時、毎日、毎週など)を提供します。
- 履歴データセット、規制レポート、コンプライアンスの使用事例のコスト効率と信頼性を向上
- コンピューティングのローカル性をソースストレージと同じ領域に確保して、パフォーマンスを向上させ、コストを最適化
- データ取り込みのユースケース:
- **Customer 360 統合プロファイルの生成。**顧客のIDおよび属性に関する唯一の信頼できる情報源を構築します。
- **規制コンプライアンスデータセットを管理します。**機密データに対して、ガバナンス、系統、監査可能性を確保します。
- **キャンペーンオーケストレーションを一元化します。**マーケティング、営業、サービスのすべてが一貫性のある信頼できるデータセットから実行されるようにします。
- 設計プラクティス:
- 履歴データや低レイテンシーが許容されるニーズ(たとえば、アーカイブレポートや定期スナップショットなど)に合わせたバッチ取り込みに対応します。
- CDC またはストリーミング API を使用して、業務ワークフローとパーソナライズワークフローの新鮮さを維持し、ほぼリアルタイムで更新できるようにします。
- データセット全体の再読み込みに代えて、インクリメンタルな読み込みを適用することで、ストレージとコンピューティングの増加を制御し、コストと効率を最適化します。
- 取り込みパイプラインを、コンピューティングのローカリティおよびインクリメンタルな処理に合わせることで、ネットワークI/Oを削減します。
- Data 360 内で変換を適用して、未加工データを不必要に移動しないようにします。
- コストに関する考慮事項:
- リアルタイム取り込みは、コンピューティングとパイプラインのコストが最も高く、価値が高く、時間的制約のあるワークフロー(パーソナライズ、運用ダッシュボード、Agentforce駆動型アクションなど)では妥当な可能性があります。
- ストリーミング取り込みには中程度のコンピューティングコストとストレージコストがかかるため、わずかな遅延を許容できる頻繁な更新 (キャンペーンオーケストレーションや運用レポートなど) に適しています。
- バッチ取り込みは、コンピューティング コストが低く、予測可能なストレージであるため、履歴データセットや頻度の低い更新に適しています。特定のコネクタを使用して Salesforce 組織から一括処理データを取り込むことは無料です。
- 更新モードでは、取り込みとコンピューティングの合計コストを削減する_インクリメンタルなリフレッシュ_モードを選択できます。Salesforceでは、可能な限り_インクリメンタルなリフレッシュ_を使用して、すべての取り込み種別の効率を最適化することをお勧めします。
- コストは、ソースから_Data 360_へのI/O量にも影響されます。バッチサイズ、パーティション、地域調整を最適化すると、転送コストが削減され、パフォーマンスが向上します。
- 業種シナリオ:
- **財務:**取り込みデータセットは、監査可能性とコンプライアンスが譲れない_顧客(KYC)_、_AML(マネー ロンダリング_対策)、不正行為の検出に必要です。
- 医療: 患者の ID 解決と HIPAA 準拠のレコードの取得を使用して、安全で統合されたビューを実現します。
- 小売: 販売時点管理(POS)、eコマース、およびロイヤルティプログラムのデータを統合プロファイルに統合して、セグメンテーションとパーソナライズを行います。
- 通信: 正規で管理された登録者データを使用して、離脱防止と利用状況の分析をサポートします。
| 機能 | リアルタイム取り込み | ストリーミング取り込み | 一括取り込み |
|---|---|---|---|
| レイテンシと鮮度 | _変更データキャプチャ(CDC)_をサポートする取り込みAPIを介した1秒未満のレイテンシの取り込みを特徴とします。継続的なストリーミングパイプラインを提供します。低遅延の運用ユースケースに適しています。 | ネイティブコネクタを使用して 1 ~ 3 分ごとにマイクロバッチを取り込みます。インクリメンタルな更新をサポートします。若干の遅延が予想されます。 | データ遅延が予想されます。スケジュール済みの大ボリューム読み込みを許可します。定期的な取り込み (毎時、毎日、毎週) を特徴とします。時間に敏感な操作には適していません。 |
| 主なユースケース | 低遅延の運用およびパーソナライズのユースケースに最適です。時間的制約のあるワークフローに使用します。イベント駆動型ワークフローをサポートします。リアルタイムの不正行為アラートと業務アラートに使用します。 | 緊急度が中程度のプロセスに適しています。キャンペーンオーケストレーション、ニアライブエンゲージメント、運用レポートに使用します。タイムリーなキャンペーントリガーに使用します。 | 大規模なデータセットに対してコスト効率が高いです。履歴分析において信頼性が高いです。履歴集計または規制対象のレポートワークフローに使用します。履歴データセットまたは低速データセットに適しています。 |
| アーキテクチャの複雑さと I/O | 高コストで複雑なアーキテクチャが含まれる。低レイテンシのソースシステムが必要。I/O 集約型。大量のソースがあると、パイプラインが飽和する可能性があります。 | リアルタイムよりもシンプルなアーキテクチャを特徴としています。I/O は中程度です。予測可能で反復的な更新パターンに適しています。バッチサイズはメモリと計算に影響します。 | 実装が容易です。読み込みウィンドウ中は I/O が集中的になります。大規模なバッチでは、ネットワークのスループットがボトルネックになる可能性があります。 |
| コストに関する考慮事項 | 最も高いコンピューティングコストとパイプラインコストが含まれます。価値が高く、時間的制約のあるワークフローでのみ有効です。 | 中程度のコンピューティングコストとストレージコストが含まれます。コストと鮮度のバランスに優れたアプローチを提供します。わずかな遅延を許容できる頻繁な更新に適しています。 | コンピューティング コストを抑え、予測可能なストレージを備えています。履歴データセットや頻度の低い更新にお勧めします。Salesforce 内部パイプラインを介した取り込みは無料です。 |
| 設計ベストプラクティス | 増分 CDC を使用して、データの入れ替えを最小限に抑えます。必要な項目を絞り込んで使用し、オーバーヘッドを削減します。 | マイクロバッチを使用して、I/O スパイクを制御します。処理の負荷を軽減するために、ウィンドウ集計を検討します。 | アーカイブレポートまたは定期的なスナップショットに使用します。コストを最適化するために、計算の局所性がソースストレージと同じ領域にあることを確認します。 |
_ゼロ コピー_を使用して、データの重複のない外部システムのリアルタイム クエリを実行し、大規模データセットまたは一時的なデータセットへの俊敏性、最新性、拡張性の高いアクセスを実現します。ライブ ダッシュボード、探索的分析、AI/MLモデルのトレーニング、Salesforce _Data 360_を介したリアルタイムの顧客エンゲージメントに適しています。
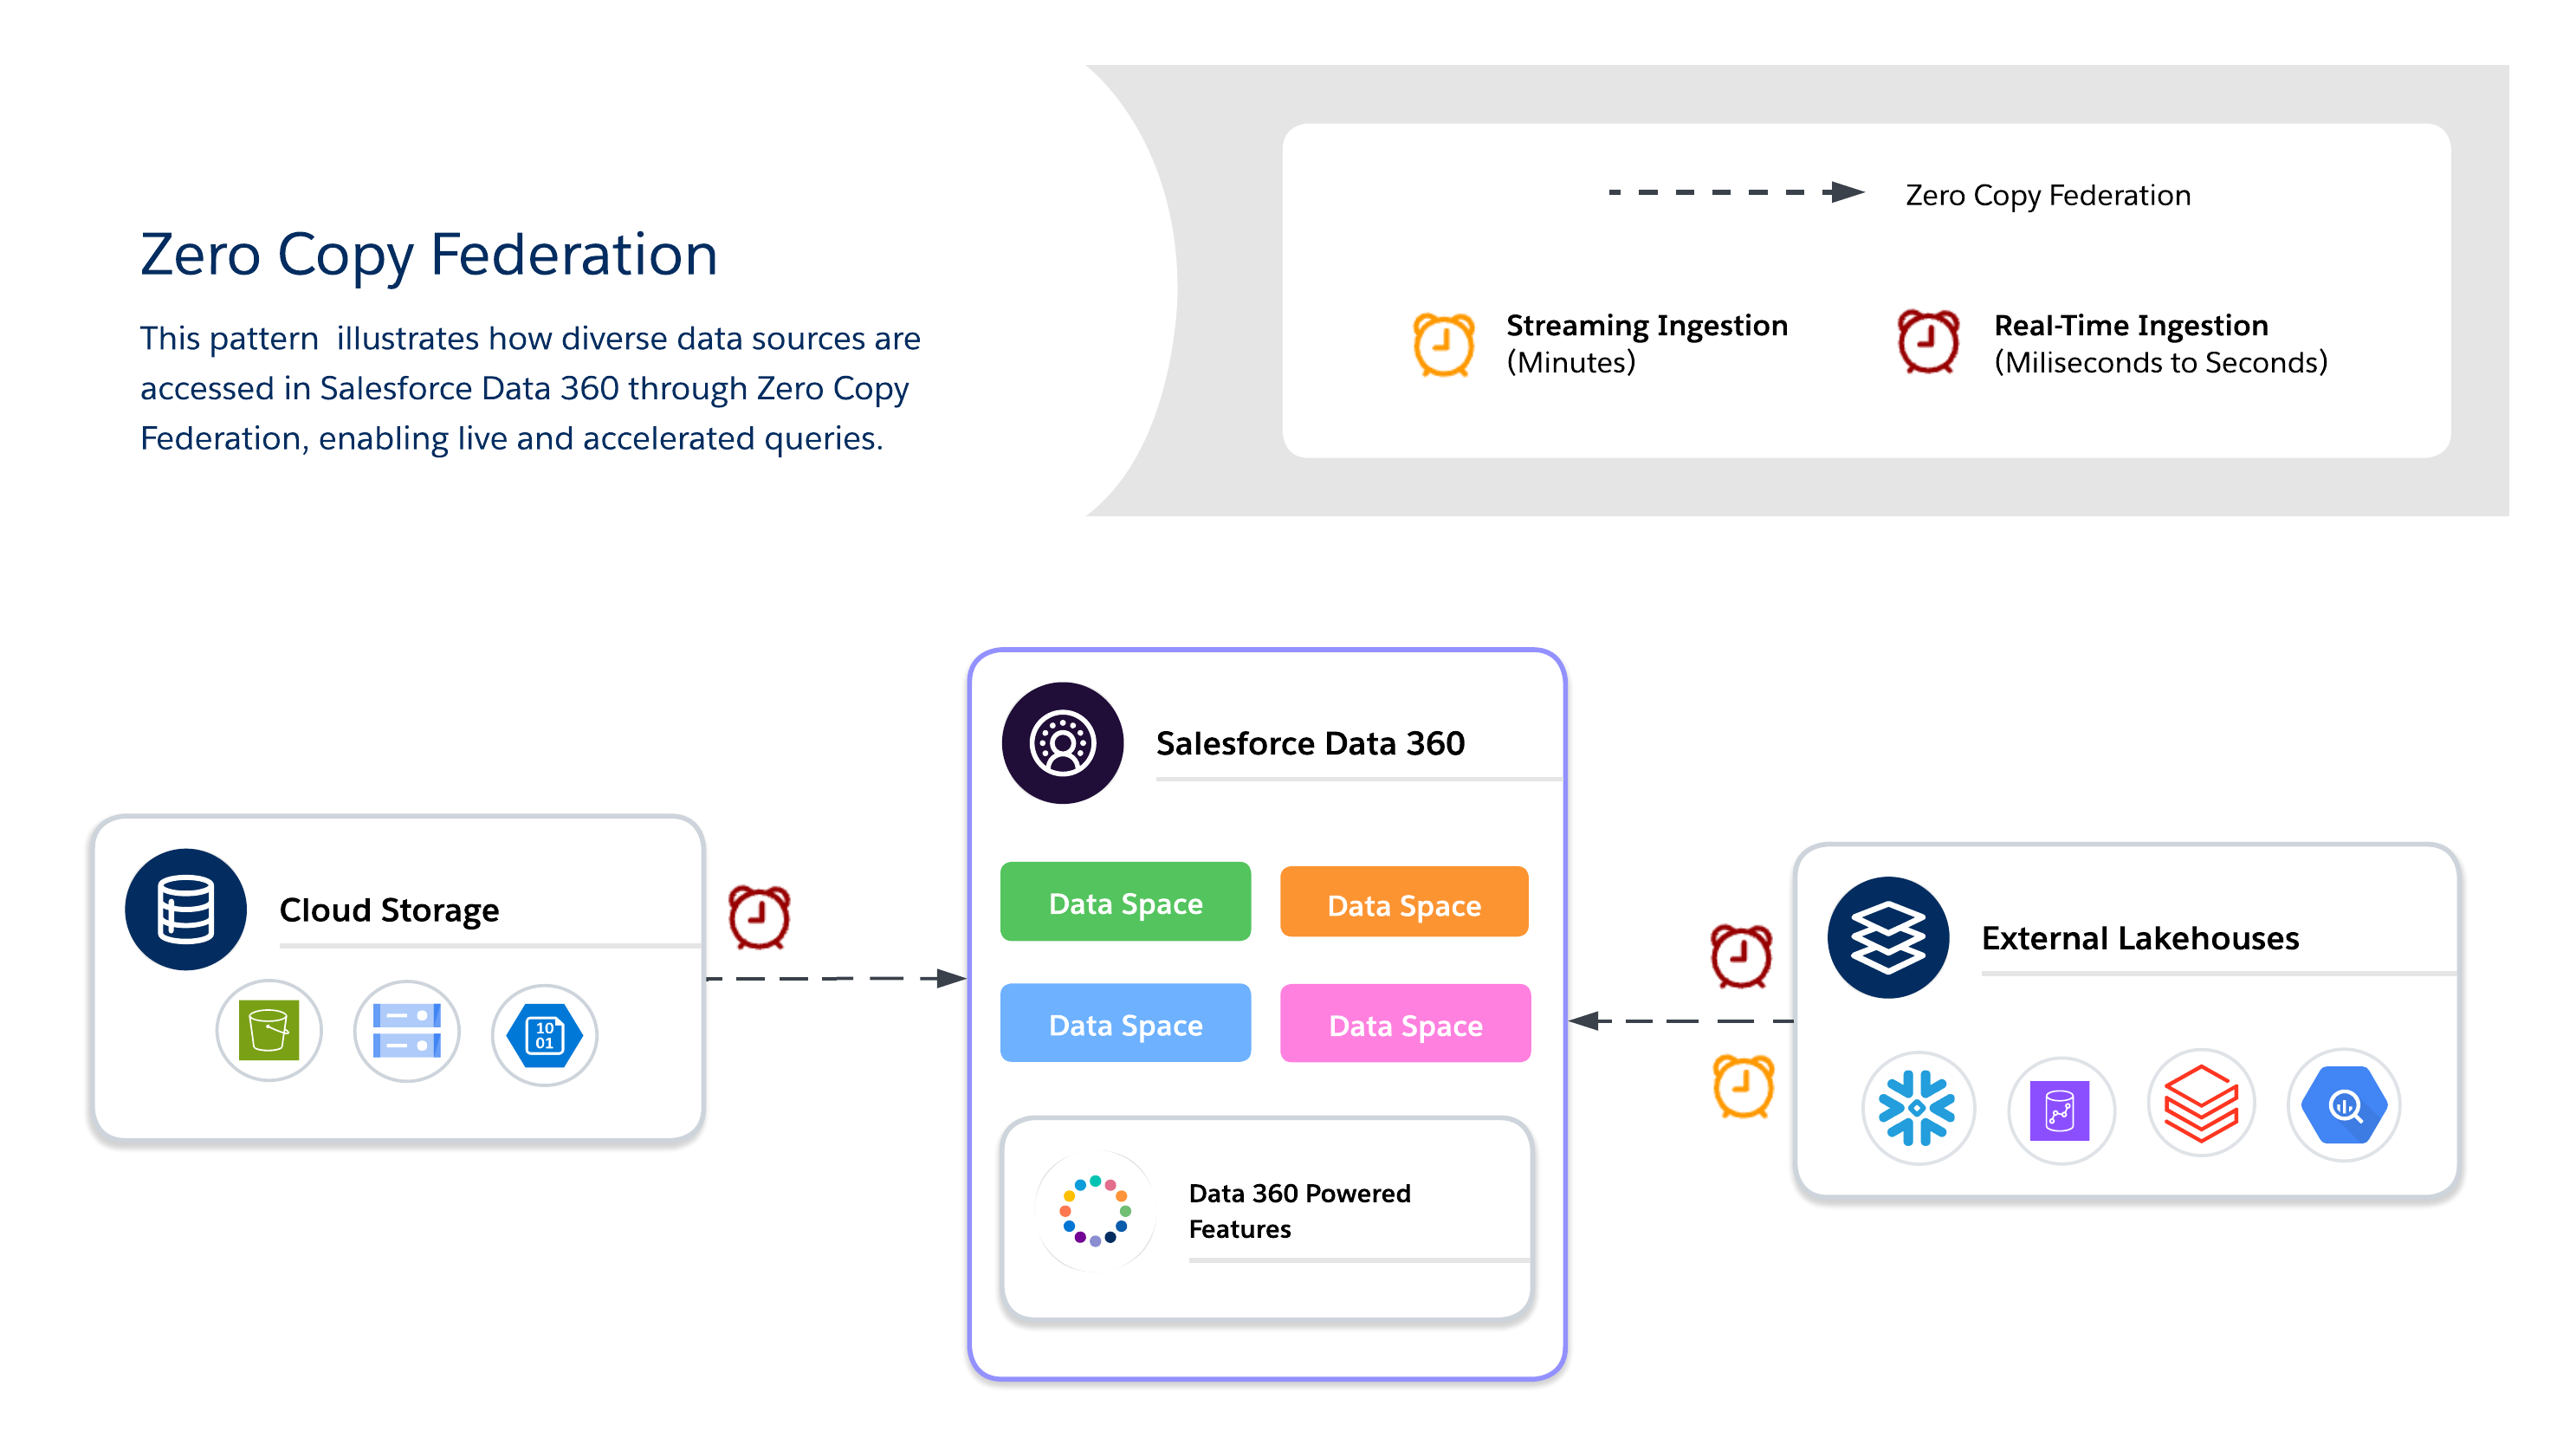
_ゼロ コピーを_使用する場合、アーキテクトは使用可能な3つのデータ統合方法のいずれかを選択する必要があります。それぞれに、新鮮さ、パフォーマンス、コストのトレードオフがあります。
- ライブクエリ
- 外部システム(Snowflake、Google BigQuery、Redshift、_Databricks_など)に対してデータの重複なしで直接クエリを実行します。
- ネットワーク上のデータ移動を最小限に抑え、Salesforce _Data 360_の計算におけるI/Oを削減します。述語や集計をプッシュダウンできる場合に最適です。
- リアルタイムのインサイトと低レイテンシの運用ダッシュボードに適しています。
- 外部システムのパフォーマンスによって異なります。
- キャッシング (高速化されたクエリ)
- 統合データのキャッシュされたコピーを Salesforce Data 360 に一時的に保存します。
- 期間 (分~日) を設定可能で、頻繁にアクセスされるデータセットの反復クエリコストと遅延を削減します。
- データは完全にはコピーされないため、更新はソースからのスケジュールされた更新で管理されます。
- _インクリメンタルなリフレッシュ_は、アップサートのみをサポートします。削除したレコードはキャッシュから削除されません。
- 定期的にフル更新を実行して、キャッシュがソースと同期されていることを確認します。
- 注: Snowflake コネクタでは、Snowflake が開始するステージングバケットを使用して加速率を高める_アンロード_機能がサポートされています。これはデフォルトで有効になっていますが、接続を編集することで無効にできます。
- ファイル統合
- オブジェクト ストアの大規模なデータセット(_Iceberg_を使用する_S3_や_GCS_など)への参照のみの直接アクセスを提供します。
- データを移動することなく、AI/ML ワークロード、履歴分析、ペタバイト規模のレポートに適しています。
- クエリのパフォーマンスは、オブジェクト形式、パーティショニング、ネットワーク I/O に大きく依存します。大規模なスキャンでは、最適化されていない場合、大量の I/O が生成される可能性があります。
- 使用事例
- リアルタイムのパーソナライズと適応型ワークフローにより、顧客の行動の変化に応じて動的な提案、おすすめ、Next Best Actionが提供されます。
- ライブ ダッシュボードと運用分析により、ビジネス クリティカルなダッシュボードとKPIを外部倉庫から直接利用できます。
- 大規模な外部データセットを使用するAI/MLモデルのトレーニングでは、ファイルフェデレーションを介して移動することなく、データレークやウェアハウスからペタバイト規模のデータを活用します。
- 業種シナリオ
- 小売/メディア: クリックストリームまたはコンテンツインタラクションデータを統合することで、パーソナライズされたおすすめとリアルタイムの顧客エンゲージメントを実現します。
- **財務:**機密データを重複させることなく外部倉庫を照会することで、不正行為の検出とリスク スコアリングをほぼリアルタイムで実行します。
- Tech/Enterprise: データセットが複数のシステムに存在する場合に、クロスクラウドレポート、ITサービスダッシュボード、運用分析をサポートします。
- デザインプラクティス
- ライブクエリ
- 新鮮度が重要な場合に、高QPSで低レイテンシのクエリに使用します。
- 述語と集計を外部システムに転送して、ネットワーク上のデータの入れ替えを減らします。
- 大量のデータを不必要にスキャンするクエリは避けてください。
- 代わりにパーティションのプルーニングとフィルターを検討してください。
- ファイル統合
- 取り込みなしでオブジェクトストアのペタバイト規模のデータセットにアクセスできます。
- オブジェクトストレージを Salesforce の計算と同じクラウド領域に保持することで、遅延と出力コストを最小限に抑えます。
- パーティション分割された列形式 (Parquet/ORC) とプッシュダウン検索条件を使用して、I/O とネットワーク転送を削減します。
- クエリと述語のプッシュダウンを活用して、ソースでデータを絞り込んで集計することで、データの移動を減らします。
- I/O、遅延、コストが増加するため、リージョン間データアクセスは、絶対に必要でない限り避けてください。
- キャッシング (高速化されたクエリ)
- コストとパフォーマンスのバランスを取るために、頻繁にアクセスするデータセットをキャッシングします。
- 更新間隔を設定して、新鮮度とクエリコストのバランスを取ります。
- **コンプライアンス:**統合システム内で_RLS(行レベルセキュリティ)_とマスキングポリシーを直接活用して、ソースでガバナンスを適用します。
- プラットフォーム間で統一された RLS とマスキングを行うためのベストプラクティスを次に示します。
- **一元化されたエンタープライズ ID を使用します。**Salesforce Data 360 のユーザーとエンティティを、外部システムの ID に対応する一意の一元化されたエンタープライズ識別子に対応付けます。
- **セキュリティポリシーを調整します。**対応付けられた ID に基づいて、統合システムの RLS およびマスキングポリシーが適用されるようにします。これにより、外部データを照会するときのコンプライアンスが保持されます。
- **ID スキーマの標準化。**不一致やアクセス違反を回避するために、すべてのデータソースで一貫した ID 属性 (メール、ユーザー ID、顧客 ID など) を維持します。
- プラットフォーム間で統一された RLS とマスキングを行うためのベストプラクティスを次に示します。
- ライブクエリ
- コストに関する考慮事項
- ライブクエリ: クエリあたりの支払モデルでは、外部レイクハウスの計算でコストが発生するため、QPS が高いスパイクが発生する可能性があります。これは、コストの変動よりもその価値が大きい、新鮮さを重視するユースケースに適しています。
- Accelerated Query (Caching): この方法では、ソースシステムへのヒットを減らすことでクエリコストを (_ライブクエリ_と比較して) 削減できますが、キャッシュへの入力と更新のためのバッチデータの取り込みコストは増加します。これは、頻繁にアクセスされるデータセットに適しています。
- **ファイルフェデレーション:**これは、オブジェクトストアのデータとして最も安価なストレージオプションです。ただし、クエリコストは、ファイルサイズ、パーティション分割、およびプルーニングによって異なります。これは、ペタバイト規模の履歴データや一括データに適しています。
| 決定ポイント | ライブクエリ | キャッシング (高速化されたクエリ) | ファイルフェデレーション |
|---|---|---|---|
| データソースの場所 | 外部データ レイク ハウス(Snowflake、Google BigQuery、Redshift、_Databricks_など) | 外部データ レイク ハウス(Snowflake、Google BigQuery、Redshift、_Databricks_など) | オブジェクト ストアまたはクラウド データ レイク(S3、ADLS、_GCS_など)。_Iceberg_のようなオープン テーブル形式がよく使用されます。 |
| 目的/使用事例 | 対話型の分析やリアルタイムダッシュボードに適しています。リアルタイムのパーソナライズと動的なワークフローに適しています。 | クエリが頻繁に発生するが、若干古い結果が許容される場合に適しています。BI ダッシュボードおよびセグメンテーションに適しています。 | 大規模なバッチ処理や AI/ML モデルのトレーニングに適しています。履歴分析やペタバイト規模のレポートに適しています。 |
| 鮮度/レイテンシ | 最大限の新鮮さを提供 リアルタイムでクエリを直接実行します。効果的な述語プッシュダウンを用いてソースシステムが低レイテンシクエリ用に最適化されている場合、1秒未満の意思決定をサポートします。 | 若干古い結果が許容される場合に使用します。新鮮度は、15 分~ 7 日間の範囲で設定できるキャッシュ間隔によって異なります。 | バッチ負荷が高く、スループット要件の厳しいジョブに適しています。リアルタイムダッシュボードには適していません。 |
| アクセスパターン | 新鮮さが重要でクエリ量が少ない頻度の低いクエリやアドホッククエリに適しています。QPS が高いとコストが大幅に上昇するため、クエリ頻度が高いときにキャッシュ (Accelerated Query) を評価することが重要です。 | 高頻度の読み取りシナリオに適しています。頻繁なアクセスパターンのパフォーマンスが向上します。 | 読み取り専用アクセスを提供します。取り込みのないペタバイト規模のデータセットに適しています。 |
| パフォーマンスの促進要因 | 外部システムのパフォーマンスに大きく依存します。述語と集計をソース側にプッシュダウンできる場合に適しています。 | 繰り返されるライブクエリと比較して遅延が短縮されます。パフォーマンスは、キャッシュ管理と間隔によって異なります。 | パフォーマンスは、オブジェクト形式、パーティショニング、外部システムのスループットに大きく依存します。パーティション分割された列形式 (Parquet/ORC) を使用します。 |
| コストへの影響 | これはクエリごとの支払モデルであるため、外部レイクハウスの計算でコストが発生します。頻繁ではないクエリではコスト効率が高くなりますが、QPS 量が多いと経費が急増する可能性があります。 | コストは、繰り返されるライブクエリよりも低くなります。これにより、外部ソースを繰り返し照会する必要がなくなりますが、キャッシュストレージと更新オーバーヘッドが追加されます。 | これは最も安価なストレージオプションです。同じリージョン、同じクラウドのAWS設定の場合(US-East-1に_Data Cloud_テナントがあるUS-East-1の_S3_など)、アクセスされる行でクレジットは消費されません。クロス リージョンまたはクロス クラウド構成(Azure、GCS、異なる_AWS_リージョンなど)では、アクセスされる行のクレジット消費が発生します。クエリコストは、ファイルサイズ、パーティショニング、述語プッシュダウンの最適化によっても異なります。 |
| 主な考慮事項 | 大量のデータを不必要にスキャンする絞り込まれていないクエリは避けてください。 | この方法では、キャッシュ管理が必要です。1秒未満の意思決定には適していません。 | クエリのパフォーマンスは、パーティショニングと述語プッシュダウンによる最適化に大きく依存します。 |
ハイブリッド アーキテクチャにより、アーキテクトは重要なデータセットを Data 360 に固定して一元化されたガバナンスを実現すると同時に、統合クエリを活用して、最新性、重複の削減、大規模な外部データセットへのスケーラブルなアクセスを実現できます。このアプローチでは、I/O、計算の局所性、コスト、コンプライアンスの要件のバランスを取ります。
ハイブリッドアプローチを使用して、データの取り込みとゼロコピーを組み合わせることで、バランスの取れたガバナンス、新鮮さ、運用効率を実現し、リアルタイムでアクション可能なインサイトを提供します。トレーサビリティ、RLS、マスキングが必要な価値の高い規制対象のデータセットには取り込みを使用し、新鮮さとパフォーマンスが重要な一時的または大量のデータセットには統合を使用します。
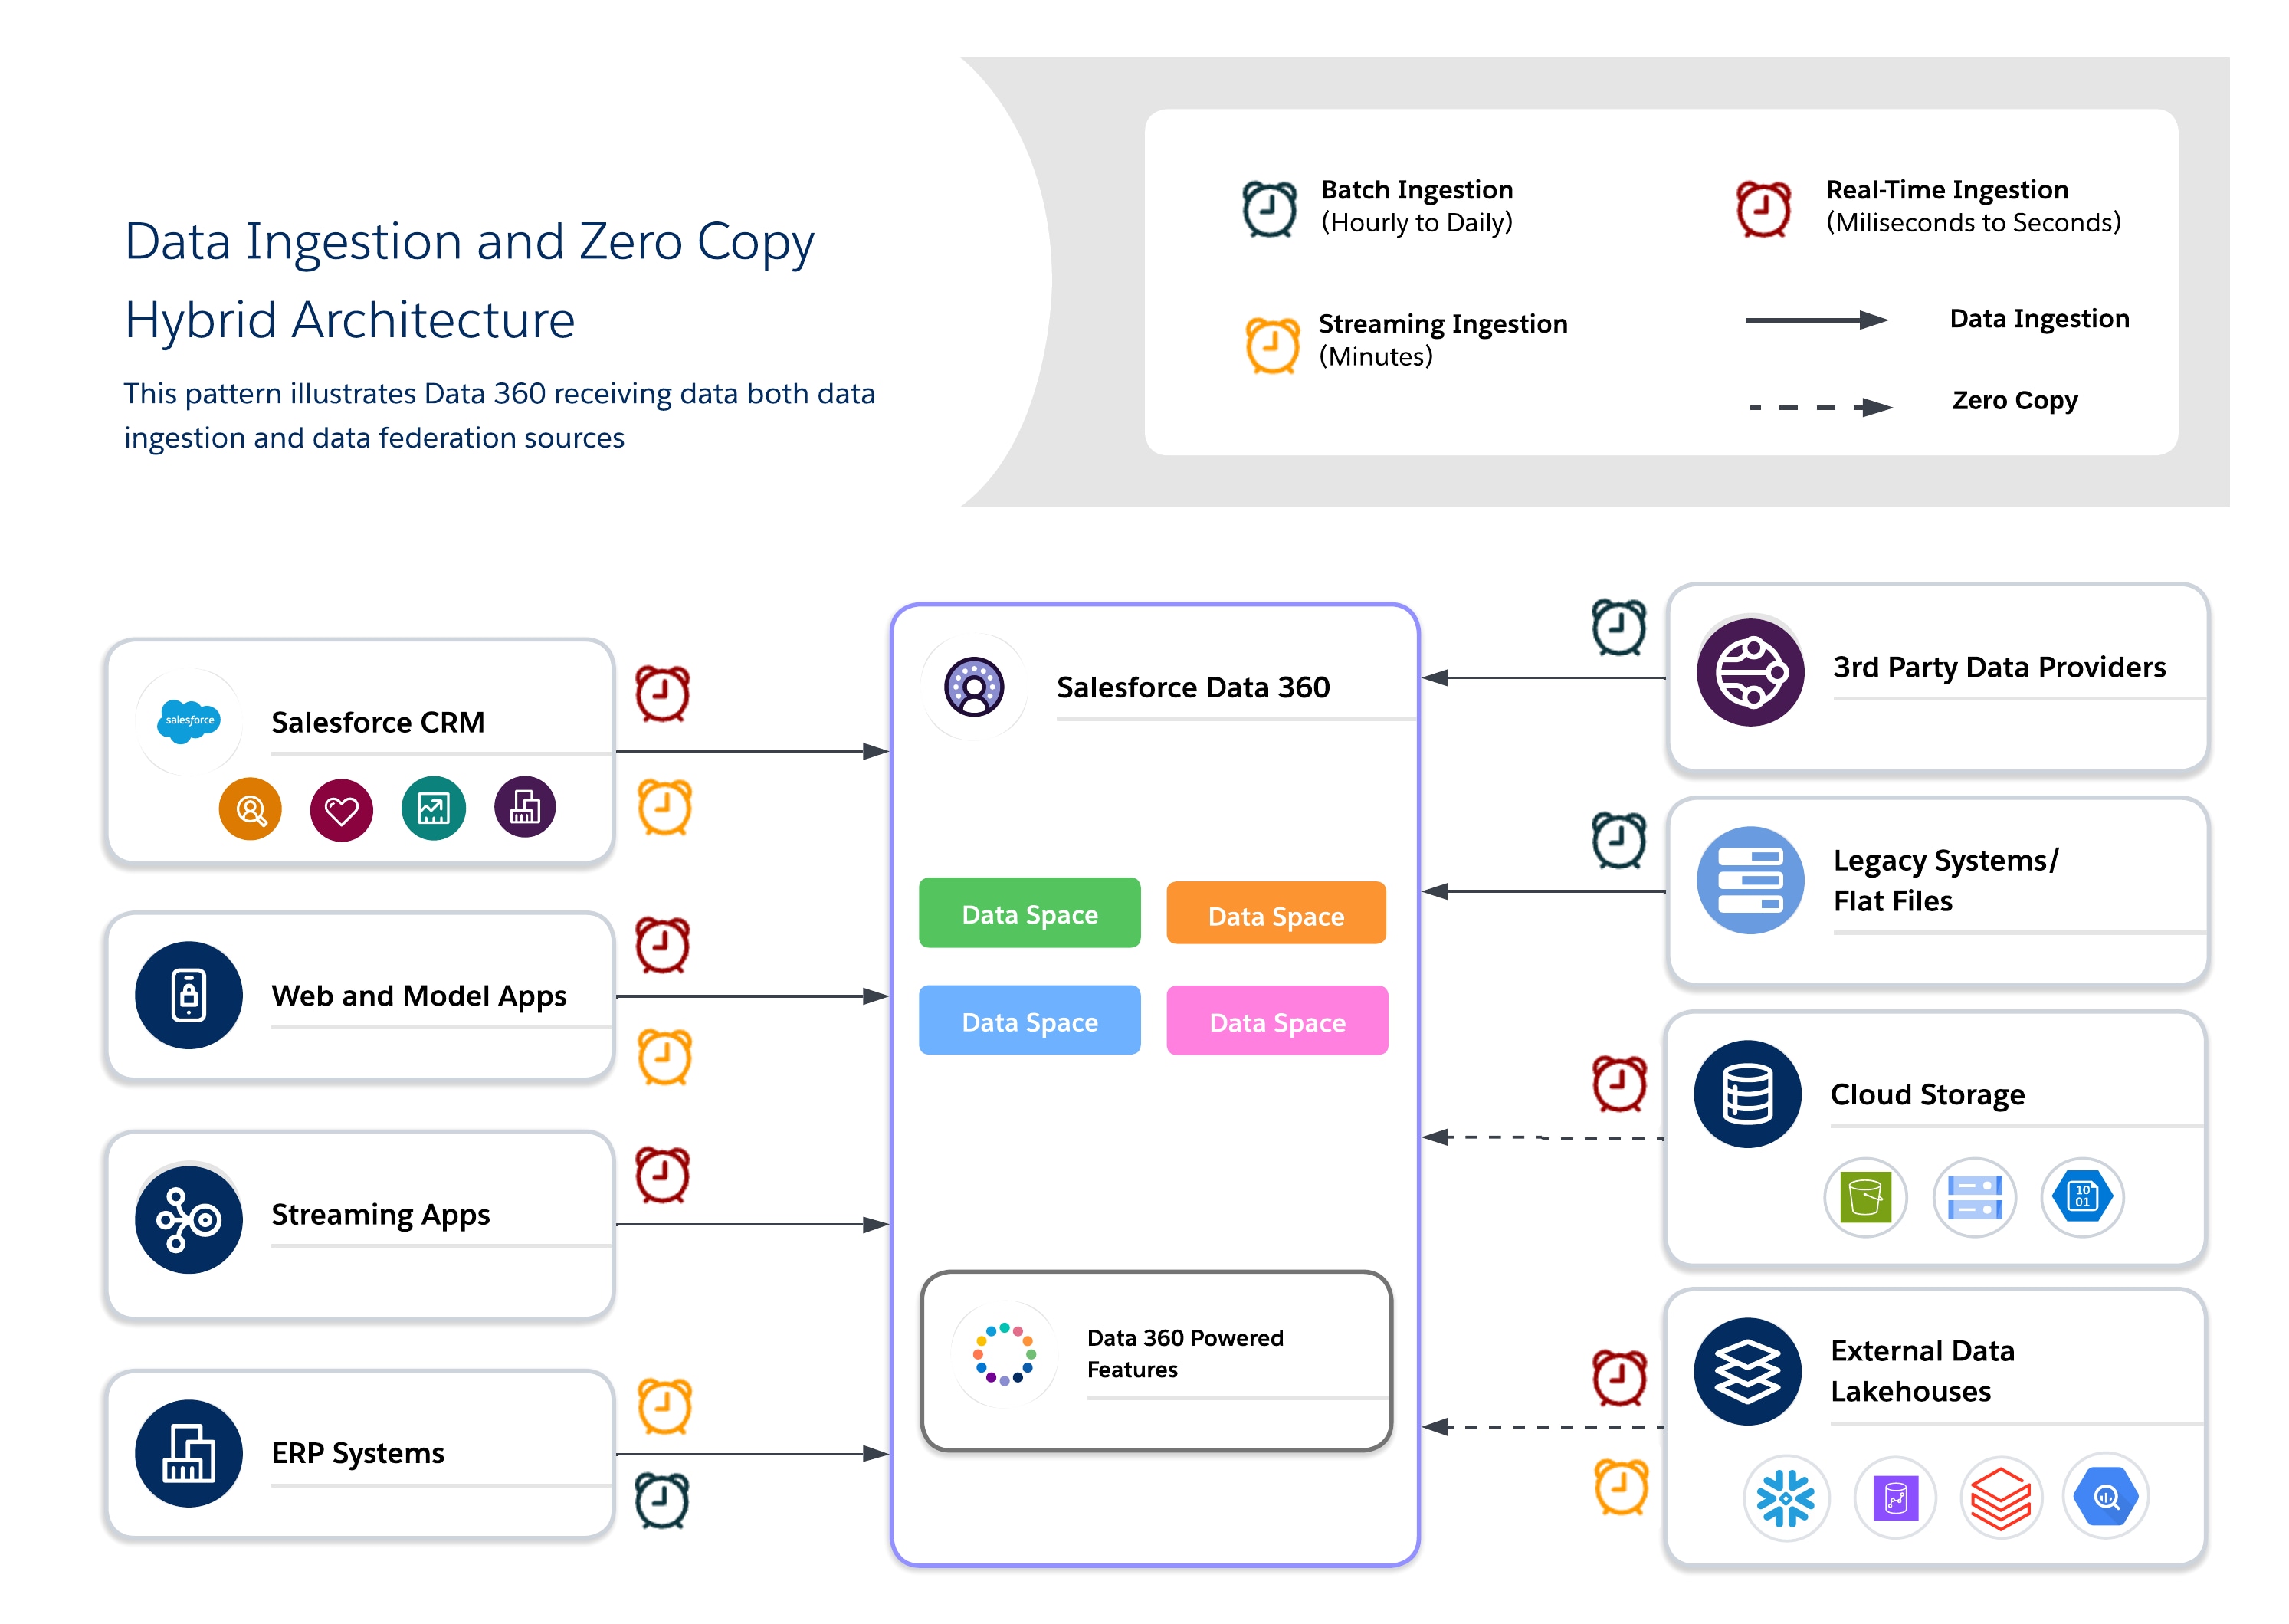
- 使用事例
- オムニチャネルエンゲージメント: 顧客の履歴データとリアルタイムの行動を組み合わせて、一貫性のあるコンテキスト対応環境を提供します。
- **AI/MLパイプライン:**厳選された正規データセットに基づいてモデルをトレーニングしながら、外部ソースからの未加工またはリアルタイムのシグナルで強化します。
- コンプライアンスと俊敏性の混在ニーズ: 機密データには厳格なガバナンスを適用し、運用の俊敏性には統合を適用します。
- 業種シナリオ
- リテール: ID解決とプロファイル統合には_取り込み_を使用し、リアルタイムのオファーとパーソナライズには_federation_を使用します。
- **医療:**IoTデバイス ストリームとセンサー データ_の統合を_使用して即時のコンテキストを確保しながら、_取り込み_によってゴールデン 患者レコードを維持します。
- **金融サービス:**外部の不正検出およびリスク モニタリング クエリに_統合_を使用しながら、規制対象のデータをコンプライアンス管理対象のレイクに取り込みます。
- 設計手法
- 取り込みによるアンカーガバナンス: 価値の高いデータや規制対象のデータを正規モデルに取り込み、Trustとコンプライアンスを確保します。
- **Use Federation for Freshness:**外部レイク ハウスが重複のないリアルタイムまたは大規模なデータ アクセスを提供できるようにします。
- コストとパフォーマンスのバランス: ワークロードをプロファイルして、_取り込み_と_統合_のどちらを使用するかを決定します。これにより、不要なストレージとクエリのコストを最小限に抑えます。
- **階層型ガバナンスの適用:**統合システムのセキュリティ制御(RLSやマスキングなど)を活用しながら、取り込まれたデータの一元的なガバナンスを適用します。
- **注:**ハイブリッド パイプラインを設計する場合、履歴データセットの増分取り込みを確保し、統合ソースに集計またはフィルターを転送してI/Oとコンピューティングの使用量を最適化することが重要です。
- コストの考慮事項
- コンプライアンスや重要なデータの_取り込み_と、新鮮さが必要な場合の_統合_を組み合わせて、総コストとパフォーマンスを比較します。
- _取り込み_と統合を混在させる場合、I/Oと_コンピューティング_の配分を考慮します。ソースシステムに対するクエリの繰り返しによる計算コストを削減するには、読み取り頻度が高く、頻繁にアクセスされる統合データセットのキャッシュ (Accelerated Query) を使用します。
- このルールを使用して、取り込みと統合に関する意思決定をガイドします。データへのアクセス頻度は高くても、変更頻度が低い場合、_Accelerated Query_のコスト パフォーマンスは通常高くなります。ただし、データが頻繁に (アクセス頻度に対して) 変更される場合は、_ライブクエリ_または_取り込み_の方が適しています。コストの例をいくつか紹介します。
- 高速化: 100万件のレコードから作成され、毎日約1万件の変更で更新されるダッシュボードは、1日あたり20回参照されます。_高速化_のコストは、_ライブ クエリ_の場合は約4,200クレジット/月であるのに対して、約600クレジット/月です。
- ライブ クエリが有利な場合: 30分ごとに変化するデータを使用して、1日に20回公開されるセグメント。_ライブ クエリの_コストは、この更新頻度では_高速化_に必要な約4,200クレジット/月であるのに対し、約28,800クレジット/月です。
このロジックを適用する方法を示すいくつかの一般的なアーキタイプを詳しく見てみましょう。
- 「Single Source of Truth」アーキタイプ: 一元化とガバナンス
- シナリオ: グローバル企業全体の準拠した統合 Customer 360 プロファイルを作成する必要があります。データはさまざまなシステムから取得され、厳格な_GDPR_および_CCPA_規制に準拠する必要があります。また、データはすべてのマーケティングおよびサービスのやりとりの情報源として機能します。
- 推奨パターン: **データ取り込み。**ここでの優先度は、ガバナンス、Trust、支配です。データを_Data 360_に取り込むことが、ソース システムから分離された、完全に監査可能な正規プロファイルを作成する唯一の方法です。
- 「リアルタイム・インサイト」の原型: 移動せずに分析
- **シナリオ:**データ サイエンス チームは、_Snowflake_で絶えず更新される大量のトランザクション テーブルに対して探索クエリを実行する必要があります。同時に、経営陣は、同じデータを活用したライブ_BI_ダッシュボードを求めています。毎日数ペタバイトのデータを移動すると、時間とコストがかかります。
- 推奨パターン: **ゼロコピーフェデレーション。**ここで優先されるのは、スピード、アジリティ、および大規模運用時の費用対効果です。_ゼロ コピー_では、既存のデータ ウェアハウスの機能を活用して、データの重複によるオーバーヘッドやレイテンシを発生させることなく、リアルタイムのクエリを実行できます。
- 「ハイブリッド インテリジェンス」のアーキタイプ: コアのガバナンス、エッジのフェデレーション
- シナリオ: データレイクからのリアルタイムの行動シグナル (Web サイトのクリックなど) を使用して、管理され、取り込まれた顧客プロファイルを強化したいと考えています。コアプロフィールの安定性が必要ですが、ライブ データの即時性によって、その場でのパーソナライズを実現できます。
- 推奨パターン:****ハイブリッド アプローチ。_データ取り込み_を使用して、本顧客データの安定した管理されたコアを作成します。_ゼロ コピー_を使用して、揮発性のリアルタイムの「エッジ」データを統合し、クエリ時にそれらを結合して、最新の完全なビューを作成します。
エンタープライズデータ戦略は、もはや 1 つのインテグレーションパターンを選択することに焦点を絞るのではなく、相互運用性のあるデータエコシステム内で制御された柔軟性を構築することに重点を置いています。適切なアプローチでは、各ソースシステムをその新鮮さ、ガバナンス、コスト、アクセス要件に最も適したパターンに対応付けます。
- コンプライアンス、ID解決、運用ワークフローのために、ミッション クリティカルな規制対象のデータセットをSalesforce _Data Cloud_に取り込みます。
- _Zero Copy_を使用してデータを統合することで、ストレージを重複させることなく、ライブ、探索、AI主導の分析を行うことができます。
- クエリ頻度が高く、データ変更頻度が低い場合のソースシステムの負荷とクレジット消費を削減するための_キャッシュ (クエリ_の高速化) の適用
Salesforce Data 360 on _Hyperforce_は、複数リージョンの復元性と拡張性を実現します。_Iceberg_テーブルを備えたオープン レイク ハウスにより、コンピューティングの分離と、Snowflake、Databricks、_S3 Iceberg_などのプラットフォームとの相互運用性を実現し、真に相互運用性のあるマルチクラウド データ エコシステムのバックボーンを形成します。
データエコシステムが進化するにつれ、アーキテクチャのアジリティを維持するために、新鮮さ、コスト、パフォーマンス、コンプライアンスのバランスを継続的に保つ必要があります。そのため、取り込まれた管理データを統合アクセスで統合することで、プラットフォームを将来にわたって使用できることが重要です。これにより、クラウド、地域、ビジネスドメイン全体でリアルタイムインテリジェンス、AI の有効化、エンタープライズ規模のパーソナライズが可能になります。
汎用的なソリューションは、ほとんどのビジネスには適していません。最適な戦略では、適切なパターンを適切なビジネスドライバーにマッピングします。
Yugandhar Boraは、Salesforceのソフトウェアエンジニアリングアーキテクトで、データおよびインテリジェンスアプリケーションプラットフォーム内のデータアーキテクチャを専門としています。データ ガバナンスと統合データ モデルに重点を置き、自動化されたプラットフォーム プロビジョニング ソリューションにも貢献するEARB(Enterprise Architecture Review Board)イニシアティブを主導しています。
Jan Fernandoは、Salesforceの_OCA(Office_ of the Chief Architect)のプリンシパル アーキテクトで、2012年にSalesforceに入社しました。スタートアップ エコシステム時代から豊富な経験があります。OCAに入社する前は、_プラットフォーム_組織で10年以上にわたり、いくつかの主要なテクノロジー トランスフォーメーションを率いていました。