Interoperabilità di Data 360
Le aziende spesso archiviano i dati in Salesforce e in altri data lake esterni (ad esempio, Snowflake, Google BigQuery, Databricks, Redshift o memoria oggetti come Amazon S3). L'inserimento dei dati in più sistemi rappresenta una sfida per le aziende che desiderano sfruttare tutto il valore dei propri dati per potenziare le esperienze basate sull'intelligenza artificiale. Salesforce Data 360 è il livello di intelligenza di base utilizzato da ogni agente AI Agentforce per accedere al contesto corretto al momento giusto.
Gli architetti che lavorano per riunire i dati in più data lake devono affrontare le principali decisioni architettoniche relative al modo migliore per integrare i dati. Data 360 offre diverse opzioni per l'integrazione dei dati, ognuna con vari pro e contro.
Questa guida fornisce un framework per valutare quale schema si adatta meglio alle proprie esigenze in termini di latenza, costo, scalabilità, governance e complessità durante l'integrazione dei dati, consentendo di scegliere quando utilizzare l'inserimento dati, la federazione dati Copia zero o un approccio ibrido. La guida consente inoltre di scegliere tra diversi metodi di inserimento dati e federazione dei dati, ognuno dei quali risponde a esigenze diverse.
L'integrazione di data lake house esterni con Data 360 richiede un'attenta considerazione dei compromessi tra aggiornamento dei dati, governance ed efficienza delle opportunità in corso di realizzazione. Ad esempio, l'utilizzo delle query live della federazione dei dati Copia zero ottimizza la freschezza dei dati ma può ridurre l'efficienza delle opportunità in corso di realizzazione poiché più dati passano attraverso la rete. Per la maggior parte delle implementazioni del mondo reale, combinare l'inserimento e la federazione in un ecosistema di case sul lago multi-cloud è il percorso ottimale. Questo approccio ibrido garantisce un'architettura scalabile, gestita e interoperabile che supporta carichi di lavoro operativi a bassa latenza (ad esempio, personalizzazione in tempo reale e rilevamento delle frodi) e carichi di lavoro analitici (ad esempio, reportistica normativa e analisi del trend storico). Questa guida consente di determinare come gestire questi compromessi utilizzando una strategia appropriata.
- L'inserimento dati copia i dati in Salesforce Data 360 e crea modelli di dati canonici governati. Questo è l'ideale per quando è necessario:
- Costruire un Customer 360 completo. Ciò consente di unificare e trasformare fonti diverse in un unico profilo affidabile.
- Rispettare la rigorosa conformità normativa. Ciò consente di creare una copia controllabile centralizzata in modo che l'accesso ai dati e la discendenza possano essere controllati da vicino.
- Zero Copy Federation esegue query sulle fonti esterne in tempo reale senza duplicazioni, abilitando la personalizzazione in tempo reale, i cruscotti digitali live e l'orientamento rapido delle fonti. Questo approccio offre due opzioni principali, ma vi sono dei compromessi che devono essere bilanciati:
- Query live: Utilizzarlo per l'analisi interattiva e i cruscotti digitali dei dati in tempo reale che vivono in piattaforme dati esterne (ad esempio, Snowflake, BigQuery, Redshift o Databricks). Ciò consente di evitare duplicazioni dei dati lente e costose inviando l'elaborazione delle query al sistema di origine e restituendo solo i risultati necessari. Questo approccio è ottimizzato per le query rare o ad hoc in cui la freschezza è fondamentale. È adatto per carichi di lavoro QPS (query al secondo) bassi (i costi delle query possono aumentare in modo significativo con QPS elevato).
- Caching (query accelerata): Utilizzarlo per le query frequenti sui dati che non cambiano spesso. Le query accelerate mantengono una cache locale che viene aggiornata a intervalli configurabili (da 15 minuti a 7 giorni), riducendo così i ripetuti colpi alla fonte. Questo approccio bilancia le prestazioni dei cruscotti digitali e i carichi di lavoro di costo, segmentazione e BI in cui i risultati leggermente obsoleti sono accettabili. Questo non è adatto per il processo decisionale sub-secondo.
- Federazione file: Utilizzarlo per l'elaborazione batch su larga scala e l'addestramento del modello AI per i dati nel data lake del cloud (ad esempio, S3 o ADLS). Questo approccio evita l'inserimento lento e costoso eseguendo query dirette sui file in formati di tabella aperti, sbloccando serie di dati ETL di grandi dimensioni e carichi di lavoro di data science.
- I modelli ibridi fondono l'inserimento per i profili unificati con la federazione per la freschezza, che supporta il coinvolgimento Omnicanale, le azioni basate su Agentforce e l'addestramento AI/ML.
- Utilizzare un'architettura ibrida. Spesso è necessario combinare l'inserimento dei dati e la federazione.
- Utilizzare l'inserimento dati sui dati critici per i modelli di dati canonici e la governance di base.
- Utilizzare Copia zero per tutte le altre federazioni di dati per mantenere la freschezza e ridurre al minimo il sovraccarico operativo di creazione e manutenzione delle opportunità in corso di realizzazione per l'inserimento dei dati.
- Questioni di frequenza di inserimento dati. Scegliere la frequenza in base al valore aziendale, alle esigenze di latenza e alla complessità operativa.
- Utilizzare in tempo reale per i flussi di lavoro sensibili al tempo (ad esempio, personalizzazione, cruscotti digitali live e azioni Agentforce).
- Utilizzare Quasi in tempo reale per i processi moderatamente urgenti (ad esempio, campagne e rapporti operativi).
- Utilizzare il batching per le serie di dati storiche o a bassa velocità.
- Abbinare gli schemi di federazione a latenza e prestazioni. Scegliere l'opzione più adatta ai propri schemi di accesso e requisiti di freschezza, prestazioni e costo.
- Utilizzare Live Query per i cruscotti digitali operativi e la personalizzazione in tempo reale in cui la latenza bassa è fondamentale.
- Utilizzare il caching (query accelerata) quando le query sono frequenti e i risultati leggermente obsoleti sono accettabili, il che consente di bilanciare prestazioni e costi.
- Utilizzare Federazione file per carichi di lavoro analitici o batch su larga scala e molto produttivi, ideali per le serie di dati storiche o meno sensibili al tempo.
- Allineare la governance ai requisiti di residenza dei dati.
- Utilizzare l'inserimento quando la governance centralizzata è fondamentale.
- Utilizzare la federazione quando la governance decentralizzata è accettabile, applicando anche una governance rigorosa alla fonte esterna.
- Utilizzare Copia zero per le policy a livello di origine (ad esempio, protezione a livello di riga e mascheramento dei dati).
- Dare priorità all'inserimento per i flussi di lavoro di alto valore. Applicare l'inserimento in modo selettivo ai processi critici (ad esempio, risoluzione dell'identità, reporting normativo e attivazione operativa).
- Costo e complessità determinano le decisioni. L'inserimento in tempo reale può essere costoso e complesso. Ecco perché è importante che gli architetti soppesino i costi di inserimento, archiviazione e trasformazione dei dati rispetto ai costi di esecuzione delle query direttamente tramite Zero Copy.
La scelta dello schema di integrazione corretto (inserimento dati, copia zero o approccio ibrido) influisce direttamente su latenza, governance, efficienza operativa e costi nelle piattaforme multi-cloud. Questa decisione determina il modo in cui gli approfondimenti in tempo reale, l'attivazione basata sull'intelligenza artificiale e il coinvolgimento personalizzato vengono forniti in modo affidabile e su larga scala.
Questa tabella confronta gli schemi di inserimento dati e copia zero in Salesforce Data 360, concentrandosi su funzionalità, compromessi e vantaggi, nonché casi d'uso e risultati aziendali. Utilizzare questa opzione come riferimento per progettare piattaforme dati ibride multi-cloud che bilanciano prestazioni, costi e conformità.
| Tipo di schema | Modalità/Strumento | Vantaggi | Considerazioni | Esiti |
|---|---|---|---|---|
| Inserimento dati |
In tempo reale:
|
|
|
Agenteforce:
|
Streaming:
|
|
|
Agenteforce:
|
|
Lotto:
|
|
|
Agenteforce:
|
|
| Copia zero |
Query live:
|
|
|
Agenteforce:
|
Query accelerata (Caching):
|
|
|
Agenteforce:
|
|
Federazione file:
|
|
|
Agenteforce:
|
Esistono tre schemi di integrazione principali per Data 360: inserimento dati, federazione dati copia zero e approccio ibrido.
Con l'inserimento dati, i dati vengono copiati fisicamente in Data 360 e completamente gestiti, a differenza di Copia zero in cui i dati rimangono all'origine. In altre parole, l'elaborazione per le trasformazioni avviene all'interno di Data 360, che fornisce una governance e un controllo centralizzati.
Utilizzare l'inserimento dati per archiviare le serie di dati canoniche governate in Salesforce Data 360 per la conformità e il controllo operativo. Utilizzare l'inserimento quando sono necessari controllo completo, controllo e tracciabilità. L'inserimento dati è ideale per i flussi di lavoro regolamentati o di valore elevato in cui l'elaborazione centralizzata e la governance sono fondamentali.
L'inserimento è adatto per creare una base affidabile per la risoluzione dell'identità, la generazione di rapporti normativi e i flussi di lavoro mission-critical basati sull'intelligenza artificiale e il coinvolgimento dei clienti.

I metodi di inserimento dati possono variare a seconda del connettore utilizzato per inserire i dati. Alcuni connettori offrono una varietà di metodi di inserimento, mentre altri funzionano solo in modalità batch o streaming. Per un elenco completo dei connettori Data 360 e dei metodi disponibili, vedere Data 360: Integrazioni e connettori.
- In tempo reale:
- Fornisce l'inserimento al di sotto del secondo utilizzando Acquisizione dati (CDC)
- Adatto a flussi di lavoro sensibili al tempo (ad esempio, rilevamento di frodi, personalizzazione e cruscotti digitali operativi)
- Le funzioni spingono le trasformazioni e le aggregazioni all'interno di Data 360, il che consente di ridurre l'I/O a valle e ottimizzare l'utilizzo del calcolo
- Supporta l'utilizzo di CDC incrementale per ridurre al minimo lo shuffle dei dati
- Streaming:
- Fornisce l'inserimento ogni 1–3 minuti in piccoli incrementi
- Equilibrio tra freschezza e costo
- Adatto per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi
- Supporta l'utilizzo di micro batch per controllare i picchi di I/O
- Aggrega i dati alla fonte (se possibile) per ridurre i volumi di trasferimento e ottimizzare l'archiviazione
- Batch (carichi pianificati):
- Fornisce l'inserimento periodico di serie di dati di grandi dimensioni (ad esempio, ogni ora, ogni giorno e ogni settimana)
- Offre efficienza e affidabilità in termini di costi per le serie di dati storiche, i rapporti normativi e i casi d'uso di conformità
- Garantisce che la località di calcolo si trovi nella stessa regione dello storage di origine per migliorare le prestazioni e ottimizzare i costi
- Casi d'uso di inserimento dati:
- Generazione di profili unificati Customer 360. Creare un'unica fonte di dati per le identità e gli attributi dei clienti.
- Gestire le serie di dati di conformità ai regolamenti. Imponi governance, discendenza e verificabilità per i dati sensibili.
- Centralizzare l'orchestrazione delle campagne. Assicurarsi che marketing, vendite e assistenza funzionino tutti da serie di dati coerenti e affidabili.
- Pratiche di progettazione:
- Consente l'inserimento in batch per esigenze storiche o tolleranti la bassa latenza (ad esempio, rapporti di archiviazione o istantanee periodiche).
- Utilizzare le API CDC o streaming per mantenere la freschezza dei flussi di lavoro operativi e di personalizzazione e garantire aggiornamenti quasi in tempo reale.
- Controllare la crescita dello storage e del calcolo applicando carichi incrementali per ottimizzare i costi e l'efficienza (anziché ricaricare intere serie di dati).
- Allineare le opportunità di inserimento in corso di realizzazione con la località di calcolo e l'elaborazione incrementale per ridurre gli I/O della rete.
- Applicare trasformazioni all'interno di Data 360 per evitare di spostare dati non elaborati inutilmente.
- Considerazioni sui costi:
- L'inserimento in tempo reale presenta i costi di calcolo e pipeline più elevati, il che può essere giustificato per flussi di lavoro sensibili al tempo e di valore elevato (ad esempio, personalizzazione, cruscotti digitali operativi o azioni basate su Agentforce).
- L'inserimento streaming ha costi di elaborazione e archiviazione moderati, che possono essere adatti per aggiornamenti frequenti che possono tollerare lievi ritardi (ad esempio, l'orchestrazione delle campagne o la generazione di rapporti operativi).
- L'inserimento batch ha costi di calcolo inferiori e memoria prevedibile, adatti per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento di dati batch da organizzazioni Salesforce utilizzando determinati connettori è gratuito.
- Modalità di aggiornamento Consente di selezionare la modalità di aggiornamento incrementale, che riduce i costi totali di inserimento e calcolo. In Salesforce, si consiglia di utilizzare l'aggiornamento incrementale ove possibile per ottimizzare l'efficienza in tutti i tipi di inserimento.
- Il costo è influenzato anche dal volume di I/O dalla fonte a Data 360. L'ottimizzazione delle dimensioni dei batch, delle partizioni e dell'allineamento regionale riduce i costi di trasferimento e migliora le prestazioni.
- Scenari di settore:
- Finanza: Le serie di dati di inserimento sono necessarie per conoscere il cliente, Antiriciclaggio (AML) e il rilevamento di frodi in cui la verificabilità e la conformità non sono negoziabili.
- Assistenza sanitaria: Utilizzare l'inserimento per la risoluzione dell'identità del paziente e i record conformi all'HIPAA, che consente visualizzazioni unificate e protette.
- Dettaglio: Consolidare i dati dei punti vendita (POS), dell'eCommerce e dei programmi fedeltà in profili unificati per la segmentazione e la personalizzazione.
- Telecom: Supportare la prevenzione dell'abbandono e l'analisi dell'utilizzo con dati canonici degli abbonati regolati.
| Funzione | Inserimento in tempo reale | Inserimento streaming | Inserimento batch |
|---|---|---|---|
| Latenza e freschezza | Include l'inserimento di latenza al di sotto del secondo tramite le API di inserimento con supporto per l'acquisizione dati (CDC). Fornisce opportunità in streaming continue. Adatto a casi d'uso operativi a bassa latenza. | Include l'inserimento di micro batch ogni 1–3 minuti tramite connettori nativi. Supporta gli aggiornamenti incrementali. È prevista una leggera latenza. | La latenza dei dati è prevista. Consente carichi pianificati a volume elevato. Include l'inserimento periodico (orario, giornaliero e settimanale). Non adatto per operazioni sensibili al tempo. |
| Casi d'uso principali | Ideale per casi d'uso operativi e di personalizzazione a bassa latenza. Utilizzare per i flussi di lavoro sensibili al tempo. Supporta i flussi di lavoro basati sugli eventi. Utilizzare per gli avvisi di frode in tempo reale e gli avvisi operativi. | Adatto per processi moderatamente urgenti. Utilizzare per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi. Utilizzare per trigger campagna tempestivi. | Economico per serie di dati di grandi dimensioni. Affidabile per l'analisi storica. Utilizzare per l'aggregazione storica o i flussi di lavoro dei rapporti regolamentati. Adatto a serie di dati storiche o a bassa velocità. |
| Complessità architettonica e I/O | Include un costo elevato e un'architettura complessa. Richiede sistemi di origine a bassa latenza. I/O intensivo. Fonti a volume elevato possono causare pipeline sature. | Presenta un'architettura più semplice rispetto a quella in tempo reale. I/O è moderato. Adatto a schemi di aggiornamento prevedibili e ripetuti. Le dimensioni del batch influiscono sulla memoria e sul calcolo. | Facile da implementare. I/O intensivo durante le finestre di carico. La produttività della rete può diventare un collo di bottiglia per batch di grandi dimensioni. |
| Considerazioni sui costi | Include i costi di elaborazione e pipeline più elevati. Giustificabile solo per i flussi di lavoro di valore elevato e sensibili al tempo. | Include costi moderati di elaborazione e memoria. Offre un approccio bilanciato tra costo e freschezza. Adatto per aggiornamenti frequenti che possono tollerare lievi ritardi. | Offre costi di calcolo inferiori e memoria prevedibile. Consigliato per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento tramite pipeline interne Salesforce è gratuito. |
| Processi di progettazione | Utilizzare CDC incrementale per ridurre al minimo il rimescolamento dei dati. Filtrare e utilizzare i campi selettivi per ridurre il sovraccarico. | Utilizzare i micro batch per controllare i picchi di I/O. Considerare l'aggregazione con finestre per ridurre il carico di elaborazione. | Utilizzare per rapporti di archivio o istantanee periodiche. Assicurarsi che la località di calcolo si trovi nella stessa regione dello spazio di archiviazione sorgente per ottimizzare i costi. |
Utilizzare Copia zero per eseguire query in tempo reale su sistemi esterni senza duplicazione dei dati per consentire agilità, freschezza e accesso scalabile a serie di dati di grandi dimensioni o temporanee. È adatto per cruscotti digitali live, analisi esplorative, formazione sui modelli AI/ML e coinvolgimento dei clienti in tempo reale direttamente tramite Salesforce Data 360.
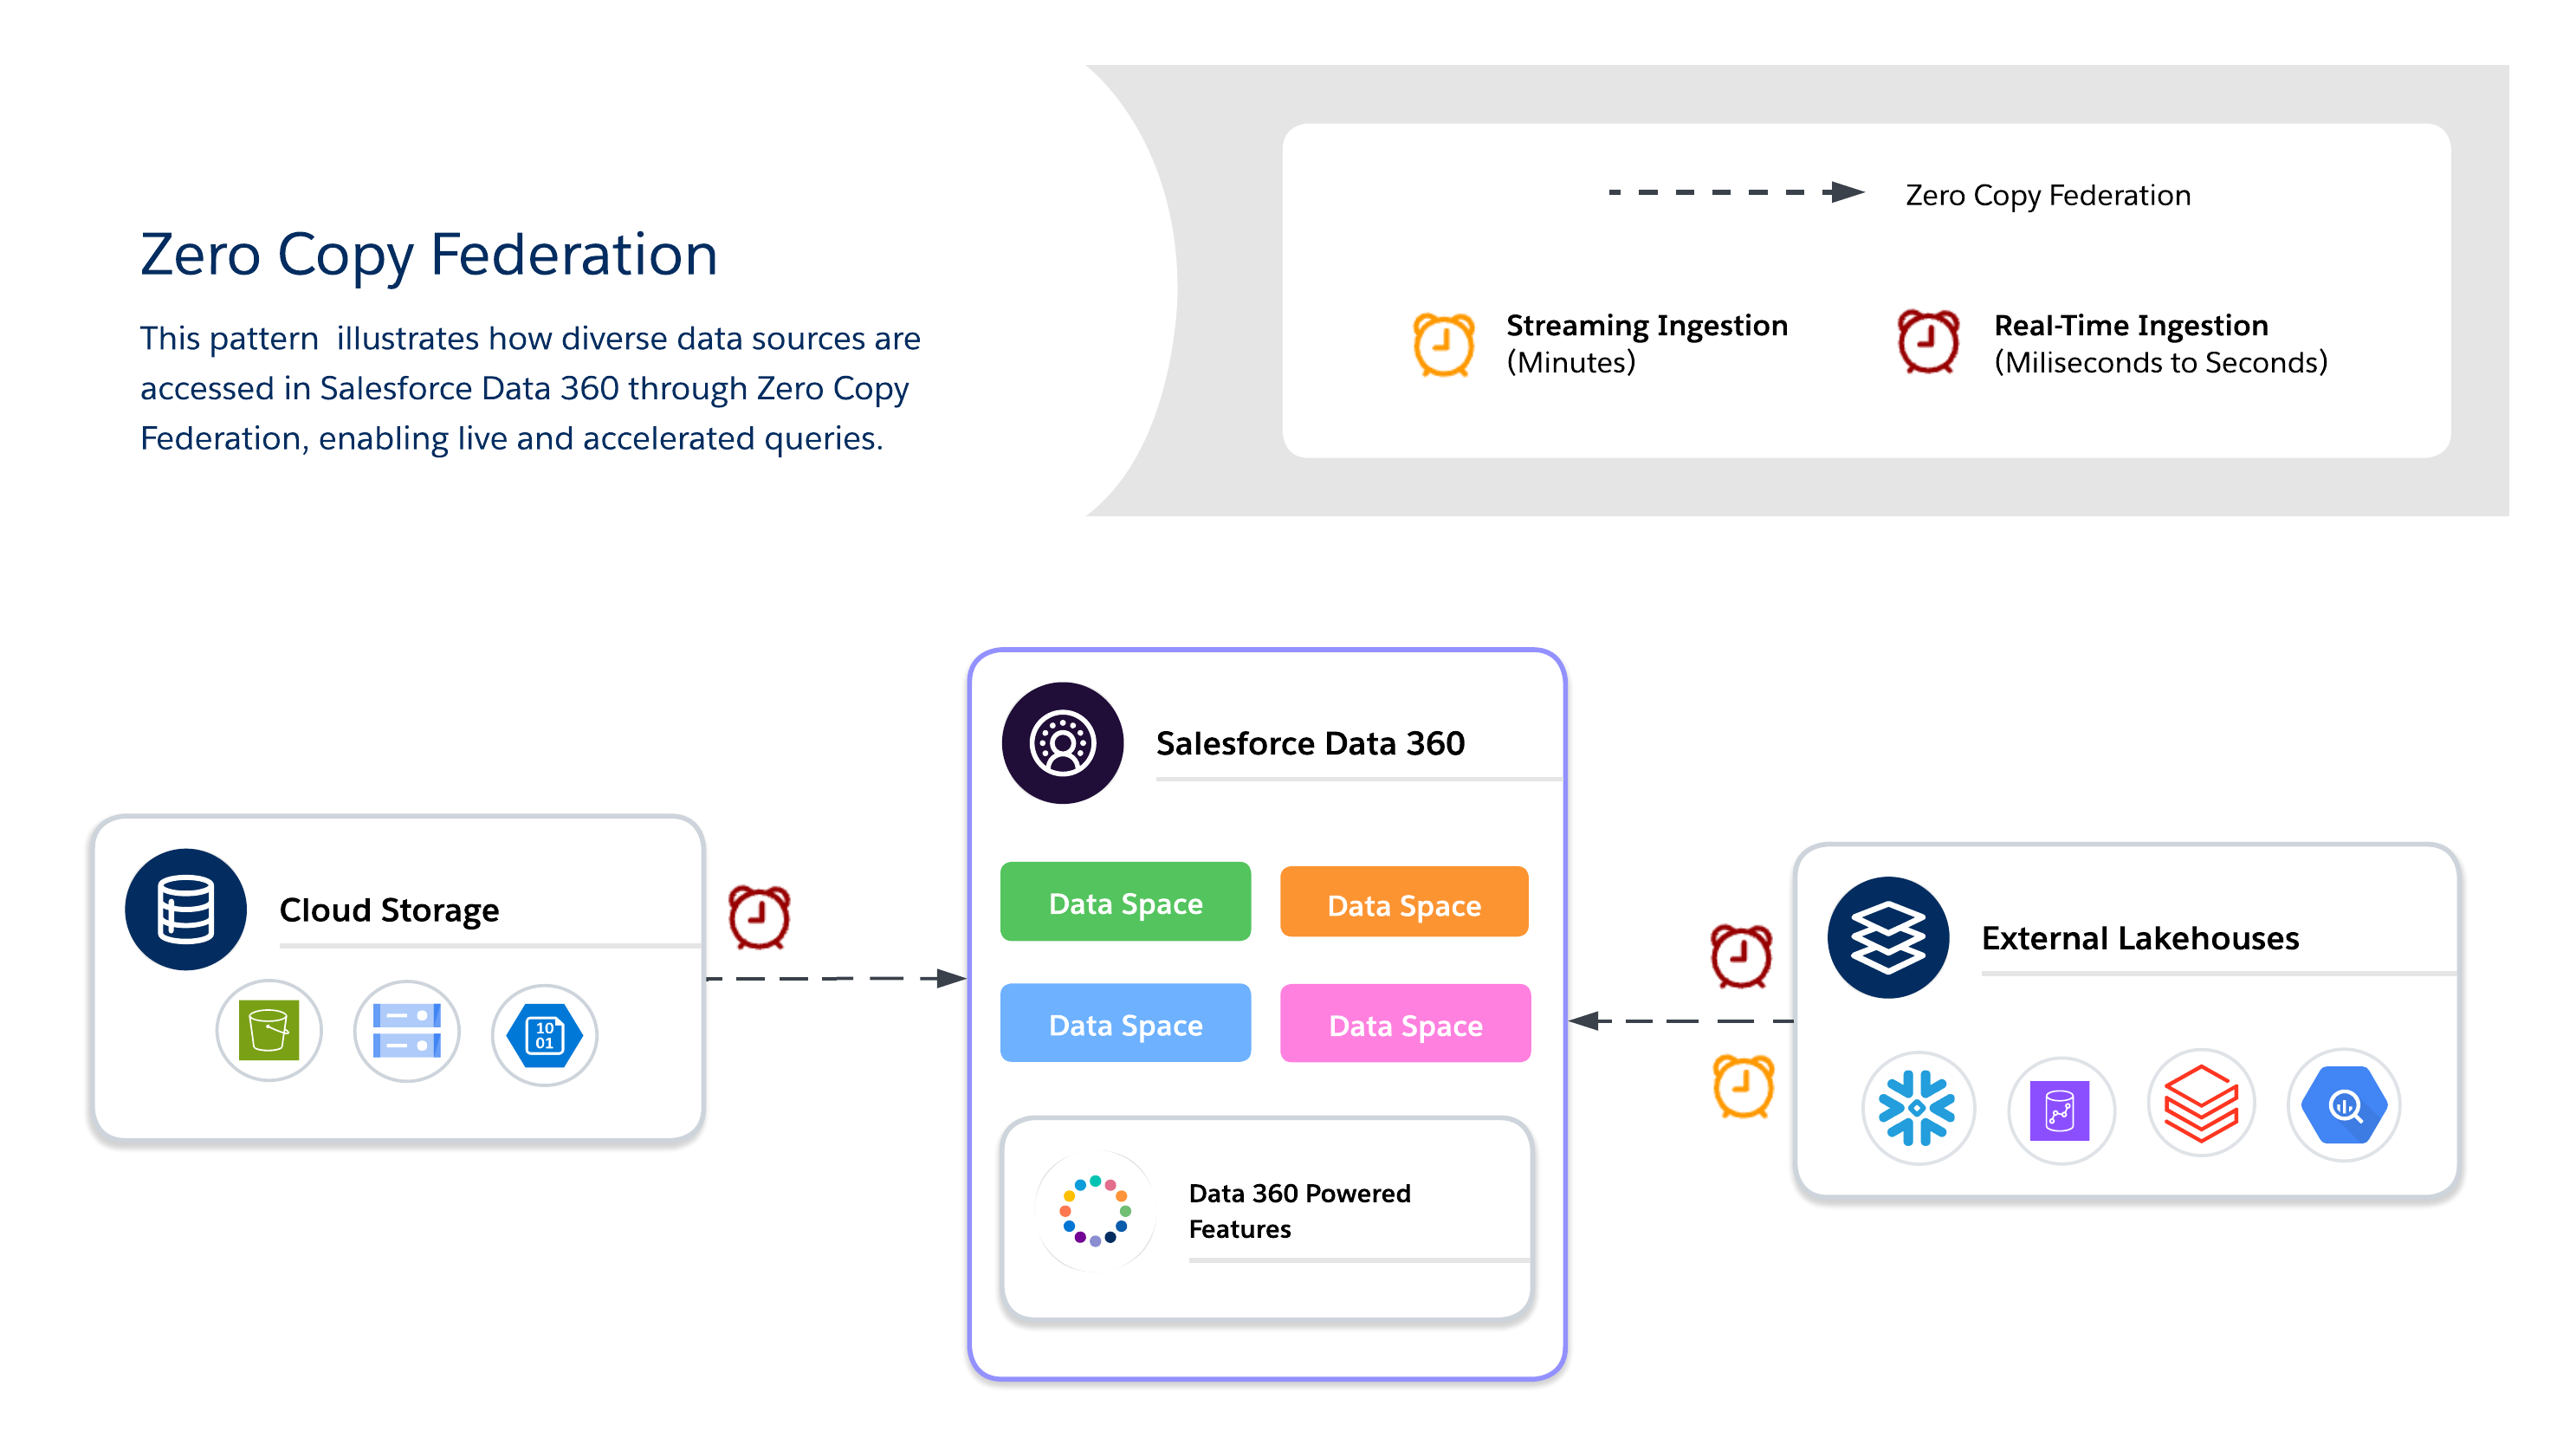
Quando si utilizza Zero Copy, gli architetti devono scegliere tra tre metodi di federazione dei dati disponibili, ciascuno dei quali offre i propri compromessi tra freschezza, prestazioni e costo.
- Query live
- Esegue query direttamente sui sistemi esterni (ad esempio, Snowflake, Google BigQuery, Redshift, Databricks e così via) senza duplicazione dei dati.
- Riduce al minimo lo spostamento dei dati sulla rete e riduce l'I/O nel calcolo di Salesforce Data 360, che è ottimale quando predicati e aggregazioni possono essere sottoposti a push.
- Adatto per approfondimenti in tempo reale e cruscotti digitali operativi a bassa latenza.
- Dipende dalle prestazioni del sistema esterno.
- Caching (query accelerata)
- Archivia temporaneamente le copie memorizzate nella cache dei dati federati in Salesforce Data 360.
- Riduce i costi di query ripetute e la latenza per le serie di dati a cui si accede di frequente con durata configurabile (da minuti a giorni).
- Poiché i dati non vengono copiati in modo permanente o completamente governati, l'aggiornamento viene gestito tramite aggiornamenti pianificati dall'origine.
- L'aggiornamento incrementale supporta solo gli inserimenti con aggiornamento. I record eliminati non vengono rimossi dalla cache.
- Eseguire periodicamente un aggiornamento completo per assicurarsi che la cache rimanga sincronizzata con l'origine.
- Nota: Il connettore Snowflake supporta la funzione Scarica, che migliora le percentuali di accelerazione utilizzando un bucket di gestione temporanea avviato da Snowflake. Questa opzione è abilitata per impostazione predefinita, ma può essere disabilitata modificando la connessione.
- Federazione file
- Fornisce accesso diretto in sola lettura alle serie di dati su larga scala negli archivi di oggetti (ad esempio, S3 e GCS con Iceberg).
- Adatto per carichi di lavoro AI/ML, analisi storica e rapporti su scala petabyte senza spostare i dati.
- Le prestazioni delle query dipendono fortemente dal formato dell'oggetto, dal partizionamento e dall'ingresso/uscita di rete. Le analisi di grandi dimensioni possono generare I/O sostanziali se non sono ottimizzate.
- Casi d'uso
- La personalizzazione in tempo reale e i flussi di lavoro adattativi offrono offerte dinamiche, consigli e azioni Next Best quando cambiano i comportamenti dei clienti.
- I cruscotti digitali live e i cruscotti digitali e i KPI business critical vengono utilizzati direttamente dai magazzini esterni.
- L'addestramento del modello AI/ML con serie di dati esterne di grandi dimensioni sfrutta i dati su scala petabyte di data lake e magazzini senza spostarli tramite federazione file.
- Scenari di settore
- Retail/Media: Abilitare i consigli personalizzati e il coinvolgimento dei clienti in tempo reale federando i dati di clickstream o di interazione con i contenuti.
- Finanza: Eseguire il rilevamento delle frodi e il calcolo del punteggio del rischio quasi in tempo reale eseguendo query sui magazzini esterni senza duplicare dati sensibili.
- Tecnologia/impresa: Supportare i rapporti tra cloud, i cruscotti digitali dei servizi IT e l'analisi operativa quando le serie di dati risiedono in più sistemi.
- Processi di progettazione
- Query live
- Utilizzare per query con QPS elevato e bassa latenza quando la freschezza è critica.
- Inviare tramite push predicati e aggregazioni al sistema esterno per ridurre il rimescolamento dei dati sulla rete.
- Evitare query che eseguono inutilmente analisi di volumi di dati elevati.
- Considerare invece la potatura delle partizioni e i filtri.
- Federazione file
- Accedere alle serie di dati su scala petabyte negli archivi di oggetti senza inserimento.
- Ridurre al minimo i costi di latenza e uscita mantenendo lo spazio di archiviazione degli oggetti nella stessa area Cloud del calcolo Salesforce.
- Utilizzare formati partizionati e colonnari (Parquet/ORC) e filtri pushdown per ridurre il trasferimento di I/O e di rete.
- Sfruttare il pushdown di query e predicati per filtrare e aggregare i dati alla fonte, riducendo così lo spostamento dei dati.
- Evitare l'accesso ai dati tra regioni, a meno che non sia assolutamente necessario, perché aumenta I/O, latenza e costi.
- Caching (query accelerata)
- Inserire nella cache le serie di dati a cui si accede di frequente per bilanciare costi e prestazioni.
- Configurare gli intervalli di aggiornamento per bilanciare freschezza e costo delle query.
- Conformità: Applicare la governance all'origine sfruttando la protezione a livello di riga e mascherando le policy direttamente all'interno dei sistemi federati.
- Di seguito sono riportate alcune procedure consigliate per uniformare l'RLS e il mascheramento tra le piattaforme:
- Utilizzare un ID Enterprise centralizzato. Mappare utenti ed entità in Salesforce Data 360 a un identificatore aziendale centralizzato univoco che corrisponde alle identità nei sistemi esterni.
- Allineare le policy di sicurezza. Assicurarsi che le policy di protezione dal traffico e mascheramento nei sistemi federati vengano applicate in base all'identità mappata. Ciò mantiene la conformità durante le query sui dati esterni.
- Standardizzare gli schemi di identità. Mantenere attributi di identità coerenti (email, ID utente, ID cliente e così via) in tutte le fonti di dati per evitare mancate corrispondenze e violazioni dell'accesso.
- Di seguito sono riportate alcune procedure consigliate per uniformare l'RLS e il mascheramento tra le piattaforme:
- Query live
- Considerazioni sui costi
- Query live: Nel modello pay-per-query, i costi si accumulano per il calcolo delle case sul lago esterne, che può causare picchi con QPS elevato. Questo è adatto per i casi d'uso critici per la freschezza in cui il valore è maggiore della variabilità dei costi.
- Query accelerata (Caching): Questo metodo riduce il costo delle query (rispetto a Live Query) riducendo gli attacchi al sistema di origine; tuttavia, aumenta i costi di inserimento dati batch per il riempimento e l'aggiornamento della cache. È adatto per le serie di dati a cui si accede di frequente.
- Federazione file: Questa è l'opzione di archiviazione più economica come dati nell'archivio oggetti; tuttavia, i costi delle query dipendono dalle dimensioni del file, dal partizionamento e dalla potatura. Questo è adatto per i dati storici o in blocco su scala petabyte.
| Punto Decisione | Live query | Caching (query accelerata) | Federazione file |
|---|---|---|---|
| Posizione fonte di dati | Case data lake esterni (ad esempio, Snowflake, Google BigQuery, Redshift e Databricks) | Case data lake esterni (ad esempio, Snowflake, Google BigQuery, Redshift e Databricks) | Object Store o data lake Cloud (ad esempio, S3, ADLS e GCS), che spesso utilizzano formati di tabelle aperte come Iceberg. |
| Scopo/Caso d'uso | Adatto per analisi interattive e cruscotti digitali in tempo reale. Adatto alla personalizzazione in tempo reale e ai flussi di lavoro dinamici. | Adatto per quando le query sono frequenti, ma i risultati leggermente obsoleti sono accettabili. Adatto per cruscotti digitali BI e segmentazione. | Adatto per l'elaborazione batch su larga scala e l'addestramento del modello AI/ML. Adatto per analisi storiche e rapporti su scala petabyte. |
| Freschezza/latenza | Esegue le query direttamente in tempo reale. Supporta le decisioni al di sotto dei secondi quando il sistema di origine è ottimizzato per le query a bassa latenza con pushdown del predicato efficace. | Utilizzare quando i risultati leggermente obsoleti sono accettabili. La freschezza dipende dall'intervallo di cache, che è configurabile da 15 minuti a 7 giorni. | Adatto per lavori intensivi e con un'elevata produttività. Non adatto per il cruscotto digitale in tempo reale. |
| Schema di accesso | Adatto per query rare o ad hoc in cui la freschezza è fondamentale e il volume delle query è basso. I costi aumentano in modo significativo con QPS elevato, quindi è importante valutare il caching (query accelerata) quando la frequenza delle query è elevata. | Adatto a scenari di lettura ad alta frequenza. Migliora le prestazioni per gli schemi di accesso frequenti. | Fornisce l'accesso di sola lettura. Adatto per serie di dati su scala petabyte senza inserimento. |
| Driver delle prestazioni | Molto dipendente dalle prestazioni del sistema sorgente esterno. Adatto per quando predicati e aggregazioni possono essere inviati alla fonte. | Riduce la latenza rispetto alle query live ripetute. Le prestazioni dipendono dalla gestione della cache e dagli intervalli. | Le prestazioni dipendono fortemente dal formato dell'oggetto, dal partizionamento e dalla produttività del sistema esterno. Utilizzare formati partizionati e colonnari (Parquet/ORC). |
| Implicazioni sui costi | Questo è un modello pay-per-query, quindi i costi si accumulano sui calcoli delle case sul lago esterne. È conveniente per le query poco frequenti, ma le spese possono aumentare con un volume QPS elevato. | Il costo è inferiore rispetto alle query live ripetute. Riduce la necessità di eseguire ripetutamente query sulla fonte esterna, ma aggiunge memoria cache e sovraccarico di aggiornamento. | Questa è l'opzione di memoria più economica. Per le impostazioni AWS same-region e same-cloud (ad esempio, S3 in US-East-1 con un tenant Data Cloud presente anche in US-East-1), i crediti non vengono consumati per le righe a cui si accede. Le configurazioni tra regioni o tra cloud (ad esempio, Azure, GCS o regioni AWS diverse) comportano il consumo di credito per le righe a cui si accede. I costi delle query dipendono anche dalle dimensioni del file, dal partizionamento e dall'ottimizzazione del pushdown del predicato. |
| Considerazione chiave | Evitare le query non filtrate che eseguono la scansione di volumi di dati elevati inutilmente. | Questo approccio richiede la gestione della cache. Non adatto per decisioni subsecondarie. | Le prestazioni delle query dipendono fortemente dall'ottimizzazione tramite partizionamento e pushdown del predicato. |
Le architetture ibride consentono agli architetti di ancorare le serie di dati critiche in Data 360 per una governance centralizzata, sfruttando al contempo le query federate per garantire freschezza, riduzione delle duplicazioni e accesso scalabile a serie di dati esterne di grandi dimensioni. Questo approccio bilancia I/O, località di calcolo, costi e requisiti di conformità.
Utilizzare un approccio ibrido per una governance equilibrata, freschezza ed efficienza operativa combinando l'inserimento dei dati e la copia zero per offrire approfondimenti fruibili in tempo reale. Utilizzare l'inserimento per le serie di dati regolamentate di valore elevato in cui sono richiesti tracciabilità, RLS e mascheramento e la federazione per le serie di dati effimere o a volume elevato in cui freschezza e prestazioni sono fondamentali.
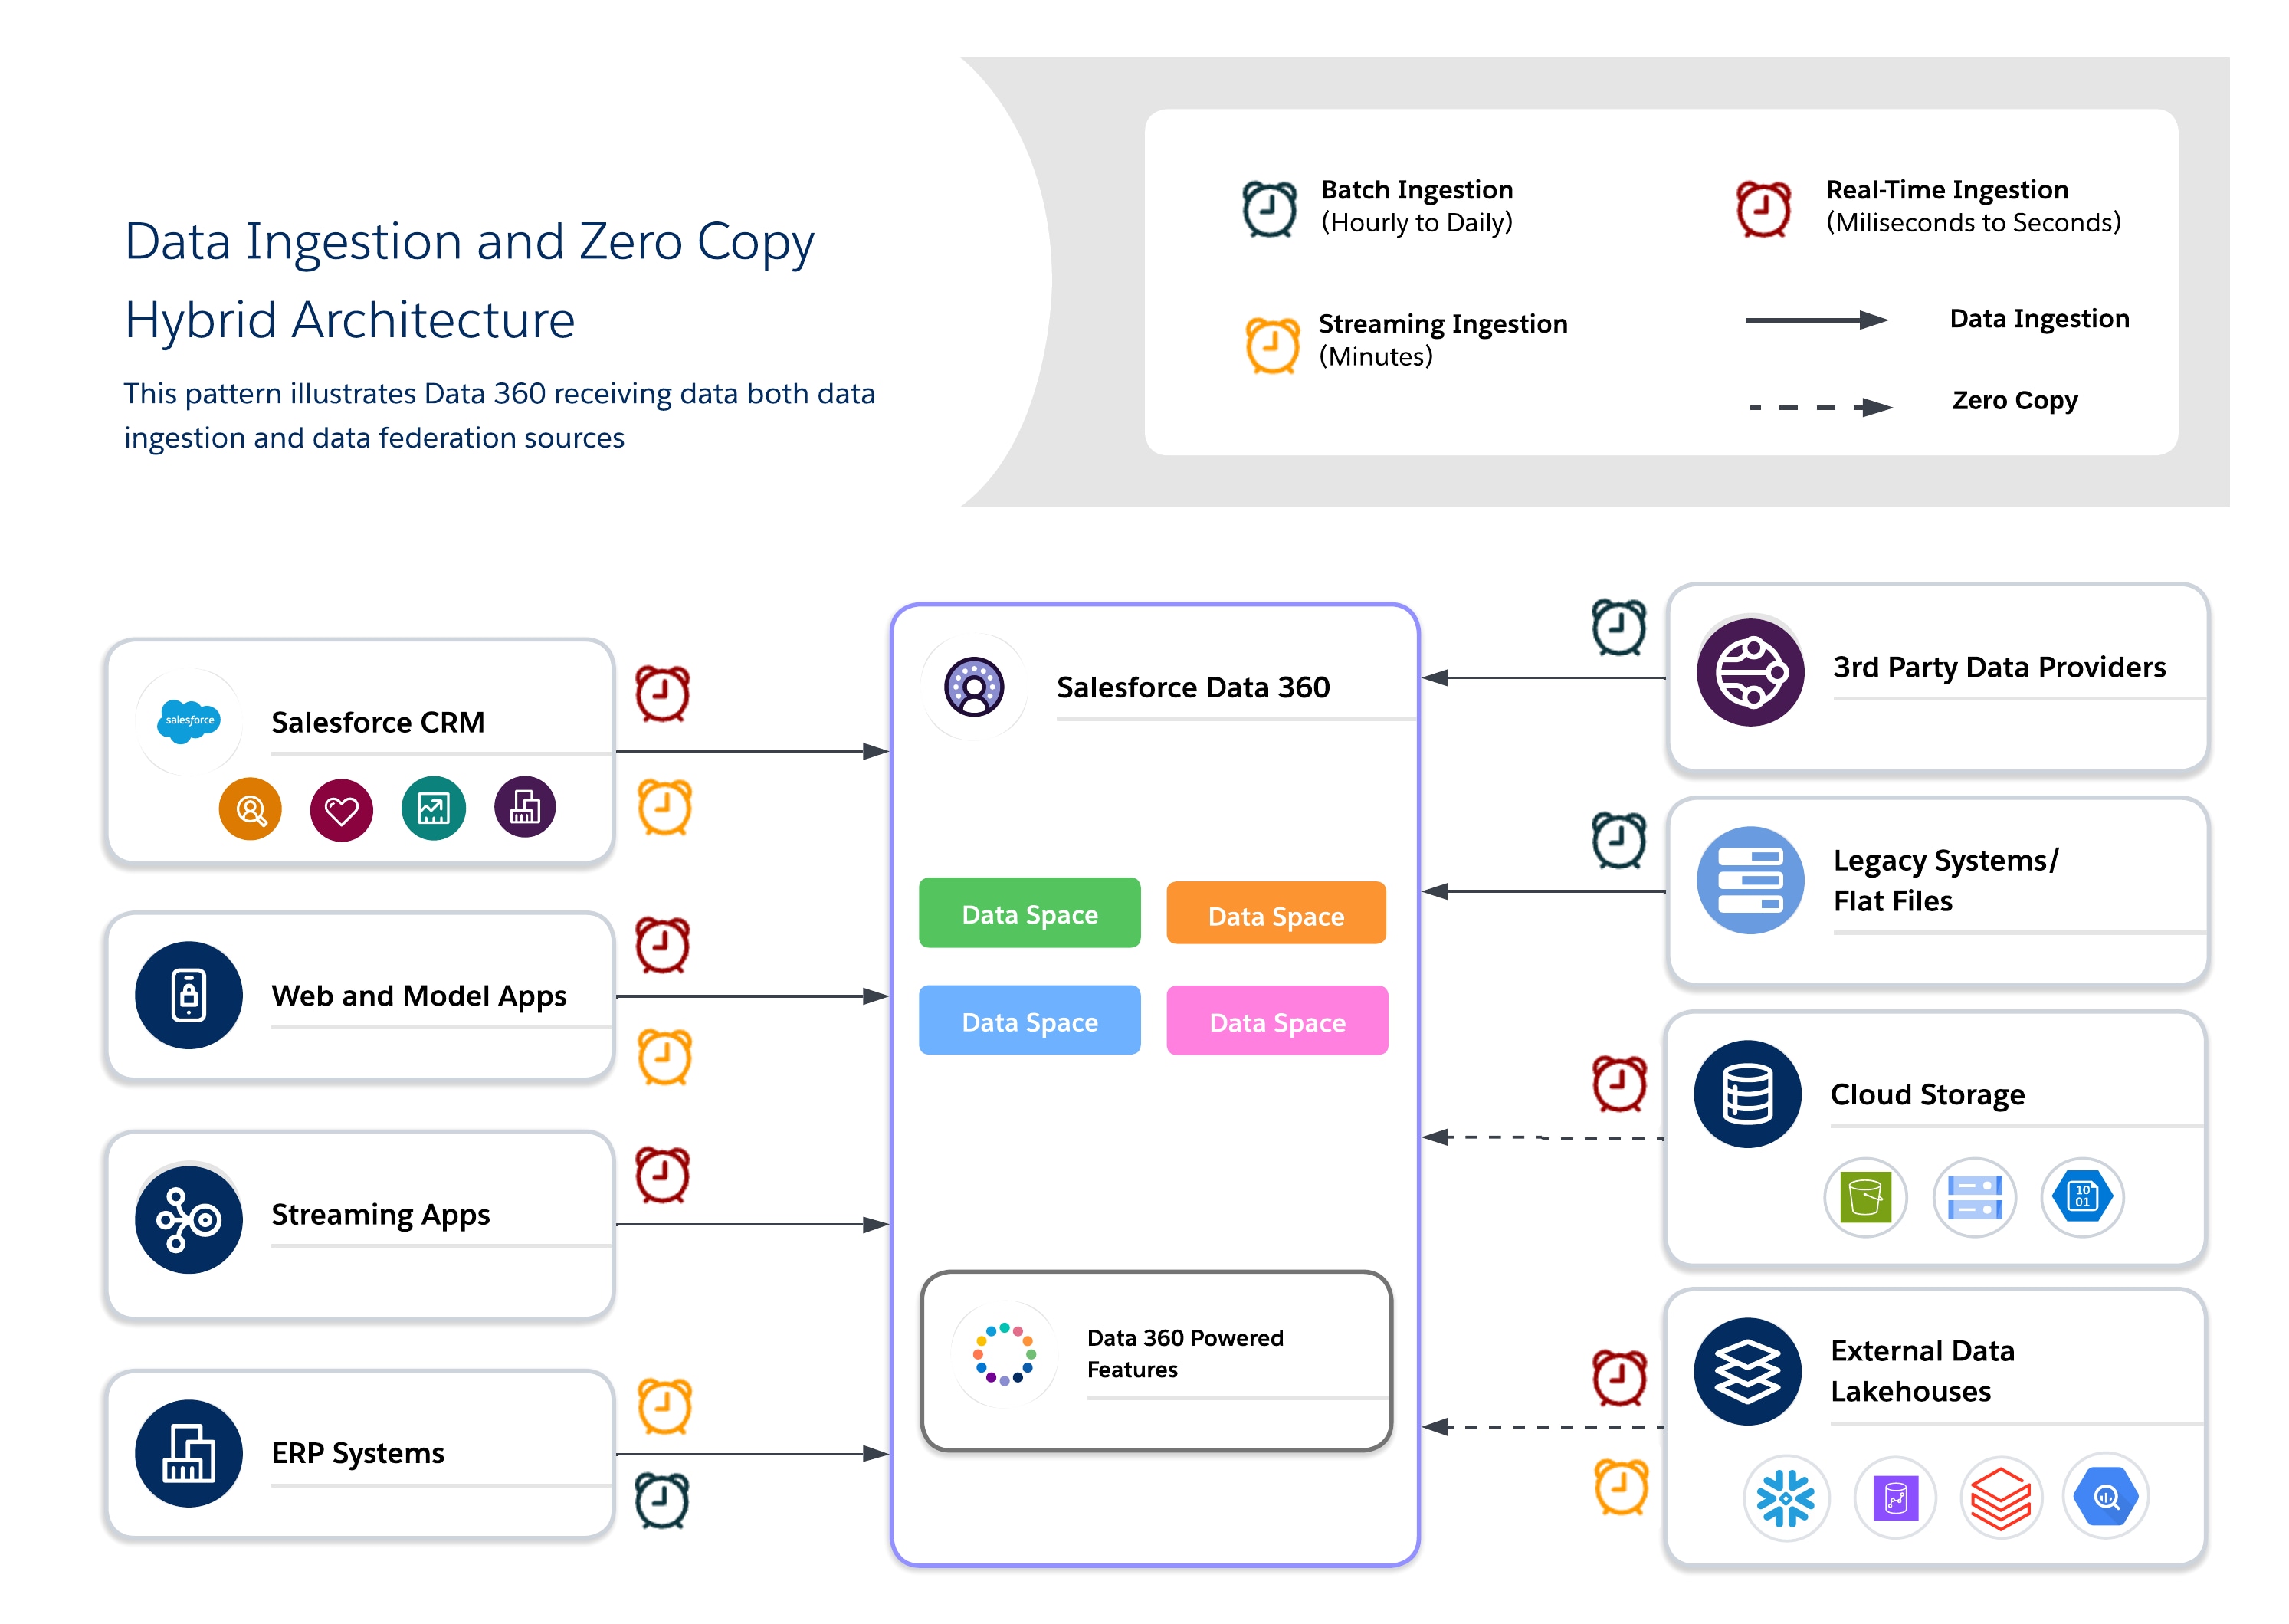
- Casi d'uso
- Coinvolgimento Omnicanale: Combinare i dati storici dei clienti con il comportamento in tempo reale per offrire esperienze coerenti e sensibili al contesto.
- Condotte AI/ML: Addestrare i modelli su serie di dati canoniche curate arricchendole con segnali grezzi o in tempo reale provenienti da fonti esterne.
- Conformità mista e agilità richiedono: Applicare una governance rigorosa per i dati sensibili e una federazione per l'agilità operativa.
- Scenari di settore
- Dettaglio: Utilizzare l'inserimento per la risoluzione dell'identità e l'unificazione dei profili e la federazione per le offerte e la personalizzazione in tempo reale.
- Assistenza sanitaria: Gestire i record paziente dorati tramite inserimento utilizzando federation sugli stream di dispositivi IoT e i dati dei sensori per il contesto immediato.
- Servizi finanziari: Inserire i dati regolamentati in un lago regolamentato dalla conformità utilizzando federation per il rilevamento delle frodi esterne e le query di monitoraggio del rischio.
- Processi di progettazione
- Ancora governance con inserimento: Inserire dati di valore elevato o regolamentati nei modelli canonici per garantire Trust e conformità.
- Utilizza Federation for Freshness: Consente alle case sul lago esterne di fornire l'accesso ai dati in tempo reale o su larga scala senza duplicazioni.
- Costo del bilanciamento rispetto alle prestazioni: Profilare i carichi di lavoro per determinare quando utilizzare l'inserimento rispetto alla federazione, riducendo al minimo i costi di archiviazione e query non necessari.
- Applica governance a livelli: Applicare una governance centralizzata per i dati inseriti sfruttando i controlli di sicurezza dei sistemi federati (ad esempio, RLS e mascheramento).
- Nota: Quando si progettano opportunità ibride in corso di realizzazione, è importante garantire l'inserimento incrementale delle serie di dati storiche e inviare aggregazioni push o filtri alle fonti federate per ottimizzare l'I/O e l'utilizzo del calcolo.
- Considerazioni sui costi
- Soppesare il costo totale rispetto alle prestazioni combinando l'inserimento di dati critici o di conformità con la federazione quando è necessario un aggiornamento.
- Tenere conto degli I/O e della distribuzione dei calcoli quando si combinano inserimento e federazione. Per ridurre il costo di calcolo delle query ripetute rispetto ai sistemi di origine, utilizzare il caching (Query accelerata) per le serie di dati federate di lettura elevata e accesso frequente.
- Utilizzare questa regola per guidare la decisione di inserimento e federazione: quando l'accesso ai dati è frequente ma le modifiche non sono frequenti, la query accelerata è in genere più conveniente. Tuttavia, quando i dati cambiano spesso (in base alla frequenza di accesso), è più appropriato eseguire una Live Query o un'inserimento. Ecco alcuni esempi di costi:
- L'accelerazione vince: Un cruscotto digitale creato a partire da 1 milione di record e aggiornato quotidianamente con circa 10.000 modifiche viene visualizzato 20 volte al giorno. I costi di accelerazione equivalgono a circa ~600 crediti/mese rispetto a ~4.200 crediti/mese per le query live.
- La Live Query vince: Segmenti pubblicati 20 volte al giorno utilizzando dati che cambiano ogni 30 minuti. Le query live costano circa ~ 4.200 crediti/mese rispetto a ~ 28.800 crediti/mese per l'accelerazione con questa frequenza di aggiornamento.
Vediamo più in dettaglio alcuni archetipi comuni che illustrano come applicare questa logica.
- L'archetipo "Un'unica fonte di verità": Centralizzare e gestire
- Scenario: È necessario creare profili Customer 360 unificati conformi per l'intera azienda globale. I dati provengono da una dozzina di sistemi diversi, devono rispettare rigidi regolamenti GDPR e CCPA e fungeranno da fonte di verità per tutte le interazioni di marketing e servizio.
- Schema consigliato: Inserimento dati. La priorità qui è governance, Trust e controllo. L'inserimento dei dati in Data 360 è l'unico modo per creare un profilo canonico completamente controllabile e isolato dai sistemi di origine.
- Archetipo di "Approfondimenti in tempo reale": Analisi senza spostamento
- Scenario: Il team di data science deve eseguire query esplorative su una tabella di transazioni massiccia e in costante aggiornamento in Snowflake. Allo stesso tempo, il team direttivo desidera un cruscotto digitale BI live basato sugli stessi dati. Lo spostamento giornaliero di petabyte di dati è lento e costoso.
- Schema consigliato: Federazione copia zero. La priorità in questo caso sono velocità, agilità ed efficienza economica su larga scala. Zero Copy consente di sfruttare la potenza del data warehouse esistente per le query in tempo reale senza sovraccarico e latenza di duplicazione dei dati.
- Archetipo di "Intelligenza ibrida": Governare il core, federare l'edge
- Scenario: Si desidera arricchire i profili cliente governati e inseriti con segnali comportamentali in tempo reale (ad esempio, clic sul sito Web) provenienti da un data lake. È necessaria la stabilità del profilo centrale ma l'immediatezza dei dati live per favorire la personalizzazione immediata.
- Schema consigliato: Un approccio ibrido. Utilizzare l'inserimento dati per creare un nucleo stabile governato per i dati dei clienti. Utilizzare Copia zero per federare i dati volatili in tempo reale e unirli insieme al momento della query per una visualizzazione completa e aggiornata.
La strategia per i dati aziendali non si concentra più sulla scelta di un unico modello di integrazione, ma sull'architettura di una flessibilità controllata all'interno di un ecosistema di dati interoperabile. L'approccio corretto mappa ogni sistema di origine allo schema più adatto ai suoi requisiti di freschezza, governance, costo e accesso:
- Inserire serie di dati regolamentate mission-critical in Salesforce Data Cloud per la conformità, la risoluzione dell'identità e i flussi di lavoro operativi.
- Federare i dati tramite Zero Copy per analisi live, esplorative e basate sull'intelligenza artificiale senza duplicare l'archiviazione.
- Applicazione del caching (query accelerata) per ridurre il carico del sistema di origine e il consumo di credito quando la frequenza delle query è alta e la frequenza di modifica dei dati è bassa
Salesforce Data 360 su Hyperforce offre resilienza e scalabilità multiregione. La sua casa sul lago aperta con tabelle Iceberg consente la separazione dei calcoli e l'interoperabilità con piattaforme come Snowflake, Databricks e S3 Iceberg, che costituisce la spina dorsale di un ecosistema di dati multi-cloud davvero interoperabile.
Man mano che gli ecosistemi di dati si evolvono, dobbiamo bilanciare costantemente freschezza, costo, prestazioni e conformità per mantenere l'agilità dell'architettura. Ecco perché è importante rendere la piattaforma a prova di futuro unificando i dati gestiti inseriti con accesso federato. Ciò consente l'intelligenza in tempo reale, l'attivazione dell'intelligenza artificiale e la personalizzazione su scala aziendale in cloud, regioni e domini aziendali.
Tenere presente che le soluzioni valide per tutti non sono adatte alla maggior parte delle aziende. La strategia ottimale mappa lo schema corretto al driver aziendale corretto.
Yugandhar Bora è un architetto di ingegneria del software di Salesforce specializzato in architettura dei dati all'interno della piattaforma Data and Intelligence Applications. Dirige iniziative dell'Enterprise Architecture Review Board incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo anche alle soluzioni di provisioning automatico della piattaforma.
Jan Fernando è Principal Architect presso lo _Office of the Chief Architect (_OCA) di Salesforce, che è entrato a far parte di Salesforce nel 2012. Prima di entrare nell'OCA, ha trascorso oltre un decennio nell'organizzazione Platform, dove ha guidato diverse trasformazioni tecnologiche chiave.