Предприятия обрабатывают широкий диапазон типов документов, включительно со счетами, заказ-нарядами, юридическими контрактами и техническими руководствами. Обработка вручную происходит медленно, подвержена ошибкам и занимает примерно 15-25% времени сотрудников. Предыдущие подходы к автоматизации (например, роботизированная автоматизация процессов (RPA), оптическое распознавание символов (OCR) и инструменты бизнес-правил) позволили частично снизить нагрузку, но создать жесткие ожидаемые продажи, высокие расходы на обслуживание и изолированное внедрение в отдельных бизнес-группах.
Документы содержат богатый структурный контекст (например, иерархии таблиц, взаимосвязи пространственных полей и разделы с перекрестными ссылками), который не может сохранить обработка плоского текста. Удаление документа из обычного текста инициирует удаление бизнес-контекста, который делает извлечение точным и полезным, что ухудшает качество аналитики в нисходящем направлении, вывода искусственного интеллекта и автоматизации процессов.
Чтобы быть эффективными, системы интеллектуальной обработки документов должны классифицировать документы по типу, точно извлекать структурированные данные из макетов переменных и поставлять эти данные в управляемом, доступном для запроса виде в последующие системы. ВПЛ должны также обрабатывать вариативность документов в масштабах, не требуя конфигурации каждого шаблона для каждого нового формата документа, и они должны быть централизованными и доступными в бизнес-единицах. Эта проблема усугубляется большим количеством ключевых вопросов: неструктурированные данные составляют около 80% всех корпоративных данных, и большинство аккумулируется в виде документа в файловых системах, облачном хранилище и хранилищах содержимого, которые недоступны системам управления взаимосвязями с клиентами (CRM), агентам на основе искусственного интеллекта и аналитическим платформам.
ИИ документа Data 360 - это возможность обработки документов Salesforce в Data 360, предназначенная для устранения этого пробела. Он извлекает, классифицирует и анализирует неструктурированное и полуструктурированное содержимое документа посредством широкоязыковых моделей (LLM), оптического распознавания символов (OCR), обработки естественного языка (NLP) и машинного обучения (ML). Результатом являются структурированные, управляемые и запрашиваемые данные, которые интегрируются в ожидаемые продажи Data 360, где агенты Agentforce, аналитические инструменты и бизнес- процессы автоматизации могут открывать их посредством стандартных интерфейсов, не требуя настраиваемых уровней извлечения или трансформации.
Корпоративные платформы данных обрабатывают структурированные табличные данные. Однако, большинство корпоративных данных поступают в виде документов и остаются недоступными для CRM, ERP, агентов искусственного интеллекта и аналитических ожидаемых продаж, пока их не извлекут вручную. Это архитектурный пробел, а не проблема бизнес-правил.
Более ранние подходы сочетали ручное повторное нажатие клавиш, OCR на основе правил и сценарии RPA. Эти методы работали в небольших масштабах, но они не могли обрабатывать объем, разнообразие и скорость типов документов, создаваемых современными предприятиями. Инструменты на основе правил требуют четких шаблонов на вариант макета. Любое изменение формата нарушает извлечение и требует наличия разработчика, нового шаблона и цикла развертывания.
В масштабе это создает хрупкие точечные решения без централизованного управления, общей схемы и пути к готовности к искусственному интеллекту. В нисходящем направлении распространяются несогласованные вытяжные трубопроводы. Другими словами, аналитика наследует несоответствия данных, модели на основе искусственного интеллекта приводят к ненадежным результатам, а регулируемое содержимое, например, личная медицинская информация и личная информация, не имеет систематического управления.
LLM извлекают поля без явных шаблонов. Единая конфигурация схемы управляет извлечением в вариантах макета, языках и форматах, что адаптируется к документу, а не требует соответствия документа фиксированной структуре. Это переносит обработку документов с обслуживаемой изолированной операции на управляемую централизованную возможность.
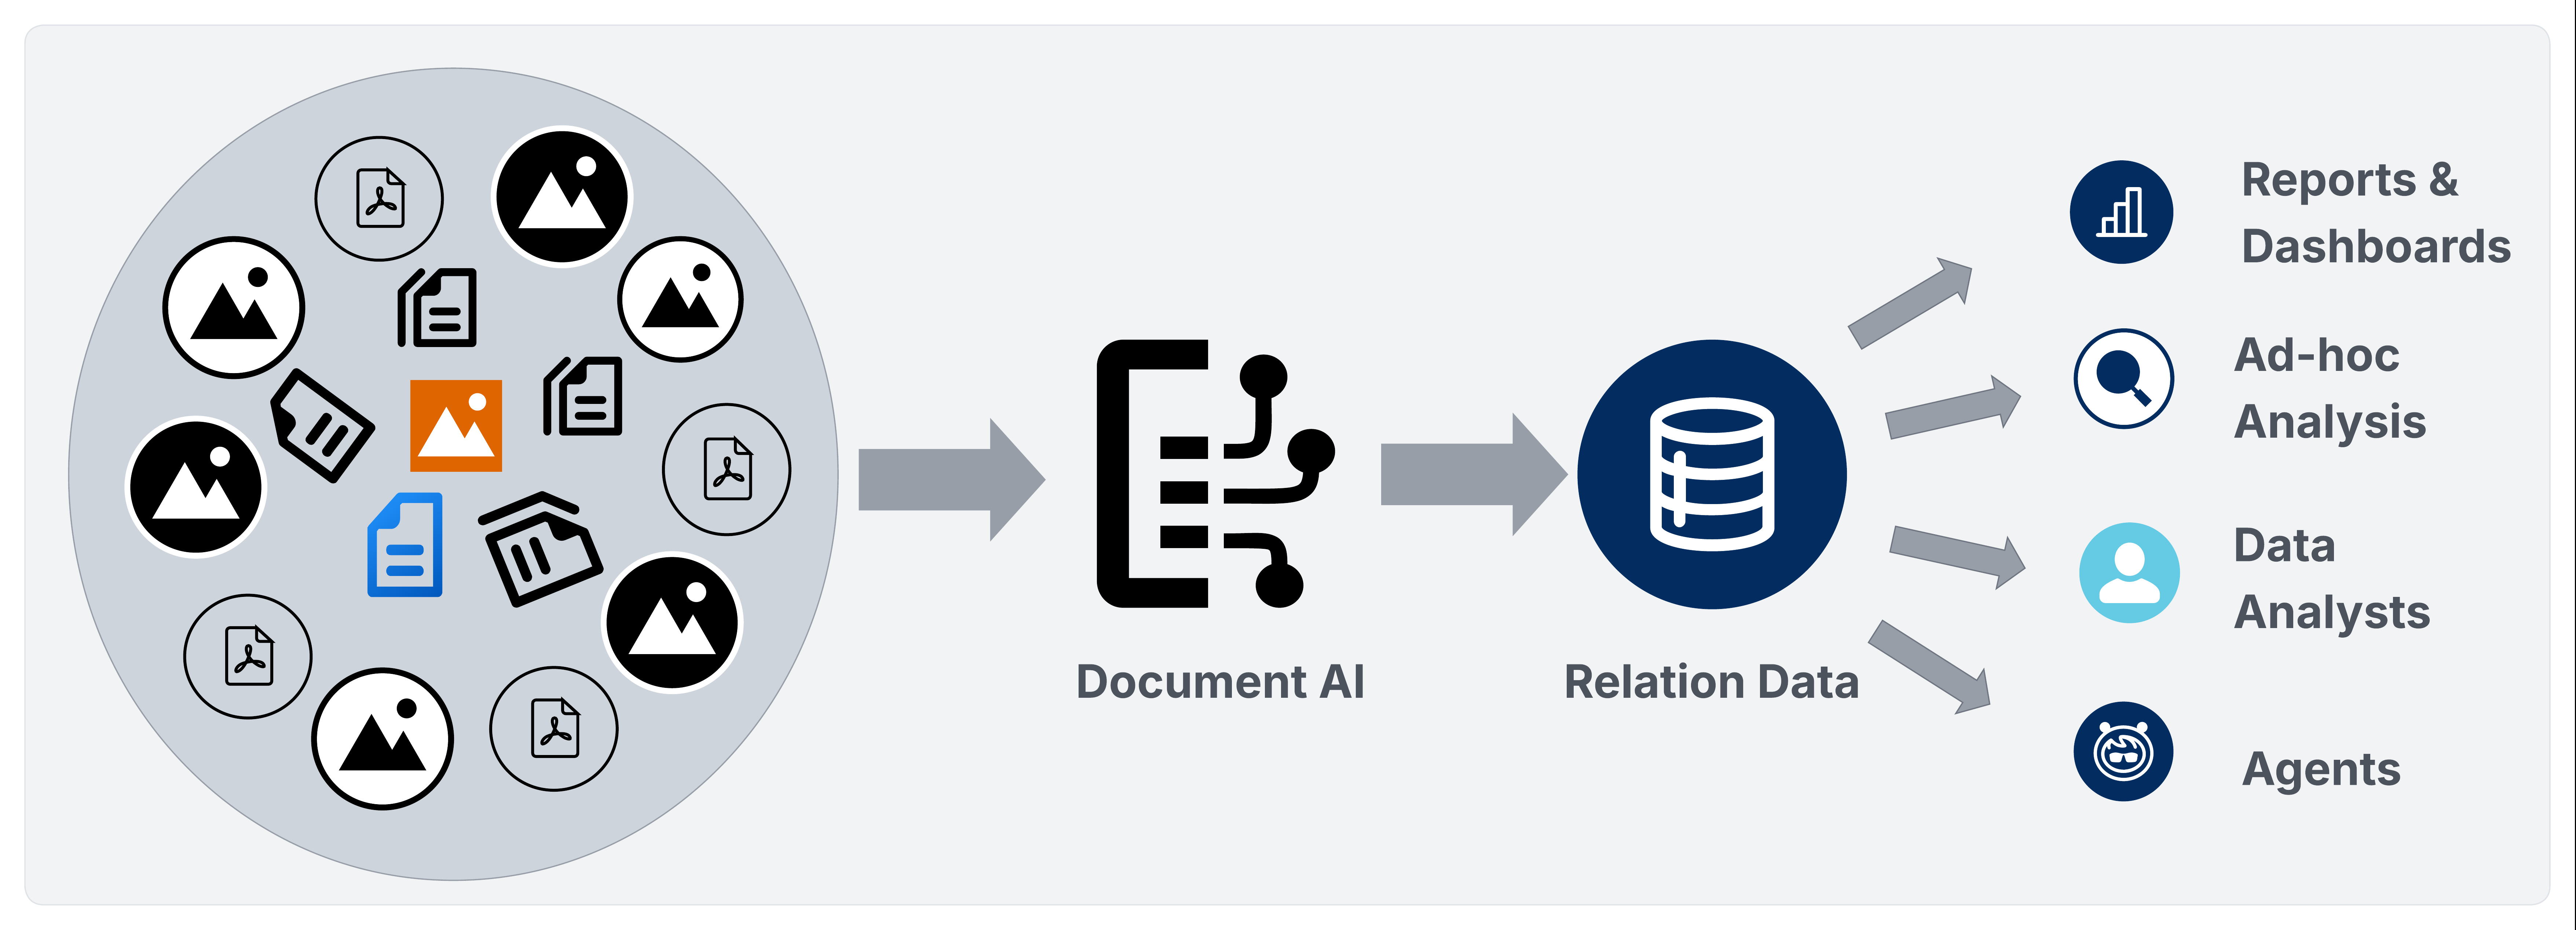
Data 360 Document AI использует обработку документов на платформе Data 360 посредством двух ожидаемых продаж.
- Пакетные ожидаемые продажи перенаправляют извлеченные данные посредством приема, разрешающей способности при опознавании, вычисленных важных данных, активаций, аналитики и активации Agentforce.
- Ожидаемые продажи транзакций открывают REST API, который синхронно возвращает структурированный JSON, что позволяет архитекторам перенаправлять данные, полученные из документа, в Sobjects Salesforce, ожидаемые продажи объекта озера данных/объекта модели данных (DLO/DMO) или внешние базы данных и склады без настройки пакета.
В обоих случаях извлеченные данные попадают в управляемую, управляемую схемой модель, а не в фрагментированный набор инструментов точек.
ИИ документа Data 360 - это нативная возможность Salesforce интеллектуальной обработки документов (IDP) на платформе Data 360. Он преобразует неструктурированное и полуструктурированное содержимое документа в управляемые данные, доступные для запроса, которые полностью участвуют на протяжении всего жизненного цикла Data 360.
ИИ документа Data 360 - это нативная возможность Salesforce интеллектуальной обработки документов (IDP) в Data 360. Он принимает неструктурированные и полуструктурированные документы, извлекает структурированные данные посредством декларативной конфигурации схемы и доставляет эти данные в ожидаемые продажи Data 360 для гармонизации, разрешающей способности при опознавании, аналитики и активации Agentforce.
ИИ документа Data 360 поддерживает два режима обработки:
- Пакетная обработка: Обрабатывает большие наборы документов, определенные в неструктурированных объектах модели данных (UDMO) на основе событий.
- Транзакционная обработка: Обрабатывает один документ посредством REST API и синхронно возвращает структурированную полезную нагрузку JSON. Архитекторы потом могут перенаправить полезные данные в ожидаемые продажи Data 360 DLO/DMO, SObjects Salesforce или внешние базы данных и склады посредством MuleSoft, выносок Apex или конвейеров Einstein Trust Layer (ETL). Целевой уровень - это архитектурное решение, определяемое задержкой, управлением и требованиями к резидентству данных.
В настоящее время искусственный интеллект документа поддерживает PDF-файлы, файлы изображений (JPEG, PNG) и документы, созданные вручную.
Data 360 Document AI объединяет четыре технологии обработки в один управляемый ожидаемый продажи. Каждый компонент обрабатывает отдельный этап жизненного цикла преобразования документа в данные:
- Оптическое распознавание символов (OCR): Преобразует отсканированные изображения, содержимое, написанное вручную, и PDF-документы на основе изображений в машиночитаемый текст перед обработкой LLM. Для надежного извлечения рекомендуется не менее 150 DPI.
- Большие языковые модели (LLM): Перенаправьте извлечение через шлюз Einstein LLM посредством выбранной пользователем модели. LLM получает вывод OCR вместе с конфигурацией схемы JSON и возвращает структурированную полезную нагрузку извлечения. Gemini и дополнительные модели планируется внедрить в будущем.
- Обработка естественного языка (NLP): Выполняет контекстуальное понимание, распознавание объекта, анализ даты и извлечение семантического поля непосредственно в LLM посредством структурированного оперативного проектирования—заданное схемой напоминание и вывод OCR служат единственными вводными данными. Все взаимодействия LLM перенаправляются через ETL, который внедряет нулевое сохранение данных с поставщиками модели и маскирует PII в текстовых вводных данных до их достижения модели. Отдельный механизм NLP не используется.
- Мультимодальная обработка: Обрабатывает встроенные изображения в PDF-документах в качестве отдельных вводных данных извлечения, что позволяет LLM извлекать данные из диаграмм, таблиц изображения и страниц смешанного содержимого, которые не может анализировать самостоятельно OCR.
В дополнение к четырем технологиям обработки документ ИИ также обрабатывает:
- Einstein Trust Layer: Перенаправляет все взаимодействия LLM посредством ETL, который внедряет нулевое сохранение данных с поставщиками модели и маскирует PII до достижения вводных данных LLM, за исключением мультимодальных данных (например, вложенных документов, обрабатываемых посредством искусственного интеллекта), где маскировка PII в данный момент не поддерживается и данные отправляются как есть во внешние модели. ETL управляет только путем взаимодействия LLM. Извлеченные данные, записанные в объекты озера данных (DLO), хранятся без изменений; маскировка уровня поля в дежурном режиме должна выполняться посредством управления данными в нисходящем направлении.
- Ограничения размера файла: ИИ документа обрабатывает файлы размером до 10 Мб на запрос. Ограничения по длине контекста LLM могут дополнительно затруднить обработку плотных многостраничных документов в пределах этой границы.
Архитекторы предприятия, развертывающие ИИ документа Data 360, должны применить эти принципы, прежде чем создавать проект внедрения.
- Перед созданием схемы выберите ожидаемые продажи. Конвейеры пакетной и транзакционной обработки отличаются моделью принятия, связыванием схемы, гибкостью цели и задержкой. Важно подтвердить, какие ожидаемые продажи требуются каждому сценарию использования, прежде чем определить схему, так как переоснащение добавляет повторную работу, которую можно избежать.
- Разработайте схемы на уровне типа документа. Использование одной продуманной схемы на тип документа более обслуживаемо, чем использование конфигураций для каждого случая использования, и это также самый большой рычаг для качества извлечения. Чтобы сделать это корректно, рекомендуем использовать разнообразный набор документов (включая краевые обращения), а не создавать на основе одного примера. Используйте напоминания на уровне поля, таблицы и схемы, чтобы найти пробелы, а потом протестируйте и настройте их по нескольким образцам документов перед завершением. Помните, что схема, хорошо работающая над одним документом, может не совпадать с другими, поэтому широта и повторяемость очень важны. Гибкость схемы, включая удаление столбцов, которые не извлекаются надежно в разных типах документов, одинаково важна. Удержание полей, создающих шум или несоответствие, подрывает общее качество извлечения, поэтому удаление столбцов важно рассматривать как первоклассное дизайнерское решение.
- Выберите правильный целевой уровень для каждой группы полей. Поля, определяющие бизнес-правила CRM или утверждения, записываются в Sobjects. Поля, пополняющие объединенный профиль или аналитику ленты, относятся к ожидаемым продажам DLO/DMO. Поля, обслуживающие внешние системы, относятся к уровню RDBMS. Помните, что одна схема может охватывать несколько уровней одновременно.
- Применение управления перед обработкой регламентированного содержимого. Регулируемые данные нуждаются в защите на каждом уровне. Поэтому важно настроить маскировку PII, теги классификации данных и управление доступом на основе атрибутов (ABAC) после сохранения извлеченных данных в выводных объектах озера данных (DLO). Это обеспечивает точное внедрение и контекстный доступ, основанный на классификации данных, роли пользователя и организационном контексте. Управление разделено на два пути: ELT управляет взаимодействием LLM, в то время как извлеченные данные, хранящиеся в DLO, должны управляться отдельно — непосредственно на уровне DLO и базы данных — посредством конфигураций пространства данных, наборов полномочий и политик ABAC. Эти элементы управления должны поддерживать согласованность на уровне хранилища, а не только на уровне приложения, поэтому ограничения доступа остаются неизменными, вне зависимости от способа доступа к данным после приема. Помните, что пробелы в любом слое могут открывать регулируемые данные в нисходящем направлении, даже если другие настроены правильно.
- Предназначение для режимов сбоя перед производством. Устранение обработки нулевых полей, порогов качества OCR, предварительной проверки размера файла, переполнения контекста LLM, импотентности записи RDBMS и ограничений кредитного бюджета перед первым запуском производственного пакета. Это не краевые случаи - это предсказуемые поверхности сбоев, которые должны быть четко обработаны при проектировании ожидаемых продаж, а не обнаружены во время выполнения.
- Считайте рейтинги надежности первоклассным сигналом маршрутизации, а не диагностическим запоздалым. Результаты извлечения несут значения надежности уровня поля, полученные из вероятностей журнала (logprobs) основного вывода модели. Для каждого извлеченного поля, таблицы или столбца оценка отображает определенность извлеченного значения на уровне маркера модели. Это делает рейтинги надежности статистически приземленным сигналом, достаточно надежным, чтобы служить основными воротами для порогов расширения HITL. Используйте рейтинги надежности для систематического определения низкокачественных извлечений и инициируйте контрольные точки HITL для значений полей низкой надежности, неоднозначных совпадений схем или повторяющихся ошибок ожидаемых продаж вместо использования эвристики или ручных выборочных проверок. Если автоматическое восстановление невозможно, рейтинг надежности, поддерживаемый HITL, обеспечивает применение человеческого суждения именно там, где это необходимо.
- Разработайте пути активации параллельно с разработкой схемы. Ценность ИИ документа заключается в возможности активации извлеченных данных в бизнес-процессах и агентах Salesforce. Он позволяет проектировать действия Agentforce, потоки и вычисленные важные данные вместе с проектированием схемы извлечения, а не после.
Документ ИИ функционирует в двух ожидаемых продажах:
- Пакетные ожидаемые продажи для массовой обработки с поддержкой УДМО
- Конвейер транзакционной обработки для извлечения в реальном времени на основе API
Оба ожидаемых продаж используют одинаковый контракт конфигурации схемы и управление ETL, но они отличаются способом входа документов в систему и местом извлечения данных.
Рассмотрим подробнее каждый ожидаемый продажи.
Пакетные ожидаемые продажи обрабатывают повторяющиеся наборы документов, определенные УДМО. Он подходит для запланированных или управляемых событиями способов использования, когда документы принимаются из корпоративного хранилища, потом проходят через извлечение документов и доставляются в ожидаемые продажи Data 360 DLO/DMO для гармонизации, разрешающей способности при опознавании и активации.
Реальный сценарий
Ежедневно страховая компания получает тысячи медицинских документов, которые загружаются в виде PDF-документов на порталы поставщиков в Amazon S3. УДМО определяет набор документов в области и отправляет все PDF-претензии в область /claims/incoming/ в течение 24 часов.
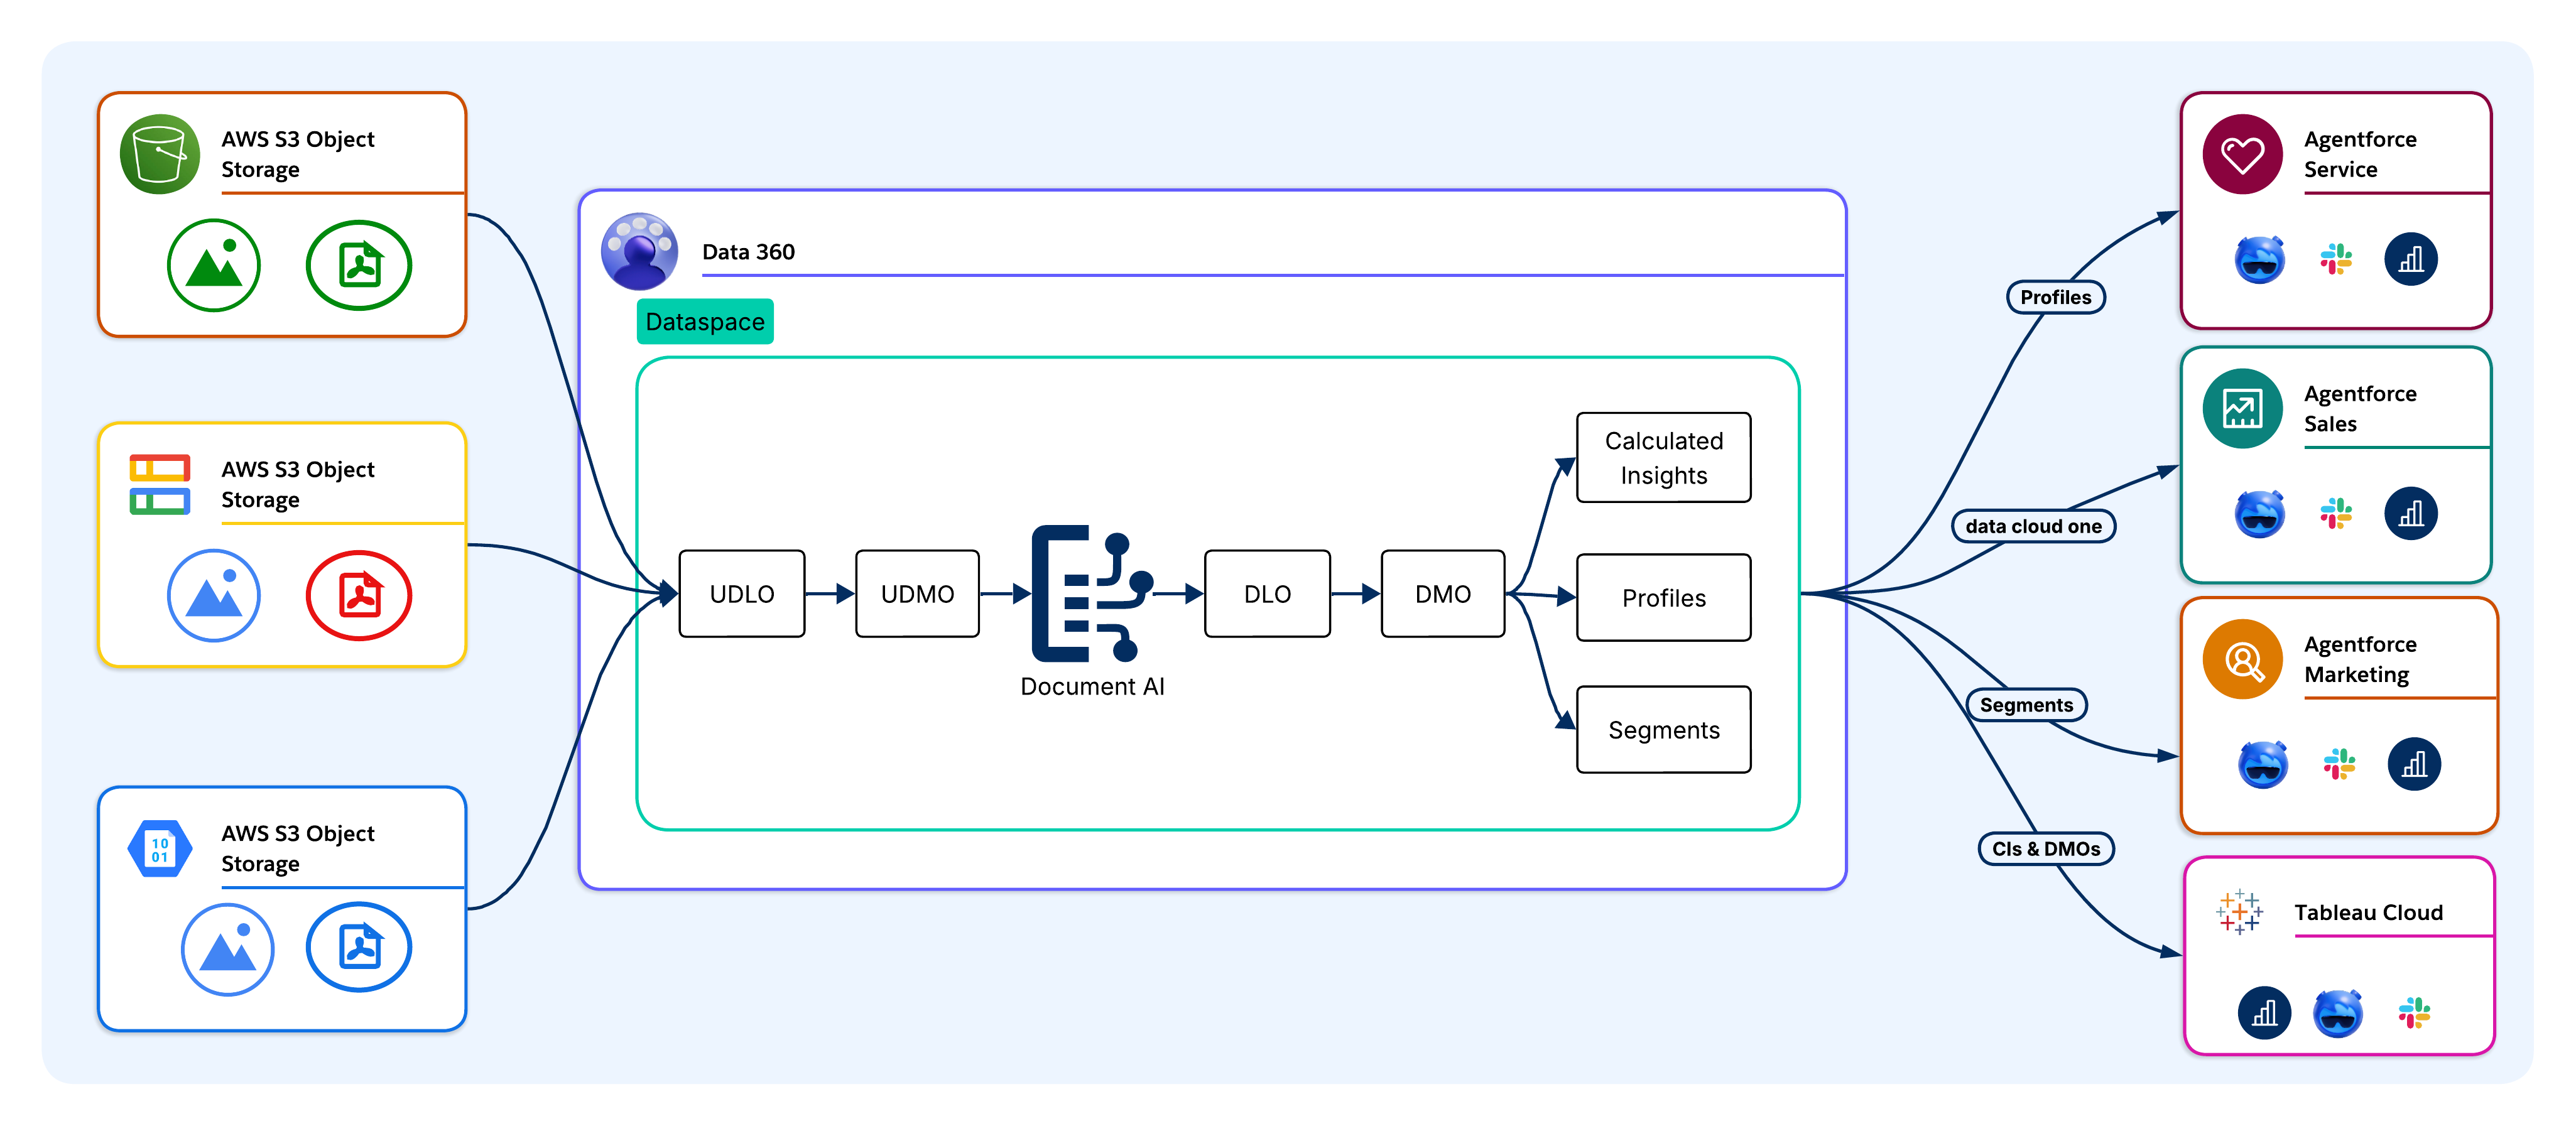
Документы принимаются в Data 360 из корпоративных исходных систем без физического дублирования. Поддерживаемыми источниками являются Amazon S3, Google Cloud Storage, объекты файлов Salesforce CRM, ожидаемые продажи MuleSoft и прямые загрузки API. В развертываниях Headless 360 документы принимаются посредством коннекторов облачного хранилища или Ingestion API, который пропускает уровень CRM. Сервер Model Context Protocol (MCP) открывает прием в качестве вызываемого инструмента для внешних агентов искусственного интеллекта и клиентов LLM.
При принятии исходные документы хранятся в виде неструктурированных объектов озера данных, которые соотносятся с физическим расположением и метаданными каждого документа без перемещения или трансформации исходного файла.
Пример:
PDF-претензии принимаются из S3 в Data 360 посредством коннектора облачного хранилища. Каждый документ хранится как UDLO, указывающее на объект S3. Физического дублирования не происходит.
Искусственный интеллект документа обрабатывает каждый UDLO относительно конфигурации схемы, определяющей поля для извлечения вместе с целевыми типами данных. УДМО определяет, какие документы относятся к области. LLM (GPT-4o, Gemini или Claude) считывает каждый документ и возвращает структурированную полезную нагрузку извлечения.
Пример:
Искусственный интеллект документа обрабатывает каждый УДЛО по схеме претензий, определяющей поля, например: ClaimID, PatientName, DiagnosisCode, BillingAmount и ServiceDate. LLM потом считывают каждый PDF-файл и возвращают структурированную полезную нагрузку извлечения.
После извлечения данных они сохраняются в ООД, являющихся исходным слоем хранилища Data 360. ООД сохраняют извлеченные поля без навязывания бизнес-логики, что сохраняет точное физическое представление для трансформации в нисходящем направлении и отслеживания. УДЛО сохраняет ссылку на исходный документ для включения реплики уровня поля в любой момент ожидаемых продаж.
Пример:
Все извлеченные поля попадают в ООД претензий, сохраняющий исходное точное представление каждой претензии с полной линией, которая может быть прослежена до исходного PDF.
Поля DLO соотносятся с DMO, которые соответствуют стандартной модели данных Customer 360. Это граница перехода данных, полученных документом, из исходных извлеченных полей в бизнес-смысловые объекты. DLO счета соотносится с DMO счета, и такие поля, как CustomerID и BillingAmount, становятся ключами присоединения и соответствуют атрибутам в объединенной модели данных. Гармонизированные данные документа участвуют в сегментации, вычисленных важных данных и активации посредством тех же интерфейсов, которые используются CRM и транзакционными данными.
Пример:
DLO претензий соотносится с DMO претензий. Поля PatientID и PolicyNumber становятся ключами присоединения, связывающими записи претензий с объединенными профилями пациентов.
Гармонизированные данные DMO участвуют в разрешающей способности при опознавании. Извлеченные поля (например, имена клиентов, адреса эл. почты или номера организаций) служат ключами соответствия для связывания записей документов с объединенными отдельными лицами (золотые записи), что устраняет пробел между документами и профилями.
Пример:
Поля извлечения (например, PatientName, DateOfBirth и PolicyNumber) служат ключами соответствия для разрешающей способности при опознавании, которая связывает записи претензий с правильным объединенным отдельным лицом. Это происходит, даже если один и тот же пациент появляется в документах под незначительно отличающимся написанием имени.
Архитекторы определяют вычисленные важные данные, являющиеся агрегированными показателями, вычисляемыми по согласованным данным документа (например, общие расходы по различным позициям строки счета, рейтинги риска продления контракта и индексы серьезности претензий).
Пример:
Вычисленные важные данные вычисляют TotalClaimsPerPatient, AverageClaimAmount и HighRiskClaimScore в согласованных данных претензий для запросов Agentforce.
Гармонизированные данные с разрешающей способностью при опознавании доступны агентам Agentforce, Tableau, маркетинговым платформам и объектам Salesforce. Целевой уровень - это архитектурное решение, определяемое задержкой, управлением и требованиями к резидентству данных.
Пример:
Claims Adjudication Agentforce запрашивает DMO Data 360 и CI для поиска претензий высокого риска для приоритетной проверки. Панели мониторинга Tableau отображают объем заявок-претензий и тенденции отклонений. Утвержденные записи претензий возвращаются в Sobject претензий для запуска бизнес-правил оплаты.
В архитектурах Headless 360 активация перенаправляется напрямую во внешние системы посредством целей активации Query API, Pub/Sub API или Cloud data store. Потом сервер MCP находит гармонизированные данные документа и вычисленные важные данные в качестве инструментов вызова для внешних агентов искусственного интеллекта.
Конвейеры транзакционной обработки обрабатывают извлечение одного документа во время выполнения без УДМО или предварительно принятого УДЛО, что соответствует сценариям использования под управлением событий (например, клиент, загружающий форму, агент, получающий PDF-документ или внешняя система, инициирующая извлечение в бизнес-процессе транзакционной обработки). Управление ETL применяется к обоим ожидаемым продажам одинаково.
Реальный сценарий
При оформлении кредита клиент банка загружает PDF-файл своей коммунальной оплаты посредством мобильного приложения банка. Событие инициирует извлечение в режиме реального времени, что означает, что предварительно принятые УДЛО или УДМО не задействованы.
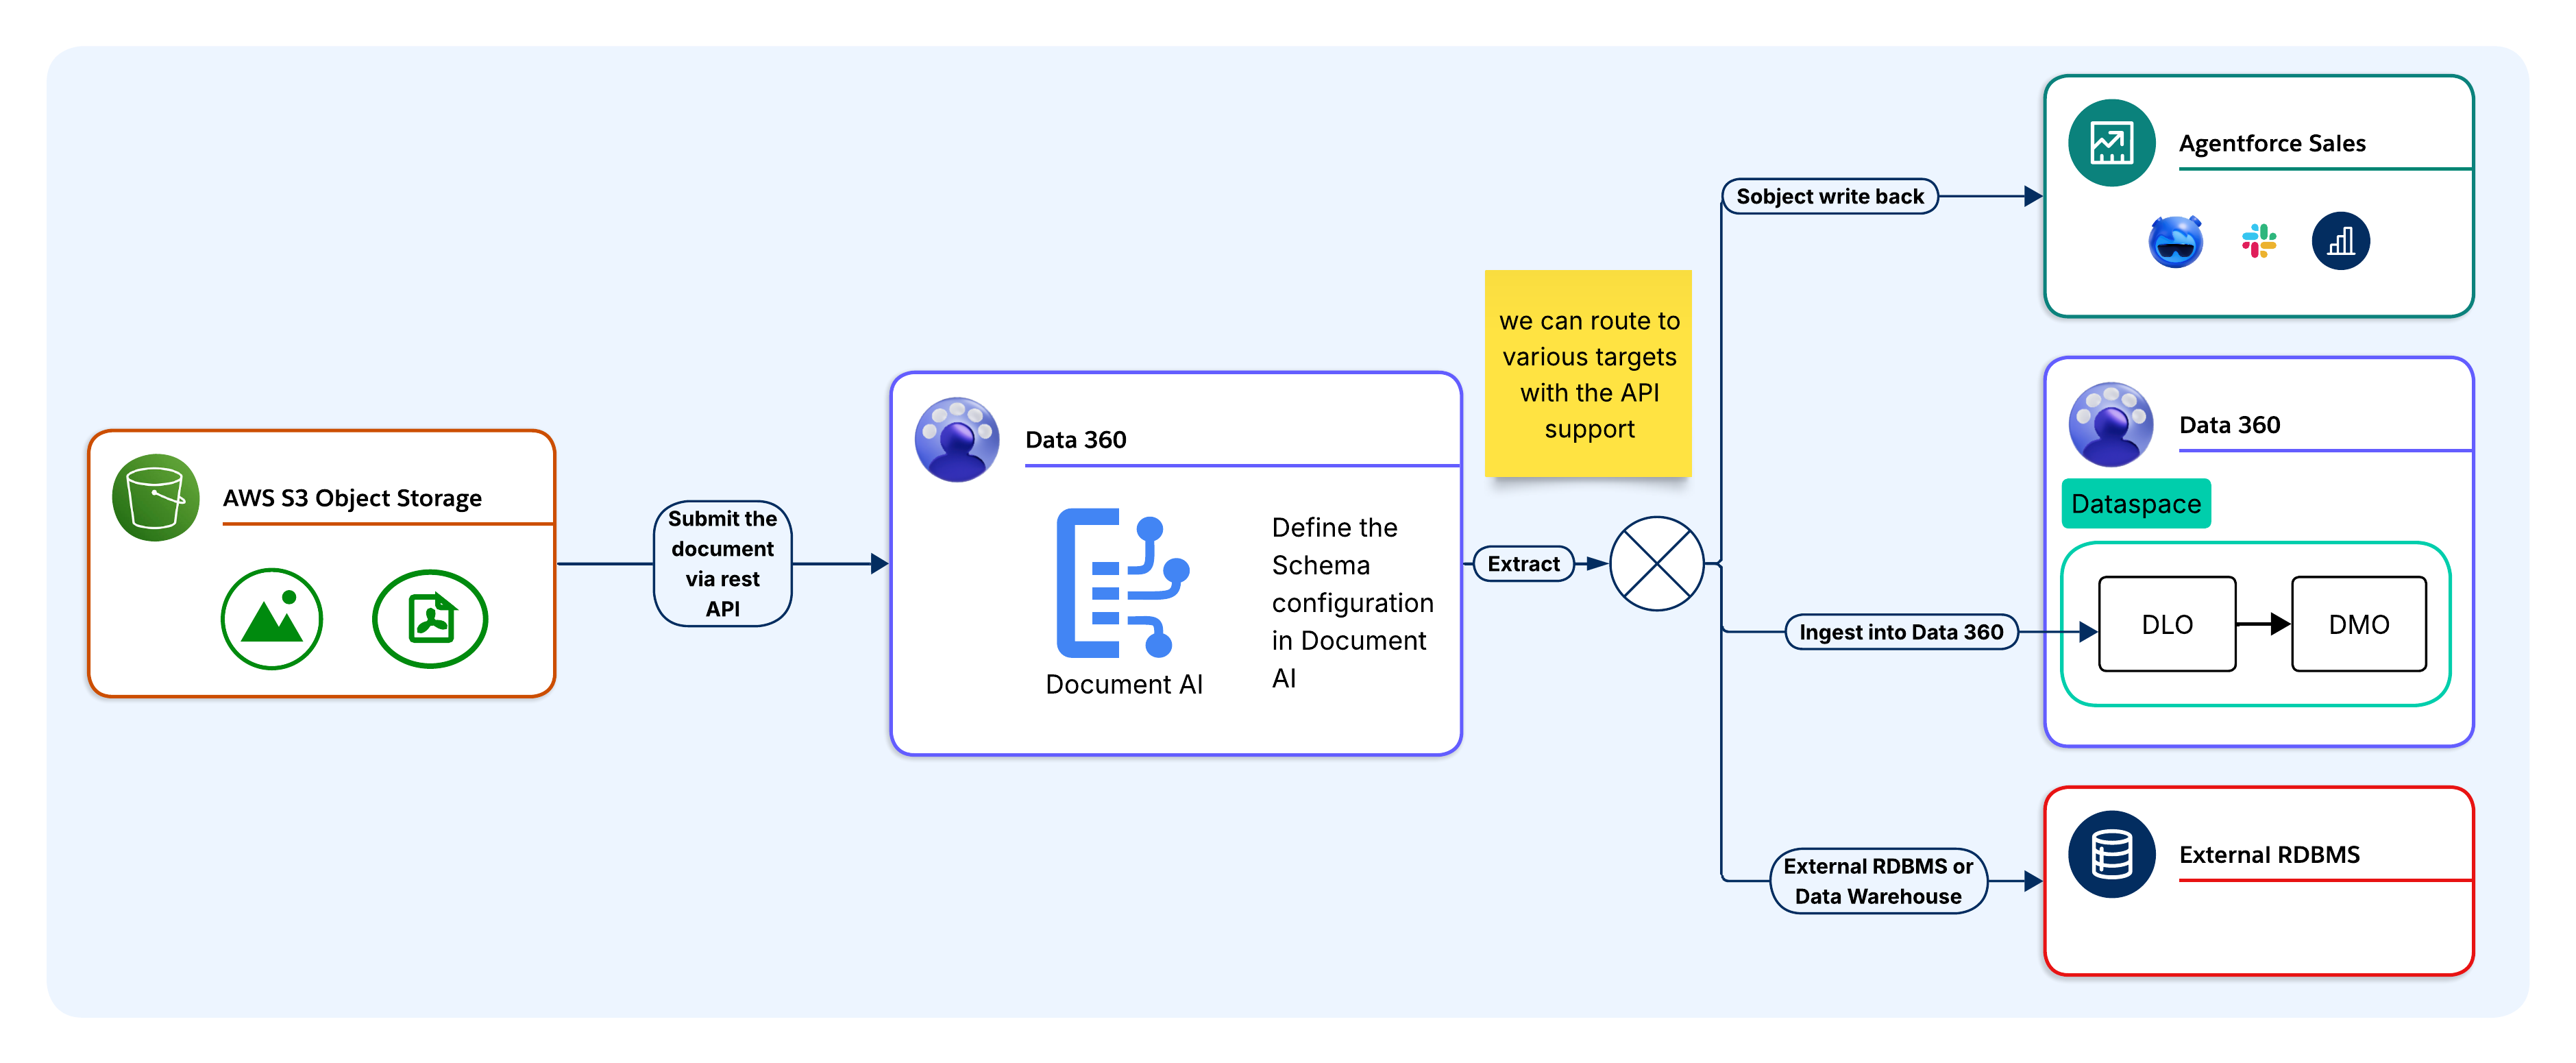
Прежде чем вызвать API, архитекторы должны определить и сохранить схему в Data 360, которая определяет поля, типы данных и инструкции извлечения в формате схемы JSON. Каждой схеме назначается уникальный код схемы. В среде выполнения вызывающее приложение ссылается на код схемы, чтобы сохранить логику извлечения централизованной в Data 360, а не встраивать ее в код приложения.
Пример:
У группы банка есть предопределенная схема ProofOfAddress в Data 360, которая указывает такие поля, как CustomerName, AddressLine1, City, PostCode и DocumentDate. Эта информация сохраняется в виде версионной конфигурации, на которую может ссылаться код схемы.
Вызывающее приложение отправляет документ и код схемы в одном запросе REST API в качестве полезной нагрузки в кодировке base64 или ссылки на файл. Прием УДЛО не требуется. Искусственный интеллект применяет извлечение документа и возвращает структурированный вывод на основе предоставленной схемы.
Пример:
Мобильное приложение отправляет коммунальный платеж в качестве полезной нагрузки в кодировке base64 вместе с кодом схемы ProofOfAddress в одном вызове REST API. Этот процесс не требует этапа принятия УДЛО.
LLM обрабатывает вывод OCR по схеме и синхронно возвращает структурированную полезную нагрузку JSON. Поля, отсутствующие в документе, возвращаются как нулевые. Абонент несет ответственность за полный ответ JSON и переходит к маршрутизации.
Пример:
Документ AI применяет OCR к PDF, а LLM возвращает структурированную полезную нагрузку JSON с извлеченными полями адреса. Не найденные поля (например, если PostCode отсутствует в счете) возвращаются как нулевые.
После извлечения полезные данные JSON могут быть перенаправлены на один или несколько целевых уровней, в зависимости от сценария использования:
- Salesforce SObject: Соотносится напрямую с полями Sobject посредством Apex или Flow для бизнес-процессов и утверждений CRM.
- Конвейеры DLO/DMO данных 360: Маршрутизирует в ООД для гармонизации, разрешающей способности при опознавании, вычисленных важных данных и заземления Agentforce.
- Внешние СУБД или хранилище данных: Маршрутизация посредством MuleSoft, выноски Apex, событий платформы или ETL для систем за пределами Salesforce.
- Настраиваемая интеграция: Возвращает структурированные полезные данные JSON в вызываемое приложение для хранения во внешней системе или хранилище данных.
- Поток в нисходящем направлении или агент: Передает структурированный вывод JSON напрямую в нисходящий поток или агенту без сохранения в SOBject. Это типичная схема для клиентов, использующих ИИ документа в качестве этапа извлечения в реальном времени в рамках более крупной автоматизации или агентского бизнес-правила.
Помните, что одна схема может одновременно охватывать несколько уровней, когда разные группы полей перенаправляют к разным целям из одной точки извлечения.
Пример:
Полезная нагрузка ProofOfAddress может достигать трех уровней одновременно (например, CustomerName и AddressLine1 записывают в сообщение контакта), что инициирует поток проверки адреса. Потом полная полезная нагрузка перенаправляется в ООД для гармонизации и оценки рисков, а копия перенаправляется в систему KYC банка посредством MuleSoft для регистрации соответствия нормативным требованиям.
После записи извлеченные данные немедленно активируются в целевой системе. Для целей SObject триггеры, потоки и процессы утверждения активируются в вставленной записи. Для целей DLO/DMO данные поступают в ожидаемые продажи гармонизации и разрешающей способности при опознавании и в контексте Agentforce. Внешние цели СУБД предоставляют данные для последующих запросов сразу после завершения записи.
Пример:
Поток проверки адреса немедленно активируется в вставленной записи контакта, что продвигает заявку на кредит к следующему этапу. Агент кредитного отдела Agentforce находит проверенный адрес в данном 360, а система KYC записывает документ, представленный для проверки.
Документ ИИ лучше всего подходит для конкретных архитектурных условий. Его применение вне этих условий создает ненужные сложности и дополнительные расходы.
Архитекторы считают важным оценить этот критерий, прежде чем использовать искусственный интеллект в качестве механизма извлечения.
Использовать искусственный интеллект документа, если:
- Документы являются основным источником данных. Необходимые сведения существуют только в форме документа и недоступны в структурированном API или базе данных (например, отсканированные контракты, лабораторные отчеты, формы приема или страховые заявки-претензии).
- Макеты документов отличаются в разных источниках. Одинаковый тип документа поступает от нескольких поставщиков, партнеров или регионов с разными позициями и форматами полей. Извлечение LLM под управлением схемы адаптируется без обслуживания каждого макета.
- Извлеченные данные должны использоваться в Data 360 или Agentforce. Извлечение должно участвовать в разрешающей способности при опознавании, вычисленных важных данных или заземлении Agentforce. Документ ИИ поставляется напрямую в ожидаемые продажи DLO/DMO без отдельного слоя ETL.
- Объем оправдывает управляемую автоматизацию. Объем документа превышает объем обработки вручную без измеримых затрат труда или рисков качества данных.
- Документы содержат регламентированное содержимое. PHI, PII или финансовые данные должны пройти сквозь слой с нулевым сохранением данных, маскирующий PII, прежде чем достичь LLM. ЭТЛ удовлетворяет это нативно. Клиенты, которым не требуется постоянное извлечение содержимого на любом этапе, должны также учитывать поток транзакционного API, который возвращает структурированный вывод напрямую в приложение вызова без записи в собственный объект или хранилище данных.
- Сценарий использования определяется событиями. Документ приходит во время выполнения (например, загрузка клиента, PDF-вложение агента или триггер внешней системы). Конвейеры транзакционной обработки обрабатывают синхронное извлечение одного документа без пакетной настройки.
Не используйте искусственный интеллект документа, если:
- Исходные данные уже структурированы. Если начальная система открывает REST API, таблицу базы данных или структурированный файл (например, CSV, JSON или XML), используйте стандартный коннектор Data 360. Выполнение структурированных данных в ожидаемых продажах извлечения LLM добавляет затраты на задержку и кредит без дополнительных преимуществ.
- Документы создаются компьютером с фиксированной схемой. Системные PDF-документы из известной платформы ERP или выставления счета со стабильным макетом лучше подходят для детерминистского анализа. Извлечение LLM создано для вариативности, и его применение к документам с фиксированной схемой приводит к потере контекста и кредитов.
- Требования к точности превышают пороги надежности LLM. Искусственный интеллект документа не гарантирует 100% точности извлечения. Используйте сценарии, когда пропущенное или неправильное значение поля содержит значительный финансовый, юридический или клинический риск, требующий этапа проверки HITL. Не используйте искусственный интеллект документа в качестве единственного слоя извлечения для важных решений без бизнес-правил проверки.
- Документы превышают ограничения платформы. Текущее ограничение размера файла 10 Мб и ограничения длины контекста LLM делают ИИ документа непригодным для больших или плотных документов без предварительной обработки для разделения и повторной сборки их за пределами платформы.
- Примечание: В Salesforce мы активно совершенствуем эти предохранительные ограждения для расширения поддерживаемых размеров файлов, количества страниц и расширений файлов. Факторы, сдерживающие прогресс, будут и далее развиваться.
Рассмотрим несколько сценариев, использующих пакетные ожидаемые продажи на основе искусственного интеллекта, поддерживаемые исходным объектом UDMO. В этих случаях извлеченные маршруты данных в ожидаемых продажах Data 360 DLO/DMO для гармонизации, разрешающей способности при опознавании, вычисленных важных данных и активации Agentforce. Каждый сценарий использования лучше подходит для запланированной или управляемой событиями массовой обработки документов.
Agentforce Sales: Аналитика контрактов и счетов
PDF-документы контракта принимаются из облачного хранилища посредством пакетных ожидаемых продаж. Схема извлекает ContractValue, RenewalDate, PaymentTerms и CounterpartyName, а потом соотносит их с DMO организации и контракта. Вычисленные важные данные извлекают оценки риска продления. Agentforce предупреждает руководителей организаций до закрытия окон продления, что исключает проверку контрактов вручную и пропущенные продления.
Agentforce Service: Отклонение обращения и заземление базы знаний
PDF-документы опросов и вложения обращений принимаются посредством пакетных ожидаемых продаж. Схема извлекает индикаторы настроения, категории проблем и примечания к решению, а потом соотносит их с DMO Case и Knowledge Article. Agentforce запрашивает гармонизированную базу Knowledge при открытии обращения и находит соответствующие этапы устранения неполадок, что уменьшает накладку поиска Agent.
Agentforce Health: Обработка клинических документов
Отчеты по лабораториям, PDF-документы о приеме и клинические формы, написанные вручную, принимаются через пакетные ожидаемые продажи. Схема извлекает поля, включительно с PatientID, DiagnosisCode, MedicationName и TestResult, а потом соотносит их с DMO Health Cloud, поддерживающим согласованную с HIPAA координацию лечения и бизнес-процессы клинических исследований.
Финансовые услуги: Автоматизация кредитных и налоговых документов
Заявки на кредит, налоговые декларации и отчеты о доходах принимаются посредством пакетных ожидаемых продаж. Схема извлекает поля, включая AnnualIncome, TaxYear и EmployerName, а потом соотносит их с DMO Financial Account. Вычисленные важные данные объединяются с данными о доходах, полученными из документа, и данными CRM, чтобы упростить автоматическую оценку кредитного риска. Agentforce находит извлеченные сведения о кредите встроенно во время взаимодействий со службой поддержки. Эта схема напрямую поддерживает сценарий использования агента предварительной квалификации кредита, опубликованный в центре разработчика Salesforce Agentic Enterprise Solutions.
ХР: Обработка документов рабочей силы
Документы адаптации, налоговые формы и PDF-сертификаты принимаются посредством пакетных ожидаемых продаж. Извлеченные поля соотносятся с DMO записи сотрудника, а потом связываются с профилем объединенного сотрудника. Конкретные потоки инициируют задачи адаптации и проверки соответствия на основе извлеченных данных. Эта схема напрямую поддерживает сценарий использования агента автоматической обработки возобновлений. Искусственный интеллект документа извлекает навыки, историю работы и квалификацию из PDF-документов резюме, которые Agentforce потом использует для сопоставления кандидатов с критериями открытой роли и маршрутизации их бизнес-процессам найма.
Профессиональные услуги: Аналитика по предложениям и исследованиям
Пакеты предложений и отчеты по исследованиям принимаются через пакетные ожидаемые продажи. Извлеченные инфраструктуры, ориентиры и сводки занятости соотносятся с настраиваемыми DMO, а потом индексируются для векторного поиска. Agentforce извлекает контекстуально значимые рекомендации во время запроса, которые основаны на извлеченном содержимом документа. Данная схема расширяет схему Ground Agentforce on Website Content. Документы индексируются посредством ИИ документа и выполняют ту же функцию заземления для ответов агента, что и содержимое веб-сайта, индексируемое посредством коннекторов Data 360.
Статус соответствия HIPAA:
Схемы Heald Cloud, описанные в настоящем документе, применяют элементы управления ETL (например, нулевое сохранение данных и маскировку PHI) для ввода текста. Эти элементы управления сами по себе не являются сертификацией HIPAA. Архитекторы, которые проектируют для регламентированных клинических сред, должны подтвердить текущий статус сертификации HIPAA в группе по соблюдению требований Salesforce, прежде чем брать на себя обязательство по созданию архитектуры на основе искусственного интеллекта документа в этих условиях.
Рассмотрим несколько сценариев, вызывающих REST API документа со схемой, не связанной с UDMO. Извлеченные полезные данные JSON синхронно перенаправляются во внешние системы во время выполнения.
Цепочка поставок: Обработка счета поставщика в ERP
Когда PDF- счет поставщика поступает в отслеживаемую область хранилища или шлюз электронной почты, триггер события вызывает документ AI REST API со счетом и предопределенным кодом схемы. Схема извлекает VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount и DueDate. Полезные данные JSON перенаправляются посредством MuleSoft в модуль «Кредиторская задолженность ERP» с нулевой проверкой поля и логикой активной вставки, что исключает обслуживание шаблона для вариативности формата поставщика.
Правовые операции: Проверка контракта в CLM
При загрузке PDF-файла контракта на юридический портал интерфейс синхронно вызывает документ AI REST API. Схема извлекает ManagementLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause и CounterpartySignatory. Полезная нагрузка JSON перенаправляется посредством вызова Apex в систему управления жизненным циклом контракта (CLM). Любые не найденные поля возвращаются как нулевые, а CLM применяет стандартные правила обязательств к отсутствующим значениям.
Заявки-претензии на страхование: Первое уведомление об обработке потерь
Когда держатель полиса отправляет форму Первого уведомления об убытке (FNOL), серверный портал синхронно вызывает документ AI REST API. Схема извлекает PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName и ContactPhone. Полезные данные JSON перенаправляются в базу данных управления заявками-претензиями посредством выноски Apex или ETL, что создает предварительно заполненную запись заявки-претензии для проверки оценщиками до открытия официальной заявки-претензии.
Прежде чем перейти к производственной среде, необходимо создать дизайн для следующих сценариев сбоев.
- Обработка нулевых полей: LLM возвращает ноль для полей, которые не могут быть обнаружены или извлечены уверенно. Проверьте логику нулевой обработки при создании схемы и внедрите стандартное значение или логику отклонения в слой интеграции, прежде чем записывать в цели с ограничениями NOT NULL или обязательными ключами соответствия.
- Ухудшение качества ОКР: Точность ОКР снижается ниже 150 DPI, при неправильном почерке или шумном сканировании. Ошибки распространяются на извлечение LLM как поврежденный ввод без сигналов ошибки. Внедрите минимальное качество сканирования при приеме и внедрите проверки порога надежности для числовых полей и полей даты.
- Несоответствие версии схемы: Обновление конфигурации схемы после запланированного пакетного задания приводит к обработке документов в полете по сравнению с предыдущей версией, которая создает отсутствующие или переименованные поля, разбивающие соотнесение в нисходящем направлении. Версии схем четко и координируют обновления с расписаниями пакетных заданий.
- Ограничения размера файла: Документы, размер которых превышает 10 Мб, отклоняются. Ошибки пакетных ожидаемых продаж молчат без настроенного мониторинга, а абоненты транзакций получают ошибку 4xx. Предварительно проверьте размеры файлов при приеме и внедрите предварительную обработку, чтобы разделить или сжать документы, которые регулярно приближаются к ограничению.
- Переполнение контекста LLM: Плотные или многостраничные документы могут превышать контекстное окно LLM в пределах 10 Мб. LLM негласно удаляет содержимое, превышающее контекст. Внедрите стратегию фрагментации, которая разделяет документы по диапазону страниц и повторно собирает извлеченные поля, прежде чем передавать их в целевой объект.
- Маскировка слоя доверия, влияющая на извлечение: ЭТЛ работает на уровне напоминания, а не документа, поэтому маскировка не применяется к содержимому документа, проходящему через ИИ документа. Поля схемы, зависящие от значений PII в документе, не зависят от политик маскировки ETL.
- Идемпотенция записи внешних RDBMS: Конвейеры транзакционной обработки не имеют встроенной импотентности для внешних целей СУБД. Повторы слоя интеграции создают повторы строк, если логика записи не обрабатывает удаление повторов. Внедрите эффективные вставки посредством отпечатка пальца документа или внешнего кода на всех внешних путях записи.
- Средняя стадия исчерпания кредита: Крупные пакетные запуски могут исчерпать кредиты Digital Wallet до обработки всех документов, что приводит к неполным наборам данных DLO, которые на последующих этапах считаются завершенными. Установите предупреждения о потреблении на 75% и 90% доступных кредитов и ограничьте размеры пакетов, чтобы не выходить за рамки кредитного бюджета для каждого цикла.
- Ограничение полей схемы — архитектурное ограничение: Искусственный интеллект документа применяет ограничение 50 полей для полей корневого уровня в конфигурации схемы. Это ограничение времени проектирования, а не ошибка среды выполнения, и архитекторы должны учитывать его во время проектирования модели данных и схемы.
- Для сценариев использования, требующих более широкого извлечения:
- Безжалостно расставьте приоритеты. Сузьте схему до полей, определяющих значение автоматизации, а не до исчерпывающего покрытия документа.
- Используйте вложенные объекты (до 3 уровней; пакетный режим только с исходным объектом), чтобы уменьшить количество полей корневого уровня, не жертвуя глубиной извлечения.
- Разместите сложные документы в нескольких конфигурациях ИИ документа, нацеленных на отдельные разделы документа, запишите результаты в отдельные ООД, присоединяющиеся в нисходящем направлении в Data 360.
- Для сценариев использования, требующих более широкого извлечения:
- Ограничения уровня API: Документ ИИ применяет ограничение 50 вызовов API извлечения в минуту на клиента. Теоретический потолок составляет 300 вызовов в минуту, что регулируется шлюзом Einstein LLM. Массовые транзакционные интеграции должны быть разработаны с экспоненциальным резервным копированием, очередью запросов и бюджетированием производительности на уровне клиента. Не думайте, что всплывающие мощности доступны в производственной среде с несколькими клиентами.
- Профиль задержки API: API извлечения искусственного интеллекта документа полностью синхронизированы. Обычное время ответа составляет от 5 до 15 секунд и зависит от размера файла и сложности схемы.
- Это имеет прямые последствия для архитектуры интеграции:
- Установите время ожидания абонента на 30 секунд минимум.
- Не вызывайте искусственный интеллект документа в потоках с требованиями субвторого соглашения об уровне обслуживания.
- Коэффициент задержки в расчетах производительности по сравнению с предельным уровнем тарифа для конвейеров пакетной обработки.
- Установите время ожидания абонента на 30 секунд минимум.
- Это имеет прямые последствия для архитектуры интеграции:
- Зашифрованные и защищенные паролем документы: Искусственный интеллект документа не обрабатывает файлы, защищенные паролем (для открытия файлов требуются пароли пользователя), или PDF- файлы, зашифрованные паролем ответственного/полномочий, включая файлы, открывающиеся нормально, но ограничивающие копирование, печать или редактирование на уровне PDF- полномочий.
- Это ограничение находится на границе приема:
- Создайте ожидаемые продажи документов для обнаружения и маршрутизации зашифрованных файлов в путь отклонения или ручной обработки до их поступления в документ ИИ.
- Не полагайтесь на обработку ошибок среды выполнения в качестве основных ворот.
- Это ограничение находится на границе приема:
Искусственный интеллект документа Data 360 согласовывается с несколькими компонентами хорошо архитектурной инфраструктуры Salesforce.
- Trust: ETL применяет нулевую сохранность данных с поставщиками LLM, маскирует вводные данные PII до их достижения модели и сканирует выводные данные на наличие конфиденциального содержимого. Архитекторы должны распространить эту позицию на извлеченные данные в дежурном режиме. Маскировка уровня поля в ООД не применяется ETL и требует политик пространства данных в нисходящем направлении и наборов полномочий.
- Надежность: Каждый режим сбоя в разделе «Рекомендации по проектированию» (извлечение нулевого поля, неправильное чтение OCR, несоответствие версии схемы, нарушение размера файла, переполнение контекста LLM, помехи маскировки ETL, импотентность записи RDBMS и исчерпание кредита) представляет отдельный класс сбоя с документированным сигналом обнаружения и путем решения.
- Operational Excellence (управление изменениями): Модель извлечения под управлением схемы отделяет логику извлечения от макета документа. Когда поставщик изменяет формат счета или обновляет нормативную форму, архитекторам нужно обновить только одну конфигурацию схемы, а не изменять код интеграции.
- Оперативное совершенство (обслуживаемость): Централизация конфигураций схемы в Data 360 вместо встраивания логики извлечения в код приложения делает намерение извлечения ясным, версионным и доступным для аудита. Все последующие цели используют одинаковый контракт схемы, вне зависимости от их целевого уровня.
- Operational Excellence (повторное использование интеграции): Искусственный интеллект открывает извлечение на нескольких поверхностях интеграции: REST API, Apex, Flow, MuleSoft, действия Agentforce и сервер MCP. Отдельная конфигурация схемы одновременно переходит на несколько целевых уровней без восстановления возможности извлечения на потребителя.
- Оптимизация ресурсов и затрат: Руководство по выбору ожидаемых продаж, граница размера файла 10 Мб и ограничения длины контекста LLM перед сборкой представляют собой учитывающие производительность проектные решения. Раздел «Когда использовать» формализует условия для случаев, когда искусственный интеллект документа не является подходящим инструментом (например, требования к подвторой задержке, полностью структурированные исходные данные и документы, созданные компьютером с фиксированной схемой).
Это структурированная начальная точка для настройки ИИ документа Data 360 в безопасной среде. Прежде чем перейти к производственной среде, выполните все этапы безопасной среды.
Прежде чем начать настройку, необходимо подтвердить следующее:
- Размер файла: Убедитесь, что размеры репрезентативного документа не превышают 10 Мб.
- Ожидаемые продажи: Убедитесь, что сценарий использования требует наличия пакетных ожидаемых продаж (с поддержкой UDMO, массовых продаж) или ожидаемых продаж транзакций обработки (с использованием API, одного документа). Таким образом определяется вся последующая конфигурация.
- Целевой уровень: Подтвердите, где находятся извлеченные данные: объект Salesforce, DLO/DMO Data 360, внешние RDBMS или комбинация.
- Agentforce Dependency: Перед развертыванием любой обработки документов, поддерживаемой Agentforce, убедитесь, что поддерживаемый LLM (например, GPT-4o) включен в вашей организации посредством параметров ETL. Agentforce является предпосылкой жесткой платформы для искусственного интеллекта документа. Вся поверхность функции ИИ документа, включая все API извлечения, недоступна до активации Agentforce в целевой организации. Учитывайте это в оценках готовности организации и в последовательности инициализации. Уделите несколько минут доступности API для стабилизации пост-включения.
- Влияние отключения Agentforce: Если Agentforce отключен после настройки и развертывания искусственного интеллекта документа, вся обработка извлечения (пользовательский интерфейс и API) будет немедленно заблокирована. То же самое относится к отключению модели. Отключение базовой модели эквивалентно доступности ИИ документа. В обоих случаях существующие конфигурации схемы сохраняются и останутся видимыми — конфигурация или потеря данных не произойдёт, но возможность полностью неработоспособна до повторного включения Agentforce и модели. Создайте операционные справочники для обработки доступности Agentforce и включения модели как зависимостей состояния искусственного интеллекта документа.
- Потребление кредита/ценообразование: Используйте кредиты Data 360 или Flex Credits для оценок TCO, полученных из репрезентативных образцов документов.
- Создание конфигурации схемы. Определите поля извлечения, типы данных и инструкции в формате схемы JSON в настройках ИИ документа Data 360. Для пакетных ожидаемых продаж свяжите их с UDMO. Для ожидаемых продаж транзакций создайте их без исходного объекта. Запишите код схемы.
- Выровнять имена полей по целевому уровню. Соотнесите имена полей с определениями столбцов DLO, именами API SObject или именами столбцов RDBMS. Несогласованные имена создают соотнесение над головой в слое интеграции.
- Настройте исходный объект UDMO (только пакетный). Определите объем документов и настройте подключение источника приема (например, S3, Google Cloud Storage, Salesforce Files или MuleSoft). Убедитесь, что организация службы приема имеет объем регистрационных данных IAM или OAuth.
- Применить политики маскировки персональных данных. Настройте политики маскировки данных в параметрах ETL перед обработкой любого регламентированного содержимого. Определите, какие типы полей (PHI, PII и финансовые идентификаторы) маскируются до получения вводных данных в LLM. Не откладывайте этот шаг.
- Назначение области пространства данных и наборов полномочий. Область обработки в соответствующем пространстве данных и настройте наборы полномочий для управления созданием схемы, выполнением пакетного задания, вызовом REST API и активацией в нисходящем направлении.
- Настройка проверки подлинности API (только ожидаемые продажи транзакций). Создайте связанное приложение с областями OAuth cdp_ingest_api и api. Для внутренних абонентов организации используйте именованные регистрационные данные, ссылающиеся на внешние регистрационные данные. Для внешних абонентов настройте регистрационные данные клиента OAuth 2.0 или поток носителя JWT. Прежде чем продолжить, протестируйте и проверьте извлечение.
- Обратная запись SObject: Внедрите элемент Apex (@InvocableMethod) или Flow, который соотносит поля ответа JSON с полями SObject. Используйте Database.upsert() с внешним кодом для предотвращения повторов. Примените безопасность поля к полям целевого объекта.
- Ожидаемые продажи DLO/DMO данных 360: Соотнесите извлеченные поля ООД с DMO, которые соответствуют модели данных Customer 360. Настройте правила разрешающей способности при опознавании для связывания записей документов с объединенными отдельными лицами. Определите вычисленные важные данные и добавьте DMO для Agentforce. В ожидаемых продажах транзакций сначала перенаправьте полезные данные JSON в DLO посредством Ingestion API.
- Внешние СУБД или хранилище данных: Выберите схему интеграции: MuleSoft (существующая ткань интеграции), выноска Apex HTTP (легкая, нативная организация), события платформы с подписчиком Pub/Sub (на основе событий) или ETL (массовый пакет). Внедрите эффективные вставки посредством отпечатка пальца документа или внешнего кода на всех внешних путях записи.
- Пути активации: Подключите действия Agentforce к конфигурациям схемы для интерактивного извлечения. Настройте триггеры Flow или Apex для автоматической обработки бизнес- процессов и настройте цели активации для каждой группы полей.
- Обработка ошибок (только ожидаемые продажи транзакций). Настройте полную поверхность ответа HTTP: 200 (успешно, включая частичные нулевые ответы), 400 (некорректный запрос или код схемы не найден), 413 (файл превышает 10 Мб), 5хх (ошибка обслуживания). Внедрите экспоненциальное резервное копирование для попыток 5xx с максимум 3 попытками. Зарегистрируйте исходный ответ JSON и код схемы при каждом вызове.
- Протестируйте схемы на основе образцов документов. Отправьте типичные образцы посредством интерфейса ИИ документа или REST API. Подтвердите точность извлечения, покрытие полей и нулевую обработку в вариантах макета.
- Проверить обработку нулевых полей. Убедитесь, что все последующие цели могут обрабатывать нулевые значения для полей, отсутствующих в документе. Помните, что ограничения NOT NULL не выполняются без явной обработки null.
- Предварительная проверка размеров файлов. Убедитесь, что производственные документы не превышают 10 Мб. Внедрите предварительную обработку для разделения или сжатия документов, которые регулярно приближаются к ограничению.
- Проверка полного извлечения. Для пакетных ожидаемых продаж запустите полный запуск и подтвердите корректность полей извлеченных в каждом целевом уровне. В ожидаемых продажах транзакций обработки отследите ответ JSON через слой интеграции к цели. Проверьте выполнение триггера и потока для целей SOBject, связь разрешающей способности при опознавании для целей DLO/DMO и импотенцию для целей RDBMS.
- Подтвердите поведение Trust Layer. ETL не применяет маскировку PII к содержимому документа, поэтому LLM возвращает данные PII в извлеченных полях без изменений. Убедитесь, что поля схемы, маршрутизация данных и хранилище в нисходящем направлении созданы для корректной обработки результатов, несущих персональные данные, и убедитесь, что любые требования к соответствию или сохранности учитываются за пределами платформы.
- Настройка предупреждений цифрового кошелька. Настройте предупреждения о потреблении на 75% и 90% доступных кредитов. Установите ограничения размера пакета и ситуативные оценки стоимости в кредитном бюджете для каждого цикла.
- Проверить пакетный мониторинг (только пакетные ожидаемые продажи). Просмотрите уровни успешности извлечения, нулевые уровни полей и выполнение заданий в консоли мониторинга Data 360. Подтвердите распространение тега из УДЛО посредством ООД в DMO в линии данных.
- Проверить обработку ошибок API (только ожидаемые продажи транзакций). Протестируйте все условия ошибки: 413 (документы более 10 Мб), 400 (недопустимые коды схемы), 200 (допустимые извлечения с частичными нулями). Убедитесь, что логика повтора запускает имитацию ответов 5xx без создания повторяющихся записей.
В настоящем документе освещаются архитектурные основы ИИ документа Data 360:
- Два конвейера обработки и когда их использовать
- Модель конфигурации схемы
- Инфраструктура решений целевого уровня
- Основные технологические ограничения
- Режимы сбоев
- Выравнивание инфраструктур
Руководство по быстрому запуску для архитекторов предоставляет последовательность конфигурации для проверки концепции безопасной среды.
Базовая архитектурная структура поддерживает данные, полученные из документа, управляемые на уровне схемы, обрабатываемые посредством внедренного ETL ожидаемого продаж LLM и доставляемые в тот же жизненный цикл данных Data 360, который управляет всеми другими корпоративными данными.
Архитекторы, применяющие эти принципы, — выбор правильного ожидаемого продаж, разработка схем на уровне документа и проектирование режимов сбоев перед производством — создают возможности извлечения, которые масштабируются и выдерживают в соответствии с регламентированными требованиями к управлению отраслью.
Югандхар Бора является архитектором программного обеспечения в Salesforce, который специализируется на архитектуре данных на платформе прикладных программ данных и интеллектуальных приложений. Он руководит инициативами Совета по обзору архитектуры предприятия (СКП), которые сосредоточены на управлении данными и объединенных моделях данных, а также содействует внедрению автоматизированных решений по обеспечению функционирования платформы.
Анант Анто является директором по управлению продуктами Salesforce Data 360, который руководит инициативами «Искусственный интеллект документа» и «График данных». Базируясь в Бангалоре, он работает с корпоративными клиентами над решением реальных проблем обработки документов и интеллектуальных данных. Он любит изучать способы использования предприятия для искусственного интеллекта.
Нишан Насир - архитектор программного обеспечения в Salesforce, работает над обработкой неструктурированных данных, конвейерами RAG и аналитикой документов. Он увлечен использованием возможностей искусственного интеллекта для решения реальных проблем и поиска творческих решений сложных проблем клиентов.