As empresas gerenciam uma ampla gama de tipos de documentos, incluindo faturas, pedidos de compra, contratos legais e manuais técnicos. O processamento manual é lento, propenso a erros e consome aproximadamente 15 a 25% do tempo do funcionário. Abordagens de automação anteriores (por exemplo, Automação de processo robótico (RPA), Reconhecimento de caracteres óptico (OCR) e ferramentas de fluxo de trabalho) reduziram parte da carga, mas geraram pipelines rígidos, alta sobrecarga de manutenção e adoção isolada em equipes de negócios individuais.
Os documentos têm um contexto estrutural avançado (por exemplo, hierarquias de tabelas, relacionamentos de campo espaciais e seções com referência cruzada) que o processamento de texto simples não pode preservar. A remoção de um documento para texto simples descarta o contexto de negócios que torna a extração precisa e útil, o que degrada a qualidade da análise a jusante, a inferência de Inteligência Artificial (IA) e a automação de processos.
Para ser eficaz, os sistemas de Processamento de documento inteligente (IDP) devem classificar documentos por tipo, extrair dados estruturados com precisão de layouts variáveis e entregar esses dados em um formato controlado e consultável para sistemas a jusante. Os IDPs também devem lidar com a variabilidade de documentos em escala sem exigir ajustes por modelo para cada novo formato de documento e devem ser centralizados e acessíveis entre unidades de negócios. Esse desafio é complicado pelo grande volume do problema principal: dados não estruturados representam aproximadamente 80% de todos os dados corporativos, e a maioria é acumulada na forma de documento em sistemas de arquivos, armazenamento na nuvem e repositórios de conteúdo que estão fora do alcance dos sistemas de Gerenciamento de relacionamento com o cliente (CRM), agentes de IA e plataformas de análise.
A IA do Data 360 Document é a funcionalidade de processamento de documentos do Salesforce no Data 360, projetada para solucionar essa lacuna. Ele extrai, classifica e analisa conteúdo de documento não estruturado e semiestruturado usando grandes modelos de linguagem (LLMs), reconhecimento de caracteres óticos (OCR), processamento de linguagem natural (NLP) e aprendizado de máquina (ML). A saída é dados estruturados, controlados e consultáveis que se integram ao pipeline do Data 360, onde agentes do Agentforce, ferramentas de análise e fluxos de trabalho de automação podem acessá-los por meio de interfaces padrão sem exigir camadas de extração ou transformação personalizadas.
As plataformas de dados corporativas processam dados estruturados tabulares. No entanto, a maioria dos dados corporativos chega como documentos e permanece inacessível a agentes de CRM, ERP, IA e pipelines de análise até que alguém os extraia manualmente. Esta é uma lacuna arquitetônica, não um problema de fluxo de trabalho.
Abordagens anteriores combinaram re-chave manual, scripts de OCR baseados em regras e RPA. Esses métodos funcionavam em pequena escala, mas não podiam lidar com o volume, a variedade e a velocidade dos tipos de documentos que as empresas modernas geram. Ferramentas baseadas em regras exigem modelos explicitos por variante de layout. Qualquer alteração de formato interrompe a extração e requer um desenvolvedor, um novo modelo e um ciclo de implementação.
Em escala, isso produz soluções de ponto frágeis sem governança centralizada, esquema compartilhado e caminho para a prontidão para IA. Pipelines de extração inconsistentes se propagam a jusante. Em outras palavras, a análise herda inconsistências de dados, os modelos de IA produzem resultados não confiáveis e conteúdos regulamentados como Informações de Saúde Pessoal (PHI) e Informações de Identificação Pessoal (PII) carecem de governança sistemática.
Os LLMs extraem campos sem modelos explícitos. Uma configuração de esquema único controla a extração entre variantes de layout, idiomas e formatos, o que se adapta ao documento em vez de exigir que o documento se ajuste a uma estrutura fixa. Isso muda o processamento de documentos de uma operação isolada pesada em manutenção para uma funcionalidade governada e centralizada.
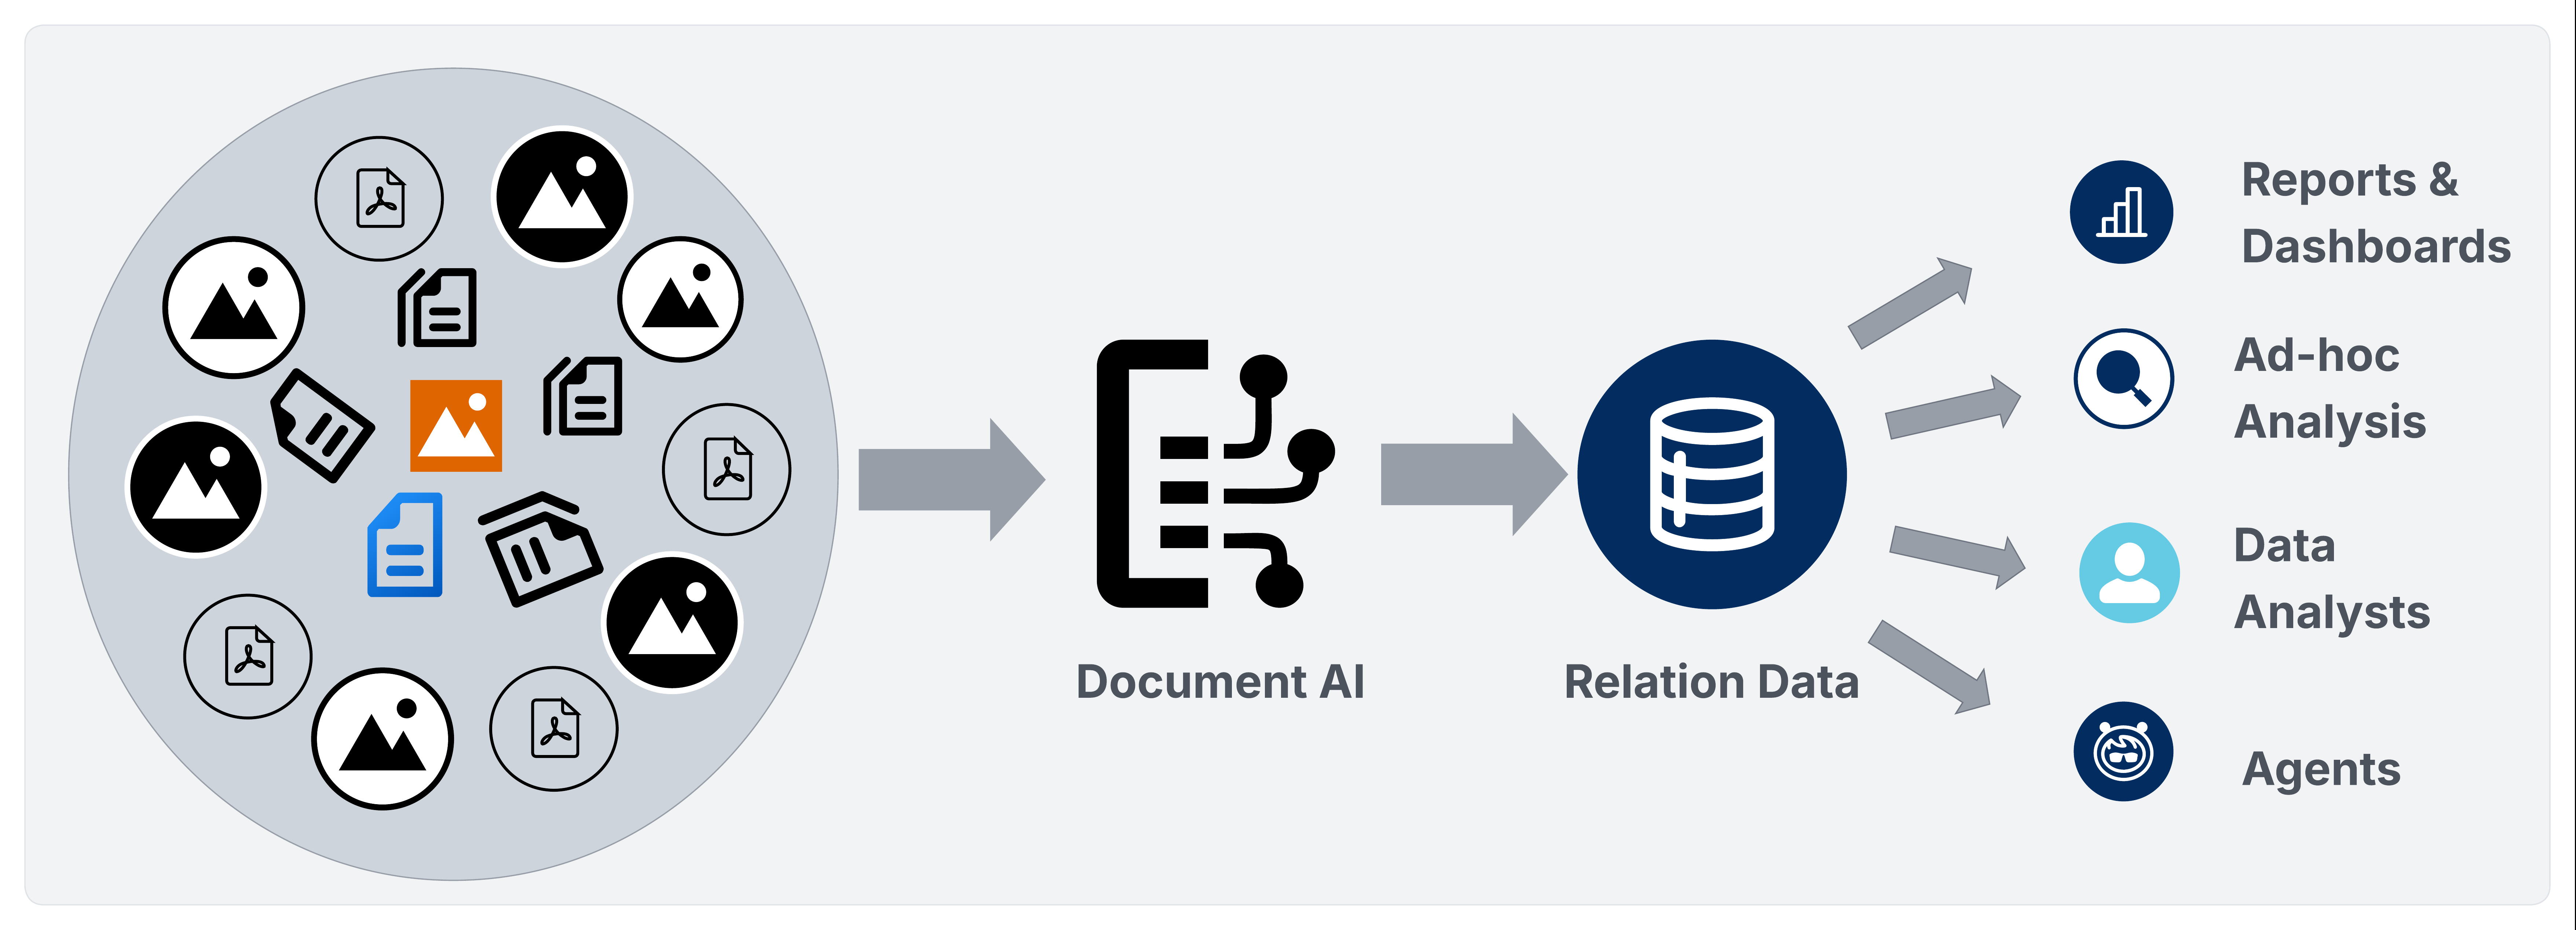
A IA do Data 360 Document operacionaliza o processamento de documentos na plataforma Data 360 por meio de dois pipelines.
- O Pipeline de lote encaminha dados extraídos por meio de ingestão, resolução de identidade, insights calculados, ativações, análise e ativação Agentforce.
- O Pipeline de processamento transacional expõe uma API REST que retorna JSON estruturado de forma síncrona, o que permite aos arquitetos encaminhar dados derivados de documentos para os SOobjects do Salesforce, o pipeline Data 360 Data Lake Object/Data Model Object (DLO/DMO) ou bancos de dados externos e armazéns sem sobrecarga de configuração em lote.
Em ambos os casos, os dados extraídos entram em um modelo guiado por esquema, em vez de um conjunto fragmentado de ferramentas de ponto.
A IA de documentos do Data 360 é a funcionalidade nativa do Salesforce de Processamento inteligente de documentos (IDP) na plataforma Data 360. Ele converte conteúdo de documento não estruturado e semiestruturado em dados gerenciados e consultáveis que participam totalmente em todo o ciclo de vida do Data 360.
A IA de documentos do Data 360 é a funcionalidade nativa do Salesforce de Processamento inteligente de documentos (IDP) no Data 360. Ele ingere documentos não estruturados e semiestruturados, extrai dados estruturados usando uma configuração de esquema declarativo e entrega esses dados ao pipeline do Data 360 para harmonização, resolução de identidade, análise e ativação do Agentforce.
A IA de documento do Data 360 oferece suporte a duas modalidades de processamento:
- Processamento em lote: Processa grandes conjuntos de documentos definidos em objetos de modelo de dados não estruturados (UDMOs) com base em eventos.
- Processamento transacional: Processa um único documento por meio da API REST e retorna uma carga útil JSON estruturada de modo síncrono. Os arquitetos então podem rotear essa carga útil para o pipeline Data 360 DLO/DMO, os SOBjects do Salesforce ou bancos de dados e armazéns externos por meio de pipelines MuleSoft, chamadas Apex ou Einstein Trust Layer (ETL). O nível de destino é uma decisão arquitetônica conduzida por requisitos de latência, governança e residência de dados.
A IA de documento atualmente oferece suporte a arquivos PDF, arquivos de imagem (JPEG, PNG) e documentos manuscritos.
A IA do Data 360 Document reúne quatro tecnologias de processamento em um único pipeline controlado. Cada componente lida com um estágio distinto do ciclo de vida de documento para dados:
- Reconhecimento óptico de caracteres (OCR): Converte imagens lidas, conteúdo manuscrito e PDFs baseados em imagem em texto legível por máquina antes do processamento do LLM. Um mínimo de 150 DPI é recomendado para extração confiável.
- Grande Modelos de Idiomas (LLMs): Encaminhe a extração pelo gateway Einstein LLM usando o modelo escolhido pelo usuário. O LLM recebe a saída OCR junto com a configuração do esquema JSON e retorna uma carga útil de extração estruturada. Gemini e modelos adicionais estão sendo planejados para implementação futura.
- Processamento de linguagem natural (NLP): Realiza compreensão contextual, reconhecimento de entidade, análise de data e extração de campo semântico diretamente no LLM por meio da engenharia de instruções estruturadas: a instrução definida por esquema e a saída do OCR servem como as únicas entradas. Todas as interações do LLM são roteadas por meio do ETL, que impõe a retenção de dados zero com provedores de modelo e mascara PII em entradas baseadas em texto antes que elas cheguem ao modelo. Nenhum mecanismo de NLP separado é empregado.
- Processamento multimodal: Processa imagens incorporadas em PDFs como entradas de extração separadas, o que permite que o LLM extraia dados de diagramas, tabelas renderizadas por imagem e páginas de conteúdo misto que o OCR sozinho não pode analisar.
Além das quatro tecnologias de processamento, a IA Document também lida com:
- Camada do Trust Einstein: Roteia todas as interações do LLM por meio do ETL, que impõe a retenção de dados zero com provedores de modelo e mascara a PII antes que as entradas cheguem ao LLM, com a exceção de dados multimodais (por exemplo, documentos anexados que são processados por meio de Document AI) em que o mascaramento de PII não é suportado atualmente e os dados são enviados como estão para modelos externos. O ETL controla apenas o caminho de interação do LLM. Dados extraídos gravados em objetos do Data Lake (DLOs) são armazenados como estão; o mascaramento em nível de campo em repouso deve ser resolvido por meio de controles de governança de dados a jusante.
- Limites de tamanho do arquivo: A IA de documento processa arquivos de até 10 MB por solicitação. Os limites de comprimento de contexto do LLM podem restringir ainda mais o processamento de documentos densos e de várias páginas dentro desse limite.
Os arquitetos empresariais que estão implementando a IA do Data 360 Document devem aplicar esses princípios antes de se comprometerem com um projeto de implementação.
- Selecione o pipeline antes de projetar o esquema. Os pipelines de processamento de lote e transaccional diferem em modelo de ingestão, associação de esquema, flexibilidade de meta e latência. É importante confirmar qual pipeline cada caso de uso exige antes de definir o esquema, pois a reajuste adiciona retrabalho evitável.
- Projete esquemas no nível do tipo de documento. Usar um único esquema bem elaborado por tipo de documento é mais mantido do que usar configurações por caso de uso e também é a maior alavanca para a qualidade da extração. Para fazer isso corretamente, é necessário usar um conjunto diversificado de documentos, incluindo casos de ponta, em vez de projetar com base em um só exemplo. Use avisos iterativamente nos níveis de campo, tabela e esquema para encontrar lacunas e, em seguida, teste e refine-os em relação a várias amostras de documento antes de finalizar. Lembre-se de que um esquema que funciona bem em um documento pode ser insuficiente em relação a outros, portanto, a largura e a iteração são essenciais. A flexibilidade do esquema, incluindo a remoção de colunas que não são extraídas com confiança entre tipos de documento, é igualmente importante. A retenção em campos que apresentam ruído ou inconsistência prejudica a qualidade geral da extração, portanto, é importante tratar a remoção de colunas como uma decisão de design de primeira classe.
- Escolha o nível de destino correto por grupo de campos. Campos que estão conduzindo fluxos de trabalho ou aprovações do CRM são gravados em SUBjects. Os campos que estão aprimorando o perfil unificado ou a análise de feed pertencem ao pipeline DLO/DMO. Os campos que estão apresentando sistemas externos pertencem ao nível RDBMS. Lembre-se de que um único esquema pode conter vários níveis simultaneamente.
- Impor governança antes de processar conteúdo regulamentado. Dados regulamentados precisam de proteção em cada camada. É por isso que é importante configurar o mascaramento de PII, as marcas de classificação de dados e o Controle de acesso baseado em atributo (ABAC) depois que os dados extraídos são armazenados nos objetos de data lake (DLOs) de saída_._ Isso fornece imposição ajustada e acesso sensível ao contexto com base na classificação de dados, no papel do usuário e no contexto organizacional. A governança é dividida em dois caminhos: o ELT rege a interação do LLM, enquanto os dados extraídos armazenados em DLOs devem ser regidos separadamente – diretamente nos níveis de DLO e banco de dados – por meio de configurações de Espaço de Dados, Conjuntos de permissões e políticas ABAC. Esses controles devem manter a consistência no nível de armazenamento, não apenas na camada do aplicativo, para que as restrições de acesso permaneçam intactas independentemente de como os dados são acessados após a ingestão. Lembre-se de que lacunas em qualquer camada podem expor dados regulados a jusante mesmo quando outros estão configurados corretamente.
- Design para modos de falha antes da produção. Lide com o tratamento de campo nulo, limites de qualidade do OCR, pré-validação de tamanho de arquivo, sobrecarga de contexto do LLM, idempotência de gravação do RDBMS e limites de orçamento de crédito antes da primeira execução em lote de produção. Esses não são casos de ponta, são surpresas de falha previsíveis que devem ser tratadas explicitamente no design de pipeline, não descobertas durante o tempo de execução.
- Trate as pontuações de confiança como um sinal de roteamento de primeira classe, não como uma análise de diagnóstico. Os resultados da extração levam valores de confiança em nível de campo derivados das probabilidades de log (logprobs) da saída do modelo subjacente. Para cada campo, tabela ou coluna extraídos, a pontuação reflete a certeza no nível do token do modelo do valor extraído. Isso torna as pontuações de confiança um sinal estatisticamente fundamentado que é confiável o suficiente para servir como o portão principal para os limites de escalação Human-in-the-Loop (HITL). Use pontuações de confiança para identificar sistematicamente extrações de baixa qualidade e iniciar pontos de verificação HITL para valores de campo de baixa confiança, correspondências de esquema ambíguas ou falhas repetidas do pipeline em vez de depender de heurística ou verificações pontuais manuais. Quando a recuperação automatizada não é possível, a pontuação de confiança baseada em HITL garante que a estimativa humana seja aplicada exatamente onde ela é necessária.
- Projete caminhos de ativação em paralelo com o design de esquema. O valor da IA de documento vem da capacidade de ativar dados extraídos em fluxos de trabalho e agentes do Salesforce. Ele permite que você projete Ações do Agentforce, Fluxos e Insights calculados junto com o design de esquema de extração, não depois.
A IA de documento opera em dois pipelines:
- Um pipeline de lote para processamento de alto volume apoiado por UDMO
- Um pipeline de processamento transaccional para extração acionada por API em tempo real
Ambos os pipelines compartilham o mesmo contrato de configuração de esquema e a governança de ETL, mas diferem em como os documentos entram no sistema e onde os dados extraídos chegam.
Vamos analisar em mais detalhes cada pipeline.
O pipeline de lote processa conjuntos de documentos recorrentes definidos por um UDMO. Ele é adequado para casos de uso agendados ou conduzidos por evento em que os documentos são ingeridos do armazenamento corporativo, depois passam pela extração de documentos e são entregues ao pipeline Data 360 DLO/DMO para harmonização, resolução de identidade e ativação.
Cenário do mundo real
Todos os dias, uma operadora de seguros recebe milhares de documentos de reclamações médicas dos portais do provedor que são carregados como PDFs no Amazon S3. O UDMO define o conjunto de documentos no escopo e envia todos os PDFs de declaração ao grupo de /claims/incoming/ em uma janela de 24 horas.
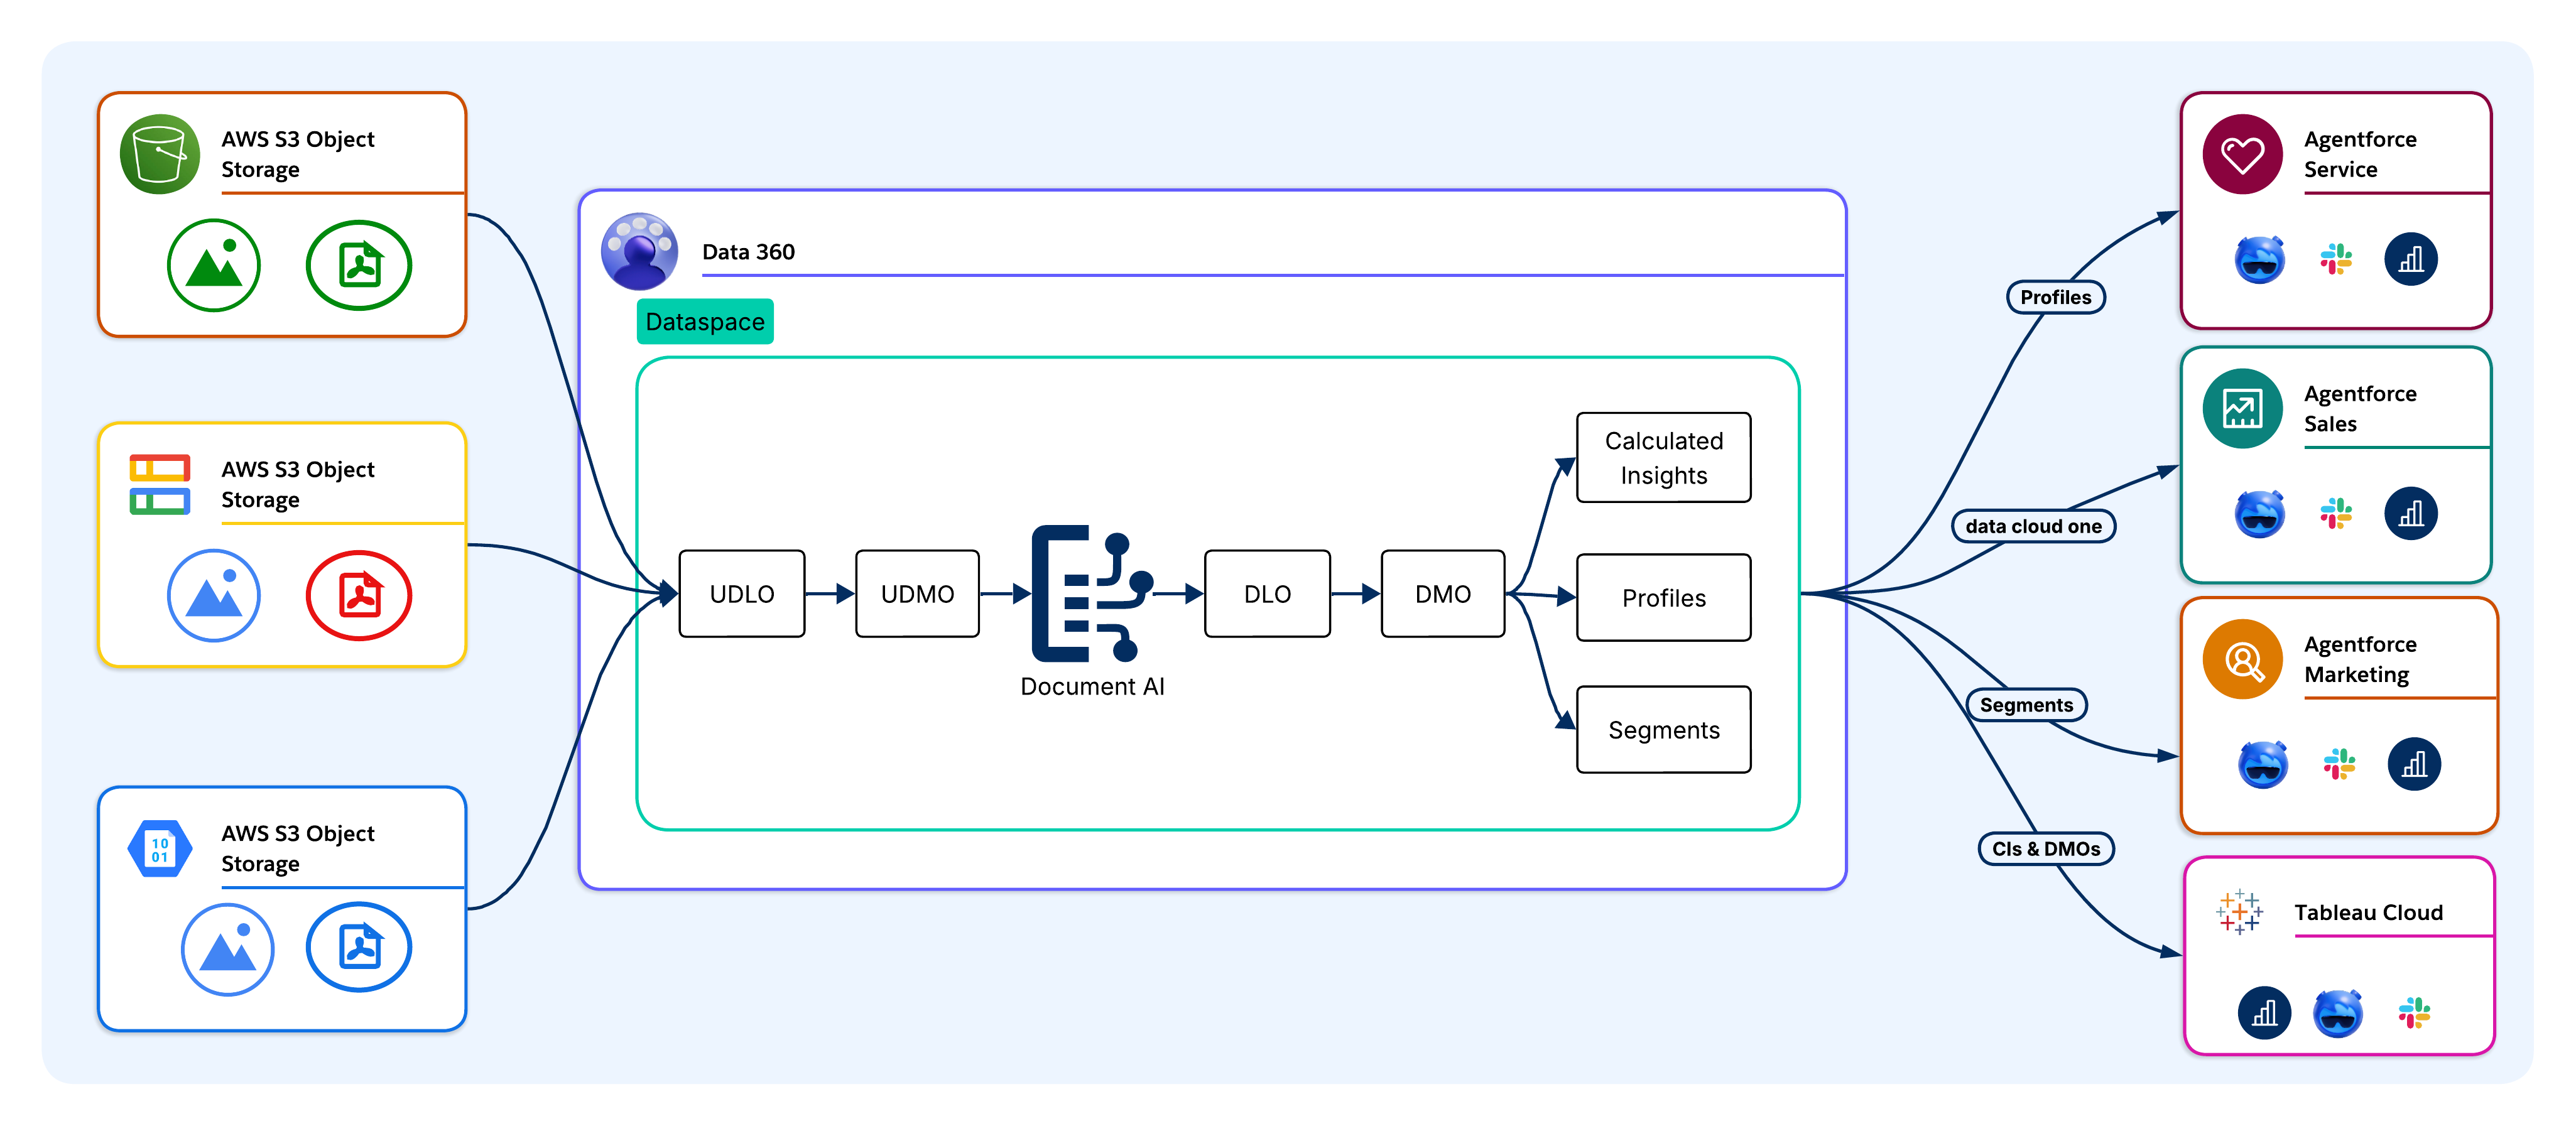
Os documentos são ingeridos no Data 360 de sistemas de origem corporativos sem duplicação física. As fontes com suporte incluem o Amazon S3, o Google Cloud Storage, objetos de arquivo do Salesforce CRM, pipelines orquestrados pela MuleSoft e uploads de API diretos. Nas implementações do Headless 360, os documentos são ingeridos por meio de conectores de armazenamento em nuvem ou da API de ingestão, que ignora a camada do CRM. O servidor Model Context Protocol (MCP) expõe a ingestão como uma ferramenta invocável para agentes de IA externos e clientes de LLM.
Após a ingestão, os documentos brutos são armazenados como Objetos de data lake não estruturados (UDLOs), que mapeiam para a localização física e os metadados de cada documento sem mover ou transformar o arquivo de origem.
Exemplo:
Os PDFs de declarações são ingeridos do S3 no Data 360 por meio do conector de armazenamento em nuvem. Cada documento é armazenado como um UDLO que aponta para o objeto S3. Nenhuma duplicação física ocorre.
A IA do documento processa cada UDLO com base em uma configuração de esquema que define quais campos extrair junto com seus tipos de dados de destino. O UDMO define quais documentos estão no escopo. O LLM (GPT-4o, Gemini ou Claude) lê cada documento e retorna uma carga útil de extração estruturada.
Exemplo:
A IA do documento processa cada UDLO em relação a um esquema de reivindicações que define campos como: ClaimID, PatientName, DiagnosisCode, BillingAmount e ServiceDate. Os LLMs então leem cada PDF e retornam uma carga útil de extração estruturada.
Depois que os dados são extraídos, eles persistem em DLOs, que são a camada de armazenamento bruto do Data 360. Os DLOs retêm campos extraídos sem impor lógica de negócios, o que preserva uma representação física precisa para transformação a jusante e rastreabilidade. O UDLO mantém uma referência ao documento de origem para habilitar a linhagem em nível de campo em qualquer ponto do pipeline.
Exemplo:
Todos os campos extraídos ficam em um DLO de declarações, que preserva uma representação bruta e precisa de cada declaração com a linhagem completa que pode ser rastreada até o PDF de origem.
Os campos de DLO mapeiam para DMOs alinhados ao padrão Customer 360 Data Model. Esse é o limite em que os dados derivados do documento fazem a transição de campos brutos e extraídos para entidades relevantes para os negócios. O DLO de fatura é mapeado para um DMO de fatura, e campos como CustomerID e BillingAmount se tornam chaves de junção e atributos de correspondência no modelo de dados unificado. Dados de documentos harmonizados participam da segmentação, dos Insights calculados e da ativação por meio das mesmas interfaces usadas pelo CRM e pelos dados transacionais.
Exemplo:
O DLO de declarações é mapeado para um DMO de declarações. Os campos PatientID e PolicyNumber se tornam chaves de junção que vinculam registros de declaração a perfis de paciente unificados.
Dados de DMO harmonizados participam da resolução de identidade. Os campos extraídos (por exemplo, nomes de clientes, endereços de email ou números de conta) servem como chaves de correspondência para vincular registros de documento a Indivíduos unificados (Registros dourados), o que fecha a lacuna entre documentos e perfis.
Exemplo:
Os campos de extração (por exemplo, PatientName, DateOfBirth e PolicyNumber) servem como chaves de correspondência para resolução de identidade, que vinculam registros de declaração ao Indivíduo unificado correto. Isso ocorrerá mesmo que o mesmo paciente apareça sob grafias de nome levemente diferentes nos documentos.
Os arquitetos definem Insights calculados, que são métricas agregadas que são calculadas em dados de documentos harmonizados (por exemplo, o gasto total de vários itens de linha de fatura, pontuações de risco de renovação de contrato e índices de gravidade de reivindicações).
Exemplo:
Os Insights calculados calculam TotalClaimsPerPatient, AverageClaimAmount e HighRiskClaimScore em dados de declaração harmonizados para consultas Agentforce.
Dados harmonizados resolvidos por identidade podem ser acessados por Agentes Agentforce, Tableau, plataformas de marketing e subjectos do Salesforce. O nível de destino é uma decisão arquitetônica conduzida pelos requisitos de latência, governança e residência de dados.
Exemplo:
Um Agente Agentforce Adjudication consulta os DMOs e CIs do Data 360 para encontrar reivindicações de alto risco para análise prioritária. Os painéis do Tableau mostram tendências de anomalia e volume de reivindicações. Registros de declaração aprovados são circulados de volta para o SObject de declarações para iniciar fluxos de trabalho de pagamento.
Em arquiteturas do Headless 360, a ativação é roteada diretamente para sistemas externos por meio da API de consulta, da API Pub/Sub ou dos destinos de ativação de data warehouse da nuvem. Em seguida, o servidor MCP encontra dados de documentos harmonizados e Insights calculados como ferramentas invocáveis para agentes de IA externos.
O pipeline de processamento transacional lida com a extração de documentos únicos no tempo de execução sem um UDMO ou UDLO pré-ingestado, o que é adequado para casos de uso conduzidos por evento (por exemplo, um cliente carregando um formulário, um agente recebendo um PDF ou um sistema externo iniciando a extração dentro de um fluxo de trabalho de processamento transacional). A governança de ETL se aplica a ambos os pipelines de modo idêntico.
Cenário do mundo real
Enquanto solicita um empréstimo, um cliente do banco carrega um PDF de sua conta de serviços públicos públicos por meio do aplicativo móvel do banco. O evento inicia a extração em tempo real, o que significa que nenhum UDLO ou UDMO pré-ingerido está envolvido.
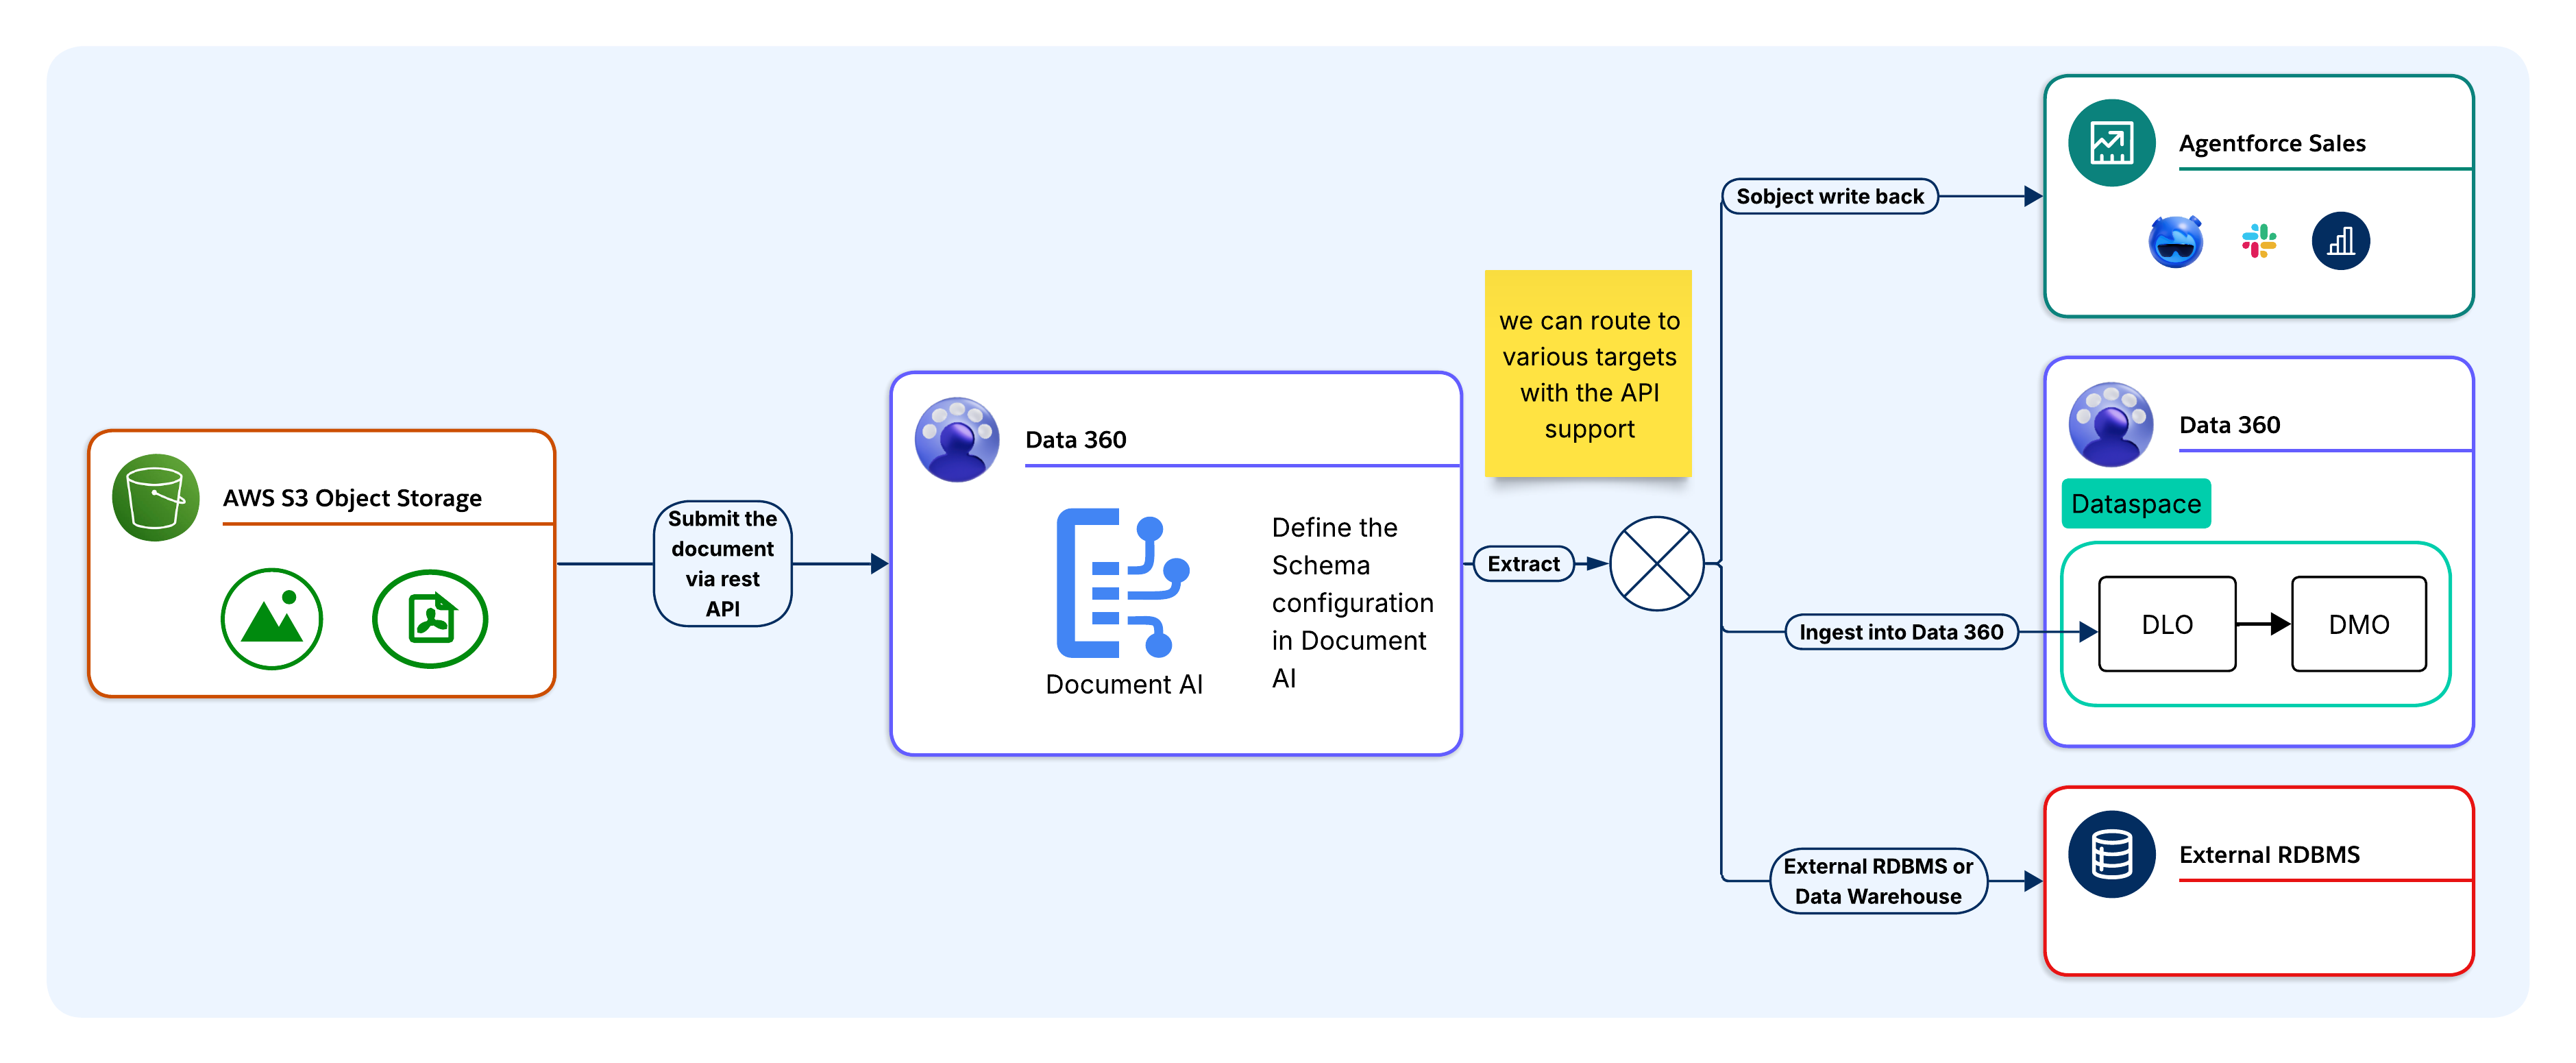
Antes de invocar a API, os arquitetos devem definir e armazenar um esquema no Data 360 que especifique os campos, os tipos de dados e as instruções de extração no formato Esquema JSON. Cada esquema recebe um ID de esquema exclusivo. No tempo de execução, o aplicativo de chamada faz referência ao ID do esquema para manter a lógica de extração centralizada no Data 360, em vez de incorporá-la ao código do aplicativo.
Exemplo:
A equipe do banco tem um esquema de ProofOfAddress predefinido no Data 360, que especifica campos como CustomerName, AddressLine1, City, PostCode e DocumentDate. Essas informações são armazenadas como uma configuração com controle de versão que pode ser referenciada por um ID de esquema.
O aplicativo de chamada envia o documento e o ID do esquema em uma única solicitação da API REST como uma carga útil codificada em base64 ou referência de arquivo. Nenhuma ingestão de UDLO é necessária. O Document AI aplica a extração de documento e retorna a saída estruturada com base no esquema fornecido.
Exemplo:
O aplicativo móvel envia a conta de serviços públicos como uma carga útil codificada em base64 junto com o ID do esquema de ProofOfAddress em uma única chamada à API REST. Esse processo não requer uma etapa de ingestão de UDLO.
O LLM processa a saída do OCR em relação ao esquema e retorna uma carga útil JSON estruturada de modo síncrono. Campos que não são encontrados no documento são retornados como nulos. O chamador é o proprietário da resposta JSON completa e avança para o roteamento.
Exemplo:
A IA do documento aplica OCR ao PDF e o LLM retorna uma carga útil JSON estruturada com campos de endereço extraídos. Campos que não são encontrados (por exemplo, se o PostCode estiver ausente na fatura) são retornados como nulos.
Depois de extraída, a carga útil JSON pode ser roteada para um ou mais níveis de destino, dependendo do caso de uso:
- Salesforce SObject: Mapeia diretamente para campos de subject por meio do Apex ou do Flow para fluxos de trabalho e aprovações de CRM.
- Pipeline de DLO/DMO do Data 360: Rotas para um DLO para harmonização, resolução de identidade, Insights calculados e fundamentação do Agentforce.
- RDBMS externo ou Data Warehouse: Roteia via MuleSoft, chamada Apex, eventos de plataforma ou ETL para sistemas que estão fora do Salesforce.
- Integração personalizada: Retorna cargas úteis JSON estruturadas para o aplicativo de chamada para armazenamento em qualquer sistema externo ou armazenamento de dados.
- Fluxo a jusante ou agente: Passa a saída JSON estruturada diretamente para um fluxo a jusante ou agente sem qualquer persistência em um SObject. Esse é um padrão comum para clientes que usam a IA de documento como uma etapa de extração em tempo real em um fluxo de trabalho de automação ou agência maior.
Lembre-se de que um único esquema pode abrir para vários níveis ao mesmo tempo, com diferentes grupos de campos roteando para diferentes destinos do mesmo ponto de extração.
Exemplo:
Uma carga útil de ProofOfAddress pode abrir até três níveis ao mesmo tempo (por exemplo, CustomerName e AddressLine1 gravam no Contact SObject), o que inicia um Fluxo de verificação de endereço. Em seguida, toda a carga útil é encaminhada para um DLO para harmonização e pontuação de risco, e uma cópia é encaminhada para o sistema KYC do banco por meio da MuleSoft para registro de conformidade regulatória.
Depois de gravado, os dados extraídos são ativados imediatamente no sistema de destino. Para destinos do SObject, os acionadores, os fluxos e os processos de aprovação são ativados no registro inserido e atualizado. Para metas de DLO/DMO, os dados entram no pipeline de harmonização e resolução de identidade e no contexto Agentforce. Para destinos externos do RDBMS, os dados ficam disponíveis para consultas a jusante assim que a gravação for concluída.
Exemplo:
O Fluxo de verificação de endereço é ativado imediatamente no registro de contato inserido, o que avança a solicitação de empréstimo para o próximo estágio. O Agentforce credit agent agent agent encontra o endereço verificado no Data 360 e o sistema KYC registra a submissão do documento para fins de auditoria.
A IA do documento é mais adequada para condições arquitetônicas específicas. Aplicá-lo fora dessas condições introduz complexidade desnecessária e custos adicionais.
Como arquitetos, é importante avaliar esses critérios antes de se comprometer com a IA do Documento como o mecanismo de extração.
Use a IA do documento quando:
- Os documentos são a principal fonte de dados. As informações necessárias existem apenas em forma de documento e estão indisponíveis de uma API ou banco de dados estruturado (por exemplo, contratos lidos, relatórios de laboratório, formulários de admissão ou reivindicações de seguro).
- Os layouts de documento variam entre as fontes. O mesmo tipo de documento vem de vários fornecedores, parceiros ou regiões com diferentes posições e formatos de campo. A extração de LLM orientada por esquema se adapta sem manutenção por layout.
- Os dados extraídos devem alimentar o Data 360 ou Agentforce. A extração deve participar da resolução de identidade, dos Insights calculados ou da fundamentação do Agentforce. A IA de documento é entregue diretamente no pipeline DLO/DMO sem uma camada ETL separada.
- Volume justifica a automação regulada. O volume de documentos excede o que o processamento manual pode lidar sem custos de trabalho mensuráveis ou riscos de qualidade de dados.
- Os documentos contêm conteúdo regulamentado. Os dados PHI, PII ou financeiros devem ser roteados por uma camada de mascaramento PII de retenção de dados zero antes de atingir um LLM. O ETL atende a isso nativamente. Os clientes que não exigem que o conteúdo extraído persista em nenhum ponto também devem considerar o fluxo de API transacional, que retorna a saída estruturada diretamente para o aplicativo de chamada sem gravar em nenhum SObject ou armazenamento de dados.
- O caso de uso é conduzido por evento. Um documento chega no tempo de execução (por exemplo, um upload do cliente, um anexo PDF do agente ou um acionador do sistema externo). O pipeline de processamento transacional lida com extração síncrona de documento único sem configuração em lote.
Não use a IA do documento quando:
- Os dados de origem já estão estruturados. Se o sistema a montante expor uma API REST, uma tabela de banco de dados ou um arquivo estruturado (por exemplo, CSV, JSON ou XML), use um conector padrão do Data 360. Executar dados estruturados por meio de um pipeline de extração de LLM adiciona custos de latência e crédito sem benefícios adicionais.
- Os documentos são gerados por máquina com um esquema fixo. PDFs gerados pelo sistema de uma ERP ou plataforma de faturamento conhecida com um layout estável são mais adequados para um analisador determinístico. A extração do LLM é projetada para variabilidade, e aplicá-la a documentos de esquema fixo desperdiça contexto e créditos.
- Os requisitos de precisão excedem os limites de confiança do LLM. A IA de documento não garante 100% de precisão de extração. Use casos em que um valor de campo perdido ou incorreto apresenta um risco financeiro, legal ou clínico significativo que exija uma etapa de validação de HITL. Não use a IA de documento como a única camada de extração para decisões de alto nível sem um fluxo de trabalho de validação.
- Os documentos excedem as restrições da plataforma. O limite atual de tamanho de arquivo de 10 MB e as restrições de comprimento de contexto do LLM tornam a IA de Documento imprópria para documentos grandes ou densos sem pré-processamento para dividi-los e montá-los novamente fora da plataforma.
- Nota: No Salesforce, estamos melhorando ativamente essas proteções de aceitação para expandir tamanhos de arquivo, contagens de páginas e extensões de arquivo com suporte. As restrições continuarão a evoluir no futuro.
Vamos dar uma olhada mais de perto em vários cenários que usam o pipeline de artificialidade de documento em lote apoiado por um objeto-fonte UDMO. Nesses casos, os dados extraídos são roteados pelo pipeline Data 360 DLO/DMO para harmonização, resolução de identidade, Insights calculados e ativação do Agentforce. Cada caso de uso é mais adequado para processamento de documento de alto volume agendado ou conduzido por evento.
Agentforce Sales: Inteligência de contrato e fatura
Os PDFs de contrato são ingeridos do armazenamento na nuvem por meio do pipeline de lote. O esquema extrai ContractValue, RenewalDate, PaymentTerms e CounterpartyName e os mapeia para os DMOs de conta e contrato. Os Insights calculados derivam pontuações de risco de renovação. O Agentforce alerta os executivos da conta antes do fechamento das janelas de renovação, o que elimina a revisão manual de contratos e renovações perdidas.
Serviço Agentforce: Desvio de caso e fundamentação do Knowledge
PDFs de pesquisa e anexos de caso são ingeridos por meio do pipeline de lote. O esquema extrai indicadores de sentimento, categorias de assunto e notas de resolução e os mapeia para os DMOs de Case e Artigo do Knowledge. A Agentforce consulta a base de Knowledge harmonizada quando o caso é aberto e localiza as etapas de solução de problemas relevantes, o que reduz a sobrecarga de pesquisa do Agente.
Agentforce Health: Processamento de documentos clínicos
Relatórios de laboratório, PDFs de ingestão e formulários clínicos manuscritos são ingeridos através do pipeline de lote. O esquema extrai campos, incluindo PatientID, DiagnosisCode, MedicationName e TestResult, e os mapeia para os DMOs do Health Cloud, que dão suporte à coordenação de cuidados alinhada à HIPAA e aos fluxos de trabalho de pesquisa clínica.
Serviços financeiros: Automação de documentos de empréstimo e imposto
Solicitações de empréstimo, devoluções de impostos e extratos de renda ingeridos por meio do pipeline em lote. O esquema extrai campos, incluindo AnnualIncome, TaxYear e EmployerName, e os mapeia para os DMOs de Conta financeira. Os Insights calculados unem dados de receita derivados de documentos e dados de CRM para facilitar a pontuação automatizada de risco de crédito. A Agentforce localiza os detalhes do empréstimo extraídos em linha durante as interações de atendimento ao cliente. Esse padrão dá suporte diretamente ao caso de uso Agente de pré-qualificação de empréstimo publicado no centro de desenvolvedores Salesforce Agentic Enterprise Solutions.
RH: Processamento de documentos de trabalho
Documentos de integração, formulários fiscais e PDFs de certificação são ingeridos por meio do pipeline de lote. Os campos extraídos são mapeados para os DMOs de Registro do funcionário e então vinculados ao perfil Unificado do funcionário. Fluxos específicos iniciam tarefas de integração e verificações de conformidade com base nos dados extraídos. Esse padrão é compatível diretamente com o caso de uso Automatizar processamento de retomada do agente. A IA do documento extrai habilidades, histórico de emprego e qualificações de PDFs de currículo, que a Agentforce usa para combinar candidatos com critérios de papel aberto e encaminhá-los para fluxos de trabalho de contratação.
Serviços profissionais: Proposta e Inteligência de Pesquisa
As propostas e os relatórios de pesquisa são ingeridos através do pipeline de lote. Estruturas, comparações e resumos de engajamento extraídos são mapeados para DMOs personalizados e então indexados para pesquisa de vetor. O Agentforce recupera recomendações contextualmente relevantes no momento da consulta, que são baseadas no conteúdo do documento extraído. Esse padrão estende o padrão Ground Agentforce no conteúdo do site. Os documentos são indexados por meio da IA do documento e servem a mesma função de fundamentação para respostas do agente que o conteúdo do site que é indexado por meio de conectores do Data 360.
Status de conformidade com HIPAA:
Os padrões do Health Cloud descritos neste artigo aplicam controles de ETL (por exemplo, retenção de dados zero e mascaramento de PHI) para entradas de texto. Apenas esses controles não constituem a certificação HIPAA. Os arquitetos que estão projetando para ambientes clínicos regulados devem confirmar o status atual da certificação HIPAA com a equipe de conformidade do Salesforce antes de se comprometer com uma arquitetura baseada em IA de documento nesses contextos.
Vamos analisar mais detalhadamente vários cenários que invocam a API REST de IA de documento com um esquema que não está vinculado a um UDMO. As cargas úteis JSON extraídas são roteadas diretamente para sistemas externos de modo síncrono no tempo de execução.
Cadeia de abastecimento: Processamento de fatura do fornecedor para ERP
Quando um PDF de fatura do fornecedor chega em um bucket de armazenamento monitorado ou gateway de email, um acionador de evento chama a API REST do Document AI com a fatura e um ID de esquema predefinido. O esquema extrai VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount e DueDate. A carga útil JSON é roteada por meio da MuleSoft para o módulo ERP Accounts Payable com validação de campo nulo e lógica de inserção e atualização idempotente, o que elimina a manutenção de modelos para variabilidade de formato do fornecedor.
Operações jurídicas: Revisão de contrato para CLM
Quando um PDF de contrato é carregado no portal legal, o back-end chama a API REST Document AI de modo síncrono. O esquema extrai GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause e CounterpartySignatory. A carga útil JSON é roteada por chamada do Apex para o sistema de Gerenciamento de ciclo de vida do contrato (CLM). Os campos que não forem encontrados serão retornados como nulos e o CLM aplicará as regras de obrigação padrão aos valores ausentes.
Reivindicações de seguro: Primeiro aviso de processamento de perda
Quando um titular de apólice envia um formulário de Primeira Notificação de perda (FNOL), o portal de back-end chama a API REST Document AI de modo síncrono. O esquema extrai PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName e ContactPhone. A carga útil JSON é roteada para o banco de dados de gerenciamento de reivindicações por meio de chamada do Apex ou ETL, que cria um registro de reivindicação preenchido para os ajustadores revisarem antes de a reivindicação formal ser aberta.
Antes de migrar para a produção, você deve criar designs para estes cenários de falha.
- Manuseio de campo nulo: O LLM retorna nulo para campos que ele não consegue localizar ou extrair com confiança. Valide a lógica de processamento nulo no design de esquema e implemente o valor padrão ou a lógica de rejeição na camada de integração antes de gravar em qualquer destino com restrições NON NULL ou chaves de correspondência obrigatórias.
- Degradação da qualidade do OCR: A precisão do OCR diminui abaixo de 150 DPI, em gravações manuais irregulares ou em verificações ruidosas. Leituras incorretas se propagam para a extração do LLM como entrada corrompida sem sinais de erro. Imponha a qualidade mínima da verificação na ingestão e implemente verificações de limite de confiança em campos numéricos e de data.
- Correspondência incorreta da versão do esquema: Atualizar uma configuração de esquema depois que um trabalho em lote é agendado faz com que os documentos em andamento sejam processados em relação à versão anterior, o que produz campos ausentes ou renomeados que quebram o mapeamento downstream. Esquemas de versão explicitamente e coordenar atualizações com agendas de trabalho em lote.
- Limites de tamanho do arquivo: Documentos que excedem 10 MB são rejeitados. Falhas de pipeline em lote são silenciosas sem monitoramento configurado, e chamadores transacionais recebem um erro 4xx. Pré-valide os tamanhos de arquivo na ingestão e implemente o pré-processamento para dividir ou compactar documentos que se aproximam regularmente do limite.
- Sobrecarga de contexto do LLM: Documentos densos ou de várias páginas podem exceder a janela de contexto do LLM dentro do limite de 10 MB. O LLM elimina silenciosamente conteúdo que excede o contexto. Implemente uma estratégia de particionamento que divida documentos por intervalo de páginas e reorganize os campos extraídos antes de transferi-los para o destino.
- Mascaramento da camada Trust que afeta a extração: O ETL opera no nível de prompt, não no nível de documento, portanto, o mascaramento não se aplica ao conteúdo do documento que passa pela IA de documento. Campos de esquema que dependem de valores de PII no documento não são afetados pelas políticas de mascaramento de ETL.
- Idempotência de gravação de RDBMS externo: O pipeline de processamento transacional não tem nenhuma idempotência integrada para destinos externos do RDBMS. As novas tentativas de camada de integração criam linhas duplicadas, a menos que a lógica de gravação lidar com a desduplicação explicitamente. Implemente inserções e atualizações idempotentes usando uma impressão digital de documento ou ID externo em todos os caminhos de gravação externos.
- Esgotamento de crédito no meio da execução: Execuções em lote grandes podem esgotar créditos Digital Wallet antes de todos os documentos serem processados, o que produz conjuntos de dados de DLO incompletos que as etapas a jusante parecem concluídos. Defina alertas de consumo para 75% e 90% dos créditos disponíveis e limite os tamanhos dos lotes para ficar dentro do orçamento de crédito para cada ciclo.
- Limite de campo de esquema – Restrição arquitetônica: A IA do documento aplica um limite de 50 campos para campos no nível raiz em uma configuração de esquema. Essa é uma restrição de tempo de design, não um erro de tempo de execução, e os arquitetos devem levá-la em conta durante o modelo de dados e o design de esquema.
- Para casos de uso que exigem extração mais ampla:
- Priorize implacavelmente. Limite o esquema a campos que geram valor de automação, não cobertura de documento exaustiva.
- Aproveite objetos aninhados (até três níveis; modo em lote apenas com objeto de origem) para reduzir a contagem de campos no nível raiz sem sacrificar a profundidade de extração.
- Divida documentos complexos em várias configurações de IA de documento que têm como alvo seções de documentos distintas, escreva resultados em DLOs separados que se unem a jusante no Data 360.
- Para casos de uso que exigem extração mais ampla:
- Limites de taxa de API: A IA do documento aplica um limite de 50 chamadas à API de extração por minuto por locatário. O limite teórico é de 300 chamadas por minuto, que é regido pelo Einstein LLM Gateway. Integrações transacionais de alto volume devem ser projetadas com pendências exponenciais, enfileiramento de solicitação e orçamento de taxa de locatário. Não presuma que a capacidade de explosão esteja disponível em ambientes de produção de vários locatários.
- Perfil de latência da API: As APIs de extração de IA de documento são totalmente síncronas. Os tempos de resposta típicos variam de 5 a 15 segundos e variam de acordo com o tamanho do arquivo e a complexidade do esquema.
- Isso tem implicações diretas para a arquitetura de integração:
- Defina o tempo limite do chamador para um mínimo de 30 segundos.
- Não invoque a IA de documento em fluxos com requisitos de SLA inferiores a um segundo.
- Latência de fator nos cálculos de rendimento em relação ao limite de taxa para pipelines de processamento em lote.
- Defina o tempo limite do chamador para um mínimo de 30 segundos.
- Isso tem implicações diretas para a arquitetura de integração:
- Documentos criptografados e protegidos por senha: A IA do documento não processa arquivos protegidos por senha (as senhas do usuário são necessárias para abrir arquivos) ou PDFs que são criptografados com uma senha de proprietário/permissões, incluindo arquivos que abrem normalmente, mas restringem a cópia, a impressão ou a edição na camada de permissões do PDF.
- Essa restrição fica no limite de ingestão:
- Projetar pipelines de entrada de documento para detectar e encaminhar arquivos criptografados para um caminho de rejeição ou processamento manual antes que eles cheguem à IA de documento.
- Não conte com a manipulação de erros de tempo de execução como o gate principal.
- Essa restrição fica no limite de ingestão:
A IA do Data 360 Document está alinhada com vários pilares do Salesforce Well-Architected Framework.
- Trust: O ETL impõe a retenção de dados zero com provedores de LLM, mascara entradas PII antes que elas cheguem ao modelo e verifica saídas em busca de conteúdo confidencial. Os arquitetos devem estender essa postura aos dados extraídos em repouso. O mascaramento em nível de campo em DLOs não é aplicado pela ETL e exige políticas de Espaço de dados posterior e conjuntos de permissões.
- Confiabilidade: Cada modo de falha na seção Considerações de design (extração de campo nulo, leitura incorreta do OCR, correspondência incorreta da versão do esquema, violação do tamanho do arquivo, sobrecarga de contexto do LLM, interferência de mascaramento do ETL, idempotência de gravação do RDBMS e esgotamento de crédito) representa uma classe de falha distinta com um sinal de detecção e caminho de resolução documentados.
- Excelência operacional (gerenciamento de mudanças): O modelo de extração conduzido por esquema desconecta a lógica de extração do layout do documento. Quando um fornecedor altera um formato de fatura ou um formulário regulatório é atualizado, os arquitetos precisam atualizar apenas uma configuração de esquema em vez de modificar o código de integração.
- Excelência operacional (capacidade de manutenção): Centralizar as configurações de esquema no Data 360 em vez de integrar a lógica de extração no código do aplicativo torna a intenção de extração explícita, com controle de versão e auditável. Todas as metas a jusante consomem o mesmo contrato de esquema, independentemente do nível de destino.
- Excelência operacional (reutilização de integração): A IA do documento expõe a extração em várias superfícies de integração: API REST, Apex, Flow, MuleSoft, Agentforce Actions e o servidor MCP. Uma única configuração de esquema gera ventilação para vários níveis de destino ao mesmo tempo sem recompilar a capacidade de extração por consumidor.
- Otimização de recursos e custos: A orientação de seleção de pipeline, o limite de tamanho de arquivo de 10 MB e as restrições de comprimento de contexto do LLM de pré-montagem representam decisões de design sensíveis ao desempenho. A seção Quando usar formaliza as condições para quando a IA do Documento não é a ferramenta certa (por exemplo, requisitos de latência de subsegundo, dados de origem totalmente estruturados e documentos gerados por máquina com esquema fixo).
Esse é um ponto de partida estruturado para configurar a IA do Data 360 Document em um ambiente de sandbox. Conclua todas as fases no sandbox antes de migrar para a produção.
Antes de iniciar a configuração, você deve confirmar:
- Tamanho do arquivo: Valide se os tamanhos de documentos representativos estão abaixo de 10 MB.
- Pipeline: Confirme se o caso de uso requer o pipeline de lote (suportado por UDMO, de alto volume) ou o pipeline de processamento transacional (acionado por API, de documento único). Isso determina todas as configurações subsequentes.
- Nível de destino: Confirme onde os dados extraídos estão: Salesforce SObject, DLO/DMO do Data 360, RDBMS externo ou uma combinação.
- Agentforce Dependence: Antes de implementar qualquer processamento de documento habilitado pelo Agentforce, confirme se um LLM compatível (por exemplo, GPT-4o) está habilitado em sua organização por meio das configurações de ETL. Agentforce é um pré-requisito de plataforma rígida para a IA de Documento. Toda a área de recursos de IA de documento, incluindo todas as APIs de extração, fica indisponível até que o Agentforce esteja ativo na organização de destino. Faça isso em avaliações de prontidão da organização e sequenciamento de provisionamento. Dê alguns minutos para a disponibilidade da API estabilizar o pós-enablement.
- Impacto da desabilitação do Agentforce: Se o Agentforce for desativado após a configuração e implementação da IA do Documento, todo o processamento de extração (UI e API) será bloqueado imediatamente. O mesmo se aplica à desabilitação do modelo. Desativar o modelo subjacente tem um efeito equivalente sobre a disponibilidade de IA de documento. Em ambos os casos, as configurações de esquema existentes são preservadas e permanecerão visíveis – nenhuma configuração ou perda de dados ocorrerá – mas a funcionalidade ficará totalmente inoperável até que o Agentforce e o modelo sejam reabilitados. Projete manuais operacionais para lidar com a disponibilidade do Agentforce e a habilitação de modelo como dependências de saúde de IA do documento.
- Consumo/preço do crédito: Use créditos Data 360 ou Flex Credits para estimativas de TCO derivadas de documentos de amostra representativos.
- Criar a configuração do esquema. Defina campos de extração, tipos de dados e instruções no formato JSON Schema na configuração de IA do Data 360 Document. Para o pipeline de lote, vincule-o a um UDMO. Para o pipeline de processamento transacional, crie-o sem um objeto de origem. Registre o ID do esquema.
- Alinhe nomes de campo ao nível de destino. Combine nomes de campo com definições de coluna de DLO, nomes de API SObject ou nomes de coluna RDBMS. Nomes desalinhados criam sobrecarga de mapeamento na camada de integração.
- Configure o objeto de origem UDMO (apenas lote). Defina documentos no escopo e configure a conectividade de fonte de ingestão (por exemplo, S3, Google Cloud Storage, Salesforce Files ou MuleSoft). Confirme se a conta de serviço de ingestão tem o escopo de credencial IAM ou OAuth necessário.
- Aplicar políticas de mascaramento de PII. Configure políticas de mascaramento de dados nas configurações de ETL antes de processar qualquer conteúdo regulamentado. Defina quais tipos de campo (PHI, PII e identificadores financeiros) são mascarados antes que as entradas cheguem ao LLM. Não adies essa etapa.
- Atribuir escopo do espaço de dados e conjuntos de permissões. Defina o escopo do processamento para o Espaço de dados apropriado e configure os Conjuntos de permissões para controlar a criação do esquema, a execução do trabalho em lote, a invocação da API REST e a ativação a jusante.
- Configurar a autenticação da API (apenas pipeline de processamento transacional). Crie um Aplicativo conectado com os escopos OAuth cdp_ingest_api e api. Para chamadores internos da organização, use uma Credencial nomeada que vincule a uma Credencial externa. Para chamadores externos, configure as credenciais de cliente OAuth 2.0 ou um fluxo de portador JWT. Teste e valide a extração antes de prosseguir.
- Sobject write-back: Implemente um elemento Apex (@InvocableMethod) ou Flow que mapeie campos de resposta JSON para campos SObject. Use Database.upsert() com um ID externo para evitar duplicatas. Aplique a segurança em nível de campo em campos de SObject de destino.
- Pipeline DLO/DMO do Data 360: Mapeie campos de DLO extraídos para DMOs alinhados ao Customer 360 Data Model. Configure regras de resolução de identidade para vincular registros de documento a Indivíduos unificados. Defina Insights calculados e adicione DMOs para Agentforce. Para o pipeline de processamento transacional, encaminhe a carga útil JSON para um DLO por meio da API de Ingestão primeiro.
- RDBMS externo ou data warehouse: Selecione o padrão de integração: MuleSoft (tecnologia de integração existente), chamada HTTP Apex (leve, nativa da organização), eventos de plataforma com o assinante Pub/Sub (acionada por evento) ou ETL (lote de alto volume). Implemente inserções e atualizações idempotentes usando uma impressão digital de documento ou ID externo em todos os caminhos de gravação externos.
- Caminhos de ativação: Conecte ações Agentforce a configurações de esquema para extração interativa. Configure acionadores Flow ou Apex para fluxos de trabalho de processamento automatizados e estabeleça os destinos da ativação para cada grupo de campos.
- Manuseio de erros (apenas pipeline de processamento transacional). Configure a superfície de resposta HTTP completa: 200 (sucedido, incluindo respostas parciais nulas), 400 (solicitação malformada ou ID do esquema não encontrado), 413 (arquivo excede 10 MB), 5xx (erro de serviço). Implemente a reversão exponencial para novas tentativas de 5xx com um máximo de 3 tentativas. Registre a resposta JSON bruta e o ID do esquema em cada chamada.
- Esquemas de teste em relação a documentos de amostra. Envie amostras representativas por meio da interface Document AI ou da API REST. Confirme a precisão da extração, a cobertura do campo e o manuseio nulo em variações de layout.
- Validar a manipulação de campo nulo. Confirme que todas as metas a jusante podem lidar com valores nulos para campos não encontrados em um documento. Lembre-se de que as restrições NÃO NULL falham silenciosamente sem manipulação nula explícita.
- Pre-validar tamanhos de arquivo. Confirme se os documentos de produção permanecem abaixo de 10 MB. Implemente o pré-processamento para dividir ou compactar documentos que se aproximam regularmente do limite.
- Valide a extração de ponta a ponta. Para o pipeline de lote, inicie uma execução completa e confirme se os campos extraídos chegam corretamente em cada nível de destino. Para o pipeline de processamento transacional, rastreie a resposta JSON pela camada de integração até o destino. Verifique a execução do acionador e do fluxo para as metas do SObject, a vinculação de resolução de identidade para as metas do DLO/DMO e a idempotência para as metas do RDBMS.
- Confirme o comportamento da Camada de confiança. A ETL não aplica o mascaramento de PII ao conteúdo do documento, portanto, o LLM retornará dados de PII em campos extraídos como estão. Confirme se os campos de esquema, o roteamento de dados e o armazenamento a jusante são projetados para lidar com a saída com PII adequadamente e garanta que quaisquer requisitos de conformidade ou retenção sejam tratados fora da plataforma.
- Definir alertas de Digital Wallet. Configure alertas de consumo em 75% e 90% dos créditos disponíveis. Estabeleça limites de tamanho do lote e estimativas de taxa ad hoc no orçamento de crédito para cada ciclo.
- Validar monitoramento em lote (apenas pipeline em lote). Revise as taxas de sucesso de extração, as taxas de campo nulas e a conclusão do trabalho no console de monitoramento do Data 360. Confirme a propagação da marcação do UDLO por meio do DLO para o DMO na linhagem de dados.
- Validar a manipulação de erros de API (apenas pipeline de processamento transacional). Testar todas as condições de erro: 413 (documentos acima de 10 MB), 400 (IDs de esquema inválidos), 200 (extrações válidas com valores parciais nulos). Confirme se a lógica de repetição é acionada em respostas simuladas de 5xx sem criar gravações duplicadas.
Este documento destaca os fundamentos arquitetônicos da IA de documento do Data 360:
- Dois pipelines de processamento e quando usá-los
- O modelo de configuração do esquema
- A estrutura de decisão de nível de destino
- Restrições de tecnologia essenciais
- Modos de falha
- Alinhamento do Quadro bem estruturado
O Guia de início rápido para arquitetos fornece a sequência de configuração para uma prova de conceito de sandbox.
A postura de arquitetura principal dá suporte a dados derivados de documentos que são regidos na camada Schema, processados por meio de um pipeline LLM aplicado ao ETL e entregues ao mesmo ciclo de vida de dados do Data 360 que rege todos os outros dados corporativos.
Os arquitetos que aplicam esses princípios, selecionando o pipeline correto, projetando esquemas no nível do tipo de documento e projetando para modos de falha antes da produção, criam recursos de extração que são dimensionados e suportam os requisitos de governança do setor regulamentados.
Yugandhar Bora é um arquiteto de engenharia de software na Salesforce especializado em arquitetura de dados dentro da plataforma Data and Intelligence Applications. Ele lidera iniciativas do Corpo de Revisão de Arquitetura Empresarial (EARB) que se concentram na governança de dados e modelos de dados unificados, além de contribuir para soluções de provisionamento de plataforma automatizadas.
Ananth Anto é diretora de gerenciamento de produto na Salesforce Data 360 e lidera as iniciativas de IA Document e Data Graph. Baseado em Bangalore, ele trabalha com clientes corporativos para resolver desafios reais de processamento de documentos e inteligência de dados. Ele gosta de explorar casos de uso da Enterprise para a IA generativa (IA de geração).
Nishan Naseer é um arquiteto de engenharia de software na Salesforce que trabalha em processamento de dados não estruturados, pipelines de RAG e inteligência de documentos. Ele é apaixonado por aproveitar o poder da IA para lidar com desafios do mundo real e encontrar soluções criativas para problemas complexos do cliente.