Ondernemingen verwerken een breed scala aan documenttypen, waaronder facturen, inkooporders, juridische contracten en technische handleidingen. Handmatige verwerking is traag, foutgevoelig en verbruikt naar schatting 15-25% van de tijd van medewerkers. Eerdere automatiseringsbenaderingen (bijvoorbeeld Robotic Process Automation (RPA), Optical Character Recognition (OCR) en werkstroomtools) verminderden een deel van de belasting, maar leidden tot starre pijplijnen, grote onderhoudsoverhead en een silo-acceptatie binnen afzonderlijke bedrijfsteams.
Documenten hebben een rijke structurele context (bijvoorbeeld tabelhiërarchieën, ruimtelijke veldrelaties en secties met verwijzingen) die platte-tekstverwerking niet kan behouden. Door een document te strippen naar platte tekst wordt de bedrijfscontext genegeerd die extractie nauwkeurig en nuttig maakt, waardoor de kwaliteit van analyses verderop in de stroom, conclusies van kunstmatige intelligentie (AI) en procesautomatisering achteruitgaat.
Om effectief te zijn, moeten systemen voor _intelligente documentverwerking (_IDP) documenten classificeren op type, gestructureerde gegevens nauwkeurig extraheren uit variabele lay-outs en deze gegevens in een beheerde, querybare vorm aanleveren aan downstreamsystemen. IDP’s moeten ook documentvariabiliteit op schaal afhandelen zonder dat hiervoor per sjabloonconfiguratie voor elke nieuwe documentindeling vereist is, en ze moeten gecentraliseerd en toegankelijk zijn voor alle bedrijfseenheden. Deze uitdaging wordt nog verergerd door het enorme volume van het belangrijkste probleem: ongestructureerde gegevens vormen ongeveer 80% van alle ondernemingsgegevens en de meerderheid verzamelt zich in documentvorm in bestandssystemen, cloudopslag en inhoudsrepository’s die buiten het bereik liggen van Customer Relationship Management-systemen (CRM), AI-agenten en analyseplatforms.
Data 360 Document AI is de Salesforce-mogelijkheid voor documentverwerking binnen Data 360, die is ontworpen om dit hiaat op te lossen. Het extraheert, classificeert en analyseert ongestructureerde en semigestructureerde documentinhoud met behulp van grote taalmodellen (LLM’s), optische tekenherkenning (OCR), natuurlijke taalverwerking (NLP) en machine learning (ML). De uitvoer bestaat uit gestructureerde, beheerde en opvraagbare gegevens die worden geïntegreerd in de Data 360 pijplijn waar Agentforce agenten, analysetools en automatiseringswerkstromen er toegang toe hebben via standaardinterfaces zonder aangepaste extractie- of transformatielagen te vereisen.
Enterprise Data Platforms verwerken gestructureerde, tabelgegevens. De meeste ondernemingsgegevens komen echter aan als documenten en blijven ontoegankelijk voor CRM-, ERP-, AI-agenten en analysepijplijnen totdat iemand ze handmatig extraheert. Dit is een architectonisch hiaat, geen werkstroomprobleem.
Eerdere benaderingen combineerden handmatig opnieuw sleutelen, op regels gebaseerde OCR en RPA-scripts. Deze methoden werkten op kleine schaal, maar konden niet omgaan met het volume, de verscheidenheid en de snelheid van de typen documenten die moderne ondernemingen genereren. Op regels gebaseerde tools vereisen expliciete sjablonen per lay-outvariant. Elke notatiewijziging verbreekt de extractie en vereist een ontwikkelaar, een nieuwe sjabloon en een implementatiecyclus.
Op grote schaal leidt dit tot breekbare puntoplossingen zonder gecentraliseerd bestuur, gedeeld schema en pad naar AI-gereedheid. Inconsistente extractiepijplijnen verspreiden zich verderop in de stroom. Met andere woorden, analyses nemen gegevensinconsistenties over, AI-modellen produceren onbetrouwbare uitvoer en gereguleerde inhoud zoals Persoonlijke gezondheidsgegevens (PHI) en Persoonlijk Identificeerbare Informatie (PII) ontbreekt aan systematisch bestuur.
LLM’s extraheren velden zonder expliciete sjablonen. Eén schemaconfiguratie bepaalt de extractie binnen lay-outvarianten, talen en indelingen, die zich aanpast aan het document in plaats van te vereisen dat het document voldoet aan een vaste structuur. Dit verschuift documentverwerking van een onderhoudszware, geïsoleerde bewerking naar een beheerde, gecentraliseerde mogelijkheid.
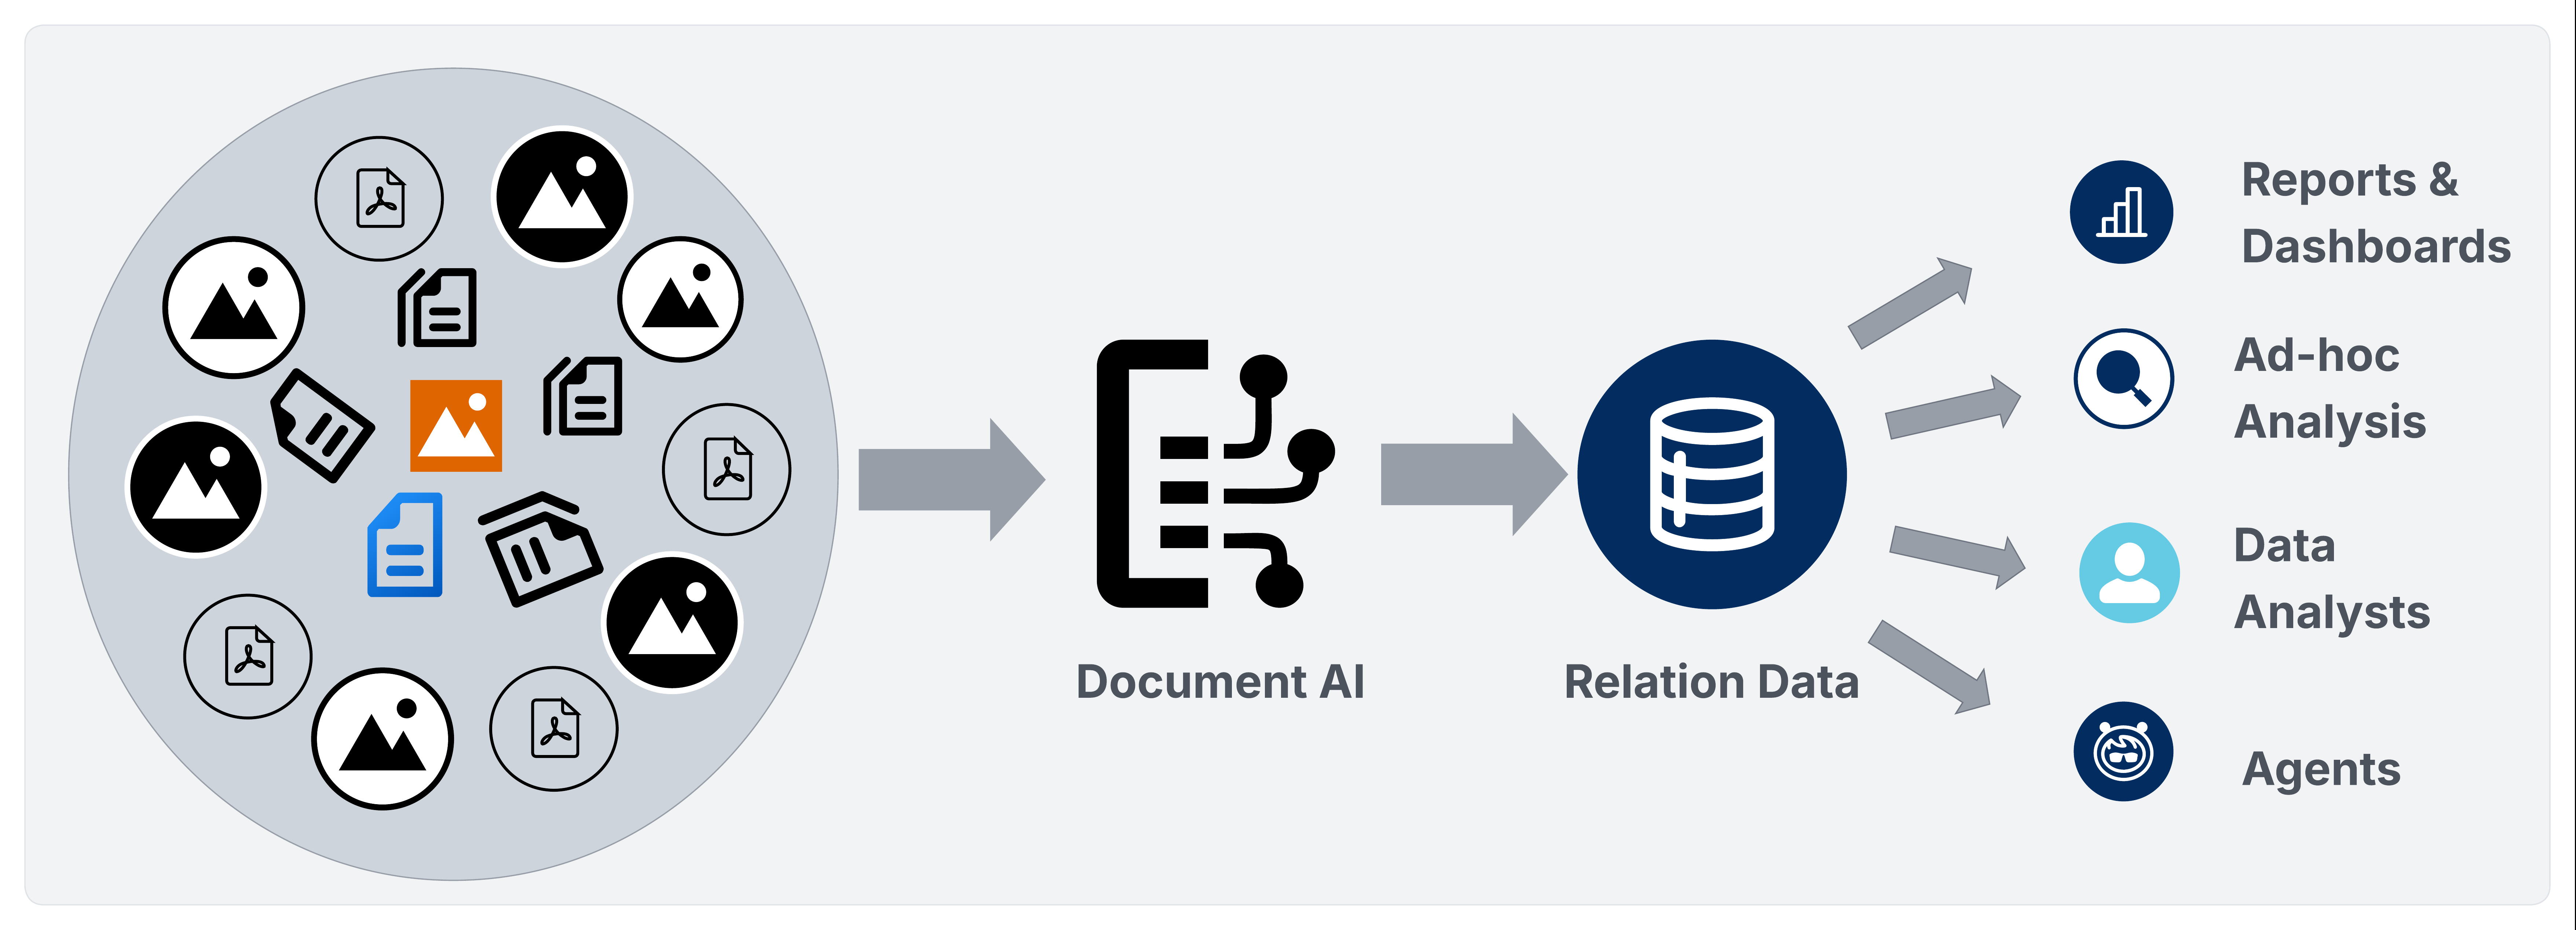
Data 360 Document AI operationaliseert documentverwerking binnen het Data 360 platform via twee pijplijnen.
- De Batchpijplijn routeert geëxtraheerde gegevens door opname, identiteitsoplossing, berekende insights, activeringen, analyses en Agentforce activering.
- De Transactionele verwerkingspijplijn maakt een REST-API beschikbaar die gesynchroniseerd gestructureerde JSON retourneert, waardoor architecten via documenten afgeleide gegevens kunnen routeren naar Salesforce SObjects, de pijplijn Data 360 Data Lake Object / Data Model Object (DLO/DMO) of externe databases en magazijnen zonder overhead voor batchinstellingen.
In beide gevallen gaan geëxtraheerde gegevens naar een beheerd, schemagestuurd model in plaats van een gefragmenteerde set punttools.
Data 360 Document AI is de native Salesforce-mogelijkheid voor Intelligent Document Processing binnen het Data 360 Platform. Het converteert ongestructureerde en semigestructureerde documentinhoud naar beheerde, opvraagbare gegevens die volledig deelnemen gedurende de gehele levenscyclus van Data 360.
Data 360 Document AI is de native Salesforce-mogelijkheid voor Intelligent Document Processing binnen Data 360. Het neemt ongestructureerde en semigestructureerde documenten op, extraheert gestructureerde gegevens met behulp van een declaratieve schemaconfiguratie en levert die gegevens aan de Data 360 pijplijn voor harmonisering, identiteitsoplossing, analyses en Agentforce activering.
Data 360 Document AI ondersteunt twee verwerkingsmodaliteiten:
- Bulkbatchverwerking: Verwerkt grote documentensets die zijn gedefinieerd in Unstructured Data Model Objects (UDMO’s) op eventgestuurde basis.
- Transactionele verwerking: Verwerkt één document via de REST-API en retourneert synchroon een gestructureerde JSON payload. Architecten kunnen die payload vervolgens routeren naar de Data 360 DLO/DMO pijplijn, Salesforce SObjects of externe databases en magazijnen via MuleSoft, Apex aanroepen of Einstein Trust Layer (ETL) pijplijnen. De doellaag is een architectonische beslissing die wordt gestuurd door vereisten voor latentie, governance en gegevensverblijf.
Document-AI ondersteunt momenteel PDF-bestanden, afbeeldingsbestanden (JPEG, PNG) en handgeschreven documenten.
Data 360 Document AI combineert vier verwerkingstechnologieën in één beheerde pijplijn. Elke component verwerkt een afzonderlijke fase van de levenscyclus van document-naar-gegevens:
- Optische tekenherkenning (OCR): Converteert gescande afbeeldingen, handgeschreven inhoud en op afbeeldingen gebaseerde PDF-bestanden naar machineleesbare tekst vóór LLM-verwerking. Een minimum van 150 DPI wordt aanbevolen voor betrouwbare extractie.
- Large Language Models (LLM’s): Routeer extractie door de Einstein LLM gateway met behulp van het door de gebruiker gekozen model. De LLM ontvangt OCR-uitvoer naast de configuratie van het JSON schema en retourneert een gestructureerde extractiepayload. Gemini en aanvullende modellen worden gepland voor toekomstige implementatie.
- Natural Language Processing (NLP): Voert contextueel inzicht, entiteitsherkenning, datumparsering en semantische veldextractie rechtstreeks binnen de LLM uit via gestructureerde aanwijzingsengineering. De door een schema gedefinieerde aanwijzing en OCR-uitvoer fungeren als de enige invoer. Alle LLM-interacties worden gerouteerd via de ETL, die nul gegevensbewaring afdwingt bij modelleveranciers en PII maskeert in op tekst gebaseerde invoer voordat ze het model bereiken. Er wordt geen afzonderlijke NLP-engine gebruikt.
- Multi-Modale verwerking: Verwerkt ingebedde afbeeldingen binnen PDF-bestanden als afzonderlijke extractie-invoer, waardoor de LLM gegevens kan extraheren uit diagrammen, door afbeeldingen weergegeven tabellen en pagina’s met gemengde inhoud die alleen door OCR niet kunnen worden geparseerd.
Naast de vier verwerkingstechnologieën verwerkt Document AI ook:
- Einstein Trust Layer: Routeert alle LLM-interacties via de ETL, die nul gegevensbewaring afdwingt bij modelleveranciers en PII maskeert voordat invoer de LLM bereikt, met uitzondering van multimodale gegevens (bijvoorbeeld bijgevoegde documenten die worden verwerkt via Document AI), waarbij PII-maskering momenteel niet wordt ondersteund en gegevens ongewijzigd naar externe modellen worden verzonden. De ETL bepaalt alleen het LLM-interactiepad. Geëxtraheerde gegevens die naar Data Lake Objects (DLO’s) worden geschreven, worden opgeslagen zoals ze zijn; maskeren op veldniveau in ruste moet worden aangepakt door middel van controles verderop in de stroom.
- Bestandsgroottelimieten: Document-AI verwerkt bestanden tot 10 MB per verzoek. LLM-contextlengtelimieten kunnen de verwerking van dichte documenten van meerdere pagina’s binnen deze grens verder beperken.
Enterprisearchitecten die Data 360 Document AI implementeren, moeten deze principes toepassen voordat ze een implementatieontwerp maken.
- Selecteer de pijplijn voordat u het schema ontwerpt. De pijplijnen voor batchverwerking en transactieverwerking verschillen in opnamemodel, schemabinding, doelflexibiliteit en latentie. Het is belangrijk om te bevestigen welke pijplijn elke gebruikscase vereist voordat u het schema definieert, aangezien retrofit vermijdbaar opnieuw werk toevoegt.
- Ontwerp schema’s op documenttypeniveau. Het gebruik van één goed samengesteld schema per documenttype is onderhoudsvriendelijker dan het gebruik van configuraties per gebruikscase, en het is ook de grootste hefboom voor extractiekwaliteit. Als u dit correct wilt doen, moet u een diverse set documenten—inclusief randcases—gebruiken, in plaats van vanuit één voorbeeld te ontwerpen. Gebruik aanwijzingen herhaaldelijk op veld-, tabel- en schemaniveau om hiaten te vinden en test en verfijn ze vervolgens op basis van meerdere documentvoorbeelden voordat u ze definitief maakt. Houd er rekening mee dat een schema dat goed werkt voor het ene document, tekort kan schieten voor andere, dus breedte en herhaling zijn essentieel. Schemaflexibiliteit, inclusief het verwijderen van kolommen die niet betrouwbaar worden geëxtraheerd tussen documenttypen, is net zo belangrijk. Vasthouden aan velden die ruis of inconsistentie veroorzaken, ondermijnt de algehele extractiekwaliteit, dus het is belangrijk om kolomverwijdering te beschouwen als een eersteklas ontwerpbeslissing.
- Kies de juiste doellaag per veldgroep. Velden die CRM-werkstromen of goedkeuringen aansturen, schrijven naar SObjects. Velden die het gecombineerde profiel of feedinganalyse verrijken, behoren tot de DLO/DMO-pijplijn. Velden die externe systemen bedienen, behoren tot de laag RDBMS. Houd er rekening mee dat één schema kan worden uitgebreid naar meerdere lagen tegelijk.
- Dwing governance af voordat u gereguleerde inhoud verwerkt. Gereguleerde gegevens moeten op elke laag worden beschermd. Daarom is het belangrijk om het maskeren van PII’s, gegevensclassificatietags en _op kenmerken gebaseerde toegangscontrole (_ABAC) te configureren nadat geëxtraheerde gegevens zijn opgeslagen in de uitvoer van Data Lake Objects (DLO’s). Dit biedt verfijnde afdwinging en contextbewuste toegang op basis van gegevensclassificatie, gebruikersrol en organisatorische context. Beheer is verdeeld over twee paden: de ELT bepaalt de LLM-interactie, terwijl de geëxtraheerde gegevens die zijn opgeslagen in DLO’s, afzonderlijk moeten worden beheerd—rechtstreeks op DLO- en databaseniveau—via configuraties van Gegevensruimte, machtigingensets en ABAC-beleidsvormen. Deze besturingselementen moeten consistentie behouden op de opslaglaag—niet alleen de toepassingslaag—zodat toegangsbeperkingen intact blijven, ongeacht de manier waarop gegevens worden geopend na opname. Houd er rekening mee dat hiaten in elke laag gereguleerde gegevens verderop in de stroom kunnen blootleggen, zelfs wanneer andere correct zijn geconfigureerd.
- Ontwerp voor mislukkingswijzen vóór productie. Los afhandeling van null-velden, OCR-kwaliteitsdrempels, prevalidatie van bestandsgrootte, LLM-contextoverloop, RDBMS-schrijfidempotentie en kredietbudgetlimieten op voordat de eerste productiebatch wordt uitgevoerd. Dit zijn geen randcases—het zijn voorspelbare foutoppervlakken die expliciet moeten worden afgehandeld in het ontwerp van de pijplijn en niet moeten worden ontdekt tijdens run-time.
- Behandel vertrouwensscores als een eersteklas routeringssignaal, niet als een diagnostische bijbedoelingen. Extractieresultaten bevatten vertrouwenswaarden op veldniveau die zijn afgeleid van de logboekwaarschijnlijkheden (logprobs) van de uitvoer van het onderliggende model. Voor elk geëxtraheerd veld, elke geëxtraheerde tabel of elke geëxtraheerde kolom weerspiegelt de score de zekerheid op tokenniveau van het model van de geëxtraheerde waarde. Dit maakt vertrouwensscores tot een statistisch geaard signaal dat betrouwbaar genoeg is om te dienen als de primaire poort voor Human-in-the-Loop (HITL) escalatiedrempels. Gebruik vertrouwensscores om systematisch extracties van lage kwaliteit te identificeren en HITL-controlepunten te initiëren voor veldwaarden met laag vertrouwen, dubbelzinnige schemaovereenkomsten of herhaalde pijplijnfouten in plaats van te vertrouwen op heuristiek of handmatige steekproeven. Wanneer geautomatiseerd herstel niet mogelijk is, zorgt HITL-ondersteunde vertrouwensscores ervoor dat menselijk oordeel precies wordt toegepast waar het nodig is.
- Ontwerp activeringstrajecten parallel met schemaontwerp. De waarde van document-AI komt voort uit het kunnen activeren van geëxtraheerde gegevens binnen Salesforce-werkstromen en -agenten. Hiermee kunt u Agentforce acties, stromen en berekende insights ontwerpen naast het ontwerp van extractieschema’s, niet daarna.
Document AI werkt binnen twee pijplijnen:
- Een batchpijplijn voor verwerking met groot volume, ondersteund door UDMO
- Een transactionele verwerkingspijplijn voor realtime, API-gestuurde extractie
Beide pijplijnen hebben hetzelfde schemaconfiguratiecontract en ETL-governance, maar ze verschillen in de manier waarop documenten het systeem binnenkomen en waar geëxtraheerde gegevens terechtkomen.
Laten we elke pijplijn nader bekijken.
De batchpijplijn verwerkt terugkerende documentensets die zijn gedefinieerd door een UDMO. Het is geschikt voor geplande of eventgestuurde gebruikscases waarbij documenten worden opgenomen uit de opslag van de onderneming, vervolgens door documentextractie gaan en worden geleverd aan de Data 360 DLO/DMO-pijplijn voor harmonisering, identiteitsoplossing en activering.
Scenario voor de echte wereld
Elke dag ontvangt een verzekeringsmaatschappij duizenden medische claimdocumenten van aanbiedersportals die als PDF-bestanden worden geüpload naar Amazon S3. De UDMO definieert de documentenset binnen het bereik en verzendt alle claim-PDF-bestanden naar de /claims/incoming/ binnen een tijdsbestek van 24 uur.
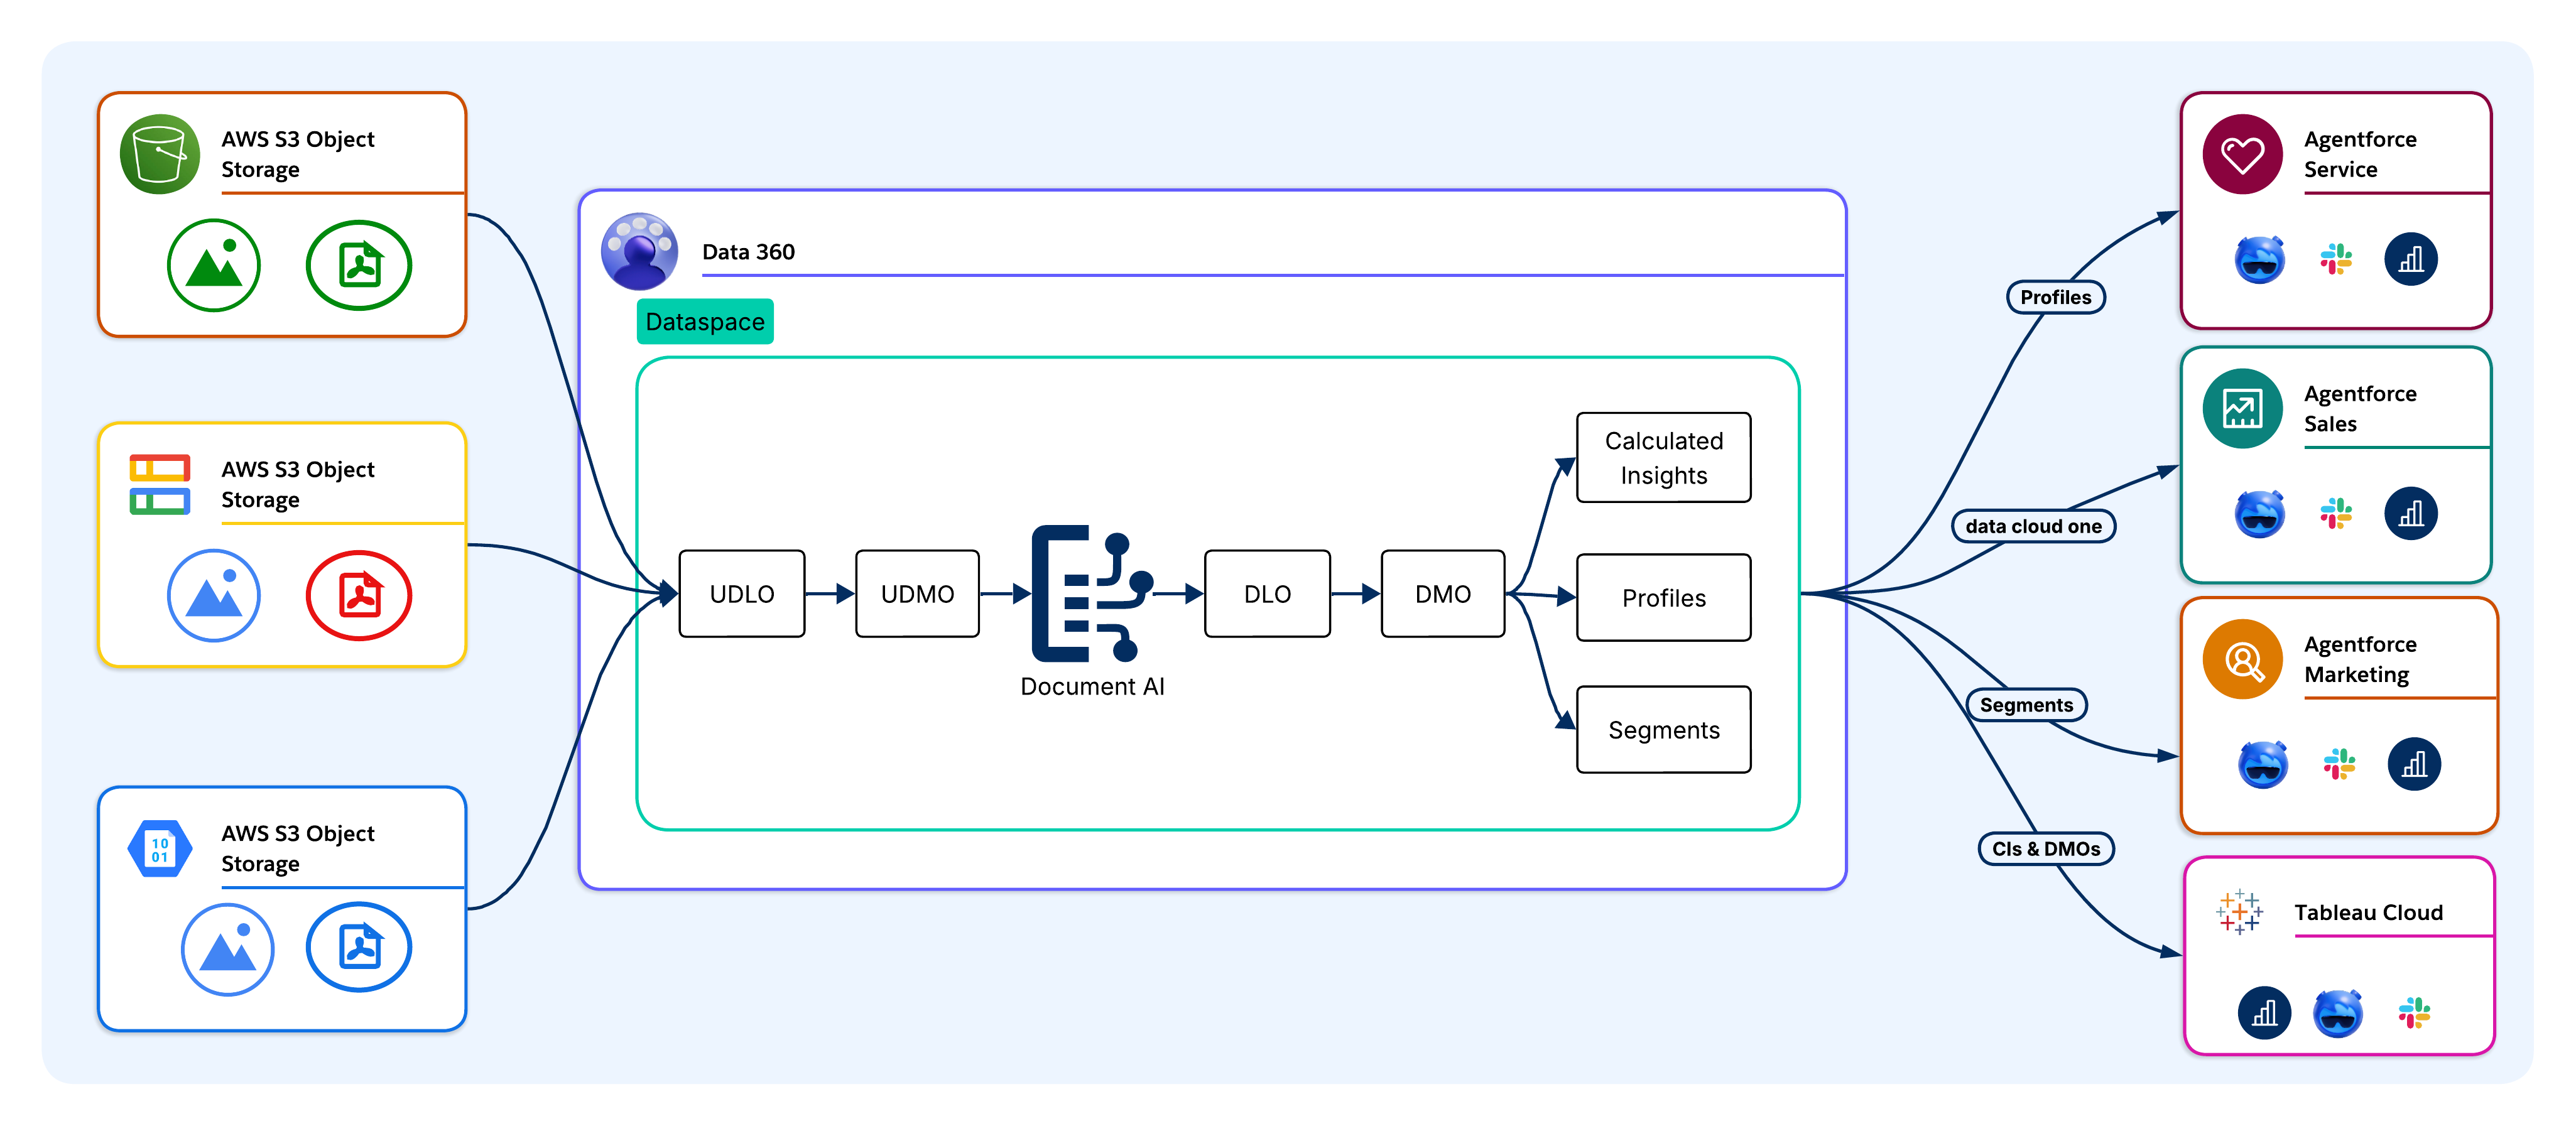
Documenten worden zonder fysieke duplicatie opgenomen in Data 360 vanuit bronsystemen voor de onderneming. Ondersteunde bronnen zijn Amazon S3, Google Cloud Storage, Salesforce CRM-bestandsobjecten, door MuleSoft georkestreerde pijplijnen en directe API-uploads. In Headless 360-implementaties worden documenten opgenomen via cloudopslagconnectoren of de Opname-API, die de CRM-laag omzeilt. De server van het _Model Context Protocol (_MCP) maakt opname zichtbaar als een aanroepbaar hulpmiddel voor externe AI-agenten en LLM-clients.
Bij opname worden ruwe documenten opgeslagen als Unstructured Data Lake Objects (UDLO’s), die worden toegewezen aan de fysieke locatie en metagegevens van elk document zonder het bronbestand te verplaatsen of transformeren.
Voorbeeld:
Claims PDF’s worden opgenomen vanuit S3 in Data 360 via de cloudopslagconnector. Elk document wordt opgeslagen als een UDLO die verwijst naar het S3 object. Er treedt geen fysieke duplicatie op.
Document-AI verwerkt elke UDLO op basis van een schemaconfiguratie die definieert welke velden moeten worden geëxtraheerd, samen met hun doelgegevenstypen. De UDMO bepaalt welke documenten binnen het bereik vallen. De LLM (GPT-4o, Gemini of Claude) leest elk document en retourneert een gestructureerde extractiepayload.
Voorbeeld:
Document-AI verwerkt elke UDLO op basis van een claimsschema dat velden definieert zoals: ClaimID, PatientName, DiagnosisCode, BillingAmount en ServiceDate. LLM’s lezen vervolgens elk PDF-bestand en retourneren een gestructureerde extractiepayload.
Zodra de gegevens zijn geëxtraheerd, blijven ze in DLO’s, de ruwe opslaglaag van Data 360. DLO’s behouden geëxtraheerde velden zonder bedrijfslogica op te leggen, waardoor een nauwkeurige fysieke weergave behouden blijft voor transformatie verderop in de stroom en traceerbaarheid. De UDLO behoudt een verwijzing naar het brondocument om afstamming op veldniveau in te schakelen op elk punt in de pijplijn.
Voorbeeld:
Alle geëxtraheerde velden komen terecht in een Claims-DLO, waardoor een ruwe, nauwkeurige weergave van elke claim met volledige herkomst wordt bewaard, die kan worden getraceerd naar de bron-PDF.
DLO-velden worden toegewezen aan DMO’s die overeenkomen met het standaard Customer 360 Data Model. Dit is de grens waar van documenten afgeleide gegevens overgaan van ruwe, geëxtraheerde velden naar zakelijke betekenisvolle entiteiten. Het Factuur-DLO wordt toegewezen aan een Factuur-DMO en velden zoals CustomerID en BillingAmount worden joinsleutels en overeenkomstenkenmerken binnen het gecombineerde gegevensmodel. Geharmoniseerde documentgegevens nemen deel aan segmentering, Berekende insights en activering via dezelfde interfaces die worden gebruikt door CRM en transactiegegevens.
Voorbeeld:
Het DLO Claims wordt toegewezen aan een DMO Claims. De velden PatientID en PolicyNumber worden joinsleutels die claimrecords koppelen aan gecombineerde patiëntenprofielen.
Geharmoniseerde DMO-gegevens nemen deel aan identiteitsoplossing. Geëxtraheerde velden (bijvoorbeeld klantnamen, e-mailadressen of accountnummers) dienen als overeenkomstensleutels voor het koppelen van documentrecords aan Gecombineerde individuen (Gouden records), waardoor het hiaat tussen documenten en profielen wordt gedicht.
Voorbeeld:
Extractievelden (bijvoorbeeld PatientName, DateOfBirth en PolicyNumber) fungeren als overeenkomstensleutels voor identiteitsoplossing, die claimrecords koppelt aan het juiste gecombineerde individu. Dit doet zich zelfs voor als dezelfde patiënt in verschillende documenten onder iets andere naamspellingen wordt weergegeven.
Architecten definiëren Berekende insights. Dit zijn geaggregeerde meetgegevens die worden berekend over geharmoniseerde documentgegevens (bijvoorbeeld de totale uitgaven van verschillende factuurregelitems, risicoscores voor contractverlenging en indexcijfers voor claimernst).
Voorbeeld:
Berekende insights berekenen TotalClaimsPerPatient, AverageClaimAmount en HighRiskClaimScore over geharmoniseerde claimgegevens voor Agentforce query’s.
Geharmoniseerde, via identiteit opgeloste gegevens zijn toegankelijk voor Agentforce Agents, Tableau, marketingplatforms en Salesforce SObjects. De doellaag is een architectonische beslissing die wordt bepaald door vereisten voor latentie, governance en gegevensverblijf.
Voorbeeld:
Een Claims Adjudication Agentforce Agent voert een query uit op de Data 360 DMO’s en CI’s om claims met hoog risico te vinden voor beoordeling van prioriteit. Tableaudashboards tonen trends in claimvolume en anomalie. Goedgekeurde claimrecords gaan terug naar het Claims SObject om betalingswerkstromen te starten.
In Headless 360 architecturen routeert activering rechtstreeks naar externe systemen via de Query-API, Pub/Sub-API of Cloud-activeringsdoelen voor gegevensmagazijnen. Vervolgens vindt de MCP-server geharmoniseerde documentgegevens en Berekende insights als aanroepbare tools voor externe AI-agenten.
De pijplijn voor transactieverwerking verwerkt extractie van één document tijdens run-time zonder een UDMO of vooraf opgenomen UDLO, wat past bij eventgestuurde gebruikscases (bijvoorbeeld een klant die een formulier uploadt, een agent die een PDF-bestand ontvangt of een extern systeem dat extractie initieert binnen een transactionele verwerkingswerkstroom). ETL-governance is op beide pijplijnen identiek van toepassing.
Scenario voor de echte wereld
Tijdens het aanvragen van een lening uploadt een bankklant een PDF-bestand van zijn of haar rekening voor nutsvoorzieningen via de mobiele app van de bank. De event initieert extractie in real-time, wat betekent dat er geen vooraf opgenomen UDLO of UDMO aan te pas komt.
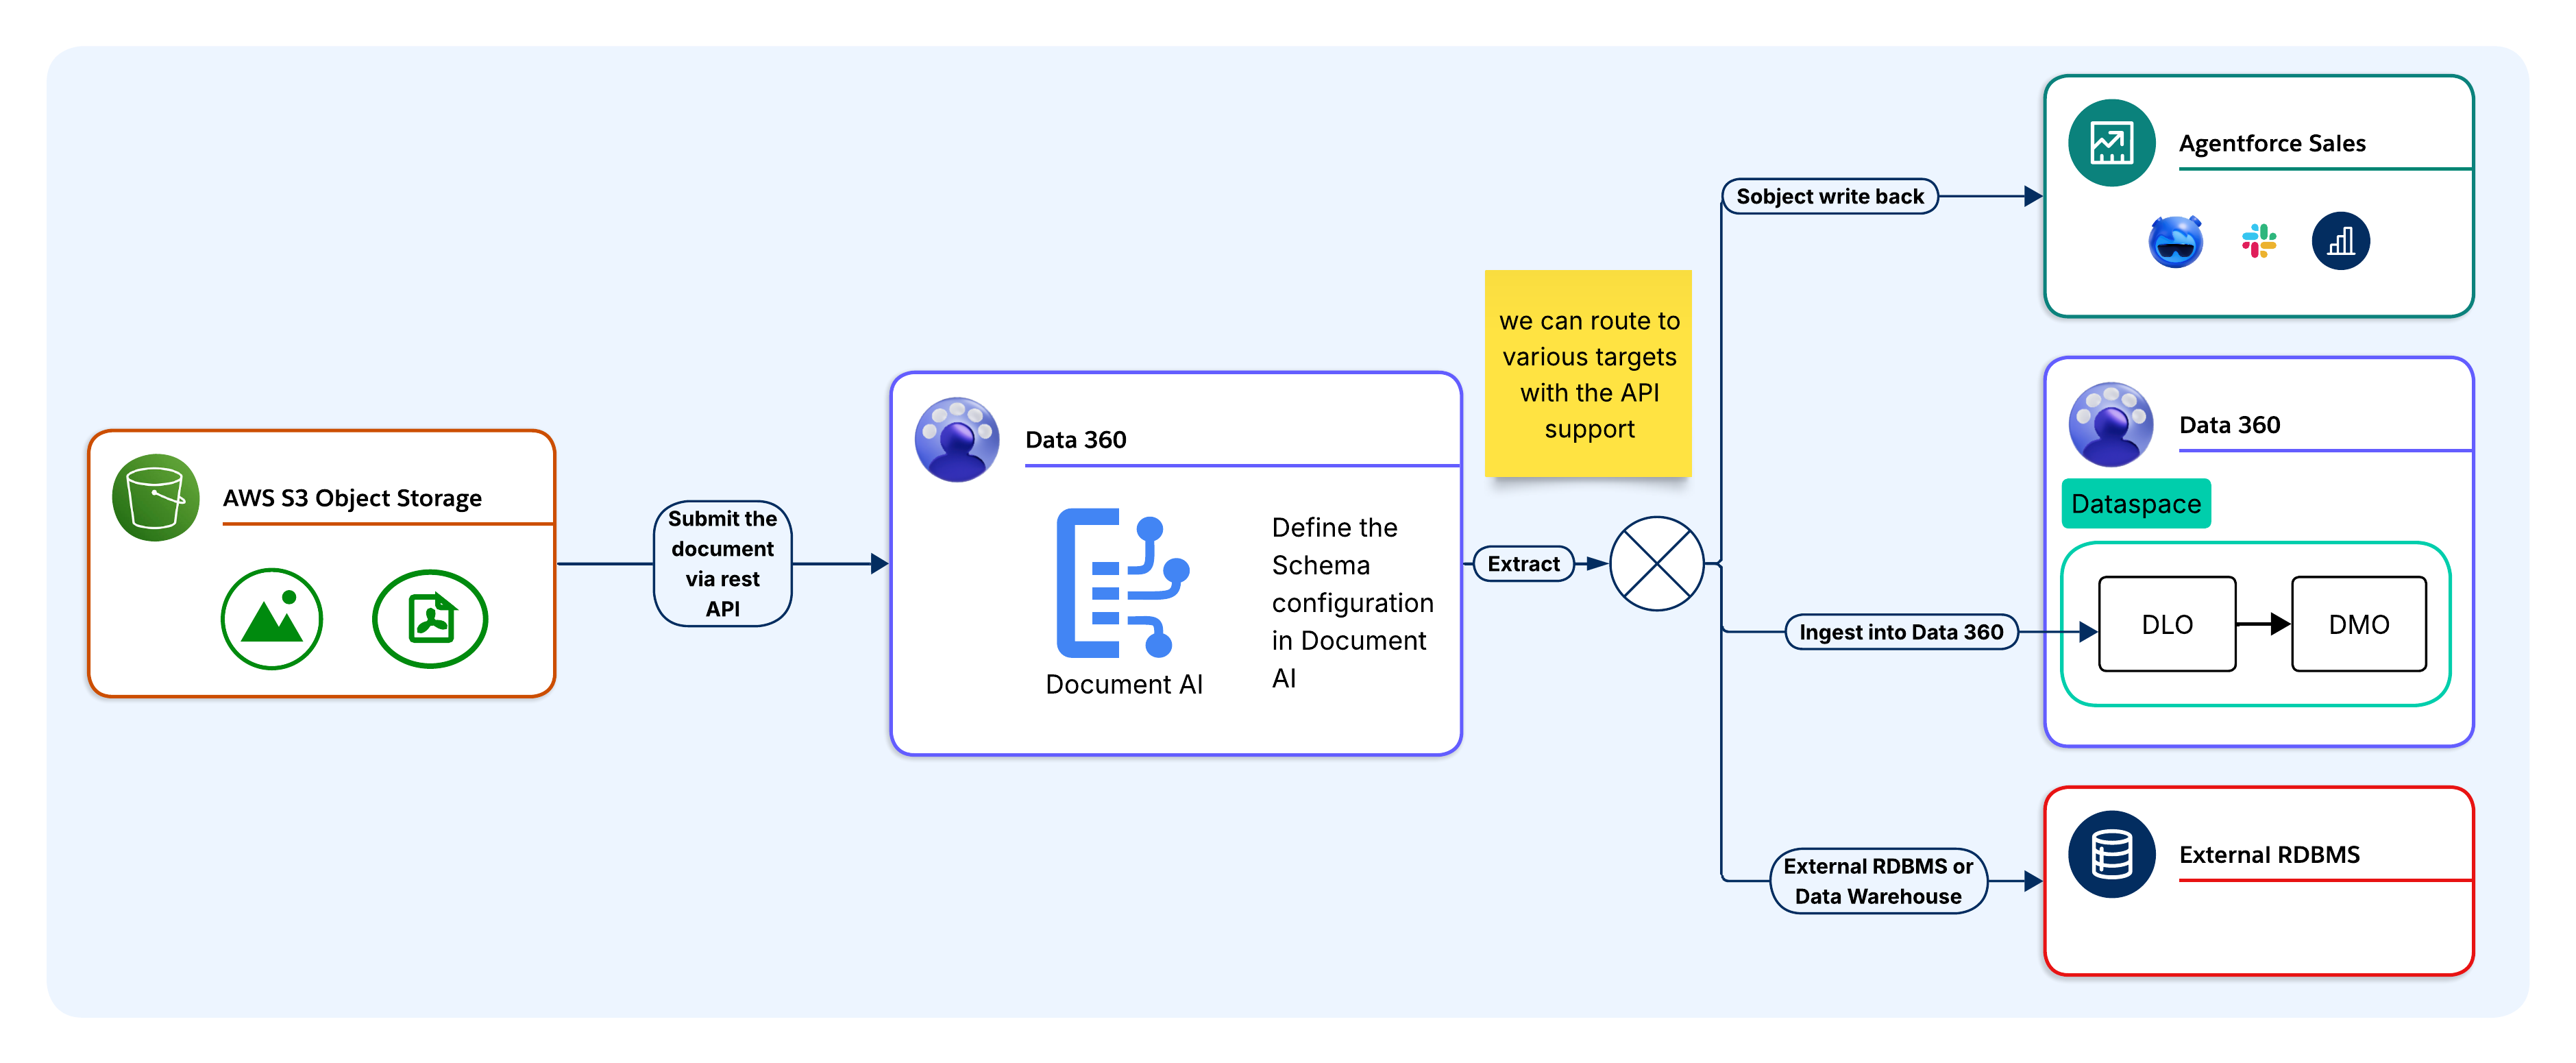
Voordat ze de API aanroepen, moeten architecten een schema definiëren en opslaan in Data 360 dat de velden, gegevenstypen en extractie-instructies opgeeft in JSON-schemanotatie. Aan elk schema wordt een unieke schema-ID toegewezen. Tijdens run-time verwijst de aanroepende toepassing naar de schema-ID om de extractielogica gecentraliseerd te houden in Data 360 in plaats van deze in te bedden in toepassingscode.
Voorbeeld:
Het team van de bank heeft een vooraf gedefinieerd ProofOfAddress in Data 360, dat velden opgeeft zoals CustomerName, AddressLine1, City, PostCode en DocumentDate. Deze informatie wordt opgeslagen als een configuratie met versiebeheer waarnaar kan worden verwezen door een schema-ID.
De aanroepende toepassing dient het document en de schema-ID in één REST-API-verzoek in als een base64-gecodeerde payload of bestandsverwijzing. Er is geen UDLO-opname vereist. Document-AI past de documentextractie toe en retourneert de gestructureerde uitvoer op basis van het geleverde schema.
Voorbeeld:
De mobiele app dient de factuur voor het hulpprogramma in als een base64-gecodeerde payload naast de ID van het ProofOfAddress in één REST-API-aanroep. Dit proces vereist geen UDLO-opnamestap.
De LLM verwerkt de OCR-uitvoer op basis van het schema en retourneert synchroon een gestructureerde JSON-payload. Velden die niet in het document worden gevonden, worden als null geretourneerd. De aanroeper is eigenaar van de volledige JSON-respons en gaat over tot routering.
Voorbeeld:
Document-AI past OCR toe op het PDF-bestand en de LLM retourneert een gestructureerde JSON-payload met geëxtraheerde adresvelden. Velden die niet worden gevonden (bijvoorbeeld als de PostCode ontbreekt in de factuur), worden als null geretourneerd.
Eenmaal geëxtraheerd, kan de JSON-payload naar een of meer doellagen worden gerouteerd, afhankelijk van de gebruikscase:
- Salesforce SObject: Wordt rechtstreeks toegewezen aan SObject-velden via Apex of Flow voor CRM-werkstromen en goedkeuringen.
- Gegevens 360 DLO/DMO-pijplijn: Routeert naar een DLO voor harmonisering, identiteitsoplossing, Berekende insights en Agentforce aarding.
- Extern RDBMS of gegevensmagazijn: Routeert via MuleSoft, Apex callout, Platform Events of ETL voor systemen die zich buiten Salesforce bevinden.
- Aangepaste integratie: Retourneert gestructureerde JSON-payloads naar de aanroepende toepassing voor opslag in een extern systeem of gegevensopslag.
- Stroom stroomafwaarts of Agent: Geeft de gestructureerde JSON-uitvoer rechtstreeks door aan een stroom of agent verderop in de stroom, zonder enige persistentie in een SObject. Dit is een veelvoorkomend patroon voor klanten die document-AI gebruiken als een realtime extractiestap binnen een grotere automatiserings- of agentische werkstroom.
Houd er rekening mee dat één schema kan worden uitgebreid naar meerdere lagen tegelijk, waarbij verschillende veldgroepen naar verschillende doelen routeren vanaf hetzelfde extractiepunt.
Voorbeeld:
Een ProofOfAddress payload kan worden verspreid over drie lagen tegelijk (bijvoorbeeld CustomerName en AddressLine1 schrijven naar het Contact SObject), waardoor een stroom voor adresverificatie wordt geïnitieerd. Vervolgens routeert de volledige payload naar een DLO voor harmonisering en risicoscores, en een kopie routeert naar het KYC-systeem van de bank via MuleSoft voor het vastleggen van naleving van regelgeving.
Zodra deze is geschreven, worden geëxtraheerde gegevens onmiddellijk binnen het doelsysteem geactiveerd. Voor SObject-doelen worden de triggers, stromen en goedkeuringsprocessen geactiveerd in de ingevoegde record. Voor DLO/DMO doelen komen gegevens in de harmonisatie en identiteitsoplossingspijplijn en Agentforce context. Voor externe RDBMS-doelen zijn gegevens beschikbaar voor query’s verderop in de stroom zodra het schrijven is voltooid.
Voorbeeld:
De adresverificatiestroom wordt onmiddellijk geactiveerd in de ingevoegde contactpersoonsrecord, waardoor de leningaanvraag doorgaat naar de volgende fase. De Agentforce leningsmedewerker Agent vindt het geverifieerde adres in de Data 360 en het KYC-systeem registreert de indiening van het document voor auditdoeleinden.
Document AI is het meest geschikt voor specifieke architectonische omstandigheden. Het toepassen ervan buiten die voorwaarden leidt tot onnodige complexiteit en extra kosten.
Als architecten is het belangrijk om deze criteria te evalueren voordat u document-AI gebruikt als extractiemechanisme.
Gebruik Document AI wanneer:
- Documenten zijn de primaire gegevensbron. De vereiste informatie bestaat alleen in documentvorm en is niet beschikbaar vanuit een gestructureerde API of database (bijvoorbeeld gescande contracten, laboratoriumrapporten, intakeformulieren of verzekeringsclaims).
- Documentlay-outs variëren per bron. Hetzelfde documenttype is afkomstig van meerdere leveranciers, partners of regio’s met verschillende veldposities en indelingen. Schemagestuurde LLM-extractie past zich aan zonder onderhoud per lay-out.
- Geëxtraheerde gegevens moeten Data 360 of Agentforce voeden. Extractie moet deelnemen aan identiteitsoplossing, Berekende insights of Agentforce huisarrest. Document-AI wordt rechtstreeks in de DLO-/DMO-pijplijn geleverd zonder een afzonderlijke ETL-laag.
- Volume rechtvaardigt gereguleerde automatisering. Documentvolume overschrijdt wat handmatige verwerking kan verwerken zonder meetbare arbeidskosten of risico’s voor de gegevenskwaliteit.
- Documenten bevatten gereguleerde inhoud. PHI-, PII- of financiële gegevens moeten door een gegevensbewaarlaag van nul worden gerouteerd voordat een LLM wordt bereikt. De ETL voldoet hier native aan. Klanten die vereisen dat er op geen enkel moment geëxtraheerde inhoud wordt bewaard, moeten ook de transactionele API-stroom overwegen, die gestructureerde uitvoer rechtstreeks naar de aanroepende toepassing retourneert zonder naar een SObject of gegevensopslag te schrijven.
- De gebruikscase is eventgestuurd. Een document arriveert tijdens run-time (bijvoorbeeld een upload van een klant, een PDF-bijlage van een agent of een externe systeemtrigger). De pijplijn voor transactieverwerking verwerkt synchrone extractie van één document zonder batchconfiguratie.
Gebruik Document AI niet wanneer:
- Brongegevens zijn al gestructureerd. Als het upstream-systeem een REST-API, databasetabel of gestructureerd bestand (bijvoorbeeld CSV, JSON of XML) zichtbaar maakt, gebruikt u een standaard Data 360-connector. Het uitvoeren van gestructureerde gegevens door een LLM-extractiepijplijn voegt latentie en kredietkosten toe zonder extra voordelen.
- Documenten worden automatisch gegenereerd met een vast schema. Door het systeem gegenereerde PDF-bestanden vanuit een bekend ERP- of factureringsplatform met een stabiele lay-out zijn beter geschikt voor een deterministische parser. LLM-extractie is ontworpen voor variabiliteit en het toepassen ervan op documenten met een vast schema verspilt context en kredieten.
- De nauwkeurigheidsvereisten overschrijden de drempelwaarden voor LLM-vertrouwen. AI van document garandeert geen 100% extractienauwkeurigheid. Gebruikscases waarin een gemiste of onjuiste veldwaarde een aanzienlijk financieel, juridisch of klinisch risico inhoudt, vereisen een HITL-validatiestap. Gebruik document-AI niet als de enige extractielaag voor beslissingen met grote belangen zonder een validatiewerkstroom.
- Documenten overschrijden platformbeperkingen. De huidige bestandsgroottelimiet van 10 MB en beperkingen voor de LLM-contextlengte maken document-AI ongeschikt voor grote of dichte documenten zonder voorbewerking om ze buiten het platform te splitsen en opnieuw samen te voegen.
- Opmerking: Bij Salesforce verbeteren we actief deze acceptatiedrempels om ondersteunde bestandsgrootten, paginatellingen en bestandsextensies uit te breiden. De beperkingen zullen zich in de toekomst blijven ontwikkelen.
Laten we eens wat beter kijken naar verschillende scenario’s die de AI-batchpijplijn Document gebruiken die wordt ondersteund door een UDMO-bronobject. In deze gevallen worden geëxtraheerde gegevens door de Data 360 DLO/DMO pijplijn gerouteerd voor harmonisering, identiteitsoplossing, Berekende insights en Agentforce activering. Elke gebruikscase is het meest geschikt voor geplande of eventgestuurde documentverwerking met groot volume.
Agentforce Sales: Contract- en factuurintelligence
Contract-PDF-bestanden worden opgenomen vanuit Cloud-opslag via de batchpijplijn. Het schema extraheert ContractValue, RenewalDate, PaymentTerms en CounterpartyName en wijst deze vervolgens toe aan de DMO’s Account en Contract. Berekende insights leiden verlengingsrisicoscores af. Agentforce waarschuwt accountmanagers voordat verlengingsperioden worden gesloten, waardoor handmatige contractbeoordeling en gemiste verlengingen worden voorkomen.
Agentforce Service: Omleiding van cases en Knowledge Grounding
Enquête-PDF-bestanden en casebijlagen worden opgenomen via de batchpijplijn. Het schema extraheert gevoelsindicatoren, probleemcategorieën en oplossingsnotities, en wijst deze vervolgens toe aan de DMO’s Case en Knowledge Artikel. Agentforce voert een query uit op de geharmoniseerde Knowledge base wanneer de case wordt geopend en vindt relevante stappen voor probleemoplossing, waardoor de overhead voor zoeken naar agenten wordt verminderd.
Agentforce gezondheid: Verwerking van klinische documenten
Labrapporten, intake-PDF-bestanden en handgeschreven klinische formulieren worden opgenomen via de batchpijplijn. Het schema extraheert velden—waaronder PatientID, DiagnosisCode, MedicationName en TestResult—en wijst deze vervolgens toe aan de DMO’s van Health Cloud, die HIPAA-afgestemde werkstromen voor zorgcoördinatie en klinisch onderzoek ondersteunt.
Financiële diensten: Automatisering van lening- en belastingdocumenten
Leningsaanvragen, belastingaangiften en inkomensverklaringen worden opgenomen via de batchpijplijn. Het schema extraheert velden—waaronder AnnualIncome, TaxYear en EmployerName—en wijst deze vervolgens toe aan de DMO’s van Financiële rekening. Berekende insights voegen uit documenten afgeleide inkomensgegevens en CRM-gegevens samen om geautomatiseerde kredietrisicoscores te vergemakkelijken. Agentforce zoekt de geëxtraheerde leningdetails inline tijdens interacties met de klantenservice. Dit patroon ondersteunt rechtstreeks de gebruikscase Voorkwalificatie agent lening die is gepubliceerd in het Salesforce Agentic Enterprise Solutions Developer Center.
HR: Verwerking van personeelsdocumenten
Onboardingdocumenten, belastingformulieren en certificerings-PDF-bestanden worden opgenomen via de batchpijplijn. De geëxtraheerde velden worden toegewezen aan de DMO’s van de werknemersrecord en vervolgens gekoppeld aan het profiel Gecombineerde medewerker. Specifieke stromen initiëren onboardingtaken en nalevingscontroles op basis van de geëxtraheerde gegevens. Dit patroon ondersteunt rechtstreeks de gebruikscase Agentische verwerking hervatten automatiseren. Document-AI extraheert vaardigheden, arbeidsverleden en kwalificaties uit CV-PDF-bestanden, die Agentforce vervolgens gebruikt om kandidaten te koppelen aan criteria voor open rollen en ze te routeren naar werkstromen.
Professionele services: Voorstel en onderzoeksintelligence
Voorsteldecks en onderzoeksrapporten worden opgenomen via de batchpijplijn. Geëxtraheerde frameworks, benchmarks en betrokkenheidssamenvattingen worden toegewezen aan aangepaste DMO’s en vervolgens geïndexeerd voor vectorzoekopdrachten. Agentforce haalt contextueel relevante aanbevelingen op tijdens de query, die zijn gebaseerd op geëxtraheerde documentinhoud. Dit patroon breidt het patroon Ground Agentforce on Website Content uit. Documenten worden geïndexeerd via Document AI en dienen dezelfde aardingsfunctie voor Agent-responsen als website-inhoud die wordt geïndexeerd via Data 360-connectoren.
HIPAA-nalevingsstatus:
De Health Cloud patronen die in deze paper worden beschreven, passen ETL-besturingselementen (bijvoorbeeld nul gegevensbewaring en PHI-maskering) toe voor tekstinvoer. Deze controles alleen vormen geen HIPAA-certificering. Architecten die ontwerpen voor gereguleerde klinische omgevingen, moeten de huidige HIPAA-certificeringsstatus bevestigen bij het Salesforce-nalevingsteam voordat ze overgaan tot een op AI gebaseerde architectuur binnen die contexten.
Laten we verschillende scenario’s nader bekijken die de Document AI REST API aanroepen met een schema dat niet is gebonden aan een UDMO. Geëxtraheerde JSON-payloads worden tijdens run-time rechtstreeks naar externe systemen gerouteerd.
Toeleveringsketen: Verwerking van leveranciersfacturen naar ERP
Wanneer een PDF-bestand van een leveranciersfactuur aankomt in een bewaakte opslagbucket of e-mailgateway, roept een eventtrigger de Document AI REST API aan met de factuur en een vooraf gedefinieerde schema-ID. Het schema extraheert VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount en DueDate. De JSON-payload wordt via MuleSoft gerouteerd naar de module ERP-accounts met validatie van null-velden en idempotente upsert-logica, waardoor sjabloononderhoud voor variabiliteit in leveranciersnotatie overbodig wordt.
Juridische bewerkingen: Contractbeoordeling aan CLM
Wanneer een contract-PDF wordt geüpload naar de juridische portal, roept de back-end de Document AI REST API synchroon aan. Het schema extraheert GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause en CounterpartySignatory. De JSON payload routeert via Apex callout naar het Contract Lifecycle Management (CLM) systeem. Alle velden die niet worden gevonden, worden als null geretourneerd en de CLM past de standaardverplichtingsregels toe op de ontbrekende waarden.
Verzekeringsclaims: Eerste kennisgeving van verwerking van verlies
Wanneer een verzekeringnemer een formulier _First Notice of Loss (_FNOL) indient, roept de back-endportal de Document AI REST-API synchroon aan. Het schema extraheert PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName en ContactPhone. De JSON payload routeert naar de database voor claimbeheer via Apex callout of ETL, die een vooraf ingevulde claimrecord maakt die taxateurs kunnen controleren voordat de formele claim wordt geopend.
Voordat u naar productie gaat, moet u ontwerpen maken voor deze foutscenario’s.
- Afhandeling van null-velden: De LLM retourneert null voor velden die niet kunnen worden gevonden of met vertrouwen kunnen worden geëxtraheerd. Valideer null-afhandelingslogica bij het ontwerp van het schema en implementeer standaardwaarde- of afwijzingslogica in de integratielaag voordat u naar doelen schrijft met NIET-NUL beperkingen of vereiste overeenkomstensleutels.
- OCR-kwaliteitsdegradatie: De OCR-nauwkeurigheid neemt af onder 150 DPI, bij onregelmatig handschrift of bij rumoerige scans. Onjuiste inlezingen worden doorgevoerd in LLM-extractie als beschadigde invoer zonder foutsignalen. Dwing minimale scankwaliteit bij opname af en implementeer controles van de drempelwaarde voor vertrouwen voor numerieke en datumvelden.
- Niet-overeenkomende schemaversie: Het bijwerken van een schemaconfiguratie nadat een batchtaak is gepland, leidt ertoe dat documenten tijdens de vlucht worden verwerkt ten opzichte van de vorige versie, wat ontbrekende of hernoemde velden oplevert die de toewijzing verderop in de stroom verbreken. Versieschema’s expliciet en coördineren updates met batchtaakplanningen.
- Bestandsgroottelimieten: Documenten die groter zijn dan 10 MB, worden afgewezen. Mislukte batchpijplijn is stil zonder geconfigureerde bewaking en transactionele bellers ontvangen een 4xx fout. Valideer vooraf bestandsgrootten bij opname en implementeer voorverwerking om documenten te splitsen of comprimeren die regelmatig de limiet benaderen.
- LLM-contextoverloop: Dichte documenten of documenten van meerdere pagina’s kunnen het LLM-contextvenster overschrijden binnen de limiet van 10 MB. De LLM laat in stilte inhoud vallen die de context overschrijdt. Implementeer een strategie voor blokken die documenten splitst op paginabereik en de geëxtraheerde velden opnieuw samenvoegt voordat ze naar het doel worden overgedragen.
- Trust Layer Masking beïnvloedt extractie: De ETL werkt op aanwijzingsniveau, niet op documentniveau, dus maskeren is niet van toepassing op documentinhoud die via document-AI wordt doorgegeven. Schemavelden die afhankelijk zijn van PII-waarden in het document, worden niet beïnvloed door ETL-masking-beleidsvormen.
- Externe RDBMS-schrijfimmuniteit: De pijplijn voor transactieverwerking heeft geen ingebouwde idempotentie voor externe RDBMS-doelen. Bij opnieuw proberen van integratielagen worden duplicaatrijen gemaakt, tenzij de schrijflogica expliciet de-duplicatie afhandelt. Implementeer idempotente upserts met behulp van een documentvingerafdruk of externe ID op alle externe schrijfpaden.
- Kredietuitputting halverwege uitvoering: Grote batchuitvoeringen kunnen Digital Wallet credits opgebruiken voordat alle documenten zijn verwerkt, wat onvolledige DLO-gegevenssets oplevert die downstream stappen als voltooid weergeven. Stel verbruikswaarschuwingen in op 75% en 90% van de beschikbare kredieten en beperk batchgrootten om binnen het kredietbudget voor elke cyclus te blijven.
- Limiet van schemaveld — Architectonische beperking: Document-AI dwingt een limiet van 50 velden af voor velden op rootniveau in een schemaconfiguratie. Dit is een ontwerptijdbeperking—geen run-time fout—en architecten moeten er rekening mee houden tijdens het ontwerpen van gegevensmodellen en schema’s.
- Voor gebruikscases die bredere extractie vereisen:
- Prioriteer meedogenloos. Beperk het schema tot velden die de automatiseringswaarde aansturen, niet de volledige documentdekking.
- Maak gebruik van geneste objecten (maximaal 3 niveaus; batchmodus met alleen bronobject) om het aantal velden op rootniveau te verminderen zonder dat dit ten koste gaat van de extractiediepte.
- Complexe documenten ontbinden in meerdere AI-documentconfiguraties die zijn gericht op afzonderlijke documentsecties, resultaten schrijven naar afzonderlijke DLO’s die verderop in de stroom worden samengevoegd in Data 360.
- Voor gebruikscases die bredere extractie vereisen:
- API-scorelimieten: Document-AI dwingt een limiet van 50 extractie-API-aanroepen per minuut per belanghebbende af. Het theoretische plafond is 300 gesprekken per minuut, dat wordt bepaald door de Einstein LLM Gateway. Transactionele integraties met groot volume moeten worden ontworpen met exponentiële backoff, verzoekwachtrijen en doorvoerbudgettering op belanghebbendenniveau. Ga er niet van uit dat burstcapaciteit beschikbaar is in productieomgevingen met meerdere belanghebbenden.
- API-latentieprofiel: AI-extractie-API’s voor documenten zijn volledig synchroon. Doorgaans variëren de reactietijden van 5 tot 15 seconden en variëren ze naargelang de bestandsgrootte en complexiteit van het schema.
- Dit heeft directe gevolgen voor de integratiearchitectuur:
- Stel time-outs van beller in op een minimum van 30 seconden.
- Roep Document AI niet aan in stromen met SLA-vereisten van minder dan een seconde.
- Rekening houden met latentie in doorvoerberekeningen ten opzichte van het plafond van de snelheidslimiet voor batchverwerkingspijplijnen.
- Stel time-outs van beller in op een minimum van 30 seconden.
- Dit heeft directe gevolgen voor de integratiearchitectuur:
- Versleutelde en met een wachtwoord beschermde documenten: Document-AI verwerkt geen met een wachtwoord beschermde bestanden (gebruikerswachtwoorden zijn vereist om bestanden te openen) of PDF-bestanden die zijn versleuteld met een eigenaars-/machtigingenwachtwoord, inclusief bestanden die normaal worden geopend, maar die kopiëren, afdrukken of bewerken beperken op de PDF-machtigingenlaag.
- Deze beperking bevindt zich op de opnamegrens:
- Ontwerp documentinvoerpijplijnen om versleutelde bestanden te detecteren en naar een afwijzings- of handmatige-verwerkingstraject te routeren voordat ze Document AI bereiken.
- Vertrouw niet op run-time foutafhandeling als de primaire poort.
- Deze beperking bevindt zich op de opnamegrens:
Data 360 Document AI komt overeen met diverse pijlers van het Salesforce Well-Architected Framework.
- Trust: De ETL dwingt nul gegevensbewaring af bij LLM-leveranciers, maskeert PII-invoer voordat deze het model bereikt en scant uitvoer op gevoelige inhoud. Architecten moeten deze status uitbreiden naar geëxtraheerde gegevens in ruste. Maskeren op veldniveau in DLO’s wordt niet toegepast door de ETL en vereist beleidsvormen en machtigingensets voor gegevensruimte verderop in de stroom.
- Betrouwbaarheid: Elke foutmodus in de sectie Ontwerpoverwegingen – extractie van null-velden, verkeerd gelezen OCR, niet-overeenkomende schemaversie, inbreuk op bestandsgrootte, LLM-contextoverloop, interferentie met ETL-maskering, RDBMS-schrijfidempotentie en kredietuitputting – vertegenwoordigt een afzonderlijke foutklasse met een gedocumenteerd detectiesignaal en oplossingspad.
- Operational Excellence (veranderingsbeheer): Het schemagestuurde extractiemodel ontkoppelt de extractielogica van de documentlay-out. Wanneer een leverancier een factuurindeling wijzigt of een regelgevingsformulier wordt bijgewerkt, hoeven architecten slechts één schemaconfiguratie bij te werken in plaats van integratiecode te wijzigen.
- Operational Excellence (onderhoudbaarheid): Het centraliseren van schemaconfiguraties in Data 360 in plaats van extractielogica in te bedden in toepassingscode maakt extractie-intent expliciet, van versie voorzien en controleerbaar. Alle doelen verderop in de stroom verbruiken hetzelfde schemacontract, ongeacht hun doellaag.
- Operational Excellence (integratie hergebruik): AI van document maakt extractie binnen meerdere integratieoppervlakken zichtbaar: REST API, Apex, Flow, MuleSoft, Agentforce Actions en de MCP-server. Eén schemaconfiguratie waaiert gelijktijdig uit naar meerdere doellagen zonder de extractiemogelijkheid per consument opnieuw samen te stellen.
- Resource- en kostenoptimalisatie: De begeleiding bij de selectie van pijplijnen, de bestandsgroottegrens van 10 MB en de beperkingen van de contextlengte van de LLM vóór montage vertegenwoordigen prestatiebewuste ontwerpbeslissingen. De sectie Wanneer te gebruiken formaliseert de voorwaarden voor wanneer document-AI niet de juiste tool is (bijvoorbeeld vereisten voor subsecondenlatentie, volledig gestructureerde brongegevens en automatisch gegenereerde documenten met een vast schema).
Dit is een gestructureerd uitgangspunt voor het configureren van Data 360 Document AI in een sandboxomgeving. Voltooi alle fasen in de sandbox voordat u overgaat naar productie.
Voordat u met de configuratie begint, moet u het volgende bevestigen:
- Bestandsgrootte: Controleer of de representatieve documentgrootte kleiner is dan 10 MB.
- Pijplijn: Controleer of de gebruikscase de batchpijplijn (door UDMO ondersteund, groot volume) of de pijplijn voor transactieverwerking (door API gestuurd, enkelvoudig document) vereist. Dit stuurt alle daaropvolgende configuraties aan.
- Doellaag: Controleer waar de geëxtraheerde gegevens terechtkomen: Salesforce SObject, Data 360 DLO/DMO, extern RDBMS of een combinatie.
- Agentforce afhankelijkheid: Voordat u door Agentforce ondersteunde documentverwerking implementeert, controleert u of een ondersteunde LLM (bijvoorbeeld GPT-4o) is ingeschakeld in uw organisatie via de ETL-instellingen. Agentforce is een harde platformvoorwaarde voor document-AI. Het gehele oppervlak van de AI-voorziening Document—inclusief alle extractie-API’s—is onbeschikbaar totdat Agentforce actief is in de doelorganisatie. Neem dit mee in de gereedheidsbeoordelingen van de organisatie en de volgorde van levering. Wacht enkele minuten tot de API-beschikbaarheid is gestabiliseerd na inschakeling.
- Invloed van Agentforce Disablement: Als Agentforce is uitgeschakeld nadat Document AI is geconfigureerd en geïmplementeerd, wordt alle extractieverwerking (UI en API) onmiddellijk geblokkeerd. Hetzelfde geldt voor het uitschakelen van het model. Het uitschakelen van het onderliggende model heeft een gelijkwaardig effect op de beschikbaarheid van AI van documenten. In beide gevallen blijven de bestaande schemaconfiguraties behouden en blijven ze zichtbaar—er treedt geen configuratie of gegevensverlies op—maar de mogelijkheid is volledig inoperabel totdat Agentforce en het model opnieuw zijn ingeschakeld. Ontwerp operationele runbooks om Agentforce beschikbaarheid en model enablement te behandelen als gezondheidsafhankelijkheden van Document AI.
- Kredietverbruik/-prijzen: Gebruik Data 360-kredietpunten of flexkredietpunten voor TCO-schattingen die zijn afgeleid van representatieve voorbeelddocumenten.
- Maak de schemaconfiguratie. Definieer extractievelden, gegevenstypen en instructies in JSON-schemaindeling in de set-up van Data 360 Document AI. Bind voor de batchpijplijn deze aan een UDMO. Maak voor de pijplijn voor transactieverwerking deze zonder bronobject. Noteer de schema-ID.
- Lijn veldnamen uit op de doellaag. Koppel veldnamen aan DLO-kolomdefinities, SObject API-namen of RDBMS-kolomnamen. Verkeerd uitgelijnde namen leiden tot toewijzingsoverhead in de integratielaag.
- Configureer het UDMO-bronobject (alleen batch). Definieer documenten binnen het bereik en configureer connectiviteit van opnamebronnen (bijvoorbeeld S3, Google Cloud Storage, Salesforce Files of MuleSoft). Controleer of de opnameserviceaccount het vereiste bereik voor IAM- of OAuth-inloggegevens heeft.
- Pas beleid voor het maskeren van persoonsgegevens toe. Configureer beleidsvormen voor Data Masking in de ETL-instellingen voordat u gereguleerde inhoud verwerkt. Definieer welke veldtypen (PHI, PII en financiële identifiers) worden gemaskeerd voordat invoer de LLM bereikt. Stel deze stap niet uit.
- Wijs bereik en machtigingensets voor gegevensruimte toe. Bereik verwerking tot de juiste gegevensruimte en configureer machtigingensets om het maken van schema’s, de uitvoering van batchtaken, het aanroepen van de REST-API en activering verderop in de stroom te bepalen.
- API-authenticatie configureren (alleen transactieverwerkingspijplijn). Maak een verbonden app met de OAuth-bereiken cdp_ingest_api en api. Gebruik voor organisatie-interne bellers een benoemd gegeven dat is gekoppeld aan een extern gegeven. Configureer voor externe bellers OAuth 2.0 clientinloggegevens of een JWT-bearer-stroom. Test en valideer extractie voordat u doorgaat.
- SObject write-back: Implementeer een Apex (@InvocableMethod) of Flow element dat JSON-responsvelden toewijst aan SObject-velden. Gebruik Database.upsert() met een externe ID om duplicaten te voorkomen. Pas Beveiliging op veldniveau toe op doelobjectvelden.
- Data 360 DLO/DMO-pijplijn: Wijs geëxtraheerde DLO-velden toe aan DMO’s die overeenkomen met het Customer 360 Data Model. Configureer identiteitsoplossingsregels om documentrecords te koppelen aan gecombineerde individuen. Definieer Berekende insights en voeg DMO’s toe voor Agentforce. Routeer voor de transactionele verwerkingspijplijn eerst de JSON-payload naar een DLO via de opname-API.
- Extern RDBMS of gegevensmagazijn: Selecteer het integratiepatroon: MuleSoft (bestaande integratiestructuur), Apex HTTP-aanroep (lichtgewicht, organisatie-native), Platform-events met de Pub/Sub-abonnee (eventgestuurd) of ETL (batch met groot volume). Implementeer idempotente upserts met behulp van een documentvingerafdruk of externe ID op alle externe schrijfpaden.
- Activeringstrajecten: Verbind Agentforce acties met schemaconfiguraties voor interactieve extractie. Configureer Flow of Apex triggers voor geautomatiseerde verwerkingswerkstromen en stel de activeringsdoelen voor elke veldgroep vast.
- Foutafhandeling (alleen transactieverwerkingspijplijn). Configureer het volledige HTTP-responsoppervlak: 200 (geslaagd, inclusief gedeeltelijke null responsen), 400 (misvormd verzoek of schema-ID niet gevonden), 413 (bestand is groter dan 10 MB), 5xx (servicefout). Implementeer exponentiële backoff voor 5xx pogingen met een maximum van 3 pogingen. Leg de ruwe JSON-respons en schema-ID vast voor elk gesprek.
- Test schema’s aan de hand van voorbeelddocumenten. Dien representatieve voorbeelden in via de Document AI interface of REST API. Controleer de extractienauwkeurigheid, velddekking en null-verwerking voor alle lay-outvariaties.
- Valideer afhandeling van null-velden. Controleer of alle doelen verderop in de stroom nullwaarden kunnen verwerken voor velden die niet voorkomen in een document. Houd er rekening mee dat beperkingen van NOT NULL stilletjes mislukken zonder expliciete afhandeling van null.
- Bevestig vooraf de bestandsgrootte. Controleer of productiedocumenten kleiner zijn dan 10 MB. Implementeer voorverwerking om documenten te splitsen of comprimeren die regelmatig de limiet benaderen.
- Valideer end-to-end extractie. Start voor de batchpijplijn een volledige uitvoering en controleer of de geëxtraheerde velden correct in elke doellaag terechtkomen. Traceer voor de pijplijn voor transactieverwerking de JSON-respons via de integratielaag naar het doel. Controleer de trigger en stroomuitvoering voor de SObject-doelen, de koppeling van de identiteitsoplossing voor de DLO-/DMO-doelen en de idempotentie voor de RDBMS-doelen.
- Bevestig Trust Layer werking. De ETL past geen maskering van PII’s toe op documentinhoud, waardoor de LLM PII-gegevens in geëxtraheerde velden retourneert zoals ze zijn. Bevestig dat uw schemavelden, gegevensroutering en opslag verderop in de stroom zijn ontworpen om uitvoer van persoonsgegevens op de juiste manier af te handelen en zorg ervoor dat aan nalevings- of bewaarvereisten wordt voldaan buiten het platform.
- Stel Digital Wallet waarschuwingen in. Configureer verbruikswaarschuwingen bij 75% en 90% van de beschikbare kredieten. Stel limieten voor batchgrootte en ad-hoc schattingen van tarieven vast binnen het kredietbudget voor elke cyclus.
- Batchbewaking valideren (alleen batchpijplijn). Bekijk de extractiesuccesscores, null-veldscores en taakvoltooiing in de Data 360 Monitoring Console. Bevestig de tagpropagatie vanuit het UDLO via het DLO naar het DMO in de gegevensafstamming.
- Valideer API-foutafhandeling (alleen transactieverwerkingspijplijn). Test alle foutvoorwaarden: 413 (documenten van meer dan 10 MB), 400 (ongeldige schema-ID’s), 200 (geldige extracties met gedeeltelijke null-waarden). Bevestig dat de logica voor opnieuw proberen wordt geactiveerd op gesimuleerde 5xx responsen zonder dubbele schrijfbewerkingen te maken.
Dit document belicht de architectonische basis van Data 360 Document AI:
- Twee verwerkingspijplijnen en wanneer deze te gebruiken
- Het schemaconfiguratiemodel
- Het raamwerk voor beslissingen op de doellaag
- Kerntechnologiebeperkingen
- Mislukte modi
- Goed ontworpen raamwerkuitlijning
De Snelstartgids voor architecten biedt de configuratievolgorde voor een proof of concept voor een sandbox.
De kernarchitectuur ondersteunt documentafgeleide gegevens die worden beheerd op de schemalaag, worden verwerkt via een via ETL afgedwongen LLM-pijplijn en worden geleverd aan dezelfde Data 360-gegevenslevenscyclus die al onze andere ondernemingsgegevens beheert.
Architecten die deze principes toepassen (de juiste pijplijn selecteren, schema’s ontwerpen op documenttypeniveau en ontwerpen voor foutmodi vóór productie), bouwen extractiemogelijkheden die kunnen worden opgeschaald en duurzaam zijn volgens de gereguleerde vereisten voor sectorgovernance.
Yugandhar Bora is een Software Engineering Architect bij Salesforce die gespecialiseerd is in gegevensarchitectuur binnen het platform Data and Intelligence Applications. Hij leidt initiatieven van de Enterprise Architecture Review Board (EARB) die zich richten op gegevensbeheer en gecombineerde gegevensmodellen, terwijl hij ook bijdraagt aan geautomatiseerde oplossingen voor platformleveringen.
Ananth Anto is directeur Productbeheer bij Salesforce Data 360 en leidt initiatieven op het gebied van document-AI en gegevensgrafieken. Hij is gevestigd in Bangalore en werkt samen met zakelijke klanten om uitdagingen op het gebied van documentverwerking en gegevensintelligence op te lossen. Hij verkent graag gebruikscases voor Enterprise voor Generative AI (Generatieve AI).
Nishan Naseer is een Software Engineering Architect bij Salesforce die werkt aan ongestructureerde gegevensverwerking, RAG-pijplijnen en documentintelligence. Hij is gepassioneerd door het benutten van de kracht van AI om uitdagingen uit de praktijk aan te pakken en creatieve oplossingen te vinden voor complexe problemen van klanten.