Le aziende gestiscono un'ampia gamma di tipi di documenti, tra cui fatture, ordini di acquisto, contratti legali e manuali tecnici. L'elaborazione manuale è lenta, soggetta a errori e consuma circa il 15-25% del tempo dei dipendenti. Gli approcci di automazione precedenti (ad esempio, Robotic Process Automation (RPA), _Optical Character Recognition (_OCR) e strumenti di flusso di lavoro) hanno ridotto parte del carico, ma hanno prodotto pipeline rigide, elevati costi di manutenzione e adozione in silo tra i singoli team aziendali.
I documenti contengono un contesto strutturale RTF (ad esempio, gerarchie di tabelle, relazioni tra campi spaziali e sezioni con riferimenti incrociati) che l'elaborazione di testo piatto non può mantenere. La rimozione di un documento dal testo normale elimina il contesto aziendale che rende l'estrazione precisa e utile, degradando la qualità dell'analisi a valle, dell'inferenza dell'intelligenza artificiale e dell'automazione dei processi.
Per essere efficaci, i sistemi di elaborazione intelligente dei documenti devono classificare i documenti in base al tipo, estrarre i dati strutturati in modo preciso dai layout variabili e fornire tali dati in un formato governato e interrogabile ai sistemi a valle. Gli IDP devono inoltre gestire la variabilità dei documenti su larga scala senza richiedere la configurazione per modello per ogni nuovo formato di documento e devono essere centralizzati e accessibili tra le unità operative. Questa sfida è aggravata dall'enorme volume del problema chiave: i dati non strutturati rappresentano circa l'80% di tutti i dati aziendali e la maggior parte si accumula sotto forma di documenti in file system, cloud storage e archivi di contenuti che non sono alla portata dei sistemi CRM (Customer Relationship Management), degli agenti AI e delle piattaforme di analisi.
Data 360 Document AI è la funzionalità di elaborazione documenti di Salesforce all'interno di Data 360, progettata per risolvere questa lacuna. Estrae, classifica e analizza il contenuto di documenti non strutturati e semi-strutturati utilizzando modelli LLM (Large Language Models), Riconoscimento ottico caratteri, elaborazione linguaggio naturale e apprendimento automatico. L'output è costituito da dati strutturati, governati e interrogabili che si integrano nella pipeline di Data 360 a cui gli agenti Agenteforce, gli strumenti di analisi e i flussi di lavoro di automazione possono accedere tramite interfacce standard senza richiedere livelli di estrazione o trasformazione personalizzati.
Le piattaforme dati aziendali elaborano dati strutturati e tabulari. Tuttavia, la maggior parte dei dati aziendali arriva sotto forma di documenti e rimane inaccessibile agli agenti CRM, ERP, AI e alle opportunità di analisi finché qualcuno non li estrae manualmente. Si tratta di una lacuna architettonica, non di un problema di flusso di lavoro.
Gli approcci precedenti combinavano reimpaginazione manuale, OCR basato su regole e script RPA. Questi metodi funzionavano su piccola scala, ma non erano in grado di gestire il volume, la varietà e la velocità dei tipi di documenti generati dalle aziende moderne. Gli strumenti basati su regole richiedono modelli espliciti per variante di layout. Qualsiasi modifica del formato interrompe l'estrazione e richiede uno sviluppatore, un nuovo modello e un ciclo di distribuzione.
Su larga scala, ciò produce soluzioni fragili senza governance centralizzata, schema condiviso e percorso per la preparazione all'intelligenza artificiale. Pipeline di estrazione incoerenti si propagano a valle. In altre parole, gli analytics ereditano le incoerenze dei dati, i modelli di intelligenza artificiale producono output inaffidabili e contenuti regolamentati come Personal Health Information (PHI) e Personaly Identifiable Information (PII) non dispongono di una governance sistematica.
Gli LLM estraggono i campi senza modelli espliciti. Un'unica configurazione dello schema regola l'estrazione tra le varianti di layout, le lingue e i formati, adattandosi al documento anziché richiedere che il documento sia conforme a una struttura fissa. In questo modo l'elaborazione dei documenti passa da un'operazione di manutenzione pesante e in silo a una funzionalità gestita e centralizzata.
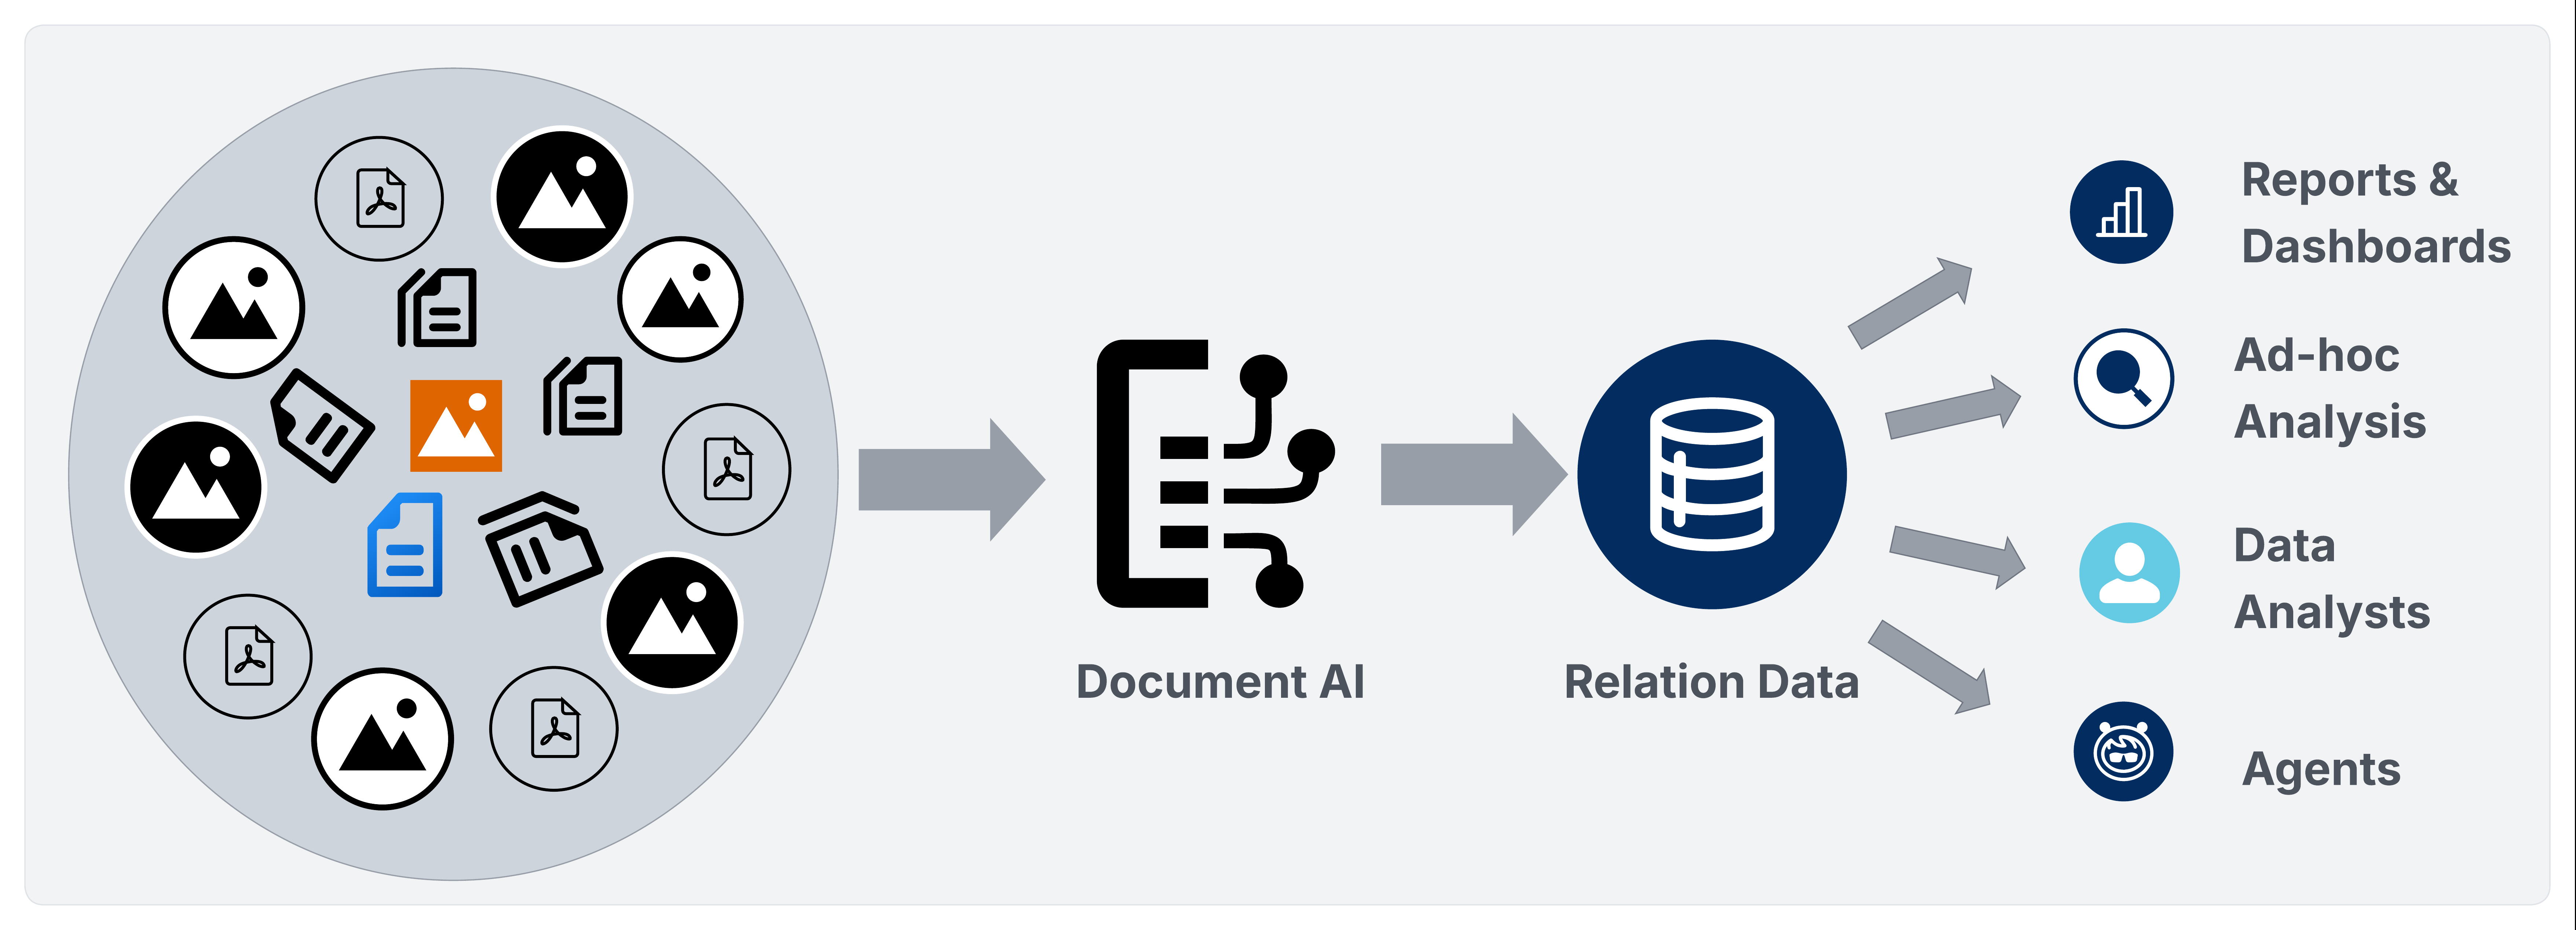
Data 360 Document AI rende operativa l'elaborazione dei documenti all'interno della piattaforma Data 360 tramite due opportunità in corso di realizzazione.
- La pipeline batch instrada i dati estratti attraverso l'inserimento, la risoluzione dell'identità, gli approfondimenti calcolati, le attivazioni, gli analytics e l'attivazione Agentforce.
- La pipeline di elaborazione transazionale espone un'API REST che restituisce JSON strutturato in modo sincrono, che consente agli architetti di instradare i dati derivati da documenti a SObject Salesforce, alla pipeline Data Lake Object/Data Model Object (DLO/DMO) o a database e magazzini esterni senza sovraccarico di impostazione batch.
In entrambi i casi, i dati estratti entrano in un modello governato basato su schema anziché in un insieme frammentato di strumenti puntuali.
Data 360 Document AI è la funzionalità nativa di elaborazione documenti intelligente di Salesforce all'interno della piattaforma Data 360. Converte il contenuto di documenti non strutturati e semistrutturati in dati governati e interrogabili che partecipano completamente all'intero ciclo di vita di Data 360.
Data 360 Document AI è la funzionalità nativa di elaborazione documenti intelligente di Salesforce all'interno di Data 360. Inserisce documenti non strutturati e semistrutturati, estrae dati strutturati utilizzando una configurazione schema dichiarativa e li consegna alle opportunità in corso di realizzazione di Data 360 per l'armonizzazione, la risoluzione dell'identità, l'analisi e l'attivazione Agentforce.
L'intelligenza artificiale dei documenti di Data 360 supporta due modalità di elaborazione:
- Elaborazione batch in blocco: Elabora insiemi di documenti di grandi dimensioni definiti negli oggetti modello di dati basati sugli eventi.
- Elaborazione transazionale: Elabora un singolo documento tramite l'API REST e restituisce un payload JSON strutturato in modo sincrono. Gli architetti possono quindi instradare il payload alle pipeline DLO/DMO Data 360, agli SObject Salesforce o ai database e magazzini esterni tramite pipeline MuleSoft, chiamate Apex o Einstein Trust Layer (ETL). Il livello di destinazione è una decisione architetturale determinata dai requisiti di latenza, governance e residenza dei dati.
L'intelligenza artificiale dei documenti attualmente supporta file PDF, file di immagine (JPEG, PNG) e documenti scritti a mano.
Data 360 Document AI riunisce quattro tecnologie di elaborazione in un'unica pipeline gestita. Ogni componente gestisce una fase distinta del ciclo di vita da documento a dati:
- Riconoscimento ottico dei caratteri (OCR): Converte le immagini acquisite, il contenuto scritto a mano e i PDF basati su immagini in testo leggibile dal computer prima dell'elaborazione LLM. Per un'estrazione affidabile si consiglia un minimo di 150 DPI.
- Modelli di lingua grandi (LLM): Instradare l'estrazione attraverso il gateway Einstein LLM utilizzando il modello scelto dall'utente. LLM riceve l'output OCR insieme alla configurazione dello schema JSON e restituisce un payload di estrazione strutturato. Gemini e altri modelli sono in fase di pianificazione per la futura implementazione.
- Elaborazione del linguaggio naturale (NLP): Esegue la comprensione contestuale, il riconoscimento delle entità, l'analisi della data e l'estrazione semantica dei campi direttamente all'interno del LLM tramite l'ingegneria dei prompt strutturati: il prompt definito dallo schema e l'output OCR fungono da unici input. Tutte le interazioni LLM vengono instradate attraverso l'ETL, che impone la conservazione zero dei dati con i provider del modello e maschera le informazioni personali negli input basati su testo prima che raggiungano il modello. Non viene utilizzato un motore NLP separato.
- Elaborazione multimodale: Elabora le immagini incorporate all'interno dei PDF come input di estrazione separati, il che consente all'LLM di estrarre i dati da diagrammi, tabelle di rendering delle immagini e pagine a contenuto misto che l'OCR da solo non può analizzare.
Oltre alle quattro tecnologie di elaborazione, Document AI gestisce anche:
- Strato Einstein Trust: Instrada tutte le interazioni LLM attraverso l'ETL, che impone la conservazione zero dei dati con i provider di modelli e maschera le informazioni personali prima che gli input raggiungano l'ETL, ad eccezione dei dati multimodali (ad esempio, i documenti allegati elaborati tramite Document AI) in cui il mascheramento delle informazioni personali non è attualmente supportato e i dati vengono inviati così come sono ai modelli esterni. L'ETL governa solo il percorso di interazione LLM. I dati estratti scritti in Oggetti data lake (DLO) sono memorizzati così come sono; il mascheramento a livello di campo a riposo deve essere gestito tramite controlli di governance dei dati a valle.
- Limite delle dimensioni dei file: Document AI elabora file fino a 10 MB per richiesta. I limiti di lunghezza del contesto LLM possono limitare ulteriormente l'elaborazione di documenti densi e multipagina all'interno di questo confine.
Gli architetti Enterprise che distribuiscono Data 360 Document AI devono applicare questi principi prima di impegnarsi in una progettazione dell'implementazione.
- Selezionare la pipeline prima di progettare lo schema. Le pipeline di elaborazione batch e transazionale si differenziano per modello di inserimento, binding dello schema, flessibilità del target e latenza. È importante confermare quali opportunità in corso di realizzazione richiede ogni caso d'uso prima di definire lo schema, poiché l'adattamento successivo aggiunge una rielaborazione evitabile.
- Progettare schemi a livello di tipo di documento. L'utilizzo di un unico schema ben elaborato per tipo di documento è più manutenibile rispetto all'utilizzo di configurazioni per caso d'uso ed è anche la leva più grande per la qualità dell'estrazione. Per eseguire correttamente questa operazione è necessario utilizzare una serie di documenti diversificata, inclusi i casi limite, anziché progettare da un singolo esempio. Utilizzare i prompt in modo iterativo a livello di campo, tabella e schema per trovare lacune e quindi testarli e perfezionarli in base a più esempi di documenti prima di finalizzare. Tenere presente che uno schema che funziona bene su un documento può non essere sufficiente su altri, quindi l'ampiezza e l'iterazione sono essenziali. La flessibilità dello schema, inclusa la rimozione delle colonne che non vengono estratte in modo affidabile tra i vari tipi di documento, è altrettanto importante. Mantenere i campi che introducono rumore o incoerenza compromette la qualità complessiva dell'estrazione, quindi è importante considerare la rimozione delle colonne come una decisione di progettazione di prima classe.
- Scegliere il livello di destinazione corretto per gruppo di campi. I campi che determinano i flussi di lavoro o le approvazioni CRM vengono scritti in SObjects. I campi che arricchiscono il profilo unificato o l'analisi dei feed appartengono alla pipeline DLO/DMO. I campi che servono sistemi esterni appartengono al livello RDBMS. Tenere presente che un singolo schema può estendersi contemporaneamente a più livelli.
- Applicare la governance prima di elaborare i contenuti regolamentati. I dati regolamentati necessitano di protezione a ogni livello. Ecco perché è importante configurare il mascheramento delle informazioni personali, i tag di classificazione dei dati e l'ABAC (Attribute-Based Access Control) dopo che i dati estratti sono stati memorizzati nei DLO (Data Lake Objects) di output Ciò offre un'applicazione più precisa e un accesso sensibile al contesto basato sulla classificazione dei dati, sul ruolo utente e sul contesto organizzativo. La governance è suddivisa in due percorsi: l'ELT governa l'interazione LLM, mentre i dati estratti archiviati nei DLO devono essere governati separatamente, direttamente a livello di DLO e database, tramite le configurazioni dello spazio dati, gli insiemi di autorizzazioni e le policy ABAC. Questi controlli devono mantenere la coerenza a livello di memoria, non solo a livello di applicazione, in modo che le restrizioni di accesso rimangano intatte indipendentemente dal modo in cui si accede ai dati dopo l'inserimento. Tenere presente che eventuali lacune in qualsiasi livello possono esporre i dati regolamentati a valle anche quando altri sono configurati correttamente.
- Progettare per le modalità di errore prima della produzione. Risolvere la gestione dei campi nulli, le soglie di qualità OCR, la pre-convalida delle dimensioni del file, l'overflow del contesto LLM, l'impotenza di scrittura RDBMS e i limiti del budget di credito prima della prima esecuzione batch di produzione. Non si tratta di casi limite, ma di superfici di errore prevedibili che devono essere gestite in modo esplicito nella progettazione delle opportunità in corso di realizzazione e non rilevate in fase di esecuzione.
- Trattare i punteggi di confidenza come un segnale di calcolo del percorso di prima classe, non come un ripensamento diagnostico. I risultati dell'estrazione contengono valori di confidenza a livello di campo derivati dalle probabilità di registrazione (logprobs) dell'output del modello sottostante. Per ogni campo, tabella o colonna estratta, il punteggio riflette la certezza a livello di token del valore estratto del modello. Ciò rende i punteggi di confidenza un segnale basato su dati statistici sufficientemente affidabile da fungere da porta principale per le soglie di inoltro al livello superiore di Human-in-the-Loop (HITL). Utilizzare i punteggi di confidenza per identificare sistematicamente le estrazioni di bassa qualità e avviare controlli HITL per i valori dei campi con bassa confidenza, corrispondenze ambigue dello schema o errori ripetuti delle opportunità in corso di realizzazione anziché affidarsi all'euristica o a controlli manuali a campione. Quando il ripristino automatico non è possibile, il calcolo del punteggio di confidenza basato su HITL garantisce che il giudizio umano venga applicato esattamente dove necessario.
- Progettare i percorsi di attivazione in parallelo alla progettazione dello schema. Il valore di Document AI deriva dalla possibilità di attivare i dati estratti all'interno dei flussi di lavoro e degli agenti Salesforce. Consente di progettare azioni Agentforce, flussi e approfondimenti calcolati insieme alla progettazione dello schema di estrazione, non dopo.
Document AI opera all'interno di due opportunità in corso di realizzazione:
- Una pipeline batch per l'elaborazione a volume elevato, supportata da UDMO
- Una pipeline di elaborazione transazionale per l'estrazione in tempo reale basata sull'API
Entrambe le opportunità in corso di realizzazione condividono lo stesso contratto di configurazione dello schema e la stessa governance ETL, ma differiscono per il modo in cui i documenti entrano nel sistema e dove finiscono i dati estratti.
Vediamo più nel dettaglio ogni pipeline.
La pipeline batch elabora gli insiemi di documenti ricorrenti definiti da un UDMO. Si adatta ai casi d'uso pianificati o basati sugli eventi in cui i documenti vengono inseriti dall'archiviazione aziendale, quindi passano attraverso l'estrazione dei documenti e vengono consegnati alla pipeline DLO/DMO Data 360 per l'armonizzazione, la risoluzione dell'identità e l'attivazione.
Scenario reale
Ogni giorno, un operatore assicurativo riceve migliaia di documenti relativi alle richieste mediche dai portali operatori che vengono caricati come PDF in Amazon S3. L'UDMO definisce l'insieme di documenti nell'ambito e invia tutti i PDF delle richieste al bucket /claims/incoming/ entro 24 ore.
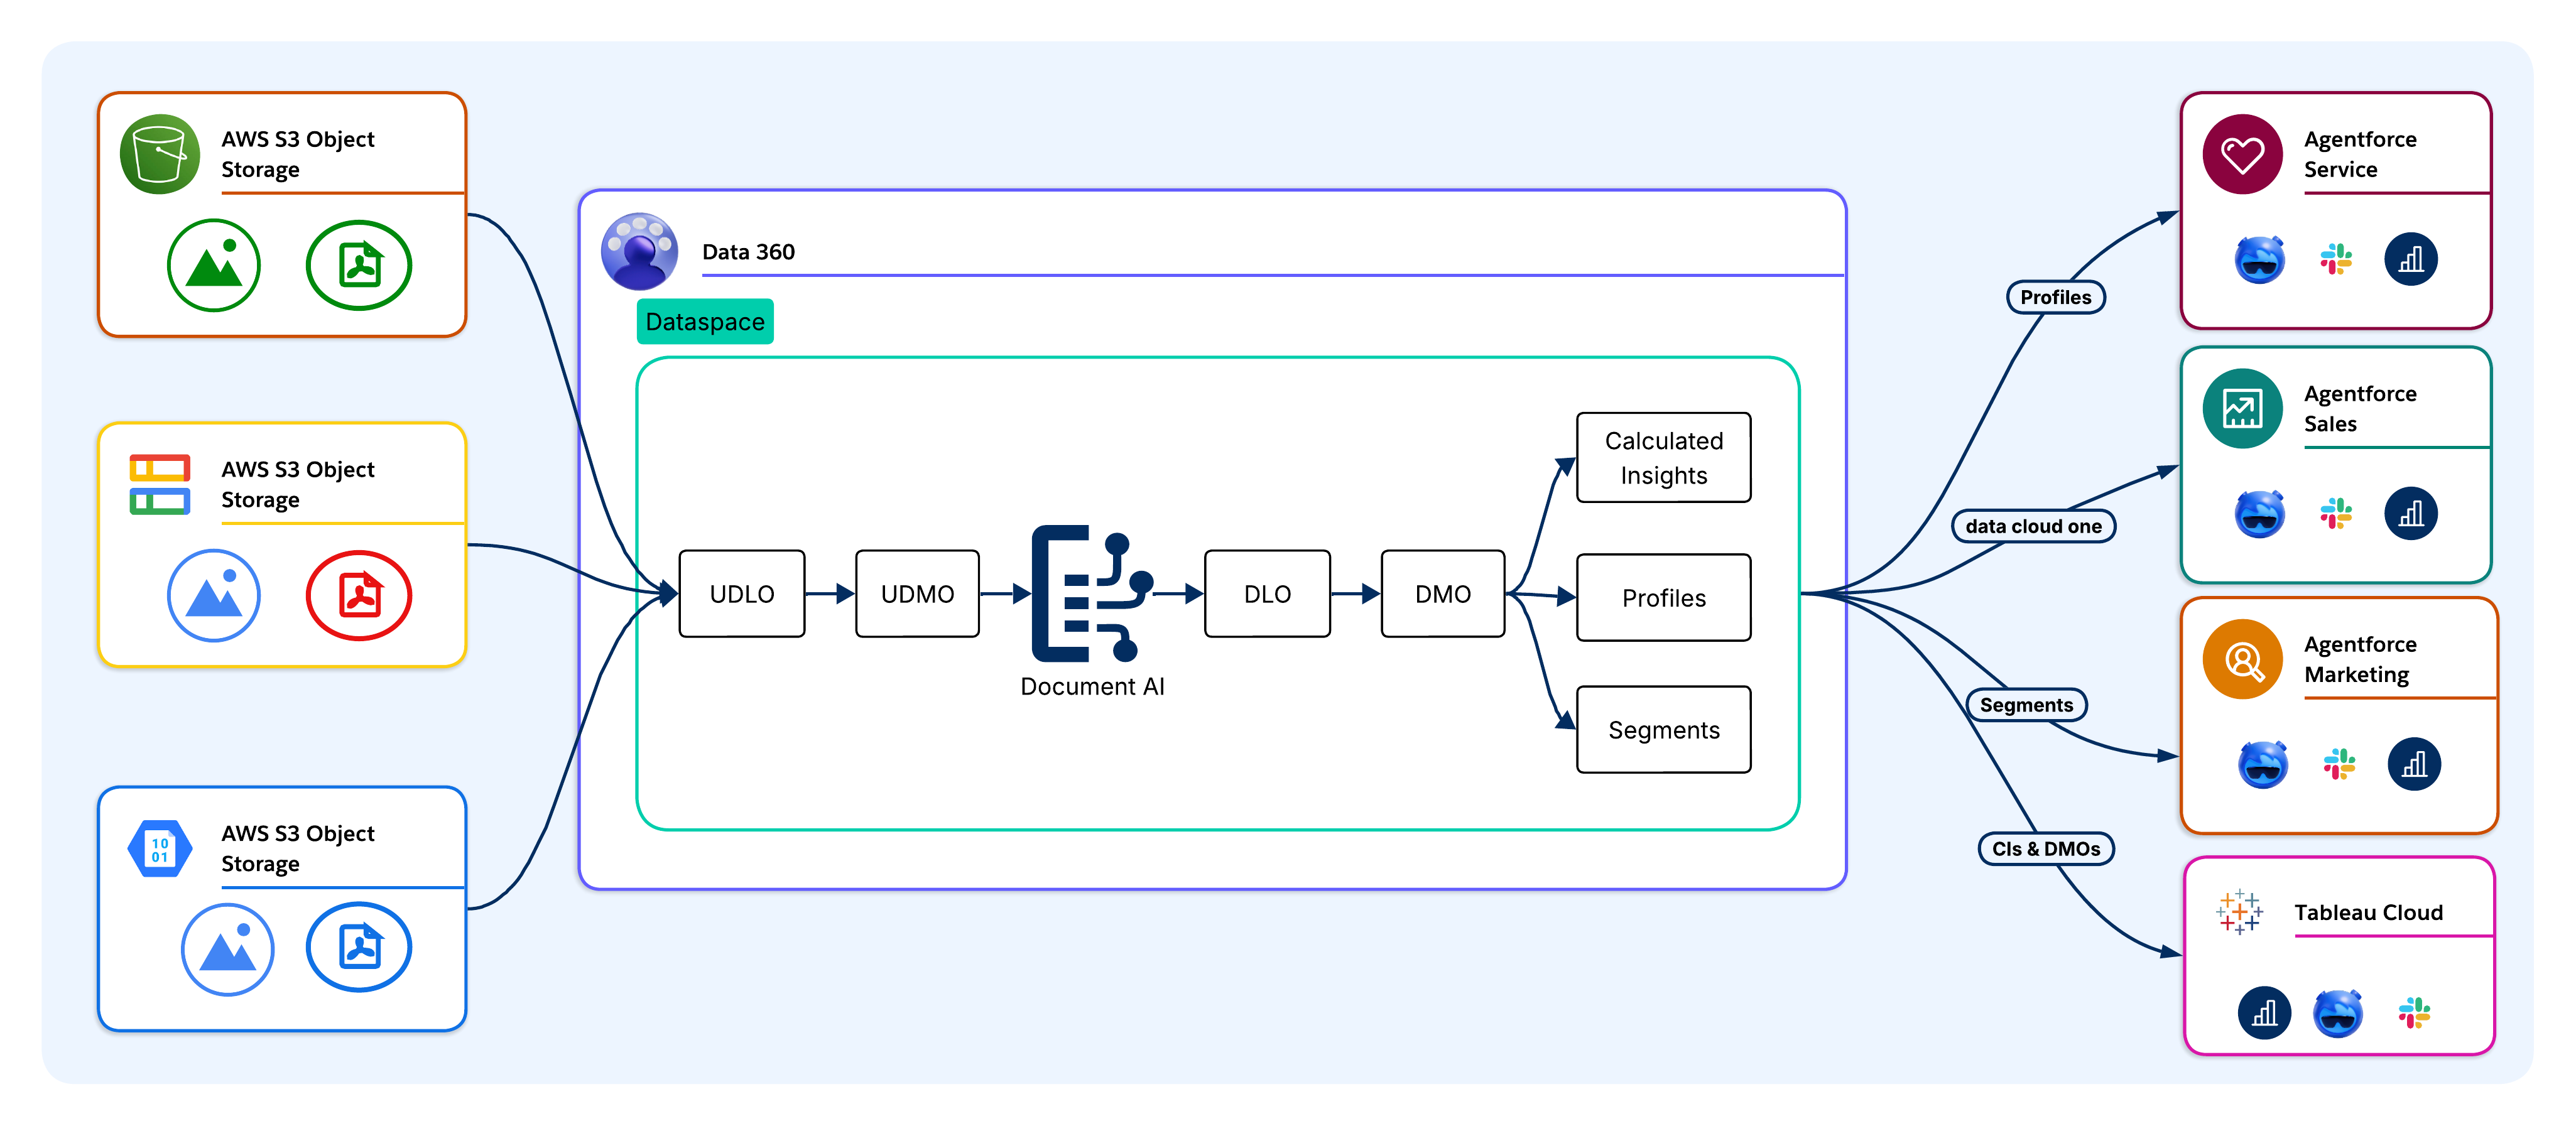
I documenti vengono inseriti in Data 360 dai sistemi di origine aziendali senza duplicazione fisica. Le fonti supportate includono Amazon S3, Google Cloud Storage, oggetti di file Salesforce CRM, pipeline orchestrate da MuleSoft e caricamenti API diretti. Nelle distribuzioni Headless 360, i documenti vengono inseriti tramite connettori di archiviazione cloud o l'API di inserimento, che ignora il livello CRM. Il server Model Context Protocol (MCP) espone l'inserimento come strumento di chiamata per gli agenti AI esterni e i client LLM.
Al momento dell'inserimento, i documenti non strutturati vengono memorizzati come Oggetti data lake non strutturati, che vengono mappati alla posizione fisica e ai metadati di ogni documento senza spostare o trasformare il file di origine.
Esempio:
I PDF delle richieste vengono inseriti da S3 in Data 360 tramite il connettore di archiviazione cloud. Ogni documento è memorizzato come UDLO che punta all'oggetto S3. Non si verifica alcuna duplicazione fisica.
Document AI elabora ogni UDLO in base a una configurazione schema che definisce i campi da estrarre insieme ai relativi tipi di dati di destinazione. L'UDMO definisce i documenti che rientrano nell'ambito di applicazione. LLM (GPT-4o, Gemini o Claude) legge ogni documento e restituisce un payload di estrazione strutturato.
Esempio:
L'intelligenza artificiale elabora ogni UDLO in base a uno schema delle richieste che definisce campi come: ClaimID, PatientName, DiagnosisCode, BillingAmount e ServiceDate. Gli LLM leggono quindi ogni PDF e restituiscono un payload di estrazione strutturato.
Una volta estratti, i dati persistono nei DLO, che sono lo strato di memoria non formattato di Data 360. I DLO conservano i campi estratti senza imporre una logica aziendale, che mantiene una rappresentazione fisica accurata per la trasformazione e la tracciabilità a valle. L'UDLO mantiene un riferimento al documento di origine per abilitare la discendenza a livello di campo in qualsiasi punto della pipeline.
Esempio:
Tutti i campi estratti vengono inseriti in un DLO Richieste, che mantiene una rappresentazione grezza e precisa di ogni richiesta con una discendenza completa che può essere ricondotta al PDF di origine.
I campi DLO vengono mappati a DMO allineati al Customer 360 Data Model standard. Questo è il confine in cui i dati derivati dai documenti passano dai campi estratti non elaborati alle entità significative per l'azienda. Il DLO Fattura viene mappato a un DMO Fattura e campi come CustomerID e BillingAmount diventano chiavi join e attributi di corrispondenza all'interno del modello di dati unificato. I dati dei documenti armonizzati partecipano alla segmentazione, agli approfondimenti calcolati e all'attivazione tramite le stesse interfacce utilizzate da CRM e dai dati transazionali.
Esempio:
Il DLO Richieste viene mappato a un DMO Richieste. I campi PatientID e PolicyNumber diventano chiavi join che collegano i record richiesta ai profili paziente unificati.
I dati DMO armonizzati partecipano alla risoluzione dell'identità. I campi estratti (ad esempio, nomi di clienti, indirizzi email o numeri di account) fungono da chiavi di corrispondenza per collegare i record documento a Persone unificate (Golden Record), colmando così il divario tra documenti e profili.
Esempio:
I campi di estrazione (ad esempio PatientName, DateOfBirth e PolicyNumber) fungono da chiavi di corrispondenza per la risoluzione dell'identità, che collega i record richiesta alla Persona unificata corretta. Ciò si verifica anche se lo stesso paziente appare con ortografie leggermente diverse nei documenti.
Gli architetti definiscono gli approfondimenti calcolati, ovvero metriche aggregate calcolate in base ai dati dei documenti armonizzati (ad esempio, la spesa totale di varie voci in fattura, i punteggi del rischio di rinnovo dei contratti e gli indici di gravità delle richieste).
Esempio:
Gli approfondimenti calcolati calcolano TotalClaimsPerPatient, AverageClaimAmount e HighRiskClaimScore nei dati delle richieste armonizzati per le query Agentforce.
I dati armonizzati e risolti in base all'identità sono accessibili agli agenti Agentforce, a Tableau, alle piattaforme di marketing e agli SObject Salesforce. Il livello di destinazione è una decisione architettonica determinata dai requisiti di latenza, governance e residenza dei dati.
Esempio:
Un agente Claims Adjudication Agentforce esegue una query sui DMO e gli IC di Data 360 per trovare richieste ad alto rischio per la revisione della priorità. I cruscotti digitali di Tableau mostrano il volume delle richieste e le tendenze delle anomalie. I record richiesta approvati tornano all'oggetto Richieste per avviare i flussi di lavoro di pagamento.
Nelle architetture Headless 360, l'attivazione viene instradata direttamente ai sistemi esterni tramite le destinazioni attivazione del data warehouse Query API, API Pub/Sub o Cloud. Quindi, il server MCP trova i dati dei documenti armonizzati e gli approfondimenti calcolati come strumenti richiamabili per gli agenti AI esterni.
La pipeline di elaborazione transazionale gestisce l'estrazione di un singolo documento in fase di esecuzione senza un UDMO o un UDLO pre-inserito, il che si adatta ai casi d'uso basati sugli eventi (ad esempio, un cliente che carica un modulo, un agente che riceve un PDF o un sistema esterno che avvia l'estrazione all'interno di un flusso di lavoro di elaborazione transazionale). La governance ETL si applica a entrambe le opportunità in corso di realizzazione in modo identico.
Scenario reale
Durante la richiesta di un prestito, un cliente bancario carica un PDF della bolletta tramite l'app mobile della banca. L'evento avvia l'estrazione in tempo reale, il che significa che non sono coinvolti UDLO o UDMO pre-inseriti.
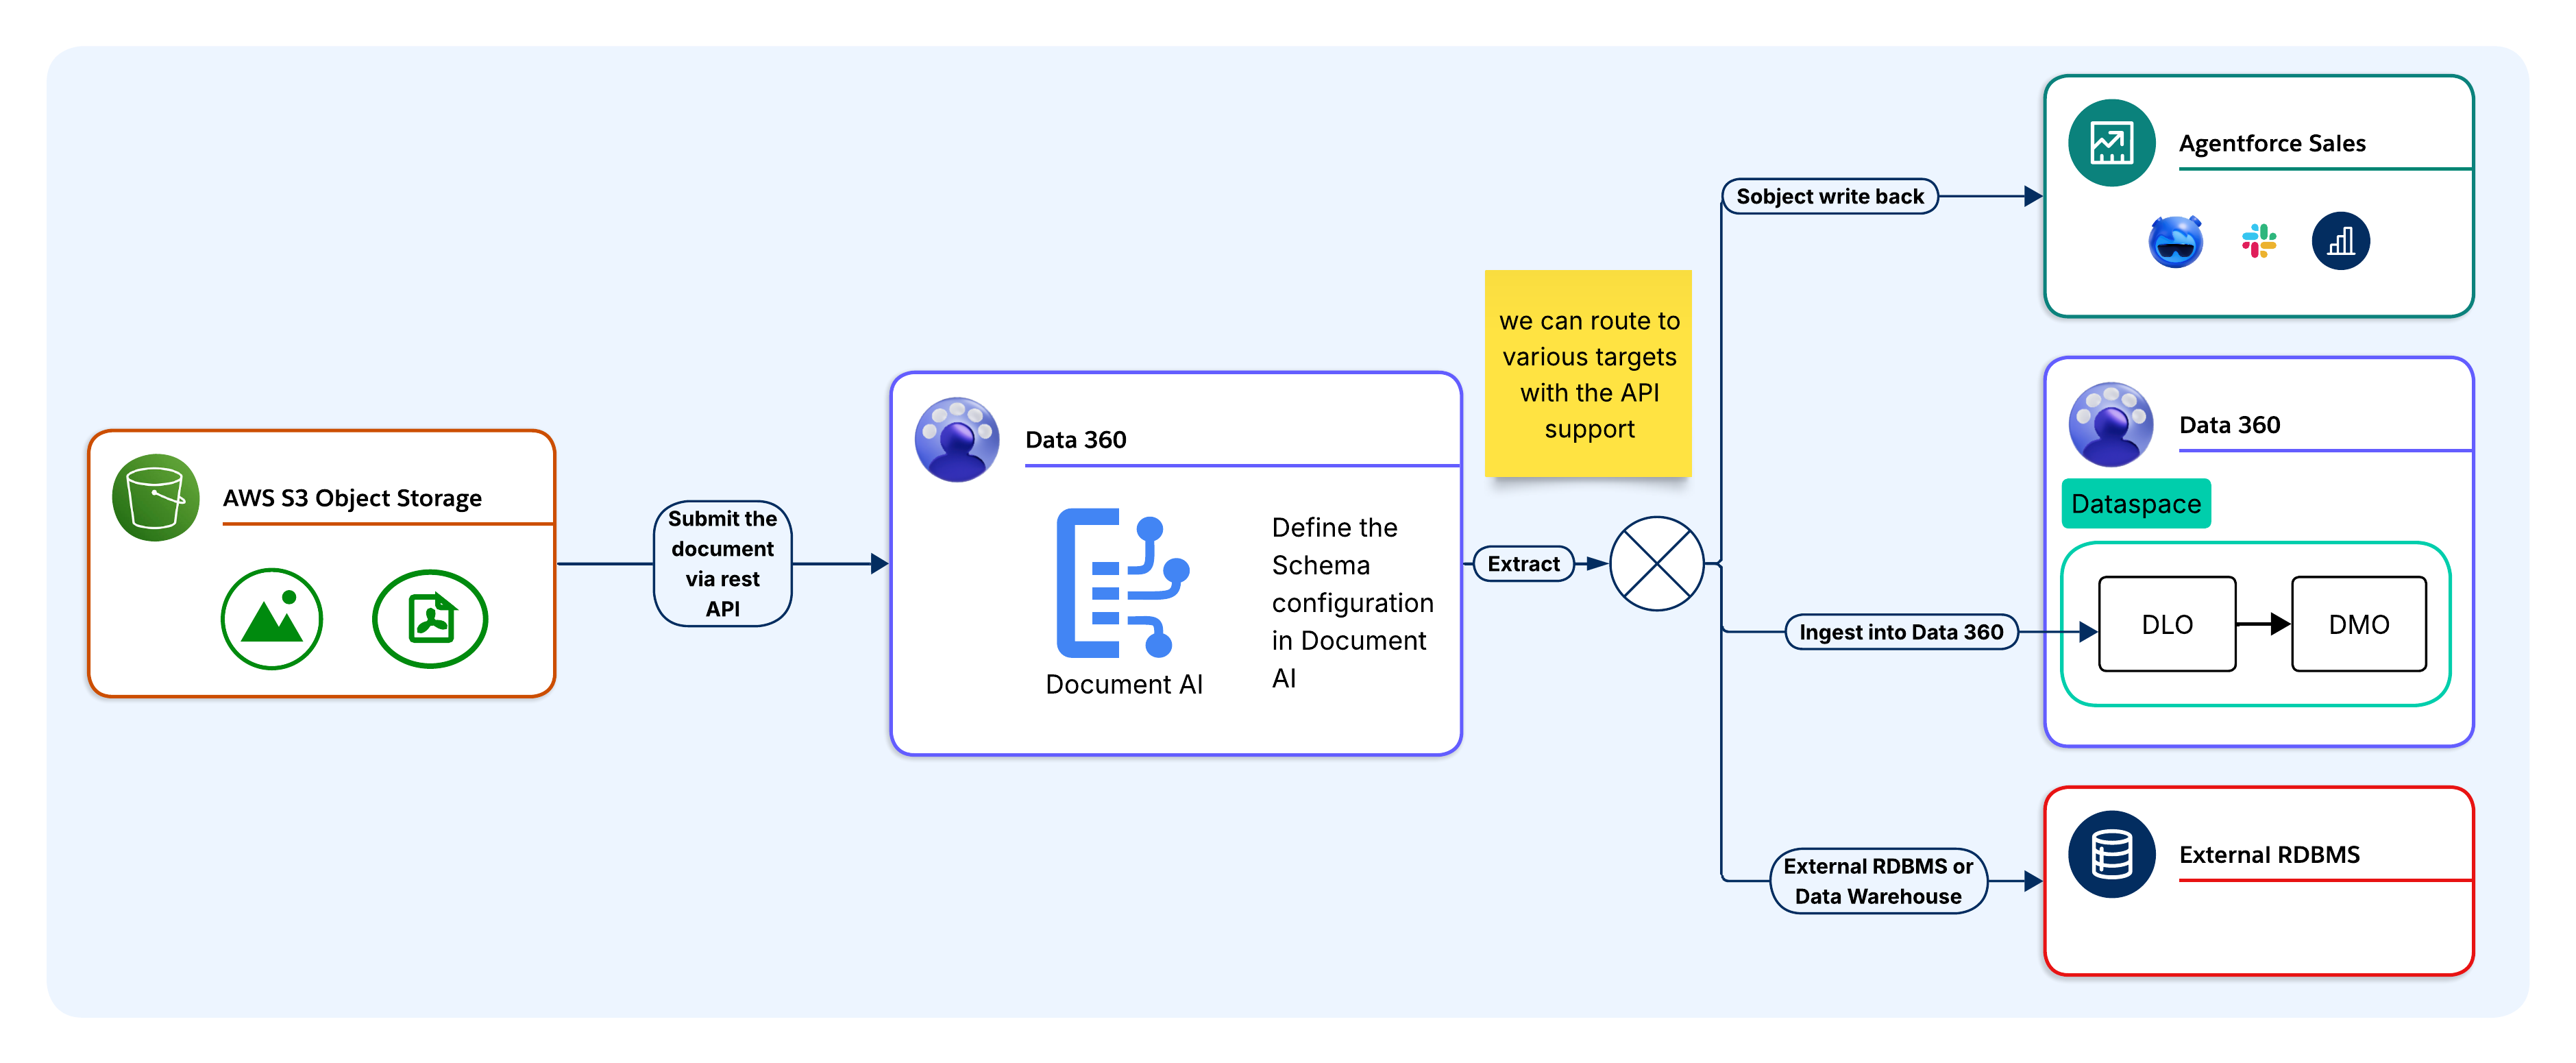
Prima di invocare l'API, gli architetti devono definire e archiviare in Data 360 uno schema che specifica i campi, i tipi di dati e le istruzioni di estrazione in formato JSON Schema. A ogni schema viene assegnato un ID schema univoco. In fase di esecuzione, l'applicazione chiamante fa riferimento all'ID schema per mantenere centralizzata la logica di estrazione in Data 360 anziché incorporarla nel codice dell'applicazione.
Esempio:
Il team della banca ha uno schema di ProofOfAddress predefinito in Data 360, che specifica campi come CustomerName, AddressLine1, City, PostCode e DocumentDate. Queste informazioni sono memorizzate come configurazione con versione a cui può fare riferimento un ID schema.
L'applicazione chiamante invia il documento e l'ID schema in una singola richiesta API REST come payload con codifica base64 o riferimento al file. Non è necessario alcun inserimento UDLO. Document AI applica l'estrazione del documento e restituisce l'output strutturato in base allo schema fornito.
Esempio:
L'app mobile invia la bolletta come payload con codifica base64 insieme all'ID schema ProofOfAddress in una singola chiamata API REST. Questo processo non richiede una fase di inserimento UDLO.
LLM elabora l'output OCR rispetto allo schema e restituisce un payload JSON strutturato in modo sincrono. I campi non trovati nel documento vengono restituiti come nulli. Il chiamante è titolare della risposta JSON completa e procede all'instradamento.
Esempio:
L'intelligenza artificiale applica OCR al PDF e LLM restituisce un payload JSON strutturato con campi indirizzo estratti. I campi che non vengono trovati (ad esempio, se il PostCode manca nella fattura) vengono restituiti come nulli.
Una volta estratto, il payload JSON può essere instradato a uno o più livelli di destinazione a seconda del caso d'uso:
- SObject Salesforce: Mappa direttamente ai campi SObject tramite Apex o Flusso per i flussi di lavoro e le approvazioni CRM.
- Pipeline DLO/DMO di Data 360: Instrada a un DLO per armonizzazione, risoluzione dell'identità, approfondimenti calcolati e radicamento Agentforce.
- RDBMS esterno o Data Warehouse: Instrada tramite MuleSoft, chiamata Apex, Eventi piattaforma o ETL per i sistemi esterni a Salesforce.
- Integrazione personalizzata: Restituisce payload JSON strutturati all'applicazione chiamante per l'archiviazione in qualsiasi sistema esterno o archivio dati.
- Flusso a valle o agente: Passa l'output JSON strutturato direttamente a un flusso o a un agente a valle senza alcuna persistenza in un SObject. Questo è uno schema comune per i clienti che utilizzano l'intelligenza artificiale documenti come fase di estrazione in tempo reale all'interno di un flusso di lavoro di automazione o agente più ampio.
Tenere presente che un singolo schema può estendersi contemporaneamente a più livelli, con gruppi di campi diversi che instradano a destinazioni diverse dallo stesso punto di estrazione.
Esempio:
Un payload ProofOfAddress può essere distribuito contemporaneamente a tre livelli (ad esempio, CustomerName e AddressLine1 scrivono nel Contact SObject), il che avvia un flusso di verifica dell'indirizzo. Quindi, il payload completo viene instradato in un DLO per l'armonizzazione e il calcolo del punteggio del rischio, e una copia viene instradata al sistema KYC della banca tramite MuleSoft per la registrazione della conformità normativa.
Una volta scritti, i dati estratti si attivano immediatamente nel sistema di destinazione. Per le destinazioni SObject, i trigger, i flussi e i processi di approvazione vengono attivati nel record inserito con aggiornamento. Per le destinazioni DLO/DMO, i dati entrano nella pipeline di armonizzazione e risoluzione dell'identità e nel contesto Agentforce. Per le destinazioni RDBMS esterne, i dati sono disponibili per le query a valle non appena viene completata la scrittura.
Esempio:
Il flusso di verifica dell'indirizzo si attiva immediatamente nel record Referente inserito con aggiornamento, il che fa avanzare la richiesta di prestito alla fase successiva. L'agente dei prestiti Agentforce trova l'indirizzo verificato da Data 360 e il sistema KYC registra l'invio del documento per scopi di controllo.
Document AI è più adatto a condizioni architettoniche specifiche. L'applicazione al di fuori di tali condizioni introduce una complessità inutile e costi aggiuntivi.
In qualità di architetti, è importante valutare questo criterio prima di impegnarsi a utilizzare Document AI come meccanismo di estrazione.
Utilizzare AI documento quando:
- I documenti sono la fonte di dati principale. Le informazioni richieste esistono solo sotto forma di documento e non sono disponibili da un'API o un database strutturato (ad esempio, contratti scansionati, rapporti di laboratorio, moduli di accettazione o richieste di risarcimento assicurativo).
- I layout dei documenti variano a seconda delle fonti. Lo stesso tipo di documento arriva da più fornitori, partner o regioni con posizioni e formati di campo diversi. L'estrazione LLM basata su schema si adatta senza manutenzione per layout.
- I dati estratti devono alimentare Data 360 o Agentforce. L'estrazione deve partecipare alla risoluzione dell'identità, agli approfondimenti calcolati o al radicamento Agentforce. L'intelligenza artificiale viene fornita direttamente nella pipeline DLO/DMO senza un livello ETL separato.
- Il volume giustifica l'automazione governata. Il volume dei documenti supera quello che l'elaborazione manuale può gestire senza costi di manodopera misurabili o rischi per la qualità dei dati.
- I documenti contengono contenuti regolamentati. I dati personali, le informazioni personali o i dati finanziari devono passare attraverso un livello di mascheramento delle informazioni personali a conservazione zero prima di raggiungere un livello LLM. L'ETL soddisfa questo requisito in modo nativo. I clienti che non richiedono la permanenza del contenuto estratto in alcun punto devono anche considerare il flusso API transazionale, che restituisce l'output strutturato direttamente all'applicazione chiamante senza scrivere in alcun SObject o archivio dati.
- Il caso d'uso è basato sugli eventi. Un documento arriva in fase di esecuzione (ad esempio, il caricamento di un cliente, un allegato PDF dell'agente o un trigger di sistema esterno). La pipeline di elaborazione delle transazioni gestisce l'estrazione sincrona di un singolo documento senza impostazione batch.
Non utilizzare l'intelligenza artificiale dei documenti quando:
- I dati di origine sono già strutturati. Se il sistema a monte espone un'API REST, una tabella di database o un file strutturato (ad esempio, CSV, JSON o XML), utilizzare un connettore Data 360 standard. L'esecuzione di dati strutturati attraverso una pipeline di estrazione LLM aumenta i costi di latenza e credito senza ulteriori vantaggi.
- I documenti vengono generati automaticamente con uno schema fisso. I PDF generati dal sistema da un sistema ERP o una piattaforma di fatturazione nota con un layout stabile sono più adatti per un parser deterministico. L'estrazione LLM è progettata per la variabilità e applicarla ai documenti a schema fisso spreca contesto e crediti.
- I requisiti di precisione superano le soglie di confidenza LLM. L'intelligenza artificiale non garantisce una precisione di estrazione del 100%. Casi d'uso in cui un valore di campo mancante o errato comporta un rischio finanziario, legale o clinico significativo richiede una fase di convalida HITL. Non utilizzare Document AI come unico livello di estrazione per le decisioni con rischi elevati senza un flusso di lavoro di convalida.
- I documenti superano i vincoli della piattaforma. L'attuale limite di 10 MB di dimensione del file e i vincoli di lunghezza del contesto LLM rendono Document AI inadatto a documenti di grandi o grandi dimensioni senza pre-elaborazione per suddividerli e riassemblarli all'esterno della piattaforma.
- Nota: Salesforce sta migliorando attivamente questi guardrail di accettazione per espandere le dimensioni dei file, i conteggi delle pagine e le estensioni dei file supportate. I vincoli continueranno a evolversi in futuro.
Vediamo in dettaglio diversi scenari che utilizzano la pipeline Batch AI documento supportata da un oggetto di origine UDMO. In questi casi, i dati estratti vengono instradati attraverso la pipeline DLO/DMO Data 360 per l'armonizzazione, la risoluzione dell'identità, gli approfondimenti calcolati e l'attivazione Agentforce. Ogni caso d'uso è più adatto per l'elaborazione pianificata o basata sugli eventi di documenti a volume elevato.
Agenteforce Sales: Intelligence su contratti e fatture
I PDF dei contratti vengono inseriti da Cloud Storage tramite la pipeline batch. Lo schema estrae ContractValue, RenewalDate, PaymentTerms e CounterpartyName e li mappa ai DMO Account e Contract. Gli approfondimenti calcolati derivano i punteggi del rischio di rinnovo. Agentforce avvisa i responsabili account prima della chiusura delle finestre di rinnovo, eliminando la revisione manuale dei contratti e i mancati rinnovi.
Servizio Agentforce: Deviazione del caso e Knowledge Grounding
I PDF dei sondaggi e gli allegati dei casi vengono inseriti tramite la pipeline batch. Lo schema estrae gli indicatori di sentiment, le categorie di problemi e le note di risoluzione e li mappa ai DMO Caso e Articolo Knowledge. Agentforce esegue una query nella Knowledge Base armonizzata quando il caso viene aperto e individua le fasi pertinenti per la risoluzione dei problemi, riducendo il sovraccarico di ricerca dell'agente.
Agenteforce Health: Elaborazione di documenti clinici
I rapporti di laboratorio, i PDF di accettazione e i moduli clinici scritti a mano vengono inseriti tramite la pipeline batch. Lo schema estrae i campi, inclusi PatientID, DiagnosisCode, MedicationName e TestResult, e li mappa ai DMO di Health Cloud, che supportano il coordinamento dell'assistenza allineato all'HIPAA e i flussi di lavoro di ricerca clinica.
Servizi finanziari: Automazione dei documenti di prestiti e imposte
Le richieste di prestito, le dichiarazioni dei redditi e i rendiconti dei redditi vengono inseriti tramite la pipeline batch. Lo schema estrae i campi, inclusi AnnualIncome, TaxYear e EmployerName, e li mappa ai DMO dell'account finanziario. Gli approfondimenti calcolati uniscono i dati di reddito derivati da documenti e i dati CRM per facilitare il calcolo automatico del punteggio del rischio di credito. Agentforce individua i dettagli del prestito estratto in linea durante le interazioni con il servizio clienti. Questo schema supporta direttamente il caso d'uso Agente prequalifica prestito pubblicato nel centro per sviluppatori Salesforce Agentic Enterprise Solutions.
HR: Elaborazione documenti del personale
I documenti di orientamento, i moduli fiscali e i PDF di certificazione vengono inseriti tramite la pipeline batch. I campi estratti vengono mappati ai DMO Record dipendente e quindi collegati al profilo Dipendente unificato. Flussi specifici avviano operazioni di onboarding e controlli di conformità basati sui dati estratti. Questo schema supporta direttamente il caso d'uso Agentic Automatizza ripresa elaborazione. L'intelligenza artificiale estrae competenze, precedenti lavorativi e qualifiche dai file PDF di ripresa, che Agentforce utilizza quindi per abbinare i candidati ai criteri dei ruoli aperti e instradarli ai flussi di lavoro di assunzione.
Servizi professionali: Intelligence delle proposte e della ricerca
Le serie di proposte e i rapporti di ricerca vengono inseriti tramite la pipeline batch. I framework, i benchmark e i riepiloghi coinvolgimento estratti vengono mappati ai DMO personalizzati e quindi indicizzati per la ricerca vettoriale. Agentforce recupera i consigli pertinenti al contesto al momento della query, basati sul contenuto del documento estratto. Questo schema estende lo schema Ground Agentforce on Website Content. I documenti vengono indicizzati tramite Document AI e svolgono la stessa funzione di base per le risposte degli agenti del contenuto del sito Web indicizzato tramite i connettori Data 360.
Stato conformità HIPAA:
Gli schemi Health Cloud descritti in questo documento applicano controlli ETL (ad esempio, conservazione dei dati zero e mascheramento PHI) per gli input di testo. Questi controlli da soli non costituiscono una certificazione HIPAA. Gli architetti che stanno progettando per ambienti clinici regolamentati devono confermare lo stato di certificazione HIPAA corrente con il team di conformità Salesforce prima di impegnarsi in un'architettura basata su AI documento in tali contesti.
Vediamo più in dettaglio diversi scenari che invocano l'API REST AI documento con uno schema che non è legato a un UDMO. I payload JSON estratti vengono instradati direttamente ai sistemi esterni in modo sincrono in fase di esecuzione.
Filiera: Elaborazione fatture fornitore a ERP
Quando un PDF della fattura fornitore arriva in un bucket di archiviazione monitorato o in un gateway email, un trigger evento chiama l'API REST AI documento con la fattura e un ID schema predefinito. Lo schema estrae VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount e DueDate. Il payload JSON viene instradato tramite MuleSoft al modulo ERP Accounts Payable con convalida completa dei campi e logica di inserimento con aggiornamento idempotente, che elimina la manutenzione del modello per la variabilità del formato del fornitore.
Operazioni legali: Revisione del contratto a CLM
Quando un PDF contratto viene caricato nel portale legale, il backend chiama l'API REST AI documento in modo sincrono. Lo schema estrae GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause e CounterpartySignatory. Il payload JSON viene instradato tramite chiamata Apex al sistema di gestione del ciclo di vita. Tutti i campi che non vengono trovati vengono restituiti come nulli e il CLM applica le regole di obbligo predefinite ai valori mancanti.
Richieste assicurative: Primo avviso di elaborazione delle perdite
Quando un contraente invia un modulo First Notice of Loss (FNOL), il portale di backend chiama l'API REST AI documento in modo sincrono. Lo schema estrae PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName e ContactPhone. Il payload JSON viene instradato al database di gestione delle richieste tramite chiamata Apex o ETL, il che crea un record richiesta precompilato che i rettificatori possono esaminare prima dell'apertura della richiesta formale.
Prima di passare alla produzione, è necessario creare progetti per questi scenari di errore.
- Gestione campi nulli: LLM restituisce nullo per i campi che non può individuare o estrarre con sicurezza. Convalidare la logica di gestione dei valori nulli durante la progettazione dello schema e implementare la logica dei valori predefiniti o dei rifiuti nel livello di integrazione prima di scrivere in qualsiasi destinazione con vincoli NOT NULL o chiavi di corrispondenza richieste.
- Degradazione della qualità OCR: La precisione OCR si degrada al di sotto dei 150 DPI, su una scrittura irregolare o su scansioni rumorose. Le letture non corrette si propagano nell'estrazione LLM come input danneggiato senza segnali di errore. Applicare una qualità di scansione minima all'inserimento e implementare controlli della soglia di confidenza sui campi numerici e data.
- Disallineamento versione schema: L'aggiornamento di una configurazione dello schema dopo la pianificazione di un processo batch provoca l'elaborazione dei documenti in volo rispetto alla versione precedente, il che produce campi mancanti o rinominati che interrompono la mappatura a valle. Schemi di versione in modo esplicito e coordinare gli aggiornamenti con le pianificazioni dei processi batch.
- Limite delle dimensioni dei file: I documenti che superano i 10 MB vengono rifiutati. Gli errori delle opportunità in corso di realizzazione batch sono silenziosi senza il monitoraggio configurato e i chiamanti transazionali ricevono un errore 4xx. Pre-convalidare le dimensioni dei file all'inserimento e implementare la pre-elaborazione per suddividere o comprimere i documenti che si avvicinano regolarmente al limite.
- Overflow contesto LLM: I documenti densi o multipagina possono superare la finestra di contesto LLM entro il limite di 10 MB. LLM rilascia silenziosamente il contenuto che supera il contesto. Implementare una strategia di suddivisione che suddivide i documenti in base all'intervallo di pagine e riassembla i campi estratti prima di trasferirli nella destinazione.
- Mascheramento livello Trust che influisce sull'estrazione: L'ETL funziona a livello di prompt, non a livello di documento, quindi il mascheramento non si applica al contenuto del documento che passa attraverso l'intelligenza artificiale. I campi dello schema che dipendono dai valori PII del documento non sono interessati dalle policy di mascheramento ETL.
- Impotenza di scrittura RDBMS esterno: La pipeline di elaborazione delle transazioni non ha alcuna impotenza incorporata per le destinazioni RDBMS esterne. I tentativi del livello di integrazione creano righe duplicate a meno che la logica di scrittura non gestisca esplicitamente la deduplicazione. Implementare inserimenti con aggiornamento idempotenti utilizzando un fingerprint documento o un ID esterno in tutti i percorsi di scrittura esterni.
- Esaurimento del credito a metà corsa: Le esecuzioni batch di grandi dimensioni possono esaurire i crediti Digital Wallet prima che tutti i documenti vengano elaborati, il che produce serie di dati DLO incomplete che le fasi a valle visualizzano come completate. Impostare gli avvisi di consumo sul 75% e 90% dei crediti disponibili e limitare le dimensioni dei batch per rispettare il budget di credito per ogni ciclo.
- Limite campi schema — Vincolo architettonico: Document AI impone un limite di 50 campi per i campi a livello principale in una configurazione dello schema. Questo è un vincolo di tempo di progettazione, non un errore di runtime, e gli architetti devono tenerne conto durante la progettazione del modello di dati e dello schema.
- Per i casi d'uso che richiedono un'estrazione più ampia:
- Assegnare priorità senza pietà. Restringere lo schema ai campi che determinano il valore dell'automazione, non alla copertura completa dei documenti.
- Sfruttare gli oggetti nidificati (fino a 3 livelli; modalità batch solo con l'oggetto di origine) per ridurre il conteggio dei campi a livello di radice senza sacrificare la profondità di estrazione.
- Scomporre documenti complessi in più configurazioni AI documento destinate a sezioni documento distinte, scrivere i risultati in DLO separati che si uniscono a valle in Data 360.
- Per i casi d'uso che richiedono un'estrazione più ampia:
- Limite dei tassi API: Document AI impone un limite di 50 chiamate API di estrazione al minuto per tenant. Il limite teorico e' di 300 chiamate al minuto, che e' regolato dal Gateway Einstein LLM. Le integrazioni transazionali a volume elevato devono essere progettate con backoff esponenziale, inserimento in area di attesa delle richieste e calcolo del budget della produttività a livello di tenant. Non presumere che la capacità di burst sia disponibile in ambienti di produzione multi-tenant.
- Profilo di latenza API: Le API di estrazione AI dei documenti sono completamente sincrone. I tempi di risposta tipici variano da 5 a 15 secondi e variano in base alle dimensioni del file e alla complessità dello schema.
- Ciò ha implicazioni dirette per l'architettura di integrazione:
- Impostare i timeout del chiamante su un minimo di 30 secondi.
- Non invocare l'intelligenza artificiale documento nei flussi con requisiti SLA inferiori al secondo.
- Tenere presente la latenza nei calcoli della produttività rispetto al limite di traffico per le opportunità in corso di elaborazione batch.
- Impostare i timeout del chiamante su un minimo di 30 secondi.
- Ciò ha implicazioni dirette per l'architettura di integrazione:
- Documenti crittografati e protetti da password: Document AI non elabora i file protetti da password (per aprire i file sono necessarie password utente) o i file PDF crittografati con una password titolare/autorizzazioni, inclusi i file che si aprono normalmente ma limitano la copia, la stampa o la modifica a livello di autorizzazione PDF.
- Questo vincolo si trova al confine dell'inserimento:
- Progettare le opportunità di accettazione dei documenti per rilevare e instradare i file crittografati a un percorso di rifiuto o elaborazione manuale prima che raggiungano l'intelligenza artificiale.
- Non affidarsi alla gestione degli errori in fase di esecuzione come cancello principale.
- Questo vincolo si trova al confine dell'inserimento:
Data 360 Document AI è in linea con diversi pilastri del Well-Architected Framework di Salesforce.
- Trust: L'ETL impone la conservazione zero dei dati con i provider LLM, maschera gli input PII prima che raggiungano il modello e analizza gli output alla ricerca di contenuti sensibili. Gli architetti devono estendere questa postura ai dati estratti a riposo. Il mascheramento a livello di campo nei DLO non viene applicato dall'ETL e richiede policy e insiemi di autorizzazioni dello spazio dati a valle.
- Affidabilità: Ogni modalità di errore nella sezione Considerazioni sulla progettazione (estrazione campo nullo, lettura errata OCR, mancata corrispondenza della versione dello schema, violazione delle dimensioni del file, overflow del contesto LLM, interferenza del mascheramento ETL, impotenza di scrittura RDBMS ed esaurimento del credito) rappresenta una classe di errore distinta con un segnale di rilevamento documentato e un percorso di risoluzione.
- Eccellenza operativa (gestione del cambiamento): Il modello di estrazione basato su schema disaccoppia la logica di estrazione dal layout del documento. Quando un fornitore modifica un formato di fattura o un modulo normativo viene aggiornato, gli architetti devono aggiornare una sola configurazione dello schema anziché modificare il codice di integrazione.
- Eccellenza operativa (manutenibilità): Centralizzare le configurazioni degli schemi in Data 360 anziché incorporare la logica di estrazione nel codice dell'applicazione rende l'intento di estrazione esplicito, con versione e controllabile. Tutti i target a valle utilizzano lo stesso contratto schema indipendentemente dal loro livello target.
- Eccellenza operativa (riutilizzo integrazione): L'intelligenza artificiale espone l'estrazione in più superfici di integrazione: API REST, Apex, Flusso, MuleSoft, Azioni Agentforce e il server MCP. Una singola configurazione dello schema si estende contemporaneamente a più livelli di destinazione senza ricreare la capacità di estrazione per consumatore.
- Ottimizzazione delle risorse e dei costi: La guida alla selezione delle opportunità in corso di realizzazione, il limite di 10 MB per le dimensioni del file e i vincoli di lunghezza del contesto LLM pre-assemblaggio rappresentano decisioni di progettazione attente alle prestazioni. La sezione Quando utilizzare formalizza le condizioni per i casi in cui l'intelligenza artificiale non è lo strumento giusto (ad esempio, requisiti di latenza al di sotto del secondo, dati di origine completamente strutturati e documenti generati automaticamente a schema fisso).
Questo è un punto di partenza strutturato per la configurazione di Data 360 Document AI in un ambiente Sandbox. Completare tutte le fasi nel Sandbox prima di passare alla produzione.
Prima di iniziare la configurazione, è necessario confermare:
- Dimensione file: Verificare che le dimensioni rappresentative dei documenti siano inferiori a 10 MB.
- In corso di realizzazione: Verificare se il caso d'uso richiede la pipeline batch (supportata da UDMO, a volume elevato) o la pipeline di elaborazione transazionale (gestita da API, a documento singolo). Questo determina tutte le configurazioni successive.
- Livello target: Verificare dove si trovano i dati estratti: SObject Salesforce, DLO/DMO Data 360, RDBMS esterno o una combinazione.
- Dipendenza Agentforce: Prima di distribuire qualsiasi elaborazione di documenti basata su Agentforce, verificare che nell'organizzazione sia abilitato un LLM supportato (ad esempio, GPT-4o) tramite le impostazioni ETL. Agentforce è un prerequisito della piattaforma per Document AI. L'intera superficie della funzione AI documento, incluse tutte le API di estrazione, non è disponibile finché Agentforce non è attivo nell'organizzazione di destinazione. Tenerne conto nelle valutazioni della preparazione dell'organizzazione e nella sequenza di provisioning. Attendere alcuni minuti perché la disponibilità API si stabilizzi dopo l'abilitazione.
- Impatto disabilitazione Agentforce: Se Agentforce viene disabilitato dopo che l'intelligenza artificiale documento è stata configurata e distribuita, tutte le operazioni di estrazione (interfaccia utente e API) verranno bloccate immediatamente. Lo stesso vale per la disabilitazione del modello. La disabilitazione del modello sottostante ha un effetto equivalente sulla disponibilità di AI documento. In entrambi i casi, le configurazioni dello schema esistenti vengono mantenute e rimarranno visibili (non si verificherà alcuna configurazione o perdita di dati), ma la funzionalità è completamente inutilizzabile finché Agentforce e il modello non vengono riabilitati. Progettare runbook operativi per trattare la disponibilità Agentforce e l'abilitazione del modello come dipendenze sanitarie AI documento.
- Consumo di credito/Prezzi: Utilizzare i crediti Data 360 o i crediti Flex per le stime del TCO derivate da documenti di esempio rappresentativi.
- Creare la configurazione dello schema. Definire i campi di estrazione, i tipi di dati e le istruzioni in formato schema JSON nell'impostazione di Data 360 Document AI. Per la pipeline batch, associarla a un UDMO. Per la pipeline di elaborazione delle transazioni, crearla senza un oggetto di origine. Registrare l'ID schema.
- Allineare i nomi dei campi al livello di destinazione. Abbinare i nomi dei campi alle definizioni delle colonne DLO, ai nomi API SObject o ai nomi delle colonne RDBMS. I nomi non allineati creano un sovraccarico di mappatura nel livello di integrazione.
- Configurare l'oggetto di origine UDMO (solo batch). Definire l'ambito dei documenti e configurare la connettività della fonte di inserimento (ad esempio, S3, Google Cloud Storage, Salesforce Files o MuleSoft). Verificare che l'account del servizio di inserimento abbia l'ambito delle credenziali IAM o OAuth richiesto.
- Applicare policy di mascheramento delle informazioni personali. Configurare le policy di mascheramento dei dati nelle impostazioni ETL prima di elaborare qualsiasi contenuto regolamentato. Definire i tipi di campo (PHI, PII e identificatori finanziari) da mascherare prima che gli input raggiungano il livello di dettaglio. Non rimandare questo passaggio.
- Assegnare l'ambito Spazio dati e gli insiemi di autorizzazioni. Limitare l'elaborazione allo Spazio dati appropriato e configurare gli insiemi di autorizzazioni per controllare la creazione dello schema, l'esecuzione dei processi batch, la chiamata dell'API REST e l'attivazione a valle.
- Configurare l'autenticazione API (solo pipeline di elaborazione delle transazioni). Creare un'applicazione connessa con ambiti OAuth cdp_ingest_api e api. Per i chiamanti interni all'organizzazione, utilizzare una credenziale denominata che si collega a una credenziale esterna. Per i chiamanti esterni, configurare le credenziali client OAuth 2.0 o un flusso JWT-bearer. Testare e convalidare l'estrazione prima di procedere.
- SObject write-back: Implementare un elemento Apex (@InvocableMethod) o Flow che mappa i campi di risposta JSON ai campi SObject. Utilizzare Database.upsert() con un ID esterno per evitare duplicati. Applicare la protezione a livello di campo ai campi SObject di destinazione.
- Condotte DLO/DMO di Data 360: Mappare i campi DLO estratti ai DMO allineati al Customer 360 Data Model. Configurare le regole di risoluzione dell'identità per collegare i record documento a Persone unificate. Definire gli approfondimenti calcolati e aggiungere DMO per Agentforce. Per la pipeline di elaborazione delle transazioni, instradare prima il payload JSON a un DLO tramite l'API di inserimento.
- RDBMS esterno o data warehouse: Selezionare lo schema di integrazione: MuleSoft (tessuto di integrazione esistente), chiamata HTTP Apex (leggera, nativa dell'organizzazione), Eventi piattaforma con abbonato Pub/Sub (gestito da eventi) o ETL (batch a volume elevato). Implementare inserimenti con aggiornamento idempotenti utilizzando un fingerprint documento o un ID esterno in tutti i percorsi di scrittura esterni.
- Percorsi di attivazione: Connettere le azioni Agentforce alle configurazioni dello schema per l'estrazione interattiva. Configurare i trigger di flusso o Apex per i flussi di lavoro di elaborazione automatica e stabilire le destinazioni attivazione per ogni gruppo di campi.
- Gestione degli errori (solo pipeline di elaborazione delle transazioni). Configurare la superficie di risposta HTTP completa: 200 (esito positivo, incluse le risposte nulle parziali), 400 (richiesta non corretta o ID schema non trovato), 413 (file superiore a 10 MB), 5xx (errore di servizio). Implementare il backoff esponenziale per 5xx tentativi con un massimo di 3 tentativi. Registrare la risposta JSON non formattata e l'ID schema a ogni chiamata.
- Testare gli schemi con documenti di esempio. Inviare esempi rappresentativi tramite l'interfaccia AI documento o l'API REST. Verificare la precisione dell'estrazione, la copertura dei campi e la gestione dei valori nulli nelle variazioni del layout.
- Convalidare la gestione dei campi nulli. Verificare che tutte le destinazioni a valle possano gestire valori nulli per i campi non trovati in un documento. Tenere presente che i vincoli NOT NULL non vengono gestiti in modo esplicito senza valori nulli.
- Pre-convalidare le dimensioni dei file. Verificare che i documenti di produzione rimangano inferiori a 10 MB. Implementare la preelaborazione per suddividere o comprimere i documenti che si avvicinano regolarmente al limite.
- Convalidare l'estrazione end-to-end. Per la pipeline batch, avviare un'esecuzione completa e verificare che i campi estratti atterrino correttamente in ogni livello di destinazione. Per la pipeline di elaborazione delle transazioni, tracciare la risposta JSON attraverso il livello di integrazione fino alla destinazione. Verificare l'esecuzione del trigger e del flusso per le destinazioni SObject, il collegamento di risoluzione dell'identità per le destinazioni DLO/DMO e l'impotenza per le destinazioni RDBMS.
- Confermare il comportamento del livello Trust. L'ETL non applica il mascheramento delle informazioni personali al contenuto del documento, quindi l'LLM restituirà i dati delle informazioni personali nei campi estratti così come sono. Verificare che i campi dello schema, l'instradamento dei dati e l'archiviazione a valle siano progettati per gestire in modo appropriato l'output contenente informazioni personali e assicurarsi che gli eventuali requisiti di conformità o conservazione vengano soddisfatti all'esterno della piattaforma.
- Imposta avvisi Digital Wallet. Configurare gli avvisi consumo al 75% e al 90% dei crediti disponibili. Stabilire limiti di dimensioni dei batch e stime dei tassi ad hoc all'interno del budget di credito per ogni ciclo.
- Convalidare il monitoraggio batch (solo pipeline batch). Rivedere le percentuali di esito positivo dell'estrazione, le percentuali di campi nulli e il completamento dei processi nella console di monitoraggio di Data 360. Confermare la propagazione del tag dall'UDLO attraverso il DLO al DMO nella discendenza dei dati.
- Convalida la gestione degli errori API (solo pipeline di elaborazione delle transazioni). Testare tutte le condizioni di errore: 413 (documenti superiori a 10 MB), 400 (ID schema non validi), 200 (estrazioni valide con valori nulli parziali). Verificare che la logica di nuovo tentativo venga attivata sulle risposte 5xx simulate senza creare scritture duplicate.
Questo documento evidenzia le basi architettoniche di Data 360 Document AI:
- Due pipeline di elaborazione e quando utilizzarle
- Modello di configurazione dello schema
- Quadro decisionale livello target
- Vincoli della tecnologia di base
- Modalità di errore
- Allineamento del framework ben progettato
La Guida introduttiva per architetti fornisce la sequenza di configurazione per una prova di concetto Sandbox.
L'impostazione dell'architettura di base supporta i dati derivati da documenti gestiti a livello di schema, elaborati tramite una pipeline LLM imposta da ETL e consegnati allo stesso ciclo di vita dei dati di Data 360 che governa tutti gli altri dati aziendali.
Gli architetti che applicano questi principi (selezione delle opportunità in corso di realizzazione corrette, progettazione di schemi a livello di tipo di documento e progettazione di modalità di errore prima della produzione) creano capacità di estrazione che si estendono e resistono ai requisiti di governance del settore regolamentati.
Yugandhar Bora è un architetto di ingegneria del software di Salesforce specializzato in architettura dei dati all'interno della piattaforma Data and Intelligence Applications. Dirige iniziative dell'Enterprise Architecture Review Board (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo anche alle soluzioni di provisioning automatico della piattaforma.
Ananth Anto è Direttore della gestione dei prodotti di Salesforce Data 360 e guida le iniziative di intelligenza artificiale documentale e grafico dati. Con sede a Bangalore, collabora con i clienti aziendali per risolvere le sfide legate all'elaborazione dei documenti e all'intelligenza dei dati nel mondo reale. Si diverte a esplorare i casi d'uso aziendali per l'intelligenza artificiale generativa (Gen AI).
Nishan Naseer è un architetto di ingegneria del software di Salesforce che si occupa di elaborazione dati non strutturati, pipeline RAG e intelligence documentale. È appassionato di sfruttare la potenza dell'intelligenza artificiale per affrontare le sfide del mondo reale e trovare soluzioni creative a problemi complessi dei clienti.