Yritykset käsittelevät useita eri asiakirjatyyppejä, kuten laskuja, ostotilauksia, lakisääteisiä sopimuksia ja teknisiä ohjeita. Manuaalinen käsittely on hidasta, virheellistä ja kuluttaa arvioiden mukaan 15–25 % työntekijöiden ajasta. Aiemmat automaatiota koskevat lähestymistavat (esimerkiksi Robotic Process Automation (RPA), Optical Character Recognition (OCR) ja työnkulun työkalut) vähensivät joitakin kuormitusta, mutta aiheuttivat jäykkiä myyntiputkia, korkean huoltokustannuksen ja erillisen käyttöönoton yksittäisissä liiketoimintatiimeissä.
Asiakirjat sisältävät muotoiltua rakenteellista kontekstia (esimerkiksi taulukoiden hierarkioita, kenttäsuhteita ja ristiviitettyjä osioita), joita taulukkotekstin käsittely ei voi säilyttää. Asiakirjan piilottaminen pelkkäksi tekstiksi hylkää liiketoimintaympäristön, joka tekee noudosta tarkkaa ja hyödyllistä, mikä heikentää myöhäisen analyysin laatua, Tekoälyn (AI) johtopäätöksiä ja prosessien automatisointia.
Jotta asiakirjojen älykkään käsittelyn (IDP) järjestelmät toimisivat tehokkaasti, niiden täytyy luokitella asiakirjat tyypin mukaan, poimia rakenteellisia tietoja tarkasti muuttujien asetteluista ja toimittaa tiedot hallitussa ja kyseltavissa muodossa alempaan järjestelmään. Myös sisäisten palveluntarjoajien täytyy käsitellä asiakirjojen vaihtelevuus laajalti ilman, että heidän täytyisi määrittää mallikokoonpanoja jokaiselle uudelle asiakirjaformaatille, ja niiden täytyy olla keskitettyjä ja käytettävissä eri liiketoimintayksiköissä. Tämä haaste lisätään tärkeimpien ongelmien määrään: Jäsentämättömät tiedot muodostavat noin 80 % kaikesta yritystiedoista, ja suurin osa niistä kerääntyy asiakirjamuotoon tiedostojärjestelmissä, pilvitallennustilassa ja sisältövarastoissa, jotka eivät ole asiakassuhteiden hallinta (CRM)-järjestelmien, tekoälyagenttien ja analyysitason käytettävissä.
Data 360 Document AI on Salesforcen asiakirjojen käsittelyominaisuus Data 360:ssa, joka on suunniteltu korjaamaan tämä aukko. Se kerää, luokittelee ja analysoi jäsentämättömän ja puolirakenteellisen asiakirjan sisältöä käyttämällä suuria kielimalleja (LLM), optisia merkkien tunnistusta (OCR), luonnollisen kielen käsittelyä (NLP) ja koneoppimista (ML). Tulos on rakenteellista, hallittua ja kyseltavaa dataa, joka integroituu Data 360 -putkeen, josta Agentforce agentit, analyysityökalut ja automatisointityönkulut voivat käyttää sitä vakiomuotoisten käyttöliittymien kautta ilman mukautettuja nouto- tai transformaatiokerroksia.
Enterprise-datalustat käsittelevät rakenteellista taulukkomuotoista dataa. Suurin osa yritystiedoista saapuu kuitenkin asiakirjoina, eikä CRM, ERP, AI-agentit ja analyysiputket voi käyttää niitä ennen kuin joku noutaa ne manuaalisesti. Tämä on arkkitehtuurinen aukko, ei työnkulkuongelma.
Aiemmat lähestymistavat yhdistävät manuaalisen uudelleenavaimen, sääntöihin perustuvat OCR- ja RPA-komentosarjat. Nämä menetelmät toimivat pienessä mittakaavassa, mutta ne eivät voineet käsitellä nykyaikaisten yritysten luomien asiakirjatyyppien määrää, lajittelua ja nopeutta. Sääntöihin perustuvat työkalut vaativat erillisiä malleja per asetteluvariantti. Kaikki muotoilun muutokset rikkovat noutoa ja vaativat kehittäjän, uuden mallin ja käyttöönottosyklin.
Mittavassa mittakaavassa tämä tuottaa hauraita pisteratkaisuja, joilla ei ole keskitettyä hallintaa, jaettua skeemaa ja polkua tekoälyvalmiuteen. Epäjohdonmukaiset noutoputket lisääntyvät alempana. Toisin sanoen analyysit perivät datan epäjohdonmukaisuuksia, tekoälymallit tuottavat epäluotettavia tuloksia ja säännelty sisältö, kuten henkilökohtaiset terveystiedot (PHI) ja henkilöllisesti tunnistettavat tiedot (PII), puuttuu järjestelmällisestä hallinnasta.
LLM:t keräävät kenttiä ilman tarkkoja malleja. Yksi skeemakokoonpano hallitsee asettelun variaatioiden, kielten ja formaattien keräämistä, mikä mukautuu asiakirjaan eikä vaadi, että asiakirja noudattaa kiinteää rakennetta. Tämä siirtää asiakirjojen käsittelyn huoltaa vaativasta, erillisestä toiminnosta hallittuun, keskitetyn kykyyn.
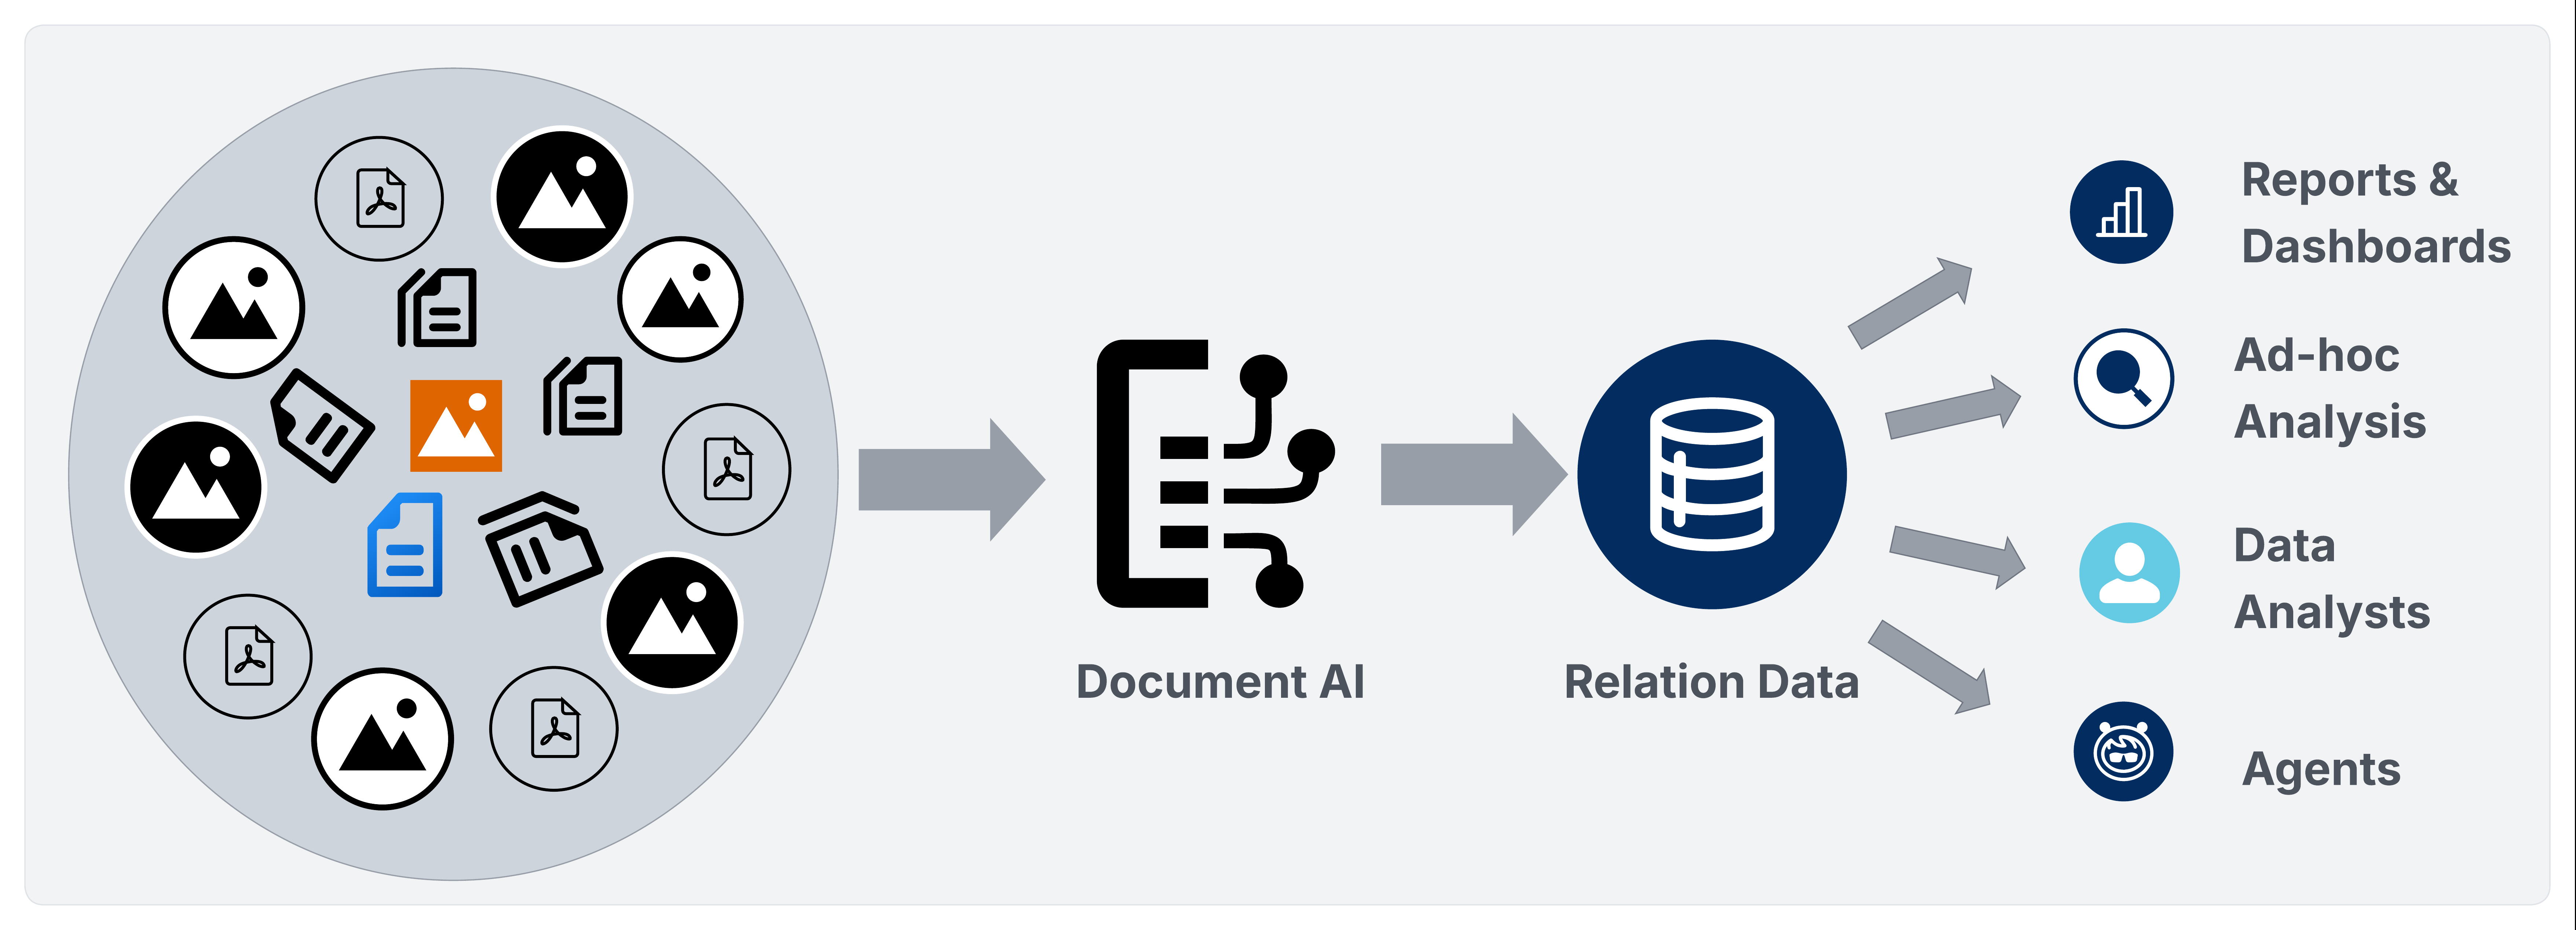
Data 360 Document AI operaattoroi asiakirjojen käsittelyn Data 360 -alustassa kahden myyntiputken kautta.
- Batch Pipeline reitittää kerätyn datan syöttämisen, identiteetin ratkaisemisen, laskettujen havaintojen, aktivointien, analyysien ja Agentforce-aktivoinnin kautta.
- Transaktioiden käsittelyputki paljastaa REST API -rajapinnan, joka palauttaa rakenteellisen JSON-tiedoston synkronoidusti, mikä sallii arkkitehtien reitittää asiakirjoista johdettua dataa Salesforcen SO-objekteihin, Data 360 Data Lake Object / Data Model Object (DLO/DMO) -putkelle tai ulkoisiin tietokantoihin ja varastoihin ilman eräasetuksia.
Molemmissa tapauksissa noudettu data siirtyy hallittuun ja skeemaan perustuvaan malliin, eikä tiettyjen pistetyökalujen hajanaiseen joukkoon.
Data 360 Document AI on Salesforcen älykkään asiakirjan käsittelyn (IDP) natiivitoiminto Data 360 -alustassa. Se muuntaa jäsentämättömän ja puolirakenteellisen asiakirjan sisällön hallituksi ja kyseltaväksi dataksi, joka osallistuu täysin koko Data 360:n elinkaaren ajan.
Data 360 Document AI on Salesforcen älykkään asiakirjan käsittelyn (IDP) natiivitoiminto Data 360issa. Se tuo jäsentämättömiä ja puolirakenteisia asiakirjoja, noutaa rakenteellisia tietoja käyttämällä deklaratiivista skeemakokoonpanoa ja toimittaa nämä tiedot Data 360 -putkelle harmonisointiin, identiteetin ratkaisemiseen, analyyseihin ja Agentforce-aktivointiin.
Data 360 Document AI tukee kahta käsittelymodaalia:
- Erän joukkokäsittely: Käsittelee suuret asiakirjojen joukot, jotka on määritetty tapahtumiin perustuvissa rakenteettomissa datamalliobjekteissa (UDMO).
- Transaktion käsittely: Käsittelee yksittäisen asiakirjan REST API:n kautta ja palauttaa rakenteellisen JSON-tiedoston synkronoidusti. Sen jälkeen arkkitehdit voivat reitittää tietosisällön Data 360 DLO/DMO -putkelle, Salesforcen SO-objekteille tai ulkoisille tietokannoille ja varastoille MuleSoftin, Apex-kutsujen tai Einstein Trust Layer (ETL) -putkien kautta. Tavoitetaso on arkkitehtoninen päätös, joka perustuu viiveen, hallinnan ja datan residenssin vaatimuksiin.
Asiakirjojen tekoäly tukee tällä hetkellä PDF-tiedostoja, kuvatiedostoja (JPEG, PNG) ja käsin kirjoitettuja asiakirjoja.
Data 360 Document AI kokoaa neljä käsittelyteknologiaa yhteen hallittuun myyntiputkeen. Jokainen komponentti käsittelee asiakirjan datan elinkaaren erillisen vaiheen:
- Optinen merkkien tunnistus (OCR): Muuntaa skannatut kuvat, käsin kirjoitetun sisällön ja kuviin perustuvat PDF-tiedostot koneellisesti luettavaksi tekstiksi ennen LLM-käsittelyä. Vähintään 150 DPI:tä suositellaan luotettavan noudon varmistamiseksi.
- Suuret kielumallit (LLM): Reititä nouto Einstein LLM -yhdyskäytävän kautta käyttämällä käyttäjän valitsemaa mallia. LLM vastaanottaa OCR-tuloksen yhdessä JSON-skeemakokoonpanon kanssa ja palauttaa rakenteellisen noutoarvon. Gemini-malleja ja muita malleja suunnitellaan tulevaa toteutusta varten.
- Luonnollisen kielen käsittely (NLP): Suorittaa asiayhteydestä riippuvaisen ymmärryksen, entiteetin tunnistuksen, päivämäärän jäsentämisen ja semanttisen kentän keruun suoraan LLM:ssä rakenteellisen kehotteiden suunnittelun kautta — skeeman määrittämä kehote ja OCR-tulos toimivat ainoina input-arvoina. Kaikki LLM-vuorovaikutukset reititetään ETL:n kautta, joka noudattaa mallin tarjoajien tietojen nollan säilyttämistä ja peittää tekstipohjaisten syötteiden PII-tiedot ennen kuin ne saavuttavat mallin. Erillistä NLP-järjestelmää ei käytetä.
- Monimenetelmäinen käsittely: Käsittelee PDF-tiedostoihin upotetut kuvat erillisinä noutotapahtumina, mikä sallii LLM:n noutaa dataa kaavioista, kuvassa näytetyistä taulukoista ja sekasisältösivuista, joita yksin OCR ei voi jäsentää.
Neljän käsittelyteknologian lisäksi Document AI käsittelee myös:
- Einstein Trust -kerros: Reitittää kaikki LLM-vuorovaikutukset ETL:n kautta, joka noudattaa mallin tarjoajien nollatietojen säilyttämistä ja peittää PII-tiedot ennen kuin syötetyt tiedot saavuttavat LLM:n, pois lukien multimodaaliset tiedot (esimerkiksi liitetyt asiakirjat, jotka käsitellään Document AI -työkalulla), joissa PII-tunnistamista ei tällä hetkellä tueta ja data lähetetään sellaisenaan ulkoisiin malleihin. ETL hallitsee vain LLM-vuorovaikutuspolkua. Poimitut tiedot, jotka on kirjoitettu Data Lake -objekteihin (DLO), tallennetaan sellaisenaan; kenttätason peittämistä täytyy käsitellä alempien datan hallinta-asetusten avulla.
- Tiedoston koon rajoitukset: Document AI käsittelee enintään 10 Mt tiedostoja per pyyntö. LLM-kontekstien pituuksien rajoitukset saattavat rajoittaa tiheiden, monisivuisten asiakirjojen käsittelyä entisestään tässä rajassa.
Yritysarkkitehtien, jotka ottavat käyttöön Data 360 Document AI -työkalun, tulisi soveltaa näitä periaatteita ennen kuin he sitoutuvat toteutussuunnitelmaan.
- Valitse myyntiputki ennen skeeman suunnittelua. Eräkäsittelyn ja transaktioiden käsittelyn myyntiputket eroavat syöttömallin, skeeman sidoksen, tavoitteen joustavuuden ja viiveen osalta. On tärkeää vahvistaa, mitä myyntiputkea jokainen käyttötarkoitus vaatii ennen kuin määrität skeeman, koska jälkiasennus lisää välttämättömän uudelleentyön.
- Suunnittele skeemoja asiakirjatyypin tasolla. Yksittäisen, hyvin laaditun skeeman käyttäminen per asiakirjatyyppi on helpompaa ylläpitää kuin käyttämällä käyttökohtaisia kokoonpanoja, ja se on myös suurin vauhti noudon laadulle. Tämän tekeminen oikein vaatii, että käytät erilaisia asiakirjoja — kuten reunatapauksia — sen sijaan, että suunnittelisit ne yhdestä esimerkistä. Käytä kehotteita iteratiivisesti kentän, taulukon ja skeeman tasoilla löytääksesi aukkoja ja testaa ja hienosäätääksesi niitä useiden asiakirjan näytteiden perusteella ennen viimeistelyä. Pidä mielessäsi, että yhdessä asiakirjassa hyvin toimiva skeema saattaa heikentyä muissa, joten leveys ja iterointi ovat tärkeitä. Skeeman joustavuus — mukaan lukien sarakkeiden poistaminen, joita ei noudeta luotettavasti asiakirjatyypeistä — on yhtä tärkeää. Noudattaminen kenttiä, jotka aiheuttavat melua tai epäjohdonmukaisuuksia, heikentää kokonaiskuvan laatua, joten on tärkeää käsitellä sarakkeiden poistamista ensiluokkaisena suunnittelupäätöksenä.
- Valitse oikea tavoitetaso per kenttäryhmä. Kentät, jotka edistävät CRM-työnkulkuja tai hyväksyntöjä, kirjoitetaan SO-objekteihin. Kentät, jotka rikastavat yhtenäistetyn profiilin tai syötteen analyysejä, kuuluvat DLO/DMO-putkeen. Ulkoisia järjestelmiä tarjoavat kentät kuuluvat RDBMS-tasoon. Pidä mielessäsi, että yksi skeema saattaa näyttää useita tasoja samanaikaisesti.
- Käytä hallintaa ennen kuin käsittelet säänneltyä sisältöä. Säännellyt tiedot tarvitsevat suojausta kaikissa kerroksissa. Tästä syystä on tärkeää määrittää PII-tietojen peittäminen, datan luokittelun tunnisteet ja attribuutteihin perustuva käyttöoikeuden hallinta (ABAC), kun noudettu data on tallennettu tuloksen Data Lake -objekteihin (DLO). Tämä tarjoaa hienosäädetyn käyttöoikeuden ja asiayhteydestä riippuvaisen käyttöoikeuden, joka perustuu datan luokitteluun, käyttäjärooliin ja organisaation asiayhteyteen. Johtaminen on jaettu kahteen polkuun: ELT hallitsee LLM-vuorovaikutusta, kun taas DLO-objekteihin tallennettuja noudettuja tietoja täytyy hallita erikseen — suoraan DLO- ja tietokantatasolla — käyttämällä datatilan kokoonpanoja, käyttöoikeusjoukkoja ja ABAC-käytäntöjä. Näiden asetusten täytyy säilyttää yhdenmukaisuus tallennustason tasolla — eikä vain sovelluksen kerroksessa — joten käyttöoikeuksien rajoitukset säilyvät ennallaan riippumatta siitä, miten dataa käytetään syöttämisen jälkeen. Pidä mielessäsi, että minkä tahansa kerroksen aukot saattavat paljastaa säänneltyjä tietoja alempana, vaikka muut olisi määritetty oikein.
- Suunnittele virhetilat ennen tuotantoympäristöä. Osoita null-kenttien käsittely, OCR-laadun kynnysarvot, tiedoston koon esivahvistus, LLM-kontekstin ylivuoto, RDBMS-kirjoitusten idempotenssi ja hyvitysbudjetin rajoitukset ennen ensimmäisen tuotanto-erän suoritusta. Nämä eivät ole reunatapauksia — ne ovat ennustettavia virhepintoja, jotka täytyy käsitellä erikseen myyntiputken suunnittelussa, eikä niitä löydetä suorituksen aikana.
- Käsittele luottamuspisteitä ensimmäisen luokan reitityssignaalina, äläkä diagnostisena jälkisuunnitteluna. Noudon tulokset sisältävät kenttätason luottamustason arvoja, jotka saadaan mallin tuloksen lokien todennäköisyydestä (logprobs). Pistemäärä vastaa kunkin noudetun kentän, taulukon tai sarakkeen mallin valtuustason tarkkuutta. Tämä tekee luottamuspisteistä tilastollisesti perustellun signaalin, joka on riittävän luotettava toimimaan ensisijaisena porttina Human-in-the-Loop (HITL) -escalation kynnysarvoille. Käytä luottamustason pisteitä tunnistaaksesi heikkolaatuisia noutoja järjestelmällisesti ja käynnistääksesi HITL-tarkastuspisteitä matalan luottamustason kenttäarvojen, epätarkkojen skeemojen vastaavuuksien tai toistuvien myyntiputken virheiden varalta, eikä sinun tarvitse luottaa heuristiikkaan tai manuaalisiin tarkastuksiin. Kun automatisoitu palautus ei ole mahdollista, HITL-pohjainen luottamustason pisteytys varmistaa, että ihmisen arviointia käytetään tarkalleen siellä, missä sitä tarvitaan.
- Suunnittele aktivointipolut rinnakkain skeeman suunnittelun kanssa. Asiakirjojen tekoälyn arvo johtuu siitä, että voit aktivoida kerättyä dataa Salesforcen työnkuluissa ja agenteissa. Sen avulla voit suunnitella Agentforce toiminnot, kulut ja lasketut havainnot keräysskeeman suunnittelun ohella, eikä sen jälkeen.
Document AI toimii kahdessa myyntiputkessa:
- Eräputki raskaan UDMO-tuettuun käsittelyyn
- Transaktioiden käsittelyn myyntiputki reaaliaikaista API-pohjaista noutoa varten
Molemmilla myyntiputkilla on sama skeemakokoonpanosopimus ja ETL-hallinta, mutta ne eroavat siitä, miten asiakirjat saapuvat järjestelmään ja mihin kerätyt tiedot laskeutuvat.
Nyt tutustumme tarkemmin kuhunkin myyntiputkeen.
Eräputki käsittelee UDMO-organisaation määrittämät toistuvat asiakirjojen joukot. Se soveltuu ajoitettuihin tai tapahtumiin perustuviin käyttötarkoituksiin, joissa asiakirjat tuodaan yrityksen tallennustilasta, siirretään asiakirjojen noutamiseen ja toimitetaan Data 360 DLO/DMO -putkelle harmonisointiin, identiteetin ratkaisemiseen ja aktivointiin.
Todellinen maailma -skenaario
Vakuutusyhtiö saa joka päivä tuhansia lääketieteellisten korvausvaatimusten asiakirjoja tarjoajan portaaleista, jotka ladataan PDF-tiedostoina Amazon S3 -palveluun. UDMO määrittää scope-asiakirjojen joukon ja lähettää kaikki PDF-vaatimukset /claims/incoming/-säiliöön 24 tunnin kuluessa.
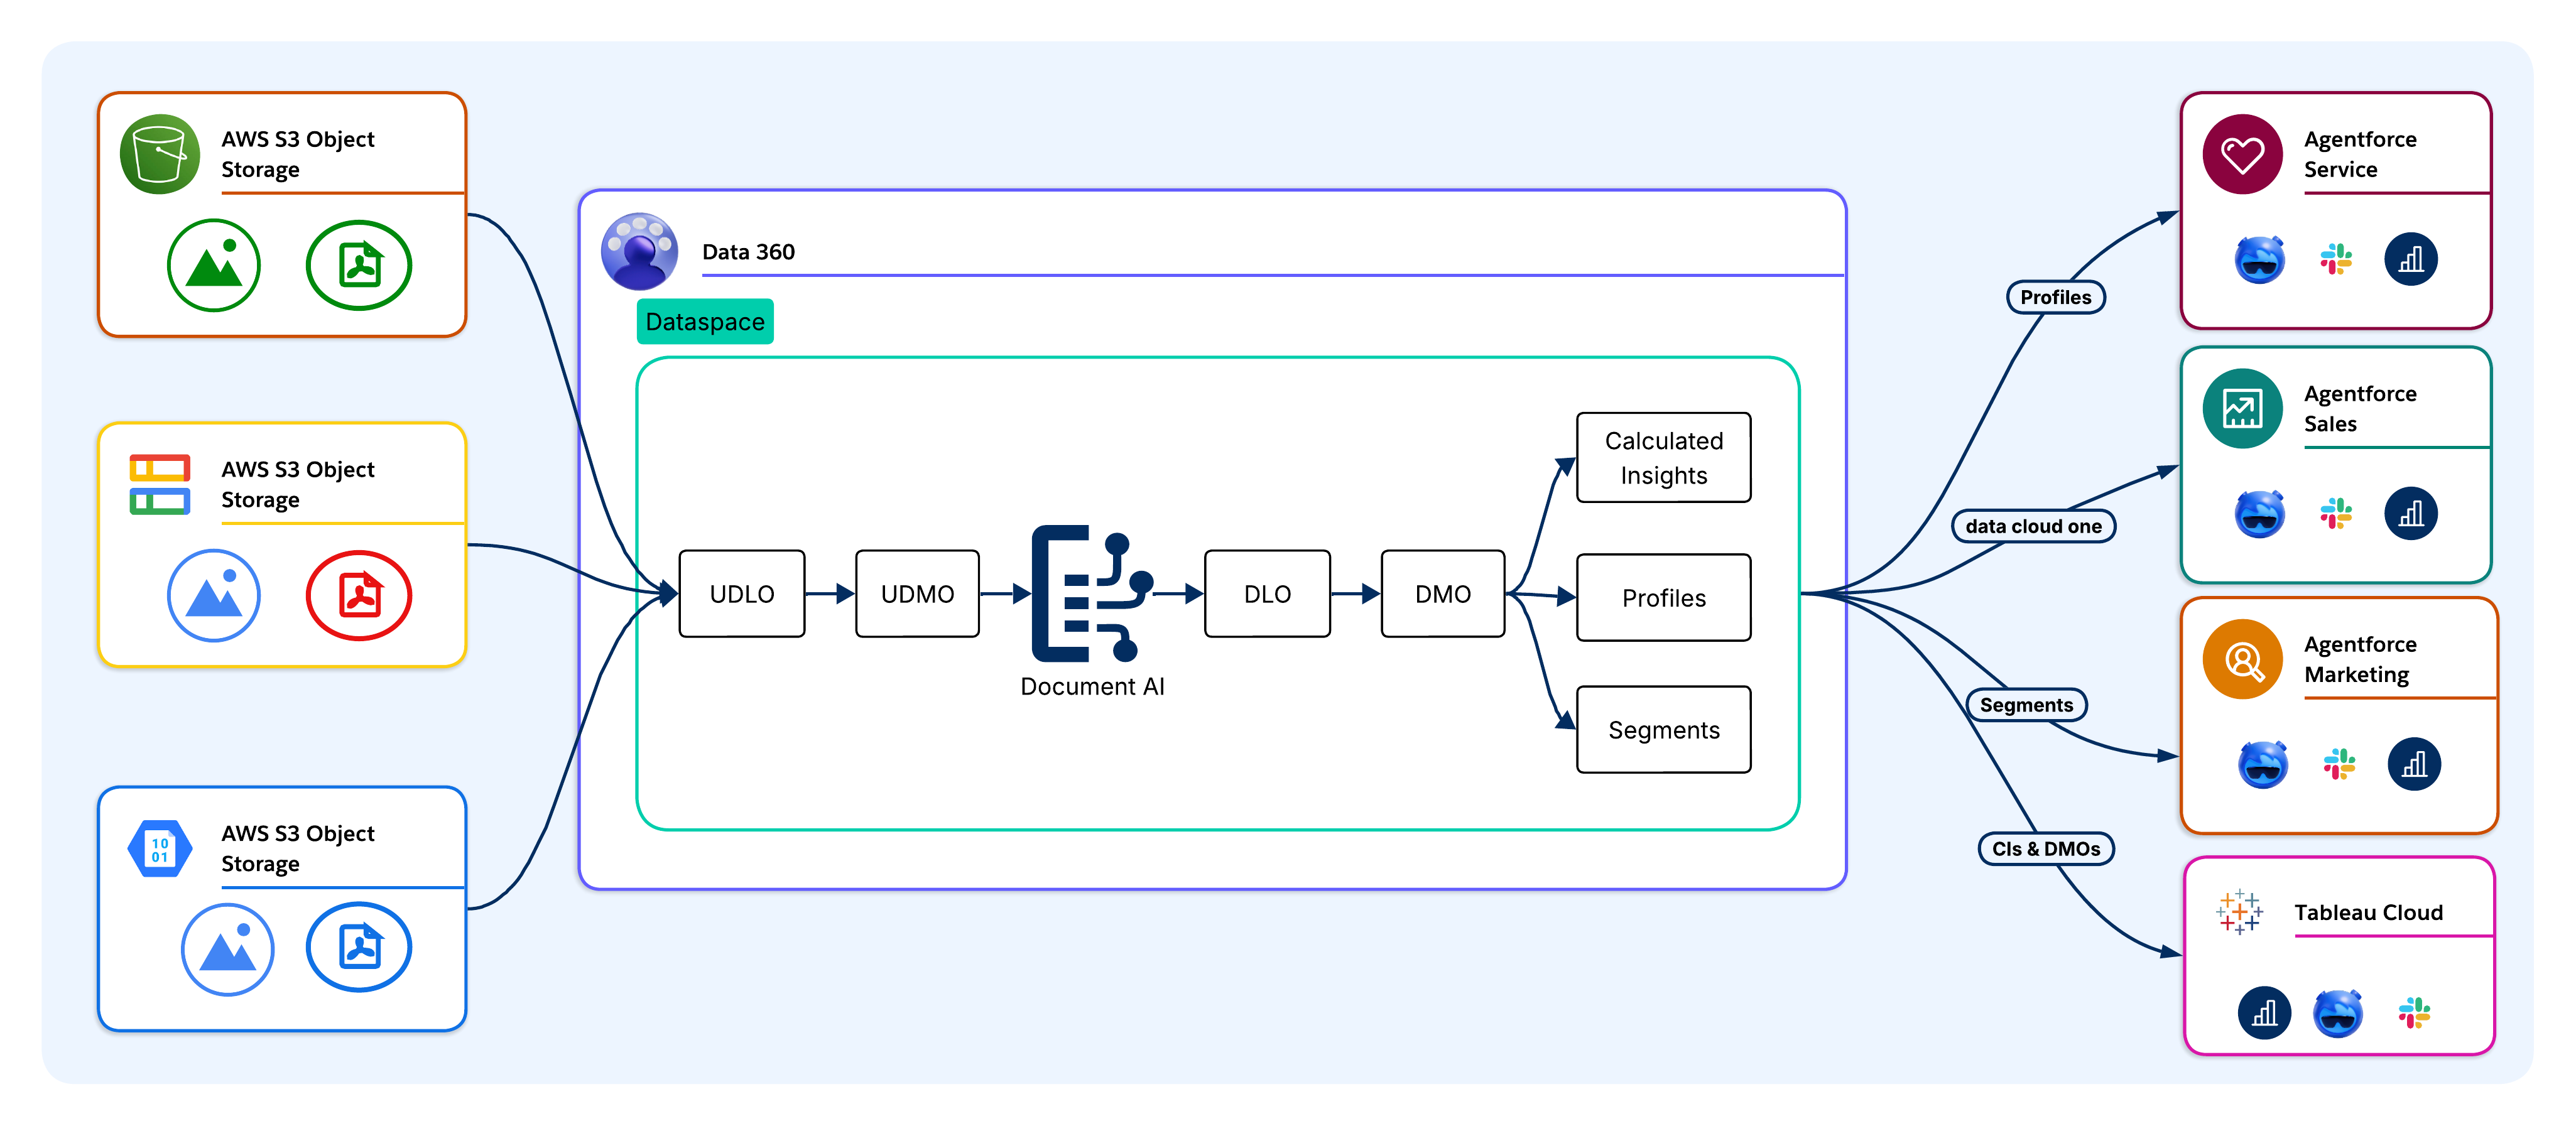
Asiakirjat tuodaan Data 360:een yrityksen lähdejärjestelmistä ilman fyysisiä kopioita. Tuettuihin lähteisiin sisältyvät Amazon S3, Google Cloud Storage, Salesforce CRM -tiedosto-objektit, MuleSoftin orkestroimat putket ja suorat API-lataukset. Headless 360 -käyttöönotoissa asiakirjat tuodaan pilvitallennustilan liittimien tai Käsittely-API:n kautta, joka ohittaa CRM-kerroksen. Mallin kontekstiprotokollan (MCP) palvelin paljastaa syötteen kutsuttavana työkaluna ulkoisille tekoälyagenteille ja LLM-asiakkaille.
Kun raakadokumentit tuodaan, ne tallennetaan rakenteettomina Data Lake -objekteina (UDLO), jotka kartoitetaan kunkin asiakirjan fyysiseen sijaintiin ja metadataan siirtämättä tai muuntamatta lähdetiedostoa.
Esimerkki:
PDF-lausekkeet tuodaan S3-tiedostosta Data 360:ään pilvitallennustilan liittimen kautta. Jokainen asiakirja tallennetaan UDLO-objektiksi, joka osoittaa S3-objektiin. Fyysistä kopiointia ei tapahdu.
Document AI käsittelee jokaisen UDLO:n skeemakokoonpanon perusteella, joka määrittää kerättävät kentät ja niiden kohdedatatyypit. UDMO määrittää, mitkä asiakirjat ovat vaikutusalueessa. LLM (GPT-4o, Gemini tai Claude) lukee jokaisen asiakirjan ja palauttaa rakenteellisen noutoarvon.
Esimerkki:
Document AI käsittelee jokaisen UDLO:n korvausvaatimusten skeemaan, joka määrittää kenttiä, kuten: ClaimID, PatientName, DiagnosisCode, BillingAmount ja ServiceDate. LLM:t lukevat sitten jokaisen PDF-tiedoston ja palauttavat rakenteellisen noutoarvon.
Kun data on noudettu, se säilyy DLO-objekteina, jotka ovat Data 360:n raaka tallennustaso. DLO-objektit säilyttävät kerätyt kentät pakottamatta liiketoimintalogiikkaa, mikä säilyttää tarkan fyysisen esitysmuodon myöhemmälle transformaatiolle ja jäljitettävyydelle. UDLO säilyttää viitteen lähdeasiakirjaan ottaakseen kenttätason linjauksen käyttöön missään myyntiputken vaiheessa.
Esimerkki:
Kaikki noudetut kentät laskeutuvat korvausvaatimusten DLO-objektiin, joka säilyttää kunkin korvausvaatimuksen raaka-arvoisen ja tarkan esityksen, jonka täysi sukupolvi voidaan jäljittää lähde-PDF-tiedostoon.
DLO-kentät kartoitetaan DMO-organisaatioihin, jotka vastaavat vakiomuotoista Customer 360 Data Modelia. Tämä on rajoitus, jossa asiakirjojen muodostama data siirtyy raakakentistä liiketoimintaan liittyviin entiteetteihin. Invoice DLO kartoitetaan Invoice DMO -organisaatioon, ja kentistä, kuten CustomerID ja BillingAmount, tulee liitosavaimia ja täsmäysattribuutteja yhtenäistetyssä datamallissa. harmonisoitu asiakirjatieto osallistuu segmentointiin, laskettuihin havaintoihin ja aktivointiin samoilla käyttöliittymillä kuin mitä CRM ja transaktiodata käyttävät.
Esimerkki:
Korvausvaatimusten DLO kartoitetaan korvausvaatimusten DMO-organisaatioon. PatientID- ja PolicyNumber-kentistä tulee liitosavaimia, jotka linkittävät korvausvaatimusten tietueet yhtenäistettyihin potilasprofiileihin.
Harmonisoitu DMO-data osallistuu identiteetin ratkaisuun. Poimitut kentät (esimerkiksi asiakkaan nimet, sähköpostiosoitteet tai tilinumerot) toimivat täsmäysavaimina, joilla voit linkittää asiakirjatietueita Yhdistettyihin yksityishenkilöihin (Kultaiset tietueet), mikä sulkee asiakirjasta profiiliin -aukon.
Esimerkki:
Nouto-kentät (esimerkiksi PatientName, DateOfBirth ja PolicyNumber) toimivat täsmäysavaimina identiteetin ratkaisemiseksi, mikä linkittää korvausvaatimustietueet oikeaan yhdistettyyn yksityishenkilöön. Tämä tapahtuu, vaikka sama potilas näytettäisiin hieman eri nimien alla eri asiakirjoissa.
Arkkitehdit määrittävät lasketut havainnot, jotka ovat aggregoituja tilastoja, jotka lasketaan yhdenmukaistetun asiakirjatietojen perusteella (esimerkiksi eri laskun rivikohteiden kokonaiskulut, sopimusten uusimisen riskipisteet ja korvausvaatimusten vakavuusindeksit).
Esimerkki:
Lasketut havainnot laskevat TotalClaimsPerPatient-, AverageClaimAmount- ja HighRiskClaimScore-arvot Agentforce-kyselyiden yhdenmukaistettujen korvausvaatimusten datalle.
Agentforce-agentit, Tableau, markkinointialustat ja Salesforce SO-objektit voivat käyttää harmonisoitua, identiteetin ratkaisemiseen perustuvaa dataa. Kohdetaso on arkkitehtoninen päätös, joka perustuu viiveen, hallinnan ja datan residenssin vaatimuksiin.
Esimerkki:
Agentforce Agentforce kyselee Data 360 -demo-organisaatioita ja -käyttäjiä löytääkseen korkean riskin korvausvaatimuksia prioriteettien tarkastamista varten. _Tableau-_mittaristot näyttävät korvausvaatimusten määrän ja poikkeavuuksien trendit. Hyväksyttyjen korvausvaatimusten tietueet pyöristetään takaisin korvausvaatimusten SObject-objektiin maksujen työnkulkujen käynnistämiseksi.
Headless 360 -arkkitehtuurissa aktivointi reititetään suoraan ulkoisiin järjestelmiin Query API:n, Pub/Sub API:n tai Cloud-tietovaraston aktivointikohteiden kautta. MCP-palvelin löytää sitten yhdenmukaistetut asiakirjatiedot ja lasketut havainnot kutsuttaviksi työkaluiksi ulkoisille tekoälyagenteille.
Transaktioiden käsittelyputki käsittelee yhden asiakirjan noutamisen suorituksen aikana ilman UDMO-organisaatiota tai valmiiksi syötettyä UDLO-organisaatiota, mikä soveltuu tapahtumiin perustuviin käyttötarkoituksiin (esimerkiksi lomakkeen lataava asiakas, PDF-tiedoston vastaanottava agentti tai ulkoinen järjestelmä, joka käynnistää noutamisen transaktioiden käsittelyn työnkulussa). ETL-hallintaa sovelletaan molempiin myyntiputkeihin identtisesti.
Todellinen maailma -skenaario
Kun pankkivirkailija hakee lainaa, hän lataa palvelimelle PDF-tiedostonsa pankin mobiilisovelluksesta. Tapahtuma käynnistää noudon reaaliajassa, mikä tarkoittaa, ettei siihen sisälly valmiiksi syötettyä UDLO- tai UDMO-objektia.
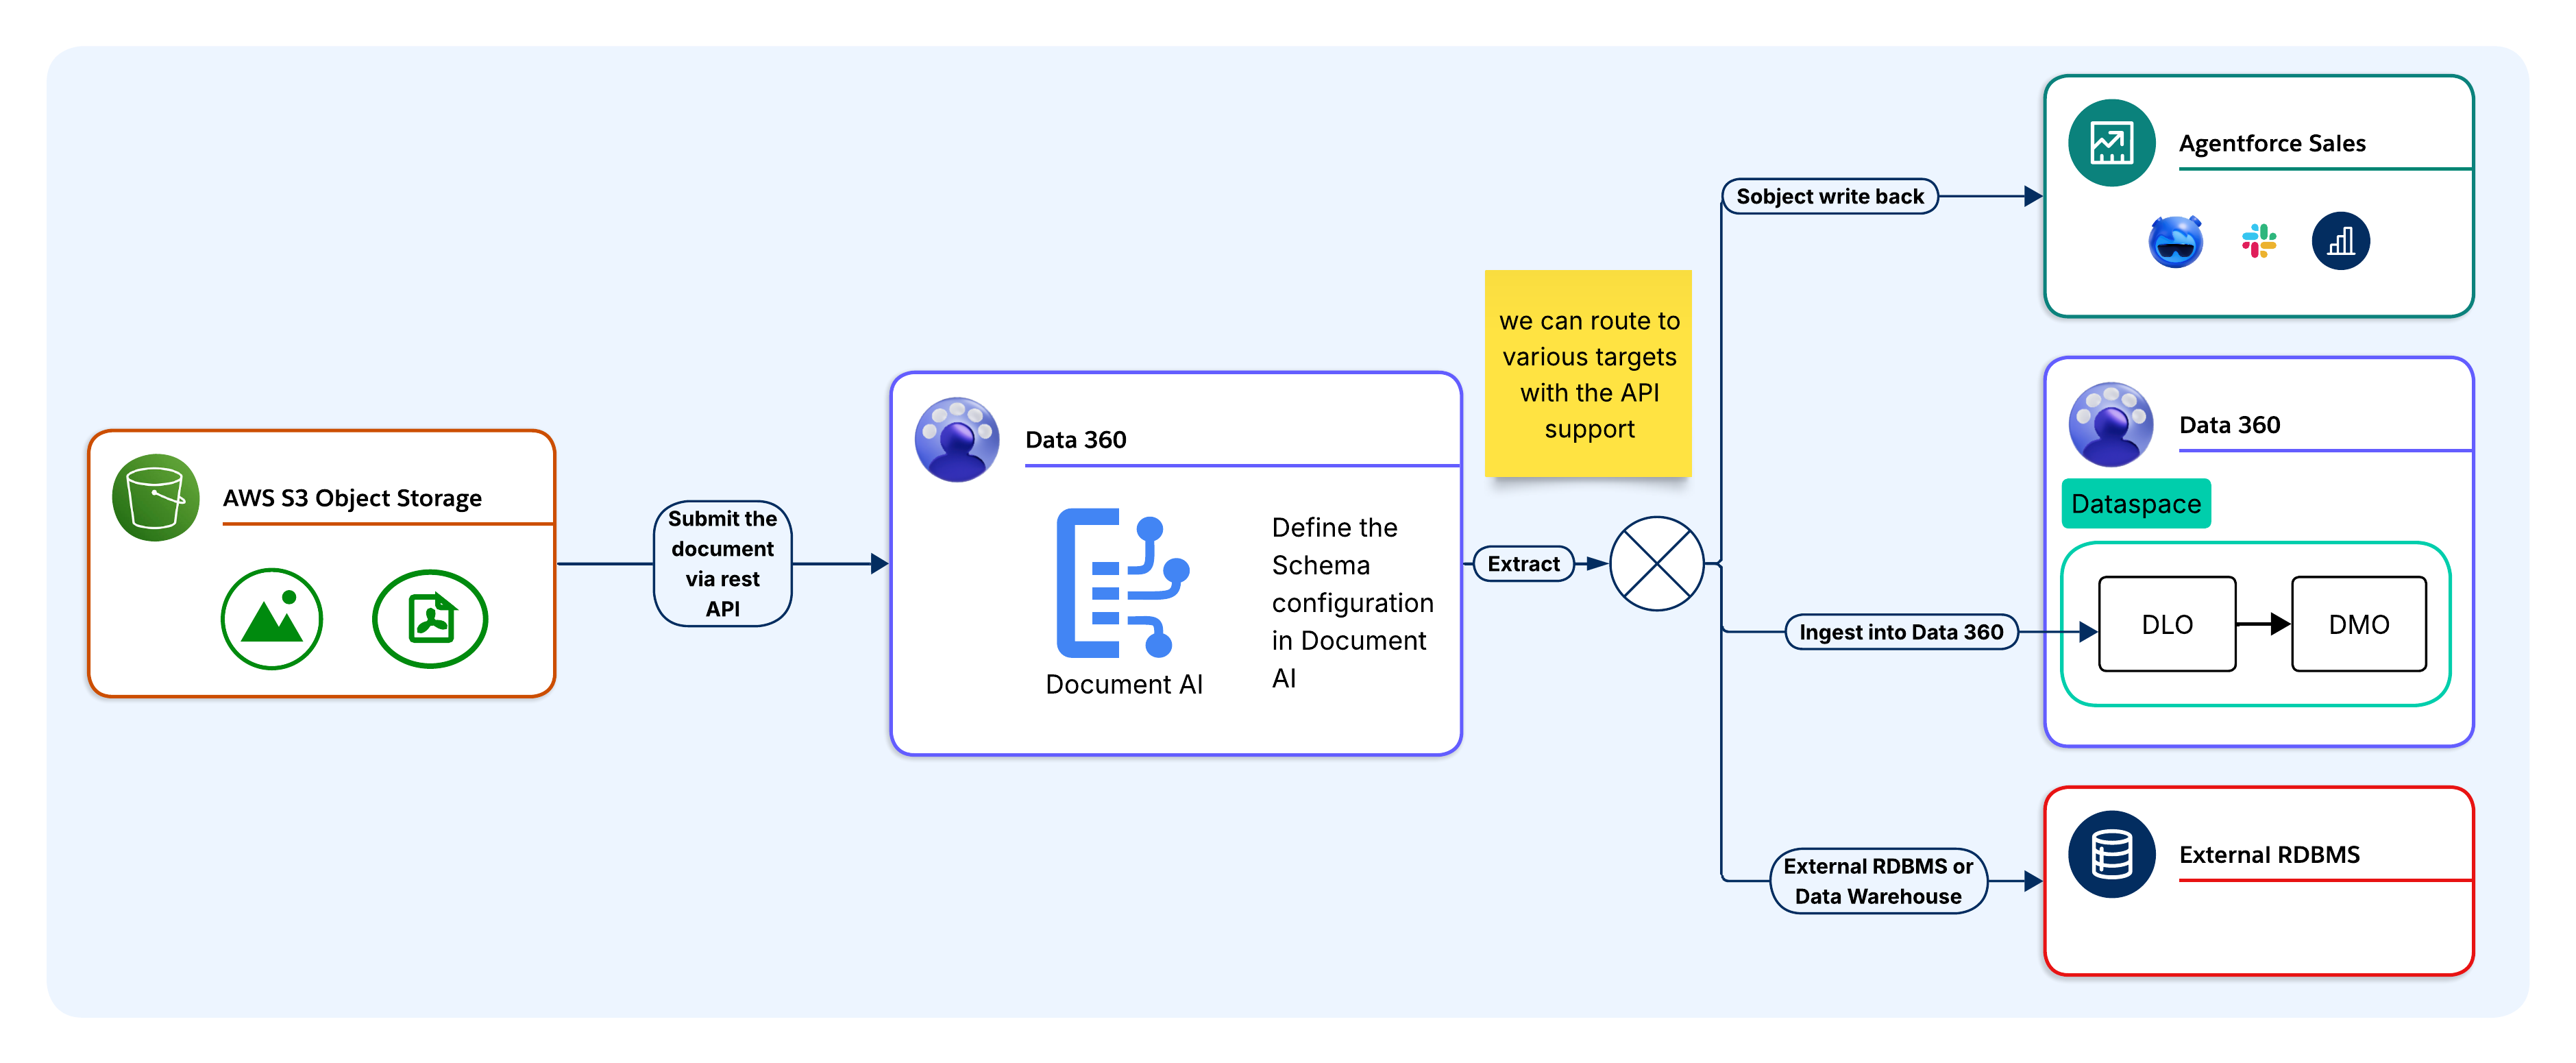
Ennen API:n kutsumista arkkitehtien täytyy määrittää ja tallentaa Data 360:ssa skeema, joka määrittää kentät, datatyypit ja noutoohjeet JSON-skeeman muodossa. Jokaiselle skeemalle kohdistetaan yksilöllinen skeeman tunnus. Suorituksen aikana kutsuttava sovellus viittaa skeeman tunnukseen pitääkseen keräyslogiikan keskitetyinä Data 360:ssa sen sijaan, että upottaisi sen sovelluskoodiin.
Esimerkki:
Pankin tiimillä on ennalta määritetty ProofOfAddress-skeema Data 360:ssa, joka määrittää kentät, kuten CustomerName, AddressLine1, City, PostCode ja DocumentDate. Nämä tiedot tallennetaan versioituna kokoonpanona, johon voidaan viitata skeeman tunnuksella.
Kutsuva sovellus lähettää asiakirjan ja skeeman tunnuksen yhdessä REST API -pyynnössä base64-koodattuna tietosisällön tai tiedostoviitteenä. UDLO-syötettä ei vaadita. Document AI käyttää asiakirjan noutamista ja palauttaa rakenteellisen tuloksen annetun skeeman perusteella.
Esimerkki:
Mobiilisovellus lähettää apupalkkion base64-koodattuna tietosisällönä yhdessä REST API -kutsussa olevan ProofOfAddress-skeeman tunnuksen kanssa. Tämä prosessi ei vaadi UDLO:n syöttövaihetta.
LLM käsittelee OCR-tuloksen skeemaan nähden ja palauttaa rakenteellisen JSON-tietosisällön synkronoidusti. Kentät, joita ei löydy asiakirjasta, palautetaan muodossa null. Soittaja omistaa täyden JSON-vastauksen ja jatkaa reititystä.
Esimerkki:
Asiakirjan tekoäly soveltaa PDF-tiedostoon OCR-arvoa ja LLM palauttaa rakenteellisen JSON-tietosisällön, jossa on noudettuja osoitekenttiä. Kentät, joita ei löydy (jos esimerkiksi laskusta puuttuu PostCode), palautetaan muodossa null.
Kun JSON on noudettu, se voidaan reitittää yhteen tai useampaan kohdetasoon, riippuen käyttötarkoituksesta:
- Salesforce SObject: Kartoita suoraan _SObject-_kenttiin Apexin tai CRM-työnkulkujen ja -hyväksyntöjen kulun kautta.
- Data 360 DLO/DMO Pipeline: Reitittää DLO-objektin harmonisointiin, identiteetin vahvistukseen, laskettuihin havaintoihin ja Agentforce-pohjaukseen.
- Ulkoinen RDBMS tai datan varasto: Reititetään Salesforcen ulkopuolisten järjestelmien MuleSoftin, Apexin callout-kutsun, alustan tapahtumien tai ETL:n kautta.
- Mukautettu integrointi: Palauttaa rakenteelliset JSON-arvolataukset kutsuvaan sovellukseen tallennusta varten mille tahansa ulkoiselle järjestelmälle tai datasäiliölle.
- Downstream-kulku tai agentti: Välittää rakenteellisen JSON-tuloksen suoraan alempaan kulkuun tai agenttiin ilman, että se pysyisi SObjectissa. Tämä on yleinen malli asiakkaille, jotka käyttävät reaaliaikaisena noutovaiheena Document AI -työkalua laajemmassa automatisoinnissa tai agenteissa.
Pidä mielessäsi, että yksi skeema saattaa näyttää useita tasoja samanaikaisesti, ja eri kenttäryhmät reititetään eri kohteisiin samasta noutopisteestä.
Esimerkki:
ProofOfAddress voi lisätä hyötykuorman kolmeen tasoon kerralla (esimerkiksi CustomerName ja AddressLine1 kirjoittavat Yhteyshenkilön SObject -kenttään), mikä käynnistää osoitteen vahvistuksen kulun. Sitten koko hyötykuorma reititetään DLO-objektiin harmonisointiin ja riskien pisteyttämiseen, ja kopio reititetään pankin KYC-järjestelmään MuleSoftin kautta säännösten noudattamisen kirjaamista varten.
Kun se on kirjoitettu, noudettu data aktivoidaan kohdejärjestelmässä välittömästi. Jos kyseessä on SObject-kohde, käynnistimet, kulut ja hyväksymisprosessit aktivoidaan upserted-tietueessa. Jos kyseessä on DLO/DMO-kohde, data syötetään harmonisointiin ja identiteettien ratkaisemiseen ja Agentforce-kontekstiin. Ulkoisille RDBMS-kohteille data on saatavilla myöhemmille kyselyille heti, kun kirjoitus on suoritettu.
Esimerkki:
Osoitteen vahvistuskulku aktivoituu välittömästi lisätyssä yhteyshenkilötietueessa, mikä siirtää lainahakemuksen seuraavaan vaiheeseen. Agentforcen luottovirkailija Agent löytää vahvistetun osoitteen Data 360:sta ja KYC-järjestelmä tallentaa asiakirjan lähetyksen tarkastusta varten.
Document AI soveltuu parhaiten tietyille arkkitehtonisille ehdoille. Sen soveltaminen näiden ehtojen ulkopuolella aiheuttaa tarpeetonta monimutkaisuutta ja lisäkustannuksia.
Arkkitehtuurina on tärkeää arvioida nämä ehdot ennen kuin sitoudut käyttämään Asiakirjan tekoälyä keruun mekanismina.
Käytä asiakirjojen tekoälyä, kun:
- Asiakirjat ovat ensisijainen tietolähde. Vaaditut tiedot ovat käytettävissä vain asiakirjoissa, eikä niitä voi käyttää rakenteellisesta API:sta tai tietokannasta (esimerkiksi skannatut sopimukset, laboratorioraportit, saantilomakkeet tai vakuutuskorvausvaatimukset).
- Asiakirjojen asettelut vaihtelevat lähteiden mukaan. Sama asiakirjatyyppi saapuu useilta toimittajilta, kumppaneilta tai alueilta, joilla on eri kenttäsijainnit ja -formaatit. Skeemaan perustuva LLM-nouto sovittuu ilman asettelua koskevaa ylläpitoa.
- Noudetun datan täytyy syöttää Data 360 tai Agentforce. Noudon täytyy osallistua identiteetin vahvistukseen, laskettuihin havaintoihin tai Agentforce-pohjaukseen. Asiakirjan tekoäly toimitetaan suoraan DLO/DMO -putkeen ilman erillistä ETL-kerrosta.
- Määrä oikeuttaa hallitun automatisoinnin. Asiakirjojen määrä ylittää sen, mitä manuaalinen käsittely voi käsitellä ilman mitattavissa olevia työvoimakustannuksia tai datan laadun riskejä.
- Asiakirjat sisältävät säänneltyä sisältöä. PHI:n, PII:n tai taloustietojen täytyy reitittää nollatietojen säilyttämisen ja PII:n peittämisen kerroksen läpi ennen LLM:n saavuttamista. ETL täyttää tämän oletusarvoisesti. Asiakkaiden, jotka eivät tarvitse kerättyä sisältöä säilytettäväksi missään vaiheessa, tulisi harkita myös transaktiivista API-kulkua, joka palauttaa rakenteellisen tuloksen suoraan kutsuttavaan sovellukseen kirjoittamatta viestejä mihinkään SObject-objektiin tai datan säiliöön.
- Käyttötarkoitus perustuu tapahtumiin. Asiakirja saapuu suorituksen aikana (esimerkiksi asiakkaan lähettäminen palvelimelle, PDF-liite agentille tai ulkoinen järjestelmäkäynnistin). Transaktioiden käsittelyputki käsittelee synkronoidun yhden asiakirjan noutamisen ilman eräasetuksia.
Älä käytä asiakirjojen tekoälyä, kun:
- Lähdödata on jo rakenteellinen. Jos ylemmässä järjestelmässä näytetään REST API, tietokantataulukko tai rakenteellinen tiedosto (esimerkiksi CSV, JSON tai XML), käytä vakiomuotoista Data 360 -liitintä. Rakenteellisen datan suorittaminen LLM-nouto-putken kautta lisää viive- ja luottokustannuksia ilman lisäetuja.
- Asiakirjat luodaan koneella kiinteällä skeemalla. Järjestelmän luomat PDF-tiedostot tunnetusta ERP-järjestelmästä tai laskutusalustasta, joilla on vakaa asettelu, sopivat paremmin deterministiselle jäsentelijälle. LLM-nouto on suunniteltu vaihtelevuutta varten, ja sen soveltaminen kiinteän skeeman asiakirjoihin tuhlaa asiayhteyden ja krediittejä.
- Tarkkuusvaatimukset ylittävät LLM:n luottamustason kynnysarvot. Asiakirjan tekoäly ei takaa 100-prosenttista poiminnan tarkkuutta. Tapaukset, joissa puuttuva tai virheellinen kenttäarvo aiheuttaa merkittävää taloudellista, lakisääteistä tai kliinistä riskiä, vaativat HITL-vahvistusvaiheen. Älä käytä Asiakirjojen tekoälyä ainoana keräyskerroksena tärkeille päätöksille ilman vahvistustyönkulkua.
- Asiakirjat ylittävät sovellusalustan rajoitukset. Nykyinen 10 Mt:n tiedostojen kokorajoitus ja LLM-kontekstien pituuksien rajoitukset tekevät Document AI -työkalusta sopimattoman suurille tai tiheille asiakirjoille, joille ei ole suoritettu esikäsittelyä, jotta ne voidaan jakaa ja koota uudelleen sovellusalustan ulkopuolelle.
- Huomautus: Salesforcessa parannamme aktiivisesti näitä hyväksymisen suojausruutuja laajentaaksemme tuettuja tiedostokoja, sivumääriä ja tiedostopäätteitä. Rajoitukset kehittyvät edelleen eteenpäin.
Tutustutaanpa tarkemmin useisiin skenaarioihin, jotka käyttävät UDMO-lähdeobjektin tukemaa Document AI -eräputkea. Näissä tapauksissa noudettu data reititetään Data 360 DLO/DMO -putken läpi harmonisointiin, identiteettien ratkaisemiseen, laskettuihin havaintoihin ja Agentforce-aktivointiin. Jokainen käyttötapa soveltuu parhaiten ajoitettuun tai tapahtumiin perustuvaan, raskaan asiakirjan käsittelyyn.
Agentforce Sales: Sopimusten ja laskujen älykkyys
Sopimusten PDF-tiedostot tuodaan pilvitallennustilasta eräputken kautta. Skeema noutaa ContractValue-, RenewalDate-, PaymentTerms- ja CounterpartyName-arvot ja kartoittaa ne sitten Tilin ja Sopimuksen DMO-organisaatioihin. Lasketut havainnot palautuksen riskin pisteytykset. Agentforce varoittaa asiakaspäälliköitä ennen kuin uusimisajat sulkeutuvat, mikä välttää sopimusten manuaaliset tarkastukset ja puuttuvat uusinnat.
Agentforce-palvelu: Tapausten ennaltaehkäisy ja Knowledge-pohja
Kyselyn PDF-tiedostot ja tapauksen liitetiedostot tuodaan eräputken kautta. Skeema noutaa sentimentti-indikaattorit, ongelmatyypit ja ratkaisuhuomautukset ja kartoittaa ne sitten Case- ja Knowledge-artikkelien DMO-organisaatioihin. Agentforce kyselee yhdenmukaistettua Knowledge, kun tapaus avataan ja löytää asiaankuuluvat vianmääritysvaiheet, mikä vähentää agentin haun ylimääräisiä kustannuksia.
Agentforcen kunto: Kliinisen asiakirjan käsittely
Lab-raportit, PDF-tiedostot ja käsin kirjoitetut lääketieteelliset lomakkeet tuodaan eräputken kautta. Skeema kerää kentät — mukaan lukien PatientID, DiagnosisCode, MedicationName ja TestResult — ja kartoittaa ne sitten Health Cloudin DMO-organisaatioihin, jotka tukevat HIPAA-koordinoitua hoidon koordinointia ja kliinisen tutkimuksen työnkulkuja.
Finanssipalvelut: Laina- ja veroasiakirjojen automatisointi
Eräputken kautta tuodut lainahakemukset, verojen palautukset ja tuottotiedot. Skeema kerää kentät — mukaan lukien AnnualIncome, TaxYear ja EmployerName — ja kartoittaa ne sitten Financial Account DMO-organisaatioihin. Lasketut havainnot -ominaisuus yhdistää asiakirjoista saatuja tuottotietoja ja CRM-dataa auttaakseen luottoriskien automatisoidussa pisteytyksessä. Agentforce löytää kerätyt lainatiedot suoraan asiakaspalvelun vuorovaikutusten aikana. Tämä kuvio tukee suoraan Salesforce Agentic Enterprise Solutions -kehityskeskuksessa julkaistua lainan esivaltuutuksen agenttia.
HR: Workforce-asiakirjojen käsittely
Perehdytysasiakirjat, verolomakkeet ja PDF-sertifikaatit tuodaan eräputken kautta. Noudetut kentät kartoitetaan DMO-organisaatioihin, jotka sisältävät työntekijätietueet, ja linkitetään sitten yhdistetyn työntekijän profiiliin. Tietyt kulut käynnistävät perehdytystehtäviä ja vaatimustenmukaisuuden tarkastuksia kerätyn datan perusteella. Tämä kuvio tukee suoraan Agentin Automaattinen jatkamisen käsittely -ominaisuuden käyttötapaa. Asiakirjan tekoäly noutaa taitoja, työhistoriaa ja pätevyyksiä PDF-tiedostoista, joita Agentforce käyttää täsmätäkseen ehdokkaat avoimien roolien ehtojen perusteella ja reitittääkseen heidät palkkaustyönkulkuihin.
Yrityspalvelut: Ehdotus- ja tutkimustieto
Ehdotuspaketit ja tutkimusraportit tuodaan eräputken kautta. Noudetut kehykset, valintamerkit ja osallistumistietojen yhteenvedot kartoitetaan mukautettuihin DMO-organisaatioihin ja indeksoidaan sitten vektorihaussa. Agentforce noutaa kyselyn aikana asiayhteydestä riippuvaisia suosituksia, jotka perustuvat noudettuun asiakirjan sisältöön. Tämä kuvio laajentaa Ground Agentforce on Website Content -kuviota. Asiakirjat indeksoidaan Document AI -työkalulla ja ne tarjoavat agenttien vastauksille saman perustason kuin verkkosivuston sisältö, joka on indeksoitu Data 360 -liittimen kautta.
HIPAA-vastaavuustila:
Tässä asiakirjassa kuvatut Health Cloud -kuviot käyttävät ETL-ohjaimia (esimerkiksi nolla datan säilyttäminen ja PHI- peittäminen) tekstin syötteille. Nämä yksittäiset ohjaimet eivät ole HIPAA-sertifikaatteja. Arkkitehtien, jotka suunnittelevat säänneltyjä kliinisiä ympäristöjä varten, täytyy vahvistaa tämänhetkinen HIPAA-sertifikaatin tila Salesforcen vaatimustenmukaisuustiimillä ennen kuin he sitoutuvat käyttämään asiayhteyksissä Document AI -pohjaista arkkitehtuuria.
Tutustutaanpa tarkemmin useisiin skenaarioihin, jotka kutsuvat Document AI REST API -rajapintaa skeemalla, joka ei ole sidoksissa UDMO-organisaatioon. Noudetut JSON-hyötykuormat reititetään suoraan ulkoisiin järjestelmiin synkronoidusti suorituksen aikana.
Toimitusketju: Toimittajan laskujen käsittely ERP:ään
Kun myyjän laskun PDF-tiedosto saapuu valvottuun säiliösä tai sähköpostien yhdyskäytävään, tapahtumakäynnistin kutsuu Document AI REST API -rajapintaa laskun ja esimääritetyn skeeman tunnuksen kera. Skeema noutaa VendorID-, InvoiceNumber-, LineItems-, TotalAmount-, TaxAmount- ja DueDate-arvot. JSON-hyötykuorma reititetään MuleSoftin kautta ERP Accounts Payable -moduuliin, jossa on kenttien _null-_vahvistus ja idempotent upsert-logiikka, mikä estää mallien ylläpidon toimittajien formaattien vaihtelusta.
Lailliset toiminnot: Sopimuksen tarkastus CLM:ään
Kun sopimusten PDF-tiedosto ladataan lakisääteiseen portaaliin, taustalla on synkronoitu kutsu Document AI REST API -rajapintaan. Skeema noutaa GoverningLaw-, IndemnityCapAmount-, TerminationNoticePeriod-, AutoRenewalClause- ja CounterpartySignatory-arvot. JSON-hyötykuorma reititetään Apexin callout-kutsun kautta Contract Lifecycle Management (CLM) -järjestelmään. Kaikki kentät, joita ei löydy, palautetaan muodossa null, ja CLM soveltaa puuttuviin arvoihin oletusarvoisia velvoitussääntöjä.
Vakuutuskorvausvaatimukset: Ensimmäinen ilmoitus häviön käsittelystä
Kun vakuutuksen omistaja lähettää ensimmäisen häviöilmoituksen (First Notice of Loss, FNOL) -lomakkeen, taustaportaali kutsuu Document AI REST API -rajapintaa synkronoidusti. Skeema noutaa PolicyNumber-, IncidentDate-, IncidentLocation-, DamageDescription-, ClaimantName- ja ContactPhone-arvot. JSON-hyötykuorma reititetään korvausvaatimusten hallinnan tietokantaan Apex -callout- tai ETL-kutsun kautta, joka luo valmiiksi täytetyn korvausvaatimustietueen, jota säätäjät voivat tarkastaa ennen kuin virallinen korvausvaatimus avataan.
Ennen kuin siirryt tuotantoympäristöön, sinun täytyy luoda suunnitelmia näille virheiden skenaarioille.
- Null-kenttien käsittely: LLM palauttaa kenttien arvon null, joita se ei voi löytää tai noutaa luottavaisesti. Vahvista null-käsittelylogiikka skeeman suunnittelussa ja toteuta oletusarvoinen tai hylkäämälogiikka integraatiokerroksessa ennen kuin kirjoitat kohteisiin, joilla on NOT NULL -rajoitukset tai vaaditut täsmäysavaimet.
- OCR-luokan heikkeneminen: OCR-tarkkuus heikkenee alle 150 DPI:n, epäsäännöllisissä käsikirjoituksissa tai meluisissa skannauksissa. Virheelliset lukemat leviävät LLM-noutoon korruptoituna syötteenä ilman virhesignaaleja. Varmista skannauksen minimaalinen laatu syötteessä ja käytä luottamustason kynnysarvotarkistuksia numero- ja päivämääräkentille.
- Skeeman version vastaavuus: Skeemakokoonpanon päivittäminen erätyön ajoittamisen jälkeen aiheuttaa, että lennon aikana olevat asiakirjat käsitellään verrattuna edelliseen versioon, mikä tuottaa puuttuvia tai uudelleen nimettyjä kenttiä, jotka rikkovat downstream-kartoituksen. Versioiden skeemat selkeästi ja koordinoida päivityksiä erätöiden aikataulujen kanssa.
- Tiedoston koon rajoitukset: Yli 10 Mt kokoiset asiakirjat hylätään. Eräputken virheet ovat hiljaisia ilman valvontaa, ja transaktioiden soittajat näkevät virheen 4xx. Vahvista tiedostojen koot valmiiksi syötteessä ja käytä esikäsittelyä jakaaksesi tai pakataksesi asiakirjoja, jotka lähestyvät rajoitusta säännöllisesti.
- LLM-kontekstin ylivuoto: Tiheät tai monisivuiset asiakirjat voivat ylittää LLM-kontekstiikkunan 10 Mt rajoituksesta. LLM tyhjentää sisältöä, joka ylittää kontekstin. Toteuta pilkkomisstrategia, joka jakaa asiakirjat sivualueen mukaan ja kokoaa noudetut kentät uudelleen ennen kuin siirrät ne kohteeseen.
- Trust-kerroksen peittäminen vaikuttaa noutoon: ETL toimii kehotteen tasolla — ei asiakirjatasolla — joten peittäminen ei koske asiakirjan sisältöä, joka kulkee läpi Asiakirjan tekoälyn. ETL- maskinkäytännöt eivät vaikuta skeemakenttiin, jotka ovat riippuvaisia asiakirjan PII-arvoista.
- External RDBMS Write Idempotency (Ulkoisen RDBMS-kirjoituksen tunnus) : Transaktioiden käsittelyputkessa ei ole sisäänrakennettuja idempotenssejä ulkoisille RDBMS-kohteille. Integrointikerroksen uudelleenyritykset luovat identtisiä rivejä, ellei kirjoituslogiikka käsittele identtisten rivien poistamista erikseen. Toteuta idempotent upserts-toimintoja käyttämällä asiakirjan sormenjälkeä tai ulkoista tunnusta kaikilla ulkoisilla kirjoituspoluilla.
- Luotonkulutuksen keskiarvo: Suuri erätöiden suoritus saattaa kuluttaa Digital Wallet -krediittejä ennen kuin kaikki asiakirjat käsitellään, mikä tuottaa keskeneräisiä DLO-datajoukkoja, joiden alempia vaiheita pidetään valmiina. Määritä kulutushälytykset 75 %:iin ja 90 %:iin saatavilla olevista krediiteistä ja rajoita erien kokoa pysyäksesi kunkin syklin luotto-budjetissa.
- Skeeman kenttärajoitus — Arkkitehtuurirajoitus: Document AI -työkalu rajoittaa rakenteen kokoonpanon juuritason kentille 50 kenttää. Tämä on suunnitteluaikainen rajoitus — ei suorituksen aikainen virhe — ja arkkitehtien täytyy ottaa se huomioon datamallin ja skeeman suunnittelussa.
- Käyttötapauksissa, jotka vaativat laajempaa noutoa:
- Priorisoi armottomasti. Rajoita skeemaa kenttiin, jotka edistävät automatisoinnin arvoa, äläkä asiakirjojen kattavuutta.
- Hyödynnä sisäkkäisiä objekteja (enintään 3 tasoa, erätila, jossa on vain lähdeobjekti) vähentääksesi juuritason kenttien määrää uhrattaaksesi noudon syvyyttä.
- Pura monimutkaisia asiakirjoja useisiin Document AI -kokoonpanoihin, jotka keskittyvät erillisiin asiakirjan osioihin, kirjoita tuloksia erillisiin DLO-objekteihin, jotka liitetään alempana Data 360:ssa.
- Käyttötapauksissa, jotka vaativat laajempaa noutoa:
- API-suhteiden rajoitukset: Asiakirjan tekoäly rajoittaa 50 nouto-API-kutsua minuutissa per vuokralainen. Teoreettinen enimmäismäärä on 300 puhelua minuutissa, jota hallitsee Einstein LLM Gateway. Raskaan transaktion integraatiot täytyy suunnitella eksponenttisella rästityksellä, pyyntöjen jonolla ja vuokralaisen tason läpimenoa koskevalla budjetoinnilla. Älä olettaa, että burst-kapasiteetti on käytettävissä usean vuokralaisen tuotantoympäristöissä.
- API-lähtöprofiili: Asiakirjojen tekoälyn keruun API-rajapinnat ovat täysin synkronoituja. Tavalliset vastausajat vaihtelevat 5–15 sekuntia, ja ne vaihtelevat tiedoston koon ja skeeman monimutkaisuuden mukaan.
- Tämä vaikuttaa suoraan integraatioarkkitehtuuriin:
- Aseta soittajan aikakatkaisut 30 sekunnin vähimmäismäärään.
- Älä käytä asiakirjojen tekoälyä kuluissa, jotka vaativat palvelutasosopimusta alle sekunnissa.
- Osatekijöiden viive läpimenoasetusten laskutoimiin verrattuna eräkäsittelyn myyntiputkien nopeusrajoitusrajoitukseen.
- Aseta soittajan aikakatkaisut 30 sekunnin vähimmäismäärään.
- Tämä vaikuttaa suoraan integraatioarkkitehtuuriin:
- Salatut ja salasanalla suojatut asiakirjat: Document AI ei käsittele salasanalla suojattuja tiedostoja (käyttäjän salasanoja tarvitaan tiedostojen avaamiseen) tai PDF-tiedostoja, jotka on salattu omistajan/käyttöoikeuksien salasanalla, mukaan lukien tiedostot, jotka avataan tavallisesti, mutta rajoittavat kopiointia, tulostamista tai muokkaamista PDF-käyttöoikeuskerroksessa.
- Tämä rajoitus sijaitsee syötteen rajassa:
- Suunnittele asiakirjojen tuontiputket havaitaksesi ja reitittääksesi salatut tiedostot hylkäämiseen tai manuaaliseen käsittelypolkuun ennen kuin ne saavuttavat Document AI -työkalun.
- Älä luota suorituksen aikaiseen virheiden käsittelyyn ensisijaisena porttina.
- Tämä rajoitus sijaitsee syötteen rajassa:
Data 360 Document AI noudattaa useita Salesforcen hyvin rakennetun kehyksen pilareita.
- Trust: ETL noudattaa nollatietojen säilyttämistä LLM-tarjoajien kanssa, peittää syötetyt PII-tiedot ennen kuin ne saavuttavat mallin ja skannaa tulokset luottamuksellisen sisällön varalta. Arkkitehtien täytyy laajentaa tätä asennetta koskemaan tietoja, jotka on kerätty paikallaan. ETL ei käytä DLO-objektien kenttätason peittämistä, ja se vaatii myöhempiä datatilan käytäntöjä ja käyttöoikeusjoukkoja.
- Luotettavuus: Jokainen Suunnittelussa huomioitavia asioita -osion epäonnistumistila — null-kentän noutaminen, OCR-virheellinen lukeminen, skeeman version vastaavuus, tiedoston koon rikkomus, LLM-kontekstin ylivuoto, ETL- peittämisen häiriö, RDBMS-kirjoituksen idempotenssi ja hyvityskatkos — edustaa erillistä epäonnistumisen luokkaa, jossa on dokumentoitu havaitsemis- ja ratkaisupolku.
- Operational Excellence (muutostenhallinta): Skeemaan perustuva noutomalli irrottaa noutologiikan asiakirjan asettelusta. Kun toimittaja muuttaa laskun muotoa tai lakilomaketta päivitetään, arkkitehtien täytyy päivittää vain yksi skeemakokoonpano integrointikoodin muokkaamisen sijaan.
- Operational Excellence (huolto): Skeemakokoonpanojen keskittäminen Data 360:ssä sen sijaan, että upottaisit noutologiikkaa sovelluskoodiin, tekee noutokohteesta selkeän, versioidun ja tarkastettavan. Kaikki alhaiset tavoitteet kuluttavat saman skeemasopimuksen riippumatta niiden tavoitetasosta.
- Operational Excellence (integraation uudelleenkäyttö): Asiakirjan tekoäly paljastaa noudon useissa integraatiopinta-alueissa: REST API, Apex, Flow, MuleSoft, Agentforce Actions ja MCP-palvelin. Yksittäinen skeemakokoonpano tuhoaa useita kohdetasoja samanaikaisesti rakentamatta keräyskykyä uudelleen per kuluttaja.
- Resurssien ja kustannusten optimointi: Myyntiputken valintaohjeet, 10 Mt:n tiedostokoon rajoitus ja LLM-kontekstin kokoonpanon edeltävät rajoitukset edustavat suorituskykyä koskevia suunnittelupäätöksiä. _Käyttöaika-_osio muodostaa ehdot, kun Asiakirjan tekoäly ei ole oikea työkalu (esimerkiksi sekuntien välisen viiveen vaatimukset, täysin rakenteelliset lähdedata ja kiinteän skeeman koneella luodut asiakirjat).
Tämä on rakenteellinen lähtökohta, josta voit määrittää Data 360 Document AI -työkalun sandbox-ympäristössä. Suorita kaikki sandboxin vaiheet ennen tuotantoympäristöön siirtymistä.
Ennen kuin aloitat kokoonpanon, sinun täytyy vahvistaa:
- Tiedoston koko: Vahvista, että edustavien asiakirjojen koko on alle 10 Mt.
- Pipeline: Tarkasta, vaatiiko käyttötarkoitus eräputken (UDMO-tuettu, raskas) vai transaktioiden käsittelyputken (API-pohjainen, yksittäinen asiakirja). Tämä määrittää kaikki myöhemmät kokoonpanot.
- Tavoitetaso: Tarkasta, missä noudettu data pysyy — Salesforce SObject, Data 360 DLO/DMO, ulkoinen RDBMS tai yhdistelmä.
- Agentforce-riippuvuus: Ennen kuin otat Agentforcen tarjoaman asiakirjan käsittelyn käyttöön, varmista, että tuettu LLM (esimerkiksi GPT-4o) on käytössä organisaatiossasi ETL-asetusten kautta. Agentforce on Document AI -työkalun edellytys laitteistolle. Koko Document AI -ominaisuuden pinta-ala — mukaan lukien kaikki nouto-API-rajapinnat — ei ole käytettävissä ennen kuin Agentforce on aktiivinen kohdeorganisaatiossa. Merkitse tämä organisaation valmiustarkistuksiin ja provisioinnin järjestykseen. Anna muutama minuutti API-käytettävyydelle vakauttaaksesi käyttöönoton jälkeen.
- Agentforce Disability -vaikutus: Jos Agentforce poistetaan käytöstä, kun Document AI on määritetty ja otettu käyttöön, kaikki noutojen käsittely (käyttöliittymä ja API) estetään välittömästi. Sama koskee mallin poistamista käytöstä. Perustana olevan mallin poistaminen käytöstä vaikuttaa vastaavasti Document AI -työkalujen saatavuuteen. Molemmissa tapauksissa olemassa olevat skeemakokoonpanot säilytetään ja ne pysyvät näkyvissä — ei kokoonpanoa tai datan katoamista — mutta kyky ei ole täysin käytettävissä ennen kuin Agentforce ja malli otetaan uudelleen käyttöön. Suunnittele toimintaohjelmia käsitelläksesi Agentforcen saatavuutta ja mallin käyttöönottoa Dokumenttien tekoälyn riippuvuuksina.
- Luoton kulutus/hinnoittelu: Käytä TCO-arvioille Data 360 -hyvityksiä tai Flex-hyvityksiä, jotka on saatu edustavista esimerkkitiedostoista.
- Luo skeemakokoonpano. Määritä nouto-kentät, datatyypit ja ohjeet JSON-skeeman muodossa Data 360 Document AI -määrityksissä. Jos käytät eräputkea, sitoa se UDMO-organisaatioon. Jos käytät transaktioiden käsittelyputkea, luo se ilman lähdeobjektia. Tallenna skeeman tunnus.
- Tasoa kenttien nimet kohdetasoon. Täsmää kenttien nimet DLO-sarakkeiden määritelmään, SObjectin API-nimiin tai RDBMS-sarakkeiden nimiin. Virheelliset nimet luovat kartoituksen ylätasolle integraatiokerroksessa.
- Määritä UDMO-lähdeobjekti (vain erä). Määritä asiakirjoja vaikutusalueella ja määritä syöttölähteen yhteys (esimerkiksi S3, Google Cloud Storage, Salesforce Files tai MuleSoft). Varmista, että syöttöpalvelun tilillä on vaadittu IAM-tunnuksen tai OAuth-tunnuksen vaikutusalue.
- Käytä henkilötietojen peittokäytäntöjä. Määritä ETL-asetuksista Datan peittokäytännöt ennen kuin käsittelet mitään säänneltyä sisältöä. Määritä kenttätyypit (PHI-, PII- ja finanssitunnisteet), jotka peitetään ennen kuin syötetyt tiedot saavuttavat LLM:n. Älä lykkää tätä vaihetta.
- Datan tilan vaikutusalueen ja käyttöoikeusjoukkojen kohdistaminen. Laajenna käsittely sopivaan datatilaan ja määritä käyttöoikeusjoukot hallitaksesi skeeman luontia, erätöiden suoritusta, REST API -kutsua ja downstream-aktivointia.
- Määritä API-todennus (vain transaktioiden käsittelyputki). Luo yhdistetty sovellus OAuth-vaikutusalueilla cdp_ingest_api ja api. Käytä organisaation sisäisille soittajille nimettyä tunnusta, joka on linkitetty ulkoiseen tunnukseen. Määritä ulkoisille soittajille asiakassovelluksen tunnukset OAuth 2.0 tai JWT-haltijan kulku. Testaa ja vahvista nouto ennen jatkamista.
- SObject-kirjoitus takaisin: Toteuta Apex (@InvocableMethod) tai Flow-elementti, joka kartoittaa JSON-vastauskentät _SObject-_kenttiin. Käytä Database.upsert()-funktiota ulkoisella tunnuksella välttyäksesi identtisiltä tietueilta. Ota käyttöön kenttätason suojaus kohdekentille SObject.
- Data 360 DLO/DMO-putki: Kartoita noudetut DLO-kentät DMO-organisaatioihin, jotka vastaavat Customer 360 Data Modelia. Määritä identiteettien ratkaisusääntöjä linkittääksesi asiakirjatietueita yhtenäistettyihin yksityishenkilöihin. Määritä lasketut havainnot ja lisää DMO-organisaatioita Agentforcelle. Jos käytät transaktioiden käsittelyputkea, reititä JSON-hyötykuorma ensin DLO:hen _Käsittely-_API:n kautta.
- Ulkoinen RDBMS tai datan varasto: Valitse integraatiokuvio: MuleSoft (edellinen integraatiotyyppi), Apex HTTP -callout (helppokäyttöinen, organisaation omistama), Platform-tapahtumat, joilla on Pub/Sub -tilaaja (tapahtumiin perustuva) tai ETL (suuren määrän erä). Toteuta idempotent upserts-toimintoja käyttämällä asiakirjan sormenjälkeä tai ulkoista tunnusta kaikilla ulkoisilla kirjoituspoluilla.
- Aktivointipolut: Yhdistä Agentforce skeemakokoonpanoihin interaktiivista noutoa varten. Määritä kulkujen tai Apex-käynnistimet automatisoituja käsittelyn työnkulkuja varten ja määritä aktivointikohteet kullekin kenttäryhmälle.
- Virheiden käsittely (vain transaktioiden käsittelyputki). Määritä täysi HTTP-vastauksen pinta: 200 (onnistui onnistuneesti, mukaan lukien osittaiset null-vastaukset), 400 (väärin muotoiltu pyyntö tai skeeman tunnus ei löytynyt), 413 (tiedosto ylittää 10 Mt), 5xx (palveluvirhe). Toteuta eksponenttinen rästitystoiminto 5xx:lle uudelleenyritykselle enintään 3 yrityksellä. Kirjaa jokaisen kutsun raaka JSON-vastaus ja skeeman tunnus lokiin.
- Testitä skeemoja esimerkkidokumenttien kanssa. Lähetä edustavia esimerkkejä Document AI -rajapinnan tai REST API:n kautta. Vahvista noudon tarkkuus, kentän kattavuus ja null-arvojen käsittely asettelun variaatioissa.
- Vahvista null-kenttien käsittely. Varmista, että kaikki alhaiset kohteet voivat käsitellä asiakirjassa olevien kenttien null-arvoja. Pidä mielessäsi, että NOT NULL -rajoitukset epäonnistuvat hiljaa ilman, että null-rajoituksia käsitellään erikseen.
- Vahvista tiedostojen koot valmiiksi. Varmista, että tuotanto-asiakirjat ovat alle 10 Mt. Ota esikäsittely käyttöön jakaaksesi tai pakataksesi asiakirjoja, jotka lähestyvät rajoitusta säännöllisesti.
- Vahvista lopusta loppuun -nouto. Käynnistä eräputken täysi suoritus ja varmista, että kerätyt kentät laskeutuvat oikein kuhunkin kohdetasoon. Jos käytät transaktioiden käsittelyputkea, seuraa JSON-vastausta integrointikerroksen kautta kohteeseen. Tarkasta _SObject-_kohteiden käynnistin ja kulun suoritus, DLO/DMO-kohteiden identiteetin ratkaisun linkitys ja RDBMS-kohteiden idempotenssi.
- Vahvista Trust Layer -toiminta. ETL ei käytä asiakirjan sisällölle PII- peittämistä, joten LLM palauttaa kerätyissä kentissä olevat PII-tiedot sellaisenaan. Varmista, että skeemakentät, datan reititys ja myöhempi tallennustila on suunniteltu käsittelemään henkilötietoja sisältävät tulokset asianmukaisesti ja varmista, että kaikki vaatimukset noudatetaan tai säilytetään sovellusalustan ulkopuolella.
- Määritä Digital Wallet -hälytykset. Määritä kulutushälytykset 75 %:iin ja 90 %:iin saatavilla olevista krediiteistä. Määritä erien kokorajoitukset ja ad hoc -kurssien arvioinnit kunkin syklin luotto-budjetissa.
- Vahvista erien valvonta (vain eräputki). Tarkasta noutojen onnistumissuhteet, kenttien null-suhteet ja työn suorittaminen Data 360 -valvontakonsolissa. Vahvista tunnisteiden propagointi UDLO:sta DLO:n kautta DMO-organisaatioon datan linjassa.
- Vahvista API-virheiden käsittely (vain transaktioiden käsittelyputki). Testaa kaikki virheen ehdot: 413 (yli 10 Mt:n asiakirjat), 400 (virheelliset skeematunnukset), 200 (virheelliset noudot, joilla on osittainen null). Varmista, että uudelleenyrityslogiikka käynnistyy simuloiduille 5xx -vastauksille luomatta identtisiä kirjoituksia.
Tämä asiakirja korostaa Data 360 Document AI -työkalun: arkkitehtoniset perusteet
- Kaksi käsittelyputkea ja milloin käyttää niitä
- Skeemakokoonpanomalli
- Kohdetason päätöksen kehys
- Ydintekniikan rajoitukset
- Epäonnistumistilat
- Hyvin rakennettu kehyksen kohdistus
Sarkkitehtien pika-aloitusopas tarjoaa sandbox-konseptien määritysjärjestyksen.
Ydinarkkitehtuurin asenne tukee asiakirjoista johdettua dataa, jota hallitaan skeemakerroksessa, käsitellään ETL:n noudattaman LLM-putken kautta ja toimitetaan samaan Data 360 -tietojen elinkaareen, joka hallitsee kaikkia muita yritystietojamme.
Arkkitehdit, jotka soveltavat näitä periaatteita — valitsemalla oikean myyntiputken, suunnittelemalla skeemoja asiakirjatyypin tasolla ja suunnittelemalla ne epäonnistumistiloille ennen tuotantoympäristöä — rakentavat keräysominaisuuksia, jotka skaalautuvat ja kestävät toimialan säänneltyjen hallintavaatimusten mukaisesti.
Yugandhar Bora on Salesforcen ohjelmistojen suunnittelu-arkkitehti, joka on erikoistunut datan arkkitehtuuriin Data and Intelligence Applications -sovellusalustalla. Hän johtaa Enterprise Architecture Review Board (EARB) -aloitteita, jotka keskittyvät datan hallintaan ja yhtenäistettyihin datamalleihin, mutta myös automatisoituihin sovellusalustan provisiointiratkaisuihin.
Ananth Anto on tuotehallinnan johtaja Salesforce Data 360:ssa, joka johtaa Document AI- ja Data Graph -aloitteita. Hän työskentelee Bangaloreen kuuluvien yritysasiakkaiden kanssa ratkaistakseen asiakirjojen käsittelyn ja datan älykkyyden haasteita. Hän nauttii Enterprise -käyttöskenaarioiden tutkimisesta Generative AI (Gen AI) -ominaisuudelle.
Nishan Naseer on Salesforcen ohjelmisto-arkkitehti, joka työskentelee rakenteettoman datan käsittelyssä, _RAG-_putkissa ja asiakirjan älykkäässä. Hän haluaa hyödyntää tekoälyn tehoa ratkaistakseen todellisia haasteita ja löytääkseen luovia ratkaisuja asiakkaiden monimutkaisiin ongelmiin.