Introduktion
Obs! “Ämnen” har bytt namn till “underagenter” i hela denna artikel, enligt våra senaste produktnamnkonventioner.
Du kan bygga en agent som fungerar bra i en testmiljö, bara för att låta den följa helt olika rutter när samma arbetsflöde bearbetas två gånger. Denna grundläggande begränsning visar hur den tidigare Agentforce modellen hanterade utförandet: varje beslut, från syftestolkning till åtgärdsval, togs i realtid av LLM, utan någon garanterad väg genom arbetsflödet.
LLM kan skapa inkonsekventa resultat som svar på identiska inmatningar. Subtila variationer i sammanhang, systemuppmaningar eller tokenskapande är tillräckligt för att skicka en agent en annan väg. För många interaktioner är denna variation acceptabel. För arbetsflöden i flera steg som kräver granskning, reproducerbarhet och spårbarhet är det dock inte det. Ett lånegodkännande, en lageröverföring eller en patienttriageprocess kan inte vara beroende av en agent som resonerar sig igenom stegen olika varje gång.
Det nya Agentforce Builder och Agentskriptet åtgärdar detta problem genom att separera deterministisk körning från LLM-resonemang. Agentforces hybridmodell säkerställer att agenten följer en exakt definierad struktur för varje arbetsflödesutförande, samtidigt som den använder LLM-resonemang där omdöme, naturlig språkförståelse eller sammanhangstolkning verkligen behövs.
I den tidigare versionen av Agentforce fungerade en agent som en enkel reaktiv loop. Varje beslut, från att tolka syfte till att välja nästa åtgärd, togs i realtid av LLM baserat endast på användarens senaste inmatning. Det fanns ingen garanterad utförandeväg, inget beständigt läge och ingen mekanism för att tillämpa en sekvens av steg.
Körningsvägar kunde inte garanteras
Eftersom varje beslut berodde på LLM:s resonemang i realtid, producerade mindre variationer i indata, systemuppmaning eller modellversion olika åtgärdsval för identiska begäranden. Detta gjorde den tidigare modellen svår att testa noggrant: ett arbetsflöde som passerade i faser kunde bete sig annorlunda i produktion och det fanns inget tillförlitligt sätt att reproducera en specifik körningsväg för felsökning eller granskning.
Varje interaktion betalade hela LLM-kostnaden
Även enkla konversationsscenarion krävde minst tre LLM-cykler: val av underagent, åtgärdsval och slutligt svarsskapande. Uppgifter i flera steg utökade till fem eller flera cykler. För arkitekter som designar arbetsflöden med hög volym eller latens var detta inte bara ett prestandaproblem. Det innebar att du inte kunde kortsluta resonemangsloopen för steg som inte krävde bedömning, eftersom arkitekturen inte hade någon mekanism för att skilja mellan de två.
Ej deterministiskt utförande skapade ett granskningsgap
I reglerade branscher innebär granskningsbarhet att kunna visa att en specifik process följdes på ett specifikt sätt för en specifik transaktion. En rent icke-deterministisk modell kan inte ge den garantin. Om utförandevägen varierar mellan körningar varierar även granskningsloggen och “agenten bestämde” är inte ett försvarbart svar i en efterlevnadsgranskning.
Staten överlevde inte konversationen
Att förlita sig på bearbetning med en vändning innebar att agenten inte hade något bestående minne av tidigare steg. Om konversationen avvek ens något kan agenten släppa tidigare insamlade sammanhang och tvinga användaren att starta om. För transaktionsflöden i flera steg skapade detta ett pålitlighetstak: ju fler steg i processen, desto högre är sannolikheten för sammanhangsförlust innan slutförande.
Slutförda steg sparades inte
Utan delstatshantering hade agenter inga uppgifter om vilka obligatoriska steg en användare redan hade utfört. Detta skapade oförutsägbara loopar, där en agent skulle gå tillbaka till ett steg som användaren redan hade slutfört. Utöver användarupplevelsens påverkan skapade detta ett djupare arkitektoniskt problem: Att utforma ett pålitligt sekventiellt arbetsflöde var omöjligt eftersom agenten inte kunde tillämpa sekvensen.
Den nya Agentforce, GA sedan februari 2026, övergår från rent probabilistiska LLM-resonemang till en hybridmodell. Istället för att dirigera varje beslut genom LLM separerar det deterministiskt utförande från LLM-resonemang och låter var och en endast hantera vad den är lämpad för. För att stödja detta introducerade Agentforce två författarverktyg: Agentskript för kodbaserad utveckling och Agentforce Studio, en byggmiljö utan kod.
Agentforce Builder
Agentforce Builder är den rekommenderade miljön för att utveckla nya agenter. Den värdas i Agentforce Studio och ersätter den äldre upplevelsen av Inställningar, som fortfarande är tillgänglig men inte längre är den primära författarvägen. I byggaren arbetar du antingen i en visuell arbetsytevy eller direkt i skriptvyn och redigerar det agentskript som definierar din agents beteende.
Agentskript
Agentskript är ett deklarativt, domänspecifikt språk (DSL) som definierar allt om hur en agent beter sig: dess konfiguration, verksamhetslogik och uppmaning. Den är strukturerad som nyckelvärdepar som kan löpa över flera rader eller inkludera kapslade underegenskaper, och den är utformad för att vara läsbar för människor utan att kräva Knowledge om den underliggande grafarkitekturen.
Agentskript låter dig uttrycka två fundamentalt olika typer av instruktioner i samma agent: instruktioner för deterministisk logik och uppmaningar. Instruktioner för deterministisk logik definierar villkor och åtgärdssekvenser som körs som kod utan LLM-inblandning. Uppmaningsanvisningar definierar vägledning på naturligt språk som LLM tolkar vid runtime. Gränsen mellan de två är tydlig och avsiktlig, och att förstå var gränsen ska placeras är ett av de viktigaste designbesluten du kommer att fatta när du bygger med nya Agentforce.
Deterministisk logik i praktiken
När instruktioner är deterministiska följer agenten en definierad utförandeväg oavsett hur användaren uttrycker sin inmatning. Exemplet nedan visar en underagent som läser in en instrumentpanel för Kundintelligens. Den letar efter ett kund-ID, hämtar profildata, orderhistorik och supportärenden och beräknar sedan kundens livstidsvärde och bortfallrisk. Inga av dessa steg kräver LLM-resonemang.
Denna logik anropar åtgärder i en fast sekvens varje gång vissa villkor uppfylls.
Uppmaningsanvisningar och avsiktlig LLM-överlämning
Där deterministisk logik hanterar villkor och sekvenser som kan uttryckas som kod hanterar uppmaningsinstruktioner allt som kräver omdöme, tolkning eller skapande av naturligt språk. När Atlas Resoning Engine stöter på en nod med uppmaningsinstruktioner utlöser den ett LLM-anrop. Om den inte gör det körs den deterministiskt.
Exemplet nedan visar en underagent för produkt och tjänster. Instruktionerna är en uppmaning med flera rader som berättar för LLM hur den ska svara, när den ska söka information och hur den ska hantera tvetydigheter. Detta är rätt mönster när intervallet av möjliga användarinmatningar är för brett för att förutses med villkorlig logik, eller när kvaliteten på svaret beror på LLM:s förmåga att tolka sammanhanget och skapa ett naturligt svar.
Uppmaningsinstruktionerna i en nod utlöser LLM-anropet. Det är ingen tillfällighet—det är mekanismen som Agentskript gör LLM-gränsen explicit och verkställbar med, istället för att lämna den till runtimeslutledning.
Denna underagent visar deterministisk logik och LLM-överlämning i åtgärd.
Pipeline för utförande i tre steg
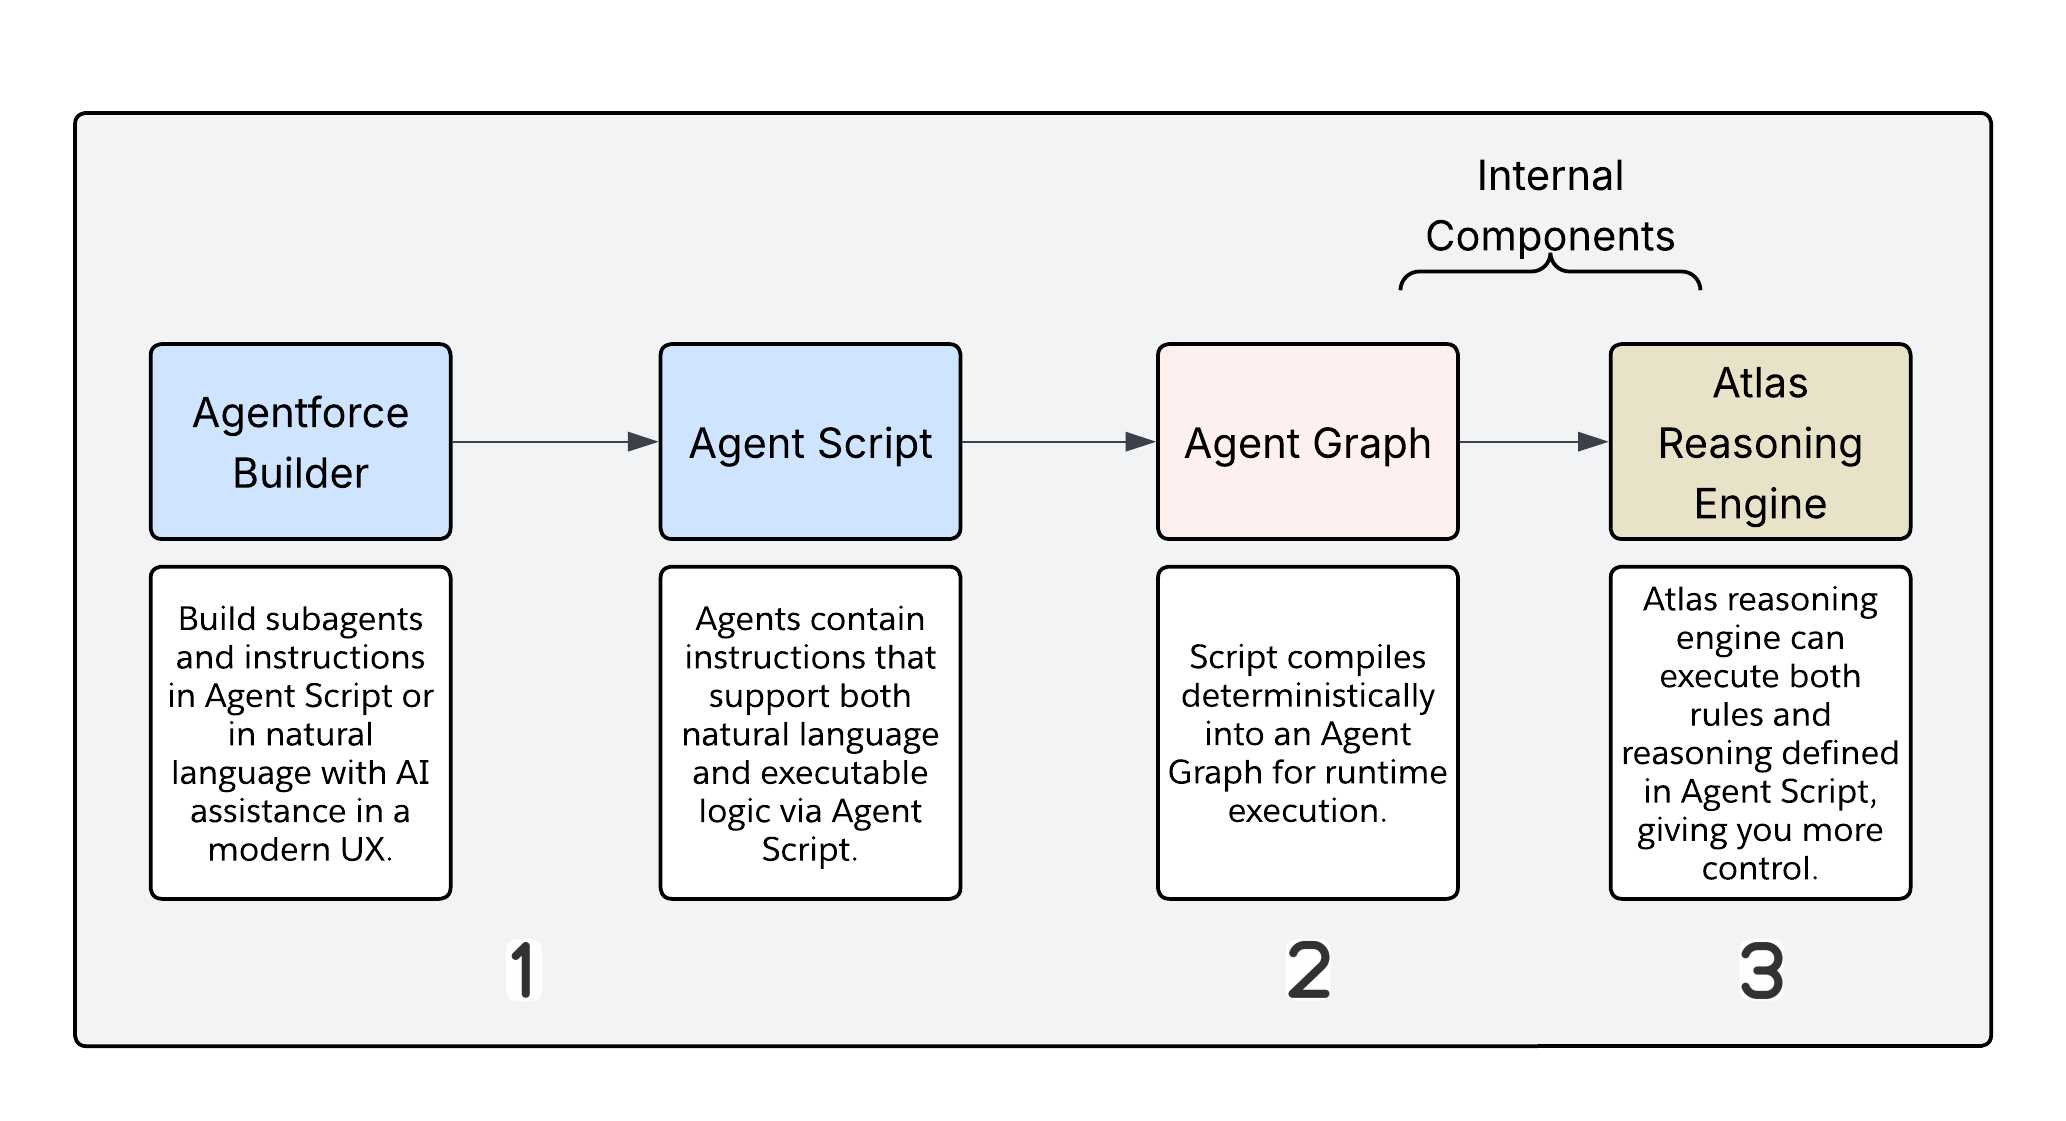
Agentforce Builder och Agent Script är författarlagret, men Agent Graph och Atlas Resoning Engine kör faktiskt din agent. Ingen av dessa komponenter är direkt tillgängliga för dig. Att separera författande och utförande låter plattformen tillämpa deterministiskt beteende oberoende av hur skriptet skrevs.
Pipeline rör sig genom tre steg.
- Du arbetar med auktorisering. Agentskript är läsbart och redigerbart för människor i antingen arbetsytevyn eller skriptvyn i Agentforce Builder. Detta är det enda lager du interagerar med direkt.
- Kompilering är platsen där Salesforce-kompileraren transformerar ditt agentskript till en agentgraf, en seriell körningsplan som är optimerad för maskinkörning istället för mänsklig läsbarhet. Du felsöker inte på detta lager. Kompilering skapar en representation som runtime kan passera effektivt.
- Runtimekörning är platsen där Atlas Resonemangsmotor tar över. Den läser Agentgrafen, går igenom den baserat på aktuell sessionsstatus och bestämmer vid varje nod om den ska köras deterministiskt eller åberopa LLM. Motorn tillämpar uttryckligen vaktklausuler och villkorlig dirigering här istället för att härleda.
Agentgraf
Agentgrafen är den mellanliggande representation som finns mellan ditt mänskligt läsbara skript och den faktiska körningen av körningen. Dess struktur är optimerad för den delstatsmaskin som konsumerar den, inte för arkitekten som skrev skriptet. Att förstå att den finns, och vad den representerar, är viktigt eftersom det är den artefakt som Resonemangsmotorn använder för att tillämpa den utförandeplan ditt skript definierar.
Motor för atlasresonemang
Atlas Resonemangsmotor är en maskinutförare i läget. I varje tur går den igenom Agentgrafen baserat på sessionsstatus, utför deterministiska noder som kod och utlöser LLM-anrop endast där uppmaningsinstruktioner finns. Den tillämpar även skyddsklausuler och hanterar villkorlig dirigering. Resonemangsmotorn är platsen där hybridresonemangsmodellen faktiskt implementeras; skriptet definierar gränsen och motorn respekterar den.
Agentgrafen är inte ett LLM-omslag. Det är en hybridresonemangsmotor som separerar deterministisk körning från probabilistiskt resonemang. Den styrande regeln är enkel: om du kan uttrycka ett beslut som kod ska det skrivas som logik. Om beslutet kräver bedömning, tolkning eller skapande av naturligt språk ska LLM hantera det. Detta designbeslut är det viktigaste arkitektoniska valet i den nya Agentforce modellen. Var LLM-gränsen hamnar påverkar direkt din lösnings kostnad, latens, granskningsbarhet och pålitlighet.
Atlas Resonemangsmotor utvärderar varje inkommande användarsväng och dirigerar den längs en av två vägar.
Väg A: deterministisk körning
Denna väg har ingen LLM-exponering. Den beter sig som kompilerad kod vid runtime. Resonemangsmotorn klassificerar användarens syfte och avgör att en logikinstruktion matchar, vilket helt kringgår LLM. Det kompilerade Agentskriptet körs uppifrån och ner, med if-else-regler som körs villkorslöst i varje tur. Flödes-, Apex eller API-åtgärder anropas med deterministiska parametrar, utan att någon uppmaning om sammanställning eller modellanrop krävs. Resultatet går tillbaka genom Trust lagret med fullständig granskningsloggning.
Väg B: LLM-resonemang
Resonemangsmotorn tar denna väg om den inte kan lösa syftet enbart med logikinstruktioner. Den går igenom agentgrafen och utvärderar varje nod. Noder med uppmaningsinstruktioner utlöser ett LLM-anrop. Noder utan dem körs deterministiskt. Närvaron av en uppmaningsinstruktion är utlösaren och den är explicit i skriptet istället för härledd vid runtime.
Vad utlöser ett LLM-anrop
Det finns åtta punkter i utförandelivscykeln där LLM åberopas. Underagentklassificering, eller att avgöra vilken underagent som matchar användarens begäran, är en, men en kortslutningsväg kan förbigå det fullständiga LLM-anropet när klassificeringen är entydig. Agentresonemang, där agenten bestämmer vilken åtgärd som ska utföras härnäst, går alltid igenom LLM. Det gör även skapande av svar, där det slutgiltiga svaret samlas från en hydrerad uppmaning.
De återstående utlösarna är mer operativa: validering av grundad utdata bekräftar att utdata är grundad i hämtade data; åtgärdssimulering emulerar svar i miljön Förhandsgranska och Simulera istället för att köra live; skapande av strukturerad utdata hanterar kundcase där svaret måste överensstämma med ett definierat schema; och skapande av lokaliserings- och förloppsindikatorer hanterar formatering och tillfälliga meddelanden där ingen förauktoriserad standard finns.
Vad förblir deterministiskt
Övergångar av grafer och tillstånd involverar aldrig LLM. Livscykelblocken before_reasoning och after_reasoning körs deterministiskt så länge de endast innehåller åtgärdsnoder utan uppmaningsinstruktioner. Matematik, datahämtning, validering och villkorlig logik hör alla hemma i kod. Alla åtgärder som utför flöden, Apex eller REST API stannar direkt på den deterministiska vägen. En nod utan uppmaningsinstruktioner körs utan ett LLM-anrop.
Att vara tydlig med denna gräns med ditt team är viktigt. Varje onödigt LLM-anrop lägger till latens, kostnad och variation. Arkitekter bör pusha deterministisk logik som standard och reservera LLM för fall där uppgiften faktiskt kräver sin resonemangskapacitet.
Utformningsvägledning: pushlogik till kod som standard
Använd logikinstruktioner för Agentskript när du skriver uppmaningsinstruktioner som kan uttryckas som ett villkor, en variabeltilldelning eller ett åtgärdsfilter. Varje onödigt LLM-anrop lägger till latens, kostnad och variation.
Standardpositionen ska vara deterministisk. Isolera varje agentbeteende som kan kodifieras som regel och flytta det till Agentskript. De återstående uppgifterna som kräver naturlig språksyntes, kontextuell bedömning eller komplex tolkning hör hemma i noder med uppmaningar. Det är ingen begränsning, det är gränsen som fungerar som den ska. LLM hanterar vad den är bäst lämpad för, och allt annat körs som kod.
Den primära utförandeenheten i Agentskript är inte användarens tur. Det är tolkningen: en enda fullständig cykel genom en underagents tre livscykelblock. Atlas Resonemangsmotor inleder en tolkning varje gång en underagent behöver bearbeta något, vilket sker i tre situationer: vid första inmatningen i underagenten, efter varje verktygsanrop när en åtgärd slutförs och returnerar ett resultat, och vid varje ny användare inom samma underagent.
Att förstå tolkningsgränsen är viktigt eftersom det avgör hur många gånger varje block körs, och därför var du kan och inte kan lita på att en given del av logiken körs exakt en gång.
Varje underagent definierar tre utförandeområden:
| Blockera | När den körs | LLM-engagemang |
|---|---|---|
before_reasoning | I början av varje tolkning, innan LLM ser något | Ingen |
reasoning | Under deterministisk lösning, innan några LLM-anrop | Blandat |
after_reasoning | När resonemanget är klart och LLM har svarat | Inga (med en kritisk varning) |
Både before_reasoning och after_reasoning är fullständigt deterministiska. De utför åtgärder, anger variabler och tillämpar villkorlig logik utan att involvera LLM. Detta gör dem till pålitliga, billiga block i skriptet.
När before_reasoning ska användas
before_reasoning körs i början av varje tolkning utan undantag. Den körs vid första inmatningen i underagenten och igen efter varje verktygsanrop eller ny användare inom den underagenten. En run @actions.X i before_reasoning är kod. Till skillnad från en instruktion inuti ett uppmaningsblock, som LLM kan följa eller inte följa, körs before_reasoning villkorslöst.
Använd detta block för sessionsinitiering: hämta sammanhangsposter, ange sessionsvariabler från Apex eller Flöde. Det är också där autentisering och rättighetskontroller hör hemma, eftersom du vill att de ska verifieras innan LLM ser några verktyg. Sammanhangshydratisering passar även här: anropar en datahämtningsåtgärd så att LLM får förifyllda variabler istället för att behöva begära dem. Alla räknare eller granskningsvariabler som måste ökas för varje tolkning bör anges här, eftersom det set direktivet i before_reasoning är garanterat på ett sätt som en pipelineinstruktion inte är.
Vad som inte hör hemma här är logik som bara ska köras en gång per session, eftersom before_reasoning körs vid varje tolkning, inte bara vid den första posten. Allt som beror på användarinmatning från det aktuella skiftet hör inte heller hemma här, eftersom inmatningen inte har bearbetats ännu. Och övergångar ska aldrig vara i before_reasoning: en transition to här aktiveras villkorslöst vid varje tolkning och skapar loopar.
Om du behöver en initialisering en gång per session, vakta den uttryckligen:
En användarvändning kan utlösa flera tolkningar: en gång vid inmatning och sedan igen efter varje verktygsanrop. Denna funktionalitet har tre praktiska konsekvenser: Initieringsåtgärder i before_reasoning kommer att köras mer än en gång per användare i fleråtgärdsflöden, räknarvariabler som ökas här kommer att återspegla antal tolkningar, inte antal vändningar, och åtgärder med sidoeffekter, externa API-anrop eller postskrivningar, bör inte vara i before_reasoning om inte omkörning vid varje tolkning uttryckligen accepteras.
before_reasoning är ingen konstruktör. Det är en kontroll före flygning som körs med varje tolkning. Utforma den enligt detta.
När after_reasoning ska användas
after_reasoning körs när resonemangsloopen är klar, efter att LLM har svarat och åtgärdsresultat har samlats in. Här hör deterministiska kontroller efter åtgärd hemma: utvärdera åtgärdsresultat och förgreningar baserat på resultat. Deterministiska övergångar, eller att flytta till nästa underagent baserat på variabelstatus istället för LLM-bedömning, finns här. Det gör även variabelrensning innan nästa tur, och orkestreringssekvensering när du behöver kedja underagenter i en förutsägbar ordning utan ett LLM-dirigeringsbeslut.
Behandla after_reasoning som skyddsräcke. Det är där du tillämpar verksamhetsregler och delstatshantering efter att LLM har utfört sitt arbete, vilket säkerställer att viktiga processflöden förblir förutsägbara oavsett vad LLM har genererat.
Använd is_displayable: True klokt
Varje arkitekt som utformar orkestreringsflöden måste förstå detta plattformsbeteende. När is_displayable: True har angetts för en åtgärd går plattformen ur resonemangsloopen så fort LLM bestämmer sig för att visa utdata. Denna utgång sker omedelbart, vilket innebär att after_reasoning aldrig körs.
Detta är ett känt plattformsbeteende, men har en direkt konsekvens för orkestrering: logik som du har placerat i after_reasoning hoppas över när en visningsbar åtgärd är en del av flödet.
Svaret är rakt på sak. Flytta logik som måste köras tillförlitligt till before_reasoning för den efterföljande underagenten istället för after_reasoning för den aktuella.
Utformningsvägledning: var initialiseringslogik ska placeras
Att bestämma var logik ska placeras är viktigt när du utformar en underagent. Detta ramverk täcker de vanligaste scenariona:
| Scenario | Var den ska placeras |
|---|---|
| Måste köras innan LLM ser något sammanhang | before_reasoning |
| Kör varje tolkning, inklusive återinmatning vid nya användarvändningar | before_reasoning |
| Beror på åtgärdsresultat från detta varv | Villkorligt if i reasoning |
| Kräver deterministisk subagentövergång baserat på resultat | after_reasoning (men se is_displayable nedan) |
Kräver orkestreringslogik när åtgärden längre ner använder is_displayable: True | before_reasoning för nästa underagent |
| Använder logik som kräver bedömning eller användarsammanhang | reasoning med uppmaningsinstruktioner |
Den underliggande principen är enkel. När du skriver en uppmaningsinstruktion som ber LLM att “alltid köra” en åtgärd är det ett förslag. LLM kan eller kan inte följa det beroende på sammanhanget. När du placerar ett run i before_reasoning är det kod. Den körs på varje tolkning utan undantag.
Tillgänglighet för villkorliga åtgärder är den mekanism genom vilken Agentskript visar eller döljer åtgärder från LLM baserat på körtidsvariabelstatus. När available when utvärderas till false tas åtgärden bort helt från verktygslistan som presenteras för LLM. Alla falska värden, inklusive None, False, 0 eller en tom sträng, förhindrar åtgärden.
Detta är inte en snabb instruktion som talar om för LLM “kalla inte detta ännu”, det är en hård plattformsnivågrind. LLM kan inte anropa en åtgärd som den inte har åtkomst till.
I detta exempel är execute_transfer osynligt för LLM tills validation_passed utvärderas till true. Grinden upprätthålls av plattformen, inte genom instruktion.
Utformningsvägledning: låt aldrig LLM ange grindvariabeln
Ge varje variabel i en available when en deterministisk kodsökväg som anger variabeln innan den associerade åtgärden utförs. Använd before_reasoning eller ett deterministiskt run och set reasoning för att hålla variabeln i ett känt läge. Om du förlitar dig på LLM för att ställa in grindvariabeln har du återinfört den variabilitet grinden utformades för att förhindra. Beroende på konversationen kan LLM ange den eller inte, vilket innebär att grinden kan eller inte kan öppnas.
Problemet med åtgärdsloopen
En åtgärdsloop inträffar när LLM anropar samma åtgärd upprepade gånger utan att någonsin uppnå ett slutgiltigt läge. Det händer när två villkor är sanna samtidigt: villkoret available when förblir uppfyllt efter att åtgärden körts, och resonemanget säger inte uttryckligen att LLM ska sluta anropa det.
Plattformen undertrycker inte automatiskt en åtgärd efter att den har anropats. Om grinden förblir öppen och resonemangsinstruktionerna är tvetydiga anropar LLM samma åtgärd för varje tolkning tills vidare.
Se available when @variables.interest != "" som ett exempel. Om åtgärden utförs men intressevariabeln inte är tom förblir grinden öppen vid nästa tolkning. LLM ser åtgärden som tillgänglig, har ingen instruktion som säger åt den att sluta och anropar den igen.
Det finns två pålitliga sätt att bryta loopen. Den första är att ställa in grindvariabeln till ett stängt läge som en del av åtgärdens logik efter körning, så att available when utvärderar till false vid nästa tolkning. Det andra är att använda en separat has_run som stänger grinden efter första körningen. Båda metoderna ger grinden ett deterministiskt stängt läge, vilket är det villkor plattformen behöver för att undertrycka åtgärden.
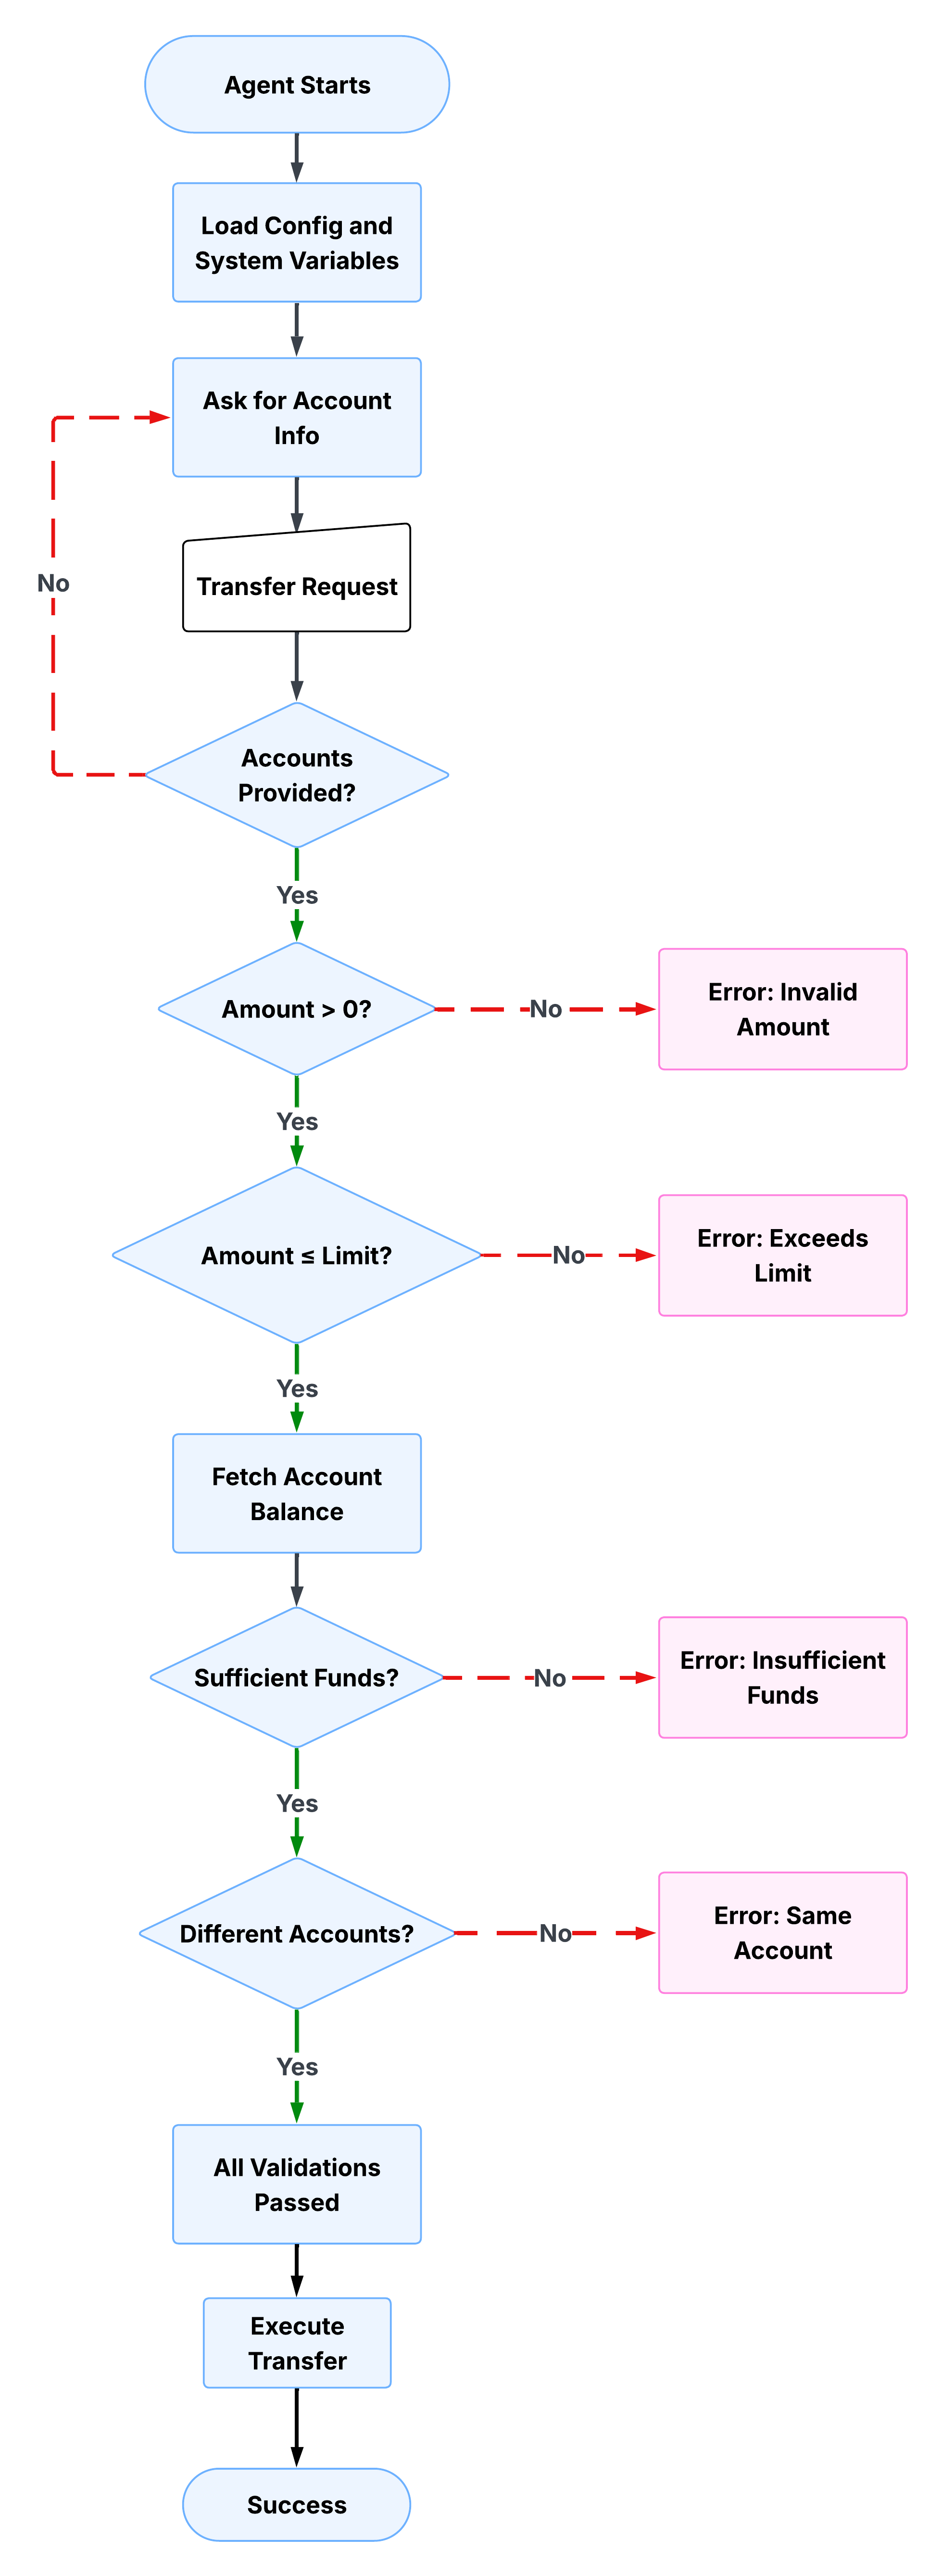
En banköverföring är en användbar lins för att förstå hur dessa mönster fungerar tillsammans i praktiken. Arbetsflödet ser enkelt ut utifrån: flytta pengar från ett konto till ett annat. Implementeringen kräver flera komplexa steg. Innan överföringen utförs måste agenten samla in kontodetaljer, validera beloppet, kontrollera överföringsgränser, bekräfta det tillgängliga saldot och endast sedan visa överföringsåtgärden. Varje steg beror på föregående steg. Ingen av dem bör lämnas till LLM-bedömning.
Samla in och validera indata
Den första underagenten samlar in källkontot, destinationskontot och överföringsbeloppet från användaren. Det fortsätter inte förrän alla tre är närvarande och giltiga. Agentskriptet kontrollerar varje fält i sekvens: om källkontot saknas frågar det. Om destinationen saknas frågar den. Om beloppet är noll eller negativt frågar det. Variabeln validation_passed är endast inställd till true efter att alla kontroller är klara.
Skriptet nedan visar detta i praktiken. Observera att validation_passed uttryckligen är inställd till false vid varje felpunkt och att LLM uppmanas att inte fortsätta. De deterministiska kontrollerna körs villkorslöst, medan uppmaningsinstruktionerna hanterar det svar som användaren har framför sig.
Tillämpa verksamhetsregler
Efter att agenten har validerat inmatningar kontrollerar den om överföringsbeloppet överskrider den konfigurerade överföringsgränsen. Här blir verksamhetsregler kod istället för instruktioner. Gränsen är inte något som LLM resonerar kring; det är en hård tröskel som definieras i skriptet och kontrolleras deterministiskt i varje tolkning.
Om beloppet överskrider gränsen sätts validation_passed tillbaka till false och LLM ger användaren tre alternativ: överföra det högsta tillåtna beloppet, dela upp i flera överföringar eller kontakta support för högre gränser. Agenten kan inte fortsätta förrän användaren har löst undantaget. Notera hur uppmaningsinstruktionen här gör exakt vad LLM-resonemang är lämpligt för: presentera alternativ konversationellt och hantera användarens svar. Själva verksamhetsregeln är deterministisk, men inte konversationen runt den.
Skriptet nedan visar hur gränskontrollen fungerar. Det deterministiska villkoret utvärderar överföringsbeloppet mot variabeln limit, ställer in validation_passed till false om tröskeln överskrids och delegerar till en uppmaning att hantera det användarvända svaret.
Tillämpa skyddsklausuler
Med kontroller av belopp och gränser slutförda hämtar agenten källkontosaldot och bekräftar att tillräckliga resurser finns tillgängliga. Skyddsklausuler förhindrar agenten från att försöka utföra åtgärder om förvillkoren inte uppfylls. Till skillnad från en uppmaningsinstruktion som talar om för LLM att kontrollera saldot gör en vaktklausul i Agentskript kontrollen ovillkorlig. LLM bestämmer inte om den ska köras.
Om saldot inte är tillräckligt beräknar agenten underskottet och presenterar ett konkret alternativ för användaren. validation_passed sätts till false tills denna kontroll är godkänd, vilket innebär att överföringsåtgärden förblir grindad.
Skriptet nedan visar ett deterministiskt åtgärdsanrop som hämtar saldot, följt av en villkorlig kontroll som utvärderar det. Hämtningen körs endast om saldot inte redan har hämtats, vilket undviker överflödiga API-anrop vid efterföljande tolkningar.
Upptäcktsfel tydligt
Vaktklausuler anger delstaten. Felmeddelanden kommunicerar det. När validation_passed är false måste agenten ge användaren tillräckligt med information för att lösa problemet utan att starta om. Vaga felmeddelanden skapar friktion; strukturerade meddelanden stänger loopen snabbare.
Skriptet nedan visar felmeddelandet om otillräckliga resurser i praktiken. Den berättar inte bara för användaren att överföringen misslyckades. Den visar det tillgängliga saldot, det begärda beloppet, det beräknade underskottet och erbjuder ett konkret nästa steg, allt sammanställt från sessionsvariabler snarare än skapat av LLM.
Bristberäkningen sker i skriptet, inte i LLM. Det föreslagna alternativet, att överföra det tillgängliga saldot, deriveras deterministiskt från sessionsstatus. LLM: s roll här är rent presentationell: den levererar ett meddelande som skriptet redan har strukturerat.
Gate överföringsåtgärden
Varje valideringskontroll i föregående steg anger eller rensar samma variabel: validation_passed. Denna variabel gör nu sitt viktigaste jobb. Åtgärden execute_transfer är villkorligt tillgänglig, vilket innebär att den endast visas i LLM:s verktygslista när validation_passed är true. Innan varje föregående kontroll har gått igenom och angett variabeln finns inte åtgärden från LLM:s perspektiv.
Detta är mönstret från den tidigare grindsektionen som tillämpades för ett produktionsflöde. Överföringsåtgärden döljs inte av en uppmaning. Den är dold av plattformen. Ingen mängd konversationstryck eller tvetydiga fraser kan göra att LLM åberopar det innan förvillkoren uppfylls.
Skriptet nedan visar hur grinden är konfigurerad. available when refererar validation_passed direkt och åtgärdsparametrarna är bundna till sessionsvariablerna som samlats in och validerats i föregående steg.
Alla tre parametrar, from_account, to_account och amount, skickas deterministiskt från sessionsvariabler. När denna åtgärd blir tillgänglig har varje värde validerats. LLM samlar inte parametrarna från konversationssammanhang; det läser dem från läget.
Följ status genom hela arbetsflödet
Mönstren i de föregående sektionerna fungerar endast eftersom sessionsstatus kvarstår över hela arbetsflödet. Kontonummer som samlats in i det första steget är tillgängliga i det fjärde. Valideringsresultat som ställts in i en kontrollgrindåtgärd i en annan. Konversationen kan avvika, användaren kan ställa uppföljningsfrågor och agenten kommer fortfarande veta exakt var den är i processen.
Variabelblocket nedan visar det fullständiga sessionsläget för detta arbetsflöde. Varje variabel har en definierad typ, ett standardvärde och en beskrivning. Två variabler hanterar det mesta av orkestreringsarbetet: validation_passed styr åtgärdstillgänglighet vid varje grind och validation_information har ett mänskligt läsbart sammanhang om varför en kontroll misslyckades, vilket LLM kan visa för användaren utan att behöva resonera kring det underliggande läget.
Varje variabel startar i ett känt standardläge. Strängar är som standard tomma, nummer noll och validation_passed booleska till false. Detta innebär att grinden är stängd som standard. Arbetsflödet måste aktivt förtjäna rätten att fortsätta i varje steg, istället för att börja med att grinden öppnas och förlita sig på kontroller för att stänga den.
Exemplet banköverföring illustrerar var deterministisk logik är rätt verktyg, men det är inte alltid det bästa valet. Att förstå gränsen är lika viktigt som att förstå mönstren.
Deterministisk logik är rätt val när arbetsflödet kräver en garanterad utförandesekvens, när fel har betydande konsekvenser, när processen behöver skapa en reproducerbar verifieringskedja eller när verksamhetsregler är tillräckligt väldefinierade för att uttryckas som villkor och tröskelvärden. Arbetsflöden för finans, vård och försäkring hamnar i allmänhet i denna kategori.
Rent LLM-resonemang utan strikta deterministiska begränsningar är mer meningsfullt när värdet i interaktionen ligger i flexibilitet snarare än precision. Öppen kundsupport, tidiga produkter där verksamhetsprocesser fortfarande utvecklas och informationsförfrågningar med låga insatser är alla fall där variationen i LLM-resonemang är en funktion, inte ett problem.
I praktiken behöver de flesta produktionsagenter båda. Beslutet om var gränsen hamnar är inte ett binärt val mellan deterministisk och probabilistisk; det är ett designbeslut du fattar på nodnivå för varje del av din agents arbetsflöde.
| Använd deterministisk logik för | Använd LLM-resonemang för |
|---|---|
| Validering och sanering av indata | Naturlig språkförståelse och syftesdetektering |
| Tillämpning av verksamhetsregler | Skapa konversationella, empatiska svar |
| Sekventiell processorkestrering | Hantera tvetydiga eller oväntade inmatningar |
| Delstatshantering och sammanhangsbevarande | Ge förklaringar och förtydliganden |
| Skyddsklausuler som förhindrar ogiltiga åtgärder | Anpassa ton och meddelanden till användarsammanhang |
Gränsen är designbeslutet
Exemplet med banköverföring är en illustration av en designfilosofi: att gränsen mellan deterministiskt utförande och LLM-resonemang är det mest följdriktiga arkitektoniska beslut du fattar när du bygger en produktionsagent.
Placera en gräns som är för stel och du får en agent som är stel, dyr att underhålla och oförmögen att hantera den naturliga variationen av verkliga konversationer. Att få gränsen fel i andra riktningen skapar en agent som är flexibel men oförutsägbar, fungerar bra i tester men beter sig annorlunda i produktion och inte kan skapa en pålitlig verifieringskedja eller anförtros en transaktion med höga insatser.
Den nya Agentforce modellen ger dig verktygen för att avsiktligt placera denna gräns. Agentskript låter dig uttrycka deterministisk logik och uppmaningsinstruktioner i samma fil, med en uttrycklig syntax för att göra gränsen synlig. Atlas Resonemangsmotor tillämpar logik och uppmaningar vid körning. Blocken before_reasoning och after_reasoning ger dig garanterade körningszoner på båda sidor om LLM-anropet. Tillgänglighet för villkorliga åtgärder säkerställer att LLM endast kan agera när förvillkoren uppfylls.
Ingen av dessa funktioner är isolerade. De arbetar tillsammans för att skapa en sammanhängande arkitektur för att bygga agenter som företag kan Trust med verksamhetskritiska arbetsflöden. Hybridresonemangsmodellen känner igen att determinism och flexibilitet båda har roller i din arkitektur; det är arkitektens jobb att bestämma exakt var var och en gäller.
Agentforces agentgraf: Mot guidad determinism med hybridresonemang
Gulal Kumar är arkitekt inom programvaruteknik på Salesforce med över 20 års erfarenhet. Hans expertis sträcker sig över AI, integration, API och företagsarkitektur, med fokus på att driva verksamhetstransformation genom säkra, motståndskraftiga och innovativa AI-lösningar. Anslut med honom på LinkedIn.
Miriam McCabe är Senior Director och ledare för Architect Evangelism-teamet. Hennes arbete fokuserar på att låta den globala Salesforce Architect Community leda i den agentiska eran genom djupt tekniskt innehåll, liveprogrammering och diskussionsgruppengagemang. Följ henne på LinkedIn.