Företag hanterar ett brett utbud av dokumenttyper, inklusive fakturor, inköpsordrar, juridiska kontrakt och tekniska manualer. Manuell bearbetning är långsam, felbenägen och upptar uppskattningsvis 15–25 % av medarbetarnas tid. Tidigare automatiseringsmetoder (till exempel Robotic Process Automation (RPA), Optical Character Recognition (OCR) och arbetsflödesverktyg) minskade en del av bördan, men gav upphov till stela pipelines, höga underhållskostnader och simulerad användning av enskilda affärsteam.
Dokument har ett rikt strukturellt sammanhang (till exempel tabellhierarkier, rumsliga fältrelationer och korsrefererade sektioner) som platttextbearbetning inte kan bevara. Att ta bort ett dokument till klartext gör att det verksamhetssammanhang som gör extraheringen korrekt och användbar ignoreras, vilket försämrar kvaliteten på analyser längre ner, artificiell intelligens (AI) och processautomatisering.
För att vara effektiva måste system för Intelligent dokumentbehandling (IDP) klassificera dokument efter typ, extrahera strukturerade data korrekt från variabellayouter och leverera dessa data i en styrd, sökbar form till system längre ner. IDP måste även hantera dokumentvariationer i stor skala utan att kräva konfiguration per mall för varje nytt dokumentformat, och de måste vara centraliserade och tillgängliga över alla affärsenheter. Denna utmaning förvärras av den stora volymen av nyckelproblemet: Ostrukturerade data står för cirka 80 % av alla företagsdata och majoriteten ackumuleras i dokumentform i filsystem, molnlagring och innehållslager som är utom räckhåll för system för kundrelationshantering (CRM), AI-agenter och analysplattformar.
Data 360 Document AI är Salesforces kapacitet för dokumentbearbetning i Data 360, som är utformad för att åtgärda detta gap. Den extraherar, klassificerar och analyserar ostrukturerat och semistrukturerat dokumentinnehåll med hjälp av stora språkmodeller (LLM), optisk teckenigenkänning (OCR), naturlig språkbehandling (NLP) och maskininlärning (ML). Utdata är strukturerade, styrda och sökbara data som integreras i Data 360-pipeline där Agentforce agenter, analysverktyg och automatiseringsflöden kan komma åt dem via standardgränssnitt utan att kräva egna extraherings- eller transformationslager.
Enterprise-dataplattformar bearbetar strukturerade data i tabellform. Majoriteten av företagsdata anländer dock som dokument och förblir oåtkomliga för CRM, ERP, AI-agenter och Analytics-pipeline tills någon extraherar dem manuellt. Detta är en arkitektonisk lucka, inte ett arbetsflödesproblem.
Tidigare metoder kombinerade manuell omnyckelring, regelbaserad OCR och RPA-skript. Dessa metoder fungerade i liten skala, men de kunde inte hantera volym, sort och hastighet för de typer av dokument som moderna företag skapar. Regelbaserade verktyg kräver explicita mallar per layoutvariant. Alla formatändringar bryter extraheringen och kräver en utvecklare, en ny mall och en distributionscykel.
I stor skala skapar detta ömtåliga punktlösningar utan centraliserad styrning, delat schema och väg till AI-beredskap. Inkonsekventa extraheringspipelines propageras längre ner. Med andra ord ärver analyser datainkonsekvenser, AI-modeller producerar opålitliga utdata och reglerat innehåll som Personlig hälsoinformation (PHI) och Personligt identifierande information (PII) saknar systematisk styrning.
LLM extraherar fält utan explicita mallar. En enskild schemakonfiguration styr extrahering över layoutvarianter, språk och format, vilket anpassar sig till dokumentet istället för att kräva att dokumentet följer en fast struktur. Detta flyttar dokumentbearbetning från en underhållstung, silobaserad operation till en styrd, centraliserad kapacitet.
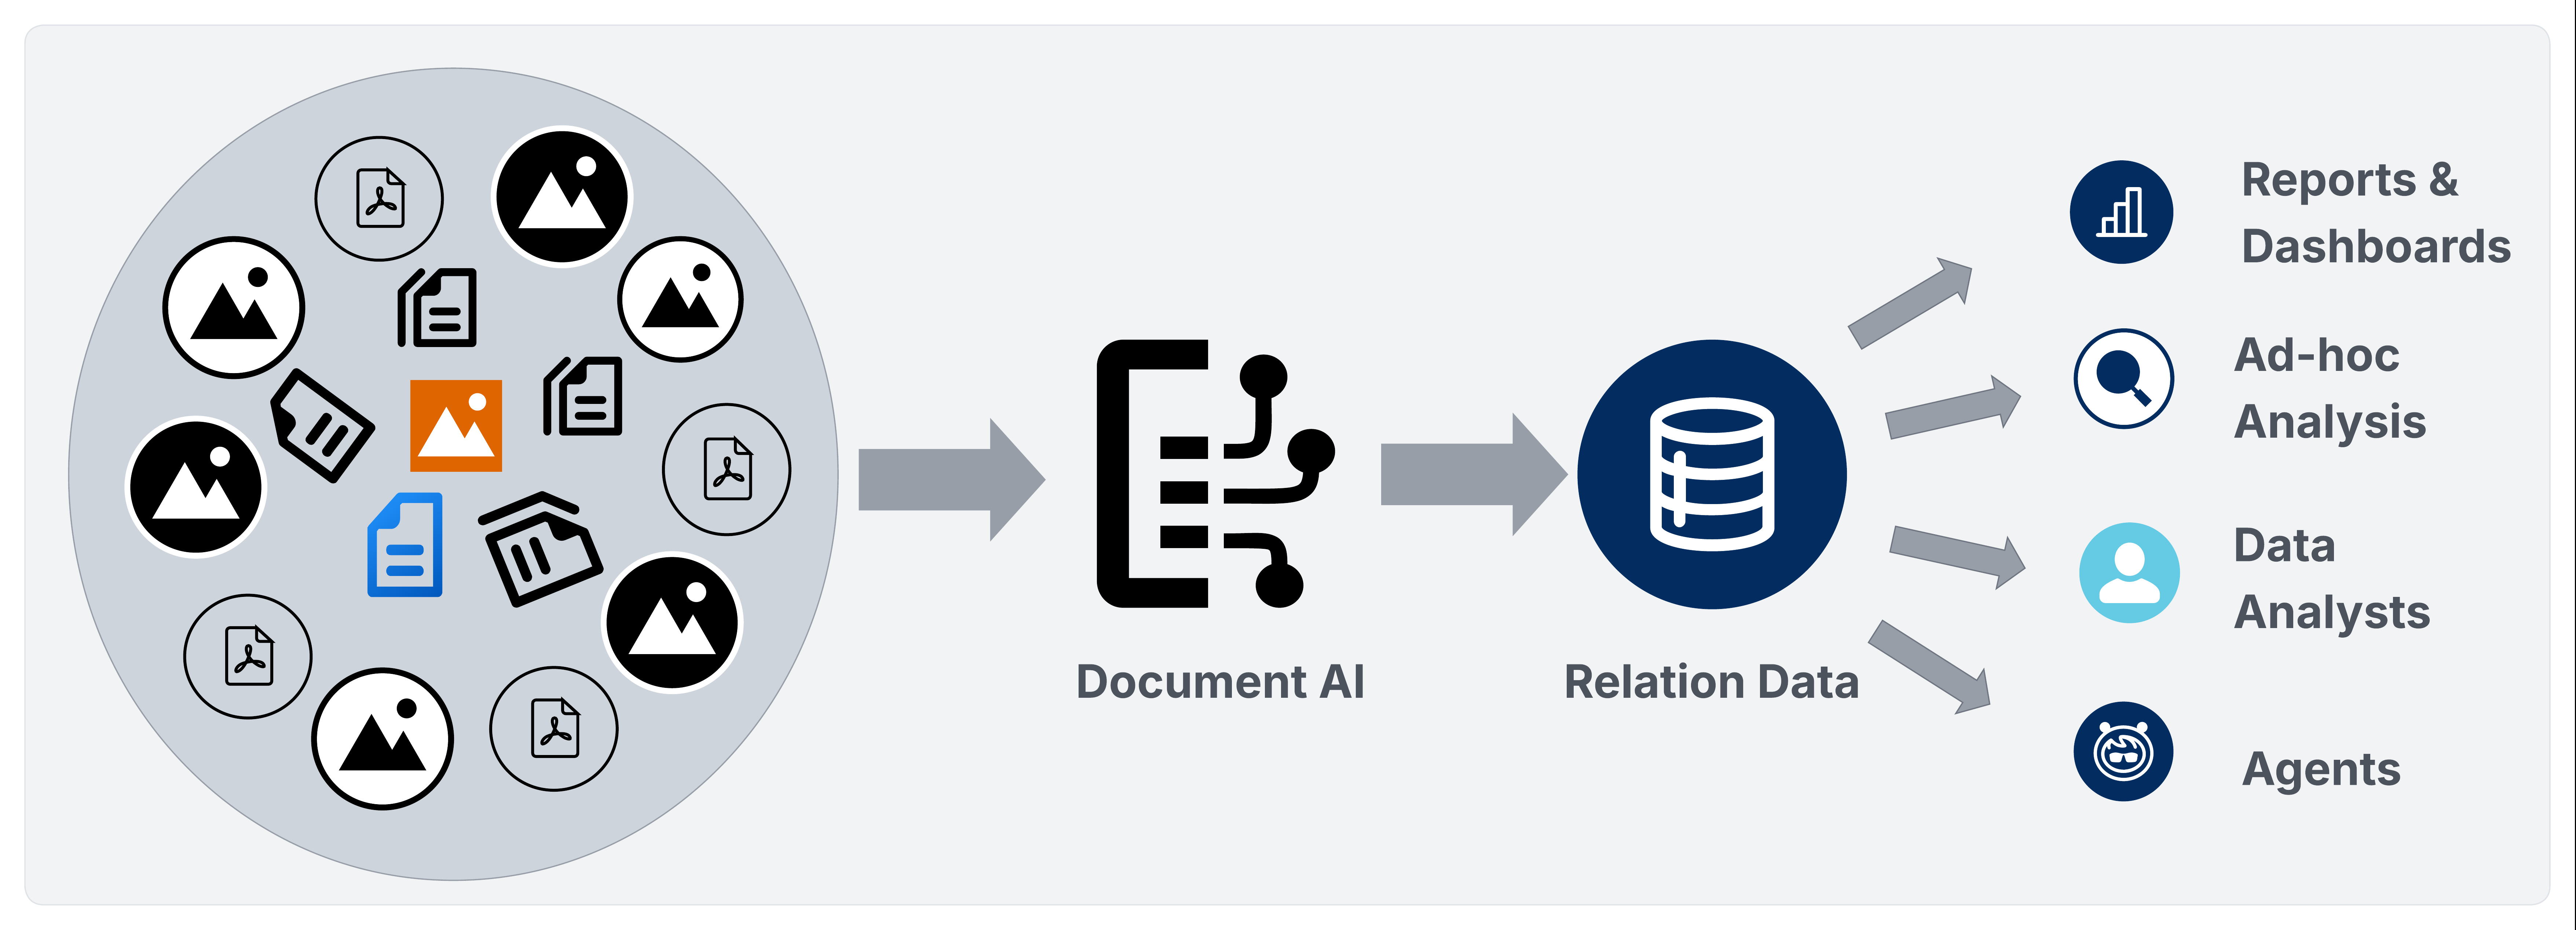
Data 360 Document AI operationaliserar dokumentbearbetning inom Data 360 Platform via två pipelines.
- Batchpipeline dirigerar extraherade data genom intag, identitetslösning, beräknade insikter, aktiveringar, analyser och Agentforce aktivering.
- Transaktionell bearbetningspipeline visar ett REST API som returnerar strukturerad JSON synkront, vilket låter arkitekter dirigera dokumentderiverade data till Salesforce SObjects, pipelinen för Data 360 Data Lake Object / Data Model Object (DLO/DMO) eller externa databaser och lagerbyggnader utan att behöva konfigurera flera satser.
I båda fallen går extraherade data in i en styrd, schemadriven modell istället för en fragmenterad uppsättning poängverktyg.
Data 360 Document AI är Salesforces inbyggda kapacitet för Intelligent dokumentbearbetning (IDP) inom Data 360 Platform. Den konverterar ostrukturerat och semistrukturerat dokumentinnehåll till styrd, sökbar data som deltar fullständigt i hela Data 360:s livscykel.
Data 360 Document AI är Salesforces inbyggda kapacitet för Intelligent dokumentbearbetning (IDP) i Data 360. Den tar in ostrukturerade och semistrukturerade dokument, extraherar strukturerade data med en deklarativ schemakonfiguration och levererar dessa data till Data 360 pipeline för harmonisering, identitetslösning, analys och Agentforce aktivering.
Data 360 Document AI har stöd för två bearbetningsmodaliteter:
- Bearbetar buntsats: Bearbetar stora dokumentuppsättningar som definieras i ostrukturerade datamodellobjekt (UDMO) på händelsedriven basis.
- Transaktionell bearbetning: Bearbetar ett enskilt dokument via REST API och returnerar en strukturerad JSON-belastning synkront. Arkitekter kan sedan dirigera denna belastning till pipeline för Data 360 DLO/DMO, Salesforce SObjects eller externa databaser och lager via pipelines MuleSoft, Apex eller Einstein Trust Layer (ETL). Målnivån är ett arkitektoniskt beslut som drivs av latens, styrning och datalagringskrav.
Dokument-AI har för närvarande stöd för PDF-filer, bildfiler (JPEG, PNG) och handskrivna dokument.
Data 360 Document AI samlar fyra bearbetningstekniker i en enda styrd pipeline. Varje komponent hanterar en distinkt fas i dokument-till-data-livscykeln:
- Optisk teckenigenkänning (OCR): Konverterar skannade bilder, handskrivet innehåll och bildbaserade PDF-filer till maskinläsbar text innan LLM-bearbetning. Minst 150 DPI rekommenderas för tillförlitlig extrahering.
- Stora språkmodeller (LLM): Dirigera extrahering genom Einstein LLM-gateway med den användarvalda modellen. LLM tar emot OCR-utdata tillsammans med schemakonfigurationen för JSON och returnerar en strukturerad extrahering. Gemini och ytterligare modeller planeras för framtida implementering.
- Naturlig språkbehandling (NLP): Utför sammanhangsförståelse, enhetsigenkänning, datumtolkning och semantisk fältextrahering direkt i LLM via strukturerad uppmaningsteknik—den schemadefinierade uppmaningen och OCR-utmatningen fungerar som de enda indata. Alla LLM-interaktioner dirigeras genom ETL, som tillämpar nolllagring av data med modellleverantörer och maskerar PII i textbaserade inmatningar innan de når modellen. Ingen separat NLP-motor används.
- Multi-Modal bearbetning: Bearbetar inbäddade bilder i PDF-filer som separata extraheringsinmatningar, vilket låter LLM extrahera data från diagram, bildåtergivningstabeller och sidor med blandat innehåll som OCR inte ensamt kan tolka.
Utöver de fyra bearbetningsteknikerna hanterar Document AI även:
- Einstein Trust Layer: Dirigerar alla LLM-interaktioner genom ETL, vilket tillämpar nolllagring av data med modellleverantörer och maskerar PII innan indata når LLM, med undantag för multimodala data (till exempel bifogade dokument som bearbetas via dokument-AI) där PII-maskering för närvarande inte stöds och data skickas som de är till externa modeller. ETL styr endast sökvägen för LLM-interaktion. Extraherade data som skrivits till Data Lake Objects (DLO) lagras i befintligt skick. Maskering på fältnivå vid vila måste hanteras genom datastyrningskontroller längre ner.
- Filstorleksgränser: Dokument-AI bearbetar filer upp till 10 MB per begäran. Gränser för längd på LLM-sammanhang kan ytterligare begränsa bearbetningen av täta flersidiga dokument inom denna gräns.
Företagsarkitekter som distribuerar Data 360 Document AI bör tillämpa dessa principer innan de bestämmer sig för en implementeringsdesign.
- Välj pipeline innan du utformar schemat. Pipeline för satsbearbetning och transaktionell bearbetning skiljer sig åt vad gäller intagsmodell, schemabindning, målflexibilitet och latens. Det är viktigt att bekräfta vilken pipeline varje användningsfall kräver innan du definierar schemat eftersom efteranpassning lägger till omarbetningar som går att undvika.
- Utforma scheman på dokumenttypnivå. Att använda ett enda, välgjort schema per dokumenttyp är mer lättskött än att använda konfigurationer per användningsfall, och det är också den största hävstången för extrahering. Att göra detta korrekt kräver att du använder en mängd olika dokument—inklusive kantfall—istället för att utforma från ett enskilt exempel. Använd uppmaningar iterativt på fält-, tabell- och schemanivå för att hitta luckor och testa och förfina dem sedan mot flera dokumentexempel innan de slutförs. Kom ihåg att ett schema som fungerar bra för ett dokument kan misslyckas med andra, så bredd och upprepning är viktigt. Schemaflexibilitet—inklusive att ta bort kolumner som inte extraheras tillförlitligt mellan dokumenttyper—är lika viktigt. Att behålla fält som introducerar brus eller inkonsekvens undergräver den övergripande extraheringskvaliteten, så det är viktigt att behandla borttagning av kolumner som ett förstklassigt designbeslut.
- Välj rätt målnivå per fältgrupp. Fält som driver CRM-flöden eller godkännanden skrivs till SObjects. Fält som förbättrar den enhetliga profilen eller kanalanalysen hör hemma i pipelinen DLO/DMO. Fält som servar externa system hör hemma på RDBMS-nivån. Kom ihåg att ett enskilt schema kan spridas till flera nivåer samtidigt.
- Tillämpa styrning innan du bearbetar reglerat innehåll. Reglerade data behöver skydd i varje lager. Därför är det viktigt att konfigurera maskering av PII, dataklassificeringstaggar och attributbaserad åtkomstkontroll (ABAC) efter att extraherade data har lagrats i utdataobjekten för Datasjön (DLO). Detta ger finjusterad tillämpning och sammanhangsberoende åtkomst som baseras på dataklassificering, användarroll och organisatoriskt sammanhang. Styrning delas upp i två vägar: ELT styr LLM-interaktionen, medan extraherade data som lagras i DLO måste styras separat—direkt på DLO- och databasnivå—genom konfigurationer för datautrymme, behörighetsuppsättningar och ABAC-policyer. Dessa kontroller måste upprätthålla enhetlighet på lagringsnivån — inte bara i programlagret — så att åtkomstbegränsningar förblir intakta oavsett hur data nås efter intag. Kom ihåg att luckor i något lager kan exponera reglerade data längre ner även om andra är korrekt konfigurerade.
- Utforma för fellägen innan produktion. Hantera nullfälthantering, trösklar för OCR-kvalitet, förvalidering av filstorlek, LLM-sammanhangsspill, RDBMS-skrividempotens och kreditbudgetgränser innan den första produktionssatskörningen. Dessa är inte kantfall—de är förutsägbara felytor som uttryckligen måste hanteras i pipelinedesign, inte upptäckas under körning.
- Behandla förtroendebetyg som en förstklassig dirigeringssignal, inte en diagnostisk eftertanke. Extraheringsresultat bär fältnivåförtroendevärden som deriveras från logsannolikheterna (logprobs) för den underliggande modellens utdata. För varje extraherat fält, tabell eller kolumn reflekterar betyget modellens tokennivåsäkerhet för det extraherade värdet. Detta gör förtroendebetyg till en statistiskt grundad signal som är pålitlig nog att fungera som den primära grinden för omflyttningströsklar för Human-in-the-Loop (HITL). Använd förtroendebetyg för att systematiskt identifiera extraheringar med låg kvalitet och initiera HITL-kontrollpunkter för fältvärden med låg förtroende, tvetydiga schemamatchningar eller upprepade pipelinefel istället för att förlita dig på heuristik eller manuella stickprov. Om automatiserad återställning inte är möjlig säkerställer HITL-stödd förtroendebetyg att mänskligt omdöme tillämpas exakt där det behövs.
- Utforma aktiveringsvägar parallellt med schemadesign. Värdet för Dokument-AI kommer från möjligheten att aktivera extraherade data i Salesforces arbetsflöden och agenter. Det låter dig utforma Agentforces åtgärder, flöden och beräknade insikter tillsammans med utformningen av extraheringsschemat, inte efteråt.
Dokument-AI arbetar inom två pipelines:
- En satspipeline för UDMO-stödd bearbetning med hög volym
- En transaktionell bearbetningspipeline för API-driven extrahering i realtid
Båda pipelines delar samma schemakonfigurationskontrakt och ETL-styrning, men de skiljer sig åt i hur dokument kommer in i systemet och var extraherade data landar.
Låt oss ta en närmare titt på varje pipeline.
Batchpipeline bearbetar återkommande dokumentuppsättningar som definieras av en UDMO. Den passar schemalagda eller händelsedrivna användningsfall där dokument tas in från företagets lagring, sedan passerar genom dokumentextrahering och levereras till Data 360 DLO/DMO för harmonisering, identitetslösning och aktivering.
Verklighetsscenario
Varje dag får en försäkringsgivare tusentals medicinska anspråksdokument från leverantörsportaler som laddas upp som PDF-filer till Amazon S3. UDMO definierar dokumentuppsättningen och skickar alla PDF-anspråk till /claims/incoming/ inom ett 24-timmarsfönster.
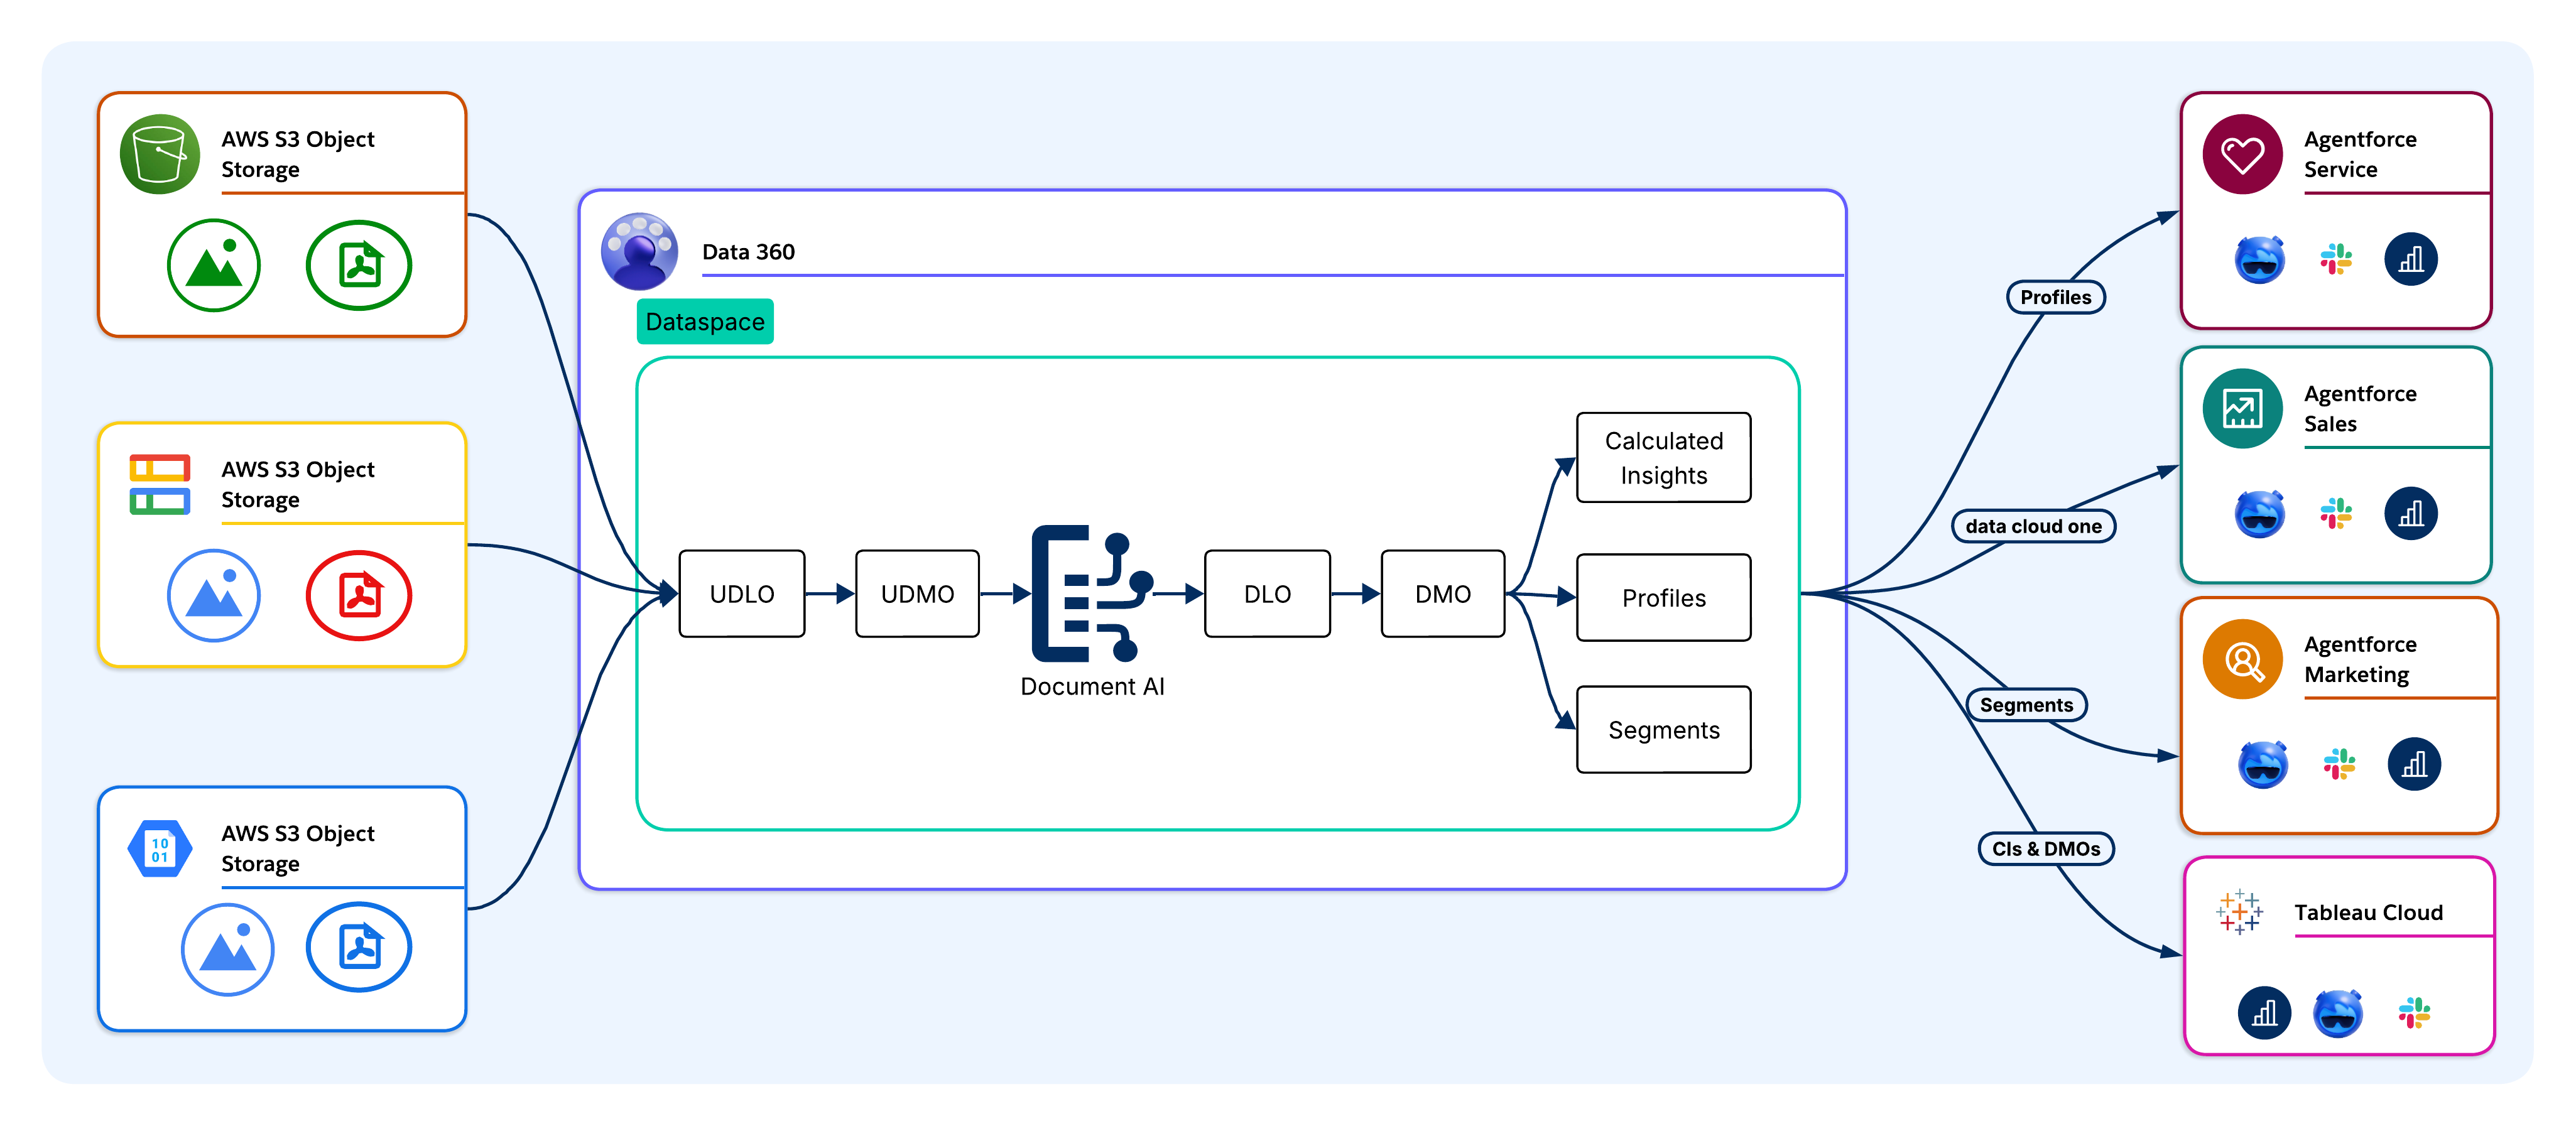
Dokument tas in i Data 360 från företagets källsystem utan fysisk duplicering. Källor som stöds inkluderar Amazon S3, Google Cloud Storage, Salesforce CRM-filobjekt, MuleSoft-orkestrerade pipelines och direkta API-uppladdningar. I Headless 360-distribueringar tas dokument in via molnlagringsanslutningar eller Ingestion API, vilket kringgår CRM-lagret. Servern för Model Context Protocol (MCP) exponerar intag som ett anropbart verktyg för externa AI-agenter och LLM-klienter.
Vid intag lagras råa dokument som ostrukturerade datasjöobjekt (UDLO), som mappar till varje dokuments fysiska plats och metadata utan att flytta eller transformera källfilen.
Exempel:
PDF-filer för anspråk tas in från S3 till Data 360 via molnlagringsanslutningen. Varje dokument lagras som ett UDLO som pekar till S3-objektet. Ingen fysisk duplicering inträffar.
Dokument-AI bearbetar varje UDLO mot en schemakonfiguration som definierar vilka fält som ska extraheras tillsammans med deras måldatatyper. UDMO definierar vilka dokument som omfattas. LLM (GPT-4o, Gemini eller Claude) läser varje dokument och returnerar en strukturerad extrahering.
Exempel:
Dokument-AI bearbetar varje UDLO mot ett anspråksschema som definierar fält som: ClaimID, PatientName, DiagnosisCode, BillingAmount och ServiceDate. LLM läser sedan varje PDF och returnerar en strukturerad extrahering.
När data har extraherats fortsätter de till DLO, som är det råa lagringslagret i Data 360. DLO behåller extraherade fält utan att införa verksamhetslogik, vilket bevarar en korrekt fysisk representation för transformation och spårbarhet längre ner. UDLO behåller en referens till källdokumentet för att aktivera härkomst på fältnivå när som helst i pipeline.
Exempel:
Alla extraherade fält landar i ett anspråks-DLO, vilket bevarar en rå och korrekt representation av varje anspråk med fullständig härkomst som kan spåras tillbaka till käll-PDF:en.
DLO-fält mappas till DMO som överensstämmer med standarddatamodellen för Customer 360. Detta är gränsen där dokumentderiverade data övergår från rådata, extraherade fält till affärsmeningsfulla enheter. Faktura-DLO mappas till en faktura-DMO och fält som CustomerID och BillingAmount blir sammanslagningsnycklar och matchningsattribut inom den sammanslagna datamodellen. Harmoniserade dokumentdata deltar i segmentering, beräknade insikter och aktivering via samma gränssnitt som används av CRM och transaktionsdata.
Exempel:
DLO för anspråk mappas till en DMO för anspråk. Fälten PatientID och PolicyNumber blir sammanslagningsnycklar som länkar anspråksposter till sammanslagna patientprofiler.
Harmoniserade DMO-data deltar i identitetslösning. Extraherade fält (till exempel kundnamn, e-postadresser eller kontonummer) fungerar som matchningsnycklar för att länka dokumentposter till enhetliga individer (gyllene poster), vilket stänger luckan mellan dokument och profil.
Exempel:
Extraheringsfält (till exempel PatientName, DateOfBirth och PolicyNumber) fungerar som matchningsnycklar för identitetslösning, vilket länkar anspråksposter till rätt enhetlig individ. Detta inträffar även om samma patient visas under lite olika namnstavningar mellan dokument.
Arkitekter definierar beräknade insikter, som är aggregerade mått som beräknas över harmoniserade dokumentdata (till exempel totala utgifter från olika fakturaradartiklar, riskbetyg för förnyande av kontrakt och allvarlighetsgradsindex för anspråk).
Exempel:
Beräknade insikter beräknar TotalClaimsPerPatient, AverageClaimAmount och HighRiskClaimScore för harmoniserade anspråksdata för Agentforce-frågor.
Harmoniserade identitetslösta data är tillgängliga för Agentforce Agenter, Tableau, marknadsföringsplattformar och Salesforce SObjects. Målnivån är ett arkitektoniskt beslut som drivs av latens, styrning och datalagringskrav.
Exempel:
En agent för anspråksbedömning Agentforce frågar Data 360 DMO och CI för att hitta högriskanspråk för prioritetsgranskning. Tableauinstrumentpaneler visar trender för anspråksvolym och avvikelser. Godkända anspråksposter går tillbaka till objektet Anspråk för att inleda betalningsflöden.
I Headless 360-arkitekturer dirigeras aktivering direkt till externa system via aktiveringsmålen Query API, Pub/Sub API eller Cloud-datalager. Sedan hittar MCP-servern harmoniserade dokumentdata och beräknade insikter som anropbara verktyg för externa AI-agenter.
Transaktionsbearbetningspipeline hanterar extrahering av enskilda dokument vid körning utan UDMO eller förintagen UDLO, vilket passar händelsedrivna användningsfall (till exempel en kund som laddar upp ett formulär, en agent som tar emot en PDF eller ett externt system som inleder extrahering inom ett transaktionsbearbetningsflöde). ETL-styrning gäller identiskt för båda pipelines.
Verklighetsscenario
När du ansöker om ett lån laddar en bankkund upp en PDF-fil med sin elräkning via bankens mobilapp. Händelsen inleder extrahering i realtid, vilket innebär att ingen förintagen UDLO eller UDMO är involverad.
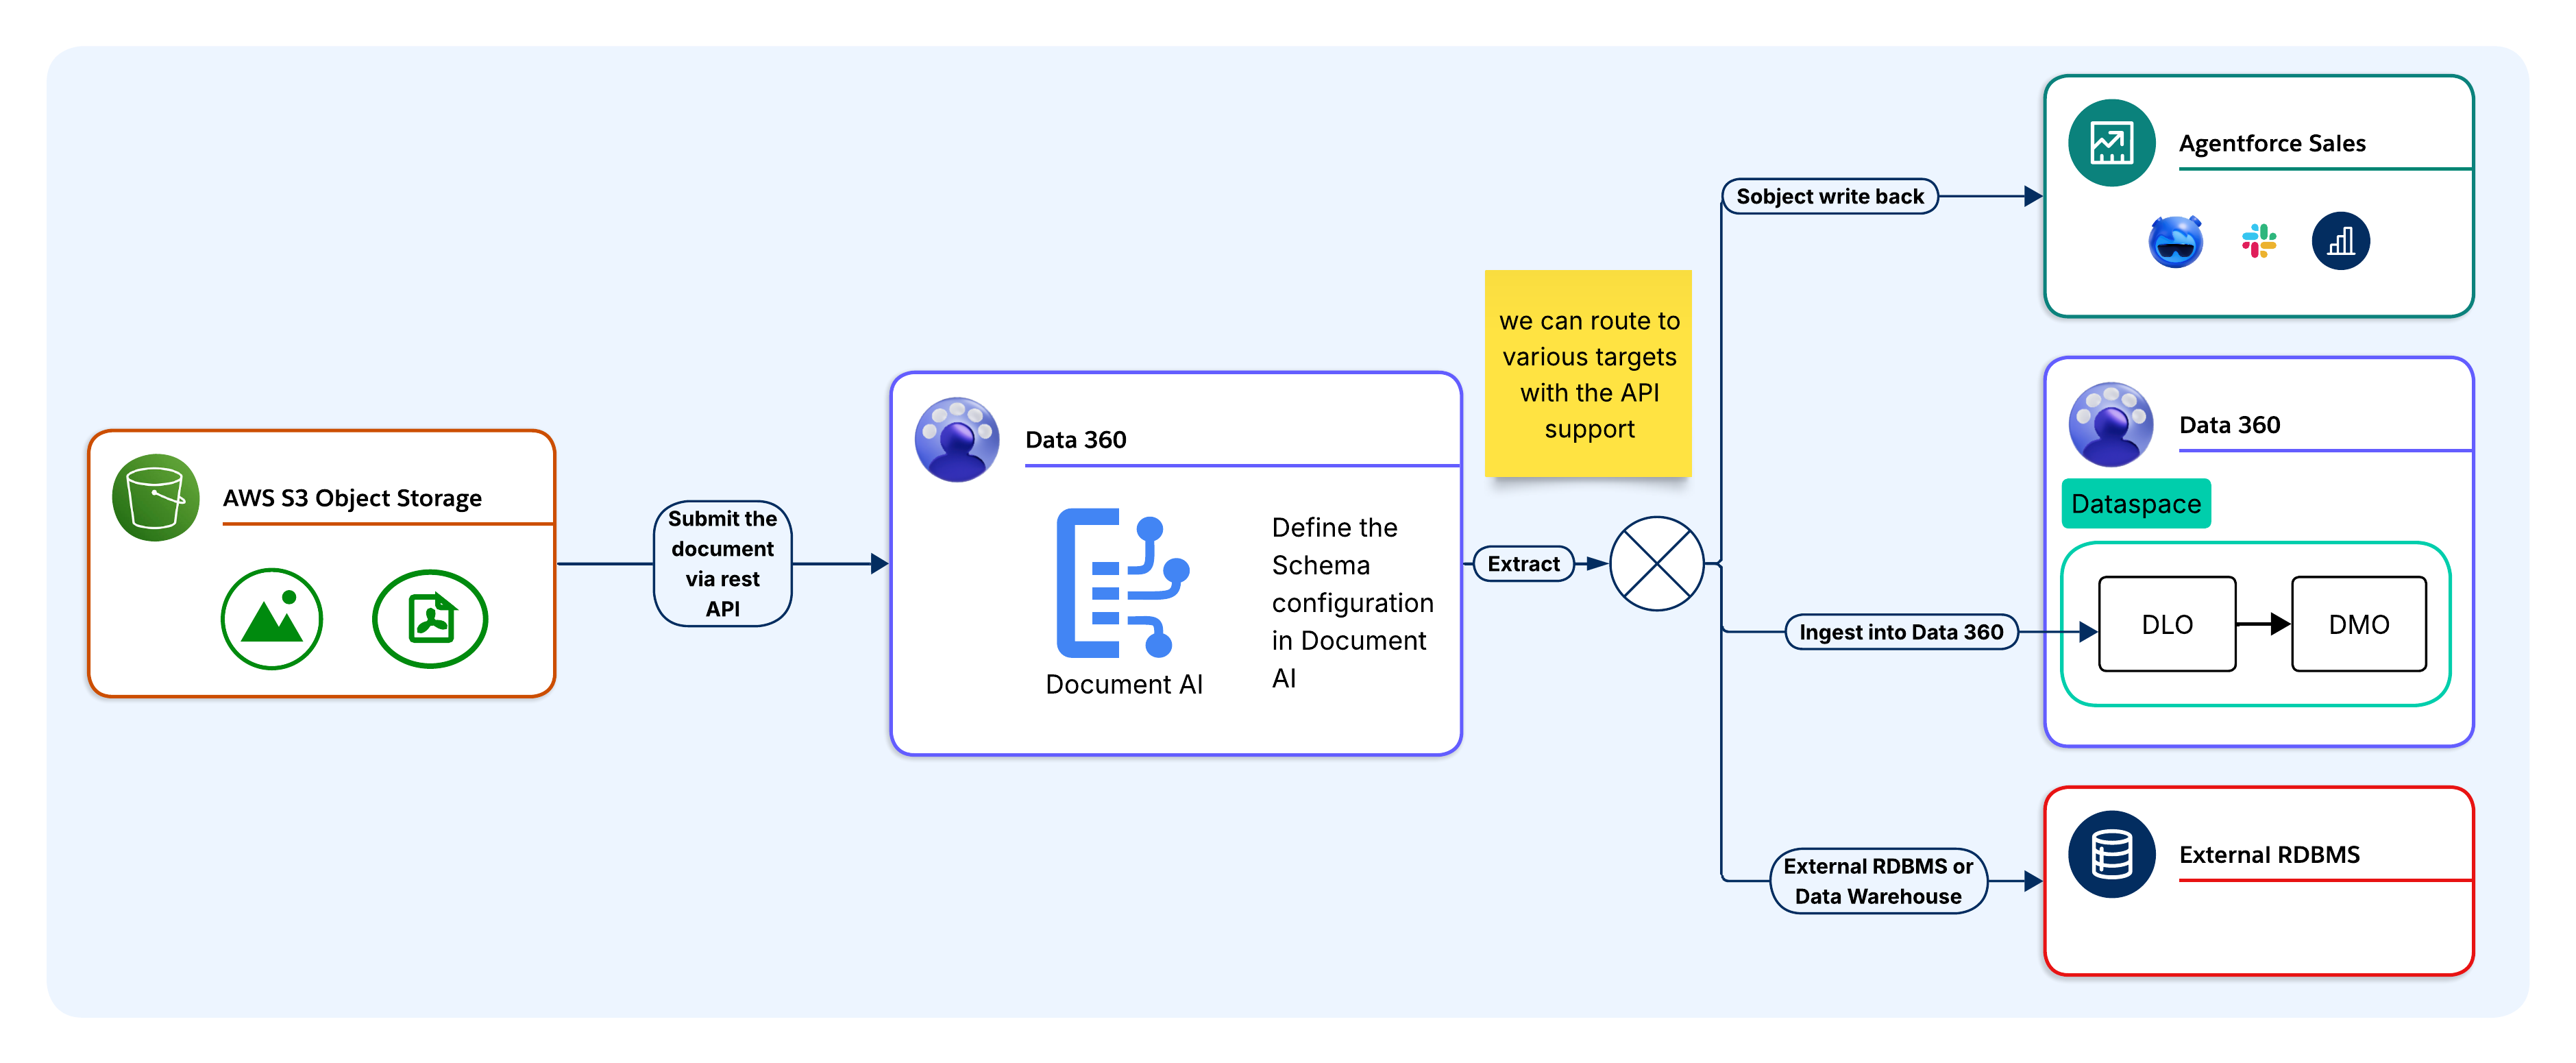
Innan API åberopas måste arkitekter definiera och lagra ett schema i Data 360 som specificerar fält, datatyper och extraheringsinstruktioner i formatet JSON Schema. Varje schema tilldelas ett unikt schema-ID. Vid runtime refererar det anropande programmet schema-ID:t för att hålla extraheringslogiken centraliserad i Data 360 istället för att bädda in den i programkoden.
Exempel:
Bankens team har ett fördefinierat ProofOfAddress i Data 360 som specificerar fält som CustomerName, AddressLine1, City, PostCode och DocumentDate. Denna information lagras som en versionerad konfiguration som kan refereras med ett schema-ID.
Anropsprogrammet skickar dokumentet och schema-ID i en enskild REST API-begäran som en base64-kodad belastning eller filreferens. Inget UDLO-intag krävs. Dokument-AI tillämpar dokumentextraheringen och returnerar den strukturerade utmatningen baserat på det schema som tillhandahålls.
Exempel:
Mobilappen skickar elräkningen som en base64-kodad belastning tillsammans med ID för ProofOfAddress i ett enskilt REST API-anrop. Denna process kräver inte ett UDLO-intagssteg.
LLM bearbetar OCR-utmatningen mot schemat och returnerar en strukturerad JSON-belastning synkront. Fält som inte hittas i dokumentet returneras som null. Anroparen äger det fullständiga JSON-svaret och fortsätter till dirigering.
Exempel:
Dokument-AI tillämpar OCR för PDF-filen och LLM returnerar en strukturerad JSON-belastning med extraherade adressfält. Fält som inte hittas (till exempel om PostCode saknas på fakturan) returneras som null.
När JSON-belastningen har extraherats kan den dirigeras till en eller flera målnivåer beroende på användningsfallet:
- Salesforce SObject: Mappar direkt till SObject-fält via Apex eller Flow för CRM-flöden och -godkännanden.
- Data 360 DLO/DMO-pipeline: Dirigerar till ett DLO för harmonisering, identitetslösning, beräknade insikter och Agentforce jordning.
- Extern RDBMS eller Datalager: Dirigerar via MuleSoft, Apex, plattformshändelser eller ETL för system utanför Salesforce.
- Egen integrering: Returnerar strukturerade JSON-belastningar till anropsprogrammet för lagring i ett externt system eller datalager.
- Flöde nedströms eller Agent: Skickar den strukturerade JSON-utmatningen direkt till ett flöde eller agent längre ner utan någon beständighet till ett SObject. Detta är ett vanligt mönster för kunder som använder dokument-AI som ett extraheringssteg i realtid i ett större automatiserings- eller agentflöde.
Kom ihåg att ett enskilt schema kan spridas till flera nivåer samtidigt, med olika fältgrupper som dirigeras till olika mål från samma extraheringspunkt.
Exempel:
En ProofOfAddress kan spridas till tre nivåer samtidigt (till exempel skriver CustomerName och AddressLine1 till Contact SObject), vilket startar ett flöde för adressverifiering. Sedan dirigeras den fullständiga nyttolasten till ett DLO för harmonisering och riskbetyg, och en kopia dirigeras till bankens KYC-system via MuleSoft för loggning av regelefterlevnad.
När de har skrivits aktiveras extraherade data inom målsystemet omedelbart. För SObject-mål aktiveras utlösare, flöden och godkännandeprocesser i den infogade posten. För mål för DLO/DMO går data in i pipeline för harmonisering och identitetslösning och Agentforce. För externa RDBMS-mål är data tillgängliga för sökfrågor längre ner så fort skrivningen är klar.
Exempel:
Adressbekräftelseflödet aktiveras omedelbart i den infogade kontaktposten, vilket tar låneansökan till nästa fas. Agentforces lånehandläggare Agent hittar den verifierade adressen från Data 360 och KYC-systemet registrerar dokumentinskickningen för granskning.
Dokument-AI passar bäst för specifika arkitektoniska förhållanden. Att tillämpa det utanför dessa villkor medför onödig komplexitet och ytterligare kostnader.
Som arkitekter är det viktigt att utvärdera dessa kriterier innan du bestämmer dig för Dokument-AI som extraheringsmekanism.
Använd Dokument-AI när:
- Dokument är den primära datakällan. Den information som behövs finns endast i dokumentform och är inte tillgänglig från en strukturerad API eller databas (till exempel skannade kontrakt, labbrapporter, intagningsformulär eller försäkringsanspråk).
- Dokumentlayouter varierar mellan källor. Samma dokumenttyp anländer från flera leverantörer, partners eller regioner med olika fältpositioner och format. Schemadriven LLM-extrahering anpassas utan underhåll per layout.
- Extraherade data måste mata Data 360 eller Agentforce. Extrahering måste delta i identitetslösning, beräknade insikter eller Agentforces jordning. Dokument-AI levereras direkt till DLO/DMO utan ett separat ETL-lager.
- Volym motiverar styrd automatisering. Dokumentvolymen överskrider vad manuell bearbetning kan hantera utan mätbara arbetskostnader eller datakvalitetsrisker.
- Dokument innehåller reglerat innehåll. PHI, PII eller finansiella data måste dirigera genom ett PII-maskerande lager med noll datalagring innan de når en LLM. ETL uppfyller detta inbyggt. Kunder som inte behöver något extraherat innehåll bör även överväga det transaktionella API-flödet, som returnerar strukturerad utdata direkt till det anropande programmet utan att skriva till något objekt eller datalagringsutrymme.
- Användningsfallet är händelsedrivet. Ett dokument anländer vid runtime (till exempel en kunduppladdning, en PDF-bilaga för agent eller en extern systemutlösare). Den transaktionella bearbetningspipeline hanterar synkron extrahering av enskilda dokument utan batchkonfiguration.
Använd inte Dokument-AI när:
- Källdata är redan strukturerade. Om systemet uppströms visar en REST API, databastabell eller strukturerad fil (till exempel CSV, JSON eller XML), använd en standardanslutare för Data 360. Att köra strukturerade data genom en LLM-extraheringpipeline lägger till latens och kreditkostnader utan ytterligare fördelar.
- Dokument skapas maskinellt med ett fast schema. Systemskapade PDF:er från en känd ERP- eller faktureringsplattform med en stabil layout är bättre lämpade för en deterministisk tolkning. LLM-extrahering är utformad för variation och att tillämpa den på dokument med fast schema slösar bort sammanhang och krediter.
- Precisionskrav överskrider LLM-förtroendetrösklar. Dokument-AI garanterar inte 100 % extrahering. Användningsfall där ett missat eller felaktigt fältvärde medför betydande ekonomisk, juridisk eller klinisk risk kräver ett HITL-valideringssteg. Använd inte Dokument-AI som det enda extraheringslagret för beslut med höga insatser utan ett valideringsflöde.
- Dokument överskrider plattformsbegränsningar. Den nuvarande gränsen för filstorlek på 10 MB och begränsningarna för LLM-sammanhangslängd gör dokument-AI olämpligt för stora eller täta dokument utan förbehandling för att dela och återmontera dem utanför plattformen.
- Obs! På Salesforce förbättrar vi aktivt dessa acceptansskyddsräcken för att utöka filstorlekar, sidantal och filtillägg som stöds. Begränsningar kommer att fortsätta att utvecklas framöver.
Låt oss ta en närmare titt på flera scenarion som använder pipeline för dokument-AI-sats som backas upp av ett UDMO-källobjekt. I dessa fall extraherades datarutter genom pipelinen Data 360 DLO/DMO för harmonisering, identitetslösning, beräknade insikter och Agentforce. Varje användningsfall passar bäst för schemalagd eller händelsedriven dokumentbearbetning med hög volym.
Agentforce försäljning: Kontrakt- och fakturainformation
PDF-filer för kontrakt tas in från molnlagring via satspipeline. Schemat extraherar ContractValue, RenewalDate, PaymentTerms och CounterpartyName och mappar dem sedan till DMO för konton och kontrakt. Beräknade insikter deriverar poäng för förnyelserisk. Agentforce meddelar kontoansvariga innan förnyelsefönster stängs, vilket eliminerar manuell kontraktgranskning och missade förnyelser.
Agentforce Service: Kundcaseavledning och Knowledge jordning
PDF-filer för undersökningar och kundcasebilagor tas in via satspipeline. Schemat extraherar sentimentindikatorer, problemkategorier och lösningsanteckningar och mappar dem sedan till DMO för kundcase och Knowledge. Agentforce frågar den harmoniserade Knowledge basen när kundcaset öppnas och letar upp relevanta felsökningssteg, vilket minskar Agentsökningen.
Agentforce hälsa: Bearbetning av kliniska dokument
Labbrapporter, intagnings-PDF:er och handskrivna kliniska formulär tas in via satspipeline. Schemat extraherar fält—inklusive PatientID, DiagnosisCode, MedicationName och TestResult—och mappar dem sedan till Health Cloud DMO, som har stöd för HIPAA-anpassad vårdsamordning och kliniska forskningsflöden.
Finansiella tjänster: Automatisering av lån och skattedokument
Låneansökningar, skattedeklarationer och resultaträkningar tas in via batchpipeline. Schemat extraherar fält—inklusive AnnualIncome, TaxYear och EmployerName—och mappar dem sedan till DMO för finanskonton. Beräknade insikter slår samman dokumentderiverade inkomstdata och CRM-data för att underlätta automatiserad kreditriskvärdering. Agentforce hittar detaljerna om extraherade lån direkt under kundtjänstinteraktioner. Detta mönster har direkt stöd för användningsfallet Förkvalificeringsagent för lån som publiceras i utvecklarcentret Salesforce Agentic Enterprise Solutions.
HR: Bearbetning av arbetskraftsdokument
Introduktionsdokument, skatteformulär och certifierings-PDF:er tas in via satspipeline. De extraherade fälten mappas till DMO för medarbetarpost och länkas sedan till profilen Samordnad medarbetare. Specifika flöden inleder introduktionsuppgifter och efterlevnadskontroller baserat på extraherade data. Detta mönster har direkt stöd för användningsfallet Agent för automatisk återupptasbearbetning. Dokument-AI extraherar kompetenser, anställningshistorik och kvalifikationer från PDF-meritförteckningar, som Agentforce sedan använder för att matcha kandidater mot öppna rollkriterier och dirigera dem till anställningsflöden.
Professionella tjänster: Förslag och forskningsinformation
Förslagsuppsättningar och forskningsrapporter tas in via satspipeline. Extraherade ramverk, riktmärken och engagemangssammanfattningar mappas till egna DMO och indexeras sedan för vektorsökning. Agentforce hämtar sammanhangsrelevanta rekommendationer vid sökfrågor, som grundar sig på extraherat dokumentinnehåll. Detta mönster utökar mönstret Ground Agentforce på webbplatsinnehåll. Dokument indexeras via Document AI och har samma jordningsfunktion för agentsvar som webbplatsinnehåll som indexeras via Data 360-anslutare.
Efterlevnadsstatus för HIPAA:
De mönster för Health Cloud som beskrivs i detta dokument tillämpar ETL-kontroller (till exempel nolllagring av data och PHI-maskering) för textinmatningar. Enbart dessa kontroller utgör inte HIPAA-certifiering. Arkitekter som utformar för reglerade kliniska miljöer måste bekräfta aktuell HIPAA-certifieringsstatus med Salesforces efterlevnadsteam innan de åtar sig att använda en dokument-AI-baserad arkitektur i dessa sammanhang.
Låt oss ta en närmare titt på flera scenarion som åberopar Document AI REST API med ett schema som inte är bundet till en UDMO. Extraherade JSON-belastningar dirigeras direkt till externa system synkront vid runtime.
Leveranskedja: Bearbetning av leverantörsfaktura till ERP
När en PDF för leverantörsfaktura anländer i en bevakad lagringshink eller e-postgateway anropar en händelseutlösare Document AI REST API med fakturan och ett fördefinierat schema-ID. Schemat extraherar VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount och DueDate. JSON-belastningen dirigerar via MuleSoft till modulen Leverantörsreskontra med validering av nullfält och idempotent uppladdningslogik, vilket eliminerar mallunderhåll för variationer i leverantörsformat.
Juridiska operationer: Kontraktgranskning till CLM
När en PDF för kontrakt laddas upp till den juridiska portalen anropar backend Document AI REST API synkront. Schemat extraherar GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause och CounterpartySignatory. JSON-belastningen dirigeras via Apex anrop till systemet för hantering av kontraktlivscykel (CLM). Alla fält som inte hittas returneras som null och CLM tillämpar standardförpliktelsereglerna för de värden som saknas.
Försäkringsanspråk: Första meddelande om förlustbearbetning
När en försäkringstagare skickar in ett formulär för Första notis om förlust anropar backendportalen Document AI REST API synkront. Schemat extraherar PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName och ContactPhone. JSON-belastningen dirigerar till databasen för anspråkshantering via Apex anrop eller ETL, vilket skapar en förifylld anspråkspost för justering innan det formella anspråket öppnas.
Innan du går till produktion måste du skapa designer för dessa felscenarion.
- Nullfälthantering: LLM returnerar noll för fält som den inte kan hitta eller säkert extrahera. Validera nullhanteringslogik vid schemautformning och implementera standardvärdeslogik eller avvisandelogik i integreringslagret innan du skriver till mål med INTE NULLbegränsningar eller obligatoriska matchningsnycklar.
- Försämrad OCR-kvalitet: OCR-precision försämras under 150 DPI, vid oregelbunden handskrift eller vid brusiga skanningar. Felläsningar propageras till LLM-extrahering som korrupt indata utan felsignaler. Tillämpa lägsta skanningskvalitet vid intag och implementera förtroendetröskelkontroller av numeriska fält och datumfält.
- Schemaversionsfel: Att uppdatera en schemakonfiguration efter att ett batchjobb har schemalagts gör att interna dokument bearbetas mot den tidigare versionen, vilket skapar fält som saknas eller byter namn som bryter mappningen längre ner. Versionsscheman uttryckligen och koordinerar uppdateringar med batchjobbscheman.
- Filstorleksgränser: Dokument som överstiger 10 MB avvisas. Pipelinefel i satser är tysta utan övervakning konfigurerad och transaktionsuppringare får ett felmeddelande på 4xx. Förvalidera filstorlekar vid intag och implementera förbearbetning för att dela eller komprimera dokument som ofta närmar sig gränsen.
- LLM-sammanhangsspill: Täta eller flersidiga dokument kan överskrida LLM-sammanhangsfönstret inom gränsen på 10 MB. LLM släpper tyst innehåll som överskrider sammanhanget. Implementera en delningsstrategi som delar upp dokument efter sidintervall och sätter samman de extraherade fälten igen innan de överförs till målet.
- Extrahering av Trust Layer Masking som påverkar: ETL fungerar på uppmaningsnivå—inte dokumentnivå—så maskering gäller inte för dokumentinnehåll som går genom Dokument-AI. Schemafält som beror på PII-värden i dokumentet påverkas inte av ETL-maskeringspolicyer.
- Externa RDBMS-skrivfel: Transaktionsbearbetningspipeline har ingen inbyggd idempotens för externa RDBMS-mål. Integreringslagerförsök skapar dubblettrader om inte skrivlogiken uttryckligen hanterar avduplicering. Implementera idempotenta infogningar med ett dokumentavtryck eller externt ID på alla externa skrivvägar.
- Mellankörning av kreditkonsumtion: Stora satskörningar kan ta slut på krediter från Digital Wallet innan alla dokument behandlas, vilket ger ofullständiga DLO-datauppsättningar som steg längre ner ser som slutförda. Ange konsumtionsvarningar till 75 % och 90 % av tillgängliga krediter och begränsa batchstorlekar för att hålla dig inom kreditbudgeten för varje cykel.
- Fältgräns för schema – Arkitektonisk begränsning: Dokument-AI tillämpar en gräns på 50 fält för rotnivåfält i en schemakonfiguration. Detta är en begränsning i design-tid—inte ett körningsfel—och arkitekter måste ta hänsyn till det under design av datamodeller och scheman.
- För användningsfall som kräver bredare extrahering:
- Prioritera hänsynslöst. Begränsa schemat till fält som driver automatiseringsvärde, inte fullständig dokumenttäckning.
- Använd kapslade objekt (upp till 3 nivåer; batchläge med endast källobjekt) för att minska antalet fält på rotnivå utan att offra extraheringsdjupet.
- Dela upp komplexa dokument i flera konfigurationer för dokument-AI som riktar in sig på olika dokumentsektioner, skriv resultat till separata DLO som slås samman längre ner i Data 360.
- För användningsfall som kräver bredare extrahering:
- API-gränsvärden: Dokument-AI tillämpar en gräns på 50 extraherade API-anrop per minut och arrendator. Det teoretiska taket är 300 samtal per minut, vilket styrs av Einstein LLM Gateway. Transaktionella integreringar med hög volym måste utformas med exponentiell backoff, begärankö och budgetering av genomströmning på arrendatornivå. Anta inte att bristningskapacitet är tillgänglig i produktionsmiljöer med flera arrendatorer.
- API-latensprofil: API:n för extrahering av dokument-AI är fullständigt synkrona. Typiska svarstider varierar mellan 5–15 sekunder och de varierar beroende på filstorlek och schemakomplexitet.
- Detta har direkta konsekvenser för integrationsarkitekturen:
- Ange timeout för samtal till minst 30 sekunder.
- Åberopa inte dokument-AI i flöden med krav på servicenivåavtal för andra gången.
- Faktorlatens i genomströmningsberäkningar jämfört med taket för hastighetsgränser för pipelines för satsbearbetning.
- Ange timeout för samtal till minst 30 sekunder.
- Detta har direkta konsekvenser för integrationsarkitekturen:
- Krypterade och lösenordsskyddade dokument: Dokument-AI bearbetar inte lösenordsskyddade filer (användarlösenord krävs för att öppna filer) eller PDF-filer som är krypterade med ett lösenord för ägare/behörigheter, inklusive filer som öppnas normalt men begränsar kopiering, utskrift eller redigering på behörighetslagret PDF.
- Denna begränsning finns vid intagsgränsen:
- Utforma pipelines för dokumentintag för att upptäcka och dirigera krypterade filer till en väg för avvisande eller manuell bearbetning innan de når Dokument-AI.
- Lita inte på hantering av körningsfel som den primära grinden.
- Denna begränsning finns vid intagsgränsen:
Data 360 Document AI följer flera pelare i Salesforces välutformade ramverk.
- Trust: ETL tillämpar nolllagring av data med LLM-leverantörer, maskerar PII-inmatningar innan de når modellen och söker efter känsligt innehåll. Arkitekter måste utöka denna hållning till extraherade data vid vila. Fältnivåmaskering i DLO tillämpas inte av ETL och kräver datautrymmespolicyer och behörighetsuppsättningar längre ner.
- Tillförlitlighet: Varje felläge i sektionen Utformningsöverväganden — nullfältextrahering, OCR-felläsning, schemaversionsfelmatchning, filstorleksöverträdelse, LLM-sammanhangsspill, ETL-maskeringsinterferens, RDBMS-skrivoförmåga och kreditkonsumtion — representerar en distinkt felklass med en dokumenterad detektionssignal och lösningssökväg.
- Operativ excellens (ändringshantering): Den schemadrivna extraheringsmodellen kopplar bort extraheringslogiken från dokumentlayouten. När en leverantör ändrar ett fakturaformat eller ett regelformulär uppdateras behöver arkitekter endast uppdatera en schemakonfiguration istället för att ändra integreringskod.
- Operativ excellens (underhållbarhet): Att centralisera schemakonfigurationer i Data 360 istället för att bädda in extraheringslogik i programkod gör extraheringssyftet explicit, versionerat och granskningsbart. Alla mål längre ner använder samma schemakontrakt oavsett målnivå.
- Operativ excellens (återanvändning av integrering): Dokument-AI exponerar extrahering över flera integreringsytor: REST API, Apex, Flow, MuleSoft, Agentforce Actions och MCP-servern. En enskild schemakonfiguration skickas till flera målnivåer samtidigt utan att extrahera kapaciteten per konsument igen.
- Resurs- och kostnadsoptimering: Vägledning för pipelineval, filstorleksgräns på 10 MB och begränsningar av LLM-sammanhangslängd för förmontering representerar prestandamedvetna designbeslut. Sektionen När man ska använda formaliserar villkoren för när dokument-AI inte är rätt verktyg (till exempel krav på latens under en sekund, fullständigt strukturerade källdata och maskinskapade dokument med fast schema).
Detta är en strukturerad utgångspunkt för att konfigurera Data 360 Document AI i en sandboxmiljö. Slutför alla faser i sandboxen innan du går till produktion.
Innan du påbörjar konfigurationen måste du bekräfta:
- Filstorlek: Kontrollera att de representativa dokumentstorlekarna är under 10 MB.
- Pipeline: Bekräfta om användningsfallet kräver satspipeline (UDMO-stödd, hög volym) eller transaktionsbearbetningspipeline (API-driven, ett enskilt dokument). Detta driver all efterföljande konfiguration.
- Målnivå: Bekräfta var extraherade data landar – Salesforce SObject, Data 360 DLO/DMO, extern RDBMS eller en kombination.
- Agentforce beroende: Innan du distribuerar någon Agentforce-driven dokumentbearbetning, se till att en LLM som stöds (till exempel GPT-4o) har aktiverats i din organisation via ETL-inställningarna. Agentforce är en hårdplattformsförutsättning för dokument-AI. Hela funktionsytan för Dokument-AI—inklusive alla extraherings-API:n—är inte tillgänglig förrän Agentforce är aktivt i målorganisationen. Faktorisera detta i organisationens beredskapsbedömningar och provisioneringssekvens. Vänta några minuter för API-tillgänglighet att stabiliseras efter aktivering.
- Agentforce Inaktiveringspåverkan: Om Agentforce inaktiveras efter att dokument-AI har konfigurerats och distribuerats kommer all extraheringsprocess (gränssnitt och API) att blockeras omedelbart. Samma sak gäller för modellinaktivering. Att inaktivera den underliggande modellen har en motsvarande effekt på tillgängligheten för dokument-AI. I båda fallen bevaras de befintliga schemakonfigurationerna och kommer att förbli synliga—ingen konfiguration eller dataförlust kommer att inträffa—men kapaciteten går inte att använda förrän Agentforce och modellen har aktiverats igen. Utforma körböcker för att behandla Agentforces tillgänglighet och modellaktivering som hälsoberoenden för dokument-AI.
- Kreditkonsumtion/prissättning: Använd Data 360 credits eller Flex Credits för TCO-uppskattningar som deriveras från representativa exempeldokument.
- Skapa schemakonfigurationen. Definiera extraheringsfält, datatyper och instruktioner i formatet JSON-schema i konfigurationen av Data 360 Document AI. För satspipeline, bind den till en UDMO. För pipeline för transaktionell bearbetning, skapa den utan ett källobjekt. Registrera schema-ID.
- Justera fältnamn till målnivån. Matcha fältnamn med DLO-kolumndefinitioner, SObjects API-namn eller RDBMS-kolumnnamn. Feljusterade namn skapar mappning ovanför i integreringslagret.
- Konfigurera UDMO-källobjektet (endast batch). Definiera dokument i omfattning och konfigurera anslutning till intagskälla (till exempel S3, Google Cloud Storage, Salesforce Files eller MuleSoft). Bekräfta att kontot för intagstjänsten har det autentiseringsomfång för IAM eller OAuth som behövs.
- Tillämpa maskeringspolicyer för PII. Konfigurera datamaskeringspolicyer i ETL-inställningarna innan du bearbetar något reglerat innehåll. Definiera vilka fälttyper (PHI, PII och ekonomiska identifierare) som är maskerade innan inmatningar når LLM. Skjut inte upp detta steg.
- Tilldela omfattning och behörighetsuppsättningar för datautrymme. Omfatta bearbetning till lämpligt datautrymme och konfigurera behörighetsuppsättningar för att styra schemaskapande, körning av batchjobb, åberopning av REST API och aktivering längre ner.
- Konfigurera API-autentisering (endast pipeline för transaktionsbearbetning). Skapa en ansluten app med OAuth-omfången cdp_ingest_api och api. För organisationsinterna anrop, använd en autentiseringsuppgift som länkar till en Extern inloggningsuppgifter. För externa anrop, konfigurera OAuth 2.0-klientuppgifter eller ett JWT-bärarflöde. Testa och validera extrahering innan du fortsätter.
- SObject writeback: Implementera ett Apex- (@InvocableMethod) eller flödeselement som mappar JSON-svarsfält till SObject-fält. Använd Database.upsert() med ett externt ID för att förhindra dubbletter. Tillämpa fältnivåsäkerhet för målfält för SObject.
- Data 360 DLO/DMO-pipeline: Mappa extraherade DLO-fält till DMO som överensstämmer med Customer 360 Data Model. Konfigurera regler för identitetslösning för att länka dokumentposter till enhetliga individer. Definiera beräknade insikter och lägg till DMO för Agentforce. För pipeline för transaktionell bearbetning, dirigera JSON-belastningen till ett DLO via Ingestion API först.
- Extern RDBMS eller datalager: Välj integreringsmönstret: MuleSoft (befintlig integreringsstruktur), Apex HTTP-anrop (lättviktigt, organisationsbaserat), plattformshändelser med prenumeranten Pub/Sub (händelsedriven) eller ETL (bunt med hög volym). Implementera idempotenta infogningar med ett dokumentavtryck eller externt ID på alla externa skrivvägar.
- Aktiveringsvägar: Anslut Agentforce åtgärder till schemakonfigurationer för interaktiv extrahering. Konfigurera flödes- eller Apex utlösare för automatiserade bearbetningsflöden och fastställa aktiveringsmålen för varje fältgrupp.
- Felhantering (endast pipeline för transaktionsbearbetning). Konfigurera den fullständiga HTTP-svarsytan: 200 (lyckade, inklusive delvisa nullsvar), 400 (felformaterad begäran eller schema-ID hittades inte), 413 (filen överskrider 10MB), 5xx (servicefel). Implementera exponentiell backoff för 5xx försök med högst 3 försök. Logga det råa JSON-svaret och schema-ID:t för varje samtal.
- Testa scheman mot exempeldokument. Skicka in representativa exempel via gränssnittet Document AI eller REST API. Bekräfta extraheringsprecision, fälttäckning och nullhantering över layoutvarianter.
- Validera nullfälthantering. Bekräfta att alla mål längre ner kan hantera nollvärden för fält som inte hittas i ett dokument. Kom ihåg att NOLL-begränsningar misslyckas tyst utan uttrycklig nullhantering.
- Validera filstorlekar i förväg. Bekräfta att produktionsdokument förblir under 10 MB. Implementera förbearbetning för att dela eller komprimera dokument som ofta närmar sig gränsen.
- Validera end-to-end-extrahering. För satspipeline, inled en fullständig körning och bekräfta att de extraherade fälten landar korrekt i varje målnivå. För pipeline för transaktionsbearbetning, spåra JSON-svaret genom integreringslagret till målet. Kontrollera utlösaren och flödeskörningen för SObject-målen, kopplingen för identitetslösning för DLO/DMO-målen och oförmågan för RDBMS-målen.
- Bekräfta Trust Layer-beteende. ETL tillämpar inte PII-maskering för dokumentinnehåll, så LLM returnerar PII-data i extraherade fält som de är. Bekräfta att dina schemafält, datadirigering och lagring längre ner är utformade för att hantera PII-bärande utdata korrekt och se till att eventuella efterlevnads- eller lagringskrav hanteras utanför plattformen.
- Sätt Digital Wallet. Konfigurera konsumtionsvarningar för 75 % och 90 % av tillgängliga krediter. Upprätta gränser för satsstorlek och ad hoc-räntor inom kreditbudgeten för varje cykel.
- Validera batchövervakning (endast batchpipeline). Gå igenom extraheringsresultat, nullfältresultat och jobbslutförande i Data 360 Monitoring Console. Bekräfta taggpropagering från UDLO genom DLO till DMO i datahärkomst.
- Validera API-felhantering (endast pipeline för transaktionsbearbetning). Testa alla felvillkor: 413 (dokument över 10MB), 400 (ogiltiga schema-ID:n), 200 (giltiga extraheringar med delvisa null). Bekräfta att logiken för att försöka igen aktiveras på simulerade 5xx svar utan att skapa dubbletter av skrivningar.
Detta dokument lyfter fram de arkitektoniska grunderna för Data 360 Document AI:
- Två bearbetningspipelines och när de ska användas
- Schemakonfigurationsmodellen
- Ramverk för beslut på målnivå
- Begränsningar för kärnteknik
- Fellägen
- Väl arkitektonisk ramverksanpassning
Snabbstartguiden för arkitekter innehåller konfigurationssekvensen för ett konceptbevis för sandbox.
Den centrala arkitekturen har stöd för dokumentderiverade data som styrs av schemalagret, bearbetas via en ETL-forcerad LLM-pipeline och levereras till samma Data 360-datalivscykel som styr alla våra andra företagsdata.
Arkitekter som tillämpar dessa principer—att välja rätt pipeline, utforma scheman på dokumenttypnivå och utforma för fellägen innan produktion—bygger extraheringskapacitet som skalar och håller i sig under reglerade krav för branschstyrning.
Yugandhar Bora är arkitekt inom programvaruteknik på Salesforce och specialiserar sig på dataarkitektur inom plattformen Data- och intelligensprogram. Han leder initiativ från Enterprise Architecture Review Board (EARB) som fokuserar på datastyrning och sammanslagna datamodeller, samtidigt som han bidrar till automatiserade plattformsprovisioneringslösningar.
Ananth Anto är produktchef på Salesforce Data 360 och leder initiativen Dokument-AI och Datagraf. Han är baserad i Bangalore och arbetar med företagskunder för att lösa verkliga utmaningar inom dokumentbearbetning och dataintelligens. Han gillar att utforska användningsfall för företag för Generativ AI (Generativ AI).
Nishan Naseer är arkitekt inom programvaruteknik på Salesforce och arbetar med ostrukturerad databearbetning, RAG pipelines och dokumentintelligens. Han brinner för att utnyttja kraften hos AI för att tackla verkliga utmaningar och hitta kreativa lösningar på komplexa kundproblem.