Enterprise-dataarkitekturer finns sällan i ett system. Salesforce hanterar kundengagemang, pipeline och serviceinteraktioner. Analytiska plattformar som Snowflake innehåller historiska transaktioner, ekonomiska poster, användningsdata och operativa mått. Traditionellt innebar bryggandet av dessa två världar att bygga och underhålla ETL-pipeline: schemalagda jobb som extraherar data från källan, transformerar dem och läser in kopior till Salesforce. Som ett resultat av dessa pipelines anländer data försenade, styrningspolicyer multipliceras mellan system och pipelines kräver kontinuerlig operativ vård.
Salesforce Data Virtualisering erbjuder en annan modell. Istället för att flytta data till Salesforce låter det Salesforce fråga data direkt vid källan, vid runtime, utan replikering. Användare ser externa livedata genom Salesforces standardgränssnitt. Datan lämnar aldrig sitt auktoritativa hem. Detta dokument förklarar hur mönstret fungerar, när det ska användas och hur du kommer igång med att använda Snowflake som ett konkret exempel.
Salesforce Data Virtualisering är ett integreringsarkitekturmönster som låter Salesforce fråga data direkt från externa system vid runtime, utan att kopiera eller replikera dessa data till Salesforce-lagring. Istället för att flytta in data skickar plattformen ut sökfrågan.
Som ett resultat av detta interagerar Salesforce-användare med externa data genom bekanta Salesforce-gränssnitt (som sidlayouter, relaterade listor, rapporter eller flöden) medan dessa data förblir i sitt auktoritativa källsystem. Styrning, åtkomstkontroll och datalagring stannar där de hör hemma.
Detta mönster bygger på en enda arkitektonisk princip: data stannar vid källan. Beräkning flyttas till datan.
De flesta Salesforce-distribueringar för företag integrerar med externa dataplattformar (som datalager, operativa databaser eller analyslager) genom replikeringspipeline. Pipelines extraherar, transformerar och läser in data till Salesforce enligt ett schema. Detta tillvägagångssätt fungerar, men replikering introducerar strukturella kompromisser:
- Replicerade data är alltid försenade. Pipelines introducerar fördröjning och gamla data driver dåliga beslut.
- Varje kopia av data utökar efterlevnadsomfånget. Känsliga data (som personligt identifierande information, ekonomiska poster eller hälsodata) i flera system kräver att flera styrningspolicyer upprätthålls.
- Pipelines kräver kontinuerliga operativa investeringar, övervakning, felhantering, hantering av schemadrift och upparbetningslogik.
Datavirtualisering hanterar dessa kompromisser direkt. Den tar bort pipeline helt för läsintensiva användningsfall, behåller data på sin auktoritativa plats och ger Salesforce-användare en styrd vy av externa data i realtid utan replikering ovanför.
Externa objekt är den primära mekanismen genom vilken datavirtualisering lyfter fram externa data inuti Salesforce. De beter sig som standardobjekt i Salesforce: sökbar via SOQL, synlig i sidlayouter och relaterade listor, och tillgänglig via Salesforces standard API. Den viktigaste skillnaden är att inga data lagras i Salesforce. Det externa objektet är en schemaprojektion: en definition av hur externa data ser ut, inte en kopia av själva datan.
När en användare läser in en sida eller kör en rapport som refererar till ett externt objekt kör Salesforce en livefråga mot det externa systemet och returnerar endast resultatuppsättningen för den interaktionen.
När Salesforce kör en SOQL-fråga mot ett externt objekt översätter det filter ( WHERE-klausuler), sorteringsordrar (ORDER BY) och gränser (LIMIT) till motsvarande SQL och skickar dem till det externa systemet. Det externa systemet kör sökfrågan på sin egen beräkningsmotor och returnerar endast den filtrerade resultatuppsättningen. Arbete sker där datan finns och endast svaret går tillbaka till Salesforce.
Datavirtualisering tillämpar två oberoende säkerhetslager samtidigt. Det externa systemet tillämpar sina egna åtkomstkontroller vid sökfrågekörning, inklusive säkerhet på radnivå, kolumnmaskering och rollbaserad åtkomst. Salesforce tillämpar sin egen säkerhetsmodell högst upp: profiler, behörighetsuppsättningar, fältnivåsäkerhet och delningsregler. Båda lagren är aktiva i varje sökfråga. Ingen av dem ersätter den andra.
Arkitekter beskriver ofta datavirtualisering som ett “nollkopieringsmönster”. Zero-copy innebär ingen beständig replikering till Salesforce-lagring. Det finns ingen ETL-pipeline som skriver poster till Salesforce-objekt. Det finns ingen schemalagd synkronisering som skapar en lokal kopia. Det externa objektet innehåller inga rader.
Nollkopiering innebär inte noll i dataöverföring. Varje gång en användare frågar ett externt objekt färdas en resultatuppsättning från det externa systemet till Salesforce över nätverket. För stora resultatuppsättningar eller hög sökfrågefrekvens är datautmatningskostnader och nätverkslatens verkliga faktorer för arkitekter att utforma. Detta är inte en begränsning att dölja: det är en designbegränsning att ta hänsyn till.
Tänk på dessa arkitektoniska skillnader om ditt användningsfall kräver stora volymer, frekvent åtkomst eller låg latens.
Snowflake är ett av de vanligaste externa systemen som är anslutna till Salesforce via datavirtualisering. Den fungerar som ett konkret exempel på hur mönstret fungerar från början till slut.
I denna konfiguration ansluter Salesforce till Snowflake med Salesforce Connect med SQL-adaptern för Snowflake. Snowflake-tabeller och vyer visas som externa objekt i Salesforce. När en användare frågar ett externt objekt översätter Salesforce SOQL till SQL och skickar det till Snowflake Statements API via ett autentiserat HTTPS-anrop. Snowflake kör sökfrågan i sitt virtuella lager, tillämpar sin egen säkerhet på radnivå och kolumnmaskering och returnerar endast resultatuppsättningen. Inga data skrivs till Salesforce-lagringen vid någon tidpunkt.
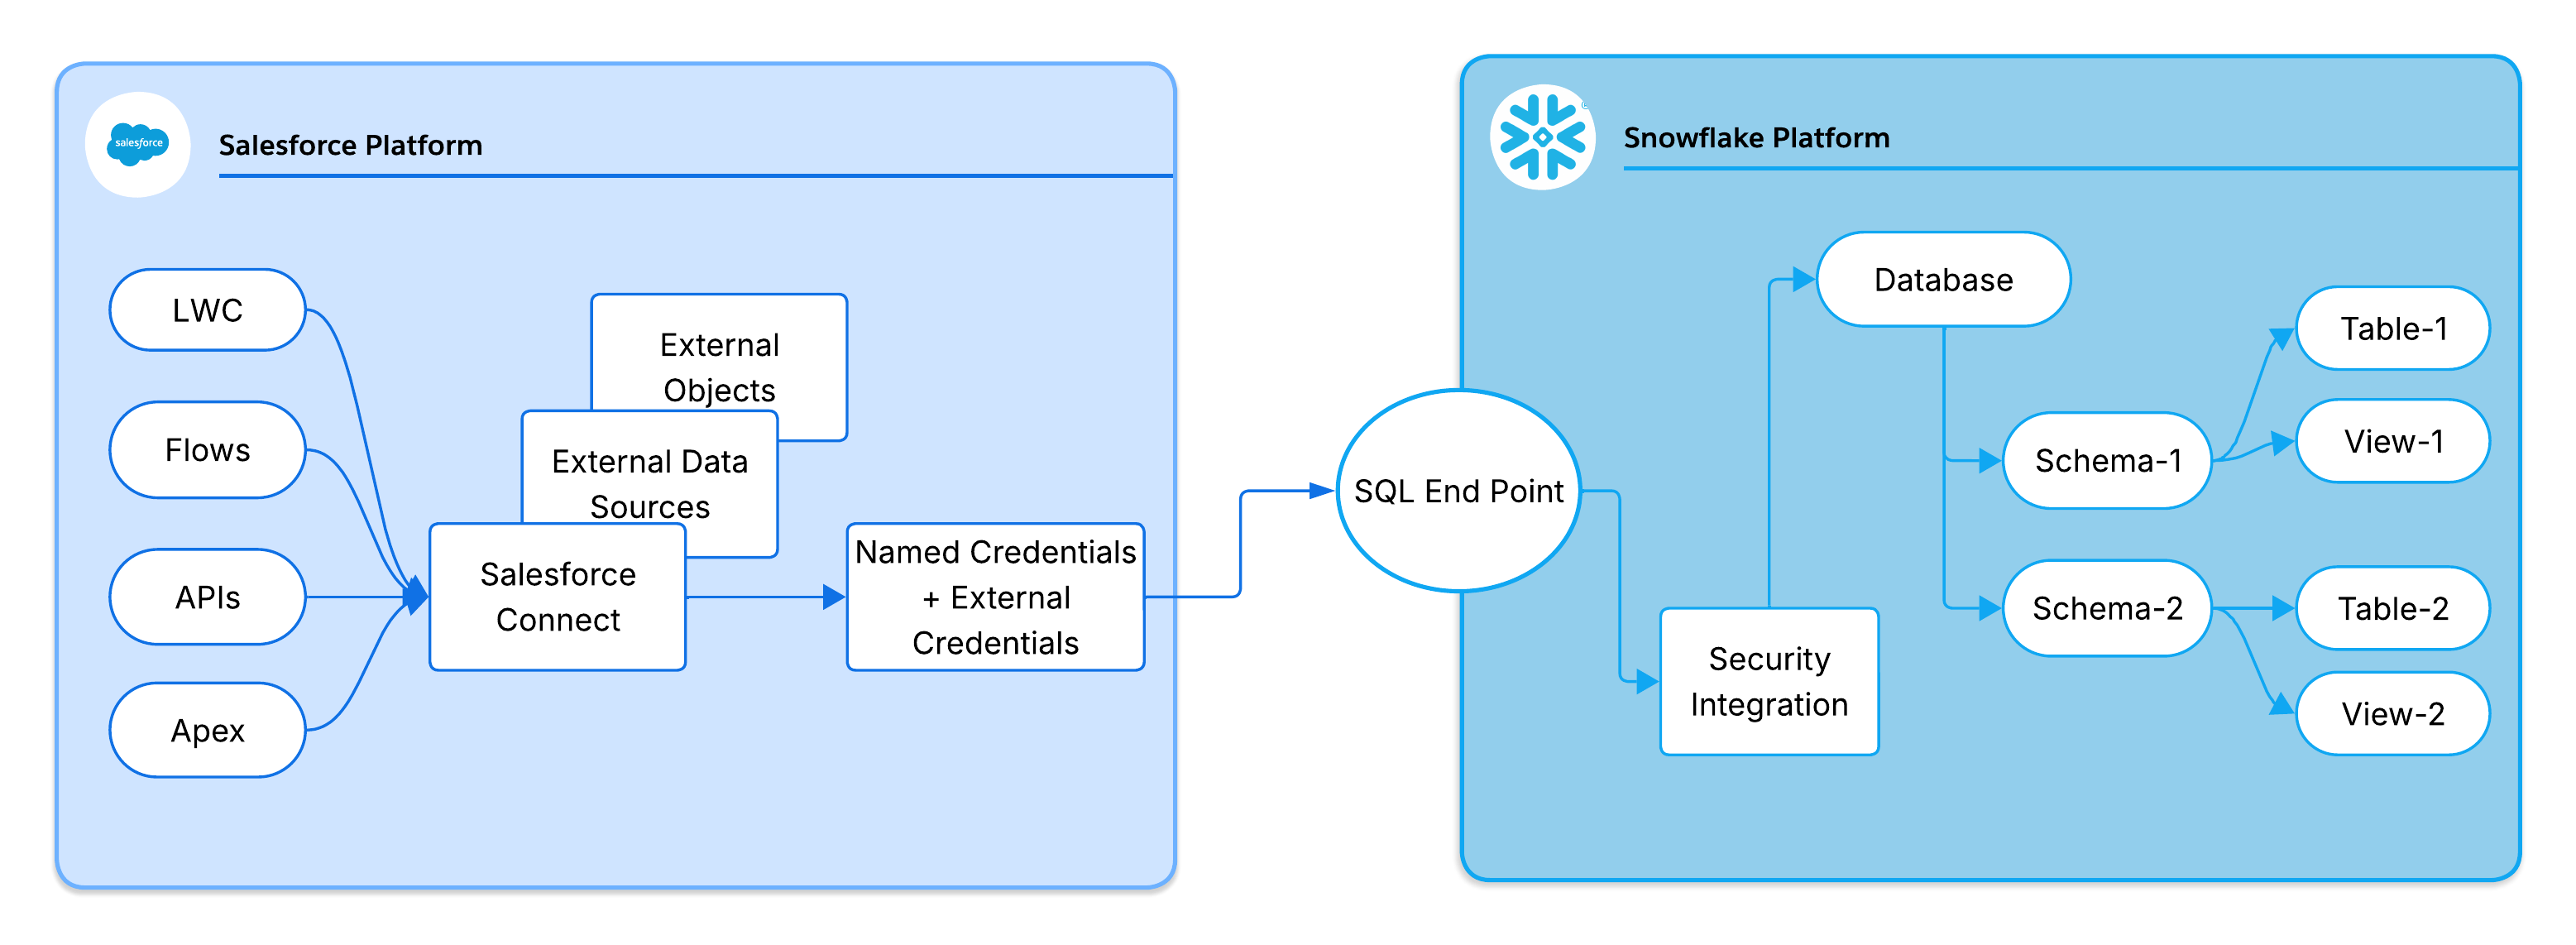
Salesforce Connect använder en delegerad OAuth 2.0-modell för att autentisera med Snowflake. Nyckelkomponenterna är:
- Autentleverantör: Hanterar OAuth-handskakningen med Snowflake. Hanterar tokenbegäranden och mappar den returnerade token till Salesforce-inloggningsuppgifter.
- Externa inloggningsuppgifter: Håller OAuth-tokens för åtkomst och uppdatering säkert i Salesforces krypterade inloggningsuppgifter och injicerar dem i utgående anrop.
- Namngiven autentiseringsuppgift: Definierar Snowflake-slutpunktens URL och refererar till Extern inloggningsuppgifter.
- Snowflake-säkerhetsintegrering: Registrerar Salesforce som en betrodd OAuth-klient i Snowflake. Definierar tillåten omdirigerings-URI, OAuth-flöden och token-TTL.
Dessa komponenter utgör en beroendekedja: Extern datakälla refererar autentiseringsuppgiften, som refererar den externa inloggningsuppgiften, som refererar autentiseringsleverantören. Att förstå denna kedja är viktigt vid felsökning av anslutning eller åtkomstfel.
Salesforce har stöd för två identitetsdelegeringsmodeller vid autentisering med Snowflake:
- Namngiven huvudman: Ett delat servicekonto autentiserar alla Salesforce-användare mot Snowflake. Detta är enklare att konfigurera, men har inte granskningsbarhet per användare eller finjusterad Snowflake-åtkomstkontroll.
- Per användares princip: Varje Salesforce-användare autentiserar med sin egen OAuth-token. Detta aktiverar säkerhet på radnivå i Snowflake och fullständiga granskningsloggar per användare, med en avvägning mellan högre tokenhanteringsoverhead (OAuth-flöden per användare, uppdatering, återkallande).
Beslutsvägledning: Använd Princip per användare för reglerade data eller personligt identifierande information (PII). Använd Namngiven princip när Salesforces delningsregler ger tillräcklig åtkomstkontroll och enkelhet är prioriteten.
Dessa styrande begränsningar i Salesforce formar lösningsdesign direkt vid användning av externa objekt med Snowflake:
- Anropsgräns: 100 per Apex transaktion. Sidor eller flöden med flera externa objektfrågor kan snabbt nå denna gräns.
- Timeout för anrop: Max 120 sekunder. Långvariga Snowflake-frågor orsakar ett runtimeundantag.
- SOQL-radgräns: 50 000 rader. Pagina stora resultatuppsättningar.
- Asynkrona begränsningar: Batch Apex och de flesta asynkrona sammanhang begränsar anrop. Håll åtkomst till Externa objekt inom synkrona transaktionsgränser. För asynkrona användningsfall som frågar Externa objekt, överväg Fortsättningsanrop för användarinledda asynkrona interaktioner, eller skapa flödet för att utföra extern dataåtkomst i en synkron transaktion och lämna över resultat asynkront.
Utformningsvägledning: Fråga inte externa objekt inuti loopar. Push WHERE-klausulfilter till Snowflake för att minska resultatstorlek och anropsfrekvens.
Varje sökfråga som Salesforce skickar till Snowflake loggas i Snowflake-sökfrågehistorik med fullständiga körningsmetadata: latens, rader som skannats, lagerbyggnad som använts och utförandeidentitet. Denna historik ger fullständig granskning från Salesforce-användaråtgärd till Snowflake-körning och är det primära diagnostiska verktyget för prestandajustering och åtkomstvalidering.
Datavirtualisering är väl lämpad för användningsfall där åtkomst i realtid, styrning och minskad replikering ovan uppväger begränsningarna hos en sammanslagen åtkomstmodell i sökfrågetid.
Använd den när:
- Läskunnig analytisk åtkomst är det primära kravet. Om användare behöver fråga och visa externa data i Salesforces användargränssnitt, rapporter eller flöden utan att skriva tillbaka, eliminerar datavirtualisering pipelineoverhead för skrivskyddade scenarion.
- Datas färskhet är viktigt. Om gamla replikerade data skapar verksamhetsrisk (som inaktuella ekonomiska saldon, lagernivåer eller efterlevnadsstatus) garanterar den sammanslagna modellen att varje sökfråga återspeglar livedata.
- Krav på styrning och datalagring är strikta. När lagstadgade eller avtalsenliga begränsningar förhindrar kopiering av känsliga data till Salesforce behåller virtualisering data på sin officiella plats och gör dem tillgängliga i Salesforce. Endast ett system håller data.
- Åtkomstkontroll med två lager krävs. När både det externa systemets inbyggda åtkomstkontroller och Salesforces säkerhetsmodell tillämpas samtidigt tillämpar den sammanslagna modellen båda utan dataduplicering.
- Det externa systemet är redan det officiella postsystemet. Om data redan är rensade, styrda och sökbara i källsystemet undviker virtualisering av dem överflödig transformation, lagringskostnad och divergensrisk.
Undvik det när:
- Skrivningar med låg latens krävs. Externa objekt är skrivskyddade. Användningsfall för writeback kräver ett annat integreringsmönster.
- Komplexa sammanslagningar av flera objekt behövs. SOQL för flera externa objekt har inte stöd för sammanslagningar. Förmaterialisera kopplade data som en enskild vy i källsystemet.
- Funktioner i Salesforce AI eller Agentforce kräver inbyggda data. För närvarande fungerar funktionerna Einstein och Agentforce (inklusive jordning för Einstein Copilot, prediktiv betygsättning och Agentforce) på inbyggda Salesforce-objekt. Dessa funktioner har inte stöd för externa objekt som en datakälla för jordning eller aktivering. Om AI-aktivering finns för dessa data är Salesforce Data 360 den rekommenderade kompletterande lösningen.
- Åtkomstmönster med hög frekvens och hög volym. Externa objekt är utformade för åtkomst på begäran. Arbetsbelastningar som utlöser hundratals sökfrågor per minut begränsar avgasreglering och försämrar prestandan.
Följande användningsfall illustrerar hur Salesforce Data Virtualisering tillämpas i vanliga företagsscenarion. Varje exempel använder Snowflake som det externa systemet, men det underliggande mönstret gäller för alla SQL-kompatibla datakällor som stöds av Salesforce Connect.
Utmaning: Supportteam behövde sammanslagna rapporter som kombinerar Salesforce Kundcasedata med ärendevolym, lösningstid och omflyttningsmått som lagras i Snowflake. Att bygga och underhålla en replikeringspipeline för dessa data introducerade fördröjning och lade till operativ overhead för ett skrivskyddat rapporteringsanvändningsfall.
Lösning: Teamet visade Snowflake-vyer som innehåller ärendemått som Externa objekt i Salesforce. Teamet konfigurerade Salesforce-rapporter så att de slår samman inbyggda kundcaseobjekt med externa ärendedata.
Resultat:
- Rapporter återspeglar alltid live Snowflake-data. Ingen pipelinefördröjning.
- Styrning av känsliga supportmått finns kvar i Snowflake.
- Ingen ETL-pipeline att bygga, övervaka eller underhålla.
Utmaning: Ett finansteam upprätthöll auktoritära kreditgräns- och saldodata i Snowflake. Att replikera dessa värden till Salesforce via omvänd ETL introducerade replikeringsfördröjning, vilket gjorde att säljare åtog sig att göra affärer baserat på gammal kreditinformation. Teamet för efterlevnad flaggade även för risken med att hålla känsliga ekonomiska data i Salesforce-lagring.
Lösning: Teamet virtualiserade Snowflake-finansvyn som ett externt objekt och visade den på sidlayouten Konto. Säljare ser nu livekreditstatus som en del av sin standardkontovy i Salesforce.
Resultat:
- Kreditdata i realtid på varje kontosida. Ingen fördröjning.
- Omvänd ETL-pipeline eliminerad för ekonomiska data.
- Känsliga ekonomiska data kopierades aldrig till Salesforce-lagring. Efterlevnadsomfånget stannar i Snowflake.
Utmaning: Under en sammanslagning behövde det förvärvande företaget ge Salesforce-användare insyn i operativa data från 6 Snowflake-datauppsättningar med hög volym som täcker transaktioner, fakturering och användning. Att replikera terabyte med data till Salesforce var inte lönsamt på sammanslagningstidslinjen, och att bygga egna ETL-pipelines för varje datauppsättning skulle ha krävt betydande tekniska investeringar.
Lösning: Teamet konfigurerade externa objekt för alla 6 Snowflake-datauppsättningar med Salesforce Connect med en integreringsroll med minst behörighet. Ingen egen kod krävs. Sökfrågor körs direkt i Snowflake och all aktivitet loggas i Snowflake-sökfrågehistorik för efterlevnadsrapportering.
Resultat:
- Fullständig deklarativ konfiguration. Ingen egen kod eller pipelines krävs.
- Datauppdatering garanteras. Varje sökfråga reflekterar live Snowflake-data vid utförande.
- Fullständig granskningslogg i Snowflake-sökfrågehistorik för rapporter om föreskrifter och efterlevnad.
Datavirtualisering introducerar en distinkt operativ profil. Utforma dessa felscenarier:
- OAuth-tokenutgång: Tokens har en ändlig tid att leva (TTL). Utgångna tokens orsakar anropsfel. Bevaka 401 Oauktoriserade svar och implementera uppdateringslogik.
- Kallstart för lagerbyggnad (specifik för snöflinga): Automatiskt avbrutna lagerbyggnader lägger till 5-30 sekunder på den första sökfrågan. För användarvända användningsfall med latenskrav, förvärm med en schemalagd lättviktsfråga under arbetstid.
- Rollfelmatchning: En felkonfigurerad roll i det externa systemet kan returnera noll rader tyst istället för ett fel. Validera roll-till-objekt-privilegier i det externa systemet oberoende av Salesforce.
- Resultatuppsättningsspill: Överdimensionerade belastningar överskrider API-gränser. Tillämpa alltid LIMIT-klausuler och visa filtrerade vyer istället för råa tabeller.
- Avbrott i externt system: Ingen reserv eller cache finns. Slå in anrop i försök/fångst och visa informativa fellägen i användargränssnittet. För verksamhetskritiska data, överväg en stegvis metod: virtualisera för åtkomst i realtid och upprätthålla en lätt replikerad reserv för de mest kritiska fälten för att garantera tillgänglighet under källsystemavbrott.
Salesforce Data Virtualisering följer följande pelare i Salesforces välarkitektoniska ramverk.
- Trust: Den delegerade OAuth 2.0-modellen och vägledning för minst privilegier överensstämmer med Trust. Åtkomstkontroll med dubbla lager (källsystem + Salesforce) upprätthåller försvaret på djupet.
- Tillförlitlighet (feltolerans): Sektionen Fellägen hanterar pålitlighet direkt: tokenutgång, kallstart, felkonfigurering av roll, spill av resultatuppsättning och avbrottshantering representerar var och en en en distinkt felklass med en dokumenterad lösningssökväg.
- Tillförlitlighet (skalbarhet): Pushdown av sökfrågor, vägledning om lagerstorlekar och anropsbegränsning optimerar effektiviteten i utförandet inom Salesforces styrande begränsningar, vilket är ett problem vad gäller pålitlighet för lösningar som arbetar i stor skala.
- Operativ excellens: Snowflake-sökfrågehistorik som det primära observerbarhetsverktyget har stöd för operativ förträfflighet: arkitekter gör ett medvetet, spårbart val att använda plattformsinbyggt verktyg för granskning från början till slut och prestandadiagnostik istället för att bygga egen loggningsinfrastruktur.
Denna sektion ger arkitekter och designers en strukturerad utgångspunkt för att bygga datavirtualiseringsmönstret i en sandboxmiljö. Det är inte en fullständig implementeringsguide — behandla den som en validerad sekvens av beslut och konfigurationssteg för att orientera ditt första konceptbevis.
Bekräfta följande innan du påbörjar något konfigurationsarbete:
- Licensrättighet: Salesforce Connect ingår inte i alla Salesforce-versioner. SQL-adaptern för Snowflake kräver en separat tilläggslicens utöver den grundläggande Salesforce Connect. Verifiera båda i din organisation innan du fortsätter.
- Sandbox först: Utför alla faser i en sandboxmiljö innan du flyttar upp din konfiguration till produktion.
- Åtkomst till snöflinga: Bekräfta att du har behörighet att skapa en säkerhetsintegrering i Snowflake och åtkomst till måldatabasen, schemat och objekten.
- Adapterversion: Bekräfta att SQL-adaptern för Snowflake är tillgänglig i din organisationsversion och att din Snowflake-konto-URL inte innehåller understreck (ersätt med bindestreck om så är fallet). Detta är en Salesforce Platform-begränsning för lösning av anropsvärdnamn).
Att konfigurera datavirtualisering med ett externt SQL-system som Snowflake är en deklarativ, konfigurationsdriven process – ingen egen kod krävs. Konfigurationen följer tre sekventiella faser: etablera identitet och Trust, konfigurera dataytan och exponera data för slutanvändare.
Denna fas etablerar en säker, delegerad OAuth 2.0 Trust kedja mellan Salesforce och det externa systemet. Slutför denna fas innan du påbörjar någon dataytekonfiguration.
- Skapa en autentiseringsleverantör i Salesforce. Använd OpenID Connect-typen. Använd platshållarvärden i denna fas — gå tillbaka för att slutföra den efter att du har hämtat värden från det externa systemet. Efter att du har sparat skapar Salesforce en callback-URL. Behåll detta värde.
- Registrera Salesforce som en OAuth-klient i det externa systemet. I Snowflake innebär detta att skapa en säkerhetsintegrering (OAuth, typen Konfidentiell klient). Ange Salesforce Callback URL som omdirigerings-URI. Hämta Client ID, Client Secret, Authorization URL och Token URL från integreringen efter skapandet.
- Färdigställ autentiseringsleverantörens konfiguration. Gå tillbaka till Salesforce-autentiseringsleverantören och fyll i den med de värden som hämtas från det externa systemet: Konsumentnyckel, Konsumenthemlighet, Auktoriserings-URL och Token-URL.
- Skapa den externa inloggningsuppgifterna. Ställ in protokollet till OAuth 2.0, länka det till autentiseringsleverantören och lägg till en princip (namngiven eller per användare, baserat på ditt beslut om identitetsmodell). Detta objekt hanterar OAuth-tokenlivscykeln.
- Skapa autentiseringsuppgiften. Ange slutpunkten till det externa systemets API URL (t.ex.
https://<account>.snowflakecomputing.com/api/v2/statements/) och länka den till den externa inloggningsuppgifterna. - Bevilja profilåtkomst till den externa inloggningsuppgifterna. Utan detta steg kan användare inte åberopa sammanslagna sökfrågor även om all annan konfiguration är korrekt.
- Inled OAuth-flödet för att slutföra autentiseringen. Utlös OAuth-handskakningen från Salesforce. Plattformen omdirigerar till den externa systeminloggningen, validerar inloggningsuppgifter och lagrar de resulterande tokens säkert i den externa inloggningsuppgifterna. Detta steg binder användarsammanhang till en giltig token. Alla sammanslagna sökfrågor misslyckas tills detta steg är klart.
Denna fas ansluter Salesforce till det externa dataschemat och skapar de externa objektdefinitioner som användare och plattformen frågar.
- Skapa den externa datakällan. Välj lämplig adapter (t.ex. SQL-adapter för Snowflake), peka den till måldatabasen och schemat och länka den till den autentiseringsuppgift du skapade i Fas 1.
- Validera anslutningen. Använd den inbyggda valideringen för den externa datakällan. Ett lyckat resultat bekräftar att OAuth Trust kedjan är färdig och att det externa systemet kan nås.
- Synkronisera metadata. Inled en metadatasynkronisering från den externa datakällan. Salesforce introspekterar målschemat och skapar externa objektdefinitioner och mappar externa kolumner till Salesforce-fälttyper.
- Välj och visa de tabeller eller vyer som behövs. Välj vilka externa tabeller eller vyer som ska visas som Externa objekt. Vi rekommenderar att du visar utvalda vyer istället för råa tabeller. Vyer tillåter förfiltrering av kolumner, begränsningar på radnivå och hårdare kontroll över vad Salesforce-lagret har åtkomst till.
Denna fas gör externa objekt synliga och användbara för slutanvändare i Salesforce Lightning Experience.
- Skapa flikar för externa objekt. Flikar gör externa objekt direkt navigerbara i Lightning.
- Lägg till externa objekt på sidlayouter. Visa relevanta externa data bredvid inbyggda Salesforce-poster (lägg till exempel till en Snowflake-finansvy på sidlayouten Konto).
- Lägg till i relaterade listor. Inkludera externa objekt i relaterade listor för att ge användare en enhetlig vy av inbyggda och externa data i sammanhanget.
- Validera sammanslutning av hela sökfrågor. Ladda en sida eller kör en sökfråga som refererar till ett externt objekt. Inspektera sedan det externa systemets sökfrågehistorik (till exempel Snowflake-sökfrågehistorik) för att bekräfta att sökfrågan utfördes vid källan. Kontrollera att rätt roll, lager och identitet körde sökfrågan.
När alla tre faser är klara kan Salesforce-användare interagera med externa livedata via Salesforces standardgränssnitt, utan att känna till att data kommer från utanför Salesforce.
Salesforce Data Virtualisering ersätter replikeringsbaserad integrering med frågetidsfederation. Data stannar i sin auktoritativa källa; Salesforce-användare interagerar med dem genom standardplattformsgränssnitt. Det finns ingen pipeline att bygga, ingen kopia att styra och ingen fördröjning att hantera.
Detta mönster är rätt val när lässtark åtkomst, färska data i realtid, strikt styrning och åtkomstkontroll med dubbla lager är de primära drivkrafterna. Det är fel val när skrivningar krävs, när AI eller automatiseringsfunktioner beror på inbyggda Salesforce-objekt eller när åtkomstmönster är för högfrekventa för styrande gränser att uppfylla.
Snowflake illustrerar mönstret bra: en styrd, sammanslagen anslutning som upprättas deklarativt utan egen kod, kan observeras från början till slut genom Snowflake-sökfrågehistorik och tillämpas genom både Snowflakes inbyggda åtkomstkontroller och den fullständiga Salesforce-säkerhetsmodellen.
Innan du bestämmer dig för denna arkitektur, validera licensrättigheter, utvärdera styrande begränsningars exponering mot dina förväntade åtkomstmönster och bekräfta OAuth-beredskap i en sandboxmiljö. Mönstret belönar genomtänkt frontdesign: Få rätt identitetsmodell, inloggningskedja och visningsstrategi, och det operativa fotavtrycket blir minimalt.
Yugandhar Bora är arkitekt inom programvaruteknik på Salesforce, specialiserad på dataarkitektur inom plattformen Data & Intelligence Applications. Han leder initiativ från EARB (Enterprise Architecture Review Board) som fokuserar på datastyrning och sammanslagna datamodeller, samtidigt som han bidrar till automatiserade plattformsprovisioneringslösningar.