De flesta pipelines för företagsintegrering mellan Salesforce och externa analysplattformar förlitar sig på egen kod. De fungerar tills något går sönder. Schemadrift, API-utmattning och hårdraderingsluckor kräver konstanta tekniska ingripanden. När företag arbetar mot flexibla, medborgarutvecklaraktiverade arkitekturer blir denna modell en flaskhals: Analytics-team väntar på tekniska sprintar för att lägga till ett Salesforce-fält i ett schema längre ner, misslyckade nattliga laddningar försenar måndag morgonrapportering och enkla konfigurationsändringar kräver kodgranskningar och distribueringar.
CRM Analytics, Salesforces inbyggda plattform för analys och verksamhetsinformation, löser detta problem genom att låta företag utforska data, bygga interaktiva instrumentpaneler och upptäcka AI-drivna insikter utan att lämna Salesforces ekosystem. Centralt för denna kapacitet är en deklarativ funktion för datasynkronisering med låg kod inbyggd i plattformen: CRM Analytics SyncOut och CRM Analytics SyncIn.
CRM Analytics SyncOut flyttar Salesforce-poster till externa datalager enligt ett konfigurerat schema, med hjälp av CDC (Ändra datainsamling) för inkrementell inläsning och inbyggd hårdraderingsspårning för att flagga permanent borttagna poster. CRM Analytics SyncIn hämtar externa data tillbaka till Salesforce, mappar kolumner till objektfält och infogar poster med Bulk API 2.0. Båda konfigureras helt genom Salesforces inställningar. Inga pipelines, inga fasningsskript, ingen egen övervakning. Administratörer konfigurerar ett synkroniseringsjobb i en enskild inställningssession. Plattformen hanterar körning, återförsök, felloggning och schemamappning automatiskt.
Denna guide förklarar mönstret, när det ska användas, hur det ska implementeras med Snowflake som ett fungerande exempel, och de arkitektoniska överväganden som avgör om det passar ett givet integreringsproblem.
Licensanteckning: CRM Analytics SyncIn och SyncOut är inte tillgängliga i Salesforce-versioner utan ett CRM Analytics-licenstillägg. Bekräfta licensrättigheter innan du utformar en synkroniseringsarkitektur som beror på dessa kapaciteter.
Dataintegrering är en av de ytor med högst friktion i företagsarkitektur. En egen ETL-pipeline från Salesforce till en analysplattform kräver vanligtvis en ansluten app för autentisering, ett schemalagt jobb för SOQL-extrahering, ett transformationslager för att stämma av fälttyper, ett mellanlagringsområde för massinläsning och ett övervakningslager för att fånga upp fel. Varje komponent i egen kod representerar en felpunkt.
Kostnaden för dessa friktionsföreningar över tid. Schemadrift i Salesforce (ett omdöpt fält, ett nytt kombinationsrutevärde, ett ändrat API-namn) bryter pipeline tyst. API-utmattning under användningstopp stoppar extraheringen. Hårdraderade poster visas aldrig i måltabellen, vilket lämnar gamla data som Analytics längre ner behandlar som live. Teknikteamet blir flaskhalsen för rutindataåtgärder.
CRM Analytics SyncIn och SyncOut ändrar verksamhetsmodellen. Konfiguration ersätter kod. Plattformen tar ansvar för utförande, felhantering, schemamappning och observerbarhet. Administratörer kan definiera, ändra och övervaka synkroniseringsjobb utan att skapa ett utvecklingsärende.
Resultatet av denna nya verksamhetsmodell är minskad tid från integreringsdesign till operativ synkronisering, lägre teknisk overhead och en integreringsmodell som skalar inom plattformsbegränsningar istället för att kräva underhåll av egen kod.
SyncIn och SyncOut är de två riktningslägena för CRM Analytics-datasynkronisering. SyncOut flyttar Salesforce-poster till en extern plattform. SyncIn hämtar externa poster till Salesforce. Båda fungerar på en deklarativ konfigurationsmodell utan att någon egen kod behövs.
Deklarativ konfiguration innebär att allt synkroniseringsbeteende definieras genom peka-och-klicka-gränssnitt i Salesforces inställningar. Källobjekt, måltabell, fältmappningar, synkroniseringsschema, synkroniseringsläge och filter ställs in genom konfigurationsmetadata. Plattformen deriverar utförandeplanen från dessa metadata och hanterar den från början till slut.
Fullständig synkronisering vs. inkrementell synkronisering styr vilka data som flyttas vid varje körning. En fullständig synkronisering frågar alla poster som matchar filterkriterierna för varje körning. En inkrementell synkronisering använder CDC för att endast fråga poster som har ändrats sedan den senaste körningen. Inkrementell synkronisering är det rekommenderade läget för objekt med hög volym, eftersom det minskar API-användningen och synkroniseringens varaktighet avsevärt.
Ändra datainsamling (CDC) är en Salesforce-plattformskapacitet som registrerar fältnivåändringar av objekt som händelseströmmar. SyncOut använder CDC för att upptäcka skapande, uppdateringar och borttagningar utan att utföra fullständiga tabellskanningar. CDC måste aktiveras per objekt i Salesforces inställningar innan det kan refereras av en synkroniseringskonfiguration.
Hårdraderingsspårning löser ett av de mest ihållande problemen i Salesforce-till-extern ETL. När en post hårdraderas i Salesforce försvinner den från standard-SOQL-frågor. Utan uttrycklig spårning får den externa plattformen aldrig reda på att posten har tagits bort. SyncOut:s hårdraderingsspårning flaggar borttagna poster i måltabellen med DEL_FLAG = 'Y' när den är aktiverad, vilket ger system längre ner en pålitlig signal för att filtrera gamla data.
Synkroniseringsfrekvensen kan konfigureras från 15 minuter till veckovis. Valet är en kompromiss mellan färskhet, API-användning och Snowflake-lagerberäkningskostnad. 15-minuterssynkroniseringar närmar sig nästan realtid för operativa instrumentpaneler; dagliga synkroniseringar är lämpliga för arbetsbelastningar för batchrapportering.
Utformning av synkroniseringsjobb begränsas av guvernörsgränser: Gränsen för Salesforce API-begäran (15 000 anrop per 24 timmar i Unlimited Edition), satsstorleken för Bulk API 2.0 på 10 000 poster och radgränsen för SOQL-frågor på 50 000 per transaktion informerar om hur synkroniseringsjobb ska storleksanpassas och schemaläggas. Plattformen hanterar uppdelning och paginering automatiskt, men arkitekter måste ta hänsyn till begränsat utrymme för alla synkroniseringsjobb som körs i organisationen.
Snowflake är ett primärt mål och en primär källa för datasynkronisering med Salesforce CRM Analytics. Den fungerar som ett konkret exempel på hur batch- och inkrementell dataflyttning fungerar från början till slut.
Detta avsnitt ger en översikt av att implementera CRM Analytics SyncOut och SyncIn med Snowflake som den externa analysplattformen. Den täcker varje metod, de delade autentiseringsmodellerna, säkerhetsramverk, viktiga plattformsöverväganden och observerbarhetsrutiner.
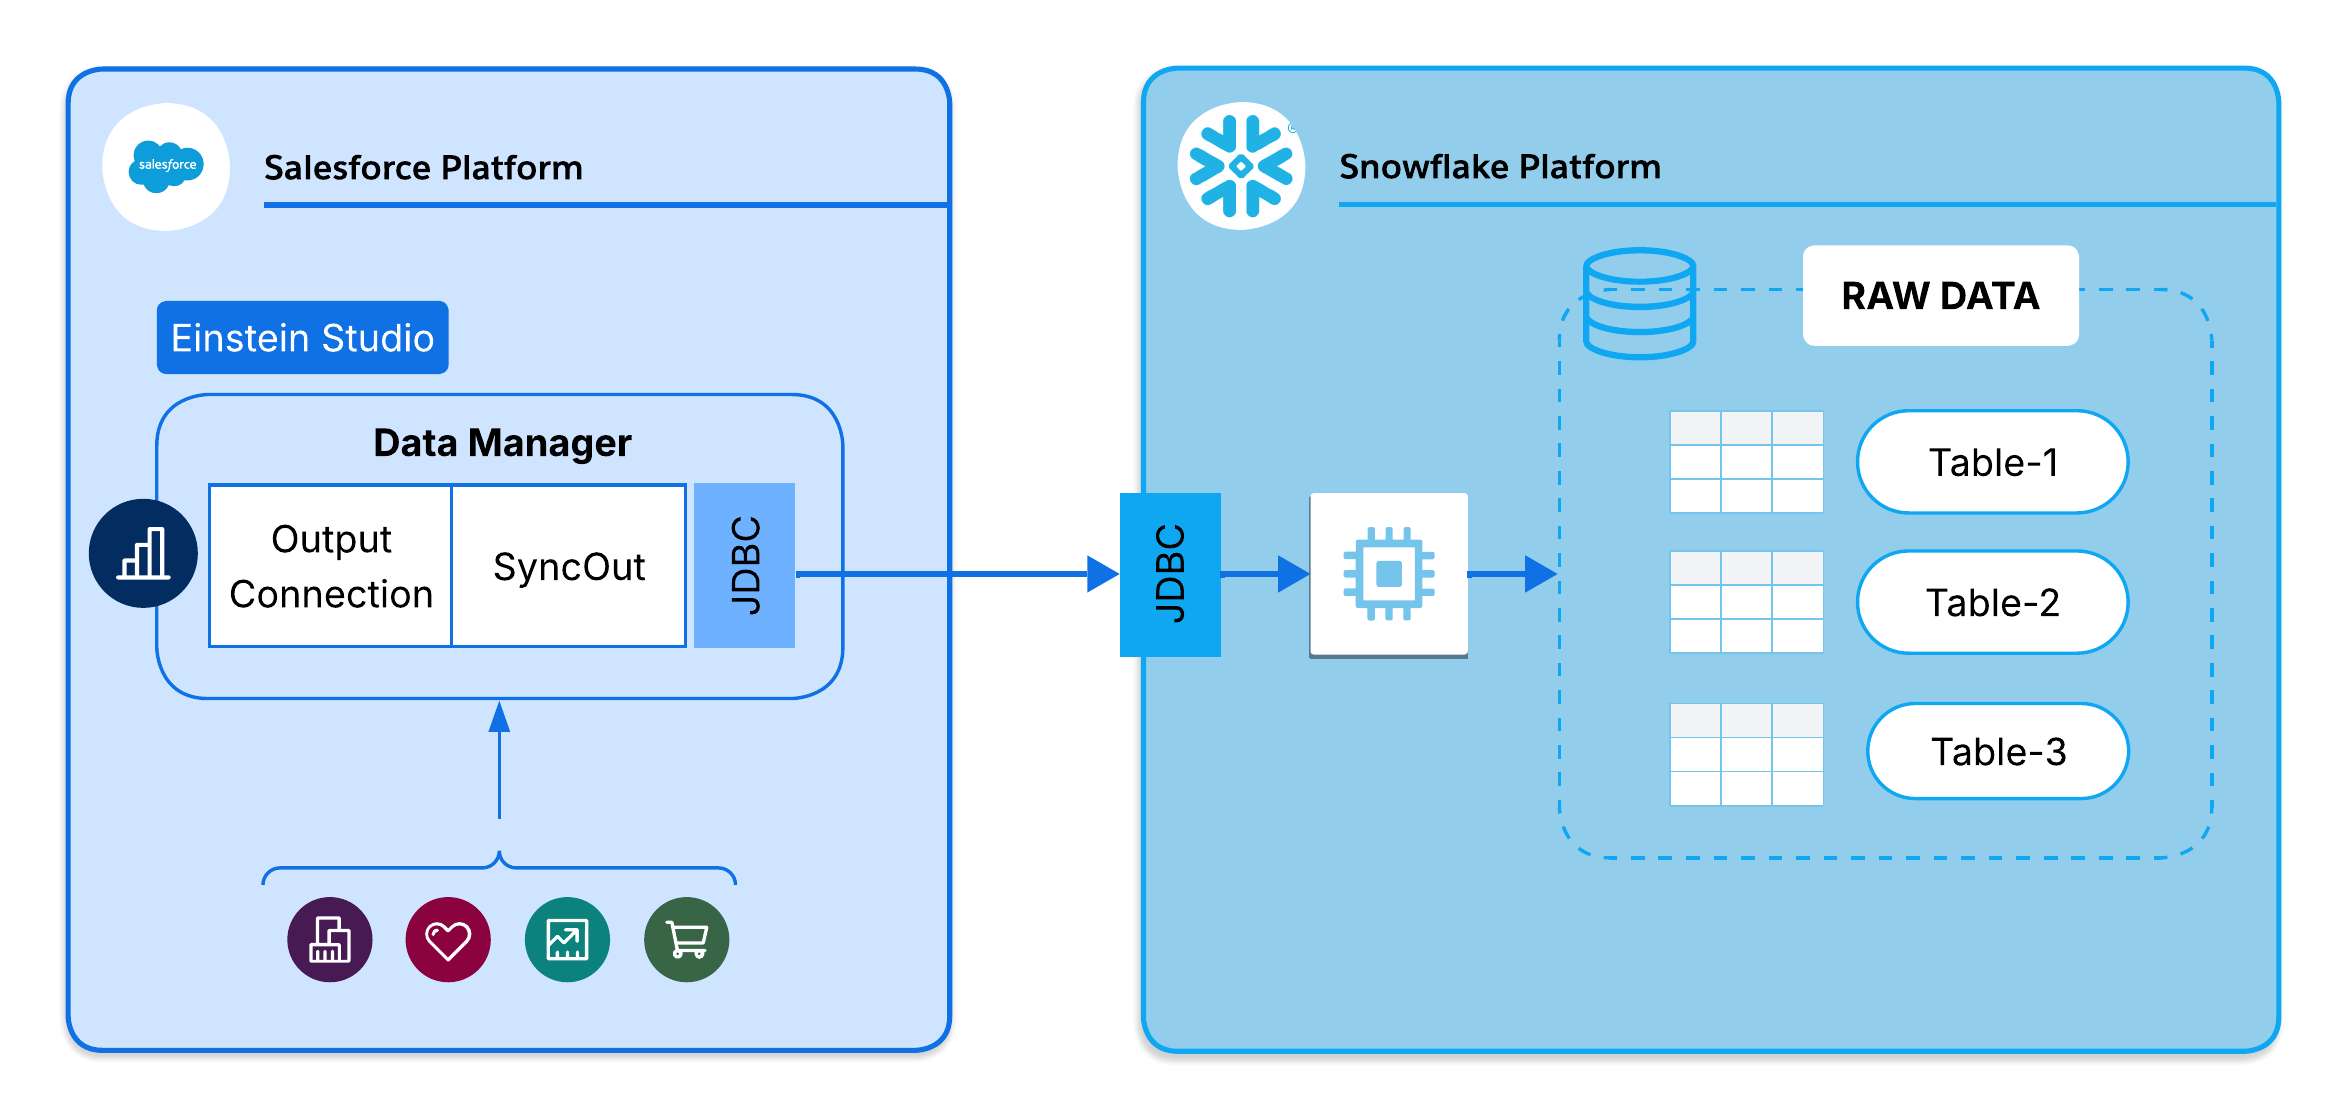
I denna SyncOut-konfiguration använder Salesforce CRM Analytics SyncOut för att pusha poster till Snowflake. Plattformen extraherar data via SOQL, hanterar typkonverteringar automatiskt och läser in dem i Snowflake-tabeller enligt ett konfigurerat schema (från 15 minuter till veckovis). Se aktuell Salesforce- och Snowflake-dokumentation för specifik inläsningssemantik.
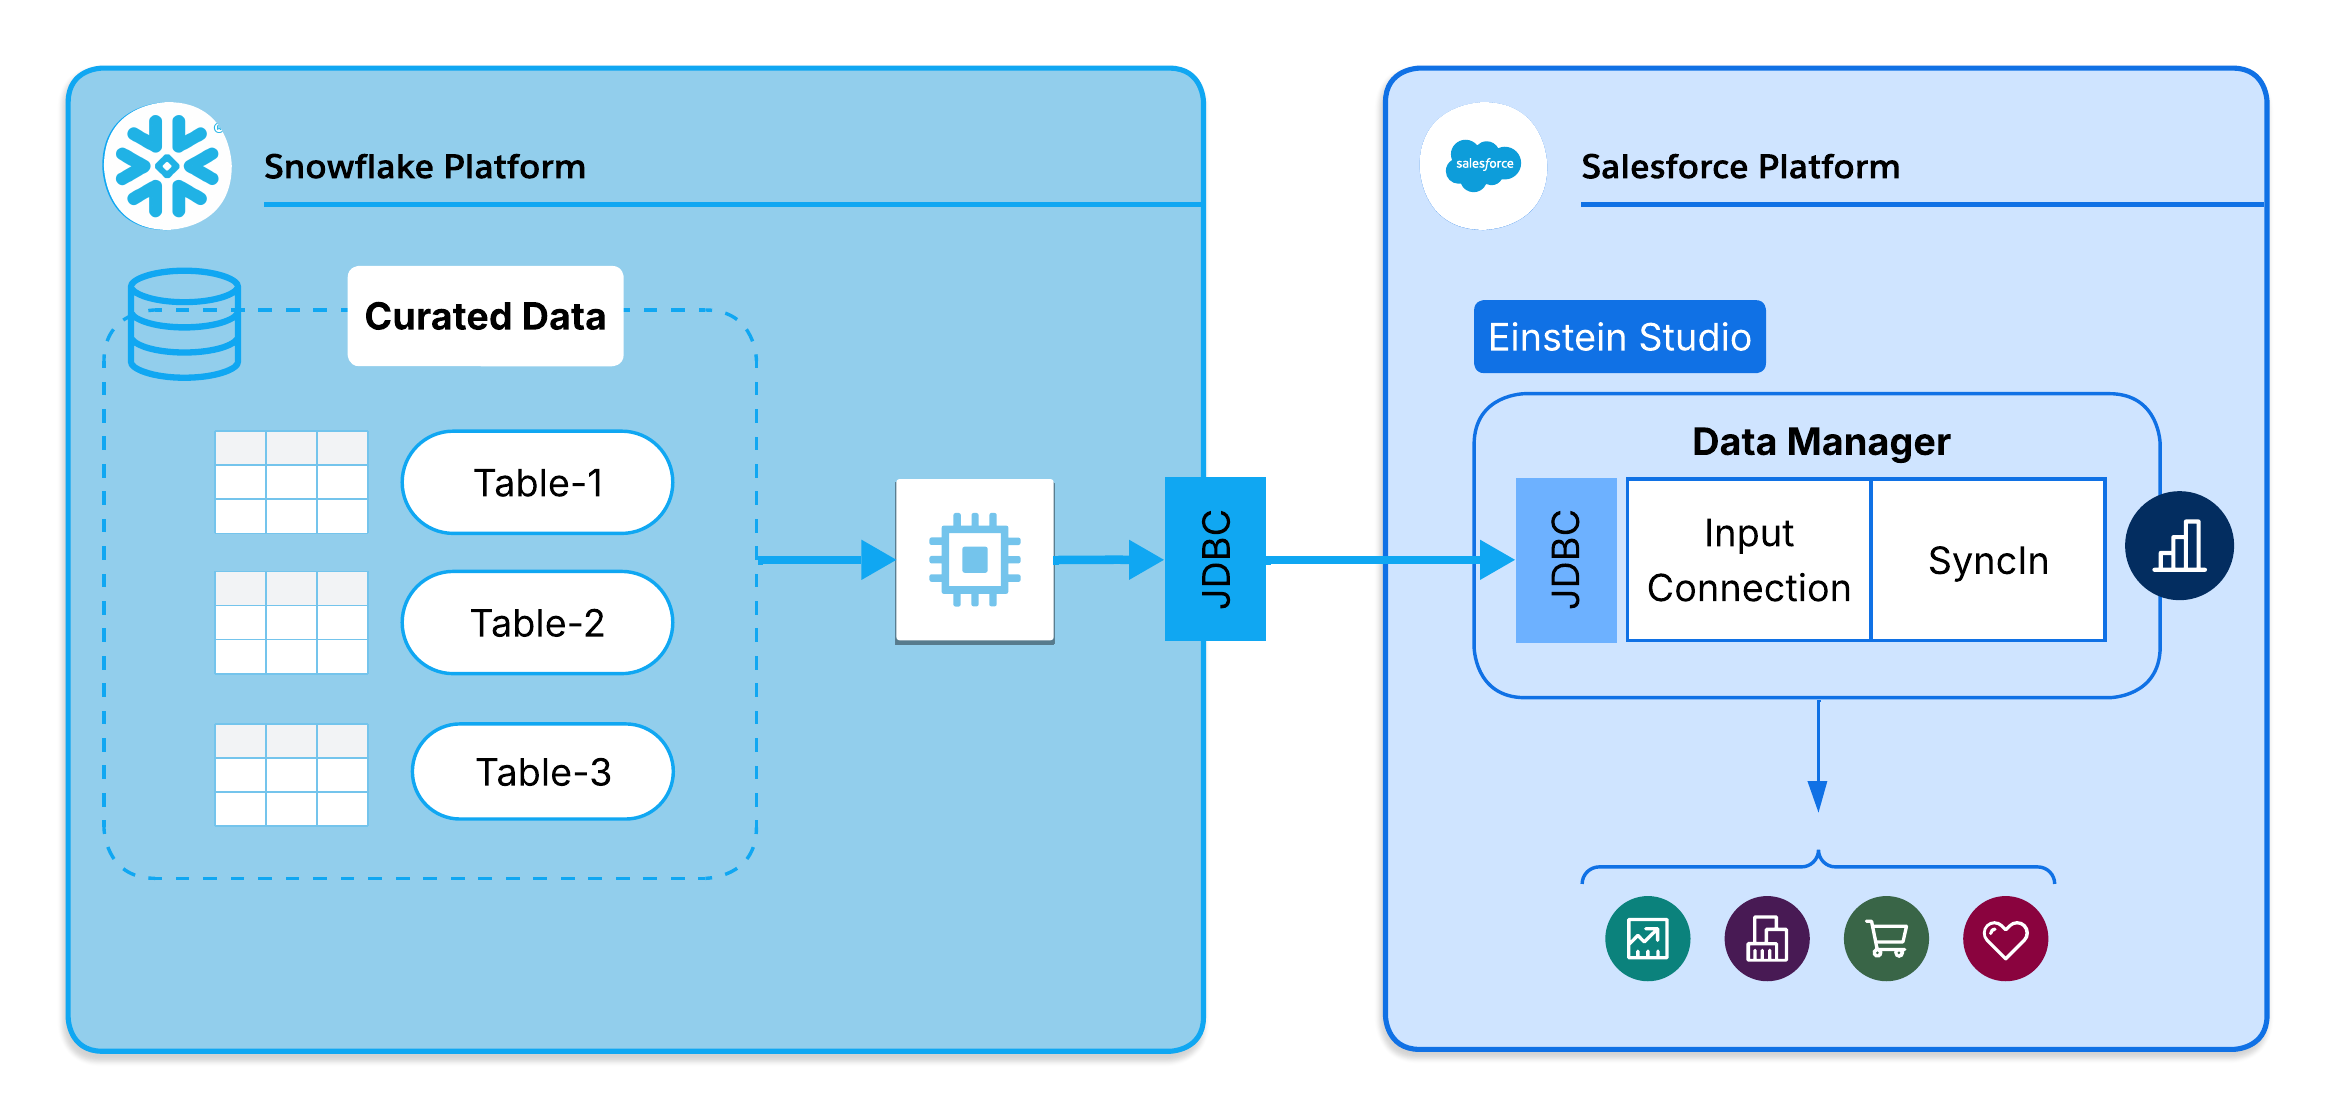
I denna SyncIn-konfiguration använder Salesforce CRM Analytics SyncIn för att hämta tillbaka data till Salesforce. Plattformen frågar Snowflake via Statements API och infogar resultat i Salesforce med Bulk API 2.0. Stora resultatuppsättningar pagineras automatiskt för att hålla sig inom API-gränser. Synkroniseringen körs enligt ett konfigurerat schema, från 15 minuter till veckovis.
Salesforce-synkronisering har stöd för flera autentiseringsmetoder för att ansluta säkert med Snowflake. De två primära metoderna för företagsintegreringar är Nyckelpar (Privat nyckel) och delegerad OAuth 2.0.
Metod 1: Autentisering med nyckelpar (privat nyckel): Nyckelparsautentisering är den rekommenderade metoden för automatiserad, system-till-system-dataförflyttning som CRM Analytics SyncIn och SyncOut. Autentisering förlitar sig på JSON Web Tokens (JWT) istället för lösenord eller uppdateringsbara tokens, vilket gör den väl lämpad för obevakade, schemalagda jobb som inte kräver tokenuppdatering.
- Salesforce-certifikat: Skapa en privat nyckel och lagra den säkert i Salesforce Certifikat och Nyckelhantering.
- Extern/Namngiven autentiseringsuppgift: Konfigurerad att använda ett JWT-utbyte. Salesforce använder den lagrade privata nyckeln för att signera begäranden om utgående anslutning.
- Offentlig nyckel för Snowflake-användare: Den matchande offentliga nyckeln tilldelas direkt till det dedikerade Snowflake-servicekontot (t.ex. ALTER USER CRM_ANALYTICS_SYNC_USER SET RSA_PUBLIC_KEY = ’…’). Snowflake använder sedan denna nyckel för att verifiera den inkommande JWT-signaturen. Ingen säkerhetsintegrering krävs för denna metod.
Metod 2: Delegerad OAuth 2.0-autentisering: Alternativt kan Salesforce använda ett OAuth-handslag för att autentisera. Nyckelkomponenterna är:
- Autentleverantör: Hanterar OAuth-handskakningen med Snowflake, med klientuppgifterna som hämtas från Snowflake Security Integration.
- Externa inloggningsuppgifter: Håller OAuth-tokens säkert inom Salesforce och injicerar dem i synkroniseringsanropen automatiskt.
- Namngiven autentiseringsuppgift: Definierar Snowflake-slutpunktens URL (t.ex. https://<account>.snowflakecomputing.com) och refererar till den externa inloggningsuppgifterna.
- Snowflake-säkerhetsintegrering: Registrerar Salesforce som en betrodd OAuth-klient i Snowflake (OAUTH_CLIENT = CUSTOM). Definierar tillåten omdirigerings-URI och aktiverar uppdateringstokens.
Konfigurationsberoende: Oavsett vilken metod som valts bildar dessa komponenter en beroendekedja som ansluter synkroniseringskonfigurationen till slutpunkten. Att bevilja relevanta Salesforce-profiler åtkomst till autentiseringsuppgiften krävs. Utan denna åtkomst misslyckas synkroniseringsjobb på grund av autentiseringsfel oavsett alla andra konfigurationer.
Bakgrundssynkronisering förlitar sig på en enskild integreringsidentitet.
- Dedikerat servicekonto: Skapa ett dedikerat Snowflake-servicekonto med en roll med minst behörighet som endast är begränsad till de databaser, scheman och tabeller som behövs för synkroniseringen.
- Granska behörigheter: För SyncOut kräver denna roll INSERT, UPDATE och SELECT i måltabeller. Använd aldrig roller med hög behörighet som ACCOUNTADMIN, SECURITYADMIN eller SYSADMIN.
- Guvörsgränser och uppdelning: Under SyncOut-extrahering delas stora resultatuppsättningar automatiskt upp för att respektera styrande gränser för Salesforce SOQL. SyncIn hämtar stora resultatuppsättningar från Snowflake Statements API via automatisk paginering för att hantera datavolymer effektivt.
- Ändra datainsamling (CDC): Inkrementell SyncOut förlitar sig på Salesforce CDC-händelseströmmen för att identifiera poster som skapats, uppdaterats eller tagits bort. Om hårdraderingsspårning har aktiverats släpps inte borttagna Salesforce-poster utan flaggas med
DEL_FLAG = 'Y'i Snowflake. - Uppdateringsbegränsningar: SyncIn förlitar sig på Bulk API 2.0 för att läsa in data i Salesforce igen. Detta kräver att ett utsett fält för Externt ID konfigureras i målobjektet Salesforce för att fungera som uppladdningsnyckel.
- Utformningsvägledning: Synkronisera alltid från utvalda Snowflake-vyer istället för råa tabeller. Vyer tillåter förfiltrering av rader, kolumnval och tillämpning av verksamhetslogik, vilket minskar datavolym, synkroniseringstid och Snowflake-lagerberäkningskostnader i proportion till den förfiltrering som tillämpas.
Varje synkroniseringskörning skapar omfattande granskningsloggar för att validera datarörelser. Instrumentpanelen Jobbövervakare för synkronisering ger status i realtid, behandlade postantal, körtider och detaljerade felloggar för både SyncIn och SyncOut. På Snowflake-sidan loggas varje sökfråga som skickas av Salesforce i Snowflake-sökfrågehistorik, vilket ger fullständig insyn i utförandelatens, skannade rader och användning av lagerberäkningar. Dessutom definierar arkitekter dedikerade Snowflake-granskningstabeller för att samla in synkroniserade körmetadata — tidsstämpel, postantal och fel; dessa skapas inte automatiskt av plattformen. För end-to-end-validering, jämför postantal över båda plattformarna: verifiera aktiva poster i Snowflake (WHERE DEL_FLAG = 'N') för SyncOut-körningar och jämföra antalet Salesforce-målobjekt direkt med den ursprungliga Snowflake-källvyn för SyncIn-körningar.
Använd CRM Analytics SyncIn och SyncOut när:
- Dubbelriktad synkronisering är ett krav: Data flödar både till Salesforce via SyncIn och ut till en extern plattform via SyncOut.
- Hårdraderingsspårning är viktigt: SyncOut:s inbyggda flaggning löser ett historiskt komplext ETL-problem utan egen avstämningslogik.
- CDC-baserad inkrementell synkronisering är genomförbar: För Salesforce-objekt med hög volym minskar CDC API-användning och synkroniseringstid betydligt jämfört med fullständiga skanningar.
- Schemalagd batchsynkronisering uppfyller latenskrav: Den lägsta synkroniseringsfrekvensen är 15 minuter, vilket är lämpligt för operativa instrumentpaneler och analysrapporter nästan i realtid.
- Låg operativ overhead är en prioritet: Inbyggda instrumentpaneler ger fullständig synkroniseringssynlighet utan egen loggning eller varningsinfrastruktur, och det deklarativa användargränssnittet för inställningar låter administratörer definiera, ändra och övervaka synkroniseringsjobb utan att skapa ett utvecklingsärende.
Använd inte detta mönster om:
- Komplexa transformationer krävs: Flertabellssammanslagningar, JSON-tolkning eller hantering av avancerad verksamhetslogik i Snowflake-vyer eller ett dedikerat transformationslager före eller efter synkronisering.
- Latens under 15 minuter krävs: För användningsfall i realtid, använd Platform Events eller Streaming APIs.
- Streamingarbetsbelastningar med mycket hög volym är i omfattning: Objekt med miljontals transaktioner per timme servas bättre av dedikerade streamingpipelines (Kafka, Plattformshändelser).
- Egen felhanteringslogik behövs: Plattformen tillhandahåller standard återförsök och felloggning. Komplexa försöksmönster eller egna varningar kräver Apex eller extern orkestrering.
- Synkronisering av flera organisationer eller moln: CRM Analytics SyncIn och SyncOut arbetar inom en enda Salesforce-organisation. MuleSoft eller ett eget integreringslager krävs för scenarion med flera organisationer.
Ett team körde komplexa ETL-pipelines för att ladda upp Snowflake-analysdata till CRM Analytics-datauppsättningar. Rörledningarna var långsamma, ömtåliga och krävde konstant tekniskt underhåll.
CRM Analytics SyncIn har konfigurerats för att synkronisera utvalda Snowflake-aggregerade vyer direkt till Salesforces egna objekt. Teamet har omkonfigurerat CRM Analytics-instrumentpaneler så att de läser från dessa objekt istället för CRM Analytics-datauppsättningar. Resultatet: två ETL-pipeline eliminerade, synkroniseringsvaraktigheten minskade från fyra timmar till 30 minuter och administratörer kunde ändra synkroniseringskonfigurationer utan att skapa ett teknikärende.
Ett datateam som behövs för att följa hårdraderade Salesforce-poster i sin Snowflake-operativdatalagring. Traditionella metoder krävde delade jobb och komplex logik för ID-avstämning som tog timmar att köra och var spröd över schemaändringar.
Teamet konfigurerade CRM Analytics SyncOut med CDC och hårdraderingsspårning aktiverat. Borttagna poster flaggas nu automatiskt med DEL_FLAG = ‘Y’ i Snowflake-konsumtionstabellen. Nedströmsanalysfrågor tillämpar WHERE DEL_FLAG = ‘N’ för att endast se aktiva poster. Avstämningslogik eliminerades helt och synkroniseringens varaktighet minskade från åtta timmar till 15 minuters inkrementella körningar.
Under ett förvärv synkroniserade det förvärvande företaget sex Salesforce-objekt med hög volym till Snowflake för korsorganisationsrapportering och regelefterlevnad inom en fast tidslinje.
Teamet konfigurerade CRM Analytics SyncOut för alla sex objekt med CDC-baserade inkrementella synkroniseringar. Granska metadatatabeller spårade schemaändringar och postantal under integreringsperioden. De skrev ingen egen kod. Datas färskhet förbättrades från dagliga till 15-minutersintervaller, och granskningens metadatatabeller gav den spårbarhet som behövs för efterlevnadsrapportering.
Synkroniseringsjobb delar organisationens API-budget. En organisation som kör många högfrekventa synkroniseringsjobb mot stora objekt riskerar att förbruka gränsen på 15 000 API-anrop per 24-timmarsperiod. Inventera alla synkroniseringsjobb, uppskatta API-användning per körning och sprid scheman för att distribuera belastning. För objekt med låga till måttliga ändringshastigheter kan CDC-baserat inkrementellt läge avsevärt minska API-användning per körning jämfört med fullständig synkronisering.
SyncIn och SyncOut utför sökfrågor och datainläsningar mot en Snowflake-lagerbyggnad och använder beräkningskrediter. För enkla SELECT-frågor är en X-Small eller Small-lager vanligtvis tillräcklig. För stora SyncOut-belastningar kan Medium eller Large krävas. Konfigurera automatiskt avbrott (5 minuter av inaktivitet) och återuppta automatiskt i lagerbyggnaden. Använd en dedikerad lagerbyggnad för produktionssynkroniseringsjobb för att isolera kostnader och förhindra tvister med användarfrågor.
Om ett Salesforce-fält byter namn, tas bort eller ändrar API-namn misslyckas motsvarande SyncOut-fältmappning tyst eller loggar fel. Etablera en ändringshanteringsprocess som inkluderar att granska aktiva synkroniseringskonfigurationer som en del av en Salesforce-metadataändring. Snowflake-granskningstabellerna ger en ändringshistorik som hjälper till att identifiera när en drifthändelse inträffade.
Hårdraderingsspårning i SyncOut kräver att CDC är aktiverat i Salesforce-objektet. Om CDC inte är aktiverat har alternativet “Spåra hårdraderingar” ingen effekt. Validera CDC-aktivering som en del av checklistan för synkroniseringskonfiguration, särskilt under inledande konfiguration eller efter organisationsmigreringar.
Den vanligaste felklassen är utgångna inloggningsuppgifter eller behörighetsförlust. Autentiseringsuppgifter måste fortsätta vara giltiga och Snowflake-servicekontot måste behålla sina tilldelningar av lageranvändning och tabellbehörigheter. För OAuth-baserade konfigurationer kan tokenuppdateringsfel tyst stoppa synkroniseringsjobb. Övervaka instrumentpanelen Övervaka synkroniseringsjobb för autentiseringsfelmönster och konfigurera Chatter eller e-postmeddelanden för jobbfel.
SyncIn använder ett Salesforce External ID-fält som uppfogningsnyckel. Om källvyn Snowflake innehåller dubbletter av värden i nyckelfältet misslyckas infogningen för poster som påverkas. Gör nyckelfältet i Snowflake-vylagret unikt innan det når synkroniseringskonfigurationen.
Om synkroniseringsjobb misslyckas loggar plattformen detaljerade felmeddelanden per post i Övervakaren för synkroniseringsjobb. Vanliga felscenarion och deras lösningar:
- Autentiseringsfel: verifiera statusen Autentiseringsuppgift och Snowflake-kontots utgång. Autentisera OAuth igen om tokenuppdatering har misslyckats.
- Fältmappningsfel: kontrollera typkompatibilitet mellan Snowflake-kolumner och Salesforce-fält. Gå igenom fältnivåsäkerheten för den aktuella användaren.
- Göteborgsdirektörsgräns överskriden: minska synkroniseringsfrekvensen eller gå till inkrementell CDC-läge för att sprida API-konsumtion.
- Snöflingelager upphävt: konfigurera automatiskt återuppta på lagerbyggnaden eller utlösa ett manuellt återuppta innan nästa schemalagda synkronisering.
- Hårdraderingsspårning fungerar inte: bekräfta att CDC har aktiverats för objektet och flaggan “Spåra hårdraderingar” är inställd i synkroniseringskonfigurationen.
CRM Analytics-datasynkronisering stämmer överens med flera pelare i Salesforces välarkitektoniska ramverk.
- Tillförlitlighet (feltolerans): Plattformen hanterar körning, återförsökslogik och delvis felhantering automatiskt. Misslyckade poster loggas individuellt i övervakaren för synkroniserade jobb. Implementera avstämning av postantal efter misslyckanden för att bekräfta enhetlighet, komplettera med notiser om misslyckanden och övervaka övervakaren för synkroniserade jobb för återkommande felmönster. CDC-baserad inkrementell synkronisering minskar explosionsradien för en misslyckad körning genom att begränsa datafönstret i omfattning.
- Trust: Inloggningsmodellen (Namngivna autentiseringsuppgifter, Externa inloggningsuppgifter, Autentiseringsleverantör) tillämpar krypterad lagring, automatisk tokenuppdatering och centraliserad hantering. Åtkomst med minst behörighet på Snowflake-sidan begränsar sprängradien för en komprometterad autentiseringsuppgift. Fältnivåsäkerhet tillämpas under synkroniseringen. Användare kan inte synkronisera fält som de inte har behörighet att komma åt.
- Resurs- och kostnadsoptimering: Inkrementellt CDC-läge är den primära hävstången för prestandaoptimering. Det minskar API-användning, synkroniseringsvaraktighet och Snowflake-beräkningskostnad jämfört med fullständig synkronisering. Förfiltrering av Snowflake-vyer minskar ytterligare datavolymen under överföring. Automatisk avstängning av lager förhindrar inaktiva beräkningsutgifter.
- Operativ excellens: Den deklarativa konfigurationsmodellen innebär att synkroniseringsjobb definieras i metadata, inte i kod. Detta gör dem granskningsbara, reproducerbara och hanterbara utan teknisk inblandning. Inbyggda övervakningsinstrumentpaneler ger fullständig observerbarhet utan egen loggningsinfrastruktur.
- Tillförlitlighet (skalbarhet): Plattformen hanterar uppdelning, paginering och buntning av API automatiskt. För objekt med mycket höga postvolymer är inkrementellt CDC-läge och schemaläggning utanför rusningstid de primära arkitektoniska hävstängerna för att upprätthålla genomströmning inom styrande begränsningar.
Denna checklista täcker de lägsta stegen för att konfigurera och validera en synkroniseringskonfiguration.
Checklista för förkonfiguration:
- Aktivera datainsamling för alla Salesforce-objekt som är avsedda för inkrementellt SyncOut-läge (Inställningar → Ändra datainsamling).
- Skapa ett dedikerat Snowflake-servicekonto med en minst privilegierad roll; bevilja endast de tabell- och lagerbehörigheter som behövs.
- Skapa en Snowflake-säkerhetsintegrering om du använder OAuth-autentisering.
- Identifiera fältet Externt ID i varje Salesforce-objekt som SyncIn kommer att använda som uppfogningsnyckel. Bekräfta att källdata är unika.
Anslutbarhet:
- Skapa autentiseringsleverantör i Salesforce (Inställningar → Autentiseringsleverantörer).
- Skapa externa inloggningsuppgifter och länka till Autentiseringsleverantör (Inställningar → Autentiseringsuppgifter → Externa inloggningsuppgifter).
- Skapa autentiseringsuppgift och länka till Externa inloggningsuppgifter (Inställningar → Autentiseringsuppgifter).
- Ge åtkomsten Autentiseringsuppgift till relevanta Salesforce-profiler.
SyncOut-konfiguration:
- Skapa Snowflake-anslutning (Inställningar → Analytics Studio → Datahanterare → Anslutningar → Snowflake-anslutningar).
- Skapa SyncOut-konfiguration: källobjekt, måltabell, synkroniseringsläge, fältmappningar, CDC, hårdraderingsspårning, schema.
- Börja med daglig synkronisering; validera denna datakvalitet och prestanda innan du ökar frekvensen.
SyncIn-konfiguration:
- Skapa extern datakälla (Inställningar → Analytics Studio → Datahanterare → Anslutningar → Snowflake-anslutningar).
- Skapa SyncIn-konfiguration: källvy, målobjekt, Externt ID-fält, fältmappningar, schema.
- Synkronisera från Snowflake-vyer, inte råa tabeller.
Validering:
- Granska Övervakare för synkroniserade jobb efter första körningen (Inställningar → Analytics Studio → Datahanterare → Övervakare för synkroniserade jobb).
- Fråga Snowflake-granskningstabell för att bekräfta att synkroniserade metadata har skrivits.
- Validera hårdraderingsflaggning genom att bekräfta att kolumnen DEL_FLAG finns och är ifylld.
- Jämför postantal mellan källa och mål.
- Konfigurera notiser om fel via Chatter eller e-post.
Använd detta mönster när schemalagd batchsynkronisering uppfyller latenskraven, dataflöde i två riktningar är nödvändigt och att minska det tekniska beroendet av integreringsåtgärder är en prioritet.
Exemplet Snowflake i denna guide illustrerar den fullständiga livscykeln: anslutningskonfiguration, konfiguration, utförandeflöde och validering. Samma principer gäller för alla externa dataplattformar som stöds.
När latens på under 15 minuter, komplexa transformationer eller scenarion med flera organisationer är i omfattning, utvärdera Plattformshändelser, Streaming API eller MuleSoft som kompletterande eller alternativa metoder.
Yugandhar Bora är arkitekt inom programvaruteknik på Salesforce, specialiserad på dataarkitektur inom plattformen Data & Intelligence Applications. Han leder initiativ från EARB (Enterprise Architecture Review Board) som fokuserar på datastyrning och sammanslagna datamodeller, samtidigt som han bidrar till automatiserade plattformsprovisioneringslösningar.