Agenter resonerar över mål, härleder parametrar från sammanhanget och väljer åtgärder dynamiskt. Som ett resultat av detta måste varje integrering en agent berör hantera tvetydighet, stödja säker upprepning och misslyckas på sätt som agenten kan återställa autonomt.
Agentsystem ogiltigförklarar flera antaganden som traditionell integreringsdesign tar för givet. Indata kommer inte alltid att vara välformulerade. En enskild användaråtgärd kan skapa en kedja av agenter över organisationsgränserna, som var och en behöver delegerad behörighet för att agera.
Detta dokument mappar de arkitektoniska skift som följer av denna verklighet: de nya designprinciperna, de agentiska mönstren och hur Salesforce Platform levererar dem.
Varje mönster i detta dokument följer samma struktur:
Namn: Mönsteridentifieraren som indikerar vilken typ av integrering som finns i mönstret.
Sammanhang: Det övergripande integreringsscenario som mönstret hanterar. Sammanhang ger information om vad användare försöker åstadkomma och hur programmet beter sig efter deras behov.
Problem: Utmaningen (uttryckt som en fråga) som mönstret är utformat för att lösa. När du granskar mönstren, läs denna sektion för att snabbt förstå om mönstret gäller för ditt integreringsscenario.
Krafter: De begränsningar och omständigheter som kan göra problemet svårt att lösa.
Program för Salesforce-mönster: Det rekommenderade sättet att tillämpa mönstret på scenariot.
Skiss: Ett UML-sekvensdiagram (Unified Modeling Language) som visar hur mönsterprogrammet hanterar scenariot.
Resultat: Hur mönstret löser de krafter som är associerade med scenariot. Denna sektion innehåller även nya utmaningar som kan uppstå som ett resultat av att tillämpa mönstret.
Att tänka på vad gäller design: Plattformsagnostisk vägledning för att tillämpa lösningen korrekt, följt av Salesforce-specifika implementeringsanteckningar. Dessa överväganden omfattar principer för åtgärdsdesign och plattformsspecifika konfigurationskrav.
Felhantering och återställning: Vägledning för att hantera fel under mönsterapplicering. Denna parameter täcker fyra områden:
- Hur åtgärder kommunicerar fel till agenten genom strukturerade, användbara felsvar som ger tillräckligt med sammanhang för beslutsfattande längre ner
- Hur agenten avgör om de ska försöka igen, korrigera sig själva eller stoppa utförandet
- Hur kompensationsåtgärder hanterar delvisa resultat och omatchade lägen mellan plattformar
- Idempotenskrav för tillbakadragna skrivoperationer
Att tänka på vad gäller säkerhet: Säkerhetskrav för att tillämpa mönstret säkert. Dessa överväganden omfattar hantering av inloggningsuppgifter, minsta privilegier för integreringsanvändare och anslutna appar, granskningsloggning av agentåberopna åtgärder och indatavalideringskrav för parametrar som kommer från användartillhandahållet eller LLM-härlett innehåll, bland annat.
Exempel: Ett heltäckande scenario som beskriver hur designmönstret används i ett verkligt Salesforce-scenario. Exemplet förklarar målen och hur man tillämpar mönstret för att uppnå dessa mål.
Följande tabell listar de implementeringsmönster som omfattas.
Lista över mönster
| Mönster | Vad den gör |
|---|---|
| Åberopning av sekventiell åtgärd | En agent åberopar en serie åtgärder där varje steg beror på det verifierade resultatet av det föregående. Agenten behåller sammanhanget i hela kedjan, som identifierare, statuskoder, mellanliggande data och använder det för att avgöra om nästa steg kan fortsätta. |
| Parallellåtgärdsåberopning | När en uppsättning åtgärder är oberoende av varandra åberopar agenten dem samtidigt istället för i sekvens. Total arbetsflödestid är bunden av det långsammaste samtalet istället för summan av alla samtal. |
| Åberopning av asynkron åtgärd | En agent skickar en operation till ett system längre ner via en plattformshändelse, meddelandekö eller bakgrundsjobb utan att vänta på resultatet. Agentens skyldighet upphör vid bekräftad åberopning; systemet längre ner tar över ägandet av utförandet oberoende av agentsessionen. |
| Åberopning av agent på begäran | Ett externt program eller AI-orkestrerare anropar en agent programmatiskt, tillhandahåller sammanhang och väntar på ett strukturerat svar. Agenten fungerar som en intelligent backendtjänst som uppringaren inleder, agenten resonerar och agerar och resultatet konsumeras av uppringaren. |
| Autonom händelsedriven agentkörning | Ett datavillkor som övergivande av varukorg, betalningsfel, användningsbortfall sparkar automatiskt en agent utan att någon människa inleder interaktionen. Det finns inget samtal som väntar på ett svar; agenten tar emot händelsebelastningen som jordningssammanhang och kör ett svarsflöde helt på egen hand. |
| Knowledge jordning från företagsinnehåll | Innan ett svar skapas hämtar agenten relevanta dokument från ett Knowledge Store-företag och infogar dem i sitt sammanhangsfönster. LLM tillhandahåller resonemanget; hämtningslagret tillhandahåller fakta. |
| Bekräftad kundsammanhangsinjektion | Verifierade, strukturerade attribut från en enhetlig kundprofil fylls i som åtgärdsinmatningar innan agenten åberopar en åtgärd. Agenten får fakta som segment, nivå, bortfallrisk och livstidsvärde istället för att härleda dem. |
| Integrering av korssystemverktyg | En agent ansluter till externa system utanför Salesforce Platform genom ett enhetligt verktygsgränssnitt baserat på standarden Model Context Protocol (MCP). Varje externt system exponerar sin kapacitet som beskrivna, anropbara verktyg; agenten upptäcker och åberopar dem utan att behöva känna till varje systems inbyggda API eller schema. |
| Verksamhetskapacitet som anropbara verktyg | Företagets verksamhetskapacitet, som affärsenheter, processer och insikter, exponeras som MCP-verktyg som alla externa agenter i alla ramverk kan upptäcka och åberopa. |
| Övergripande delegering | En anropande agent delar upp en komplex begäran och delegerar domänspecifika underuppgifter till specialiserade peer-agenter på olika plattformar eller leverantörssystem med hjälp av protokollet Agent-till-agent (A2A). Den anropande agenten hanterar uppgiftens livscykel och aggregerar resultat från fjärragenterna. |
| Agenter som anropbara tjänster | En intern Agentforce publicerar sin domänkapacitet som en styrd, upptäckbar A2A-slutpunkt så att externa orkestrerare eller peer-agenter kan delegera uppgifter till den. Agenten hanterar livscykeln för inkommande uppgifter och returnerar strukturerade resultat till fjärruppringaren. |
Mönstren i detta dokument är klassificerade i tre kategorier. Denna kategorisering hjälper arkitekter att snabbt identifiera vilka mönster som är relevanta för den integreringsutmaning de löser, oavsett om de utformar vad en agent anropar, vad som utlöser en agent eller hur en agent är grundad med Knowledge innan den agerar. Istället för att läsa varje mönster kan du gå direkt till den kategori som matchar dina designproblem.
Åtgärdsåberopning:
Dessa mönster täcker hur en agent anropar externa system för att hämta data eller utföra åtgärder som en del av sin resonemangscykel. Dessa är utgående mönster där agenten är initiativtagare. De hanterar sekvensering (när steg beror på varandra), parallellism (om de inte gör det), idempotens och delvis felhantering. Använd dessa mönster när du utformar verktygen som en agent åberopar för att få arbetet gjort.
Agentåberopning:
Dessa mönster hanterar hur externa system eller händelser aktiverar en agent. Dessa är inkommande mönster där externa system utlöser dessa agenter. Utlösaren kan vara ett mänskligt program som gör ett programmatiskt anrop och väntar på ett svar, eller ett autonomt datavillkor som utlöser agenten. Använd dessa mönster när du utformar hur och när en agent utlöses.
Jordning med företagsdata:
Mönstren i denna kategori täcker hur agenter är grundade med korrekt, aktuell, organisationsspecifik Knowledge innan den resonerar eller agerar.
Att välja rätt strategi är inte trivialt. Varje mönster är inriktat på ett specifikt problem: systemkapacitet, datavolym, felhantering och transaktionalitet.
Urvalsmatristabellerna listar mönstren och deras nyckelaspekter för att hjälpa dig avgöra vilket mönster som passar dina integreringskrav bäst. Mönstren kategoriseras med hjälp av dessa dimensioner.
| Aspekt | Beskrivning |
|---|---|
| Typ | Anger kategorin för integrering: Åtgärdsåberopning, Agentåberopning eller jordning med Enterprise Data Action-åberopning: Dessa utgående integreringar sträcker sig från enkla verktygsanrop i ett steg till komplexa sekvenser i flera steg och parallella utflyttningar, och kräver noggrant övervägande av orderbegränsningar, idempotens och delvis felhantering över heterogena backends. Agentåberopning: Agentåberopningar är de sätt som externa system eller händelser aktiverar en agent. Dessa inkommande integreringar sträcker sig från synkrona programmatiska anrop som görs av program som väntar på ett strukturerat svar, till helt autonoma händelsedrivna körningar där ett datavillkor utlöser agenten utan att någon människa inleder eller väntar på interaktionen. Jordning med företagsdata: Jordningsintegreringar är de sätt som en agent förses med korrekt, aktuell organisationsspecifik Knowledge innan den resonerar eller agerar. Dessa integreringar sträcker sig från att hämta ostrukturerade dokument från företagets innehållslager till att injicera verifierade strukturerade attribut från sammanslagna kundprofiler, vilket säkerställer att agenten arbetar på fakta snarare än hallucinerade slutsatser. |
| Timing | Anger integreringsstilen baserat på timing: Synkron eller asynkron synkron vs. asynkron i detta dokument refererar till hur agenten själv utlöses eller hur den åberopar åtgärderna. Det täcker inte vad som händer internt. Men i allmänhet väntar en användare medan agenten åberopar åtgärder och bearbetar resultat. Agenten kommer inte att hantera nästa användarmeddelande förrän den har avslutat den aktuella vändningen. Synkron: Blockerings- och realtidsbegäranden är begäran-/svarsåtgärder. Resultatet returneras till uppringaren omedelbart via denna operation. Asynkron: Icke-blockerande, kö- eller meddelandebaserade begäranden åberopas av en enkelriktad operation som sker nästan i realtid. Resultaten och eventuella fel returneras genom att åberopa andra envägsoperationer. Samtalet gör därför begäran och fortsätter utan att vänta på ett svar. |
Denna tabell listar mönstren och deras nyckelaspekter för att hjälpa dig avgöra vilket mönster som passar dina krav bäst när din integrering är från Salesforce till ett annat system.
| Typ | Timing | Nyckelmönster att tänka på |
|---|---|---|
| Åberopning av åtgärd | Synkron | Åberopning av sekventiell åtgärd Parallellåtgärdsåberopning Integrering av korssystemverktyg Övergripande delegering |
| Åberopning av åtgärd | Asynkron | Åberopning av asynkron åtgärd |
| Agentåberopning | Synkron | Åberopning av agent på begäran Agenter som anropbara tjänster |
| Agentåberopning | Asynkron | Autonom händelsedriven agentkörning |
| Jordning med företagsdata | Synkron | Knowledge jordning från företagsinnehåll Bekräftad kundsammanhangsinjektion |
Varje sektion av mönster beskriver hur man bygger dem. Varje mönster är en upprepningsbar lösning på ett specifikt integreringsproblem i agentarkitekturer. Den täcker när mönstret ska användas, vilka krafter som formar beslutet och hur Salesforce Platform levererar det.
Sammanhang
Många verksamhetsflöden är sekventiella – varje steg kräver ett verifierat resultat från det föregående innan det kan fortsätta. Till exempel kan en återbetalning inte inledas förrän rätten har bekräftats, ett faktureringskonto inte kan skapas förrän orderposten finns och en efterlevnadskontroll inte kan loggas förrän kontrollen har gått igenom.
I traditionell automatisering kodas dessa beroenden som hårdkodad flödeslogik. I ett agentsystem utvärderar agenten resultatet av varje åtgärd och avgör om förkraven för nästa steg har uppfyllts.
Detta mönster beskriver den grundläggande utgående integreringsmodellen. Här arbetar en enskild agent inom en domän och åberopar en sekvens, där varje åtgärds utdata grindar åberopningen av nästa åtgärd i kedjan. Den orkestrerade agenten upprätthåller transaktionssammanhang över hela kedjan och samlar identifierare, statuskoder och data som returneras av varje steg. Den använder detta sammanhang för att driva efterföljande beslut.
Detta mönster är den agentiska motsvarigheten till Åberopning av fjärrprocess – Begäran och svar från guiden Integreringsmönster som beskriver ett enskilt synkront anrop. Det agentiska mönstret utökar mönstret till en agentdriven kedja av beroende samtal inom en enda resonemangscykel.
Problem
När en agent kör ett arbetsflöde i flera steg som sträcker sig över värdsystemet och ett eller flera fjärrsystem måste fyra utmaningar hanteras:
- Sekvensering - Åtgärder måste åberopas i rätt ordning, med varje steg inhägnat efter det att det föregående har utförts.
- Datapropagering - Svarsdata från varje steg måste skickas som indata till nästa.
- Isolering av fel – Fel i någon del av kedjan får inte orsaka delvisa eller inkonsekventa tillstånd i olika system.
- Verifiering - Agenten måste bekräfta att alla steg har utförts innan ett resultat rapporteras.
Krafter
När du tillämpar detta mönster, svara på följande frågor:
-
Beror varje åtgärd i kedjan på data som returneras av den föregående åtgärden, eller beror beroendena endast på statusen för framgång eller misslyckande?
Databeroenden kräver att agenten bär identifierare och attribut över steg.
-
Kan alla fjärrslutpunkter svara inom agentens timeout för resonemangscykel?
Ett långsamt externt system i något steg i kedjan blockerar hela sekvensen.
-
Kräver kedjan fullständig framgång från början till slut, eller är delvis slutförande acceptabelt?
-
Om fullständig framgång från början till slut krävs, definiera en kompensationsstrategi för steg som behöver dras tillbaka om ett fel inträffar längre ner.
-
Kan någon av skrivoperationerna i kedjan testas säkert?
Alla skrivåtgärder måste vara idempotenta; agentens resonemangsloop kan åberopa samma åtgärd mer än en gång på grund av försök med stor språkmodell (LLM) eller tvetydiga bekräftelser.
-
Åberopas kedjan av en användarinteraktion (konversation, låg samtidighet) eller av en automatiserad utlösare (potentiellt hög samtidighet)?
Detta avgör om synkron blockering är acceptabelt eller om ett asynkront mönster krävs.
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Apex åtgärder | Bäst för externa anrop och komplex logik | Ett steg kräver ett HTTP-anrop till ett fjärrsystem, egen datatransformation eller felhanteringslogik som överskrider Flödets deklarativa kapacitet. Apex exponerar den fullständiga plattformen för integrering medan agenten fortfarande kan anropa den via annoteringen @InvocableMethod. |
| Flödesåtgärder (automatiskt startade) | Bäst för affärsregelsteg och lätta CRM-operationer | Ett steg tillämpar deklarativ verksamhetslogik, frågar eller uppdaterar CRM-poster, eller orkestrerar en process som inte kräver egen kod. Autostartade flöden kan anropas inbyggt från Agentforces underagenter och returtypade utdatavariabler som agenten använder för att avgöra nästa steg. |
| Externa tjänster (OpenAPI-import) | Bäst för maskinskriven, upptäckbar extern API-integrering | Ett externt system exponerar en OpenAPI-specifikation. Externa tjänster skapar starkt skrivna Apex stubbar som är direkt anropbara som agentåtgärder, vilket eliminerar manuell schemamappning och gör den externa API:ns operationer synliga för agenten som namngivna kapaciteter. Varje operation i den importerade specifikationen blir en namngiven, anropbar åtgärd. Agenten väljer åtgärder baserat på deras genererade semantiska etiketter. Registrera skapade åtgärder i Agentforces ämnescenter så att agenten kan upptäcka dem när de resonerar. Anteckning: om den externt värda tjänsten är RESTful, men OpenAPI-specifikationen inte är tillgänglig eller livskraftig, använd Autentiseringsuppgifter i Apex eller Flöden för att göra HTTP-anropet direkt. Apex kod behövs för att tolka resultaten. |
| MuleSoft-anslutna åtgärder | Bäst för komplex mellanprogramvara eller äldre systemintegrering | Använd när fjärrsystemet kräver protokollöversättning, datatransformation eller orkestrering över flera backendsystem innan ett svar returneras. Agenten gör ett enda anrop till MuleSoft och MuleSoft hanterar komplexiteten längre ner och returnerar ett enhetligt svar. |
Skiss
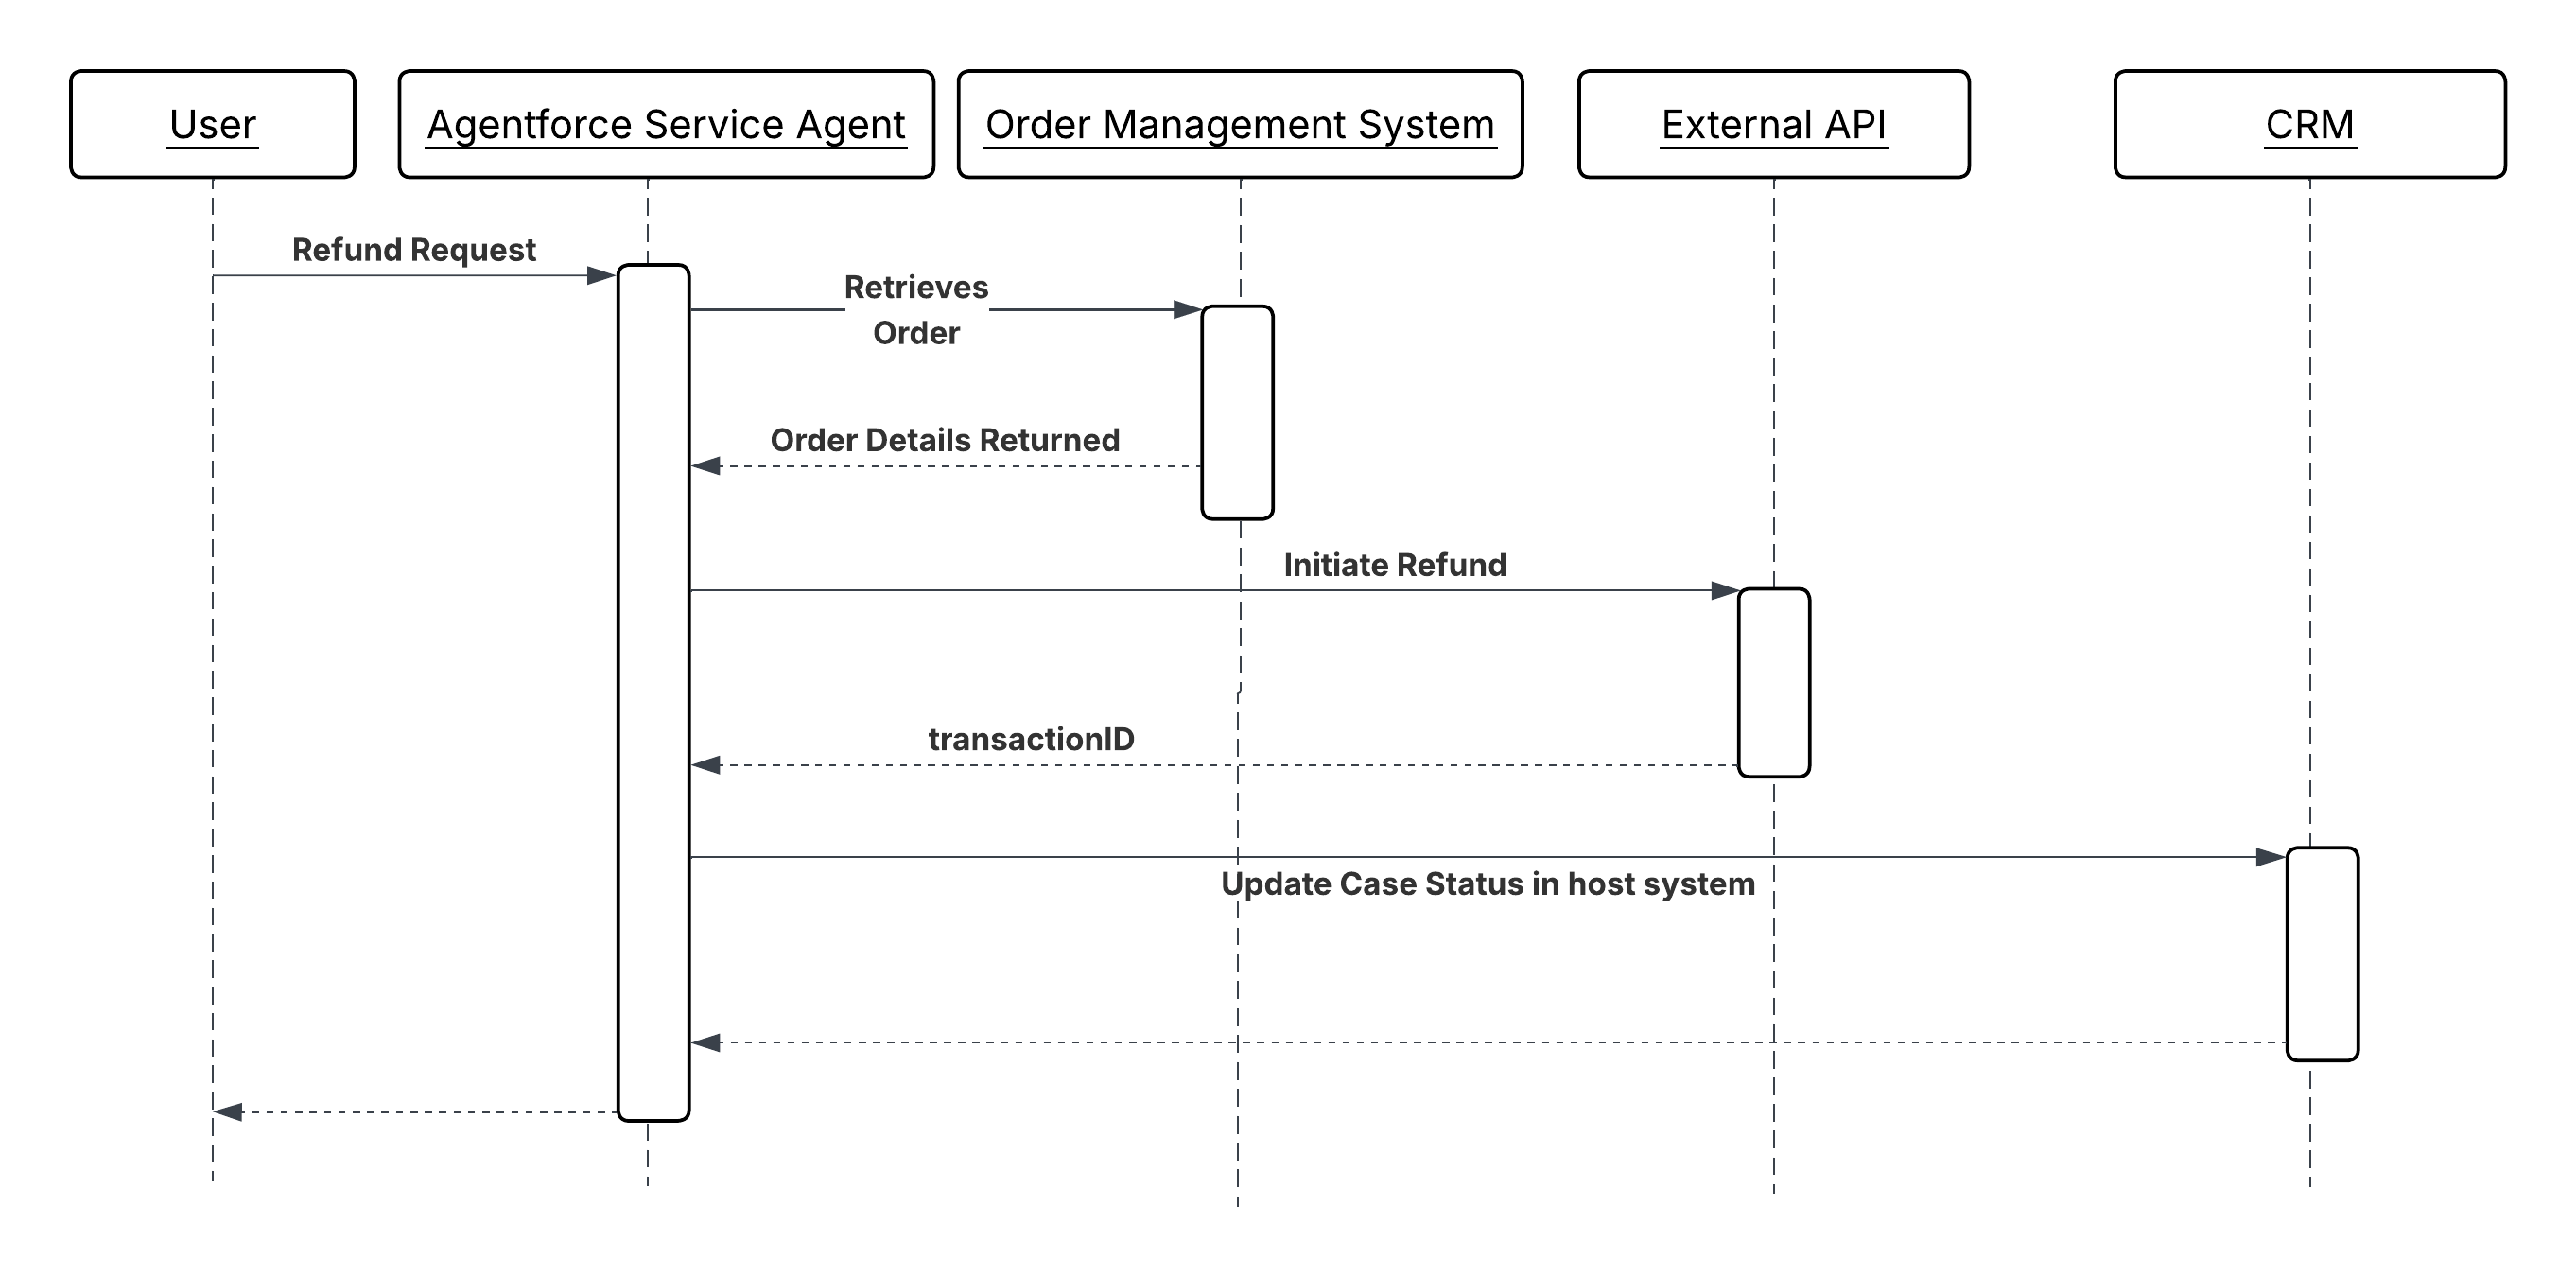
Sekvensdiagram för åberopning av sekventiell åtgärd
Resultat
Agenten kör ett korssystemflöde som en sammanhängande, övervakad sekvens och inte ett fire-and-glöm-skript. Varje stegs resultat utvärderas innan nästa steg åberopas, så agenten upptäcker fel vid tidigast möjliga tidpunkt istället för att upptäcka delvis slutförande efter fakta.
Värdsystemet (Salesforce CRM) uppdateras endast efter att fjärråtgärden har bekräftat statusen (framgång eller misslyckande). Identifierare och status som returneras av externa system, som faktureringskontonummer, transaktions-ID:n, bekräftelsekoder sprids genom kedjan och kvarstår, vilket skapar en fullständig, spårbar post för arbetsflödesresultatet.
Agenten ansvarar för att resonera kring resultat och sekvensera beslut. Varje åtgärd är endast ansvarig för sin egen åtgärd och för att returnera ett strukturerat resultat. Inget av lagren kodar den andras logik.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Se till att varje åtgärd i kedjan har en semantisk beskrivning skriven på syftesbaserat språk och inte som en teknisk metodsignatur. Agenten väljer åtgärder baserat på dessa beskrivningar. En beskrivning som lyder “anropar fakturerings-API” är mindre användbar än en som lyder “skapar ett faktureringskonto i faktureringssystemet och returnerar den nya kontoidentifieraren”.
- Gör alla skrivoperationer i kedjan idempotenta. Agentens resonemangsloop kan försöka utföra en åtgärd igen om den får ett tvetydigt svar. Åtgärden måste ge samma resultat vid upprepad åberopning.
- Validera alla LLM-härledda indataparametrar defensivt vid åtgärdsgränsen. Anta aldrig att parametrar som skickas av agenten är välformade, inom intervallet eller av den förväntade typen.
- Utforma varje åtgärd för ett enskilt ansvar. En åtgärd som skapar ett faktureringskonto och skickar en e-postbekräftelse i samma samtal är svårare att försöka igen, svårare att testa och svårare för agenten att resonera över än två diskreta åtgärder.
Genomförandeanteckningar för Salesforce
- För Apex-åtgärder, annotera med @InvocableMethod(label=’…’ description=’…’). “Beskrivningen” läses av agenten för att avgöra när åtgärden ska åberopas. Deklarera alla indata- och utdatavariabler med @InvocableVariable med hjälp av beskrivande “etikett”- och “beskrivning”-fält. Returnera strukturerade resultatobjekt med uttryckliga indikatorer för framgång/misslyckande och felmeddelanden som kan läsas av människor.
- För Flödesåtgärder, använd endast Autostartade flöden. Skärmflöden stöds inte i autonoma agentsammanhang. Håll varje flöde atomärt; en åtgärd, ett ansvar. Konfigurera felvägar för varje externt anropselement för att fånga upp integreringsfel och returnera användbara felmeddelanden till agenten istället för att låta ofångade undantag avsluta sessionen.
- För Externa tjänster, importera målsystemets OpenAPI-specifikation och registrera de åtgärder som skapas i Agentforce-ämnet. Omge de stubbar som skapas med autentiseringsuppgifter för att undvika hårdkodning av slutpunkter eller inloggningsuppgifter i åtgärdsdefinitionen.
- För alla externa anrop, ange uttryckliga anropstimeouter. Ett anrop som hänger sig utan en timeout kommer att blockera agentens resonemangscykel tills sessionsgränsen uppnås. Returnera ett graciöst fel med ett beskrivande felmeddelande om timeouten överskrids. Alla externa anrop har en konfigurerbar timeout på upp till 120 sekunder. De är även föremål för Apex synkrona styrande begränsningar för transaktioner, så se till att minska risken för instansiering av fler än 50 transaktioner som körs i mer än fem sekunder vardera.
Felhantering och återställning
- Agenten grindar varje steg på den uttryckliga framgången för stegets föregångare. Åtgärder måste returnera ett strukturerat resultat som inkluderar en tydlig indikator för framgång eller misslyckande. Agenten kan inte på ett tillförlitligt sätt sluta sig till misslyckande enbart från ett svar som saknas eller null.
- Om en åtgärd misslyckas använder agenten felmeddelandet som returneras av åtgärden för att avgöra dess nästa drag: uppmana användaren om korrigerad inmatning, försöka göra ett självläkande försök igen med justerade parametrar eller stoppa kedjan och logga felet för mänsklig granskning. Felmeddelanden måste därför vara specifika och användbara: “Ogiltigt datumintervall: endDate kan inte föregå startDate” går att använda; endast 400 statuskod gör det inte.
- För kedjor där delvis slutförande skapar inkonsekvent läge (till exempel att faktureringskontot skapades men CRM-posten inte uppdaterades) åberopar agenten en kompensationsåtgärd för att dra tillbaka eller flagga det delvisa läget innan felet visas. Utforma kompensationsvägar som namngivna åtgärder bredvid den framåtriktade vägen.
- Om en skrivåtgärd potentiellt lyckades, men returnerade ett tvetydigt svar (nätverkstimeout, inget godkännande), måste försöket använda samma idempotensnyckel eller externa referens-ID som det ursprungliga anropet. Utfärda aldrig ett omarkerat försök på en icke-idempotent skrivning.
Säkerhetsöverväganden
- Omge alla externa anrop med autentiseringsuppgifter. Hårdkoda aldrig slutpunkter eller inloggningsuppgifter i Apex kod- eller flödeskonfigurationer. Dessa måste hanteras genom plattformens säkra inloggningsuppgifter och roteras utan kodändringar.
- Tillämpa principen om minst privilegier för integreringsanvändaren eller den anslutna appen som används av varje åtgärd. En åtgärd som endast läser orderdata ska inte ha skrivbehörigheter för faktureringssystemet. Inloggningsuppgifter för omfattning till de minsta operationer åtgärden kräver.
- Logga åberopningen av varje åtgärd i kedjan med dess sessions-ID, indataparametrar (sanerade för känsliga värden) och resultat. Om resultatet är omtvistat är denna verifieringskedja den primära mekanismen för att rekonstruera varför agenten utförde en given sekvens av åtgärder.
- Sanera alla indataparametrar som kommer från användarlevererad text innan du skickar dem till externa system. Användarinmatning som skickas genom agenten till ett externt API-anrop är en potentiell injektionsvektor. Validera typ, format och intervall vid åtgärdsgränsen innan anropet görs.
Exempel
En kundtjänstagent som hanterar en begäran om återbetalning kör en sekventiell kedja i fyra steg:
GetOrderDetails(Apex Action) hämtar orderposten från orderhanteringssystemet med hjälp av det order-ID som tillhandahålls av användaren. Den returnerar orderstatus, radartiklar, inköpsdatum och betalningsmetod. Agenten utvärderar om ordern är i ett återbetalningsbart läge innan de fortsätter.ValidateRefundEligibility(Autostartat flöde) tillämpar verksamhetsreglerna för rätt till återbetalning, inklusive returfönster, produktkategoribegränsningar och tidigare återbetalningshistorik. Den returnerar en “berättigad” boolesk och, om den inte är berättigad, en klarspråklig anledning till att agenten kan visa upp för användaren.InitiateRefund(Apex Action) anropar API för extern betalningsgateway med order-ID och återbetalningsbelopp. Returnerar ett “refundTransactionId” vid framgång. Denna åtgärd är idempotent. Om det anropas en andra gång med samma order-ID returneras det befintliga transaktions-ID:t istället för att skapa en dubblett av återbetalningen.UpdateCaseStatus(Autostartat flöde) uppdaterar CRM-kundcaseposten med ID för återbetalningstransaktion, ställer in kundcasestatusen till “Löst återbetalning utfärdad” och skapar en uppföljningsuppgift för kontoägaren. Detta steg körs endast efter att “InitiateRefund” har returnerat ett bekräftat transaktions-ID.
Om InitiateRefund går ut eller returnerar ett fel stoppar agenten kedjan, åberopar inte UpdateCaseStatus och visar ett åtgärdsmeddelande för användaren. Kundcaset förblir öppet och olöst, vilket bevarar korrekt status i CRM.
Sammanhang
Sekventiella åtgärdskedjor är effektiva när utförandesteg är beroende av varandra. Ett steg grindar nästa. Men många arbetsflöden innehåller en uppsättning steg som inte har några ömsesidiga beroenden. Till exempel kan steg som inkluderar att hämta produktlager, hämta kunders rättigheter och kontrollera en leveransuppskattning utföras samtidigt, eftersom inget stegs indata kräver utdata från ett annat. Att utföra dessa steg sekventiellt slösar tid i proportion till antalet steg.
I ett parallellt åberopningsmönster identifierar agenten att en uppsättning åtgärder är oberoende och åberopar dem samtidigt snarare än i sekvens. Den övergripande arbetsflödestiden är bunden av den långsammaste individuella åtgärden snarare än summan av alla åtgärdstider. När alla resultat har returnerats aggregerar agenten dem till ett enda sammanhängande svar eller använder dem tillsammans som indata till nästa steg i resonemanget.
Den viktigaste arkitektoniska utmaningen är inte själva parallellåberopningen. Den hanterar utslussning inom plattformens samtidighetsbegränsningar och säkerställer att aggregeringssteget hanterar delvisa fel smidigt, utan att ignorera de resultat som lyckades.
Problem
Hur orkestrerar en agent effektivt det samtidiga utförandet av flera, oberoende kapaciteter och aggregerar de individuella resultaten till ett enskilt, sammanhängande svar för användaren eller efterföljande steg?
Krafter
När du tillämpar detta mönster, svara på följande frågor:
- Vilka är övervägandena för åtgärder gällande trådsäkerhet och delning av mutable state?
- Hur kommer lösningen att hantera och undvika att uppnå Salesforces styrande gränser för parallella Apex inom en enskild transaktion?
- Behöver du använda asynkrona mönster (som Queueable Apex eller Platform Events) för att undvika styrande begränsningar?
- Krävs synkron aggregering av resultaten innan agenten kan fortsätta?
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Middleware-metod | Bäst för höga fan outs (>5 slutpunkter) och aggregering mellan plattformar | Du behöver ett mellanlager. Agenten gör ett anrop till mellanprogramvaran. Sedan fläktar middleware som ut till 10 system parallellt, aggregerar datan och skickar ett enskilt svar tillbaka till agenten. Detta föredras när agenten måste anropa många heterogena externa system. Mellanprogramvaran absorberar komplexiteten hos utfläktning och returnerar ett enskilt aggregerat svar. |
| Köbar Apex | Bäst för Salesforces interna parallellism | Du behöver sparka flera köjobb. Salesforce hanterar kön, men om du har tillräckligt med “luckor” i din samtidighetsgräns kan dessa köras samtidigt. Använd när parallella operationer finns inom Salesforce-organisationen och samtidiga luckor är tillgängliga. Detta är inte lämpligt när omedelbart aggregerat svar krävs. |
| Plattformshändelser | Bäst för brand-glömska eller så småningom enhetlighet | Resultaten behöver inte aggregeras synkront. Varje händelse utlöser en isolerad transaktion, vilket maximerar genomströmningen men kräver avstämning längre ner. Använd denna mekanism när slutgiltig enhetlighet är acceptabel och genomströmning är viktigare än svarslatens. |
Skiss
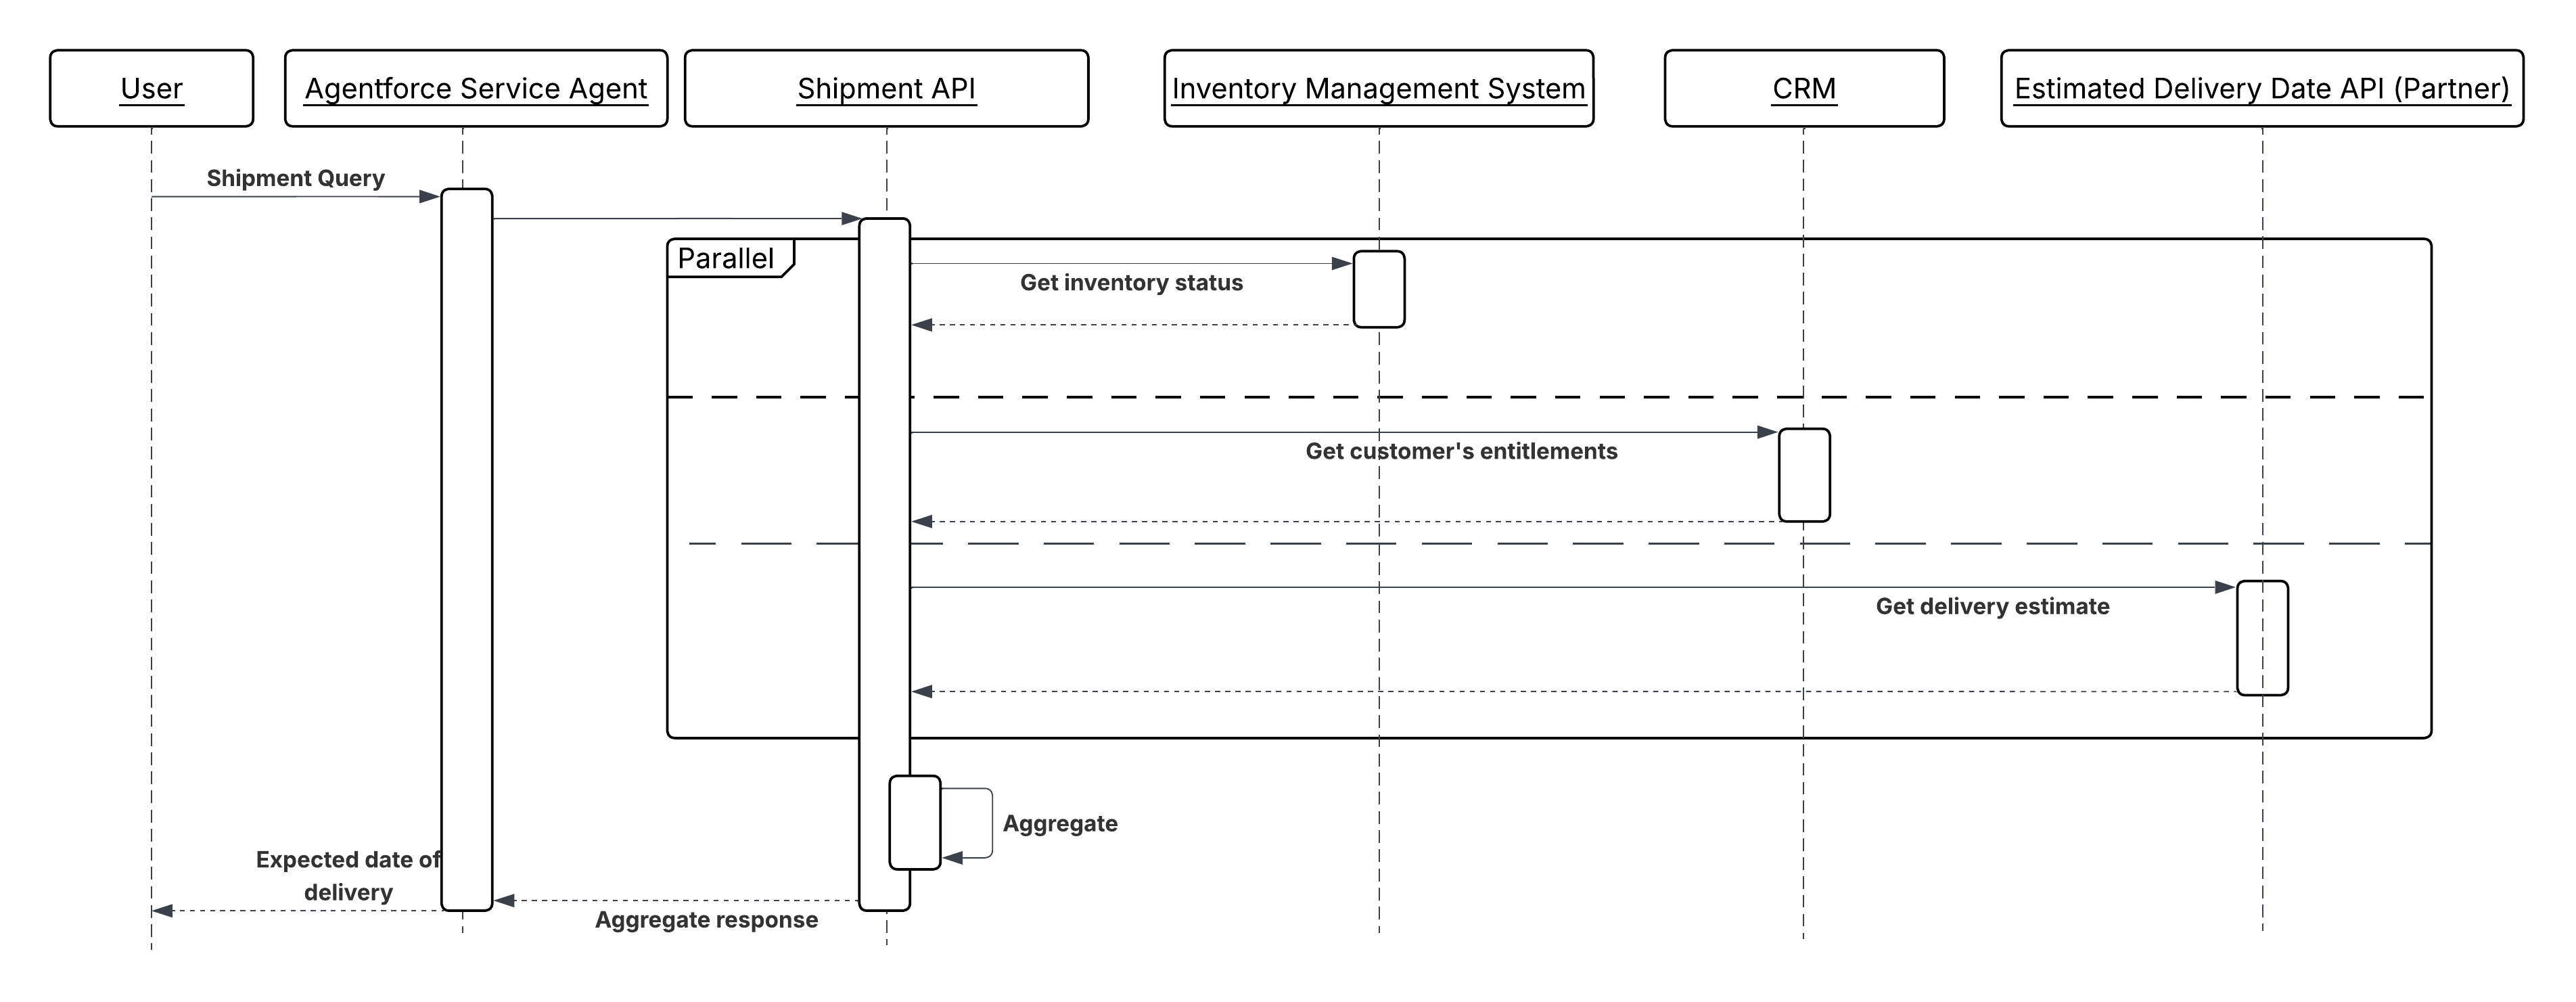
Sekvensdiagram för åberopande av parallellåtgärd
Resultat
När oberoende åtgärder utförs parallellt är arbetsflödestiden från början till slut bunden av den långsammaste individuella åtgärden istället för summan av alla åtgärder. För ett arbetsflöde med tre oberoende anrop på i genomsnitt 300 ms vardera slutförs parallell körning på ~300 ms; sekventiell körning tar ~900 ms. I stor skala förvärras denna skillnad över varje agentsession som körs samtidigt.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Bekräfta oberoende innan parallellisering. Åtgärder är säkra att köra parallellt endast om ingen av åtgärderna läser läget som skrivits av den andra och ingen av åtgärdernas misslyckanden bör avbryta den andra. Om ett beroende finns, även ett mjukt, använd sekventiell kedja istället.
- Utforma aggregeringssteget uttryckligen. Definiera i förväg hur en fullständig resultatuppsättning ser ut, vad en delvis resultatuppsättning innebär för resonemang längre ner och om agenten ska vänta på alla resultat eller fortsätta när en tröskel (till exempel fem av sju totala samtal) har returnerats.
- Alla parallella skrivoperationer måste vara idempotenta. Varje operation körs isolerad utan en delad transaktionsgräns, så att försöka igen med en enskild filial kan inte duplicera sidoeffekter.
Genomförandeanteckningar för Salesforce
- För köbar Apex: Skicka in alla jobb inom en enskild transaktion för att maximera chansen till samtidig körning. Var medveten om att tillgängliga samtidiga luckor delas över hela organisationen. Utforma med antagandet att luckor kanske inte alltid är tillgängliga och bygg en reserv för sekventiell körning när de inte är det.
- För plattformshändelser: Skriv varje operations resultat till en dedikerad fasningspost (nyckeld av ett delat korrelations-ID) istället för att uppdatera målposten direkt. Ett slutgiltigt aggregeringsflöde eller Apex läser alla fasningsposter när det förväntade antalet har uppnåtts och tillämpar sedan den konsoliderade uppdateringen atomiskt.
- För Middleware Fan-Out: Ange en uttrycklig timeout för det enskilda anropet som är längre än den förväntade sämsta svarstiden för den långsammaste backend, men fortfarande inom gränsen för Salesforce-anropets timeout. Middleware returnerar delvisa resultat med en tydlig indikation på vilka backends som misslyckades, istället för att timeouta hela svaret.
Felhantering och återställning
- Behandla delvis framgång som ett förstklassigt resultat. Om tre eller fyra parallella operationer lyckas använder agenten de tre framgångsrika resultaten och hanterar felet genom att uttryckligen visa det för användaren, logga det för försök igen eller åberopa en kompenserande åtgärd istället för att ignorera alla resultat eller fortsätta som om felet inte inträffade.
- För kö- och plattformshändelsemönster, använd ett korrelations-ID (skapat vid punkten för utflyttning) för att länka alla parallella grenar tillbaka till den ursprungliga agentsessionen. Detta ID krävs för att sammanställa resultat igen och för att spåra fel tillbaka till deras källa i loggar.
- Om en parallell gren misslyckas och operationen är säker att försöka igen, köa endast den misslyckade grenen med det ursprungliga korrelations-ID:t och idempotensnyckeln. Åberopa inte alla grenar igen.
- Definiera en timeouttröskel för aggregeringssteget. Om inte alla resultat anländer inom tröskeln, fortsätt med tillgängliga resultat och flagga den ofullständiga uppsättningen istället för att vänta tills vidare.
Säkerhetsöverväganden
- Varje parallellt utförandesammanhang, oavsett om det är ett köjobb, en plattformshändelseutlösare eller ett mellanprogramsanrop, måste tillämpa samma åtkomstkontroller som ett sekventiellt anrop. Parallellism minskar inte dataåtkomstregler. Varje filial måste ha samma minst privilegierade inloggningsuppgifter som den skulle ha om den åberopades ensam.
- För mellanprogram som är uttjänta cachar eller loggar inte mellanprogramlagret svarsbelastningar från individuella backends utöver aggregeringsfönstret. Varje backends svar kan innehålla känsliga data som inte ska finnas kvar utanför den omedelbara operationen.
- Se till att de fasningsposter som används för plattformshändelseaggregering inte kan läsas av agentens slutanvändare. Dessa poster kan innehålla mellanliggande, delvis formade data som ännu inte är lämpliga för användning.
Exempel
En serviceagent svarar på en komplex uppfyllandefråga: “Kan du skicka ordern till mig på fredag?” Svaret kräver data från alla oberoende system samtidigt, enligt nedan:
- Agenten identifierar tre oberoende databehov: aktuell lagernivå, kundens aktiva rättigheter och transportörens uppskattade leveransfönster för kundens plats.
- Tre åtgärder åberopas parallellt:
GetInventoryStatus(från det externa lagersystemet via middleware),GetCustomerEntitlements(från Salesforce CRM) ochGetDeliveryEstimate(från leverantörs-API via middleware). - Varje åtgärd returneras oberoende. Agenten väntar tills alla tre svar har tagits emot (eller aggregeringens timeout har uppnåtts).
- Med alla tre tillgängliga resultat resonerar agenten över de kombinerade data, bedömer om lagret är tillräckligt, kundens rättighet täcker expressleverans och transportören bekräftar att fredagsleverans är genomförbar för kundens postnummer.
- Agenten returnerar ett enskilt, jordat svar till användaren, hämtat från tre system, under den tid det tog det långsammaste av de tre samtalen att svara.
Sammanhang
Vissa agentinledda operationer ger inte ett resultat som agenten behöver för att fortsätta sin nuvarande resonemangscykel. Att skicka en notis, utlösa en batchprocess längre ner, publicera en händelse i en meddelandekö eller skicka in ett jobb som körs länge är alla operationer där agentens skyldighet slutar vid utskick; systemet längre ner tar över ägarskapet och slutför arbetet oberoende.
I traditionell automatisering modelleras dessa som eld-och-glöm-anrop eller plattformshändelsepubliceringar. I ett agentsystem bestämmer agenten under resonemanget att operationen inte är blockerande, skickar ut den, registrerar bekräftelse av utskick och fortsätter eller avslutar vändningen utan att vänta på resultatet längre ner.
Detta mönster är den agentiska motsvarigheten till Åberopning av fjärrprocess – Eld och glöm från guiden Integreringsmönster. Det agentiska mönstret utökar det genom att göra utskicksbeslutet till en del av agentens resonemang och genom att säkerställa att utskicket går att spåra även om inget svar returneras till agenten.
Problem
När en agent behöver inleda en operation längre ner som körs utöver agentens session eller resonemangscykel måste tre utmaningar hanteras:
- Icke-blockerande åberopning: Agenten måste starta operationen och bekräfta leveransen utan att hålla resonemangscykeln öppen i väntan på ett resultat.
- Leveransbekräftelse: Agenten måste skilja mellan ett framgångsrikt utskick (meddelandet accepterades) och ett framgångsrikt resultat (processen längre ner slutfördes). Den kan bara hävda det förra.
- Spårbarhet: Eftersom agenten inte får något resultat måste operationen kunna observeras genom loggar, händelseposter eller plattformsövervakning oberoende av agentsessionen.
Krafter
När du tillämpar detta mönster, svara på följande frågor:
-
Behöver agenten resultatet av denna operation för att slutföra sin aktuella tur? Om ja, är detta inte rätt mönster. Använd Åberopning av sekventiell åtgärd istället.
-
Kan systemet längre ner ta emot och bearbeta det skickade meddelandet eller händelsen på ett tillförlitligt sätt utan ett synkront godkännande? Målsystemet måste vara hållbart. Den får inte förlora meddelandet om den tillfälligt inte är tillgänglig.
-
Är operationen idempotent eller måste dubblettutskick bevakas? Försök på nätverksnivå och försök till agentresonemang kan göra att samma utskick försöks mer än en gång. Om operationen längre ner inte är idempotent måste åtgärden ha en dedupliceringsnyckel.
-
Behöver användaren eller en process längre ner veta när operationen slutförs? Agenten kan endast bekräfta utskick. Om slutförandestatus krävs, utforma en separat notis- eller uppföljningsmekanism. En plattformshändelse, en kundcaseuppdatering eller en callback - som ligger utanför denna resonemangscykel.
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Pub/Sub API . | Bäst för streaming med hög genomströmning eller extern händelse | Agenten åberopar en Apex åtgärd som publicerar en händelse till Salesforce Pub/Sub API över gRPC. Åtgärden returnerar ett PublishResult replayId till agenten som en bekräftelse på utskicket. Använd när konsumenter längre ner är externa system som prenumererar via Pub/Sub API istället för Salesforce-inbyggda flöden eller Apex, eller när strömmande händelser med hög genomströmning krävs. |
| Plattformshändelser (Apex åtgärd) | Bäst för asynkrona utskick inom Salesforce | Agenten åberopar en Apex åtgärd som publicerar en plattformshändelse. Händelsen levereras till alla prenumeranter asynkront. Åtgärden returnerar en publiceringsbekräftelse till agenten; den returnerar inte ett bearbetningsresultat. Används när konsumenten längre ner är inom Salesforce Platform. Agenten åberopar en Apex åtgärd som anropar EventBus.publish(). Åtgärden returnerar ett SaveResult som bekräftar godkännande. |
| Apex köbar / Batch (Apex åtgärd) | Bäst för långvarig bakgrundsbearbetning | Agenten åberopar en Apex åtgärd som köar ett köjobb eller ett batchjobb. Jobbet körs utanför agentens transaktion. Åtgärden returnerar ett jobb-ID som agenten kan visa för användaren som en referens. Används när det efterföljande arbetet är en långvarig Salesforce-operationsdatabearbetning, uppdateringar av flera objekt eller externa anrop som överskrider synkrona gränser. System.enqueueJob() returnerar ett jobb-ID som agenten registrerar som en referens. |
| MuleSoft asynkront flöde | Bäst för utskick av externa meddelandeköer | Agenten åberopar en MuleSoft-exponerad åtgärd som placerar ett meddelande i en extern kö (Kafka, JMS, SQS). MuleSoft hanterar protokollöversättning och leveransbekräftelse. Agenten får en bekräftelse på att meddelandet accepterades av MuleSoft, inte att det bearbetades längre ner. |
| Extern REST-slutpunkt (Apex åtgärd) | Bäst för inskickning av externa systemhändelser | Målsystemet visar en slutpunkt som accepterar ett inskickande och returnerar ett bekräftelse-ID direkt, vilket slutför bearbetningen asynkront. Agenten får bekräftelse-ID och registrerar det. |
Skiss
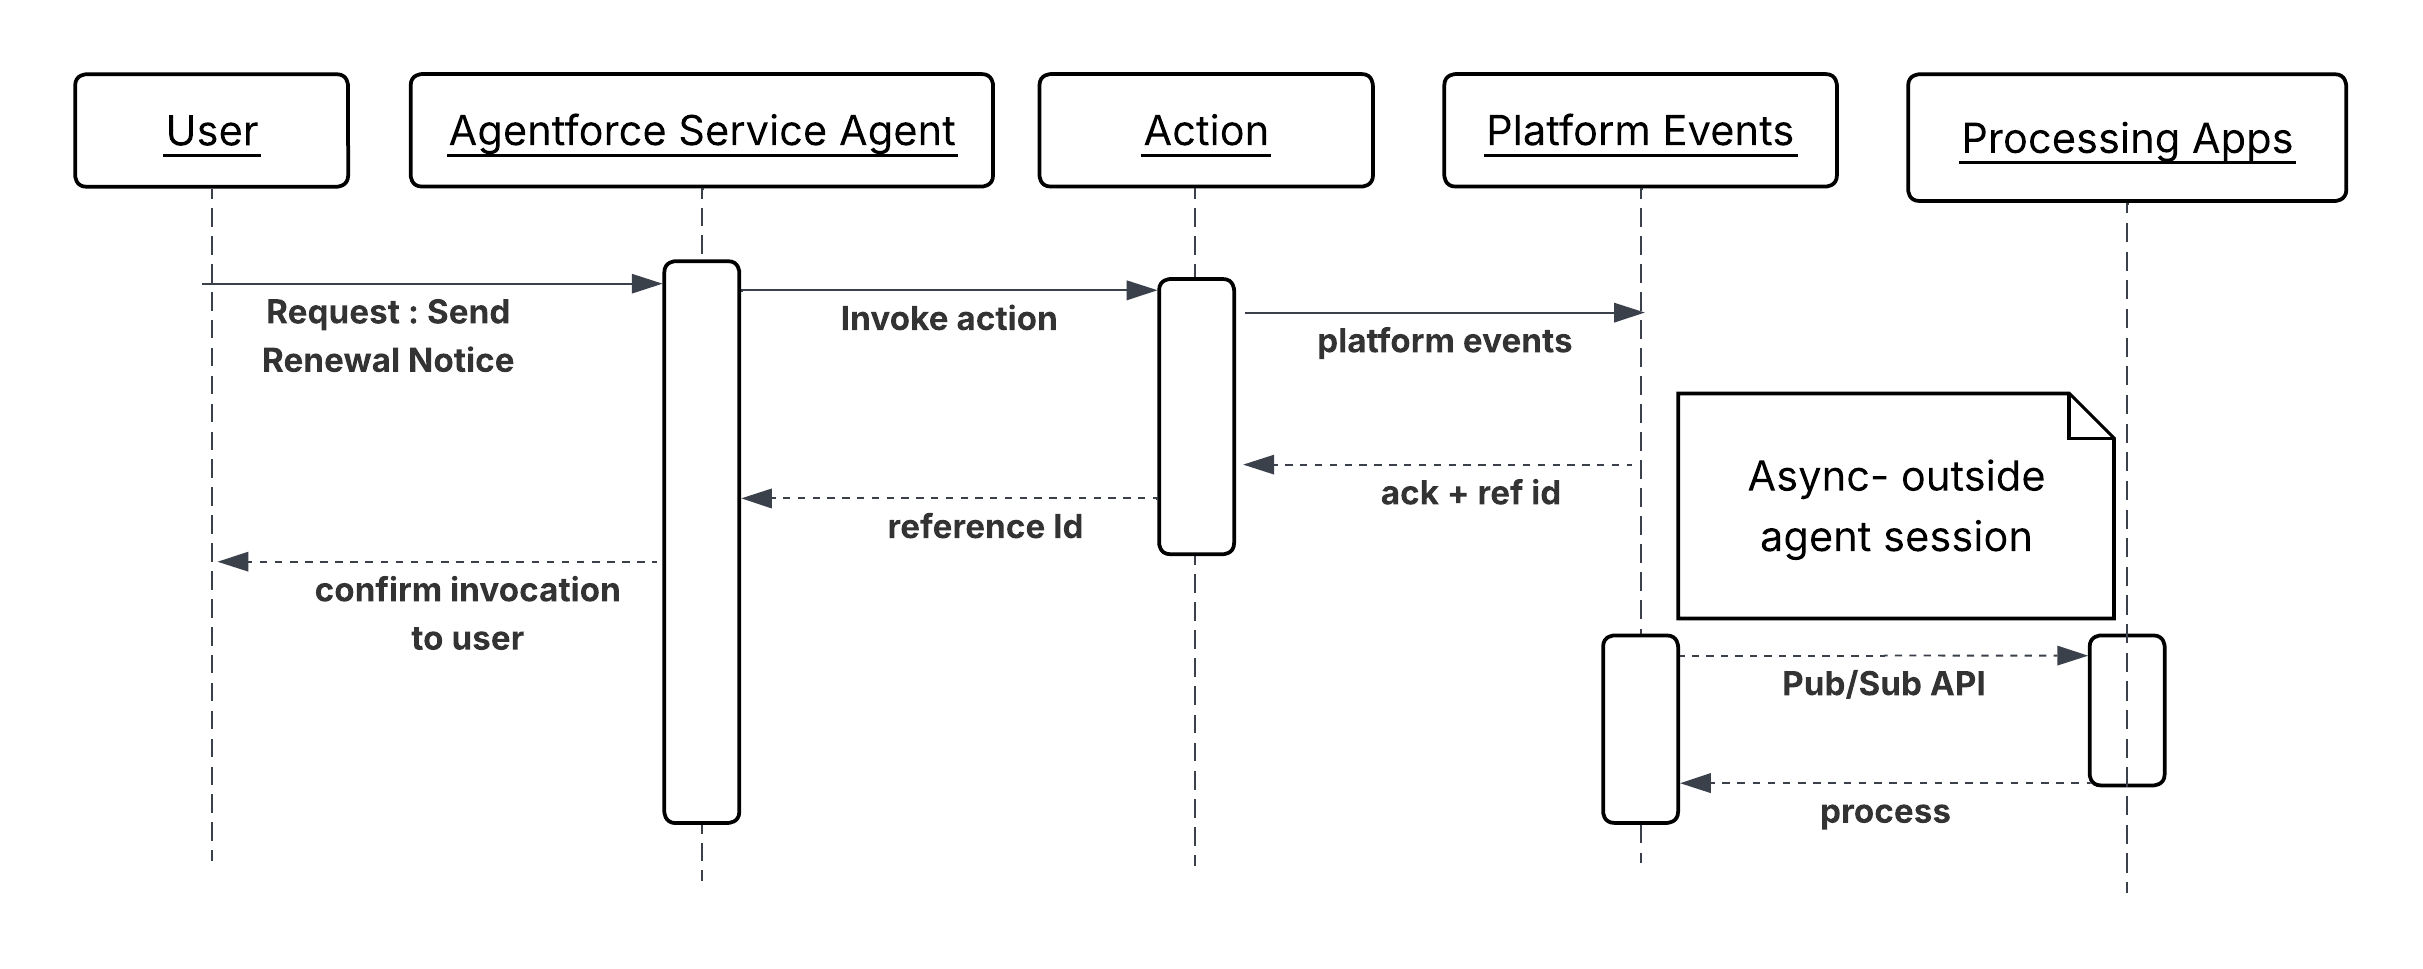
Sekvensdiagram för åberopning av asynkron åtgärd
Resultat
Agenten åberopar en operation längre ner utan att blockera dess resonemangscykel för resultatet. Vändningen slutförs med en bekräftelse på att operationen accepterades, inte att den slutfördes. Systemet längre ner tar fullt ansvar för utförandet. Den skickade operationen kan spåras genom prenumeranter på plattformshändelser, jobb-ID:n eller externa köbekräftelse-ID:n som registreras i CRM vid utskick. Om operationen längre ner misslyckas visas detta fel genom systemets egen övervakning, inte genom agentsessionen som initierade den.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Skriv åtgärdsbeskrivningar på syftesbaserat språk. Till exempel är “Skickar en förnyelsenotis till meddelandekön och returnerar ett referens-ID för utskick” mer användbart för agenten än “anropar notisens slutpunkt”.
- Beskriv aldrig en utskicksåtgärd som “skickar och bekräftar leverans av”. Agenten kan endast bekräfta godkännande. Leverans och bearbetning längre ner är utanför agentens observerbarhet.
Genomförandeanteckningar för Salesforce
- Returnera ett referens-ID från varje åberopningsåtgärd, till exempel ett
ReplayIdför plattformshändelse, ett köbart jobb-ID, ett Pub/Sub APIPublishResultreplayId eller en extern bekräftelsetoken. Registrera den i en CRM-post vid åberopning. Detta är den enda verifieringslogg agentsessionen kommer att skapa. - För Pub/Sub API åberopar agenten en Apex åtgärd som gör ett gRPC-anrop till Pub/Sub API ‘/Publish’-slutpunkten. Åtgärden måste hantera schemaregistreringssteget - händelser måste serialiseras i Avro-format mot det registrerade schemat. Returnera
PublishResult ‘replayId’till agenten som referens för utskick. - För Plattformshändelser, anropa
EventBus.publish()inuti Apex-åtgärden och kontrollera SaveResult för fel innan du returnerar en framgångsindikator till agenten. Anta inte att publiceringen lyckas; validera den. - För Köbara jobb, implementera gränssnittet Köbart och anropa System.enqueueJob() från åtgärden. Returnera det resulterande AsyncApexJob-ID till agenten.
- För externa asynkrona slutpunkter måste målslutpunkten returnera ett erkännande omedelbart (HTTP 202 Accepted) med ett referens-ID. Om slutpunkten blockeras tills bearbetningen är klar är den synkron och detta mönster gäller inte.
Felhantering och återställning
- En åberopningsåtgärd måste skilja mellan utskicksfel (meddelandet accepterades inte) och bearbetningsfel (meddelandet accepterades men åtgärden längre ner misslyckades senare). Agenten kan endast hantera det förstnämnda.
- Om åberopning misslyckas måste åtgärden returnera ett strukturerat fel med en tydlig orsak. Agenten kan försöka skicka igen, flytta om till en människa eller logga en misslyckad utskickspost, men den kan inte återställa ett bearbetningsfel längre ner inom samma session.
- För operationer där fel i efterföljande led så småningom måste visas, utforma en separat feedbackloop som en plattformshändelse som publiceras av processen längre ner, ett schemalagt flöde som kontrollerar jobbstatus eller ett uppföljningskundcase som ligger utanför agentsessionen.
Säkerhetsöverväganden
- Omge alla externa asynkrona anrop med autentiseringsuppgifter. Åberopningsåtgärden bäddar inte in slutpunkts-URL:er eller inloggningsuppgifter i kod.
- Validera och desinficera alla parametrar som skickas till åberopningsåtgärden innan de bäddas in i händelsebelastningen eller meddelandets brödtext. Användarlevererad text som skickas till ett asynkront meddelande är en potentiell injektionsvektor i konsumenten längre ner.
- Logga varje utskick med sessions-ID, referens-ID och sanerad belastning vid tidpunkten för utskicket. Eftersom inget svar returneras till agenten är denna logg den primära mekanismen för att rekonstruera vad agenten initierade.
- Tillämpa minst behörighet för integreringsanvändaren eller den anslutna appen. En utskicksåtgärd som publicerar till en notiskö ska inte ha inloggningsuppgifter som tillåter läsning eller skrivning i orelaterade system.
Exempel
En agent för förnyelsehantering som hanterar ett kontrakt som närmar sig utgången avgör att kunden är kvalificerad för ett meddelande om automatisk förnyelse. Agenten behöver ingen bekräftelse på att e-postmeddelandet har levererats innan vändningen avslutas.
CheckRenewalEligibility(Autostartat flöde) utvärderar kontraktvillkor, kundnivå och status för att avböja. Returnerar en “berättigad” boolesk och den föredragna notiskanalen.DispatchRenewalNotification(Apex Action) publicerar enRenewalNotification\_\_esom innehåller kontrakt-ID, kund-ID, notiskanal och en genererad idempotensnyckel. Returnerar ett ReplayId som bekräftar att händelsen har accepterats av plattformen.UpdateContractRecord(Autostartat flöde) skriver tidsstämpeln förReplayIdoch utskick till kontraktposten och anger statusflaggan “Skickad notis”.
Sammanhang
Externa program som kundportaler, mobilappar, SaaS-plattformar från tredje part och partnersystem måste åberopa agenter programmatiskt för att hantera servicebegäranden, inleda arbetsflöden eller lyfta fram AI-drivna svar i sina egna gränssnitt. Agenten fungerar som en intelligent backendtjänst. Det externa systemet tillhandahåller sammanhang, agentens orsaker och åtgärder, och samtalet konsumerar svaret.
Anroparen är i allt högre grad själv en AI-agent eller orkestrerare snarare än ett mänskligt program. I dessa AI-till-AI-mönster delegerar en orkestrerad agent ett resonemangssteg, CRM-sökning eller åtgärd till Agentforce som ett diskret verktygsanrop. Vi måste exponera en MCP-server (Modelle Context Protocol) för att stödja detta mönster.
Problem
När ett externt system eller en AI-agent behöver utnyttja en Agentforce agents kapacitet på begäran, hur autentiserar den, skapar en agentsession, skickar nödvändiga konversations- och sammanhangsdata och tillförlitligt tar emot agentens strukturerade svar för att driva sin egen logik längre ner?
Krafter
När du tillämpar detta mönster, svara på följande frågor:
- Förväntar sig det externa samtalet ett synkront svar med låg latens, eller är en asynkron callback acceptabel?
- Hur etableras och propageras uppringarens identitet till agentens utförandesammanhang för dataåtkomst och personanpassning?
- Vad är den förväntade volymen av samtidiga API-utlösta sessioner, och hur interagerar det med Salesforces gränser för API-resultat och samtidighet?
- Behöver det externa systemet upprätthålla sessionskontinuitet över flera omgångar (konversation med flera omgångar), eller är varje begäran statuslös?
- Hur ska agentens svar struktureras så att det anropande systemet kan tolka och agera programmatiskt?
- Är anroparen ett program som är riktat mot människor och kräver direkt REST-integrering, eller en AI-agent eller orkestrerare som kan åberopa Agentforce som ett verktyg via ett standardprotokoll, till exempel MCP?
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Agentforce Agent API - Enkel vändning (synkron) | Bäst för integreringar av begäran-svar utan status | Anropssystemet kräver ett omedelbart, strukturerat svar och agentens resonemang förväntas slutföras inom anropets timeouttolerans. Anropssystemet hanterar den fullständiga sessionens livscykelfaser - skapande, vändningar och avslutande. Det externa systemet autentiserar, skapar en session med sammanhangsvariabler, skickar ett enskilt meddelande, tar emot agentens svar och stänger sessionen. Detta Agentforce API är det primära REST-gränssnittet genom vilket externa system skapar sessioner, utbytesmeddelanden och stänger sessioner programmatiskt. Hela utbytet slutförs inom en HTTP-begäransvarscykel. Svar inkluderar agentens utdata på naturligt språk och alla strukturerade utdatavariabler som skapats av åtgärder agenten åberopat under resonemanget. |
| Agentforce Agent API - Multi-Turn (Sessionskontinuitet) | Bäst för konversationsintegreringar som kräver status över varv | Det externa gränssnittet är konversationsvänligt (till exempel en chattwidget eller ett röstgränssnitt) och interaktionen kräver flera utbyten för att nå en lösning. Det externa systemet skapar en session en gång och återanvänder sessions-ID över flera meddelandeutbyten. Agenten behåller konversationssammanhanget mellan omgångar som tidigare frågor, hämtade data, beslut som fattats utan att uppringaren har angett det igen. |
| Asynkron med pollning eller Webhook-callback | Bäst för arbetsflöden för resonemang med hög latens eller tidskänsliga användargränssnitt | Agentbearbetningstiden är inte trivial och att hålla en öppen HTTP-anslutning skulle försämra användarupplevelsen eller utlösa timeout uppströms. Det externa systemet skickar in begäran och får omedelbart en bekräftelse med ett jobb- eller sessions-ID. Det pollar sedan en statusslutpunkt eller registrerar en webhook för att få agentens svar när resonemanget är klart. För närvarande kan detta mönster implementeras med en wrapper API som värdas på en mellanprogramvara som MuleSoft. Extern konsument åberopar denna Wrapper API och registrerar webhook-slutpunkten. Wrapper API skickar tillbaka bekräftelsen till det externa systemet efter att Agentforce har åberopats. Denna wrapper-API underhåller även Agentforce agentsessionen och returnerar svaret tillbaka till det externa systemet med den registrerade webhook-slutpunkten när agenten svarar. |
| Agentforce via MCP (Salesforce Headless 360) | Bäst för AI-till-AI-anrop där anroparen är en MCP-kompatibel klient | Den anropande MCP-klienten åberopar Agentforce som ett verktyg genom den färdiga MCP-servern som tillhandahålls av Salesforce Headless 360. Sessionens livscykel hanteras transparent av MCP-servern och den anropande agenten interagerar genom standardverktygsanrop utan att bygga en egen REST-integrering. Använd denna lösning när uppringaren är en MCP-klient som behöver delegera resonemang, CRM-sammanhangshämtning eller åtgärdsutförande till Agentforce som ett diskret steg i ett bredare agentiskt arbetsflöde. |
Skiss
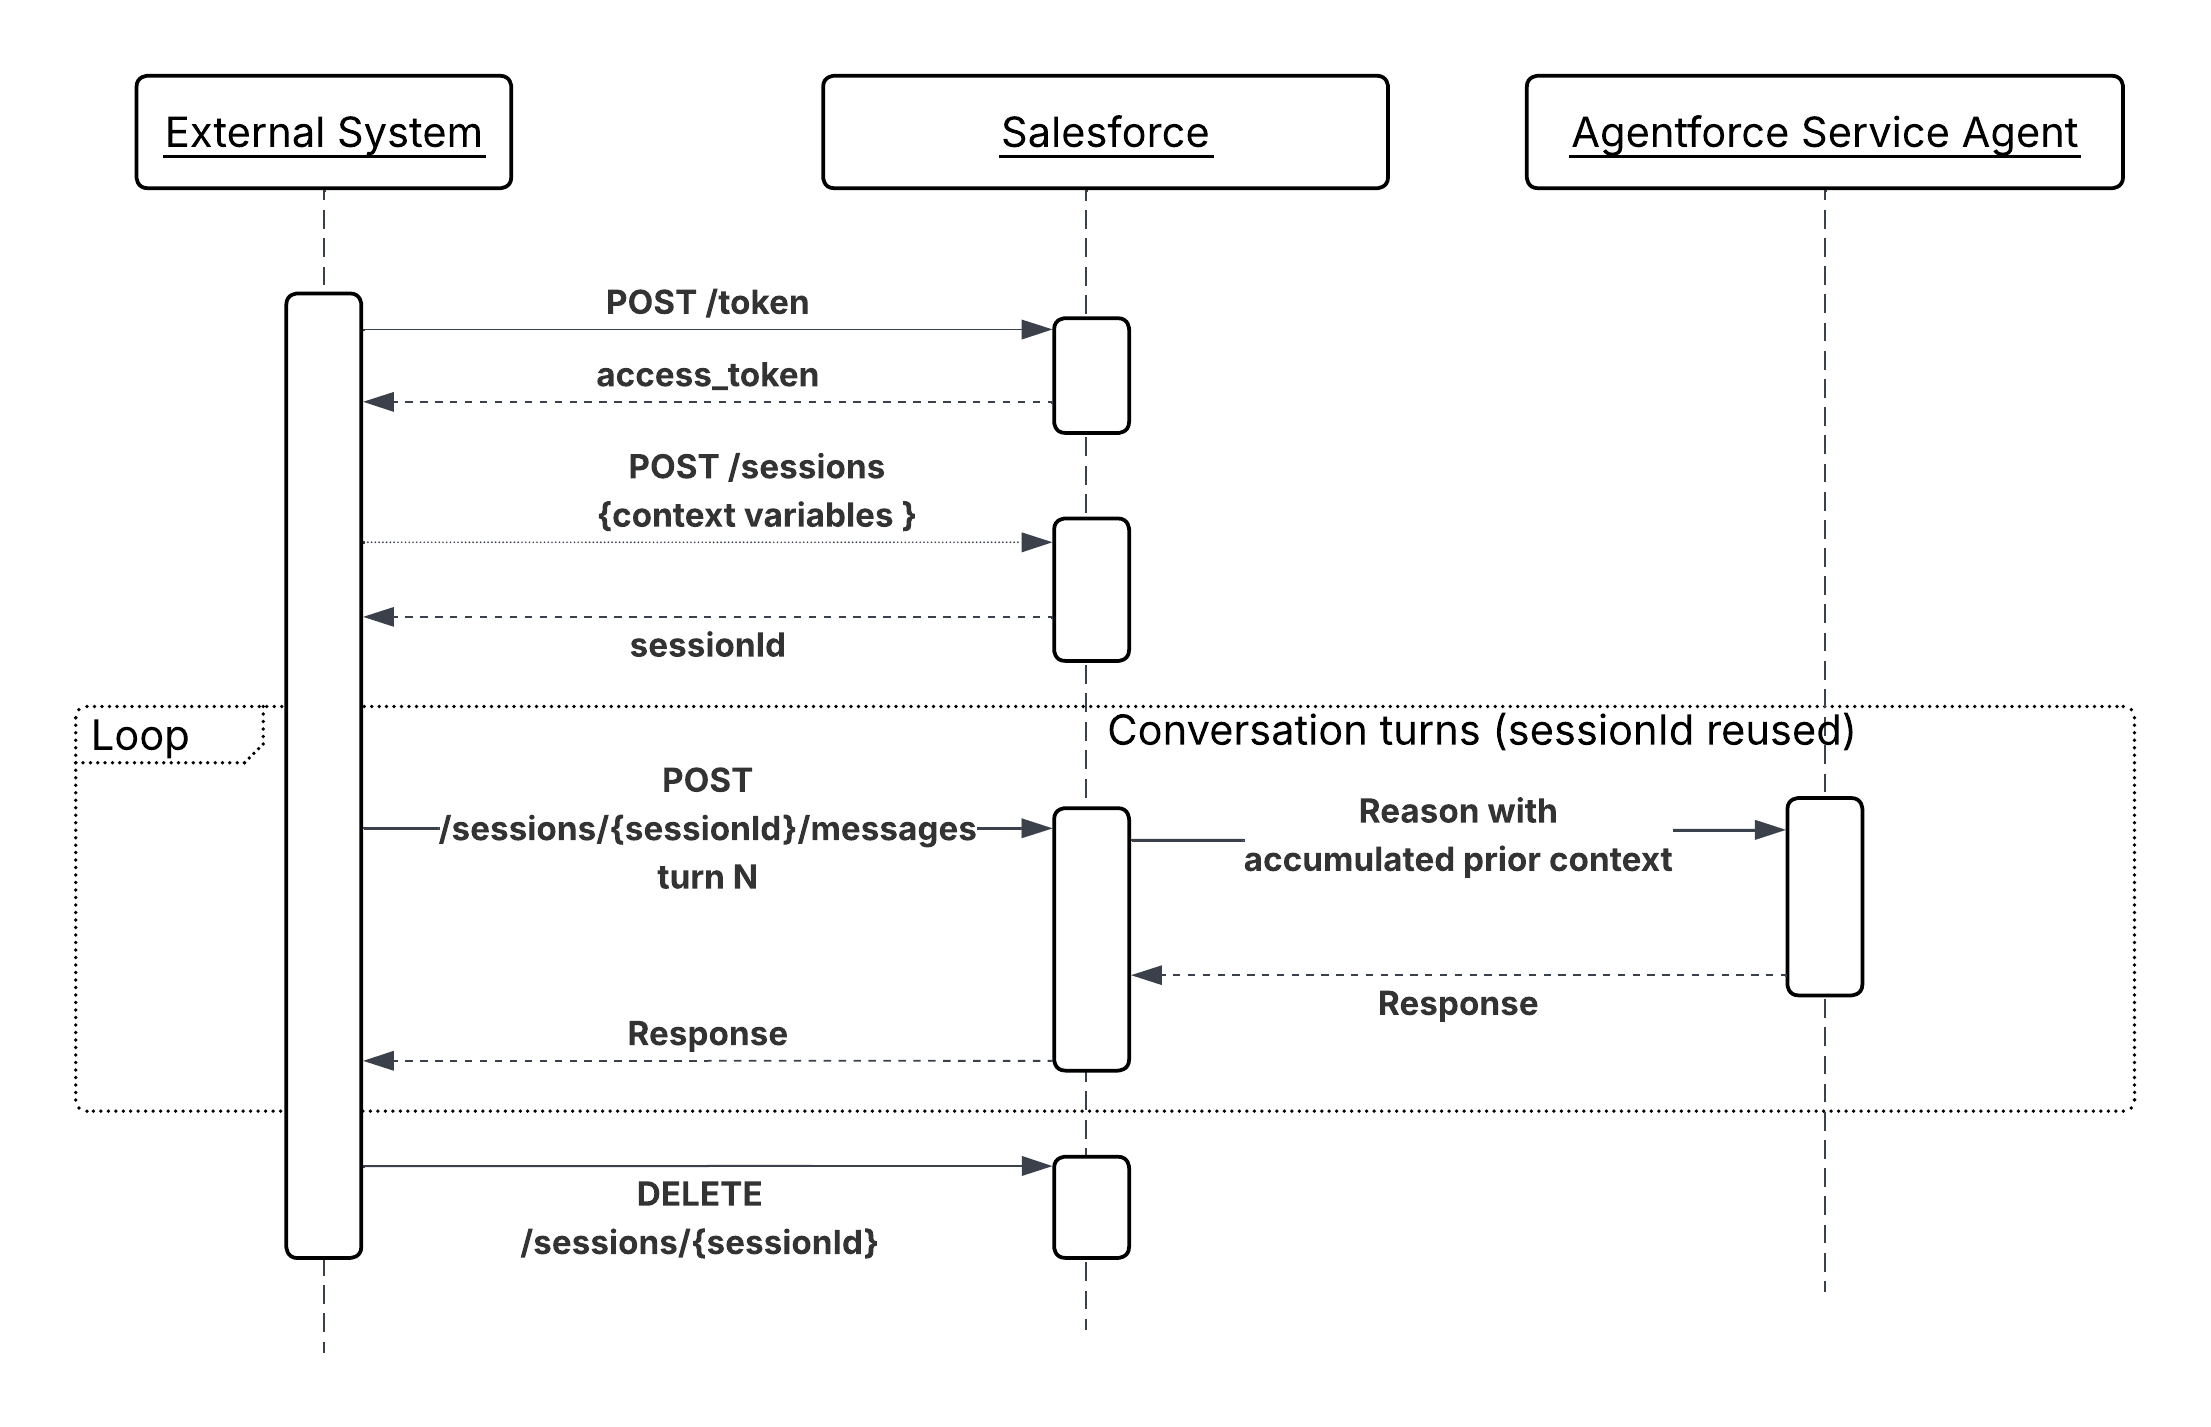
Sekvensdiagram för åberopning av agent på begäran
Resultat
Detta mönster visar Agentforce som en anropbar AI-tjänst. Externa system får åtkomst till agentens resonemang, verktyg och CRM-sammanhang utan att replikera denna logik. Anroparen förblir ansvarig för sessionens livscykelhantering och återgivande av svaret. Agenten förblir ansvarig för alla resonemang, verktygsval och svarssyntes.
Om anroparen är en AI-agent eller orkestrerare tar Agentforce via MCP-mekanismen (tillgänglig färdigbyggd via Salesforce Headless 360) bort behovet av en egen REST-integrering helt. MCP-servern hanterar sessionslivscykeln åt den anropande agenten, vilket låter Agentforce delta som ett förstklassigt verktyg i arbetsflöden med flera agenter utan ytterligare rörmokeri.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Undvik att göra det externa API-anropet synkront och blockera i tidskänsliga användargränssnittflöden. Använd ett callbackmönster för pollning eller webhook där agenters svarstider inte är triviala, för att koppla bort användarupplevelsen från agentens bearbetningstid.
- Välj samtalsmekanism baserat på typen av samtal, inte tillgänglighet. Applikationer och systemintegreringar med mänskligt ansikte ska använda Agent API direkt. Verktyg som har stöd för MCP ska använda Agentforce MCP-servern. Att blanda mekanismer för samma samtalstyp lägger till onödig komplexitet utan arkitektoniska fördelar.
Genomförandeanteckningar för Salesforce
- Injicera sessionssammanhang i POST-begäran för att skapa sessionen, inte i det första användarmeddelandet. När det externa systemet skapar sessionen har det möjlighet att skicka strukturerade sammanhangsvariabler (konto-ID, rättighetsdata, tidigare interaktionssammanfattning) direkt som namngivna sessionsparametrar. Dessa variabler är tillgängliga för agenten innan den bearbetar ett enskilt varv, så den börjar resonera från ett jordat läge utan att göra söksamtal för att fastställa vem kunden är eller vad de har rätt till. Att skicka samma data inuti meddelandets brödtext tvingar istället agenten att tolka ostrukturerad text för att extrahera fakta som den kunde ha fått som inskrivna variabler - vilket ökar latensen, introducerar extraheringsfel och konsumerar resonemangssteg som inte ger något affärsvärde.
- Utforma agentsvar som ska vara strukturerade och maskinellt tolkningsbara. Använd utdatavariabelkonventioner och uppmaningsinstruktioner som guidar agenten att returnera JSON-vänliga eller tydligt avgränsade svar när anropet är ett system istället för ett mänskligt.
- Hantera sessionens livscykel uttryckligen. Avsluta sessioner omedelbart efter användning av
DELETE /einstein/ai-agent/v1/sessions/{sessionId}för att frigöra samtidiga luckor och undvika att gamla sammanhang kvarstår i orelaterade interaktioner. - Ta hänsyn till Salesforces gränser för samtidiga sessioner. För scenarion med hög genomströmning, implementera en sessionspool eller ett kölager i anropssystemet för att förhindra att begäran avvisas under toppbelastning.
- När Agentforce åberopas via MCP, skicka sammanhanget som verktygsinmatningsparametrar istället för som sessionsvariabler. MCP-servern hanterar sessionens livscykel transparent, så den anropande agenten kan inte ange namngivna sessionsparametrar direkt när de skapas. Se till att alla obligatoriska sammanhang (post-ID:n, användaridentitet, rättighetsdata) inkluderas i verktygsanropets belastning så att agenten börjar resonera från ett jordat läge.
- Behandla MCP-serverns transparenta sessionshantering som en bekvämlighet, inte en förbigång av samtidighet. Varje verktygsåberopning konsumerar fortfarande en Salesforce-agentsessionslucka. Högfrekventa orkestrerare som anropar Agentforce via MCP i skala måste ta hänsyn till samma samtidiga sessionsgränser som gäller för direkta Agent API-anrop.
Felhantering och återställning
- Agent API returnerar standardfelkoder för HTTP. Anropssystemet måste hantera “429 För många begäranden” (avgiftsgräns) med exponentiell backoff och “503 Tjänsten är inte tillgänglig” med logik för återförsök.
- Om agenten själv stöter på ett verktygsfel som inte går att lösa returnerar det ett graciöst naturligt språkfel i svarets brödtext. Anropssystemet upptäcker dessa sentinelsvar (till exempel att kontrollera om det finns ett “fel”-statusfält i svaret) och dirigerar enligt detta antingen genom att försöka igen med ytterligare sammanhang, presentera en grundupplevelse eller flytta om till en människa.
- Vid åberopning via MCP visas fel i två separata lager: MCP-transportfel (verktygsanrop med fel format, serverns tillgänglighet) och Agentforces resonemangsfel (verktygskörningsfel, åtgärder som inte går att lösa). Den orkestrerade agenten måste hantera båda lagren oberoende av varandra. MCP-transportfel ska utlösa försök på protokollnivå. Agentforces resonemangsfel som returneras i verktygssvaret ska hanteras av orkestrerarens egen grund- eller omflyttningslogik.
Säkerhetsöverväganden
- Använd smalast möjliga OAuth-omfång för den externa klientappen. En integrering som endast behöver åberopa en agent bör inte ha omfattningar för dataåtkomst utöver vad agenten själv behöver.
- Validera och rengör alla inmatningar från det externa systemet innan du injicerar dem som sessionsvariabler. Externa indata är en attackyta för snabb injektion. Till exempel kan ett skadligt samtal skapa ett “customerQuery”-fält som är utformat för att åsidosätta agentinstruktioner.
- Tillämpa IP-tillåtelselistning i den externa klientappen för att begränsa vilka externa system som kan autentisera och anropa Agent API.
- Logga alla inkommande API-utlösta sessioner med anroparidentitet, sessions-ID och metadata för begäran/svar i gransknings- och säkerhetssyfte.
- När Agentforce åberopas via MCP autentiseras MCP-servern till Salesforce åt den anropande användaren. Se till att inloggningsuppgifter för MCP-serverns anslutna app är begränsade till de lägsta behörigheterna som behövs, och att slutanvändarens identitet (med MCP-verktyg som Claude) - identitet propageras till sessionssammanhanget uttryckligen via verktygsinmatningsparametrar.
Exempel
En finanstjänstportal utlöser en Agentforce agent för att hantera en hypoteksförfrågan.
- Portalen autentiseras med OAuth-flödet Client Credentials och erhåller en bärartoken.
- Den anropar “POST /Einstein/ai-agent/v1/sessions” med sessionsvariabler: “{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }”.
- Användaren skickar in sin fråga: “Vilka dokument behöver jag för att slutföra min ansökan?”
- Portalen anropar “POST /Einstein/ai-agent/v1/sessions/{sessionId}/messages” med användarens text.
- Agentforce åberopar flödesåtgärden “GetDocumentChecklist”, hämtar de lånetypspecifika kraven och returnerar en strukturerad lista.
- Portalen återger agentens svar direkt och stänger sessionen vid användaravgång.
Sammanhang
Inte alla agentiska arbetsflöden kommer från en mänsklig begäran. Affärskritiska signaler som en plötslig nedgång i produktanvändningsmått, en övergiven varukorg med högt värde eller ett betalningsfel som överskrider en risktröskel inträffar ofta i operativa data. När dessa signaler kräver intelligenta svar i flera steg introducerar väntan på att en människa ska märka och agera latens som förvärras i den verkliga verksamhetskostnaden.
Detta mönster beskriver hur realtidshändelser fungerar som autonoma inkörsportar för agenter. Agenten åberopas av ett datavillkor snarare än en användare, resonerar över händelsesammanhanget och kör ett svarsflöde utan mänsklig inledning.
Problem
När en verksamhetshändelse i realtid inträffar i Data 360 eller Salesforce Platform, hur kan den händelsen automatiskt instansiera en agentsession, tillhandahålla händelsebelastningen som jordningssammanhang och driva ett arbetsflöde för icke-konversationsåtgärder till slutförande utan att en människa inleder eller guidar interaktionen?
Krafter
När du tillämpar detta mönster, svara på följande frågor:
- Krävs ett svar direkt när händelsen utlöses, eller är bearbetning nästan i realtid (sekunder till minuter) acceptabel?
- Innehåller händelsebelastningen tillräckligt med sammanhang för att jorda agenten, eller behöver agenten utföra ytterligare sökningar innan den kan resonera effektivt?
- Vad är den förväntade händelsevolymen och frekvensen? Händelseströmmar med hög genomströmning kräver prishantering för att undvika att uttömma agenters samtidighetsgränser.
- Kan samma händelse aktiveras mer än en gång för samma affärsenhet (minst en leverans)? Om så är fallet måste åtgärderna vara idempotenta.
- Finns det en mänsklig omflyttningsväg om agenten inte kan lösa händelsen autonomt?
- Hur ska misslyckad händelsebearbetning visas? Med en kö med döda bokstäver, en varning eller kundcaseskapande?
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Data 360-utlösta flöden | Bäst för beteende- och måttbaserade signaler | Detta passar bäst när utlösarvillkoret definieras som en ändring av medlemskap i Data 360-segment eller måtttröskel. Data 360 upptäcker verksamhetstillståndet (till exempel att vagnen har övergetts, användning har övergetts) och startar ett utlöst flöde. Flödet mappar attribut för händelsebelastning till agentsessionsvariabler och skapar Agentforce. |
| Plattformshändelser + Autostartat flöde eller Apex | Bäst för plattformsinterna händelser och korssystemhändelser | Använd denna lösning när händelsekällan finns inom Salesforce Platform eller när ett mellanlager publicerar händelsen efter att villkoret har upptäckts i ett externt system. En plattformshändelse som publiceras av en Salesforce-process eller ett externt system utlöser en Apex eller ett autostartat flöde, som konstruerar agentsessionen med händelsebelastningen som sammanhang. |
Skiss
Sekvensdiagram för händelsedriven agentkörning
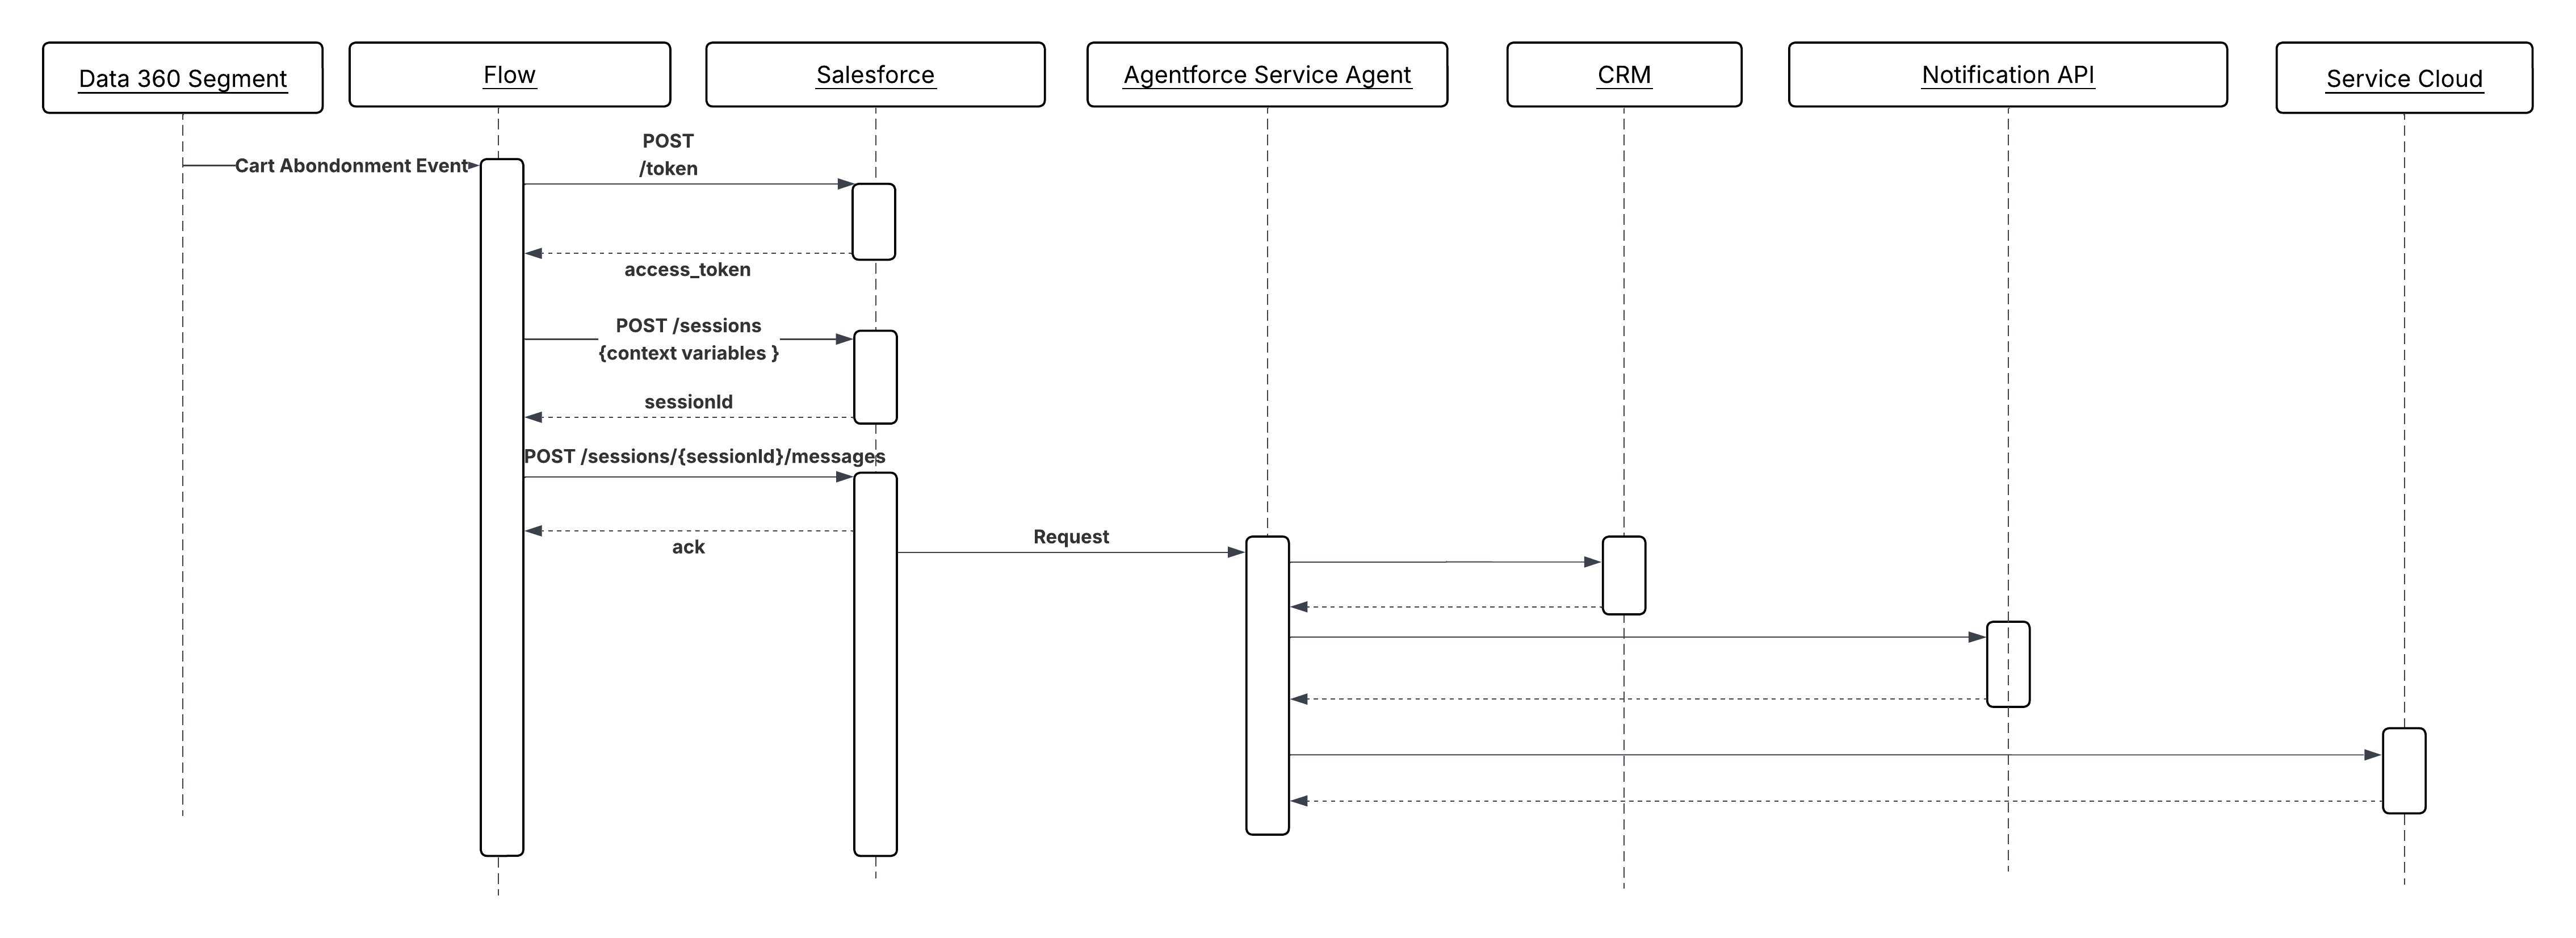
Resultat
Agenter blir reaktiva deltagare i affärsverksamheter i realtid, inte passiva svar på mänskliga förfrågningar. Händelseutlösta agenter kan utföra återställnings-, prioriterings- och omflyttningsflöden med samma hastighet som data istället för med samma hastighet som mänsklig uppmärksamhet.
Det utlösande systemet (Data 360 eller plattformshändelser) fortsätter vara ansvarigt för händelsedetektering och skapande av nyttolast. Agenten förblir ansvarig för att resonera kring denna belastning och välja rätt åtgärdskedja. Ingen konversation krävs; händelsebelastningen är den fullständiga inmatningen.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Utforma alla åtgärder för icke-konversationsanrop. Det finns ingen användarvändning; agenten måste nå en lösning från det inledande jordningssammanhanget ensam. Åtgärder bör returnera strukturerade, deterministiska resultat snarare än att uppmana till förtydliganden.
- Se till att händelsebelastningen har tillräckligt jordningssammanhang innan agentsessionen skapas. En mager belastning som tvingar agenten att göra flera söksamtal innan den kan resonera ökar latens och samtidig användning.
- Gör alla skrivoperationer utlösta av händelsedrivna agenter idempotenta. Händelseleveranssystem ger vanligtvis garantier minst en gång. Dubbletter av händelsebearbetning kan inte skapa dubbletter av sidoeffekter.
Genomförandeanteckningar för Salesforce
- I Data 360-utlösta flöden, mappa attribut för händelsebelastning (till exempel “accountId”, “eventType”, “metricValue”, “productIds”) direkt till namngivna sessionsvariabler när sessionen skapas. Detta utesluter agenten från det första resonemangssteget utan att kräva en hämtningsåtgärd.
- För plattformshändelseutlösare, använd ett Autostartat flöde istället för ett skärmflöde. Skärmflöden stöds inte i autonoma, icke-konversationssammanhang.
- Ange en uttrycklig sessionstimeout för händelseutlösta sessioner. Till skillnad från konversationssessioner finns det ingen användare som utökar interaktionen; en session som stannar på en misslyckad åtgärd ska inte ha en samtidighetslucka för evigt.
- Använd flödesfelsökvägar för att hantera fel när agentsessioner skapas. Om sessionen inte kan skapas ska felvägen publicera en kompenserande händelse eller skapa ett kundcase för mänsklig uppföljning istället för att tyst släppa händelsen.
Felhantering och återställning
- Händelser som misslyckas med att utlösa en agentsession på grund av samtidighetsgränser, sessionsskapandefel eller valideringsfel för nyttolast ska dirigeras till en felsökväg som skapar ett kundcase, utlöser en varning eller publicerar händelsen till en kö med döda bokstäver för ombearbetning.
- Agentfel mitt i körningen (till exempel timeout för en krävd åtgärd) ska loggas med det ursprungliga händelse-ID:t. Eftersom utlösaren är asynkron och det inte finns något väntande anrop är felytan helt observerbar: loggar, instrumentpaneler och varningströsklar.
- Implementera ett återförsökstak. Om en händelse orsakar agentfel på ett tillförlitligt sätt kommer obegränsade försök att uttömma samtidighetsgränser. Efter ett konfigurerbart maximalt antal försök, dirigera händelsen till en mänsklig granskningskö med fullständigt sammanhang bifogat.
- Följ händelse-ID:t genom hela agentsessionens livscykel. Denna spårning aktiverar korrelation mellan den ursprungliga datasignalen och alla åtgärder längre ner för granskning och felsökning.
Säkerhetsöverväganden
- Validera och sanera alla attribut för händelsebelastning innan du injicerar dem som agentsessionsvariabler. Händelsebelastningar från Data 360 eller externa utgivare är en attackyta för snabb injektion. Till exempel kan ett skapat payload-fält utformas för att åsidosätta agentinstruktioner.
- Kör händelseutlösta agentsessioner under en dedikerad integreringsanvändare med minst behörighet istället för en administratörsidentitet med hög behörighet. Agenten har endast de behörigheter som behövs för att utföra dess definierade åtgärdsuppsättning.
- Logga alla händelseutlösta sessioner med det ursprungliga händelse-ID:t, händelsetypen och sessionsvariablerna som injicerades vid skapandet. Denna verifieringskedja krävs för att rekonstruera varför agenten vidtog en given åtgärd om resultatet är omtvistat.
Exempel
Ett detaljhandelsföretag använder Data 360 för att följa varukorgsbeteenden i realtid. När en varukorg med ett värde över en definierad tröskel överges:
- Data 360 upptäcker övergivandesignalen och startar ett utlöst flöde med händelsebelastningen: “customerId”, “cartValue”, “productIds” och “abandonmentTimestamp”.
- Flödet mappar dessa attribut till Agentforces sessionsvariabler och skapar en ny agentsession. Ingen användarinteraktion krävs.
- Agenten utvärderar kundens inköpshistorik, aktuella rättigheter och varukorgssammansättning med hjälp av dess tillgängliga hämtningsåtgärder.
- Agenten åberopar en
SelectRecoveryOffer, som tillämpar lämplig rabattnivå baserat på kundsegment, ochSendProactiveNotificationför att leverera erbjudandet via kundens föredragna kanal. - Agenten åberopar
CreateFollowUpTaskför att logga interaktionen i CRM för kontoägarens synlighet. - Sessionen stängs automatiskt efter att åtgärdskedjan har slutförts. Det ursprungliga händelse-ID:t bevaras i sessionsloggen för spårbarhet.
Sammanhang
LLMs utbildas på offentliga data. De har ingen Knowledge om din organisations produkter, policyer, kundcasehistorik eller kontrakt om inte denna information uttryckligen anges när du resonerar. Utan utegångsförbud kommer en agent som frågas om en kunds servicerättighet eller villkoren i ett specifikt kontrakt antingen hallucinera ett svar eller erkänna att det inte vet. Inget av resultaten är acceptabelt i ett företagssammanhang.
RAG (Retrieval-Augmented Generation) löser detta genom att hämta relevanta dokument från ett Knowledge Store-företag och injicera dem i agentens sammanhangsfönster innan det skapar ett svar. Agenten resonerar över hämtat innehåll som en Knowledge artikel, en tidigare lösning på kundcase, en produktspecifikation som om den hade fått denna information direkt. LLM tillhandahåller resonemanget; hämtningslagret tillhandahåller fakta.
Till exempel behöver en serviceagent som hanterar ett komplext garantianspråk inte ha garantipolicyvillkor inbäddade i sina instruktioner. Istället, när kunden beskriver sitt problem, utför agenten en semantisk sökning eller hybridsökning (nyckelordssökning + semantisk sökning) mot ett vektorindex för garantidokumentation, hämtar de tillämpliga termerna och använder dem för att avgöra behörighet och nästa steg. Svaret grundas i det aktuella, auktoritativa policydokumentet, inte i modellens utbildningsdata.
Problem
En agent måste svara på en fråga eller fatta ett beslut som beror på egen organisatorisk Knowledge som policyer, kontrakt, produktdokumentation eller historiska kundcasedata som inte var en del av LLM:s utbildningsdata. Hur hämtar agenten det mest relevanta innehållet vid resonemang, säkerställer att det hämtade innehållet är aktuellt och auktoritativt och injicerar det i sammanhanget med tillräcklig precision för att undvika brus?
Krafter
Vid tillämpning av detta mönster, svara på följande frågor
- Är Knowledge statiskt och uppdateras sällan (till exempel produkthandböcker), eller ändras det kontinuerligt (till exempel kundcaselösningar, lagerbeskrivningar)? Uppdateringsfrekvensen avgör utformningen av intagspipeline.
- Hur stort är innehållet? En liten Knowledge kan hämtas uttömmande; en stor kräver uppdelning, inbäddning och semantisk indexering för att endast returnera de mest relevanta avsnitten.
- Har sökfrågan någon nytta av en enda fokuserad hämtning, eller skulle en kombination av resultat från flera Knowledge källor (till exempel dokumentation och tidigare kundcase samtidigt) ge ett bättre grundat svar? Det senare kräver ensemblehämtning.
- Behöver du filtrera hämtat innehåll efter metadata innan semantisk rangordning, till exempel begränsa resultaten till dokument som är relevanta för kundens produktnivå eller geografi?
- Hur känsligt är Knowledge? Hämtat innehåll injiceras i LLM-sammanhangsfönstret och påverkar agentens svar. Innehåll som inte ska visas för vissa användare måste styras i hämtningslagret, inte antas filtreras av LLM.
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Utökat skapande av hämtning (RAG) med Data 360 | Bäst för företagsanvändning | Agenten utför en semantisk sökning mot Data 360-vektorindex innan ett svar skapas. Det hämtade innehållet, som Knowledge, tidigare kundcase och produktdokumentation, injiceras i LLM-sammanhanget som jordning. Detta kan anropas med Hämtaråtgärder, Flöde eller egen Apex. Observera att Data 360 har stöd för en integrerad pipeline från rått innehåll till agentredo sammanhang, inte bara en vektorlagring:
Alla dessa funktioner erbjuds i båda nyckelfärdiga mode med fullständig konfigurerbarhet. Vi har två typer av retrievers för Data360: Individuell hämtning: En konfigurerad Salesforce Retriever-åtgärd utför en semantisk sökning mot ett enskilt definierat sökindex och returnerar de mest relevanta innehållsdelarna. Resultaten injiceras direkt i LLM-uppmaningen som jordningssammanhang. Använd Individuell hämtningsåtgärd när sökfrågan bäst hanteras av en enskild Knowledge källa med fokus. Ensemblehämtning: En Ensemblehämtningsåtgärd kombinerar resultaten från flera individuella hämtare, till exempel ett index för produktdokumentation och ett index för lösta kundcase. Ensemblehämtare kombinerar inte relevansbetyg från individuellahämtare eftersom dessa betyg inte är jämförbara mellan heterogena index. Istället skickas alla hämtade delar genom en korskodares omrangordningsmodell som oberoende betygsätter varje (fråga, del)par, vilket ger en enhetlig rangordning. Detta är arkitektoniskt betydelsefullt: det innebär att kvaliteten på rangordningen mellan källor förbättras med rerankermodellen, inte med manuell betygskalibrering. Efter att ha rangordnat dem igen blir det enhetliga resultatet tillgängligt för LLM-uppmaningar som grundsammanhang. Använd Åtgärd för ensemblehämtning när ett mer fullständigt svar kräver bevis från mer än en Knowledge domän. |
| RAG med vektordatabaser från tredje part | Lämplig vid arbete inom befintliga infrastrukturbegränsningar | Detta tillvägagångssätt integrerar vektorlagringar från tredje part som kanske redan finns i din infrastruktur för att indexera egenutvecklade datainbäddningar och använda dem för semantisk sökning och innehållshämtning i realtid. Detta kan implementeras med Flöde eller egen Apex. |
Skiss
Sekvensdiagram för Knowledge Grounding från företagsinnehåll
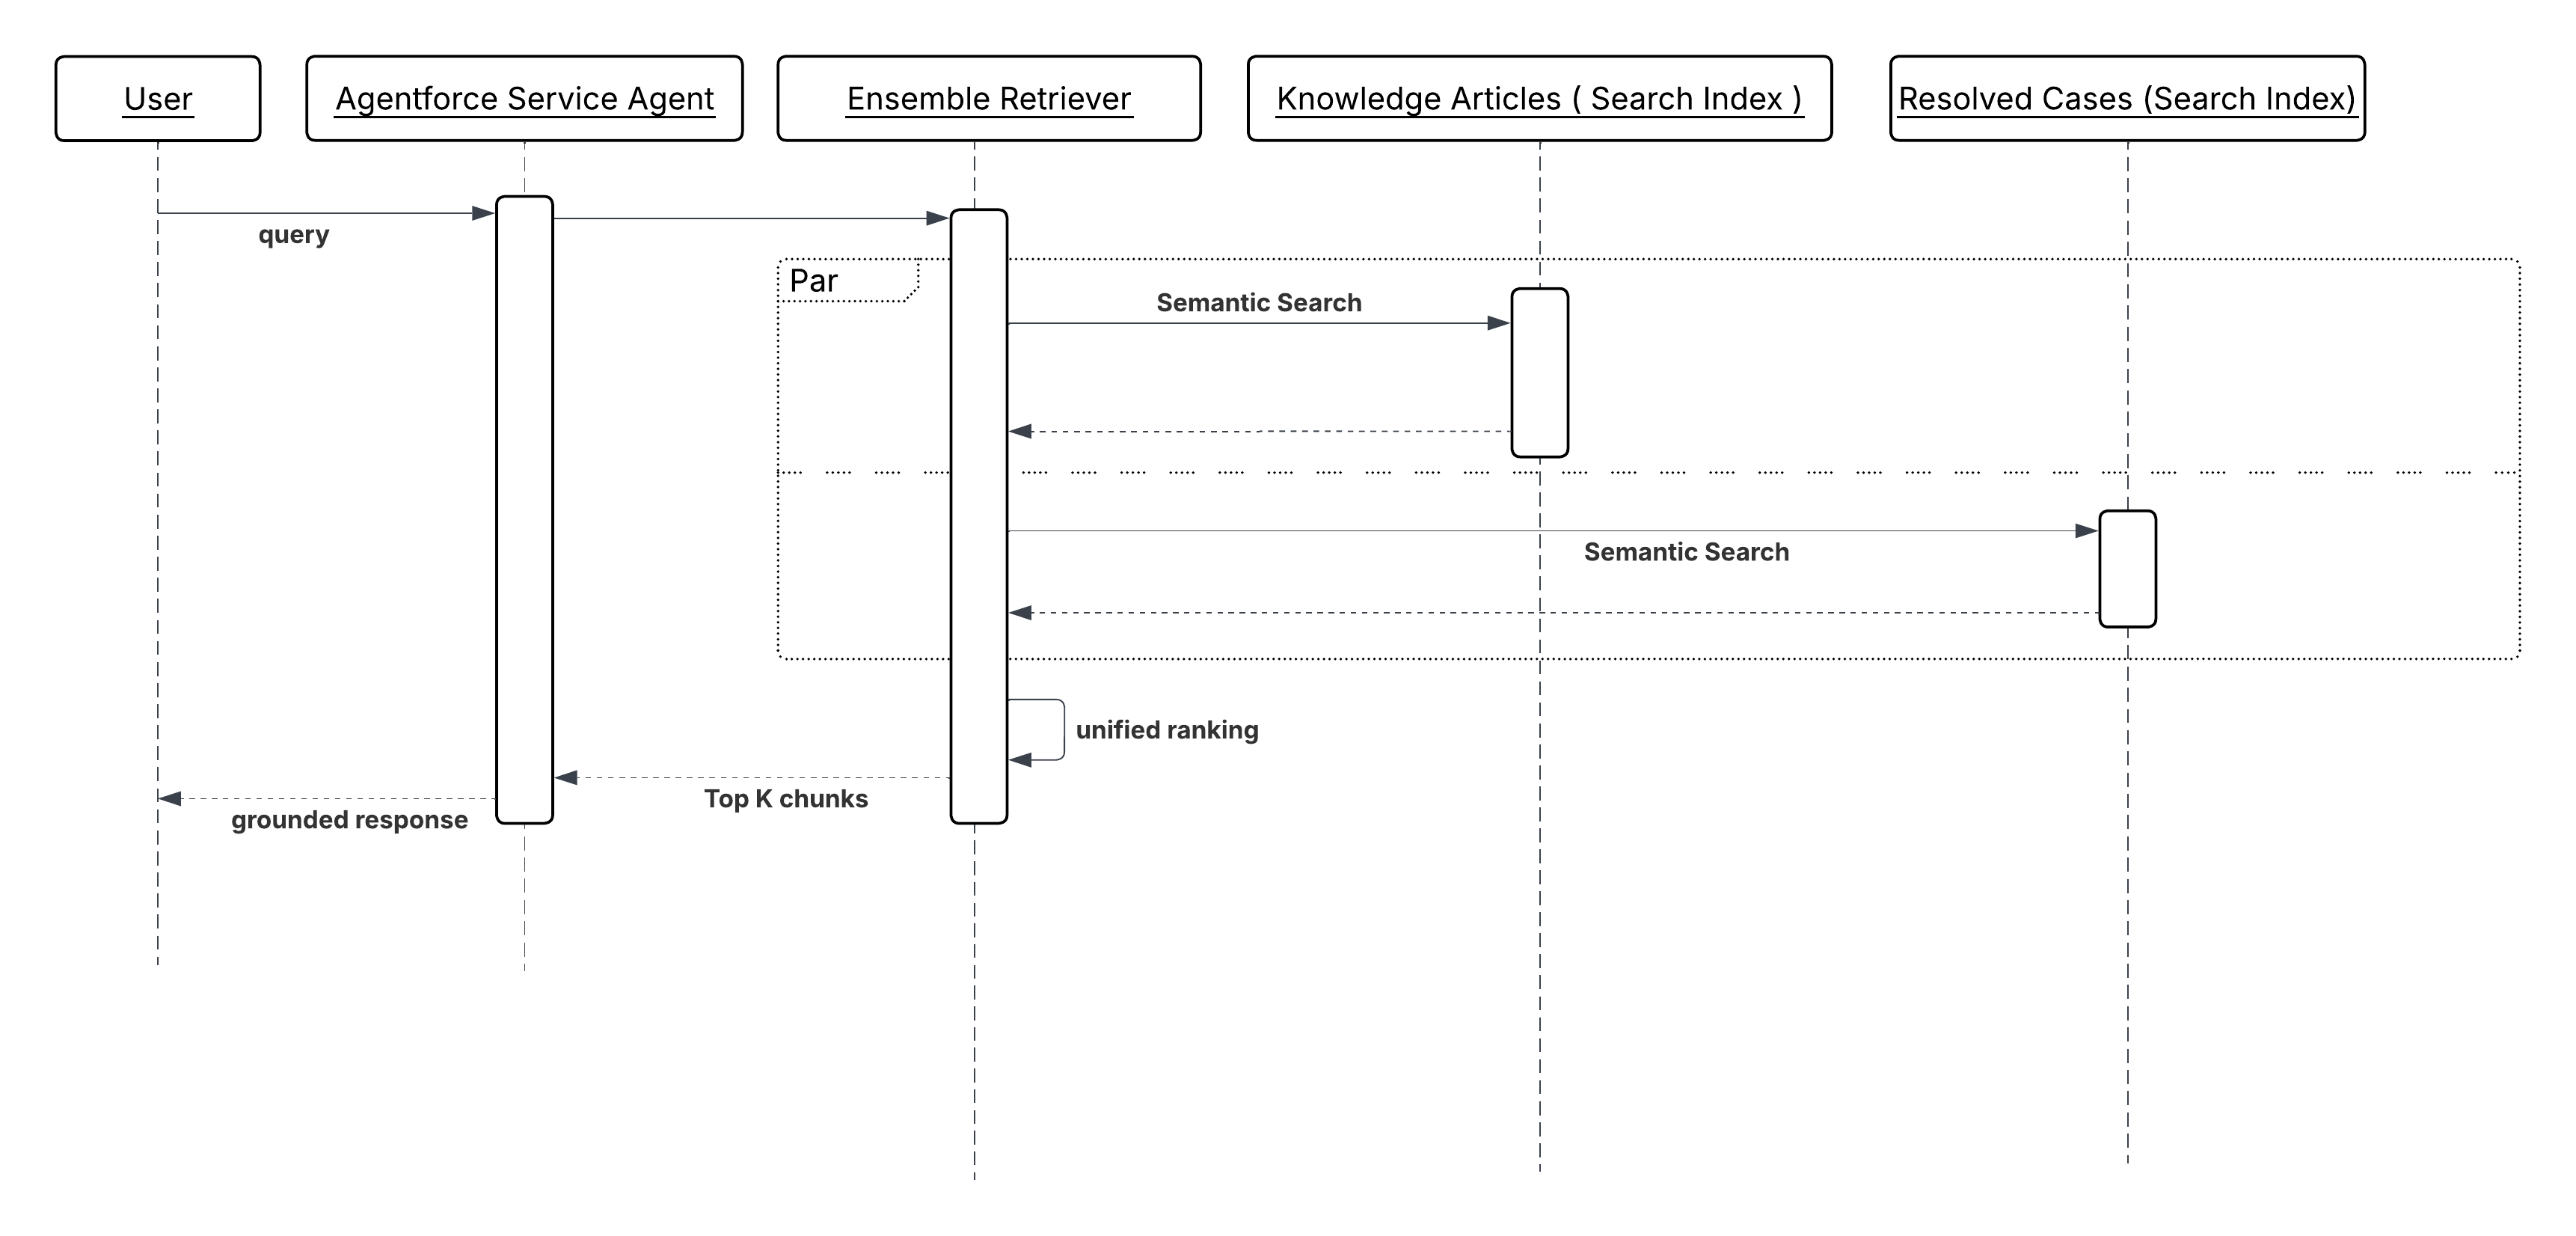
Resultat
Agentens svar är baserade på organisationens aktuella, auktoritativa Knowledge istället för LLM:s utbildningsdata. Hallucinationsrisk för faktafrågor som policyvillkor, produktspecifikationer och rättighetsdetaljer minskas eftersom modellen resonerar över hämtade bevis, inte skapar från minnet.
Knowledge förblir oberoende underhållsbart. Att uppdatera ett policydokument eller lägga till en ny kundcaselösning i indexet börjar gälla omedelbart för alla efterföljande agentinteraktioner, utan att behöva omskola eller distribuera modellen igen.
Att hämta ger även en implicit granskningslogg. Eftersom agentens svar hämtas från specifika hämtade dokument kan källinnehållet loggas bredvid svaret, vilket gör det möjligt att spåra varför agenten gav ett visst svar.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Dela upp och bädda in Knowledge med rätt detaljnivå. Delar som är för stora försvagar relevansen. Delar som är för små förlorar det omgivande sammanhanget som LLM behöver för att resonera korrekt. För de flesta företagsdokumenttyper ger uppdelning på styckenivå med överlappande sammanhangsfönster den bästa hämtningskvaliteten.
- Behandla precision för hämtning som en förstklassig design. Att injicera innehåll med låg relevans i agentens sammanhangsfönster är inte neutralt. Den introducerar brus som försämrar svarskvaliteten. Justera trösklar för hämtning och topp-k-gränser för att balansera återkallande mot precision för varje Knowledge domän.
- Intagslatens är ett operativt servicenivåavtal. Om ett policydokument uppdateras men vektorindexet inte har uppdaterats hämtar och agerar agenten efter gammal information. Definiera acceptabel gammalhetstolerans för varje typ av innehåll och utforma pipelines för intag enligt detta.
Genomförandeanteckningar för Salesforce
- Fyll i vektorindex för Data 360 via lämplig intagspipeline för uppdateringsfrekvensen för innehåll. Använd batchintag för statiska dokument och strömmande eller ändra datainsamling (CDC) för poster som ändras kontinuerligt.
- För Ensemblehämtare, konfigurera relevansrangordningsvikter per källa. Ett index för lösta kundcase kan behöva recency-biasering, men inte ett index för policydokumentation. Justera vikter baserat på de sökfrågetyper agenten förväntas hantera.
- Använd metadatafilter i egna Apex eller flödesåterställare för att samla in information innan semantisk sökning utförs. Filtrering efter produktlinje, region eller dokumenttyp innan rangordning minskar brus och förbättrar precisionen för vad som injiceras i sammanhanget.
- Injicera inte det fullständiga hämtade dokumentet i LLM-sammanhanget. Skicka endast relevanta delar eller utdrag. Stora sammanhangsinjektioner konsumerar tokenbudget, ökar latensen och minskar proportionen av sammanhangsfönstret som är tillgängligt för agentens resonemang.
Felhantering och återställning
- Om hämtning inte returnerar några resultat, returnera en uttrycklig “inga resultat hittades”-status istället för att fortsätta utan grund. Agenten kan sedan bredda sökfrågan, be användaren om förtydliganden eller flytta om till en människa.
- Varje returnerad del från retrievers innehåller ett relevansbetyg. Beroende på användningsfallet ska ett visst tröskelvärde för förtroende/relevans konfigureras över vilket agenten ska behandla hämtningen som säker annars återgår den till förtydligande eller omflyttning.
- Om vektorindexet eller hämtningstjänsten tillfälligt inte är tillgänglig ska hämtningsåtgärden eller Apex returnera ett strukturerat fel med en beskrivande orsak. Logga felet med sessions-ID och sökfråga så att hämtningsluckor kan identifieras och indexet eller tjänsten kan bevakas för tillgänglighet.
- För tidskänsliga Knowledge domäner, implementera en färskhetskontroll som en del av hämtningssvaret. Om det senaste matchande dokumentet senast uppdaterades efter en definierad inaktualitetströskel, flagga detta för agenten så att det kan kvalificera sitt svar eller uppmaning till verifiering.
Säkerhetsöverväganden
- Hämtning måste respektera dataåtkomstbehörigheterna för den användare för vars räkning agenten agerar. En agentsession som körs inom ramen för en kundinteraktion får inte hämta interna operativa dokument, anteckningar om prissättningsstrategier eller poster som slutanvändaren annars inte skulle ha åtkomst till. Tillämpa säkerhet på fältnivå och postnivå i hämtningslagret. Lita inte på att LLM håller inne känsligt hämtat innehåll.
- Hämtat innehåll injiceras i LLM-sammanhangsfönstret och kan påverka eller visas i agentens svar. Behandla varje dokument i hämtningsinnehållet som potentiellt synligt för slutanvändaren och styr innehållsmedlemskap enligt detta.
- Logga alla hämtningsfrågor och dokumentidentifierarna för hämtade delar bredvid sessions-ID:t. Denna granskningslogg möjliggör rekonstruktion av de bevis agenten använde när de svarade, vilket kan krävas för efterlevnad, tvistlösning eller förklarlighet.
Exempel
En finanstjänstagent hanterar en kundfråga om straffavgifter för förtida inlösen för en tidsbegränsad sparprodukt:
- Kunden frågar: “Vilken straffavgift skulle jag få om jag tog ut mina pengar sex månader för tidigt?”
- Agenten åberopar en individuell hämtningsåtgärd konfigurerad mot ett vektorindex för produktvillkorsdokument.
- Hämtaren utför en semantisk sökning med sökfrågesammanhanget, som produkttyp och kundkonto, och den specifika frågan och returnerar de tre mest relevanta dokumentdelarna - klausulen om förtida inlösen, tabellen över straffberäkning och undantagen som gäller för svåra kundcase.
- De hämtade delarna injiceras i agentens sammanhangsfönster tillsammans med kundens fråga.
- Agenten resonerar över de hämtade villkoren, identifierar den tillämpliga straffsatsen för kundens produktnivå och tidslinje för inlösen och returnerar ett exakt, policygrundat svar, med hänvisning till giltighetsdatumet för de termer den använde.
- Dokumentidentifierarna för de hämtade delarna loggas med sessionsposten för granskning.
Sammanhang
LLM är probabilistiska till sin natur. När de ombes resonera kring en specifik kund härleder de, uppskattar eller hallucinerar fakta som de inte uttryckligen fått. En agent som åberopar en prissättningsåtgärd utan att veta att kunden är ett företagskonto med högt värde på en föredragen nivå kan tillämpa fel rabattlogik. En agent som flyttar om ett supportkundcase utan att känna till kundens bortfallriskbetyg kan nedprioritera ett konto som är dagar från bortfall.
Verifierad kundsammanhangsinjektion åtgärdar detta genom att fylla i åtgärdsinmatningsparametrar i förväg med verifierade, strukturerade attribut från den enhetliga profilen innan agenten åberopar en åtgärd. Agenten härleder inte kundens trend för segment, livstidsvärde eller kundnöjdhet (CSAT). Den får dessa fakta som grundinmatningar och orsaker över dem. Detta mönster minskar hallucinationsrisken för kundspecifika beslut och eliminerar överflödiga söksamtal under resonemangscykeln.
Till exempel, innan en prissättningsagent åberopar en “GenerateQuote”-åtgärd, injicerar underagentkonfigurationen automatiskt kundens segment, nivå och livstidsvärde från deras sammanslagna profil. Åtgärden får verifierade fakta snarare än LLM-härledda approximationer och offerten är förankrad i kundens faktiska kommersiella relation.
Detta är inte ett alternativ till mönstret “Knowledge från Enterprise Content”. En välutformad agent kan använda både: “Knowledge Grounding from Enterprise Content” ger dokumentbaserad Knowledge, medan “Verifierad injektion av kundsammanhang” etablerar kundens identitet.
Problem
Hur ser du till att en agent har korrekta, kundspecifika fakta som segment, nivå, livstidsvärde, bortfallrisk eller andra profilattribut innan den utför en åtgärd, istället för att gissa dessa fakta på egen hand?
Krafter
Vid tillämpning av detta mönster, svara på följande frågor:
- Vilka åtgärdsindataparametrar representerar kundspecifika fakta som, om de härleds istället för hämtas, skulle ge felaktiga eller inkonsekventa resultat?
- Är de profilattribut som behövs tillgängliga som standardprofilfält för Data 360, eller kräver de beräknade insikter som härleds från rådata om beteende och transaktioner?
- Hur ofta ändras de relevanta profilattributen? Attribut som bortfallriskbetyg eller CSAT-trend kräver en färskhetsgaranti; gamla profildata leder till samma felaktiga resultat som hallucinerade data.
- Ska profilattribut injiceras när sessionen skapas (konstant för sessionens varaktighet) eller hämtas färskt vid åberopningen (för att återspegla statusändringar mitt i sessionen)?
- Behöver agenten resonera över profilattributen direkt, eller används de endast av åtgärden och är ogenomskinliga för agentens resonemangsloop?
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Underagentkonfiguration - Profilattributmappning | Bäst för statisk jordning på sessionsnivå | Passar bäst när profilattributen är stabila i en enskild interaktion. Mappa enhetliga profilattribut för Data 360 (till exempel “customerSegment”, “tier”, “lifetimeValue”) direkt till åtgärdsinmatningsparametrar i Agentforce underagentkonfiguration. Attribut löses när sessionen skapas och hålls konstanta under sessionens varaktighet. |
| Anslutna Data 360-flöden | Bäst för dynamisk uppdatering eller uppdatering mitt i sessionen | Använd när profilattribut ändras ofta eller när åtgärden kräver det mest aktuella läget. Använd ett Data 360-anslutet flöde som ett åtgärdssteg för att lyfta fram det senaste profilläget vid anropspunkten.Flödet frågar den sammanslagna profilen, tillämpar nödvändiga transformationer och returnerar attributen som utdatavariabler konsumerade av nästa åtgärd i kedjan. |
| Beräknade insikter som åtgärdsinmatningar | Bäst för komplexa deriverade mått | Använd när agenter behöver resonera över beräknade verksamhetsmått (betyg för bortfallrisk, CSAT-trender, produktanvändningsindex) istället för att tolka rådata. Definieras i Data 360 som deriverade mått beräknade över beteende-, transaktions- och engagemangsdata. Beräknade insikter visas som sökbara profilattribut och kan mappas till åtgärdsinmatningar via ämneskonfiguration eller ett anslutet flöde. |
Skiss
Sekvensdiagram för verifierad injicering av kundsammanhang
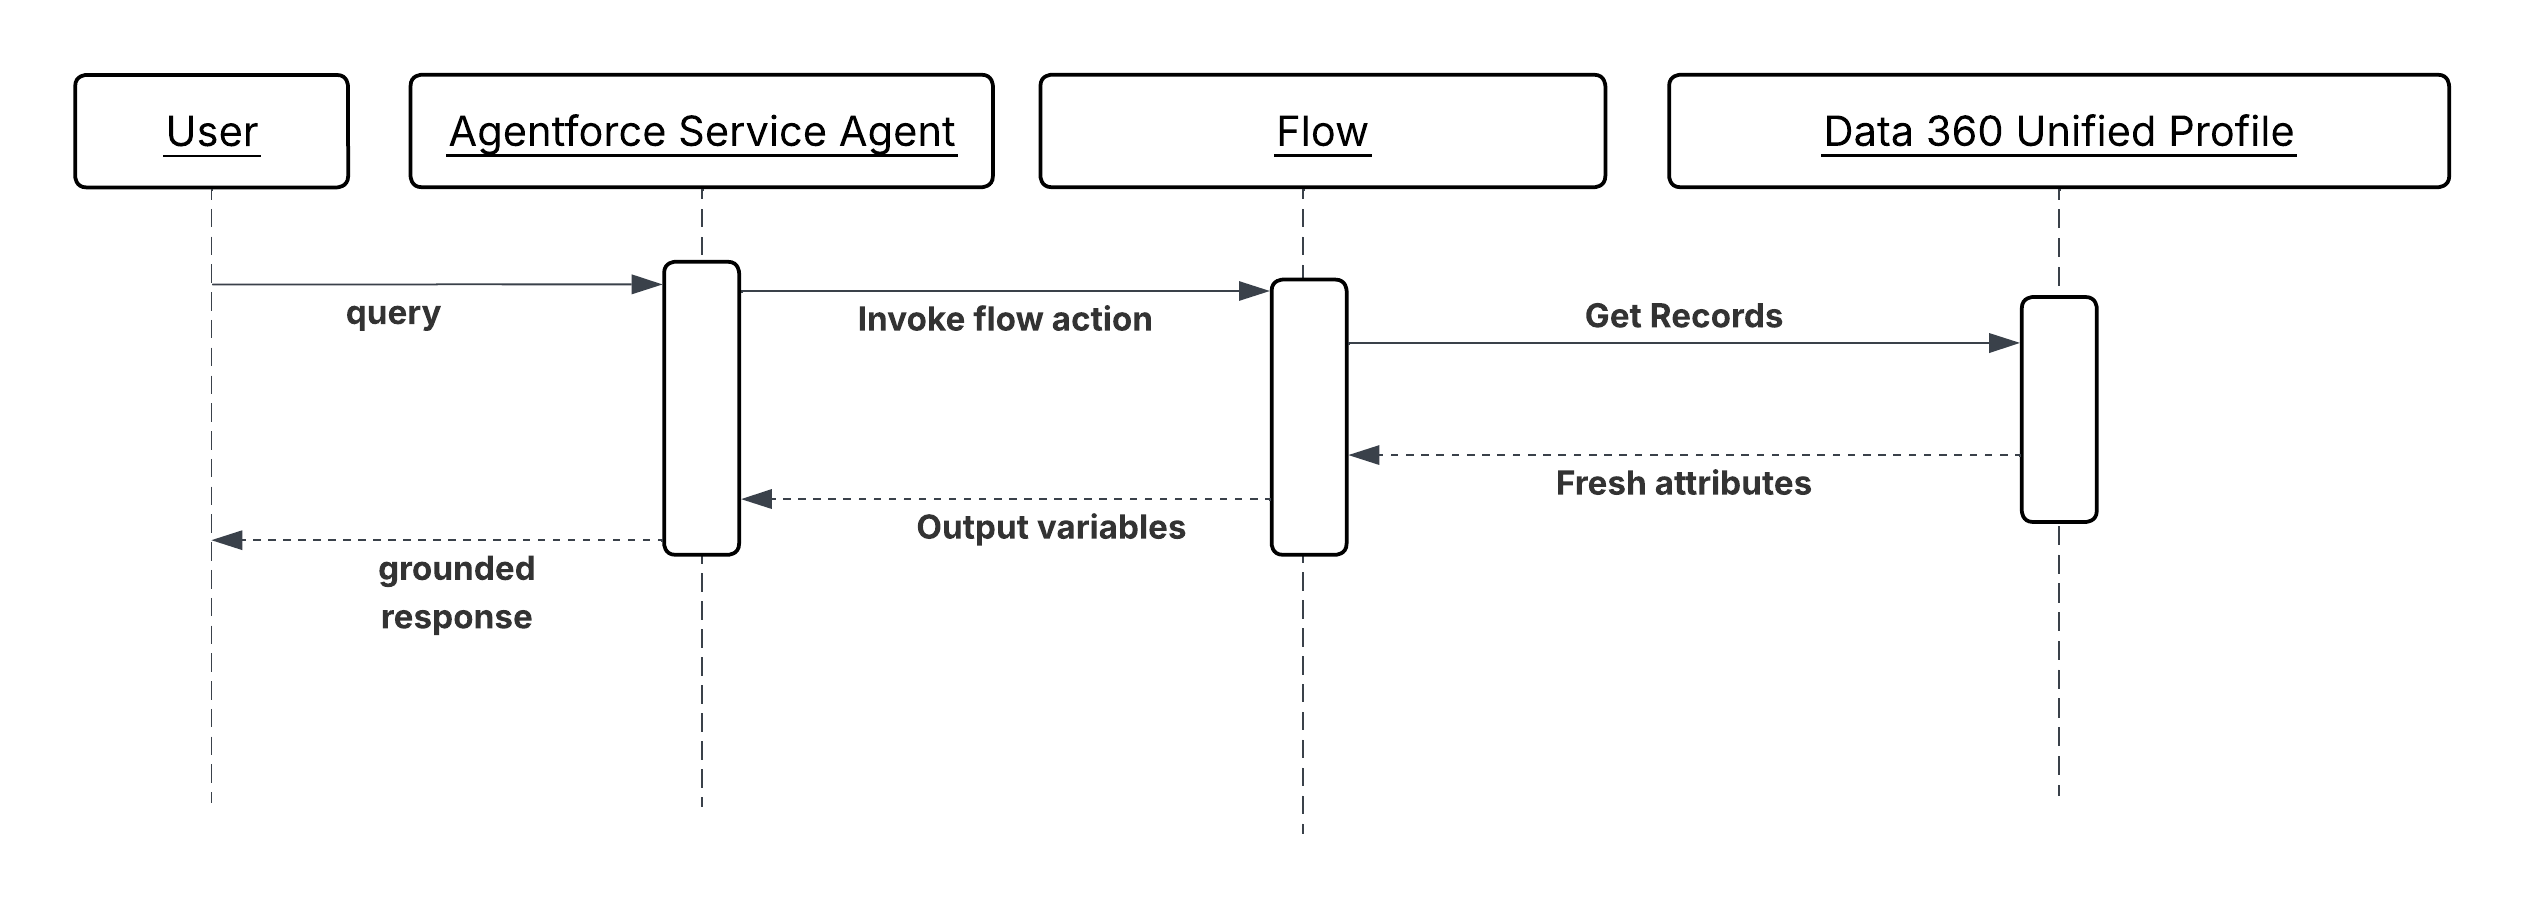
Resultat
Åtgärder får verifierade, strukturerade kundfakta istället för LLM-härledda approximationer. Agentens resonemang är förankrat i kundens faktiska profilstatus, vilket minskar hallucinationsrisken för beslut där faktaprecision avgör resultatkvalitet som prissättning, rättighetskontroller, omflyttningsdirigering, lagringserbjudanden.
Profiljordning minskar även latens för resonemang. Om agenten inte behöver göra några söksamtal för att etablera ett grundläggande kundsammanhang blir resonemangscykeln kortare och samtidighet används för färre varv.
Den enhetliga profilen för Data 360 förblir den officiella källan för kundfakta. Underagentkonfigurationen eller det anslutna flödet är integreringssömmen. Agenten är ansvarig för att resonera kring dessa fakta och välja åtgärder, inte för att hämta själva fakta.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Identifiera alla åtgärdsinmatningar som medför hallucinationsrisk—där LLM-slutledning kan ge ett felaktigt resultat istället för ett verifierat värde. Indata med hallucinationsrisk är kandidater för profiljordning. Inte varje inmatning kräver jordning; att injicera profildata för mycket lägger till brus i agentens sammanhangsfönster.
- Behandla profilfräschhet som ett designbeslut, inte som en eftertanke. Definiera den acceptabla toleransen för gammalhet för varje jordat attribut och välj injektionsmekanismen enligt detta: sessionsnivåmappning för stabila attribut, flödesbaserad uppdatering för flyktiga sådana.
- Beräknade insikter ska koda verksamhetslogik, inte råa mått. En agent som resonerar över ett “churnRiskScore” på 0,87 är mer effektiv än en agent som resonerar över 14 råa beteendesignaler. Beräkna tolkningen i Data 360; skicka resultatet till agenten.
Genomförandeanteckningar för Salesforce
- Profiljordning är bara så pålitlig som sammanslagningen bakom den. Till exempel beror värdet för den enhetliga profilen helt på kvaliteten på identitetslösning uppströms. Om en kund har fragmenterade identiteter mellan källsystem som inte har slagits samman kommer profilattributen agenten får att vara ofullständiga eller så representerar de endast en delvis vy (till exempel Livstidsvärde beräknat med data från en kanal men inte en annan).
- För anslutna Data 360-flöden, använd elementet Hämta poster med ett filter på den aktuella sessionens “recordId” eller “accountId” för att endast hämta den relevanta profilposten. Returnera endast de attribut som krävs av åtgärden längre ner. Returnera inte det fullständiga profilobjektet.
- Beräknade insikter måste hållas aktuella via pipelines för Data 360-intag. Konfigurera streaming eller uppdatering nästan i realtid för insikter som används i tidskänsliga beslut (till exempel bortfallrisk i ett lagringsflöde). Satsuppdaterade insikter är acceptabla för långsammare attribut (till exempel årlig kontraktvärdenivå).
- Kontrollera att mappade profilattribut inte är null innan åtgärd åberopning. Ett null-”customerTier” som skickas till en prissättningsåtgärd är lika skadligt som ett hallucinerat värde. Använd element för flödesbeslut för att upptäcka saknade profildata och dirigera till en reserv som antingen hämtar en standard eller uppmanar till förtydligande.
- I underagentkonfigurationen, mappa profilattribut till åtgärdsinmatningsparametrar med hjälp av beskrivande, semantiskt tydliga variabelnamn (till exempel “customerTier”, “lifetimeValueUSD”, “churnRiskScore”). LLM läser dessa namn när de väljer och skriver åtgärder; tvetydiga namn försämrar urvalsnoggrannheten.
Felhantering och återställning
- Om ett obligatoriskt profilattribut är null eller inte tillgängligt vid tidpunkten för åtgärdens åberopning ska agenten inte fortsätta med en potentiellt felaktig standard. Åtgärden ska returnera ett strukturerat fel som indikerar att attributet saknas, och agenten ska antingen be användaren om förtydligande eller flyttas om till en människa om de arbetar icke-konversationellt.
- Om ett Data 360-anslutet flöde inte kan hämta profildata (till exempel på grund av ett Data 360-serviceavbrott) ska flödets felsökväg returnera ett strukturerat fel till agenten med den specifika felorsaken. Agenten kan sedan bestämma om de vill försöka igen, fortsätta med en försämrad upplevelse eller visa felet för användaren.
- Logga alla profilattributvärden som injicerats vid skapande av sessionen eller åberopning av åtgärden bredvid session-ID:t. Detta säkerställer att alla omtvistade agentbeslut kan rekonstrueras med exakt den kundfakta agenten fick vid den tidpunkten.
Säkerhetsöverväganden
- Profilattribut som injiceras i agentsammanhang är föremål för samma dataåtkomstkontroller som alla CRM-poster. Se till att integreringsanvändaren eller den anslutna appen som används för att lösa profilattribut endast har de fältnivåbehörigheter som krävs för attributen som visas och inte bredare profilåtkomst.
- Beräknade insikter som kodar känsliga härledda mått (till exempel förutsagt hälsobetyg, ekonomisk risknivå) ska behandlas som känsliga fält och styras av samma åtkomstkontroller som underliggande data. Att visa ett högt bortfallriskbetyg för en agent som arbetar i ett kundsammanhang kräver noggrant övervägande av vad agenten kan kommunicera.
- Visa inte profilattribut som inte krävs av åtgärden. Varje ytterligare attribut i agentens sammanhangsfönster är ett ytterligare dataelement som skulle kunna återges i agentens svar. Tillämpa en princip som är absolut nödvändig för profiljordning.
- Granska alla sessioner där Beräknade insikter eller känsliga profilattribut injicerades som indata. Dessa sessioner representerar beslut som fattas baserat på härledd Kundintelligens och kan vara föremål för krav på förklaring eller föreskrifter i vissa branscher.
Exempel
Ett telekommunikationsföretag använder Agentforce för att hantera lagringskonversationer med kunder som har inlett en begäran om annullering.
- När ett annulleringskundcase öppnas skapas agentsessionen med kundens “accountId” som sammanhang.
- Underagentkonfigurationen mappar tre Data 360-attribut för enhetlig profil till sessionsvariabler vid skapandet: “customerTier” (Enterprise), “lifetimeValueUSD” (42 000) och “contractRenewalDate” (60 dagar).
- En beräknad insikt som “churnRiskScore” (0.91, beräknat från användningsminskning, supportärendefrekvens och NPS-trend) mappas som en ytterligare sessionsvariabel via ett Data 360-anslutet flöde som åberopas som det första åtgärdssteget.
- Agenten, som nu är grundad i verifierade kundfakta, åberopar en “SelectRetentionOffer”-åtgärd. Eftersom indata inkluderar “customerTier = Enterprise”, “lifetimeValueUSD = 42000” och “churnRiskScore = 0.91” returnerar åtgärden lagringserbjudandet på högsta nivå istället för ett standarderbjudande.
- Agenten åberopar “PresentOffer” för att leverera erbjudandet i konversationen och “LogRetentionAttempt” för att registrera interaktionen i CRM med alla jordade attribut bevarade för granskning.
Sammanhang
Företagsdata är fragmenterade. En agent som endast kan agera på vad som finns inuti Salesforce Platform är begränsad till en bråkdel av den information den behöver för att resonera effektivt. Att svara på en servicefråga kan kräva att läsa en kunds öppna ärende i Service Cloud. Att förbereda ett förslag kan kräva att en fil hämtas från Google Drive. Att analysera produktanvändning kan kräva att ett datalager frågas. Vart och ett av dessa system har sina egna API:n, sin egen autentiseringsmodell och sitt eget dataschema och kostnaden för att skriva skräddarsydd integreringskod för vart och ett av dem är det som historiskt har gjort agent-till-system-anslutning dyrt och ömtåligt.
MCP är en öppen standard som hanterar detta direkt. Den definierar ett enhetligt gränssnitt genom vilket en agent kan upptäcka och åberopa verktyg som exponeras av en MCP-kompatibel server, oavsett det underliggande systemet. Varje MCP-server fungerar som en adapter: det omger ett målsystems inbyggda gränssnitt i ett standardiserat, verktygscentrerat gränssnitt som agenten kan fråga, åberopa och skapa utan att veta något om systemets specifika protokoll eller scheman.
Från agentens perspektiv ser anslutningen till Slack, en SQL-databas (Structured Query Language) och ett dokumenthanteringssystem identiskt ut, tre MCP-servrar, var och en med en uppsättning beskrivna, anropbara verktyg. Agenten väljer och sekvenserar dem baserat på deras semantiska beskrivningar och det mål den försöker uppnå.
Problem
När en agent behöver hämta information eller utlösa åtgärder över flera externa system – vart och ett med olika API:n, autentisering och scheman – hur kan den upptäcka, åberopa och komponera sin kapacitet utan skräddarsydd integreringskod per system eller tät koppling till något systems implementering?
Krafter
När du tillämpar detta mönster, svara på följande frågor:
- Behöver agenten nå system utanför Salesforce Platform som dokumentlagringar, samarbetsverktyg, databaser, SaaS från tredje part, vars API inte representeras som Agentforce åtgärder?
- Krävs dynamisk verktygsupptäckt, där agenten identifierar rätt integreringsslutpunkt vid resonemang baserat på den aktuella begäran, istället för att ha integreringar hårdkodade i sin konfiguration?
- Ändras integreringslandskapet ofta; nya system läggs till, befintliga uppdateras och andra ändringar kan kräva att en skräddarsydd metod skulle skapa ohållbara underhållskostnader?
- Finns det ett behov av att koppla bort agentens resonemangslager från implementeringsdetaljerna för system längre ner, så att en ändring av ett målsystems API inte kräver ändringar av agentens instruktioner eller underagentkonfiguration?
- Ägs målsystemen av olika team eller leverantörer, var och en ansvarig för att exponera sin egen kapacitet, vilket gör en MCP-servermodell på leverantörssidan mer praktisk än en integrering på konsumentsidan per agent?
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Salesforce MCP-servrar | Bäst för Salesforce-ekosystemmål | Använd när målsystemet är inom Salesforces ekosystem och en MCP-server från första part är tillgänglig. Salesforce Headless 360 tillhandahåller MCP-servrar för sina egna plattformskapaciteter och exponerar CRM-data, flöden och plattformsåtgärder som MCP-kompatibla verktyg. Minskar implementeringsarbetet till konfiguration istället för utveckling. Anteckning: För närvarande har Salesforce MCP-servrar endast stöd för slutanvändaruppgifter för autentisering och auktorisering. |
| Egna MuleSoft MCP-servrar | Bäst när det inte finns någon MCP-server från första part | Använd för äldre system, egna interna program eller SaaS-plattformar från tredje part innan MCP-standarden. Om ett målsystem inte har sin egen MCP-server kan ett MuleSoft-integreringslager omges av en egen MCP-server som exponerar systemets kapacitet som verktyg. Den kan även användas med Salesforce API om MCP krävs för agenter som endast ska användas med systemanvändaruppgifter. MuleSoft hanterar protokollöversättning, autentisering och datatransformation; MCP-lagret gör att resultatet kan upptäckas av agenter. |
| MCP-servrar från tredje part | Bäst för råvarusystem med aktiva MCP-ekosystem | En leverantörsunderhållen MCP-server finns för din plattform (GitHub, Google Workspace) och uppfyller säkerhets- och underhållskraven. Ett ökande antal företagsplattformar som GitHub, Google Workspace och andra publicerar sina egna MCP-servrar. Om det finns en produktionsklar, leverantörsunderhållen server föredrar du den framför att bygga en egen. Utvärdera för säkerhetsstatus och underhållsåtagande innan användning. |
Skiss
Sekvensdiagram för verifierad injicering av kundsammanhang
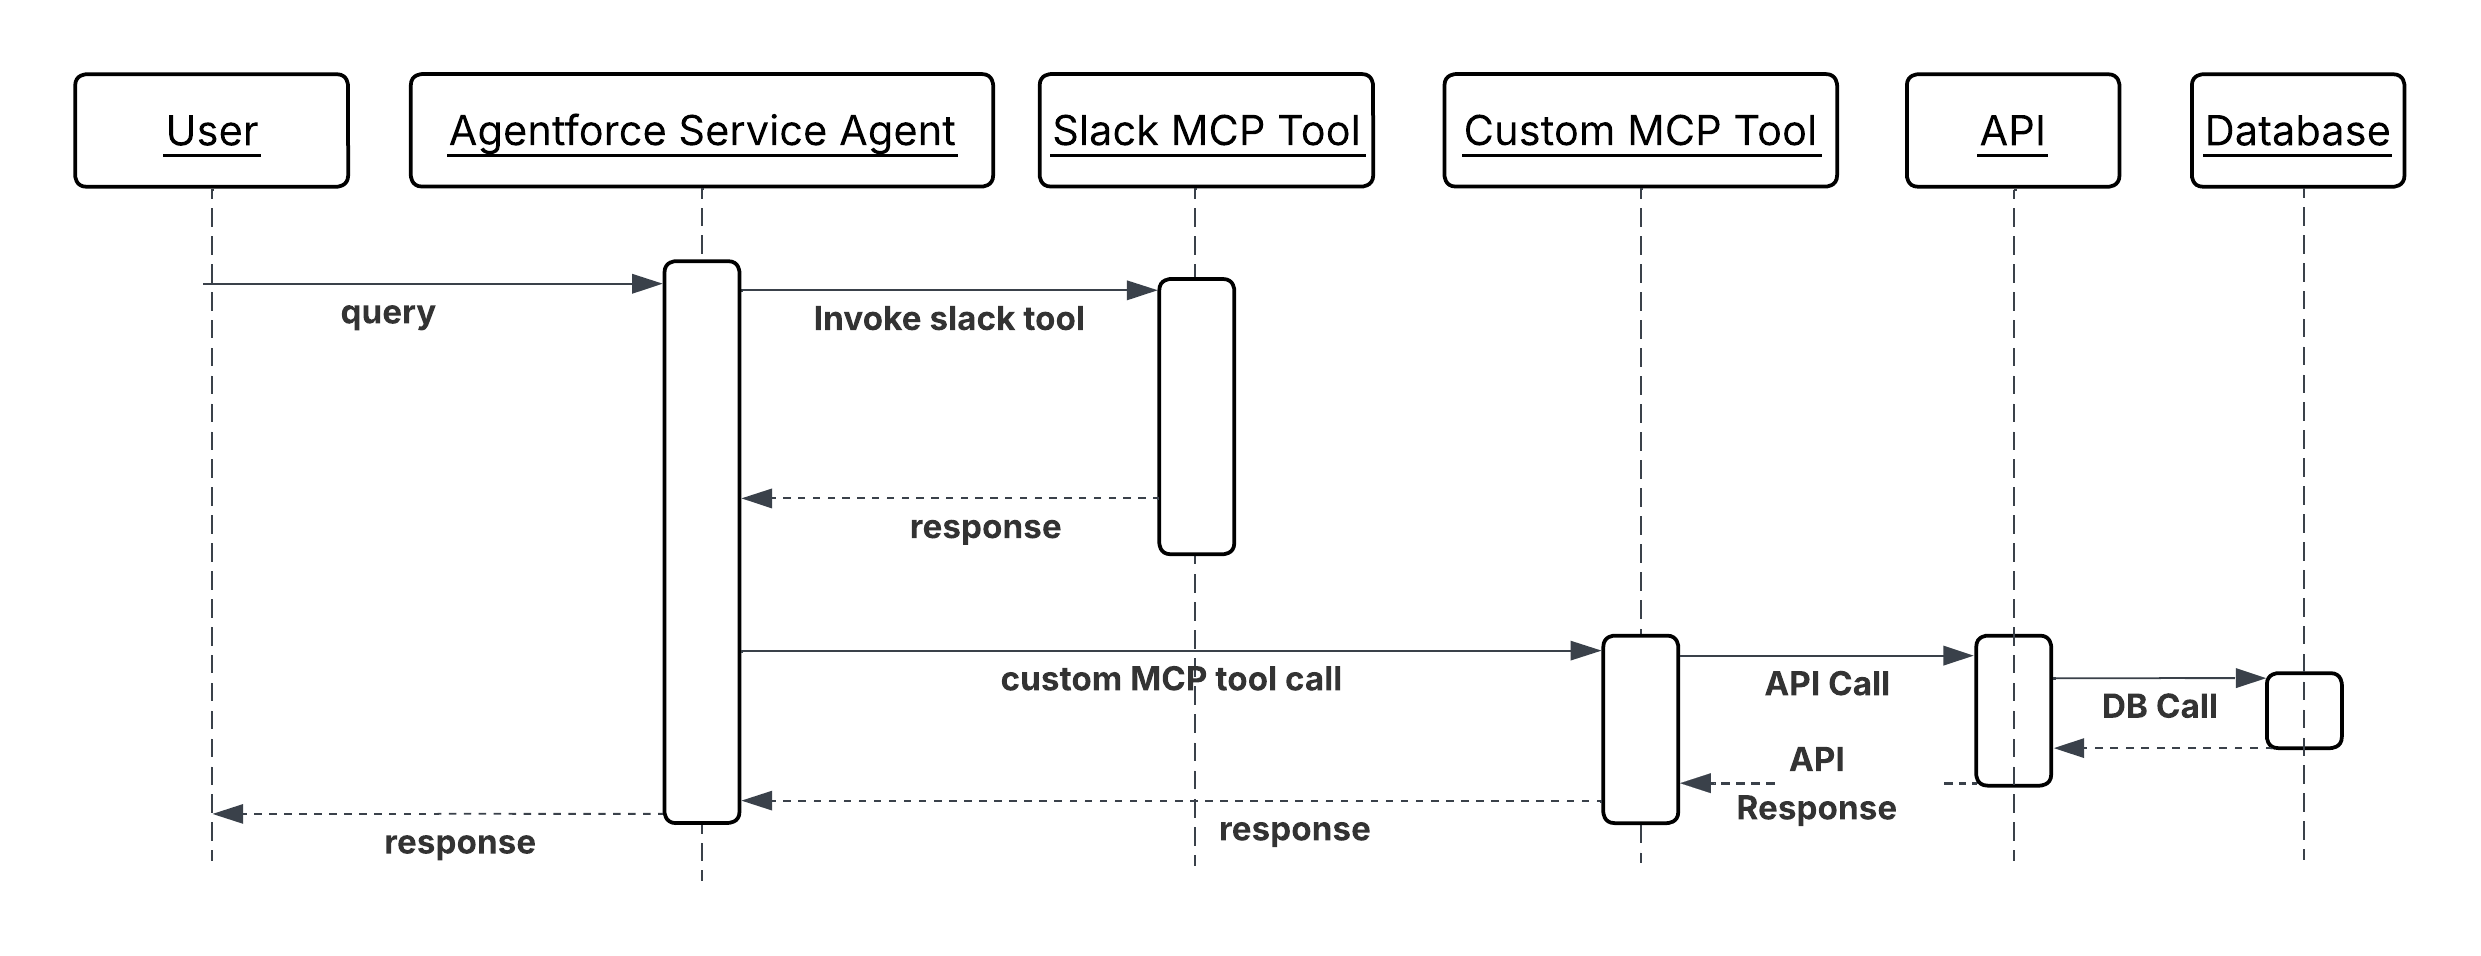
Resultat
Agentens nåbara yta utökas utan att öka dess integreringskomplexitet. Att lägga till ett nytt externt system innebär att distribuera eller konfigurera en MCP-server för det och inte skriva skräddarsydda Apex eller flödesintegreringar per agent. Agentens resonemangslager förblir oförändrat; det upptäcker och åberopar endast de nya verktygen baserat på deras semantiska beskrivningar.
MCP-standarden skapar även en ren separation av ägandeskap: Teamet som är ansvarigt för ett system exponerar dess kapacitet som en MCP-server. Agentteamet konsumerar dessa kapaciteter utan att behöva förstå systemets interna. Denna gräns minskar koordinationen i takt med att antalet integrerade system ökar.
Verktygets sammansättning är ett direkt resultat. Eftersom alla verktyg delar samma åberopningsgränssnitt kan agenten kedja verktyg från olika system, hämta en fil från Google Drive, extrahera data från den och skriva resultatet till en CRM-post lika naturligt som att kedja åtgärder inom ett system.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Verktygsbeskrivningar är agentens enda grund för att avgöra om och hur ett verktyg ska åberopas. Skriv beskrivningar på ett tydligt, syftesbaserat språk som anger vad verktyget gör, när det tillämpas och vad det returnerar. En beskrivning där det står “frågar CRM-databasen” är mindre användbar än “hämtar kontots öppna kundcase, ordnade efter prioritet, för ett givet konto-ID”. Dåliga beskrivningar ger dåligt verktygsval.
- Begränsa varje MCP-verktyg till en enskild atomkapacitet. Ett verktyg som hämtar ett dokument och även skriver en sammanfattning tillbaka till källsystemet är svårare för agenten att resonera kring, svårare att försöka igen vid fel och svårare att säkra än två diskreta verktyg. Ett verktyg, ett ansvar.
- Utforma verktyg så att utdata är komponerbara indata. Resultatet av ett hämtningsverktyg ska struktureras på ett sätt som mappar naturligt till indataparametrarna för de åtgärdsverktyg som vanligtvis följer det, vilket minskar det transformationsarbete agenten måste utföra mellan stegen.
- MCP-servrar för fjärrvärd. Lokala binära installationer skapar komplexitet för distribuering och versioner som växer med antalet agentmiljöer. En fjärrserver kan uppdateras oberoende av de agenter som konsumerar den.
Genomförandeanteckningar för Salesforce
- Om du vill ha enhetlig MCP-autentisering, begränsning av hastighet och validering av nyttolast för alla utgående MCP-anrop, använd AI Gateway som MuleSoft Omni Gateway med stöd för MCP-servrar och konfigurera den innan du exponerar en MCP-server för agenter.
- Använd OAuth 2.0-inloggningsuppgifter för alla inloggningsuppgifter som krävs av MCP Server-anslutningar. Inloggningsuppgifter får inte visas i verktygsparametrar, åtgärdskonfigurationer eller Apex kod.
- Vissa MCP-verktyg kan behöva slutanvändaruppgifter för att utföra vissa åtgärder beroende på verksamhetens användningsfall (som fondöverföring). För att propagera slutanvändaridentitetstokens, använd OAuth 2.0-injektionspolicyn På uppdrag av inloggningsuppgifter som för närvarande stöds med MuleSoft Omni Gateway.
- För egna MuleSoft MCP-servrar: definiera MCP-verktygsschemat i MuleSofts API-specifikation och registrera serverns slutpunkt i Agentforces verktygskatalog. Testa verktygsbeskrivningar mot representativa agentfrågor för att verifiera att agenten väljer rätt verktyg för rätt uppgift innan de distribueras till produktion.
Felhantering och återställning
- När ett MCP-verktygsanrop returnerar ett fel inspekterar agenten den maskinläsbara felkoden för att avgöra lämplig återställningsåtgärd: begära saknade parametrar från användaren, försöka igen med korrigerad indata eller flytta om till en människa. Den konsumerar aldrig fel i tysthet eller fortsätter resonera som om verktygsanropet lyckades.
- Agenten implementerar återförsökslogik för tillfälliga fel direkt.
- Logga varje åberopning av MCP-verktyg från klientsidan med verktygsnamnet, rengjorda indataparametrar och resultatet. Denna spårning på klientsidan i kombination med loggar på serversidan är den primära mekanismen för att diagnostisera varför en agent tog en viss åtgärdsväg när ett arbetsflöde inte ger det förväntade resultatet.
Säkerhetsöverväganden
- Alla utgående MCP-serveranslutningar passerar genom gateway. gateway tillämpar autentiseringsbekräftelse, begränsning av hastighet för att förhindra verktygsmissbruk och inspektion av nyttolast för att upptäcka snabba injektionsförsök i verktygsparametrar. Direkta, omedierade anslutningar från agenter till MCP-servrar kringgår dessa kontroller och är inte tillåtna.
- Omfatta varje agents MCP-serveranslutningar till endast de servrar vars verktyg agenten faktiskt behöver. En agent som är konfigurerad med åtkomst till alla tillgängliga MCP-servrar har en större attackyta än en som endast är ansluten till de verktyg dess definierade uppgifter kräver.
- Validera och desinficera verktygsinmatningsparametrar innan du skickar dem till verktyget, särskilt när parametervärden härrör från användarlevererad text eller LLM-skapat innehåll. Skicka inte ovaliderad LLM-utdata direkt som verktygsparametrar; en attackerare som kan påverka agentens resonemang kan använda denna väg för att injicera skadliga värden i systemanrop längre ner.
- Behandla agentens lista över anslutna MCP-servrar och deras verktygslager som känslig konfiguration. En attackerare som vet vilka verktyg en agent har tillgängliga och vilka parametrar de accepterar har en karta för att skapa snabbinjektionsbelastningar utformade för att missbruka dessa verktyg.
Exempel
En försäljningsagent förbereder en omfattande kontogenomgång innan ett kundsamtal med högt värde:
- Agenten får begäran: “Förbered en genomgång om Acme Corp inför morgondagens diskussion om förnyelse.”
- Agenten frågar MCP-verktygskatalogen och identifierar tre relevanta verktyg över två MCP-servrar:
GetRecentEmails,GetOpenOpportunitiesochGetSupportTicketSummary. - Agenten åberopar alla tre verktygen parallellt. Varje MCP-server översätter anropet till sitt målsystems inbyggda API, hämtar relevanta data och returnerar ett strukturerat resultat.
- Agenten får de tre resultaten. Senaste e-posttrådar, det öppna förnyelseprojektet med affärsstorlek och fas, och en sammanfattning av öppna supportärenden efter prioritet, och sammanfattar dem till en strukturerad kontogenomgång.
- Agenten åberopar
CreateAccountNoteför att spara genomgången till kontoposten och returnerar en sammanfattning till den begärande användaren. - Alla fyra åberopningar av MCP-verktyg loggas av gateway med verktygsnamn, serveridentiteter och resultat för sessionsgranskningsposten.
Sammanhang
Det utgående MCP-mönstret beskriver en Agentforce agent som använder verktyg från externa MCP-servrar. Det inkommande mönstret inverterar detta. Salesforce Platform-funktioner som CRM-poster, flöden, Apex logik och Data 360-insikter exponeras som MCP-verktyg som externa agenter kan upptäcka och åberopa på alla LLM-ramverk.
Detta mönster är viktigt eftersom AI-distribueringar i företag sällan är en enskild leverantör. En partners agent byggd på ett annat ramverk kan behöva söka efter en kunds kontostatus i Salesforce. Ett internt datavetenskapsteam som kör en Python-baserad agent kan behöva utlösa ett Salesforce-flöde för att starta en godkännandeprocess. Utan en standardiserad exponeringsmekanism behöver varje extern konsument en skräddarsydd integrering. Att exponera Salesforce-kapacitet som en MCP-server ger varje MCP-kompatibel agent ett enhetligt, upptäckbart gränssnitt till plattformens verktyg oavsett hur den anropande agenten är byggd.
Till exempel måste en partners anskaffningsagent, byggd på ett tredjepartsramverk, verifiera en leverantörs kontraktstatus i Salesforce innan en inköpsorder godkänns. Istället för att bygga en direkt REST-integrering åberopar den ett GetContractStatus på Salesforce MCP Server. Verktyget tillämpar samma åtkomstkontroller som alla inbyggda Salesforce-operationer; den anropande agenten ser endast resultatet.
Problem
När en extern agent som bygger på ett annat ramverk, ägs av en partner eller på annat sätt körs utanför Salesforce Platform behöver åberopa Salesforce-kapacitet som en del av sitt eget arbetsflöde, hur kan dessa kapaciteter exponeras på ett standardiserat, upptäckbart och säkert styrt sätt som inte kräver en skräddarsydd integrering per extern konsument?
Krafter
När du tillämpar detta mönster, svara på följande frågor:
- Byggs de externa agenter som behöver konsumera Salesforce-kapacitet på ramverk som stöder MCP-standarden? Annars kan en REST API eller en webhook-metod vara mer lämplig än MCP.
- Vilka Salesforce-kapaciteter behöver exponeras - skrivskyddad datahämtning, skrivoperationer, flödesåberopningar eller en kombination? Exponeringens omfattning avgör direkt det säkerhetsområde som måste regleras.
- Hur ska identiteten för den externa samtalsagenten verifieras, och vilka Salesforce-behörigheter ska dess åberopningar köras under? Agent-till-plattform-anrop får inte ärva bredare behörigheter än den specifika operationen kräver.
- Är Salesforce MCP-servern avsedd för interna konsumenter (andra teams agenter inom samma organisation) eller externa konsumenter (partner- och kundagenter)? Trust modellen och autentiseringskraven skiljer sig avsevärt mellan dessa målgrupper.
- Hur kommer uppsättningen exponerade verktyg att utvecklas över tid? Nya Salesforce-funktioner som läggs till i MCP-servern blir omedelbart upptäckbara för alla anslutna agenter. Oavsiktlig verktygsexponering måste styras genom en avsiktlig publiceringsprocess.
Program för Salesforce-mönster
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Salesforce som MCP-server (inbyggd) | Bäst för att exponera Salesforce-kapacitet från första part | Använd när verktygen som ska visas mappar direkt till befintliga Salesforce Platform-operationer och samtalsagenterna är MCP-kompatibla. Salesforce Headless 360:s inbyggda MCP-serverkapacitet låter plattformsåtgärder som postfrågor, flödesåberopningar och Apex åtgärder deklareras som MCP-verktyg och exponeras för alla MCP-kompatibla externa agenter. Åtkomst styrs av behörighetsmodellen Salesforce. Observera att dessa Headless 360 MCP-servrar endast kan kommas åt med slutanvändaruppgifter för närvarande. |
| MuleSoft som MCP-serverfasad | Bäst när transformation eller aggregering av flera system krävs | Används när den uppringande agenten behöver en kapacitet som kräver data från mer än ett Salesforce-objekt, transformation innan leverans eller komposition med data från andra system. MCP-gränssnittet förblir rent och enkelt; komplexiteten absorberas av MuleSoft. Ett MuleSoft MCP-lager sitter framför Salesforce och visar det aggregerade resultatet av flera plattformsoperationer som ett enskilt MCP-verktyg. Denna lösning kan även användas av agenter där slutanvändarens identitet inte kan propageras för Salesforce-autentisering och -auktorisering. Till exempel, om Agentforce Agenter behöver MCP-servrar med systeminloggningsuppgifter måste vi förlita oss på egna MCP-servrar som en som byggts med och värdas på MuleSoft. |
Skiss
Sekvensdiagram för verksamhetskapacitet som anropbart verktyg
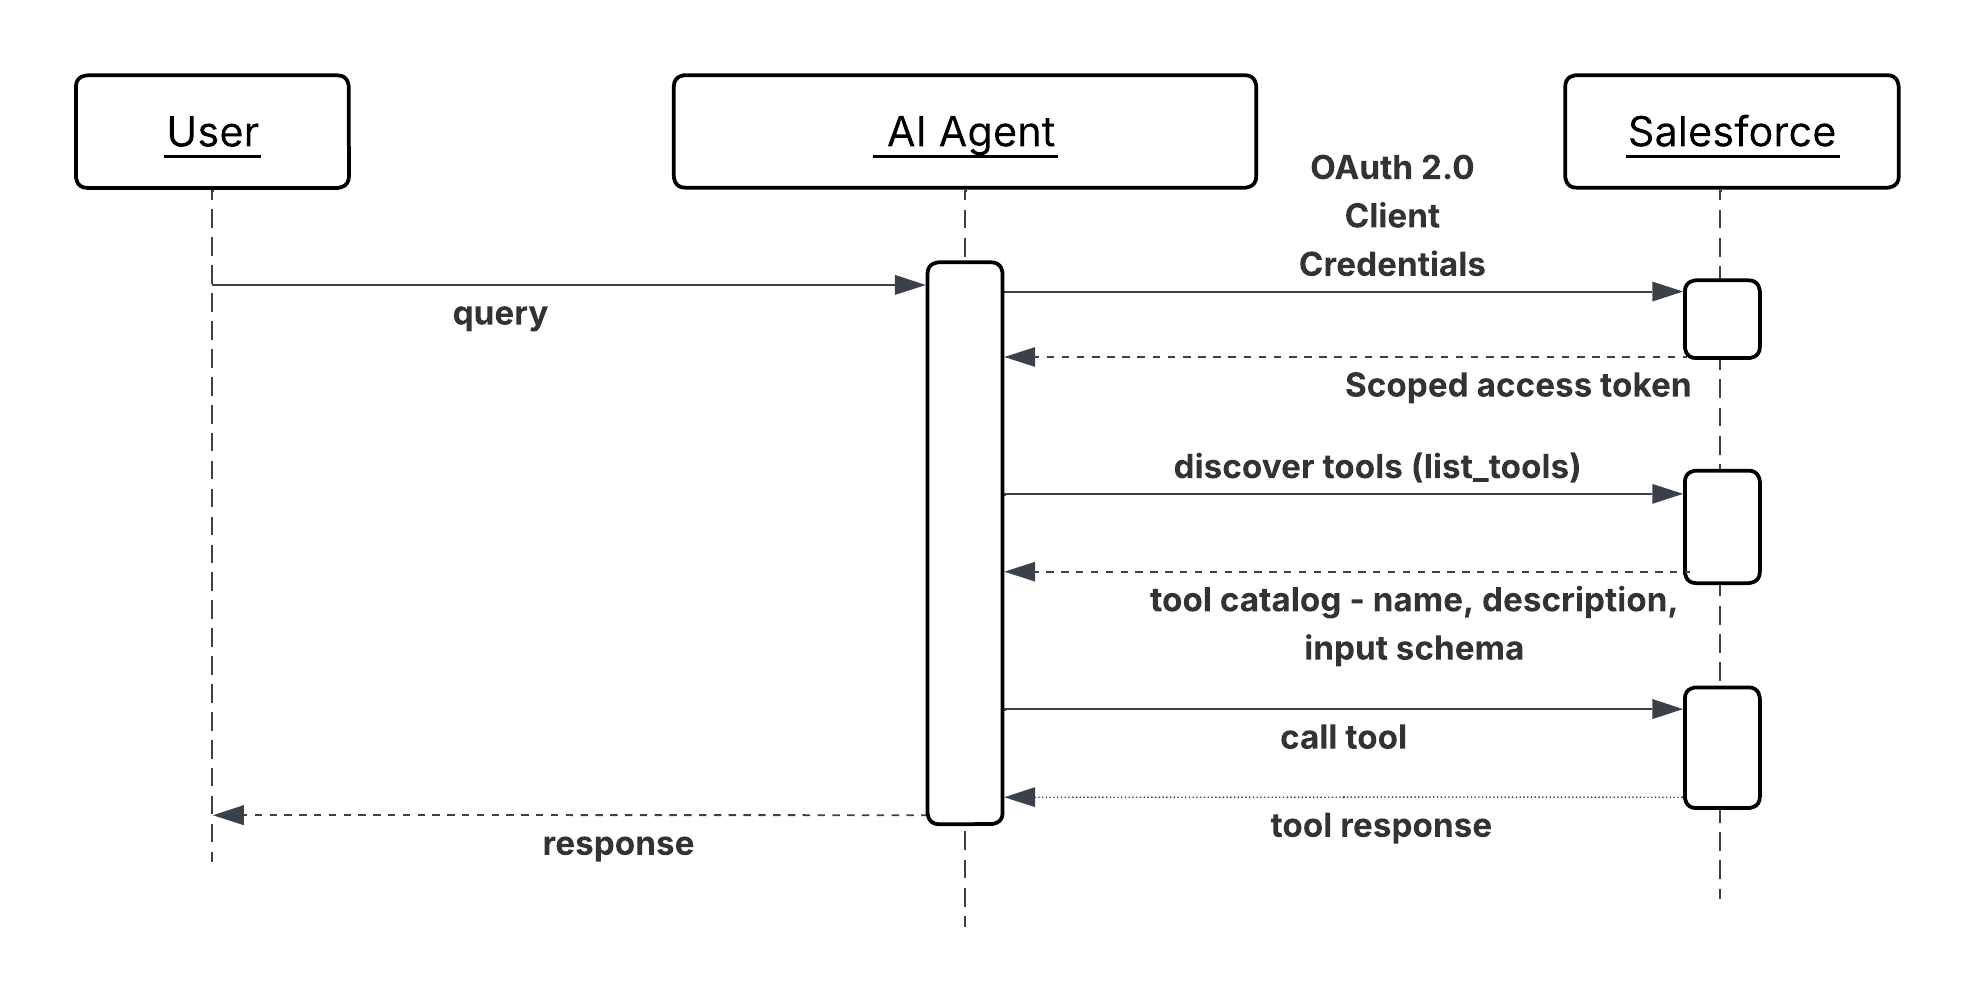
Resultat
Salesforce blir en förstklassig deltagare i ekosystem med agenter från flera leverantörer. Externa agenter kan upptäcka och konsumera plattformskapacitet utan att kräva en egen REST-integrering per konsument eller per användningsfall. Antalet konsumenter kan växa utan proportionell tillväxt i underhållskostnader för integration.
Med Headless 360 styr behörighetsmodellen Salesforce varje åberopning av inkommande verktyg. Externa MCP-klienter kringgår inte befintliga dataåtkomstkontroller; de arbetar inom dem. Detta innebär att säkerhetsstatusen för att exponera kapacitet via MCP motsvarar att exponera dem via någon annan autentiserad API-yta.
Verktygsupptäckt är en sammansatt fördel. När nya Salesforce-kapaciteter läggs till i MCP-serverns verktygskatalog blir de omedelbart tillgängliga för alla anslutna externa agenter utan att kräva att dessa agenter uppdaterar sina konfigurationer.
Utformningsöverväganden
Plattformsagnostisk vägledning
- Publicera endast vad externa agenter behöver. Varje verktyg som läggs till i MCP-serverns katalog utökar attackytan och styrningsbördan. Granska verktygslagret avsiktligt. Definiera vilka kapaciteter som är godkända för extern användning och behandla ej godkänd exponering som en konfigurationslucka, inte som standard.
- Skriv verktygsbeskrivningar för externa konsumenter. En extern agents operator har ingen Knowledge om din interna datamodell eller namnkonventioner. Håll beskrivningar fristående: vad verktyget gör, vad varje parameter betyder, vad resultatet representerar och eventuella begränsningar eller förkrav som anroparen måste uppfylla.
- Versionsverktyg uttryckligen när deras indata- eller utdatascheman ändras. En extern agent som är beroende av ett verktygs aktuella schema kommer att brytas tyst om schemat ändras utan föregående meddelande. Behandla brytändringar av ett MCP-verktygs gränssnitt med samma disciplin som en brytändring av en offentlig REST API.
Genomförandeanteckningar för Salesforce
- Kör varje inkommande Salesforce Out-of-the-Box (OOTB) MCP-verktyg (Headless 360) under en slutanvändare vars behörigheter endast är begränsade till de operationer som de exponerade verktygen kräver. Kör inte inkommande agentsamtal under en administratörsidentitet med hög behörighet.
- För att tillämpa autentisering, begränsning av hastighet, schemavalidering och detektering av personligt identifierande information (PII) enhetligt i alla MCP-verktyg, använd AI Gateway som MuleSoft Omni Gateway.
- För MuleSoft MCP-fasader, definiera MCP-verktygsschemat i MuleSoft oberoende av det underliggande Salesforce API-schemat. MCP-gränssnittet ska återspegla samtalsagentens konceptuella behov och inte formen på Salesforce-objektet som backar upp det. Denna frånkoppling låter Salesforce-implementeringen utvecklas utan att bryta det externa verktygskontraktet.
Felhantering och återställning
- Fel i verktygsåberopning måste returnera strukturerade MCP-felsvar med en maskinläsbar kod och en beskrivning på enkelt språk. Den anropande externa agenten har ingen insyn i Salesforce-plattformens interna funktioner, eftersom felmeddelanden måste vara fristående och användbara utan att kräva Knowledge om Salesforce-specifika felkoder eller objektmodeller.
- Fel i gränsvärden och autentiseringsfel måste returneras omedelbart med tillräckligt med information för att den externa agentens operatör ska kunna diagnostisera och åtgärda vilken gräns som har uppnåtts, eller vilken autentiseringsuppgift som har avvisats utan att visa interna konfigurationsdetaljer.
- Logga alla åberopningar av inkommande MCP-verktyg i Omni Gateway med den anropande agentens identitet, det verktyg som åberopas, indataparametrarna (sanerade för känsliga värden) och resultatet. Denna logg är den primära bevisloggen för att diagnostisera fel som rapporterats av externa konsumenter och för att granska vad externa agenter har åtkomst till.
Säkerhetsöverväganden
- Varje inkommande MCP-anslutning måste autentiseras innan något verktyg kan nås. Tillåt inte ej inloggad upptäckt av verktygskatalogen; listan över exponerade kapaciteter är i sig känslig information.
- Tillämpa auktorisering på verktygsnivå utöver autentisering på anslutningsnivå. En registrerad extern agent ska endast kunna åberopa de specifika verktyg den uttryckligen har beviljats åtkomst till, inte den fullständiga katalogen. Tillämpa detta vid gateway, inte vid programlagret.
- Validera och desinficera alla parametrar för inkommande verktyg innan du skickar dem till Salesforce Platform-operationer. Parametrar från externa agenter är en opålitlig indatayta – en skadligt skapad parameter kan försöka åsidosätta sökfrågefilter, injicera fragment av Salesforce Object Query Language (SOQL) eller påverka flödesvariabler. Validera typ, format och intervall vid MCP-servern eller fasadgränsen.
- Utför en periodisk åtkomstgranskning av registrerade externa konsumenter. Återkalla inloggningsuppgifter för agenter som inte längre är aktiva eller vars åtkomstomfång har ändrats. En vilande men giltig autentiseringsuppgift för en avvecklad partnerintegrering är en onödig stående risk.
- Skydda mot att bryta mot plattformsgränser genom att begränsa inkommande MCP-meddelanden i gateway. Minska trafiken för icke-kritiska agenter vid belastning med hjälp av SLA-baserade nivåpolicyer.
Exempel
En inköpsagent som drivs av en logistikpartner måste verifiera en leverantörs kontrakt och kreditstatus innan en inköpsorder med högt värde godkänns:
- Partnerns agent autentiserar till gateway med sina registrerade OAuth 2.0-klientuppgifter och får en åtkomsttoken med omfattning.
- Agenten frågar Salesforce MCP-serverns verktygskatalog och identifierar två relevanta verktyg:
GetSupplierContractStatusochGetAccountCreditSummary. - Agenten åberopar
GetSupplierContractStatusmed leverantörens identifierare. MCP-servern översätter detta till en Salesforce-postfråga, tillämpar integreringsanvändarens fältnivåsäkerhet och returnerar kontraktets aktuella status, utgångsdatum och eventuella flaggade efterlevnadar. - Agenten åberopar
GetAccountCreditSummary, som dirigeras genom MuleSoft MCP-fasaden. Fasaden aggregerar leverantörens utestående fakturasaldo och betalningshistorik från två Salesforce-objekt och returnerar en enda sammansatt kreditsammanfattning. - Med båda resultaten avgör partnerns agent att kontraktet är aktivt och kreditpositionen är inom acceptabla gränser, och godkänner inköpsordern i sitt eget system.
- Båda verktygsåberopningarna loggas av gateway med partneragentens identitet, de verktyg som åberopas och resultaten som skapar en granskningsbar post för vilken extern åtkomst som beviljades och vilka data som returnerades.
Sammanhang
Enterprise-system förlitar sig nu på samarbetsagentsvämningar eller nätverk, där komplexa begäranden delas upp och delegeras till specialiserade agenter över olika domäner eller leverantörsplattformar. Dessa agenter, var och en med sin egen roll, kapacitet och verktyg, behöver en standardiserad, säker kommunikationsmetod för att koordinera mot delade mål utan att kräva mänskligt ingripande i varje steg.
Problem
Hur kan en anropande AI-agent dynamiskt upptäcka, säkert interagera med och delegera komplexa eller domänspecifika uppgifter till en fjärragent som kan byggas på ett annat ramverk eller drivas av en annan leverantör och få strukturerade resultat för att slutföra ett större företagsflöde?
Krafter
När du tillämpar detta mönster, svara på följande frågor:
- Hur samverkar agenter, som utvecklats med hjälp av olika ramverk eller som arbetar över silonerade applikationsområden?
- Hur kan agenter samarbeta och delegera uppgifter utan att exponera sin interna logik, minne eller egna verktyg?
- Hur stöder agenter komplexa, tidskrävande uppgifter samtidigt som de tillhandahåller uppdateringar av status i realtid, streaming och pushnotiser?
- Hur tillämpar agenter säkerhet i företagsklass (autentisering, auktorisering) och policyefterlevnad för kommunikation mellan agenter?
- Hur hanterar agenter strukturerade uppgiftsflöden (inledning, förlopp, slutförande) som går utöver enkla API-anrop?
Program för Salesforce-mönster
A2A-protokollet är en öppen standard som låter agenter upptäcka, delegera till och samarbeta med andra agenter som kollegor. Det ger ett gemensamt språk för agenter att säkert utbyta information och samordna åtgärder mellan olika plattformar och leverantörer. A2A fokuserar på peer-to-peer-kommunikation, som ett komplement till MCP, som fokuserar på att ansluta agenter till verktyg och API.
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Orkestrering av flera agenter (SOMA) med en organisation | Bäst när alla domänagenter bor i en organisation och ingen dirigering mellan leverantörer krävs | En superagent (orkestrerare) delar upp begäranden och dirigerar till upp till ~7 anslutna underagenter med LLM-baserad dirigering (Atlas Resonemangsmotor läser beskrivningar av underagenter) eller deterministisk dirigering (Agentskript). Detta är det rekommenderade standardmönstret innan du når A2A. Kombinationer som stöds: Agentforce Serviceagent→Agentforce Serviceagent Agentforce Medarbetare Agentforce Medarbetare Agentforce Medarbetare Agent→Agentforce Serviceagent Endast orkestreraren kan flyttas om till en människa. Underagenter kan inte det. |
| Orkestrerledd fleragentsdelegation | Bäst för komplexa arbetsflöden som kräver flera specialiserade agenter | Använd när arbetsflödet sträcker sig över flera domäner, till exempel källa, verifiering och godkännande som båda ägs av olika agenter. En orkestreragent delar upp begäran på högsta nivå och delegerar underuppgifter till två eller flera peer-agenter i sekvens eller parallellt. Varje peer-agent utför sin specialiserade domänfunktion och returnerar en artefakt; orkestreraren aggregerar resultat och driver nästa steg. |
Skiss
Arkitekturen involverar att en samtalsagent inleder kommunikation, underlättad av en agentkatalog/ett register för upptäckt:
Sekvensdiagram för korsagentdelegering
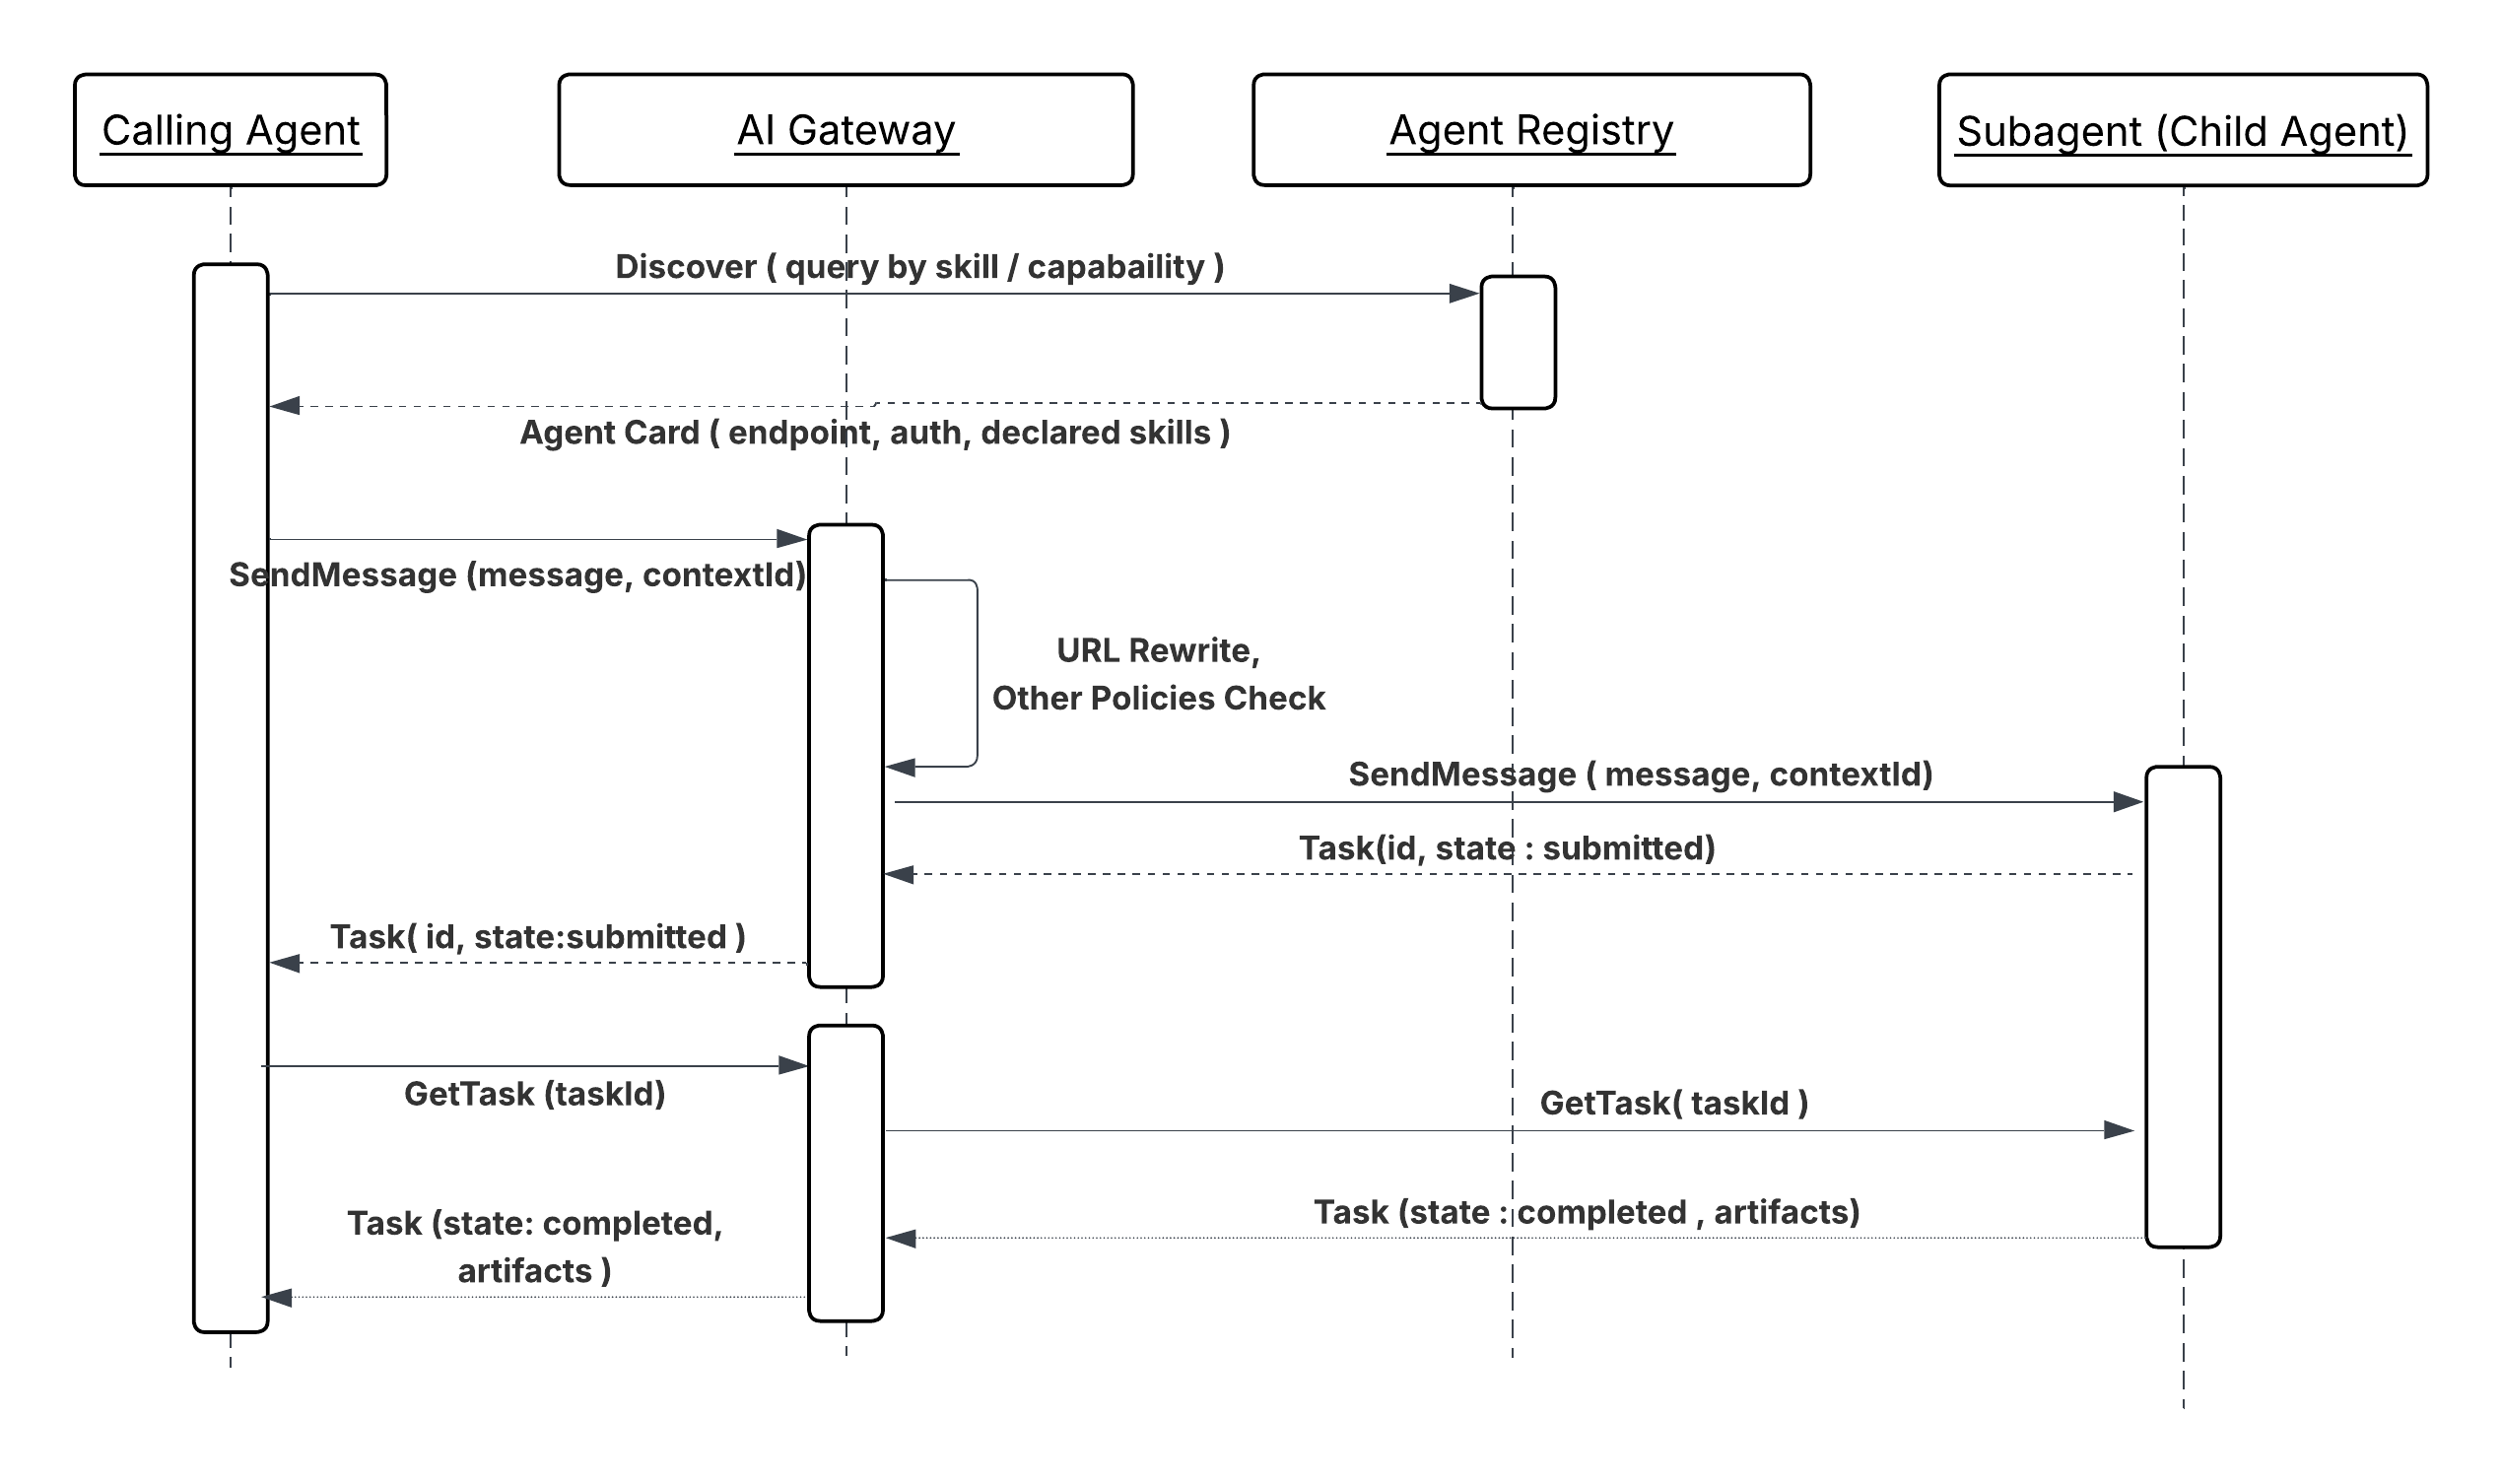
Den peer agenten bearbetar begäran med dess domänspecifika logik, minne och verktyg och returnerar sedan strukturerade resultat till den anropande agenten.
Resultat
A2A-delegering separerar domänägande från arbetsflödesorkestrering. Den anropande agenten behöver inte veta hur peer-agenten är byggd, vilken plattform den körs på eller vilka verktyg den använder internt; den delegerar en uppgift och tar emot en strukturerad artefakt. Denna gräns innebär att en specialistagent (bakgrundsverifiering, ekonomisk riskvärdering, logistikdirigering) kan utvecklas, distribueras och förbättras oberoende av de arbetsflöden som åberopar den.
Protokollets livscykelmodell för uppgifter (skickad, arbetad, slutförd, misslyckad) har stöd för
långa operationer inbyggt. Den uppringande agenten kan registrera sig för statusuppdateringar istället
än att hålla en blockerande anslutning, vilket innebär att A2A-uppgifter kan löpa över minuter eller timmar
utan att kräva att den orkestrerade agenten fortsätter vara aktiv under hela processen.
Utformningsöverväganden
Plattformsagnostisk vägledning
- I komplexa scenarion kan en agentmäklare fungera som en intelligent dirigeringstjänst eller “smart växel” för att samordna uppgiftsdelegering mellan specialiserade agenter och hantera processer i flera steg.
- Eftersom A2A har stöd för uppgifter som körts länge måste kommunikationen vara inriktad på att slutföra uppgiften, definiera en livscykel för uppgiftsobjektet och tillhandahålla uppdateringar och notiser i realtid.
- Protokollet är utformat för att stödja olika innehållstyper, inklusive text, filer, strukturerade data, ljud och videostreaming.
- Relationerna och beroendena mellan agenter och deras kapacitet definieras deklarativt i en konfigurationsfil (till exempel “agent-network.yaml”) och publiceras till agentregistret.
Genomförandeanteckningar för Salesforce
- För effektiv SOMA-orkestrering, håll anslutna underagenter under 7 för att bevara dirigeringskvaliteten.
- För närvarande stöds endast det enskilda delegeringslagret (superagent → underagent); djupare kedjor pushar latens till en “ohållbar hastighet”. För närvarande kan underagenter inte delegera till andra anslutna underagenter.
- Mänsklig överlämning stöds endast på orkestrernivå; underagenter kan inte flyttas om.
- Inom SOMA, använd Agentskript när LLM-baserad dirigering skapar feldirigering för tvetydiga inmatningar för deterministisk dirigering. Agentskript aktiverar utvalt delat sammanhang mellan agenter.
Felhantering och återställning
A2A-protokollet definierar omfattande felkoder för att underlätta robust felsökning och felhantering.
- Återställningslogik: Agenter bör införliva policyer för återförsök (försök), växlingslogik till alternativa agenter och uttryckliga timeouter.
- Spårning av uppgiftsstatus: Arbetsflödet för uppgiftshantering säkerställer att agenter kan hålla sig synkroniserade med den senaste statusen för en uppgift, vilket underlättar återställning i händelse av avbrott.
- Observerbarhet: Loggning av interaktionsdetaljer, som latens, resultat och felfrekvenser, är viktigt för att övervaka kvalitet och felsökning.
Säkerhetsöverväganden
- Företagsklassad autentisering: A2A är utformad för att överensstämma med autentiserings- och auktoriseringsstandarder i företagsklass, som OAuth 2.0 och JWT, som ofta hanteras av externa plattformar som Okta.
- Port för att skydda A2A: En gateway (till exempel MuleSoft Omni Gateway) är viktig för att tillämpa policyer för all A2A-kommunikation och fungerar som både en ingress- och egressgateway för att skydda agenter och kontrollera utgående trafik till externa agenter och tjänster.
- Policytillämpning: Agentkortomskrivning, schemavalidering, spikkontroll, PII-detektor och andra policyer ska tillämpas för A2A-server och dataskydd.
Exempel
Arbetsflöde för kandidatinsamling
En anställningschef ger sin centrala orkestreringsagent i uppdrag att hitta kandidater som matchar en jobbannons och kompetensuppsättning.
- Upptäckt: Orkestreringsagenten frågar agentregistret och upptäcker en specialiserad rekryteringsagent och en bakgrundskontrollagent (båda peer-agenter).
- Delegering (A2A): Orkestreringsagenten skickar en strukturerad uppgiftsbegäran (A2A-meddelande) till den rekryterande agenten för att hämta kandidater.
- Inbördes bearbetning: Rekryteringsagenten kör sitt eget arbetsflöde (till exempel anropar ett externt LinkedIn-verktyg via MCP).
- Artefaktretur (A2A): Rekryteringsagenten returnerar en lista över föreslagna kandidater (artefakten).
- Sekventiell delegering: Orkestreringsagenten delegerar sedan en annan uppgift (A2A) till bakgrundskontrollen för toppkandidaten. Denna agent utför kontrollen och returnerar resultatet och slutför den övergripande uppgiften.
Sammanhang
Komplexa företagsflöden kräver ofta specialiserade agenter på externa plattformar eller partnersystem för att inleda uppgifter, delegera sökfrågor eller tillhandahålla uppdateringar till interna agenter (till exempel de på Salesforce Platform). Detta mönster hanterar hur en intern Agentforce säkert och tillförlitligt tar emot och bearbetar begäranden från en fjärragent för att utföra en domänspecifik kapacitet.
Problem
Hur kan en intern specialiserad AI-agent (till exempel en agent för bakgrundskontroll i Agentforce) säkert exponera sin domänspecifika funktionalitet för externa peer-agenter, bearbeta en inkommande, strukturerad A2A-begäran och hantera uppgiftens livscykel (inklusive statusuppdateringar i realtid) för att returnera strukturerade artefakter till fjärranropsagenten?
Krafter
När du tillämpar detta mönster, svara på följande frågor:
- Hur exponerar du intern agentkapacitet för externa agenter på ett säkert sätt utan att kompromissa med intern logik eller verktyg?
- Hur tillämpar du säkerhetspolicyer av företagsklass för att bekräfta den uppringande agentens identitet och delegerade behörighet innan du bearbetar begäranden?
- Hur hanterar du inkommande uppgifter som körts länge och samtidigt tillhandahåller strukturerade, asynkrona lägesuppdateringar?
- Hur säkerställer du sömlös interaktion med agenter byggda på olika, externa ramverk?
Program för Salesforce-mönster
A2A-protokollet tillhandahåller den öppna standarden för säker peer-to-peer-delegering och samarbete. Den interna agenten agerar som peer agent och annonserar sin kapacitet genom en agentkatalog/register och använder A2A över säkra kanaler (HTTPS/SSE) för att ta emot och svara på strukturerade begäranden.
| Lösning | Anpassa | Kommentarer |
|---|---|---|
| Agentforce ansluten underagent (SOMA) | Bäst när den uppringande agenten är en annan Agentforce agent i samma organisation | Använd när båda agenterna bor i samma Salesforce-organisation och uppringaren är en Agentforce Orchestrator. Agenten ansluts som en underagent via Agentforce Builder och exponeras för orkestreraren genom dess beskrivning och deklarerade åtgärder. Orkestreraren dirigerar uppgifter med LLM-baserad dirigering (Atlas Reasoning Engine) eller deterministisk dirigering (Agent Script). Inget A2A-protokoll, gateway eller extern registrering krävs. Kombinationer som stöds: Agentforce serviceagentAgentforce serviceagent Agentforce Employee Agent→ Agentforce Employee Agentforce Employee Agent→Agentforce serviceagent Endast orkestreraren kan flyttas om till en människa. Underagenter kan inte det. |
| Agentmäklardirigering (inkommande) | Bäst när organisationen har flera Agentforce-agenter med kompletterande kapacitet och den uppringande agenten inte kan eller bör välja ett specifikt mål | Använd när den uppringande agenten är extern till Salesforce eller en annan Salesforce-organisation och inte behöver veta vilken specifik intern agent (Agentforce eller andra leverantörsagenter) som hanterar dess begäran. En MuleSoft-agentmäklare sitter mellan MuleSoft Omni Gateway och poolen av interna Agentforce. Den tar emot den inkommande A2A-uppgiften, utvärderar den deklarerade kapaciteten för tillgängliga interna agenter mot uppgiftens krav och dirigerar begäran till den agent som passar bäst. Mäklaren hanterar även failover om den primära målagenten inte är tillgänglig eller returnerar ett fel, omdirigerar mäklaren till en motsvarande agent utan att gå vidare till det externa samtalet. Det externa samtalet är aldrig medvetet om interna dirigeringsbeslut eller försök. |
Skiss
Sekvensdiagram för agenter som anropbara tjänster
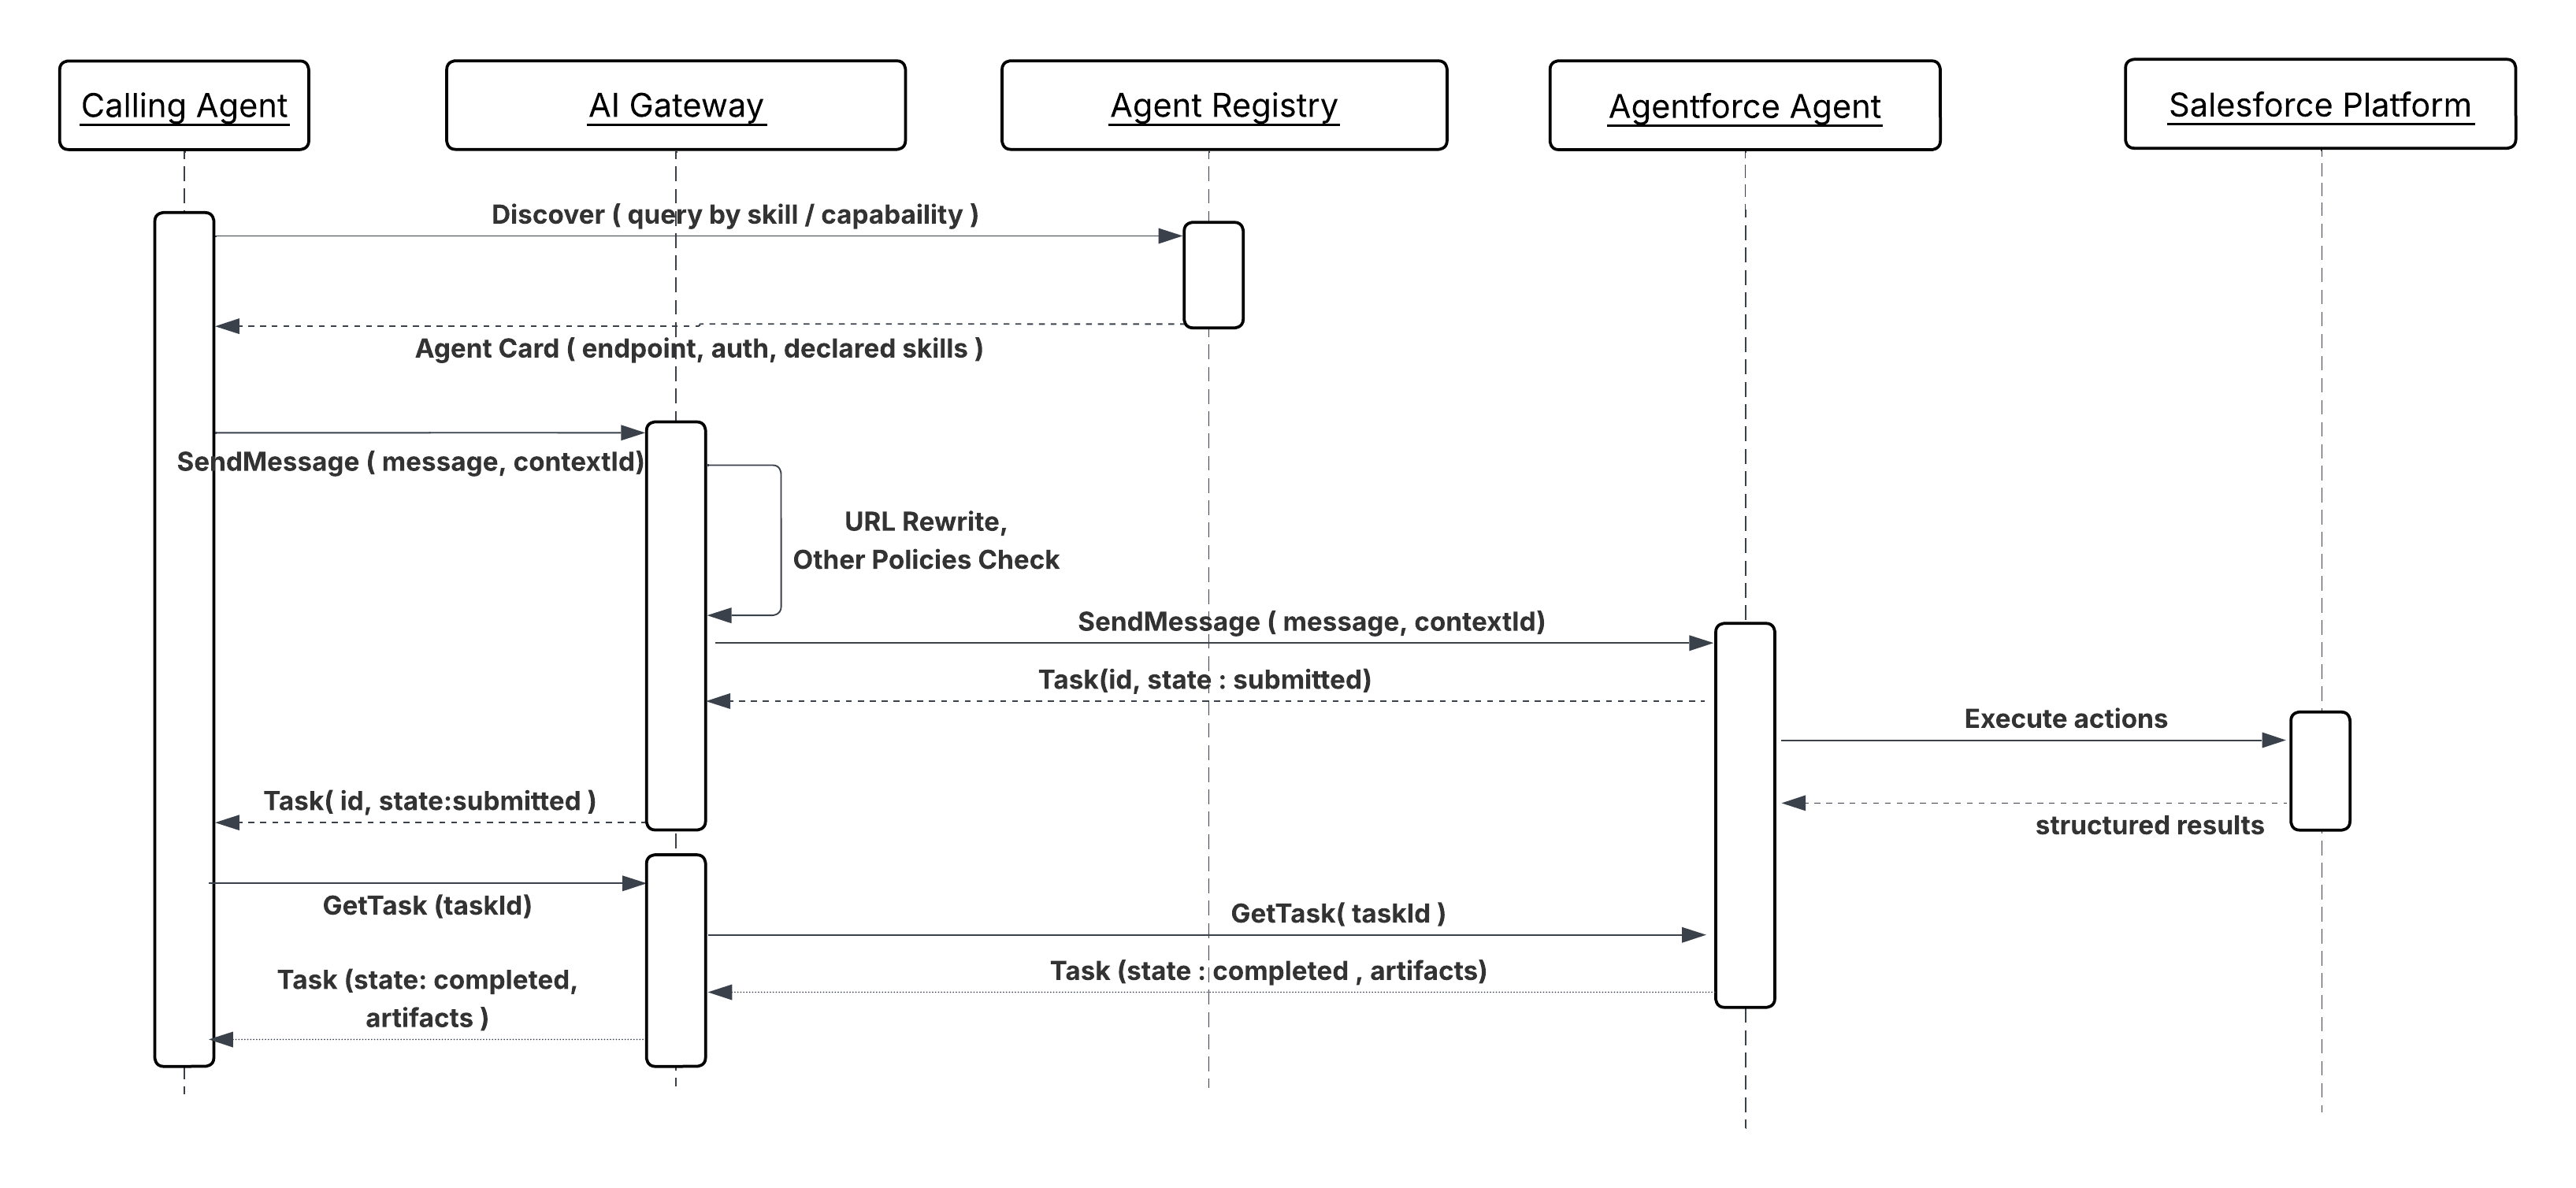
Resultat
Detta mönster exponerar interna agenter som specialiserade tjänster inom ett nätverk med flera agenter. Externa agenter kan säkert delegera uppgifter till interna kapaciteter medan organisationen upprätthåller kontroll, granskningsbarhet och policytillämpning.
Utformningsöverväganden
Plattformsagnostisk vägledning
- En gateway (till exempel MuleSoft Omni Gateway) måste placeras som en inträngningspunkt för att tillämpa policyer, inklusive begränsning av hastighet, autentisering och validering av nyttolast, för alla inkommande A2A-begäranden.
- Interna agenter måste hantera status för uppgiftsobjektet från extern inledning till slutförande, vilket säkerställer att agenten för fjärrsamtal får enhetliga, verifierbara statusuppdateringar.
- Se till att agentens publicerade kapacitet på agentkortet är tydlig, syftesbaserad och innehåller nödvändiga säkerhetsomfång för delegering.
Felhantering och återställning
- Strukturerade felkoder: Vid fel måste den interna agenten returnera A2A-kompatibla strukturerade felmeddelanden till den anropande agenten för att aktivera fjärrlogik för återförsök eller alternativa mekanismer för växling vid fel.
- Idempotens: Agenten måste verifiera att eventuella biverkningar som utlöses av en prövad A2A-begäran från en extern agent (på grund av nätverksavbrott eller återställning) är idempotenta.
Säkerhetsöverväganden
- Tillämpning av inkommande policy: Gatewayen måste tillämpa policyer för att tillåta/blocklista externa agenter och validera JWT/OAuth 2.0-tokens för att bekräfta den anropande agentens identitet och delegerade behörighet.
- Sanering av indata: Validera och sanera alla inkommande begäranden för att minska potentiella injektioner eller skadliga dataattacker.
- Identitetspropagering: Mappa den externa agentens identitet och dess delegerade behörighet till interna säkerhetssammanhang (till exempel Salesforce-användarprofiler) innan åtgärder utförs mot interna system.
Exempel
Extern systemfråga
- Begäran: En rekryteringsagent i ett partnersystem skickar en begäran om A2A-uppgift till en intern agent för verifiering av medarbetare (peer agent) på Agentforce för att bekräfta anställningsstatus för en ny kandidat.
- Bearbetar: Agenten för medarbetarbekräftelse tar emot begäran via gateway, verifierar partneragentens inloggningsuppgifter, utför dess interna arbetsflöde (till exempel anropar ett internt HR-system) och formaterar svaret.
- Svar: Peer Agent returnerar en strukturerad A2A-artefakt (till exempel startdatum för anställning och jobbtitel) till fjärrrekryteringsagenten, som sedan fortsätter med sitt externa arbetsflöde.
-
Port för skydd av MCP, A2As och API
En gateway krävs som den enskilda tillämpningspunkten för all agent-till-system-trafik och system-till-agent-trafik.
-
Säkrade anslutningar: En gateway säkerställer att endast autentiserade och auktoriserade agenter interagerar med MCP-, A2A- och API-slutpunkter genom att begränsa åtkomst.
-
Tillämpade servicenivåavtal: En gateway kan tillämpa hastighetsgränser, hjälpa organisationer uppfylla prestandakraven och förhindra överbelastning av MCP- och A2A-servrar.
-
Förenklad styrning: En gateway erbjuder centraliserad synlighet och kontroll över alla serverinteraktioner, vilket förenklar hantering och övervakning av agentaktivitet.
-
Konsekvens och skydd av data: Policyer, som schemavalidering, tillämpar enhetlighet i data och PII-identifiering kan skydda känslig information.
MueleSoft Omni Gateway
- Identitetspropageringskedja
När företag omfamnar det agentiska paradigmet uppstår en ny säkerhetsutmaning: Hur flödar slutanvändarens identitet genom ett nätverk av autonoma AI-agenter? I traditionella API-arkitekturer autentiserar en användare en gång och programmet anropar backendtjänster åt användaren. Identitetskedjan är kort, lättförståelig och hanteras vanligtvis inom en enskild Trust domän.
Agentarkitekturer har dock mycket längre kedjor där en enskild begäran skickas ut över olika agenter, tjänster och MCP-servrar, var och en potentiellt över servicegränser, Trust domäner och till och med organisationsgränser. Utan en medveten strategi för identitetspropagering står företag inför ett val mellan säkerhet och funktionalitet – ett dilemma som ingen arkitekt behöver hantera.
MuleSoft hanterar komplexiteten i identitetspropagering med sin funktion Betrodd agentidentitet. Denna lösning använder en policybaserad, gatewayhanterad strategi för att säkerställa att slutanvändarens identitet upprätthålls över olika interaktionstyper, inklusive A2A-protokoll, MCP-verktygsanrop och REST API-begäranden. Genom att centralisera identitetshantering på Omni Gateway-lagret genom utgående autentiseringspolicyer kan företag säkra hela sitt agentnätverk utan att ändra backendtjänster eller agenter. Mer information finns i Betrodd agentidentitet för agentföretaget.
- RAG-säkerhet i Data 360
Data 360 har stöd för attributbaserad åtkomstkontroll (ABAC) på objekt-, fält- och radnivå via inställningar för datastyrningspolicy. Detta är det primära sättet att styra vilka data som är synliga för vem, inklusive inom RAG-sökindex. För strukturerade data implementeras användaråtkomstvillkor med hjälp av användarattribut och behörighetsuppsättningar. För ostrukturerade data kan metadatafiltrering (förfilter på sökindex) begränsa vad som hämtas.
Kommunikation med LLM går igenom Einstein Trust Layer, som maskerar konfidentiell information/PII-information innan den når modellen och skyddar datasekretess, inte bara under sökning utan även innan skapande.
För att skydda mot RAG-förgiftning, se till att strikta regler för datastyrning och validering tillämpas innan data blir tillgängliga för vektorsökning. Einstein Trust Layer kan även tillämpa snabba maskerings-/toxicitetskontroller. Du kan tillämpa strikta behörighetsuppsättningar på profilen Agentanvändare.
- Ny autentiseringsmodell Salesforce har uppdaterat sin autentiseringsarkitektur genom att introducera en modell med två nivåer av autentiseringsuppgifter som tydligt separerar problem mellan anslutning och identitet. Använd detta när du gör anrop via Apex och undvik att skapa ditt eget autentiseringsprotokoll. Denna modell ger även utökning och utökad säkerhet. Externa inloggningsuppgifter finns i grunden för denna modell. De lagrar de faktiska autentiseringsdetaljerna och har stöd för en omfattande uppsättning protokoll, inklusive OAuth 2.0 Client Credentials, JWT Bearer och AWS Signature V4, samtidigt som de definierar hur principer mappas: antingen som en enskild namngiven princip (delad över alla användare) eller som principer per användare (där varje användare autentiserar med sin egen identitet). Autentiseringsuppgifter fungerar i sin tur som slutpunktslagret. De definierar anrops-URL:en och refererar till en extern autentiseringsuppgift för att hantera autentiseringshandskakningen, vilket håller slutpunktskonfigurationen rent frånkopplad från inloggningshantering. För att aktivera autentiseringsflöden per användare mappar administratörer behörighetsuppsättningar till lämplig princip för Externa inloggningsuppgifter, så att endast användare med rätt tilldelning av behörighetsuppsättningar kan åberopa anrop under sin egen identitet. Denna design i två nivåer förenklar inte bara säker anropskonfiguration utan ger även arkitekter mycket större flexibilitet och styrningskontroll över hur integreringar autentiseras över Salesforce-anslutna system. Mer information finns i dokumentationen Autentiseringsuppgifter.
Denna sektion mappar arkitekturens datahanteringsmönster till de efterlevnadskrav som oftast stöter på i reglerade företagsdistribueringar.
Åtkomstkontroll: Den minst privilegierade användarmodellen för integrering som beskrivs i integreringsmönstren (omfattade autentiseringsuppgifter, OAuth 2.0-omfång per agent, tillåtelselistor för gateway) mappar direkt till logiska åtkomstkontroller. Behåll bevis för att varje agents inloggningsomfång har granskats och godkänts.
Granskningslogg: Loggkrav för granskning per mönster (sessions-ID, verktygsåberopningar, indataparametrar som rensats för känsliga värden, resultat) uppfyller kontrollerna för övervakning och loggning. Se till att loggarna inte manipuleras, behålls under den period som behövs och är tillgängliga för säkerhetsteamet utan åtkomst till produktionssystem.
Ändringshantering: Ändringar av MCP-verktygsscheman och uppdateringar av A2A-agentkort som påverkar konsumenter utgör gränssnittsändringar och bör vara föremål för ändringshanteringskontroller. Versionsverktyg som uttryckligen nämns i inkommande MCP-mönster och behandlar ändringar som konfigurationshändelser som kräver godkännande.
Tillgänglighet: Gränser för agenters samtidighet, återförsökstak för händelseutlösta mönster och dirigering av döda bokstäver för misslyckade händelser utgör tillgänglighetskontroller. Dokumentera det förväntade genomströmningskuvertet och felbeteendet för varje distribuerat mönster som en del av bevispaketet för tillgänglighet.
Anteckning: Denna lista representerar inte en fullständig guide för att säkerställa efterlevnaden av dina agentlösningar. Alla tillämpliga lagstadgade krav måste uppfyllas.
- Kom igång med Agent API
- Aktivera betrodda agenter med Data 360
- Översikt av MuleSoft Omni Gateway
- Injektionspolicy för OAuth 2.0 på uppdrag av inloggningsuppgifter
- Betrodd agentidentitet för agentföretaget
Gulal Kumar är arkitekt inom programvaruteknik på Salesforce med över 20 års erfarenhet. Hans expertis sträcker sig över AI, integration, API och företagsarkitektur, med fokus på att driva verksamhetstransformation genom säkra, motståndskraftiga och innovativa AI-lösningar. Anslut med honom på LinkedIn.