Data 360-interoperabilitet
Företag lagrar ofta data i Salesforce och andra externa datasjöar (till exempel Snowflake, Google BigQuery, Databricks, Redshift eller objektlagring som Amazon S3). Att simulera data i flera system skapar en utmaning för företag som vill utnyttja det fulla värdet av sina data för att driva AI-drivna upplevelser. Salesforce Data 360 är det grundläggande intelligenslagret som varje Agentforce AI-agent använder för att komma åt rätt sammanhang vid rätt tillfälle.
Arkitekter som arbetar med att föra samman data över flera datasjöar står inför viktiga arkitektoniska beslut om hur dessa data bäst integreras. Data 360 har flera alternativ för dataintegrering, var och en med olika för- och nackdelar.
Denna guide tillhandahåller ett ramverk för att utvärdera vilket mönster som bäst passar dina krav på latens, kostnad, skalbarhet, styrning och komplexitet vid integrering av data, vilket hjälper dig välja när du vill använda dataintag, Zero Copy-datafederation eller en hybridmetod. Guiden hjälper dig även att välja mellan olika metoder för dataintag och datafederation, var och en med olika behov.
Att integrera externa datasjöhus med Data 360 kräver noggrant övervägande av kompromisserna mellan färskhet, styrning och pipelineeffektivitet. Till exempel maximerar livefrågor för Zero Copy-datafederation färskheten på data men kan minska pipelineeffektiviteten när mer data flyttas över nätverket. För de flesta implementeringar i verkligheten är kombination av intag och federation i ett ekosystem med flera moln av sjöar den optimala vägen. Denna hybridmetod säkerställer en skalbar, styrd, interoperabel arkitektur som har stöd för operativa arbetsbelastningar med låg latens (till exempel personanpassning i realtid och upptäckt av bedrägerier) och analytiska arbetsbelastningar (till exempel regelrapportering och historisk trendanalys). Denna guide hjälper dig avgöra hur du navigerar i dessa kompromisser med hjälp av en lämplig strategi.
- Dataintag kopierar data till Salesforce Data 360 och skapar styrda, kanoniska datamodeller. Detta är idealiskt för när du behöver:
- Bygg en omfattande Customer 360 som låter dig slå samman och transformera olika källor till en enda betrodd profil.
- Uppfyll strikt regelefterlevnad. Detta låter dig skapa en granskningsbar, centraliserad kopia så att dataåtkomst och härkomst kan kontrolleras noggrant.
- Zero Copy Federation frågar externa källor i realtid utan dubbletter, vilket möjliggör personanpassning i realtid, liveinstrumentpaneler och snabb källintroduktion. Detta tillvägagångssätt ger två huvudalternativ, men det finns kompromisser som måste balanseras:
- Livesökfråga: Använd detta för interaktiv analys och instrumentpaneler med data i realtid som finns på externa dataplattformar (till exempel Snowflake, BigQuery, Redshift eller Databricks). Detta hjälper till att undvika långsam, kostsam dataduplicering genom att driva sökfrågebearbetning till källsystemet och endast returnera nödvändiga resultat. Detta tillvägagångssätt är optimerat för sällan förekommande eller tillfälliga sökfrågor där färskhet är viktigt. Den är lämplig för arbetsbelastningar med låg fråga per sekund (QPS) (sökfrågekostnaderna kan öka betydligt vid hög QPS).
- Cachning (påskyndad sökfråga): Använd detta för frekventa datafrågor som inte ändras ofta. Snabbare sökfrågor upprätthåller en lokal cache som uppdateras med konfigurerbara intervall (15 minuter till 7 dagar), vilket minskar upprepade källträffar. Detta tillvägagångssätt balanserar instrumentpanelens prestanda och kostnader, segmentering och BI-arbetsbelastningar där något gamla resultat är acceptabla. Detta är inte lämpligt för beslutsfattande under andra sekunden.
- Filfederation: Använd detta för storskalig batchbearbetning och AI-modellutbildning för data i ditt molns datasjö (till exempel S3 eller ADLS). Detta tillvägagångssätt undviker långsamt, kostsamt intag genom att direkt fråga filer i öppna tabellformat, vilket låser upp massiva ETL-datauppsättningar och datavetenskapsarbetsbelastningar.
- Hybridmodeller blandar intag för enhetliga profiler med federation för färskhet, vilket stöder engagemang i flera kanaler, Agentforce-drivna åtgärder och AI/ML-utbildning.
- Använd en hybridarkitektur. Att blanda dataintag och sammanslagning är ofta nödvändigt.
- Använd dataintag för viktiga data för kanoniska datamodeller och kärnstyrning.
- Använd Zero Copy för alla andra datasammanslagningar för att upprätthålla färskhet och minimera driftkostnaderna för att bygga och underhålla pipelines för dataintag.
- Frekvens för dataintag spelar roll. Välj frekvens baserat på verksamhetsvärde, latensbehov och operativ komplexitet.
- Använd realtid för tidskänsliga arbetsflöden (till exempel personanpassning, liveinstrumentpaneler och Agentforce åtgärder).
- Använd nästan i realtid för måttligt brådskande processer (till exempel kampanjer och verksamhetsrapporter).
- Använd batchning för historiska datauppsättningar eller datauppsättningar med låg hastighet.
- Matcha sammanslagningsmönster till latens och prestanda. Välj det alternativ som bäst matchar dina åtkomstmönster och krav på färskhet, prestanda och kostnad.
- Använd livesökfrågor för operativa instrumentpaneler och personanpassning i realtid där låg latens är viktigt.
- Använd cachelagring (snabbsökning) när sökfrågor är vanliga och lite gamla resultat accepteras, vilket hjälper till att balansera prestanda och kostnad.
- Använd Filfederation för storskaliga, genomströmningstunga analyser eller batcharbetsbelastningar, som är idealiska för historiska eller mindre tidskänsliga datauppsättningar.
- Anpassa styrningen till kraven för datalagring.
- Använd intag när centraliserad styrning är viktigt.
- Använd federation när decentraliserad styrning är acceptabelt, men tillämpa även strikt styrning vid den externa källan.
- Använd Zero Copy för källnivåpolicyer (till exempel radnivåsäkerhet (RLS) och datamaskering).
- Prioritera intag för arbetsflöden med högt värde. Tillämpa intag selektivt för viktiga processer (till exempel identitetslösning, regelrapportering och operativ aktivering).
- Kostnader och komplexitet driver beslut. Intag i realtid kan vara dyrt och komplext. Därför är det viktigt för arkitekter att väga kostnaden för att introducera, lagra och transformera data mot kostnaden för att fråga dem direkt via Zero Copy.
Att välja rätt integreringsmönster—Dataintag, Zero Copy eller en hybridmetod—påverkar latens, styrning, operativ effektivitet och kostnad för flera molnplattformar direkt. Detta beslut formar hur insikter i realtid, AI-driven aktivering och personligt engagemang levereras tillförlitligt och i stor skala.
Denna tabell jämför mönstren Dataintag och Zero Copy i Salesforce Data 360, med fokus på kapacitet, kompromisser och fördelar, samt användningsfall och resultat för företag. Använd detta som en referens för att utforma hybriddataplattformar med flera moln som balanserar prestanda, kostnad och efterlevnad.
| Mönstertyp | Läge/verktyg | Fördelar | Att tänka på | Resultat |
|---|---|---|---|---|
| Dataintag |
Realtid:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Sats:
|
|
|
Agentforce:
|
|
| Noll kopia |
Livesökfråga:
|
|
|
Agentforce:
|
Accelererad sökfråga (cache):
|
|
|
Agentforce:
|
|
Filfederation:
|
|
|
Agentforce:
|
Det finns tre primära integreringsmönster för Data 360 – dataintag, datafederation utan kopia och en hybridmetod.
Med dataintag kopieras data fysiskt till Data 360 och styrs fullständigt, till skillnad från Zero Copy där data finns kvar vid källan. Med andra ord sker beräkningarna för transformationer inom Data 360, vilket ger centraliserad styrning och granskning.
Använd Dataintag för att lagra kanoniska, styrda datauppsättningar i Salesforce Data 360 för efterlevnad och operativ kontroll. Använd intag när fullständig kontroll, granskning och spårbarhet krävs. Dataintag är idealiskt för reglerade eller värdefulla arbetsflöden där centraliserad beräkning och styrning är viktigt.
Intag är lämpligt för att bygga en betrodd grund för identitetslösning, regelrapportering och verksamhetskritiska AI-drivna arbetsflöden och kundengagemang.

Metoder för dataintag kan variera beroende på vilken anslutare du använder för att ta in dina data. Vissa anslutare erbjuder flera olika intagsmetoder, medan andra endast arbetar i batch- eller streamingläge. En fullständig lista över Data 360-anslutare och tillgängliga metoder finns i Data 360: Integreringar och anslutare.
- Realtid:
- Ger subsekundintag med datainsamling (CDC)
- Lämplig för tidskänsliga arbetsflöden (till exempel bedrägeridetektering, personanpassning och operativa instrumentpaneler)
- Innehåller pushtransformationer och -aggregeringar i Data 360, vilket hjälper till att minska I/O-användning längre ner och optimera beräkningsanvändningen
- Stöder användning av inkrementell CDC för att minimera datablandning
- Streaming:
- Ger intag var 1-3:e minut i små steg
- Balanserar färskhet och kostnad
- Lämplig för kampanjorkestrering, engagemang nästan live och verksamhetsrapportering
- Stöder användning av mikrosatser för att styra I/O-toppar
- Aggregerar data vid källan (om möjligt) för att minska överföringsvolymer och optimera lagring
- Batch (schemalagda laddningar):
- Ger periodiskt intag av stora datauppsättningar (till exempel per timme, dag och vecka)
- Ger kostnadseffektivitet och pålitlighet för historiska datauppsättningar, regelrapportering och användningsfall för efterlevnad
- Säkerställer att beräkningsplatsen är i samma region som källlagringen för att förbättra prestanda och optimera kostnader
- Användningsfall för dataintag:
- Skapa enhetliga Customer 360-profiler. Bygg en enskild källa för kundidentiteter och attribut.
- Upprätthåll datauppsättningar för regelefterlevnad. Tillämpa styrning, härkomst och granskningsbarhet för känsliga data.
- Centralisera kampanjorkestrering. Se till att marknadsföring, försäljning och service fungerar från enhetliga, betrodda datauppsättningar.
- Designpraxis:
- Tillgodoser batchintag för historiska eller låglatenstoleranta behov (till exempel arkivrapportering eller periodiska ögonblicksbilder).
- Använd CDC eller strömmande API:n för att upprätthålla färskhet för arbetsflöden för drift och personanpassning för att säkerställa uppdateringar nästan i realtid.
- Styr lagring och beräkna tillväxt genom att tillämpa inkrementella belastningar för att optimera kostnad och effektivitet (istället för att läsa in hela datauppsättningar igen).
- Anpassa pipelines för intag med beräkningsplats och inkrementell bearbetning för att minska nätverks-I/O.
- Tillämpa transformationer inuti Data 360 för att undvika att flytta rådata i onödan.
- Kostnadsöverväganden:
- Intag i realtid har de högsta beräknings- och pipelinekostnaderna, vilket kan vara motiverat för tidskänsliga arbetsflöden med högt värde (till exempel personanpassning, operativa instrumentpaneler eller Agentforce-drivna åtgärder).
- Streamingintag har måttliga beräknings- och lagringskostnader, vilket kan vara lämpligt för frekventa uppdateringar som kan tolerera mindre förseningar (till exempel kampanjorkestrering eller verksamhetsrapportering).
- Batchintag har lägre beräkningskostnader och förutsägbar lagring, vilket är lämpligt för historiska datauppsättningar eller uppdateringar med låg frekvens. Att ta in batchdata från Salesforce-organisationer med vissa anslutare är gratis.
- Uppdateringsläge Låter dig välja läget Inkrementell uppdatering, vilket minskar det totala intaget och beräknar kostnader. På Salesforce rekommenderar vi att använda inkrementell uppdatering där det är möjligt för att optimera effektiviteten för alla typer av intag.
- Kostnaden påverkas även av I/O-volym från källan till Data 360. Att optimera batchstorlekar, partitioner och regional anpassning minskar överföringskostnader och förbättrar prestandan.
- Branschscenarier:
- Finans: Datauppsättningar för intag krävs för att känna din kund, mot penningtvätt (AML) och upptäcka bedrägerier där granskning och efterlevnad inte är förhandlingsbart.
- Hälsovård: Använd intag för patientidentitetslösning och HIPAA-kompatibla poster, vilket möjliggör säkra, enhetliga vyer.
- Butik: Slå samman data om försäljningsställen (POS), e-handel och lojalitetsprogram till sammanslagna profiler för segmentering och personanpassning.
- Telekom: Stöd för förebyggande av bortfall och användningsanalyser med kanoniska, styrda prenumerantdata.
| Funktion | Intag i realtid | Strömmande intag | Satsintag |
|---|---|---|---|
| Latens och fräschör | Innehåller intagning av latens under en sekund via Ingestion API med stöd för ändring av datainsamling (CDC). Ger kontinuerliga streamingpipelines. Lämplig för användningsfall med låg latens. | Innehåller intag av mikrosatser var 1-3:e minut via inbyggda anslutare. Stöder inkrementella uppdateringar. Lite latens förväntas. | Datalatens förväntas. Tillåter schemalagda inläsningar med stor volym. Innehåller periodiskt intag (per timme, dag och vecka). Inte lämplig för tidskänsliga operationer. |
| Primära användningsfall | Idealisk för användningsfall med låg latens och personanpassning. Använd för tidskänsliga arbetsflöden. Stöder händelsedrivna arbetsflöden. Använd för bedrägerivarningar och operativa varningar i realtid. | Lämplig för måttligt brådskande processer. Använd för kampanjorkestrering, engagemang nästan live och verksamhetsrapportering. Använd för kampanjutlösare i rätt tid. | Kostnadseffektiv för massiva datauppsättningar. Tillförlitlig för historisk analys. Använd för historiska aggregeringar eller reglerade rapporteringsflöden. Lämplig för historiska datauppsättningar eller datauppsättningar med låg hastighet. |
| Arkitektonisk komplexitet och I/O | Inkluderar hög kostnad och komplex arkitektur. Kräver källsystem med låg latens. Intensiv I/O. Källor med hög volym kan orsaka mättade pipelines. | Innehåller enklare arkitektur än realtid. I/O är måttligt. Lämplig för förutsägbara, upprepade uppdateringsmönster. Satsstorlek påverkar minne och beräkning. | Lätt att implementera. I/O-intensiv under laddningsfönster. Nätverksgenomströmning kan bli en flaskhals för stora satser. |
| Kostnadsöverväganden | Inkluderar de högsta beräknings- och pipelinekostnaderna. Endast motiverat för tidskänsliga arbetsflöden med högt värde. | Inkluderar måttliga beräknings- och lagringskostnader. Ger en balanserad metod för kostnad vs färskhet. Lämplig för frekventa uppdateringar som kan tolerera små fördröjningar. | Ger lägre beräkningskostnader och förutsägbar lagring. Rekommenderas för historiska datauppsättningar eller uppdateringar med låg frekvens. Intag via Salesforces interna pipelines är gratis. |
| Designpraxis | Använd inkrementell CDC för att minimera datablandning. Filtrera och använd selektiva fält för att minska overhead. | Använd mikrosatser för att styra I/O-toppar. Överväg aggregering i fönster för att minska bearbetningsbelastningen. | Använd för arkivrapportering eller periodiska ögonblicksbilder. Se till att beräkningsplatsen är i samma region som källlagring för kostnadsoptimering. |
Använd Zero Copy för sökfrågor i realtid av externa system utan dataduplicering för att aktivera smidighet, färskhet och skalbar åtkomst till stora eller tillfälliga datauppsättningar. Den är lämplig för liveinstrumentpaneler, utforskande analyser, utbildning i AI/ML-modeller och kundengagemang i realtid direkt via Salesforce Data 360.
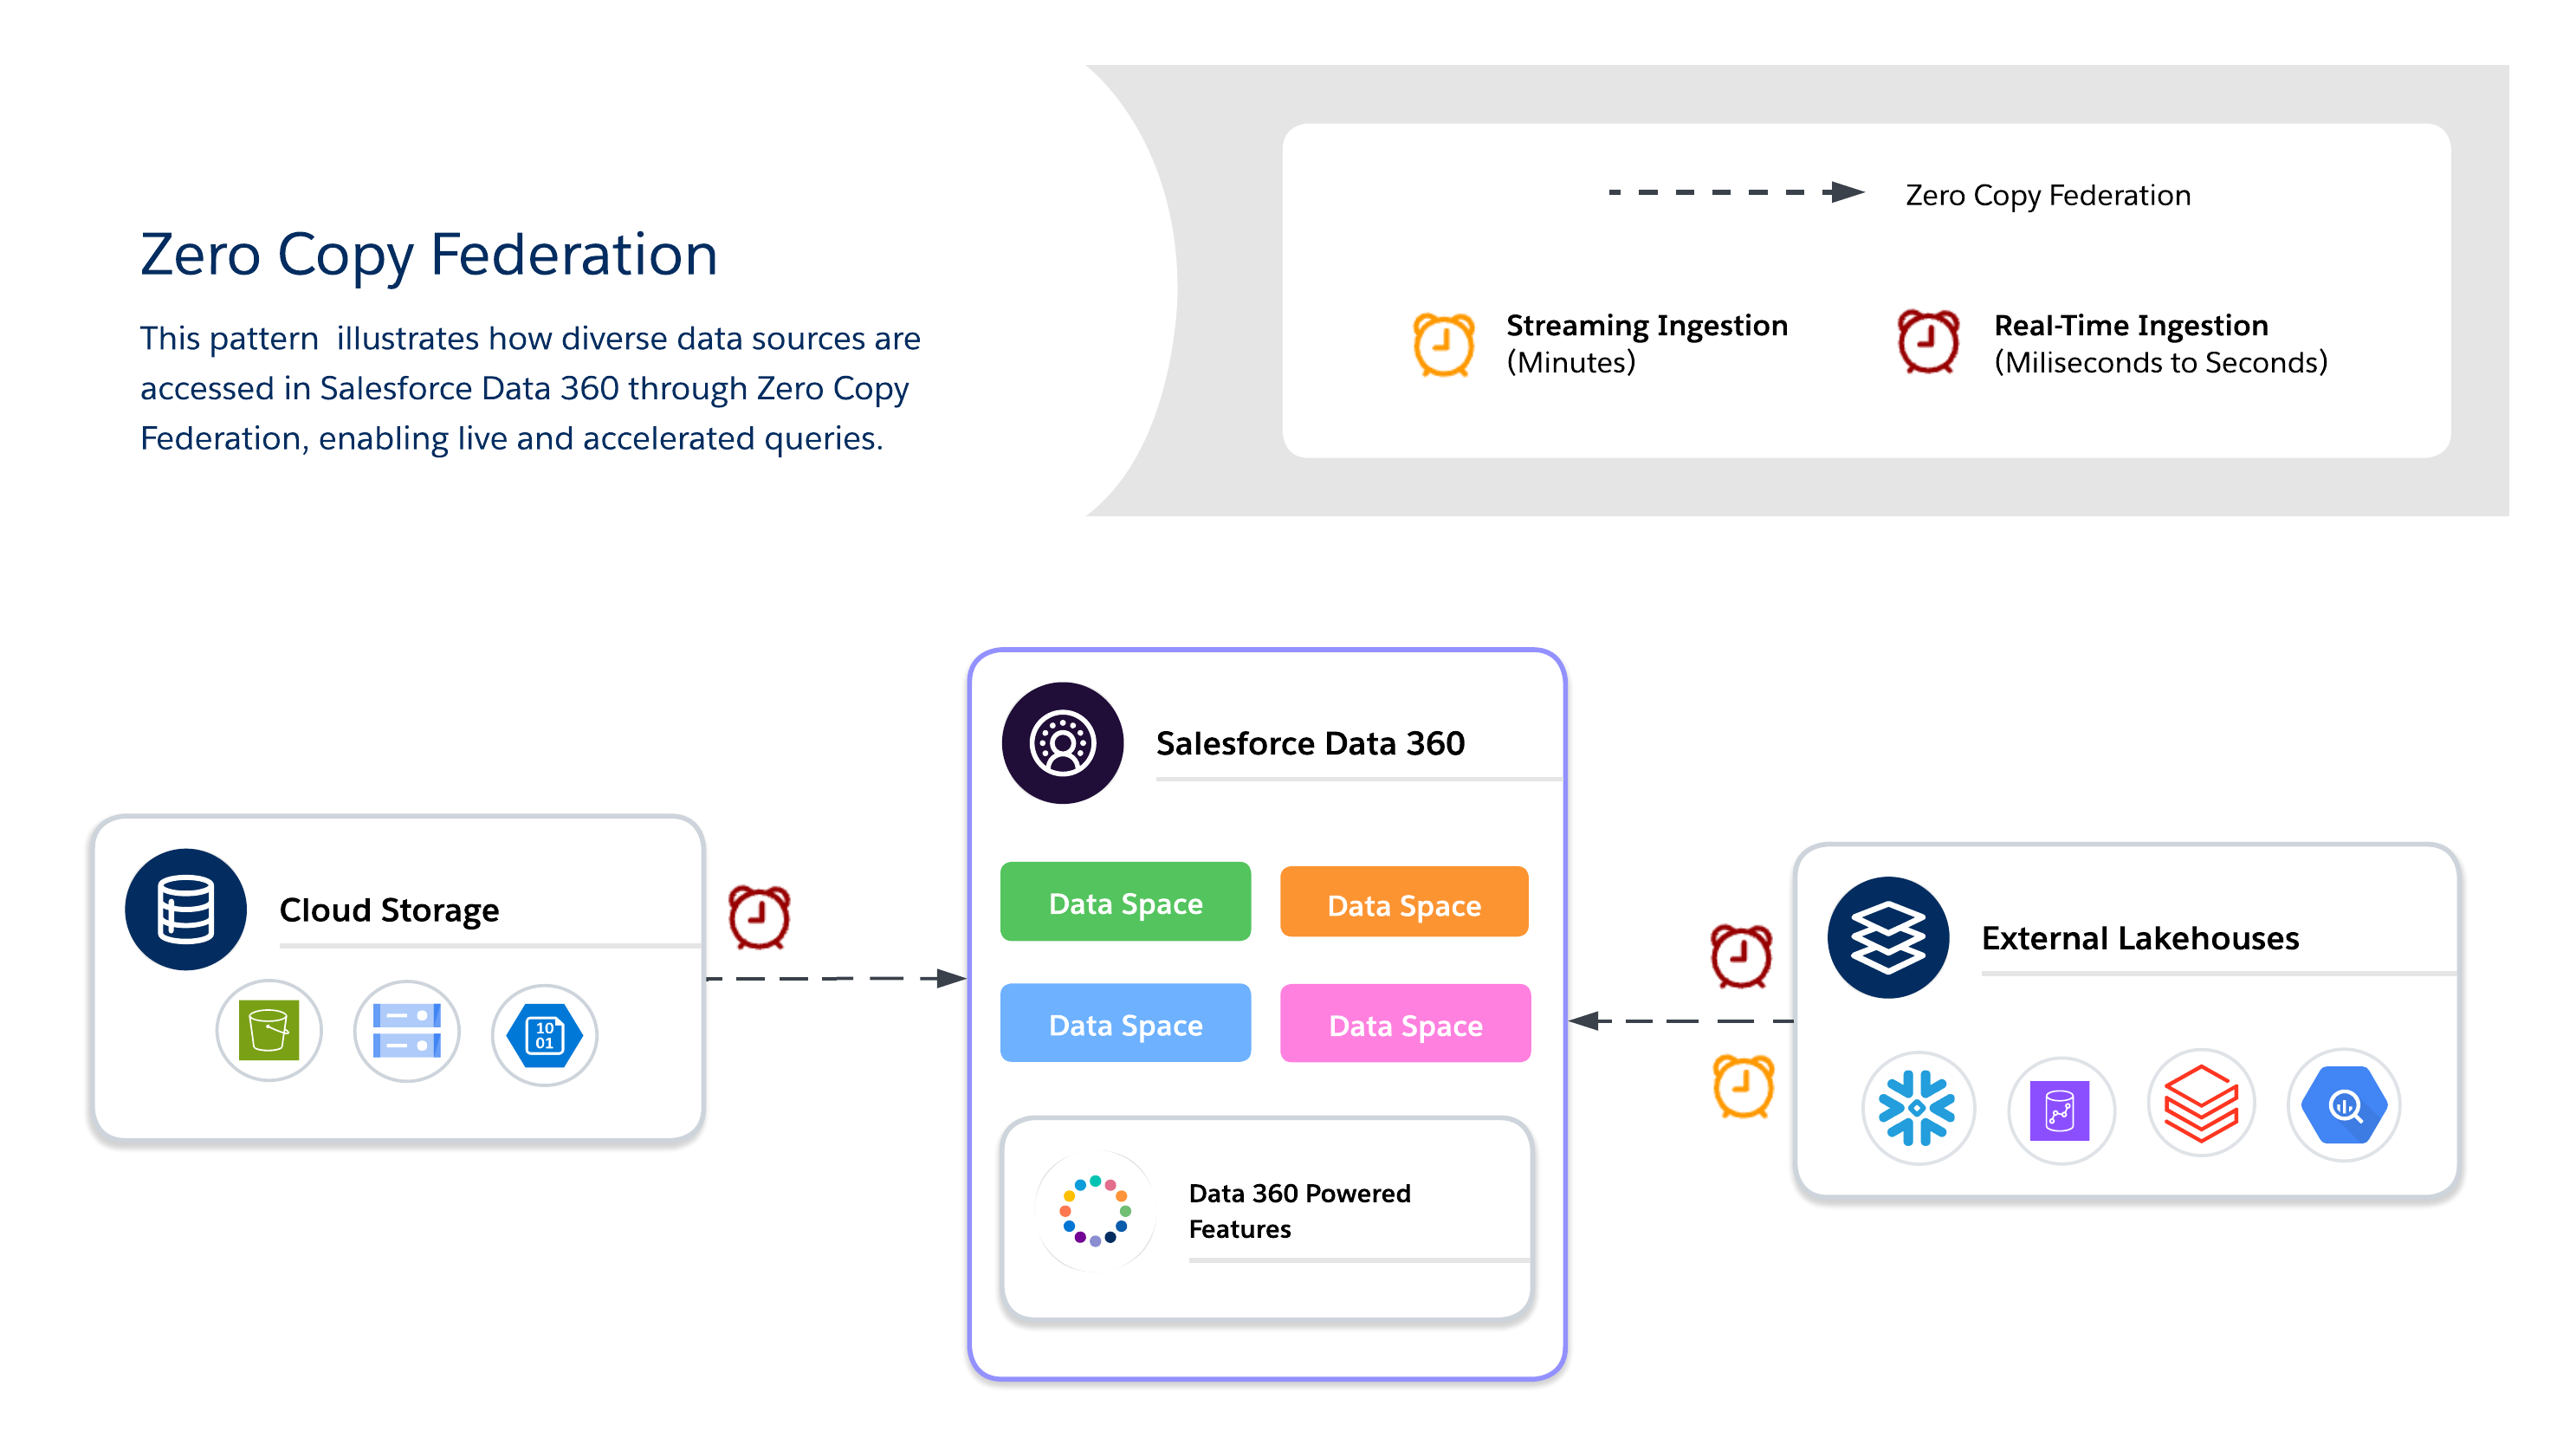
När du använder Zero Copy måste arkitekter välja mellan tre tillgängliga datafederationsmetoder, var och en med sin egen kompromiss mellan färskhet, prestanda och kostnad.
- Livefråga
- Kör sökfrågor direkt mot externa system (till exempel Snowflake, Google BigQuery, Redshift, Databricks och så vidare) utan duplicering av data.
- Minimerar dataförflyttning över nätverket och minskar I/O på Salesforce Data 360-beräkningar, vilket är optimalt när predikat och aggregeringar kan tryckas ner.
- Lämplig för insikter i realtid och operativa instrumentpaneler med låg latens.
- Beroende på externa systemprestanda.
- Cachning (påskyndad sökfråga)
- Lagrar tillfälligt cachade kopior av sammanslagna data i Salesforce Data 360.
- Minskar upprepade sökfrågekostnader och latens för ofta besökta datauppsättningar med konfigurerbar varaktighet (minuter till dagar).
- Data kopieras inte permanent eller styrs fullständigt, så färskhet hanteras via schemalagda uppdateringar från källan.
- Inkrementell uppdatering har endast stöd för infogningar. Borttagna poster tas inte bort från cacheminnet.
- Utför en fullständig uppdatering regelbundet för att säkerställa att cacheminnet förblir synkroniserat med källan.
- Obs! Snowflake-anslutaren har stöd för funktionen Unload, som förbättrar accelerationshastigheten genom att använda en Snowflake-initierad fasningsskopa. Detta är aktiverat som standard, men kan inaktiveras genom att redigera anslutningen.
- Filfederation
- Ger direkt, skrivskyddad åtkomst till storskaliga datauppsättningar i objektlagringar (till exempel S3 och GCS med Iceberg).
- Lämplig för AI/ML-arbetsbelastningar, historiska analyser och rapportering i petabyteskala utan att flytta data.
- Sökfrågeprestanda beror mycket på objektformat, partitionering och nätverks-I/O. Stora skanningar kan generera betydande I/O om de inte är optimerade.
- Användningsfall
- Personanpassning i realtid och anpassningsbara arbetsflöden levererar dynamiska erbjudanden, rekommendationer och nästa bästa åtgärder när kundbeteenden ändras.
- Liveinstrumentpaneler och operativa analyser driver affärskritiska instrumentpaneler och nyckeltal direkt från externa lagerbyggnader.
- AI/ML-modellutbildning med stora externa datauppsättningar använder data i petabyteskala från datasjöar och lagerbyggnader utan att flytta dem via filfederation.
- Branschscenarier
- Butik/Media: Aktivera personliga rekommendationer och kundengagemang i realtid genom att sammanföra data om klickströmmar eller innehållsinteraktioner.
- Finans: Kör upptäckt av bedrägeri och riskbetyg nästan i realtid genom att fråga externa lagerbyggnader utan att duplicera känsliga data.
- Teknik/Företag: Stöd för korsmolnrapportering, IT-tjänstinstrumentpaneler och operativa analyser när datauppsättningar finns i flera system.
- Designpraxis
- Livefråga
- Använd för sökfrågor med hög QPS och låg latens när färskhet är viktigt.
- Pusha predikat och aggregeringar till det externa systemet för att minska datablandning över nätverket.
- Undvik sökfrågor som i onödan skannar massiva datavolymer.
- Överväg partitionsbeskärning och filter istället.
- Filfederation
- Åtkomst till datauppsättningar i petabyteskala i objektaffärer utan intag.
- Minimera latens- och utgångskostnader genom att hålla objektlagring i samma molnregion som Salesforce-beräkning.
- Använd partitionerade, kolumnära format (Parkett/ORC) och pushdown-filter för att minska I/O och nätverksöverföring.
- Använd sökfrågor och predikatpushdown för att filtrera och aggregera data vid källan, vilket minskar datarörelser.
- Undvik dataåtkomst mellan regioner—om det inte är absolut nödvändigt—eftersom det ökar I/O, latens och kostnader.
- Cachning (påskyndad sökfråga)
- Cache ofta besökta datauppsättningar för att balansera kostnad och prestanda.
- Konfigurera uppdateringsintervall för att balansera färskhet jämfört med sökfrågekostnad.
- Efterlevnad: Tillämpa styrning vid källan genom att använda radnivåsäkerhet (RLS) och maskera policyer direkt i sammanslagna system.
- Här är några rekommenderade metoder för enhetlig RLS och maskering över plattformar:
- Använd ett centraliserat företags-ID. Mappa användare och enheter i Salesforce Data 360 till en unik, centraliserad företagsidentifierare som motsvarar identiteter i externa system.
- Anpassa säkerhetspolicyer. Se till att RLS- och maskeringspolicyer i sammanslagna system tillämpas baserat på den mappade identiteten. Detta bevarar efterlevnaden vid förfrågan av externa data.
- Standardisera identitetsscheman. Upprätthåll enhetliga identitetsattribut (e-post, användar-ID, kund-ID och så vidare) i alla datakällor för att undvika felaktiga matchningar och åtkomstöverträdelser.
- Här är några rekommenderade metoder för enhetlig RLS och maskering över plattformar:
- Livefråga
- Kostnadsöverväganden
- Livesökfråga: I pay-per-query-modellen uppstår kostnader för externa sjöhusberäkningar, vilket kan orsaka ökningar med hög QPS. Detta är lämpligt för färskhetskritiska användningsfall där värdet är större än kostnadsvariationen.
- Accelererad sökfråga (cache): Denna metod sänker sökfrågekostnaden (jämfört med livesökfråga) genom att minska antalet träffar i källsystemet. Den lägger dock till kostnader för att fylla i och uppdatera cacheminnet i batchdataintag. Detta är lämpligt för ofta besökta datauppsättningar.
- Filfederation: Detta är det billigaste lagringsalternativet som data i Objektlagring. Sökfrågekostnaderna beror dock på filstorleken, partitioneringen och beskärningen. Detta är lämpligt för historiska data eller massdata i petabyteskala.
| Beslutspunkt | Livefråga | Caching (påskyndad sökfråga) | Filfederation |
|---|---|---|---|
| Datakällas plats | Externa datasjöhus (till exempel Snowflake, Google BigQuery, Redshift och Databricks) | Externa datasjöhus (till exempel Snowflake, Google BigQuery, Redshift och Databricks) | Objektlagringar eller molndatasjöar (till exempel S3, ADLS och GCS), som ofta använder öppna tabellformat som Iceberg. |
| Syfte/användningsfall | Lämplig för interaktiv analys och instrumentpaneler i realtid. Lämplig för personanpassning i realtid och dynamiska arbetsflöden. | Lämplig för när sökfrågor är frekventa, men lite gamla resultat är acceptabla. Lämplig för BI-instrumentpaneler och segmentering. | Lämplig för storskalig batchbearbetning och AI/ML-modellutbildning. Lämplig för historiska analyser och rapportering i petabyteskala. |
| Färskhet/Latens | Ger maximal färskhet Kör sökfrågor direkt i realtid. Stöder beslut under andra sekunden när källsystemet är optimerat för sökfrågor med låg latens med effektiv pushdown för predikat. | Använd när något gamla resultat är acceptabla. Färskheten beror på cacheintervallet, som kan konfigureras från 15 minuter till 7 dagar. | Lämplig för batchtunga, genomströmningsintensiva jobb. Inte lämplig för instrumentpaneler i realtid. |
| Åtkomstmönster | Lämplig för ovanliga eller ad hoc-frågor där färskhet är viktigt och sökfrågevolymen är låg. Kostnaderna ökar betydligt vid hög QPS, så det är viktigt att utvärdera cachning (snabbsökning) när sökfrågefrekvensen är hög. | Lämplig för högfrekventa lässcenarion. Förbättrar prestandan för frekventa åtkomstmönster. | Ger skrivskyddad åtkomst. Lämplig för datauppsättningar i petabyteskala utan intag. |
| Prestandadrivkrafter | Mycket beroende av prestandan i det externa källsystemet. Lämplig för när predikat och aggregeringar kan pushas ner till källan. | Minskar latens jämfört med upprepade livefrågor. Prestanda beror på cachehantering och intervall. | Prestandan beror mycket på objektformat, partitionering och extern systemgenomströmning. Använd partitionerade kolumnformat (Parkett/ORC). |
| Kostnadskonsekvenser | Detta är en pay-per-query-modell, så kostnader uppstår för externa sjöhusberäkningar. Det är kostnadseffektivt för sällan förekommande sökfrågor, men utgifterna kan öka med hög QPS-volym. | Kostnaden är lägre än upprepade livefrågor. Det minskar behovet av att upprepat fråga den externa källan, men lägger till cachelagring och uppdatering ovanför. | Detta är det billigaste lagringsalternativet. För AWS-konfigurationer i samma region (till exempel S3 i US-East-1 med en Data Cloud-arrendator som också är i US-East-1) används inte krediter för de rader som öppnas. Konfigurationer mellan regioner eller moln (till exempel Azure, GCS eller olika AWS-regioner) medför kreditkonsumtion för de rader som öppnas. Sökfrågekostnaderna beror även på filstorlek, partitionering och predikatpushdownoptimering. |
| Viktigt att tänka på | Undvik ofiltrerade sökfrågor som skannar massiva datavolymer i onödan. | Detta tillvägagångssätt kräver cachehantering. Inte lämplig för beslut under andra sekunden. | Sökfrågeprestanda är starkt beroende av optimering via partitionering och predikatpushdown. |
Hybridarkitekturer låter arkitekter förankra viktiga datauppsättningar i Data 360 för centraliserad styrning och samtidigt använda sammanslagna sökfrågor för färskhet, minskad dubblett och skalbar åtkomst till stora, externa datauppsättningar. Detta tillvägagångssätt balanserar krav på I/O, beräkningsplats, kostnad och efterlevnad.
Använd en hybridmetod för balanserad styrning, färskhet och operativ effektivitet genom att kombinera dataintag och nollkopiering för att leverera användbara insikter i realtid. Använd intag för reglerade datauppsättningar med högt värde där spårbarhet, RLS och maskering krävs, och sammanslagning för kortlivade datauppsättningar eller datauppsättningar med hög volym där färskhet och prestanda är nyckeln.
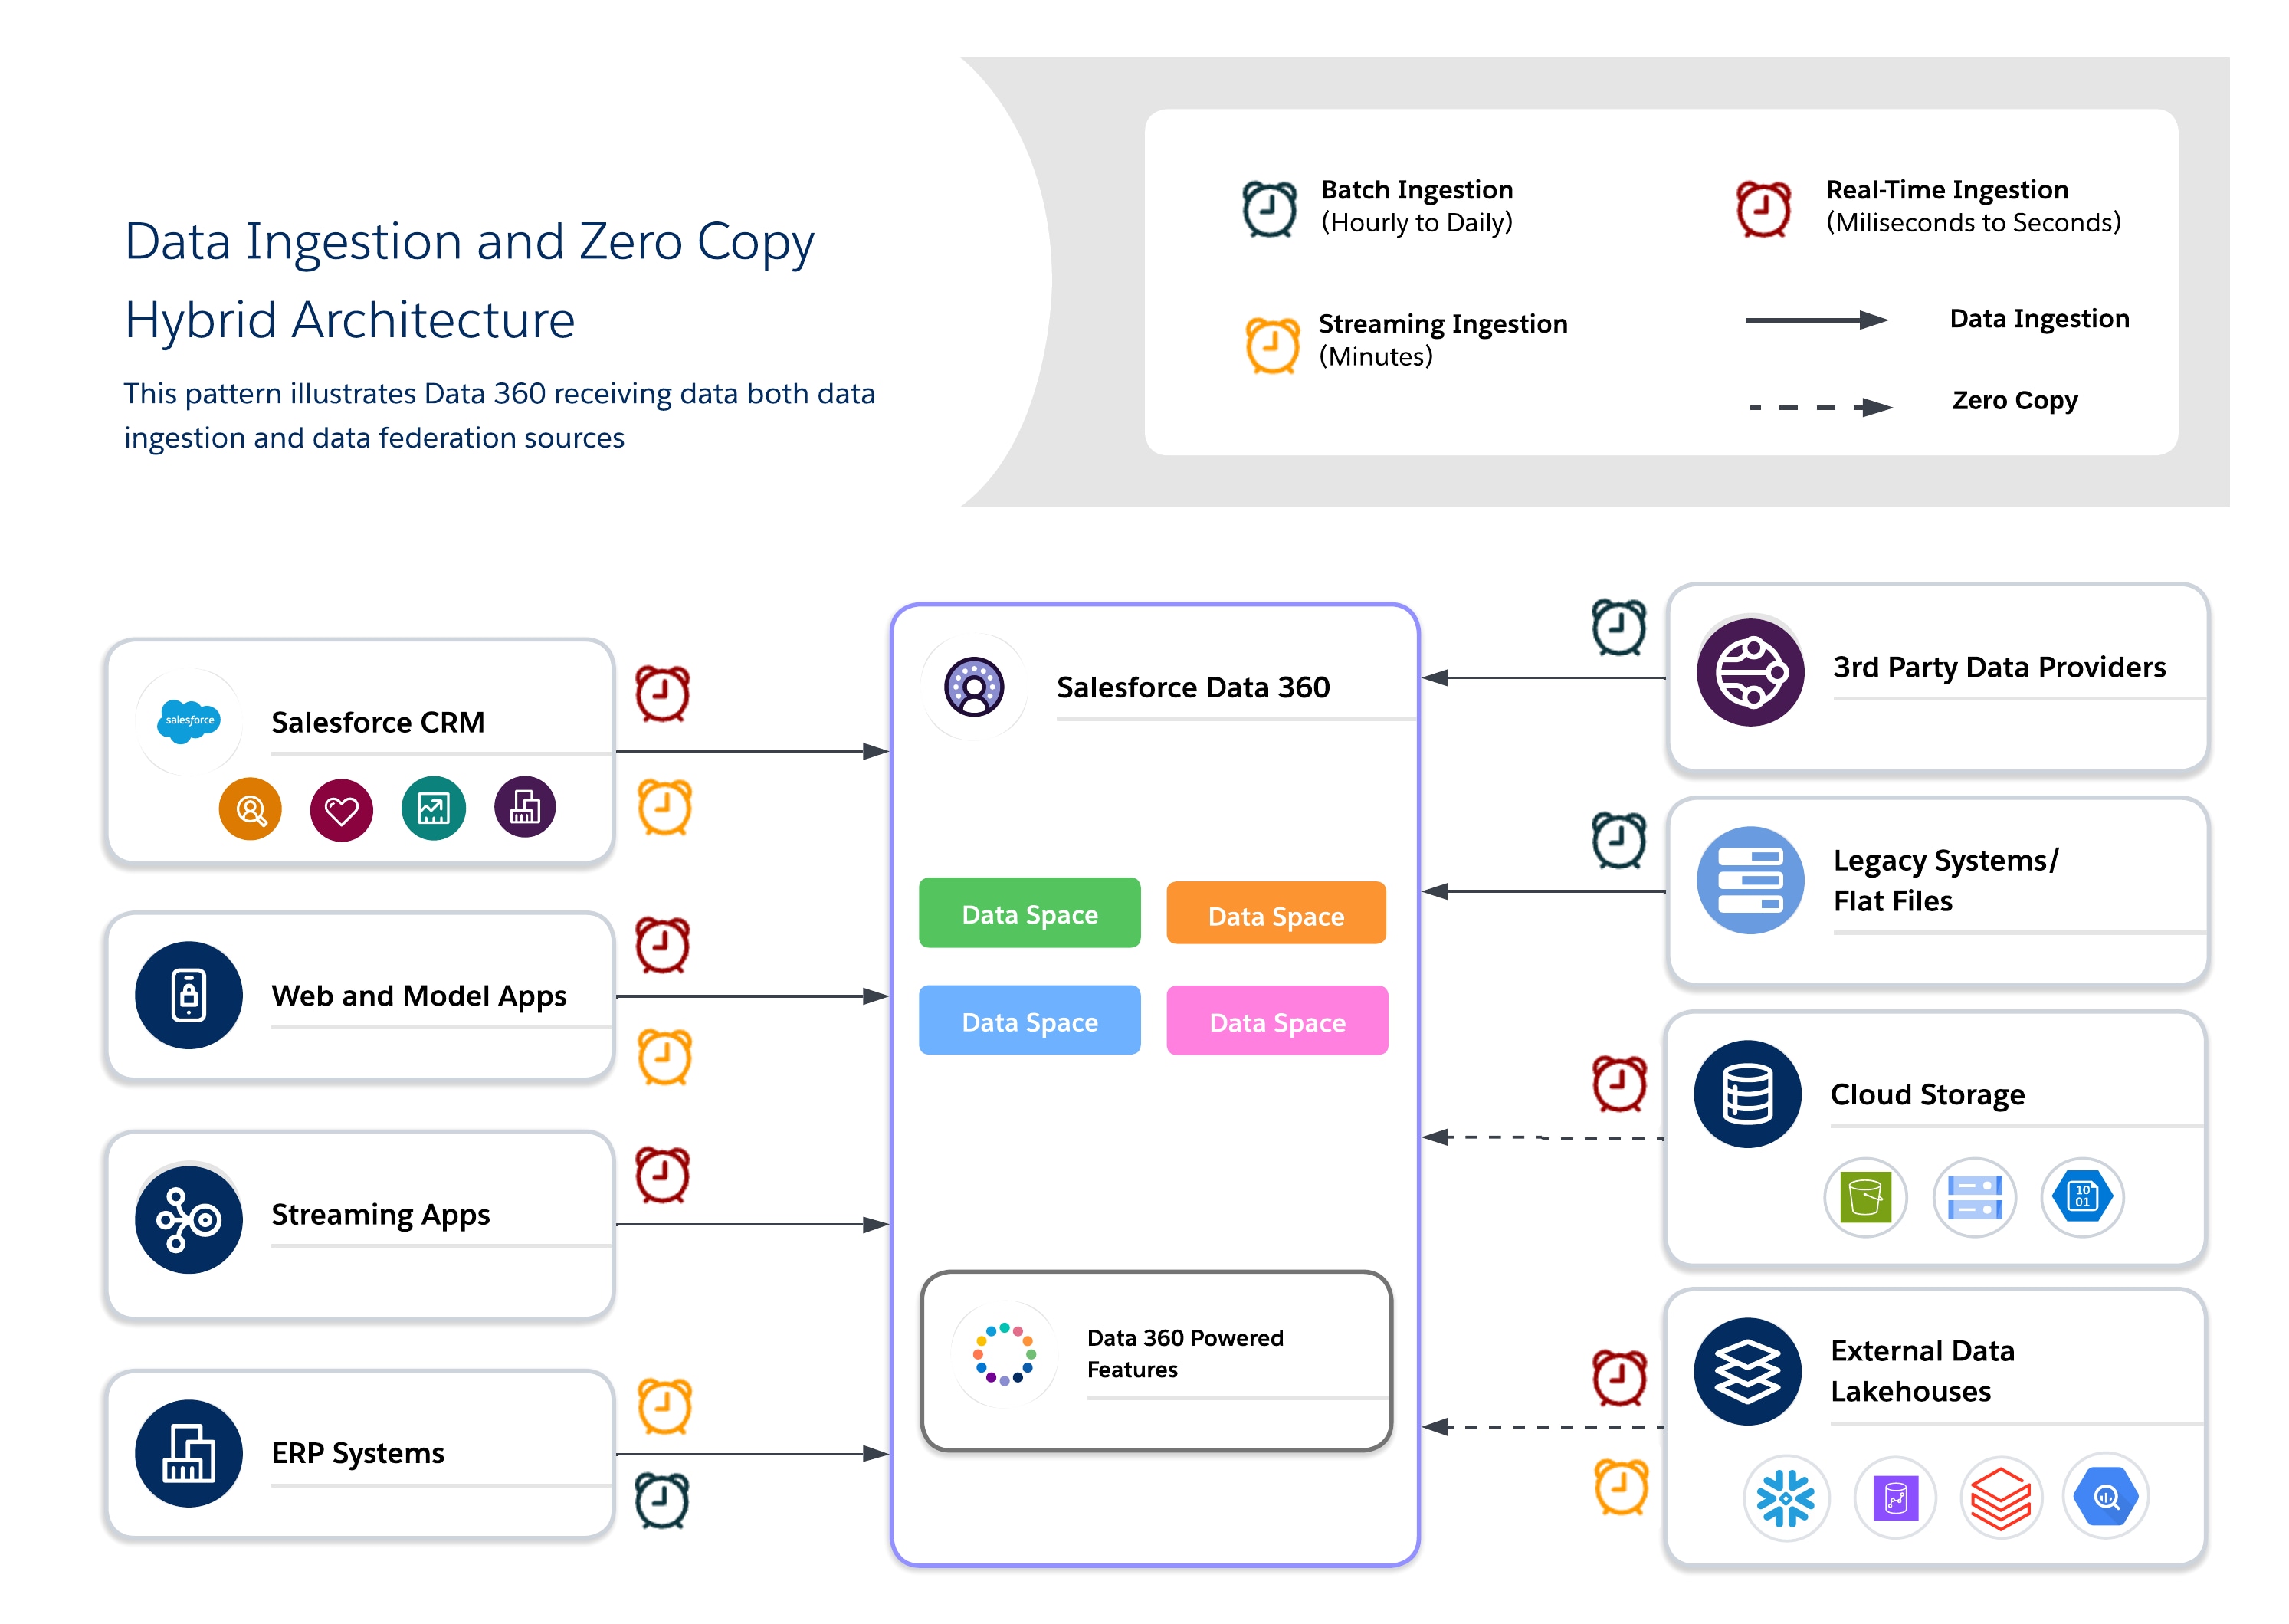
- Användningsfall
- Engagemang i flera kanaler: Blanda historiska kunddata med beteenden i realtid för att leverera enhetliga, sammanhangsbaserade upplevelser.
- AI/ML-pipeline: Utbilda modeller på utvalda, kanoniska datauppsättningar och berika dem med rådata eller realtidssignaler från externa källor.
- Blandade behov av efterlevnad och flexibilitet: Tillämpa strikt styrning för känsliga data och federation för operativ flexibilitet.
- Branschscenarier
- Butik: Använd intag för identitetslösning och profilsammanslagning, och sammanslagning för erbjudanden och personanpassning i realtid.
- Hälsovård: Hantera patientposter i guld via intag samtidigt som du använder federation för IoT-enhetsströmmar och sensordata för omedelbar sammanhang.
- Finansiella tjänster: Ta in reglerade data i en efterlevnadsstyrd sjö medan du använder federation för att upptäcka externa bedrägerier och övervaka risker.
- Designpraxis
- Förankra styrning med intag: Ta in data med högt värde eller reglerade data i kanoniska modeller för att säkerställa Trust och efterlevnad.
- Använd Federation för färskhet: Låter externa sjöhus tillhandahålla dataåtkomst i realtid eller i stor skala utan dubbletter.
- Balanskostnad vs. Prestanda: Profilarbetsbelastningar för att avgöra när man ska använda intag vs. federation, vilket minimerar onödiga lagrings- och sökfrågekostnader.
- Tillämpa skiktad styrning: Tillämpa centraliserad styrning för intagna data samtidigt som du använder säkerhetskontroller för sammanslagna system (till exempel RLS och maskering).
- Obs! När du utformar hybridpipelines är det viktigt att säkerställa inkrementellt intag för historiska datauppsättningar och pushaggregeringar eller filter till sammanslagna källor för att optimera I/O och beräkna användning.
- Kostnadsöverväganden
- Väg totalkostnaden mot prestanda genom att kombinera intag för efterlevnad eller viktiga data med sammanslagning när färskhet behövs.
- Ta hänsyn till I/O och beräkna distribution när du blandar intag och sammanslagning. För att minska beräkningskostnaden för upprepade sökfrågor mot källsystem, använd cachning (Accelerated Query) för sammanslagna datauppsättningar med hög läsbarhet.
- Använd denna regel för att styra beslutet om intag vs. federation: När data öppnas ofta men ändras sällan är Accelerated Query vanligtvis mer kostnadseffektivt. Om data ändras ofta (i förhållande till åtkomstfrekvens) är livesökfråga eller intag mer lämpligt. Här är några kostnadsexempel:
- Acceleration vinner: En instrumentpanel som är byggd från 1M-poster och uppdateras dagligen med ~10K-ändringar visas 20 gånger per dag. Accelerationskostnader motsvarar ungefär ~600 krediter/månad jämfört med ~4 200 krediter/månad för livefrågor.
- Vinner livefråga: Segment som publiceras 20 gånger per dag med data som ändras var 30:e minut. Livefrågor kostar ungefär ~4 200 krediter/månad jämfört med ~28 800 krediter/månad för acceleration med denna uppdateringsfrekvens.
Låt oss ta en närmare titt på några vanliga arketyper som illustrerar hur man tillämpar denna logik.
- Arketypen "Enskild källa till sanning": Centralisera och styr
- Scenario: Du behöver bygga enhetliga profiler för hela ditt globala företag som följer Customer 360. Data kommer från ett dussin olika system, de måste följa strikta GDPR- och CCPA-föreskrifter, och de kommer att fungera som sanningskälla för all marknadsföring och serviceinteraktioner.
- Rekommenderade mönster: Dataintag. Prioritet här är governance, Trust och control. Att lägga till data i Data 360 är det enda sättet att skapa en fullständigt granskningsbar, kanonisk profil som är isolerad från källsystemen.
- Arketypen "Realtidsinsikter": Analysera utan att flytta
- Scenario: Ditt datavetenskapsteam behöver köra utforskande sökfrågor på en massiv, ständigt uppdaterad transaktionstabell i Snowflake. Samtidigt vill ditt chefsteam ha en liveinstrumentpanel för BI som drivs av samma data. Att flytta petabyte data dagligen är långsamt och dyrt.
- Rekommenderade mönster: Zero Copy Federation. Prioritet här är snabbhet, smidighet och kostnadseffektivitet i stor skala. Med Zero Copy kan du använda kraften hos ditt befintliga datalager för sökfrågor i realtid utan att duplicera data över tid och latens.
- Arketypen "Hybrid Intelligence": Styr kärnan, Sammanslagna kanten
- Scenario: Du vill berika dina styrda, intagna kundprofiler med beteendesignaler i realtid (till exempel webbplatsklick) från en datasjö. Du behöver stabiliteten hos kärnprofilen men omedelbarheten hos livedata för att driva personanpassning direkt.
- Rekommenderade mönster: En hybridmetod. Använd dataintag för att skapa en stabil, styrd kärna för dina kunddata. Använd Zero Copy för att slå samman flyktiga "edge"-data i realtid och slå sedan samman dem vid sökfrågetid för en fullständig, uppdaterad vy.
Företagets datastrategi fokuserar inte längre på att välja ett enskilt integreringsmönster—det handlar om att skapa kontrollerad flexibilitet inom ett interoperabelt dataekosystem. Den korrekta metoden mappar varje källsystem till det mönster som bäst passar dess färskhet, styrning, kostnad och åtkomstkrav:
- Ta in verksamhetskritiska, reglerade datauppsättningar i Salesforce Data Cloud för efterlevnad, identitetslösning och operativa arbetsflöden.
- Sammanslagna data via Zero Copy för liveanalyser, utforskande analyser och AI-drivna analyser utan att duplicera lagring.
- Tillämpa cache (snabbfråga) för att minska källsystemets belastning och kreditkonsumtion när sökfrågefrekvensen är hög och dataändringsfrekvensen är låg
Salesforce Data 360 i Hyperforce ger motståndskraft och skalbarhet i flera regioner. Dess öppna sjöhus med Icebergtabeller möjliggör beräkningsseparation och interoperabilitet med plattformar som Snowflake, Databricks och S3 Iceberg, vilket utgör ryggraden i ett verkligt interoperabelt dataekosystem med flera moln.
När dataekosystem utvecklas måste vi kontinuerligt balansera färskhet, kostnad, prestanda och efterlevnad för att upprätthålla arkitektonisk smidighet. Därför är det viktigt att framtidssäkra din plattform genom att slå samman intagna, styrda data med sammanslagen åtkomst. Detta möjliggör intelligens i realtid, AI-aktivering och personanpassning i företagsskala över moln, regioner och verksamhetsdomäner.
Kom ihåg att lösningar som passar alla inte passar de flesta verksamheter. Den optimala strategin mappar rätt mönster till rätt verksamhetsdrivkraft.
Yugandhar Bora är arkitekt inom programvaruteknik på Salesforce och specialiserar sig på dataarkitektur inom plattformen Data and Intelligence Applications. Han leder initiativ inom granskningsnämnden för företagsarkitektur (EARB) som fokuserar på datastyrning och sammanslagna datamodeller och samtidigt bidrar till automatiserade plattformsprovisioneringslösningar.
Jan Fernando är chefsarkitekt på kontoret för chefsarkitekten på Salesforce som började på Salesforce 2012. Han har stor erfarenhet från sin tid i ekosystemet för uppstartsföretag. Innan han anslöt sig till OCA tillbringade han över ett decennium i plattformsorganisationen, där han ledde flera viktiga tekniktransformationer.