Интерактивность данных 360
Предприятия часто хранят данные в Salesforce и других внешних озерах данных (например, Snowflake, Google BigQuery, Databricks, Redshift или хранилище объектов, например, Amazon S3). Изолирование данных в нескольких системах создает проблему для компаний, которые хотят использовать всю ценность своих данных для внедрения взаимодействий на основе искусственного интеллекта. Salesforce Data 360 - это базовый интеллектуальный уровень, используемый каждым агентом Agentforce AI для доступа к правильному контексту в нужный момент.
Архитекторы, работающие над объединением данных в нескольких озерах данных, сталкиваются с ключевыми архитектурными решениями относительно оптимальных путей интеграции этих данных. Data 360 предоставляет несколько вариантов интеграции данных, каждый из которых содержит разные плюсы и минусы.
Это руководство предоставляет основу для оценки схемы, наиболее соответствующей вашим требованиям к задержке, стоимости, масштабируемости, управлению и сложности при интеграции данных, помогая выбрать, когда использовать прием данных, федерацию данных Zero Copy или гибридный подход. Руководство также поможет выбрать между разными методами приема данных и интегрирования данных, каждый из которых удовлетворяет разные потребности.
Интеграция внешних центров обработки данных-озер с Data 360 требует тщательного рассмотрения компромиссов между свежестью данных, управлением и эффективностью ожидаемых продаж. Например, использование оперативных запросов федерации данных Zero Copy повышает свежесть данных, но может снизить эффективность ожидаемых продаж при перемещении большего количества данных по сети. Для большинства реальных реализаций сочетание приема и федерации в экосистеме многооблачных озерных домиков является оптимальным путем. Этот гибридный подход обеспечивает масштабируемую, управляемую и совместимую архитектуру, поддерживающую оперативные нагрузки с низкой задержкой (например, персонализация в реальном времени и обнаружение мошенничества) и аналитические нагрузки (например, отчетность по нормативным актам и анализ архивных тенденций). Это руководство помогает определить, как ориентироваться в этих компромиссах с помощью соответствующей стратегии.
- Прием данных копирует данные в Salesforce Data 360 и создает управляемые канонические модели данных. Это идеально подходит для следующих случаев:
- Build a comprehensive Customer 360. Это позволяет объединять и трансформировать разные источники в единый надежный профиль.
- Соответствовать строгому регламенту. Это позволяет создать проверяемую централизованную копию, чтобы обеспечить строгий контроль доступа к данным и родословной.
- Федерация нулевого копирования запрашивает внешние источники в режиме реального времени без дублирования, включая персонализацию в режиме реального времени, панели мониторинга в реальном времени и адаптацию к быстрому источнику. Этот подход предоставляет два основных варианта, но существуют компромиссы, которые необходимо сбалансировать:
- Живой запрос: Используйте это для интерактивного анализа и панелей мониторинга данных в реальном времени, которые живут на внешних платформах данных (например, Snowflake, BigQuery, Redshift или Databricks). Это помогает избежать медленного и дорогостоящего дублирования данных, перенося обработку запросов в исходную систему и возвращая только необходимые результаты. Этот метод оптимизирован для нечастых или ситуативных запросов, где свежесть является критически важной. Он подходит для низкой загруженности запросов в секунду (QPS) (стоимость запросов может значительно возрасти при высоком QPS).
- Кэширование (ускоренный запрос): Используйте это для частых запросов данных, которые меняются редко. Ускоренные запросы поддерживают локальный кэш, обновляемый через настраиваемые интервалы (от 15 минут до 7 дней), что уменьшает повторные исходные обращения. Этот метод балансирует производительность панели мониторинга и стоимость, сегментацию и загруженность BI, где допустимы слегка устаревшие результаты. Это не подходит для принятия подсекундных решений.
- Интеграция файлов: Используйте это для широкомасштабной пакетной обработки и обучения модели на основе искусственного интеллекта для данных в озере данных облака (например, S3 или ADLS). Этот метод позволяет избежать медленного и дорогостоящего приема путем прямого запроса файлов в открытых форматах таблиц, что разблокирует массивы данных ETL и загруженность наукой о данных.
- Гибридные модели смешивают прием для объединенных профилей с федерацией для свежести, которая поддерживает занятость мультиканала, действия под управлением Agentforce и обучение на основе искусственного интеллекта/ML.
- Использование гибридной архитектуры. Смешивание приема данных и интегрирования часто необходимо.
- Используйте прием данных для важных данных для канонических моделей данных и базового управления.
- Используйте Zero Copy для всех других федераций данных, чтобы поддерживать свежесть и минимизировать операционные затраты на создание и обслуживание ожидаемых продаж принятия данных.
- Вопросы частоты принятия данных. Выберите частоту на основе бизнес-ценности, потребностей задержки и операционной сложности.
- Используйте режим реального времени для бизнес- процессов, требующих срочного выполнения (например, персонализация, интерактивные панели мониторинга и действия Agentforce).
- Рекомендуем использовать функцию «Практически в режиме реального времени» для процессов с умеренно срочными потребностями (например, кампании и отчеты по операциям).
- Используйте пакетирование для архивных или низкоскоростных наборов данных.
- Соотнесение схем интегрирования с задержкой и производительностью. Выберите вариант, наиболее соответствующий схемам доступа и требованиям к свежести, производительности и стоимости.
- Используйте оперативный запрос для операционных панелей мониторинга и персонализации в реальном времени, где низкая задержка является критической.
- Используйте кэширование (ускоренный запрос), если запросы частые и допустимые результаты, что помогает сбалансировать производительность и стоимость.
- Используйте интеграцию файлов для крупномасштабной аналитики производительности или пакетных нагрузок, которые идеально подходят для архивных или менее срочных наборов данных.
- Согласование управления с требованиями к пребыванию данных.
- Используйте прием, если централизованное управление имеет решающее значение.
- Использование федеративного устройства, когда децентрализованное управление является приемлемым, а также обеспечение строгого управления из внешних источников.
- Используйте Zero Copy для политик исходного уровня (например, безопасность строки и маскировка данных).
- Приоритет принятия для ценных бизнес-правил. Выборочно применять прием к критическим процессам (например, разрешающая способность при опознавании, нормативная отчетность и активация операции).
- Решения по стоимости и сложности. Прием в реальном времени может быть дорогим и сложным. Поэтому архитекторам важно соотносить затраты на адаптацию, хранение и трансформацию данных с затратами на их запрос напрямую посредством Zero Copy.
Выбор правильной схемы интеграции (принятие данных, нулевая копия или гибридный подход) напрямую влияет на задержку, управление, эффективность работы и стоимость на многооблачных платформах. Это решение определяет способ надежной и масштабной доставки важных данных в реальном времени, активации на основе искусственного интеллекта и персонализированной занятости.
Данная таблица сравнивает схемы принятия данных и нулевой копии в Salesforce Data 360, уделяя особое внимание возможностям, преимуществам и преимуществам, а также сценариям корпоративного использования и результатам. Используйте это в качестве ссылки для создания гибридных многооблачных платформ данных, которые балансируют производительность, стоимость и соответствие.
| Тип схемы | Режим/инструмент | Пособия | Рекомендации | Результаты |
|---|---|---|---|---|
| Прием данных |
В реальном времени:
|
|
|
Agentforce:
|
Потоковая передача:
|
|
|
Agentforce:
|
|
Пакет:
|
|
|
Agentforce:
|
|
| Zero Copy |
Живой запрос:
|
|
|
Agentforce:
|
Ускоренный запрос (кеширование):
|
|
|
Agentforce:
|
|
Интеграция файлов:
|
|
|
Agentforce:
|
Существует три основные схемы интеграции для Data 360 - прием данных, объединение данных нулевой копии и гибридный подход.
С помощью принятия данных данные физически копируются в данные 360 и полностью управляются, в отличие от Zero Copy, где данные остаются в источнике. Другими словами, обработка трансформаций осуществляется в рамках данных 360, которые обеспечивают централизованное управление и аудит.
Используйте прием данных для хранения канонических управляемых наборов данных в Salesforce Data 360 для соответствия и оперативного контроля. Используйте прием, когда требуется полный контроль, аудит и отслеживаемость. Прием данных идеально подходит для регламентированных или ценных бизнес-правил, где централизованные вычисления и управление имеют решающее значение.
Прием подходит для создания надежной основы разрешающей способности при опознавании, составления отчетов по нормативным актам и бизнес-процессов на основе искусственного интеллекта и вовлечения клиентов.

Методы приема данных могут отличаться, в зависимости от используемого коннектора для приема данных. Некоторые коннекторы предлагают разные методы приема, в то время как другие работают только в пакетном или потоковом режиме. Полный список коннекторов Data 360 и доступных методов см. в разделе Data 360: Интеграции и коннекторы.
- В реальном времени:
- Обеспечивает субвторой прием посредством сбора данных об изменении (CDC)
- Подходит для срочных бизнес-правил (например, обнаружение мошенничества, персонализация и операционные панели мониторинга)
- Функция всплывающих трансформаций и агрегаций в Data 360, что помогает сократить последующий ввод-вывод и оптимизировать использование вычислений
- Поддерживает использование инкрементного CDC для минимизации перетасовки данных
- Потоковая передача:
- Обеспечивает прием каждые 1-3 минуты с небольшим шагом
- Баланс свежести и стоимости
- Подходит для оркестрации кампаний, взаимодействия в близком к реальному режиме и оперативной отчетности
- Поддерживает использование микропакетов для управления скачками ввода-вывода
- Агрегация данных в источнике (при возможности) для уменьшения объемов передачи и оптимизации хранилища
- Пакет (запланированные загрузки):
- Периодический прием больших наборов данных (например, ежечасно, ежедневно и еженедельно)
- Предоставляет экономичность и надежность для архивных наборов данных, нормативной отчетности и сценариев использования соответствия
- Обеспечивает вычисление локальности в одном регионе с исходным хранилищем для повышения производительности и оптимизации затрат
- Сценарии использования принятия данных:
- Создание объединенных профилей Customer 360. Создайте единый источник истины для удостоверений и атрибутов клиентов.
- Обслуживание наборов данных о соответствии нормативным требованиям. Внедрите управление, родословную и возможность аудита конфиденциальных данных.
- Централизация оркестрации кампании. Убедитесь, что маркетинг, продажи и обслуживание функционируют на основе последовательных надежных наборов данных.
- Практика проектирования:
- Разрешите пакетный прием для архивных или низколатентных нужд (например, архивная отчетность или периодические снимки).
- Используйте CDC или потоковые API для поддержки обновления операционных и персональных бизнес-правил, чтобы обеспечить обновления в близком к реальному режиме времени.
- Управление хранилищем и вычисление роста путем применения дополнительных нагрузок для оптимизации затрат и эффективности (вместо перегрузки целых наборов данных).
- Выравнивание ожидаемых приемов с вычислением местности и инкрементной обработки для уменьшения ввода-вывода сети.
- Примените трансформации в Data 360, чтобы избежать ненужного перемещения исходных данных.
- Рекомендации по стоимости:
- Прием в реальном времени сопряжен с самыми высокими затратами на компьютеры и ожидаемые продажи, что может быть оправдано для ценных, чувствительных к времени бизнес-процессов (например, персонализация, операционные панели мониторинга или действия под управлением Agentforce).
- Потоковое принятие сопряжено с умеренными расходами на компьютеры и хранение данных, что может использоваться для частых обновлений, которые могут допускать незначительные задержки (например, оркестрация кампании или оперативная отчетность).
- Пакетное принятие имеет меньшую стоимость вычислений и предсказуемое хранилище, что подходит для архивных наборов данных или низкочастотных обновлений. Прием пакетных данных из организаций Salesforce посредством определенных коннекторов бесплатен.
- Режим обновления Позволяет выбрать режим дополнительного обновления, что уменьшает общие расходы на прием и вычисление. В Salesforce рекомендуем использовать инкрементное обновление при любой возможности для оптимизации эффективности во всех типах приема.
- На стоимость также влияет объем ввода-вывода из источника в Data 360. Оптимизация размеров пакетов, разделов и регионального выравнивания уменьшает расходы на перемещение и повышает производительность.
- Сценарии отрасли:
- Финансы: Наборы данных принятия обязательны для знания клиента (KYC), борьбы с отмыванием денег (AML) и обнаружения мошенничества, если проверяемость и соответствие не подлежат обсуждению.
- Здравоохранение: Используйте прием для разрешающей способности при опознавании пациента и записей, соответствующих протоколу HIPAA, что обеспечивает безопасные объединенные представления.
- Розница: Консолидируйте данные точек продаж (POS), eCommerce и программы лояльности в объединенные профили для сегментации и персонализации.
- Телекоммуникации: Поддержка аналитики по предотвращению оттока и использованию с помощью канонических управляемых данных подписчика.
| Функция | Прием в реальном времени | Потоковое принятие | Пакетное принятие |
|---|---|---|---|
| Задержка и свежесть | Функция принятия с субвторой задержкой посредством API принятия с поддержкой сбора данных (CDC). Предоставляет непрерывные потоковые ожидаемые продажи. Подходит для сценариев оперативного использования с низкой задержкой. | Особенности микропакетного приема каждые 1-3 минуты посредством собственных коннекторов. Поддерживает инкрементные обновления. Ожидается небольшая задержка. | Ожидается задержка данных. Разрешает запланированные массовые загрузки. Особенности периодического приема (ежечасно, ежедневно и еженедельно). Не подходит для срочных операций. |
| Сценарии основного использования | Идеально подходит для сценариев использования операций с низкой задержкой и персонализации. Используется для бизнес-правил, чувствительных к времени. Поддерживает бизнес-процессы под управлением событий. Используются для предупреждений о мошенничестве и оперативных предупреждений в реальном времени. | Подходит для умеренно срочных процессов. Используются для оркестрации кампаний, оперативной занятости и оперативной отчетности. Используется для своевременных триггеров кампании. | Экономичность для массивных наборов данных. Надежно для архивной аналитики. Используются для архивного агрегирования или регламентированных бизнес-правил отчетности. Подходит для архивных или низкоскоростных наборов данных. |
| Архитектурная сложность и ввод-вывод | Содержит высокую стоимость и сложную архитектуру. Требуются исходные системы с низкой задержкой. Интенсивный ввод-вывод. Массовые источники могут стать причиной насыщения трубопроводов. | Особенности более простой архитектуры, чем в реальном времени. Ввод-вывод умеренный. Подходит для предсказуемых повторяющихся схем обновления. Размер пакета влияет на память и вычисления. | Простота внедрения. Интенсивный ввод-вывод во время окон загрузки. Пропускная способность сети может стать препятствием для больших пакетов. |
| Рекомендации по затратам | Содержит самые высокие затраты на вычисления и ожидаемые продажи. Оправдано только для ценных, срочных бизнес-правил. | Включает умеренные затраты на компьютер и хранение. Предоставляет сбалансированный подход стоимости и свежести. Подходит для частых обновлений, которые могут переносить небольшие задержки. | Отличается более низкими затратами на вычисления и предсказуемым хранилищем. Рекомендуется для архивных наборов данных или низкочастотных обновлений. Прием через внутренние конвейеры Salesforce бесплатный. |
| Практика проектирования | Используйте инкрементный CDC для минимизации перетасовки данных. Фильтруйте и используйте выборочные поля для уменьшения накладных расходов. | Используйте микропакеты для управления скачками ввода-вывода. Рекомендуем использовать агрегацию окон для уменьшения загрузки обработки. | Используются для архивирования отчетов или периодических снимков. Убедитесь, что населенный пункт вычисляется в одном регионе с хранилищем источников для оптимизации затрат. |
Используйте Zero Copy для запросов внешних систем в реальном времени без дублирования данных, чтобы включить гибкость, свежесть и масштабируемый доступ к большим или временным наборам данных. Он подходит для оперативных панелей мониторинга, аналитики, обучения модели на основе искусственного интеллекта/ML и взаимодействия с клиентами в реальном времени напрямую посредством Salesforce Data 360.
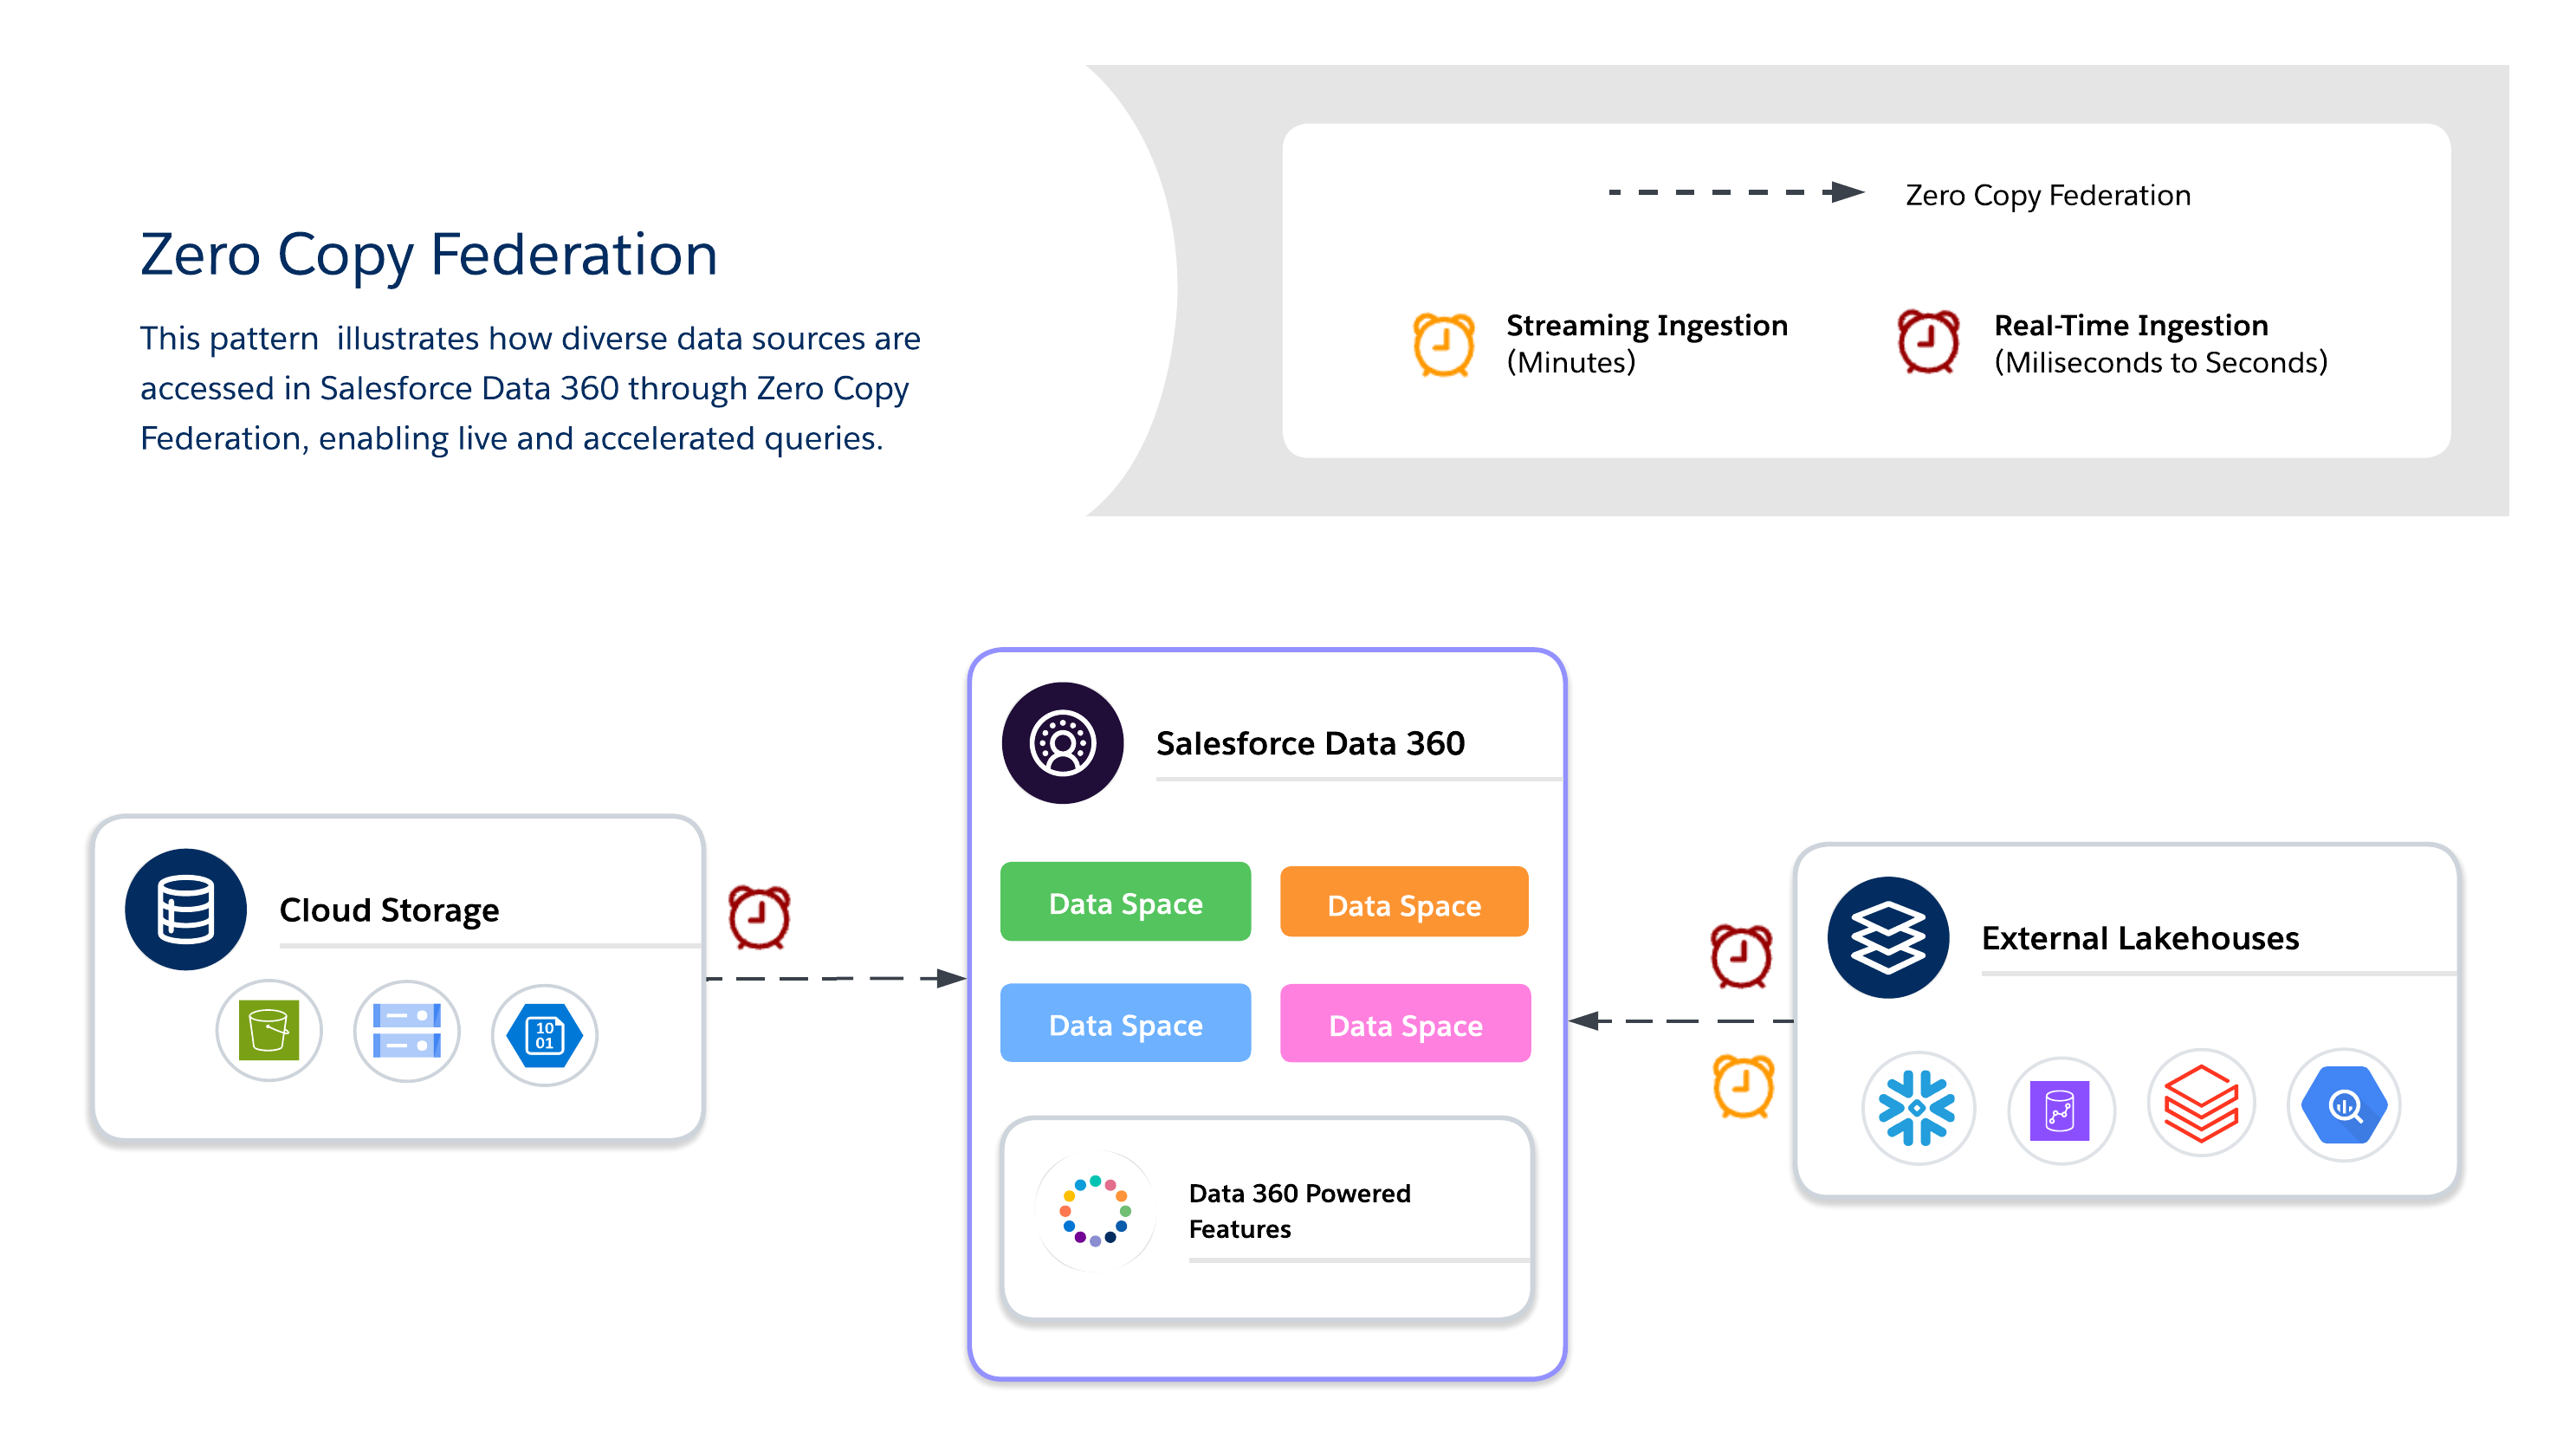
При использовании Zero Copy архитекторы должны выбрать один из трех доступных методов интегрирования данных, каждый из которых предлагает собственные преимущества между свежестью, производительностью и стоимостью.
- Живой запрос
- Выполняет запросы напрямую к внешним системам (например, Snowflake, Google BigQuery, Redshift, Databricks и т. д.) без дублирования данных.
- Минимизирует перемещение данных по сети и уменьшает ввод-вывод в вычислении Salesforce Data 360, что оптимально при переносе предикатов и агрегаций вниз.
- Подходит для важных данных в реальном времени и панелей мониторинга с низкой задержкой.
- Зависит от производительности внешней системы.
- Кэширование (ускоренный запрос)
- Временно сохраняет кэшированные копии интегрированных данных в Salesforce Data 360.
- Уменьшает повторные затраты на запрос и задержку для часто используемых наборов данных с настраиваемой продолжительностью (от минут до дней).
- Данные не копируются постоянно или не управляются полностью, поэтому обновлением можно управлять посредством запланированных обновлений из источника.
- Инкрементное обновление поддерживает только обновления. Удаленные записи не удаляются из кэша.
- Периодически выполняйте полное обновление, чтобы обеспечить синхронизацию кэша с источником.
- Примечание: Коннектор Snowflake поддерживает функцию «Выгрузка», которая повышает скорость ускорения посредством инициированной Snowflake области этапирования. Данный параметр включен по умолчанию, но его можно отключить, отредактировав подключение.
- Интеграция файлов
- Предоставляет прямой доступ только для чтения к крупномасштабным наборам данных в объектных магазинах (например, S3 и GCS с Айсбергом).
- Подходит для загруженности искусственным интеллектом/ML, архивной аналитики и составления отчетов в петабайтном масштабе без перемещения данных.
- Производительность запроса сильно зависит от формата объекта, разделения и ввода-вывода сети. Крупное сканирование может создать существенный ввод-вывод, если оно не оптимизировано.
- Использование сценариев
- Персонализация в реальном времени и адаптивные бизнес-правила предоставляют динамические предложения, рекомендации и действия следующего качества по мере изменения поведения клиентов.
- Оперативные панели мониторинга и оперативная аналитика поддерживают важные для бизнеса панели мониторинга и КПЭ напрямую из внешних складов.
- Обучение модели на основе ИИ/ML с использованием больших внешних наборов данных позволяет использовать данные в петабайтном масштабе из озер данных и складов без их переноса посредством интеграции файлов.
- Сценарии отрасли
- Retail/Media: Включите персонализированные рекомендации и вовлечение клиентов в реальном времени, настроив кликстрим или данные взаимодействия содержимого.
- Финансы: Выполните обнаружение мошенничества и рискуйте оценить в близком к реальному режиме времени, запросив внешние склады, не дублируя конфиденциальные данные.
- Техника/предприятие: Поддерживайте межоблачные отчеты, панели мониторинга ИТ-служб и операционную аналитику, когда наборы данных находятся в нескольких системах.
- Практика проектирования
- Живой запрос
- Рекомендуем использовать для запросов с высоким QPS и низкой задержкой при критической свежести.
- Внедрение предикатов и агрегаций во внешнюю систему для уменьшения перетасовки данных по сети.
- Избегайте запросов, которые излишне сканируют массивы данных.
- Рекомендуем использовать обрезку разделов и фильтры.
- Интеграция файлов
- Доступ к наборам данных в петабайтном масштабе в магазинах объектов без приема.
- Уменьшите затраты на задержку и выход, сохранив хранилище объектов в той же области Cloud, что и вычисления Salesforce.
- Используйте разделенные, столбчатые форматы (Parquet/ORC) и раскрывающиеся фильтры для уменьшения ввода-вывода и передачи сети.
- Используйте всплывающее окно запроса и предиката для фильтрации и агрегации данных в источнике, что уменьшает перемещение данных.
- Избегайте межрегионального доступа к данным, если он не является абсолютно необходимым, поскольку он увеличивает ввод-вывод, задержку и затраты.
- Кэширование (ускоренный запрос)
- Кэшируйте часто используемые наборы данных для баланса стоимости и производительности.
- Настройте интервалы обновления для баланса свежести и стоимости запроса.
- Соответствие: Внедрение управления в источнике посредством использования политик безопасности строки (RLS) и маскировки напрямую в федеративных системах.
- Ниже указаны рекомендации по единообразному RLS и маскировке на платформах:
- Использовать централизованный код предприятия. Соотнесите пользователей и объекты в Salesforce Data 360 с уникальным централизованным идентификатором предприятия, соответствующим удостоверениям во внешних системах.
- Выравнивание политик безопасности. Убедитесь, что политики RLS и маскировки в федеративных системах применяются на основе соотнесенного удостоверения. Это сохраняет соответствие при запросе внешних данных.
- Стандартизация схем удостоверений. Поддерживайте последовательные атрибуты удостоверений (электронная почта, код пользователя, код клиента и т. д.) во всех источниках данных во избежание несоответствий и нарушений доступа.
- Ниже указаны рекомендации по единообразному RLS и маскировке на платформах:
- Живой запрос
- Рекомендации по затратам
- Живой запрос: В модели оплаты за запрос расходы начисляются при вычислении внешнего дома озера, что может привести к скачкам с высоким QPS. Это подходит для сценариев использования, важных для свежести, где значение больше переменной стоимости.
- Ускоренный запрос (кеширование): Этот метод снижает стоимость запроса (по сравнению с оперативным запросом), уменьшая обращения к исходной системе; однако он увеличивает расходы на пакетное принятие данных для заполнения и обновления кэша. Это подходит для часто используемых наборов данных.
- Интеграция файлов: Это самый дешевый вариант хранилища данных в Object Store, однако стоимость запроса зависит от размера файла, разделения и обрезки. Данная функция поддерживает архивные или пакетные данные в петабайтном масштабе.
| Момент принятия решения | Live Query | Кэширование (ускоренный запрос) | Интеграция файлов |
|---|---|---|---|
| Расположение источника данных | Дома озера внешних данных (например, Snowflake, Google BigQuery, Redshift и Databricks) | Дома озера внешних данных (например, Snowflake, Google BigQuery, Redshift и Databricks) | Магазины объектов или озера данных Cloud (например, S3, ADLS и GCS), которые часто используют форматы открытых таблиц, например, «Айсберг». |
| Цель/Использование | Подходит для интерактивного анализа и панелей мониторинга в реальном времени. Подходит для персонализации в реальном времени и динамических бизнес-правил. | Подходит для частых запросов, но допустимы слегка устаревшие результаты. Подходит для панелей мониторинга BI и сегментации. | Подходит для масштабной пакетной обработки и обучения модели на основе искусственного интеллекта/ML. Подходит для архивной аналитики и составления отчетов в петабайтном масштабе. |
| Свежесть/задержка | Предоставляет максимальную свежесть Выполняет запросы напрямую в режиме реального времени. Поддерживает подвторое принятие решений, когда исходная система оптимизирована для запросов с низкой задержкой с эффективным вытеснением предиката. | Используйте, когда допустимы слегка устаревшие результаты. Свежесть зависит от интервала кэширования, настраиваемого от 15 минут до 7 дней. | Подходит для пакетных, интенсивных заданий. Не подходит для панели мониторинга в реальном времени. |
| Схема доступа | Подходит для нечастых или ситуативных запросов, где свежесть является критической, а объем запросов низким. Стоимость значительно возрастает при высоком QPS, поэтому важно оценивать кэширование (Ускоренный запрос) при высокой частоте запросов. | Подходит для сценариев высокочастотного чтения. Повышает производительность для схем частого доступа. | Предоставляет доступ только для чтения. Подходит для наборов данных в петабайтном масштабе без приема. |
| Движущие факторы производительности | Сильно зависит от производительности внешней исходной системы. Подходит для случаев, когда предикаты и агрегации могут быть перенесены в источник. | Уменьшает задержку по сравнению с повторяющимися оперативными запросами. Производительность зависит от управления кэшем и интервалов. | Производительность сильно зависит от формата объекта, разделения и производительности внешней системы. Используйте разделенные, столбчатые форматы (Паркет/ORC). |
| Затратные последствия | Это платная модель запроса, поэтому расходы начисляются по расчетам внешнего озера. Это экономически эффективно для нечастых запросов, но расходы могут резко возрасти при большом объеме QPS. | Стоимость ниже, чем у повторяющихся оперативных запросов. Он уменьшает необходимость многократного запроса внешнего источника, но добавляет хранилище кэша и обновление над головой. | Это самый дешевый вариант хранилища. В настройках AWS одинакового региона (например, S3 в US- East-1 с клиентом Data Cloud, который также в US- East-1) кредиты не расходуются для строк, к которым есть доступ. Межрегиональные или межоблачные конфигурации (например, Azure, GCS или разные регионы AWS) используют кредитное потребление для доступных строк. Стоимость запроса также зависит от размера файла, разделения и оптимизации всплывающего меню предиката. |
| Ключевое соображение | Избегайте нефильтрованных запросов, которые без необходимости сканируют массивы данных. | Этот метод требует управления кэшем. Не подходит для подсекундного решения. | Производительность запроса во многом зависит от оптимизации посредством разделения и вытеснения предиката. |
Гибридная архитектура позволяет архитекторам закреплять критические наборы данных в Data 360 для централизованного управления, а также использовать интегрированные запросы для обеспечения свежести, сокращения дублирования и масштабируемого доступа к большим внешним наборам данных. Этот метод балансирует требования ввода-вывода, вычисления местности, стоимости и соответствия.
Используйте гибридный подход для сбалансированного управления, свежести и операционной эффективности, сочетая прием данных и нулевое копирование для предоставления в реальном времени действенных важных данных. Используйте прием для ценных, регулируемых наборов данных, где требуется отслеживаемость, RLS и маскировка, и интегрирование для эфемерных или массовых наборов данных, где ключевое значение имеют свежесть и производительность.
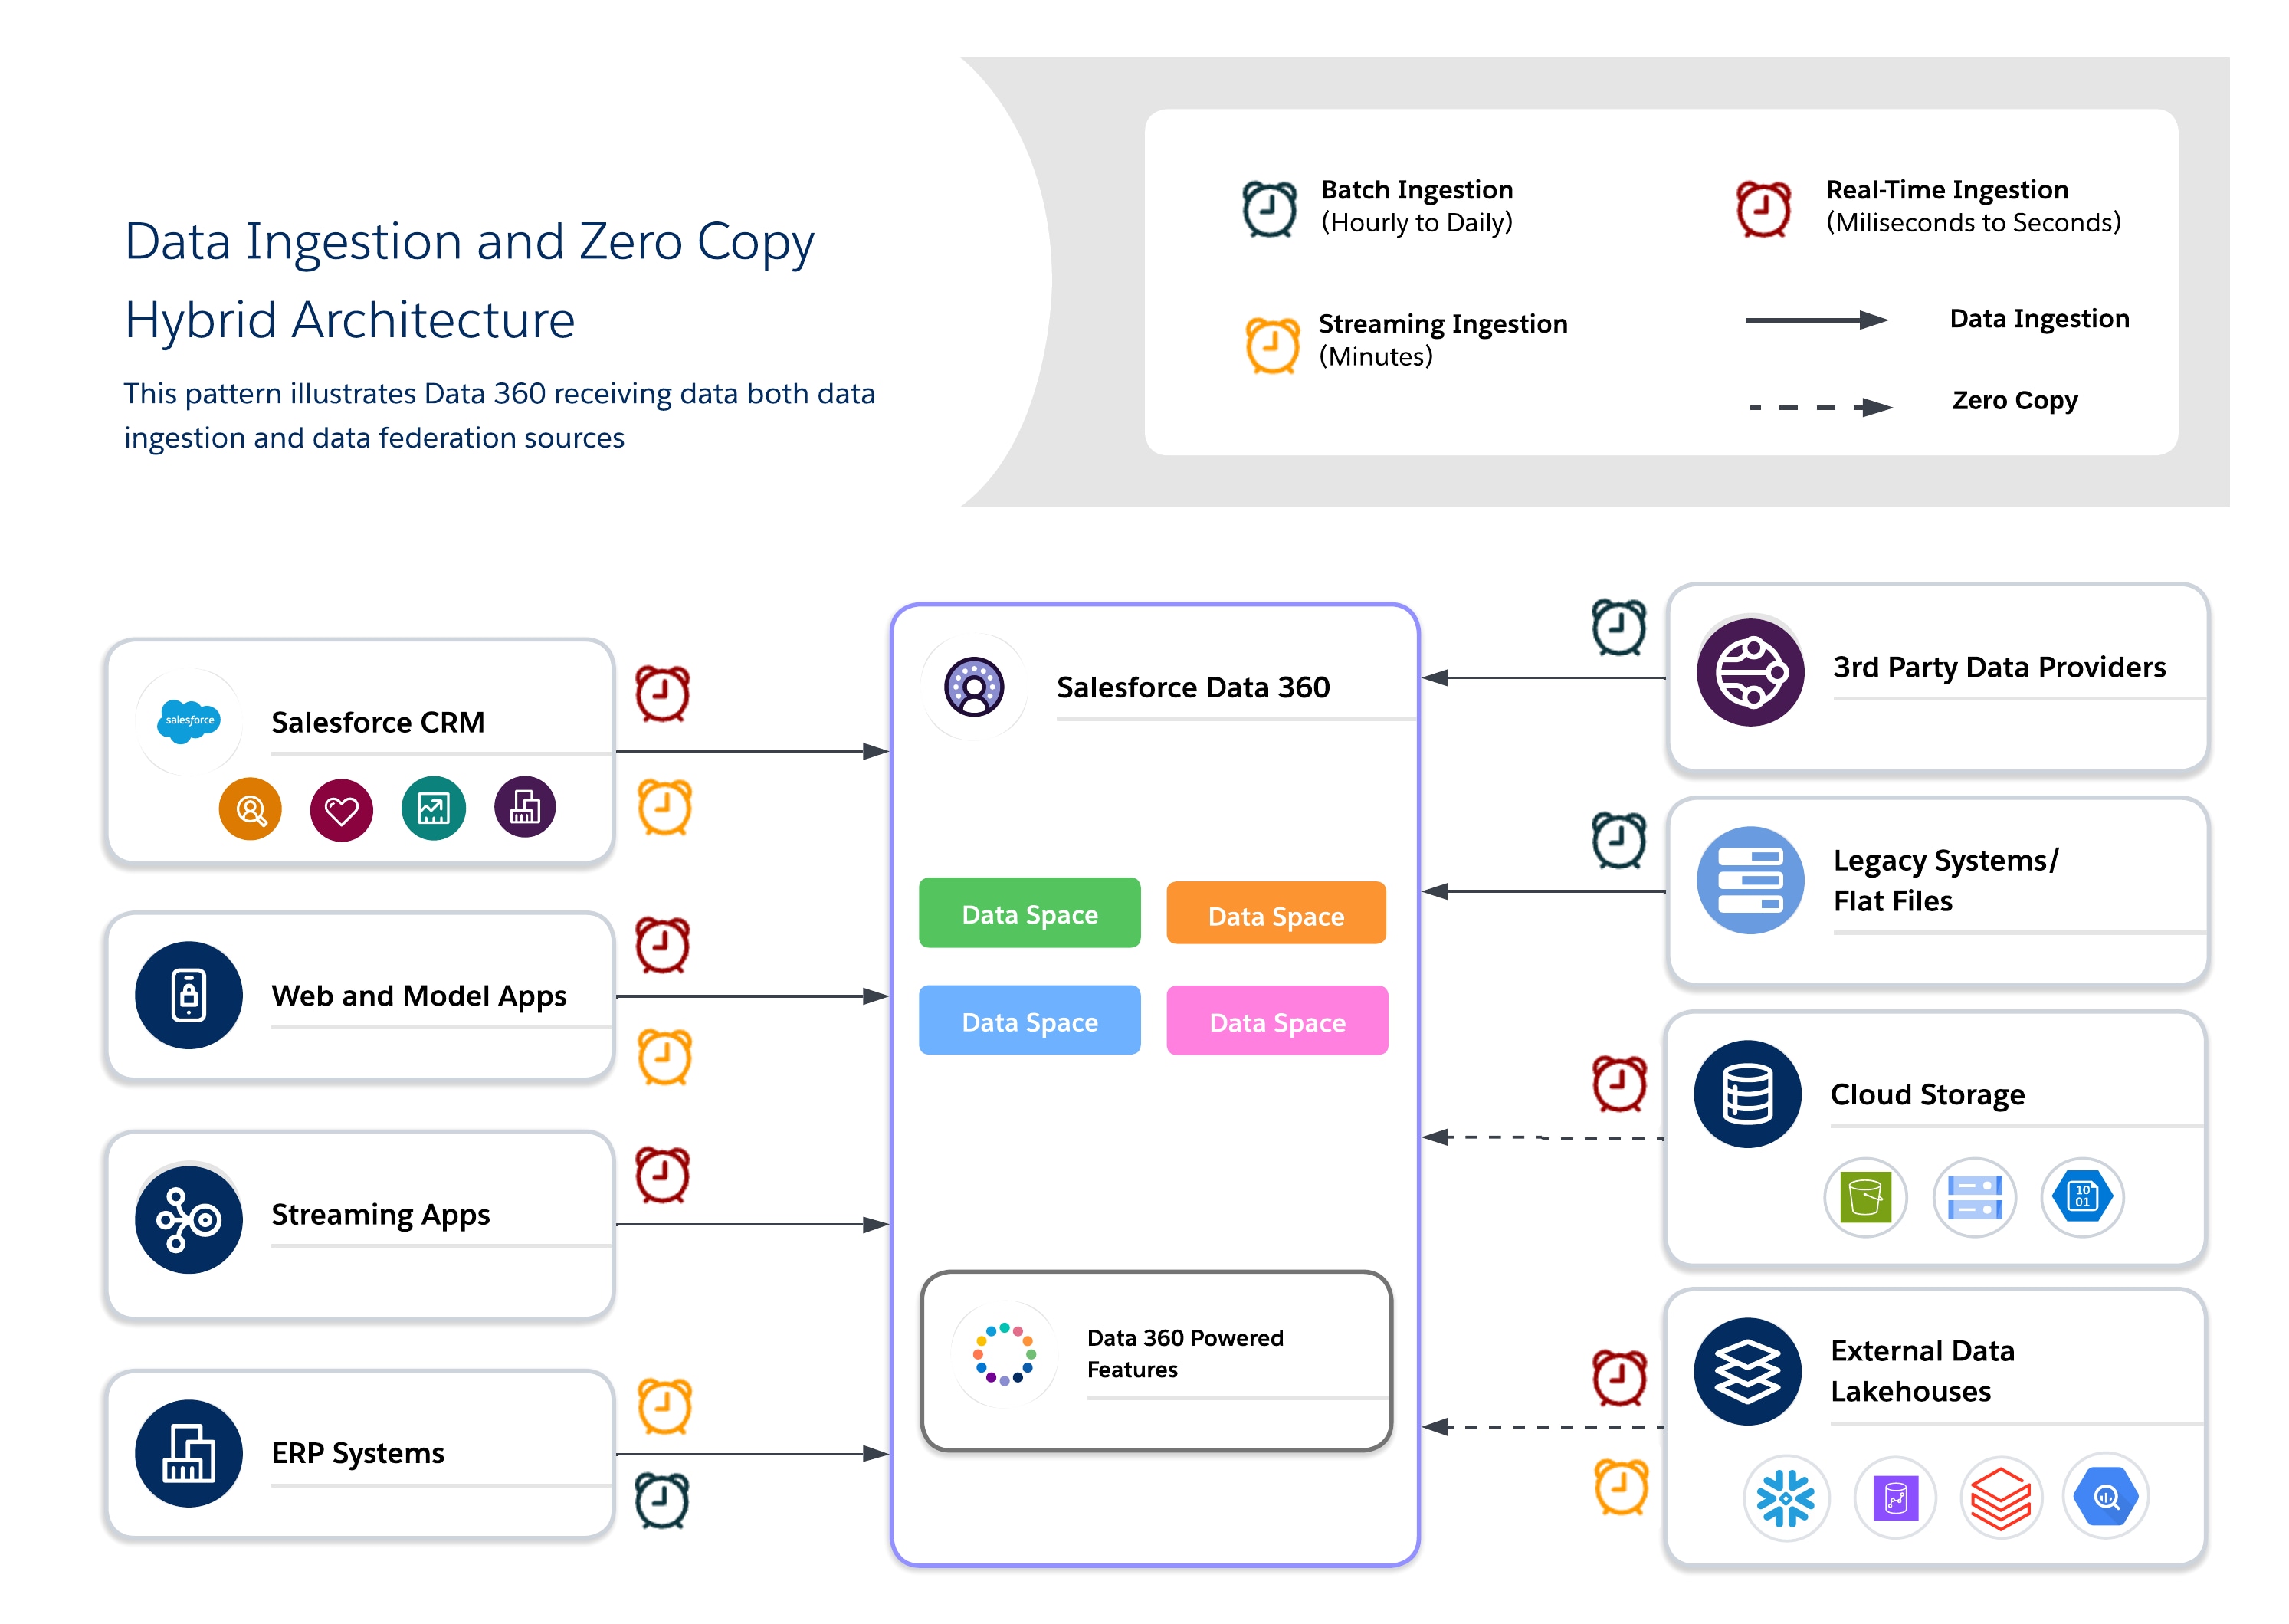
- Использование сценариев
- Занятость мультиканала: Смешайте архивные данные клиентов с поведением в реальном времени, чтобы предоставить последовательные контекстные взаимодействия.
- Конвейеры искусственного интеллекта/ML: Обучите модели на курируемых канонических наборах данных, пополняя их исходными сигналами из внешних источников или в режиме реального времени.
- Смешанные потребности в соблюдении и гибкости: Примените строгое управление для конфиденциальных данных и интегрирование для операционной гибкости.
- Сценарии отрасли
- Розница: Используйте прием для разрешающей способности при опознавании и объединения профиля, а также конфедерацию для предложений в реальном времени и персонализации.
- Здравоохранение: Ведите золотые записи пациентов посредством приема, используя функцию на потоках устройств IoT и данные сенсоров для немедленного контекста.
- Финансовые услуги: Принимать регулируемые данные в озеро, регулируемое соответствием, используя федерацию для внешних запросов обнаружения мошенничества и мониторинга рисков.
- Практика проектирования
- Управление привязкой посредством принятия: Принимать ценные или регулируемые данные в канонические модели для обеспечения Trust и соответствия.
- Использование Federation for Freshness: Позволяет внешним озерам предоставлять доступ к данным в режиме реального времени или в больших масштабах без дублирования.
- Сбалансированная стоимость и производительность: Профилируйте загруженность, чтобы определить, когда использовать прием в сравнении с федерацией, что минимизирует ненужные затраты на хранение и запрос.
- Применить многоуровневое управление: Внедрите централизованное управление для принимаемых данных, используя средства управления безопасностью интегрированных систем (например, RLS и маскировка).
- Примечание: При создании гибридных ожидаемых продаж важно обеспечить инкрементный прием для архивных наборов данных и форсирование агрегаций или фильтров в интегрированных источниках для оптимизации ввода-вывода и вычисления использования.
- Рекомендации по затратам
- Взвесить общую стоимость по сравнению с производительностью, сочетая прием для соответствия или критических данных с федерацией, когда это необходимо.
- Учитывайте ввод-вывод и вычисляйте распределение при смешивании приема и федерации. Чтобы сократить стоимость вычисления повторяющихся запросов к исходным системам, используйте кэширование (Ускоренный запрос) для читаемых, часто доступных интегрированных наборов данных.
- Используйте это правило для принятия и принятия решения федерации: при частом доступе к данным, но редком изменении, ускоренный запрос обычно более эффективен с точки зрения затрат. Однако при частом изменении данных (относительно частоты доступа) более подходящим является оперативный запрос или прием. Ниже указаны примеры стоимости:
- Победы ускорения: Панель мониторинга, созданная на основе записей 1M и обновляемая ежедневно с изменениями ~10K, просматривается 20 раз в день. Стоимость ускорения составляет примерно ~600 кредитов в месяц по сравнению с ~4200 кредитов в месяц для оперативных запросов.
- Победы Live Query: Сегменты, публикуемые 20 раз в день посредством данных, изменяемых каждые 30 минут. Стоимость оперативных запросов составляет примерно 4 200 кредитов в месяц по сравнению с 28 800 кредитов в месяц для ускорения при такой частоте обновления.
Рассмотрим несколько распространенных архетипов, иллюстрирующих, как применять эту логику.
- Архетип "Единый источник истины": Централизация и управление
- Сценарий: Вам нужно создать совместимые, объединенные профили C Customer 360 для всего вашего глобального предприятия. Данные поступают из десятка различных систем, они должны соответствовать строгим регламентам GDPR и CCPA и служить источником истины для всех взаимодействий в области маркетинга и обслуживания.
- Рекомендуемая схема: Прием данных. Приоритет здесь - управление, Trust и контроль. Встраивание данных в Data 360 - это единственный способ создать полностью проверяемый канонический профиль, изолированный от исходных систем.
- Архетип "Важные данные в реальном времени": Анализ без перемещения
- Сценарий: Ваша группа, работающая с данными, должна выполнять поисковые запросы в массивной, постоянно обновляемой таблице транзакций в Snowflake. В то же время, ваша рабочая группа хочет оперативную панель мониторинга BI, работающую на тех же данных. Ежедневное перемещение петабайт данных является медленным и дорогостоящим.
- Рекомендуемая схема: Zero Copy Federation. Приоритетом здесь является скорость, гибкость и эффективность затрат в масштабах. Zero Copy позволяет использовать возможности текущего хранилища данных для запросов в реальном времени без накладок и задержек дублирования данных.
- Архетип "Гибридный интеллект": Управление ядром, объединение края
- Сценарий: Вы хотите пополнить управляемые, принимаемые профили клиентов поведенческими сигналами в реальном времени (например, нажатием на веб-сайт) из озера данных. Вам нужна стабильность базового профиля, но немедленность оперативных данных для мгновенной персонализации.
- Рекомендуемая схема: Гибридный подход. Используйте прием данных для создания стабильного управляемого ядра для данных клиентов. Используйте Zero Copy для создания изменчивых данных в реальном времени, а потом объедините их во время запроса для получения полного и актуального представления.
Стратегия корпоративных данных больше не ориентирована на выбор единой схемы интеграции - это архитектура управляемой гибкости в совместимой экосистеме данных. Правильный подход соотносит каждую исходную систему со схемой, наиболее соответствующей ее требованиям к свежести, управлению, стоимости и доступу:
- Примите важные, регламентированные наборы данных в Salesforce Data Cloud для соответствия, разрешающей способности при опознавании и операционных бизнес-правил.
- Объединяйте данные посредством Zero Copy для оперативной, проверочной аналитики и аналитики на основе искусственного интеллекта без дублирования хранилища.
- Применение кэширования (ускоренного запроса) для уменьшения загрузки исходной системы и потребления кредита при высокой частоте запросов и низкой частоте изменения данных
Salesforce Data 360 в Hyperforce обеспечивает многорегиональную устойчивость и масштабируемость. Открытый озерный дом с таблицами Айсберга поддерживает разделение вычислений и совместимость с такими платформами, как Snowflake, Databricks и S3 Iceberg, что составляет основу подлинно совместимой экосистемы данных с несколькими облачными приложениями.
По мере развития экосистем данных мы должны постоянно балансировать между свежестью, стоимостью, производительностью и соответствием, чтобы поддерживать архитектурную гибкость. Поэтому важно защитить платформу в будущем, объединив принятые управляемые данные с интегрированным доступом. Это включает интеллектуальный анализ в реальном времени, активацию искусственного интеллекта и персонализацию в масштабах предприятия в облаках, регионах и бизнес-доменах.
Помните, что универсальные решения не подходят большинству предприятий. Оптимальная стратегия соотносит правильную схему с правильным бизнес-драйвером.
Югандхар Бора является архитектором программного обеспечения в Salesforce, который специализируется на архитектуре данных на платформе приложений Data and Intelligence. Он руководит инициативами Совета по обзору архитектуры предприятия (СКР), которые сосредоточены на управлении данными и объединенных моделях данных, а также содействуют внедрению автоматизированных решений по обеспечению функционирования платформы.
Ян Фернандо является главным архитектором в Управлении главного архитектора Salesforce, который присоединился к Salesforce в 2012 году. До прихода в ОЦА он провел более десяти лет в организации Платформы, где руководил несколькими ключевыми технологическими преобразованиями.