Introdução
Nota: “Tópicos” foram renomeados para “subagentes” ao longo deste artigo, de acordo com nossas convenções de nomenclatura de produto mais recentes.
Você pode criar um agente com bom desempenho em um ambiente de teste, apenas para que ele siga rotas totalmente diferentes ao processar o mesmo fluxo de trabalho duas vezes. Esta limitação fundamental mostra como o modelo anterior Agentforce tratava da execução: todas as decisões, da interpretação de intenção à seleção de ação, foram tomadas em tempo real pelo LLM, sem um caminho garantido pelo fluxo de trabalho.
Os LLMs podem produzir resultados inconsistentes em resposta a entradas idênticas. Variações sutis no contexto, avisos do sistema ou geração de token são suficientes para enviar um agente por uma rota diferente. Para muitas interações, essa variabilidade é aceitável. No entanto, para fluxos de trabalho de vários estágios que exigem auditoria, reprodutibilidade e rastreabilidade, não é. Uma aprovação de empréstimo, uma transferência de inventário ou um processo de triagem de pacientes não podem depender de um agente que justifique seu caminho pelas etapas de maneira diferente a cada vez.
O novo Agentforce Builder e o Agent Script abordam esse problema separando a execução determinística do raciocínio LLM. O modelo híbrido da Agentforce garante que o agente siga uma estrutura precisamente definida para cada execução de fluxo de trabalho, enquanto ainda usa o raciocínio LLM quando julgamento, compreensão de linguagem natural ou interpretação contextual são verdadeiramente necessários.
Na versão anterior do Agentforce, um agente operava como um simples loop reativo. Todas as decisões, da interpretação da intenção à seleção da próxima ação, foram tomadas em tempo real pelo LLM com base apenas na entrada mais recente do usuário. Não havia caminho de execução garantido, nenhum estado persistente e nenhum mecanismo para aplicar uma sequência de etapas.
Caminhos de execução não podem ser garantidos
Como cada decisão dependia do raciocínio em tempo real do LLM, pequenas variações na entrada, no aviso do sistema ou na versão do modelo produziam diferentes seleções de ação em solicitações idênticas. Isso dificultava o teste rigoroso do modelo anterior: um fluxo de trabalho que passou no preparo pode se comportar de maneira diferente na produção, e não havia uma maneira confiável de reproduzir um caminho de execução específico para fins de depuração ou auditoria.
Cada interação pagou o custo total do LLM
Até mesmo cenários conversacionais simples exigiam pelo menos três ciclos de LLM: seleção de subagente, seleção de ação e geração de resposta final. Tarefas de várias etapas estendidas para cinco ou mais ciclos. Para arquitetos que projetam fluxos de trabalho de alto volume ou sensíveis à latência, isso não era apenas uma preocupação com o desempenho. Isso significava que não era possível encurtar o loop de raciocínio para etapas que não exigiam estimativa, pois a arquitetura não tinha nenhum mecanismo para distinguir os dois.
Execução não determinista criou uma lacuna de auditoria
Em setores regulamentados, a capacidade de auditoria significa poder demonstrar que um processo específico foi seguido de uma maneira específica para uma transação específica. Um modelo puramente não determinístico não pode fornecer essa garantia. Se o caminho de execução variar entre as execuções, a trilha de auditoria também variará e “o agente decidiu” não será uma resposta defensível em uma revisão de conformidade.
O Estado não sobreviveu à conversa.
Com base no processamento de turno único, o agente não tinha memória persistente de etapas anteriores. Se a conversa se desviou um pouco, o agente poderia eliminar o contexto capturado anteriormente e forçar o usuário a reiniciar. Para fluxos de trabalho transacionais de várias etapas, isso criou um limite de confiabilidade: quanto mais etapas no processo, maior é a probabilidade de perda de contexto antes da conclusão.
As etapas concluídas não foram lembradas
Sem o gerenciamento de estado, os agentes não tinham registro das etapas obrigatórias que um usuário já tinha concluído. Isso produziu um loop imprevisível, em que um agente retornaria a uma etapa que o usuário já havia concluído. Além do impacto da experiência do usuário, isso criou um problema arquitetônico mais profundo: projetar um fluxo de trabalho sequencial confiável era impossível porque o agente não podia impor a sequência.
O novo Agentforce, GA desde fevereiro de 2026, muda do raciocínio de LLM puramente probabilístico para um modelo híbrido. Em vez de encaminhar cada decisão pelo LLM, ela separa a execução determinística do raciocínio do LLM e permite que cada uma lide apenas com o que é adequado. Para apoiar isso, a Agentforce introduziu duas ferramentas de criação: Agent Script para desenvolvimento baseado em código e Agentforce Studio, um ambiente de criação sem código.
Agentforce Builder
O Agentforce Builder é o ambiente recomendado para desenvolver novos agentes. Ele está hospedado no Agentforce Studio e substitui a experiência de Configuração legada, que continua disponível, mas não é mais o caminho principal de criação. No Criador, você trabalha em uma visualização de tela visual ou diretamente na visualização de script, editando o script do agente que define o comportamento do agente.
Script do agente
O Script do agente é uma linguagem declarativa específica do domínio (DSL) que define tudo sobre como um agente se comporta: sua configuração, lógica de negócios e prompting. Ele é estruturado como pares de chave-valor que podem abranger várias linhas ou incluir subpropriedades aninhadas, e foi projetado para ser legível pelo ser humano sem exigir Knowledge da arquitetura de gráfico subjacente.
O Script do agente permite que você expresse dois tipos fundamentalmente diferentes de instruções no mesmo agente: instruções de lógica determinística e instruções de prompt. Instruções de lógica determinística definem condições e sequências de ação que são executadas como código sem envolvimento de LLM. As instruções de prompt definem a orientação de linguagem natural que o LLM interpreta em tempo de execução. O limite entre os dois é explícito e deliberado, e entender onde colocar esse limite é uma das principais decisões de design que você tomará ao criar com o novo Agentforce.
Lógica determinística na prática
Quando as instruções são determinísticas, o agente segue um caminho de execução definido, independentemente de como o usuário fraseia sua entrada. O exemplo abaixo mostra um subagente que carrega um painel de Inteligência do cliente. Ele verifica um ID do cliente, busca dados de perfil, histórico de pedidos e pedidos de suporte, então calcula o valor da vida útil do cliente e o risco de rotatividade. Nenhuma dessas etapas requer raciocínio de LLM.
Essa lógica chama ações em uma sequência fixa sempre que determinadas condições são atendidas.
Prompt instruções e deliberada transferência de LLM
Quando a lógica determinística lida com condições e sequências que podem ser expressas como código, as instruções de prompt tratam de tudo o que requer estimativa, interpretação ou geração de linguagem natural. Quando o Mecanismo de raciocínio do Atlas encontra um nó com instruções de prompt, ele aciona uma chamada de LLM. Quando não é, ele é executado de modo determinístico.
O exemplo abaixo mostra um subagente para produtos e serviços. As instruções são um aviso de várias linhas que informa ao LLM como responder, quando pesquisar informações e como lidar com ambiguidade. Esse é o padrão certo quando o intervalo de possíveis entradas do usuário é muito amplo para ser previsto com lógica condicional ou quando a qualidade da resposta depende da capacidade do LLM de interpretar o contexto e gerar uma resposta natural.
As instruções de prompt em um nó acionam a chamada LLM. Isso não é incidente, é o mecanismo pelo qual o Script do agente torna o limite do LLM explícito e aplicável, em vez de deixá-lo para inferência de tempo de execução.
Esse subagente mostra a lógica determinística e a transferência de LLM em ação.
O pipeline de execução de três estágios
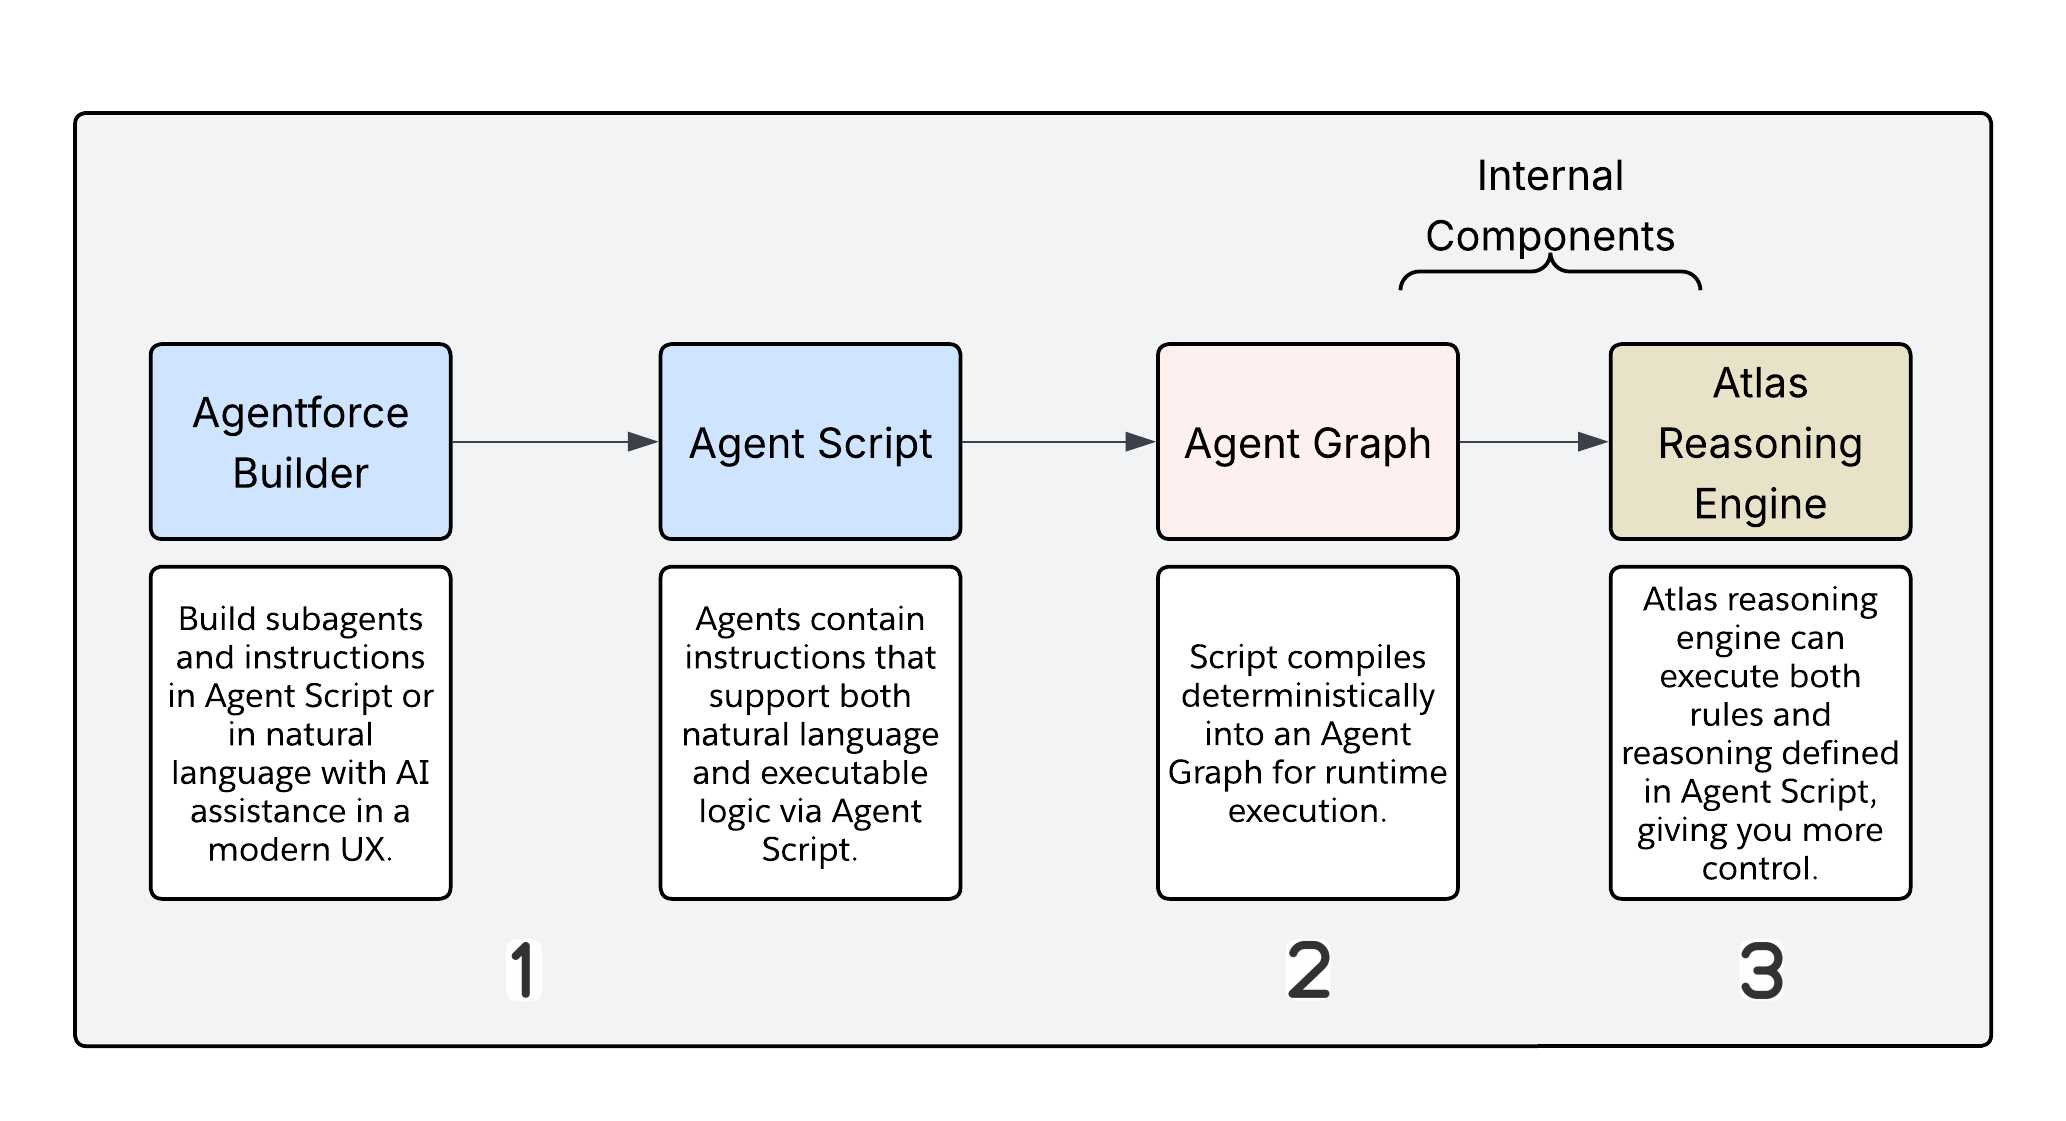
O Criador do Agentforce e o Script do agente são a camada de criação, mas o Gráfico do agente e o Mecanismo de raciocínio do Atlas executam seu agente. Por padrão, nenhum desses componentes está diretamente acessível a você. Separar a criação e a execução permite que a plataforma aplique o comportamento determinístico independentemente de como o script foi escrito.
O pipeline percorre três estágios.
- A autoria é onde você trabalha. O Script do agente é legível e editável no modo de exibição de tela ou no modo de exibição de script no Agentforce Builder. Esta é a única camada com a qual você interage diretamente.
- É na compilação que o compilador do Salesforce transforma seu Script do agente em um Gráfico do agente, um plano de execução serializado otimizado para execução de máquina, em vez de legibilidade humana. Você não depura nessa camada. A compilação produz uma representação que o tempo de execução pode percorrer de modo eficiente.
- É na execução de tempo de execução que o Mecanismo de raciocínio Atlas assume o controle. Ele lê o Gráfico do agente, o percorre com base no estado da sessão atual e decide em cada nó se deseja executar deterministicamente ou invocar o LLM. O mecanismo aplica explicitamente cláusulas de proteção e roteamento condicional aqui, em vez de inferir.
Gráfico de agente
O Gráfico do agente é a representação intermediária que fica entre seu script legível por humanos e a execução real do tempo de execução. Sua estrutura é otimizada para a máquina de estado que a consome, não para o arquiteto que criou o script. Entender que ele existe e o que ele representa é importante porque é o artefato que o Mecanismo de raciocínio usa para impor o plano de execução que seu script define.
Mecanismo de raciocínio do Atlas
O Mecanismo de raciocínio do Atlas é um executor de máquina de estado. Em cada turno, ele percorre o Gráfico do agente com base no estado da sessão, executa nós determinísticos como código e aciona chamadas de LLM apenas quando as instruções de prompt estão presentes. Também impõe cláusulas de proteção e lida com roteamento condicional. É no Mecanismo de raciocínio que o modelo de raciocínio híbrido é realmente implementado; o script define o limite e o mecanismo o respeita.
O Gráfico do agente não é um encapsulador de LLM. É um mecanismo de raciocínio híbrido que separa a execução determinística do raciocínio probabilístico. A regra de regra é simples: se você puder expressar uma decisão como código, ela deverá ser escrita como lógica. Se a decisão exigir estimativa, interpretação ou geração de linguagem natural, o LLM deverá processá-la. Esta decisão de projeto é a escolha arquitetônica mais importante no novo modelo Agentforce. Onde o limite do LLM se enquadra afeta diretamente o custo, a latência, a capacidade de auditoria e a confiabilidade da solução.
O Mecanismo de raciocínio do Atlas avalia cada turno do usuário recebido e o encaminha para um dos dois caminhos.
Caminho A: execução determinística
Esse caminho não tem exposição de LLM. Ele se comporta como código compilado no tempo de execução. O Mecanismo de raciocínio classifica a intenção do usuário e determina que uma instrução de lógica corresponde, ignorando totalmente o LLM. O script do agente compilado é executado de cima para baixo, com as regras if-else sendo executadas incondicionalmente a cada turno. Ações de fluxo, Apex ou API são chamadas com parâmetros determinísticos, sem montagem de prompt ou chamada de modelo envolvida. O resultado é passado de volta pela camada Trust com registro de auditoria completo.
Caminho B: Raciocínio de LLM
O Mecanismo de justificativo segue esse caminho quando não consegue resolver a intenção apenas usando instruções de lógica. Ela percorre o Gráfico do agente e avalia cada nó. Nós com instruções de prompt acionam uma chamada de LLM. Nós sem eles são executados de modo determinístico. A presença de uma instrução de prompt é o acionador e é explícita no script em vez de inferida no tempo de execução.
O que aciona uma chamada LLM
Há oito pontos no ciclo de vida de execução em que o LLM é chamado. A classificação de subagente, ou decidir qual subagente corresponde à solicitação do usuário, é uma, embora um caminho de atalho possa ignorar a chamada completa do LLM quando a classificação é inequívoca. O raciocínio do agente, em que o agente decide qual ação realizar em seguida, sempre passa pelo LLM. Assim como a geração de resposta, em que a resposta final é montada a partir de um aviso hidratado.
Os acionadores restantes são mais operacionais: a validação de fundamentação confirma que a saída está fundamentada em dados recuperados; a simulação de ação emula respostas no ambiente Visualizar e Simular em vez de executar ativamente; a geração de saída estruturada lida com casos em que a resposta precisa se ajustar a um esquema definido; e a geração de indicador de progresso e localização lida com a formatação e mensagens temporárias em que não existe um padrão pré-autorizado.
O que permanece determinístico
As transições de estado e de atravessamento de gráfico nunca envolvem o LLM. Os blocos de ciclo de vida de before_reasoning e after_reasoning são executados de forma determinística, desde que contenham apenas nós de ação sem instruções de prompt. Matemática, busca de dados, validação e lógica condicional pertencem ao código. Qualquer ação que execute o Fluxo, o Apex ou uma API REST permanece diretamente no caminho determinístico. Qualquer nó sem instruções de prompt é executado sem uma chamada de LLM.
Ser explícito sobre esse limite com sua equipe é importante. Cada chamada de LLM desnecessária adiciona latência, custo e variabilidade. Os arquitetos devem enviar por push a lógica determinística por padrão, reservando o LLM para casos em que a tarefa realmente requer sua capacidade de raciocínio.
Diretrizes de design: pressionar lógica para código por padrão
Use as instruções de lógica de script do agente ao escrever instruções de prompt que podem ser expressas como uma condição, uma atribuição de variável ou um filtro de ação. Cada chamada de LLM desnecessária adiciona latência, custo e variabilidade.
A posição padrão deve ser determinística. Isole cada comportamento do agente que possa ser codificado como uma regra e mova-o para o Script do agente. As tarefas restantes que exigem uma síntese de linguagem natural, um julgamento contextual ou uma interpretação complexa pertencem a nós com instruções. Isso não é uma limitação; é o limite que funciona conforme o desejado. O LLM lida com o que é mais adequado e tudo o mais é executado como código.
A unidade principal de execução no Script do agente não é o turno do usuário. É a análise: um único ciclo completo pelos três blocos de ciclo de vida de um subagente. O Mecanismo de raciocínio do Atlas inicia uma análise sempre que um subagente precisa processar algo, o que ocorre em três situações: na primeira entrada no subagente, após cada chamada de ferramenta quando uma ação for concluída e retornar um resultado e, em cada novo usuário, dentro do mesmo subagente.
Entender o limite de análise é importante porque determina quantas vezes cada bloco é executado e, portanto, onde você pode e não pode contar com uma determinada lógica executada exatamente uma vez.
Cada subagente define três zonas de execução:
| Bloquear | Quando é executado | Engajamento de LLM |
|---|---|---|
before_reasoning | No início de cada análise, antes que o LLM veja qualquer coisa | Nenhum |
reasoning | Durante a resolução determinística, antes de qualquer chamada de LLM | Misto |
after_reasoning | Após a conclusão do raciocínio e a resposta do LLM | Nenhum (com uma advertência crítica) |
Tanto a before_reasoning quanto a after_reasoning são totalmente deterministas. Eles executam ações, definem variáveis e aplicam lógica condicional sem envolver o LLM. Isso os torna os blocos confiáveis e de baixo custo no script.
Quando usar before_reasoning
O before_reasoning é executado no início de cada análise sem exceção. Ele é executado na primeira entrada no subagente e novamente após cada chamada de ferramenta ou nova ativação do usuário dentro desse subagente. Um run @actions.X em before_reasoning é código. Diferentemente de uma instrução dentro de um bloco de instruções, que o LLM pode ou não seguir, o before_reasoning é executado incondicionalmente.
Use este bloco para inicialização da sessão: buscar registros de contexto, configurar variáveis de sessão do Apex ou do Fluxo. É também onde a autenticação e as verificações de direitos pertencem, pois você quer que sejam verificadas antes de o LLM ver nenhuma ferramenta. A hidratação de contexto também se aplica aqui: chamar uma ação de recuperação de dados para que o LLM receba variáveis pré-preenchidas em vez de precisar solicitá-las. Qualquer variável de contagem ou auditoria que deve ser incrementada em cada análise deve ser definida aqui, porque a directiva de set em before_reasoning é garantida de uma forma que uma instrução de pipeline não é.
O que não pertence aqui é a lógica que deve ser executada apenas uma vez por sessão, uma vez que o before_reasoning é executado em cada análise, não apenas na primeira entrada. Qualquer coisa que dependa da entrada do usuário do turno atual também não pertence aqui, pois essa entrada ainda não foi processada. E as transições nunca devem estar em before_reasoning: uma instrução de transition to aqui vai disparar incondicionalmente em cada parse e criar loops.
Se você precisar de inicialização uma vez por sessão, proteja-a explicitamente:
Um turno de usuário pode acionar várias análises: uma vez na entrada e outra vez após cada chamada de ferramenta. Essa funcionalidade tem três consequências práticas: as ações de inicialização em before_reasoning serão executadas mais de uma vez por usuário girar em fluxos de múltiplas ações, as variáveis contadoras incrementadas aqui refletirão a contagem de análises, não a contagem de turnos, e as ações com efeitos colaterais, chamadas de API externas ou gravações de registro, não devem viver em before_reasoning a menos que a reexecução em cada análises seja explicitamente aceitável.
before_reasoning não é um construtor. É uma verificação pré-ativação que é executada com cada análise. Projete-o de acordo.
Quando usar after_reasoning
A after_reasoning é executada quando o loop de raciocínio é concluído, depois que o LLM respondeu e as saídas de ação foram capturadas. É aqui que as verificações determinísticas pós-ação pertencem: avaliando saídas de ação e ramificação com base nos resultados. Transições determinísticas, ou passar para o próximo subagente com base no estado da variável em vez de na estimativa do LLM, fiquem sentados aqui. Assim como a limpeza de variável antes do próximo turno e a sequência de orquestração quando você precisa encadear subagentes em uma ordem previsível sem uma decisão de roteamento de LLM.
Trate o after_reasoning como a camada de proteção. É onde você aplica regras de negócios e gerenciamento de estado depois que o LLM tem feito seu trabalho, garantindo que os fluxos de processo críticos permaneçam previsíveis independentemente do que o LLM gerou.
Use is_displayable: True com sabedoria
Todo arquiteto que projeta fluxos de orquestração precisa entender esse comportamento de plataforma. Quando a is_displayable: True é definida em uma ação, a plataforma sai do loop de raciocínio assim que o LLM decide detectar essa saída. Essa saída acontece imediatamente, o que significa que o after_reasoning nunca é executado.
Esse é um comportamento de plataforma conhecido, mas tem uma consequência direta para orquestração: qualquer lógica colocada em after_reasoning será ignorada quando uma ação exibível fizer parte do fluxo.
A resposta é simples. Mover lógica que deve ser executada de forma confiável no bloco de before_reasoning do subagente subsequente em vez do bloco de after_reasoning do atual.
Diretrizes de design: onde colocar a lógica de inicialização
Decidir onde colocar a lógica é consequente ao projetar um subagente. Essa estrutura abrange os cenários mais comuns:
| Cenário | Onde colocar |
|---|---|
| Deve ser executado antes que o LLM veja qualquer contexto | before_reasoning |
| Executa cada análise, incluindo reentrada em novos turnos de usuário | before_reasoning |
| Depende da saída da ação desse turno | Bloco de if condicional em reasoning |
| Requer transição de subagente determinística com base no resultado | after_reasoning (mas veja a advertência de is_displayable abaixo) |
Requer lógica de orquestração quando a ação a jusante usa is_displayable: True | before_reasoning do próximo subagente |
| Usa lógica que requer estimativa ou contexto do usuário | reasoning com instruções de prompt |
O princípio subjacente é simples. Quando você escreve uma instrução de prompt informando ao LLM para “sempre executar” uma ação, isso é uma sugestão. O LLM pode ou não seguí-lo dependendo do contexto. Quando você coloca uma directiva de run em before_reasoning, isso é código. Ele é executado em cada análise sem exceção.
A disponibilidade da ação condicional é o mecanismo pelo qual o Script do agente expõe ou oculta ações do LLM com base no estado da variável de tempo de execução. Quando a condição de available when é avaliada para false, a ação é removida completamente da lista de ferramentas apresentada ao LLM. Qualquer valor falso, incluindo None, False, 0 ou uma string vazia, suprime a ação.
Esta não é uma instrução urgente dizendo ao LLM “Não chame isso ainda”, é um gateway rígido no nível da plataforma. O LLM não pode chamar uma ação que não pode acessar.
Neste exemplo, a execute_transfer fica invisível para o LLM até que a validation_passed avalie para a true. O gate é imposto pela plataforma, não por instrução.
Diretrizes de design: nunca deixe o LLM definir a variável de gate
Dê a cada variável em uma cláusula de available when um caminho de código determinístico que define a variável antes da execução da ação associada. Use before_reasoning ou um determinístico run e set em reasoning para manter a variável em um estado conhecido. Se você depender do LLM para definir a variável de gate, reintroduzirá a variabilidade que o gate foi projetado para evitar. Dependendo da conversa, o LLM pode ou não defini-lo, o que significa que o portão pode ou não ser aberto.
O problema do loop de ação
Um loop de ação ocorre quando o LLM chama a mesma ação repetidamente sem nunca atingir um estado terminal. Isso acontece quando duas condições são verdadeiras ao mesmo tempo: a condição de available when permanece satisfeita após a execução da ação, e as instruções de raciocínio não dizem explicitamente ao LLM para parar de chamá-la.
A plataforma não suprimirá automaticamente uma ação depois de ela ser chamada. Se o portão permanecer aberto e as instruções de raciocínio forem ambíguas, o LLM chamará a mesma ação em cada análise indefinidamente.
Considere available when @variables.interest != "" como exemplo. Se a ação for executada, mas a variável de interesse não estiver vazia, o gate permanecerá aberto na próxima análise. O LLM vê a ação como disponível, não tem instruções para parar e a chama novamente.
Há duas maneiras confiáveis de interromper o loop. A primeira é definir a variável de gate para um estado fechado como parte da lógica pós-execução da ação, de modo que available when avalia para false na próxima análise. A segunda é usar um booleano has_run separado que feche o portão após a primeira execução. Ambas as abordagens dão ao gate um estado fechado determinístico, que é a condição de que a plataforma precisa para suprimir a ação.
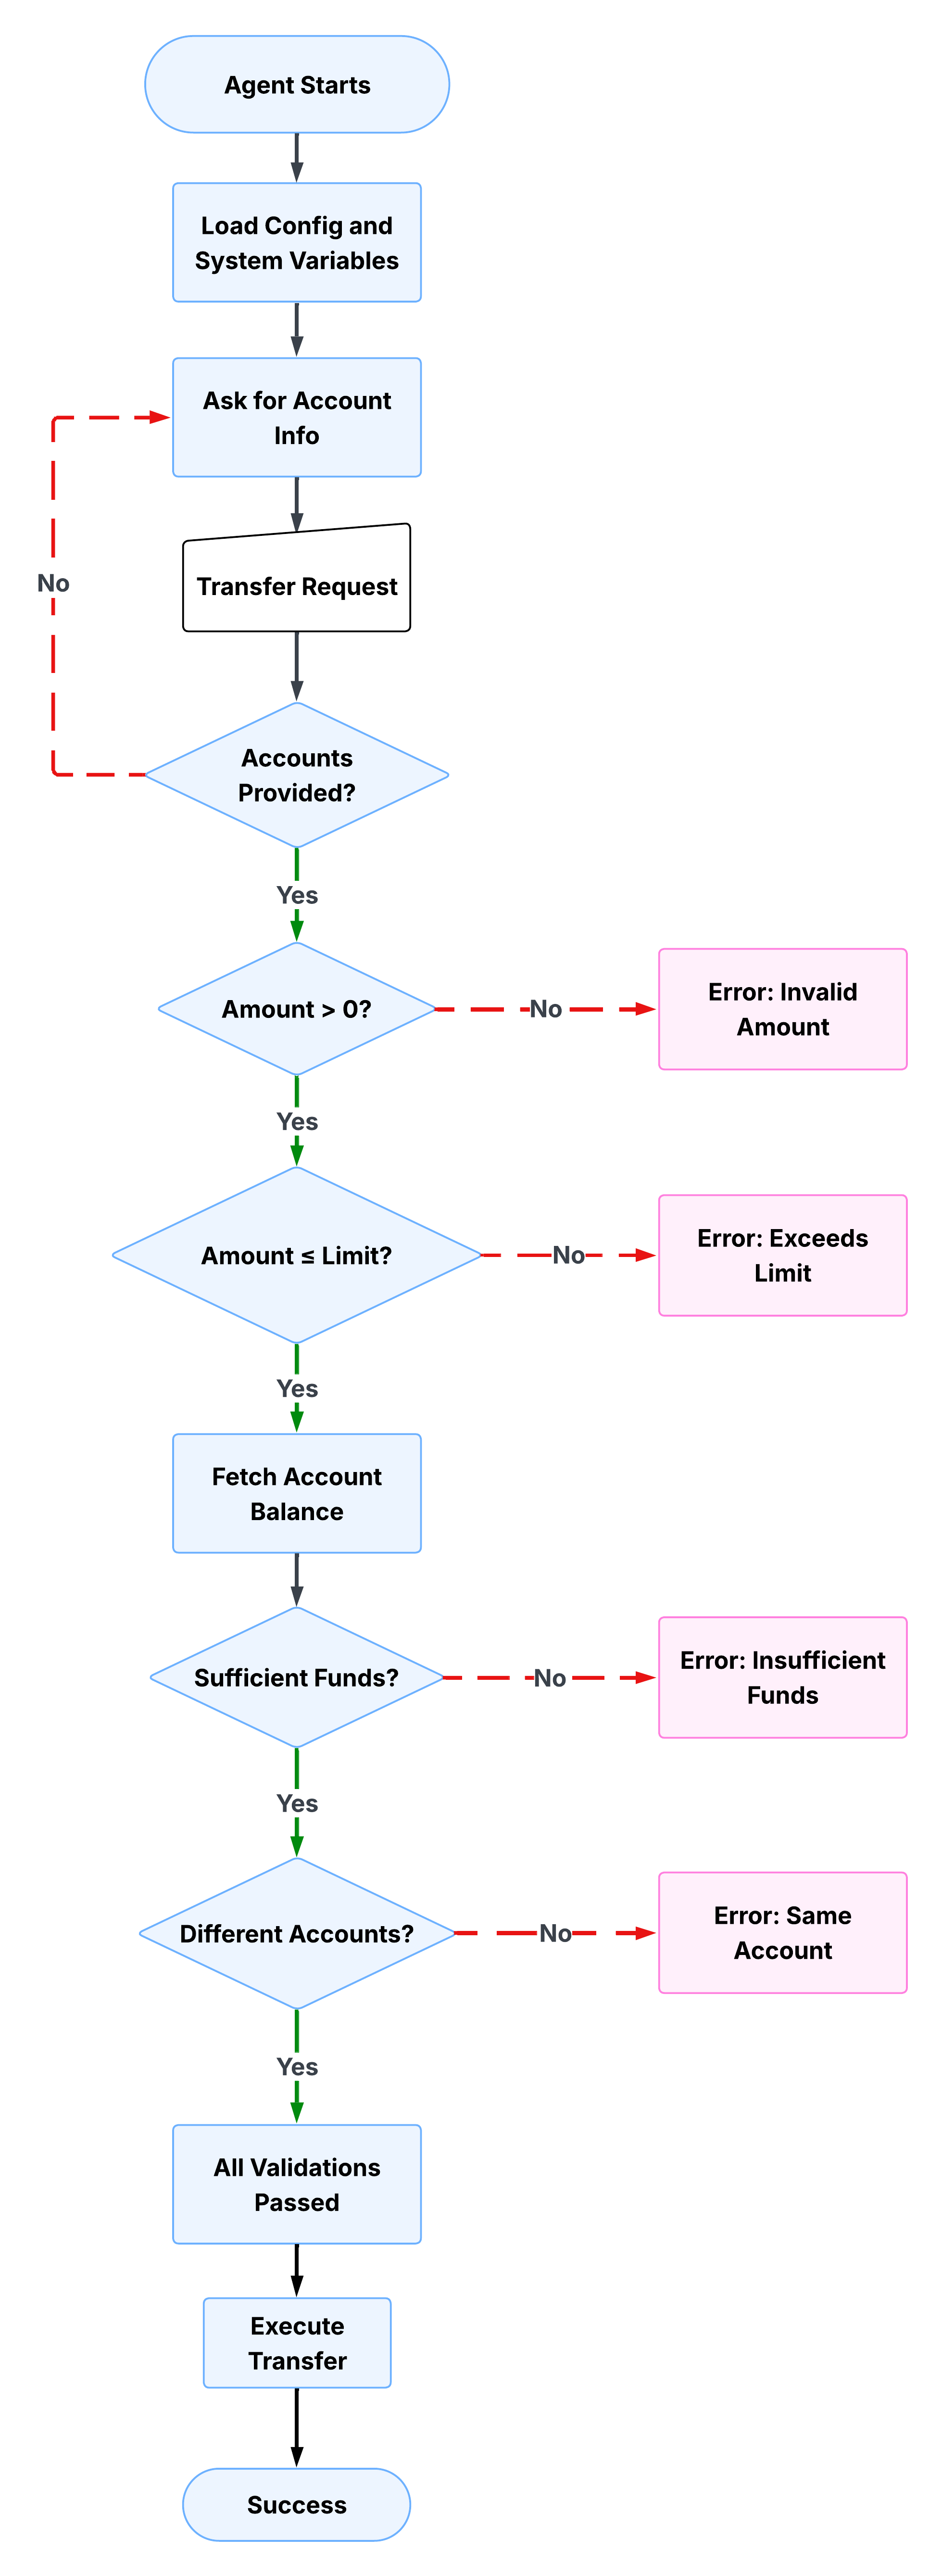
Uma transferência bancária é uma lente útil para entender como esses padrões funcionam juntos na prática. O fluxo de trabalho parece simples de fora: mover dinheiro de uma conta para outra. A implementação exige várias etapas complexas. Antes da execução da transferência, o agente deve coletar detalhes da conta, validar o valor, verificar os limites de transferência, confirmar o saldo disponível e apenas então expor a ação de transferência. Cada etapa depende das etapas anteriores. Nenhum deles deve ser deixado para a estimativa do LLM.
Coletar e validar entradas
O primeiro subagente coleta a conta de origem, a conta de destino e o valor da transferência do usuário. Não continuará até que todos os três estejam presentes e sejam válidos. O Script do agente verifica cada campo na sequência: se a conta de origem estiver ausente, ele perguntará. Se o destino estiver ausente, ele perguntará. Se o valor for zero ou negativo, ele perguntará. A variável validation_passed é definida como true apenas depois de todas as verificações estarem prontas.
O script abaixo mostra isso na prática. Observe que o validation_passed é definido explicitamente como false em cada ponto de falha, e o LLM é instruído a não prosseguir. As verificações determinísticas são executadas de modo incondicional, enquanto as instruções de prompt lidam com a resposta voltada para o usuário.
Impor regras de negócios
Depois que o agente valida as entradas, ele verifica se o valor da transferência excede o limite de transferência configurado. É aí que as regras de negócios se tornam código, em vez de instruções. O limite não é algo dos motivos do LLM; é um limite rígido definido no script e verificado deterministicamente em cada análise.
Se o valor exceder o limite, a validation_passed será redefinida para false e o LLM apresentará ao usuário três opções: transferir o valor máximo permitido, dividir em várias transferências ou contatar o suporte para maiores limites. O agente não pode continuar até que o usuário resolva a exceção. Observe como a instrução de prompt aqui está fazendo exatamente para o que o raciocínio de LLM é adequado: apresentando opções de modo conversacional e lidando com a resposta do usuário. A regra de negócios em si é determinística, mas a conversa em torno dela não é.
O script abaixo mostra como a verificação de limite funciona. A condição determinística avalia o valor da transferência em relação à variável limite, define validation_passed para false se o limite for violado e delega a uma instrução de prompt para lidar com a resposta voltada para o usuário.
Aplicar cláusulas de proteção
Com as verificações de valor e limite concluídas, o agente busca o saldo da conta de origem e confirma que há fundos suficientes disponíveis. As cláusulas de proteção impedem que o agente tente operações quando as pré-condições não são atendidas. Diferentemente de uma instrução de prompt que informa ao LLM para verificar o saldo, uma cláusula de proteção no script do agente torna a verificação incondicional. O LLM não decide se deseja executá-lo.
Se o saldo for insuficiente, o agente calculará a escassez e apresentará ao usuário uma alternativa concreta. O validation_passed é definido como false até que essa verificação seja aprovada, o que significa que a ação de transferência permanece bloqueada.
O script abaixo mostra uma chamada de ação determinística que busca o saldo, seguida por uma verificação condicional que o avalia. A busca será executada apenas se o saldo ainda não tiver sido recuperado, evitando chamadas de API redundantes em análises subsequentes.
Erros de superfície claramente
Cláusulas de proteção definem o estado. Mensagens de erro o comunicam. Quando validation_passed é false, o agente precisa fornecer ao usuário informações suficientes para resolver o problema sem reiniciar. Mensagens de erro vagas criam atrito; as estruturadas fecham o loop mais rapidamente.
O script abaixo mostra a mensagem de erro de fundos insuficientes na prática. Não diz apenas ao usuário que a transferência falhou. Ele mostra o saldo disponível, o valor solicitado, a escassez calculada e oferece uma próxima etapa concreta, tudo montado a partir de variáveis da sessão, em vez de gerado pelo LLM.
O cálculo da escassez ocorre no script, não no LLM. A alternativa sugerida, transferindo o saldo disponível, é derivada deterministicamente do estado da sessão. O papel do LLM aqui é puramente de apresentação: ela entrega uma mensagem que o script já estruturou.
Gate a ação de transferência
Cada verificação de validação nas etapas anteriores define ou limpa a mesma variável: validation_passed. Essa variável agora está fazendo seu trabalho mais importante. A ação execute_transfer está disponível condicionalmente, o que significa que ela só aparece na lista de ferramentas do LLM quando validation_passed é true. Até que cada verificação anterior seja aprovada e defina essa variável, a ação não existe da perspectiva do LLM.
Esse é o padrão da seção de gate anterior aplicada a um fluxo de trabalho de produção. A ação de transferência não é ocultada por uma instrução de prompt. Está oculto pela plataforma. Nenhuma quantidade de pressão conversacional ou frases ambíguas pode fazer o LLM invocá-lo antes que as pré-condições sejam atendidas.
O script abaixo mostra como o gate é configurado. A cláusula available when faz referência a validation_passed diretamente, e os parâmetros de ação estão vinculados às variáveis de sessão coletadas e validadas nas etapas anteriores.
Todos os três parâmetros, from_account, to_account e amount, são passados deterministicamente de variáveis de sessão. No momento em que essa ação ficar disponível, todos os valores serão validados. O LLM não está montando os parâmetros do contexto da conversa; ele está lendo-os do estado.
Rastreie o estado em todo o fluxo de trabalho
Os padrões nas seções anteriores funcionam apenas porque o estado da sessão persiste em todo o fluxo de trabalho. Os números de conta capturados na primeira etapa estão disponíveis na quarta. Os resultados da validação definidos em ações de gate de verificação em outras. A conversa pode se desviar, o usuário pode fazer perguntas de acompanhamento e o agente ainda saberá exatamente onde está no processo.
O bloco de variáveis abaixo mostra o estado da sessão completa para esse fluxo de trabalho. Cada variável tem um tipo definido, um valor padrão e uma descrição. Duas variáveis tratam da maior parte do trabalho de orquestração: O validation_passed controla a disponibilidade de ação em cada gate, e o validation_information traz contexto legível por humanos sobre por que uma verificação falhou, que o LLM pode expor ao usuário sem precisar justificar o estado subjacente.
Cada variável começa em um estado padrão conhecido. Strings padrão para vazio, números para zero, e o booleano validation_passed para false. Isso significa que o portão está fechado por padrão. O fluxo de trabalho precisa ganhar ativamente o direito de prosseguir em cada etapa, em vez de começar com o portão aberto e contar com verificações para fechá-lo.
O exemplo de transferência bancária ilustra onde a lógica determinística é a ferramenta certa, mas nem sempre é a melhor opção. Entender o limite é tão importante quanto entender os padrões.
A lógica determinística é a escolha certa quando o fluxo de trabalho requer uma sequência de execução garantida, quando os erros têm consequências significativas, quando o processo precisa produzir uma trilha de auditoria reproducível ou quando as regras de negócios são suficientemente bem definidas para serem expressas como condições e limites. Fluxos de trabalho financeiros, de saúde e de seguro geralmente se enquadram nessa categoria.
O raciocínio de LLM puro sem restrições determinísticas rígidas faz mais sentido quando o valor da interação reside na flexibilidade, em vez de precisão. Suporte ao cliente de término aberto, produtos de estágio inicial em que os processos de negócios ainda estão evoluindo e consultas informativas de baixa participação são todos os casos em que a variabilidade do raciocínio do LLM é um recurso, não um problema.
Na prática, a maioria dos agentes de produção precisa de ambos. A decisão de onde o limite se enquadra não é uma escolha binária entre determinística e probabilística; é uma decisão de design que você toma no nível do nó para cada parte do fluxo de trabalho do seu agente.
| Usar lógica determinística para | Usar o raciocínio de LLM para |
|---|---|
| Validação e limpeza de entrada | Compreensão de linguagem natural e detecção de intenção |
| Aplicação de regra de negócios | Gerar respostas conversacionais e empáticas |
| Orquestração de processo sequencial | Tratamento de entradas ambíguas ou inesperadas |
| Gerenciamento de estado e preservação de contexto | Fornecer explicações e esclarecimentos |
| Cláusulas de proteção que impedem operações inválidas | Adaptar o tom e as mensagens ao contexto do usuário |
O limite é a decisão de projeto
O exemplo de transferência bancária é uma ilustração de uma filosofia de design: que o limite entre a execução determinística e o raciocínio do LLM é a decisão arquitetônica mais consequente que você toma ao criar um agente de produção.
Coloque um limite muito rígido e você terá um agente rígido, caro de manter e incapaz de lidar com a variação natural de conversas reais. Se o limite estiver errado na outra direção, será criado um agente flexível, mas imprevisível, com um bom desempenho em testes, mas com um comportamento diferente na produção, e que não pode produzir uma trilha de auditoria confiável ou ser confiável com uma transação de alta participação.
O novo modelo Agentforce oferece as ferramentas para definir esse limite deliberadamente. O Script do agente permite expressar a lógica determinística e instruções de prompt no mesmo arquivo, com uma sintaxe explícita para tornar o limite visível. O Mecanismo de raciocínio do Atlas aplica lógica e avisos em tempo de execução. Os blocos de before_reasoning e after_reasoning dão a você zonas de execução garantidas em ambos os lados da chamada LLM. A disponibilidade de ação condicional garante que o LLM possa agir apenas quando as pré-condições forem atendidas.
Nenhum desses recursos está isolado. Eles trabalham juntos para criar uma arquitetura coesa para criar agentes que as empresas podem Trust com fluxos de trabalho críticos para a missão. O modelo de raciocínio híbrido reconhece que o determinismo e a flexibilidade têm papéis na sua arquitetura; é o trabalho do arquiteto decidir exatamente onde cada um se aplica.
Guia do desenvolvedor do Agentforce
Gráfico do agente da Agentforce: Para o determinismo guiado com raciocínio híbrido
Gulal Kumar é um arquiteto de engenharia de software na Salesforce com mais de 20 anos de experiência. Sua experiência abrange IA, integração, APIs e arquitetura corporativa, com foco em promover a transformação de negócios por meio de soluções de IA seguras, resilientes e inovadoras. Conecte-se com ele no LinkedIn.
Miriam McCabe é diretora sênior e líder da equipe Arquiteto Evangelismo. Seu trabalho se concentra em capacitar a comunidade global de arquitetos do Salesforce a liderar a era da agência por meio de conteúdo profundamente técnico, programação ativa e engajamento da comunidade. Siga-a no LinkedIn.