As arquiteturas de dados corporativas raramente ficam em um sistema. O Salesforce gerencia o engajamento do cliente, o pipeline e as interações de serviço. Plataformas analíticas como o Snowflake abrigam transações históricas, registros financeiros, dados de uso e métricas operacionais. Tradicionalmente, conectar esses dois mundos significava criar e manter pipelines de ETL: trabalhos agendados que extraem dados da origem, os transformam e carregam cópias no Salesforce. Como resultado desses pipelines, os dados chegam atrasados, as políticas de governança se multiplicam entre sistemas e os pipelines exigem cuidados operacionais contínuos.
A Virtualização de dados do Salesforce oferece um modelo diferente. Em vez de mover dados para o Salesforce, ele permite que o Salesforce consulte dados diretamente na origem, no tempo de execução, sem replicação. Os usuários veem dados externos ativos por meio de interfaces padrão do Salesforce. Os dados nunca saem de sua página inicial de autoridade. Este documento explica como o padrão funciona, quando usá-lo e como começar, usando o Snowflake como um exemplo concreto de trabalho.
A Virtualização de dados do Salesforce é um padrão de arquitetura de integração que permite que o Salesforce consulte dados diretamente de sistemas externos em tempo de execução, sem copiar nem replicar esses dados no armazenamento do Salesforce. Em vez de mover dados para dentro, a plataforma envia a consulta.
Como resultado, os usuários do Salesforce interagem com dados externos por meio de interfaces familiares do Salesforce (como layouts de página, listas relacionadas, relatórios ou fluxos) enquanto os dados permanecem em seu sistema de origem autorizado. Governança, controle de acesso e residência de dados permanecem onde eles pertencem.
Esse padrão é baseado em um único princípio arquitetônico: os dados permanecem na origem. A computação passa para os dados.
A maioria das implantações corporativas do Salesforce se integra a plataformas de dados externas (como armazéns de dados, bancos de dados operacionais ou lojas analíticas) por meio de pipelines de replicação. Os pipelines extraem, transformam e carregam dados no Salesforce de acordo com um cronograma. Essa abordagem funciona, mas a replicação introduz desvantagens estruturais:
- Dados replicados sempre são atrasados. Os pipelines apresentam atrasos e dados obsoletos levam a decisões ruins.
- Cada cópia de dados expande o escopo de conformidade. Dados confidenciais (como informações de identificação pessoal, registros financeiros ou dados de saúde) em vários sistemas exigem a manutenção de várias políticas de governança.
- Os pipelines exigem investimento operacional contínuo, monitoramento, tratamento de falhas, gerenciamento de desvio de esquema e lógica de reprocessamento.
A virtualização de dados lida com esses prós e os contras diretamente. Ele remove o pipeline totalmente para casos de uso pesados de leitura, mantém os dados em seu local de autoridade e oferece aos usuários do Salesforce uma visualização governada em tempo real de dados externos sem sobrecarga de replicação.
Objetos externos são o mecanismo principal pelo qual a virtualização de dados detecta dados externos dentro do Salesforce. Eles se comportam como objetos padrão do Salesforce: consultável por SOQL, visível em layouts de página e listas relacionadas e acessível por meio de APIs padrão do Salesforce. A principal diferença é que nenhum dado é armazenado no Salesforce. O Objeto externo é uma projeção de esquema: uma definição da aparência dos dados externos, não uma cópia dos dados em si.
Quando um usuário carrega uma página ou executa um relatório que faz referência a um Objeto externo, o Salesforce executa uma consulta ativa com relação ao sistema externo e retorna apenas o resultado definido para essa interação.
Quando o Salesforce executa uma consulta SOQL em um objeto externo, ele traduz filtros (cláusulas WHERE), ordens de classificação (ORDER BY) e limites (LIMIT) para o SQL equivalente e os envia para o sistema externo. O sistema externo executa a consulta em seu próprio mecanismo de computação e retorna apenas o conjunto de resultados filtrado. O trabalho acontece onde os dados estão, e somente a resposta volta para o Salesforce.
A virtualização de dados aplica duas camadas de segurança independentes simultaneamente. O sistema externo aplica seus próprios controles de acesso no tempo de execução da consulta, incluindo segurança em nível de linha, mascaramento de coluna e acesso baseado em papel. A Salesforce aplica seu próprio modelo de segurança: perfis, conjuntos de permissões, segurança em nível de campo e regras de compartilhamento. Ambas as camadas estão ativas em todas as consultas. Nenhum substitui o outro.
Os arquitetos costumam descrever a virtualização de dados como um padrão de “cópia zero”. Cópia zero significa nenhuma replicação persistente no armazenamento do Salesforce. Não há registros de gravação de pipeline ETL em objetos do Salesforce. Não há sincronização agendada para criar uma cópia local. O Objeto externo não contém linhas.
Cópia zero não significa nenhuma transmissão de dados. Sempre que um usuário consulta um Objeto externo, um conjunto de resultados viaja do sistema externo para o Salesforce por meio da rede. Para grandes conjuntos de resultados ou alta frequência de consulta, os custos de saída de dados e a latência de rede são fatores reais para os arquitetos projetarem. Esta não é uma limitação para ocultar: é uma restrição de design a considerar.
Considere essas diferenças arquitetônicas se seu caso de uso exigir altos volumes, acesso frequente ou baixa latência.
O Snowflake é um dos sistemas externos mais comuns conectados ao Salesforce por meio da Virtualização de dados. Ela serve como um exemplo concreto de como o padrão funciona de ponta a ponta.
Nessa configuração, o Salesforce se conecta ao Snowflake usando o Salesforce Connect com o adaptador SQL para Snowflake. As tabelas e visualizações do Snowflake são exibidas como objetos externos no Salesforce. Quando um usuário consulta um Objeto externo, o Salesforce traduz o SOQL para SQL e o envia para a API de declarações do Snowflake por meio de uma chamada HTTPS autenticada. O Snowflake executa a consulta em seu armazém virtual, aplica sua própria segurança em nível de linha e mascaramento de coluna e retorna apenas o conjunto de resultados. Nenhum dado é gravado no armazenamento do Salesforce em nenhum ponto.
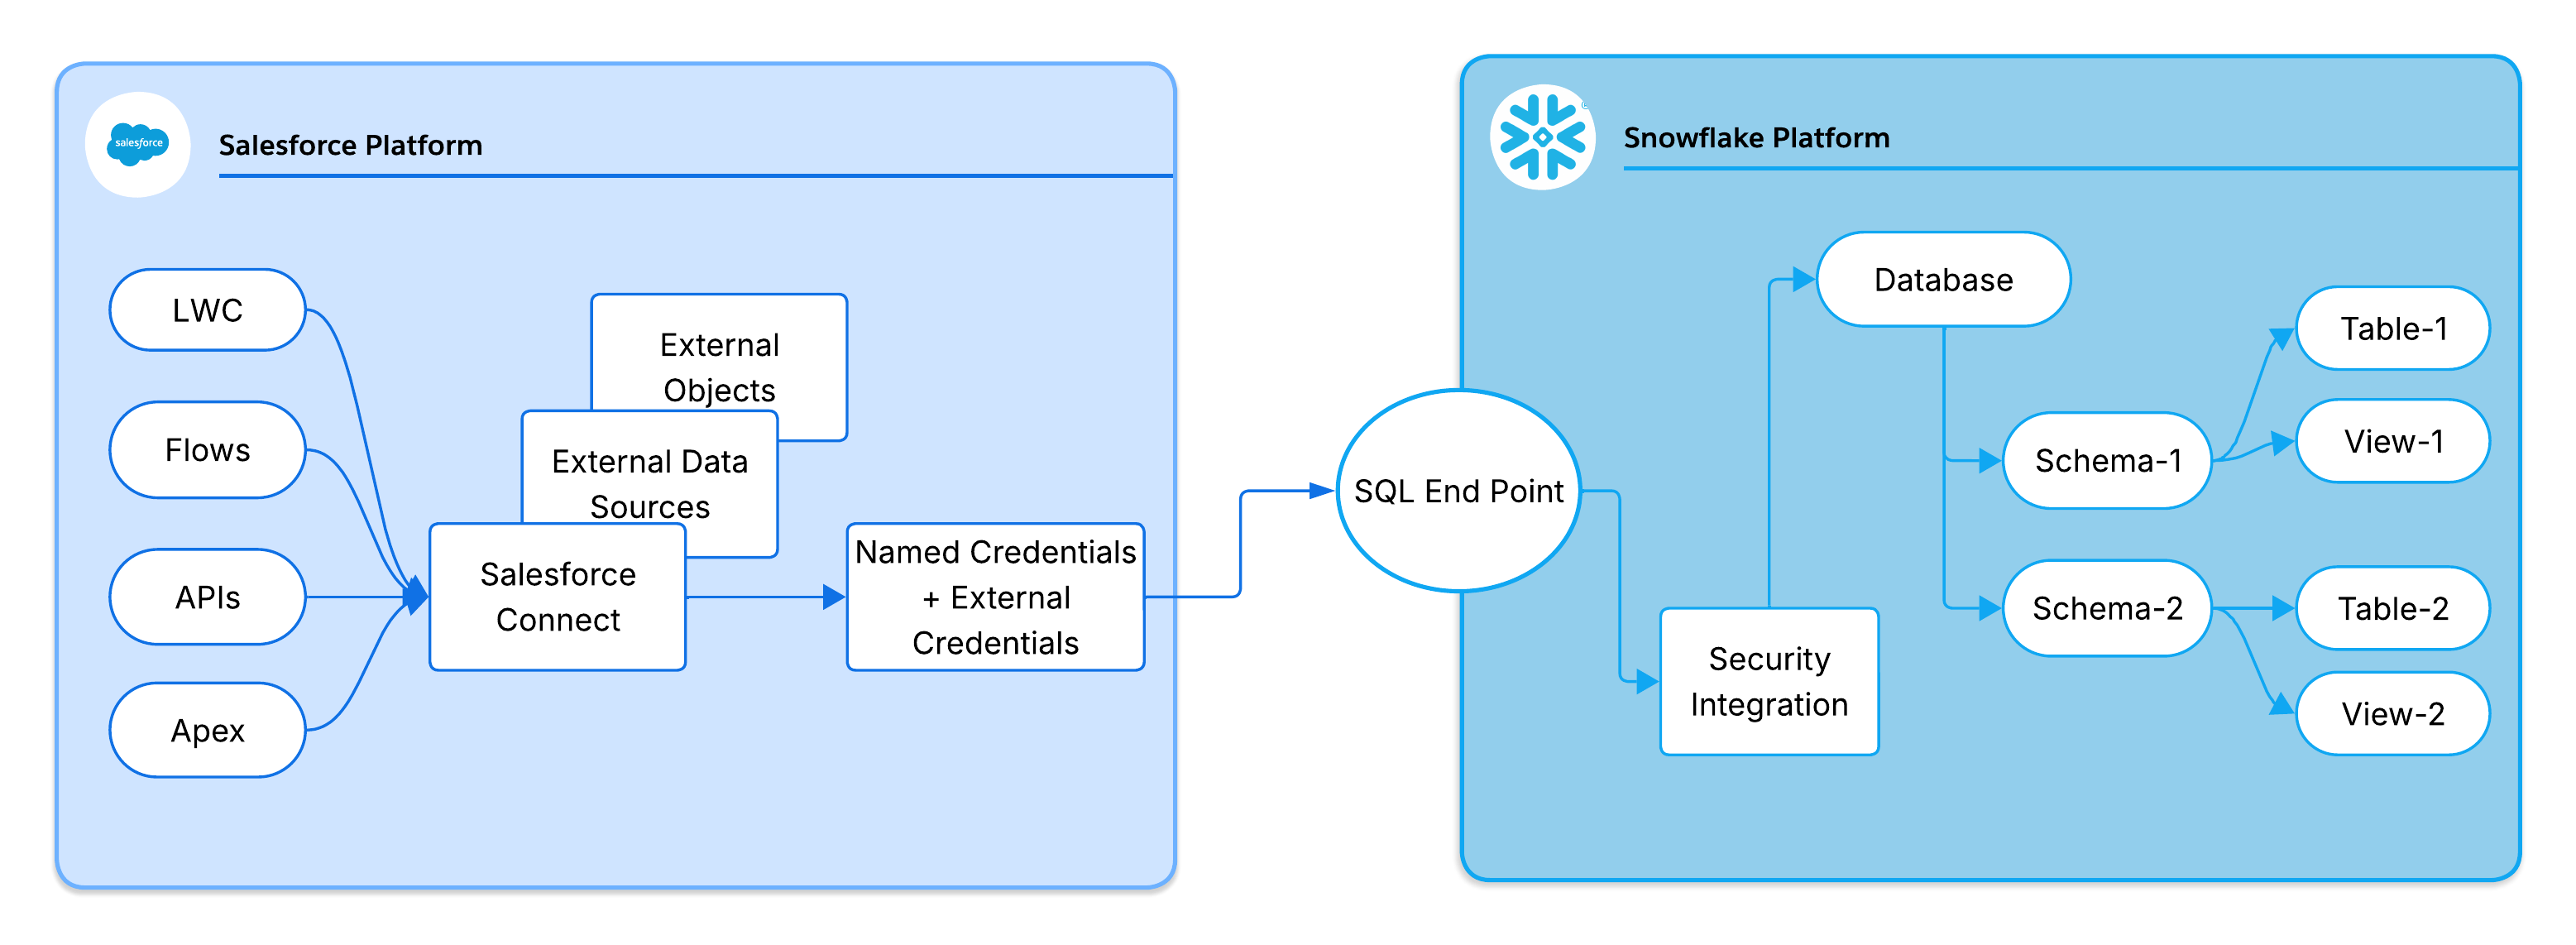
O Salesforce Connect usa um modelo do OAuth 2.0 delegado para autenticação com o Snowflake. Os principais componentes são:
- Provedor de autenticação: Gerencia o apelido do OAuth com o Snowflake. Lida com solicitações de token e mapeia o token retornado para a credencial do Salesforce.
- Credencial externa: Armazena os tokens de acesso e atualização do OAuth com segurança no armazenamento de credenciais criptografadas do Salesforce e os insere em chamadas de saída.
- Credencial nomeada: Define o URL do ponto de extremidade do Snowflake e faz referência à Credencial externa.
- Integração de segurança do Snowflake: Registra o Salesforce como um cliente OAuth confiável no Snowflake. Define o URI de redirecionamento permitido, os fluxos OAuth e o TTL do token.
Estes componentes formam uma cadeia de dependência: A Origem de dados externa faz referência à Credencial nomeada, que faz referência à Credencial externa, que faz referência ao Provedor de autenticação. Entender essa cadeia é essencial ao solucionar problemas de conectividade ou falhas de acesso.
O Salesforce oferece suporte a dois modelos de delegação de identidade ao autenticar com o Snowflake:
- Principal nomeado: Uma conta de serviço compartilhada autentica todos os usuários do Salesforce no Snowflake. É mais simples de configurar, mas não tem capacidade de auditoria por usuário ou controle de acesso fino ao Snowflake.
- Principal por usuário: Cada usuário do Salesforce se autentica com seu próprio token OAuth. Isso habilita a segurança em nível de linha do Snowflake e as trilhas de auditoria completas por usuário, com uma compensação de maior sobrecarga de gerenciamento de token (fluxos de OAuth por usuário, atualização, revogação).
Orientação de decisão: Use Entidade de segurança por usuário para dados regulados ou informações de identificação pessoal (PII). Use Entidade de segurança nomeada quando as regras de compartilhamento do Salesforce fornecerem controle de acesso suficiente e simplicidade for a prioridade.
Estes limites do controlador do Salesforce limitam diretamente o design de soluções de formato ao usar objetos externos com o Snowflake:
- Limite de chamada: 100 por transação do Apex. Páginas ou fluxos com várias consultas de Objeto externo podem atingir esse limite rapidamente.
- Tempo limite de chamada: 120 segundos no máximo. Consultas do Snowflake de execução longa causam uma exceção de tempo de execução.
- Limite de linhas SOQL: 50.000 linhas. Paginar conjuntos de resultados grandes.
- Restrições assíncronas: O Apex em lote e a maioria dos contextos assíncronos restringem chamadas. Mantenha o acesso a objeto externo dentro dos limites de transações síncronas. Para casos de uso assíncronos que consultam objetos externos, considere as chamadas de Continuação para interações assíncronas iniciadas pelo usuário ou arquive o fluxo para realizar o acesso a dados externos em uma transação síncrona e entregar os resultados de modo assíncrono.
Diretrizes de design: Não consulte objetos externos dentro de loops. Envie por push filtros de cláusula WHERE para o Snowflake para reduzir o tamanho dos resultados e a frequência das chamadas.
Todas as consultas que o Salesforce envia ao Snowflake são registradas no Histórico de consultas do Snowflake com metadados de execução completos: latência, linhas verificadas, armazém usado e identidade de execução. Esse histórico fornece capacidade de auditoria completa da ação do usuário do Salesforce à execução do Snowflake e é a ferramenta de diagnóstico principal para ajuste de desempenho e validação de acesso.
A virtualização de dados é adequada para usar casos em que acesso em tempo real, governança e sobrecarga de replicação reduzida sobrepõem as restrições de um modelo de acesso de tempo de consulta federado.
Use-o quando:
- O acesso analítico pesado é o requisito primordial. Se os usuários precisarem consultar e exibir dados externos em UIs, relatórios ou fluxos do Salesforce sem escrever de volta, a Virtualização de dados elimina a sobrecarga do pipeline para cenários somente leitura.
- A atualização dos dados é essencial. Quando dados replicados obsoletos criam risco de negócios (como saldos financeiros desatualizados, níveis de inventário ou status de conformidade), o modelo federado garante que cada consulta reflita dados ativos.
- Os requisitos de governança e residência de dados são rígidos. Quando restrições regulatórias ou contratuais proíbem copiar dados confidenciais para o Salesforce, a virtualização mantém os dados em seu local autorizado enquanto os torna acessíveis no Salesforce. Apenas um sistema contém os dados.
- É necessário um controle de acesso de duas camadas. Quando os controles de acesso nativos do sistema externo e o modelo de segurança do Salesforce se aplicam ao mesmo tempo, o modelo federado impõe ambos sem duplicação de dados.
- O sistema externo já é o sistema de registro autorizado. Se os dados já estiverem limpos, controlados e consultáveis no sistema de origem, sua virtualização evitará transformação redundante, custo de armazenamento e risco de discrepância.
Evite quando:
- É necessário gravar com baixa latência. Objetos externos são somente leitura. Os casos de uso de write-back exigem um padrão de integração diferente.
- Junções complexas de vários objetos são necessárias. O SOQL em vários objetos externos não oferece suporte a junções. Pré-materialize os dados combinados como uma só visualização no sistema de origem.
- A IA do Salesforce ou os recursos do Agentforce exigem dados nativos. Atualmente, os recursos do Einstein e Agentforce (incluindo a fundamentação para o Einstein Copilot, pontuação preditiva e ações do Agentforce) operam em objetos nativos do Salesforce. Esses recursos não oferecem suporte a objetos externos como uma fonte de dados de fundamentação ou ativação. Se a ativação de IA estiver no escopo para esses dados, o Salesforce Data 360 é a solução complementar recomendada.
- Padrões de acesso de alta frequência. Objetos externos são projetados para acesso sob demanda. Cargas de trabalho que acionam centenas de consultas por minuto reduzem os limites do regulador de escape e o desempenho.
Os casos de uso a seguir ilustram como a Virtualização de dados do Salesforce se aplica a cenários empresariais comuns. Cada exemplo usa o Snowflake como sistema externo, mas o padrão subjacente se aplica a qualquer fonte de dados compatível com SQL compatível com o Salesforce Connect.
Desafios: As equipes de suporte precisavam de relatórios unificados combinando dados de caso do Salesforce com métricas de volume de pedido, tempo de resolução e escalação armazenadas no Snowflake. Criar e manter um pipeline de replicação para esses dados introduziu um atraso e adicionou sobrecarga operacional para um caso de uso de relatórios somente leitura.
Solução: A equipe expôs visualizações do Snowflake contendo métricas de pedido como Objetos externos no Salesforce. A equipe configurou Relatórios do Salesforce para unir objetos de caso nativos aos dados de pedido externos.
Resultado:
- Os relatórios sempre refletem dados ativos do Snowflake. Sem atraso de pipeline.
- A governança de métricas de suporte confidenciais permanece no Snowflake.
- Nenhum pipeline ETL para criar, monitorar ou manter.
Desafios: Uma equipe financeira mantinha o limite de crédito autorizado e os dados de saldo no Snowflake. Replicar esses valores no Salesforce por meio de ETL reverso introduziu um atraso de replicação, fazendo os representantes de vendas se comprometerem com negócios com base em informações de crédito obsoletas. A equipe de conformidade também sinalizou o risco de conter dados financeiros confidenciais no armazenamento do Salesforce.
Solução: A equipe virtualizou a visualização financeira do Snowflake como um Objeto externo e a apresentou no layout da página Conta. Os representantes de vendas agora veem o status de crédito ativo como parte da visualização padrão Conta no Salesforce.
Resultado:
- Dados de crédito em tempo real em cada página de Conta. Sem atraso.
- Funil ETL reverso eliminado para dados financeiros.
- Dados financeiros confidenciais nunca copiados para o armazenamento do Salesforce. O escopo de conformidade permanece no Snowflake.
Desafios: Durante uma fusão, a empresa adquirente precisava dar aos usuários do Salesforce visibilidade dos dados operacionais de seis conjuntos de dados do Snowflake de alto volume que cobrem transações, faturamento e uso. Replicar terabytes de dados no Salesforce não era viável na linha do tempo de mesclagem, e a criação de pipelines de ETL personalizados para cada conjunto de dados exigiria um investimento significativo em engenharia.
Solução: A equipe configurou Objetos externos para todos os seis conjuntos de dados do Snowflake usando o Salesforce Connect com um papel de integração de privilégio mínimo. Nenhum código personalizado necessário. As consultas são executadas diretamente no Snowflake e todas as atividades são registradas no Histórico de consultas do Snowflake para relatórios de conformidade.
Resultado:
- Configuração totalmente declarativa. Nenhum código personalizado ou pipelines necessário.
- A atualidade dos dados garantida. Cada consulta reflete dados ativos do Snowflake no tempo de execução.
- Trilha de auditoria completa no Histórico de consultas do Snowflake para relatórios regulatórios e de conformidade.
A Virtualização de dados introduz um perfil operacional distinto. Projeto para estes cenários de falha:
- Expiration of OAuth token: Os tokens têm um tempo de vida finito (TTL). Tokens expirados causam falhas de chamada. Monitore por respostas 401 não autorizadas e implemente a lógica de atualização.
- Início a frio do armazém (especificamente Snowflake): Armazéns suspendidos automaticamente adicionam 5 a 30 segundos na primeira consulta. Para casos de uso voltados para o usuário com requisitos de latência, pré-calme com uma consulta leve agendada durante o horário comercial.
- Correspondência de papel: Um papel configurado incorretamente no sistema externo pode retornar zero linhas silenciosamente em vez de um erro. Valide os privilégios de papel a objeto no sistema externo de modo independente do Salesforce.
- Sobrecarga do conjunto de resultados: Cargas úteis grandes excedem os limites da API. Sempre aplique cláusulas LIMIT e exponha visualizações filtradas em vez de tabelas brutas.
- Falha do sistema externo: Nenhum fallback ou cache existe. Encerre chamadas em try/catch e detecte estados de erro informativos na UI. Para dados críticos para a missão, considere uma abordagem estratificada: virtualize para acesso em tempo real e mantenha um fallback replicado leve para os campos mais críticos para garantir a disponibilidade durante falhas do sistema de origem.
A Virtualização de dados do Salesforce está alinhada aos seguintes pilares da Estrutura bem arquitetada do Salesforce.
- Trust: O modelo delegado do OAuth 2.0 e a orientação do papel de privilégio mínimo estão alinhados com o Trust. O controle de acesso de duas camadas (sistema de origem + Salesforce) aplica a defesa em profundidade.
- Confiabilidade (tolerância a falhas): A seção de modos de falha aborda a confiabilidade diretamente: expiração do token, início a frio, configuração incorreta do papel, sobrecarga do conjunto de resultados e tratamento de interrupção, cada um representam uma classe de falha distinta com um caminho de resolução documentado.
- Confiabilidade (escalabilidade): O push-down de consulta, a orientação de dimensionamento de armazém e a consciência de limite de chamada otimizam a eficiência de execução dentro das restrições do controlador do Salesforce, uma preocupação de confiabilidade para soluções que operam em escala.
- Excelência operacional: Histórico de consulta do Snowflake como a ferramenta principal de observabilidade dá suporte à excelência operacional: os arquitetos fazem uma escolha deliberada e rastreável para usar ferramentas nativas da plataforma para auditoria completa e diagnóstico de desempenho em vez de criar uma infraestrutura de registro personalizada.
Esta seção oferece aos arquitetos e designers um ponto de partida estruturado para criar o padrão de Virtualização de dados em um ambiente de sandbox. Não é um guia de implementação completo. Trate-o como uma sequência validada de decisões e etapas de configuração para orientar sua primeira prova de conceito.
Confirme o seguinte antes de iniciar qualquer trabalho de configuração:
- Direito de licença: O Salesforce Connect não está incluído em todas as edições do Salesforce. O adaptador SQL para Snowflake requer uma licença de complemento separada além do direito de base do Salesforce Connect. Verifique ambos na sua organização antes de prosseguir.
- Sandbox primeiro: Conclua todas as fases em um ambiente de sandbox antes de promover sua configuração para produção.
- Acesso a flocos de neve: Confirme se você tem permissão para criar uma Integração de segurança no Snowflake e acesso ao banco de dados de destino, ao esquema e aos objetos.
- Versão do adaptador: Confirme se o adaptador SQL para Snowflake está disponível na sua edição da organização e se o URL da conta do Snowflake não contém sublinhados (se houver, substitua por hifens. Essa é uma restrição da Salesforce Platform para resolução de nome de host de chamada).
A configuração da virtualização de dados com um sistema SQL externo, como o Snowflake, é um processo declarativo conduzido por configuração, sem necessidade de código personalizado. A configuração segue três fases sequenciais: estabelecer identidade e Trust, configurar a superfície de dados e expor os dados aos usuários finais.
Essa fase estabelece uma cadeia de Trust OAuth 2.0 segura delegada entre o Salesforce e o sistema externo. Conclua essa fase antes de iniciar qualquer configuração de superfície de dados.
- Criar um provedor de autenticação no Salesforce. Use o tipo OpenID Connect. Use valores de espaço reservado nesse estágio – volte para concluí-lo depois de recuperar valores do sistema externo. Depois de salvar, o Salesforce gera um URL de retorno. Retenha esse valor.
- Registre o Salesforce como um cliente OAuth no sistema externo. No Snowflake, isso significa criar uma Integração de segurança (OAuth, tipo Cliente confidencial). Forneça o URL de retorno do Salesforce como o URI de redirecionamento. Recupere o ID do cliente, o Segredo do cliente, o URL de autorização e o URL do token da integração após a criação.
- Conclua a configuração do Provedor de autenticação. Volte para o Provedor de autenticação do Salesforce e preencha-o com os valores recuperados do sistema externo: Chave de consumidor, Segredo de consumidor, URL de autorização e URL de token.
- Criar a credencial externa. Defina o Protocolo como OAuth 2.0, vincule-o ao Provedor de autenticação e adicione uma Entidade de segurança (Nomeada ou Por usuário, com base na sua decisão de modelo de identidade). Esse objeto gerencia o ciclo de vida do token OAuth.
- Criar a credencial nomeada. Defina o ponto de extremidade como o URL da API do sistema externo (por exemplo,
https://<account>.snowflakecomputing.com/api/v2/statements/) e vincule-o à Credencial externa. - Concedem acesso de perfil à Credencial externa. Sem essa etapa, os usuários não poderão invocar consultas federadas mesmo que todas as outras configurações estejam corretas.
- Iniciar o fluxo OAuth para concluir a autenticação. Acione o apelido do OAuth do Salesforce. A plataforma redireciona para o login do sistema externo, valida as credenciais e armazena os tokens resultantes com segurança na Credencial externa. Esta etapa vincula o contexto do usuário a um token válido. Todas as consultas federadas falham até que essa etapa seja concluída.
Essa fase conecta o Salesforce ao esquema de dados externos e cria as definições de Objeto externo que os usuários e a plataforma consultam.
- Criar a origem de dados externa. Selecione o adaptador apropriado (por exemplo, o adaptador SQL para Snowflake), aponte-o para o banco de dados e o esquema de destino e vincule-o à Credencial nomeada criada na Fase 1.
- Valide a conexão. Use a validação integrada na Origem de dados externa. Um resultado bem-sucedido confirma que a cadeia de Trust do OAuth está concluída e o sistema externo está acessível.
- Sincronizar metadados. Inicie uma sincronização de metadados na Origem de dados externa. O Salesforce verifica internamente o esquema de destino e gera definições de Objeto externo, mapeando colunas externas para tipos de campo do Salesforce.
- Selecione e exponha as tabelas ou visualizações necessárias. Escolha quais tabelas ou visualizações externas serão exibidas como Objetos externos. Como prática recomendada, exponha visualizações selecionadas em vez de tabelas brutas. As visualizações permitem pré-filtragem de colunas, restrições no nível da linha e controle mais rígido sobre o que a camada do Salesforce pode acessar.
Essa fase torna Objetos externos visíveis e usáveis para usuários finais no Salesforce Lightning Experience.
- Criar guias para objetos externos. As guias tornam os objetos externos diretamente navegáveis nos aplicativos Lightning.
- Adicionar objetos externos aos layouts de página. Detecte dados externos relevantes junto com registros nativos do Salesforce (por exemplo, adicione uma visualização financeira do Snowflake ao layout de página Conta).
- Adicionar às listas relacionadas. Inclua Objetos externos em listas relacionadas para dar aos usuários uma visualização unificada de dados nativos e externos no contexto.
- Validar federação de consulta de ponta a ponta. Carregue uma página ou execute uma consulta que faça referência a um Objeto externo. Em seguida, inspecione o histórico de consultas do sistema externo (por exemplo, Histórico de consultas do Snowflake) para confirmar que a consulta foi executada na origem. Verifique se o papel, o armazém e a identidade corretos executaram a consulta.
Depois que todas as três fases forem concluídas, os usuários do Salesforce poderão interagir com dados externos ativos por meio de interfaces padrão do Salesforce, sem saber que os dados se originam fora do Salesforce.
A Virtualização de dados do Salesforce substitui a integração baseada em replicação pela federação de tempo de consulta. Os dados permanecem em sua origem autorizada; os usuários do Salesforce interagem com eles por meio de interfaces de plataforma padrão. Não há pipeline para criar, nenhuma cópia para governar e nenhum atraso para gerenciar.
Esse padrão é a escolha certa quando acesso pesado de leitura, atualização de dados em tempo real, governança rígida e controle de acesso de duas camadas são os principais fatores. É a escolha errada quando as gravações são necessárias, quando os recursos de IA ou automação dependem de objetos nativos do Salesforce ou quando os padrões de acesso são de frequência muito alta para os limites do regulador acomodarem.
O Snowflake ilustra bem o padrão: uma conexão federada governada estabelecida de modo declarativo sem código personalizado, observável de ponta a ponta por meio do Histórico de consulta do Snowflake e aplicável por meio dos controles de acesso nativos do Snowflake e do modelo de segurança completo do Salesforce.
Antes de confirmar essa arquitetura, valide o direito de licença, avalie a exposição de limite do controlador em relação aos padrões de acesso esperados e confirme a prontidão do OAuth em um ambiente de sandbox. O padrão recompensa um design inicial cuidadoso: obtenha o modelo de identidade, a cadeia de credenciais e a estratégia de visualização corretas e a pegada operacional será mínima.
Yugandhar Bora é um arquiteto de engenharia de software na Salesforce, especializado em arquitetura de dados na plataforma de aplicativos de dados e inteligência. Ele lidera iniciativas do Conselho de revisão de arquitetura empresarial (EARB) focadas na governança de dados e modelos de dados unificados, ao mesmo tempo que contribui para soluções de provisionamento de plataforma automatizadas.