A maioria dos pipelines de integração entre o Salesforce e plataformas de análise externas depende de código personalizado. Eles funcionam até que algo falhe. Desvio de esquema, esgotamento de API e lacunas de exclusão permanente exigem intervenção de engenharia constante. À medida que as empresas avançam em direção a arquiteturas ágeis habilitadas para desenvolvedor e cidadão, esse modelo se torna um gargalo: as equipes de análise aguardam os sprints de engenharia para adicionar um campo do Salesforce a um esquema a jusante, carregamentos noturnos com falha atrasam os relatórios de segunda-feira pela manhã e alterações simples de configuração exigem revisões e implantações de código.
O CRM Analytics, a plataforma nativa de análise e inteligência de negócios do Salesforce, resolve esse problema permitindo que as empresas explorem dados, criem painéis interativos e descobram percepções conduzidas por IA sem sair do ecossistema do Salesforce. Central para esse recurso é um recurso de sincronização de dados declarativo com pouco código integrado nativamente na plataforma: SyncOut do CRM Analytics e SyncIn do CRM Analytics.
O CRM Analytics SyncOut move registros do Salesforce para armazenamentos de dados externos em um cronograma configurado, usando a Captura de dados de alteração (CDC) para cargas incrementais e o rastreamento integrado de exclusão permanente para sinalizar registros removidos permanentemente. O CRM Analytics SyncIn leva dados externos de volta ao Salesforce, mapeia colunas para campos de objeto e insere e atualiza registros usando a API em massa 2.0. Ambos são configurados totalmente por meio da Configuração do Salesforce. Sem pipelines, sem scripts de preparação, sem monitoramento personalizado. Os administradores configuram um trabalho de sincronização em uma única sessão de Configuração; a plataforma lida com execução, nova tentativa, registro de erros e mapeamento de esquema automaticamente.
Este guia explica o padrão, quando usá-lo, como implementá-lo com o Snowflake como um exemplo de trabalho e as considerações arquitetônicas que determinam se ele atende a um determinado problema de integração.
Nota de licença: O CRM Analytics SyncIn e o SyncOut não estão disponíveis nas edições do Salesforce sem um complemento de licença do CRM Analytics. Confirme os direitos de licença antes de projetar uma arquitetura de sincronização que dependa desses recursos.
A integração de dados é uma das superfícies com maior atrito na arquitetura corporativa. Um pipeline ETL personalizado do Salesforce para uma plataforma de análise geralmente requer um Aplicativo conectado para autenticação, um trabalho agendado para extração SOQL, uma camada de transformação para reconciliar tipos de campo, uma área de preparação para carga em massa e uma camada de monitoramento para detectar falhas. Cada componente do código personalizado representa um ponto de falha.
O custo desses compostos de atrito ao longo do tempo. O desvio de esquema no Salesforce (um campo renomeado, um novo valor de lista de opções, um nome de API alterado) quebra o pipeline silenciosamente. O esgotamento da API durante o uso de pico interrompe a extração. Registros excluídos permanentemente nunca aparecem na tabela de destino, deixando dados obsoletos que a análise downstream trata como ativos. A equipe de engenharia se torna o gargalo para operações de dados de rotina.
O CRM Analytics SyncIn e o SyncOut alteram o modelo operacional. A configuração substitui o código. A plataforma assume a responsabilidade pela execução, tratamento de erros, mapeamento de esquema e capacidade de observação. Os administradores podem definir, modificar e monitorar trabalhos de sincronização sem gerar um pedido de desenvolvimento.
O resultado desse novo modelo operacional é um tempo reduzido do design de integração à sincronização operacional, menos sobrecarga de engenharia e um modelo de integração que escala dentro das restrições da plataforma em vez de exigir manutenção de código personalizado.
SyncIn e SyncOut são os dois modos direcionais da sincronização de dados do CRM Analytics. O SyncOut move registros do Salesforce para uma plataforma externa. O SyncIn leva registros externos para o Salesforce. Ambos operam em um modelo de configuração declarativa sem código personalizado necessário.
A configuração declarativa significa que todo o comportamento de sincronização é definido por meio da interface do usuário de apontar e clicar na Configuração do Salesforce. Objeto de origem, tabela de destino, mapeamentos de campo, agenda de sincronização, modo de sincronização e filtros são definidos por meio de metadados de configuração. A plataforma deriva o plano de execução desses metadados e os gerencia de ponta a ponta.
Sincronização completa vs. sincronização incremental controla quais dados se movem em cada execução. Uma sincronização completa consulta todos os registros que correspondem aos critérios de filtro em cada execução. Uma sincronização incremental usa a CDC para consultar apenas registros que foram alterados desde a última execução. A sincronização incremental é o modo recomendado para objetos de alto volume, pois reduz significativamente o consumo de API e a duração da sincronização.
A Captura de dados de alteração (CDC) é uma funcionalidade de plataforma do Salesforce que registra alterações em nível de campo em objetos como fluxos de evento. O SyncOut usa a CDC para detectar criações, atualizações e exclusões sem realizar verificações de tabela completa. O CDC deve estar habilitado por objeto na Configuração do Salesforce para que possa ser referenciado por uma configuração de sincronização.
O rastreamento de exclusão permanente resolve um dos problemas mais persistentes no Salesforce-to-external ETL. Quando um registro é excluído permanentemente no Salesforce, ele desaparece de consultas SOQL padrão. Sem rastreamento explícito, a plataforma externa nunca descobre que o registro foi removido. O rastreamento de exclusão permanente do SyncOut, quando habilitado, sinaliza registros excluídos na tabela de destino com DEL_FLAG = 'Y', dando aos sistemas a jusante um sinal confiável para filtrar dados obsoletos.
A frequência de sincronização pode ser configurada de 15 minutos para semanalmente. A escolha é uma compensação entre a atualidade dos dados, o consumo da API e o custo de computação do armazém do Snowflake. Sincronizações de 15 minutos se aproximam quase em tempo real para painéis operacionais; as sincronizações diárias são adequadas para cargas de trabalho de relatórios em lote.
Governor limita o design do trabalho de sincronização: O limite de solicitações da API do Salesforce (15.000 chamadas por 24 horas na Unlimited Edition), o tamanho de lote da API 2.0 em massa de 10.000 registros e o limite de linha de consulta SOQL de 50.000 por transação informam como dimensionar e agendar trabalhos de sincronização. A plataforma lida com o particionamento e a paginação automaticamente, mas os arquitetos devem considerar o espaço limitado em todos os trabalhos de sincronização em execução na organização.
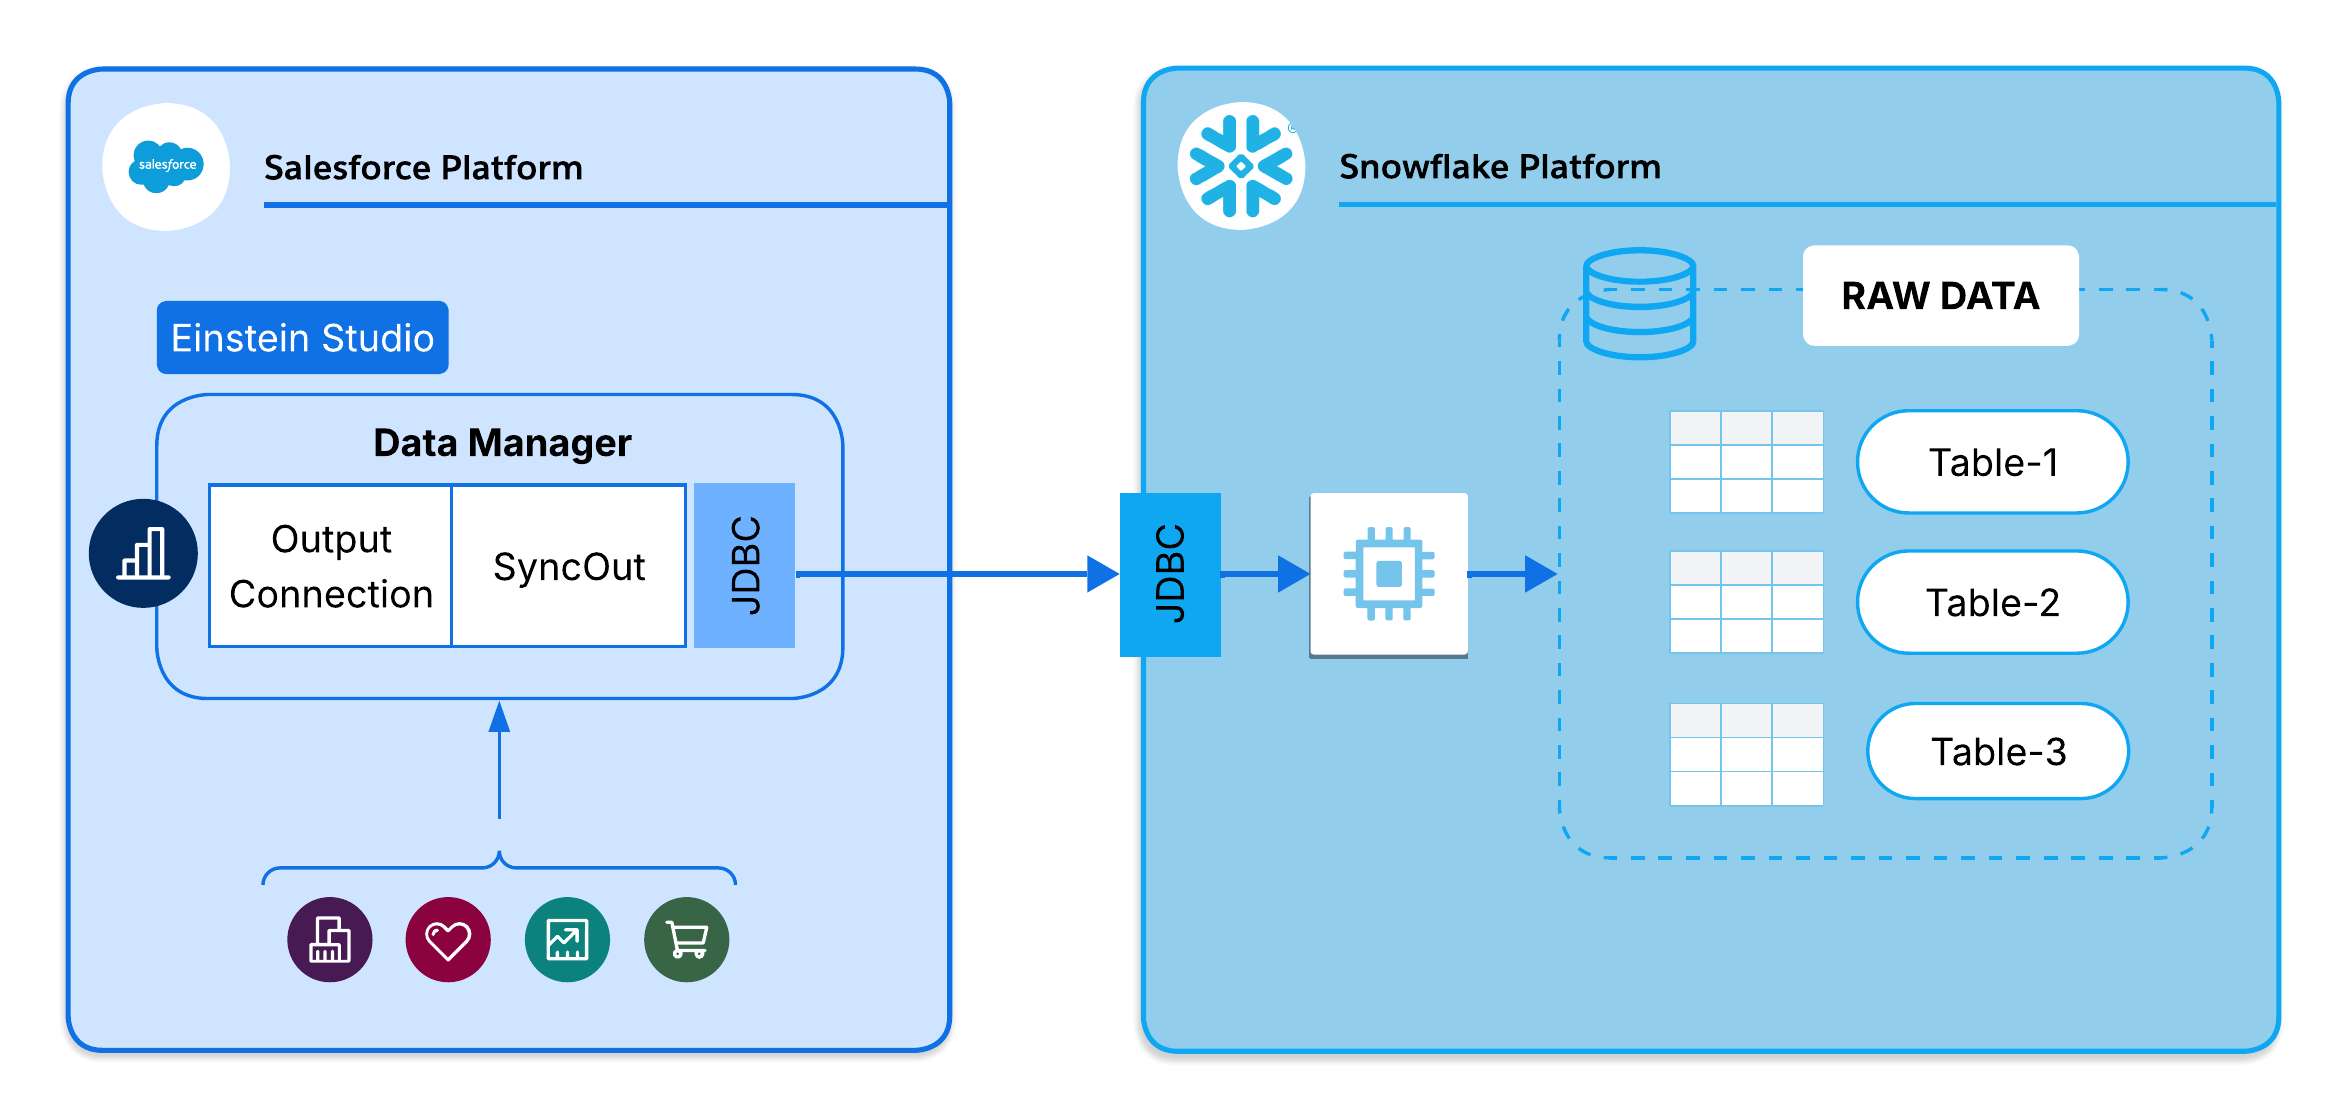
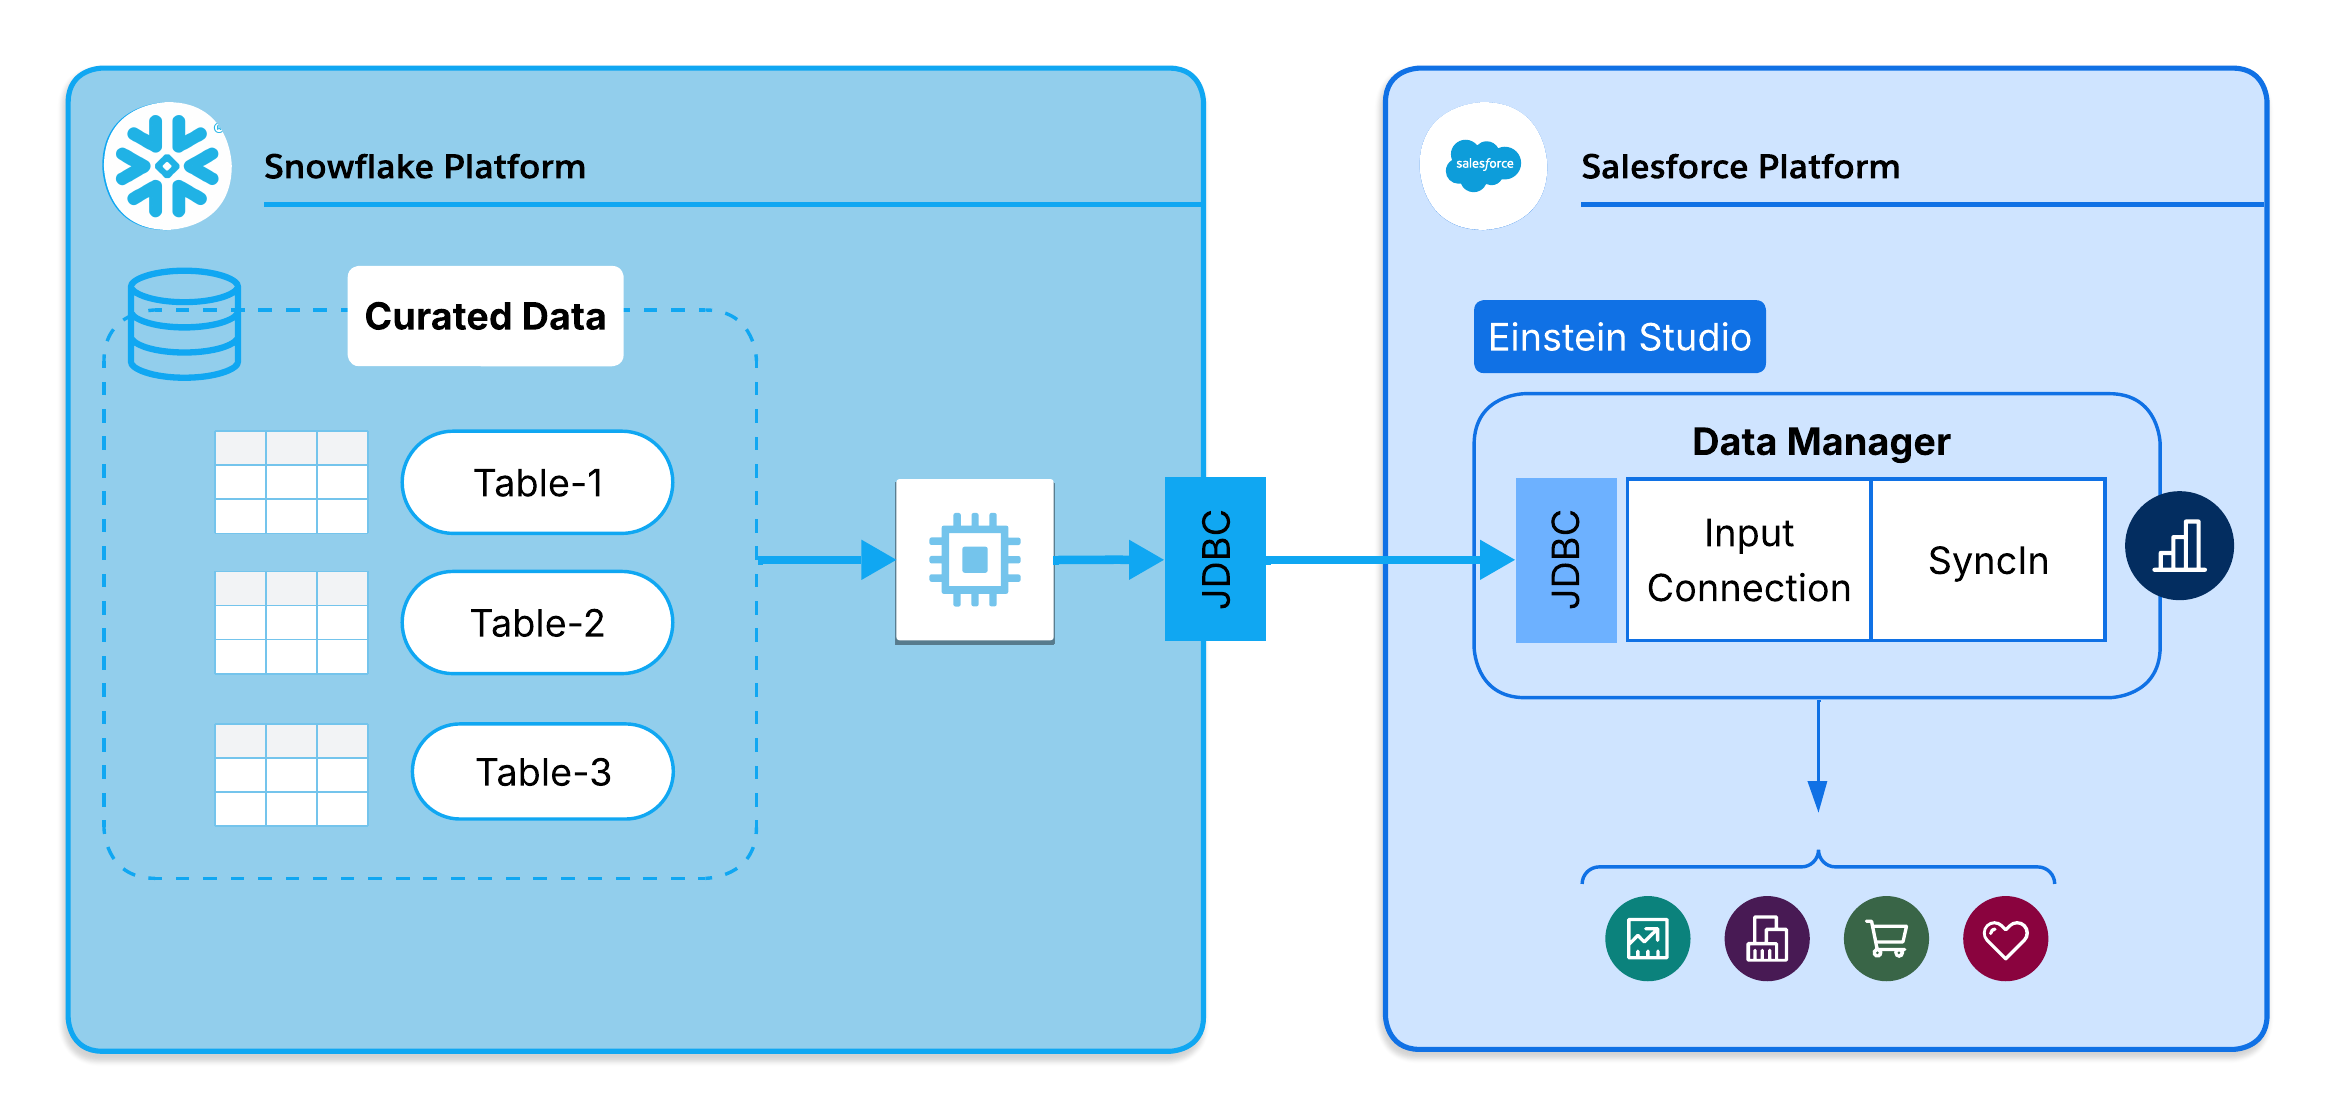
O Snowflake é um destino principal e fonte para sincronização de dados com o Salesforce CRM Analytics. Ele serve como um exemplo concreto de como o trabalho de movimentação de dados incrementais e em lote termina.
Esta seção apresenta uma visão geral da implementação do CRM Analytics SyncOut e do SyncIn usando o Snowflake como plataforma de análise externa. Ele abrange cada método, os modelos de autenticação compartilhados, as estruturas de segurança, as principais considerações de plataforma e as práticas de capacidade de observação.
Nessa configuração do SyncOut, o Salesforce usa o CRM Analytics SyncOut para enviar por push registros para o Snowflake. A plataforma extrai dados por meio de SOQL, lida com conversões de tipo automaticamente e os carrega em tabelas do Snowflake em uma agenda configurada (de 15 minutos a semanalmente). Consulte a documentação atual do Salesforce e do Snowflake para obter uma semântica de carregamento específica.
Nessa configuração do SyncIn, o Salesforce usa o CRM Analytics SyncIn para capturar dados de volta para o Salesforce. A plataforma consulta o Snowflake por meio da API de declarações e insere e atualiza os resultados no Salesforce usando a API em massa 2.0. Conjuntos de resultados grandes são paginados automaticamente para permanecer dentro dos limites da API. A sincronização é executada em uma agenda configurada, variando de 15 minutos a semanalmente.
A sincronização do Salesforce oferece suporte a vários métodos de autenticação para se conectar com segurança ao Snowflake. As duas abordagens principais para integrações corporativas são Chave-par (chave privada) e OAuth 2.0.
Método 1: autenticação de par de chaves (chave privada): A autenticação de pares de chaves é a abordagem recomendada para a movimentação automatizada de dados entre sistemas, como o CRM Analytics SyncIn e o SyncOut. A autenticação depende de tokens da Web JSON (JWT) em vez de senhas ou tokens atualizáveis, tornando-a perfeita para trabalhos agendados e não agendados que não exigem atualização de token.
- Certificado do Salesforce: Gere uma chave privada e armazene-a com segurança no Gerenciamento de certificados e chaves do Salesforce.
- Credencial externa/nomeada: Configurado para usar uma troca JWT. O Salesforce usa a chave privada armazenada para assinar solicitações de conexão de saída.
- Chave pública do usuário do Snowflake: A chave pública correspondente é atribuída diretamente à conta de serviço do Snowflake dedicada (por exemplo, ALTER USER CRM_ANALYTICS_SYNC_USER SET RSA_PUBLIC_KEY = ’…’). O Snowflake então usa essa chave para verificar a assinatura JWT recebida. Nenhuma integração de segurança é necessária para esse método.
Método 2: autenticação delegada do OAuth 2.0: Como alternativa, o Salesforce pode usar um apelido de OAuth para autenticar. Os principais componentes são:
- Provedor de autenticação: Gerencia o apelido do OAuth com o Snowflake usando as credenciais do cliente recuperadas da Integração de segurança do Snowflake.
- Credencial externa: Armazena os tokens de OAuth com segurança no Salesforce e os insere automaticamente nas chamadas de sincronização.
- Credencial nomeada: Define o URL do ponto de extremidade do Snowflake (por exemplo, https://<account>.snowflakecomputing.com) e faz referência à Credencial externa.
- Integração de segurança do Snowflake: Registra o Salesforce como um cliente OAuth confiável no Snowflake (OAUTH_CLIENT = CUSTOM). Define o URI de redirecionamento permitido e habilita tokens de atualização.
Dependência de configuração: Independentemente do método escolhido, esses componentes formam uma cadeia de dependência conectando a configuração de sincronização ao ponto de extremidade. Conceder aos perfis relevantes do Salesforce o acesso à Credencial nomeada é necessário; sem esse acesso, os trabalhos de sincronização falham devido a erros de autenticação, independentemente de todas as outras configurações.
A sincronização em segundo plano depende de uma única identidade de integração.
- Conta de serviço dedicado: Crie uma conta de serviço do Snowflake dedicada com um papel de privilégio mínimo no escopo apenas para os bancos de dados, esquemas e tabelas necessários para a sincronização.
- Permissões granulares: Para SyncOut, esse papel requer INSERT, UPDATE e SELECT em tabelas de destino. Nunca use papéis de alto privilégio, como ACCOUNTADMIN, SECURITYADMIN ou SYSADMIN.
- Limites do governador e fragmentação: Durante a extração do SyncOut, grandes conjuntos de resultados são divididos automaticamente para respeitar os limites do controlador do Salesforce SOQL. O SyncIn busca grandes conjuntos de resultados da API de declarações do Snowflake por meio de paginação automática para gerenciar volumes de dados de maneira eficiente.
- Captura de dados de alteração (CDC): O SyncOut incremental depende do fluxo de eventos da CDC do Salesforce para identificar registros criados, atualizados ou excluídos. Se o rastreamento de exclusão permanente estiver habilitado, os registros do Salesforce excluídos não serão descartados, mas sinalizados com
DEL_FLAG = 'Y'no Snowflake. - Restrições de inserção e atualização: O SyncIn conta com a API em massa 2.0 para carregar dados de volta no Salesforce. Isso exige que um campo de ID externo designado seja configurado no objeto do Salesforce de destino para atuar como a chave de inserção e atualização.
- Diretrizes de design: Sempre sincronize de visualizações do Snowflake selecionadas em vez de tabelas brutas. As visualizações permitem a pré-filtragem de linhas, seleção de coluna e aplicação da lógica de negócios, reduzindo o volume de dados, a duração da sincronização e os custos de cálculo do armazém do Snowflake proporcionalmente à pré-filtragem aplicada.
Cada execução de sincronização gera trilhas de auditoria abrangentes para validar a movimentação dos dados. O painel Monitoramento de trabalho de sincronização fornece status em tempo real, contagens de registros processados, durações de execução e registros de erro detalhados para SyncIn e SyncOut. No lado do Snowflake, cada consulta enviada pelo Salesforce é registrada no Histórico de consultas do Snowflake, fornecendo visibilidade total sobre a latência de execução, as linhas verificadas e o uso de computação de armazém. Além disso, os arquitetos definem tabelas de auditoria dedicadas do Snowflake para capturar metadados de execução de sincronização (carimbo de data e hora, contagens de registros e erros); eles não são gerados automaticamente pela plataforma. Para validação completa, compare contagens de registros entre as duas plataformas: verifique os registros ativos no Snowflake (WHERE DEL_FLAG = 'N') para execuções do SyncOut e compare contagens de objetos de destino do Salesforce diretamente com a visualização de origem original do Snowflake para execuções do SyncIn.
Use o CRM Analytics SyncIn e SyncOut quando:
- A sincronização bidirecional é um requisito: Os dados fluem para o Salesforce por meio do SyncIn e para uma plataforma externa por meio do SyncOut.
- O rastreamento de exclusão permanente é essencial: A sinalização integrada do SyncOut resolve um problema de ETL historicamente complexo sem lógica de reconciliação personalizada.
- A sincronização incremental baseada em CDC é viável: Para objetos do Salesforce de alto volume, a CDC reduz significativamente o consumo da API e a duração da sincronização em comparação a verificações completas.
- Sincronização em lote agendada cumpre os requisitos de latência: A frequência mínima de sincronização é de 15 minutos, adequada para painéis operacionais e relatórios de análise quase em tempo real.
- Baixa sobrecarga operacional é uma prioridade: Os painéis integrados fornecem visibilidade de sincronização completa sem uma infraestrutura de registro ou alerta personalizada, e a IU de Configuração declarativa permite que os administradores definam, modifiquem e monitorem trabalhos de sincronização sem gerar um pedido de desenvolvimento.
Não use este padrão se:
- Requerem-se transformações complexas: Junções de várias tabelas, análise JSON ou gerenciamento de lógica de negócios avançada em visualizações do Snowflake ou em uma camada de transformação dedicada antes ou depois da sincronização.
- Latença inferior a 15 minutos é necessária: Para casos de uso em tempo real, use Eventos de plataforma ou APIs de streaming.
- Cargas de trabalho de streaming de muito alto volume estão no escopo: Objetos com milhões de transações por hora são atendidos melhor por pipelines de streaming dedicados (Kafka, Eventos de plataforma).
- Lógica de tratamento de erro personalizada é necessária: A plataforma fornece registro de erro e nova tentativa padrão. Padrões de nova tentativa complexos ou alertas personalizados exigem orquestração do Apex ou externa.
- Sincronização entre organizações ou entre nuvens: O CRM Analytics SyncIn e o SyncOut operam em uma única organização do Salesforce. O MuleSoft ou uma camada de integração personalizada é necessário para cenários de várias organizações.
Uma equipe executou pipelines ETL complexos para carregar dados de análise do Snowflake em conjuntos de dados do CRM Analytics. Os pipelines eram lentos, frágeis e exigiam manutenção de engenharia constante.
O CRM Analytics SyncIn foi configurado para sincronizar visualizações agregadas do Snowflake selecionadas diretamente em objetos personalizados do Salesforce. A equipe reconfigurou os painéis do CRM Analytics para ler desses objetos em vez de conjuntos de dados do CRM Analytics. O resultado: dois pipelines ETL eliminados, a duração da sincronização reduzida de quatro horas para 30 minutos e os administradores podem modificar as configurações de sincronização sem gerar um pedido de engenharia.
Uma equipe de dados precisava rastrear registros do Salesforce excluídos permanentemente em seu repositório de dados operacional do Snowflake. Abordagens tradicionais exigiam trabalhos de divisão e lógica de reconciliação de ID complexo que levava horas para ser executada e era frágil em relação a alterações de esquema.
A equipe configurou o CRM Analytics SyncOut com CDC e rastreamento de exclusão permanente habilitado. Os registros excluídos agora são sinalizados automaticamente com DEL_FLAG = ‘Y’ na tabela de consumo do Snowflake. Consultas de análise a jusante aplicam WHERE DEL_FLAG = ‘N’ para ver apenas registros ativos. A lógica de reconciliação foi totalmente eliminada e a duração da sincronização caiu de oito horas para execuções incrementais de 15 minutos.
Durante uma aquisição, a empresa adquirente sincronizou seis objetos do Salesforce de alto volume com o Snowflake para relatórios entre organizações e conformidade regulatória dentro de um cronograma fixo.
A equipe configurou o CRM Analytics SyncOut para todos os seis objetos com sincronizações incrementais baseadas em CDC. As tabelas de metadados de auditoria rastreiam alterações de esquema e contagens de registro ao longo do período de integração. Eles não escreveram nenhum código personalizado. A atualidade dos dados foi aprimorada de intervalos diários para intervalos de 15 minutos, e as tabelas de metadados de auditoria forneceram a rastreabilidade necessária para relatórios de conformidade.
Os trabalhos de sincronização compartilham o orçamento da API da organização. Uma organização que executa muitos trabalhos de sincronização de alta frequência em objetos grandes corre o risco de esgotar o limite de 15 mil chamadas à API por 24 horas. Inventar todos os trabalhos de sincronização, estimar o consumo da API por execução e escalonar agendas para distribuir a carga. Para objetos com taxas de alteração baixas a moderadas, o modo incremental baseado em CDC pode reduzir significativamente o consumo por API de execução em comparação à sincronização completa.
SyncIn e SyncOut executam consultas e carregam dados em um armazém do Snowflake, consumindo créditos de computação. Para consultas simples SELECT, um armazém X-Small ou Small geralmente é suficiente. Para cargas grandes do SyncOut, pode ser necessário Medium ou Grande. Configure a suspensão automática (5 minutos de inatividade) e a retomada automática no armazém. Use um armazém dedicado para trabalhos de sincronização de produção para isolar custos e evitar contenção com consultas do usuário.
Se um campo do Salesforce for renomeado, removido ou alterar o nome da API, o mapeamento de campo SyncOut correspondente falhará silenciosamente ou registrará erros. Estabeleça um processo de gerenciamento de alteração que inclua revisar as configurações de sincronização ativas como parte de qualquer alteração de metadados do Salesforce. As tabelas de auditoria do Snowflake fornecem um histórico de alterações que ajuda a identificar quando um evento de desvio ocorreu.
O rastreamento de exclusão permanente no SyncOut exige que a CDC esteja habilitada no objeto do Salesforce. Se o CDC não estiver habilitado, a opção “Rastrear exclusões permanentes” não terá efeito. Valide a habilitação do CDC como parte da lista de verificação de configuração de sincronização, particularmente durante a configuração inicial ou após as migrações da organização.
A classe de falha mais comum é expiração da credencial ou perda de permissão. As Credenciais nomeadas devem permanecer válidas e a conta de serviço do Snowflake deve reter suas concessões de uso de armazém e permissões de tabela. Para configurações baseadas em OAuth, falhas de atualização de token podem silenciar trabalhos de sincronização. Monitore o painel Monitor de trabalho de sincronização para padrões de erro de autenticação e configure notificações do Chatter ou de email para falhas de trabalho.
O SyncIn usa um campo de ID externo do Salesforce como a chave de inserção e atualização. Se a visualização do Snowflake de origem contiver valores duplicados no campo de chave, a inserção e atualização falhará para os registros afetados. Imponha exclusividade ao campo de chave na camada de visualização do Snowflake antes que ele atinja a configuração de sincronização.
Quando os trabalhos de sincronização falham, a plataforma registra mensagens de erro detalhadas por registro no Monitor de trabalho de sincronização. Cenários de falha comuns e suas resoluções:
- Falha de autenticação: verifique o status da Credencial nomeada e a expiração da conta do Snowflake. Reautentique o OAuth se a atualização do token tiver falhado.
- Erro de mapeamento de campo: verifique a compatibilidade do tipo entre colunas do Snowflake e campos do Salesforce. Revise a segurança em nível de campo para o usuário em execução.
- Limite de governador excedido: reduza a frequência de sincronização ou mude para o modo de CDC incremental para distribuir o consumo de API.
- Snowflake warehouse suspenso: configure a retomada automática no armazém ou acione uma retomada manual antes da próxima sincronização agendada.
- Rastreamento de exclusão permanente não funciona: confirme que o CDC está habilitado no objeto e que o sinalizador “Rastrear exclusões permanentes” está definido na configuração de sincronização.
A sincronização de dados do CRM Analytics se alinha a vários pilares da Estrutura bem arquiteturada do Salesforce.
- Confiabilidade (tolerância a falhas): A plataforma gerencia a execução, a lógica de nova tentativa e a manipulação de falha parcial automaticamente. Registros com falha são registrados individualmente no Monitor de trabalho de sincronização. Implemente a reconciliação de contagem de registros após falhas para confirmar a consistência, suplementar com notificações de falha e monitorar o Monitor de trabalho de sincronização para padrões de erro recorrentes. A sincronização incremental baseada em CDC reduz o raio de explosão de uma execução com falha limitando a janela de dados no escopo.
- Trust: O modelo de credencial (Credenciais nomeadas, Credenciais externas, Provedor de autenticação) impõe armazenamento criptografado, atualização automática de token e gerenciamento centralizado. O acesso de privilégio mínimo no lado do Snowflake limita o raio de explosão de uma credencial comprometida. A segurança em nível de campo é imposta durante a sincronização; os usuários não podem sincronizar campos que não estão autorizados a acessar.
- Otimização de recursos e custos: O modo de CDC incremental é a alavanca primária para otimização de desempenho. Ele reduz o consumo da API, a duração da sincronização e o custo de computação do Snowflake em comparação à sincronização completa. A filtragem pré-visualização do Snowflake reduz ainda mais o volume de dados em trânsito. A suspensão automática do armazém evita gastos de computação ociosos.
- Excelência operacional: O modelo de configuração declarativa significa que os trabalhos de sincronização são definidos em metadados, não em código. Isso os torna auditáveis, reproduíveis e gerenciáveis sem envolvimento de engenharia. Painéis de monitoramento integrados fornecem observação total sem infraestrutura de registro personalizada.
- Confiabilidade (escalabilidade): A plataforma lida com agrupamento, paginação e lote da API em massa automaticamente. Para objetos com volumes de registro muito altos, o modo de CDC incremental e o agendamento fora do pico são as principais alavancas arquitetônicas para manter a taxa de transferência dentro das restrições de limite do regulador.
Essa lista de verificação abrange as etapas mínimas para configurar e validar uma configuração de sincronização.
Lista de verificação de pré-configuração:
- Habilite a Captura de dados de alteração em todos os objetos do Salesforce destinados ao modo incremental SyncOut (Configuração → Captura de dados de alteração).
- Crie uma conta de serviço do Snowflake dedicada com um papel de privilégio mínimo; conceda apenas as permissões de tabela e armazém necessárias.
- Crie uma Integração de segurança do Snowflake se estiver usando autenticação OAuth.
- Identifique o campo ID externo em cada objeto do Salesforce que o SyncIn usará como a chave de inserção e atualização; confirme a exclusividade nos dados de origem.
Conectividade:
- Criar provedor de autenticação no Salesforce (Configuração → Provedores de autenticação).
- Crie uma credencial externa e vincule-a ao Provedor de autenticação (Configuração → Credenciais nomeadas → Credenciais externas).
- Crie uma credencial nomeada e vincule a Credencial externa (Configuração → Credenciais nomeadas).
- Conceda acesso de Credencial nomeada a perfis relevantes do Salesforce.
Configuração SyncOut:
- Crie conexão do Snowflake (Configuração → Analytics Studio → Gerenciador de dados → Conexões → Conexões do Snowflake).
- Criar configuração do SyncOut: objeto de origem, tabela de destino, modo de sincronização, mapeamentos de campo, CDC, rastreamento de exclusão permanente, agendamento.
- Comece com a sincronização diária; valide a qualidade e o desempenho dos dados antes de aumentar a frequência.
Configuração de sincronização:
- Criar origem de dados externa (Configuração → Analytics Studio → Gerenciador de dados → Conexões → Conexões do Snowflake).
- Criar configuração do SyncIn: visualização de origem, objeto de destino, campo ID externo, mapeamentos de campo, agenda.
- Sincronize das visualizações do Snowflake, não tabelas brutas.
Validação:
- Revise o Monitor de trabalho de sincronização após a primeira execução (Configuração → Analytics Studio → Gerenciador de dados → Monitor de trabalho de sincronização).
- Consulte a tabela de auditoria do Snowflake para confirmar que os metadados de sincronização foram escritos.
- Valide a sinalização de exclusão permanente confirmando que a coluna DEL_FLAG esteja presente e preenchida.
- Compare contagens de registros entre origem e destino.
- Configure notificações de falha pelo Chatter ou email.
Use esse padrão quando a sincronização em lote agendada atender aos requisitos de latência, o fluxo de dados bidirecional for necessário e a redução da dependência de engenharia em operações de integração for uma prioridade.
O exemplo de trabalho do Snowflake neste guia ilustra o ciclo de vida completo: configuração, configuração, fluxo de execução e validação da conectividade. Os mesmos princípios se aplicam a qualquer plataforma de dados externa com suporte.
Quando latência inferior a 15 minutos, transformações complexas ou cenários de várias organizações estão no escopo, avalie Eventos de plataforma, APIs de streaming ou MuleSoft como abordagens complementares ou alternativas.
Yugandhar Bora é um arquiteto de engenharia de software na Salesforce, especializado em arquitetura de dados na plataforma de aplicativos de dados e inteligência. Ele lidera iniciativas do Conselho de revisão de arquitetura empresarial (EARB) focadas na governança de dados e modelos de dados unificados, ao mesmo tempo que contribui para soluções de provisionamento de plataforma automatizadas.