Os agentes consideram as metas, inferem parâmetros do contexto e selecionam ações dinamicamente. Como resultado, cada integração que um agente toca deve lidar com ambiguidade, dar suporte à repetição segura e falhar de maneiras que o agente pode recuperar de modo autônomo.
Os sistemas agentes invalidam várias pressuposições que o design de integração tradicional considera como óbvias. As entradas nem sempre serão bem formadas. Uma única ação do usuário pode gerar uma cadeia de agentes entre limites organizacionais, cada um dos quais precisa de autoridade delegada para agir.
Este documento mapeia os turnos arquitetônicos que se seguem dessa realidade: os novos princípios de design, os padrões de agência e como a Salesforce Platform os oferece.
Cada padrão neste documento segue a mesma estrutura:
Nome: O identificador de padrão que indica o tipo de integração contido no padrão.
Contexto: O cenário geral de integração que o padrão aborda. O contexto fornece informações sobre o que os usuários estão tentando realizar e como o aplicativo se comporta de acordo com suas necessidades.
Problema: O desafio (expresso como uma pergunta) que o padrão foi projetado para resolver. Ao revisar os padrões, leia esta seção para entender rapidamente se o padrão se aplica ao seu cenário de integração.
Forças: As restrições e circunstâncias que podem tornar o problema difícil de resolver.
Aplicativo de padrão do Salesforce: A maneira recomendada de aplicar o padrão ao cenário.
Esboço: Um diagrama de sequência da Linguagem de modelagem unificada (UML) que mostra como o aplicativo de padrão lida com o cenário.
Resultados: Como o padrão resolve as forças associadas ao cenário. Esta seção também contém novos desafios que podem surgir como resultado da aplicação do padrão.
Considerações de design: Orientação sem distinção de plataforma para aplicar a solução corretamente, seguida de notas de implementação específicas do Salesforce. Essas considerações abrangem princípios de design de ação e requisitos de configuração específicos da plataforma.
Manuseio e recuperação de erros: Orientação para gerenciar falhas durante a aplicação de padrão. Esse parâmetro abrange quatro áreas:
- Como as ações comunicam a falha ao agente por meio de respostas de erro estruturadas e acionáveis que fornecem contexto suficiente para tomada de decisão posterior
- Como o agente determina se deseja tentar novamente, auto-corrigir ou interromper a execução
- Como as ações de compensação lidam com resultados parciais e estado entre plataformas sem correspondência
- Requisitos de idempotência para operações de gravação descontinuadas
Considerações de segurança: Requisitos de segurança para aplicar o padrão com segurança. Essas considerações abrangem o gerenciamento de credenciais, o escopo de privilégio mínimo de usuários de integração e aplicativos conectados, o registro de auditoria de ações invocadas pelo agente e os requisitos de validação de entrada para parâmetros originários de conteúdo fornecido pelo usuário ou gerado pelo LLM, entre outros.
Exemplo: Um cenário de ponta a ponta que descreve como o padrão de design é usado em um cenário do Salesforce do mundo real. O exemplo explica as metas e como aplicar o padrão para atingir essas metas.
A tabela a seguir lista os padrões de implementação cobertos.
Lista de padrões
| Padrão | O que faz |
|---|---|
| Invoque ação sequencial | Um agente chama uma série de ações em que cada etapa depende do resultado verificado do anterior. O agente mantém o contexto em toda a cadeia, como identificadores, códigos de status e dados intermediários, e o usa para decidir se a próxima etapa pode continuar. |
| Invoque ação paralela | Quando um conjunto de ações é independente um do outro, o agente as chama simultaneamente, em vez de em sequência. O tempo de fluxo de trabalho total é limitado pela chamada mais lenta em vez da soma de todas as chamadas. |
| Invocação de ação assíncrona | Um agente envia uma operação para um sistema downstream por meio de um evento de plataforma, uma fila de mensagens ou um trabalho em segundo plano sem esperar o resultado. A obrigação do agente termina na invocação confirmada; o sistema downstream assume a propriedade da execução independentemente da sessão do agente. |
| Invoque agente sob demanda | Um aplicativo externo ou um orquestrador de IA chama um agente programaticamente, fornece contexto e espera uma resposta estruturada. O agente atua como um serviço de back-end inteligente que o chamador inicia, o agente motiva e age e o resultado é consumido pelo chamador. |
| Execução autônoma do agente conduzido por evento | Uma condição de dados, como abandono do carrinho, falha no pagamento, queda de uso, dispara automaticamente um agente sem qualquer pessoa iniciar a interação. Não há chamador esperando por uma resposta; o agente recebe a carga útil do evento como contexto de fundamentação e executa um fluxo de trabalho de resposta totalmente sozinho. |
| Baseamento de Knowledge do Enterprise Content | Antes de gerar uma resposta, o agente recupera documentos relevantes de um repositório do Knowledge corporativo e os insere em sua janela de contexto. O LLM fornece o raciocínio; a camada de recuperação fornece os fatos. |
| Injeção de contexto do cliente verificado | Atributos verificados e estruturados de um perfil de cliente unificado são preenchidos previamente como entradas de ação antes de o agente invocar uma ação. O agente recebe fatos como segmento, nível, risco de rotatividade e valor da vida útil em vez de inferí-los. |
| Integração de ferramentas entre sistemas | Um agente se conecta a sistemas externos fora da plataforma Salesforce por meio de uma interface de ferramenta uniforme baseada no padrão Protocolo de contexto do modelo (MCP). Cada sistema externo expõe seus recursos como ferramentas chamáveis descritas; o agente as descobre e chama sem precisar conhecer a API ou o esquema nativo de cada sistema. |
| Funcionalidades de negócios como ferramentas invocáveis | Funcionalidades de negócios corporativas, como entidades de negócios, processos e percepções, são expostas como ferramentas de MCP que qualquer agente externo em qualquer estrutura pode descobrir e invocar. |
| Delegação entre agentes | Um agente de chamada descompõe uma solicitação complexa e delega subtarefas específicas do domínio a agentes pares especializados em diferentes plataformas ou sistemas do fornecedor usando o protocolo Agente para agente (A2A). O agente de chamada gerencia o ciclo de vida da tarefa e agrega os resultados dos agentes remotos. |
| Agentes como serviços chamáveis | Um agente interno do Agentforce publica seus recursos de domínio como um ponto final A2A controlado e descobrível para que orquestradores externos ou agentes pares possam delegar tarefas a ele. O agente gerencia o ciclo de vida da tarefa recebida e retorna resultados estruturados ao chamador remoto. |
Os padrões neste documento são classificados em três categorias. Essa categorização ajuda os arquitetos a identificar rapidamente quais padrões são relevantes para o desafio de integração que estão resolvendo, estejam eles projetando o que um agente chama, o que aciona um agente ou como um agente se baseia no Knowledge antes de agir. Em vez de ler cada padrão, você pode navegar diretamente para a categoria que corresponde à sua preocupação de design.
Invoque ação:
Esses padrões abrangem como um agente chama sistemas externos para recuperar dados ou executar operações como parte de seu ciclo de raciocínio. Esses são padrões de saída em que o agente é o iniciador. Eles tratam de sequenciamento (quando as etapas dependem umas das outras), paralelismo (quando não dependem), idempotência e tratamento de falha parcial. Use esses padrões ao projetar as ferramentas que um agente vai invocar para concluir o trabalho.
Invoque agente:
Esses padrões tratam de como os sistemas ou eventos externos levam um agente a agir. Esses são padrões de entrada em que os sistemas externos acionam esses agentes. O acionador pode ser um aplicativo voltado para humanos fazendo uma chamada programática e aguardando uma resposta, ou uma condição de dados autônoma que aciona o agente. Use esses padrões ao projetar como e quando um agente é acionado.
Substituição com dados empresariais:
Os padrões nesta categoria abrangem como os agentes são fundamentados com o Knowledge preciso, atual e específico da organização antes de seus motivos ou ações.
Escolher a estratégia certa não é trivial. Cada padrão tem como alvo uma preocupação específica: funcionalidades do sistema, volume de dados, tratamento de falha e transacionalidade.
As tabelas de matriz de seleção listam os padrões e seus principais aspectos para ajudá-lo a determinar qual padrão atende melhor aos seus requisitos de integração. Os padrões são categorizados usando estas dimensões.
| Aspecto | Descrição |
|---|---|
| Tipo | Especifica a categoria de integração: Invocação de ação, Invocação do agente ou fundamento com dados corporativos Invocação de ação: Essas integrações de saída variam de chamadas de ferramenta simples de etapa única a sequências complexas de várias etapas e janelas paralelas, e exigem consideração cuidadosa de restrições de pedido, idempotency e processamento de falha parcial em backends heterogêneos. Invoque agente: As invocações de agente são as maneiras como os sistemas ou eventos externos levam um agente a agir. Essas integrações de entrada variam de chamadas programáticas síncronas feitas por aplicativos voltados para humanos que aguardam uma resposta estruturada a execuções totalmente autônomas conduzidas por evento em que uma condição de dados aciona o agente sem qualquer início humano ou espera pela interação. Substituição com dados empresariais: Integrações fundamentadas são as maneiras como um agente recebe o Knowledge preciso, atual e específico da organização antes de agir ou agir. Essas integrações variam de recuperar documentos não estruturados de lojas de conteúdo corporativas a injetar atributos estruturados verificados de perfis de cliente unificados, garantindo que o agente opere com base em fatos, em vez de inferências alucinadas. |
| Tempo | Especifica o estilo de integração com base no momento: Síncrono ou Assíncrono Síncrono vs. Assíncrono neste documento se refere a como o próprio agente é acionado ou como ele chama as ações. Não abrange o que acontece internamente. Porém, em geral, um usuário espera durante o tempo em que o agente está invocando ações e processando os resultados. O agente não abordará a próxima mensagem do usuário até que tenha concluído o turno atual. Síncrono: As solicitações de bloqueio e em tempo real são operações de solicitação/resposta. O resultado é retornado ao chamador imediatamente por meio dessa operação. Assíncrono: As solicitações sem bloqueio, de fila ou baseadas em mensagem são invocadas por uma operação unidirecional que é quase em tempo real. Os resultados e quaisquer falhas são retornados invocando outras operações unidirecionais. Assim, o chamador faz a solicitação e continua sem esperar uma resposta. |
Esta tabela lista os padrões e seus principais aspectos para ajudá-lo a determinar qual padrão atende melhor aos seus requisitos quando sua integração é do Salesforce para outro sistema.
| Tipo | Tempo | Padrão principal a considerar |
|---|---|---|
| Invocação de ação | Síncrono | Invoque ação sequencial Invoque ação paralela Integração de ferramentas entre sistemas Delegação entre agentes |
| Invocação de ação | Assíncrono | Invocação de ação assíncrona |
| Chamada do agente | Síncrono | Invoque agente sob demanda Agentes como serviços chamáveis |
| Chamada do agente | Assíncrono | Execução autônoma do agente conduzido por evento |
| Fundamentação com dados empresariais | Síncrono | Baseamento de Knowledge do Enterprise Content Injeção de contexto do cliente verificado |
Cada seção de padrões descreve como criá-los. Cada padrão é uma solução repetível para um problema de integração específico em arquiteturas agentes. Ele abrange quando usar o padrão, quais forças moldam a decisão e como a plataforma Salesforce a fornece.
Contexto
Muitos fluxos de trabalho de negócios são inerentemente sequenciais. Cada etapa exige um resultado verificado do anterior antes de continuar. Por exemplo, um reembolso não pode ser iniciado até que a elegibilidade seja confirmada, uma conta de faturamento não pode ser criada até que o registro do pedido exista e uma verificação de conformidade não pode ser registrada até que a verificação seja aprovada.
Na automação tradicional, essas dependências são codificadas como lógica de fluxo embutida em código. Em um sistema agente, o agente avalia o resultado de cada ação e determina se as pré-condições para a próxima etapa foram atendidas.
Esse padrão descreve o modelo de integração de saída fundamental. Aqui, um único agente opera dentro de um domínio e chama uma sequência, em que a saída de cada ação leva à invocação da próxima ação na cadeia. O agente de orquestração mantém o contexto transacional em toda a cadeia, acumulando identificadores, códigos de status e dados retornados por cada etapa. Ele usa esse contexto para conduzir decisões subsequentes.
Esse padrão é o equivalente agencial ao Guia de Padrões de integração Remote Process Invocation – Request and Answer, que descreve uma única chamada síncrona. O padrão agencial estende o padrão para uma cadeia conduzida pelo agente de chamadas dependentes em um só ciclo de raciocínio.
Problema
Quando um agente executa um fluxo de trabalho de várias etapas que abrange o sistema de host e um ou mais sistemas remotos, são necessários quatro desafios:
- Sequenciamento - As ações devem ser invocadas na ordem correta, com cada etapa marcada na conclusão bem-sucedida da anterior.
- Propagação de Dados - Os dados de resposta de cada etapa devem ser passados como entrada para a próxima.
- Isolamento de falha - Falhas em qualquer ponto da cadeia não devem produzir estado parcial ou inconsistente entre sistemas.
- Verificação de conclusão - O agente deve confirmar que todas as etapas foram concluídas com êxito antes de relatar um resultado.
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
-
Cada ação na cadeia depende dos dados retornados pela ação anterior ou as dependências dependem apenas do status de sucesso ou falha?
As dependências de dados exigem que o agente carregue identificadores e atributos entre as etapas.
-
Todos os pontos de extremidade remotos podem responder dentro do tempo limite do ciclo de raciocínio do agente?
Um sistema externo lento em qualquer etapa da cadeia bloqueia toda a sequência.
-
A cadeia exige um sucesso completo ou a conclusão parcial é aceitável?
-
Se o sucesso completo de ponta a ponta for necessário, defina uma estratégia de compensação para etapas que precisam ser revertidas quando ocorrer uma falha a jusante.
-
Qualquer operação de gravação na cadeia pode ser repetida com segurança?
Todas as ações de gravação devem ser idempotentes; o loop de raciocínio do agente pode invocar a mesma ação mais de uma vez devido a novas tentativas de Modelo de idioma grande (LLM) ou confirmações ambíguas.
-
A cadeia é invocada por uma interação do usuário (conversa, baixa simultaneidade) ou por um acionador automatizado (potencialmente alta simultaneidade)?
Isso determina se o bloqueio síncrono é aceitável ou se um padrão assíncrono é necessário.
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| Ações do Apex | Melhor para chamadas externas e lógica complexa | Uma etapa exige uma chamada HTTP para um sistema remoto, uma transformação de dados personalizada ou uma lógica de tratamento de erros que exceda os recursos declarativos do Fluxo. Ações do Apex expõem a plataforma completa para integração enquanto permanecem chamáveis pelo agente por meio da anotação @InvocableMethod. |
| Ações de fluxo (iniciado automaticamente) | Melhor para etapas de regra de negócios e operações de CRM leves | Uma etapa aplica lógica de negócios declarativa, consulta ou atualiza registros do CRM ou orquestra um processo que não requer código personalizado. Fluxos iniciados automaticamente são chamáveis nativamente de subagentes do Agentforce e retornam variáveis de saída digitadas que o agente usa para determinar a próxima etapa. |
| Serviços externos (importação OpenAPI) | Melhor para integração de API externa digitada e descobrível | Um sistema externo expõe uma especificação OpenAPI. Os Serviços externos geram fragmento de código do Apex de tipo forte que podem ser chamados diretamente como ações do agente, eliminando o mapeamento manual de esquema e tornando as operações da API externa visíveis ao agente como recursos nomeados. Cada operação na especificação importada se torna uma ação nomeada e chamada. O agente seleciona ações com base nos rótulos semânticos gerados. Registre ações geradas no Centro de tópicos do Agentforce para que o agente possa descobri-las no momento do raciocínio. Nota: se o serviço hospedado externamente for RESTful, mas a especificação OpenAPI não estiver disponível ou viável, use Credenciais nomeadas no Apex ou em Fluxos para fazer a chamada HTTP diretamente. O Apex code é necessário para analisar os resultados. |
| Ações conectadas do MuleSoft | Melhor para fanout de middleware complexo ou integração do sistema legado | Use quando o sistema remoto exigir tradução de protocolo, transformação de dados ou orquestração em vários sistemas de back-end antes de retornar uma resposta. O agente faz uma única chamada para o MuleSoft, e o MuleSoft lida com a complexidade posterior e retorna uma resposta unificada. |
Esboço
Diagrama de sequência para invocação de ação sequencial
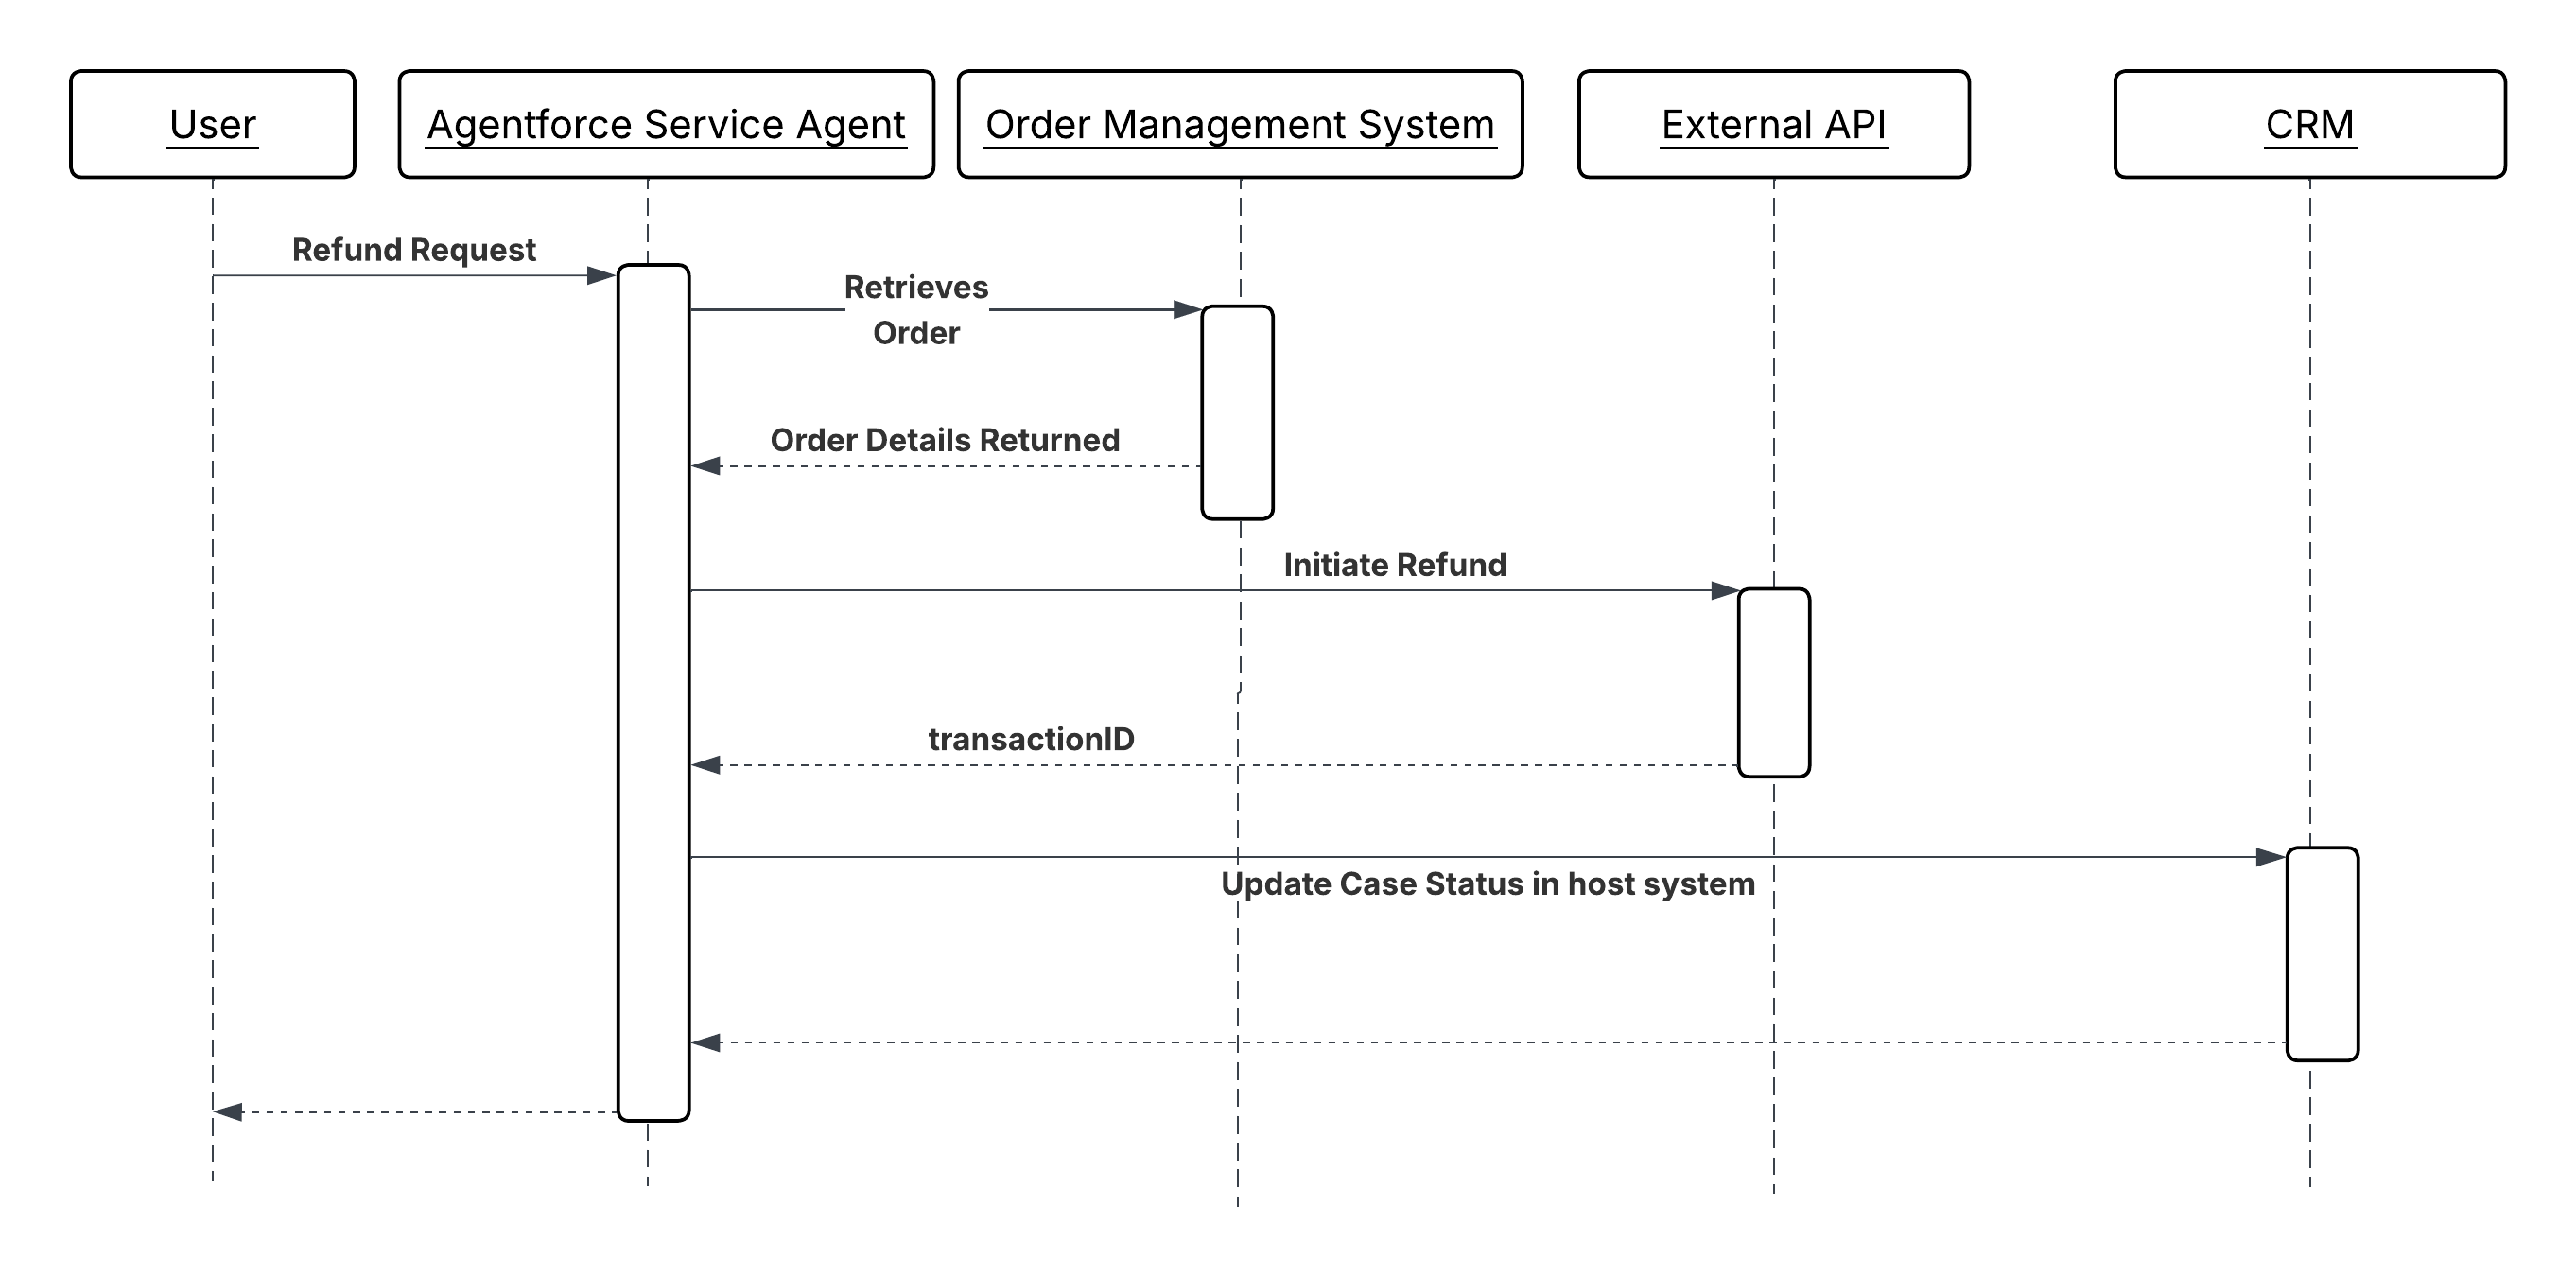
Resultados
O agente executa um fluxo de trabalho entre sistemas como uma sequência coesa e supervisionada, não como um script de foco e esquecimento. O resultado de cada etapa é avaliado antes de a próxima etapa ser invocada, assim, o agente detecta falhas o mais cedo possível, em vez de descobrir a conclusão parcial após o fato.
O sistema de host (Salesforce CRM) é atualizado apenas depois que a operação remota confirmou o status (sucesso ou falha). Os identificadores e os estados retornados por sistemas externos, como números de conta de faturamento, IDs de transação e códigos de confirmação, são propagados pela cadeia e persistiam, criando um registro completo e rastreável do resultado do fluxo de trabalho.
O agente é responsável por justificar os resultados e as decisões de sequenciamento. Cada ação é responsável apenas por sua própria operação e por retornar um resultado estruturado. Nenhuma camada codifica a lógica da outra.
Considerações de design
Orientação sem plataforma
- Certifique-se de que cada ação na cadeia tenha uma descrição semântica escrita em linguagem baseada em intenção e não como uma assinatura de método técnico. O agente seleciona ações com base nessas descrições. Uma descrição que diz “chamando a API de faturamento” é menos útil que uma descrição que diz “criando uma conta de faturamento no sistema de faturamento e retornando o novo identificador de conta”.
- Torne todas as operações de gravação na cadeia idempotentes. O loop de raciocínio do agente poderá tentar uma ação novamente se receber uma resposta ambígua. A ação deve produzir o mesmo resultado em invocações repetidas.
- Valide todos os parâmetros de entrada inferidos do LLM defensivamente no limite de ação. Nunca presuma que os parâmetros passados pelo agente estejam bem formados, dentro do intervalo ou do tipo esperado.
- Projete cada ação para uma única responsabilidade. Uma ação que cria uma conta de faturamento e envia um email de confirmação na mesma chamada é mais difícil de tentar novamente, mais difícil de testar e mais difícil para o agente justificar em relação a duas ações distintas.
Notas de implementação do Salesforce
- Para Ações do Apex, anote com @InvocableMethod(label=’…’ description=”…”). A “descrição” é lida pelo agente para determinar quando invocar a ação. Declare todas as variáveis de entrada e saída com @InvocableVariable usando os campos descritivos “rotulo” e “descrição”. Retorne objetos de resultado estruturados com indicadores de sucesso/falha explícitos e mensagens de erro legíveis por humanos.
- Para Ações de fluxo, use Fluxos iniciados automaticamente exclusivamente; fluxos de tela não têm suporte em contextos de agente autônomo. Mantenha cada fluxo atômico; uma ação, uma responsabilidade. Configure caminhos de falha em cada elemento de chamada externa para capturar erros de integração e retornar mensagens de erro acionáveis ao agente, em vez de permitir que exceções não capturadas encerrem a sessão.
- Para Serviços externos, importe a especificação OpenAPI do sistema de destino e registre as ações geradas no Tópico do Agentforce. Encapsule os fragmento de código gerados em Credenciais nomeadas para evitar a codificação de pontos de extremidade ou credenciais na definição de ação.
- Para todas as chamadas externas, defina tempos limite de chamada explícitos. Uma chamada pendente sem um tempo limite bloqueará o ciclo de raciocínio do agente até que o limite da sessão seja alcançado. Retorne uma falha fácil com uma mensagem de erro descritiva quando o tempo limite for excedido. Todas as chamadas externas têm um tempo limite configurável de até 120 segundos. Eles também estão sujeitos aos limites do regulador de transações síncronas do Apex, portanto, certifique-se de reduzir o risco de instanciar mais de 50 transações que sejam executadas por mais de cinco segundos cada.
Manuseio e recuperação de erros
- O agente define cada etapa no sucesso explícito do predecessor da etapa. As ações devem retornar um resultado estruturado que inclua um indicador claro de sucesso ou falha. O agente não pode inferir com confiança a falha apenas de uma resposta ausente ou nula.
- Quando uma ação falha, o agente usa a mensagem de erro retornada pela ação para determinar sua próxima etapa: solicite ao usuário a entrada corrigida, tente uma nova tentativa de auto-cura com parâmetros ajustados ou pare a cadeia e registre a falha para revisão humana. Portanto, as mensagens de erro devem ser específicas e acionáveis: “Intervalo de datas inválido: endDate não pode preceder startDate” é usável; apenas o código de status 400 não é.
- Para cadeias em que a conclusão parcial cria um estado inconsistente (por exemplo, a conta de faturamento foi criada, mas o registro do CRM não foi atualizado), o agente invoca uma ação de compensação para reverter ou sinalizar o estado parcial antes de detectar a falha. Projete caminhos de compensação como ações nomeadas junto com o caminho avançado.
- Se uma ação de gravação tiver potencialmente sido bem-sucedida, mas retornou uma resposta ambígua (tempo limite de rede, nenhuma confirmação), a nova tentativa deverá usar a mesma chave de idempotency ou ID de referência externa da chamada original. Nunca emita uma nova tentativa não marcada em uma gravação não idempotente.
Considerações de segurança
- Encapsule todas as chamadas externas em credenciais nomeadas. Nunca codifique pontos de extremidade ou credenciais em ajustes do Apex code ou do Fluxo. Eles devem ser gerenciados por meio do armazenamento de credenciais seguras da plataforma e girados sem alterações de código.
- Aplique o princípio de privilégio mínimo ao usuário de integração ou ao aplicativo conectado usado por cada ação. Uma ação que somente lê dados do pedido não deve ter permissões de gravação no sistema de faturamento. Credenciais de escopo para as operações mínimas que a ação exige.
- Registre a invocação de cada ação na cadeia com seu ID de sessão, parâmetros de entrada (saneados de valores confidenciais) e resultado. Se o resultado for contestado, essa trilha de auditoria será o mecanismo principal para reconstruir por que o agente executou uma determinada sequência de ações.
- Limpe todos os parâmetros de entrada originados de texto fornecido pelo usuário antes de passá-los para sistemas externos. A entrada do usuário passada pelo agente em uma chamada de API externa é um potencial vetor de injeção. Valide o tipo, o formato e o intervalo no limite de ações antes de a chamada ser feita.
Exemplo
Um agente de serviço ao cliente que lida com uma solicitação de reembolso executa uma cadeia sequencial de quatro etapas:
- O
GetOrderDetails(Apex Action) recupera o registro do pedido do Sistema de gerenciamento de pedidos usando o ID do pedido fornecido pelo usuário. Retorna o status do pedido, os itens de linha, a data da compra e o método de pagamento. O agente avalia se o pedido está em um estado reembolsável antes de prosseguir. - O
ValidateRefundEligibility(Fluxo iniciado automaticamente) aplica as regras de negócio para elegibilidade de reembolso, incluindo janela de devolução, restrições de categoria de produto e histórico de reembolso anterior. Ele retorna um booleano “elegível” e, se não for elegível, um motivo de linguagem simples que o agente pode apresentar ao usuário. - O
InitiateRefund(Apex Action) chama a API do gateway de pagamento externo com o ID do pedido e o valor do reembolso. Retorna um “refundTransactionId” no sucesso. Essa ação é idempotente. Se for chamada uma segunda vez com o mesmo ID do pedido, ela retornará o ID da transação existente em vez de criar um reembolso duplicado. - O
UpdateCaseStatus(Fluxo iniciado automaticamente) atualiza o registro de caso do CRM com o ID da transação de reembolso, define o status do caso como “Reembolso resolvido emitido” e cria uma tarefa de acompanhamento para o proprietário da conta. Essa etapa é executada apenas depois que “InitiateRefund” retornou um ID de transação confirmado.
Se o InitiateRefund atingir o tempo limite ou retornar um erro, o agente interromperá a cadeia, não invocará o UpdateCaseStatus e apresentará uma mensagem acionável ao usuário. O caso permanece aberto e não resolvido, preservando o estado preciso no CRM.
Contexto
As cadeias de ação sequenciais são eficientes quando as etapas de execução dependem umas das outras. Uma etapa leva à próxima. Porém, muitos fluxos de trabalho contêm um conjunto de etapas que não têm interdependências. Por exemplo, etapas que incluem recuperar o inventário de produtos, buscar direitos do cliente e verificar uma estimativa de envio podem acontecer simultaneamente, pois nenhuma entrada de etapa exige a saída de outra. Executar essas etapas sequencialmente desperdiça tempo proporcional ao número de etapas.
Em um padrão de invocação paralelo, o agente identifica que um conjunto de ações é independente e as chama simultaneamente, em vez de em sequência. O tempo de fluxo de trabalho geral é limitado pela ação individual mais lenta em vez da soma de todos os tempos de ação. Quando todos os resultados são retornados, o agente os agrega em uma única resposta coesa ou os usa juntos como entradas para o próximo estágio de raciocínio.
O principal desafio arquitetônico não é a invocação paralela em si. Ele está gerenciando a desativação nas restrições de simultaneidade da plataforma e garantindo que a etapa de agregação lide com falhas parciais de maneira fácil, sem descartar os resultados que obtiveram sucesso.
Problema
Como um agente orquestra de modo eficiente a execução simultânea de vários recursos independentes e agrega os resultados individuais em uma única resposta coesa para o usuário ou etapas subsequentes?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- Quais são as considerações para ações relacionadas à segurança de thread e compartilhamento de estado mutável?
- Como a solução gerencia e evita atingir os limites do controlador do Salesforce para chamadas paralelas do Apex em uma única transação?
- É necessário usar padrões assíncronos (como Apex enfileirável ou Eventos de plataforma) para evitar limites de regulador?
- É necessária agregação síncrona dos resultados para que o agente possa prosseguir?
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| Abordagem intermediária | Melhor para alta saída de fãs (>5 pontos de extremidade) e agregação entre plataformas | Você precisa de uma camada de middleware. O agente faz uma chamada ao middleware. Em seguida, os ventiladores de middleware que geram até 10 sistemas em paralelo agregam os dados e enviam uma única resposta de volta ao agente. Isso é preferível quando o agente deve chamar muitos sistemas externos heterogêneos. O middleware absorve a complexidade do fan-out e retorna uma única resposta agregada. |
| Apex enfileirável | Melhor para o paralelismo interno do Salesforce | Você precisa acionar vários trabalhos enfileiráveis. Enquanto o Salesforce gerencia a fila, se você tiver “slots” suficientes no limite de simultaneidade, eles poderão ser executados ao mesmo tempo. Use quando operações paralelas estiverem na organização do Salesforce e períodos simultâneos estiverem disponíveis. Isso não é adequado quando uma resposta agregada imediata é necessária. |
| Eventos de plataforma | Melhor para evitar incêndios ou consistência eventual | Os resultados não precisam ser agregados de modo síncrono. Cada evento aciona uma transação isolada, maximizando a taxa de transferência, mas exigindo reconciliação posterior. Use esse mecanismo quando a consistência eventual for aceitável e a taxa de transferência for mais importante que a latência da resposta. |
Esboço
Diagrama de sequência para invocação de ação paralela
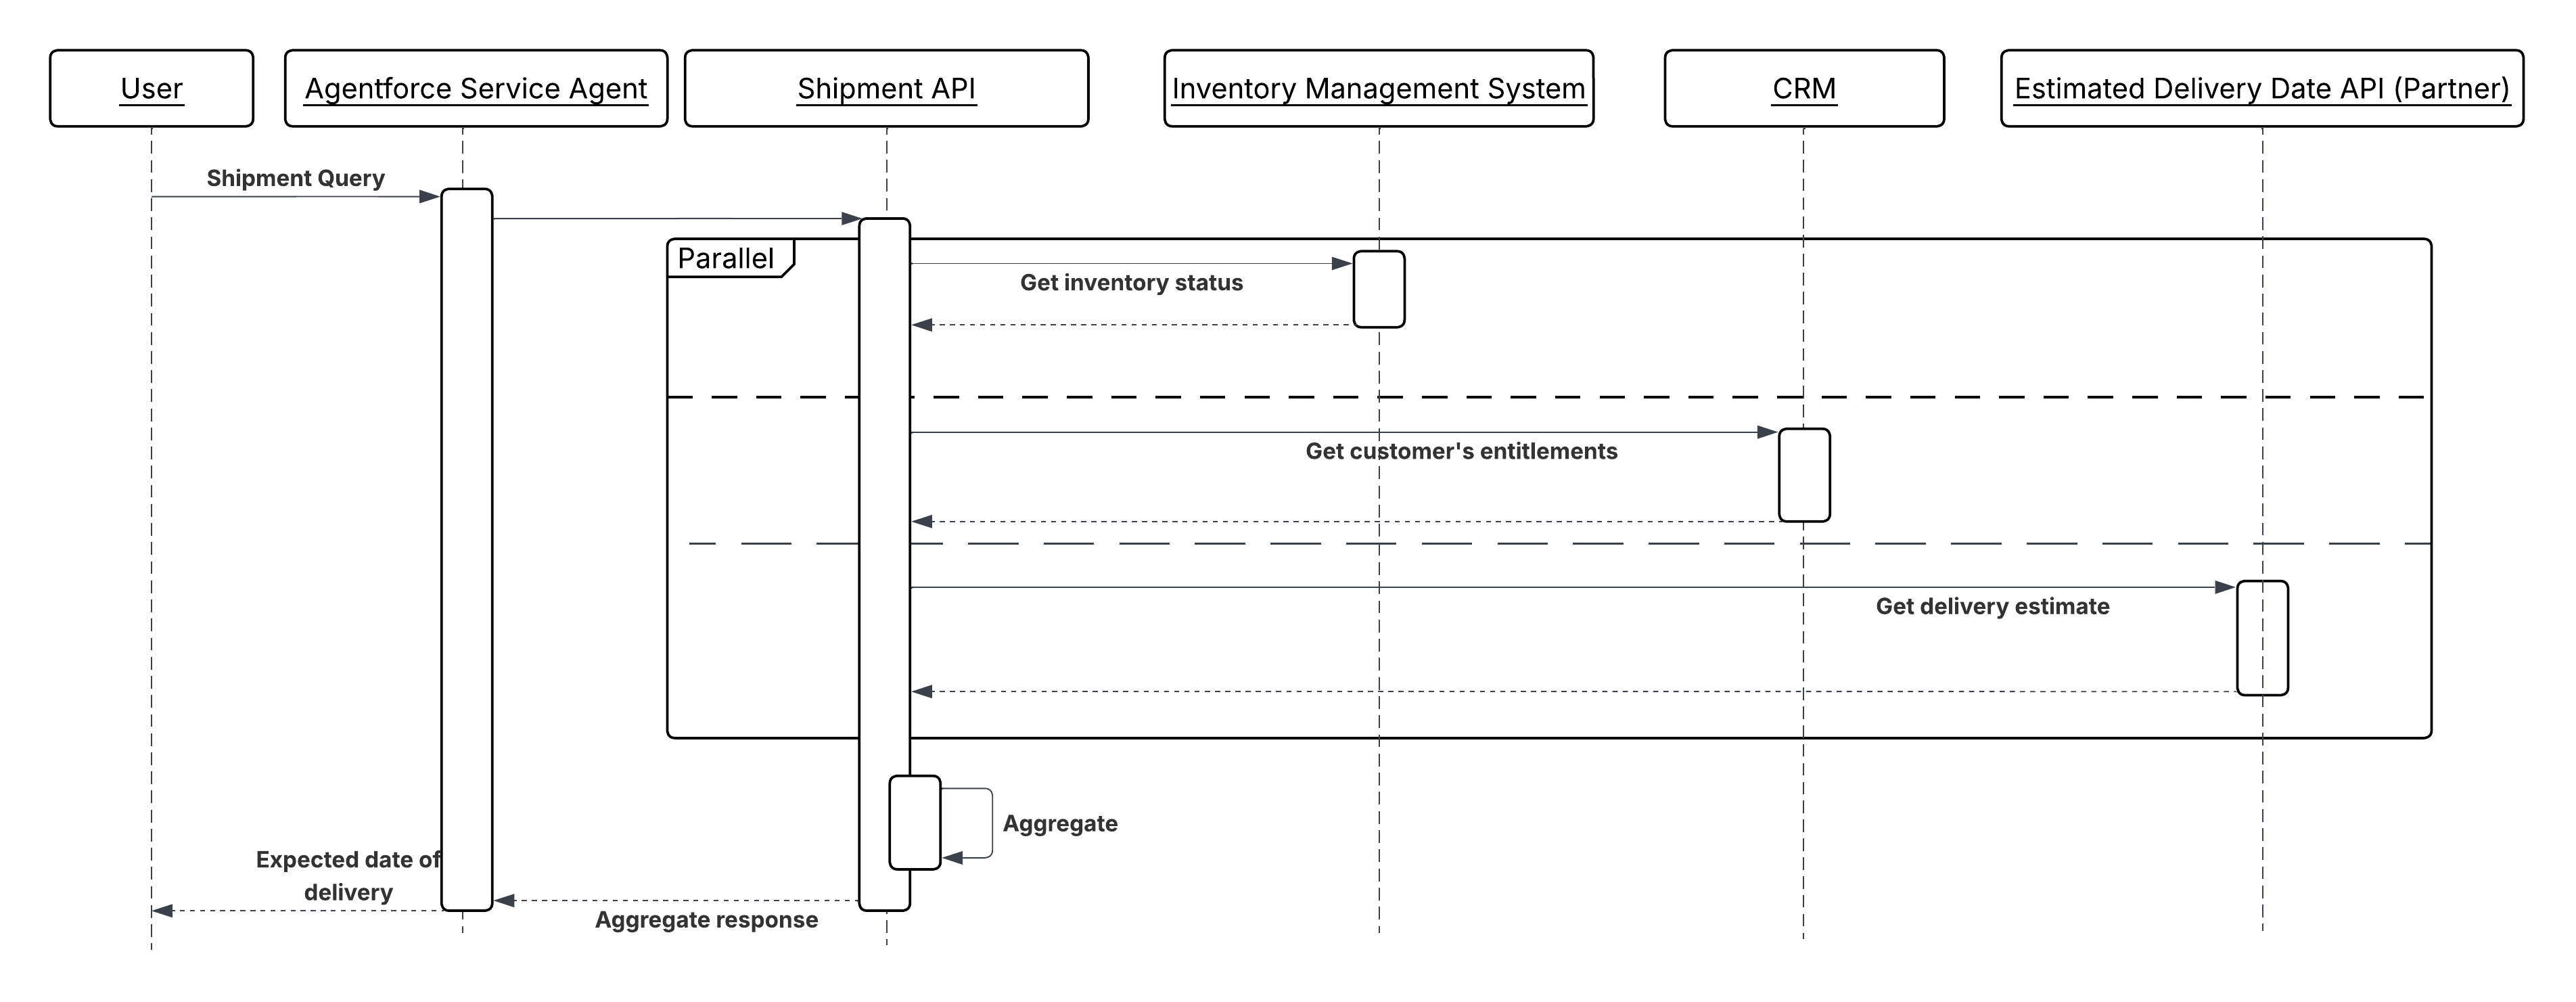
Resultados
Quando ações independentes são executadas em paralelo, o tempo de fluxo de trabalho de ponta a ponta é limitado pela ação individual mais lenta em vez da soma de todas as ações. Para um fluxo de trabalho com três chamadas independentes com média de 300 ms cada, a execução paralela é concluída em ~300 ms; a execução sequencial leva ~900 ms. Em escala, essa diferença se compõe em cada sessão do agente executada simultaneamente.
Considerações de design
Orientação sem plataforma
- Confirme a independência antes de paralelar. É seguro executar ações em paralelo apenas se nenhuma das ações ler o estado escrito pela outra e a falha de nenhuma das ações não cancelar a outra. Se houver uma dependência, mesmo de baixa, use a encadeamento sequencial.
- Projete a etapa de agregação explicitamente. Defina antecipadamente a aparência de um conjunto de resultados completo, o que um conjunto de resultados parcial significa para o raciocínio posterior e se o agente deve esperar por todos os resultados ou prosseguir depois que um limite (por exemplo, cinco de sete chamadas no total) for retornado.
- Todas as operações de gravação paralelas devem ser idempotentes. Cada operação é executada isoladamente sem um limite de transação compartilhado, portanto, tentar novamente qualquer ramificação individual não pode causar efeitos colaterais duplicados.
Notas de implementação do Salesforce
- Para o Apex enfileirável: Envie todos os trabalhos em uma única transação para maximizar a chance de execução concomitante. Esteja ciente de que os períodos simultâneos disponíveis são compartilhados em toda a organização; projete com a pressuposição de que os períodos talvez nem sempre estejam disponíveis e crie um fallback para execução sequencial quando não estiverem.
- Para eventos de plataforma: Escreva o resultado de cada operação em um registro de preparação dedicado (chaveado por um ID de correlação compartilhado) em vez de atualizar o registro de destino diretamente. Um Fluxo de agregação final ou acionador do Apex lê todos os registros de preparação quando a contagem esperada é alcançada e, em seguida, aplica a atualização consolidada atomicamente.
- Para o Fan-Out Middleware: Defina um tempo limite explícito na chamada única que seja maior que o tempo de resposta do pior caso esperado do back-end mais lento, mas ainda dentro do limite de tempo limite da chamada do Salesforce. O middleware retorna resultados parciais com uma indicação clara de quais backends falharam, em vez de atingir o tempo limite de toda a resposta.
Manuseio e recuperação de erros
- Trate o sucesso parcial como um resultado de primeira classe. Se três ou quatro operações paralelas forem bem-sucedidas, o agente usará os três resultados bem-sucedidos e lidará com a falha expondo-a explicitamente ao usuário, registrando-a para nova tentativa ou invocando uma ação compensatória em vez de descartar todos os resultados ou prosseguindo como se a falha não tivesse ocorrido.
- Para os padrões Enfileirável e Evento de plataforma, use um ID de correlação (gerado no ponto de janela) para vincular todas as ramificações paralelas de volta à sessão do agente de origem. Esse ID é necessário para reorganizar os resultados e rastrear falhas de volta à origem nos registros.
- Se uma ramificação paralela falhar e a operação for segura para tentar novamente, coloque novamente na fila apenas a ramificação com falha usando o ID de correlação original e a chave de idempotency. Não chame novamente todas as ramificações.
- Defina um limite de tempo limite para a etapa de agregação. Se nem todos os resultados chegarem dentro do limite, prossiga com os resultados disponíveis e sinalize o conjunto incompleto em vez de aguardar indefinidamente.
Considerações de segurança
- Cada contexto de execução paralelo, seja um trabalho enfileirável, um acionador de evento de plataforma ou uma chamada de middleware, deve aplicar os mesmos controles de acesso que uma chamada sequencial. O paralelismo não diminui as regras de acesso aos dados. Cada ramificação deve operar sob a mesma credencial de privilégio mínimo que faria se fosse invocada sozinha.
- Para fanout de middleware, a camada de middleware não armazena em cache nem registra as cargas úteis de resposta de backends individuais além da janela de agregação. A resposta de cada back-end pode conter dados confidenciais que não devem persistir fora do escopo da operação imediata.
- Certifique-se de que os registros de preparação usados para agregação de evento de plataforma não sejam legíveis pelo usuário final do agente. Esses registros podem conter dados intermediários parcialmente formados que ainda não são adequados para consumo.
Exemplo
Um agente de serviço responde a uma pergunta complexa: “Você pode enviar esse pedido até sexta-feira?” A resposta exige dados de todos os sistemas independentes simultaneamente, conforme explicado abaixo:
- O agente identifica três necessidades de dados independentes: o nível de inventário atual, os direitos ativos do cliente e a janela de entrega estimada da transportadora para o local do cliente.
- Três ações são invocadas em paralelo:
GetInventoryStatus(do sistema de inventário externo por meio de middleware),GetCustomerEntitlements(do Salesforce CRM) eGetDeliveryEstimate(da API da operadora por meio de middleware). - Cada ação retorna de modo independente. O agente espera até que todas as três respostas sejam recebidas (ou o tempo limite de agregação seja alcançado).
- Com todos os três resultados disponíveis, os motivos do agente sobre os dados combinados, avaliando se o inventário é suficiente, o direito do cliente cobre o envio expresso e a transportadora confirma que a entrega de sexta-feira é viável para o CEP do cliente.
- O agente retorna uma única resposta fundamentada ao usuário, obtida de três sistemas, no tempo que a resposta da chamada mais lenta das três levou.
Contexto
Algumas operações iniciadas pelo agente não produzem um resultado de que o agente precisa para continuar seu ciclo de raciocínio atual. Enviar uma notificação, acionar um processo em lote a jusante, publicar um evento em uma fila de mensagens ou enviar um trabalho de execução longa são todas as operações em que a obrigação do agente termina no envio; o sistema a jusante assume a propriedade e conclui o trabalho de forma independente.
Na automação tradicional, eles são modelados como chamadas de foco e esquecimento ou publicações de evento de plataforma. Em um sistema agente, o agente decide durante o raciocínio que a operação não é de bloqueio, envia-a, registra a confirmação do envio e continua ou conclui o turno sem esperar o resultado a jusante.
Este padrão é o equivalente agencial ao Invocation Process Remoto – Fire and Forget do guia Padrões de integração. O padrão agencial o estende tornando a decisão de envio parte do raciocínio do agente e garantindo que o envio seja rastreável mesmo que nenhuma resposta seja retornada ao agente.
Problema
Quando um agente precisa iniciar uma operação a jusante que vai além da sessão ou do ciclo de raciocínio do agente, três desafios devem ser resolvidos:
- Invoque sem bloqueio: O agente deve acionar a operação e confirmar a entrega sem manter o ciclo de raciocínio aberto aguardando um resultado.
- Confirmação de entrega: O agente deve distinguir entre um envio bem-sucedido (a mensagem foi aceita) e um resultado bem-sucedido (o processo posterior foi concluído). Ele só pode declarar o primeiro.
- Rastreabilidade: Como o agente não recebe nenhum resultado, a operação deve ser observável por meio de logs, registros de evento ou monitoramento de plataforma independentemente da sessão do agente.
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
-
O agente precisa do resultado dessa operação para concluir seu turno atual? Se sim, esse não é o padrão certo. Use a invocação de ação sequencial em vez disso.
-
O sistema downstream é capaz de receber e processar com confiança a mensagem ou o evento despachado sem uma confirmação síncrona? O sistema de destino deve ser durável. Ele não deve perder a mensagem se estiver temporariamente indisponível.
-
A operação é idempotente ou o envio duplicado precisa ser protegido? As novas tentativas no nível da rede e as novas tentativas de racificação do agente podem fazer com que o mesmo envio seja tentado mais de uma vez. Se a operação a jusante não for idempotente, a ação deverá conter uma chave de desduplicação.
-
O usuário ou um processo a jusante precisa saber quando a operação é concluída? O agente só pode confirmar o envio. Se o status de conclusão for obrigatório, projete uma notificação ou mecanismo de acompanhamento separado. Um Evento de plataforma, uma atualização de caso ou um retorno, que está fora desse ciclo de raciocínio.
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| API Pub/Sub | Melhor para transmissão de evento externo ou de alta taxa de transferência | O agente chama uma ação do Apex que publica um evento na API Pub/Sub do Salesforce por meio de gRPC. A ação retorna um replayId de PublishResult ao agente como confirmação do envio. Use quando os consumidores a jusante forem sistemas externos que assinam por meio da API Pub/Sub em vez de acionadores nativos do Salesforce ou do Apex ou quando for necessário transmitir eventos de alta taxa de transferência. |
| Eventos de plataforma (Apex Action) | Melhor para envio assíncrono intra-Salesforce | O agente invoca uma ação do Apex que publica um Evento de plataforma. O evento é entregue a todos os assinantes de modo assíncrono. A ação retorna uma confirmação de publicação ao agente; ela não retorna um resultado de processamento. Usado quando o consumidor downstream está na plataforma Salesforce. O agente chama uma ação do Apex que chama EventBus.publish(). A ação retorna um SaveResult confirmando a aceitação. |
| Apex enfileirável / lote (Apex Action) | Melhor para processamento em segundo plano de execução longa | O agente chama uma ação do Apex que enfileira um trabalho Queueable ou Lote. O trabalho é executado fora da transação do agente. A ação retorna um ID de trabalho que o agente pode apresentar ao usuário como referência. Usado quando o trabalho a jusante é um processamento de dados de operação do Salesforce de execução longa, atualizações de vários objetos ou chamadas externas que excedem limites síncronos. O System.enqueueJob() retorna um ID de trabalho que o agente registra como referência. |
| Fluxo assíncrono do MuleSoft | Melhor para despacho de fila de mensagens externas | O agente chama uma ação exposta pelo MuleSoft que coloca uma mensagem em uma fila externa (Kafka, JMS, SQS). O MuleSoft lida com a tradução do protocolo e a confirmação de entrega. O agente recebe confirmação de que a mensagem foi aceita pela MuleSoft, não de que ela foi processada posteriormente. |
| Ponto de extremidade REST externo (Ação do Apex) | Melhor para envio de evento do sistema externo | O sistema de destino expõe um ponto de extremidade que aceita um envio e retorna um ID de confirmação imediatamente, concluindo o processamento de modo assíncrono. O agente recebe o ID de confirmação e o registra. |
Esboço
Diagrama de sequência para invocação de ação assíncrona
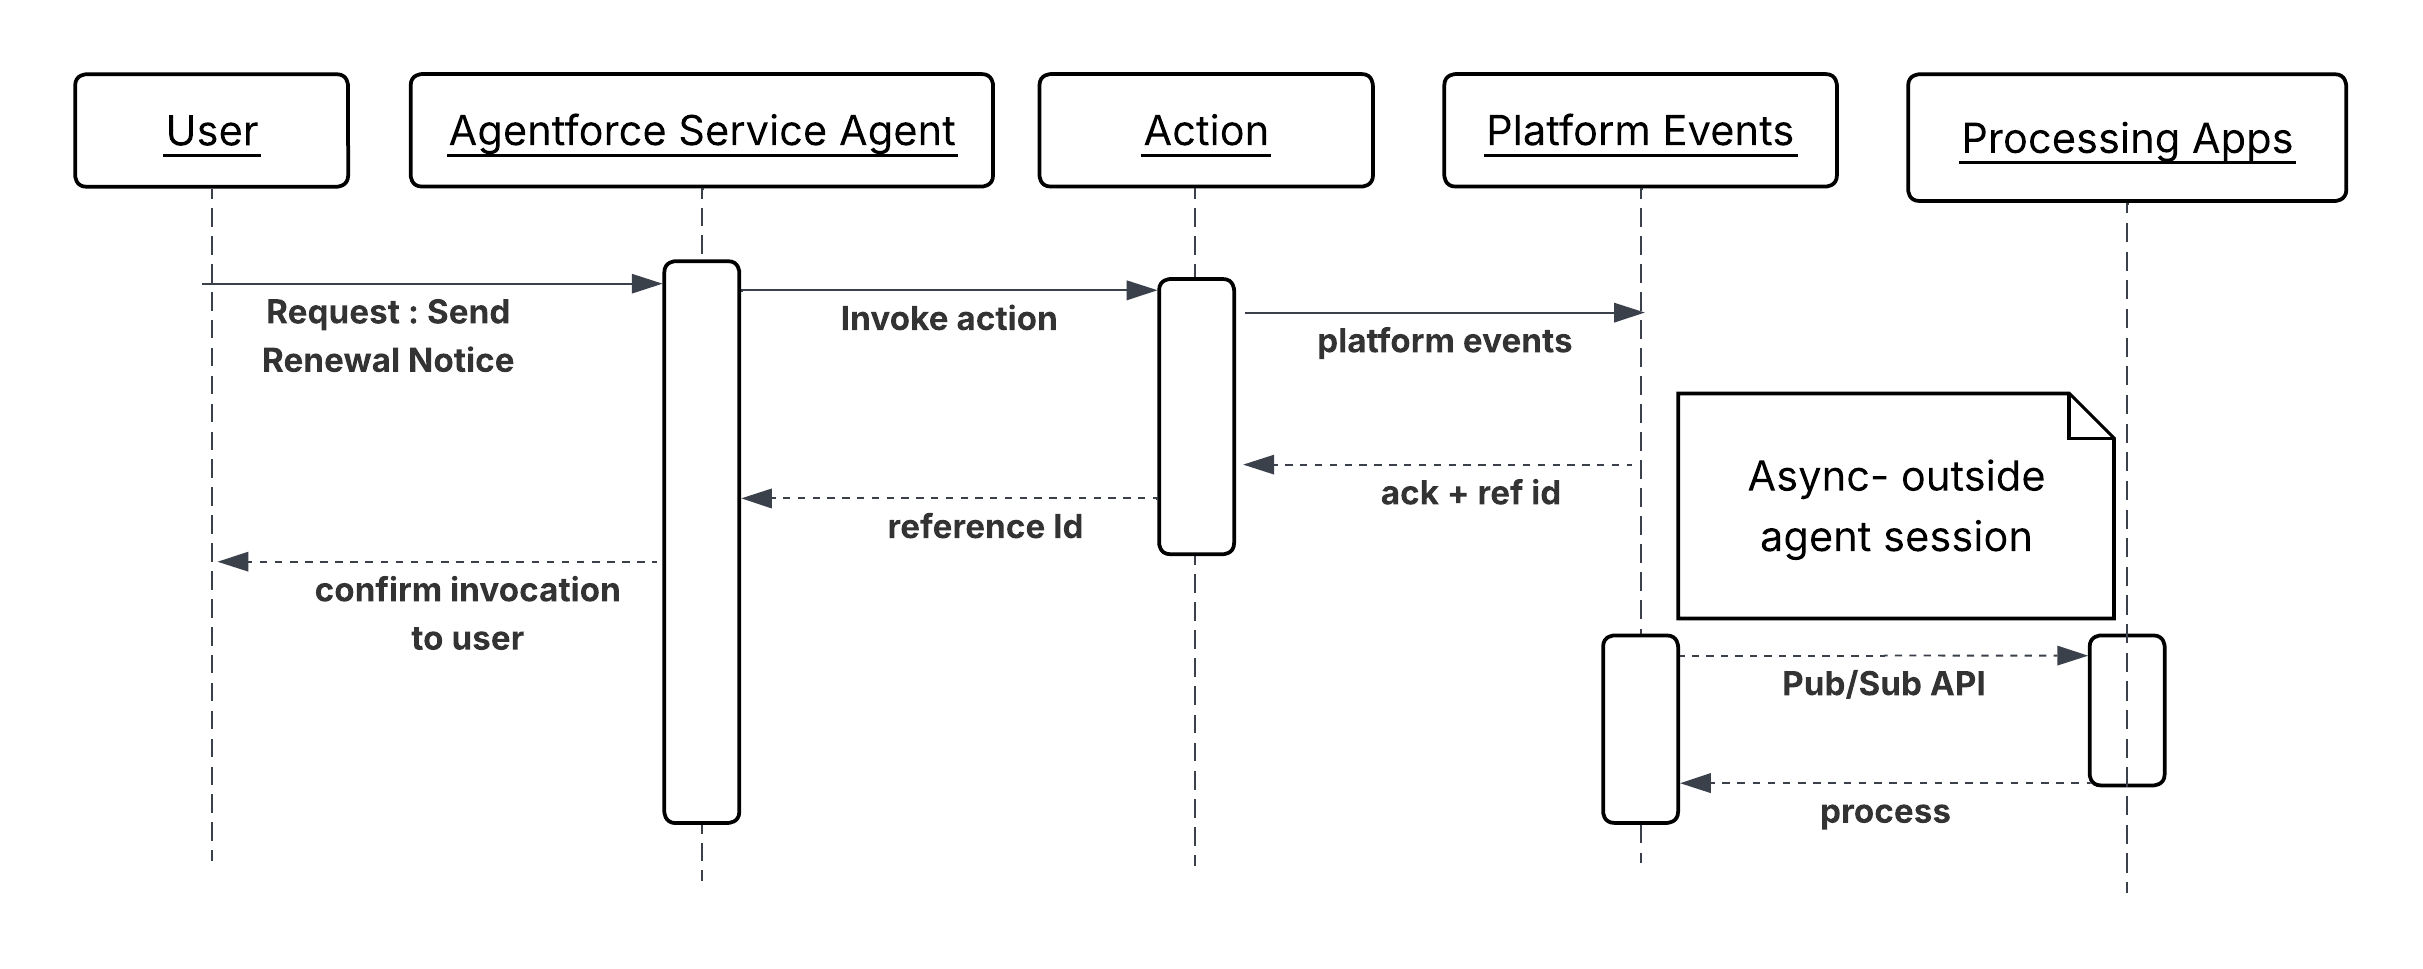
Resultados
O agente chama uma operação a jusante sem bloquear seu ciclo de raciocínio sobre o resultado. O turno é concluído com confirmação de que a operação foi aceita, não de que foi concluída. O sistema downstream assume a propriedade total da execução. A operação despachada é rastreável por meio de assinantes de evento de plataforma, IDs de trabalho ou IDs de confirmação de fila externa registrados no CRM no momento do envio. Se a operação a jusante falhar, essa falha será detectada por meio do monitoramento próprio do sistema a jusante, não pela sessão do agente que a iniciou.
Considerações de design
Orientação sem plataforma
- Escreva descrições de ação em linguagem baseada em intenção. Por exemplo, “Envia uma notificação de renovação à fila de mensagens e retorna um ID de referência de envio” é mais útil para o agente do que “chama o ponto final de notificação”.
- Nunca descreva uma ação de envio como “envia e confirma a entrega”. O agente só pode confirmar a aceitação. A entrega e o processamento a jusante estão fora da observabilidade do agente.
Notas de implementação do Salesforce
- Retorne um ID de referência de cada ação de invocação, por exemplo, um
ReplayIdde evento de plataforma, um ID de trabalho enfileirável, um Pub/Sub APIPublishResultreplayId ou um token de confirmação externo. Registre-o em um registro do CRM no horário de invocação. Esta é a única trilha de auditoria que a sessão do agente produzirá. - Para a API Pub/Sub, o agente invoca uma ação do Apex que faz uma chamada gRPC para o ponto de extremidade da API Pub/Sub ‘/Publish’. A ação deve lidar com a etapa de registro do esquema – os eventos devem ser serializados no formato Avro com relação ao esquema registrado. Devolva o
PublishResult ‘replayId’ao agente como referência de envio. - Para Eventos de plataforma, chame
EventBus.publish()dentro da ação do Apex e verifique se há erros no SaveResult antes de retornar um indicador de sucesso ao agente. Não presuma o sucesso da publicação; valide-o. - Para Trabalhos enfileiráveis, implemente a interface Enfileirável e chame System.enqueueJob() dentro da ação. Retorne o ID de AsyncApexJob resultante para o agente.
- Para pontos de extremidade assíncronos externos, o ponto de extremidade de destino deve retornar uma confirmação imediatamente (HTTP 202 Aceito) com um ID de referência. Se o ponto de extremidade bloquear até a conclusão do processamento, ele será síncrono e esse padrão não será aplicado.
Manuseio e recuperação de erros
- Uma ação de invocação deve distinguir entre falha de envio (a mensagem não foi aceita) e falha de processamento (a mensagem foi aceita, mas a operação downstream falhou mais tarde). O agente só pode lidar com o primeiro.
- Se a invocação falhar, a ação deverá retornar uma falha estruturada com um motivo claro. O agente pode tentar o envio novamente, escalar para um humano ou registrar um registro de envio com falha, mas não pode recuperar uma falha de processamento downstream na mesma sessão.
- Para operações em que a falha a jusante eventualmente deve ser detectada, projete um loop de feedback separado, como um Evento de plataforma publicado pelo processo a jusante, um fluxo agendado que verifica o status do trabalho ou um caso de acompanhamento que esteja fora da sessão do agente.
Considerações de segurança
- Encapsule todas as chamadas assíncronas externas em credenciais nomeadas. A ação de invocação não integra URLs ou credenciais de ponto de extremidade ao código.
- Valide e limpe todos os parâmetros passados para a ação de invocação antes de serem integrados à carga útil do evento ou ao corpo da mensagem. O texto fornecido pelo usuário passado para uma mensagem assíncrona é um potencial vetor de injeção no consumidor downstream.
- Registre cada envio com ID da sessão, ID de referência e carga útil limpa no momento do envio. Como nenhuma resposta retorna ao agente, esse registro é o mecanismo principal para reconstruir o que o agente iniciou.
- Aplique o privilégio mínimo ao usuário de integração ou ao aplicativo conectado. Uma ação de despacho que é publicada em uma fila de notificação não deve conter credenciais que permitem leitura ou gravação em sistemas não relacionados.
Exemplo
Um agente de gerenciamento de renovação que lida com um contrato que está prestes a expirar determina que o cliente está qualificado para uma notificação de renovação automática. O agente não precisa de confirmação de que o email foi entregue antes de encerrar o turno.
- O
CheckRenewalEligibility(Fluxo iniciado automaticamente) avalia os termos do contrato, o nível do cliente e o status de recusa. Retorna um booleano “elegível” e o canal de notificação preferencial. DispatchRenewalNotification(Ação do Apex) publica um Evento de plataforma deRenewalNotification\_\_econtendo o ID do contrato, o ID do cliente, o canal de notificação e uma chave de idempotency gerada. Retorna um ReplayId confirmando que o evento foi aceito pela plataforma.UpdateContractRecord(Fluxo iniciado automaticamente) grava o carimbo de data e hora deReplayIde envio no registro Contrato e define um sinalizador de status “Notificação enviada”.
Contexto
Aplicativos externos, como portais de clientes, aplicativos móveis, plataformas SaaS de terceiros e sistemas de parceiros, precisam chamar agentes de modo programático para lidar com solicitações de serviço, iniciar fluxos de trabalho ou detectar respostas conduzidas por IA em suas próprias interfaces. O agente atua como um serviço de back-end inteligente. O sistema externo fornece contexto, os motivos e ações do agente e o chamador consome a resposta.
Cada vez mais, o chamador é um agente ou orquestrador de IA em si, em vez de um aplicativo voltado para humanos. Nesses padrões de IA para IA, um agente de orquestração delega uma etapa de raciocínio, pesquisa de CRM ou ação para o Agentforce como uma chamada de ferramenta discreta. Precisamos expor um servidor de Protocolo de contexto de modelo (MCP) para dar suporte a esse padrão.
Problema
Quando um agente de IA ou sistema externo precisa aproveitar as capacidades de um agente Agentforce sob demanda, como ele autentica, cria uma sessão do agente, passa os dados conversacionais e contextuais necessários e recebe com confiança a resposta estruturada do agente para conduzir sua própria lógica a jusante?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- O chamador externo está esperando uma resposta síncrona de baixa latência ou um retorno de chamada assíncrono é aceitável?
- Como a identidade do chamador é estabelecida e propagada para o contexto de execução do agente para acesso e personalização de dados?
- Qual é o volume esperado de sessões acionadas por API simultâneas e como isso interage com os limites de simultaneidade e taxa da API do Salesforce?
- O sistema externo precisa manter a continuidade da sessão em vários turnos (conversa de vários turnos) ou cada solicitação é sem estado?
- Como a resposta do agente deve ser estruturada para que o sistema de chamada possa analisar e agir programaticamente?
- O chamador é um aplicativo voltado para humanos que requer integração REST direta, ou um agente ou orquestrador de IA que pode invocar Agentforce como uma ferramenta por meio de um protocolo padrão, como MCP?
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| API Agentforce Agent – Fuso único (síncrono) | Melhor para integrações de solicitação-resposta sem estado | O sistema de chamada requer uma resposta imediata e estruturada e o raciocínio do agente deve ser concluído dentro da tolerância de tempo limite do chamador. O sistema de chamada gerencia as fases do ciclo de vida completo da sessão: criação, turnos e encerramento. O sistema externo autentica, cria uma sessão com variáveis de contexto, envia uma única mensagem, recebe a resposta do agente e fecha a sessão. Essa API Agentforce é a interface REST principal através da qual os sistemas externos criam sessões, trocam mensagens e fecham sessões programaticamente. Toda a troca é concluída em um ciclo de solicitação-resposta HTTP. As respostas incluem a saída em idioma natural do agente e quaisquer variáveis de saída estruturadas produzidas por ações que o agente invocou durante o raciocínio. |
| API do Agentforce Agent – Multi-Turn (Continuidade da sessão) | Melhor para integrações conversacionais que exigem estado entre turnos | A interface externa é conversacional (por exemplo, um widget de chat ou interface de voz) e a interação exige várias trocas para chegar a uma resolução. O sistema externo cria uma sessão uma vez e reutiliza o ID da sessão em várias trocas de mensagens. O agente mantém o contexto da conversa entre turnos, como perguntas anteriores, dados recuperados, decisões tomadas sem o chamador reenviá-las. |
| Assíncrono com retorno de consulta ou Webhook | Melhor para fluxos de trabalho de raciocínio de alta latência ou UIs urgentes | O tempo de processamento do agente não é trivial e manter uma conexão HTTP aberta prejudicaria a experiência do usuário do chamador ou acionaria tempos limite a montante. O sistema externo envia a solicitação e recebe imediatamente uma confirmação com um trabalho ou ID da sessão. Em seguida, consulta um ponto de extremidade de status ou registra um webhook para receber a resposta do agente quando o raciocínio é concluído. No momento, esse padrão pode ser implementado com uma API de encapsulador hospedada em um middleware como o MuleSoft. O consumidor externo chama essa API do Wrapper e registra o ponto de extremidade do webhook. A API Wrapper envia a confirmação de volta ao sistema externo depois de invocar o agente Agentforce. Essa API wrapper também mantém a sessão do agente do Agentforce e retorna a resposta de volta ao sistema externo usando o ponto final do webhook registrado quando o agente responde. |
| Agentforce via MCP (Salesforce Headless 360) | Melhor para a invocação de IA para IA em que o chamador é um cliente compatível com MCP | O cliente MCP de chamada chama o Agentforce como uma ferramenta por meio do servidor MCP pronto para uso fornecido pelo Salesforce Headless 360. O ciclo de vida da sessão é gerenciado de forma transparente pelo servidor MCP e o agente de chamada interage por meio de chamada de ferramenta padrão sem criar uma integração REST personalizada. Use essa solução quando o chamador for um cliente MCP que precisa delegar o raciocínio, a recuperação de contexto do CRM ou a execução de ação para Agentforce como uma etapa discreta em um fluxo de trabalho agente mais amplo. |
Esboço
Diagrama de sequência para invocação do agente sob demanda
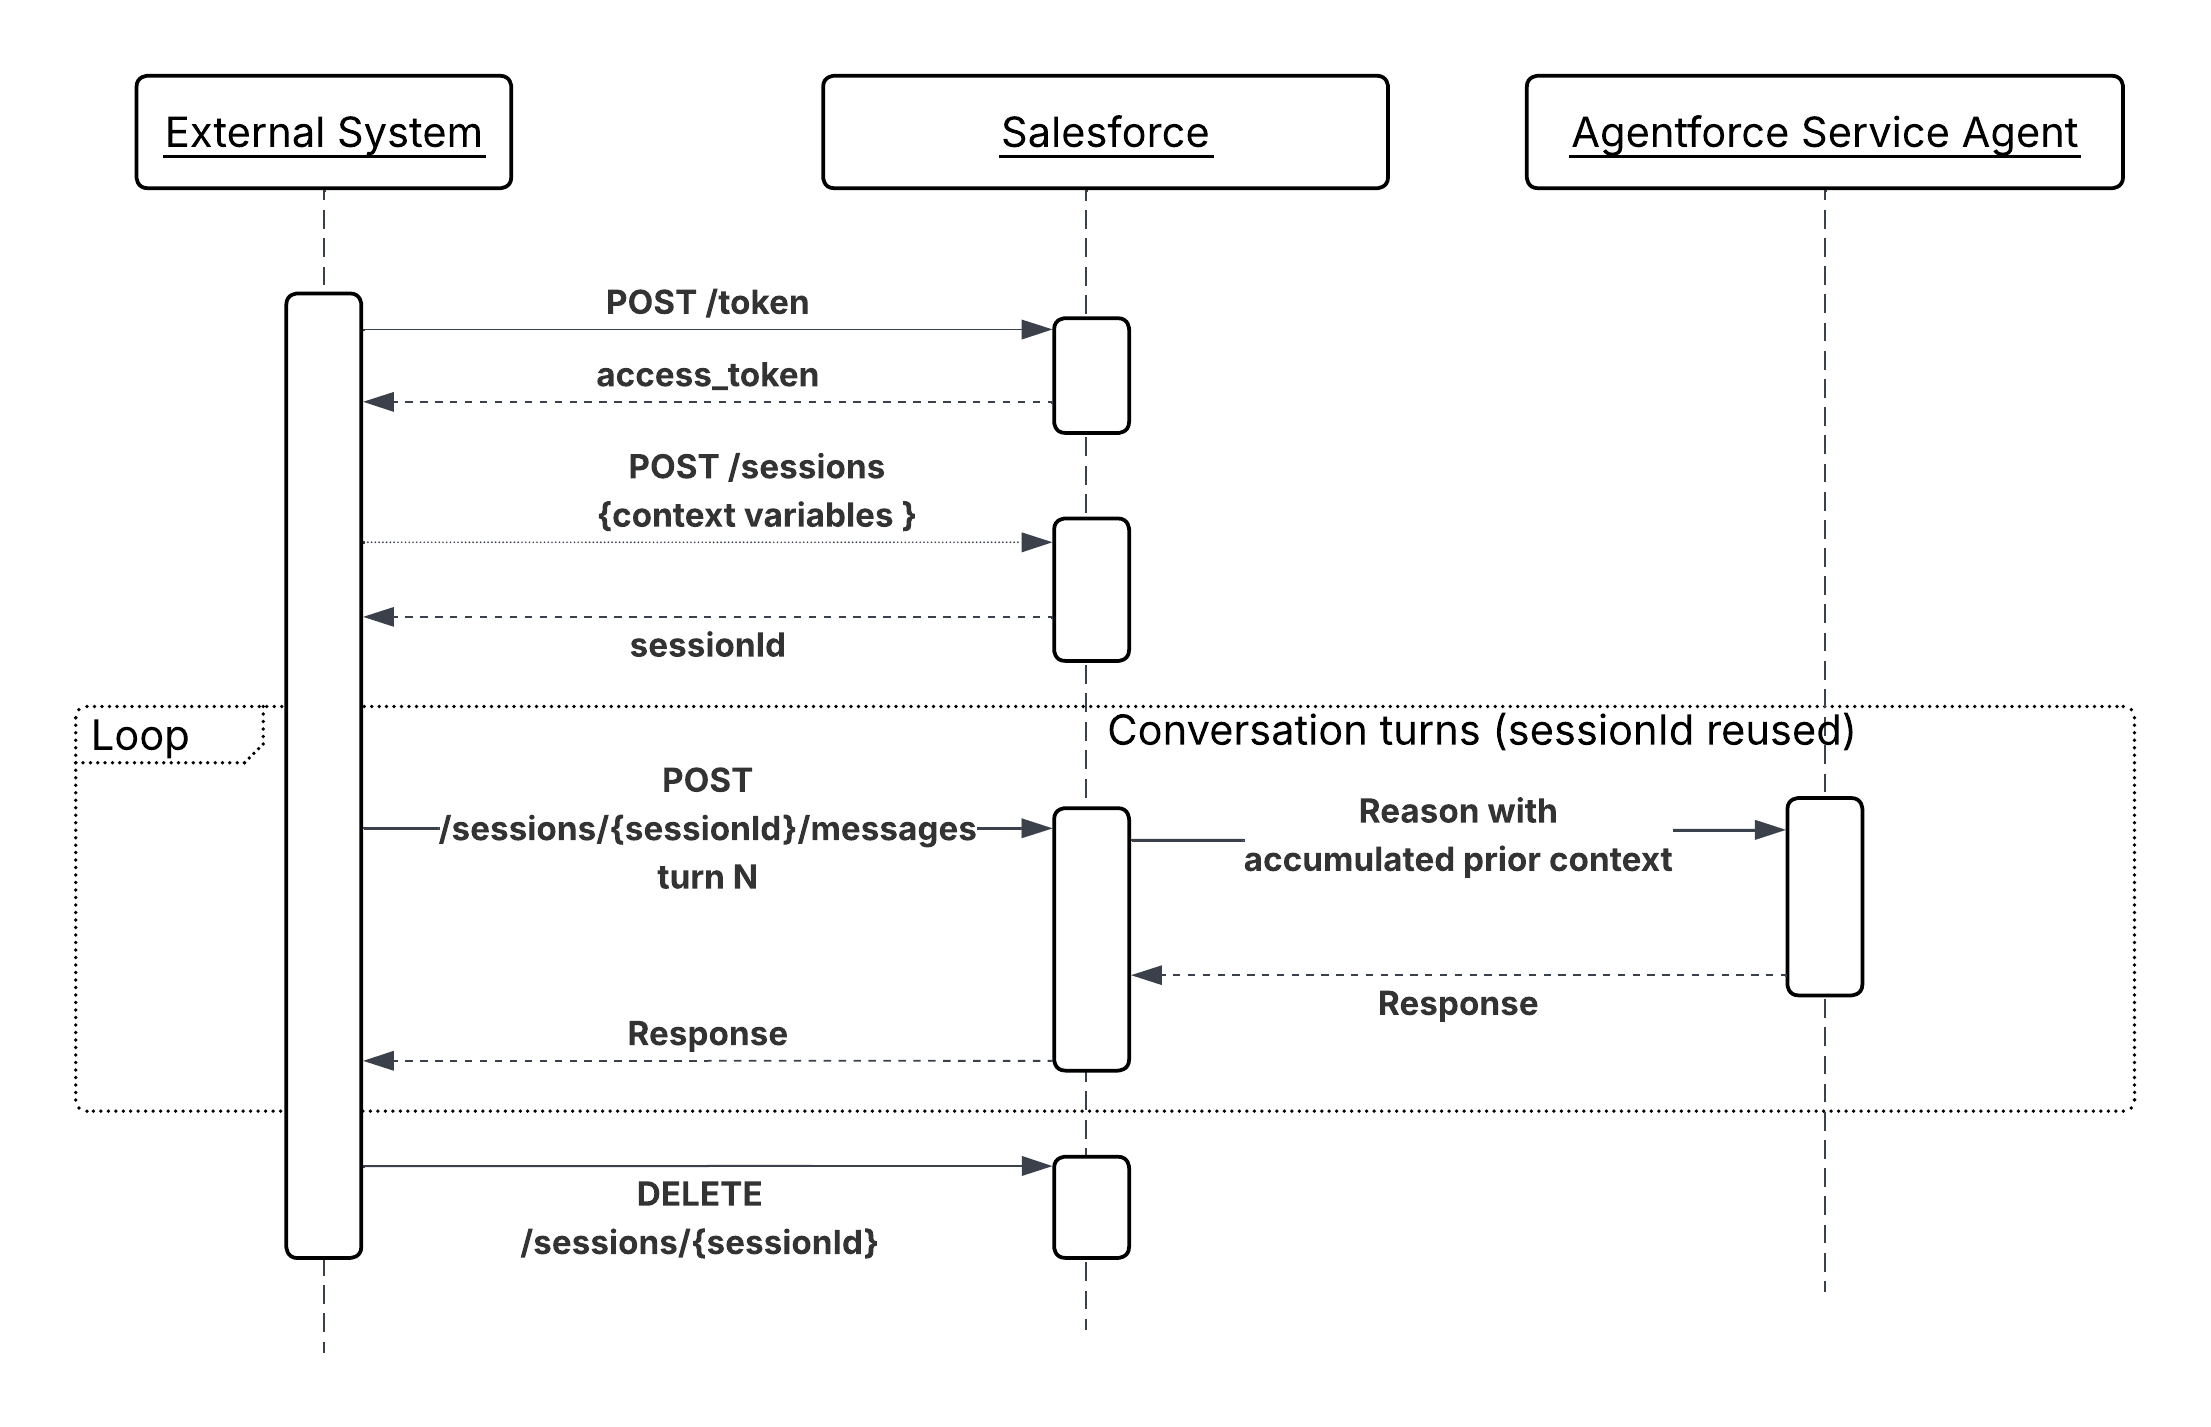
Resultados
Esse padrão expõe o Agentforce como um serviço de IA que pode ser chamado. Os sistemas externos obtêm acesso ao raciocínio, às ferramentas e ao contexto do CRM do agente sem replicar essa lógica. O chamador continua responsável pelo gerenciamento do ciclo de vida da sessão e pela renderização da resposta. O agente continua responsável por todo o raciocínio, seleção de ferramentas e síntese de resposta.
Quando o chamador é um agente ou orquestrador de IA, o mecanismo Agentforce via MCP (disponível prontamente no Salesforce Headless 360) elimina totalmente a necessidade de uma integração REST personalizada. O servidor MCP gerencia o ciclo de vida da sessão em nome do agente de chamada, permitindo que a Agentforce participe como uma ferramenta de primeira classe em fluxos de trabalho de vários agentes sem encanamento adicional.
Considerações de design
Orientação sem plataforma
- Evite tornar a chamada de API externa síncrona e bloquear fluxos de interface do usuário urgentes. Adote um padrão de retorno de chamada de consulta ou webhook em que os tempos de resposta do agente não sejam triviais para desacoplar a experiência do usuário do tempo de processamento do agente.
- Selecione o mecanismo de chamada com base na natureza do chamador, não na disponibilidade. Aplicativos voltados para humanos e integrações do sistema devem usar a API do agente diretamente. As ferramentas que oferecem suporte a MCPs devem usar o servidor Agentforce MCP. Misturar mecanismos para o mesmo tipo de chamador adiciona complexidade desnecessária sem benefício arquitetônico.
Notas de implementação do Salesforce
- Injecte o contexto da sessão na solicitação POST de criação da sessão, não na primeira mensagem do usuário. Quando o sistema externo cria a sessão, ele tem a oportunidade de passar variáveis de contexto estruturadas (ID da conta, dados de direito, resumo da interação anterior) diretamente como parâmetros da sessão nomeada. Essas variáveis estão disponíveis ao agente antes de processar um único turno, assim, ele começa a racificar de um estado fundamentado sem emitir chamadas de pesquisa para estabelecer quem é o cliente ou ao que ele tem direito. Passar os mesmos dados dentro do corpo da mensagem, em vez disso, força o agente a analisar texto não estruturado para extrair fatos que ele poderia ter recebido como variáveis digitadas – aumentando a latência, introduzindo erros de extração e consumindo etapas de raciocínio que não adicionam nenhum valor comercial.
- Projete respostas do agente para serem estruturadas e analisáveis por máquina. Use convenções de variável de saída e instruções de prompt que conduzam o agente a retornar respostas JSON adequadas ou claramente delimitadas quando o chamador for um sistema, em vez de um humano.
- Gerencie o ciclo de vida da sessão explicitamente. Encerre sessões imediatamente após usar o
DELETE /einstein/ai-agent/v1/sessions/{sessionId}para slots simultâneos livres e evite que o contexto obsoleto persista em interações não relacionadas. - Conta para limites de sessão simultâneas do Salesforce. Para cenários de alta taxa de transferência, implemente um pool de sessão ou uma camada de enfileiramento no sistema de chamada para evitar a rejeição da solicitação durante a carga máxima.
- Ao invocar o Agentforce por meio do MCP, passe o contexto como parâmetros de entrada de ferramenta em vez de variáveis de sessão. O servidor MCP gerencia o ciclo de vida da sessão de modo transparente, portanto, o agente que está chamando não pode definir parâmetros da sessão nomeada diretamente no momento da criação. Garanta que todo o contexto necessário (IDs de registro, identidade do usuário, dados de direito) esteja incluído na carga útil da chamada de ferramenta para que o agente comece a raciocinar com base em um estado fundamentado.
- Trate o gerenciamento de sessão transparente do servidor MCP como uma conveniência, não um desvio simultâneo. Cada invocação de ferramenta ainda consome um período de sessão do agente do Salesforce. Os orquestradores de alta frequência que chamam o Agentforce por meio do MCP em escala devem considerar os mesmos limites de sessão simultâneos que se aplicam aos chamadores diretos da API do agente.
Manuseio e recuperação de erros
- A API do agente retorna códigos de erro HTTP padrão. O sistema de chamada deve lidar com “429 solicitações demais” (limite de taxa) com desvio exponencial e “503 serviço indisponível” com lógica de nova tentativa.
- Quando o próprio agente encontra uma falha de ferramenta irresolável, ele retorna um erro de linguagem natural agradável no corpo da resposta. O sistema de chamada detecta essas respostas de sentinela (por exemplo, verificando um campo de status “erro” na resposta) e roteia de acordo, tentando novamente usar contexto adicional, apresentando uma experiência de fallback ou escalando para um humano.
- Ao invocar por meio de MCP, os erros aparecem em duas camadas distintas: Erros de transporte do MCP (chamadas de ferramentas malformadas, indisponibilidade do servidor) e falhas de raciocínio do Agentforce (erros de execução de ferramentas, ações não resolvidas). O agente de orquestração deve lidar com ambas as camadas de modo independente. Erros de transporte de MCP devem acionar novas tentativas no nível do protocolo; Falhas de raciocínio do Agentforce retornadas na resposta da ferramenta devem ser tratadas pela própria lógica de fallback ou escalonamento do orquestrador.
Considerações de segurança
- Use os escopos OAuth mais estreitos possíveis para o aplicativo cliente externo. Uma integração que precisa invocar apenas um agente não deve ter escopos para acesso a dados além do que o próprio agente exige.
- Valide e limpe todas as entradas do sistema externo antes de injetá-las como variáveis da sessão. Entradas externas são uma superfície de ataque para injeção de prompt. Por exemplo, um chamador mal-intencionado pode criar um campo “customerQuery” projetado para substituir as instruções do agente.
- Aplique a lista de permissões de IP ao aplicativo cliente externo para restringir quais sistemas externos podem autenticar e chamar a API do agente.
- Registre todas as sessões acionadas por API de entrada com identidade do chamador, ID da sessão e metadados de solicitação/resposta para fins de auditoria e segurança.
- Quando o Agentforce é chamado por meio do MCP, o servidor MCP autentica-se com o Salesforce em nome do usuário que está chamando. Certifique-se de que as credenciais do aplicativo conectado do servidor MCP estejam no escopo das permissões mínimas necessárias e que a identidade do usuário final (usando ferramentas MCP como Claude) - identidade seja propagada no contexto da sessão explicitamente por meio de parâmetros de entrada de ferramenta.
Exemplo
Um portal de serviços financeiros aciona um agente Agentforce para lidar com uma investigação de hipoteca.
- O portal se autentica usando o fluxo OAuth de Credenciais do cliente e obtém um token de portador.
- Ele chama “POST / Einstein/ai-agent/v1/sessions” com as variáveis da sessão: ”{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }”.
- O usuário envia sua pergunta: “De quais documentos eu preciso para concluir minha solicitação?”
- O portal chama “POST / Einstein/ai-agent/v1/sessions/{sessionId}/messages” com o texto do usuário.
- O agente Agentforce invoca uma ação de Fluxo “GetDocumentChecklist”, recupera os requisitos específicos do tipo de empréstimo e retorna uma lista estruturada.
- O portal renderiza a resposta do agente em linha e fecha a sessão na saída do usuário.
Contexto
Nem todos os fluxos de trabalho agentes se originam de uma solicitação humana. Sinais críticos para os negócios, como uma queda repentina nas métricas de uso de produto, um abandono de carrinho de alto valor ou uma falha no pagamento que ultrapassa um limite de risco, ocorrem com frequência nos dados operacionais. Quando esses sinais exigem respostas inteligentes de várias etapas, esperar que um humano observe e aja introduz uma latência que se compõe em um custo comercial real.
Esse padrão descreve como os eventos em tempo real servem como pontos de entrada autônomos para agentes. O agente é chamado por uma condição de dados em vez de um usuário, motivos sobre o contexto do evento e executa um fluxo de trabalho de resposta, tudo sem iniciação humana.
Problema
Quando um evento de negócios em tempo real ocorre no Data 360 ou na Salesforce Platform, como esse evento pode instanciar automaticamente uma sessão do agente, fornecer a carga útil do evento como contexto de fundamentação e conduzir um fluxo de trabalho de ação não conversacional para a conclusão sem um humano iniciando ou guiando a interação?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- Uma resposta é necessária imediatamente no momento em que o evento é acionado ou o processamento quase em tempo real (de segundos a minutos) é aceitável?
- A carga útil do evento contém contexto suficiente para fundamentar o agente ou o agente precisa realizar pesquisas adicionais para que possa justificar de modo eficaz?
- Qual é o volume e a frequência esperados do evento? Fluxos de evento de alta taxa de transferência exigem gerenciamento de taxa para evitar esgotar os limites de simultaneidade do agente.
- O mesmo evento pode ser acionado mais de uma vez para a mesma pessoa jurídica (pelo menos uma entrega)? Em caso afirmativo, as ações devem ser idempotentes.
- Há um caminho de escalação humano se o agente não puder resolver o evento de modo autônomo?
- Como o processamento de evento com falha deve ser detectado? Com uma fila de falha, um alerta ou criação de caso?
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| Fluxos acionados pelo Data 360 | Melhor para sinais baseados em métricas e comportamentais | Isso é mais adequado quando a condição do acionador é definida como uma alteração de associação de segmento do Data 360 ou limite de métrica. O Data 360 detecta a condição de negócios (por exemplo, abandono do carrinho, perda de uso) e aciona um fluxo acionado. O fluxo mapeia atributos de carga útil de evento para variáveis de sessão do agente e cria a sessão do Agentforce. |
| Eventos de plataforma + Fluxo iniciado automaticamente ou Apex | Melhor para eventos internos da plataforma e entre sistemas | Use essa solução quando a origem do evento estiver dentro da Salesforce Platform ou quando uma camada de middleware publicar o evento depois de detectar a condição em um sistema externo. Um evento de plataforma publicado por qualquer processo do Salesforce ou sistema externo aciona um acionador do Apex ou Fluxo iniciado automaticamente, que cria a sessão do agente com a carga útil do evento como contexto. |
Esboço
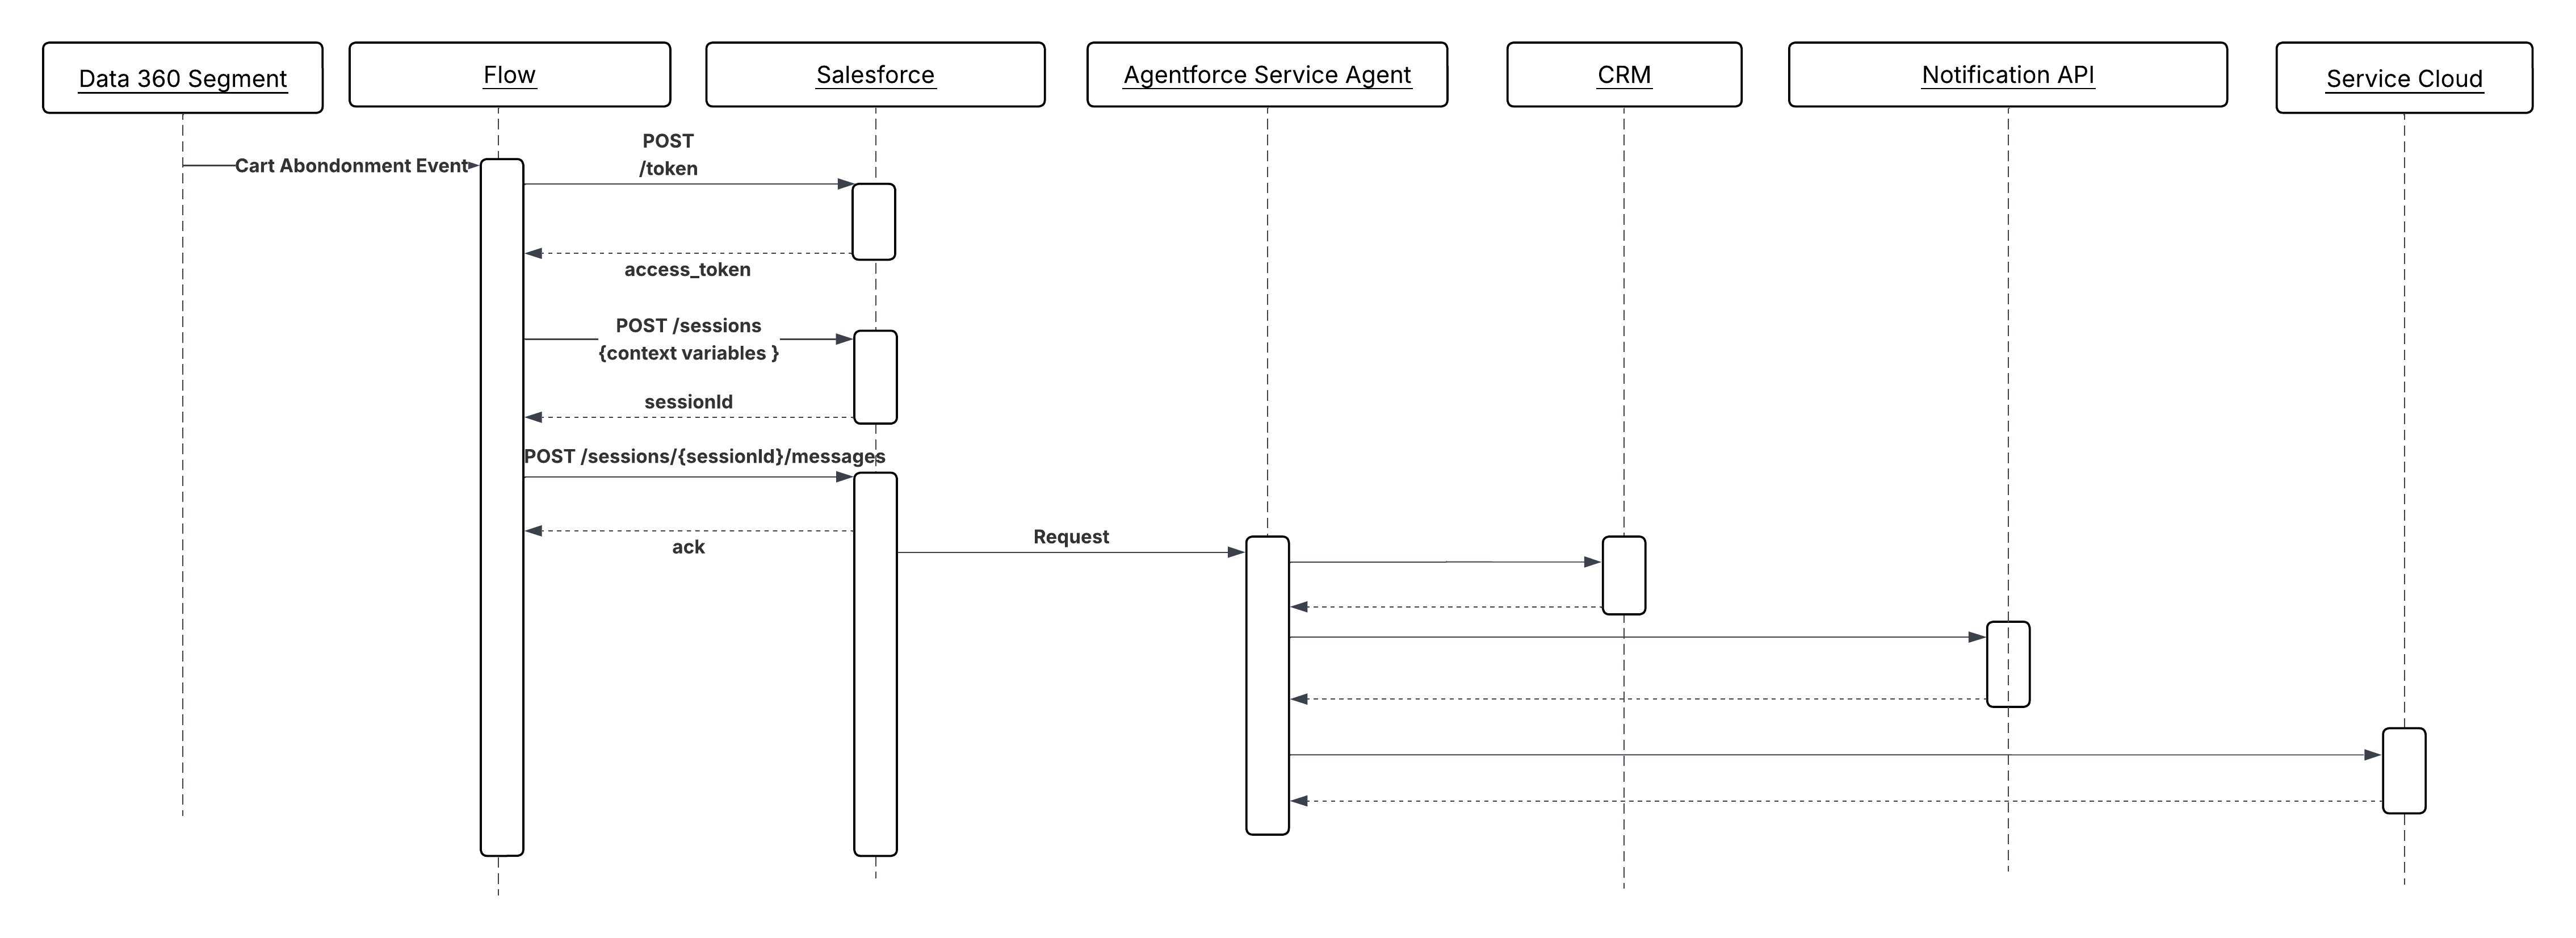
Diagrama de sequência para execução do agente conduzido por evento
Resultados
Os agentes se tornam participantes reativos em operações comerciais em tempo real, não respondentes passivos a solicitações humanas. Os agentes acionados por evento podem executar fluxos de trabalho de recuperação, triagem e escalação na velocidade dos dados, em vez da velocidade da atenção humana.
O sistema de acionamento (Data 360 ou eventos de plataforma) continua responsável pela detecção de evento e pela formação da carga útil. O agente continua responsável por justificar essa carga útil e selecionar a cadeia de ações correta. Nenhum turno conversacional é necessário; a carga útil do evento é a entrada completa.
Considerações de design
Orientação sem plataforma
- Projete todas as ações para invocação não conversacional. Não há turno do usuário; o agente deve chegar a uma resolução apenas no contexto de fundamentação inicial. As ações devem retornar saídas determinísticas estruturadas em vez de solicitar esclarecimento.
- Certifique-se de que a carga útil do evento tenha contexto de fundamentação suficiente antes da criação da sessão do agente. Uma carga útil mínima que força o agente a fazer várias chamadas de pesquisa antes que possa justificar aumenta a latência e o consumo simultâneo.
- Torne todas as operações de gravação acionadas por agentes conduzidos por evento idempotentes. Os sistemas de entrega de eventos geralmente fornecem garantias de pelo menos uma vez. O processamento de evento duplicado não pode produzir efeitos colaterais duplicados.
Notas de implementação do Salesforce
- Em Fluxos acionados do Data 360, mapeie atributos de carga útil de evento (por exemplo, “accountId”, “eventType”, “metricValue”, “productIds”) diretamente para variáveis da sessão nomeada no momento da criação da sessão. Isso baseia o agente na primeira etapa de raciocínio sem exigir uma ação de recuperação.
- Para acionadores de evento de plataforma, use um Fluxo iniciado automaticamente em vez de um fluxo de tela. Não há suporte para fluxos de tela em contextos autônomos e não conversacionais.
- Defina um tempo limite de sessão explícito em sessões acionadas por evento. Diferentemente de sessões conversacionais, não há usuário para estender a interação. Uma sessão que fica paralisada em uma ação com falha não deve conter um período de simultaneidade indefinidamente.
- Use caminhos de falha de fluxo para lidar com falhas na criação da sessão do agente. Se a sessão não puder ser criada, o caminho de falha deverá publicar um evento de compensação ou criar um caso para acompanhamento humano, em vez de descartar silenciosamente o evento.
Manuseio e recuperação de erros
- Eventos que falham ao acionar uma sessão do agente com sucesso devido a limites de simultaneidade, erros de criação de sessão ou falhas de validação de carga útil devem ser roteados para um caminho de falha que crie um caso, acione um alerta ou publique o evento em uma fila de letra morta para reprocessamento.
- As falhas do agente durante a execução (por exemplo, tempo limite de uma ação obrigatória) devem ser registradas com o ID do evento de origem. Como o acionamento é assíncrono e não há chamador em espera, a exibição de erros é inteiramente baseada na capacidade de observação: registros, painéis e limites de alerta.
- Implemente um novo teto de tentativa. Se um evento causar com confiança a falha do agente, as novas tentativas não vinculadas esgotarão os limites de simultaneidade. Depois de um número máximo configurável de tentativas, encaminhe o evento para uma fila de revisão humana com contexto completo anexado.
- Acompanhe o ID do evento pelo ciclo de vida completo da sessão do agente. Esse rastreamento habilita a correlação entre o sinal de dados de origem e todas as ações a jusante para auditoria e depuração.
Considerações de segurança
- Valide e limpe todos os atributos de carga útil de evento antes de injetá-los como variáveis de sessão do agente. As cargas úteis de evento do Data 360 ou de editores externos são uma superfície de ataque para injeção de prompt. Por exemplo, um campo de carga útil criado pode ser projetado para substituir as instruções do agente.
- Execute sessões do agente acionadas por evento em um usuário de integração dedicado de menor privilégio em vez de uma identidade de administrador de alto privilégio. O agente contém apenas as permissões necessárias para executar seu conjunto de ações definido.
- Registre todas as sessões acionadas por evento com o ID do evento de origem, o tipo de evento e as variáveis da sessão injetadas na criação. Essa trilha de auditoria é necessária para reconstruir por que o agente executou uma determinada ação se o resultado for contestado.
Exemplo
Uma empresa de varejo usa o Data 360 para rastrear o comportamento do carrinho em tempo real. Quando um carrinho com um valor acima de um limite definido é abandonado:
- O Data 360 detecta o sinal de abandono e aciona um Fluxo acionado com a carga útil do evento: “customerId”, “cartValue”, “productIds” e “abandonmentTimestamp”.
- O Fluxo mapeia esses atributos para variáveis de sessão do Agentforce e cria uma nova sessão do agente. Nenhuma interação do usuário é necessária.
- O agente avalia o histórico de compra do cliente, os direitos atuais e a composição do carrinho usando suas ações de recuperação disponíveis.
- O agente invoca uma ação de
SelectRecoveryOffer, que aplica o nível de desconto apropriado com base no segmento do cliente, e uma ação deSendProactiveNotificationpara entregar a oferta por meio do canal preferencial do cliente. - O agente invoca
CreateFollowUpTaskpara registrar a interação no CRM para a visibilidade do proprietário da conta. - A sessão é fechada automaticamente após a conclusão da cadeia de ações. O ID do evento de origem é preservado no registro da sessão para rastreabilidade.
Contexto
Os LLMs são treinados em dados públicos. Eles não têm o Knowledge dos produtos, políticas, histórico de casos ou contratos da sua organização, a menos que essas informações sejam fornecidas explicitamente no momento do raciocínio. Sem fundamentação, um agente perguntado sobre o direito de serviço de um cliente ou os termos de um contrato específico alucinará uma resposta ou admitirá que ele não sabe. Nenhum dos resultados é aceitável em um contexto corporativo.
A Geração de recuperação ampliada (RAG) resolve isso recuperando documentos relevantes de um repositório do Knowledge corporativo e injetando-os na janela de contexto do agente antes que ele gere uma resposta. Os motivos do agente sobre o conteúdo recuperado como um artigo do Knowledge, uma resolução de caso passada, uma especificação do produto como se tivesse recebido essa informação diretamente. O LLM fornece o raciocínio; a camada de recuperação fornece os fatos.
Por exemplo, um agente de serviço que lida com uma declaração de garantia complexa não precisa ter termos de política de garantia incorporados em suas instruções. Em vez disso, quando o cliente descreve seu problema, o agente realiza uma pesquisa semântica ou híbrida (pesquisa de palavra-chave + pesquisa semântica) em relação a um índice vetorial da documentação de garantia, recupera os termos aplicáveis e os usa para determinar a elegibilidade e as próximas etapas. A resposta está baseada no documento de política atual e de autoridade, não nos dados de treinamento do modelo.
Problema
Um agente precisa responder a uma pergunta ou tomar uma decisão que depende do Knowledge organizacional proprietário, como apólices, contratos, documentação do produto ou dados de caso históricos que não faziam parte dos dados de treinamento do LLM. Como o agente recupera o conteúdo mais relevante no momento do raciocínio, garante que o conteúdo recuperado seja atual e de autoridade e o insere no contexto com precisão suficiente para evitar o ruído?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas
- O conteúdo do Knowledge é estático e atualizado com pouca frequência (por exemplo, manuais de produto) ou muda continuamente (por exemplo, resoluções de caso, descrições de inventário)? A frequência de atualização determina o design do pipeline de ingestão.
- Quão grande é o conteúdo? Uma pequena base de Knowledge pode ser recuperada de forma exaustiva; uma grande requer fragmentação, incorporação e indexação semântica para retornar apenas as passagens mais relevantes.
- A consulta se beneficia de uma única recuperação focada ou a combinação de resultados de várias fontes do Knowledge (por exemplo, documentação e casos anteriores simultaneamente) produziria uma resposta mais fundamentada? Este último requer recuperação de ensemble.
- Há necessidade de filtrar o conteúdo recuperado por metadados antes da classificação semântica, por exemplo, restringindo resultados a documentos relevantes para o nível ou a geografia do produto do cliente?
- Qual é a sensibilidade do conteúdo do Knowledge? O conteúdo recuperado é injetado na janela de contexto do LLM e influencia a resposta do agente. O conteúdo que não deve ser apresentado a determinados usuários deve ser regido na camada de recuperação, não presumindo ser filtrado pelo LLM.
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| Geração ampliada por recuperação (RAG) com o Data 360 | Melhor para casos de uso corporativos | O agente realiza uma pesquisa semântica em relação a índices vetoriais do Data 360 antes de gerar uma resposta. O conteúdo recuperado como artigos do Knowledge, casos passados, documentação do produto é injetado no contexto do LLM como fundamento. Isso pode ser chamado usando ações do Retriever, Fluxo ou Apex personalizado. Observe que o Data 360 oferece suporte a um pipeline integrado do conteúdo bruto para o contexto pronto para o agente, não apenas uma loja de vetores:
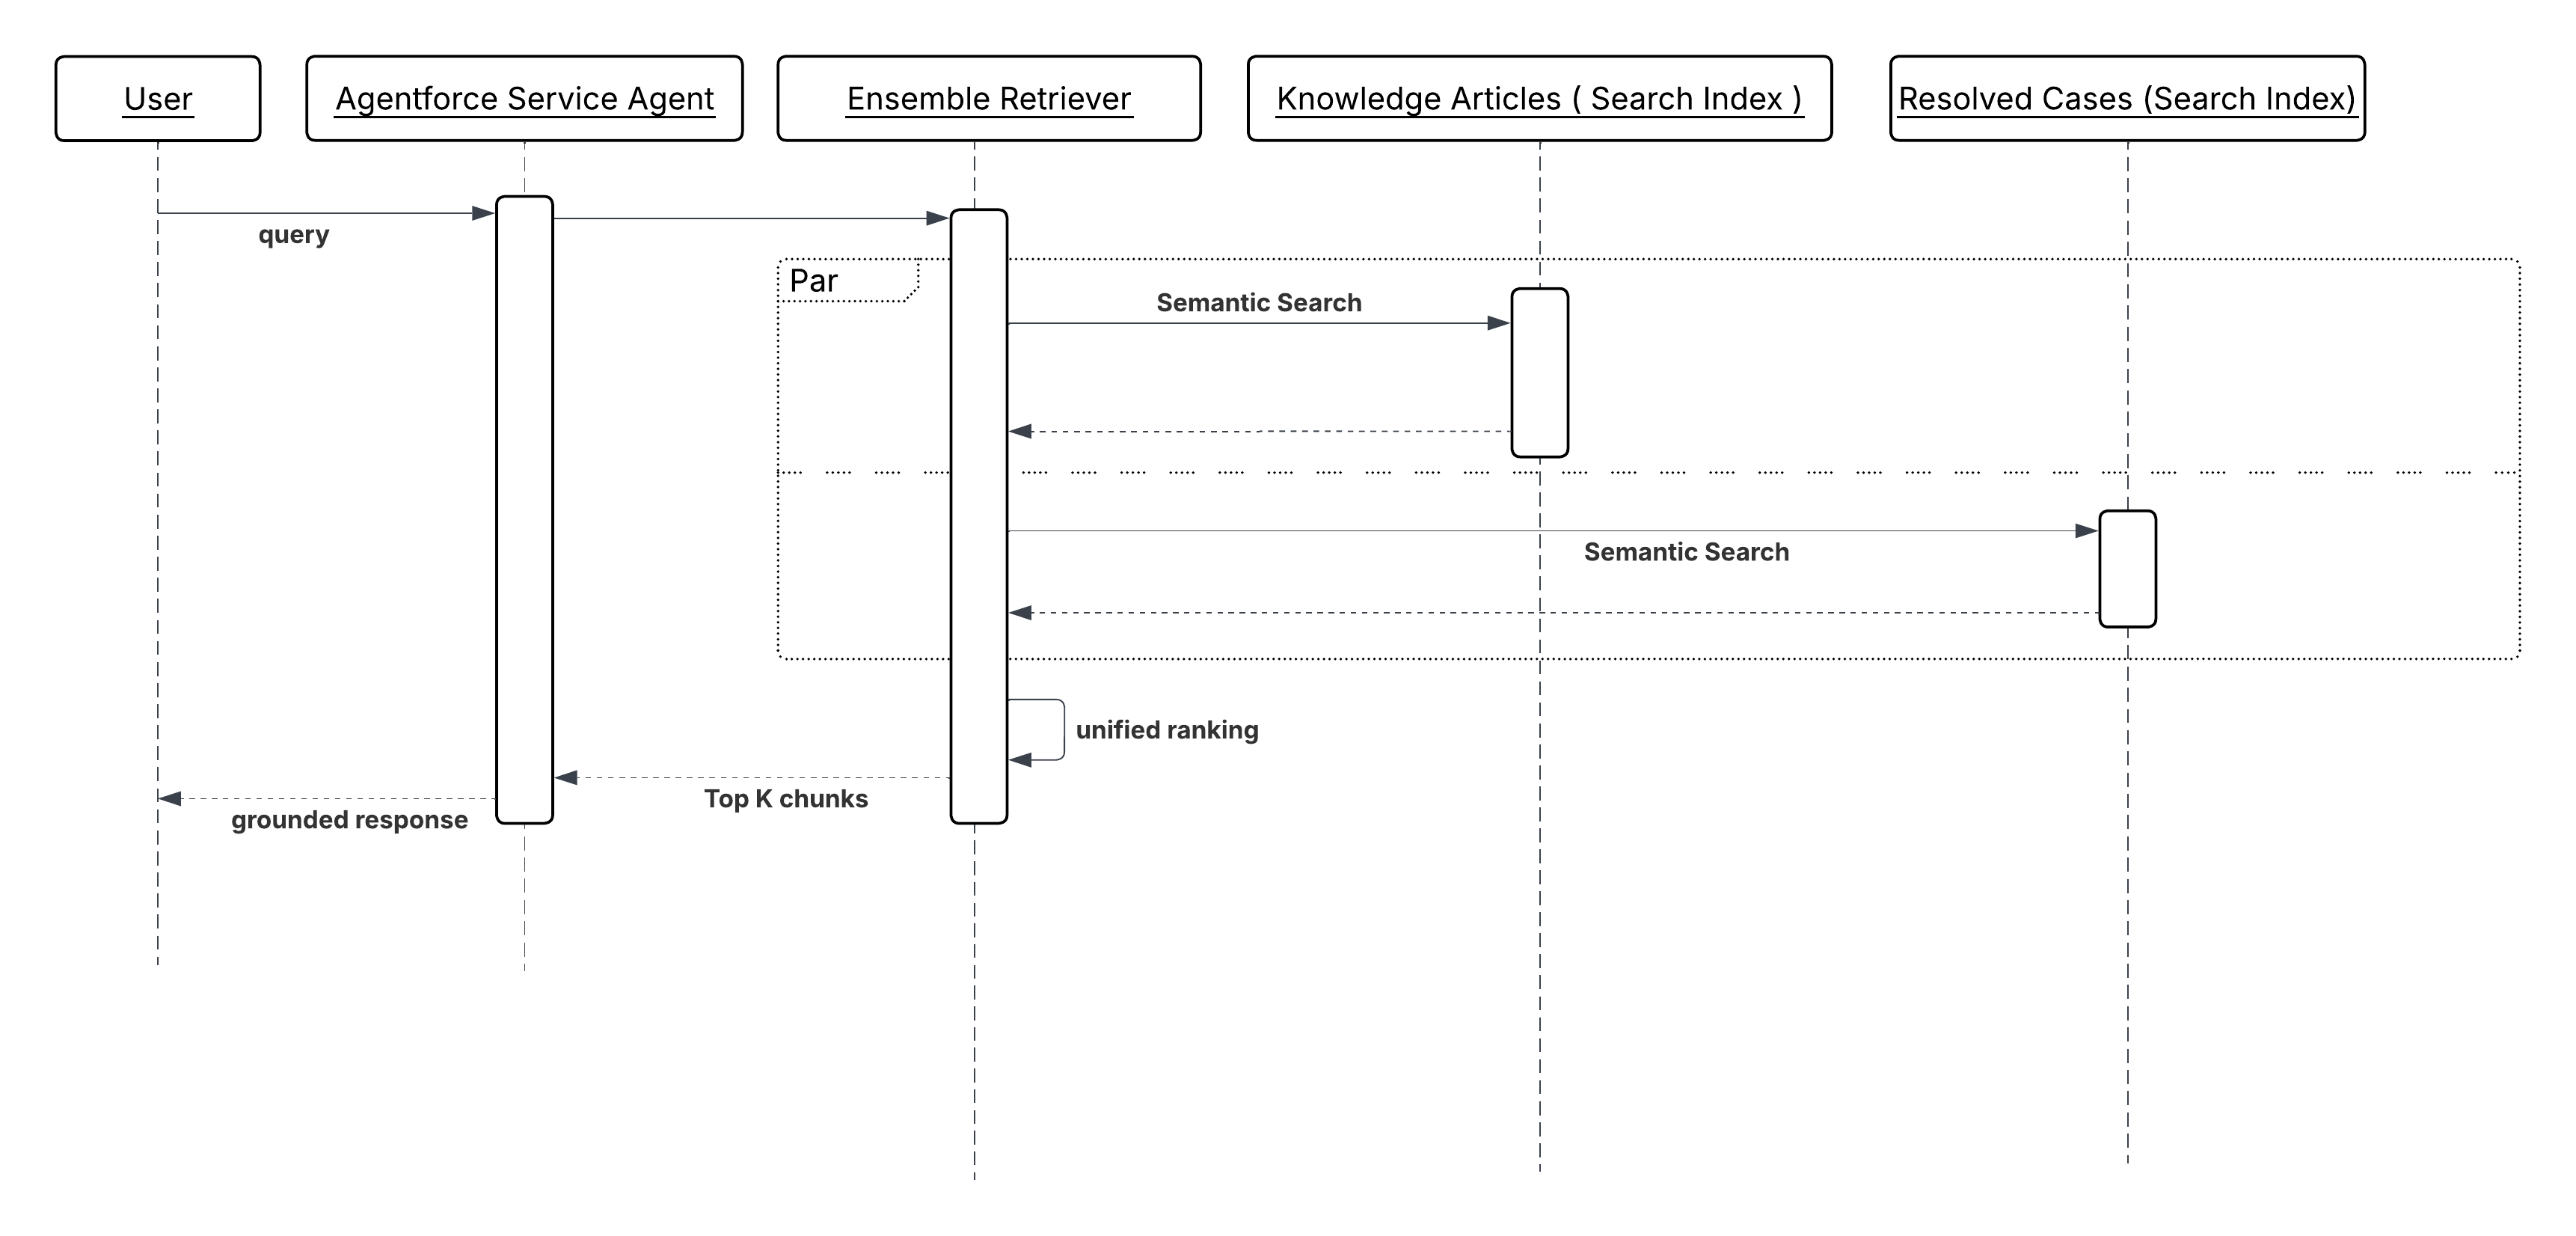
Todos esses recursos são oferecidos em modo pronto para uso com total capacidade de configuração. Temos dois tipos de recuperadores para o Data360: Retransmissor individual: Uma Ação de recuperação do Salesforce configurada realiza uma pesquisa semântica em relação a um único índice de pesquisa definido e retorna os blocos de conteúdo mais relevantes. Os resultados são injetados diretamente no aviso de LLM como contexto de fundamentação. Use Ação de recuperador individual quando a consulta for melhor atendida por uma única fonte focada do Knowledge. Ensemble Retriever: Uma Ação de recuperação de conjunto combina os resultados de vários recuperadores individuais, por exemplo, um índice de documentação do produto e um índice de casos resolvidos. Os recuperadores de ensaio não combinam pontuações de relevância de recuperadores individuais, pois essas pontuações não são comparáveis entre índices heterogêneos. Em vez disso, todos os blocos recuperados são passados por um modelo de reclassificador entre codificadores que pontua de modo independente cada par (consulta, bloco), produzindo uma classificação unificada. Isto é arquitetonicamente significativo: isso significa que a qualidade da classificação entre origens melhora com o modelo de nova classificação, não com a calibração de pontuação manual. Depois de classificá-los novamente, ele disponibiliza o resultado unificado para avisos de LLM como contexto de fundamentação. Use Ensemble Retriever Action quando uma resposta mais completa exigir evidências de mais de um domínio do Knowledge. |
| RAG com bancos de dados de vetores de terceiros | Adequado ao trabalhar dentro de restrições de infraestrutura existentes | Essa abordagem integra lojas de vetores de terceiros que podem já existir em sua infraestrutura para indexar integrações de dados proprietárias, aproveitando-as para pesquisa semântica em tempo real e recuperação de conteúdo. Isso pode ser implementado usando Fluxo ou Apex personalizado. |
Esboço
Diagrama de sequência para a fundamentação do Knowledge do Enterprise Content
Resultados
As respostas do agente são ancoradas ao Knowledge atual da organização e não aos dados de treinamento do LLM. O risco de alucinação em perguntas factuais, como termos da apólice, especificações do produto e detalhes do direito, é reduzido porque o modelo está argumentando sobre evidências recuperadas, não gerando da memória.
O conteúdo do Knowledge permanece independentemente mantido. Atualizar um documento de política ou adicionar uma nova resolução de caso ao índice entra em vigor imediatamente para todas as interações subsequentes do agente, sem treinar nem reimplantar o modelo.
A recuperação também fornece uma trilha de auditoria implícita. Como a resposta do agente é derivada de documentos recuperados específicos, o conteúdo de origem pode ser registrado junto com a resposta, permitindo rastrear por que o agente deu uma resposta específica.
Considerações de design
Orientação sem plataforma
- Particione e insira conteúdo do Knowledge na granularidade certa. Os blocos grandes diluem a relevância. Os blocos que são pequenos demais perdem o contexto circundante que o LLM precisa justificar corretamente. Para a maioria dos tipos de documentos corporativos, o particionamento em nível de parágrafo com janelas de contexto sobrepostas produz a melhor qualidade de recuperação.
- Trate a precisão da recuperação como uma preocupação de design de primeira classe. Injectar conteúdo de baixa relevância na janela de contexto do agente não é neutro. Ele introduz ruído que diminui a qualidade da resposta. Ajuste os limites de recuperação e os limites de top-k para equilibrar o recall com a precisão para cada domínio do Knowledge.
- A latência de ingestão é um SLA operacional. Se um documento de apólice for atualizado, mas o índice vetorial não tiver sido atualizado, o agente recuperará e executará ações quanto a informações obsoletas. Defina a tolerância de obsolescência aceitável para cada tipo de conteúdo e projete pipelines de ingestão de acordo.
Notas de implementação do Salesforce
- Preencha índices vetoriais do Data 360 por meio do pipeline de ingestão adequado para a frequência de atualização de conteúdo. Use a ingestão em lote para documentos estáticos e streaming ou Captura de dados de alteração (CDC) para registros que mudam continuamente.
- Para Recuperadores de ensaio, configure os pesos de classificação de relevância por origem. Um índice de casos resolvidos pode precisar de um viés de recentidade; um índice de documentação de apólice pode não precisar. Ajuste os pesos com base nos tipos de consulta que o agente deve atender.
- Use filtros de metadados em Apex ou recuperadores de fluxo personalizados para definir o escopo da recuperação antes da execução da pesquisa semântica. Filtrar por linha de produto, região ou tipo de documento antes da classificação reduz o ruído e melhora a precisão do que é inserido no contexto.
- Não injecte o documento recuperado completo no contexto do LLM. Passe apenas os fragmentos ou fragmentos relevantes. Injeções de contexto grandes consomem orçamento de token, aumentam a latência e reduzem a proporção da janela de contexto disponível para o raciocínio do agente.
Manuseio e recuperação de erros
- Se a recuperação não retornar nenhum resultado, retorne um status explícito de “nenhum resultado encontrado”, em vez de prosseguir sem fundamento. O agente então pode ampliar a consulta, pedir esclarecimento ao usuário ou escalar para um humano.
- Cada pedaço retornado dos recuperadores contém uma pontuação de relevância. Dependendo do caso de uso, um determinado valor de confiança/relevância do limite deve ser configurado acima do qual o agente deve tratar a recuperação como confiável, caso contrário, ela deverá voltar para esclarecimento ou escalação.
- Se o índice do vetor ou o serviço de recuperação estiver temporariamente indisponível, a ação de recuperação ou a chamada do Apex deverá retornar um erro estruturado com um motivo descritivo. Registre a falha com o ID da sessão e a consulta para que as lacunas de recuperação possam ser identificadas e o índice ou serviço possa ser monitorado quanto à disponibilidade.
- Para domínios do Knowledge sensíveis ao tempo, implemente uma verificação de atualidade como parte da resposta de recuperação. Se o documento correspondente mais recente tiver sido atualizado pela última vez além de um limite de obsolescência definido, sinalize isso para o agente para que ele possa qualificar sua resposta ou solicitação para verificação.
Considerações de segurança
- A recuperação deve respeitar as permissões de acesso a dados do usuário em nome do qual o agente está agindo. Uma sessão do agente executada no contexto de uma interação voltada para o cliente não deve recuperar documentos operacionais internos, notas da estratégia de precificação ou registros aos quais o usuário final não teria acesso de outra forma. Aplique segurança em nível de campo e nível de registro à camada de recuperação. Não conte com o LLM para conter conteúdo recuperado confidencial.
- O conteúdo recuperado é injetado na janela de contexto do LLM e pode influenciar ou aparecer na resposta do agente. Trate cada documento no conteúdo de recuperação como potencialmente visível para o usuário final e regule a associação do conteúdo de acordo.
- Registre todas as consultas de recuperação e os identificadores de documento de partes recuperadas junto com o ID da sessão. Essa trilha de auditoria habilita a reconstrução da evidência usada pelo agente ao responder, que pode ser necessária para obrigações de conformidade, resolução de disputa ou capacidade de explicação.
Exemplo
Um agente de serviços financeiros lida com uma consulta do cliente sobre penalidades de resgate antecipado em um produto de economia de prazo fixo:
- O cliente pergunta: “Qual seria a penalidade se eu retirasse meus fundos seis meses antes?”
- O agente chama uma Ação de recuperador individual configurada em relação a um índice vetorial de documentos de termos e condições do produto.
- O recuperador realiza uma pesquisa semântica usando o contexto da consulta, como tipo de produto e conta do cliente, e a pergunta específica, e retorna os três blocos de documento mais relevantes: a cláusula de resgate antecipado, a tabela de cálculo de penalidade e as exceções aplicáveis a casos de dificuldade.
- As partes recuperadas são injetadas na janela de contexto do agente junto com a pergunta do cliente.
- Os motivos do agente sobre os termos recuperados, identificam a taxa de penalidade aplicável para o nível do produto e a linha do tempo de resgate do cliente e retornam uma resposta precisa baseada em política, citando a data efetiva dos termos usados.
- Os identificadores de documento das partes recuperadas são registrados com o registro da sessão para capacidade de auditoria.
Contexto
Os LLMs são probabilísticos por natureza. Quando solicitados a justificar um cliente específico, eles inferem, estimam ou alucinam fatos que não foram explicitamente informados. Um agente que chame uma ação de precificação sem saber que o cliente é uma conta corporativa de alto valor em um nível preferencial pode aplicar a lógica de desconto incorreta. Um agente que está escalando um caso de suporte sem saber a pontuação de risco de rotatividade do cliente pode despriorizar uma conta que está a dias da rotatividade.
A Injeção de contexto do cliente verificado lida com isso preenchendo previamente os parâmetros de entrada de ação com atributos verificados e estruturados do perfil unificado antes que o agente invoque uma ação. O agente não inferirá o segmento, o valor da vida útil ou a tendência de satisfação do cliente (CSAT). Ele recebe esses fatos como entradas de fundamentação e motivos para eles. Esse padrão reduz o risco de alucinação em decisões específicas do cliente e elimina chamadas de pesquisa redundantes durante o ciclo de raciocínio.
Por exemplo, antes de um agente de precificação invocar uma ação “GenerateQuote”, a configuração de subagente injetará automaticamente o segmento, o nível e o valor da vida útil do cliente de seu perfil unificado. A ação recebe fatos verificados, em vez de aproximações de LLM, e a cotação é ancorada ao relacionamento comercial real do cliente.
Esta não é uma alternativa ao padrão de base do Knowledge do Enterprise Content. Um agente bem projetado pode usar: O Knowledge Grounding from Enterprise Content fornece Knowledge baseado em documentos, enquanto o Knowledge Verified Customer Context Injection estabelece a identidade do cliente.
Problema
Como garantir que um agente tenha fatos precisos específicos do cliente, como segmento, nível, valor da vida útil, risco de rotatividade ou outros atributos de perfil antes de realizar uma ação, em vez de adivinhar esses fatos por conta própria?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- Quais parâmetros de entrada de ação representam fatos específicos do cliente que, se inferidos em vez de adquiridos, produziam resultados incorretos ou inconsistentes?
- Os atributos de perfil obrigatórios estão disponíveis como campos de perfil unificados padrão do Data 360 ou exigem percepções calculadas derivadas de dados comportamentais brutos e transacionais?
- Com que frequência os atributos de perfil relevantes mudam? Atributos como pontuação de risco de rotatividade ou tendência de CSAT exigem uma garantia de atualidade; dados de perfil obsoletos levam aos mesmos resultados incorretos que dados alucinados.
- Os atributos de perfil devem ser injetados no momento da criação da sessão (constante para a duração da sessão) ou buscar novamente no ponto da invocação da ação (para refletir alterações de estado no meio da sessão)?
- O agente precisa pensar sobre os atributos de perfil diretamente ou eles são consumidos apenas pela ação e opacos para o loop de raciocínio do agente?
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| Configuração de subagente – Mapeamento de atributo de perfil | Melhor para a fundamentação no nível da sessão estática | É mais adequado quando os atributos de perfil são estáveis em uma única interação. Mapeie atributos de perfil unificado do Data 360 (por exemplo, “customerSegment”, “tier”, “lifetimeValue”) diretamente para parâmetros de entrada de ação na configuração de subagentes do Agentforce. Os atributos são resolvidos na criação da sessão e mantidos constantes durante a duração da sessão. |
| Fluxos conectados do Data 360 | Melhor para atualização dinâmica ou no meio da sessão | Use quando os atributos de perfil mudarem com frequência ou quando a ação exigir o estado mais atual. Use um fluxo conectado ao Data 360 como uma etapa de ação para detectar o estado do perfil mais recente no ponto de invocação.O fluxo consulta o perfil unificado, aplica qualquer transformação necessária e retorna os atributos como variáveis de saída consumidas pela próxima ação na cadeia. |
| Insights calculados como entradas de ação | Melhor para métricas derivadas complexas | Use quando os agentes precisarem se preocupar com métricas de negócios calculadas (pontuação de risco de rotatividade, tendências de CSAT, índice de adoção do produto) em vez de interpretar dados brutos. Definido no Data 360 como métricas derivadas calculadas com base em dados comportamentais, transacionais e de engajamento. Insights calculados são exibidos como atributos de perfil consultáveis e podem ser mapeados para entradas de ação por meio de ajustes de tópico ou um fluxo conectado. |
Esboço
Diagrama de sequência para injeção de contexto do cliente verificado
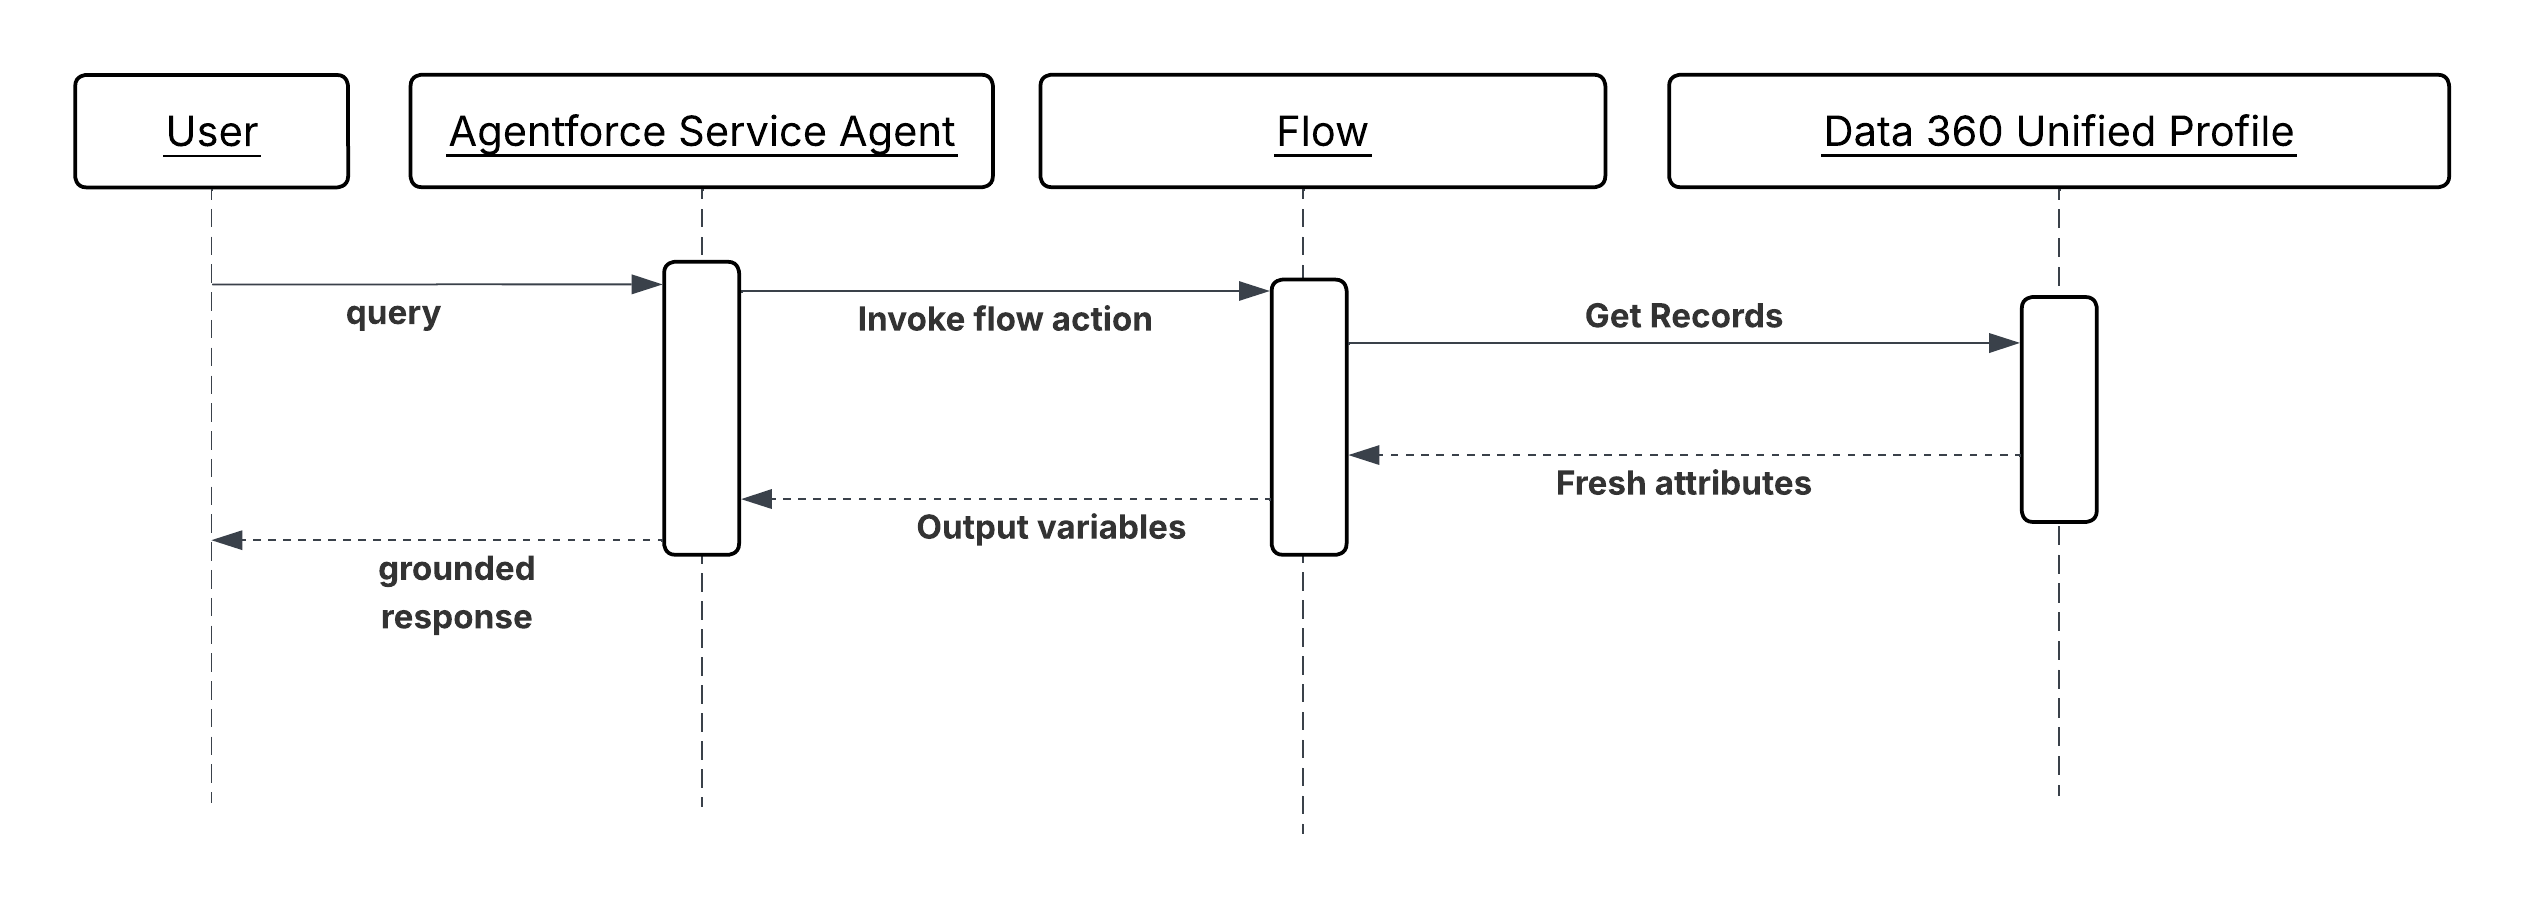
Resultados
As ações recebem fatos do cliente verificados e estruturados em vez de aproximações informadas por LLM. O raciocínio do agente é ancorado ao estado real do perfil do cliente, reduzindo o risco de alucinações em decisões em que a precisão fatal determina a qualidade do resultado, como precificação, verificações de direitos, roteamento de escalação e ofertas de retenção.
A fundamentação do perfil também reduz a latência de raciocínio. Quando o agente não precisa emitir chamadas de pesquisa para estabelecer o contexto básico do cliente, o ciclo de raciocínio é mais curto e a simultaneidade é consumida para menos turnos.
O perfil unificado do Data 360 continua sendo a fonte autoritária de fatos do cliente. A configuração do subagente ou fluxo conectado é a costura de integração. O agente é responsável por justificar esses fatos e selecionar ações, não por obter os próprios fatos.
Considerações de design
Orientação sem plataforma
- Identifique todas as entradas de ação que têm risco de alucinação, em que a inferência do LLM pode produzir um resultado incorreto em vez de um valor verificado. Entradas com risco de alucinação são candidatos à fundamentação de perfil. Nem toda entrada requer fundamentação; a injeção excessiva de dados de perfil adiciona ruído à janela de contexto do agente.
- Trate a frescura do perfil como uma decisão de design, não uma reflexão posterior. Defina a tolerância de obsolescência aceitável para cada atributo fundamentado e escolha o mecanismo de injeção de acordo: mapeamento no nível da sessão para atributos estáveis, atualização baseada em fluxo para atributos voláteis.
- Insights calculados devem codificar a lógica de negócios, não métricas brutas. Um agente fundamentando um “churnRiskScore” de 0,87 é mais eficaz que um agente fundamentando 14 sinais comportamentais brutos. Calcule a interpretação no Data 360; passe o resultado para o agente.
Notas de implementação do Salesforce
- A fundamentação do perfil é tão confiável quanto a unificação por trás dela. Por exemplo, o valor do Perfil unificado depende inteiramente da qualidade da resolução de identidade a montante. Se um cliente tiver identidades fragmentadas entre sistemas de origem que não foram unificados, os atributos de perfil que o agente receberá serão incompletos ou representarão apenas uma visualização parcial (por exemplo, Valor da vida útil calculado com dados de um canal, mas não de outro).
- Para Fluxos conectados do Data 360, use o elemento Obter registros com um filtro no “recordId” ou “accountId” da sessão atual para recuperar apenas o registro de perfil relevante. Retorne apenas os atributos exigidos pela ação a jusante; não retorne o objeto de perfil completo.
- Insights calculados devem ser mantidos atualizados por meio de pipelines de ingestão do Data 360. Configure a atualização de streaming ou quase em tempo real para percepções usadas em decisões urgentes (por exemplo, risco de rotatividade em um fluxo de trabalho de retenção). Percepções atualizadas em lote são aceitáveis para atributos de movimento mais lento (por exemplo, nível de valor de contrato anual).
- Valide se os atributos de perfil mapeados não são nulos antes da invocação da ação. Um “customerTier” nulo passado para uma ação de precificação é tão prejudicial quanto um valor alucinado. Use elementos de decisão de fluxo para detectar dados de perfil ausentes e encaminhar para um fallback que recupere um padrão ou solicite esclarecimento.
- Na configuração de subagente, mapeie atributos de perfil para parâmetros de entrada de ação usando nomes de variável descritivos e semânticamente claros (por exemplo, “customerTier”, “lifetimeValueUSD”, “churnRiskScore”). O LLM lê esses nomes ao selecionar e compor ações; nomes ambíguos reduzem a precisão da seleção.
Manuseio e recuperação de erros
- Se um atributo de perfil obrigatório for nulo ou indisponível no momento da invocação da ação, o agente não deverá prosseguir com um padrão potencialmente incorreto. A ação deve retornar um erro estruturado indicando o atributo ausente e o agente deve solicitar esclarecimento ao usuário ou escalar para um humano se estiver operando de modo não conversacional.
- Se um fluxo conectado ao Data 360 falhar na recuperação de dados de perfil (por exemplo, devido a uma interrupção de serviço do Data 360), o caminho de falha do fluxo deverá retornar um erro estruturado ao agente com o motivo da falha específico. O agente então pode decidir se deseja tentar novamente, prosseguir com uma experiência degradada ou detectar a falha ao usuário.
- Registre todos os valores de atributo de perfil injetados na criação da sessão ou na invocação de ação junto com o ID da sessão. Isso garante que qualquer decisão do agente contestada possa ser reconstruída com os fatos exatos do cliente que o agente recebeu no momento.
Considerações de segurança
- Atributos de perfil injetados no contexto do agente estão sujeitos aos mesmos controles de acesso a dados de qualquer registro do CRM. Garanta que o usuário de integração ou o aplicativo conectado usado para resolver atributos de perfil contenha apenas as permissões em nível de campo necessárias para os atributos serem exibidos e não acesso de leitura de perfil mais amplo.
- Insights calculados que codificam métricas derivadas confidenciais (por exemplo, pontuação de saúde prevista, nível de risco financeiro) devem ser tratados como campos confidenciais e regidos pelos mesmos controles de acesso dos dados subjacentes. Detectar uma pontuação de alto risco de rotatividade para um agente que opera em um contexto voltado para o cliente requer uma consideração cuidadosa do que o agente pode comunicar.
- Não detecte atributos de perfil que não sejam necessários para a ação. Cada atributo adicional na janela de contexto do agente é um elemento de dados adicional que pode ser reproduzido na resposta do agente. Aplique um princípio mínimo necessário à fundamentação de perfil.
- Audite todas as sessões em que Insights calculados ou atributos de perfil confidenciais foram injetados como entradas. Essas sessões representam decisões tomadas com base na Inteligência do cliente derivada e podem estar sujeitas a requisitos de explicabilidade ou regulamentação em determinados setores.
Exemplo
Uma empresa de telecomunicações usa o Agentforce para lidar com conversas de retenção com clientes que iniciaram uma solicitação de cancelamento.
- Quando um caso de cancelamento é aberto, a sessão do agente é criada com o “accountId” do cliente como contexto.
- A configuração de subagente mapeia três atributos de Perfil unificado do Data 360 para variáveis da sessão no momento da criação: “customerTier” (Enterprise), “lifetimeValueUSD” (42.000) e “contractRenewalDate” (60 dias).
- Um Insight calculado como “churnRiskScore” (0,91, calculado a partir da recusa de uso, da frequência do pedido de suporte e da tendência de NPS) é mapeado como uma variável de sessão adicional por meio de um fluxo conectado ao Data 360 invocado como a primeira etapa de ação.
- O agente, agora baseado em fatos verificados do cliente, chama uma ação “SelectRetentionOffer”. Como as entradas incluem “customerTier = Enterprise”, “lifetimeValueUSD = 42000” e “churnRiskScore = 0,91”, a ação retorna a oferta de retenção de nível máximo em vez de uma oferta padrão.
- O agente chama “PresentOffer” para entregar a oferta na conversa e “LogRetentionAttempt” para registrar a interação no CRM com todos os atributos fundamentados preservados para capacidade de auditoria.
Contexto
Os dados corporativos são fragmentados. Um agente que pode agir apenas com base no que está dentro da Salesforce Platform está limitado a uma fração das informações necessárias para justificar de modo eficaz. Responder a uma pergunta de serviço pode exigir a leitura do pedido aberto de um cliente no Service Cloud. Preparar uma proposta pode exigir a recuperação de um arquivo do Google Drive. Analisar o uso do produto pode exigir consultar um armazém de dados. Cada um desses sistemas tem suas próprias APIs, seu próprio modelo de autenticação e seu próprio esquema de dados, e o custo de escrever um código de integração personalizado para cada um é o que historicamente tornou a conectividade entre agentes caro e frágil.
O MCP é um padrão aberto que lida com isso diretamente. Ela define uma interface uniforme por meio da qual um agente pode descobrir e invocar ferramentas expostas por qualquer servidor em conformidade com MCP, independentemente do sistema subjacente. Cada servidor MCP atua como um adaptador: ele engloba as interfaces nativas de um sistema de destino em uma interface padronizada centralizada em ferramentas que o agente pode consultar, invocar e compor sem saber nada sobre os protocolos ou esquemas específicos do sistema.
Na perspectiva do agente, conectar-se ao Slack, um banco de dados de Structured Query Language (SQL) e um sistema de gerenciamento de documentos parece idêntico, três servidores MCP, cada um expondo um conjunto de ferramentas descritas e invocáveis. O agente os seleciona e sequencia com base nas descrições semânticas e na meta que está tentando atingir.
Problema
Quando um agente precisa recuperar informações ou acionar ações em vários sistemas externos, cada um com diferentes APIs, autenticação e esquemas, como ele pode descobrir, invocar e compor seus recursos sem código de integração personalizado por sistema ou acoplamento estreito com a implementação de qualquer sistema?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- O agente precisa acessar sistemas fora da plataforma Salesforce, como lojas de documentos, ferramentas de colaboração, bancos de dados, SaaS de terceiros, cujas APIs não são nativamente representadas como ações do Agentforce?
- É necessária descoberta de ferramenta dinâmica, em que o agente identifica o ponto de extremidade de integração certo no tempo de raciocínio com base na solicitação atual, em vez de ter integrações embutidas em código em sua configuração?
- A paisagem de integração muda com frequência; novos sistemas adicionados, os existentes atualizados e outras alterações podem exigir que uma abordagem personalizada por sistema crie despesas de manutenção não sustentáveis?
- É necessário desacoplar a camada de raciocínio do agente dos detalhes da implementação dos sistemas downstream para que uma alteração na API do sistema de destino não exija alterações nas instruções do agente ou na configuração do subagente?
- Os sistemas de destino pertencem a equipes ou fornecedores diferentes, cada um responsável por expor seus próprios recursos, tornando um modelo de MCP Server no lado do provedor mais prático do que uma integração no lado do consumidor por agente?
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| Servidores Salesforce MCP | Melhor para metas do ecossistema do Salesforce | Use quando o sistema de destino estiver dentro do ecossistema do Salesforce e um servidor MCP de primeira parte estiver disponível. O Salesforce Headless 360 fornece servidores MCP para seus próprios recursos de plataforma, expondo dados de CRM, fluxos e ações de plataforma como ferramentas compatíveis com MCP. Reduz o esforço de implementação para ajustes, em vez de desenvolvimento. Nota: No momento, os servidores do Salesforce MCP oferecem suporte apenas a credenciais do usuário final para autenticação e autorização. |
| Servidores MCP personalizados do MuleSoft | Melhor quando não existe um servidor MCP de primeira parte | Usar para sistemas legados, aplicativos internos proprietários ou plataformas SaaS de terceiros precede o padrão MCP. Quando um sistema de destino não fornece seu próprio servidor MCP, uma camada de integração do MuleSoft pode ser agrupada em um servidor MCP personalizado que expõe os recursos do sistema como ferramentas. Ele também pode ser usado com APIs do Salesforce se MCPs forem necessários para que os agentes sejam consumidos apenas com credenciais de usuário do sistema. O MuleSoft lida com tradução de protocolo, autenticação e transformação de dados; a camada MCP torna os resultados descobríveis pelos agentes. |
| Servidores MCP de terceiros | Melhor para sistemas de commodities com ecossistemas MCP ativos | Há um servidor MCP mantido pelo fornecedor para sua plataforma (GitHub, Google Workspace) e cumpre os requisitos de segurança e manutenção. Um número crescente de plataformas corporativas, como o GitHub, o Google Workspace e outras, publicam seus próprios servidores MCP. Quando existe um servidor pronto para produção e mantido pelo fornecedor, prefira-o ao criar um personalizado. Avalie a condição de segurança e o compromisso de manutenção antes de adotar. |
Esboço
Diagrama de sequência para injeção de contexto do cliente verificado
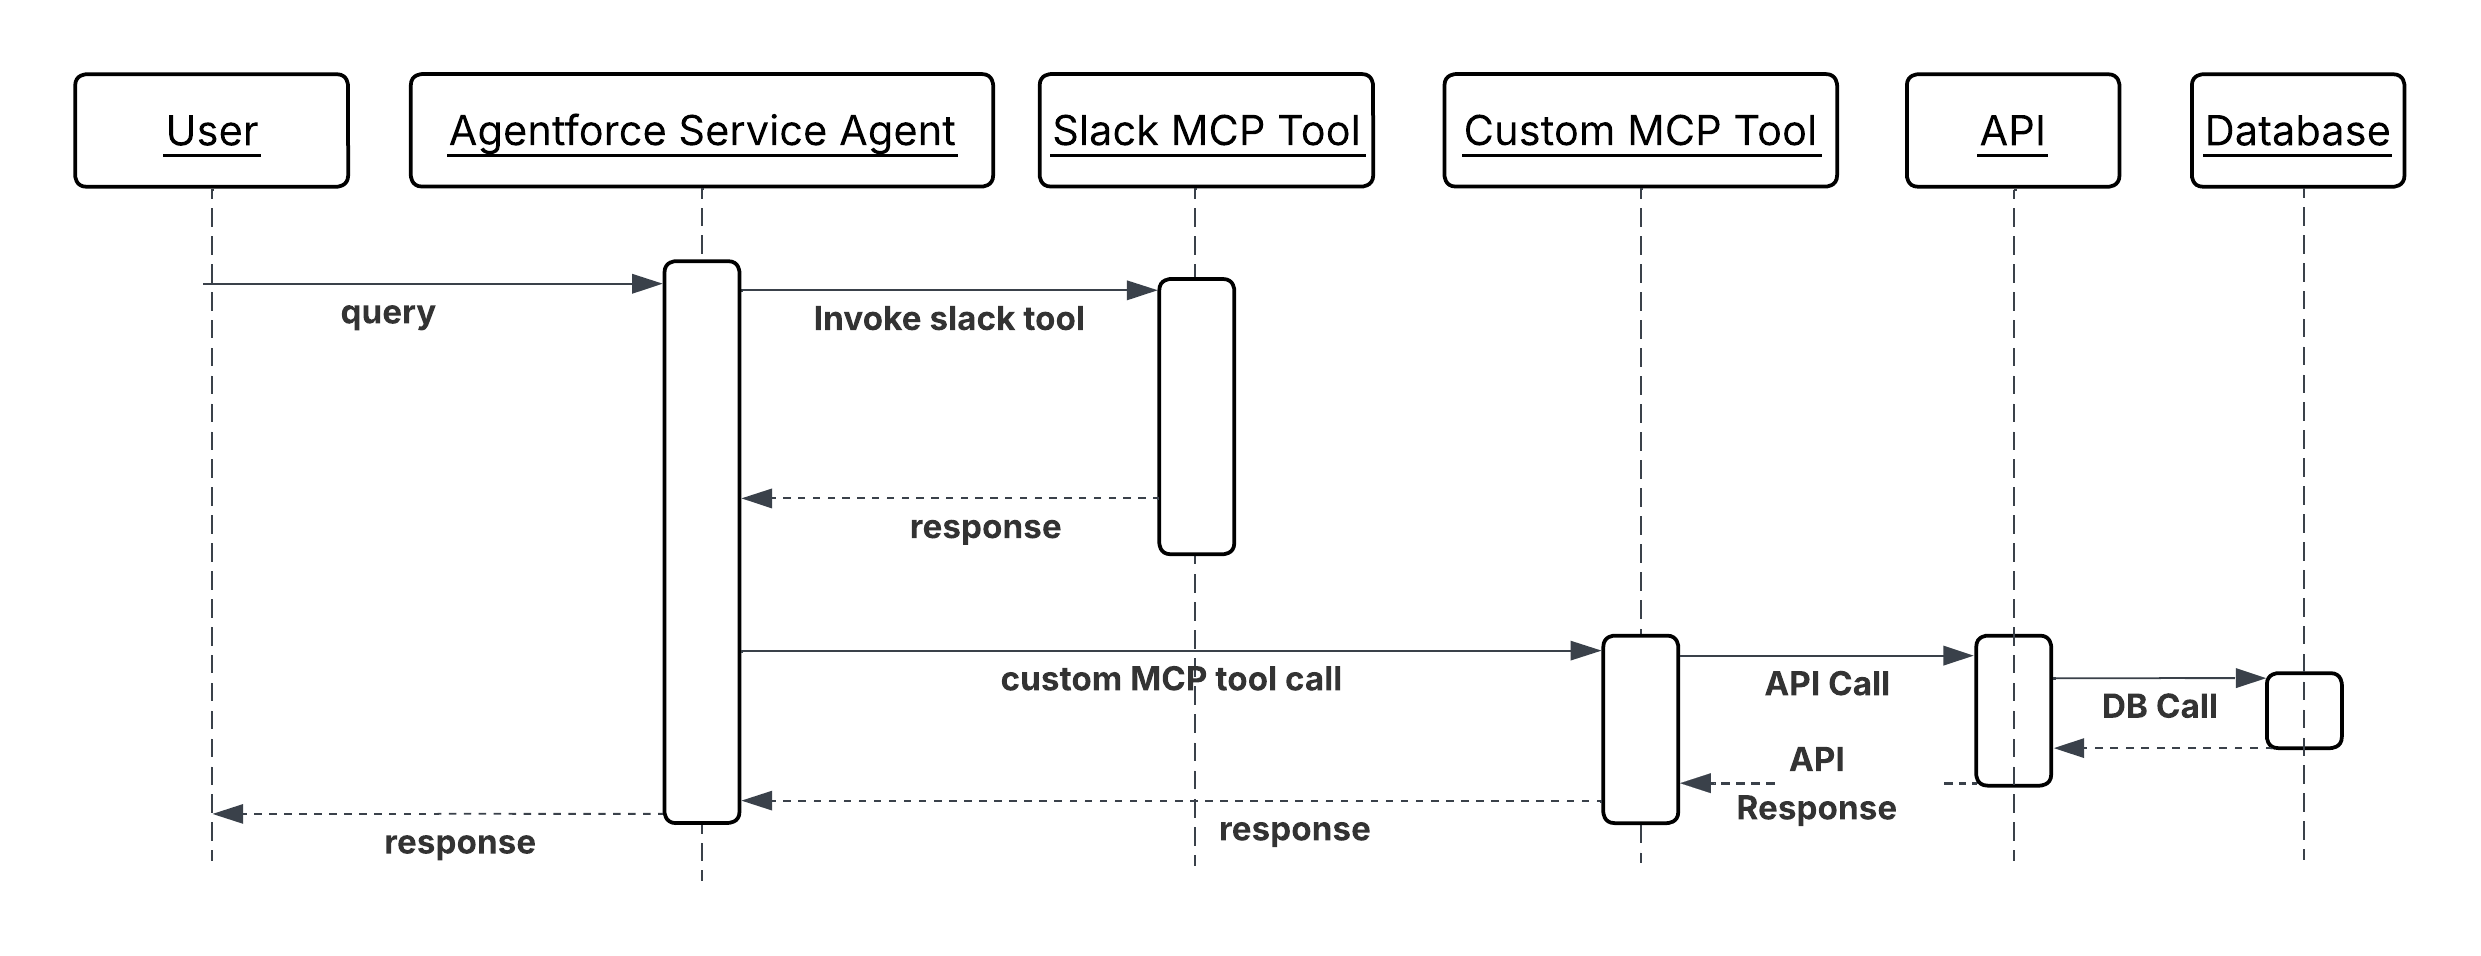
Resultados
A área de superfície acessível do agente se expande sem aumentar sua complexidade de integração. Adicionar um novo sistema externo significa implantar ou configurar um servidor MCP para ele e não escrever chamadas do Apex ou integrações de fluxo personalizadas por agente. A camada de raciocínio do agente permanece inalterada; ela descobre e chama as novas ferramentas com base apenas nas descrições semânticas.
O padrão MCP também cria uma separação limpa de propriedade: a equipe responsável por um sistema expõe seus recursos como um servidor MCP; a equipe do agente consome esses recursos sem precisar entender os aspectos internos do sistema. Esse limite reduz a sobrecarga de coordenação à medida que o número de sistemas integrados aumenta.
A capacidade de composição da ferramenta é um resultado direto. Como todas as ferramentas compartilham a mesma interface de invocação, o agente pode encadear ferramentas de diferentes sistemas, recuperar um arquivo do Google Drive, extrair dados dele e gravar o resultado em um registro do CRM naturalmente como ações de encadeamento em um sistema.
Considerações de design
Orientação sem plataforma
- As descrições da ferramenta são a única base do agente para decidir se e como invocar uma ferramenta. Escreva descrições em linguagem clara e baseada em intenção que diz o que a ferramenta faz, quando ela é aplicada e o que ela retorna. Uma descrição que diz “consulta o banco de dados do CRM” é menos útil que “recupera os casos abertos da conta, ordenados por prioridade, para um determinado ID de conta”. Descrições ruins geram seleção de ferramentas ruim.
- Escale cada ferramenta de MCP para um único recurso atômico. Uma ferramenta que recupera um documento e também grava um resumo no sistema de origem é mais difícil para o agente raciocinar, mais difícil de tentar novamente em caso de falha e mais difícil de proteger do que duas ferramentas separadas. Uma ferramenta, uma responsabilidade.
- Projete ferramentas para que as saídas sejam entradas composíveis. O resultado de uma ferramenta de recuperação deve ser estruturado de modo que seja mapeado naturalmente para os parâmetros de entrada das ferramentas de ação que normalmente o seguem, reduzindo o trabalho de transformação que o agente deve realizar entre as etapas.
- Servidores MCP de host remoto. Instalações binárias locais criam complexidade de implementação e controle de versão que aumenta com o número de ambientes do agente. Um servidor hospedado remotamente pode ser atualizado independentemente dos agentes que o consomem.
Notas de implementação do Salesforce
- Se você quiser autenticação de MCP consistente, limite de taxa e validações de carga útil em todas as chamadas de MCP de saída, use o Gateway de IA como o Gateway Omni do MuleSoft que oferece suporte a servidores MCP e configure-o antes de expor qualquer Servidor MCP a agentes.
- Use as credenciais do OAuth 2.0 para todas as credenciais exigidas por conexões do Servidor MCP. As credenciais não devem aparecer em parâmetros de ferramenta, configurações de ação ou Apex code.
- Algumas ferramentas de MCP podem precisar de credenciais do usuário final para realizar algumas ações dependendo do caso de uso de negócios (como transferência de fundos). Para propagar tokens de identidade do usuário final, use a política OAuth 2.0 Injeção de credenciais em nome, que atualmente tem suporte no MuleSoft Omni Gateway.
- Para servidores MCP personalizados do MuleSoft: Defina o esquema de ferramentas MCP na especificação da API da MuleSoft e registre o ponto final do servidor no catálogo de ferramentas Agentforce. Teste as descrições da ferramenta em consultas do agente representativo para verificar se o agente seleciona a ferramenta certa para a tarefa certa antes de implementar na produção.
Manuseio e recuperação de erros
- Quando uma chamada de ferramenta MCP retorna um erro, o agente inspeciona o código de erro legível por máquina para determinar a ação de recuperação adequada: solicitar parâmetros ausentes do usuário, tentar novamente com entrada corrigida ou escalar para um humano. Ele nunca consome erros ou continua a raciocinar como se a chamada de ferramenta tivesse sucesso.
- O agente implementa a lógica de nova tentativa para falhas temporárias diretamente.
- Registre cada invocação da ferramenta MCP do lado do cliente com o nome da ferramenta, parâmetros de entrada limpos e o resultado. Esse rastreamento no lado do cliente combinado com registros no lado do servidor é o mecanismo principal para diagnosticar por que um agente adotou um caminho de ação específico quando um fluxo de trabalho não produz o resultado esperado.
Considerações de segurança
- Todas as conexões de servidor MCP de saída passam pelo gateway. O gateway impõe a verificação de autenticação, a limitação de taxa para evitar o uso indevido da ferramenta e a inspeção da carga útil para detectar tentativas de injeção imediata nos parâmetros da ferramenta. Conexões diretas e não mediadas de agentes para servidores MCP ignoram esses controles e não são permitidas.
- Escale as conexões de servidor MCP de cada agente para apenas os servidores cujas ferramentas o agente realmente precisa. Um agente configurado com acesso a todos os servidores MCP disponíveis tem uma superfície de ataque maior do que aquela conectada apenas às ferramentas necessárias para suas tarefas definidas.
- Valide e limpe os parâmetros de entrada da ferramenta antes de passá-los para a ferramenta, especialmente quando os valores de parâmetro derivam de texto fornecido pelo usuário ou conteúdo gerado pelo LLM. Não passe a saída LLM não validada diretamente como parâmetros de ferramenta; um invasor que possa influenciar o raciocínio do agente pode usar esse caminho para injetar valores mal-intencionados em chamadas do sistema downstream.
- Trate a lista do agente de servidores MCP conectados e seus inventários de ferramentas como configuração confidencial. Um invasor que sabe quais ferramentas um agente tem disponíveis e quais parâmetros ele aceita tem um mapa para criar cargas úteis de injeção de prompt projetadas para abusar dessas ferramentas.
Exemplo
Um agente de vendas prepara um resumo de conta abrangente antes de uma chamada ao cliente de alto valor:
- O agente recebe a solicitação: “Prepare um resumo sobre a Acme Corp antes da discussão de renovação de amanhã.”
- O agente consulta o catálogo de ferramentas MCP e identifica três ferramentas relevantes em dois servidores MCP:
GetRecentEmails,GetOpenOpportunitieseGetSupportTicketSummary. - O agente invoca todas as três ferramentas em paralelo. Cada servidor MCP traduz a chamada para a API nativa do sistema de destino, recupera os dados relevantes e retorna um resultado estruturado.
- O agente recebe os três resultados. Segmentos de email recentes, a oportunidade de renovação aberta com tamanho e estágio do negócio e um resumo dos pedidos de suporte abertos por prioridade e os sintetiza em um resumo de conta estruturado.
- O agente invoca
CreateAccountNotepara salvar a apresentação no registro da conta e retorna um resumo ao usuário solicitante. - Todas as quatro invocações de ferramenta MCP são registradas pelo gateway com nomes de ferramenta, identidades de servidor e resultados para o registro de auditoria da sessão.
Contexto
O padrão de MCP de saída descreve um agente Agentforce que consome ferramentas de servidores MCP externos. O padrão de entrada inverte isso. Os recursos da plataforma Salesforce, como registros de CRM, fluxos, lógica do Apex e percepções do Data 360, são expostos como ferramentas de MCP que agentes externos, executando em qualquer estrutura de LLM, podem descobrir e invocar.
Esse padrão é importante porque as implantações de IA corporativa raramente são de fornecedor único. Um agente do parceiro criado em uma estrutura diferente pode precisar pesquisar o status da conta de um cliente no Salesforce. Uma equipe de ciência de dados interna que executa um agente baseado em Python pode precisar acionar um fluxo do Salesforce para iniciar um processo de aprovação. Sem um mecanismo de exposição padronizado, cada consumidor externo requer uma integração personalizada. Expor os recursos do Salesforce como um servidor MCP oferece a cada agente compatível com MCP uma interface uniforme e descobrível para as ferramentas da plataforma, independentemente de como o agente de chamada é criado.
Por exemplo, o agente de aquisição de um parceiro, criado em uma estrutura de terceiros, precisa verificar o status do contrato de um fornecedor no Salesforce antes de aprovar um pedido de compra. Em vez de criar uma integração REST direta, ela chama uma ferramenta de GetContractStatus no Salesforce MCP Server. A ferramenta impõe os mesmos controles de acesso de qualquer operação nativa do Salesforce; o agente que está chamando vê apenas o resultado.
Problema
Quando um agente externo criado em uma estrutura diferente, de propriedade de um parceiro ou executando de outra forma fora da plataforma Salesforce precisa invocar os recursos do Salesforce como parte de seu próprio fluxo de trabalho, como esses recursos podem ser expostos de uma maneira padronizada, descobrível e controlada com segurança que não exija uma integração personalizada por consumidor externo?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- Os agentes externos que precisam consumir os recursos do Salesforce são criados em estruturas compatíveis com o padrão MCP? Caso contrário, uma abordagem de webhook ou API REST pode ser mais adequada do que MCP.
- Quais recursos do Salesforce precisam ser expostos: recuperação de dados somente leitura, operações de gravação, invocações de fluxo ou uma combinação? O escopo da exposição determina diretamente a área de superfície de segurança que deve ser governada.
- Como a identidade do agente de chamada externo deve ser verificada e sob quais permissões do Salesforce suas invocações devem ser executadas? Chamadas de agente para plataforma não devem herdar permissões mais amplas do que a operação específica exige.
- O Salesforce MCP Server é destinado a consumidores internos (agentes de outras equipes na mesma organização) ou a consumidores externos (agentes de parceiros e clientes)? O modelo Trust e os requisitos de autenticação diferem significativamente entre esses públicos.
- Como o conjunto de ferramentas expostas evoluirá ao longo do tempo? Novos recursos do Salesforce adicionados ao Servidor MCP tornam-se imediatamente descobríveis por todos os agentes conectados; a exposição indesejada da ferramenta deve ser controlada por meio de um processo de publicação deliberado.
Aplicativo de padrão do Salesforce
| Solução | Ajuste | Comentários |
|---|---|---|
| Salesforce como servidor MCP (nativo) | Melhor para expor funcionalidades do Salesforce de primeira parte | Use quando as ferramentas a serem expostas são mapeadas diretamente para operações da plataforma Salesforce existentes e os agentes que fazem a chamada são compatíveis com MCP. A funcionalidade nativa do servidor MCP do Salesforce Headless 360 permite que operações de plataforma como consultas de registro, invocações de fluxo e ações do Apex sejam declaradas como ferramentas MCP e expostas a qualquer agente externo compatível com MCP. O acesso é controlado pelo modelo de permissão do Salesforce. Observe que esses servidores MCP do 360 autônomos podem ser acessados apenas com credenciais do usuário final no momento. |
| MuleSoft como fachada do servidor MCP | Melhor quando a transformação ou agregação de vários sistemas é necessária | Use quando o agente de chamada precisar de um recurso que exija dados de mais de um objeto do Salesforce, transformação antes da entrega ou composição com dados de outros sistemas. A interface MCP permanece limpa e simples; a complexidade é absorvida pela MuleSoft. Uma camada de MCP do MuleSoft fica na frente do Salesforce e expõe o resultado agregado de várias operações de plataforma como uma única ferramenta de MCP. Essa solução também pode ser usada por agentes em que a identidade do usuário final não pode ser propagada para autenticação e autorização do Salesforce. Por exemplo, se os Agentes do Agentforce precisarem de servidores MCP com credenciais do sistema, teremos que contar com servidores MCP personalizados, como um criado com e hospedado no MuleSoft. |
Esboço
Diagrama de sequência para funcionalidades de negócios como ferramenta invocável
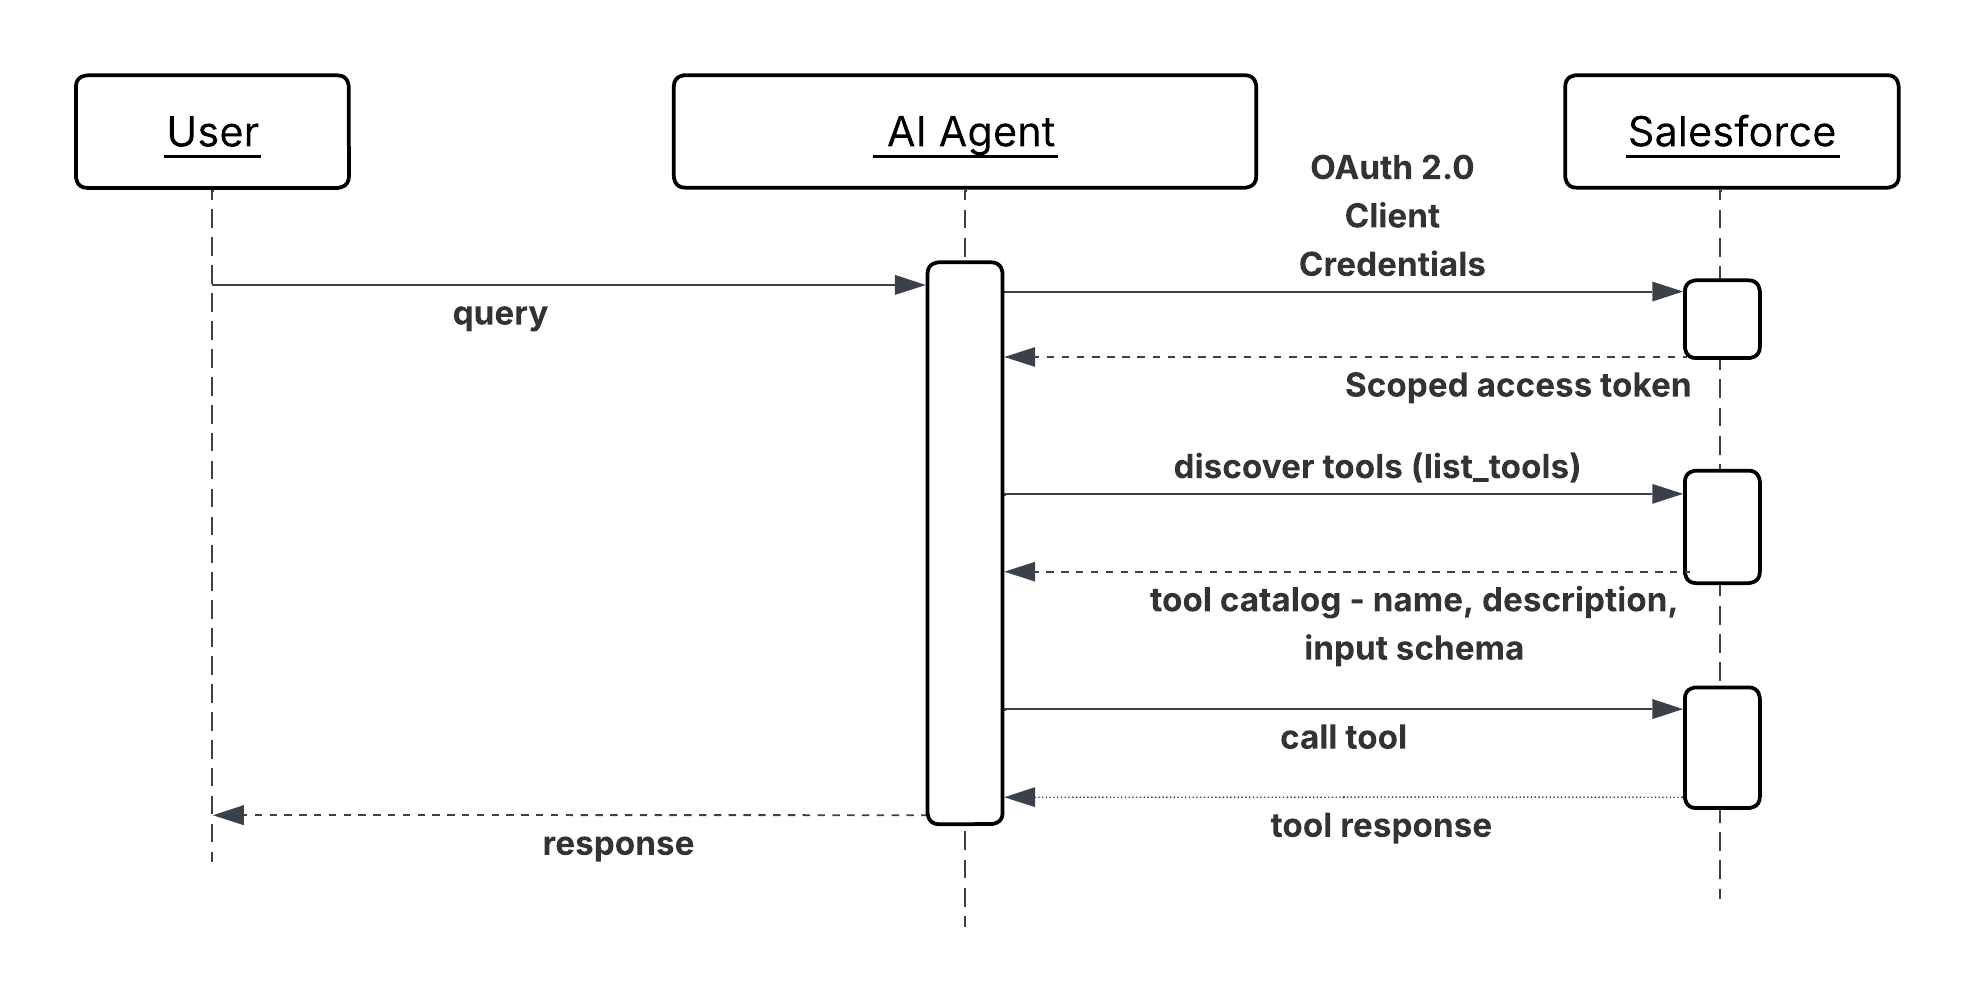
Resultados
O Salesforce se torna um participante de primeira classe em ecossistemas de agentes de vários fornecedores. Os agentes externos podem descobrir e consumir recursos da plataforma sem exigir uma integração REST personalizada por consumidor ou por caso de uso. O número de consumidores pode aumentar sem crescimento proporcional na sobrecarga de manutenção de integração.
Com o Headless 360, o modelo de permissão do Salesforce controla cada invocação de ferramenta de entrada. Os clientes de MCP externos não ignoram os controles de acesso a dados existentes; eles operam dentro deles. Isso significa que a postura de segurança de expor recursos por meio de MCP é equivalente a expô-los por meio de qualquer outra superfície de API autenticada.
A capacidade de descoberta da ferramenta é um benefício composto. Conforme novos recursos do Salesforce são adicionados ao catálogo de ferramentas do Servidor MCP, eles ficam imediatamente disponíveis a todos os agentes externos conectados sem exigir que esses agentes atualizem suas configurações.
Considerações de design
Orientação sem plataforma
- Publique apenas o que os agentes externos precisam. Cada ferramenta adicionada ao catálogo do Servidor MCP expande a superfície de ataque e a carga de governança. Audite o inventário de ferramentas deliberadamente. Defina quais recursos são aprovados para consumo externo e trate a exposição não aprovada como uma lacuna de configuração, não como padrão.
- Escreva descrições da ferramenta para consumidores externos. O operador de um agente externo não tem o Knowledge do seu modelo de dados interno ou convenções de nomenclatura. Mantenha as descrições independentes: o que a ferramenta faz, o que cada parâmetro significa, o que o resultado representa e quaisquer restrições ou pré-requisitos que o chamador deve cumprir.
- Ferramentas de versão explicitamente quando seus esquemas de entrada ou saída mudam. Um agente externo que depende do esquema atual de uma ferramenta interromperá silenciosamente se o esquema mudar sem aviso prévio. Trate alterações de interrupção na interface de uma ferramenta MCP com a mesma disciplina que uma alteração de interrupção em uma API REST pública.
Notas de implementação do Salesforce
- Execute cada invocação de ferramenta do Salesforce pronto para uso (OOTB) MCP (Headless 360) de entrada sob um usuário final cujas permissões estejam no escopo apenas das operações que as ferramentas expostas exigem. Não execute chamadas de agente de entrada com uma identidade de administrador de alto privilégio.
- Para aplicar a autenticação, a limitação de taxa, a validação de esquema e a detecção de informações de identificação pessoal (PII) de maneira consistente em todas as ferramentas de MCP, use o Gateway de IA, como o MuleSoft Omni Gateway.
- Para as fachadas do MCP da MuleSoft, defina o esquema de ferramentas do MCP no MuleSoft independentemente do esquema da API do Salesforce subjacente. A interface MCP deve refletir a necessidade conceitual do agente que está chamando, não a forma do objeto do Salesforce que dá suporte a ela. Esse desacoplamento permite que a implementação do Salesforce evolua sem quebrar o contrato de ferramenta externa.
Manuseio e recuperação de erros
- As falhas de invocação de ferramenta devem retornar respostas de erro de MCP estruturadas com um código legível por máquina e uma descrição em linguagem simples. O agente externo que faz a chamada não tem visibilidade dos itens internos da Salesforce Platform, pois as mensagens de erro devem ser autônomas e acionáveis sem exigir o Knowledge de códigos de erro ou modelos de objeto específicos do Salesforce.
- Erros de limite de frequência e falhas de autenticação devem ser retornados imediatamente com informações suficientes para que o operador do agente externo diagnostique e remedia qual limite de frequência foi atingido ou qual credencial foi rejeitada sem expor detalhes internos de configuração.
- Registre todas as invocações de ferramentas de MCP de entrada no Omni Gateway com a identidade do agente que está chamando, a ferramenta invocada, os parâmetros de entrada (saneados de valores confidenciais) e o resultado. Esse registro é a trilha de evidência principal para diagnosticar falhas relatadas por consumidores externos e para auditar o que os agentes externos acessaram.
Considerações de segurança
- Cada conexão de MCP de entrada deve ser autenticada antes que qualquer ferramenta seja acessível. Não permita a descoberta não autenticada do catálogo de ferramentas; a lista de recursos expostos é em si uma informação confidencial.
- Aplique a autorização no nível da ferramenta além da autenticação no nível da conexão. Um agente externo registrado deve poder invocar apenas as ferramentas específicas às quais ele recebeu acesso explicitamente, não o catálogo completo. Imponha isso no gateway, não na camada do aplicativo.
- Valide e limpe todos os parâmetros de ferramenta de entrada antes de passá-los para operações da Salesforce Platform. Parâmetros de agentes externos são uma entrada não confiável. Um parâmetro criado de modo mal-intencionado pode tentar substituir filtros de consulta, injetar fragmentos de Salesforce Object Query Language (SOQL) ou influenciar variáveis de fluxo. Valide o tipo, o formato e o intervalo no limite do servidor MCP ou da fachada.
- Realize uma revisão de acesso periódica de consumidores externos registrados. Revogue as credenciais de agentes que não estão mais ativos ou cujo escopo de acesso mudou. Uma credencial dormente, mas válida, para uma integração de parceiro desativada é um risco permanente desnecessário.
- Proteja-se contra violar limites de plataforma limitando a taxa de mensagens MCP de entrada no gateway. Reduza o tráfego de agentes não críticos quando estiverem em carregamento usando políticas de nivelamento baseadas em SLA.
Exemplo
Um agente de aquisição operado por um parceiro de logística precisa verificar o contrato e o status de crédito de um fornecedor antes de aprovar um pedido de compra de alto valor:
- O agente do parceiro se autentica no gateway usando suas credenciais de cliente OAuth 2.0 registradas e recebe um token de acesso com escopo.
- O agente consulta o catálogo de ferramentas do Salesforce MCP Server e identifica duas ferramentas relevantes:
GetSupplierContractStatuseGetAccountCreditSummary. - O agente invoca
GetSupplierContractStatuscom o identificador do fornecedor. O Servidor MCP traduz isso para uma consulta de registro do Salesforce, aplica a segurança em nível de campo do usuário de integração e retorna o status atual do contrato, a data de expiração e quaisquer retenções de conformidade sinalizadas. - O agente chama o
GetAccountCreditSummary, que é roteado pela MuleSoft MCP Facade. A fachada agrega o saldo da fatura pendente e o histórico de pagamento do fornecedor de dois objetos do Salesforce e retorna um único resumo de crédito composto. - Com ambos os resultados, o agente do parceiro determina que o contrato está ativo e a posição de crédito está dentro dos limites aceitáveis e aprova o pedido de compra em seu próprio sistema.
- Ambas as invocações de ferramentas são registradas pelo gateway com a identidade do agente parceiro, as ferramentas invocadas e os resultados que criam um registro auditável de que acesso externo foi concedido e quais dados foram retornados.
Contexto
Os sistemas empresariais agora dependem de mutirões ou redes de agentes colaborativos, em que solicitações complexas são divididas e delegadas a agentes especializados em diferentes domínios ou plataformas do fornecedor. Esses agentes, cada um com seu próprio papel, recursos e ferramentas, precisam de um método de comunicação padronizado e seguro para coordenar em direção a metas compartilhadas sem exigir intervenção humana em cada etapa.
Problema
Como um agente de IA de chamada pode descobrir, interagir com segurança e delegar tarefas complexas ou específicas de domínio a um agente par remoto que pode ser criado em uma estrutura diferente ou operado por um fornecedor diferente e receber resultados estruturados para concluir um fluxo de trabalho corporativo maior?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- Como os agentes, desenvolvidos usando estruturas diversas ou operando em estados de aplicativos isolados, interoperam?
- Como os agentes podem colaborar e delegar tarefas sem expor sua lógica interna, memória ou ferramentas proprietárias?
- Como os agentes oferecem suporte a tarefas complexas de execução longa enquanto fornecem atualizações de estado em tempo real, transmissões e notificações por push?
- Como os agentes aplicam a segurança corporativa (autenticação, autorização) e a adesão à política para comunicação entre agentes?
- Como os agentes lidam com fluxos de trabalho de tarefas estruturadas (iniciação, progresso, conclusão) que vão além de chamadas de API simples?
Aplicativo de padrão do Salesforce
O Protocolo A2A é um padrão aberto que permite que os agentes descubram, delegem e colaborem com outros agentes como colegas. Ele fornece uma linguagem comum para que os agentes troquem informações com segurança e coordenem ações entre diferentes plataformas e fornecedores. O A2A se concentra na comunicação entre pares, complementando o MCP, que se concentra em conectar agentes a ferramentas e APIs.
| Solução | Ajuste | Comentários |
|---|---|---|
| Orquestração multifator de organização única (SOMA) | Melhor quando todos os agentes de domínio moram em uma organização e nenhum roteamento entre fornecedores é necessário | Um superagente (orquestrador) descompõe solicitações e roteia para até sete subagentes conectados usando roteamento baseado em LLM (o Mecanismo de raciocínio do Atlas lê descrições de subagentes) ou roteamento determinístico (script do agente). Esse é o padrão padrão recomendado antes de alcançar A2A. Combinações com suporte: Agentforce Agente de serviço→Agente de serviço Agentforce Agente de serviço Agentforce Agente de serviço Agentforce Agente de serviço Agentforce Agente de serviço Agentforce Agente de serviço Agentforce Agente de serviço Somente o orquestrador pode ser escalado para um humano; os subagentes não podem. |
| Delegação de vários agentes conduzida por orquestrador | Melhor para fluxos de trabalho complexos que exigem vários agentes especializados | Use quando o fluxo de trabalho abranger vários domínios, por exemplo, aquisição, verificação e aprovação, cada um de propriedade de um agente diferente. Um agente de orquestrador descompõe a solicitação de nível superior e delega subtarefas a dois ou mais agentes pares em sequência ou em paralelo. Cada agente par executa sua função de domínio especializada e retorna um artefato; o orquestrador agrega os resultados e conduz a próxima etapa. |
Esboço
A arquitetura envolve um agente de chamada iniciando a comunicação, facilitada por um catálogo/registro do agente para descoberta:
Diagrama de sequência para Delegação entre agentes
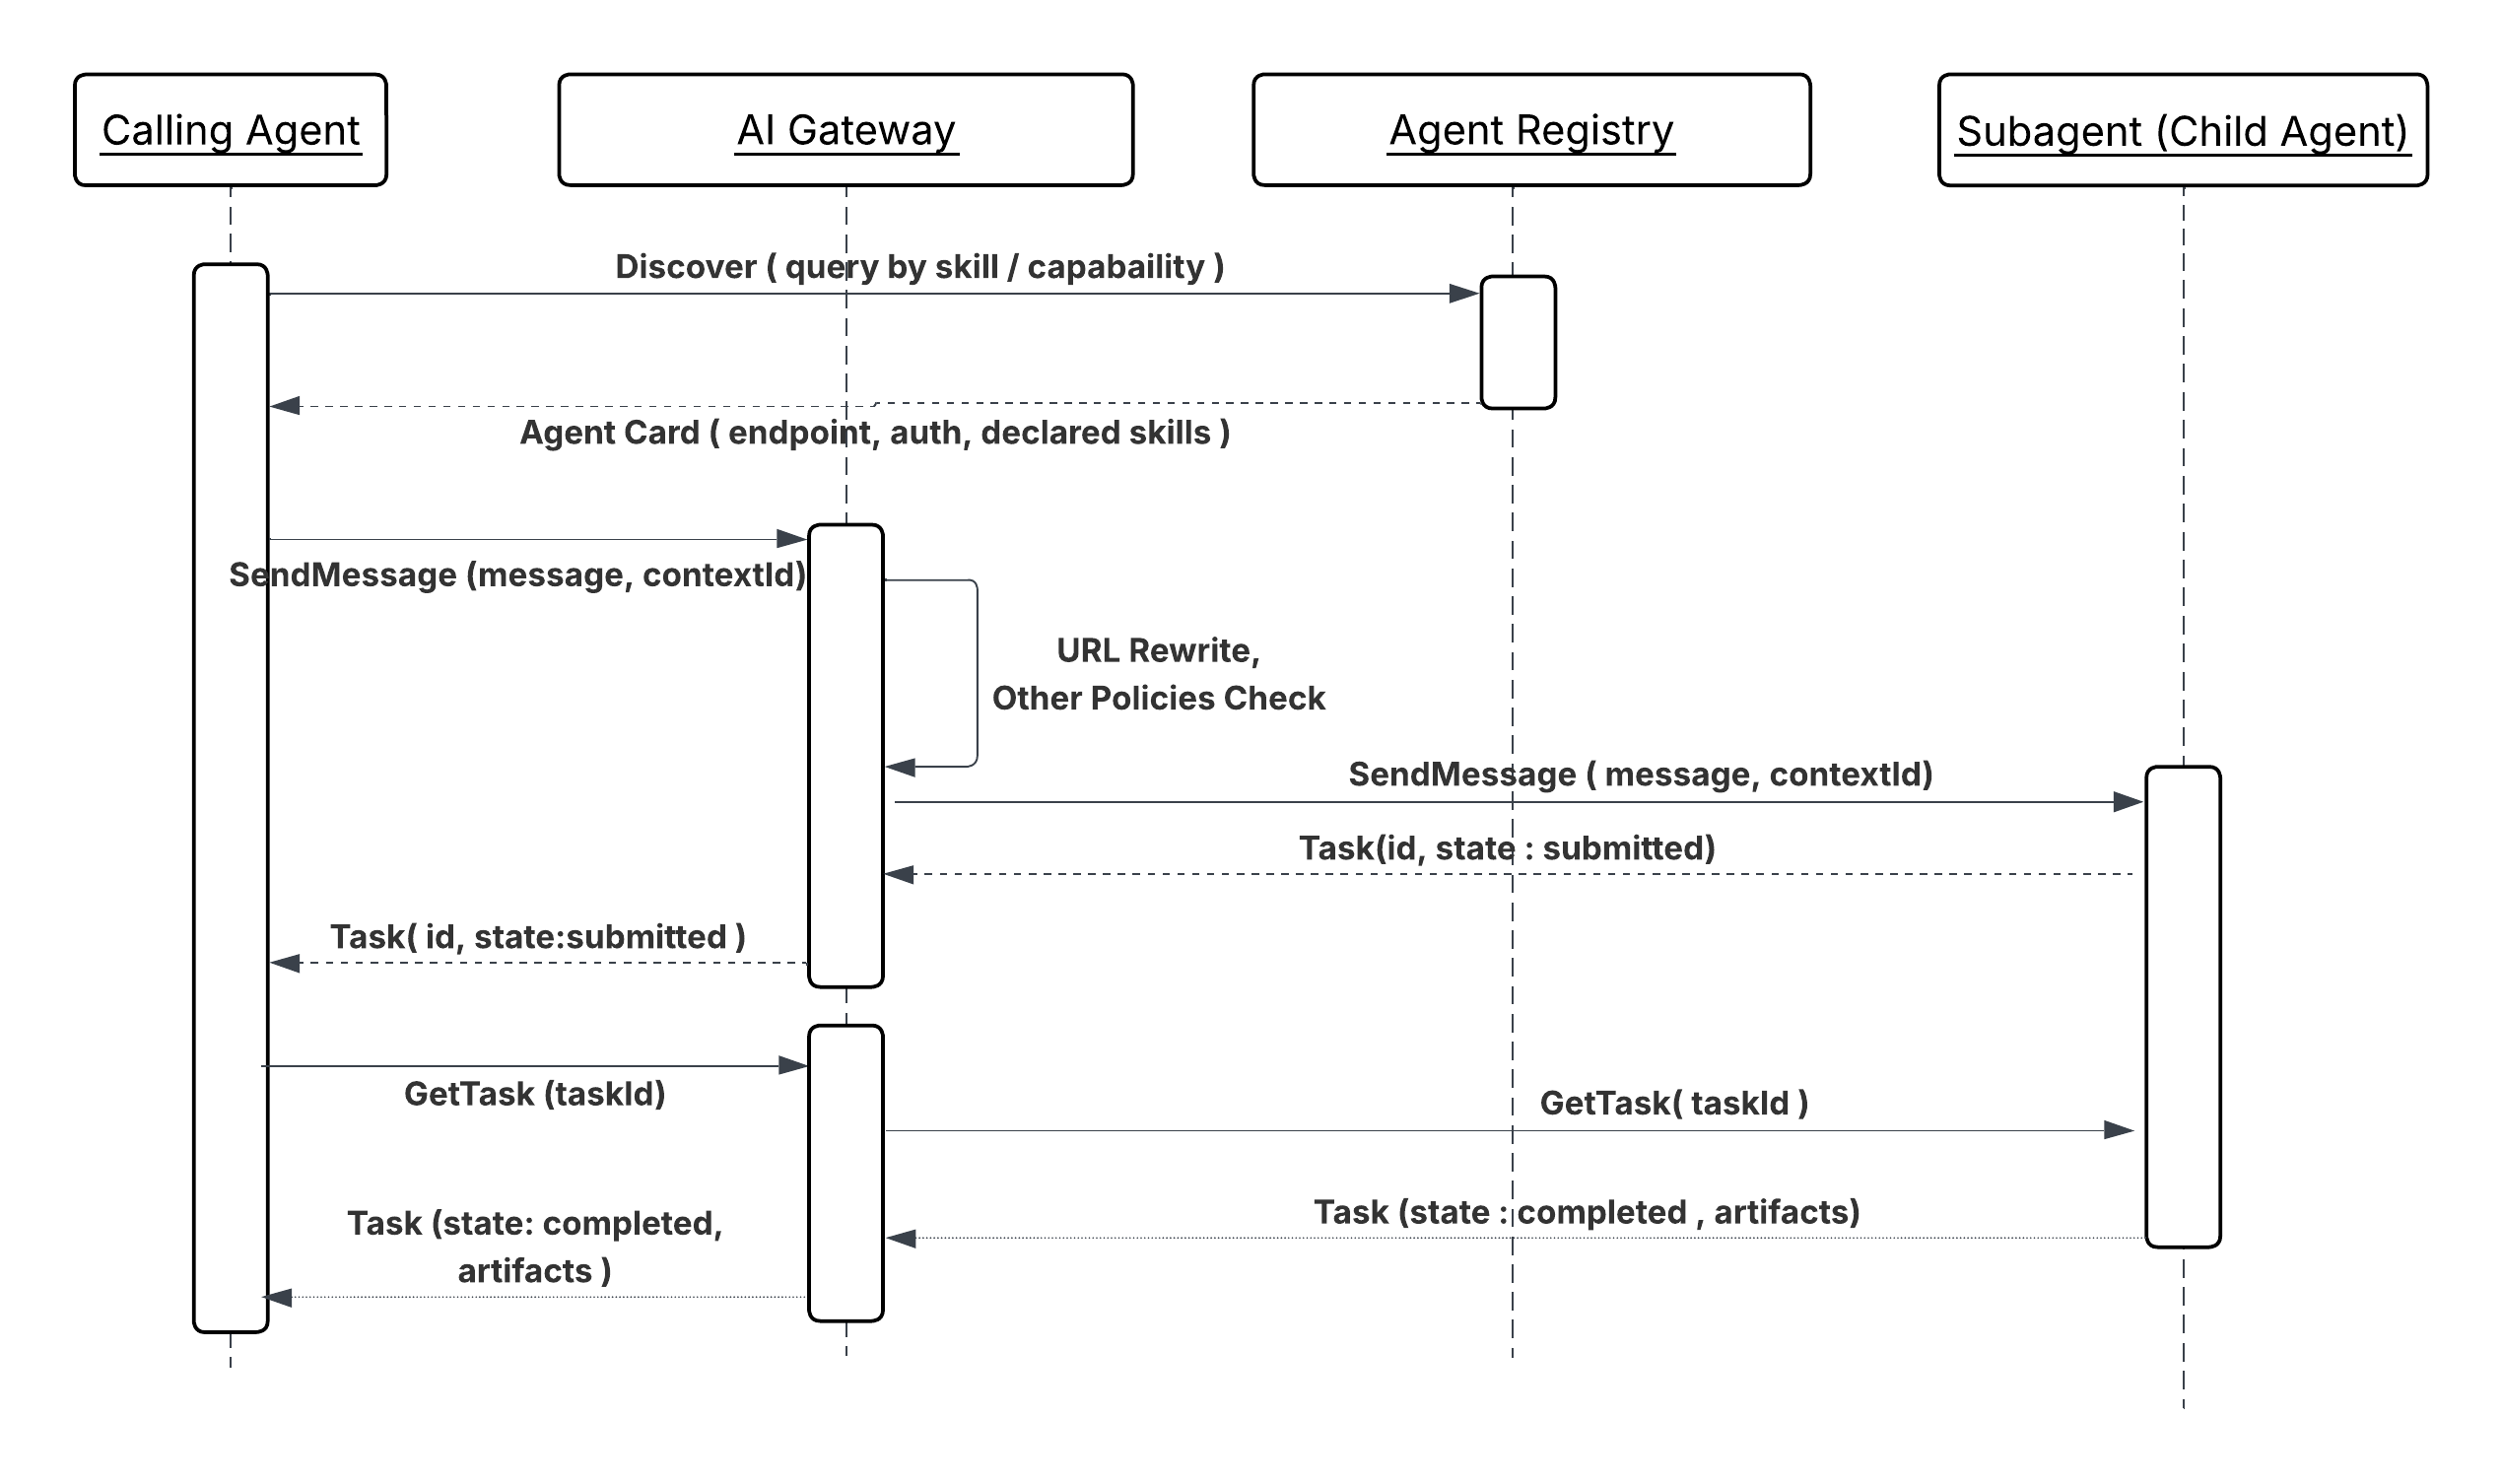
O agente par processa a solicitação usando sua lógica, memória e ferramentas específicas do domínio, então retorna resultados estruturados para o agente que está chamando.
Resultados
A delegação A2A separa a propriedade do domínio da orquestração de fluxo de trabalho. O agente de chamada não precisa saber como o agente par é criado, em qual plataforma ele é executado ou quais ferramentas ele usa internamente; ele delega uma tarefa e recebe um artefato estruturado. Esse limite significa que um agente especializado (verificação em segundo plano, pontuação de risco financeiro, roteamento de logística) pode ser desenvolvido, implantado e melhorado independentemente dos fluxos de trabalho que o invocam.
O modelo de ciclo de vida da tarefa do protocolo (enviado, funcionando, concluído, falhou) é compatível
operações de execução longa nativamente. O agente de chamada pode se registrar para atualizações de estado em vez
do que manter uma conexão de bloqueio, o que significa que as tarefas A2A podem durar minutos ou horas
sem exigir que o agente de orquestração permaneça ativo durante todo o processo.
Considerações de design
Orientação sem plataforma
- Em cenários complexos, um agente agente pode atuar como um serviço de roteamento inteligente ou um “comutador inteligente” para coordenar a delegação de tarefas entre agentes especializados e gerenciar processos de várias etapas.
- Como o A2A oferece suporte a tarefas de execução longa, a comunicação deve ser orientada para a conclusão da tarefa, definindo um ciclo de vida para o objeto de tarefa e fornecendo atualizações de estado e notificações em tempo real.
- O protocolo é projetado para dar suporte a vários tipos de conteúdo, incluindo texto, arquivos, dados estruturados, áudio e streaming de vídeo.
- Os relacionamentos e as dependências entre agentes e seus recursos são definidos declarativamente em um arquivo de configuração (por exemplo, “agent-network.yaml”) e publicados no registro do agente.
Notas de implementação do Salesforce
- Para uma orquestração SOMA eficaz, mantenha os subagentes conectados abaixo de 7 para preservar a qualidade do roteamento.
- No momento, há suporte apenas para a camada de delegação única (superagente → subagente); cadeias mais profundas enviam a latência para uma “taxa não sustentável”. No momento, os subagentes não podem delegar para outros subagentes conectados.
- Há suporte para transferência humana apenas no nível do orquestrador; os subagentes não podem ser escalados.
- Em SOMA, use o Script do agente quando o roteamento baseado em LLM produzir roteamento incorreto em entradas ambíguas para roteamento determinístico. O Script do agente habilita o contexto compartilhado selecionado entre agentes.
Manuseio e recuperação de erros
O protocolo A2A define códigos de erro abrangentes para facilitar a depuração robusta e o gerenciamento de erros.
- Lógica de recuperação: Os agentes devem incorporar políticas de nova tentativa (retrie), lógica de failover a agentes alternativos capazes e tempos limite explícitos.
- Rastreamento de estado da tarefa: O fluxo de trabalho de gerenciamento de tarefas garante que os agentes possam se manter em sincronia com o status mais recente de uma tarefa, facilitando a recuperação em caso de interrupção.
- Observabilidade: Registrar detalhes da interação, como latência, taxas de sucesso e frequências de erro, é essencial para monitorar a qualidade e solucionar problemas.
Considerações de segurança
- Autenticação corporativa: O A2A é projetado para se alinhar aos padrões de autenticação e autorização corporativos, como OAuth 2.0 e JWT, geralmente gerenciados por plataformas externas, como Okta.
- Gateway para proteger A2A: Um gateway (por exemplo, o MuleSoft Omni Gateway) é essencial para aplicar políticas em todas as comunicações A2A, atuando como um gateway de entrada e saída para proteger agentes e controlar o tráfego de saída para agentes e serviços externos.
- Imposição de políticas: Reescrever cartão do agente, Validação de esquema, Spike Control, Detector de PII e outras políticas devem ser aplicadas ao servidor A2A e à proteção de dados.
Exemplo
Fluxo de trabalho de origem de candidatos
Um gerente de contratação encarrega seu agente orquestrador central de encontrar candidatos que correspondam a uma lista de trabalhos e conjunto de habilidades.
- Descoberta: O agente de orquestrador consulta o registro do agente e descobre um agente de recrutamento especializado e um agente de verificação em segundo plano (ambos agentes pares).
- Delegância (A2A): O agente do orquestrador envia uma solicitação de tarefa estruturada (mensagem A2A) ao agente de recrutamento para candidatas de origem.
- Processamento de pares: O agente de recrutamento executa seu próprio fluxo de trabalho (por exemplo, chamar uma ferramenta do LinkedIn externa por meio do MCP).
- Retorno de artefato (A2A): O agente de recrutamento retorna uma lista de candidatos sugeridos (o artefato).
- Delegação sequencial: O agente do orquestrador então delega outra tarefa (A2A) ao agente de verificação em segundo plano para o candidato principal. Esse agente realiza a verificação e retorna o resultado, concluindo a tarefa geral.
Contexto
Fluxos de trabalho empresariais complexos geralmente exigem que agentes especializados hospedados em plataformas externas ou sistemas de parceiros iniciem tarefas, delegem consultas ou forneçam atualizações a agentes internos (por exemplo, aqueles na Salesforce Platform). Esse padrão aborda como um agente interno do Agentforce recebe e processa de forma segura e confiável solicitações de um agente de pares remoto para executar um recurso específico do domínio.
Problema
Como um agente de IA especializado interno (por exemplo, um agente de verificação em segundo plano no Agentforce) pode expor com segurança sua funcionalidade específica de domínio a agentes pares externos, processar uma solicitação A2A estruturada recebida e gerenciar o ciclo de vida da tarefa (incluindo atualizações de status em tempo real) para retornar artefatos estruturados ao agente de chamada remota?
Forças
Ao aplicar esse padrão, responda às seguintes perguntas:
- Como expor com segurança os recursos do agente interno a agentes externos sem comprometer a lógica ou as ferramentas internas?
- Como você aplica políticas de segurança corporativas para verificar a identidade do agente que está chamando e a autoridade delegada antes de processar solicitações?
- Como lidar com tarefas de entrada de execução longa enquanto fornece atualizações de estado estruturadas assíncronas?
- Como você garante uma interação perfeita com agentes criados em estruturas externas diversas?
Aplicativo de padrão do Salesforce
O Protocolo A2A fornece o padrão aberto para delegação e colaboração de pares e seguras. O agente interno atua como o agente par, anunciando seus recursos por meio de um Catálogo/Registro do agente e usando A2A em canais seguros (HTTPS/SSE) para receber e responder a solicitações estruturadas.
| Solução | Ajuste | Comentários |
|---|---|---|
| Subagente conectado do Agentforce (SOMA) | Melhor quando o agente de chamada é outro agente Agentforce na mesma organização | Use quando ambos os agentes estiverem na mesma organização do Salesforce e o chamador for um orquestrador do Agentforce. O agente é conectado como um subagente por meio do Agentforce Builder e exposto ao orquestrador por meio de sua descrição e ações declaradas. O orquestrador roteia tarefas usando roteamento baseado em LLM (Atlas Reasoning Engine) ou roteamento determinístico (Agent Script). Nenhum protocolo, gateway ou registro externo A2A é necessário. Combinações com suporte: Agentforce Agente de serviço→Agente de serviço Agentforce Agente de funcionário Agentforce Agente de funcionário Agentforce Agente de funcionário Agentforce Agente de funcionário Agentforce →Agente de serviço Agentforce Apenas o orquestrador pode escalar para um ser humano; subagentes não podem. |
| Roteamento de agente de agentes (entrada) | Melhor quando a organização hospeda vários agentes Agentforce com funcionalidades complementares e o agente de chamada não pode ou deve selecionar um destino específico | Use quando o agente de chamada for externo ao Salesforce ou a outra organização do Salesforce e não precisar saber qual agente interno específico (Agentforce ou outros agentes do fornecedor) processa a solicitação. Um agente da MuleSoft fica entre o Omni Gateway da MuleSoft e o conjunto de agentes internos do Agentforce. Ele recebe a tarefa A2A de entrada, avalia os recursos declarados dos agentes internos disponíveis em relação aos requisitos da tarefa e encaminha a solicitação para o agente mais adequado. O agente também lidará com o failover se o agente de destino principal estiver indisponível ou retornar uma falha, o agente redirecionará para um agente equivalente sem apresentar a nova tentativa ao chamador externo; o chamador externo nunca ficará ciente de decisões ou novas tentativas de roteamento internas. |
Esboço
Diagrama de sequência para agentes como serviços chamáveis
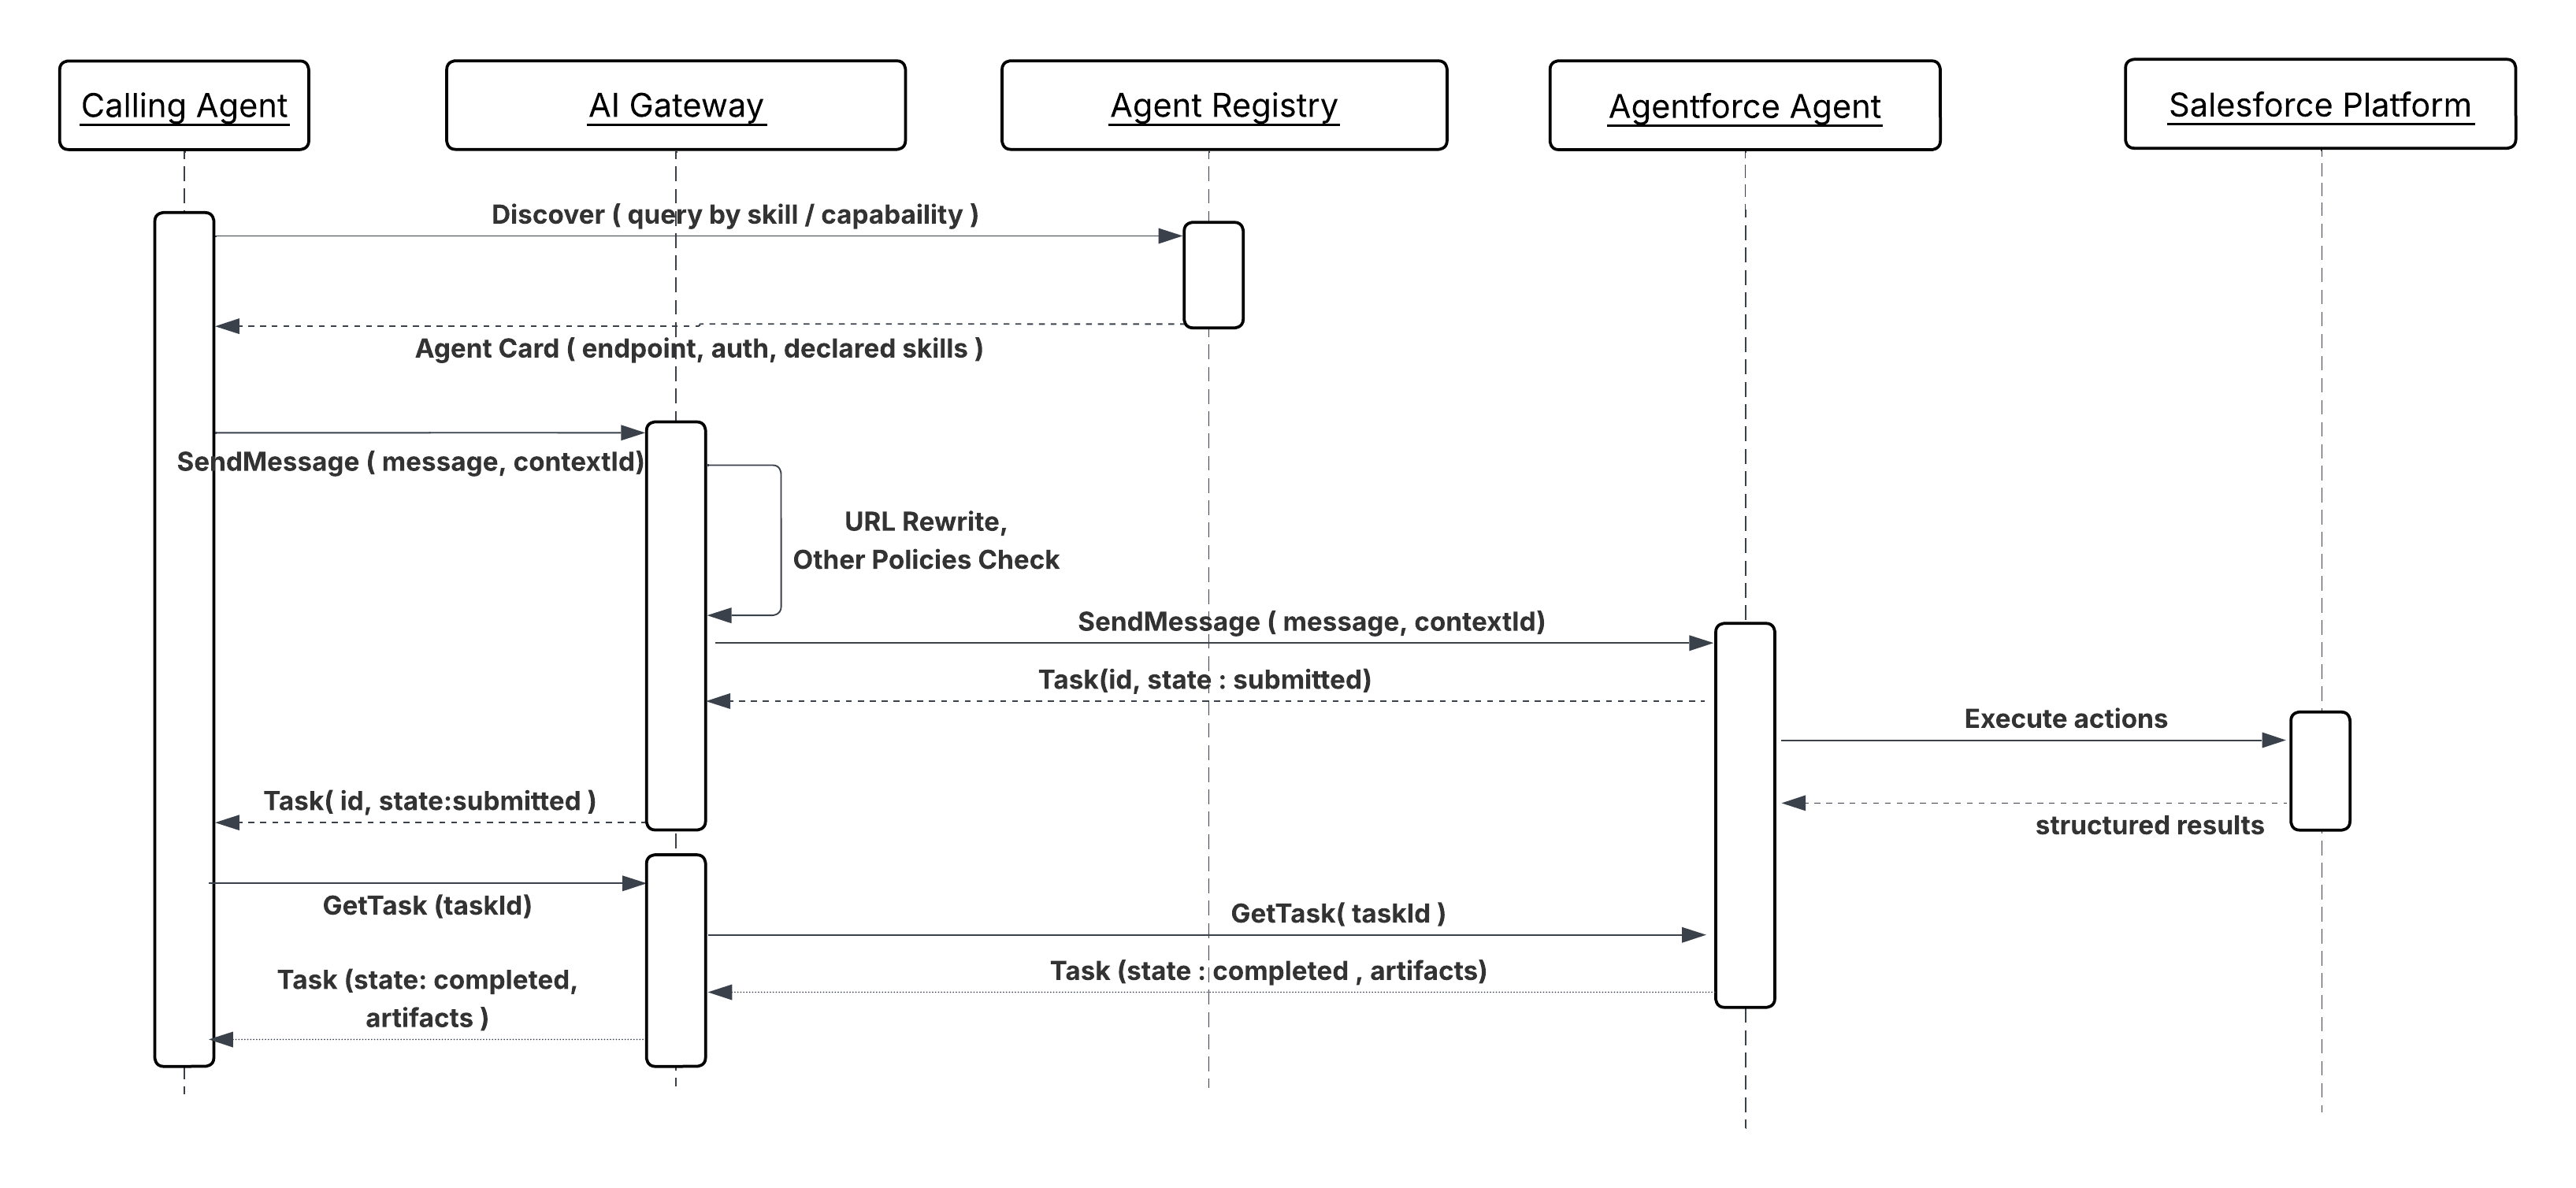
Resultados
Esse padrão expõe agentes internos como serviços especializados em uma rede de vários agentes. Os agentes externos podem delegar tarefas com segurança a funcionalidades internas enquanto a organização mantém o controle, a auditoria e a imposição de políticas.
Considerações de design
Orientação sem plataforma
- Um gateway (por exemplo, MuleSoft Omni Gateway) deve ser posicionado como um ponto de entrada para aplicar políticas, incluindo limitação de taxa, autenticação e validação de carga útil, em todas as solicitações A2A recebidas.
- Os agentes internos devem gerenciar o estado do objeto de tarefa do início externo à conclusão, garantindo que o agente de chamada remota receba atualizações de status consistentes e verificáveis.
- Certifique-se de que os recursos publicados do agente no cartão do agente sejam claros, baseados em intenção e incluam os escopos de segurança necessários para a delegação.
Manuseio e recuperação de erros
- Códigos de erro estruturados: Em caso de falha, o agente interno deve retornar mensagens de erro estruturadas em conformidade com A2A ao agente que está chamando para habilitar a lógica de nova tentativa remota ou mecanismos alternativos de failover.
- Idempotência: O agente deve verificar se os efeitos colaterais acionados por uma solicitação A2A repetida de um agente externo (devido à interrupção ou recuperação da rede) são idempotentes.
Considerações de segurança
- Imposição de políticas de entrada: O gateway deve aplicar políticas para permitir/bloquear agentes externos na lista de permissões e validar tokens JWT/OAuth 2.0 para verificar a identidade e a autoridade delegada do agente de chamada.
- Saneamento de entrada: Valide e limpe todas as cargas úteis de solicitação recebidas para mitigar possíveis injeções de prompt ou ataques de dados mal-intencionados.
- Propagação de identidade: Mapeie com segurança a identidade do agente externo e sua autoridade delegada para contextos de segurança internos (por exemplo, perfis de usuário do Salesforce) antes de executar ações em sistemas internos.
Exemplo
Inquérito de sistema externo
- Pedido: Um agente de recrutamento em um sistema de parceiro envia uma solicitação de tarefa A2A a um agente de verificação de funcionários interno (agente par) no Agentforce para confirmar o status de emprego de um novo candidato.
- Processamento: O Agente de verificação do funcionário recebe a solicitação por meio do gateway, verifica as credenciais do agente parceiro, executa seu fluxo de trabalho interno (por exemplo, ligando para um sistema de RH interno) e formata a resposta.
- Resposta: O Agente par retorna um artefato A2A estruturado (por exemplo, data de início do emprego e cargo) para o Agente de recrutamento remoto, que então prossegue com seu fluxo de trabalho externo.
-
Gateway para proteção de MCPs, A2As e APIs
Um gateway é necessário como o único ponto de imposição para todo o tráfego de agente para sistema e sistema para agente.
-
Conexões seguras: Um gateway garante que apenas agentes autenticados e autorizados interajam com pontos de extremidade de MCP, A2A e API restringindo o acesso.
-
SLAs aplicados: Um gateway pode impor limites de frequência, ajudando as organizações a cumprir os requisitos de desempenho e prevenindo a sobrecarga de servidores MCP e A2A.
-
Governação simplificada: Um gateway oferece visibilidade e controle centralizados sobre todas as interações do servidor, simplificando o gerenciamento e o monitoramento de atividades do agente.
-
Consistência e proteção de dados: Políticas, como validação de esquema, aplicam consistência de dados e detecção de PII podem proteger informações confidenciais.
MueleSoft Omni Gateway
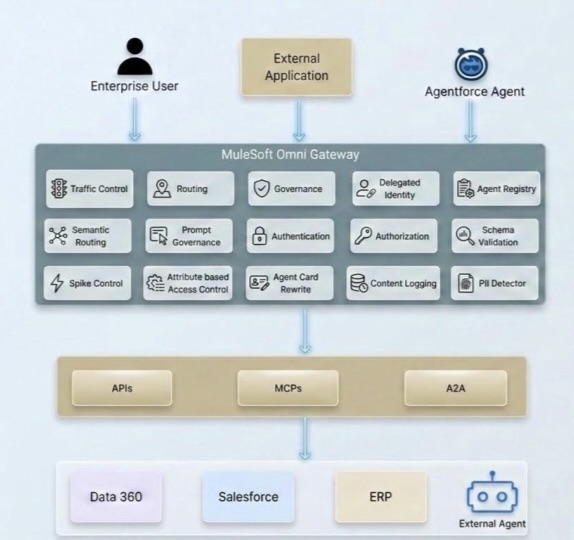
- Cadeia de propagação de identidade
Conforme as empresas adotam o paradigma de agência, um novo desafio de segurança aparece: Como a identidade do usuário final flui por uma rede de agentes de IA autônomos? Em arquiteturas de API tradicionais, um usuário autentica uma vez e o aplicativo chama serviços de back-end em nome do usuário. A cadeia de identidade é curta, bem compreendida e geralmente gerenciada dentro de um único domínio Trust.
No entanto, as arquiteturas agentes apresentam cadeias muito mais longas em que uma única solicitação é enviada para vários agentes, serviços e servidores MCP, cada um dos quais pode cruzar limites de serviço, domínios Trust e até mesmo limites organizacionais. Sem uma estratégia deliberada para propagação de identidade, as empresas enfrentam uma escolha entre segurança e funcionalidade, um dilema que nenhum arquiteto precisa resolver.
A MuleSoft lida com as complexidades da propagação de identidade com seu recurso de identidade do agente confiável. Essa solução utiliza uma estratégia gerenciada por gateway baseada em política para garantir que a identidade do usuário final seja mantida em vários tipos de interação, incluindo protocolos A2A, chamadas de ferramenta MCP e solicitações da API REST. Ao centralizar o gerenciamento de identidade na camada do Omni Gateway por meio de políticas de autenticação de saída, as empresas podem proteger toda a rede de agentes sem modificar serviços ou agentes de back-end. Para obter mais detalhes, consulte Identidade do agente confiável para a empresa agente.
- Segurança RAG no Data 360
O Data 360 oferece suporte ao controle de acesso baseado em atributo (ABAC) nos níveis de objeto, campo e linha por meio das configurações da Política de governança de dados. Essa é a maneira principal de controlar quais dados estão visíveis a quem, inclusive dentro dos índices de pesquisa RAG. Para dados estruturados, as condições de acesso do usuário são implementadas usando conjuntos de permissões e atributos do usuário. Para dados não estruturados, a filtragem de metadados (pré-filtros em índices de pesquisa) pode restringir o que é recuperado.
A comunicação com o LLM passa pela Camada de Trust do Einstein, que mascara informações confidenciais/PII antes de chegar ao modelo que protege a privacidade dos dados não apenas durante a pesquisa, mas também antes da geração.
Para proteger contra a intoxicação de RAG, garanta a aplicação de regras de validação e governança de dados rígidas antes que os dados fiquem disponíveis para pesquisa de vetor. A Camada do Einstein Trust também pode impor verificações de mascaramento/toxicidade imediatas. Você pode aplicar conjuntos de permissões rígidos ao perfil de Usuário agente.
- Novo modelo de credencial nomeada A Salesforce remodelou sua arquitetura de autenticação introduzindo um modelo de credenciais nomeadas de dois níveis que separa claramente as preocupações entre conectividade e identidade. Use isso sempre que fizer chamadas por meio do Apex e evite criar seu próprio protocolo de autenticação. Esse modelo também oferece extensibilidade e segurança aprimorada. As credenciais externas estão na base desse modelo. Eles armazenam os detalhes de autenticação reais e dão suporte a um conjunto avançado de protocolos, incluindo Credenciais do cliente do OAuth 2.0, Portador JWT e AWS Signature V4, ao mesmo tempo que também definem como as entidades de segurança são mapeadas: como uma única Entidade de segurança nomeada (compartilhada entre todos os usuários) ou Entidade de segurança Por usuário (em que cada usuário autentica com sua própria identidade). Credenciais nomeadas, por sua vez, atuam como a camada do ponto de extremidade. Eles definem o URL de chamada e fazem referência a uma Credencial externa para lidar com o apelido de autenticação, mantendo a configuração do ponto de extremidade desconectada do gerenciamento de credenciais. Para habilitar fluxos de autenticação por usuário, os administradores mapeiam Conjuntos de permissões para a entidade de segurança Credencial externa adequada para que apenas usuários com a atribuição de Conjunto de permissões certa possam chamar chamadas sob sua própria identidade. Esse design de duas camadas não apenas simplifica a configuração de chamada segura, mas também dá aos arquitetos muito mais flexibilidade e controle de governança sobre como as integrações são autenticadas entre sistemas conectados ao Salesforce. Para obter mais detalhes, consulte a documentação Credenciais nomeadas.
Esta seção mapeia os padrões de processamento de dados da arquitetura para as obrigações de conformidade mais comuns em implantações corporativas regulamentadas.
Controle de acesso: O modelo de usuário de integração de privilégio mínimo descrito em todos os padrões de integração (Credenciais nomeadas no escopo, escopos do OAuth 2.0 por agente, listas de permissões de gateway) é mapeado diretamente para controles de acesso lógicos. Mantenha a prova de que o escopo da credencial de cada agente foi revisado e aprovado.
Registro de auditoria: Requisitos de registro de auditoria por padrão (ID da sessão, invocações de ferramenta, parâmetros de entrada limpos de valores confidenciais, resultados) atendem aos controles de monitoramento e registro. Certifique-se de que os registros sejam evidentes de adulteração, retidos pelo período necessário e acessíveis à equipe de segurança sem exigir acesso aos sistemas de produção.
Gerenciamento de mudanças: Alterações de esquema de ferramenta MCP e atualizações de cartão do agente A2A que afetam os consumidores constituem alterações de interface e devem estar sujeitas a controles de gerenciamento de alterações. Ferramentas de versão explicitamente (mencionado no padrão de entrada do MCP) e trate alterações de interrupção como eventos de configuração que exigem aprovação.
Disponibilidade: Limites de simultaneidade do agente, tectos de nova tentativa em padrões acionados por evento e roteamento de letra morta para eventos com falha constituem controles de disponibilidade. Documente o envelope de taxa de transferência esperado e o comportamento de falha para cada padrão implantado como parte do pacote de evidências de disponibilidade.
Nota: Essa lista não representa um guia completo para garantir a conformidade de suas soluções agentes. Todos os requisitos regulatórios aplicáveis devem ser atendidos.
- Introdução à API do agente
- Ativar agentes confiáveis com o Data 360
- Visão geral do MuleSoft Omni Gateway
- Política de injeção de credenciais em nome do OAuth 2.0
- Trusted Agent Identity para a Agência
Gulal Kumar é um arquiteto de engenharia de software na Salesforce com mais de 20 anos de experiência. Sua experiência abrange IA, integração, APIs e arquitetura corporativa, com foco em promover a transformação de negócios por meio de soluções de IA seguras, resilientes e inovadoras. Conecte-se com ele no LinkedIn.