Inleiding
Opmerking: “Onderwerpen” zijn in dit artikel hernoemd naar “subagenten”, volgens onze nieuwste productnaamgevingsconventies.
Mogelijk stelt u een agent samen die goed presteert in een testomgeving, maar die vervolgens geheel andere routes volgt wanneer dezelfde werkstroom twee keer wordt verwerkt. Deze fundamentele beperking laat zien hoe het vorige Agentforce model omging met uitvoering: elke beslissing, van intentinterpretatie tot actieselectie, werd in real-time genomen door de LLM, zonder gegarandeerd pad door de werkstroom.
LLM’s kunnen inconsistente uitkomsten produceren als reactie op identieke invoer. Subtiele variaties in context, systeemaanwijzingen of het genereren van tokens zijn voldoende om een agent een andere route te laten volgen. Voor veel interacties is deze variabiliteit acceptabel. Voor werkstromen met meerdere fasen die controle, reproduceerbaarheid en traceerbaarheid vereisen, is dat echter niet het geval. Een goedkeuring van een lening, een voorraadoverdracht of een triageproces voor patiënten kan niet afhankelijk zijn van een agent die de stappen elke keer anders doorloopt.
De nieuwe Agentforce Builder en Agent Script lossen dit probleem op door deterministische uitvoering te scheiden van LLM-redenering. Het hybride model van Agentforce zorgt ervoor dat de agent een nauwkeurig gedefinieerde structuur volgt voor elke werkstroomuitvoering, terwijl toch LLM-redenering wordt gebruikt waar beoordeling, inzicht in natuurlijke taal of contextuele interpretatie echt nodig is.
In de vorige versie van Agentforce werkte een agent als een eenvoudige reactieve lus. Elke beslissing, van het interpreteren van de intentie tot het selecteren van de volgende actie, werd in real-time genomen door de LLM op basis van uitsluitend de meest recente invoer van de gebruiker. Er was geen gegarandeerd uitvoeringstraject, geen aanhoudende status en geen mechanisme om een reeks stappen af te dwingen.
Uitvoeringstrajecten kunnen niet worden gegarandeerd
Omdat elke beslissing afhankelijk was van de real-time redenering van de LLM, leidden kleine variaties in invoer, systeemaanwijzing of modelversie tot verschillende actieselecties voor identieke verzoeken. Dit maakte het vorige model moeilijk om rigoureus te testen: een werkstroom die in fasering werd doorlopen, kon anders werken in de productie en er bestond geen betrouwbare manier om een specifiek uitvoeringstraject te reproduceren voor foutopsporings- of controledoeleinden.
Elke interactie betaalde de volledige LLM-kosten
Zelfs eenvoudige gespreksscenario’s vereisten minimaal drie LLM-cycli: selectie van subagenten, selectie van acties en genereren van definitieve reacties. Taken met meerdere stappen uitgebreid naar vijf of meer cycli. Voor architecten die werkstromen met groot volume of latentiegevoelige werkstromen ontwerpen, was dit niet alleen een prestatieprobleem. Het betekende dat je de redeneringslus niet kon kortsluiten voor stappen die geen oordeel vereisten, omdat de architectuur geen mechanisme had om onderscheid te maken tussen de twee.
Niet-deterministische uitvoering heeft een controlehiaat veroorzaakt
In gereguleerde sectoren betekent auditeerbaarheid dat kan worden aangetoond dat een specifiek proces op een specifieke manier is gevolgd voor een specifieke transactie. Een puur niet-deterministisch model kan die garantie niet bieden. Als het uitvoeringstraject varieert tussen uitvoeringen, varieert ook het controletraject en is “de agent heeft besloten” geen verdedigbaar antwoord in een nalevingsbeoordeling.
Staat heeft het gesprek niet overleefd
Vertrouwen op verwerking met één beurt betekende dat de agent geen aanhoudend geheugen had van eerdere stappen. Als het gesprek ook maar enigszins afwijkt, kan de agent eerder vastgelegde context laten vallen en de gebruiker dwingen opnieuw te starten. Voor transactionele werkstromen met meerdere stappen is hierdoor een betrouwbaarheidsplafond ontstaan: hoe meer stappen in het proces, hoe groter de kans op contextverlies vóór voltooiing.
Voltooide stappen werden niet onthouden
Zonder statusbeheer konden agenten niet vastleggen welke verplichte stappen een gebruiker al had voltooid. Dit leidde tot onvoorspelbare lussen, waarbij een agent terugging naar een stap die de gebruiker al had voltooid. Naast de impact op de gebruikerservaring, creëerde dit een dieper architectonisch probleem: het ontwerpen van een betrouwbare sequentiële werkstroom was onmogelijk omdat de agent de volgorde niet kon afdwingen.
De nieuwe Agentforce, GA sinds februari 2026, verschuift van puur probabilistische LLM-redenering naar een hybride model. In plaats van elke beslissing via de LLM te routeren, scheidt het deterministische uitvoering van LLM-redenering en laat elke beslissing alleen afhandelen waarvoor deze geschikt is. Om dit te ondersteunen introduceerde Agentforce twee schrijftools: Agent Script voor op code gebaseerde ontwikkeling en Agentforce Studio, een omgeving zonder code.
Agentforce Builder
Agentforce Builder is de aanbevolen omgeving voor het ontwikkelen van nieuwe agenten. Het wordt gehost binnen Agentforce Studio en vervangt de verouderde Set-upomgeving, die wel beschikbaar blijft, maar niet langer het primaire schrijfpad is. In de Samensteller werkt u in een visuele doekweergave of rechtstreeks in een scriptweergave, waarbij u het script Agent bewerkt dat het gedrag van uw agent definieert.
Script Agent
Agentscript is een declaratieve, domeinspecifieke taal (DSL) die alles definieert over de manier waarop een agent zich gedraagt: de configuratie, bedrijfslogica en aanwijzingen. Het is gestructureerd als sleutel-waardeparen die meerdere regels kunnen bestrijken of geneste subeigenschappen kunnen bevatten, en het is ontworpen om door mensen te worden gelezen zonder Knowledge van de onderliggende grafische architectuur te vereisen.
Met Agentscript kunt u twee fundamenteel verschillende typen instructies in dezelfde agent uitdrukken: deterministische logica-instructies en promptinstructies. Deterministische logica-instructies definiëren voorwaarden en actiereeksen die worden uitgevoerd als code zonder betrokkenheid van LLM. Aanwijzingsinstructies definiëren natuurlijke taalbegeleiding die de LLM interpreteert tijdens run-time. De grens tussen beide is expliciet en weloverwogen, en begrijpen waar die grens moet komen is een van de belangrijkste ontwerpbeslissingen die u neemt bij het bouwen met de nieuwe Agentforce.
Deterministische logica in de praktijk
Wanneer instructies deterministisch zijn, volgt de agent een gedefinieerd uitvoeringspad, ongeacht de manier waarop de gebruiker zijn invoer verwoordt. Het onderstaande voorbeeld toont een subagent die een Klantenintelligence dashboard laadt. Het controleert op een klant-ID, haalt profielgegevens, orderhistorie en ondersteuningstickets op en berekent vervolgens de levensduur van de klant en het verlooprisico. Geen van deze stappen vereist LLM-redenering.
Deze logica roept acties in een vaste volgorde aan telkens wanneer aan bepaalde voorwaarden wordt voldaan.
Instructies en opzettelijke LLM-handoff
Waar deterministische logica voorwaarden en reeksen afhandelt die kunnen worden uitgedrukt als code, handelen promptinstructies alles af dat beoordeling, interpretatie of genereren van natuurlijke taal vereist. Wanneer de Atlas Reasoning Engine een knooppunt met aanwijzingen tegenkomt, activeert het een LLM-aanroep. Als dat niet zo is, wordt het deterministisch uitgevoerd.
Het onderstaande voorbeeld toont een subagent voor producten en services. De instructies zijn een aanwijzing van meerdere regels die de LLM vertelt hoe te reageren, wanneer informatie moet worden opgezocht en hoe onduidelijkheid moet worden afgehandeld. Dit is het juiste patroon wanneer het bereik van mogelijke gebruikersinvoer te breed is om te anticiperen met voorwaardelijke logica of wanneer de kwaliteit van de respons afhankelijk is van het vermogen van de LLM om context te interpreteren en een natuurlijk antwoord te genereren.
De aanwijzingsinstructies voor een knooppunt activeren de LLM-aanroep. Dat is niet incidenteel—het is het mechanisme waarmee Agent Script de LLM-grens expliciet en afdwingbaar maakt, in plaats van deze over te laten aan run-time gevolgtrekkingen.
Deze subagent toont deterministische logica en LLM-handoff in actie.
De uitvoeringspijplijn in drie fasen
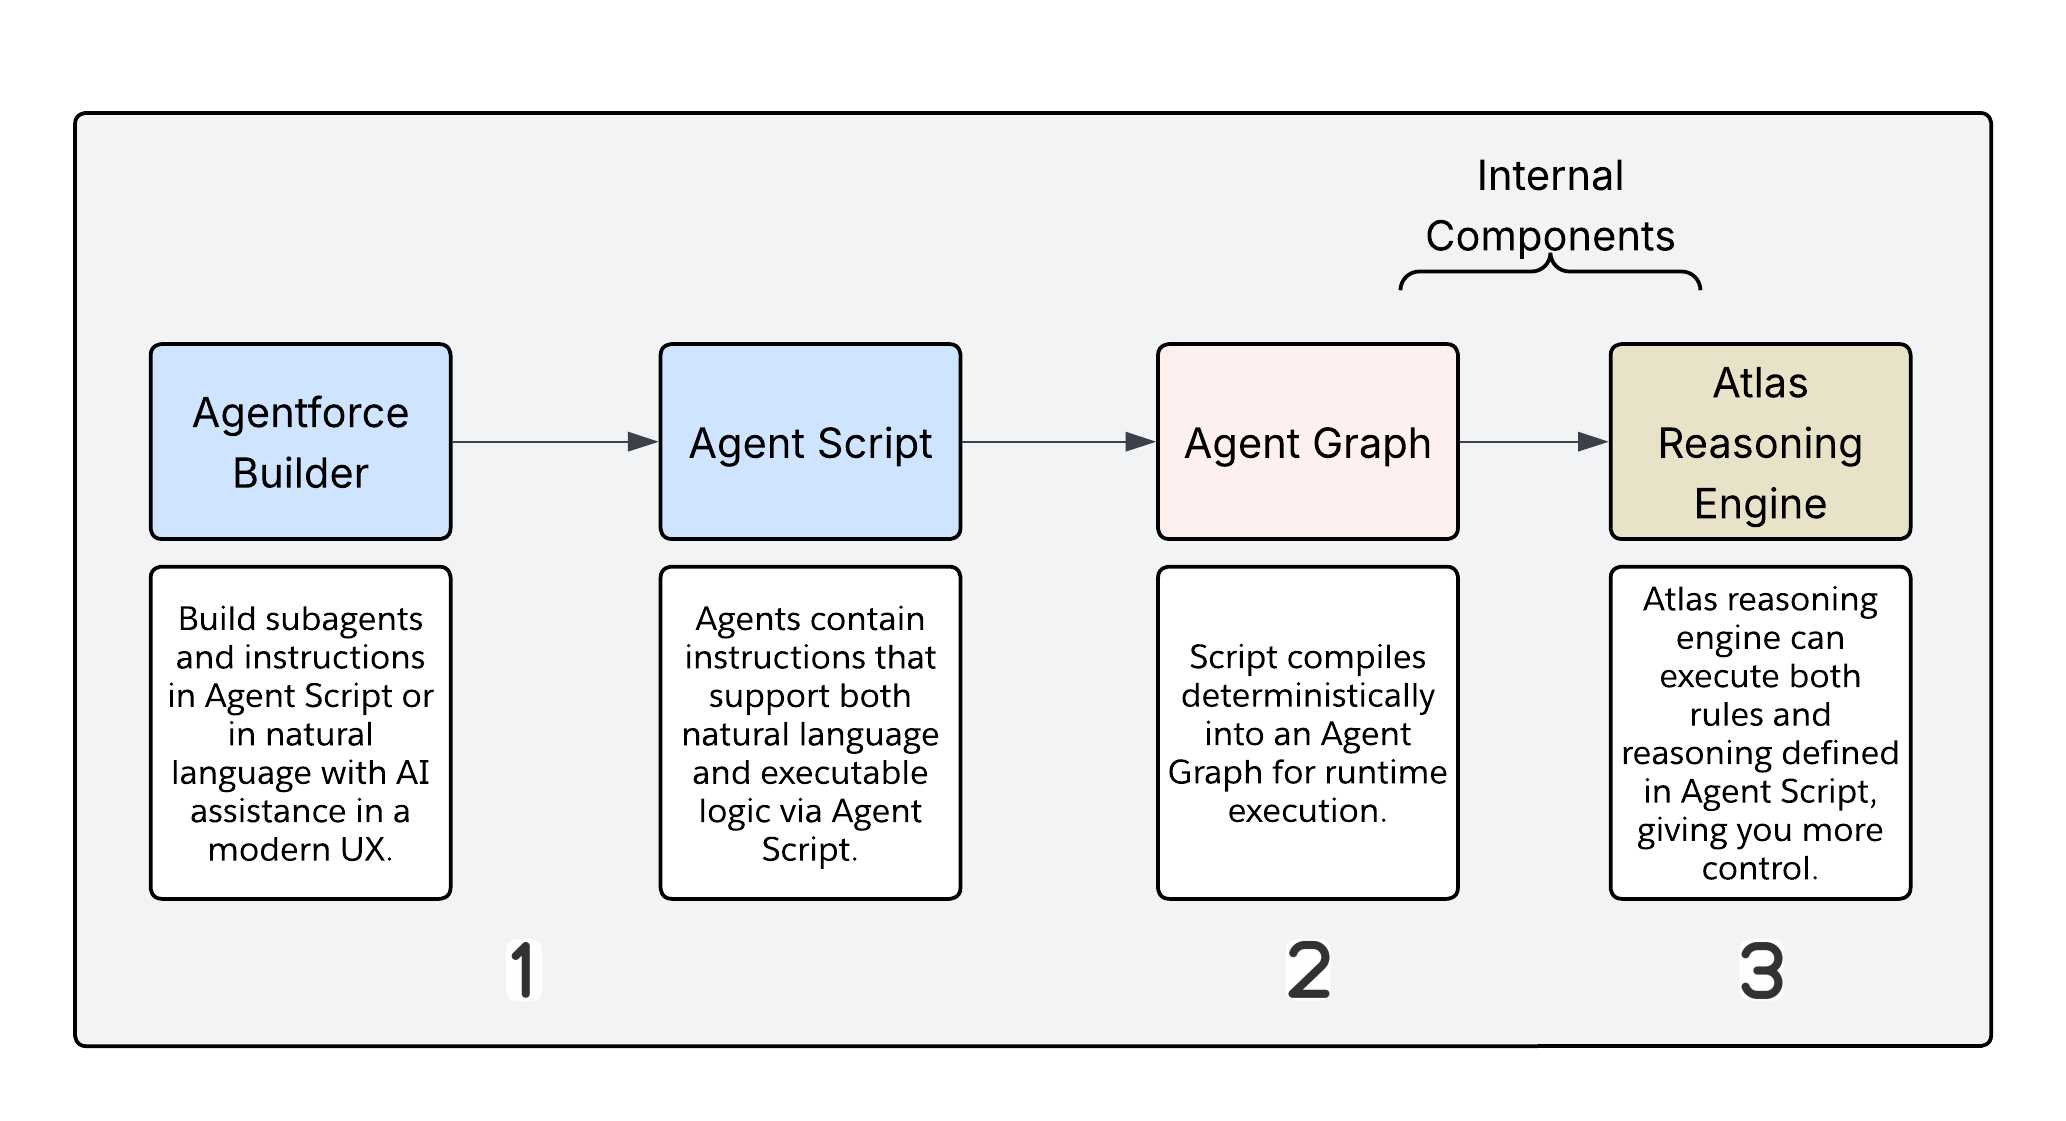
Agentforce Builder en Agent Script zijn de schrijflaag, maar Agent Graph en de Atlas Reasoning Engine voeren uw agent feitelijk uit. Door het ontwerp is geen van deze componenten rechtstreeks toegankelijk voor u. Door schrijven en uitvoering te scheiden kan het platform deterministisch gedrag afdwingen, onafhankelijk van de manier waarop het script is geschreven.
De pijplijn doorloopt drie fasen.
- Autoriseren is waar je werkt. Agentscript is voor mensen leesbaar en bewerkbaar in de doekweergave of de scriptweergave in Agentforce Builder. Dit is de enige laag waarmee u rechtstreeks communiceert.
- Bij compilatie transformeert de Salesforce-compiler uw Agent-script in een Agent-grafiek, een uitvoeringsplan met serienummer dat is geoptimaliseerd voor machine-uitvoering in plaats van menselijke leesbaarheid. U hoeft niet te foutopsporing op deze laag. Compilatie produceert een weergave die de run-time efficiënt kan doorlopen.
- Uitvoering in runtime is waar de Atlas Reasoning Engine het overneemt. Het leest de Agent-grafiek, doorloopt deze op basis van de huidige sessiestatus en besluit bij elk knooppunt of het deterministisch moet worden uitgevoerd of de LLM moet worden aangeroepen. De engine dwingt hier expliciet vrijwaringsclausules en voorwaardelijke routering af, in plaats van te concluderen.
Agentgrafiek
Agentgrafiek is de tussenliggende weergave tussen uw voor mensen leesbare script en de feitelijke uitvoering in run-time. De structuur is geoptimaliseerd voor de staatsmachine die het script verbruikt, niet voor de architect die het script heeft geschreven. Begrijpen dat het bestaat en wat het vertegenwoordigt, is belangrijk omdat het het artefact is dat de Redeneringsengine gebruikt om het uitvoeringsplan af te dwingen dat uw script definieert.
Atlasredeneringsengine
De Atlas Reasoning Engine is een uitvoerder van staatsmachines. Bij elke beurt doorloopt deze de Agentgrafiek op basis van sessiestatus, voert deze deterministische knooppunten uit als code en activeert deze alleen LLM-aanroepen wanneer er promptinstructies aanwezig zijn. Het dwingt ook vrijwaringsclausules af en handelt voorwaardelijke routering af. De Redeneringsengine is de plaats waar het hybride redeneermodel daadwerkelijk wordt geïmplementeerd; het script definieert de grens en de engine respecteert deze.
Agent Graph is geen LLM-verpakking. Het is een hybride redeneringsengine die deterministische uitvoering scheidt van probabilistisch redeneren. De regel is eenvoudig: als je een beslissing kunt uitdrukken als code, moet deze worden geschreven als logica. Als de beslissing oordeel, interpretatie of genereren van natuurlijke taal vereist, moet de LLM deze afhandelen. Deze ontwerpbeslissing is de belangrijkste architectonische keuze in het nieuwe Agentforce model. Waar de LLM-grens valt, heeft rechtstreeks invloed op de kosten, latentie, controleerbaarheid en betrouwbaarheid van uw oplossing.
De Atlas Reasoning Engine evalueert elke inkomende gebruikersbeurt en routeert deze langs een van de twee paden.
Pad A: deterministische uitvoering
Dit pad heeft geen LLM-blootstelling. Het gedraagt zich als gecompileerde code tijdens run-time. De Redeneringsengine classificeert de intent van de gebruiker en bepaalt dat een logica-instructie overeenkomt, waarbij de LLM volledig wordt omzeild. Het gecompileerde Agent-script wordt van boven naar beneden uitgevoerd, waarbij if-else-regels bij elke beurt onvoorwaardelijk worden uitgevoerd. Stroom-, Apex of API-acties worden aangeroepen met deterministische parameters, zonder dat er een prompte assembly of modelaanroep aan te pas komt. Het resultaat gaat terug door de Trust laag met volledige audit logging.
Pad B: LLM-redenering
De Redeneringsengine neemt dit traject wanneer deze intent niet alleen kan oplossen met behulp van logica-instructies. Deze doorloopt de Agent-grafiek en evalueert elk knooppunt. Knooppunten met aanwijzingen activeren een LLM-aanroep. Knooppunten zonder deze worden deterministisch uitgevoerd. De aanwezigheid van een aanwijzingsinstructie is de trigger en is expliciet in het script in plaats van afgeleid tijdens run-time.
Wat activeert een LLM-aanroep
Er zijn acht punten in de uitvoeringslevenscyclus waarop de LLM wordt aangeroepen. Subagentclassificatie, of beslissen welke subagent overeenkomt met het verzoek van de gebruiker, is er een, hoewel een kortsluitingspad de volledige LLM-aanroep kan omzeilen wanneer classificatie ondubbelzinnig is. Agentredenering, waarbij de agent bepaalt welke actie als volgende moet worden ondernomen, verloopt altijd via de LLM. Dat geldt ook voor het genereren van respons, waarbij het definitieve antwoord wordt samengesteld vanuit een gehydrateerde aanwijzing.
De resterende triggers zijn operationeler: validatie van geaardheid bevestigt dat de uitvoer is gegrond in opgehaalde gegevens; actiesimulatie emuleert responsen in de omgeving Voorbeeld en Simuleer in plaats van live uit te voeren; gestructureerd genereren van uitvoer verwerkt cases waarbij de respons moet voldoen aan een gedefinieerd schema; en opmaak van lokalisatie- en voortgangsindicatoren voor genereren en tijdelijk berichtenverkeer waar geen vooraf geschreven standaardinstelling bestaat.
Wat blijft deterministisch
Grafiekdoorsnede en toestandsovergangen omvatten nooit de LLM. De levenscyclusblokken before_reasoning en after_reasoning worden deterministisch uitgevoerd zolang ze alleen actieknooppunten zonder aanwijzingsinstructies bevatten. Wiskunde, het ophalen van gegevens, validatie en voorwaardelijke logica behoren allemaal tot code. Elke actie die Flow, Apex of een REST-API uitvoert, blijft rechtstreeks op het deterministische pad. Elk knooppunt zonder aanwijzingsinstructies wordt uitgevoerd zonder een LLM-aanroep.
Het is belangrijk om expliciet te zijn over deze grens met uw team. Elke onnodige LLM-aanroep voegt latentie, kosten en variabiliteit toe. Architecten moeten standaard deterministische logica pushen en de LLM reserveren voor gevallen waarin de taak daadwerkelijk zijn redeneervermogen vereist.
Ontwerpbegeleiding: push logica standaard naar code
Gebruik scriptlogica-instructies voor agenten bij het schrijven van aanwijzingsinstructies die kunnen worden uitgedrukt als een voorwaarde, een variabelentoewijzing of een actiefilter. Elke onnodige LLM-aanroep voegt latentie, kosten en variabiliteit toe.
De standaardpositie moet deterministisch zijn. Isoleer elk agentgedrag dat als regel kan worden gecodificeerd en verplaats het naar Agentscript. De resterende taken die natuurlijke-taalsynthese, contextueel oordeel of complexe interpretatie vereisen, behoren tot aanwijzingsknooppunten. Dat is geen beperking; het is de grens die werkt zoals bedoeld. De LLM handelt af waar deze het meest geschikt voor is, terwijl de rest als code wordt uitgevoerd.
De primaire uitvoeringseenheid in Agentscript is niet de beurt aan de gebruiker. Het is de parse: één volledige cyclus door de drie levenscyclusblokken van een subagent. De Atlas Reasoning Engine initieert een parseerbewerking telkens wanneer een subagent iets moet verwerken. Dit gebeurt in drie situaties: bij de eerste invoer in de subagent, na elke toolaanroep wanneer een actie is voltooid en een resultaat retourneert, en bij elke nieuwe gebruiker die binnen dezelfde subagent komt.
Inzicht in de parseergrens is belangrijk, omdat dit bepaalt hoe vaak elk blok wordt uitgevoerd, en dus ook waar u er wel en niet op kunt vertrouwen dat een bepaald stuk logica precies één keer wordt uitgevoerd.
Elke subagent definieert drie uitvoeringszones:
| Blokkeren | Wanneer het wordt uitgevoerd | LLM-betrokkenheid |
|---|---|---|
before_reasoning | Aan het begin van elke parse, voordat de LLM iets ziet | Geen |
reasoning | Tijdens deterministische oplossing, voorafgaand aan LLM-aanroepen | Gemengd |
after_reasoning | Nadat de redenering is voltooid en de LLM heeft gereageerd | Geen (met een kritisch voorbehoud) |
Zowel before_reasoning als after_reasoning zijn volledig deterministisch. Ze voeren acties uit, stellen variabelen in en passen voorwaardelijke logica toe zonder de LLM erbij te betrekken. Dit maakt ze de betrouwbare, goedkope blokken in het script.
Wanneer gebruikt u before_reasoning
before_reasoning wordt zonder uitzondering aan het begin van elke parse uitgevoerd. Het wordt uitgevoerd bij de eerste invoer in de subagent en opnieuw na elke toolaanroep of nieuwe gebruikersbeurt binnen die subagent. Een run @actions.X in before_reasoning is code. In tegenstelling tot een instructie binnen een aanwijzingsblok, die de LLM al dan niet volgt, wordt before_reasoning onvoorwaardelijk uitgevoerd.
Gebruik dit blok voor sessieinitialisatie: contextrecords ophalen, sessievariabelen instellen vanuit Apex of Flow. Dit is ook de plaats waar authenticatie- en rechtencontroles thuishoren, omdat u deze wilt laten verifiëren voordat de LLM tools ziet. Contexthydratatie past hier ook: het aanroepen van een actie voor het ophalen van gegevens zodat de LLM vooraf ingevulde variabelen ontvangt in plaats van ze te hoeven opvragen. Elke teller- of auditvariabele die voor elke parse moet worden verhoogd, moet hier worden ingesteld, omdat de before_reasoning set wordt gegarandeerd op een manier die een pijpinstructie niet is.
Wat hier niet thuishoort, is logica die slechts één maal per sessie mag worden uitgevoerd, aangezien before_reasoning bij elke parse wordt uitgevoerd, niet alleen bij het eerste item. Alles wat afhankelijk is van gebruikersinvoer van de huidige beurt, hoort hier ook niet thuis, omdat die invoer nog niet is verwerkt. En overgangen mogen nooit in before_reasoning zijn: een transition to hier zal onvoorwaardelijk op elke parseer vuren en lussen maken.
Als u initialisatie één maal per sessie nodig hebt, bewaakt u deze expliciet:
Eén gebruikersbeurt kan meerdere parseringen activeren: één maal bij binnenkomst en vervolgens na elke toolaanroep. Die functionaliteit heeft drie praktische gevolgen: initialisatieacties in before_reasoning worden meer dan één maal per beurt van een gebruiker uitgevoerd in stromen met meerdere acties, tellervariabelen die hier worden opgeteld, weerspiegelen de parsetelling, niet de beurttelling, en acties met neveneffecten, externe API-aanroepen of recordschrijven, zouden niet live in before_reasoning moeten zijn, tenzij het opnieuw uitvoeren van elke parse expliciet acceptabel is.
before_reasoning is geen constructeur. Het is een pre-flight controle die bij elke parse wordt uitgevoerd. Ontwerp het overeenkomstig.
Wanneer gebruikt u after_reasoning
after_reasoning wordt uitgevoerd zodra de redeneringslus is voltooid, nadat de LLM heeft gereageerd en actie-uitvoer is vastgelegd. Dit is waar deterministische controles na de actie thuishoren: het evalueren van actie-uitvoer en vertakking op basis van resultaten. Deterministische overgangen, of overgaan naar de volgende subagent op basis van variabele status in plaats van LLM-oordeel, zitten hier. Dat geldt ook voor het opschonen van variabelen vóór de volgende beurt en doeltreffende volgordebepaling wanneer u subagenten in een voorspelbare volgorde moet ketenen zonder een LLM-routeringsbeslissing.
Behandel after_reasoning als de vangraillaag. Hier dwingt u bedrijfsregels en statusbeheer af nadat de LLM zijn werk heeft gedaan, zodat kritieke processtromen voorspelbaar blijven, ongeacht wat de LLM heeft gegenereerd.
Gebruik is_displayable: True verstandig
Elke architect die doeltreffende stromen ontwerpt, moet deze platformwerking begrijpen. Wanneer is_displayable: True is ingesteld voor een actie, verlaat het platform de redeneringslus zodra de LLM besluit die uitvoer zichtbaar te maken. Die exit gebeurt onmiddellijk, wat betekent dat after_reasoning nooit wordt uitgevoerd.
Dit is een bekende platformwerking, maar het heeft een direct gevolg voor doeltreffende combinaties: elke logica die u in after_reasoning hebt geplaatst, wordt overgeslagen wanneer een weer te geven actie deel uitmaakt van de stroom.
Het antwoord is eenvoudig. Verplaats logica die betrouwbaar moet worden uitgevoerd, naar het before_reasoning van de daaropvolgende subagent in plaats van het after_reasoning van de huidige.
Ontwerpbegeleiding: waar initialisatielogica te plaatsen
Bepalen waar logica moet worden geplaatst, is van belang bij het ontwerpen van een subagent. Dit framework bestrijkt de meest voorkomende scenario’s:
| Scenario | Waar te zetten |
|---|---|
| Moet worden uitgevoerd voordat de LLM context ziet | before_reasoning |
| Voert elke parse uit, inclusief opnieuw invoeren bij beurten van nieuwe gebruikers | before_reasoning |
| Hangt af van actie-uitvoer van deze beurt | Blok voor voorwaardelijke if in reasoning |
| Vereist deterministische overgang van subagent op basis van uitkomst | after_reasoning (maar zie is_displayable hieronder) |
Vereist doeltreffende combinatielogica wanneer stroomafwaartse actie is_displayable: True gebruikt | before_reasoning van de volgende subagent |
| Gebruikt logica die oordeel of gebruikerscontext vereist | reasoning met aanwijzingen |
Het onderliggende principe is eenvoudig. Wanneer u een aanwijzingsinstructie schrijft die de LLM vertelt om een actie altijd uit te voeren, is dat een suggestie. De LLM kan deze al dan niet volgen, afhankelijk van de context. Wanneer u een run in before_reasoning plaatst, is dat code. Het wordt zonder uitzondering uitgevoerd op elke parse.
Beschikbaarheid van voorwaardelijke acties is het mechanisme waarmee Agentscript acties zichtbaar maakt of verbergt voor de LLM op basis van de status van de run-time variabele. Wanneer de available when tot false wordt geëvalueerd, wordt de actie volledig verwijderd uit de toollijst die aan de LLM wordt gepresenteerd. Elke waarde false (onwaar), inclusief None, False, 0 of een lege tekenreeks, onderdrukt de actie.
Dit is geen aanwijzing aan de LLM om dit nog niet te bellen, het is een harde poort op platformniveau. De LLM kan geen actie aanroepen waartoe deze geen toegang heeft.
In dit voorbeeld is execute_transfer onzichtbaar voor de LLM totdat validation_passed evalueert naar true. De poort wordt afgedwongen door het platform, niet door instructies.
Ontwerpbegeleiding: laat de LLM nooit de poortvariabele instellen
Geef elke variabele in een available when een deterministisch codepad dat de variabele instelt voordat de gekoppelde actie wordt uitgevoerd. Gebruik before_reasoning of een deterministisch run en set reasoning om de variabele een bekende status te geven. Als u vertrouwt op de LLM om de poortvariabele in te stellen, hebt u de variabiliteit opnieuw geïntroduceerd die de poort moest voorkomen. Afhankelijk van het gesprek kan de LLM dit al dan niet instellen, wat betekent dat de poort al dan niet open kan gaan.
Het actielusprobleem
Een actielus treedt op wanneer de LLM dezelfde actie herhaaldelijk aanroept zonder ooit een eindstatus te bereiken. Dit gebeurt wanneer twee voorwaarden tegelijkertijd true (waar) zijn: aan de available when blijft voldaan nadat de actie is uitgevoerd en de redeneringsinstructies geven de LLM niet expliciet de opdracht om te stoppen met het aanroepen ervan.
Het platform onderdrukt een actie niet automatisch nadat deze is aangeroepen. Als de poort open blijft en de redeneringsinstructies onduidelijk zijn, roept de LLM voor onbepaalde tijd dezelfde actie voor elke parsering aan.
Neem available when @variables.interest != "" als voorbeeld. Als de actie wordt uitgevoerd maar de interestvariabele niet leeg is, blijft de poort open bij de volgende parsering. De LLM ziet de actie als beschikbaar, heeft geen instructie om te stoppen en roept de actie opnieuw aan.
Er zijn twee betrouwbare manieren om de lus te doorbreken. De eerste is om de poortvariabele in te stellen op een gesloten status als onderdeel van de post-uitvoeringslogica van de actie, zodat available when bij de volgende parsering naar false wordt geëvalueerd. De tweede is om een aparte booleaanse has_run te gebruiken die de poort sluit na de eerste uitvoering. Beide benaderingen geven de poort een deterministische gesloten status, wat de voorwaarde is die het platform nodig heeft om de actie te onderdrukken.
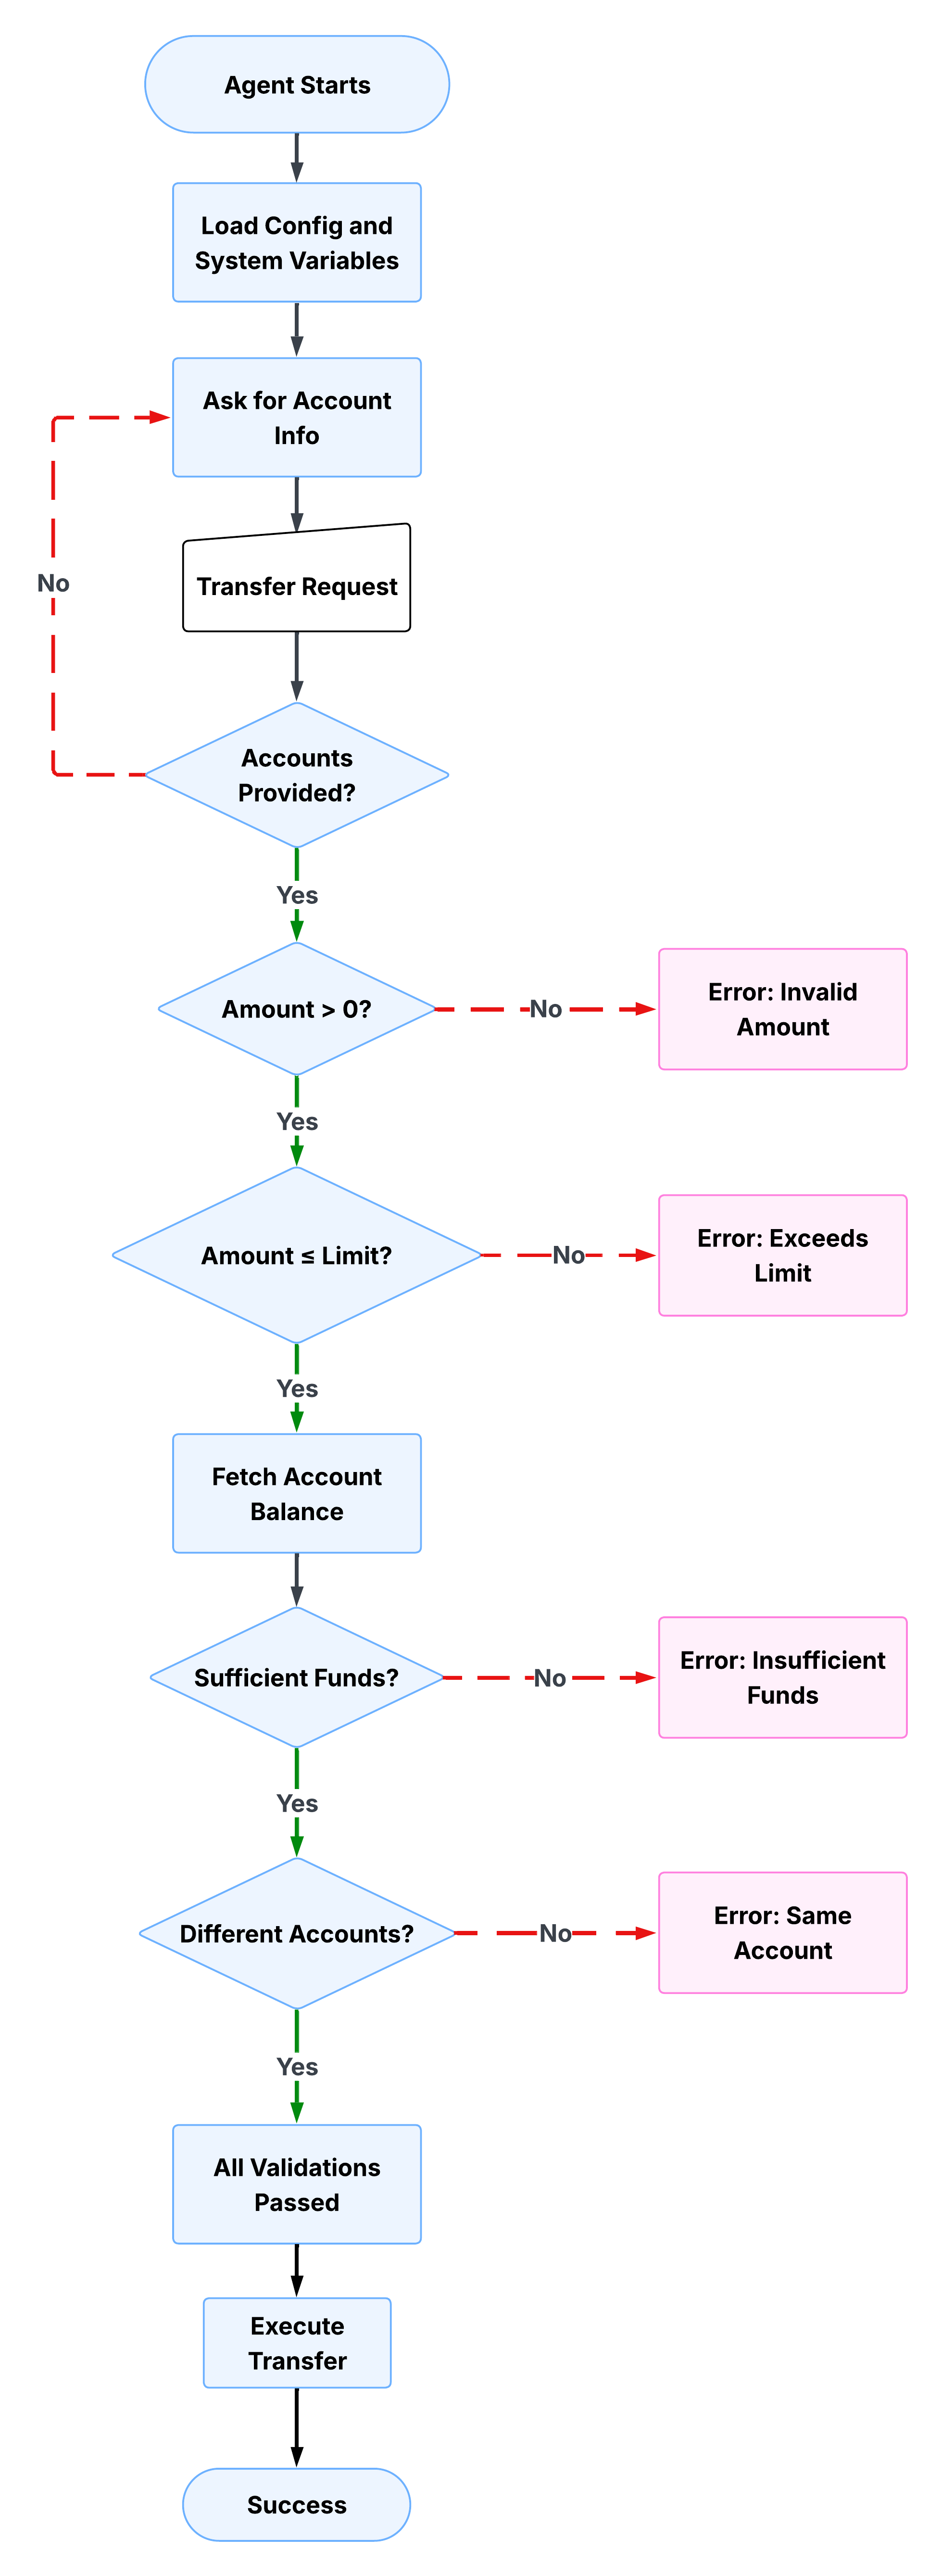
Een bankoverschrijving is een handige lens om te begrijpen hoe deze patronen in de praktijk samenwerken. De werkstroom ziet er van buiten eenvoudig uit: geld verplaatsen van de ene rekening naar de andere. De implementatie vereist meerdere complexe stappen. Voordat de overdracht wordt uitgevoerd, moet de agent accountdetails verzamelen, het bedrag valideren, overdrachtslimieten controleren, het beschikbare saldo bevestigen en de overdrachtsactie pas zichtbaar maken. Elke stap is afhankelijk van de vorige stappen. Geen van hen mag aan het LLM-oordeel worden overgelaten.
Invoer verzamelen en valideren
De eerste subagent verzamelt de bronaccount, de bestemmingsaccount en het overdrachtsbedrag van de gebruiker. Het zal pas doorgaan als alle drie aanwezig en geldig zijn. Het Agent-script controleert elk veld in de juiste volgorde: als de bronaccount ontbreekt, wordt ernaar gevraagd. Als de bestemming ontbreekt, wordt ernaar gevraagd. Als het bedrag nul of negatief is, vraagt het. De variabele validation_passed wordt pas ingesteld op true nadat alle controles zijn gewist.
Het onderstaande script laat dit in de praktijk zien. U ziet dat validation_passed expliciet is ingesteld op false op elk foutpunt en dat de LLM wordt geïnstrueerd om niet door te gaan. De deterministische controles worden onvoorwaardelijk uitgevoerd, terwijl de aanwijzingsinstructies de voor de gebruiker bestemde reactie afhandelen.
Bedrijfsregels afdwingen
Nadat de agent invoer heeft gevalideerd, controleert deze of het overdrachtsbedrag de geconfigureerde overdrachtslimiet overschrijdt. Hier worden bedrijfsregels code in plaats van instructies. De limiet is niet iets waar de LLM over redeneert; het is een harde drempelwaarde die in het script is gedefinieerd en deterministisch wordt gecontroleerd bij elke parse.
Als het bedrag de limiet overschrijdt, wordt validation_passed weer ingesteld op false en biedt de LLM de gebruiker drie opties: het maximaal toegestane bedrag overdragen, splitsen in meerdere overdrachten of contact opnemen met de ondersteuning voor hogere limieten. De agent kan pas doorgaan als de gebruiker de uitzondering heeft opgelost. Zie hoe de aanwijzingsinstructie hier precies doet waarvoor LLM-redenering geschikt is: opties in gesprek presenteren en de reactie van de gebruiker afhandelen. De bedrijfsregel zelf is deterministisch, maar het gesprek eromheen niet.
Het onderstaande script toont hoe de limietcontrole werkt. De deterministische voorwaarde evalueert het overdrachtsbedrag op basis van de limietvariabele, stelt validation_passed in op false als de drempelwaarde wordt overschreden en delegeert een aanwijzingsinstructie om de gebruikersgerichte reactie af te handelen.
Vrijwaringsclausules toepassen
Nadat de controles van bedrag en limiet zijn voltooid, haalt de agent het saldo van de bronaccount op en controleert of er voldoende fondsen beschikbaar zijn. Bewakingsclausules voorkomen dat de agent bewerkingen probeert uit te voeren wanneer niet aan randvoorwaarden wordt voldaan. In tegenstelling tot een aanwijzingsinstructie die de LLM vertelt het saldo te controleren, maakt een vrijwaringsclausule in Agentscript de controle onvoorwaardelijk. De LLM beslist niet of deze wordt uitgevoerd.
Als het saldo onvoldoende is, berekent de agent het tekort en stelt de gebruiker een concreet alternatief voor. De validation_passed wordt ingesteld op false totdat deze controle is geslaagd, wat betekent dat de overdrachtsactie omheind blijft.
Het onderstaande script toont een deterministische actieaanroep die het saldo ophaalt, gevolgd door een voorwaardelijke controle die het evalueert. Het ophalen wordt alleen uitgevoerd als het saldo nog niet is opgehaald, waardoor redundante API-aanroepen bij daaropvolgende parseringen worden vermeden.
Oppervlaktefouten duidelijk
Bewakingsclausules bepalen de staat/provincie. Foutberichten communiceren het. Wanneer validation_passed false is, moet de agent de gebruiker voldoende informatie geven om het probleem op te lossen zonder opnieuw op te starten. Vage foutberichten leiden tot wrijving; gestructureerde berichten sluiten de lus sneller.
Het onderstaande script toont het foutbericht Onvoldoende fondsen in de praktijk. Het vertelt de gebruiker niet alleen dat de overdracht is mislukt. Het toont het beschikbare saldo, het aangevraagde bedrag, het berekende tekort en biedt een concrete volgende stap, allemaal samengesteld uit sessievariabelen in plaats van gegenereerd door de LLM.
De berekening van het tekort vindt plaats in het script, niet in de LLM. Het voorgestelde alternatief, het overdragen van het beschikbare saldo, wordt deterministisch afgeleid van de sessiestatus. De rol van de LLM is hier puur presentatief: het geeft een boodschap die het script al gestructureerd heeft.
De overdrachtsactie gateren
Elke validatiecontrole in de vorige stappen stelt dezelfde variabele in of wist deze: validation_passed. Die variabele doet nu zijn belangrijkste werk. De actie execute_transfer is voorwaardelijk beschikbaar, wat betekent dat deze alleen wordt weergegeven in de toollijst van de LLM wanneer validation_passed true is. Totdat elke voorafgaande controle is geslaagd en die variabele is ingesteld, bestaat de actie niet vanuit het perspectief van de LLM.
Dit is het patroon uit de eerdere poortsectie toegepast op een productiewerkstroom. De overdrachtsactie wordt niet verborgen door een aanwijzingsinstructie. Het is verborgen bij het platform. Geen enkele hoeveelheid gespreksdruk of ambigue frasering kan ertoe leiden dat de LLM deze aanroept voordat aan de randvoorwaarden wordt voldaan.
Het onderstaande script toont hoe de poort is geconfigureerd. De available when verwijst rechtstreeks naar validation_passed en de actieparameters zijn gebonden aan de sessievariabelen die in de vorige stappen zijn verzameld en gevalideerd.
Alle drie parameters, from_account, to_account en amount, worden deterministisch doorgegeven vanuit sessievariabelen. Tegen de tijd dat deze actie beschikbaar komt, is elke waarde gevalideerd. De LLM verzamelt de parameters niet vanuit gesprekscontext, maar leest ze vanuit de staat.
Status bijhouden in de gehele werkstroom
De patronen in de vorige secties werken alleen omdat de sessiestatus in de gehele werkstroom blijft bestaan. Accountnummers die in de eerste stap zijn vastgelegd, zijn beschikbaar in de vierde. Validatieresultaten die zijn ingesteld in de ene controlepoortactie in de andere. Het gesprek kan afwijken, de gebruiker kan vervolgvragen stellen en de agent weet nog steeds precies waar het in het proces is.
Het blok Variabelen hieronder toont de volledige sessiestatus voor deze werkstroom. Elke variabele heeft een gedefinieerd type, een standaardwaarde en een beschrijving. Twee variabelen handelen het meeste doeltreffende werk af: validation_passed bepaalt de beschikbaarheid van acties bij elke poort en validation_information bevat voor mensen leesbare context over waarom een controle is mislukt, die de LLM zichtbaar kan maken voor de gebruiker zonder te hoeven redeneren over de onderliggende status.
Elke variabele begint met een bekende standaardstatus. Tekenreeksen worden standaard leeg, getallen nul en de validation_passed booleaans false. Dit betekent dat de poort standaard gesloten is. De werkstroom moet actief het recht verdienen om bij elke stap door te gaan, in plaats van te beginnen met de poort open en te vertrouwen op controles om deze te sluiten.
Het voorbeeld van een bankoverschrijving illustreert waar deterministische logica de juiste tool is, maar niet altijd de beste keuze. Het begrijpen van de grens is net zo belangrijk als het begrijpen van de patronen.
Deterministische logica is de juiste keuze wanneer de werkstroom een gegarandeerde uitvoeringsvolgorde vereist, wanneer fouten aanzienlijke gevolgen hebben, wanneer het proces een reproduceerbaar controletraject moet opleveren of wanneer bedrijfsregels goed gedefinieerd genoeg zijn om te worden uitgedrukt als voorwaarden en drempelwaarden. Werkstromen voor financiën, gezondheidszorg en verzekeringen vallen over het algemeen in deze categorie.
Puur LLM redeneren zonder strikte deterministische beperkingen is logischer wanneer de waarde van de interactie ligt in flexibiliteit in plaats van precisie. Klantenondersteuning met een open einde, producten in een vroeg stadium waarin bedrijfsprocessen nog steeds in ontwikkeling zijn, en informatieve query’s met weinig inzet zijn allemaal gevallen waarin de variabiliteit van LLM-redenen een voorziening is, geen probleem.
In de praktijk hebben de meeste productieagenten beide nodig. De beslissing waar de grens ligt, is geen binaire keuze tussen deterministisch en probabilistisch; het is een ontwerpbeslissing die u neemt op knooppuntniveau voor elk onderdeel van de werkstroom van uw agent.
| Gebruik deterministische logica voor | Gebruik LLM-redenering voor |
|---|---|
| Invoervalidatie en sanering | Natuurlijk taalbegrip en intentdetectie |
| Afdwingen van bedrijfsregels | Gespreks- en empathische reacties genereren |
| Sequentiële procescombinatie | Omgaan met onduidelijke of onverwachte invoer |
| Statusbeheer en behoud van context | Verklaringen en verduidelijkingen geven |
| Bewakingsclausules die ongeldige bewerkingen voorkomen | Toon en berichtenverkeer aanpassen aan gebruikerscontext |
De grens is de ontwerpbeslissing
Het voorbeeld van een bankoverschrijving is een illustratie van een ontwerpfilosofie: dat de grens tussen deterministische uitvoering en LLM-redenering de meest relevante architectonische beslissing is die u maakt bij het samenstellen van een productieagent.
Plaats een grens die te stijf is en je krijgt een agent die stijf is, duur in onderhoud en niet in staat om de natuurlijke variatie van echte gesprekken aan te kunnen. Als u de grens de andere kant op gaat, ontstaat een agent die flexibel maar onvoorspelbaar is, goed presteert bij testen, maar zich anders gedraagt in de productie, en geen betrouwbaar controletraject kan produceren of kan worden vertrouwd met een transactie met een hoge inzet.
Het nieuwe Agentforce model biedt u de tools om die grens bewust te plaatsen. Agentscript laat u deterministische logica en aanwijzingsinstructies in hetzelfde bestand uitdrukken, met een expliciete syntaxis om de grens zichtbaar te maken. De Atlas Reasoning Engine dwingt logica en aanwijzingen af tijdens run-time. De before_reasoning en after_reasoning bieden gegarandeerde uitvoeringszones aan weerszijden van de LLM-aanroep. Beschikbaarheid van voorwaardelijke acties zorgt ervoor dat de LLM alleen kan handelen wanneer aan randvoorwaarden wordt voldaan.
Geen van deze voorzieningen staat op zichzelf. Ze werken samen om een coherente architectuur te creëren voor het samenstellen van agenten die ondernemingen kunnen Trusten met missiekritieke werkstromen. Het hybride redeneermodel erkent dat determinisme en flexibiliteit beide rollen hebben in uw architectuur; het is de taak van de architect om precies te beslissen waar elk van hen van toepassing is.
Agentforce Developer Guide (Ontwikkelaarshandleiding voor Agentforce)
Agentforce Agent-grafiek: Naar geleid determinisme met hybride redenering
Gulal Kumar is een Software Engineering Architect bij Salesforce met meer dan 20 jaar ervaring. Zijn expertise omvat AI, integratie, API’s en enterprisearchitectuur, met een focus op het stimuleren van bedrijfstransformatie door middel van veilige, veerkrachtige en innovatieve AI-oplossingen. Verbind met hem via LinkedIn.
Miriam McCabe is Senior Director en leider van het Architect Evangelisatieteam. Haar werk richt zich op het in staat stellen van de wereldwijde Salesforce-architectencommunity om leiding te geven in het agentische tijdperk door middel van diep technische inhoud, live programmering en betrokkenheid bij de community. Volg haar op LinkedIn.