Enterprise-gegevensarchitecturen leven zelden in één systeem. Salesforce beheert klantbetrokkenheid, pijplijn- en service-interacties. Analytische platforms zoals Snowflake bevatten historische transacties, financiële records, gebruiksgegevens en operationele meetgegevens. Traditioneel betekende het overbruggen van deze twee werelden het samenstellen en onderhouden van ETL-pijplijnen: geplande taken die gegevens extraheren uit de bron, deze transformeren en kopieën laden in Salesforce. Als gevolg van deze pijplijnen arriveren de gegevens vertraagd, vermenigvuldigt het governancebeleid zich binnen systemen en vereisen pijplijnen doorlopende operationele zorg.
Salesforce Data Virtualization biedt een ander model. In plaats van gegevens te verplaatsen naar Salesforce, stelt het Salesforce in staat om gegevens rechtstreeks bij de bron op te vragen, tijdens run-time, zonder replicatie. Gebruikers zien live externe gegevens via standaard Salesforce-interfaces. De gegevens verlaten nooit hun gezaghebbende thuis. In dit document wordt uitgelegd hoe het patroon werkt, wanneer het te gebruiken en hoe u aan de slag gaat, met Snowflake als een concreet voorbeeld.
Salesforce-gegevensvirtualisatie is een integratiearchitectuurpatroon waarmee Salesforce tijdens run-time gegevens rechtstreeks vanuit externe systemen kan opvragen, zonder die gegevens naar Salesforce-opslag te kopiëren of te repliceren. In plaats van gegevens te verplaatsen, verzendt het platform de query.
Hierdoor hebben Salesforce-gebruikers interactie met externe gegevens via vertrouwde Salesforce-interfaces (zoals paginalay-outs, gerelateerde lijsten, rapporten of stromen) terwijl de gegevens in het gezaghebbende bronsysteem blijven. Beheer, toegangscontrole en gegevensverblijf blijven waar ze horen.
Dit patroon is gebaseerd op één architectonisch principe: gegevens blijven bij de bron. Berekening wordt verplaatst naar de gegevens.
De meeste Salesforce-implementaties voor ondernemingen kunnen worden geïntegreerd met externe gegevensplatforms (zoals gegevensmagazijnen, operationele databases of analytische stores) via replicatiepijplijnen. Pijplijnen extraheren, transformeren en laden gegevens in Salesforce volgens een planning. Deze benadering werkt, maar replicatie leidt tot structurele nadelen:
- Gerepliceerde gegevens zijn altijd vertraagd. Pijplijnen introduceren vertraging en verouderde gegevens leiden tot slechte beslissingen.
- Met elke kopie van gegevens wordt het nalevingsbereik uitgebreid. Gevoelige gegevens (zoals persoonsgegevens, financiële records of gezondheidsgegevens) in meerdere systemen vereisen het voeren van meerdere governancebeleidsvormen.
- Pijplijnen vereisen continue operationele investeringen, bewaking, foutafhandeling, schemadriftbeheer en opwerkingslogica.
Gegevensvirtualisatie richt zich rechtstreeks op deze nadelen. Het verwijdert de pijplijn volledig voor gebruikscases met veel lezen, behoudt gegevens op de gezaghebbende locatie en geeft Salesforce-gebruikers een realtime, gereguleerde weergave van externe gegevens zonder de replicatie-overhead.
Externe objecten vormen het primaire mechanisme waarmee gegevensvirtualisatie externe gegevens binnen Salesforce zichtbaar maakt. Ze gedragen zich als standaard Salesforce-objecten: opvraagbaar via SOQL, zichtbaar in paginalay-outs en gerelateerde lijsten, en toegankelijk via standaard Salesforce-API’s. Het belangrijkste verschil is dat er geen gegevens worden opgeslagen in Salesforce. Het externe object is een schemaprojectie: een definitie van hoe de externe gegevens eruitzien, niet een kopie van de gegevens zelf.
Wanneer een gebruiker een pagina laadt of een rapport uitvoert dat verwijst naar een extern object, voert Salesforce een live query uit op het externe systeem en retourneert alleen de resultatenset voor die interactie.
Wanneer Salesforce een SOQL-query uitvoert op een extern object, vertaalt het filters ( WHERE-clausules), sorteerorders (ORDEN OP) en limieten (LIMIT) naar de equivalente SQL en stuurt het deze naar het externe systeem. Het externe systeem voert de query uit op zijn eigen rekenengine en retourneert alleen de gefilterde resultatenset. Werk vindt plaats waar de gegevens zich bevinden en alleen het antwoord wordt teruggestuurd naar Salesforce.
Gegevensvirtualisatie dwingt twee onafhankelijke beveiligingslagen tegelijkertijd af. Het externe systeem past zijn eigen toegangselementen toe op het moment van uitvoering van de query, inclusief beveiliging op rijniveau, kolommaskering en op rollen gebaseerde toegang. Salesforce past bovendien een eigen beveiligingsmodel toe: profielen, machtigingensets, beveiliging op veldniveau en regels voor delen. Beide lagen zijn actief voor elke query. Geen van beide vervangt de andere.
Architecten beschrijven Data Virtualization vaak als een “zero-copy” patroon. Zero-copy betekent geen aanhoudende replicatie naar Salesforce-opslag. Er is geen ETL-pijplijn die records naar Salesforce-objecten schrijft. Er is geen geplande synchronisatie die een lokale kopie maakt. Het externe object bevat geen rijen.
Zero-copy betekent niet nul gegevensoverdracht. Telkens wanneer een gebruiker een query uitvoert op een extern object, wordt er een resultatenset van het externe systeem naar Salesforce verzonden via het netwerk. Voor grote resultatensets of een hoge queryfrequentie zijn kosten voor gegevensuitgang en netwerklatentie echte factoren voor architecten om voor te ontwerpen. Dit is geen beperking om te verbergen: het is een ontwerpbeperking om rekening mee te houden.
Denk aan deze architectonische verschillen als uw gebruikscase grote volumes, frequente toegang of een lage latentie vereist.
Snowflake is een van de meest gebruikte externe systemen die via gegevensvirtualisatie met Salesforce zijn verbonden. Het dient als een concreet voorbeeld van hoe het patroon van begin tot eind werkt.
In deze configuratie maakt Salesforce verbinding met Snowflake met behulp van Salesforce Connect met de SQL-adapter voor Snowflake. Snowflake-tabellen en -weergaven worden weergegeven als Externe objecten in Salesforce. Wanneer een gebruiker een query uitvoert op een extern object, vertaalt Salesforce de SOQL naar SQL en dient deze in bij de Snowflake Statements API via een geauthenticeerde HTTPS-aanroep. Snowflake voert de query uit op zijn virtuele magazijn, past zijn eigen beveiliging op rijniveau en kolommaskering toe en retourneert alleen de resultatenset. Er worden op geen enkel moment gegevens naar Salesforce-opslag geschreven.
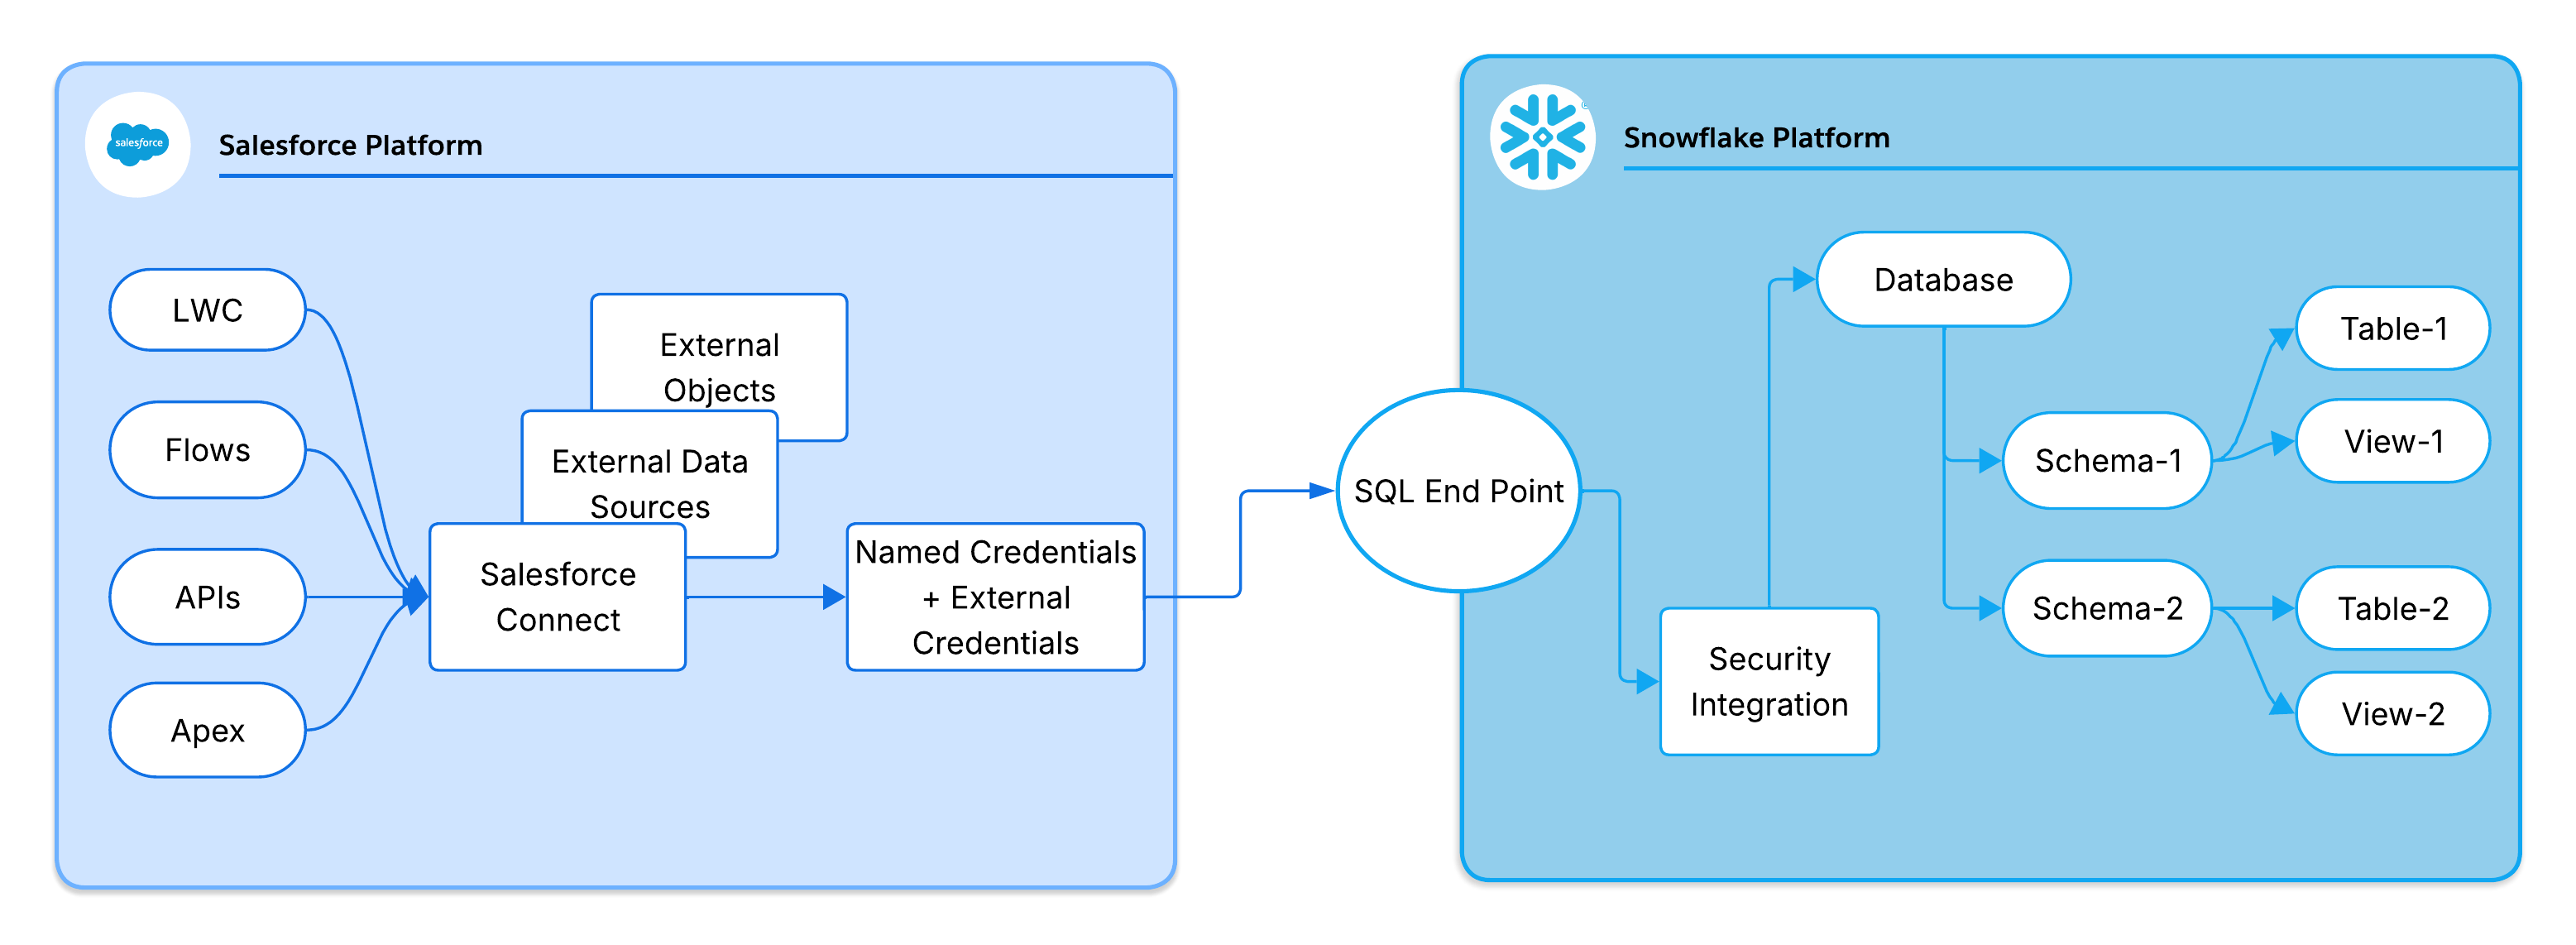
Salesforce Connect gebruikt een gedelegeerd OAuth 2.0-model voor authenticatie met Snowflake. De belangrijkste componenten zijn:
- Auth.-leverancier: Beheert de OAuth-handdruk met Snowflake. Verwerkt tokenaanvragen en wijst het geretourneerde token toe aan het Salesforce-inloggegeven.
- Extern inloggegeven: Bewaart de OAuth-toegangstokens en -vernieuwingstokens veilig in de met Salesforce versleutelde inloggegevensopslag en injecteert ze in uitgaande aanroepen.
- Benoemd gegeven: Definieert de Snowflake-eindpunt-URL en verwijst naar het externe inloggegeven.
- Integratie Snowflake-beveiliging: Registreert Salesforce als een vertrouwde OAuth-client in Snowflake. Definieert de toegestane omleidings-URI, OAuth-stromen en token-TL.
Deze componenten vormen een afhankelijkheidsketen: Externe gegevensbron verwijst naar het benoemde gegeven, dat verwijst naar het externe gegeven, dat verwijst naar de authenticatieleverancier. Inzicht in deze keten is essentieel bij het oplossen van problemen met connectiviteit of toegangsfouten.
Salesforce ondersteunt twee identiteitsdelegatiemodellen bij authenticatie met Snowflake:
- Met naam genoemde hoofdpersoon: Eén gedeelde serviceaccount authenticeert alle Salesforce-gebruikers op basis van Snowflake. Dit is eenvoudiger te configureren, maar heeft geen controle per gebruiker of fijnmazige Snowflake-toegangscontrole.
- Principal per gebruiker: Elke Salesforce-gebruiker authenticeert met een eigen OAuth-token. Dit maakt Snowflake-beveiliging op rijniveau en volledige controletrajecten per gebruiker mogelijk, met een nadeel voor hogere overhead voor tokenbeheer (OAuth-stromen per gebruiker, vernieuwen, intrekken).
Beslissingsbegeleiding: Gebruik Hoofdpersoon per gebruiker voor gereguleerde gegevens of persoonsgegevens. Gebruik Met naam genoemde hoofdpersoon wanneer Salesforce-regels voor delen voldoende toegangscontrole en eenvoud bieden.
Deze Salesforce-beheerlimieten bepalen rechtstreeks het oplossingsontwerp bij het gebruik van Externe objecten met Snowflake:
- Aanroeplimiet: 100 per Apex transactie. Pagina’s of stromen met meerdere Extern-objectquery’s kunnen deze limiet snel bereiken.
- Time-out van aanroep: Maximaal 120 seconden. Langdurige Snowflake-query’s veroorzaken een run-time uitzondering.
- SOQL-rijlimiet: 50.000 rijen. Pageteer grote resultatensets.
- Asynchrone beperkingen: Batch Apex en de meeste asynchrone contexten beperken aanroepen. Houd toegang tot externe objecten binnen synchrone transactiegrenzen. Voor asynchrone gebruikscases die een query uitvoeren op Externe objecten, kunt u overwegen om aanroepen voor voortzetting te gebruiken voor door de gebruiker geïnitieerde asynchrone interacties of de stroom zo te ontwerpen dat toegang tot externe gegevens wordt uitgevoerd in een synchrone transactie en resultaten asynchroon worden overgedragen.
Ontwerpbegeleiding: Voer geen query’s uit op Externe objecten binnen lussen. Push WHERE-clausulefilters naar Snowflake om de resultaatgrootte en aanroepfrequentie te verminderen.
Elke query die Salesforce naar Snowflake verzendt, wordt vastgelegd in Snowflake Queryhistorie met volledige uitvoeringsmetagegevens: latentie, gescande rijen, gebruikt magazijn en de uitvoerende identiteit. Deze historie biedt end-to-end controlemogelijkheden van Salesforce-gebruikersactie tot Snowflake-uitvoering en is de primaire diagnostische tool voor prestatieafstemming en toegangsvalidatie.
Gegevensvirtualisatie is zeer geschikt voor gebruikscases waarin realtime toegang, governance en gereduceerde replicatieoverhead zwaarder wegen dan de beperkingen van een gebundeld querytijdtoegangsmodel.
Gebruik deze wanneer:
- Lezen-zware analytische toegang is de primaire vereiste. Als gebruikers een query moeten uitvoeren op en externe gegevens moeten weergeven in Salesforce-UI’s, rapporten of stromen zonder terug te schrijven, elimineert Gegevensvirtualisatie pijplijnoverhead voor alleen-lezen scenario’s.
- Gegevensversheid is cruciaal. Waar verouderde gerepliceerde gegevens bedrijfsrisico’s veroorzaken (zoals verouderde financiële saldi, voorraadniveaus of nalevingsstatus), garandeert het gebundelde model dat elke query live gegevens weerspiegelt.
- De vereisten voor governance en gegevensverblijf zijn streng. Wanneer wettelijke of contractuele beperkingen het kopiëren van gevoelige gegevens naar Salesforce verbieden, houdt virtualisatie gegevens op de gezaghebbende locatie en maakt deze toegankelijk binnen Salesforce. Slechts één systeem bevat de gegevens.
- Toegangscontrole met twee lagen is vereist. Wanneer zowel de native toegangscontroles van het externe systeem als het Salesforce-beveiligingsmodel gelijktijdig van toepassing zijn, dwingt het gebundelde model beide af zonder gegevensduplicatie.
- Het externe systeem is al het gezaghebbende systeem van de record. Als de gegevens al schoon, beheerd en bevraagbaar zijn in het bronsysteem, vermijdt het virtualiseren ervan redundante transformatie, opslagkosten en divergentierisico.
Vermijd het wanneer:
- Schrijven met een lage latentie is vereist. Externe objecten zijn alleen-lezen. Write-back gebruikscases vereisen een ander integratiepatroon.
- Complexe joins voor meerdere objecten zijn nodig. SOQL voor meerdere externe objecten ondersteunt geen joins. Maak samengevoegde gegevens vooraf zichtbaar als één weergave in het bronsysteem.
- Voor Salesforce AI- of Agentforce voorzieningen zijn native gegevens vereist. Momenteel werken Einstein en Agentforce voorzieningen (waaronder aarding voor Einstein Copilot, voorspellende scores en Agentforce acties) op native Salesforce objecten. Deze voorzieningen ondersteunen geen externe objecten als aardings- of activeringsgegevensbron. Als AI-activering binnen het bereik van deze gegevens valt, is Salesforce Data 360 de aanbevolen aanvullende oplossing.
- Toegangspatronen met hoge frequentie en groot volume. Externe objecten zijn ontworpen voor on-demand toegang. Werkbelastingen die honderden query’s per minuut activeren, putten beheerlimieten uit en verslechteren de prestaties.
De volgende gebruikscases illustreren hoe Salesforce-gegevensvirtualisatie wordt toegepast in veelvoorkomende ondernemingsscenario’s. Elk voorbeeld gebruikt Snowflake als extern systeem, maar het onderliggende patroon is van toepassing op elke SQL-compatibele gegevensbron die wordt ondersteund door Salesforce Connect.
Uitdaging: Ondersteuningsteams hadden gecombineerde rapporten nodig die Salesforce-casegegevens combineerden met ticketvolume-, oplossingstijd- en escalatiemeetgegevens die waren opgeslagen in Snowflake. Het samenstellen en onderhouden van een replicatiepijplijn voor deze gegevens heeft vertraging geïntroduceerd en operationele overhead toegevoegd voor een alleen-lezen rapportagegebruikscase.
Oplossing: Het team heeft Snowflake-weergaven met daarin ticketmeetgegevens zichtbaar gemaakt als Externe objecten in Salesforce. Het team heeft Salesforce Reports geconfigureerd om native caseobjecten samen te voegen met de externe ticketgegevens.
Resultaat:
- Rapporten weerspiegelen altijd live Snowflake-gegevens. Geen pijplijnvertraging.
- Het beheer van gevoelige ondersteuningsmeetgegevens blijft in Snowflake.
- Geen ETL-pijplijn om te bouwen, bewaken of onderhouden.
Uitdaging: Een financieel team handhaafde gezaghebbende kredietlimiet- en saldogegevens in Snowflake. Het repliceren van deze waarden in Salesforce via reverse ETL introduceerde replicatievertraging, waardoor verkoopvertegenwoordigers zich verplichtten tot deals op basis van verouderde kredietgegevens. Het nalevingsteam signaleerde ook het risico van het vasthouden van gevoelige financiële gegevens in Salesforce-opslag.
Oplossing: Het team heeft de financiële weergave Snowflake gevirtualiseerd als een extern object en zichtbaar gemaakt op de paginalay-out Account. Verkoopvertegenwoordigers zien live kredietstatus nu als onderdeel van hun standaard accountweergave in Salesforce.
Resultaat:
- Realtime kredietgegevens op elke accountpagina. Geen lag.
- Omgekeerde ETL-pijplijn geëlimineerd voor financiële gegevens.
- Gevoelige financiële gegevens nooit gekopieerd naar Salesforce-opslag. Nalevingsbereik blijft in Snowflake.
Uitdaging: Tijdens een fusie moest het overnemende bedrijf Salesforce-gebruikers inzicht geven in operationele gegevens uit zes Snowflake-gegevenssets met groot volume, die transacties, facturering en gebruik omvatten. Het repliceren van terabytes aan gegevens naar Salesforce was niet haalbaar op de fusietijdlijn en het bouwen van aangepaste ETL-pijplijnen voor elke gegevensset zou aanzienlijke technische investeringen hebben vereist.
Oplossing: Het team heeft Externe objecten geconfigureerd voor alle 6 Snowflake-gegevenssets met behulp van Salesforce Connect met een integratierol met de minste rechten. Geen aangepaste code vereist. Query’s worden rechtstreeks in Snowflake uitgevoerd en alle activiteit wordt vastgelegd in Snowflake Queryhistorie voor nalevingsrapportage.
Resultaat:
- Volledig declaratieve configuratie. Geen aangepaste code of pijplijnen vereist.
- Gegevensversheid gegarandeerd. Elke query weerspiegelt live Snowflake-gegevens op uitvoeringstijd.
- Volledig controletraject in Snowflake Queryhistorie voor rapportage over regelgeving en naleving.
Gegevensvirtualisatie introduceert een duidelijk operationeel profiel. Ontwerp voor deze foutscenario’s:
- Verval van OAuth-token: Tokens hebben een finite time to live (TTL). Verlopen tokens leiden tot aanroepfouten. Controleer op 401 ongeoorloofde reacties en implementeer vernieuwingslogica.
- Magazijn met koude start (sneeuwvlokspecifiek): Automatisch opgeschorte magazijnen voegen 5-30 seconden toe aan de eerste query. Voor op de gebruiker gerichte gebruikscases met latentievereisten warmt u vooraf op met een geplande lichtgewicht query tijdens kantooruren.
- Rolmismatch: Een verkeerd geconfigureerde rol in het externe systeem kan in stilte nul rijen retourneren in plaats van een fout. Valideer rol-naar-object-machtigingen in het externe systeem onafhankelijk van Salesforce.
- Overloop van resultatenset: Extra grote payloads overschrijden API-limieten. Pas altijd LIMIT-clausules toe en maak gefilterde weergaven zichtbaar in plaats van ruwe tabellen.
- Externe systeemuitval: Er bestaat geen reserve of cachegeheugen. Neem aanroepen op in try/catch en maak informatieve foutstatussen zichtbaar in de UI. Overweeg voor bedrijfskritieke gegevens een gelaagde aanpak: virtualiseer voor real-time toegang en behoud een lichtgewicht gerepliceerde reserve voor de meest kritieke velden om beschikbaarheid te garanderen tijdens uitval van bronsystemen.
Salesforce-gegevensvirtualisatie komt overeen met de volgende pijlers van het Salesforce Well-Architected Framework.
- Trust: Het gedelegeerde OAuth 2.0-model en de rolbegeleiding met de minste rechten komen overeen met Trust. Toegangscontrole met twee lagen (bronsysteem + Salesforce) dwingt diepgaande verdediging af.
- Betrouwbaarheid (fouttolerantie): De sectie met foutmodi richt zich rechtstreeks op betrouwbaarheid: tokenverval, koude start, onjuiste configuratie van rollen, overloop van resultatensets en afhandeling van uitval vertegenwoordigen elk een afzonderlijke foutklasse met een gedocumenteerd oplossingspad.
- Betrouwbaarheid (schaalbaarheid): Querypushdown, richtlijnen voor het dimensioneren van magazijnen en bewustzijn van aanroepenlimieten optimaliseren de uitvoeringsefficiëntie binnen Salesforce-beheerbeperkingen, een zorgwekkende factor voor betrouwbaarheid bij oplossingen die op schaal werken.
- Operationele uitmuntendheid: Snowflake Queryhistorie als de primaire observatietool ondersteunt operational excellence: architecten maken een bewuste, traceerbare keuze om platformeigen tooling te gebruiken voor end-to-end auditeerbaarheid en prestatiediagnostiek in plaats van aangepaste logboekinfrastructuur te bouwen.
Deze sectie biedt architecten en ontwerpers een gestructureerd uitgangspunt voor het samenstellen van het gegevensvirtualisatiepatroon in een sandboxomgeving. Het is geen volledige implementatiehandleiding. Beschouw deze als een gevalideerde reeks beslissingen en configuratiestappen om uw eerste proof of concept te bepalen.
Bevestig het volgende voordat u begint met configuratiewerk:
- Licentierecht: Salesforce Connect is niet inbegrepen in alle Salesforce editions. De SQL-adapter voor Snowflake vereist een afzonderlijke uitbreidingslicentie die verder gaat dan het basisrecht van Salesforce Connect. Controleer beide in uw organisatie voordat u doorgaat.
- Sandbox eerst: Voltooi alle fasen in een sandboxomgeving voordat u uw configuratie doorzet naar productie.
- Snowflake-toegang: Bevestig dat u de machtiging hebt om een beveiligingsintegratie in Snowflake te maken en toegang hebt tot de doeldatabase, het schema en de objecten.
- Adapterversie: Controleer of de SQL-adapter voor Snowflake beschikbaar is in uw organisatie-editie en of de URL van uw Snowflake-account geen onderstrepingstekens bevat (vervang deze door afbreekstreepjes als dat wel het geval is. Dit is een Salesforce-platformbeperking voor het oplossen van hostnaam van aanroepen).
Het instellen van gegevensvirtualisatie met een extern SQL-systeem zoals Snowflake is een declaratief, configuratiegestuurd proces – er is geen aangepaste code vereist. De set-up bestaat uit drie opeenvolgende fasen: het vaststellen van identiteit en Trust, het configureren van het gegevensoppervlak en het beschikbaar stellen van gegevens aan eindgebruikers.
In deze fase wordt een veilige, gedelegeerde OAuth 2.0 Trust Chain tot stand gebracht tussen Salesforce en het externe systeem. Voltooi deze fase voordat u een configuratie van het gegevensoppervlak start.
- Maak een authenticatieleverancier in Salesforce. Gebruik het type OpenID Connect. Gebruik plaatshouderwaarden in deze fase — ga terug om deze te voltooien nadat u waarden hebt opgehaald uit het externe systeem. Nadat u hebt opgeslagen, genereert Salesforce een call-back-URL. Behoud deze waarde.
- Registreer Salesforce als een OAuth-client in het externe systeem. In Snowflake betekent dit het maken van een beveiligingsintegratie (OAuth, type vertrouwelijke client). Geef de callback-URL van Salesforce op als de omleidings-URI. Haal de client-ID, het klantgeheim, de autorisatie-URL en de token-URL na het maken op uit de integratie.
- Voltooi de configuratie van Auth.-leverancier. Ga terug naar de Salesforce-authenticatieleverancier en vul deze in met de waarden die zijn opgehaald uit het externe systeem: Consumentensleutel, Consumentengeheim, Autorisatie-URL en Token-URL.
- Maak het externe inloggegeven. Stel Protocol in op OAuth 2.0, koppel het aan de Auth-leverancier en voeg een principal toe (met naam of per gebruiker, afhankelijk van de beslissing over uw identiteitsmodel). Dit object beheert de OAuth-tokenlevenscyclus.
- Maak het benoemde gegeven. Stel het eindpunt in op de API-URL van het externe systeem (bijv.
https://<account>.snowflakecomputing.com/api/v2/statements/) en koppel het aan het externe inloggegeven. - Verleen profieltoegang tot het externe inloggegeven. Zonder deze stap kunnen gebruikers geen gebundelde query’s aanroepen, zelfs niet als alle andere configuraties correct zijn.
- Start de OAuth-stroom om de authenticatie te voltooien. Activeer de OAuth-handdruk vanuit Salesforce. Het platform leidt om naar de externe systeemlogin, valideert inloggegevens en slaat de resulterende tokens veilig op in het externe inloggegeven. Deze stap bindt gebruikerscontext aan een geldig token. Alle gebundelde query’s mislukken totdat deze stap is voltooid.
Deze fase verbindt Salesforce met het schema voor externe gegevens en maakt de Extern-objectdefinities waarop gebruikers en het platform een query uitvoeren.
- Maak de externe gegevensbron. Selecteer de juiste adapter (bijv. SQL-adapter voor Snowflake), laat deze verwijzen naar de doeldatabase en het doelschema en koppel deze aan het benoemde gegeven dat u in fase 1 hebt gemaakt.
- Valideer de verbinding. Gebruik de ingebouwde validatie voor de externe gegevensbron. Een succesvol resultaat bevestigt dat de OAuth Trust Chain is voltooid en dat het externe systeem toegankelijk is.
- Metagegevens synchroniseren. Start een metagegevenssynchronisatie vanuit de Externe gegevensbron. Salesforce controleert het doelschema en genereert definities van externe objecten, waarbij externe kolommen worden toegewezen aan Salesforce-veldtypen.
- Selecteer en maak de vereiste tabellen of weergaven zichtbaar. Kies welke externe tabellen of weergaven zichtbaar worden als Externe objecten. Als best practice kunt u beter gemodereerde weergaven weergeven dan ruwe tabellen. Weergaven maken vooraf filteren van kolommen, beperkingen op rijniveau en een betere controle over waartoe de Salesforce-laag toegang heeft, mogelijk.
Deze fase maakt Externe objecten zichtbaar en bruikbaar voor eindgebruikers binnen de Salesforce Lightning Experience.
- Maak tabbladen voor externe objecten. Tabbladen maken Externe objecten direct navigeerbaar binnen Lightning Apps.
- Voeg externe objecten toe aan paginalay-outs. Relevante externe gegevens zichtbaar maken naast native Salesforce-records (voeg bijvoorbeeld een financiële Snowflake-weergave toe aan de paginalay-out Account).
- Toevoegen aan gerelateerde lijsten. Neem externe objecten op in gerelateerde lijsten om gebruikers een gecombineerde weergave te geven van native en externe gegevens in context.
- Valideer end-to-end querybundeling. Laad een pagina of voer een query uit die verwijst naar een extern object. Inspecteer vervolgens de queryhistorie van het externe systeem (bijvoorbeeld Snowflake-queryhistorie) om te controleren of de query is uitgevoerd bij de bron. Controleer of de query is uitgevoerd met de juiste rol, het juiste magazijn en de juiste identiteit.
Nadat alle drie de fasen zijn voltooid, kunnen Salesforce-gebruikers werken met live externe gegevens via standaard Salesforce-interfaces, zonder dat ze zich ervan bewust zijn dat de gegevens afkomstig zijn van buiten Salesforce.
Salesforce-gegevensvirtualisatie vervangt op replicatie gebaseerde integratie door bundeling van querytijd. Gegevens blijven in hun gezaghebbende bron; Salesforce-gebruikers hebben er interactie mee via standaardplatforminterfaces. Er is geen pijplijn om te bouwen, geen kopie om te beheren en geen vertraging om te beheren.
Dit patroon is de juiste keuze wanneer leestoegang, real-time gegevensversheid, strikte governance en toegangscontrole met twee lagen de primaire drijfveren zijn. Het is de verkeerde keuze wanneer schrijven verplicht is, wanneer AI- of automatiseringsvoorzieningen afhankelijk zijn van native Salesforce-objecten of wanneer toegangspatronen te hoogfrequent zijn om beheerlimieten te kunnen verwerken.
Snowflake illustreert het patroon goed: een beheerde, gebundelde verbinding met querytijd die declaratief tot stand is gebracht zonder aangepaste code, die end-to-end kan worden gevolgd door Snowflake Query History, en die kan worden afgedwongen door zowel de native toegangscontroles van Snowflake als het volledige Salesforce-beveiligingsmodel.
Voordat u overgaat tot deze architectuur, valideert u het licentierecht, beoordeelt u blootstelling van beheerlimieten op basis van uw verwachte toegangspatronen en controleert u of OAuth gereed is in een sandboxomgeving. Het patroon beloont doordachte ontwerpen vooraf: zorg voor het juiste identiteitsmodel, de juiste inloggegevensketen en weergavestrategie, en de operationele voetafdruk is minimaal.
Yugandhar Bora is een Software Engineering Architect bij Salesforce, gespecialiseerd in gegevensarchitectuur binnen het Data & Intelligence Applications-platform. Hij leidt initiatieven van de Enterprise Architecture Review Board (EARB) gericht op data governance en gecombineerde gegevensmodellen, terwijl hij bijdraagt aan oplossingen voor geautomatiseerde platformleveringen.