Data 360-interoperabiliteit
Ondernemingen slaan gegevens vaak op in Salesforce en andere externe gegevens-lakes (bijvoorbeeld Snowflake, Google BigQuery, Databricks, Redshift of objectopslag zoals Amazon S3). Het isoleren van gegevens over meerdere systemen vormt een uitdaging voor bedrijven die de volledige waarde van hun gegevens willen benutten om AI-gestuurde omgevingen te stimuleren. Salesforce Data 360 is de fundamentele intelligentielaag die elke Agentforce AI Agent gebruikt om op het juiste moment toegang te krijgen tot de juiste context.
Architecten die werken aan het samenbrengen van gegevens binnen meerdere gegevens-lakes, staan voor belangrijke architectonische beslissingen over de beste manier om die gegevens te integreren. Data 360 biedt meerdere opties voor gegevensintegratie, elk met verschillende voor- en nadelen.
Deze handleiding biedt een raamwerk om te evalueren welk patroon het beste past bij uw vereisten voor latentie, kosten, schaalbaarheid, governance en complexiteit bij het integreren van gegevens, en helpt u te kiezen wanneer u gegevensopname, Zero Copy-gegevensbundeling of een hybride benadering gebruikt. De handleiding helpt u ook bij het kiezen tussen verschillende methoden voor gegevensopname en gegevensbundeling, waarbij elke methode een andere behoefte vervult.
Het integreren van externe data-lake-huizen met Data 360 vereist een zorgvuldige afweging van de nadelen tussen gegevensversheid, governance en pijplijnefficiëntie. Als u bijvoorbeeld live query’s voor gegevensbundeling met nul kopieën gebruikt, wordt de versheid van de gegevens gemaximaliseerd, maar kan de efficiëntie van de pijplijn afnemen naarmate er meer gegevens over het netwerk gaan. Voor de meeste implementaties in de praktijk is het combineren van opname en bundeling in een ecosysteem met meerdere cloud-lakehuizen het optimale pad. Deze hybride benadering zorgt voor een schaalbare, beheerde, interoperabele architectuur die operationele werkbelastingen met lage latentie (bijvoorbeeld real-time personalisatie en fraudedetectie) en analytische werkbelastingen (bijvoorbeeld rapportage over regelgeving en historische trendanalyse) ondersteunt. Deze handleiding helpt u te bepalen hoe u deze nadelen kunt oplossen met behulp van een geschikte strategie.
- Gegevensopname kopieert gegevens naar Salesforce Data 360 en maakt beheerde, canonieke gegevensmodellen. Dit is ideaal voor wanneer u:
- Bouw een uitgebreide Customer 360. Hierdoor kunt u ongelijksoortige bronnen combineren en transformeren tot één vertrouwd profiel.
- Voldoe aan strikte naleving van regelgeving. Hierdoor kunt u een controleerbare, gecentraliseerde kopie maken, zodat gegevenstoegang en herkomst nauwkeurig kunnen worden gecontroleerd.
- Zero Copy Federation voert in real-time query’s uit op externe bronnen zonder duplicatie, waardoor real-time personalisatie, live dashboards en snelle brononboarding mogelijk worden. Deze benadering biedt twee primaire opties, maar er zijn nadelen die in evenwicht moeten worden gebracht:
- Live query: Gebruik dit voor interactieve analyses en real-time gegevensdashboards die live zijn op externe gegevensplatforms (bijvoorbeeld Snowflake, BigQuery, Redshift of Databricks). Dit helpt langzame, kostbare gegevensduplicatie te voorkomen door queryverwerking naar het bronsysteem te pushen en alleen de noodzakelijke resultaten te retourneren. Deze benadering is geoptimaliseerd voor zeldzame of ad-hocquery’s waarbij versheid van cruciaal belang is. Het is geschikt voor lage query-per-seconde (QPS) werkbelastingen (querykosten kunnen aanzienlijk stijgen bij hoge QPS).
- Caching (versnelde query): Gebruik dit voor frequente gegevensquery’s die niet vaak worden gewijzigd. Versnelde query’s onderhouden een lokaal cachegeheugen dat met configureerbare intervallen (15 minuten tot 7 dagen) wordt bijgewerkt, waardoor herhaalde brontreffers worden verminderd. Bij deze benadering worden dashboardprestaties en -kosten, segmentering en BI-werkbelasting in evenwicht gebracht, waarbij enigszins verouderde resultaten acceptabel zijn. Dit is niet geschikt voor beslissingen van minder dan een seconde.
- Bestandsbundeling: Gebruik dit voor grootschalige batchverwerking en AI-modeltraining voor gegevens in het gegevens-lake van uw cloud (bijvoorbeeld S3 of ADLS). Deze benadering vermijdt langzame, kostbare opname door rechtstreeks query’s uit te voeren op bestanden in open tabelindelingen, waardoor enorme ETL-gegevenssets en werklasten voor gegevenswetenschappen worden ontgrendeld.
- Hybride modellen combineren opname voor gecombineerde profielen met bundeling voor versheid, wat omni-channel betrokkenheid, Agentforce gestuurde acties en AI/ML-training ondersteunt.
- Gebruik een hybride architectuur. Het combineren van gegevensopname en bundeling is vaak noodzakelijk.
- Gebruik Data Ingest voor kritieke gegevens voor canonieke gegevensmodellen en core governance.
- Gebruik Zero Copy voor alle andere gegevensbundeling om versheid te behouden en de operationele overhead van het samenstellen en onderhouden van gegevensopnamepijplijnen te minimaliseren.
- Gegevensopnamefrequentie is belangrijk. Kies de frequentie op basis van bedrijfswaarde, latentiebehoeften en operationele complexiteit.
- Gebruik realtime voor tijdgevoelige werkstromen (bijvoorbeeld personalisatie, live dashboards en Agentforce acties).
- Gebruik Bijna realtime voor matig urgente processen (bijvoorbeeld campagnes en operationele rapporten).
- Gebruik batching voor historische of lagesnelheidsgegevenssets.
- Koppel bundelpatronen aan latentie en prestaties. Kies de optie die het beste past bij uw toegangspatronen en vereisten voor versheid, prestaties en kosten.
- Gebruik Live Query voor operationele dashboards en real-time personalisatie waar een lage latentie van cruciaal belang is.
- Gebruik Caching (versnelde query) wanneer query’s frequent zijn en enigszins verouderde resultaten acceptabel zijn, wat helpt prestaties en kosten in evenwicht te houden.
- Gebruik bestandsbundeling voor grootschalige, doorvoerzware analyses of batchwerkbelastingen, die ideaal zijn voor historische of minder tijdgevoelige gegevenssets.
- Governance afstemmen op vereisten voor gegevensverblijf.
- Gebruik opname wanneer gecentraliseerd bestuur van cruciaal belang is.
- Gebruik bundeling wanneer gedecentraliseerd bestuur acceptabel is, terwijl u ook strikt bestuur aan de externe bron afdwingt.
- Gebruik Zero Copy voor beleidsvormen op bronniveau (bijvoorbeeld beveiliging op rijniveau (RLS) en gegevensmaskering).
- Prioriteit geven aan opname voor waardevolle werkstromen. Pas opname selectief toe op kritieke processen (bijvoorbeeld identiteitsoplossing, rapportage over regelgeving en operationele activering).
- Beslissingen over kosten en complexiteit. Realtime opname kan duur en complex zijn. Daarom is het belangrijk voor architecten om de kosten van onboarding, opslag en transformatie van gegevens af te wegen tegen de kosten van het rechtstreeks uitvoeren van een query via Zero Copy.
Het kiezen van het juiste integratiepatroon (Gegevensopname, Zero Copy of een hybride benadering) heeft een directe invloed op latentie, governance, operationele efficiëntie en kosten voor meerdere cloudplatforms. Deze beslissing bepaalt hoe real-time insights, AI-gestuurde activering en gepersonaliseerde betrokkenheid betrouwbaar en op schaal worden geleverd.
Deze tabel vergelijkt de patronen Gegevensopname en Nul kopiëren in Salesforce Data 360, waarbij de nadruk ligt op mogelijkheden, nadelen en voordelen, alsmede gebruikscases en uitkomsten voor de onderneming. Gebruik dit als referentie voor het ontwerpen van hybride gegevensplatforms met meerdere clouds die prestaties, kosten en naleving in balans brengen.
| Patroontype | Modus/tool | Voordelen | Overwegingen | Uitkomsten |
|---|---|---|---|---|
| Gegevensopname |
Realtime:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Batch:
|
|
|
Agentforce:
|
|
| Zero Copy |
Live query:
|
|
|
Agentforce:
|
Versnelde query (caching):
|
|
|
Agentforce:
|
|
Bestandsbundeling:
|
|
|
Agentforce:
|
Er zijn drie primaire integratiepatronen voor Data 360: gegevensopname, nulkopiegegevensbundeling en een hybride benadering.
Met Gegevensopname worden gegevens fysiek gekopieerd naar Data 360 en volledig beheerd, in tegenstelling tot Zero Copy, waarbij gegevens bij de bron blijven. Met andere woorden, het computergebruik voor transformaties vindt plaats binnen Data 360, dat gecentraliseerd bestuur en controle biedt.
Gebruik Gegevensopname om canonieke, beheerde gegevenssets op te slaan in Salesforce Data 360 voor naleving en operationele controle. Gebruik opname wanneer volledige controle, controle en traceerbaarheid vereist zijn. Gegevensopname is ideaal voor gereguleerde of hoogwaardige werkstromen waarin gecentraliseerde berekening en governance van cruciaal belang zijn.
Opname is geschikt om een vertrouwde basis te leggen voor identiteitsoplossing, rapportage door regelgeving en missiekritieke AI-gestuurde werkstromen en klantbetrokkenheid.

Methoden voor gegevensopname kunnen variëren, afhankelijk van de connector die u gebruikt om uw gegevens op te nemen. Sommige connectoren bieden een verscheidenheid aan opnamemethoden, terwijl andere alleen in batch- of streamingmodus werken. Zie Data 360 voor een volledige lijst van Data 360-connectoren en beschikbare methoden: Integraties en connectoren.
- Realtime:
- Biedt opname in subseconden met behulp van Change Gegevensvastlegging (CDC)
- Geschikt voor tijdgevoelige werkstromen (bijvoorbeeld fraudedetectie, personalisatie en operationele dashboards)
- Bevat push-transformaties en aggregaties binnen Data 360, wat helpt I/O verderop in de stroom te verminderen en het gebruik van berekeningen te optimaliseren
- Ondersteunt het gebruik van incrementele CDC om het verschuiven van gegevens te minimaliseren
- Streaming:
- Biedt inname elke 1–3 minuten in kleine stappen
- Balanceert versheid en kosten
- Geschikt voor campagne-indeling, near-live betrokkenheid en operationele rapportage
- Ondersteunt het gebruik van microbatches om I/O-pieken te controleren
- Aggregeert gegevens bij de bron (indien mogelijk) om overdrachtvolumes te verminderen en opslag te optimaliseren
- Batch (geplande ladingen):
- Biedt periodieke opname van grote gegevenssets (bijvoorbeeld elk uur, dagelijks en wekelijks)
- Biedt kostenefficiëntie en betrouwbaarheid voor historische gegevenssets, rapportage over regelgeving en gebruikscases voor naleving
- Zorgt ervoor dat de locatie van de berekening in dezelfde regio ligt als de bronopslag om de prestaties te verbeteren en de kosten te optimaliseren
- Gebruikscases voor gegevensopname:
- Genereer Customer 360 gecombineerde profielen. Stel één waarheidsbron samen voor klantidentiteiten en -kenmerken.
- Onderhoud gegevenssets voor naleving van regelgeving. Dwing governance, afkomst en controleerbaarheid af voor gevoelige gegevens.
- Centraliseer campagne-indeling. Zorg ervoor dat marketing, verkoop en service allemaal werken vanuit consistente, vertrouwde gegevenssets.
- Ontwerppraktijken:
- Houd rekening met batchopname voor historische of lage latentietolerante behoeften (bijvoorbeeld archiveringsrapportage of periodieke momentopnamen).
- Gebruik CDC- of streaming-API’s om operationele werkstromen en personalisatiewerkstromen vers te houden en vrijwel realtime updates te garanderen.
- Beheers opslag en groei van berekeningen door incrementele belastingen toe te passen om kosten en efficiëntie te optimaliseren (in plaats van complete gegevenssets opnieuw te laden).
- Stem opnamepijplijnen af op de locatie van de berekening en incrementele verwerking om netwerk-I/O te verminderen.
- Pas transformaties toe binnen Data 360 om onnodige verplaatsing van ruwe gegevens te voorkomen.
- Overwegingen bij kosten:
- Real-time opname heeft de hoogste berekenings- en pijplijnkosten, wat gerechtvaardigd kan zijn voor waardevolle, tijdgevoelige werkstromen (bijvoorbeeld personalisatie, operationele dashboards of Agentforce gestuurde acties).
- Streamingopname heeft matige berekenings- en opslagkosten, die geschikt kunnen zijn voor frequente updates die lichte vertragingen kunnen verdragen (bijvoorbeeld campagne-indeling of operationele rapportage).
- Batchopname heeft lagere berekeningskosten en voorspelbare opslag, die geschikt is voor historische gegevenssets of updates met een lage frequentie. Het opnemen van batchgegevens uit Salesforce-organisaties met behulp van bepaalde connectoren is gratis.
- Vernieuwingsmodus Hiermee kunt u de modus Incrementeel vernieuwen selecteren, die de totale opname- en berekeningskosten verlaagt. Bij Salesforce wordt aangeraden om waar mogelijk incrementele vernieuwing te gebruiken om de efficiëntie voor alle opnametypen te optimaliseren.
- Kosten worden ook beïnvloed door I/O-volume van de bron naar Data 360. Het optimaliseren van batchgrootten, partities en regionale uitlijning verlaagt de overdrachtskosten en verbetert de prestaties.
- Industriescenario’s:
- Financiën: Gegevenssets voor opname zijn vereist voor het kennen van uw klant, Antiwitwassen (AML) en fraudedetectie waarbij controle en naleving niet bespreekbaar zijn.
- Gezondheidszorg: Gebruik opname voor patiëntenidentiteitsoplossing en HIPAA-conforme records, wat veilige, gecombineerde weergaven mogelijk maakt.
- Retail: Consolideer gegevens van verkooppunten, eCommerce en loyaliteitsprogramma’s in gecombineerde profielen voor segmentering en personalisering.
- Telecom: Ondersteun verlooppreventie en gebruiksanalyses met canonieke, beheerde abonneegegevens.
| Functie | Real-time opname | Streamingopname | Batchopname |
|---|---|---|---|
| Latency en versheid | Bevat opname van subseconden latentie via opname-API’s met ondersteuning voor Change Gegevensvastlegging (CDC). Biedt continue streamingpijplijnen. Geschikt voor operationele gebruikscases met lage latentie. | Bevat microbatchopname elke 1–3 minuten via native connectoren. Ondersteunt incrementele updates. Lichte latentie wordt verwacht. | Gegevenslatentie wordt verwacht. Staat geplande ladingen met groot volume toe. Bevat periodieke opname (elk uur, dagelijks en wekelijks). Niet geschikt voor tijdgevoelige bewerkingen. |
| Primaire gebruikscases | Ideaal voor operationele gebruikscases met lage latentie en personalisatie. Gebruik dit voor tijdgevoelige werkstromen. Ondersteunt eventgestuurde werkstromen. Gebruik dit voor realtime fraudewaarschuwingen en operationele waarschuwingen. | Geschikt voor matig dringende processen. Gebruik dit voor campagne-indeling, near-live betrokkenheid en operationele rapportage. Gebruik dit voor tijdige campagnetriggers. | Kostenefficiënt voor enorme gegevenssets. Betrouwbaar voor historische analyses. Gebruik dit voor historische aggregatie of gereguleerde rapportagewerkstromen. Geschikt voor historische of gegevenssets met lage snelheid. |
| Architectonische complexiteit en I/O | Omvat hoge kosten en complexe architectuur. Vereist bronsystemen met lage latentie. I/O intensief. Bronnen met groot volume kunnen verzadigde pijplijnen veroorzaken. | Bevat eenvoudigere architectuur dan real-time. I/O is matig. Geschikt voor voorspelbare, herhaalde updatepatronen. Batchgrootte heeft invloed op geheugen en berekening. | Eenvoudig te implementeren. I/O intensief tijdens laadvensters. Netwerkdoorvoer kan een bottleneck worden voor grote batches. |
| Overwegingen bij kosten | Omvat de hoogste berekenings- en pijplijnkosten. Alleen gerechtvaardigd voor waardevolle, tijdgevoelige werkstromen. | Omvat matige berekenings- en opslagkosten. Biedt een evenwichtige benadering van kosten en versheid. Geschikt voor frequente updates die lichte vertragingen kunnen verdragen. | Lagere berekeningskosten en voorspelbare opslag. Aanbevolen voor historische gegevenssets of updates met een lage frequentie. Opname via interne Salesforce-pijplijnen is gratis. |
| Ontwerppraktijken | Gebruik incrementele CDC om het verschuiven van gegevens te minimaliseren. Filter en gebruik selectieve velden om overhead te verminderen. | Gebruik microbatches om I/O-pieken te controleren. Overweeg aggregatie met vensters om de verwerkingsbelasting te verminderen. | Gebruik dit voor archiveringsrapportage of periodieke momentopnamen. Zorg ervoor dat de locatie van de berekening in dezelfde regio ligt als bronopslag voor kostenoptimalisering. |
Gebruik Zero Copy voor real-time query’s op externe systemen zonder gegevensduplicatie om flexibiliteit, versheid en schaalbare toegang tot grote of tijdelijke gegevenssets in te schakelen. Het is geschikt voor live dashboards, verkennende analyses, AI/ML-modeltraining en realtime klantbetrokkenheid rechtstreeks via Salesforce Data 360.
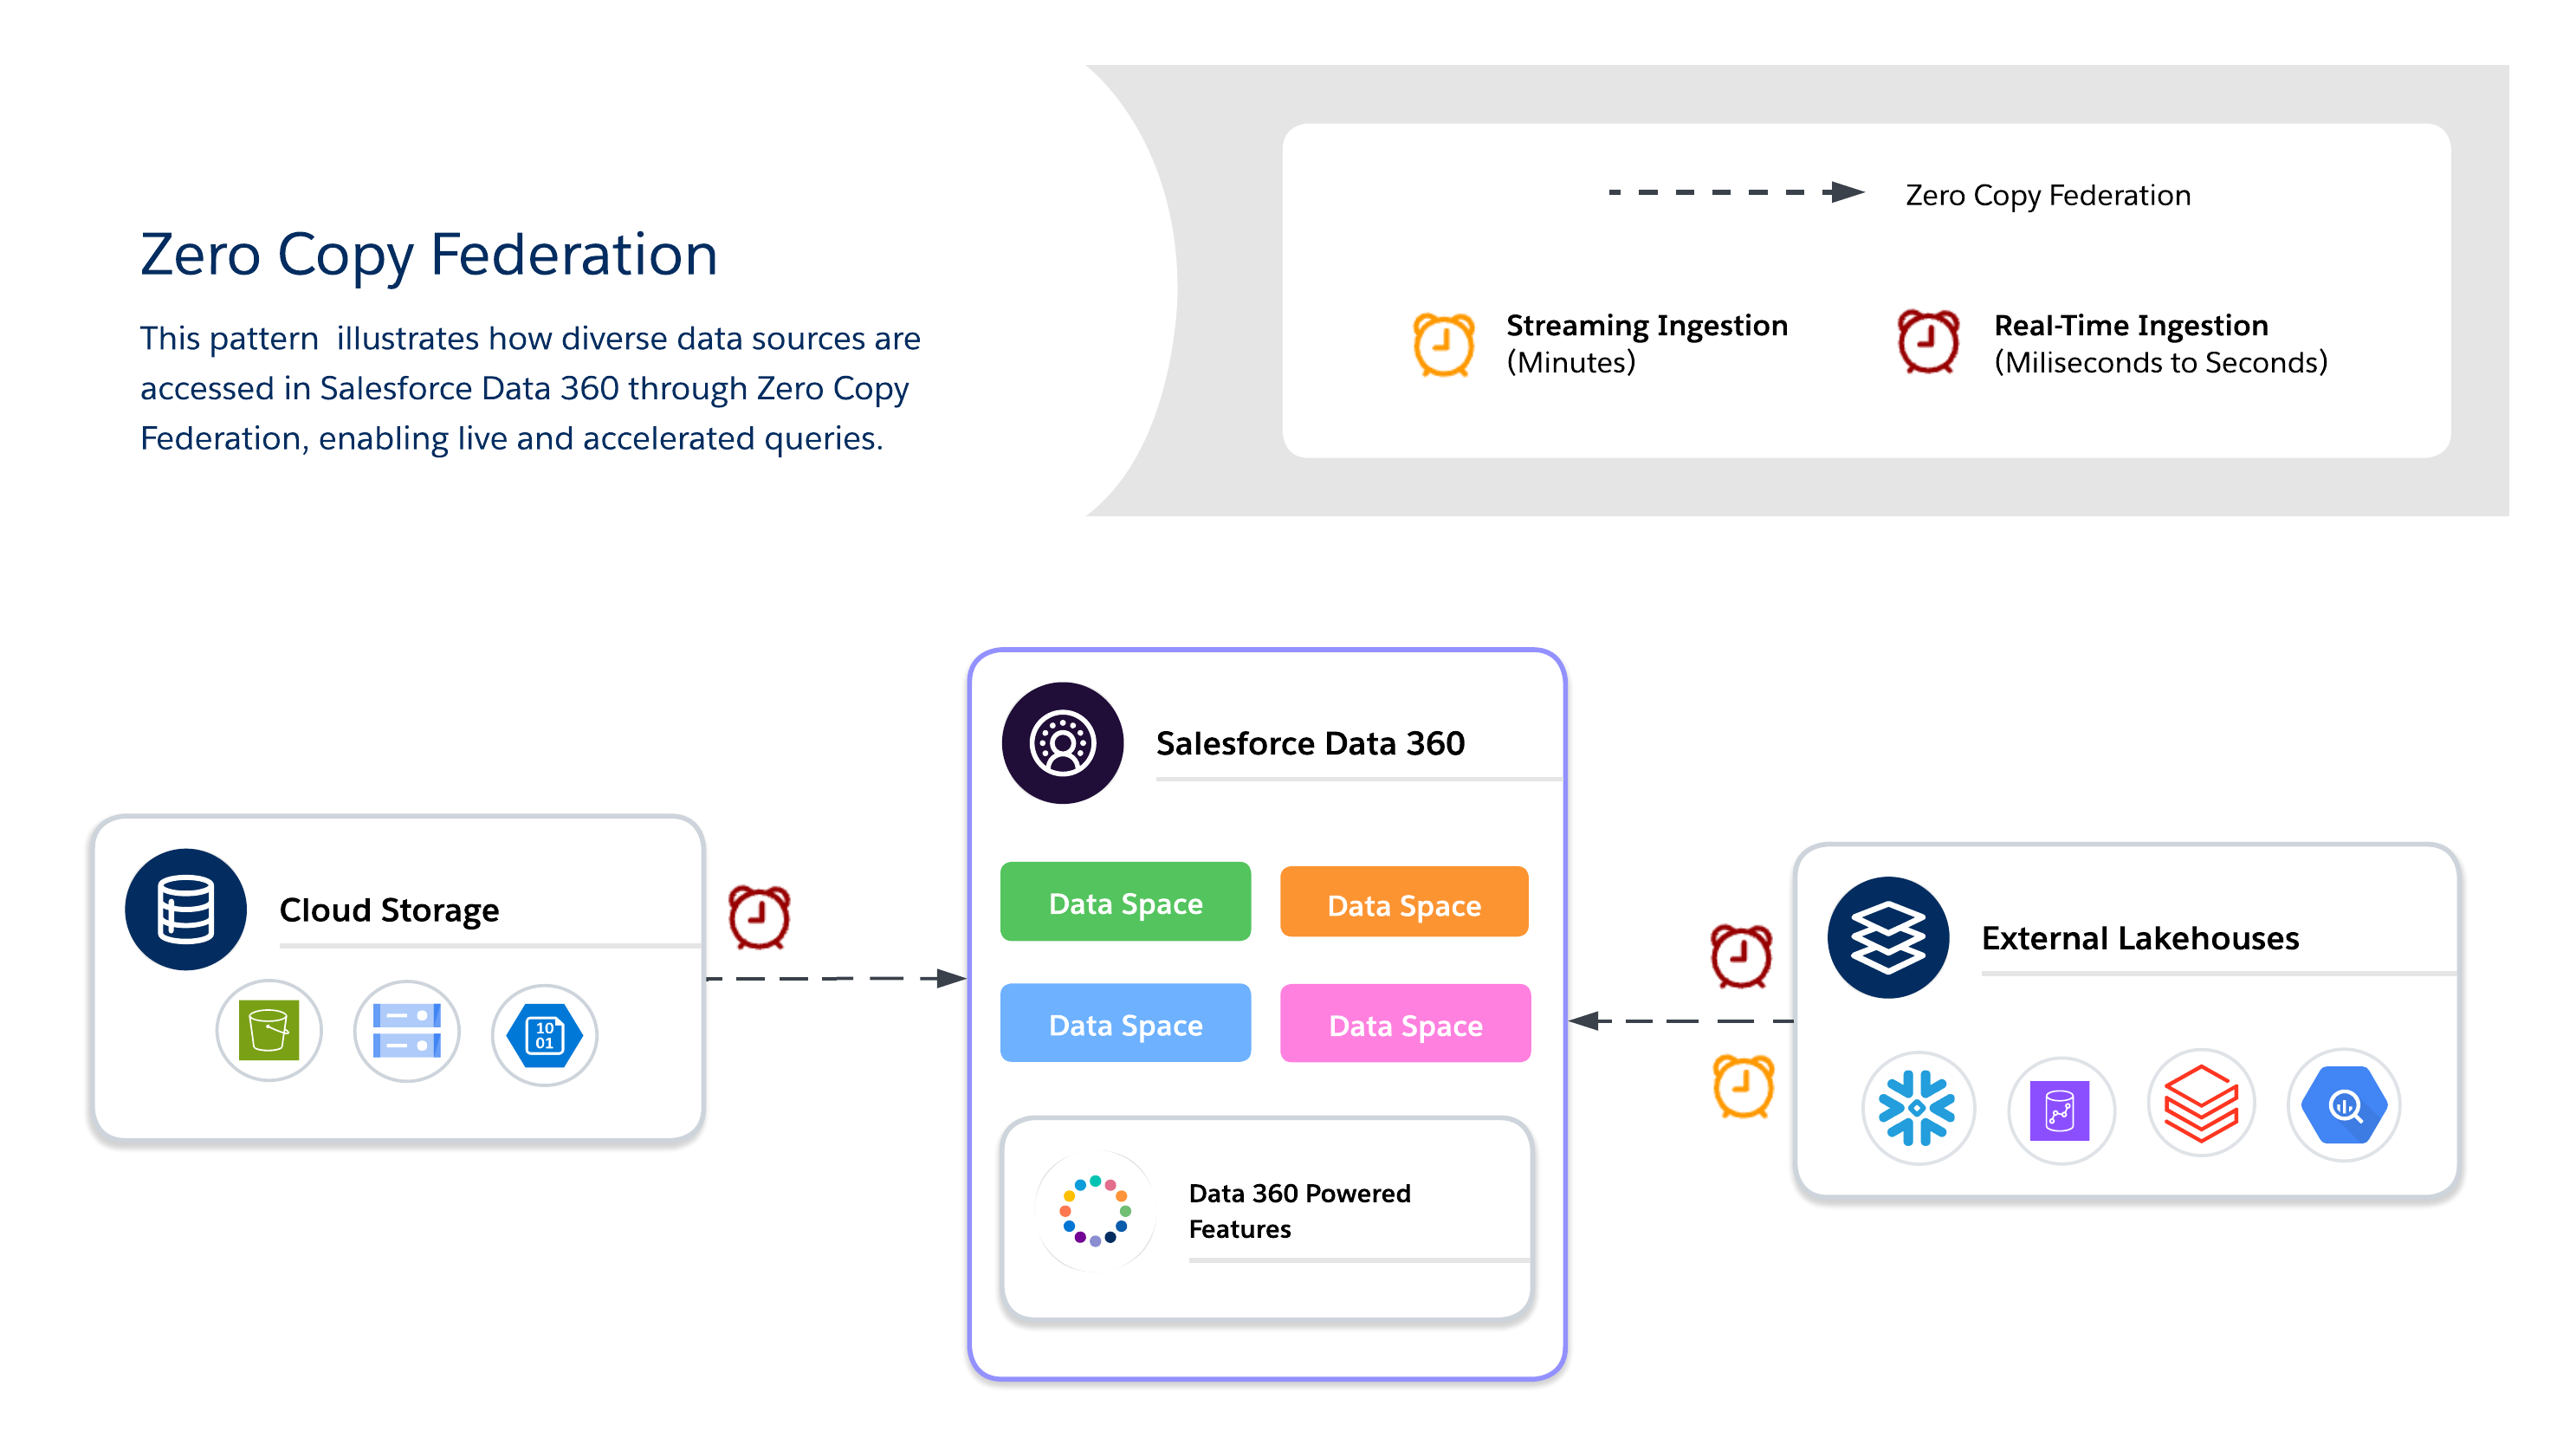
Bij het gebruik van Zero Copy moeten architecten kiezen tussen drie beschikbare methoden voor gegevensbundeling, die elk hun eigen nadelen bieden tussen versheid, prestaties en kosten.
- Live query
- Voert query’s rechtstreeks uit op externe systemen (bijvoorbeeld Snowflake, Google BigQuery, Redshift, Databricks, enzovoort) zonder gegevensduplicatie.
- Minimaliseert gegevensverplaatsing over het netwerk en vermindert I/O voor de Salesforce Data 360-berekening, wat optimaal is wanneer predicaten en aggregaties omlaag kunnen worden geduwd.
- Geschikt voor realtime insights en operationele dashboards met lage latentie.
- Afhankelijk van externe systeemprestaties.
- Caching (versnelde query)
- Slaat tijdelijk cachekopieën van gebundelde gegevens op in Salesforce Data 360.
- Vermindert de kosten van herhaalde query’s en de latentie voor vaak geopende gegevenssets met configureerbare duur (minuten tot dagen).
- Gegevens worden niet permanent gekopieerd of volledig beheerd, waardoor versheid wordt beheerd via geplande vernieuwingen vanuit de bron.
- Incrementele vernieuwing ondersteunt alleen upserts. Verwijderde records worden niet uit het cachegeheugen verwijderd.
- Voer periodiek een volledige vernieuwing uit om ervoor te zorgen dat het cachegeheugen gesynchroniseerd blijft met de bron.
- Opmerking: De Snowflake-connector ondersteunt de functie Ontladen, die de acceleratiesnelheid verhoogt door middel van een door Snowflake geïnitieerde faseringsbucket. Dit is standaard ingeschakeld, maar kan worden uitgeschakeld door de verbinding te bewerken.
- Bestandsbundeling
- Biedt directe, alleen-lezen toegang tot grootschalige gegevenssets in objectstores (bijvoorbeeld S3 en GCS met Iceberg).
- Geschikt voor AI/ML-werkbelastingen, historische analyses en rapportage op petabyteschaal zonder gegevens te verplaatsen.
- Queryprestaties zijn sterk afhankelijk van objectindeling, partitionering en netwerk-I/O. Grote scans kunnen aanzienlijke I/O genereren als ze niet zijn geoptimaliseerd.
- Gebruikscases
- Realtime personalisatie en adaptieve werkstromen bieden dynamische aanbiedingen, aanbevelingen en next-best acties naarmate de werking van klanten verandert.
- Live dashboards en operationele analyses ondersteunen bedrijfskritieke dashboards en KPI’s rechtstreeks vanuit externe magazijnen.
- AI/ML-modeltraining met grote externe gegevenssets maakt gebruik van gegevens op petabyteschaal uit gegevens-lakes en magazijnen zonder deze te verplaatsen via bestandsbundeling.
- Industriescenario’s
- Retail/Media: Schakel gepersonaliseerde aanbevelingen en real-time klantbetrokkenheid in door klikstroom- of inhoudsinteractiegegevens te bundelen.
- Financiën: Voer fraudedetectie en risicoscores in vrijwel realtime uit door een query uit te voeren op externe magazijnen zonder vertrouwelijke gegevens te dupliceren.
- Tech/Enterprise: Ondersteun cross-cloud rapportage, IT-servicedashboards en operationele analyses wanneer gegevenssets zich in meerdere systemen bevinden.
- Ontwerppraktijken
- Live query
- Gebruik dit voor query’s met een hoge QPS en lage latentie wanneer versheid kritiek is.
- Push predicaten en aggregaties naar het externe systeem om het schuiven van gegevens over het netwerk te verminderen.
- Vermijd query’s die onnodig grote hoeveelheden gegevens scannen.
- Overweeg in plaats daarvan het snoeien van partities en filters.
- Bestandsbundeling
- Toegang tot gegevenssets op petabyteschaal in objectstores zonder opname.
- Minimaliseer latentie- en uitgangskosten door objectopslag in dezelfde Cloud-regio te houden als Salesforce-berekening.
- Gebruik gepartitioneerde, kolomindelingen (Parquet/ORC) en pushdownfilters om I/O- en netwerkoverdracht te verminderen.
- Maak gebruik van pushdown van query’s en predicaten om gegevens bij de bron te filteren en aggregeren, wat de verplaatsing van gegevens vermindert.
- Vermijd toegang tot gegevens over meerdere regio’s—tenzij het absoluut noodzakelijk is—omdat dit de I/O, latentie en kosten verhoogt.
- Caching (versnelde query)
- Vaak geopende gegevenssets in het cachegeheugen opslaan om kosten en prestaties in evenwicht te brengen.
- Configureer vernieuwingsintervallen om de versheid en querykosten in evenwicht te brengen.
- Naleving: Dwing governance bij de bron af door gebruik te maken van beveiliging op rijniveau en beleidsvormen rechtstreeks binnen gebundelde systemen te maskeren.
- Hier zijn enkele best practices voor uniforme RLS en maskeren over platforms:
- Gebruik een gecentraliseerde ondernemings-ID. Wijs gebruikers en entiteiten in Salesforce Data 360 toe aan een unieke, gecentraliseerde ondernemings-ID die overeenkomt met identiteiten in externe systemen.
- Beveiligingsbeleid afstemmen. Zorg ervoor dat RLS en beleid voor maskeren in gebundelde systemen worden toegepast op basis van de toegewezen identiteit. Dit behoudt naleving bij het uitvoeren van query’s op externe gegevens.
- Identiteitsschema’s standaardiseren. Handhaaf consistente identiteitskenmerken (e-mail, gebruikers-ID, klant-ID, enzovoort) voor alle gegevensbronnen om mismatches en toegangsschendingen te voorkomen.
- Hier zijn enkele best practices voor uniforme RLS en maskeren over platforms:
- Live query
- Overwegingen bij kosten
- Live query: In het pay-per-query-model worden kosten opgeteld bij de berekening van externe lakehouses, wat pieken met hoge QPS kan veroorzaken. Dit is geschikt voor versheidskritische gebruikscases waarbij de waarde groter is dan de kostenvariabiliteit.
- Versnelde query (caching): Deze methode verlaagt de querykosten (in vergelijking met Live query) door het aantal hits naar het bronsysteem te verminderen; het verhoogt echter de kosten voor het opnemen van batchgegevens voor het vullen en vernieuwen van het cachegeheugen. Dit is geschikt voor gegevenssets die vaak worden geopend.
- Bestandsbundeling: Dit is de goedkoopste opslagoptie als gegevens in Objectstore; de querykosten zijn echter afhankelijk van de bestandsgrootte, partitionering en afkappen. Dit is geschikt voor historische of bulkgegevens op petabyteschaal.
| Beslissingspunt | Live query | Caching (versnelde query) | Bestandsbundeling |
|---|---|---|---|
| Gegevensbronlocatie | Externe gegevens-lakehuizen (bijvoorbeeld Snowflake, Google BigQuery, Redshift en Databricks) | Externe gegevens-lakehuizen (bijvoorbeeld Snowflake, Google BigQuery, Redshift en Databricks) | Objectstores of Cloud-gegevens-lakes (bijvoorbeeld S3, ADLS en GCS), die vaak open-table indelingen zoals Iceberg gebruiken. |
| Doel/gebruikscase | Geschikt voor interactieve analyses en realtime dashboards. Geschikt voor real-time personalisatie en dynamische werkstromen. | Geschikt voor wanneer query’s frequent zijn, maar enigszins verouderde resultaten acceptabel zijn. Geschikt voor BI dashboards en segmentering. | Geschikt voor grootschalige batchverwerking en AI/ML-modeltraining. Geschikt voor historische analyses en rapportage op petabyteschaal. |
| Versheid/latentie | Biedt maximale versheid Voert query’s rechtstreeks in realtime uit. Ondersteunt beslissingen van minder dan een seconde wanneer het bronsysteem is geoptimaliseerd voor query’s met lage latentie met een effectieve predicaatpushdown. | Gebruik dit wanneer licht muffe resultaten acceptabel zijn. De versheid is afhankelijk van het cache-interval, dat kan worden geconfigureerd van 15 minuten tot 7 dagen. | Geschikt voor batchzware, doorvoerintensieve taken. Niet geschikt voor realtime dashboarding. |
| Toegangspatroon | Geschikt voor zeldzame of ad-hocquery’s waarbij versheid kritiek is en het queryvolume laag is. Kosten stijgen aanzienlijk bij hoge QPS, dus het is belangrijk om caching (Versnelde query) te evalueren wanneer de queryfrequentie hoog is. | Geschikt voor scenario’s met hoge leesfrequentie. Verbetert prestaties voor frequente toegangspatronen. | Biedt alleen-lezen toegang. Geschikt voor gegevenssets op petabyteschaal zonder opname. |
| Prestatiedrivers | Zeer afhankelijk van externe bronsysteemprestaties. Geschikt voor wanneer predicaten en aggregaties naar de bron kunnen worden gepusht. | Vermindert de latentie in vergelijking met herhaalde live query’s. Prestaties zijn afhankelijk van cachebeheer en intervallen. | Prestaties zijn sterk afhankelijk van objectindeling, partitionering en externe systeemdoorvoer. Gebruik gepartitioneerde, kolomindelingen (Parket/ORC). |
| Gevolgen voor kosten | Dit is een pay-per-query-model, waardoor kosten worden gemaakt voor externe berekeningen van Lake House. Het is kostenefficiënt voor zeldzame query’s, maar de onkosten kunnen pieken bij een hoog QPS-volume. | De kosten zijn lager dan herhaalde live query’s. Het vermindert de noodzaak om herhaaldelijk een query uit te voeren op de externe bron, maar voegt cacheopslag en vernieuwingsoverhead toe. | Dit is de goedkoopste opslagoptie. Voor AWS-instellingen voor dezelfde regio en dezelfde cloud (bijvoorbeeld S3 in US-East-1 met een Data Cloud-belanghebbende die ook US-East-1 gebruikt), worden geen kredieten verbruikt voor de rijen die worden geopend. Configuraties tussen regio’s of clouds (bijvoorbeeld Azure, GCS of verschillende AWS regio’s) leiden tot kredietverbruik voor de rijen die worden geopend. Querykosten zijn ook afhankelijk van bestandsgrootte, partitionering en optimalisering van predicaatpushdown. |
| Belangrijkste overweging | Vermijd ongefilterde query’s die onnodig grote hoeveelheden gegevens scannen. | Deze benadering vereist cachebeheer. Niet geschikt voor subsecondenbeslissing. | Queryprestaties zijn sterk afhankelijk van optimalisering via partitionering en predicaatpushdown. |
Hybride architecturen stellen architecten in staat om kritieke gegevenssets te verankeren in Data 360 voor gecentraliseerd beheer, terwijl ze ook gebundelde query’s gebruiken voor versheid, minder duplicering en schaalbare toegang tot grote, externe gegevenssets. Deze benadering houdt rekening met I/O, berekeningslocatie, kosten en nalevingsvereisten.
Gebruik een hybride benadering voor evenwichtig bestuur, versheid en operationele efficiëntie door gegevensopname en zero copy te combineren om real-time, navolgbare insights te leveren. Gebruik opname voor hoogwaardige, gereguleerde gegevenssets waarbij traceerbaarheid, RLS en maskering vereist zijn, en bundeling voor gegevenssets met een kort of groot volume waarbij versheid en prestaties essentieel zijn.
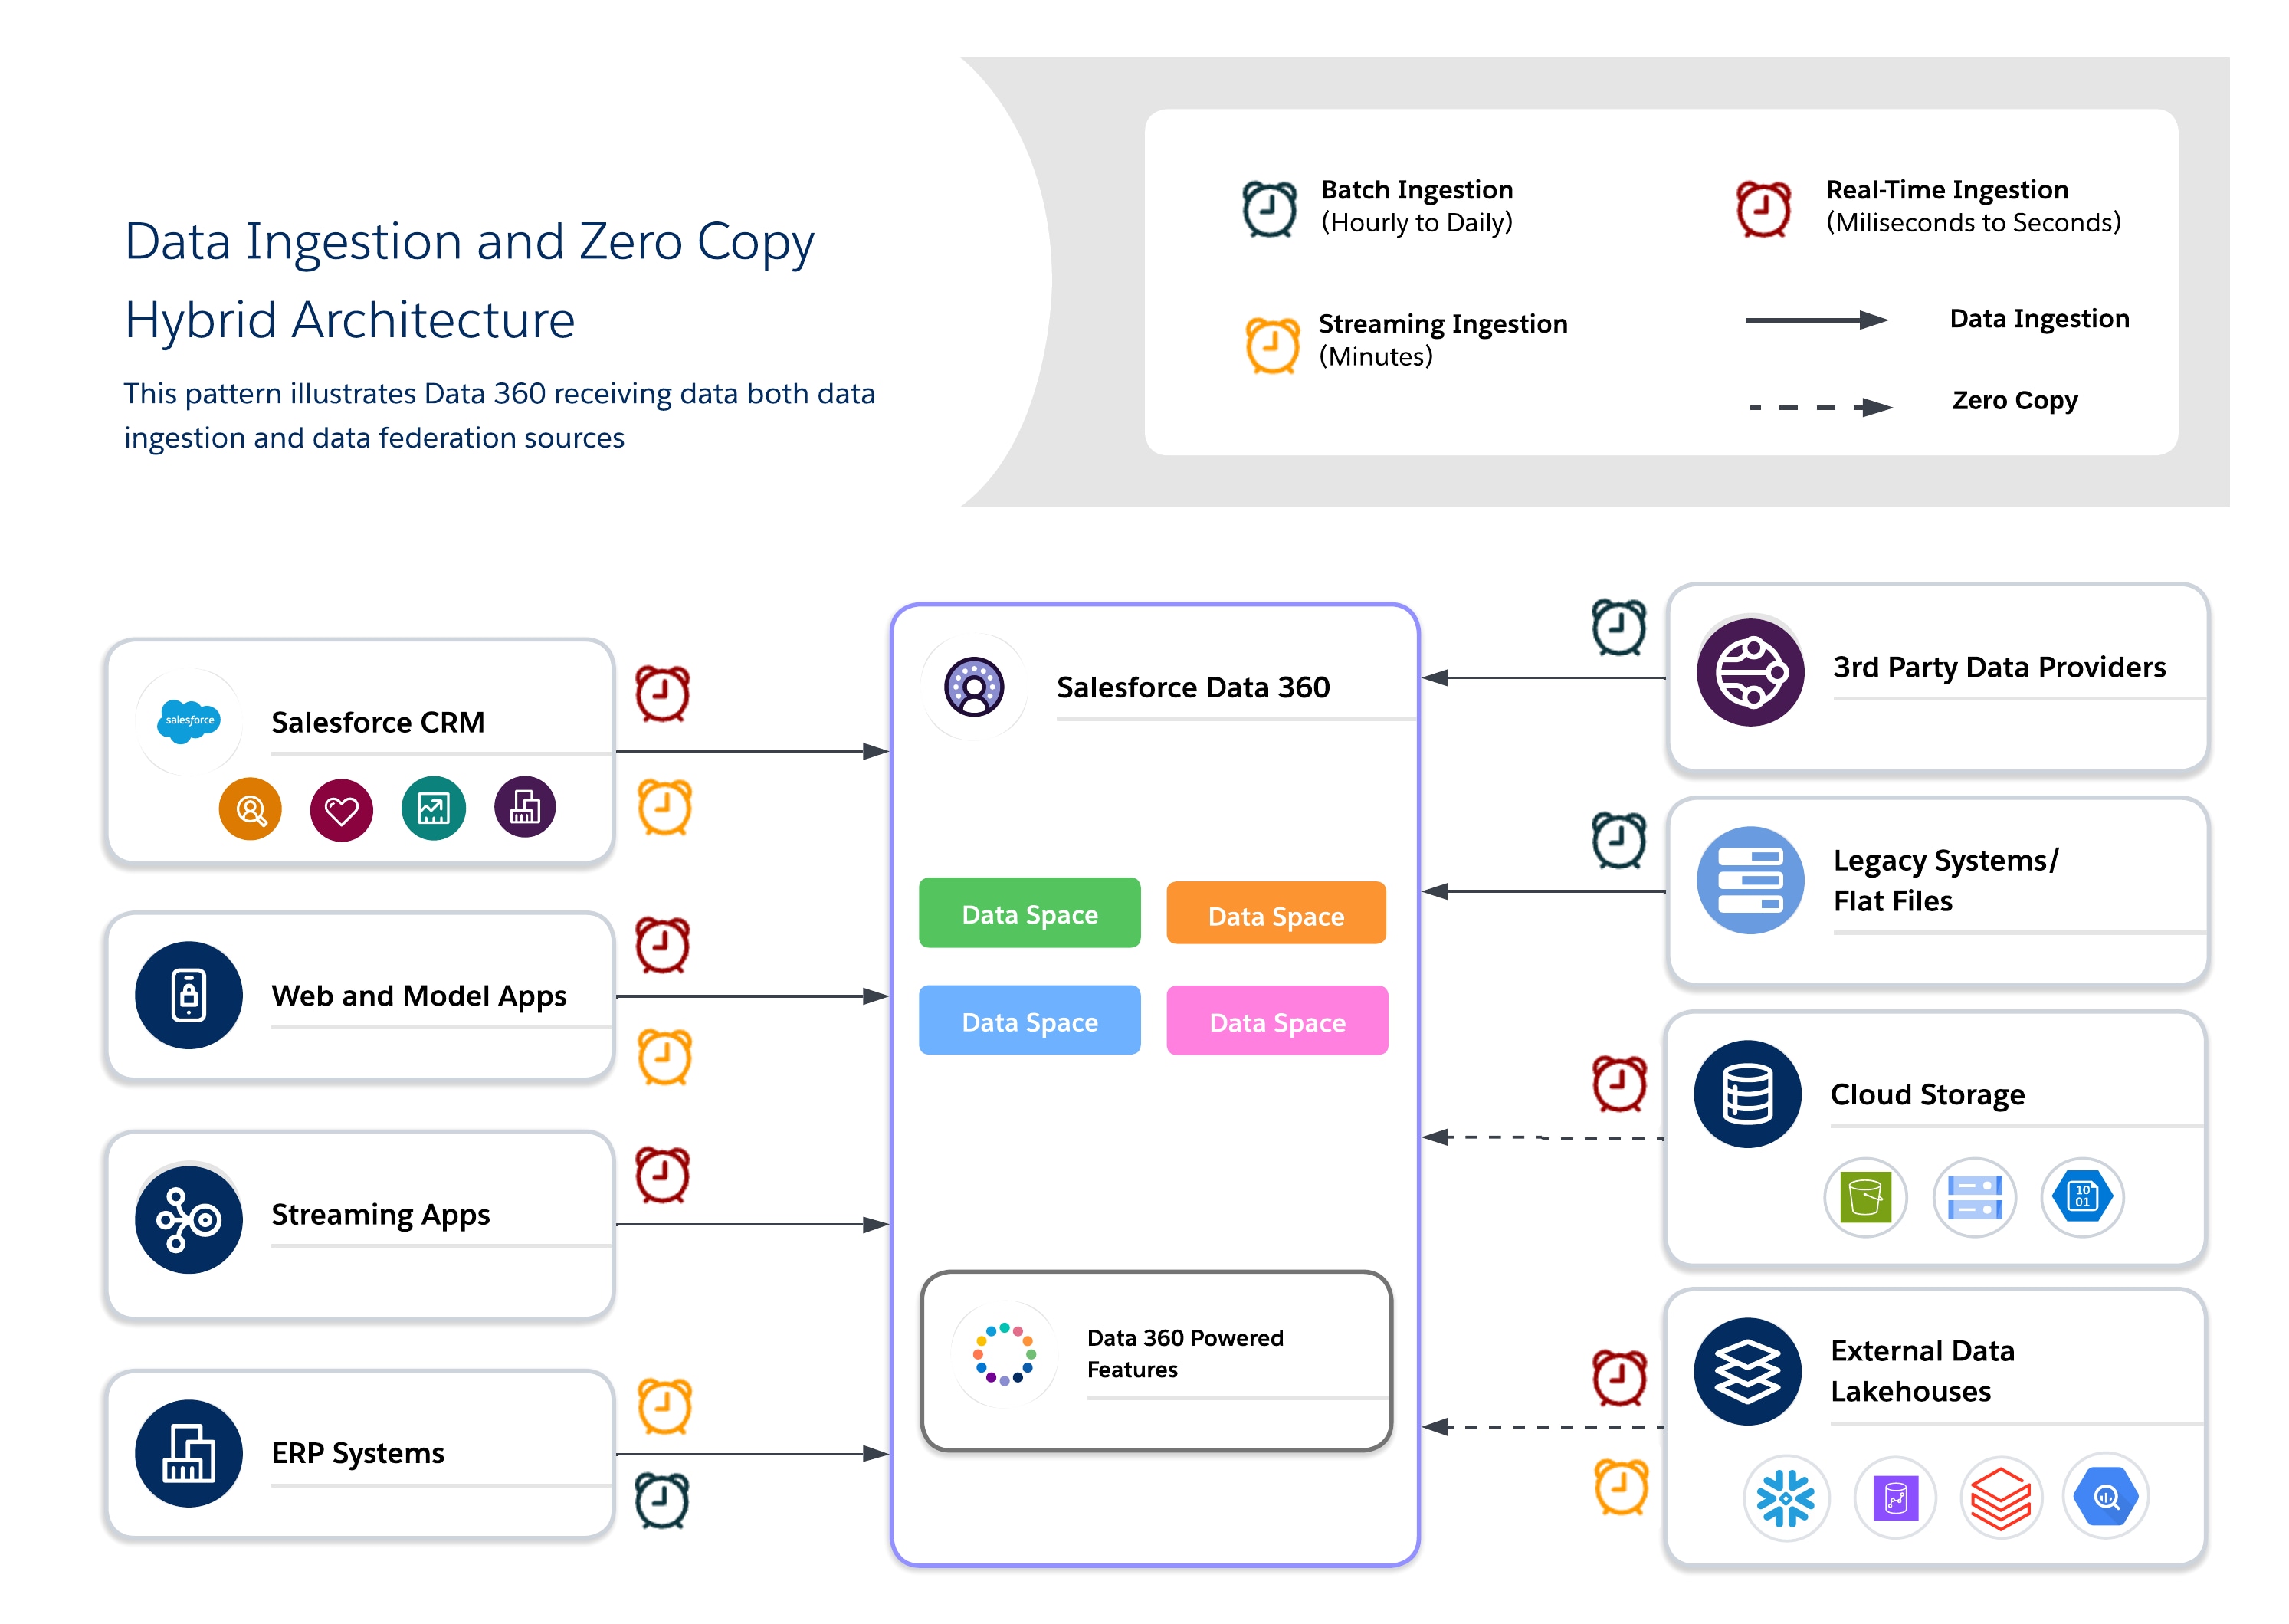
- Gebruikscases
- Omni-channel betrokkenheid: Combineer historische klantgegevens met real-time gedrag om consistente, contextbewuste ervaringen te bieden.
- AI/ML-pijplijnen: Train modellen op gemodereerde, canonieke gegevenssets en verrijk ze met ruwe of realtime signalen van externe bronnen.
- Gemengde nalevings- en flexibiliteitsbehoeften: Pas strikte governance toe voor gevoelige gegevens en bundeling voor operationele flexibiliteit.
- Industriescenario’s
- Retail: Gebruik opname voor identiteitsoplossing en profielsamenvoeging, en bundeling voor realtime aanbiedingen en personalisering.
- Gezondheidszorg: Houd gouden patiëntenrecords bij via opname tijdens het gebruik van bundeling op IoT-apparaatstromen en sensorgegevens voor directe context.
- Financiële diensten: Neem gereguleerde gegevens op in een door naleving bestuurd meer terwijl u bundeling gebruikt voor externe query’s voor fraudedetectie en risicobewaking.
- Ontwerppraktijken
- Governance van anker met opname: Neem waardevolle of gereguleerde gegevens op in canonieke modellen om Trust en naleving te garanderen.
- Federatie voor versheid gebruiken: Hiermee kunnen externe meerhuizen realtime of grootschalige gegevenstoegang bieden zonder dupliceren.
- Evenwicht tussen kosten en prestaties: Profielwerkbelastingen om te bepalen wanneer opname versus bundeling moet worden gebruikt, waardoor onnodige opslag- en querykosten worden geminimaliseerd.
- Gelaagde governance toepassen: Dwing gecentraliseerd bestuur af voor opgenomen gegevens en maak daarbij gebruik van de beveiligingsmaatregelen van gebundelde systemen (bijvoorbeeld RLS en maskeren).
- Opmerking: Wanneer u hybride pijplijnen ontwerpt, is het belangrijk dat u zorgt voor incrementele opname voor historische gegevenssets en aggregaties of filters pusht naar gebundelde bronnen om I/O- en rekengebruik te optimaliseren.
- Overwegingen bij kosten
- Weeg de totale kosten versus prestaties af door opname voor naleving of kritieke gegevens te combineren met bundeling wanneer versheid noodzakelijk is.
- Houd rekening met I/O- en berekeningsdistributie bij het mengen van opname en bundeling. Als u de berekeningskosten van herhaalde query’s op bronsystemen wilt verlagen, gebruikt u caching (Versnelde query) voor veelgelezen, vaak geopende gebundelde gegevenssets.
- Gebruik deze regel als leidraad voor de beslissing over opname versus bundeling: wanneer gegevens vaak worden geopend, maar niet vaak worden gewijzigd, is Versnelde query doorgaans kosteneffectiever. Wanneer gegevens echter vaak veranderen (ten opzichte van de toegangsfrequentie), is Live query of opname geschikter. Hier zijn enkele kostenvoorbeelden:
- Versnelling wint: Een dashboard dat is samengesteld op basis van 1M-records en dagelijks wordt bijgewerkt met ~10K wijzigingen, wordt 20 keer per dag weergegeven. De versnellingskosten zijn ongeveer ~600 credits/maand versus ~4200 credits/maand voor Live query’s.
- Live query wint: Segmenten die 20 keer per dag worden gepubliceerd met behulp van gegevens die elke 30 minuten veranderen. Live query’s kosten ruwweg ~4.200 credits/maand versus ~28.800 credits/maand voor versnelling met deze vernieuwingsfrequentie.
Laten we eens wat beter kijken naar een paar veelvoorkomende archetypen die illustreren hoe deze logica toe te passen.
- Het archetype “Enige bron van waarheid”: Centraliseren en beheren
- Scenario: U moet conforme, gecombineerde Customer 360 profielen samenstellen voor uw gehele wereldwijde onderneming. De gegevens zijn afkomstig uit een dozijn verschillende systemen, moeten voldoen aan strenge GDPR- en CCPA-regelgeving en dienen als de bron van waarheid voor alle marketing- en service-interacties.
- Aanbevolen patroon: Gegevensopname. De prioriteit ligt hier bij governance, Trust en controle. Het opnemen van de gegevens in Data 360 is de enige manier om een volledig controleerbaar, canoniek profiel te maken dat is geïsoleerd van de bronsystemen.
- Archetype “Real-time Insights”: Analyseren zonder te verplaatsen
- Scenario: Uw Data Science-team moet verkennende query’s uitvoeren op een enorme transactietabel die voortdurend wordt bijgewerkt in Snowflake. Tegelijkertijd wil uw leidinggevende team een live BI dashboard dat wordt aangestuurd door diezelfde gegevens. Het dagelijks verplaatsen van petabytes aan gegevens is traag en duur.
- Aanbevolen patroon: Zero Copy Federation. Snelheid, wendbaarheid en kostenefficiëntie op schaal staan hierbij voorop. Met Zero Copy kunt u de kracht van uw bestaande gegevensmagazijn benutten voor real-time query’s zonder de overhead en latentie van gegevensduplicering.
- Het archetype “Hybride intelligentie”: De kern besturen, de rand bundelen
- Scenario: U wilt uw beheerde, opgenomen klantprofielen verrijken met realtime gedragssignalen (bijvoorbeeld klikken op een website) uit een gegevens-lake. U hebt de stabiliteit van het kernprofiel nodig, maar de directheid van de live gegevens om personalisatie op het moment mogelijk te maken.
- Aanbevolen patroon: Een hybride aanpak. Gebruik Gegevensopname om een stabiele, gecontroleerde kern voor uw klantgegevens te maken. Gebruik Zero Copy om de vluchtige, real-time “edge”-gegevens te bundelen en voeg ze vervolgens samen op querytijd voor een volledige, tot op de seconde nauwkeurige weergave.
Enterprise Data Strategy is niet langer gericht op het kiezen van één integratiepatroon, maar op het ontwerpen van gecontroleerde flexibiliteit binnen een interoperabel gegevensecosysteem. De juiste benadering wijst elk bronsysteem toe aan het patroon dat het beste past bij de vereisten voor versheid, governance, kosten en toegang:
- Neem missiekritieke, gereguleerde gegevenssets op in Salesforce Data Cloud voor naleving, identiteitsoplossing en operationele werkstromen.
- Bundel gegevens via Zero Copy voor live, verkennende en AI-gestuurde analyses zonder opslag te dupliceren.
- Pas caching (versnelde query) toe om bronsysteembelasting en kredietverbruik te verminderen wanneer de queryfrequentie hoog is en de frequentie van gegevenswijziging laag
Salesforce Data 360 voor Hyperforce biedt veerkracht en schaalbaarheid voor meerdere regio’s. Het open Lake House met Iceberg-tabellen maakt scheiding van berekeningen en interoperabiliteit mogelijk met platforms zoals Snowflake, Databricks en S3 Iceberg, die de ruggengraat vormen van een echt interoperabel gegevensecosysteem met meerdere clouds.
Terwijl gegevensecosystemen zich ontwikkelen, moeten we continu een evenwicht vinden tussen versheid, kosten, prestaties en naleving om architectonische flexibiliteit te behouden. Daarom is het belangrijk om uw platform toekomstbestendig te maken door opgenomen, gereguleerde gegevens te combineren met gebundelde toegang. Dit maakt real-time intelligence, AI-activering en personalisering op ondernemingsniveau mogelijk in clouds, regio’s en bedrijfsdomeinen.
Houd er rekening mee dat one-size-fits-all oplossingen niet geschikt zijn voor de meeste bedrijven. De optimale strategie wijst het juiste patroon toe aan de juiste business driver.
Yugandhar Bora is een Software Engineering Architect bij Salesforce die gespecialiseerd is in gegevensarchitectuur binnen het Data and Intelligence Applications-platform. Hij geeft leiding aan initiatieven van de Enterprise Architecture Review Board (EARB) die zich richten op data governance en gecombineerde gegevensmodellen, terwijl hij ook bijdraagt aan oplossingen voor geautomatiseerde platformleveringen.
Jan Fernando is hoofdarchitect bij het kantoor van de Chief Architect (OCA) bij Salesforce, die in 2012 bij Salesforce kwam werken. Hij heeft een schat aan ervaring opgedaan in het startup-ecosysteem. Voordat hij bij de OCA kwam, werkte hij meer dan tien jaar in de Platform organisatie, waar hij verschillende belangrijke technologische transformaties leidde.