Introduksjon
Notat: "Emner" har blitt endret til "underagenter" i løpet av denne artikkelen, i henhold til våre nyeste produktnavnkonvensjoner.
Du kan bygge en agent som gjør det bra i et testmiljø, bare for å få den til å følge helt forskjellige ruter når den behandler samme arbeidsflyt to ganger. Denne grunnleggende begrensningen viser hvordan den tidligere Agentforce håndterte utførelse: Alle beslutninger, fra hensiktstolkning til handlingsvalg, ble gjort i sanntid av LLM, uten noen garantert bane gjennom arbeidsflyten.
LLM-er kan produsere inkonsekvente utfall som svar på identiske inndata. Små variasjoner i kontekst, systemledetekster eller tokengenerering er nok til å sende en agent ned en annen rute. For mange interaksjoner er denne variabiliteten akseptabel. For arbeidsflyter med flere faser som krever revisjon, reproduserbarhet og sporbarhet, er det imidlertid ikke det. En lånegodkjenning, en lagerbeholdningsoverføring eller en pasientsorteringsprosess kan ikke være avhengig av at en agent begrenser sin vei gjennom trinnene forskjellig hver gang.
Den nye Agentforce Builder og Agent Script løse dette problemet ved å skille deterministisk utførelse fra LLM resonnement. Agentforces hybridmodell sikrer at agenten følger en nøyaktig definert struktur for hver arbeidsflytutførelse, samtidig som man fortsatt bruker LLM-reaksjoner der det virkelig er behov for vurdering, forståelse av naturlig språk eller kontekstuell tolkning.
I den tidligere versjonen av Agentforce fungerte en agent som en enkel reaktiv sløyfe. Alle beslutninger, fra å tolke hensikt til å velge neste handling, ble gjort i sanntid av LLM basert utelukkende på brukerens siste inndata. Det var ingen garantert utførelsesbane, ingen fast tilstand og ingen mekanisme for å håndheve en sekvens av trinn.
Utførelsesbaner kunne ikke garanteres
Fordi hver beslutning var avhengig av LLMs sanntidsgjennomgang, produserte mindre variasjoner i inndata, systemmelding eller modellversjon forskjellige handlingsvalg for identiske forespørsler. Dette gjorde det vanskelig å teste den forrige modellen nøye: en arbeidsflyt som er overført i oppstillingen, kan virke annerledes i produksjon, og det fantes ingen pålitelig måte å reprodusere en bestemt utførelsesbane for feilsøking eller revisjonsformål.
Hver interaksjon betalte full LLM kostnad
Selv enkle samtalescenarier krever minst tre LLM-sykluser: Underagentvalg, handlingsvalg og generering av endelig svar. Flertrinnsoppgaver som utvides til fem eller flere sykluser. For arkitekter som utformer arbeidsflyter med stor trafikk eller som skiller mellom ventiler, var dette ikke bare et ytelsesproblem. Det betydde at du ikke kunne forkorte resonanssløyfen for trinn som ikke krevde vurdering, fordi arkitekturen ikke hadde noen mekanisme for å skille mellom de to.
Ikke-deterministisk utførelse skapte et revisjonsgap
I regulerte bransjer betyr revisjonsmulighet å kunne demonstrere at en bestemt prosess ble fulgt på en bestemt måte for en bestemt transaksjon. En rent ikke-deterministisk modell kan ikke gi denne garantien. Hvis utførelsesbanen varierer mellom kjøringer, varierer revisjonssporet også, og "agenten bestemte seg" er ikke et svar som kan forsvares i en samsvarsvurdering.
Staten overlevde ikke samtalen.
Å basere seg på behandling med én omgang betyr at agenten ikke hadde noen fast minne for tidligere trinn. Hvis samtalen avviker enda litt, kan agenten slippe tidligere fanget kontekst og tvinge brukeren til å starte på nytt. For flertrinns transaksjonsarbeidsflyter opprettet dette et pålitelighetstak: Jo flere trinn i prosessen, desto større sannsynlighet for tap av kontekst før fullføring.
Fullførte trinn ble ikke husket
Uten delstatsbehandling hadde ikke agenter noen registrering av hvilke obligatoriske trinn en bruker allerede hadde fullført. Dette førte til uforutsigbar sløyfe, der en agent ville gå tilbake til et trinn brukeren allerede hadde fullført. Ut over innvirkningen på brukeropplevelsen opprettet dette et dypere arkitektonisk problem: utforming av en pålitelig sekvensiell arbeidsflyt var umulig fordi agenten ikke kunne håndheve sekvens.
Den nye Agentforce, GA siden februar 2026, skifter fra rent sannsynlighetsbasert LLM-grunnlag til en hybridmodell. I stedet for å rute alle beslutninger gjennom LLM, skiller den deterministisk utførelse fra LLM-vurdering og lar hver av dem håndtere bare det den er egnet for. For å støtte dette introduserte Agentforce to redigeringsverktøy: Agent Script for kodebasert utvikling, og Agentforce Studio, et miljø uten kode.
Agentforce Builder
Agentforce Builder er det anbefalte miljøet for utvikling av nye agenter. Den er lagret i Agentforce Studio og erstatter den tidligere Oppsett-opplevelsen, som forblir tilgjengelig, men ikke lenger er den primære forfatterbanen. I byggeren arbeider du enten i en visuell lerretsvisning eller direkte i Skript-visning, og redigerer Agent-skriptet som definerer agentens virkemåte.
Agentskript
Agentskript er et deklarativt, domenespesifikt språk (DSL) som definerer alt om hvordan en agent oppfører seg: dens konfigurasjon, forretningslogikk og ledetekster. Den er strukturert som nøkkel-verdi-par som kan spenne over flere linjer eller inkludere nestede underegenskaper, og den er utformet for å være menneskelig lesbar uten å kreve Knowledge av den underliggende grafarkitekturen.
Med Agent Script kan du uttrykke to fundamentalt forskjellige typer instruksjoner i samme agent: instruksjoner for deterministisk logikk og ledetekstinstruksjoner. Deterministisk logikk-instruksjoner definerer betingelser og handlingssekvenser som utføres som kode uten LLM-engasjement. Ledetekstinstruksjoner definerer veiledning med naturlig språk som LLM tolker ved kjøretid. Grensen mellom de to er eksplisitt og hensiktsmessig, og å forstå hvor denne grensen skal plasseres, er en av kjerneutformingsbeslutningene du vil ta når du bygger med den nye Agentforce.
Deterministisk logikk i praksis
Når instruksjoner er deterministiske, følger agenten en definert utførelsesbane uavhengig av hvordan brukeren uttrykker inndataene sine. Eksempelet nedenfor viser en underagent som laster inn et kontrollpanel for Kundeintelligens. Den ser etter en kunde-ID, henter profildata, bestillingshistorikk og kundestøttebilletter, og beregner deretter kundens levetidsverdi og utfallsrisiko. Ingen av disse trinnene krever LLM-vurdering.
Denne logikken kaller opp handlinger i en fast sekvens hver gang bestemte betingelser oppfylles.
Prompt instruksjoner og bevisst LLM overdragelse
Der deterministisk logikk håndterer betingelser og sekvenser som kan uttrykkes som kode, håndterer ledetekstinstruksjoner alt som krever vurdering, tolkning eller generering av naturlig språk. Når Atlas Reasoning Engine støter på en node med ledetekstinstruksjoner, utløses et LLM-kall. Når den ikke gjør det, utføres den deterministisk.
Eksempelet nedenfor viser en underagent for produkter og tjenester. Instruksjonene er en flerlinjemelding som forteller LLM hvordan de skal svare, når de skal slå opp informasjon og hvordan de skal håndtere tvetydighet. Dette er det riktige mønsteret når området med mulige brukerinndata er for bredt til å forutsies med betinget logikk, eller når kvaliteten på svaret avhenger av LLMs evne til å tolke kontekst og generere et naturlig svar.
Ledetekstinstruksjonene i en node utløser LLM-kallet. Det er ikke tilfeldig – det er mekanismen som agentskript gjør LLM-grensen eksplisitt og håndhevbar, i stedet for å overlate den til kjøretidsutledninger.
Denne underagent viser deterministisk logikk og LLM-overføring i praksis.
Den tretrinnvise gjennomføringen
Agentforce Builder og Agent Script er redigeringslag, men Agent Graph og Atlas Reasoning Engine kjører faktisk agenten. Ingen av disse komponentene er direkte tilgjengelig for deg ut fra utformingen. Ved å skille redigering og utføring kan plattformen håndheve deterministisk virkemåte uavhengig av hvordan skriptet ble skrevet.
Pipelinen går gjennom tre faser.
- Forfatterskap er der du arbeider. Agent-skriptet er lesbart og kan redigeres i lerretsvisning eller skriptvisning i Agentforce Builder. Dette er det eneste laget du samhandler direkte med.
- Kompilering er der Salesforce-kompilatoren transformerer Agent Script til en Agent Graph, en serialisert utførelsesplan optimalisert for maskinutførelse i stedet for menneskelig lesbarhet. Du feilsøker ikke dette laget. Sammendrag produserer en representasjon som kjøretiden effektivt kan gå gjennom.
- Kjøretidsutførelse er der Atlas Reasoning Engine tar over. Den leser Agent-grafen, går gjennom den basert på gjeldende øktstatus, og bestemmer ved hver node om den skal utføres deterministisk eller kalle opp LLM. Motoren håndhever eksplisitt guard-setninger og betinget ruting her, i stedet for å utlede.
Agentgraf
Agentgraf er den mellomliggende representasjonen som befinner seg mellom det menneskelig lesbare skriptet og faktisk kjøretidsutføring. Strukturen er optimalisert for statens maskin som bruker den, ikke for arkitekten som forfattet skriptet. Forstå at den finnes, og hva den representerer, er viktig fordi det er artefakten som Reasoning Engine bruker til å håndheve utførelsesplanen skriptet definerer.
Atlas resonansmotor
Atlas Reasoning Engine er en maskinutfører med stat. På hver sving går den gjennom Agentgrafen basert på øktstatus, utfører deterministiske noder som kode og utløser LLM-kall bare der ledetekstinstruksjoner finnes. Den håndhever også guard-setninger og håndterer betinget ruting. Reasoning Engine er stedet der hybridreaksjonsmodellen faktisk implementeres. Skriptet definerer grensen, og motoren respekterer den.
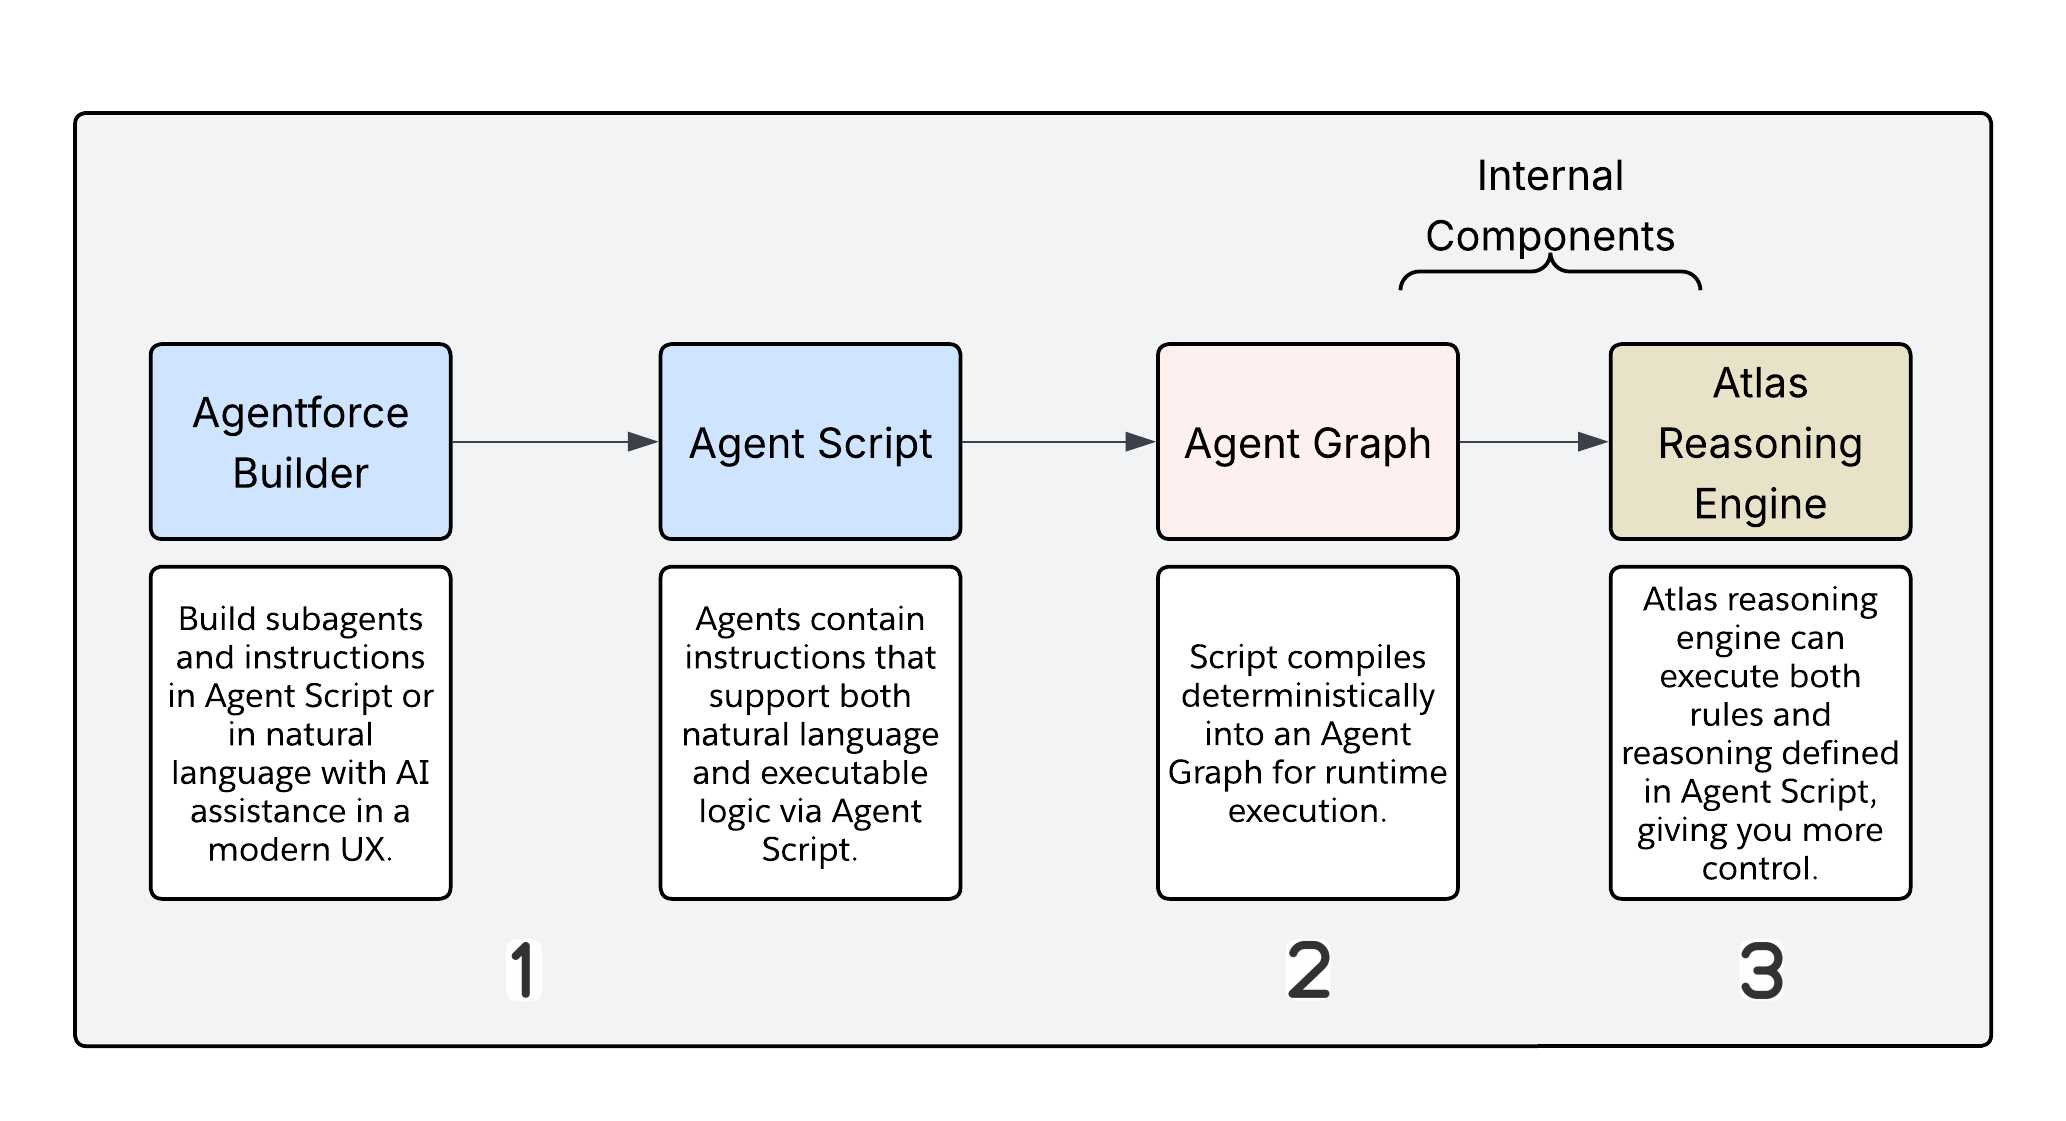
Agentgraf er ikke en LLM-bryter. Det er en hybrid resonansmotor som skiller deterministisk utførelse fra sannsynlighetsresonans. Den styrende regelen er enkel: Hvis du kan uttrykke en beslutning som kode, skal den skrives som logikk. Hvis beslutningen krever vurdering, tolkning eller generering av naturlig språk, skal LLM håndtere den. Denne utformingsbeslutningen er det viktigste arkitektoniske valget i den nye Agentforce. Hvor LLM-grensen faller, påvirker direkte løsningens kostnad, latens, revisjonskapasitet og pålitelighet.
Atlas Reasoning Engine evaluerer hver innkommende brukers tur og ruter den ned en av to baner.
Bane A: deterministisk utførelse
Denne banen har ingen LLM-eksponering. Den fungerer som kompilert kode ved kjøretid. Reasoning Engine klassifiserer brukerens hensikt og bestemmer at en logikkinstruksjon samsvarer, og omgår LLM helt. Det kompilerte Agent-skriptet kjører fra øverst til nederst, med if-else-regler som utføres ubetinget ved hver sving. Flythandlinger, Apex eller API-handlinger kalles opp med deterministiske parametere uten at det er involvert en meldingssammenstilling eller et modellkall. Resultatet går tilbake gjennom Trust med full revisjonslogging.
Bane B: LLM argumentasjon
Reasoning Engine tar denne banen når den ikke kan løse hensikt ved å bruke logikkinstruksjoner alene. Den går gjennom Agent-grafen og evaluerer hver node. Noder med ledetekstinstruksjoner utløser et LLM-kall. Noder uten dem utføres deterministisk. Tilstedeværelsen av en ledetekstinstruksjon er utløseren, og den er eksplisitt i skriptet i stedet for utledet ved kjøretid.
Hva utløser en LLM-kall
Det er åtte punkter i utførelsessyklusen der LLM kalles opp. Underagentklassifisering, eller å bestemme hvilken underagent som samsvarer med brukerens forespørsel, er én, selv om en kortkretsbane kan omgå det fullstendige LLM-kallet når klassifiseringen er entydig. Agentrelasjon, der agenten bestemmer hvilken handling som skal utføres videre, går alltid gjennom LLM. Det samme gjelder generering av svar, der det endelige svaret settes sammen fra en hydratisert ledetekst.
De resterende utløserne er mer operative: jordethet-validering bekrefter at utdataene er jordet i hentede data, handlingssimulering emulerer svar i Forhåndsvisning- og Simulering-miljøet i stedet for å utføre direkte, strukturert utdatagenerering håndterer saker der svaret må samsvare med et definert skjema, og lokalisering og fremdriftsindikatorgenerering håndterer formatering og midlertidig melding der det ikke finnes noen forhåndsforfattet standard.
Hva forblir deterministisk
Grafgjennomgang og delstatsoverganger involverer aldri LLM. before_reasoning- og after_reasoning-livssyklusblokkene utføres deterministisk så lenge de bare inneholder handlingsnoder uten ledetekstinstruksjoner. Matematik, datafangst, validering og betinget logikk hører til i koden. Alle handlinger som utfører Flyt, Apex eller et REST API, forblir direkte på den deterministiske banen. Alle noder uten ledetekstinstruksjoner utføres uten et LLM-kall.
Å være eksplisitt om denne grensen med teamet ditt er viktig. Hvert unødvendig LLM-kall legger til latens, kostnad og variabilitet. Arkitekter bør overføre deterministisk logikk som standard, og reserverer LLM-et til saker der oppgaven faktisk krever sin begrunnelsesfunksjon.
Designveiledning: push-logikk til kode som standard
Bruk instruksjoner for agentskriptlogikk når du skriver ledetekstinstruksjoner som kan uttrykkes som en betingelse, en variabeltildeling eller et handlingsfilter. Hvert unødvendig LLM-kall legger til latens, kostnad og variabilitet.
Standardposisjonen skal være deterministisk. Isoler hver agentvirkemåte som kan kodes som en regel, og flytt den til Agent-skript. De resterende oppgavene som krever syntese av naturlig språk, kontekstgjennomgang eller kompleks tolkning, tilhører ledetekstbærende noder. Det er ikke en begrensning, det er grensen som fungerer som forventet. LLM håndterer det som er best egnet for, og alt annet kjøres som kode.
Den primære utførelsesenheten i Agent-skriptet er ikke brukerskiftet. Det er analysen: en enkelt fullført syklus gjennom en underagentens tre livssyklusblokker. Atlas-motoren initierer en analysering hver gang en underagent må behandle noe, som skjer i tre situasjoner: ved første oppføring i underagenten, etter hvert verktøykall når en handling fullføres og returnerer et resultat, og ved hver ny bruker slå inn i samme underagent.
Det er viktig å forstå tolkingsgrensen fordi den bestemmer hvor mange ganger hver blokk kjøres, og derfor hvor du kan og ikke kan stole på at en gitt bit logikk utføres nøyaktig én gang.
Hver underagent definerer tre utførelsessoner:
| Blokk | Når den kjører | LLM-engasjement |
|---|---|---|
before_reasoning | Ved starten av hver analys, før LLM ser noe | Ingen |
reasoning | Under deterministisk løsning, før eventuelle LLM-kall | Blandet |
after_reasoning | Etter at årsaken er fullført og LLM har svart | Ingen (med en viktig advarsel) |
Både before_reasoning og after_reasoning er helt deterministiske. De utfører handlinger, angir variabler og bruker betinget logikk uten å involvere LLM. Det gjør dem til pålitelige, billige blokker i skriptet.
Når brukes before_reasoning
before_reasoning kjøres i begynnelsen av hver analys uten unntak. Den utføres ved første oppføring i underagenten og på nytt etter hvert verktøykall eller ny bruker som slår seg inn i denne underagenten. En run @actions.X i before_reasoning er kode. Til forskjell fra en instruksjon i en ledetekstblokk, som LLM kan eller ikke kan følge, utføres before_reasoning ubetinget.
Bruk denne blokken til øktinitiering: hente kontekstposter, angi øktvariabler fra Apex eller Flyt. Det er også der godkjennings- og berettigelseskontroller hører til, fordi du vil at disse skal bekreftes før LLM ser noen verktøy. Konteksthydratisering passer også her: kalle opp en datahentingshandling slik at LLM mottar forhåndsutfylte variabler i stedet for å be om dem. Eventuelle teller- eller revisjonsvariabler som må inkrementeres på hver analyse, bør angis her, fordi set-direktivet i before_reasoning er garantert på en måte som en rørinstruksjon ikke er.
Det som ikke hører her til er logikk som bare skal kjøres én gang per økt, siden before_reasoning kjøres på hver parse, ikke bare på den første oppføringen. Alt som avhenger av brukerinndata fra gjeldende omgang, hører heller ikke her, fordi de inndataene ikke er behandlet ennå. Og overganger bør aldri være i before_reasoning: en transition to instruksjon her vil skyte ubetinget på hver parse og skape sløyfer.
Hvis du trenger initialisering én gang per økt, beholder du den eksplisitt:
Én brukervindu kan utløse flere analyser: én gang ved oppføring og deretter på nytt etter hvert verktøykall. Denne funksjonaliteten har tre praktiske konsekvenser: initialiseringshandlinger i before_reasoning vil kjøre mer enn én gang per bruker slå i flerhandlinger flyter, tellervariabler inkrementert her vil gjenspeile parse antall, ikke turn antall, og handlinger med bivirkninger, eksterne API-kall eller post skrives, bør ikke leve i before_reasoning med mindre gjenkjøring på hver parse er eksplisitt akseptabelt.
before_reasoning er ikke en konstruktør. Det er en pre-flight check som kjøres med hver analys. Utform den i henhold til dette.
Når brukes after_reasoning
after_reasoning kjøres når resoneringsløyfen er ferdig, etter at LLM har svart og handlingsutdata har blitt fanget opp. Dette er stedet der deterministiske kontroller etter handling hører til: evaluering av handlingsutdata og forgrening basert på resultater. Deterministiske overganger, eller flytting til neste underagent basert på variabelstatus i stedet for LLM-gjennomgang, sitter her. Det gjør også variabelopprydding før neste omgang, og orkestreringssekvensering når du må kjede underagenter i en forutsigbar rekkefølge uten en LLM-rutingsbeslutning.
Behandle after_reasoning som guardrail-laget. Det er der du håndhever forretningsregler og delstatsforvaltning etter at LLM har gjort jobben sin, slik at viktige prosessflyter forblir forutsigbare uavhengig av hva LLM genererte.
Bruk is_displayable: True klokt
Alle arkitekter som utformer orkestreringsflyter, må forstå denne plattformvirkemåten. Når is_displayable: True angis for en handling, går plattformen ut av resonanssløyfen så snart LLM bestemmer seg for å vise disse utdataene. Denne utgangen skjer umiddelbart, som betyr at after_reasoning aldri utføres.
Dette er en kjent plattformvirkemåte, men den har en direkte konsekvens for orkestrering: all logikk som du har plassert i after_reasoning, hoppes over når en visbar handling er en del av flyten.
Svaret er enkelt. Flytt logikk som må utføres pålitelig inn i before_reasoning-blokken til den etterfølgende underagent i stedet for after_reasoning-blokken til den gjeldende.
Designveiledning: hvor initialiseringslogikk skal plasseres
Det å bestemme hvor logikken skal plasseres, er avgjørende når du utformer en underagent. Dette rammeverket dekker de vanligste scenariene:
| Scenario | Hvor den skal legges inn |
|---|---|
| Må kjøres før LLM ser kontekst | before_reasoning |
| Kjører alle analyser, inkludert gjenoppføring ved nye brukerskift | before_reasoning |
| Avhenger av handlingsutdata fra denne omgangen | Betinget if i reasoning |
| Krever overgang for deterministisk underagent basert på utfall | after_reasoning (men se is_displayable nedenfor) |
Krever orkestreringslogikk når nedstrømshandling bruker is_displayable: True | before_reasoning av neste underagent |
| Bruker logikk som krever vurdering eller brukerkontekst | reasoning med ledetekstinstruksjoner |
Det underliggende prinsippet er enkelt. Når du skriver en ledetekstinstruksjon som ber LLM om å "alltid kjøre" en handling, er det et forslag. LLM kan eller ikke følge den avhengig av kontekst. Når du plasserer et run-direktiv i before_reasoning, er det kode. Den utføres på alle analyser uten unntak.
Betinget tilgjengelighet av handlinger er mekanismen som Agent Script bruker til å vise eller skjule handlinger fra LLM-et basert på kjøretidsvariabelstatusen. Når available when-betingelsen evalueres til false, fjernes handlingen helt fra verktøylisten som presenteres for LLM. Eventuelle usanne verdier, inkludert None, False, 0 eller en tom streng, undertrykker handlingen.
Dette er ikke en ledetekstinstruksjon som forteller LLM "ikke ring dette ennå", det er en hard portal på plattformnivå. LLM kan ikke kalle opp en handling som den ikke har tilgang til.
I dette eksemplet er execute_transfer usynlig for LLM før validation_passed evalueres til true. Porten håndheves av plattformen, ikke av instruksjoner.
Designveiledning: aldri la LLM angi gatevariabelen
Gi hver variabel i en available when-setning en deterministisk kodebane som angir variabelen før den tilknyttede handlingen utføres. Bruk before_reasoning eller en deterministisk run og set-blokk i reasoning for å holde variabelen i en kjent tilstand. Hvis du bruker LLM til å angi gatevariabelen, har du introdusert variabiliteten som porten ble utformet for å hindre, på nytt. Avhengig av samtalen kan LLM angi det eller ikke, som betyr at porten kan åpnes eller ikke åpnes.
Handlingsløyfeproblemet
En handlingsløyfe oppstår når LLM kaller opp den samme handlingen gjentatte ganger uten å nå en endelig tilstand. Det skjer når to betingelser er sanne samtidig: available when-betingelsen forblir oppfylt etter at handlingen har blitt utført, og begrunnelsesinstruksjonene forteller ikke eksplisitt LLM å slutte å kalle den.
Plattformen undertrykker ikke automatisk en handling etter at den har blitt kalt opp. Hvis porten forblir åpen og begrunnelsesinstruksjonene er tvetydige, kaller LLM opp den samme handlingen på hver analys på ubestemt tid.
Ta available when @variables.interest != "" som et eksempel. Hvis handlingen utføres, men interessevariabelen ikke er tom, forblir porten åpen ved neste tolking. LLM ser handlingen som tilgjengelig, har ingen instruksjon som ber den stoppe, og kaller den opp igjen.
Det finnes to pålitelige måter å bryte sløyfen på. Den første er å sette gatevariabelen til en avsluttet tilstand som en del av handlingens etterutførelseslogikk, slik at available when evaluerer til false ved neste analys. Den andre er å bruke en separat has_run boolsk som lukker porten etter første utførelse. Begge løsningene gir porten en deterministisk avsluttet tilstand, som er betingelsen plattformen trenger for å undertrykke handlingen.
En bankoverføring er en nyttig linse for å forstå hvordan disse mønstrene fungerer sammen i praksis. Arbeidsflyten ser enkel ut fra utsiden: flytte penger fra én konto til en annen. Implementeringen krever flere komplekse trinn. Før overføringen utføres må agenten innhente kontodetaljer, validere beløpet, kontrollere overføringsgrenser, bekrefte den tilgjengelige saldoen og først da vise overføringshandlingen. Hvert trinn avhenger av de forrige trinnene. Ingen av dem bør overlates til LLM-gjennomgang.
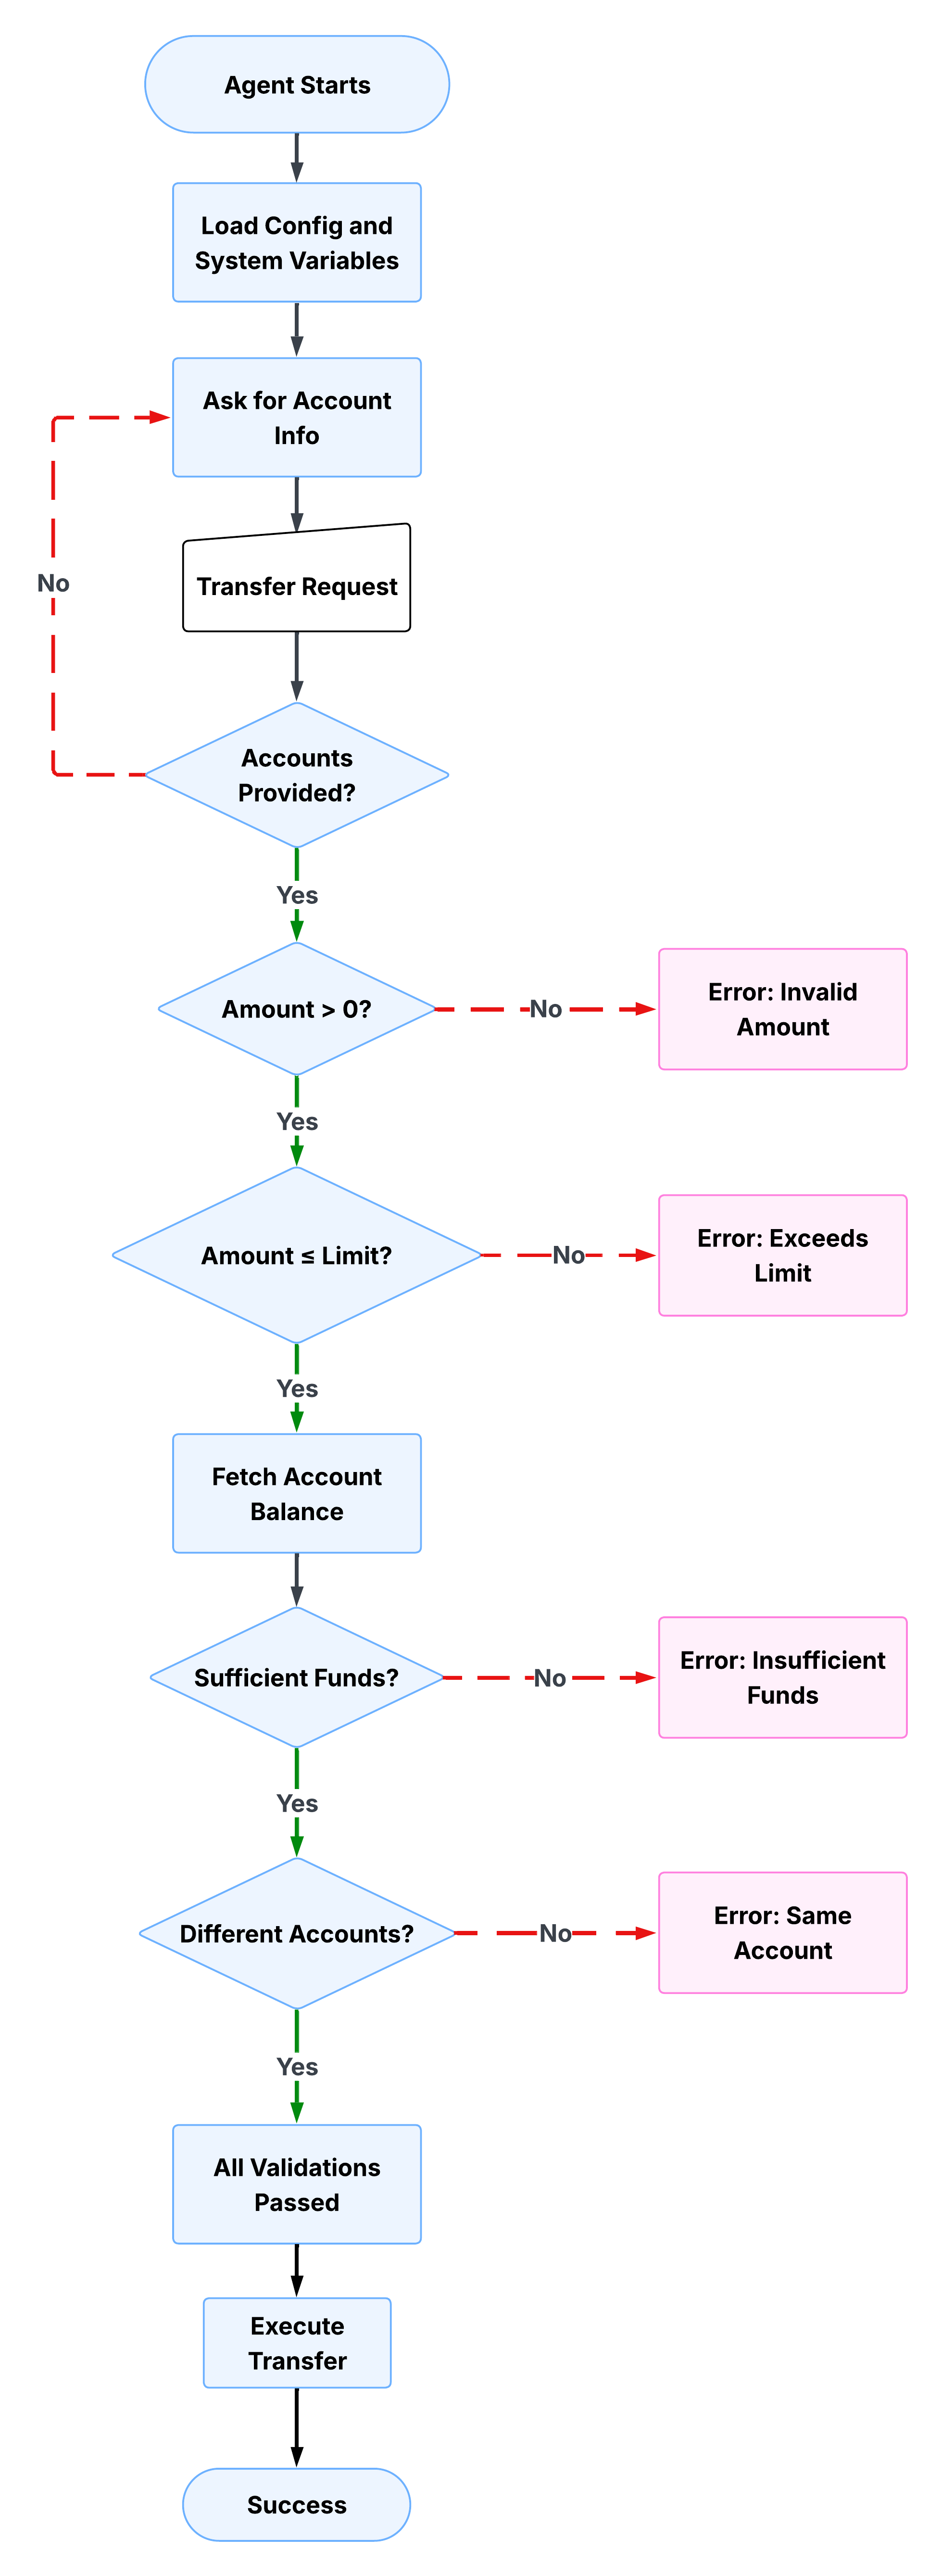
Samle inn og valider inndata
Den første underagenten samler inn kildekontoen, målkontoen og overføringsbeløpet fra brukeren. Det fortsetter ikke før alle tre er til stede og gyldige. Agentskriptet kontrollerer hvert felt i sekvensen: Hvis kildekontoen mangler, spør den. Hvis målet mangler, spør den. Hvis beløpet er null eller negativt, spør den. validation_passed-variabelen settes til true først etter at alle kontroller er klare.
Skriptet nedenfor viser dette i praksis. Vær oppmerksom på at validation_passed er eksplisitt satt til false ved hvert feilpunkt, og LLM er instruert til ikke å fortsette. Deterministiske kontroller kjøres ubetinget, mens ledetekstinstruksjonene håndterer det brukervennlige svaret.
Håndheve forretningsregler
Når agenten har validert inndataene, kontrollerer den om overføringsbeløpet overskrider den konfigurerte grensen for overføring. Det er her forretningsregler blir til kode i stedet for instruksjoner. Grensen er ikke noe LLM-årsakene gjelder for. Den er en hard terskel som er definert i skriptet og kontrollert deterministisk i hver analys.
Hvis beløpet overskrider grensen, settes validation_passed tilbake til false, og LLM gir brukeren tre alternativer: overføre maksimalt tillatte beløp, dele opp i flere overføringer, eller kontakt kundestøtte for høyere grenser. Agenten kan ikke fortsette før brukeren har løst unntaket. Legg merke til hvordan instruksjonen her gjør nøyaktig det LLM-vurderingen er egnet for: presentere alternativer i samtalen og håndtere brukerens svar. Selve forretningsregelen er deterministisk, men diskusjonen rundt den er ikke det.
Skriptet nedenfor viser hvordan grensekontrollen fungerer. Den deterministiske betingelsen evaluerer overføringsbeløpet mot grensevariabelen, setter validation_passed til false hvis terskelen brytes, og delegerer til en ledetekstinstruksjon for å håndtere det brukerrettede svaret.
Bruk beskyttelsesklausuler
Når beløps- og grensekontrollen er fullført, henter agenten kildekontosaldoen og bekrefter at det er tilstrekkelige midler tilgjengelig. Vakter hindrer agenten i å forsøke operasjoner når forutsetninger ikke oppfylles. Til forskjell fra en ledetekstinstruksjon som ber LLM kontrollere saldoen, gjør en guard-setning i Agent-skript kontrollen ubetinget. LLM bestemmer ikke om det skal kjøres.
Hvis saldoen er utilstrekkelig, beregner agenten mankoen og presenterer brukeren med et konkret alternativ. validation_passed settes til false til denne kontrollen passerer, som betyr at overføringshandlingen forblir avgrenset.
Skriptet nedenfor viser et deterministisk handlingskall som henter saldoen, fulgt av en betinget kontroll som evaluerer den. Hentingen kjøres bare hvis saldoen ikke allerede er hentet, og unngår overflødige API-kall på etterfølgende tolkninger.
Overflate feil klart
Vakter angir statusen. Feilmeldinger kommuniserer den. Når validation_passed er false, må agenten gi brukeren nok informasjon til å løse problemet uten å starte på nytt. Vage feilmeldinger skaper friksjon, strukturerte avslutter sløyfen raskere.
Skriptet nedenfor viser feilmeldingen om ikke tilstrekkelige midler i praksis. Det forteller ikke bare brukeren at overføringen mislyktes. Den viser den tilgjengelige saldoen, det forespurte beløpet, det beregnede manko, og tilbyr et konkret neste trinn, alt samlet fra øktvariabler i stedet for generert av LLM.
Mangelberegningen skjer i skriptet, ikke i LLM. Det foreslåtte alternativet, som overfører den tilgjengelige saldoen, utledes deterministisk fra øktstatus. LLMs rolle her er rent presentasjonsorientert: den leverer en melding som skriptet allerede har strukturert.
Gate overføringshandlingen
Hver valideringskontroll i de foregående trinnene angir eller fjerner samme variabel: validation_passed. Den variabelen gjør nå sin viktigste jobb. execute_transfer-handlingen er betinget tilgjengelig, som betyr at den bare vises i LLMs verktøyliste når validation_passed er true. Handlingen eksisterer ikke fra LLMs perspektiv før alle forrige kontroller er bestått og angitt denne variabelen.
Dette er mønsteret fra den tidligere portdelen som brukes på en produksjonsarbeidsflyt. Overføringshandlingen skjules ikke av en ledetekstinstruksjon. Den skjules av plattformen. Ingen mengde diskusjonstrykk eller tvetydig uttrykk kan få LLM til å kalle den opp før forutsetningene er oppfylt.
Skriptet nedenfor viser hvordan porten er konfigurert. available when refererer direkte til validation_passed, og handlingsparameterne er bundet til øktvariablene som er samlet inn og validert i de foregående trinnene.
Alle tre parametere, from_account, to_account og amount, overføres deterministisk fra øktvariabler. Når denne handlingen blir tilgjengelig, er alle verdiene validert. LLM samler ikke parameterne fra diskusjonskontekst, den leser dem fra statusen.
Spore status gjennom arbeidsflyten
Mønstrene i de foregående delene fungerer bare fordi øktstatusen beholdes på tvers av hele arbeidsflyten. Kontonumre som fanges opp i det første trinnet, er tilgjengelig i det fjerde trinnet. Valideringsresultater angitt i én sjekkgatehandling i en annen. Samtalen kan avvike, brukeren kan stille oppfølgingsspørsmål, og agenten vil fremdeles vite nøyaktig hvor den er i prosessen.
Variabelblokken nedenfor viser den fullstendige øktstatusen for denne arbeidsflyten. Hver variabel har en definert type, en standardverdi og en beskrivelse. To variabler håndterer det meste av orkestreringsarbeidet: validation_passed styrer tilgjengeligheten av handlinger ved hver port, og validation_information bærer menneskelig lesbar kontekst om hvorfor en sjekk mislyktes, som LLM kan vise til brukeren uten å måtte begrunnelse om den underliggende tilstanden.
Hver variabel starter med en kjent standardstatus. Strenger er som standard tomme, tall er null, og validation_passed er false. Det betyr at porten er lukket som standard. Arbeidsflyten må aktivt oppnå rett til å fortsette ved hvert trinn, i stedet for å starte med porten åpen og stole på sjekker for å lukke den.
Eksempelet på bankoverføring illustrerer hvor deterministisk logikk er det riktige verktøyet, men det er ikke alltid det beste valget. Forstå grensen er like viktig som å forstå mønstrene.
Deterministisk logikk er det riktige valget når arbeidsflyten krever en garantert utførelsessekvens, når feil har betydelige konsekvenser, når prosessen må produsere et reproduserbart revisjonsspor, eller når forretningsregler er godt definert nok til å uttrykkes som betingelser og terskler. Arbeidsflyter for økonomi, behandling og forsikring hører generelt til denne kategorien.
Ren LLM-reaksjon uten strenge deterministiske begrensninger er mer fornuftig når verdien av interaksjonen ligger i fleksibilitet i stedet for presisjon. Åpent kundestøtte, produkter i tidlig fase der forretningsprosesser fremdeles utvikler seg, og informasjonsspørringer med lave satser er alle tilfeller der variabiliteten i LLM-vurderinger er en funksjon, ikke et problem.
I praksis trenger de fleste produksjonsagenter begge deler. Beslutningen om hvor grensen skal falle, er ikke et binært valg mellom deterministisk og sannsynlighetsbasert, det er en utformingsbeslutning du tar på nodenivå for hver del av agentens arbeidsflyt.
| Bruk deterministisk logikk for | Bruke LLM-vurdering for |
|---|---|
| Validering av inndata og rengjøring | Forståelse av naturlig språk og hensiktsoppdagelse |
| Håndhevelse av forretningsregler | generere samtalebaserte, empatiske svar |
| Sekvensiell prosessorkestrering | Håndtering av tvetydige eller uventede inndata |
| Statbehandling og kontekstbevaring | gi forklaringer og klargjøringer |
| Forsikringssetninger som hindrer ugyldige operasjoner | Tilpasse tone og meldinger til brukerkontekst |
Grensen er designbeslutningen
Eksempelet på bankoverføring er en illustrasjon av en designfilosofi: at grensen mellom deterministisk utførelse og LLM-vurdering er den viktigste arkitektoniske beslutningen du tar når du bygger en produksjonsagent.
Placer en grænse, der er for stiv, og du ender med en agent, der er stiv, dyr at vedligeholde og ikke kan håndtere den naturlige variation af reelle samtaler. Hvis grensen blir feil i den andre retningen, opprettes det en agent som er fleksibel, men ikke forutsigbar, som gjør det bra i testing, men som oppfører seg annerledes i produksjon, og som ikke kan produsere et pålitelig revisjonsspor eller bli klarert med en transaksjon med stor innsats.
Den nye Agentforce gir deg verktøyene for å plassere denne grensen med vilje. Med Agent Script kan du uttrykke deterministisk logikk og ledetekstinstruksjoner i den samme filen, med en eksplisitt syntaks for å gjøre grensen synlig. Atlas Reasoning Engine håndhever logikk og ledetekster ved kjøretid. before_reasoning og after_reasoning blokker gir deg garantert utførelse soner på begge sider av LLM samtalen. Betinget tilgjengelighet av handlinger sikrer at LLM kan handle bare når forutsetninger er oppfylt.
Ingen av disse funksjonene er isolerte. De arbeider sammen for å skape en sammenhengende arkitektur for byggeagenter som virksomheter kan Trust med oppgavekritiske arbeidsflyter. Hybridgjennomgangsmodellen anerkjenner at både deterministisme og fleksibilitet har roller i arkitekturen din. Det er arkitektens jobb å bestemme nøyaktig hvor hver av dem skal gjelde.
Agentforces agentgraf: Mot veiledet determinisme med hybrid resonans
Gulal Kumar er Software Engineering Architect på Salesforce med over 20 års erfaring. Hans ekspertise omfatter AI, integrasjon, API-er og bedriftsarkitektur, med fokus på å drive forretningstransformasjon gjennom sikre, fleksible og innovative AI-løsninger. Kontakt ham på LinkedIn.
Miriam McCabe er Senior Director og leder for teamet Architect Evangelism. Hennes arbeid fokuserer på å gi det globale Salesforce-arkitektsamfunnet mulighet til å lede i agenttiden gjennom dypt teknisk innhold, direkteprogrammering og fellesskapsengasjement. Følg henne på LinkedIn.