Virksomheter håndterer et bredt spekter av dokumenttyper, inkludert fakturaer, innkjøpsbestillinger, juridiske kontrakter og tekniske manualer. Manuell behandling er langsom, feilsøkende og bruker anslått 15–25 % av ansatttiden. Tidligere automatiseringsmetoder (for eksempel Robotic Process Automation (RPA), Optical Character Recognition (OCR) og arbeidsflytverktøy) reduserte en del av byrden, men førte til stiv pipelines, høye vedlikeholdsutgifter og isolert tilpassing på tvers av individuelle forretningsteam.
Dokumenter bærer rik strukturkontekst (for eksempel tabellhierarkier, områderelaterte feltrelasjoner og kryssrefererte deler) som behandling med flat tekst ikke kan beholde. Hvis du fjerner et dokument fra ren tekst, forkastes forretningskonteksten som gjør uttrekkingen nøyaktig og nyttig, noe som reduserer kvaliteten på nedstrøms analyser, kunstlig intelligens (AI)-utledninger og prosessautomatisering.
For å være effektive må IDP-systemer klassifisere dokumenter etter type, trekke ut strukturerte data nøyaktig fra variabeloppsett og levere disse dataene i en styrt, spørrbar form til nedstrøms systemer. IDP-er må også håndtere dokumentvariabilitet i stor skala uten å kreve konfigurasjon per mal for hvert nytt dokumentformat, og de må være sentraliserte og tilgjengelige på tvers av forretningsenheter. Denne utfordringen utfylles av det store volumet av nøkkelproblemet: ustrukturerte data utgjør omtrent 80 % av alle bedriftsdata, og flertallet er akkumulert i dokumentform på tvers av filsystemer, skylagring og innholdsoppbevaringssteder som er utenfor rekkevidden til _CRM-_systemer, AI-agenter og analyseplattformer.
Data 360 Document AI er Salesforce-dokumentbehandlingsfunksjonen i Data 360, som er utformet for å løse dette gapet. Det trekker ut, klassifiserer og analyserer ustrukturert og semi-strukturert dokumentinnhold ved hjelp av store språkmodeller (LLM), optisk tegngjenkjenning (OCR), naturlig språkbehandling (NLP) og maskinlæring (ML). Utdataene er strukturerte, styrte og spørrbare data som integreres i Data 360 pipeline der Agentforce agenter, analyseverktøy og automatiseringsarbeidsflyter kan få tilgang til dem via standardgrensesnitt uten å kreve tilpasset uttrekking eller transformasjonslag.
Virksomhetens dataplattformer behandler strukturerte tabelldata. De fleste data fra virksomheten ankommer imidlertid som dokumenter og forblir utilgjengelige for CRM-, ERP-, AI-agenter og analyse under behandling til noen trekker dem ut manuelt. Dette er et arkitektonisk hull, ikke et arbeidsflytproblem.
Tidligere tilnærminger kombinerte manuell ny nøkkel, regelbasert OCR og RPA-skript. Disse metodene fungerte i liten skala, men de kunne ikke håndtere volumet, variasjonen og hastigheten til dokumenttypene som moderne virksomheter genererer. Regelbaserte verktøy krever eksplisitte maler per oppsettvariant. Eventuell formatendring avbryter uttrekkingen og krever en utvikler, en ny mal og en distribusjonssyklus.
I stor skala produserer dette sårbare poengløsninger uten sentralisert styring, delt skjema og vei til AI-klargjøring. Inkonsistente uttrekksledninger overføres nedstrøms. Med andre ord arver analyser datainkonsistens, AI-modeller produserer upålitelige utdata, og regulert innhold som personlig helseinformasjon (PHI) og personlig identifiserbar informasjon (PII) mangler systematisk styring.
LLM-er trekker ut felt uten eksplisitte maler. En enkelt skjemakonfigurasjon styrer uttrekking på tvers av oppsettvarianter, språk og formater, noe som tilpasser seg dokumentet i stedet for å kreve at dokumentet samsvarer med en fast struktur. Dette skifter dokumentbehandling fra en vedlikeholdsfylt, isolert operasjon til en styrt, sentralisert funksjon.
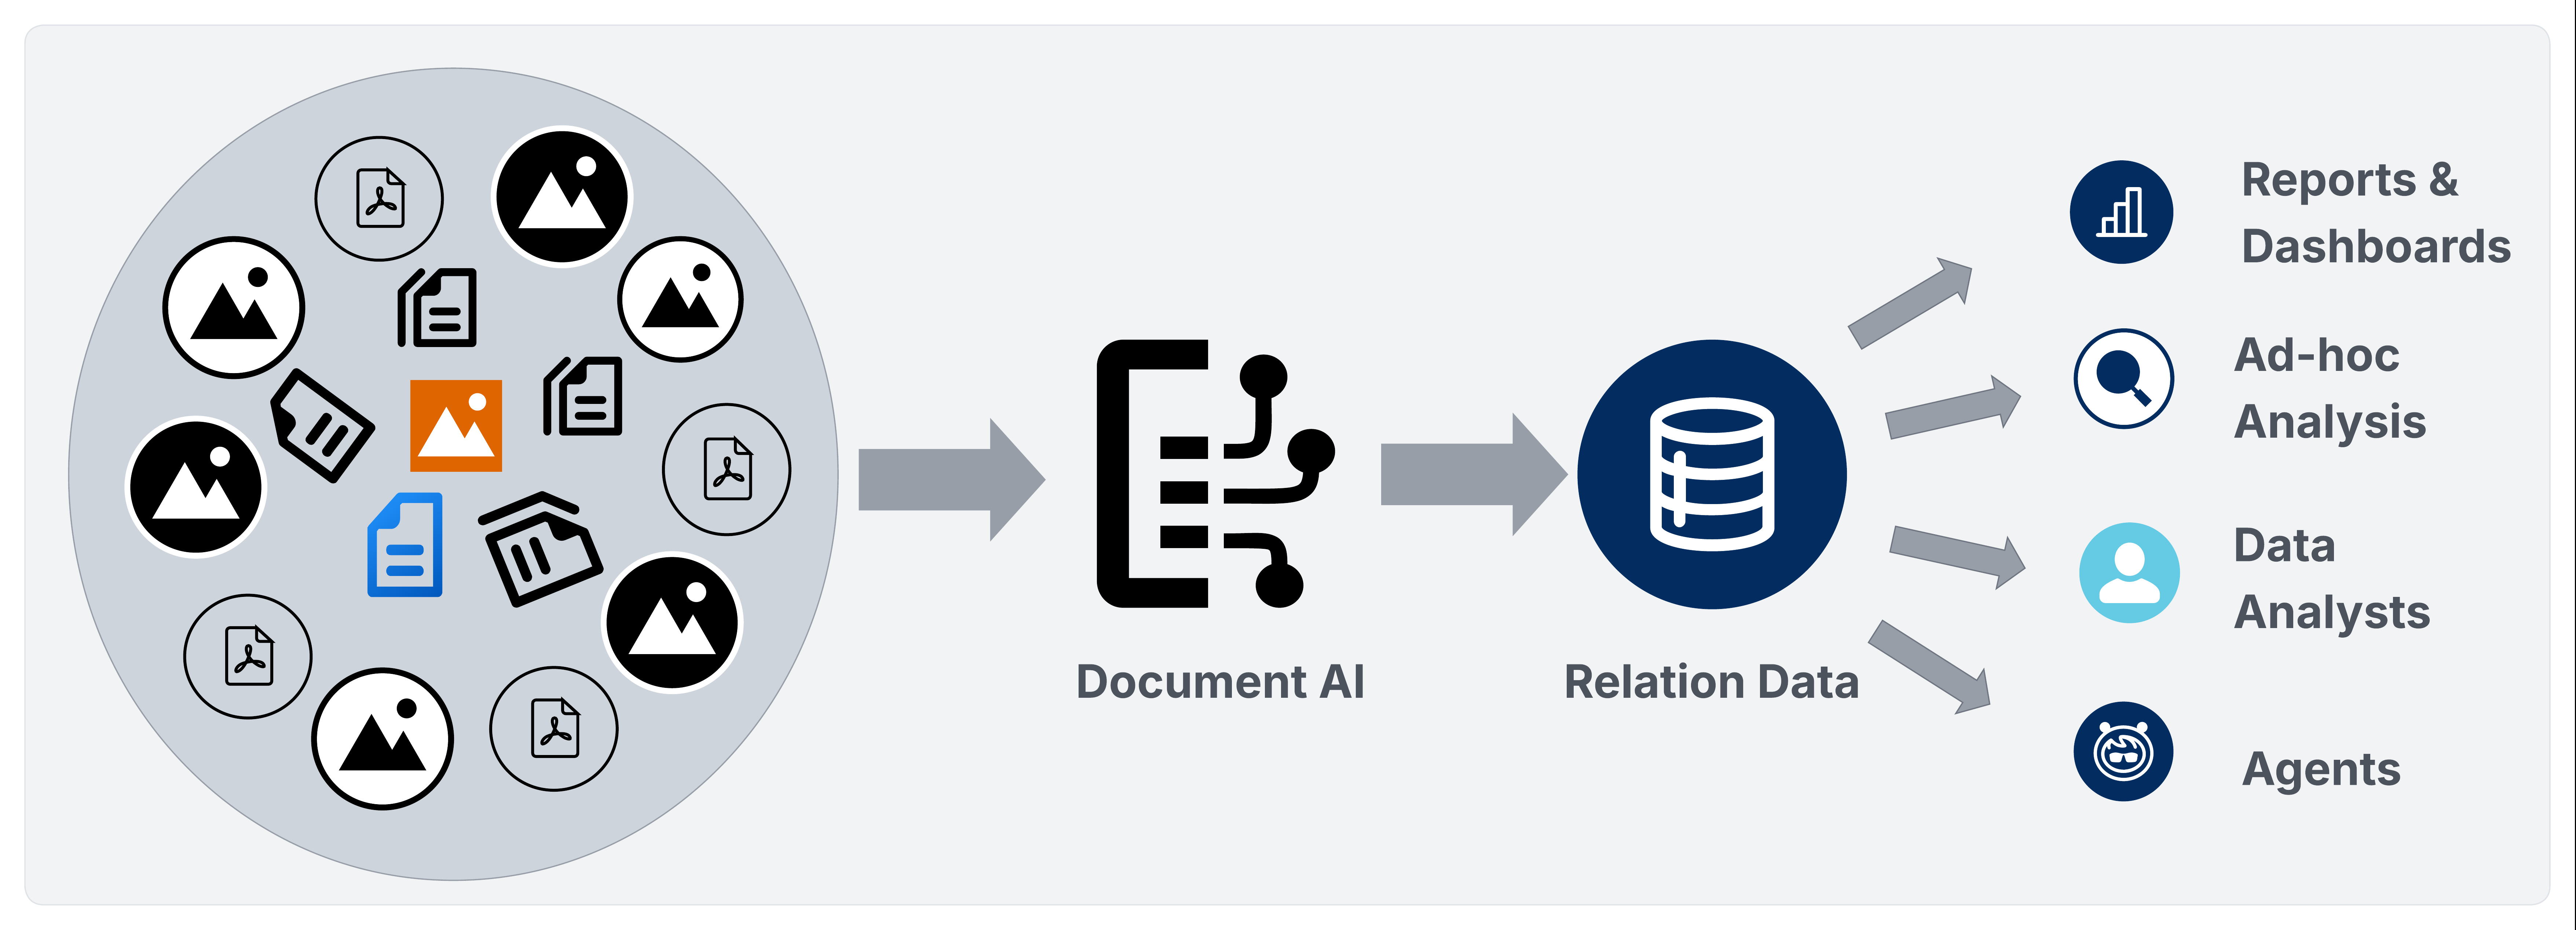
Data 360 Document AI opererer dokumentbehandling i Data 360-plattformen via to pipelines.
- Batch Pipeline ruter uttrukne data gjennom inntak, identitetsløsning, beregnet innsikt, aktiveringer, analyser og Agentforce aktivering.
- Transaksjonsbehandling Pipeline viser en REST API som returnerer strukturert JSON synkront, som lar arkitekter rute dokumentutledede data til Salesforce SOobjects, Data 360 Data Lake Object / Data Model Object (DLO/DMO) pipeline eller eksterne databaser og lagre uten batchoppsettoverhead.
I begge tilfellene kommer uttrukne data inn i en styrt, skjemadrevet modell i stedet for et fragmentert sett poengverktøy.
Data 360 Document AI er Salesforces innebygde funksjon for Intelligent dokumentbehandling (IDP) i Data 360-plattformen. Den konverterer ustrukturert og semi-strukturert dokumentinnhold til styrte, spørrbare data som fullt ut deltar i hele livssyklusen til Data 360.
Data 360 Dokument-AI er Salesforces innebygde funksjon for Intelligent dokumentbehandling (IDP) i Data 360. Det henter inn ustrukturerte og semi-strukturerte dokumenter, trekker ut strukturerte data ved hjelp av en deklarativ skjemakonfigurasjon, og leverer disse dataene til Data 360 pipeline for harmonisering, identitetsløsning, analyse og Agentforce aktivering.
Data 360 Dokument-AI støtter to behandlingsmodaliteter:
- Bulk batch behandling: Behandler store dokumentsett som er definert i ustrukturerte datamodellobjekter (UDMO) på en hendelsesdrevet basis.
- Transaksjonsbehandling: Behandler et enkelt dokument via REST API og returnerer en strukturert JSON last synkront. Arkitekter kan deretter rute denne lasten til Data 360 DLO/DMO pipeline, Salesforce SOobjects eller eksterne databaser og lagre via MuleSoft, Apex oppkall eller Einstein Trust Layer (ETL) pipelines. Målnivået er en arkitektonisk beslutning drevet av krav til latens, styring og dataoppbevaring.
Dokumenter AI støtter for øyeblikket PDF-filer, bildefiler (JPEG, PNG) og håndskrevne dokumenter.
Data 360 Document AI samler fire behandlingsteknologier i en enkelt styrt pipeline. Hver komponent håndterer en distinkt fase av dokument-til-data-livssyklusen:
- Optical Character Recognition (OCR): Konverterer skannede bilder, håndskrevet innhold og bildebaserte PDF-filer til maskinlesbar tekst før LLM-behandling. Minst 150 DPI anbefales for pålitelig uttrekking.
- Store språkmodeller (LLM-er): Rut uttrekking gjennom Einstein LLM-gatewayen med den brukervalgte modellen. LLM mottar OCR-utdata sammen med JSON-skjemakonfigurasjonen og returnerer en strukturert uttrekksbelastning. Gemini og ytterligere modeller er planlagt for fremtidig implementering.
- Naturlig språkbehandling (NLP): Utfører kontekstforståelse, enhetsgjenkjenning, datoanalyser og semantisk feltuttrekking direkte i LLM via strukturert ledetekstteknikk – den skjemadefinerte ledeteksten og OCR-utdataene tjener som de eneste inndataene. Alle LLM-interaksjoner rutes gjennom ETL, som håndhever null dataoppbevaring med modellleverandører og maskerer PII i tekstbaserte inndata før de når modellen. Ingen separat NLP-motor brukes.
- Multi-modal behandling: Behandler innebygde bilder i PDF-filer som separate uttrekksinndata, noe som gjør det mulig for LLM å trekke ut data fra diagrammer, bildegenererte tabeller og sider med blandet innhold som OCR alene ikke kan analysere.
I tillegg til de fire behandlingsteknologiene håndterer Document AI også:
- Einstein Trust-lag: Ruter alle LLM-interaksjoner gjennom ETL, som håndhever null dataoppbevaring med modellleverandører og maskerer PII før inndata når LLM med unntak av multimodale data (for eksempel vedlagte dokumenter som behandles via Document AI) der PII-maskering ikke støttes for øyeblikket og data sendes som de er til eksterne modeller. ETL styrer bare LLM-interaksjonsbanen. Uttrukne data som skrives til Data Lake-objekter (DLO), lagres som de er. Maskering på feltnivå under lagring må håndteres via nedstrøms datastyringskontroller.
- Filstørrelsesgrenser: Document AI behandler filer på opptil 10 MB per forespørsel. Grenser for LLM-kontekstlengde kan begrense behandling ytterligere for tett, flersiders dokumenter innenfor denne grensen.
Foretaksarkitekter som distribuerer Data 360 Document AI, bør bruke disse prinsippene før de forplikter seg til en implementeringsutforming.
- Velg pipelinen før du utformer skjemaet. De batch og transaksjonelle behandlingsrørledninger er forskjellige i inntak modell, skjema binding, mål fleksibilitet og latens. Det er viktig å bekrefte hvilken pipeline hvert bruksområde krever før du definerer skjemaet, fordi ettertilpassing legger til omarbeid som kan unngås.
- Design skjemaer på dokumenttypenivå. Bruk av ett enkelt, godt utformet skjema per dokumenttype er mer vedlikeholdbart enn å bruke konfigurasjoner per bruksområde, og det er også den største håndtaksen for uttrekkskvalitet. Å gjøre dette riktig krever å bruke et mangfoldig sett dokumenter – inkludert kantsaker – i stedet for å utforme fra ett enkelt eksempel. Bruk ledetekster gjentakende på felt-, tabell- og skjemanivåene for å finne hull, og test og begrens dem deretter mot flere dokumenteksempler før du avslutter. Husk at et skjema som fungerer godt på ett dokument, kan være lite på andre, så bredde og gjentagelse er viktig. Skjemafleksibilitet – inkludert å fjerne kolonner som ikke trekker ut på en pålitelig måte på tvers av dokumenttyper – er like viktig. Å holde seg til felt som introduserer støy eller inkonsistens, undergraver den generelle uttrekkskvaliteten, så det er viktig å behandle kolonnefjerning som en førsteklasses utformingsbeslutning.
- Velg riktig målnivå per feltgruppe. Felt som utløser CRM-arbeidsflyter eller -godkjenninger, skriver til SOobjects. Felt som beriker den forente profilen eller feedanalysen, hører til i pipelinen DLO/DMO. Felt som betjener eksterne systemer, tilhører RDBMS-nivået. Husk at ett enkelt skjema kan åpne opp til flere nivåer samtidig.
- Håndhev styring før du behandler regulert innhold. Regulerte data trenger beskyttelse på alle lag. Derfor er det viktig å konfigurere PII-maskering, dataklassifiseringsetiketter og Attributtbasert tilgangskontroll (ABAC) etter at uttrukne data er lagret i utdataobjektene Data Lake-objekter (DLO-er). Dette gir finjustert håndheving og kontekstbevisst tilgang som er basert på dataklassifisering, brukerrolle og organisasjonskontekst. Styring er delt på to baner: ELT styrer LLM-interaksjonen, mens uttrukne data som er lagret i DLO-er, må styres separat – direkte på DLO- og databasenivå – gjennom Data Space-konfigurasjoner, tillatelsessett og ABAC-policyer. Disse kontrollene må opprettholde konsistens på lagringsnivået – ikke bare på programlaget – slik at tilgangsbegrensninger forblir intakte uavhengig av hvordan data får tilgang etter inntak. Husk at gap i hvilket som helst lag kan vise regulerte data nedstrøms selv om andre er riktig konfigurert.
- Design for feilmoduser før produksjon. Håndtering av nullfelt, OCR-kvalitetsterskeler, forhåndsvalidering av filstørrelse, LLM-kontekstoverflyt, RDBMS-skrivebeskyttelse og kredittbudsjettgrenser før første produksjonsbatchkjøring. Dette er ikke kanttilfeller – de er forutsigbare feilflater som eksplisitt må håndteres i pipelineutformingen, ikke oppdages under kjøretid.
- Behandle konfidensscore som et rutingssignal av første klasse, ikke en diagnostisk ettertanke. Uttrekksresultater bærer feltnivåkonfidensverdier som utledes fra loggsannsynlighetene (loggprobs) i den underliggende modellutdataene. For hvert uttrukne felt, tabell eller kolonne gjenspeiler scoren modellens sikkerhet på tokennivå for den uttrukne verdien. Dette gjør konfidensscore til et statistisk basert signal som er pålitelig nok til å fungere som den primære porten for eskaleringsterskelverdier for HITL (Human-in-the-Loop). Bruk konfidensscore til å systematisk identifisere uttrekk av lav kvalitet og starte HITL-sjekkpunkter for feltverdier med lav konfidens, tvetydige skjema-matches eller gjentatte pipelinefeil i stedet for å stole på heuristikker eller manuelle spot-checks. Når automatisk gjenoppretting ikke er mulig, sikrer HITL-støttet konfidensscore at menneskelig vurdering brukes nøyaktig der det er nødvendig.
- Design aktiveringsbaner parallelt med skjemautforming. Verdien av Document AI kommer fra muligheten til å aktivere uttrukne data i Salesforce-arbeidsflyter og -agenter. Du kan utforme Agentforce handlinger, flyter og beregnede innsikter ved siden av uttrekkingsskjemautformingen, ikke etterpå.
Document AI opererer innenfor to pipelines:
- En batch pipeline for høyvolum, UDMO-støttet behandling
- En transaksjonell behandlings pipeline for sanntids, API-drevet uttrekking
Begge pipeliner deler samme skjemakonfigurasjonskontrakt og ETL-styring, men de er forskjellige i hvordan dokumenter kommer inn i systemet og hvor uttrukne data lander.
La oss ta en nærmere titt på hver pipeline.
Batteripipipeline behandler gjentakende dokumentsett som er definert av et UDMO. Den passer til planlagte eller hendelsesdrevne brukstilfeller der dokumenter hentes inn fra virksomhetens lagring, deretter går gjennom dokumentuttrekking og leveres til Data 360 DLO/DMO pipeline for harmonisering, identitetsløsning og aktivering.
Sannverdens scenario
Hver dag mottar et forsikringsselskap tusenvis av medisinske kravdokumenter fra leverandørportaler som lastes opp som PDF-filer til Amazon S3. UDMO definerer dokumentsettet i omfanget og sender alle krav-PDF-filer til /claims/incoming/ innen et 24-timers vindu.
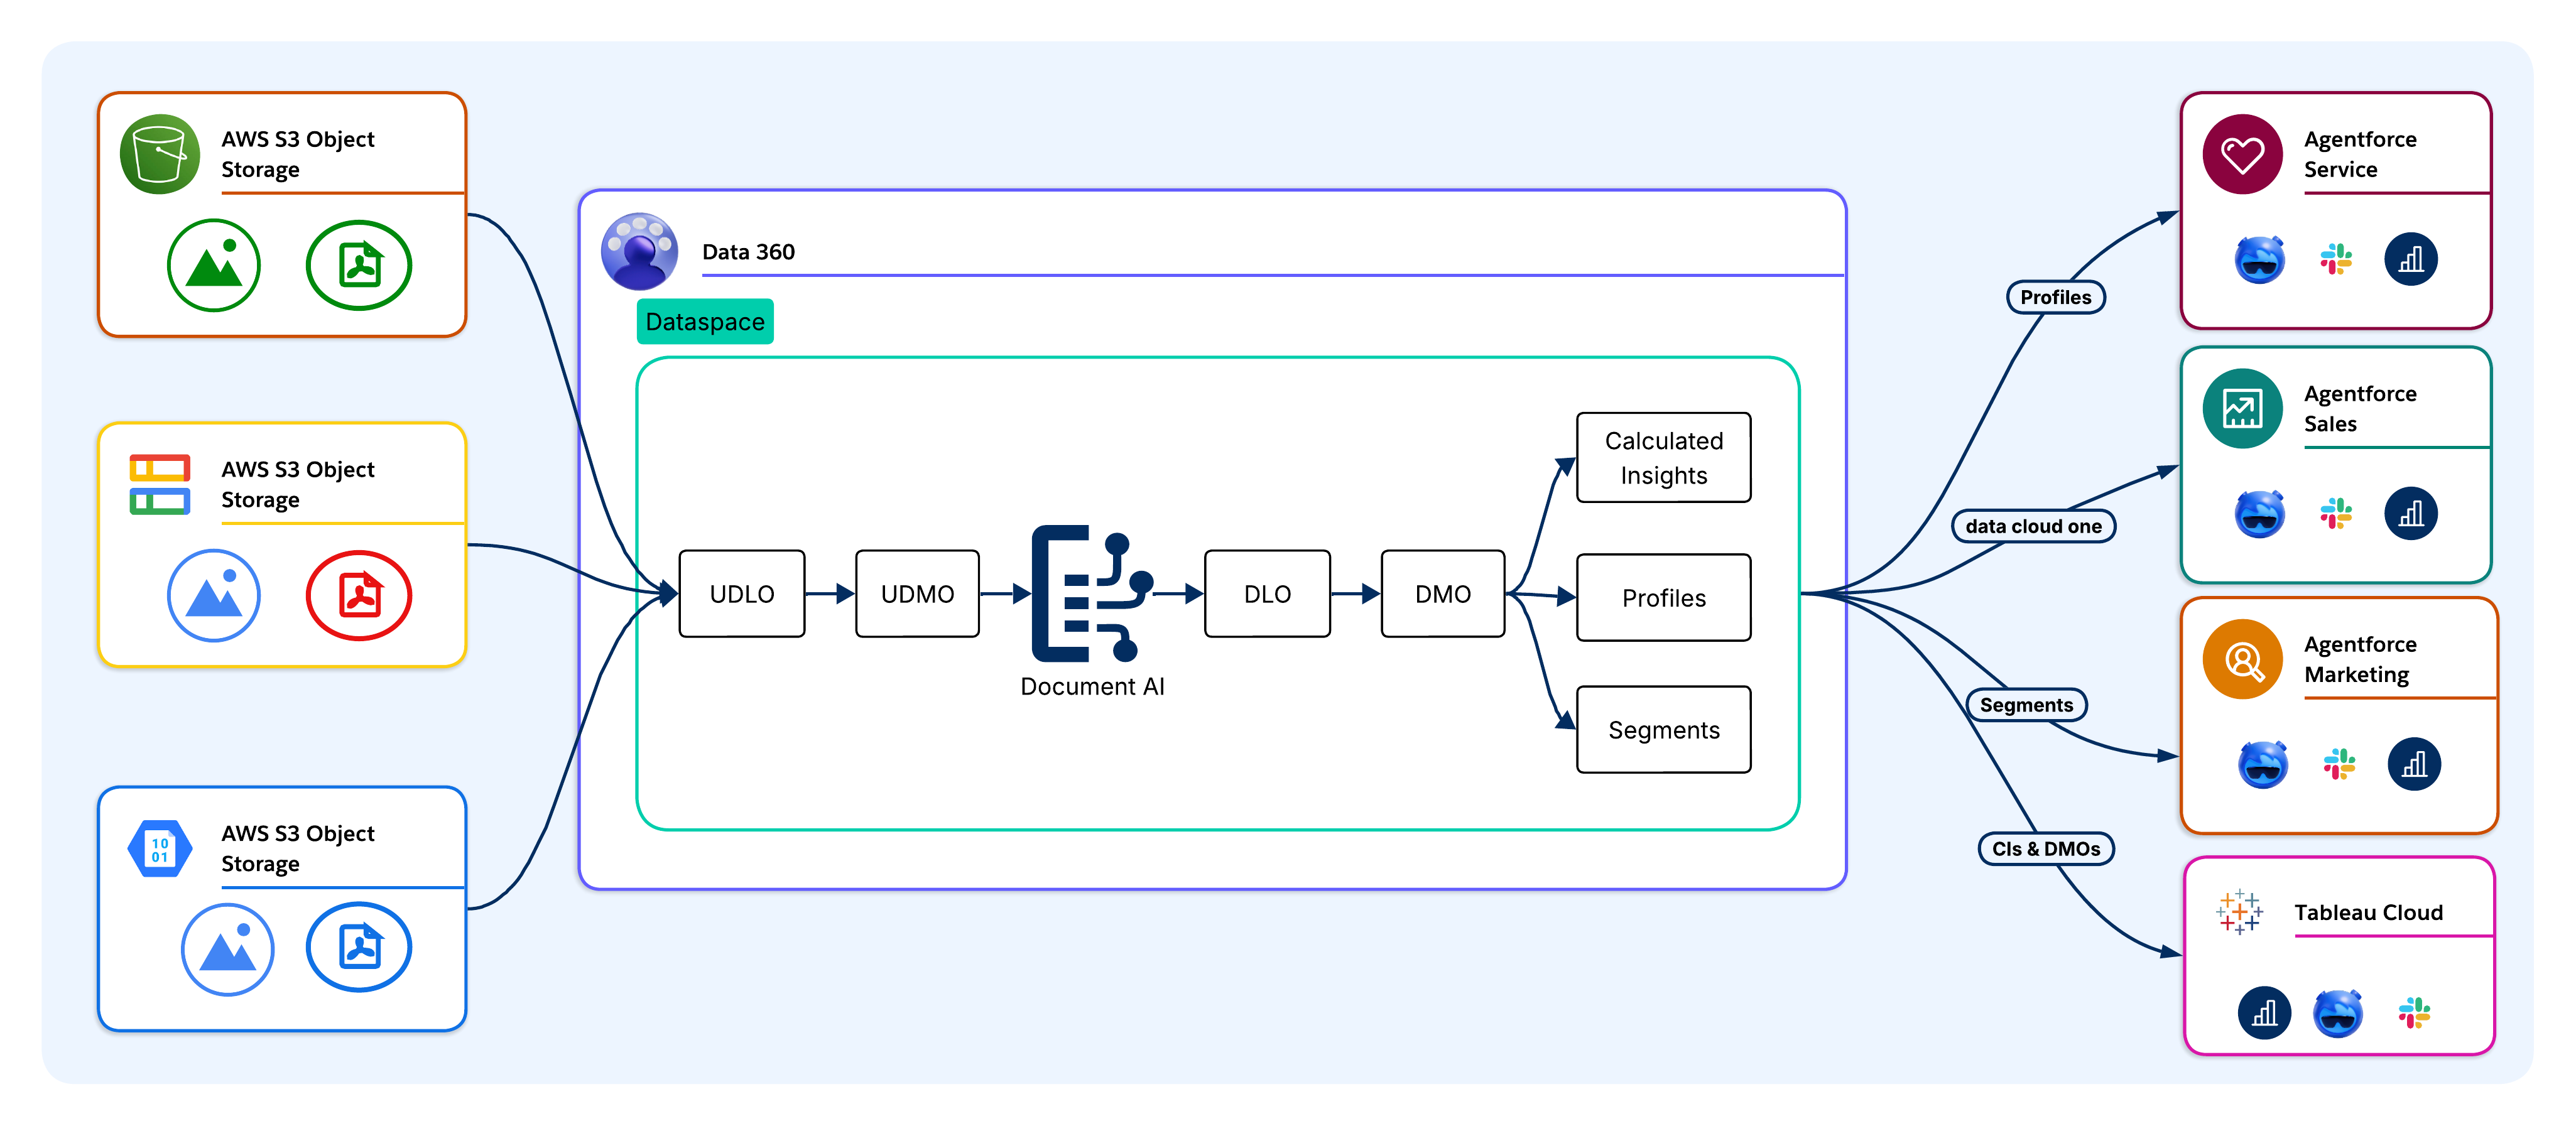
Dokumenter hentes inn i Data 360 fra Enterprise-kildesystemer uten fysisk duplisering. Støttede kilder inkluderer Amazon S3, Google Cloud Storage, Salesforce CRM-filobjekter, MuleSoft-orkesterte pipelines og direkte API-opplastinger. I hodeløse 360-distribusjoner hentes dokumenter inn via koblinger til skylagring eller Inntaks-APIen, som omgår CRM-laget. Model Context Protocol (MCP)-serveren viser inntak som et kallbart verktøy for eksterne AI-agenter og LLM-klienter.
Ved inntak lagres rådokumenter som ustrukturerte datasjøobjekter (UDLO-er), som tilordner det fysiske stedet og metadataene til hvert dokument uten å flytte eller transformere kildefilen.
Eksempel:
Krav-PDF-filer hentes inn fra S3 til Data 360 via koblingen for skylagring. Hvert dokument lagres som en UDLO som peker til S3-objektet. Ingen fysisk duplisering skjer.
Document AI behandler hver UDLO mot en skjemakonfigurasjon som definerer hvilke felt som skal trekkes ut sammen med måldatatypene. UDMO-et definerer hvilke dokumenter som er i omfang. LLM (GPT-4o, Gemini eller Claude) leser hvert dokument og returnerer en strukturert uttrekksbelastning.
Eksempel:
Document AI behandler hver UDLO mot et kravskjema som definerer felt som: ClaimID, PatientName, DiagnosisCode, BillingAmount og ServiceDate. LLM-er leser deretter hver PDF-fil og returnerer en strukturert uttrekksbelastning.
Når dataene trekkes ut, beholdes de i DLO-er, som er det rå lagringslaget i Data 360. DLO-er beholder uttrukne felt uten å tvinge forretningslogikk, noe som beholder en nøyaktig fysisk representasjon for nedstrøms transformasjon og sporing. UDLO beholder en referanse til kildedokumentet for å aktivere feltenivålinje på hvilket som helst tidspunkt i pipelinen.
Eksempel:
Alle uttrukne felt lander i en krav-DLO, som beholder en rå, nøyaktig representasjon av hvert krav med full linje som kan spores tilbake til kilde-PDF-filen.
DLO-felt tilordnes til DMO-er som er i samsvar med standard Customer 360-datamodell. Dette er grensen der dokumentutledede data går over fra rå, uttrukne felt til forretningsmessige enheter. Faktura-DLOen tilordnes til et Faktura-DMO, og felt som CustomerID og BillingAmount blir koblingsnøkler og samsvarsattributter i den forente datamodellen. Harmoniserte dokumentdata deltar i segmentering, beregnet innsikt og aktivering via de samme grensesnittene som brukes av CRM og transaksjonsdata.
Eksempel:
Krav-DLO tilordnes til et krav-DMO. Feltet PatientID og PolicyNumber blir koblingsnøkler som kobler kravposter til forente pasientprofiler.
Harmoniserte DMO-data deltar i identitetsløsning. Uttrukne felt (for eksempel kundenavn, e-postadresser eller kontonumre) tjener som samsvarsnøkler for å koble dokumentposter til Forente persondata (Gyldne poster), som lukker gapet mellom dokument og profil.
Eksempel:
Uttrekksfelt (for eksempel PatientName, DateOfBirth og PolicyNumber) tjener som samsvarsnøkler for identitetsløsning, som kobler kravposter til den riktige Forente persondata. Dette skjer selv om den samme pasienten vises under litt forskjellig stavemåte på tvers av dokumenter.
Arkitekter definerer beregnede innsikter, som er aggregerte målinger som beregnes på tvers av harmoniserte dokumentdata (for eksempel totalt utgift fra ulike fakturalinjer, risikoscore for kontraktfornyelse og indekser for kravets alvorlighetsgrad).
Eksempel:
Beregnede innsikter beregner TotalClaimsPerPatient, AverageClaimAmount og HighRiskClaimScore på tvers av harmoniserte kravdata for Agentforce-spørringer.
Harmoniserte, identitetsløste data er tilgjengelig for Agentforce-agenter, Tableau, markedsføringsplattformer og Salesforce subjects. Målnivået er en arkitektonisk beslutning som drives av krav til latens, styring og dataoppbevaring.
Eksempel:
A Claims Adjudication Agentforce Agent spør Data 360 DMO-ene og CIs for å finne krav med høy risiko for prioritetsgjennomgang. Tableau-kontrollpaneler viser kravvolum og avvikstrender. Godkjente kravposter sirler tilbake til krav-SObject for å starte betalingsarbeidsflyter.
I hodeløse 360-arkitekturer rutes aktivering direkte til eksterne systemer via aktiveringsmålene for Query API, Pub/Sub API eller Cloud-datalageret. Deretter finner MCP-serveren harmoniserte dokumentdata og beregnede innsikter som kallbare verktøy for eksterne AI-agenter.
Transaksjonsbehandling- pipelinen håndterer uttrekking av enkeltdokumenter ved kjøretid uten UDMO eller forhåndsinntak av UDLO, noe som passer til hendelsesdrevne brukstilfeller (for eksempel en kunde som laster opp et skjema, en agent som mottar en PDF-fil, eller et eksternt system som starter uttrekkingen i en transaksjonsbehandlingsarbeidsflyt). ETL-styring gjelder for begge pipelines identisk.
Sannverdens scenario
Når en bankkunde søker om et lån, laster den opp en PDF-fil med sin strømregning via bankens mobilapp. Hendelsen starter uttrekking i sanntid, som betyr at ingen forhåndsinntatt UDLO eller UDMO er involvert.
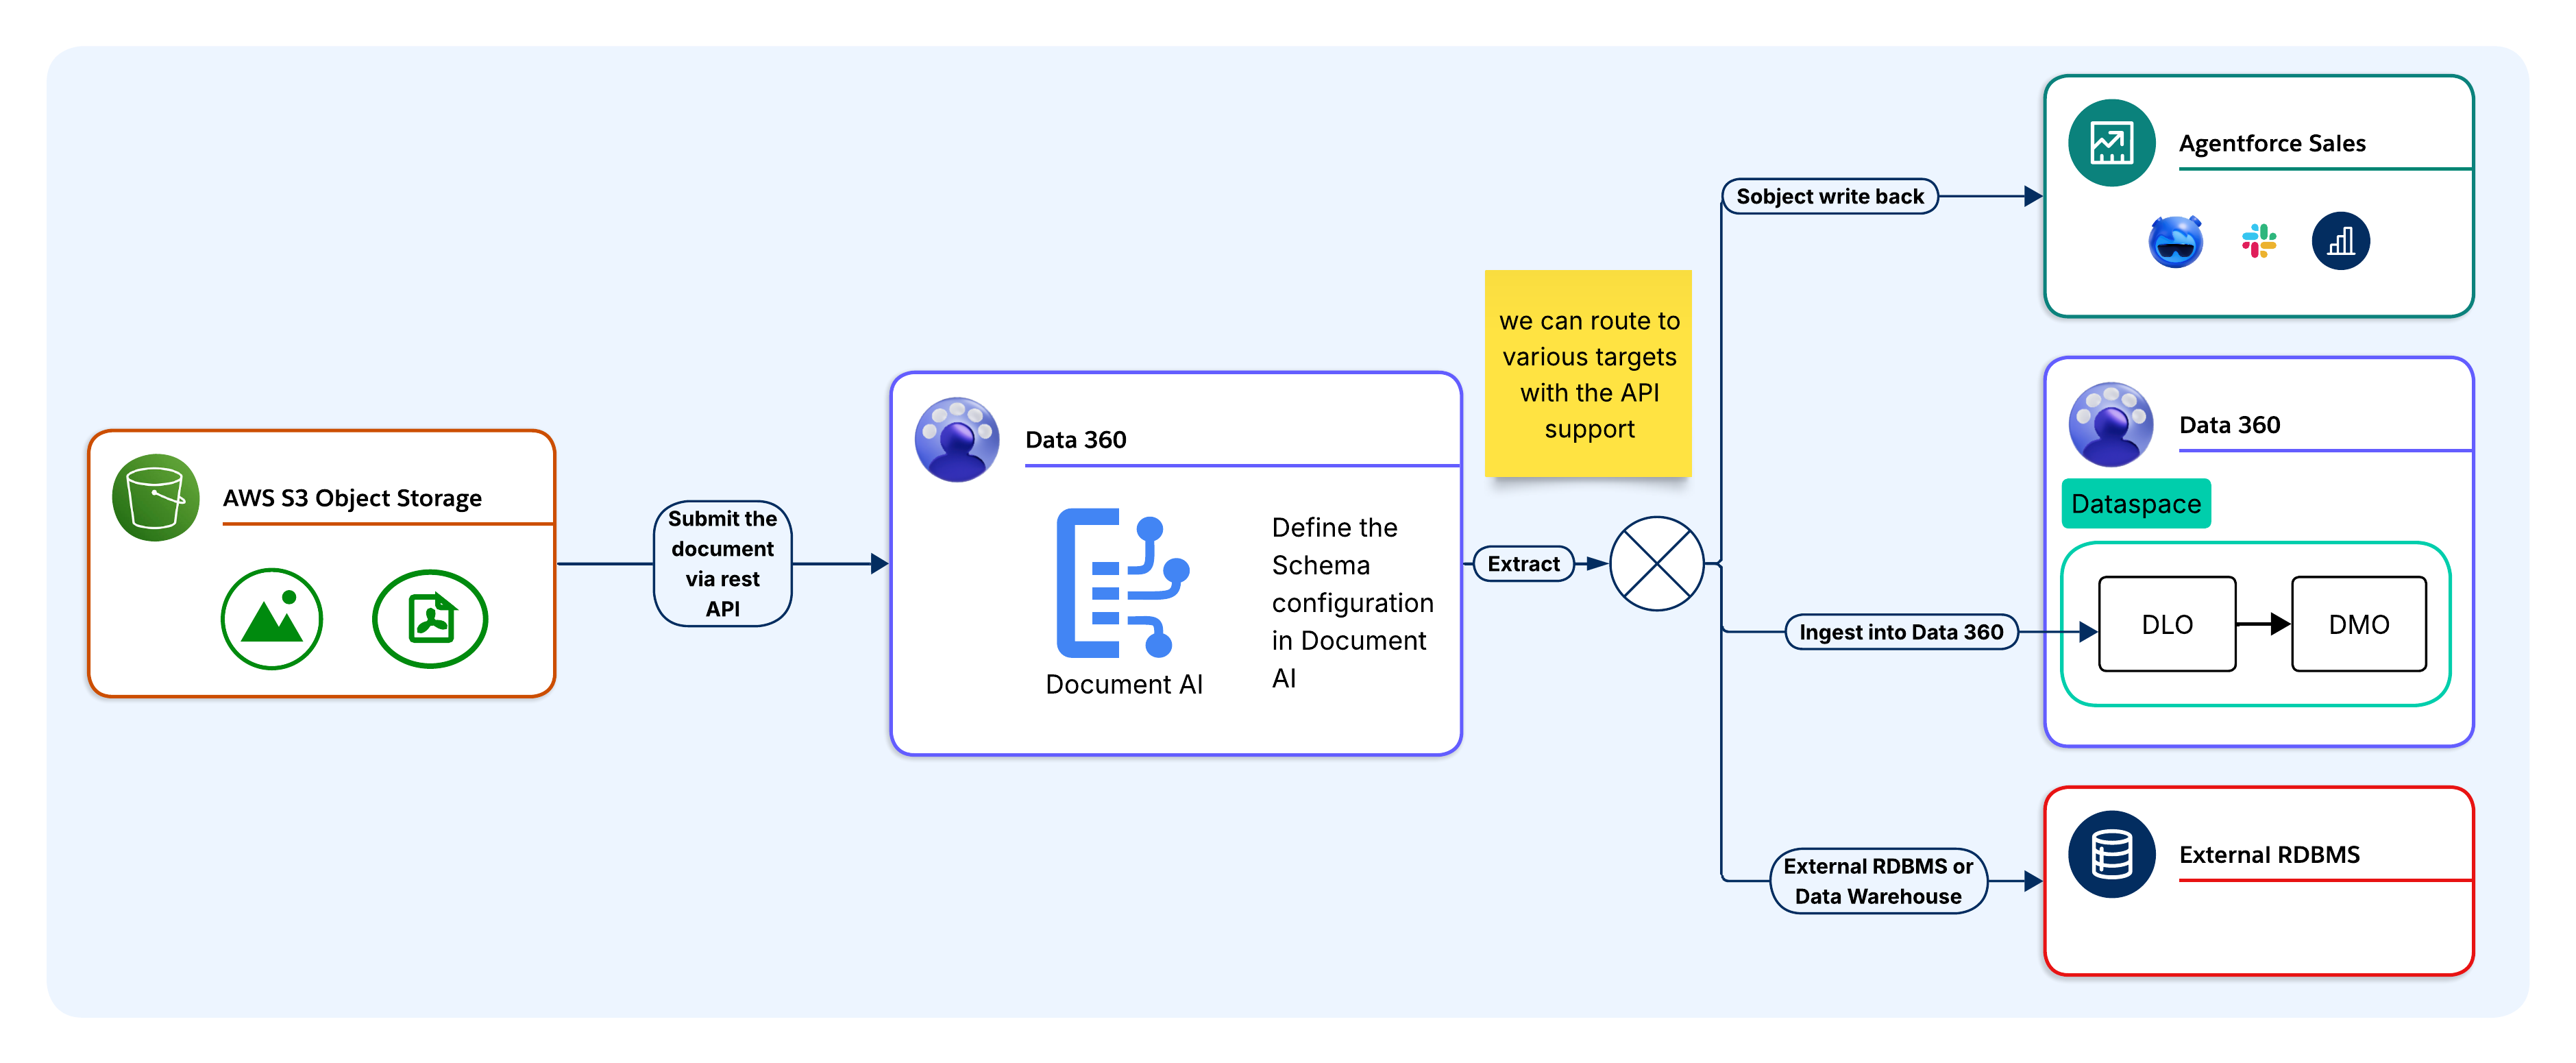
Før du kaller opp API-et må arkitekter definere og lagre et skjema i Data 360 som angir feltene, datatypene og uttrekkingsinstruksjonene i JSON-skjema-format. Hvert skjema tildeles en unik skjema-ID. Ved kjøretid refererer kallprogrammet til skjema-IDen for å holde uttrekkslogikken sentralisert i Data 360 i stedet for å bygge den inn i programkode.
Eksempel:
Bankens team har et forhåndsdefinert ProofOfAddress skjema i Data 360, som spesifiserer felt som CustomerName, AddressLine1, City, PostCode og DocumentDate. Denne informasjonen lagres som en versjonskonfigurasjon som det kan refereres til med en skjema-ID.
Det kallende programmet sender dokument- og skjema-ID-en i en enkelt REST API-forespørsel som en base64-kodet last eller filreferanse. Ingen UDLO-inntak kreves. Dokument AI bruker dokumentuttrekkingen og returnerer den strukturerte utdata basert på det gitte skjemaet.
Eksempel:
Mobilappen sender verktøykontoen som en base64-kodet last sammen med ProofOfAddress-skjema-IDen i et enkelt REST API-kall. Denne prosessen krever ikke et UDLO-inntakstrinn.
LLM behandler OCR-utdata mot skjemaet og returnerer en strukturert JSON-belastning synkront. Felt som ikke finnes i dokumentet, returneres som null. Anroperen eier det fullstendige JSON-svaret og fortsetter til ruting.
Eksempel:
Dokument-AI bruker OCR på PDF-filen, og LLM returnerer en strukturert JSON-belastning med uttrukne adressefelt. Felt som ikke blir funnet (for eksempel hvis PostCode mangler i fakturaen), returneres som null.
Når den er trukket ut, kan JSON-belastningen rutes til ett eller flere målnivåer avhengig av bruksområdet:
- Salesforce SObject: Tilordnes direkte til SObject-felt via Apex eller Flyt for CRM-arbeidsflyter og godkjenninger.
- Data 360 DLO/DMO Pipeline: Ruter til et DLO for harmonisering, identitetsløsning, beregnede innsikter og Agentforce-grunning.
- Eksternt RDBMS eller Data Warehouse: Ruter via MuleSoft, Apex-oppkall, plattformhendelser eller ETL for systemer som er utenfor Salesforce.
- Tilpasset integrasjon: Returnerer strukturerte JSON-belastninger til det kallende programmet for lagring i et hvilket som helst eksternt system eller datalager.
- Nedstrøms flyt eller agent: Overfører den strukturerte JSON-utdata direkte til en nedstrøms flyt eller agent uten noen vedvarende i et SObject. Dette er et vanlig mønster for kunder som bruker Document AI som et sanntidsuttrekkstrinn i en større automatiserings- eller agentisk arbeidsflyt.
Husk at et enkelt skjema kan åpne opp til flere nivåer samtidig, med forskjellige feltgrupper ruting til forskjellige mål fra samme uttrekkspunkt.
Eksempel:
En ProofOfAddress kan ventilere ut til tre nivåer samtidig (for eksempel CustomerName og AddressLine1 skrive til Contact SObject), som starter en adresseverifiserings-flyt. Deretter rutes hele nyttelasten til en DLO for harmonisering og risikoscore, og en kopi rutes til bankens KYC-system via MuleSoft for overholdelseslogging.
Når den er skrevet, aktiveres uttrukne data umiddelbart i målsystemet. For _SObject-_mål aktiveres utløserne, flytene og godkjenningsprosessene i den oppgitte posten. Når det gjelder mål for DLO/DMO, legges data inn i konteksten for harmonisering og identitetsløsning og Agentforce. For eksterne _RDBMS-_mål er data tilgjengelig for nedstrømsspørringer så snart skrivingen er fullført.
Eksempel:
Addressverification Flow aktiveres umiddelbart i den oppgitte Kontakt-posten, noe som fører lånesøknaden til neste fase. Agentforces låneansvarlige Agent finner den bekreftede adressen fra Data 360, og KYC-systemet registrerer dokumentet for revisjonsformål.
Document AI er best egnet for spesifikke arkitektoniske forhold. Bruk av den utenfor disse betingelsene fører til unødvendig kompleksitet og ekstra kostnader.
Som arkitekter er det viktig å evaluere dette kriteriet før vi bruker Document AI som uttrekksmekanisme.
Bruk dokument-AI når:
- Dokumenter er den primære datakilden. Den nødvendige informasjonen finnes bare i dokumentform og er ikke tilgjengelig fra en strukturert API eller database (for eksempel skannede kontrakter, laboratorierapporter, inntaksskjemaer eller forsikringskrav).
- Dokumentoppsett varierer etter kilde. Den samme dokumenttypen kommer fra flere leverandører, partnere eller regioner med forskjellige feltposisjoner og formater. Skjemadrevet LLM-uttrekk tilpasses uten vedlikehold per oppsett.
- Uttrukne data må mates til Data 360 eller Agentforce. Trekking må delta i identitetsløsning, beregnede innsikter eller Agentforce-grunning. Dokument-AI leveres direkte til DLO/DMO pipelinen uten et eget ETL-lag.
- Volume berettiger styrt automatisering. Dokumentvolumet overskrider det manuell behandling kan håndtere uten målbare arbeidsomkostninger eller risiko for datakvalitet.
- Dokumenter inneholder regulert innhold. PHI, PII eller økonomiske data må rutes gjennom et null-data-oppbevaring, PII-maskering lag før du når en LLM. ETL tilfredsstiller dette som standard. Kunder som ikke krever at noe uttrukket innhold opprettholdes på noe tidspunkt, bør også vurdere transaksjons-API-flyten, som returnerer strukturert utdata direkte til det oppringende programmet uten å skrive til noe SOobject eller datalager.
- Brukstilfellet er hendelsesdrevet. Et dokument ankommer ved kjøretid (for eksempel en kundeopplasting, et PDF-vedlegg for en agent eller en ekstern systemutløser). Transaksjonsbehandling Pipeline håndterer synkron uttrekking av enkeltdokumenter uten gruppeoppsett.
Ikke bruk dokument-AI når:
- Kildedata er allerede strukturert. Hvis oppstrømsystemet viser en REST API, databasetabell eller strukturert fil (for eksempel CSV, JSON eller XML), bruker du en standard Data 360-kobling. Kjøring av strukturerte data gjennom en LLM-uttrekking under behandling øker latens- og kredittkostnader uten ekstra fordeler.
- Dokumenter genereres maskinvis med et fast skjema. Systemgenererte PDF-filer fra en kjent ERP- eller faktureringsplattform med et stabilt oppsett er bedre egnet for en deterministisk analysator. LLM-uttrekking er utformet for variabilitet, og bruk av den på dokumenter med faste skjemaer ødelegger kontekst og kreditter.
- Nøyaktighetskrav overskrider LLM konfidens terskler. Dokument-AI garanterer ikke 100% uttrekksnøyaktighet. Brukstilfeller der en manglende eller feil feltverdi medfører betydelig økonomisk, juridisk eller klinisk risiko, krever et HITL-valideringstrinn. Ikke bruk Document AI som det eneste uttrekkslaget for viktige beslutninger uten en valideringsarbeidsflyt.
- Dokumenter overskrider plattformbegrensninger. Den nåværende filstørrelsesgrensen på 10 MB og begrensningene for LLM-kontekstlengde gjør Document AI upassende for store eller tette dokumenter uten forhåndsbehandling for å dele opp og montere dem på nytt utenfor plattformen.
- Notat: I Salesforce forbedrer vi aktivt disse akseptforanstaltningene for å utvide støttede filstørrelser, sidetall og filtyper. Begrensninger vil fortsette å utvikle seg fremover.
La oss ta en nærmere titt på flere scenarier som bruker Document AI batch pipeline som støttes av et UDMO-kildeobjekt. I disse tilfellene trekker uttrukne data ruter gjennom Data 360 DLO/DMO pipeline for harmonisering, identitetsløsning, beregnede innsikter og Agentforce aktivering. Hvert bruksområde er best egnet for planlagt eller hendelsesdrevet dokumentbehandling med stor trafikk.
Agentforce Sales: Kontrakt- og fakturainformasjon
_Kontrakts-_PDF-filer hentes inn fra skylagring via batch pipelinen. Skjemaet trekker ut ContractValue, RenewalDate, PaymentTerms og CounterpartyName, og tilordner dem deretter til DMO-ene for konto og kontrakt. Beregnede innsikter utleder fornyelsesrisiko-score. Agentforce varsler kundeansvarlige før fornyelsesvinduer lukkes, noe som eliminerer manuell kontraktgjennomgang og manglende fornyelser.
Agentforce Service: Saksdefleksjon og Knowledge Grounding
_Undersøkelses-_PDF-filer og saksvedlegg hentes inn via batch pipelinen. Skjemaet trekker ut stemningsindikatorer, problemkategorier og løsningsnotater, og tilordner dem deretter til DMO-ene for sak og Knowledge-artikkel. Agentforce spør den harmoniserte Knowledge når saken åpnes og finner relevante feilsøkingstrinn, noe som reduserer overskridelsen av Agent-søk.
Agentforce Health: Behandling av kliniske dokumenter
Laboratorierapporter, inntaks-PDF-filer og håndskrevne kliniske skjemaer tas inn via batch pipelinen. Skjemaet trekker ut felt – inkludert PatientID, DiagnosisCode, MedicationName og TestResult – og tilordner dem deretter til Health Cloud DMO-er, som støtter HIPAA-justert behandlingskoordinasjon og kliniske forskningsarbeidsflyter.
Finansetjenester: Automatisering av lån og skattedokumenter
Lånesøknader, avgiftsdeklarasjoner og omsetningsrapporter hentes inn via gruppebehandlingen under behandling. Skjemaet trekker ut felt – inkludert AnnualIncome, TaxYear og EmployerName – og tilordner dem deretter til DMO-ene for finanskontoer. Beregnede innsikter kombinerer dokumentutledede omsetningsdata og CRM-data for å lette automatisert kredittrisikoscore. Agentforce finner uttrukne lånedetaljer innebygd under interaksjoner med kundeservice. Dette mønsteret støtter direkte brukstilfellet Loan Prequalification Agent som er publisert i Salesforce Agent Enterprise Solutions-utviklersenteret.
HR: Arbeidsstyrke dokumentbehandling
Introduksjonsdokumenter, skatter og sertifiserings-PDF-filer hentes inn via batch pipelinen. De uttrukne feltene tilordnes til DMO-ene for ansattposten og kobles deretter til profilen Forente ansatte. Spesifikke flyter initierer introduksjonsoppgaver og samsvarskontroller basert på uttrukne data. Dette mønsteret støtter direkte brukstilfellet Automatisert gjenopptagelsesbehandling Agentisk. Dokument-AI trekker ut kvalifikasjoner, ansettelseshistorikk og kvalifikasjoner fra PDF-filer for fortsettelse, som Agentforce deretter bruker til å samsvare kandidater mot kriterier for åpne roller og rute dem til arbeidsflyter for ansettelse.
Professional Services: Forslag og forskning
Forslagsdekker og forskningsrapporter hentes inn via batch pipelinen. Uttrukne rammeverk, sammenligninger og engasjementssammendrag tilordnes til tilpassede DMO-er og indekseres deretter for vektorsøk. Agentforce henter kontekstrelevante anbefalinger på spørringstidspunktet, som er basert på uttrukket dokumentinnhold. Dette mønsteret utvider mønsteret Ground Agentforce on Website Content. Dokumenter indekseres via Document AI og har samme grunnfunksjon for agentsvar som nettstedsinnhold som indekseres via Data 360-koblinger.
HIPAA-samsvarstatus:
Health Cloud mønstrene som er beskrevet i denne artikkelen, bruker ETL-kontroller (for eksempel null dataoppbevaring og PHI-maskering) for tekstinndata. Disse kontrollene alene utgjør ikke HIPAA-sertifisering. Arkitekter som utformer for regulerte kliniske miljøer, må bekrefte gjeldende HIPAA-sertifiseringsstatus med Salesforce-samsvarsteamet før de forplikter seg til en Document AI-basert arkitektur innenfor disse kontekstene.
La oss ta en nærmere titt på flere scenarier som kaller opp Document AI REST API med et skjema som ikke er bundet til et UDMO. Uttrukne JSON-belastninger rutes direkte til eksterne systemer synkront ved kjøretid.
Supply Chain: Leverandørfakturabehandling til ERP
Når en PDF-fil for en leverandørfaktura ankommer en overvåket lagringskategori eller e-postgateway, kaller en hendelsesutløser opp REST API-et for Document AI med fakturaen og en forhåndsdefinert skjema-ID. Skjemaet trekker ut VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount og DueDate. JSON-belastningen rutes via MuleSoft til ERP Accounts Payable-modulen med null-feltvalidering og idempotent upsert-logikk, noe som eliminerer malvedlikehold for leverandørformatvariabilitet.
Juridiske operasjoner: Kontraktgjennomgang til CLM
Når en _kontrakts-_PDF-fil lastes opp til den juridiske portalen, kaller serveren Document AI REST API synkront. Skjemaet trekker ut GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause og CounterpartySignatory. JSON-belastningen rutes via Apex-kall til systemet Contract Lifecycle Management (CLM). Eventuelle felt som ikke blir funnet, returneres som null, og CLM bruker standardforpliktelsesreglene på de manglende verdiene.
Forsikringskrav: Første varsel om tapsbehandling
Når en forsikringsinnehaver sender inn et First Notice of Loss (FNOL)-skjema, kaller serverportalen Document AI REST API synkront. Skjemaet trekker ut PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName og ContactPhone. JSON-belastningen rutes til kravbehandlingsdatabasen via Apex-oppkall eller ETL, som oppretter en forhåndsutfylt kravpost som justerepersonene kan se gjennom før den formelle kravet åpnes.
Før du går over til produksjon må du opprette utforminger for disse feilscenariene.
- Håndtering av null-felt: LLM returnerer null for felt det ikke kan finne eller trygt trekke ut. Valider null-handlingslogikk ved utforming av skjemaer og implementer standardverdi- eller avvisningslogikk i integrasjonslaget før du skriver til eventuelle mål med NOT NULL-begrensninger eller nødvendige samsvarsnøkler.
- OCR Kvalitetsforringelse: OCR-nøyaktigheten reduseres til under 150 DPI, ved uregelmessig håndskrift eller ved støyende skanning. Feilskrivinger overføres til LLM-uttrekk som ødelagte inndata uten feilsignaler. Håndhev minste skannekvalitet ved inntak, og implementer konfidens terskelkontroller på tall- og datofelt.
- Skjemaversjonssamsvar: Oppdatering av en skjemakonfigurasjon etter at en gruppejobb er planlagt, fører til at dokumenter underveis behandles mot den forrige versjonen, noe som produserer felt som mangler eller gir nytt navn, som bryter nedstrøms tilordning. Versjonsskjemaer eksplisitt og koordinere oppdateringer med gruppejobbplaner.
- Filstørrelsesgrenser: Dokumenter som overskrider 10 MB, avvises. Batch pipeline-feil er stille uten overvåking konfigurert, og transaksjonelle anropere mottar en 4xx-feil. Forhåndsvalider filstørrelser ved inntak og implementer forhåndsbehandling for å dele opp eller komprimere dokumenter som regelmessig nærmer seg grensen.
- LLM Context Overflyt: Tette eller flersidede dokumenter kan overskride LLM-kontekstvinduet innenfor grensen på 10 MB. LLM slipper stille innhold som overskrider kontekst. Implementer en fordelingsstrategi som deler opp dokumenter etter sideområde og samler uttrukne felt på nytt før du overfører dem til målet.
- Trust-lag maskering påvirker uttrekking: ETL-et fungerer på ledetekstnivået, ikke på dokumentnivået, så maskering gjelder ikke for dokumentinnhold som går gjennom Document AI. Skjemafelt som er avhengige av _PII-_verdier i dokumentet, påvirkes ikke av ETL-maskeringspolicyer.
- Ekstern skrivebeskyttelse for RDBMS: Den transaksjonsbehandling pipeline har ingen innebygd idempotens for eksterne RDBMS mål. Nye forsøk med integreringslag oppretter duplikatrader med mindre skrivelogikken eksplisitt håndterer fjerning av duplikater. Implementer idempotent upserts med et dokumentspringavtrykk eller en ekstern ID på alle eksterne skrivebaner.
- Kredittutløp midt i løpet: Store batchkjøringer kan bruke ut Digital Wallet-kreditter før alle dokumenter behandles, noe som produserer ufullstendige DLO-datasett som nedstrøms trinn ser ut som fullstendige. Angi forbruksvarsler til 75 % og 90 % av tilgjengelige kreditter, og begrens batchstørrelser for å holde seg innenfor kredittbudsjettet for hver syklus.
- Skjemafeltgrense – arkitektonisk begrensning: Document AI håndhever en grense på 50 felt for felt på rotnivå i en skjemakonfigurasjon. Dette er en begrensning for utformingstid – ikke en kjøretidsfeil – og arkitekter må ta hensyn til den under datamodell- og skjemautformingen.
- For brukstilfeller som krever mer omfattende uttrekk:
- Prioriter utilsiktet. Begrens skjemaet til felt som gir automatiseringsverdi, ikke omfattende dokumentdekning.
- Bruk nestede objekter (opptil tre nivåer, gruppemodus bare med kildeobjekt) for å redusere antall felt på rotnivå uten å ofre uttrekksdybden.
- Dekomponer komplekse dokumenter på tvers av flere Document AI-konfigurasjoner som er rettet mot forskjellige dokumentdeler, og skriv resultater til separate DLO-er som slås sammen nedstrøms i Data 360.
- For brukstilfeller som krever mer omfattende uttrekk:
- API-grenser: Document AI håndhever en grense på 50 uttrekks-API-kall per minutt per leietaker. Det teoretiske taket er 300 samtaler per minutt, som styres av Einstein LLM Gateway. Transaksjonsintegrasjoner med stor trafikk må utformes med eksponentiell tilbakemelding, forespørselskø og budsjettering av gjennomløp på leietagernivå. Ikke anta at burst-kapasitet er tilgjengelig i produksjonsmiljøer med flere leietagere.
- API-latensprofil: API-er for utvinning av dokument-AI er fullstendig synkrone. Vanlige responstider varierer fra 5 til 15 sekunder, og de varierer etter filstørrelse og skjemaets kompleksitet.
- Dette har direkte konsekvenser for integrasjonsarkitektur:
- Angi tidsavbrudd for anropere til et minimum på 30 sekunder.
- Ikke kall Document AI i flyter med undersekunders SLA-krav.
- Faktorlatens i gjennomløpsberegninger mot grensen for frekvensgrense for batchbehandlingsrørledninger.
- Angi tidsavbrudd for anropere til et minimum på 30 sekunder.
- Dette har direkte konsekvenser for integrasjonsarkitektur:
- Krypterte og passordbeskyttede dokumenter: Document AI behandler ikke passordbeskyttede filer (brukerpassord kreves for å åpne filer) eller PDF-filer som er kryptert med et eier/tillatelsespassord, inkludert filer som åpnes normalt, men begrenser kopiering, utskrift eller redigering på PDF-tillatelsessjiktet.
- Denne begrensningen ligger ved inntaksgrensen:
- Design dokumentinntak pipelines for å oppdage og rute krypterte filer til en avvisning eller manuell behandling bane før de når Document AI.
- Ikke bruk kjøretidsfeilhåndtering som primærgate.
- Denne begrensningen ligger ved inntaksgrensen:
Data 360 Document AI er i samsvar med flere søyler i Salesforces velbygde rammeverk.
- Trust: ETL håndhever null dataoppbevaring med LLM-leverandører, maskerer PII-inndata før de når modellen, og skanner utdata for sensitivt innhold. Arkitekter må utvide denne holdningen til uttrukne data under lagring. Maskering på feltnivå i DLO-er brukes ikke av ETL, og krever nedstrøms policyer for datareal og tillatelsessett.
- Pålitelighet: Hver feilmodus i delen Designvurderinger – null-feltuttrekking, feillesing av OCR, feil samsvar med skjemaversjon, brudd på filstørrelse, LLM-kontekstoverflyt, ETL-maskeringsinterferens, RDBMS-skrivingstidpotens og kredittuttømming – representerer en distinkt feilklasse med et dokumentert deteksjonssignal og løsningsbane.
- Operational Excellence (endringsledelse): Den skjemadrevne uttrekksmodellen kobler uttrekkslogikken fra dokumentoppsettet. Når en leverandør endrer et fakturaformat eller et lovpålagt skjema oppdateres, trenger arkitekter bare å oppdatere én skjemakonfigurasjon i stedet for å endre integreringskode.
- Operational Excellence (vedlikehold): Ved å sentralisere skjemakonfigurasjoner i Data 360 i stedet for å bygge inn uttrekkslogikk i programkode, blir uttrekkshensikten eksplisitt, versjonert og reviderbar. Alle nedstrøms mål bruker samme skjemakontrakt uavhengig av målnivået.
- Operational Excellence (integrasjonsgjenbruk): Dokument-AI viser uttrekking på tvers av flere integrasjonsoverflater: REST API, Apex, Flow, MuleSoft, Agentforce Actions og MCP-serveren. En enkelt skjemakonfigurasjon viser flere målnivåer samtidig uten å bygge uttrekksfunksjonen på nytt per forbruker.
- Ressurs- og kostnadsoptimalisering: Veiledningen for valg av pipeline, grensen for filstørrelse på 10 MB og begrensningene for lengden av LLM-kontekst før montasje representerer ytelsesbevisste designbeslutninger. Delen Når den skal brukes formaliserer betingelsene for når Document AI ikke er det riktige verktøyet (for eksempel latenskrav under sekunder, fullt strukturerte kildedata og maskingenererte dokumenter med fast skjema).
Dette er et strukturert utgangspunkt for konfigurering av Data 360 Document AI i et Sandbox-miljø. Fullfør alle fasene i Sandbox-organisasjonen før du går til produksjon.
Før du starter konfigurasjonen må du bekrefte følgende:
- Filstørrelse: Kontroller at de representative dokumentstørrelsene er under 10 MB.
- Pipeline: Kontroller om brukstilfellet krever batch pipeline (UDMO-støttet, høyvolum) eller transaksjonsbehandling pipeline (API-drevet, enkeltdokument). Dette driver all etterfølgende konfigurasjon.
- Målnivå: Bekreft hvor de uttrukne dataene befinner seg – Salesforce SObject, Data 360 DLO/DMO, eksternt RDBMS eller en kombinasjon.
- Agentforce Dependency: Før du distribuerer en Agentforce-drevet dokumentbehandling, må du kontrollere at en støttet LLM (for eksempel GPT-4o) er aktivert i organisasjonen via ETL-innstillingene. Agentforce er en hard plattform forutsetning for Document AI. Hele funksjonsoverflaten for Document AI, inkludert alle uttrekks-API-er, er ikke tilgjengelig før Agentforce er aktiv i målorganisasjonen. Ta hensyn til dette i vurderinger av organisasjonens klargjøring og klargjøringssekvensering. La det ta noen minutter før API-tilgjengelighet stabiliseres etter aktivering.
- Innvirkning på deaktivering av Agentforce: Hvis Agentforce deaktiveres etter at Document AI er konfigurert og distribuert, blokkeres all uttrekksbehandling (grensesnitt og API) umiddelbart. Det samme gjelder for deaktivering av modeller. Deaktivering av den underliggende modellen har en tilsvarende effekt på tilgjengeligheten av Document AI. I begge tilfellene beholdes de eksisterende skjemakonfigurasjonene og vil forbli synlige – ingen konfigurasjon eller tap av data vil skje – men funksjonen er fullstendig ubrukbar før Agentforce og modellen er aktivert på nytt. Utform operasjonelle kjørebøker for å behandle Agentforce tilgjengelighet og modellaktivering som avhengigheter av dokumenter for AI.
- Kredittforbruk/priser: Bruk Data 360-kreditter eller Flex-kreditter til TCO-beregninger som er utledet fra representative eksempeldokumenter.
- Opprett skjemakonfigurasjonen. Definer uttrekksfelt, datatyper og instruksjoner i JSON Schema-format i oppsettet for Data 360 Document AI. For batch pipelinen kobler du den til et UDMO. For transaksjonsbehandling under behandling oppretter du den uten et kildeobjekt. Registrer skjema-IDen.
- Juster feltnavnene til målnivået. Sammenhold feltnavn med DLO-kolonnedefinisjoner, API-navn for SObject eller RDBMS-kolonnenavn. Feiljusterte navn oppretter tilordningsoverhead i integrasjonslaget.
- Konfigurer UDMO-kildeobjektet (bare batch). Definer dokumenter i omfang og konfigurer inntakskildetilkobling (for eksempel S3, Google Cloud Storage, Salesforce Files eller MuleSoft). Kontroller at inntakstjenestekontoen har det nødvendige IAM- eller OAuth-legitimasjonsomfanget.
- Bruk policyer for PII-maskering. Konfigurer policyer for Data Masking i ETL-innstillingene før du behandler noe regulert innhold. Definer hvilke felttyper (PHI, PII og økonomiske identifikatorer) som maskeres før inndata når LLM. Ikke utsett dette trinnet.
- Tildel dataområde og tillatelsessett. Omfangsbehandling til det riktige datarommet og konfigurer tillatelsessett for å kontrollere opprettelse av skjemaer, gruppejobbutføring, REST API-kall og nedstrøms aktivering.
- Konfigurer API-godkjenning (bare transaksjonsbehandling under behandling). Opprett en tilkoblet app med OAuth omfang cdp_ingest_api og api. For organisasjonsinterne anropere bruker du en navngitt legitimasjon som kobler til en ekstern legitimasjon. For eksterne anropere konfigurerer du OAuth 2.0-klientlegitimasjon eller en JWT-bærerflyt. Test og valider uttrekkingen før du fortsetter.
- Subject-skriv tilbake: Implementer et Apex (@InvocableMethod) eller _Flyt-_element som tilordner JSON-svarfelt til _SObject-_felt. Bruk Database.upsert() med en ekstern ID for å hindre duplikater. Bruk Feltnivåsikkerhet på _SObject-_målfelt.
- Data 360 DLO/DMO pipeline: Tilordne uttrukne DLO-felt til DMO-er som er i samsvar med Customer 360-datamodellen. Konfigurer identitetsløsningsregler for å koble dokumentposter til Forente persondata. Definer beregnede innsikter og legg til DMO-er for Agentforce. For transaksjonsbehandling under behandling ruter du JSON-belastningen til en DLO via Inntaks-APIen først.
- Eksternt RDBMS eller datalager: Velg integrasjonsmønsteret: MuleSoft (eksisterende integrasjonstekst), Apex HTTP-oppkall (lett, organisasjonsbasert), Plattformhendelser med Pub/Sub-abonnenten (arrangementsdrevet) eller ETL (høyvolumbatch). Implementer idempotent upserts med et dokumentspringavtrykk eller en ekstern ID på alle eksterne skrivebaner.
- Aktiveringsbaner: Koble Agentforce til skjemakonfigurasjoner for interaktiv uttrekking. Konfigurer Flytutløsere eller Apex-utløsere for automatiserte arbeidsflyter og etabler aktiveringsmålene for hver feltgruppe.
- Feilhåndtering (bare transaksjonsbehandling under behandling). Konfigurer hele HTTP-svaroverflaten: 200 (vellykket, inkludert delvise null-svar), 400 (feilformet forespørsel eller skjema-ID ikke funnet), 413 (fil overskrider 10 MB), 5xx (tjenestefeil). Implementer eksponentiell tilbakemelding for 5xx gjenopptak med maksimalt 3 forsøk. Logg det rå JSON-svaret og skjema-IDen for alle samtaler.
- Testskjemaer mot prøvedokumenter. Send representative eksempler via grensesnittet Document AI eller REST API. Bekreft uttrekksnøyaktighet, feltdekning og null-behandling på tvers av oppsettvariasjoner.
- Valider håndtering av null-felt. Kontroller at alle nedstrøms mål kan håndtere null-verdier for felt som ikke finnes i et dokument. Husk at NOT NULL-begrensninger mislykkes stille uten eksplisitt null-behandling.
- Forhåndsvalider filstørrelser. Kontroller at produksjonsdokumenter er under 10 MB. Implementer forhåndsbehandling for å dele opp eller komprimere dokumenter som regelmessig nærmer seg grensen.
- Valider ende-til-ende-uttrekking. For batch pipeline starter du en full kjøring og kontrollerer at de uttrukne feltene lander riktig i hvert målnivå. For transaksjonsbehandling under arbeid sporer du JSON-svaret gjennom integreringslaget til målet. Kontroller utløseren og flytutførelsen for SObject-målene, identitetsløsningskoblingen for DLO/DMO-målene og idempotensialet for RDBMS-målene.
- Bekreft virkemåten til Trust Layer. ETL bruker ikke PII maskering på dokumentinnhold, så LLM returnerer PII-data i uttrukne felt slik de er. Kontroller at skjemafeltene, dataruting og nedstrømslagring er utformet for å håndtere PII-bærende utdata riktig, og forsikre deg om at eventuelle krav til overholdelse eller oppbevaring håndteres utenfor plattformen.
- Angi Digital Wallet-varsler. Konfigurer forbruksvarsler på 75 % og 90 % av tilgjengelige kreditter. Fastsett grenser for batchstørrelse og ad hoc-frekvensberegninger innenfor kredittbudsjettet for hver syklus.
- Valider gruppeovervåking (bare gruppe under arbeid). Se gjennom uttrekksresultater, null-feltfrekvenser og fullføring av jobb i overvåkningskonsollen Data 360. Bekreft kodeforbredelsen fra UDLO via DLO til DMO i datalinjement.
- Valider API-feilhåndtering (bare transaksjonsbehandling under behandling). Teste alle feiltilstander: 413 (dokumenter over 10 MB), 400 (ugyldige skjema-IDer), 200 (gyldige uttrekk med delvise null-verdier). Kontroller at forsøkslogikken utløses på simulerte 5xx-svar uten å opprette duplikatskrivinger.
Dette dokumentet fremhever det arkitektoniske grunnlaget for Data 360 Document AI:
- To behandlingslinjer under behandling og når de skal brukes
- Skjemakonfigurasjonsmodellen
- Rammeverket for målnivåbeslutninger
- Kjerneteknologibegrensninger
- Feilmoduser
- Velkonstruert rammeverk
Hurtigstartveiledningen for arkitekter gir konfigurasjonssekvensen for en Sandbox-konseptbekreftelse.
Kjernearkitekturen støtter dokumentutledede data som styres på Schema-laget, behandles via en ETL-håndhevet LLM pipeline og leveres til den samme Data 360-datalivssyklusen som styres av alle andre bedriftsdata.
Arkitekter som bruker disse prinsippene – velger riktig pipeline, utformer skjemaer på dokumenttypenivå og utformer for feilmoduser før produksjon – bygger uttrekksfunksjoner som skaleres og holder seg under regulerte krav til bransjestyring.
Yugandhar Bora er Software Engineering Architect på Salesforce som spesialiserer seg på dataarkitektur innenfor plattformen Data and Intelligence Applications. Han leder Enterprise Architecture Review Board (EARB) initiativer som fokuserer på datastyring og forente datamodeller, samtidig som han bidrar til automatiserte plattformklargjøringsløsninger.
Ananth Anto er produktleder for Salesforce Data 360 og leder initiativene Document AI og Data Graph. Basert i Bangalore samarbeider han med bedriftskunder om å løse utfordringer i den virkelige verden for dokumentbehandling og datavitenskap. Han liker å utforske Enterprise brukstilfeller for generativ AI (gen AI).
Nishan Naseer er en programvarearkitekt ved Salesforce som arbeider med ustrukturert databehandling, RAG pipelines og Document Intelligence. Han er opptatt av å utnytte kraften i AI til å takle utfordringer i den virkelige verden og finne kreative løsninger på komplekse kundeproblemer.