Virksomhetens dataarkitekturer lever sjelden i ett system. Salesforce behandler kundeengasjement, pågående arbeid og tjenesteinteraksjoner. Analytiske plattformer som Snowflake inneholder historiske transaksjoner, økonomiske poster, bruksdata og driftsmålinger. Tradisjonelt betyr å bygge en bro mellom disse to verdenene å bygge og vedlikeholde ETL under arbeid: planlagte jobber som trekker ut data fra kilden, transformerer dem og laster inn kopier i Salesforce. Som et resultat av disse pipelinene kommer dataene forsinket, styringspolicyer multipliseres på tvers av systemer, og pipelines krever kontinuerlig operasjonell behandling.
Salesforce-datavirtualisering tilbyr en annen modell. I stedet for å flytte data til Salesforce, gir den Salesforce mulighet til å spørre mot data direkte ved kilden, ved kjøretid, uten replikering. Brukere ser direkte eksterne data via standard Salesforce-grensesnitt. Dataene forlater aldri sin autoriserte hjemmebase. Dette dokumentet forklarer hvordan mønsteret fungerer, når det skal brukes, og hvordan du kommer i gang, ved å bruke Snowflake som et konkret eksempel på arbeid.
Salesforce-datavirtualisering er et integrasjonsarkitekturmønster som gir Salesforce mulighet til å spørre mot data direkte fra eksterne systemer ved kjøretid uten å kopiere eller replikere disse dataene til Salesforce-lager. I stedet for å flytte data inn, sender plattformen spørringen ut.
Resultatet er at Salesforce-brukere samhandler med eksterne data via kjente Salesforce-grensesnitt (som sideoppsett, relaterte lister, rapporter eller flyter) mens dataene forblir i sitt autoriserte kildesystem. Styring, tilgangskontroll og dataoppbevaring beholdes der de tilhører.
Dette mønsteret bygger på ett enkelt arkitektonisk prinsipp: data forblir ved kilden. Beregning flyttes til dataene.
De fleste Salesforce-distribusjoner for virksomheter integreres med eksterne dataplattformer (som datalagrer, driftsdatabaser eller analysebutikker) via replikering under behandling. Pipelines trekker ut, transformerer og laster inn data i Salesforce etter en tidsplan. Denne løsningen fungerer, men replikering introduserer strukturelle avveininger:
- Replikerte data forsinkes alltid. Pipelines innfører forsinkelser, og foreldede data fører til dårlige beslutninger.
- Hver kopi av data utvider omfanget av samsvar. Sensitive data (som personlig identifiserbar informasjon, økonomiske poster eller helsedata) i flere systemer krever at flere styringspolicyer vedlikeholdes.
- Pipelines krever løpende driftsinvesteringer, overvåking, feilhåndtering, skjemadriftsbehandling og logikk for påfølgende behandling.
Datavirtualisering håndterer disse avveiningene direkte. Den fjerner pipelinen helt for lesbare brukstilfeller, beholder data på sin autoriserte plassering og gir Salesforce-brukere en sanntids, styrt visning av eksterne data uten replikeringskostnadene.
 |
Salesforce Connect er plattformfunksjonen som aktiverer datavirtualisering i Salesforce. Den leverer adapterrammeverket som oversetter SOQL-spørringer til spørringsspråket til et eksternt system, behandler godkjente oppkall og tilordner resultatsett tilbake til Salesforce-felttyper. Den leverer Eksterne objekter, Salesforce-metadatakonstruksjonen som viser eksterne data som spørbare, plattformbaserte enheter uten å replikere data til Salesforce-lagring. Eksterne objekter fungerer som standard Salesforce-objekter – synlige i sideoppsett, relaterte lister og rapporter og tilgjengelige via SOQL og standard-API-er – men inneholder ingen data. Eksterne objekter er en skjemaprojeksjon over kildesystemet. |
Eksterne objekter er den primære mekanismen som datavirtualisering bruker til å vise eksterne data i Salesforce. De fungerer som standard Salesforce-objekter: kan spørres via SOQL, synlig i sideoppsett og relaterte lister og tilgjengelig via standard Salesforce-API-er. Nøkkelforskjellen er at ingen data lagres i Salesforce. Det eksterne objektet er en skjemaprojeksjon: en definisjon av hvordan de eksterne dataene ser ut, ikke en kopi av selve dataene.
Når en bruker laster inn en side eller kjører en rapport som refererer til et eksternt objekt, utfører Salesforce en direktespørring mot det eksterne systemet og returnerer bare resultatsettet for denne interaksjonen.
Når Salesforce utfører en SOQL-spørring mot et eksternt objekt, oversetter den filtre (WHERE-setninger), sorteringsrekkefølger (ORDER BY) og grenser (LIMIT) til tilsvarende SQL og sender dem til det eksterne systemet. Det eksterne systemet utfører spørringen på sin egen datamotor og returnerer bare det filtrerte resultatsettet. Arbeid skjer der dataene befinner seg, og bare svaret reiser tilbake til Salesforce.
Datavirtualisering håndhever to uavhengige sikkerhetslag samtidig. Det eksterne systemet bruker sine egne tilgangskontroller på spørringsutførelsestidspunktet, inkludert sikkerhet på radnivå, kolonnemaskering og rollebasert tilgang. Salesforce bruker sin egen sikkerhetsmodell øverst: profiler, tillatelsessett, feltnivåsikkerhet og delingsregler. Begge lagene er aktive i alle spørringer. Ingen av dem erstatter den andre.
Arkitekter beskriver ofte datavirtualisering som et "nullkopierings"-mønster. Zero-copy betyr ingen fast replikering i Salesforce-lagring. Det er ingen ETL under arbeid som skriver poster til Salesforce-objekter. Det er ingen planlagt synkronisering ved oppretting av en lokal kopi. Det eksterne objektet inneholder ingen rader.
Zero-copy betyr ikke null dataoverføring. Hver gang en bruker spør et eksternt objekt, reiser et resultatsett fra det eksterne systemet til Salesforce over nettverket. For store resultatsett eller høy spørringsfrekvens er kostnader for datautgang og nettverkslatens reelle faktorer som arkitekter må utforme for. Dette er ikke en begrensning for å skjule: det er en utformingsbegrensning som du må ta hensyn til.
Ta hensyn til disse arkitektoniske forskjellene hvis bruksområdet krever høye volumer, hyppig tilgang eller lav latens.
Snowflake er et av de vanligste eksterne systemene som er koblet til Salesforce via datavirtualisering. Den tjener som et konkret eksempel på hvordan mønsteret fungerer fra ende til ende.
I denne konfigurasjonen kobler Salesforce til Snowflake med Salesforce Connect med SQL-adapteren for Snowflake. Snowflake-tabeller og -visninger vises som eksterne objekter i Salesforce. Når en bruker spør et eksternt objekt, oversetter Salesforce SOQL til SQL og sender det til Snowflake Statements API via et godkjent HTTPS-oppkall. Snowflake utfører spørringen på sitt virtuelle lager, bruker sin egen sikkerhet på radnivå og kolonnemaskering, og returnerer bare resultatsettet. Ingen data skrives til Salesforce-lager på noe tidspunkt.
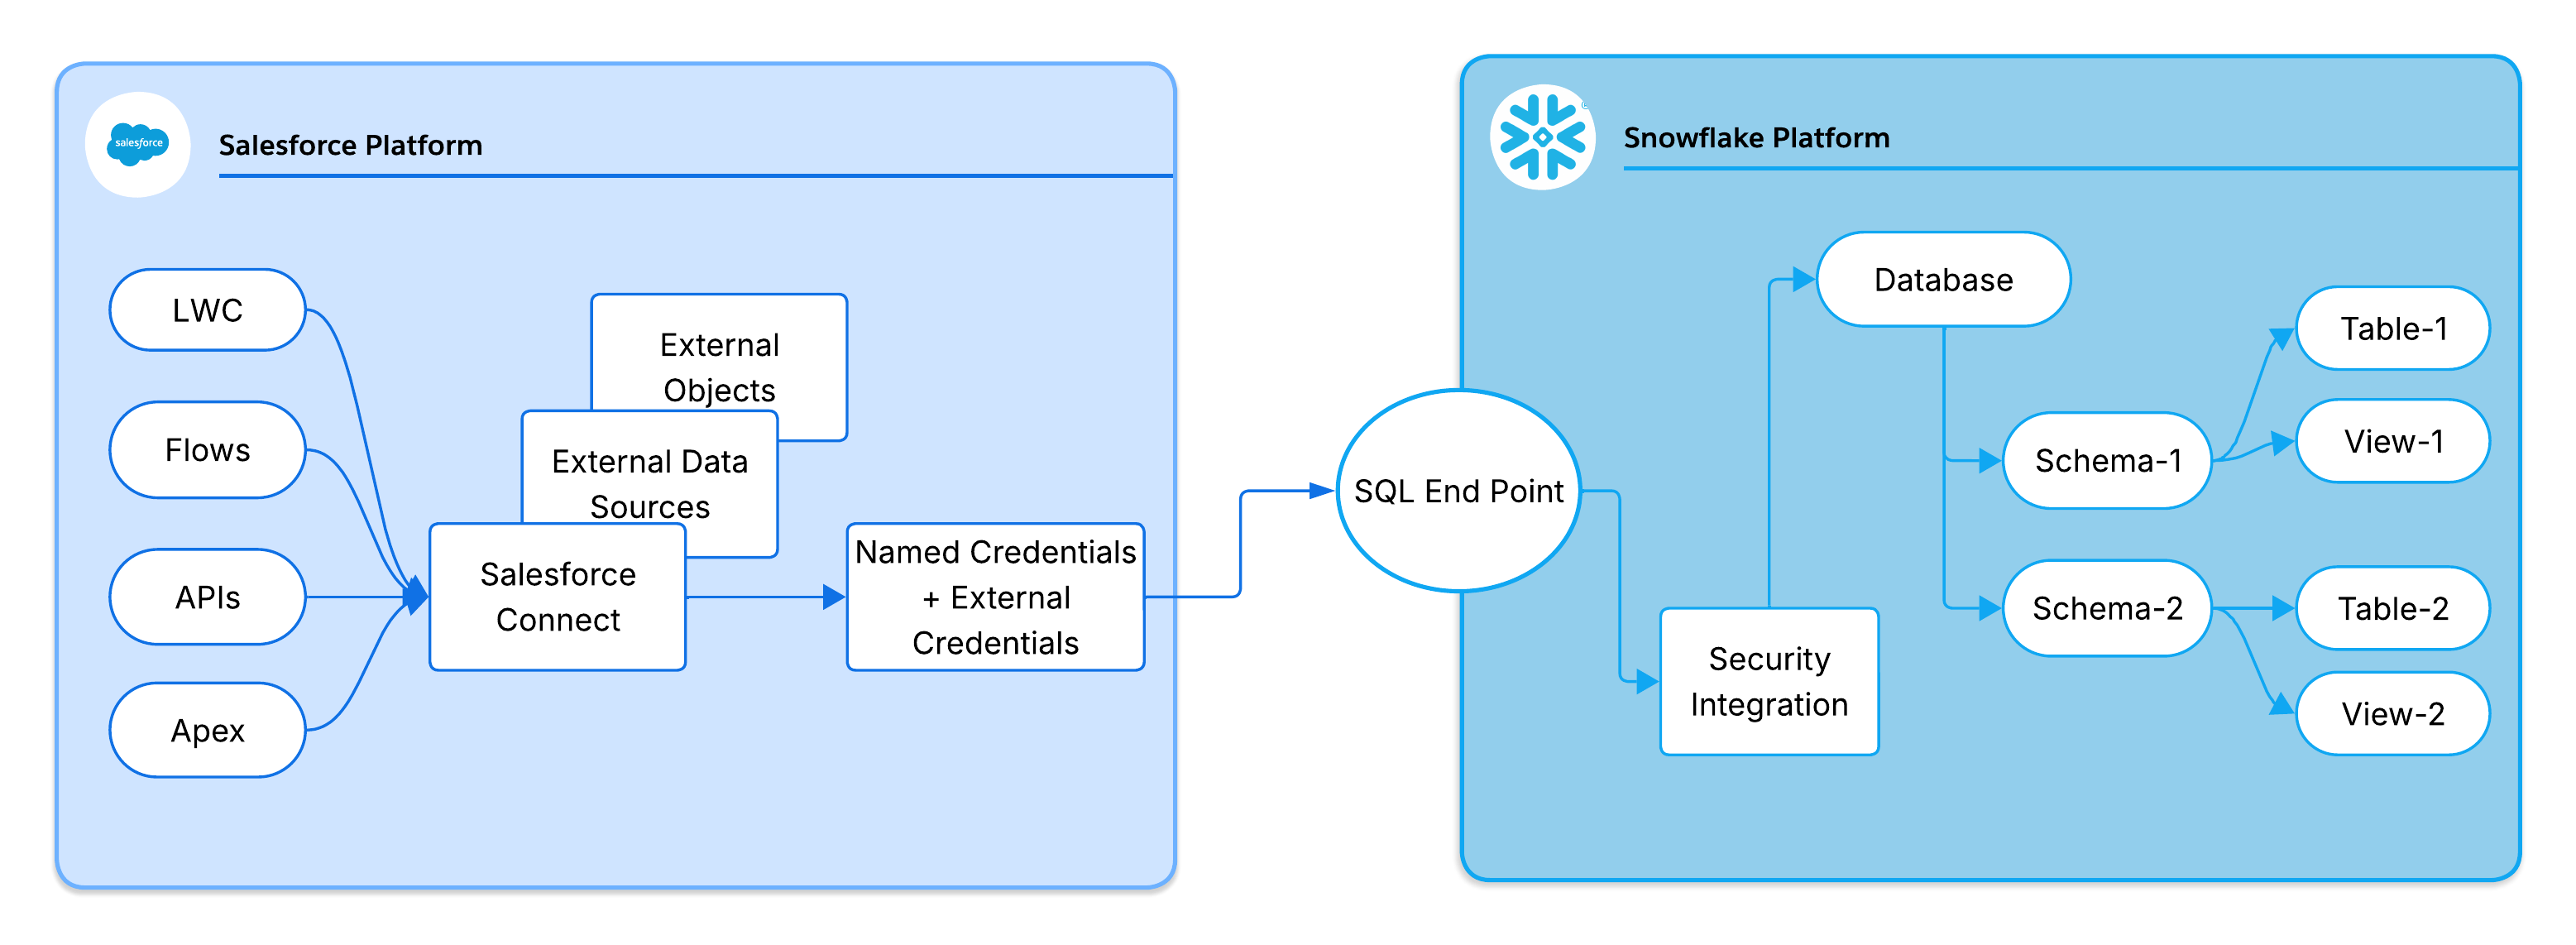
Salesforce Connect bruker en delegert OAuth 2.0-modell til å godkjenne med Snowflake. Nøkkelkomponentene er:
- Auth-leverandør: Behandler OAuth-håndtaket med Snowflake. Håndterer tokenforespørsler og tilordner det returnerte tokenet til Salesforce-legitimasjonen.
- Ekstern legitimasjon: Holder OAuth-tilgang og oppdateringstokener sikkert i det krypterte legitimasjonslager i Salesforce, og injiserer dem i utgående oppkall.
- Navngitt legitimasjon: Definerer URL-adressen til Snowflake-sluttpunktet og refererer til den eksterne legitimasjonen.
- Snowflake-sikkerhetsintegrering: Registrerer Salesforce som en klarert OAuth-klient i Snowflake. Definerer den tillatte URI-en for omdirigering, OAuth-flyter og tokent-TTL.
Disse komponentene danner en avhengighetskjede: Ekstern datakilde refererer til den navngitte legitimasjonen, som refererer til den eksterne legitimasjonen, som refererer til godkjenningsleverandøren. Det er viktig å forstå denne kjeden når du feilsøker tilkobling eller tilgangsfeil.
Salesforce støtter to identitetsdelegeringsmodeller ved godkjenning med Snowflake:
- Navngitt hovedansvarlig: Én delt tjenestekonto godkjenner alle Salesforce-brukere mot Snowflake. Dette er enklere å konfigurere, men har ikke revisjon per bruker eller detaljert Snowflake-tilgangskontroll.
- Per bruker hovedbruker: Hver Salesforce-bruker godkjennes med sitt eget OAuth-token. Dette aktiverer sikkerhet på Snowflake-radnivå og fullstendige revisjonsspor per bruker, med en avveining av høyere tokenadministrasjonsoverhead (OAuth-flyter per bruker, oppdatering, oppheving).
Beslutningsveiledning: Bruk Hovedbruker per bruker for regulerte data eller personlig identifiserbar informasjon (PII). Bruk Navngitt hovedbruker når Salesforce-delingsregler gir tilstrekkelig tilgangskontroll, og enkelhet er prioritet.
Disse Salesforce-styringene begrenser direkte utforming av løsning når du bruker eksterne objekter med Snowflake:
- Oppkallgrense: 100 per Apex. Sider eller flyter med flere External Object-spørringer kan raskt nå denne grensen.
- Tidsavbrudd for oppkall: Maksimum 120 sekunder. Langvarige Snowflake-spørringer fører til et kjøretidsunntak.
- SOQL-radgrense: 50 000 rader. Sider for store resultatsett.
- Asynkrone begrensninger: Apex og de fleste asynkrone kontekster begrenser oppkall. Behold Eksternt objekt-tilgang innenfor synkrone transaksjonsgrenser. For asynkrone brukstilfeller som spør mot eksterne objekter, kan du vurdere Fortsett-oppkall for brukerinitierte asynkrone interaksjoner, eller arkitektere flyten for å utføre ekstern datatilgang i en synkron transaksjon og overføre resultater asynkront.
Designveiledning: Ikke spør eksterne objekter i sløyfer. Push WHERE-setningsfiltre til Snowflake for å redusere resultattall og oppkallfrekvens.
Hver spørring som Salesforce sender til Snowflake, logges i Snowflake-spørringshistorikk med fullstendige utførelsesmetadata: latens, skannede rader, brukt lagerbygning og utførende identitet. Denne historikken gir ende-til-ende-revisjon fra Salesforce-brukerhandling til Snowflake-utførelse, og er det primære diagnostiske verktøyet for ytelsesjustering og tilgangsvalidering.
Datavirtualisering er godt egnet for brukstilfeller der sanntidstilgang, styring og redusert replikasjonsoverhead oppveier begrensningene i en forent, spørringstidstilgangsmodell.
Bruk den når:
- Lese tung analytisk tilgang er det primære kravet. Hvis brukere må spørre og vise eksterne data i Salesforce-grensesnitt, rapporter eller flyter uten å skrive tilbake, eliminerer Data Virtualization overhead for skrivebeskyttede scenarier.
- Datafriskhet er avgjørende. Der foreldede replikerte data skaper forretningsrisiko (som utdatert økonomisk saldo, beholdningsnivåer eller samsvarsstatus), sikrer den forente modellen at alle spørringer gjenspeiler direktedata.
- Krav til styring og datarelasjon er strenge. Når lovpålagte eller kontraktsmessige begrensninger hindrer kopiering av sensitive data til Salesforce, beholder virtualisering data på sin autoriserte plassering samtidig som de blir tilgjengelige i Salesforce. Bare ett system inneholder dataene.
- Dobbel tilgangskontroll kreves. Når både det eksterne systemets innebygde tilgangskontroller og Salesforce-sikkerhetsmodellen brukes samtidig, håndhever den forente modellen begge uten dataduplisering.
- Det eksterne systemet er allerede det autoritative systemet for posten. Hvis dataene allerede er ryddige, administrerte og spørres i kildesystemet, unngår virtualisering av dem overflødig transformasjon, lagerkostnader og avviksrisiko.
Unngå det når:
- Skriving med lav latens kreves. Eksterne objekter er skrivebeskyttet. Tilbakeskrivingsbrukstilfeller krever et annet integrasjonsmønster.
- Komplekse flerobjektsammenføyninger er nødvendig. SOQL på tvers av flere eksterne objekter støtter ikke koblinger. Forhåndsmaterialiser samlede data som en enkelt visning i kildesystemet.
- Salesforce AI- eller Agentforce-funksjoner krever innebygde data. For øyeblikket opererer Einstein og Agentforce (inkludert tilgrening for Einstein Copilot, prediktiv scoring og Agentforce) på innebygde Salesforce-objekter. Disse funksjonene støtter ikke eksterne objekter som en jordings- eller aktiveringsdatakilde. Hvis AI-aktivering er i omfanget for disse dataene, er Salesforce Data 360 den anbefalte komplementære løsningen.
- Høyfrekvente tilgangsmønstre med stor trafikk. Eksterne objekter er utformet for tilgang på forespørsel. Arbeidsbelastninger som utløser hundrevis av spørringer per minutt, fører til grenser for utløserstyringer og reduserer ytelsen.
Følgende brukstilfeller illustrerer hvordan Salesforce-datavirtualisering brukes på tvers av vanlige forretningsscenarier. Hvert eksempel bruker Snowflake som det eksterne systemet, men det underliggende mønsteret gjelder for alle SQL-kompatible datakilder som støttes av Salesforce Connect.
Utfordring: Kundestøtteteam trenger forente rapporter som kombinerer Salesforce-saksdata med billettvolum, løsningstid og eskaleringsmålinger lagret i Snowflake. Opbygning og vedligeholdelse af en replikering under behandling for disse data introducerede forsinkelse og tilføjede driftsoverhead for et skrivebeskyttet rapporteringsanvendelsessituation.
Løsning: Teamet viste Snowflake-visninger som inneholder billettmålinger som eksterne objekter i Salesforce. Teamet konfigurerte Salesforce-rapporter til å koble sammen innebygde saksobjekter med de eksterne billettdataene.
Resultat:
- Rapporter gjenspeiler alltid direkte Snowflake-data. Ikke noe pipelineforsinkelse.
- Styring av sensitive kundestøttemålinger beholdes i Snowflake.
- Ingen ETL under arbeid å bygge, overvåke eller vedlikeholde.
Utfordring: Et finansteam opprettholdt autoriserte kredittgrense- og saldodata i Snowflake. Replikering av disse verdiene i Salesforce via omvendt ETL innførte replikeringsforsinkelse, noe som førte til at selgere forpliktet seg til avtaler basert på utdatert kredittinformasjon. Samsvarsteamet flagget også risikoen ved å holde sensitive økonomiske data i Salesforce-lager.
Løsning: Teamet virtualiserte Snowflake-finansieringsvisningen som et eksternt objekt og presenterte den på Konto-sideoppsettet. Selgere ser nå direkte kredittstatus som en del av standardkontovisningen i Salesforce.
Resultat:
- Sanntidskredittdata på alle Konto-sider. Ingen forsinkelse.
- Omvendt ETL under arbeid eliminert for økonomiske data.
- Sensitive økonomiske data kopieres aldri til Salesforce-lagring. Samsvarsomfanget beholdes i Snowflake.
Utfordring: Under en fletting trengte det overtagende firmaet å gi Salesforce-brukere synlighet til driftsdata fra seks Snowflake-datasett med stor trafikk som dekker transaksjoner, fakturering og bruk. Replikering av terabyte data til Salesforce var ikke mulig på tidslinjen for flettingen, og bygging av tilpassede ETL-ledninger for hvert datasett ville ha krevd betydelige tekniske investeringer.
Løsning: Teamet konfigurerte eksterne objekter for alle de seks Snowflake-datasettene ved bruk av Salesforce Connect med en integrasjonsrolle med færrest rettigheter. Ingen tilpasset kode kreves. Spørringer utføres direkte i Snowflake, og all aktivitet logges i Snowflake-spørringshistorikk for samsvarsrapportering.
Resultat:
- Fullt deklarativ konfigurasjon. Ingen tilpasset kode eller pågående arbeid kreves.
- Dataoppdatering garantert. Hver spørring gjenspeiler direkte Snowflake-data på utførelsestidspunktet.
- Full revisjonsspor i Snowflake-spørringshistorikk for rapportering av forskrifter og samsvar.
Datavirtualisering introduserer en distinkt driftsprofil. Utforming for disse feilscenariene:
- OAuth-tokenutløp: Tokener har en endelig levetid (TTL). Utløpte tokener fører til oppkallsfeil. Overvåk for 401-Uautoriserte svar, og implementer oppdateringslogikk.
- Kaldstart (Snowflake-spesifikk): Automatisk suspenderte lagre legger til 5–30 sekunder ved første spørring. For brukervennlige brukstilfeller med latenskrav, forhåndsvarm med en planlagt enkel spørring i åpningstidene.
- Rolle mismatch: En feil konfigurert rolle i det eksterne systemet kan stille returnere null rader i stedet for en feil. Valider rolle-til-objekt-rettigheter i det eksterne systemet uavhengig av Salesforce.
- Resultatsettoverflyt: Overstørrede belastninger overskrider API-grenser. Bruk alltid LIMIT-setninger og vis filtrerte visninger i stedet for rådata.
- Eksternt systemavbrudd: Det finnes ingen reserveserver eller buffer. Avslutt oppkall i try/catch og vis informative feiltilstander i grensesnittet. Vurder en gradert tilnærming for oppgavekritiske data: virtualisere for sanntidstilgang, og vedlikehold en enkel replikert reserveserver for de mest kritiske feltene for å garantere tilgjengelighet under kildesystemavbrudd.
Salesforce-datavirtualisering er i samsvar med følgende søyler i det velbygde Salesforce-rammeverket.
- Trust: Den delegerte OAuth 2.0-modellen og veiledningen for roller med færrest rettigheter er i samsvar med Trust. Tilgangskontroll med to lag (kildesystem + Salesforce) håndhever forsvaret i dybden.
- Pålitelighet (feiltoleranse): Delen om feilmoduser tar direkte hånd om pålitelighet: tokenutløp, kald start, feilkonfigurasjon av roller, resultatsettoverflyt og behandling av avbrudd representerer hver en distinkt feilklasse med en dokumentert løsningsbane.
- Pålitelighet (skalering): Spørringsnedtrekksmeny, veiledning om lagerstørrelse og oppkall av begrensningsbevis optimaliserer utførelseseffektiviteten innenfor Salesforce-styringsbegrensninger, som er en pålitelighetspørsmål for løsninger som opererer i stor skala.
- Operational Excellence: Snowflake-spørringshistorikk som primært observasjonsverktøy støtter operasjonell dyktighet: arkitekter gjør et bevisst, sporbart valg for å bruke plattformbaserte verktøy for ende-til-ende-revisjon og ytelsesdiagnostikk i stedet for å bygge tilpasset loggingsinfrastruktur.
Denne delen gir arkitekter og designere et strukturert utgangspunkt for å bygge datavirtualiseringsmønsteret i et Sandbox-miljø. Det er ikke en fullstendig implementeringsveiledning – behandle den som en validert sekvens av beslutninger og konfigureringstrinn for å orientere den første bevisen på konseptet.
Kontroller følgende før du starter noe konfigurasjonsarbeid:
- Lisensberettigelse: Salesforce Connect er ikke inkludert i alle Salesforce-versjoner. SQL-adapteren for Snowflake krever en separat tilleggslisens utover grunnleggende Salesforce Connect. Kontroller begge i organisasjonen før du fortsetter.
- Sandbox først: Fullfør alle fasene i et Sandbox-miljø før du promoterer konfigurasjonen til produksjon.
- Snowflake tilgang: Kontroller at du har tillatelse til å opprette en sikkerhetsintegrering i Snowflake og tilgang til måldatabasen, skjemaet og objektene.
- Adapterversjon: Kontroller at SQL-adapteren for Snowflake er tilgjengelig i organisasjonsversjonen og at Snowflake-kontoens URL-adresse ikke inneholder understrek (erstatt med bindestreker hvis den gjør det). Dette er en Salesforce Platform-begrensning for oppkallvertsnavnløsning).
Konfigurering av datavirtualisering med et eksternt SQL-system som Snowflake er en deklarativ, konfigurasjonsdrevet prosess – ingen tilpasset kode kreves. Oppsettet følger tre sekvensielle faser: etablering av identitet og Trust, konfigurering av dataoverflaten og eksponering av data til sluttbrukere.
Denne fasen etablerer en sikker, delegert OAuth Trust mellom Salesforce og det eksterne systemet. Fullfør denne fasen før du starter en dataoverflatekonfigurasjon.
- Opprett en godkjenningsleverandør i Salesforce. Bruk OpenID Connect-typen. Bruk plassholderverdier i denne fasen – gå tilbake for å fullføre den etter å ha hentet verdier fra det eksterne systemet. Når du har lagret, genererer Salesforce en URL-adresse for tilbakekall. Behold denne verdien.
- Registrer Salesforce som en OAuth-klient i det eksterne systemet. I Snowflake betyr dette å opprette en sikkerhetsintegrering (OAuth, konfidensiell klienttype). Oppgi Salesforce-URL-adressen for tilbakekall som URI for omdirigering. Hent klient-IDen, klienthemmeligheten, URL-adressen for godkjenning og URL-adressen for token fra integrasjonen etter opprettelse.
- Fullfør godkjenningsleverandørkonfigurasjonen. Gå tilbake til Salesforce-godkjenningsleverandøren og fyll ut den med verdiene som hentes fra det eksterne systemet: Forbrukernøkkel, Forbrukerhemmelighet, URL-adresse for godkjenning og URL-adresse for token.
- Opprett den eksterne legitimasjonen. Angi protokollen til OAuth 2.0, koble den til godkjenningsleverandøren og legg til en hovedbruker (Navngitt eller Per bruker, basert på identitetsmodellbeslutningen). Dette objektet behandler OAuth-tokenlivssyklusen.
- Opprett den navngitte legitimasjonen. Angi endepunktet til det eksterne systemets API-URL (for eksempel
https://<account>.snowflakecomputing.com/api/v2/statements/) og koble det til den eksterne legitimasjonen. - Gi profiltilgang til den eksterne legitimasjonen. Uten dette trinnet kan ikke brukere kalle opp forente spørringer selv om alle andre konfigurasjoner er riktige.
- Starte OAuth-flyten for å fullføre godkjenningen. Utløs OAuth-håndtaket fra Salesforce. Plattformen omdirigerer til den eksterne systempåloggingen, validerer legitimasjon og lagrer de resulterende tokenene sikkert i den eksterne legitimasjonen. Dette trinnet binder brukerkontekst til et gyldig token. Alle forente spørringer mislykkes til dette trinnet er fullført.
Denne fasen kobler Salesforce til det eksterne dataskjemaet og oppretter definisjonene for det eksterne objektet som brukere og plattformen spør.
- Opprett den eksterne datakilden. Velg den riktige adapteren (for eksempel SQL-adapter for Snowflake), pek den til måldatabasen og skjemaet, og koble den til den navngitte legitimasjonen du opprettet i fase 1.
- Valider tilkoblingen. Bruk den innebygde valideringen i den eksterne datakilden. Et vellykket resultat bekrefter at Trust er fullført og at det eksterne systemet er tilgjengelig.
- Synkrone metadata. Start en metadatasynkronisering fra den eksterne datakilden. Salesforce ser gjennom målskjemaet og genererer Definisjoner av eksternt objekt, og tilordner eksterne kolonner til Salesforce-felttyper.
- Velg og vis de nødvendige tabellene eller visningene. Velg hvilke eksterne tabeller eller visninger som skal vises som eksterne objekter. En god fremgangsmåte er å vise kuraterte visninger i stedet for rådata. Visninger tillater forhåndsfiltrering av kolonner, begrensninger på radnivå og strengere kontroll over hva Salesforce-laget kan få tilgang til.
Denne fasen gjør eksterne objekter synlige og brukbare for sluttbrukere i Salesforce Lightning Experience.
- Opprett faner for eksterne objekter. Faner gjør det mulig å navigere direkte i eksterne objekter i Lightning.
- Legg til eksterne objekter i sideoppsett. Vis relevante eksterne data sammen med innebygde Salesforce-poster (legg for eksempel til en Snowflake-økonomivisning i Konto-sideoppsettet).
- Legg til i relaterte lister. Inkluder eksterne objekter i relaterte lister for å gi brukere en forent oversikt over innebygde og eksterne data i kontekst.
- Valider ende-til-slutt-spørringsforbund. Last inn en side eller kjør en spørring som refererer til et eksternt objekt. Inspiser deretter det eksterne systemets spørringshistorikk (for eksempel Snowflake-spørringshistorikk) for å bekrefte at spørringen ble utført på kilden. Kontroller at den riktige rollen, lagerbygningen og identiteten kjørte spørringen.
Når alle de tre fasene er fullført, kan Salesforce-brukere samhandle med direkte eksterne data via standard Salesforce-grensesnitt uten å være klar over at dataene kommer fra utenfor Salesforce.
Salesforce-datavirtualisering erstatter replikeringsbasert integrasjon med spørringstidsforbund. Data beholdes i sin autoritative kilde. Salesforce-brukere samhandler med den via standard plattformgrensesnitt. Det er ingen pipeline å bygge, ingen kopi å kontrollere og ingen forsinkelse å behandle.
Dette mønsteret er det riktige valget når tung lesetilgang, sanntids dataoppdatering, streng styring og tilgangskontroll med to lag er hovedfaktorene. Det er feil valg når skriving kreves, når AI eller automatiseringsfunksjoner avhenger av innebygde Salesforce-objekter, eller når tilgangsmønstre er for høyfrekvente til at styringsgrenser kan tilpasses.
Snowflake illustrerer mønsteret godt: en styrt, spørringstidsforent tilkobling etablert deklarativt uten tilpasset kode, observerbar ende-til-ende gjennom Snowflake-spørringshistorikk, og håndheves via både de innebygde Snowflake-tilgangskontrollene og den fullstendige Salesforce-sikkerhetsmodellen.
Før du forplikter deg til denne arkitekturen, bør du validere lisensberettigelse, vurdere styringsgrenseeksponering mot forventede tilgangsmønstre og bekrefte OAuth-klargjøring i et Sandbox-miljø. Mønsteret belønner gjennomtenkt forhåndsutforming: Få identitetsmodellen, legitimasjonskjeden og visningsstrategien riktig, og det operative fotavtrykket er minimalt.
Yugandhar Bora er Software Engineering Architect på Salesforce, spesialiserer seg på dataarkitektur innenfor plattformen Data & Intelligence Applications. Han leder EARB-initiativer (Enterprise Architecture Review Board) fokusert på datastyring og forente datamodeller, samtidig som han bidrar til automatiserte plattformklargjøringsløsninger.