Agenter tar hensyn over mål, utleder parametere fra kontekst og velger handlinger dynamisk. Resultatet er at hver integrasjon som en agent berører, må håndtere tvetydighet, støtte sikker gjentakelse og mislykkes på måter som agenten kan gjenopprette automatisk.
Agentiske systemer gjør flere forutsetninger ugyldige som tradisjonell integrasjonsutforming tar for gitt. Inndata vil ikke alltid være godt utformet. En enkelt brukerhandling kan utløse en kjede av agenter på tvers av organisasjonsgrenser, og hver av dem trenger delegert myndighet til å handle.
Dette dokumentet tilordner de arkitektoniske skiftene som følger fra denne virkeligheten: de nye designprinsippene, agentmønstrene og hvordan Salesforce-plattformen leverer dem.
Hvert mønster i dette dokumentet følger samme struktur:
Navn: Mønsteridentifikatoren som angir typen integrasjon som finnes i mønsteret.
Kontekst: Det generelle integreringsscenarie, som mønsteret håndterer. Kontekst gir informasjon om hva brukere prøver å oppnå og hvordan programmet oppfører seg i henhold til deres behov.
Problem: Utfordringen (uttrykt som et spørsmål) som mønsteret er utformet for å løse. Når du går gjennom mønstrene, leser du denne delen for å raskt forstå om mønsteret gjelder for integreringsscenariet.
Styrker: Begrensningene og omstendighetene som kan gjøre det vanskelig å løse problemet.
Salesforce mønsterprogram: Den anbefalte måten å bruke mønsteret på scenariet på.
Skisse: Et UML-sekvensdiagram (United Modeling Language) som viser hvordan mønsterprogrammet håndterer scenariet.
Resultater: Hvordan mønsteret løser kreftene som er knyttet til scenariet. Denne delen inneholder også nye utfordringer som kan oppstå som et resultat av å bruke mønsteret.
Design vurderinger: Plattformagnostisk veiledning for riktig bruk av løsningen fulgt av Salesforce-spesifikke implementeringsmerknader. Disse punktene dekker handlingsutformingsprinsipper og plattformspesifikke konfigurasjonskrav.
Feilhåndtering og gjenoppretting: Veiledning for behandling av feil under mønsterbruk. Denne parameteren dekker fire områder:
- Hvordan handlinger kommuniserer feil til agenten via strukturerte, handlingsorienterte feilsvar som gir tilstrekkelig kontekst for nedstrøms beslutningstaking
- Hvordan agenten bestemmer om utførelse skal prøves på nytt, selvkorrigeres eller stoppes
- Slik håndterer kompensasjonshandlinger delvise utfall og ikke-samsvarende status på tvers av plattformer
- Idempotency-krav for pensjonerte skriveoperasjoner
Sikkerhetshensyn: Sikkerhetskrav for å bruke mønsteret sikkert. Disse punktene dekker blant annet legitimasjonsbehandling, omfang med minst rettigheter for integrasjonsbrukere og tilkoblede apper, revisjonslogging av agentoppkallte handlinger og valideringskrav for inndata for parametere som kommer fra brukerlevert eller LLM-innledet innhold.
Eksempel: Et ende-til-ende-scenarium som beskriver hvordan utformingsmønsteret brukes i et virkelig Salesforce-scenarium. Eksempelet forklarer målene og hvordan du bruker mønsteret til å oppnå disse målene.
Følgende tabell viser implementeringsmønstrene som dekkes.
Liste over mønstre
| Mønster | Hva den gjør |
|---|---|
| Sekvensiell handlingskall | En agent kaller opp en serie handlinger der hvert trinn avhenger av det bekreftede resultatet av det forrige. Agenten opprettholder kontekst på tvers av kjeden, som identifikatorer, statuskoder og mellomliggende data, og bruker den til å bestemme om neste trinn kan fortsette. |
| Parallell handling oppkall | Når et sett handlinger er uavhengige av hverandre, kaller agenten opp dem samtidig i stedet for i sekvens. Samlet arbeidsflyttid er avhengig av den treeste samtalen i stedet for summen av alle samtaler. |
| Asynkron handlingskall | En agent sender en operasjon til et nedstrøms system via en plattformhendelse, meldingskø eller bakgrunnsjobb uten å vente på utfallet. Agentens forpliktelse avsluttes ved bekreftet kall. Nedstrømsystemet tar eierskap til utførelsen uavhengig av agentøkten. |
| Oppkall av agent på forespørsel | Et eksternt program eller AI-orkestrator ringer opp en agent programmatisk, gir kontekst og venter på et strukturert svar. Agenten fungerer som en intelligent serverdeltjeneste som anroperen initierer, agenten motiverer og handler, og resultatet forbrukes av anroperen. |
| Autonom hendelsesdrevet agentutførelse | En datatilstand som handlevognavbrudd, betalingsfeil og bruksnedgang avslutter automatisk en agent uten at noen person starter interaksjonen. Det er ingen anroper som venter på et svar. Agenten mottar hendelsesbelastningen som jordkontekst og utfører en svararbeidsflyt helt på egen hånd. |
| Knowledge Grounding fra Enterprise Content | Før du genererer et svar henter agenten relevante dokumenter fra et Enterprise Knowledge-lager og setter dem inn i kontekstvinduet. LLM leverer årsaken, og hentelaget leverer faktaene. |
| Verifisert kundekontekstinnsetting | Verifiserte, strukturerte attributter fra en forent kundeprofil fylles ut på forhånd som handlingsinndata før agenten kaller opp en handling. Agenten mottar fakta som segment, nivå, frafallsrisiko og levetidsverdi i stedet for å utlede dem. |
| Integrasjon av verktøy på tvers av systemer | En agent kobler til eksterne systemer utenfor Salesforce-plattformen via et ensartet verktøygrensesnitt basert på MCP-standarden (Model Context Protocol). Hvert eksternt system viser sine egenskaper som beskrevne, kallbare verktøy. Agenten oppdager og kaller opp dem uten å måtte kjenne hvert systems innebygde API eller skjema. |
| Forretningsmuligheter som kallbare verktøy | Foretaksforretningsfunksjonalitet som forretningsenheter, prosesser og innsikt vises som MCP-verktøy som alle eksterne agenter i et hvilket som helst rammeverk kan oppdage og kalle opp. |
| Tverragentdelegasjon | En anropende agent dekomponerer en kompleks forespørsel og delegerer domenespesifikke underoppgaver til spesialiserte fagfelleagenter på forskjellige plattformer eller leverandørsystemer ved bruk av Agent-til-agent-protokollen (A2A). Den oppringende agenten behandler oppgavelivssyklusen og samler resultater fra de eksterne agentene. |
| Agenter som kallbare tjenester | En intern Agentforce publiserer domenekapasiteten sin som et styrt, oppdagbart A2A-endepunkt, slik at eksterne orkestratorer eller fagfelleagenter kan delegere oppgaver til seg. Agenten behandler den innkommende oppgavelivssyklusen og returnerer strukturerte resultater til den eksterne anroperen. |
Mønstrene i dette dokumentet er klassifisert i tre kategorier. Denne kategoriseringen hjelper arkitekter med å raskt identifisere hvilke mønstre som er relevante for integrasjonsutfordringen de løser, enten de utformer det en agent kaller, hva som utløser en agent, eller hvordan en agent er grunnlagt med Knowledge før den handler. I stedet for å lese alle mønstrene kan du navigere direkte til kategorien som samsvarer med utformingsbehovet ditt.
Handlingsoppkall:
Disse mønstrene dekker hvordan en agent kaller opp eksterne systemer for å hente data eller utføre operasjoner som en del av sin vurderingssyklus. Dette er utgående mønstre der agenten er initiatoren. De tar seg av sekvensering (når trinn avhenger av hverandre), parallellisme (når de ikke gjør det), idempotency og delvis feilhåndtering. Bruk disse mønstrene når du utformer verktøyene en agent skal kalle opp for å få arbeidet gjort.
Agentoppkall:
Disse mønstrene tar for seg hvordan eksterne systemer eller hendelser tar en agent i bruk. Dette er innkommende mønstre der eksterne systemer utløser disse agentene. Utløseren kan være et brukervindu som utfører et programmatisk kall og venter på et svar, eller en autonom datatilstand som utløser agenten. Bruk disse mønstrene når du utformer hvordan og når en agent utløses.
Landing med Enterprise-data:
Mønstrene i denne kategorien dekker hvordan agenter er grunnlagt med nøyaktig, nåværende, organisasjonsspesifikk Knowledge før det årsaker eller handlinger.
Det er ikke noe trivielt å velge den riktige strategien. Hvert mønster har et bestemt mål: systemfunksjonalitet, datavolum, feilhåndtering og transaksjonalitet.
Valgmatrisetabellene viser mønstrene og deres viktige aspekter for å hjelpe deg med å finne ut hvilket mønster som passer best til integrasjonskravene dine. Mønstrene kategoriseres med disse dimensjonene.
| Aspekt | Beskrivelse |
|---|---|
| Type | Angir kategorien for integrasjon: Handlingsoppkall, Agentoppkall eller grunning med Enterprise Data Handlingsoppkall: Disse utgående integrasjonene spenner fra enkle verktøykall med ett trinn til komplekse sekvenser med flere trinn og parallelle fan-out-er, og krever nøye vurdering av bestillingsbegrensninger, idempotency og delvis feilhåndtering på tvers av heterogene serverdeler. Agentoppkall: Agentoppkall er måtene eksterne systemer eller hendelser tar en agent i bruk på. Disse innkommende integrasjonene spenner fra synkrone programmatiske samtaler som utføres av brukervennlige programmer som venter på en strukturert respons, til fullstendig autonome hendelsesdrevne utførelser der en datatilstand utløser agenten uten noen menneskelig initiering eller vent på interaksjonen. Landing med Enterprise-data: Grunnleggende integrasjoner er måtene en agent får nøyaktig, oppdatert, organisasjonsspesifikk Knowledge på før den gir årsaker eller handler. Disse integrasjonene går fra å hente ustrukturerte dokumenter fra forretningsinnholdsbutikker til å injisere bekreftede, strukturerte attributter fra forente kundeprofiler, slik at agenten fungerer på fakta i stedet for hallusinerte utledninger. |
| Tidsplan | Angir integreringstypen basert på tidspunkter: Synkron eller Asynkron Synkron kontra Asynkron i dette dokumentet refererer til hvordan selve agenten utløses, eller hvordan den kaller opp handlingene. Det dekker ikke hva som skjer internt. Men generelt venter en bruker i løpet av den tiden agenten kaller opp handlinger og behandler resultater. Agenten tar ikke hånd om neste brukermelding før den har fullført den gjeldende omgangen. Synkron: Blokkerings- og sanntidsforespørsler er forespørsels-/svaroperasjoner. Resultatet returneres til anroperen umiddelbart via denne operasjonen. Asynkron: Ikke-blokkerende, købaserte eller meldingsbaserte forespørsler kalles opp av en enveis operasjon som er nær sanntid. Resultatene og eventuelle feil returneres ved å kalle opp andre enveis operasjoner. Anroperen gjør derfor forespørselen og fortsetter uten å vente på svar. |
Denne tabellen viser mønstrene og deres viktige aspekter for å hjelpe deg med å finne ut hvilket mønster som passer best til behovene dine når integrasjonen er fra Salesforce til et annet system.
| Type | Tidsplan | Nøkkelmønster som bør vurderes |
|---|---|---|
| Handlingsoppkall | Synkron | Sekvensiell handlingskall Parallell handling oppkall Integrasjon av verktøy på tvers av systemer Tverragentdelegasjon |
| Handlingsoppkall | Asynkron | Asynkron handlingskall |
| Agentoppkall | Synkron | Oppkall av agent på forespørsel Agenter som kallbare tjenester |
| Agentoppkall | Asynkron | Autonom hendelsesdrevet agentutførelse |
| Tilordning med Enterprise-data | Synkron | Knowledge Grounding fra Enterprise Content Verifisert kundekontekstinnsetting |
Hver del av mønstre beskriver hvordan de bygges. Hvert mønster er en gjentagende løsning på et bestemt integrasjonsproblem i agentiske arkitekturer. Den dekker når mønsteret skal brukes, hvilke krefter som former beslutningen, og hvordan Salesforce-plattformen leverer det.
Kontekst
Mange forretningsarbeidsflyter er iboende sekvensielle – hvert trinn krever et bekreftet resultat fra det forrige før det kan fortsette. En refusjon kan for eksempel ikke startes før berettigelse er bekreftet, en faktureringskonto kan ikke opprettes før bestillingsposten finnes, og en samsvarskontroll kan ikke logges før sjekken er bestått.
I tradisjonell automatisering kodes disse avhengighetene som hardkodet flytlogikk. I et agentisk system evaluerer agenten resultatet av hver handling og finner ut om forutsetningene for neste trinn er oppfylt.
Dette mønsteret beskriver den grunnleggende utgående integrasjonsmodellen. Her opererer en enkelt agent innenfor ett domene og kaller opp en sekvens, der hver handlings utdata gir oppkall til neste handling i kjeden. Orkestreringsagenten opprettholder transaksjonskontekst på tvers av kjeden og akkumulerer identifikatorer, statuskoder og data som returneres av hvert trinn. Den bruker denne konteksten til å lede etterfølgende beslutninger.
Dette mønsteret er den agentiske motstykket til Fjernprosessoppkall – Forespørsel og svar fra Integrasjonsmønstre-veiledningen som beskriver et enkelt synkront oppkall. Det agentiske mønsteret utvider mønsteret til en agentdrevet kjede med avhengige kall i en enkelt vurderingssyklus.
Problem
Når en agent utfører en arbeidsflyt med flere trinn som omfatter vertssystemet og ett eller flere eksterne systemer, må fire utfordringer løses:
- Sekvensering - Handlinger må kalles opp i riktig rekkefølge, med hvert trinn avgrenset etter vellykket fullføring av det forrige.
- Datafordeling - Svardata fra hvert trinn må overføres som inndata til neste.
- Feilisolering - Feil på noe punkt i kjeden må ikke gi delvis eller inkonsekvent tilstand på tvers av systemer.
- Fullføringsbekreftelse - Agenten må bekrefte at alle trinnene er fullført riktig før resultat rapporteres.
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
-
Afhænger hver handling i kæden af data, der returneres af den foregående handling, eller er afhængighederne kun på status for succes eller fejl?
Datavhengigheter krever at agenten bærer identifikatorer og attributter på tvers av trinn.
-
Er alle eksterne endepunkter i stand til å svare innenfor agentens tidsavbrudd for vurderingssyklus?
Et tregt eksternt system i et hvilket som helst trinn i kjeden blokkerer hele sekvensen.
-
Krever kjeden fullstendig fullføring eller er delvis fullføring akseptabel?
-
Hvis full ende-til-slutt-suksess kreves, definerer du en kompensasjonsstrategi for trinn som må rulles tilbake når det oppstår en nedstrøms feil.
-
Kan noen av skriveoperasjonene i kjeden prøves på nytt på en sikker måte?
Alle skrivingshandlinger må være idempotent. Agentenes resonanssløyfe kan kalle opp den samme handlingen flere ganger på grunn av nye forsøk med stor språkmodell (LLM) eller tvetydige bekreftelser.
-
Kalles kjeden opp av en brukerinteraksjon (samtale, lav samtidighet) eller av en automatisk utløser (potensielt høy samtidighet)?
Dette bestemmer om synkron blokkering er akseptabel eller om det kreves et asynkront mønster.
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Apex | Best for eksterne oppkall og kompleks logikk | Et trinn krever et HTTP-oppkall til et eksternt system, tilpasset datatransformasjon eller feilhåndteringslogikk som overskrider Flyts deklarative funksjoner. Apex viser hele plattformen for integrering mens de forblir kallbare av agenten via @InvocableMethod-kommentaren. |
| Flythandlinger (automatisk startet) | Best for forretningsregeltrinn og enkle CRM-operasjoner | Et trinn bruker deklarativ forretningslogikk, spør eller oppdaterer CRM-poster, eller orkestrerer en prosess som ikke krever tilpasset kode. Automatisk startede flyter kan kalles opp som standard fra Agentforce og returnerer typede utdatavariabler som agenten bruker til å bestemme neste trinn. |
| Eksterne tjenester (OpenAPI-import) | Best for typet, oppdagbar ekstern API-integrering | Et eksternt system viser en OpenAPI-spesifikasjon. Eksterne tjenester genererer sterke Apex som kan kalles opp direkte som agenthandlinger, og eliminerer manuell skjematilordning og gjør den eksterne API-ens operasjoner synlige for agenten som navngitte funksjoner. Hver operasjon i den importerte spesifikasjonen blir en navngitt, kallbar handling. Agenten velger handlinger basert på deres genererte semantiske etiketter. Registrer genererte handlinger i Emnesenter i Agentforce, slik at agenten kan oppdage dem ved gjennomgang. Notat: Hvis den eksternt driftede tjenesten er RESTful, men OpenAPI-spesifikasjonen ikke er tilgjengelig eller mulig, bruker du Navngitt legitimasjon i Apex eller Flyter til å utføre HTTP-kallet direkte. Apex er nødvendig for å analysere resultatet. |
| Tilkoblede MuleSoft-handlinger | Best for komplisert mellomprodukt fan-out eller eldre systemintegrering | Brukes når det eksterne systemet krever protokolloversettelse, datatransformasjon eller orkestrering på tvers av flere serverdelsystemer før du returnerer et svar. Agenten sender et enkelt kall til MuleSoft, og MuleSoft håndterer nedstrøms kompleksiteten og returnerer et forent svar. |
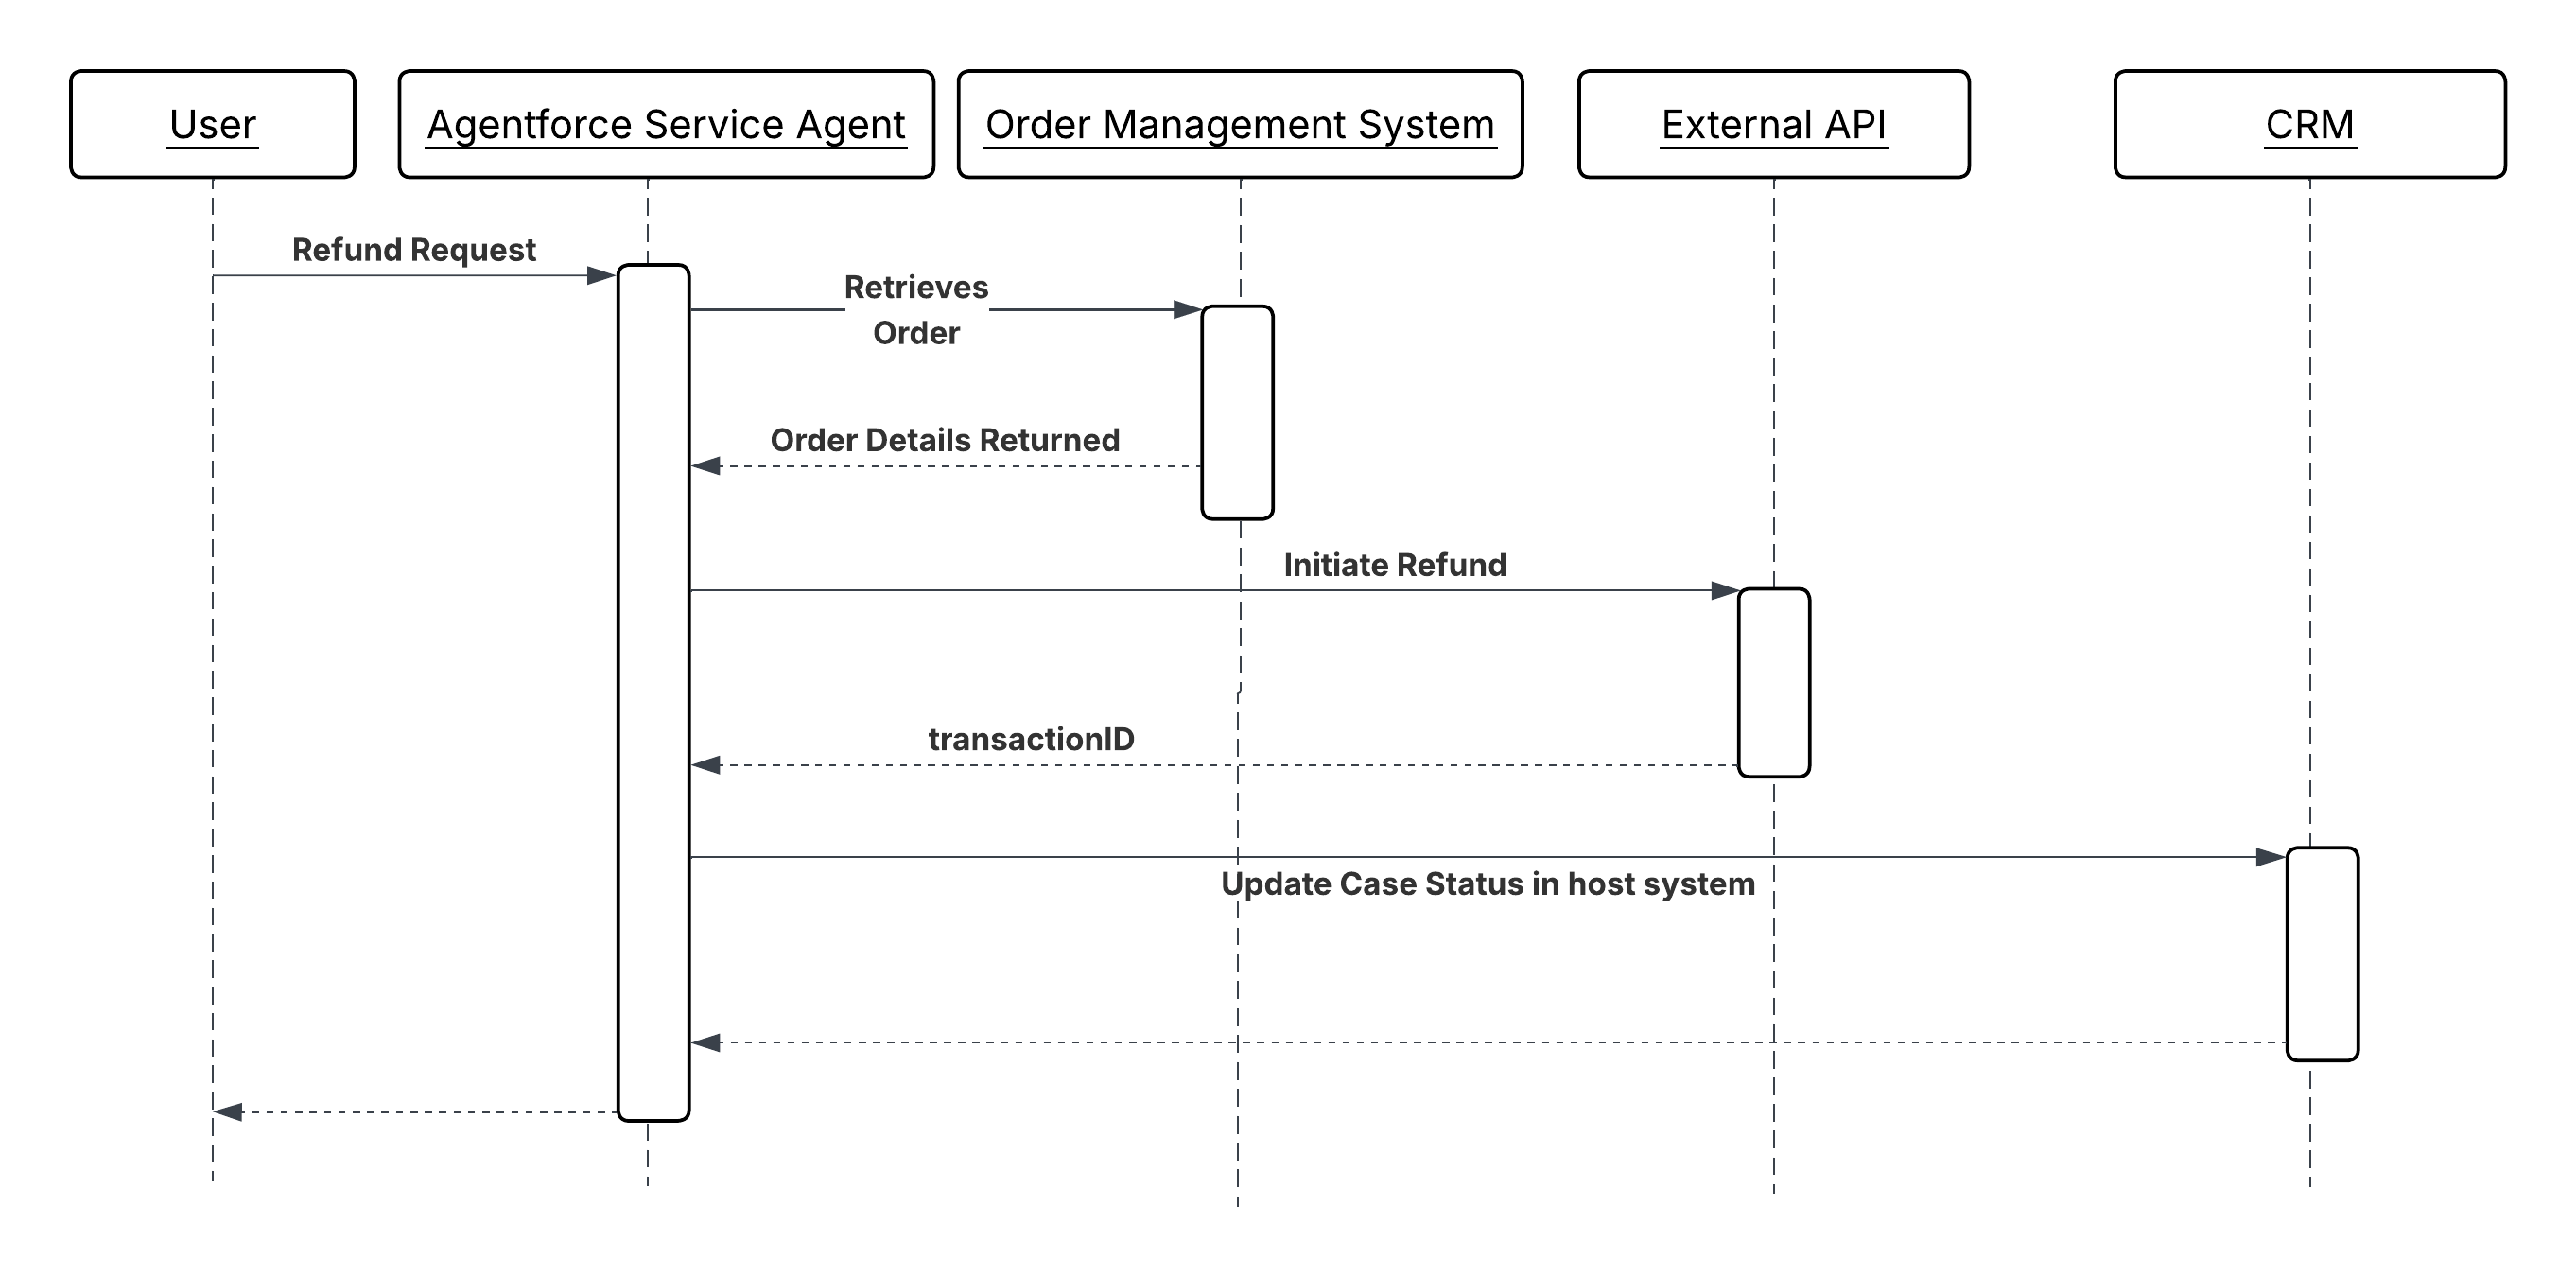
Skiss
Sekvensdiagram for oppkall av sekvensiell handling
Resultater
Agenten utfører en arbeidsflyt på tvers av systemer som en sammenhengende, overvåket sekvens, og ikke som et brann-og-glem-skript. Resultatet av hvert trinn evalueres før neste trinn kalles opp, så agenten oppdager feil så tidlig som mulig i stedet for å oppdage delvis fullføring etter faktumet.
Vertsystemet (Salesforce CRM) oppdateres først etter at den eksterne operasjonen har bekreftet statusen (vellykket eller mislykket). Identifikatorer og status som returneres av eksterne systemer, som faktureringskontonumre, transaksjons-ID-er og bekreftelseskoder, overføres gjennom kjeden og beholdes, slik at en fullstendig, sporbar post for arbeidsflytutfallet opprettes.
Agenten er ansvarlig for å vurdere resultater og sekvensere beslutninger. Hver handling er bare ansvarlig for sin egen operasjon og for å returnere et strukturert resultat. Ingen av lagene koder for den andre logikken.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Forsikre deg om at hver handling i kjeden har en semantisk beskrivelse skrevet på hensiktsbasert språk og ikke som en signatur for en teknisk metode. Agenten velger handlinger basert på disse beskrivelsene. En beskrivelse som sier "kaller opp fakturerings-APIen" er mindre nyttig enn en som sier "oppretter en faktureringskonto i faktureringssystemet og returnerer den nye kontoidentifikatoren."
- Gjør alle skriveoperasjoner i kjeden idempotent. Agentens resonanssløyfe kan prøve en handling på nytt hvis den mottar et tvetydig svar. Handlingen må gi det samme utfallet ved gjentatte kall.
- Valider alle LLM-utledede inndataparametere defensivt ved handlingens grense. Anta aldri at parametere som sendes av agenten, er godt utformet, innenfor området eller av den forventede typen.
- Utform hver handling for et enkelt ansvar. En handling som oppretter en faktureringskonto og sender en e-postbekreftelse i samme samtale, er vanskeligere å prøve på nytt, vanskeligere å teste og vanskeligere for agenten å resonnere enn to diskrete handlinger.
Implementeringsmerknader fra Salesforce
- For Apex-handlinger merker du med @InvocableMethod(label=’...” description=’...”). "beskrivelsen" leses av agenten for å bestemme når handlingen skal kalles opp. Deklarer alle inndata- og utdatavariabler med @InvocableVariable ved bruk av beskrivende "etikett"- og "beskrivelse"-felt. Returner strukturerte resultatobjekter med eksplisitte indikatorer for suksess/suksess og feilmeldinger som kan leses av mennesker.
- Bruk automatisk startede flyter eksklusivt for flythandlinger. Skjermflyter støttes ikke i autonome agentkontekster. Hold hver flyt atomisk, én handling, én ansvar. Konfigurer feilbaner på hvert eksterne oppkallselement for å fange opp integrasjonsfeil og returnere handlingsfeilmeldinger til agenten i stedet for å la ikke-oppfangede unntak avslutte økten.
- For Eksterne tjenester importerer du målsystemets OpenAPI-spesifikasjon og registrerer de genererte handlingene i Agentforce-emnet. Bryt de genererte punktene i Navngitt legitimasjon for å unngå hardkoding av endepunkter eller legitimasjoner i handlingsdefinisjonen.
- Angi eksplisitte oppkallstidsavbrudd for alle eksterne oppkall. Et oppkall som henger uten et tidsavbrudd, blokkerer agentens vurderingssyklus til øktgrensen er nådd. Returner en god feilmelding med en beskrivende feilmelding når tidsavbruddet overskrides. Alle eksterne oppkall har en konfigurerbar tidsavbrudd på opptil 120 sekunder. De er også underlagt Apex synkrone transaksjonsstyringsgrenser, så sørg for å redusere risikoen for instansiering av mer enn 50 transaksjoner som kjører i mer enn fem sekunder hver.
Feilhåndtering og gjenoppretting
- Agenten avslutter hvert trinn med den eksplisitte suksessen til trinnets forgjenger. Handlinger må returnere et strukturert resultat som inkluderer en tydelig indikator for suksess eller feil. Agenten kan ikke utlede feil på en pålitelig måte fra et manglende eller null-svar alene.
- Når en handling mislykkes, bruker agenten feilmeldingen som returneres av handlingen, til å bestemme neste bevegelse: be brukeren om korrigerte inndata, forsøke å gjenopprette selvbehandling med justerte parametere, eller stoppe kjeden og logge feilen for gjennomgang. Feilmeldinger må derfor være spesifikke og handlingsorienterte: "Ugyldig datoområde: endDate kan ikke komme før startDate" kan brukes, bare statuskoden 400 er ikke det.
- For kjeder der delvis fullføring oppretter inkonsekvent tilstand (for eksempel faktureringskontoen ble opprettet, men CRM-posten ble ikke oppdatert), kaller agenten opp en kompensasjonshandling for å rulle tilbake eller flagge den delvise tilstanden før feilen vises. Utform kompensasjonsbaner som navngitte handlinger ved siden av banen videre.
- Hvis en skrivehandling potensielt var vellykket, men returnerte et tvetydig svar (nettverkstidsavbrudd, ingen bekreftelse), må forsøket på nytt bruke samme idempotency-nøkkel eller ekstern referanse-ID som den opprinnelige samtalen. Utgi aldri et ikke merket nytt forsøk på en ikke-idempotent skrivelse.
Sikkerhetshensyn
- Bryt alle eksterne oppkall i navngitt legitimasjon. Aldri hardkod endepunkter eller legitimasjon i Apex eller flytkonfigurasjoner. Disse må behandles via plattformens sikre legitimasjonslager og roteres uten kodeendringer.
- Bruk prinsippet om minst privilegium på integrasjonsbrukeren eller den tilkoblede appen som brukes av hver handling. En handling som bare leser bestillingsdata, bør ikke inneholde skrivetillatelser i faktureringssystemet. Omfanglegitimasjon til minimumsoperasjonene handlingen krever.
- Logg oppkallet for hver handling i kjeden med økt-ID, inndataparametere (sortert fra sensitive verdier) og utfall. Hvis resultatet kontroverseres, er dette revisjonssporet den primære mekanismen for å rekonstruere hvorfor agenten utførte en gitt sekvens av handlinger.
- Fjern alle inndataparametere som kommer fra brukergitt tekst, før du overfører dem til eksterne systemer. Brukerinndata som overføres via agenten til et eksternt API-oppkall, er en potensiell injeksjonsvektor. Valider type, format og område ved handlingsgrensen før oppkallet utføres.
Eksempel
En kundeserviceagent som håndterer en refusjonsforespørsel, utfører en sekvensiell kjede med fire trinn:
GetOrderDetails(Apex Action) henter bestillingsposten fra Bestillingsbehandling-systemet med bestillings-ID-en som brukeren oppga. Den returnerer bestillingsstatus, linjer, kjøpsdato og betalingsmetode. Agenten evaluerer om bestillingen er i en refusjonsbar tilstand før den fortsetter.ValidateRefundEligibility(automatisert flyt) bruker forretningsreglene for berettigelse til refusjon, inkludert returvindu, produktkategoribegrensninger og tidligere refusjonshistorikk. Den returnerer en "berettiget" boolsk og, hvis ikke berettiget, en renspråklig årsak til at agenten kan vises til brukeren.InitiateRefund(Apex Action) kaller opp API-et for den eksterne betalingsgatewayen med bestillings-IDen og refusjonsbeløpet. Returnerer "refundTransactionId" ved vellykket utførelse. Denne handlingen er idempotent. Hvis det kalles opp en gang til med samme bestillings-ID, returneres den eksisterende transaksjons-IDen i stedet for å opprette en duplikat refusjon.UpdateCaseStatus(Automaint Started Flow) oppdaterer CRM-saksposten med refusjonstransaksjons-IDen, angir saksstatusen til "Løst refusjon utstedt", og oppretter en oppfølgingsoppgave for kontoeieren. Dette trinnet utføres først etter at InitiateRefund har returnert en bekreftet transaksjons-ID.
Hvis InitiateRefund tidsavbryter eller returnerer en feil, stopper agenten kjeden, kaller ikke opp UpdateCaseStatus og viser en handlingsmelding til brukeren. Saken forblir åpen og uløst, og beholder nøyaktig status i CRM.
Kontekst
Sekvensielle handlingskjeder er effektive når utførelsestrinn er avhengige av hverandre. Ett trinn fører til det neste. Men mange arbeidsflyter inneholder et sett trinn som ikke har noen gjensidige avhengigheter. Trinn som for eksempel inkluderer henting av produktlager, henting av kundeberettigelser og kontroll av en leveringsberegning, kan alle skje samtidig, fordi ingen trinns inndata krever utdata fra andre. Utføring av disse trinnene sekvensielt ødelegger tid som er proporsjonal med antall trinn.
I et parallelt oppkallsmønster identifiserer agenten at et sett handlinger er uavhengige og kaller dem opp samtidig i stedet for i sekvens. Den samlede arbeidsflytiden er avhengig av den tregere individuelle handlingen i stedet for summen av alle handlingstider. Når alle resultatene returneres, samler agenten dem til et enkelt koherent svar eller bruker dem sammen som inndata til neste fases resonnement.
Den viktigste arkitektoniske utfordringen er ikke selve parallellkallet. Den administrerer fan-out innenfor plattformens samtidige begrensninger og sikrer at aggregeringstrinnet håndterer delvise feil på en behagelig måte, uten å forkaste resultatene som var vellykkede.
Problem
Hvordan orkestrerer en agent effektivt samtidig utføring av flere uavhengige funksjoner og samler de individuelle resultatene til et enkelt, sammenhengende svar for brukeren eller etterfølgende trinn?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Hva er viktige punkter om handlinger med hensyn til trådsikkerhet og deling av endringsstatus?
- Hvordan vil løsningen håndtere og unngå å nå Salesforce-styringsgrenser for parallelle Apex i en enkelt transaksjon?
- Er det behov for å bruke asynkrone mønstre (som Apex eller plattformhendelser) for å unngå styringsgrenser?
- Er det nødvendig med synkron aggregering av resultatene før agenten kan fortsette?
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Middelsware-tilnærming | Best for høye faner (>5 endepunkter) og aggregering på tvers av plattformer | Du trenger et mellomproduktlag. Agenten sender ett kall til mellomproduktet. Deretter samler mellomprogramvennene som viser til 10 systemer parallelt, dataene og sender et enkelt svar tilbake til agenten. Dette foretrekkes når agenten må kalle opp mange heterogene eksterne systemer. Mellomprogramvaren absorberer fan-out-kompleksitet og returnerer et enkelt samlet svar. |
| Apex som kan legges i kø | Best for Salesforce intern parallellisme | Du må utløse flere jobber som kan legges i kø. Mens Salesforce administrerer køen, kan disse utføres samtidig hvis du har nok "sluker" i grensen for samtidighet. Brukes når parallelle operasjoner er i Salesforce-organisasjonen og samtidige luker er tilgjengelig. Dette er ikke egnet når umiddelbar samlet respons kreves. |
| Plattformhendelser | Best for å glemme brann eller eventuell konsistens | Resultater trenger ikke å aggregeres synkront. Hver hendelse utløser en isolert transaksjon som maksimerer gjennomløp, men krever nedstrøms avstemming. Bruk denne mekanismen når endelig konsistens er akseptabel og gjennomløp er viktigere enn responslatens. |
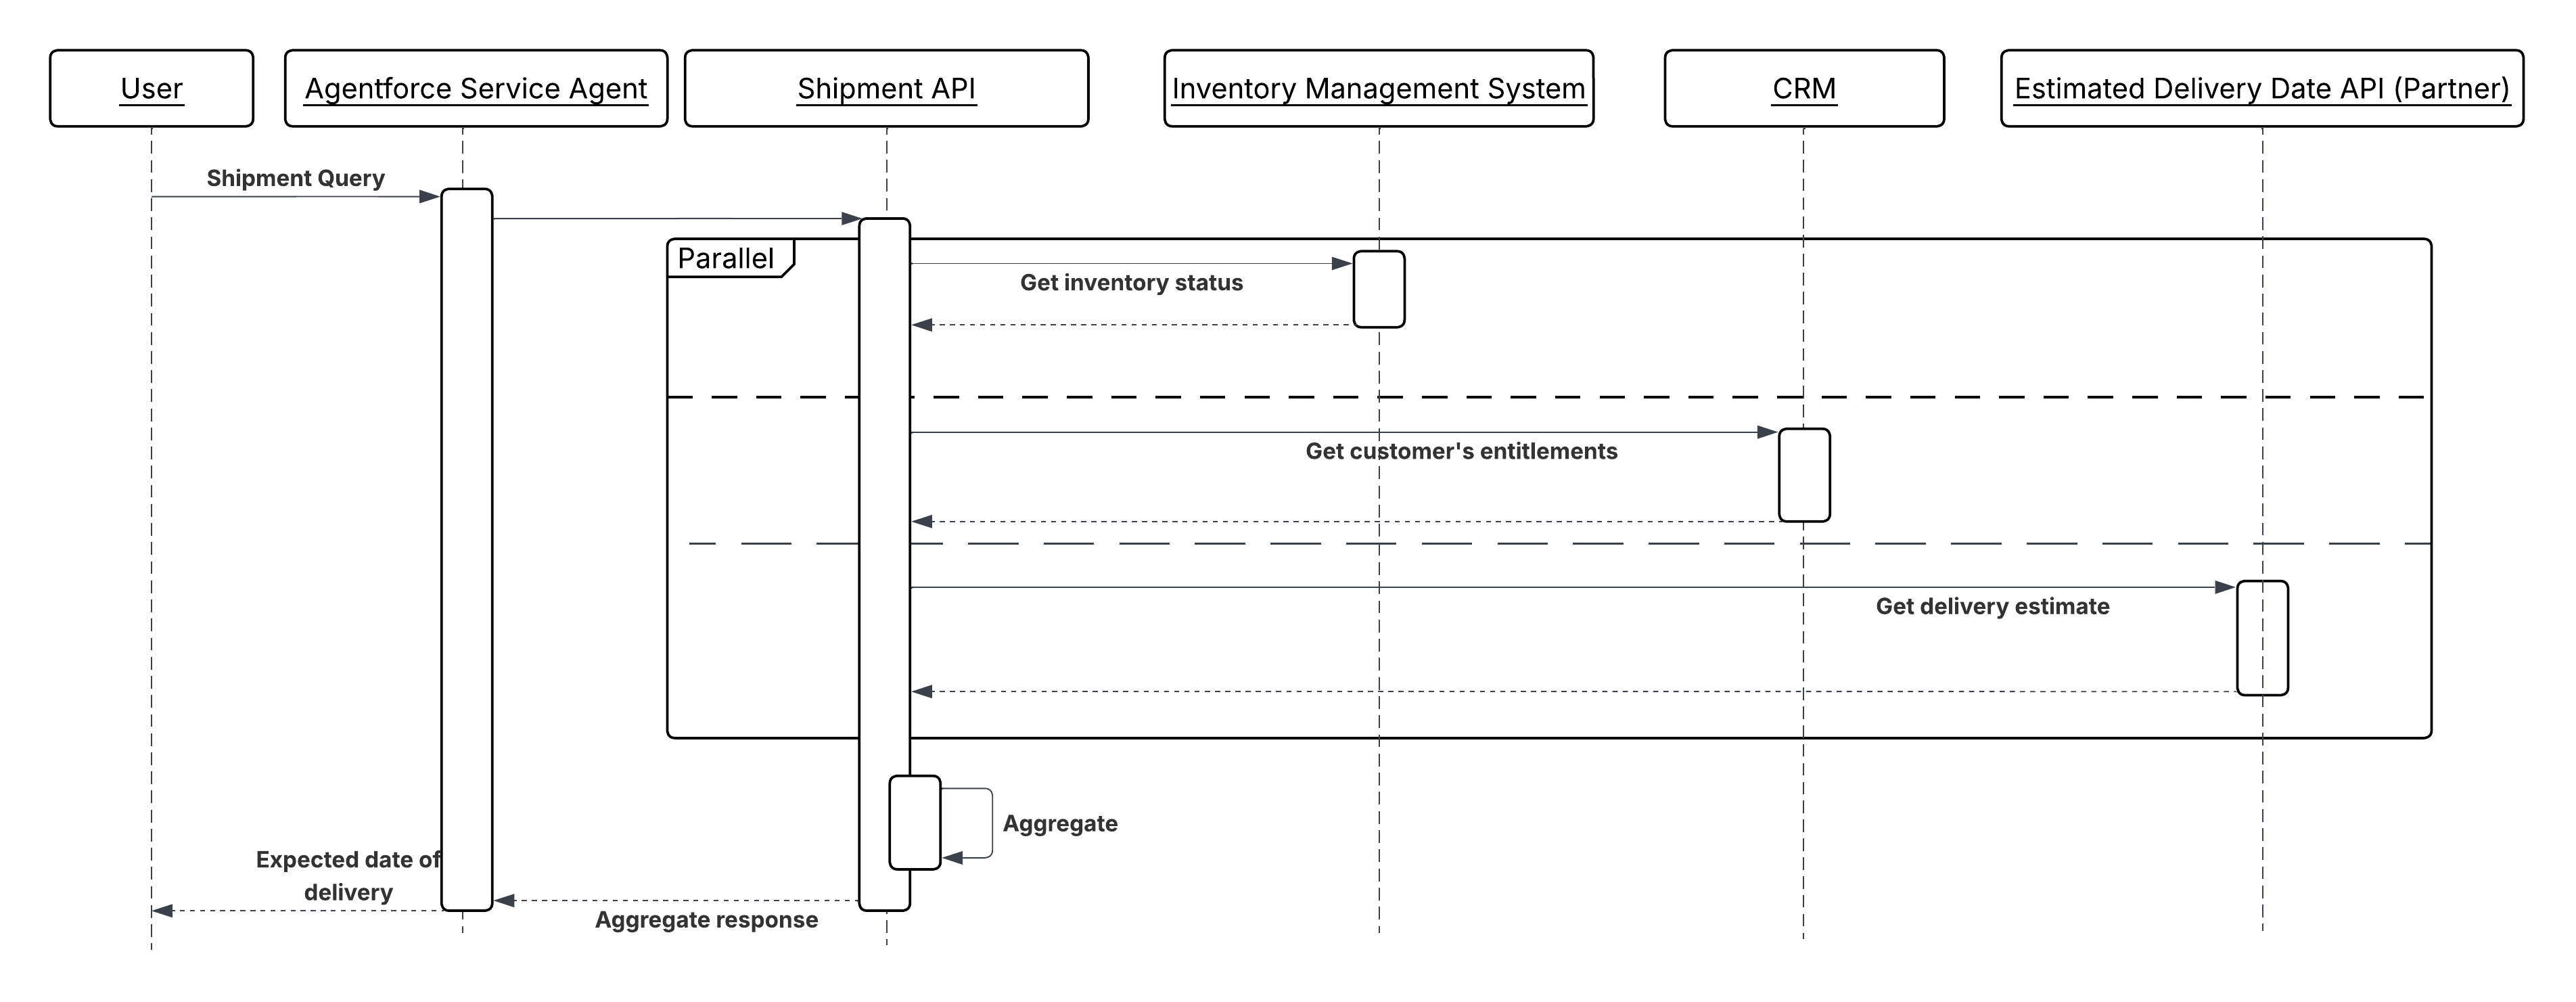
Skiss
Sekvensdiagram for parallell handlingsoppkall
Resultater
Når uavhengige handlinger utføres parallelt, er arbeidsflyttiden slutt-til-slutt avhengig av den tregere individuelle handlingen i stedet for summen av alle handlinger. For en arbeidsflyt med tre uavhengige oppkall med gjennomsnitt på 300 ms, fullføres parallell utførelse på ~300 ms, sekvensiell utførelse tar ~900 ms. I stor skala sammensettes denne forskjellen på tvers av alle agentøkter som kjører samtidig.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Bekreft uavhengighet før parallellering. Handlinger er trygge å kjøre parallelt bare hvis ingen av handlingene leser statusen som er skrevet av den andre, og ingen av handlingens feil bør avbryte den andre. Hvis det finnes en avhengighet, også en myk avhengighet, bruker du i stedet sekvensiell kjetting.
- Utform aggregeringstrinnet eksplisitt. Definer på forhånd hvordan et fullstendig resultatsett ser ut, hva et delvis resultatsett betyr for nedstrøms resonnement, og om agenten skal vente på alle resultatene eller fortsette når en terskel (for eksempel fem av totalt sju kall) har blitt returnert.
- Alle parallelle skrivingsoperasjoner må være idempotent. Hver operasjon kjører isolert uten en delt transaksjonsgrense, så hvis du prøver på nytt en enkeltforgrening, kan det ikke oppstå duplikater av bivirkninger.
Implementeringsmerknader fra Salesforce
- For Apex i kø: Send alle jobbene i én enkelt transaksjon for å maksimere sjansen for samtidig utførelse. Vær oppmerksom på at tilgjengelige samtidige luker deles på tvers av organisasjonen. Utform med forutsetningen at luker kanskje ikke alltid er tilgjengelige, og bygg et reservesystem for sekvensiell utførelse når de ikke er det.
- For plattformhendelser: Skriv resultatet av hver operasjon til en dedikert oppstillingspost (nøkkelt av en delt korrelasjons-ID) i stedet for å oppdatere målposten direkte. En endelig aggregeringsflyt- eller Apex leser alle oppstillingsposter når det forventede antallet er nådd, og deretter brukes den konsoliderte oppdateringen atomvis.
- For Mellomutstyr: Angi et eksplisitt tidsavbrudd for det ene oppkallet som er lengre enn forventet responstid i verste tilfeller for den tregere serverdelen, men fremdeles innenfor Salesforce-tidsavbruddsgrensen. Mellomprogramvaren returnerer delvise resultater med en tydelig indikasjon på hvilke serverdeler som mislyktes, i stedet for å tidsavbryte hele svaret.
Feilhåndtering og gjenoppretting
- Behandle delvis suksess som et utfall i første klasse. Hvis tre eller fire parallelle operasjoner lykkes, bruker agenten de tre vellykkede resultatene og håndterer feilen eksplisitt ved å vise den til brukeren, logge den for å prøve på nytt eller kalle opp en kompenserende handling i stedet for å forkaste alle resultatene eller fortsette som om feilen ikke skjedde.
- Når det gjelder kø- og plattformhendelsesmønstre, bruker du en korrelasjons-ID (generert ved fan-out-punktet) til å lenke alle parallelle grener tilbake til den opprinnelige agentøkten. Denne ID-en kreves for å sette sammen resultater på nytt og spore feil tilbake til kilden i logger.
- Hvis en parallell forgreining mislykkes og operasjonen er sikker å prøve på nytt, køer du bare den mislykkede forgreiningen på nytt med den opprinnelige korrelasjons-IDen og idempotency-nøkkelen. Ikke kall alle grener på nytt.
- Definer en tidsavbrudds terskel for aggregeringstrinnet. Hvis ikke alle resultater kommer innenfor terskelen, fortsetter du med tilgjengelige resultater og flagger det ufullstendige settet i stedet for å vente på ubestemt tid.
Sikkerhetshensyn
- Hver parallell utførelseskontekst, enten det er en jobb som kan legges i kø, en plattformhendelsesutløser eller et mellomliggende oppkall, må bruke de samme tilgangskontrollene som et sekvensielt oppkall. Parallellitet lindrer ikke datatilgangsregler. Hver forgreining må operere med samme legitimasjon med minst rettigheter som hvis den kalles opp alene.
- Når det gjelder mellomprodukt, bufrer eller logger ikke mellomproduktlaget responsbelastninger fra individuelle serverdeler utover aggregeringsvinduet. Svaret til hver serverdel kan inneholde sensitive data som ikke bør beholdes utenfor omfanget av den umiddelbare operasjonen.
- Forsikre deg om at oppstillingspostene som brukes til plattformhendelsesaggregering, ikke er lesbare for agentens sluttbruker. Disse postene kan inneholde midlertidige, delvis dannede data som ennå ikke er egnet for forbruk.
Eksempel
En tjenesteagent besvarer et komplekst innfrielsesspørsmål: "Kan du sende denne bestillingen til meg innen fredag?" Svaret krever data fra alle uavhengige systemer samtidig, som forklart nedenfor:
- Agenten identifiserer tre uavhengige databehov: gjeldende lagerbeholdningsnivå, kundens aktive berettigelser og operatørens anslåtte leveringsvindu for kundens plassering.
- Tre handlinger kalles opp parallelt:
GetInventoryStatus(fra det eksterne lagerbeholdningssystemet via mellomprogramvare),GetCustomerEntitlements(fra Salesforce CRM) ogGetDeliveryEstimate(fra operatør-APIen via mellomprogramvare). - Hver handling returneres uavhengig. Agenten venter til alle tre svar mottas (eller tidsavbruddet for aggregering nås).
- Med alle tre resultatene tilgjengelig, agenten årsaker over de kombinerte dataene, vurderer om lagerbeholdningen er tilstrekkelig, kundens berettigelse dekker ekspress forsendelse, og operatøren bekrefter fredag levering er mulig for kundens postnummer.
- Agenten returnerer et enkelt, jordet svar til brukeren, trukket fra tre systemer, i det tidspunktet det tok den langsomste av de tre samtalen å svare.
Kontekst
Enkelte agentstartede operasjoner gir ikke et resultat som agenten trenger for å fortsette sin gjeldende vurderingssyklus. Sending av et varsel, utløselse av en nedstrøms gruppeprosess, publisering av en hendelse til en meldingskø eller sending av en langvarig jobb er alle operasjoner der agentens forpliktelse avsluttes ved sending. Nedstrømsystemet tar eierskap og fullfører arbeidet uavhengig.
I tradisjonell automatisering modelleres disse som oppkall som brenner og glemmer eller publiserer plattformhendelser. I et agentisk system bestemmer agenten under begrunnelse at operasjonen ikke blokkerer, sender den, registrerer bekreftelse på sending og fortsetter eller avslutter omgangen uten å vente på nedstrømsresultatet.
Dette mønsteret er den agente motstykket til Fjernprosessoppkall – brann og glem fra Integrasjonsmønstre-veiledningen. Det agentiske mønsteret utvider det ved å gjøre sendebeslutningen til en del av agentens resonnement og ved å sikre at sendingen kan spores selv om det ikke returneres noe svar til agenten.
Problem
Når en agent må starte en nedstrøms operasjon som går utover agentens økt- eller vurderingssyklus, må tre utfordringer løses:
- Ikke blokkerende oppkall: Agenten må utløse operasjonen og bekrefte levering uten å holde vurderingssyklusen åpen og vente på et resultat.
- ** Leveringsbekreftelse:** Agenten må skille mellom en vellykket sending (meldingen ble godtatt) og et vellykket utfall (nedstrømsprosessen er fullført). Den kan bare deklarere den forrige.
- Sporbarhet: Fordi agenten ikke mottar noe resultat, må operasjonen være observerbar via logger, hendelsesposter eller plattformovervåking uavhengig av agentøkten.
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
-
Trenger agenten resultatet av denne handlingen for å fullføre sin gjeldende tur? Hvis ja, er dette ikke det riktige mønsteret. Bruk i stedet Sekvensiell handlingskall.
-
Er nedstrømsystemet i stand til å motta og pålitelig behandle den sendte meldingen eller hendelsen uten en synkron bekreftelse? Målsystemet må være holdbart. Den må ikke miste meldingen hvis den midlertidig ikke er tilgjengelig.
-
Er operasjonen idempotent eller må duplikatutsending beskyttes? Gjenopptagende forsøk på nettverksnivå og gjenopptagende agentenes vurderinger kan føre til at samme sending blir forsøkt flere ganger. Hvis nedstrømsoperasjonen ikke er idempotent, må handlingen bære en nøkkel for å fjerne duplikater.
-
Trenger brukeren eller en nedstrøms prosess å vite når operasjonen fullføres? Agenten kan bare bekrefte sending. Hvis fullføringsstatus kreves, utformer du en separat varsel- eller oppfølgingsmekanisme. En plattformhendelse, en saksoppdatering eller et tilbakekall – som er utenfor denne vurderingssyklusen.
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Pub/Sub API | Best for strømming av høy trafikk eller eksterne hendelser | Agenten kaller opp en Apex som publiserer en hendelse til Salesforce Pub/Sub API over gRPC. Handlingen returnerer en PublishResult replayId til agenten som bekreftelse på sending. Brukes når nedstrømsforbrukerne er eksterne systemer som abonnerer via Pub/Sub API i stedet for Salesforce-baserte Flyt- eller Apex, eller når strømming av hendelser med stor gjennomstrømning kreves. |
| Plattformhendelser (Apex) | Optimalt for asynkron sending i Salesforce | Agenten kaller opp en Apex som publiserer en plattformhendelse. Hendelsen leveres til alle abonnenter asynkront. Handlingen returnerer en publiseringsbekreftelse til agenten. Den returnerer ikke et behandlingsutfall. Brukes når nedstrømsforbrukeren er innenfor Salesforce-plattformen. Agenten kaller opp en Apex-handling som kaller opp EventBus.publish(). Handlingen returnerer en SaveResult som bekrefter godkjenning. |
| Apex/gruppe (Apex) | Best for langvarig bakgrunnsbehandling | Agenten kaller opp en Apex som legger en Købar- eller Batch-jobb i kø. Jobben kjører utenfor agentens transaksjon. Handlingen returnerer en jobb-ID som agenten kan vise til brukeren som en referanse. Brukes når nedstrømsarbeid er en langvarig Salesforce-operasjonsdatabehandling, oppdateringer med flere objekter eller eksterne oppkall som overskrider synkrone grenser. System.enqueueJob() returnerer en jobb-ID som agenten registrerer som referanse. |
| MuleSoft asynkron flyt | Best for levering av kø for eksterne meldinger | Agenten kaller opp en MuleSoft-eksponert handling som plasserer en melding i en ekstern kø (Kafka, JMS, SQS). MuleSoft håndterer protokolloversettelse og leveringsbekreftelse. Agenten mottar bekreftelse på at meldingen ble godtatt av MuleSoft, ikke at den ble behandlet nedstrøms. |
| Eksternt REST-endepunkt (Apex) | Best for sending av eksterne systemhendelser | Målsystemet viser et endepunkt som godtar en innsending, og returnerer umiddelbart en bekreftelses-ID og fullfører behandlingen asynkront. Agenten mottar bekreftelses-IDen og registrerer den. |
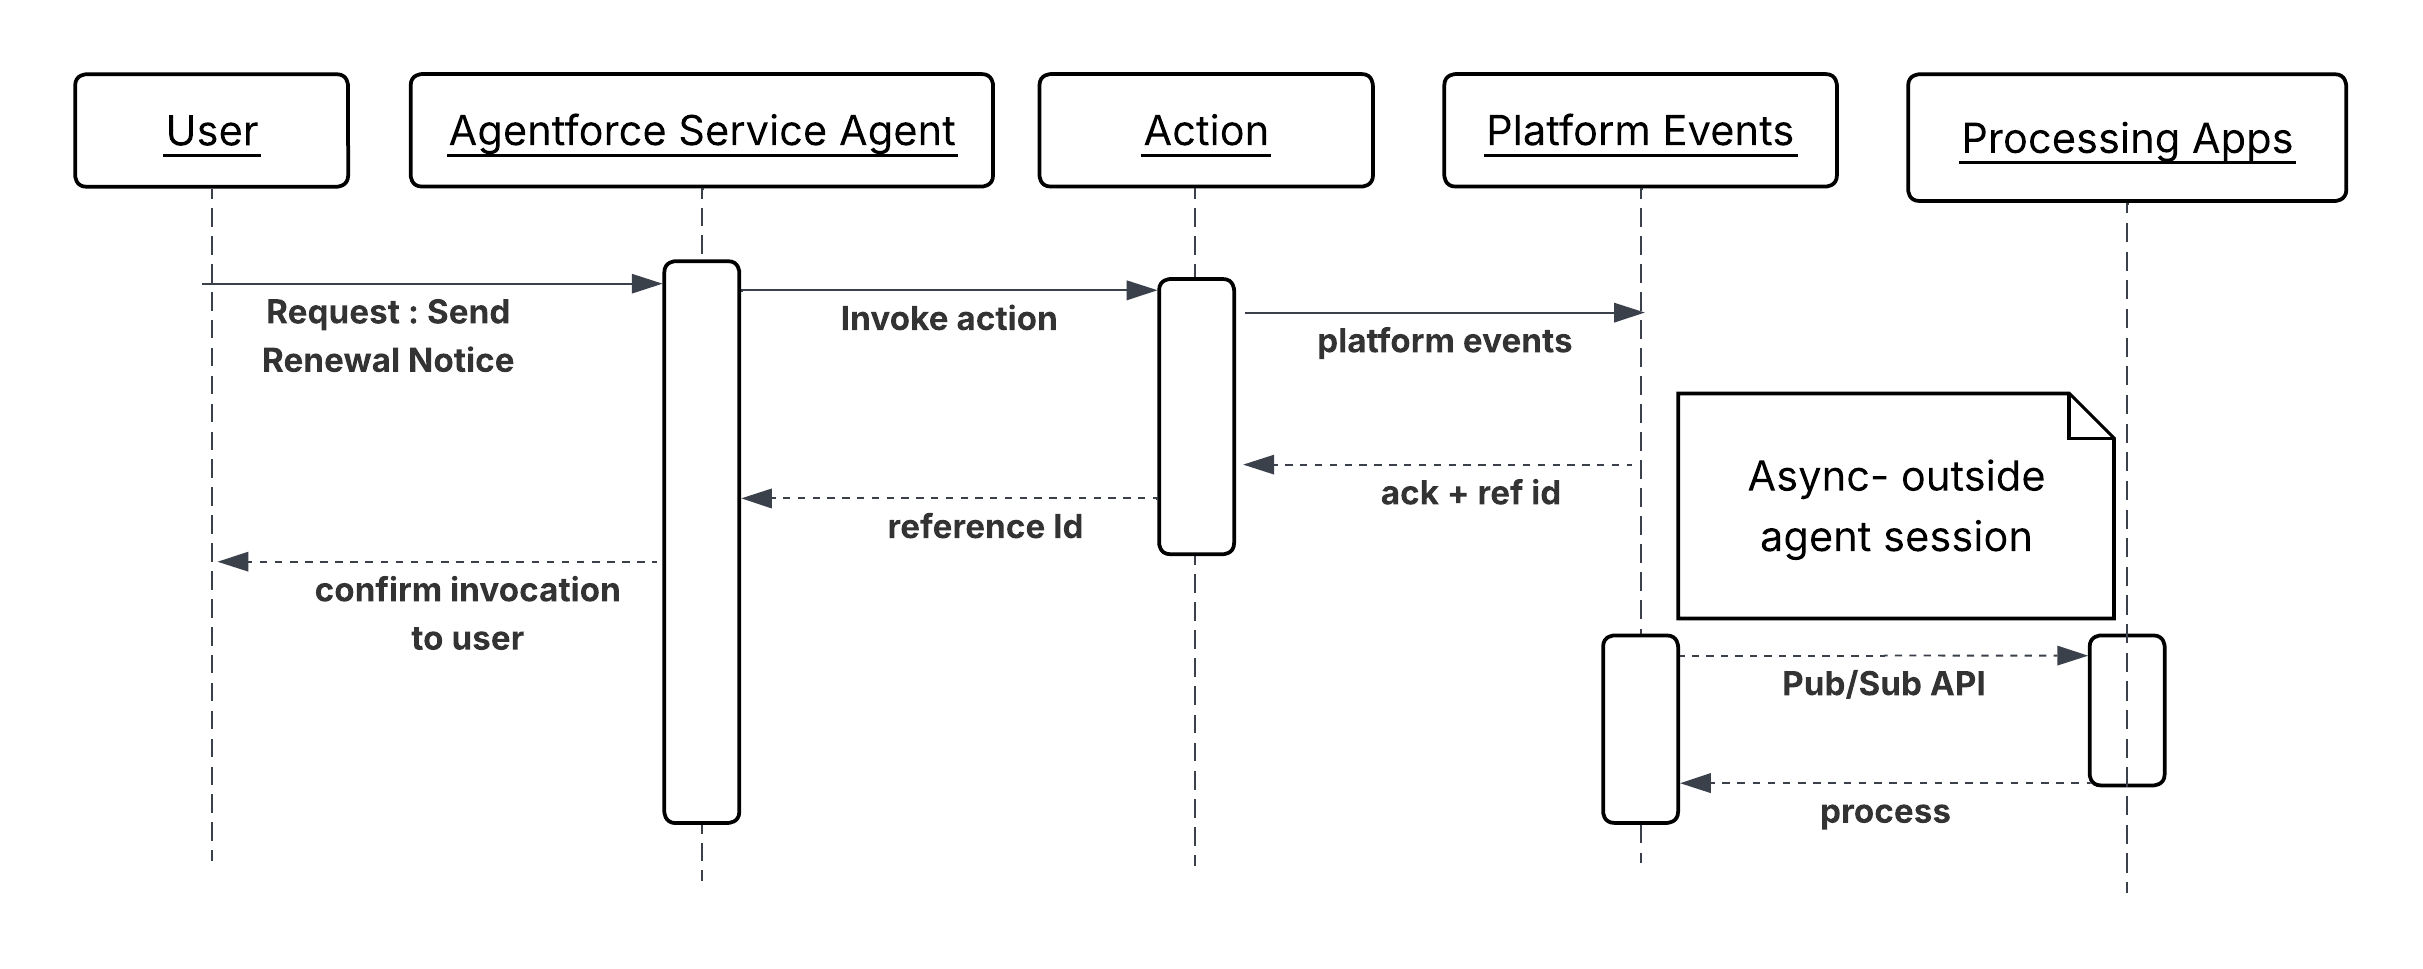
Skiss
Sekvensdiagram for asynkron handlingskall
Resultater
Agenten kaller opp en nedstrøms operasjon uten å blokkere dens vurderingssyklus for utfallet. Omgangen fullføres med bekreftelse på at operasjonen ble godtatt, ikke at den ble fullført. Nedstrømsystemet tar full eierskap til utførelsen. Den sendte operasjonen kan spores via plattformhendelsesabonnenter, jobb-ID-er eller eksterne købekreftelses-ID-er som registreres i CRM på sendetidspunktet. Hvis nedstrømsoperasjonen mislykkes, vises feilen gjennom nedstrømsystemets egen overvåking, ikke via agentøkten som startet den.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Skriv handlingsbeskrivelser på hensiktsbasert språk. Eksempel: "Sender et fornyelsesvarsel til meldingskøen og returnerer en senderreferanse-ID" er mer nyttig for agenten enn "kaller opp varslingssluttpunktet".
- Beskriv aldri en senderhandling som "sender og bekrefter levering av". Agenten kan bare bekrefte godkjenning. Nedstrøms levering og behandling er utenfor agentens observasjon.
Implementeringsmerknader fra Salesforce
- Returner en referanse-ID fra hver kallhandling, for eksempel en plattformhendelses-
ReplayId, en Købar-jobb-ID, en Pub/Sub APIPublishResultreplayId eller et eksternt bekreftelsestoken. Registrer den i en CRM-post på oppkalltidspunktet. Dette er det eneste revisjonssporet som agentøkten skal produsere. - For Pub/Sub API kaller agenten opp en Apex som gjør et gRPC-oppkall til sluttpunktet Pub/Sub API '/Publish'. Handlingen må håndtere skjemaregistreringstrinnet - hendelser må serialiseres i Avro-format mot det registrerte skjemaet. Returner
PublishResult ‘replayId’til agenten som sendereferanse. - For plattformhendelser kaller du opp
EventBus.publish()i Apex-handlingen og sjekker SaveResult for feil før du returnerer en suksessindikator til agenten. Ikke anta at publiseringen er vellykket, valider den. - Når det gjelder jobber i kø, implementerer du Købar-grensesnittet og kaller opp System.enqueueJob() fra handlingen. Returner den resulterende AsyncApexJob-IDen til agenten.
- For eksterne asynkrone endepunkter må målendepunktet umiddelbart returnere en bekreftelse (HTTP 202 Godtatt) med en referanse-ID. Hvis endepunktet blokkeres til behandlingen er fullført, er det synkront, og dette mønsteret gjelder ikke.
Feilhåndtering og gjenoppretting
- En kallhandling må skille mellom sendingsfeil (meldingen ble ikke godtatt) og behandlingsfeil (meldingen ble godtatt, men nedstrømsoperasjonen mislyktes senere). Agenten kan bare håndtere den forrige.
- Hvis oppkall mislykkes, må handlingen returnere en strukturert feil med en tydelig årsak. Agenten kan prøve sendingen på nytt, eskalere til et menneske eller logge en mislykket senderegistrering, men den kan ikke gjenopprette en nedstrøms behandlingsfeil i samme økt.
- For operasjoner der nedstrøms feil til slutt må fremheves, utformer du en separat tilbakemeldingsløyfe som en plattformhendelse publisert av nedstrømsprosessen, en planlagt flyt som sjekker jobbstatus, eller en oppfølgingssak som er utenfor agentøkten.
Sikkerhetshensyn
- Bryt alle eksterne asynkrone oppkall i navngitt legitimasjon. Oppkallshandlingen bygger ikke inn endepunkt-URL-adresser eller legitimasjon i kode.
- Valider og fjern alle parametere som er overført til kallhandlingen, før de bygges inn i hendelsesbelastningen eller meldingsteksten. Brukergitt tekst som overføres til en asynkron melding, er en potensiell injeksjonsvektor i nedstrømsforbrukeren.
- Logg alle sendinger med økt-ID, referanse-ID og sanitert last på utsendelsestidspunktet. Fordi ingen svar returneres til agenten, er denne loggen den primære mekanismen for å rekonstruere det agenten startet.
- Bruk minste privilegium på integrasjonsbrukeren eller den tilkoblede appen. En senderhandling som publiseres til en varselkø, bør ikke inneholde legitimasjon som tillater lesing eller skriving på ikke-relaterte systemer.
Eksempel
En fornyelsesbehandlingsagent som håndterer en kontrakt som nærmer seg utløp, bestemmer at kunden er kvalifisert for et varsel om automatisk fornyelse. Agenten trenger ikke bekreftelse på at e-postmeldingen ble levert før avslutningen av omgangen.
CheckRenewalEligibility(Automaint Started Flow) evaluerer kontraktsvilkår, kundelager og reservasjonsstatus. Returnerer en "berettiget" boolsk og den foretrukne varselkanalen.DispatchRenewalNotification(Apex-handling) publiserer enRenewalNotification\_\_ePlatform-hendelse som inneholder kontrakt-IDen, kunde-IDen, varslingskanalen og en generert idempotency-nøkkel. Returnerer en ReplayId som bekrefter at hendelsen ble godtatt av plattformen.UpdateContractRecord(Autostartet flyt) skriver inn tidsstempelet forReplayIdog sending i Kontrakt-posten og angir statusflagget "Varsel sendt".
Kontekst
Eksterne programmer som kundeportaler, mobilapper, tredjeparts SaaS-plattformer og partnersystemer må kalle opp agenter programmatisk for å håndtere tjenesteforespørsler, starte arbeidsflyter eller vise AI-drevne svar i sine egne grensesnitt. Agenten fungerer som en intelligent serverdeltjeneste. Det eksterne systemet gir kontekst, agenten gir årsaker og handlinger, og anroperen bruker svaret.
I økende grad er anroperen selv en AI-agent eller orkestrator i stedet for et brukervennlig program. I disse AI-til-AI-mønstrene delegerer en orkestreringsagent et tenkningstrinn, CRM-oppslag eller handling til Agentforce som et diskret verktøykall. Vi må vise en MCP-server (Model Context Protocol) for å støtte dette mønsteret.
Problem
Når et eksternt system eller en AI-agent trenger å utnytte en Agentforce muligheter på forespørsel, hvordan godkjenner den, oppretter en agentøkt, sender de nødvendige samtale- og kontekstuelle dataene og pålitelig mottar agentens strukturerte respons for å drive sin egen nedstrøms logikk?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Forventer den eksterne anroperen et synkront svar med lav latens, eller er et asynkront tilbakekall akseptabelt?
- Hvordan etableres anroperens identitet og overføres til agentens utførelseskontekst for datatilgang og tilpassing?
- Hva er det forventede volumet av samtidige API-utløste økter, og hvordan samhandler dette med Salesforce API-frekvens- og samtidige grenser?
- Trenger det eksterne systemet å opprettholde øktekontinuitet på tvers av flere omgange (samtale med flere omgange), eller er hver forespørsel uten status?
- Hvordan skal agentens svar struktureres slik at anropssystemet kan analysere og handle programmatisk på det?
- Er anroperen et menneskeorientert program som krever direkte REST-integrering, eller en AI-agent eller orkester som kan kalle opp Agentforce som et verktøy via en standardprotokoll, for eksempel MCP?
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Agentforce Agent API - enkeltvendt (synkron) | Best for integrasjoner uten status, forespørsel/svar | Samtalesystemet krever et umiddelbart, strukturert svar, og agentens resonnement forventes å fullføre innenfor anroperens tidsavbruddstoleranse. Samtalesystemet behandler fasene i hele øktlivssyklusen – opprettelse, svinger og avslutning. Det eksterne systemet godkjenner, oppretter en økt med kontekstvariabler, sender en enkelt melding, mottar agentens svar og avslutter økten. Dette Agentforce API er det primære REST-grensesnittet der eksterne systemer oppretter økter, utveksler meldinger og avslutter økter programmatisk. Hele utvekslingen fullføres innen én HTTP-forespørsel-svar-syklus. Svar inkluderer agentens utdata på naturlig språk og eventuelle strukturerte utdatavariabler som er produsert av handlinger som agenten kalte opp under vurderingen. |
| Agentforce Agent API - Multi-Turn (øktkontinuitet) | Best for samtaleintegrasjoner som krever status på tvers av omgange | Det eksterne grensesnittet er konversasjonsbasert (for eksempel en chattewidget eller talegrensesnitt), og interaksjonen krever flere utvekslinger for å nå en løsning. Det eksterne systemet oppretter en økt én gang og gjenbruker økt-IDen på tvers av flere meldingsutvekslinger. Agenten beholder samtalekontekst mellom omganger som tidligere spørsmål, hentede data og beslutninger som tas uten at anroperen leverer dem på nytt. |
| Asynkron med avstemming eller Webhook-tilbakekall | Best for arbeidsflyter med høy latens for vurderinger eller tidssensitive brukergrensesnitt | Agentbehandlingstiden er ikke triviell, og å holde en åpen HTTP-tilkobling vil redusere anroperens brukeropplevelse eller utløse oppstrøms tidsavbrudd. Det eksterne systemet sender forespørselen og mottar umiddelbart en bekreftelse med en jobb- eller økt-ID. Det spør deretter et statusendepunkt eller registrerer en webhook for å motta agentens svar når årsaken er fullført. For øyeblikket kan dette mønsteret implementeres med en wrapper API som befinner seg på en mellomprogramvare som MuleSoft. Ekstern forbruker kaller opp denne Wrapper API og registrerer webhook-endepunktet. Wrapper API sender bekreftelsen tilbake til det eksterne systemet etter å ha kalt opp Agentforce. Denne wrapper API vedlikeholder også Agentforce og returnerer svaret tilbake til det eksterne systemet ved å bruke det registrerte webhook-endepunktet når agenten svarer. |
| Agentforce via MCP (Salesforce Headless 360) | Best for AI-til-AI-kall der anroperen er en MCP-kompatibel klient | Den oppringende MCP-klienten kaller opp Agentforce som et verktøy via den forhåndsdefinerte MCP-serveren som leveres av Salesforce Headless 360. Øktlivssyklusen administreres gjennomsiktig av MCP-serveren, og den oppringende agenten samhandler gjennom standardverktøykall uten å bygge en tilpasset REST-integrasjon. Bruk denne løsningen når anroperen er en MCP-klient som trenger å delegere resonans, CRM-konteksthenting eller handlingsutføring til Agentforce som et diskret trinn i en mer omfattende agentisk arbeidsflyt. |
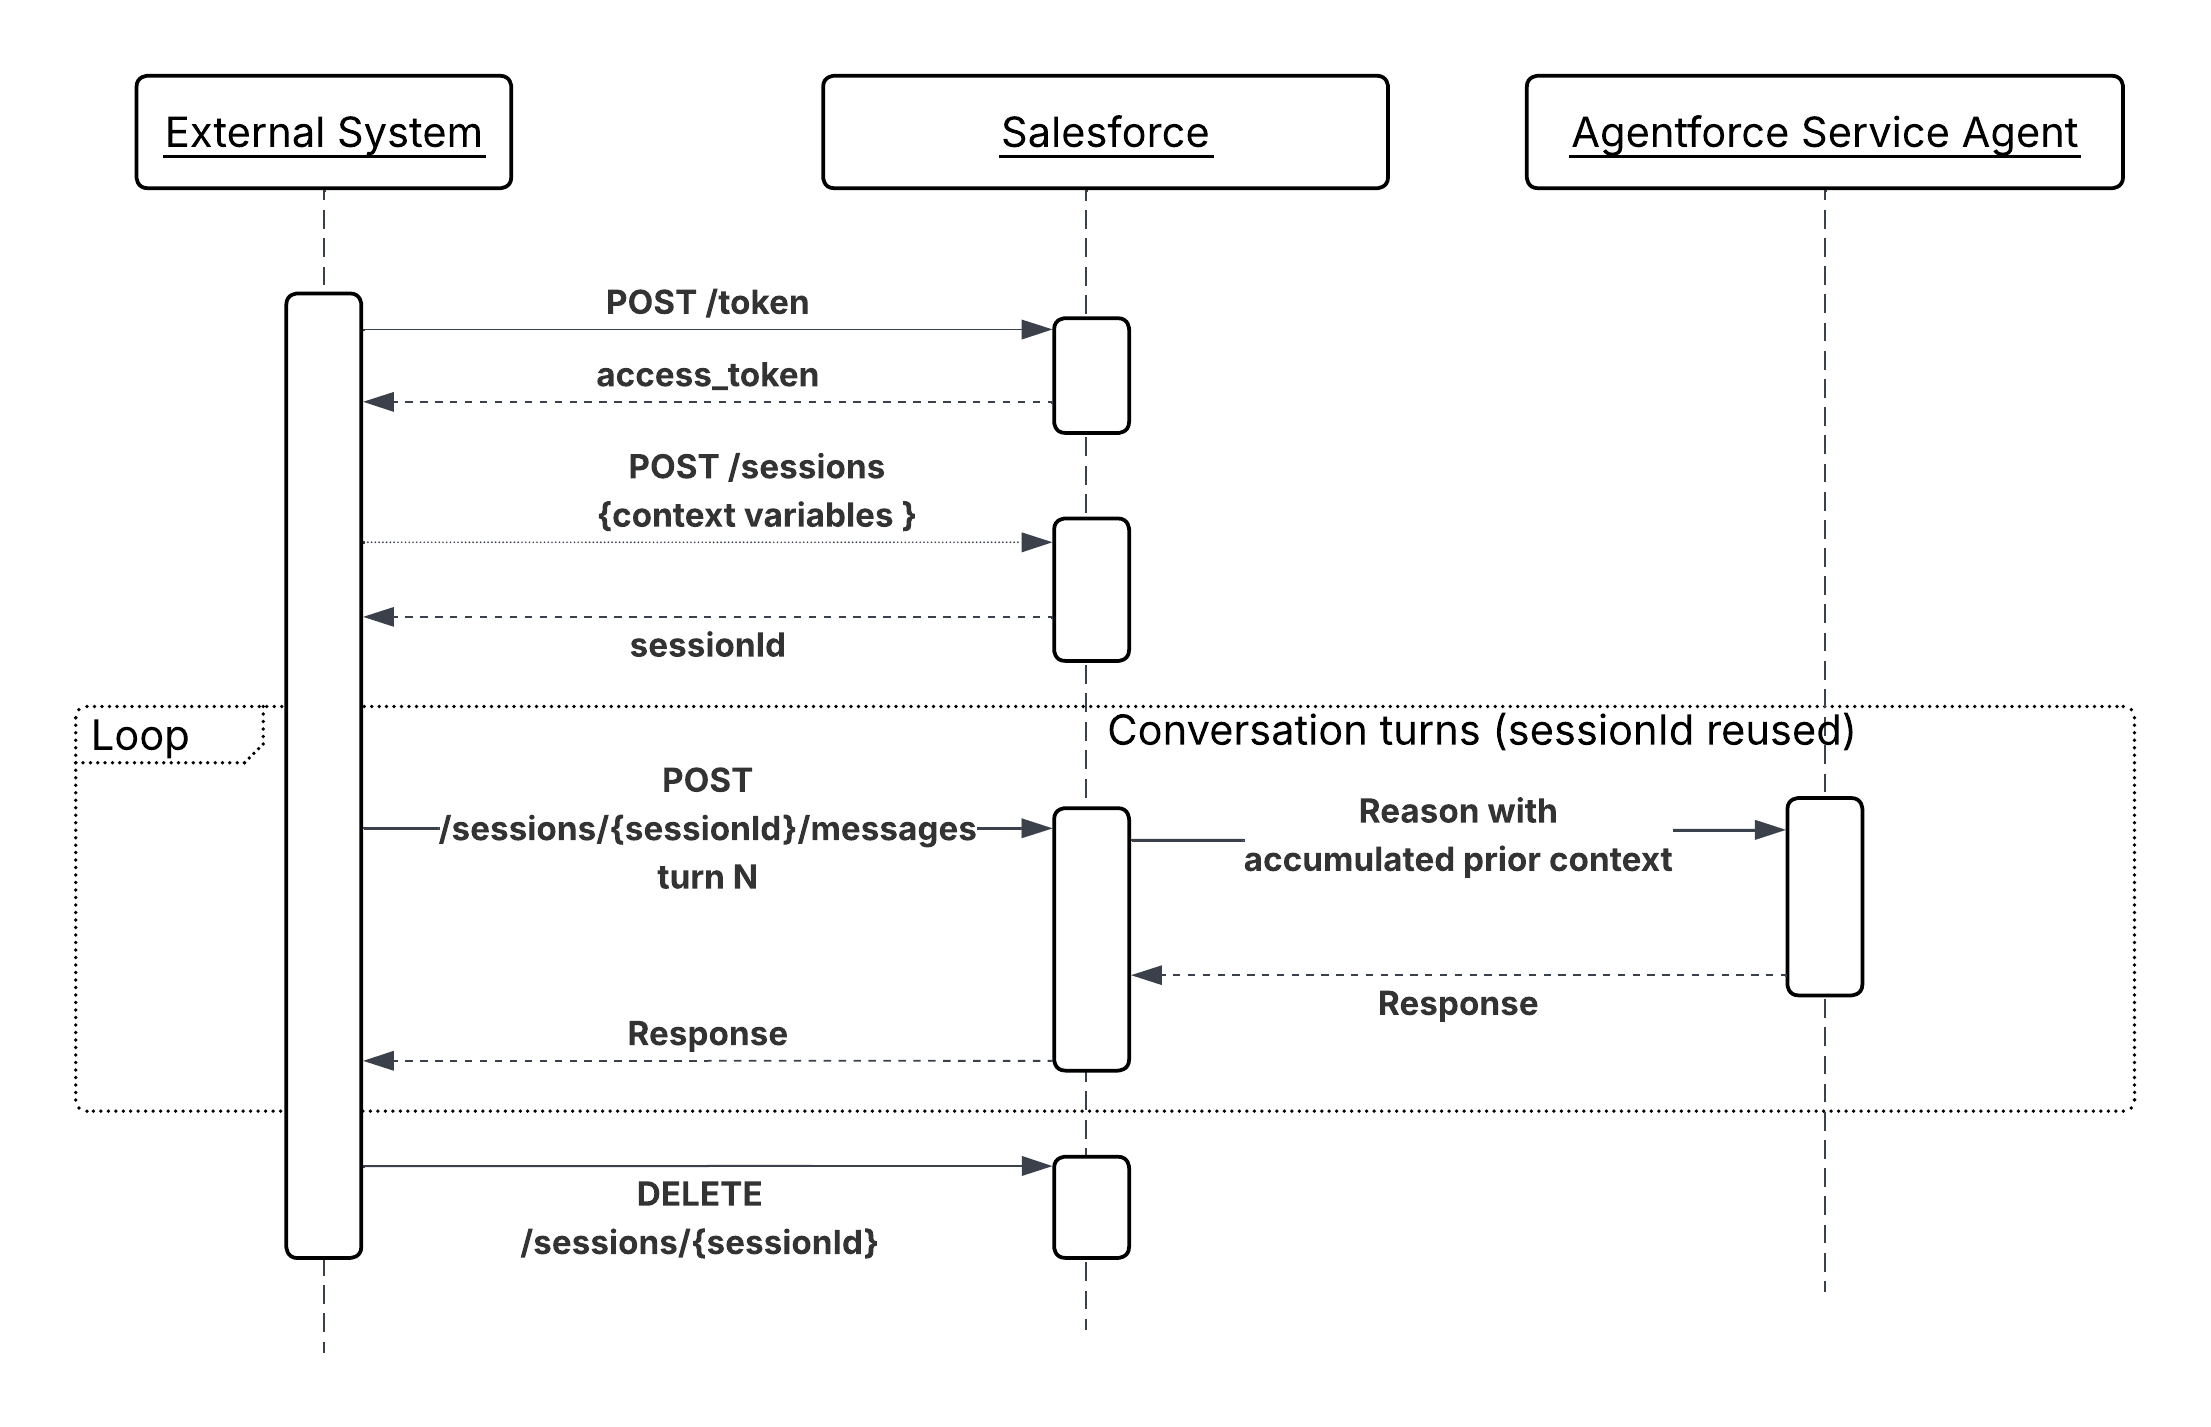
Skiss
Sekvensdiagram for oppkall av agent på forespørsel
Resultater
Dette mønsteret viser Agentforce som en kallbar AI-tjeneste. Eksterne systemer får tilgang til agentens vurderinger, verktøy og CRM-kontekst uten å replikere logikken. Anroperen forblir ansvarlig for behandling av øktlivssyklusen og gjengivelse av svaret. Agenten forblir ansvarlig for all resonans, verktøyvalg og svarsyntese.
Når anroperen er en AI-agent eller orkestrator, fjerner Agentforce via MCP-mekanismen (tilgjengelig via Salesforce Headless 360) behovet for en tilpasset REST-integrasjon helt. MCP-serveren håndterer livssyklusen til økten på vegne av den oppringende agenten, slik at Agentforce kan delta som et førsteklasses verktøy i arbeidsflyter for flere agenter uten ekstra rørlegging.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Unngå å gjøre det eksterne API-kallet synkront og blokkere i tidsfølsomme brukergrensesnittflyter. Ta i bruk et mønster for avspørring eller webhook-tilbakekall der responstider for agenter ikke er trivielle, for å koble brukeropplevelsen fra agentens behandlingstid.
- Velg samtalemekanismen basert på oppringeren, ikke tilgjengeligheten. Personrettede programmer og systemintegrasjoner bør bruke Agent-API direkte. Verktøy som støtter MCP-er, bør bruke Agentforce MCP-serveren. Blanding av mekanismer for samme anropertype legger til unødvendig kompleksitet uten arkitektonisk fordel.
Implementeringsmerknader fra Salesforce
- Injiser øktkontekst i POST-forespørselen for opprettelse av økt, ikke i den første brukermeldingen. Når det eksterne systemet oppretter økten, har det en mulighet til å overføre strukturerte kontekstvariabler (konto-ID, berettigelsesdata, sammendrag av tidligere interaksjoner) direkte som navngitte øktparametere. Disse variablene er tilgjengelige for agenten før den behandler en enkelt omgang, så den begynner å resonnere fra en jordet tilstand uten å utstede oppkall for å fastslå hvem kunden er eller hva kunden er berettiget til. Overføring av de samme dataene i meldingsteksten tvinger i stedet agenten til å analysere ustrukturert tekst for å trekke ut fakta den kunne ha mottatt som skrivevariabler - øker latensen, introduserer uttrekksfeil og bruker begrunnelsestrinn som ikke legger til noen forretningsverdi.
- Utform agentsvar slik at de er strukturerte og maskinlæsbare. Bruk konvensjoner for utdatavariabler og ledetekster som veileder agenten til å returnere JSON-vennlige eller tydelig avgrensede svar når anroperen er et system i stedet for et menneske.
- Behandle øktenes livssyklus eksplisitt. Avslutt økter umiddelbart etter å ha brukt
DELETE /einstein/ai-agent/v1/sessions/{sessionId}til å frigjøre samtidige luker og unngå foreldet kontekst som vedvarer på tvers av ikke-relaterte interaksjoner. - Konto for Salesforce-grenser for samtidige økter. I scenarier med stor gjennomstrømning implementerer du en øktgruppe eller et kølag i samtalesystemet for å hindre avvisning av forespørsler under toppinnlasting.
- Når du kaller opp Agentforce via MCP, overfører du kontekst som verktøyinndataparametere i stedet for som øktvariabler. MCP-serveren behandler øktlivssyklusen gjennomsiktig, så anroperagenten kan ikke angi navngitte øktparametere direkte på opprettelsestidspunktet. Forsikre deg om at all nødvendig kontekst (post-ID-er, brukeridentitet, berettigelsesdata) er inkludert i verktøykallbelastningen, slik at agenten begynner å tenke fra en jordet tilstand.
- Behandle MCP-serverens gjennomsiktige øktbehandling som en bekvemmelighet, ikke en samtidig omvei. Hver verktøykall forbruker fremdeles en øktsluke for Salesforce-agenter. Høyfrekvensorkestratorer som kaller opp Agentforce via MCP i stor skala, må ta hensyn til de samme grensene for samtidige økter som gjelder for direkte Agent API-kallere.
Feilhåndtering og gjenoppretting
- Agent API returnerer standard HTTP-feilkoder. Oppkallsystemet må håndtere "429 For mange forespørsler" (frekvensgrense) med eksponentiell tilbakemelding og "503 Tjeneste ikke tilgjengelig" med logikk for å prøve på nytt.
- Når agenten selv støter på en uløselig verktøyfeil, returnerer den en grasiøs feil med naturlig språk i svarteksten. Oppkallsystemet oppdager disse sentinelsvarene (for eksempel sjekker om det er et "feil"-statusfelt i svaret), og ruter i henhold til dette enten ved å prøve på nytt med ekstra kontekst, presentere en reservasjonsopplevelse eller eskalere til et menneske.
- Når du kaller opp via MCP, vises feil på to distinkte lag: MCP-transportfeil (feilt utformede verktøykall, server utilgjengelighet) og Agentforce resonansfeil (verktøykjøringsfeil, uløselige handlinger). Orchestreringsagenten må håndtere begge lag uavhengig. MCP-overføringsfeil bør utløse nye forsøk på protokollnivå. Mislykkede Agentforce som returneres i verktøysvaret, bør håndteres av orkestrerens egen reservestøtte- eller eskaleringslogikk.
Sikkerhetshensyn
- Bruk de smaleste mulige OAuth-omfangene for den eksterne klientappen. En integrasjon som bare trenger å kalle opp en agent, bør ikke inneholde omfang for datatilgang utover det selve agenten krever.
- Valider og fjern alle inndata fra det eksterne systemet før du injiserer dem som øktvariabler. Eksterne inndata er en angrepsflate for ledetekstinnsetting. En skadelig anroper kan for eksempel lage et CustomerQuery-felt utformet for å overstyre agentinstruksjoner.
- Bruk IP-tillatelsesliste på den eksterne klientappen for å begrense hvilke eksterne systemer som kan godkjenne og kalle opp Agent API.
- Logg alle innkommende API-utløste økter med anroperidentitet, økt-ID og forespørsels/svar-metadata for revisjons- og sikkerhetsformål.
- Når Agentforce kalles opp via MCP, godkjennes MCP-serveren til Salesforce på vegne av brukeren som ringer. Kontroller at MCP-serverens tilkoblede applegitimasjon er omfattende til minimum nødvendig tillatelser, og at sluttbrukerens identitet (ved bruk av MCP-verktøy som Claude) -identitet overføres eksplisitt til øktkonteksten via verktøyinndataparametere.
Eksempel
En Financial Services-portal utløser en Agentforce til å håndtere en lånespørring.
- Portalen godkjennes med OAuth-flyten Client Credentials (Klientlegitimasjon) og henter et bærertoken.
- Den kaller opp "POST / Einstein/ai-agent/v1/sessions" med øktvariabler: "{ "accountId": "001xx...", "productType": "mortgage", "loanAmount": 450000 }".
- Brukeren sender inn spørsmålet sitt: "Hvilke dokumenter trenger jeg for å fullføre søknaden?"
- Portalen kaller opp "POST / Einstein/ai-agent/v1/sessions/{sessionId}/messages" med brukerens tekst.
- Agentforce kaller opp en GetDocumentChecklist-flythandling, henter de lånetypespesifikke kravene og returnerer en strukturert liste.
- Portalen gjengir agentens svar innebygd og avslutter økten ved brukeravslutting.
Kontekst
Ikke alle agentiske arbeidsflyter kommer fra en menneskelig forespørsel. Forretningskritiske signaler som en plutselig nedgang i produktbruksmålinger, et opphør av handlevogn med høy verdi eller en betalingsfeil som krysser en risikostørrelse, oppstår ofte i driftsdata. Når disse signalene krever intelligente, flertrinns svar, innfører ventende på at en person skal merke seg og handle, latens som sammenslås til reelle forretningskostnader.
Dette mønsteret beskriver hvordan sanntidshendelser fungerer som autonome inngangspunkter for agenter. Agenten kalles opp av en datatilstand i stedet for en bruker, årsaker over hendelseskonteksten, og utfører en svararbeidsflyt alt uten menneskelig initiering.
Problem
Når en sanntids forretningshendelse skjer i Data 360 eller Salesforce-plattformen, hvordan kan denne hendelsen automatisk instansiere en agentøkt, levere hendelsesbelastningen som jordingskontekst og drive en ikke-samtalehandlingsarbeidsflyt til fullføring uten at en person initierer eller veileder interaksjonen?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Kreves det et svar umiddelbart på det tidspunktet hendelsen utløses, eller er nær sanntidsbehandling (sekunder til minutter) akseptabel?
- Inneholder hendelsesbelastningen tilstrekkelig kontekst til at agenten får grunnlag, eller må agenten utføre flere oppslag før den kan begrunde seg effektivt?
- Hva er forventet hendelsesvolum og -frekvens? Hendelsesstrømmer med stor gjennomstrømning krever frekvensbehandling for å unngå utmattende grenser for agentens samtidighet.
- Kan den samme hendelsen utløses flere ganger for den samme forretningsenheten (minst én levering)? I så fall må handlinger være idempotent.
- Finnes det en menneskelig eskaleringsbane hvis agenten ikke kan løse hendelsen selvstendig?
- Hvordan skal mislykket hendelsesbehandling presenteres? Med en dødskrivetekø, et varsel eller opprettelse av sak?
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Data 360-utløste flyter | Best for virkemåte- og målingsbaserte signaler | Dette passer best når utløserbetingelsen er definert som en endring av medlemskap i et Data 360-segment eller en målings terskel. Data 360 oppdager forretningsbetingelsen (for eksempel handlevognavbrudd, bruksfall) og utløser en utløst flyt. Flyten tilordner hendelsesbelastningsattributter til agentøktvariabler og oppretter Agentforce. |
| Plattformhendelser + automatisk startet flyt eller Apex | Best for plattforminterne og krysssystemhendelser | Bruk denne løsningen når hendelseskilden er innenfor Salesforce-plattformen eller når et mellomliggende lag publiserer hendelsen etter å ha oppdaget tilstanden i et eksternt system. En plattformhendelse som er publisert av en hvilken som helst Salesforce-prosess eller eksternt system, utløser en Apex eller automatisk startet flyt, som konstruerer agentøkten med hendelsesbelastningen som kontekst. |
Skiss
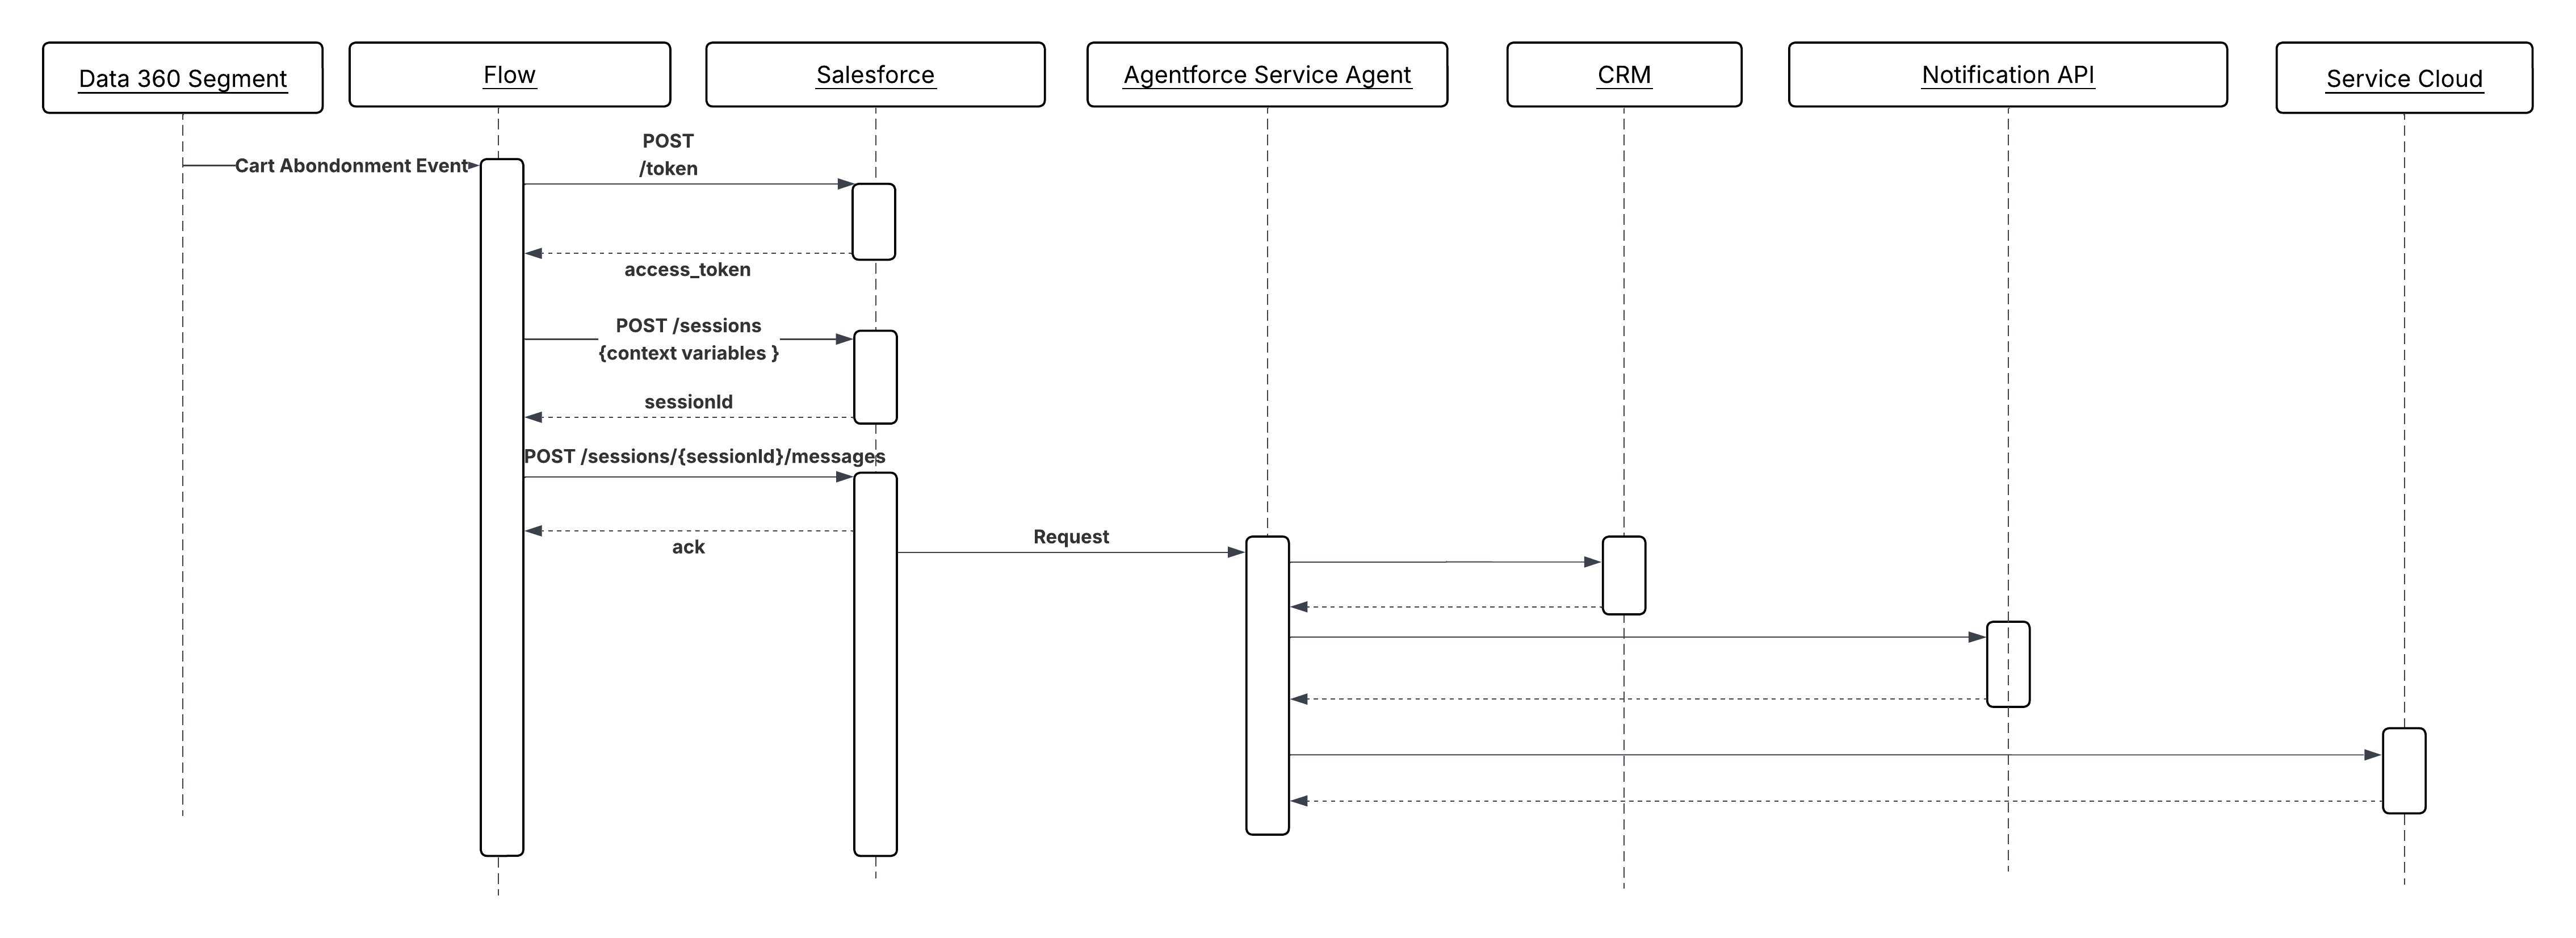
Sekvensdiagram for hendelsesdrevet agentutførelse
Resultater
Agenter blir aktive deltakere i sanntids forretningsdrift, ikke passive respondenter på forespørsler fra mennesker. Hendelsesutløste agenter kan utføre gjenopprettings-, sorterings- og eskaleringsarbeidsflyter med hastigheten på data i stedet for hastigheten på menneskelig oppmerksomhet.
Utløsersystemet (Data 360 eller plattformhendelser) forblir ansvarlig for hendelsesdeteksjon og belastningsdannelse. Agenten forblir ansvarlig for å vurdere denne belastningen og velge riktig handlingskjede. Ingen samtaleavgang kreves. Hendelsesbelastningen er de fullstendige inndataene.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Utform alle handlinger for kall som ikke er samtaler. Det er ingen brukervindu. Agenten må nå en løsning bare fra den første jordingskonteksten. Handlinger bør returnere strukturerte, deterministiske utdata i stedet for å be om klargjøring.
- Forsikre deg om at hendelsesbelastningen inneholder tilstrekkelig jordingskontekst før agentøkten opprettes. En mager belastning som tvinger agenten til å utføre flere oppkall før den kan begrenses, øker latens og samtidig forbruk.
- Gjør alle skriveoperasjoner som utløses av hendelsesdrevne agenter, idempotente. Hendelsesleveringssystemer gir vanligvis garantier minst én gang. Duplikathendelsesbehandling kan ikke gi duplikate bivirkninger.
Implementeringsmerknader fra Salesforce
- I Data 360-utløste flyter tilordner du hendelsesbelastningsattributter (for eksempel "accountId", "eventType", "metricValue", "productIds") direkte til navngitte øktvariabler på tidspunktet økten opprettes. Dette begrenser agenten fra det første vurderingstrinnet uten å kreve en hentingshandling.
- Til plattformhendelsesutløsere bruker du en automatisk startet flyt i stedet for en skjermflyt. Skjermflyter støttes ikke i autonome, ikke-samtalekontekster.
- Angi en eksplisitt tidsavbrudd for hendelsesutløste økter. Til forskjell fra diskusjonsøkter er det ingen bruker som kan utvide interaksjonen. En økt som stanser på en mislykket handling, bør ikke inneholde en samtidig tidsluke på ubestemt tid.
- Bruk flytfeilbaner til å håndtere feil ved opprettelse av agentøkter. Hvis økten ikke kan opprettes, bør feilbanen publisere en kompensasjonshendelse eller opprette en sak for menneskelig oppfølging i stedet for å stille utelate hendelsen.
Feilhåndtering og gjenoppretting
- Hendelser som mislykkes i å utløse en agentøkt på grunn av samtidige grenser, feil ved opprettelse av økter eller feil ved belastningsvalidering, skal rutes til en feilbane som oppretter en sak, utløser et varsel eller publiserer hendelsen til en dødskrivet kø for gjenbehandling.
- Mislykkede agentutførelser midt i utførelsen (for eksempel tidsavbrudd for en nødvendig handling) bør logges med den opprinnelige hendelses-ID-en. I og med at utløsingen er asynkron og det ikke er noen ventende anroper, er feilsiden helt observabilitetsbasert: logger, kontrollpaneler og terskler for varsler.
- Implementer et nytt forsøk på tak. Hvis en hendelse på en pålitelig måte fører til agentfeil, vil ikke-begrensede nye forsøk utnytte grenser for samtidighet. Etter et konfigurerbart maksimalt antall forsøk ruter du hendelsen til en kø for menneskelig gjennomgang med full kontekst lagt ved.
- Spor hendelses-IDen gjennom hele livssyklusen til agentøkten. Denne sporingen aktiverer korrelasjon mellom opphavsdatasignalet og alle nedstrøms handlinger for revisjon og feilsøking.
Sikkerhetshensyn
- Valider og saniter alle hendelsesbelastningsattributter før du injiserer dem som agentøktvariabler. Hendelsesbelastninger fra Data 360-publiseringer eller eksterne publiseringer er en angrepsflate for ledetekstinnsetting. Et utformet belastningsfelt kan for eksempel utformes for å overstyre agentinstruksjoner.
- Kjør hendelsesutløste agentøkter under en dedikert integrasjonsbruker med færrest rettigheter i stedet for en administratoridentitet med høye rettigheter. Agenten har bare tillatelsene som kreves for å utføre sitt definerte handlingssett.
- Logg alle hendelsesutløste økter med den opprinnelige hendelses-IDen, hendelsestypen og øktvariablene som ble injisert ved opprettelse. Dette revisjonssporet kreves for å rekonstruere hvorfor agenten utførte en gitt handling hvis utfallet er omstridt.
Eksempel
Et detaljvarefirma bruker Data 360 til å spore virkemåten til handlevognen i sanntid. Når en handlevogn med en verdi over en definert terskel blir avbrutt:
- Data 360 oppdager avbruddsignalet og utløser en utløst flyt med hendelsesbelastningen: "customerId", "cartValue", "productIds" og "abandonmentTimestamp".
- Flyten tilordner disse attributtene til Agentforce og oppretter en ny agentøkt. Ingen brukermedvirkning kreves.
- Agenten evaluerer kundens kjøpshistorikk, gjeldende berettigelser og handlevognutforming ved å bruke sine tilgjengelige hentingshandlinger.
- Agenten kaller opp en
SelectRecoveryOffer-handling, som bruker det riktige rabattnivået basert på kundesegmentet, ogSendProactiveNotification-handling for å levere tilbudet via kundens foretrukne kanal. - Agenten kaller opp
CreateFollowUpTaskfor å logge interaksjonen i CRM for kontoeierens synlighet. - Økten avsluttes automatisk etter at handlingskjeden er fullført. Den opprinnelige hendelses-IDen beholdes i øktloggen for sporbarhet.
Kontekst
LLM-er blir opplært i felles data. De har ingen Knowledge om organisasjonens produkter, policyer, sakshistorikk eller kontrakter med mindre denne informasjonen er eksplisitt gitt på grunnlag av årsaken. Uten grunnlag vil en agent som spør om en kundes tjenesteberettigelse eller vilkårene i en bestemt kontrakt, enten hallusinerer et svar eller innrømme at den ikke vet det. Ingen av utfallene er akseptable i en forretningskontekst.
Retrieval-Augmented Generation (RAG) løser dette ved å hente relevante dokumenter fra et Enterprise Knowledge-lager og sette dem inn i agentens kontekstvindu før det genererer et svar. Agenten grunner over hentet innhold som en Knowledge artikkel, en tidligere saksoppløsning, en produktspesifikasjon som om det hadde blitt gitt denne informasjonen direkte. LLM leverer årsaken, og hentelaget leverer faktaene.
En tjenesteagent som håndterer et komplekst garantikrav, trenger for eksempel ikke å ha garantibetingelser innebygd i instruksjonene sine. Når kunden beskriver problemet sitt, utfører i stedet agenten et semantisk søk eller hybrid søk (nøkkelordsøk + semantisk søk) mot en vektorindeks for garantidokumentasjonen, henter de aktuelle vilkårene og bruker dem til å bestemme berettigelse og neste trinn. Svaret er basert på det gjeldende, autoritative policydokumentet, ikke modellens opplæringsdata.
Problem
En agent må svare på et spørsmål eller ta en beslutning som avhenger av proprietær organisasjons Knowledge som policyer, kontrakter, produktdokumentasjon eller historiske saksdata som ikke var en del av LLMs opplæringsdata. Hvordan henter agenten det mest relevante innholdet på grunnleggingstidspunktet, sikrer at det hentede innholdet er oppdatert og autorisert, og setter det inn i kontekst med tilstrekkelig presisjon for å unngå støy?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål
- Er Knowledge statisk og oppdateres sjelden (for eksempel produkthåndbøker), eller endres det kontinuerlig (for eksempel saksløsninger, lagerbeholdningsbeskrivelser)? Oppdateringsfrekvensen bestemmer inntaksutformingen under behandling.
- Hvor stort er innholdet? En liten Knowledge kan hentes uttømmende. En stor krever fordeling, innbygging og semantisk indeksering for å returnere bare de mest relevante avsnittene.
- Har spørringen nytte av en enkelt fokusert henting, eller vil kombinasjon av resultater fra flere Knowledge (for eksempel dokumentasjon og tidligere saker samtidig) gi et bedre basert svar? Den sistnevnte krever samlet henting.
- Er det behov for å filtrere hentet innhold etter metadata før semantisk rangering, for eksempel å begrense resultater til dokumenter som er relevante for kundens produktnivå eller geografi?
- Hvor sensitivt er Knowledge? Hentet innhold injiseres i LLM-kontekstvinduet og påvirker agentens svar. Innhold som ikke skal vises til bestemte brukere, må styres på hentingssjiktet, ikke antas å bli filtrert av LLM.
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Hentningsforbedret generering (RAG) med Data 360 | Best for brukstilfeller i virksomheten | Agenten utfører et semantisk søk mot Data 360-vektorindekser før en respons genereres. Det hentede innholdet, som Knowledge, tidligere saker og produktdokumentasjon, settes inn i LLM-konteksten som grunnlag. Dette kan kalles opp med Retriever-handlinger, Flyt eller tilpasset Apex. Vær oppmerksom på at Data 360 støtter en integrert pipeline fra råt innhold til agentklar kontekst, ikke bare en vektorbutikk:
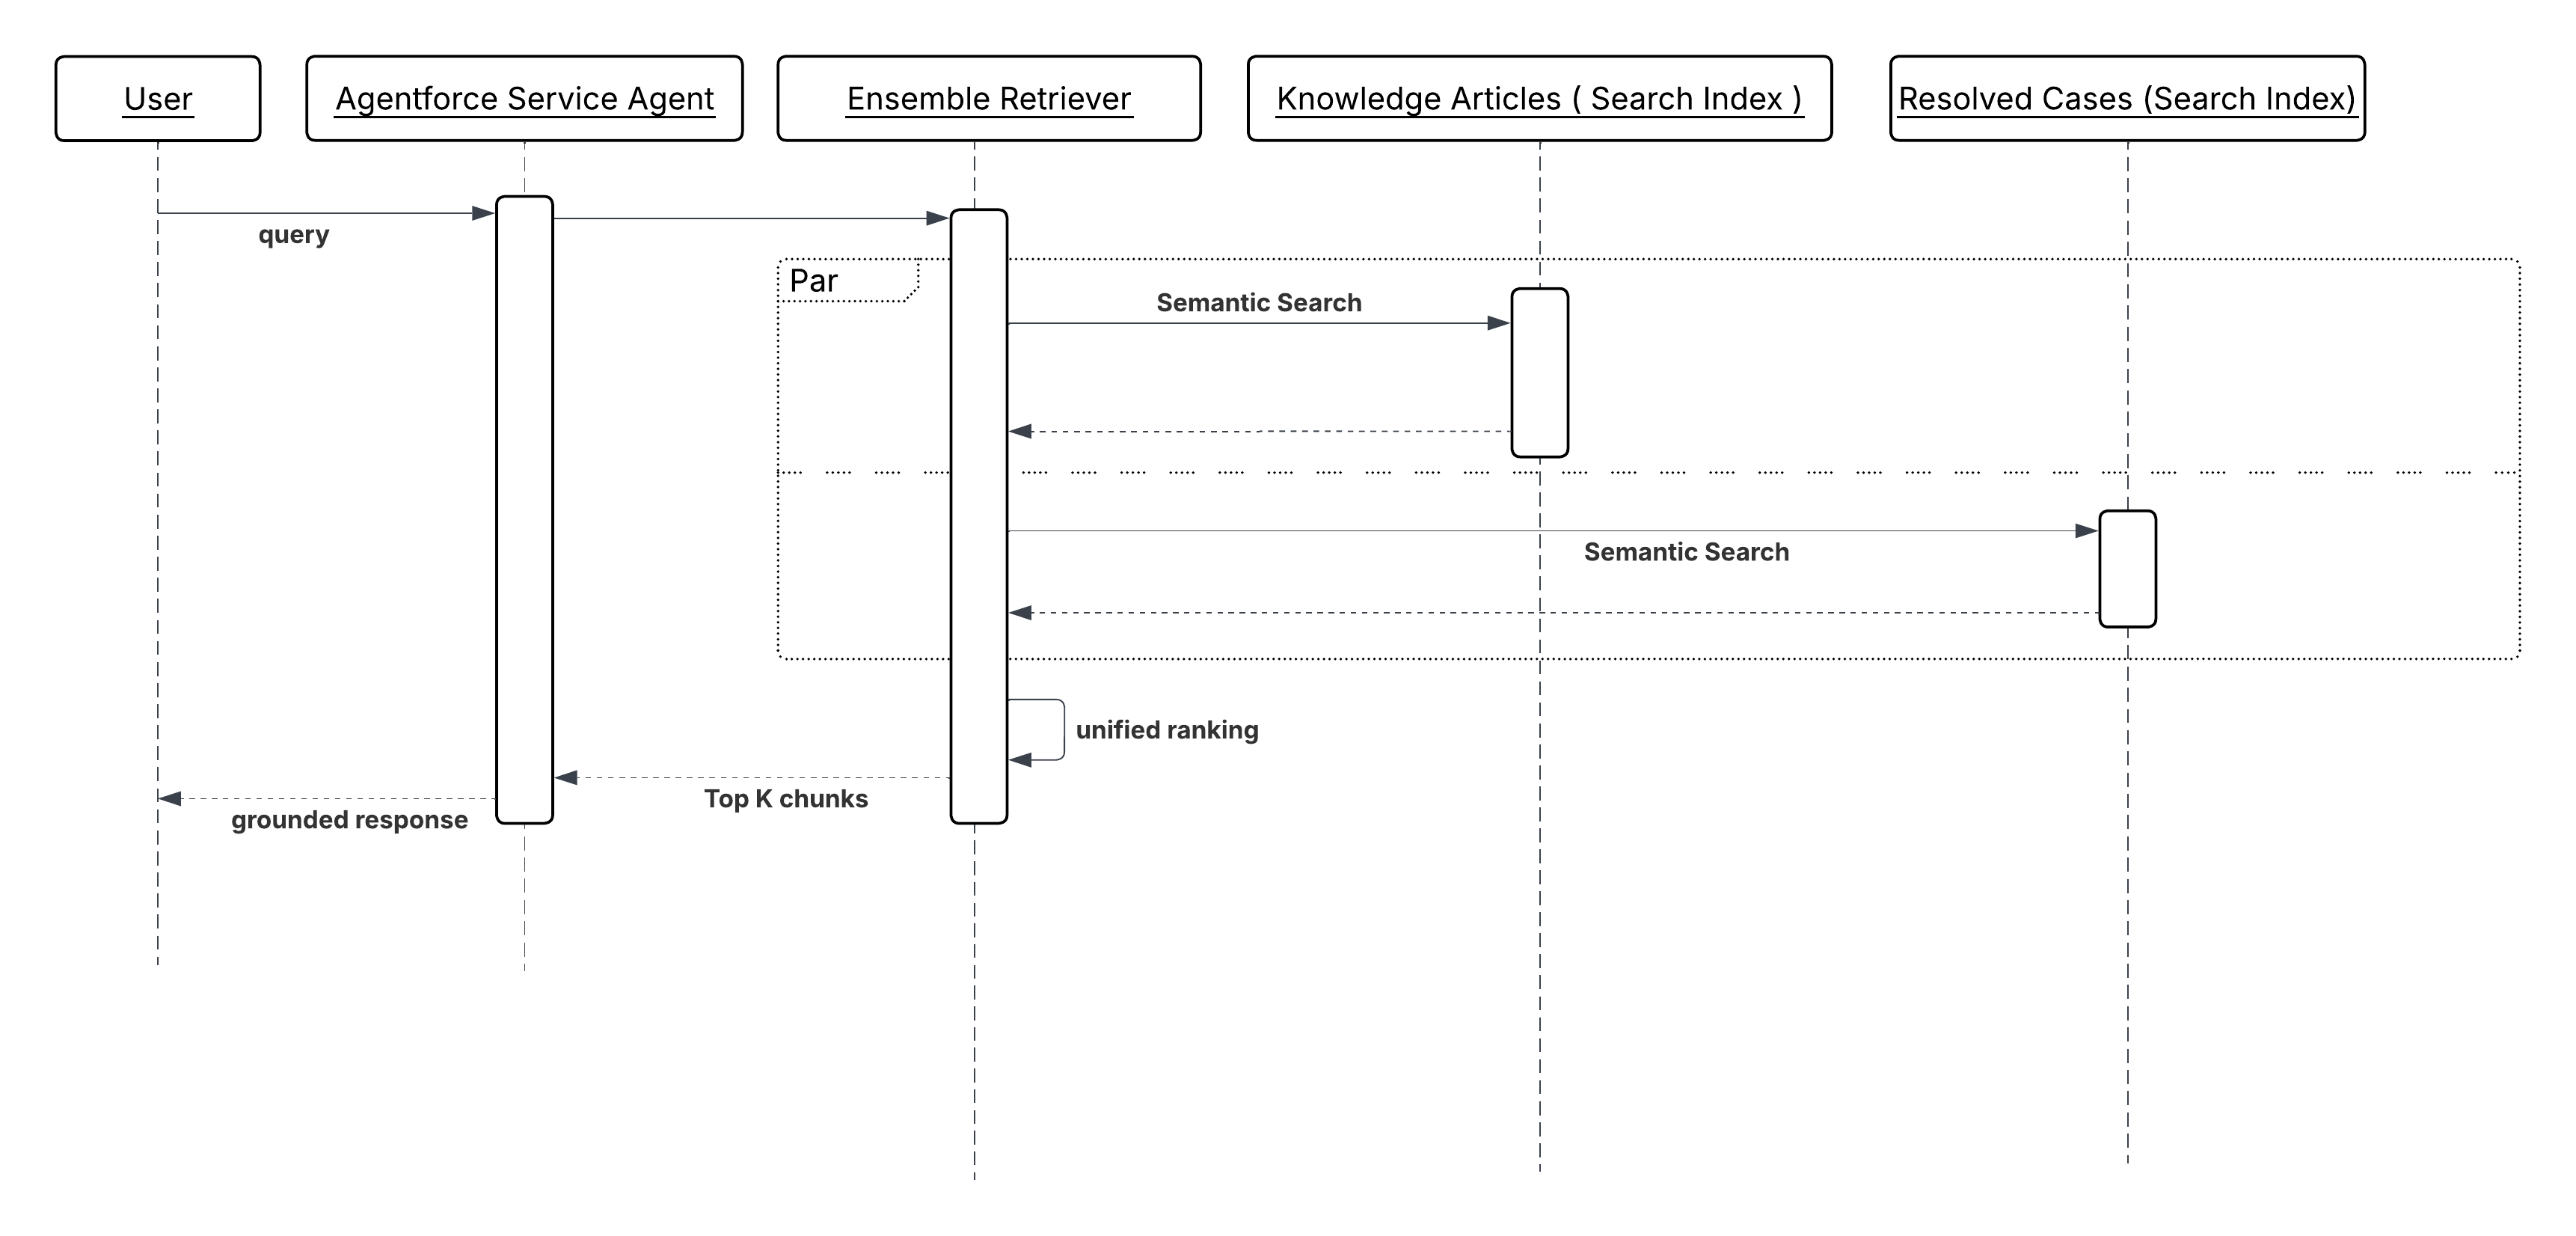
Alle disse funksjonene tilbys på begge nøkkelmodusene med full konfigurerbarhet. Vi har to typer hentere for Data360: Individual Retriever: En konfigurert Salesforce Retriever-handling utfører et semantisk søk mot en enkelt definert søkeindeks og returnerer de mest relevante innholdsbunkene. Resultater injiseres direkte i LLM-meldingen som jordingskontekst. Bruk Individual Retriever-handling når spørringen best betjenes av en enkelt fokusert Knowledge. Ensemble Retriever: En Ensemble Retriever-handling kombinerer resultatene fra flere individuelle henter, for eksempel en produktdokumentasjonsindeks og en indeks for løste saker. Ensembletrenser kombinerer ikke relevansscorer fra individuelle retriever siden disse scorene ikke kan sammenlignes på tvers av heterogene indekser. I stedet blir alle hentede biter sendt gjennom en omrangeringsmodell på tvers av kodere som uavhengig scorer hvert par (spørring, biter) og produserer en forent rangering. Dette er arkitektonisk viktig: det betyr at kvaliteten på rangeringen på tvers av kilder forbedres med den nye rangeringsmodellen, ikke med manuell scorekalibrering. Når du har rangeret dem på nytt, blir det forente resultatet tilgjengelig for LLM-ledetekster som jordingskontekst. Bruk Ensemble Retriever-handling når et mer fullstendig svar krever bevis fra flere enn ett Knowledge. |
| RAG med tredjeparts vektordatabaser | Egnet når du arbeider innenfor eksisterende infrastrukturbegrensninger | Denne tilnærmingen integrerer tredjeparts vektorbutikker som kanskje allerede finnes i infrastrukturen, for å indeksere proprietære datainnbygginger, og benytter dem til sanntidssemantikksøk og innholdsinnhenting. Dette kan implementeres med Flyt eller tilpasset Apex. |
Skiss
Sekvensdiagram for Knowledge Grounding fra Enterprise Content
Resultater
Agentenes svar er forankret i organisasjonens nåværende, autoritative Knowledge i stedet for LLMs opplæringsdata. Risikoen for hallusinasjoner på faktiske spørsmål som poliseperioder, produktspesifikasjoner og berettigelsesdetaljer reduseres fordi modellen tenker over hentet bevis, ikke genererer fra minnet.
Knowledge forblir uavhengig vedlikeholdsbart. Oppdatering av et policydokument eller å legge til en ny saksløsning i indeksen trer i kraft umiddelbart for alle etterfølgende agentinteraksjoner, uten å lære opp eller distribuere modellen på nytt.
Henting gir også et implisitt revisjonsspor. I og med at agentens svar utledes fra bestemte hentede dokumenter, kan kildeinnholdet logges sammen med svaret slik at det blir mulig å spore hvorfor agenten ga et bestemt svar.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Del inn og bygg inn Knowledge med riktig detaljnivå. Biter som er for store, har for stor relevans. Biter som er for små, mister den omgivende konteksten som LLM må begrunnes riktig. For de fleste firmadokumenttyper gir avsnittsnivådeling med overlappende kontekstvinduer den beste hentingskvaliteten.
- Behandle henting presisjon som en førsteklasses designproblem. Å sette inn innhold med liten relevans i agentens kontekstvindu er ikke nøytralt. Det introduserer støy som reduserer svarkvaliteten. Juster henteterskler og top-k-grenser for å balansere tilbakekalling mot presisjon for hvert Knowledge.
- Inntakslatens er en operasjonell tjenestenivåavtale. Hvis et policydokument oppdateres, men vektorindeksen ikke har blitt oppdatert, henter agenten og handler på foreldet informasjon. Definer akseptabel foreldethetstoleranse for hver type innhold, og utform inntakslinjer i henhold til dette.
Implementeringsmerknader fra Salesforce
- Fyll ut Data 360-vektorindekser via den riktige inntakslinjen for innholdsoppdateringsfrekvensen. Bruk batchinntak for statiske dokumenter og strømming eller CDC (Change datafangst) for poster som endres kontinuerlig.
- For Ensemble Retrievers konfigurerer du relevansrangeringsvektene per kilde. En indeks for løste saker kan kreve et systematisk system for nylig bruk, men en policydokumentasjonsindeks trenger kanskje ikke det. Juster vekter basert på spørringstypene som agenten forventes å håndtere.
- Bruk metadatafiltre i tilpassede Apex eller flythenter til å finne omfang før semantisk søk utføres. Filtrering etter produktlinje, område eller dokumenttype før rangering reduserer støy og forbedrer presisjonen av det som settes inn i kontekst.
- Ikke sett inn det fullstendige hentede dokumentet i LLM-konteksten. Overfør bare de relevante bitene eller uddragene. Store kontekstinntak forbruker tokenbudsjett, øker latens og reduserer andelen av kontekstvinduet som er tilgjengelig for agentens resonnement.
Feilhåndtering og gjenoppretting
- Hvis henting ikke returnerer noen resultater, returnerer du en eksplisitt "ingen resultater funnet"-status i stedet for å fortsette uten grunnlag. Agenten kan deretter utvide spørringen, be brukeren om klargjøring eller eskalere til et menneske.
- Hver returnerte bit fra retrieverne inneholder en relevansscore. Avhengig av bruksområdet skal det konfigureres en bestemt terskelverdi for konfidens/relevans over hvilken agenten skal behandle henting som konfidens, ellers bør det falle tilbake til klargjøring eller eskalering.
- Hvis vektorindeksen eller hentingstjenesten midlertidig ikke er tilgjengelig, bør hentingshandlingen eller Apex returnere en strukturert feil med en beskrivende årsak. Logg feilen med økt-IDen og spørringen slik at hentingshull kan identifiseres og indeksen eller tjenesten kan overvåkes for tilgjengelighet.
- For tidssensitive Knowledge implementerer du en ferskhetskontroll som en del av hentingssvaret. Hvis det siste samsvarsdokumentet sist ble oppdatert ut over en definert foreldelsesterskel, flagger du dette til agenten slik at den kan kvalifisere svaret eller meldingen for bekreftelse.
Sikkerhetshensyn
- Hentingen må respektere datatilgangstillatelsene til brukeren som agenten handler på vegne av. En agentøkt som kjører i forbindelse med en kunderettet interaksjon, må ikke hente interne driftsdokumenter, notater om prisstrategier eller poster som sluttbrukeren ellers ikke ville hatt tilgang til. Bruk feltnivåsikkerhet og postnivåsikkerhet på hentelaget. Ikke bruk LLM til å holde tilbake sensitivt hentet innhold.
- Hentet innhold settes inn i LLM-kontekstvinduet og kan påvirke eller vises i agentens svar. Behandle hvert dokument i innholdet for henting som potensielt synlig for sluttbrukeren, og styr innholdsmedlemskap i henhold til dette.
- Logg alle hentingspørringer og dokumentidentifikatorene for hentede biter sammen med økt-ID-en. Dette revisjonssporet aktiverer rekonstruksjon av bevisene agenten brukte ved svar, noe som kan være nødvendig for samsvars-, tvisteløsnings- eller forklarbarhetsforpliktelser.
Eksempel
En finansiell servicerepresentant håndterer en kundespørring om sanktioner for tidlig innløsning på et midlertidig sparingsprodukt:
- Kunden spør: "Hvilket straff vil jeg få hvis jeg trekker ut midlene mine seks måneder tidligere?"
- Agenten kaller opp en Enkeltperson-senderhandling konfigurert mot en vektorindeks av produktvilkår og betingelsesdokumenter.
- Henteren utfører et semantisk søk ved bruk av spørringskonteksten, som produkttype og kundekonto, og det spesifikke spørsmålet, og returnerer de tre mest relevante dokumentbitene - tidlig innløsningssetningen, straffeberegningstabellen og unntakene som gjelder for vanskelighetsfall.
- De hentede bitene settes inn i agentens kontekstvindu ved siden av kundens spørsmål.
- Agentårsakene over de hentede vilkårene, identifiserer den aktuelle straffesatsen for kundens produktnivå og innløpstidslinje, og returnerer et presist, policybasert svar med angivelse av gyldighetsdatoen for vilkårene den brukte.
- Dokumentidentifikatorene for de hentede bitene logges med øktposten for revisjon.
Kontekst
LLM-er er sannsynlighetsmessige av natur. Når de blir bedt om å begrunde en bestemt kunde, utleder, beregner eller hallusinerer de fakta de ikke ble gitt eksplisitt. En agent som kaller opp en prishandling uten å vite at kunden er en firmakonto med høy verdi på et foretrukket nivå, kan bruke feil rabattlogikk. En agent som eskalerer en kundestøttesak uten å vite kundens risiko for utfall, kan redusere prioriteten til en konto som er dager unna.
Bekreftet kundekontekstinntak løser dette ved å forhåndsutfylle handlingsinndataparametere med bekreftede, strukturerte attributter fra den forente profilen før agenten kaller opp en handling. Agenten utleder ikke kundens segment, levetidsverdi eller kundetilfredshetstrend (CSAT). Den mottar disse faktaene som jordingsinndata og årsaker over dem. Dette mønsteret reduserer hallusinasjonsrisikoen for kundespesifikke beslutninger og eliminerer overflødige oppslagskall i løpet av vurderingssyklusen.
Før en prisagent for eksempel kaller opp en GenerateQuote-handling, injiserer underagentkonfigurasjonen automatisk kundens segment, nivå og levetidsverdi fra sin forente profil. Handlingen mottar bekreftede fakta i stedet for LLM-utledede tilnærminger, og tilbudet forankres til kundens faktiske forretningsrelasjon.
Dette er ikke et alternativ til "Knowledge Grounding fra Enterprise Content"-mønsteret. En godt utformet agent kan bruke begge: Knowledge Grounding fra Enterprise Content gir dokumentbasert Knowledge, mens Verified Customer Context Injection etablerer kundeidentitet.
Problem
Hvordan kan du forsikre deg om at en agent har nøyaktige, kundespesifikke fakta som segment, nivå, levetidsverdi, frafallsrisiko eller andre profilattributter før den utfører en handling, i stedet for å gjette disse faktaene alene?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Hvilke handlingsinndataparametere representerer kundespesifikke fakta som, hvis de utledes i stedet for kildes, vil gi feil eller inkonsekvente utfall?
- Er de nødvendige profilattributtene tilgjengelige som standard Data 360-forente profilfelt, eller krever de beregnet innsikt utledet fra rådata om virkemåte og transaksjonsdata?
- Hvor ofte endres de relevante profilattributtene? Attributter som frafallsrisiko eller kundetilfredshetstrend krever en nyhetsgaranti. Foreldede profildata fører til de samme feilaktige utfallene som hallusinerte data.
- Skal profilattributter legges inn på opprettelsestidspunktet for økten (konstant for øktens varighet) eller hentes på nytt på det tidspunktet handlingen kalles opp (for å gjenspeile statusendringer midt i økten)?
- Trenger agenten å tenke over profilattributtene direkte, eller forbrukes de bare av handlingen og er ugjennomsiktige for agentens resonanssløyfe?
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Underagentkonfigurasjon - attributttilordning for profiler | Best for statisk tilordning på øktnivå | Best egnet når profilattributtene er stabile i en enkelt interaksjon. Tilordne Data 360 forente profilattributter (for eksempel "customerSegment", "tier", "lifetimeValue") direkte til handlingsinndataparametere i Agentforce underagentkonfigurasjonen. Attributter løses ved opprettelse av økten og holdes konstant i øktens varighet. |
| Data 360 tilkoblede flyter | Best for dynamisk eller mellomøktoppdatering | Brukes når profilattributter endres ofte eller når handlingen krever den siste statusen. Bruk en Data 360-tilkoblet flyt som et handlingstrinn for å vise den siste profilstatusen på oppkallspunktet.Flyten spør den forente profilen, bruker eventuell nødvendig transformasjon og returnerer attributtene som utdatavariabler som forbrukes av neste handling i kjeden. |
| Beregnede innsikter som handlingsinndata | Optimalt for komplekse utledede målinger | Brukes når agenter trenger å tenke over beregnede forretningsmålinger (risikoscore for frafall, kundetilfredshetstrender, produkttilpassingsindeks) i stedet for å tolke rådata. Definert i Data 360 som utledede målinger beregnet på atferds-, transaksjons- og engasjementsdata. Beregnede innsikter vises som profilattributter som kan spørres, og kan tilordnes til handlingsinndata via emnekonfigurasjon eller en tilkoblet flyt. |
Skiss
Sekvensdiagram for verifisert kundekontekstinnsetting
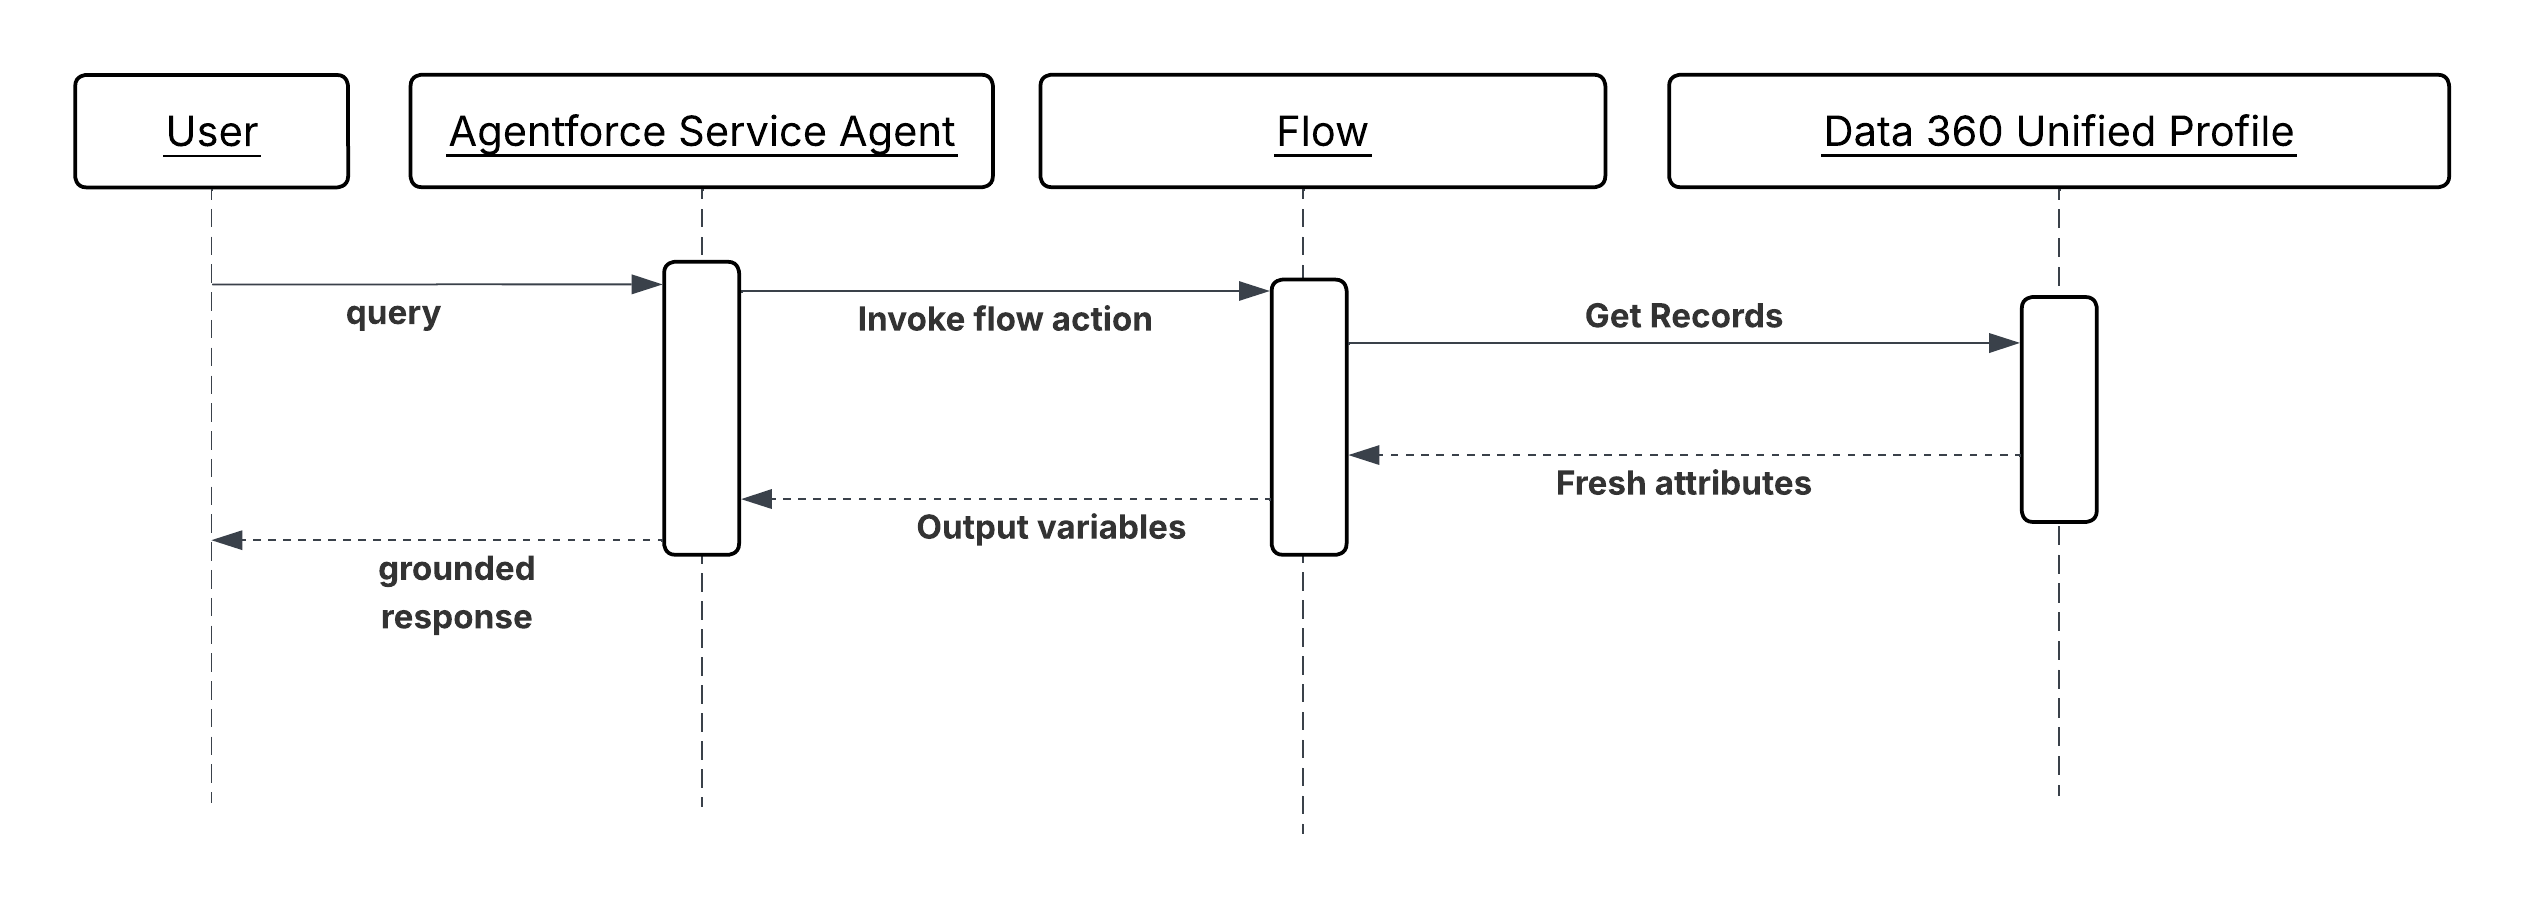
Resultater
Handlinger mottar bekreftede, strukturerte kundefakta i stedet for LLM-utledede anledninger. Agentenes resonans er forankret i kundens faktiske profiltilstand, noe som reduserer hallusinasjonsrisikoen for beslutninger der faktisk nøyaktighet bestemmer utfallskvaliteten, som priser, berettigelseskontroller, eskaleringsruting og tilbakeholdstilbud.
Profiltilordning reduserer også begrunnelseslatens. Når agenten ikke trenger å utstede oppkall for å etablere grunnleggende kundekontekst, blir vurderingssyklusen kortere, og samtidighet forbrukes for færre omgange.
Den forente Data 360-profilen forblir den autoritative kilden til kundefakta. Underagentkonfigurasjonen eller den tilkoblede flyten er integrasjonssømmen. Agenten er ansvarlig for å begrunde disse faktaene og velge handlinger, ikke for å hente ut selve faktaene.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Identifiser alle handlingsinndata som bærer hallusinasjonsrisiko – der LLM-utledning kan gi et feil utfall i stedet for en bekreftet verdi. Inndata med hallusinasjonsrisiko er kandidater for profilplassering. Ikke alle inndata krever jording. Overinnsetting av profildata legger til støy i agentens kontekstvindu.
- Behandle profiloppdatering som en designbeslutning, ikke en ettertanke. Definer den akseptable foreldethetstoleransen for hvert landede attributt, og velg injeksjonsmekanismen i henhold til dette: tilordning på øktnivå for stabile attributter, flytbasert oppdatering for flytende attributter
- Beregnede innsikter skal kode forretningslogikk, ikke rådata. En agentransaksjon over en "churnRiskScore" på 0,87 er mer effektiv enn en agentransaksjon over 14 rå atferdsignaler. Beregn tolkningen i Data 360. Overfør resultatet til agenten.
Implementeringsmerknader fra Salesforce
- Profiltilordning er bare så pålitelig som foreningen bak den. Verdien av den forente profilen er for eksempel helt avhengig av kvaliteten på identitetsløsningen oppstrøms. Hvis en kunde har fragmenterte identiteter på tvers av kildesystemer som ikke har blitt forent, vil profilattributtene som agenten mottar, være ufullstendige eller representere bare en delvis visning (for eksempel Levetidsverdi beregnet med data fra én kanal, men ikke en annen).
- For Data 360-tilkoblede flyter bruker du Hent poster-elementet med et filter på gjeldende økts recordId eller accountId for å hente bare den relevante profilposten. Returner bare attributtene som kreves av nedstrømshandlingen. Ikke returner hele profilobjektet.
- Beregnede innsikter må holdes oppdatert via Data 360-inntak under behandling. Konfigurer strømming eller oppdatering i nær sanntid for innsikt som brukes i tidssensitive beslutninger (for eksempel frafallsrisiko i en oppbevaringsarbeidsflyt). Batchoppdaterte innsikter godtas for attributter som beveger seg tregere (for eksempel årlig kontraktsverdisjikt).
- Kontroller at tilordnede profilattributter ikke er tomme verdier før handlingen kalles opp. En null "customerTier" overført til en prishandling er like skadelig som en hallusinert verdi. Bruk flytbeslutningselementer til å oppdage manglende profildata og rute til en reserveserver som henter en standard eller ber om klargjøring.
- I underagentkonfigurasjonen tilordner du profilattributter til handlingsinndataparametere ved å bruke beskrivende, semantisk tydelige variabelnavn (for eksempel "customerTier", "lifetimeValueUSD", "churnRiskScore"). LLM leser disse navnene når handlinger velges og skrives ut. Tvetydige navn reduserer valgens nøyaktighet.
Feilhåndtering og gjenoppretting
- Hvis et nødvendig profilattributt er null eller utilgjengelig på tidspunktet handlingen kalles opp, bør ikke agenten fortsette med en potensielt feil standardinnstilling. Handlingen skal returnere en strukturert feil som angir attributtet som mangler, og agenten skal enten be brukeren om å få klargjøring eller eskalere til en person hvis den opererer uten samtaler.
- Hvis en Data 360-tilkoblet flyt mislykkes i å hente profildata (for eksempel på grunn av et Data 360-tjenesteavbrudd), bør flytens feilbane returnere en strukturert feil til agenten med den spesifikke årsaken til feilen. Agenten kan deretter bestemme om brukeren skal prøve på nytt, fortsette med en degradert opplevelse eller vise feil.
- Logg alle profilattributtverdier som legges inn ved opprettelse av en økt eller ved oppkall av en handling, sammen med økt-ID-en. Dette sikrer at eventuelle angripne agentbeslutninger kan rekonstrueres med nøyaktige kundefakta som agenten fikk på det tidspunktet.
Sikkerhetshensyn
- Profilattributter som legges inn i agentkontekst, er underlagt de samme datatilgangskontrollene som alle CRM-poster. Forsikre deg om at integrasjonsbrukeren eller den tilkoblede appen som brukes til å løse profilattributter, bare har tillatelsene på feltnivå som kreves for attributtene som vises, og ikke bredere profilleseilgang.
- Beregnede innsikter som koder sensitive utledede målinger (for eksempel forutsagt tilstandsscore, finansiell risiko) skal behandles som sensitive felt og styres av de samme tilgangskontrollene som de underliggende dataene. Å vise en høy frafallsrisiko til en agent som opererer i en kunderettet kontekst, krever nøye vurdering av hva agenten kan kommunisere.
- Ikke vis profilattributter som ikke kreves av handlingen. Hvert ekstra attributt i agentens kontekstvindu er et ekstra dataelement som kan gjengis i agentens svar. Bruk et minimumsnødvendig prinsipp på profilering av jording.
- Revider alle økter der Beregnet innsikt eller sensitive profilattributter ble satt inn som inndata. Disse sesjonene representerer beslutninger som tas på grunnlag av utledet Kundeintelligens, og kan være underlagt forklarbarhetskrav eller regulatoriske krav i enkelte bransjer.
Eksempel
Et telekommunikasjonsselskap bruker Agentforce til å håndtere oppbevaringssamtaler med kunder som har startet en kanselleringsforespørsel.
- Når en kanselleringssak åpnes, opprettes agentøkten med kundens accountId som kontekst.
- Underagentkonfigurasjonen tilordner tre Data 360 Unified Profile-attributter til øktvariabler på opprettelsestidspunktet: "customerTier" (Enterprise), "lifetimeValueUSD" (42 000) og "contractRenewalDate" (60 dager).
- En Beregnet innsikt som "churnRiskScore" (0,91, beregnet fra bruksnedgang, støttebillettfrekvens og NPS-trend) tilordnes som en ekstra øktvariabel via en tilkoblet Data 360-flyt som kalles opp som det første handlingstrinnet.
- Agenten, som nå er basert på bekreftede kundefakta, kaller opp handlingen SelectRetentionOffer. Fordi inndataene inkluderer "customerTier = Enterprise", "lifetimeValueUSD = 42000" og "churnRiskScore = 0,91", returnerer handlingen tilbudet om oppbevaring med maksimalt nivå i stedet for et standardtilbud.
- Agenten kaller opp "PresentOffer" for å levere tilbudet i samtalen, og "LogRetentionAttempt" for å registrere interaksjonen i CRM med alle landede attributter beholdt for revisjonsmuligheter.
Kontekst
Virksomhetens data er fragmentert. En agent som bare kan handle på det som befinner seg innenfor Salesforce-plattformen, er begrenset til en del av informasjonen den trenger for å tenke effektivt. Svar på et tjenestespørsmål kan kreve å lese en kundes åpne billett i Service Cloud. Klargjøring av et forslag kan kreve å hente en fil fra Google Disk. Analysering av produktbruk kan kreve spørring i en datalagring. Hvert av disse systemene har sine egne API-er, sin egen godkjenningsmodell og sitt eget dataskjema, og kostnaden for å skrive tilpasset integreringskode for hvert av dem er det som historisk har gjort agent-til-system-tilkobling dyr og sårbar.
MCP er en åpen standard som håndterer dette direkte. Den definerer et ensartet grensesnitt der en agent kan oppdage og kalle opp verktøy som vises av en hvilken som helst MCP-kompatibel server, uavhengig av det underliggende systemet. Hver MCP-server fungerer som en adapter: den pakker inn et målsystems innebygde grensesnitt i et standardisert, verktøysentrisk grensesnitt som agenten kan spørre, kalle opp og komponere uten å vite noe om systemets spesifikke protokoller eller skjemaer.
Fra agentens perspektiv ser tilkobling til Slack, en SQL-database (Structured Query Language) og et dokumentbehandlingssystem identisk ut, tre MCP-servere, som hver viser et sett av beskrevne, kallbare verktøy. Agenten velger og sekvenserer dem basert på deres semantiske beskrivelser og målet den prøver å oppnå.
Problem
Når en agent trenger å hente informasjon eller utløse handlinger på tvers av flere eksterne systemer, hver med forskjellige API-er, godkjenning og skjemaer, hvordan kan den oppdage, kalle opp og komponere sine egenskaper uten skreddersydd integreringskode per system eller tett kobling til systemets implementering?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Trenger agenten å nå systemer utenfor Salesforce-plattformen, som dokumentbutikker, samarbeidsverktøy, databaser, tredjeparts SaaS, der API-er ikke er innebygd representert som Agentforce?
- Er det nødvendig med oppdagelse av dynamiske verktøy, der agenten identifiserer det riktige integrasjonsendepunktet på grunnlag av den gjeldende forespørselen, i stedet for å ha integrasjoner hardkodet i konfigurasjonen?
- Endres integrasjonslandskapet ofte, kan nye systemer legges til, eksisterende oppdateres og andre endringer kreves slik at en skreddersydd tilnærming for hvert system vil skape ikke-vedlikeholdskostnader?
- Er det behov for å koble agentens resonanslag fra implementeringsdetaljene for nedstrømsystemer, slik at en endring i et målsystems API ikke krever endringer i agentens instruksjoner eller underagentkonfigurasjon?
- Gjør målsystemene som eies av forskjellige team eller leverandører, som hver er ansvarlig for å vise sine egne egenskaper, en MCP Server-modell på leverandørsiden mer praktisk enn en integrasjon på forbrukersiden per agent?
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Salesforce MCP-servere | Best for Salesforce-økosystemmål | Brukes når målsystemet er innenfor Salesforce-økosystemet og en førsteparts MCP-server er tilgjengelig. Salesforce Headless 360 tilbyr MCP-servere for sin egen plattformfunksjonalitet, som viser CRM-data, flyter og plattformhandlinger som MCP-kompatible verktøy. Reduserer implementeringsinnsatsen til konfigurasjon i stedet for utvikling. Notat: For øyeblikket støtter Salesforce MCP-servere bare sluttbrukerlegitimasjon for godkjenning og godkjenning. |
| Tilpassede MuleSoft MCP-servere | Best når det ikke finnes noen førsteparts MCP-server | Brukes for eldre systemer, proprietære interne programmer eller tredjeparts SaaS-plattformer som er før MCP-standarden. Når et målsystem ikke har sin egen MCP-server, kan et MuleSoft-integreringslag pakkes inn i en tilpasset MCP-server som viser systemets funksjonalitet som verktøy. Den kan også brukes med Salesforce API-er hvis det kreves MCP-er for at agenter skal forbrukes bare med systembrukerlegitimasjon. MuleSoft håndterer protokolloversettelse, godkjenning og datatransformasjon. MCP-laget gjør resultatet oppdagbart for agenter. |
| Tredjeparts MCP-servere | Best for varer med aktive MCP-økosystemer | Det finnes en leverandørvedlikeholdt MCP-server for plattformen (GitHub, Google Workspace) og oppfyller sikkerhets- og vedlikeholdskravene. Et økende antall bedriftsplattformer som GitHub, Google Workspace og andre publiserer sine egne MCP-servere. Når det finnes en produksjonsklar, leverandørvedlikeholdt server, foretrekker du den fremfor å bygge en tilpasset. Evaluer sikkerhetstilstanden og vedlikeholdsforpliktelsen før du tar i bruk. |
Skiss
Sekvensdiagram for verifisert kundekontekstinnsetting
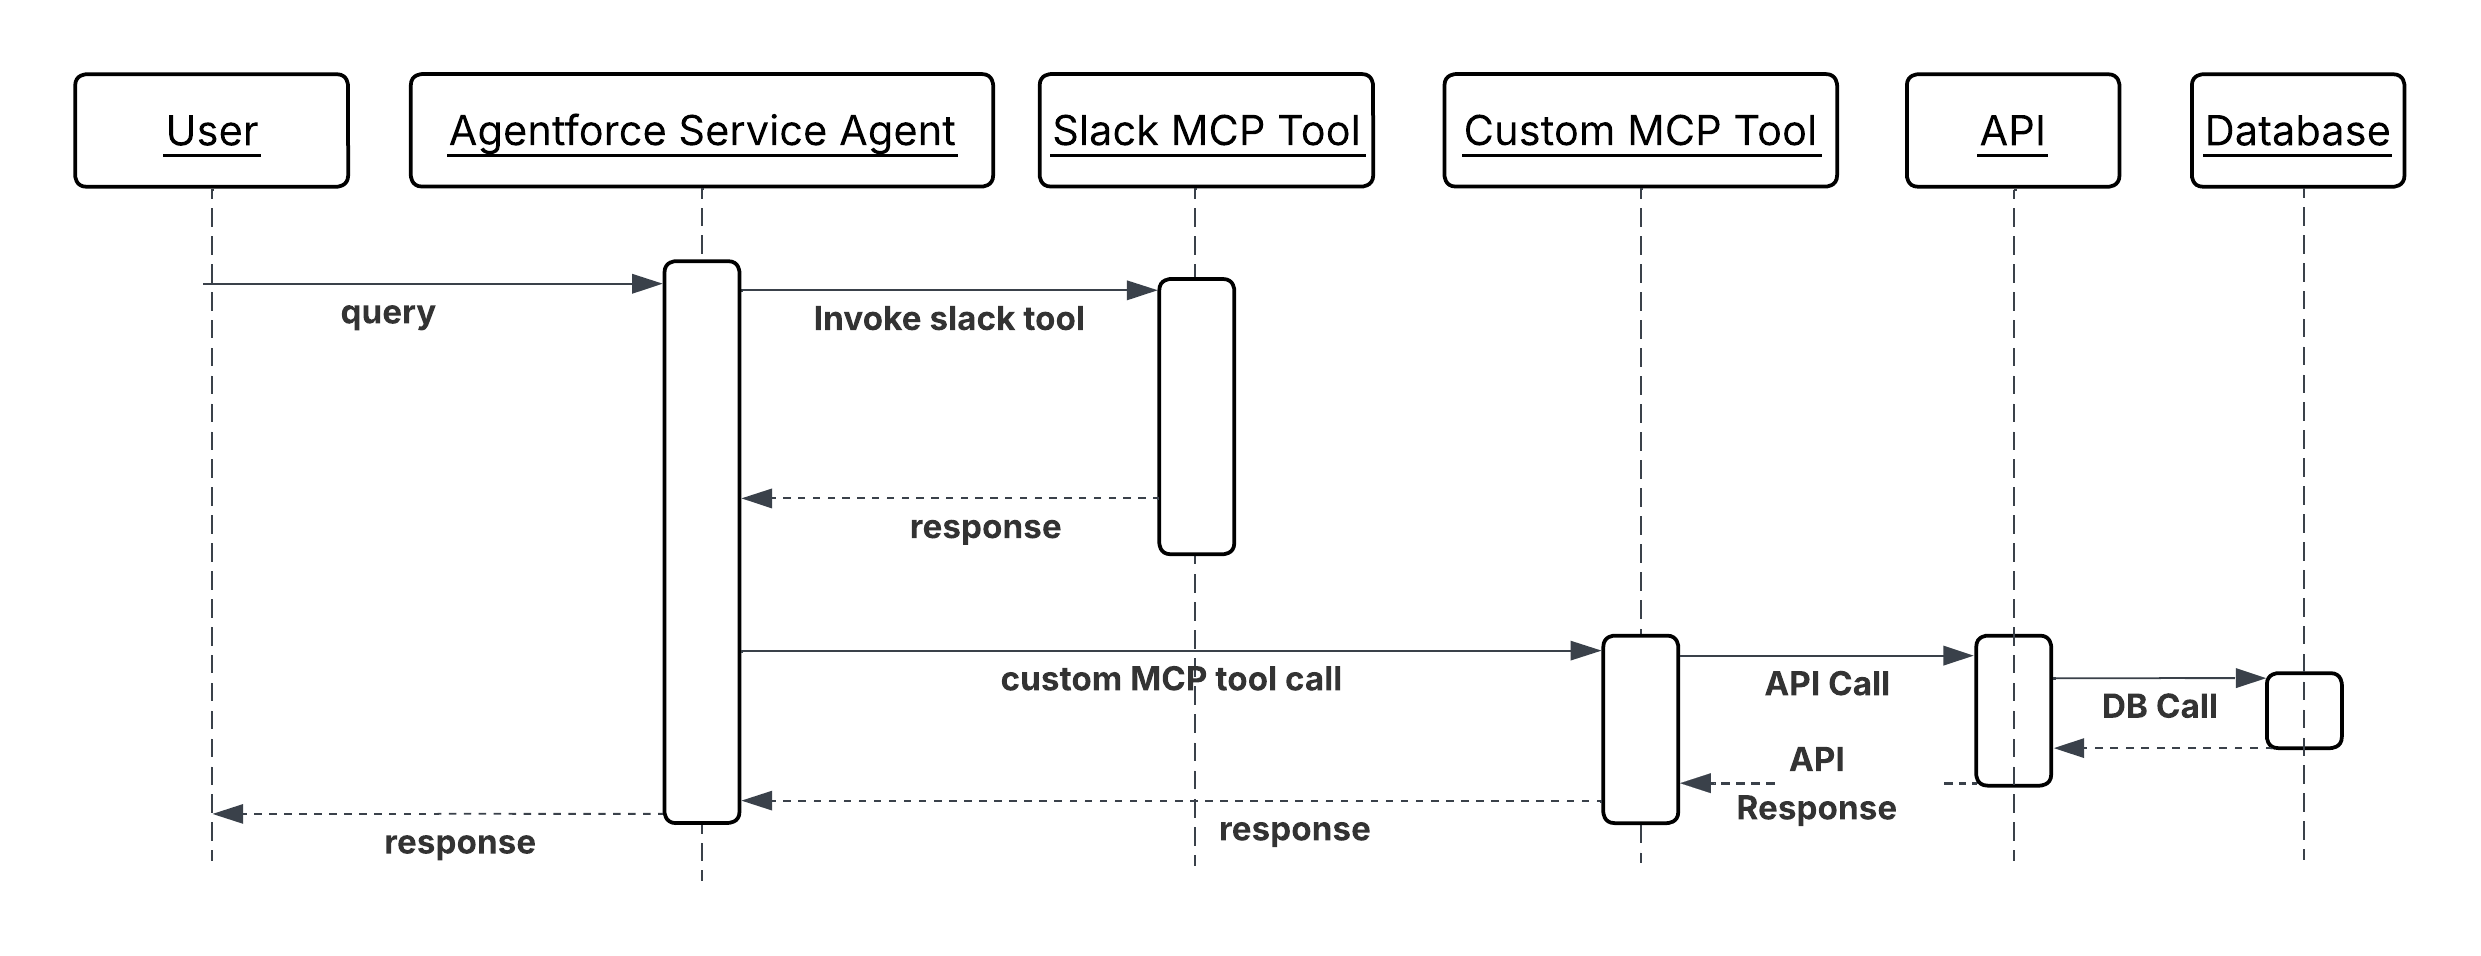
Resultater
Agentens tilgjengelige areal utvides uten å øke integrasjonskompleksiteten. Å legge til et nytt eksternt system betyr å distribuere eller konfigurere en MCP-server for det, og ikke å skrive tilpassede Apex eller flytintegrasjoner per agent. Agentens begrunnelseslag forblir uendret. Det oppdager og kaller opp de nye verktøyene basert bare på deres semantiske beskrivelser.
MCP-standarden oppretter også en ren adskillelse av eierskap: teamet som er ansvarlig for et system, viser dets funksjoner som en MCP-server. Agentteamet forbruker disse funksjonene uten å måtte forstå systemets interne elementer. Denne grensen reduserer koordinasjonsoverhead etter hvert som antall integrerte systemer øker.
Verktøykomponering er et direkte utfall. I og med at alle verktøy deler det samme kallgrensesnittet, kan agenten kjede verktøy fra forskjellige systemer, hente en fil fra Google Drive, trekke ut data fra den og skrive resultatet til en CRM-post på samme måte som kjedehandlinger i ett system.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Verktøybeskrivelser er agentens eneste grunnlag for å bestemme om og hvordan et verktøy skal kalles opp. Skriv beskrivelser på et tydelig, hensiktsbasert språk som angir hva verktøyet gjør, når det brukes og hva det returnerer. En beskrivelse som sier "spørrer i CRM-databasen" er mindre nyttig enn "henter kontoens åpne saker, sortert etter prioritet, for en gitt konto-ID." Dårlige beskrivelser fører til dårlig verktøyvalg.
- Omfang hvert MCP-verktøy til en enkelt, atomisk egenskap. Et verktøy som henter et dokument og også skriver et sammendrag tilbake til kildesystemet, er vanskeligere for agenten å argumentere, vanskeligere å prøve på nytt ved feil og vanskeligere å sikre enn to diskrete verktøy. Ett verktøy, ett ansvar.
- Utform verktøy slik at utdata er komponerbare inndata. Resultatet av et henteverktøy bør struktureres på en måte som tilordner seg naturlig til inndataparameterne til handlingsverktøyene som vanligvis følger det, og reduserer transformasjonsarbeidet som agenten må utføre mellom trinnene.
- Eksterne MCP-servere. Lokale binære installasjoner skaper distribusjons- og versjonskompleksitet som øker med antall agentmiljøer. En eksternt driftet server kan oppdateres uavhengig av agentene som bruker den.
Implementeringsmerknader fra Salesforce
- Hvis du ønsker konsistent MCP-godkjenning, frekvensgrense og belastningsvalideringer på tvers av alle utgående MCP-kall, bruker du AI-gateway som MuleSoft Omni Gateway som støtter MCP-servere, og konfigurerer den før du eksponerer en MCP-server for agenter.
- Bruk OAuth 2.0-legitimasjon for all legitimasjon som kreves av MCP Server-tilkoblinger. Legitimasjon må ikke vises i verktøyparametere, handlingskonfigurasjoner eller Apex.
- Enkelte MCP-verktøy kan kreve sluttbrukerlegitimasjon for å utføre noen handlinger avhengig av forretningsbruksområdet (som overføring av midler). Hvis du vil overføre identitetstokener for sluttbrukere, bruker du policyen OAuth 2.0 På vegne av legitimasjonsinnsetting som for øyeblikket støttes med MuleSoft Omni Gateway.
- For tilpassede MuleSoft MCP-servere: definere MCP-verktøyskjemaet i MuleSofts API-spesifikasjon og registrere serverens endepunkt i Agentforce verktøykatalogen. Test verktøybeskrivelser mot representative agentspørringer for å kontrollere at agenten velger riktig verktøy for den riktige oppgaven før distribusjon til produksjon.
Feilhåndtering og gjenoppretting
- Når et MCP-verktøykall returnerer en feil, inspiserer agenten den maskinlesbare feilkoden for å bestemme den riktige gjenopprettingshandlingen: be om manglende parametere fra brukeren, prøve på nytt med korrigerte inndata eller eskalere til et menneske. Den forbruker aldri feil stille eller fortsetter å tenke som om verktøykallet var vellykket.
- Agenten implementerer forsøkslogikk på nytt for midlertidige feil direkte.
- Logg alle MCP-verktøykall fra klientsiden med verktøynavnet, de saniterte inndataparameterne og utfallet. Denne sporingen på klientsiden kombinert med logger på serversiden er den primære mekanismen for å diagnostisere hvorfor en agent tok en bestemt handlingsbane når en arbeidsflyt ikke produserer det forventede resultatet.
Sikkerhetshensyn
- Alle utgående MCP-servertilkoblinger går gjennom gatewayen. Gatewayen håndhever godkjenningsbekreftelse, frekvensbegrensninger for å hindre misbruk av verktøy, og belastningsinspeksjon for å oppdage meldingsinnsettingsforsøk i verktøyparametere. Direkte, ikke-medierte tilkoblinger fra agenter til MCP-servere omgår disse kontrollene og er ikke tillatt.
- Omfang hver agents MCP-servertilkoblinger bare til serverne der denne agenten faktisk trenger verktøy. En agent som er konfigurert med tilgang til alle tilgjengelige MCP-servere, har en større angrepsflate enn en som er koblet bare til verktøyene som dens definerte oppgaver krever.
- Valider og fjern verktøyinndataparametere før du overfører dem til verktøyet, spesielt når parameterverdier utledes fra brukergitt tekst eller LLM-generert innhold. Ikke overfør ikke-validerte LLM-utdata direkte som verktøyparametere. En angriper som kan påvirke agentens resonnement, kan bruke banen til å injisere skadelige verdier i nedstrøms systemkall.
- Behandle agentens liste over tilkoblede MCP-servere og deres verktøylager som sensitiv konfigurasjon. En angriper som vet hvilke verktøy en agent har tilgjengelig og hvilke parametere de godtar, har et kart for opprettelse av innsettingsbelastninger med ledetekster utformet for å misbruke disse verktøyene.
Eksempel
En selger klargjør en omfattende kontoinformasjon før en kundesamtale med høy verdi:
- Agenten mottar forespørselen: "Forbered en briefing om Acme Corp før fornyelsesdiskusjonen i morgen."
- Agenten spør MCP-verktøykatalogen og identifiserer tre relevante verktøy på tvers av to MCP-servere:
GetRecentEmails,GetOpenOpportunitiesogGetSupportTicketSummary. - Agenten kaller opp alle de tre verktøyene parallelt. Hver MCP-server oversetter samtalen til målsystemets innebygde API, henter de relevante dataene og returnerer et strukturert resultat.
- Agenten mottar de tre resultatene. Siste e-posttråder, den åpne fornyelsesmuligheten med avtalestørrelse og -fase og et sammendrag av åpne kundestøttebilletter etter prioritet, og syntetiserer dem til en strukturert kontoinformasjon.
- Agenten kaller opp
CreateAccountNotefor å lagre briefingen i kontoposten, og returnerer et sammendrag til brukeren som ber om det. - Alle fire MCP-verktøykall logges av gatewayen med verktøynavn, serveridentiteter og utfall for øktrevisjonsposten.
Kontekst
Det utgående MCP-mønsteret beskriver en Agentforce som bruker verktøy fra eksterne MCP-servere. Det innkommende mønsteret inverterer dette. Salesforce Platform-funksjoner som CRM-poster, flyter, Apex og Data 360-innsikt vises som MCP-verktøy som eksterne agenter som kjører på et hvilket som helst LLM-rammeverk, kan oppdage og kalle opp.
Dette mønsteret er viktig fordi distribusjoner av virksomhetens AI sjelden er enkeltleverandør. En partners agent som bygger på et annet rammeverk, må kanskje slå opp på kundens kontostatus i Salesforce. Et internt datavitenskapsteam som kjører en Python-basert agent, må kanskje utløse en Salesforce-flyt for å starte en godkjenningsprosess. Uten en standardisert eksponeringsmekanisme krever hver eksterne forbruker en skreddersydd integrasjon. Eksponering av Salesforce-funksjoner som en MCP-server gir hver MCP-kompatibel agent et ensartet, oppdagbart grensesnitt til plattformens verktøy uavhengig av hvordan anroperen er bygd.
En partners anskaffelsesagent, som bygger på et tredjeparts rammeverk, må for eksempel bekrefte en leverandørs kontraktstatus i Salesforce før en kjøpsbestilling godkjennes. I stedet for å bygge en direkte REST-integrasjon kaller den opp et GetContractStatus-verktøy på Salesforce MCP Server. Verktøyet håndhever de samme tilgangskontrollene som alle innebygde Salesforce-operasjoner. Den oppringende agenten ser bare resultatet.
Problem
Når en ekstern agent som bygger på et annet rammeverk, eies av en partner eller på annen måte kjører utenfor Salesforce-plattformen, må kalle opp Salesforce-funksjoner som en del av sin egen arbeidsflyt, hvordan kan disse funksjonene eksponeres på en standardisert, oppdagbar og sikkert styrt måte som ikke krever en skreddersydd integrering per ekstern forbruker?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Bygges de eksterne agentene som trenger å bruke Salesforce-funksjonalitet, på rammeverk som støtter MCP-standarden? Hvis ikke, kan en REST API eller en webhook-tilnærming være mer hensiktsmessig enn MCP.
- Hvilke Salesforce-funksjoner må eksponeres – henting av skrivebeskyttede data, skriveoperasjoner, oppkall av flyter eller en kombinasjon? Eksponeringsomfanget bestemmer direkte sikkerhetsarealet som må styres.
- Hvordan skal identiteten til den eksterne oppringingsagenten bekreftes, og hvilke Salesforce-tillatelser skal kallene utføres under? Agent-til-plattform-kall må ikke arve bredere tillatelser enn den spesifikke operasjonen krever.
- Er Salesforce MCP Server beregnet for interne forbrukere (andre teams agenter i samme organisasjon) eller eksterne forbrukere (partner- og kunderepresentanter)? Trust og godkjenningskravene varierer betydelig mellom disse målgruppene.
- Hvordan vil settet med eksponerte verktøy utvikle seg over tid? Nye Salesforce-funksjoner som legges til i MCP-serveren, blir umiddelbart oppdagbare for alle tilkoblede agenter. Uforutsett verktøyeksponering må styres gjennom en bevisst publiseringsprosess.
Salesforce mønsterprogram
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Salesforce som MCP-server (innebygd) | Best for å vise førsteparts Salesforce-funksjonalitet | Brukes når verktøyene som skal eksponeres, tilordnes direkte til eksisterende Salesforce Platform-operasjoner og de oppringende agentene er MCP-kompatible. Med Salesforce Headless 360s innebygde MCP-serverfunksjonalitet kan plattformoperasjoner som postspørringer, flytoppkall og Apex erklæres som MCP-verktøy og eksponeres for en hvilken som helst MCP-kompatibel ekstern agent. Tilgang styres av Salesforce-tillatelsesmodellen. Vær oppmerksom på at disse Headless 360 MCP-serverne bare er tilgjengelig med sluttbrukerlegitimasjon for øyeblikket. |
| MuleSoft som MCP-serverfasade | Best når transformasjon eller flersystemaggregering kreves | Brukes når anroperen trenger en funksjon som krever data fra flere enn ett Salesforce-objekt, transformasjon før levering eller utforming med data fra andre systemer. MCP-grensesnittet forblir ryddig og enkelt. Kompleksiteten absorberes av MuleSoft. Et MuleSoft MCP-lag ligger foran Salesforce og viser det samlede resultatet av flere plattformoperasjoner som et enkelt MCP-verktøy. Denne løsningen kan også brukes av agenter der sluttbrukeridentiteten ikke kan overføres for Salesforce-godkjenning og -godkjenning. Hvis Agentforce Agenter for eksempel trenger MCP-servere med systemlegitimasjon, må vi stole på tilpassede MCP-servere som en som er bygd med og vert på MuleSoft. |
Skiss
Sekvensdiagram for forretningskapasiteter som kallbare verktøy
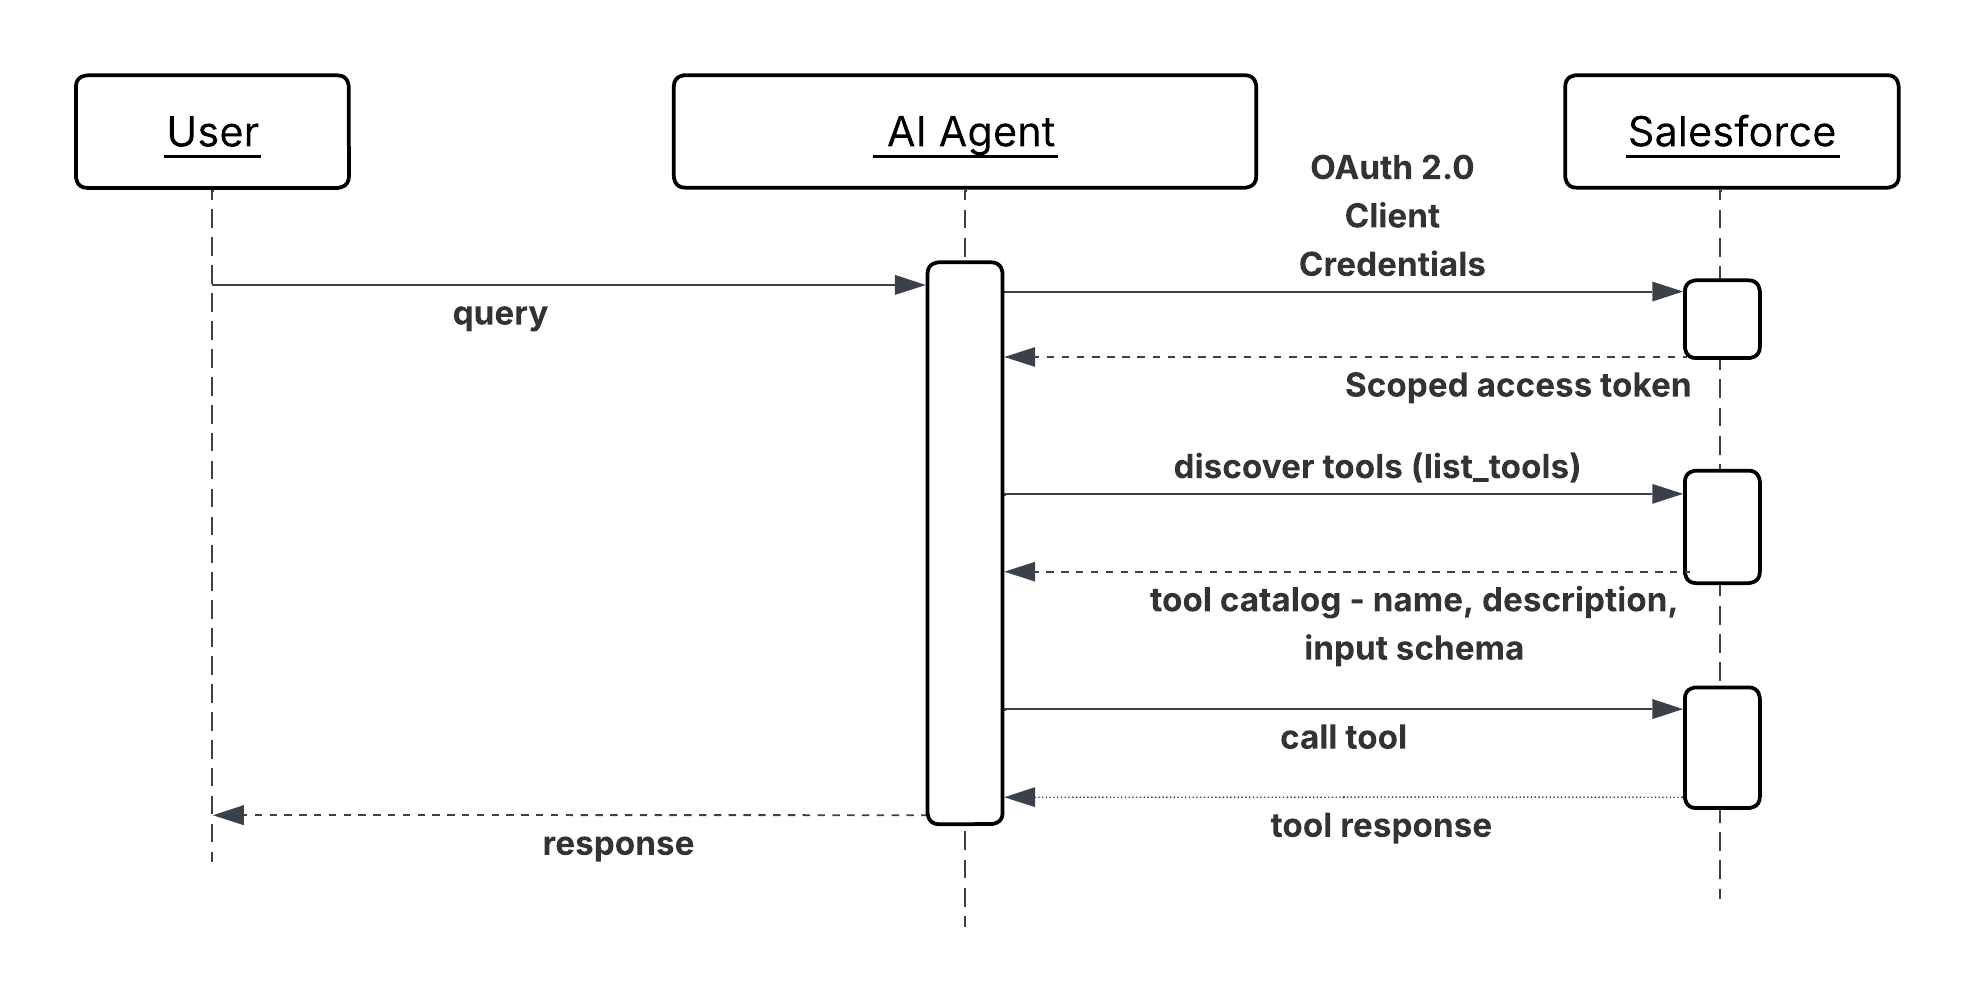
Resultater
Salesforce blir en førsteklassedeltaker i ekosystemer for flere leverandører. Eksterne agenter kan oppdage og forbruke plattformfunksjonalitet uten å kreve en tilpasset REST-integrering per forbruker eller per bruksområde. Antall forbrukere kan øke uten proporsjonal vekst i overhead for integrasjonsvedlikehold.
Med Headless 360 styrer Salesforce-tillatelsesmodellen alle oppkall av innkommende verktøy. Eksterne MCP-klienter omgår ikke eksisterende datatilgangskontroller, de opererer i seg selv. Det betyr at sikkerhetstilstanden ved eksponering av funksjoner via MCP tilsvarer eksponering via en hvilken som helst annen godkjent API-overflate.
Utforskbarhet av verktøy er en sammensatt fordel. Når nye Salesforce-funksjoner legges til i MCP Server-verktøykatalogen, blir de umiddelbart tilgjengelig for alle tilkoblede eksterne agenter uten at disse agentene må oppdatere konfigurasjonene sine.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- Publiser bare det eksterne agenter trenger. Hvert verktøy som legges til i MCP Server-katalogen, utvider angrepsoverflaten og styringsbelastningen. Revider verktøylageret med vilje. Definer hvilke funksjoner som er godkjent for ekstern forbruk, og behandle ikke-godkjent eksponering som et konfigurasjonshull, ikke som en standard.
- Skriv verktøybeskrivelser for eksterne forbrukere. En ekstern agents operator har ingen Knowledge om din interne datamodell eller navngivingskonvensjoner. Behold beskrivelser selvstendige: hva verktøyet gjør, hva hver parameter betyr, hva resultatet representerer og eventuelle begrensninger eller forutsetninger anroperen må oppfylle.
- Versjonsverktøy eksplisitt når deres inndata- eller utdataskjemaer endres. En ekstern agent som avhenger av et verktøys gjeldende skjema, brytes stille hvis skjemaet endres uten varsel. Behandle endringer ved brudd i et MCP-verktøys grensesnitt med samme disiplin som en endring ved brudd i et felles REST API.
Implementeringsmerknader fra Salesforce
- Kjør alle innkommende Salesforce Out-of-the-Box (OOTB) MCP (Headless 360)-verktøykall under en sluttbruker der tillatelsene er omfanget bare til operasjonene som de eksponerte verktøyene krever. Ikke kjør innkommende agentkall under en administratoridentitet med høy rettigheter.
- Hvis du vil bruke godkjenning, frekvensbegrensning, skjemavalidering og deteksjon av personlig identifiserbar informasjon (PII) konsekvent på tvers av alle MCP-verktøy, bruker du AI-gateway som MuleSoft Omni Gateway.
- For MuleSoft MCP-fasader definerer du MCP-verktøysskjemaet i MuleSoft uavhengig av det underliggende Salesforce API-skjemaet. MCP-grensesnittet skal gjenspeile anroperens konseptuelle behov, og ikke formen på Salesforce-objektet som støtter det. Denne frakoblingen gjør det mulig for Salesforce-implementeringen å utvikle seg uten å bryte den eksterne verktøykontrakten.
Feilhåndtering og gjenoppretting
- Mislykkede oppkall av verktøy må returnere strukturerte MCP-feilsvar med maskinlesbar kode og en beskrivelse på ren språk. Den oppkallende eksterne agenten har ingen innsikt i Salesforce Platforms internt, slik som feilmeldinger må være selvstendige og handlingsbare uten å kreve Knowledge av Salesforce-spesifikke feilkoder eller objektmodeller.
- Frekvensgrensefeil og godkjenningsfeil må returneres umiddelbart med nok informasjon til at den eksterne agentens operator kan diagnostisere og rette opp hvilken frekvensgrense som ble nådd, eller hvilken legitimasjon som ble avvist uten å vise interne konfigurasjonsdetaljer.
- Logg alle innkommende MCP-verktøykall i Omni-gatewayen med den oppringende agentens identitet, verktøyet som kalles opp, inndataparameterne (sanitert for sensitive verdier) og utfallet. Denne loggen er det primære bevisspor for å diagnostisere feil som er rapportert av eksterne forbrukere, og for å revidere hva eksterne agenter har tilgang til.
Sikkerhetshensyn
- Hver innkommende MCP-tilkobling må godkjennes før et verktøy kan nås. Ikke tillat ikke-godkjent oppdagelse av verktøykatalogen. Listen over eksponerte funksjoner er i seg selv sensitiv informasjon.
- Bruk godkjenning på verktøynivå i tillegg til godkjenning på tilkoblingsnivå. En registrert ekstern agent bør bare kunne kalle opp de spesifikke verktøyene den eksplisitt har fått tilgang til, ikke hele katalogen. Håndhev dette på gatewayen, ikke på programlaget.
- Valider og saniter alle innkommende verktøyparametere før du overfører dem til Salesforce Platform-operasjoner. Parametere fra eksterne agenter er en ikke-klarert inndataflate – en skadelig opprettet parameter kan forsøke å overstyre spørringsfiltre, injisere SOQL-fragmenter (Salesforce Object Query Language) eller påvirke flytvariabler. Valider type, format og område på grensen for MCP-serveren eller fasaden.
- Utfør en regelmessig tilgangsvurdering av registrerte eksterne forbrukere. Opphev legitimasjon for agenter som ikke lenger er aktive eller hvis tilgangsomfang er endret. En hvilende, men gyldig legitimasjon for en deaktivert partnerintegrering er en unødvendig risiko.
- Forsikre deg mot brudd på plattformgrenser ved å begrense antall innkommende MCP-meldinger i gatewayen. Begrens trafikk for ikke-kritiske agenter under innlasting ved å bruke SLA-baserte nivåpolicyer.
Eksempel
En anskaffelsesagent som drives av en logistikkpartner, må bekrefte en leverandørs kontrakt- og kredittstatus før en bestilling med høy verdi godkjennes:
- Partnerens agent godkjenner til gatewayen med sin registrerte OAuth 2.0-klientlegitimasjon og mottar et tilgangstoken med omfang.
- Agenten spør Salesforce MCP Server-verktøykatalogen og identifiserer to relevante verktøy:
GetSupplierContractStatusogGetAccountCreditSummary. - Agenten kaller opp
GetSupplierContractStatusmed leverandørens identifikator. MCP-serveren oversetter dette til en Salesforce-postspørring, bruker integrasjonsbrukerens feltnivåsikkerhet og returnerer kontraktens gjeldende status, utløpsdato og eventuelle flaggede samsvarsholder. - Agenten kaller opp
GetAccountCreditSummary, som ruter gjennom MuleSoft MCP-fasaden. Fasaden samler leverandørens utestående fakturasaldo og betalingshistorikk fra to Salesforce-objekter, og returnerer en enkelt sammensatt kredittsammendrag. - Med begge resultatene finner partnerens agent at kontrakten er aktiv og kredittposisjonen er innenfor akseptable grenser, og godkjenner innkjøpsbestillingen i sitt eget system.
- Begge verktøykallene logges av gatewayen med partneragentens identitet, verktøyene som kalles opp, og utfallene som oppretter en reviderbar post for hvilke eksterne tilganger som ble gitt og hvilke data som ble returnert.
Kontekst
Virksomhetssystemer er nå avhengig av samarbeidsagent-sversjoner eller -nettverk, der komplekse forespørsler dekomponeres og delegeres til spesialiserte agenter på tvers av forskjellige domener eller leverandørplattformer. Disse agentene, hver med sin egen rolle, funksjonalitet og verktøy, trenger en standardisert, sikker kommunikasjonsmetode for å koordinere mot felles mål uten å kreve menneskelig intervensjon i hvert trinn.
Problem
Hvordan kan en AI-agent som ringer opp, dynamisk oppdage, sikkert samhandle med og delegere komplekse eller domenespesifikke oppgaver til en ekstern fagfelleagent som kan bygges på et annet rammeverk eller drives av en annen leverandør og motta strukturerte resultater for å fullføre en større arbeidsflyt for virksomheten?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Hvordan fungerer agenter, som er utviklet med ulike rammeverk eller opererer på tvers av isolerte programområder, sammen?
- Hvordan kan agenter samarbeide og delegere oppgaver uten å vise sin interne logikk, minne eller proprietære verktøy?
- Hvordan støtter agenter komplekse, langvarige oppgaver samtidig som de gir sanntids statusoppdateringer, strømming og push-varsler?
- Hvordan håndhever agenter sikkerhet på bedriftsnivå (godkjenning, godkjenning) og policyoverholdelse for kommunikasjon på tvers av agenter?
- Hvordan håndterer agenter strukturerte oppgavearbeidsflyter (initiering, fremdrift, fullføring) som går utover enkle API-kall?
Salesforce mønsterprogram
A2A-protokollen er en åpen standard som gir agenter mulighet til å oppdage, delegere til og samarbeide med andre agenter som medarbeidere. Den sørger for et felles språk for at agenter trygt kan utveksle informasjon og koordinere handlinger på tvers av ulike plattformer og leverandører. A2A fokuserer på node-til-node-kommunikasjon, som supplerer MCP, som fokuserer på å koble agenter til verktøy og API-er.
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Orchestration for flere agenter (SOMA) for enkeltorganisasjoner | Best når alle domeneagenter bor i én organisasjon og ingen ruting på tvers av leverandører kreves | En superagent (orkestrator) dekomponerer forespørsler og ruter til opptil ~7 tilkoblede underagenter ved å bruke LLM-basert ruting (Atlas Reasoning Engine leser underagentbeskrivelser) eller deterministisk ruting (Agent Script). Dette er standard anbefalt mønster før A2A nås. Støttede kombinasjoner: Agentforce tjenesteagent→Agentforce tjenesteagent Agentforce ansatt agent→Agentforce ansatt agent Agentforce ansatt agent→Agentforce tjenesteagent Bare orkestreringen kan eskalere til et menneske, underagenter kan ikke. |
| Orchestrator-ledet fleragentdelegering | Best for komplekse arbeidsflyter som krever flere spesialiserte agenter | Brukes når arbeidsflyten spenner over flere domener, for eksempel kilding, bekreftelse og godkjenning som hver eies av en annen agent. En orkestreringsagent dekomponerer forespørselen på øverste nivå og delegerer deloppgaver til to eller flere fagfelleagenter i rekkefølge eller parallelt. Hver fagfelleagent utfører sin spesialiserte domenefunksjon og returnerer et artefakt. Orchestrator samler resultater og driver neste trinn. |
Skiss
Arkitekturen involverer en anroperagent som starter kommunikasjon, som er gjort mulig av en agentkatalog/register for oppdagelse:
Sekvensdiagram for delegering på tvers av agenter
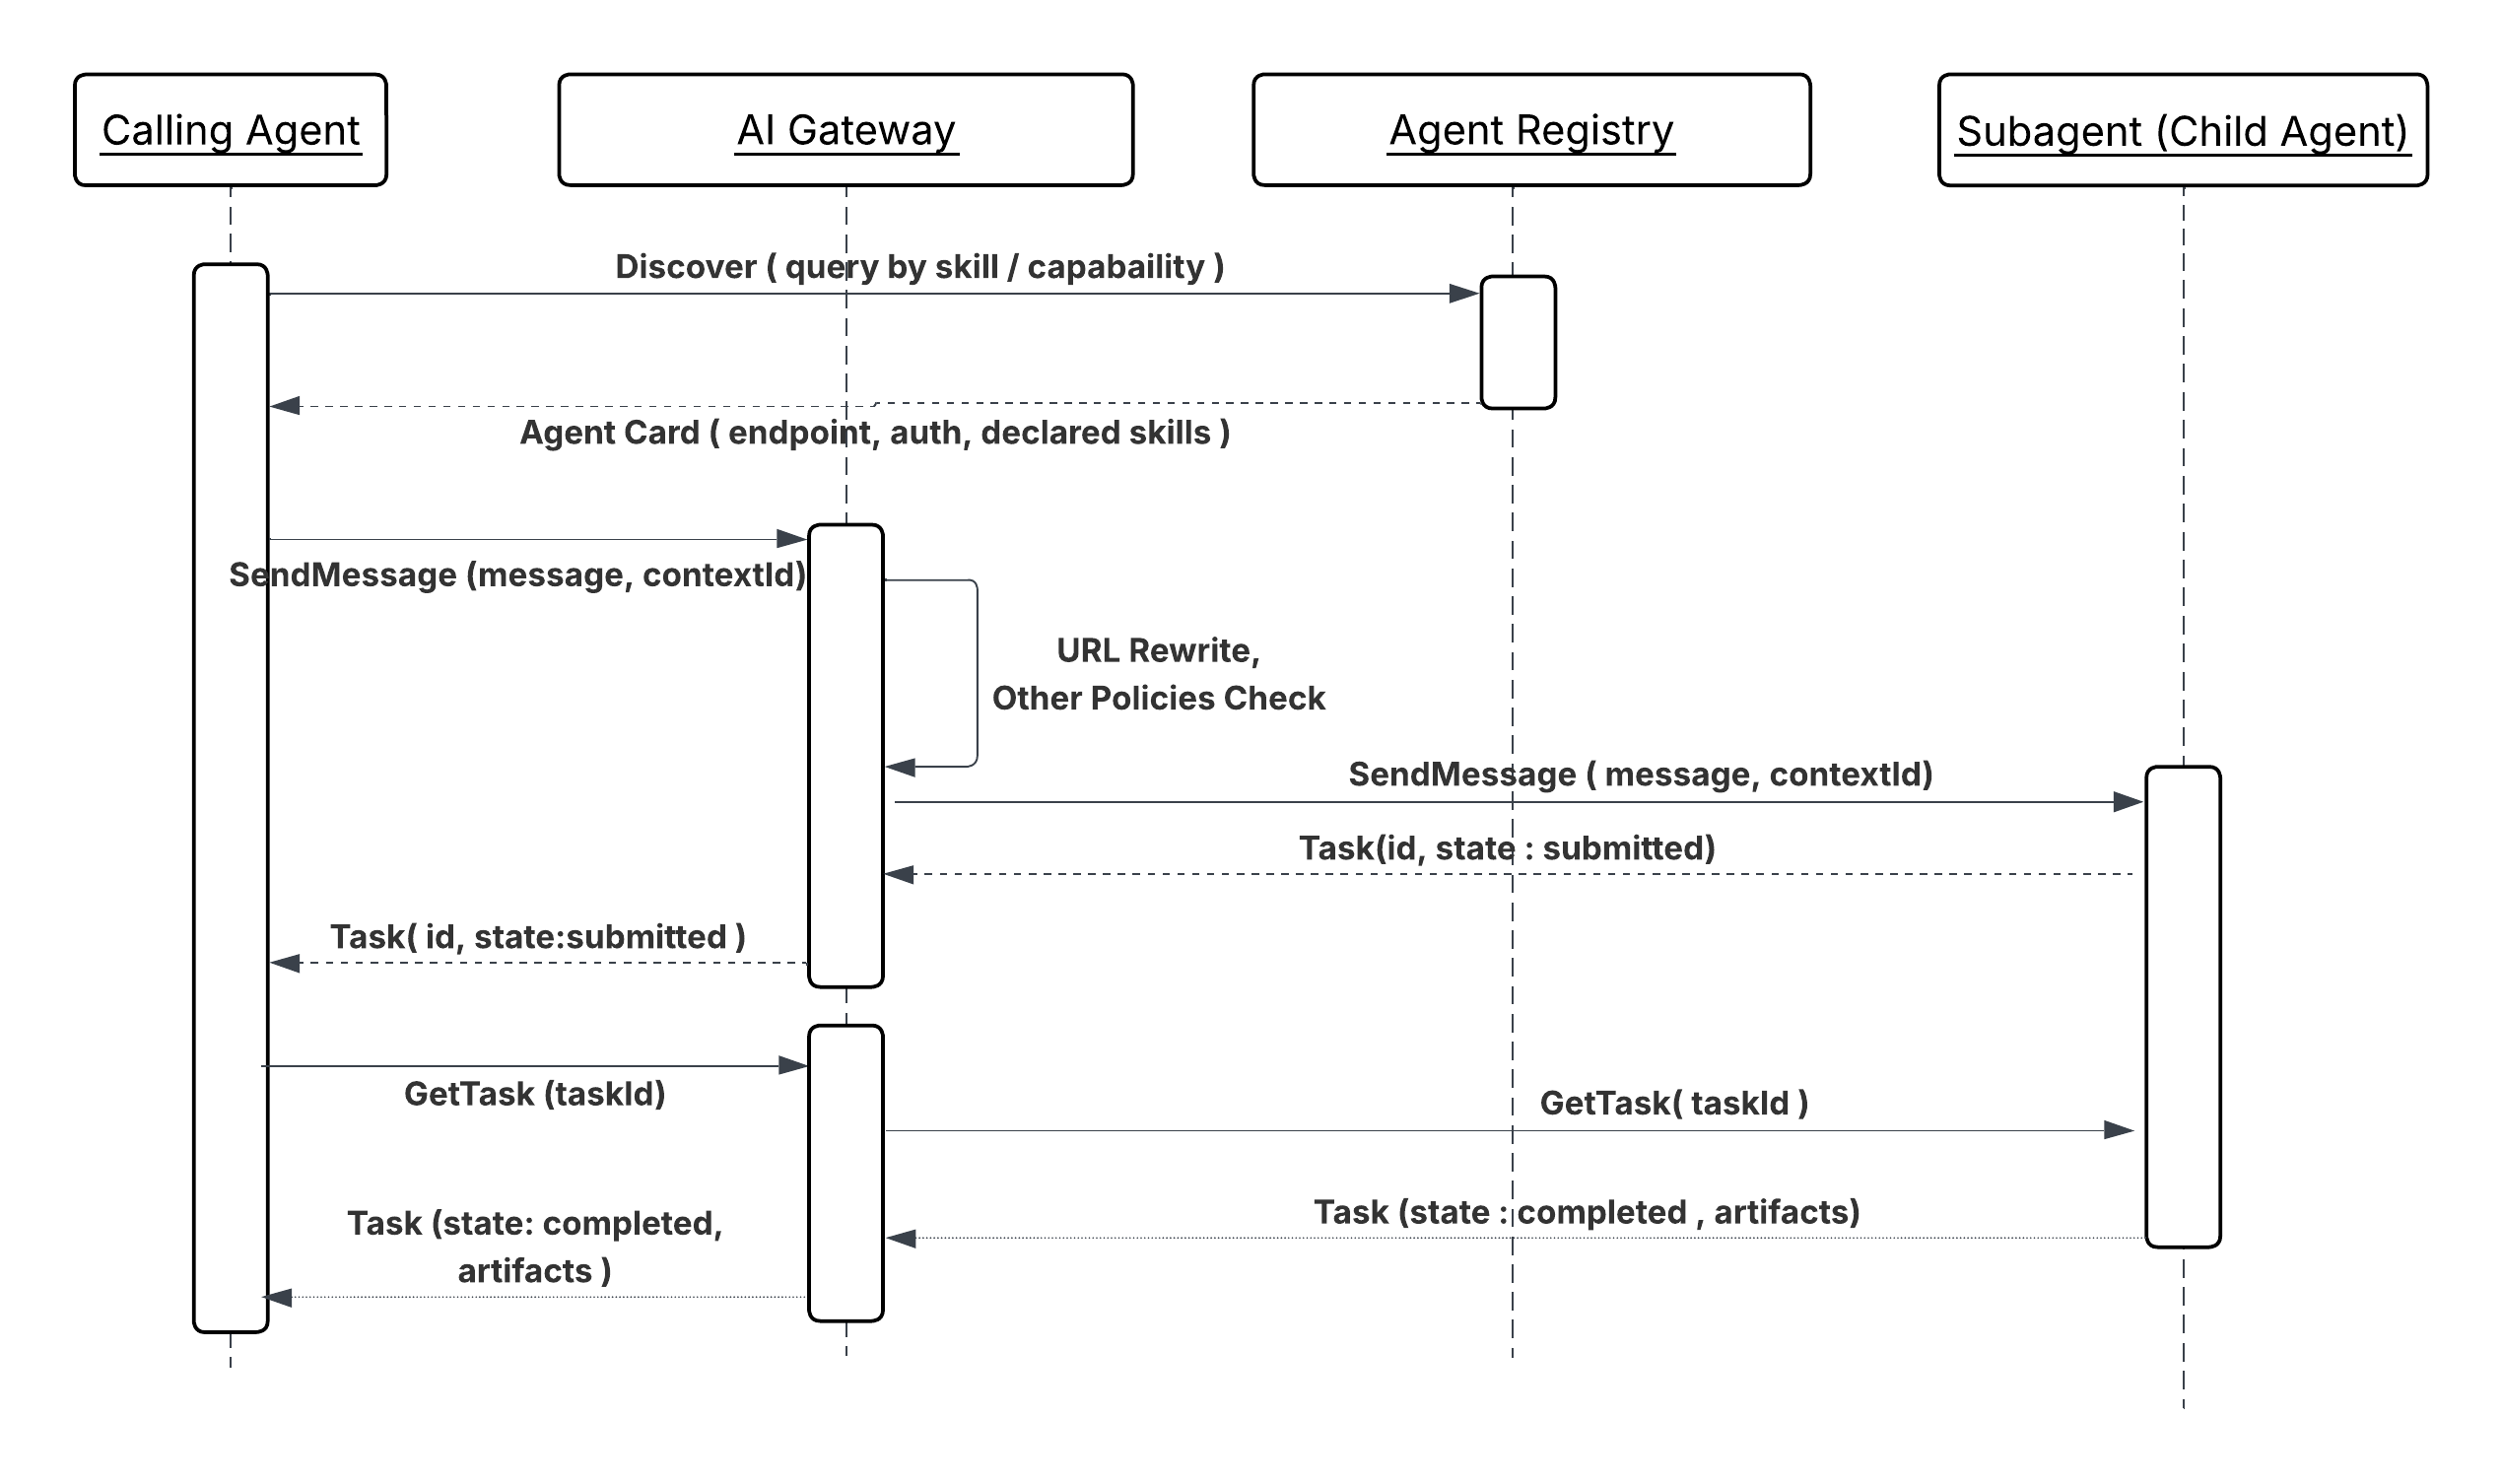
Den fagfelle agenten behandler forespørselen ved å bruke sin domenespesifikke logikk, minne og verktøy, og returnerer deretter strukturerte resultater til anroperen.
Resultater
A2A-delegering skiller domeneeierskap fra arbeidsflytorkestrering. Den oppringende agenten trenger ikke å vite hvordan fagfelleagenten er bygd, hvilken plattform den kjører på eller hvilke verktøy den bruker internt. Den delegerer en oppgave og mottar et strukturert artefakt. Denne grensen betyr at en spesialistagent (bakgrunnsbekreftelse, økonomisk risikoscore, logistisk ruting) kan utvikles, distribueres og forbedres uavhengig av arbeidsflytene som kaller den opp.
Protokollens oppgavelivssyklusmodell (sendt, arbeid, fullført, mislykket) støtter
operasjoner som kjører lenge som standard Den anropende agenten kan registrere seg for statusoppdateringer i stedet
enn å holde en blokkeringstilkobling, som betyr at A2A-oppgaver kan omfatte minutter eller timer
uten at orkestreringsagenten må forbli aktiv hele tiden.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- I komplekse scenarier kan en agentmegler fungere som en intelligent rutingstjeneste eller et "smart byttepanel" for å koordinere oppgavedelegering på tvers av spesialiserte agenter og behandle prosesser med flere trinn.
- I og med at A2A støtter langvarige oppgaver, må kommunikasjonen være orientert mot fullføring av oppgaven, definere en livssyklus for oppgaveobjektet og gi sanntids statusoppdateringer og varsler.
- Protokollen er utformet for å støtte ulike innholdstyper, inkludert tekst, filer, strukturerte data, lyd og strømming av video.
- Relasjonene og avhengighetene mellom agenter og deres egenskaper er deklarativt definert i en konfigurasjonsfil (for eksempel "agent-network.yaml") og publisert i agentregisteret.
Implementeringsmerknader fra Salesforce
- For å få effektiv SOMA-orkestrering holder du tilkoblede underagenter under 7 for å beholde rutingskvalitet.
- For øyeblikket støttes bare det ene delegeringslaget (superagent → subagent); dypere kjeder overfører latens til en "uholdbar frekvens". For øyeblikket kan ikke underagenter delegere til andre tilkoblede underagenter.
- Menneskelig overføring støttes bare på orkesternivå. Underagenter kan ikke eskaleres.
- I SOMA bruker du Agent Script når LLM-basert ruting produserer feil ruting på tvetydige inndata for deterministisk ruting. Agentskript aktiverer kuratert delt kontekst mellom agenter.
Feilhåndtering og gjenoppretting
A2A-protokollen definerer omfattende feilkoder for å forenkle robust feilsøking og feilhåndtering.
- Gjenopprettingslogikk: Agenter må innlemme policyene for å prøve på nytt (gjentakelser), overføringslogikk til alternative, kvalifiserte agenter og eksplisitte tidsavbrudd.
- Oppgavestatussporing: Arbeidsflyten for oppgavebehandling sikrer at agenter kan være synkronisert med den siste statusen til en oppgave, slik at gjenoppretting blir enklere i tilfelle avbrudd.
- Observasjon: Logging av interaksjonsdetaljer, som latens, suksessfrekvenser og feilfrekvenser, er avgjørende for å overvåke kvalitet og feilsøking.
Sikkerhetshensyn
- Foretaksgodkjenning: A2A er utformet for å samsvare med godkjennings- og godkjenningsstandarder på bedriftsnivå, som OAuth 2.0 og JWT, som ofte administreres av eksterne plattformer som Okta.
- Gateway for å beskytte A2A: En gateway (for eksempel MuleSoft Omni Gateway) er viktig for å håndheve policyer på all A2A-kommunikasjon, som fungerer som både en inngangs- og utgangsgateway for å beskytte agenter og kontrollere utgående trafikk til eksterne agenter og tjenester.
- Policy Enforcement: Omskriving av agentkort, Skjemavalidering, Spike Control, PII Detector og andre policyer skal brukes for A2A-server og databeskyttelse.
Eksempel
Candidate Sourcing-arbeidsflyt
En ansettelsesleder oppgir sin sentrale orkestreringsagent til å finne kandidater som samsvarer med en jobbliste og et kvalifikasjonssett.
- Oppdagelse: Orchestrator-agenten spør agentregisteret og oppdager en spesialisert rekrutteringsagent og en bakgrunnssjekkagent (begge fagfelleagenter).
- Delegasjon (A2A): Orchestrator-agenten sender en strukturert oppgaveforespørsel (A2A-melding) til rekrutteringsagenten for å hente kandidater.
- Peer-behandling: Den rekrutterende agenten utfører sin egen arbeidsflyt (for eksempel ved å kalle opp et eksternt LinkedIn-verktøy via MCP).
- Artifakt Return (A2A): Den rekrutterende agenten returnerer en liste over foreslåtte kandidater (artefakten).
- Sekvensiell delegasjon: Orchestrator-agenten delegerer deretter en annen oppgave (A2A) til bakgrunnssjekkeagenten for den øverste kandidaten. Denne agenten utfører kontrollen og returnerer resultatet og fullfører den generelle oppgaven.
Kontekst
Komplekse arbeidsflyter i virksomheter krever ofte at spesialiserte agenter som befinner seg på eksterne plattformer eller partnersystemer, initierer oppgaver, delegerer spørringer eller leverer oppdateringer til interne agenter (for eksempel de på Salesforce-plattformen). Dette mønsteret tar for seg hvordan en intern Agentforce trygt og pålitelig mottar og behandler forespørsler fra en ekstern, fagfelleagent for å utføre en domenespesifikk funksjonalitet.
Problem
Hvordan kan en intern spesialisert AI-agent (for eksempel en bakgrunnskontrollagent på Agentforce) eksponere sin domenespesifikke funksjonalitet sikkert for eksterne fagfelleagenter, behandle en innkommende, strukturert A2A-forespørsel og administrere oppgavelivssyklusen (inkludert sanntids statusoppdateringer) for å returnere strukturerte gjenstander til den eksterne oppringingsagenten?
Krefter
Når du bruker dette mønsteret, svarer du på følgende spørsmål:
- Hvordan eksponerer du interne agentfunksjoner sikkert for eksterne agenter uten å kompromittere intern logikk eller verktøy?
- Hvordan håndhever du sikkerhetspolicyer på bedriftsnivå for å bekrefte den oppringende agentens identitet og delegerte myndighet før forespørsler behandles?
- Hvordan håndterer du langvarige innkommende oppgaver samtidig som du sørger for strukturerte, asynkrone statusoppdateringer?
- Hvordan sikrer du sømløs interaksjon med agenter som bygger på ulike, eksterne rammeverk?
Salesforce mønsterprogram
A2A-protokollen er den åpne standarden for sikker, node-til-node-delegering og samarbeid. Den interne agenten fungerer som fagfelleagenten og annonserer sin egenskap gjennom en agentkatalog/register og bruker A2A over sikre kanaler (HTTPS/SSE) til å motta og svare på strukturerte forespørsler.
| Løsning | Tilpass | Kommentarer |
|---|---|---|
| Agentforce Connected Subagent (SOMA) | Best når anroperagenten er en annen Agentforce i samme organisasjon | Brukes når begge agentene bor i samme Salesforce-organisasjon og anroperen er en Agentforce. Agenten er koblet som en underagent via Agentforce Builder og eksponert for orkestrator gjennom sin beskrivelse og erklærte handlinger. Orchestrator ruter oppgaver med LLM-basert ruting (Atlas Reasoning Engine) eller deterministisk ruting (Agent Script). Ingen A2A-protokoll, gateway eller ekstern registrering kreves. Støttede kombinasjoner: Agentforce tjenesteagent→Agentforce tjenesteagent Agentforce ansatt agent→Agentforce ansatt agent Agentforce ansatt agent→Agentforce tjenesteagent Bare orkestrator kan eskalere til en person, underagenter kan ikke. |
| Agent Broker-ruting (innkommende) | Best når organisasjonen er vert for flere Agentforce-agenter med komplementære funksjoner og anroperagenten kan ikke eller skulle ikke velge et bestemt mål | Brukes når anroperen er ekstern for Salesforce eller en annen Salesforce-organisasjon og ikke trenger å vite hvilken spesifikk intern agent (Agentforce eller andre leverandøragenter) som håndterer forespørselen. En MuleSoft-agentmegler befinner seg mellom MuleSoft Omni Gateway og gruppen med interne Agentforce. Den mottar den innkommende A2A-oppgaven, evaluerer de deklarerte funksjonene til tilgjengelige interne agenter mot oppgavens krav, og ruter forespørselen til den best egnede agenten. Megleren håndterer også overføring av feil hvis den primære målagenten ikke er tilgjengelig eller returnerer en feil, omdirigerer megleren til en tilsvarende agent uten å vise nytt forsøk til den eksterne anroperen. Den eksterne anroperen er aldri klar over interne rutingsbeslutninger eller nye forsøk. |
Skiss
Sekvensdiagram for agenter som kallbare tjenester
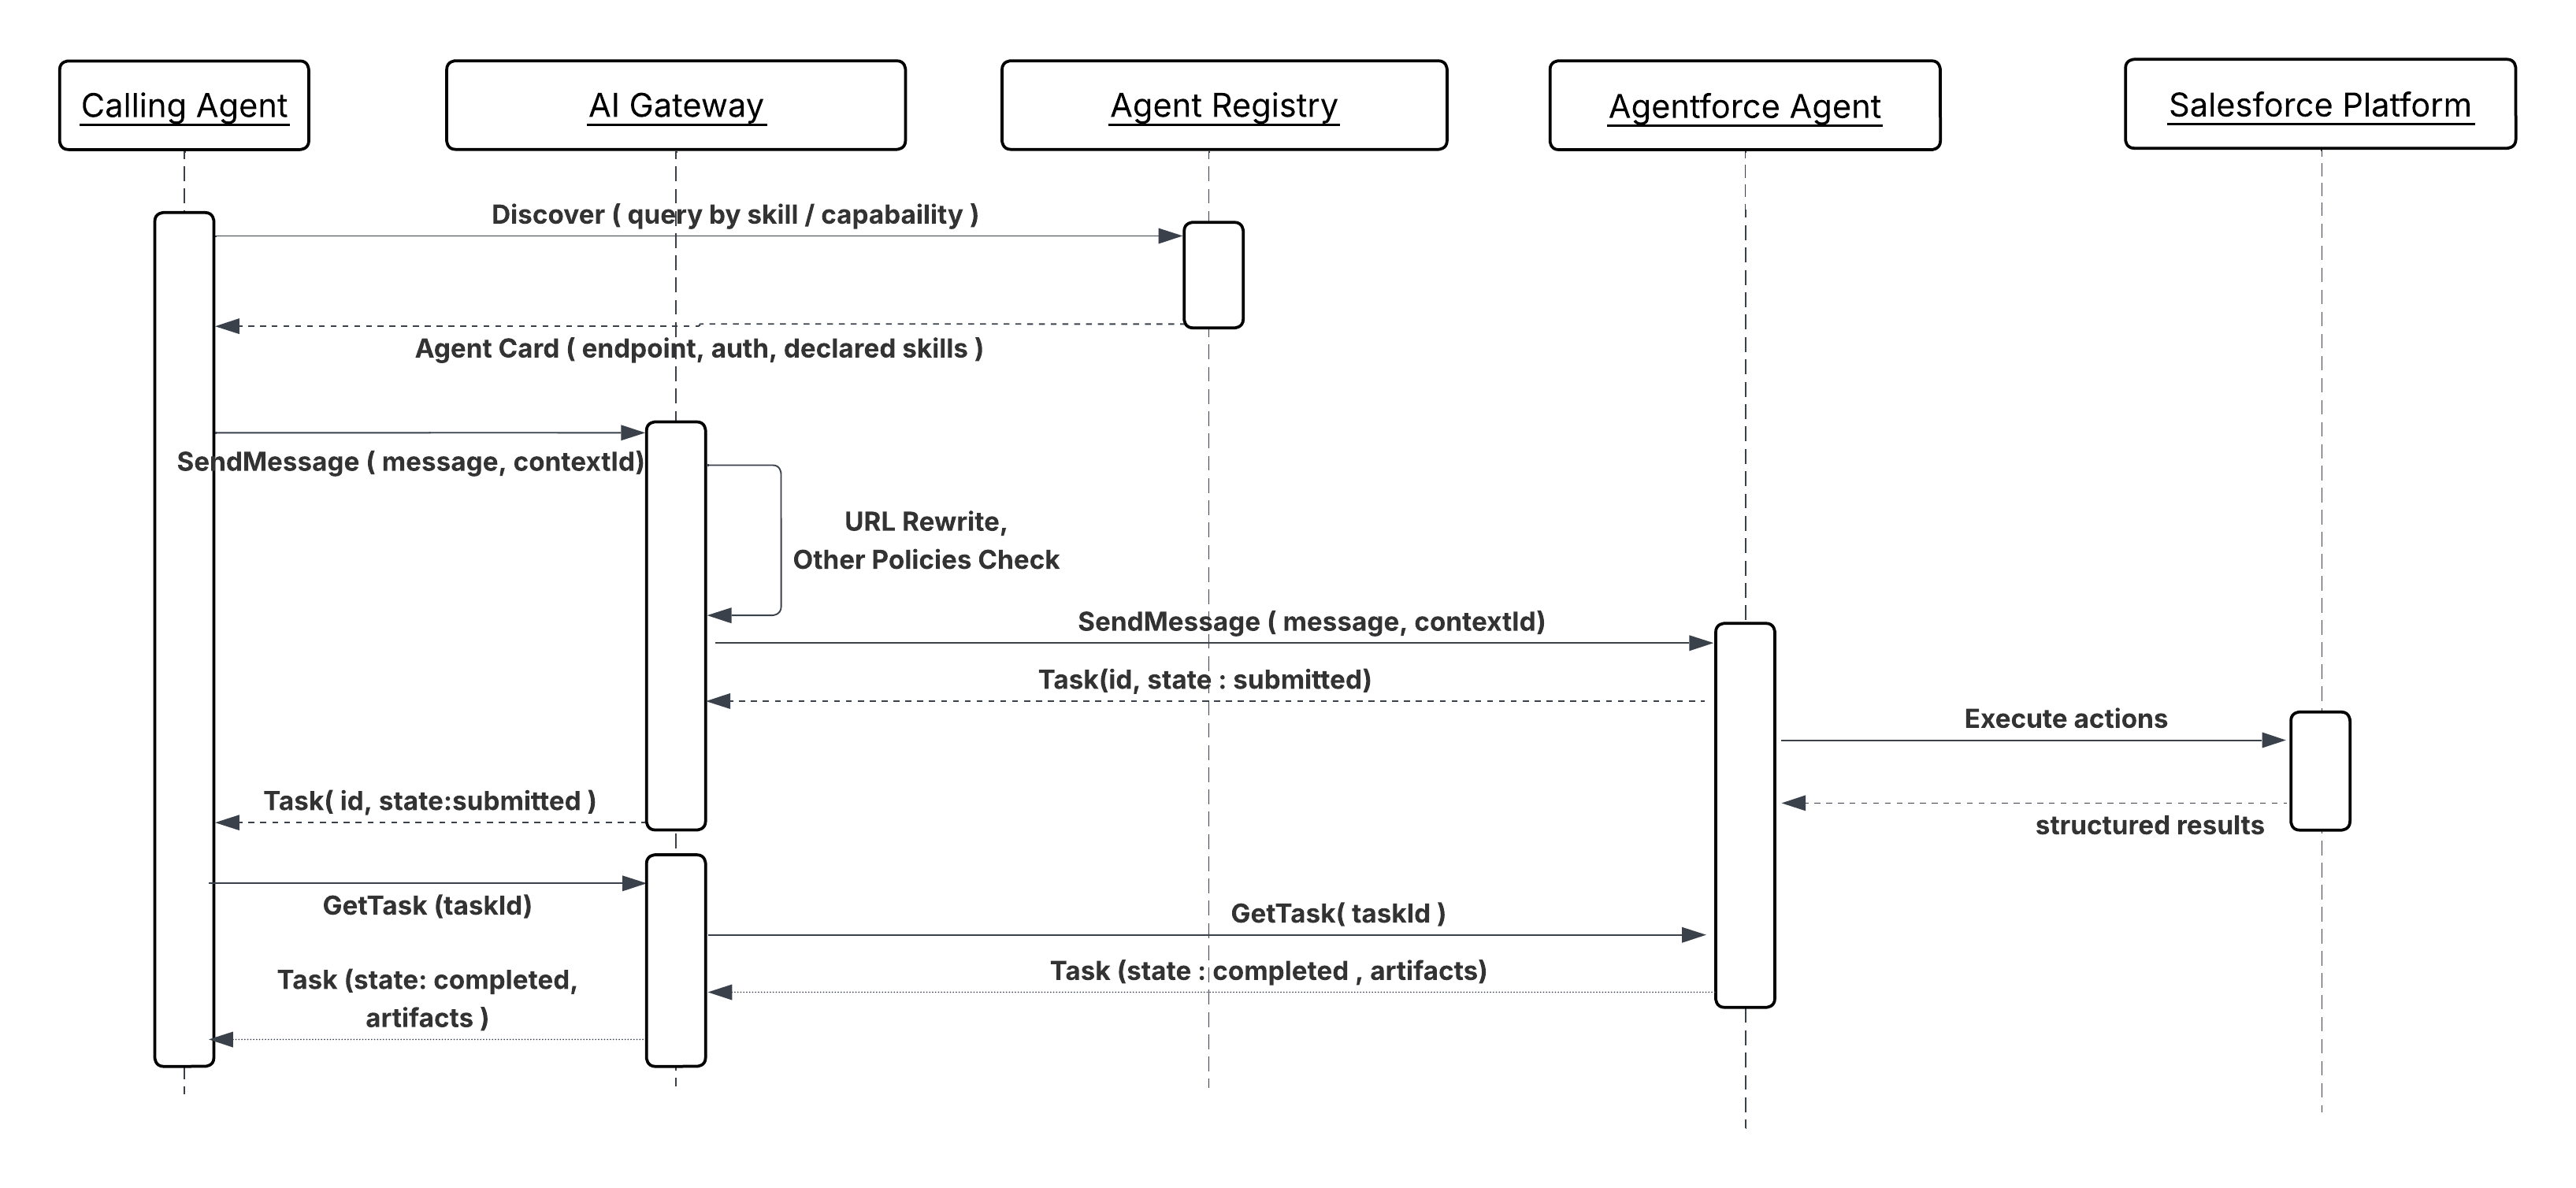
Resultater
Dette mønsteret viser interne agenter som spesialiserte tjenester i et fleragentnettverk. Eksterne agenter kan sikkert delegere oppgaver til interne funksjoner mens organisasjonen opprettholder kontroll, revisjon og policyhåndhevelse.
Konstruksjonsvurderinger
Plattformagnostisk veiledning
- En gateway (for eksempel MuleSoft Omni Gateway) må plasseres som et inngangspunkt for å håndheve policyer, inkludert frekvensbegrensning, godkjenning og belastningsvalidering, på alle innkommende A2A-forespørsler.
- Interne agenter må behandle statusen til oppgaveobjektet fra ekstern initiering til fullføring, slik at den eksterne oppringingsagenten mottar konsistente, bekreftbare statusoppdateringer.
- Kontroller at agentens publiserte funksjoner på agentkortet er tydelige, hensiktsbaserte og inkluderer nødvendige sikkerhetsomfang for delegering.
Feilhåndtering og gjenoppretting
- Strukturerte feilkoder: Ved feil må den interne agenten returnere A2A-kompatible strukturerte feilmeldinger til anroperen for å aktivere logikk for eksterne forsøk på nytt eller alternative overføringsmekanismer.
- Idempotens: Agenten må kontrollere at eventuelle bivirkninger som utløses av en prøvd A2A-forespørsel på nytt fra en ekstern agent (på grunn av nettverksavbrudd eller gjenoppretting), er idempotente.
Sikkerhetshensyn
- Håndhevelse av innkommende poliser: Gatewayen må håndheve policyer for tillatelsesliste/blokkering av eksterne agenter og validering av JWT/OAuth 2.0-tokener for å bekrefte identiteten til og den delegerte autoriteten til den oppringende agenten.
- Input Sanitization: Valider og saniter alle innkommende forespørselsbelastninger for å avhjelpe potensielle ledetekstinnsetting eller skadelige dataangrep.
- Identity propagation: Tilordne den eksterne agentens identitet og dens delegerte myndighet sikkert til interne sikkerhetskontekster (for eksempel Salesforce-brukerprofiler) før du utfører handlinger mot interne systemer.
Eksempel
Ekstern systemforespørsel
- Forespørsel: En rekrutteringsagent i et partnersystem sender en A2A-oppgaveforespørsel til en intern medarbeiderbekreftelsesagent (peer agent) i Agentforce for å bekrefte ansettelsesstatusen til en ny kandidat.
- Behandling: Agent for ansattbekreftelse mottar forespørselen via gatewayen, bekrefter partneragentens legitimasjon, utfører sin interne arbeidsflyt (for eksempel å kalle opp et internt HR-system) og formaterer svaret.
- Svar: Felleagent returnerer et strukturert A2A-artefakt (for eksempel startdato for ansettelse og jobbtittel) til den eksterne rekrutteringsagenten, som deretter fortsetter med sin eksterne arbeidsflyt.
-
Gateway for beskyttelse av MCP-er, A2As og API-er
Det kreves en gateway som det ene håndhevingspunktet for all agent-til-system- og system-til-agent-trafikk.
-
Sikrede forbindelser: En gateway sikrer at bare godkjente og autoriserte agenter samhandler med MCP-, A2A- og API-endepunkter ved å begrense tilgang.
-
Utførte tjenesteavtaler: En gateway kan håndheve grenser slik at organisasjoner kan oppfylle ytelseskravene og hindre overbelastning av MCP- og A2A-servere.
-
Forenklet styring: En gateway tilbyr sentralisert synlighet og kontroll over alle serverinteraksjoner, noe som forenkler behandling og overvåking av agentaktivitet.
-
Datakonsistens og beskyttelse: Policyer, som skjemavalidering, håndheving av datakonsistens og PII-deteksjon, kan beskytte sensitiv informasjon.
MueleSoft Omni Gateway
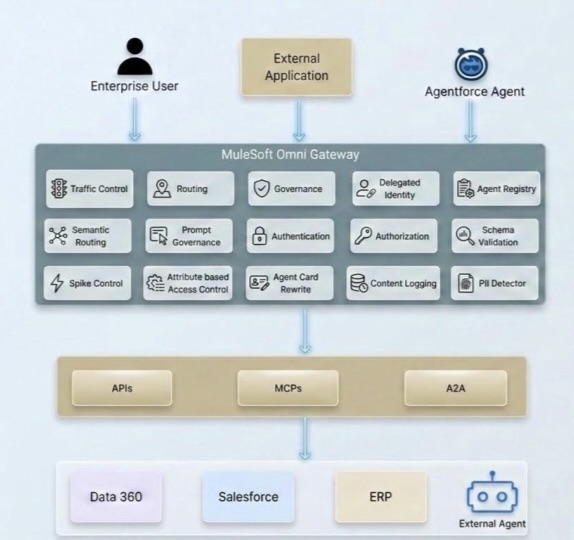
- Identity propagation chain
Etter hvert som virksomheter tar imot det agentiske paradigmet, dukker det opp en ny sikkerhetsutfordring: Hvordan flyter sluttbrukeridentitet gjennom et nettverk av autonome AI-agenter? I tradisjonelle API-arkitekturer godkjennes en bruker én gang, og programmet kaller opp serverdeltjenester på vegne av brukeren. Identitetskjeden er kort, godt forstått og behandles vanligvis innenfor ett enkelt Trust domene.
Agentiske arkitekturer har imidlertid mye lengre kjeder der en enkelt forespørsel støtter på tvers av ulike agenter, tjenester og MCP-servere, som alle potensielt krysser tjenestegrenser, Trust domener og til og med organisasjonsgrenser. Uten en hensiktsmessig strategi for identitetsfordeling står virksomheter overfor et valg mellom sikkerhet og funksjonalitet – et dilemma ingen arkitekt trenger å løse.
MuleSoft løser kompleksiteten i identitetsforplantning med sin Trusted Agent Identity-funksjon. Denne løsningen bruker en policybasert, gatewayadministrert strategi for å sikre at sluttbrukeridentitet opprettholdes på tvers av ulike interaksjonstyper, inkludert A2A-protokoller, MCP-verktøykall og REST API-forespørsler. Ved å sentralisere identitetsbehandling på Omnikanal-gatewaylaget gjennom utgående godkjenningspolicyer kan virksomheter sikre hele agentnettverket uten å endre serverdeltjenester eller agenter. Du finner flere detaljer i Trusted Agent Identity for the Agentic Enterprise.
- RAG-sikkerhet i Data 360
Data 360 støtter attributtbasert tilgangskontroll (ABAC) på objekt-, felt- og radnivåer via innstillingene for datastyringspolicy. Dette er den primære måten å bestemme hvilke data som skal være synlige for hvem, inkludert i RAG-søkeindekser. For strukturerte data implementeres brukertilgangsbetingelser ved bruk av brukerattributter og tillatelsessett. For ustrukturerte data kan metadatafiltrering (forhåndsfiltrering på søkeindekser) begrense hva som hentes.
Kommunikasjon med LLM går gjennom Einstein Trust Layer, som maskerer konfidensiell / PII informasjon før den når modellen som beskytter datapersonvern ikke bare under søk, men også før generering.
For å beskytte mot RAG-forgiftning må du forsikre deg om at strenge datastyrings- og valideringsregler brukes før data blir tilgjengelig for vektorsøk. Einstein Trust kan også håndheve meldingsmaskering/toksisitetskontroller. Du kan bruke strenge tillatelsessett på Agentbruker-profilen.
- Ny navngitt legitimasjonsmodell Salesforce har forbedret godkjenningsarkitekturen ved å introdusere en modell med to nivåer for navngitt legitimasjon som skiller bekymringer mellom tilkobling og identitet. Bruk dette når du gjør oppkall via Apex og unngå å opprette din egen godkjenningsprotokoll. Denne modellen gir også utvidbarhet og forbedret sikkerhet. Eksterne legitimasjoner er grunnlaget for denne modellen. De lagrer de faktiske godkjenningsdetaljene og støtter et rikt sett av protokoller, inkludert OAuth 2.0 Client Credentials, JWT Bearer og AWS Signature V4, samtidig som de også definerer hvordan hovedbrukere tilordnes: enten som en enkelt navngitt hovedbruker (delt på tvers av alle brukere) eller som Per bruker-hoveder (der hver bruker godkjenner med sin egen identitet). Navngitt legitimasjon fungerer i sin tur som endepunktlaget. De definerer URL-adressen for oppkall og refererer til en ekstern legitimasjon for å håndtere godkjenningshåndtaket, og holder endepunktkonfigurasjonen tydelig frakoblet fra legitimasjonsbehandling. For å aktivere godkjenningsflyter per bruker tilordner administratorer tillatelsessett til den riktige hovedbrukeren for ekstern legitimasjon, slik at bare brukere med den riktige tillatelsessettildelingen kan kalle opp kall under sin egen identitet. Denne tosjiktede utformingen forenkler ikke bare sikker oppkallskonfigurasjon, men gir også arkitekter mye større fleksibilitet og styringskontroll over hvordan integrasjoner godkjennes på tvers av Salesforce-tilkoblede systemer. Se Dokumentasjonen for navngitt legitimasjon for å få mer informasjon.
Denne delen tilordner arkitekturens databehandlingsmønstre til samsvarsforpliktelsene som oftest oppstår i regulerte distribusjoner for virksomheten.
Tilgangskontroll: Brukermodellen for integrering med færrest rettigheter som er beskrevet gjennom integrasjonsmønstrene (omfangsbasert navngitt legitimasjon, OAuth 2.0-omfang per agent, gatewaytillatelseslister) tilordnes direkte til logiske tilgangskontroller. Vedlikehold bevis for at hver agents legitimasjonsomfang er gjennomgått og godkjent.
Revisjonslogging: Krav til logging av revisjon per mønster (økt-ID, verktøykall, inndataparametere som er fjernet fra sensitive verdier, utfall) tilfredsstiller kontrollene for overvåking og logging. Sørg for at logger er manipulasjonssikre, beholdes i den nødvendige perioden og er tilgjengelig for sikkerhetsteamet uten å kreve tilgang til produksjonssystemer.
Endringsledelse: Endringer i MCP-verktøyskjema og A2A-agentkortoppdateringer som påvirker forbrukere, utgjør grensesnittendringer og bør være underlagt endringsbehandlingskontroller. Versjonsverktøy eksplisitt (omtalt i MCP-innkommende mønster) og behandle endringer som bryter som konfigurasjonshendelser som krever godkjenning.
Tilgjengelighet: Agent-samtidighetsgrenser, gjenprøvingstak for hendelsesutløste mønstre og dødskrivet ruting for mislykkede hendelser utgjør tilgjengelighetskontroller. Dokumenter den forventede gjennomløpsomfanget og feilvirkemåten for hvert distribuert mønster som en del av tilgjengelighetsbevispakken.
Notat: Denne listen representerer ikke en fullstendig veiledning for å sikre samsvar med agentiske løsninger. Alle gjeldende lovpålagte krav må oppfylles.
- Komme i gang med Agent API
- Aktiver klarerte agenter med Data 360
- Oversikt over MuleSoft Omni Gateway
- OAuth 2.0-policy for innsetting av legitimasjon på forhånd
- Trusted Agent Identity for Agentic Enterprise
Gulal Kumar er Software Engineering Architect på Salesforce med over 20 års erfaring. Hans ekspertise omfatter AI, integrasjon, API-er og bedriftsarkitektur, med fokus på å drive forretningstransformasjon gjennom sikre, fleksible og innovative AI-løsninger. Kontakt ham på LinkedIn.