Data 360-interoperabilitet
Virksomheter lagrer ofte data i Salesforce og andre eksterne datasjøer (for eksempel Snowflake, Google BigQuery, Databricks, Redshift eller objektlagring som Amazon S3). Å isolere data på tvers av flere systemer skaper en utfordring for firmaer som ønsker å utnytte hele verdien av dataene sine for å gi bedre AI-drevne opplevelser. Salesforce Data 360 er det grunnleggende intelligenslaget som alle Agentforce AI-agenter bruker for å få tilgang til riktig kontekst på riktig tidspunkt.
Arkitekter som arbeider med å samle data på tvers av flere datasjøer, står overfor viktige arkitektoniske beslutninger om hvordan de best kan integrere disse dataene. Data 360 tilbyr flere alternativer for dataintegrering, som hver tilbyr ulike fordeler og ulemper.
Denne veiledningen gir et rammeverk for å evaluere hvilket mønster som passer best til kravene dine for latens, kostnad, skalerbarhet, styring og kompleksitet når du integrerer data, og hjelper deg med å velge når du skal bruke datainntak, datakopiforbund eller en hybrid tilnærming. Veiledningen vil også hjelpe deg med å velge mellom forskjellige metoder for datainntak og dataforbund, som alle dekker et annet behov.
Integrering av eksterne datasjøer med Data 360 krever nøye vurdering av avveiningen mellom dataoppdatering, styring og pipelineeffektivitet. Bruk av Live-spørringer for datakonfederasjon med Zero Copy maksimerer for eksempel nyheten av dataene, men kan redusere pipelineffektiviteten etter hvert som flere data flyttes over nettverket. For de fleste implementeringer i den virkelige verden er kombinasjon av inntak og forening i et multi-cloud lake house-økosystem den optimale banen. Denne hybridtilnærmingen sikrer en skalerbar, styrt, interoperabel arkitektur som støtter driftsarbeidsbelastninger med lav latens (for eksempel tilpassing i sanntid og oppdagelse av svindel) og analytiske arbeidsbelastninger (for eksempel regulatorisk rapportering og analyse av historiske trender). Denne veiledningen hjelper deg å finne ut hvordan du navigerer i disse avveiningene ved å bruke en riktig strategi.
- Datainntak kopierer data til Salesforce Data 360 og oppretter styrte, kanoniske datamodeller. Dette er ideelt når du trenger å
- Bygge en omfattende Customer 360. Dette gjør at du kan forene og transformere ulike kilder til en enkelt, klarert profil.
- Møte strenge forskrift overholdelse. Da kan du opprette en reviderbar, sentralisert kopi slik at datatilgang og datatilknytning kan kontrolleres nøye.
- Zero Copy Federation spør eksterne kilder i sanntid uten duplikater, og aktiverer tilpassing i sanntid, direktekontrollpaneler og rask introduksjon av kilder. Denne løsningen tilbyr to primære alternativer, men det er avveininger som må balanseres:
- Direkte spørring: Bruk dette til interaktiv analyse og sanntids datakontrollpaneler som finnes i eksterne dataplattformer (for eksempel Snowflake, BigQuery, Redshift eller Databricks). Dette bidrar til å unngå langsom, kostbar dataduplisering ved å pushe spørringsbehandling til kildesystemet og returnere bare nødvendige resultater. Denne løsningen er optimalisert for sjeldne eller ad hoc-spørringer der friskhet er avgjørende. Den er egnet for arbeidsbelastninger med lav spørring per sekund (QPS) (spørringskostnader kan øke betydelig ved høy QPS).
- Buffering (Accelerated Query): Bruk denne til hyppige dataspørringer som ikke endres ofte. Akselererte spørringer vedlikeholder en lokal buffer som oppdateres med konfigurerbare intervaller (15 minutter til 7 dager), noe som reduserer antall gjentagende kildetrekk. Denne tilnærmingen balanserer kontrollpanelresultater og kostnader, segmentering og BI-arbeidsbelastninger der noe foreldede resultater er akseptable. Dette er ikke egnet for sub-second decision making.
- Filforbund: Bruk dette til batchbehandling i stor skala og AI-modellopplæring for data i skyen (for eksempel S3 eller ADLS). Denne tilnærmingen unngår langsomt og kostbart inntak ved å spørre filer direkte i åpne tabellformater, noe som låser opp massive ETL-datasett og datavitenskapsarbeidsbelastninger.
- Hybridmodeller kombinerer inntak for Unified Profiles med forening for friskhet, som støtter omnikanalengasjement, Agentforce-drevne handlinger og AI/ML-opplæring.
- Bruk en hybridarkitektur. Det er ofte nødvendig å blande datainntak og forbund.
- Bruk datainntak på kritiske data for kanoniske datamodeller og kjernestyring.
- Bruk Zero Copy for alle andre dataforbund for å opprettholde friskhet og minimere driftskostnadene ved bygging og vedlikehold av datainntaksledninger.
- Datainntakets frekvens er viktig. Velg frekvensen basert på forretningsverdi, latensbehov og operasjonell kompleksitet.
- Bruk sanntid til tidsfølsomme arbeidsflyter (for eksempel tilpassing, direktekontrollpaneler og Agentforce-handlinger).
- Bruk nesten sanntid til prosesser med middels stor haster (for eksempel kampanjer og driftsrapporter).
- Bruk batching for historiske eller datasett med lav hastighet.
- Samsvar Federasjonsmønstre med latens og ytelse. Velg alternativet som passer best til tilgangsmønstrene og kravene til friskhet, ytelse og kostnad.
- Bruk direktespørring til operasjonelle kontrollpaneler og tilpassing i sanntid der lav latens er avgjørende.
- Bruk bufring (Accelerated Query) når spørringer er hyppige og resultater som er litt foreldet, er akseptable, noe som bidrar til å balansere ytelse og kostnad.
- Bruk Filforbund til analyser i stor skala og med stor kapasitet eller batcharbeidsbelastninger, som er ideelle for historiske eller mindre tidssensitive datasett.
- Juster styring med krav til dataoppbevaring.
- Bruk inntak når sentralisert styring er avgjørende.
- Bruk føderasjon når desentralisert styring er akseptabelt, samtidig som det også håndheves streng styring fra den eksterne kilden.
- Bruk Zero Copy når det gjelder policyer på kildenivå (for eksempel radenivåsikkerhet (RLS) og datamaskering).
- Prioriter inntak for arbeidsflyter med høy verdi. Bruk inntak selektivt på viktige prosesser (for eksempel identitetsløsning, regulatorisk rapportering og operasjonell aktivering).
- Kost- og kompleksitetsbeslutninger. Inntak i sanntid kan være kostbart og komplekst. Derfor er det viktig at arkitekter veier kostnadene ved introduksjon, lagring og transformasjon av data mot kostnadene ved spørring direkte via Zero Copy.
Valg av riktig integrasjonsmønster – Datainntak, Zero Copy eller en hybrid tilnærming – påvirker direkte latens, styring, driftseffektivitet og kostnader på tvers av plattformer med flere skyer. Denne beslutningen bestemmer hvordan sanntidsinnsikt, AI-drevet aktivering og tilpasset engasjement leveres pålitelig og i stor skala.
Denne tabellen sammenligner mønstrene for datainntak og nullkopiering i Salesforce Data 360, med fokus på funksjoner, avveininger og fordeler, samt brukstilfeller og utfall i virksomheten. Bruk dette som en referanse for å utforme hybrid, flerskydataplattformer som balanserer ytelse, kostnad og samsvar.
| Mønstertype | Modus/verktøy | Fordeler | Vurderinger | Utfall |
|---|---|---|---|---|
| Datainntak |
Sanntid:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Batch:
|
|
|
Agentforce:
|
|
| Zero Copy |
Direkte spørring:
|
|
|
Agentforce:
|
Akselerert spørring (bufring):
|
|
|
Agentforce:
|
|
Filforbund:
|
|
|
Agentforce:
|
Det finnes tre primære integrasjonsmønstre for Data 360 - datainntak, null kopieringsdataforbund og en hybridtilnærming.
Med Datainntak blir data fysisk kopiert til Data 360 og fullstendig styrt, i motsetning til Zero Copy der data forblir ved kilden. Med andre ord skjer databehandlingen for transformasjoner i Data 360, som gir sentralisert styring og revisjon.
Bruk Datainntak til å lagre kanoniske, administrerte datasett i Salesforce Data 360 for overholdelse og driftskontroll. Bruk inntak når full kontroll, revisjon og sporing kreves. Datainntak er ideelt for regulerte eller arbeidsflyter med høy verdi der sentralisert databehandling og styring er avgjørende.
Inntak er egnet for å bygge et klarert grunnlag for identitetsløsning, regulatorisk rapportering og oppgavekritiske AI-drevne arbeidsflyter og kundeengasjement.

Metoder for datainntak kan variere avhengig av hvilken kobling du bruker til å hente inn data. Enkelte koblinger tilbyr en rekke inntaksmetoder, mens andre bare fungerer i gruppemodus eller strømmemodus. Se Data 360: Integrasjoner og koblinger for å få en fullstendig liste over Data 360-koblinger og tilgjengelige metoder.
- Sanntid:
- Gir sub-sekunders inntak ved hjelp av Change Datafangst (CDC)
- Egnet for tidssensitive arbeidsflyter (for eksempel deteksjon av svindel, tilpassing og driftskontrollpaneler)
- Funksjoner push-transformasjoner og aggregeringer i Data 360, som bidrar til å redusere nedstrøms I/O og optimalisere databehandlingen
- Støtter bruk av inkrementell CDC for å minimere datahulling
- Streaming:
- Gir inntak hvert 1-3 minutt i små trinn
- Balanserer friskhet og kostnad
- Egnet for kampanjeorkestrering, nærliggende engasjement og operasjonell rapportering
- Støtter bruk av mikro-batcher til å kontrollere I/O-spikes
- Aggregerer data ved kilden (hvis det er mulig) for å redusere overføringsvolumer og optimalisere lagringsplass
- Batch (Planlagte innlastinger):
- Gir regelmessig inntak av store datasett (for eksempel timevis, daglig og ukentlig)
- Gir kostnadseffektivitet og pålitelighet for brukstilfeller med historiske datasett, regelrapportering og samsvar
- Sikrer at dataplattformen er i samme område som kildelageret for å forbedre ytelsen og optimalisere kostnader
- Brukstilfeller ved datainntak:
- Generer Customer 360 Unified-profiler. Bygg en enkelt sannhetskilde for kundeidentiteter og -attributter.
- Vedlikeholde datasett for etterlevelse av forskrifter. Håndhev styring, linje og revisjonskapasitet for sensitive data.
- Sentralisere kampanjeorkestrering. Forsikre deg om at markedsføring, salg og service alle opererer fra konsistente, klarerte datasett.
- Designpraksis:
- Tilpass inntak av batcher for historiske behov eller behov med lav latens (for eksempel arkiveringsrapportering eller periodiske øyeblikksbilder).
- Bruk CDC- eller strømmede API-er til å opprettholde oppdateringer for drifts- og tilpassingsarbeidsflyter for å sikre nesten sanntidsoppdateringer.
- Kontrollere vekst av lagringsplassering og databehandling ved å bruke inkrementelle belastninger for å optimalisere kostnad og effektivitet (i stedet for å laste hele datasett på nytt).
- Juster inntaks under arbeid med datamaskinlokalisering og inkrementell behandling for å redusere nettverksinntak.
- Bruk transformasjoner i Data 360 for å unngå unødvendig flytting av rådata.
- Kostnadsvurderinger:
- Sanntidsinntak har de høyeste beregnings- og pipelinekostnadene, noe som kan være berettiget for arbeidsflyter med høy verdi og tidssensitivitet (for eksempel tilpassing, driftskontrollpaneler eller Agentforce-drevne handlinger).
- Streaminginntak har moderate kostnader for databehandling og lagring, noe som kan være egnet for hyppige oppdateringer som tåler små forsinkelser (for eksempel kampanjeorkestrasjon eller driftsrapportering).
- Batchinntak har lavere datakostnader og forutsigbar lagring, noe som passer for historiske datasett eller lavfrekvente oppdateringer. Henting av gruppedata fra Salesforce-organisasjoner med bestemte koblinger er gratis.
- Oppdateringsmodus Lar deg velge Inkrementell oppdateringsmodus, noe som reduserer totale inntak og beregningskostnader. Hos Salesforce anbefaler vi å bruke inkrementell oppdatering der det er mulig for å optimalisere effektiviteten på tvers av alle inntakstyper.
- Kostnad påvirkes også av I/O-volumet fra kilden til Data 360. Optimalisering av batchstørrelser, partisjoner og områdejustering reduserer overføringskostnader og forbedrer ytelsen.
- Scenarier for bransjen:
- Finans: Inntaksdatasett kreves for å kjenne kunden din (KYC), Anti Money Laundering (AML) og svindeloppdagelse der revisjonsevne og overholdelse ikke kan forhandles.
- Helse: Bruk inntak for pasientidentitetsløsning og HIPAA-kompatible poster, som aktiverer sikre, forente visninger.
- Detaljhandel: Konsolidere salgsstedsdata, eCommerce og lojalitetsprogramdata i forente profiler for segmentering og tilpassing.
- Telekom: Støtt forhindring av frafall og bruksanalyse med kanoniske, administrerte abonnentdata.
| Funksjon | Sanntids inntak | Strømmede inntak | Batchinntak |
|---|---|---|---|
| Latency and Freshness | Funksjonerer inntak av sub-sekunders latens via Inntaks-API-er med støtte for Change Datafangst (CDC). Gir kontinuerlige streaming under arbeid. Egnet for operative brukstilfeller med lav latens. | Funksjonerer mikro-batchinntak hvert 1-3 minutt via innebygde koblinger. Støtter trinnvise oppdateringer. Liten latens forventes. | Datalatens er forventet. Tillater planlagte lastinger med stor trafikk. Funksjoner med periodisk inntak (timevis, daglig og ukentlig). Ikke egnet for tidssensitive operasjoner. |
| Hovedbrukstilfeller | Ideelt for brukstilfeller med lav latens for drift og tilpassing. Brukes til tidssensitive arbeidsflyter. Støtter hendelsesdrevne arbeidsflyter. Brukes til sanntidsvarsler om bedrageri og driftsvarsler. | Egnet for prosesser med middels stor haster. Brukes til kampanjeorkestrering, nærliggende engasjement og operasjonell rapportering. Brukes til tidsriktige kampanjeutløsere. | Kostnadseffektiv for massive datasett. Pålitelig for historiske analyser. Brukes til historiske aggregerings- eller regulerte rapporteringsarbeidsflyter. Egnet for historiske datasett eller datasett med lav hastighet. |
| Arkitektonisk kompleksitet og I/O | Inkluderer høy kostnad og kompleks arkitektur. Krever kildesystemer med lav latens. I/O intensiv. Kilder med stor trafikk kan føre til mettet under arbeid. | Har enklere arkitektur enn i sanntid. I/O er moderat. Egnet for forutsigbare, gjentatte oppdateringsmønstre. Batchstørrelse påvirker minne og beregning. | Enkel å implementere. I/O intensivt under innlastingsvinduer. Nettverksgjennomgang kan bli en flaskehals for store batcher. |
| Kostnadsvurderinger | Inkluderer de høyeste beregnings- og pipelinekostnadene. Bare for arbeidsflyter med høy verdi og som skiller mellom tid og verdi. | Inkluderer moderate beregnings- og lagringskostnader. Gir en balansert kostnads- kontra oppdateringstilnærming. Egnet for hyppige oppdateringer som tåler små forsinkelser. | Gir lavere datakostnader og forutsigbar lagring. Anbefales for historiske datasett eller oppdateringer med lav frekvens. Inntak via interne Salesforce pipelines er gratis. |
| Design Practices | Bruk inkrementell CDC til å minimere dataoppheving. Filtrer og bruk selektive felt til å redusere overhead. | Bruk mikrobatcher til å kontrollere I/O-spikes. Vurder vindusaggregering for å redusere behandlingsbelastningen. | Brukes til arkiveringsrapportering eller periodiske øyeblikksbilder. Forsikre deg om at datalokaliteten er i samme område som kildelageret for kostnadsoptimalisering. |
Bruk Zero Copy til sanntids spørring av eksterne systemer uten dataduplisering for å gi fleksibilitet, friskhet og skalerbar tilgang til store eller midlertidige datasett. Den er egnet for direktekontrollpaneler, undersøkelsesanalyse, AI/ML-modellopplæring og kundeengasjement i sanntid direkte via Salesforce Data 360.
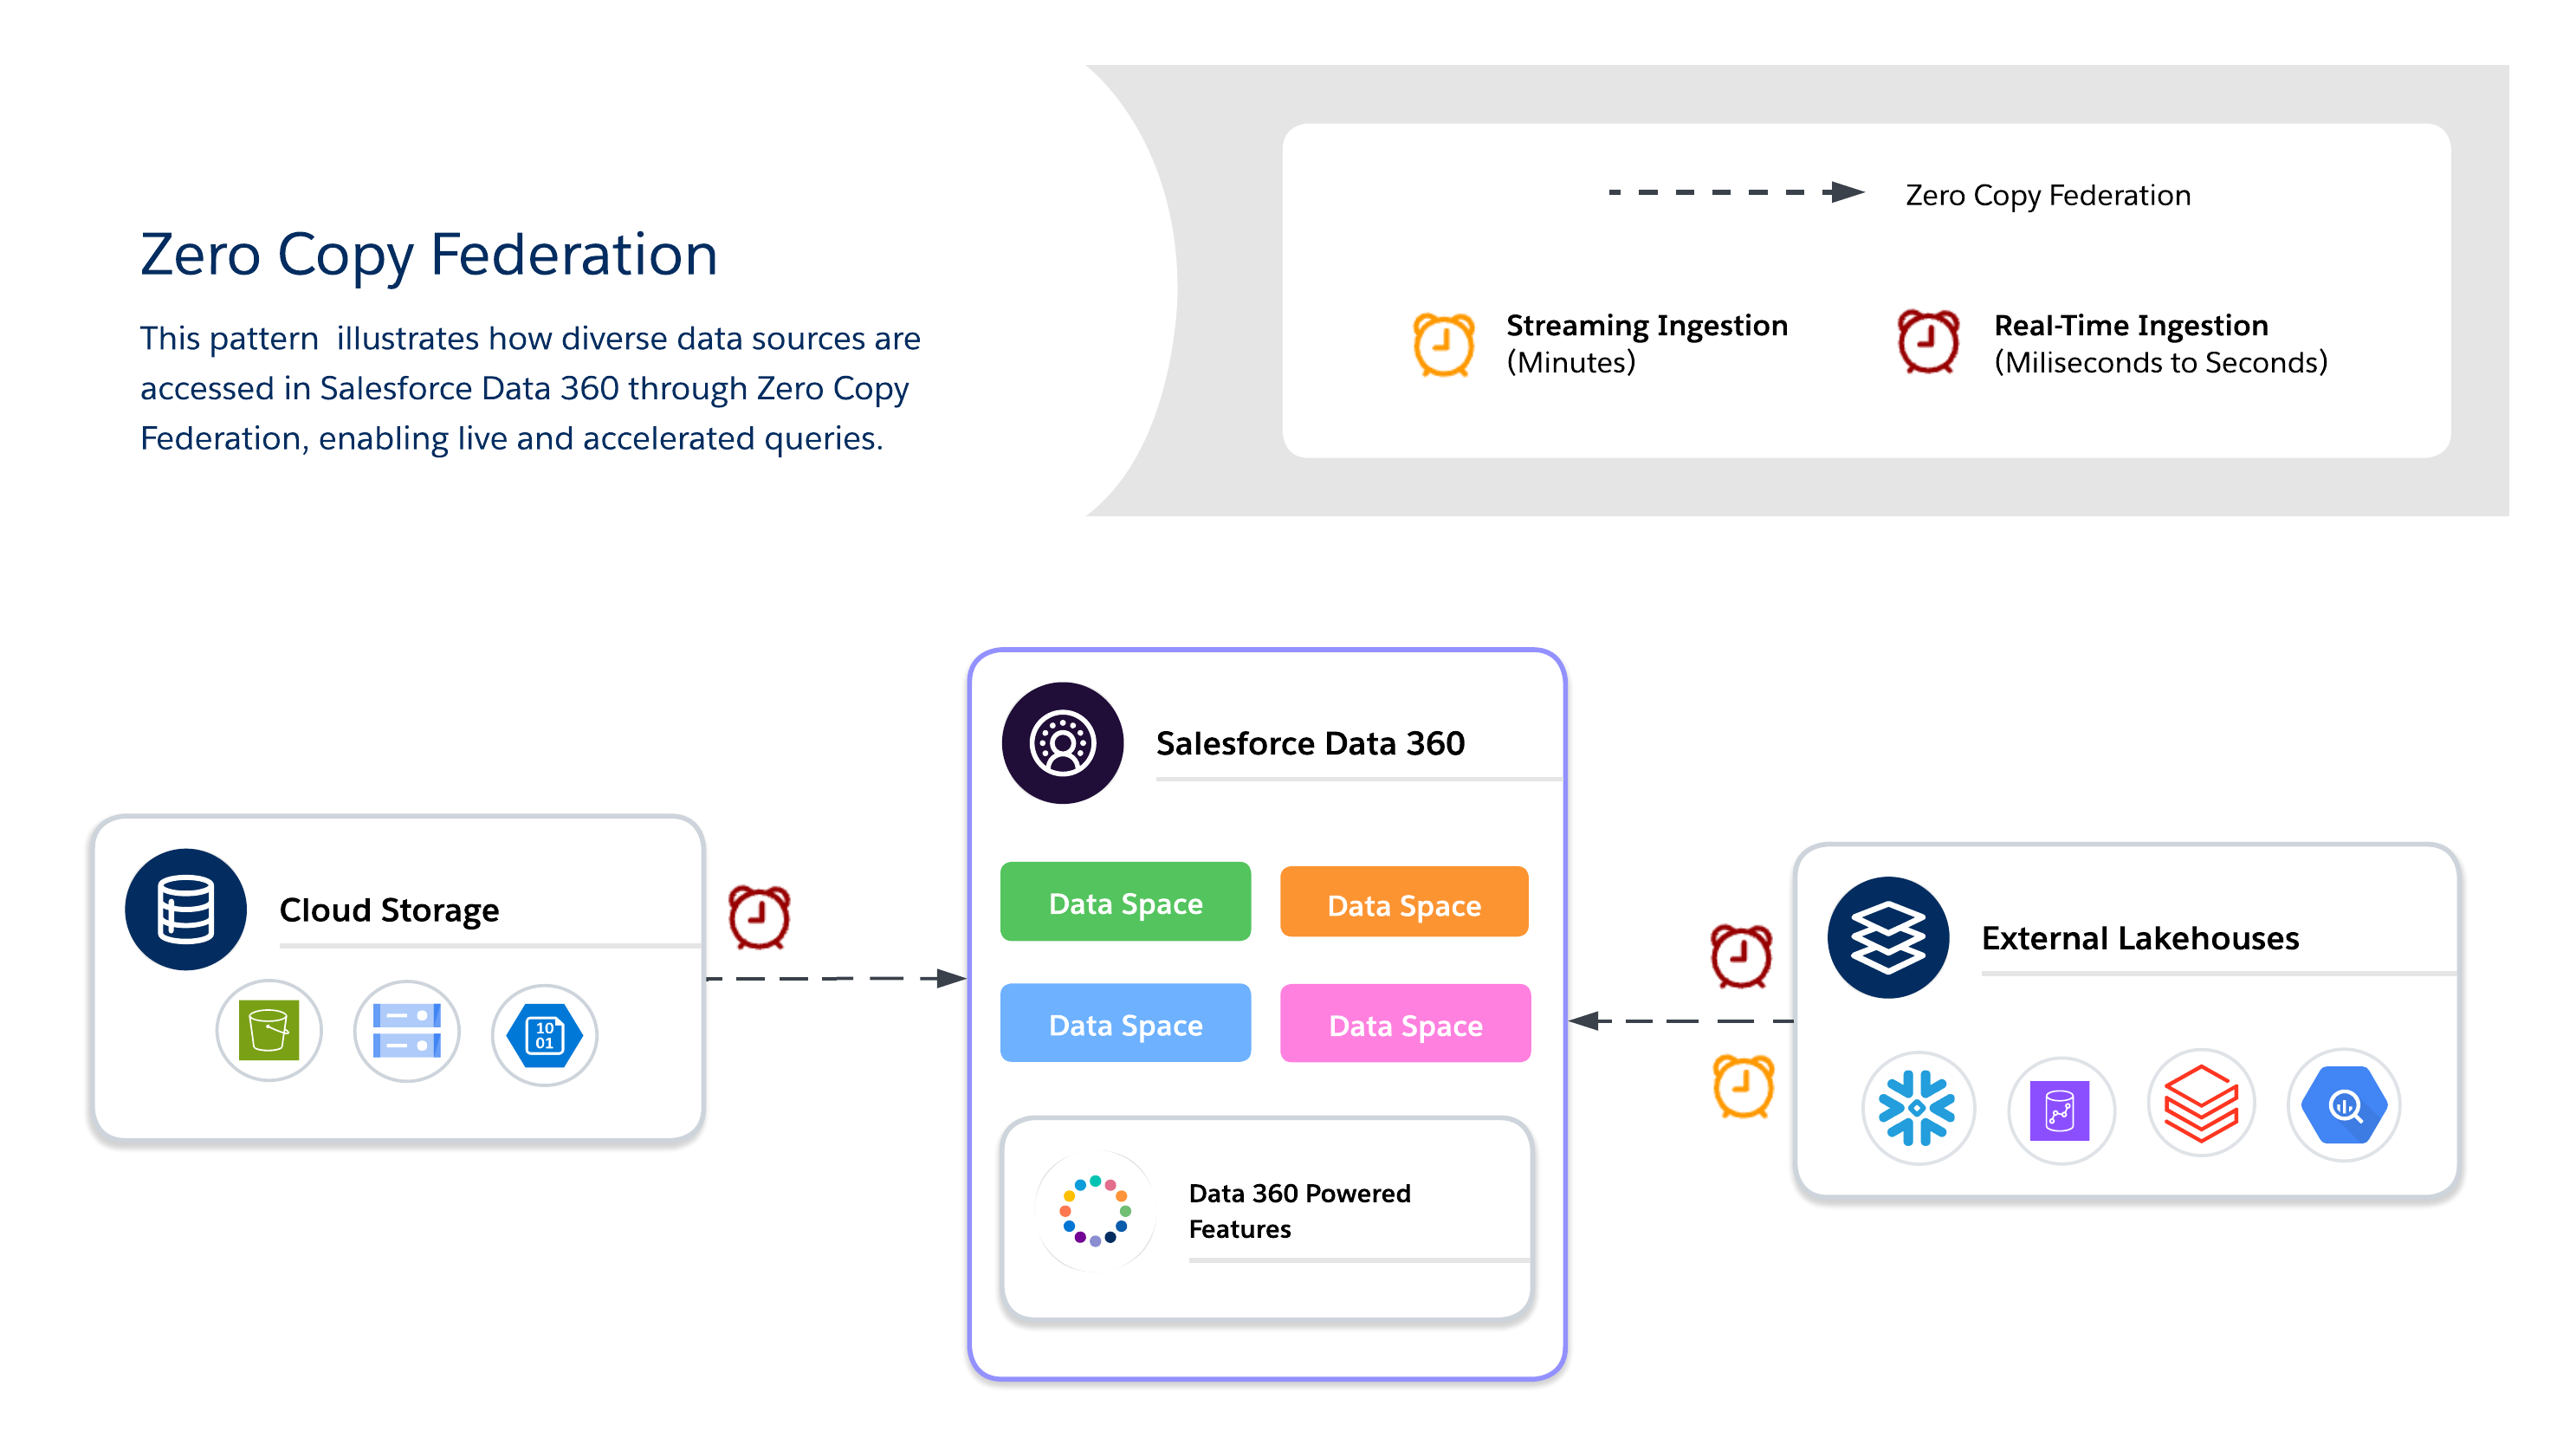
Når du bruker Zero Copy, må arkitekter velge mellom tre tilgjengelige dataforbundsmetoder, som hver tilbyr sin egen avveining mellom ferskhet, ytelse og kostnad.
- Direkte spørring
- Kjører spørringer direkte mot eksterne systemer (for eksempel Snowflake, Google BigQuery, Redshift, Databricks og så videre) uten dataduplisering.
- Minimerer dataoverføringen over nettverket og reduserer I/O på Salesforce Data 360-beregningen, noe som er optimalt når predikater og aggregeringer kan skyves ned.
- Egnet for sanntidsinnsikt og driftskontrollpaneler med lav latens.
- Avhengig av ytelsen til det eksterne systemet.
- Buffering (Accelerated Query)
- Lagrer midlertidig bufrede kopier av forente data i Salesforce Data 360.
- Reduserer gjentagende spørringskostnader og latens for datasett med frekvent tilgang med konfigurerbar varighet (minutter til dager).
- Data kopieres ikke permanent eller styres ikke fullstendig, så friskhet behandles via planlagte oppdateringer fra kilden.
- Inkrementell oppdatering støtter bare oppdateringer. Slettede poster fjernes ikke fra bufferen.
- Utfør en full oppdatering regelmessig for å sikre at bufferen forblir synkronisert med kilden.
- Notat: Snowflake-koblingen støtter funksjonen Last av, som øker akselerasjonshastigheten ved å bruke en Snowflake-initiert oppstillingsbeholder. Dette er aktivert som standard, men det kan deaktiveres ved å redigere tilkoblingen.
- Filforbund
- Gir direkte, skrivebeskyttet tilgang til datasett i stor skala i objektbutikker (for eksempel S3 og GCS med Iceberg).
- Egnet for AI/ML-arbeidsbelastninger, historiske analyser og rapportering i petabyteformat uten å flytte data.
- Spørringsytelsen er sterkt avhengig av objektformat, partisjonering og nettverksinnstillinger. Store skanninger kan generere betydelige I/O hvis de ikke er optimalisert.
- Brukstilfeller
- Sanntidspersonlig tilpassing og tilpassede arbeidsflyter gir dynamiske tilbud, anbefalinger og Next Best-handlinger etter hvert som kundeadferd endres.
- Direktekontrollpaneler og driftsanalyse leverer forretningskritiske kontrollpaneler og ytelsesindikatorer direkte fra eksterne lagre.
- AI/ML modellopplæring med store eksterne datasett benytter data i petabyte-skala fra datasjøer og lagre uten å flytte dem via filforbund.
- Industry Scenarios
- Detaljhandel/Media: Aktiver tilpassede anbefalinger og sanntids kundeengasjement ved å forene klikkstrøm- eller innholdsinteraksjonsdata.
- Finans: Kjør oppdagelse av svindel og risikoscore i nær sanntid ved å spørre eksterne lagre uten å duplisere sensitive data.
- Tech/Enterprise: Støtt rapportering på tvers av skyer, kontrollpaneler for IT-tjenester og operasjonell analyse når datasett befinner seg i flere systemer.
- Design Practices
- Direkte spørring
- Brukes til spørringer med høy QPS og lav latens når friskhet er avgjørende.
- Pushe predikater og aggregeringer til det eksterne systemet for å redusere datahulling over nettverket.
- Unngå spørringer som unødvendig skanner store datavolumer.
- Vurder å beskjære partisjoner og filtrere i stedet.
- Filforbund
- Få tilgang til datasett i petabyte-skala i objektbutikker uten inntak.
- Minimer latens- og utgangskostnader ved å beholde objektlagring i samme skyregion som Salesforce-beregning.
- Bruk partisjonerte, kolonneformater (Parquet/ORC) og nedtrekksfiltre for å redusere I/O- og nettverksoverføring.
- Bruk spørring og predikat nedtrekksmeny til å filtrere og aggregere data ved kilden, noe som reduserer dataflyten.
- Unngå datatilgang på tvers av områder, med mindre det er absolutt nødvendig, fordi det øker I/O, latens og kostnader.
- Buffering (Accelerated Query)
- Bufr ofte brukte datasett for å balansere kostnad og ytelse.
- Konfigurer oppdateringsintervaller for å balansere friskhet kontra spørringskostnader.
- Samsvar: Håndhev styring ved kilden ved å benytte sikkerhet på radnivå (RLS) og maskere policyer direkte i forente systemer.
- Her er noen gode fremgangsmåter for ensartet RLS og maskering på tvers av plattformer:
- Bruk en sentralisert Enterprise-ID. Tilordne brukere og enheter i Salesforce Data 360 til en unik, sentralisert forretningsidentifikator som samsvarer med identiteter i eksterne systemer.
- Juster sikkerhetspolicyer. Forsikre deg om at RLS- og maskeringspolicyer i forente systemer brukes basert på den tilordnede identiteten. Dette beholder samsvar når du spør mot eksterne data.
- Standardiser identitetskjemaer. Oppretthold ensartede identitetsattributter (e-postadresse, bruker-ID, kunde-ID og så videre) på tvers av alle datakilder for å unngå mismatch og tilgangsbrudd.
- Her er noen gode fremgangsmåter for ensartet RLS og maskering på tvers av plattformer:
- Direkte spørring
- Kostnadsvurderinger
- Direkte spørring: I betalingsmodellen per spørring oppstår det kostnader ved beregning av eksternt innsjøhus, noe som kan føre til høy QPS. Dette er egnet for nytteskritiske brukstilfeller der verdien er større enn kostnadsvariabelen.
- Akselerert spørring (bufring): Denne metoden reduserer spørringskostnader (sammenlignet med direkte spørring) ved å redusere treff til kildesystemet, men det øker batchdatainntakskostnadene for fylling og oppdatering av bufferen. Dette er egnet for datasett med hyppig tilgang.
- Filforbund: Dette er det billigste lagringsalternativet som data i objektbutikk, men spørringskostnadene avhenger av filstørrelse, partisjonering og beskjæring. Dette er egnet for historiske data eller gruppedata i stor skala.
| Beslutningspunkt | Direkte spørring | Bufring (accelerated query) | Filforbund |
|---|---|---|---|
| Datakildeplassering | Eksterne datasjøer (for eksempel Snowflake, Google BigQuery, Redshift og Databricks) | Eksterne datasjøer (for eksempel Snowflake, Google BigQuery, Redshift og Databricks) | Objektbutikker eller skydatasjøer (for eksempel S3, ADLS og GCS), som ofte bruker åpne tabellformater som Iceberg. |
| Formål/brukstilfelle | Egnet for interaktiv analyse og sanntidskontrollpaneler. Egnet for tilpassing i sanntid og dynamiske arbeidsflyter. | Egnet for når spørringer er hyppige, men noe foreldede resultater er akseptable. Egnet for BI-kontrollpaneler og segmentering. | Egnet for batchbehandling i stor skala og AI/ML-modellopplæring. Egnet for historiske analyser og rapportering i petabyteformat. |
| Friskhet/latens | Gir maksimal oppdatering Kjører spørringer direkte i sanntid. Støtter under-sekunders beslutninger når kildesystemet er optimalisert for spørringer med lav latens med effektive predikat nedtrekksmenyer. | Brukes når et litt foreldet resultat er akseptabelt. Ferskheten avhenger av bufferintervallet, som kan konfigureres fra 15 minutter til 7 dager. | Egnet for batchtunge, gjennomløpsintensive jobber. Ikke egnet for kontrollpaneler i sanntid. |
| Tilgangsmønster | Egnet for sjeldne eller ad hoc-spørringer der friskhet er avgjørende og spørringsvolumet er lite. Kostnader øker betydelig ved høy QPS, så det er viktig å evaluere bufring (Accelerated Query) når spørringsfrekvensen er høy. | Egnet for lesescenarier med høy frekvens. Forbedrer ytelsen for hyppige tilgangsmønstre. | Gir tilgang bare for ead. Egnet for datasett i petabyteformat uten inntak. |
| Ytelsesdrivere | Sterkt avhengig av ytelsen til det eksterne kildesystemet. Egnet for når predikater og aggregeringer kan pushes ned til kilden. | Reduserer latens sammenliknet med gjentatte direktespørringer. Ytelsen avhenger av bufferbehandling og intervaller. | Ytelsen avhenger sterkt av objektformat, partisjonering og ekstern systemgjennomgang. Bruk partisjonerte, kolonneformater (Parquet/ORC). |
| Kostnadskonsekvenser | Dette er en betalingsmodell per spørring, så kostnader akkumuleres på eksterne beregninger av innsjøhus. Det er kostnadseffektivt for sjeldne spørringer, men utgiftene kan øke med høyt QPS-volum. | Kostnaden er lavere enn gjentatte direktespørringer. Det reduserer behovet for å spørre den eksterne kilden gjentatte ganger, men det legger til bufferlagring og oppdateringsoverhead. | Dette er det billigste lagringsalternativet. Når det gjelder AWS-oppsett i samme område (for eksempel S3 i US-East-1 med en Data Cloud-leietaker som også er i US-East-1), brukes ikke kreditter for radene som åpnes. Konfigurasjoner på tvers av områder eller på tvers av skyer (for eksempel Azure, GCS eller forskjellige AWS-områder) medfører kredittforbruk for radene som åpnes. Spørringskostnader er også avhengig av filstørrelse, partisjonering og push-down-optimalisering av predikat. |
| Nøkkelvurderinger | Unngå ufiltrerte spørringer som skanner store datavolumer unødvendig. | Denne løsningen krever bufferbehandling. Ikke egnet for under andre beslutninger. | Spørringsytelsen er sterkt avhengig av optimalisering via partisjonering og rullegardinliste for predikater. |
Hybridarkitekturer gjør det mulig for arkitekter å forankre viktige datasett i Data 360 for sentralisert styring, samtidig som de benytter forente spørringer for oppdatering, redusert duplisering og skalerbar tilgang til store, eksterne datasett. Denne tilnærmingen balanserer kravene til I/O, datalokalitet, kostnad og samsvar.
Bruk en hybridtilnærming for balansert styring, friskhet og driftseffektivitet ved å kombinere datainntak og null kopiering for å levere sanntids og handlingsorienterte innsikter. Bruk inntak for datasett med høy verdi og regulerte datasett der sporbarhet, RLS og maskering kreves, og forbund for datasett med kortvarig eller stor trafikk der friskhet og ytelse er nøkkelen.
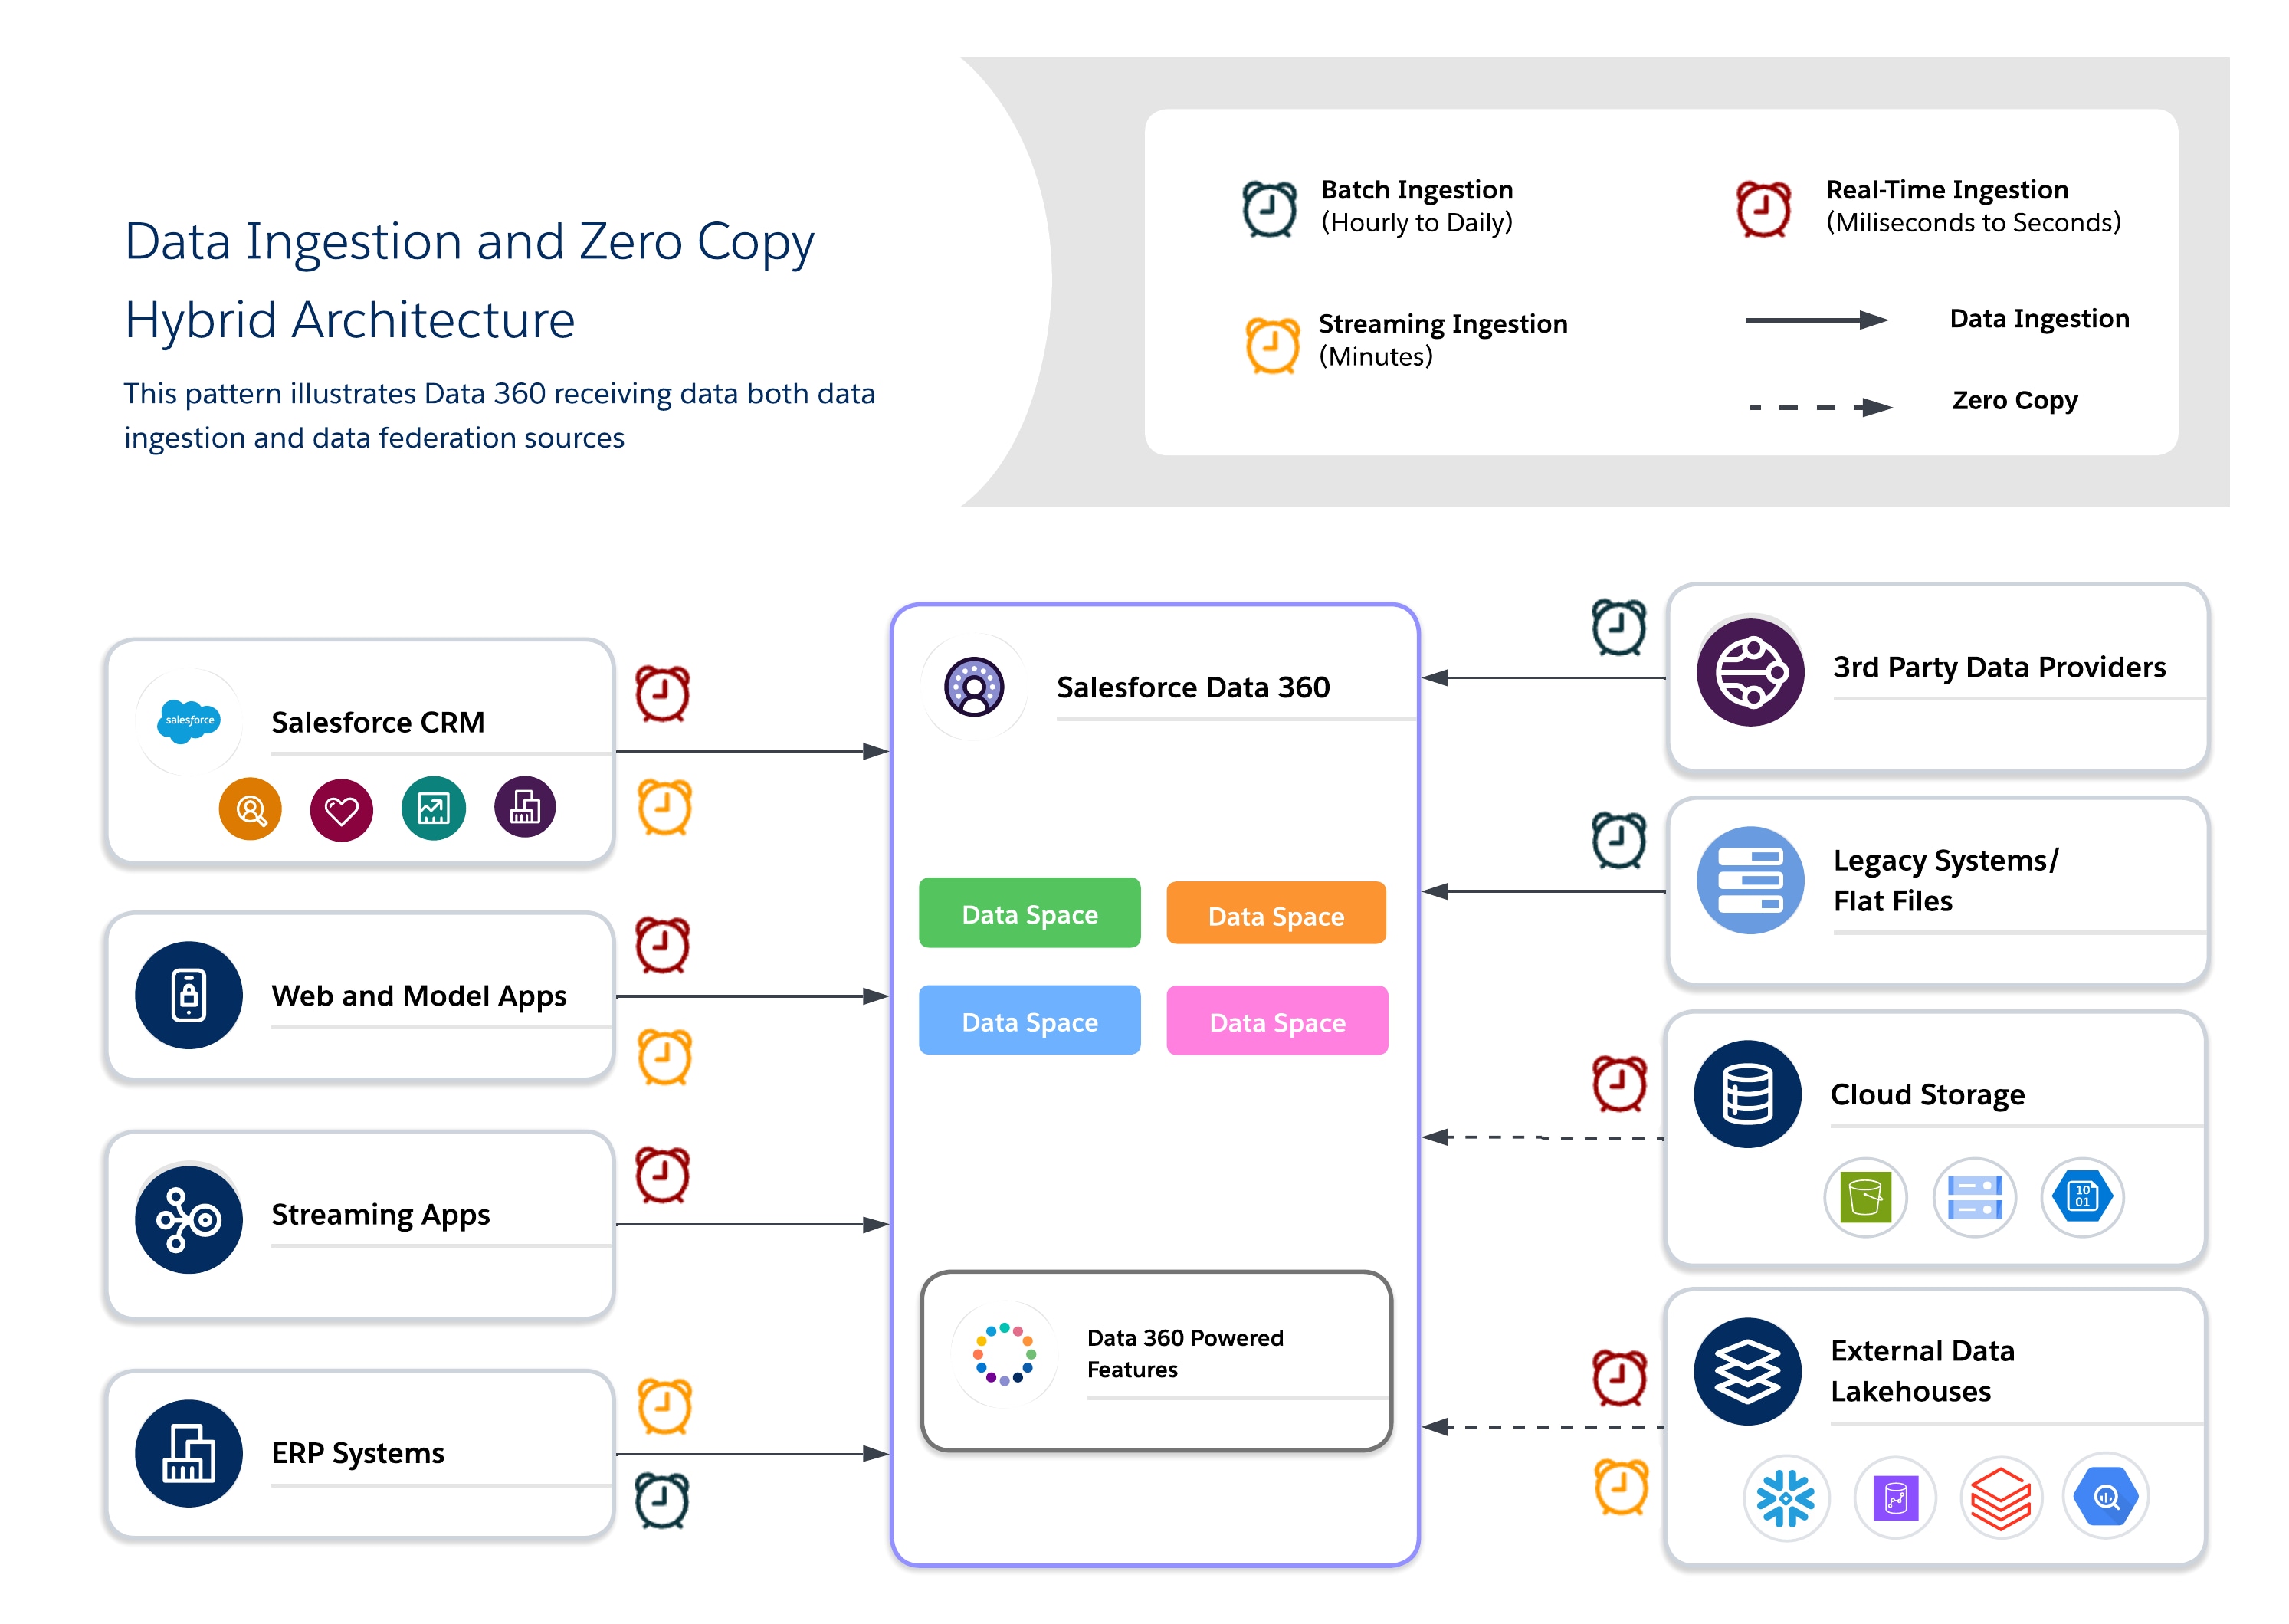
- Brukstilfeller
- Omnikanal-engasjement: Bland historiske kundedata med virkemåte i sanntid for å levere konsistente, kontekstbevisste opplevelser.
- AI/ML pipelines: Lær opp modeller på kuraterte, kanoniske datasett samtidig som du beriker dem med rå eller sanntids signaler fra eksterne kilder.
- Blandte samsvars- og fleksibilitetsbehov: Bruk streng styring for sensitive data, og forbund for operasjonell fleksibilitet.
- Industry Scenarios
- Detaljhandel: Bruk inntak til identitetsløsning og profilforening, og føderasjon til sanntidstilbud og tilpassing.
- Helse: Oppretthold gyldne pasientposter via inntak mens du bruker federasjon på IoT-enhetsstrømmer og sensordata for umiddelbar kontekst.
- Finansetjenester: Hent inn regulerte data i en overholdelsesstyrt innsjø mens du bruker federation til eksterne spørringer for å oppdage svindel og overvåke risiko.
- Design Practices
- Ankerstyring med inntak: Hent inn verdifulle eller regulerte data i kanoniske modeller for å sikre Trust og overholdelse.
- Bruk Federasjon for friskhet: Lar eksterne innsjøhus gi sanntidstilgang eller datatilgang i stor skala uten duplisering.
- Balanskostnad kontra ytelse: Profiler arbeidsbelastninger for å bestemme når det skal brukes inntak kontra føderering, noe som minimerer unødvendige lagrings- og spørringskostnader.
- Bruk lagdelt styring: Håndhev sentralisert styring for inntatte data samtidig som du benytter sikkerhetskontrollene for forente systemer (for eksempel RLS og maskering).
- Notat: Når du utformer hybrid under arbeid, er det viktig å sikre inkrementelt inntak for historiske datasett og push-aggregeringer eller filtre til forente kilder for å optimalisere I/O- og databehandlingsbruk.
- Kostnadsvurderinger
- Vekt den totale kostnaden mot ytelsen ved å kombinere inntak for overholdelse eller kritiske data med føderasjon når friskhet er nødvendig.
- Beregning av I/O- og datadistribusjon ved blanding av inntak og føderasjon. Hvis du vil redusere beregningskostnaden for gjentatte spørringer mot kildesystemer, bruker du bufring (Accelerated Query) for høyt lesede, ofte åpnede, forente datasett.
- Bruk denne regelen til å veilede inntaksbeslutningen kontra forbundsbeslutningen: Når data åpnes ofte, men endres sjeldent, er Accelerated Query vanligvis mer kostnadseffektivt. Men når data endres ofte (relativt til tilgangsfrekvensen), er direkte spørring eller inntak mer hensiktsmessig. Her er noen eksempler på kostnader:
- Acceleration vinner: Et kontrollpanel som er bygd fra 1M poster og oppdateres daglig med ~10 000 endringer, vises 20 ganger per dag. Acceleration kostnader tilsvarer omtrent ~600 studiepoeng / måned mot ~4,200 studiepoeng / måned for direkte spørringer.
- Live Query vinner: Segmenter som publiseres 20 ganger per dag med data som endres hvert 30. minutt. Direkte spørringer koster omtrent ~4,200 studiepoeng/måned mot ~28,800 studiepoeng/måned for akselerasjon med denne oppdateringsfrekvensen.
La oss se nærmere på noen få vanlige arketyper som illustrerer hvordan denne logikken brukes.
- Arketypen "Enkel sannhetskilde": Sentralisere og styre
- Scenario: Du må bygge samsvarende, forente Customer 360-profiler for hele den globale virksomheten. Dataene kommer fra et dusin forskjellige systemer, de må overholde strenge GDPR- og CCPA-forskrifter, og de vil tjene som sannhetskilde for all markedsføring og serviceinteraksjon.
- Anbefalt mønster: Datainntak. Prioriteten her er styring, Trust og kontroll. Å hente inn dataene i Data 360 er den eneste måten å opprette en fullstendig reviderbar, kanonisk profil som er isolert fra kildesystemene.
- Arkitypen "Sanntidsinnsikt": Analysere uten å flytte
- Scenario: Datavitenskapsteamet ditt må kjøre undersøkelsesspørringer på en massiv, kontinuerlig oppdaterende transaksjonstabell i Snowflake. Samtidig vil lederteamet ditt ha et direkte BI-kontrollpanel som leveres av de samme dataene. Flytting av petabyte data daglig er langsom og kostbar.
- Anbefalt mønster: Zero Copy Federation. Prioriteten her er hastighet, fleksibilitet og kostnadseffektivitet i stor skala. Med Zero Copy kan du utnytte kraften i ditt eksisterende datalager til sanntidsspørringer uten overhead og latens for dataduplisering.
- Arketypen "Hybrid intelligens": Styre kjernen, forene kanten
- Scenario: Du vil berike dine styrte, inntatte kundeprofiler med sanntids atferdsignaler (for eksempel klikk på nettsteder) fra en datasjø. Du trenger stabiliteten til kjerneprofilen, men umiddelbarheten til direktedataene for å kunne tilpasse i øyeblikket.
- Anbefalt mønster: En hybrid tilnærming. Bruk Datainntak til å opprette en stabil, styrt kjerne for kundedataene dine. Bruk Zero Copy til å forene de flyktige, sanntids "kantdataene" og deretter slå dem sammen på spørringstidspunktet for å få en fullstendig, oppdatert visning.
Virksomhetens datastrategi er ikke lenger fokusert på å velge ett enkelt integrasjonsmønster – det handler om å arkitektere kontrollert fleksibilitet i et interoperabelt dataøkosystem. Den riktige tilnærmingen tilordner hvert kildesystem til det mønsteret som passer best til kravene til friskhet, styring, kostnader og tilgang:
- Hent oppgavekritiske, regulerte datasett til Salesforce Data Cloud for overholdelse av krav, identitetsløsning og driftsarbeidsflyter.
- Samle data via Zero Copy for direkte, utforskende og AI-drevne analyser uten duplikatlagring.
- Bruk bufring (Accelerated Query) for å redusere kildesystembelastningen og kredittforbruket når spørringsfrekvensen er høy og dataendringsfrekvensen er lav
Salesforce Data 360 på Hyperforce gir fleksibilitet og skalerbarhet for flere områder. Det åpne innsjøhuset med _Iceberg-_tabeller muliggjør dataseparasjon og interoperabilitet med plattformer som Snowflake, Databricks og S3 Iceberg, som danner ryggraden i et virkelig interoperabelt, multi-cloud-datasystem.
Etter hvert som datasystemer utvikler seg, må vi kontinuerlig balansere friskhet, kostnader, ytelse og samsvar for å opprettholde arkitektonisk fleksibilitet. Derfor er det viktig å sikre plattformen i fremtiden ved å forene inntatte, administrerte data med samlet tilgang. Dette aktiverer sanntids intelligens, AI-aktivering og tilpassing i bedriftsskala på tvers av skyer, regioner og forretningsdomener.
Husk at løsninger som passer alle, passer ikke de fleste virksomheter. Den optimale strategien tilordner det riktige mønsteret til den riktige forretningsdriveren.
Yugandhar Bora er Software Engineering Architect på Salesforce som spesialiserer seg på dataarkitektur innenfor plattformen Data og Intelligence Applications. Han leder _EARB-_initiativer som fokuserer på datastyring og forente datamodeller, samtidig som han bidrar til automatiserte plattformklargjøringsløsninger.
Jan Fernando er hovedarkitekt i Salesforces Office of Chief Architect (OCA) som ble med i Salesforce i 2012. Han har mye erfaring fra oppstartsøkosystemet. Før han sluttet seg til OCA, var han i over ti år i organisasjonen Plattform, der han ledet flere viktige teknologitransformasjoner.