개요
현대 Salesforce 아키텍처는 단순한 편의를 넘어서, 규모 확장을 위한 전략적 요구사항으로 비동기 처리 방식을 채택하고 있습니다. 최근 몇 년 동안, 많은 기업들은 폭증하는 데이터 용량, 다중 터치포인트를 포함한 복잡한 통합, 그리고 24시간, 7일, 365일 가동되는 자율 시스템의 부상과 같은 문제에 직면해 있습니다. 이러한 모든 요소들은 시스템 아키텍트들이 비동기 우선 시스템을 설계하도록 유도합니다.
Salesforce에서의 비동기 처리는 거버너 제한과 복잡성을 고려하여 설계해야 함을 의미합니다. 이러한 제한들은 대량 데이터 처리에 안전하고 확장 가능한 시스템을 구축하는 데 도움이 되는 가드레일 및 아키텍처 제약의 역할을 합니다. 플랫폼 제한은 복잡성을 직접 관리하는 데 도움이 되지 않지만, 설계 패턴은 해당 측면에서 위험을 완화하는 데 도움이 됩니다. 내부적으로 Salesforce는 종종 플랫폼의 경계를 푸시하여 새로운 기능을 사전 테스트하고 복잡한 비즈니스 프로세스를 자동화합니다. 임의의 수의 단계를 사용하여 비동기 작업을 실행하기 위한 단계 기반 비동기 처리 프레임워크를 구축했습니다. 각 단계는 중앙 집중식 로깅을 통해 공유 관리 제어 및 전체 운영 가시성을 사용하여 독립적으로 실행, 재시도, 재시작할 수 있습니다. 이 문서는 핵심 아키텍처 구성 요소를 개략적으로 설명합니다. 대기 가능한 Apex 및 파이널라이저, 예약된 플로, Apex 커서, 호출 가능한 작업 및 Slack과의 통합 이러한 구성 요소들은 함께 변화하는 엔터프라이즈 요구에 적합한 모듈식, 확장 가능하며 관찰 가능한 아키텍처를 제공합니다.
- 현대 Salesforce 아키텍처는 비동기식 우선 접근 방식을 채택하여 규모, 복원력, 운영 투명성을 달성해야 합니다.
- 복잡한 작업을 독립적으로 실행 가능한 단계로 나누면 핵심 워크플로를 재설계하지 않고 예측 가능한 성능, 안전한 재시도, 점검 포인트, 롤백, 모듈식 진화가 가능합니다.
- 프레임워크는 단일 및 오래된 배치 작업, 체인화된 비동기 호출, 심층적으로 중첩된 플로에 확장 가능한 대안을 제공하며 플랫폼 외부 오케스트레이션 없이 Salesforce 내에서 가로로 확장해야 하는 대용량 워크로드에 대해 구축되어 있습니다.
- 결정적이고 관찰 가능한 실행은 중앙 집중식 로깅 및 거버넌스를 통해 진행률 추적, SLA 모니터링, 오류 진단, 감사 수준 투명성을 보장합니다.
- 장기 실행 비즈니스 프로세스 전반에서 통합 관리, 규정 준수, 분산된 시/도 제어 등 엔터프라이즈급 엄격성을 위해 설계되었습니다.
요구 사항을 검토하기 전에, 이러한 프레임워크를 사용할 때의 주의사항(해야 할 일과 하지 말아야 할 일)을 안내합니다. 무엇보다 신뢰할 수 있는 단일 소스인 시스템을 고려하십시오. Salesforce 조직이 외부 데이터에 최소한 의존하지만 레코드를 수백 개에서 수백만 개까지 확장해야 하는 경우 단계 기반 비동기 프레임워크를 고려하십시오.
다음과 같은 경우 이 프레임워크를 사용하십시오
- 작업할 정보의 대부분 또는 전부가 이미 CRM에 있습니다.
- 외부 데이터를 조화하기 위해 ETL(Extract Transform Load) 작업을 유지 관리하는 초기 또는 진행 중인 비용이 너무 높습니다.
- 설정된 일정에 따라 대량의 Salesforce 레코드 처리를 지연해야 합니다.
- 처리를 개별 단계로 세분화할 수 있습니다. 예를 들어, 데이터 용량이 계층 구조나 트리 형태로 확산되는 경우, 계층적 또는 트리 기반의 레코드 집합을 만들 수 있습니다.
다음과 같은 경우 이 프레임워크를 사용하지 마십시오
- 레코드를 만들거나 업데이트하려면 즉시 재계산해야 합니다.
- 외부 시스템에서 레코드 업데이트를 위한 기본 데이터를 호스팅하므로 통합이 어려울 수 있습니다. (대량 API를 사용하여 업데이트된 데이터를 Salesforce로 푸시하는 것이 좋습니다.)
이러한 관행을 염두에 두고 요구 사항을 검토하고 구축을 시작해 보겠습니다.
문제 설명:
매일 실행해야 하는 작업에 따라 특정 레코드가 사전 설정된 추가 처리를 위한 기준을 충족하는지 확인합니다. 기준을 충족하면 해당 처리 작업을 시작하십시오. 레코드를 처리하면 여러 외부 시스템에서 데이터를 가져와 계산을 수행할 수 있습니다. 작업의 단계는 Slack을 통해 처리된 레코드를 검토할 준비가 되었음을 사람들에게 알립니다. 또한 단계는 첫 번째 알림 라운드 후 구성 가능한 지연을 기반으로 역할 계층의 관리자 및 상위에 알림을 에스컬레이션해야 합니다.
이 문제는 몇 가지 다른 단계에 포함되며 일부 단계는 서로 독립적으로 수행될 수 있습니다. 여러 가지 방법으로 작업을 분할할 수 있습니다. 다음은 하나의 그룹화입니다.
- 스케줄러.
- 처리 유형에 관계없이 레코드를 처리하는 단계 인터페이스 및 구체적인 구현입니다.
- 단계를 구성하는 프로세서입니다.
- 스케줄러가 호출하는 Apex 인보커블 액션입니다.
- 알림 항목입니다. Apex Slack SDK를 사용합니다.
- “구성 가능한 지연”이라는 구문에는 몇 가지 복잡성이 숨겨져 있습니다. 이 문서에서는 나중에 이 복잡성을 검토하겠습니다.
다음은 구축된 프레임워크에 대한 의견이 반영된 다이어그램입니다.
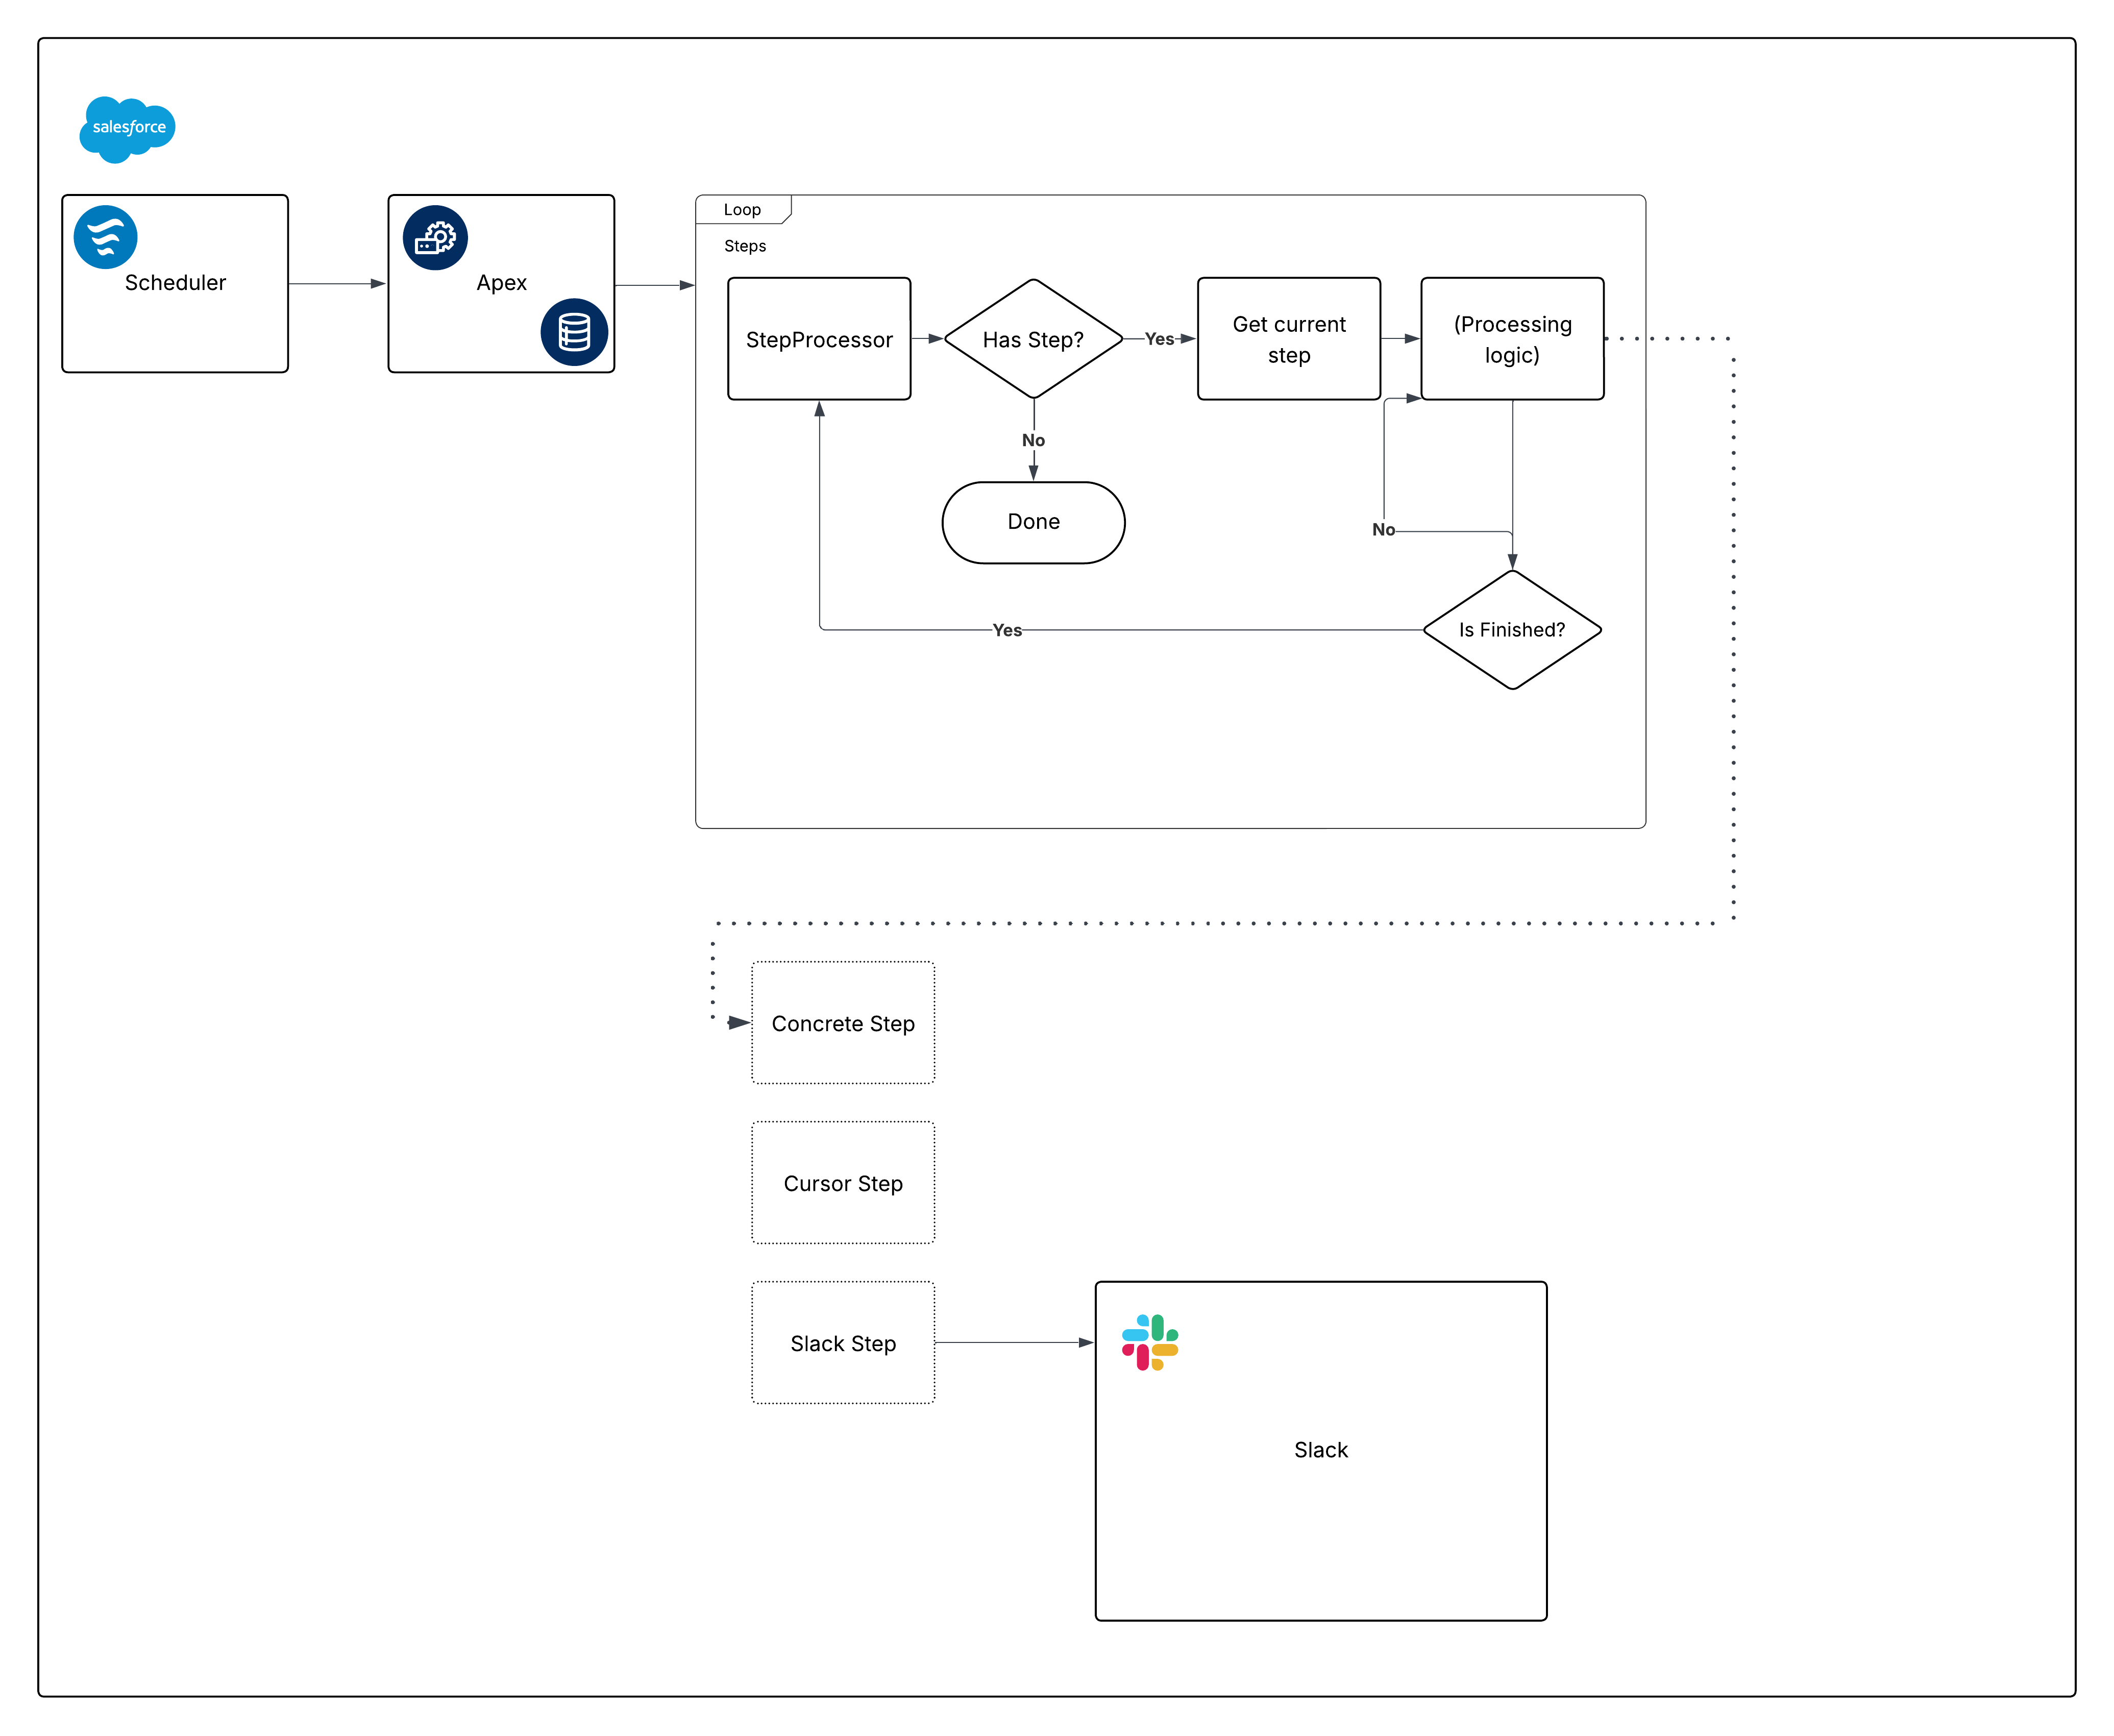 이제 그 다이어그램을 분해하고 각 부분을 만들어 봅시다.
예약된 플로우는 예약 메커니즘으로서 다음과 같은 몇 가지 장점을 제공합니다.
- 예약된 플로는 패키지화하고 메타데이터로 배포할 수 있습니다. 이는 Apex(또는 예약된 작업 페이지)를 통해 예약된 작업에는 해당되지 않습니다.
- 대기 요소는 콜아웃이 필요한 프레임워크에 중요합니다. 플로에서 이를 사용하면 프레임워크의 호출 가능 부분에서 콜아웃이 필요하지 않습니다.
- 스케줄링의 세분화는 요건을 충족합니다. 예약 플로의 최소 간격은 매일입니다. 빈도가 더 높아야 하는 경우(예: 시간별) 이 요구 사항에는 예약 플로가 적합하지 않을 수 있으니 다시 검토하십시오.
예약된 플로를 구성할 때 고려해야 할 또 다른 사항은 환경 게이팅입니다. Apex 작업을 호출하기 전에 {!$Api.Enterprise_Server_URL_100} 변수를 평가하는 Decision 요소를 추가합니다. 이렇게 하면 작업이 UAT 및 프로덕션과 같은 의도한 환경에서만 실행됩니다. 이 패턴은 샌드박스가 SDLC 동안 자주 새로 고쳐지거나 새로 생성되므로 중요하며, 명시적인 환경 확인이 없으면 프레임워크가 실행되어서는 안 되는 환경에서 예약된 플로우가 의도치 않게 실행될 수 있습니다. 결정 요소에서 contains 연산자를 사용하면 설정이 향후 샌드박스 생성 또는 URL 변경에 대응할 수 있습니다.
마지막으로 프레임워크에서 실패를 처리하는 방법을 고려합니다. 항상 플로에서 액션을 호출할 때 오류 경로를 추가합니다. 예를 들어, 오류를 Nebula Logger의 “로그 항목 추가” 액션에 연결할 수 있습니다. Nebula Logger는 로그를 사용자 정의 개체에 작성하므로 고객은 로그 데이터가 Org 저장소를 사용한다는 사실을 알고 있어야 합니다. 기본적으로 로그는 Org 내에 14일 동안 저장되고 이후 정리됩니다. 이 보존 기간은 구성할 수 있습니다. Nebula Logger는 플랫폼 이벤트를 사용하여 로그를 게시하므로 로그 항목이 기본 데이터 처리 트랜잭션과 독립적으로 저장되어, 기본 플로우 또는 Apex 액션이 롤백되는 경우에도 실패가 캡처됩니다. 고객은 로깅 프레임워크 추가를 고려할 때 예상되는 로그 용량 및 보존 요구 사항을 평가해야 합니다.
다음은 플로의 모습입니다.
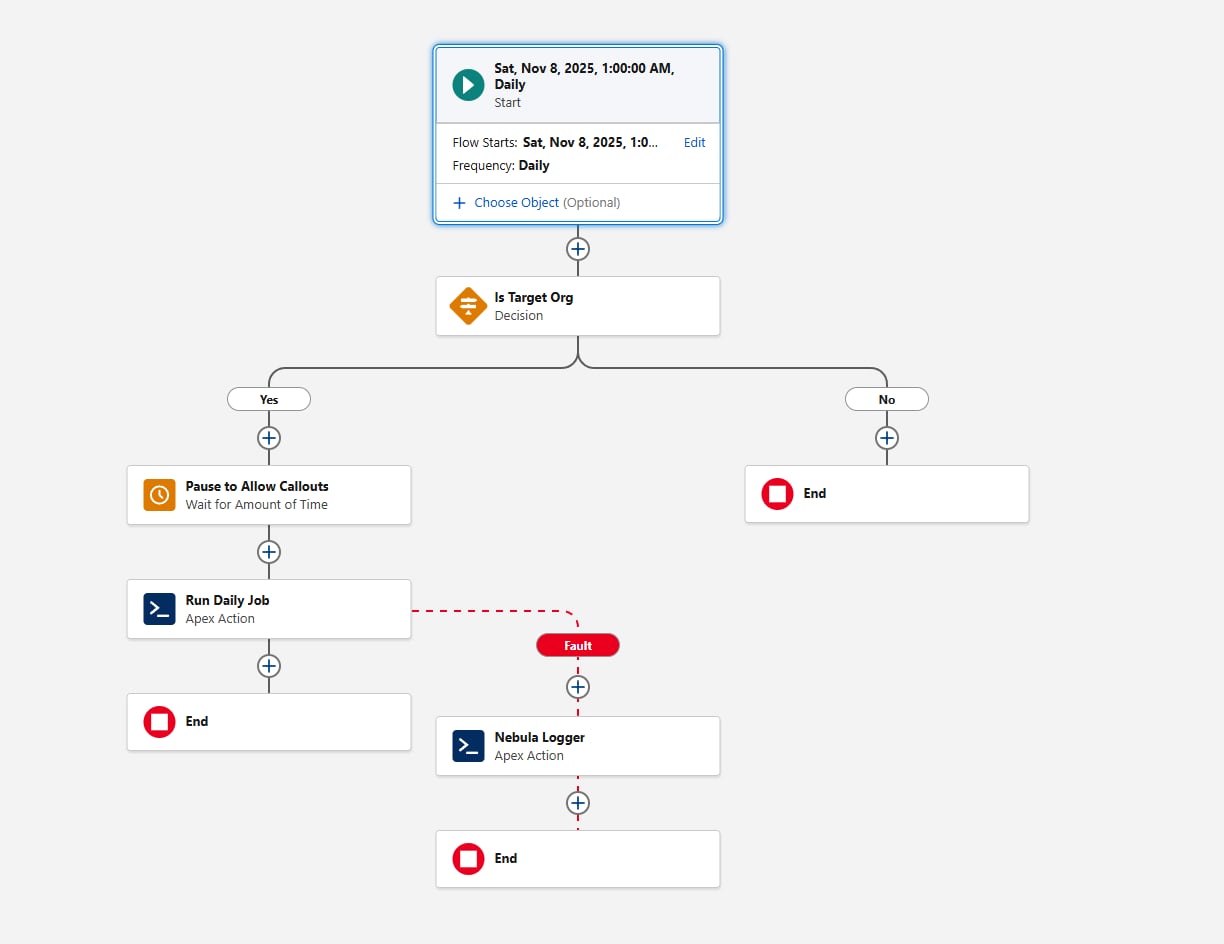
이제 예약 요구 사항을 충족했으니 Apex 코드의 첫 부분으로 넘어가겠습니다.
Step 인터페이스 정의:
이 문서의 경우 명확성을 위해 step 인터페이스가 외부 클래스로 표시됩니다. 프레임워크 자체는 유연합니다. 팀은 모든 단계 클래스가 동일한 인터페이스를 참조하는 한 원하는 Apex 패키징 패턴을 사용하여 인터페이스 및 구현을 구성할 수 있습니다.
인터페이스 내에 정의된 메서드에 대해 참고해야 할 몇 가지 사항이 있습니다.
execute는 현재 매개변수가 없지만, 순서가 중요한 경우 단계 간 데이터 오케스트레이션을 위해State클래스(또는 인터페이스)를 전달하면 더욱 효과적입니다.getName은System.Type대신String값을 반환할 수 있습니다. 목표는 오케스트레이션 레이어에 다른 속성을 노출하지 않고 단계 이름을 기록하는 방법을 제공하는 것입니다.
다음은 이러한 조각이 함께 어울리는 방식을 보여주는 첫 번째 구체적인 구현입니다. 한 가지 예외를 제외하고 Apex 내에서 비동기 처리를 구현하기 위해 Queueable Apex를 사용하는 것이 좋습니다. Batch Apex는 일반적으로 필요하지 않으며 (@future 메서드는 권장되지 않습니다). Queueable Apex는 빠르게 시작되며, Apex 커서를 사용하면 배치 Apex에 비해 많은 장점이 있습니다.
Apex Cursors는 전통적인 Batch Apex 모델에 대한 현대적인 대안을 제공합니다. 배치 처리와 유사하게, 커서 구현은 청크로 레코드를 가져올 수 있습니다(배치당 최대 2,000개). 그러나 커서는 단일 트랜잭션 내에서 여러 개의 가져오기를 허용하므로 대용량 작업의 처리량이 현저하게 높아집니다.
이 프레임워크의 일부로 커서를 도입할 때에는 팀이 현재의 테스트 및 모의 가능성 제한 사항을 인지해야 합니다. 테스트의 커서 동작은 프로덕션 동작과 다를 수 있으므로 커서 내부에 의존하지 않고 경계에서 오케스트레이션 논리를 확인하는 테스트 전략을 설계하는 것이 중요합니다. 플랫폼이 발전함에 따라 이러한 영역은 계속해서 개선되지만 핵심 지침은 다음과 같습니다. 커서는 많은 사용 사례에서 배치 Apex에 비해 더 높은 성능과 감소된 오케스트레이션 오버헤드를 제공합니다.
시스템에서 제공하는 커서와 자체 코드 간의 명확한 경계를 정의하려면 Step 인터페이스를 구현할 때 커서와 유사한 표현을 만드는 것이 좋습니다. 다음 코드를 고려하십시오.
Cursor 클래스에 주목하십시오. Apex 커서는 Database.Cursor의 인스턴스이지만, Cursor 구현은 Cursors의 단점에 대해 유연성을 제공합니다. 다음은 구현 방법입니다.
이 문서의 나머지 부분에서는 Apex 클래스를 참조할 때 sharing 선언을 생략합니다. 실제로 최상위 클래스에서 with sharing 또는 without sharing을 명시적으로 사용하여 오브젝트 모델 및 권한을 준수하도록 하십시오.
또한 저희의 Cursor 구현은 플랫폼 Database.Cursor에 위임되며, 추가적인 이점에 대해서는 다음에서 논의합니다.
먼저, 다음은 이에 해당하는 테스트입니다.
Cursor을 가상으로 만들면, 구체적인 CursorStep 구현체는 대량의 레코드 집합을 반복할 필요가 없을 때 Database.Cursor 없이 작동할 수 있습니다. 이는 Batch Apex에서 Database.QueryLocator 대신 System.Iterable<T>를 반환하는 것과 유사합니다. 다음은 예시입니다:
이 클래스가 추상 클래스이기 때문에, 구체적인 innerExecute 구현은 하위 클래스에 위임됩니다.
CursorLike 내부 하위 클래스의 대안도 있습니다. 이와 같은 단계의 구체적인 버전이 다른 Governor 한도를 초과하지 않을 경우 CursorLike.fetch에서 this.records를 반환하고, 상위 CursorStep.shouldRestart()를 false로 재정의할 수 있습니다. 이렇게 하면 비동기 트랜잭션 당 12MB의 Apex 힙 제한만을 경계로 리스트를 순회할 수 있습니다.
우리의 커서 기반 구현은 대량의 데이터를 페이지 단위로 처리할 때 상당한 유연성을 제공합니다. 한편, Step 인터페이스는 다양한 단계를 설명하고 캡슐화할 수 있는 유연성을 제공합니다.
플로우 기반 단계의 예를 고려해 보십시오:
플로우는 Apex에서 정의한 타입에 부합하는 출력 매개변수를 반환할 수 없으므로, 사용 전에 shouldRestart 출력 매개변수의 존재 여부를 확인합니다.
일부 단계는 기능 플래그 처리가 적용될 수 있습니다. 어떤 단계를 포함할지 결정하는 로직을 구현하거나, 비활성화된 기능에 대해서는 동작 없는(no‑op) 단계를 사용할 수 있습니다. Null 객체 패턴은 오케스트레이션 계층 내에서 복잡성을 줄이는 일반적인 방법입니다.
이제 우리가 활용할 수 있는 빌딩 블록들이 상당히 많이 마련되었습니다. 단계를 순회하는 역할을 담당하는 오케스트레이션 레이어를 살펴보겠습니다.
프로세서는 아키텍처의 변화 지점입니다. 어떤 단계가 어디에서 초기화되는지, 그리고 누가 이를 정의하는지 결정해야 합니다. 옵션은 다음과 같습니다:
- 프로세서가 비즈니스 논리에 매핑되는 단계를 정의하도록 합니다. 이 옵션은 간단하지만, 가독성 측면에서는 확장성이 떨어집니다.
- 사용자 정의 메타데이터(CMDT)를 사용하여 매핑을 정의합니다. Metadata 관계 필드는
ApexClass을 지원하지 않아, 클래스 이름의 철자가 비즈니스 프로세스 설정에 느슨하게 결합됩니다. 필드를 선택 목록으로 만들고 유형이 있는지 확인(Type.forName()또는ApexClass쿼리)하여 관리자 위험을 줄일 수 있지만 CMDT 레코드에서 트리거를 지원하지 않으므로 런타임 시 확인이 수행됩니다. 이 경로는 테스트할 수 있지만 관리자는 프로덕션에서만 CMDT 레코드를 만들 수 있습니다. 주의를 기울여 진행하십시오. - 레코드와 매핑을 정의합니다. 비관리자도 단계를 구성할 수 있지만, 배포가 더 어려워지고 환경이 달라질 수 있습니다. 주의를 기울여 진행하십시오.
Clean Code의 유명한 인용은 이 특정한 복잡성을 처리하는 방법에 관한 것입니다.
이 문제의 해결책은 [개체 생성을 위한]
switch문구를 추상 공장의 지하실에 숨기고, 아무도 보지 못하도록 하는 것입니다.
이를 염두에 두고 현재 단계 수가 잘 정의되어 너무 커질 가능성이 없으므로 단계 프로세서도 단계의 공장이 될 수 있습니다. 다음과 같이 열거형을 사용하여 switch 문을 구동할 수 있습니다.
그리고 우리의 StepProcessor:
addTypeOneSteps()와 같이 표시된 공장 방법은 기능 플래그 지정과 같은 우려 사항을 위임할 수 있습니다. cleanSteps()는 수집된 단계를 한 번 확인하여 진정한 비동기화 이전에 “비어 있는” 단계가 없는지 확인합니다. 다음과 같이 표시될 수 있습니다.
예약된 플로우 섹션에서 Nebula Logger를 언급한 이후로 오류 처리에 대해 논의하지 않았습니다. 이는 System.Finalizer가 각 단계에서 별도의 오류 처리를 추가하지 않고도 모든 오류 조건에 대해 포괄적인 로깅을 가능하게 하기 때문입니다. 각 Step는 실행에 초점을 맞추고, 문제 발생 경로를 로깅한 후 재전달하여 단위 테스트에서 드러나도록 합니다. 이는 안전한 반복 및 프로덕션 수준 경고(모든 WARN 및 ERROR 로그에 대해 Nebula용 Slack Logger 플러그인 사용)를 지원합니다.
오류 로깅에 대한 한 가지 참고 사항: 단계 인스턴스를 로그 메시지에 전달하면 로그에 표시되는 것에 대한 신뢰 수준을 가정합니다. Apex 클래스의 기본 toString()에는 메시지의 모든 정적 및 인스턴스 수준 속성이 포함됩니다. 이는 바람직하거나 민감한 정보가 누출될 수 있습니다. 로깅 및 보안이 여기서 초점이 아니지만, 일부 시스템의 경우 Step와 같은 인터페이스를 준수하면 toString()에 대한 강제 재정의도 포함될 수 있습니다.
이러한 방법은 각 객체 생성자에게 무엇을 출력할 수 있는지 결정할 책임을 부여하며, 이는 바람직할 수 있습니다.
로그 수준에 대해: StepProcessor 단계에서는 오류가 아닌 가장 높은 수준인 INFO를 사용합니다. 응용 프로그램 내에서 세분화되면 로그 수준이 그에 따라 감소해야 합니다. 개별 단계에서는 높은 수준의 정보에 대한 DEBUG를 사용할 수 있으며, FINE, FINER 및 FINEST는 점점 더 자세한 결과를 위해 예약됩니다. 로깅은 과학만큼이나 예술이기도 합니다. 이러한 원칙을 따르면 로그를 일관되고 유용하게 유지할 수 있습니다.
진행하기 전에 단계 프로세서에서 사용되는 단계 논리를 호스팅하도록 결정하는 것에 대해 간략하게 생각해 보겠습니다. 대규모 코드베이스에서는 StepProcessor를 가상 또는 추상으로 만들어 하위 클래스가 특정 단계를 식별하여 적절하게 관심사를 분리할 수 있도록 하는 것을 고려하십시오.
스케줄러가 결국 Apex를 호출합니다. 나머지 설정이 완료되면 호출 가능한 Apex 섹션에서 실행할 단계를 결정하고 프로세서에 List<StepType>를 전달할 수 있습니다.
이는 레코드, 데이터 또는 논리를 사용하여 실행할 단계 유형을 결정하는 방정식의 간단한 부분입니다. 호출 가능한 작업은 복잡성을 다른 곳으로 캡슐화하므로 간단합니다. 또한 예기치 않은 예외를 방지하고 각 항목을 격리적으로 쉽게 테스트할 수 있습니다.
Apex Slack SDK는 이 문서의 범위를 벗어나지만, 요구 사항 중 하나의 잠재적인 장애물은 구성 가능한 지연을 기반으로 역할 계층에서 상향으로 사람을 알리는 것입니다. 문서상으로는 간단하며, (정확하게도) StepProcessor 내에서 System.enqueueJob(this)를 고려할 수 있습니다. System.AsyncOptions를 사용하면서, 당초에는 이 요구 사항을 충족하기 위해 enqueueJob 오버로드를 사용하는 것을 고려했습니다.
그러나 System.AsyncOptions.MinimumQueueableDelayInMinutes를 통한 최대 지연 시간은 10분입니다. 요구 사항은 120분이므로 몇 가지 옵션이 남아 있습니다. 순진한 접근 방식은 다음과 같습니다.
실제로는 지연값이 구성에 따라 이 클래스에 전달될 것입니다.
지연된 알림 유형이 한 개만 있는지 확신하지 않는 한 이 접근 방식을 사용하지 않는 것이 좋습니다. 시작 전에 추가적으로 11개의 비동기 작업을 소모하며, 지연이 증가하면 그 수가 더 많아질 수 있습니다. 해당 비용은 한 작업에는 괜찮을 수 있지만, 여러 작업에는 적합하지 않습니다. 또한 Step 인터페이스에 메서드를 추가해야 하므로, 각 단계가 재시작 전 대기 시간을 프로세서에 전달하게 되어 불필요한 복잡함이 가중됩니다.
두 가지 흥미로운 가능성이 있습니다.
- 이미 적절한 간격으로 폴링 작업이 예약되어 있다면, 기존 작업 프레임워크에 지연된 단계를 추가할 수 있습니다. 지정된 지연이 최대 15분 늦어져도 문제가 없어야 합니다(15분은 Apex 예약 CRON 식의 최소 새로 고침 간격입니다). 이는 대략적으로 호출 가능한 Apex 예와 일치하며, 대신 Apex를 통해 예약이 수행됩니다. 즉, 동일한
Step기반 아키텍처를 재사용하여 ‘Start After’ 타임스탬프를 기준으로 레코드를 처리하고, 이전에 제시된StepType열거형 값에 대응하는 선택 목록이나 다중 선택 목록 매핑을 기반으로 사용할 단계를 결정할 수 있습니다. - 또는 추가 외부 Apex 클래스를 정의하는 데 편한 경우
System.scheduleBatch()를 사용하여 배치 Apex로 돌아갑니다(내부 클래스를 지원하는 Queueable Apex와 달리 배치 Apex 클래스는 외부 클래스여야 합니다).
배치 Apex 예제를 고려하십시오. 일반적으로 유연성과 제어를 위해 Queueable Apex를 권장하지만, 배치 Apex가 여전히 최상의 선택인 경우가 있습니다:
그리고 StepProcessor 내에서 이전에 제시된 addTypeOneSteps() 메서드가 이 지연 단계로 업데이트된다고 가정해봅니다.
비록 이런 복잡한 절차는 일반적으로 권장되지는 않지만, 이 단계 지연은 또 다른 재사용 가능한 구성 요소가 됩니다. Queueable Apex에서 더 긴 지연이 허용되기 전까지, 이 방식은 (폴링 메커니즘 없이) 동일한 효과를 내는 가장 쉬운 방법입니다.
개체 중심 설계를 사용하여 요구 사항을 충족하고 건물 및 유지 관리 비용의 장기적인 균형을 유지하면서 확장할 수 있는 시스템을 만들었습니다. 단계 선언 및 인스턴스화는 결국 StepProcessor의 범위를 벗어날 수 있지만, 추가적인 기술 부채는 거의 없습니다. FlowStep를 통해 관리자와 개발자는 코드 없음 또는 프로코드 솔루션이 가장 적합한 시점을 함께 결정할 수 있습니다.
Apex의 Queueable 프레임워크 내의 System.Finalizer 인터페이스를 사용하여 Nebula Logger와 함께 강력하고 테스트 가능한 시스템을 구축하여 향후 단계에 명시적인 로깅이 없더라도 예기치 않은 실패를 경고합니다. 이 시스템은 안정적으로 성능을 발휘하며 비용과 복잡성을 줄입니다. 또한, 실제 작업 부하 하에서 Apex Cursors의 동작에 관한 귀중한 인사이트를 제공하여 접근 방식을 개선하고 기능 자체를 향상하는 데 기여했습니다.
복잡한 대용량 작업 부하를 모듈식 실행 단계로 분해함으로써, 단계 기반 비동기 처리 프레임워크는 플랫폼 제약을 오히려 엔지니어링된 장점으로 전환하여 예측 가능한 성능, 관찰 가능성 및 기업 규모의 거버넌스를 구현합니다. 관리자와 개발자 모두 단계를 설정할 수 있으며, 이 경우 단계 작성자는 각 단계를 확장하는 방법에 대해 신경 쓸 필요 없이 DML 행 수나 조회 행 수와 같은 기본 플랫폼 거버넌스 제한을 준수하는 데 집중할 수 있습니다.
엔터프라이즈 구현에서 이 패턴을 운영하고 채택하려면 설계자가 다음을 수행해야 합니다.
- 기존 자동화 평가를 통해 비동기 오케스트레이션이 성능과 관찰성 향상에 도움이 될 수 있는 영역을 식별합니다.
- 대규모 프로세스를 분해하여 명확한 처리 목표와 개별 작성 지점(예: Flow 또는 Apex)을 가진 독립적으로 실행 가능한 단계로 나눕니다.
- 단계 유형을 정의하고 그룹화하여 사업부 전반에 걸쳐 단계 재사용과 표준화를 가속화할 수 있습니다.
- 방식을 시범 운영하여 새로운 프로세스나 기존 자동화에 적용해 봅니다. 내장된 로깅과 관찰성 덕분에, 단계 내에서 추가 비용 없이 많은 엣지 케이스가 자연스럽게 드러나는 것을 경험할 수 있습니다.
James Simone은 Salesforce의 주 소프트웨어 엔지니어이며 플랫폼에서 10년 이상 작업한 경험을 보유하고 있습니다. 그는 개발을 시작하기 전에 Salesforce 고객이자 제품 소유자였으며, 2019년부터 The Joys Of Apex에서 Salesforce에 대한 기술적 심층 분석을 작성하고 있습니다. 이전에는 Salesforce 개발자 블로그 및 Salesforce 엔지니어링 블로그에도 기사를 게시했습니다.