기업은 인보이스, 구매 주문, 법률 계약, 기술 설명서 등 다양한 문서 유형을 처리합니다. 수동 처리는 느리고 오류가 발생하기 쉬우며 직원 시간의 예상 15~25%를 소비합니다. 이전 자동화 접근 방식(예: 로봇 프로세스 자동화(RPA), 광학 문자 인식(OCR) 및 워크플로 도구)은 일부 부담을 줄였지만, 견고한 파이프라인, 높은 유지 보수 오버헤드, 개별 비즈니스 팀 간의 단독 채택이 발생했습니다.
문서에는 일반 텍스트 처리로는 보존할 수 없는 풍부한 구조적 컨텍스트(예: 테이블 계층, 공간 필드 관계, 교차 참조 섹션)가 포함되어 있습니다. 문서를 일반 텍스트로 제거하면 추출을 정확하고 유용하게 만드는 비즈니스 컨텍스트가 삭제되고 다운스트림 분석, 인공 지능(AI) 추론 및 프로세스 자동화의 품질이 저하됩니다.
효과적으로 사용할 수 있도록 인텔리전트 문서 처리(IDP) 시스템은 문서를 유형별로 분류하고, 가변 레이아웃에서 구조화된 데이터를 정확하게 추출한 다음, 관리 가능한 쿼리 가능한 형식으로 다운스트림 시스템에 해당 데이터를 전달해야 합니다. 또한 IDP는 모든 새 문서 형식에 대해 템플릿별 구성을 요구하지 않고 대규모로 문서의 다양성을 처리해야 하며, 각 사업부에서 중앙에서 접근할 수 있어야 합니다. 비정형 데이터는 모든 엔터프라이즈 데이터의 약 80%를 차지하며, 대부분은 파일 시스템, 클라우드 저장소, Customer Relationship Management(CRM) 시스템, AI 에이전트, 분석 플랫폼의 손쉽지 않은 컨텐츠 저장소에서 문서 형식으로 축적됩니다.
_Data 360 문서 AI_는 이 격차를 해결하도록 설계된 Data 360 내의 Salesforce 문서 처리 기능입니다. Language Models(LLM), Optical Character Recognition(OCR), Natural Language Processing(NLP), _Machine Learning(ML)_을 사용하여 비정형 및 반정형 문서 콘텐츠를 추출, 분류 및 분석합니다. 출력은 Data 360 파이프라인에 통합되는 구조화, 관리 및 쿼리 가능한 데이터이며, 여기서 Agentforce 에이전트, 분석 도구 및 자동화 워크플로가 사용자 정의 추출 또는 변환 계층 없이 표준 인터페이스를 통해 액세스할 수 있습니다.
엔터프라이즈 데이터 플랫폼은 구조화된 테이블 형식의 데이터를 처리합니다. 그러나 대부분의 엔터프라이즈 데이터는 문서로 도착하며, 누군가가 수동으로 추출할 때까지 CRM, ERP, AI 에이전트, 분석 파이프라인에서 접근할 수 없습니다. 이는 워크플로 문제가 아닌 아키텍처 격차입니다.
이전 접근 방식은 수동 재입력, 규칙 기반 OCR, RPA 스크립트를 결합했습니다. 이러한 방법들은 소규모에서는 작동했지만, 현대 기업에서 생성하는 문서 유형의 대량, 다양성 및 속도를 처리할 수 없었습니다. 규칙 기반 도구는 레이아웃 변형당 명시적 템플릿을 필요로 합니다. 형식이 변경되면 추출이 중단되어 개발자, 새 템플릿, 그리고 배포 과정이 필요합니다.
확장 시 중앙 집중식 관리, 공유 스키마, AI 준비 경로가 없는 취약한 포인트 솔루션이 생성됩니다. 불일치하는 추출 파이프라인이 다운스트림으로 전파됩니다. 즉, 분석은 데이터 불일치를 상속하고, AI 모델은 신뢰할 수 없는 결과를 제공하며, 개인 건강 정보(PHI) 및 _개인 식별 정보(PII)_와 같은 규제된 콘텐츠는 체계적인 관리가 부족합니다.
LLM은 명시적 템플릿 없이 필드를 추출합니다. 단일 스키마 구성은 레이아웃 변형, 언어, 형식 전반의 추출을 관리하며, 이는 문서가 고정된 구조에 맞춰야 하는 것이 아니라, 문서에 맞게 적응합니다. 이로써 문서 처리는 유지 관리가 많이 필요한 사일로화된 작업에서 관리되고 중앙 집중화된 기능으로 전환됩니다.
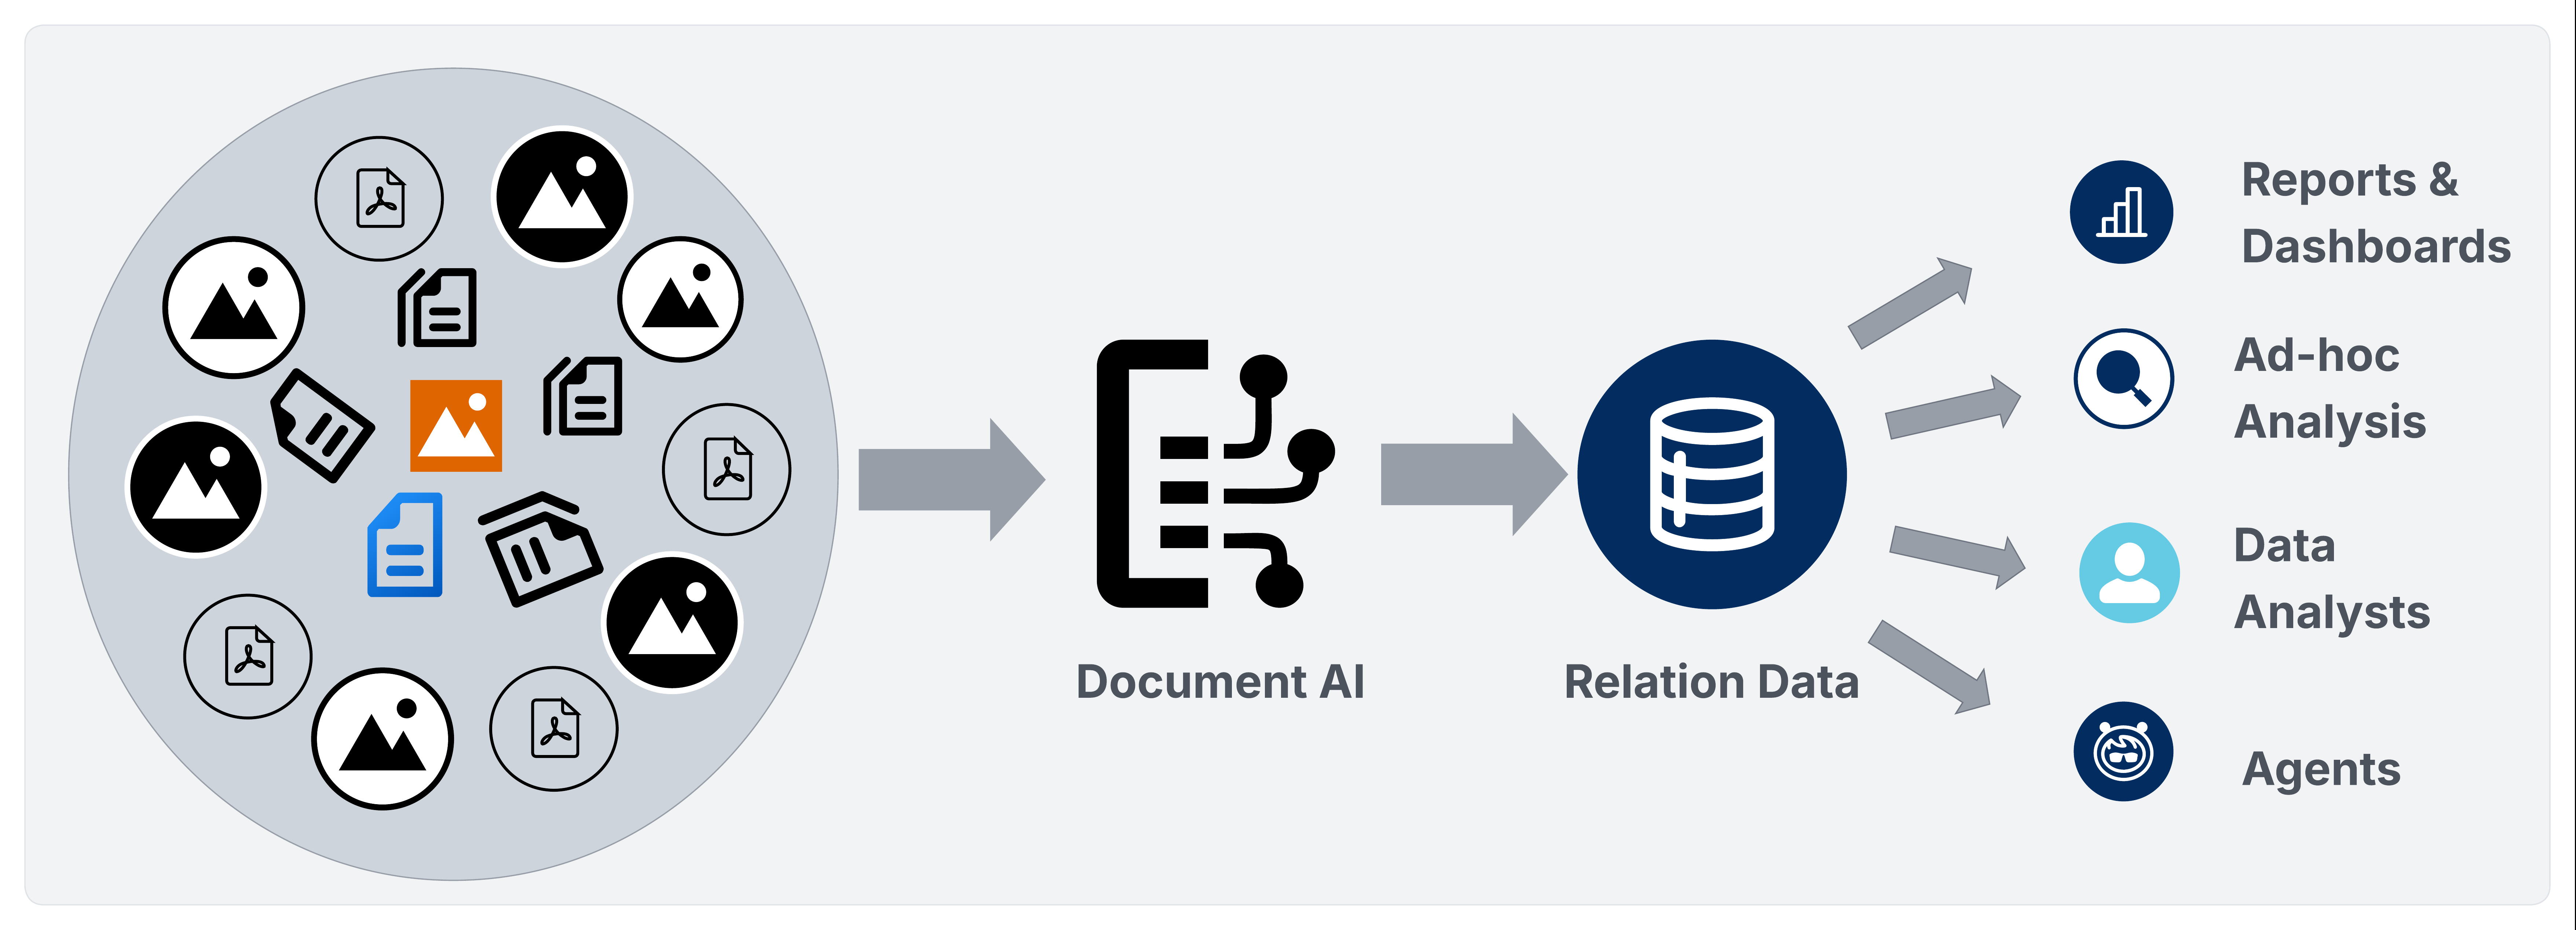
_Data 360 Document AI_는 두 파이프라인을 통해 Data 360 플랫폼 내에서 문서 처리를 운영합니다.
- _배치 파이프라인_은 수집, ID 확인, 계산된 인사이트, 활성화, 분석 및 Agentforce 활성화를 통해 추출된 데이터를 라우팅합니다.
- _트랜잭션 처리 파이프라인_은 구조화된 _JSON_을 동기식으로 반환하는 REST API를 제공하므로, 아키텍트가 문서에서 파생된 데이터를 Salesforce SObjects, Data 360 Data Lake Object/Data Model Object(DLO/DMO) 파이프라인 또는 외부 데이터베이스 및 창고로 배치 설정 오버헤드 없이 라우팅할 수 있습니다.
두 경우 모두 추출된 데이터가 분산된 포인트 툴 집합이 아닌, 관리되는 스키마 기반의 모델에 들어갑니다.
Data 360 문서 AI는 Data 360 플랫폼 내의 Salesforce 기본 인텔리전트 문서 처리(IDP) 기능입니다. 비정형 및 반정형 문서 콘텐츠를 관리되고 쿼리 가능한 데이터로 변환하여 전체 Data 360 수명 주기 전반에 걸쳐 완전히 활용할 수 있도록 합니다.
Data 360 문서 AI는 Data 360 내의 Salesforce 기본 인텔리전트 문서 처리(IDP) 기능입니다. 비정형 및 반정형 문서를 수집하고, 선언적 스키마 구성을 사용하여 구조화된 데이터를 추출하고, 조합, ID 확인, 분석 및 Agentforce 활성화를 위해 해당 데이터를 Data 360 파이프라인에 전달합니다.
Data 360 문서 AI는 다음 두 가지 처리 모달을 지원합니다.
- 대량 배치 처리: 이벤트 기반으로 _비정형 데이터 모델 개체(UDMO)_에 정의된 대규모 문서 집합을 처리합니다.
- 트랜잭션 처리: REST API를 통해 단일 문서를 처리하고 구조화된 JSON 페이로드를 동기식으로 반환합니다. 그런 다음, 설계자는 해당 페이로드를 Data 360 DLO/DMO 파이프라인, Salesforce SObjects 또는 외부 데이터베이스 및 창고로 라우팅할 수 있습니다. MuleSoft, Apex 콜아웃 또는 Einstein Trust Layer(ETL) 파이프라인을 통해. 대상 계층은 대기 시간, 거버넌스, 데이터 보존 요구 사항에 따라 결정되는 아키텍처적 선택입니다.
문서 AI는 현재 PDF 파일, 이미지 파일(JPEG, PNG), 수기 문서를 지원합니다.
Data 360 Document AI는 네 가지 처리 기술을 하나의 관리형 파이프라인으로 조합합니다. 각 구성 요소는 문서-데이터 수명 주기의 고유한 단계를 처리합니다.
- 광학 문자 인식(OCR): LLM 처리가 시작되기 전에 스캔된 이미지, 수기 작성된 콘텐츠, 이미지 기반 PDF를 기계가 읽을 수 있는 텍스트로 변환합니다. 신뢰할 수 있는 추출을 위해 최소 150 DPI를 사용하는 것이 좋습니다.
- 대형 언어 모델(LLM): 사용자가 선택한 모델을 사용하여 Einstein LLM 게이트웨이를 통해 추출을 라우팅합니다. LLM은 JSON 스키마 구성과 함께 OCR 출력을 수신하고 구조화된 추출 페이로드를 반환합니다. Gemini 및 추가 모델은 향후 구현을 위해 계획되고 있습니다.
- 자연어 처리(NLP): 구조화된 프롬프트 엔지니어링을 통해 LLM 내에서 직접 상황별 이해, 엔티티 인식, 날짜 구문 분석, 시맨틱 필드 추출을 수행합니다. 스키마 정의 프롬프트 및 OCR 출력은 유일한 입력 항목입니다. 모든 LLM 상호 작용은 ETL을 통해 라우팅됩니다. ETL은 모델 공급자와의 데이터 보존을 제로 적용하고 모델에 도달하기 전에 텍스트 기반 입력에서 _PII_를 마스킹합니다. 별도의 NLP 엔진이 적용되지 않습니다.
- 다중 모달 처리: PDF 내에 포함된 이미지를 별도의 추출 입력으로 처리하여 LLM이 다이어그램, 이미지 렌더링 테이블, 혼합 콘텐츠 페이지에서 데이터를 추출할 수 있으므로 OCR만 분석할 수 없습니다.
네 가지 처리 기술 외에도 _Document AI_도 다음을 처리합니다.
- Einstein Trust 레이어: ETL을 통해 모든 LLM 상호 작용을 라우팅합니다. ETL은 모델 공급자와의 데이터 보존을 제로 적용하고 입력이 LLM에 도달하기 전에 _PII_를 마스킹합니다. 현재 PII 마스킹이 지원되지 않고 데이터가 외부 모델로 그대로 전송되는 멀티모델 데이터(예: Document AI를 통해 처리되는 첨부된 문서)는 제외됩니다. ETL은 LLM 상호 작용 경로만 관리합니다. _Data Lake Objects(DLO)_에 기록된 추출된 데이터는 그대로 저장됩니다. 미사용 상태인 필드 수준 마스킹은 다운스트림 데이터 거버넌스 컨트롤을 통해 해결해야 합니다.
- 파일 크기 제한: _Document AI_는 요청당 최대 10MB의 파일을 처리합니다. LLM 컨텍스트 길이 제한은 이 경계 내에서 밀집형 다중 페이지 문서의 처리를 추가로 제약할 수 있습니다.
_Data 360 Document AI_를 구축하는 엔터프라이즈 아키텍트는 구현 설계에 착수하기 전에 이러한 원칙을 적용해야 합니다.
- 스키마를 설계하기 전에 파이프라인을 선택합니다. 배치 및 트랜잭션 처리 파이프라인은 수집 모델, 스키마 바인딩, 목표 유연성 및 지연 시간에 차이가 있습니다. 구체적으로 수정하면 불가능한 재작업이 추가되므로 스키마를 정의하기 전에 각 사용 사례에 필요한 파이프라인을 확인해야 합니다.
- 문서 유형 수준에서 스키마를 설계하세요. 문서 유형별로 잘 설계된 단일 스키마를 사용하는 것이 사용 사례별 구성을 사용하는 것보다 유지 관리가 더 쉽고, 추출 품질을 높이는 데 가장 큰 역할을 합니다. 이 작업을 올바르게 수행하려면 단일 예시만으로 설계하는 것이 아니라, 다양한 문서 집합(특이 사례 포함)을 사용해야 합니다. 필드, 테이블 및 스키마 수준에서 프롬프트를 반복적으로 사용하여 간격을 찾은 다음, 완료하기 전에 여러 문서 샘플을 테스트하고 세분화합니다. 한 문서에서 잘 작동하는 스키마가 다른 문서에서는 부족할 수 있으므로, 다양한 문서에 대한 폭넓은 적용과 반복이 필수적임을 명심하세요. 문서 유형 전반에서 신뢰성 있게 추출되지 않는 열을 제거하는 등, 스키마의 유연성도 똑같이 중요합니다. 노이즈나 불일치를 유발하는 필드를 유지하면 전체 추출 품질이 저하되므로, 열 제거를 중요한 설계 결정으로 간주하는 것이 중요합니다.
- 필드 그룹당 올바른 대상 계층을 선택합니다. CRM 워크플로 또는 승인을 실행하는 필드는 _SObjects_에 작성됩니다. 통합 프로필 또는 피드 분석을 보강하는 필드는 DLO/DMO 파이프라인에 속합니다. 외부 시스템을 제공하는 필드는 RDBMS 계층에 속합니다. 단일 스키마는 동시에 여러 계층에 확산될 수 있다는 점에 유의하십시오.
- 규제 대상 콘텐츠를 처리하기 전에 거버넌스를 적용합니다. 규제된 데이터는 모든 계층에서 보호해야 합니다. 따라서 추출된 데이터가 출력 _데이터 레이크 개체(DLO)에 저장된 후에 PII 마스킹, 데이터 분류 태그 및 _특성 기반 액세스 제어(ABAC)를 구성하는 것이 중요합니다. 이를 통해 데이터 분류, 사용자 역할, 조직 컨텍스트를 기반으로 미세 조정된 적용 및 컨텍스트 인식 액세스를 제공합니다. _거버넌스_는 두 경로로 나뉩니다. _ELT_는 LLM 상호작용을 관리하고, DLO에 저장된 추출 데이터는 데이터 공간 구성, 권한 집합, ABAC 정책을 통해 DLO 및 데이터베이스 수준에서 별도로 관리해야 합니다. 이러한 제어는 응용 프로그램 계층뿐만 아니라 저장소 계층에서 일관성을 유지해야 하므로 수집 후 데이터 액세스 방법에 관계없이 액세스 제한이 그대로 유지됩니다. 어느 한 레이어에 취약점이 있으면 다른 레이어가 올바르게 구성되어 있더라도 규제 대상 데이터가 후속 단계에서 노출될 수 있다는 점에 유의하십시오.
- 생산 전에 장애 모드에 대비한 설계를 진행합니다. 첫 번째 프로덕션 배치 실행 전에 null 필드 처리, OCR 품질 임계값, 파일 크기 사전 유효성 검사, LLM 컨텍스트 오버플로, RDBMS 쓰기 멱등성 및 크레딧 예산 제한을 해결합니다. 이들은 예외적인 경우가 아니라, 파이프라인 설계 시 명시적으로 처리해야 하는 예측 가능한 실패 표면입니다.
- 신뢰도 점수를 진단용 부가 요소가 아닌, 주된 라우팅 신호로 취급하십시오. 추출 결과는 기본 모델 출력의 로그 확률(logprobs)에서 파생된 필드 수준 신뢰도 값을 포함합니다. 추출된 모든 필드, 테이블 또는 열에 대해 점수는 추출된 값에 대한 모델의 토큰 수준 확신을 반영합니다. 따라서 신뢰도 점수는 HITL(Human-in-the-Loop) 에스컬레이션 임계값의 주요 게이트로 사용할 수 있는 충분히 신뢰할 수 있는 통계적으로 기초화된 신호입니다. 신뢰도 점수를 사용하여 체계적으로 품질이 낮은 추출을 식별하고, 신뢰도가 낮은 필드 값, 모호한 스키마 일치 또는 반복되는 파이프라인 실패에 대해 HITL 검사점을 시작하여 휴리스틱이나 수동 점검에 의존하지 않도록 합니다. 자동 복구가 불가능할 경우 HITL 기반 신뢰도 점수 매기기를 통해 필요한 곳에 인간의 판단이 적용됩니다.
- 스키마 설계와 병렬로 활성화 경로를 설계합니다. Document AI의 가치는 Salesforce 워크플로 및 에이전트 내에서 추출된 데이터를 활성화할 수 있기 때문입니다. 추출 스키마 설계와 함께 Agentforce Actions, 플로우 및 _계산된 인사이트_를 설계할 수 있습니다.
Document AI는 두 가지 파이프라인 내에서 작동합니다.
- 대용량 UDMO 지원 처리용 배치 파이프라인
- 실시간 API 기반 추출을 위한 트랜잭션 처리 파이프라인
두 파이프라인 모두 동일한 스키마 구성 계약 및 ETL 거버넌스를 공유하지만, 문서가 시스템에 들어가는 방식과 추출된 데이터가 위치에 따라 다릅니다.
각 파이프라인을 자세히 살펴보겠습니다.
배치 파이프라인은 UDMO로 정의된 반복 문서 집합을 처리합니다. 이는 문서가 엔터프라이즈 저장소에서 수집되고 문서 추출을 거쳐 조합, ID 확인 및 활성화를 위해 Data 360 DLO/DMO 파이프라인에 전달되는 예약 또는 이벤트 기반 사용 사례에 적합합니다.
실제 시나리오
매일, 보험 회사는 _Amazon S3_에 PDF로 업로드되는 제공자 포털에서 수천 개의 의료 청구 문서를 받습니다. UDMO는 범위 내 문서 집합을 정의하고 모든 청구 PDF를 24시간 이내에 /claims/incoming/ 버킷으로 보냅니다.
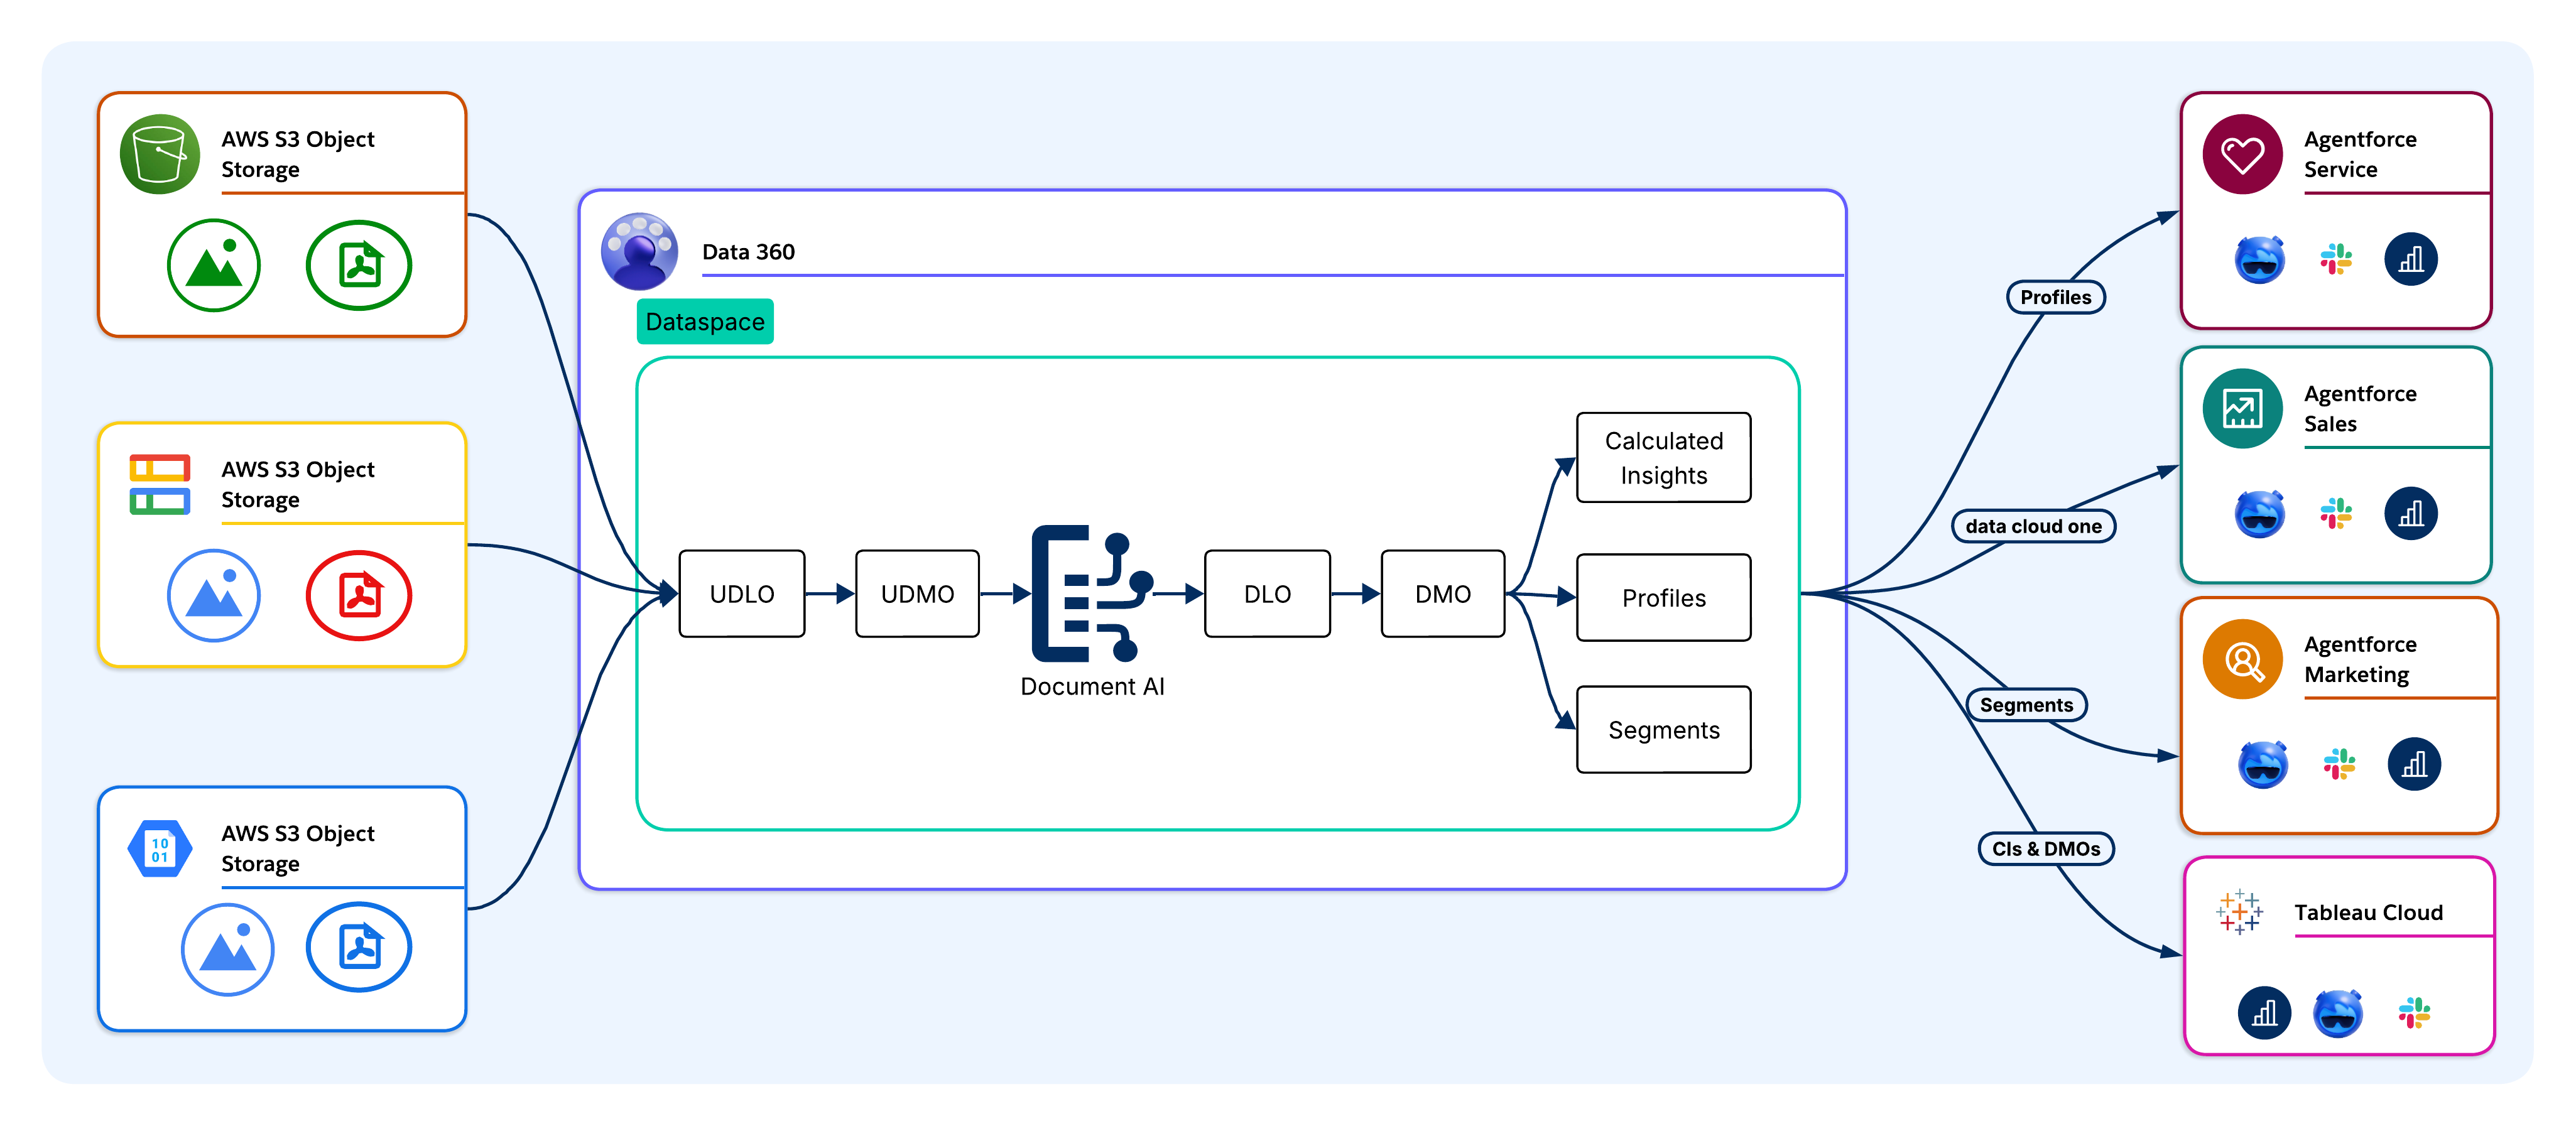
문서는 물리적 복제 없이 엔터프라이즈 소스 시스템에서 _Data 360_으로 수집됩니다. 지원되는 소스는 Amazon S3, Google Cloud Storage, Salesforce CRM 파일 개체, MuleSoft 오케스트레이션 파이프라인, 직접 API 업로드 등이 있습니다. Headless 360 배포에서는 CRM 레이어를 우회하는 클라우드 스토리지 커넥터 또는 _Intension API_를 통해 문서가 수집됩니다. 모델 컨텍스트 프로토콜(MCP) 서버는 외부 AI 에이전트와 LLM 클라이언트가 호출할 수 있는 도구 형태로 수집 기능을 제공합니다.
수집 시 원시 문서가 _비정형 데이터 레이크 객체(UDLO)_로 저장되며, 소스 파일을 이동하거나 변환하지 않고 각 문서의 실제 위치 및 메타데이터에 매핑됩니다.
예:
클라우드 스토리지 커넥터를 통해 _S3_에서 _Data 360_으로 PDF가 수집됩니다. 각 문서는 S3 객체를 가리키는 UDLO로 저장됩니다. 물리적 중복은 발생하지 않습니다.
Document AI는 각 UDLO를 추출할 필드와 대상 데이터 유형을 정의하는 스키마 구성에 따라 처리합니다. UDMO는 범위에 속하는 문서를 정의합니다. LLM(GPT-4o, Gemini 또는 Claude)은 각 문서를 읽고 구조화된 추출 페이로드를 반환합니다.
예:
_Document AI_는 ClaimID, PatientName, DiagnosisCode, BillingAmount, ServiceDate와 같은 필드를 정의하는 클레임 스키마에 따라 각 UDLO를 처리합니다. ClaimID, PatientName, DiagnosisCode, BillingAmount, ServiceDate 그런 다음 LLM은 각 PDF를 읽고 구조화된 추출 페이로드를 반환합니다.
데이터가 추출되면 _Data 360_의 원시 저장 계층인 DLO로 유지됩니다. DLO는 비즈니스 논리를 강제 적용하지 않고 추출된 필드를 유지하며, 다운스트림 변환 및 추적 가능성을 위해 정확한 물리적 표현을 유지합니다. UDLO는 파이프라인의 모든 지점에서 필드 수준 계보를 활성화하기 위해 소스 문서에 대한 참조를 유지합니다.
예:
추출된 모든 필드는 원본 PDF로 추적할 수 있는 전체 계보와 함께 각 클레임의 원시이자 정확한 표현을 보존하는 _Claims DLO_에 저장됩니다.
DLO 필드는 표준 _Customer 360 데이터 모델_에 부합하는 DMO에 매핑됩니다. 이는 문서에서 파생한 데이터가 원시 추출된 필드에서 비즈니스를 의미하는 엔티티로 전환되는 경계입니다. _Invoice DLO_는 _Invoice DMO_에 매핑되며, CustomerID 및 _BillingAmount_와 같은 필드는 통합 데이터 모델 내에서 조인 키 및 일치 특성이 됩니다. 조화된 문서 데이터는 CRM 및 트랜잭션 데이터에서 사용하는 것과 동일한 인터페이스를 통해 세분화, 계산된 인사이트 및 활성화에 참여합니다.
예:
_Claims DLO_는 _Claims DMO_에 매핑됩니다. PatientID 및 PolicyNumber 필드는 청구 레코드를 통합 환자 프로필에 연결하는 조인 키가 됩니다.
정합화된 DMO 데이터는 식별 해소에 참여합니다. 추출된 필드(예: 고객 이름, 이메일 주소 또는 계정 번호)는 문서 레코드를 _통합 개인(Golden Records)_에 연결하는 일치 키로 사용되므로 문서-프로필 간 격차가 닫힙니다.
예:
추출 필드(예: PatientName, DateOfBirth 및 PolicyNumber)는 ID 확인을 위한 일치 키로 사용되며, 이 필드는 청구 레코드를 올바른 _통합 개인_에 연결합니다. 이는 동일한 환자가 문서마다 약간씩 다른 이름 철자로 나타나더라도 발생합니다.
아키텍트는 _계산된 인사이트_를 정의하며, 이는 조화된 문서 데이터(예: 다양한 송장 행 항목의 총 지출, 계약 갱신 위험 점수, 청구 심각도 지표)에서 계산되는 집계 메트릭입니다.
예:
_계산된 인사이트_는 Agentforce 쿼리에 대한 조화된 청구 데이터에서 TotalClaimsPerPatient, AverageClaimAmount, HighRiskClaimScore를 계산합니다.
Agentforce 에이전트, Tableau, 마케팅 플랫폼, Salesforce _SObjects_에서 정합된 ID 확인 데이터에 액세스할 수 있습니다. 대상 계층은 대기 시간, 거버넌스, 데이터 상주 요구 사항에 따라 결정되는 아키텍처 결정입니다.
예:
_Claims Adjudication Agentforce Agent_는 Data 360 DMO 및 CI를 쿼리하여 우선순위 검토를 위해 고위험 청구를 찾습니다. Tableau 대시보드에는 청구량 및 이상 추세가 표시됩니다. 승인된 청구 레코드는 결제 워크플로를 시작하기 위해 다시 _청구 SObject_로 돌아갑니다.
Headless 360 아키텍처에서 활성화는 쿼리 API, Pub/Sub API 또는 클라우드 데이터 웨어하우스 활성화 타겟을 통해 외부 시스템으로 직접 라우팅됩니다. 그런 다음, MCP 서버는 외부 AI 에이전트를 위해 호출 가능한 도구로 조화된 문서 데이터와 _계산된 인사이트_를 찾습니다.
트랜잭션 처리 파이프라인은 이벤트 중심의 사용 사례(예: 양식을 업로드하는 고객, PDF를 수신하는 에이전트 또는 트랜잭션 처리 워크플로 내에서 추출을 시작하는 외부 시스템)에 적합한 UDMO 또는 미리 수집된 UDLO 없이 런타임 시 단일 문서 추출을 처리합니다. ETL 거버넌스는 두 파이프라인에 모두 동일하게 적용됩니다.
실제 시나리오
대출을 신청하는 동안 은행 고객이 은행의 모바일 앱을 통해 공공 요금 청구서의 PDF를 업로드합니다. 이벤트가 실시간으로 추출을 시작합니다. 즉, 미리 수집된 UDLO 또는 UDMO가 포함되지 않습니다.
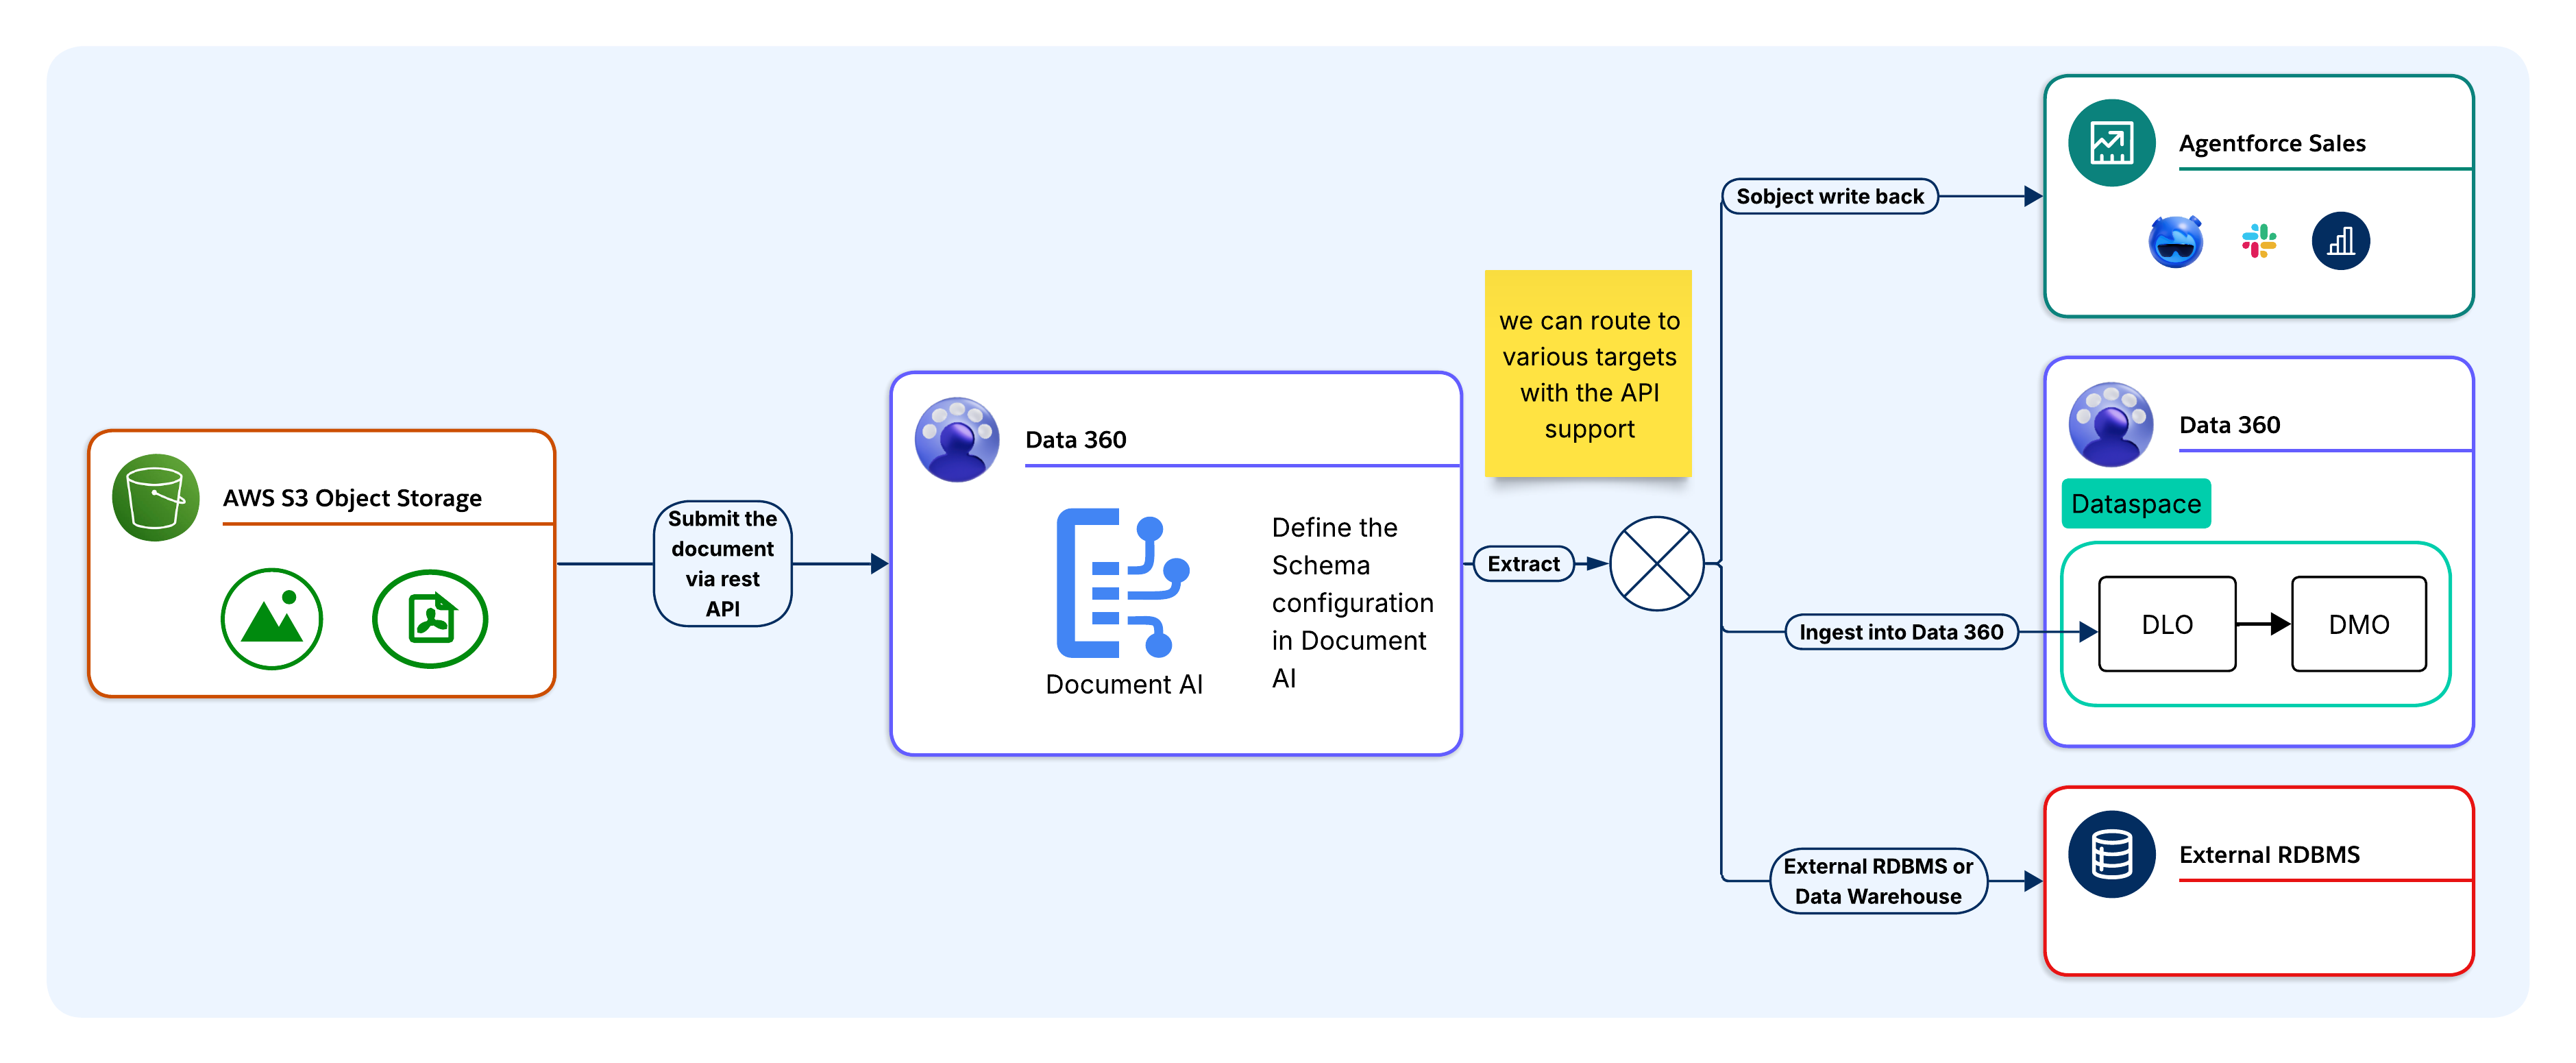
API를 호출하기 전에 설계자는 필드, 데이터 유형 및 추출 지침을 JSON 스키마 형식으로 지정하는 스키마를 정의하고 _Data 360_에 저장해야 합니다. 각 스키마에 고유한 _스키마 ID_가 할당됩니다. 런타임 시, 호출 애플리케이션은 스키마 ID를 참조하여 추출 논리를 애플리케이션 코드에 포함하는 대신 _Data 360_에 중앙 집중화된 상태로 유지합니다.
예:
은행의 팀은 _Data 360_에서 CustomerName, AddressLine1, City, PostCode 및 DocumentDate와 같은 필드를 지정하는 사전 정의된 ProofOfAddress 스키마를 가지고 있습니다. 이 정보는 _스키마 ID_로 참조할 수 있는 버전이 지정된 구성으로 저장됩니다.
호출 애플리케이션은 문서와 스키마 ID를 base64 인코딩된 페이로드 또는 파일 참조로 단일 REST API 요청에 제출합니다. UDLO 수집이 필요하지 않습니다. Document AI는 문서 추출을 적용하고 제공된 스키마를 기반으로 구조화된 출력을 반환합니다.
예:
모바일 앱은 단일 REST API 호출에서 ProofOfAddress 스키마 ID와 함께 공공요금 청구서를 base64로 인코딩된 페이로드로 제출합니다. 이 프로세스에서는 UDLO 수집 단계가 필요하지 않습니다.
LLM은 스키마에 대한 OCR 출력을 처리하고 구조화된 JSON 페이로드를 동기식으로 반환합니다. 문서에서 찾을 수 없는 필드는 _null_으로 반환됩니다. 발신자가 전체 JSON 응답을 소유하고 라우팅을 진행합니다.
예:
Document AI는 OCR을 PDF에 적용하고 LLM은 추출된 주소 필드가 포함된 구조화된 JSON 페이로드를 반환합니다. 찾을 수 없는 필드(예: 청구서에서 PostCode가 누락된 경우)는 _null_으로 반환됩니다.
추출되면 JSON 페이로드를 사용 사례에 따라 하나 이상의 대상 계층으로 라우팅할 수 있습니다.
- Salesforce SObject: CRM 워크플로 및 승인을 위해 Apex 또는 _Flow_를 통해 SObject 필드에 직접 매핑합니다.
- Data 360 DLO/DMO 파이프라인: 조화, 신원 확인, 계산된 인사이트, 그리고 Agentforce 그라운딩을 위해 DLO로 라우팅합니다.
- 외부 RDBMS 또는 데이터 웨어하우스: Salesforce 외부 시스템의 경우 MuleSoft, Apex 콜아웃, Platform 이벤트 또는 ETL을 통해 라우팅합니다.
- 사용자 지정 통합: 구조화된 JSON 페이로드를 호출 애플리케이션으로 반환하여 외부 시스템 또는 데이터 저장소에 저장할 수 있도록 합니다.
- 다운스트림 플로 또는 에이전트: 구조화된 JSON 출력을 _SObject_에 저장하지 않고 다운스트림 플로 또는 에이전트로 직접 전달합니다. 이는 대규모 자동화 또는 에이전트 워크플로 내에서 실시간 추출 단계로 Document AI를 사용하는 고객에게 일반적인 패턴입니다.
단일 스키마는 동일한 추출 지점에서 서로 다른 대상으로 라우팅되는 여러 필드 그룹을 사용하여 동시에 여러 계층으로 분기될 수 있다는 점에 유의하십시오.
예:
ProofOfAddress 페이로드는 한 번에 3개의 계층(예: CustomerName 및 AddressLine1가 _Contact SObject_에 쓰기)으로 분기될 수 있으며, 이로 인해 주소 확인 _플로_가 시작됩니다. 그런 다음 전체 페이로드는 조화 및 위험 평가를 위해 DLO로 라우팅되고, 복사본은 규정 준수 로깅을 위해 _MuleSoft_를 통해 은행의 KYC 시스템으로 라우팅됩니다.
작성되면 추출된 데이터가 대상 시스템 내에서 즉시 활성화됩니다. SObject 대상의 경우 트리거, 플로 및 승인 프로세스가 업서트된 레코드에서 활성화됩니다. DLO/DMO 대상의 경우, 데이터는 조화 및 신원 확인 파이프라인과 Agentforce 컨텍스트에 들어갑니다. 외부 RDBMS 대상의 경우 쓰기가 완료되면 다운스트림 쿼리에 데이터를 사용할 수 있습니다.
예:
업서트된 연락처 레코드에서 즉시 _주소 확인 플로_가 활성화되어 대출 신청을 다음 단계로 진행합니다. Agentforce _대출 담당자 Agent_는 _Data 360_에서 확인된 주소를 찾고 KYC 시스템은 감사 목적으로 문서 제출을 기록합니다.
_Document AI_는 특정 아키텍처 조건에 가장 적합합니다. 이러한 조건 외에 적용하면 불필요한 복잡성과 추가 비용이 발생합니다.
아키텍처는 _Document AI_를 추출 메커니즘으로 사용하기 전에 이러한 기준을 평가하는 것이 중요합니다.
Document AI를 사용해야 하는 경우:
- 문서가 주요 데이터 소스입니다. 필수 정보는 문서 형식에만 존재하며 구조화된 API 또는 데이터베이스에서 사용할 수 없습니다(예: 스캔된 계약, 실습 보고서, 인테이크 양식 또는 보험 청구).
- 문서 레이아웃은 소스에 따라 다릅니다. 동일한 문서 유형이 여러 공급업체, 파트너 또는 지역에서 필드 위치와 형식이 다르게 도착합니다. 스키마 중심 LLM 추출은 레이아웃별 유지 관리 없이 조정됩니다.
- ** 추출된 데이터는 Data 360 또는 Agentforce에 입력해야 합니다.** 추출은 ID 확인, 계산된 인사이트 또는 Agentforce 기초 교육에 참여해야 합니다. _Document AI_는 별도의 ETL 레이어 없이 DLO/DMO 파이프라인에 직접 전달됩니다.
- 볼륨은 제어 자동화를 정당화합니다. 문서 용량은 측정 가능한 인건비 또는 데이터 품질 위험 없이 수동 처리가 처리할 수 있는 용량을 초과합니다.
- 문서에는 규제된 내용이 포함되어 있습니다. LLM에 도달하기 전에 PHI, PII 또는 금융 데이터를 제로 데이터 보존, PII 마스킹 레이어를 통해 라우팅해야 합니다. ETL은 기본적으로 이를 충족합니다. 어떤 시점에서도 추출된 콘텐츠가 저장되지 않기를 요구하는 고객은 트랜잭션 API 플로를 고려해야 합니다. 이 플로는 어떤 _SObject_나 데이터 저장소에도 기록하지 않고 호출 애플리케이션에 직접 구조화된 출력을 반환합니다.
- 사용 사례는 이벤트 기반입니다. 런타임 시 문서가 도착합니다(예: 고객 업로드, 에이전트 PDF 첨부 파일 또는 외부 시스템 트리거). 트랜잭션 처리 파이프라인은 배치 설정 없이 동기식 단일 문서 추출을 처리합니다.
Document AI를 사용하지 말아야 하는 경우:
- 소스 데이터는 이미 구조화되어 있습니다. 업스트림 시스템에서 REST API, 데이터베이스 테이블 또는 구조화된 파일(예: CSV, JSON 또는 XML)을 노출할 경우 표준 Data 360 커넥터를 사용합니다. LLM 추출 파이프라인을 통해 구조화된 데이터를 실행하면 추가 혜택 없이 대기 시간과 크레딧 비용이 추가됩니다.
- 문서는 고정된 스키마로 기계 생성됩니다. 안정적인 레이아웃을 가진 알려진 ERP 또는 청구 플랫폼에서 시스템이 생성한 PDF는 결정론적 파서에 더 적합합니다. LLM 추출은 다양한 형태에 맞게 설계되었으며, 고정 스키마 문서에 적용하면 문맥 정보와 크레딧이 낭비됩니다.
- 정밀도 요구 사항이 LLM 신뢰 임계값을 초과합니다. _Document AI_는 추출 정확도를 100% 보장하지 않습니다. 누락되었거나 잘못된 필드 값이 상당한 재정, 법률 또는 임상적 위험을 수반하는 경우 HITL 유효성 검사 단계가 필요합니다. 유효성 검사 워크플로 없이 중요한 결정을 위한 유일한 추출 계층으로 문서 AI를 사용하지 마십시오.
- 문서가 플랫폼의 제약을 초과합니다. 현재 10MB 파일 크기 제한과 LLM 컨텍스트 길이 제약으로 인해, 사전 처리를 통해 문서를 분할하고 재조립하지 않으면 _Document AI_는 대용량 또는 밀도가 높은 문서에 적합하지 않습니다.
- 참고: Salesforce에서는 지원되는 파일 크기, 페이지 수 및 파일 확장자를 확장하기 위해 이러한 허용 가드 레일을 적극적으로 개선하고 있습니다. 제약은 앞으로도 계속해서 변화할 것입니다.
UDMO 소스 개체가 지원하는 _Document AI 배치 파이프라인_을 사용하는 몇 가지 시나리오를 자세히 살펴보겠습니다. 이 경우 추출된 데이터는 조합, ID 확인, 계산된 인사이트 및 Agentforce 활성화를 위해 Data 360 DLO/DMO 파이프라인을 통해 라우팅됩니다. 각 사용 사례는 예약 또는 이벤트 기반의 대용량 문서 처리에 가장 적합합니다.
Agentforce Sales: 계약 및 송장 정보
계약 PDF는 배치 파이프라인을 통해 클라우드 스토리지에서 수집됩니다. 스키마는 ContractValue, RenewalDate, PaymentTerms, CounterpartyName을 추출한 다음, 계정 및 계정 DMO에 매핑합니다. _계산된 인사이트_는 갱신 위험 점수를 도출합니다. Agentforce는 갱신 기간이 끝나기 전에 계정 담당자에게 알림을 보내 수동 계약 검토와 갱신 누락을 방지합니다.
Agentforce Service: 사례 전환 및 지식 그라운딩
질문 조사 PDF 및 사례 첨부 파일은 배치 파이프라인을 통해 수집됩니다. 스키마는 감정 지표, 문제 범주 및 해결 메모를 추출한 다음, Case 및 Knowledge Article DMOs에 매핑합니다. 사례가 열리면 Agentforce는 조화된 지식 베이스를 쿼리하고 관련 문제 해결 단계를 찾아 에이전트의 검색 오버헤드를 줄입니다.
Agentforce 헬스: 임상 문서 처리
실험실 보고서, 접수 PDF 및 수기 임상 양식은 배치 파이프라인을 통해 수집됩니다. 스키마는 필드(예: PatientID, DiagnosisCode, MedicationName 및 TestResult)를 추출한 다음, HIPAA 지정 케어 조정 및 임상 연구 워크플로를 지원하는 Health Cloud DMO에 매핑합니다.
금융 서비스: 대출 및 세금 문서 자동화
대출 신청, 세금 신고서, 소득 내역서가 배치 파이프라인을 통해 수집됩니다. 스키마는 AnnualIncome, TaxYear, EmployerName을 비롯한 필드를 추출한 다음, 해당 필드를 Financial Account DMO에 매핑합니다. _Calculated Insights_는 문서에서 가져온 소득 데이터와 CRM 데이터를 결합하여 자동화된 신용 위험 점수 매기기를 지원합니다. Agentforce 고객 서비스 상호 작용 중에 추출된 대출 세부 사항을 인라인으로 찾습니다. 이 패턴은 Salesforce Agentic Enterprise Solutions 개발자 센터에 게시된 대출 사전 자격 심사 에이전트 사용 사례를 직접 지원합니다.
HR: 직원 문서 처리
온보딩 문서, 세금 양식 및 인증 PDF는 배치 파이프라인을 통해 수집됩니다. 추출된 필드는 직원 레코드 DMO에 매핑된 다음, _통합 직원 프로필_에 연결됩니다. 특정 _플로_은 추출된 데이터를 기반으로 온보딩 작업 및 규정 준수 확인을 시작합니다. 이 패턴은 이력서 자동 처리 Agentic 사용 사례를 직접 지원합니다. _Document AI_는 이력서 PDF에서 기술, 고용 내역, 자격을 추출하여 Agentforce가 공개 직무 기준에 따라 후보자를 일치시키고 채용 워크플로로 안내합니다.
전문 서비스: 제안 및 연구 인텔리전스
제안서 및 연구 보고서는 배치 파이프라인을 통해 수집됩니다. 추출된 프레임워크, 벤치마크, 참여 요약이 사용자 정의 DMOs에 매핑된 다음, 벡터 검색을 위해 색인화됩니다. Agentforce 쿼리 시 컨텍스트와 관련된 권장 사항을 검색하며, 이는 추출된 문서 콘텐츠에 기반합니다. 이 패턴은 웹사이트 콘텐츠를 기반으로 한 Agentforce 패턴을 확장합니다. 문서는 _Document AI_를 통해 인덱싱되며, Data 360 커넥터를 통해 인덱싱되는 웹사이트 콘텐츠와 동일하게 에이전트 응답의 기반 기능을 제공합니다.
HIPAA 준수 상태:
이 문서에 설명된 Health Cloud 패턴은 텍스트 입력에 ETL 컨트롤(예: 제로 데이터 보존 및 PHI 마스킹)을 적용합니다. 해당 컨트롤만으로는 HIPAA 인증을 구성하지 않습니다. 규제된 임상 환경을 위해 설계하는 설계자는 해당 컨텍스트 내에서 Document AI 기반 아키텍처를 사용하기 전에 Salesforce 규정 준수 팀과 최신 HIPAA 인증 상태를 확인해야 합니다.
UDMO에 바인딩되지 않은 스키마를 사용하여 Document AI REST API를 호출하는 몇 가지 시나리오를 자세히 살펴보겠습니다. 추출된 JSON 페이로드는 런타임 시 외부 시스템에 직접 동기식으로 라우팅됩니다.
공급망: 공급업체 인보이스를 ERP로 처리
모니터링된 저장소 버킷 또는 이메일 게이트웨이에 공급업체 인보이스 PDF가 도착하면 이벤트 트리거가 인보이스와 사전 정의된 스키마 ID가 포함된 Document AI REST API를 호출합니다. 스키마는 VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount, DueDate를 추출합니다. JSON 페이로드는 _MuleSoft_를 통해 ERP 매입채무 모듈로 라우팅되며, null 필드 검증 및 멱등성 업서트 논리를 사용하여 공급자 형식의 변동성에 대한 템플릿 유지 관리를 제거합니다.
법적 운영: 계약 검토를 CLM으로
법적 포털에 계약 PDF가 업로드되면 백엔드에서 Document AI REST API를 동기식으로 호출합니다. 스키마는 GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause, CounterpartySignatory를 추출합니다. JSON 페이로드는 Apex 콜아웃을 통해 Contract Lifecycle Management(CLM) 시스템으로 라우팅됩니다. 찾을 수 없는 모든 필드는 _null_으로 반환되며, CLM은 누락된 값에 기본 의무 규칙을 적용합니다.
보험 청구: 손실 최초 통보 처리
보험 소유자가 First Notice of Loss(FNOL) 양식을 제출하면 백엔드 포털에서 Document AI REST API를 동기식으로 호출합니다. 스키마는 PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName, ContactPhone을 추출합니다. JSON 페이로드는 Apex 콜아웃 또는 ETL을 통해 _ 클레임 관리_ 데이터베이스로 라우팅되며, 이는 공식 클레임을 열기 전에 조정자가 검토할 수 있는 미리 채워진 클레임 레코드를 만듭니다.
프로덕션으로 전환하기 전에 다음 실패 시나리오에 대한 설계를 만들어야 합니다.
- Null 필드 처리: LLM은 찾을 수 없거나 확실하게 추출할 수 없는 필드에 대해 _null_을 반환합니다. 스키마 설계 시 null 처리 논리를 검증하고, 통합 레이어에 기본값 또는 거부 로직을 구현한 다음, NOT NULL 제약이나 필수 일치 키가 있는 대상에 쓰기 전에 이를 적용해야 합니다.
- OCR 품질 저하: OCR 정확도는 150 DPI 미만이거나, 불규칙한 필기 또는 노이즈가 많은 스캔에서 저하됩니다. 잘못 인식된 데이터는 오류 신호 없이 손상된 입력으로 LLM 추출 과정에 전달됩니다. 수집 시 최소 스캔 품질을 적용하고 숫자 및 날짜 필드에 대한 신뢰 임계값 검사를 구현합니다.
- 스키마 버전 불일치: 배치 작업이 예약된 후 스키마 구성을 업데이트하면, 진행 중인 문서가 이전 버전으로 처리되어 필드가 누락되거나 이름이 변경되어 다운스트림 매핑이 중단됩니다. 버전 스키마를 명시적으로 지정하고, 배치 작업 일정과 조정하여 업데이트를 진행합니다.
- 파일 크기 제한: 10MB를 초과하는 문서는 거부됩니다. 모니터링이 구성되지 않으면 배치 파이프라인 오류는 감지되지 않으며, 트랜잭션 호출자는 4xx 오류를 수신합니다. 수집 시 파일 크기를 미리 확인하고 사전 처리를 구현하여 정기적으로 제한에 도달하는 문서를 분할하거나 압축합니다.
- LLM 컨텍스트 오버플로우: 밀도가 높거나 여러 페이지로 구성된 문서는 10MB 제한 이내라도 LLM 컨텍스트 창을 초과할 수 있습니다. LLM은 컨텍스트를 초과하는 콘텐츠를 자동으로 삭제합니다. 문서를 페이지 범위별로 분할하고 추출된 필드를 재조합한 후 대상에 전송하는 청크 전략을 구현합니다.
- Trust Layer 마스킹이 추출에 미치는 영향: ETL은 문서 수준이 아닌 프롬프트 수준에서 작동하므로, 문서 AI를 통해 전달되는 문서 콘텐츠에는 마스킹이 적용되지 않습니다. 문서의 PII 값에 의존하는 스키마 필드는 ETL 마스킹 정책에 영향을 받지 않습니다.
- 외부 RDBMS 쓰기 멱등성: 트랜잭션 처리 파이프라인에는 외부 RDBMS 타겟에 대해 내장된 멱등성이 없습니다. _통합 레이어_의 재시도는 쓰기 논리가 중복 제거를 명시적으로 처리하지 않는 한 중복 행을 생성합니다. 문서 지문 또는 외부 ID를 사용하여 모든 외부 쓰기 경로에서 멱등성 업서트를 구현합니다.
- 실행 중 신용 소진: 대규모 배치 실행은 모든 문서가 처리되기 전에 Digital Wallet 크레딧을 소모하여 불완전한 DLO 데이터 집합을 생성하며, 후속 단계에서는 이를 완료된 것으로 간주합니다. 사용 가능한 크레딧의 75% 및 90%에 소비 경고를 설정하고, 각 주기의 크레딧 예산 내에서 배치 크기를 제한합니다.
- 스키마 필드 제한 — 아키텍처 제약: Document AI는 스키마 구성에서 루트 수준 필드에 대해 50개 필드 제한을 적용합니다. 이는 런타임 오류가 아닌 설계 시간 제약이며, 설계자는 데이터 모델 및 스키마 설계 시 이를 고려해야 합니다.
- 광범위한 추출이 필요한 사용 사례:
- 가차 없이 우선순위를 정하세요. 전체 문서 적용 범위가 아닌 자동화 값을 촉진하는 필드로 스키마 범위를 좁힙니다.
- 중첩된 객체(최대 3단계; 소스 객체만 사용하는 배치 모드)를 활용하여 추출 깊이를 희생하지 않고 루트 수준 필드 수를 줄입니다.
- 고유한 문서 섹션을 대상으로 하는 여러 개의 Document AI 구성에서 복잡한 문서를 분해하고, _Data 360_의 다운스트림에 연결되는 별도의 DLO에 결과를 작성합니다.
- 광범위한 추출이 필요한 사용 사례:
- API 속도 제한: _Document AI_는 테넌트당 분당 추출 API 호출 50개로 제한합니다. 이론적 한도는 _Einstein LLM 게이트웨이_에 따라 분당 300번의 통화입니다. 대용량 트랜잭션 통합은 지수 백오프, 요청 대기열, 테넌트 수준 처리량 예산을 사용하여 설계해야 합니다. 다중 테넌트 프로덕션 환경에서 버스트 용량을 사용할 수 있다고 가정하지 마십시오.
- API 대기 시간 프로필: Document AI 추출 API는 완전히 동기적으로 동작합니다. 일반적인 응답 시간은 5~15초이며 파일 크기 및 스키마 복잡성에 따라 다릅니다.
- 이는 통합 아키텍처에 직접적인 영향을 미칩니다.
- 발신자 시간 제한을 최소 30초로 설정합니다.
- 1초 미만 SLA 요구 사항이 있는 플로우에서는 _Document AI_를 호출하지 마십시오.
- 지연 시간을 처리량 계산에 반영하여 배치 처리 파이프라인의 속도 제한 한도를 고려하십시오.
- 발신자 시간 제한을 최소 30초로 설정합니다.
- 이는 통합 아키텍처에 직접적인 영향을 미칩니다.
- 암호화 및 비밀번호 보호 문서: Document AI는 암호로 보호된 파일(파일을 열려면 사용자 암호가 필요) 또는 소유자/권한 암호로 암호화된 PDF를 처리하지 않습니다. PDF 권한 레이어에서 복사, 인쇄 또는 편집을 제한하지만 정상적으로 열리는 파일을 포함합니다.
- 이 제약은 수집 경계에 있습니다.
- 문서 접수 파이프라인을 설계하여 암호화된 파일을 감지하고 _문서 AI_에 도달하기 전에 거부 또는 수동 처리 경로로 라우팅합니다.
- 런타임 오류 처리를 주요 게이트로 의존하지 마십시오.
- 이 제약은 수집 경계에 있습니다.
Data 360 문서 AI는 Salesforce _완벽하게 설계된 프레임워크_의 여러 기둥에 부합합니다.
- Trust: ETL은 LLM 공급자의 데이터 보존을 제로 적용하고, 모델에 도달하기 전에 PII 입력을 마스킹하고, 민감한 콘텐츠에 대한 출력을 스캔합니다. 설계자는 저장된 추출 데이터에도 이 원칙을 적용해야 합니다. DLO의 필드 수준 마스킹은 ETL에서 적용되지 않으며 다운스트림 데이터 스페이스 정책 및 _권한 집합_이 필요합니다.
- 신뢰성: 설계 고려 사항 섹션의 각 실패 모드—null 필드 추출, OCR 오인식, 스키마 버전 불일치, 파일 크기 초과, LLM 컨텍스트 오버플로, ETL 마스킹 간섭, RDBMS 쓰기 멱등성 및 크레딧 소진—는 문서화된 감지 신호와 해결 경로가 있는 고유한 실패 클래스를 나타냅니다.
- 운영적 우수성(변경 관리): 스키마 중심 추출 모델은 문서 레이아웃에서 추출 논리를 분리합니다. 공급업체가 인보이스 형식을 변경하거나 규제 양식이 업데이트되면 설계자는 통합 코드를 수정하는 대신 스키마 구성을 하나만 업데이트해야 합니다.
- 운영적 우수성(기존성): 애플리케이션 코드에 추출 논리를 포함하는 대신 _Data 360_에서 스키마 구성을 중앙 집중화하면 추출 의도가 명시적이고 버전이 지정되어 감사할 수 있습니다. 모든 다운스트림 대상은 대상 계층에 관계없이 동일한 스키마 계약을 사용합니다.
- Operational Excellence(통합 재사용): _Document AI_는 여러 통합 표면에서 추출을 노출합니다. REST API, Apex, Flow, MuleSoft, Agentforce Actions 및 MCP 서버 단일 스키마 구성은 소비자당 추출 기능을 재구축하지 않고 여러 대상 계층에 동시에 확장됩니다.
- 자원 및 비용 최적화: 파이프라인 선택 지침, 10MB 파일 크기 경계, 사전 어셈블리 LLM 컨텍스트 길이 제약은 성능 인식 설계 결정을 나타냅니다. 사용 시기 섹션은 _Document AI_가 올바르지 않은 도구인 경우에 대한 조건을 공식화합니다(예: sub-second 지연 요구 사항, 전체 구조화된 소스 데이터 및 고정 스키마 시스템 생성 문서).
이것은 Sandbox 환경에서 _Data 360 문서 AI_를 구성하기 위한 구조화된 시작 지점입니다. 프로덕션으로 이동하기 전에 Sandbox의 모든 단계를 완료합니다.
구성을 시작하기 전에 다음을 확인해야 합니다.
- 파일 크기: 대표 문서 크기가 10MB 미만인지 확인합니다.
- 파이프라인: 사용 사례에 배치 파이프라인(UDMO 지원, 대용량) 또는 트랜잭션 처리 파이프라인(API 구동, 단일 문서)이 필요한지 확인합니다. 이렇게 하면 모든 후속 구성이 구동됩니다.
- 목표 계층: 추출된 데이터의 위치 확인(Salesforce SObject, Data 360 DLO/DMO, 외부 RDBMS 또는 조합).
- Agentforce 종속성: Agentforce 지원 문서 처리를 배포하기 전에 ETL 설정을 통해 조직에서 지원되는 LLM(예: GPT-4o)이 활성화되어 있는지 확인하십시오. Agentforce는 _Document AI_의 필수 플랫폼 전제 조건입니다. 모든 추출 API를 포함한 전체 Document AI 기능 표면은 대상 조직에서 Agentforce가 활성화될 때까지 사용할 수 없습니다. 이 점을 조직 준비 상태 평가 및 프로비저닝 순서에 반드시 반영하세요. API 가용성이 활성화된 후 안정화될 때까지 몇 분 정도 기다리세요.
- Agentforce 장애 영향: Document AI 구성 및 배포 후 Agentforce가 비활성화된 경우 모든 추출 처리(UI 및 API)가 즉시 차단됩니다. 모델 비활성화에도 동일하게 적용됩니다. 기본 모델을 비활성화하면 Document AI 가용성에 동등한 영향을 미칩니다. 두 경우 모두 기존 스키마 구성이 유지되고 표시되지 않습니다. 구성이나 데이터 손실이 발생하지 않지만 Agentforce 및 모델이 다시 활성화될 때까지 기능이 완전히 비활성화됩니다. 운영 실행 문서를 설계하여 Agentforce 가용성 및 모델 활성화를 Document AI 상태 종속성으로 처리합니다.
- 신용 소비/가격: 대표 샘플 문서에서 산출된 TCO 추정에는 Data 360 크레딧 또는 _Flex 크레딧_을 사용하세요.
- 스키마 구성을 만듭니다. Data 360 문서 AI 설정에서 추출 필드, 데이터 유형 및 지침을 JSON 스키마 형식으로 정의합니다. 배치 파이프라인의 경우 UDMO에 연결합니다. 트랜잭션 처리 파이프라인의 경우 소스 개체 없이 생성합니다. 스키마 ID를 기록합니다.
- 대상 계층에 필드 이름 맞추기. 필드 이름을 DLO 열 정의, SObject API 이름 또는 RDBMS 열 이름과 일치시킵니다. 잘못 정렬된 이름은 통합 레이어에서 매핑 오버헤드를 발생시킵니다.
- UDMO 소스 개체를 구성합니다(배치 전용). 범위에서 문서를 정의하고 수집 소스 연결(예: S3, Google Cloud Storage, Salesforce Files 또는 MuleSoft)을 구성합니다. 수집 서비스 계정에 필요한 IAM 또는 OAuth 자격 증명 범위가 있는지 확인합니다.
- PII 마스킹 정책 적용. 규제된 콘텐츠를 처리하기 전에 ETL 설정에서 데이터 마스킹 정책을 구성합니다. 입력이 LLM에 도달하기 전에 마스킹되는 필드 유형(PHI, PII 및 금융 식별자)을 정의합니다. Don’t 이 단계를 미루지 마십시오.
- 데이터 공간 범위 및 권한 집합 할당. 범위 처리를 해당 _데이터 공간_에 지정하고 스키마 생성, 배치 작업 실행, REST API 호출, 다운스트림 활성화를 제어하는 권한 집합을 구성합니다.
- API 인증을 구성합니다(트랜잭션 처리 파이프라인에만 해당). OAuth 범위 cdp_ingest_api 및 api로 _연결된 앱_을 만듭니다. 조직 내부 호출자의 경우 _외부 자격 증명_에 연결하는 명명된 자격 증명을 사용합니다. 외부 호출자의 경우 OAuth 2.0 클라이언트 자격 증명 또는 JWT 전달자 플로를 구성합니다. 진행하기 전에 추출을 테스트하고 유효성을 검사합니다.
- SObject write-back: JSON 응답 필드를 SObject 필드에 매핑하는 Apex (@InvocableMethod) 또는 Flow 요소를 구현합니다. 중복을 방지하려면 외부 ID와 함께 Database.upsert()를 사용하십시오. 대상 SObject 필드에 _필드 수준 보안_을 적용합니다.
- Data 360 DLO/DMO 파이프라인: 추출된 DLO 필드를 _Customer 360 데이터 모델_과 일치하는 DMO에 매핑합니다. 문서 레코드를 _Unified Individuals_에 연결하도록 신원 확인 규칙을 구성합니다. 계산된 인사이트_를 정의하고 Agentforce에 DMO를 추가합니다. 트랜잭션 처리 파이프라인의 경우 먼저 _ 수집 API를 통해 JSON 페이로드를 DLO로 라우팅합니다.
- 외부 RDBMS 또는 데이터 웨어하우스: 통합 패턴을 선택합니다. MuleSoft(기존 통합 패브릭), Apex HTTP 콜아웃(Lightweight, Organ-Native), Pub/Sub 가입자와의 플랫폼 이벤트(Event-Driven) 또는 ETL(High-Volume Batch) 문서 지문 또는 외부 ID를 사용하여 모든 외부 쓰기 경로에서 멱등 업서트를 구현합니다.
- 활성화 경로: 대화형 추출을 위해 Agentforce 작업을 스키마 구성에 연결합니다. 자동화된 처리 워크플로를 위해 플로 또는 Apex 트리거를 구성하고 각 필드 그룹에 대한 활성화 목표를 설정합니다.
- 오류 처리(트랜잭션 처리 파이프라인에만 해당) 전체 HTTP 응답 영역 구성: 200개(성공된 결과, 부분적인 null 응답 포함), 400개(잘못된 요청 또는 스키마 ID 찾을 수 없음), 413개(파일이 10MB를 초과), 5xx개(서비스 오류). 최대 3번의 시도를 통해 5xx 재시도에 기하급수 백오프를 구현합니다. 모든 호출에 대한 원시 JSON 응답 및 스키마 ID를 기록합니다.
- 샘플 문서를 대상으로 스키마를 테스트합니다. Document AI 인터페이스 또는 REST API를 통해 대표적인 샘플을 제출합니다. 레이아웃 변형 전반에서 추출 정확성, 필드 적용 범위, null 처리를 확인합니다.
- null 필드 처리를 확인합니다. 모든 다운스트림 대상이 문서에서 _찾을 수 없는 필드_의 null 값을 처리할 수 있는지 확인합니다. 명시적 null 처리를 하지 않으면 NOT NULL 제약 조건이 조용히 실패한다는 점을 기억하십시오.
- 파일 크기를 사전 검증합니다. 프로덕션 문서가 10MB 미만인지 확인합니다. 사전 처리를 구현하여 정기적으로 제한에 도달하는 문서를 분할하거나 압축합니다.
- 단계별 추출 검증. 배치 파이프라인의 경우 전체 실행을 시작하고 추출된 필드가 각 대상 계층에 올바르게 도달하는지 확인합니다. 트랜잭션 처리 파이프라인의 경우 통합 레이어를 통해 대상에 대한 JSON 응답을 추적합니다. SObject 대상의 트리거 및 플로 실행, DLO/DMO 대상의 ID 확인 링크, RDBMS 대상의 idempotency를 확인합니다.
- Trust Layer의 동작을 확인합니다. ETL은 문서 콘텐츠에 PII 마스킹을 적용하지 않으므로 LLM은 추출된 필드의 PII 데이터를 그대로 반환합니다. 스키마 필드, 데이터 라우팅, 다운스트림 저장소가 PII 전달 출력을 적절하게 처리하도록 설계되었는지 확인하고 플랫폼 외부에서 규정 준수 또는 유지 요구 사항이 해결되었는지 확인합니다.
- Digital Wallet 알림을 설정합니다. 사용 가능한 크레딧의 75% 및 90%에 도달하면 소비 알림을 구성합니다. 각 주기의 크레딧 예산 내에서 배치 크기 제한과 임시 요율 추정을 설정합니다.
- 배치 모니터링을 검증합니다(배치 파이프라인에만 해당). 추출 성공률, null 필드 비율 및 작업 완료를 Data 360 모니터링 콘솔에서 검토합니다. UDLO에서 DLO를 통해 데이터 계보의 DMO로 태그 전파를 확인합니다.
- API 오류 처리를 검증합니다(트랜잭션 처리 파이프라인에만 해당). 모든 오류 조건 테스트: 413(10MB 이상의 문서), 400(유효하지 않은 스키마 ID), 200(일부 null이 있는 유효한 추출). 중복 쓰기 없이 시뮬레이션된 5xx 응답에서 재시도 논리가 실행되는지 확인합니다.
이 문서에서는 Data 360 문서 AI:의 아키텍처 기반을 강조합니다.
- 두 개의 처리 파이프라인 및 사용 시기
- 스키마 구성 모델
- 목표 계층 결정 프레임워크
- 핵심 기술 제약 사항
- 실패 모드
- Well-Architected Framework 준수
건축가용 빠른 시작 가이드는 샌드박스 개념 증명을 위한 구성 순서를 제공합니다.
핵심 아키텍처는 스키마 계층에서 관리되는 문서에서 파생된 데이터를 지원하며, ETL 적용 LLM 파이프라인을 통해 처리되고, 다른 모든 엔터프라이즈 데이터를 관리하는 동일한 Data 360 데이터 수명 주기에 전달됩니다.
올바른 파이프라인을 선택하고, 문서 유형 수준에서 스키마를 설계하고, 프로덕션 전에 실패 모드를 설계하는 등 이러한 원칙을 적용하는 설계자는 규제된 산업 거버넌스 요구 사항에 따라 확장되고 지속되는 추출 기능을 구축합니다.
Yugandhar Bora는 Salesforce의 소프트웨어 엔지니어링 아키텍처로, 데이터 및 인텔리전스 애플리케이션 플랫폼 내에서 데이터 아키텍처를 전문으로 합니다. 그는 데이터 거버넌스 및 통합 데이터 모델에 초점을 맞춘 엔터프라이즈 아키텍처 검토 위원회(EARB) 이니셔티브를 이끌고 있으며, 자동화된 플랫폼 프로비저닝 솔루션에도 기여합니다.
Ananth Anto는 Salesforce _Data 360_의 제품 관리 책임자로서 Document AI 및 Data Graph 이니셔티브를 이끌고 있습니다. 방갈로르에 위치한 그는 엔터프라이즈 고객과 협력하여 실제 문서 처리 및 데이터 인텔리전스 문제를 해결합니다. 그는 Enterprise 사용 사례 중 _Generative AI (Gen AI)_에 관한 내용을 탐구하는 것을 즐깁니다.
Salesforce의 소프트웨어 엔지니어링 아키텍트인 Nishan Naseer은 비정형 데이터 처리, RAG 파이프라인, 문서 인텔리전스 분야에서 근무합니다. 그는 AI의 능력을 활용하여 실제 문제를 해결하고 복잡한 고객 문제에 대한 창의적인 솔루션을 찾는 데 열정적입니다.