에이전트는 목표에 대해 추론하고, 상황에서 매개변수를 도출하며, 동적으로 행동을 선택합니다. 따라서 에이전트가 접하는 모든 통합은 모호성을 처리하고 안전한 반복을 지원하며 에이전트가 독립적으로 복구할 수 있는 방식으로 실패해야 합니다.
에이전트 시스템은 기존 통합 설계에서 공백으로 간주하는 몇 가지 가정을 무효화합니다. 입력은 항상 올바르게 구성되지 않을 수 있습니다. 단일 사용자 작업은 조직 범위에 걸쳐 에이전트의 체인을 생성할 수 있으며, 각각의 작업에는 위임된 권한이 필요합니다.
이 문서에서는 새로운 설계 원리, 에이전트 패턴 및 Salesforce Platform이 제공하는 방식과 같이 해당 현실에 따른 아키텍처 교대 근무를 매핑합니다.
이 문서의 각 패턴은 동일한 구조를 따릅니다.
이름: 패턴에 포함된 통합 유형을 나타내는 패턴 식별자입니다.
컨텍스트: 패턴이 해결하는 전체 통합 시나리오입니다. 컨텍스트는 사용자가 달성하려는 작업과 응용 프로그램이 요구에 맞는 방식에 대한 정보를 제공합니다.
문제: 패턴이 해결하도록 설계된 질문으로 표시된 문제입니다. 패턴을 검토할 때 패턴이 통합 시나리오에 적용되는지 빠르게 이해하려면 이 섹션을 읽으십시오.
군력: 문제를 해결하기 어려울 수 있는 제약 및 상황입니다.
Salesforce 패턴 응용 프로그램: 시나리오에 패턴을 적용하는 권장 방법입니다.
스케치: 패턴 응용 프로그램이 시나리오를 해결하는 방법을 보여주는 UML(Unified Modeling Language) 순서 다이어그램
결과: 패턴이 시나리오와 관련된 요인을 해결하는 방법입니다. 이 섹션에는 패턴 적용으로 인해 발생할 수 있는 새로운 문제도 포함되어 있습니다.
설계 고려 사항: 솔루션을 올바르게 적용하기 위한 플랫폼에 구애받지 않는 지침과 이어서 Salesforce 전용 구현 노트를 제공합니다. 다음 고려 사항은 작업 설계 원리 및 플랫폼별 구성 요구 사항을 다룹니다.
오류 처리 및 복구: 패턴 적용 시 실패를 관리하기 위한 지침입니다. 이 매개 변수는 다음 네 가지 영역을 포함합니다.
- 작업이 에이전트에게 실패를 전달하는 방식은, 후속 의사결정을 위한 충분한 정보를 제공하는 구조화된 실행 가능한 오류 응답을 통해 이루어집니다.
- 에이전트가 재시도, 자체 수정 또는 실행 중지를 결정하는 방법입니다.
- 보상 작업이 부분 결과 및 불일치하는 플랫폼 간 상태를 처리하는 방법
- 사용 중지된 쓰기 작업에 대한 역량 요구 사항
보안 고려 사항: 패턴을 안전하게 적용하기 위한 보안 요구 사항입니다. 이러한 고려 사항에는 자격 증명 관리, 통합 사용자 및 연결된 앱의 최소 권한 범위 지정, 에이전트가 호출한 작업의 감사 로깅, 사용자 제공 또는 LLM에서 파생된 콘텐츠에서 생성되는 매개 변수에 대한 입력 확인 요구 사항 등이 포함됩니다.
예: 설계 패턴이 실제 Salesforce 시나리오에서 사용되는 방식을 설명하는 전체 시나리오입니다. 이 예에서는 목표와 해당 목표를 달성하기 위해 패턴을 적용하는 방법을 설명합니다.
다음 표에 적용되는 구현 패턴이 나열되어 있습니다.
패턴 목록
| 패턴 | 역할 |
|---|---|
| 순차 작업 호출 | 에이전트가 일련의 작업을 호출하며, 각 단계는 이전 단계의 확인된 결과에 따라 다릅니다. 에이전트는 식별자, 상태 코드, 중간 데이터와 같은 체인 전반의 컨텍스트를 유지하고 이를 사용하여 다음 단계를 진행할 수 있는지 여부를 결정합니다. |
| 병렬 작업 호출 | 작업들이 서로 독립적인 경우, 에이전트는 순차적으로 호출하기보다는 동시에 호출합니다. 총 워크플로 시간은 모든 호출의 합산이 아닌 가장 느린 호출에 의해 결정됩니다. |
| 비동기식 작업 호출 | 에이전트가 결과를 기다리지 않고 플랫폼 이벤트, 메시지 대기열 또는 백그라운드 작업을 통해 다운스트림 시스템에 작업을 발송합니다. 에이전트의 의무는 확인된 호출 시 종료되며 다운스트림 시스템은 에이전트 세션과 독립적으로 실행의 소유권을 획득합니다. |
| On-Demand Agent 호출 | 외부 애플리케이션 또는 AI 오케스트레이터가 에이전트를 프로그래밍 방식으로 호출하고 컨텍스트를 제공하며 구조화된 응답을 기다립니다. 에이전트는 호출자가 시작하는 지능형 백엔드 서비스로 동작하며, 에이전트가 추론하고 동작하고, 그 결과는 호출자가 소비합니다. |
| 자율 이벤트 기반 에이전트 실행 | 장바구니 중단, 결제 실패, 사용 감소와 같은 데이터 조건은 사람이 상호작용을 시작하지 않아도 에이전트를 자동으로 실행합니다. 발신자가 응답을 기다리지 않습니다. 에이전트는 이벤트 페이로드를 근거 컨텍스트로 받아 자체적으로 응답 워크플로를 실행합니다. |
| 엔터프라이즈 콘텐츠 기반 지식 근거 | 응답을 생성하기 전에 에이전트가 엔터프라이즈 지식 저장소에서 관련 문서를 검색하여 해당 컨텍스트 창에 주입합니다. LLM은 추론을 제공하고 검색 레이어는 사실을 제공합니다. |
| 확인된 고객 컨텍스트 인젝션 | 에이전트가 작업을 호출하기 전에 통합 고객 프로필의 확인된 구조화된 특성이 작업 입력으로 미리 채워집니다. 에이전트는 세그먼트, 등급, 이탈 위험, 평생 가치와 같은 사실을 추론하는 대신 직접 전달받습니다. |
| 교차 시스템 도구 통합 | 에이전트가 모델 컨텍스트 프로토콜(MCP) 표준을 기반으로 하는 일관된 도구 인터페이스를 통해 Salesforce Platform 외부 시스템에 연결합니다. 각 외부 시스템은 설명된 호출 가능한 도구로 기능을 노출합니다. 에이전트는 각 시스템의 기본 API 또는 스키마를 알 필요 없이 해당 기능을 검색하고 호출합니다. |
| 호출 가능한 도구로서의 비즈니스 기능 | 비즈니스 엔티티, 프로세스, 인사이트와 같은 엔터프라이즈 비즈니스 기능은 모든 프레임워크의 외부 에이전트가 검색하고 호출할 수 있는 MCP 도구로 노출됩니다. |
| 교차 에이전트 위임 | 호출 에이전트가 복잡한 요청을 세분화하고 Agent-to-Agent(A2A) 프로토콜을 사용하여 다른 플랫폼 또는 공급업체 시스템의 전문 피어 에이전트에게 도메인별 하위 과업을 위임합니다. 발신 에이전트가 과업 수명 주기를 관리하고 원격 에이전트의 결과를 집계합니다. |
| 호출 가능한 서비스로서의 에이전트 | 내부 Agentforce 에이전트는 외부 오케스트레이터 또는 피어 에이전트가 과업을 위임할 수 있도록 도메인 기능을 관리되고 검색 가능한 A2A 엔드포인트로 게시합니다. 에이전트가 수신 과업 수명 주기를 관리하고 원격 발신자에게 구조화된 결과를 반환합니다. |
이 문서의 패턴은 세 가지 범주로 분류됩니다. 이 범주를 사용하면 에이전트가 호출하는 항목, 에이전트를 트리거하는 항목 또는 작업하기 전에 에이전트가 지식 기반으로 하는 방식을 설계하는지 여부와 상관없이 해결 중인 통합 문제와 관련된 패턴을 빠르게 식별할 수 있습니다. 모든 패턴을 읽지 않고 설계 문제와 일치하는 범주로 직접 이동할 수 있습니다.
작업 호출:
이러한 패턴은 에이전트가 추론 주기의 일부로 데이터를 검색하거나 작업을 실행하기 위해 외부 시스템에 콜아웃하는 방법에 대해 다룹니다. 에이전트가 이니시에이터인 아웃바운드 패턴입니다. 순서 지정(단계가 서로 종속되는 경우), 병렬화(절대 적용되지 않는 경우), 균일성, 부분 실패 처리를 다룹니다. 에이전트가 작업을 완료하기 위해 호출할 도구를 설계할 때 다음 패턴을 사용합니다.
에이전트 호출:
이러한 패턴은 외부 시스템 또는 이벤트가 에이전트를 작동시키는 방식을 다룹니다. 외부 시스템에서 해당 에이전트를 트리거하는 인바운드 패턴입니다. 트리거는 프로그래밍 방식으로 전화를 걸고 응답을 대기하는 응용 프로그램 또는 에이전트를 트리거하는 자율 데이터 조건일 수 있습니다. 에이전트가 트리거되는 방법 및 시기를 설계할 때 다음 패턴을 사용합니다.
엔터프라이즈 데이터로 그라운딩:
이 범주의 패턴은 에이전트가 이유를 내리거나 조치를 취하기 전에 정확하고 최신의 조직별 지식으로 기반을 다지는 방식을 다룹니다.
올바른 전략을 선택하는 것은 중요하지 않습니다. 각 패턴은 시스템 기능, 데이터 용량, 오류 처리, 트랜잭션성과 같은 특정한 우려 사항을 대상으로 합니다.
선택 매트릭스 테이블에 패턴 및 주요 측면이 나열되어 통합 요구 사항에 가장 적합한 패턴을 결정할 수 있습니다. 패턴은 다음 차원을 사용하여 분류됩니다.
| 모양 | 설명 |
|---|---|
| 유형 | 통합의 범주를 지정합니다. 작업 호출, 에이전트 호출 또는 엔터프라이즈 데이터로 그라운딩 작업 호출: 이러한 아웃바운드 통합은 간단한 단일 단계 도구 호출에서 복잡한 다단계 시퀀스 및 병렬 팬아웃에 이르기까지 다양하며, 이종 백엔드 전반에 걸쳐 순서 제약, 멱등성, 부분 실패 처리를 주의 깊게 고려해야 합니다. 에이전트 호출: 에이전트 호출은 외부 시스템 또는 이벤트가 에이전트를 작동시키는 방식입니다. 이러한 인바운드 통합은 구조화된 응답을 기다리는 사람 대면 응용 프로그램에서 이루어진 동기식 프로그래밍 호출에서 데이터 조건이 에이전트를 트리거하는 완전히 자율적인 이벤트 중심 실행에 이르기까지 다양합니다. 엔터프라이즈 데이터로 그라운딩: 그라운딩 통합은 에이전트가 추론하거나 행동하기 전에 정확하고 최신의 조직별 지식을 제공받는 방식을 의미합니다. 이러한 통합은 엔터프라이즈 콘텐츠 저장소에서 구조화되지 않은 문서를 검색하는 것부터 통합 고객 프로필에서 확인된 구조화된 특성을 삽입하는 것까지 다양하며, 에이전트가 환각 추론이 아닌 사실을 기반으로 작업할 수 있도록 합니다. |
| 시기 | 타이밍에 따라 통합 스타일을 지정합니다. 이 문서에서 동기식 또는 동기식 동기식 vs. 비동기식은 에이전트 자체가 트리거되는 방식 또는 작업을 호출하는 방법을 말합니다. 내부에서 발생하는 상황에는 적용되지 않습니다. 그러나 일반적으로 사용자는 에이전트가 작업을 호출하고 결과를 처리하는 동안 대기합니다. 에이전트는 현재 순환을 완료할 때까지 다음 사용자 메시지를 처리하지 않습니다. 동기식: 차단 및 실시간 요청은 요청/응답 작업입니다. 이 작업을 통해 결과가 발신자에게 즉시 반환됩니다. 비동기식: 차단되지 않는 요청, 대기열 또는 메시지 기반 요청은 거의 실시간인 단방향 작업에 의해 호출됩니다. 결과 및 오류는 다른 단방향 작업을 호출하여 반환됩니다. 따라서 발신자가 요청을 하고 응답을 기다리지 않고 계속합니다. |
이 표에는 Salesforce에서 다른 시스템으로 통합할 때 요구 사항에 가장 적합한 패턴을 결정하는 데 도움이 되는 패턴 및 주요 측면이 나열되어 있습니다.
| 유형 | 시기 | 고려할 핵심 패턴 |
|---|---|---|
| 작업 호출 | 동기식 | 순차적 작업 호출 병렬 작업 호출 교차 시스템 도구 통합 교차 대리인 위임 |
| 작업 호출 | 비동기식 | 비동기식 작업 호출 |
| 에이전트 호출 | 동기식 | 온디맨드 에이전트 호출 호출 가능한 서비스로서의 에이전트 |
| 에이전트 호출 | 비동기식 | 자율 이벤트 기반 에이전트 실행 |
| 엔터프라이즈 데이터로 그라운딩 | 동기식 | 엔터프라이즈 콘텐츠 기반 지식 그라운딩 확인된 고객 컨텍스트 인젝션 |
각 패턴 섹션은 패턴을 구축하는 방법을 설명합니다. 각 패턴은 에이전트 아키텍처의 특정 통합 문제에 대한 반복 가능한 솔루션입니다. 패턴을 사용하는 시기, 결정에 영향을 미치는 요인, Salesforce Platform에서 패턴을 제공하는 방법에 대해 다룹니다.
컨텍스트
많은 비즈니스 워크플로는 본질적으로 순차적이며, 각 단계를 진행하려면 먼저 이전 단계의 확인된 결과가 필요합니다. 예를 들어 자격이 확인될 때까지 환불을 시작할 수 없으며, 주문 레코드가 존재할 때까지 청구 계정을 만들 수 없으며, 확인을 통과할 때까지 규정 준수 확인을 기록할 수 없습니다.
기존 자동화에서 이러한 종속성은 하드 코딩된 플로 논리로 인코딩됩니다. 에이전트 시스템에서 에이전트는 각 작업의 결과를 평가하고 다음 단계의 전제 조건을 충족했는지 여부를 결정합니다.
이 패턴은 기본 아웃바운드 통합 모델을 설명합니다. 여기에서 단일 에이전트가 하나의 도메인 내에서 작업하고 순서를 호출합니다. 각 작업의 출력이 체인에서 다음 작업의 호출을 제어합니다. 오케스트레이션 에이전트는 체인 전반에 걸쳐 트랜잭션 컨텍스트를 유지하며, 식별자, 상태 코드, 각 단계에서 반환되는 데이터를 누적합니다. 이 컨텍스트를 사용하여 후속 결정을 내릴 수 있습니다.
이 패턴은 단일 동기식 콜아웃을 설명하는 통합 패턴 가이드의 원격 프로세스 호출 – 요청 및 회신에 대한 대응 요소입니다. 에이전트 패턴은 단일 추론 주기 내에서 종속 호출의 에이전트 구동 체인으로 패턴을 확장합니다.
문제
에이전트가 호스트 시스템 및 하나 이상의 원격 시스템에 걸쳐 다단계 워크플로를 실행하는 경우 다음의 네 가지 문제를 해결해야 합니다.
- 순서 지정 - 작업을 올바른 순서로 호출해야 하며, 각 단계는 이전 단계의 성공적인 완료를 기준으로 합니다.
- 데이터 전파 - 각 단계의 응답 데이터를 입력으로 다음 단계로 전달해야 합니다.
- 실패 격리 - 체인에서 어떤 지점에서도 장애가 발생하면 시스템 간에 부분적 상태나 불일치가 발생하지 않아야 합니다.
- 완료 확인 - 에이전트는 결과를 보고하기 전에 모든 단계가 성공적으로 완료되었는지 확인해야 합니다.
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
-
체인의 각 작업은 이전 작업에서 반환된 데이터에 의존합니까, 아니면 성공 또는 실패 상태에만 종속합니까?
데이터 종속성은 에이전트가 단계 전체에서 식별자 및 특성을 가져와야 합니다.
-
모든 원격 끝점이 에이전트의 추론 주기 시간 초과 내에 응답할 수 있습니까?
체인에서 어느 단계에서나 외부 시스템이 느리면 전체 순서가 차단됩니다.
-
체인에 완전한 종단간 성공이 필요합니까, 아니면 부분적인 완료를 허용합니까?
-
전체 종단 간 성공이 필요한 경우 다운스트림 실패 발생 시 롤백해야 하는 단계에 대한 보상 전략을 정의합니다.
-
체인에서 쓰기 작업을 안전하게 다시 시도할 수 있습니까?
모든 쓰기 작업은 멱등해야 하며, LLM(대규모 언어 모델) 재시도 또는 모호한 확인으로 인해 에이전트의 추론 루프에서 같은 작업을 두 번 이상 호출할 수 있습니다.
-
사용자 상호 작용(대화, 낮은 동시성) 또는 자동 트리거(잠재적으로 높은 동시성)에 의해 체인이 호출되었습니까?
이는 동기 차단이 허용되는지 또는 비동기 패턴이 필요한지 여부를 결정합니다.
Salesforce 패턴 응용 프로그램
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| Apex 작업 | 외부 콜아웃 및 복잡한 논리에 가장 적합 | 단계에는 원격 시스템에 대한 HTTP 콜아웃, 사용자 정의 데이터 변환 또는 Flow의 선언적 기능을 초과하는 오류 처리 논리가 필요합니다. Apex 작업은 @InvocableMethod 애노테이션을 통해 에이전트가 호출할 수 있도록 전체 플랫폼의 통합 기능을 노출합니다. |
| Flow 작업(자동 실행) | 비즈니스 규칙 단계 및 경량 CRM 작업에 가장 적합 | 단계는 선언적 비즈니스 논리를 적용하고 CRM 레코드를 쿼리하거나 업데이트하거나 사용자 정의 코드가 필요하지 않은 프로세스를 오케스트레이션합니다. 자동 실행 플로는 기본적으로 Agentforce 하위 에이전트에서 호출할 수 있으며, 에이전트가 다음 단계를 결정하는 데 사용하는 입력된 출력 변수를 반환합니다. |
| 외부 서비스(OpenAPI 가져오기) | 유형이 있는 검색 가능한 외부 API 통합에 가장 적합 | 외부 시스템이 OpenAPI 사양을 노출합니다. 외부 서비스는 에이전트 작업으로 직접 호출할 수 있는 강력한 타입의 Apex 스텁을 생성하여 수동 스키마 매핑을 제거하고 외부 API의 작업을 에이전트에게 명명된 기능으로 노출합니다. 가져온 사양의 각 작업이 명명된 호출 가능한 작업이 됩니다. 에이전트가 생성된 시맨틱 레이블을 기반으로 작업을 선택합니다. Agentforce 주제 센터에 생성된 작업을 등록하여, 에이전트가 추론할 때 이를 발견할 수 있도록 합니다. 참고: 외부 호스팅 서비스가 RESTful이지만 OpenAPI 사양을 사용할 수 없거나 실행할 수 없는 경우 Apex 또는 플로에서 명명된 자격 증명을 사용하여 HTTP 콜아웃을 직접 만듭니다. 결과를 구문 분석하는 데 Apex 코드가 필요합니다. |
| MuleSoft 연결된 작업 | 복잡한 미들웨어 팬 아웃 또는 레거시 시스템 통합에 가장 적합 | 응답을 반환하기 전에 원격 시스템에 여러 백엔드 시스템에서 프로토콜 번역, 데이터 변환 또는 오케스트레이션이 필요한 경우 사용합니다. 에이전트가 MuleSoft에 단일 콜아웃을 하고, MuleSoft가 다운스트림 복잡성을 처리하고 통합 응답을 반환합니다. |
스케치
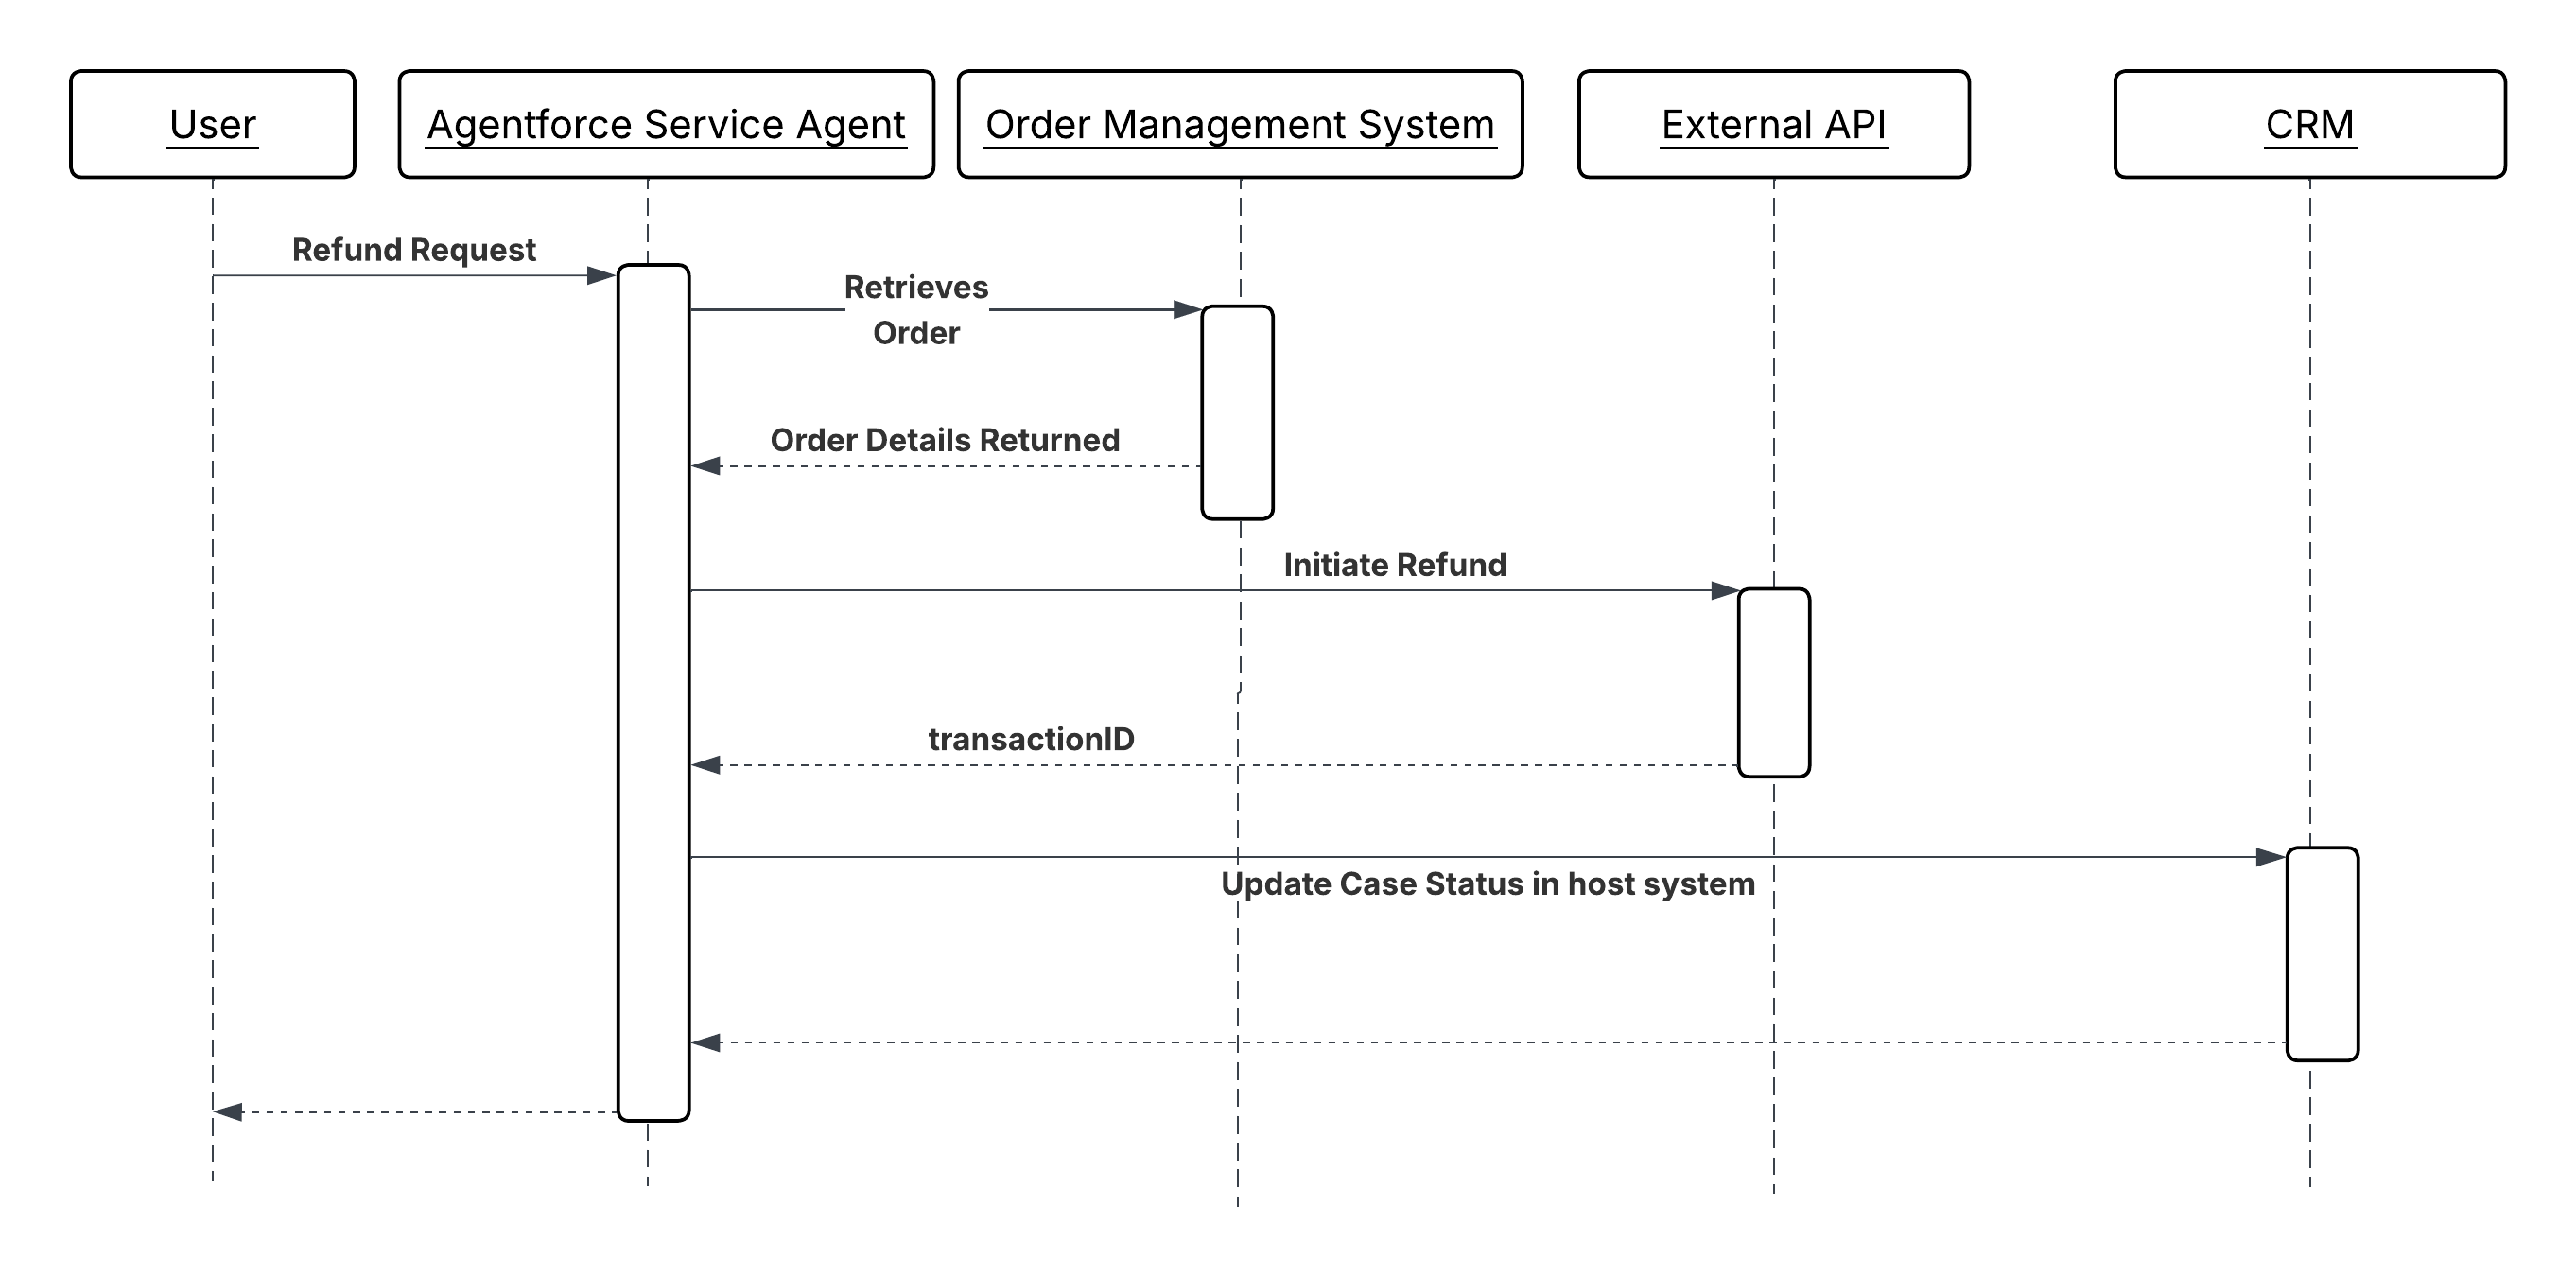
순차적 작업 호출을 위한 시퀀스 다이어그램
결과
에이전트는 교차 시스템 워크플로를 일관되고 감독되는 순서로 실행하며, Fire-and-Forget 스크립트처럼 실행하지 않습니다. 각 단계의 결과는 다음 단계가 호출되기 전에 평가되므로 에이전트가 실행 후 부분 완료를 발견하는 대신 가능한 한 빨리 실패를 감지합니다.
원격 작업이 상태(성공 또는 실패)를 확인한 후에만 호스트 시스템(Salesforce CRM)이 업데이트됩니다. 청구 계정 번호, 트랜잭션 ID, 확인 코드와 같은 외부 시스템에서 반환되는 식별자 및 상태가 체인에서 전파되고 유지되므로 워크플로 결과의 완전한 추적 레코드가 생성됩니다.
에이전트는 결과에 대한 추론 및 순서 결정에 대한 책임이 있습니다. 각 작업은 자체 작업 및 구조화된 결과 반환에만 책임이 있습니다. 두 레이어 모두 상대방의 논리를 포함하지 않습니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 체인의 각 작업에 기술 메서드 서명이 아닌 의도 기반 언어로 작성된 의미 있는 설명이 포함되어 있는지 확인합니다. 에이전트가 다음 설명을 기반으로 작업을 선택합니다. “청구 API 호출”이라는 설명은 “청구 시스템에서 청구 계정을 만들고 새 계정 식별자를 반환한다”라는 설명보다 덜 유용합니다.
- 체인에 있는 모든 쓰기 작업을 멱등하게 만드십시오. 에이전트의 추론 루프가 모호한 응답을 받으면 작업을 다시 시도할 수 있습니다. 반복 호출 시 작업이 동일한 결과를 생성해야 합니다.
- 작업 경계에서 모든 LLM 추론 입력 매개 변수를 방어적으로 확인합니다. 에이전트가 전달한 매개 변수가 범위 내에서 제대로 구성되었거나 예상 유형인 것으로 가정하지 마십시오.
- 단일 책임에 대한 각 작업을 설계합니다. 청구 계정을 생성하고 동일한 호출에서 확인 이메일을 보내는 작업은 두 개의 개별 작업에 비해 재시도하기 어렵고, 테스트하기 어렵고, 에이전트가 추론하기도 더 어렵습니다.
Salesforce 구현 참고 사항
- Apex 작업의 경우 @InvocableMethod(label=’…’ description=’…’)를 주석으로 지정합니다. 작업을 호출할 시기를 결정하기 위해 에이전트가 “설명”을 읽습니다. “label” 및 “description” 필드를 사용하여 @InvocableVariable을 사용하여 모든 입력 및 출력 변수를 선언합니다. 명시적 성공/실패 지표 및 사람이 읽을 수 있는 오류 메시지가 포함된 구조화된 결과 개체를 반환합니다.
- 플로 작업의 경우 자동 실행 플로우만 사용하십시오. 자율 에이전트 컨텍스트에서는 화면 플로우가 지원되지 않습니다. 각 플로우를 원자적으로 유지하십시오. 하나의 작업, 하나의 책임. 모든 외부 콜아웃 요소에 대해 오류 경로를 설정하여 통합 오류를 포착하고, 포착되지 않은 예외로 인해 세션이 종료되는 것을 방지하면서 에이전트에게 실행 가능한 오류 메시지를 반환합니다.
- 외부 서비스의 경우 대상 시스템의 OpenAPI 사양을 가져오고 Agentforce 주제에 생성된 작업을 등록합니다. 작업 정의에서 끝점 또는 자격 증명을 하드 코딩하지 않도록 Named Credentials에 생성된 스텁을 래핑합니다.
- 모든 외부 콜아웃에 대해 명시적인 콜아웃 타임아웃을 설정합니다. 시간 제한 없이 종료되는 콜아웃은 세션 제한에 도달할 때까지 에이전트의 추론 주기를 차단합니다. 시간 초과가 발생하면 설명이 포함된 오류 메시지와 함께 우아하게 실패를 반환합니다. 모든 외부 콜아웃의 구성 가능한 시간 제한은 최대 120초입니다. 또한 Apex 동기 트랜잭션 거버너 제한이 적용되므로, 각각 5초 이상 실행되는 트랜잭션이 50개를 초과하지 않도록 위험을 완화해야 합니다.
오류 처리 및 복구
- 에이전트는 각 단계를 이전 단계의 명시적인 성공에 따라 진행합니다. 작업은 명확한 성공 또는 실패 지표가 포함된 구조화된 결과를 반환해야 합니다. 에이전트는 누락되거나 null인 응답만으로는 실패를 신뢰성 있게 추론할 수 없습니다.
- 작업이 실패하면, 에이전트는 작업에서 반환한 오류 메시지를 바탕으로 다음 조치를 결정합니다. 예를 들어, 사용자에게 올바른 입력을 요청하거나, 조정된 매개변수를 사용하여 자가 복구 재시도를 하거나, 체인을 중단하고 실패를 기록하여 사람이 확인할 수 있도록 합니다. 따라서 오류 메시지는 구체적이고 실행 가능한 상태여야 합니다. “유효하지 않은 날짜 범위: endDate가 startDate 앞에 있지 않음”은 사용할 수 있으며, 400 상태 코드만 사용할 수 없습니다.
- 부분 완료로 인해 일관되지 않는 상태가 생성되는 체인의 경우(예: 청구 계정이 생성되었지만 CRM 레코드가 업데이트되지 않았음) 에이전트는 실패를 알리기 전에 보상 작업을 호출하여 부분 상태를 롤백하거나 플래그를 지정합니다. 보상 경로를 앞으로의 경로와 함께 명명된 작업으로 설계합니다.
- 쓰기 작업이 잠재적으로 성공했지만 모호한 응답(네트워크 시간 초과, 승인 없음)을 반환한 경우, 재시도 시 원래 호출과 동일한 멱등성 키 또는 외부 참조 ID를 사용해야 합니다. 멱등성이 없는 쓰기에 대해 확인되지 않은 재시도를 실행하지 마십시오.
보안 고려 사항
- 모든 외부 콜아웃을 명명된 자격 증명으로 래핑합니다. Apex 코드 또는 플로우 구성에서 끝점이나 자격 증명을 하드 코딩하지 마십시오. 플랫폼의 보안 자격 증명 저장소를 통해 관리하고 코드를 변경하지 않고 순환해야 합니다.
- 각 작업에 사용된 통합 사용자 또는 연결된 앱에 최소 권한 원칙을 적용합니다. 주문 데이터만 읽는 작업은 청구 시스템에 쓰기 권한을 보유하지 않아야 합니다. 작업에 필요한 최소한의 작업만 수행할 수 있도록 자격 증명의 범위를 제한하세요.
- 세션 ID, 민감한 값이 제거된 입력 매개변수, 그리고 결과와 함께 체인 내 각 작업의 호출을 기록합니다. 결과가 분쟁되는 경우 이 감사 내역은 에이전트가 지정된 작업 순서를 실행한 이유를 재구성하는 기본 메커니즘입니다.
- 사용자 제공 텍스트에서 생성된 모든 입력 매개 변수를 비활성화한 후 외부 시스템에 전달합니다. 에이전트를 통해 외부 API 콜아웃에 전달된 사용자 입력은 잠재적인 삽입 벡터입니다. 콜아웃을 만들기 전에 작업 경계에서 유형, 형식, 범위를 확인합니다.
예제
환불 요청을 처리하는 고객 서비스 에이전트 4단계 순차적 체인을 실행합니다.
GetOrderDetails(Apex Action)는 사용자가 제공한 주문 ID를 사용하여 주문 관리 시스템에서 주문 레코드를 검색합니다. 주문 상태, 행 항목, 구매 날짜, 결제 방법을 반환합니다. 진행하기 전에 에이전트가 주문이 환불 가능한 상태인지 평가합니다.ValidateRefundEligibility(자동 실행 플로)은 반품 기간, 제품 범주 제한, 이전 환불 내역 등 환불 자격을 위한 비즈니스 규칙을 적용합니다. “적격” 부울과 자격이 없는 경우 에이전트가 사용자에게 표시할 수 있는 일반 언어의 이유를 반환합니다.InitiateRefund(Apex Action)는 주문 ID 및 환불 금액을 사용하여 외부 결제 게이트웨이 API를 호출합니다. 성공에 대한 “refundTransactionId”를 반환합니다. 이 작업은 멱등성(idempotent)을 가집니다. 같은 주문 ID로 두 번째 호출 시, 중복 환불을 생성하는 대신 기존 트랜잭션 ID를 반환합니다.UpdateCaseStatus(자동 실행 플로우)는 환불 트랜잭션 ID를 사용하여 CRM 사례 레코드를 업데이트하고, 사례 상태를 “해결된 환불 발급”으로 설정하며, 계정 소유자에 대한 후속 작업을 생성합니다. 이 단계는 “InitiateRefund”가 확인된 트랜잭션 ID를 반환한 후에만 실행됩니다.
만약 InitiateRefund가 시간 초과되거나 오류를 반환하면, 에이전트는 체인을 중단하고 UpdateCaseStatus를 호출하지 않으며 사용자에게 실행 가능한 메시지를 표시합니다. 사례는 진행 중이며 해결되지 않아 CRM에서 정확한 상태를 유지합니다.
컨텍스트
실행 단계가 서로 종속되는 경우 순차적인 작업 체인이 효율적입니다. 한 단계가 다음 단계의 시작을 제어합니다. 그러나 많은 워크플로에 상호 종속성이 없는 일련의 단계가 포함되어 있습니다. 예를 들어 제품 재고 검색, 고객 권리 가져오기, 배송 예상 확인이 포함된 단계는 모두 동시에 수행할 수 있습니다. 단계의 입력에 다른 단계의 출력이 필요하지 않으므로 이러한 단계를 순차적으로 실행하면 단계 수에 비례하는 시간이 낭비됩니다.
병렬 호출 패턴에서 에이전트는 작업 집합이 독립적임을 식별하고 순서가 아닌 동시에 호출합니다. 전체 워크플로 시간은 모든 작업 시간의 합이 아니라 가장 느린 개별 작업에 의해 결정됩니다. 모든 결과가 반환되면, 에이전트는 이를 하나의 일관된 응답으로 집계하거나 다음 추론 단계의 입력으로 함께 사용합니다.
주요 아키텍처 문제는 병렬 호출 자체가 아닙니다. 플랫폼의 동시성 제약 내에서 팬아웃을 관리하고, 집계 단계에서 부분 실패를 우아하게 처리하며, 성공한 결과는 그대로 보존하는 것이 중요합니다.
문제
에이전트가 여러 독립형 기능의 동시 실행을 효율적으로 오케스트레이션하고 개별 결과를 사용자 또는 후속 단계에 대해 일관된 단일 응답으로 집계하는 방법은 무엇입니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 스레드 안전 및 변동 가능 상태 공유와 관련된 조치에 대한 고려 사항은 무엇입니까?
- 솔루션은 단일 트랜잭션 내에서 병렬 Apex 콜아웃으로 Salesforce 거버너 제한에 도달하지 않도록 어떻게 관리하고 방지할 수 있습니까?
- 비동기 패턴(예: Queueable Apex 또는 Platform Events)을 사용하여 거버너 제한을 회피해야 합니까?
- 에이전트가 진행하기 전에 결과의 동기식 집계가 필요합니까?
Salesforce 패턴 응용 프로그램
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| 중간웨어 접근 방식 | 높은 팬 아웃(5개 초과 엔드포인트) 및 플랫폼 간 집계에 가장 적합 | 미들웨어 레이어가 필요합니다. 에이전트는 미들웨어에 한 번의 콜아웃을 수행합니다. 그런 다음, 미들웨어가 병렬로 10개의 시스템에 요청을 보내 데이터를 집계한 후, 단일 응답을 에이전트에게 다시 보냅니다. 이 옵션은 에이전트가 여러 개의 이기종 외부 시스템을 호출해야 하는 경우에 기본 설정됩니다. 미들웨어는 팬 아웃 복잡성을 흡수하고 단일 집계된 응답을 반환합니다. |
| 대기 가능한 Apex | Salesforce 내부 병렬 처리에 가장 적합합니다. | 대기 가능한 작업을 여러 개 해제해야 합니다. Salesforce에서 대기열을 관리하는 동안 동시성 제한에 “슬롯”이 충분한 경우 동시에 실행할 수 있습니다. Salesforce 조직 내에 병렬 작업이 있고 동시 슬롯을 사용할 수 있는 경우 사용합니다. 즉시 집계된 응답이 필요한 경우에는 적합하지 않습니다. |
| 플랫폼 이벤트 | 파이어-포겟 또는 최종 정합성에 가장 적합 | 결과를 동기식으로 집계할 필요가 없습니다. 각 이벤트는 분리된 트랜잭션을 트리거하여 처리량을 극대화하지만 다운스트림 조정이 필요합니다. 최종 정합성이 허용되고 처리량이 응답 대기 시간보다 더 중요한 경우 이 메커니즘을 사용합니다. |
스케치
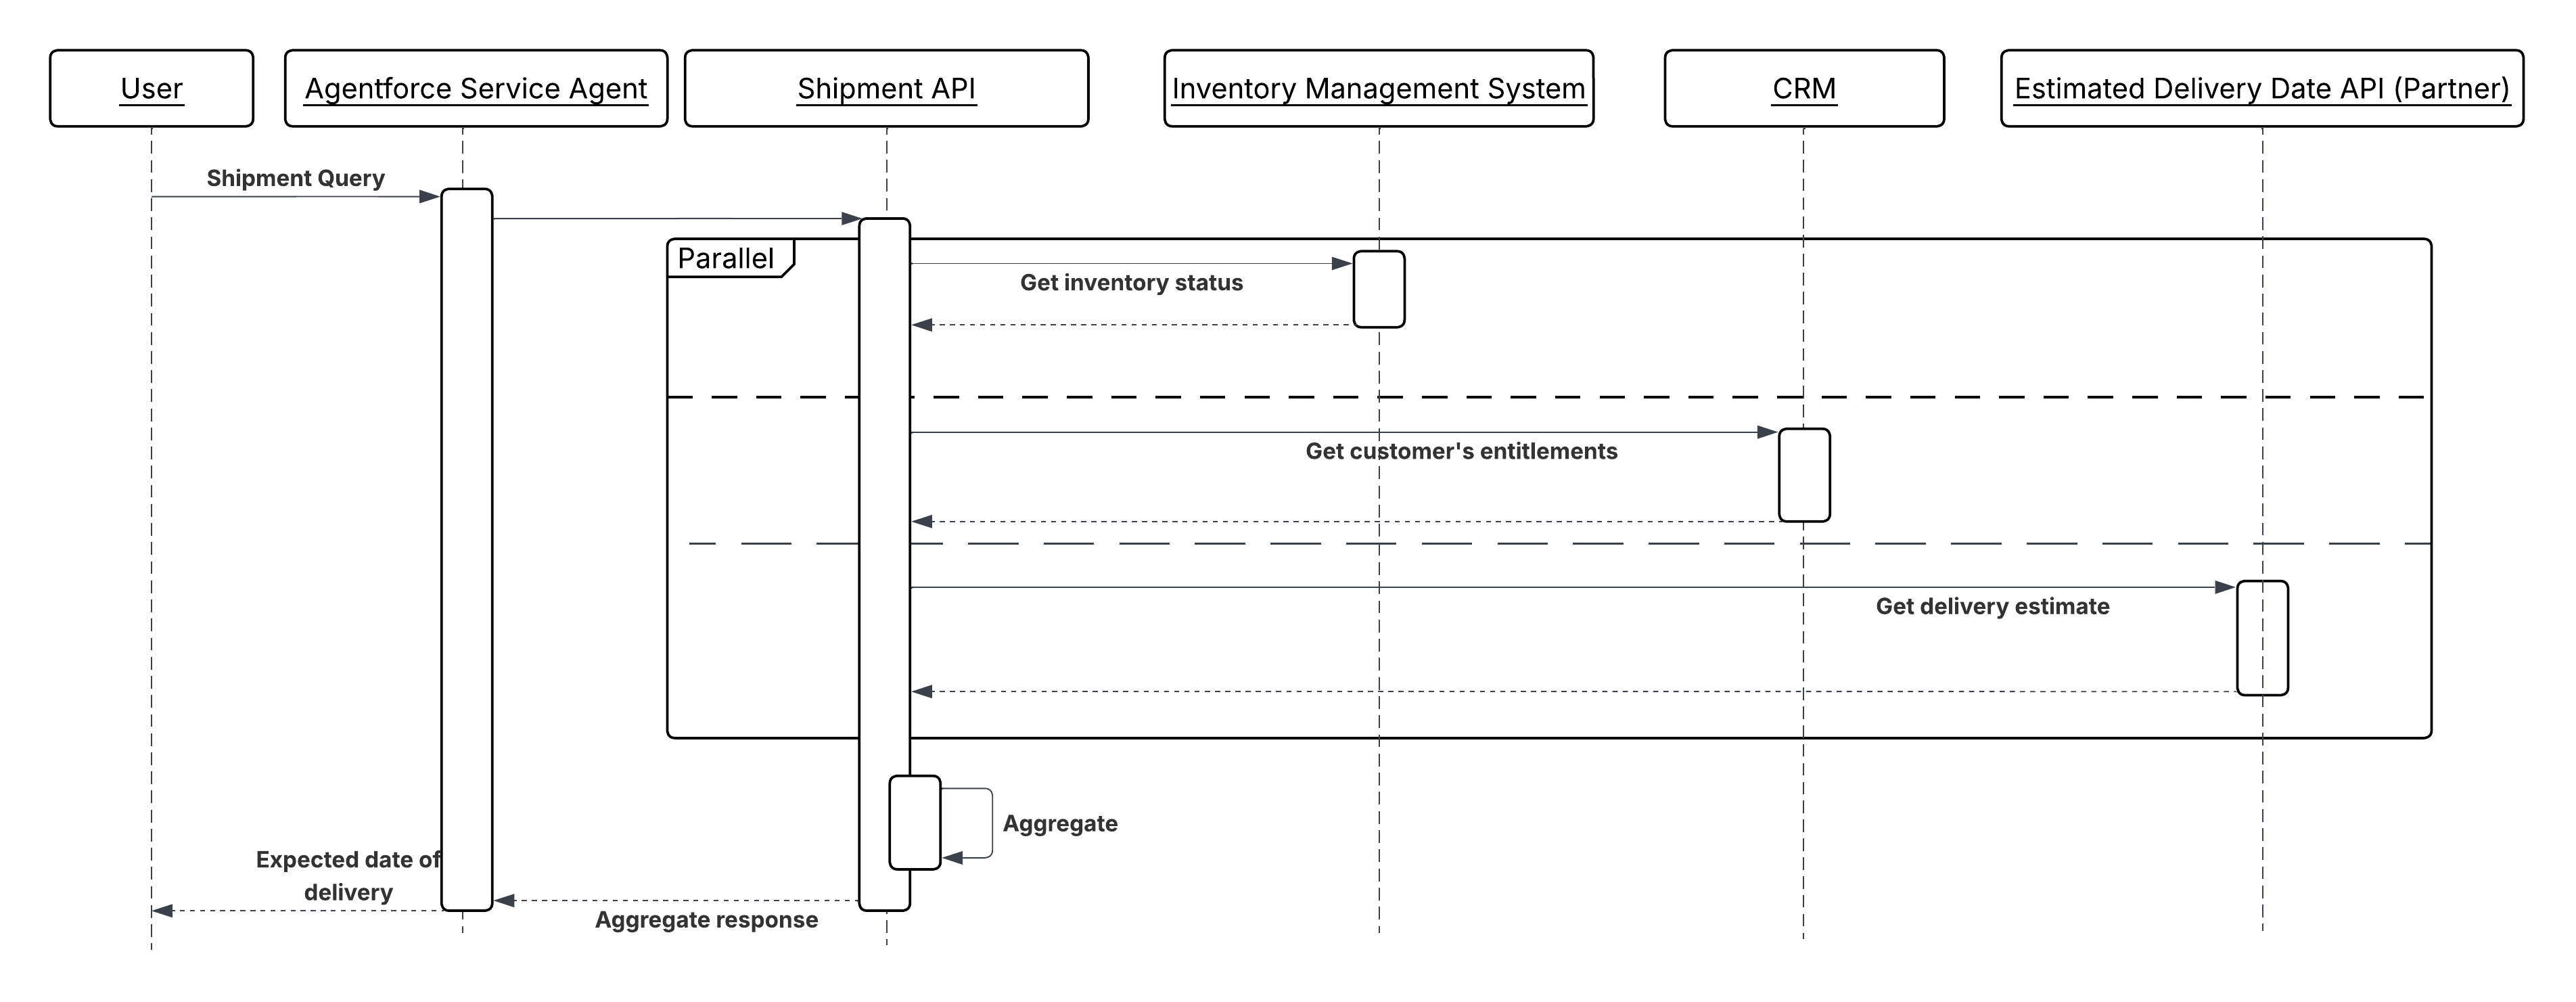
병렬 작업 호출의 순서 다이어그램
결과
독립적인 작업이 병렬로 실행될 때, 종단 간 워크플로 시간은 모든 작업의 합이 아니라 가장 느린 개별 작업에 의해 결정됩니다. 각각 평균 300ms인 3개의 독립 콜아웃이 있는 워크플로의 경우, 병렬 실행은 약 300ms에 완료되고, 순차 실행은 약 900ms가 소요됩니다. 규모가 커질수록 이 차이는 동시에 실행되는 모든 에이전트 세션에서 누적됩니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 병렬화하기 전에 독립성을 확인합니다. 두 작업 중 어느 것도 다른 작업이 기록한 상태를 읽지 않고, 어느 한 작업의 실패도 다른 작업을 취소하지 않는 경우에만 작업을 병렬로 실행하는 것이 안전합니다. 종속성이 있는 경우, 심지어 약한 종속성이라도, 대신 순차적 체인화를 사용하십시오.
- 집계 단계를 명시적으로 설계합니다. 전체 결과 집합의 모양, 다운스트림 추론에 대한 부분 결과 집합의 의미, 에이전트가 모든 결과를 기다리거나 임계값(예: 총 7건 중 5건)이 반환되면 계속 진행해야 하는지 여부를 미리 정의합니다.
- 모든 병렬 쓰기 작업은 동일해야 합니다. 각 작업은 공유 트랜잭션 경계 없이 분리적으로 실행되므로 개별 지점을 재시도해도 부작용이 중복되지 않습니다.
Salesforce 구현 참고 사항
- 대기 가능 Apex의 경우: 단일 트랜잭션 내에서 모든 작업을 제출하여 동시 실행 가능성을 극대화합니다. 사용 가능한 동시 슬롯은 조직 전체에서 공유되므로, 슬롯을 항상 사용할 수 없다는 가정하에 설계하고, 사용할 수 없는 경우 순차 실행으로 대체할 수 있도록 하십시오.
- 플랫폼 이벤트: 대상 레코드를 직접 업데이트하는 대신 공유 상관 관계 ID로 키가 지정된 전용 스테이징 레코드에 각 작업의 결과를 작성합니다. 최종 집계 플로 또는 Apex 트리거는 예상 수에 도달하면 모든 스테이징 레코드를 읽은 다음, 통합된 업데이트를 원자적으로 적용합니다.
- Middleware Fan-Out의 경우: 가장 느린 백엔드의 예상 최악의 사례 응답 시간보다 길지만 Salesforce 콜아웃 시간 제한 이내인 단일 콜아웃에 명시적 시간 제한을 설정합니다. 미들웨어는 전체 응답이 시간 초과되는 대신, 실패한 백엔드를 명확하게 표시하여 부분 결과를 반환합니다.
오류 처리 및 복구
- 부분적인 성공을 최상위 결과로 취급합니다. 3~4개의 병렬 작업이 성공하더라도, 에이전트는 성공한 결과를 사용하고 남은 실패는 사용자에게 명시적으로 표시하거나 재시도를 위해 기록하거나 보상 조치를 취해야 하며, 모든 결과를 버리거나 실패가 없는 것처럼 진행해서는 안 됩니다.
- 대기 가능 및 플랫폼 이벤트 패턴의 경우 상관 관계 ID(팬아웃 시점에 생성됨)를 사용하여 모든 병렬 지점을 다시 원래 에이전트 세션에 연결합니다. 이 ID는 결과를 재구성하고 실패를 로그에서 소스로 다시 추적하는 데 필요합니다.
- 병렬 지점이 실패하고 작업을 재시도할 수 있는 안전한 경우, 원래 상관 관계 ID와 멱등성 키를 사용하여 실패한 지점만 다시 대기열에 할당합니다. 모든 지점을 다시 호출하지 마십시오.
- 집계 단계에 대한 시간 초과 임계값을 정의합니다. 만약 모든 결과가 임계값 내에 도착하지 않는다면, 사용 가능한 결과로 진행하고 무기한 대기하는 대신 불완전한 결과 집합에 플래그를 지정합니다.
보안 고려 사항
- 대기 가능한 작업, 플랫폼 이벤트 트리거 또는 미들웨어 콜아웃과 같은 각 병렬 실행 컨텍스트는 순차적 콜아웃과 동일한 액세스 제어를 적용해야 합니다. 병렬은 데이터 액세스 규칙을 완화하지 않습니다. 각 지점은 별도로 호출될 경우와 동일한 최소 권한 자격 증명 아래에서 작동해야 합니다.
- 미들웨어 팬아웃의 경우 미들웨어 레이어는 집계 기간 외부의 개별 백엔드에서 응답 페이로드를 캐시하거나 기록하지 않습니다. 각 백엔드의 응답에 즉각적인 작업 범위를 벗어나지 않아야 하는 중요한 데이터가 포함될 수 있습니다.
- 플랫폼 이벤트 집계에 사용된 스테이징 레코드는 에이전트의 최종 사용자가 읽을 수 없는지 확인합니다. 이러한 기록에는 중간 단계의, 부분적으로 완성되지 않은 데이터가 포함되어 있을 수 있습니다.
예제
서비스 에이전트가 복잡한 이행 관련 질문에 답변합니다. “금요일까지 이 주문을 배송할 수 있습니까?” 다음과 같이 답변하려면 모든 독립 시스템의 데이터가 동시에 필요합니다.
- 에이전트는 현재 재고 수준, 고객의 활성 권리, 고객 위치에 대한 통신사의 예상 배달 기간과 같은 3가지 독립적 데이터 요구 사항을 식별합니다.
- 세 가지 작업이 동시에 호출됩니다.
GetInventoryStatus(외부 인벤토리 시스템에서 미들웨어를 통해),GetCustomerEntitlements(Salesforce CRM에서),GetDeliveryEstimate(통신사 API에서 미들웨어를 통해). - 각 작업은 독립적으로 반환됩니다. 에이전트는 세 개의 응답이 모두 수신되거나 집계 시간 제한에 도달할 때까지 기다립니다.
- 세 가지 결과를 모두 사용할 수 있게 되면 에이전트가 결합된 데이터에 대해 이유를 내리고 재고가 충분한지 여부를 평가하고 고객의 권리가 간편 배송을 포함하고 통신사가 고객의 우편 번호에 대해 금요일 배송이 가능한지 확인합니다.
- 에이전트는 세 가지 시스템에서 가져온 단일 근거 있는 답변을 사용자에게 반환하며, 세 가지 호출 중 가장 느린 응답 시간 내에 이를 제공합니다.
컨텍스트
일부 에이전트가 시작한 작업은 현재 추론 주기를 계속하기 위해 필요한 결과를 생성하지 않습니다. 알림 전송, 다운스트림 배치 프로세스 트리거, 메시지 대기열에 이벤트 게시, 또는 장기 실행 작업 제출과 같은 작업에서는 에이전트의 의무가 발송 시 종료되며, 이후 다운스트림 시스템이 소유권을 인수해 독립적으로 작업을 완료합니다.
기존 자동화에서는 이를 fire-and-forget 콜아웃 또는 플랫폼 이벤트 게시로 모델링합니다. 에이전트적 시스템에서, 에이전트는 추론 과정 중 작업이 차단되지 않음을 판단한 후 해당 작업을 발송하고, 발송 확인을 기록하며, 다운스트림 결과를 기다리지 않고 턴을 계속하거나 종료합니다.
이 패턴은 통합 패턴 가이드의 Remote Process Invocation – Fire and Forget(원격 프로세스 호출)에 대한 에이전트적 대응입니다. 에이전트적 패턴은 발송 결정을 에이전트의 추론 과정에 포함시키고, 에이전트에게 응답이 반환되지 않더라도 발송을 추적할 수 있도록 확장됩니다.
문제
에이전트가 에이전트의 세션 또는 추론 주기를 넘어 실행되는 다운스트림 작업을 시작해야 하는 경우 다음 세 가지 문제를 해결해야 합니다.
- 비차단 호출: 에이전트는 결과를 기다리는 추론 주기를 열지 않고 작업을 실행하고 전달을 확인해야 합니다.
- 배달 확인: 에이전트는 성공적인 발송(메시지가 수락됨)과 성공적인 결과(다운스트림 프로세스가 완료됨)를 구분해야 합니다. 에이전트는 오직 전자만 확인할 수 있습니다.
- 추적 가능: 에이전트가 결과를 수신하지 않으므로 에이전트 세션과 무관한 로그, 이벤트 레코드 또는 플랫폼 모니터링을 통해 작업을 관찰할 수 있어야 합니다.
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
-
에이전트가 현재 턴을 완료하기 위해 이 작업의 결과가 필요합니까? 예인 경우, 이것은 올바른 패턴이 아닙니다. 대신 순차적 작업 호출을 사용하십시오.
-
다운스트림 시스템이 동기식 확인 없이 발송된 메시지나 이벤트를 수신하고 신뢰성 있게 처리할 수 있습니까? 대상 시스템은 내구성이 있어야 합니다. 일시적으로 사용할 수 없는 경우 메시지를 분실해서는 안 됩니다.
-
작업이 멱등성인지, 아니면 중복 발송을 방지해야 하는지 확인합니까? 네트워크 수준 재시도 및 에이전트 추론 재시도로 인해 같은 발송이 두 번 이상 시도될 수 있습니다. 다운스트림 작업이 멱등성이 아닌 경우, 작업에 중복 제거 키를 포함해야 합니다.
-
사용자 또는 다운스트림 프로세스가 작업이 완료되면 알아야 합니까? 에이전트는 발송만 확인할 수 있습니다. 완료 상태가 필수인 경우 별도의 알림 또는 팔로우업 메커니즘을 설계합니다. 플랫폼 이벤트, 사례 업데이트 또는 콜백 - 이 추론 주기를 벗어난 경우
Salesforce 패턴 적용
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| Pub/Sub API | 대량 또는 외부 이벤트 스트리밍에 가장 적합 | 에이전트가 gRPC를 통해 Salesforce Pub/Sub API에 이벤트를 게시하는 Apex 작업을 호출합니다. 작업은 발송 확인으로 에이전트에게 PublishResult replayId를 반환합니다. 다운스트림 소비자가 Salesforce 네이티브 플로 또는 Apex 트리거가 아닌 Pub/Sub API를 통해 구독하는 외부 시스템인 경우 또는 대량 이벤트 스트리밍이 필요한 경우 사용합니다. |
| 플랫폼 이벤트(Apex 작업) | Salesforce 내 비동기 발송에 가장 적합 | 에이전트가 플랫폼 이벤트를 게시하는 Apex 작업을 호출합니다. 이벤트는 모든 구독자에게 비동기식으로 전달됩니다. 작업은 에이전트에게 게시 확인을 반환하며 처리 결과는 반환하지 않습니다. 다운스트림 소비자가 Salesforce Platform 내에 있는 경우 사용됩니다. 에이전트가 EventBus.publish()를 호출하는 Apex 작업을 호출합니다. 작업은 수락을 확인하는 SaveResult을 반환합니다. |
| Apex 대기 가능/배치(Apex 작업) | 장기 실행 백그라운드 처리에 가장 적합합니다. | 에이전트가 Queueable 또는 Batch 작업을 대기열에 지정하는 Apex 작업을 호출합니다. 작업이 에이전트의 트랜잭션 외부에서 실행됩니다. 작업은 에이전트가 사용자에게 참조로 표시할 수 있는 작업 ID를 반환합니다. 다운스트림 작업이 장기 실행 Salesforce 작업 데이터 처리, 다중 개체 업데이트 또는 동기 제한을 초과하는 외부 콜아웃인 경우 사용됩니다. System.enqueueJob()는 에이전트가 참조로 기록한 작업 ID를 반환합니다. |
| MuleSoft 비동기 플로 | 외부 메시지 대기열 발송에 가장 적합 | 에이전트가 외부 대기열(Kafka, JMS, SQS)에 메시지를 배치하는 MuleSoft 노출 작업을 호출합니다. MuleSoft는 프로토콜 번역 및 전달 승인을 처리합니다. 에이전트는 메시지가 다운스트림에서 처리된 것이 아니라 MuleSoft에서 수락되었음을 확인합니다. |
| 외부 REST 끝점(Apex 작업) | 외부 시스템 이벤트 제출에 가장 적합 | 대상 시스템이 제출을 수락하는 끝점을 노출하고 즉시 승인 ID를 반환하여 비동기식으로 처리를 완료합니다. 에이전트가 승인 ID를 수신하고 기록합니다. |
스케치
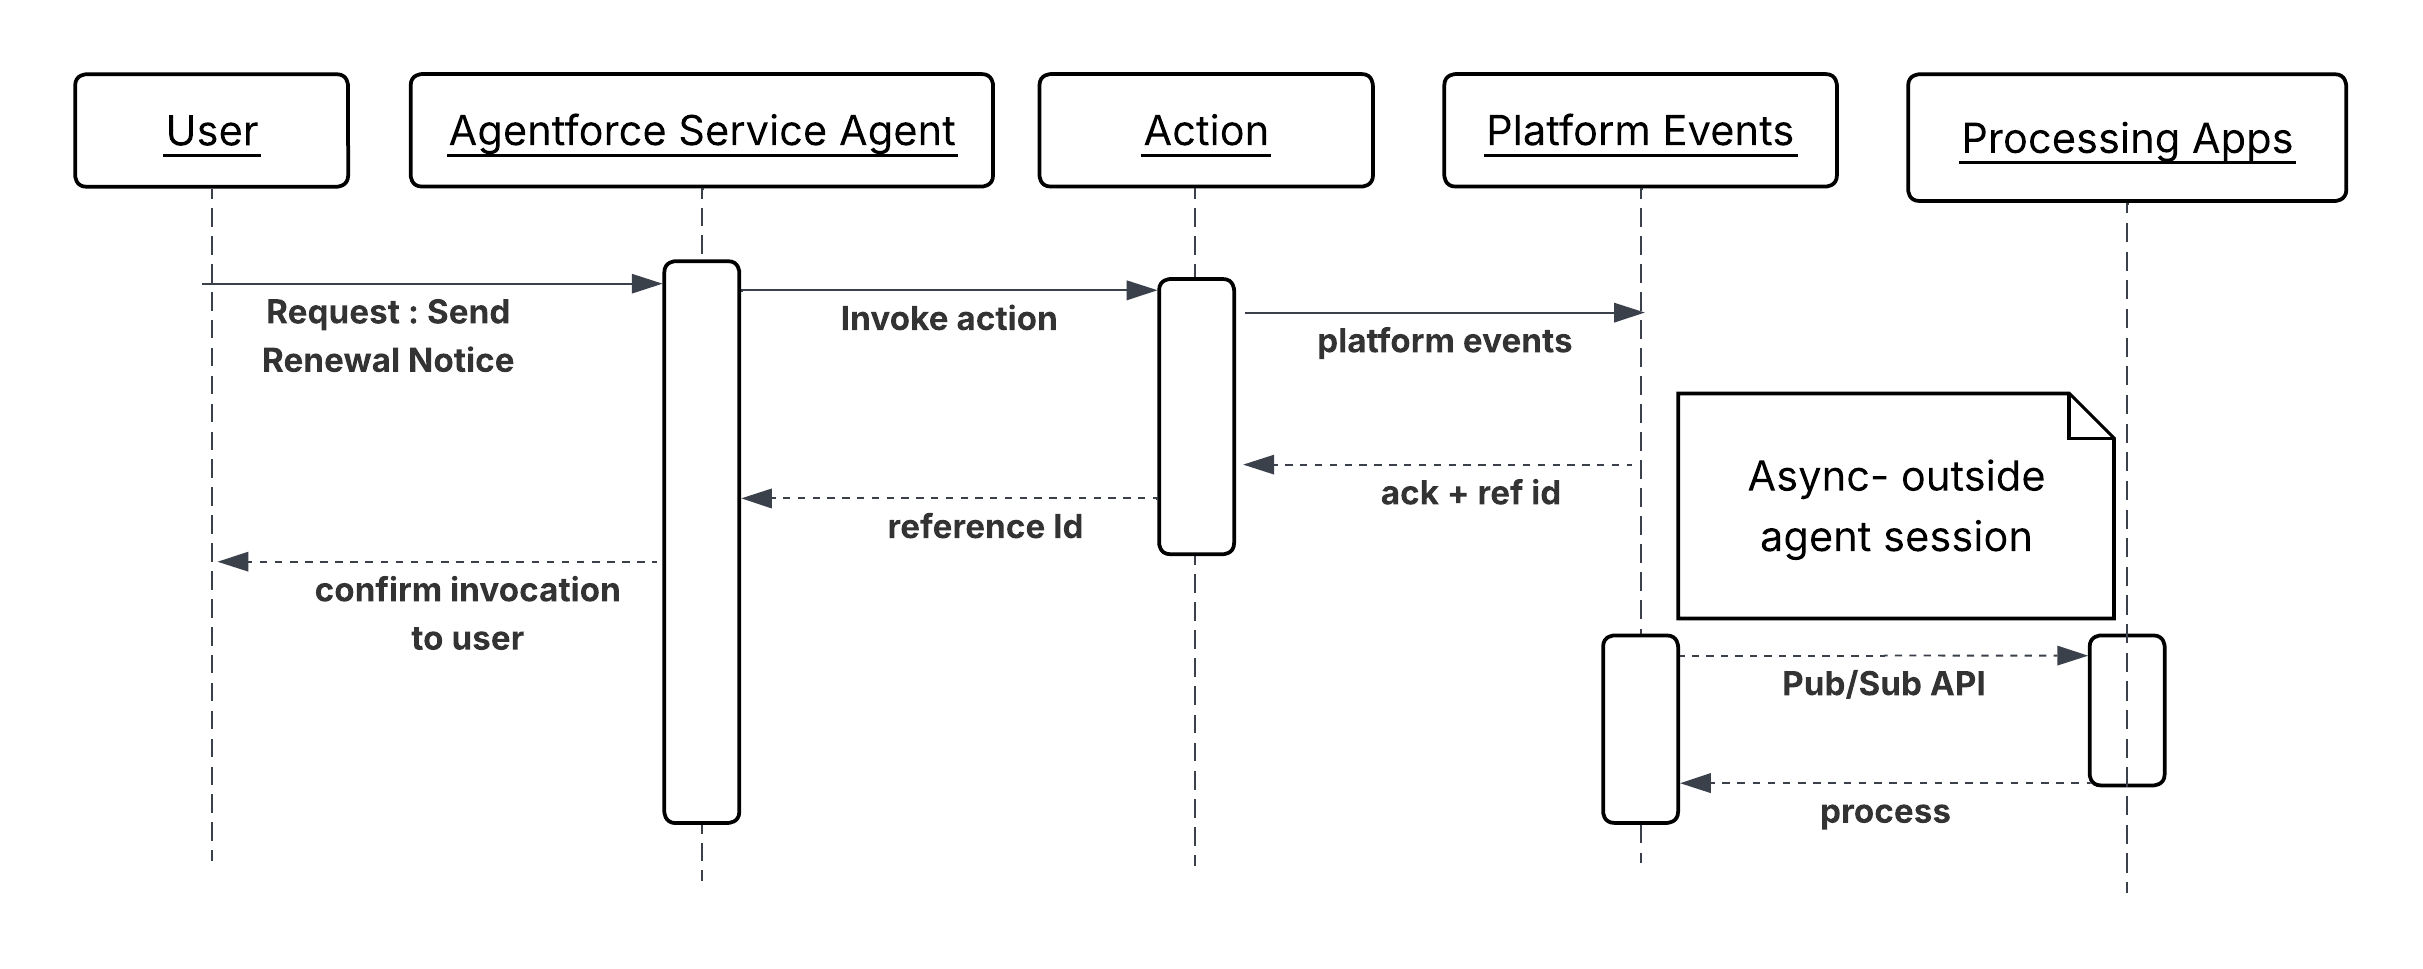
비동기식 작업 호출의 순서 다이어그램
결과
에이전트가 결과에 대한 추론 주기를 차단하지 않고 다운스트림 작업을 호출합니다. 에이전트의 턴은 작업이 완료되었음을 기다리지 않고, 수락되었음을 확인함으로써 종료됩니다. 다운스트림 시스템은 실행의 전체 소유권을 가집니다. 발송된 작업은 발송 시 CRM에 기록된 플랫폼 이벤트 구독자, 작업 ID 또는 외부 대기열 승인 ID를 통해 추적할 수 있습니다. 다운스트림 작업이 실패하면, 해당 실패는 호출한 에이전트 세션이 아니라 다운스트림 시스템의 자체 모니터링을 통해 확인됩니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 의도 기반 언어로 작업 설명을 작성합니다. 예를 들어, ‘갱신 알림을 메시징 대기열에 제출하고 발송 참조 ID를 반환함’은 ‘알림 엔드포인트를 호출함’보다 에이전트에게 더 유용합니다.
- 발송 작업을 ‘전송 및 배달 확인’으로 설명하지 마십시오. 에이전트는 수락만 확인할 수 있습니다. 다운스트림 배달 및 처리는 에이전트의 관찰 능력이 아닙니다.
Salesforce 구현 참고 사항
- 모든 호출 작업에서 참조 ID(예: 플랫폼 이벤트
ReplayId, 대기 가능 작업 ID, Pub/Sub APIPublishResultreplayId, 또는 외부 확인 토큰)를 반환합니다. 호출 시간에 CRM 레코드에 기록합니다. 이는 에이전트 세션이 생성하는 유일한 감사 내역입니다. - Pub/Sub API의 경우, 에이전트는 Pub/Sub API ‘/Publish’ 끝점에 gRPC 콜아웃을 수행하는 Apex 작업을 호출합니다. 작업은 스키마 등록 단계를 처리해야 합니다. 등록된 스키마에 대해 Avro 형식으로 이벤트를 직렬화해야 합니다. 에이전트에게
PublishResult ‘replayId’을 발송 참조로 반환합니다. - 플랫폼 이벤트의 경우 Apex 작업 내에서
EventBus.publish()를 호출하고 에이전트에게 성공 표시기를 반환하기 전에 SaveResult에 오류가 있는지 확인합니다. 게시에 성공했다고 가정하지 말고 반드시 검증하십시오. - 대기 가능 작업의 경우 대기 가능 인터페이스를 구현하고 작업 내에서 System.enqueueJob()를 호출합니다. 에이전트에게 결과 AsyncApexJob ID를 반환합니다.
- 외부 비동기 끝점의 경우 대상 끝점이 참조 ID와 함께 즉시 확인(HTTP 202 수락됨)을 반환해야 합니다. 처리가 완료될 때까지 끝점이 차단되는 경우 동기식이며 이 패턴이 적용되지 않습니다.
오류 처리 및 복구
- 호출 작업은 발송 실패(메시지가 수락되지 않음) 및 처리 실패(메시지가 수락되었지만 다운스트림 작업이 나중에 실패)를 구분해야 합니다. 에이전트는 이전 항목만 처리할 수 있습니다.
- 호출이 실패할 경우 작업이 명확한 이유와 함께 구조화된 실패를 반환해야 합니다. 에이전트는 발송을 재시도하거나, 사람에게 에스컬레이션하거나, 실패한 발송 레코드를 기록할 수 있지만, 동일한 세션 내에서 다운스트림 처리 실패를 복구할 수 없습니다.
- 다운스트림 실패가 결국 표시되어야 하는 작업의 경우, 다운스트림 프로세스에서 게시된 플랫폼 이벤트, 작업 상태를 확인하는 예약 플로우 또는 에이전트 세션 외부의 후속 사례와 같은 별도의 피드백 루프를 설계합니다.
보안 고려 사항
- 모든 외부 비동기식 콜아웃을 명명된 자격 증명으로 래핑합니다. 호출 작업은 끝점 URL 또는 자격 증명을 코드에 포함하지 않습니다.
- 이벤트 페이로드 또는 메시지 본문에 포함되기 전에 호출 작업에 전달된 모든 매개 변수를 확인하고 비활성화합니다. 비동기 메시지에 전달된 사용자 제공 텍스트는 다운스트림 소비자의 잠재적인 주입 벡터입니다.
- 발송 시 모든 발송을 세션 ID, 참조 ID, 정제된 페이로드로 기록합니다. 에이전트에게 응답이 반환되지 않으므로 이 로그는 에이전트가 시작한 내용을 재구성하는 기본 메커니즘입니다.
- 통합 사용자 또는 연결된 앱에 최소 권한을 적용합니다. 알림 대기열에 게시되는 발송 작업에는 관련되지 않은 시스템에서 읽기 또는 쓰기를 허용하는 자격 증명이 포함되지 않아야 합니다.
예제
갱신 관리 에이전트가 만료 예정인 계약을 처리하면 고객이 자동 갱신 알림을 받을 자격이 결정됩니다. 에이전트는 전환을 마치기 전에 이메일이 전달되었음을 확인하지 않아도 됩니다.
CheckRenewalEligibility(자동 실행 플로우)는 계약 조건, 고객 등급 및 수신 거부 상태를 평가합니다. “적격” 부울 및 선호하는 알림 채널을 반환합니다.DispatchRenewalNotification(Apex 작업)은 계약 ID, 고객 ID, 알림 채널, 생성된 멱등성 키가 포함된RenewalNotification\_\_e플랫폼 이벤트를 게시합니다. 플랫폼에서 이벤트가 수락되었음을 확인하는 ReplayId를 반환합니다.UpdateContractRecord(자동 실행 플로우)는 계약 레코드에ReplayId와 발송 타임스탬프를 기록하고 “알림 발송됨” 상태 플래그를 설정합니다.
컨텍스트
고객 포털, 모바일 앱, 타사 SaaS 플랫폼, 파트너 시스템과 같은 외부 응용 프로그램은 자체 인터페이스 내에서 서비스 요청을 처리하거나 워크플로를 시작하거나 AI 기반 응답을 표시하기 위해 에이전트를 프로그래밍 방식으로 호출해야 합니다. 에이전트는 지능형 백엔드 서비스 역할을 합니다. 외부 시스템은 컨텍스트를 제공하고, 에이전트는 추론 후 행동하며, 발신자는 응답을 사용하는 구조입니다.
발신자는 점점 사람 대면 응용 프로그램이 아닌 AI 에이전트 또는 오케스트레이터가 됩니다. 이러한 AI-AI 패턴에서 오케스트레이션 에이전트는 추론 단계, CRM 조회 또는 작업을 추가 도구 호출로 Agentforce 위임합니다. 이 패턴을 지원하려면 MCP(모델 컨텍스트 프로토콜) 서버를 노출해야 합니다.
문제
외부 시스템 또는 AI 에이전트가 Agentforce 에이전트의 기능을 요청 시 활용해야 할 경우 어떻게 인증하고 에이전트 세션을 만들고 필요한 대화형 및 컨텍스트 데이터를 전달하고 에이전트의 구조화된 응답을 신뢰할 수 있게 수신하여 자체 다운스트림 논리를 구동합니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 외부 발신자가 동기식 대기 시간이 낮은 응답을 기대합니까, 아니면 비동기식 콜백을 허용합니까?
- 발신자의 ID가 설정되고 데이터 액세스 및 개인 설정에 대한 에이전트의 실행 컨텍스트로 전파되는 방법은 무엇입니까?
- 동시 API 트리거 세션의 예상 용량은 얼마이며 Salesforce API 속도 및 동시성 제한과 어떻게 상호 작용합니까?
- 외부 시스템에서 여러 차례에 걸쳐 세션 연속성을 유지해야 하는지(다중 턴 대화), 아니면 각 요청이 상태가 없는지 여부는 무엇입니까?
- 호출 시스템이 프로그래밍 방식으로 구문 분석하고 조치를 취할 수 있도록 에이전트의 응답을 어떻게 구조화해야 합니까?
- 발신자는 직접 REST 통합이 필요한 사람 대면 응용 프로그램이거나 MCP와 같은 표준 프로토콜을 통해 Agentforce 도구로 호출할 수 있는 AI 에이전트 또는 오케스트레이터입니까?
Salesforce 패턴 응용 프로그램
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| Agentforce Agent API - 단일 턴(동기식) | 상태가 없는 요청-응답 통합에 가장 적합 | 호출 시스템에는 즉각적이고 구조화된 응답이 필요하며, 에이전트의 추론은 호출 시스템의 시간 초과 허용 범위 내에서 완료될 것으로 예상됩니다. 호출 시스템은 생성, 전환, 종료와 같은 전체 세션 수명 주기 단계를 관리합니다. 외부 시스템이 인증하고, 컨텍스트 변수를 사용하여 세션을 만들고, 단일 메시지를 보내고, 에이전트의 응답을 수신하고, 세션을 닫습니다. 이 Agentforce API는 외부 시스템이 프로그래밍 방식으로 세션을 생성하고 메시지를 교환하고 세션을 닫는 기본 REST 인터페이스입니다. 전체 교환은 하나의 HTTP 요청 응답 주기 내에 완료됩니다. 응답에는 에이전트의 자연어 출력과 에이전트가 추론하는 동안 호출한 작업에 의해 생성된 구조화된 출력 변수가 포함됩니다. |
| Agentforce Agent API - 다중 턴(세션 연속성) | 여러 턴에 걸쳐 상태를 유지해야 하는 대화형 통합에 가장 적합합니다. | 외부 인터페이스는 대화형(예: 채팅 위젯 또는 음성 인터페이스)이며, 상호 작용에는 해결에 도달하기 위해 여러 차례의 메시지 교환이 필요합니다. 외부 시스템에서 세션을 한 번 만들고 여러 메시지 교환에서 세션 ID를 재사용합니다. 에이전트는 이전 질문, 검색된 데이터, 발신자가 다시 공급하지 않고 이루어진 결정을 비롯한 전환 간의 대화 컨텍스트를 유지합니다. |
| 폴링 또는 웹후크 콜백을 통한 비동기식 | 대기 시간이 높은 추론 워크플로 또는 시간이 중요한 UI에 가장 적합 | 에이전트 처리 시간은 무시할 수 없으며, 열린 HTTP 연결을 유지하면 발신자의 사용자 경험이 저하되거나 업스트림 시간 초과가 발생할 수 있습니다. 외부 시스템에서 요청을 제출하고 작업 또는 세션 ID와 함께 즉시 확인을 받습니다. 그런 다음, 상태 끝점을 폴링하거나 웹후크를 등록하여 추론이 완료되면 에이전트의 응답을 수신합니다. 현재 이 패턴은 MuleSoft와 같은 미들웨어에서 호스팅되는 래퍼 API를 사용하여 구현할 수 있습니다. 외부 소비자가 이 래퍼 API를 호출하고 웹후크 끝점을 등록합니다. Wrapper API는 Agentforce 에이전트를 호출한 후 확인을 외부 시스템으로 다시 보냅니다. 이 래퍼 API는 Agentforce 에이전트 세션을 유지하고 에이전트가 응답하면 등록된 웹후크 끝점을 사용하여 외부 시스템에 응답을 반환합니다. |
| MCP를 통한 Agentforce(Salesforce 헤드리스 360) | 발신자가 MCP 호환 클라이언트인 AI-AI 호출에 가장 적합 | 호출하는 MCP 클라이언트는 Salesforce 헤드리스 360에서 제공하는 기본 MCP 서버를 통해 Agentforce 도구로 호출합니다. 세션 수명 주기는 MCP 서버에서 투명하게 관리되고, 호출하는 에이전트는 사용자 정의 REST 통합을 구축하지 않고 표준 도구 호출을 통해 상호 작용합니다. 발신자가 추론, CRM 컨텍스트 검색 또는 작업 실행을 더 넓은 에이전트 워크플로의 별도의 단계로 Agentforce에 위임해야 하는 MCP 클라이언트인 경우 이 솔루션을 사용합니다. |
스케치
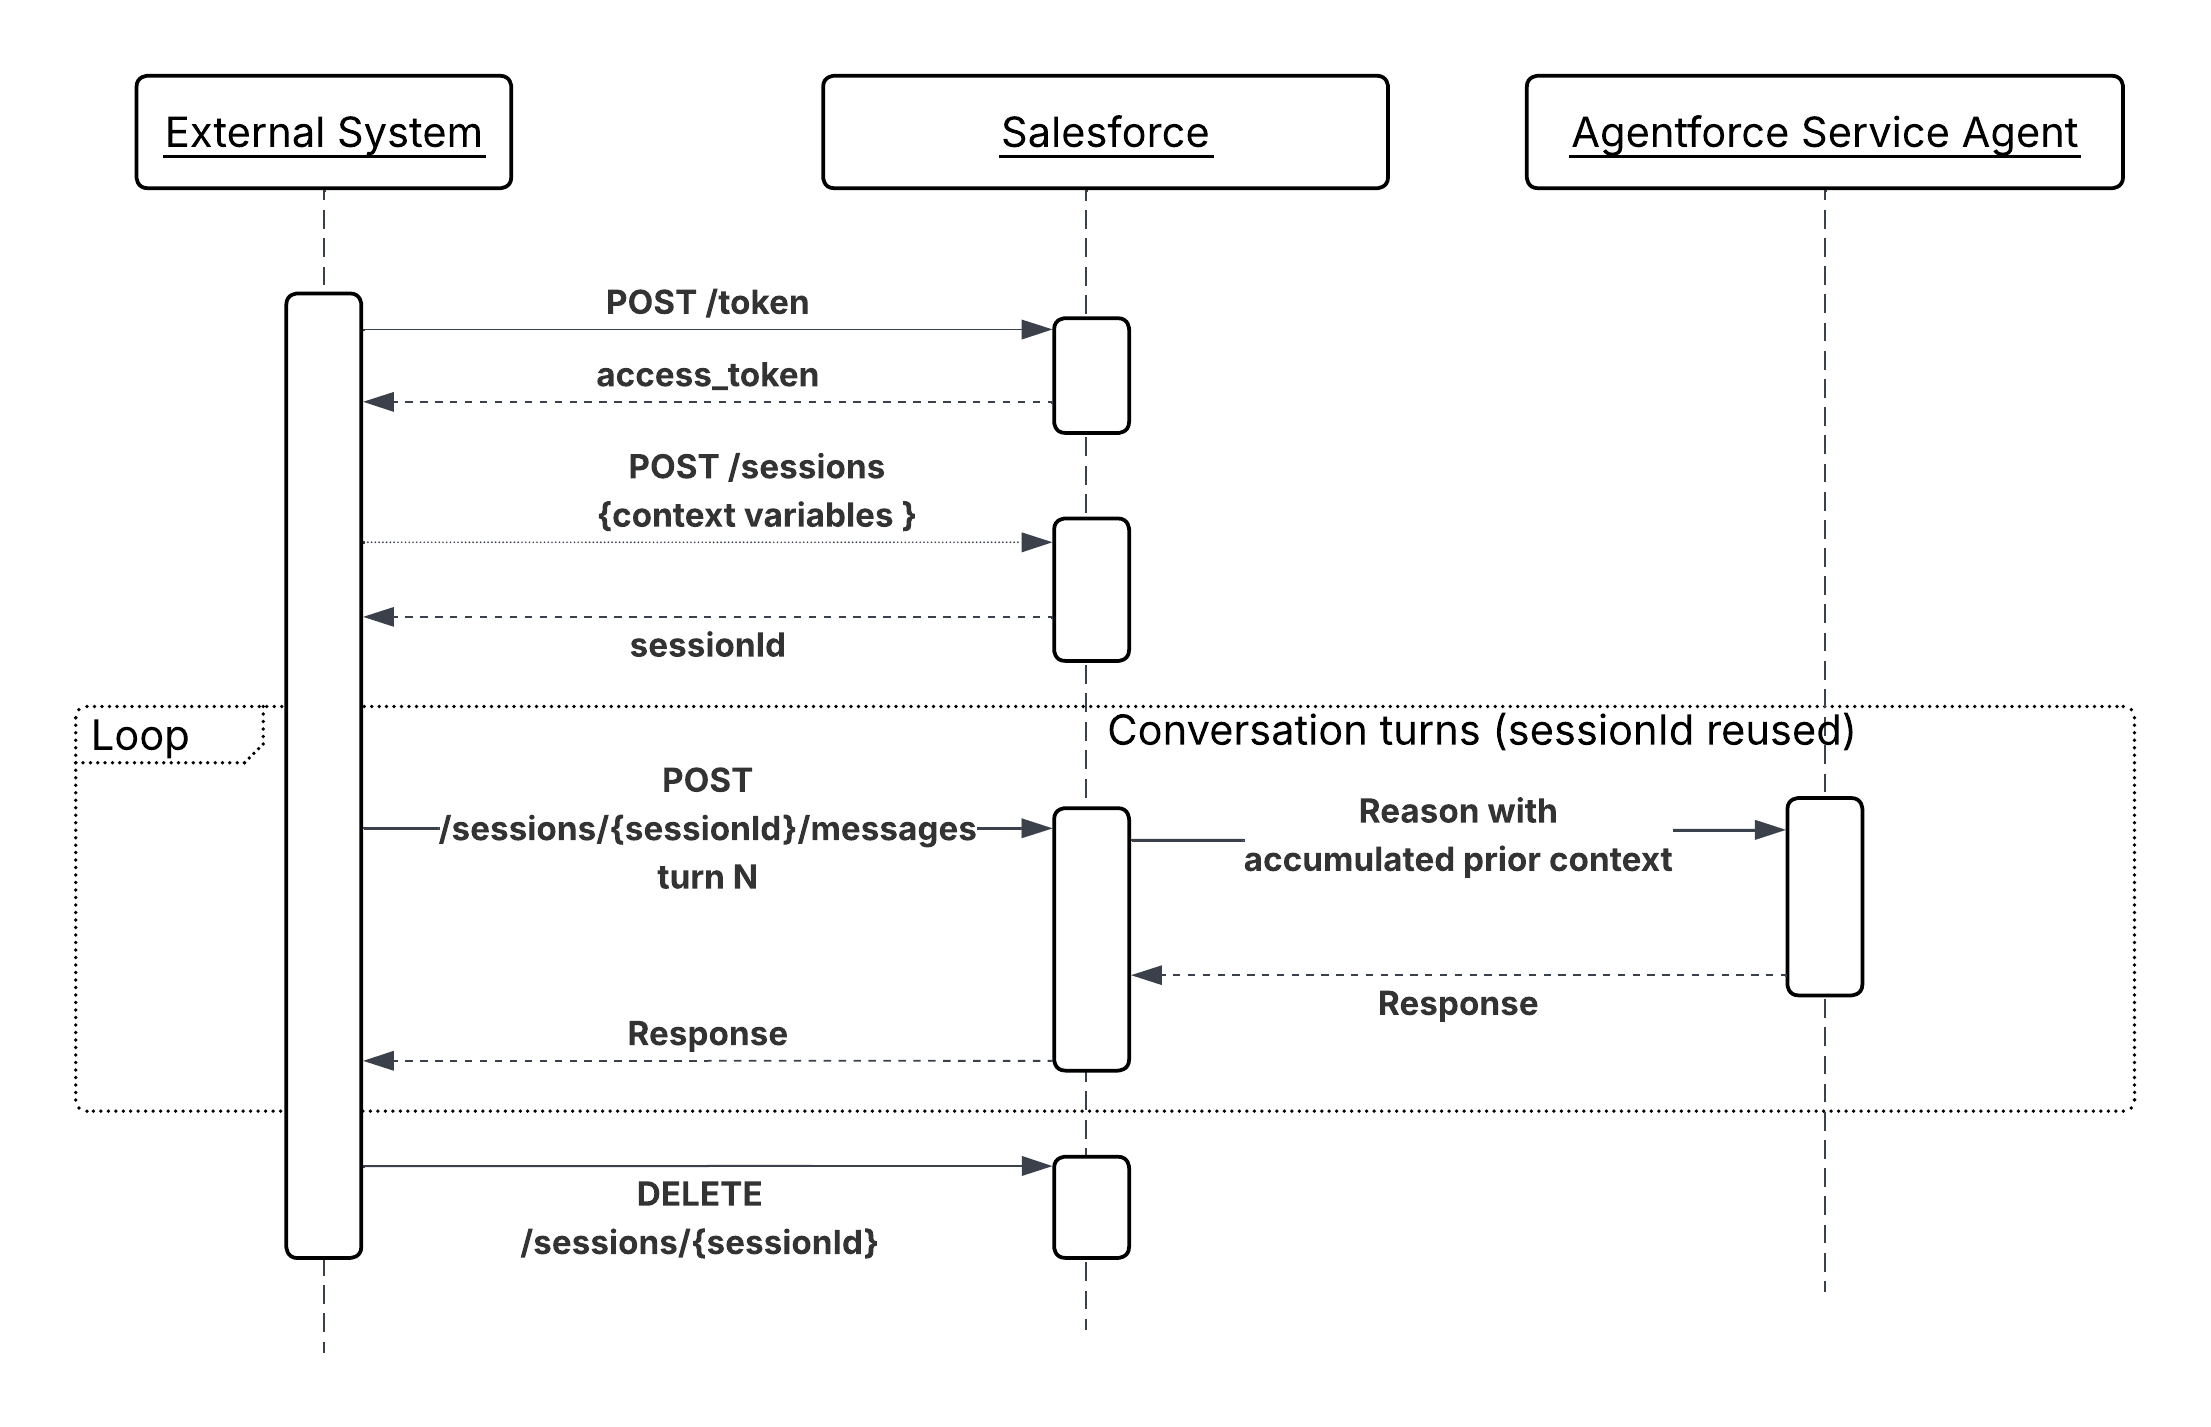
On-Demand Agent 호출을 위한 시퀀스 다이어그램
결과
이 패턴은 Agentforce 호출 가능한 AI 서비스로 노출합니다. 외부 시스템은 해당 논리를 복제하지 않고 에이전트의 추론, 도구, CRM 컨텍스트에 액세스할 수 있습니다. 발신자는 세션 수명 주기 관리 및 응답 렌더링에 대한 책임이 있습니다. 에이전트는 모든 추론, 도구 선택, 응답 합성을 담당합니다.
발신자가 AI 에이전트 또는 오케스트레이터인 경우 Agentforce via MCP 메커니즘(Salesforce 헤드리스 360을 통해 기본적으로 사용 가능)을 통해 사용자 정의 REST 통합이 완전히 필요하지 않습니다. MCP 서버는 발신 에이전트를 대신하여 세션 수명 주기를 처리하므로 Agentforce는 별도의 추가 작업 없이 다중 에이전트 워크플로에 주요 도구로 참여할 수 있습니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드
- 시간이 중요한 UI 플로우에서 외부 API 호출을 동기식으로 수행하거나 차단하지 마십시오. 에이전트 응답 시간이 소소하지 않은 폴링 또는 웹후크 콜백 패턴을 채택하여 에이전트의 처리 시간과 사용자 환경을 분리합니다.
- 가용성이 아닌 발신자의 특성을 기반으로 호출 메커니즘을 선택합니다. 사람 대면 응용 프로그램 및 시스템 통합은 에이전트 API를 직접 사용해야 합니다. MCP를 지원하는 도구는 Agentforce MCP 서버를 사용해야 합니다. 같은 발신자 유형에 대한 메커니즘을 혼합하면 아키텍처의 이점 없이 불필요한 복잡성이 추가됩니다.
Salesforce 구현 참고 사항
- 첫 번째 사용자 메시지가 아닌 세션 생성 POST 요청에 세션 컨텍스트를 삽입합니다. 외부 시스템에서 세션을 만들면 구조화된 컨텍스트 변수(계정 ID, 권리 데이터, 이전 상호 작용 요약)를 명명된 세션 매개 변수로 직접 전달할 수 있습니다. 이러한 변수는 에이전트가 단일 순환을 처리하기 전에 사용할 수 있으므로 고객이 누구인지 또는 고객의 자격이 있는 항목을 확인하기 위한 조회 호출을 발행하지 않고 기초 교육 상태에서 추론을 시작합니다. 대신 메시지 본문에 동일한 데이터를 전달하면 에이전트가 구조화되지 않은 텍스트를 구문 분석하여 원래 입력 변수로 받을 수 있었던 사실을 추출해야 하므로, 대기 시간이 증가하고 추출 오류가 발생하며 비즈니스 가치가 없는 추론 단계가 소모됩니다.
- 구조화되고 기계 분석 가능하도록 에이전트 응답을 설계합니다. 발신자가 사람이 아닌 시스템인 경우 에이전트가 JSON 친화적이거나 명확하게 구분된 응답을 반환하도록 안내하는 출력 변수 규칙 및 프롬프트 지침을 사용합니다.
- 세션 수명 주기를 명시적으로 관리합니다. 사용 후
DELETE /einstein/ai-agent/v1/sessions/{sessionId}즉시 세션을 종료하여 동시 슬롯을 확보하고, 관련 없는 상호작용 간에 오래된 컨텍스트가 남지 않도록 합니다. - Salesforce 동시 세션 제한을 고려합니다. 고처리량 시나리오의 경우, 최대 부하 시 요청 거부를 방지하기 위해 호출 시스템에 세션 풀 또는 대기열 계층을 구현합니다.
- MCP를 통해 Agentforce 호출할 경우 컨텍스트를 세션 변수가 아닌 도구 입력 매개 변수로 전달합니다. MCP 서버는 세션 수명 주기를 투명하게 관리하므로 발신 에이전트가 생성 시 직접 명명된 세션 매개 변수를 설정할 수 없습니다. 에이전트가 근거가 있는 상태에서 추론을 시작할 수 있도록 모든 필수 컨텍스트(레코드 ID, 사용자 신원, 권리 데이터)가 도구 호출 페이로드에 포함되어 있는지 확인합니다.
- MCP 서버의 투명한 세션 관리를 동시 우회가 아닌 편의로 취급하십시오. 각 도구 호출은 계속해서 Salesforce 에이전트 세션 슬롯을 사용합니다. 대규모 MCP를 통해 Agentforce 호출하는 고주파 오케스트레이터는 직접 에이전트 API 발신자에 적용되는 동시 세션 제한과 동일해야 합니다.
오류 처리 및 복구
- 에이전트 API가 표준 HTTP 오류 코드를 반환합니다. 호출 시스템은 지수 백오프를 사용하여 “429 Too Many Requests(요청 과다)”를 처리하고, “503 Service Unavailable(서비스 이용 불가)”은 재시도 로직으로 처리해야 합니다.
- 에이전트가 해결할 수 없는 도구에 장애가 발생하면 응답 본문에 정상적인 자연어 오류가 반환됩니다. 호출 시스템은 이러한 센티넬 응답(예: 응답에서 “오류” 상태 필드 확인)을 감지하고, 추가 컨텍스트로 재시도하거나 대체 경험을 제공하거나 사람에게 에스컬레이션하여 그에 따라 라우팅합니다.
- MCP를 통해 호출할 때 오류는 두 가지 별도의 계층에서 발생합니다. MCP 전송 오류(잘못된 도구 호출, 서버 가용성 부재) 및 Agentforce 추론 실패(도구 실행 오류, 해결할 수 없는 작업). 오케스트레이션 에이전트는 두 계층을 독립적으로 처리해야 합니다. MCP 전송 오류는 프로토콜 수준에서 재시도를 트리거해야 합니다. 도구 응답에서 반환된 Agentforce 추론 실패는 오케스트레이터의 자체 대체 또는 에스컬레이션 논리로 처리해야 합니다.
보안 고려 사항
- 외부 클라이언트 앱에 가능한 한 좁은 OAuth 범위를 사용합니다. 에이전트만 호출해야 하는 통합은 에이전트 자체가 요구하는 것 이상으로 데이터 액세스 범위를 유지하지 않아야 합니다.
- 세션 변수로 입력하기 전에 외부 시스템의 모든 입력을 확인하고 비활성화합니다. 외부 입력은 프롬프트 인젝션을 위한 공격 표면입니다. 예를 들어 악의적인 발신자가 에이전트 명령을 재정의하도록 설계된 “customerQuery” 필드를 만들 수 있습니다.
- 외부 클라이언트 앱에 IP 허용 목록을 적용하여 인증하고 에이전트 API를 호출할 수 있는 외부 시스템을 제한합니다.
- 감사 및 보안 목적으로 모든 인바운드 API 트리거 세션을 발신자 ID, 세션 ID, 요청/응답 메타데이터로 기록합니다.
- Agentforce MCP를 통해 호출되면 MCP 서버가 호출하는 사용자를 대신하여 Salesforce에 인증합니다. MCP 서버의 연결된 앱 자격 증명이 최소한의 필수 권한 범위로 설정되어 있고, Claude와 같은 MCP 도구를 사용하는 최종 사용자의 신원이 도구 입력 매개 변수로 명시적으로 세션 컨텍스트에 전달되는지 확인합니다.
예제
금융 서비스 포털은 Agentforce 에이전트를 트리거하여 주택 담보 대출 문의를 처리합니다.
- 포털은 클라이언트 자격 증명 OAuth 플로를 사용하여 인증하고 전달자 토큰을 가져옵니다.
- 세션 변수가 “{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }”인 “POST /einstein/ai-agent/v1/sessions”를 호출합니다.
- 사용자가 질문을 제출합니다. “신청서를 완료하는 데 필요한 문서는 무엇입니까?”
- 포털은 사용자의 텍스트와 함께 “POST / Einstein/ai-agent/v1/sessions/{sessionId}/messages”를 호출합니다.
- Agentforce 에이전트는 “GetDocumentChecklist” 플로 작업을 호출하고 대출 유형별 요구 사항을 검색하고 구조화된 목록을 반환합니다.
- 포털은 에이전트의 응답을 인라인으로 렌더링하고 사용자 종료 시 세션을 닫습니다.
컨텍스트
일부 에이전트 워크플로는 사람의 요청에서 생성되지는 않습니다. 제품 사용 메트릭이 갑자기 떨어지거나, 중요한 장바구니가 폐기되거나, 위험 임계값을 넘는 결제 실패와 같은 비즈니스에 중요한 신호는 운영 데이터에서 자주 발생합니다. 이러한 신호에 지능적인 다단계 응답이 필요한 경우 사람이 관찰하고 조치를 취할 때까지 기다리는 대기 시간이 실제 비즈니스 비용으로 복합됩니다.
이 패턴은 실시간 이벤트가 에이전트의 독립적인 진입점으로 작동하는 방식을 설명합니다. 에이전트는 사용자가 아닌 데이터 조건에 의해 호출되고, 이벤트 컨텍스트를 기반으로 판단하며, 사람의 개입 없이 응답 워크플로를 모두 실행합니다.
문제
Data 360 또는 Salesforce 플랫폼에서 실시간 비즈니스 이벤트가 발생할 때, 해당 이벤트가 에이전트 세션을 자동으로 생성하고 이벤트 페이로드를 기반 컨텍스트로 제공하며, 사람이 상호작용을 시작하거나 안내하지 않고 비대화형 작업 워크플로를 완료하도록 하는 방법은 무엇입니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 이벤트가 시작되는 순간 즉시 응답이 필요합니까, 아니면 거의 실시간(초~분) 처리를 허용합니까?
- 이벤트 페이로드에 에이전트를 기반할 충분한 컨텍스트가 포함되어 있습니까, 아니면 에이전트가 효과적으로 추론하기 전에 추가 조회를 수행해야 합니까?
- 예상되는 이벤트 규모와 빈도는 얼마입니까? 대량 이벤트 스트림은 에이전트 동시성 제한이 소모되지 않도록 속도 관리를 필요로 합니다.
- 동일한 이벤트가 동일한 비즈니스 엔티티에서 두 번 이상 발생할 수 있습니까(최소 1회 전달)? 이 경우, 작업은 멱등성을 가져야 합니다.
- 에이전트가 이벤트를 독립적으로 해결할 수 없는 경우 에스컬레이션 경로가 있습니까?
- 실패한 이벤트 처리를 어떻게 표시해야 합니까? 데드레터 큐, 알림 또는 사례 생성을 통해 처리해야 합니까?
Salesforce 패턴 응용 프로그램
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
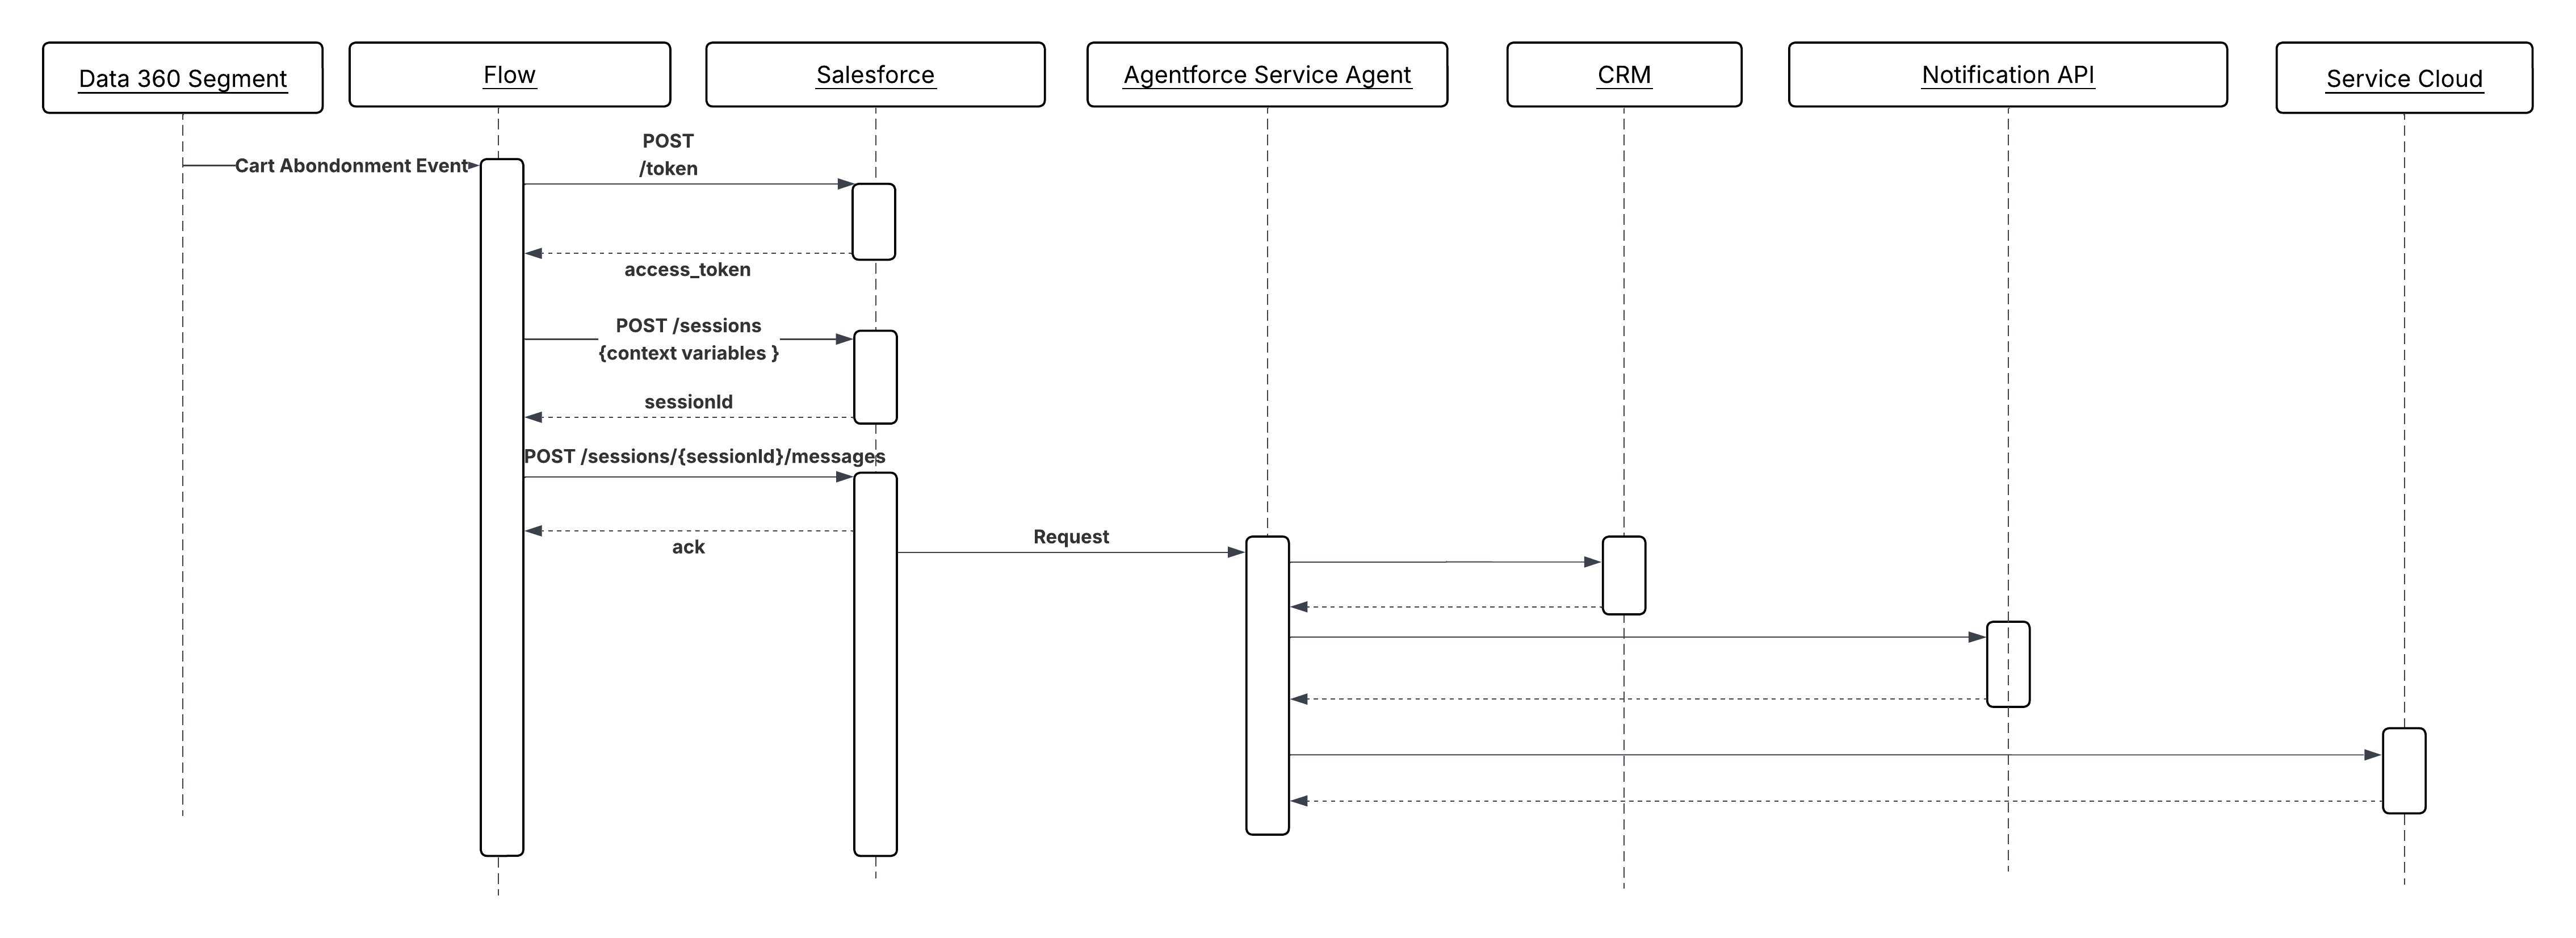
| Data 360 트리거 플로 | 행동 및 메트릭 기반 신호에 가장 적합 | 이는 트리거 조건이 Data 360 세그먼트 멤버십 변경 또는 메트릭 임계값으로 정의된 경우에 가장 적합합니다. Data 360은 비즈니스 조건(예: 장바구니 포기, 사용량 감소)을 감지하고 트리거된 플로를 실행합니다. 플로는 이벤트 페이로드 특성을 에이전트 세션 변수에 매핑하고 Agentforce 세션을 만듭니다. |
| 플랫폼 이벤트 + 자동 실행 플로 또는 Apex | 플랫폼 내부 및 교차 시스템 이벤트에 가장 적합 | 이벤트 소스가 Salesforce Platform 내에 있거나 미들웨어 계층이 외부 시스템에서 조건을 감지한 후 이벤트를 게시하는 경우 이 솔루션을 사용합니다. Salesforce 프로세스 또는 외부 시스템에서 게시된 플랫폼 이벤트는 Apex 트리거 또는 자동 실행 플로를 트리거하며, 이는 이벤트 페이로드를 컨텍스트로 사용하여 에이전트 세션을 구성합니다. |
스케치
이벤트 중심 에이전트 실행의 순서 다이어그램
결과
에이전트는 사람의 요청에 수동적으로 응답하는 존재가 아니라, 실시간 비즈니스 운영에 반응형 참가자가 됩니다. 이벤트 트리거형 에이전트는 사람의 주의 속도가 아닌 데이터 속도로 복구, 정렬, 에스컬레이션 워크플로를 실행할 수 있습니다.
트리거 시스템(Data 360 또는 플랫폼 이벤트)은 이벤트 감지 및 페이로드 형성을 담당합니다. 에이전트는 해당 페이로드를 바탕으로 추론하여 올바른 작업 체인을 선택할 책임이 있습니다. 대화 전환이 필요하지 않으며, 이벤트 페이로드는 전체 입력입니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 대화 외 호출을 위한 모든 작업을 설계합니다. 대화 전환이 필요하지 않으며, 에이전트는 초기 기반 컨텍스트만으로 결론을 도출해야 합니다. 작업은 명확성 확인을 위한 질문을 대신해 구조화되고 결정론적인 출력을 반환해야 합니다.
- 에이전트 세션이 생성되기 전에 이벤트 페이로드에 충분한 기반 컨텍스트가 포함되어 있는지 확인합니다. 에이전트가 추론을 시작하기 전에 여러 번의 조회 호출을 해야 하는 최소화된 페이로드는 지연 시간과 동시 처리 자원 소비를 증가시킵니다.
- 이벤트 중심 에이전트가 트리거한 모든 쓰기 작업을 멱등하게 만듭니다. 이벤트 배달 시스템은 일반적으로 최소한 한 번의 보장을 제공합니다. 중복 이벤트 처리는 중복 부작용이 발생해서는 안 됩니다.
Salesforce 구현 참고 사항
- Data 360 트리거 플로에서 세션 생성 시 이벤트 페이로드 특성(예: “accountId”, “eventType”, “metricValue”, “productIds”)을 명명된 세션 변수에 직접 매핑합니다. 이렇게 하면 검색 작업이 필요하지 않은 첫 번째 추론 단계에서 에이전트가 기반을 마련할 수 있습니다.
- 플랫폼 이벤트 트리거의 경우 화면 플로 대신 자동 실행 플로를 사용합니다. 화면 플로는 자동 비대화 컨텍스트에서 지원되지 않습니다.
- 이벤트 트리거 세션에 대한 명시적 세션 시간 제한을 설정합니다. 대화형 세션과 달리 상호작용을 연장할 사용자가 없으므로, 실패한 작업으로 인해 지연되는 세션은 동시성 슬롯을 무기한 점유해서는 안 됩니다.
- 플로 오류 경로를 사용하여 에이전트 세션 생성 실패를 처리합니다. 세션을 만들 수 없는 경우 오류 경로에서 이벤트를 아무런 조치 없이 무시하는 대신 보상 이벤트를 게시하거나 후속 작업을 위한 사례를 만들어야 합니다.
오류 처리 및 복구
- 동시성 제한, 세션 생성 오류 또는 페이로드 유효성 검사 실패로 인해 에이전트 세션을 성공적으로 트리거하지 못한 이벤트는 사례를 생성하거나 경고를 실행하거나 다시 처리하기 위해 이벤트를 대기열에 게시하는 오류 경로로 라우팅되어야 합니다.
- 에이전트가 실행 도중 실패한 경우(예: 필수 작업의 시간 초과), 원래 이벤트 ID로 기록해야 합니다. 트리거가 비동기 방식이며 대기하는 호출자가 없기 때문에 오류 노출은 로그, 대시보드, 경고 임계값 등 관찰 가능한 수단에 전적으로 의존합니다.
- 재시도 제한을 구현합니다. 이벤트로 인해 에이전트가 실패할 경우 제한되지 않은 재시도가 동시성 제한을 소진합니다. 구성 가능한 최대 시도 횟수에 따라 전체 컨텍스트가 첨부된 사람 검토 대기열에 이벤트를 라우팅합니다.
- 전체 에이전트 세션 수명 주기를 통해 이벤트 ID를 추적합니다. 이 추적은 감사 및 디버깅을 위해 원래 데이터 신호와 모든 다운스트림 작업 간의 상관 관계를 활성화합니다.
보안 고려 사항
- 모든 이벤트 페이로드 특성을 확인하고 비활성화한 후 에이전트 세션 변수로 삽입합니다. Data 360 또는 외부 게시자의 이벤트 페이로드는 프롬프트 삽입을 위한 공격 표면입니다. 예를 들어, 조작된 페이로드 필드는 에이전트의 지침을 재정의하도록 설계될 수 있습니다.
- 높은 권한이 있는 관리자 ID가 아닌 최소 권한이 있는 전용 통합 사용자 아래에서 이벤트 트리거형 에이전트 세션을 실행합니다. 에이전트는 정의된 작업 집합을 실행하는 데 필요한 권한만 보유합니다.
- 생성 시에 삽입된 이벤트 ID, 이벤트 유형 및 세션 변수를 사용하여 모든 이벤트 트리거 세션을 기록합니다. 이 감사 내역은 결과가 분쟁되는 경우 에이전트가 지정된 조치를 취한 이유를 재구성하기 위해 필요합니다.
예제
리테일 회사는 Data 360을 사용하여 실시간 장바구니 동작을 추적합니다. 정의된 임계값을 초과하는 값이 있는 장바구니가 중단되는 경우:
- Data 360이 중단 신호를 감지하고 이벤트 페이로드인 “customerId”, “cartValue”, “productIds”, “abandonmentTimestamp”를 사용하여 트리거된 플로를 실행합니다.
- 플로는 이러한 특성을 Agentforce 세션 변수에 매핑하고 새 에이전트 세션을 만듭니다. 사용자 상호 작용이 필요하지 않습니다.
- 에이전트는 사용 가능한 검색 작업을 사용하여 고객의 구매 내역, 현재 권리, 장바구니 구성을 평가합니다.
- 에이전트는 고객 세그먼트를 기반으로 적절한 할인 계층을 적용하는
SelectRecoveryOffer작업을 호출하고 고객이 선호하는 채널을 통해 제안을 전달하는SendProactiveNotification작업을 호출합니다. - 에이전트는 계정 소유자가 확인할 수 있도록 CRM에 상호 작용을 기록하기 위해
CreateFollowUpTask작업을 호출합니다. - 작업 체인이 완료되면 세션이 자동으로 닫힙니다. 원래 이벤트 ID는 추적 가능성을 위해 세션 로그에 유지됩니다.
컨텍스트
LLM들은 공개 데이터로 훈련됩니다. 해당 정보가 명시적으로 제공되지 않는 한, 조직의 제품, 정책, 사례 내역 또는 계약에 대한 지식이 없습니다. 기초 교육 없이 에이전트가 고객의 서비스 권리 또는 특정 계약 조건에 대해 묻는 경우 답변이 환각화되거나 모르는 것으로 인정됩니다. 두 결과 모두 기업 환경에서는 허용되지 않습니다.
RAG(Retrieval-Augmented Generation)는 기업 지식 저장소에서 관련 문서를 검색하고, 응답을 생성하기 전에 에이전트의 컨텍스트 창에 주입하여 이 문제를 해결합니다. 에이전트는 지식 문서, 과거 사례 해결, 제품 사양 등 검색된 콘텐츠를 마치 직접 제공받은 것처럼 활용하여 추론합니다. LLM은 추론을 제공하고 검색 레이어는 사실을 제공합니다.
예를 들어, 복잡한 보증 청구를 처리하는 서비스 에이전트는 지침에 보증 정책 조건이 내장될 필요가 없습니다. 대신 고객이 문제를 설명할 때 에이전트는 보증 문서의 벡터 색인에 대한 시맨틱 검색 또는 하이브리드 검색(키워드 검색 + 시맨틱 검색)을 수행하고 해당 용어를 검색한 후 해당 용어를 사용하여 자격 및 다음 단계를 결정합니다. 답변은 모델의 교육 데이터가 아닌 현재 권위 있는 정책 문서에 기반합니다.
문제
에이전트는 LLM의 훈련 데이터에 포함되지 않은 독점적 조직 지식(예: 정책, 계약, 제품 문서 또는 과거 사례 데이터)에 따라 질문에 답변하거나 결정을 내려야 합니다. 에이전트가 추론 시 가장 관련성이 높은 콘텐츠를 검색하고, 검색된 콘텐츠가 최신이며 권위 있는지 확인하며, 소음을 방지할 정도의 정밀도로 컨텍스트에 주입하는 방법은 무엇입니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 지식 콘텐츠가 정적이고 자주 업데이트되지 않나요(예: 제품 설명서)? 아니면 지속적으로 변경되나요(예: 사례 해결, 재고 설명)? 업데이트 주기는 수집 파이프라인 설계를 결정합니다.
- 콘텐츠는 얼마나 넓습니까? 작은 지식 데이터베이스는 모두 검색할 수 있지만, 큰 데이터베이스는 청크, 임베딩, 시맨틱 인덱싱이 필요하여 가장 관련성 높은 단락만 반환할 수 있습니다.
- 쿼리가 단일 집중 검색으로 충분한가요, 아니면 여러 지식 소스(예: 문서와 과거 사례 등)의 결과를 결합해야 더 근거 있는 답변을 얻을 수 있나요? 후자는 앙상블 검색이 필요합니다.
- 시맨틱 순위 이전에 검색된 콘텐츠를 메타데이터별로 필터링해야 합니까? 예를 들어 결과를 고객의 제품 계층 또는 지역과 관련된 문서로 제한해야 합니까?
- 지식 콘텐츠가 얼마나 민감합니까? 검색된 콘텐츠는 LLM 컨텍스트 창에 삽입되며 에이전트의 응답에 영향을 미치며, 특정 사용자에게 표시되지 않아야 하는 콘텐츠는 검색 계층에서 관리해야 하며, LLM에서 필터링되는 것으로 간주되지 않습니다.
Salesforce 패턴 적용
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
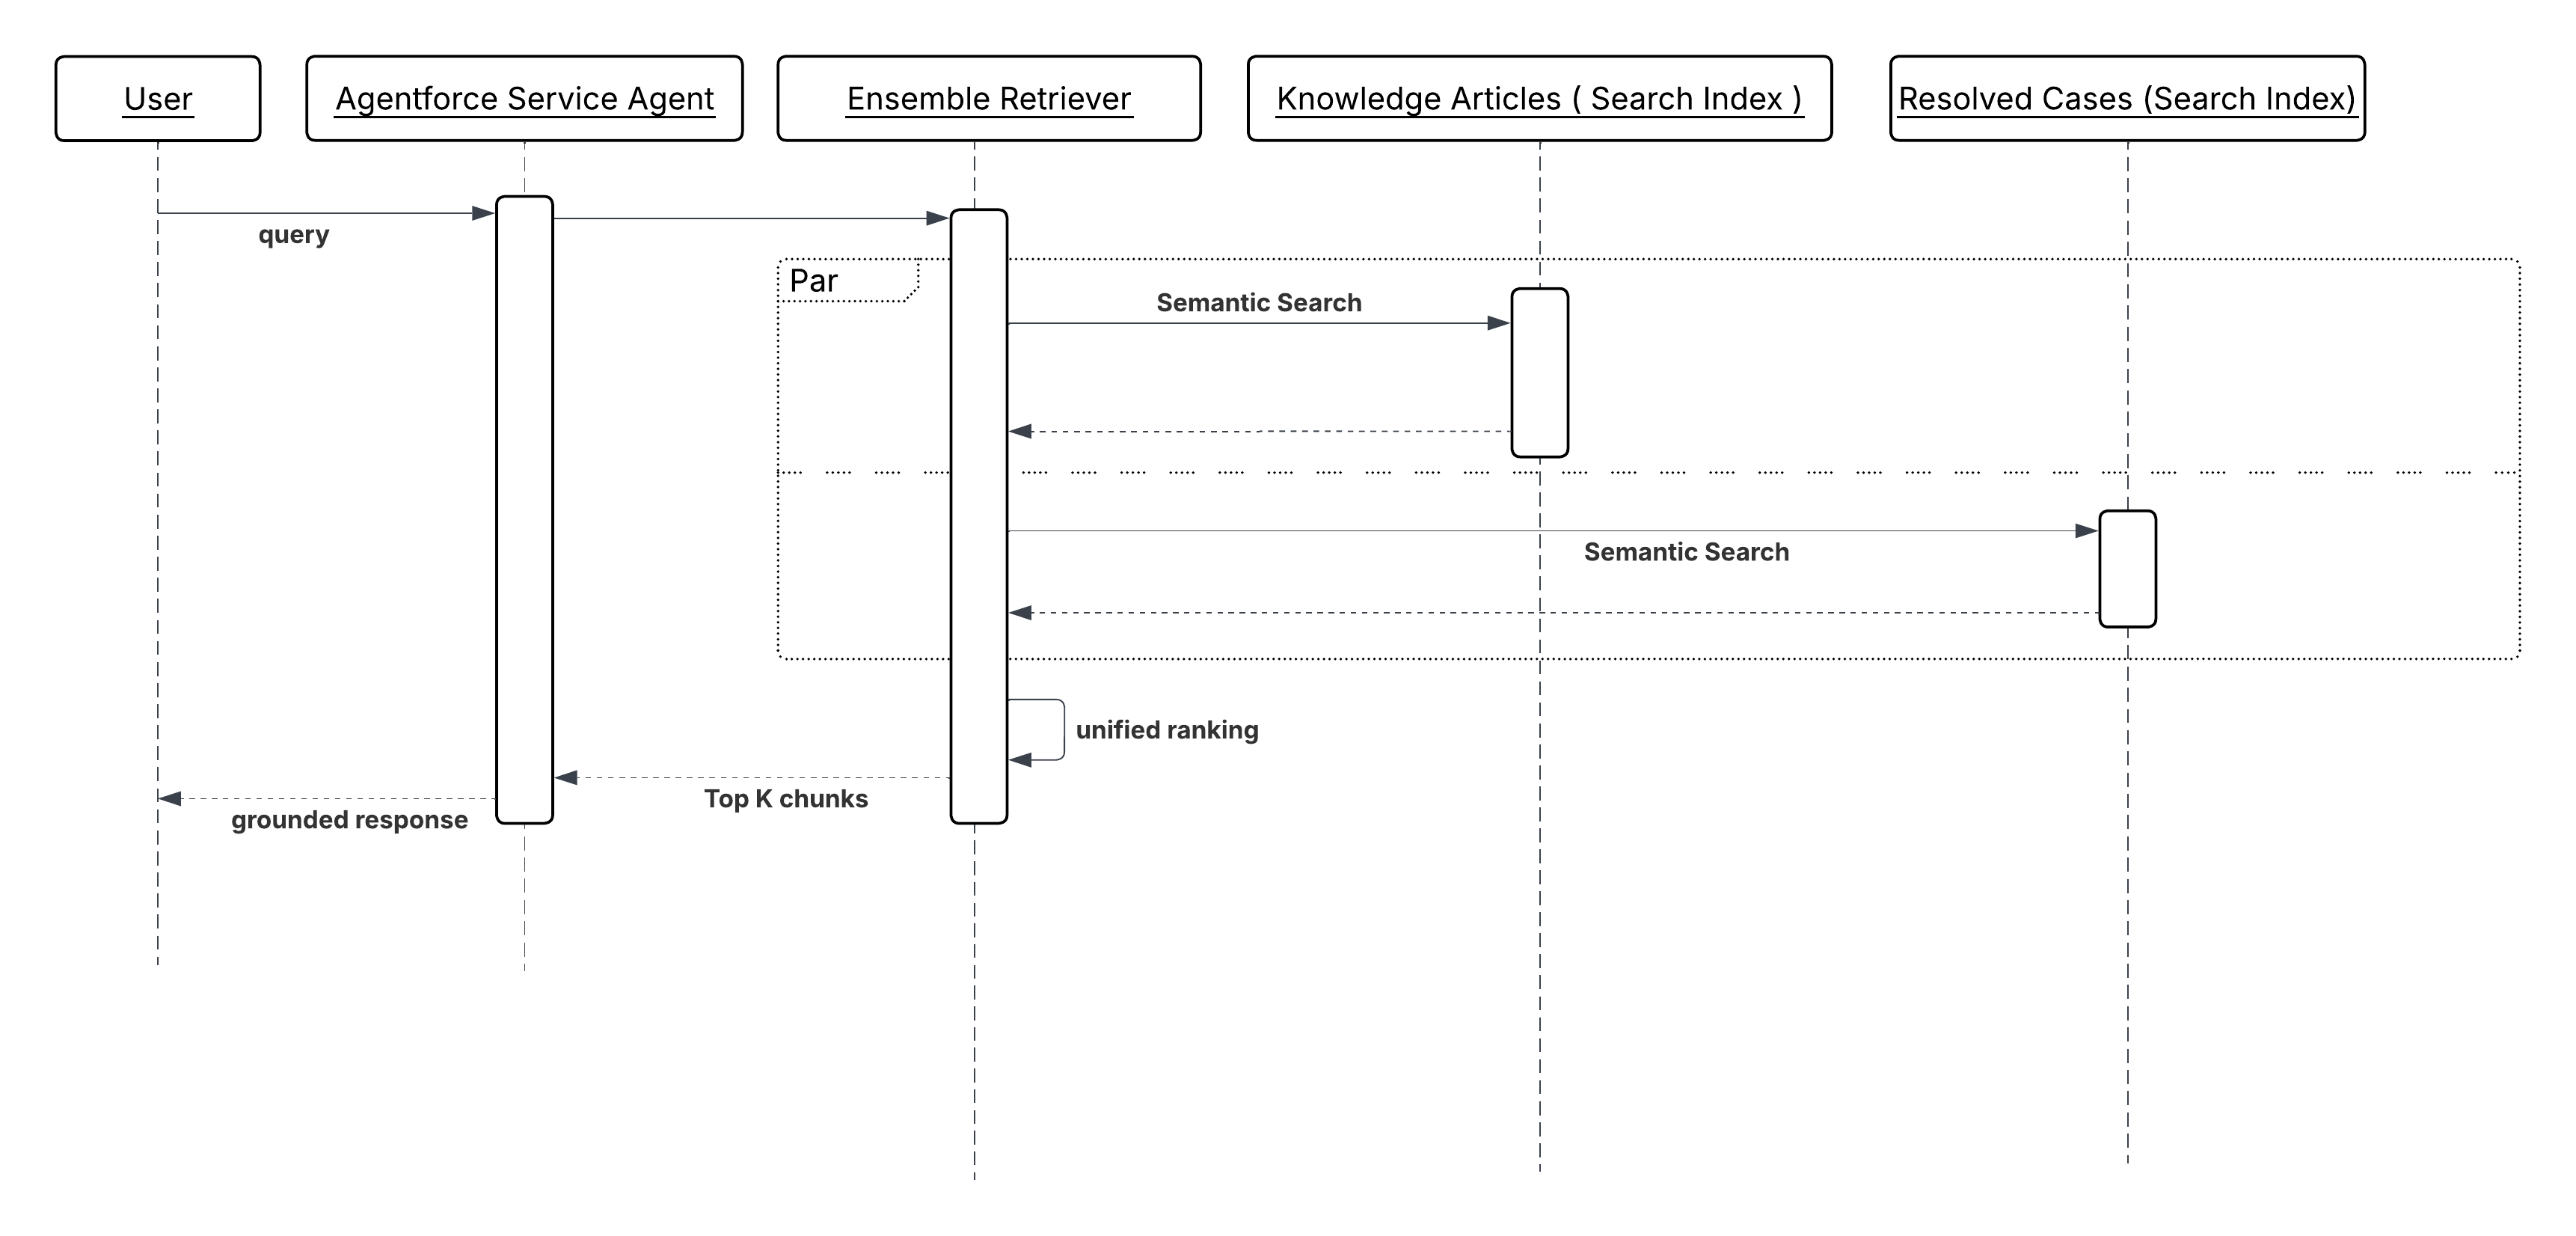
| Data 360을 활용한 Retrieval-Augmented Generation (RAG) | 엔터프라이즈 사용 사례에 가장 적합 | 에이전트가 응답을 생성하기 전에 Data 360 벡터 색인에 대한 시맨틱 검색을 수행합니다. Knowledge 기사, 과거 사례, 제품 문서와 같은 검색된 콘텐츠는 LLM 컨텍스트에 기초 교육으로 주입됩니다. 이는 Retriever 작업, 플로우 또는 사용자 정의 Apex를 사용하여 호출할 수 있습니다. Data 360은 벡터 저장소뿐만 아니라 원시 콘텐츠에서 에이전트 지원 컨텍스트로의 통합 파이프라인을 지원합니다.
이러한 모든 기능은 완벽한 구성 가능성을 갖춘 턴키 모드로 제공됩니다. Data360에는 다음과 같은 두 가지 유형의 검색기가 있습니다. 개별 검색기: 구성된 Salesforce 검색 작업은 단일 정의된 검색 색인에 대한 시맨틱 검색을 수행하고 가장 관련성이 높은 콘텐츠 청크를 반환합니다. 결과는 LLM 프롬프트에 직접 근거 컨텍스트로 삽입됩니다. 쿼리를 하나의 집중된 지식 소스에서 가장 잘 처리할 경우 개별 검색 작업을 사용합니다. Ensemble Retriever: Ensemble Retriever 작업은 여러 개별 검색기의 결과를 결합합니다(예: 제품 문서 색인 및 해결된 사례 색인). 이기종 색인 간에는 해당 점수를 비교할 수 없으므로 앙상블 검색기는 개별 검색기의 관련성 점수를 결합하지 않습니다. 대신, 검색된 모든 청크는 교차 인코더 재정렬기 모델을 통해 각 (쿼리, 청크) 쌍에 대해 독립적으로 점수를 부여받아 통합 순위를 생성합니다. 이는 아키텍처적으로 중요합니다. 이는 수동 점수 교정이 아닌 순위 재지정 모델로 교차 소스 순위의 품질이 향상됨을 의미합니다. 재정렬 후, 통합 결과를 LLM 프롬프트에서 근거 컨텍스트로 사용할 수 있게 됩니다. 보다 완전한 답변에 하나 이상의 지식 도메인에서 증거가 필요한 경우 Ensemble Retriever 작업을 사용합니다. |
| 타사 벡터 데이터베이스가 있는 RAG | 기존 인프라 제약 내에서 작업할 때 적합합니다. | 이 접근 방식은 인프라에 이미 존재할 수 있는 타사 벡터 저장소를 통합하여 독점 데이터 임베딩을 색인화하고, 이를 실시간 시맨틱 검색 및 콘텐츠 검색에 활용합니다. 플로우 또는 사용자 정의 Apex를 사용하여 구현할 수 있습니다. |
스케치
엔터프라이즈 콘텐츠에서 지식 그라운딩을 위한 순서 다이어그램
결과
에이전트의 응답은 LLM의 학습 데이터가 아니라 조직의 최신 공식 지식에 기반합니다. 모델이 검색된 증거에 대해 추론하고 메모리에서 생성하지 않으므로 정책 조건, 제품 사양, 권리 세부 사항과 같은 실제 질문에 대한 환각 위험이 줄어듭니다.
지식 콘텐츠는 독립적으로 유지 관리할 수 있습니다. 정책 문서를 업데이트하거나 색인에 새 사례 해결을 추가하면 모델을 재교육하거나 재배포하지 않고 모든 후속 에이전트 상호 작용에 즉시 적용됩니다.
검색은 암시적 감사 내역도 제공합니다. 에이전트의 답변은 검색된 특정 문서에서 파생되므로 에이전트가 특정 답변을 제공한 이유를 추적할 수 있도록 응답과 함께 소스 콘텐츠를 기록할 수 있습니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 적절한 세분화로 지식 콘텐츠를 청크하고 임베딩합니다. 너무 큰 청크는 연관성이 희석됩니다. 너무 작은 청크는 LLM이 올바르게 추론하는 데 필요한 주변 컨텍스트를 잃게 만듭니다. 대부분의 엔터프라이즈 문서 유형에서는 겹치는 컨텍스트 창을 가진 단락 단위 청크가 최상의 검색 품질을 제공합니다.
- 검색 정밀도를 최상위 설계 문제로 취급합니다. 에이전트의 컨텍스트 창에 관련도가 낮은 콘텐츠를 삽입하는 것은 중립적이지 않습니다. 이는 반응 품질을 저하하는 노이즈를 유발합니다. 검색 임계값과 Top-k 제한을 조정하여 각 지식 도메인별로 재현율과 정밀도의 균형을 맞춥니다.
- 수집 대기 시간은 운영 SLA입니다. 정책 문서가 업데이트되었지만 벡터 색인이 새로 고쳐지지 않은 경우 에이전트가 오래된 정보를 검색하고 조치를 취합니다. 각 유형의 콘텐츠에 허용되는 신선도 허용 범위를 정의하고 그에 따라 수집 파이프라인을 설계합니다.
Salesforce 구현 참고 사항
- 콘텐츠 업데이트 주기의 적절한 수집 파이프라인을 통해 Data 360 벡터 색인을 채웁니다. 정적 문서의 경우 배치 수집을 사용하고 지속적으로 변경되는 레코드의 경우 스트리밍 또는 변경 데이터 수집(CDC)을 사용합니다.
- Ensemble Retrievers의 경우 소스당 관련성 순위 가중치를 구성합니다. 해결된 사례 색인에는 최근 편차가 필요할 수 있으며, 정책 문서 색인에는 필요하지 않을 수 있습니다. 에이전트가 처리할 쿼리 유형을 기반으로 가중치를 조정합니다.
- 시맨틱 검색을 실행하기 전에 사용자 정의 Apex 또는 플로 검색기의 메타데이터 필터를 사용하여 범위 검색을 수행합니다. 순위가 지정되기 전에 제품 라인, 지역 또는 문서 유형별로 필터링하면 노이즈가 줄어들고 컨텍스트에 삽입되는 내용의 정밀도가 향상됩니다.
- 검색된 전체 문서를 LLM 컨텍스트에 삽입하지 마십시오. 관련 청크 또는 발췌만 전달합니다. 대규모 컨텍스트 삽입은 토큰 예산을 사용하고, 대기 시간을 늘리고, 에이전트의 추론에 사용할 수 있는 컨텍스트 창의 비율을 줄입니다.
오류 처리 및 복구
- 검색 시 결과가 반환되지 않는 경우 명시적 “결과 없음” 상태를 반환하고, 근거 없이 진행하지 마십시오. 그러면 에이전트가 쿼리를 확대하거나 사용자에게 명확성을 요청하거나 사람에게 에스컬레이션할 수 있습니다.
- 검색에서 반환된 각 청크에 관련성 점수가 포함됩니다. 사용 사례에 따라 특정 임계 신뢰도/관련도 값을 구성해야 하며, 이 값을 초과할 경우 에이전트가 검색 결과를 신뢰할 수 있다고 간주해야 합니다. 그렇지 않으면 명확화 요청이나 에스컬레이션으로 전환해야 합니다.
- 벡터 인덱스 또는 검색 서비스를 일시적으로 사용할 수 없는 경우, 검색기 작업 또는 Apex 콜아웃은 설명적인 이유와 함께 구조화된 오류를 반환해야 합니다. 검색 공백을 식별하고 색인 또는 서비스를 가용성을 모니터링할 수 있도록 세션 ID 및 쿼리를 사용하여 실패를 기록합니다.
- 시간에 민감한 지식 도메인의 경우 검색 응답의 일부로 신선도 검사를 구현합니다. 가장 최근에 일치하는 문서가 정의된 비활성 임계값을 초과하여 마지막으로 업데이트된 경우, 에이전트가 응답을 보완하거나 확인을 요청할 수 있도록 해당 사실을 에이전트에 알리십시오.
보안 고려 사항
- 검색 시 에이전트가 대신 작업하는 사용자의 데이터 액세스 권한을 반영해야 합니다. 고객 대면 상호 작용 컨텍스트에서 실행되는 에이전트 세션은 내부 운영 문서, 가격 책정 전략 노트 또는 최종 사용자가 액세스할 수 없는 레코드를 검색하지 않아야 합니다. 검색 레이어에 필드 수준 및 레코드 수준 보안을 적용합니다. LLM에 의존하여 민감한 검색 콘텐츠의 노출을 차단하도록 기대하지 마십시오.
- 검색된 콘텐츠는 LLM 컨텍스트 창에 삽입되며 에이전트의 응답에 영향을 미치거나 표시될 수 있습니다. 검색 콘텐츠의 모든 문서를 최종 사용자에게 잠재적으로 표시되는 것으로 취급하고 그에 따라 콘텐츠 멤버십을 관리합니다.
- 모든 검색 쿼리 및 검색된 청크의 문서 식별자를 세션 ID와 함께 기록합니다. 이 감사 내역을 통해 규정 준수, 분쟁 해결 또는 설명 가능성 의무에 필요한 에이전트가 응답할 때 사용한 증거를 재구축할 수 있습니다.
예제
금융 서비스 에이전트가 특정 비용 절감 제품에 대한 조기 상환 벌금에 대한 고객 쿼리를 처리합니다.
- 고객이 질문합니다: “6개월 전에 자금을 인출하면 어떤 벌금을 부과할까요?”
- 에이전트가 제품 조건 및 조건 문서의 벡터 색인에 대해 구성된 개별 검색자 작업을 호출합니다.
- 검색기는 제품 유형, 고객 계정 및 특정 질문과 같은 쿼리 컨텍스트를 사용하여 시맨틱 검색을 수행하고, 가장 관련성이 높은 세 개의 문서 청크(조기 상환 조항, 벌금 계산 표, 어려움 사례에 적용되는 예외)를 반환합니다.
- 검색된 청크는 고객의 질문과 함께 에이전트의 컨텍스트 창에 삽입됩니다.
- 에이전트가 검색된 조건에 대한 이유를 제시하고 고객의 제품 계층 및 상환 타임라인에 해당하는 벌금 비율을 식별하고 사용된 조건의 유효 일자를 따르는 정확한 정책 기반 답변을 반환합니다.
- 검색된 청크의 문서 식별자는 감사 가능성을 위해 세션 레코드와 함께 기록됩니다.
컨텍스트
LLM은 본질적으로 확률적입니다. 특정 고객에 대한 이유를 묻는 경우 명시적으로 제공되지 않은 사실을 추론, 추정 또는 환각합니다. 고객이 선호 계층의 가치가 높은 엔터프라이즈 계정임을 알지 못하고 가격 책정 작업을 호출하는 에이전트는 잘못된 할인 논리를 적용할 수 있습니다. 고객의 이탈 위험 점수를 알지 못하고 지원 사례를 에스컬레이션하는 에이전트는 곧 이탈할 계정의 우선순위를 낮출 수 있습니다.
확인된 고객 컨텍스트 삽입은 에이전트가 작업을 호출하기 전에 확인된 구조화된 특성을 사용하여 작업 입력 매개 변수를 미리 채워 이 문제를 해결합니다. 에이전트는 고객의 세그먼트, 평생 가치 또는 고객 만족도(CSAT) 추세를 추론하지 않습니다. 이러한 사실을 근거 입력으로 받아 이를 바탕으로 판단합니다. 이 패턴은 고객별 결정에 대한 환각 위험을 줄이고, 추론 주기 동안 중복 조회 호출을 제거합니다.
예를 들어 가격 책정 에이전트가 “GenerateQuote” 작업을 호출하기 전에 하위 에이전트 구성이 통합 프로필에서 고객의 세그먼트, 계층, 평생 가치를 자동으로 삽입합니다. 작업은 LLM에서 도출한 근사치가 아닌 확인된 사실을 수신하며 견적서가 고객의 실제 상업적 관계에 고정됩니다.
이것은 “엔터프라이즈 콘텐츠 기반 지식 그라운딩” 패턴의 대안이 아닙니다. 잘 설계된 에이전트는 둘 다 사용할 수 있습니다. “엔터프라이즈 콘텐츠 기반 지식 그라운딩”은 문서 기반 지식을 제공하고, “확인된 고객 컨텍스트 삽입”은 고객 신원을 확립합니다.
문제
에이전트가 세그먼트, 계층, 평생 가치, 이탈 위험 등과 같은 정확한 고객별 사실을 가지고 있는지, 스스로 추측하는 대신 이를 보장하려면 어떻게 해야 합니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 소스가 아닌 추론된 경우 잘못되거나 일관되지 않은 결과를 생성하는 고객별 팩트를 나타내는 작업 입력 매개 변수는 무엇입니까?
- 표준 Data 360 통합 프로필 필드로 필수 프로필 특성을 사용할 수 있습니까, 아니면 원시 동작 및 트랜잭션 데이터에서 파생된 계산된 인사이트가 필요합니까?
- 관련 프로필 특성 변경 빈도는 어느 정도입니까? 이탈 위험 점수 또는 CSAT 추세와 같은 특성은 신선도 보장이 필요합니다. 오래된 프로필 데이터는 환각 데이터와 동일한 잘못된 결과로 이어집니다.
- 세션 생성 시(세션 기간 동안 고정) 프로필 특성을 삽입하거나, 작업 호출 시(세션 중 상태 변경 사항을 반영하기 위해) 새로 가져와야 합니까?
- 에이전트가 직접 프로필 특성을 고려해야 하는지 아니면 작업에서만 사용되고 에이전트의 추론 루프에 불투명합니까?
Salesforce 패턴 응용 프로그램
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| 하위 에이전트 구성 - 프로필 특성 매핑 | 정적 세션 수준의 그라운딩에 가장 적합 | 프로필 특성이 단일 상호 작용 내에서 안정적일 때 가장 적합합니다. Data 360 통합 프로필 속성(예: “customerSegment”, “tier”, “lifetimeValue”)을 Agentforce 하위 에이전트 구성의 작업 입력 매개 변수에 직접 매핑합니다. 세션 생성 시 특성이 확인되고 세션 기간 동안 상수로 유지됩니다. |
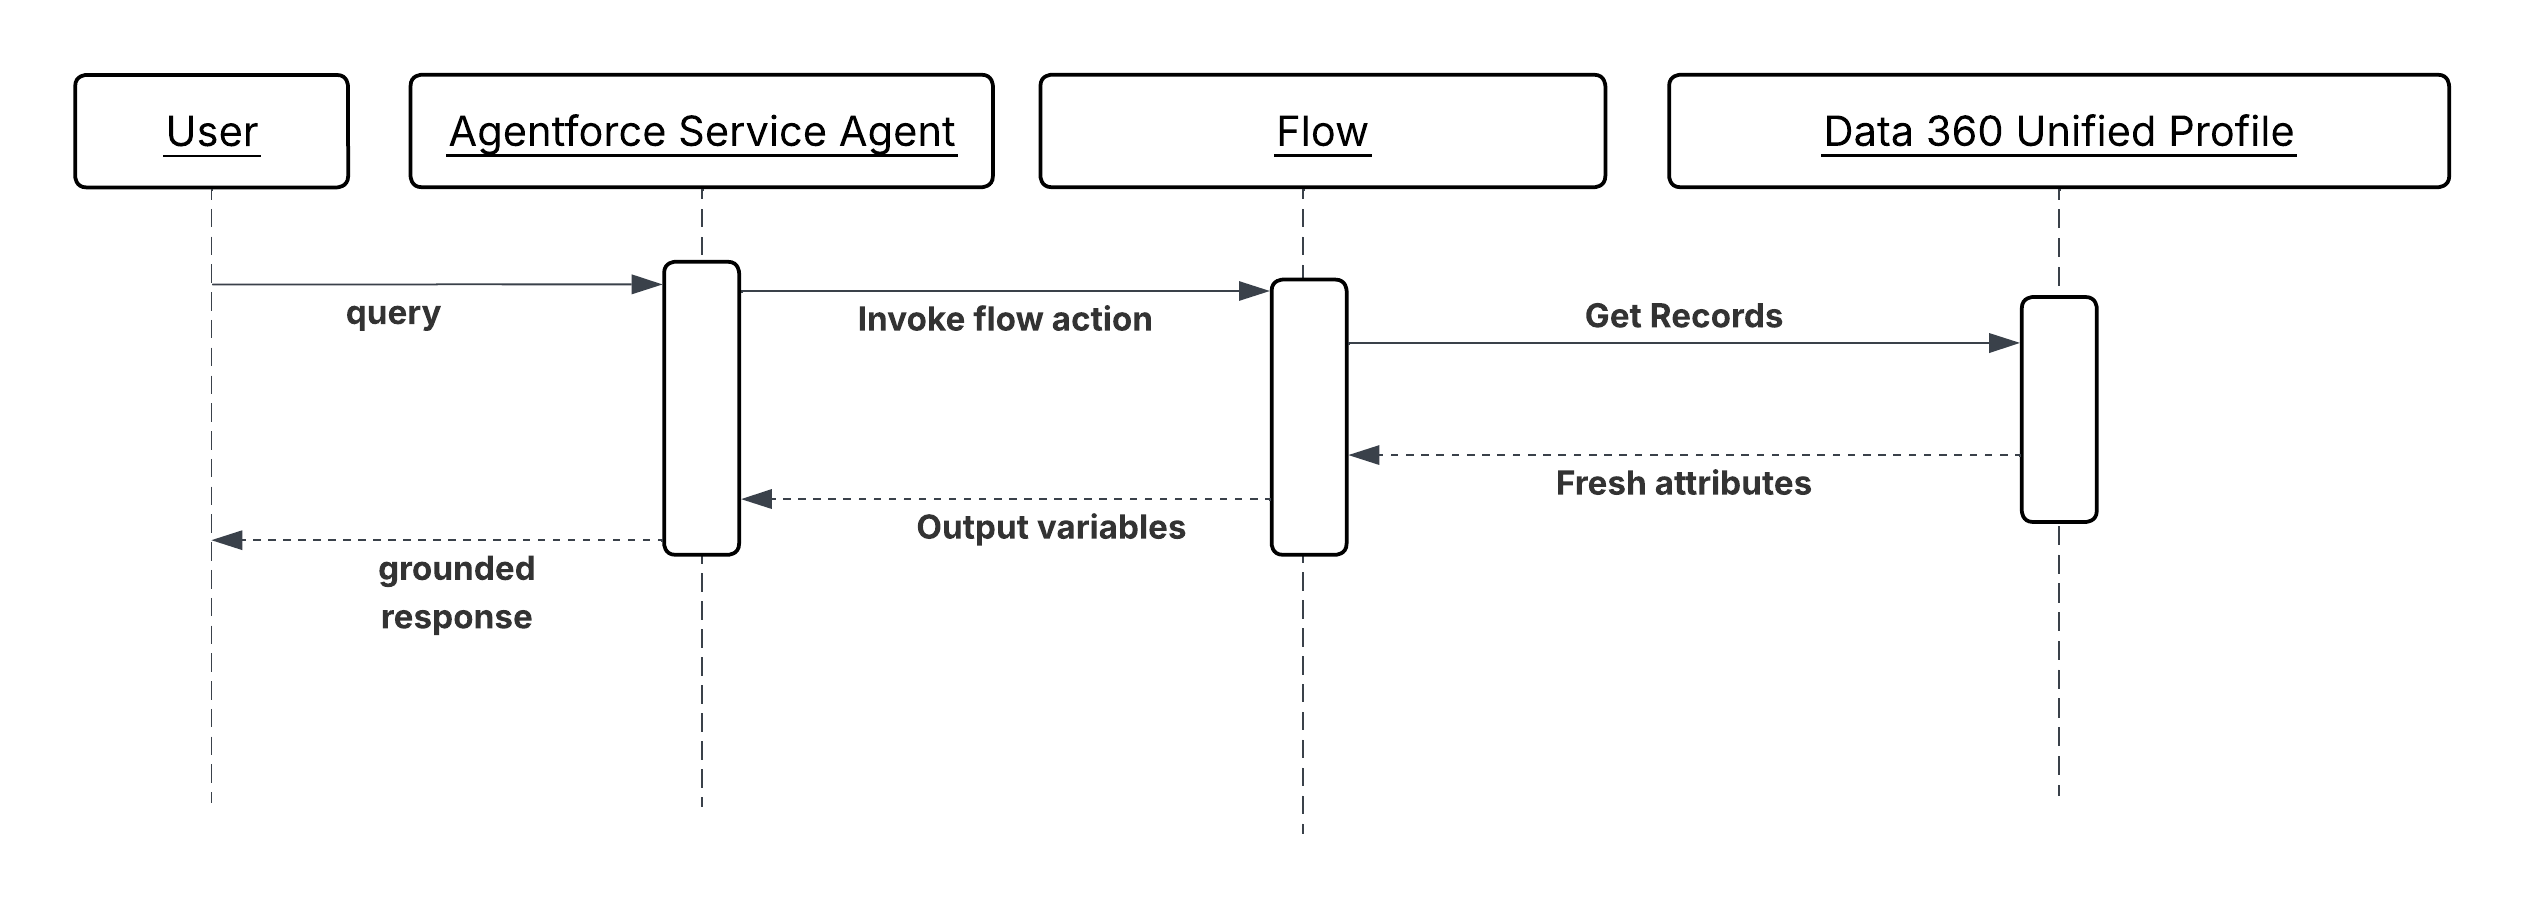
| Data 360 연결 플로우 | 동적 또는 세션 중 새로 고침에 가장 적합 | 프로필 특성이 자주 변경되거나 작업에 최신 상태가 필요한 경우 사용합니다. Data 360 연결 플로우를 작업 단계로 사용하여 호출 시점에서 최신 프로필 상태를 표시합니다. 플로우는 통합 프로필을 쿼리하고 필요한 변환을 적용하며, 특성을 체인에서 다음 작업에 사용되는 출력 변수로 반환합니다. |
| 작업 입력으로 계산된 인사이트 | 복잡한 파생 메트릭에 가장 적합 | 에이전트가 원시 데이터를 해석하는 대신 계산된 비즈니스 메트릭( 이탈 위험 점수, CSAT 추세, 제품 채택 지표)을 고려해야 하는 경우 사용합니다. 동작, 트랜잭션, 참여 데이터를 통해 계산된 파생 메트릭으로 Data 360에서 정의됩니다. 계산된 인사이트는 쿼리 가능한 프로필 특성으로 표시되며 주제 구성 또는 연결된 플로를 통해 작업 입력에 매핑할 수 있습니다. |
스케치
확인된 고객 컨텍스트 삽입의 순서 다이어그램
결과
작업은 LLM에서 도출한 근사치가 아닌 확인된 구조화된 고객 사실을 수신합니다. 에이전트의 추론은 고객의 실제 프로필 상태에 고정되므로, 사실적 정확도가 가격 책정, 권리 점검, 에스컬레이션 라우팅, 유지 제안과 같은 결과 품질을 결정하는 결정에서 환각 위험을 줄입니다.
프로필 그라운딩은 또한 추론 지연을 줄입니다. 에이전트가 기본 고객 컨텍스트를 설정하기 위해 조회 통화를 걸 필요가 없을 경우 추론 주기가 짧아지고 동시성이 더 적은 횟수에 사용됩니다.
Data 360 통합 프로필은 고객 사실의 권위 있는 소스로 남아 있습니다. 하위 에이전트 구성 또는 연결된 플로우는 통합의 접점 역할을 합니다. 에이전트는 해당 사실에 대한 추론 및 작업 선택에 대한 책임이 있으며, 사실을 직접 가져오는 것은 책임이 없습니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- LLM 추론으로 인해 확인된 값 대신 잘못된 결과가 생성될 수 있는 환각 위험이 있는 모든 작업 입력을 식별합니다. 환각 위험이 있는 입력은 프로필 그라운딩 후보입니다. 모든 입력에 그라운딩이 필요하지는 않습니다. 프로필 데이터를 과도하게 삽입하면 에이전트의 컨텍스트 창에 소음이 추가됩니다.
- 프로필의 최신성을 사후에 고려하는 것이 아니라 설계 결정으로 취급하십시오. 각 그라운딩된 속성에 대해 허용 가능한 데이터 신선도를 정의하고, 이에 따라 주입 메커니즘을 선택합니다. 안정적인 속성에는 세션 수준 매핑을, 변동성이 큰 속성에는 플로 기반 새로 고침을 사용합니다.
- 계산된 인사이트는 원시 메트릭이 아닌 비즈니스 논리를 인코딩해야 합니다. 0.87의 “churnRiskScore”에 대해 추론하는 에이전트가 14개의 원시 동작 신호에 대해 추론하는 에이전트보다 더 효과적입니다. Data 360에서 해석을 계산하고 에이전트에게 결과를 전달합니다.
Salesforce 구현 참고 사항
- 프로필 그라운딩은 그 기반이 되는 통합의 신뢰도만큼만 신뢰할 수 있습니다. 예를 들어, 통합 프로필의 가치는 상위 단계의 신원 확인 품질에 전적으로 달려 있습니다. 고객이 통합되지 않은 소스 시스템 전반에 분산된 신원을 가지고 있다면, 에이전트가 받는 프로필 속성은 불완전하거나 부분적인 정보만을 제공하게 됩니다(예: 한 채널의 데이터로만 계산된 평생 가치 등).
- Data 360이 연결된 플로우의 경우, 현재 세션의 “recordId” 또는 “accountId”에 필터를 적용한 Get Records 요소를 사용하여 관련 프로필 레코드만 조회합니다. 다운스트림 작업에 필요한 특성만 반환합니다. 전체 프로필 개체를 반환하지 마십시오.
- Data 360 수집 파이프라인을 통해 계산된 인사이트를 최신 상태로 유지해야 합니다. 시간이 중요한 결정에 사용되는 인사이트(예: 보존 워크플로의 이탈 위험)에 대해 스트리밍 또는 거의 실시간 새로 고침을 설정합니다. 배치 방식으로 갱신되는 인사이트는 변동이 느린 속성(예: 연간 계약 가치 등)에 적합합니다.
- 작업을 호출하기 전에 매핑된 프로필 특성이 null이 아닌지 확인합니다. 가격 책정 작업에 전달된 null “customerTier”는 환각된 값만큼이나 해롭습니다. 플로우 결정 요소를 사용하여 누락된 프로필 데이터를 감지하고 기본값을 검색하거나 명확성을 묻는 대체로 라우팅합니다.
- 하위 에이전트 구성에서 설명적이고 시맨틱하게 명확한 변수 이름(예: “customerTier”, “lifetimeValueUSD”, “churnRiskScore”)을 사용하여 프로필 특성을 작업 입력 매개변수에 매핑합니다. LLM은 작업을 선택하고 구성할 때 해당 이름을 참조하며, 모호한 이름은 선택 정확도를 떨어뜨립니다.
오류 처리 및 복구
- 필수 프로필 특성이 null이거나 작업 호출 시 사용할 수 없는 경우 에이전트가 잠재적으로 잘못된 기본값으로 진행하지 않아야 합니다. 작업은 누락된 속성을 나타내는 구조화된 오류를 반환해야 하며, 에이전트는 명확성을 위해 사용자에게 질문하거나 비대화형으로 동작하는 경우 사람에게 에스컬레이션해야 합니다.
- Data 360 연결 플로에서 프로필 데이터를 검색하지 못할 경우(예: Data 360 서비스 중단으로 인해) 플로의 오류 경로가 구체적인 오류 이유와 함께 에이전트에게 구조화된 오류를 반환해야 합니다. 그러면 에이전트가 재시도할지, 저하된 환경으로 진행할지 또는 사용자에게 실패를 표시할지 여부를 결정할 수 있습니다.
- 세션 생성 또는 작업 호출 시 세션 ID와 함께 삽입된 모든 프로필 특성 값을 기록합니다. 이렇게 하면 분쟁 중인 에이전트의 결정을 에이전트가 그 당시 받았던 정확한 고객 사실을 바탕으로 재구성할 수 있습니다.
보안 고려 사항
- 에이전트 컨텍스트에 삽입된 프로필 특성에는 CRM 레코드와 동일한 데이터 액세스 제어가 적용됩니다. 프로필 특성을 해결하는 데 사용되는 통합 사용자 또는 연결된 앱이, 표시되는 특성에 필요한 필드 수준 권한만 보유하며 더 광범위한 프로필 읽기 권한은 갖고 있지 않은지 확인하십시오.
- 민감한 파생 메트릭(예: 예측 건강 점수, 금융 위험 계층)을 인코딩하는 계산된 인사이트는 민감한 필드로 취급되고 기본 데이터와 동일한 액세스 제어에 따라 관리해야 합니다. 고객 대면 컨텍스트에서 작업하는 에이전트에게 높은 이탈 위험 점수를 표시하려면 에이전트가 전달할 수 있는 내용을 주의 깊게 고려해야 합니다.
- 작업에 필요하지 않은 프로필 특성을 표시하지 마십시오. 에이전트의 컨텍스트 창에 있는 각 추가 특성은 에이전트의 응답에서 재현할 수 있는 추가 데이터 요소입니다. 프로필 그라운딩에는 필요한 최소한의 원칙을 적용합니다.
- 계산된 인사이트 또는 민감한 프로필 특성이 입력으로 삽입된 모든 세션에 대해 감사를 수행해야 합니다. 이러한 세션은 파생된 고객 인텔리전스 기반으로 한 결정을 나타내며 특정 산업의 설명 가능성 또는 규제 요구 사항이 적용될 수 있습니다.
예제
한 통신 회사가 Agentforce를 사용하여 취소 요청을 시작한 고객과의 보존 대화를 처리합니다.
- 취소 사례가 열리면 고객의 “accountId”를 컨텍스트로 사용하여 에이전트 세션이 생성됩니다.
- 하위 에이전트 구성은 생성 시 세션 변수에 “customerTier”(Enterprise), “lifetimeValueUSD”(42,000), “contractRenewalDate”(60일) 세 가지 Data 360 통합 프로필 특성을 매핑합니다.
- “churnRiskScore”(사용량 하락, 지원 티켓 빈도, NPS 추세에서 계산된 0.91)와 같은 계산된 인사이트는 첫 번째 작업 단계로 호출된 Data 360 연결 플로를 통해 추가 세션 변수로 매핑됩니다.
- 이제 확인된 고객 팩트를 기반으로 하는 에이전트가 “SelectRetentionOffer” 작업을 호출합니다. 입력에 “customerTier = Enterprise”, “lifetimeValueUSD = 42000”, “churnRiskScore = 0.91”이 포함되므로 작업은 표준 보존 제안이 아닌 최대 계층 보존 제안을 반환합니다.
- 에이전트가 “PresentOffer”를 호출하여 대화에서 제안을 전달하고 “LogRetentionAttempt”를 호출하여 감사 가능성을 위해 보존된 모든 기반 특성으로 CRM에서 상호 작용을 기록합니다.
컨텍스트
엔터프라이즈 데이터가 조각화됩니다. Salesforce Platform 내에 있는 항목에 대해서만 작업할 수 있는 에이전트는 효과적으로 설명해야 하는 정보의 일부로 제한됩니다. 서비스 질문에 답변하려면 Service Cloud에서 고객의 진행 중인 티켓을 읽어야 할 수 있습니다. 제안을 준비하려면 Google Drive에서 파일을 검색해야 할 수 있습니다. 제품 사용을 분석하려면 데이터 웨어하우스를 쿼리해야 할 수 있습니다. 이러한 시스템에는 각각 자체 API, 자체 인증 모델, 자체 데이터 스키마가 있으며, 각각에 대한 맞춤형 통합 코드를 작성하는 비용은 과거에 에이전트와 시스템 간의 연결이 비싸고 취약해졌습니다.
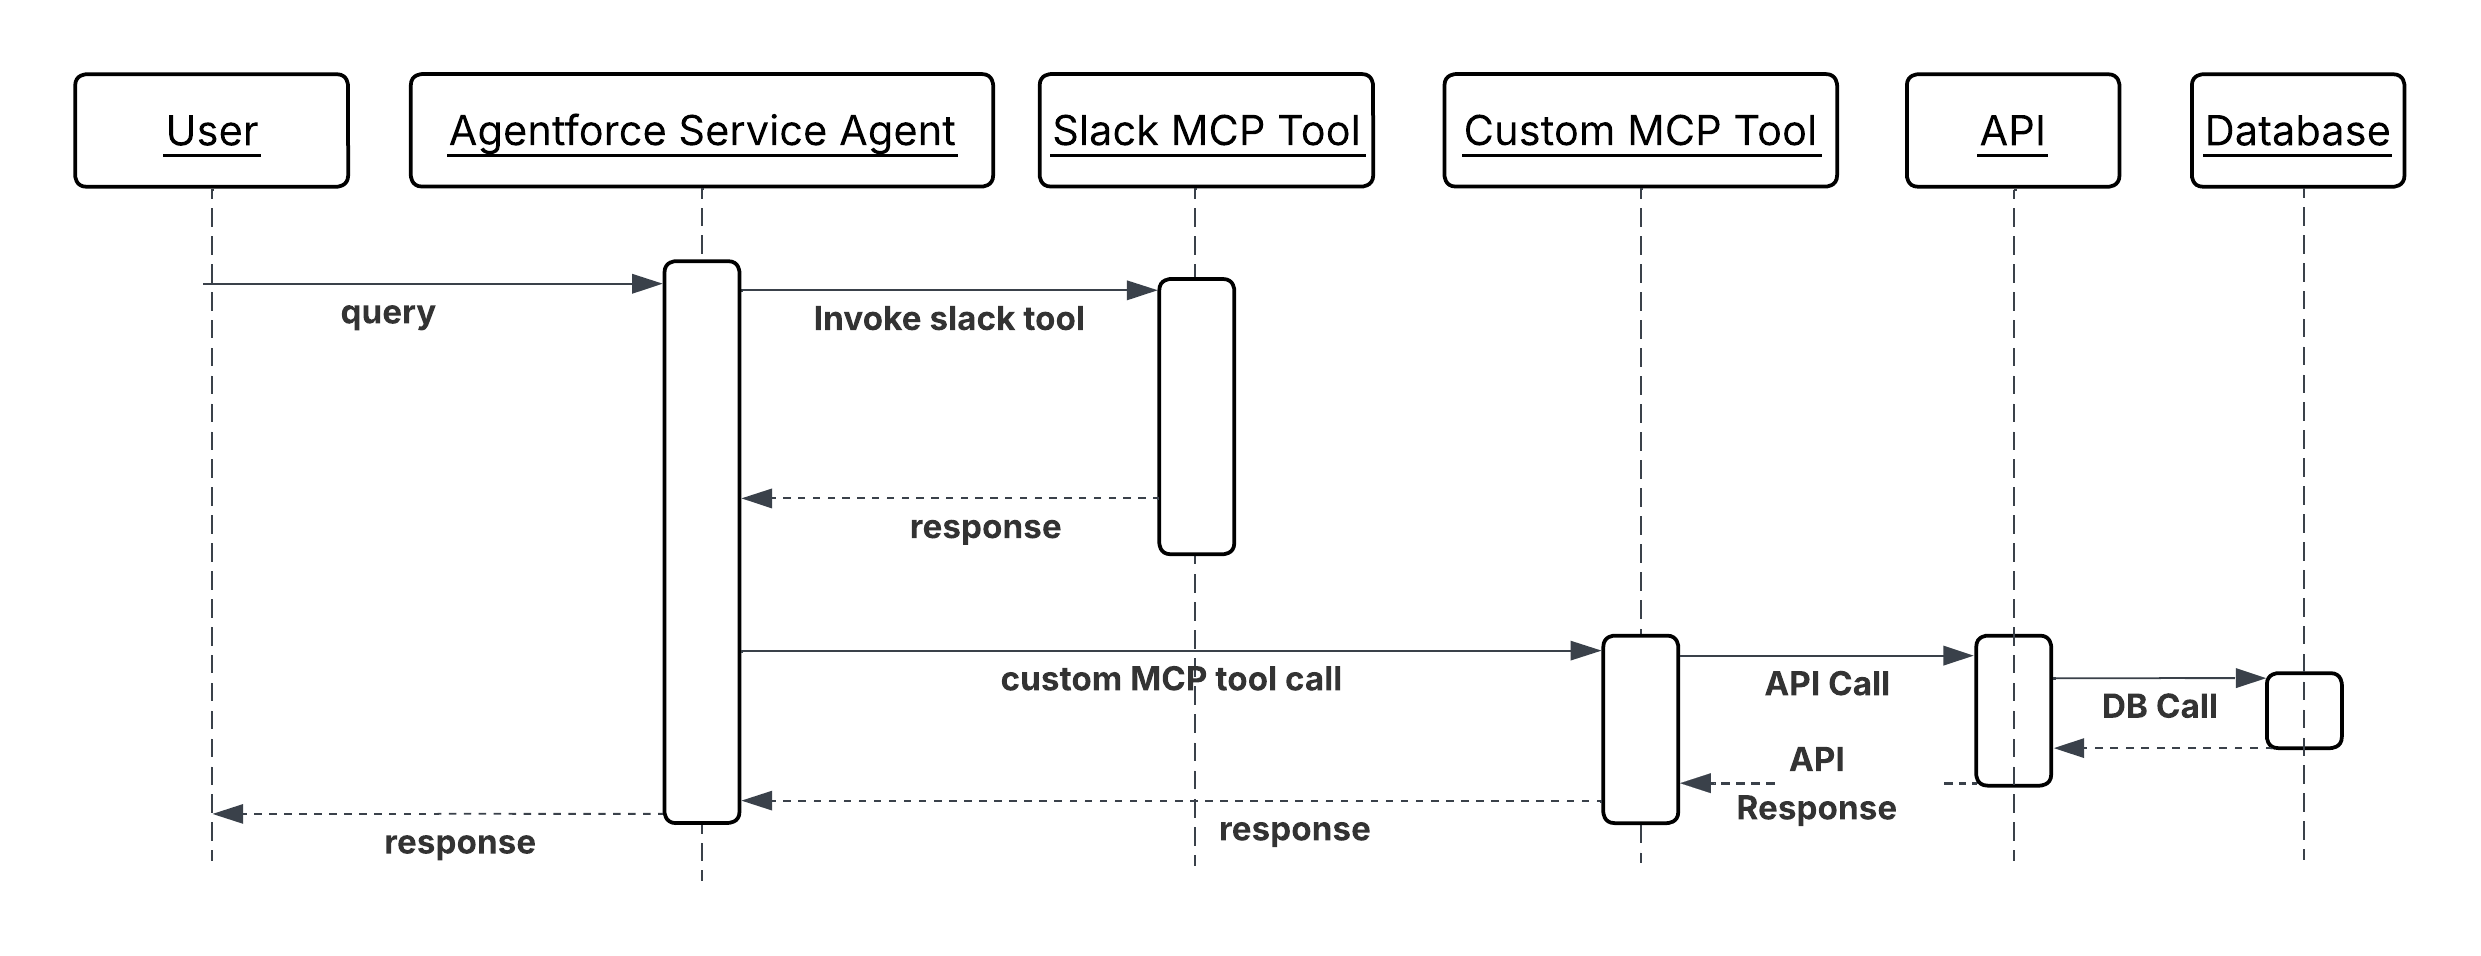
MCP는 이 문제를 직접 해결하는 개방형 표준입니다. 에이전트가 기본 시스템과 상관없이 MCP 호환 서버에서 노출된 도구를 검색하고 호출할 수 있는 일관된 인터페이스를 정의합니다. 각 MCP 서버는 어댑터 역할을 합니다. 이는 표준화된 도구 중심 인터페이스에 대상 시스템의 기본 인터페이스를 래핑하여 에이전트가 시스템의 특정 프로토콜 또는 스키마에 대해 아무것도 모르면서 쿼리, 호출, 작성할 수 있습니다.
에이전트의 관점에서 Slack, SQL(Structured Query Language) 데이터베이스 및 문서 관리 시스템에 연결하는 작업은 3개의 MCP 서버와 동일하게 표시되며, 각각에 설명된 호출 가능한 도구 집합이 표시됩니다. 에이전트는 시맨틱 설명 및 달성하려는 목표를 기반으로 이를 선택하고 순서대로 정렬합니다.
문제
에이전트가 서로 다른 API, 인증 및 스키마를 가진 여러 외부 시스템에서 정보를 검색하거나 작업을 트리거해야 할 때, 시스템별 맞춤형 통합 코드나 시스템 구현에의 긴밀한 결합 없이 이들의 기능을 어떻게 검색, 호출 및 구성할 수 있습니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 에이전트는 문서 저장소, 공동 작업 도구, 데이터베이스, 타사 SaaS와 같은 Salesforce 플랫폼 외부 시스템에 액세스해야 하며, 해당 API가 기본적으로 Agentforce 작업으로 표시되지 않습니까?
- 에이전트가 구성에 통합이 하드 코딩된 대신 현재 요청을 기반으로 추론 시 올바른 통합 끝점을 식별하는 동적 도구 검색이 필요합니까?
- 통합 환경이 자주 변경되며, 신규 시스템이 추가되거나 기존 시스템이 업데이트되거나 시스템별로 맞춤형 접근 방식으로 지속 가능하지 않은 서비스 점검 오버헤드가 발생할 수 있는 기타 변경 사항이 필요합니까?
- 대상 시스템의 API가 변경되더라도 에이전트의 지침이나 하위 에이전트 구성이 수정될 필요가 없도록, 다운스트림 시스템의 구현 세부 사항으로부터 에이전트의 추론 레이어를 분리해야 합니까?
- 대상 시스템이 각각 자신의 기능을 노출할 책임이 있는 서로 다른 팀이나 공급업체에 의해 소유되고 있다면, 에이전트마다 소비자측 통합을 하는 것보다 공급자측 MCP Server 모델이 더 실용적이지 않습니까?
Salesforce 패턴 애플리케이션
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| Salesforce MCP 서버 | Salesforce 에코시스템 내 대상 시스템에 가장 적합 | 대상 시스템이 Salesforce 에코시스템 내에 있고 자사 MCP 서버를 사용할 수 있는 경우 사용합니다. Salesforce Headless 360은 자체 플랫폼 기능에 대한 MCP 서버를 제공하며 CRM 데이터, 플로우 및 플랫폼 작업을 MCP 호환 도구로 노출합니다. 구현 노력을 개발 대신 구성으로 줄입니다. 노트: 현재 Salesforce MCP 서버는 인증 및 권한 부여를 위한 최종 사용자 자격 증명만 지원합니다. |
| 사용자 정의 MuleSoft MCP 서버 | 자사 MCP 서버가 없는 경우 가장 좋음 | 기존 시스템, 독점 내부 애플리케이션 또는 MCP 표준 이전의 타사 SaaS 플랫폼에 사용합니다. 대상 시스템에서 자체 MCP 서버를 제공하지 않는 경우 시스템 기능을 도구로 노출하는 사용자 정의 MCP 서버에 MuleSoft 통합 레이어를 래핑할 수 있습니다. 에이전트가 시스템 사용자 자격 증명만으로 활용되어야 하는 경우에 MCP가 요구된다면, Salesforce API와 함께 사용할 수도 있습니다. MuleSoft는 프로토콜 변환, 인증, 데이터 변환을 처리하며, MCP 레이어를 통해 에이전트가 결과를 발견할 수 있게 합니다. |
| 타사 MCP 서버 | 활성 MCP 에코시스템이 있는 상품 시스템에 가장 적합 | 플랫폼에 공급업체에서 관리하는 MCP 서버(GitHub, Google Workspace)가 있으며 보안 및 유지 관리 요구 사항을 충족합니다. GitHub, Google Workspace 등과 같은 여러 엔터프라이즈 플랫폼이 자체 MCP 서버를 게시하고 있습니다. 프로덕션 환경에서 사용할 수 있는 공급업체 관리 서버가 있다면, 사용자 정의 서버를 구축하는 것보다 이를 사용하는 것이 좋습니다. 채택하기 전에 보안 상태와 유지 관리 계획을 평가하십시오. |
스케치
확인된 고객 컨텍스트 삽입의 순서 다이어그램
결과
에이전트의 접근 가능 영역은 통합 복잡성을 늘리지 않고 확장됩니다. 새 외부 시스템을 추가할 때는 에이전트마다 맞춤형 Apex 콜아웃이나 플로우 통합을 작성하지 않고, 해당 시스템을 위한 MCP 서버를 배포하거나 구성하면 됩니다. 에이전트의 추론 레이어는 그대로 유지되며, 시맨틱 설명만을 기반으로 새 도구를 검색하고 호출합니다.
MCP 표준은 소유권을 명확하게 분리합니다. 시스템을 담당하는 팀은 해당 기능을 MCP 서버로 노출하고, 에이전트 팀은 시스템의 내부를 이해할 필요 없이 그 기능을 활용합니다. 이 경계는 통합 시스템 수가 증가함에 따라 조정 오버헤드를 줄입니다.
도구 구성 기능은 직접적인 결과입니다. 모든 도구가 동일한 호출 인터페이스를 공유하므로 에이전트는 다른 시스템에서 도구를 연결하고, Google Drive에서 파일을 검색하고, 데이터를 추출하고, 하나의 시스템 내에서 작업을 연결하는 것처럼 결과를 CRM 레코드에 작성할 수 있습니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 도구 설명은 에이전트가 도구를 호출할지 여부 및 방법을 결정하는 유일한 기준입니다. 도구가 수행하는 작업, 적용 시기, 반환되는 내용을 설명하는 명확한 의도 기반 언어로 설명을 작성합니다. “CRM 데이터베이스를 쿼리”라는 설명은 “지정된 계정 ID에 대해 우선 순위별로 계정의 진행 중인 사례를 검색”보다 덜 유용합니다. 부실한 설명은 부적절한 도구 선택을 초래합니다.
- 각 MCP 도구는 단일의 원자적 기능으로 한정되도록 하십시오. 문서를 검색하고 요약을 소스 시스템에 다시 쓰는 도구는, 두 개의 개별 도구보다 에이전트가 추론하기, 실패 시 재시도하기, 그리고 보안을 강화하기가 더 어렵습니다. 하나의 도구, 하나의 책임.
- 출력이 구성 가능한 입력이 되도록 도구를 설계합니다. 검색 도구의 결과는 일반적으로 따라오는 작업 도구의 입력 매개 변수에 자연스럽게 매핑되는 방식으로 구조화되어 있어 에이전트가 단계 간에 수행해야 하는 변환 작업을 줄여야 합니다.
- 원격 호스트 MCP 서버. 로컬 바이너리 설치는 에이전트 환경 수가 증가함에 따라 배포 및 버전 관리의 복잡성을 초래합니다. 원격 호스팅 서버를 사용하는 에이전트와 독립적으로 업데이트할 수 있습니다.
Salesforce 구현 참고 사항
- 모든 아웃바운드 MCP 호출에서 일관된 MCP 인증, 속도 제한, 페이로드 유효성 검사를 원할 경우 MCP 서버를 지원하는 MuleSoft 옴니 게이트웨이와 같은 AI 게이트웨이를 사용하고 에이전트에게 MCP 서버를 노출하기 전에 구성하십시오.
- MCP Server 연결에 필요한 모든 자격 증명에 OAuth 2.0 자격 증명을 사용합니다. 자격 증명은 도구 매개 변수, 작업 구성 또는 Apex 코드에 표시되지 않아야 합니다.
- 일부 MCP 도구는 비즈니스 사용 사례(예: 자금 이체)에 따라 특정 작업을 수행하기 위해 최종 사용자 자격 증명이 필요할 수 있습니다. 최종 사용자 ID 토큰을 전파하려면 현재 MuleSoft 옴니 게이트웨이에서 지원되는 OAuth 2.0 On behalf Of Credentials Injection 정책을 사용하십시오.
- 사용자 지정 MuleSoft MCP 서버의 경우: MuleSoft의 API 사양에서 MCP 도구 스키마를 정의하고 Agentforce 도구 카탈로그에 서버의 끝점을 등록합니다. 에이전트가 프로덕션에 배포하기 전에 올바른 과업에 적합한 도구를 선택했는지 확인하기 위해 담당자 에이전트 쿼리에 대한 도구 설명을 테스트합니다.
오류 처리 및 복구
- MCP 도구 호출이 오류를 반환하면, 에이전트는 기계가 읽을 수 있는 오류 코드를 검사하여 누락된 매개 변수를 사용자에게 요청하거나, 수정된 입력으로 재시도하거나, 담당자에게 에스컬레이션하는 등의 적절한 복구 조치를 결정합니다. 오류를 묵살하거나 도구 호출이 성공한 것처럼 추론을 지속하지 않습니다.
- 에이전트가 임시 실패에 대한 재시도 논리를 직접 구현합니다.
- 클라이언트 측에서 도구 이름, 정제된 입력 매개 변수 및 결과와 함께 모든 MCP 도구 호출을 기록합니다. 이 클라이언트 측 추적은 서버 측 로그와 결합되어, 워크플로가 예상한 결과를 생성하지 않을 때 에이전트가 특정 작업 경로를 선택한 이유를 진단하는 기본 메커니즘입니다.
보안 고려 사항
- 모든 아웃바운드 MCP 서버 연결이 게이트웨이를 통해 전달됩니다. 게이트웨이는 도구 매개 변수 내 프롬프트 삽입 시도를 감지하기 위해 페이로드 검사를 수행하며, 인증 확인과 속도 제한을 적용해 도구 오용을 방지합니다. 에이전트에서 MCP 서버로의 직접 및 중재되지 않은 연결은 이러한 제어를 우회하며 허용되지 않습니다.
- 각 에이전트의 MCP 서버 연결 범위를 실제로 해당 에이전트에게 도구가 필요한 서버로만 지정합니다. 사용 가능한 모든 MCP 서버에 대한 액세스 권한을 사용하여 구성된 에이전트는 정의된 과업 요구 사항에만 연결된 에이전트보다 더 큰 공격 표면을 보유합니다.
- 특히 매개 변수 값이 사용자 제공 텍스트 또는 LLM 생성 콘텐츠에서 파생된 경우 도구에 입력 매개 변수를 전달하기 전에 유효성을 검사하고 정제합니다. 유효성 검사되지 않은 LLM 출력을 도구 매개 변수로 직접 전달하지 마십시오. 에이전트의 추론에 영향을 미칠 수 있는 공격자는 해당 경로를 사용하여 다운스트림 시스템 호출에 악성 값을 삽입할 수 있습니다.
- 에이전트의 연결된 MCP 서버 및 도구 인벤토리 목록을 민감한 구성으로 취급합니다. 에이전트가 사용할 수 있는 도구와 해당 도구가 수용하는 매개 변수를 파악한 공격자는, 이를 악용하기 위한 프롬프트 주입 페이로드를 제작할 수 있는 청사진을 얻게 됩니다.
예제
영업 에이전트가 고부가가치 고객과의 통화 전에 종합적인 계정 브리핑을 준비합니다.
- 에이전트가 요청을 수신합니다. “내일 갱신 토론 전에 Acme Corp에 대한 브리핑을 준비하십시오.”
- 에이전트가 MCP 도구 카탈로그를 쿼리하고
GetRecentEmails,GetOpenOpportunities및GetSupportTicketSummary의 두 개의 MCP 서버에서 세 가지 관련 도구를 식별합니다. - 에이전트가 세 가지 도구를 모두 병렬로 호출합니다. 각 MCP 서버가 호출을 대상 시스템의 기본 API로 번역하고 관련 데이터를 검색한 후 구조화된 결과를 반환합니다.
- 에이전트는 세 가지 결과를 수신합니다. 최근 이메일 스레드, 거래 규모와 단계가 포함된 진행 중인 갱신 기회, 그리고 우선순위별 진행 중인 지원 티켓 요약을 하나로 결합하여 구조화된 계정 브리핑을 작성합니다.
- 에이전트가
CreateAccountNote를 호출하여 브리핑을 계정 레코드에 저장하고 요청한 사용자에게 요약을 반환합니다. - 네 개의 MCP 도구 호출은 도구 이름, 서버 식별 정보 및 세션 감사 기록을 위한 결과와 함께 게이트웨이에 기록됩니다.
컨텍스트
아웃바운드 MCP 패턴은 외부 MCP 서버에서 도구를 사용하는 Agentforce 에이전트를 설명합니다. 인바운드 패턴은 이와 반대로 작동합니다. CRM 레코드, 플로, Apex 논리 및 Data 360 통찰력과 같은 Salesforce 플랫폼 기능은 모든 LLM 프레임워크에서 실행되는 외부 에이전트가 검색하고 호출할 수 있는 MCP 도구로 노출됩니다.
이 패턴이 중요한 이유는 엔터프라이즈 AI 배포가 단일 공급업체에 의해 이루어지는 경우가 드물기 때문입니다. 다른 프레임워크에 구축된 파트너의 에이전트가 Salesforce에서 고객의 계정 상태를 조회해야 할 수 있습니다. Python 기반 에이전트를 실행하는 내부 데이터 과학 팀은 승인 프로세스를 시작하기 위해 Salesforce 플로를 트리거해야 할 수 있습니다. 표준화된 노출 메커니즘이 없으면 각 외부 소비자에게 맞춤 통합이 필요합니다. Salesforce 기능을 MCP 서버로 표시하면 모든 MCP 호환 에이전트에게 호출 에이전트가 구축된 방식과 상관없이 플랫폼의 도구에 대한 일관되고 검색 가능한 인터페이스가 제공됩니다.
예를 들어 타사 프레임워크를 기반으로 구축된 파트너의 조달 에이전트가 구매 주문을 승인하기 전에 Salesforce에서 공급업체의 계약 상태를 확인해야 합니다. 직접 REST 통합을 구축하는 대신 Salesforce MCP Server에서 GetContractStatus 도구를 호출합니다. 이 도구는 모든 기본 Salesforce 작업과 동일한 액세스 제어를 적용하며, 호출하는 에이전트에게는 결과만 제공됩니다.
문제
다른 프레임워크에 구축되고 파트너가 소유하거나 Salesforce Platform 외부에서 실행되는 외부 에이전트가 자체 워크플로의 일부로 Salesforce 기능을 호출해야 하는 경우 외부 소비자별로 맞춤형 통합이 필요하지 않은 표준화되고, 검색 가능하며, 안전하게 관리되는 방식으로 해당 기능을 노출할 수 있는 방법은 무엇입니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- Salesforce 기능을 사용해야 하는 외부 에이전트가 MCP 표준을 지원하는 프레임워크에 구축되어 있습니까? 그렇지 않은 경우 REST API 또는 웹후크 접근 방식이 MCP보다 더 적합할 수 있습니다.
- 읽기 전용 데이터 검색, 쓰기 작업, 플로 호출 또는 조합과 같이 노출해야 하는 Salesforce 기능은 무엇입니까? 노출 범위에 따라 관리해야 하는 보안 표면 영역이 직접 결정됩니다.
- 외부 호출 에이전트의 ID를 확인하는 방법 및 호출을 실행해야 하는 Salesforce 권한은 무엇입니까? 에이전트가 플랫폼에 호출을 할 때, 해당 특정 작업에 필요한 범위를 넘어선 권한을 부여받아서는 안 됩니다.
- Salesforce MCP Server는 내부 소비자(동일한 조직 내의 다른 팀의 에이전트) 또는 외부 소비자(파트너 및 고객 에이전트)용입니까? 신뢰 모델 및 인증 요구 사항은 이러한 대상 그룹 간에 크게 다릅니다.
- 시간에 따른 노출된 도구 집합의 발전은 어떻습니까? MCP 서버에 추가된 새로운 Salesforce 기능은 모든 연결된 에이전트가 즉시 검색할 수 있으며 의도한 게시 프로세스를 통해 의도하지 않은 도구 노출을 관리해야 합니다.
Salesforce 패턴 응용 프로그램
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| MCP 서버로 Salesforce(Native) | 자사 Salesforce 기능 노출에 가장 적합 | 노출할 도구가 기존 Salesforce Platform 작업에 직접 매핑되고 통화 에이전트가 MCP와 호환되는 경우 사용합니다. Salesforce Headless 360의 네이티브 MCP 서버 기능을 사용하면 레코드 쿼리, 플로 호출 및 Apex 작업과 같은 플랫폼 작업을 MCP 도구로 선언하고 MCP 호환 외부 에이전트에 노출할 수 있습니다. 액세스는 Salesforce 권한 모델에 따라 관리됩니다. 현재 최종 사용자 자격 증명으로만 헤드리스 360 MCP 서버에 액세스할 수 있습니다. |
| MuleSoft(MCP 서버 패싯) | 변환 또는 다중 시스템 집계가 필요한 경우 가장 적합 | 통화 에이전트에게 두 개 이상의 Salesforce 개체의 데이터, 배달 전 변환 또는 다른 시스템의 데이터로 구성이 필요한 기능이 필요한 경우 사용합니다. MCP 인터페이스는 깔끔하고 단순하며 MuleSoft는 복잡성을 흡수합니다. MuleSoft MCP 레이어는 Salesforce 앞에 있으며 여러 플랫폼 작업의 집계 결과를 단일 MCP 도구로 노출합니다. 이 솔루션은 Salesforce 인증 및 권한 부여를 위해 최종 사용자 ID를 전파할 수 없는 에이전트에서도 사용할 수 있습니다. 예를 들어 Agentforce 에이전트가 시스템 자격 증명이 있는 MCP 서버를 필요로 할 경우 MuleSoft에서 구축하고 호스팅하는 것과 같은 맞춤형 MCP 서버를 사용해야 합니다. |
스케치
수신 가능한 도구로서의 비즈니스 기능 순서 다이어그램
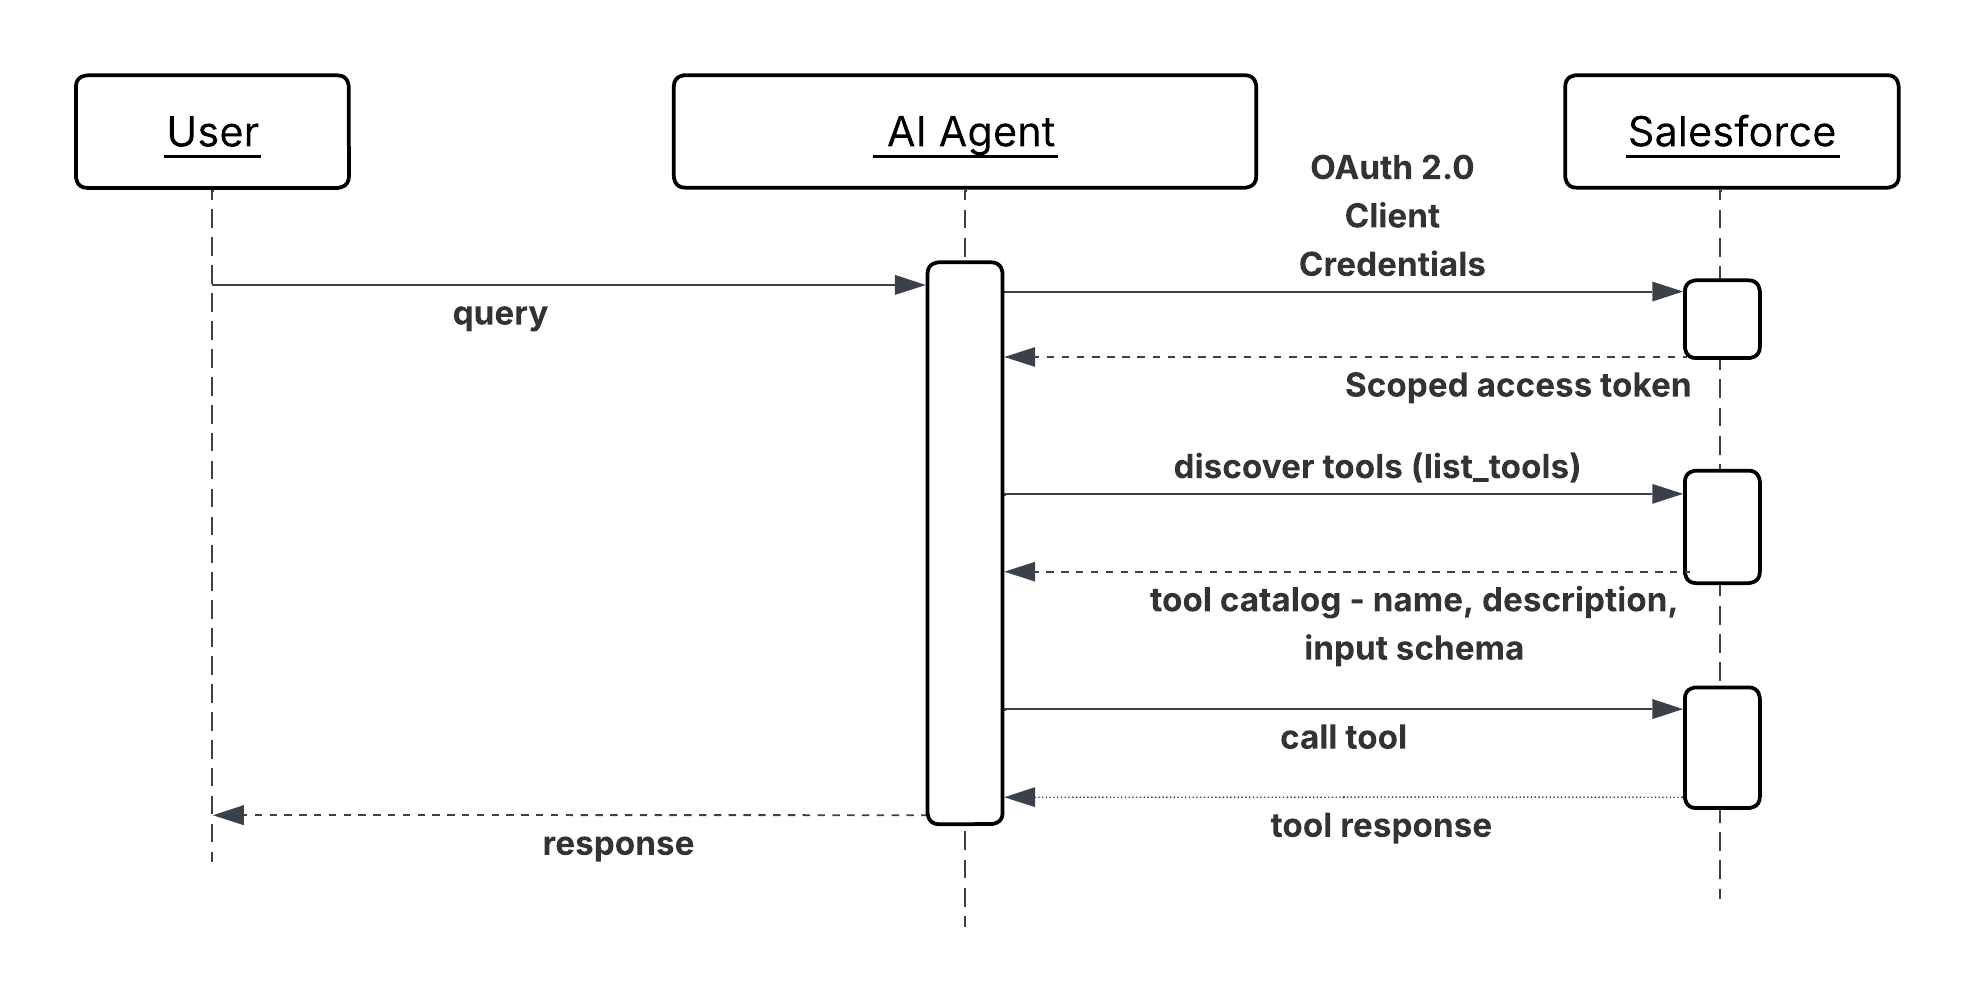
결과
Salesforce는 다중 공급업체 에이전트 에코시스템의 최상위 참가자가 됩니다. 외부 에이전트는 소비자별 또는 사용 사례별로 사용자 정의 REST 통합을 필요로 하지 않고도 플랫폼 기능을 검색하고 사용할 수 있습니다. 통합 유지보수 오버헤드의 비례 증가 없이 소비자 수가 증가할 수 있습니다.
헤드리스 360을 사용하면 Salesforce 권한 모델이 모든 인바운드 도구 호출을 관리합니다. 외부 MCP 클라이언트는 기존 데이터 액세스 제어를 무시하지 않으며 해당 클라이언트 내에서 작업합니다. 즉, MCP를 통해 기능을 노출하는 보안 조치가 다른 인증된 API 표면을 통해 기능을 노출하는 것과 동일합니다.
도구 검색 가능성은 복합 혜택입니다. MCP 서버의 도구 카탈로그에 새 Salesforce 기능이 추가되면 해당 에이전트가 구성을 업데이트하지 않아도 연결된 모든 외부 에이전트에서 즉시 사용할 수 있습니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 외부 에이전트에게 필요한 사항만 게시합니다. MCP 서버 카탈로그에 추가된 모든 도구는 공격 표면 및 거버넌스 부담을 확장합니다. 도구 재고에 대한 감사를 신중하게 수행합니다. 외부 사용에 승인되는 기능을 정의하고, 승인되지 않은 노출을 기본값이 아닌 구성 공백으로 처리합니다.
- 외부 소비자를 위한 도구 설명을 작성합니다. 외부 에이전트의 연산자는 내부 데이터 모델이나 명명 규칙을 알지 못합니다. 설명은 독립적으로 완결되어야 합니다: 도구의 기능, 각 매개변수의 의미, 결과가 나타내는 내용, 그리고 호출자가 만족해야 할 제약 조건 또는 전제 조건을 포함합니다.
- 입력 또는 출력 스키마가 변경되면 버전 도구를 명시적으로 표시합니다. 도구의 현재 스키마에 의존하는 외부 에이전트는 사전 통지 없이 스키마가 변경될 경우 자동으로 중단됩니다. 공개 REST API에 대한 주요 변경 사항과 동일한 규칙으로 MCP 도구의 인터페이스에 대한 주요 변경 사항을 처리합니다.
Salesforce 구현 참고 사항
- 권한이 노출된 도구에 필요한 작업에만 범위가 지정된 최종 사용자 아래에서 모든 인바운드 Salesforce 기본(OOTB) MCP(헤드리스 360) 도구 호출을 실행합니다. 높은 권한이 있는 관리자 ID 아래에서 인바운드 에이전트 통화를 실행하지 마십시오.
- 모든 MCP 도구에서 인증, 속도 제한, 스키마 유효성 검사, 개인 식별 정보(PII) 감지를 일관되게 적용하려면 MuleSoft 옴니 게이트웨이와 같은 AI 게이트웨이를 사용합니다.
- MuleSoft MCP 패싯의 경우 기본 Salesforce API 스키마와 독립적으로 MuleSoft에서 MCP 도구 스키마를 정의합니다. MCP 인터페이스는 백업하는 Salesforce 개체의 형태가 아닌 전화를 건 에이전트의 개념적 필요를 반영해야 합니다. 이러한 분리를 통해 외부 도구 계약을 깨뜨리지 않고 Salesforce 구현이 발전할 수 있습니다.
오류 처리 및 복구
- 도구 호출 실패는 기계가 읽을 수 있는 코드와 일반 언어 설명이 포함된 구조화된 MCP 오류 응답을 반환해야 합니다. 외부 에이전트는 Salesforce 플랫폼의 내부를 볼 수 없으므로, 오류 메시지는 Salesforce 특정 오류 코드나 개체 모델에 대한 지식 없이도 자체적으로 완결되고 실행 가능해야 합니다.
- 속도 제한 오류 및 인증 실패는 외부 에이전트의 연산자가 내부 구성 세부 사항을 노출하지 않고 어떤 속도 제한에 도달했는지 또는 어떤 자격 증명이 거부되었는지 진단하고 수정할 수 있는 충분한 정보와 함께 즉시 반환해야 합니다.
- 옴니 게이트웨이에서는 호출한 에이전트의 ID, 호출된 도구, 입력 매개변수(민감한 값은 제거됨) 및 결과를 기록합니다. 이 로그는 외부 소비자가 보고한 실패를 진단하고 외부 에이전트가 액세스한 내용을 감사하기 위한 기본 증거 추적입니다.
보안 고려 사항
- 도구에 액세스하기 전에 모든 인바운드 MCP 연결을 인증해야 합니다. 도구 카탈로그의 인증되지 않은 검색을 허용하지 마십시오. 노출된 기능 목록 자체가 중요한 정보입니다.
- 연결 수준 인증 외에도 도구 수준 인증을 적용합니다. 등록된 외부 에이전트는 전체 카탈로그가 아닌 명시적으로 액세스 권한이 부여된 특정 도구만 호출할 수 있어야 합니다. 응용 프로그램 계층이 아닌 게이트웨이에 적용합니다.
- 모든 인바운드 도구 매개 변수를 확인하고 비활성화한 후 Salesforce Platform 작업에 전달합니다. 외부 에이전트의 매개 변수는 신뢰할 수 없는 입력 표면입니다. 악의적으로 생성된 매개 변수는 쿼리 필터를 재정의하거나, Salesforce 개체 쿼리 언어(SOQL) 조각을 주입하거나, 플로 변수에 영향을 미칠 수 있습니다. MCP 서버 또는 패싯 경계에서 유형, 형식, 범위를 확인합니다.
- 등록된 외부 소비자의 액세스를 정기적으로 검토합니다. 더 이상 활성 상태가 아니거나 액세스 범위가 변경된 에이전트의 자격 증명을 취소합니다. 해지된 파트너 통합에 대해 유효하지만 사용되지 않는 자격 증명은 불필요한 상시 위험입니다.
- 게이트웨이에서 인바운드 MCP 메시지를 속도 제한하여 플랫폼 제한을 위반하지 않도록 보호합니다. SLA 기반 계층화 정책을 사용하여 부하 중일 때 비중요 에이전트의 트래픽을 줄입니다.
예제
물류 파트너가 운영하는 조달 에이전트는 중요한 구매 주문을 승인하기 전에 공급업체의 계약 및 신용 상태를 확인해야 합니다.
- 파트너의 에이전트가 등록된 OAuth 2.0 클라이언트 자격 증명을 사용하여 게이트웨이에 인증하고 범위가 지정된 액세스 토큰을 수신합니다.
- 에이전트가 Salesforce MCP Server의 도구 카탈로그를 쿼리하고
GetSupplierContractStatus및GetAccountCreditSummary의 두 가지 관련 도구를 식별합니다. - 에이전트가 공급업체의 식별자를 사용하여
GetSupplierContractStatus를 호출합니다. MCP 서버가 이를 Salesforce 레코드 쿼리로 번역하고 통합 사용자의 필드 수준 보안을 적용하고 계약의 현재 상태, 만료 일자 및 플래그가 지정된 모든 규정 준수 유지를 반환합니다. - 에이전트가 MuleSoft MCP 패싯을 통해 라우팅되는
GetAccountCreditSummary을 호출합니다. 패싯은 2개의 Salesforce 개체에서 공급업체의 미결제 인보이스 잔액 및 결제 내역을 집계하여 단일 복합 신용 요약을 반환합니다. - 두 결과 모두 파트너의 에이전트가 계약이 활성 상태이고 신용 자산이 허용되는 한도 내에 있는지 확인하고 자체 시스템에서 구매 주문을 승인합니다.
- 게이트웨이는 파트너 에이전트의 신원, 호출된 도구 및 결과를 기록하여 외부에 부여된 액세스 권한과 반환된 데이터를 감사할 수 있는 기록을 생성합니다.
컨텍스트
엔터프라이즈 시스템은 이제 복잡한 요청이 분해되고 다양한 도메인 또는 공급업체 플랫폼 전반의 전문 에이전트에게 위임되는 공동 작업 에이전트 스워밍 또는 네트워크에 의존합니다. 각각 고유한 역할, 기능 및 도구가 있는 해당 에이전트는 표준화되고 안전한 커뮤니케이션 방법이 있어야만 모든 단계에서 인적 개입이 필요하지 않고 공유 목표를 조율할 수 있습니다.
문제
호출하는 AI 에이전트가 어떻게 동적으로 탐색하고, 안전하게 상호 작용하며, 복잡하거나 도메인별 과업을 원격 피어 에이전트에 위임하여, 보다 큰 엔터프라이즈 워크플로를 완료하기 위한 구조화된 결과를 받을 수 있습니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 다양한 프레임워크로 개발되었거나 분리된 애플리케이션 환경에서 운영되는 에이전트들은 어떻게 상호 운용합니까?
- 에이전트들이 내부 로직, 메모리 또는 독점 도구를 노출하지 않고 어떻게 협력하며 과업을 위임할 수 있습니까?
- 에이전트가 실시간 상태 업데이트, 스트리밍, 푸시 알림을 제공하면서 복잡한 장기 실행 과업을 지원하는 방법은 무엇입니까?
- 에이전트가 에이전트 간 커뮤니케이션에 대한 엔터프라이즈급 보안(인증, 권한 부여) 및 정책 준수를 어떻게 적용합니까?
- 간단한 API 호출 외에도 에이전트가 구조화된 과업 워크플로(시작, 진행, 완료)를 처리하는 방법은 무엇입니까?
Salesforce 패턴 응용 프로그램
A2A 프로토콜은 에이전트가 다른 에이전트를 동료로 발견, 위임 및 협력할 수 있도록 하는 개방형 표준입니다. 에이전트들이 다양한 플랫폼 및 공급업체 간에 정보를 안전하게 교환하고 행동을 조율할 수 있는 공통 언어를 제공합니다. A2A는 MCP를 보완하는 P2P 커뮤니케이션에 중점을 두며, 이는 에이전트를 도구 및 API에 연결하는 데 중점을 둡니다.
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| 단일 조직 다중 에이전트 오케스트레이션(SOMA) | 모든 도메인 에이전트가 한 조직에 거주하며 크로스벤더 라우팅이 필요하지 않은 경우에 가장 적합합니다. | 상위 에이전트(오케스트레이터)는 LLM 기반 라우팅(아래 에이전트 설명을 읽는 Atlas Reasoning Engine) 또는 결정적 라우팅(에이전트 스크립트)을 사용하여 요청을 분해하고 연결된 하위 에이전트를 최대 7개까지 라우팅합니다. 이는 A2A에 도달하기 전의 기본 권장 패턴입니다. 지원되는 조합: Agentforce 서비스 에이전트→Agentforce 서비스 에이전트 Agentforce 직원 에이전트→Agentforce 직원 에이전트 Agentforce 직원 에이전트→Agentforce 서비스 에이전트 오케스트레이터만 사람에게 에스컬레이션할 수 있으며, 하위 에이전트는 에스컬레이션할 수 없습니다. |
| 오케스트레이터 주도 다중 에이전트 위임 | 여러 전문 에이전트가 필요한 복잡한 워크플로에 가장 적합 | 워크플로가 여러 도메인(예: 다른 에이전트가 각각 소유한 소싱, 확인, 승인)에 걸쳐 있는 경우 사용합니다. 오케스트레이터 에이전트가 최상위 요청을 세분화하고 2개 이상의 피어 에이전트에 순서대로 또는 병렬로 하위 과업을 위임합니다. 각 동료 에이전트가 특수 도메인 함수를 실행하고 아티팩트를 반환합니다. 오케스트레이터가 결과를 집계하고 다음 단계를 실행합니다. |
스케치
아키텍처는 에이전트 카탈로그/레지스트리를 통한 검색을 지원하여 호출 에이전트가 커뮤니케이션을 시작하는 구조를 포함합니다.
교차 에이전트 위임의 순서 다이어그램
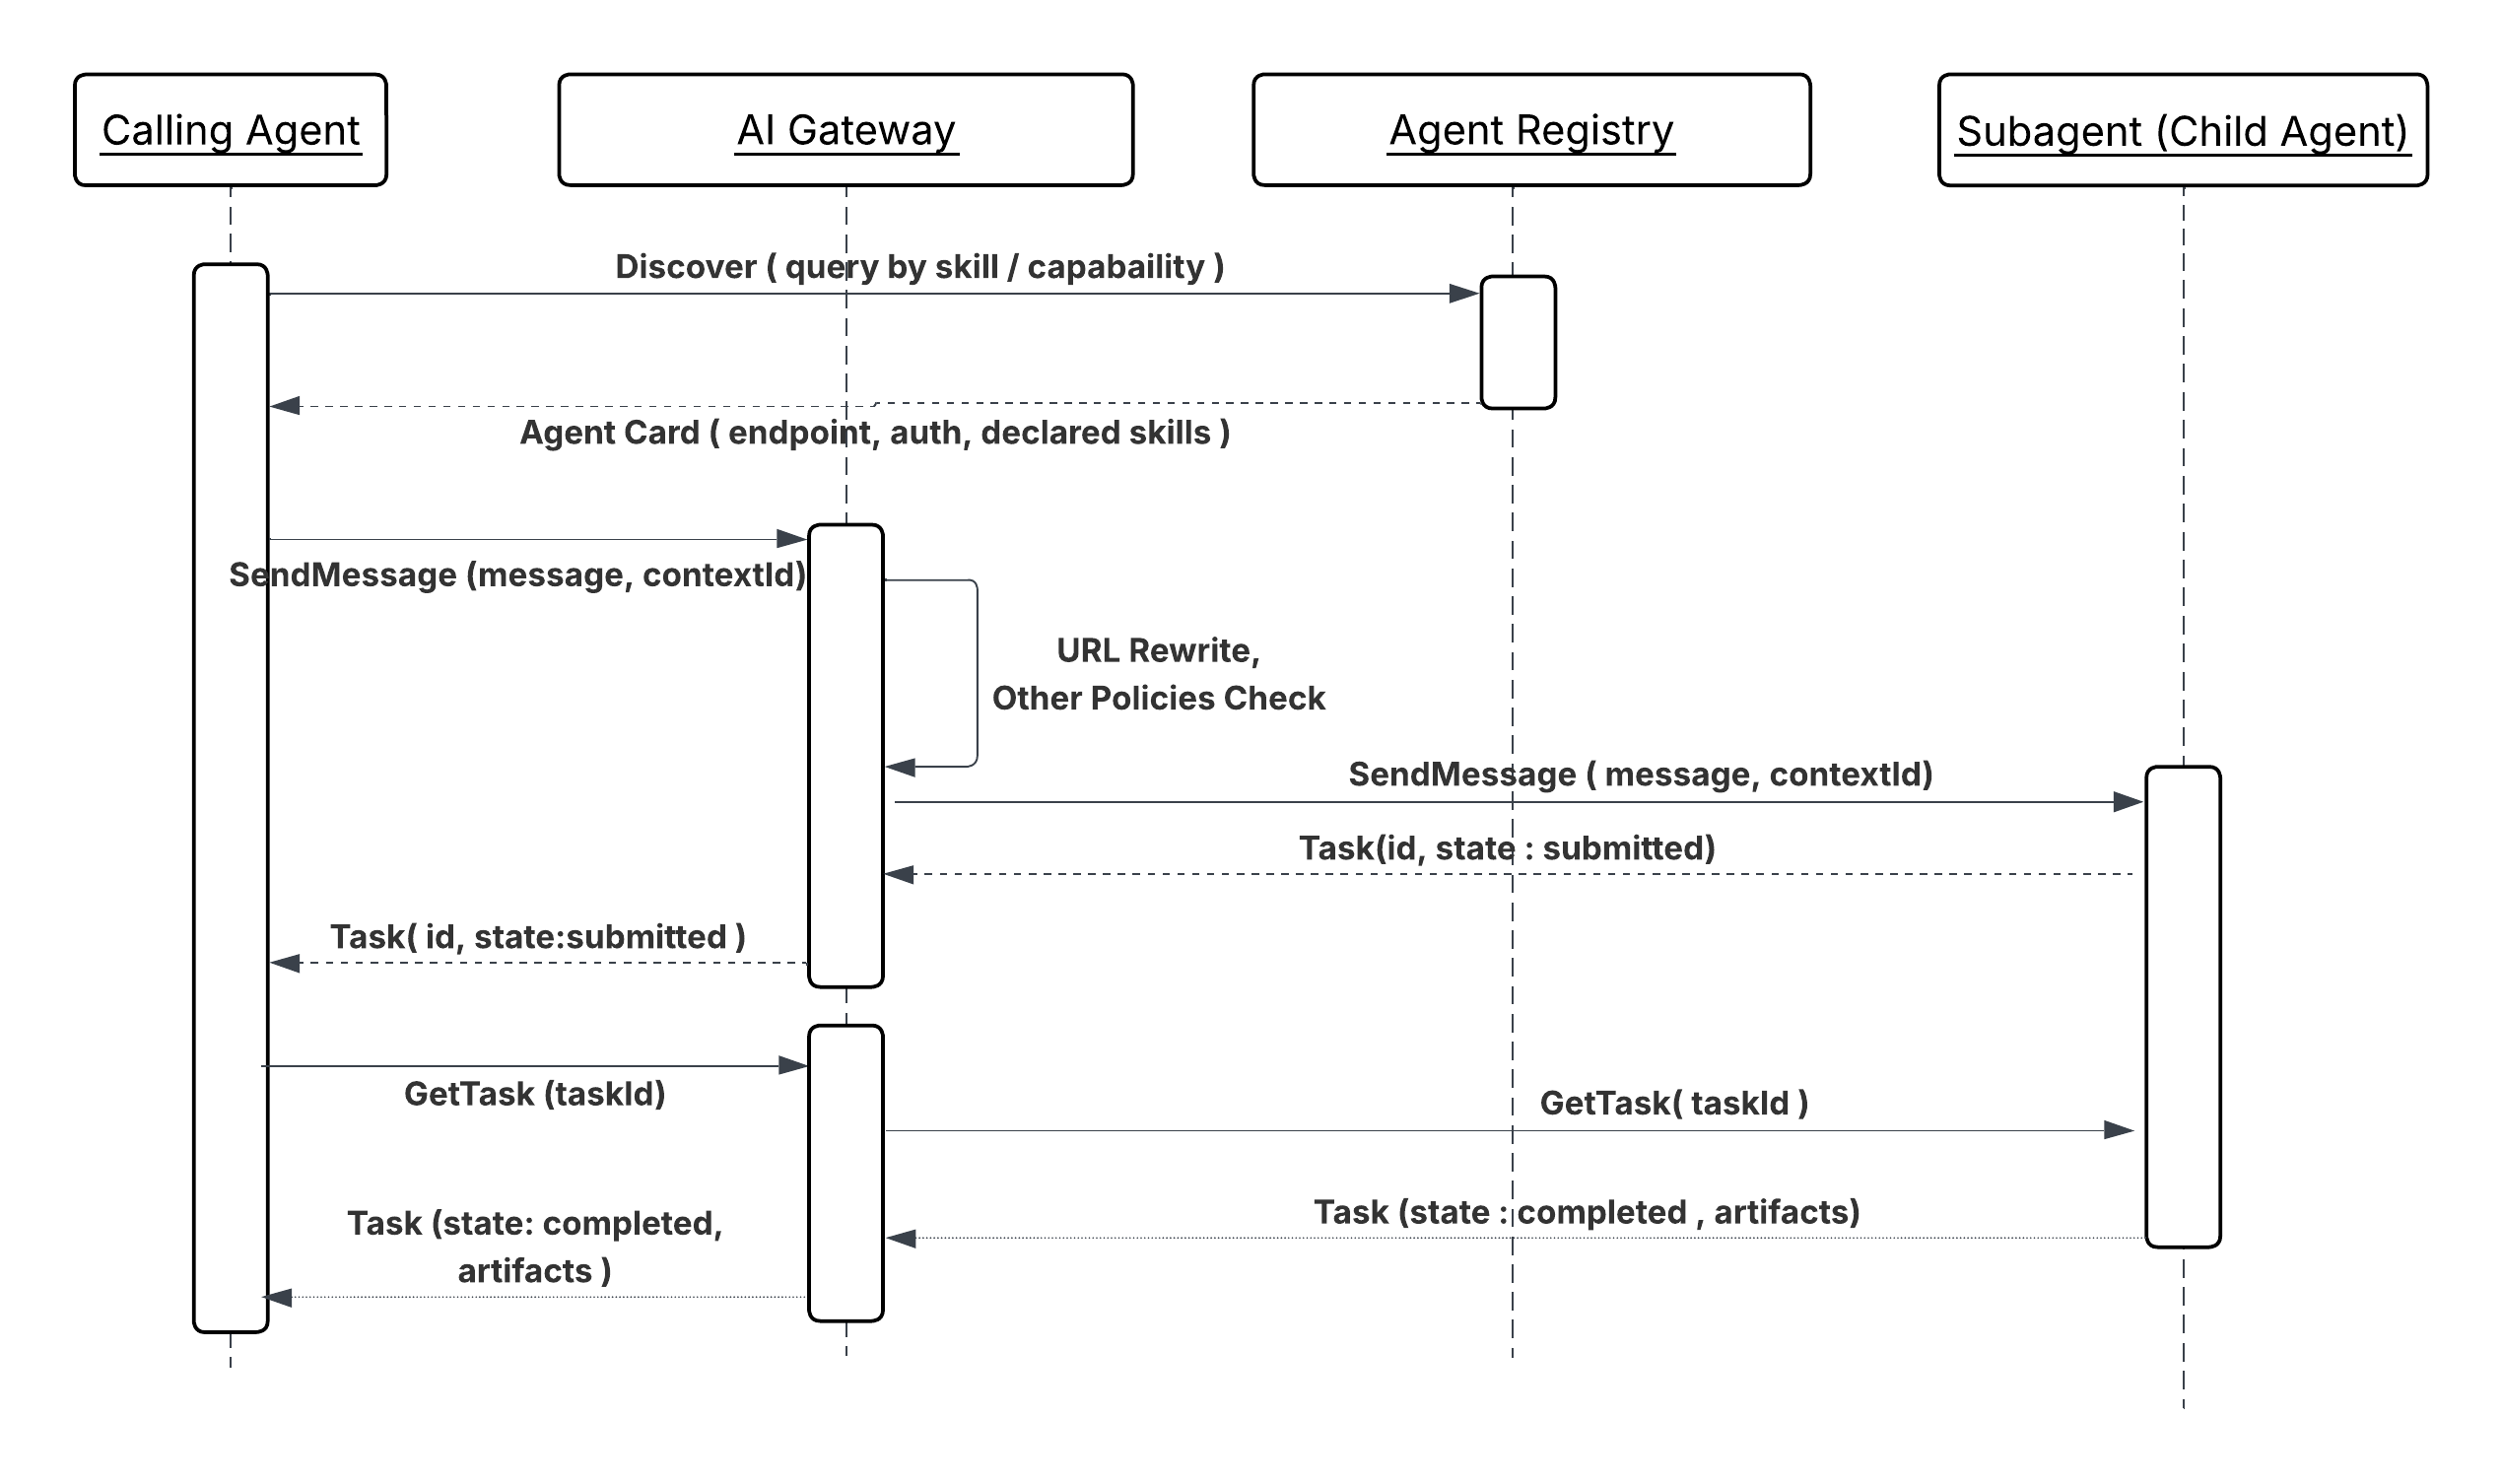
피어 에이전트가 도메인별 논리, 메모리, 도구를 사용하여 요청을 처리한 다음, 통화하는 에이전트에게 구조화된 결과를 반환합니다.
결과
A2A 위임은 워크플로 오케스트레이션과 도메인 소유권을 구분합니다. 호출 에이전트는 피어 에이전트가 어떻게 구축되었는지, 어떤 플랫폼에서 실행되는지, 내부적으로 어떤 도구를 사용하는지 알 필요 없이 과업을 위임하고 구조화된 산출물을 받습니다. 이 경계는 에이전트(백그라운드 확인, 금융 위험 점수 매기기, 물류 라우팅)를 호출하는 워크플로와 독립적으로 개발, 배포, 개선할 수 있음을 의미합니다.
프로토콜의 과업 수명 주기 모델(제출, 작업 중, 완료, 실패)은
기본적으로 장기 실행 작업을 지원합니다. 호출 에이전트가 상태 업데이트를 등록하는 대신
대신 차단 연결을 유지하지 않으므로, A2A 과업은 수 분 또는 수 시간에 걸쳐 진행될 수 있습니다.
오케스트레이터 에이전트가 전체 과정 동안 활성 상태를 유지할 필요가 없습니다.
설계 고려 사항
플랫폼 독립적 가이드라인
- 복잡한 시나리오에서 에이전트 중개자는 지능형 라우팅 서비스 또는 “스마트 스위치보드” 역할을 수행하여 전문 에이전트 간의 과업 위임을 조율하고 다단계 프로세스를 관리할 수 있습니다.
- A2A는 장기 실행 과업을 지원하므로 커뮤니케이션이 과업 완료에 맞춰야 하며, 과업 개체에 대한 수명 주기를 정의하고 실시간 상태 업데이트 및 알림을 제공해야 합니다.
- 프로토콜은 텍스트, 파일, 구조화된 데이터, 오디오, 비디오 스트리밍 등 다양한 콘텐츠 유형을 지원하도록 설계되었습니다.
- 에이전트와 해당 기능 간의 관계 및 종속성은 구성 파일(예: “agent-network.yaml”)에서 선언적으로 정의되고 에이전트 레지스트리에 게시됩니다.
Salesforce 구현 참고 사항
- 효과적인 SOMA 오케스트레이션을 위해 연결된 하위 에이전트를 7개 미만으로 유지하여 라우팅 품질을 유지합니다.
- 현재 단일 위임 레이어만 지원됩니다(수퍼에이전트 → 하위 에이전트); 더 깊은 체인은 대기 시간을 “감당할 수 없는 수준”으로 증가시킵니다. 현재 하위 에이전트는 다른 연결된 하위 에이전트에 위임할 수 없습니다.
- 인적 핸드오프는 오케스트레이터 수준에서만 지원되며 하위 에이전트는 에스컬레이션할 수 없습니다.
- SOMA 내에서 LLM 기반 라우팅이 모호한 입력에 대해 잘못된 라우팅을 발생시킬 때, 결정적인 라우팅을 위해 에이전트 스크립트를 사용합니다. 에이전트 스크립트는 에이전트 간에 선별된 공유 컨텍스트를 활성화합니다.
오류 처리 및 복구
A2A 프로토콜은 강력한 디버깅 및 오류 관리를 촉진하는 포괄적인 오류 코드를 정의합니다.
- 복구 논리: 에이전트는 재시도 정책(재시도), 대체 가능한 에이전트에 페일오버 논리, 명시적인 시간 제한을 통합해야 합니다.
- 과업 상태 추적: 과업 관리 워크플로는 에이전트가 과업의 최신 상태와 동기화 상태를 유지하여 중단 시 쉽게 복구할 수 있도록 합니다.
- 관찰 가능: 대기 시간, 성공률, 오류 빈도와 같은 상호 작용 세부 사항을 기록하는 것은 품질 및 문제 해결을 모니터링하는 데 매우 중요합니다.
보안 고려 사항
- 엔터프라이즈급 인증: A2A는 Okta와 같은 외부 플랫폼에서 자주 관리하는 OAuth 2.0 및 JWT와 같은 엔터프라이즈급 인증 및 권한 부여 표준에 부합하도록 설계되었습니다.
- A2A를 보호하는 게이트웨이: 게이트웨이(예: MuleSoft 옴니 게이트웨이)는 모든 A2A 통신에 정책을 적용하는 데 필수적이며, 에이전트를 보호하고 외부 에이전트 및 서비스에 대한 아웃바운드 트래픽을 제어하기 위해 입력 및 탈퇴 게이트웨이 역할을 합니다.
- 정책 집행: 에이전트 카드 재작성, 스키마 유효성 검사, 스파이크 제어, PII 감지기 및 기타 정책은 A2A 서버 및 데이터 보호에 적용되어야 합니다.
예제
Candidate Sourcing 워크플로우
고용 관리자는 중앙 오케스트레이터 에이전트에게 채용 공고 및 기술 집합과 일치하는 후보를 찾는 작업을 지시합니다.
- 검색: 오케스트레이터 에이전트가 에이전트 레지스트리를 쿼리하고 전문 채용 에이전트와 백그라운드 확인 에이전트(둘 다 동료 에이전트)를 찾습니다.
- 대리인 (A2A): 오케스트레이터 에이전트가 후보를 찾기 위해 구조화된 작업 요청(A2A 메시지)을 채용 에이전트에게 보냅니다.
- 피어 처리: 채용 에이전트가 자체 워크플로를 실행합니다(예: MCP를 통해 외부 LinkedIn 도구 호출).
- 아티팩트 반환(A2A): 채용 에이전트가 제안된 후보(아티팩트) 목록을 반환합니다.
- 순차적 위임: 그런 다음 오케스트레이터 에이전트가 상위 후보에 대한 백그라운드 확인 에이전트에 다른 과업(A2A)을 위임합니다. 이 에이전트가 검사를 수행하고 결과를 반환하여 전체 과업을 완료합니다.
컨텍스트
복잡한 엔터프라이즈 워크플로는 외부 플랫폼 또는 파트너 시스템에서 호스팅되는 전문 에이전트가 과업을 시작하거나, 쿼리를 위임하거나, 내부 에이전트(예: Salesforce Platform의 에이전트)에 업데이트를 제공해야 하는 경우가 많습니다. 이 패턴은 내부 Agentforce 에이전트가 도메인별 기능을 실행하기 위한 원격 피어 에이전트의 요청을 안전하고 신뢰할 수 있게 수신하고 처리하는 방법을 다룹니다.
문제
내부 전문화된 AI 에이전트(예: Agentforce 백그라운드 확인 에이전트)가 외부 피어 에이전트에게 도메인별 기능을 안전하게 노출하고, 들어오는 구조화된 A2A 요청을 처리하고, 실시간 상태 업데이트를 포함한 과업 수명 주기를 관리하여 구조화된 아티팩트를 원격 호출 에이전트에 반환하는 방법은 무엇입니까?
군력
이 패턴을 적용할 때 다음 질문에 답변하십시오.
- 내부 논리 또는 도구를 저하하지 않고 내부 에이전트에 내부 에이전트 기능을 안전하게 노출하는 방법은 무엇입니까?
- 요청을 처리하기 전에 엔터프라이즈급 보안 정책을 적용하여 통화 에이전트의 ID 및 위임된 권한을 확인하는 방법은 무엇입니까?
- 구조화된 비동기식 상태 업데이트를 제공하면서 장기 실행 인바운드 과업을 처리하는 방법은 무엇입니까?
- 다양한 외부 프레임워크에 구축된 에이전트와 원활하게 상호 작용하는 방법은 무엇입니까?
Salesforce 패턴 적용
A2A 프로토콜은 안전한 P2P 위임 및 공동 작업을 위한 개방형 표준을 제공합니다. 내부 에이전트는 동료 에이전트 역할을 하며 에이전트 카탈로그/레지스트리를 통해 기능을 광고하고 보안 채널(HTTPS/SSE)을 통해 A2A를 사용하여 구조화된 요청을 수신하고 응답합니다.
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| Agentforce 연결된 하위 에이전트(SOMA) | 통화 에이전트가 동일한 조직의 다른 Agentforce 에이전트인 경우에 가장 적합합니다. | 두 에이전트가 동일한 Salesforce 조직에 거주하며 발신자가 Agentforce 오케스트레이터인 경우 사용합니다. 에이전트는 Agentforce Builder를 통해 하위 에이전트로 연결되고 설명 및 선언된 작업을 통해 오케스트레이터에게 노출됩니다. 오케스트레이터는 LLM 기반 라우팅(Atlas Reasoning Engine) 또는 결정적 라우팅(Agent Script)을 사용하여 작업을 라우팅합니다. A2A 프로토콜, 게이트웨이 또는 외부 등록이 필요하지 않습니다. 지원되는 조합: Agentforce 서비스 에이전트→Agentforce 서비스 에이전트 Agentforce 직원 에이전트→Agentforce 직원 에이전트 Agentforce 직원 에이전트→Agentforce 서비스 에이전트 오케스트레이터만 에스컬레이션할 수 있으며 하위 에이전트는 에스컬레이션할 수 없습니다. |
| 에이전트 중개인 라우팅(인바운드) | 조직에서 보완 기능을 갖춘 여러 Agentforce 에이전트를 호스팅할 때, 호출하는 에이전트가 특정 대상을 can not 또는 should not 선택하지 않는 경우에 가장 적합합니다. | 통화 에이전트가 Salesforce 또는 다른 Salesforce 조직 외부인 경우 사용하고 요청을 처리하는 특정 내부 에이전트(Agentforce 또는 다른 공급업체 에이전트)를 알 필요가 없습니다. MuleSoft 에이전트 브로커는 MuleSoft 옴니 게이트웨이와 내부 Agentforce 에이전트 풀 사이에 있습니다. 인바운드 A2A 과업을 수신하고 과업의 요구 사항에 대해 사용 가능한 내부 에이전트의 선언된 기능을 평가하고 가장 적합한 에이전트에게 요청을 라우팅합니다. 또한 중개인은 기본 대상 에이전트를 사용할 수 없거나 실패를 반환하는 경우 페일오버를 처리하며, 외부 발신자에게 재시도를 표시하지 않고 동등한 에이전트로 리디렉션합니다. 외부 발신자는 내부 라우팅 결정 또는 재시도를 인지하지 않습니다. |
스케치
Agents as Callable Services의 순서 다이어그램
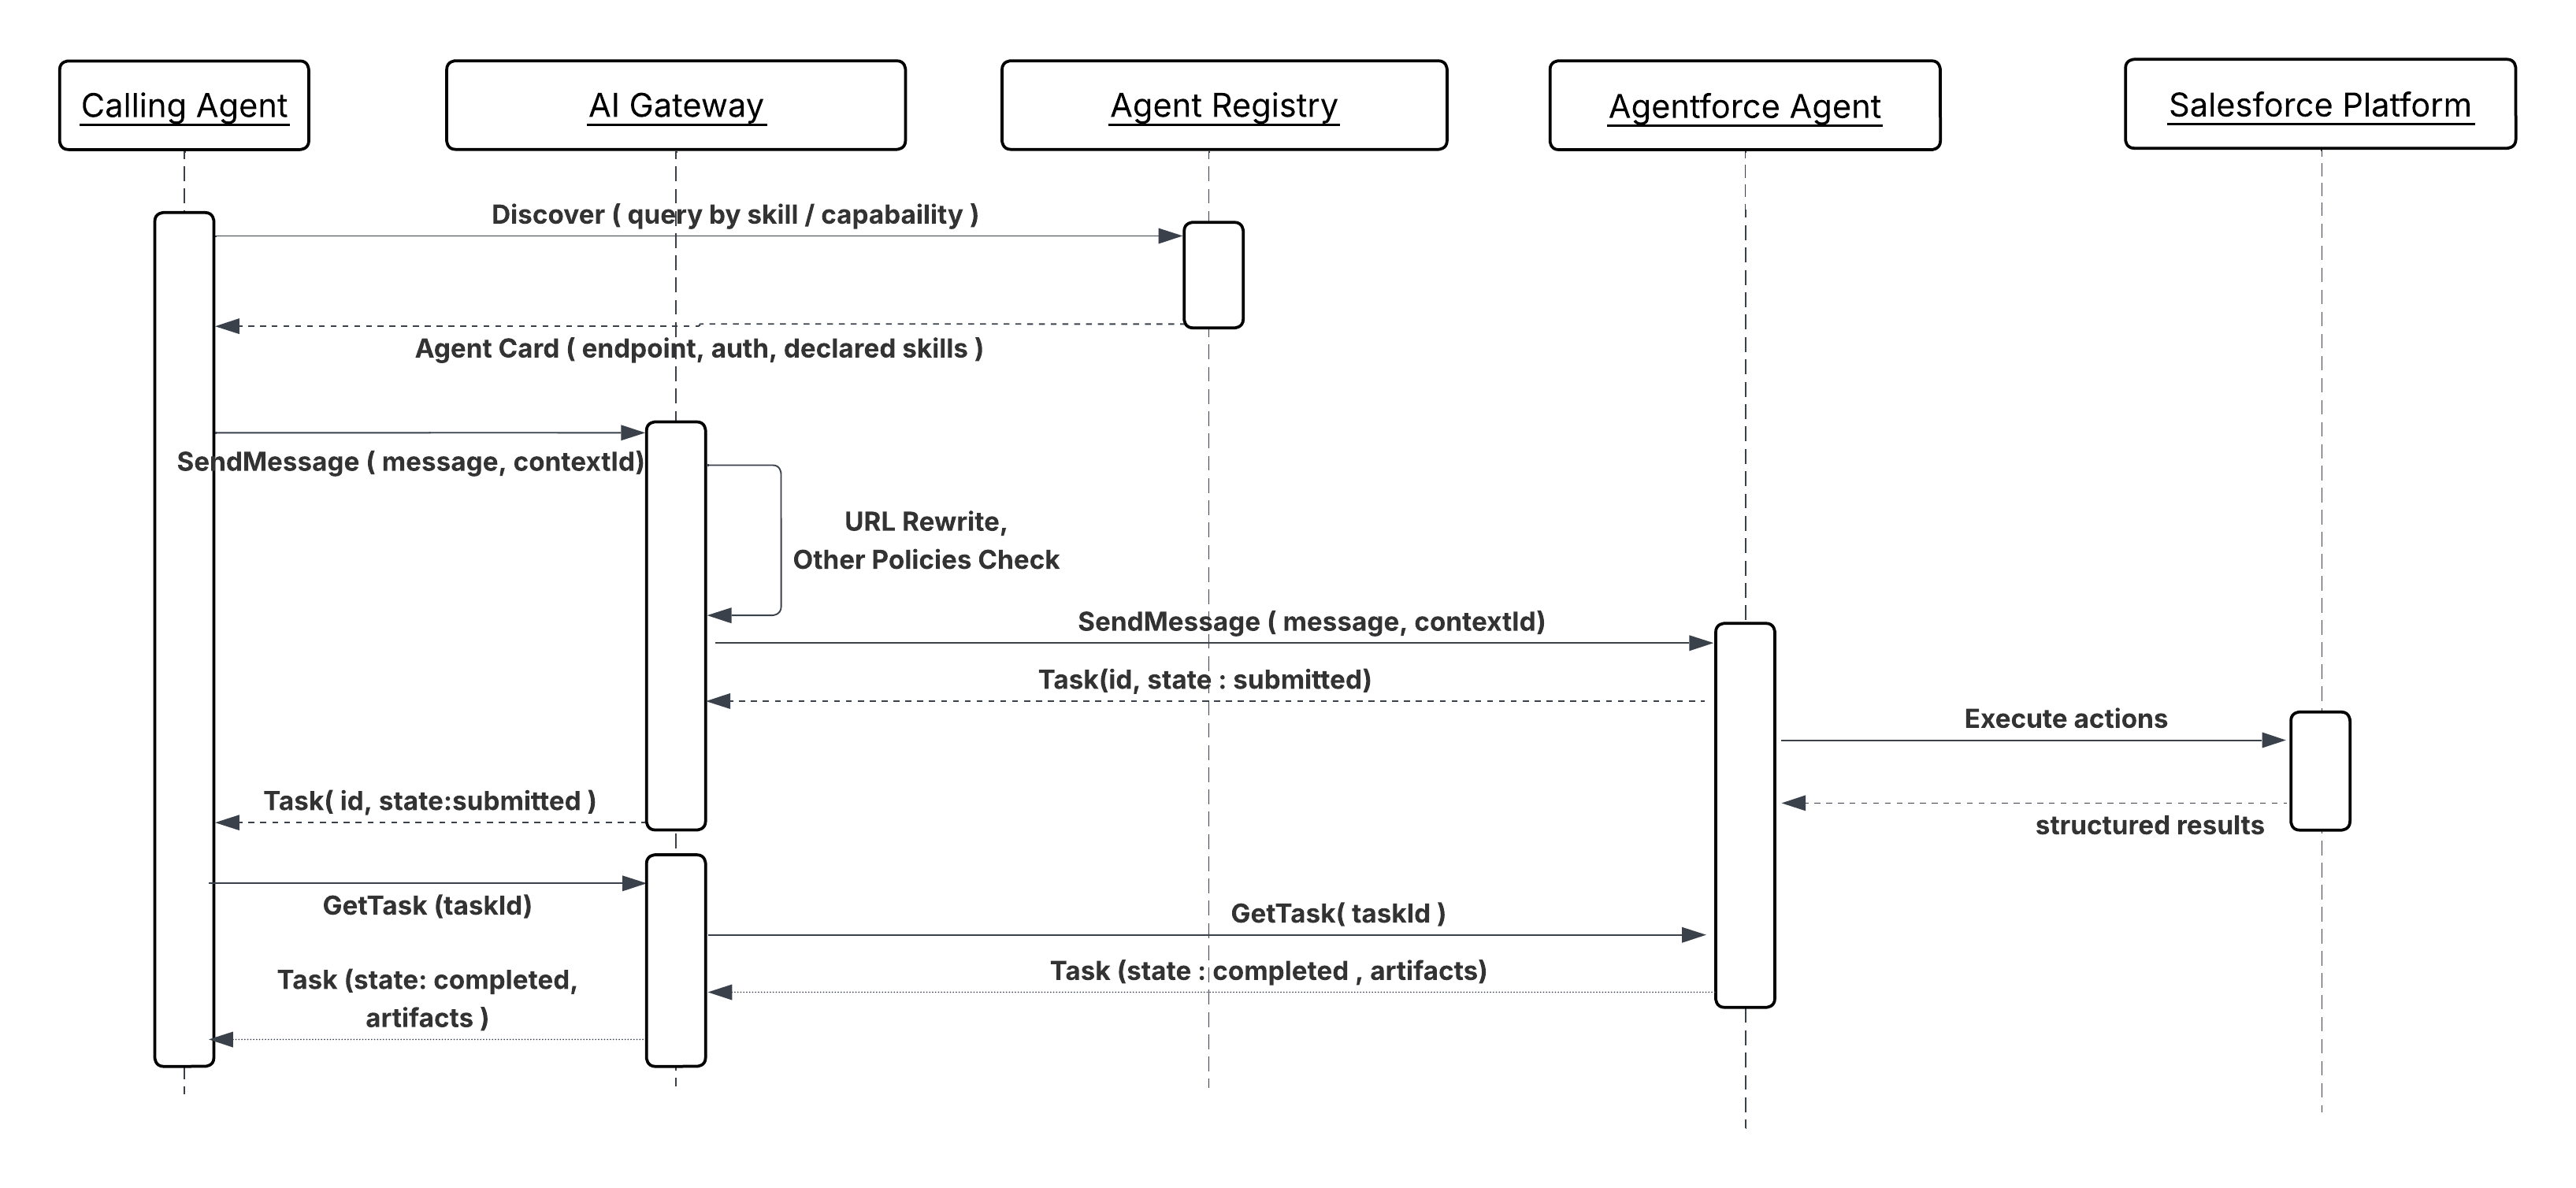
결과
이 패턴은 내부 에이전트를 다중 에이전트 네트워크 내의 전문 서비스로 노출합니다. 외부 에이전트는 조직에서 제어, 감사 가능성, 정책 집행을 유지하면서 과업을 내부 기능에 안전하게 위임할 수 있습니다.
설계 고려 사항
플랫폼에 구애받지 않는 가이드라인
- 게이트웨이(예: MuleSoft 옴니 게이트웨이)는 모든 수신 A2A 요청에 대해 속도 제한, 인증, 페이로드 유효성 검사를 비롯한 정책을 적용하기 위해 입력 지점으로 배치해야 합니다.
- 내부 에이전트는 외부 시작에서 완료까지 과업 개체의 상태를 관리해야만 원격 호출 에이전트가 확인 가능한 일관된 상태 업데이트를 수신할 수 있습니다.
- 에이전트 카드에 게시된 에이전트의 성능이 명확하고 의도 기반이며 위임에 필요한 보안 범위를 포함해야 합니다.
오류 처리 및 복구
- 정형 오류 코드: 실패 시 내부 에이전트가 원격 재시도 논리 또는 대체 페일오버 메커니즘을 활성화하려면 호출하는 에이전트에게 A2A 호환 구조화된 오류 메시지를 반환해야 합니다.
- 멱등성: 에이전트는 외부 에이전트의 재시도된 A2A 요청으로 인해 트리거된 모든 부작용(네트워크 중단 또는 복구로 인해)이 동일한 부작용인지 확인해야 합니다.
보안 고려 사항
- 인바운드 정책 적용: 게이트웨이는 외부 에이전트 허용 목록/차단 목록 및 JWT/OAuth 2.0 토큰 유효성 검사를 위한 정책을 적용하여 _통화 에이전트_의 ID 및 위임된 권한을 확인해야 합니다.
- 입력값 정제: 수신되는 모든 요청 페이로드를 확인하고 비활성화하여 잠재적인 프롬프트 주입 또는 악성 데이터 공격을 완화합니다.
- 신원 전파: 내부 시스템에 대한 작업을 실행하기 전에 외부 에이전트의 ID 및 위임받은 권한을 내부 보안 컨텍스트(예: Salesforce 사용자 프로필)에 안전하게 매핑합니다.
예제
외부 시스템 문의
- 요청: 파트너 시스템의 채용 에이전트가 새 후보의 고용 상태를 확인하기 위해 Agentforce 내부 직원 확인 에이전트(피어 에이전트)에 A2A 과업 요청을 보냅니다.
- 처리: 직원 확인 에이전트는 게이트웨이를 통해 요청을 수신하고, 파트너 에이전트의 자격 증명을 확인하고, 내부 워크플로(예: 내부 HR 시스템 호출)를 실행하고, 응답의 서식을 지정합니다.
- 대답: 피어 에이전트가 구조화된 A2A 아티팩트(예: 고용 시작 일자 및 직함)를 원격 채용 에이전트에 반환한 다음, 외부 워크플로를 진행합니다.
-
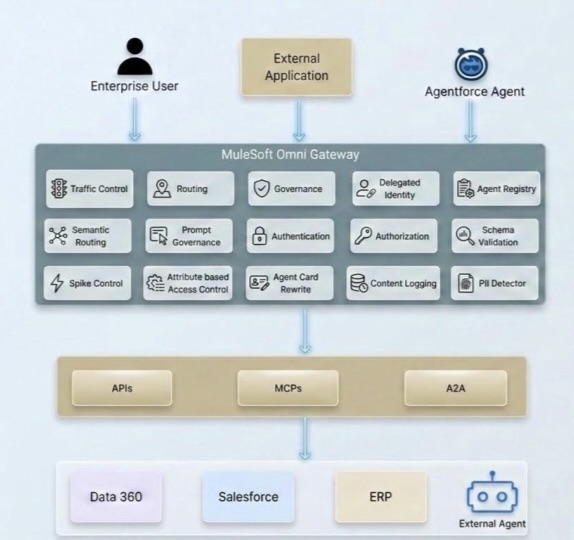
MCP, A2A 및 API 보호를 위한 게이트웨이
모든 에이전트-시스템 및 시스템-에이전트 트래픽의 단일 적용 지점으로 게이트웨이가 필요합니다.
-
보안 연결: 게이트웨이는 액세스를 제한하여 인증 및 권한이 있는 에이전트만 MCP, A2A, API 끝점과 상호 작용합니다.
-
강제 SLA: 게이트웨이는 속도 제한을 적용하여 조직이 성능 요구 사항을 충족하고 MCP 및 A2A 서버 오버로드를 방지할 수 있습니다.
-
간소화된 거버넌스: 게이트웨이는 모든 서버 상호 작용을 중앙 집중식으로 표시하고 제어하여 에이전트 활동 관리 및 모니터링을 간소화합니다.
-
데이터 일관성 및 보호: 스키마 유효성 검사, 데이터 일관성 적용, PII 감지와 같은 정책은 민감한 정보를 보호할 수 있습니다.
MuleSoft 옴니 게이트웨이
- 신원 전파 체인
엔터프라이즈가 에이전트 패러다임을 채택함에 따라 새로운 보안 문제가 나타납니다. 최종 사용자 ID는 자율 AI 에이전트의 네트워크를 통해 어떻게 흐릅니까? 기존 API 아키텍처에서는 사용자가 한 번 인증하고 응용 프로그램이 사용자를 대신하여 백엔드 서비스를 호출합니다. ID 체인은 짧고 잘 이해되며 일반적으로 단일 Trust 도메인 내에서 관리됩니다.
그러나 에이전트 기반 아키텍처는 하나의 요청이 다양한 에이전트, 서비스 및 MCP 서버로 분산되면서 훨씬 긴 체인을 형성하며, 각각이 서비스 경계, 신뢰 도메인, 심지어 조직 경계를 넘나들 수 있습니다. ID 전파를 위한 의도적인 전략이 없으면 엔터프라이즈는 보안과 기능 사이에서 선택해야 합니다. 이는 설계자가 해결할 필요가 없는 딜레마입니다.
MuleSoft는 Trusted Agent Identity 기능을 사용하여 ID 전파의 복잡성을 해결합니다. 이 솔루션은 정책 기반 게이트웨이 관리 전략을 활용하여 A2A 프로토콜, MCP 도구 호출, REST API 요청 등 다양한 상호 작용 유형에서 최종 사용자 ID를 유지합니다. 옴니 게이트웨이 계층에서 아웃바운드 인증 정책을 통해 ID 관리를 중앙 집중화하면 백엔드 서비스 또는 에이전트를 수정하지 않고 전체 에이전트 네트워크를 보호할 수 있습니다. 자세한 내용은 Agentic Enterprise의 신뢰할 수 있는 에이전트 ID를 참조하십시오.
- Data 360의 RAG 보안
Data 360은 데이터 거버넌스 정책 설정을 통해 개체, 필드, 행 수준에서 특성 기반 액세스 제어(ABAC)를 지원합니다. 이는 RAG 검색 색인 내를 포함하여, 누구에게 어떤 데이터가 표시되는지를 제어하는 기본 방법입니다. 구조화된 데이터의 경우 사용자 특성 및 권한 집합을 사용하여 사용자 액세스 조건이 구현됩니다. 비정형 데이터의 경우 메타데이터 필터링(검색 색인에 대한 사전 필터)은 검색되는 내용을 제한할 수 있습니다.
LLM과의 커뮤니케이션은 Einstein Trust Layer를 통해 이루어지며, 이 계층은 모델에 도달하기 전에 기밀 정보 및 PII 정보를 마스킹하여, 검색 시뿐만 아니라 생성 전에 데이터 프라이버시를 보호합니다.
RAG 오염으로부터 보호하려면 벡터 검색에 데이터를 사용할 수 있게 되기 전에 엄격한 데이터 거버넌스 및 검증 규칙이 적용되어야 합니다. Einstein Trust Layer는 프롬프트 마스킹/독성 검사를 적용할 수도 있습니다. 에이전트 사용자 프로필에 엄격한 권한 집합을 적용할 수 있습니다.
- 새 명명된 자격 증명 모델 Salesforce는 연결성과 ID 간의 우려 사항을 명확하게 구분하는 2계층 명명된 자격 증명 모델을 도입하여 인증 아키텍처를 개정했습니다. Apex 통해 콜아웃을 만들 때마다 이를 사용하고 자체 인증 프로토콜을 만들지 마십시오. 이 모델은 확장성 및 보안 향상을 제공합니다. 외부 자격 증명은 이 모델의 기반에 있습니다. 실제 인증 세부 사항을 저장하고 OAuth 2.0 클라이언트 자격 증명, JWT 전달자, AWS Signature V4를 비롯한 다양한 프로토콜 집합을 지원하며 주체가 매핑되는 방법을 정의합니다(단일 명명된 주체(모든 사용자 간 공유) 또는 사용자별 주체(각 사용자가 자체 ID로 인증). 명명된 자격 증명은 마찬가지로 끝점 레이어로 작동합니다. 콜아웃 URL을 정의하고 외부 자격 증명을 참조하여 인증 핸드셰이크를 처리함으로써, 끝점 구성을 자격 증명 관리와 명확하게 분리합니다. 사용자별 인증 플로를 활성화하기 위해 관리자가 권한 집합을 해당 외부 자격 증명 주체에 매핑하여 권한 집합 할당이 올바른 사용자만 자체 ID 아래에서 콜아웃을 호출할 수 있도록 합니다. 이 2계층 설계는 보안 콜아웃 구성을 단순화할 뿐만 아니라, Salesforce에 연결된 시스템 간 통합 인증 방식에 대해 아키텍트에게 훨씬 더 큰 유연성과 거버넌스 통제 기능을 제공합니다. 자세한 내용은 명명된 자격 증명 문서를 참조하십시오.
이 섹션에서는 아키텍처의 데이터 처리 패턴을 규제된 엔터프라이즈 배포에서 가장 일반적으로 발생하는 규제 준수 의무에 매핑합니다.
액세스 제어: 통합 패턴 전체에 설명된 최소 권한 통합 사용자 모델(범위가 지정된 명명된 자격 증명, 에이전트당 OAuth 2.0 범위, 게이트웨이 허용 목록)은 논리적 액세스 제어에 직접 매핑됩니다. 각 에이전트의 자격 증명 범위가 검토 및 승인되었다는 증거를 유지합니다.
** 감사 로깅:** 패턴별 감사 로깅 요구 사항(세션 ID, 도구 호출, 민감한 값의 입력 매개 변수 제거, 결과)은 모니터링 및 로깅 제어를 충족합니다. 로그가 변조 방지 기능을 갖추고, 필요한 기간 동안 보관되며, 프로덕션 시스템에 대한 접근 없이 보안 팀이 접근할 수 있도록 해야 합니다.
변경 관리: 소비자에게 영향을 미치는 MCP 도구 스키마 변경 사항 및 A2A 에이전트 카드 업데이트는 인터페이스 변경 사항이며 변경 관리 제어에 적용되어야 합니다. MCP 인바운드 패턴에 언급된 버전 도구를 명시적으로 지정하고 중단 변경 사항을 승인이 필요한 구성 이벤트로 처리합니다.
가용성: 에이전트 동시성 제한, 이벤트 트리거 패턴의 재시도 한계, 실패한 이벤트에 대한 데드 레터 라우팅은 가용성 제어입니다. 가용성 증거 패키지의 일부로 배포된 각 패턴에 대해 예상 처리량 봉합 및 실패 동작을 문서화합니다.
노트: 이 목록은 에이전트 솔루션의 규정 준수를 위한 완전한 가이드가 아닙니다. 모든 해당 규제 요구 사항을 충족해야 합니다.
- 에이전트 API 시작하기
- Data 360을 사용하여 신뢰할 수 있는 에이전트 활성화
- MuleSoft 옴니 게이트웨이 개요
- OAuth 2.0 대리 자격 증명 주입 정책
- 에이전트 엔터프라이즈를 위한 신뢰할 수 있는 에이전트 ID
Gulal Kumar는 20년 이상의 경험을 보유한 Salesforce의 소프트웨어 엔지니어링 아키텍트입니다. 그의 전문 지식은 AI, 통합, API, 엔터프라이즈 아키텍처에 걸쳐 있으며, 안전하고 복원 가능하며 혁신적인 AI 솔루션을 통해 비즈니스 전환을 촉진하는 데 중점을 둡니다. LinkedIn에서 그와 연결하십시오.