はじめに
注意: 最新の製品命名規則に従って、この記事の「トピック」は「サブエージェント」に変更されました。
同じワークフローを 2 回処理するときにまったく異なるルートを辿るだけで、テスト環境で適切に動作するエージェントを作成できます。この基本的な制限は、以前の Agentforce モデルで実行がどのように処理されたかを示しています。つまり、インテントの解釈からアクションの選択まで、すべての決定はワークフロー内の保証されたパスなしで LLM によってリアルタイムで下されました。
LLM では、同じ入力に対して一貫性のない結果が生成される可能性があります。コンテキスト、システムプロンプト、トークン生成の微妙な違いによって、エージェントが別のルートを辿ることがあります。多くのインタラクションでは、この変動は許容されます。しかし、監査可能性、再現性、トレーサビリティが求められる複数フェーズのワークフローでは、この変動は許容されません。ローン承認、在庫移送、または患者トリアージのプロセスは、毎回異なる推論に基づいてステップを進めるエージェントに依存することはできません。
新しい Agentforce Builder と Agent Script は、確定的実行と LLM 推論を分離することで、この問題に対処します。Agentforceのハイブリッド・モデルでは、エージェントがすべてのワークフローの実行で厳密に定義された構造に従うと同時に、判断、自然言語理解、コンテキスト解釈が本当に必要なLLMの推論を使用します。
以前のバージョンの Agentforce では、エージェントは単純な反応型ループとして動作していました。インテントの解釈から次のアクションの選択まで、すべての決定はユーザーの最新の入力のみに基づいて LLM によってリアルタイムで行われました。保証された実行パス、永続的な状態、一連のステップを適用するメカニズムはありませんでした。
実行パスを保証できませんでした
すべての決定は LLM のリアルタイムの推論に依存するため、入力、システムプロンプト、またはモデルバージョンにわずかな違いが生じると、同じ要求でも異なるアクションの選択肢が生成されます。以前のモデルでは、ステージングで渡されるワークフローの動作が本番で異なる可能性があり、デバッグや監査の目的で特定の実行パスを再現するための信頼性の高い方法が存在しませんでした。
すべてのインタラクションで LLM コストが全額発生した
単純な会話シナリオでも、少なくとも 3 つの LLM サイクル (サブエージェントの選択、アクションの選択、最終応答の生成) が必要でした。複数ステップのタスクは 5 サイクル以上に拡張されました。大量のワークフローやレイテンシの影響を受けやすいワークフローを設計するアーキテクトにとって、これは単なるパフォーマンスの問題ではありません。つまり、判断を必要としないステップに対して推論ループを省略することができなかったのは、アーキテクチャに両者を区別するメカニズムがなかったためです。
非確定的実行によって監査履歴にギャップが生じた
規制対象の業界では、監査可能性とは、特定の取引で特定のプロセスが特定の方法で実行されたことを示すことができることを意味します。純粋に非確定的なモデルでは、その保証を提供できません。実行パスが実行ごとに異なる場合、監査履歴も変動し、「エージェントの判断」はコンプライアンスレビューにおいて正当な回答とは言えません。
会話中に状態が保持されなかった
1 ターンの処理に依存するため、エージェントには以前のステップの永続的な記憶がありません。会話が少しでも逸脱すると、エージェントは以前に取得されたコンテキストを削除し、ユーザーを強制的に再起動させる可能性があります。複数ステップのトランザクションワークフローでは、プロセス内のステップが多いほど、完了前にコンテキストが失われる可能性が高くなります。
完了したステップが記憶されなかった
状態管理を使用しない場合、エージェントは本ユーザがどの必須ステップをすでに完了したかを記録しませんでした。これにより、ユーザーがすでに完了したステップにエージェントが戻るという、予測できないループが発生していました。ユーザーエクスペリエンスへの影響だけでなく、アーキテクチャ上のより深い問題も生じました。エージェントが順序を適用できないため、信頼性の高い順次ワークフローを設計することは不可能でした。
2026 年 2 月以降に正式リリースされた新しい Agentforce は、純粋な確率的 LLM 推論からハイブリッド モデルに移行します。すべての決定を LLM を介してルーティングするのではなく、確定的実行を LLM の推論から分離し、それぞれが適切な処理のみを実行できるようにします。これをサポートするために、Agentforce では 2 つの作成ツールが導入されました。コードベースの開発用の Agent Script と、コード不要の構築環境である Agentforce Studio です。
Agentforce ビルダー
Agentforce Builder は、新しいエージェントを開発するための推奨環境です。Agentforce Studio内でホストされ、引き続き使用できますが、主作成パスではなくなった従来の設定環境を置き換えます。ビルダーでは、ビジュアルキャンバスビューまたはスクリプトビューで直接作業し、エージェントの動作を定義するエージェントスクリプトを編集します。
Agent Script
エージェントスクリプトは、エージェントの動作 (設定、ビジネスロジック、プロンプト) に関するすべてを定義する宣言型のドメイン固有言語 (DSL) です。キーと値のペアとして構造化され、複数行にまたがることや、ネストされたサブプロパティを含めることができます。また、基盤となるグラフアーキテクチャのKnowledgeがなくても判読できるように設計されています。
エージェントスクリプトでは、同じエージェント内で 2 つの根本的に異なる種別の指示 (確定的ロジックの指示とプロンプトの指示) を表現できます。確定的ロジック命令では、LLM の関与なしでコードとして実行される条件とアクションシーケンスを定義します。プロンプト命令は、実行時に LLM が解釈する自然言語ガイダンスを定義します。この2つの境界は明示的および慎重に設定されており、その境界をどこに設定するかを理解することは、新しいAgentforceを使用して構築するときに行う設計上の重要な意思決定の1つです。
確定的ロジックの実践
命令が確定的である場合、エージェントはユーザーが入力をどのように表現しているかに関係なく、定義された実行パスに従います。次の例は、顧客インテリジェンスダッシュボードを読み込むサブエージェントを示しています。顧客IDを確認し、プロファイル、注文履歴、チケットを取得して、顧客の生涯価値と離脱リスクを計算します。これらのステップのいずれも LLM 推論を必要としません。
このロジックでは、特定の条件が満たされるたびにアクションが固定の順序でコールされます。
プロンプトの指示と意図的な LLM ハンドオフ
確定的ロジックがコードとして表現できる条件と順序を処理するのに対し、プロンプト命令は判断、解釈、自然言語の生成を必要とするすべてを処理します。Atlas Reasoning Engine は、プロンプト命令を含むノードを検出すると、LLM コールをトリガーします。そうでない場合は確定的に実行されます。
次の例は、商品およびサービスのサブエージェントを示しています。命令は、応答方法、情報を検索するタイミング、あいまい性の処理方法を LLM に指示する複数行のプロンプトです。これは、可能なユーザー入力の範囲が広すぎて条件ロジックで予測できない場合、または応答の品質が LLM のコンテキストを解釈して自然な応答を生成する機能に依存している場合に適切なパターンです。
ノードのプロンプト命令によって LLM コールがトリガーされます。これは偶発的なものではなく、エージェントスクリプトが実行時の推論に委ねるのではなく、LLM 境界を明示的かつ強制可能にする仕組みです。
このサブエージェントは、確定的ロジックと LLM ハンドオフを実際に実行している様子を示しています。
3つのステージの実行パイプライン
Agentforce Builder と Agent Script は作成レイヤーですが、実際には Agent Graph と Atlas Reasoning Engine によってエージェントが実行されます。仕様上、どちらのコンポーネントにも直接アクセスできません。作成と実行を分離することで、プラットフォームはスクリプトの記述方法に関係なく確定的動作を適用できます。
パイプラインは3つのフェーズを通過します。
- 作成は、あなたが作業する場所です。エージェントスクリプトは、Agentforce ビルダーのキャンバスビューまたはスクリプトビューで人間が読める形式で表示され、編集可能です。これは、直接操作する唯一のレイヤーです。
- コンパイルでは、Salesforce コンパイラによってエージェントスクリプトがエージェントグラフに変換されます。エージェントグラフは、人間が読みやすくするのではなく、マシンで実行できるように最適化されたシリアル管理された実行計画です。このレイヤーではデバッグしません。コンパイルにより、ランタイムが効率的にトラバースできる表現が生成されます。
- ランタイム実行は、Atlas Reasoning Engine が引き継ぐ場所です。エージェントグラフを読み取り、現在のセッション状態に基づいてトラバースし、各ノードで確定的に実行するか LLM を呼び出すかを決定します。このエンジンでは、推測ではなく、ガード句と条件付きルーティングがここで明示的に適用されます。
エージェントグラフ
エージェントグラフは、人間が判読可能なスクリプトと実際のランタイム実行の間に位置する中間表現です。構造は、スクリプトを作成したアーキテクトではなく、そのスクリプトを使用するステートマシン用に最適化されています。スクリプトで定義された実行計画を適用するために Reasoning Engine で使用されるアーティファクトであるため、その存在と意味を理解することは重要です。
Atlas Reasoning Engine
Atlas Reasoning Engine はステートマシンエグゼキューターです。各ターンで、セッション状態に基づいてエージェントグラフをトラバースし、確定的ノードをコードとして実行し、プロンプト命令がある場所でのみ LLM コールをトリガーします。また、guard 句を適用し、条件付きルーティングを処理します。Reasoning Engine は、ハイブリッド推論モデルが実際に実装される場所です。スクリプトで境界が定義され、エンジンがそれを尊重します。
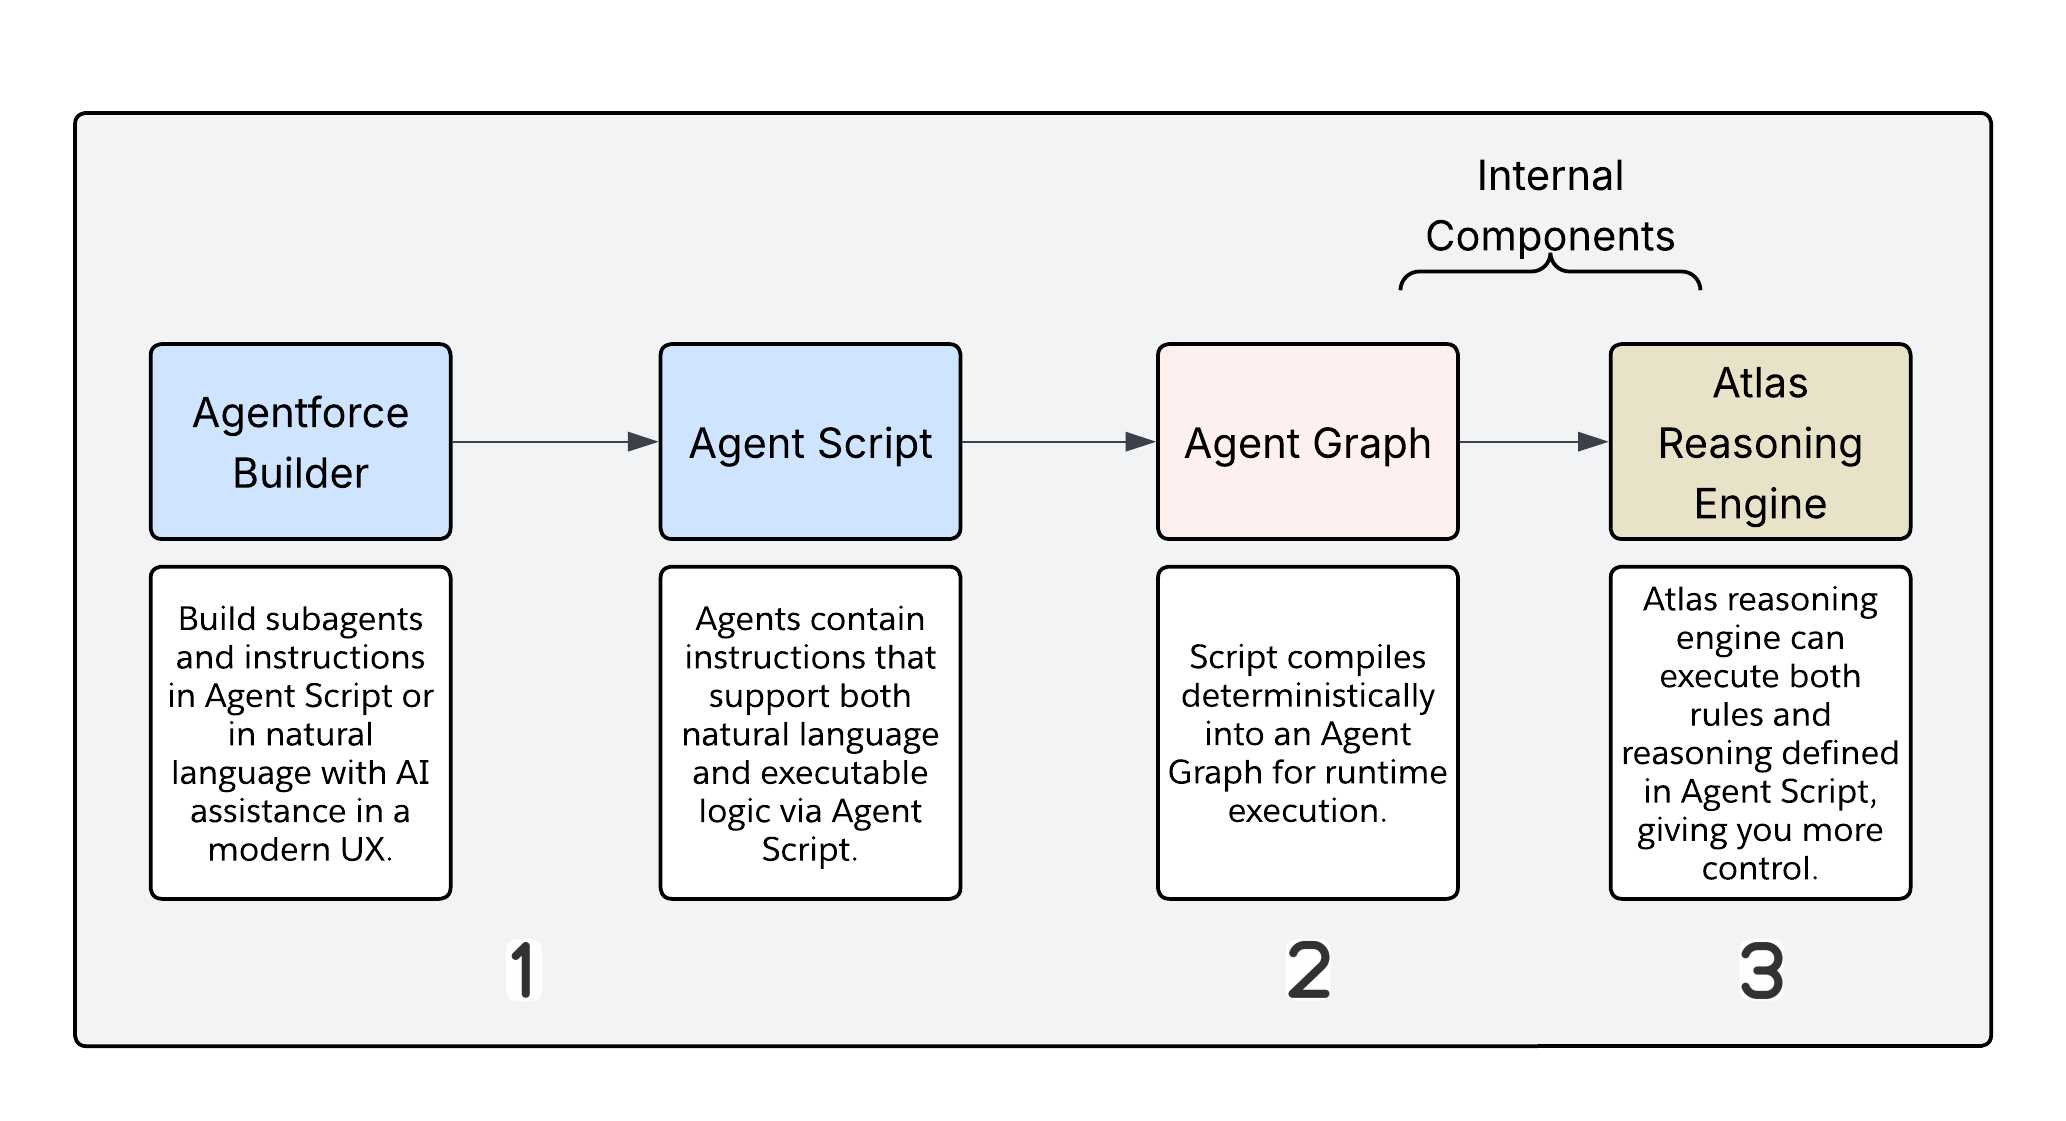
エージェントグラフは LLM ラッパーではありません。確定的実行と確率的推論を分離するハイブリッド推論エンジンです。管理ルールは簡単です。決定をコードとして表すことができる場合は、決定をロジックとして記述する必要があります。判断、解釈、自然言語生成が必要な場合は、LLM で処理する必要があります。この設計上の決定は、新しい Agentforce モデルの最も重要なアーキテクチャの選択肢です。LLM 境界がソリューションのコスト、遅延、監査可能性、信頼性に直接影響する場所。
Atlas Reasoning Engine は、すべての受信ユーザーのターンを評価し、2 つのパスのいずれかにルーティングします。
パス A: 確定的実行
このパスには LLM 公開はありません。実行時にコンパイル済みコードのように動作します。Reasoning Engine はユーザーのインテントを分類し、LLM を完全にスキップしてロジック命令が一致するかどうかを判断します。コンパイルされたエージェントスクリプトは上から下まで実行され、if-else ルールは各ターンで無条件に実行されます。フロー、Apex、または API アクションは、確定的パラメータを使用してコールされ、プロンプトアセンブリやモデルコールは行われません。結果は完全な監査ログとともにTrustレイヤーを通過します。
パス B: LLM の推論
ロジック命令のみでインテントを解決できない場合、Reasoning Engine はこのパスを選択します。エージェントグラフをトラバースし、各ノードを評価します。プロンプト命令があるノードは、LLM コールをトリガーします。プロンプト命令がないノードは、確定的に実行されます。プロンプト命令の存在はトリガーであり、実行時に推測されるのではなく、スクリプト内で明示的に示されます。
LLM コールをトリガーするもの
LLM が呼び出される実行ライフサイクルには 8 つのポイントがあります。サブエージェント分類(本ユーザの要求に一致するサブエージェントの決定)は1つですが、分類が明確な場合は、ショートサーキットパスで完全なLLMコールをバイパスできます。エージェントが次に実行するアクションを決定するエージェントの推論では、常に LLM が使用されます。応答の生成も、ハイドレートプロンプトから最終的な返信が組み立てられます。
残りのトリガーはより適切に機能します。グラウンディング検証では、取得したデータで出力がグラウンディングされていることを確認します。アクションシミュレーションでは、ライブ実行ではなくプレビューおよびシミュレーション環境で応答をエミュレートします。構造化された出力生成では、応答が定義されたスキーマに準拠する必要がある場合を処理します。ローカライズと進行状況インジケーターの生成では、事前作成済みのデフォルトが存在しない書式設定と一時的なメッセージングを処理します。
何が確定的か
グラフのトラバースと状態遷移に LLM は含まれません。before_reasoningおよびafter_reasoningライフサイクルブロックには、プロンプトの指示がないアクションノードのみが含まれている場合、確定的に実行されます。算術、データ取得、検証、条件付きロジックはすべてコード内に属します。フロー、Apex、または REST API を実行するすべてのアクションは、確定的パスに直接残ります。プロンプト命令がないノードは、LLM コールなしで実行されます。
チームとの境界を明確に示すことが重要です。不要な LLM コールが発生するたびに、遅延、コスト、変動が生じます。アーキテクトは、デフォルトでは確定的ロジックを優先し、タスクに推論機能が本当に必要な場合にのみ LLM を使用すべきです。
設計ガイダンス: デフォルトでロジックをコードにプッシュ
条件、変数割り当て、またはアクション検索条件として表すことができるプロンプト命令を記述する場合は、エージェントスクリプトロジック命令を使用します。不要な LLM コールが発生するたびに、遅延、コスト、変動が生じます。
デフォルトの位置は確定的である必要があります。ルールとしてコード化できるすべてのエージェントの動作を分離し、エージェントスクリプトに移動します。自然言語合成、状況判断、複雑な解釈が必要な残りの ToDo は、プロンプト対応ノードに属します。これは制限ではありません。それは、意図したとおりに機能する境界です。LLM は最適なものを処理し、他のすべてはコードとして実行されます。
エージェントスクリプトの主な実行単位はユーザーターンではありません。これは解析です。サブエージェントの3つのライフサイクルブロックを完全に一巡するサイクルとなります。Atlas Reasoning Engine は、サブエージェントが処理する必要があるたびに解析を開始します。これは、3 つの状況で発生します。1 つはサブエージェントへの最初の入力時、もう 1 つはアクションが完了して結果が返されるたびにツールコールが実行されるとき、もう 1 つは新規ユーザーが同じサブエージェント内で処理を開始するときです。
解析境界を理解することは重要です。解析境界によって各ブロックの実行回数が決まるため、特定のロジックを 1 回のみ実行して信頼できる場所と信頼できない場所が決まります。
各サブエージェントは、次の 3 つの実行ゾーンを定義します。
| ブロック | When it runs (実行されるタイミング) | LLMの関与 |
|---|---|---|
before_reasoning | すべての解析の開始時に LLM に何かが表示される前 | なし |
reasoning | 確定的解決の際、いかなる LLM コールよりも前に | 混在 |
after_reasoning | 推論が完了し、LLM が応答した後 | なし (重大な警告あり) |
before_reasoning と after_reasoning の両方が完全に確定的です。LLM を使用せずに、アクションの実行、変数の設定、条件付きロジックの適用を行います。これにより、スクリプト内で信頼性が高く低コストのブロックになります。
before_reasoningを使用するケース
before_reasoning は、例外なくすべての解析の開始時に実行されます。サブエージェントへの最初の入力時と、そのサブエージェント内でツールコールまたは新規ユーザーが操作するたびに実行されます。run @actions.X は before_reasoning のコードです。LLMが従う場合と従わない場合があるプロンプトブロック内の命令とは異なり、before_reasoningは無条件で実行されます。
このブロックは、セッションの初期化 (コンテキスト レコードの取得、Apex またはフローからのセッション変数の設定) に使用します。また、LLM にツールが表示される前に認証およびエンタイトルメントチェックが検証される必要があるため、これらのチェックもここで行われます。コンテキストハイドレーションは、LLM が事前入力された変数を要求するのではなく受け取るようにデータ取得アクションをコールするという場合にも適しています。解析のたびに増分する必要があるカウンタまたは監査変数は、ここで設定する必要があります。before_reasoning の set ディレクティブは、パイプ命令とは異なる方法で保証されているためです。
ここで指定しないのは、セッションごとに 1 回のみ実行する必要があるロジックです。before_reasoning は最初のエントリだけでなくすべての解析で実行されるためです。また、現在のターンにおけるユーザー入力に依存するロジックも、入力がまだ処理されていないため、ここに含めるべきではありません。また、トランジションをbefore_reasoningにしないでください。ここでの transition to 命令は、すべての解析で無条件に起動され、ループが作成されます。
セッションごとに一度だけ初期化が必要な場合は、明示的にガードしてください:
1 回のユーザーターンで複数の解析をトリガーできます。1 回は入力時に、2 回目はツールコール後に実行されます。この機能には、3 つの実用的な影響があります。before_reasoning の初期化アクションは、マルチアクションフローでユーザーのターンごとに複数回実行されます。ここで増分されるカウンタ変数は、ターン数ではなく解析数を反映します。副作用のあるアクション (外部 API コールまたはレコード書き込み) は、すべての解析での再実行が明示的に受け入れられる場合を除き、before_reasoningで実行しないでください。
before_reasoning はコンストラクタではありません。これは、すべての解析で実行されるフライト前チェックです。それに合わせて設計してください。
after_reasoningを使用するケース
after_reasoning は、LLM が応答し、アクション出力が取得された後に、推論ループが終了すると実行されます。ここでは、アクション後の確定的チェック、すなわちアクション出力の評価とその結果に基づく分岐を行います。確定的トランジション、すなわちLLMの判断ではなく変数の状態に基づいて次のサブエージェントへ移行する処理は、ここで実施されます。また、次のユーザーターンの前に変数をクリーンアップし、LLMによるルーティング判断を伴わずに予測可能な順序でサブエージェントを連結するためのオーケストレーションシーケンスも、ここで行われます。
after_reasoning をガードレールレイヤーとして扱います。ここでは、LLM の作業が完了した後にビジネスルールと状態管理を適用し、LLM で生成された内容に関係なく重要なプロセスフローを予測可能にします。
is_displayable: Trueを賢く使用
オーケストレーションフローを設計するすべてのアーキテクトは、このプラットフォームの動作を理解する必要があります。アクションにis_displayable: Trueが設定されている場合、プラットフォームは LLM がその出力を表示することを決定するとすぐに推論ループを終了します。この終了は直ちに実行されます。つまり、after_reasoningは実行されません。
これは既知のプラットフォームの動作ですが、オーケストレーションに直接影響します。つまり、表示可能なアクションがフローの一部である場合、after_reasoningに配置したロジックはスキップされます。
答えは簡単です。確実に実行する必要のあるロジックを、現在のサブエージェントのbefore_reasoningブロックではなく、後続のサブエージェントのafter_reasoningブロックに移動します。
設計ガイダンス: 初期化ロジックを配置する場所
サブエージェントを設計する場合、ロジックを配置する場所を決定することが重要です。このフレームワークでは、最も一般的なシナリオについて説明します。
| シナリオ | 場所 |
|---|---|
| LLM にコンテキストが表示される前に実行する必要がある | before_reasoning |
| 新規ユーザーのターンでの再入力を含め、すべての解析を実行する | before_reasoning |
| このターンのアクション出力による | if内の条件付きブロックreasoning |
| 結果に基づく確定的サブエージェント移行が必要 | after_reasoning (ただし、以下のis_displayableの警告を参照) |
ダウンストリームアクションでis_displayable: Trueを使用する場合にオーケストレーションロジックが必要 | 次のサブエージェントのbefore_reasoning |
| 判断またはユーザーコンテキストを必要とするロジックを使用する | reasoningプロンプトの指示を含む |
基本原則は簡単です。アクションを「常に実行」するように LLM に指示するプロンプト命令を記述する場合、これは推奨事項です。LLM はコンテキストに応じて従う場合と従わない場合があります。run ディレクティブを before_reasoning に配置するのはコードです。すべての解析で例外なく実行されます。
条件付きアクションの可用性は、エージェントスクリプトが実行時変数の状態に基づいてアクションを LLM に公開または非表示にするメカニズムです。available when条件が false と評価されると、アクションは LLM に完全に表示されるツールリストから削除されます。false 値 (None、False、0、空の文字列など) は、アクションを抑制します。
これは、LLM に「まだコールしないでください」と指示するプロンプト命令ではなく、ハードプラットフォームレベルのゲートです。LLM はアクセスできないアクションをコールできません。
この例では、validation_passed が true と評価されるまで、LLM には execute_transfer が表示されません。ゲートは命令ではなくプラットフォームによって適用されます。
設計ガイダンス: LLM にゲート変数を設定させない
available when 句内のすべての変数に、関連付けられたアクションを実行する前に変数を設定する確定的コードパスを指定します。変数を既知の状態に保つために、before_reasoning、またはreasoning内の確定的なrunおよびsetブロックを使用します。LLM を使用してゲート変数を設定する場合、ゲートが防止するように設計された変動が再度導入されました。会話に応じて、LLM が設定する場合としない場合、つまりゲートが開く場合と開かない場合があります。
アクションループの問題
アクションループは、LLM が終了状態に達することなく同じアクションを繰り返しコールした場合に発生します。これは、2 つの条件が同時に true の場合に発生します。つまり、アクションの実行後もavailable when条件が満たされたままで、理由の説明で LLM にコールを停止するように明示的に指示されていない場合です。
プラットフォームは、コールされたアクションを自動的に抑制しません。ゲートが開いたままで理由の指示があいまいな場合、LLM は各解析で同じアクションを無期限にコールします。
例として、available when @variables.interest != "" を考えてみましょう。アクションが実行されても関心変数が空でない場合、次の解析ではゲートが開いたままになります。LLM はアクションを利用可能と見なし、停止を指示する命令がなく、アクションを再度コールします。
ループを切断するには、2 つの信頼できる方法があります。1 つ目は、アクションの実行後ロジックの一部としてゲート変数を閉じた状態に設定し、available whenが次の解析で false と評価されるようにすることです。2 つ目は、最初の実行後にゲートを閉じる個別の has_run Boolean を使用することです。どちらのアプローチでも、ゲートは確定的なクローズ状態になります。これは、プラットフォームがアクションを抑制するために必要な条件です。
銀行振り込みは、これらのパターンが実際にどのように連携するかを理解するのに役立つレンズです。ワークフローは外部からはシンプルに見え、あるアカウントから別のアカウントにお金を移動します。実装には複数の複雑なステップが必要です。転送を実行する前に、エージェントはアカウントの詳細をコレクトし、金額を検証し、転送制限を確認し、入手可能な残高を確認してから、転送アクションを公開する必要があります。各ステップは、前のステップによって異なります。いずれも LLM の判断に任せるべきではない。
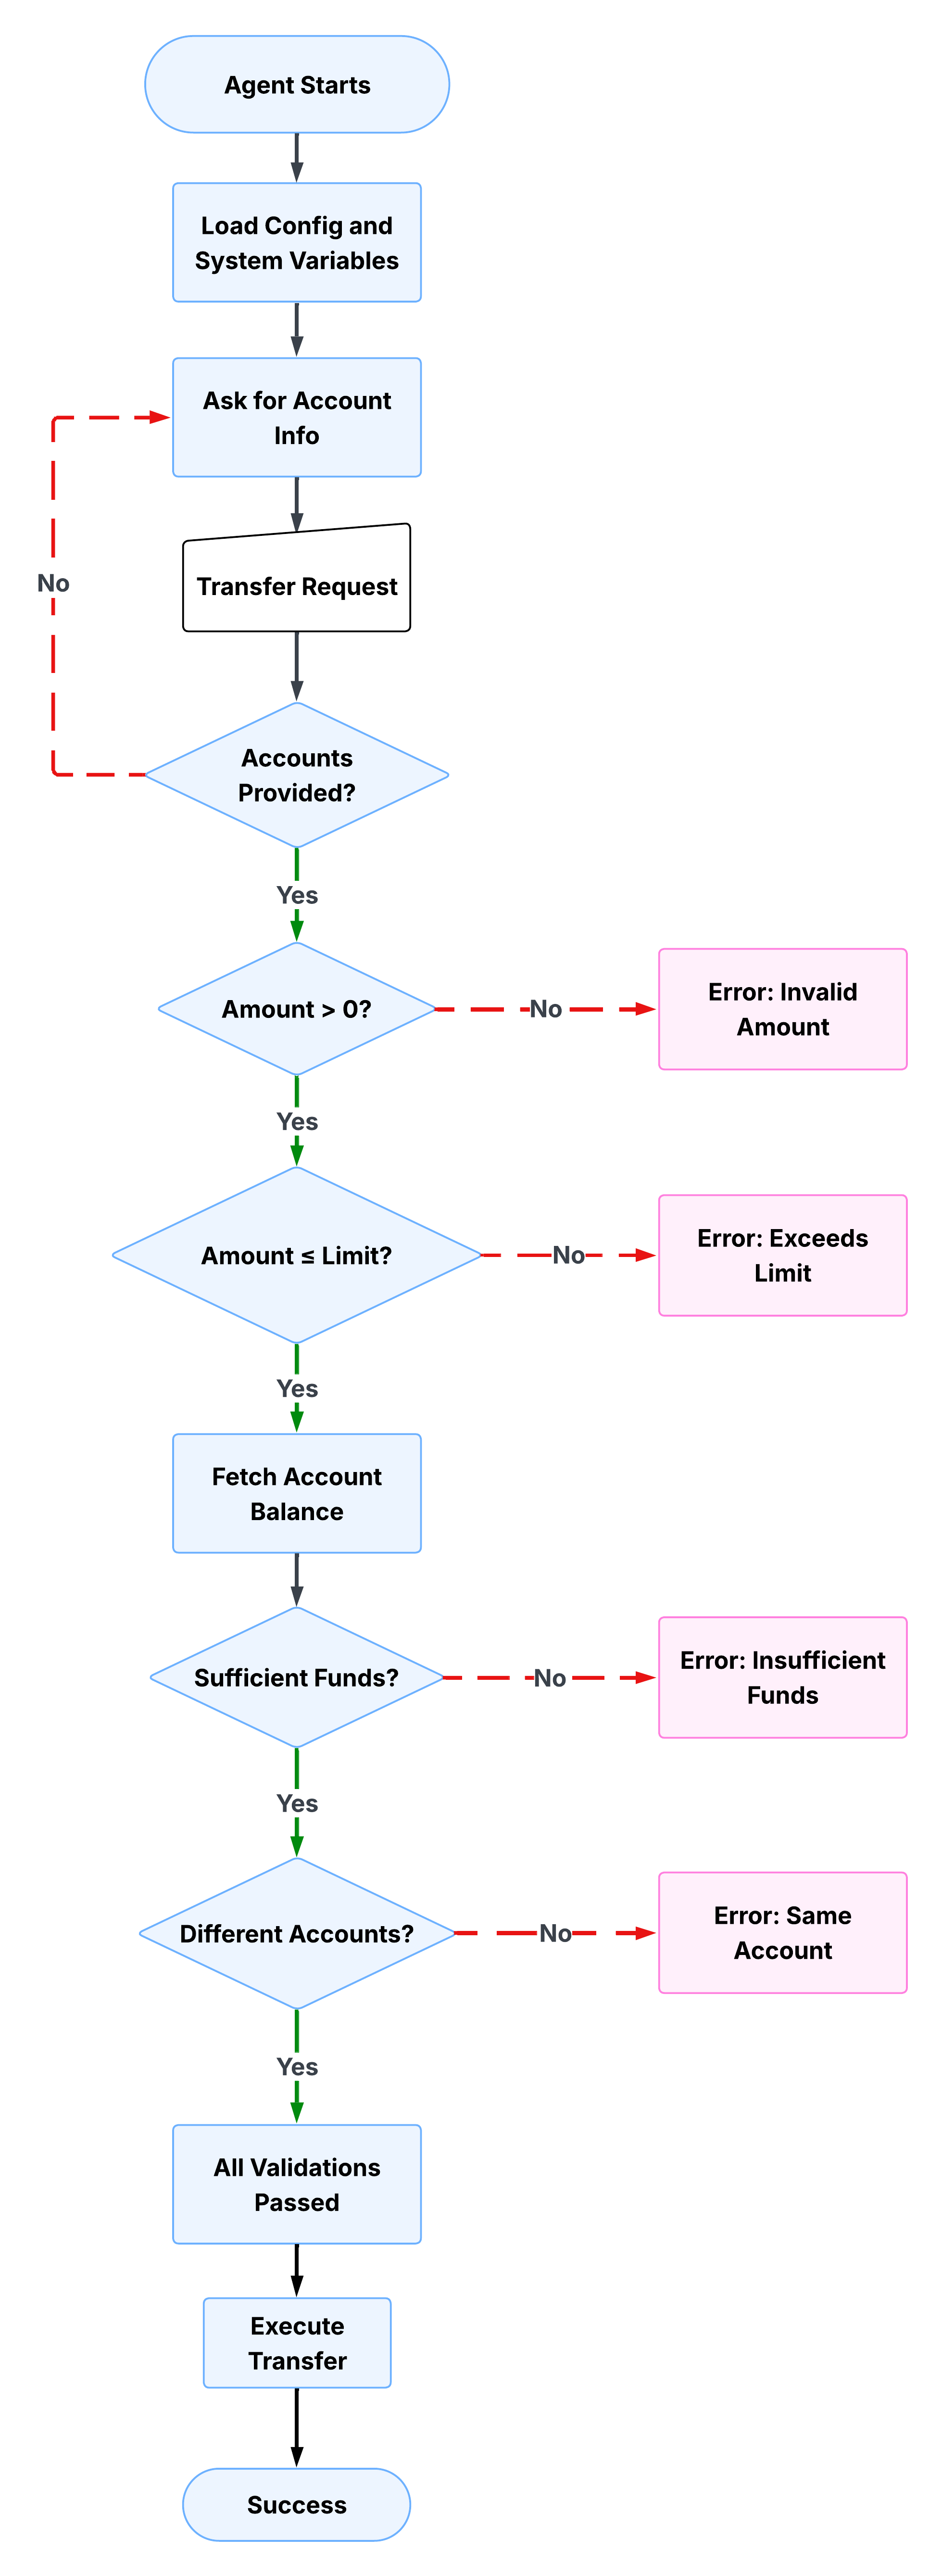
入力の収集と検証
最初のサブエージェントは、本ユーザからソースアカウント、デスティネーションアカウント、および送金金額をコレクトします。この 3 つがすべて存在して有効になるまで続行されません。エージェントスクリプトは各項目を順番にチェックします。ソースアカウントがない場合は、確認されます。送金先口座がない場合は、尋ねます。金額が 0 または負の場合、質問されます。validation_passed 変数は、すべてのチェックがクリアされた後にのみ true に設定されます。
以下のスクリプトは、実際にこれを示しています。各障害ポイントで validation_passed が明示的に false に設定され、LLM は続行しないように指示されます。確定的チェックは無条件に実行されますが、プロンプト命令はユーザー向けの応答を処理します。
ビジネスルールの適用
エージェントは入力を検証した後、転送金額が設定された転送制限を超えているかどうかを確認します。ここで、ビジネスルールは命令ではなくコードになります。この制限は LLM の理由ではありません。スクリプトで定義され、すべての解析で確定的にチェックされるハードしきい値です。
金額が制限を超えた場合、validation_passedはfalseに設定され、LLM はユーザーに最大許容量の転送、複数の転送への分割、制限の引き上げに関するサポートへの問い合わせの 3 つのオプションを表示します。エージェントは、ユーザーが例外を解決するまで続行できません。ここでのプロンプト命令は、LLM 推論に適した方法、つまりオプションを対話形式で提示し、本ユーザの応答を処理することを正確に行っています。ビジネスルール自体は確定的ですが、ビジネスルールに関する会話は確定的ではありません。
次のスクリプトは、制限チェックの仕組みを示しています。確定的条件では、転送金額を limit 変数に対して評価し、しきい値を超えた場合にvalidation_passedを false に設定し、ユーザー向けの応答を処理するプロンプト命令に委任します。
ガード句を適用
金額と制限のチェックが完了したら、エージェントは送金元アカウントの残高を取得し、十分な資金が入手可能であることを確認します。Guard 句を使用すると、前提条件が満たされていない場合にエージェントが操作を実行できなくなります。残高を確認するように LLM に指示するプロンプト命令とは異なり、エージェントスクリプトの guard 句ではチェックが無条件になります。LLM は実行するかどうかを決定しません。
残高が不足している場合、エージェントは不足を計算し、ユーザーに具体的な代替策を提示します。validation_passed は、このチェックに合格するまで false に設定されます。つまり、転送アクションはゲートされたままになります。
次のスクリプトは、残高を取得する確定的アクションコールと、それを評価する条件付きチェックを示しています。フェッチは、残高がまだ取得されていない場合にのみ実行され、後続の解析で冗長な API コールが回避されます。
エラーを明確に表示する
ガード句は状態を設定します。エラーメッセージがそれを伝えます。[validation_passed] が [false] の場合、エージェントは再起動せずに問題を解決するための十分な情報をユーザーに提供する必要があります。漠然としたエラーメッセージは摩擦を引き起こします。構造化されたエラーメッセージは、ループをより迅速に完結させます。
次のスクリプトは、実際には資金が不足していますというエラーメッセージを示しています。転送に失敗したことをユーザーに知らせるだけではありません。使用可能な残高、要求された金額、計算された不足が表示され、次のステップが具体的に示されます。すべて LLM によって生成されるのではなく、セッション変数から組み立てられます。
不足の計算は、LLM ではなくスクリプトで行われます。推奨の代替手段である入手可能な残高の振替は、セッション状態から確定的に取得されます。ここでの LLM の役割は、スクリプトがすでに構造化されているメッセージを配信する、単なるプレゼンテーションです。
転送アクションを制限する
前のステップの検証チェックでは、すべて同じ変数 validation_passed を設定またはクリアします。その変数は、最も重要な仕事をしています。execute_transfer アクションは条件付きで使用できます。つまり、validation_passed がtrueの場合にのみ LLM のツールリストに表示されます。先行するすべてのチェックに合格してその変数を設定するまで、アクションは LLM の観点からは存在しません。
これは、本番ワークフローに適用される前のゲートセクションのパターンです。転送アクションは、プロンプト命令で非表示になりません。プラットフォームで非表示になっています。会話の圧力やあいまいな言い回しによって、前提条件が満たされる前に LLM が呼び出すことはありません。
以下のスクリプトは、ゲートの設定方法を示しています。available when 句はvalidation_passedを直接参照し、アクションパラメーターは前の手順で収集および検証されたセッション変数にバインドされます。
from_account、to_account、amount の 3 つのパラメータはすべて、セッション変数から確定的に渡されます。このアクションが使用可能になるまでに、すべての値が検証されています。LLM は会話コンテキストからパラメーターを組み立てるのではなく、状態からパラメーターを読み取ります。
ワークフロー全体の状態の追跡
前のセクションのパターンは、セッション状態がワークフロー全体で維持されるため、機能します。最初のステップで取得したアカウント番号は、4 番目のステップで使用できます。検証結果は、あるチェックゲートのアクションで設定され、別のチェックゲートのアクションで利用されます。会話が逸脱する可能性があり、ユーザーはフォローアップの質問ができますが、エージェントはプロセスのどこにあるかを正確に把握できます。
次の変数ブロックは、このワークフローの完全なセッション状態を示しています。各変数には、定義済みの種別、デフォルト値、説明があります。2 つの変数がほとんどのオーケストレーション作業を処理します。validation_passed はすべてのゲートでのアクションの使用可能状況を制御し、validation_information はチェックに失敗した理由に関する人間が判読可能なコンテキストを伝達します。LLM は、基礎となる状態を理由付けすることなく、このコンテキストをユーザに表示できます。
すべての変数は、既知のデフォルト状態で開始されます。文字列はデフォルトで空、数値は0、そしてvalidation_passedのブール値はfalseです。これは、デフォルトでゲートが閉じられていることを意味します。ワークフローは、ゲートを開いたままにしてチェックで閉じるのではなく、各ステップで続行する権利を積極的に獲得する必要があります。
銀行振り込みの例は、確定的ロジックが適切なツールであることを示していますが、常に最適な選択であるとは限りません。境界を理解することは、パターンを理解することと同じくらい重要です。
ワークフローで保証された実行順序が必要な場合、エラーが重大な結果をもたらす場合、プロセスが再現可能な監査履歴を生成する必要がある場合、またはビジネスルールが条件としきい値として十分に定義されている場合、確定的ロジックが適切な選択です。通常、金融、医療、保険のワークフローはこのカテゴリに分類されます。
厳密な確定的制約のない純粋な LLM 推論は、インタラクションの価値が精度ではなく柔軟性にある場合、より理にかなっています。オープンエンドのカスタマーサポート、ビジネスプロセスがまだ発展中の初期段階の製品、およびリスクの低い情報クエリはすべて、LLM の推論の変動が問題ではなく機能であるケースです。
実際には、ほとんどのProduction (本番)エージェントには両方が必要です。境界がどこにあるかの決定は、確定的か確率的かの二者択一ではなく、エージェントのワークフローの各部分でノードレベルで決定します。
| 確定的ロジックを使用する | LLM 推論を使用する |
|---|---|
| 入力の検証と無害化 | 自然言語理解とインテント検出 |
| ビジネスルールの適用 | 対話的で共感的な応答の生成 |
| 順次プロセスオーケストレーション | あいまいな入力や予期しない入力の処理 |
| 状態管理とコンテキストの保存 | 説明や明確化の提供 |
| 無効な操作を防止する保護条項 | ユーザーコンテキストに合わせた口調とメッセージング |
境界は設計上の決定事項
銀行振り込みの例は、確定的実行と LLM 推論の境界が、本番エージェントの作成時に行う最も重大なアーキテクチャ上の決定である、という設計思想を示しています。
境界が硬すぎると、エージェントが硬直し、維持にコストがかかり、実際の会話の自然な変化を処理できなくなります。境界を別の方向に間違えると、エージェントは柔軟性があるが予測不能になり、テストでは適切に機能するが本番では動作が異なるため、信頼できる監査履歴を生成できなかったり、リスクの高いトランザクションを信頼できなくなったりします。
新しい Agentforce モデルには、意図的にその境界を配置するツールが用意されています。エージェントスクリプトでは、確定的ロジックとプロンプト命令を同じファイルに表現し、境界を表示する明示的な構文を使用できます。Atlas Reasoning Engine は、実行時にロジックとプロンプトを適用します。[before_reasoning] および [after_reasoning] ブロックでは、LLM コールの両側に保証された実行ゾーンが提供されます。条件付きアクションの可用性により、LLM は前提条件が満たされた場合にのみ機能できます。
これらの機能はそれぞれ独立していません。これらが連携して、ミッションクリティカルなワークフローで企業が信頼できるエージェントを構築するための一貫したアーキテクチャを作成します。ハイブリッド推論モデルでは、決定論と柔軟性の両方がアーキテクチャで役割を持っていることを認識します。それぞれを適用する場所を正確に決定するのはアーキテクトの仕事です。
Agentforce の Agent グラフ:ハイブリッド推論によるガイド付き決定論に向けて
Gulal Kumar は、20 年以上の経験を有する Salesforce のソフトウェアエンジニアリングアーキテクトです。彼の専門知識は、AI、インテグレーション、API、そしてエンタープライズアーキテクチャに及び、安全で堅牢かつ革新的なAIソリューションを通してビジネス変革を推進することに注力しています。LinkedInで彼とつながりましょう。
Miriam McCabe はアーキテクト伝道チームのシニアディレクター兼リーダーです。エージェント時代において、深く技術的なコンテンツ、ライブプログラミング、コミュニティエンゲージメントを通じて、グローバルな Salesforce アーキテクトコミュニティを牽引することに重点を置いています。LinkedInで彼女をフォローしてください。