企業は、請求書、購入注文、法的契約、技術マニュアルなど、さまざまな種類のドキュメントを処理します。手動処理は時間がかかり、エラーが発生しやすく、従業員の時間の 15 ~ 25% が消費されます。以前の自動化アプローチ(RPA(ロボティック プロセス オートメーション)、_OCR(光学_式文字認識)、ワークフロー ツールなど)では、一部の負担が軽減されましたが、パイプラインの柔軟性が低下し、メンテナンスのオーバーヘッドが大きくなり、個々のビジネス チーム間で採用がサイロ化していました。
ドキュメントには、フラットテキスト処理では保持できない豊富な構造コンテキスト (テーブル階層、空間項目リレーション、相互参照セクションなど) が伝達されます。ドキュメントをプレーン テキストにストリップすると、抽出の正確性と有用性を高めるビジネス コンテキストが破棄され、下流の分析、_AI(人工知能)_の推測、プロセスの自動化の品質が低下します。
効果的に機能させるには、_インテリジェント・ドキュメント処理(IDP)_システムでドキュメントをタイプ別に分類し、構造化データを可変レイアウトから正確に抽出し、そのデータを管理されたクエリ可能な形式でダウンストリーム・システムに配信する必要があります。また、IDP は、すべての新しいドキュメント形式のテンプレートごとの設定を必要とせずに、ドキュメントの変動を大規模に処理する必要があり、ビジネスユニット全体で一元的にアクセスできなければなりません。この課題は、すべてのエンタープライズ データの約80%が非構造化データで占められており、その大半は、CRM(カスタマー リレーション管理)システム、AIエージェント、分析プラットフォームの届かないファイル システム、クラウド ストレージ、コンテンツ リポジトリにわたってドキュメント形式で蓄積されているという重要な問題によってさらに増加しています。
_Data 360 Document AI_は、このギャップに対応するために設計された、_Data 360_内のSalesforceドキュメント処理能力です。LLM(大言語モデル)、_OCR(光学_文字認識)、NLP(自然言語処理)、_ML(機械学習)_を使用して、非構造化および半構造化ドキュメント・コンテンツを抽出、分類、分析します。出力は構造化され、管理され、照会可能なデータで、_Data 360_パイプラインに統合されます。_Agentforce_エージェント、分析ツール、自動化ワークフローは、カスタム抽出レイヤーや変換レイヤーを使用せずに標準インターフェースからアクセスできます。
エンタープライズデータプラットフォームは、構造化された表形式データを処理します。ただし、エンタープライズデータの大部分はドキュメントとして到着し、誰かが手動で抽出するまで CRM、ERP、AI エージェント、分析パイプラインにはアクセスできません。これはアーキテクチャ上のギャップであり、ワークフローの問題ではありません。
以前のアプローチでは、手動キー再生成、ルールベースの OCR、RPA スクリプトを組み合わせて使用していました。これらの方法は小規模では機能しましたが、現代の企業が生成するドキュメントの量、種類、速度に対応できませんでした。ルールベースのツールでは、レイアウトバリエーションごとに明示的なテンプレートが必要です。形式を変更すると抽出が中断され、開発者、新しいテンプレート、リリースサイクルが必要になります。
大規模な運用においては、中央集約型のガバナンスや共有スキーマ、さらにはAI対応への道筋が欠如した、脆弱な単発ソリューションが生み出されます。一貫性のない抽出パイプラインは、その影響を下流に波及させます。つまり、分析はデータの矛盾を継承し、AIモデルは信頼性の低い出力を生成し、_PHI(個人医療情報)_やPII(_個人識別情報)_などの規制対象コンテンツには体系的なガバナンスがありません。
LLM は、明示的なテンプレートなしで項目を抽出します。1 つのスキーマ設定によってレイアウトバリエーション、言語、形式間の抽出が制御され、ドキュメントが固定構造に準拠するのではなく、ドキュメントに適応します。これにより、ドキュメント処理は、メンテナンス負荷が高くサイロ化された運用から、管理された一元的な機能へと転換されます。
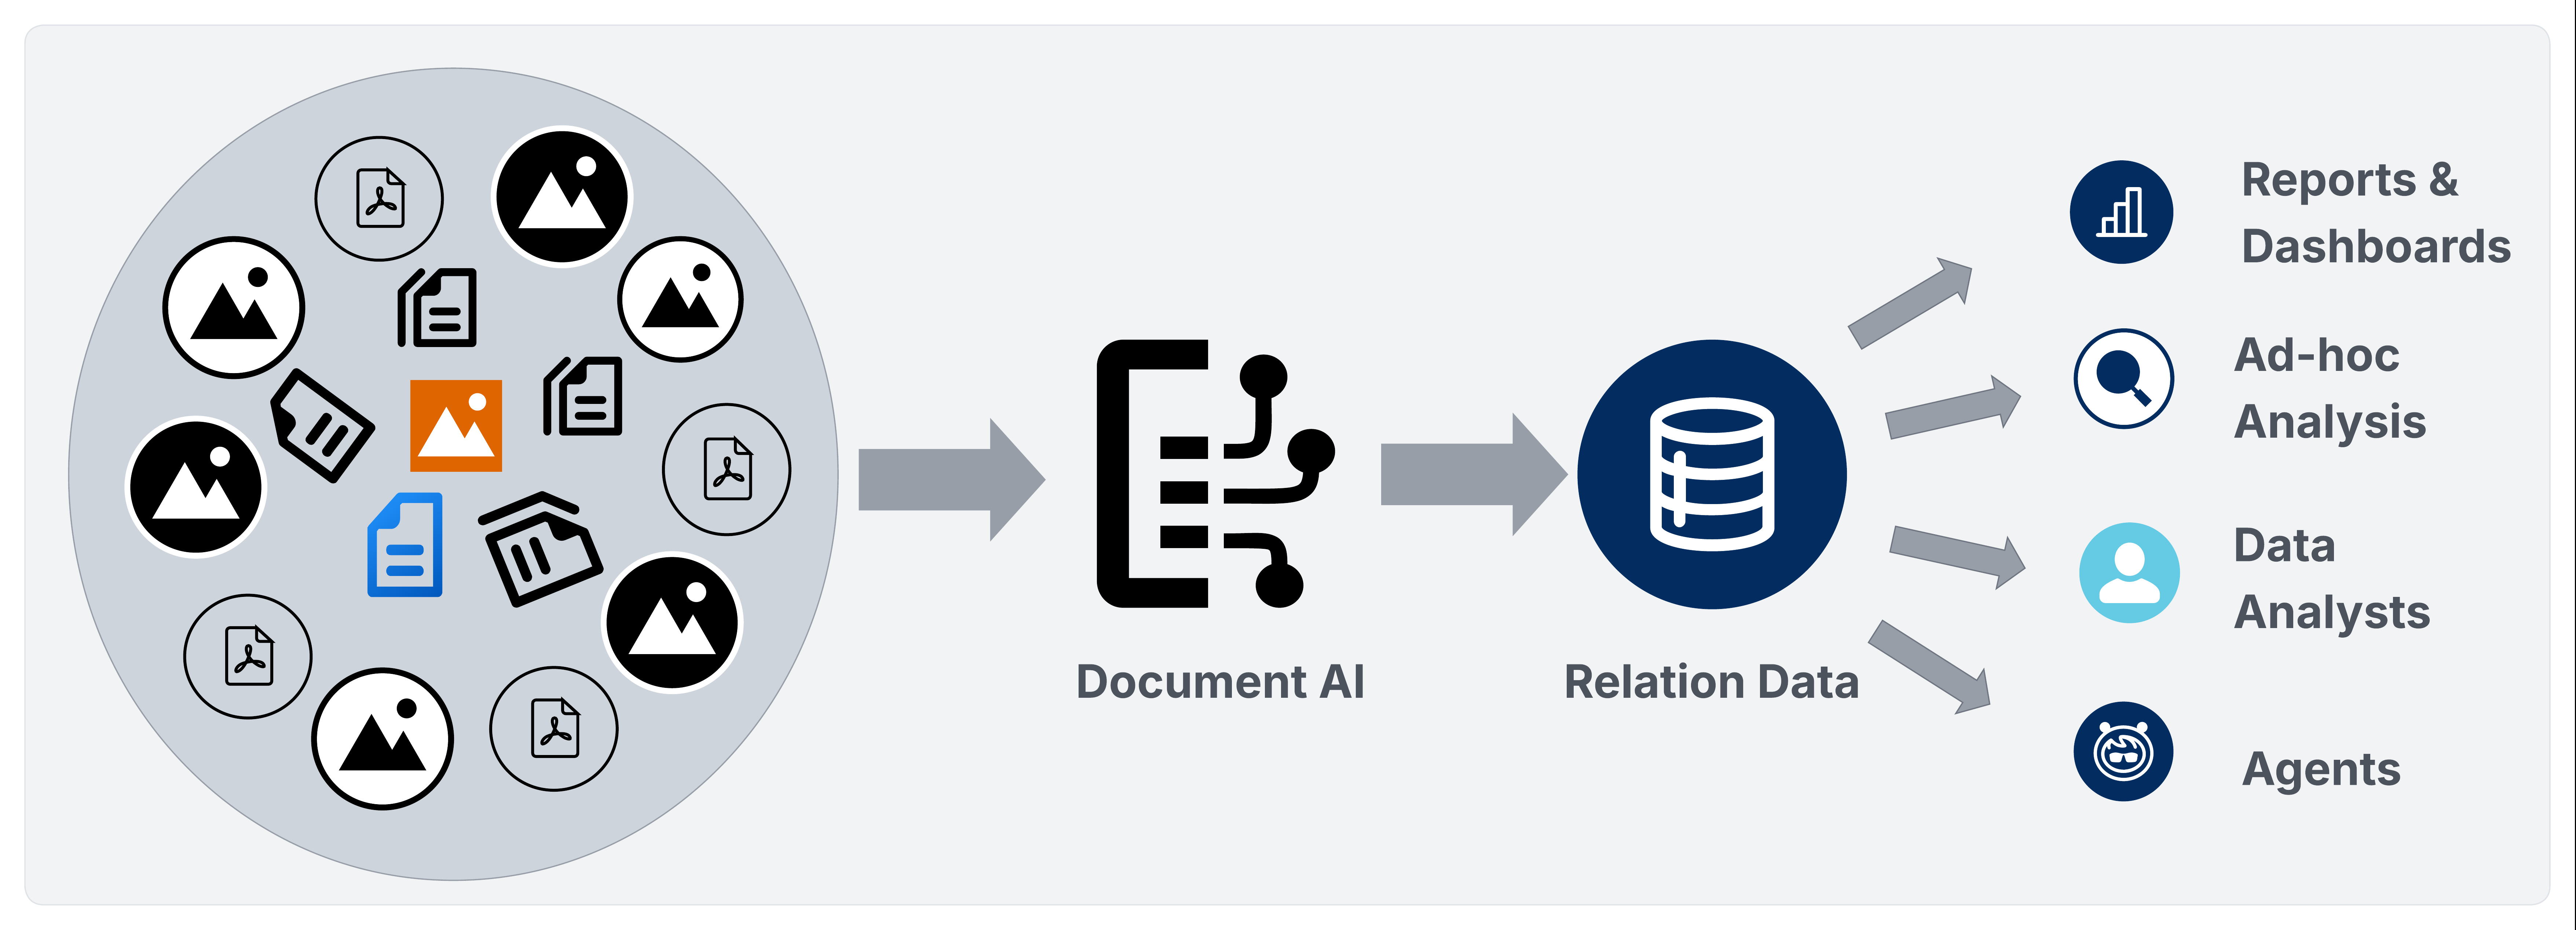
_Data 360 Document AI_は、2つのパイプラインを介して_Data 360_プラットフォーム内のドキュメント処理を運用します。
- _バッチ パイプライン_は、取り込み、ID解決、計算済みインサイト、有効化、分析、Agentforce有効化を通じて抽出されたデータを転送します。
- _トランザクション処理パイプライン_では、構造化され_たJSON_を同期して返すREST APIが公開されます。これにより、アーキテクトはバッチ設定のオーバーヘッドなしで、ドキュメントから派生したデータをSalesforce SObject、Data 360 Data Lake Object/Data Model Object(DLO/DMO)パイプライン、または外部のデータベースやウェアハウスにルーティングできます。
どちらの場合も、抽出されたデータは、断片化されたポイントツールセットではなく、管理されたスキーマ駆動モデルに入ります。
Data 360 Document AIは、_Data 360_プラットフォーム内のSalesforceネイティブの_インテリジェントドキュメント処理(IDP)_機能です。非構造化および半構造化ドキュメント・コンテンツを、_Data 360_のライフサイクル全体にわたって完全に関与する管理されたクエリ可能なデータに変換します。
Data 360 Document AIは、_Data 360_内のSalesforceネイティブの_インテリジェント ドキュメント処理(IDP)_機能です。非構造化ドキュメントと準構造化ドキュメントを取り込み、宣言型スキーマ構成を使用して構造化データを抽出し、ハーモナイゼーション、ID解決、分析、Agentforceの有効化のためにそのデータを_Data 360_パイプラインに提供します。
Data 360 Document AI では、次の 2 つの処理モダリティがサポートされています。
- 一括処理: 非構造化データモデルオブジェクト (UDMO) で定義された大規模なドキュメントセットをイベント駆動型で処理します。
- トランザクション処理: REST API を介して 1 つのドキュメントを処理し、構造化された JSON ペイロードを同期的に返します。その後、アーキテクトは_MuleSoft_、_Apex_コールアウト、ETL(_Einstein Trust Layer)_パイプラインを使用して、そのペイロードを_Data 360 DLO/DMO_パイプライン、Salesforce SObject、または外部のデータベースとウェアハウスにルーティングできます。対象階層は、レイテンシ、ガバナンス、およびデータレジデンシーの要件によって決定されるアーキテクチャ上の決定事項です。
現在、ドキュメント AI は PDF ファイル、画像ファイル (JPEG、PNG)、手書きドキュメントをサポートしています。
_Data 360 Document AI_は、4つの処理テクノロジーを1つの管理パイプラインにまとめます。各コンポーネントは、ドキュメントからデータへのライフサイクルの個別のフェーズを処理します。
- 光学式文字認識(OCR): LLM処理の前に、スキャンされた画像、手書きコンテンツ、画像ベースのPDFを機械で判読可能なテキストに変換します。信頼性の高い抽出のためには、150 DPI 以上をお勧めします。
- **Large Language Models(LLM; 大言語モデル):**ユーザが選択したモデルを使用して Einstein LLM ゲートウェイを通過するルートを抽出します。LLM は JSON スキーマ設定と共に OCR 出力を受信し、構造化された抽出ペイロードを返します。Gemini および追加モデルは、今後の実装で計画済みです。
- 自然言語処理(NLP): 構造化プロンプトエンジニアリングを使用して、LLM内でコンテキスト理解、エンティティ認識、日付の解析、セマンティック項目の抽出を直接実行します。スキーマ定義プロンプトとOCR出力が唯一の入力として機能します。すべての LLM インタラクションは ETL を介してルーティングされます。ETL では、モデルプロバイダーとのデータ保持がゼロになり、テキストベースの入力がモデルに到達する前に _PII が_マスクされます。個別の NLP エンジンは採用されません。
- マルチモーダル処理: PDF 内の埋め込み画像を個別の抽出入力として処理します。これにより、LLM は、OCR だけでは解析できない図、画像で表示されたテーブル、および混在コンテンツページからデータを抽出できます。
4つの処理テクノロジーに加えて、Document AI も次の処理を行います。
- **Einstein Trust Layer:**すべてのLLMインタラクションをETLを介してルーティングします。ETLでは、モデル プロバイダーとのデータ保持がゼロになり、入力がLLMに到達する前に_PII_がマスキングされます。ただし、マルチモーダル データ(_ドキュメントAI_で処理される添付ドキュメントなど)は例外で、PIIマスキングは現在サポートされておらず、データはそのまま外部モデルに送信されます。ETL は LLM インタラクションパスのみを管理します。_DLO(データレーク オブジェクト)_に書き込まれる抽出されたデータはそのまま保存されます。保存時の項目レベルのマスキングは、ダウンストリームのデータ ガバナンス制御を使用して対処する必要があります。
- ファイルサイズ制限:_ドキュメントAI_は、要求あたり最大10 MBのファイルを処理します。LLM コンテキストの長さ制限により、この境界内の高密度の複数ページドキュメントの処理がさらに制約される場合があります。
_Data 360 Document AI_をリリースしているエンタープライズ アーキテクトは、実装設計に取り組む前に次の原則を適用する必要があります。
- スキーマを設計する前にパイプラインを選択します。_バッチ_処理パイプラインと_トランザクション_処理パイプラインでは、取り込みモデル、スキーマのバインド、対象の柔軟性、レイテンシが異なります。スキーマを定義する前に、各使用事例で必要なパイプラインを確認することが重要です。後付けにより回避可能な手戻りが発生するためです。
- **ドキュメント種別レベルでスキーマを設計します。**ドキュメント種別ごとに 1 つの適切に作成されたスキーマを使用すると、使用事例ごとの設定を使用するよりもメンテナンスが容易になり、抽出品質の最大のテコにもなります。これを正しく行うには、1 つの例から設計するのではなく、エッジケースを含むさまざまなドキュメントセットを使用する必要があります。プロンプトを_項目_、テーブル、_スキーマ_のレベルで繰り返し使用してギャップを見つけ、最終処理する前に複数のドキュメントサンプルに対してテストおよび調整します。1 つの文書で適切に機能するスキーマが他の文書で不足する可能性があるため、幅広さと反復が不可欠です。スキーマの柔軟性 (ドキュメント種別間で確実に抽出されない列の削除など) も同様に重要です。ノイズや一貫性のない項目に固執すると全体的な抽出品質が低下するため、列の削除を第一級の設計上の決定として処理することが重要です。
- **フィールドグループごとに適切な対象層を選択します。**CRM ワークフローまたは承認を促進するフィールドは、SObject に書き込みます。統合プロファイルまたはフィード分析を強化する項目は、_DLO/DMO_パイプラインに属します。外部システムを提供するフィールドは、RDBMS 層に属します。1 つのスキーマが複数の階層に同時に分散される可能性があります。
- **規制対象のコンテンツを処理する前にガバナンスを適用します。**規制対象のデータは、すべてのレイヤーで保護する必要があります。そのため、抽出されたデータが出力_データ レイク オブジェクト_(DLO)に保存された後に_、PII_マスキング、データ分類タグ、ABAC(属性ベース アクセス制御)を設定することが重要ですこれにより、データ分類、ユーザーロール、および組織のコンテキストに基づいて、きめ細かな適用とコンテキスト対応アクセス権が提供されます。_ガバナンス_は2つのパスに分割されます。1つは_ELT_がLLMインタラクションを制御することですが、DLOに保存される抽出されたデータは、_データスペース_構成、権限セット、_ABAC_ポリシーを使用して個別に(DLOおよびデータベースレベルで直接)管理する必要があります。これらの制御は、取り込み後のデータアクセス方法にかかわらずアクセス制限が保たれるよう、アプリケーションレイヤーだけでなくストレージランクでも一貫性を維持する必要があります。どのレイヤーでもギャップがあると、他のレイヤーが正しく設定されていても規制対象データが下流に公開される可能性があります。
- **本番稼働前の障害モード用に設計します。**最初の本番バッチの実行前に、null 項目の処理、OCR 品質しきい値、ファイルサイズの事前検証、LLM コンテキストのオーバーフロー、RDBMS 書き込みの可能性、クレジット予算の制限に対処します。これらはエッジケースではなく、パイプライン設計で明示的に処理する必要がある予測可能な失敗サーフェスであり、実行時に発見されるものではありません。
- **信頼性スコアは、診断の後付けではなく、第一級のルーティング信号として扱います。**抽出結果には、基盤となるモデル出力の対数確率 (logprobs) から算出されたフィールドレベルの信頼度値が反映されます。抽出された項目、テーブル、または列ごとに、抽出された値のモデルのトークンレベルの確実性がスコアに反映されます。これにより、信頼度スコアは統計的に裏付けられたシグナルとなり、_ヒューマンインザループ (HITL)_エスカレーションしきい値の主ゲートとして機能するのに十分な信頼性があります。信頼度スコアを使用して、ヒューリスティックや手動のスポットチェックに依存することなく、品質の低い抽出を体系的に特定し、信頼度の低いフィールド値、あいまいなスキーマの一致、繰り返しのパイプライン失敗についてヒューマンインザループ (HITL) チェックポイントを開始します。自動リカバリが不可能な場合、ヒューマンインザループ (HITL) に支援された信頼度スコアリングにより、人による判断が必要な場所に確実に適用されます。
- スキーマ設計と並行して有効化パスを設計します。_ドキュメントAI_の価値は、Salesforceワークフローとエージェント内で抽出されたデータを有効化できることにあります。Agentforce アクション、フロー、および_計算済みインサイト_を、抽出スキーマ設計の後にではなく、抽出スキーマ設計と一緒に設計できます。
_ドキュメントAI_は、2つのパイプライン内で動作します。
- UDMO に支援された大量の処理のための_バッチ_パイプライン
- リアルタイムのAPI駆動型抽出のための_トランザクション__処理_パイプライン
どちらのパイプラインもスキーマ設定契約と ETL ガバナンスは同じですが、ドキュメントがシステムに入力される方法や抽出されたデータがどこに保存されるかが異なります。
各パイプラインを詳しく見てみましょう。
_バッチ_パイプラインは、UDMO で定義された定期的なドキュメントセットを処理します。ドキュメントがエンタープライズ・ストレージから取り込まれ、ドキュメントの抽出を経て、ハーモナイゼーション、ID解決、有効化のために_Data 360 DLO/DMO_パイプラインに配信される、スケジュール済みまたはイベント・ドリブンの使用事例に適しています。
実際のシナリオ
ある保険会社は、提供者ポータルから毎日何千もの医療請求ドキュメントを受信し、PDFとして_Amazon S3_にアップロードしています。UDMO は対象範囲のドキュメントセットを定義し、24 時間以内にすべての請求 PDF を/claims/incoming/バケットに送信します。
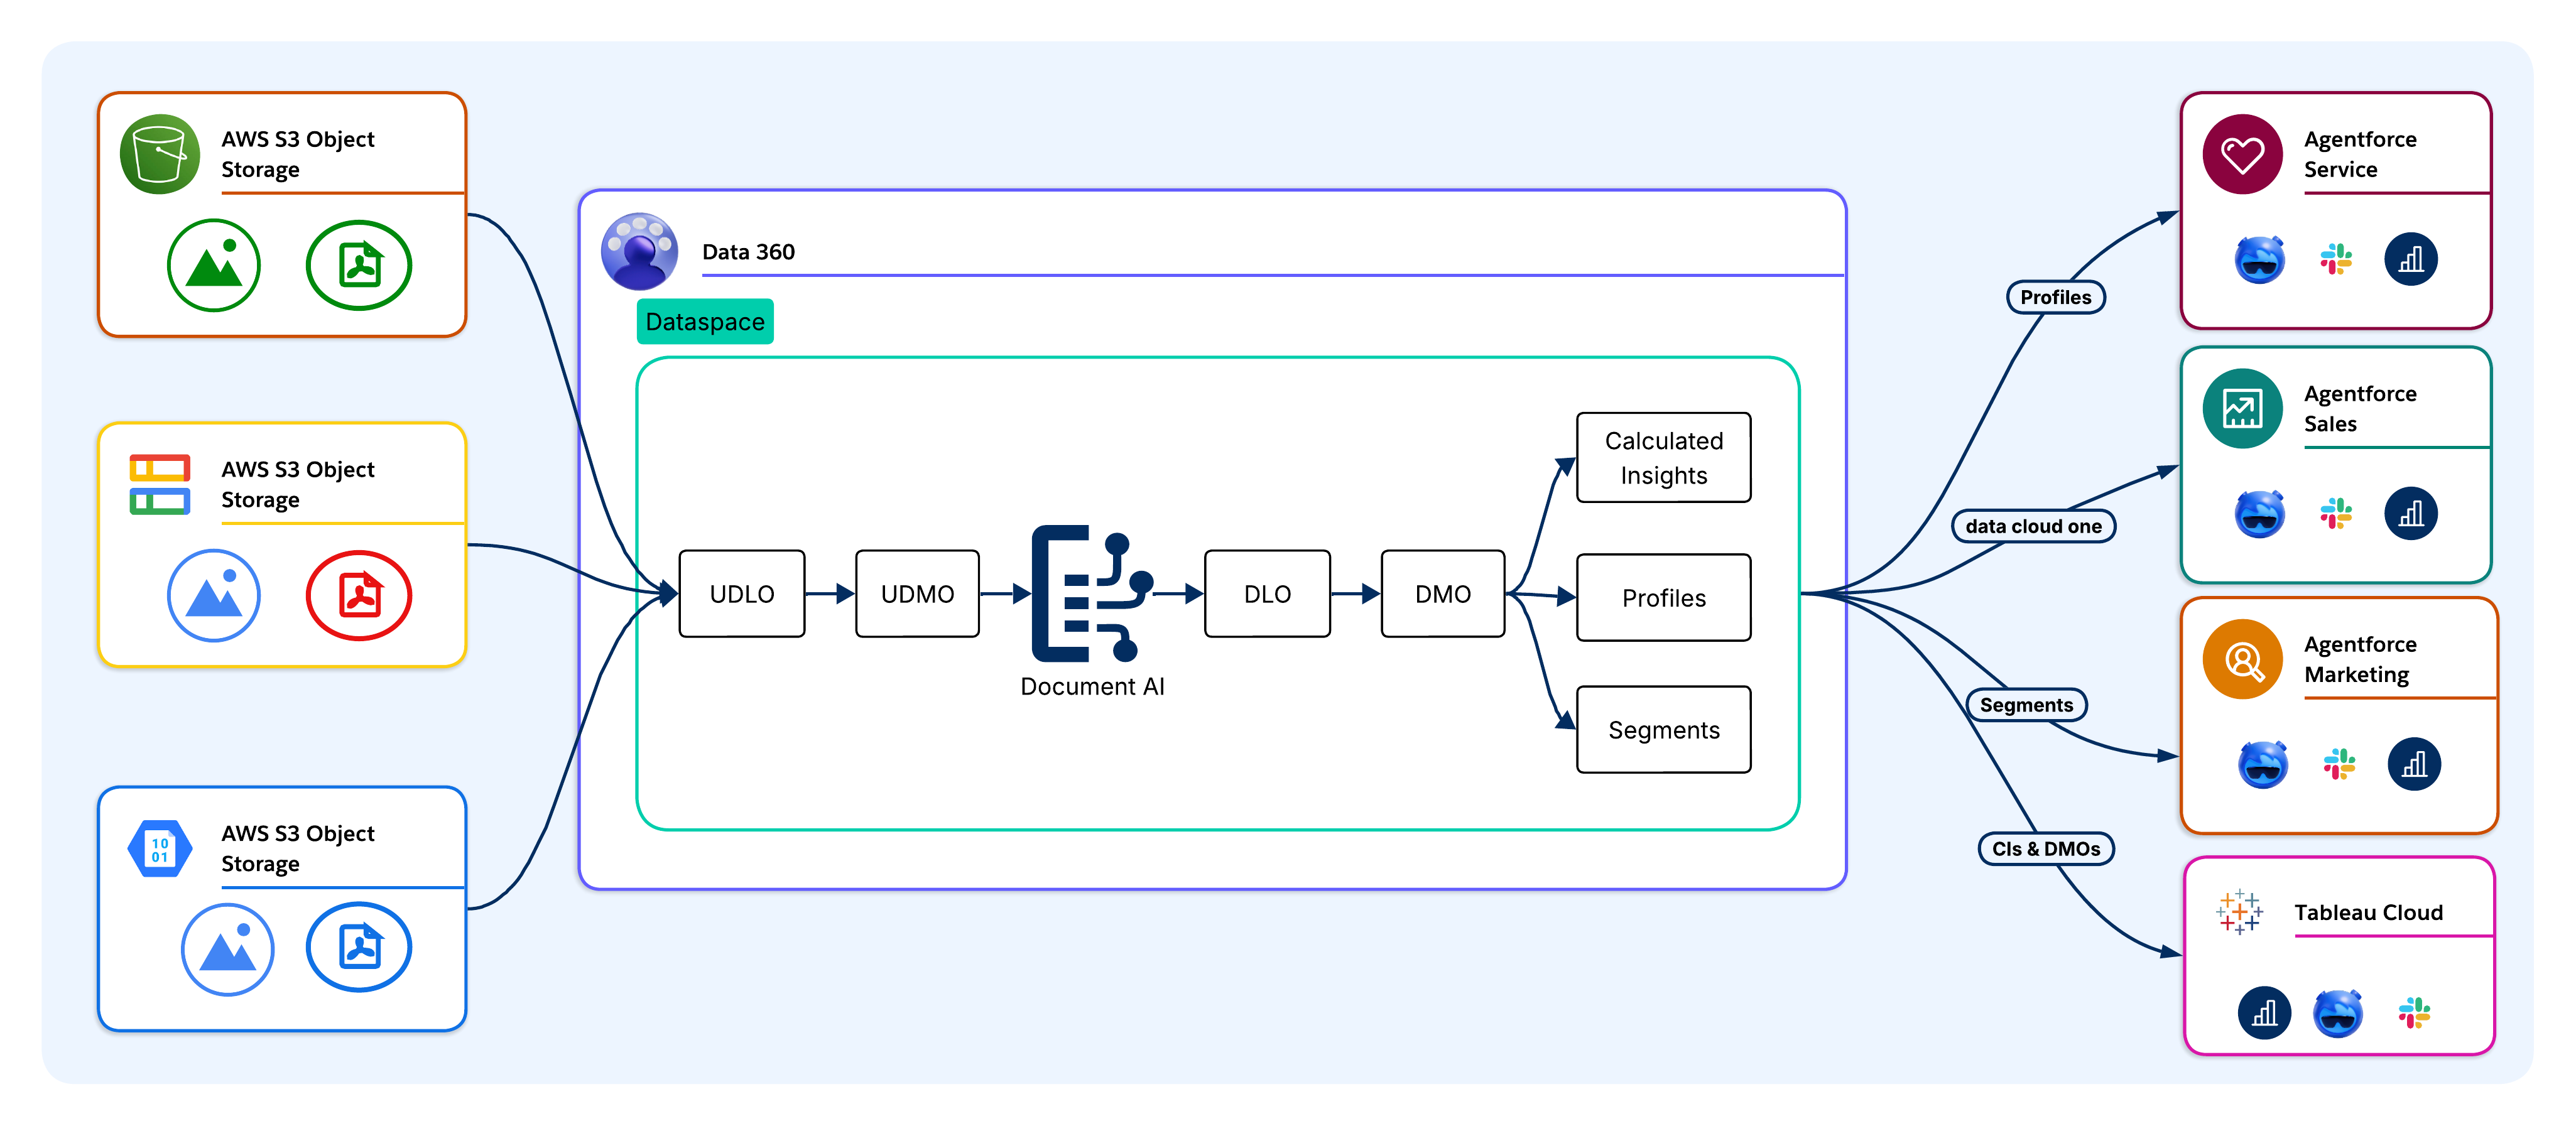
ドキュメントは、物理的な重複なしでエンタープライズソースシステムから Data 360 に取り込まれます。サポートされるソースには、Amazon S3、Google Cloud Storage、Salesforce CRMファイル オブジェクト、_MuleSoftでオーケストレーション_されたパイプライン、APIの直接アップロードなどがあります。_Headless 360_の展開では、ドキュメントはクラウドストレージコネクタまたはCRMレイヤーをバイパスする_Ingestion API_を介して取り込まれます。_MCP(モデル コンテキスト プロトコル)_サーバーは、取り込みを外部AIエージェントとLLMクライアント用のコール可能ツールとして公開します。
取り込み時に、未加工ドキュメントはUDLO(_非構造化_データ・レイク・オブジェクト)として保存されます。UDLOは、ソースファイルを移動または変換することなく、各ドキュメントの物理的な場所とメタデータに対応付けられます。
例:
請求PDFは、クラウド ストレージ コネクタを介して_S3_から_Data 360_に取り込まれます。各ドキュメントは、S3 オブジェクトを参照する UDLO として保存されます。物理的な重複は発生しません。
ドキュメントAIは、抽出するフィールドとその対象データ型を定義するスキーマ構成に対して各UDLOを処理します。UDMO は、どのドキュメントが範囲に含まれるかを定義します。LLM (GPT-4o、Gemini、また_は Claude_) は各ドキュメントを読み取り、構造化された抽出ペイロードを返します。
例:
_ドキュメントAI_は、ClaimID、PatientName、DiagnosticCode、BillingAmount、ServiceDateなどのフィールドを定義する請求スキーマに対して各UDLOを処理します。その後、LLM は各 PDF を読み取り、構造化された抽出ペイロードを返します。
いったん抽出されたデータは、_Data 360_の未フォーマット ストレージ レイヤーであるDLOに保持されます。DLO はビジネスロジックを強制せずに抽出された項目を維持し、下流の変換とトレーサビリティのために正確な物理表現を維持します。UDLO はソース文書への参照を保持し、パイプラインの任意の時点で項目レベルの系統を有効にします。
例:
抽出されたすべてのフィールドは_請求 DLO_ に格納されます。これにより、ソース PDF まで遡ることができる完全な系統の各請求の未加工の正確な表現が保持されます。
DLO フィールドは、標準の Customer 360 データモデル_に準拠する DMO にマッピングされます。これは、ドキュメントから派生したデータが未加工の抽出項目からビジネス上意味のあるエンティティに移行する境界です。請求書 DLO が_請求書 DMO にマッピングされ、CustomerID や BillingAmount などの項目が統合データモデル内の結合キーおよび一致属性になります。ハーモナイズされたドキュメントデータは、CRM およびトランザクションデータで使用されるのと同じインターフェースを介してセグメンテーション、計算済みインサイト、有効化に参加します。
例:
請求 DLO は_請求 DMO_ にマッピングされます。PatientID 項目と PolicyNumber 項目は、請求レコードを統合患者プロファイルにリンクする結合キーになります。
ハーモナイズされた DMO データは、ID 解決に寄与します。抽出されたフィールド (顧客名、メールアドレス、取引先番号など) は、ドキュメントレコードを_統合個人 (ゴールデンレコード)_ にリンクするための一致キーとして機能し、ドキュメントとプロファイルのギャップを解消します。
例:
抽出フィールド(PatientName、DateOfBirth、PolicyNumber など)は、請求レコードを正しい_統合個人_にリンクする ID 解決の一致キーとして機能します。これは、同じ患者がドキュメント間で名前のスペルが若干異なる場合でも発生します。
アーキテクトは_計算済みインサイト_を定義します。これは、ハーモナイズされたドキュメント データ全体で計算される集計された総計値です(さまざまな請求書品目からの支出合計、契約更新リスク スコア、請求重要度インデックスなど)。
例:
_計算済みインサイト_は、Agentforceクエリのハーモナイズされた請求データ全体で TotalClaimsPerPatient、AverageClaimAmount、HighRiskClaimScore を計算します。
ハーモナイズされたID解決済みデータには、Agentforce Agent、Tableau、マーケティング・プラットフォーム、Salesforce _SObject_からアクセスできます。対象ランクは、レイテンシ、ガバナンス、データレジデンシーの要件に基づくアーキテクチャ上の意思決定です。
例:
Claims Adjudication Agentforce Agent は、優先審査のために Data 360 DMO と CI を照会して、リスクの高い請求を見つけます。_Tableau_ダッシュボードには、請求量と異常のトレンドが表示されます。承認された請求レコードは_請求オブジェクト_に円で囲まれ、支払ワークフローが開始されます。
ヘッドレス360_アーキテクチャでは、有効化は_クエリAPI、Pub/Sub API、またはクラウド データウェアハウスの有効化対象を介して外部システムに直接ルーティングされます。次に、MCP Server は、ハーモナイズされたドキュメントデータと_計算済みインサイト_を外部AIエージェント向けの呼び出し可能なツールとして検出します。
_トランザクション処理_パイプラインは、UDMOや事前に取り込まれたUDLOを使用せずに、実行時に単一ドキュメントの抽出を処理します。これは、イベント駆動の使用事例(フォームをアップロードする顧客、PDFを受信するエージェント、トランザクション処理ワークフロー内の抽出を開始する外部システムなど)に適しています。ETL ガバナンスは両方のパイプラインにまったく同じ方法で適用されます。
実際のシナリオ
銀行の顧客がローンを申請するときに、銀行のモバイルアプリケーションを使用して公共料金の PDF をアップロードします。イベントはリアルタイムで抽出を開始します。つまり、事前に取り込まれた UDLO や UDMO は関与しません。
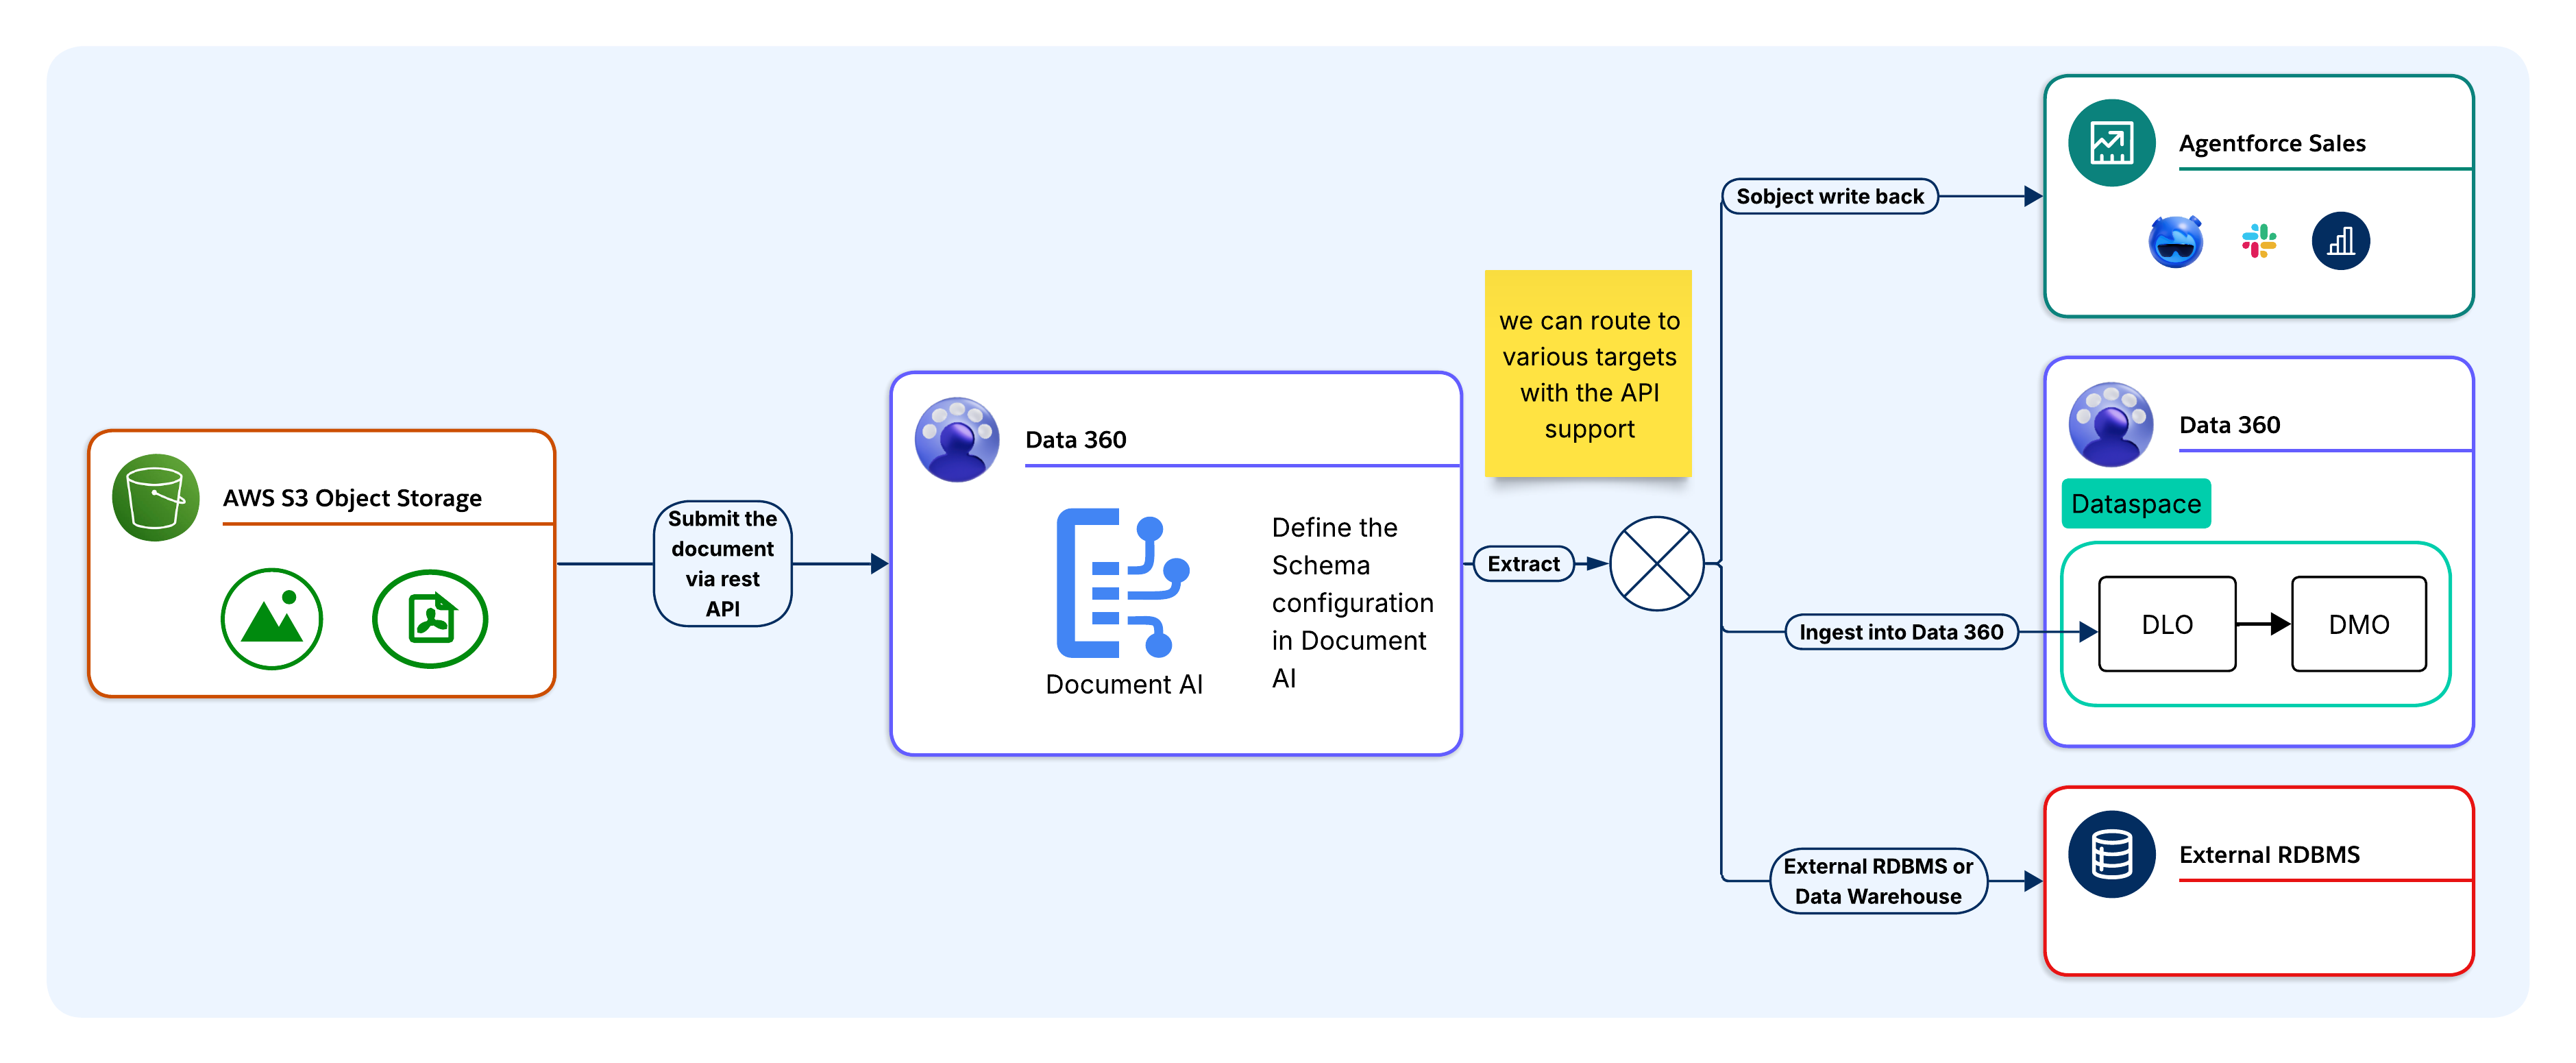
APIを呼び出す前に、アーキテクトは_JSONスキーマ_形式で項目、データ型、抽出手順を指定するスキーマを_Data 360_で定義して保存する必要があります。各スキーマには一意の_スキーマ ID_ が割り当てられます。実行時に、コール元アプリケーションはスキーマ ID を参照して、抽出ロジックをアプリケーションコードに埋め込むのではなく Data 360 で一元化します。
例:
この銀行のチームには、_Data 360_の定義済みProofOfAddressスキーマがあり、CustomerName、AddressLine1、City、PostCode、DocumentDateなどの項目が指定されています。この情報は、スキーマ ID で参照できるバージョン管理された設定として保存されます。
コール元アプリケーションは、ドキュメントとスキーマ ID を base64 エンコードされたペイロードまたはファイル参照として 1 つの REST API 要求で送信します。UDLO の取り込みは必要ありません。_ドキュメントAIは_ドキュメントの抽出を適用し、提供されたスキーマに基づいて構造化された出力を返します。
例:
モバイルアプリケーションは、1 回の REST API コールでProofOfAddressスキーマ ID と共に base64 エンコードされたペイロードとして公共料金を送信します。このプロセスでは、UDLO の取り込みステップは必要ありません。
LLM はスキーマに対して OCR 出力を処理し、構造化された JSON ペイロードを同期して返します。ドキュメントで見つからないフィールドは、 null として返されます 。通話者は完全な JSON 応答を所有し、ルーティングに進みます。
例:
_ドキュメントAI_はOCRをPDFに適用し、LLMは抽出された住所フィールドを含む構造化されたJSONペイロードを返します。見つからない項目 (請求書にPostCodeがない場合など) は、null として返されます。
抽出された JSON ペイロードは、使用事例に応じて 1 つ以上の対象ランクにルーティングできます。
- Salesforce SObject: CRM ワークフローおよび承認用の Apex または_フローを_介し_て SObject_ 項目に直接マッピングします。
- **Data 360 DLO/DMO パイプライン:**は、ハーモナイゼーション、ID 解決、計算済みインサイト、および Agentforce グラウンディングのために DLO にルーティングします。
- 外部 RDBMS またはデータウェアハウス: Salesforce の外部にあるシステムに対して、MuleSoft、Apex コールアウト、プラットフォームイベント、または ETL 経由でルーティングします。
- カスタムインテグレーション: 構造化 JSON ペイロードをコール元アプリケーションに返し、外部システムまたはデータストアに保存します。
- ダウンストリームフローまたはエージェント: 構造化された JSON 出力を SObject に保持せずに、ダウンストリームフローまたはエージェントに直接渡します。これは、大規模な自動化ワークフローまたはエージェント ワークフロー内のリアルタイム抽出ステップとして_ドキュメントAI_を使用するお客様に一般的なパターンです。
同じ抽出ポイントから、異なる項目グループが異なる対象にルーティングされ、1 つのスキーマが複数のランクに同時に分散される可能性があります。
例:
ProofOfAddress ペイロードは一度に 3 つの階層にファンアウトできます(たとえば、Contact SObject へのCustomerNameとAddressLine1の書き込み)。これにより、アドレス検証_フロー_が開始されます。次に、フル ペイロードがハーモナイゼーションとリスク スコアリングのためにDLOにルーティングされ、コピーが規制コンプライアンス ログのために_MuleSoft_経由で銀行のKYCシステムにルーティングされます。
いったん書き込まれると、抽出されたデータは対象システム内ですぐに有効化されます。SObject ターゲットの場合、トリガー、フロー、および承認プロセスは、更新/挿入されたレコードで有効化されます。DLO/DMO ターゲットの場合、データは_ハーモナイゼーションおよび ID 解決_パイプラインと Agentforce コンテキストに入ります。外部 RDBMS ターゲットの場合、書き込みが完了するとすぐにダウンストリームクエリでデータを使用できるようになります。
例:
_住所確認フロー_は、更新/挿入された_取引先責任者_レコードですぐに有効化され、ローン出願が次のフェーズに進みます。Agentforce ローン担当者 Agent が Data 360 から検証済みの住所を見つけ、KYC システムが監査目的でドキュメント送信を記録します。
_ドキュメント AI_は、特定のアーキテクチャ条件に最適です。これらの条件以外で適用すると、不必要な複雑さと追加コストが発生します。
アーキテクトは、抽出メカニズムとして_ドキュメント AI_を採用する前に、この基準を評価することが重要です。
ドキュメント AI は、次の場合に使用します。
- **ドキュメントは主データソースです。**必要な情報はドキュメント形式でのみ存在し、構造化された API またはデータベース (スキャンされた契約、ラボレポート、受入フォーム、保険請求など) からは使用できません。
- **ドキュメントレイアウトはソースによって異なります。**同じドキュメント種別が、複数のベンダー、パートナー、またはリージョンから、異なる項目の位置や形式で届きます。スキーマ駆動の LLM 抽出は、レイアウトごとのメンテナンスなしで適応します。
- **抽出されたデータは、Data 360 または Agentforce に入力する必要があります。**抽出は、ID 解決、計算済みインサイト、または Agentforce グラウンディングに関与する必要があります。_ドキュメントAI_は、個別のETLレイヤーなしで_DLO/DMO_パイプラインに直接配信されます。
- **ボリュームは管理されたオートメーションを正当化します。**ドキュメント量は、測定可能な人件費やデータ品質リスクなしで手動処理で処理できる量を超えています。
- ドキュメントには規制されたコンテンツが含まれます。PHI、PII、または財務データは、LLMに到達する前に、データ保存ゼロのPIIマスキング レイヤーを通過する必要があります。ETL はこれをネイティブに実現します。抽出されたコンテンツを常に保持する必要のないお客様は、構造化された出力を SObject やデータストアに書き込まずに呼び出し元アプリケーションに直接返す_トランザクション API_ フローも考慮する必要があります。
- **ユースケースはイベント駆動型です。**ドキュメントが実行時に到着する (顧客のアップロード、エージェントの PDF 添付ファイル、外部システムトリガーなど)。Transactional Processing パイプラインは、バッチ設定を行わずに同期的な単一ドキュメント抽出を処理します。
次の場合は Document AI を使用しないでください:
- **ソース データはすでに構造化されています。**上流システムが REST API、データベーステーブル、または構造化ファイル (CSV、JSON、XML など) を公開する場合は、標準 Data 360 コネクタを使用します。LLM 抽出パイプラインで構造化データを実行すると、遅延とクレジットコストが増加しますが、メリットはありません。
- **ドキュメントは固定スキーマで機械生成されます。**安定したレイアウトの既知の ERP または請求プラットフォームからシステムで生成された PDF は、確定的パーサーに適しています。LLM 抽出は可変性を目的として設計されており、固定スキーマドキュメントに適用するとコンテキストとクレジットが無駄になります。
- 精度要件が LLM の信頼度しきい値を超えています。_ドキュメントAI_は100%の抽出精度を保証するものではありません。項目値の欠如や不正確な値によって重大な財務上、法的、臨床上のリスクが生じる場合、HITL 検証ステップが必要です。検証ワークフローのないリスクの高い意思決定のための唯一の抽出レイヤーとして_ドキュメントAI_を使用しないでください。
- **ドキュメントがプラットフォームの制約を超えている。**現在の10 MBのファイルサイズ制限とLLMコンテキスト長の制限により、_Document AI_は、プラットフォーム外で分割および再構成するための前処理を行わない大規模または高密度のドキュメントには適していません。
- 注意: Salesforceでは、これらの受け入れガードレールを積極的に改善し、サポートされるファイルサイズ、ページ数、およびファイル拡張子を拡張しています。制約は今後も進化し続けます。
UDMOソース オブジェクトに裏打ちされた_Document AIバッチ_ パイプラインを使用するいくつかのシナリオを詳しく見てみましょう。このような場合、抽出されたデータは、ハーモナイゼーション、ID解決、計算済みインサイト、Agentforce有効化のために_Data 360 DLO/DMO_パイプラインを介してルーティングされます。各ユースケースは、スケジュール済みまたはイベント駆動型の大量ドキュメント処理に最適です。
Agentforce セールス: 契約および請求書インテリジェンス
_契約_PDFは、バッチ パイプラインを介してクラウド ストレージから取り込まれます。このスキーマでは、ContractValue、RenewalDate、PaymentTerms、CounterpartyName を抽出し、Account DMO および Contract DMO に対応付けます。_計算済みインサイト_は、更新リスクスコアを算出します。Agentforceは、更新ウィンドウが閉じる前にアカウントエグゼクティブにアラートを送信するため、手動での契約確認や更新漏れがなくなります。
Agentforce サービス: ケースデフレクションとナレッジグラウンディング
アンケート PDF とケースの添付ファイルは、_バッチ_パイプラインを介して取り込まれます。このスキーマでは、センチメント インジケータ、問題カテゴリ、解決メモを抽出し、_ケース記事_と_Knowledge記事_のDMOに対応付けます。Agentforce は、ケースがオープンするとハーモナイズされた知識ベースを照会し、関連するトラブルシューティング手順を見つけるため、エージェントの検索作業負荷が軽減されます。
Agentforce Health: 臨床ドキュメント処理
ラボレポート、受入PDF、手書きの臨床フォームは、_一括処理_パイプラインを介して取り込まれます。スキーマでは、PatientID、DiagnosisCode、MedicationName、TestResult などのフィールドが抽出され、HIPAA に準拠したケア連携と臨床研究ワークフローをサポートする Health Cloud DMO にマッピングされます。
金融事業: ローンおよび税金文書の自動化
ローンアプリケーション、税金申告、損益計算書は一括処理パイプラインを介して取り込まれます。このスキーマでは、AnnualIncome、TaxYear、EmployerName などのフィールドが抽出され、金融口座 DMO に対応付けられます。_計算済みインサイト_は、ドキュメントから派生した収入データとCRMデータを結合して、クレジットリスクスコアリングの自動化を促進します。Agentforce は、カスタマーサービスのインタラクション中に抽出されたローン詳細をインラインで特定します。このパターンは、Salesforce Agentic Enterprise Solutions 開発者センターで公開されている Loan Prequalification Agent の使用事例を直接サポートします。
HR: ワークフォースドキュメント処理
オンボーディング ドキュメント、税金フォーム、認定PDFは、バッチ パイプラインを介して取り込まれます。抽出されたフィールドは_従業員レコード_DMOにマッピングされ、_統合従業員_プロフィールにリンク済みになります。特定_のフロー_は、抽出されたデータに基づいてオンボーディング タスクとコンプライアンス チェックを開始します。このパターンは、Automate Resume Processing エージェント型ユースケースを直接サポートします。ドキュメントAIは、スキル、雇用履歴、資格を履歴書PDFから抽出し、Agentforceで候補者を公募条件と照合して採用ワークフローに転送します。
プロフェッショナルサービス: 提案および調査インテリジェンス
提案デッキと調査レポートは、バッチ パイプラインを介して取り込まれます。抽出されたフレームワーク、ベンチマーク、エンゲージメント概要はカスタム DMO にマッピングされ、ベクトル検索用にインデックス付けされます。Agentforce は、抽出されたドキュメントコンテンツに基づいて、クエリ時にコンテキストに関連するレコメンデーションを取得します。このパターンは、Ground Agentforce on Website Content パターンを拡張します。ドキュメントは_Document AI_によってインデックス付けされ、_Data 360_コネクタを介してインデックス付けされたWebサイトコンテンツと同じグラウンディング機能でエージェント応答に対応します。
HIPAAコンプライアンス状況:
このホワイト ペーパーで説明する_Health Cloud_パターンでは、テキスト入力にETLコントロール(データ保持ゼロやPHIマスキングなど)が適用されます。これらの管理だけでは HIPAA 認証とはなりません。規制対象の臨床環境向けに設計するアーキテクトは、それらのコンテキスト内で_ドキュメントAI_ベースのアーキテクチャに取り組む前に、Salesforceコンプライアンス チームに現在のHIPAA認定状況を確認する必要があります。
UDMOにバインドされていないスキーマを使用して_Document AI_ REST APIを呼び出すいくつかのシナリオを詳しく見てみましょう。抽出された JSON ペイロードは、実行時に外部システムに同期して直接転送されます。
サプライチェーン: ベンダー請求書処理から ERP
監視対象のストレージ バケットまたはメール ゲートウェイに_ベンダー請求書_PDFが届くと、イベント トリガーによって請求書と定義済みのスキーマIDを使用して_Document AI_ REST APIがコールされます。このスキーマでは、VendorID、InvoiceNumber、LineItems、TotalAmount、TaxAmount、DueDateが抽出されます。JSON ペイロードは_、MuleSoft_ 経由で ERP Accounts Payable モジュールにルーティングします。このモジュールでは、null 項目の検証と更新/挿入ロジックが使用されるため、サプライヤー形式の可変性に関するテンプレートのメンテナンスが不要になります。
法務部門: Contract Review to CLM (CLM への契約レビュー)
契約_PDFが法務ポータルにアップロードされると、バックエンドは_Document AI REST APIを同期的にコールします。このスキーマでは、GoverningLaw、IndemnityCapAmount、TerminationNoticePeriod、AutoRenewalClause、CounterpartySignatory が抽出されます。JSON ペイロードは、Apex コールアウトを介して _CLM(契約ライフサイクル管理)_システムにルーティングされます。フィールドが見つからない場合は null として返され、CLM はデフォルトの義務ルールを欠損値に適用します。
保険請求: 最初の損失通知処理
保険契約者が_FNOL(First Notice of Loss_)フォームを送信すると、バックエンド ポータルは_Document AI_ REST APIを同期的にコールします。このスキーマでは、PolicyNumber、IncidentDate、IncidentLocation、DamageDescription、ClaimantName、ContactPhone が抽出されます。JSON ペイロードは Apex コールアウトまたは ETL を介して_請求管理_データベースに転送され、調整担当者が正式な請求を開く前に確認できるように事前入力済みの請求レコードが作成されます。
本番に移行する前に、次の失敗シナリオの設計を作成する必要があります。
- Null 項目処理: LLM が、検出できない項目または自信を持って抽出できない項目に対して null を返します。NOT NULL 制約または必須の一致キーがある対象に書き込む前に、スキーマ設計で null 処理ロジックを検証し、インテグレーションレイヤーでデフォルト値または却下ロジックを実装します。
- OCR 品質劣化: 150 DPI 未満、不規則な手書き、またはノイズの多いスキャンでは、OCR 精度が低下します。ミスリードは、エラーシグナルのない破損した入力として LLM 抽出に伝播されます。取り込み時に最小スキャン品質を確保し、数値フィールドと日付フィールドに対して信頼度しきい値のチェックを実装します。
- スキーマバージョン不一致: 一括処理ジョブがスケジュールされた後にスキーマ設定を更新すると、未処理ドキュメントが以前のバージョンに対して処理され、欠落または名前変更された項目が生成されて下流の対応付けが破損する。スキーマを明示的にバージョン管理し、一括処理ジョブスケジュールを使用して更新を調整します。
- ファイルサイズ制限: 10 MB を超えるドキュメントは却下されます。バッチ パイプラインの失敗は、監視が設定されていない場合は通知されず、トランザクション発信者は 4xx エラーを受信します。取り込み時にファイルサイズを事前に検証し、定期的に制限に近づいているドキュメントをスプリットまたは圧縮する事前処理を実装します。
- LLM コンテキストオーバーフロー: 高密度または複数ページのドキュメントが 10 MB の制限内で LLM コンテキストウィンドウを超えることがあります。LLM は、コンテキストを超えるコンテンツを通知なしで削除します。ドキュメントをページ範囲でスプリットし、抽出された項目を対象に転送する前に再構成するチャンク戦略を実装します。
- **Trust Layer Masking Affecting Extraction:**ETLはドキュメント レベルではなくプロンプト レベルで動作するため、マスキングは_ドキュメントAI_を通過するドキュメント コンテンツには適用されません。ドキュメント内の PII 値に依存するスキーマ項目は、ETL マスキングポリシーの影響を受けません。
- External RDBMS Write Idempotency: _トランザクション処理_パイプラインには、外部 RDBMS ターゲットに対する緊急性が組み込まれていません。書き込みロジックで明示的に重複除外が処理されない限り、_インテグレーションレイヤー_の再試行で重複行が作成されます。すべての外部書き込みパスでドキュメントフィンガープリントまたは外部 ID を使用して、冪等なアップサートを実装します。
- Credit Exhaustion Mid-Run: 大規模なバッチの実行では、すべてのドキュメントが処理される前に Digital Wallet クレジットが枯渇し、下流ステップが完了として表示される不完全な DLO データセットが生成されます。消費アラートを使用可能なクレジットの 75% と 90% に設定し、各サイクルのクレジット予算を超えないようにバッチサイズを制限します。
- スキーマ項目制限 — アーキテクチャ上の制約: _ドキュメント AI で_は、スキーマ構成のルートレベルの項目に 50 項目の制限が適用されます。これは設計時の制約であり、ランタイムエラーではありません。アーキテクトはデータモデルとスキーマの設計時にこの制約を考慮する必要があります。
- より広範な抽出が必要なユースケースの場合:
- 無慈悲に優先順位を付けます。ドキュメントを網羅するのではなく、自動化の価値を高めるフィールドにスキーマを絞り込みます。
- ネストされたオブジェクト (最大 3 レベル、取得元オブジェクトのみのバッチモード) を活用して、抽出深度を犠牲にすることなくルートレベルの項目数を減らします。
- 個別のドキュメント セクションを対象とする複数の_ドキュメント AI_ 構成で複雑なドキュメントを分解し、Data 360 の下流で結合する個別の DLO に結果を書き込みます。
- より広範な抽出が必要なユースケースの場合:
- APIレート制限:_ドキュメントAI_では、テナントごとに1分あたり50個の抽出APIコールの制限が適用されます。理論の上限は 1 分あたり 300 コールで、_Einstein LLM ゲートウェイ_によって制御されます。大規模なトランザクションインテグレーションは、指数関数的なバックオフ、要求キュー、テナントレベルのスループット予算を使用して設計する必要があります。バースト容量がマルチテナント本番環境で入手可能であると仮定しないでください。
- API レイテンシプロファイル:ドキュメントAI 抽出APIは完全に同期型です。一般的な応答時間は 5 ~ 15 秒で、ファイルサイズやスキーマの複雑さによって異なります。
- これはインテグレーションアーキテクチャに直接影響します。
- 通話者のタイムアウトを最小 30 秒に設定します。
- 1 秒未満の SLA 要件があるフローで Document AI を起動しないでください。
- スループット計算には、_バッチ処理_パイプラインのレート制限の上限に対する遅延を考慮に入れます。
- 通話者のタイムアウトを最小 30 秒に設定します。
- これはインテグレーションアーキテクチャに直接影響します。
- 暗号化およびパスワードで保護されたドキュメント:ドキュメントAIは、パスワードで保護されたファイル(ファイルを開くためにユーザー パスワードが必要)や、所有者/権限のパスワードで暗号化されたPDF(通常開くが、_PDF権限_レイヤーでコピー、印刷、編集が制限されているファイルを含む)を処理しません。
- この制約は受入境界に位置します。
- _ドキュメント受入_パイプラインを設計して、暗号化されたファイルを検出して、_ドキュメントAI_に到達する前_に却下_または_手動処理_パスにルーティングします。
- 実行時エラー処理をプライマリゲートとして使用しないでください。
- この制約は受入境界に位置します。
_Data 360 Document AI_は、Salesforce _Well-Architected Framework_のいくつかの柱と連携しています。
- Trust: ETLは、LLMプロバイダーにデータ保持をゼロにし、モデルに到達する前_にPII_入力をマスキングして、機密コンテンツを出力をスキャンします。アーキテクトは、この姿勢を抽出された静止データにも拡張する必要があります。DLO の項目レベルのマスキングは ETL では適用されず、ダウンストリーム_のデータスペース_ポリシーと_権限セット_が必要です。
- 信頼性: [Design Considerations (設計上の考慮事項)] セクションの各障害モード(null 項目の抽出、OCR の読み取りミス、スキーマバージョンの不一致、ファイルサイズの侵害、LLM コンテキストのオーバーフロー、ETL マスキング干渉、RDBMS 書き込みの妥当性、クレジットの枯渇)は、文書化されている検出信号と解決パスで個別の障害クラスを表します。
- Operational Excellence (変更管理): スキーマ駆動の抽出モデルでは、抽出ロジックがドキュメントレイアウトから分離されます。ベンダーが請求書形式を変更したり、規制フォームが更新されたりした場合、アーキテクトはインテグレーションコードを変更するのではなく、1 つのスキーマ設定を更新するだけで済みます。
- Operational Excellence (運用性): アプリケーションコードに抽出ロジックを埋め込むのではなく、Data 360 でスキーマ設定を一元化することで、抽出インテントを明示し、バージョン管理して監査できるようにします。すべてのダウンストリーム対象は、対象階層に関係なく同じスキーマ契約を使用します。
- Operational Excellence(インテグレーションの再利用):ドキュメントAIは、REST API、Apex、フロー、MuleSoft、Agentforce_アクション_、MCPサーバーなど、複数のインテグレーション サーフェスにわたって抽出を公開します。1つのスキーマ設定で、各コンシューマーごとに抽出機能を再構築することなく、複数の対象ランクへ同時に展開できます。
- リソースとコストの最適化: パイプラインの選択ガイダンス、10 MBのファイルサイズ境界、事前アセンブリLLMコンテキスト長の制約は、パフォーマンスを考慮した設計上の意思決定を表します。[_いつ使用_するか]セクションでは、_ドキュメントAI_が適切なツールでない場合の条件(1秒未満のレイテンシー要件、完全に構造化されたソース データ、固定スキーマのマシン生成ドキュメントなど)を正式に設定します。
これは、Sandbox 環境で Data 360 Document AI を設定するための構造化された開始点です。本番に移行する前に Sandbox のすべてのフェーズを完了します。
設定を開始する前に、次のことを確認する必要があります。
- ファイルサイズ: 代表的なドキュメントサイズが 10 MB 未満であることを確認します。
- パイプライン: 使用事例で_バッチ_パイプライン (UDMO 支援の大規模) と_トランザクション処理_パイプライン (API 駆動の単一ドキュメント) のどちらが必要かを確認します。これがすべての後続の設定の指針となります。
- **対象階層:**抽出されたデータが格納されている場所(Salesforce SObject、Data 360 DLO/DMO、外部RDBMS、またはその組み合わせ)を確認します。
- Agentforce 連動関係: Agentforce を使用したドキュメント処理をリリースする前に、ETL 設定を使用してサポートされる LLM(GPT-4o など)が組織で有効になっていることを確認します。Agentforceは、ドキュメントAI_のハード プラットフォームの前提条件です。Agentforce がターゲット組織で有効になるまで、すべての抽出 API を含む_ドキュメント AI 機能の表面全体は使用できません。組織の準備状況評価とプロビジョニングの順序付けにこれを加味します。API の入手可能性が有効化後に安定するまで、数分かかる場合があります。
- Agentforce 無効化の影響:ドキュメント AI が設定およびリリースされた後に Agentforce が無効化されると、すべての抽出処理 (UI および API) がすぐにブロックされます。モデルの無効化についても同様です。基礎となるモデルを無効にすると、_ドキュメント AI の_可用性に相当します。どちらの場合も、既存のスキーマ設定は保持され、表示されたままになります。設定やデータの損失はありませんが、Agentforce とモデルを再度有効にするまで、この機能は完全に動作しません。Agentforceの可用性とモデル イネーブルメントを_ドキュメントAIの_正常性連動関係として処理するように運用ランブックを設計します。
- クレジット消費/価格設定: 代表的なサンプルドキュメントから取得された TCO の推定に Data 360 クレジットまたは Flex Credits を使用します。
- スキーマ設定を作成します。Data 360 Document AI 設定で、_JSON スキーマ_形式で抽出項目、データ型、命令を定義します。_バッチ_パイプラインの場合は、UDMO にバインドします。_トランザクション処理_パイプラインの場合、ソースオブジェクトなしで作成します。スキーマ ID を記録します。
- **フィールド名をターゲット階層に合わせます。**フィールド名を DLO 列定義、SObject API 参照名、または RDBMS 列名と照合します。名前が一致しないと、インテグレーションレイヤーの対応付けのオーバーヘッドが発生します。
- **UDMO ソース オブジェクトを設定します(バッチのみ)。**範囲内のドキュメントを定義し、取り込みソースの接続を設定します(S3、Google Cloud Storage、Salesforce Files、MuleSoftなど)。取り込みサービスアカウントに必要_な IAM_ または OAuth ログイン情報範囲があることを確認します。
- **PII マスキングポリシーを適用します。**規制対象のコンテンツを処理する前に、ETL 設定で_データマスキング_ポリシーを設定します。入力が LLM に到達する前にマスキングするデータ型 (PHI、PII、財務識別子) を定義します。延期しないでください。
- **データスペース範囲と権限セットを割り当てます。**適切な_データスペース_に処理の範囲を設定し、スキーマの作成、一括処理ジョブの実行、REST APIの呼び出し、ダウンストリームの有効化を制御する_権限セット_を設定します。
- API 認証を設定します (トランザクション処理パイプラインのみ)。OAuth 範囲が cdp_ingest_api および api の_接続アプリケーション_を作成します。組織内部通話者の場合は、_外部ログイン情報_にリンクする_指定ログイン情報_を使用します。外部通話者の場合は、OAuth 2.0 クライアントログイン情報または JWT ベアラーフローを設定します。続行する前に抽出をテストして検証します。
- SObject 書き戻し: JSON 応答フィールドを SObject フィールドにマッピングする Apex ($InvocableMethod) または_フロー_要素を実装します。Database.upsert() を外部 ID と共に使用して、重複を回避します。対象 SObject 項目に_項目レベルセキュリティ_を適用します。
- Data 360 DLO/DMOパイプライン: 抽出したDLOフィールドを_Customer 360データモデル_に準拠したDMOにマッピングします。ドキュメントレコードを_統合個人_にリンクするように ID 解決ルールを設定します。計算済みインサイト_を定義し、Agentforce の DMO を追加します。トランザクション処理パイプラインの場合、最初に_取り込み API を使用して JSON ペイロードを DLO にルーティングします。
- 外部 RDBMS またはデータウェアハウス: インテグレーションパターンとして、MuleSoft(既存のインテグレーションファブリック)、Apex HTTP コールアウト(軽量、組織ネイティブ)、Pub/Sub 登録者による_プラットフォームイベント_(イベント駆動型)、または ETL(大規模バッチ)を選択します。すべての外部書き込みパスでドキュメントフィンガープリントまたは外部 ID を使用して、冪等なアップサートを実装します。
- アクティベーションパス: Agentforce アクションをスキーマ設定に接続して対話形式で抽出します。自動処理ワークフローの_フロー_または Apex トリガーを設定し、各フィールド グループの有効化対象を設定します。
- **エラー処理 (トランザクション処理パイプラインのみ)。**完全な HTTP 応答表面を設定します。200 (成功、部分的_な null_ 応答を含む)、400 (_不正な要求_または_スキーマ ID が_見つからない)、413 (ファイルが 10 MB を超える)、5xx (サービスエラー)。最大 3 回の試行で 5xx 回の再試行に対して指数バックオフを実装します。すべてのコールで未加工の JSON 応答とスキーマ ID を記録します。
- サンプルドキュメントに対してスキーマをテストします。_Document AI_インターフェースまたはREST APIを使用して、代表的なサンプルを送信します。レイアウトのバリエーション全体で抽出の精度、項目カバー率、null の処理を確認します。
- **null フィールドの処理を検証します。**すべてのダウンストリームターゲットで、ドキュメントに_ない項目_の null 値を処理できることを確認します。NOT NULL 制約は、明示的な null 処理なしでサイレントに失敗します。
- **ファイルサイズの事前検証を行います。**本番ドキュメントが 10 MB 未満であることを確認します。定期的に制限に近づくドキュメントをスプリットまたは圧縮するための事前処理を実装します。
- エンドツーエンドの抽出を検証します。バッチ パイプラインの場合、フル実行を開始し、抽出されたフィールドが各ターゲット階層に正しく配置されることを確認します。_トランザクション処理_パイプラインの場合、JSON 応答を_インテグレーション_レイヤーからターゲットまで追跡します。SObject ターゲットのトリガーとフローの実行、DLO/DMO ターゲットの ID 解決リンク、RDBMS ターゲットの可能性を確認します。
- **Trust Layer の動作を確認します。**ETL では_、PII_ マスキングはドキュメントコンテンツに適用されないため、LLM は抽出されたフィールドの PII データをそのまま返します。スキーマ項目、データルーティング、ダウンストリームストレージが PII ベアリングの出力を適切に処理するように設計されていることを確認し、コンプライアンス要件や保持要件がプラットフォーム外で対処されていることを確認します。
- **Digital Wallet アラートを設定します。**利用可能なクレジットの 75% と 90% で消費アラートを設定します。各サイクルのクレジット予算内でバッチサイズ制限とアドホックレート見積を設定します。
- バッチ監視を検証します (バッチパイプラインのみ)。Data 360 監視コンソールで抽出成功率、null 項目率、ジョブ完了を確認します。UDLO から DLO を経由してデータ系統の DMO にタグが伝播されることを確認します。
- API エラー処理を検証します (トランザクション処理パイプラインのみ)。すべてのエラー条件をテストします: 413 (10 MB を超えるドキュメント)、400 (無効なスキーマ ID)、200 (部分的な null を含む有効な抽出)。再試行ロジックが、シミュレートされた 5xx 応答で重複書き込みを作成せずに起動されることを確認します。
このドキュメントでは、Data 360 Document AI:のアーキテクチャ基盤について説明します。
- 2 つの処理パイプラインとそのパイプラインを使用するケース
- スキーマ設定モデル
- 対象ランク決定フレームワーク
- Core テクノロジーの制約
- 失敗モード
- Well-Architected Framework との整合性
『Quick-Start Guide for Architects (アーキテクト向けクイックスタートガイド)』には、Sandbox の概念実証の設定順序が記載されています。
アーキテクチャのコアとなる姿勢は、スキーマ レイヤーで管理され、ETL適用LLMパイプラインを介して処理され、他のすべてのエンタープライズ データを管理する同じ_Data 360_データ ライフサイクルに提供されるドキュメント派生データをサポートします。
これらの原則(適切なパイプラインの選択、ドキュメント種別レベルでのスキーマ設計、本番稼働前の障害モード対策)を適用するアーキテクトは、規制対象の業界ガバナンス要件の下でスケールし、長期間にわたって維持できる抽出機能を構築します。
Yugandhar Boraは、_データおよびインテリジェンスアプリケーション_プラットフォーム内のデータアーキテクチャを専門とするSalesforceのソフトウェアエンジニアリングアーキテクトです。データ ガバナンスと統合データ モデルに重点を置く_EARB(Enterprise Architecture Review Board)_イニシアティブを主導すると同時に、自動化されたプラットフォーム プロビジョニング ソリューションにも貢献しています。
Ananth Antoは、Salesforce _Data 360_の製品管理ディレクターであり、ドキュメントAIおよびデータグラフ イニシアティブを主導しています。バンガロールを拠点として、企業のお客様と協力して、実際のドキュメント処理とデータインテリジェンスの課題を解決します。_Enterprise_向けの_生成 AI (Gen AI)_ユースケースの探索を楽しんでいます。
Nishan Naseerは、非構造化データ処理、_RAG_パイプライン、_ドキュメント インテリジェンス_を担当するSalesforceのソフトウェア エンジニアリング アーキテクトです。AI のパワーを活用して実際の課題に取り組み、複雑な顧客の問題に対するクリエイティブなソリューションを見つけることに情熱を注いでいます。