エンタープライズデータアーキテクチャが 1 つのシステムに存在することはほとんどありません。Salesforce は、顧客エンゲージメント、パイプライン、サービスインタラクションを管理します。Snowflake などの分析プラットフォームには、取引履歴、財務レコード、利用状況データ、業務評価指標が格納されます。従来、この 2 つの世界を橋渡しするには、ソースからデータを抽出して変換し、コピーを Salesforce に読み込むスケジュール済みジョブである ETL パイプラインを構築して維持する必要がありました。これらのパイプラインの結果として、データ到着が遅れ、ガバナンスポリシーがシステム間で増殖し、パイプラインで継続的な運用上のケアが必要になります。
Salesforce Data Virtualization では、異なるモデルが用意されています。データを Salesforce に移動する代わりに、Salesforce はレプリケーションなしで実行時にデータをソースで直接照会できます。ユーザーには、標準の Salesforce インターフェースでライブ外部データが表示されます。データは、信頼できる場所から一切離れることはありません。このドキュメントでは、Snowflake を具体的な作業例として使用して、パターンのしくみ、使用条件、使用開始方法について説明します。
Salesforce データ仮想化は、実行時にデータを Salesforce ストレージにコピーまたは複製することなく、Salesforce が外部システムから直接データを照会できるようにするインテグレーションアーキテクチャパターンです。データを移動する代わりに、プラットフォームはクエリを送信します。
そのため、Salesforce ユーザーは使い慣れた Salesforce インターフェース (ページレイアウト、関連リスト、レポート、フローなど) を使用して外部データを操作できますが、データは権限のあるソースシステムに残ります。ガバナンス、アクセス制御、データレジデンシーは、本来あるべき場所にとどまります。
このパターンは、1 つのアーキテクチャ原則 (データはソースに保持) に基づいて構築されています。計算はデータに移動します。
ほとんどのエンタープライズ Salesforce リリースは、レプリケーションパイプラインを介して外部データプラットフォーム (データウェアハウス、業務データベース、分析ストアなど) と統合されます。パイプラインは、スケジュールに従ってデータを抽出、変換し、Salesforce に読み込みます。このアプローチは有効ですが、レプリケーションには構造的なトレードオフが生じます。
- 複製されたデータは常に遅延します。パイプラインでは遅延が発生し、古いデータによって誤った意思決定が引き起こされます。
- データのコピーごとにコンプライアンスの範囲が広がります。複数のシステムの機密データ (個人識別情報、財務レコード、健康データなど) には、複数のガバナンスポリシーを維持する必要があります。
- パイプラインには、継続的な運用投資、監視、障害処理、スキーマドリフト管理、再処理ロジックが必要です。
データ仮想化では、これらのトレードオフに直接対処します。読み取り負荷の高いユースケースにおいては、パイプライン自体を完全に排除し、データをその正統な場所に保持するとともに、Salesforce ユーザーにレプリケーションのオーバーヘッドなしで、リアルタイムかつガバナンスが保たれた外部データのビューを提供します。
外部オブジェクトは、データ仮想化によって外部データが Salesforce 内に現れる主要なメカニズムです。標準 Salesforce オブジェクトと同様に機能し、SOQL で照会でき、ページレイアウトと関連リストで表示され、標準 Salesforce API でアクセスできます。大きな違いは、Salesforce にデータが保存されないことです。外部オブジェクトはスキーマ投影法であり、データ自体のコピーではなく、外部データの外観の定義です。
ユーザーがページを読み込むか、外部オブジェクトを参照するレポートを実行すると、Salesforce は外部システムに対してライブクエリを実行し、そのインタラクションの結果セットのみを返します。
Salesforce が外部オブジェクトに対して SOQL クエリを実行すると、検索条件 (WHERE 句)、並び替え順 (ORDER BY)、制限 (LIMIT) が同等の SQL に変換され、外部システムに送信されます。外部システムは、独自の計算エンジンでクエリを実行し、絞り込まれた結果セットのみを返します。データは存在する場所で作業が行われ、回答のみが Salesforce に戻されます。
データ仮想化では、2 つの独立したセキュリティレイヤーが同時に適用されます。外部システムは、行レベルセキュリティ、列のマスキング、ロールベースのアクセスなど、クエリ実行時に独自のアクセス制御を適用します。Salesforce は、プロファイル、権限セット、項目レベルセキュリティ、共有ルールという独自のセキュリティモデルを適用します。どちらのレイヤーもすべてのクエリで有効になります。どちらももう一方を置き換えません。
アーキテクトはデータ仮想化を「ゼロコピー」パターンとよく言います。ゼロコピーとは、Salesforce ストレージへの永続的なレプリケーションを行わないことを意味します。Salesforce オブジェクトにレコードを書き込む ETL パイプラインはありません。ローカルコピーを作成するスケジュール済み同期はありません。外部オブジェクトには行が保持されません。
ゼロコピーは、データ送信がゼロであるという意味ではありません。ユーザーが外部オブジェクトを照会するたびに、結果セットが外部システムからネットワークを介して Salesforce に送信されます。結果セットが大きい場合やクエリ頻度が高い場合、データ出力コストとネットワークレイテンシは、アーキテクトが設計時に考慮すべき要因となります。これは非表示にする制限ではなく、考慮すべき設計上の制約です。
大量のデータ、高頻度のアクセス、または低レイテンシが求められる場合、これらのアーキテクチャ上の違いを検討してください。
Snowflake は、データ仮想化を介して Salesforce に接続されている最も一般的な外部システムの 1 つです。これは、パターンがエンドツーエンドでどのように機能するかを示す具体的な例です。
この設定では、Salesforce Connect と Snowflake の SQL アダプタを使用して Snowflake に接続します。Snowflake のテーブルとビューは、Salesforce では外部オブジェクトとして表示されます。ユーザーが外部オブジェクトを照会すると、Salesforce は SOQL を SQL に変換し、認証済み HTTPS コールアウトを介して Snowflake ステートメント API に送信します。Snowflake は仮想倉庫でクエリを実行し、独自の行レベルセキュリティと列マスキングを適用して、結果セットのみを返します。データはいかなる時点でも Salesforce ストレージに書き込まれません。
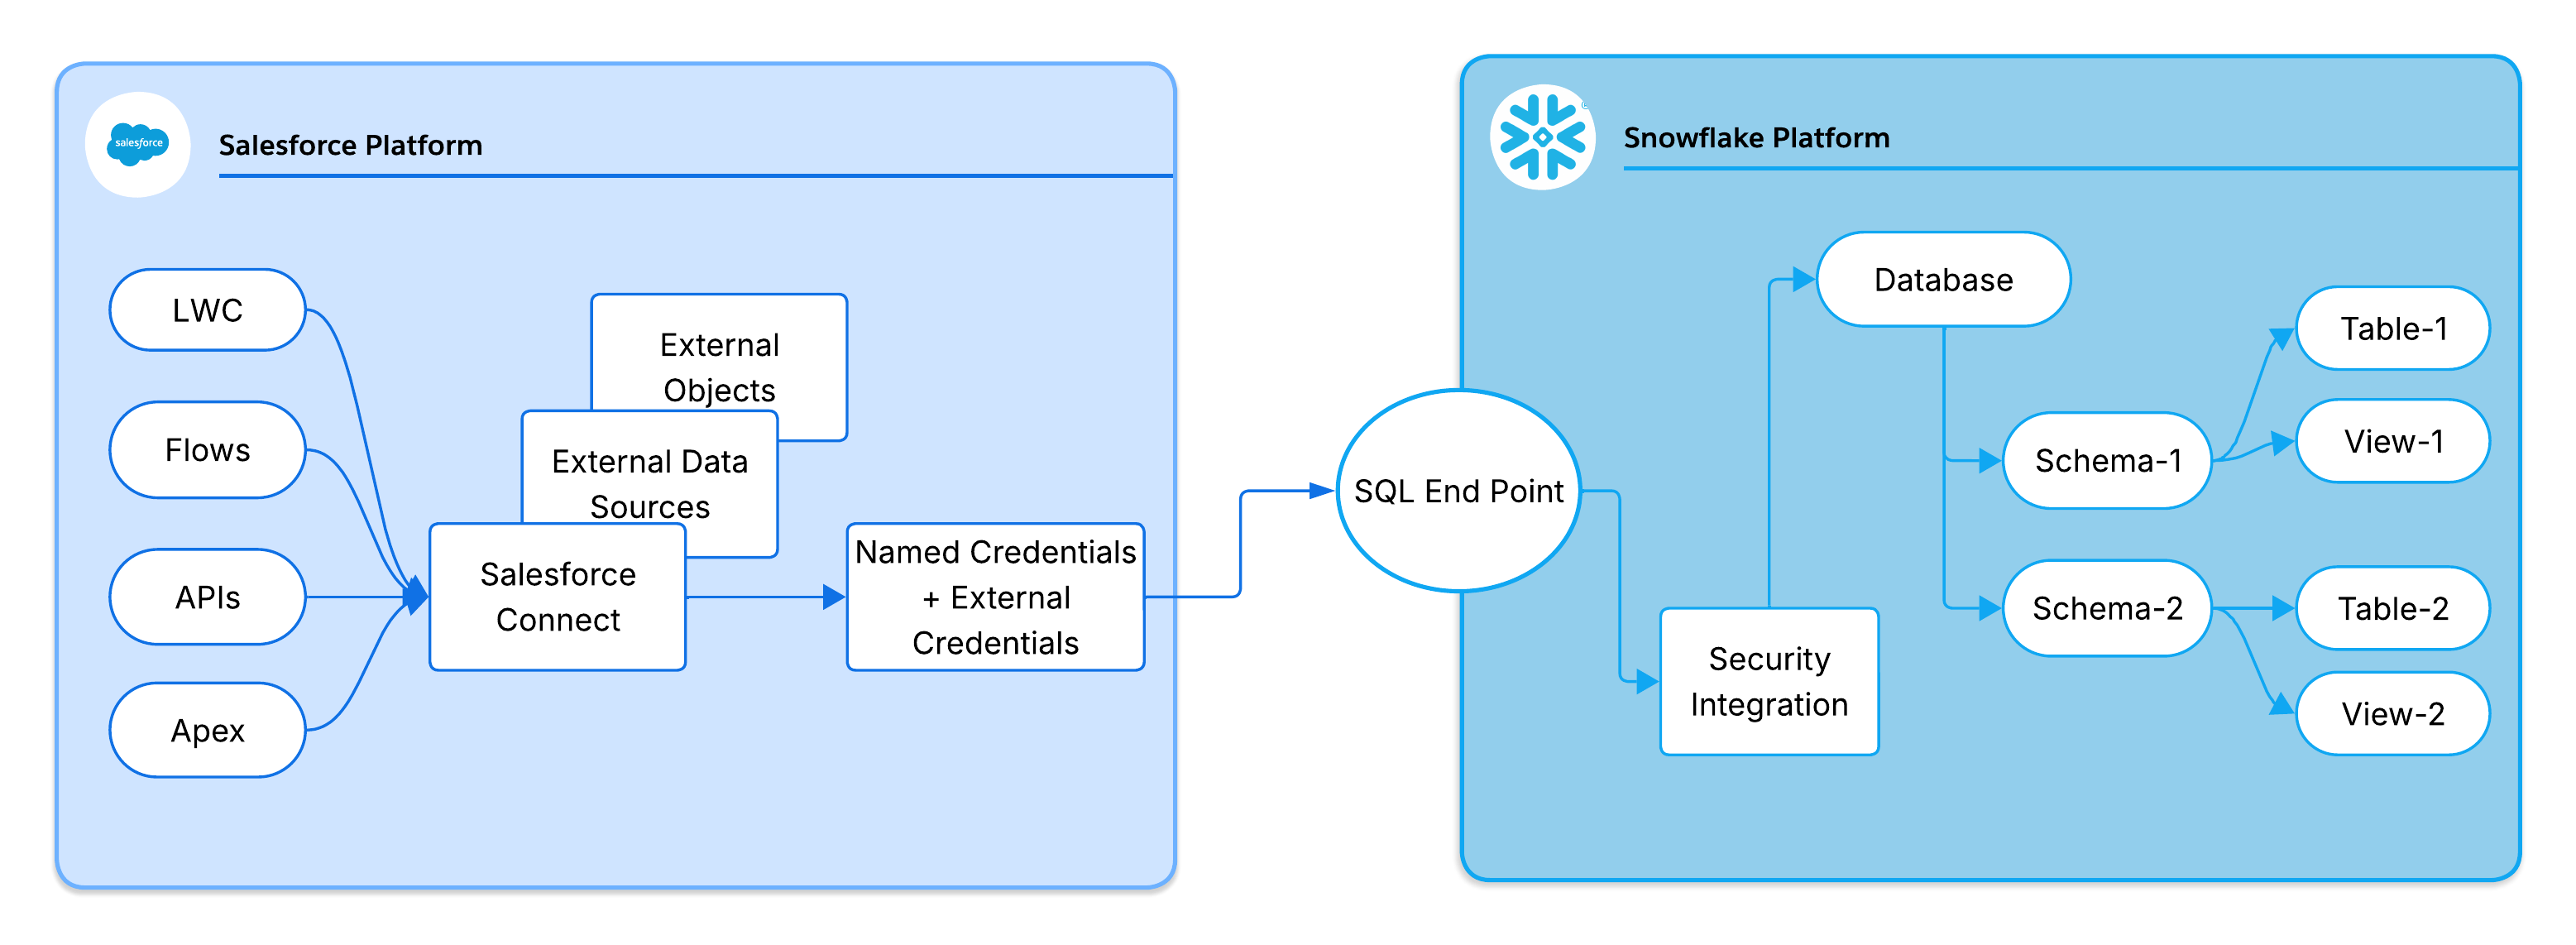
Salesforce Connectは代理OAuth 2.0モデルを使用してSnowflakeで認証します。主要なコンポーネントは次のとおりです。
- 認証プロバイダー: Snowflake との OAuth ハンドシェイクを管理します。トークン要求を処理し、返されたトークンを Salesforce ログイン情報に対応付けます。
- 外部ログイン情報: OAuth アクセストークンと更新トークンを Salesforce 暗号化ログイン情報ストアに安全に保持し、送信コールアウトに挿入します。
- 指定ログイン情報: Snowflake エンドポイント URL を定義し、外部ログイン情報を参照します。
- Snowflake Security Integration: Snowflake で Salesforce を信頼できる OAuth クライアントとして登録します。許可されるリダイレクト URI、OAuth フロー、トークン TTL を定義します。
外部データソースは指定ログイン情報を参照し、外部ログイン情報は認証プロバイダーを参照します。これらのコンポーネントは連動関係チェーンを形成します。接続またはアクセスの失敗をトラブルシューティングする場合、このチェーンを理解することが不可欠です。
Salesforce では、Snowflake での認証時に次の 2 つの ID 委任モデルをサポートしています。
- 指定ユーザー: 1 つの共有サービスアカウントが Snowflake に対してすべての Salesforce ユーザーを認証します。この設定の方が簡単ですが、ユーザーごとの監査機能や詳細な Snowflake アクセスコントロールはありません。
- Per-User Principal: 各 Salesforce ユーザーは、独自の OAuth トークンを使用して認証します。これにより、Snowflake の行レベルセキュリティとユーザーごとの完全な監査履歴が有効になりますが、トークン管理のオーバーヘッド (ユーザーごとの OAuth フロー、更新、取り消し) は高くなります。
決定ガイダンス: 規制対象データまたは個人識別情報 (PII) にはユーザーごとのプリンシパルを使用します。Salesforce 共有ルールで十分なアクセス制御が提供されていて、シンプルさが優先されている場合は、[指定ユーザー] を使用します。
Snowflake で外部オブジェクトを使用する場合、次の Salesforce ガバナ制限によってソリューション設計が直接形成されます。
- **コールアウト制限:**Apex トランザクションあたり 100。複数の外部オブジェクトクエリを使用するページまたはフローは、すぐにこの制限に達する可能性があります。
- コールアウトタイムアウト: 最大 120 秒。Snowflake クエリの実行時間が長いと、ランタイム例外が発生します。
- SOQL 行制限: 50,000 行。大規模な結果セットをページ分割します。
- 非**同期制約:**バッチ Apex およびほとんどの非同期コンテキストでコールアウトが制限されます。外部オブジェクトへのアクセスは同期トランザクション境界内に維持します。外部オブジェクトを照会する非同期使用事例では、ユーザーが開始する非同期インタラクションの継続コールアウトを考慮するか、同期トランザクションで外部データアクセスを実行し、結果を非同期で渡すようにフローを設計します。
設計ガイダンス: ループ内で外部オブジェクトを照会しないでください。WHERE 句の検索条件を Snowflake にプッシュして、結果サイズとコールアウト頻度を減らします。
Salesforce が Snowflake に送信するすべてのクエリは、完全な実行メタデータ (遅延、スキャンされた行数、使用された倉庫、実行 ID) と共に Snowflake クエリ履歴に記録されます。この履歴は、Salesforce ユーザーアクションから Snowflake の実行までのエンドツーエンドの監査を提供し、パフォーマンスチューニングとアクセス検証の主要な診断ツールです。
データ仮想化は、リアルタイムアクセス、ガバナンス、およびレプリケーションオーバーヘッドの削減が、連携クエリ時アクセスモデルの制約を上回るユースケースに適しています。
次のような場合に使用します。
- **読み取りの多い分析アクセスが主な要件です。**ユーザーが書き戻さずに Salesforce UI、レポート、またはフローで外部データを照会および表示する必要がある場合、データ仮想化により、参照のみのシナリオのパイプラインオーバーヘッドが排除されます。
- **データの新鮮さは重要です。**古い複製データによってビジネスリスク (期限切れの財務残高、在庫レベル、コンプライアンス状況など) が発生する場合、統合モデルではすべてのクエリにライブデータが反映されます。
- **ガバナンスとデータ レジデンシーの要件は厳格です。**規制や契約上の制約により機密データを Salesforce にコピーできない場合、仮想化によってデータが権限のある場所に保持され、Salesforce 内でアクセスできるようになります。1 つのシステムのみがデータを保持します。
- **2 層のアクセス制御が必要です。**外部システムのネイティブのアクセス制御と Salesforce セキュリティモデルの両方が同時に適用される場合、統合モデルではデータの重複なしで両方が適用されます。
- **外部システムはすでに権威ある記録システムです。**ソースシステムでデータがすでにクリーンアップされ、管理され、照会可能な場合、データを仮想化することで、冗長な変換、ストレージコスト、および分散のリスクを回避できます。
避けるべき場合:
- **低レイテンシの書き込みが必要です。**外部オブジェクトは参照のみです。書き戻しのユースケースでは、異なるインテグレーションパターンが必要です。
- **複雑な複数オブジェクトの結合が必要です。**複数の外部オブジェクトの SOQL では結合はサポートされません。結合したデータをソースシステム内で一つのビューとして事前に具体化します。
- **Salesforce AIまたはAgentforce機能にはネイティブ データが必要です。**現在、Einstein および Agentforce 機能(Einstein Copilot、予測スコアリング、Agentforce アクションのグラウンディングを含む)は、ネイティブ Salesforce オブジェクトで動作します。これらの機能では、グラウンディングまたは有効化データソースとして外部オブジェクトはサポートされません。AIの有効化がこのデータを対象とする場合、Salesforce Data 360が推奨される補完ソリューションです。
- **高頻度で大量のアクセスパターン。**外部オブジェクトは、オンデマンドアクセス用に設計されています。1 分間に数百件のクエリを実行するワークロードでは、ガバナ制限が緩和され、パフォーマンスが低下します。
次の使用事例は、Salesforce Data Virtualization が一般的なエンタープライズシナリオにどのように適用されるかを示しています。各例では外部システムとしてSnowflakeを使用していますが、基盤となるパターンは、Salesforce ConnectでサポートされるSQL互換のすべてのデータソースに適用されます。
課題: サポートチームは、SalesforceケースデータとSnowflakeに保存されているチケット量、解決時間、およびエスカレーション評価指標を組み合わせた統合レポートを必要としていました。このデータのレプリケーションパイプラインを構築および管理することで、参照専用レポートユースケースにおいて遅延が発生し、運用オーバーヘッドが増加しました。
ソリューション: チームはチケット総計値を含む Snowflake ビューを Salesforce の外部オブジェクトとして公開しました。チームは、ネイティブのケースオブジェクトを外部チケットデータと結合するように Salesforce レポートを設定しました。
結果:
- レポートには、常にライブ Snowflake データが反映されます。パイプライン遅延なし。
- 機密サポート評価指標のガバナンスは Snowflake に残ります。
- 作成、監視、維持する ETL パイプラインがない。
課題: 財務チームは、Snowflake で信頼できる与信限度と残高データを管理していました。リバース ETL を使用してこれらの値を Salesforce に複製すると、複製の遅延が発生し、営業担当は古いクレジット情報に基づいて案件にコミットしていました。また、コンプライアンスチームは機密財務データを Salesforce ストレージに保持するリスクにもフラグを付けました。
ソリューション: チームは Snowflake 財務ビューを外部オブジェクトとして仮想化し、取引先ページレイアウトに表示しました。営業担当は、Salesforce の標準取引先ビューの一部としてライブクレジット状況を確認できるようになりました。
結果:
- すべての取引先ページのリアルタイムクレジットデータ。遅延なし。
- 財務データのリバース ETL パイプラインを排除しました。
- 機密財務データが Salesforce ストレージにコピーされることはありません。コンプライアンス範囲は Snowflake のままです。
**課題:**合併中、買収した会社は、トランザクション、請求、使用量をカバーする6つの大規模なSnowflakeデータセットの運用データをSalesforceユーザーに表示できるようにする必要がありました。テラバイト単位のデータを Salesforce に複製することは、マージタイムラインでは実行できず、データセットごとにカスタム ETL パイプラインを構築するには多大なエンジニアリング投資が必要でした。
ソリューション: チームは、最小権限のインテグレーション ロールを持つSalesforce Connectを使用して、6つのすべてのSnowflakeデータセットの外部オブジェクトを構成しました。カスタムコードは必要ありません。クエリは Snowflake で直接実行され、すべての活動はコンプライアンスレポートのために Snowflake クエリ履歴に記録されます。
結果:
- 完全宣言型の設定。カスタムコードやパイプラインは必要ありません。
- データの鮮度が保証されます。すべてのクエリには、実行時にライブ Snowflake データが反映されます。
- Snowflake クエリ履歴に完全な監査履歴が記録され、規制およびコンプライアンスのレポートに利用されます。
データ仮想化では、独自の運用プロファイルが導入されます。以下の障害シナリオを考慮して設計します。
- OAuth トークンの有効期限: トークンには有限の TTL(有効期限)があります。期限切れのトークンはコールアウトに失敗します。401 件の未承認応答を監視し、更新ロジックを実装します。
- Warehouse cold-start (Snowflake 固有): 自動サスペンドされた倉庫は、最初のクエリで 5 ~ 30 秒加算されます。レイテンシ要件があるユーザー向けユースケースの場合、営業時間内にスケジュール済みの軽量クエリで事前にウォームアップします。
- ロールの不一致: 外部システムで誤って設定されたロールでは、エラーではなく通知なしで 0 行を返すことがあります。Salesforce とは独立して、外部システムにおけるロールとオブジェクト間の権限を検証します。
- 結果セットのオーバーフロー: 大きすぎるペイロードが API 制限を超えています。常に LIMIT 句を適用し、未加工のテーブルではなく絞り込まれたビューを公開します。
- **外部システム停止:**フォールバックまたはキャッシュが存在しません。コールアウトを try/catch でラップし、UI で有益なエラー状態を表示します。ミッションクリティカルなデータの場合、階層的なアプローチを検討します。すなわち、リアルタイムアクセスのために仮想化し、最も重要な項目については軽量なフォールバック(レプリケーション済み)を維持することで、ソースシステム停止時の入手可能性を保証します。
Salesforce データ仮想化は、Salesforce Well-Architected Framework の次の柱に沿っています。
- **Trust:**代理OAuth 2.0モデルと最小権限ロールのガイダンスはTrustに準拠しています。2 層のアクセス制御 (ソースシステムと Salesforce) により、多層防御が適用されます。
- 信頼性 (フォールトトレランス): [障害モード] セクションでは信頼性に直接対応します。トークンの有効期限、コールドスタート、ロールの設定ミス、結果セットのオーバーフロー、停止処理は、それぞれ解決パスが文書化されている個別の障害クラスを表します。
- 信頼性(スケーラビリティ): クエリプッシュダウン、倉庫サイズガイダンス、およびコールアウト制限認識により、大規模に運用されるソリューションの信頼性の懸念事項であるSalesforceガバナ制約内での実行効率が最適化されます。
- Operational Excellence: Snowflake Query Historyは、主要なオブザーバビリティ ツールとして優れた運用性をサポートします。アーキテクトは、カスタム ログ インフラストラクチャを構築するのではなく、プラットフォーム ネイティブのツールを使用してエンドツーエンドの監査性とパフォーマンス診断を行うことを慎重に追跡可能な方法で選択します。
このセクションでは、アーキテクトとデザイナーが Sandbox 環境でデータ仮想化パターンを構築するための構造化された開始点について説明します。完全な実装ガイドではありません。最初の概念実証に向けて、検証済みの決定と設定手順の順序として扱います。
設定作業を開始する前に、次の点を確認してください。
- ライセンスエンタイトルメント: Salesforce Connect は、一部の Salesforce エディションに含まれていません。Snowflake の SQL Adapter には、Salesforce Connect の基本エンタイトルメント以外の個別のアドオンライセンスが必要です。続行する前に、両方を組織で確認してください。
- Sandbox First: 設定を本番に昇格する前に Sandbox 環境ですべてのフェーズを完了します。
- Snowflake アクセス: Snowflake でセキュリティインテグレーションを作成する権限と、対象データベース、スキーマ、およびオブジェクトへのアクセス権があることを確認します。
- アダプタバージョン: Snowflake の SQL アダプタが組織のエディションで使用可能であり、Snowflake アカウントの URL にアンダースコアが含まれていないことを確認します (含まれている場合はハイフンに置き換えます)。これは、コールアウトホスト名解決のための Salesforce プラットフォームの制約です)。
Snowflake などの外部 SQL システムを使用してデータ仮想化を設定する手順は、宣言型の設定主導のプロセスであり、カスタムコードは必要ありません。設定は、ID と Trust の確立、データ表面の設定、エンドユーザーへのデータの公開という 3 つの連続したフェーズに従います。
このフェーズでは、Salesforce と外部システム間で安全な委任された OAuth 2.0 トラスト チェーンを確立します。データ表面の設定を開始する前に、このフェーズを完了します。
- **Salesforce で認証プロバイダーを作成します。**OpenID Connect 種別を使用します。この段階ではプレースホルダーを使用します。外部システムから値を取得したら、戻って完了します。保存すると、Salesforce によってコールバック URL が生成されます。この値を維持します。
- **Salesforce を外部システムの OAuth クライアントとして登録します。**Snowflake では、これはセキュリティインテグレーション (OAuth、機密クライアント種別) を作成することを意味します。リダイレクト URI として Salesforce コールバック URL を指定します。作成後にインテグレーションからクライアント ID、クライアントの秘密、認証 URL、トークン URL を取得します。
- **認証プロバイダーの設定を完了します。**Salesforce 認証プロバイダーに戻り、外部システムから取得した値 (コンシューマー鍵、コンシューマーの秘密、認証 URL、トークン URL) を入力します。
- 外部認証情報を作成します。[プロトコル] を [OAuth 2.0] に設定し、認証プロバイダーにリンクして、プリンシパル (ID モデルの決定に応じて指定ユーザーまたはユーザーごと) を追加します。このオブジェクトは、OAuth トークンのライフサイクルを管理します。
- **指定ログイン情報を作成します。**エンドポイントを外部システムの API URL (
https://<account>.snowflakecomputing.com/api/v2/statements/など) に設定し、外部ログイン情報にリンクします。 - **プロファイルに外部認証情報へのアクセス権を付与します。**このステップを実行しないと、他のすべての設定が正しくても、ユーザーは統合クエリを呼び出すことができません。
- **OAuth フローを開始して認証を完了します。**Salesforce から OAuth ハンドシェイクをトリガーします。プラットフォームは外部システムのログインにリダイレクトし、認証情報を検証し、結果のトークンを外部認証情報に安全に保存します。このステップでは、ユーザーコンテキストを有効なトークンにバインドします。このステップが完了するまで、すべての統合クエリは失敗します。
このフェーズでは、Salesforce を外部データスキーマに接続し、ユーザーとプラットフォームが照会する外部オブジェクト定義を作成します。
- **外部データソースを作成します。**適切なアダプター (Snowflake の SQL アダプターなど) を選択し、対象データベースとスキーマを指定して、フェーズ 1 で作成した指定ログイン情報にリンクします。
- **接続を検証します。**外部データソースで組み込み検証を使用します。成功すれば、OAuth トラストチェーンが完了し、外部システムにアクセス可能であることが確認されます。
- **メタデータを同期します。**外部データソースからメタデータ同期を開始します。Salesforce は対象スキーマを調べて外部オブジェクト定義を生成し、外部列を Salesforce データ型に対応付けます。
- **必要なテーブルまたはビューを選択して公開します。**外部オブジェクトとして表示する外部テーブルまたはビューを選択します。ベストプラクティスとして、未加工のテーブルではなく選定されたビューを表示します。ビューを使用すると、列の事前絞り込み、行レベルの制限、Salesforce レイヤーがアクセスできる項目のより厳格な制御が可能になります。
このフェーズでは、Salesforce Lightning Experience 内のエンドユーザーが外部オブジェクトを表示して使用できるようにします。
- **外部オブジェクトのタブを作成します。**タブを使用すると、外部オブジェクトを Lightning アプリケーション内で直接操作できます。
- **外部オブジェクトをページレイアウトに追加します。**関連する外部データをネイティブ Salesforce レコードと共に表示します (たとえば、Snowflake 財務ビューを取引先ページレイアウトに追加します)。
- **関連リストに追加します。**関連リストに外部オブジェクトを含めることで、ユーザーはコンテキストに応じてネイティブデータと外部データの統合ビューを表示できます。
- **エンドツーエンドのクエリ統合を検証します。**ページを読み込むか、外部オブジェクトを参照するクエリを実行します。次に、外部システムのクエリ履歴 (Snowflake クエリ履歴など) を調べて、クエリがソースで実行されたことを確認します。正しいロール、倉庫、ID でクエリが実行されたことを確認します。
3 つのフェーズがすべて完了すると、Salesforce ユーザーは、データが Salesforce の外部にあることを意識せずに、標準の Salesforce インターフェースを使用してライブ外部データを操作できます。
Salesforce Data Virtualization は、レプリケーションベースのインテグレーションをクエリ時フェデレーションで置き換えます。データは権威あるソースに保持され、Salesforce ユーザーは標準のプラットフォームインターフェースを介してデータを操作します。構築すべきパイプラインも、管理すべきコピーも、対処すべき遅延も存在しません。
このパターンは、読み取り負荷の高いアクセス、リアルタイムのデータ更新、厳格なガバナンス、および 2 階層のアクセス制御が主な要因である場合に適しています。書き込みが必要な場合、AI または自動化機能がネイティブの Salesforce オブジェクトに依存している場合、またはアクセスパターンの頻度が高すぎてガバナ制限に対応できない場合、これは誤った選択です。
Snowflake はこのパターンをよく表しています。カスタムコードなしで宣言的に確立され、Snowflake クエリ履歴でエンドツーエンドで監視でき、Snowflake ネイティブアクセス制御と Salesforce フルセキュリティモデルの両方で適用可能な、管理されたクエリ時統合接続です。
このアーキテクチャに取り組む前に、ライセンスエンタイトルメントを検証し、予想されるアクセスパターンに対するガバナ制限の公開を評価し、Sandbox 環境での OAuth の準備状況を確認します。このパターンは、しっかりとした初期設計への努力に報いるものです。IDモデル、認証情報チェーン、そしてビュー戦略を適切に整えれば、運用にかかる負荷は最小限に抑えられます。
Yugandhar Boraは、Salesforce のソフトウェアエンジニアリングアーキテクトで、Data & インテリジェンスアプリケーションプラットフォーム内のデータアーキテクチャを専門としています。データガバナンスと統合データモデルに焦点を絞った Enterprise Architecture Review Board (EARB) イニシアチブを主導しながら、自動化されたプラットフォームプロビジョニングソリューションに貢献しています。