エージェントは、目標を推論し、コンテキストからパラメーターを推測し、アクションを動的に選択します。そのため、エージェントが接触するすべてのインテグレーションでは、あいまいさを処理し、安全な繰り返しをサポートし、エージェントが自律的に復旧できる方法で失敗する必要があります。
エージェントシステムは、従来のインテグレーション設計で当然のように想定されていたいくつかの前提条件を無効にします。入力は常に整形式とは限りません。1 つのユーザーアクションで組織の境界を越えてエージェントのチェーンを生成できます。各エージェントには、アクションを実行するための代理権限が必要です。
このドキュメントでは、新しい設計原則、エージェントパターン、および Salesforce Platform でそれらを実現する方法といった、実際のアーキテクチャのシフトについて説明します。
このドキュメントの各パターンは同じ構造に従います。
名前: パターンに含まれるインテグレーションの種別を示すパターン識別子。
コンテキスト: パターンが対応する全体的なインテグレーションシナリオ。コンテキストは、ユーザーが何を達成しようとしているか、およびアプリケーションがどのようにユーザーのニーズに応じて動作するかに関する情報を提供します。
問題: パターンで解決するように設計された課題 (質問として表現)。パターンを確認するときは、このセクションを読んで、パターンがインテグレーションシナリオに適用されるかどうかをすばやく理解してください。
強制: 問題の解決を困難にする可能性がある制約と状況。
Salesforce Pattern Application: パターンをシナリオに適用する推奨方法。
スケッチ: パターンアプリケーションがシナリオにどのように対処するかを示す統合モデリング言語 (UML) シーケンス図。
結果: パターンによってシナリオに関連付けられたフォースが解決される方法。このセクションでは、パターンの適用によって発生する可能性のある新しい課題についても説明します。
設計に関する考慮事項: プラットフォームに依存しないソリューション適用のためのガイダンスと、Salesforce固有の実装メモ。次の考慮事項では、アクション設計の原則とプラットフォーム固有の設定要件について説明します。
エラー処理と回復: パターン適用中の失敗を管理するためのガイダンス。このパラメーターは、次の 4 つの領域をカバーします。
- 下流の意思決定に十分なコンテキストを提供する構造化されたアクション可能なエラー応答を介してアクションが失敗をエージェントに伝達する方法
- エージェントが再試行、自己修正、実行中止を判断する方法
- 部分的な結果と不一致のクロスプラットフォーム状態に対する補償アクションの対処方法
- 廃止された書き込み操作の冪等性の要件
セキュリティの考慮事項: パターンを安全に適用するためのセキュリティ要件。これらの考慮事項には、ログイン情報管理、インテグレーションユーザーと接続アプリケーションの最小権限の範囲設定、エージェントが呼び出すアクションの監査ログ、ユーザーが指定したコンテンツまたは LLM で推測されたコンテンツから生じるパラメーターの入力検証要件などがあります。
例: 実際の Salesforce シナリオでデザインパターンがどのように使用されるかを説明するエンドツーエンドのシナリオ。この例では、目標と、その目標を達成するためにパターンを適用する方法について説明します。
次の表に、対象となる実装パターンを示します。
パターンのリスト
| パターン | 実行する内容 |
|---|---|
| 順次アクションの呼び出し | エージェントは、各ステップが前のステップの検証結果に依存する一連のアクションを呼び出します。エージェントは、ID、状況コード、中間データなどのチェーン全体のコンテキストを保持し、それを使用して次のステップに進むことができるかどうかを判断します。 |
| 並列アクションの呼び出し | 一連のアクションが互いに独立している場合、エージェントはアクションを順番ではなく同時に呼び出します。ワークフローの合計時間は、すべての通話の合計ではなく、最も遅い通話に制限されます。 |
| 非同期アクションの呼び出し | エージェントが結果を待たずに、プラットフォームイベント、メッセージキュー、またはバックグラウンドジョブを介して下流システムに操作を派遣します。エージェントの義務は確認済みの呼び出しで終了します。エージェントセッションとは独立して、下流のシステムが実行の所有権を取得します。 |
| オンデマンドエージェントの呼び出し | 外部アプリケーションまたは AI オーケストレーターがプログラムでエージェントをコールし、コンテキストを提供して、構造化された応答を待機します。エージェントは通話者が開始するインテリジェントなバックエンドサービスとして動作し、エージェントが理由付けとアクションを実行し、その結果が通話者によって消費されます。 |
| イベント駆動型エージェントの自律実行 | カートの放棄、支払の失敗、使用量の減少などのデータ条件により、人間がインタラクションを開始することなくエージェントが自動的に起動されます。応答を待機している通話者はいません。エージェントはイベントペイロードをグラウンディングコンテキストとして受信し、応答ワークフローを完全に単独で実行します。 |
| エンタープライズコンテンツからのKnowledgeグラウンディング | 応答を生成する前に、エージェントはエンタープライズKnowledgeストアから関連ドキュメントを取得してコンテキストウィンドウに挿入します。LLM は理由を提供し、取得レイヤーは結果を提供します。 |
| 検証済み本顧客コンテキストインジェクション | 統合顧客プロファイルの検証済みの構造化された属性は、エージェントがアクションを呼び出す前にアクション入力として事前入力されます。エージェントは、セグメント、ランク、離脱リスク、生涯価値などの事実を推測するのではなく受け取ります。 |
| クロスシステムツールインテグレーション | エージェントは、モデルコンテキストプロトコル (MCP) 標準に基づく統一されたツールインターフェースを使用して、Salesforce Platform 外の外部システムに接続します。各外部システムは、説明されているコール可能なツールに従って機能を公開します。エージェントは各システムのネイティブ API やスキーマを把握することなく、機能を検出して呼び出します。 |
| 呼び出し可能なツールとしてのビジネス機能 | ビジネスエンティティ、プロセス、インサイトなどのエンタープライズビジネス機能は、任意のフレームワークの外部エージェントが検出および呼び出すことができる MCP ツールとして公開されます。 |
| クロスエージェント委任 | コール元エージェントは、エージェント間 (A2A) プロトコルを使用して、複雑な要求を分解し、ドメイン固有のサブタスクを異なるプラットフォームまたはベンダーシステムの専門のピアエージェントに委任します。コール元エージェントは ToDo ライフサイクルを管理し、リモートエージェントからの結果を集計します。 |
| コール可能サービスとしてのエージェント | 内部 Agentforce エージェントは、そのドメイン機能を管理された検出可能な A2A エンドポイントとして公開し、外部オーケストレーターまたはピアエージェントがタスクを委任できるようにします。エージェントは受信 ToDo ライフサイクルを管理し、構造化された結果をリモート通話者に返します。 |
このドキュメントのパターンは 3 つのカテゴリに分類されます。この分類により、アーキテクトは、エージェントがコールする内容を設計しているか、何がエージェントをトリガーしているか、エージェントが動作する前にKnowledgeをどのようにグラウンディングしているかなど、解決しようとしているインテグレーションの課題に関連するパターンをすばやく特定できます。すべてのパターンを読むのではなく、設計上の懸念事項に一致するカテゴリに直接移動できます。
アクションの呼び出し:
これらのパターンでは、エージェントが推論サイクルの一環としてデータを取得したり操作を実行したりするために外部システムにコールアウトする方法を扱います。これらは、エージェントが発信側となるアウトバウンドパターンです。これらは、順序付け(ステップが相互に依存している場合)、並列化(ステップが相互に依存していない場合)、冪等性、部分的な失敗の処理に対応します。エージェントが作業を完了するために呼び出すツールを設計するときは、次のパターンを使用します。
エージェントの呼び出し:
これらのパターンは、外部システムまたはイベントでエージェントがどのようにアクションを実行するかを示します。これらは、外部システムがこれらのエージェントをトリガーする受信パターンです。トリガーは、プログラムでコールして応答を待機している人間向けアプリケーション、またはエージェントをトリガーする自律データ条件です。エージェントがトリガーされる方法とタイミングを設計するときは、次のパターンを使用します。
Enterprise Data を用いたグラウンディング:
このカテゴリのパターンでは、エージェントが推論やアクションを実行する前に、正確かつ最新の組織固有の知識をどのように使用するかを説明します。
適切な戦略を選択することは容易ではありません。各パターンは、システム機能、データ量、障害処理、トランザクション性など、特定の問題を対象とします。
選択マトリックステーブルには、インテグレーション要件に最も適したパターンを判断するのに役立つパターンとその主要な側面がリストされています。パターンは次のディメンションを使用して分類されます。
| アスペクト | 説明 |
|---|---|
| Type | インテグレーションのカテゴリ (アクション呼び出し、エージェント呼び出し、エンタープライズデータアクション呼び出しによるグラウンディング) を指定します**。**これらの送信インテグレーションは、単純な 1 ステップのツールコールから、複雑な複数ステップのシーケンス、並列ファンアウトまで多岐にわたり、異種バックエンド全体の順序制約、可能性、部分的な障害処理について慎重に検討する必要があります。エージェント呼び出し: エージェント呼び出しは、外部システムまたはイベントでエージェントがアクションを実行する方法です。これらの受信インテグレーションは、構造化された応答を待つ人間向けアプリケーションによる同期のプログラム呼び出しから、人間がインタラクションを開始したり待機したりすることなく、データ条件によってエージェントがトリガーされる完全に自律的なイベント駆動型実行まで、多岐にわたります。Grounding with Enterprise Data: グラウンディングインテグレーションは、エージェントが推論やアクションを実行する前に、正確で最新の組織固有の Knowledge を提供する方法です。これらのインテグレーションは、エンタープライズコンテンツストアからの非構造化ドキュメントの取得から、統合顧客プロファイルから検証済みの構造化属性の挿入まで多岐にわたり、エージェントが幻覚的な推測ではなく事実に基づいて操作できるようにします。 |
| タイミング | タイミングに基づいてインテグレーションのスタイルを指定します。このドキュメントでは、同期または非同期同期と非同期は、エージェント自体がトリガーされる方法、またはエージェントがアクションを呼び出す方法を指します。内部で何が起こるかは説明しません。ただし、通常、ユーザーはエージェントがアクションを呼び出して結果を処理している間待機します。現在のターンが終了するまで、エージェントは次のユーザーメッセージに対処しません。同期: ブロック要求とリアルタイム要求は要求/応答操作です。結果は、この操作ですぐに呼び出し元に返されます。非同期: ノンブロッキング、キュー、またはメッセージベースの要求は、ほぼリアルタイムの一方向操作によって呼び出されます。結果と障害は、他の一方向の操作を呼び出すことで返されます。そのため、呼び出し元は要求を実行し、応答を待たずに続行します。 |
次の表は、Salesforce から別のシステムへのインテグレーションの場合に要件に最も適したパターンを判断するのに役立つパターンとその主要な側面を示しています。
| タイプ | タイミング | 考慮すべきキー値パターン |
|---|---|---|
| アクションの呼び出し | 同期 | 順次アクション呼び出し 並列アクションの呼び出し クロスシステムツールインテグレーション クロスエージェント委任 |
| アクションの呼び出し | 非同期 | 非同期アクションの呼び出し |
| エージェントの呼び出し | 同期 | オンデマンドエージェントの呼び出し コール可能サービスとしてのエージェント |
| エージェントの呼び出し | 非同期 | イベント駆動型エージェントの自律実行 |
| Enterprise Data を用いたグラウンディング | 同期 | エンタープライズコンテンツからの知識グラウンディング 検証済み本顧客コンテキストインジェクション |
パターンの各セクションでは、パターンの作成方法について説明します。各パターンは、エージェントアーキテクチャの特定のインテグレーション問題に対する繰り返し可能なソリューションです。パターンを使用する状況、決定を形成する要因、および Salesforce Platform によるパターンの提供方法について説明します。
コンテキスト
多くのビジネスワークフローは本質的に順次です。各ステップを進める前に、前のステップの確認済みの結果が必要です。たとえば、適格性が確認されるまで返金を開始できず、注文レコードが存在するまで請求アカウントを作成できず、チェックに合格するまでコンプライアンスチェックを記録できません。
従来の自動化では、これらの連動関係はハードコードされたフローロジックとしてエンコードされます。エージェントシステムでは、エージェントは各アクションの結果を評価し、次のステップの前提条件を満たしているかどうかを判断します。
このパターンは、基本的なアウトバウンドインテグレーションモデルを表します。ここでは、1 つのエージェントが 1 つのドメイン内で操作し、シーケンスを呼び出します。各アクションの出力によって、チェーンの次のアクションの呼び出しがゲートされます。オーケストレーションエージェントは、チェーン全体でトランザクションコンテキストを維持し、各ステップで返された識別子、状況コード、データを蓄積します。このコンテキストを使用して、後続の決定を促進します。
このパターンは、1 つの同期コールアウトについて説明する『Integration Patterns (インテグレーションパターン)』ガイドの「Remote Process Invocation – Request and Reply (リモートプロセス呼び出し – 要求と返信)」のエージェント型パターンです。エージェント型パターンは、1 つの推論サイクル内の連動通話のエージェント駆動型チェーンにパターンを拡張します。
問題
エージェントがホストシステムと 1 つ以上のリモートシステムにまたがる複数ステップのワークフローを実行する場合、次の 4 つの問題に対処する必要があります。
- Sequencing (順序付け) - アクションは正しい順序で呼び出す必要があります。各ステップは、前のステップが正常に完了したかどうかでゲートされます。
- データ伝達 - 各ステップの応答データを次のステップの入力として渡す必要があります。
- 障害の分離 - チェーンのいずれかの時点で障害が発生した場合、システム全体で部分的な状態や一貫性のない状態が発生しないようにする必要があります。
- 完了確認 - エージェントは、結果をレポートする前にすべてのステップが正常に完了したことを確認する必要があります。
勢力
このパターンを適用する場合は、次の質問に回答してください。
-
チェーンの各アクションは、前のアクションから返されたデータに依存しますか? それとも成功または失敗の状況のみに依存しますか?
データの連動関係では、エージェントがステップ間で識別子と属性を伝達する必要があります。
-
すべてのリモートエンドポイントでエージェントの推論サイクルタイムアウト内に応答できますか?
チェーンのどのステップでも外部システムが遅いと、シーケンス全体がブロックされます。
-
チェーンでは完全なエンドツーエンドの成功が必要ですか? それとも部分的な完了で問題ありませんか?
-
完全なエンドツーエンドの成功が必要な場合、ダウンストリーム障害が発生したときにロールバックする必要があるステップのコンペンセーション戦略を定義します。
-
チェーン内の書き込みオペレーションを安全に再試行できるか?
すべての書き込みアクションは適切である必要があります。大規模言語モデル (LLM) の再試行やあいまいな確認のために、エージェントの推論ループが同じアクションを複数回呼び出すことがあります。
-
チェーンはユーザー操作 (会話、低同時実行) または自動トリガー (高同時実行の可能性) のどちらで呼び出されますか?
これにより、同期ブロックが受け入れられるかどうか、または非同期パターンが必要かどうかが決まります。
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| Apex アクション | 外部コールアウトや複雑なロジックに最適 | ステップには、リモートシステムへの HTTP コールアウト、カスタムデータ変換、またはフローの宣言型機能を超えるエラー処理ロジックが必要です。Apex アクションは、統合用のプラットフォーム全体を公開しますが、エージェントは @InvocableMethod アノテーションを使用してコール可能なままです。 |
| フローアクション (自動起動) | ビジネスルールステップと軽量な CRM 操作に最適 | ステップでは、宣言型ビジネスロジックを適用したり、CRM レコードを照会または更新したり、カスタムコードを必要としないプロセスをオーケストレーションしたりします。自動起動フローは、Agentforce サブエージェントからネイティブにコールでき、エージェントが次のステップの決定に使用する型付き出力変数を返します。 |
| 外部サービス (OpenAPI インポート) | 型指定された検出可能な外部 API インテグレーションに最適 | 外部システムは OpenAPI 仕様を公開します。外部サービスでは、エージェントアクションとして直接コールできる強い型付けの Apex スタブが生成されるため、手動によるスキーマの対応付けが不要になり、外部 API の操作が名前付き機能としてエージェントに表示されます。インポートされた仕様の各操作は、名前付きコール可能アクションになります。エージェントは、生成されたセマンティック表示ラベルに基づいてアクションを選択します。生成されたアクションを Agentforce Topic Center に登録して、エージェントが推論時に検出できるようにします。注: 外部でホストされるサービスが RESTful で、OpenAPI 仕様が使用できないか実行できない場合は、Apex またはフローの指定ログイン情報を使用して HTTP コールアウトを直接実行します。結果を解析するには Apex コードが必要です。 |
| MuleSoft 接続アクション | 複雑なミドルウェアのファンアウトやレガシーシステムインテグレーションに最適 | 応答を返す前に、リモートシステムで複数のバックエンドシステムのプロトコル変換、データ変換、オーケストレーションが必要な場合に使用します。エージェントが MuleSoft に 1 つのコールアウトを実行し、MuleSoft が下流の複雑さを処理して統合応答を返します。 |
スケッチ
順次アクション呼び出しのシーケンス図
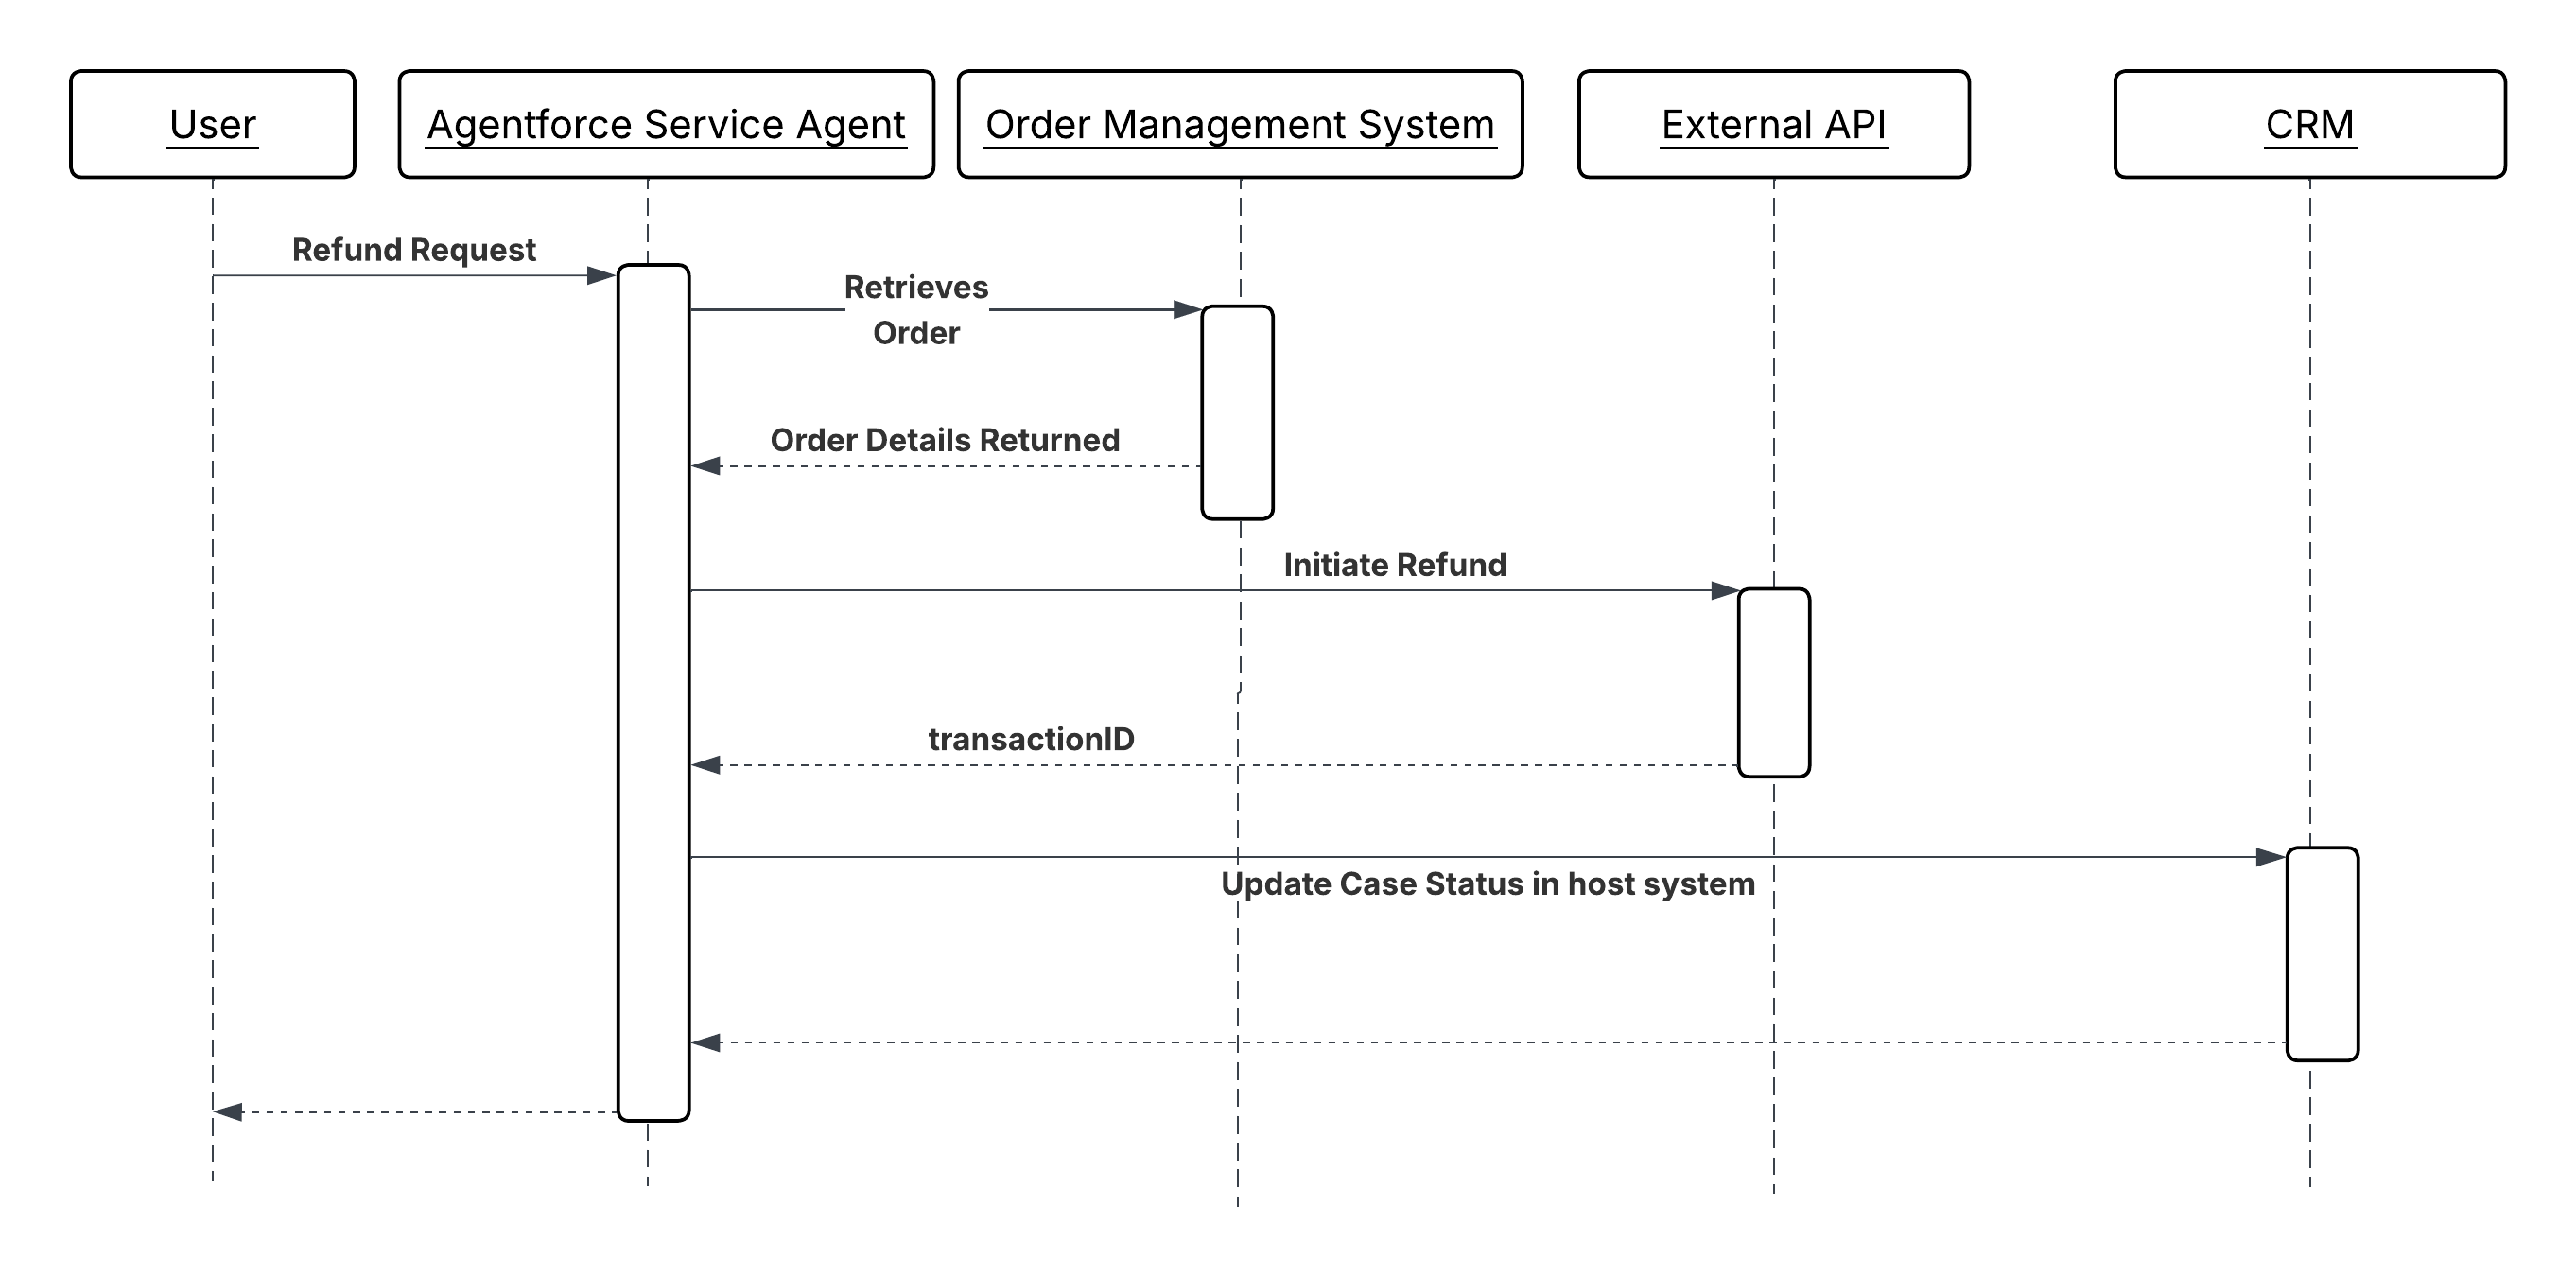
結果
エージェントは、一貫性のある監視された順序で、ファイアーアンドフォーゲットスクリプトではなく、クロスシステムワークフローを実行します。各ステップの結果は次のステップが呼び出される前に評価されるため、エージェントは事後に部分的な完了を検出するのではなく、できるだけ早く失敗を検出します。
ホストシステム (Salesforce CRM) は、リモート操作で状況 (成功または失敗) を確認した後にのみ更新されます。請求口座番号、取引 ID、確認コードなど、外部システムから返された識別子と状態はチェーンを介して伝搬され、保持されるため、ワークフロー結果の完全な追跡可能なレコードが作成されます。
エージェントは結果の推論と決定の順序付けを行います。各アクションは、独自の操作のみを行い、構造化された結果を返します。どちらのレイヤーも、他方のロジックをエンコードしません。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- チェーンの各アクションには、技術的なメソッドの署名ではなく、インテントベースの言語で記述されたセマンティックな説明を使用してください。エージェントは次の説明に基づいてアクションを選択します。「calls the billing API (請求 API をコール)」という説明は、「creates a Billing Account in the Billing System and return the new account identifier (請求システムで請求取引先を作成し、新しい取引先識別子を返す)」という説明よりも役立ちません。
- チェーンのすべての書き込み操作を最適にします。あいまいな応答を受信した場合、エージェントの推論ループがアクションを再試行することがあります。このアクションは、繰り返し呼び出しで同じ結果を生成する必要があります。
- LLM で推測されるすべての入力パラメーターをアクション境界で防御的に検証します。エージェントから渡されるパラメーターの形式が適切である、範囲内である、または予期されるタイプである、とは決して考えないでください。
- 各アクションは単一の責任となるように設計します。同じ通話で請求取引先を作成して確認メールを送信するアクションは、再試行が難しく、テストが難しく、エージェントが 2 つ以上の個別のアクションを推論することが難しくなります。
Salesforce 実装ノート
- Apex アクションの場合、@InvocableMethod(label=’…’description=’…’)。「説明」はエージェントが読み取られ、アクションを呼び出すタイミングが判断されます。説明的な「label」項目と「description」項目を使用して、すべての入力変数と出力変数を @InvocableVariable で宣言します。明示的な成功/失敗インジケーターと人間が判読可能なエラーメッセージを使用して、構造化された結果オブジェクトを返します。
- フローアクションでは、自動起動フローのみを使用します。画面フローは自律エージェントコンテキストではサポートされません。各フローをアトミック (1 つのアクション、1 つの責任) に保ちます。すべての外部コールアウト要素で障害パスを設定して、インテグレーションエラーを検出し、アクション可能なエラーメッセージをエージェントに返します。これにより、捕捉されなかった例外がセッションを終了するのを防ぐことができます。
- 外部サービスでは、ターゲットシステムの OpenAPI 仕様をインポートし、生成されたアクションを Agentforce トピックに登録します。生成されたスタブを指定ログイン情報でラップして、アクション定義のエンドポイントやログイン情報をハードコードしないようにします。
- すべての外部コールアウトで、明示的なコールアウトタイムアウトを設定します。タイムアウトなしでハングアウトすると、セッション制限に達するまでエージェントの推論サイクルがブロックされます。タイムアウトを超過した場合は、説明的なエラーメッセージとともに適切な失敗を返します。すべての外部コールアウトには、最大 120 秒のタイムアウトを設定できます。また、Apex 同期トランザクションガバナ制限の対象にもなるため、それぞれが5秒を超えるトランザクションを50件以上インスタンス化するリスクを軽減してください。
エラー処理と回復
- エージェントは、各ステップを先行ステップの明示的な成功によって制御します。アクションは、明確な成功または失敗インジケーターを含む構造化された結果を返す必要があります。エージェントは、欠落またはnullの応答のみから失敗を確実に推測できません。
- アクションが失敗すると、エージェントはアクションから返されたエラーメッセージを使用して次のアクションを決定します。つまり、ユーザーに修正入力を求めるか、パラメーターを調整して自動修復を再試行するか、チェーンを停止して失敗を記録して人間によるレビューを行います。したがって、エラーメッセージは具体的でアクション可能なものでなければなりません。「無効な日付範囲: endDate cannot precede startDate」は使用できますが、400 状況コードのみは使用できません。
- 部分的な完了によって整合性のない状態が生じるチェーン (請求取引先は作成されたが CRM レコードが更新されなかったなど) の場合、エージェントは失敗を明らかにする前に、補償アクションを呼び出して部分的な状態をロールバックまたはフラグ設定します。補償パスを前方パスに沿った名前付きアクションとして設計します。
- 書き込みアクションが成功した可能性があるがあいまいな応答(ネットワークタイムアウト、確認応答なし)を返した場合、再試行では、元の呼び出しと同じキー値または外部参照IDを使用する必要があります。非冪等な書き込みに対して、チェックなしの再試行は実行しないでください。
セキュリティに関する考慮事項
- すべての外部コールアウトを指定ログイン情報でラップします。Apex コードまたはフロー構成では、エンドポイントまたはログイン情報をハードコードしないでください。これらは、プラットフォームのセキュアな認証情報ストアで管理し、コードを変更することなくローテーションする必要があります。
- 各アクションで使用されるインテグレーションユーザーまたは接続アプリケーションに最小権限の原則を適用します。注文データの参照のみを行うアクションでは、請求システムに対する書き込み権限を保持できません。ログイン情報の範囲をアクションで必要な最小限の操作に限定します。
- セッション ID、入力パラメーター (機密値のサニタイズ済み)、結果を使用して、チェーンの各アクションの呼び出しを記録します。結果が紛争中の場合、この監査履歴は、エージェントが特定の一連のアクションを実行した理由を再構築するための主なメカニズムです。
- ユーザーが指定したテキストから取得されるすべての入力パラメーターを外部システムに渡す前にサニタイズします。エージェントを介して外部 API コールアウトに渡されるユーザー入力は、潜在的なインジェクションベクトルです。コールアウトを行う前に、アクション境界で種別、形式、範囲を検証します。
例
返金要求を処理するカスタマーサービスエージェントは、4 ステップの順次チェーンを実行します。
GetOrderDetails(Apexアクション)は、ユーザーが指定した注文IDを使用して注文管理システムから注文レコードを取得します。注文状況、品目、購入日、支払方法が返されます。エージェントは、続行する前に注文が返金可能状態かどうかを評価します。ValidateRefundEligibility(自動起動フロー)では、返品期間、商品カテゴリの制限、以前の返金履歴など、返金対象資格に関するビジネスルールが適用されます。「適格」な Boolean 値と、適格でない場合はエージェントがユーザーに表示できるプレーンランゲージの理由を返します。InitiateRefund(Apex アクション)は、注文 ID と返金金額を使用して外部支払ゲートウェイ API をコールします。成功した場合は「refundTransactionId」を返します。このアクションは冪等です。同じ注文 ID で 2 回目にコールされた場合、重複する返金を作成するのではなく、既存のトランザクション ID を返します。UpdateCaseStatus(自動起動フロー)は、返金トランザクションIDでCRMケースレコードを更新し、ケースの状況を「解決済み返金を発行済み」に設定して、取引先所有者のフォローアップタスクを作成します。このステップは、「InitiateRefund」が確認済みのトランザクション ID を返した後にのみ実行されます。
InitiateRefund がタイムアウトするかエラーを返した場合、エージェントはチェーンを停止し、UpdateCaseStatus を起動せずに、アクション可能メッセージをユーザーに表示します。ケースは未解決のままになり、CRM の正確な状態が保持されます。
コンテキスト
順次アクションチェーンは、実行ステップが相互に連動している場合に効率的です。あるステップが次のステップの実行条件となります。ただし、多くのワークフローには相互連動関係のない一連のステップが含まれます。たとえば、商品在庫の取得、顧客エンタイトルメントの取得、配送見積の確認を含むステップは、どのステップの入力でも別のステップの出力を必要としないため、すべて同時に実行できます。これらのステップを連続して実行すると、ステップ数に比例して時間が無駄になります。
並列呼び出しパターンでは、エージェントは一連のアクションが独立していることを識別し、順序ではなく同時に呼び出します。全体的なワークフロー時間は、すべてのアクション時間の合計ではなく、最も遅い個々のアクションに制限されます。すべての結果が返されると、エージェントはそれらを 1 つの一貫した応答に集約するか、推論の次のステージへの入力としてまとめて使用します。
アーキテクチャ上の重要な課題は、並列呼び出し自体ではありません。プラットフォームの同時実行制約内のファンアウトを管理し、成功した結果を破棄することなく、集計ステップで部分的な失敗を適切に処理できるようにします。
問題
エージェントは、複数の独立した機能の同時実行を効率的にオーケストレーションし、個々の結果をユーザーまたは後続のステップの 1 つの一貫した応答にどのように集約しますか?
勢力
このパターンを適用する場合は、次の質問に回答してください。
- スレッドの安全性と可変状態の共有に関するアクションの考慮事項は?
- ソリューションは、1つのトランザクション内の並列ApexコールアウトのSalesforceガバナ制限をどのように管理し、制限に達しないようにしますか?
- ガバナ制限を回避するために非同期パターン(キュー可能 Apex やプラットフォームイベントなど)を使用する必要がありますか?
- エージェントが処理を続行する前に結果の同期集計が必要ですか?
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| ミドルウェアアプローチ | 高ファンアウト(5 つを超えるエンドポイント)およびクロスプラットフォーム集計に最適 | ミドルウェアレイヤーが必要です。エージェントがミドルウェアに対して 1 つのコールアウトを実行します。次に、ミドルウェアは並列で 10 台のシステムにファンアウトしてデータを集計し、1 つの応答をエージェントに送信します。 これは、エージェントが多数の異種外部システムをコールする必要がある場合に推奨されます。このミドルウェアは、ファンアウトの複雑さを解消し、1 つの集計された応答を返します。 |
| Queueable Apex | Salesforce の内部並列処理に最適 | 複数のキュー可能なジョブを起動する必要があります。Salesforce がキューを管理している間、同時実行制限に十分な「時間枠」がある場合、これらは同時に実行できます。 並列操作が Salesforce 組織内にあり、同時実行時間枠を使用できる場合に使用します。これは、すぐに集計された応答が必要な場合には適していません。 |
| プラットフォームイベント | Fire-Forget や最終的な一貫性を保つのに最適 | 結果を同期して集計する必要はありません。各イベントは分離されたトランザクションをトリガーし、スループットを最大化しますが、下流の調整が必要になります。 このメカニズムは、最終的な一貫性が許容され、応答遅延よりもスループットが重要な場合に使用します。 |
スケッチ
並列アクション呼び出しのシーケンス図
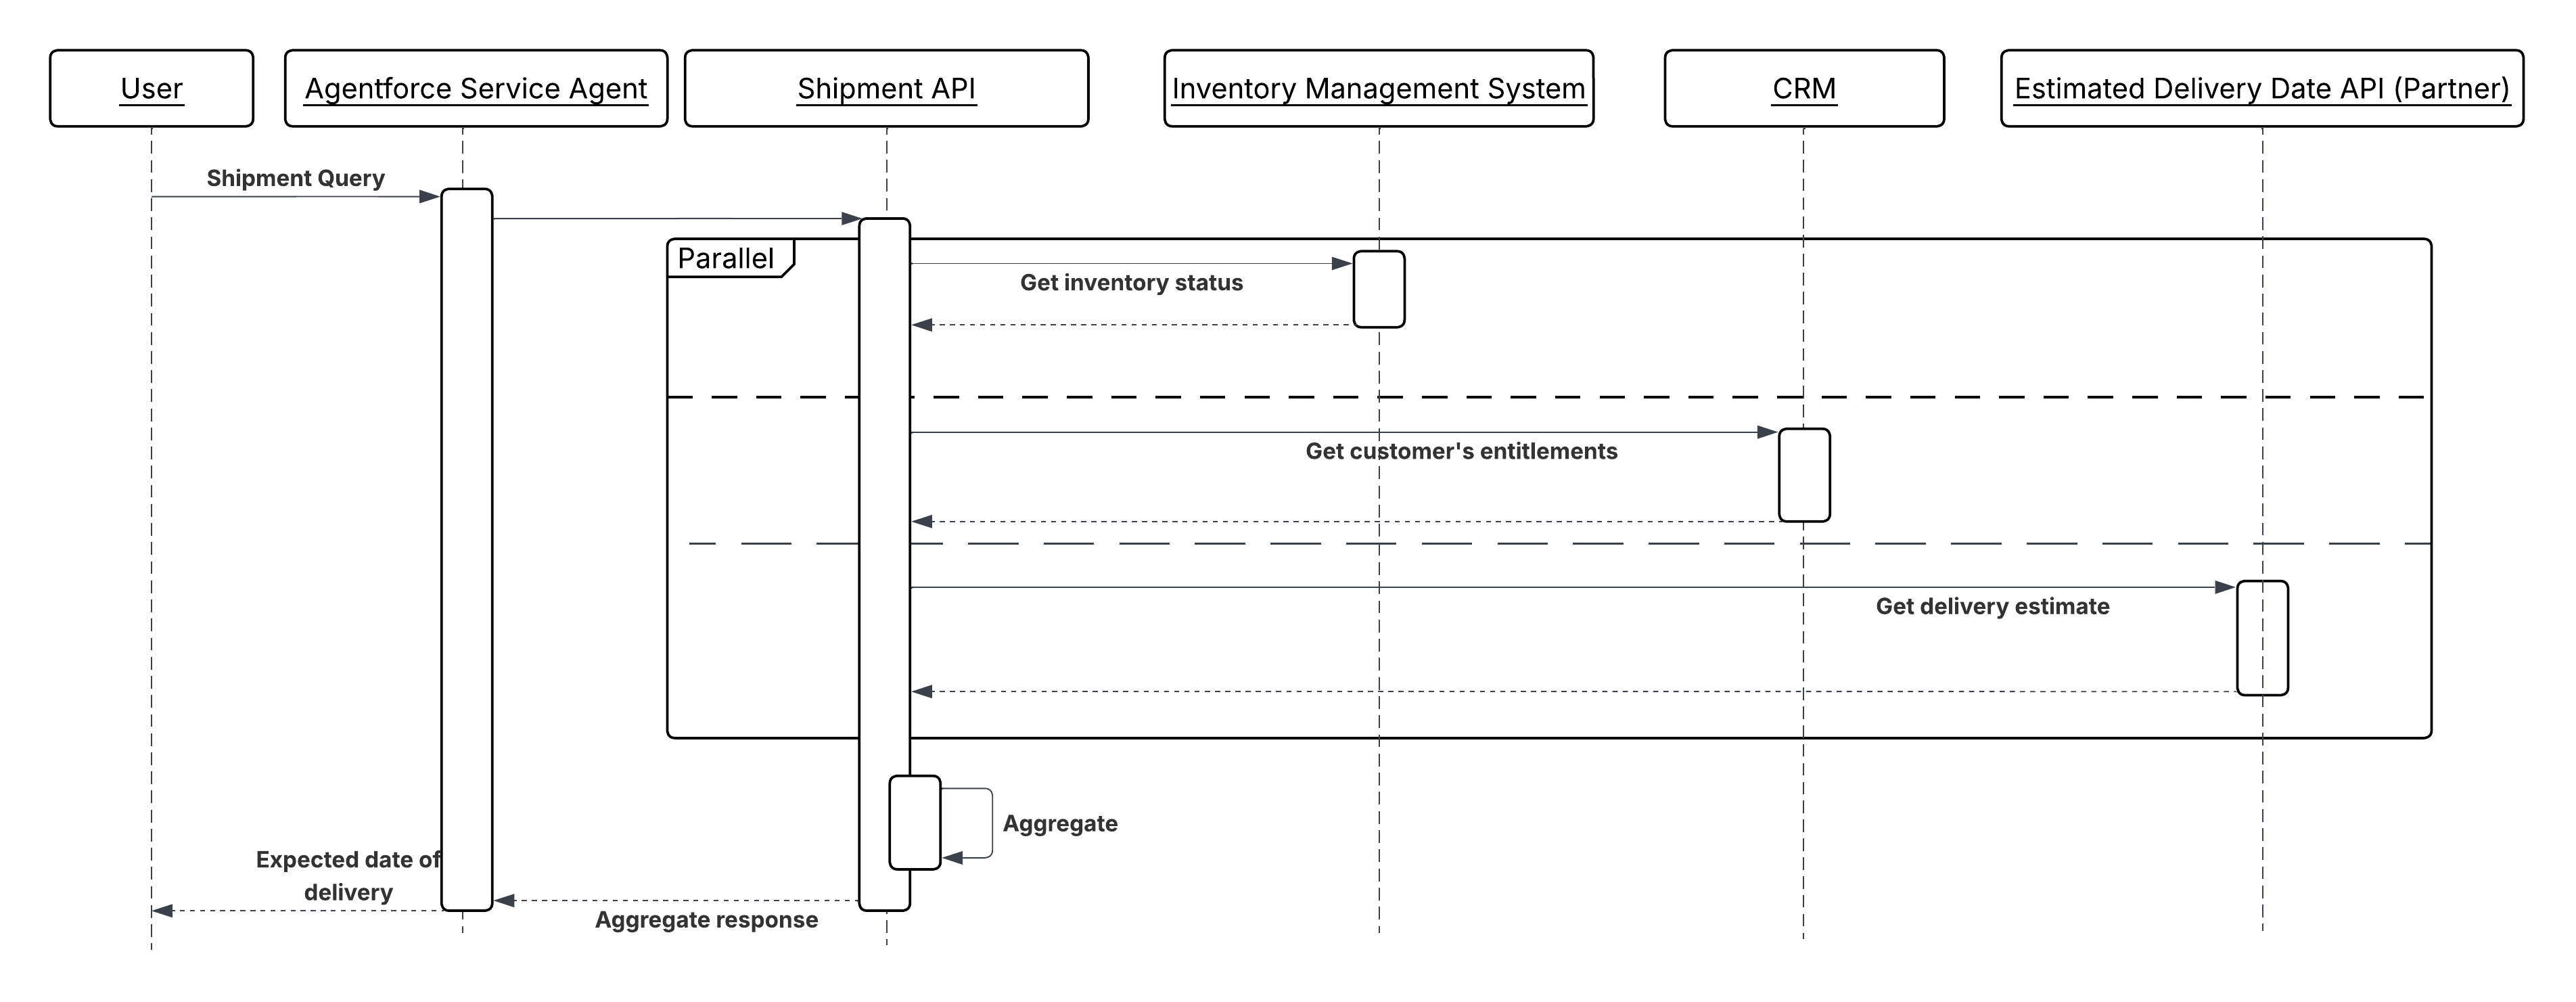
結果
独立したアクションが並列で実行される場合、エンドツーエンドのワークフロー時間は、すべてのアクションの合計ではなく、最も遅い個々のアクションに制限されます。3 つの独立したコールアウトがそれぞれ平均 300 ミリ秒のワークフローの場合、並列実行は約 300 ミリ秒で完了し、順次実行は約 900 ミリ秒で完了します。大規模になると、この違いは同時に実行されているすべてのエージェントセッションでさらに大きくなります。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- 並列化する前に独立性を確認します。どちらのアクションも、他方が書き込んだ状態を読み取らず、どちらのアクションの失敗も他方をキャンセルできない場合にのみ、アクションを並列実行しても安全です。連動関係が存在する場合は、ソフト連動関係であっても、代わりに順次チェーニングを使用します。
- 集計ステップを明示的に設計します。完全な結果セットの概要、下流の推論での部分的な結果セットの意味、およびエージェントがすべての結果を待機するか、しきい値 (7 コールのうち 5 コールなど) が返されたら続行するかを事前に定義します。
- すべての並列書き込み操作は即効性が必要です。各操作は共有トランザクション境界なしで個別に実行されるため、個々のブランチを再試行しても副次的な影響が重複することはありません。
Salesforce 実装メモ
- キュー可能 Apex: 1 つのトランザクション内ですべてのジョブを送信し、同時実行の可能性を最大化します。使用可能な同時実行時間枠は組織全体で共有されることに注意してください。時間枠が常に使用できるとは限らないことを前提として設計し、使用できないときは順次実行へのフォールバックを構築します。
- プラットフォームイベント: 対象レコードを直接更新するのではなく、専用のステージングレコード (共有の相関関係 ID をキーとする) に各操作の結果を書き込みます。最終集計フローまたは Apex トリガーは、予想される件数に達するとすべてのステージング レコードを読み取り、統合更新をアトミックに適用します。
- ミドルウェアファンアウトの場合: 1 つのコールアウトの明示的なタイムアウトを、最も遅いバックエンドの予測最悪応答時間よりも長く、Salesforce コールアウトタイムアウト制限内に設定します。ミドルウェアは、応答全体をタイムアウトするのではなく、失敗したバックエンドを明確に示す部分的な結果を返します。
エラー処理と回復
- 部分的な成功を主要な結果として扱います。3つまたは4つの並列オペレーションが成功した場合、エージェントは3つの成功した結果を使用し、失敗を明示的にユーザーに表示したり、再試行のためにログに記録したり、補償アクションを実行したりします。すべての結果を破棄したり、失敗がなかったかのように処理したりするのではありません。
- [キュー可能] および [プラットフォームイベント] パターンの場合、(ファンアウトの時点で生成された) 相関関係 ID を使用して、すべての並列ブランチを元のエージェントセッションにリンクします。この ID は、結果を再構成し、ログで失敗をソースまで追跡するために必要です。
- 並列ブランチが失敗し、安全に再試行できる操作の場合、元の相関IDとキー値を使用して、失敗したブランチのみを再キューイングします。すべてのブランチを再呼び出ししないでください。
- 集計ステップのタイムアウトしきい値を定義します。すべての結果がしきい値内に収まらない場合は、無期限に待機するのではなく、入手可能な結果で続行し、不完全なセットにフラグをつけます。
セキュリティに関する考慮事項
- 各並列実行コンテキスト (キュー可能ジョブ、プラットフォームイベントトリガー、ミドルウェアコールアウト) では、順次コールアウトと同じアクセス制御を適用する必要があります。並列処理では、データアクセスルールは緩和されません。各ブランチは、単独で起動した場合と同じ最小権限のログイン情報で操作する必要があります。
- ミドルウェアのファンアウトの場合、ミドルウェアレイヤーは集計期間外の個々のバックエンドからの応答ペイロードをキャッシュまたは記録しません。各バックエンドの応答には、直接操作の範囲外で保持してはならない機密データが含まれている可能性があります。
- プラットフォームイベントの集計に使用されるステージングレコードがエージェントのエンドユーザーに読み取られないようにします。これらのレコードには、まだ消費に適していない、部分的に形成された中間データが含まれている可能性があります。
例
サービスエージェントが、「この注文を金曜日までに配送していただけますか?」という複雑な履行の質問に回答します。回答には、次のようにすべての独立したシステムからのデータを同時に取得する必要があります。
- エージェントは、現在の在庫レベル、顧客の有効なエンタイトルメント、および顧客のロケーションに対する配送予定期間という 3 つの独立したデータニーズを特定します。
- 3 つのアクション (
GetInventoryStatus(ミドルウェアを介して外部在庫システムから)、GetCustomerEntitlements(Salesforce CRM から)、およびGetDeliveryEstimate(ミドルウェアを介して通信キャリア API から)) が並列で呼び出されます。 - 各アクションは独立して返されます。エージェントは、3 つの応答がすべて受信されるまで (または集計タイムアウトに達するまで) 待機します。
- これら 3 つの結果をすべて使用できるため、エージェントは組み合わせたデータに基づいて理由を設定し、在庫が十分かどうか、顧客のエンタイトルメントが速達配送を対象としているかどうか、顧客の郵便番号で金曜日の配送が可能かどうかを評価します。
- エージェントは、3 つのシステムから取得したグラウンディング済みの 1 つの回答を、3 つの通話のうち最も遅い応答時間でユーザーに返します。
コンテキスト
エージェントが開始する一部の操作では、エージェントが現在の推論サイクルを続行するために必要な結果は生成されません。通知の送信、下流の一括処理のトリガー、メッセージキューへのイベントの公開、実行時間の長いジョブの送信はすべて、エージェントの義務が派遣時に終了するため、下流のシステムが所有権を取得し、独立して作業を完了します。
従来の自動化では、これらは緊急コールアウトまたはプラットフォームイベント公開としてモデル化されます。エージェントシステムでは、エージェントは推論中に操作がノンブロッキングであると判断して派遣し、派遣の確認を記録し、下流の結果を待たずにターンを続行または終了します。
このパターンは、『Integration Patterns (インテグレーションパターン)』ガイドの「Remote Process Invocation – Fire and Forget (リモートプロセス呼び出し – 起動と忘れ)」のエージェントパターンです。エージェント型パターンでは、派遣の決定をエージェントの推論の一部とし、エージェントに応答が返されなくても派遣を追跡できるようにすることで、このパターンを拡張します。
問題
エージェントが、エージェントのセッションまたは推論サイクルを超えるダウンストリーム操作を開始する必要がある場合、次の 3 つの問題に対処する必要があります。
- ノンブロッキング呼び出し: エージェントは、結果を待つ理由付けサイクルを開いたままにせずに、操作を起動して配信を確認する必要があります。
- Delivery Confirmation: エージェントは、成功したディスパッチ (メッセージが受け入れられた) と成功した結果 (下流プロセスが完了した) を区別する必要があります。前者のみを確認できます。
- トレーサビリティ: エージェントは結果を受信しないため、操作はエージェントセッションから独立したログ、イベントレコード、またはプラットフォーム監視で監視できる必要があります。
勢力
このパターンを適用する場合は、次の質問に回答してください。
-
現在のターンを完了するためにエージェントにこの操作の結果が必要ですか? はいの場合、これは正しいパターンではありません。代わりに、順次アクションの呼び出しを使用してください。
-
ダウンストリームシステムは、同期確認応答なしで、送信されたメッセージまたはイベントを受信して確実に処理できますか? ターゲットシステムは耐久性がある必要があります。一時的に使用できなくなった場合でも、メッセージが失われないようにする必要があります。
-
操作は冪等ですか?それとも重複する派遣を防ぐ必要がありますか? ネットワークレベルの再試行とエージェントの推論の再試行により、同じ派遣が複数回試行される可能性があります。ダウンストリーム操作が適切でない場合は、アクションで重複排除キーを伝達する必要があります。
-
ユーザーまたは下流プロセスは、操作の完了時期を知る必要がありますか? エージェントは派遣のみを確認できます。完了状況が必要な場合は、個別の通知またはフォローアップメカニズムを設計します。プラットフォームイベント、ケースの更新、またはコールバック (この推論サイクル外)。
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| Pub/Sub API | 高スループットまたは外部イベントストリーミングに最適 | エージェントは、gRPC を介してイベントを Salesforce Pub/Sub API に公開する Apex アクションを呼び出します。このアクションは、ディスパッチの確認として PublishResult replayId をエージェントに返します。ダウンストリーム コンシューマーが、Salesforce ネイティブのフローや Apex トリガーではなく Pub/Sub API を介して登録する外部システムである場合、または高スループットのイベント ストリーミングが必要な場合に使用します。 |
| プラットフォームイベント (Apex アクション) | Salesforce 内の非同期ディスパッチに最適 | エージェントは、プラットフォームイベントを公開する Apex アクションを呼び出します。イベントはすべての登録者に非同期で配信されます。このアクションでは、公開確認がエージェントに返されますが、処理結果は返されません。 下流のコンシューマーが Salesforce Platform 内にある場合に使用します。エージェントが EventBus.publish() を呼び出す Apex アクションを呼び出します。このアクションは、承諾を確認する SaveResult を返します。 |
| Apex キュー可能/バッチ (Apex アクション) | 長時間のバックグラウンド処理に最適 | エージェントは、Queueable または Batch ジョブをキューに入れる Apex アクションを呼び出します。ジョブがエージェントのトランザクション外で実行される。このアクションは、エージェントが参照としてユーザーに表示できるジョブ ID を返します。下流作業が長時間の Salesforce 操作データ処理、複数オブジェクトの更新、または同期制限を超える外部コールアウトの場合に使用されます。System.enqueueJob() は、エージェントが参照として記録したジョブ ID を返します。 |
| MuleSoft 非同期フロー | 外部メッセージキューのディスパッチに最適 | エージェントは、メッセージを外部キュー (Kafka、JMS、SQS) に配置する MuleSoft 公開アクションを呼び出します。MuleSoft はプロトコルの翻訳と配信確認を処理します。エージェントは、メッセージが下流で処理されたのではなく、MuleSoft によって受け入れられたことを確認します。 |
| 外部 REST エンドポイント (Apex アクション) | 外部システムイベント登録に最適 | ターゲットシステムは、送信を受け入れてすぐに確認 ID を返すエンドポイントを公開し、非同期で処理を完了します。エージェントは確認 ID を受信して記録する。 |
スケッチ
非同期アクション呼び出しのシーケンス図
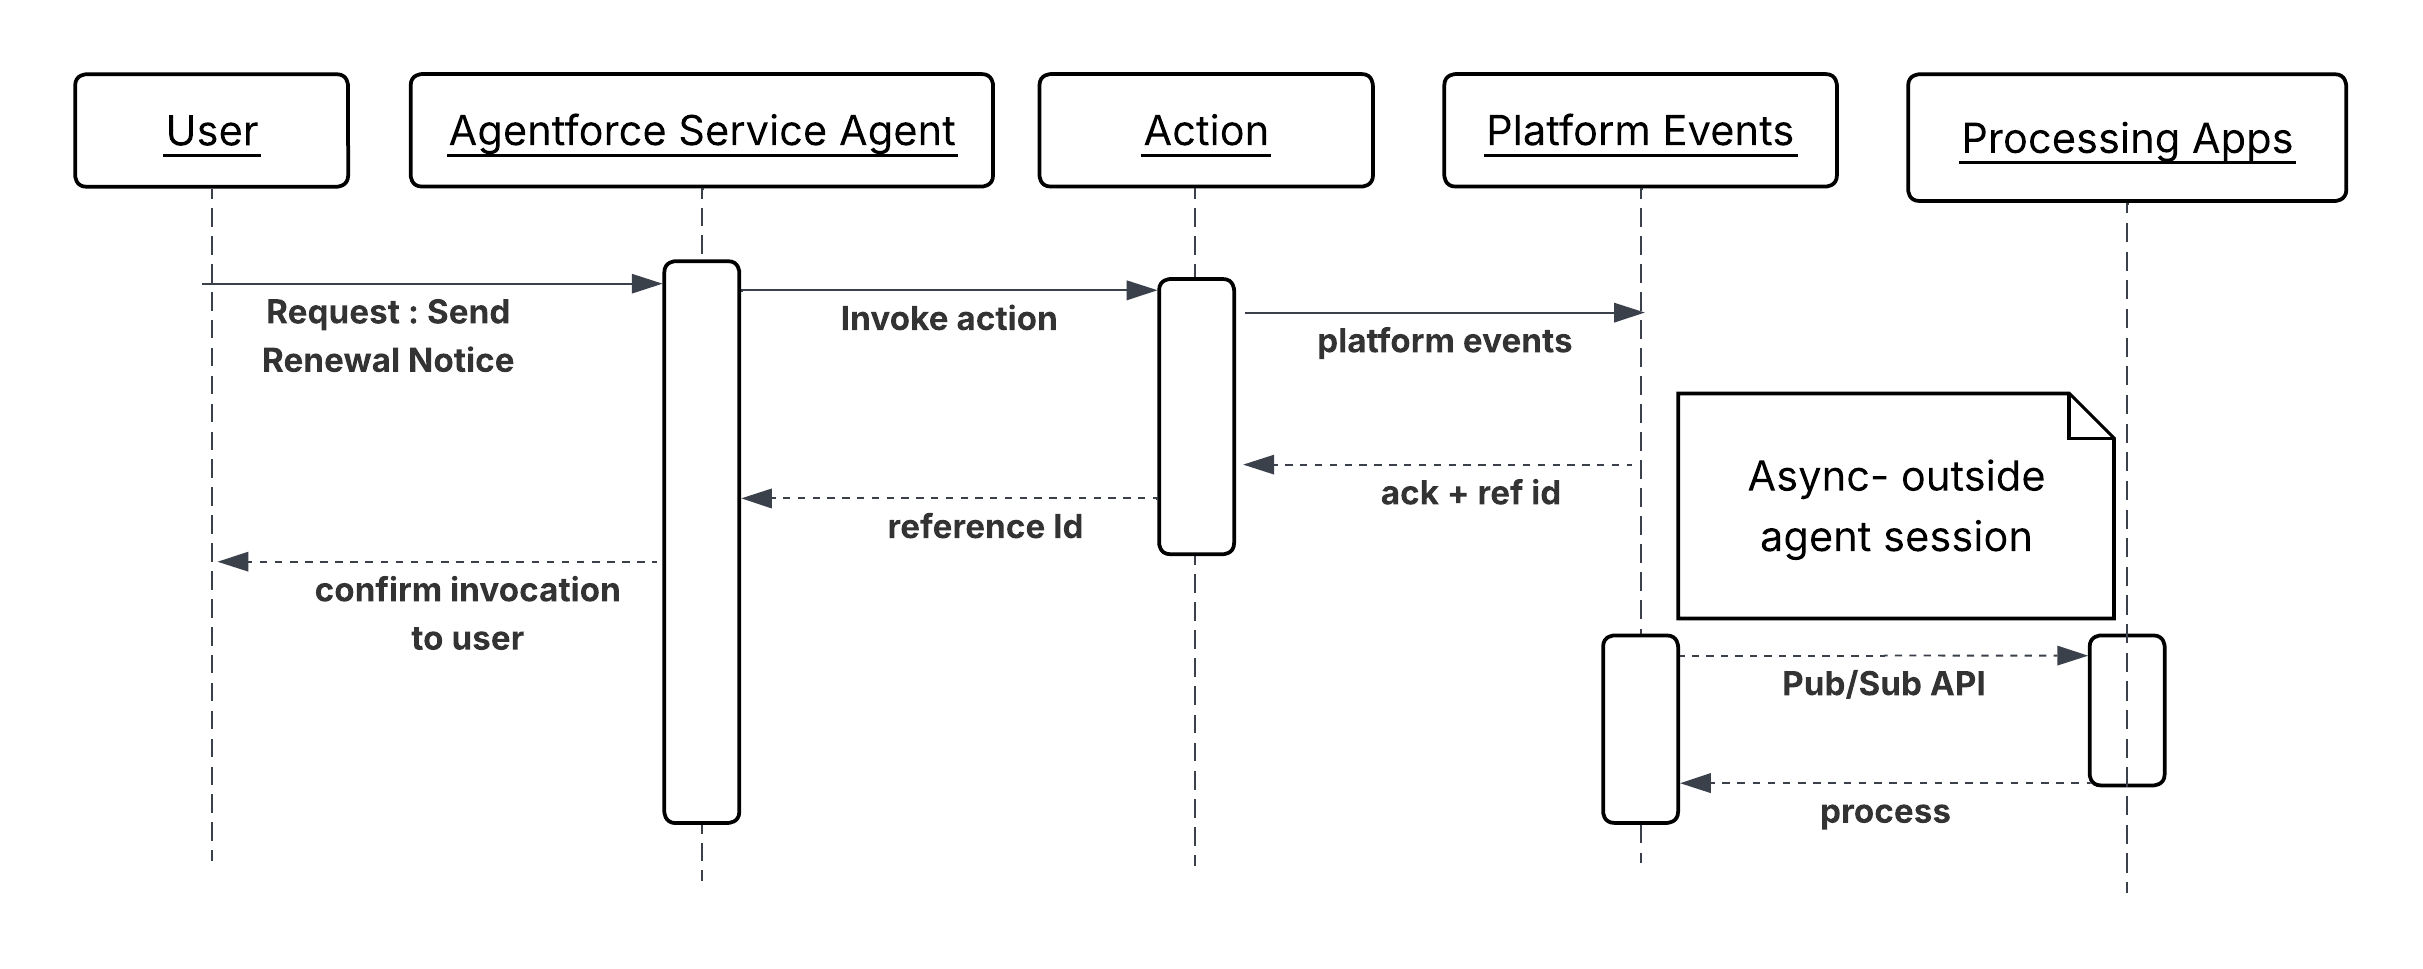
結果
エージェントは、結果の推論サイクルをブロックせずに下流の操作を呼び出します。操作が完了したのではなく、操作が受け入れられたことを確認してターンが完了します。下流のシステムが実行の完全な所有権を持ちます。派遣された操作は、派遣時に CRM に記録されるプラットフォームイベント購読者、ジョブ ID、または外部キュー確認 ID で追跡できます。下流の操作が失敗した場合、その失敗は、その操作を開始したエージェントセッションではなく、下流システム自身のモニタリングによって明らかにされます。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- インテントベースの言語でアクションの説明を記述します。たとえば、「更新通知をメッセージングキューに送信し、派遣参照 ID を返す」は「通知エンドポイントを呼び出す」よりもエージェントにとって有用です。
- ディスパッチアクションを「Sends and confirms delivery of (配送の送信と確認)」とは記述しないでください。エージェントは承諾のみを確認できます。下流への配送と処理は、エージェントの観測範囲外です。
Salesforce 実装メモ
- すべての呼び出しアクション (プラットフォームイベント
ReplayId、キュー可能ジョブ ID、Pub/Sub APIPublishResultreplayId、外部確認トークンなど) から参照 ID を返します。呼び出し時に CRM レコードに記録します。これは、エージェントセッションで生成される唯一の監査履歴です。 - Pub/Sub APIの場合、エージェントはPub/Sub APIの「/Publish」エンドポイントに対してgRPCコールアウトを実行するApexアクションを呼び出します。アクションでスキーマ登録ステップを処理する必要があります。イベントは、登録済みスキーマに対して Avro 形式でシリアライズする必要があります。
PublishResult ‘replayId’を派遣参照としてエージェントに返します。 - プラットフォームイベントの場合、成功インジケータをエージェントに返す前に、Apex アクション内で
EventBus.publish()をコールし、SaveResult でエラーがないかどうかを確認します。公開の成功を仮定せず、検証します。 - Queueable Jobs では、Queueable インターフェースを実装し、アクション内から System.enqueueJob() をコールします。結果の AsyncApexJob ID をエージェントに返します。
- 外部非同期エンドポイントの場合、対象エンドポイントは参照 ID を使用してすぐに確認応答 (HTTP 202 Accepted) を返す必要があります。 処理が完了するまでエンドポイントがブロックされると、同期され、このパターンは適用されません。
エラー処理と回復
- 呼び出しアクションでは、ディスパッチの失敗 (メッセージが受け入れられなかった) と処理の失敗 (メッセージが受け入れられたが、後でダウンストリーム操作が失敗した) を区別する必要があります。エージェントは前者のみを処理できます。
- 呼び出しに失敗した場合、アクションは明確な理由と共に構造化された失敗を返す必要があります。エージェントは派遣を再試行したり、人間にエスカレーションしたり、失敗した派遣レコードを記録したりできますが、同じセッション内で下流の処理の失敗を回復することはできません。
- 最終的にダウンストリームの失敗を明らかにする必要がある業務の場合、ダウンストリームプロセスによって公開されたプラットフォームイベント、ジョブの状況をチェックするスケジュール済みフロー、エージェントセッション外のフォローアップケースなど、個別のフィードバックループを設計します。
セキュリティに関する考慮事項
- すべての外部非同期コールアウトを指定ログイン情報でラップします。呼び出しアクションでは、コードにエンドポイント URL やログイン情報は埋め込まれません。
- イベントペイロードまたはメッセージボディに埋め込む前に、呼び出しアクションに渡されるすべてのパラメーターを検証してサニタイズします。非同期メッセージに渡されるユーザー指定テキストは、下流のコンシューマーの潜在的なインジェクションベクトルです。
- セッション ID、参照 ID、派遣時にサニタイズされたペイロードを使用して、すべての派遣を記録します。応答がエージェントに返されないため、このログはエージェントが開始した内容を再構築するための主要なメカニズムです。
- インテグレーションユーザーまたは接続アプリケーションに最小権限を適用します。通知キューに公開する派遣アクションには、関連しないシステムでの参照または更新を許可する資格情報を保持しないでください。
例
有効期限が近づいている契約を処理している更新管理エージェントは、顧客が自動更新通知の対象となることを判断します。エージェントは、ターンを終了する前にメールが配信されたことを確認する必要はありません。
CheckRenewalEligibility(自動起動フロー)では、契約期間、顧客ランク、オプトアウト状況が評価されます。「適格」な Boolean と優先通知チャネルを返します。DispatchRenewalNotification(Apex アクション) は、契約ID、顧客ID、通知チャネル、及び生成された冪等性キーを含むRenewalNotification\_\_eプラットフォームイベントを発行します。イベントがプラットフォームで受け入れられたことを確認する ReplayId を返します。UpdateContractRecord(自動起動フロー) は、ReplayIdと派遣のタイムスタンプを契約レコードに書き込み、「Notification Dispatched (通知が派遣されました)」状況フラグを設定します。
コンテキスト
カスタマーポータル、モバイルアプリケーション、サードパーティの SaaS プラットフォーム、パートナーシステムなどの外部アプリケーションは、プログラムでエージェントを呼び出してサービス要求を処理したり、ワークフローを開始したり、独自のインターフェース内で AI 駆動の応答を表示したりする必要があります。エージェントはインテリジェントなバックエンドサービスとして動作します。外部システムがコンテキストを提供し、エージェントが理由付けを行い、アクションを実行し、呼び出し元が応答をコンシュームします。
通話者は、人間向けのアプリケーションではなく、それ自体が AI エージェントまたはオーケストレーターであることが増えてきました。これらのAI-to-AIパターンでは、オーケストレーション エージェントが個別のツール コールとして、推論ステップ、CRM参照、またはアクションをAgentforceに委任します。このパターンをサポートするには、モデルコンテキストプロトコル (MCP) サーバーを公開する必要があります。
問題
外部システムまたはAIエージェントがオンデマンドでAgentforceエージェントの機能を活用する必要がある場合、エージェントはどのようにして認証を行い、エージェント セッションを作成し、必要な会話データとコンテキスト データを渡し、エージェントの構造化された応答を確実に受信して、独自のダウンストリーム ロジックを実行しますか。
勢力
このパターンを適用する場合は、次の質問に回答してください。
- 外部呼び出し元は同期で低レイテンシの応答を期待していますか?それとも非同期コールバックでも問題ありませんか?
- 通話者の ID はどのように確立され、データアクセスとパーソナライズのためにエージェントの実行コンテキストに伝達されますか?
- 同時にAPIによってトリガーされるセッションの予想数はどれくらいですか?また、それはSalesforce APIのレート制限や同時実行制限にどのように影響しますか?
- 外部システムは複数ターン (複数ターンの会話) にわたってセッションの継続性を維持する必要がありますか? それとも各要求はステートレスですか?
- コール元システムがプログラムで応答を解析して処理できるように、エージェントの応答をどのように構成する必要がありますか?
- 通話者は、RESTの直接統合を必要とする人向けアプリケーションですか、それともMCPなどの標準プロトコルを介してツールとしてAgentforceを呼び出すことができるAIエージェントまたはオーケストレーターですか。
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| Agentforce Agent API - シングルターン (同期) | ステートレスなリクエスト-レスポンスインテグレーションに最適 | 呼び出し元システムは即時に構造化されたレスポンスを必要とし、エージェントの推論は呼び出し元のタイムアウト許容範囲内に完了することが期待されます。 コール元システムは、セッションライフサイクルの全フェーズ (作成、ターン、終了) を管理します。外部システムが認証し、コンテキスト変数を使用してセッションを作成し、1 つのメッセージを送信し、エージェントの応答を受信して、セッションを閉じます。 この Agentforce API は、外部システムでセッションの作成、メッセージの交換、プログラムでのセッションの終了を行うためのプライマリ REST インターフェイスです。交換全体が 1 つの HTTP 要求-応答サイクルで完了します。 応答には、エージェントの自然言語出力と、エージェントが推論中に呼び出したアクションによって生成された構造化された出力変数が含まれます。 |
| Agentforce Agent API - 複数ターン (セッション継続性) | ターン間で状態が必要な会話型インテグレーションに最適 | 外部インターフェースは会話型 (チャットウィジェットや音声インターフェースなど) であり、インタラクションでは解決に至るまでに複数のやりとりが必要です。 外部システムはセッションを 1 回作成し、複数のメッセージ交換でセッション ID を再利用します。 エージェントは、前の質問、取得されたデータ、呼び出し元が再度提供しなくても済む決定など、ターン間の会話コンテキストを保持します。 |
| ポーリングまたはWebhookコールバックを使用した非同期 | 高遅延の推論ワークフローや時間的制約のある UI に最適 | エージェントの処理時間は非常に短く、開いている HTTP 接続を保持すると、通話者のユーザーエクスペリエンスが低下したり、アップストリームタイムアウトがトリガーされたりします。 外部システムはリクエストを送信し、ジョブまたはセッションIDを含む確認応答をすぐに受信します。次に、ステータスエンドポイントをポーリングするか、推論が完了したときにエージェントの応答を受信するWebhookを登録します。 現在、このパターンは MuleSoft などのミドルウェアでホストされるラッパー API を使用して実装できます。外部コンシューマーはこのラッパーAPIを呼び出して、Webhookエンドポイントを登録します。ラッパー API は、Agentforce エージェントを呼び出した後に確認応答を外部システムに送信します。このラッパー API は Agentforce エージェント セッションも維持し、エージェントが応答すると、登録済みの Web フック エンドポイントを使用して外部システムに応答を返します。 |
| MCP による Agentforce (Salesforce Headless 360) | 通話者が MCP 互換クライアントである AI-to-AI 呼び出しに最適 | コール元 MCP クライアントは、Salesforce ヘッドレス 360 によって提供される標準の MCP サーバを介して、ツールとして Agentforce を呼び出します。 セッションのライフサイクルは MCP サーバによって透過的に管理され、コール元エージェントはカスタム REST インテグレーションを構築せずに標準のツールコールを介してやりとりします。 このソリューションは、通話者が MCP クライアントであり、より広範なエージェント型ワークフローの個別のステップとして、推論、CRM コンテキストの取得、またはアクションの実行を Agentforce に委任する必要がある場合に使用します。 |
スケッチ
オンデマンドエージェント呼び出しのシーケンス図
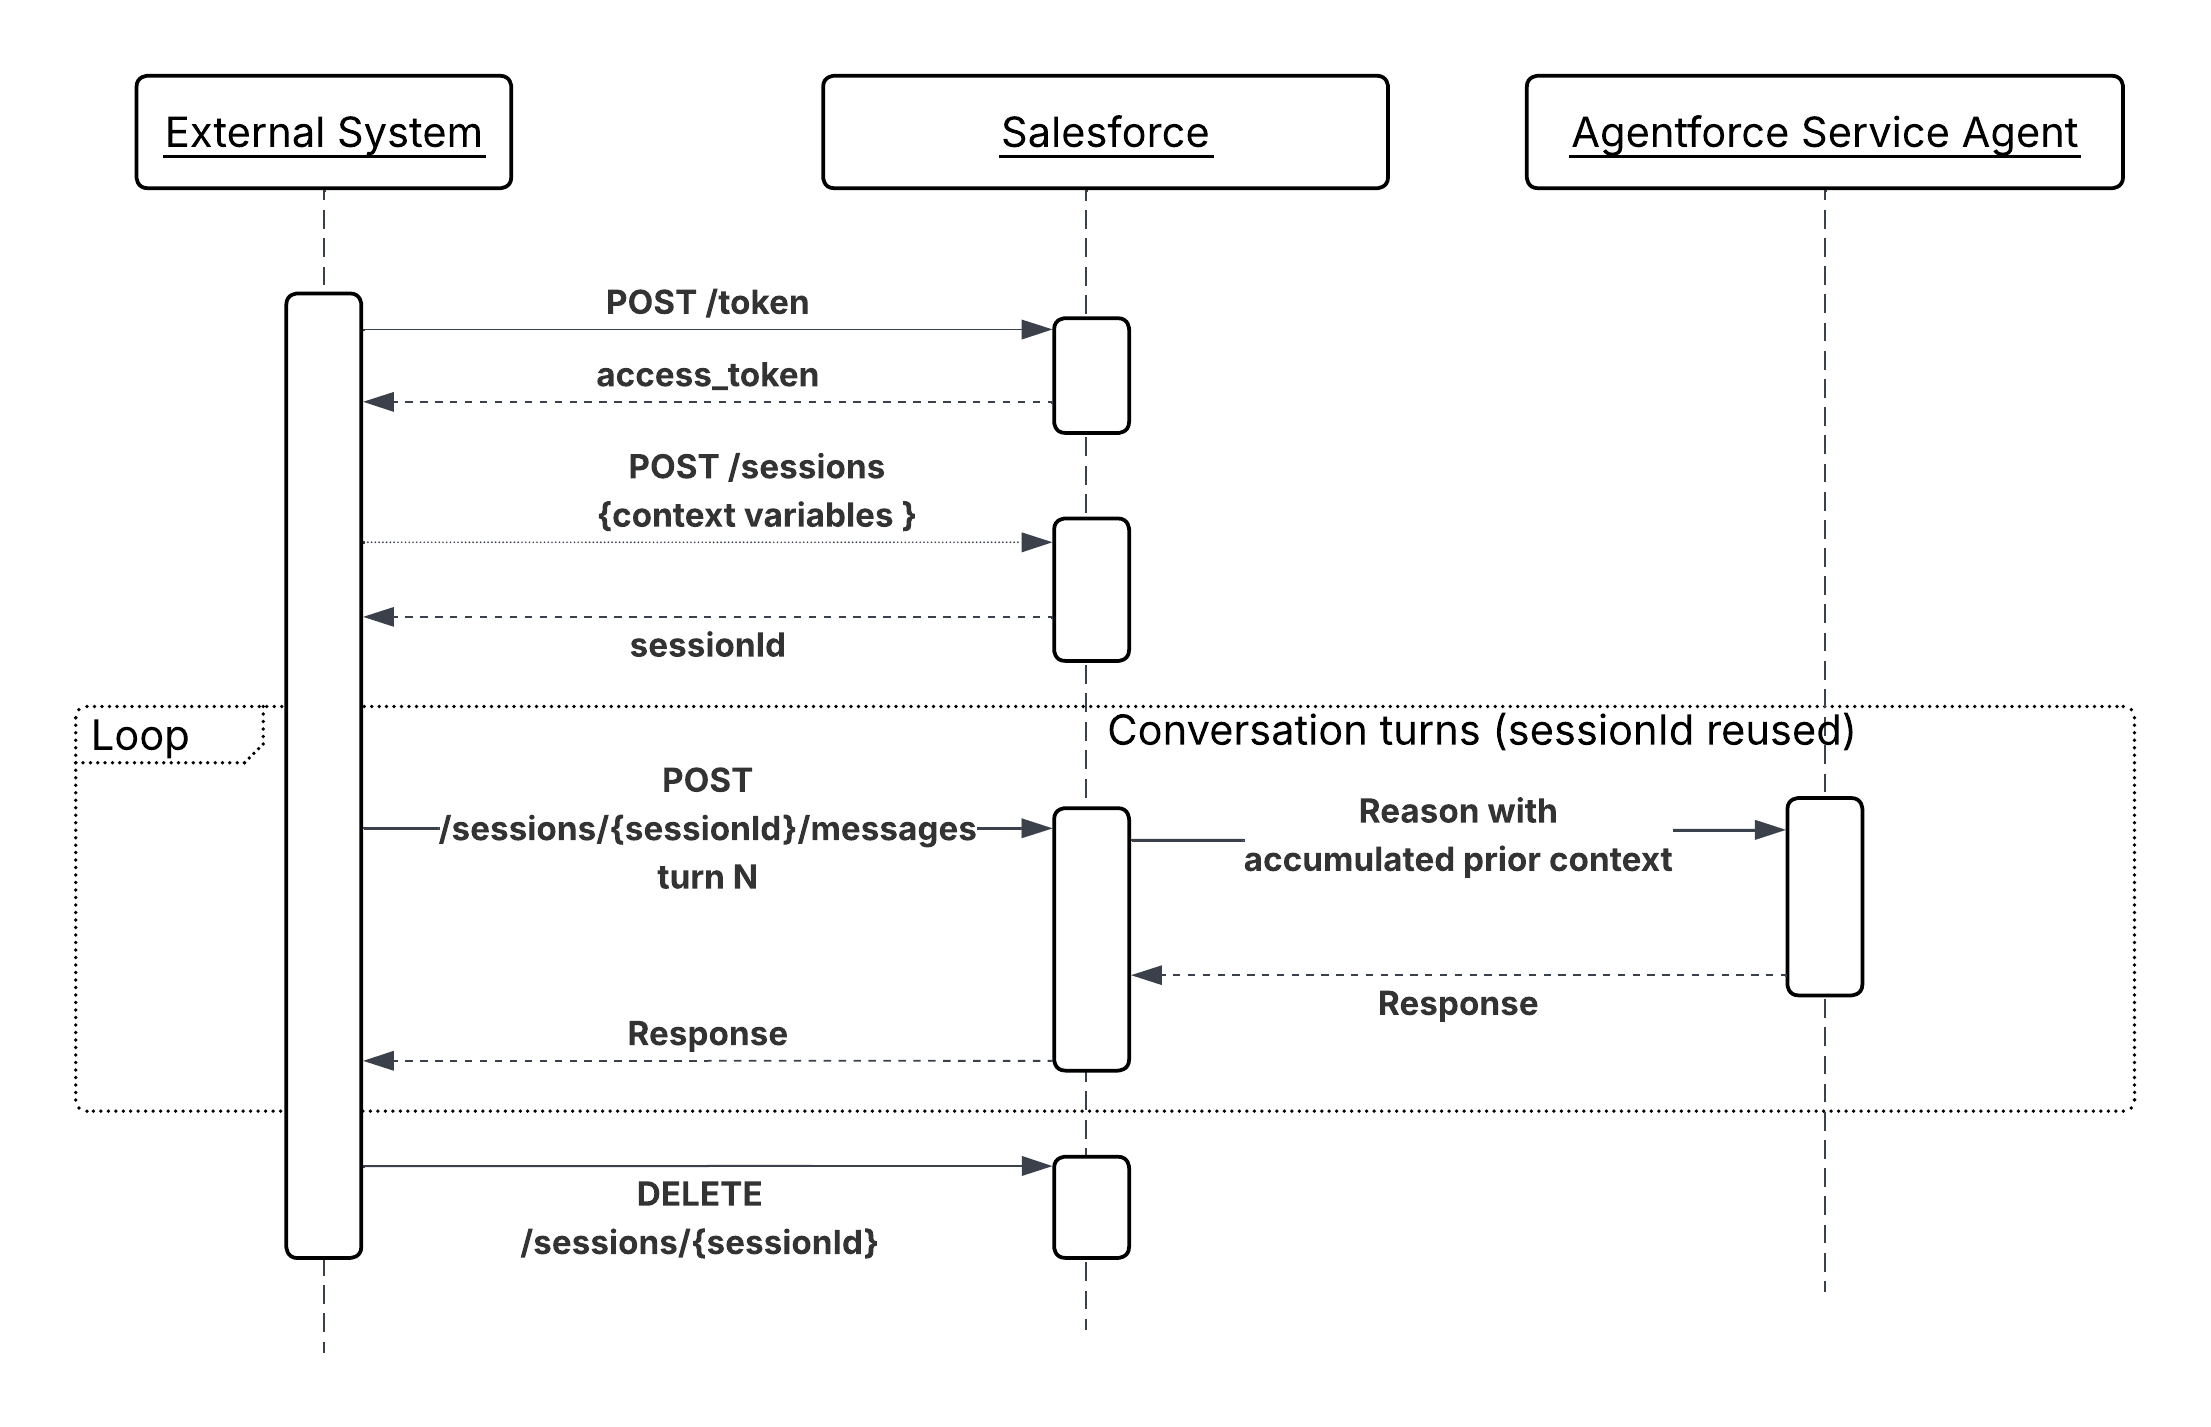
結果
このパターンでは、Agentforce をコール可能な AI サービスとして公開します。外部システムは、ロジックを複製することなく、エージェントの推論、ツール、CRM コンテキストにアクセスできます。通話者はセッションライフサイクル管理と応答の表示に引き続き責任を負います。エージェントは、すべての推論、ツール選択、そして応答の合成に引き続き責任を負います。
通話者がAIエージェントまたはオーケストレーターの場合、MCPを介したAgentforceメカニズム(Salesforce Headless 360を介して標準で使用可能)により、カスタムRESTインテグレーションの必要性が完全に排除されます。MCP サーバは、コール元エージェントの代わりにセッションライフサイクルを処理します。これにより、Agentforce は、追加の配管なしで、マルチエージェントワークフローに一流のツールとして参加できます。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- 時間的制約のある UI フローでは、外部 API コールを同期およびブロックしないでください。エージェントの応答時間が無視できない場合は、ポーリングまたは Webhook コールバックパターンを採用して、ユーザーエクスペリエンスとエージェントの処理時間を分離します。
- 対応可能状況ではなく通話者の性質に基づいて通話メカニズムを選択します。人間向けのアプリケーションやシステムインテグレーションでは、エージェント API を直接使用する必要があります。MCP をサポートするツールでは、Agentforce MCP サーバを使用する必要があります。同じ通話者種別にメカニズムを混在させると、アーキテクチャ上の利点がなく、不必要に複雑になります。
Salesforce 実装メモ
- 最初のユーザーメッセージではなく、セッション作成 POST 要求にセッションコンテキストを挿入します。外部システムはセッションを作成するときに、構造化されたコンテキスト変数 (取引先 ID、エンタイトルメントデータ、以前のインタラクション概要) を名前付きセッションパラメーターとして直接渡すことができます。これらの変数は、エージェントが 1 つのターンを処理する前に使用できるため、ルックアップコールを発行せずにグラウンディング状態から推論を開始して、顧客が誰であるかや顧客の権利があるかを確認します。代わりに、メッセージ本文内で同じデータを渡すと、エージェントは非構造化テキストを解析し、型付き変数として受け取ることができた事実を抽出する必要があります。これにより、遅延が増加し、抽出エラーが発生し、ビジネス価値のない推論ステップが消費されます。
- エージェントの応答は構造化され、機械が容易に解析できる形式になるように設計します。通話者が人間ではなくシステムである場合に JSON 対応応答または明確に区切られた応答を返すようにエージェントを誘導する出力変数の規則とプロンプト指示を使用します。
- セッションライフサイクルを明示的に管理します。使用後は
DELETE /einstein/ai-agent/v1/sessions/{sessionId}を用いて、セッションを迅速に終了し、同時実行枠を解放するとともに、無関係なインタラクション間で古いコンテキストが残留しないようにします。 - Salesforce の同時セッション制限を考慮します。高スループットシナリオの場合、ピーク負荷時に要求が却下されないように、コール元システムにセッションプールまたはキューイングレイヤーを実装します。
- MCP を介して Agentforce を呼び出す場合は、コンテキストをセッション変数としてではなくツール入力パラメータとして渡します。MCP Server はセッションライフサイクルを透過的に管理するため、コール元エージェントが作成時に指定セッションパラメーターを直接設定することはできません。エージェントがグラウンディング状態から推論を開始できるように、必要なすべてのコンテキスト (レコード ID、ユーザー ID、エンタイトルメントデータ) がツールコールペイロードに含まれていることを確認します。
- MCP Server の透過的なセッション管理は、同時実行のバイパスではなく便宜的なものとして扱います。ツールを呼び出すたびに、Salesforce エージェントセッション時間枠が消費されます。MCP を介して大規模に Agentforce をコールする頻度の高いオーケストレーターは、エージェント API の直接コール元に適用される同時セッション制限と同じ制限を考慮する必要があります。
エラー処理と回復
- エージェント API は標準 HTTP エラーコードを返します。コール元システムは、指数バックオフを使用する「429 Too Many Requests」(レート制限) と再試行ロジックを使用する「503 Service Unavailable」を処理する必要があります。
- エージェント自身が解決できないツール障害に遭遇すると、応答本文に正常な自然言語エラーが返されます。コール元システムは、これらのセンチネル応答(たとえば、応答内の「エラー」ステータスフィールドの確認など)を検出し、追加のコンテキストで再試行するか、フォールバックエクスペリエンスを提示するか、または人間にエスカレーションするなど、適切にルーティングします。
- MCP を介して を呼び出す場合、MCP トランスポート エラー(不正な形式のツール コール、サーバの使用不可)と Agentforce 推論エラー(ツール実行エラー、解決できないアクション)という 2 つの異なるレイヤーでエラーが表示されます。オーケストレーションエージェントは、両方のレイヤーを個別に処理する必要があります。MCP転送エラーはプロトコル レベルで再試行をトリガーする必要があります。ツール応答で返されたAgentforce推論エラーは、オーケストレーター独自のフォールバックまたはエスカレーション ロジックで処理する必要があります。
セキュリティに関する考慮事項
- 外部クライアントアプリケーションの OAuth 範囲はできるだけ狭くしてください。エージェントを呼び出す必要があるインテグレーションでは、エージェント自身が必要とするスコープを超えてデータアクセスのスコープを保持しないでください。
- 外部システムからのすべての入力をセッション変数として挿入する前に検証およびサニタイズします。外部入力は、プロンプトインジェクションの攻撃対象領域です。たとえば、悪意のある通話者がエージェントの指示を上書きするように設計された「customerQuery」項目を作成できます。
- 外部クライアントアプリケーションに IP 許可リストを適用して、エージェント API を認証およびコールできる外部システムを制限します。
- 監査とセキュリティの目的で、通話者 ID、セッション ID、要求/応答メタデータを含むすべての受信 API トリガーセッションを記録します。
- MCP を介して Agentforce を呼び出すと、MCP サーバはコール元ユーザの代わりに Salesforce に対して認証を行います。MCP Server の接続アプリケーションのログイン情報の範囲が最小限必要な権限に設定され、エンドユーザーの ID (Claude などの MCP ツールを使用) がツール入力パラメーターを介して明示的にセッションコンテキストに反映されていることを確認します。
例
金融サービスポータルによって、Agentforce エージェントが住宅ローンの照会を処理します。
- ポータルはクライアントログイン情報 OAuth フローを使用して認証し、ベアラートークンを取得します。
- セッション変数「{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }」を使用して「POST /Einstein/ai-agent/v1/sessions」をコールします。
- ユーザーは、「申請を完了するために必要なドキュメントは?」という質問を送信します。
- ポータルはユーザーのテキストを使用して「POST /Einstein/ai-agent/v1/sessions/{sessionId}/messages」をコールします。
- Agentforce エージェントは「GetDocumentChecklist」フローアクションを呼び出し、ローン種別固有の要件を取得して、構造化リストを返します。
- ポータルではエージェントの応答がインラインで表示され、ユーザー終了時にセッションが終了します。
コンテキスト
すべてのエージェントワークフローが人間の要求から発生するわけではありません。商品使用状況総計値の急激な低下、高価値のカートの放棄、リスクしきい値を超える支払の失敗など、ビジネスに不可欠な兆候は、運用データで頻繁に発生します。これらのシグナルにインテリジェントな複数ステップの応答が必要な場合、人間が気づいて行動するのを待つと、実際のビジネスコストに遅延が生じます。
このパターンでは、リアルタイムイベントがエージェントの自律エントリポイントとして機能する方法について説明します。エージェントは、ユーザーではなくデータ条件によって呼び出され、イベントコンテキストに基づいて推論し、すべて人間の介入なしに応答ワークフローを実行します。
問題
Data 360 または Salesforce Platform でリアルタイムビジネスイベントが発生したときに、そのイベントでエージェントセッションを自律的にインスタンス化し、グラウンディングコンテキストとしてイベントペイロードを提供し、対話以外のアクションワークフローを完了まで人間が開始またはガイドすることなく進めるにはどうすればよいでしょうか?
勢力
このパターンを適用する場合は、次の質問に回答してください。
- イベントが発生した瞬間に応答が必須か、またはほぼリアルタイムの処理(秒から分)が許容されるか?
- イベントペイロードにエージェントをグラウンディングするのに十分なコンテキストが含まれているか、エージェントが効果的に推論する前に追加のルックアップを実行する必要があるか?
- 予想されるイベント量と頻度は?高スループットのイベントストリームでは、エージェントの同時実行制限を使い切らないようにレート管理を行う必要があります。
- 同じビジネスエンティティで同じイベントを複数回起動できますか (少なくとも 1 回は配送)?その場合、アクションは冪等である必要があります。
- エージェントがイベントを自律的に解決できない場合、人間のエスカレーションパスはありますか?
- 失敗したイベント処理はどのように表示される必要がありますか?デッドレターキュー、アラート、またはケース作成で対応しますか?
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| Data 360 トリガーフロー | 行動ベースのシグナルや指標ベースのシグナルに最適 | これは、トリガー条件が Data 360 セグメントメンバーシップの変更または総計値のしきい値として定義されている場合に最適です。Data 360 はビジネス状況 (カートの放棄、利用状況の低下など) を検出し、トリガーされたフローを起動します。このフローでは、イベント ペイロード属性がエージェント セッション変数に対応付けられ、Agentforce セッションが作成されます。 |
| プラットフォームイベント + 自動起動フローまたは Apex | プラットフォーム内部およびシステム間のイベントに最適 | このソリューションは、イベントソースが Salesforce Platform 内にある場合、またはミドルウェアレイヤーが外部システムで状況を検出した後にイベントを公開する場合に使用します。Salesforce プロセスまたは外部システムによって公開されたプラットフォームイベントは、イベントペイロードをコンテキストとしてエージェントセッションを構築する Apex トリガーまたは自動起動フローをトリガーします。 |
スケッチ
イベント駆動型エージェントの実行のシーケンス図
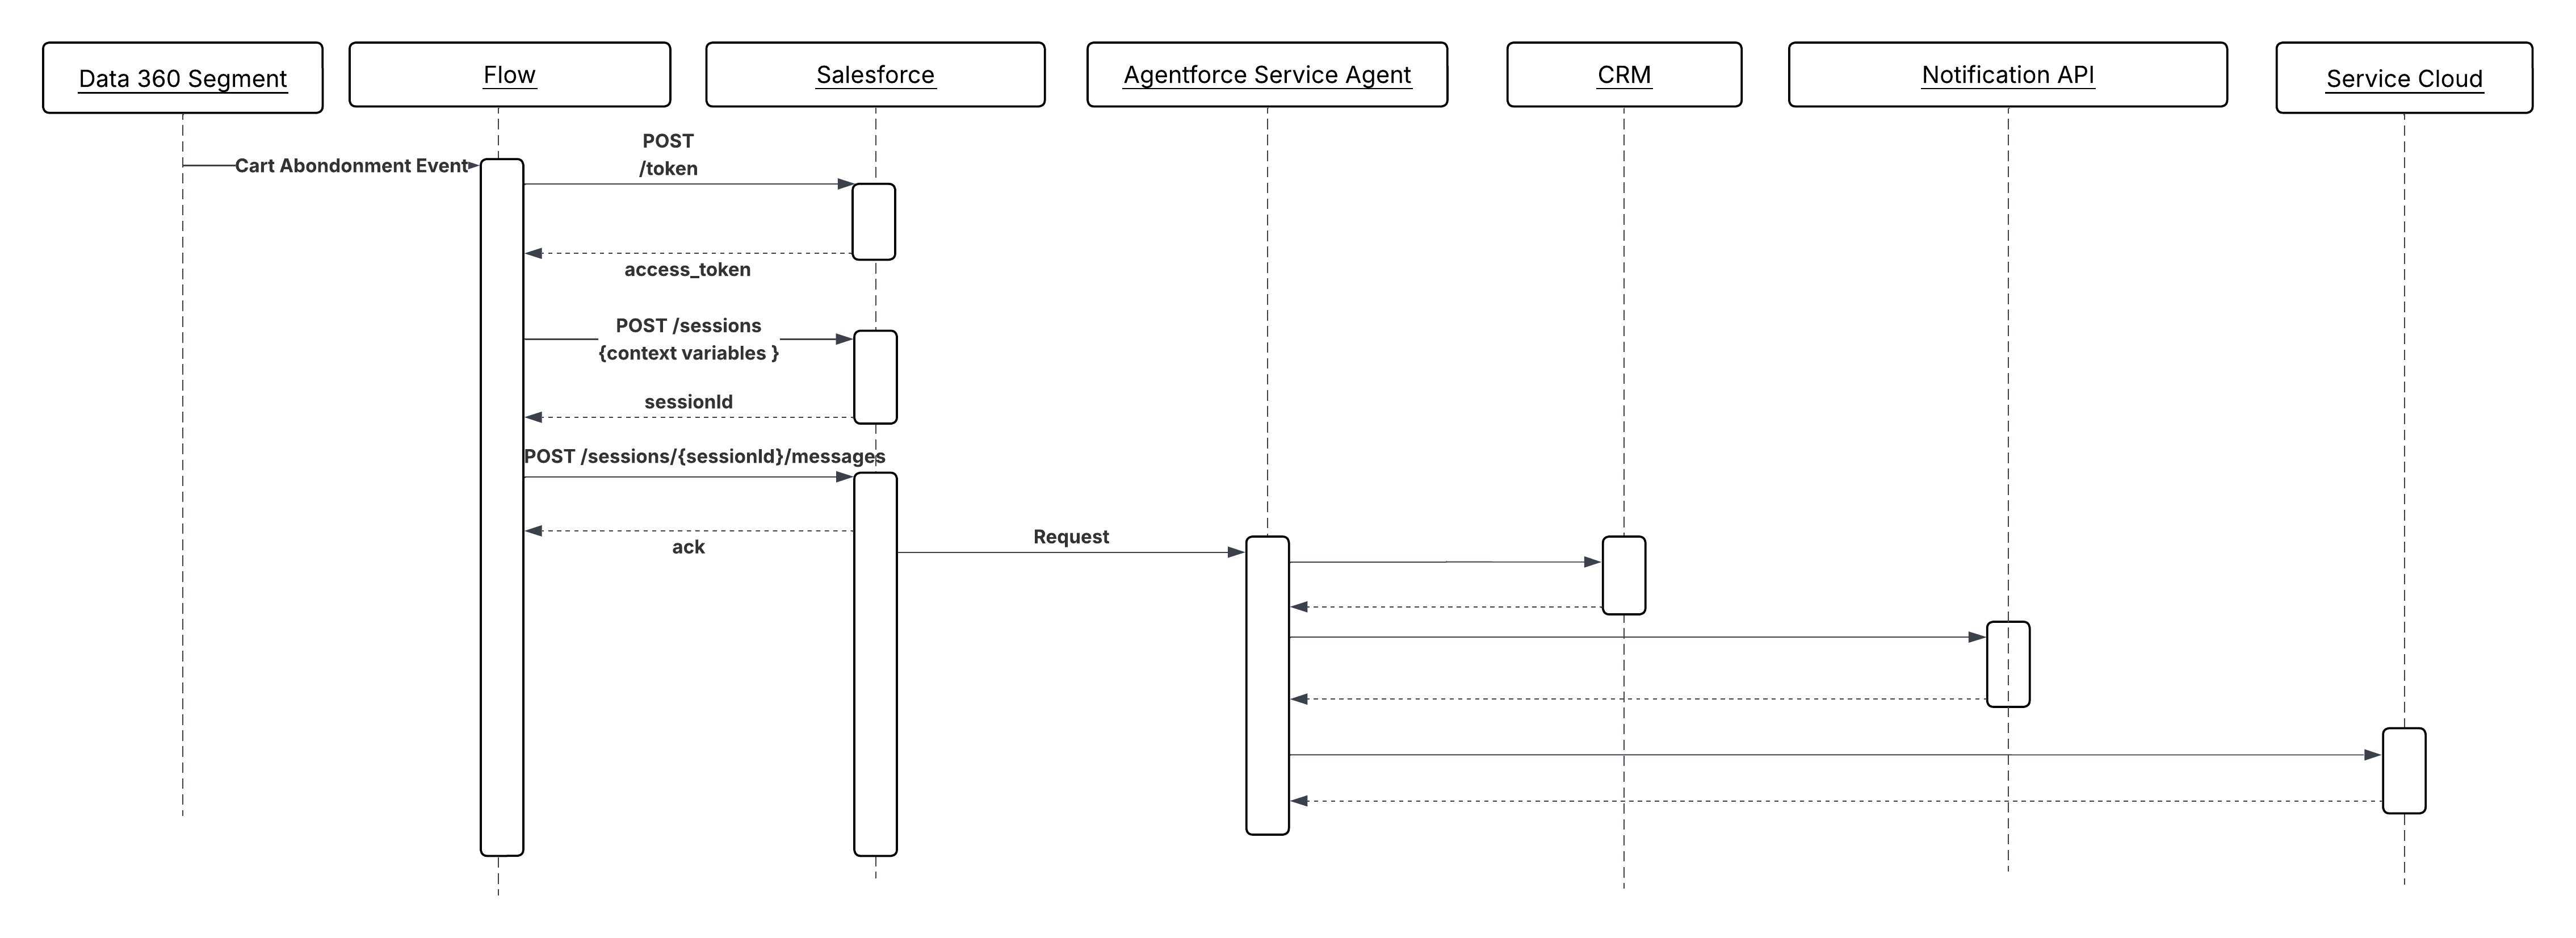
結果
エージェントは、人間の要求にただ受動的に応答するのではなく、リアルタイムの業務に積極的に関与します。イベントトリガーエージェントは、人間が注意を払う速度ではなく、データの速度でリカバリ、トリアージ、およびエスカレーションワークフローを実行できます。
トリガーシステム (Data 360 またはプラットフォームイベント) は引き続きイベント検出とペイロード形成を担当します。エージェントは、そのペイロードを推論し、正しいアクションチェーンを選択する責任を負います。会話のターンは必要ありません。イベントペイロードが完全な入力です。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- 会話以外の呼び出し用のすべてのアクションを設計します。ユーザーのターンは存在せず、エージェントは初期のグラウンディングコンテキストのみを基に解決策に到達しなければなりません。アクションは、明確化を促すのではなく、構造化された確定的な出力を返す必要があります。
- エージェントセッションを作成する前に、イベントペイロードで十分なグラウンディングコンテキストが伝送されていることを確認します。エージェントが十分に推論する前に複数のルックアップを実行せざるを得なくなるような、極端に簡素なペイロードは、レイテンシと同時実行リソースの消費を増加させます。
- イベント駆動型エージェントによってトリガーされるすべての書き込み操作を即効性のあるものにします。通常、イベント配信システムは少なくとも1回の保証を提供します。重複したイベント処理によって副次的な影響が重複して発生してはなりません。
Salesforce 実装メモ
- Data 360 トリガーフローでは、セッションの作成時にイベントペイロード属性 (「accountId」、「eventType」、「metricValue」、「productIds」など) を名前付きセッション変数に直接対応付けます。これにより、取得アクションを必要とせずに、最初の推論ステップからエージェントがグラウンディングされます。
- プラットフォームイベントトリガーの場合は、画面フローではなく自動起動フローを使用してください。画面フローは、自律的で会話以外のコンテキストではサポートされません。
- イベントトリガーセッションで明示的なセッションタイムアウトを設定します。対話型セッションとは異なり、インタラクションを拡張するユーザーはいません。失敗したアクションで停止したセッションで、同時実行時間枠が無期限に保持されるとは限りません。
- フロー障害パスを使用して、エージェントセッションの作成の失敗を処理します。セッションを作成できない場合、フォールトパスは補償イベントを公開するか、イベントを黙って削除するのではなく、人間のフォローアップ用のケースを作成する必要があります。
エラー処理と回復
- 同時実行制限、セッション作成エラー、ペイロード検証エラーのためにエージェントセッションを正常にトリガーできなかったイベントは、ケースの作成、アラートの起動、または再処理のためにイベントをデッドレターキューに公開する障害パスに転送されます。
- 実行中のエージェントの失敗 (必須アクションのタイムアウトなど) は、元のイベント ID を使用して記録する必要があります。 トリガーは非同期であり、待機中の通話者がないため、エラー表面は完全に監視可能性 (ログ、ダッシュボード、アラートしきい値) に基づいています。
- 再試行の上限を実装します。イベントによって確実にエージェントが失敗する場合、無制限の再試行で同時実行の制限がなくなります。設定可能な最大試行回数に達したら、完全なコンテキストが添付された人間レビューキューにイベントを転送します。
- エージェントセッションのライフサイクル全体でイベント ID を追跡します。この追跡により、元のデータシグナルとすべてのダウンストリームアクションを相関付けて監査およびデバッグできます。
セキュリティに関する考慮事項
- エージェントセッション変数として挿入する前に、すべてのイベントペイロード属性を検証してサニタイズします。Data 360 または外部パブリッシャーからのイベントペイロードは、プロンプトインジェクションの攻撃対象領域です。たとえば、エージェントの指示を上書きするように細工されたペイロード項目を設計できます。
- イベントトリガーされたエージェントセッションは、高権限の管理者ではなく、権限が最も少ない専用のインテグレーションユーザーで実行します。エージェントは、定義されたアクションセットを実行するために必要な権限のみを保持します。
- 元のイベント ID、イベント種別、作成時に差し込まれたセッション変数を使用して、すべてのイベントトリガーセッションを記録します。この監査履歴は、結果が紛争の場合にエージェントが特定のアクションを実行した理由を再構築するために必要です。
例
ある小売会社は、Data 360 を使用してリアルタイムのカートの行動を追跡しています。定義済みのしきい値を超える値のカートが放棄された場合:
- Data 360 は放棄シグナルを検出し、イベントペイロード (「customerId」、「cartValue」、「productIds」、「abandonmentTimestamp」) を使用してトリガーされたフローを起動します。
- フローでは、これらの属性が Agentforce セッション変数に対応付けられ、新しいエージェントセッションが作成されます。ユーザー操作は必要ありません。
- エージェントは、使用可能な取得アクションを使用して、顧客の購入履歴、現在のエンタイトルメント、カート構成を評価します。
- エージェントは、顧客セグメントに基づいて適切な割引層を適用する
SelectRecoveryOfferアクションと、顧客の希望チャネルを介してオファーを提供するSendProactiveNotificationアクションを呼び出します。 - エージェントは
CreateFollowUpTaskを呼び出して、取引先所有者に表示されるように CRM に操作を記録します。 - アクションチェーンが完了すると、セッションは自動的に閉じます。追跡できるように、元のイベント ID はセッションログに保持されます。
コンテキスト
LLM は公開データに基づいてトレーニングされます。組織の商品、保険契約、ケース履歴、または契約に関する情報は、推論時に明示的に提供されない限り、ユーザーにはKnowledgeません。グラウンディングなしでは、エージェントが顧客のサービスエンタイトルメントや特定の契約条件について尋ねられた場合、回答をでっち上げるか、知らないことを認めることになります。どちらの結果も企業コンテキストでは受け入れられません。
検索拡張生成 (RAG) は、応答を生成する前に企業ナレッジストアから関連ドキュメントを取得し、エージェントのコンテキストウィンドウに挿入することで、この問題を解決します。エージェントは、Knowledge 記事、過去のケース解決、製品仕様などの取得済みコンテンツを、その情報を直接与えられたかのように理由付けします。LLM は理由を提供し、取得レイヤーは結果を提供します。
たとえば、複雑な保証請求を処理するサービスエージェントの手順に保証ポリシー条件を組み込む必要はありません。代わりに、顧客が問題について説明すると、エージェントは保証ドキュメントのベクトルインデックスに対してセマンティック検索またはハイブリッド検索 (キーワード検索 + セマンティック検索) を実行し、該当する用語を取得して、それらを使用して対象資格と次のステップを判断します。この回答は、モデルの学習データではなく、現在の権威あるポリシードキュメントに基づいています。
問題
エージェントは、LLMのトレーニング データに含まれていなかったポリシー、契約、製品ドキュメント、過去のケース データなどの独自の組織Knowledgeに基づいて、質問に回答したり意思決定を行ったりする必要があります。エージェントは、推論時に最も関連性の高いコンテンツを取得し、取得されたコンテンツが最新かつ信頼性のあるものであることを確認し、ノイズを回避するために十分な精度でコンテキストに挿入する方法は何ですか?
勢力
このパターンを適用する場合は、次の質問に回答してください。
- 知識コンテンツは静的で更新頻度が低いか(製品マニュアルなど)、それとも継続的に変更されるか(ケース解決、在庫説明など)?更新頻度によって、取り込みパイプラインの設計が決まります。
- コンテンツの大きさは?小さなKnowledge Baseは網羅的に取得できますが、大きなKnowledge Baseでは、チャンク、埋め込み、セマンティック インデックス付けを行って、最も関連性の高いパッセージのみを返す必要があります。
- クエリでは、1つの焦点を絞った取得からメリットが得られますか。それとも、複数のKnowledgeソース(ドキュメントと過去のケースを同時に取得など)からの結果を組み合わせて、より適切なグラウンディングの回答が得られるでしょうか。後者ではアンサンブルの取得が必要です。
- セマンティックランキングの前に取得したコンテンツをメタデータで絞り込む必要がありますか? (たとえば、顧客の商品層や場所に関連するドキュメントに結果を制限する必要がありますか?)
- Knowledgeコンテンツの機密性は?取得されたコンテンツは LLM コンテキストウィンドウに挿入され、エージェントの応答に影響します。特定のユーザーに表示してはならないコンテンツは、LLM で絞り込まれることが前提ではなく、取得レイヤーで管理する必要があります。
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| Data 360 を使用した取得拡張生成 (RAG) | 企業向けユースケースに最適 | エージェントは、応答を生成する前に Data 360 ベクトルインデックスに対してセマンティック検索を実行します。Knowledge Article、過去のケース、製品ドキュメントなどの取得されたコンテンツは、グラウンディングとしてLLMコンテキストに挿入されます。これは、リトリーバーアクション、フロー、またはカスタム Apex を使用して /call できます。Data 360 では、ベクトルストアだけでなく、未加工コンテンツからエージェント対応コンテキストへの統合パイプラインがサポートされます。
これらのすべての機能は、完全な設定が可能な両方のターンキー方式で提供されます。 Data 360 には 2 種類のリトリーバーがあります。 個人の取得: 設定された Salesforce 取得アクションは、定義された 1 つの検索インデックスに対してセマンティック検索を実行し、最も関連性の高いコンテンツチャンクを返します。結果はグラウンディングコンテキストとして LLM プロンプトに直接挿入されます。クエリが 1 つの焦点を絞った Knowledge ソースによって最適に処理される場合には、個人リトリーバーアクションを使用します。 アンサンブル取得者: アンサンブル取得者アクションは、商品ドキュメントインデックスや解決済みケースインデックスなど、複数の個々の取得者の結果を結合します。アンサンブルレトリーバーは、異種インデックス間で関連性スコアを比較できないため、個々のリトリーバーの関連性スコアを結合しません。代わりに、取得されたすべてのチャンクは、各 (クエリ、チャンク) ペアを個別にスコアリングするクロスエンコーダリランカーモデルに渡され、統合されたランキングが生成されます。これはアーキテクチャ上重要です。つまり、クロスソースランキングの品質は、スコアの手動調整ではなく、再ランカーモデルによって向上します。再ランク付けした後、統合結果がグラウンディングコンテキストとしてLLMプロンプトに利用できるようになります。より完全な回答で複数のKnowledgeドメインからの証拠が必要な場合は、アンサンブルレトリーバーアクションを使用します。 |
| サードパーティのベクトルデータベースを使用した RAG | 既存のインフラストラクチャの制約内で作業する場合に適しています。 | このアプローチでは、インフラストラクチャにすでに存在する可能性があるサードパーティのベクトルストアを統合し、独自のデータ埋め込みにインデックスを付け、リアルタイムのセマンティック検索とコンテンツ取得に使用します。これは、フローまたはカスタム Apex を使用して実装できます。 |
スケッチ
エンタープライズ・コンテンツからのKnowledgeグラウンディングのシーケンス図
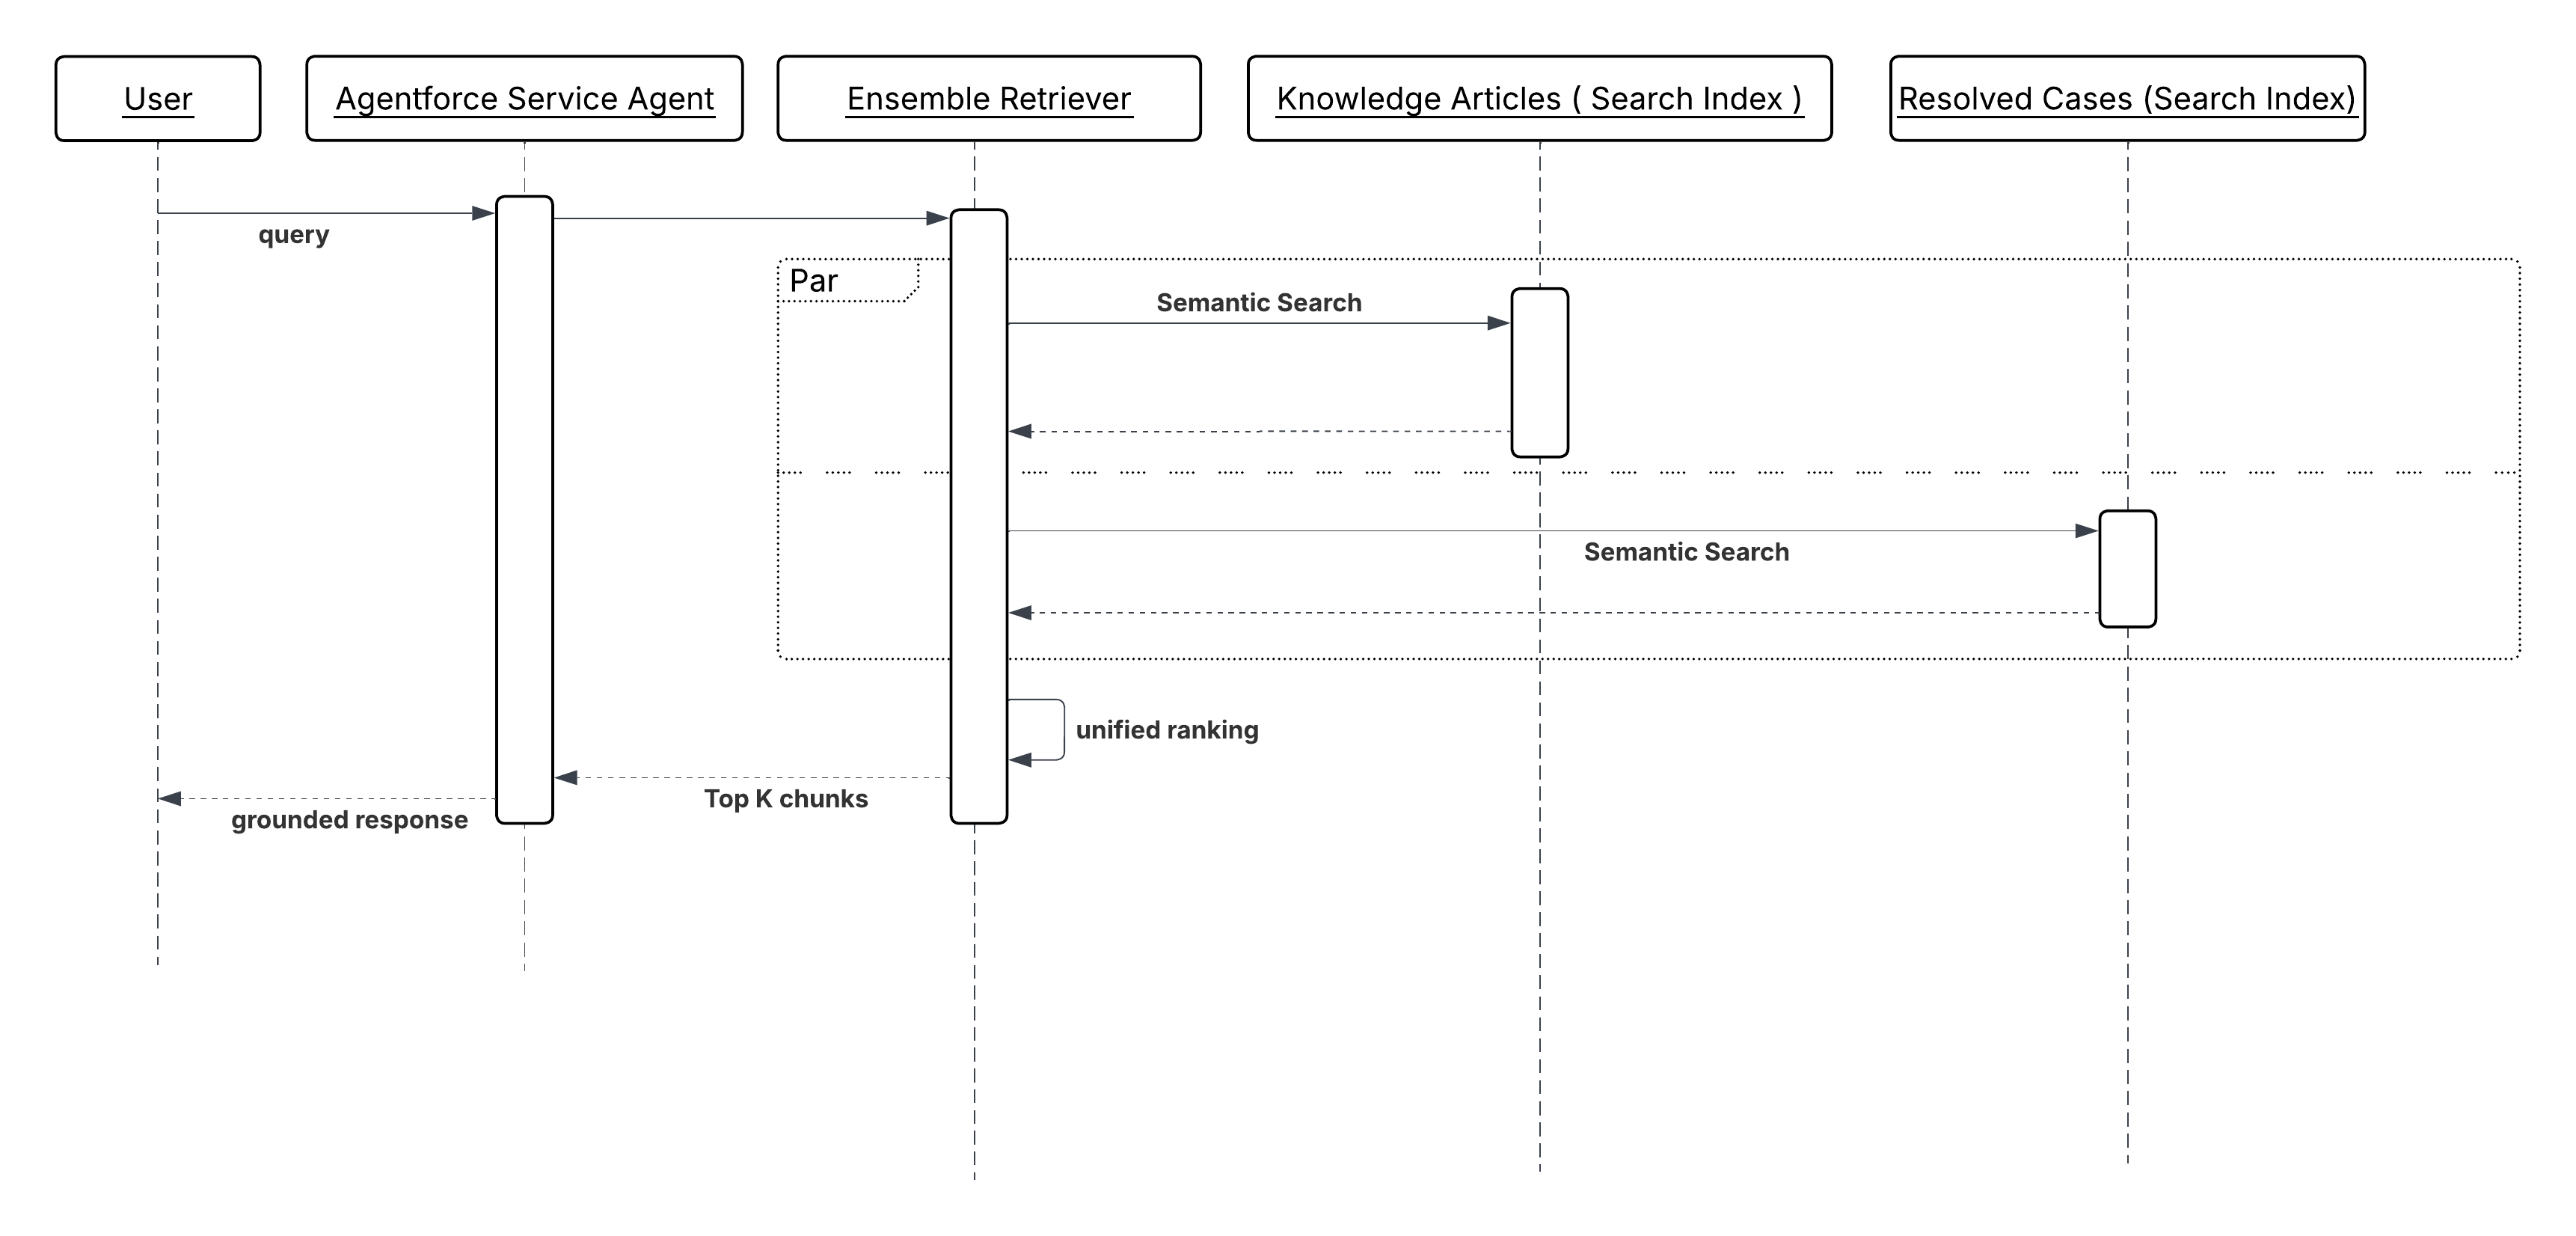
結果
エージェントの応答は、LLM のトレーニング データではなく、組織の最新の権威ある Knowledge に固定されます。モデルは記憶からではなく、取得された証拠に基づいて推論されるため、保険契約条件、商品仕様、エンタイトルメントの詳細などの事実に関する質問に対する幻覚リスクが軽減されます。
Knowledgeコンテンツは個別に保守できます。保険契約ドキュメントを更新したり、インデックスに新しいケース解決を追加したりすると、モデルを再トレーニングまたは再リリースすることなく、その後のすべてのエージェントインタラクションですぐに有効になります。
取得では、暗黙的な監査履歴も提供されます。エージェントの回答は特定の取得済みドキュメントから取得されるため、ソースコンテンツを回答と共に記録し、エージェントが特定の回答をした理由を追跡できます。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- Knowledge コンテンツを適切な粒度でチャンク化し、埋め込みます。大きすぎるチャンクは関連性が薄れます。小さすぎるチャンクは、LLM が正しく推論する必要がある周囲のコンテキストを失います。ほとんどの企業ドキュメント種別では、コンテキストウィンドウが重複する段落レベルでチャンク化することで、最適な取得品質が得られます。
- 取得精度は、最重要な設計上の懸念事項と見なされます。関連性の低いコンテンツをエージェントのコンテキストウィンドウに挿入することは中立ではありません。応答品質を低下させるノイズが発生します。取得のしきい値とtop-k制限を調整し、各Knowledgeドメインごとに回収率と精度のバランスを取ります。
- 取り込み遅延は動作上の SLA です。保険契約ドキュメントが更新されてもベクトルインデックスが更新されていない場合、エージェントは古い情報を取得して対応します。コンテンツ種別ごとに許容される失効許容範囲を定義し、それに応じて取り込みパイプラインを設計します。
Salesforce 実装メモ
- コンテンツの更新頻度に適した取り込みパイプラインを使用して、Data 360 ベクトルインデックスに入力します。静的ドキュメントには一括取り込みを使用し、継続的に変更されるレコードにはストリーミングまたは変更データキャプチャ (CDC) を使用します。
- アンサンブル取得者の場合、ソースごとの関連性ランキングの加重を設定します。解決済みケースインデックスにはリーセンシーバイアスが必要な場合がありますが、ポリシー本ドキュメンテーションインデックスには不要な場合があります。エージェントが処理することが想定されるクエリ種別に基づいて加重を調整します。
- カスタム Apex またはフロー取得でメタデータ フィルタを使用して、セマンティック検索を実行する前に取得の範囲を設定します。ランキングの前に商品品目、地域、またはドキュメント種別で絞り込むと、ノイズが減り、コンテキストに挿入される内容の精度が向上します。
- 取得したドキュメント全体を LLM コンテキストに挿入しないでください。関連するチャンクまたは抜粋のみを渡します。大きなコンテキストインジェクションでは、トークンバジェットが消費され、遅延が増加し、エージェントの推論に使用できるコンテキストウィンドウの比率が減少します。
エラー処理と回復
- 取得で結果が返されない場合は、グラウンディングされていない状態で続行するのではなく、明示的に「結果が見つかりません」と返します。その後、エージェントはクエリを拡張したり、ユーザーに説明を求めたり、人間にエスカレーションしたりできます。
- 取得者から返された各チャンクには関連性スコアが含まれます。使用事例に応じて、特定の信頼性/関連性のしきい値を設定し、その値を上回る場合はエージェントが取得内容を信頼できるものとして扱い、そうでない場合は説明を求めるかエスカレーションに移行します。
- ベクトル インデックスまたは取得サービスが一時的に使用できない場合、取得アクションまたは Apex コールアウトは、理由を説明する構造化エラーを返す必要があります。セッション ID とクエリを使用して失敗を記録すると、取得ギャップを特定し、インデックスまたはサービスが使用可能かどうかを監視できます。
- 時間的な制約がある知識領域の場合、取得応答の一部として鮮度チェックを実装します。もし最も最近一致した文書が、定義済みの失効しきい値を超えて更新された場合、その情報に対してエージェントにフラグをつけ、エージェントが応答を適切に調整するか、認定資格の確認を促すようにします。
セキュリティに関する考慮事項
- 取得では、エージェントが代理で操作するユーザーのデータアクセス権限を考慮する必要があります。顧客対応インタラクションのコンテキストで実行されるエージェントセッションでは、エンドユーザーがアクセスできない内部業務ドキュメント、価格設定戦略メモ、レコードを取得しないでください。取得レイヤーで項目レベルおよびレコードレベルセキュリティを適用します。LLM に依存して、取得した機密コンテンツを保留しないでください。
- 取得されたコンテンツは LLM コンテキストウィンドウに挿入され、エージェントの応答に影響または表示される可能性があります。取得コンテンツのすべてのドキュメントをエンドユーザーに表示される可能性があるものとして扱い、それに応じてコンテンツメンバーシップを管理します。
- 取得したチャンクのすべての取得クエリとドキュメント識別子をセッション ID と共に記録します。 この監査履歴により、コンプライアンス、紛争解決、説明責任の義務で必要となる可能性がある、エージェントが回答時に使用した証拠を再構築できます。
例
金融事業のサービスエージェントは、定期預金商品の早期引き換えペナルティに関する顧客のクエリを処理します。
- 顧客は「6か月早く資金を引き出した場合、どのようなペナルティが発生しますか?」と尋ねます。
- エージェントは、商品契約条件ドキュメントのベクトルインデックスに対して設定された個人取得アクションを呼び出します。
- 取得者は、商品種別や顧客取引先などのクエリコンテキストと特定の質問を使用してセマンティック検索を実行し、最も関連性の高い 3 つのドキュメントチャンク (早期償還条項、ペナルティ計算表、困難ケースに適用される例外) を返します。
- 取得したチャンクは、顧客の質問と共にエージェントのコンテキストウィンドウに挿入されます。
- エージェントは、取得した条件の理由を確認し、顧客の商品ランクと償還タイムラインの適用可能なペナルティ率を特定し、使用した条件の発効日を引用するポリシーに基づいた正確な回答を返します。
- 取得されたチャンクのドキュメント識別子は、監査できるようにセッションレコードに記録されます。
コンテキスト
LLM は本質的に確率的です。特定の顧客について理由を尋ねられると、明示的に与えられていない事実を推測したり、推定したり、幻覚を見たりします。顧客が優先階層で価値の高いエンタープライズ取引先であることを知らずに価格設定アクションを呼び出すエージェントは、誤った割引ロジックを適用する可能性があります。エージェントが顧客の離脱リスクスコアを知らずにサポートケースをエスカレーションすると、数日後に離脱するアカウントが優先されなくなる可能性があります。
検証済み顧客コンテキストインジェクションでは、エージェントがアクションを呼び出す前に、統合プロファイルの検証済み構造化属性をアクション入力パラメーターに事前入力することで、この問題に対応します。エージェントは顧客のセグメント、生涯価値、顧客満足度 (CSAT) のトレンドを推測しません。それらの事実はグラウンディング入力として受け取り、それらについて推論します。このパターンにより、顧客固有の判断における幻覚リスクが軽減され、推論サイクル中の重複するルックアップコールが排除されます。
たとえば、価格設定エージェントが「GenerateQuote」アクションを呼び出す前に、サブエージェント設定によって顧客のセグメント、ランク、生涯価値が統合プロファイルから自動的に挿入されます。アクションは LLM で推測された近似値ではなく検証済みの事実を受信し、Quote は顧客の実際の商用リレーションにアンカーされます。
これは、「エンタープライズ・コンテンツからのKnowledge Grounding」パターンに代わるものではありません。優れた設計のエージェントは両方を使用できます。「Knowledge Grounding from Enterprise Content」はドキュメントベースのKnowledgeを提供し、「Verified Customer Context Injection」は顧客のIDを確立します。
問題
エージェントがアクションを実行する前に、セグメント、ランク、生涯価値、離脱リスク、その他のプロファイル属性など、顧客固有の正確な事実をエージェントが把握していることを確認する方法は?
勢力
このパターンを適用するときは、次の質問に回答してください。
- ソースではなく推測した場合、不正確または一貫性のない結果になる顧客固有の事実を表すアクション入力パラメーターは?
- 必須プロファイル属性は標準の Data 360 統合プロファイル項目として使用できますか? それとも、未加工の行動データやトランザクションデータから計算済みインサイトを取得する必要がありますか?
- 関連するプロファイル属性が変更される頻度は?離脱リスクスコアや CSAT トレンドなどの属性には新鮮度保証が必要です。古いプロファイルデータでは、幻覚データと同じ誤った結果になります。
- プロファイル属性は、セッションの作成時に挿入するか (セッションの期間中一定)、アクションの呼び出し時に新しく取得するか (セッション中の状態変更を反映するため)?
- エージェントがプロファイル属性について直接推論する必要があるのか、それともアクションでのみコンシュームされ、エージェントの推論ループには不透明なのか?
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| サブエージェント設定 - プロファイル属性の対応付け | 静的セッションレベルのグラウンディングに最適 | プロファイル属性が 1 つのインタラクション内で安定している場合に最適です。 Data 360 統合プロファイル属性(「customerSegment」、「tier」、「lifetimeValue」など)を Agentforce サブエージェント設定のアクション入力パラメータに直接マッピングします。属性はセッションの作成時に解決され、セッション期間中は一定に保持されます。 |
| Data 360 接続フロー | 動的またはセッション中の更新に最適 | プロファイル属性が頻繁に変更される場合や、アクションで最新の状態が必要な場合に使用します。 Data 360 接続フローをアクションステップとして使用し、呼び出し時点で最新のプロファイル状態を表示します。フローは統合プロファイルを照会し、必要な変換を適用して、チェーンの次のアクションで消費される出力変数として属性を返します。 |
| アクション入力としての計算済みインサイト | 複雑な派生指標に最適 | エージェントが未加工データを解釈するのではなく、計算されたビジネス評価指標 (離脱リスクスコア、CSAT トレンド、商品採用インデックス) に基づいて推論する必要がある場合に使用します。Data 360 で、行動データ、トランザクションデータ、エンゲージメントデータに基づいて計算された派生指標として定義されます。計算済みインサイトはクエリ可能なプロファイル属性として表示され、トピック設定または接続済みフローを介してアクション入力に対応付けることができます。 |
スケッチ
検証済み本顧客コンテキスト注入のシーケンス図
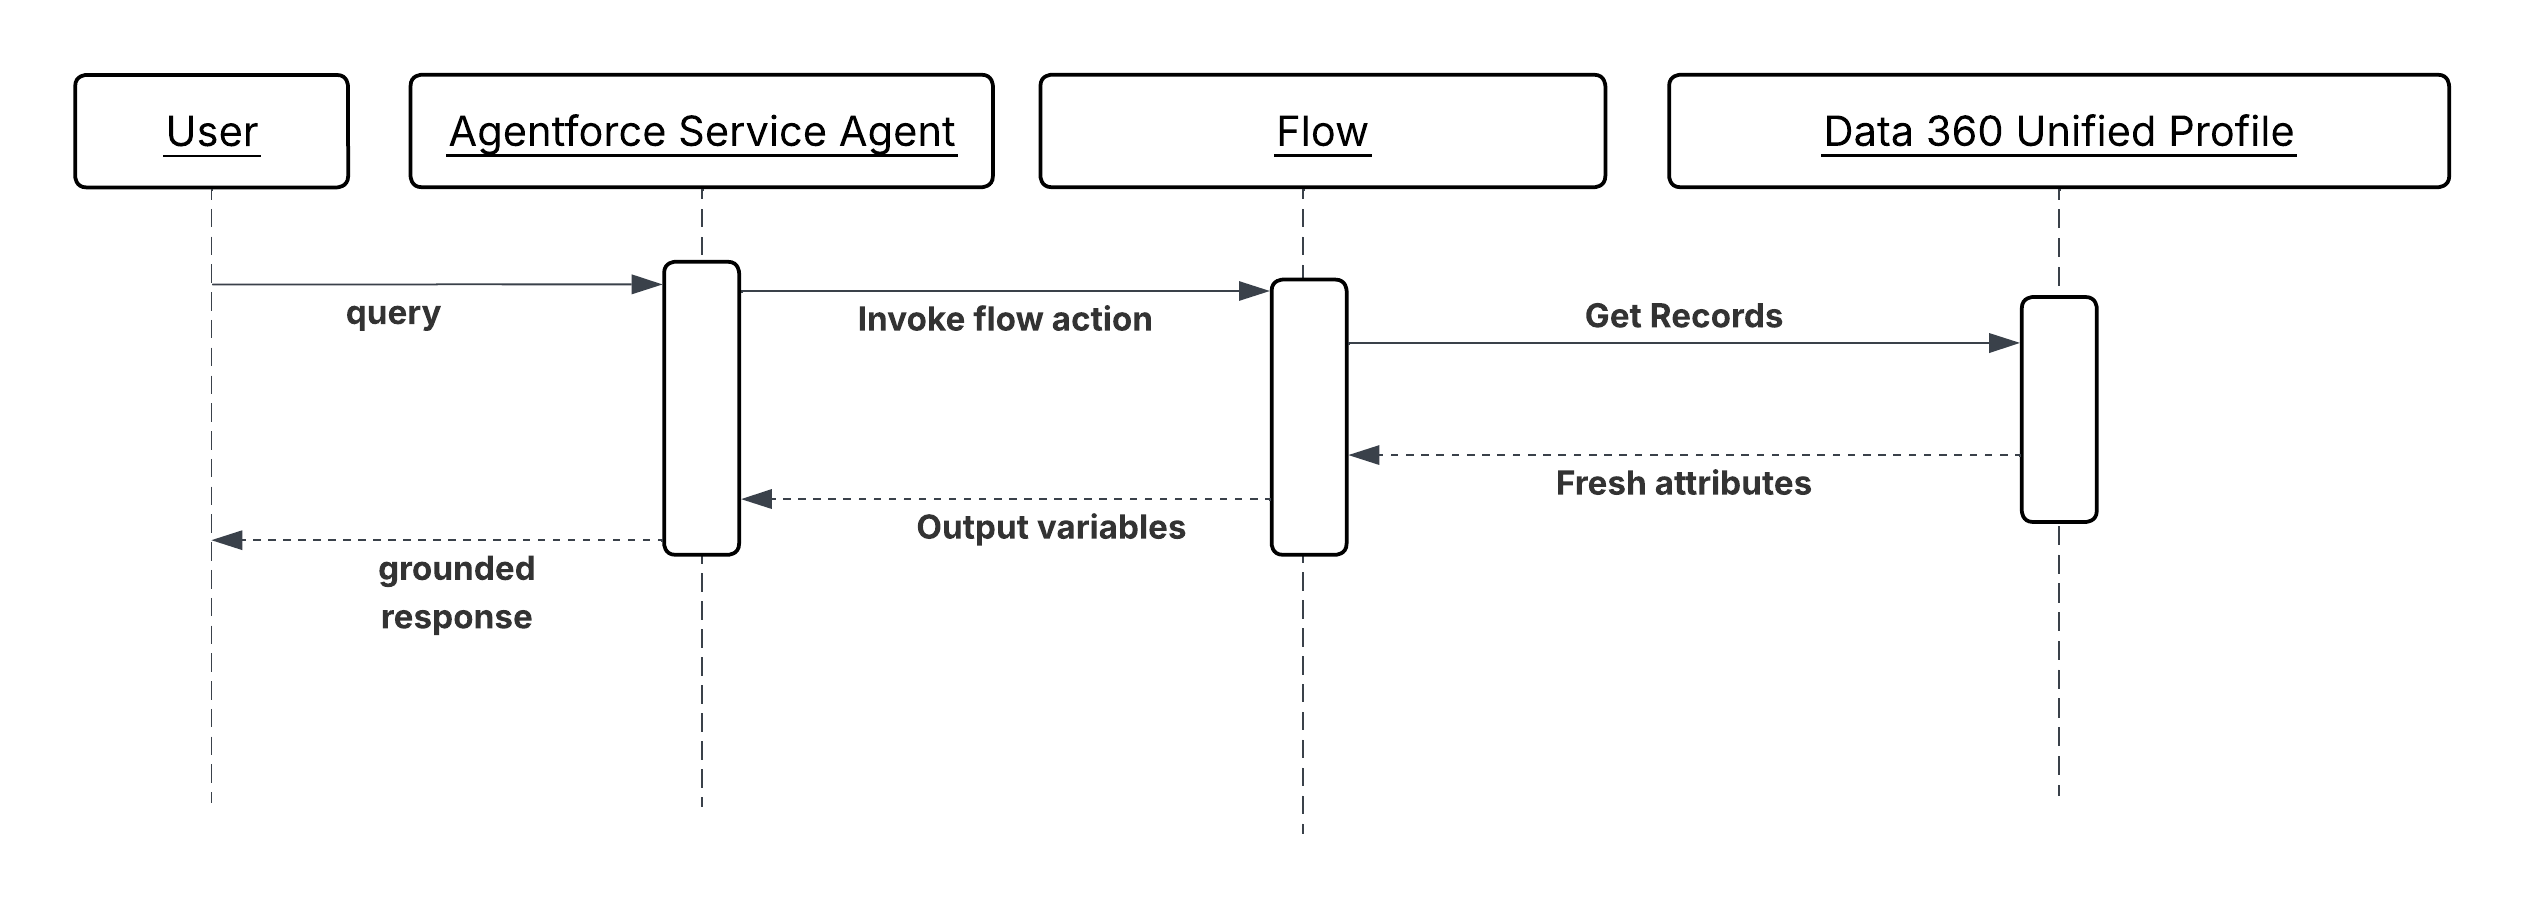
結果
アクションは、LLM で推測された近似値ではなく、検証済みの構造化された顧客の事実を受信します。エージェントの推論は顧客の実際のプロファイル状態に固定されるため、価格設定、エンタイトルメントチェック、エスカレーションルーティング、保持オファーなど、結果の品質が事実の精度によって左右される意思決定での幻覚リスクが軽減されます。
プロファイルグラウンディングにより、推論レイテンシも短縮されます。エージェントが基本的な顧客コンテキストを確立するためにルックアップコールを発行する必要がない場合、推論サイクルは短縮され、同時実行のターン数が減少します。
Data 360 統合プロファイルは、依然として顧客情報の信頼できるソースです。サブエージェント設定または接続済みフローはインテグレーションシームです。エージェントは、事実自体ではなく、それらの事実を推論し、アクションを選択する責任があります。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- LLM 推測で検証済みの値ではなく誤った結果が生成される可能性がある、幻覚リスクを伴うすべてのアクション入力を特定します。幻覚リスクのある入力は、プロファイルグラウンディングの候補になります。すべての入力にグラウンディングが必要なわけではありません。プロファイルデータを過度に挿入すると、エージェントのコンテキストウィンドウにノイズが追加されます。
- プロファイルの新鮮さは、後付けではなく設計上の決定として扱います。グラウンディングされた属性ごとに許容される失効許容範囲を定義し、それに応じてインジェクションメカニズム (安定した属性の場合はセッションレベルのマッピング、一時的な属性の場合はフローベースの更新) を選択します。
- 計算済みインサイトは、生のメトリクスではなくビジネスロジックをエンコードする必要があります。「churnRiskScore」が 0.87 のエージェントの推論は、14 個の未加工の行動シグナルのエージェントの推論よりも効果的です。Data 360 で解釈を計算し、結果をエージェントに渡します。
Salesforce 実装メモ
- プロファイルグラウンディングは、その背後にある統合によってのみ信頼できます。たとえば、統合プロファイルの値は、上流の ID 解決の品質に完全に依存します。統合されていないソースシステム間で顧客の ID が断片化されていると、エージェントが受け取るプロファイル属性が不完全になったり、部分的なビュー (たとえば、あるチャネルのデータのみで計算され、別のチャネルのデータでは計算されない生涯価値) のみを表すようになります。
- Data 360 接続フローの場合、現在のセッションの「recordId」または「accountId」で検索条件を使用してレコードを取得要素を使用し、関連するプロファイルレコードのみを取得します。ダウンストリームアクションに必要な属性のみを返します。完全なプロファイルオブジェクトは返しません。
- 計算済みインサイトは、Data 360 取り込みパイプラインを使用して最新の状態に維持する必要があります。時間的制約のある意思決定 (保持ワークフローでの離脱リスクなど) で使用されるインサイトのストリーミングまたはほぼリアルタイムの更新を設定します。一括更新インサイトは、変化の遅い属性(例:年間契約金額ランクなど)で使用できます。
- アクションを呼び出す前に、対応付けられたプロファイル属性が null でないことを確認します。価格設定アクションに渡される null の「customerTier」は、幻覚のような値です。フロー決定要素を使用して、欠落しているプロファイルデータを検出し、デフォルトを取得するか、説明を求めるフォールバックルートに転送します。
- サブエージェント設定で、わかりやすいセマンティックな変数名 (「customerTier」、「lifetimeValueUSD」、「churnRiskScore」など) を使用して、プロファイル属性をアクション入力パラメーターに対応付けます。LLM はアクションを選択および構成するときにこれらの名前を読み取ります。あいまいな名前では、選択の精度が低下します。
エラー処理と回復
- アクションの呼び出し時に必須のプロファイル属性が null または使用できない場合、エージェントは誤ったデフォルトのままで続行しないでください。このアクションでは、欠落している属性を示す構造化されたエラーを返す必要があり、エージェントはユーザーに説明を求めるか、会話以外で操作する場合は人間にエスカレーションする必要があります。
- Data 360 接続フローでプロファイルデータの取得に失敗した場合 (Data 360 サービスの中断など)、フローの障害パスは特定の失敗理由と共に構造化エラーをエージェントに返します。その後、エージェントは再試行するか、低下したエクスペリエンスで続行するか、失敗をユーザーに明らかにするかを決定できます。
- セッションの作成時またはアクションの呼び出し時に差し込まれたすべてのプロファイル属性値をセッション ID と共に記録します。これにより、紛争中のエージェントの意思決定を、その時点でエージェントが提供した正確な顧客情報で再構築できます。
セキュリティに関する考慮事項
- エージェントコンテキストに挿入されたプロファイル属性には、CRM レコードと同じデータアクセス制御が適用されます。プロファイル属性の解決に使用するインテグレーションユーザーまたは接続アプリケーションが、表示される属性に必要な項目レベルの権限のみを保持し、プロファイルの参照アクセス権は拡張しないことを確認します。
- 機密派生総計値 (予測健康スコア、財務リスク層など) をエンコードする計算済みインサイトは、機密項目として扱われ、基礎となるデータと同じアクセス制御で管理される必要があります。顧客対応コンテキストで業務を行うエージェントに高い離脱リスクスコアを提示するためには、エージェントがコミュニケーションする内容を慎重に検討する必要があります。
- アクションで不要なプロファイル属性は表示しません。エージェントのコンテキストウィンドウの各追加属性は、エージェントの応答で再現できる追加データ要素です。プロファイルのグラウンディングに必要最小限の原則を適用します。
- 計算済みインサイトまたは機密プロファイル属性が入力として注入されたすべてのセッションを監査します。これらのセッションは、派生顧客インテリジェンスに基づいて下された意思決定を表し、特定の業界の説明可能性や規制要件の対象となる場合があります。
例
ある通信会社は、キャンセル要求を開始した顧客との保持に関する会話を処理するために Agentforce を使用しています。
- キャンセルケースがオープンされると、顧客の「accountId」をコンテキストとしてエージェントセッションが作成されます。
- サブエージェント設定では、作成時に「customerTier」(Enterprise)、「lifetimeValueUSD」(42,000)、「contractRenewalDate」(60 日) の 3 つの Data 360 統合プロファイル属性がセッション変数に対応付けられます。
- 「churnRiskScore」 (0.91、使用量の減少、サポートチケット頻度、NPS トレンドから計算) のような計算済みインサイトは、最初のアクションステップとして呼び出される Data 360 接続フローを介して追加のセッション変数としてマッピングされます。
- 検証済みの顧客情報に基づいて、エージェントは「SelectRetentionOffer」アクションを呼び出します。入力には「customerTier = Enterprise」、「lifetimeValueUSD = 42000」、「churnRiskScore = 0.91」が含まれるため、このアクションでは標準ではなく最大ランク保持オファーが返されます。
- エージェントは「PresentOffer」を呼び出して会話で提案を提供し、「LogRetentionAttempt」を呼び出して、監査できるようにグラウンディングされたすべての属性を使用して CRM でやりとりを記録します。
コンテキスト
企業データは断片化されています。Salesforce Platform 内に存在するものに基づいてのみ行動できるエージェントは、効果的に推論するために必要な情報のほんの一部に制限されます。サービスの質問に回答するには、Service Cloud で顧客の進行中のチケットを参照する必要がある場合があります。提案の準備では、Google ドライブからファイルを取得する必要がある場合があります。商品の使用状況を分析するには、データウェアハウスのクエリが必要な場合があります。これらの各システムには、独自の API、独自の認証モデル、独自のデータスキーマがあり、それぞれにカスタマイズされたインテグレーションコードを記述するコストは、これまでエージェントとシステムの接続を高価で脆弱なものにしてきました。
MCP は、これに直接対応するオープン標準です。基盤となるシステムに関係なく、MCP 準拠のサーバーによって公開されているツールをエージェントが検出および呼び出すことができる、統一されたインターフェースを定義します。各 MCP Server はアダプターとして機能します。つまり、ターゲットシステムのネイティブインターフェースを標準化されたツール中心のインターフェースでラップし、エージェントがシステムの特定のプロトコルやスキーマについて何も知らなくても照会、呼び出し、構成できます。
エージェントから見ると、Slack、Structured Query Language (SQL) データベース、ドキュメント管理システムへの接続は 3 つの MCP Server で同一に見え、それぞれに説明付きのコール可能なツールのセットが公開されています。エージェントは、セマンティックな説明と達成しようとしている目標に基づいてエージェントを選択して順序付けます。
問題
エージェントが API、認証、スキーマが異なる複数の外部システム間で情報を取得したりアクションをトリガーしたりする必要がある場合、システムごとにカスタマイズされたインテグレーションコードや、システムの実装との密接な結合を使用せずにエージェントの機能を検出、呼び出し、構成する方法は?
勢力
このパターンを適用する場合は、次の質問に回答してください。
- エージェントは、API が Agentforce アクションとしてネイティブに表現されていないドキュメントストア、コラボレーションツール、データベース、サードパーティの SaaS などの Salesforce Platform 外のシステムにアクセスする必要がありますか?
- エージェントが、設定でインテグレーションがハードコードされるのではなく、現在のリクエストに基づいて推論時に適切なインテグレーションエンドポイントを特定する必要がある場合、動的ツール検出は必要ですか?
- インテグレーションの状況は頻繁に変更されますか? 新しいシステムの追加、既存のシステムの更新、その他の変更により、システムごとに調整したアプローチでは維持できないメンテナンスオーバーヘッドが発生することがありますか?
- 対象システムの API の変更によってエージェントの指示やサブエージェント設定を変更する必要がないように、エージェントの推論レイヤーを下流システムの実装の詳細から分離する必要がありますか?
- 対象システムはさまざまなチームまたはベンダーが所有しており、それぞれが独自の機能を公開しているため、エージェントごとのコンシューマー側インテグレーションよりもプロバイダ側のMCP Serverモデルの方が実用的ですか?
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| Salesforce MCP サーバー | Salesforce エコシステム目標に最適 | 対象システムが Salesforce エコシステム内にあり、ファーストパーティ MCP Server を使用できる場合に使用します。Salesforce Headless 360は、独自のプラットフォーム機能にMCP Serverを提供し、CRMデータ、フロー、プラットフォームアクションをMCP準拠のツールとして公開します。開発ではなく設定によって実装作業が軽減されます。 注意: 現在、Salesforce MCP サーバーでは、認証と承認にエンドユーザーログイン情報のみがサポートされます。 |
| カスタム MuleSoft MCP サーバー | ファーストパーティ MCP Server が存在しない場合に最適 | MCP 標準より前のレガシーシステム、独自の内部アプリケーション、またはサードパーティの SaaS プラットフォームで使用します。対象システムで独自の MCP Server が提供されていない場合、MuleSoft インテグレーションレイヤーをカスタム MCP Server でラップして、システムの機能をツールとして公開できます。エージェントがシステムユーザーログイン情報のみを使用して MCP を使用する必要がある場合は、Salesforce API でも使用できます。MuleSoft はプロトコル翻訳、認証、データ変換を処理します。MCP レイヤーにより、エージェントは結果を検出できます。 |
| サードパーティ MCP サーバ | MCP エコシステムが活発なコモディティシステムに最適です。 | プラットフォーム (GitHub、Google Workspace) 用にベンダーが管理する MCP サーバーが存在し、セキュリティとメンテナンスの要件を満たしている。GitHub、Google Workspace などのエンタープライズプラットフォームで独自の MCP Server が公開されるケースが増加しています。ベンダーが管理する本番対応のサーバが存在する場合は、カスタムサーバを構築するよりも優先します。採用前にセキュリティに対する姿勢とメンテナンスコミットメントを評価します。 |
スケッチ
検証済み顧客コンテキスト注入のシーケンス図
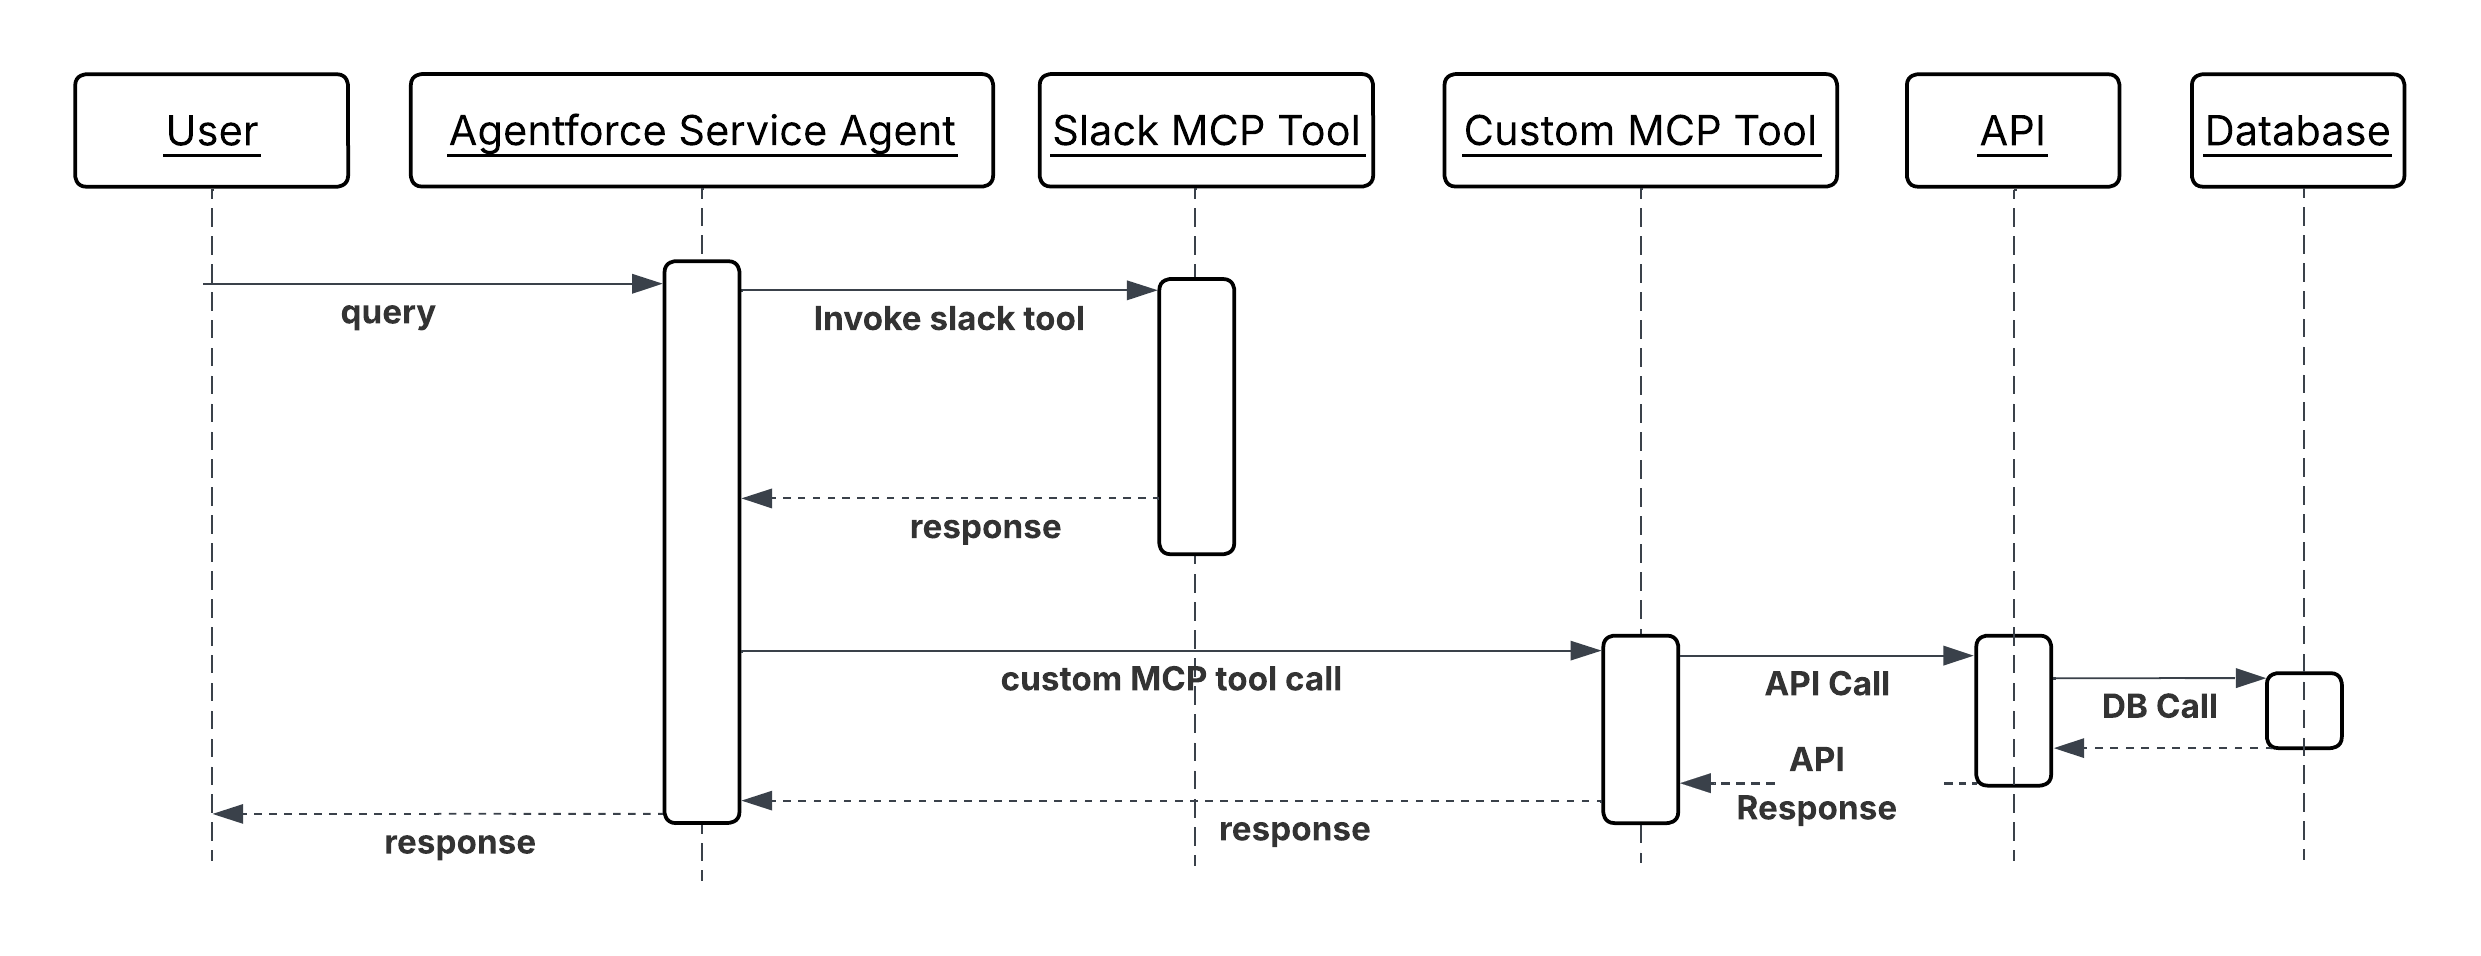
結果
エージェントの到達可能な表面積は、インテグレーションの複雑さを増すことなく拡大します。新しい外部システムの追加とは、その外部システム用に MCP Server をリリースまたは設定することであり、エージェントごとにカスタマイズされた Apex コールアウトやフローインテグレーションを記述することではありません。エージェントの推論レイヤーは変更されず、セマンティックな説明のみに基づいて新しいツールを検出して呼び出します。
MCP 標準では、所有権の明確な分離も作成されます。システムを担当するチームは MCP Server として機能を公開し、エージェントチームはシステムの内部を理解せずにこれらの機能を使用します。この境界により、統合システムの数が増えても調整のオーバーヘッドが軽減されます。
ツールのコンポーザビリティは直接的な結果です。すべてのツールが同じ呼び出しインターフェースを共有しているため、エージェントは 1 つのシステム内のチェーンアクションと同じように、異なるシステムのツールをチェーニングし、Google ドライブからファイルを取得して、そこからデータを抽出し、結果を CRM レコードに書き込むことができます。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- ツールの説明は、エージェントがツールを呼び出すかどうかと方法を決定する唯一の基礎です。ツールの機能、適用時期、返される内容を明確にしたインテントベースの言葉で説明を記述します。「CRM データベースを照会する」という説明は、「指定された取引先 ID の取引先のオープンケースを優先度順に取得します」という説明よりも役立ちません。 説明が稚拙だと、ツールの選択も稚拙です。
- 各 MCP ツールの範囲を 1 つのアトミック機能に限定します。ドキュメントを取得し、ソースシステムにも概要を書き戻すツールは、2 つの個別のツールよりもエージェントにとって理由付けが難しく、失敗時の再試行も難しく、セキュリティ保護も困難です。1 つのツール、1 つの責任。
- 出力が合成可能な入力になるようにツールを設計します。取得ツールの結果は、通常それに続くアクションツールの入力パラメーターに自然に対応付けられるように構造化する必要があり、エージェントがステップ間で実行する必要がある変換作業が軽減されます。
- リモートホスト MCP サーバ。ローカルバイナリをインストールすると、エージェント環境の数に応じてリリースとバージョン管理が複雑になります。リモートホストサーバーは、そのサーバーを使用するエージェントとは独立して更新できます。
Salesforce 実装メモ
- すべての発信 MCP コールで一貫した MCP 認証、レート制限、ペイロード検証が必要な場合は、MCP サーバーをサポートする MuleSoft Omni Gateway などの AI ゲートウェイを使用して、MCP サーバーをエージェントに公開する前に設定します。
- MCP Server 接続に必要なすべてのログイン情報に OAuth 2.0 ログイン情報を使用します。ログイン情報は、ツール パラメータ、アクション設定、Apex コードに記述しないでください。
- 一部の MCP ツールでは、ビジネスの使用事例 (資金移動など) に応じて、何らかのアクションを実行するためにエンドユーザーログイン情報が必要な場合があります。エンドユーザー ID トークンを反映するには、MuleSoft Omni Gateway で現在サポートされている OAuth 2.0 代理ログイン情報挿入ポリシーを使用します。
- カスタム MuleSoft MCP サーバの場合:MuleSoft の API 仕様で MCP ツールスキーマを定義し、サーバのエンドポイントを Agentforce ツールカタログに登録します。本番にリリースする前に、代表的なエージェントクエリに対してツールの説明をテストし、エージェントが適切なタスクに適したツールを選択していることを確認します。
エラー処理と回復
- MCP ツールコールでエラーが返されると、エージェントは機械で読み取り可能なエラーコードを検査して、適切な復旧アクション (ユーザーに欠落しているパラメーターを要求したり、修正した入力で再試行したり、人間にエスカレーションしたり) を判断します。エラーを黙ってコンシュームしたり、ツールコールが成功したかのように推論を続行したりすることはありません。
- エージェントは一時的な失敗の再試行ロジックを直接実装します。
- ツール名、サニタイズされた入力パラメーター、結果を使用して、クライアント側からのすべての MCP ツール呼び出しを記録します。このクライアント側のトレースとサーバー側のログの組み合わせは、ワークフローで期待した結果が生成されないときにエージェントが特定のアクションパスを使用した理由を診断するための主要なメカニズムです。
セキュリティに関する考慮事項
- すべての送信 MCP サーバ接続がゲートウェイを通過します。ゲートウェイは、認証検証、ツールの不正使用を防止するためのレート制限、ツールパラメーターのプロンプトインジェクション試行を検出するためのペイロード検査を適用します。エージェントから MCP Server への直接の仲介なしの接続は、これらの制御をスキップするため許可されません。
- 各エージェントの MCP サーバー接続の範囲を、エージェントが実際に必要とするツールがあるサーバーのみに設定します。使用可能なすべての MCP サーバーへのアクセス権が設定されているエージェントは、定義された ToDo が要求するツールにのみ接続された攻撃対象領域よりも大きな攻撃対象領域を持ちます。
- ツールに渡す前にツールの入力パラメーターを検証してサニタイズします。特に、パラメーター値がユーザー指定のテキストまたは LLM で生成されたコンテンツから取得される場合に便利です。未検証の LLM 出力をツールパラメーターとして直接渡さないでください。エージェントの推論に影響を与える可能性のある攻撃者は、そのパスを使用して悪意のある値をダウンストリームシステムコールに挿入できます。
- エージェントの接続済み MCP Server のリストとそのツールインベントリを機密設定として扱います。エージェントが使用できるツールと受け入れるパラメーターを知っている攻撃者は、それらのツールを悪用するように設計されたプロンプトインジェクションペイロードを作成するためのマップを持っています。
例
営業担当者は、価値の高い顧客との電話の前に包括的な取引先ブリーフィングを準備します。
- エージェントは「明日の更新に関するディスカッションの前にABC社に関する概要を準備してください」という要求を受け取ります。
- エージェントは MCP ツールカタログを照会し、2 つの MCP Server にまたがる 3 つの関連ツール (
GetRecentEmails、GetOpenOpportunities、GetSupportTicketSummary) を特定します。 - エージェントは 3 つのツールをすべて並列で呼び出します。各 MCP Server は、コールをターゲットシステムのネイティブ API に変換し、関連データを取得して構造化された結果を返します。
- エージェントは 3 つの結果を受け取ります。最近のメールスレッド、商談規模とフェーズが設定された進行中の更新商談、優先度別の進行中のサポートチケットの概要。これらを体系的な取引先ブリーフィングに統合します。
- エージェントは
CreateAccountNoteを呼び出してブリーフィングを取引先レコードに保存し、概要を要求元ユーザーに返します。 - 4 つの MCP ツールの呼び出しはすべて、ゲートウェイによってツール名、サーバー ID、セッション監査レコードの結果と共に記録されます。
コンテキスト
送信 MCP パターンでは、Agentforce エージェントが外部 MCP Server からツールを消費します。受信パターンでは、これが反転されます。CRMレコード、フロー、Apexロジック、Data 360インサイトなどのSalesforce Platform機能は、外部エージェントがLLMフレームワーク上で実行して検出および呼び出すことができるMCPツールとして公開されます。
エンタープライズ AI 展開は単一ベンダーになることはまれであるため、このパターンは重要です。別のフレームワークで構築されたパートナーのエージェントは、Salesforce で顧客の取引先状況を検索する必要がある場合があります。Python ベースのエージェントを実行している内部データサイエンスチームは、承認プロセスを開始するために Salesforce フローをトリガーする必要がある場合があります。標準化された公開メカニズムがない場合、外部コンシューマーごとにカスタマイズされたインテグレーションが必要です。Salesforce 機能を MCP Server として公開すると、通話エージェントの作成方法に関係なく、すべての MCP 互換エージェントにプラットフォームのツールへの一貫した検出可能なインターフェースが提供されます。
たとえば、サードパーティフレームワーク上に構築されたパートナーの調達エージェントは、購入注文を承認する前に Salesforce でサプライヤーの契約状況を確認する必要があります。直接 REST インテグレーションを構築するのではなく、Salesforce MCP Server でGetContractStatusツールを呼び出します。このツールでは、ネイティブの Salesforce 操作と同じアクセス制御が適用されます。コール元エージェントには結果のみが表示されます。
問題
別のフレームワークで構築された外部エージェント (パートナーが所有している場合など、Salesforce Platform の外部で実行されている場合) が独自のワークフローの一部として Salesforce 機能を呼び出す必要がある場合、外部コンシューマーごとにカスタマイズされたインテグレーションを必要としない標準化された検出可能な安全な方法でこれらの機能をどのように公開できますか?
勢力
このパターンを適用する場合は、次の質問に回答してください。
- Salesforce 機能を使用する必要がある外部エージェントは、MCP 標準をサポートするフレームワーク上に構築されていますか?そうでない場合は、MCP よりも REST API または Webhook のアプローチが適している可能性があります。
- 公開する必要がある Salesforce 機能 (参照のみのデータ取得、書き込み操作、フローの呼び出し、または組み合わせ) は?公開の範囲によって、管理する必要があるセキュリティ表面領域が直接決まります。
- 外部通話エージェントの ID はどのように検証する必要があり、その呼び出しはどのような Salesforce 権限で実行される必要がありますか?エージェントからプラットフォームへの呼び出しは、特定の操作で必要とされるより広範な権限を継承してはなりません。
- Salesforce MCP Server は内部消費者 (同じ組織内の他のチームのエージェント) 向けですか、それとも外部消費者 (パートナーおよび顧客エージェント) 向けですか?Trust モデルと認証要件は、これらのオーディエンス間で大幅に異なります。
- 公開されたツールのセットは、今後どのように進化していくのでしょうか?MCP Server に追加された新しい Salesforce 機能は、すべての接続済みエージェントがすぐに検出できるようになります。意図しないツールの公開は、慎重な公開プロセスで管理する必要があります。
Salesforce パターンアプリケーション
| ソリューション | 適合 | コメント |
|---|---|---|
| MCP サーバーとしての Salesforce (ネイティブ) | ファーストパーティの Salesforce 機能を公開する場合に最適 | 公開するツールが既存の Salesforce Platform 操作に直接対応付けられていて、通話エージェントが MCP と互換性がある場合に使用します。 Salesforce Headless 360 のネイティブ MCP サーバ機能を使用すると、レコードクエリ、フローの呼び出し、Apex アクションなどのプラットフォーム操作を MCP ツールとして宣言し、MCP 互換の外部エージェントに公開できます。アクセス権は Salesforce 権限モデルによって管理されます。 現在、これらの Headless 360 MCP サーバーにはエンドユーザー認証情報でのみアクセスできます。 |
| MCP Server Facade としての MuleSoft | 変換または複数システムの集計が必要な場合に最適 | 通話エージェントが複数の Salesforce オブジェクトのデータを必要とする機能、配信前の変換、または他のシステムのデータとの合成を必要とする場合に使用します。MCP インターフェースはクリーンでシンプルであり、複雑さは MuleSoft に吸収されています。 MuleSoft MCP レイヤーは Salesforce の前にあり、複数のプラットフォーム操作の集計結果を 1 つの MCP ツールとして公開します。 このソリューションは、エンドユーザー ID を Salesforce 認証および承認に反映できないエージェントにも使用できます。たとえば、Agentforce Agentsがシステムログイン情報を持つMCPサーバを必要とする場合、MuleSoftで構築され、MuleSoftでホストされているようなカスタムMCPサーバに依存せざるを得なくなります。 |
スケッチ
呼び出し可能なツールとしてのビジネス機能のシーケンス図
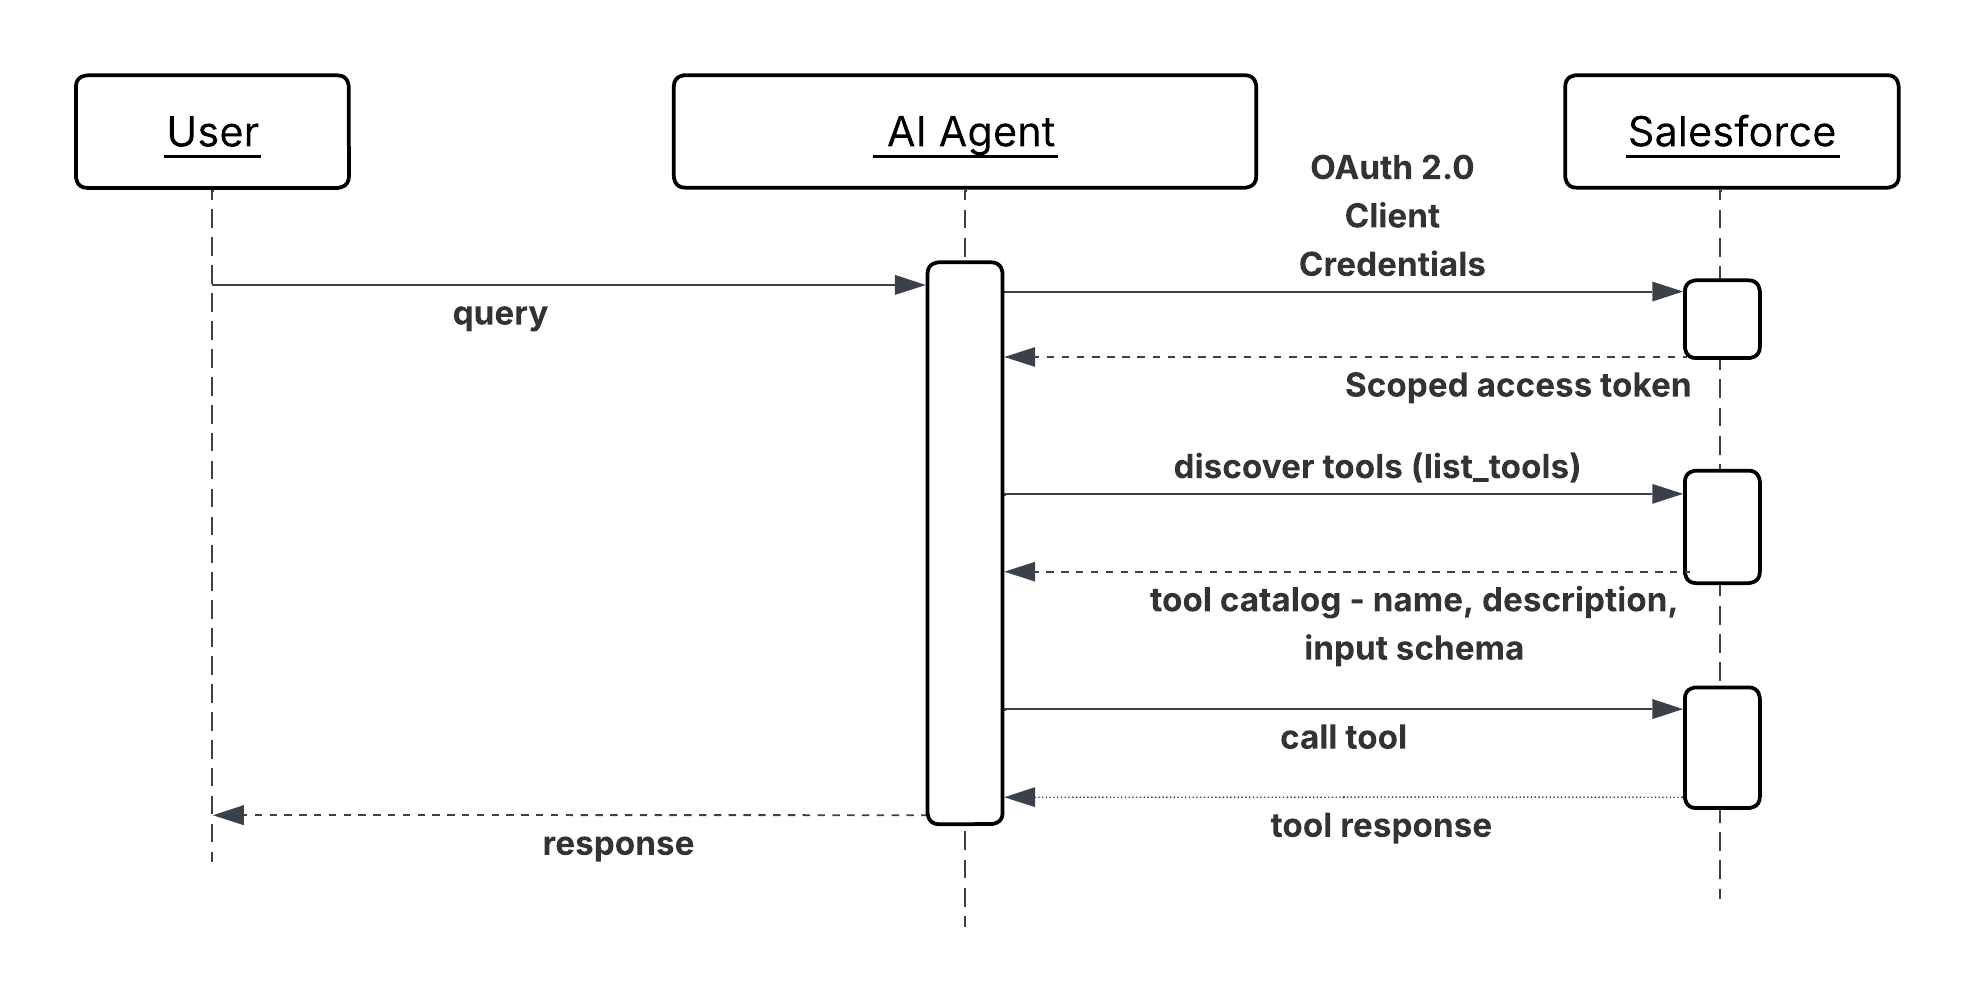
結果
Salesforce は、マルチベンダーエージェントエコシステムの第一級の関係者になります。外部エージェントは、コンシューマーごと、または使用事例ごとにカスタム REST インテグレーションを必要とせずに、プラットフォーム機能を検出してコンシュームできます。インテグレーションメンテナンスのオーバーヘッドの増加に比例せずにコンシューマーの数が増加する可能性があります。
Headless 360 では、Salesforce 権限モデルがすべての受信ツールの呼び出しを制御します。外部 MCP クライアントは、既存のデータアクセス制御をバイパスするのではなく、その中で動作します。つまり、MCP を介して機能を公開する場合のセキュリティ体制は、他の認証済み API 表面を介して機能を公開する場合と同じです。
ツールの発見のしやすさは複合的なメリットです。新しい Salesforce 機能が MCP Server のツールカタログに追加されると、接続されたすべての外部エージェントがすぐに使用できるようになります。エージェントが設定を更新する必要はありません。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- 外部エージェントが必要とするもののみを公開します。MCP Server のカタログにツールが追加されるたびに、攻撃対象領域とガバナンスの負担が増加します。ツール在庫を意図的に監査します。外部での使用が承認される機能を定義し、未承認の公開をデフォルトではなく設定ギャップとして扱います。
- 外部消費者向けのツールの説明を記述します。外部エージェントのオペレーターは、内部データモデルや命名規則に関する知識がありません。ツールの機能、各パラメーターの意味、結果の意味、通話者が満たす必要がある制約や前提条件など、説明は自己完結型にします。
- 入力スキーマまたは出力スキーマが変更されたときにツールを明示的にバージョン管理する。ツールの現在のスキーマに依存する外部エージェントは、スキーマが予告なしに変更されると、警告なしで破損します。MCP ツールのインターフェースへの変更を、公開 REST API への変更と同様に扱います。
Salesforce 実装メモ
- 公開されたツールで必要な操作のみに権限が及ぶエンドユーザーの下で、Salesforce 標準 (OOTB) MCP (ヘッドレス 360) ツールのすべての受信呼び出しを実行します。高権限の管理者 ID で受信エージェントコールを実行しないでください。
- 認証、レート制限、スキーマ検証、個人識別情報 (PII) 検出をすべての MCP ツールで一貫して適用するには、MuleSoft オムニゲートウェイなどの AI ゲートウェイを使用します。
- MuleSoft MCP Facades の場合、基盤となる Salesforce API スキーマとは別に MuleSoft で MCP ツールスキーマを定義します。MCP インターフェースには、通話エージェントの概念的なニーズが反映され、それを支える Salesforce オブジェクトの形状が反映されていない必要があります。この分離により、Salesforce 実装を外部ツール契約を損なうことなく進化させることができます。
エラー処理と回復
- ツールの呼び出しに失敗した場合、機械で判読可能なコードとプレーンランゲージの説明を含む構造化された MCP エラー応答を返す必要があります。呼び出し元の外部エージェントは Salesforce プラットフォームの内部を表示できません。エラーメッセージは自己完結型でアクション可能で、Salesforce 固有のエラーコードやオブジェクトモデルのKnowledgeは必要ありません。
- レート制限エラーと認証失敗は、外部エージェントのオペレーターが、内部設定の詳細を公開せずに、どのレート制限に達したか、またはどのログイン情報が拒否されたかを診断して修正するための十分な情報と共に、速やかに返される必要があります。
- オムニゲートウェイで、通話エージェントの ID、呼び出されたツール、入力パラメーター (機密値のサニタイズ済み)、結果を使用してすべての受信 MCP ツールの呼び出しを記録します。このログは、外部コンシューマーから報告された失敗を診断し、外部エージェントがアクセスした内容を監査するための主要な証拠トレイルです。
セキュリティに関する考慮事項
- ツールにアクセスするには、すべての受信 MCP 接続を認証する必要があります。ツールカタログの認証されていない検出は許可しないでください。公開された機能のリストはそれ自体が機密情報です。
- 接続レベルの認証に加えてツールレベルの認証を適用します。登録済みの外部エージェントは、明示的にアクセス権が付与された特定のツールのみを呼び出すことができ、カタログ全体を呼び出すことはできません。これをアプリケーションレイヤーではなくゲートウェイで適用します。
- Salesforce Platform の操作に渡す前に、すべての受信ツールパラメーターを検証してサニタイズします。外部エージェントからのパラメーターは信頼できない入力表面です。悪意のある方法で作成されたパラメーターは、クエリ検索条件の上書き、Salesforce Object Query Language (SOQL) フラグメントの挿入、フロー変数への影響を試みる可能性があります。MCP Server または正面境界で種別、形式、範囲を検証します。
- 登録済みの外部コンシューマーの定期的なアクセスレビューを実施します。無効になったエージェントやアクセス範囲が変更されたエージェントのログイン情報を取り消します。パートナーインテグレーションの廃止に伴う休眠状態だが有効な資格情報は、不要なリスクとなります。
- ゲートウェイで受信 MCP メッセージをレート制限して、プラットフォーム制限違反から保護します。SLA ベースの階層化ポリシーを使用して、負荷がかかっているときに重要でないエージェントのトラフィックを削減します。
例
物流パートナーが運営する調達エージェントは、価値の高い購入注文を承認する前にサプライヤーの契約とクレジット状況を確認する必要があります。
- パートナーのエージェントは、登録済みの OAuth 2.0 クライアントログイン情報を使用してゲートウェイを認証し、範囲設定済みアクセストークンを受け取ります。
- エージェントは Salesforce MCP Server のツールカタログを照会し、
GetSupplierContractStatusとGetAccountCreditSummaryの 2 つの関連ツールを特定します。 - エージェントは、サプライヤの識別子を使用して
GetSupplierContractStatusを呼び出します。MCP Server はこれを Salesforce レコードクエリに変換し、インテグレーションユーザーの項目レベルセキュリティを適用して、契約の現在の状況、有効期限、およびフラグ付きコンプライアンス保持を返します。 - エージェントが
GetAccountCreditSummaryを呼び出し、MuleSoft MCP Facade を介してルーティングします。正面では、2 つの Salesforce オブジェクトからサプライヤーの未払い請求書残高と支払履歴が集計され、1 つの複合クレジット概要が返されます。 - 両方の結果から、パートナーのエージェントは契約が有効でクレジットポジションが許容範囲内であると判断し、独自のシステムで購入注文を承認します。
- どちらのツールの呼び出しも、ゲートウェイによってパートナーエージェントの ID、呼び出されたツール、およびその結果と共に記録され、どの外部アクセス権が付与され、どのデータが返されたかに関する監査可能なレコードが作成されます。
コンテキスト
エンタープライズシステムは、複雑なリクエストを分解し、さまざまなドメインまたはベンダープラットフォームの専門エージェントに委任するコラボレーションエージェントスウォームまたはネットワークを使用するようになりました。これらのエージェントにはそれぞれ独自の役割、機能、ツールがあり、すべてのステップで人の介入を必要とせずに共通の目標に向けて調整するための標準化された安全なコミュニケーション方法が必要です。
問題
異なるフレームワークで構築されたり、異なるベンダーによって運用されたりするリモートピアエージェントが、より大規模なエンタープライズワークフローを完了するために構造化された結果を受け取ったりする場合に、通話 AI エージェントが複雑な ToDo やドメイン固有の ToDo を動的に検出し、安全に操作して、そのタスクをリモートピアエージェントに委任する方法は?
勢力
このパターンを適用する場合は、次の質問に回答してください。
- 多様なフレームワークを使用して開発されたエージェントや、サイロ化されたアプリケーション資産間で運用されているエージェントは、どのように相互運用しますか?
- エージェントが内部ロジック、メモリ、または独自のツールを公開せずにコラボレーションや ToDo の委任を行うにはどうすればよいでしょうか?
- エージェントは、リアルタイムの状態更新、ストリーミング、プッシュ通知を提供しながら、複雑で時間のかかる ToDo をどのようにサポートしていますか?
- エージェントは、クロスエージェントコミュニケーションのためにエンタープライズクラスのセキュリティ (認証、承認) とポリシー遵守をどのように適用しますか?
- 単純な API コールを超えた構造化された ToDo ワークフロー (開始、進行、完了) をエージェントはどのように処理しますか?
Salesforce パターンアプリケーション
A2A プロトコルは、エージェントが他のエージェントを同僚として検出、委任、コラボレーションできるオープン標準です。エージェントがさまざまなプラットフォームやベンダー間で情報を安全に交換し、アクションを調整するための共通言語が提供されます。A2A は、エージェントをツールや API に接続することに重点を置いた MCP を補完するピアツーピアコミュニケーションに焦点を当てています。
| ソリューション | 適合 | コメント |
|---|---|---|
| シングル組織マルチエージェントオーケストレーション (SOMA) | すべてのドメインエージェントが 1 つの組織に存在し、ベンダー間のルーティングが不要な場合に最適 | スーパーエージェント(オーケストレータ)は、LLM ベースのルーティング(Atlas Reasoning Engine でサブエージェントの説明が読み取られる)または確定的ルーティング(エージェントスクリプト)を使用して、リクエストを分解し、最大 7 個の接続済みサブエージェントに転送します。これは、A2A に達する前のデフォルトの推奨パターンです。 サポートされる組み合わせ:Agentforce サービスエージェント → Agentforce サービスエージェント Agentforce 従業員エージェント → Agentforce 従業員エージェント Agentforce 従業員エージェント → Agentforce サービスエージェント 人間にエスカレーションできるのはオーケストレーターのみです。サブエージェントはエスカレーションできません。 |
| オーケストレータ主導のマルチエージェント委任 | 複数の専門エージェントを必要とする複雑なワークフローに最適 | ワークフローが複数のドメインにまたがる場合 (調達、検証、承認など)、それぞれ異なるエージェントが所有する場合に使用します。 オーケストレーターエージェントが最上位の要求を分解し、サブタスクを 2 人以上のピアエージェントに順序どおりまたは並列で委任します。各ピアエージェントは、その特殊なドメイン機能を実行してアーティファクトを返します。オーケストレーターは結果を集計して次のステップに進みます。 |
スケッチ
このアーキテクチャでは、コール元エージェントが通信を開始し、検出用のエージェントカタログ/レジストリによって促進されます。
クロスエージェント委任のシーケンス図
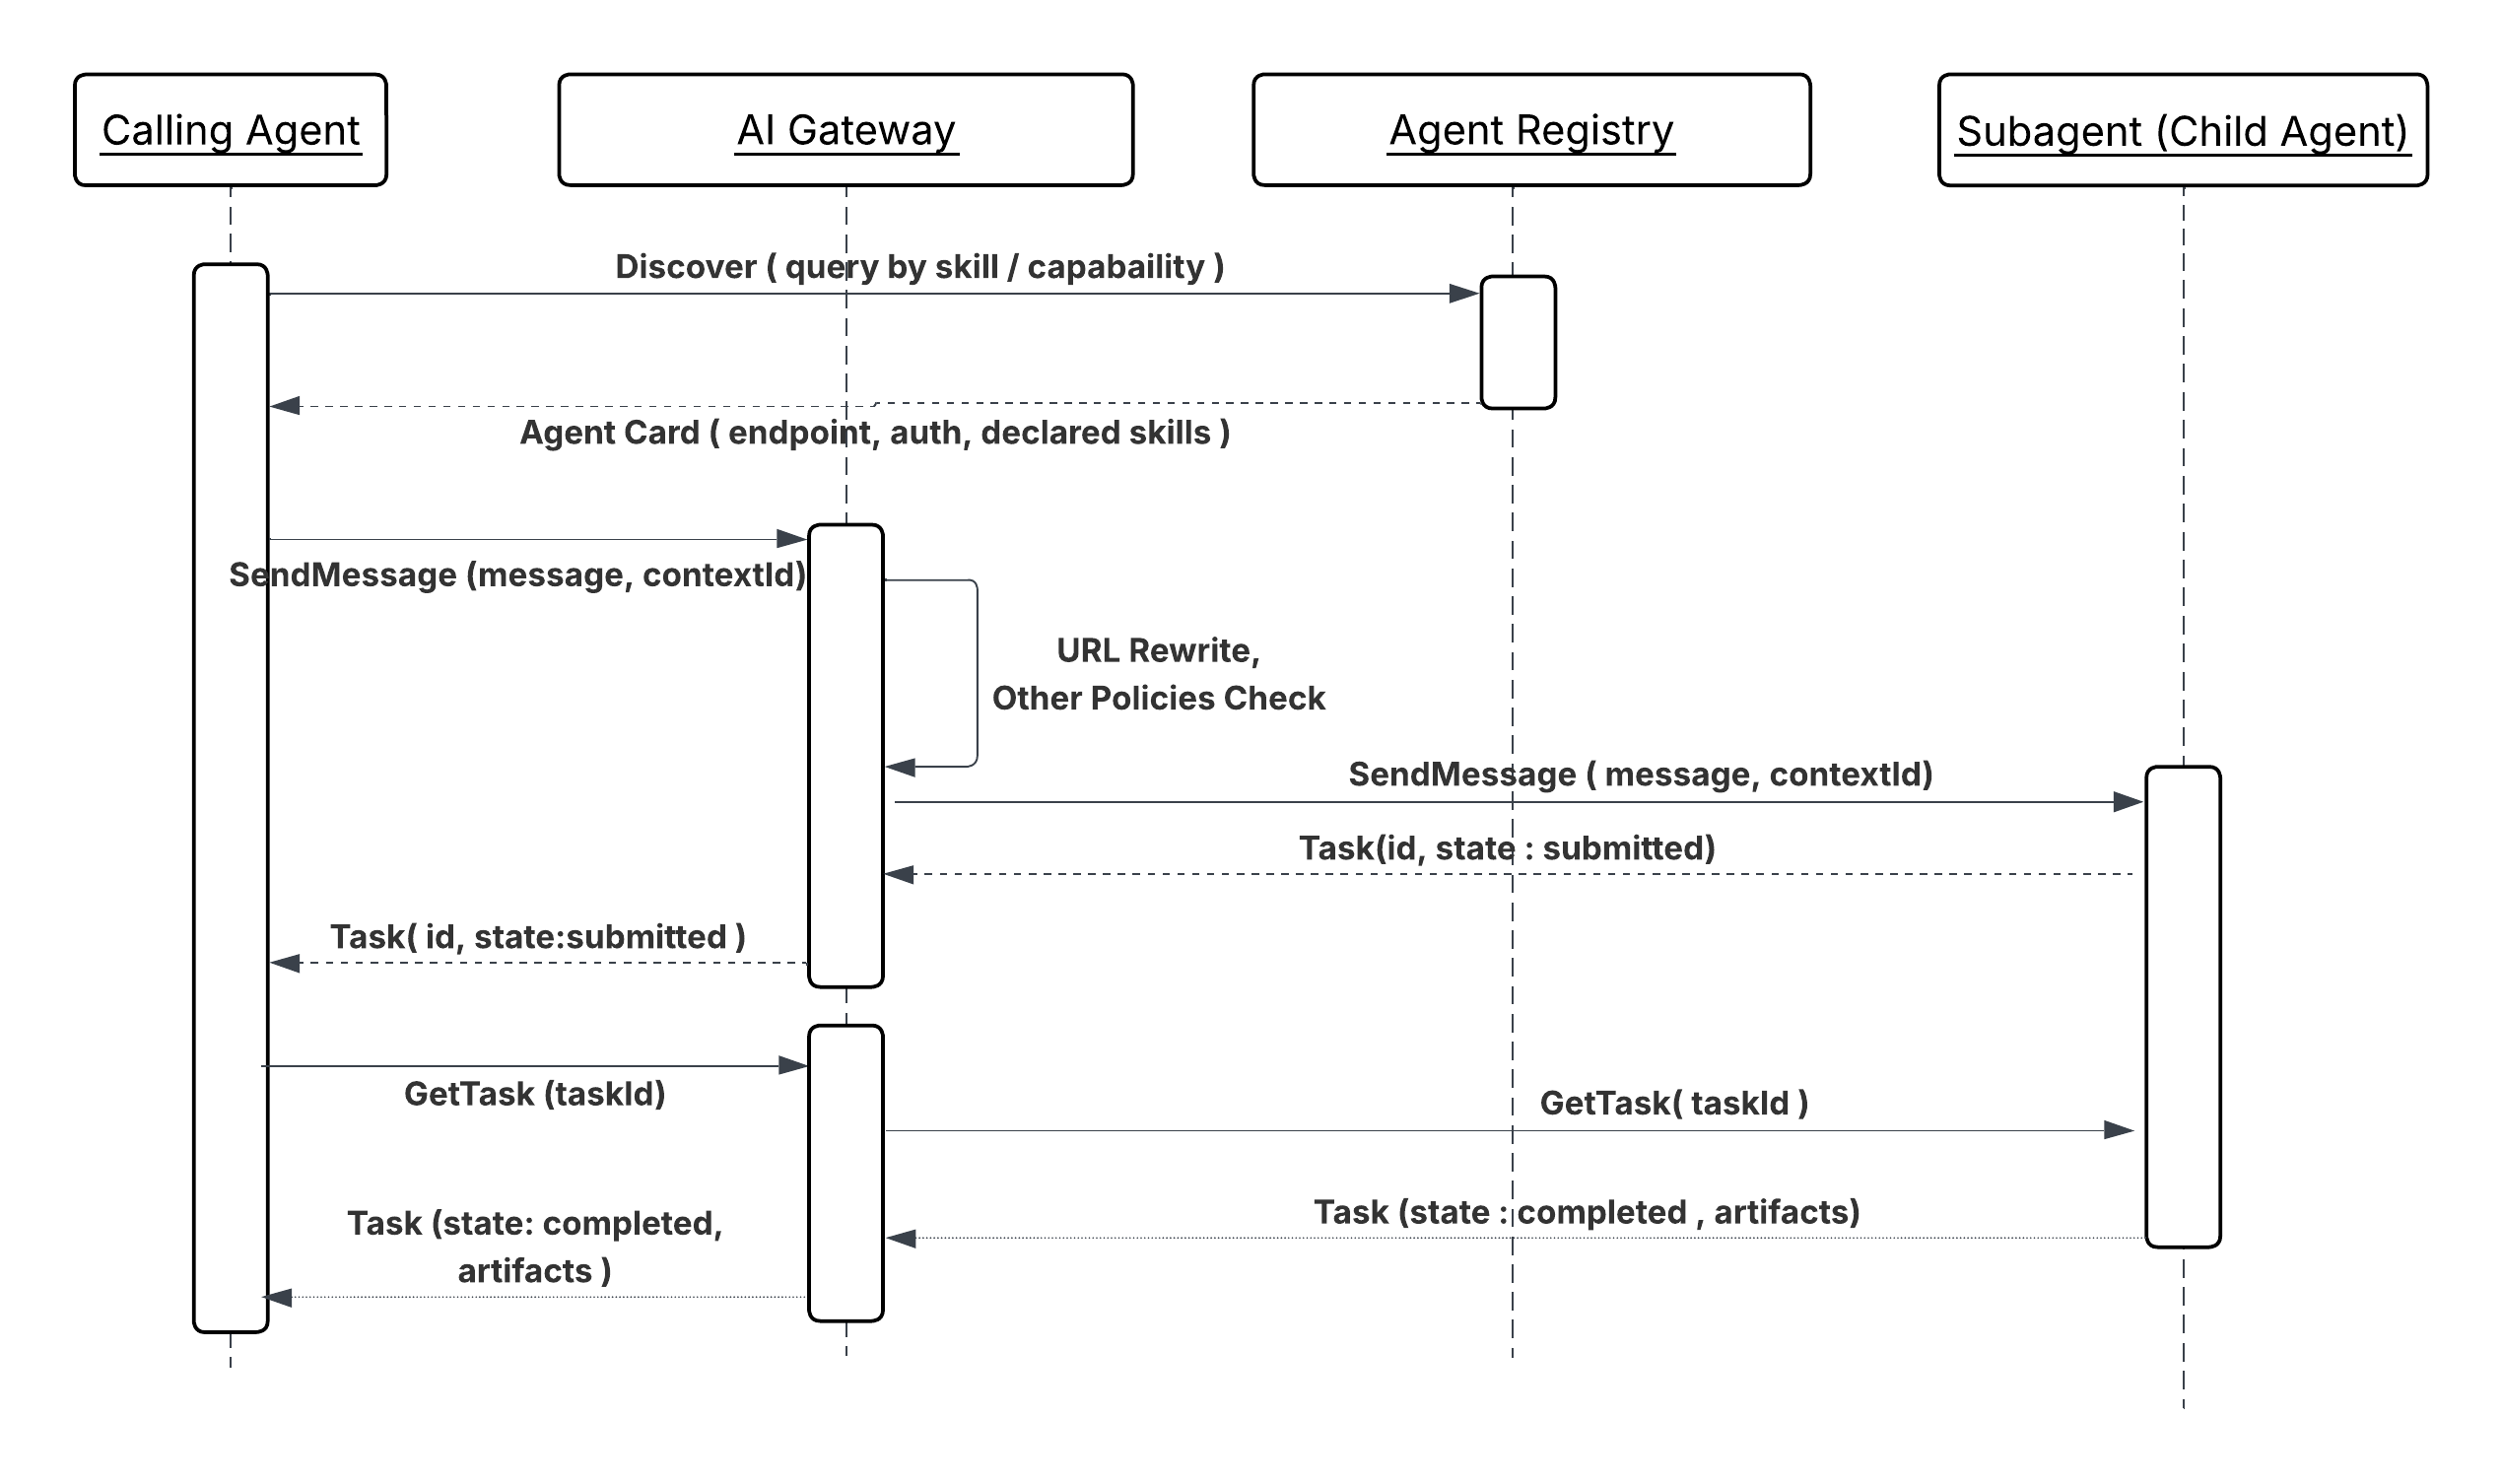
ピアエージェントは、ドメイン固有のロジック、メモリ、およびツールを使用して要求を処理し、構造化された結果をコール元エージェントに返します。
結果
A2A 委任により、ドメインの所有権がワークフローオーケストレーションから分離されます。コール元エージェントは、ピアエージェントの作成方法、ピアエージェントを実行するプラットフォーム、ピアエージェントが内部で使用するツールを把握する必要はありません。タスクを委任し、構造化されたアーティファクトを受信します。この境界は、スペシャリストエージェント (バックグラウンド検証、財務リスクスコアリング、物流ルーティング) が、それを呼び出すワークフローから独立して開発、リリース、改善できることを意味します。
プロトコルの ToDo ライフサイクルモデル (送信済み、作業中、完了、失敗) では、
ネイティブで実行時間の長いオペレーションをサポートします。コール元エージェントは、ブロッキング接続を維持するのではなく、状態更新の登録を行うことができます。
A2A タスクが数分から数時間に及ぶ場合があるため、ブロッキング接続を保持する場合よりも
オーケストレータが常にアクティブである必要はありません。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- 複雑なシナリオでは、エージェントブローカーはインテリジェントなルーティングサービスまたは「スマートスイッチボード」として機能して、専門エージェント間で ToDo 委任を調整し、複数ステップのプロセスを管理できます。
- A2A は実行時間の長い ToDo をサポートしているため、コミュニケーションは ToDo オブジェクトのライフサイクルを定義し、リアルタイムの状態更新と通知を提供する ToDo 完了に向けて行う必要があります。
- このプロトコルは、テキスト、ファイル、構造化データ、オーディオ、ビデオストリーミングなどのさまざまなコンテンツタイプをサポートするように設計されています。
- エージェントとその機能間のリレーションと連動関係は、設定ファイル (「agent-network.yaml」など) で宣言的に定義され、エージェントレジストリに公開されます。
Salesforce 実装メモ
- SOMA オーケストレーションを効果的に行うには、接続済みサブエージェントを 7 未満に抑えてルーティング品質を維持します。
- 現在、1 つの委任レイヤー (スーパーエージェント → サブエージェント) のみがサポートされています。より深いチェーンでは、遅延は「対応できないレート」に転送されます。現在、サブエージェントは他の接続済みサブエージェントに委任できません。
- 手動の引き継ぎはオーケストレーターレベルでのみサポートされます。サブエージェントはエスカレーションできません。
- SOMA 内では、LLM ベースのルーティングで確定的ルーティングのあいまいな入力で誤ルーティングが発生する場合にエージェントスクリプトを使用します。エージェントスクリプトにより、エージェント間で選定された共有コンテキストが有効になります。
エラー処理と回復
A2A プロトコルでは、堅牢なデバッグとエラー管理を促進する包括的なエラーコードが定義されています。
- リカバリロジック: エージェントは再試行ポリシー (再試行)、代替可能なエージェントへのフェールオーバーロジック、明示的なタイムアウトを組み込む必要があります。
- ToDo 状態追跡: ToDo 管理ワークフローにより、エージェントは常に ToDo の最新状況を把握できるため、中断が発生した場合でもリカバリが容易になります。
- 可観測性: 遅延、成功率、エラー頻度などのインタラクションの詳細を記録することは、品質の監視とトラブルシューティングに不可欠です。
セキュリティに関する考慮事項
- **エンタープライズ グレード認証:**A2Aは、OAuth 2.0やJWTなど、多くの場合Oktaなどの外部プラットフォームによって管理されるエンタープライズ グレードの認証および承認標準に準拠するように設計されています。
- A2A を保護するゲートウェイ (MuleSoft Omni Gateway など) は、すべての A2A 通信にポリシーを適用するために不可欠です。ゲートウェイは、エージェントを保護し、外部エージェントおよびサービスへの送信トラフィックを制御する入力ゲートウェイと出力ゲートウェイの両方として機能します。
- ポリシーの適用: A2A サーバとデータ保護には、エージェントカードの書き換え、スキーマ検証、スパイク制御、PII 検出器、およびその他のポリシーを適用する必要があります。
例
Candidate Sourcing Workflow (候補者調達ワークフロー)
採用マネージャーは、中央オーケストレータ エージェントに、求人リストとスキルセットに一致する候補者を見つけるよう依頼します。
- 検出: オーケストレーターエージェントがエージェントレジストリを照会し、専門の募集エージェントとバックグラウンドチェックエージェント (どちらもピアエージェント) を検出します。
- 委任 (A2A): Orchestrator エージェントは、ソースの候補者に対して構造化された ToDo 要求 (A2A メッセージ) を募集エージェントに送信します。
- ピア処理: 募集エージェントが独自のワークフローを実行します (MCP を介して外部 LinkedIn ツールを呼び出す場合など)。
- アーティファクトの返却 (A2A): 募集エージェントが推奨候補のリスト (アーティファクト) を返します。
- 順次委任: 次に、オーケストレーター エージェントは、上位の候補者のバックグラウンド チェック エージェントに別のタスク (A2A) を委任します。このエージェントはチェックを実行して結果を返し、全体的なタスクを完了します。
コンテキスト
多くの場合、複雑なエンタープライズワークフローでは、外部プラットフォームまたはパートナーシステムでホストされる専門エージェントが ToDo を開始したり、クエリを委任したり、内部エージェント (Salesforce Platform のエージェントなど) に更新を提供したりする必要があります。このパターンは、内部 Agentforce エージェントが、ドメイン固有の機能を実行するリモートのピア エージェントからの要求を安全に確実に受信して処理する方法に対応します。
問題
内部の特殊なAIエージェント(Agentforceのバックグラウンド チェック エージェントなど)は、ドメイン固有の機能を外部ピア エージェントに安全に公開し、受信した構造化されたA2A要求を処理し、構造化されたアーティファクトをリモート通話エージェントに返すためのタスク ライフサイクル(リアルタイムの状況更新を含む)を管理するには、どうすればよいでしょうか。
勢力
このパターンを適用する場合は、次の質問に回答してください。
- 内部ロジックやツールを損なうことなく、内部エージェントの機能を外部エージェントに安全に公開する方法は?
- 要求を処理する前に、エンタープライズクラスのセキュリティポリシーを適用して、通話エージェントの ID と委任された権限を検証する方法は?
- 構造化された非同期状態の更新を提供しながら、実行時間の長いインバウンドタスクを処理する方法は?
- 多様な外部フレームワークで構築されたエージェントとのシームレスなやりとりを確保する方法は?
Salesforce パターンアプリケーション
A2A プロトコルは、セキュアなピアツーピア委任とコラボレーションのためのオープン標準を提供します。内部エージェントはピアエージェントとして機能し、エージェントカタログ/レジストリを介して機能をアドバタイズし、セキュアなチャネル (HTTPS/SSE) を介して A2A を使用して構造化された要求を受信して応答します。
| ソリューション | 適合 | コメント |
|---|---|---|
| Agentforce 接続サブエージェント (SOMA) | コール元エージェントが同じ組織内の別の Agentforce エージェントである場合に最適 | 両方のエージェントが同じ Salesforce 組織に属し、通話者が Agentforce オーケストレーターである場合に使用します。エージェントは Agentforce Builder を介してサブエージェントとして接続され、説明と宣言されたアクションを介してオーケストレーターに公開されます。オーケストレーターは、LLM ベースのルーティング (Atlas Reasoning Engine) または確定的ルーティング (エージェントスクリプト) を使用して ToDo を転送します。 A2A プロトコル、ゲートウェイ、外部登録は必要ありません。 サポートされる組み合わせ:Agentforce サービスエージェント → Agentforce サービスエージェント Agentforce 従業員エージェント → Agentforce 従業員エージェント → Agentforce サービスエージェント オーケストレーターのみを人間にエスカレーションできます。サブエージェントはエスカレーションできません。 |
| エージェントブローカールーティング (受信) | 組織で補完機能を持つ複数の Agentforce エージェントをホストしていて、発信側エージェントが特定の対象を選択_でき_ない、または選択_すべきで_ない場合に最適 | 発信側エージェントが Salesforce または別の Salesforce 組織の外部にあり、その要求を処理する特定の内部エージェント(Agentforce またはその他のベンダーのエージェント)を知る必要がない場合に使用します。 MuleSoft エージェントブローカーは、MuleSoft Omni Gateway と内部 Agentforce エージェントのプールの間に配置されます。受信 A2A ToDo を受信し、ToDo の要件に対して対応可能な内部エージェントの宣言された機能を評価し、要求を最適なエージェントに転送します。ブローカーは、プライマリ対象エージェントが対応できない場合や障害を返した場合にもフェールオーバーを処理します。ブローカーは、外部通話者に再試行を提示せずに同等のエージェントにリダイレクトします。外部通話者は、内部ルーティングの決定や再試行を認識することはありません。 |
スケッチ
コール可能サービスとしてのエージェントのシーケンス図
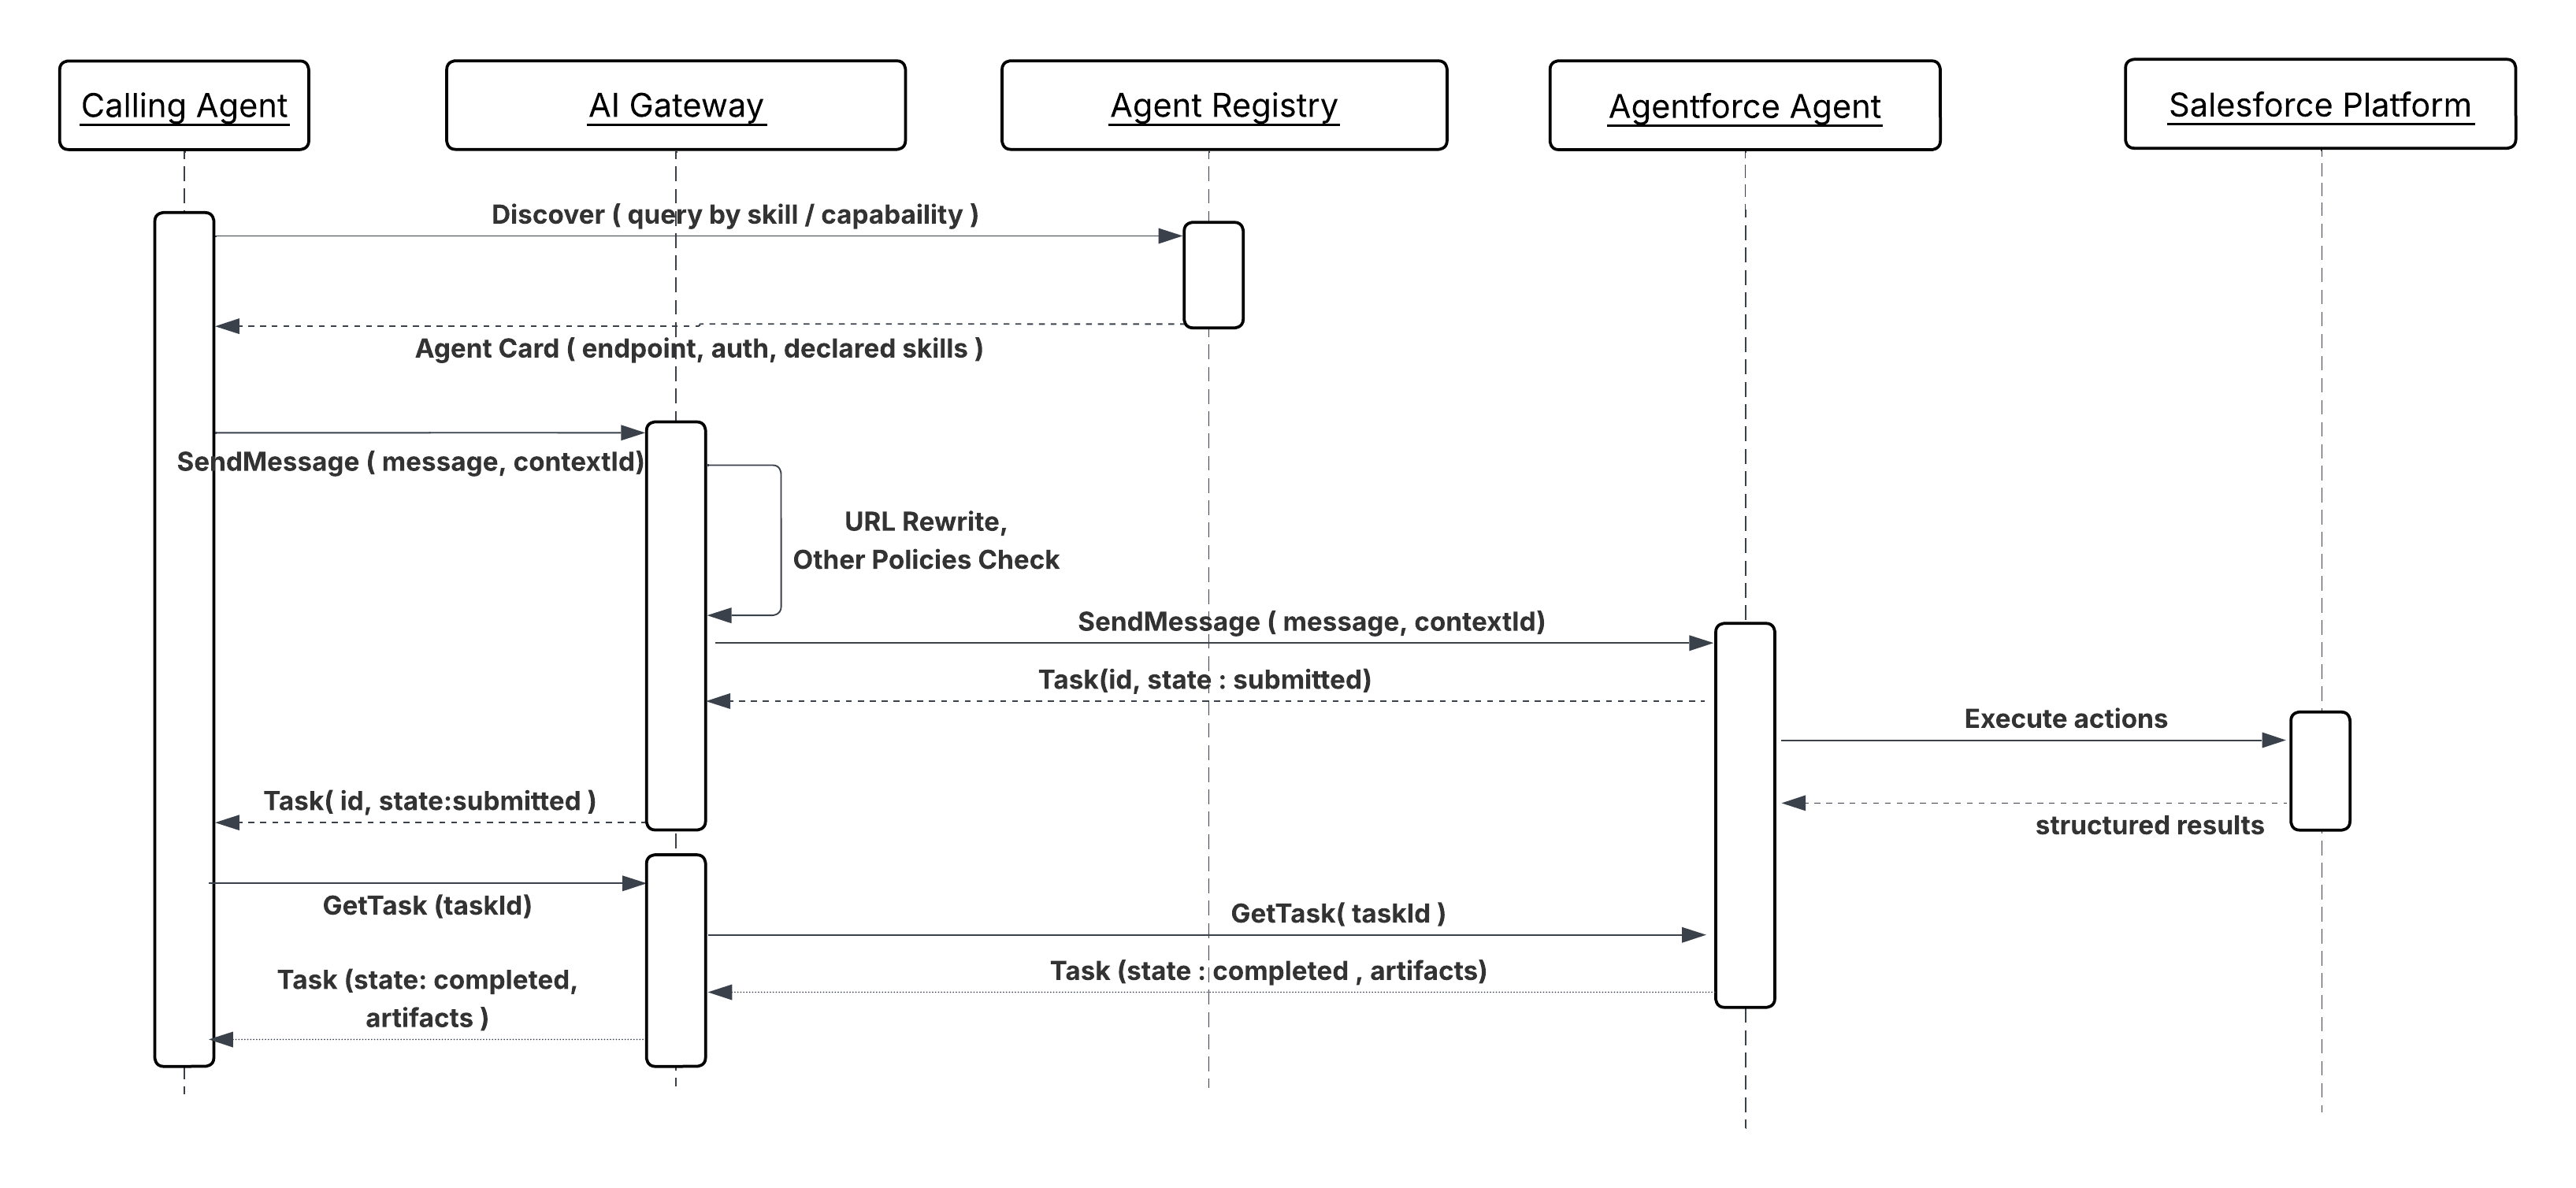
結果
このパターンでは、内部エージェントがマルチエージェントネットワーク内の専門サービスとして公開されます。外部エージェントは、組織が管理、監査可能性、ポリシー適用を維持する中で、安全にタスクを内部機能に委任できます。
デザインの考慮事項
プラットフォームに依存しないガイダンス
- ゲートウェイ (MuleSoft Omni Gateway など) は、すべての着信 A2A 要求でレート制限、認証、ペイロード検証などのポリシーを適用する入力ポイントとして位置付ける必要があります。
- 内部エージェントは、外部での開始から完了まで ToDo オブジェクトの状態を管理して、リモート通話エージェントが一貫した検証可能な状況の更新を受信するようにする必要があります。
- エージェントカードでエージェントが公開する機能が明確でインテントベースであり、委任に必要なセキュリティ範囲が含まれていることを確認します。
エラー処理と回復
- 構造化エラーコード: 失敗した場合、内部エージェントは A2A 準拠の構造化エラーメッセージをコール元エージェントに返し、リモート再試行ロジックまたは代替フェールオーバーメカニズムを有効にする必要があります。
- **無力性:**エージェントは、外部エージェントからの再試行された A2A 要求によってトリガーされる副次的影響(ネットワークの中断または回復による)が無力であることを確認する必要があります。
セキュリティに関する考慮事項
- 受信ポリシーの適用: ゲートウェイは、外部エージェントの許可リスト/ブロックリストへの登録と、JWT/OAuth 2.0 トークンの検証に関するポリシーを適用して、_発信側エージェント_の ID と代理権限を検証する必要があります。
- 入力サニタイズ: すべての受信要求ペイロードを検証してサニタイズし、潜在的なプロンプトインジェクションや悪意のあるデータ攻撃を軽減します。
- ID 伝達: 内部システムに対してアクションを実行する前に、外部エージェントの ID とその代理権限を内部セキュリティコンテキスト (Salesforce ユーザープロファイルなど) に安全に対応付けます。
例
外部システム照会
- リクエスト: パートナーシステム上の募集エージェントが、Agentforce上の内部従業員検証エージェント(ピアエージェント)にA2Aタスクリクエストを送信して、新規候補者の雇用状況を確認します。
- **処理:**従業員検証エージェントはゲートウェイ経由で要求を受信し、パートナーエージェントのログイン情報を検証し、その内部ワークフローを実行し (たとえば、内部の HR システムを呼び出し)、応答を書式設定します。
- 応答: ピアエージェントは構造化されたA2Aアーティファクト(雇用開始日や役職など)をリモートの募集エージェントに返し、その外部ワークフローに進みます。
-
MCP、A2A、APIを保護するゲートウェイ
ゲートウェイは、すべてのエージェントからシステムへのトラフィックとシステムからエージェントへのトラフィックの 1 つの適用ポイントとして必要です。
-
セキュアな接続: ゲートウェイは、アクセスを制限することで、認証済みで承認されたエージェントのみが MCP、A2A、および API エンドポイントとやりとりできるようにします。
-
SLA の適用: ゲートウェイによってレート制限を適用できるため、組織はパフォーマンス要件を満たし、MCP および A2A サーバの過負荷を回避できます。
-
シンプルなガバナンス: ゲートウェイにより、すべてのサーバインタラクションを一元的に表示および制御できるため、エージェントの活動の管理と監視がシンプルになります。
-
データの一貫性と保護: スキーマ検証などのポリシーによってデータの一貫性が確保され、PII検出によって機密情報を保護できます。
MueleSoft Omni Gateway
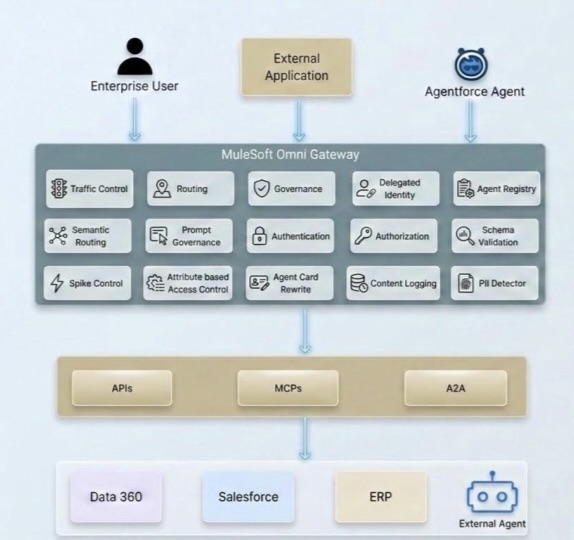
- ID 伝達チェーン
企業がエージェント型パラダイムを採用すると、エンドユーザー ID が自律型 AI エージェントのネットワークをどのように通過するか? という新しいセキュリティ上の課題が生じます。従来の API アーキテクチャでは、ユーザーは一度認証すると、アプリケーションがユーザーの代わりにバックエンドサービスをコールします。IDチェーンは短く、よく理解されており、通常は1つのTrustドメイン内で管理されます。
ただし、エージェント型アーキテクチャでは、1 つの要求がさまざまなエージェント、サービス、および MCP サーバに分散され、それぞれがサービス境界、Trust ドメイン、さらには組織の境界を超える可能性がある、より長いチェーンを備えています。ID伝播の明確な戦略がなければ、企業はセキュリティと機能性のどちらを選択せざるを得ないという、アーキテクトが対処する必要のないジレンマに直面します。
MuleSoft は、信頼済みエージェント ID 機能を使用して ID の伝達の複雑さに対処します。このソリューションでは、ポリシーベースのゲートウェイ管理戦略を使用して、A2A プロトコル、MCP ツールコール、REST API 要求などのさまざまなインタラクション種別でエンドユーザーの ID が維持されるようにします。送信認証ポリシーを使用してオムニゲートウェイレイヤーで ID 管理を一元化することで、企業はバックエンドサービスやエージェントを変更せずにエージェントネットワーク全体を保護できます。詳細は、「Trusted Agent Identity for the Agentic Enterprise (エージェントエンタープライズの信頼済みエージェント ID)」を参照してください。
- Data 360 の RAG セキュリティ
Data 360 では、データガバナンスポリシー設定を使用して、オブジェクトレベル、項目レベル、行レベルで属性ベースのアクセス制御 (ABAC) がサポートされます。これは、RAG 検索インデックス内を含め、どのデータを誰に表示するかを制御する主要な方法です。構造化データの場合、ユーザーアクセス条件はユーザー属性と権限セットを使用して実装されます。非構造化データの場合、メタデータの絞り込み (検索インデックスの事前絞り込み) によって、取得される内容が制限される場合があります。
LLMとの通信は、Einstein Trust Layerを介して行われます。Einstein Trust Layerでは、機密/PII情報がモデルに到達する前にマスキングされ、検索中だけでなく生成前でもデータ プライバシーが保護されます。
RAGポイズニングから保護するために、データがベクトル検索で使用可能になる前に、厳格なデータガバナンスおよび検証規則を適用してください。Einstein Trust Layer では、プロンプトのマスキング/有害性チェックも実行できます。エージェントユーザープロファイルに厳格な権限セットを適用できます。
- 新規指定ログイン情報モデル Salesforce は、接続と ID の懸念を明確に区別する 2 階層の指定ログイン情報モデルを導入して認証アーキテクチャを刷新しました。Apex を使用してコールアウトを実行するときは必ずこれを使用し、独自の認証プロトコルを作成しないようにします。このモデルは拡張性とセキュリティも強化されています。 外部ログイン情報は、このモデルの基盤となります。実際の認証の詳細を保存し、OAuth 2.0 クライアントログイン情報、JWT ベアラー、AWS 署名 V4 などの豊富なプロトコルをサポートすると同時に、プリンシパルのマッピング方法 (1 つの指定ユーザー (すべてのユーザーで共有) またはユーザーごとのプリンシパル (各ユーザーが独自の ID を使用して認証)) を定義します。 次に、指定ログイン情報はエンドポイントレイヤーとして機能します。コールアウト URL を定義し、外部ログイン情報を参照して認証ハンドシェイクを処理し、エンドポイント設定を認証情報管理から明確に分離します。 ユーザーごとの認証フローを有効にするには、適切な権限セットが割り当てられているユーザーのみが自分の ID でコールアウトを呼び出せるように、管理者が権限セットを適切な外部ログイン情報プリンシパルに対応付けます。この 2 層設計により、セキュアなコールアウト設定が簡略化されるだけでなく、アーキテクトは Salesforce 接続システム全体でインテグレーションを認証する方法の柔軟性とガバナンスをはるかに高めることができます。詳細については、指定ログイン情報ドキュメントを参照してください。
このセクションでは、アーキテクチャのデータ処理パターンを、規制対象のエンタープライズリリースで一般的に発生するコンプライアンス義務に対応付けます。
アクセス制御: インテグレーションパターン全体 (範囲指定ログイン情報、エージェントごとの OAuth 2.0 範囲、ゲートウェイ許可リスト) で説明されている最小権限のインテグレーションユーザーモデルは、論理アクセス制御に直接対応付けられます。各エージェントの認証情報スコープがレビューおよび承認されたことを示す証拠を維持します。
監査ログ: パターンごとの監査ログ要件 (セッション ID、ツールの呼び出し、機密値でサニタイズされた入力パラメーター、結果) は、監視およびログ制御を満たします。ログが改ざんされていないこと、必要な期間保持されていること、本番システムにアクセスしなくてもセキュリティチームがアクセスできることを確認します。
変更管理: コンシューマーに影響する MCP ツールのスキーマ変更と A2A エージェントカードの更新は、インターフェイスの変更を構成し、変更管理コントロールの対象になります。ツールに対して明示的なバージョン設定を行い (MCP 受信パターンで記載されている)、破壊的変更を承認が必要な設定イベントとして扱います。
可用性: エージェントの同時実行制限、イベントトリガーパターンの再試行の上限、失敗したイベントのデッドレタールーティングが可用性制御を構成します。入手可能性証拠パッケージの一部として、各展開済みパターンの予想されるスループットエンベロープと障害時の挙動を文書化します。
注意: このリストは、エージェントソリューションのコンプライアンスを確保するための完全なガイドを示すものではありません。該当するすべての規制要件を満たす必要があります。
- エージェント API の使用開始
- Data 360 を使用した信頼済みエージェントの有効化
- MuleSoft Omni Gateway の概要
- OAuth 2.0 代理ログイン情報注入ポリシー
- Agentic Enterprise の信頼済みエージェント ID
Gulal Kumar は、20 年以上の経験を有する Salesforce のソフトウェアエンジニアリングアーキテクトです。彼の専門知識は、安全でレジリエントかつ革新的なAIソリューションによるビジネス変革の推進に注力しており、AI、インテグレーション、API、Enterpriseアーキテクチャに及びます。LinkedInで彼とつながりましょう。