Introduzione
Nota: Gli "argomenti" sono stati rinominati in "subagenti" in questo articolo, in base alle convenzioni di denominazione dei prodotti più recenti.
È possibile creare un agente che funziona bene in un ambiente di test, solo per fargli seguire percorsi completamente diversi quando si elabora due volte lo stesso flusso di lavoro. Questa limitazione fondamentale mostra come il modello Agentforce precedente gestiva l'esecuzione: ogni decisione, dall'interpretazione degli intenti alla selezione delle azioni, veniva presa in tempo reale dal LLM, senza alcun percorso garantito attraverso il flusso di lavoro.
Gli LLM possono produrre esiti incoerenti in risposta a input identici. Sono sufficienti lievi variazioni di contesto, prompt di sistema o generazione di token per indirizzare un agente su un percorso diverso. Per molte interazioni, questa variabilità è accettabile. Tuttavia, per i flussi di lavoro a più fasi che richiedono verificabilità, riproducibilità e tracciabilità, non lo è. L'approvazione di un prestito, un trasferimento di inventario o un processo di triage dei pazienti non possono dipendere dal fatto che un agente agisca in modo diverso ogni volta.
Il nuovo Agentforce Builder e il nuovo script agente risolvono questo problema separando l'esecuzione deterministica dal ragionamento LLM. Il modello ibrido di Agentforce garantisce che l'agente segua una struttura definita con precisione per ogni esecuzione del flusso di lavoro, pur continuando a utilizzare il ragionamento LLM dove è realmente necessario il giudizio, la comprensione del linguaggio naturale o l'interpretazione contestuale.
Nella versione precedente di Agentforce, un agente funzionava come un semplice loop reattivo. Ogni decisione, dall'interpretazione dell'intento alla selezione dell'azione successiva, è stata presa in tempo reale dall'LLM in base esclusivamente all'input più recente dell'utente. Non esisteva un percorso di esecuzione garantito, uno stato persistente e un meccanismo per imporre una sequenza di fasi.
Impossibile garantire i percorsi di esecuzione
Poiché ogni decisione dipendeva dal ragionamento in tempo reale del componente LLM, piccole variazioni nell'input, nel prompt di sistema o nella versione del modello producevano selezioni di azioni diverse su richieste identiche. Ciò rendeva difficile testare rigorosamente il modello precedente: un flusso di lavoro passato in gestione temporanea poteva comportarsi in modo diverso in produzione e non esisteva un modo affidabile per riprodurre un percorso di esecuzione specifico a scopo di debug o controllo.
Ogni interazione ha pagato l'intero costo LLM
Anche scenari di conversazione semplici richiedevano almeno tre cicli LLM: selezione del subagente, selezione dell'azione e generazione della risposta finale. Operazioni a più fasi estese a cinque o più cicli. Per gli architetti che progettano flussi di lavoro a volume elevato o sensibili alla latenza, questo non era solo un problema di prestazioni. Significava che non si poteva cortocircuitare il loop di ragionamento per le fasi che non richiedevano giudizio, perché l'architettura non aveva alcun meccanismo per distinguere le due cose.
L'esecuzione non deterministica ha creato un gap di controllo
Nei settori regolamentati, l'auditability significa poter dimostrare che un processo specifico è stato seguito in modo specifico per una transazione specifica. Un modello puramente non deterministico non può fornire tale garanzia. Se il percorso di esecuzione varia tra le esecuzioni, varia anche l'itinerario di controllo e "l'agente ha deciso" non è una risposta difendibile in un esame della conformità.
Lo stato non è sopravvissuto alla conversazione
Affidandosi all'elaborazione a turno singolo, l'agente non aveva memoria permanente delle fasi precedenti. Se la conversazione si discosta anche solo leggermente, l'agente potrebbe eliminare il contesto acquisito in precedenza e costringere l'utente a riavviare. Per i flussi di lavoro transazionali a più fasi, questo ha creato un limite di affidabilità: più fasi del processo, maggiore è la probabilità di perdita di contesto prima del completamento.
I passaggi completati non sono stati ricordati
Senza la gestione dello stato, gli agenti non avevano alcun record delle fasi obbligatorie già completate da un utente. Ciò generava un loop imprevedibile, in cui un agente tornava a una fase già terminata dall'utente. Al di là dell'impatto sull'esperienza utente, questo ha creato un problema architettonico più profondo: la progettazione di un flusso di lavoro sequenziale affidabile era impossibile perché l'agente non era in grado di imporre la sequenza.
Il nuovo Agentforce, GA da febbraio 2026, passa dal ragionamento LLM puramente probabilistico a un modello ibrido. Anziché instradare ogni decisione attraverso il LLM, separa l'esecuzione deterministica dal ragionamento LLM e consente a ciascuno di gestire solo ciò per cui è adatto. A supporto di ciò, Agentforce ha introdotto due strumenti di creazione: Agent Script per lo sviluppo basato su codice e Agentforce Studio, un ambiente di creazione senza codice.
Agentforce Builder
Agentforce Builder è l'ambiente consigliato per lo sviluppo di nuovi agenti. È ospitato in Agentforce Studio e sostituisce l'esperienza di impostazione legacy, che rimane disponibile ma non è più il percorso di creazione principale. In Generatore, si lavora in una visualizzazione area di disegno visiva o direttamente nella visualizzazione Script, modificando lo script agente che definisce il comportamento dell'agente.
Script agente
Agent Script è un linguaggio dichiarativo specifico del dominio (DSL) che definisce tutto ciò che riguarda il comportamento di un agente: configurazione, logica aziendale e prompt. È strutturato come coppie chiave-valore che possono estendersi su più righe o includere sotto-proprietà nidificate ed è progettato per essere leggibile dagli utenti senza richiedere Knowledge dell'architettura dei grafici sottostante.
Lo script agente consente di esprimere due tipi di istruzioni sostanzialmente diversi nello stesso agente: istruzioni di logica deterministica e istruzioni prompt. Le istruzioni di logica deterministica definiscono le condizioni e le sequenze di azioni che vengono eseguite come codice senza alcun coinvolgimento LLM. Le istruzioni del prompt definiscono una guida per il linguaggio naturale che l'LLM interpreta in fase di esecuzione. Il confine tra i due è esplicito e deliberato e capire dove posizionare quel confine è una delle decisioni di progettazione principali che si prenderanno quando si crea con il nuovo Agentforce.
Logica deterministica nella pratica
Quando le istruzioni sono deterministiche, l'agente segue un percorso di esecuzione definito indipendentemente dal modo in cui l'utente esprime il proprio input. L'esempio seguente mostra un subagente che carica un cruscotto digitale Intelligence clienti. Controlla l'ID di un cliente, recupera i dati del profilo, la cronologia ordini e i ticket di assistenza, quindi calcola il valore di durata del cliente e il rischio di abbandono. Nessuno di questi passaggi richiede il ragionamento LLM.
Questa logica chiama le azioni in sequenza fissa ogni volta che vengono soddisfatte determinate condizioni.
Istruzioni del prompt e consegna LLM deliberata
Quando la logica deterministica gestisce condizioni e sequenze che possono essere espresse come codice, le istruzioni prompt gestiscono tutto ciò che richiede giudizio, interpretazione o generazione di linguaggio naturale. Quando il Motore di ragionamento Atlas incontra un nodo con istruzioni rapide, attiva una chiamata LLM. Quando non lo fa, viene eseguita in modo deterministico.
L'esempio seguente mostra un sottoagente per prodotti e servizi. Le istruzioni sono un prompt multi riga che indica al componente LLM come rispondere, quando cercare le informazioni e come gestire le ambiguità. Questo è lo schema corretto quando l'intervallo dei possibili input dell'utente è troppo ampio per essere previsto con la logica condizionale o quando la qualità della risposta dipende dalla capacità del componente LLM di interpretare il contesto e generare una risposta naturale.
Le istruzioni del prompt su un nodo attivano la chiamata LLM. Non si tratta di un'operazione incidentale: è il meccanismo con cui lo script agente rende esplicito e applicabile il confine LLM, anziché lasciarlo all'inferenza in fase di esecuzione.
Questo subagente mostra la logica deterministica e il passaggio LLM in azione.
La pipeline di esecuzione in tre fasi
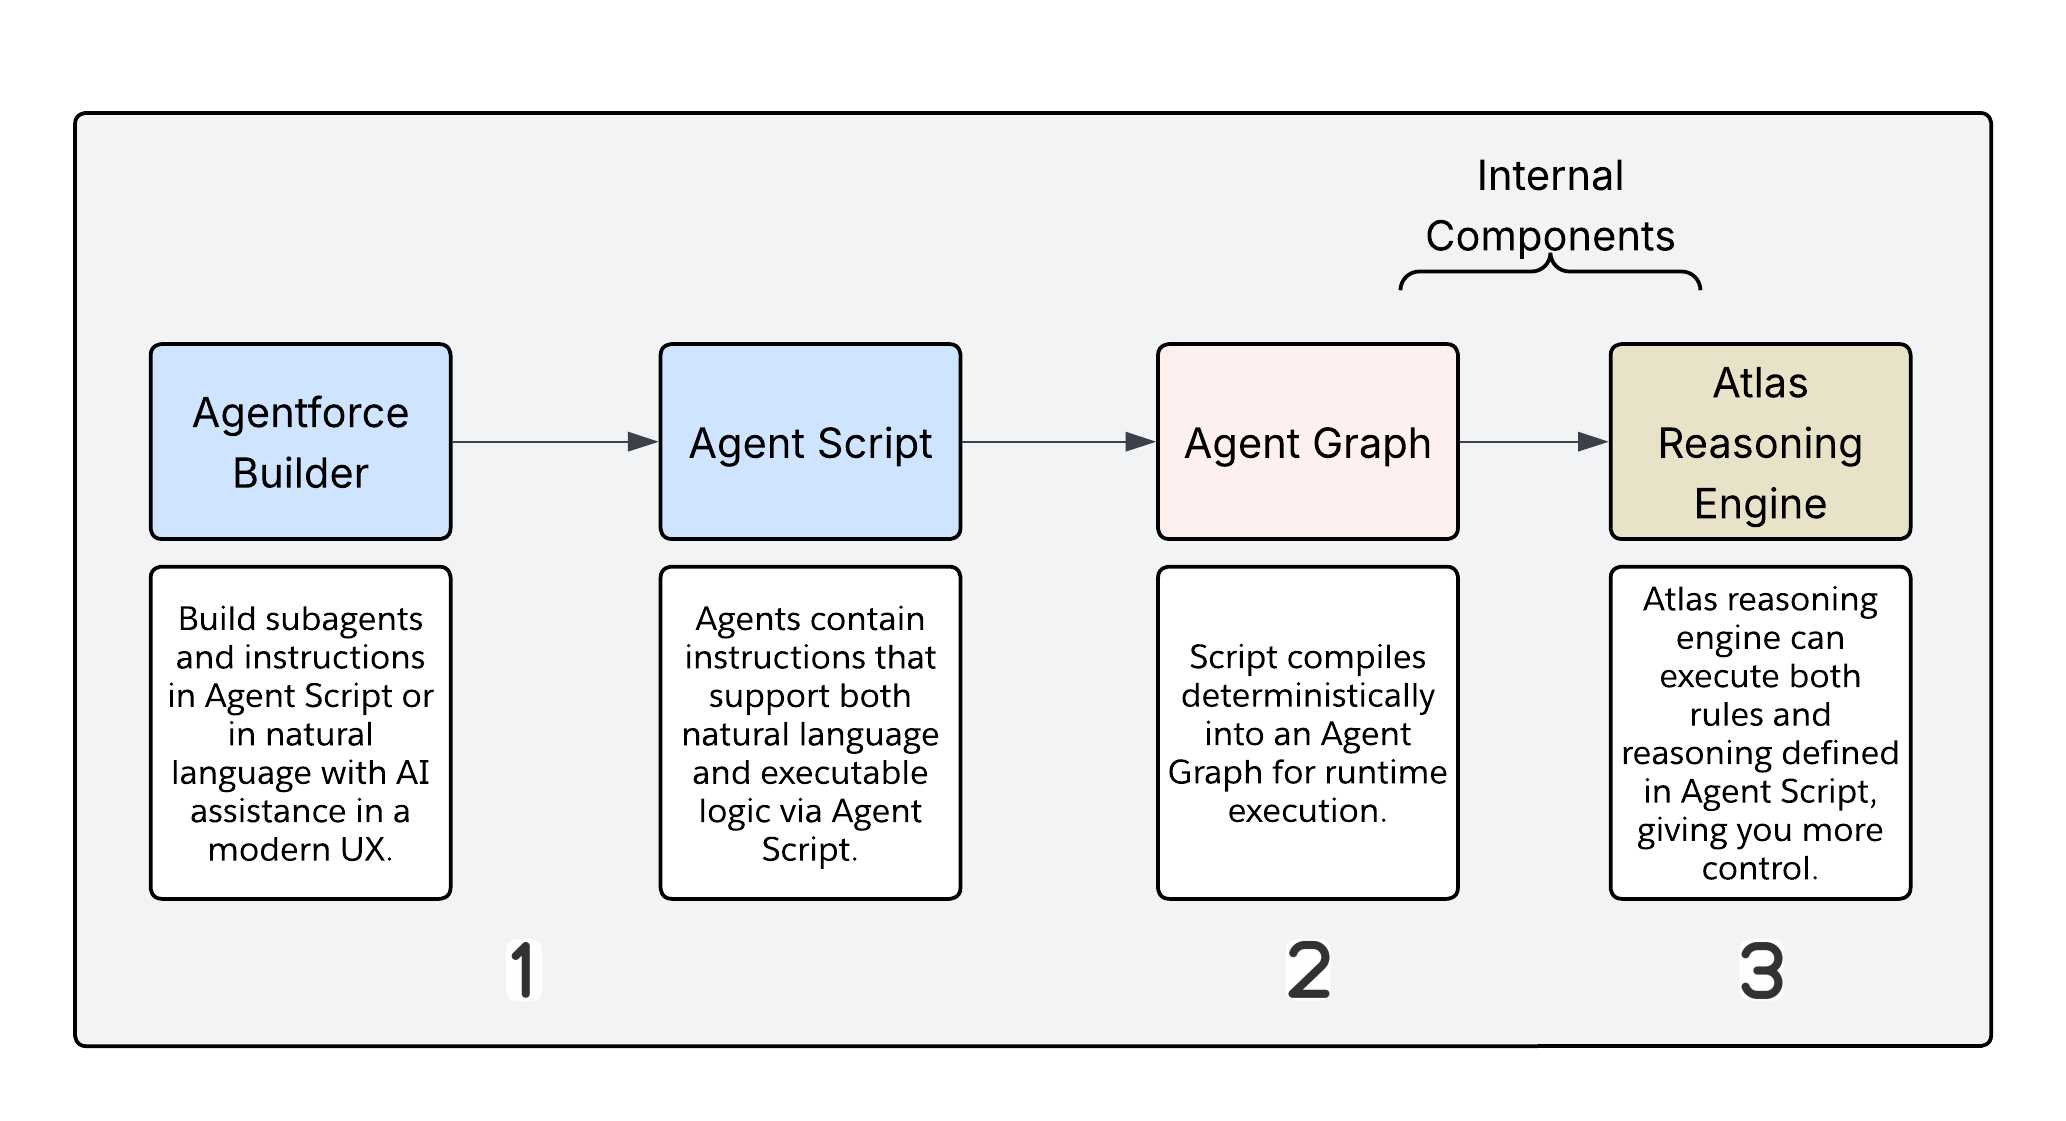
Agentforce Builder e Agent Script sono il livello di creazione, ma Agent Graph e il Motore di ragionamento Atlas eseguono effettivamente l'agente. Per progettazione, nessuno di questi componenti è direttamente accessibile. La separazione tra creazione ed esecuzione consente alla piattaforma di imporre un comportamento deterministico indipendentemente da come è stato scritto lo script.
La pipeline passa attraverso tre fasi.
- L'autore è il luogo in cui si lavora. Agent Script è leggibile da tutti e modificabile nella visualizzazione Area di disegno o Script in Agentforce Builder. Questo è l'unico livello con cui si interagisce direttamente.
- La compilazione è il momento in cui il compilatore Salesforce trasforma lo script agente in un grafico agente, un piano di esecuzione serializzato ottimizzato per l'esecuzione su computer anziché per la leggibilità umana. Non si esegue il debug a questo livello. La compilazione produce una rappresentazione che il runtime può attraversare in modo efficiente.
- L'esecuzione in fase di esecuzione è il punto in cui il Motore di ragionamento Atlas prende il sopravvento. Legge il grafico agente, lo attraversa in base allo stato corrente della sessione e decide in corrispondenza di ogni nodo se eseguire in modo deterministico o invocare il LLM. Il motore applica esplicitamente le clausole di protezione e il calcolo del percorso condizionale, anziché dedurre.
Grafico agente
Il grafico agente è la rappresentazione intermedia che si trova tra lo script in formato leggibile e l'effettiva esecuzione in fase di esecuzione. La sua struttura è ottimizzata per la macchina statale che la consuma, non per l'architetto che ha creato lo script. Capire che esiste e che cosa rappresenta è importante perché è l'artefatto utilizzato dal Motore di ragionamento per applicare il piano di esecuzione definito dallo script.
Motore di ragionamento Atlas
Il Motore di ragionamento Atlas è un esecutore di macchine statali. Ad ogni turno, attraversa il grafico agente in base allo stato della sessione, esegue i nodi deterministici come codice e attiva le chiamate LLM solo dove sono presenti istruzioni prompt. Applica inoltre le clausole di protezione e gestisce l'instradamento condizionale. Il Motore di ragionamento è il luogo in cui il modello di ragionamento ibrido viene effettivamente implementato; lo script definisce il confine e il motore lo rispetta.
Agent Graph non è un wrapper LLM. E' un motore di ragionamento ibrido che separa l'esecuzione deterministica dal ragionamento probabilistico. La regola di governo è semplice: se si può esprimere una decisione come codice, deve essere scritta come logica. Se la decisione richiede giudizio, interpretazione o generazione di linguaggio naturale, il LLM deve gestirla. Questa scelta progettuale è la scelta architettonica più importante nel nuovo modello Agentforce. Laddove il limite LLM cade influisce direttamente sul costo, la latenza, la possibilità di controllo e l'affidabilità della soluzione.
Il Motore di ragionamento Atlas valuta ogni turno utente in entrata e lo instrada lungo uno dei due percorsi.
Percorso A: esecuzione deterministica
Questo percorso non ha esposizione LLM. Si comporta come codice compilato in fase di esecuzione. Il Motore di ragionamento classifica l'intento dell'utente e determina che un'istruzione di logica corrisponda, ignorando completamente l'LLM. Lo script agente compilato viene eseguito dall'alto verso il basso, con le regole if-else eseguite incondizionatamente a ogni turno. Le azioni di flusso, Apex o API vengono chiamate con parametri deterministici, senza assemblaggio rapido o chiamata al modello. Il risultato passa di nuovo attraverso il livello Trust con la registrazione di controllo completa.
Percorso B: Ragionamento LLM
Il Motore di ragionamento segue questa strada quando non è in grado di risolvere l'intento utilizzando solo istruzioni di logica. Attraversa il grafico agente e valuta ogni nodo. I nodi con istruzioni rapide attivano una chiamata LLM. I nodi senza di essi vengono eseguiti in modo deterministico. La presenza di un'istruzione prompt è il trigger ed è esplicita nello script anziché dedotta in fase di esecuzione.
Cosa attiva una chiamata LLM
Esistono otto punti del ciclo di vita dell'esecuzione in cui viene invocato il componente LLM. La classificazione dei subagenti, o la decisione di quale subagente corrisponde alla richiesta dell'utente, è una di queste, anche se un percorso di corto circuito può ignorare la chiamata LLM completa quando la classificazione non è ambigua. Il ragionamento dell'agente, in cui l'agente decide quale azione intraprendere successivamente, passa sempre attraverso il LLM. Lo stesso vale per la generazione della risposta, in cui la risposta finale viene assemblata da un prompt idratato.
I trigger rimanenti sono più operativi: la convalida della solidità conferma che l'output è basato sui dati recuperati; la simulazione dell'azione emula le risposte nell'ambiente Anteprima e Simula anziché eseguire in tempo reale; la generazione di output strutturati gestisce i casi in cui la risposta deve essere conforme a uno schema definito; e la generazione di indicatori di localizzazione e avanzamento gestisce la formattazione e la messaggistica transitoria dove non esiste un'impostazione predefinita pre-creata.
Cosa rimane deterministico
Le transizioni tra grafici e stati non coinvolgono mai il componente LLM. I blocchi del ciclo di vita di before_reasoning e after_reasoning vengono eseguiti in modo deterministico a condizione che contengano solo nodi azione senza istruzioni rapide. Matematica, recupero dei dati, convalida e logica condizionale appartengono tutti al codice. Qualsiasi azione che esegue Flusso, Apex o un'API REST rimane direttamente sul percorso deterministico. Qualsiasi nodo senza istruzioni prompt viene eseguito senza una chiamata LLM.
Essere espliciti su questo confine con il team è importante. Ogni chiamata LLM non necessaria aggiunge latenza, costo e variabilità. Gli architetti dovrebbero spingere la logica deterministica per impostazione predefinita, riservando il LLM ai casi in cui l'operazione richiede effettivamente la sua capacità di ragionamento.
Guida alla progettazione: codifica push della logica per impostazione predefinita
Utilizzare le istruzioni di logica script agente per scrivere istruzioni del prompt che potrebbero essere espresse come condizione, assegnazione di variabili o filtro di azione. Ogni chiamata LLM non necessaria aggiunge latenza, costo e variabilità.
La posizione predefinita deve essere deterministica. Isolare ogni comportamento degli agenti che può essere codificato di regola e spostarlo in Script agente. Le operazioni rimanenti che richiedono sintesi del linguaggio naturale, giudizio contestuale o interpretazione complessa appartengono a nodi che forniscono suggerimenti. Questa non è una limitazione; è il confine che funziona come previsto. LLM gestisce ciò per cui è più adatto e tutto il resto viene eseguito come codice.
L'unità di esecuzione principale nello script agente non è il turno dell'utente. È l'analisi: un singolo ciclo completo attraverso i tre blocchi del ciclo di vita di un subagente. Il Motore di ragionamento Atlas avvia un'analisi ogni volta che un subagente deve elaborare qualcosa, il che accade in tre situazioni: al primo ingresso nel subagente, dopo ogni chiamata allo strumento quando un'azione viene completata e restituisce un risultato e a ogni nuovo turno utente all'interno dello stesso subagente.
La comprensione del confine dell'analisi è importante perché determina quante volte viene eseguito ogni blocco e quindi dove si può e non si può fare affidamento sull'esecuzione di un determinato elemento di logica esattamente una volta.
Ogni subagente definisce tre zone di esecuzione:
| Blocca | Quando viene eseguito | Coinvolgimento LLM |
|---|---|---|
before_reasoning | All'inizio di ogni analisi, prima che l'LLM veda qualcosa | Nessuno |
reasoning | Durante la risoluzione deterministica, prima di qualsiasi chiamata LLM | Misto |
after_reasoning | Dopo che il ragionamento è stato completato e il LLM ha risposto | Nessuno (con un avvertimento critico) |
Sia before_reasoning che after_reasoning sono completamente deterministiche. Eseguono azioni, impostano variabili e applicano logica condizionale senza coinvolgere il componente LLM. Questo li rende i blocchi affidabili e a basso costo nello script.
Quando usare before_reasoning
before_reasoning viene eseguito all'inizio di ogni analisi senza eccezioni. Viene eseguita al primo ingresso nel subagente e di nuovo dopo ogni chiamata allo strumento o nuovo utente che si trasforma in quel subagente. Un run @actions.X in before_reasoning è il codice. A differenza di un'istruzione all'interno di un blocco prompt, che il componente LLM può seguire o meno, before_reasoning viene eseguito incondizionatamente.
Utilizzare questo blocco per l'inizializzazione della sessione: recupero dei record di contesto, impostazione delle variabili di sessione da Apex o Flusso. Questo è anche il luogo in cui devono essere eseguiti i controlli di autenticazione e diritti, perché si desidera che vengano verificati prima che il componente LLM veda qualsiasi strumento. L'idratazione del contesto si adatta anche a questo: chiamare un'azione di recupero dati in modo che l'LLM riceva variabili precompilate anziché doverle richiedere. Qualsiasi contatore o variabile di controllo che deve essere incrementata su ogni analisi deve essere impostata qui, perché la direttiva set in before_reasoning è garantita in modo diverso da un'istruzione pipe.
Ciò che non appartiene a questo campo è la logica che dovrebbe essere eseguita una sola volta per sessione, poiché before_reasoning viene eseguito su ogni analisi, non solo sulla prima voce. Anche tutto ciò che dipende dall'input dell'utente del turno corrente non appartiene a questo campo, perché quell'input non è ancora stato elaborato. E le transizioni non dovrebbero mai essere in before_reasoning: un'istruzione transition to qui viene attivata incondizionatamente su ogni analisi e crea dei loop.
Se è necessaria l'inizializzazione una volta per sessione, proteggerla esplicitamente:
Un turno utente può attivare più analisi: una volta all'immissione, poi di nuovo dopo ogni chiamata allo strumento. Questa funzionalità ha tre conseguenze pratiche: le azioni di inizializzazione in before_reasoning verranno eseguite più di una volta per utente nei flussi multi-azione, le variabili contatore incrementate qui rifletteranno il conteggio delle analisi, non il conteggio dei turni, e le azioni con effetti collaterali, chiamate API esterne o scritture di record non dovrebbero rimanere before_reasoning a meno che la riesecuzione su ogni analisi non sia esplicitamente accettabile.
before_reasoning non è un costruttore. E' un controllo pre-volo eseguito con ogni analisi. Progettarlo di conseguenza.
Quando usare after_reasoning
after_reasoning viene eseguito una volta terminato il loop di ragionamento, dopo che il componente LLM ha risposto e gli output delle azioni sono stati acquisiti. Questo è ciò a cui appartengono i controlli deterministici post-azione: valutare gli output delle azioni e la ramificazione in base ai risultati. Le transizioni deterministiche o il passaggio al sottoagente successivo in base allo stato variabile anziché al giudizio LLM, si trovano qui. Lo stesso vale per la pulitura delle variabili prima del turno successivo e la sequenza dell'orchestrazione quando è necessario concatenare i subagenti in un ordine prevedibile senza una decisione di instradamento LLM.
Considerare l'after_reasoning come lo strato guardrail. È il punto in cui si applicano le regole aziendali e la gestione statale dopo che il LLM ha svolto il proprio lavoro, assicurando che i flussi dei processi critici rimangano prevedibili indipendentemente da ciò che il LLM ha generato.
Usa saggiamente is_displayable: True
Ogni architetto che progetta flussi di orchestrazione deve comprendere questo comportamento della piattaforma. Quando is_displayable: True è impostato su un'azione, la piattaforma esce dal loop di ragionamento non appena il componente LLM decide di rendere visibile l'output. L'uscita avviene immediatamente, il che significa che after_reasoning non viene mai eseguito.
Questo è un comportamento noto della piattaforma, ma ha una conseguenza diretta sull'orchestrazione: qualsiasi logica impostata in after_reasoning verrà ignorata quando un'azione visualizzabile fa parte del flusso.
La risposta è semplice. Spostare la logica che deve essere eseguita in modo affidabile nel blocco di before_reasoning del subagente successivo anziché nel blocco di after_reasoning di quello corrente.
Guida alla progettazione: dove collocare la logica di inizializzazione
Decidere dove collocare la logica è consequenziale quando si progetta un subagente. Questo framework copre gli scenari più comuni:
| Scenari | Dove metterlo |
|---|---|
| Deve essere eseguito prima che il componente LLM visualizzi qualsiasi contesto | before_reasoning |
| Esegue ogni analisi, incluso il rientro nei turni dei nuovi utenti | before_reasoning |
| Dipende dall'output dell'azione da questo turno | Blocco di if condizionale in reasoning |
| Richiede la transizione deterministica del subagente in base al risultato | after_reasoning (ma vedere is_displayable sotto) |
Richiede logica di orchestrazione quando l'azione a valle utilizza is_displayable: True | before_reasoning del subagente successivo |
| Utilizza una logica che richiede giudizio o contesto utente | reasoning con istruzioni rapide |
Il principio di fondo è semplice. Quando si scrive un'istruzione prompt che dice all'LLM di "eseguire sempre" un'azione, questo è un suggerimento. LLM può seguirlo o meno a seconda del contesto. Quando si inserisce una direttiva run in before_reasoning, significa codice. Viene eseguito su ogni analisi senza eccezioni.
La disponibilità delle azioni condizionali è il meccanismo con cui lo script agente espone o nasconde le azioni dal componente LLM in base allo stato della variabile di runtime. Quando la condizione di available when restituisce false, l'azione viene rimossa completamente dall'elenco degli strumenti presentato a LLM. Qualsiasi valore falso, inclusi None, False, 0 o una stringa vuota, sopprime l'azione.
Questa non è un'istruzione pronta che dice all'LLM "non chiamarlo ancora", è un cancello a livello di piattaforma. LLM non può chiamare un'azione a cui non può accedere.
In questo esempio, execute_transfer è invisibile al componente LLM finché validation_passed non restituisce true. Il cancello viene imposto dalla piattaforma, non dalle istruzioni.
Guida alla progettazione: non lasciare mai che l'LLM imposti la variabile del cancello
Assegnare a ogni variabile di una clausola available when un percorso di codice deterministico che imposta la variabile prima che venga eseguita l'azione associata. Utilizzare before_reasoning o un blocco di run e set deterministico al reasoning di mantenere la variabile in uno stato noto. Se ci si affida a LLM per impostare la variabile gate, è stata reintrodotta la variabilità che il gate era stato progettato per impedire. A seconda della conversazione, il componente LLM può impostarlo o meno, il che significa che il cancello può aprirsi o meno.
Problema del loop di azione
Un loop di azione si verifica quando il componente LLM chiama ripetutamente la stessa azione senza mai raggiungere uno stato terminale. Si verifica quando due condizioni sono vere contemporaneamente: la condizione di available when rimane soddisfatta dopo l'esecuzione dell'azione e le istruzioni di ragionamento non indicano esplicitamente al componente LLM di smettere di chiamarla.
La piattaforma non sopprime automaticamente un'azione dopo che è stata chiamata. Se il cancello rimane aperto e le istruzioni di ragionamento sono ambigue, LLM chiama la stessa azione su ogni analisi all'infinito.
Considerare available when @variables.interest != "" come esempio. Se l'azione viene eseguita ma la variabile di interesse non è vuota, il cancelletto rimane aperto nell'analisi successiva. LLM vede l'azione come disponibile, non ha istruzioni che gli dicono di fermarsi e la richiama.
Esistono due metodi affidabili per interrompere il loop. Il primo consiste nell'impostare la variabile gate su uno stato chiuso come parte della logica post-esecuzione dell'azione, in modo che available when valuti false all'analisi successiva. La seconda è utilizzare un booleano has_run separato che chiude il cancello dopo la prima esecuzione. Entrambi gli approcci conferiscono al cancello uno stato deterministico chiuso, che è la condizione necessaria alla piattaforma per sopprimere l'azione.
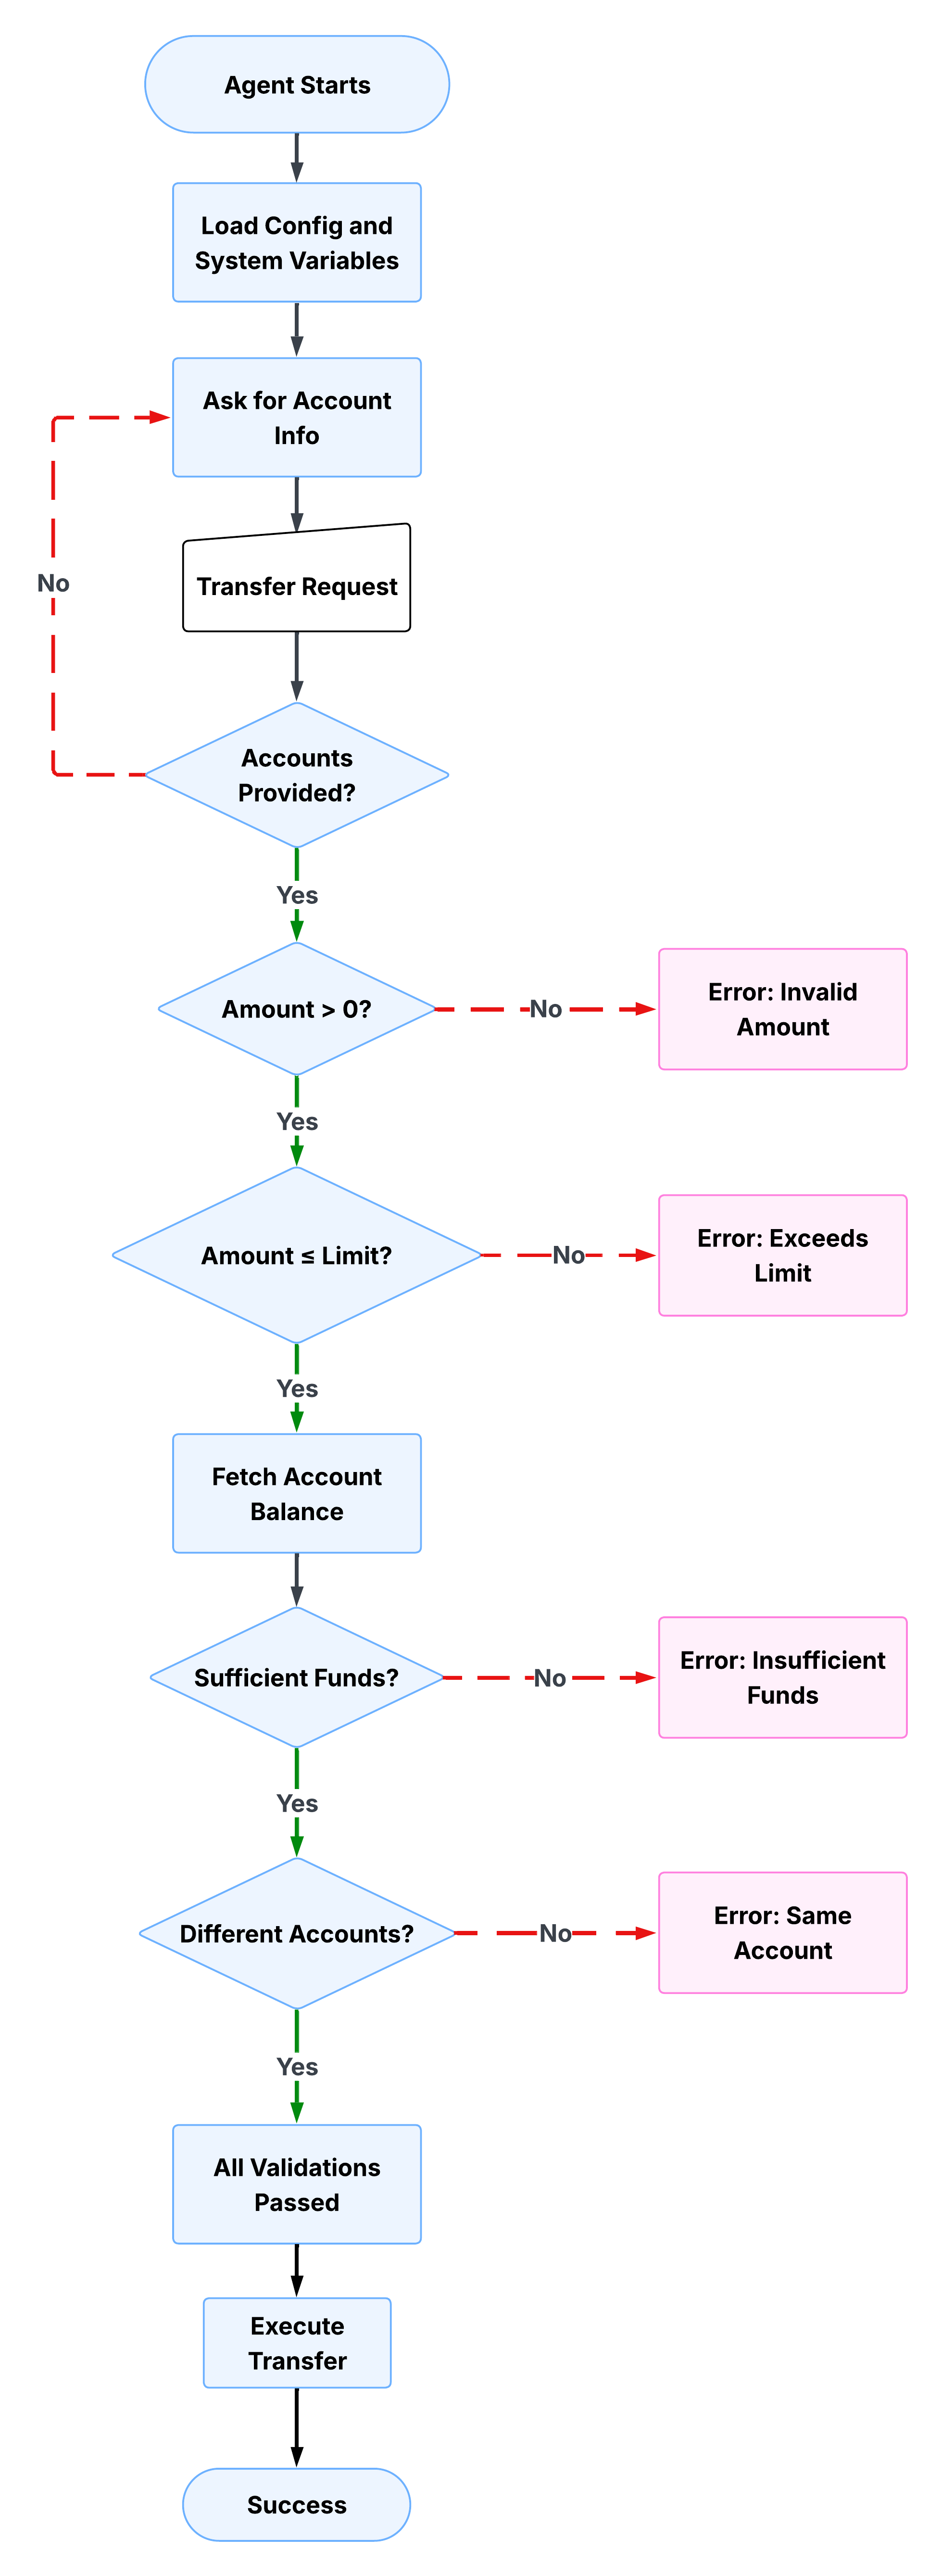
Un bonifico bancario è una lente utile per capire come funzionano questi schemi nella pratica. Il flusso di lavoro sembra semplice dall'esterno: spostare denaro da un account a un altro. L'implementazione richiede più passaggi complessi. Prima dell'esecuzione del trasferimento, l'agente deve raccogliere i dettagli dell'account, convalidare l'ammontare, controllare i limiti del trasferimento, confermare il saldo disponibile e solo in seguito esporre l'azione di trasferimento. Ogni fase dipende dalle fasi precedenti. Nessuno di loro dovrebbe essere lasciato al giudizio del LLM.
Raccogliere e convalidare gli input
Il primo subagente raccoglie l'account di origine, l'account di destinazione e l'ammontare del trasferimento dall'utente. Non procederà finché tutti e tre non saranno presenti e validi. Lo script agente controlla ogni campo in sequenza: se manca l'account di origine, chiede. Se la destinazione manca, viene chiesto. Se l'ammontare è zero o negativo, chiede. La variabile validation_passed viene impostata su true solo dopo che sono stati eliminati tutti i controlli.
Lo script riportato sotto lo mostra nella pratica. Si noti che la validation_passed è impostata esplicitamente su false in ogni punto di errore e che il componente LLM viene informato di non procedere. I controlli deterministici vengono eseguiti incondizionatamente, mentre le istruzioni del prompt gestiscono la risposta rivolta all'utente.
Applica regole aziendali
Dopo aver convalidato gli input, l'agente verifica se l'ammontare del trasferimento supera il limite di trasferimento configurato. Qui le regole aziendali diventano codice anziché istruzioni. Il limite non è qualcosa su cui ragiona LLM; è una soglia definita nello script e controllata deterministicamente su ogni analisi.
Se l'ammontare supera il limite, la validation_passed viene reimpostata su false e LLM offre all'utente tre opzioni: trasferire l'ammontare massimo consentito, suddividerlo in più trasferimenti o contattare l'assistenza per limiti più elevati. L'agente non può procedere finché l'utente non risolve l'eccezione. Si noti come l'istruzione prompt qui stia facendo esattamente quello per cui il ragionamento LLM è adatto: presentare le opzioni in conversazione e gestire la risposta dell'utente. La regola aziendale in sé è deterministica, ma la conversazione intorno ad essa non lo è.
Lo script riportato sotto mostra come funziona il controllo del limite. La condizione deterministica valuta l'ammontare del trasferimento rispetto alla variabile limite, imposta validation_passed su false se la soglia viene superata e delega a un'istruzione pronta per gestire la risposta rivolta all'utente.
Applicare clausole di protezione
Completati i controlli di ammontare e limite, l'agente recupera il saldo dell'account di origine e conferma che sono disponibili fondi sufficienti. Le clausole Guard impediscono all'agente di tentare operazioni quando non sono soddisfatte le precondizioni. A differenza di un'istruzione prompt che indica al componente LLM di controllare il saldo, una clausola guard nello script agente rende il controllo incondizionato. L'LLM non decide se eseguirlo.
Se il saldo è insufficiente, l'agente calcola la carenza e presenta all'utente un'alternativa concreta. Il validation_passed viene impostato su false finché non viene superato questo controllo, il che significa che l'azione di trasferimento rimane bloccata.
Lo script riportato sotto mostra una chiamata all'azione deterministica che recupera il saldo, seguita da un controllo condizionale che lo valuta. Il recupero viene eseguito solo se il saldo non è già stato recuperato, evitando chiamate API ridondanti nelle analisi successive.
Errori evidenti
Le clausole Guard impostano lo stato. Messaggi di errore lo comunicano. Quando validation_passed è false, l'agente deve fornire all'utente informazioni sufficienti per risolvere il problema senza riavviare. I messaggi di errore vaghi creano attrito; quelli strutturati chiudono il loop più velocemente.
Lo script riportato sotto mostra il messaggio di errore di fondi insufficienti nella pratica. Non indica solo che il trasferimento non è riuscito. Mostra il saldo disponibile, l'ammontare richiesto, la carenza calcolata e offre una fase successiva concreta, il tutto assemblato a partire da variabili di sessione anziché generato da LLM.
Il calcolo della carenza avviene nello script, non nel file LLM. L'alternativa suggerita, che trasferisce il saldo disponibile, è derivata deterministicamente dallo stato della sessione. Il ruolo del LLM qui è puramente di presentazione: consegna un messaggio che lo script ha già strutturato.
Porta l'azione di trasferimento
Ogni controllo di convalida nei passaggi precedenti imposta o cancella la stessa variabile: validation_passed. Quella variabile sta ora svolgendo il suo lavoro più importante. L'azione execute_transfer è disponibile in modo condizionale, ovvero appare nell'elenco degli strumenti di LLM solo quando validation_passed è true. Finché ogni controllo precedente non ha superato e impostato la variabile, l'azione non esiste dal punto di vista del componente LLM.
Questo è lo schema della sezione del cancello precedente applicato a un flusso di lavoro di produzione. L'azione di trasferimento non è nascosta da un'istruzione prompt. E' nascosto dalla piattaforma. Nessuna pressione conversazionale o frase ambigua può fare in modo che il componente LLM lo invochi prima che le precondizioni siano soddisfatte.
Lo script riportato sotto mostra come è configurato il cancello. La clausola available when fa riferimento direttamente a validation_passed e i parametri dell'azione sono legati alle variabili di sessione raccolte e convalidate nei passaggi precedenti.
Tutti e tre i parametri, from_account, to_account e amount, vengono passati in modo deterministico dalle variabili di sessione. Quando questa azione diventa disponibile, ogni valore è stato convalidato. LLM non sta assemblando i parametri dal contesto della conversazione; li sta leggendo dallo stato.
Stato di tracciamento in tutto il flusso di lavoro
Gli schemi delle sezioni precedenti funzionano solo perché lo stato della sessione persiste nell'intero flusso di lavoro. I numeri di account acquisiti nella prima fase sono disponibili nella quarta. Risultati della convalida impostati in un'azione check gate in un'altra. La conversazione può deviare, l'utente può porre domande di follow-up e l'agente saprà comunque esattamente a che punto del processo si trova.
Il blocco di variabili sotto mostra lo stato completo della sessione per questo flusso di lavoro. Ogni variabile ha un tipo definito, un valore predefinito e una descrizione. Due variabili gestiscono la maggior parte del lavoro di orchestrazione: validation_passed controlla la disponibilità delle azioni a ogni gate e validation_information fornisce un contesto in formato leggibile sul motivo per cui un controllo non è riuscito, che l'LLM può rendere visibile all'utente senza dover ragionare sullo stato sottostante.
Ogni variabile inizia in uno stato predefinito noto. Per impostazione predefinita, le stringhe sono vuote, i numeri zero e il validation_passed booleano false. Ciò significa che il cancello è chiuso per impostazione predefinita. Il flusso di lavoro deve guadagnare attivamente il diritto di procedere a ogni fase, anziché iniziare con il cancello aperto e affidarsi ai controlli per chiuderlo.
L'esempio di bonifico bancario illustra dove la logica deterministica è lo strumento giusto, ma non è sempre la scelta migliore. Comprendere il confine è importante tanto quanto comprendere gli schemi.
La logica deterministica è la scelta giusta quando il flusso di lavoro richiede una sequenza di esecuzione garantita, quando gli errori hanno conseguenze significative, quando il processo deve produrre un itinerario di controllo riproducibile o quando le regole aziendali sono abbastanza definite da essere espresse come condizioni e soglie. I flussi di lavoro finanziari, sanitari e assicurativi rientrano generalmente in questa categoria.
Il ragionamento LLM puro senza vincoli deterministici rigorosi ha più senso quando il valore dell'interazione risiede nella flessibilità piuttosto che nella precisione. L'assistenza clienti aperta, i prodotti nelle fasi iniziali in cui i processi aziendali sono ancora in evoluzione e le query informative a basso rischio sono tutti casi in cui la variabilità del ragionamento LLM è una caratteristica, non un problema.
In pratica, la maggior parte degli agenti di produzione necessita di entrambi. La decisione di dove cade il confine non è una scelta binaria tra deterministica e probabilistica; è una decisione di progettazione che si prende a livello di nodo per ogni parte del flusso di lavoro dell'agente.
| Utilizzare la logica deterministica per | Utilizzare il ragionamento LLM per |
|---|---|
| Convalida e sanificazione degli input | Comprensione del linguaggio naturale e rilevamento degli intenti |
| Applicazione delle regole aziendali | Generazione di risposte conversazionali ed empatiche |
| Orchestrazione di processi sequenziali | Gestione di input ambigui o imprevisti |
| Gestione dello stato e conservazione del contesto | Fornire spiegazioni e chiarimenti |
| Clausole di protezione che impediscono operazioni non valide | Adattamento del tono e della messaggistica al contesto dell'utente |
Il confine è la decisione di progettazione
L'esempio di bonifico bancario illustra una filosofia di progettazione: il confine tra esecuzione deterministica e ragionamento LLM è la decisione architettonica più consequenziale che si prende quando si crea un agente di produzione.
Posizionare un confine troppo rigido e si otterrà un agente rigido, costoso da mantenere e incapace di gestire la variazione naturale delle conversazioni reali. Sbagliando il confine nell'altra direzione, si crea un agente flessibile ma imprevedibile, che funziona bene nei test ma si comporta in modo diverso in produzione e non può generare un itinerario di controllo affidabile o essere affidabile per una transazione con rischi elevati.
Il nuovo modello Agentforce offre gli strumenti per posizionare deliberatamente quel confine. Lo script agente consente di esprimere la logica deterministica e le istruzioni del prompt nello stesso file, con una sintassi esplicita per rendere visibile il confine. Il Motore di ragionamento Atlas applica la logica e i prompt in fase di esecuzione. I blocchi before_reasoning e after_reasoning offrono zone di esecuzione garantite su entrambi i lati della chiamata LLM. La disponibilità delle azioni condizionali assicura che il componente LLM possa agire solo quando sono soddisfatte le precondizioni.
Nessuna di queste funzioni è isolata. Lavorano insieme per creare un'architettura coerente per gli agenti immobiliari di cui le aziende possono Trust con flussi di lavoro mission-critical. Il modello di ragionamento ibrido riconosce che determinismo e flessibilità hanno entrambi un ruolo nell'architettura; è compito dell'architetto decidere esattamente dove applicare ciascuno di essi.
Grafico agente di Agentforce: Verso il determinismo guidato con il ragionamento ibrido
Gulal Kumar è un architetto di ingegneria del software di Salesforce con oltre 20 anni di esperienza. La sua esperienza si estende all'intelligenza artificiale, all'integrazione, alle API e all'architettura aziendale, con particolare attenzione alla guida della trasformazione aziendale attraverso soluzioni di intelligenza artificiale sicure, resilienti e innovative. Contattarlo su LinkedIn.
Miriam McCabe è Senior Director e leader del team di Architect Evangelism. Il suo lavoro si concentra sull'abilitazione della comunità di architetti Salesforce globale a guidare l'era degli agenti attraverso contenuti profondamente tecnici, programmazione live e coinvolgimento della comunità. Seguila su LinkedIn.