Le architetture di dati aziendali raramente vivono in un unico sistema. Salesforce gestisce il coinvolgimento dei clienti, le opportunità in corso di realizzazione e le interazioni di assistenza. Piattaforme di analisi come Snowflake contengono transazioni storiche, record finanziari, dati di utilizzo e metriche operative. Tradizionalmente, collegare questi due mondi significava creare e gestire le pipeline ETL: processi pianificati che estraggono i dati dalla fonte, li trasformano e caricano le copie in Salesforce. Come risultato di queste opportunità in corso di realizzazione, i dati arrivano in ritardo, le policy di governance si moltiplicano tra i sistemi e le opportunità in corso di realizzazione richiedono un'assistenza operativa continua.
Salesforce Data Virtualization offre un modello diverso. Anziché spostare i dati in Salesforce, consente a Salesforce di eseguire query sui dati direttamente alla fonte, in fase di esecuzione, senza replica. Gli utenti visualizzano i dati esterni live tramite le interfacce Salesforce standard. I dati non lasciano mai la loro casa autorevole. Questo documento spiega come funziona lo schema, quando utilizzarlo e come iniziare, utilizzando Snowflake come esempio concreto.
Salesforce Data Virtualization è uno schema dell'architettura di integrazione che consente a Salesforce di eseguire query sui dati direttamente da sistemi esterni in fase di esecuzione, senza copiare o replicare tali dati nell'archiviazione Salesforce. Anziché spostare i dati, la piattaforma invia la query.
Di conseguenza, gli utenti Salesforce interagiscono con i dati esterni tramite interfacce Salesforce familiari (ad esempio layout di pagina, elenchi correlati, rapporti o flussi) mentre i dati rimangono nel sistema di origine autorevole. La governance, il controllo degli accessi e la residenza dei dati rimangono al loro posto.
Questo schema si basa su un unico principio architettonico: i dati rimangono alla fonte. Il calcolo passa ai dati.
La maggior parte delle distribuzioni Salesforce aziendali si integra con piattaforme dati esterne (ad esempio data warehouse, database operativi o archivi analitici) tramite opportunità di replica in corso di realizzazione. Le opportunità in corso di realizzazione estraggono, trasformano e caricano i dati in Salesforce secondo una pianificazione. Questo approccio funziona, ma la replica introduce compromessi strutturali:
- I dati replicati vengono sempre ritardati. Le opportunità in corso di realizzazione introducono dati obsoleti e ritardati che determinano decisioni inadeguate.
- Ogni copia dei dati espande l'ambito di conformità. I dati sensibili (come informazioni personali, record finanziari o dati sanitari) in più sistemi richiedono la gestione di più policy di governance.
- Le opportunità in corso di realizzazione richiedono investimenti operativi continui, monitoraggio, gestione dei guasti, gestione della fluttuazione dello schema e logica di rielaborazione.
Data Virtualization risolve direttamente questi compromessi. Elimina completamente le opportunità in corso di realizzazione per i casi d'uso di grande rilevanza, mantiene i dati nella loro posizione autorevole e offre agli utenti Salesforce una visualizzazione in tempo reale dei dati esterni senza sovraccarico di replica.
 |
Salesforce Connect è la funzionalità della piattaforma che consente la virtualizzazione dei dati in Salesforce. Fornisce il framework adattatore che traduce le query SOQL nel linguaggio di query di un sistema esterno, gestisce le chiamate autenticate e mappa gli insiemi di risultati ai tipi di campi Salesforce. Supporta gli oggetti esterni, il costrutto di metadati Salesforce che mette in evidenza i dati esterni come entità interrogabili native della piattaforma senza replicare i dati nell'archiviazione Salesforce. Gli oggetti esterni si comportano come oggetti Salesforce standard, visibili nei layout di pagina, negli elenchi correlati e nei rapporti e accessibili tramite SOQL e le API standard, ma non contengono dati. Gli oggetti esterni sono una proiezione dello schema sul sistema di origine. |
Gli oggetti esterni sono il meccanismo principale attraverso il quale Data Virtualization mette in evidenza i dati esterni all'interno di Salesforce. Si comportano come oggetti Salesforce standard: interrogabili tramite SOQL, visibili nei layout di pagina e negli elenchi correlati e accessibili tramite le API Salesforce standard. La differenza principale è che non vengono memorizzati dati in Salesforce. L'oggetto esterno è una proiezione schematica: una definizione dell'aspetto dei dati esterni, non una copia dei dati stessi.
Quando un utente carica una pagina o esegue un rapporto che fa riferimento a un oggetto esterno, Salesforce esegue una query live sul sistema esterno e restituisce solo l'insieme di risultati per quell'interazione.
Quando esegue una query SOQL su un oggetto esterno, Salesforce traduce i filtri (clausole WHERE), ordina gli ordini (ORDER BY) e limita (LIMIT) nell'SQL equivalente e li invia al sistema esterno. Il sistema esterno esegue la query sul proprio motore di calcolo e restituisce solo l'insieme di risultati filtrato. Il lavoro viene eseguito dove vivono i dati e solo la risposta torna a Salesforce.
Virtualizzazione dei dati impone due livelli di sicurezza indipendenti contemporaneamente. Il sistema esterno applica i propri controlli di accesso in fase di esecuzione della query, tra cui la protezione a livello di riga, il mascheramento delle colonne e l'accesso basato sui ruoli. Salesforce applica il proprio modello di sicurezza: profili, insiemi di autorizzazioni, protezione a livello di campo e regole di condivisione. Entrambi i livelli sono attivi in ogni query. Nessuno dei due sostituisce l'altro.
Gli architetti descrivono spesso Data Virtualization come uno schema "copia zero". Copia zero significa nessuna replica persistente nell'archiviazione Salesforce. Non è presente alcuna pipeline ETL che scrive record negli oggetti Salesforce. Non viene eseguita alcuna sincronizzazione pianificata per la creazione di una copia locale. L'oggetto esterno non contiene righe.
Copia zero non significa trasmissione di dati zero. Ogni volta che un utente esegue una query su un oggetto esterno, un insieme di risultati passa dal sistema esterno a Salesforce tramite la rete. Per insiemi di risultati di grandi dimensioni o alta frequenza di query, i costi di uscita dei dati e la latenza di rete sono fattori reali per cui gli architetti devono progettare. Questa non è una limitazione da nascondere: è un vincolo di progettazione di cui tenere conto.
Tenere presenti queste differenze architettoniche se il caso d'uso richiede volumi elevati, accesso frequente o bassa latenza.
Snowflake è uno dei sistemi esterni più comuni connessi a Salesforce tramite Data Virtualization. Serve come esempio concreto di come funziona lo schema da un capo all'altro.
In questa configurazione, Salesforce si connette a Snowflake utilizzando Salesforce Connect con l'adattatore SQL per Snowflake. Le tabelle e le visualizzazioni Snowflake vengono visualizzate come Oggetti esterni in Salesforce. Quando un utente esegue una query su un oggetto esterno, Salesforce traduce l'SOQL in SQL e lo invia all'API Snowflake Statements tramite una chiamata HTTPS autenticata. Snowflake esegue la query nel magazzino virtuale, applica la propria protezione a livello di riga e il mascheramento delle colonne e restituisce solo l'insieme di risultati. Non vengono scritti dati nell'archiviazione Salesforce in alcun punto.
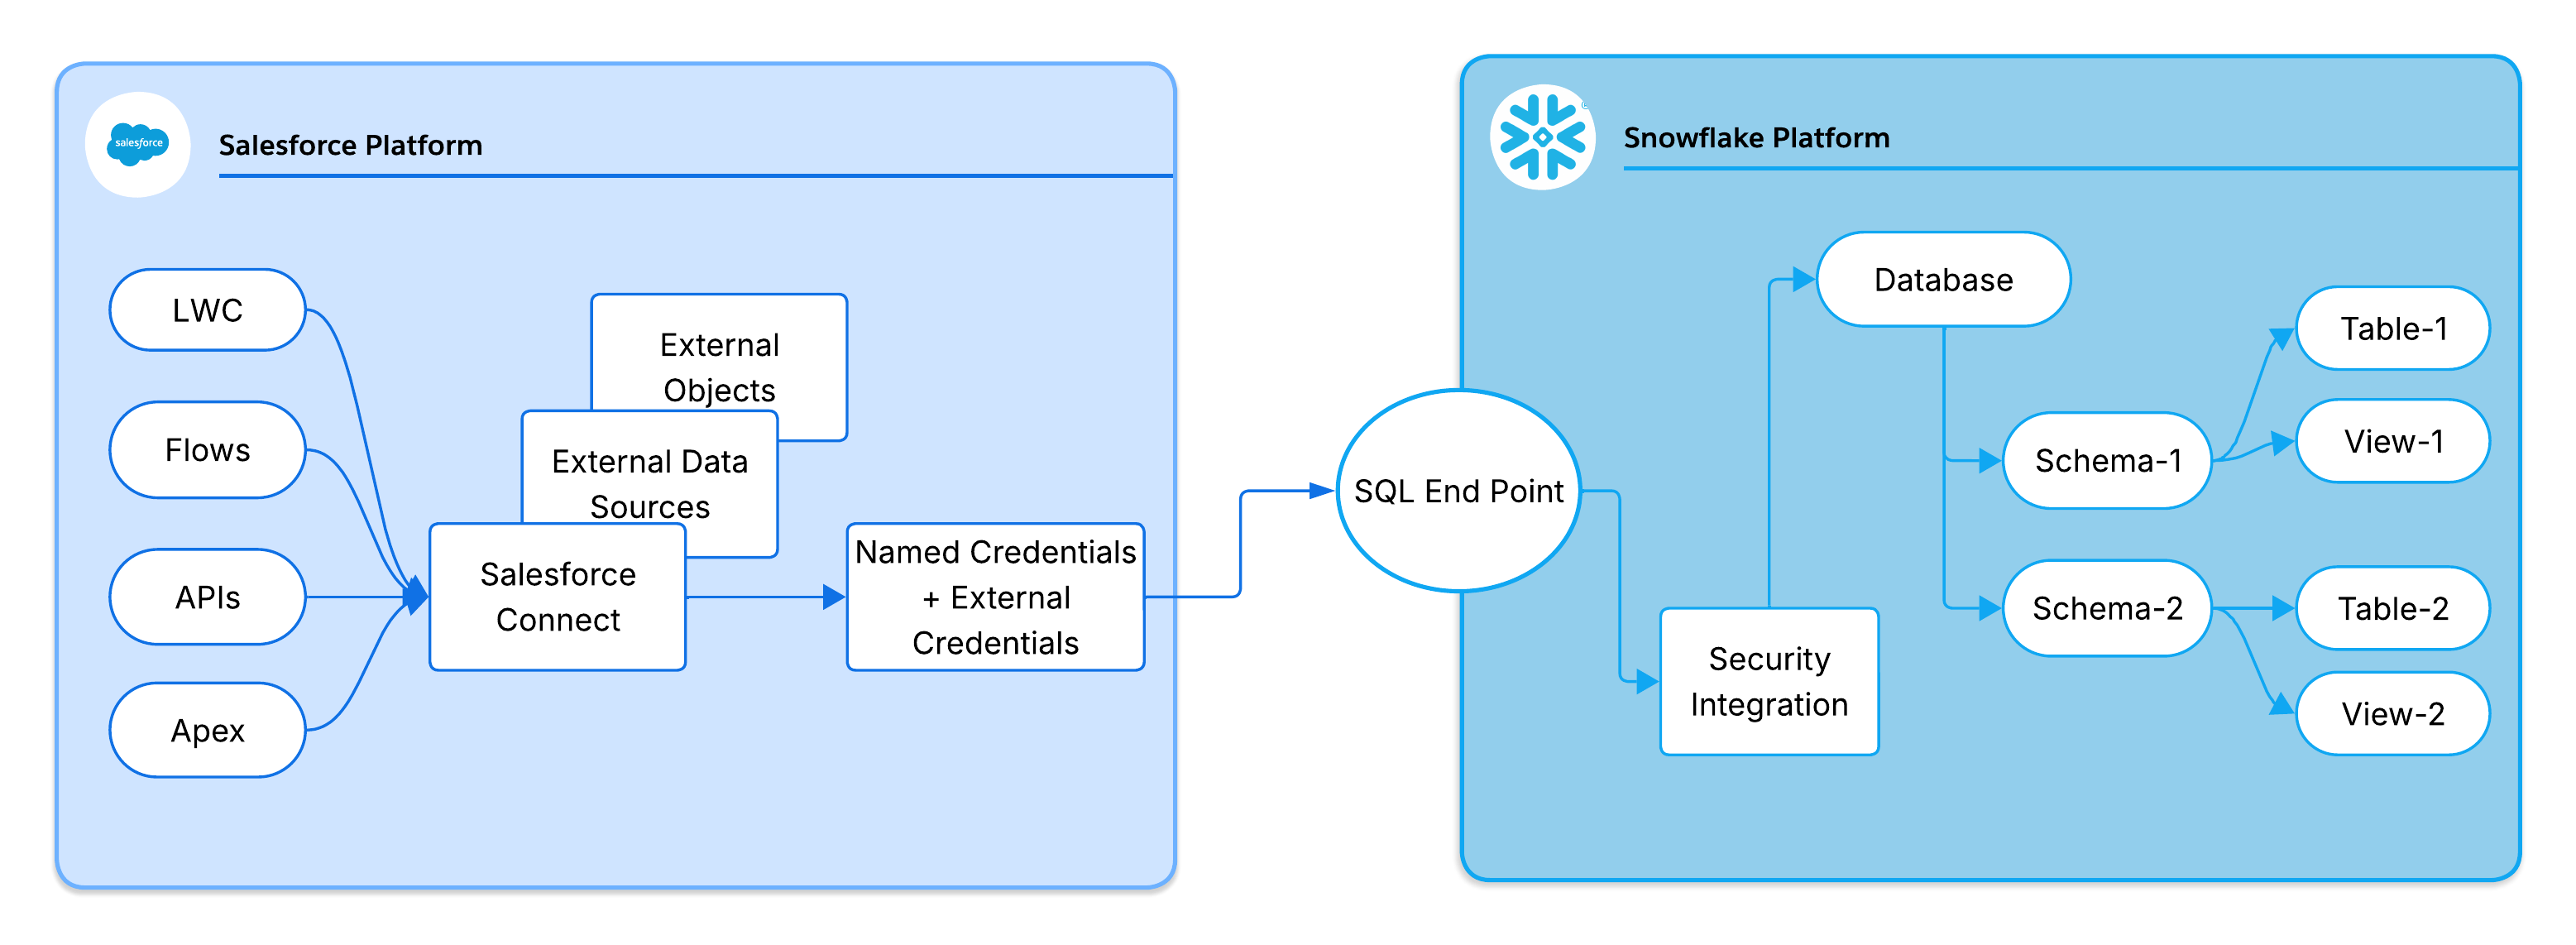
Salesforce Connect utilizza un modello OAuth 2.0 delegato per eseguire l'autenticazione con Snowflake. I componenti chiave sono:
- Provider di autenticazione: Gestisce la stretta di mano OAuth con Snowflake. Gestisce le richieste di token e mappa il token restituito alla credenziale Salesforce.
- Credenziale esterna: Mantiene i token di accesso e aggiornamento OAuth in modo sicuro nell'archivio delle credenziali crittografate Salesforce e li inietta nelle chiamate in uscita.
- Credenziale denominata: Definisce l'URL endpoint Snowflake e fa riferimento alla credenziale esterna.
- Integrazione di sicurezza Snowflake: Registra Salesforce come client OAuth affidabile in Snowflake. Definisce l'URI di reindirizzamento consentito, i flussi OAuth e il TTL del token.
Questi componenti formano una catena di dipendenze: Fonte di dati esterna fa riferimento alla credenziale denominata, che fa riferimento alla credenziale esterna, che fa riferimento al provider di autenticazione. La comprensione di questa catena è essenziale quando si risolvono i problemi di connettività o gli errori di accesso.
Salesforce supporta due modelli di delega dell'identità durante l'autenticazione con Snowflake:
- Principale denominato: Un account di servizio condiviso autentica tutti gli utenti Salesforce in Snowflake. È più semplice da configurare, ma non dispone di possibilità di controllo dell'accesso per utente o Snowflake a grana fine.
- Principale per utente: Ogni utente Salesforce esegue l'autenticazione con il proprio token OAuth. Ciò consente la protezione a livello di riga di Snowflake e gli itinerari di controllo completi per utente, con un compromesso di un overhead di gestione dei token più elevato (flussi OAuth per utente, aggiornamento, revoca).
Guida alle decisioni: Utilizzare Entità per utente per i dati regolamentati o le informazioni personali (PII). Utilizzare Entità denominata quando le regole di condivisione Salesforce offrono un controllo sufficiente dell'accesso e la semplicità è la priorità.
Questi limiti del governor Salesforce definiscono direttamente la progettazione delle soluzioni quando si utilizzano gli oggetti esterni con Snowflake:
- Limite di chiamata: 100 per transazione Apex. Le pagine o i flussi con più query Oggetto esterno possono raggiungere rapidamente questo limite.
- Timeout chiamata: 120 secondi al massimo. Le query Snowflake di lunga durata causano un'eccezione in fase di esecuzione.
- Limite di righe SOQL: 50.000 righe. Paginare insiemi di risultati di grandi dimensioni.
- Vincoli asincroni: Apex batch e la maggior parte dei contesti asincroni limitano le chiamate. Mantenere l'accesso agli oggetti esterni entro i confini delle transazioni sincrone. Per i casi d'uso asincroni che eseguono query sugli oggetti esterni, considerare le chiamate di continuazione per le interazioni asincrone avviate dall'utente o progettare il flusso in modo che esegua l'accesso ai dati esterni in una transazione sincrona e trasmetta i risultati in modo asincrono.
Guida alla progettazione: Non eseguire query sugli oggetti esterni all'interno dei loop. Inviare tramite push i filtri della clausola WHERE a Snowflake per ridurre le dimensioni dei risultati e la frequenza di chiamata.
Ogni query inviata da Salesforce a Snowflake viene registrata nella Cronologia query Snowflake con metadati di esecuzione completi: latenza, righe analizzate, magazzino utilizzato e identità in esecuzione. Questa cronologia offre un controllo completo dall'azione dell'utente Salesforce all'esecuzione di Snowflake ed è lo strumento diagnostico principale per la messa a punto delle prestazioni e la convalida dell'accesso.
La virtualizzazione dei dati è adatta per i casi in cui l'accesso in tempo reale, la governance e il sovraccarico di replica ridotto superano i vincoli di un modello di accesso federato in tempo di query.
Utilizzarlo quando:
- L'accesso analitico in lettura è il requisito principale. Se gli utenti devono eseguire query e visualizzare dati esterni nelle interfaccia utente, nei rapporti o nei flussi Salesforce senza scrivere, Virtualizzazione dei dati elimina il sovraccarico delle opportunità in corso di realizzazione per gli scenari di sola lettura.
- La freschezza dei dati è fondamentale. Quando i dati replicati obsoleti creano un rischio aziendale (ad esempio saldi finanziari scaduti, livelli di inventario o stato di conformità), il modello federato garantisce che ogni query rifletta i dati live.
- I requisiti di governance e di residenza dei dati sono rigorosi. Quando vincoli normativi o contrattuali vietano la copia di dati sensibili in Salesforce, la virtualizzazione mantiene i dati nella posizione autorevole rendendoli accessibili all'interno di Salesforce. Solo un sistema contiene i dati.
- È richiesto il controllo dell'accesso a due livelli. Quando si applicano contemporaneamente sia i controlli di accesso nativi del sistema esterno che il modello di sicurezza Salesforce, il modello federato li applica entrambi senza duplicazione dei dati.
- Il sistema esterno è già il sistema autorevole di registrazione. Se i dati sono già puliti, gestiti e interrogabili nel sistema di origine, la loro virtualizzazione evita trasformazioni ridondanti, costi di archiviazione e rischi di divergenza.
Evitarlo quando:
- Le scritture a bassa latenza sono obbligatorie. Gli oggetti esterni sono di sola lettura. I casi d'uso di write-back richiedono uno schema di integrazione diverso.
- Sono necessari join multi-oggetto complessi. SOQL in più oggetti esterni non supporta i join. Pre-materializzare i dati uniti come visualizzazione singola nel sistema di origine.
- Le funzioni di Salesforce AI o Agentforce richiedono dati nativi. Attualmente, le funzioni Einstein e Agentforce (tra cui il radicamento nel contesto di Einstein Copilot, il calcolo del punteggio predittivo e le azioni Agentforce) funzionano su oggetti Salesforce nativi. Queste funzioni non supportano gli oggetti esterni come fonte di dati di radicamento o attivazione. Se l'attivazione AI è nell'ambito di questi dati, Salesforce Data 360 è la soluzione complementare consigliata.
- Modelli di accesso ad alta frequenza e a volume elevato. Gli oggetti esterni sono progettati per l'accesso on-demand. I carichi di lavoro che attivano centinaia di query al minuto limitano il governor dei gas di scarico e peggiorano le prestazioni.
I seguenti casi d'uso illustrano come si applica Salesforce Data Virtualization negli scenari aziendali più comuni. Ogni esempio utilizza Snowflake come sistema esterno, ma lo schema sottostante si applica a qualsiasi fonte di dati compatibile con SQL supportata da Salesforce Connect.
Sfida: I team di assistenza necessitavano di rapporti unificati che combinassero i dati dei casi Salesforce con il volume dei ticket, il tempo di risoluzione e le metriche di inoltro al livello superiore archiviate in Snowflake. La creazione e la gestione di una pipeline di replica per questi dati ha introdotto un ritardo e un sovraccarico operativo aggiuntivo per un caso d'uso di sola lettura per la generazione di rapporti.
Soluzione: Il team ha esposto le visualizzazioni Snowflake contenenti le metriche dei ticket come oggetti esterni in Salesforce. Il team ha configurato i rapporti Salesforce per unire gli oggetti Caso nativi ai dati dei ticket esterni.
Risultato:
- I rapporti riflettono sempre i dati Snowflake live. Nessun ritardo della pipeline.
- La governance delle metriche di assistenza sensibili rimane in Snowflake.
- Nessuna pipeline ETL da creare, monitorare o gestire.
Sfida: Un team finanziario ha gestito dati autorevoli sui limiti di credito e sul saldo in Snowflake. La replica di questi valori in Salesforce tramite ETL inverso ha introdotto un ritardo di replica che ha indotto gli agenti di vendita a impegnarsi in trattative basate su informazioni creditizie obsolete. Il team di conformità ha inoltre segnalato il rischio di conservare dati finanziari sensibili nell'archivio Salesforce.
Soluzione: Il team ha virtualizzato la visualizzazione finanziaria Snowflake come oggetto esterno e l'ha presentata nel layout di pagina Account. Gli agenti di vendita ora visualizzano lo stato del credito live come parte della visualizzazione Account standard in Salesforce.
Risultato:
- Dati di credito in tempo reale in ogni pagina Account. Nessun ritardo.
- Inversione della pipeline ETL eliminata per i dati finanziari.
- Dati finanziari sensibili mai copiati nell'archiviazione Salesforce. L'ambito di conformità rimane in Snowflake.
Sfida: Durante una fusione, la società acquirente doveva fornire agli utenti Salesforce la visibilità dei dati operativi di 6 serie di dati Snowflake a volume elevato che coprivano transazioni, fatturazione e utilizzo. La replica di terabyte di dati in Salesforce non era praticabile nella tempistica di fusione e la creazione di pipeline ETL personalizzate per ogni serie di dati avrebbe richiesto investimenti ingegneristici significativi.
Soluzione: Il team ha configurato gli oggetti esterni per tutte e 6 le serie di dati Snowflake utilizzando Salesforce Connect con un ruolo di integrazione con i privilegi minimi. Non è richiesto alcun codice personalizzato. Le query vengono eseguite direttamente in Snowflake e tutte le attività vengono registrate nella cronologia delle query Snowflake per la generazione di rapporti sulla conformità.
Risultato:
- Configurazione completamente dichiarativa. Nessun codice personalizzato o pipeline richiesto.
- Aggiornamento dei dati garantito. Ogni query riflette i dati Snowflake live al momento dell'esecuzione.
- Itinerario di controllo completo nella cronologia delle query Snowflake per i rapporti normativi e di conformità.
Data Virtualization introduce un profilo operativo distinto. Progettare per questi scenari di errore:
- Scadenza token OAuth: I token hanno un tempo di vita finito (TTL). I token scaduti causano errori di callout. Monitorare le risposte non autorizzate 401 e implementare la logica di aggiornamento.
- Avviamento a freddo magazzino (specifico per Fiocco di neve): I magazzini sospesi automaticamente aggiungono 5-30 secondi alla prima query. Per i casi d'uso rivolti agli utenti con requisiti di latenza, preriscaldare con una query leggera pianificata durante l'orario di ufficio.
- Mancata corrispondenza dei ruoli: Un ruolo non configurato correttamente nel sistema esterno può restituire zero righe in modo silenzioso anziché un errore. Convalidare i privilegi da ruolo a oggetto nel sistema esterno indipendentemente da Salesforce.
- Overflow dell'insieme di risultati: I payload di grandi dimensioni superano i limiti API. Applicare sempre le clausole LIMIT ed esporre le visualizzazioni filtrate anziché le tabelle non elaborate.
- Arresto del sistema esterno: Non esiste fallback o cache. Avvolgere le chiamate negli stati di errore try/catch e di informativa nell'interfaccia utente. Per i dati mission-critical, considerare un approccio a livelli: virtualizzare per l'accesso in tempo reale e gestire un fallback replicato leggero per i campi più critici per garantire la disponibilità durante le interruzioni del sistema di origine.
Salesforce Data Virtualization è conforme ai seguenti pilastri del framework Salesforce Well-Architected.
- Trust: Il modello OAuth 2.0 delegato e la guida sui ruoli con privilegi minimi sono in linea con Trust. Il controllo dell'accesso a due livelli (sistema di origine + Salesforce) impone una difesa approfondita.
- Affidabilità (tolleranza ai guasti): La sezione delle modalità di errore affronta direttamente l'affidabilità: scadenza del token, avvio a freddo, configurazione errata del ruolo, overflow dell'insieme di risultati e gestione dei guasti rappresentano ciascuna una classe di errore distinta con un percorso di risoluzione documentato.
- Affidabilità (scalabilità): Il pushdown delle query, la guida al dimensionamento del magazzino e la consapevolezza del limite di chiamate ottimizzano l'efficienza di esecuzione entro i vincoli del governor Salesforce, un problema di affidabilità per le soluzioni che operano su larga scala.
- Eccellenza operativa: Snowflake Query History come strumento principale di osservabilità supporta l'eccellenza operativa: gli architetti fanno una scelta deliberata e tracciabile di utilizzare strumenti nativi della piattaforma per la verificabilità end-to-end e la diagnostica delle prestazioni anziché creare un'infrastruttura di registrazione personalizzata.
Questa sezione offre ad architetti e designer un punto di partenza strutturato per la creazione dello schema di virtualizzazione dei dati in un ambiente Sandbox. Non si tratta di una guida completa all'implementazione: trattarla come una sequenza convalidata di decisioni e fasi di configurazione per orientare la prima prova di concetto.
Confermare quanto segue prima di iniziare qualsiasi lavoro di configurazione:
- Diritto di licenza: Salesforce Connect non è incluso in tutte le versioni di Salesforce. L'adattatore SQL per Snowflake richiede una licenza aggiuntiva separata oltre ai diritti Salesforce Connect di base. Verificare entrambi nell'organizzazione prima di procedere.
- Prima Sandbox: Completare tutte le fasi in un ambiente Sandbox prima di promuovere la configurazione in produzione.
- Accesso Snowflake: Verificare di essere autorizzati a creare un'integrazione di protezione in Snowflake e ad accedere al database di destinazione, allo schema e agli oggetti.
- Versione adattatore: Verificare che l'adattatore SQL per Snowflake sia disponibile nella versione dell'organizzazione e che l'URL dell'account Snowflake non contenga caratteri di sottolineatura (sostituire con trattini in caso affermativo. Questo è un vincolo di Salesforce Platform per la risoluzione dei nomi host delle chiamate).
L'impostazione della virtualizzazione dei dati con un sistema SQL esterno come Snowflake è un processo dichiarativo e basato sulla configurazione, non richiede codice personalizzato. L'impostazione segue tre fasi sequenziali: definizione di identità e Trust, configurazione della superficie dei dati ed esposizione dei dati agli utenti finali.
Questa fase stabilisce una catena Trust OAuth 2.0 delegata sicura tra Salesforce e il sistema esterno. Completare questa fase prima di iniziare qualsiasi configurazione della superficie dati.
- Creazione di un provider di autenticazione in Salesforce. Utilizzare il tipo OpenID Connect. Utilizzare i valori segnaposto in questa fase: tornare per completarli dopo aver recuperato i valori dal sistema esterno. Dopo il salvataggio, Salesforce genera un URL di richiamata. Mantenere questo valore.
- Registrare Salesforce come client OAuth nel sistema esterno. In Snowflake, questo significa creare un'integrazione di protezione (OAuth, tipo client riservato). Specificare l'URL di richiamata Salesforce come URI di reindirizzamento. Recuperare l'ID client, il segreto client, l'URL di autorizzazione e l'URL token dall'integrazione dopo la creazione.
- Completare la configurazione del provider di autenticazione. Tornare al provider di autenticazione Salesforce e compilarlo con i valori recuperati dal sistema esterno: Chiave consumatore, segreto consumatore, URL di autorizzazione e URL token.
- Creare la credenziale esterna. Impostare il protocollo su OAuth 2.0, collegarlo al provider di autenticazione e aggiungere un'entità (denominata o per utente, in base alla decisione del modello di identità). Questo oggetto gestisce il ciclo di vita del token OAuth.
- Creare la credenziale denominata. Impostare l'endpoint sull'URL API del sistema esterno (ad esempio,
https://<account>.snowflakecomputing.com/api/v2/statements/) e collegarlo alla credenziale esterna. - Concedere al profilo l'accesso alla credenziale esterna. Senza questo passaggio, gli utenti non possono invocare le query federate anche se tutte le altre configurazioni sono corrette.
- Avviare il flusso OAuth per completare l'autenticazione. Attivare la stretta di mano OAuth da Salesforce. La piattaforma reindirizza all'accesso al sistema esterno, convalida le credenziali e archivia i token risultanti in modo sicuro nella credenziale esterna. Questo passaggio collega il contesto utente a un token valido. Tutte le query federate hanno esito negativo fino al completamento di questo passaggio.
Questa fase connette Salesforce allo schema dei dati esterni e crea le definizioni oggetto esterno che gli utenti e la piattaforma eseguono.
- Creare la fonte di dati esterna. Selezionare l'adattatore appropriato (ad esempio, l'adattatore SQL per Snowflake), puntarlo al database e allo schema di destinazione e collegarlo alla credenziale denominata creata nella fase 1.
- Convalidare la connessione. Utilizzare la convalida incorporata nella fonte di dati esterna. Un risultato positivo conferma che la catena Trust OAuth è stata completata e che il sistema esterno è raggiungibile.
- Sincronizzare i metadati. Avviare una sincronizzazione dei metadati dalla fonte di dati esterna. Salesforce analizza lo schema di destinazione e genera definizioni di oggetti esterni, mappando le colonne esterne ai tipi di campo Salesforce.
- Selezionare ed esporre le tabelle o le visualizzazioni richieste. Scegliere le tabelle o le visualizzazioni esterne da visualizzare come Oggetti esterni. È consigliabile esporre le visualizzazioni curate anziché le tabelle non elaborate. Le visualizzazioni consentono il pre-filtraggio delle colonne, restrizioni a livello di riga e un controllo più rigoroso su ciò a cui può accedere il livello Salesforce.
Questa fase rende gli oggetti esterni visibili e utilizzabili dagli utenti finali all'interno di Salesforce Lightning Experience.
- Creare schede per gli oggetti esterni. Le schede rendono gli oggetti esterni direttamente navigabili all'interno delle app Lightning.
- Aggiungere Oggetti esterni ai layout di pagina. Far emergere i dati esterni pertinenti insieme ai record Salesforce nativi (ad esempio, aggiungere una visualizzazione finanziaria Snowflake al layout di pagina Account).
- Aggiungere agli elenchi correlati. Includere gli oggetti esterni negli elenchi correlati per offrire agli utenti una visualizzazione unificata dei dati nativi ed esterni nel contesto.
- Convalidare la federazione delle query end-to-end. Caricare una pagina o eseguire una query che fa riferimento a un oggetto esterno. Esaminare quindi la cronologia delle query del sistema esterno (ad esempio, Cronologia query Snowflake) per verificare che la query sia stata eseguita all'origine. Verificare che il ruolo, il magazzino e l'identità corretti abbiano eseguito la query.
Al termine di tutte e tre le fasi, gli utenti Salesforce possono interagire con i dati esterni live tramite le interfacce Salesforce standard, senza essere consapevoli che i dati provengono dall'esterno di Salesforce.
Salesforce Data Virtualization sostituisce l'integrazione basata su replica con la federazione in fase di query. I dati rimangono nella fonte autorevole; gli utenti Salesforce interagiscono con essi tramite interfacce piattaforma standard. Non vi sono opportunità in corso di realizzazione, né copie da gestire e nessun ritardo da gestire.
Questo schema è la scelta giusta quando l'accesso in lettura, l'aggiornamento dei dati in tempo reale, la governance rigorosa e il controllo dell'accesso a due livelli sono i fattori principali. È la scelta sbagliata quando sono richieste le scritture, quando l'intelligenza artificiale o le funzioni di automazione dipendono da oggetti Salesforce nativi o quando gli schemi di accesso sono troppo ad alta frequenza per essere rispettati dai limiti del governor.
Snowflake illustra bene lo schema: una connessione federata governata in tempo di query stabilita in modo dichiarativo senza codice personalizzato, osservabile end-to-end tramite la cronologia delle query Snowflake e applicabile sia tramite i controlli di accesso nativi Snowflake che il modello di sicurezza Salesforce completo.
Prima di impegnarsi in questa architettura, convalidare il diritto di licenza, valutare l'esposizione del governor limit rispetto agli schemi di accesso previsti e verificare la preparazione OAuth in un ambiente Sandbox. Lo schema premia la progettazione tempestiva e ponderata: ottenere il modello di identità, la catena delle credenziali e la strategia di visualizzazione corretti e l'impronta operativa è minima.
Yugandhar Bora è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data & Intelligence Applications. Dirige iniziative dell'Enterprise Architecture Review Board (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma.