La maggior parte delle opportunità di integrazione a livello aziendale tra Salesforce e le piattaforme di analisi esterne si basano su codice personalizzato. Funzionano finche' qualcosa non si rompe. La fluttuazione dello schema, l'esaurimento dell'API e i gap di eliminazione definitiva richiedono un intervento ingegneristico costante. Man mano che le aziende si orientano verso architetture agili e abilitate per gli sviluppatori cittadini, questo modello diventa un collo di bottiglia: i team di analisi attendono gli sprint ingegneristici per aggiungere un campo Salesforce a uno schema a valle, i caricamenti notturni non riusciti ritardano la generazione di rapporti il lunedì mattina e le semplici modifiche della configurazione richiedono revisioni del codice e distribuzioni.
CRM Analytics, la piattaforma di analisi e business intelligence nativa di Salesforce, risolve questo problema consentendo alle aziende di esplorare i dati, creare cruscotti digitali interattivi e scoprire approfondimenti basati sull'intelligenza artificiale senza uscire dall'ecosistema Salesforce. Fondamentale per questa funzionalità è una funzione dichiarativa di sincronizzazione dei dati a basso codice integrata in modo nativo nella piattaforma: CRM Analytics SyncOut e CRM Analytics SyncIn.
CRM Analytics SyncOut sposta i record Salesforce in archivi di dati esterni secondo una pianificazione configurata, utilizzando Acquisizione dati di modifica (CDC) per i caricamenti incrementali e il tracciamento dell'eliminazione definitiva incorporato per segnalare i record rimossi in modo permanente. CRM Analytics SyncIn riporta i dati esterni in Salesforce, mappando le colonne ai campi oggetto e aggiornando i record utilizzando l'API in blocco 2.0. Entrambi vengono configurati interamente tramite Imposta in Salesforce. Nessuna pipeline, nessun script di gestione temporanea, nessun monitoraggio personalizzato. Gli amministratori configurano un processo di sincronizzazione in una singola sessione di impostazione; la piattaforma gestisce automaticamente l'esecuzione, i tentativi, la registrazione degli errori e la mappatura dello schema.
Questa guida spiega lo schema, quando utilizzarlo, come implementarlo con Snowflake come esempio lavorato e le considerazioni sull'architettura che determinano se si adatta a un determinato problema di integrazione.
 |
CRM Analytics è la piattaforma di analisi e business intelligence nativa di Salesforce che consente agli utenti di esplorare i dati, creare cruscotti digitali interattivi e scoprire approfondimenti basati sull'intelligenza artificiale, il tutto all'interno dell'ecosistema Salesforce. Questa piattaforma sposta i dati tra Salesforce e i sistemi esterni tramite due funzionalità chiave\: CRM Analytics SyncOut e CRM Analytics SyncIn. CRM Analytics SyncOut invia i dati degli oggetti Salesforce a una piattaforma dati esterna, supportando sia la modalità di sincronizzazione completa che incrementale (CDC) con tracciamento dell'eliminazione definitiva incorporato. CRM Analytics SyncIn completa il loop bidirezionale reinserendo i dati da una piattaforma esterna negli oggetti Salesforce utilizzando l'API in blocco 2.0, garantendo che volumi elevati di dati vengano gestiti in modo affidabile ed efficiente. |
Nota di licenza: CRM Analytics SyncIn e SyncOut non sono disponibili nelle versioni Salesforce di base senza un componente aggiuntivo per la licenza CRM Analytics. Confermare i diritti di licenza prima di progettare un'architettura di sincronizzazione che dipende da queste funzionalità.
L'integrazione dei dati è una delle superfici con il maggior attrito nell'architettura aziendale. Una pipeline ETL personalizzata da Salesforce a una piattaforma di analisi richiede in genere un'applicazione connessa per l'autenticazione, un processo pianificato per l'estrazione SOQL, un livello di trasformazione per riconciliare i tipi di campo, un'area di gestione temporanea per il caricamento in blocco e un livello di monitoraggio per rilevare gli errori. Ogni componente del codice personalizzato rappresenta un punto di errore.
Il costo di questo composto di attrito nel tempo. La fluttuazione dello schema in Salesforce (un campo rinominato, un nuovo valore dell'elenco di selezione, un nome API modificato) interrompe silenziosamente la pipeline. L'esaurimento API durante i picchi di utilizzo rallenta l'estrazione. I record eliminati definitivamente non vengono mai visualizzati nella tabella di destinazione, lasciando dati non aggiornati che vengono trattati come live dagli elementi di analisi a valle. Il team di progettazione diventa il collo di bottiglia per le operazioni di routine sui dati.
CRM Analytics SyncIn e SyncOut modificano il modello operativo. La configurazione sostituisce il codice. La piattaforma si assume la responsabilità dell'esecuzione, della gestione degli errori, della mappatura dello schema e dell'osservabilità. Gli amministratori possono definire, modificare e monitorare i processi di sincronizzazione senza generare un ticket di sviluppo.
Il risultato di questo nuovo modello operativo è una riduzione del tempo dalla progettazione dell'integrazione alla sincronizzazione operativa, un minor sovraccarico tecnico e un modello di integrazione che si adatta ai vincoli della piattaforma anziché richiedere la manutenzione del codice personalizzato.
SyncIn e SyncOut sono le due modalità direzionali della sincronizzazione dei dati di CRM Analytics. SyncOut sposta i record Salesforce in una piattaforma esterna. SyncIn porta i record esterni in Salesforce. Entrambi operano su un modello di configurazione dichiarativo senza codice personalizzato.
La configurazione dichiarativa indica che tutto il comportamento di sincronizzazione viene definito tramite l'interfaccia utente "point-and-click" in Imposta in Salesforce. L'oggetto di origine, la tabella di destinazione, le mappature dei campi, la pianificazione della sincronizzazione, la modalità di sincronizzazione e i filtri sono tutti impostati tramite i metadati di configurazione. La piattaforma deriva il piano di esecuzione da tali metadati e lo gestisce dall'inizio alla fine.
La sincronizzazione completa e la sincronizzazione incrementale controllano quali dati vengono spostati a ogni esecuzione. Una sincronizzazione completa esegue una query su tutti i record che soddisfano i criteri di filtro a ogni esecuzione. Una sincronizzazione incrementale utilizza CDC per eseguire query solo sui record che sono stati modificati dall'ultima esecuzione. La sincronizzazione incrementale è la modalità consigliata per gli oggetti a volume elevato, poiché riduce in modo significativo il consumo API e la durata della sincronizzazione.
Acquisizione dati modifica è una funzionalità di Salesforce Platform che registra le modifiche a livello di campo agli oggetti come stream di eventi. SyncOut utilizza CDC per rilevare le creazioni, gli aggiornamenti e le eliminazioni senza eseguire analisi complete delle tabelle. CDC deve essere abilitato per ogni oggetto in Imposta in Salesforce prima di potervi fare riferimento da una configurazione di sincronizzazione.
Il tracciamento con eliminazione definitiva risolve uno dei problemi più persistenti nell'ETL da Salesforce a esterno. Quando un record viene eliminato definitivamente in Salesforce, scompare dalle query SOQL standard. Senza un tracciamento esplicito, la piattaforma esterna non viene mai a sapere che il record è stato rimosso. Il tracciamento dell'eliminazione definitiva di SyncOut, se abilitato, contrassegna i record eliminati nella tabella di destinazione con DEL_FLAG = 'Y', offrendo ai sistemi a valle un segnale affidabile per filtrare i dati non aggiornati.
La frequenza di sincronizzazione è configurabile da 15 minuti a settimana. La scelta è un compromesso tra aggiornamento dei dati, consumo API e costo di calcolo del warehouse Snowflake. Le sincronizzazioni di 15 minuti si avvicinano quasi in tempo reale per i cruscotti digitali operativi; le sincronizzazioni giornaliere sono appropriate per i carichi di lavoro dei rapporti batch.
I limiti del governatore limitano la progettazione dei processi di sincronizzazione: Il limite di richieste API Salesforce (15.000 chiamate per 24 ore nella Unlimited Edition), la dimensione batch API 2.0 in blocco di 10.000 record e il limite di righe di query SOQL di 50.000 per transazione sono tutti elementi che spiegano come dimensionare e pianificare i processi di sincronizzazione. La piattaforma gestisce automaticamente la suddivisione e la paginazione, ma gli architetti devono tenere conto di un margine di manovra limitato in tutti i processi di sincronizzazione in esecuzione nell'organizzazione.
Snowflake è una destinazione principale e una fonte per la sincronizzazione dei dati con Salesforce CRM Analytics. È un esempio concreto di come funziona lo spostamento dei dati batch e incrementale.
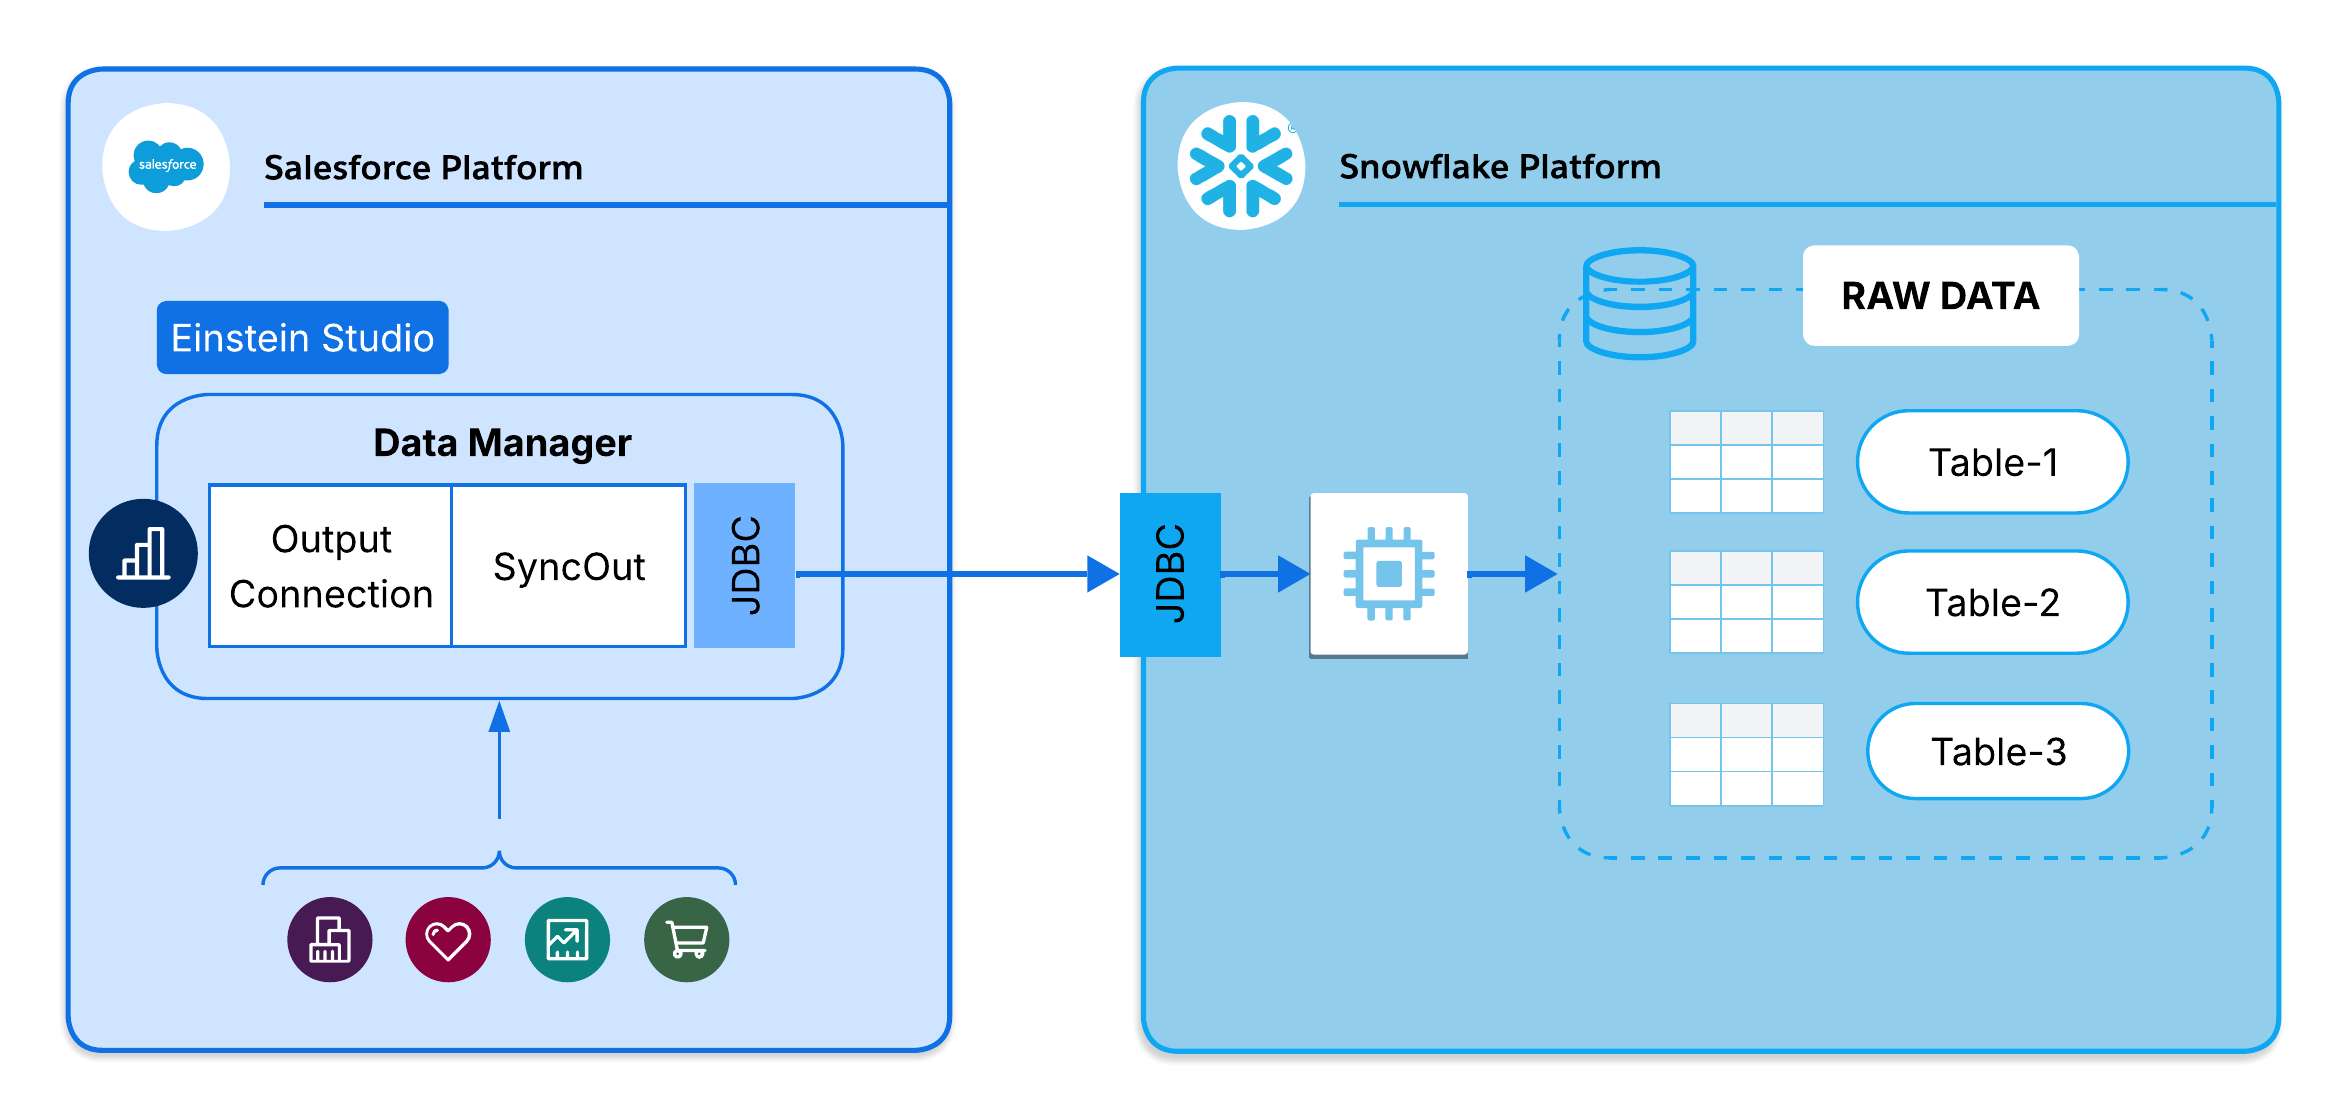
Questa sezione offre una panoramica dell'implementazione di CRM Analytics SyncOut e SyncIn utilizzando Snowflake come piattaforma di analisi esterna. Include ogni metodo, i modelli di autenticazione condivisi, i framework di sicurezza, le considerazioni chiave sulla piattaforma e le procedure di osservabilità.
In questa configurazione di SyncOut, Salesforce utilizza CRM Analytics SyncOut per inviare tramite push i record a Snowflake. La piattaforma estrae i dati tramite SOQL, gestisce automaticamente le conversioni dei tipi e li carica nelle tabelle Snowflake secondo una pianificazione configurata (da 15 minuti a settimana). Fare riferimento alla documentazione corrente di Salesforce e Snowflake per informazioni specifiche sulla semantica di caricamento.
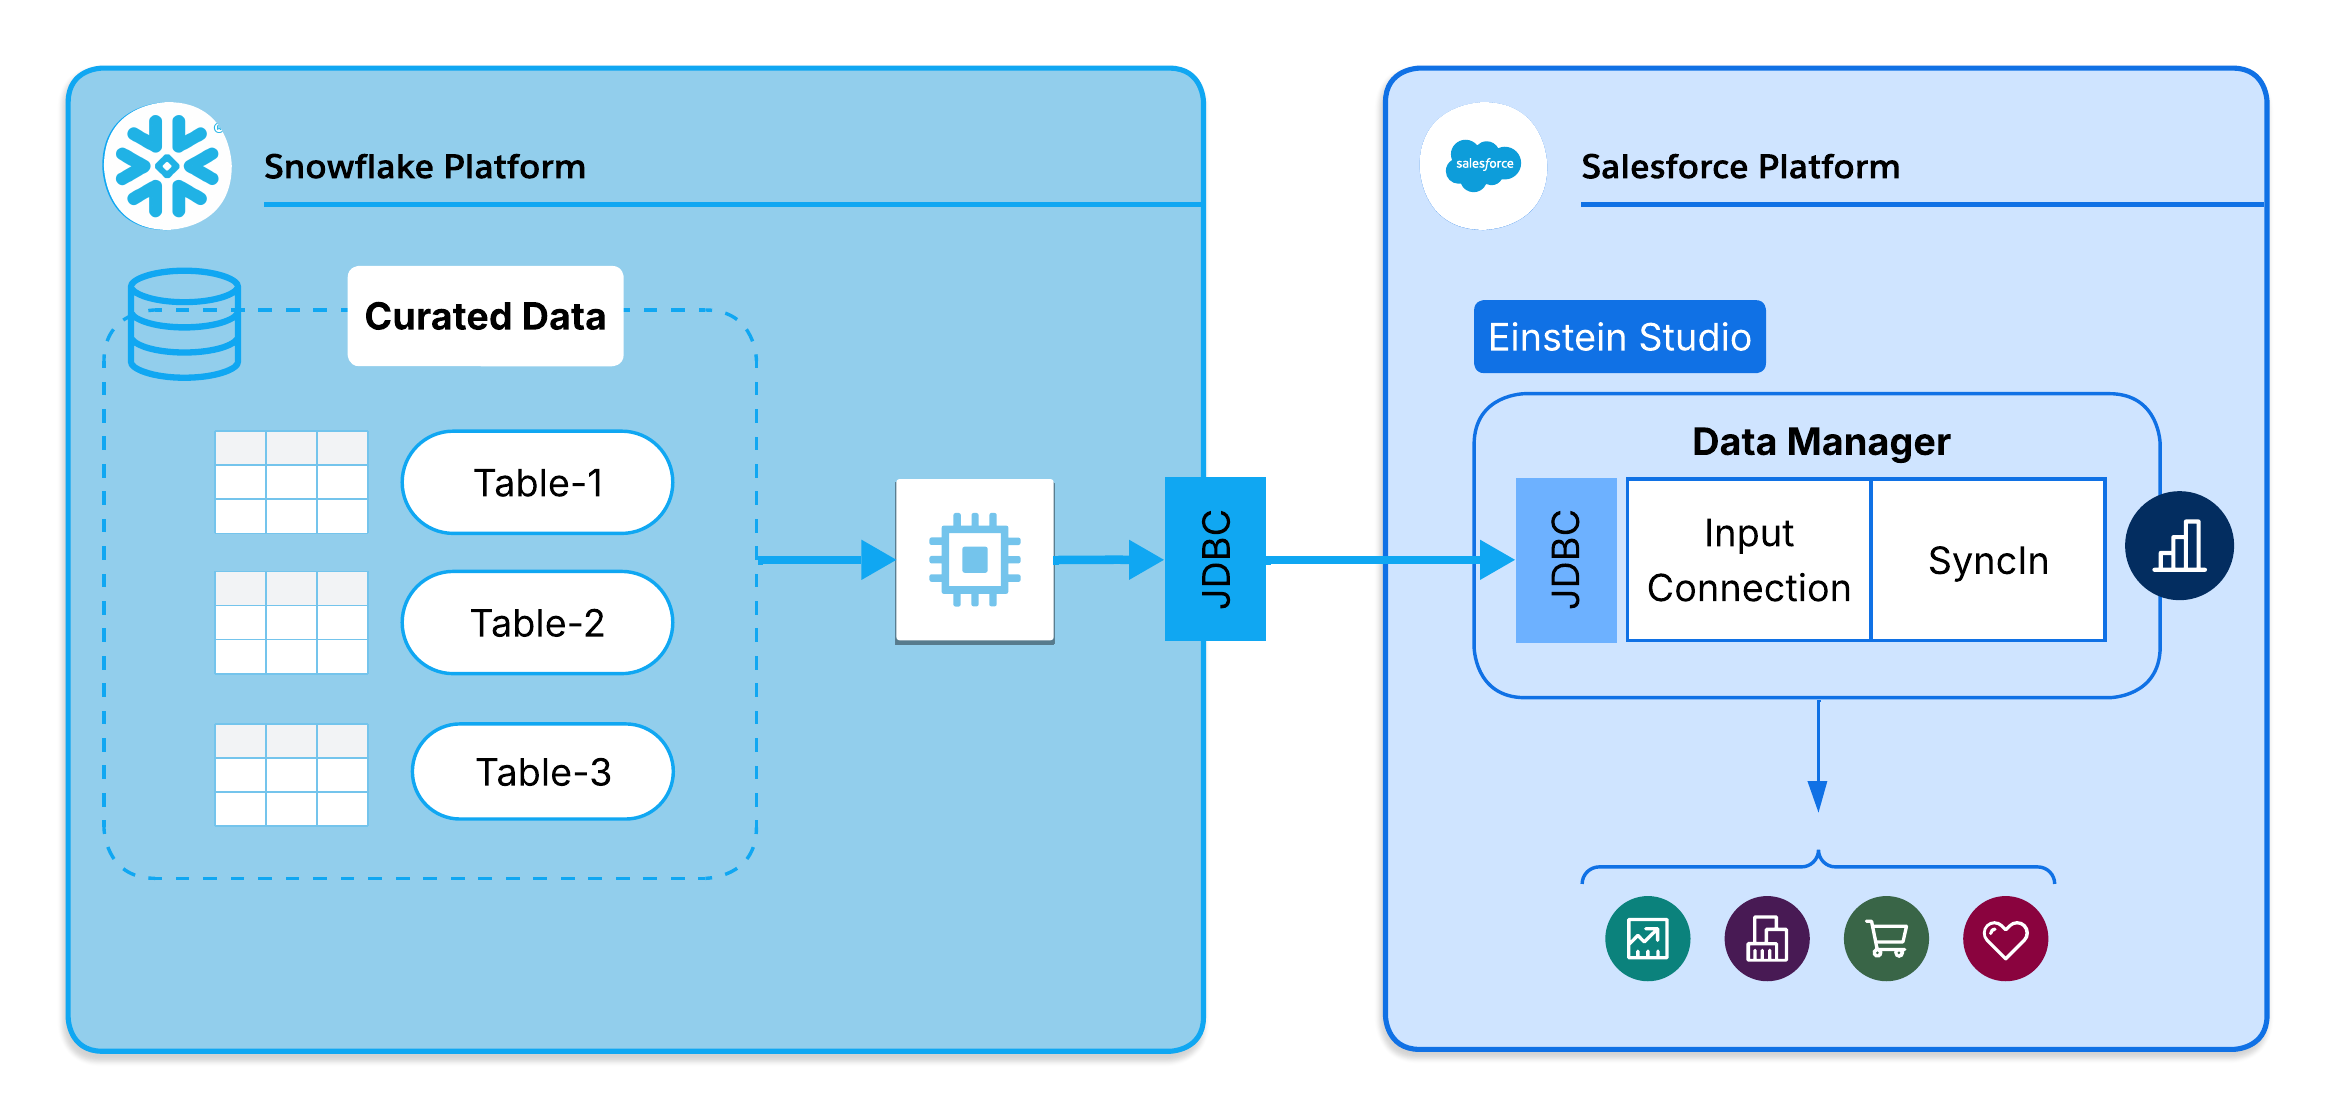
In questa configurazione di SyncIn, Salesforce utilizza CRM Analytics SyncIn per estrarre nuovamente i dati in Salesforce. La piattaforma esegue query su Snowflake tramite l'API Estratti conto e inserisce con aggiornamento i risultati in Salesforce utilizzando l'API in blocco 2.0. Gli insiemi di risultati di grandi dimensioni vengono impaginati automaticamente per rimanere entro i limiti API. La sincronizzazione viene eseguita secondo una pianificazione configurata, che varia da 15 minuti a settimana.
La sincronizzazione Salesforce supporta più metodi di autenticazione per connettersi in modo sicuro con Snowflake. I due approcci principali per le integrazioni aziendali sono Key-Pair (Chiave privata) e OAuth 2.0 delegato.
Metodo 1: Autenticazione: coppia di chiavi (chiave privata) L'autenticazione a coppie di chiavi è l'approccio consigliato per lo spostamento automatico dei dati da sistema a sistema, ad esempio CRM Analytics SyncIn e SyncOut. L'autenticazione si basa su token Web JSON (JWT) anziché su password o token aggiornabili, il che la rende adatta per i processi pianificati non presidiati che non richiedono l'aggiornamento del token.
- Certificato Salesforce: Generare una chiave privata e archiviarla in modo sicuro in Gestione certificati e chiavi Salesforce.
- Credenziale esterna/denominata: Configurato per l'utilizzo di uno scambio JWT. Salesforce utilizza la chiave privata memorizzata per firmare le richieste di connessione in uscita.
- Chiave pubblica utente Snowflake: La chiave pubblica corrispondente viene assegnata direttamente all'account di servizio Snowflake dedicato (ad esempio, ALTER USER CRM_ANALYTICS_SYNC_USER SET RSA_PUBLIC_KEY = '...'). Snowflake utilizza quindi questa chiave per verificare la firma JWT in entrata. Per questo metodo non è necessaria alcuna integrazione della protezione.
Metodo 2: Autenticazione OAuth 2.0 delegata: In alternativa, Salesforce può utilizzare una stretta di mano OAuth per eseguire l'autenticazione. I componenti chiave sono:
- Provider di autenticazione: Gestisce la stretta di mano OAuth con Snowflake, utilizzando le credenziali client recuperate dall'integrazione di sicurezza Snowflake.
- Credenziale esterna: Mantiene i token OAuth in modo sicuro in Salesforce e li inietta automaticamente nelle chiamate di sincronizzazione.
- Credenziale denominata: Definisce l'URL endpoint Snowflake (ad esempio, https://<account>.snowflakecomputing.com) e fa riferimento alla credenziale esterna.
- Integrazione di sicurezza Snowflake: Registra Salesforce come client OAuth affidabile in Snowflake (OAUTH_CLIENT = CUSTOM). Definisce l'URI di reindirizzamento consentito e abilita i token di aggiornamento.
Dipendenza di configurazione: Indipendentemente dal metodo scelto, questi componenti formano una catena di dipendenze che collega la configurazione di sincronizzazione all'endpoint. È necessario concedere ai profili Salesforce interessati l'accesso alla credenziale denominata; senza questo accesso, i processi di sincronizzazione non vengono eseguiti a causa di errori di autenticazione indipendentemente da tutte le altre configurazioni.
La sincronizzazione in background si basa su una singola identità di integrazione.
- Account di servizio dedicato: Creare un account di servizio Snowflake dedicato con un ruolo con privilegi minimi limitato solo ai database, agli schemi e alle tabelle necessari per la sincronizzazione.
- Autorizzazioni granulari: Per SyncOut, questo ruolo richiede INSERT, UPDATE e SELECT nelle tabelle di destinazione. Non utilizzare mai ruoli con privilegi elevati come ACCOUNTADMIN, SECURITYADMIN o SYSADMIN.
- Limite e suddivisione del governor: Durante l'estrazione di SyncOut, gli insiemi di risultati di grandi dimensioni vengono suddivisi automaticamente in blocchi per rispettare i limiti del governor SOQL Salesforce. SyncIn recupera insiemi di risultati di grandi dimensioni dall'API Snowflake Statements tramite la paginazione automatica per gestire i volumi di dati in modo efficiente.
- Cambia acquisizione dati (CDC): SyncOut incrementale si basa sullo stream di eventi CDC di Salesforce per identificare i record creati, aggiornati o eliminati. Se è abilitato il tracciamento dell'eliminazione definitiva, i record Salesforce eliminati non vengono eliminati ma contrassegnati con
DEL_FLAG = 'Y'in Snowflake. - Vincoli di inserimento con aggiornamento: SyncIn si basa sull'API in blocco 2.0 per caricare nuovamente i dati in Salesforce. Ciò richiede la configurazione di un campo ID esterno designato nell'oggetto Salesforce di destinazione per fungere da chiave di inserimento con aggiornamento.
- Guida alla progettazione: Sincronizzare sempre dalle visualizzazioni Snowflake curate anziché dalle tabelle non elaborate. Le visualizzazioni consentono il prefiltraggio delle righe, la selezione delle colonne e l'applicazione della logica aziendale, riducendo il volume dei dati, la durata della sincronizzazione e i costi di calcolo del warehouse Snowflake in proporzione al prefiltraggio applicato.
Ogni esecuzione della sincronizzazione genera percorsi di controllo completi per convalidare lo spostamento dei dati. Il cruscotto digitale Sync Job Monitor (Monitor processi di sincronizzazione) fornisce lo stato in tempo reale, i conteggi dei record elaborati, le durate di esecuzione e i registri errori dettagliati sia per SyncIn che per SyncOut. Sul lato Snowflake, ogni query inviata da Salesforce viene registrata nella cronologia delle query Snowflake, offrendo una visibilità completa della latenza di esecuzione, delle righe analizzate e dell'utilizzo del warehouse compute. Inoltre, gli architetti definiscono tabelle di controllo Snowflake dedicate per acquisire i metadati delle esecuzioni di sincronizzazione (indicazione oraria, conteggi dei record ed errori), che non vengono generati automaticamente dalla piattaforma. Per una convalida completa, confrontare i conteggi dei record in entrambe le piattaforme: verificare i record attivi in Snowflake (WHERE DEL_FLAG = 'N') per le esecuzioni di SyncOut e confrontare i conteggi degli oggetti di destinazione Salesforce direttamente con la visualizzazione sorgente Snowflake originale per le esecuzioni di SyncIn.
Utilizzare SyncIn e SyncOut di CRM Analytics quando:
- La sincronizzazione bidirezionale è un requisito: I dati vengono inviati sia a Salesforce tramite SyncIn che a una piattaforma esterna tramite SyncOut.
- Il tracciamento dell'eliminazione definitiva è fondamentale: La segnalazione incorporata di SyncOut risolve un problema ETL storicamente complesso senza una logica di riconciliazione personalizzata.
- La sincronizzazione incrementale basata su CDC è praticabile: Per gli oggetti Salesforce a volume elevato, CDC riduce in modo significativo il consumo dell'API e la durata della sincronizzazione rispetto alle analisi complete.
- La sincronizzazione batch pianificata soddisfa i requisiti di latenza: La frequenza di sincronizzazione minima è di 15 minuti, adatta per i cruscotti digitali operativi e i rapporti analitici quasi in tempo reale.
- Una priorità è un basso sovraccarico operativo: I cruscotti digitali integrati offrono una visibilità completa della sincronizzazione senza registrazione personalizzata o infrastruttura di avviso e l'interfaccia utente di impostazione dichiarativa consente agli amministratori di definire, modificare e monitorare i processi di sincronizzazione senza generare un ticket di sviluppo.
Non utilizzare questo schema se:
- Sono richieste trasformazioni complesse: I join multitabella, l'analisi JSON o la gestione della logica aziendale avanzata nelle visualizzazioni Snowflake o in un livello di trasformazione dedicato prima o dopo la sincronizzazione.
- È richiesta una latenza sub-15 minuti: Per i casi d'uso in tempo reale, utilizzare Eventi piattaforma o Streaming API.
- I carichi di lavoro in streaming a volume molto elevato rientrano nell'ambito: Gli oggetti con milioni di transazioni all'ora vengono serviti meglio da opportunità in streaming dedicate (Kafka, Eventi piattaforma).
- È necessaria una logica di gestione degli errori personalizzata: La piattaforma fornisce tentativi standard e la registrazione degli errori. Schemi di tentativo complessi o avvisi personalizzati richiedono Apex o un'orchestrazione esterna.
- Sincronizzazione multi-organizzazione o cross-cloud: CRM Analytics SyncIn e SyncOut funzionano all'interno di una singola organizzazione Salesforce. Per gli scenari multi-organizzazioni è necessario MuleSoft o un livello di integrazione personalizzato.
Un team ha eseguito pipeline ETL complesse per caricare i dati di analisi Snowflake nelle serie di dati CRM Analytics. Le condutture erano lente, fragili e richiedevano una costante manutenzione ingegneristica.
CRM Analytics SyncIn è stato configurato per sincronizzare le visualizzazioni aggregate Snowflake curate direttamente negli oggetti personalizzati Salesforce. Il team ha riconfigurato i cruscotti digitali CRM Analytics per la lettura da tali oggetti anziché dalle serie di dati CRM Analytics. Il risultato: due pipeline ETL eliminate, la durata della sincronizzazione ridotta da quattro ore a 30 minuti e la possibilità per gli amministratori di modificare le configurazioni di sincronizzazione senza elevare un ticket di ingegneria.
Un team dati aveva bisogno di tenere traccia dei record Salesforce eliminati in modo definitivo nell'archivio dati operativo Snowflake. Gli approcci tradizionali richiedevano processi di ripartizione e una logica di riconciliazione ID complessa che richiedeva ore di esecuzione ed era fragile nelle modifiche dello schema.
Il team ha configurato CRM Analytics SyncOut con CDC e tracciamento dell'eliminazione definitiva abilitati. I record eliminati vengono ora contrassegnati automaticamente con DEL_FLAG = 'Y' nella tabella di consumo Snowflake. Le query analitiche a valle applicano WHERE DEL_FLAG = 'N' per visualizzare solo i record attivi. La logica di riconciliazione è stata eliminata completamente e la durata della sincronizzazione è scesa da otto ore a esecuzioni incrementali di 15 minuti.
Durante un'acquisizione, la società acquirente ha sincronizzato sei oggetti Salesforce a volume elevato in Snowflake per la creazione di rapporti tra organizzazioni e la conformità alle normative entro una tempistica fissa.
Il team ha configurato CRM Analytics SyncOut per tutti e sei gli oggetti con sincronizzazioni incrementali basate su CDC. Le tabelle dei metadati di controllo hanno tenuto traccia delle modifiche dello schema e dei conteggi dei record durante il periodo di integrazione. Non hanno scritto alcun codice personalizzato. L'aggiornamento dei dati è migliorato da intervalli giornalieri a intervalli di 15 minuti e le tabelle dei metadati di controllo hanno fornito la tracciabilità necessaria per i rapporti sulla conformità.
I processi di sincronizzazione condividono il budget API dell'organizzazione. Un'organizzazione che esegue molti processi di sincronizzazione ad alta frequenza per oggetti di grandi dimensioni rischia di esaurire il limite di 15.000 chiamate API per 24 ore. Inventariare tutti i processi di sincronizzazione, stimare il consumo API per esecuzione e scaglionare le pianificazioni per distribuire il carico. Per gli oggetti con tassi di modifica da bassi a moderati, la modalità incrementale basata su CDC può ridurre in modo significativo il consumo API per esecuzione rispetto alla sincronizzazione completa.
SyncIn e SyncOut eseguono query e caricamenti di dati in un warehouse Snowflake, consumando crediti di calcolo. Per le query SELECT semplici, in genere è sufficiente un magazzino X-Small o Small. Per i carichi SyncOut di grandi dimensioni, possono essere necessari Medium o Large. Configurare la sospensione automatica (5 minuti di inattività) e la ripresa automatica del magazzino. Utilizzare un magazzino dedicato per i processi di sincronizzazione della produzione per isolare i costi ed evitare contenziosi con le query degli utenti.
Se un campo Salesforce viene rinominato, rimosso o cambia nome API, la mappatura del campo SyncOut corrispondente non riesce o registra errori. Stabilire un processo di gestione del cambiamento che includa la revisione delle configurazioni di sincronizzazione attive come parte di qualsiasi modifica dei metadati Salesforce. Le tabelle di controllo Snowflake forniscono una cronologia delle modifiche che consente di identificare quando si è verificato un evento di fluttuazione.
Il tracciamento dell'eliminazione definitiva in SyncOut richiede l'abilitazione di CDC per l'oggetto Salesforce. Se CDC non è abilitato, l'opzione "Traccia eliminazioni definitive" non ha alcun effetto. Convalidare l'abilitazione CDC nell'elenco di controllo della configurazione di sincronizzazione, in particolare durante l'impostazione iniziale o dopo le migrazioni dell'organizzazione.
La classe di errore più comune è la scadenza delle credenziali o la perdita delle autorizzazioni. Le credenziali denominate devono rimanere valide e l'account di servizio Snowflake deve mantenere le sovvenzioni di utilizzo del magazzino e le autorizzazioni tabella. Per le impostazioni basate su OAuth, gli errori di aggiornamento dei token possono rallentare silenziosamente i processi di sincronizzazione. Monitorare il cruscotto digitale Sync Job Monitor (Monitor processi di sincronizzazione) per individuare gli schemi di errore di autenticazione e configurare le notifiche Chatter o email per gli errori dei processi.
SyncIn utilizza un campo ID esterno Salesforce come chiave di inserimento con aggiornamento. Se la visualizzazione Snowflake di origine contiene valori duplicati nel campo chiave, l'inserimento con aggiornamento non riesce per i record interessati. Applicare l'univocità al campo chiave nel livello di visualizzazione Snowflake prima che raggiunga la configurazione di sincronizzazione.
Quando i processi di sincronizzazione non riescono, la piattaforma registra messaggi di errore dettagliati per record in Monitor processo di sincronizzazione. Scenari di errore comuni e relative soluzioni:
- Errore autenticazione: verificare lo stato della credenziale denominata e la scadenza dell'account Snowflake. Riautenticare OAuth se l'aggiornamento del token non è riuscito.
- Errore mappatura campi: verificare la compatibilità dei tipi tra le colonne Snowflake e i campi Salesforce. Esaminare la protezione a livello di campo per l'utente in esecuzione.
- Limite superiore superato: ridurre la frequenza di sincronizzazione o passare alla modalità CDC incrementale per ripartire il consumo dell'API.
- Magazzino Snowflake sospeso: configurare la ripresa automatica del magazzino o attivare una ripresa manuale prima della successiva sincronizzazione pianificata.
- Tracciamento eliminazione definitiva non funzionante: verificare che CDC sia abilitato per l'oggetto e che il flag "Traccia eliminazioni definitive" sia impostato nella configurazione di sincronizzazione.
La sincronizzazione dei dati di CRM Analytics è in linea con più pilastri del framework Salesforce Well-Architected.
- Affidabilità (tolleranza ai guasti): La piattaforma gestisce automaticamente l'esecuzione, la logica dei nuovi tentativi e la gestione parziale degli errori. I record non riusciti vengono registrati singolarmente in Monitor processo di sincronizzazione. Implementare la riconciliazione del conteggio dei record dopo errori per confermare la coerenza, integrare con le notifiche di errore e monitorare il Monitor processo di sincronizzazione per rilevare eventuali schemi di errore ricorrenti. La sincronizzazione incrementale basata su CDC riduce il raggio di esplosione di un'esecuzione non riuscita limitando l'ambito della finestra di dati.
- Trust: Il modello di credenziali (credenziali denominate, credenziali esterne, provider di autenticazione) impone l'archiviazione crittografata, l'aggiornamento automatico dei token e la gestione centralizzata. L'accesso con privilegi minimi sul lato Snowflake limita il raggio di esplosione di una credenziale compromessa. La protezione a livello di campo viene applicata durante la sincronizzazione; gli utenti non possono sincronizzare i campi a cui non sono autorizzati ad accedere.
- Ottimizzazione delle risorse e dei costi: La modalità CDC incrementale è la leva principale per l'ottimizzazione delle prestazioni. Riduce il consumo API, la durata della sincronizzazione e il costo di calcolo Snowflake rispetto alla sincronizzazione completa. Il prefiltraggio della visualizzazione Snowflake riduce ulteriormente il volume di dati in transito. La sospensione automatica del magazzino impedisce la spesa di calcolo inattiva.
- Eccellenza operativa: Il modello di configurazione dichiarativo indica che i processi di sincronizzazione sono definiti nei metadati, non nel codice. Ciò li rende controllabili, riproducibili e gestibili senza intervento tecnico. I cruscotti digitali di monitoraggio incorporati offrono la massima osservabilità senza infrastrutture di registrazione personalizzate.
- Affidabilità (scalabilità): La piattaforma gestisce automaticamente la suddivisione in blocchi, la paginazione e il batching API in blocco. Per gli oggetti con volumi di record molto elevati, la modalità CDC incrementale e la pianificazione off-peak sono le leve architettoniche principali per mantenere la produttività entro i vincoli del governor limit.
Questo elenco di controllo descrive i passaggi minimi per impostare e convalidare una configurazione di sincronizzazione.
Elenco di controllo pre-configurazione:
- Abilitare Acquisizione dati di modifica su tutti gli oggetti Salesforce destinati alla modalità incrementale SyncOut (Imposta → Acquisizione dati di modifica).
- Creare un account di servizio Snowflake dedicato con un ruolo con privilegi minimi; concedere solo le autorizzazioni necessarie per tabelle e magazzini.
- Creare un'integrazione di sicurezza Snowflake se si utilizza l'autenticazione OAuth.
- Identificare il campo ID esterno in ogni oggetto Salesforce che SyncIn utilizzerà come chiave di inserimento con aggiornamento; confermare l'univocità nei dati di origine.
Connettività:
- Crea provider di autenticazione in Salesforce (Imposta → Provider di autenticazione).
- Creare una credenziale esterna e collegarsi al provider di autenticazione (Imposta → Credenziali denominate → Credenziali esterne).
- Creare la credenziale denominata e collegarsi alla credenziale esterna (Imposta → Credenziali denominate).
- Concedere l'accesso alle credenziali denominate ai profili Salesforce pertinenti.
Configurazione di SyncOut:
- Crea connessione Snowflake (Imposta → Analytics Studio → Gestore dati → Connessioni → Connessioni Snowflake).
- Creare la configurazione SyncOut: oggetto di origine, tabella di destinazione, modalità di sincronizzazione, mappature dei campi, CDC, tracciamento dell'eliminazione definitiva, pianificazione.
- Iniziare con la sincronizzazione giornaliera; convalidare la qualità e le prestazioni dei dati prima di aumentare la frequenza.
Configurazione SyncIn:
- Crea fonte di dati esterna (Imposta → Analytics Studio → Gestore dati → Connessioni → Connessioni Snowflake).
- Creare la configurazione SyncIn: visualizzazione di origine, oggetto di destinazione, campo ID esterno, mappature dei campi, pianificazione.
- Sincronizza dalle visualizzazioni Snowflake, non dalle tabelle non elaborate.
Convalida:
- Rivedere Monitor processi di sincronizzazione dopo la prima esecuzione (Imposta → Analytics Studio → Gestore dati → Monitor processi di sincronizzazione).
- Eseguire una query sulla tabella di controllo Snowflake per verificare che siano stati scritti i metadati di sincronizzazione.
- Convalidare la segnalazione di eliminazione definitiva verificando che la colonna DEL_FLAG sia presente e compilata.
- Confrontare i conteggi dei record tra origine e destinazione.
- Configurare le notifiche di errore tramite Chatter o email.
Utilizzare questo schema quando la sincronizzazione batch pianificata soddisfa i requisiti di latenza, è necessario un flusso di dati bidirezionale e la riduzione della dipendenza tecnica dalle operazioni di integrazione è una priorità.
L'esempio di Snowflake illustrato in questa guida illustra l'intero ciclo di vita: impostazione della connettività, configurazione, flusso di esecuzione e convalida. Gli stessi principi si applicano a qualsiasi piattaforma dati esterna supportata.
Quando la latenza sotto i 15 minuti, le trasformazioni complesse o gli scenari multi-organizzazione sono nell'ambito, valutare gli eventi piattaforma, le Streaming API o MuleSoft come approcci complementari o alternativi.
Yugandhar Bora è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data & Intelligence Applications. Dirige iniziative dell'Enterprise Architecture Review Board (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma.