Gli agenti ragionano sugli obiettivi, deducono parametri dal contesto e selezionano le azioni in modo dinamico. Di conseguenza, ogni integrazione toccata da un agente deve gestire l'ambiguità, supportare la ripetizione sicura e impedire all'agente di recuperare in autonomia.
I sistemi agentici invalidano diversi presupposti che la progettazione di integrazione tradizionale dà per scontati. Gli input non saranno sempre in formato corretto. Una singola azione utente può generare una catena di agenti oltre i confini dell'organizzazione, ognuno dei quali necessita di un'autorità delegata per agire.
Questo documento mappa i cambiamenti architettonici che seguono da quella realtà: i nuovi principi di progettazione, gli schemi degli agenti e il modo in cui Salesforce Platform li fornisce.
Ogni schema di questo documento segue la stessa struttura:
Nome: Identificatore dello schema che indica il tipo di integrazione contenuto nello schema.
Contesto: Scenario di integrazione generale affrontato dallo schema. Contesto fornisce informazioni su ciò che gli utenti stanno cercando di ottenere e su come l'applicazione si comporta in base alle loro esigenze.
Problema: La sfida (espressa come domanda) che lo schema è progettato per risolvere. Quando si rivedono gli schemi, leggere questa sezione per capire rapidamente se lo schema si applica allo scenario di integrazione.
Forze: I vincoli e le circostanze che possono rendere il problema difficile da risolvere.
Applicazione modello Salesforce: Il modo consigliato per applicare lo schema allo scenario.
Schizzo: Diagramma di sequenza UML (Unified Modeling Language) che mostra come l'applicazione pattern affronta lo scenario.
Risultati: Come lo schema risolve le forze associate allo scenario. Questa sezione contiene anche nuove sfide che possono sorgere in seguito all'applicazione dello schema.
Considerazioni sulla progettazione: Guida indipendente dalla piattaforma per la corretta applicazione della soluzione, seguita da note di implementazione specifiche di Salesforce. Queste considerazioni riguardano i principi di progettazione delle azioni e i requisiti di configurazione specifici della piattaforma.
Gestione e ripristino degli errori: Guida per la gestione degli errori durante l'applicazione dello schema. Questo parametro copre quattro aree:
- Come le azioni comunicano l'errore all'agente attraverso risposte agli errori strutturate e fruibili che forniscono un contesto sufficiente per il processo decisionale a valle
- Come l'agente determina se riprovare, autocorreggersi o interrompere l'esecuzione
- Come le azioni di risarcimento risolvono gli esiti parziali e lo stato multipiattaforma non corrispondente
- Requisiti di impotenza per le operazioni di scrittura ritirate
Considerazioni sulla sicurezza: Requisiti di sicurezza per applicare lo schema in modo sicuro. Queste considerazioni riguardano, tra le altre, la gestione delle credenziali, l'ambito con privilegi minimi degli utenti integrazione e delle applicazioni connesse, la registrazione di controllo delle azioni invocate dagli agenti e i requisiti di convalida degli input per i parametri che hanno origine da contenuti forniti dagli utenti o dedotti da LLM.
Esempio: Uno scenario completo che descrive come viene utilizzato lo schema di progettazione in uno scenario Salesforce reale. L'esempio spiega gli obiettivi e come applicare lo schema per raggiungerli.
La tabella seguente elenca gli schemi di implementazione trattati.
Elenco degli schemi
| Schema | Cosa fa |
|---|---|
| Invocazione azione sequenziale | Un agente invoca una serie di azioni in cui ogni fase dipende dal risultato verificato di quella precedente. L'agente mantiene il contesto in tutta la catena, ad esempio identificatori, codici di stato e dati intermedi, e lo utilizza per decidere se la fase successiva può procedere. |
| Invocazione azione parallela | Quando un insieme di azioni è indipendente l'una dall'altra, l'agente le invoca contemporaneamente anziché in sequenza. Il tempo di flusso di lavoro totale è legato alla chiamata più lenta anziché alla somma di tutte le chiamate. |
| Invocazione azione asincrona | Un agente invia un'operazione a un sistema a valle tramite un evento piattaforma, un'area di attesa messaggi o un processo in background senza attendere l'esito. L'obbligo dell'agente termina con la chiamata confermata; il sistema a valle diventa titolare dell'esecuzione indipendentemente dalla sessione dell'agente. |
| Invocazione agente on-demand | Un'applicazione esterna o un orchestratore AI chiama un agente a livello di programmazione, fornisce il contesto e attende una risposta strutturata. L'agente funge da servizio di backend intelligente avviato dal chiamante, ragiona e agisce e il risultato viene consumato dal chiamante. |
| Esecuzione autonoma degli agenti basata sugli eventi | Una condizione dei dati come l'abbandono del carrello, l'errore di pagamento, la riduzione dell'utilizzo attiva autonomamente un agente senza che alcun utente avvii l'interazione. Non vi è alcun chiamante in attesa di una risposta; l'agente riceve il payload dell'evento come contesto di radicamento ed esegue un flusso di lavoro di risposta interamente da solo. |
| Knowledge Grounding da contenuto aziendale | Prima di generare una risposta, l'agente recupera i documenti pertinenti da un archivio Enterprise Knowledge e li inserisce nella finestra di contesto. Il LLM fornisce il ragionamento; il livello di recupero fornisce i fatti. |
| Iniezione contesto cliente verificata | Gli attributi strutturati e verificati di un profilo cliente unificato vengono precompilati come input di azioni prima che l'agente invochi un'azione. L'agente riceve dati come segmento, livello, rischio di abbandono e valore durata anziché dedurli. |
| Integrazione tra strumenti di sistema | Un agente si connette a sistemi esterni esterni alla piattaforma Salesforce tramite un'interfaccia strumento uniforme basata sullo standard MCP (Model Context Protocol). Ogni sistema esterno espone le sue funzionalità come descritto, strumenti richiamabili; l'agente li rileva e li invoca senza dover conoscere l'API o lo schema nativo di ogni sistema. |
| Funzioni aziendali come strumenti richiamabili | Le funzionalità aziendali aziendali come entità aziendali, processi e approfondimenti sono esposte come strumenti MCP che qualsiasi agente esterno su qualsiasi framework può scoprire e invocare. |
| Delegazione incrociata | Un agente chiamante scompone una richiesta complessa e delega operazioni secondarie specifiche del dominio ad agenti peer specializzati su piattaforme o sistemi di fornitori diversi utilizzando il protocollo Agent-to-Agent (A2A). L'agente chiamante gestisce il ciclo di vita dell'operazione e aggrega i risultati degli agenti remoti. |
| Agenti come servizi chiamabili | Un agente Agentforce interno pubblica le sue funzionalità di dominio come endpoint A2A governato e rilevabile in modo che gli orchestratori esterni o gli agenti di pari grado possano delegargli le operazioni. L'agente gestisce il ciclo di vita delle operazioni in entrata e restituisce risultati strutturati al chiamante remoto. |
Gli schemi di questo documento sono classificati in tre categorie. Questa categorizzazione consente agli architetti di identificare rapidamente gli schemi pertinenti alla sfida dell'integrazione che stanno risolvendo, sia che stiano progettando ciò che un agente chiama, ciò che attiva un agente o in che modo un agente è basato su Knowledge prima che agisca. Anziché leggere ogni schema, è possibile passare direttamente alla categoria che corrisponde alla propria preoccupazione di progettazione.
Invocazione azione:
Questi schemi descrivono il modo in cui un agente chiama i sistemi esterni per recuperare dati o eseguire operazioni nell'ambito del suo ciclo di ragionamento. Si tratta di schemi in uscita in cui l'agente è l'iniziatore. Affrontano la sequenza (quando le fasi dipendono l'una dall'altra), il parallelismo (quando non lo fanno), l'impotenza e la gestione parziale degli errori. Utilizzare questi schemi quando si progettano gli strumenti che un agente invocherà per completare il lavoro.
Invocazione agente:
Questi schemi riguardano il modo in cui i sistemi o gli eventi esterni attivano un agente. Si tratta di schemi in entrata in cui i sistemi esterni attivano questi agenti. Il trigger può essere un'applicazione rivolta all'uomo che effettua una chiamata a livello di programmazione e attende una risposta, oppure una condizione dati autonoma che attiva l'agente. Utilizzare questi schemi per progettare come e quando viene attivato un agente.
Grounding con dati aziendali:
Gli schemi di questa categoria descrivono il modo in cui gli agenti sono basati su Knowledge accurate, aggiornate e specifiche dell'organizzazione prima che ragioni o agisca.
Scegliere la strategia giusta non è banale. Ogni schema si rivolge a una preoccupazione specifica: funzionalità del sistema, volume di dati, gestione degli errori e transazionalità.
Le tabelle a matrice di selezione elencano gli schemi e i relativi aspetti chiave per consentire di determinare quale schema si adatta meglio alle proprie esigenze di integrazione. Gli schemi vengono classificati utilizzando le seguenti dimensioni.
| Aspetto | Descrizione |
|---|---|
| Tipo | Specifica la categoria di integrazione: Invocazione azione, invocazione agente o basamento con Enterprise Data Action Invocation: Queste integrazioni in uscita vanno da semplici chiamate a uno strumento a una sola fase a complesse sequenze a più fasi e fan-out paralleli e richiedono un'attenta considerazione dei vincoli di ordinazione, dell'impotenza e della gestione parziale degli errori in backend eterogenei. Invocazione agente: Le invocazioni degli agenti sono il modo in cui i sistemi o gli eventi esterni attivano un agente. Queste integrazioni in entrata vanno dalle chiamate sincrone a livello di programmazione effettuate da applicazioni rivolte all'uomo che attendono una risposta strutturata alle esecuzioni completamente autonome basate sugli eventi in cui una condizione dei dati attiva l'agente senza che alcun agente inizi o attenda l'interazione. Grounding con dati aziendali: Le integrazioni di base sono il modo in cui un agente riceve Knowledge accurate, aggiornate e specifiche dell'organizzazione prima che ragioni o agisca. Queste integrazioni vanno dal recupero di documenti non strutturati dagli archivi di contenuti aziendali all'inserimento di attributi strutturati verificati dai profili cliente unificati, assicurando che l'agente operi sui fatti anziché sull'inferenza allucinata. |
| Tempistica | Specifica lo stile dell'integrazione in base alla tempistica: Sincrono o Asincrono rispetto ad Asincrono in questo documento si riferisce al modo in cui l'agente stesso viene attivato o al modo in cui invoca le azioni. Non copre ciò che accade internamente. Tuttavia, in generale, un utente attende durante il tempo in cui invoca le azioni e elabora i risultati. L'agente non indirizzerà il messaggio utente successivo finché non ha completato il turno corrente. Sincrona: Il blocco e le richieste in tempo reale sono operazioni di richiesta/risposta. Il risultato viene restituito immediatamente al chiamante tramite questa operazione. Asincrono: Le richieste non di blocco, di area di attesa o basate su messaggi vengono richiamate da un'operazione unidirezionale quasi in tempo reale. I risultati e gli eventuali errori vengono restituiti invocando altre operazioni unidirezionali. Il chiamante effettua quindi la richiesta e prosegue senza attendere una risposta. |
In questa tabella sono elencati gli schemi e i relativi aspetti chiave per consentire di determinare quale schema si adatta meglio alle proprie esigenze quando l'integrazione passa da Salesforce a un altro sistema.
| Tipo | Tempistica | Schema chiave da considerare |
|---|---|---|
| Invocazione azione | Sincrona | Invocazione azione sequenziale Invocazione azione parallela Integrazione tra strumenti di sistema Delegazione incrociata |
| Invocazione azione | Asincrono | Invocazione azione asincrona |
| Invocazione agente | Sincrona | Invocazione agente on-demand Agenti come servizi chiamabili |
| Invocazione agente | Asincrono | Esecuzione autonoma degli agenti basata sugli eventi |
| Messa a terra con dati aziendali | Sincrona | Knowledge Grounding da contenuto aziendale Iniezione contesto cliente verificata |
Ogni sezione di schemi descrive come crearli. Ogni schema è una soluzione ripetibile a un problema di integrazione specifico nelle architetture agenti. Descrive quando utilizzare lo schema, quali forze modellano la decisione e come Salesforce Platform la fornisce.
Contesto
Molti flussi di lavoro aziendali sono intrinsecamente sequenziali: ogni fase richiede un risultato verificato da quello precedente prima di poter procedere. Ad esempio, non è possibile avviare un rimborso finché non viene confermata l'idoneità, non è possibile creare un account di fatturazione finché non esiste il record ordine e non è possibile registrare un controllo di conformità finché il controllo non è passato.
Nell'automazione tradizionale, queste dipendenze sono codificate come logica di flusso codificata. In un sistema agente, l'agente valuta il risultato di ogni azione e determina se i prerequisiti per la fase successiva sono stati soddisfatti.
Questo schema descrive il modello di integrazione in uscita di base. Qui, un singolo agente opera all'interno di un dominio e invoca una sequenza, in cui l'output di ogni azione blocca l'invocazione dell'azione successiva nella catena. L'agente orchestratore mantiene il contesto transazionale in tutta la catena, accumulando identificatori, codici di stato e dati restituiti da ogni fase. Utilizza questo contesto per guidare le decisioni successive.
Questo schema è la controparte agente di Remote Process Invocation – Request and Reply della guida Integration Patterns (Schemi di integrazione), che descrive una singola chiamata sincrona. Lo schema agente estende lo schema a una catena di chiamate dipendenti basate sugli agenti all'interno di un singolo ciclo di ragionamento.
Problema
Quando un agente esegue un flusso di lavoro a più fasi che si estende al sistema host e a uno o più sistemi remoti, è necessario affrontare quattro sfide:
- Sequenziamento: le azioni devono essere richiamate nell'ordine corretto, con ogni fase bloccata al completamento di quella precedente.
- Propagazione dei dati: i dati di risposta di ogni fase devono essere passati come input al passaggio successivo.
- Isolamento dei guasti: i guasti in qualsiasi punto della catena non devono produrre uno stato parziale o incoerente tra i sistemi.
- Verifica completamento: l'agente deve confermare che tutte le fasi sono state completate correttamente prima di segnalare un risultato.
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
-
Ogni azione nella catena dipende dai dati restituiti dall'azione precedente o dipende solo dallo stato di esito positivo o di errore?
Le dipendenze tra i dati richiedono che l'agente inserisca identificatori e attributi nelle varie fasi.
-
Tutti gli endpoint remoti sono in grado di rispondere entro il timeout del ciclo di ragionamento dell'agente?
Un sistema esterno lento in qualsiasi fase della catena blocca l'intera sequenza.
-
La catena richiede un successo completo end-to-end o il completamento parziale è accettabile?
-
Se è necessaria una riuscita completa, definire una strategia di compensazione per le fasi che devono essere ritirate quando si verifica un errore a valle.
-
È possibile ripetere una qualsiasi delle operazioni di scrittura nella catena in modo sicuro?
Tutte le azioni di scrittura devono essere idempotenti; il loop di ragionamento dell'agente può invocare la stessa azione più di una volta a causa di tentativi di Large Language Model (LLM) o conferme ambigue.
-
La catena viene richiamata da un'interazione utente (conversazionale, bassa concomitanza) o da un trigger automatico (potenzialmente alta concomitanza)?
Questo determina se il blocco sincrono è accettabile o se è necessario uno schema asincrono.
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| Azioni Apex | Ideale per chiamate esterne e logica complessa | Una fase richiede una chiamata HTTP a un sistema remoto, una trasformazione dati personalizzata o una logica di gestione degli errori che supera le funzionalità dichiarative del flusso. Le azioni Apex espongono la piattaforma completa per l'integrazione pur rimanendo richiamabili dall'agente tramite l'annotazione @InvocableMethod. |
| Azioni di flusso (AutoLaunched) | Ideale per le fasi delle regole aziendali e le operazioni CRM leggere | Una fase applica una logica aziendale dichiarativa, esegue query o aggiorna record CRM o orchestra un processo che non richiede codice personalizzato. I flussi AutoLaunched sono richiamabili in modo nativo dai subagenti Agentforce e restituiscono variabili di output tipizzate utilizzate dall'agente per determinare la fase successiva. |
| Servizi esterni (importazione OpenAPI) | Ideale per l'integrazione API esterna digitata e individuabile | Un sistema esterno espone una specifica OpenAPI. Servizi esterni genera stub Apex fortemente tipizzati che possono essere chiamati direttamente come azioni agente, eliminando la mappatura manuale dello schema e rendendo visibili all'agente le operazioni dell'API esterna come funzionalità denominate. Ogni operazione nella specifica importata diventa un'azione denominata e richiamabile. L'agente seleziona le azioni in base alle etichette semantiche generate. Registrare le azioni generate nel Centro argomenti Agentforce in modo che l'agente possa scoprirle al momento del ragionamento. Nota: se il servizio ospitato esternamente è RESTful ma la specifica OpenAPI non è disponibile o non è redditizia, utilizzare le credenziali denominate in Apex o nei flussi per effettuare direttamente la chiamata HTTP. Apex Code è necessario per analizzare i risultati. |
| Azioni connesse MuleSoft | Ideale per integrazione di sistemi middleware complessi o legacy | Utilizzare quando il sistema remoto richiede la traduzione del protocollo, la trasformazione dei dati o l'orchestrazione in più sistemi di backend prima di restituire una risposta. L'agente effettua una singola chiamata a MuleSoft e MuleSoft gestisce la complessità a valle e restituisce una risposta unificata. |
Schizzo
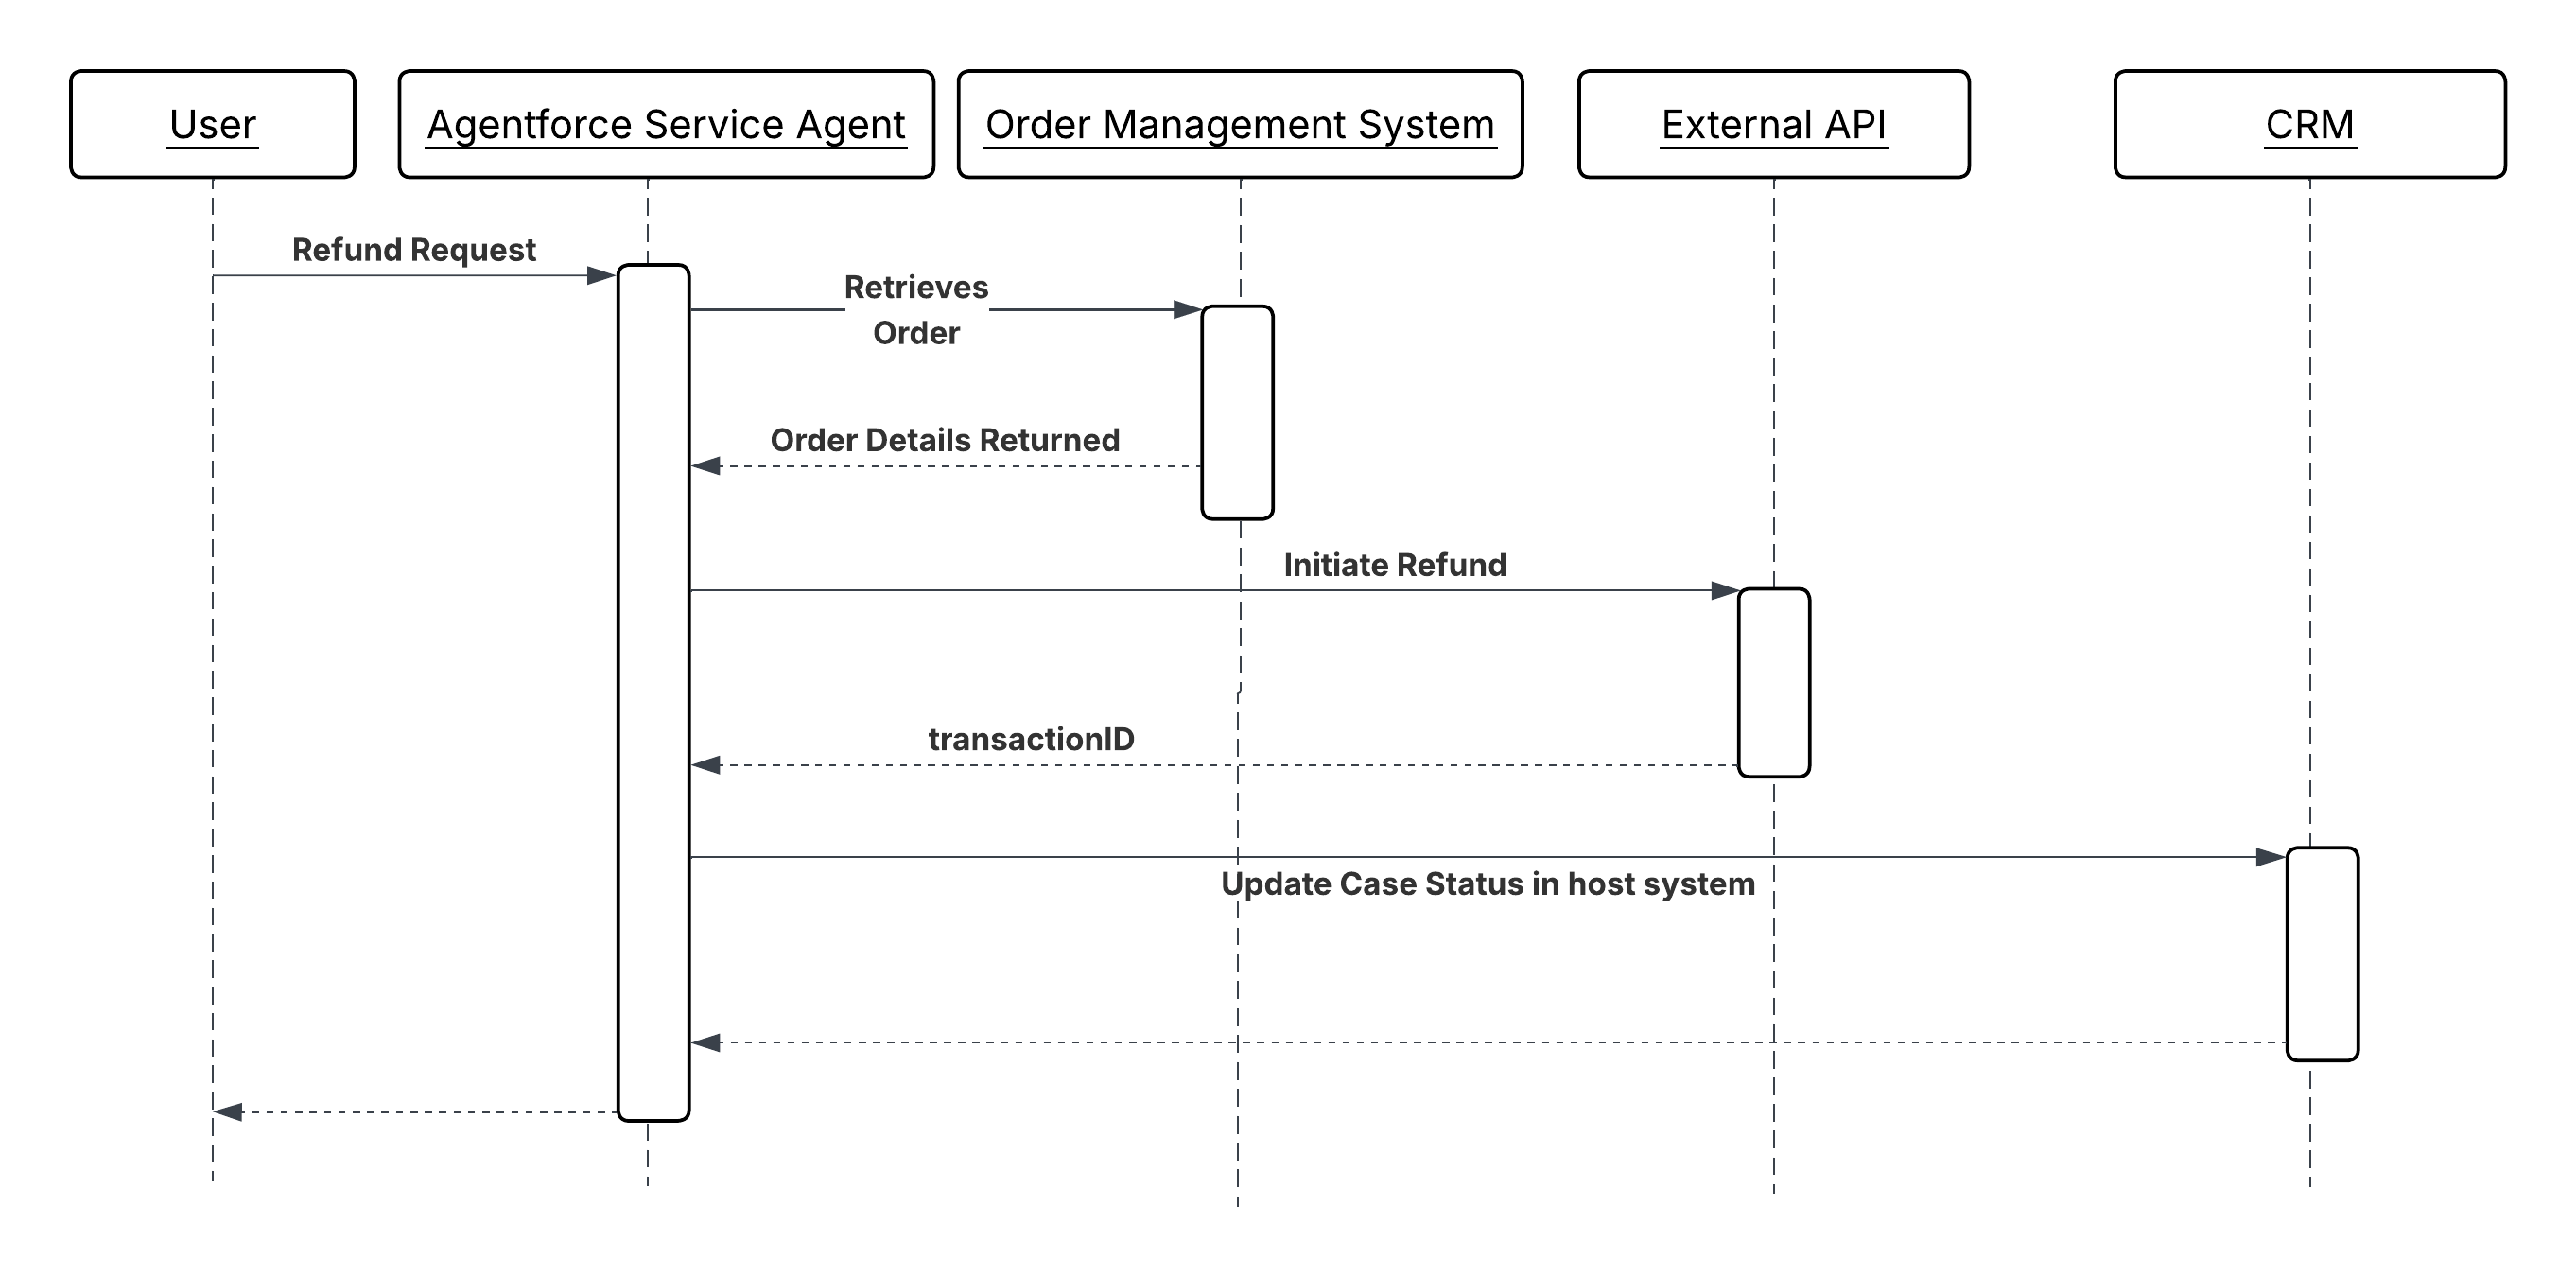
Diagramma di sequenza per l'invocazione di azioni sequenziali
Risultati
L'agente esegue un flusso di lavoro tra sistemi come sequenza coerente e supervisionata e non come script fire-and-forget. Il risultato di ogni fase viene valutato prima che venga richiamata la fase successiva, in modo che l'agente rilevi gli errori il prima possibile anziché scoprire il completamento parziale dopo il fatto.
Il sistema host (Salesforce CRM) viene aggiornato solo dopo che l'operazione remota ha confermato lo stato (esito positivo o negativo). Gli identificativi e lo stato restituiti dai sistemi esterni, ad esempio i numeri di account di fatturazione, gli ID transazione e i codici di conferma, vengono propagati attraverso la catena e mantenuti, creando un record completo e tracciabile dell'esito del flusso di lavoro.
L'agente è responsabile del ragionamento sui risultati e delle decisioni di sequenza. Ogni azione è responsabile solo del proprio funzionamento e della restituzione di un risultato strutturato. Nessuno dei due livelli codifica la logica dell'altro.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Assicurarsi che ogni azione nella catena riporti una descrizione semantica scritta in un linguaggio basato sugli intenti e non come firma tecnica del metodo. L'agente seleziona le azioni in base a queste descrizioni. Una descrizione che recita "chiama l'API di fatturazione" è meno utile di una che recita "crea un account di fatturazione nel sistema di fatturazione e restituisce il nuovo identificativo account".
- Rendere tutte le operazioni di scrittura nella catena idempotenti. Il loop di ragionamento dell'agente può ritentare un'azione se riceve una risposta ambigua. L'azione deve produrre lo stesso risultato in caso di invocazione ripetuta.
- Convalidare tutti i parametri di input dedotti da LLM in modo difensivo al confine dell'azione. Non presumere mai che i parametri passati dall'agente siano ben formati, compresi nell'intervallo o del tipo previsto.
- Progettare ogni azione per una singola responsabilità. Un'azione che crea un account di fatturazione e invia un'email di conferma nella stessa chiamata è più difficile da provare, testare e per l'agente ragionare su due azioni discrete.
Note sull'implementazione di Salesforce
- Per Azioni Apex, annotare con @InvocableMethod(label=’...’ description=’...’). La "descrizione" viene letta dall'agente per determinare quando invocare l'azione. Dichiarare tutte le variabili di input e output con @InvocableVariable utilizzando i campi descrittivi "etichetta" e "descrizione". Restituire oggetti risultato strutturati con indicatori espliciti di successo/fallimento e messaggi di errore in formato leggibile.
- Per le azioni, utilizzare esclusivamente i flussi AutoLaunched; i flussi schermata non sono supportati nei contesti degli agenti autonomi. Mantenere ogni flusso atomico; un'azione, una responsabilità. Configurare i percorsi di errore su ogni elemento di chiamata esterno per individuare gli errori di integrazione e restituire messaggi di errore fruibili all'agente anziché consentire alle eccezioni non rilevate di terminare la sessione.
- Per Servizi esterni, importare la specifica OpenAPI del sistema di destinazione e registrare le azioni generate nell'argomento Agentforce. Racchiudere gli stub generati nelle credenziali denominate per evitare endpoint o credenziali di codifica nella definizione dell'azione.
- Per tutte le chiamate esterne, impostare timeout di chiamata espliciti. Una chiamata sospesa senza timeout bloccherà il ciclo di ragionamento dell'agente fino a quando non viene raggiunto il limite della sessione. Restituire un errore non corretto con un messaggio di errore descrittivo quando viene superato il timeout. Tutte le chiamate esterne hanno un timeout configurabile fino a 120 secondi. Poiché sono anche soggette ai limiti del governor di transazioni sincrone Apex, assicurarsi di ridurre il rischio di istanziare più di 50 transazioni che vengono eseguite per più di cinque secondi ciascuna.
Gestione e ripristino degli errori
- L'agente chiude ogni fase in base al successo esplicito del predecessore della fase. Le azioni devono restituire un risultato strutturato che includa un chiaro indicatore di esito positivo o negativo. L'agente non può dedurre in modo affidabile un errore solo da una risposta mancante o nulla.
- Quando un'azione non riesce, l'agente utilizza il messaggio di errore restituito dall'azione per determinarne la mossa successiva: richiedere all'utente l'input corretto, tentare un tentativo di autoguarigione con parametri rettificati o arrestare la catena e registrare l'errore per la revisione umana. Pertanto, i messaggi di errore devono essere specifici e di immediato valore pratico: "Intervallo di date non valido: endDate non può precedere startDate" è utilizzabile; il solo codice di stato 400 non lo è.
- Per le catene in cui il completamento parziale crea uno stato incoerente (ad esempio, l'account di fatturazione è stato creato ma il record CRM non è stato aggiornato), l'agente invoca un'azione di risarcimento per ritirare o segnalare lo stato parziale prima di evidenziare l'errore. Progettare i percorsi di compensazione come azioni denominate insieme al percorso di avanzamento.
- Se un'azione di scrittura ha potenzialmente avuto esito positivo ma ha restituito una risposta ambigua (timeout rete, nessuna conferma), il nuovo tentativo deve utilizzare la stessa chiave idempotency o lo stesso ID riferimento esterno della chiamata originale. Non emettere mai un nuovo tentativo non controllato su una scrittura non idempotente.
Considerazioni sulla sicurezza
- Racchiudere tutte le chiamate esterne in credenziali denominate. Non codificare mai endpoint o credenziali in Apex Code o configurazioni di flusso. Questi devono essere gestiti tramite l'archivio credenziali sicuro della piattaforma e ruotati senza modifiche del codice.
- Applicare il principio dei privilegi minimi all'utente integrazione o all'applicazione connessa utilizzata da ogni azione. Un'azione che legge solo i dati dell'ordine non deve contenere autorizzazioni di scrittura sul sistema di fatturazione. Limitare le credenziali alle operazioni minime richieste dall'azione.
- Registrare l'invocazione di ogni azione nella catena con il relativo ID sessione, i parametri di input (disinfettati dai valori sensibili) e l'esito. Se il risultato è contestato, questo itinerario di controllo è il meccanismo principale per ricostruire il motivo per cui l'agente ha eseguito una determinata sequenza di azioni.
- Disinfettare tutti i parametri di input originati dal testo fornito dall'utente prima di trasmetterli a sistemi esterni. L'input dell'utente passato attraverso l'agente in una chiamata API esterna è un potenziale vettore di iniezione. Convalidare il tipo, il formato e l'intervallo al confine dell'azione prima di effettuare la chiamata.
Esempio
Un agente dell'assistenza clienti che gestisce una richiesta di rimborso esegue una catena sequenziale in quattro fasi:
GetOrderDetails(Azione Apex) recupera il record ordine dal sistema di gestione ordini utilizzando l'ID ordine fornito dall'utente. Restituisce lo stato dell'ordine, le voci, la data di acquisto e il metodo di pagamento. L'agente valuta se l'ordine è rimborsabile prima di procedere.ValidateRefundEligibility(AutoLaunched Flow) applica le regole aziendali per l'idoneità al rimborso, incluse la finestra di reso, le restrizioni delle categorie di prodotto e la cronologia dei rimborsi precedenti. Restituisce un valore booleano "idoneo" e, se non idoneo, un motivo per cui l'agente può essere visualizzato all'utente.InitiateRefund(Azione Apex) chiama l'API gateway di pagamento esterno con l'ID ordine e l'ammontare del rimborso. Restituisce un "refundTransactionId" in caso di esito positivo. Questa azione è idempotente. Se chiamato una seconda volta con lo stesso ID ordine, restituisce l'ID transazione esistente anziché creare un rimborso duplicato.UpdateCaseStatus(AutoLaunched Flow) aggiorna il record caso CRM con l'ID transazione rimborso, imposta lo stato del caso su "Risolto rimborso emesso" e crea un'operazione di follow-up per il titolare dell'account. Questo passaggio viene eseguito solo dopo che "InitiateRefund" ha restituito un ID transazione confermato.
Se InitiateRefund scade o restituisce un errore, l'agente arresta la catena, non invoca UpdateCaseStatus e visualizza un messaggio di immediato valore pratico per l'utente. Il caso rimane aperto e irrisolto, mantenendo lo stato preciso nel CRM.
Contesto
Le catene di azioni sequenziali sono efficienti quando le fasi di esecuzione sono dipendenti l'una dall'altra. Un passo porta il successivo. Tuttavia, molti flussi di lavoro contengono una serie di passaggi che non hanno interdipendenze. Ad esempio, le fasi che includono il recupero dell'inventario dei prodotti, il recupero dei diritti dei clienti e il controllo di un preventivo di spedizione possono avvenire tutte contemporaneamente, poiché nessun input di fase richiede l'output di un altro. L'esecuzione sequenziale di queste fasi fa perdere tempo in proporzione al numero di fasi.
In uno schema di invocazione parallelo, l'agente identifica che un insieme di azioni è indipendente e le invoca contemporaneamente anziché in sequenza. Il tempo di flusso di lavoro complessivo è legato all'azione individuale più lenta anziché alla somma di tutti i tempi dell'azione. Una volta restituiti tutti i risultati, l'agente li aggrega in un'unica risposta coerente o li utilizza insieme come input per la fase successiva del ragionamento.
La sfida architettonica chiave non è l'invocazione parallela in sé. Gestisce il fan-out entro i vincoli di concomitanza della piattaforma e garantisce che la fase di aggregazione gestisca gli errori parziali con grazia, senza scartare i risultati che hanno avuto esito positivo.
Problema
In che modo un agente orchestra in modo efficiente l'esecuzione simultanea di più funzionalità indipendenti e aggrega i singoli risultati in un'unica risposta coerente per l'utente o nelle fasi successive?
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
- Quali sono le considerazioni per le azioni relative alla sicurezza del thread e alla condivisione dello stato variabile?
- Come gestirà la soluzione ed eviterà di superare i limiti del governor Salesforce per le chiamate Apex parallele all'interno di una singola transazione?
- È necessario utilizzare schemi asincroni (ad esempio Apex in area di attesa o Eventi piattaforma) per evitare i limiti del governor?
- L'aggregazione sincrona dei risultati è necessaria prima che l'agente possa procedere?
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| Approccio middleware | Ideale per i fan out elevati (>5 endpoint) e l'aggregazione multipiattaforma | È necessario un livello middleware. L'agente effettua una chiamata al middleware. Quindi, i ventilatori middleware che eseguono fino a 10 sistemi in parallelo, aggregano i dati e inviano una singola risposta all'agente. Questo è preferibile quando l'agente deve chiamare molti sistemi esterni eterogenei. Il middleware assorbe la complessità del fan-out e restituisce una singola risposta aggregata. |
| Apex in area di attesa | Ideale per il parallelismo interno Salesforce | È necessario attivare più processi in attesa. Mentre Salesforce gestisce l'area di attesa, se il limite di simultaneità è sufficiente, queste possono essere eseguite contemporaneamente. Utilizzare quando le operazioni parallele sono all'interno dell'organizzazione Salesforce e sono disponibili finestre di concomitanza. Non è adatto quando è richiesta una risposta aggregata immediata. |
| Eventi piattaforma | Ideale per dimenticare il fuoco o per una coerenza finale | Non è necessario aggregare i risultati in modo sincronizzato. Ogni evento attiva una transazione isolata, massimizzando la produttività ma richiedendo la riconciliazione a valle. Utilizzare questo meccanismo quando la coerenza finale è accettabile e la produttività è più importante della latenza di risposta. |
Schizzo
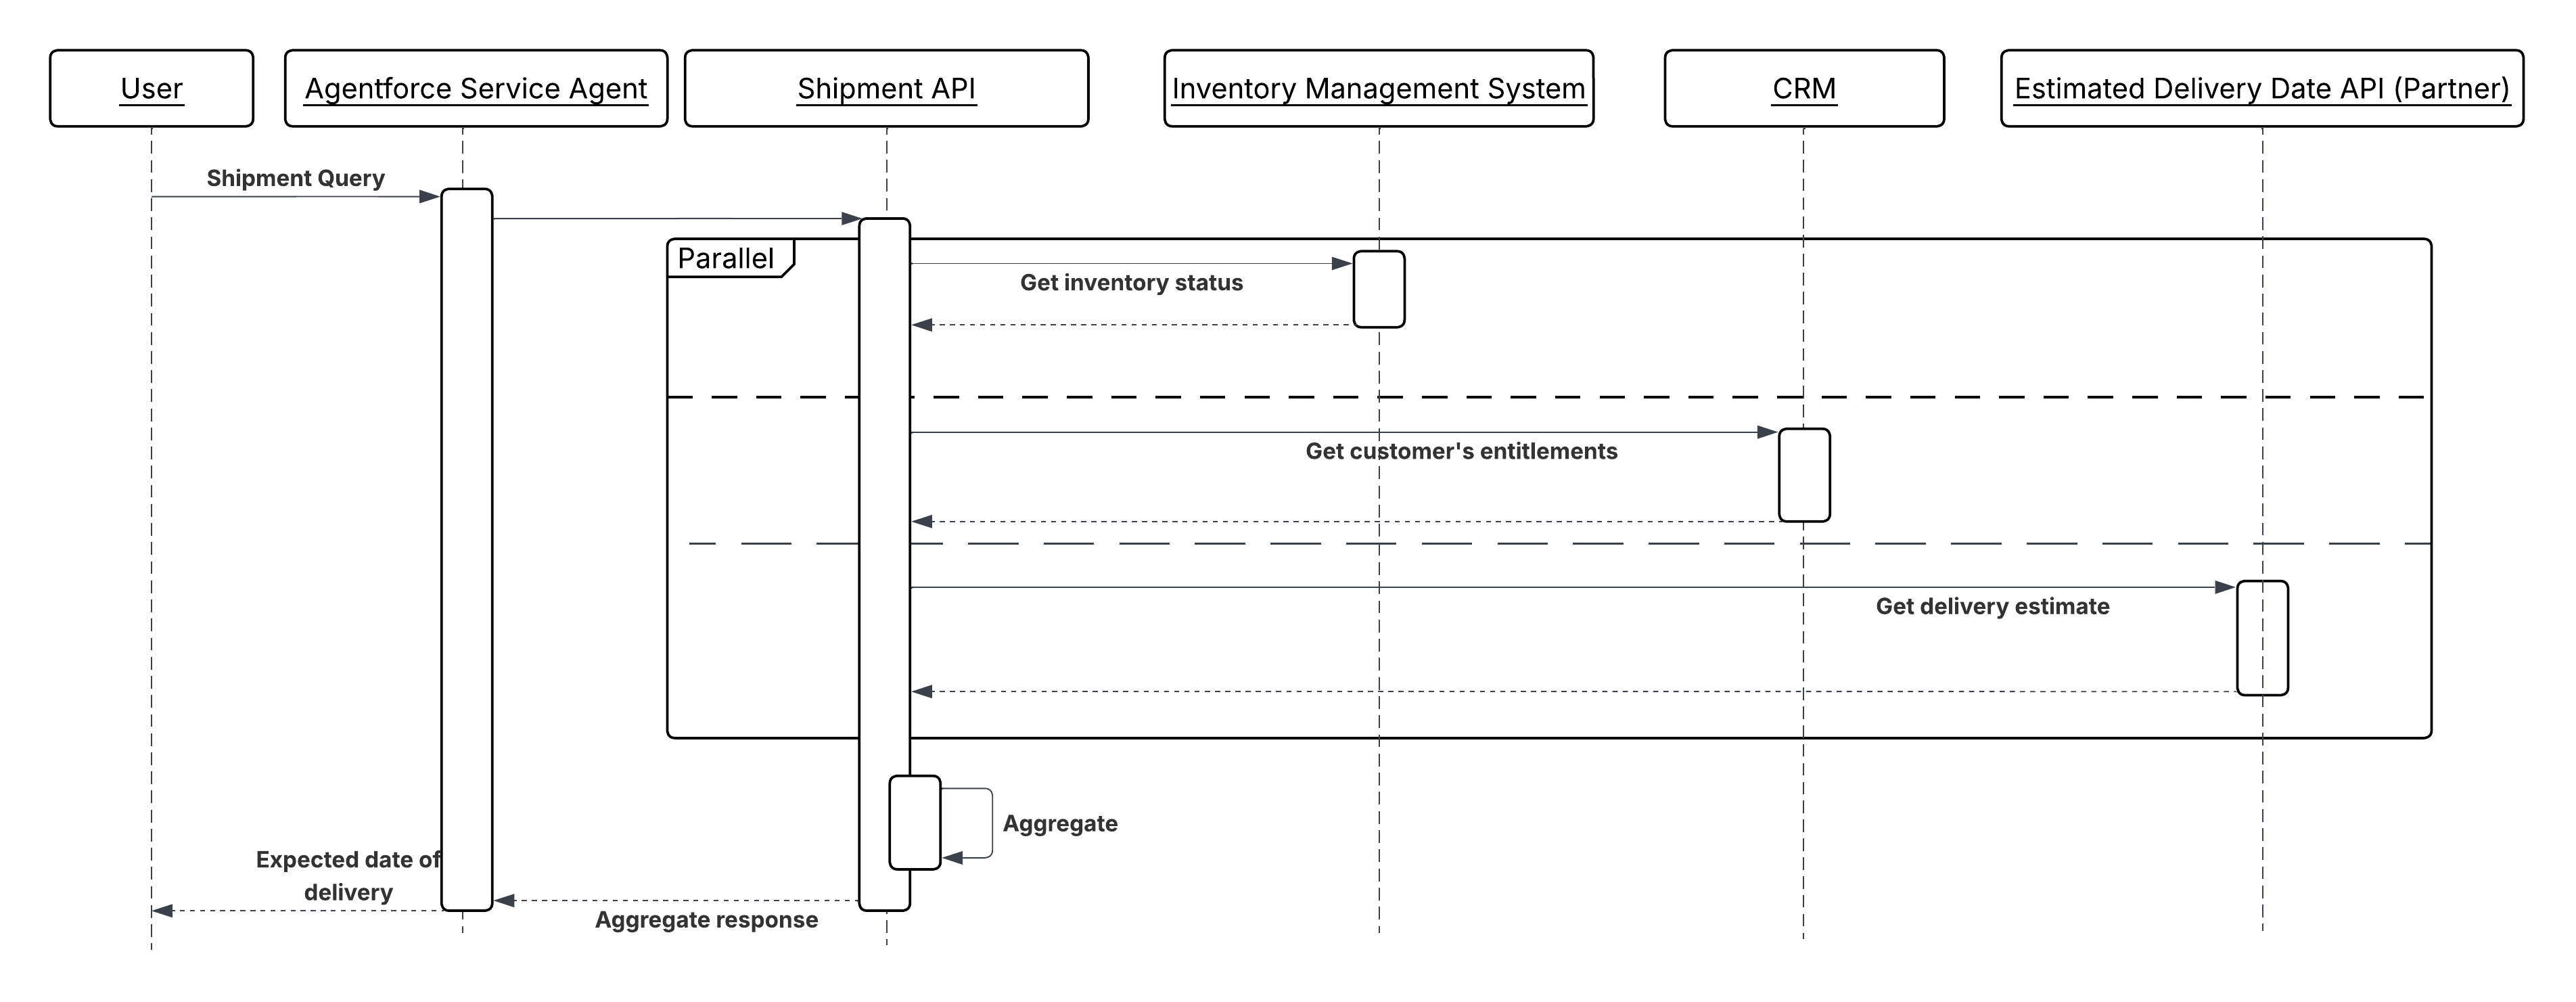
Diagramma di sequenza per l'invocazione di azioni parallele
Risultati
Quando le azioni indipendenti vengono eseguite in parallelo, il tempo di flusso di lavoro end-to-end è legato all'azione individuale più lenta anziché alla somma di tutte le azioni. Per un flusso di lavoro con tre chiamate indipendenti della media di 300 ms ciascuna, l'esecuzione parallela viene completata in ~300 ms; l'esecuzione sequenziale richiede ~900 ms. Su larga scala, questa differenza si somma in ogni sessione agente in esecuzione simultanea.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Confermare l'indipendenza prima di procedere al parallelismo. Le azioni possono essere eseguite in parallelo solo se nessuna delle due legge lo stato scritto dall'altra e se l'errore di nessuna delle due azioni annulla l'altra. Se esiste una dipendenza, anche soft, utilizzare invece il concatenamento sequenziale.
- Progettare esplicitamente la fase di aggregazione. Definire in anticipo l'aspetto di un insieme di risultati completo, il significato di un insieme di risultati parziale per il ragionamento a valle e se l'agente deve attendere tutti i risultati o procedere una volta restituita una soglia (ad esempio, cinque chiamate totali su sette).
- Tutte le operazioni di scrittura parallela devono essere idempotenti. Ogni operazione viene eseguita isolatamente senza un confine di transazione condiviso, quindi riprovare qualsiasi singolo branch non può duplicare gli effetti collaterali.
Note sull'implementazione di Salesforce
- Per Queueable Apex: Inviare tutti i processi in un'unica transazione per aumentare al massimo la possibilità di esecuzione simultanea. Tenere presente che le finestre di concomitanza disponibili sono condivise in tutta l'organizzazione; progettare partendo dal presupposto che le finestre potrebbero non essere sempre disponibili e creare un fallback all'esecuzione sequenziale quando non lo sono.
- Per gli eventi piattaforma: Scrivere il risultato di ogni operazione in un record di gestione temporanea dedicato (con la chiave di un ID correlazione condiviso) anziché aggiornare direttamente il record di destinazione. Un trigger Flusso di aggregazione finale o Apex legge tutti i record di gestione temporanea una volta raggiunto il conteggio previsto, quindi applica l'aggiornamento consolidato in modo atomico.
- Per Middleware Fan-Out: Impostare un timeout esplicito per la singola chiamata che sia più lungo del tempo di risposta nel peggiore dei casi previsto per il backend più lento, ma comunque entro il limite di timeout della chiamata Salesforce. Il middleware restituisce risultati parziali con una chiara indicazione dei backend non riusciti, anziché calcolare il timeout dell'intera risposta.
Gestione e ripristino degli errori
- Considerare il successo parziale come un risultato di prima classe. Se tre o quattro operazioni parallele hanno esito positivo, l'agente utilizza i tre risultati riusciti e gestisce l'errore facendolo emergere esplicitamente all'utente, registrandolo per un nuovo tentativo o invocando un'azione compensativa anziché scartare tutti i risultati o procedere come se l'errore non si fosse verificato.
- Per gli schemi Area di attesa ed Evento piattaforma, utilizzare un ID correlazione (generato in corrispondenza del fan-out) per collegare tutti i rami paralleli alla sessione agente di origine. Questo ID è necessario per riassemblare i risultati e tracciare gli errori fino all'origine nei registri.
- Se un branch parallelo ha esito negativo e l'operazione può essere ritentata, accodare nuovamente solo il branch guasto utilizzando l'ID correlazione e la chiave idempotency originali. Non invocare nuovamente tutti i rami.
- Definire una soglia di timeout per la fase di aggregazione. Se non tutti i risultati arrivano entro la soglia, procedere con i risultati disponibili e contrassegnare l'insieme incompleto anziché attendere all'infinito.
Considerazioni sulla sicurezza
- Ogni contesto di esecuzione parallela, sia che si tratti di un processo in attesa, di un trigger evento piattaforma o di una chiamata middleware, deve applicare gli stessi controlli di accesso di una chiamata sequenziale. Il parallelismo non riduce le regole di accesso ai dati. Ogni branch deve operare con la stessa credenziale con privilegi minimi che verrebbe invocata da sola.
- Per il fan-out del middleware, il livello middleware non memorizza nella cache né registra i payload delle risposte dai singoli backend oltre la finestra di aggregazione. Ogni risposta di backend può contenere dati sensibili che non devono persistere al di fuori dell'ambito dell'operazione immediata.
- Assicurarsi che i record di gestione temporanea utilizzati per l'aggregazione degli eventi piattaforma non siano leggibili dall'utente finale dell'agente. Questi record possono contenere dati intermedi parzialmente formati non ancora idonei al consumo.
Esempio
Un agente dell'assistenza risponde a una domanda di evasione complessa: "Può spedirmi questo ordine entro venerdì?" La risposta richiede i dati di tutti i sistemi indipendenti contemporaneamente, come spiegato di seguito:
- L'agente identifica tre esigenze di dati indipendenti: il livello di inventario corrente, i diritti attivi del cliente e la finestra di consegna stimata dell'operatore per la posizione del cliente.
- Vengono richiamate tre azioni in parallelo:
GetInventoryStatus(dal sistema di inventario esterno tramite middleware),GetCustomerEntitlements(da Salesforce CRM) eGetDeliveryEstimate(dall'API operatore tramite middleware). - Ogni azione viene restituita in modo indipendente. L'agente attende finché non vengono ricevute tutte e tre le risposte (o finché non viene raggiunto il timeout di aggregazione).
- Con tutti e tre i risultati disponibili, l'agente ragiona sui dati combinati, valutando se l'inventario è sufficiente, il diritto del cliente copre la spedizione espressa e il corriere conferma che la consegna del venerdì è fattibile per il codice postale del cliente.
- L'agente restituisce all'utente un'unica risposta basata su dati provenienti da tre sistemi, nel tempo impiegato dalla più lenta delle tre chiamate per rispondere.
Contesto
Alcune operazioni avviate dall'agente non producono un risultato necessario all'agente per continuare il ciclo di ragionamento corrente. L'invio di una notifica, l'attivazione di un processo batch a valle, la pubblicazione di un evento in un'area di attesa messaggi o l'invio di un processo di lunga durata sono tutte operazioni in cui l'obbligo dell'agente termina con l'invio; il sistema a valle ne assume la proprietà e completa il lavoro in modo indipendente.
Nell'automazione tradizionale, questi sono modellati come chiamate "fire-and-forget" o pubblicazioni di eventi piattaforma. In un sistema agente, l'agente decide durante il ragionamento che l'operazione non è un blocco, la manda, registra la conferma dell'invio e continua o conclude il turno senza attendere l'esito a valle.
Questo schema è la controparte agente della guida Remote Process Invocation – Fire and Forget from the Integration Patterns. Lo schema agente lo estende rendendo la decisione di invio parte del ragionamento dell'agente e assicurando la tracciabilità dell'invio anche se non viene restituita alcuna risposta all'agente.
Problema
Quando un agente deve avviare un'operazione a valle che va oltre la sessione o il ciclo di ragionamento dell'agente, è necessario affrontare tre sfide:
- Invocazione non bloccante: L'agente deve attivare l'operazione e confermare la consegna senza tenere aperto il ciclo di ragionamento in attesa di un risultato.
- Conferma di consegna: L'agente deve distinguere tra un invio riuscito (il messaggio è stato accettato) e un esito positivo (il processo a valle è stato completato). Può solo affermare il primo.
- Tracciabilità: Poiché l'agente non riceve alcun risultato, l'operazione deve essere osservabile tramite registri, record evento o monitoraggio piattaforma indipendentemente dalla sessione dell'agente.
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
-
L'agente necessita del risultato di questa operazione per completare il turno corrente? Se sì, questo non è lo schema giusto. Utilizzare invece Invocazione azione sequenziale.
-
Il sistema a valle è in grado di ricevere ed elaborare in modo affidabile il messaggio o l'evento inviato senza una conferma sincrona? Il sistema di destinazione deve essere durevole. Non deve perdere il messaggio se è temporaneamente non disponibile.
-
L'operazione è idempotente o è necessario proteggere l'invio duplicato? I tentativi a livello di rete e i tentativi di ragionamento degli agenti possono causare più di una volta il tentativo dello stesso invio. Se l'operazione a valle non è idempotente, l'azione deve contenere una chiave di deduplica.
-
L'utente o un processo a valle deve sapere quando viene completata l'operazione? L'agente può solo confermare l'invio. Se è richiesto lo stato di completamento, progettare un meccanismo separato di notifica o follow-up. Evento piattaforma, aggiornamento di un caso o richiamata - che non rientra in questo ciclo di ragionamento.
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| API Pub/Sub | Ideale per lo streaming di eventi esterni o ad alta produttività | L'agente invoca un'azione Apex che pubblica un evento nell'API Salesforce Pub/Sub su gRPC. L'azione restituisce un replayId PublishResult all'agente come conferma dell'invio. Utilizzare quando i consumatori a valle sono sistemi esterni che si abbonano tramite l'API Pub/Sub anziché trigger Flusso o Apex nativi di Salesforce o quando è richiesto lo streaming di eventi a elevata produttività. |
| Eventi piattaforma (Apex Action) | Ideale per l'invio asincrono intra-Salesforce | L'agente invoca un'azione Apex che pubblica un evento piattaforma. L'evento viene consegnato a tutti gli abbonati in modo asincrono. L'azione restituisce una conferma di pubblicazione all'agente; non restituisce un esito dell'elaborazione. Utilizzato quando il consumatore a valle si trova all'interno della piattaforma Salesforce. L'agente invoca un'azione Apex che chiama EventBus.publish(). L'azione restituisce un SaveResult che conferma l'accettazione. |
| Apex Queueable / Batch (Azione Apex) | Ideale per l'elaborazione in background di lunga durata | L'agente invoca un'azione Apex che inserisce in area di attesa un processo Area di attesa o Batch. Il processo viene eseguito all'esterno della transazione dell'agente. L'azione restituisce un ID processo che l'agente può presentare all'utente come riferimento. Utilizzato quando il lavoro a valle è un'operazione di Salesforce di lunga durata che elabora i dati, aggiorna più oggetti o chiama chiamate esterne che superano i limiti sincroni. System.enqueueJob() restituisce un ID processo registrato dall'agente come riferimento. |
| Flusso asincrono MuleSoft | Ideale per l'invio di messaggi esterni all'area di attesa | L'agente invoca un'azione MuleSoft esposta che inserisce un messaggio in un'area di attesa esterna (Kafka, JMS, SQS). MuleSoft gestisce la traduzione del protocollo e la conferma di consegna. L'agente riceve la conferma che il messaggio è stato accettato da MuleSoft, non che è stato elaborato a valle. |
| Endpoint REST esterno (Apex Action) | Ideale per l'invio di eventi di sistema esterni | Il sistema di destinazione espone un endpoint che accetta un invio e restituisce immediatamente un ID di conferma, completando l'elaborazione in modo asincrono. L'agente riceve l'ID conferma e lo registra. |
Schizzo
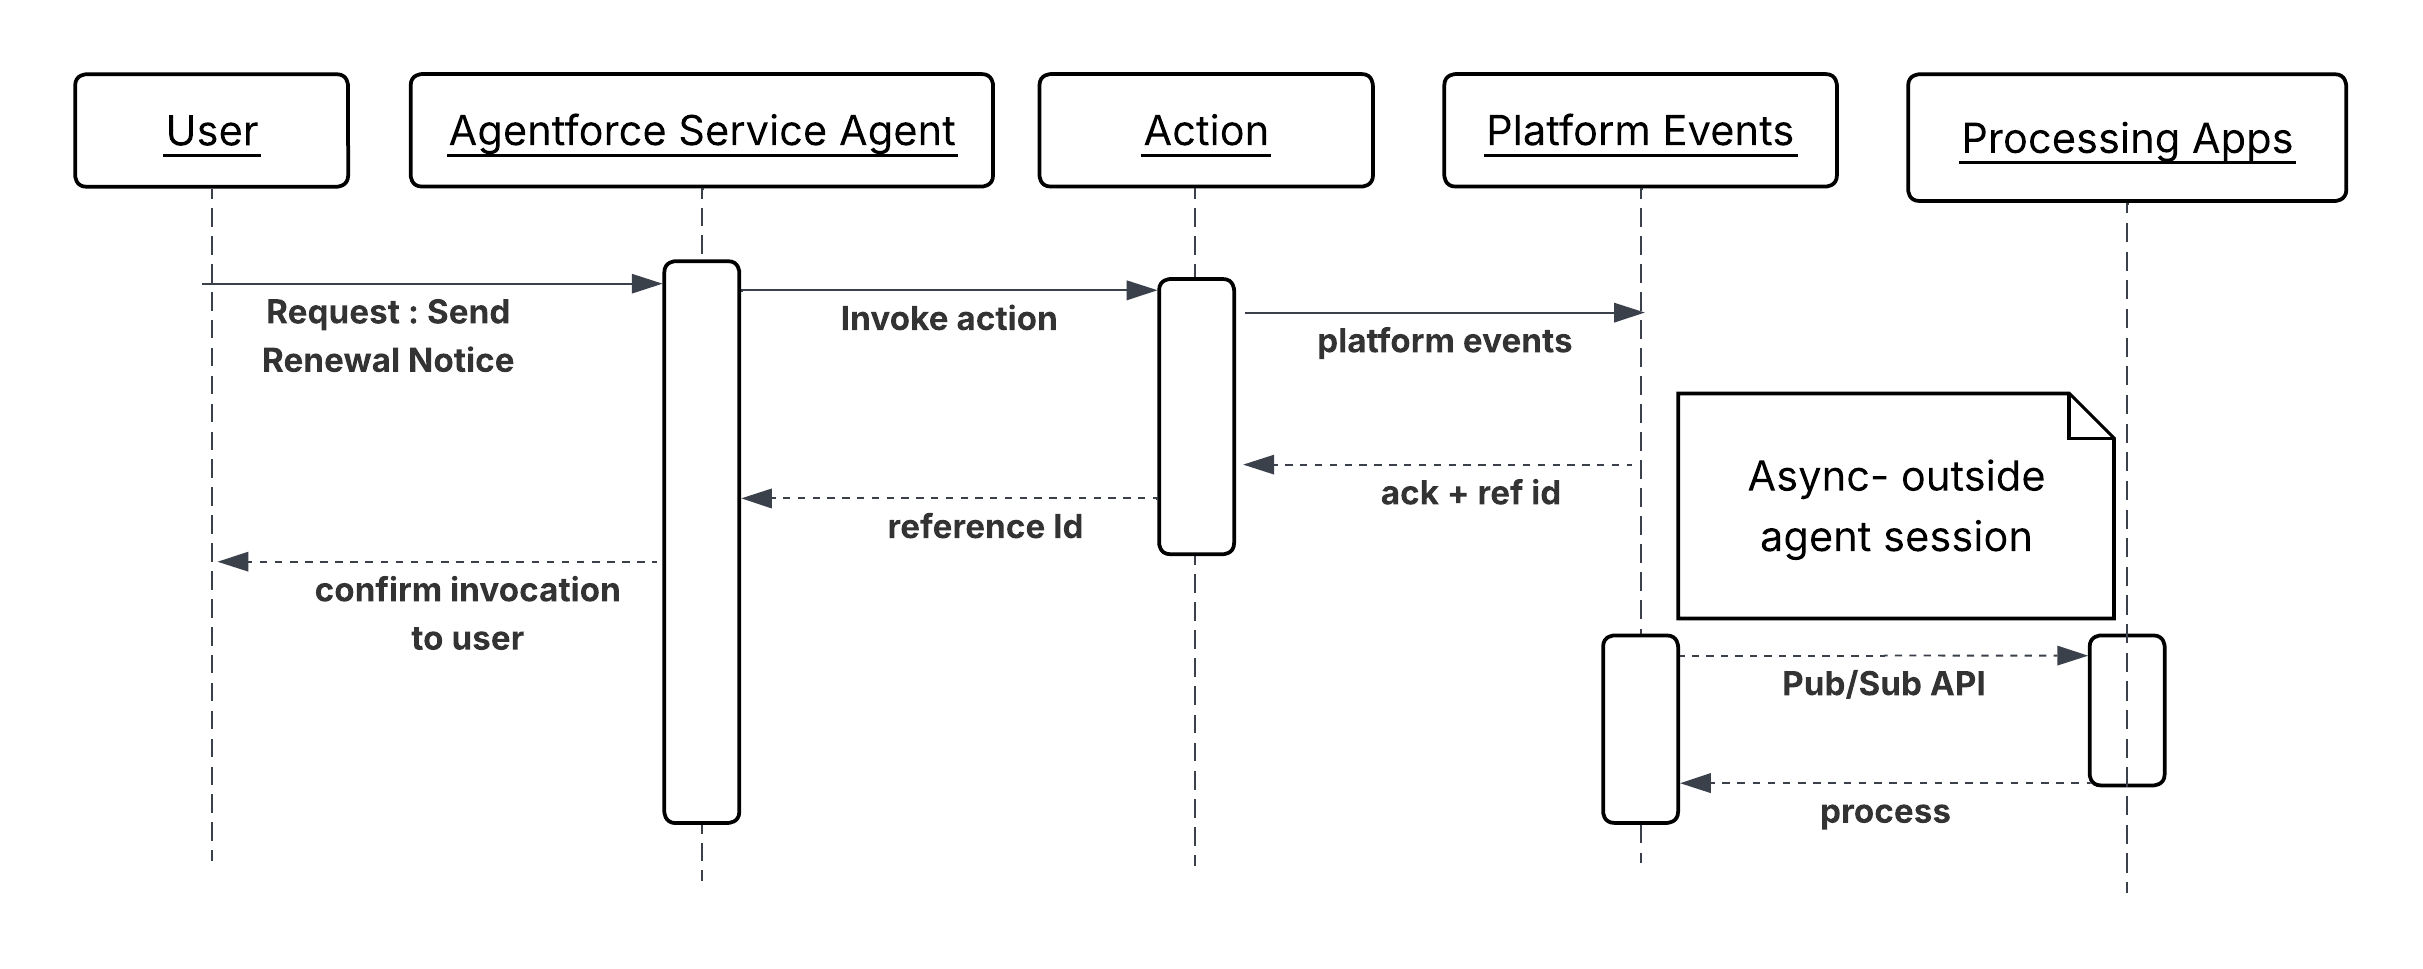
Diagramma di sequenza per l'invocazione di azioni asincrone
Risultati
L'agente invoca un'operazione a valle senza bloccarne il ciclo di ragionamento sull'esito. Il turno viene completato con la conferma che l'operazione è stata accettata, non che è stata completata. Il sistema a valle assume la piena proprietà dell'esecuzione. L'operazione inviata è tracciabile tramite gli abbonati agli eventi piattaforma, gli ID processo o gli ID di conferma dell'area di attesa esterna registrati nel CRM al momento dell'invio. Se l'operazione a valle non riesce, l'errore viene evidenziato attraverso il monitoraggio del sistema a valle, non attraverso la sessione dell'agente che l'ha avviata.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Scrivere le descrizioni delle azioni in un linguaggio basato sugli intenti. Ad esempio, "Invia una notifica di rinnovo all'area di attesa di messaggistica e restituisce un ID riferimento spedizione" è più utile per l'agente che "chiama l'endpoint di notifica".
- Non descrivere mai un'azione di invio come "invia e conferma la consegna di". L'agente può solo confermare l'accettazione. La consegna e l'elaborazione a valle non sono osservabili dall'agente.
Note sull'implementazione di Salesforce
- Restituire un ID riferimento da ogni azione di invocazione, ad esempio Evento piattaforma
ReplayId, ID processo inseribile nell'area di attesa, replayId API PPublishResultub/Sub o token di conferma esterno. Registrarlo in un record CRM al momento della chiamata. Questo è l'unico itinerario di controllo prodotto dalla sessione agente. - Per l'API Pub/Sub, l'agente invoca un'azione Apex che esegue una chiamata gRPC all'endpoint "/Publish" dell'API Pub/Sub. L'azione deve gestire la fase di registrazione dello schema - gli eventi devono essere serializzati in formato Avro rispetto allo schema registrato. Restituire il
PublishResult ‘replayId’all'agente come riferimento dell'invio. - Per Eventi piattaforma, chiamare
EventBus.publish()all'interno dell'azione Apex e controllare la presenza di errori in SaveResult prima di restituire un indicatore di esito positivo all'agente. Non presumere che la pubblicazione sia riuscita; convalidarla. - Per Processi in attesa, implementare l'interfaccia In attesa e chiamare System.enqueueJob() dall'interno dell'azione. Restituire l'ID AsyncApexJob risultante all'agente.
- Per gli endpoint asincroni esterni, l'endpoint di destinazione deve restituire immediatamente una conferma (HTTP 202 accettato) con un ID riferimento. Se l'endpoint si blocca fino al completamento dell'elaborazione, è sincrono e questo schema non si applica.
Gestione e ripristino degli errori
- Un'azione di invocazione deve distinguere tra errore di invio (il messaggio non è stato accettato) e errore di elaborazione (il messaggio è stato accettato ma l'operazione a valle non è riuscita in seguito). L'agente può gestire solo il primo.
- Se l'invocazione non riesce, l'azione deve restituire un errore strutturato con un motivo chiaro. L'agente può ritentare l'invio, inoltrarlo al livello superiore a un utente o registrare un record invio non riuscito, ma non può recuperare un errore di elaborazione a valle nella stessa sessione.
- Per le operazioni in cui alla fine deve emergere un errore a valle, progettare un loop di feedback separato come un evento piattaforma pubblicato dal processo a valle, un flusso pianificato che controlla lo stato del processo o un caso di follow-up esterno alla sessione dell'agente.
Considerazioni sulla sicurezza
- Racchiudere tutte le chiamate asincrone esterne in credenziali denominate. L'azione di invocazione non incorpora URL endpoint o credenziali nel codice.
- Convalidare e disinfettare tutti i parametri passati all'azione di invocazione prima di incorporarli nel payload dell'evento o nel corpo del messaggio. Il testo fornito dall'utente passato in un messaggio asincrono è un potenziale vettore di iniezione nel consumatore a valle.
- Registrare ogni invio con ID sessione, ID riferimento e payload disinfettato al momento dell'invio. Poiché all'agente non viene restituita alcuna risposta, questo registro è il meccanismo principale per ricostruire ciò che l'agente ha avviato.
- Applicare i privilegi minimi all'utente integrazione o all'applicazione connessa. Un'azione di invio che viene pubblicata in un'area di attesa di notifica non deve contenere credenziali che consentono letture o scritture su sistemi non correlati.
Esempio
Un agente di gestione dei rinnovi che gestisce un contratto prossimo alla scadenza determina che il cliente è idoneo per una notifica di rinnovo automatico. L'agente non ha bisogno di confermare che l'email è stata consegnata prima di concludere il turno.
CheckRenewalEligibility(AutoLaunched Flow) valuta le condizioni del contratto, il livello del cliente e lo stato di rifiuto esplicito. Restituisce un valore booleano "idoneo" e il canale di notifica preferito.DispatchRenewalNotification(Azione Apex) pubblica un Evento piattaformaRenewalNotification\_\_econtenente l'ID contratto, l'ID cliente, il canale di notifica e una chiave di impotenza generata. Restituisce un ReplayId che conferma che l'evento è stato accettato dalla piattaforma.UpdateContractRecord(AutoLaunched Flow) scrive l'indicazione oraria delReplayIde dell'invio nel record Contratto e imposta un flag di stato "Notifica inviata".
Contesto
Applicazioni esterne come portali clienti, app mobili, piattaforme SaaS di terze parti e sistemi partner devono invocare gli agenti a livello di programmazione per gestire le richieste di assistenza, avviare flussi di lavoro o presentare risposte basate sull'intelligenza artificiale all'interno delle proprie interfacce. L'agente funge da servizio di backend intelligente. Il sistema esterno fornisce il contesto, i motivi e gli atti dell'agente e il chiamante consuma la risposta.
Sempre più spesso, il chiamante è esso stesso un agente AI o un orchestratore anziché un'applicazione rivolta all'uomo. In questi schemi da AI a AI, un agente orchestratore delega una fase di ragionamento, una ricerca CRM o un'azione ad Agentforce come chiamata strumento discreta. È necessario esporre un server MCP (Model Context Protocol) per supportare questo schema.
Problema
Quando un sistema esterno o un agente di intelligenza artificiale deve sfruttare le funzionalità di un agente Agentforce su richiesta, come può eseguire l'autenticazione, creare una sessione dell'agente, passare i dati conversazionali e contestuali necessari e ricevere in modo affidabile la risposta strutturata dell'agente per guidare la propria logica a valle?
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
- Il chiamante esterno si aspetta una risposta sincrona a bassa latenza o una richiamata asincrona è accettabile?
- Come viene stabilita e propagata l'identità del chiamante nel contesto di esecuzione dell'agente per l'accesso ai dati e la personalizzazione?
- Qual è il volume previsto di sessioni attivate dall'API simultanee e come interagisce con il tasso API Salesforce e i limiti di concomitanza?
- Il sistema esterno deve mantenere la continuità della sessione in più turni (conversazione a più turni) o ogni richiesta è apolide?
- Come deve essere strutturata la risposta dell'agente in modo che il sistema chiamante possa analizzarla ed eseguire azioni a livello di programmazione?
- Il chiamante è un'applicazione rivolta all'uomo che richiede un'integrazione REST diretta o un agente AI o un orchestratore che può invocare Agentforce come strumento tramite un protocollo standard, ad esempio MCP?
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| API Agentforce Agent - Single-Turn (Sincrona) | Ideale per le integrazioni stateless richiesta-risposta | Il sistema di chiamata richiede una risposta immediata e strutturata e il ragionamento dell'agente dovrebbe essere completato entro la tolleranza di timeout del chiamante. Il sistema chiamante gestisce le fasi del ciclo di vita completo della sessione: creazione, turni e terminazione. Il sistema esterno esegue l'autenticazione, crea una sessione con variabili di contesto, invia un singolo messaggio, riceve la risposta dell'agente e chiude la sessione. Questa API Agentforce è l'interfaccia REST principale attraverso la quale i sistemi esterni creano sessioni, scambiano messaggi e chiudono le sessioni a livello di programmazione. L'intero scambio viene completato entro un ciclo di richiesta-risposta HTTP. Le risposte includono l'output in linguaggio naturale dell'agente e tutte le variabili di output strutturate prodotte dalle azioni invocate dall'agente durante il ragionamento. |
| API Agentforce Agent - Multi-Turn (continuità della sessione) | Ideale per le integrazioni conversazionali che richiedono lo stato in più turni | L'interfaccia esterna è conversazionale (ad esempio, un widget chat o un'interfaccia vocale) e l'interazione richiede più scambi per raggiungere una risoluzione. Il sistema esterno crea una sessione una volta e riutilizza l'ID sessione in più scambi di messaggi. L'agente mantiene il contesto di conversazione tra turni come domande precedenti, dati recuperati, decisioni prese senza che il chiamante li fornisca nuovamente. |
| Asincrono con polling o richiamata Webhook | Ideale per flussi di lavoro di ragionamento ad alta latenza o interfaccia utente sensibile al tempo | Il tempo di elaborazione dell'agente non è banale e tenere una connessione HTTP aperta comprometterebbe l'esperienza utente del chiamante o attiverebbe timeout a monte. Il sistema esterno invia la richiesta e riceve immediatamente una conferma con un processo o un ID sessione. Quindi esegue il polling di un endpoint di stato o registra un webhook per ricevere la risposta dell'agente al termine del ragionamento. Attualmente, questo schema può essere implementato con un'API wrapper ospitata su un middleware come MuleSoft. Il consumatore esterno invoca questa API Wrapper e registra l'endpoint webhook. L'API Wrapper invia nuovamente la conferma al sistema esterno dopo aver invocato l'agente Agentforce. Questa API wrapper gestisce anche la sessione dell'agente Agentforce e restituisce la risposta al sistema esterno utilizzando l'endpoint webhook registrato una volta che l'agente risponde. |
| Agentforce tramite MCP (Salesforce Headless 360) | Ideale per la chiamata da AI a AI in cui il chiamante è un client compatibile con MCP | Il client MCP chiamante invoca Agentforce come strumento tramite il server MCP pronto all'uso fornito da Salesforce Headless 360. Il ciclo di vita della sessione è gestito in modo trasparente dal server MCP e l'agente chiamante interagisce tramite la chiamata standard senza creare un'integrazione REST personalizzata. Utilizzare questa soluzione quando il chiamante è un client MCP che deve delegare il ragionamento, il recupero del contesto CRM o l'esecuzione di azioni ad Agentforce come fase discreta in un flusso di lavoro agente più ampio. |
Schizzo
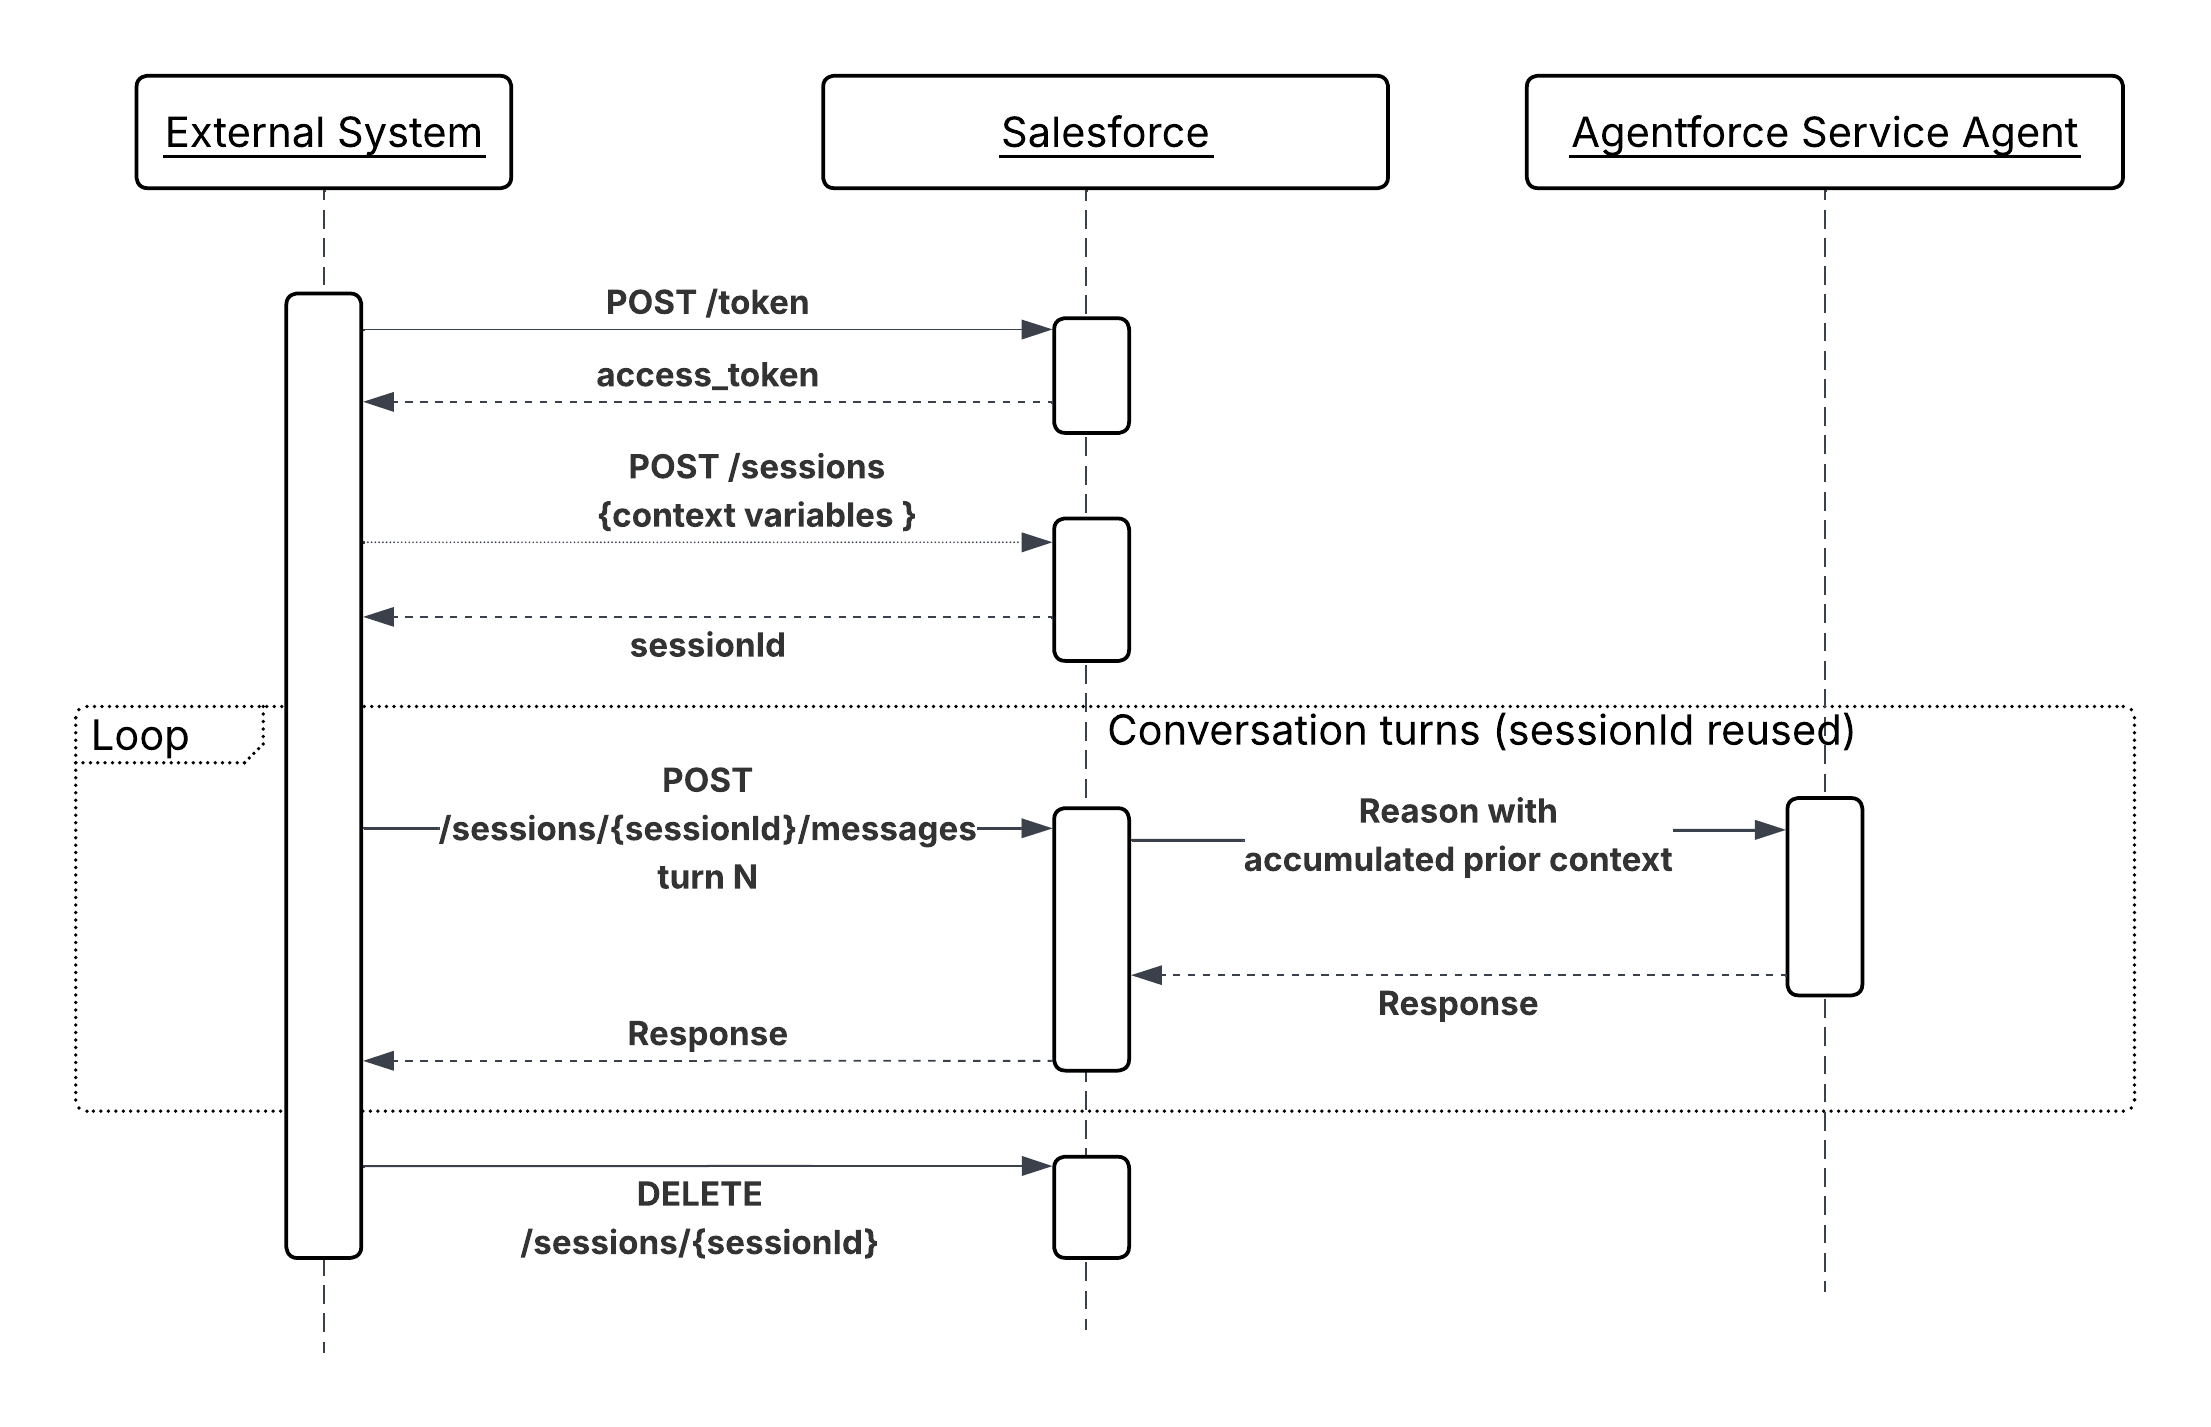
Diagramma di sequenza per l'invocazione agente on-demand
Risultati
Questo schema espone Agentforce come servizio di intelligenza artificiale chiamabile. I sistemi esterni ottengono l'accesso al ragionamento, agli strumenti e al contesto CRM dell'agente senza replicare tale logica. Il chiamante rimane responsabile della gestione del ciclo di vita della sessione e del rendering della risposta. L'agente rimane responsabile di tutti i ragionamenti, della selezione degli strumenti e della sintesi delle risposte.
Quando il chiamante è un agente AI o un orchestratore, il meccanismo Agentforce tramite MCP (disponibile pronto all'uso tramite Salesforce Headless 360) elimina completamente la necessità di un'integrazione REST personalizzata. Il server MCP gestisce il ciclo di vita della sessione per conto dell'agente chiamante, consentendo a Agentforce di partecipare come strumento di prima classe ai flussi di lavoro multi-agente senza alcun impianto idraulico aggiuntivo.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Evitare di rendere sincrona la chiamata API esterna e il blocco nei flussi dell'interfaccia utente sensibili al tempo. Adottare uno schema di richiamata di polling o webhook in cui i tempi di risposta dell'agente non sono banali per separare l'esperienza utente dal tempo di elaborazione dell'agente.
- Selezionare il meccanismo di chiamata in base alla natura del chiamante e non alla disponibilità. Le applicazioni rivolte all'uomo e le integrazioni di sistemi devono utilizzare direttamente l'API agente. Gli strumenti che supportano gli MCP devono utilizzare il server MCP Agentforce. La combinazione di meccanismi per lo stesso tipo di chiamante aggiunge una complessità inutile senza vantaggi architetturali.
Note sull'implementazione di Salesforce
- Inserire il contesto della sessione nella richiesta POST di creazione della sessione, non nel primo messaggio utente. Quando il sistema esterno crea la sessione, ha la possibilità di passare variabili di contesto strutturate (ID account, dati diritti, riepilogo interazione precedente) direttamente come parametri di sessione denominati. Queste variabili sono disponibili per l'agente prima che elabori un singolo turno, quindi inizia a ragionare da uno stato basato senza eseguire chiamate di ricerca per stabilire chi è il cliente o a cosa ha diritto. Il passaggio degli stessi dati all'interno del corpo del messaggio costringe invece l'agente ad analizzare il testo non strutturato per estrarre i dati che avrebbe potuto ricevere come variabili tipizzate, aumentando la latenza, introducendo errori di estrazione e consumando passaggi di ragionamento che non aggiungono alcun valore aziendale.
- Progettare le risposte degli agenti in modo che siano strutturate e confrontabili con le macchine. Utilizzare le convenzioni delle variabili di output e le istruzioni prompt che guidano l'agente a restituire risposte in formato JSON o chiaramente delimitate quando il chiamante è un sistema anziché un essere umano.
- Gestire esplicitamente il ciclo di vita della sessione. Terminare le sessioni immediatamente dopo l'uso
DELETE /einstein/ai-agent/v1/sessions/{sessionId}per liberare finestre di concomitanza ed evitare il persistere di un contesto non aggiornato tra interazioni non correlate. - Tenere presenti i limiti delle sessioni simultanee di Salesforce. Per gli scenari a elevata produttività, implementare un pool di sessioni o un livello di area di attesa nel sistema di chiamata per impedire il rifiuto delle richieste durante i picchi di carico.
- Quando si invoca Agentforce tramite MCP, passare il contesto come parametri di input dello strumento anziché come variabili di sessione. Il server MCP gestisce il ciclo di vita della sessione in modo trasparente, quindi l'agente chiamante non può impostare i parametri della sessione denominata direttamente al momento della creazione. Assicurarsi che tutto il contesto richiesto (ID record, identità utente, dati diritti) sia incluso nel payload della chiamata strumento in modo che l'agente inizi a ragionare da uno stato basato.
- Considerare la gestione trasparente delle sessioni del server MCP come una comodità, non come un bypass della concomitanza. Ogni chiamata allo strumento continua a utilizzare una finestra di sessione dell'agente Salesforce. Gli orchestratori ad alta frequenza che chiamano Agentforce tramite MCP su larga scala devono tenere conto degli stessi limiti di sessione simultanea validi per i chiamanti API agenti diretti.
Gestione e ripristino degli errori
- L'API agente restituisce codici di errore HTTP standard. Il sistema chiamante deve gestire "429 Too Many Requests" (limite di traffico) con backoff esponenziale e "503 Service Unavailable" con logica di tentativo.
- Quando l'agente stesso rileva un errore irrisolvibile dello strumento, restituisce un errore di linguaggio naturale nel corpo della risposta. Il sistema di chiamata rileva queste risposte sentinella (ad esempio, verificando la presenza di un campo stato "errore" nella risposta) e instrada di conseguenza eseguendo un nuovo tentativo con contesto aggiuntivo, presentando un'esperienza di fallback o inoltrando al livello superiore a un utente.
- Durante l'invocazione tramite MCP, gli errori vengono visualizzati in due livelli distinti: Errori di trasporto MCP (chiamate di strumenti non corrette, indisponibilità del server) e errori di ragionamento Agentforce (errori di esecuzione degli strumenti, azioni non risolvibili). L'agente orchestratore deve gestire entrambi i livelli in modo indipendente. Gli errori di trasporto MCP dovrebbero attivare nuovi tentativi a livello di protocollo; gli errori di ragionamento Agentforce restituiti nella risposta dello strumento dovrebbero essere gestiti dalla logica di fallback o di inoltro al livello superiore dell'orchestratore.
Considerazioni sulla sicurezza
- Utilizzare gli ambiti OAuth più ristretti possibili per l'app client esterna. Un'integrazione che deve invocare solo un agente non deve contenere ambiti per l'accesso ai dati oltre a quelli richiesti dall'agente stesso.
- Convalidare e disinfettare tutti gli input del sistema esterno prima di inserirli come variabili di sessione. Gli input esterni sono una superficie di attacco per una pronta iniezione. Ad esempio, un chiamante malintenzionato può creare un campo "customerQuery" progettato per ignorare le istruzioni dell'agente.
- Applicare l'elenco IP consentiti nell'app client esterna per limitare i sistemi esterni che possono eseguire l'autenticazione e chiamare l'API agente.
- Registrare tutte le sessioni attivate dall'API in entrata con l'identità del chiamante, l'ID sessione e i metadati di richiesta/risposta per scopi di controllo e sicurezza.
- Quando Agentforce viene richiamato tramite MCP, il server MCP esegue l'autenticazione in Salesforce per conto dell'utente chiamante. Assicurarsi che le credenziali dell'applicazione connessa del server MCP siano limitate alle autorizzazioni minime richieste e che l'identità dell'utente finale (utilizzando strumenti MCP come Claude) - identità venga propagata nel contesto della sessione in modo esplicito tramite i parametri di input dello strumento.
Esempio
Un portale di servizi finanziari attiva un agente Agentforce per gestire una richiesta di mutuo.
- Il portale esegue l'autenticazione utilizzando il flusso OAuth Credenziali client e ottiene un token bearer.
- Si chiama “POST /Einstein/ai-agent/v1/sessions” con variabili di sessione: “{ "accountId": "001xx...", "productType": "mortgage", "loanAmount": 450000 }”.
- L'utente invia la domanda: "Quali documenti sono necessari per completare la mia richiesta?"
- Il portale chiama “POST /Einstein/ai-agent/v1/sessions/{sessionId}/messages” con il testo dell’utente.
- L'agente Agentforce invoca un'azione Flusso "GetDocumentChecklist", recupera i requisiti specifici del tipo di prestito e restituisce un elenco strutturato.
- Il portale visualizza la risposta dell'agente in linea e chiude la sessione all'uscita dell'utente.
Contesto
Non tutti i flussi di lavoro agenti hanno origine da una richiesta umana. Segnali critici per l'azienda come un calo improvviso delle metriche di utilizzo dei prodotti, un abbandono del carrello di valore elevato o un errore di pagamento che supera una soglia di rischio si verificano spesso nei dati operativi. Quando questi segnali richiedono risposte intelligenti a più fasi, attendere che un essere umano se ne accorga e agisca introduce una latenza che si traduce in un costo aziendale reale.
Questo schema descrive come gli eventi in tempo reale fungono da punti di ingresso autonomi per gli agenti. L'agente viene richiamato da una condizione dei dati anziché da un utente, ragiona sul contesto dell'evento ed esegue un flusso di lavoro di risposta senza avvio umano.
Problema
Quando un evento aziendale in tempo reale si verifica in Data 360 o nella piattaforma Salesforce, come può l'evento istanziare in modo autonomo una sessione agente, fornire il payload dell'evento come contesto di base e portare a termine un flusso di lavoro di azione non conversazionale senza che un essere umano avvii o guidi l'interazione?
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
- È necessaria una risposta immediata al momento dell'attivazione dell'evento o l'elaborazione quasi in tempo reale (da secondi a minuti) è accettabile?
- Il payload dell'evento contiene un contesto sufficiente per basare l'agente o l'agente deve eseguire ulteriori ricerche prima di poter ragionare in modo efficace?
- Qual è il volume e la frequenza degli eventi previsti? Gli stream di eventi ad alta produttività richiedono la gestione delle percentuali per evitare l'esaurimento dei limiti di concomitanza degli agenti.
- Lo stesso evento può essere attivato più di una volta per la stessa entità aziendale (almeno una consegna)? In tal caso, le azioni devono essere idempotenti.
- Esiste un percorso di inoltro al livello superiore umano se l'agente non è in grado di risolvere l'evento autonomamente?
- Come deve essere presentata l'elaborazione degli eventi non riuscita? Con un'area di attesa senza risposta, un avviso o la creazione di un caso?
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| Flussi attivati da Data 360 | Ideale per segnali comportamentali e basati su metriche | Questa condizione è più adatta quando la condizione di trigger è definita come modifica dell'appartenenza al segmento Data 360 o soglia della metrica. Data 360 rileva la condizione aziendale (ad esempio, abbandono del carrello, calo dell'utilizzo) e attiva un flusso attivato. Il flusso mappa gli attributi del payload evento alle variabili di sessione agente e crea la sessione Agentforce. |
| Eventi piattaforma + flusso AutoLaunched o Apex | Ideale per eventi interni alla piattaforma e tra sistemi | Utilizzare questa soluzione quando l'origine dell'evento si trova all'interno della piattaforma Salesforce o quando un livello middleware pubblica l'evento dopo aver rilevato la condizione in un sistema esterno. Un evento piattaforma pubblicato da qualsiasi processo Salesforce o sistema esterno attiva un trigger Apex o un flusso AutoLaunched, che costruisce la sessione agente con il payload dell'evento come contesto. |
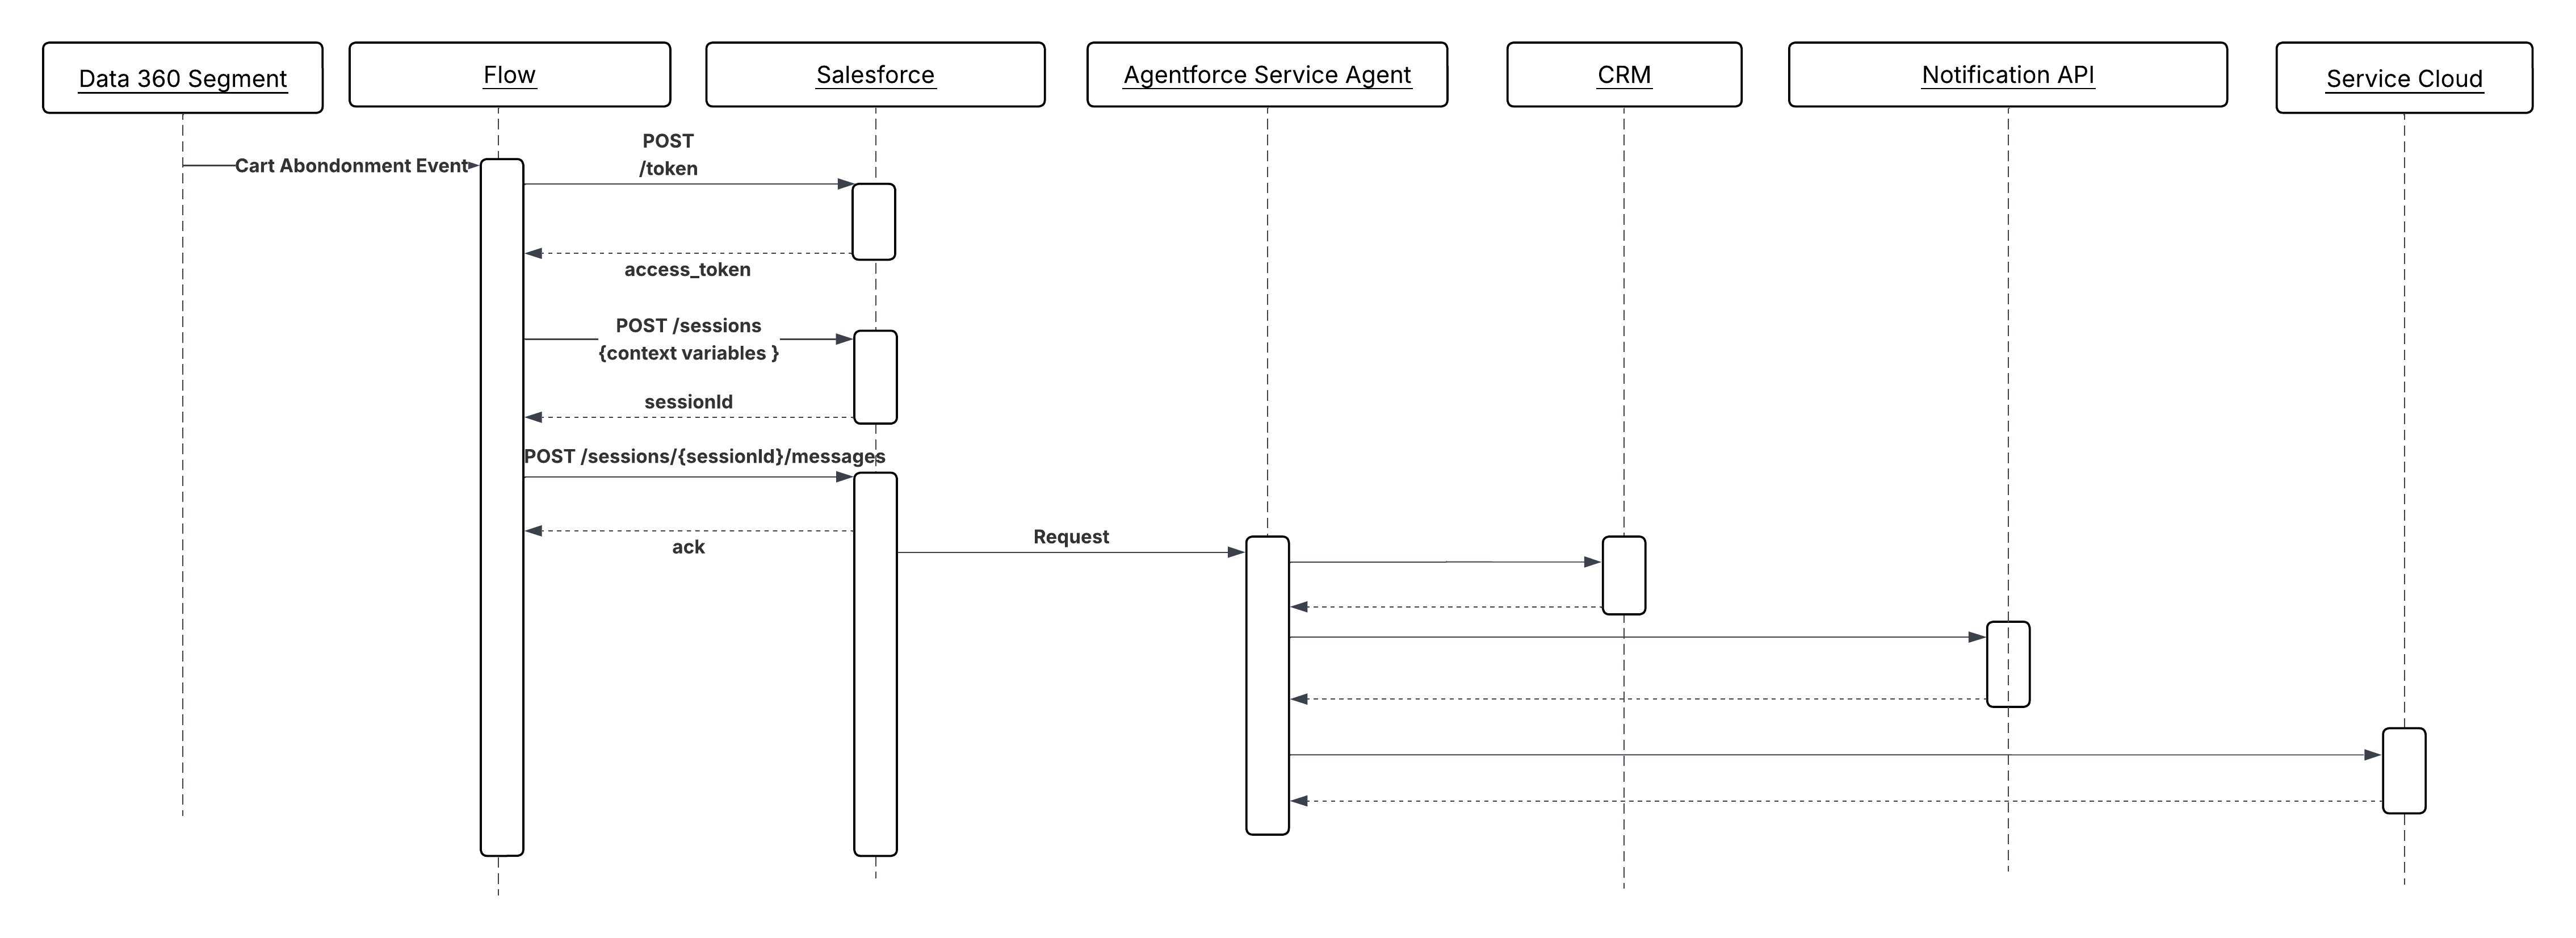
Schizzo
Diagramma di sequenza per l'esecuzione degli agenti basata sugli eventi
Risultati
Gli agenti diventano partecipanti reattivi alle operazioni aziendali in tempo reale, non risponditori passivi alle richieste umane. Gli agenti attivati da eventi possono eseguire flussi di lavoro di ripristino, triage e inoltro al livello superiore alla velocità dei dati anziché alla velocità dell'attenzione umana.
Il sistema di attivazione (Data 360 o eventi piattaforma) rimane responsabile del rilevamento degli eventi e della formazione del payload. L'agente rimane responsabile del ragionamento su quel payload e della selezione della catena di azioni corretta. Non è richiesto alcun turno di conversazione; il payload dell'evento è l'input completo.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Progettare tutte le azioni per l'invocazione non conversazionale. Non esiste un turno utente; l'agente deve raggiungere una risoluzione solo dal contesto di base iniziale. Le azioni dovrebbero restituire risultati strutturati e deterministici anziché richiedere chiarimenti.
- Assicurarsi che il payload dell'evento contenga un contesto di base sufficiente prima di creare la sessione dell'agente. Un payload snello che costringe l'agente a effettuare più chiamate di ricerca prima di poter ragionare aumenta la latenza e il consumo simultaneo.
- Rendere tutte le operazioni di scrittura attivate dagli agenti basati sugli eventi idempotenti. I sistemi di consegna degli eventi in genere offrono garanzie almeno una volta. L'elaborazione degli eventi duplicati non può produrre effetti collaterali duplicati.
Note sull'implementazione di Salesforce
- Nei flussi attivati di Data 360, mappare gli attributi del payload degli eventi (ad esempio, "accountId", "eventType", "metricValue", "productId") direttamente alle variabili di sessione denominate al momento della creazione della sessione. Ciò consente all'agente di partire dalla prima fase di ragionamento senza richiedere un'azione di recupero.
- Per i trigger evento piattaforma, utilizzare un flusso AutoLaunched anziché un flusso schermata. I flussi schermata non sono supportati in contesti autonomi e non conversazionali.
- Impostare un timeout sessione esplicito per le sessioni attivate da eventi. A differenza delle sessioni conversazionali, non esiste un utente che estenda l'interazione; una sessione in stallo su un'azione non riuscita non dovrebbe contenere una finestra temporale di concomitanza a tempo indeterminato.
- Utilizzare i percorsi di errore del flusso per gestire gli errori di creazione delle sessioni degli agenti. Se la sessione non può essere creata, il percorso di errore dovrebbe pubblicare un evento di compensazione o creare un caso per il follow-up umano anziché abbandonare silenziosamente l'evento.
Gestione e ripristino degli errori
- Gli eventi che non riescono ad attivare correttamente una sessione agente a causa di limiti di concomitanza, errori di creazione della sessione o errori di convalida del payload devono essere instradati a un percorso di errore che crea un caso, attiva un avviso o pubblica l'evento in un'area di attesa a lettera morta per la rielaborazione.
- Gli errori degli agenti durante l'esecuzione (ad esempio, il timeout di un'azione obbligatoria) devono essere registrati con l'ID evento di origine. Poiché l'attivazione è asincrona e non è presente alcun chiamante in attesa, la superficie dell'errore è interamente osservabile in base a registri, cruscotti digitali e soglie di avviso.
- Implementare un tetto per i nuovi tentativi. Se un evento causa in modo affidabile un errore dell'agente, i nuovi tentativi senza limiti esauriranno i limiti di concomitanza. Dopo un numero massimo configurabile di tentativi, instradare l'evento a un'area di attesa di revisione umana con contesto completo allegato.
- Tenere traccia dell'ID evento per tutto il ciclo di vita della sessione agente. Questo tracciamento consente la correlazione tra il segnale dati di origine e tutte le azioni a valle per il controllo e il debug.
Considerazioni sulla sicurezza
- Convalidare e disinfettare tutti gli attributi del payload evento prima di inserirli come variabili di sessione agente. I payload degli eventi di Data 360 o publisher esterni sono una superficie di attacco per una pronta iniezione. Ad esempio, un campo payload creato può essere progettato per ignorare le istruzioni dell'agente.
- Eseguire le sessioni degli agenti attivate da eventi con un utente integrazione dedicato con privilegi minimi anziché con un'identità di amministratore con privilegi elevati. L'agente dispone solo delle autorizzazioni necessarie per eseguire l'insieme di azioni definito.
- Registrare tutte le sessioni attivate da eventi con l'ID evento di origine, il tipo di evento e le variabili di sessione inserite al momento della creazione. Questo itinerario di controllo è necessario per ricostruire il motivo per cui l'agente ha intrapreso una determinata azione se l'esito è contestato.
Esempio
Una società di vendita al dettaglio utilizza Data 360 per tenere traccia del comportamento del carrello in tempo reale. Quando un carrello con un valore superiore a una soglia definita viene abbandonato:
- Data 360 rileva il segnale di abbandono e attiva un flusso attivato con il payload dell'evento: "customerId", "cartValue", "productId" e "abandonmentTimestamp".
- Il flusso mappa questi attributi alle variabili di sessione Agentforce e crea una nuova sessione agente. Non è richiesta alcuna interazione dell'utente.
- L'agente valuta la cronologia acquisti del cliente, i diritti correnti e la composizione del carrello utilizzando le azioni di recupero disponibili.
- L'agente invoca un'azione
SelectRecoveryOffer, che applica il livello di sconto appropriato in base al segmento di clientela, e un'azioneSendProactiveNotificationper consegnare l'offerta tramite il canale preferito del cliente. - L'agente invoca
CreateFollowUpTaskper registrare l'interazione nel CRM per la visibilità del titolare dell'account. - La sessione si chiude automaticamente al termine della catena di azioni. L'ID evento di origine viene conservato nel registro di sessione per la tracciabilità.
Contesto
Gli LLM vengono addestrati sui dati pubblici. Non hanno Knowledge dei prodotti, delle policy, della cronologia dei casi o dei contratti dell'organizzazione a meno che tali informazioni non vengano fornite esplicitamente al momento del ragionamento. Senza fondamento, un agente ha chiesto informazioni sul diritto al servizio di un cliente o sui termini di un contratto specifico, allusionerà a una risposta o ammetterà di non saperlo. Nessuno dei due risultati è accettabile in un contesto aziendale.
Retrieval-Augmented Generation (RAG) risolve questo problema recuperando i documenti pertinenti da un archivio Enterprise Knowledge e inserendoli nella finestra contesto dell'agente prima di generare una risposta. L'agente ragiona sul contenuto recuperato, ad esempio un articolo Knowledge, una risoluzione di un caso precedente o una specifica di prodotto, come se le informazioni fossero state fornite direttamente. Il LLM fornisce il ragionamento; il livello di recupero fornisce i fatti.
Ad esempio, un agente dell'assistenza che gestisce una richiesta di garanzia complessa non deve necessariamente includere condizioni della polizza di garanzia nelle istruzioni. Quando invece il cliente descrive il problema, l'agente esegue una ricerca semantica o ibrida (ricerca per parola chiave + ricerca semantica) rispetto a un indice vettoriale della documentazione di garanzia, recupera i termini applicabili e li utilizza per determinare l'idoneità e le fasi successive. La risposta è basata sul documento di policy corrente e autorevole, non sui dati di addestramento del modello.
Problema
Un agente deve rispondere a una domanda o prendere una decisione che dipende da Knowledge organizzative proprietarie come policy, contratti, documentazione sui prodotti o dati di casi storici che non facevano parte dei dati di formazione del LLM. In che modo l'agente recupera il contenuto più pertinente al momento del ragionamento, garantisce che il contenuto recuperato sia aggiornato e autorevole e lo inserisce nel contesto con una precisione sufficiente per evitare problemi?
Forze
Quando si applica questo schema, rispondere alle seguenti domande
- Il contenuto Knowledge è statico e raramente aggiornato (ad esempio, i manuali dei prodotti) o cambia continuamente (ad esempio, le risoluzioni dei casi, le descrizioni dell'inventario)? La frequenza di aggiornamento determina la progettazione della pipeline di inserimento.
- Quanto è grande il contenuto? Una Knowledge Base di piccole dimensioni può essere recuperata in modo completo; una di grandi dimensioni richiede la suddivisione, l'incorporamento e l'indicizzazione semantica per restituire solo i passaggi più pertinenti.
- La query trae vantaggio da un unico recupero mirato o la combinazione di risultati provenienti da più fonti Knowledge (ad esempio, documentazione e casi passati contemporaneamente) produrrebbe una risposta più fondata? Quest'ultimo richiede il recupero dell'insieme.
- È necessario filtrare il contenuto recuperato in base ai metadati prima della classificazione semantica, ad esempio limitando i risultati ai documenti relativi al livello di prodotto o all'area geografica del cliente?
- Quanto è sensibile il contenuto Knowledge? Il contenuto recuperato viene inserito nella finestra contesto LLM e influenza la risposta dell'agente; il contenuto che non deve essere presentato a determinati utenti deve essere regolato a livello di recupero, non deve essere filtrato dal LLM.
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| Retrieval-Augmented Generation (RAG) con Data 360 | Ideale per i casi d'uso aziendali | L'agente esegue una ricerca semantica con gli indici vettoriali di Data 360 prima di generare una risposta. Il contenuto recuperato, ad esempio articoli Knowledge, casi passati, documentazione del prodotto, viene inserito nel contesto LLM come base. Questo può essere chiamato utilizzando azioni Retriever, Flusso o Apex personalizzato. Tenere presente che Data 360 supporta una pipeline integrata dal contenuto non formattato al contesto pronto per l'agente, non solo un vector store:
Tutte queste funzionalità sono offerte in entrambe le modalità chiavi in mano con piena configurabilità. Esistono due tipi di retriever per Data360: Recupero individuale: Un'azione Salesforce Retriever configurata esegue una ricerca semantica rispetto a un singolo indice di ricerca definito e restituisce i blocchi di contenuto più pertinenti. I risultati vengono inseriti direttamente nel prompt LLM come contesto di radicamento. Utilizzare Azione di recupero persona quando la query è servita al meglio da una singola fonte Knowledge mirata. Ensemble Retriever: Un'azione di recupero dell'insieme combina i risultati di più recuperi singoli, ad esempio un indice della documentazione del prodotto e un indice dei casi risolti. I retriever insieme non combinano i punteggi di pertinenza dei singoli retriever poiché tali punteggi non sono confrontabili in indici eterogenei. Tutti i blocchi recuperati vengono invece passati attraverso un modello di reranker codificatore incrociato che calcola in modo indipendente il punteggio di ogni coppia (query, blocco), generando una classificazione unificata. Questo è architettonicamente significativo: significa che la qualità della classificazione tra fonti migliora con il modello di reranker, non con la calibrazione manuale del punteggio. Dopo averli riclassificati, il risultato unificato viene reso disponibile ai prompt LLM come contesto di radicamento. Utilizzare Azione di recupero dell'insieme quando una risposta più completa richiede prove da più di un dominio Knowledge. |
| RAG con database vettoriali di terze parti | Adatto quando si lavora entro i limiti dell'infrastruttura esistente | Questo approccio integra archivi vettoriali di terze parti che potrebbero già esistere nell'infrastruttura per indicizzare gli incorporamenti di dati proprietari, utilizzandoli per la ricerca semantica in tempo reale e il recupero dei contenuti. Questo può essere implementato utilizzando Flusso o Apex personalizzato. |
Schizzo
Diagramma di sequenza per Knowledge Grounding da contenuto aziendale
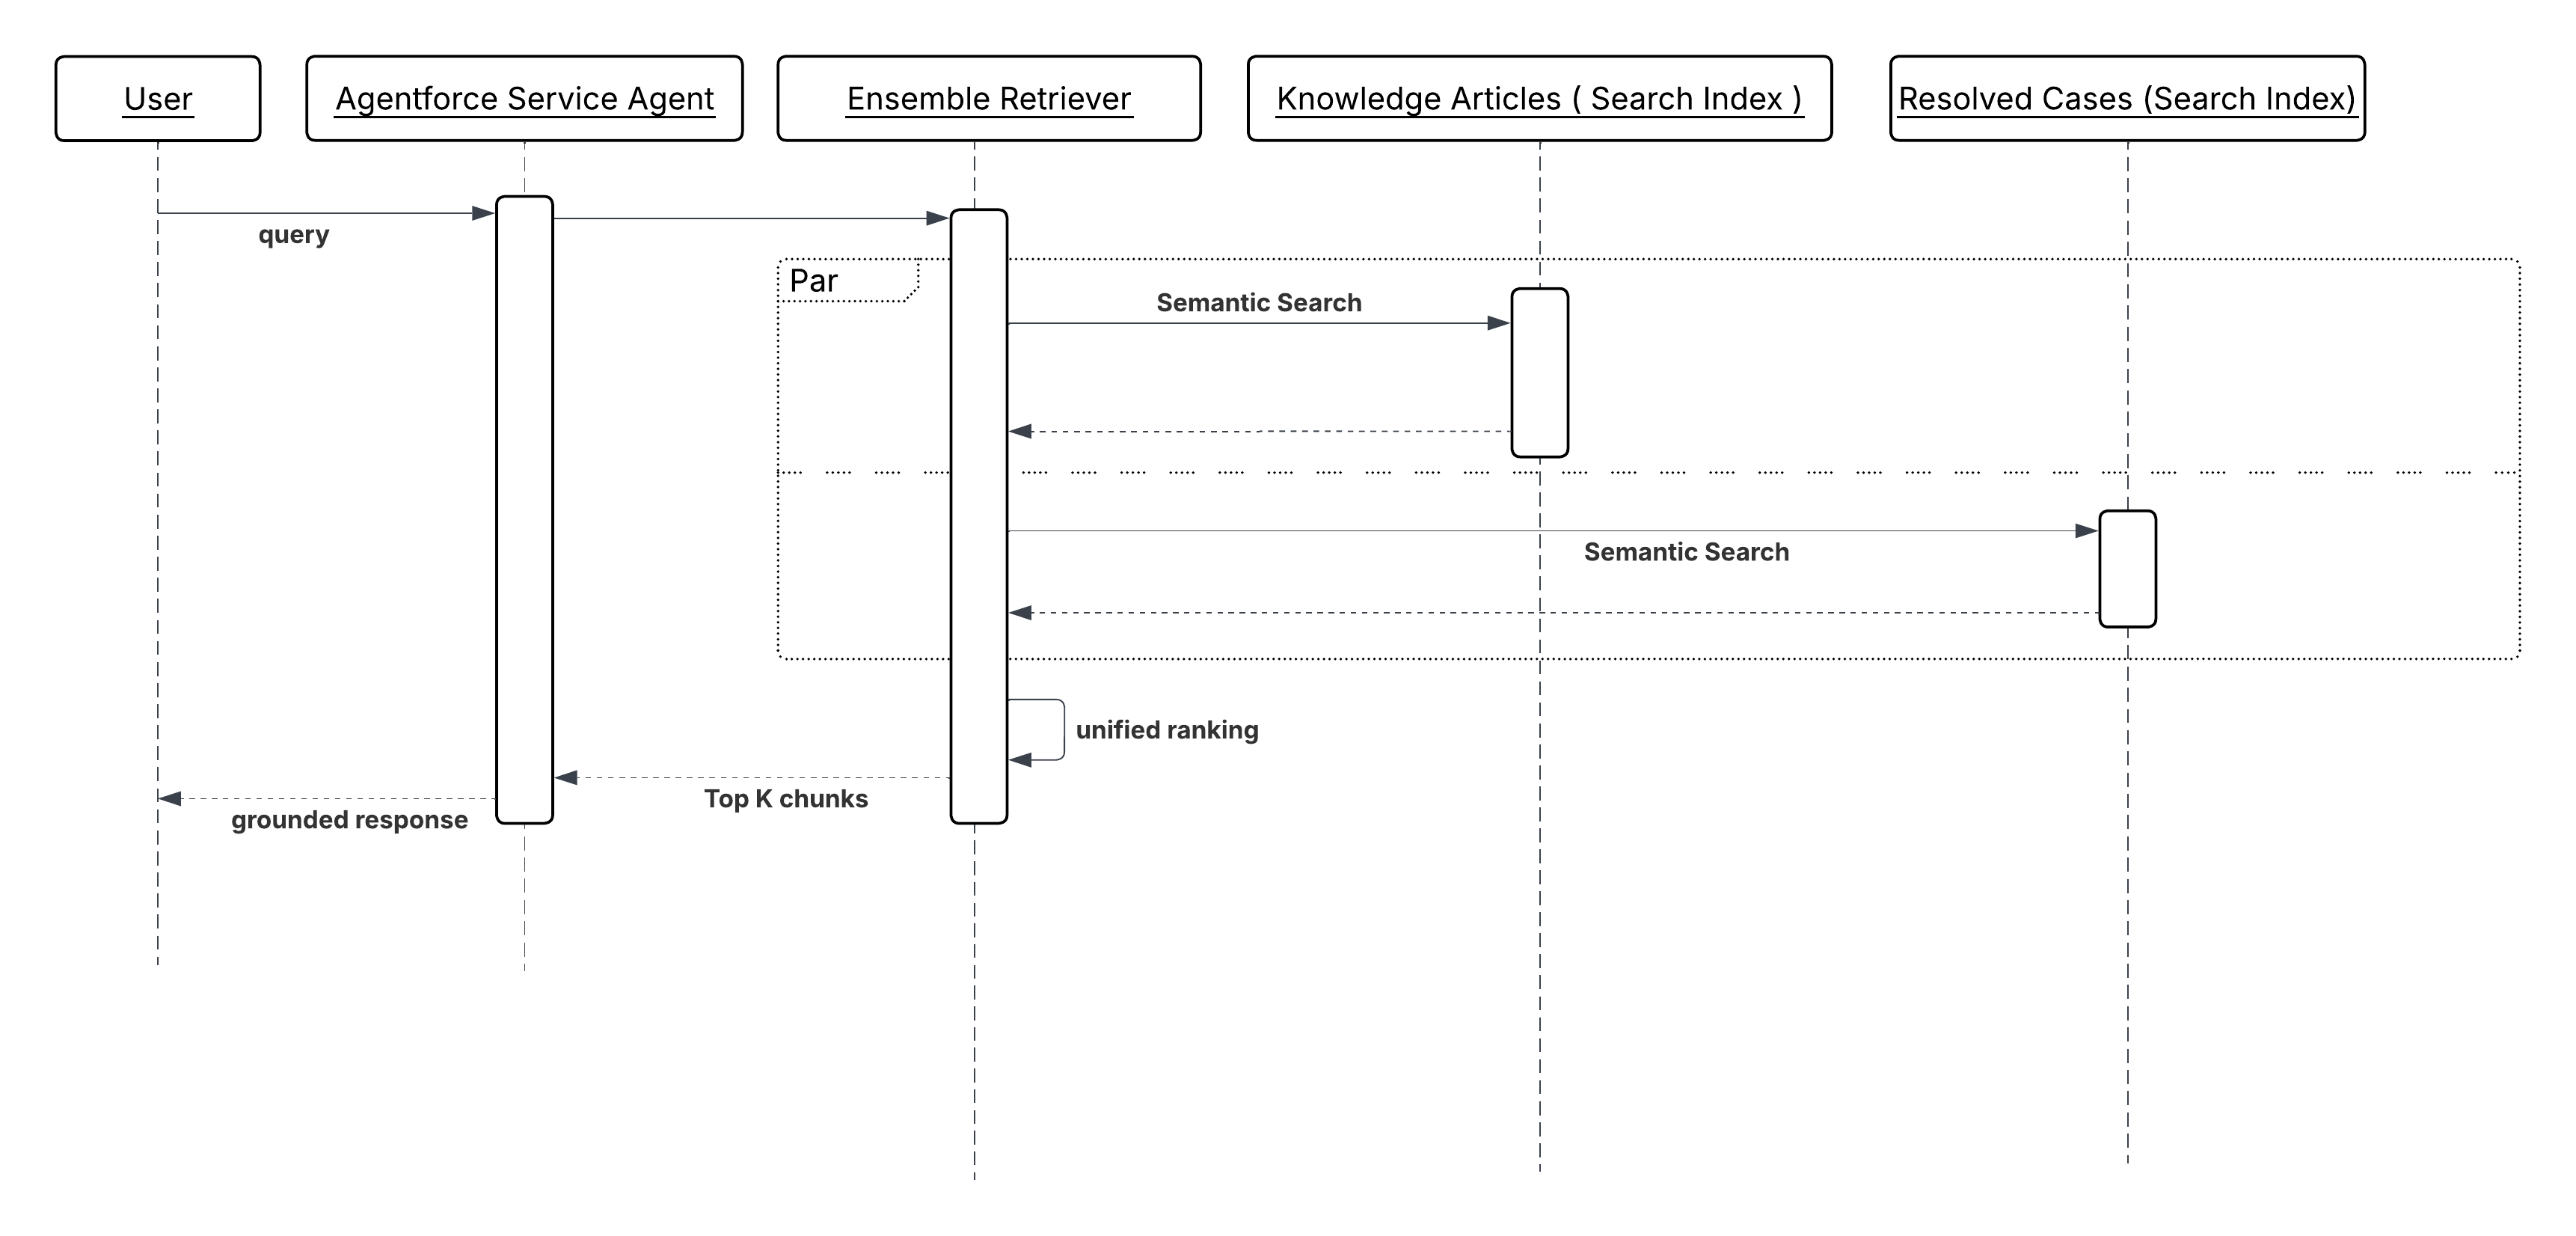
Risultati
Le risposte dell'agente sono ancorate alla Knowledge corrente e autorevole dell'organizzazione anziché ai dati di addestramento del LLM. Il rischio di allucinazioni su domande fattuali come termini della polizza, specifiche del prodotto, dettagli dei diritti è ridotto perché il modello ragiona sulle prove recuperate, non generando dalla memoria.
Il contenuto Knowledge rimane gestibile in modo indipendente. L'aggiornamento di un documento di policy o l'aggiunta di una nuova risoluzione dei casi all'indice ha effetto immediato per tutte le interazioni successive degli agenti, senza addestramento o nuova distribuzione del modello.
Il recupero fornisce anche un itinerario di controllo implicito. Poiché la risposta dell'agente deriva da documenti specifici recuperati, il contenuto di origine può essere registrato insieme alla risposta, consentendo di risalire al motivo per cui l'agente ha fornito una particolare risposta.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Suddividere e incorporare il contenuto Knowledge con la massima precisione. I blocchi troppo grandi diluiscono la pertinenza. I blocchi troppo piccoli perdono il contesto circostante di cui il componente LLM ha bisogno per ragionare correttamente. Per la maggior parte dei tipi di documenti aziendali, la suddivisione a livello di paragrafo con finestre di contesto sovrapposte produce la migliore qualità di recupero.
- Considerare la precisione di recupero come una preoccupazione di progettazione di prima classe. L'inserimento di contenuti di scarsa rilevanza nella finestra di contesto dell'agente non è neutro. Introduce un rumore che degrada la qualità della risposta. Sintonizzare le soglie di recupero e i limiti principali di k per bilanciare il richiamo con la precisione per ogni dominio Knowledge.
- La latenza di inserimento è uno SLA operativo. Se un documento della policy viene aggiornato ma l'indice vettoriale non è stato aggiornato, l'agente recupera e agisce su informazioni non aggiornate. Definire una tolleranza accettabile per ogni tipo di contenuto e progettare le opportunità di inserimento in corso di realizzazione di conseguenza.
Note sull'implementazione di Salesforce
- Compilare gli indici vettoriali di Data 360 tramite la pipeline di inserimento appropriata per la frequenza di aggiornamento del contenuto. Utilizzare l'inserimento batch per i documenti statici e lo streaming o Acquisizione dati di modifica (CDC) per i record che cambiano continuamente.
- Per Recuperatori insieme, configurare i pesi della classificazione della pertinenza per fonte. Un indice dei casi risolti può richiedere una distorsione di recency, mentre un indice della documentazione della policy potrebbe non richiederla. Regolare i pesi in base ai tipi di query che l'agente dovrà gestire.
- Utilizzare i filtri dei metadati nei retriever Apex o di flusso personalizzati per limitare il recupero prima dell'esecuzione della ricerca semantica. Filtrare per linea di prodotto, regione o tipo di documento prima di classificare riduce il rumore e migliora la precisione degli elementi inseriti nel contesto.
- Non iniettare il documento completo recuperato nel contesto LLM. Passare solo i blocchi o gli estratti pertinenti. Le iniezioni di contesto di grandi dimensioni consumano il budget del token, aumentano la latenza e riducono la proporzione della finestra di contesto disponibile per il ragionamento dell'agente.
Gestione e ripristino degli errori
- Se il recupero non restituisce alcun risultato, restituisce uno stato esplicito "nessun risultato trovato" anziché procedere senza basi. L'agente può quindi ampliare la query, chiedere chiarimenti all'utente o inoltrare la query a un utente.
- Ogni blocco restituito dai retriever contiene un punteggio di pertinenza. A seconda del caso d'uso, deve essere configurato un determinato valore di confidenza/pertinenza della soglia al di sopra del quale l'agente deve considerare il recupero come sicuro, altrimenti deve tornare al chiarimento o all'inoltro al livello superiore.
- Se l'indice vettoriale o il servizio di recupero non è temporaneamente disponibile, l'azione di recupero o la chiamata Apex devono restituire un errore strutturato con un motivo descrittivo. Registrare l'errore con l'ID sessione e la query in modo da poter identificare eventuali lacune di recupero e monitorare la disponibilità dell'indice o del servizio.
- Per i domini Knowledge sensibili al tempo, implementare un controllo della freschezza come parte della risposta di recupero. Se il documento corrispondente più recente è stato aggiornato più di una soglia di stallo definita, segnalarlo all'agente in modo che possa qualificare la risposta o richiedere la verifica.
Considerazioni sulla sicurezza
- Il recupero deve rispettare le autorizzazioni di accesso ai dati dell'utente per conto del quale l'agente agisce. Una sessione agente in esecuzione nel contesto di un'interazione indirizzata al cliente non deve recuperare documenti operativi interni, note sulla strategia dei prezzi o record a cui l'utente finale non avrebbe altrimenti accesso. Applicare la protezione a livello di campo e di record a livello di recupero. Non affidarsi al componente LLM per trattenere i contenuti sensibili recuperati.
- Il contenuto recuperato viene inserito nella finestra contesto LLM e può influenzare o apparire nella risposta dell'agente. Considerare ogni documento nel contenuto di recupero come potenzialmente visibile all'utente finale e disciplinare l'appartenenza al contenuto di conseguenza.
- Registrare tutte le query di recupero e gli identificatori documento dei blocchi recuperati insieme all'ID sessione. Questo itinerario di controllo consente di ricostruire le prove utilizzate dall'agente per rispondere, che possono essere richieste per obblighi di conformità, risoluzione delle controversie o spiegabilità.
Esempio
Un agente dei servizi finanziari gestisce una query del cliente sulle penali di rimborso anticipato per un prodotto di risparmio a tempo determinato:
- Il cliente chiede: “Quale penale incorrerei se ritirassi i miei fondi con sei mesi di anticipo?”
- L'agente invoca un'azione di recupero persona configurata in un indice vettoriale di termini e condizioni del prodotto.
- Il retriever esegue una ricerca semantica utilizzando il contesto della query, ad esempio il tipo di prodotto e l'account cliente, e la domanda specifica e restituisce i tre blocchi di documento più pertinenti: la clausola di riscatto anticipato, la tabella di calcolo della penale e le eccezioni applicabili ai casi di difficoltà.
- I blocchi recuperati vengono inseriti nella finestra di contesto dell'agente insieme alla domanda del cliente.
- L'agente ragiona sui termini recuperati, identifica il tasso di penalità applicabile per il livello di prodotto e la tempistica di rimborso del cliente e restituisce una risposta precisa e basata sulla polizza, citando la data effettiva dei termini utilizzati.
- Gli identificatori documento dei blocchi recuperati vengono registrati con il record sessione per la verificabilità.
Contesto
Gli LLM sono probabilistici per natura. Quando gli viene chiesto di ragionare su un cliente specifico, deducono, stimano o hanno allucinazioni su fatti che non sono stati esplicitamente forniti. Un agente che invoca un'azione prezzi senza sapere che il cliente è un account aziendale di alto valore su un livello preferito può applicare una logica di sconto sbagliata. Un agente che inoltra un caso di assistenza al livello superiore senza conoscere il punteggio di rischio di abbandono del cliente può eliminare la priorità di un account a pochi giorni dall'abbandono.
L'iniezione contesto cliente verificata risolve questo problema precompilando i parametri di input dell'azione con attributi verificati e strutturati del profilo unificato prima che l'agente invochi un'azione. L'agente non deduce la tendenza del segmento, del valore di durata o della soddisfazione del cliente (CSAT). Riceve tali fatti come input di base e ragioni su di essi. Questo schema riduce il rischio di allucinazioni nelle decisioni specifiche del cliente ed elimina le chiamate di ricerca ridondanti durante il ciclo di ragionamento.
Ad esempio, prima che un agente prezzi invochi un'azione "Genera preventivo", la configurazione del subagente inserisce automaticamente il segmento, il livello e il valore di durata del cliente dal profilo unificato. L'azione riceve i fatti verificati anziché le approssimazioni dedotte da LLM e il preventivo è ancorato alla relazione commerciale effettiva del cliente.
Questa non è un'alternativa allo schema "Knowledge Grounding from Enterprise Content". Un agente ben progettato può utilizzare entrambi: "Knowledge Grounding from Enterprise Content" fornisce Knowledge basato su documenti, mentre "Verified Customer Context Injection" stabilisce l'identità del cliente.
Problema
Come assicurarsi che un agente disponga di dati precisi e specifici del cliente come segmento, livello, valore di durata, rischio di abbandono o altri attributi del profilo prima di intraprendere un'azione, anziché indovinare tali dati da soli?
Forze
Quando si applica questo patter, rispondere alle seguenti domande:
- Quali parametri di input dell'azione rappresentano fatti specifici del cliente che, se dedotti anziché ricavati, produrrebbero risultati errati o incoerenti?
- Gli attributi profilo obbligatori sono disponibili come campi profilo unificato standard di Data 360 o richiedono approfondimenti calcolati derivati da dati comportamentali e transazionali non elaborati?
- Con che frequenza cambiano gli attributi del profilo pertinenti? Attributi come il punteggio di rischio di abbandono o il trend CSAT richiedono una garanzia di freschezza; i dati di profilo non aggiornati portano agli stessi risultati errati dei dati allucinati.
- Gli attributi del profilo devono essere inseriti al momento della creazione della sessione (costante per la durata della sessione) o recuperati di nuovo al momento dell'invocazione dell'azione (per riflettere i cambiamenti di stato a metà sessione)?
- L'agente deve ragionare direttamente sugli attributi del profilo o sono consumati solo dall'azione e opachi al loop di ragionamento dell'agente?
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| Configurazione subagente - Mappatura attributi profilo | Ideale per il radicamento statico a livello di sessione | Si adatta meglio quando gli attributi del profilo sono stabili all'interno di una singola interazione. Mappare gli attributi del profilo unificato di Data 360 (ad esempio, "customerSegment", "tier", "lifetimeValue") direttamente ai parametri di input delle azioni nella configurazione dei subagenti Agentforce. Gli attributi vengono risolti alla creazione della sessione e mantenuti costanti per la durata della sessione. |
| Flussi connessi a Data 360 | Ideale per l'aggiornamento dinamico o a metà sessione | Utilizzare quando gli attributi del profilo cambiano spesso o quando l'azione richiede lo stato più corrente. Utilizzare un flusso connesso a Data 360 come fase dell'azione per mettere in evidenza lo stato del profilo più recente nel punto di invocazione.Il flusso esegue una query sul profilo unificato, applica tutte le trasformazioni necessarie e restituisce gli attributi come variabili di output consumate dall'azione successiva nella catena. |
| Approfondimenti calcolati come input di azioni | Ideale per metriche derivate complesse | Utilizzare quando gli agenti devono ragionare sulle metriche aziendali calcolate (punteggio di rischio di abbandono, tendenze CSAT, indice di adozione dei prodotti) anziché interpretare i dati non elaborati. Definite in Data 360 come metriche derivate calcolate su dati comportamentali, transazionali e di coinvolgimento. Gli approfondimenti calcolati vengono visualizzati come attributi del profilo interrogabili e possono essere mappati agli input delle azioni tramite la configurazione dell'argomento o un flusso connesso. |
Schizzo
Diagramma di sequenza per l'iniezione contesto cliente verificata
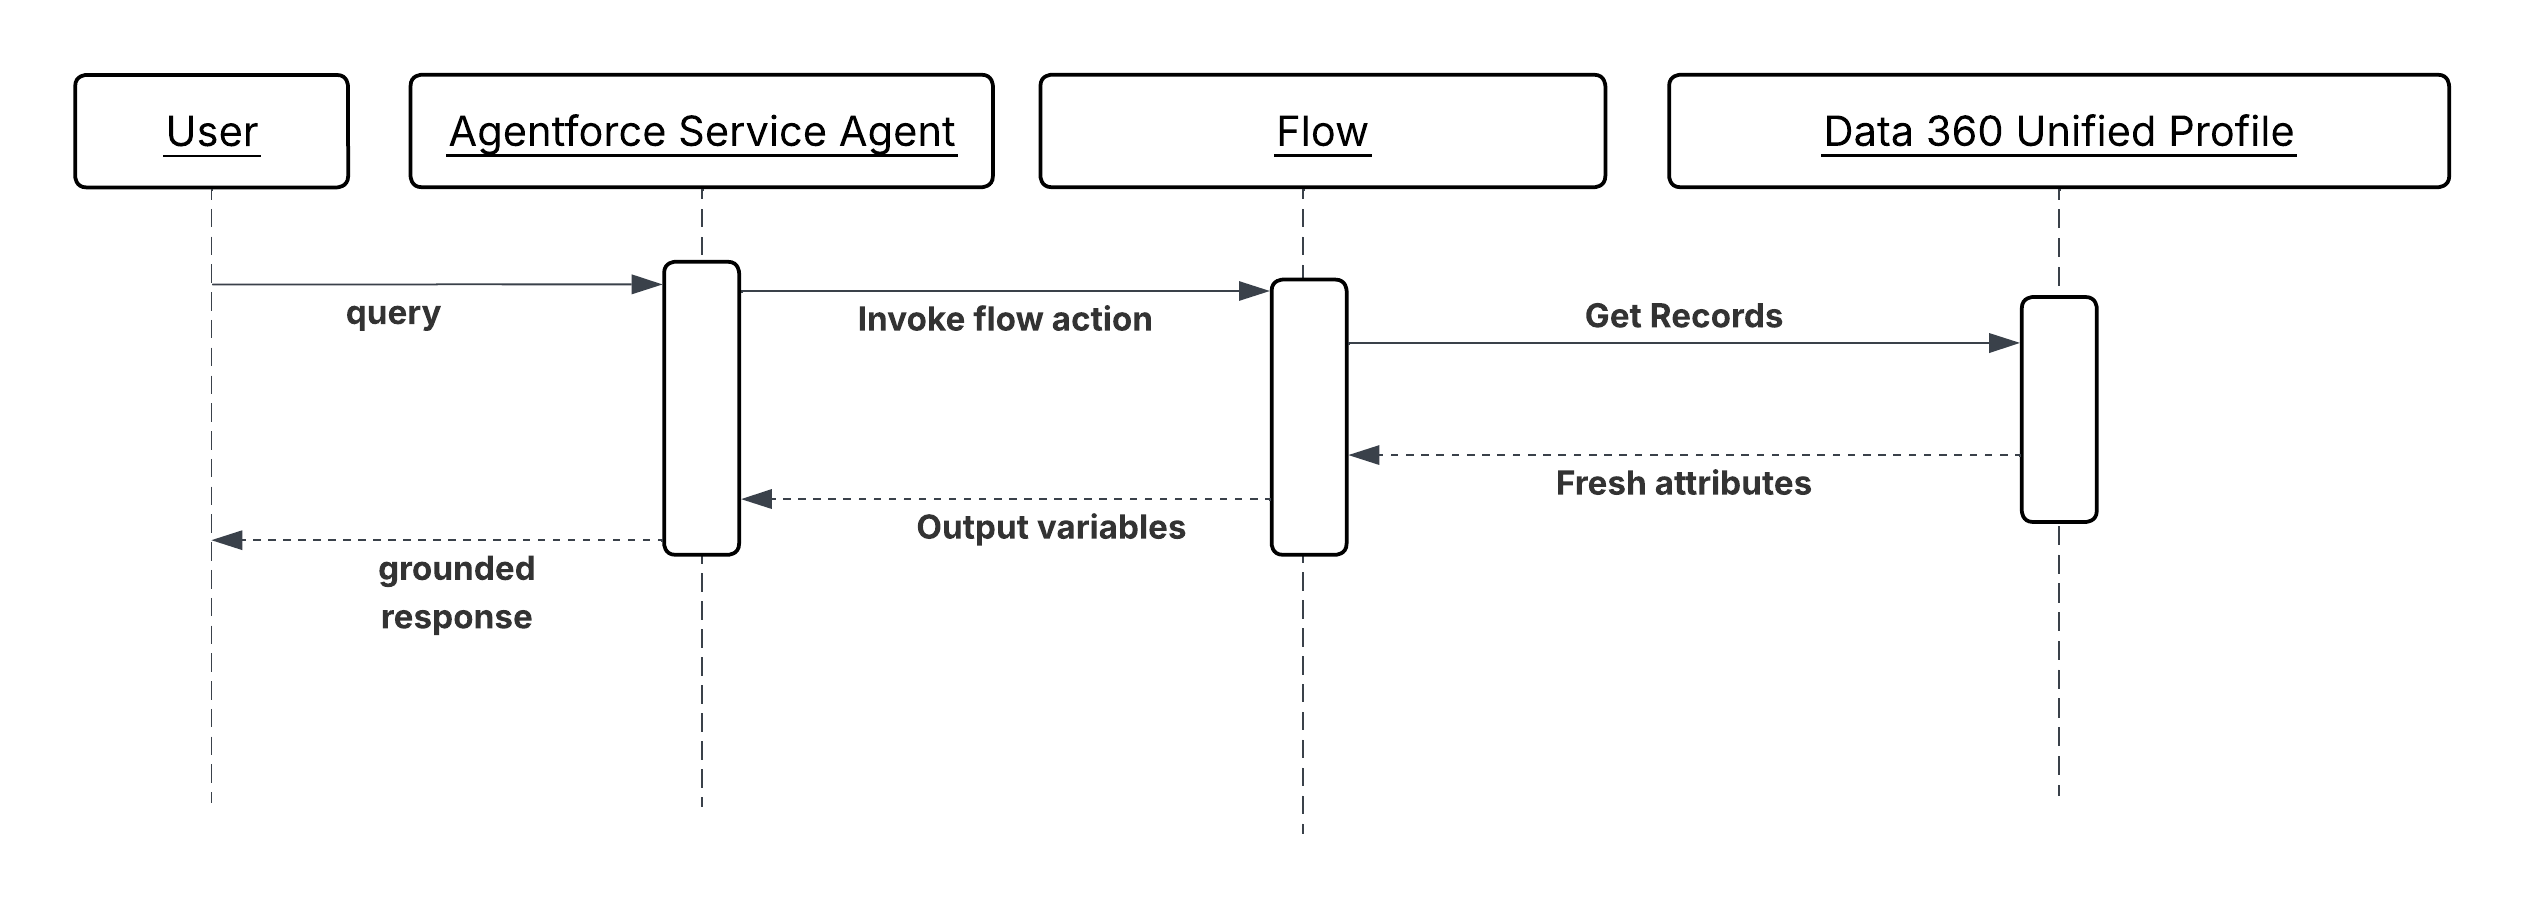
Risultati
Le azioni ricevono dati dei clienti verificati e strutturati anziché approssimazioni dedotte da LLM. Il ragionamento dell'agente è ancorato allo stato profilo effettivo del cliente, riducendo il rischio di allucinazioni nelle decisioni in cui la precisione fattuale determina la qualità del risultato, ad esempio prezzi, controlli dei diritti, instradamento al livello superiore, offerte di fidelizzazione.
Il radicamento nel profilo riduce anche la latenza di ragionamento. Quando l'agente non deve effettuare chiamate di ricerca per stabilire il contesto di base del cliente, il ciclo di ragionamento è più breve e la concomitanza viene consumata per un minor numero di turni.
Il profilo unificato di Data 360 rimane la fonte autorevole dei fatti dei clienti. La configurazione subagente o il flusso connesso è la cucitura di integrazione. L'agente è responsabile del ragionamento su tali fatti e della selezione delle azioni, non dell'origine dei fatti stessi.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Identificare tutti gli input dell'azione che comportano il rischio di allucinazioni, in cui l'inferenza LLM potrebbe produrre un esito errato anziché un valore verificato. Gli input con rischio di allucinazioni sono candidati per il radicamento nel profilo. Non tutti gli input richiedono il radicamento nel contesto; l'inserimento eccessivo dei dati del profilo aggiunge rumore alla finestra di contesto dell'agente.
- Considerare la freschezza del profilo come una decisione progettuale, non come un ripensamento. Definire la tolleranza di stallo accettabile per ogni attributo con base e scegliere il meccanismo di iniezione di conseguenza: mappatura a livello di sessione per gli attributi stabili, aggiornamento basato sul flusso per quelli volatili.
- Gli approfondimenti calcolati devono codificare la logica aziendale, non le metriche non elaborate. Un agente che ragiona su un "churnRiskScore" di 0,87 è più efficace di un agente che ragiona su 14 segnali comportamentali non elaborati. Calcolare l'interpretazione in Data 360; passare il risultato all'agente.
Note sull'implementazione di Salesforce
- Il radicamento nel profilo è affidabile solo quanto l'unificazione che lo sta dietro. Ad esempio, il valore del Profilo unificato dipende interamente dalla qualità della risoluzione dell'identità a monte. Se un cliente ha identità frammentate in sistemi di origine che non sono stati unificati, gli attributi del profilo ricevuti dall'agente saranno incompleti o rappresentano solo una visualizzazione parziale (ad esempio, Valore durata calcolato con i dati di un canale ma non di un altro).
- Per i flussi connessi a Data 360, utilizzare l'elemento Ottieni record con un filtro "recordId" o "accountId" della sessione corrente per recuperare solo il record del profilo pertinente. Restituire solo gli attributi richiesti dall'azione a valle; non restituire l'oggetto profilo completo.
- Gli approfondimenti calcolati devono essere mantenuti aggiornati tramite le opportunità in corso di realizzazione di inserimento di Data 360. Impostare lo streaming o l'aggiornamento quasi in tempo reale per gli approfondimenti utilizzati nelle decisioni sensibili al tempo (ad esempio, il rischio di abbandono in un flusso di lavoro di conservazione). Gli approfondimenti aggiornati in batch sono accettabili per gli attributi che si muovono più lentamente (ad esempio, livello di valore contratto annuale).
- Verificare che gli attributi del profilo mappati non siano nulli prima dell'invocazione dell'azione. Un "customerTier" nullo passato a un'azione prezzi è dannoso quanto un valore allucinato. Utilizzare gli elementi decisionali del flusso per rilevare i dati del profilo mancanti e passare a un fallback che recupera un valore predefinito o richiede chiarimenti.
- Nella configurazione del subagente, mappare gli attributi del profilo ai parametri di input dell'azione utilizzando nomi di variabili descrittivi e semanticamente chiari (ad esempio, "customerTier", "lifetimeValueUSD", "churnRiskScore"). LLM legge questi nomi quando seleziona e compone le azioni; i nomi ambigui peggiorano la precisione della selezione.
Gestione e ripristino degli errori
- Se un attributo profilo obbligatorio è nullo o non disponibile al momento della chiamata dell'azione, l'agente non deve procedere con un'impostazione predefinita potenzialmente errata. L'azione deve restituire un errore strutturato che indica l'attributo mancante e l'agente deve richiedere chiarimenti all'utente o inoltrare al livello superiore a un utente se opera in modo non conversazionale.
- Se un flusso connesso a Data 360 non recupera i dati del profilo (ad esempio, a causa di un'interruzione del servizio Data 360), il percorso di errore del flusso dovrebbe restituire un errore strutturato all'agente con il motivo dell'errore specifico. L'agente può quindi decidere se riprovare, procedere con un'esperienza degradata o presentare l'errore all'utente.
- Registrare tutti i valori degli attributi di profilo iniettati alla creazione della sessione o all'invocazione di azioni insieme all'ID sessione. Ciò garantisce che qualsiasi decisione dell'agente contestata possa essere ricostruita con i fatti esatti del cliente forniti all'agente in quel momento.
Considerazioni sulla sicurezza
- Gli attributi di profilo inseriti nel contesto dell'agente sono soggetti agli stessi controlli di accesso ai dati di qualsiasi record CRM. Assicurarsi che l'utente integrazione o l'applicazione connessa utilizzata per risolvere gli attributi del profilo disponga solo delle autorizzazioni a livello di campo necessarie per gli attributi in evidenza e non dell'accesso in lettura al profilo più ampio.
- Gli approfondimenti calcolati che codificano metriche derivate sensibili (ad esempio, punteggio di salute previsto, livello di rischio finanziario) devono essere trattati come campi sensibili e disciplinati dagli stessi controlli di accesso dei dati sottostanti. Far emergere un punteggio di rischio di abbandono elevato per un agente che opera in un contesto rivolto al cliente richiede un'attenta considerazione di ciò che l'agente può comunicare.
- Non mettere in evidenza attributi del profilo non richiesti dall'azione. Ogni attributo aggiuntivo nella finestra di contesto dell'agente è un elemento di dati aggiuntivo che potrebbe essere riprodotto nella risposta dell'agente. Applicare un principio minimo necessario al radicamento nel profilo.
- Controllare tutte le sessioni in cui Approfondimenti calcolati o attributi di profilo sensibili sono stati inseriti come input. Queste sessioni rappresentano decisioni prese sulla base di Intelligence clienti derivata e possono essere soggette a requisiti di spiegabilità o normativi in alcuni settori.
Esempio
Una società di telecomunicazioni utilizza Agentforce per gestire le conversazioni di conservazione con i clienti che hanno avviato una richiesta di annullamento.
- Quando viene aperto un caso di annullamento, viene creata la sessione agente con l'"accountId" del cliente come contesto.
- La configurazione del profilo unificato di Data 360 mappa tre attributi alle variabili di sessione al momento della creazione: "customerTier" (Enterprise), "lifetimeValueUSD" (42.000) e "contractRenewalDate" (60 giorni).
- Un approfondimento calcolato come "churnRiskScore" (0.91, calcolato in base al declino dell'utilizzo, alla frequenza dei ticket di assistenza e al trend NPS) viene mappato come variabile di sessione aggiuntiva tramite un flusso connesso a Data 360 invocato come prima fase dell'azione.
- L'agente, ora basato su fatti verificati del cliente, invoca un'azione "SelectRetentionOffer". Poiché gli input includono "customerTier = Enterprise", "lifetimeValueUSD = 42000" e "churnRiskScore = 0,91", l'azione restituisce l'offerta di fidelizzazione di livello massimo anziché quella standard.
- L'agente invoca "PresentOffer" per consegnare l'offerta nella conversazione e "LogRetentionAttempt" per registrare l'interazione nel CRM con tutti gli attributi basati conservati per la verificabilità.
Contesto
I dati aziendali sono frammentati. Un agente che può agire solo su ciò che risiede all'interno della piattaforma Salesforce è limitato a una frazione delle informazioni necessarie per ragionare in modo efficace. La risposta a una domanda sul servizio può richiedere la lettura del ticket aperto di un cliente in Service Cloud. La preparazione di una proposta può richiedere il recupero di un file da Google Drive. L'analisi dell'utilizzo dei prodotti può richiedere l'esecuzione di query in un data warehouse. Ciascuno di questi sistemi ha le proprie API, il proprio modello di autenticazione e il proprio schema di dati e il costo della scrittura di codice di integrazione personalizzato per ciascuno di essi è ciò che storicamente ha reso costosa e fragile la connettività da agente a sistema.
MCP è uno standard aperto che affronta direttamente questo aspetto. Definisce un'interfaccia uniforme attraverso la quale un agente può scoprire e invocare gli strumenti esposti da qualsiasi server compatibile con MCP, indipendentemente dal sistema sottostante. Ogni server MCP funge da adattatore: racchiude le interfacce native di un sistema di destinazione in un'interfaccia standardizzata incentrata sugli strumenti che l'agente può eseguire query, invocare e comporre senza conoscere i protocolli o gli schemi specifici del sistema.
Dal punto di vista dell'agente, la connessione a Slack, a un database SQL (Structured Query Language) e a un sistema di gestione dei documenti è identica: tre server MCP, ciascuno dei quali espone una serie di strumenti descritti e richiamabili. L'agente li seleziona e li mette in sequenza in base alle descrizioni semantiche e all'obiettivo che sta cercando di raggiungere.
Problema
Quando un agente deve recuperare informazioni o attivare azioni in più sistemi esterni, ciascuno con API, autenticazione e schemi diversi, come può scoprire, invocare e comporre le proprie funzionalità senza codice di integrazione personalizzato per sistema o accoppiarsi strettamente all'implementazione di qualsiasi sistema?
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
- L'agente deve raggiungere sistemi esterni alla piattaforma Salesforce come archivi di documenti, strumenti di collaborazione, database, SaaS di terze parti, le cui API non sono rappresentate in modo nativo come azioni Agentforce?
- È necessaria l'individuazione dinamica dello strumento, in cui l'agente identifica l'endpoint di integrazione giusto in fase di ragionamento in base alla richiesta corrente, anziché avere integrazioni codificate nella configurazione?
- Il panorama dell'integrazione cambia spesso; i nuovi sistemi aggiunti, quelli esistenti aggiornati e altri cambiamenti possono richiedere un approccio personalizzato per sistema che creerebbe costi di manutenzione insostenibili?
- È necessario separare il livello di ragionamento dell'agente dai dettagli di implementazione dei sistemi a valle, in modo che una modifica nell'API di un sistema di destinazione non richieda modifiche alle istruzioni dell'agente o alla configurazione del subagente?
- I sistemi di destinazione sono di proprietà di team o fornitori diversi, ciascuno responsabile dell'esposizione delle proprie capacità, rendendo un modello di server MCP lato provider più pratico di un'integrazione lato consumatore per agente?
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| Server MCP Salesforce | Ideale per i target dell'ecosistema Salesforce | Utilizzare quando il sistema di destinazione è all'interno dell'ecosistema Salesforce ed è disponibile un server MCP first party. Salesforce Headless 360 fornisce server MCP per le proprie funzionalità della piattaforma, esponendo i dati CRM, i flussi e le azioni della piattaforma come strumenti conformi a MCP. Riduce il lavoro di implementazione alla configurazione anziché allo sviluppo. Nota: Attualmente, i server MCP di Salesforce supportano solo le credenziali utente finale per l'autenticazione e l'autorizzazione. |
| Server MCP MuleSoft personalizzati | Meglio quando non esiste un server MCP first party | L'utilizzo per sistemi legacy, applicazioni interne proprietarie o piattaforme SaaS di terze parti è precedente allo standard MCP. Quando un sistema di destinazione non fornisce il proprio server MCP, un livello di integrazione MuleSoft può essere racchiuso in un server MCP personalizzato che espone le funzionalità del sistema come strumenti. Può essere utilizzato anche con le API Salesforce se gli MCP sono necessari per consentire agli agenti di utilizzare solo le credenziali utente di sistema. MuleSoft gestisce la traduzione del protocollo, l'autenticazione e la trasformazione dei dati; il livello MCP rende il risultato individuabile dagli agenti. |
| Server MCP di terze parti | Ideale per i sistemi di materie prime con ecosistemi MCP attivi | Esiste un server MCP gestito dal fornitore per la piattaforma (GitHub, Google Workspace) e soddisfa i requisiti di sicurezza e manutenzione. Un numero crescente di piattaforme aziendali come GitHub, Google Workspace e altre pubblicano i propri server MCP. Se esiste un server gestito dal fornitore pronto per la produzione, preferirlo alla creazione di un server personalizzato. Valutare il comportamento di sicurezza e l'impegno di manutenzione prima di adottare. |
Schizzo
Diagramma di sequenza per l'iniezione contesto cliente verificata
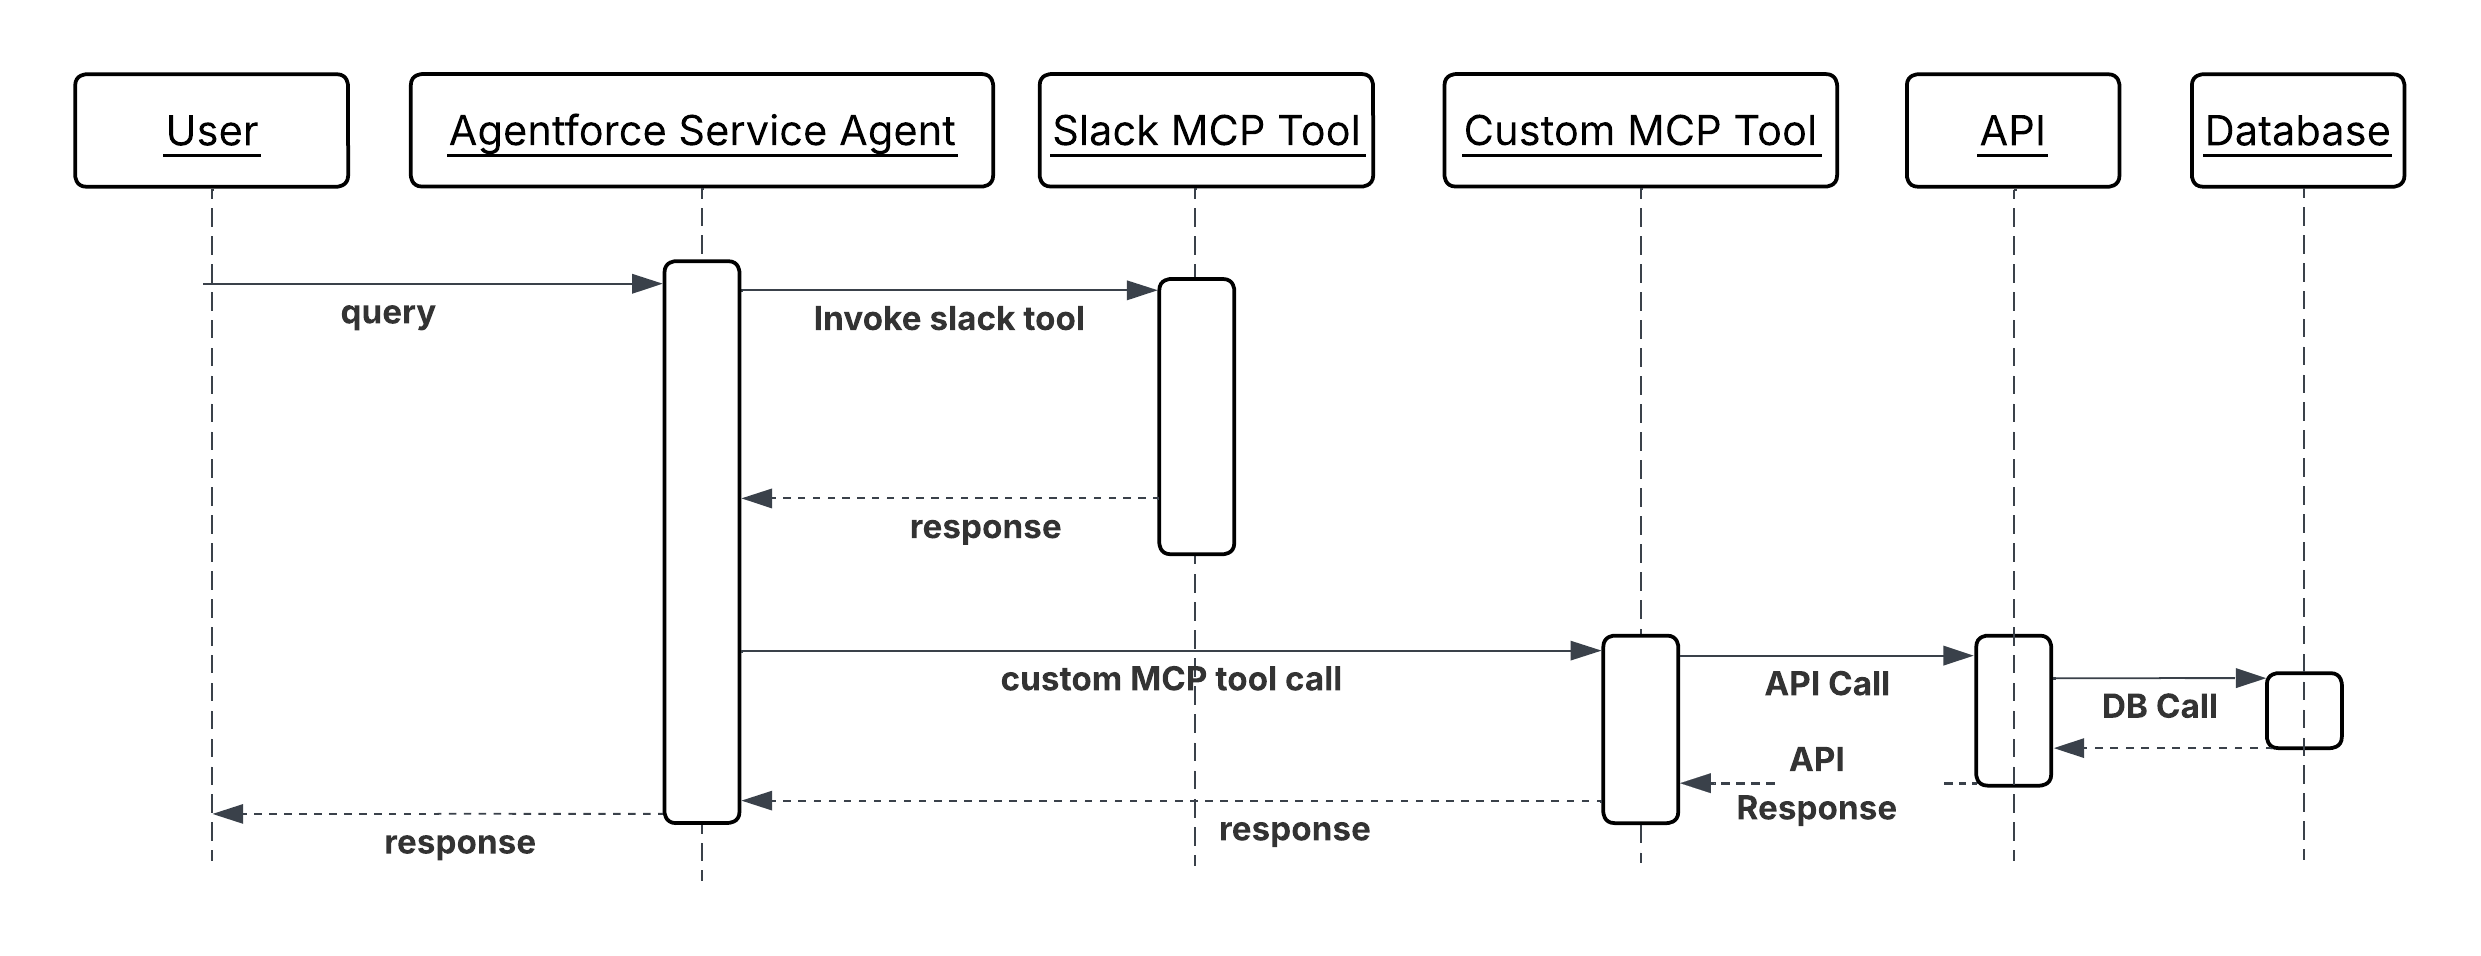
Risultati
La superficie raggiungibile dell'agente si espande senza aumentare la complessità dell'integrazione. Aggiungere un nuovo sistema esterno significa distribuire o configurare un server MCP per il sistema e non scrivere chiamate Apex personalizzate o integrazioni di flussi per agente. Il livello di ragionamento dell'agente rimane invariato; individua e invoca i nuovi strumenti solo in base alle descrizioni semantiche.
Lo standard MCP crea anche una separazione netta della proprietà: il team responsabile di un sistema espone le sue funzionalità come server MCP; il team dell'agente utilizza tali funzionalità senza dover comprendere gli elementi interni del sistema. Questo limite riduce il sovraccarico di coordinamento man mano che aumenta il numero di sistemi integrati.
La componibilità degli utensili è un risultato diretto. Poiché tutti gli strumenti condividono la stessa interfaccia di chiamata, l'agente può concatenare strumenti da sistemi diversi, recuperare un file da Google Drive, estrarre dati da esso e scrivere il risultato in un record CRM in modo naturale come concatenare azioni all'interno di un unico sistema.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Le descrizioni degli strumenti sono l'unica base per l'agente per decidere se e come invocare uno strumento. Scrivere descrizioni in un linguaggio chiaro e basato sugli intenti che indichi che cosa fa lo strumento, quando si applica e che cosa restituisce. Una descrizione che dice "esegue query nel database CRM" è meno utile di "recupera i casi aperti dell'account, ordinati per priorità, per un determinato ID account". Descrizioni scadenti generano una selezione insufficiente degli strumenti.
- Ambito di ogni strumento MCP a una singola funzionalità atomica. Uno strumento che recupera un documento e scrive anche un riepilogo nel sistema di origine è più difficile da ragionare per l'agente, più difficile da riprovare in caso di errore e più difficile da proteggere rispetto a due strumenti discreti. Uno strumento, una responsabilità.
- Progettare gli strumenti in modo che gli output siano input componibili. Il risultato di uno strumento di recupero deve essere strutturato in modo da mapparsi naturalmente ai parametri di input degli strumenti di azione che in genere lo seguono, riducendo il lavoro di trasformazione che l'agente deve eseguire tra le fasi.
- Server MCP host remoto. Le installazioni binarie locali creano una complessità di distribuzione e controllo delle versioni che aumenta con il numero di ambienti degli agenti. Un server ospitato da remoto può essere aggiornato indipendentemente dagli agenti che lo consumano.
Note sull'implementazione di Salesforce
- Se si desidera un'autenticazione MCP coerente, un limite di traffico e convalide del payload in tutte le chiamate MCP in uscita, utilizzare gateway AI come MuleSoft Omni Gateway che supporta i server MCP e configurarlo prima di esporre qualsiasi server MCP agli agenti.
- Utilizzare le credenziali OAuth 2.0 per tutte le credenziali richieste dalle connessioni al server MCP. Le credenziali non devono comparire nei parametri degli strumenti, nelle configurazioni delle azioni o nell'Apex Code.
- Alcuni strumenti MCP possono richiedere le credenziali dell'utente finale per eseguire alcune azioni a seconda del caso d'uso aziendale (ad esempio, il trasferimento di fondi). Per propagare i token di identità dell'utente finale, utilizzare la policy di iniezione OAuth 2.0 per conto delle credenziali attualmente supportata con MuleSoft Omni Gateway.
- Per i server MCP MuleSoft personalizzati: definire lo schema dello strumento MCP nella specifica API di MuleSoft e registrare l'endpoint del server nel catalogo di strumenti Agentforce. Testare le descrizioni degli strumenti con le query degli agenti rappresentativi per verificare che l'agente selezioni lo strumento giusto per l'operazione corretta prima di distribuirlo in produzione.
Gestione e ripristino degli errori
- Quando una chiamata strumento MCP restituisce un errore, l'agente esamina il codice di errore leggibile dal computer per determinare l'azione di ripristino appropriata: richiedere parametri mancanti all'utente, riprovare con l'input corretto o inoltrare al livello superiore a un utente. Non consuma mai gli errori silenziosamente o continua a ragionare come se la chiamata allo strumento fosse riuscita.
- L'agente implementa direttamente la logica di tentativo per gli errori temporanei.
- Registrare ogni chiamata allo strumento MCP dal lato client con il nome dello strumento, i parametri di input sanificati e l'esito. Questa traccia lato client combinata con i registri lato server è il meccanismo principale per diagnosticare il motivo per cui un agente ha intrapreso un particolare percorso di azione quando un flusso di lavoro non produce il risultato atteso.
Considerazioni sulla sicurezza
- Tutte le connessioni server MCP in uscita passano attraverso il gateway. Il gateway impone la verifica dell'autenticazione, la limitazione del tasso per impedire l'abuso degli strumenti e l'ispezione del payload per rilevare tentativi di iniezione rapida nei parametri degli strumenti. Le connessioni dirette e non mediate dagli agenti ai server MCP ignorano questi controlli e non sono consentite.
- Ambito delle connessioni server MCP di ogni agente solo ai server di cui l'agente necessita effettivamente degli strumenti. Un agente configurato con accesso a tutti i server MCP disponibili ha una superficie di attacco più ampia di uno connesso solo agli strumenti richiesti dalle operazioni definite.
- Convalidare e disinfettare i parametri di input dello strumento prima di trasmetterli allo strumento, in particolare quando i valori dei parametri derivano da testo fornito dall'utente o contenuto generato da LLM. Non passare l'output LLM non convalidato direttamente come parametri dello strumento; un aggressore che può influenzare il ragionamento dell'agente può utilizzare quel percorso per inserire valori dannosi nelle chiamate di sistema a valle.
- Considerare l'elenco dei server MCP connessi dell'agente e i relativi inventari di strumenti come configurazione sensibile. Un aggressore che sa quali strumenti ha a disposizione un agente e quali parametri accetta ha una mappa per creare payload di prompt injection progettati per abusare di tali strumenti.
Esempio
Un agente di vendita prepara un briefing account completo prima di una chiamata al cliente di valore elevato:
- L'agente riceve la richiesta: "Preparare un briefing su Acme Corp prima della discussione di rinnovo di domani."
- L'agente esegue una query nel catalogo di strumenti MCP e identifica tre strumenti pertinenti in due server MCP:
GetRecentEmails,GetOpenOpportunitieseGetSupportTicketSummary. - L'agente richiama tutti e tre gli strumenti in parallelo. Ogni server MCP traduce la chiamata all'API nativa del sistema di destinazione, recupera i dati pertinenti e restituisce un risultato strutturato.
- L'agente riceve i tre risultati. Thread email recenti, l'opportunità di rinnovo aperta con le dimensioni e la fase della trattativa e un riepilogo dei ticket di assistenza aperti in base alla priorità e li sintetizza in un briefing account strutturato.
- L'agente invoca
CreateAccountNoteper salvare il briefing nel record account e restituisce un riepilogo all'utente richiedente. - Tutte e quattro le chiamate allo strumento MCP vengono registrate dal gateway con i nomi degli strumenti, le identità del server e gli esiti del record di controllo della sessione.
Contesto
Lo schema MCP in uscita descrive un agente Agentforce che utilizza strumenti da server MCP esterni. Lo schema in entrata lo inverte. Le funzionalità della piattaforma Salesforce come record CRM, flussi, logica Apex e approfondimenti di Data 360 sono esposte come strumenti MCP che gli agenti esterni, in esecuzione su qualsiasi framework LLM, possono scoprire e invocare.
Questo schema è importante perché le distribuzioni di intelligenza artificiale a livello aziendale sono raramente a fornitore singolo. L'agente di un partner basato su un framework diverso può avere la necessità di cercare lo stato dell'account di un cliente in Salesforce. Un team interno di data science che esegue un agente basato su Python potrebbe avere la necessità di attivare un flusso Salesforce per avviare un processo di approvazione. Senza un meccanismo di esposizione standardizzato, ogni consumatore esterno richiede un'integrazione personalizzata. L'esposizione delle funzionalità di Salesforce come server MCP offre a ogni agente compatibile con MCP un'interfaccia uniforme e individuabile per gli strumenti della piattaforma, indipendentemente da come è creato l'agente chiamante.
Ad esempio, l'agente procurement di un partner, basato su un framework di terze parti, deve verificare lo stato del contratto di un fornitore in Salesforce prima di approvare un ordine di acquisto. Anziché creare un'integrazione REST diretta, invoca uno strumento di GetContractStatus sul server MCP di Salesforce. Lo strumento applica gli stessi controlli di accesso di qualsiasi operazione Salesforce nativa; l'agente chiamante visualizza solo il risultato.
Problema
Quando un agente esterno creato su un framework diverso, di proprietà di un partner o in altro modo eseguito all'esterno della piattaforma Salesforce deve invocare le funzionalità di Salesforce come parte del proprio flusso di lavoro, come è possibile esporre tali funzionalità in modo standardizzato, individuabile e gestito in modo sicuro che non richieda un'integrazione personalizzata per consumatore esterno?
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
- Gli agenti esterni che devono utilizzare le funzionalità di Salesforce sono basati su framework che supportano lo standard MCP? In caso contrario, un'API REST o un approccio webhook possono essere più appropriati di MCP.
- Quali funzionalità di Salesforce devono essere esposte: recupero dati di sola lettura, operazioni di scrittura, chiamate di flussi o una combinazione? L'entità dell'esposizione determina direttamente la superficie di sicurezza che deve essere regolata.
- Come deve essere verificata l'identità dell'agente chiamante esterno e sotto quali autorizzazioni Salesforce devono essere eseguite le sue chiamate? Le chiamate da agente a piattaforma non devono ereditare autorizzazioni più ampie di quelle richieste dall'operazione specifica.
- Il server MCP Salesforce è destinato ai consumatori interni (agenti di altri team all'interno della stessa organizzazione) o ai consumatori esterni (agenti partner e clienti)? Il modello Trust e i requisiti di autenticazione variano in modo significativo tra questi tipi di pubblico.
- Come evolverà nel tempo il set di strumenti esposti? Le nuove funzionalità di Salesforce aggiunte al server MCP diventano immediatamente individuabili da tutti gli agenti connessi; l'esposizione involontaria degli strumenti deve essere regolata da un processo di pubblicazione deliberato.
Applicazione modello Salesforce
| Soluzione | Adatta | Commenti |
|---|---|---|
| Salesforce come server MCP (nativo) | Ideale per esporre le funzionalità di Salesforce first party | Utilizzare quando gli strumenti da esporre vengono mappati direttamente alle operazioni Salesforce Platform esistenti e gli agenti chiamanti sono compatibili con MCP. La funzionalità nativa del server MCP di Salesforce Headless 360 consente alle operazioni della piattaforma come query di record, chiamate di flussi e azioni Apex di essere dichiarate come strumenti MCP ed esposte a qualsiasi agente esterno compatibile con MCP. L'accesso è regolato dal modello di autorizzazione Salesforce. Tenere presente che attualmente è possibile accedere a questi server MCP Headless 360 solo con le credenziali dell'utente finale. |
| MuleSoft come facciata server MCP | Ideale quando è necessaria una trasformazione o un'aggregazione multi-sistema | Utilizzare quando l'agente chiamante necessita di una funzionalità che richiede i dati di più di un oggetto Salesforce, una trasformazione prima della consegna o una composizione con i dati di altri sistemi. L'interfaccia MCP rimane pulita e semplice; la complessità viene assorbita da MuleSoft. Un livello MCP MuleSoft si trova di fronte a Salesforce ed espone il risultato aggregato di più operazioni piattaforma come un unico strumento MCP. Questa soluzione può essere utilizzata anche dagli agenti in cui l'identità dell'utente finale non può essere propagata per l'autenticazione e l'autorizzazione Salesforce. Ad esempio, se gli agenti Agentforce necessitano di server MCP con credenziali di sistema, dovremo affidarci a server MCP personalizzati come uno creato e ospitato su MuleSoft. |
Schizzo
Diagramma di sequenza per le funzionalità aziendali come strumento richiamabile
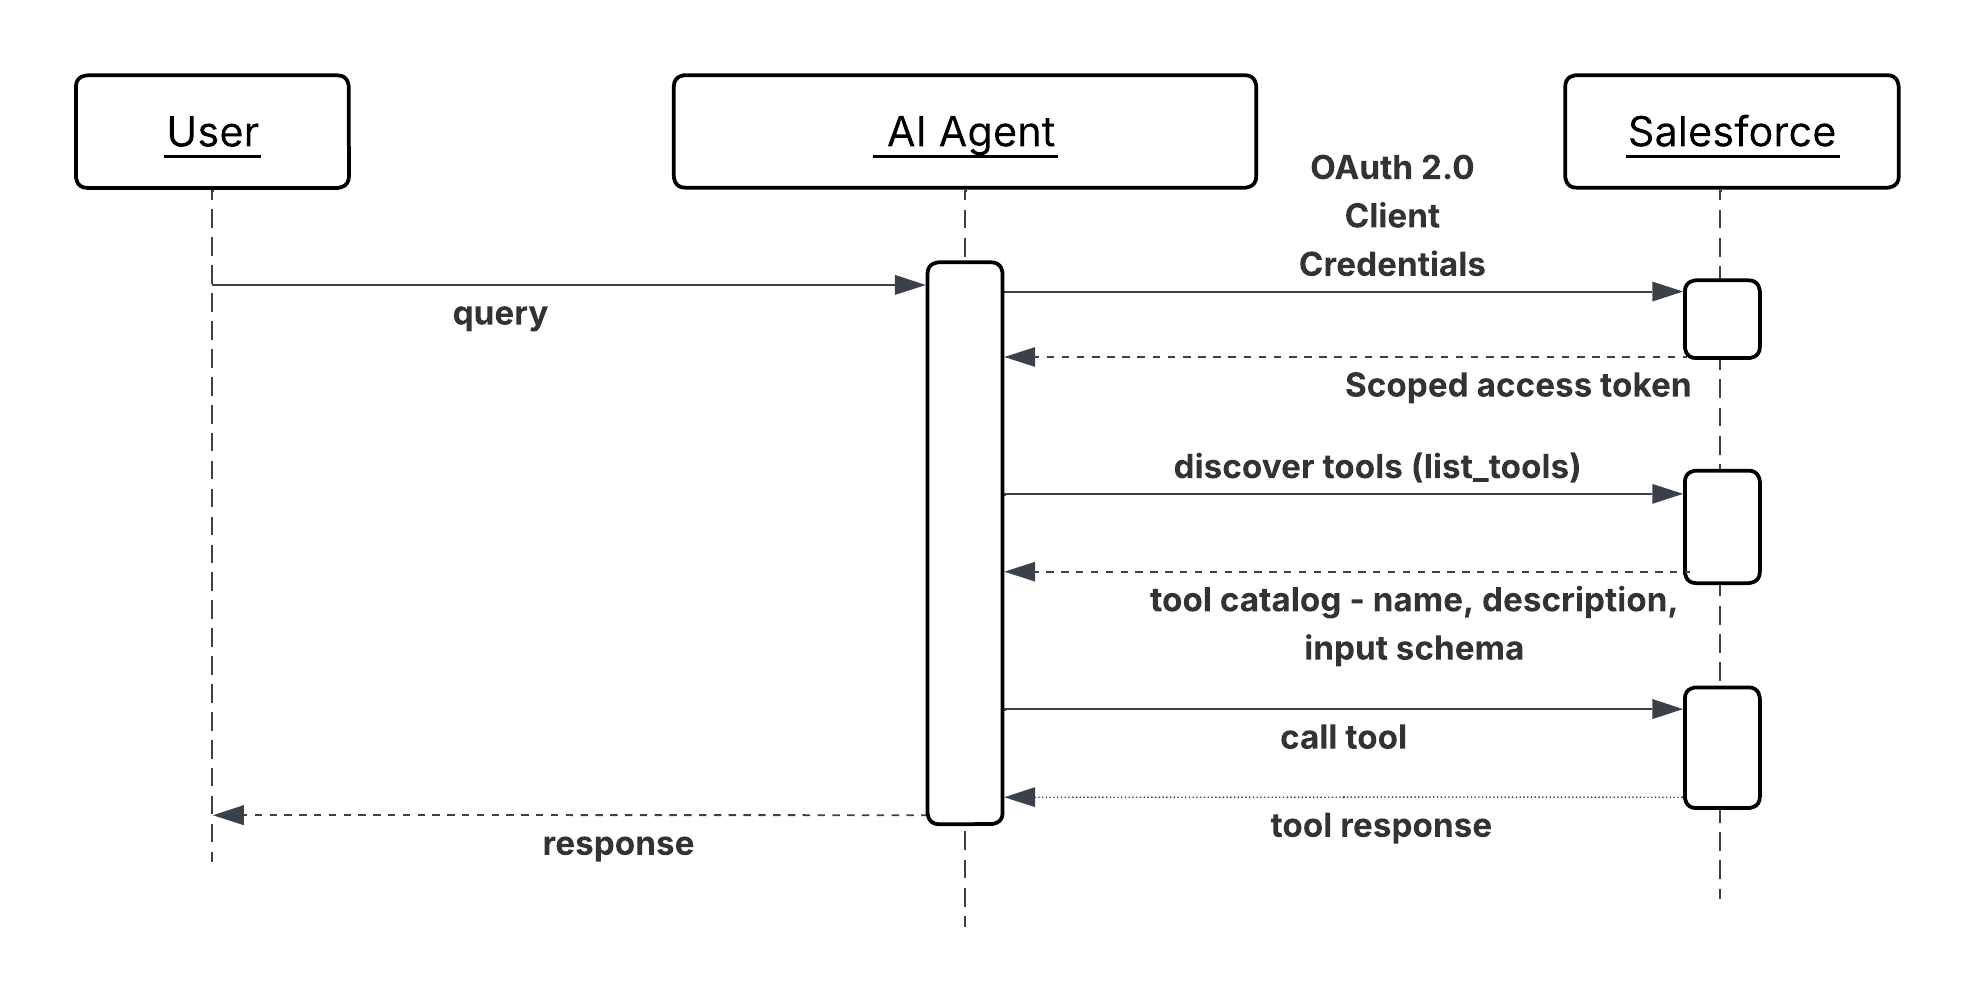
Risultati
Salesforce diventa un partecipante di prima classe negli ecosistemi di agenti multi-vendor. Gli agenti esterni possono scoprire e utilizzare le funzionalità della piattaforma senza richiedere un'integrazione REST personalizzata per consumatore o per caso d'uso. Il numero di consumatori può crescere senza una crescita proporzionale del sovraccarico di manutenzione dell'integrazione.
Con Headless 360, il modello di autorizzazioni Salesforce regola ogni chiamata dello strumento in entrata. I client MCP esterni non ignorano i controlli di accesso ai dati esistenti, ma operano al loro interno. Ciò significa che il comportamento di sicurezza dell'esposizione delle funzionalità tramite MCP equivale all'esposizione tramite qualsiasi altra superficie API autenticata.
La possibilità di individuare gli strumenti è un vantaggio composto. Man mano che le nuove funzionalità di Salesforce vengono aggiunte al catalogo di strumenti del server MCP, diventano immediatamente disponibili per tutti gli agenti esterni connessi senza che sia necessario aggiornare le configurazioni.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Pubblicare solo ciò di cui gli agenti esterni hanno bisogno. Ogni strumento aggiunto al catalogo del server MCP espande la superficie di attacco e il carico di governance. Controllare deliberatamente l'inventario degli utensili. Definire le funzionalità approvate per il consumo esterno e considerare l'esposizione non approvata come una lacuna di configurazione, non come impostazione predefinita.
- Scrivere le descrizioni degli strumenti per i consumatori esterni. L'operatore di un agente esterno non ha Knowledge del modello di dati interno o delle convenzioni di denominazione. Mantenere le descrizioni indipendenti: cosa fa lo strumento, cosa significa ogni parametro, cosa rappresenta il risultato ed eventuali vincoli o prerequisiti che il chiamante deve soddisfare.
- Strumenti di versione esplicitamente quando gli schemi di input o output cambiano. Un agente esterno che dipende dallo schema corrente di uno strumento si interrompe in modo silenzioso se lo schema cambia senza preavviso. Considerare le modifiche apportate all'interfaccia di uno strumento MCP come una modifica apportata a un'API REST pubblica.
Note sull'implementazione di Salesforce
- Eseguire ogni chiamata allo strumento MCP (Headless 360) Salesforce pronto all'uso in entrata sotto un utente finale le cui autorizzazioni sono limitate alle operazioni richieste dagli strumenti esposti. Non eseguire chiamate degli agenti in entrata con un'identità di amministratore con privilegi elevati.
- Per applicare in modo coerente l'autenticazione, la limitazione del tasso, la convalida dello schema e il rilevamento delle informazioni personali (PII) in tutti gli strumenti MCP, utilizzare gateway AI come MuleSoft Omni Gateway.
- Per le facciate MCP MuleSoft, definire lo schema dello strumento MCP in MuleSoft indipendentemente dallo schema API Salesforce sottostante. L'interfaccia MCP deve riflettere le esigenze concettuali dell'agente chiamante e non la forma dell'oggetto Salesforce che lo supporta. Questo disaccoppiamento consente all'implementazione Salesforce di evolversi senza interrompere il contratto dello strumento esterno.
Gestione e ripristino degli errori
- Gli errori di invocazione dello strumento devono restituire risposte di errore MCP strutturate con un codice leggibile dal computer e una descrizione in linguaggio normale. L'agente esterno chiamante non ha visibilità sui dati interni della piattaforma Salesforce, ad esempio i messaggi di errore devono essere autonomi e fruibili senza richiedere Knowledge dei codici di errore o dei modelli di oggetti specifici di Salesforce.
- Gli errori dei limiti di traffico e gli errori di autenticazione devono essere restituiti tempestivamente con informazioni sufficienti per consentire all'operatore dell'agente esterno di diagnosticare e correggere il limite di traffico colpito o la credenziale rifiutata senza esporre i dettagli della configurazione interna.
- Registrare tutte le chiamate allo strumento MCP in entrata nel gateway Omni con l'identità dell'agente chiamante, lo strumento invocato, i parametri di input (disinfettati dai valori sensibili) e l'esito. Questo registro è l'itinerario di prova principale per diagnosticare gli errori segnalati dai consumatori esterni e per controllare a cosa hanno avuto accesso gli agenti esterni.
Considerazioni sulla sicurezza
- Ogni connessione MCP in entrata deve eseguire l'autenticazione prima che uno strumento sia raggiungibile. Non consentire l'individuazione non autenticata del catalogo di strumenti; l'elenco delle funzionalità esposte è esso stesso informazioni sensibili.
- Applicare l'autorizzazione a livello di strumento in aggiunta all'autenticazione a livello di connessione. Un agente esterno registrato deve poter invocare solo gli strumenti specifici a cui è stato esplicitamente concesso l'accesso, non il catalogo completo. Applicarlo al gateway, non al livello dell'applicazione.
- Convalidare e disinfettare tutti i parametri dello strumento in entrata prima di trasmetterli alle operazioni della piattaforma Salesforce. I parametri degli agenti esterni sono una superficie di input non affidabile: un parametro pericoloso potrebbe tentare di ignorare i filtri di query, iniettare frammenti SOQL (Object Query Language) di Salesforce o influenzare le variabili del flusso. Convalidare il tipo, il formato e l'intervallo al confine del server MCP o della facciata.
- Eseguire una revisione periodica dell'accesso dei consumatori esterni registrati. Revocare le credenziali per gli agenti che non sono più attivi o il cui ambito di accesso è cambiato. Una credenziale dormiente ma valida per l'integrazione di un partner disattivata è un rischio fisso non necessario.
- Proteggersi dalla violazione dei limiti della piattaforma limitando la frequenza dei messaggi MCP in entrata nel gateway. Ridurre il traffico degli agenti non critici quando sono sotto carico utilizzando policy di livelli basate sugli SLA.
Esempio
Un agente procurement gestito da un partner logistico deve verificare lo stato del contratto e del credito di un fornitore prima di approvare un ordine di acquisto di valore elevato:
- L'agente del partner esegue l'autenticazione al gateway utilizzando le credenziali client OAuth 2.0 registrate e riceve un token di accesso con ambito.
- L'agente esegue una query nel catalogo di strumenti del server MCP Salesforce e identifica due strumenti pertinenti:
GetSupplierContractStatuseGetAccountCreditSummary. - L'agente invoca
GetSupplierContractStatuscon l'identificatore del fornitore. Il server MCP lo traduce in una query record Salesforce, applica la protezione a livello di campo dell'utente integrazione e restituisce lo stato corrente del contratto, la data di scadenza e gli eventuali requisiti di conformità segnalati. - L'agente invoca
GetAccountCreditSummary, che esegue l'instradamento attraverso MuleSoft MCP Facade. La facciata aggrega il saldo delle fatture in sospeso del fornitore e la cronologia dei pagamenti da due oggetti Salesforce e restituisce un unico riepilogo crediti composito. - Con entrambi i risultati, l'agente del partner determina che il contratto è attivo e la posizione creditizia entro limiti accettabili e approva l'ordine di acquisto nel proprio sistema.
- Entrambe le chiamate agli strumenti vengono registrate dal gateway con l'identità dell'agente partner, gli strumenti richiamati e i risultati, creando un record controllabile di quale accesso esterno è stato concesso e quali dati sono stati restituiti.
Contesto
I sistemi aziendali ora si basano su interventi collettivi di agenti o reti collaborative, in cui le richieste complesse vengono scomposte e delegate ad agenti specializzati in diversi domini o piattaforme di fornitori. Questi agenti, ciascuno con il proprio ruolo, le proprie capacità e i propri strumenti, necessitano di un metodo di comunicazione standardizzato e sicuro per coordinarsi verso obiettivi condivisi senza richiedere l'intervento umano in ogni fase.
Problema
Come può un agente di intelligenza artificiale chiamante individuare dinamicamente, interagire in modo sicuro e delegare operazioni complesse o specifiche del dominio a un agente peer remoto che può essere creato su un framework diverso o gestito da un fornitore diverso e ricevere risultati strutturati per completare un flusso di lavoro aziendale più ampio?
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
- Come interagiscono gli agenti, sviluppati utilizzando framework diversificati o operando in aree di applicazione in silo?
- Come possono gli agenti collaborare e delegare le operazioni senza esporre la loro logica interna, la memoria o gli strumenti proprietari?
- In che modo gli agenti supportano operazioni complesse e di lunga durata, fornendo aggiornamenti di stato in tempo reale, streaming e notifiche push?
- In che modo gli agenti impongono una protezione di livello aziendale (autenticazione, autorizzazione) e l'osservanza delle policy per la comunicazione tra agenti?
- Come gestiscono gli agenti i flussi di lavoro strutturati delle operazioni (avvio, avanzamento, completamento) che vanno oltre le semplici chiamate API?
Applicazione modello Salesforce
Il protocollo A2A è uno standard aperto che consente agli agenti di individuare, delegare e collaborare con altri agenti come pari. Fornisce agli agenti un linguaggio comune per scambiare in modo sicuro informazioni e coordinare le azioni tra piattaforme e fornitori diversi. A2A si concentra sulla comunicazione peer-to-peer, completando l'MPC, che si concentra sulla connessione degli agenti a strumenti e API.
| Soluzione | Adatta | Commenti |
|---|---|---|
| Orchestrazione multiagente a organizzazione singola (SOMA) | È consigliabile quando tutti gli agenti di dominio vivono in un'unica organizzazione e non è richiesto l'instradamento tra fornitori | Un superagente (orchestratore) decompone le richieste e instrada fino a ~7 subagenti connessi utilizzando l'instradamento basato su LLM (il Motore di ragionamento Atlas legge le descrizioni dei subagenti) o l'instradamento deterministico (Script agente). Questo è lo schema consigliato predefinito prima di raggiungere A2A. Combinazioni supportate: Agente dell'assistenza Agentforce→Agente dell'assistenza Agentforce Agentforce Employee Agent→ Agentforce Employee Agent Agentforce Employee Agent→Agente dell'assistenza Agentforce Solo l'orchestratore può inoltrare al livello superiore un essere umano; i subagenti no. |
| Delegazione multiagente guidata dall'orchestratore | Ideale per flussi di lavoro complessi che richiedono più agenti specializzati | Utilizzare quando il flusso di lavoro si estende a più domini, ad esempio sourcing, verifica e approvazione di proprietà di un agente diverso. Un agente orchestratore scompone la richiesta di livello massimo e delega le operazioni secondarie a due o più agenti peer in sequenza o in parallelo. Ogni agente peer esegue la sua funzione di dominio specializzato e restituisce un artefatto; l'orchestratore aggrega i risultati e guida la fase successiva. |
Schizzo
L'architettura prevede che un agente chiamante avvii la comunicazione, facilitata da un catalogo/registro agenti per l'individuazione:
Diagramma di sequenza per la delega incrociata tra agenti
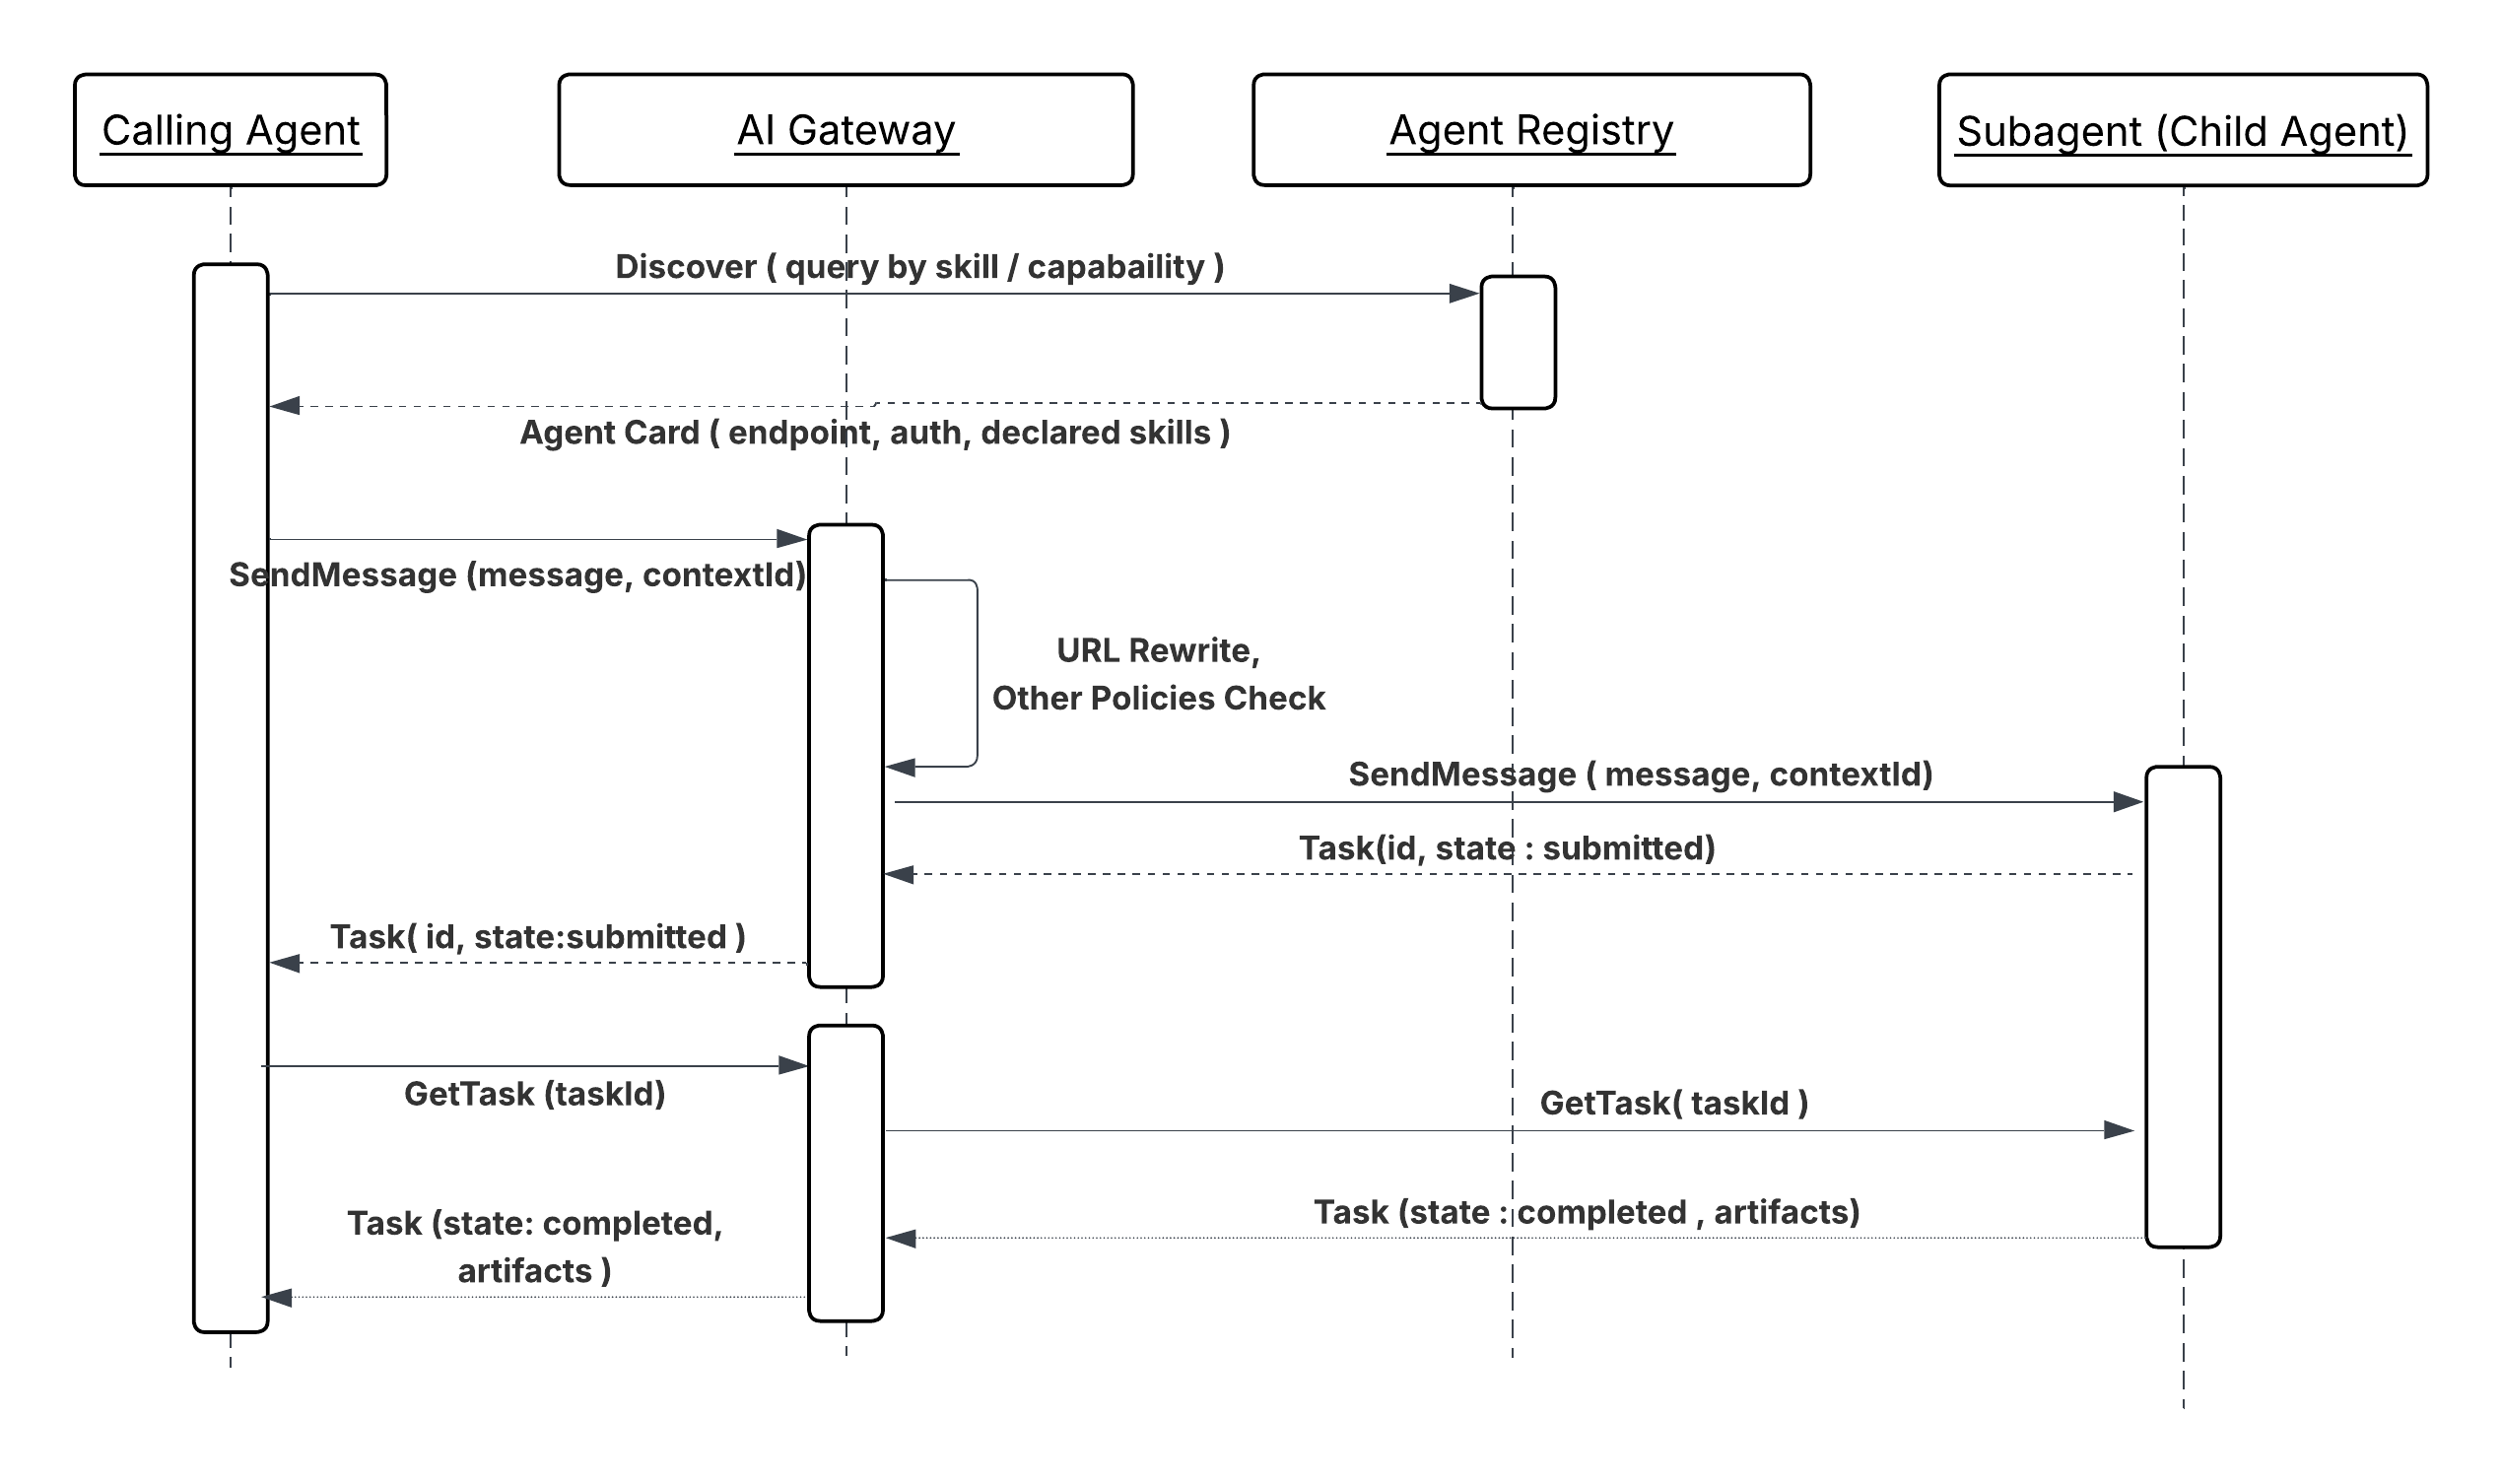
L'agente peer elabora la richiesta utilizzando la logica, la memoria e gli strumenti specifici del dominio, quindi restituisce risultati strutturati all'agente chiamante.
Risultati
La delegazione A2A separa la proprietà del dominio dall'orchestrazione del flusso di lavoro. L'agente chiamante non ha bisogno di sapere come viene creato l'agente peer, su quale piattaforma viene eseguito o quali strumenti utilizza internamente; delega un'operazione e riceve un artefatto strutturato. Questo limite consente di sviluppare, distribuire e migliorare un agente specializzato (verifica in background, calcolo del punteggio del rischio finanziario, calcolo del percorso logistico) indipendentemente dai flussi di lavoro che lo richiamano.
Il modello di ciclo di vita delle operazioni del protocollo (inviato, funzionante, completato, non riuscito) supporta
operazioni di lunga durata in modo nativo. L'agente chiamante può registrarsi per gli aggiornamenti di stato
rispetto al blocco di una connessione, il che significa che le operazioni A2A possono durare minuti o ore
senza richiedere all'agente orchestratore di rimanere attivo per tutto il tempo.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- In scenari complessi, un broker agente può agire come servizio di instradamento intelligente o "centralino intelligente" per coordinare la delega delle operazioni tra agenti specializzati e gestire processi in più fasi.
- Poiché A2A supporta operazioni di lunga durata, la comunicazione deve essere orientata al completamento delle operazioni, definendo un ciclo di vita per l'oggetto operazione e fornendo aggiornamenti e notifiche in tempo reale sullo stato.
- Il protocollo è progettato per supportare vari tipi di contenuto, inclusi testo, file, dati strutturati, streaming audio e video.
- Le relazioni e le dipendenze tra gli agenti e le relative funzionalità sono definite in modo dichiarativo in un file di configurazione (ad esempio, "agent-network.yaml") e pubblicate nel registro agenti.
Note sull'implementazione di Salesforce
- Per un'orchestrazione SOMA efficace, mantenere gli agenti secondari connessi al di sotto di 7 per preservare la qualità dell'instradamento.
- Attualmente è supportato solo il livello di delega singolo (superagente → subagente); le catene più profonde spingono la latenza a un "tasso insostenibile". Attualmente, i subagenti non possono delegare ad altri subagenti connessi.
- La consegna di esseri umani è supportata solo a livello di orchestratore; i subagenti non possono inoltrarsi al livello superiore.
- All'interno di SOMA, utilizzare lo script agente quando l'instradamento basato su LLM produce un instradamento errato su input ambigui per l'instradamento deterministico. Lo script agente abilita il contesto condiviso curato tra gli agenti.
Gestione e ripristino degli errori
Il protocollo A2A definisce codici di errore completi per facilitare il debug e la gestione degli errori.
- Logica di ripristino: Gli agenti devono incorporare policy di tentativo (tentativi), logica di failover per agenti con capacità alternative e timeout espliciti.
- Tracciamento stato operazione: Il flusso di lavoro di gestione delle operazioni assicura che gli agenti possano rimanere sincronizzati con lo stato più recente di un'operazione, facilitando il ripristino in caso di interruzione.
- Osservabilità: La registrazione dei dettagli delle interazioni, ad esempio latenza, percentuali di successo e frequenze di errore, è fondamentale per il monitoraggio della qualità e la risoluzione dei problemi.
Considerazioni sulla sicurezza
- Autenticazione di livello aziendale: A2A è progettato per allinearsi agli standard di autenticazione e autorizzazione di livello aziendale, ad esempio OAuth 2.0 e JWT, spesso gestiti da piattaforme esterne come Okta.
- Gateway per proteggere A2A: Un gateway (ad esempio, MuleSoft Omni Gateway) è essenziale per imporre policy su tutte le comunicazioni A2A, fungendo sia da gateway di ingresso che di uscita per proteggere gli agenti e controllare il traffico in uscita verso agenti e servizi esterni.
- Applicazione delle policy: Per il server A2A e la protezione dei dati devono essere applicate le policy Agent Card Rewrite, Schema Validation, Spike Control, PII Detector e altre policy.
Esempio
Flusso di lavoro di origine candidato
Un responsabile assunzioni incarica il proprio agente orchestratore centrale di trovare i candidati che corrispondono a un annuncio di lavoro e a un insieme di competenze.
- Scoperta: L'agente orchestratore esegue una query nel registro agenti e trova un agente di reclutamento specializzato e un agente di controllo del background (entrambi agenti peer).
- Delegazione (A2A): L'agente orchestratore invia una richiesta di operazione strutturata (messaggio A2A) all'agente di selezione per individuare i candidati.
- Elaborazione tra pari: L'agente di selezione esegue il proprio flusso di lavoro (ad esempio, chiamando uno strumento LinkedIn esterno tramite MCP).
- Restituzione artefatto (A2A): L'agente di selezione restituisce un elenco di candidati suggeriti (l'artefatto).
- Delega sequenziale: L'agente orchestratore delega quindi un'altra operazione (A2A) all'agente di controllo in background per il candidato migliore. Questo agente esegue il controllo e restituisce il risultato, completando l'operazione complessiva.
Contesto
I flussi di lavoro aziendali complessi spesso richiedono agenti specializzati ospitati su piattaforme esterne o sistemi partner per avviare operazioni, delegare query o fornire aggiornamenti agli agenti interni (ad esempio, quelli sulla piattaforma Salesforce). Questo schema descrive il modo in cui un agente Agentforce interno riceve ed elabora in modo sicuro e affidabile le richieste di un agente peer remoto per eseguire una funzionalità specifica del dominio.
Problema
Come può un agente di intelligenza artificiale specializzato interno (ad esempio, un agente di controllo in background su Agentforce) esporre in modo sicuro le sue funzionalità specifiche del dominio agli agenti di pari livello esterni, elaborare una richiesta A2A strutturata in entrata e gestire il ciclo di vita delle operazioni (inclusi gli aggiornamenti di stato in tempo reale) per restituire artefatti strutturati all'agente chiamante remoto?
Forze
Quando si applica questo schema, rispondere alle seguenti domande:
- Come esporre in modo sicuro le funzionalità degli agenti interni agli agenti esterni senza compromettere la logica o gli strumenti interni?
- Come si applicano le policy di protezione di livello aziendale per verificare l'identità dell'agente chiamante e l'autorità delegata prima di elaborare le richieste?
- Come si gestiscono le operazioni in entrata di lunga durata fornendo al contempo aggiornamenti strutturati e asincroni degli stati?
- Come garantire un'interazione senza interruzioni con gli agenti basata su framework esterni diversificati?
Applicazione modello Salesforce
Il protocollo A2A fornisce lo standard aperto per la delega e la collaborazione sicure e peer-to-peer. L'agente interno funge da agente peer, pubblicizzando le sue funzionalità tramite un Catalogo/Registro agenti e utilizzando A2A su canali protetti (HTTPS/SSE) per ricevere e rispondere alle richieste strutturate.
| Soluzione | Adatta | Commenti |
|---|---|---|
| Agentforce Connected Subagent (SOMA) | È consigliabile quando l'agente chiamante è un altro agente Agentforce nella stessa organizzazione | Utilizzare quando entrambi gli agenti vivono nella stessa organizzazione Salesforce e il chiamante è un orchestratore Agentforce. L'agente viene connesso come subagente tramite Agentforce Builder ed esposto all'orchestratore tramite la descrizione e le azioni dichiarate. L'orchestratore instrada le operazioni utilizzando l'instradamento basato su LLM (Motore di ragionamento Atlas) o l'instradamento deterministico (Script agente). Non è richiesto alcun protocollo A2A, gateway o registrazione esterna. Combinazioni supportate: Agente dell'assistenza Agentforce→Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agentforce Agente dipendente Agente dell'assistenza Agentforce Agente dell'assistenza Agentforce Agente dell'assistenza Agentforce Agente dell'assistenza Agentforce Agente dipendente Agente dell'assistenza Agente dell'assistenza Agentforce Agente dell'assistenza Agente dell'assistenza Agentforce Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agente dell'assistenza Agente |
| Instradamento broker agente (in entrata) | È consigliabile quando l'organizzazione ospita più agenti Agentforce con funzionalità complementari e l'agente chiamante non può o non deve selezionare una destinazione specifica | Utilizzare quando l'agente chiamante è esterno a Salesforce o a un'altra organizzazione Salesforce e non deve sapere quale agente interno specifico (Agentforce o altri agenti del fornitore) gestisce la richiesta. Un broker di agenti MuleSoft si trova tra il gateway Omni MuleSoft e il pool di agenti Agentforce interni. Riceve l'operazione A2A in entrata, valuta le capacità dichiarate degli agenti interni disponibili rispetto ai requisiti dell'operazione e instrada la richiesta all'agente più adatto. Il broker gestisce anche il failover se l'agente di destinazione principale non è disponibile o restituisce un errore, il broker reindirizza a un agente equivalente senza riportare il tentativo al chiamante esterno; il chiamante esterno non è mai a conoscenza delle decisioni di instradamento interno o dei tentativi. |
Schizzo
Diagramma di sequenza per gli agenti come servizi chiamabili
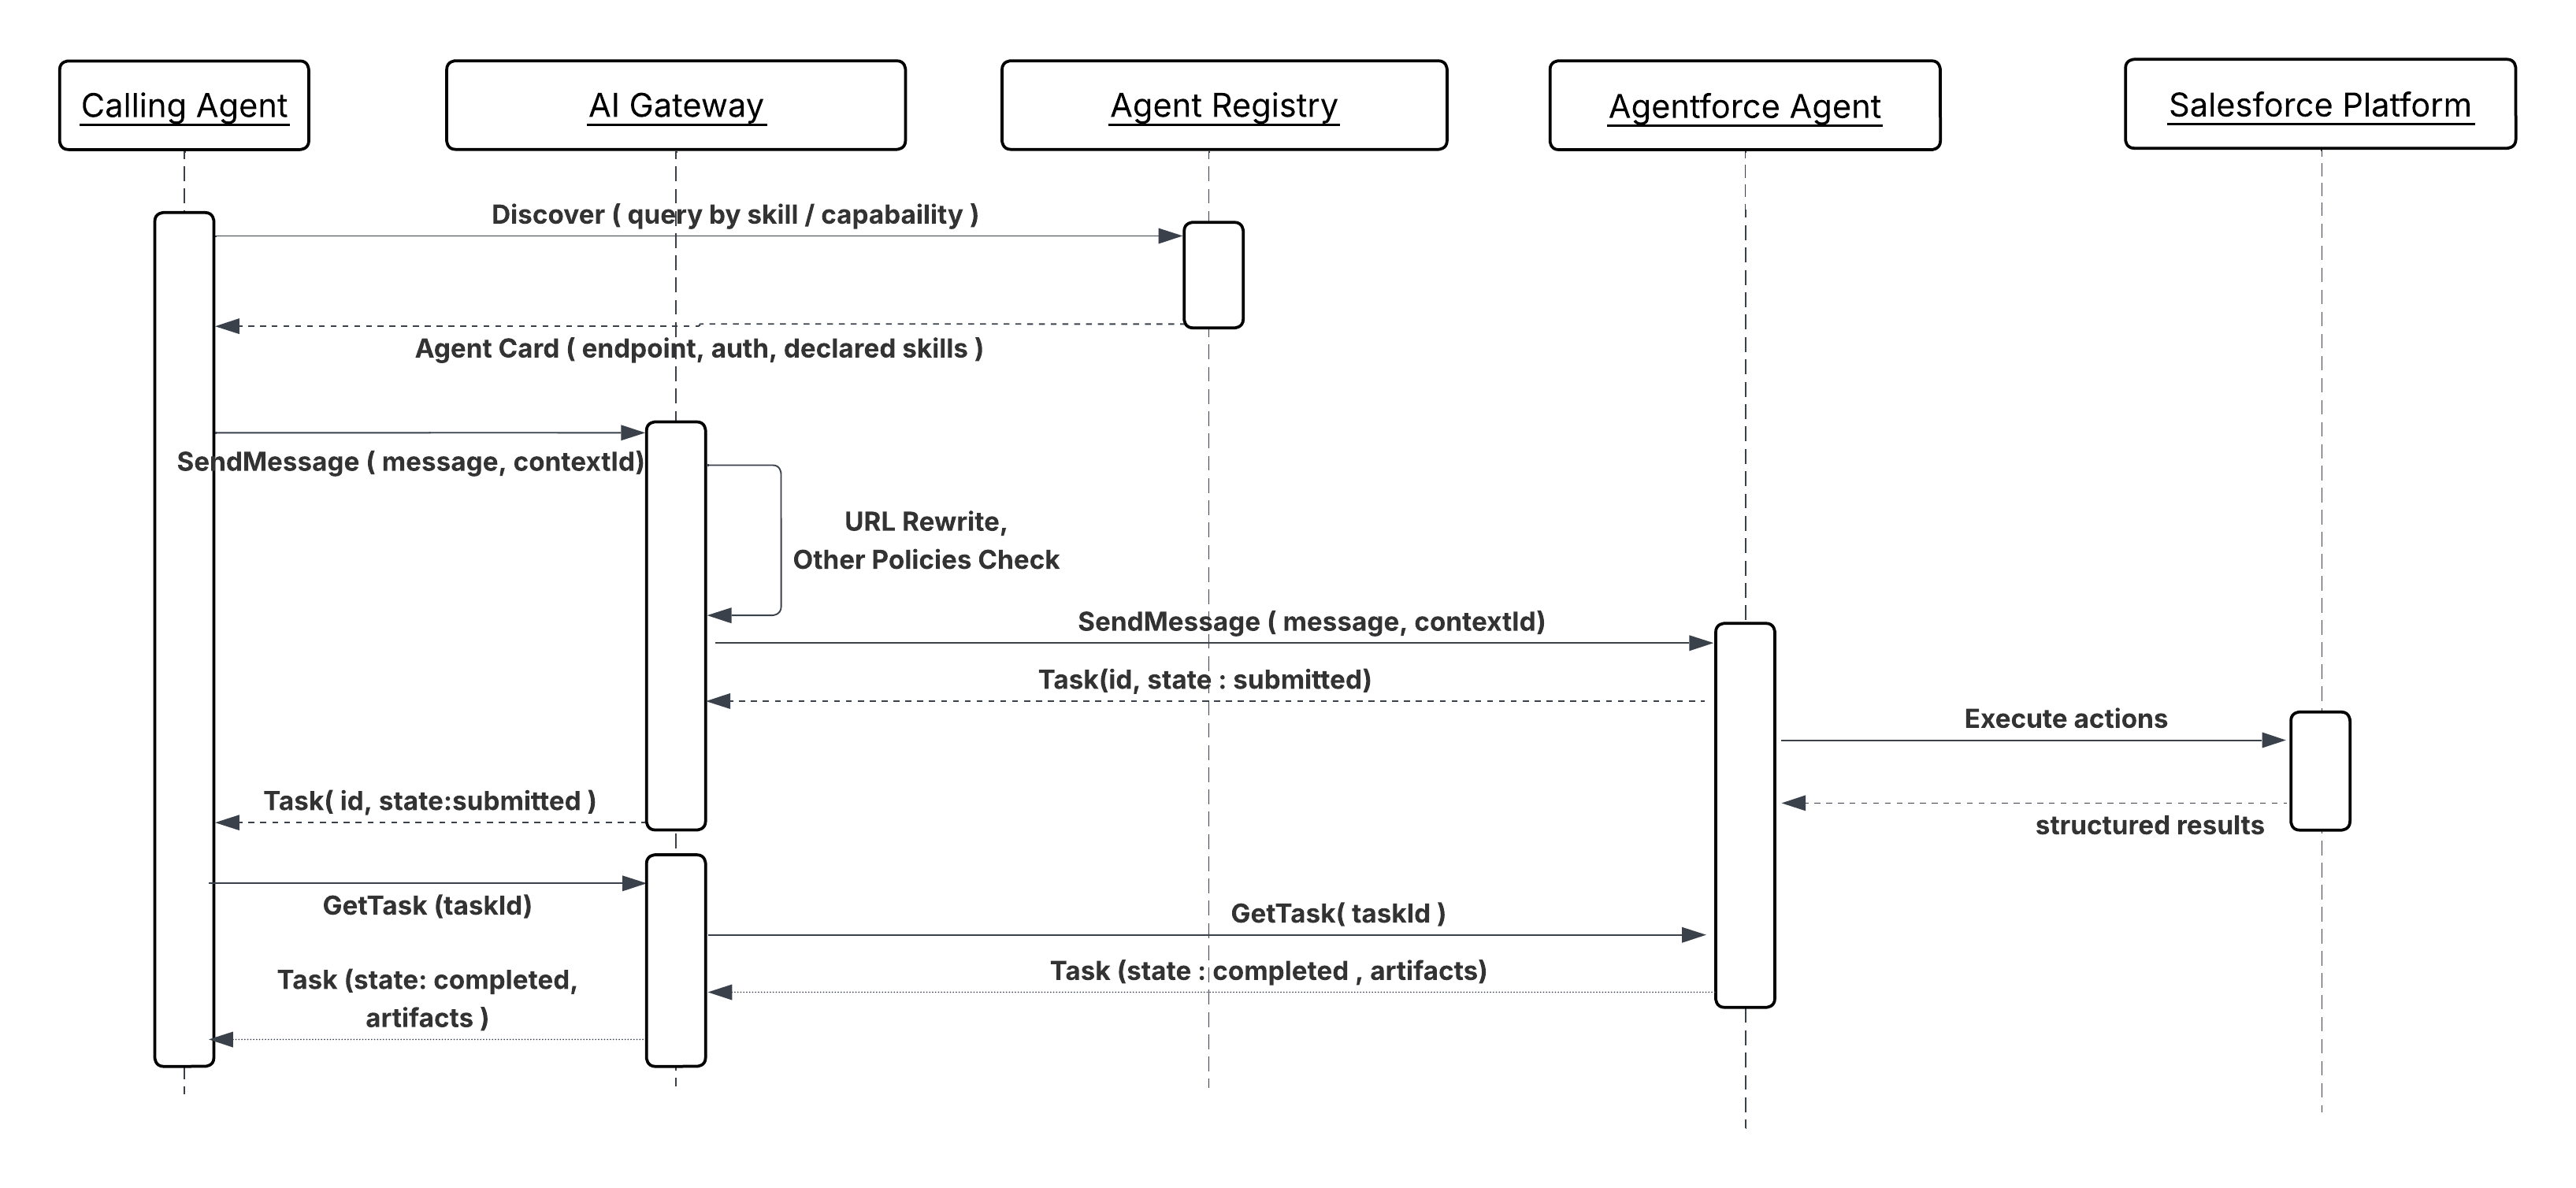
Risultati
Questo schema espone gli agenti interni come servizi specializzati all'interno di una rete con più agenti. Gli agenti esterni possono delegare in modo sicuro le operazioni alle funzionalità interne mentre l'organizzazione mantiene il controllo, la verificabilità e l'applicazione delle policy.
Considerazioni sulla progettazione
Guida indipendente dalla piattaforma
- Un gateway (ad esempio, MuleSoft Omni Gateway) deve essere posizionato come punto di ingresso per imporre policy, tra cui limitazione dei tassi, autenticazione e convalida del payload, su tutte le richieste A2A in entrata.
- Gli agenti interni devono gestire lo stato dell'oggetto operazione dall'inizio al completamento, assicurando che l'agente chiamante remoto riceva aggiornamenti di stato coerenti e verificabili.
- Assicurarsi che le funzionalità pubblicate dell'agente nella scheda agente siano chiare, basate sugli intenti e includano gli ambiti di sicurezza necessari per la delega.
Gestione e ripristino degli errori
- Codici di errore strutturati: In caso di errore, l'agente interno deve restituire all'agente chiamante messaggi di errore strutturati compatibili con A2A per abilitare la logica di tentativo remoto o meccanismi di failover alternativi.
- Impotenza: L'agente deve verificare che gli eventuali effetti collaterali attivati da una richiesta A2A tentata da un agente esterno (a causa di un'interruzione o di un ripristino della rete) siano idempotenti.
Considerazioni sulla sicurezza
- Applicazione delle policy in entrata: Il gateway deve applicare policy per l'inserimento nell'elenco consentiti/blocco degli agenti esterni e la convalida dei token JWT/OAuth 2.0 per verificare l'identità e l'autorità delegata dell'agente chiamante.
- Sanificazione degli input: Convalidare e disinfettare tutti i payload delle richieste in entrata per mitigare potenziali attacchi di prompt injection o dati dannosi.
- Propagazione dell'identità: Mappare in modo sicuro l'identità dell'agente esterno e la relativa autorità delegata ai contesti di sicurezza interni (ad esempio, i profili utente Salesforce) prima di eseguire azioni contro i sistemi interni.
Esempio
Indagine sul sistema esterno
- Richiesta: Un agente di selezione in un sistema di partner invia una richiesta di operazione A2A a un agente di verifica dei dipendenti interno (agente di pari grado) su Agentforce per confermare lo stato lavorativo di un nuovo candidato.
- Elaborazione: L'agente di verifica del dipendente riceve la richiesta tramite il gateway, verifica le credenziali dell'agente partner, esegue il flusso di lavoro interno (ad esempio, chiamando un sistema di risorse umane interno) e formatta la risposta.
- Risposta: L'agente peer restituisce un artefatto A2A strutturato (ad esempio, data di inizio impiego e qualifica professionale) all'agente di reclutamento remoto, che quindi procede con il flusso di lavoro esterno.
-
Gateway per la protezione di MCP, A2A e API
Un gateway è necessario come punto di applicazione unico per tutto il traffico da agente a sistema e da sistema ad agente.
-
Connessioni protette: Un gateway garantisce che solo gli agenti autenticati e autorizzati interagiscano con gli endpoint MCP, A2A e API limitando l'accesso.
-
SLA imposti: Un gateway può imporre limiti di traffico, aiutando le organizzazioni a soddisfare i requisiti di prestazioni e impedendo il sovraccarico di server MCP e A2A.
-
Governance semplificata: Un gateway offre visibilità e controllo centralizzati su tutte le interazioni del server, semplificando la gestione e il monitoraggio delle attività degli agenti.
-
Coerenza e protezione dei dati: Policy come la convalida dello schema impongono la coerenza dei dati e il rilevamento delle informazioni personali può proteggere le informazioni sensibili.
Gateway Omni MueleSoft
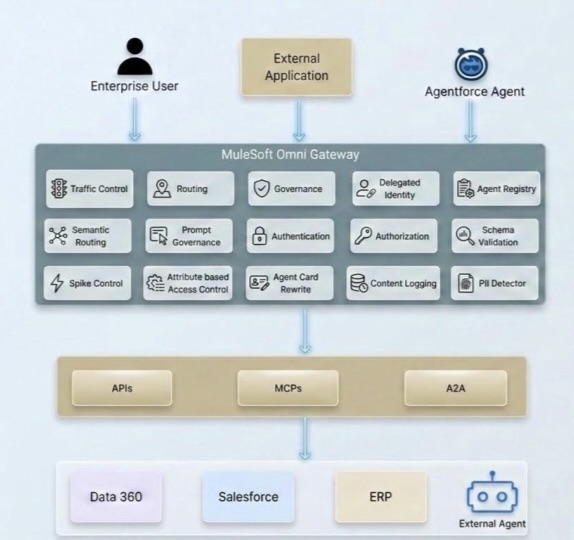
- Catena di propagazione dell'identità
Man mano che le aziende abbracciano il paradigma degli agenti, emerge una nuova sfida per la sicurezza: Come scorre l'identità dell'utente finale attraverso una rete di agenti AI autonomi? Nelle architetture API tradizionali, un utente esegue l'autenticazione una volta e l'applicazione chiama i servizi di backend per conto dell'utente. La catena dell'identità è breve, ben compresa e in genere gestita all'interno di un unico dominio Trust.
Le architetture agentiche, tuttavia, sono caratterizzate da catene molto più lunghe in cui una singola richiesta si diffonde attraverso vari agenti, servizi e server MCP, ciascuno dei quali potenzialmente supera i confini di servizi, domini Trust e persino i confini dell'organizzazione. Senza una strategia deliberata per la propagazione dell'identità, le aziende devono scegliere tra sicurezza e funzionalità, un dilemma che nessun architetto deve affrontare.
MuleSoft risolve le complessità della propagazione dell'identità con la sua funzione Trusted Agent Identity. Questa soluzione utilizza una strategia gestita dal gateway basata su policy per garantire il mantenimento dell'identità dell'utente finale in vari tipi di interazioni, inclusi protocolli A2A, chiamate a strumenti MCP e richieste API REST. Centralizzando la gestione dell'identità a livello di gateway Omni tramite le politiche di autenticazione in uscita, le aziende possono proteggere l'intera rete di agenti senza modificare i servizi di backend o gli agenti. Per ulteriori dettagli, vedere Trusted Agent Identity for the Agentic Enterprise.
- Protezione dei file RAG in Data 360
Data 360 supporta il controllo dell'accesso basato sugli attributi (ABAC) a livello di oggetto, campo e riga tramite le impostazioni della policy di governance dei dati. Questo è il modo principale per controllare quali dati sono visibili a chi, anche all'interno degli indici di ricerca RAG. Per i dati strutturati, le condizioni di accesso degli utenti vengono implementate utilizzando attributi utente e insiemi di autorizzazioni. Per i dati non strutturati, i filtri dei metadati (pre-filtri sugli indici di ricerca) possono limitare gli elementi recuperati.
La comunicazione con LLM passa attraverso Einstein Trust Layer, che maschera le informazioni riservate/PII prima che raggiungano il modello proteggendo la privacy dei dati non solo durante la ricerca ma anche prima della generazione.
Per proteggersi dall'avvelenamento da RAG, assicurarsi che vengano applicate rigorose regole di governance e convalida dei dati prima che i dati diventino disponibili per la ricerca vettoriale. Einstein Trust Layer può anche imporre controlli rapidi di mascheramento/tossicità. È possibile applicare insiemi di autorizzazioni rigorosi al profilo Utente agente.
- Nuovo modello di credenziale denominata Salesforce ha rinnovato la propria architettura di autenticazione introducendo un modello a due livelli di credenziali denominate che separa in modo netto le preoccupazioni tra connettività e identità. Utilizzare questa opzione ogni volta che si effettuano chiamate tramite Apex ed evitare di creare il proprio protocollo di autenticazione. Questo modello offre anche estensibilità e sicurezza ottimizzata. Le credenziali esterne sono alla base di questo modello. Memorizzano i dettagli di autenticazione effettivi e supportano un insieme completo di protocolli, tra cui credenziali client OAuth 2.0, bearer JWT e AWS Signature V4, definendo anche come mappare le entità: come entità denominata singola (condivisa tra tutti gli utenti) o come entità per utente (in cui ogni utente esegue l'autenticazione con la propria identità). Le credenziali denominate, a loro volta, fungono da livello endpoint. Definiscono l'URL di chiamata e fanno riferimento a una credenziale esterna per gestire la stretta di mano di autenticazione, mantenendo la configurazione dell'endpoint chiaramente separata dalla gestione delle credenziali. Per abilitare i flussi di autenticazione per utente, gli amministratori mappano gli insiemi di autorizzazioni all'entità Credenziale esterna appropriata, in modo che solo gli utenti con l'assegnazione dell'insieme di autorizzazioni corretta possano invocare le chiamate con la propria identità. Questo design a due livelli non solo semplifica la configurazione sicura delle chiamate, ma offre anche agli architetti una flessibilità e un controllo di governance molto maggiori su come le integrazioni vengono autenticate nei sistemi connessi a Salesforce. Per ulteriori dettagli, vedere la documentazione sulle credenziali denominate.
Questa sezione mappa gli schemi di gestione dei dati dell'architettura agli obblighi di conformità più comuni nelle distribuzioni aziendali regolamentate.
Controllo dell'accesso: Il modello utente di integrazione con privilegi minimi descritto negli schemi di integrazione (credenziali denominate con ambito, ambiti OAuth 2.0 per agente, elenchi consentiti gateway) viene mappato direttamente ai controlli di accesso logici. Mantenere la prova che l'ambito delle credenziali di ogni agente è stato rivisto e approvato.
Registrazione controllo: I requisiti di registrazione del controllo per schema (ID sessione, invocazioni di strumenti, parametri di input puliti da valori sensibili, esiti) soddisfano i controlli di monitoraggio e registrazione. Assicurarsi che i registri non siano manomessi, conservati per il periodo richiesto e accessibili al team di sicurezza senza richiedere l'accesso ai sistemi di produzione.
Gestione del cambiamento: Le modifiche dello schema dello strumento MCP e gli aggiornamenti della scheda agente A2A che interessano i consumatori costituiscono modifiche dell'interfaccia e devono essere soggetti a controlli di gestione del cambiamento. Strumenti di versione esplicitamente (menzionati nello schema in entrata MCP) e considerano le modifiche dell'interruzione come eventi di configurazione che richiedono l'approvazione.
Disponibilità: I limiti di concomitanza degli agenti, i massimali di tentativi per gli schemi attivati da eventi e l'instradamento a lettera morta per gli eventi non riusciti costituiscono controlli della disponibilità. Documentare l'inviluppo di produttività previsto e il comportamento di errore per ogni schema distribuito come parte del pacchetto di prove della disponibilità.
Nota: Questo elenco non rappresenta una guida completa per garantire la conformità delle soluzioni per agenti. Devono essere soddisfatti tutti i requisiti normativi applicabili.
- Suggerimenti introduttivi sull'API agente
- Abilitazione degli agenti affidabili con Data 360
- Panoramica di MuleSoft Omni Gateway
- Policy di iniezione credenziali OAuth 2.0 per conto
- Identità agente affidabile per l'azienda agente
Gulal Kumar è un architetto di ingegneria del software di Salesforce con oltre 20 anni di esperienza. La sua esperienza si estende all'intelligenza artificiale, all'integrazione, alle API e all'architettura aziendale, con particolare attenzione alla guida della trasformazione aziendale attraverso soluzioni di intelligenza artificiale sicure, resilienti e innovative. Contattarlo su LinkedIn.