Introduction
Note : Les « rubriques » ont été renommées en « sous-agents » dans cet article, conformément à nos dernières conventions de nommage de produits.
Vous pouvez élaborer un agent performant dans un environnement de test, mais il suit des itinéraires totalement différents en traitant deux fois le même workflow. Cette limitation fondamentale montre comment le modèle Agentforce précédent gérait l’exécution: Chaque décision, depuis l’interprétation de l’intention jusqu’à la sélection de l’action, a été prise en temps réel par le LLM, sans chemin garanti à travers le workflow.
Les LLM peuvent produire des résultats incohérents en réponse à des entrées identiques. De subtiles variations de contexte, d’invites système ou de génération de jetons suffisent pour orienter un agent vers un autre itinéraire. Pour de nombreuses interactions, cette variabilité est acceptable. Cependant, pour les workflows à plusieurs étapes qui nécessitent l’auditabilité, la reproductibilité et la traçabilité, ce n’est pas le cas. Une approbation de prêt, un transfert d’inventaire ou un processus de tri du patient ne peut pas dépendre d’un agent qui raisonne chaque fois différemment à travers les étapes.
Les nouveaux Agentforce Builder et Agent Script répondent à ce problème en séparant l’exécution déterministe du raisonnement LLM. Le modèle hybride d’Agentforce garantit que l’agent suit une structure définie avec précision pour chaque exécution de workflow, tout en utilisant un raisonnement LLM où le jugement, la compréhension du langage naturel ou l’interprétation contextuelle sont véritablement nécessaires.
Dans la version précédente d’Agentforce, un agent fonctionnait comme une simple boucle réactive. Chaque décision, depuis l’interprétation de l’intention jusqu’à la sélection de l’action suivante, a été prise en temps réel par le grand livre uniquement en fonction de l’entrée la plus récente de l’utilisateur. Il n’y avait aucun chemin d’exécution garanti, aucun état permanent et aucun mécanisme pour appliquer une séquence d’étapes.
Les parcours d’exécution ne pouvaient être garantis
Chaque décision dépendait du raisonnement en temps réel du grand livre. Par conséquent, des variations mineures dans l’entrée, l’invite système ou la version du modèle entraînaient différentes sélections d’actions dans des requêtes identiques. Cela rendait le modèle précédent difficile à tester rigoureusement : un workflow transmis par étapes pouvait avoir un comportement différent en production, et il n’existait aucun moyen fiable de reproduire un parcours d’exécution spécifique à des fins de débogage ou d’audit.
Chaque interaction a payé le coût complet du LLM
Même les scénarios conversationnels simples nécessitaient au moins trois cycles de maîtrise en langage naturel : subagent selection, action selection, and final response generation. Tâches à plusieurs étapes étendues à cinq cycles ou plus. Pour les architectes qui conçoivent des workflows à haut volume ou sensibles à la latence, ce n’était pas seulement un problème de performance. Cela signifiait que vous ne pouviez pas court-circuiter la boucle de raisonnement pour des étapes qui ne nécessitaient pas de jugement, car l’architecture n’avait aucun mécanisme pour distinguer les deux.
L’exécution non déterministe a créé un écart d’audit
Dans les secteurs réglementés, l’auditabilité signifie être en mesure de démontrer qu’un processus spécifique a été suivi d’une manière spécifique pour une transaction spécifique. Un modèle purement non déterministe ne peut pas fournir cette garantie. Si le parcours d’exécution varie entre les exécutions, le parcours d’audit varie également et « l’agent a décidé » n’est pas une réponse défendable dans un examen de conformité.
L’État n’a pas survécu à la conversation
En s’appuyant sur un traitement à tour de rôle, l’agent n’avait aucun souvenir permanent des étapes précédentes. Si la conversation déviait même légèrement, l’agent pouvait abandonner le contexte précédemment capturé et forcer l’utilisateur à redémarrer. Pour les workflows transactionnels à plusieurs étapes, cela a créé un plafond de fiabilité : plus le processus comporte d’étapes, plus la probabilité de perte de contexte avant la réalisation est élevée.
Les étapes terminées n’étaient pas mémorisées
Sans gestion d’état, les agents n’avaient aucun enregistrement des étapes obligatoires qu’un utilisateur avait déjà effectuées. Cela produisait un looping imprévisible, où un agent revenait à une étape que l’utilisateur avait déjà terminée. Au-delà de l’impact de l’expérience utilisateur, cela a créé un problème architectural plus profond : La conception d’un workflow séquentiel fiable était impossible, car l’agent ne pouvait pas forcer la séquence.
Le nouvel Agentforce, GA depuis février 2026, bascule du raisonnement LLM purement probabiliste vers un modèle hybride. Au lieu d’acheminer chaque décision à travers le LLM, il sépare l’exécution déterministe du raisonnement LLM et laisse chacun gérer uniquement ce pour quoi il convient. Pour prendre en charge cela, Agentforce introduit deux outils de création : Agent Script pour le développement basé sur le code, et Agentforce Studio, un environnement de construction sans code.
Agentforce Builder
Agentforce Builder est l’environnement recommandé pour développer de nouveaux agents. Il est hébergé dans Agentforce Studio et remplace l’expérience de configuration héritée, qui reste disponible, mais n’est plus le chemin de création principal. Dans le Générateur, vous travaillez dans une vue de zone de dessin visuelle ou directement dans la vue Script, en modifiant le Script de l’agent qui définit le comportement de votre agent.
Agent Script
Agent Script est un langage déclaratif spécifique au domaine (DSL) qui définit tout sur le comportement d’un agent : sa configuration, sa logique métier et la génération d’invites. Il est structuré sous forme de paires clé-valeur qui peuvent couvrir plusieurs lignes ou inclure des sous-propriétés imbriquées, et il est conçu pour être lisible par l’homme sans nécessiter Knowledge de l’architecture graphique sous-jacente.
Le script Agent permet d’exprimer deux types d’instruction fondamentalement différents dans le même agent : instructions de logique déterministe et instructions d’invite. Les instructions de logique déterministe définissent des conditions et des séquences d’action qui s’exécutent sous forme de code sans implication de LLM. Les instructions d’invite définissent des instructions en langage naturel que le LLM interprète à l’exécution. La frontière entre les deux est explicite et délibérée, et comprendre où placer cette frontière est l’une des principales décisions de conception que vous prendrez lors de l’élaboration avec le nouvel Agentforce.
La logique déterministe dans la pratique
Lorsque les instructions sont déterministes, l’agent suit un parcours d’exécution défini, quelle que soit la formulation de la saisie par l’utilisateur. L’exemple ci-dessous montre un sous-agent qui charge un tableau de bord Intelligence client. Il recherche un ID de client, récupère les données de profil, l’historique des commandes et les tickets de support, puis calcule la valeur de durée de vie du client et le risque d’attrition. Aucune de ces étapes ne nécessite un raisonnement LLM.
Cette logique appelle les actions dans une séquence fixe chaque fois que certaines conditions sont remplies.
Instructions d’invite et transfert délibéré au LLM
Lorsque la logique déterministe gère les conditions et les séquences qui peuvent être exprimées sous forme de code, les instructions d’invite gèrent tout ce qui nécessite un jugement, une interprétation ou la génération d’un langage naturel. Lorsque le Moteur de raisonnement Atlas rencontre un nœud avec des instructions d’invite, il déclenche un appel LLM. Quand il ne le fait pas, il s’exécute de façon déterministe.
L’exemple ci-dessous montre un sous-agent pour les produits et services. Les instructions sont une invite multiligne qui indique au grand livre comment répondre, quand référencer des informations et comment gérer l’ambiguïté. C’est le schéma approprié lorsque la gamme des entrées utilisateur possibles est trop large pour être anticipée avec une logique conditionnelle, ou lorsque la qualité de la réponse dépend de la capacité du grand livre à interpréter le contexte et à générer une réponse naturelle.
Les instructions d’invite d’un nœud déclenchent l’appel LLM. Ce n’est pas fortuit, c’est le mécanisme par lequel Agent Script rend la frontière du LLM explicite et exécutoire, au lieu de la laisser à l’inférence à l’exécution.
Ce sous-agent illustre la logique déterministe et le transfert vers le LLM en action.
Le pipeline d’exécution en trois étapes
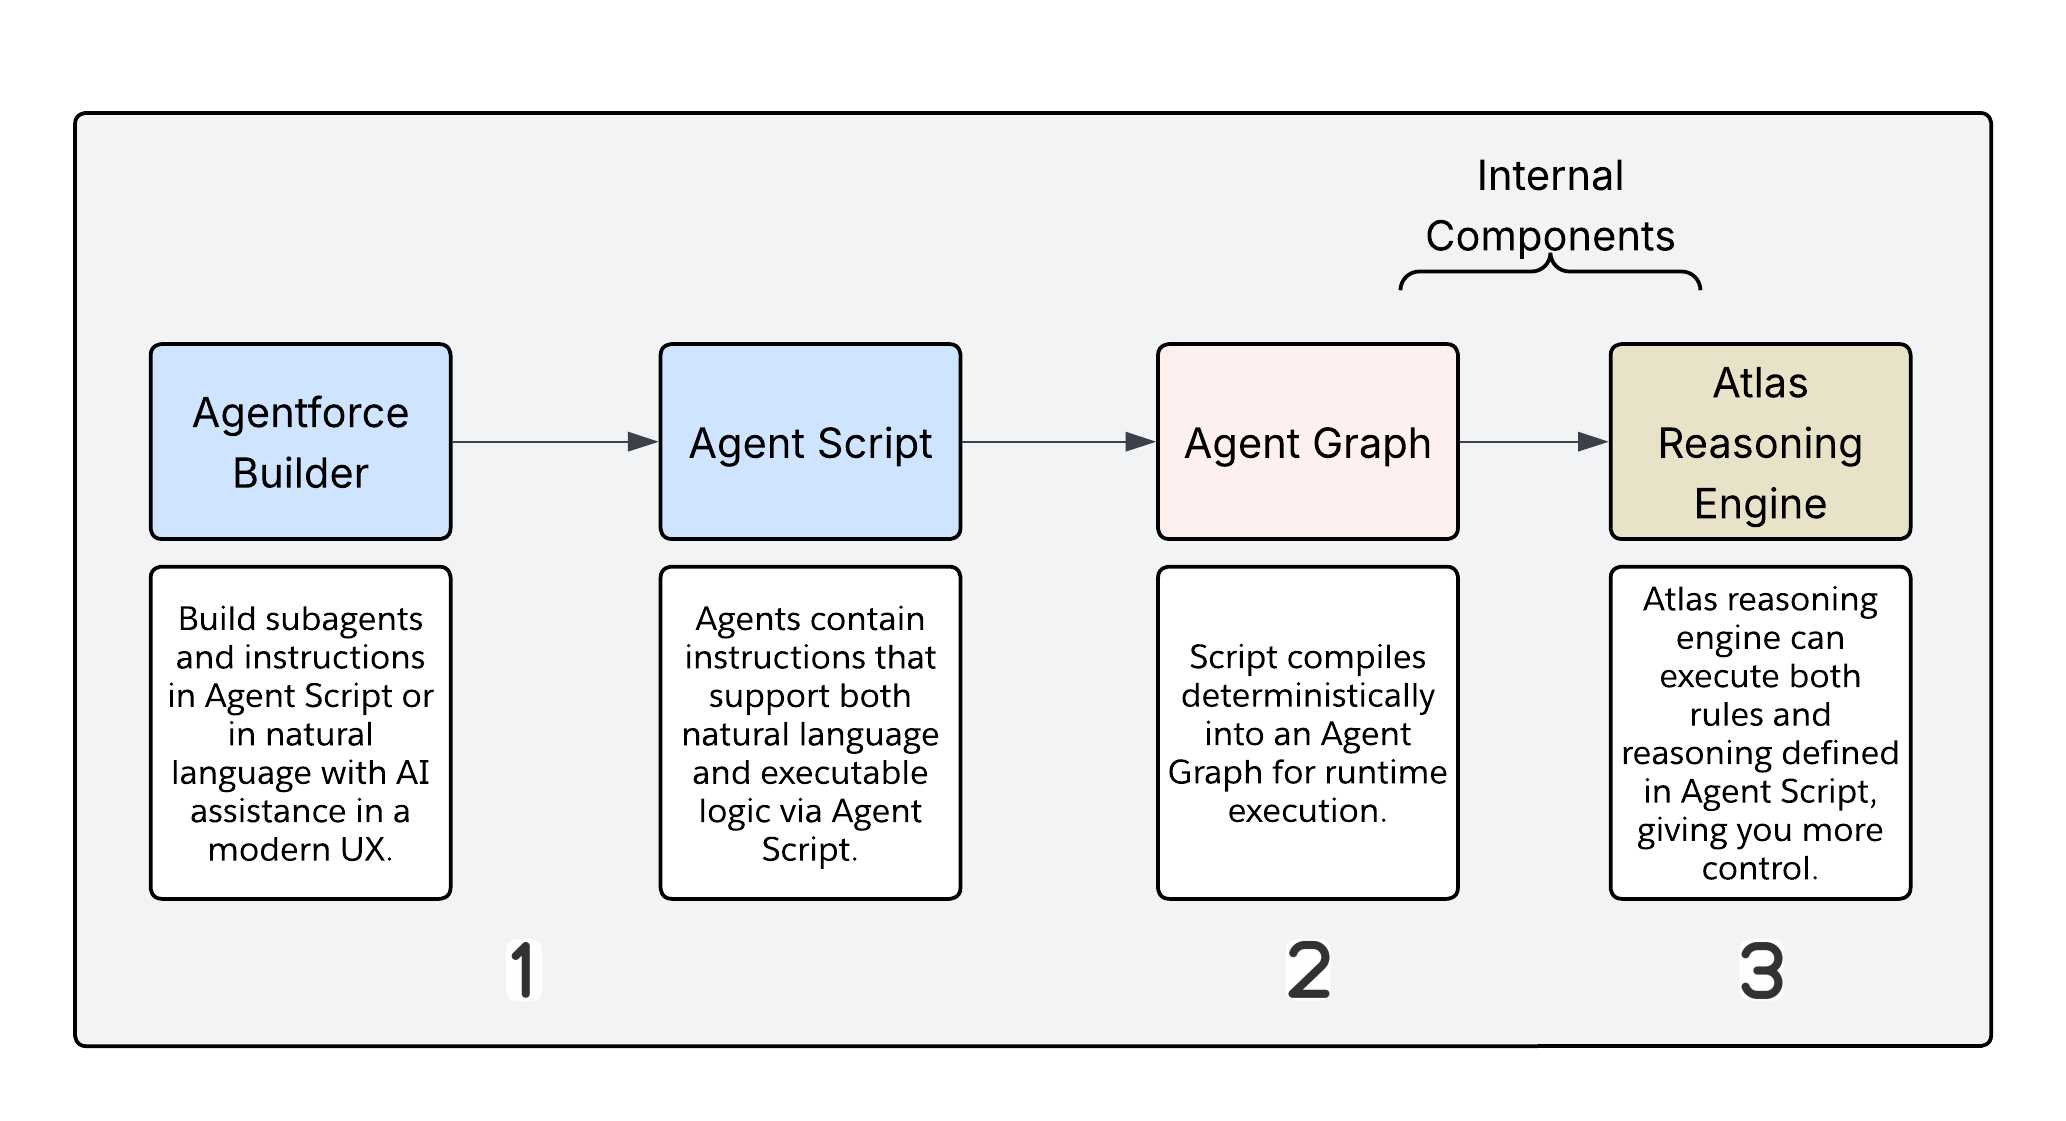
Agentforce Builder et Agent Script sont la couche de création, mais Agent Graph et le Moteur de Raisonnement Atlas exécutent réellement votre agent. Par conception, aucun de ces composants n’est directement accessible pour vous. Séparer la création et l’exécution permet à la plate-forme d’appliquer un comportement déterministe indépendamment de la méthode d’écriture du script.
Le pipeline progresse à travers trois étapes.
- La création est l’endroit où vous travaillez. Agent Script est lisible et modifiable, que ce soit en vue Canvas ou en vue Script dans Agentforce Builder. C’est la seule couche avec laquelle vous interagissez directement.
- La compilation permet au compilateur Salesforce de transformer votre script Agent en graphique Agent, un plan d’exécution numéroté optimisé pour l’exécution machine plutôt que pour la lisibilité humaine. Vous ne déboguez pas à cette couche. La compilation produit une représentation que l’exécution peut traverser efficacement.
- Exécution du runtime est l’étape où le moteur de raisonnement Atlas prend le relais. Il lit le Graphique de l’agent, le traverse en fonction de l’état actuel de la session et décide à chaque nœud d’exécuter de façon déterministe ou d’invoquer le LLM. Le moteur applique explicitement les clauses de protection et l’acheminement conditionnel ici, plutôt que d’inférer.
Graphique de l’agent
Le Graphique de l’agent est la représentation intermédiaire qui se situe entre votre script lisible par l’utilisateur et l’exécution réelle. Sa structure est optimisée pour la machine d’état qui la consomme, pas pour l’architecte auteur du script. Comprendre qu’il existe, et ce qu’il représente, est important, car c’est l’artefact que le Moteur de Raisonnement utilise pour appliquer le plan d’exécution que votre script définit.
Moteur de raisonnement Atlas
Le moteur de raisonnement Atlas est un exécuteur de machine d’état. À chaque tour, il traverse le Graphique de l’agent en fonction de l’état de la session, exécute des nœuds déterministes sous forme de code et déclenche des appels LLM uniquement lorsque des instructions d’invite sont présentes. Il applique également les clauses de protection et gère l’acheminement conditionnel. Le moteur de raisonnement est l’emplacement où le modèle de raisonnement hybride est réellement implémenté. Le script définit la frontière et le moteur la respecte.
Agent Graph n’est pas un wrapper LLM. C’est un moteur de raisonnement hybride qui sépare l’exécution déterministe du raisonnement probabiliste. La règle directrice est simple : si vous pouvez exprimer une décision sous forme de code, elle doit être écrite sous forme de logique. Si la décision nécessite un jugement, une interprétation ou la génération d’un langage naturel, le LLM doit s’en occuper. Cette décision de conception est le choix architectural le plus important dans le nouveau modèle Agentforce. L’emplacement de la limite du grand livre affecte directement le coût, la latence, l’auditabilité et la fiabilité de votre solution.
Le moteur de raisonnement Atlas évalue chaque tour d’utilisateur entrant et l’achemine vers l’un des deux chemins.
Chemin A : Exécution déterministe
Ce chemin n’implique pas le LLM. Il se comporte comme un code compilé à l’exécution. Le moteur de raisonnement classe l’intention de l’utilisateur et détermine qu’une instruction logique correspond, en contournant entièrement le grand livre. Le script Agent compilé est exécuté de haut en bas, avec des règles if-else exécutées sans condition à chaque tour. Les actions Flow, Apex ou d’une API REST sont appelées avec des paramètres déterministes, sans assemblage d’invite ni appel de modèle. Le résultat transite par la couche Trust avec une consignation d’audit complète.
Chemin B : Raisonnement LLM
Le moteur de raisonnement suit ce chemin lorsqu’il ne peut pas résoudre l’intention en utilisant uniquement des instructions logiques. Il traverse le Graphique de l’agent et évalue chaque nœud. Les nœuds avec des instructions d’invite déclenchent un appel LLM. Les nœuds qui en sont dépourvus sont exécutés de façon déterministe. La présence d’une instruction d’invite est le déclencheur, et elle est explicite dans le script plutôt qu’inférée à l’exécution.
Ce qui déclenche un appel LLM
Le LLM est invoqué à huit moments du cycle de vie d’exécution. La classification des sous-agents, ou le choix du sous-agent qui correspond à la demande de l’utilisateur, est un, bien qu’un chemin de court-circuit puisse contourner l’appel LLM complet lorsque la classification est sans ambiguïté. Le raisonnement de l’agent, où l’agent décide de l’action suivante, passe toujours par le LLM. Tout comme la génération de réponses, où la réponse finale est assemblée à partir d’une invite hydratée.
Les autres déclencheurs sont plus opérationnels : la validation de l’ancrage confirme que la sortie est ancrée sur les données récupérées ; la simulation d’action émule les réponses dans l’environnement Aperçu et Simuler au lieu d’exécuter en direct ; la génération de sortie structurée gère les cas où la réponse doit être conforme à un schéma défini ; et la génération d’indicateurs de localisation et de progression gère la mise en forme et la messagerie transitoire lorsqu’aucun paramètre par défaut pré-écrit n’existe.
Ce qui reste déterministe
La traversée du graphe et les transitions d’état n’impliquent jamais le LLM. Les blocs de cycle de vie before_reasoning et after_reasoning sont exécutés de façon déterministe s’ils contiennent uniquement des nœuds d’action sans instructions d’invite. Les mathématiques, la récupération de données, la validation et la logique conditionnelle appartiennent toutes au code. Toute action exécutant Flow, Apex ou une API REST reste directement sur la voie déterministe. Tout nœud sans instructions d’invite est exécuté sans appel LLM.
Être explicite sur cette frontière avec votre équipe est important. Chaque appel LLM inutile ajoute latence, coût et variabilité. Les architectes doivent pousser la logique déterministe par défaut, en réservant le LLM aux cas où la tâche nécessite réellement sa capacité de raisonnement.
Guide de conception : Poussez la logique dans le code par défaut
Utilisez des instructions logiques de script d’agent en écrivant des instructions d’invite qui peuvent être exprimées sous forme de condition, d’attribution de variable ou de filtre d’action. Chaque appel LLM inutile ajoute latence, coût et variabilité.
La position par défaut doit être déterministe. Isolez chaque comportement de l’agent qui peut être codifié en règle générale et déplacez-le vers Script Agent. Les autres tâches qui nécessitent une synthèse en langage naturel, un jugement contextuel ou une interprétation complexe appartiennent à des nœuds porteurs d’invites. Ce n’est pas une limitation, c’est la frontière qui fonctionne comme prévu. Le LLM gère ce qui lui convient le mieux, et tout le reste est exécuté sous forme de code.
L’unité d’exécution principale dans Agent Script n’est pas le tour de l’utilisateur. C’est l’analyse : un seul cycle complet à travers les trois blocs de cycle de vie d’un sous-agent. Le moteur de raisonnement Atlas initie une analyse chaque fois qu’un sous-agent doit traiter quelque chose, ce qui se produit dans trois situations : lors de la première entrée dans le sous-agent, après chaque appel d’outil lorsqu’une action se termine et renvoie un résultat, et à chaque nouveau tour d’utilisateur dans le même sous-agent.
Comprendre la frontière d’analyse est important, car il détermine le nombre d’exécutions de chaque bloc, et par conséquent où vous pouvez et ne pouvez pas compter sur une logique donnée exécutée exactement une seule fois.
Chaque sous-agent définit trois zones d’exécution :
| Bloc | Quand il est exécuté | Participation au LLM |
|---|---|---|
before_reasoning | Au début de chaque analyse, avant que le LLM ne voie quoi que ce soit | Aucun |
reasoning | Pendant la résolution déterministe, avant tout appel LLM | Mixte |
after_reasoning | Lorsque le raisonnement est terminé et que le LLM a répondu | Aucun (avec une mise en garde critique) |
Les before_reasoning et after_reasoning sont entièrement déterministes. Ils exécutent des actions, définissent des variables et appliquent une logique conditionnelle sans impliquer le grand livre. Cela en fait les blocs fiables et peu coûteux du script.
Quand utiliser before_reasoning
before_reasoning est exécuté au début de chaque analyse sans exception. Il s’exécute lors de la première entrée dans le sous-agent, puis après chaque appel d’outil ou tour de vis d’un nouvel utilisateur dans ce sous-agent. Un run @actions.X placé dans before_reasoning constitue du code. Contrairement à une instruction dans un bloc d’invite, que le LLM peut suivre ou non, before_reasoning s’exécute sans condition.
Utilisez ce bloc pour l’initialisation de la session : récupération d’enregistrements de contexte, définition de variables de session depuis Apex ou Flux. C’est également là que se situent les contrôles d’authentification et d’autorisation, car vous souhaitez qu’ils soient vérifiés avant que le LLM ne voie les outils. L’hydratation du contexte convient aussi ici : Appel d’une action de récupération de données pour que le grand livre reçoive des variables préremplies au lieu de les demander. Tout compteur ou variable d’audit qui doit être incrémenté à chaque analyse doit être défini ici, car la directive set en before_reasoning est garantie d’une manière qui n’est pas une instruction Pipe.
Ce qui n’appartient pas ici, c’est une logique qui ne devrait être exécutée qu’une seule fois par session, car before_reasoning est exécutée à chaque analyse, pas seulement à la première entrée. Tout ce qui dépend de l’entrée de l’utilisateur du tour actuel n’appartient pas non plus à cette section, car cette entrée n’a pas encore été traitée. Et les transitions ne devraient jamais figurer dans before_reasoning: une instruction transition to est déclenchée inconditionnellement à chaque analyse et crée des boucles.
Si vous avez besoin d’une initialisation une fois par session, protégez-la explicitement :
Un tour utilisateur peut déclencher plusieurs analyses : Une fois à l’entrée, puis une autre fois après chaque appel à l’outil. Cette fonctionnalité a trois conséquences pratiques : Les actions d’initialisation dans before_reasoning sont exécutées plus d’une fois par tour d’utilisateur dans des flux multi-actions, les variables de compteur incrémentées ici reflètent le nombre d’analyses, pas le nombre de tours, et les actions avec des effets secondaires, des appels d’API externes ou des écritures d’enregistrement, ne doivent pas vivre en before_reasoning, sauf si une réexécution à chaque analyse est explicitement acceptable.
before_reasoning n’est pas un constructeur. C’est un contrôle préalable qui est exécuté avec chaque analyse. Concevez-le en conséquence.
Quand utiliser after_reasoning
after_reasoning s’exécute une fois la boucle de raisonnement terminée, après que le LLM a répondu et que les sorties d’action ont été capturées. Les contrôles déterministes postérieurs à l’action sont les suivants : évaluer les sorties d’action et la branchement en fonction des résultats. Les transitions déterministes, ou le passage au sous-agent suivant basé sur l’état de la variable plutôt que sur le jugement du LLM, se trouvent ici. Tout comme le nettoyage des variables avant le prochain tour, et le séquencement d’orchestration lorsque vous devez enchaîner les sous-agents dans un ordre prévisible sans décision d’acheminement LLM.
Traitez after_reasoning comme la couche de garde-fou. C’est là que vous appliquez les règles métier et la gestion de l’état une fois que le LLM a fait son travail, en vous assurant que les flux de processus critiques restent prévisibles, quel que soit le contenu généré par le LLM.
Utilisez is_displayable: True judicieusement
Chaque architecte qui conçoit des flux d’orchestration doit comprendre ce comportement de plate-forme. Lorsque is_displayable: True est défini sur une action, la plate-forme quitte la boucle de raisonnement dès que le LLM décide d’exposer cette sortie. Cette sortie se produit immédiatement, ce qui signifie que after_reasoning n’exécute jamais.
C’est un comportement de plate-forme connu, mais qui a une conséquence directe sur l’orchestration : toute logique que vous avez placée dans after_reasoning est ignorée lorsqu’une action affichable fait partie du flux.
La réponse est simple. Déplacez la logique qui doit être exécutée de façon fiable dans le bloc de before_reasoning du sous-agent suivant plutôt que dans le bloc de after_reasoning de l’agent actuel.
**Guide de conception : où placer la logique d’initialisation **
Le choix de l’emplacement de la logique est conséquent lors de la conception d’un sous-agent. Ce cadre couvre les scénarios les plus courants :
| Scénario | Où le mettre |
|---|---|
| Doit être exécuté avant que le LLM ne voie le moindre contexte | before_reasoning |
| s’exécute à chaque analyse, y compris lors d’une nouvelle entrée à chaque tour utilisateur. | before_reasoning |
| Dépend de la sortie de l’action de ce tour | Bloc if conditionnel dans reasoning |
| Nécessite une transition de sous-agent déterministe basée sur le résultat | after_reasoning (voir ci-dessous la mise en garde de la is_displayable) |
Nécessite une logique d’orchestration lorsque l’action en aval utilise is_displayable: True | before_reasoning du sous-agent suivant |
| Utilise une logique qui nécessite un jugement ou un contexte utilisateur | reasoning avec des instructions d’invite |
Le principe sous-jacent est simple. Lorsque vous écrivez une instruction d’invite demandant au LLM de « toujours exécuter » une action, c’est une suggestion. Le LLM peut le suivre ou non selon le contexte. Lorsque vous placez une directive run en before_reasoning, cela correspond à un code. Il est exécuté sur chaque analyse sans exception.
La disponibilité des actions conditionnelles est le mécanisme par lequel Script Agent expose ou masque les actions du LLM en fonction de l’état de la variable d’exécution. Lorsque la condition de available when est évaluée à false, l’action est entièrement retirée de la liste d’outils présentée au grand livre. Toute valeur false, y compris None, False, 0 ou une chaîne vide, supprime l’action.
Ce n’est pas une instruction d’invite demandant au LLM de « ne pas appeler ceci pour l’instant » ; c’est une barrière rigoureuse au niveau de la plate-forme. Le LLM ne peut pas appeler une action à laquelle il n’a pas accès.
Dans cet exemple, execute_transfer est invisible pour le LLM jusqu’à ce que validation_passed soit évalué à true. La barrière est appliquée par la plate-forme, pas par instruction.
Guide de conception : Ne laissez jamais le LLM définir la variable de porte
Attribuez à chaque variable d’une clause de available when un chemin de code déterministe qui définit la variable avant l’exécution de l’action associée. Utilisez before_reasoning ou un bloc de run et de set déterministe en reasoning pour garder la variable dans un état connu. Si vous vous appuyez sur le LLM pour définir la variable de porte, vous avez réintroduit la variabilité que la porte a été conçue pour empêcher. Selon la conversation, le LLM peut la définir ou non, ce qui signifie que la porte peut s’ouvrir ou non.
Le problème de boucle d’action
Une boucle d’action se produit lorsque le grand livre appelle la même action plusieurs fois sans jamais atteindre un état terminal. Cela se produit lorsque deux conditions sont vérifiées simultanément : la condition de available when reste remplie après l’exécution de l’action, et les instructions de raisonnement n’indiquent pas explicitement au LLM d’arrêter de l’appeler.
La plate-forme ne supprime pas automatiquement une action après son appel. Si la porte reste ouverte et que les instructions de raisonnement sont ambiguës, le LLM appelle la même action à chaque analyse indéfiniment.
Prenons l’exemple de available when @variables.interest != "". Si l’action est exécutée, mais que la variable d’intérêt n’est pas vide, la porte reste ouverte lors de l’analyse suivante. Le LLM voit l’action comme disponible, n’a aucune instruction lui demandant d’arrêter et l’appelle de nouveau.
Il existe deux méthodes fiables pour rompre la boucle. La première consiste à définir la variable de porte sur un état fermé dans le cadre de la logique de post-exécution de l’action, afin que available when évalue à false à l’analyse suivante. La deuxième consiste à utiliser un booléen has_run séparé qui ferme la porte après la première exécution. Les deux approches donnent à la porte un état fermé déterministe, qui est la condition nécessaire à la plate-forme pour supprimer l’action.
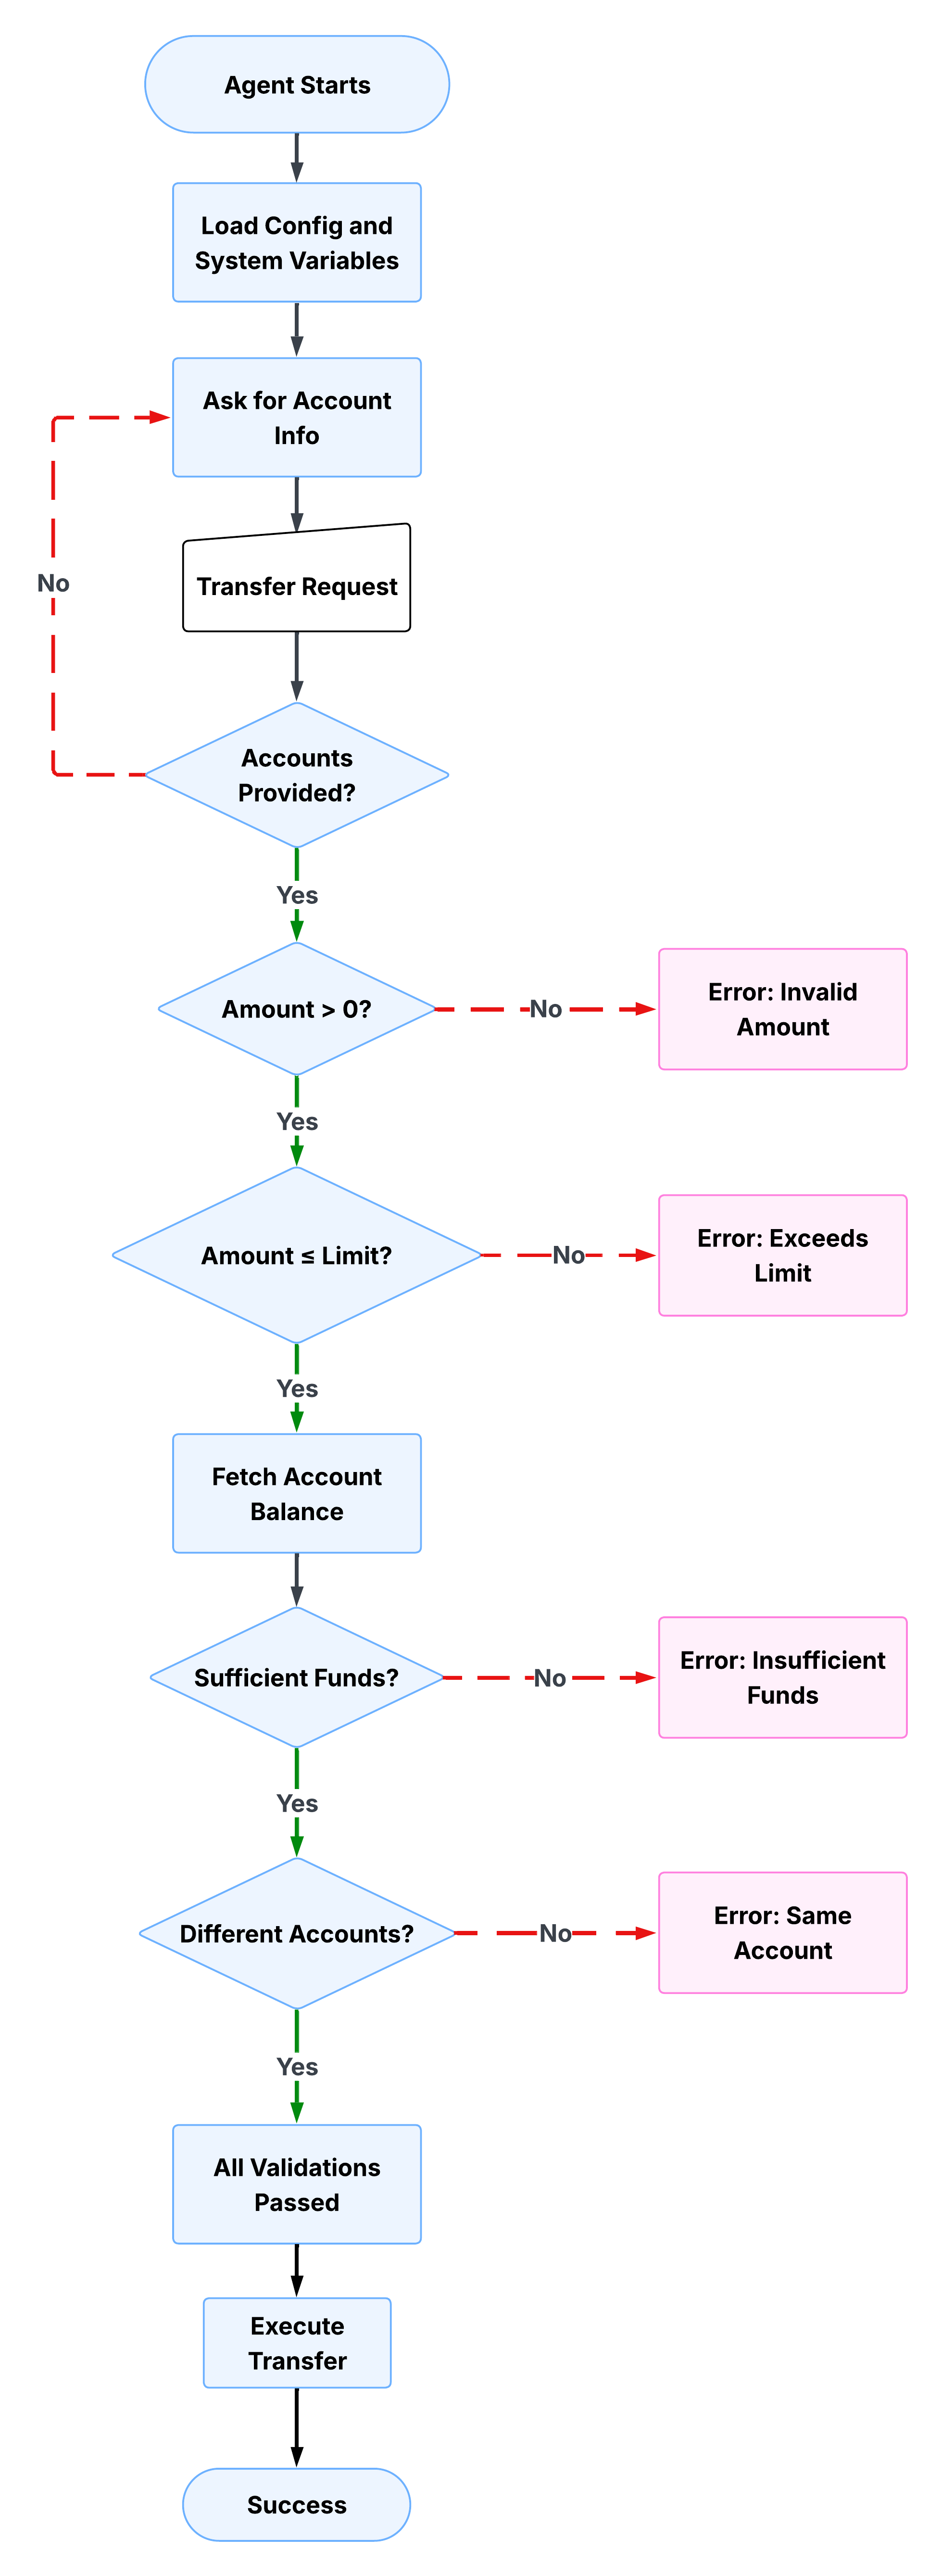
Un virement bancaire est une perspective utile pour comprendre comment ces modèles fonctionnent ensemble dans la pratique. Le workflow semble simple de l’extérieur : déplacer de l’argent d’un compte à un autre. L’implémentation nécessite plusieurs étapes complexes. Avant l’exécution du transfert, l’agent doit collecter les détails du compte, valider le montant, vérifier les limites de transfert, confirmer le solde disponible, puis exposer l’action de transfert. Chaque étape dépend des étapes précédentes. Aucun d’entre eux ne devrait être laissé au jugement du LLM.
Collecter et valider les entrées
Le premier sous-agent collecte le compte source, le compte de destination et le montant du transfert auprès de l’utilisateur. Il n’ira pas de l’avant tant que les trois éléments ne seront pas présents et valides. Le script Agent vérifie chaque champ dans l’ordre suivant : si le compte source est manquant, il demande. Si la destination est manquante, il la demande. Si le montant est égal à zéro ou négatif, il le demande. La variable validation_passed est définie sur true uniquement lorsque toutes les vérifications sont terminées.
Le script ci-dessous le montre en pratique. Notez que validation_passed est explicitement définie sur false à chaque point d’échec, et il est demandé au LLM de ne pas poursuivre. Les contrôles déterministes sont exécutés sans condition, tandis que les instructions de l’invite gèrent la réponse présentée à l’utilisateur.
Appliquer des règles métier
Lorsque l’agent valide les entrées, il vérifie si le montant du transfert dépasse la limite de transfert configurée. C’est là que les règles métier deviennent du code plutôt que de simples instructions. La limite n’est pas quelque chose pour lequel le LLM raisonne, c’est un seuil défini dans le script et vérifié de façon déterministe à chaque analyse.
Si le montant dépasse la limite, validation_passed est reporté à false et le grand livre présente à l’utilisateur trois options : transférer le montant maximal autorisé, le séparer en plusieurs transferts ou contacter le support pour des limites plus élevées. L’agent ne peut pas continuer tant que l’utilisateur n’a pas résolu l’exception. Notez comment l’instruction d’invite ici accomplit exactement ce pour quoi le raisonnement du LLM est conçu : Présenter les options de façon conversationnelle et gérer la réponse de l’utilisateur. La règle métier elle-même est déterministe, mais pas la conversation qui l’entoure.
Le script ci-dessous montre le fonctionnement du contrôle de limite. La condition déterministe évalue le montant du transfert par rapport à la variable de limite, définit la validation_passed sur false si le seuil est franchi, et délègue à une instruction rapide la gestion de la réponse présentée à l’utilisateur.
Appliquer des clauses de protection
Lorsque les contrôles de montant et de limite sont terminés, l’agent récupère le solde du compte source et confirme que des fonds suffisants sont disponibles. Les clauses de protection empêchent l’agent de tenter des opérations lorsque les conditions préalables ne sont pas remplies. Contrairement à une instruction d’invite qui demande au LLM de vérifier le solde, une clause de protection dans le script Agent rend le contrôle inconditionnel. Le LLM ne décide pas s’il l’exécute.
Si le solde est insuffisant, l’agent calcule le déficit et présente à l’utilisateur une alternative concrète. validation_passed est défini sur false jusqu’à ce que ce contrôle réussisse, ce qui signifie que l’action de transfert reste bloquée.
Le script ci-dessous affiche un appel d’action déterministe qui récupère le solde, suivi d’une vérification conditionnelle qui l’évalue. La récupération est exécutée uniquement si le solde n’a pas encore été récupéré, ce qui évite les appels d’API redondants dans les analyses suivantes.
Exposer clairement les erreurs
Les clauses de protection définissent l’état. Les messages d’erreur le communiquent. Lorsque validation_passed est false, l’agent doit fournir à l’utilisateur suffisamment d’informations pour résoudre le problème sans redémarrer. Les messages d’erreur vagues créent des frictions ; les messages structurés ferment la boucle plus rapidement.
Le script ci-dessous affiche le message d’erreur Fonds insuffisants dans la pratique. Il n’indique pas seulement à l’utilisateur que le transfert a échoué. Il affiche le solde disponible, le montant demandé, le manque à gagner calculé et offre une étape suivante concrète, le tout assemblé à partir de variables de session plutôt que généré par le grand livre.
Le calcul du déficit est effectué dans le script, pas dans le LLM. L’alternative suggérée, le transfert du solde disponible, est dérivée de façon déterministe de l’état de la session. Le rôle du LLM est ici purement de présentation : il délivre un message que le script a déjà structuré.
Restreindre l’action de transfert
Chaque contrôle de validation des étapes précédentes définit ou efface la même variable : validation_passed. Cette variable fait maintenant son travail le plus important. L’action execute_transfer est disponible sous certaines conditions, ce qui signifie qu’elle est affichée dans la liste des outils du grand livre uniquement lorsque validation_passed est true. Tant que chaque vérification précédente n’a pas réussi et défini cette variable, l’action n’existe pas du point de vue du grand livre.
Il correspond au schéma de la section de portail précédente appliquée à un workflow de production. L’action de transfert n’est pas masquée par une instruction d’invite. Il est caché par la plate-forme. Aucune pression conversationnelle ou phrase ambiguë ne peut amener le LLM à l’invoquer avant que les conditions préalables soient remplies.
Le script ci-dessous montre comment la porte est configurée. La clause available when référence directement validation_passed, et les paramètres d’action sont liés aux variables de session collectées et validées dans les étapes précédentes.
Les trois paramètres, from_account, to_account et amount, sont transmis de façon déterministe à partir de variables de session. Lorsque cette action est disponible, chaque valeur a été validée. Le LLM n’assemble pas les paramètres à partir du contexte de la conversation, il les lit à partir de l’état.
Suivre l’état dans tout le workflow
Les schémas des sections précédentes fonctionnent uniquement parce que l’état de session est conservé dans l’ensemble du workflow. Les numéros de compte capturés à la première étape sont disponibles à la quatrième étape. Les résultats de validation sont définis dans une action de barrière de contrôle dans une autre. La conversation peut dévier, l’utilisateur peut poser des questions de suivi et l’agent sait exactement où il en est dans le processus.
Le bloc de variables ci-dessous affiche l’état complet de la session pour ce workflow. Chaque variable a un type défini, une valeur par défaut et une description. Deux variables gèrent la majeure partie du travail d’orchestration : validation_passed contrôle la disponibilité des actions à chaque porte, et validation_information renvoie un contexte lisible par l’utilisateur sur les raisons de l’échec d’un contrôle, que le grand livre peut exposer à l’utilisateur sans avoir à raisonner sur l’état sous-jacent.
Chaque variable démarre dans un état par défaut connu. Les chaînes sont définies par défaut sur vide, les nombres sur zéro et le validation_passed booléen sur false. Cela signifie que la porte est fermée par défaut. Le workflow doit gagner activement le droit de procéder à chaque étape, plutôt que de commencer avec la barrière ouverte et de compter sur des contrôles pour la fermer.
L’exemple de virement bancaire montre où la logique déterministe est le bon outil, mais pas toujours le meilleur choix. Comprendre la frontière est aussi important que de comprendre les modèles.
La logique déterministe est le bon choix lorsque le workflow nécessite une séquence d’exécution garantie, lorsque les erreurs ont des conséquences importantes, lorsque le processus doit produire un journal d’audit reproductible ou lorsque les règles métiers sont suffisamment bien définies pour être exprimées en conditions et en seuils. Les workflows de finance, de santé et d’assurance appartiennent généralement à cette catégorie.
Un raisonnement LLM pur sans contrainte déterministe stricte est plus logique lorsque la valeur de l’interaction réside dans la flexibilité plutôt que dans la précision. Le support client illimité, les produits en phase initiale où les processus métiers évoluent encore et les requêtes d’information à faible enjeu sont autant de cas où la variabilité du raisonnement LLM est une fonctionnalité, pas un problème.
En pratique, la plupart des agents de production ont besoin des deux. La décision de l’emplacement de la frontière n’est pas un choix binaire entre déterministe et probabiliste, mais une décision de conception que vous prenez au niveau du nœud pour chaque partie du workflow de votre agent.
| Utiliser une logique déterministe pour | Utiliser le raisonnement LLM pour |
|---|---|
| Validation et assainissement des entrées | Compréhension du langage naturel et détection des intentions |
| Application des règles métiers | Générer des réponses conversationnelles et empathiques |
| Orchestration de processus séquentiels | Traitement des entrées ambiguës ou inattendues |
| Gestion de l’État et préservation du contexte | Fournir des explications et des précisions |
| Clauses de protection empêchant les opérations non valides | Adaptation du ton et de la messagerie au contexte de l’utilisateur |
La frontière est la décision de conception
L’exemple de virement bancaire illustre une philosophie de conception : que la frontière entre l’exécution déterministe et le raisonnement LLM est la décision architecturale la plus conséquente que vous prenez en construisant un agent de production.
Placez une frontière trop rigide et vous vous retrouverez avec un agent rigide, coûteux à entretenir et incapable de gérer la variation naturelle des conversations réelles. Se tromper de frontière dans l’autre sens crée un agent flexible, mais imprévisible, performant dans les tests, mais dont le comportement diffère en production, et auquel on ne peut confier une transaction à fort enjeu.
Le nouveau modèle Agentforce vous donne les outils nécessaires pour placer délibérément cette frontière. Agent Script permet d’exprimer une logique déterministe et des instructions rapides dans le même fichier, avec une syntaxe explicite pour rendre la frontière visible. Le moteur de raisonnement Atlas force la logique et les invites à l’exécution. Les blocs before_reasoning et after_reasoning offrent des zones d’exécution garanties de chaque côté de l’appel LLM. La disponibilité des actions conditionnelles garantit que le grand livre ne peut agir que lorsque les conditions préalables sont remplies.
Aucune de ces fonctionnalités n’est isolée. Ils travaillent ensemble pour créer une architecture cohérente permettant de construire des agents auxquels les entreprises peuvent faire confiance pour des workflows critiques. Le modèle de raisonnement hybride reconnaît que le déterminisme et la flexibilité ont tous deux des rôles dans votre architecture. C’est le travail de l’architecte de décider précisément où chacun s’applique.
Guide du développeur Agentforce
Graphique de l’agent Agentforce : Vers le déterminisme guidé avec le raisonnement hybride
Gulal Kumar est architecte en génie logiciel chez Salesforce avec plus de 20 ans d’expérience. Son expertise couvre l’IA, l’intégration, les API et l’architecture d’entreprise, avec un focus sur la conduite de la transformation métier à travers des solutions IA sécurisées, résilientes et innovantes. Communiquez avec lui sur LinkedIn.
Miriam McCabe est directrice principale et chef de l’équipe d’évangélisation des architectes. Son travail se concentre sur la capacité de la communauté internationale des architectes Salesforce à jouer un rôle de leader dans l’ère des agents grâce à des contenus profondément techniques, des programmes live et l’engagement de la communauté. Suivez-la sur LinkedIn.