Les entreprises gèrent un large éventail de types de document, notamment des factures, des bons de commande, des contrats juridiques et des manuels techniques. Le traitement manuel est lent, source d’erreurs et consomme de 15 à 25 % du temps des employés. Les approches d’automatisation antérieures (par exemple, l’automatisation robotisée des processus, la reconnaissance optique des caractères et les outils de workflow) ont réduit une partie du fardeau, mais ont produit des pipelines rigides, des frais généraux de maintenance élevés et une adoption cloisonnée entre les équipes commerciales individuelles.
Les documents contiennent un contexte structurel enrichi (par exemple, des hiérarchies de tableaux, des relations de champ spatial et des sections référencées) que le traitement de texte plat ne peut pas conserver. Le retrait d’un document en texte brut ignore le contexte métier qui rend l’extraction précise et utile, ce qui dégrade la qualité des analytiques en aval, de l’inférence en intelligence artificielle (IA) et de l’automatisation des processus.
Pour être efficaces, les systèmes de traitement intelligent des documents doivent classer les documents par type, extraire des données structurées avec précision à partir de présentations de variables et livrer ces données sous une forme régie et interrogeable aux systèmes en aval. Les systèmes IDP doivent également gérer la variabilité des documents à grande échelle sans configuration par modèle pour chaque nouveau format de document, et ils doivent être centralisés et accessibles au sein des unités commerciales. À ce défi s’ajoute l’ampleur de la question clé : Les données non structurées représentent environ 80 % de toutes les données de l’entreprise, et la majorité s’accumule sous forme de document dans les systèmes de fichiers, le stockage Cloud et les référentiels de contenus qui sont hors de portée des systèmes CRM (Customer Relationship Management), des agents IA et des plates-formes d’analyse.
Data 360 Document AI est la capacité de traitement des documents Salesforce dans Data 360, conçue pour combler cette lacune. Il extrait, classe et analyse les contenus de documents non structurés et semi-structurés en utilisant des grands modèles de langage, la reconnaissance optique des caractères, le traitement du langage naturel et l’apprentissage machine. La sortie est composée de données structurées, régies et interrogeables qui s’intègrent dans le pipeline Data 360 où les agents Agentforce, les outils d’analyse et les workflows d’automatisation peuvent y accéder via des interfaces standard sans nécessiter de couches d’extraction ou de transformation personnalisées.
Les plates-formes de données d’entreprise traitent des données structurées et tabulaires. Cependant, la majorité des données d’entreprise sont envoyées sous forme de documents et restent inaccessibles aux CRM, aux ERP, aux agents IA et aux pipelines d’analyse jusqu’à ce qu’une personne les extraie manuellement. Il s’agit d’une lacune architecturale, pas d’un problème de workflow.
Les approches antérieures combinaient la re-saisie manuelle, l’OCR basée sur des règles et les scripts RPA. Ces méthodes fonctionnaient à petite échelle, mais elles ne pouvaient pas gérer le volume, la variété et la rapidité des types de documents générés par les entreprises modernes. Les outils basés sur des règles nécessitent des modèles explicites par variante de présentation. Tout changement de format rompt l’extraction et nécessite un développeur, un nouveau modèle et un cycle de déploiement.
À l’échelle, cela produit des solutions ponctuelles fragiles sans gouvernance centralisée, schéma partagé et chemin vers la préparation à l’IA. Les pipelines d’extraction incohérents se propagent en aval. En d’autres termes, les analytiques héritent d’incohérences dans les données, les modèles d’IA produisent des résultats peu fiables et les contenus réglementés tels que les informations de santé et les informations d’identification personnelle manquent de gouvernance systématique.
Les LLM extraient les champs sans modèle explicite. Une configuration de schéma unique régit l’extraction à travers les variantes de présentation, les langues et les formats, qui s’adapte au document plutôt que d’exiger qu’il respecte une structure fixe. Le traitement des documents passe ainsi d’une opération cloisonnée lourde en maintenance à une capacité centralisée et gouvernée.
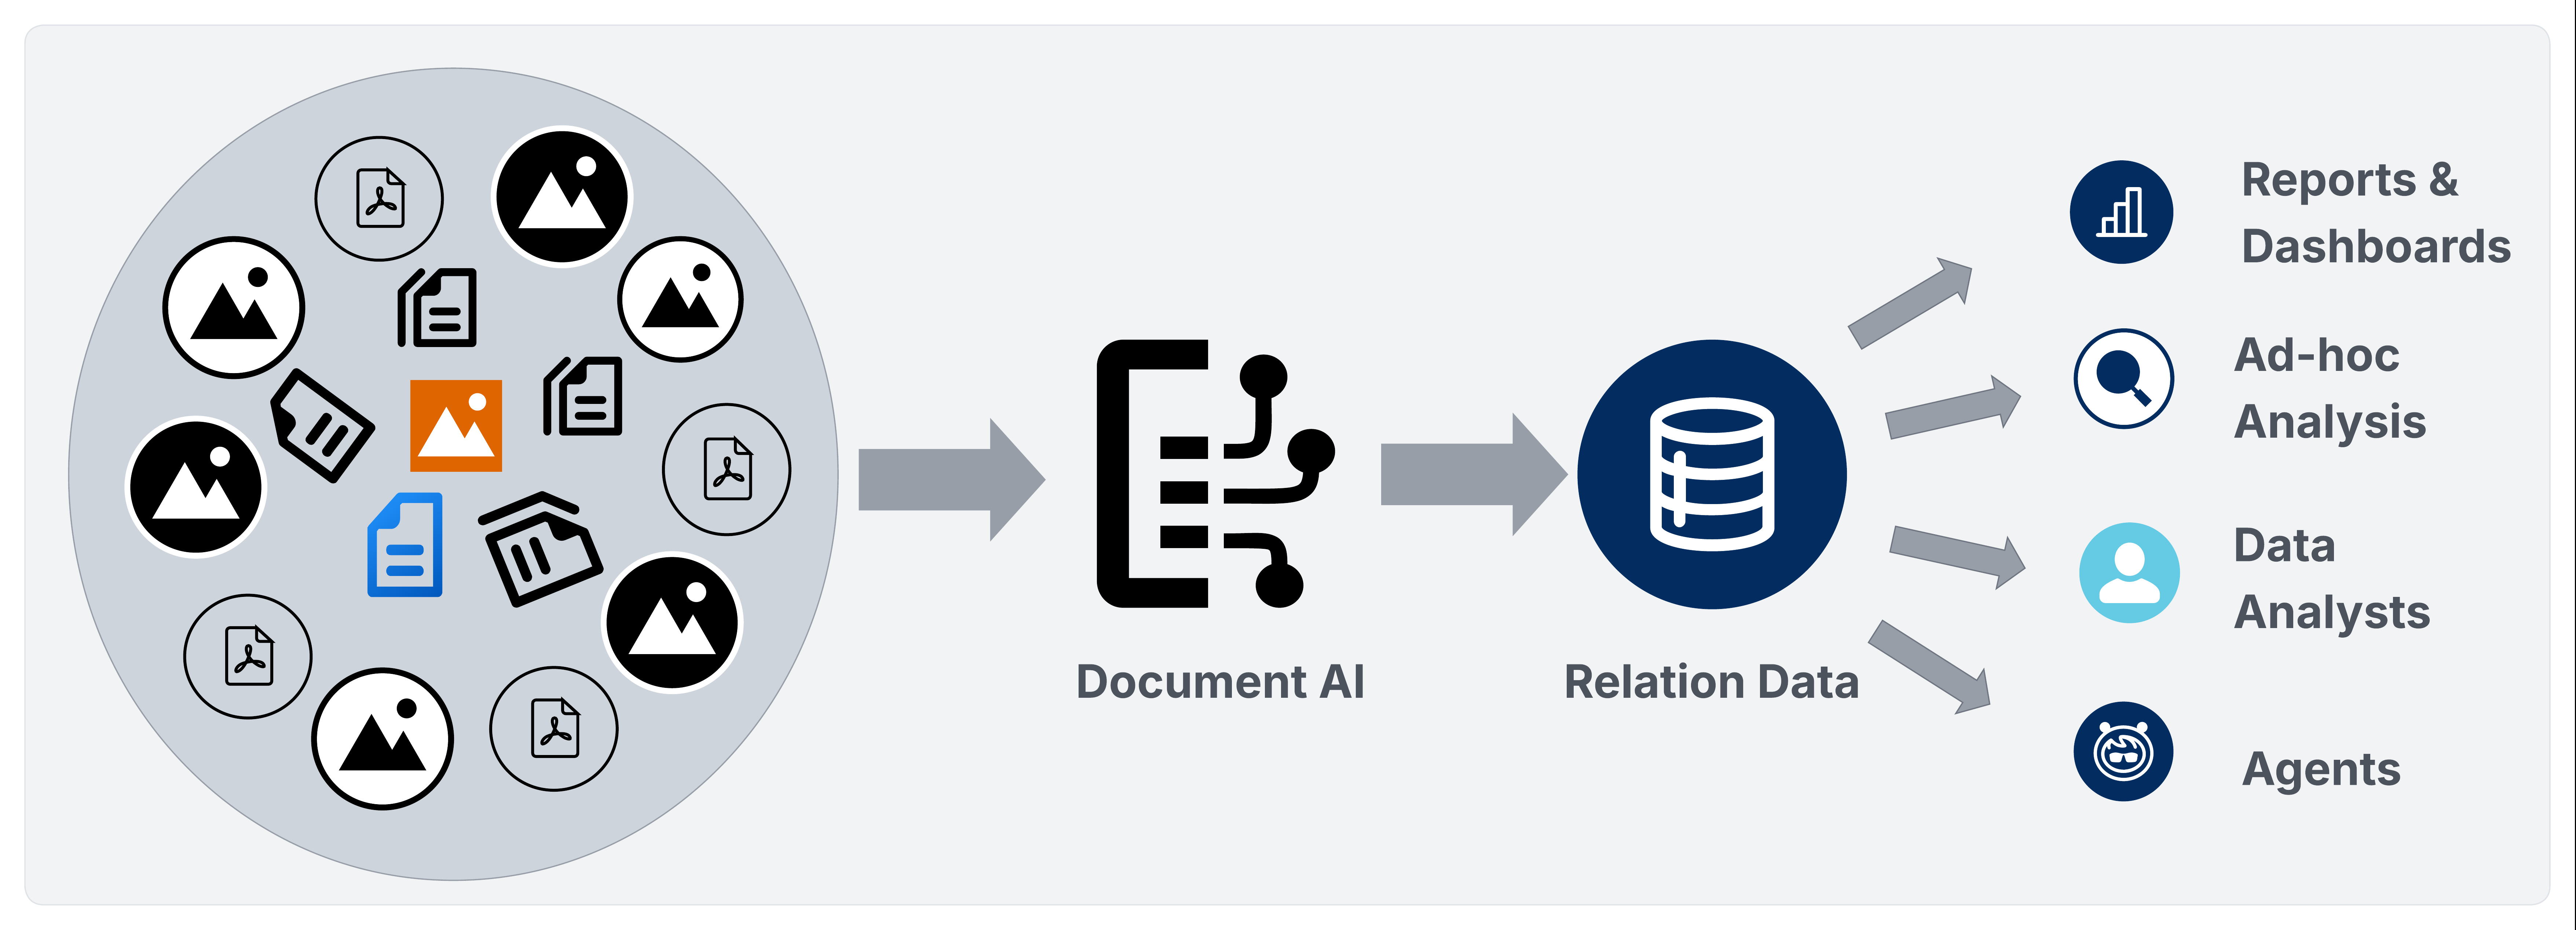
Data 360 Document AI opérationnalise le traitement des documents sur la plate-forme Data 360 via deux pipelines.
- L ’ oléoduc par lot achemine les données extraites par ingestion, résolution de l ’ identité, connaissances calculées, activations, analytiques et activation Agentforce.
- Le pipeline de traitement des transactions expose une API REST qui renvoie un JSON structuré de façon synchrone, ce qui permet aux architectes d’acheminer les données dérivées de documents vers des SObjects Salesforce, le pipeline Data 360 Data Lake Object/Data Model Object (DLO/DMO) ou des bases de données et des entrepôts externes sans configuration par lot.
Dans les deux cas, les données extraites entrent dans un modèle gouverné piloté par le schéma plutôt que dans un ensemble fragmenté d’outils ponctuels.
Data 360 Document AI est la capacité native de Salesforce Intelligent Document Processing (IDP) au sein de la plate-forme Data 360. Il convertit les contenus de documents non structurés et semi-structurés en données régies et interrogeables qui participent pleinement au cycle de vie complet de Data 360.
Data 360 Document AI est la capacité native de Salesforce Intelligent Document Processing (IDP) dans Data 360. Il ingère des documents non structurés et semi-structurés, extrait des données structurées en utilisant une configuration de schéma déclaratif, et livre ces données au pipeline Data 360 pour harmonisation, résolution de l’identité, analytiques et activation Agentforce.
Data 360 Document AI prend en charge deux modalités de traitement:
- Traitement par lots: Traite les grands ensembles de documents définis dans les objets modèle de données non structurés (UDMO) en fonction de l’événement.
- Traitement transactionnela: Traite un document unique via l’API REST et renvoie une charge utile JSON structurée de façon synchrone. Les architectes peuvent ensuite acheminer cette charge utile vers le pipeline d’objet lac de données/objet modèle de données Data 360, les objets SObject Salesforce, ou des bases de données et des entrepôts externes via MuleSoft, des appels Apex ou des pipelines ETL (Einstein Trust Layer). Le niveau cible est une décision architecturale pilotée par les exigences de latence, de gouvernance et de résidence des données.
Document AI prend actuellement en charge les fichiers PDF, les fichiers image (JPEG, PNG) et les documents manuscrits.
Data 360 Document AI assemble quatre technologies de traitement dans un pipeline régi unique. Chaque composant gère une étape distincte du cycle de vie de document à données :
- Reconnaissance optique des caractères (OCR): Convertit les images scannées, les contenus manuscrits et les fichiers PDF basés sur l’image en texte lisible par machine avant le traitement LLM. Un minimum de 150 DPI est recommandé pour une extraction fiable.
- Grands modèles de langage (LLMs): Acheminer l ’ extraction via la passerelle Einstein LLM en utilisant le modèle choisi par l ’ utilisateur. Le LLM reçoit la sortie OCR avec la configuration du schéma JSON et renvoie une charge utile d’extraction structurée. Gemini et d ’ autres modèles sont prévus pour une mise en œuvre ultérieure.
- Traitement du langage naturel (NLP) : Effectue la compréhension contextuelle, la reconnaissance d’entités, l’analyse de dates et l’extraction de champs sémantiques directement dans le grand livre via l’ingénierie des invites structurées (l’invite définie par le schéma et la sortie OCR servent d’entrées uniques). Toutes les interactions LLM sont acheminées via l’ETL, qui applique une rétention de données nulle avec les fournisseurs de modèle et masque les informations d’identification personnelle dans les entrées textuelles avant qu’elles atteignent le modèle. Aucun moteur NLP séparé n’est utilisé.
- Traitement multimodal : Traite les images incorporées dans des fichiers PDF en tant qu’entrées d’extraction séparées, ce qui permet au grand livre d’extraire des données de diagrammes, de tableaux restitués par des images et de pages à contenu mixte que l’OCR seul ne peut pas analyser.
En plus des quatre technologies de traitement, l’IA Document gère également :
- Einstein Trust Layer : Achemine toutes les interactions LLM via l’ETL, qui applique une rétention de données nulle avec les fournisseurs de modèle et masque les PII avant que les entrées n’atteignent le LLM, à l’exception des données multimodales (par exemple, les documents joints qui sont traités via l’IA Document) où le masquage des PII n’est pas actuellement pris en charge et les données sont envoyées telles quelles à des modèles externes. L’ETL régit uniquement le chemin d’interaction LLM. Les données extraites qui sont écrites dans des objets lac de données sont stockées en l’état. Le masquage au niveau du champ au repos doit être traité par des contrôles de gouvernance des données en aval.
- Limites de taille de fichier : Document AI traite les fichiers jusqu’à 10 Mo par requête. Les limites en longueur du contexte du grand livre peuvent limiter davantage le traitement des documents denses de plusieurs pages à l’intérieur de cette limite.
Les architectes d’entreprise qui déploient Data 360 Document AI doivent appliquer ces principes avant de s’engager dans une conception d’implémentation.
- Sélectionnez le pipeline avant de concevoir le schéma. Les pipelines de traitement par lot et transactionnel diffèrent par le modèle d’ingestion, la liaison du schéma, la flexibilité de la cible et la latence. Il est important de confirmer le pipeline requis par chaque cas d’utilisation avant de définir le schéma, car la modernisation ajoute des travaux évitables.
- Concevoir des schémas au niveau du type de document. L’utilisation d’un schéma unique et bien conçu par type de document est plus facile à gérer que l’utilisation de configurations par cas d’utilisation, et c’est également le plus grand levier de qualité d’extraction. Pour ce faire, vous devez utiliser une série de documents divers, y compris des requêtes de bord, plutôt que de concevoir à partir d’un seul exemple. Utilisez itérativement des invites au niveau du champ, du tableau et du schéma pour identifier les écarts, puis testez-les et affinez-les par rapport à plusieurs échantillons de documents avant de les finaliser. Notez qu’un schéma qui fonctionne bien sur un document peut être insuffisant sur d’autres. Par conséquent, l’étendue et l’itération sont essentielles. La flexibilité du schéma, notamment le retrait des colonnes qui ne sont pas extraites de façon fiable entre les types de document, est tout aussi importante. S’accrocher à des champs qui introduisent du bruit ou de l’incohérence nuit à la qualité générale de l’extraction. Par conséquent, il est important de traiter l’enlèvement des colonnes comme une décision de conception de premier ordre.
- Choisissez le niveau cible correct par groupe de champs. Les champs qui pilotent des workflows CRM ou des approbations écrivent dans SObjects. Les champs qui enrichissent le profil unifié ou alimentent les analytiques appartiennent au pipeline DLO/DMO. Les champs qui servent des systèmes externes appartiennent au RDBMS. Notez qu’un schéma unique peut atteindre simultanément plusieurs niveaux.
- Appliquer la gouvernance avant de traiter les contenus réglementés. Les données réglementées doivent être protégées à chaque couche. Par conséquent, il est important de configurer le masquage des informations d’identification personnelle, les balises de classification des données et le contrôle d’accès basé sur l’attribut (ABAC) une fois les données extraites stockées dans les objets lac de données (DLO) de sortie. Cela permet d’ajuster l’application de la loi et d’accéder au contexte en fonction de la classification des données, du rôle de l’utilisateur et du contexte organisationnel. La gouvernance est divisée en deux voies : L’ELT régit l’interaction LLM, tandis que les données extraites stockées dans des Data Lake Objects (DLOs) doivent être régies séparément (directement au niveau des Data Lake Objects (DLOs) et de la base de données) via des configurations Data Space, Permission Sets et des stratégies ABAC. Ces contrôles doivent maintenir la cohérence au niveau du stockage, pas seulement au niveau de la couche application. Par conséquent, les restrictions d’accès restent inchangées, quel que soit le mode d’accès aux données après l’ingestion. Notez que les écarts dans n’importe quelle couche peuvent exposer des données réglementées en aval, même lorsque d’autres sont correctement configurées.
- Concevoir pour les modes de défaillance avant la production. Répondez au traitement des champs nuls, aux seuils de qualité OCR, à la pré-validation de la taille du fichier, au dépassement du contexte LLM, à l’idempotence en écriture du SGBDR et aux limites du budget de crédit avant la première exécution de lot de production. Ce ne sont pas des cas de bord, ce sont des surfaces de défaillance prévisibles qui doivent être traitées explicitement dans la conception du pipeline, pas découvertes à l’exécution.
- Traitez les scores de confiance comme un signal d’acheminement de première classe, pas comme un diagnostic après coup. Les résultats d’extraction contiennent des valeurs de confiance au niveau du champ dérivées des probabilités de consignation (logprobs) de la sortie du modèle sous-jacent. Pour chaque champ, tableau ou colonne extrait, le score reflète la certitude de la valeur extraite au niveau du jeton du modèle. Cela fait des scores de confiance un signal statistiquement ancré suffisamment fiable pour servir de porte principale aux seuils d’escalade Human-in-the-Loop (HITL). Utilisez des scores de confiance pour identifier systématiquement les extractions de faible qualité et initier des points de contrôle HITL pour les valeurs de champ de faible confiance, les correspondances de schéma ambiguës ou les défaillances répétées du pipeline au lieu de vous appuyer sur des heuristiques ou des contrôles ponctuels manuels. Lorsque la récupération automatisée n’est pas possible, le score de confiance soutenu par HITL garantit que le jugement humain est appliqué exactement là où il est nécessaire.
- Concevez des parcours d’activation en parallèle avec la conception du schéma. L’intérêt de l’IA Document réside dans la possibilité d’activer des données extraites dans des workflows et des agents Salesforce. Il permet de concevoir des actions, des flux et des connaissances calculées Agentforce parallèlement à la conception d’un schéma d’extraction, pas après.
Document AI fonctionne dans deux pipelines :
- Un pipeline par lot pour le traitement à haut volume soutenu par UDMO
- Un pipeline transactionnel de traitement pour l’extraction pilotée par l’API en temps réel
Les deux pipelines partagent le même contrat de configuration de schéma et la même gouvernance ETL, mais ils diffèrent dans la façon dont les documents entrent dans le système et l’emplacement d’arrivée des données extraites.
Examinons de plus près chaque pipeline.
Le pipeline par lot traite les ensembles de documents récurrents définis par un UDMO. Il convient aux cas d ’ utilisation planifiés ou pilotés par un événement, où des documents sont ingérés à partir d ’ un espace de stockage d ’ entreprise, puis extraits et livrés au pipeline d ’ objets lac de données/objet modèle de données Data 360 pour harmonisation, résolution de l ’ identité et activation.
Scénario réel
Chaque jour, un transporteur d’assurance reçoit des milliers de documents de réclamation médicale provenant de portails de prestataires, qui sont chargés sous forme de fichiers PDF dans Amazon S3. L’UDMO définit l’ensemble de documents dans le périmètre et envoie tous les fichiers PDF de réclamation au compartiment /claims/incoming/ dans un délai de 24 heures.
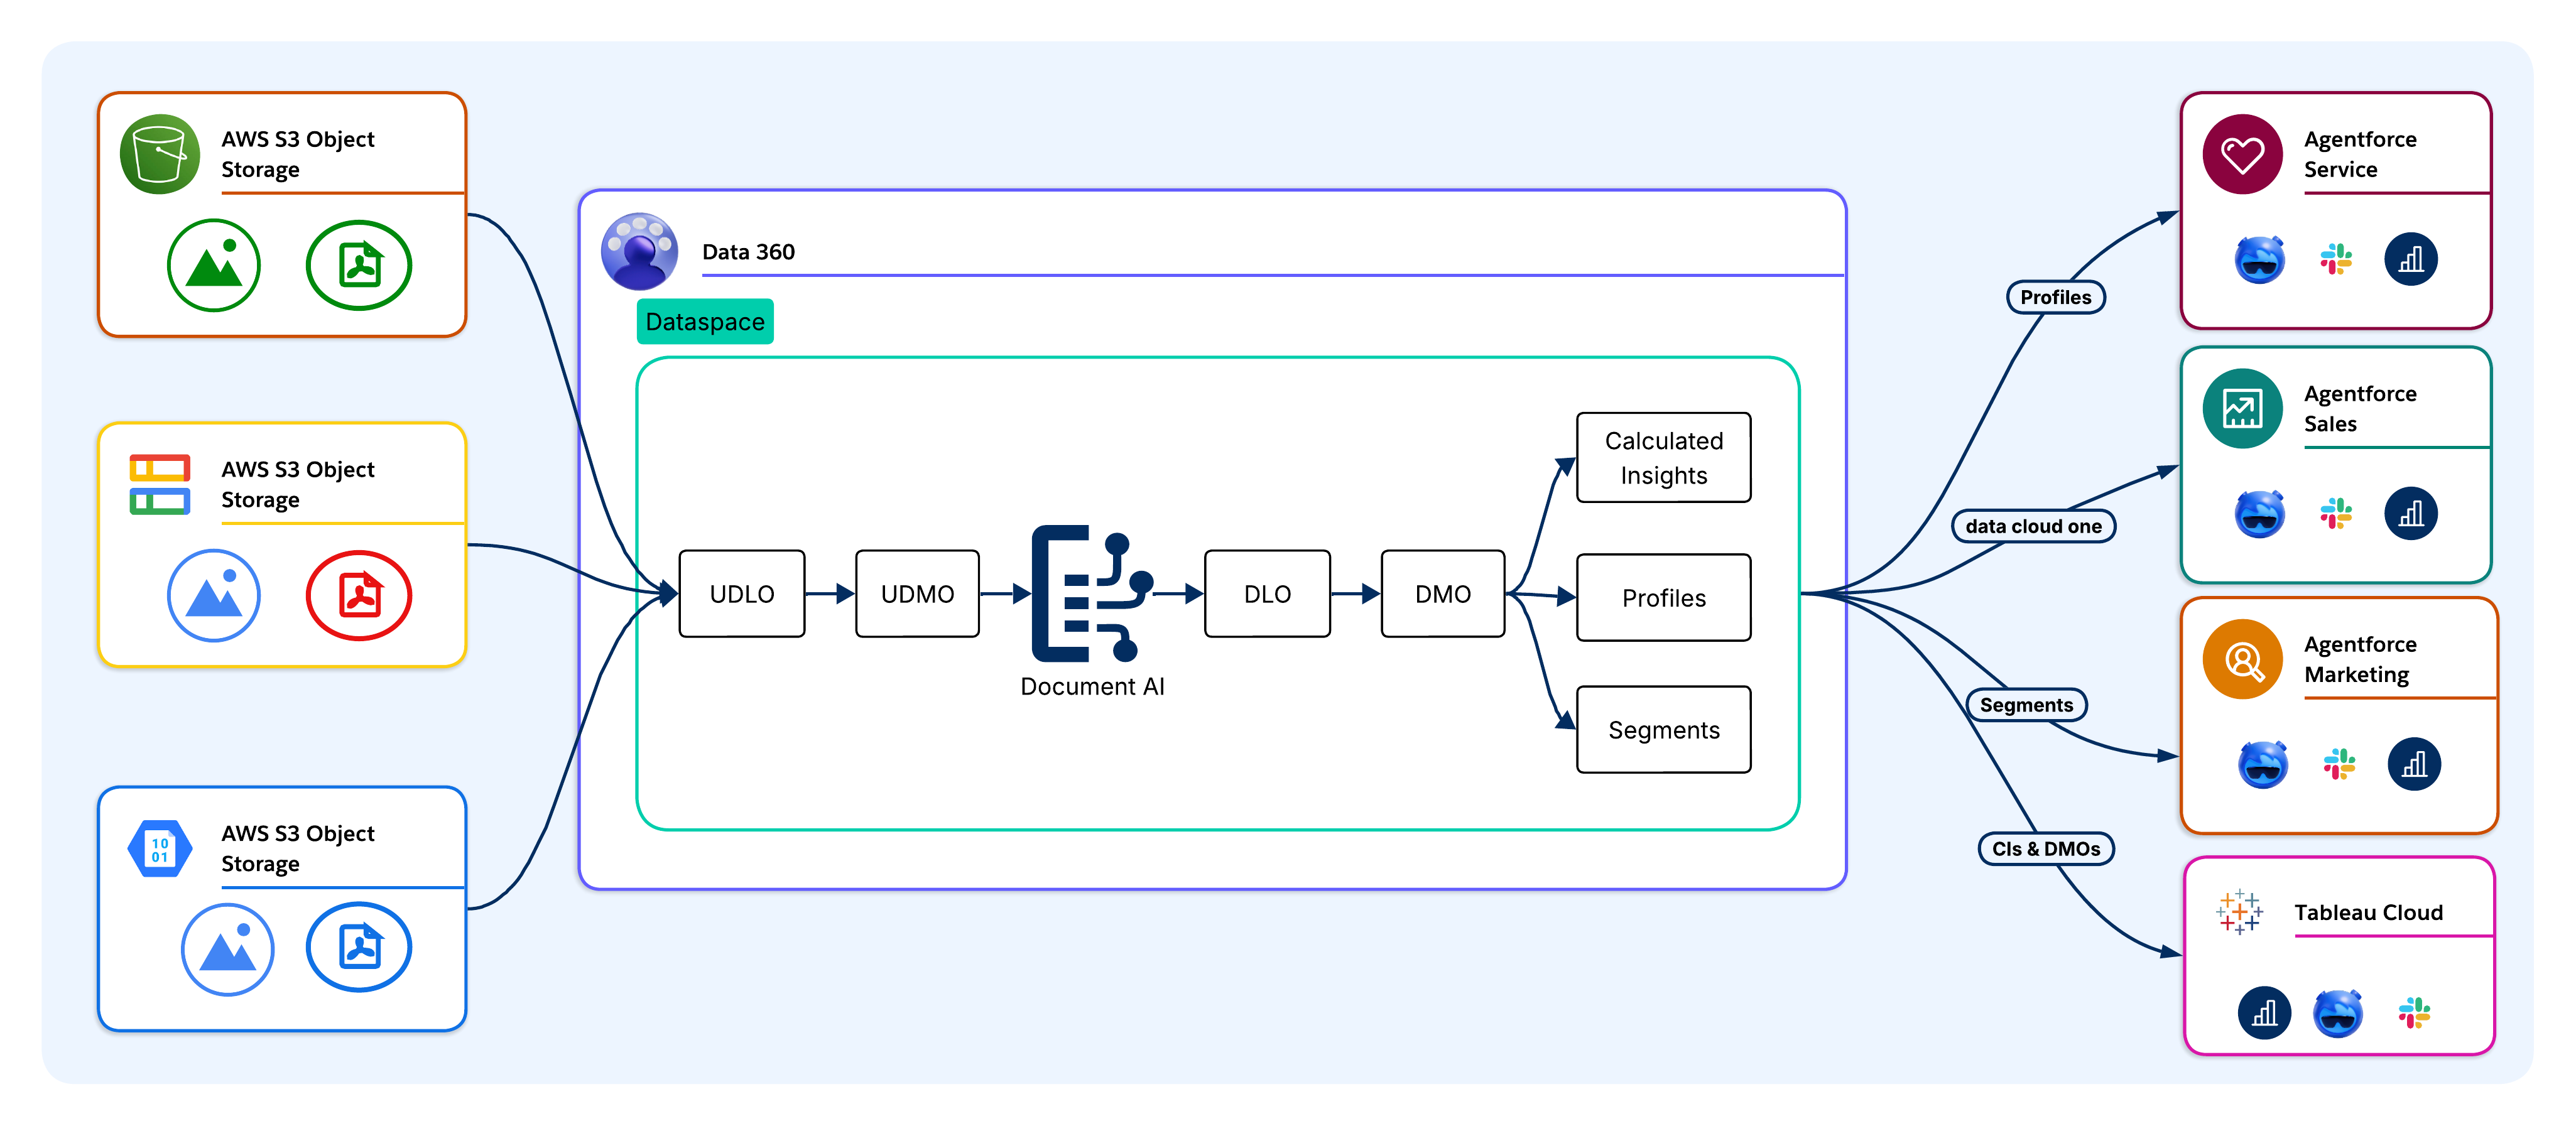
Les documents sont ingérés dans Data 360 à partir de systèmes sources d’entreprise sans duplication physique. Les sources prises en charge comprennent Amazon S3, Google Cloud Storage, les objets fichiers Salesforce CRM, les pipelines orchestrés par MuleSoft et les chargements d’API directs. Dans les déploiements Headless 360, les documents sont ingérés via des connecteurs de stockage Cloud ou l’API Ingestion, qui contourne la couche CRM. Le serveur Model Context Protocol (MCP) expose l’ingestion en tant qu’outil appelable pour les agents IA externes et les clients LLM.
Lors de l’ingestion, les documents bruts sont stockés sous forme d’obje _ts lac de données non structurés (UDLO), qu_i sont mappés avec l’emplacement physique et les métadonnées de chaque document sans déplacer ni transformer le fichier source.
Exemple :
Les fichiers PDF de réclamation sont ingérés depuis S3 dans Data 360 via le connecteur de stockage Cloud. Chaque document est stocké sous forme d’UDLO qui pointe vers l’objet S3. Aucune duplication physique ne se produit.
L’IA du document traite chaque UDLO par rapport à une configuration de schéma qui définit les champs à extraire avec leurs types de données cibles. L’UDMO définit quels documents sont concernés. Le LLM (GPT-4o, Gemini ou Claude) lit chaque document et renvoie une charge utile d’extraction structurée.
Exemple :
L’IA du document traite chaque objet lac de données par rapport à un schéma de réclamation qui définit des champs tels que : ClaimID, PatientName, DiagnosisCode, BillingAmount et ServiceDate. Les LLM lisent ensuite chaque fichier PDF et renvoient une charge utile d’extraction structurée.
Une fois extraites, les données sont conservées dans des objets lac de données, qui sont la couche de stockage brute de Data 360. Les objets lac de données conservent les champs extraits sans imposer de logique métier, ce qui préserve une représentation physique précise pour la transformation en aval et la traçabilité. L’UDLO conserve une référence au document source pour activer le lignage au niveau du champ à n’importe quel point du pipeline.
Exemple :
Tous les champs extraits se retrouvent dans un Claims DLO, qui conserve une représentation brute et précise de chaque réclamation avec une traçabilité complète jusqu’au PDF source.
Les champs d’objet lac de données sont mappés avec des objets modèle de données conformes au modèle Customer 360 standard. Il s’agit de la frontière dans laquelle les données dérivées de documents passent de champs bruts extraits à des entités importantes pour l’entreprise. L’objet lac de données Facture est mappé avec un objet modèle de données Facture, et des champs tels que CustomerID et BillingAmount deviennent des clés de jointure et des attributs de correspondance dans le modèle de données unifié. Les données harmonisées des documents participent à la segmentation, aux connaissances calculées et à l’activation via les mêmes interfaces que celles utilisées par CRM et les données transactionnelles.
Exemple :
Le Claims DLO est mappé à un Claims DMO. Les champs PatientID et PolicyNumber deviennent des clés de jointure qui lient les enregistrements de réclamation à des profils de patient unifiés.
Les données d’objet modèle de données harmonisées participent à la résolution de l’identité. Les champs extraits (par exemple, les noms de clients, les adresses e-mail ou les numéros de compte) servent de clés de correspondance pour lier des enregistrements de document à des Individus unifiés (enregistrements dorés), ce qui comble l’écart entre le document et le profil.
Exemple :
Les champs d’extraction (par exemple PatientName, DateOfBirth et PolicyNumber) servent de clés de correspondance pour la résolution de l’identité, qui associe les enregistrements de réclamation à l’Individu unifié approprié. Cela se produit même si le même patient est affiché sous des orthographes de nom légèrement différentes dans les documents.
Les architectes définissent les Connaissances calculées, qui sont des métriques agrégées calculées à partir de données de documents harmonisées (par exemple, les dépenses totales de divers éléments de ligne de facture, les scores de risque de renouvellement de contrat et les indices de sévérité des déclarations).
Exemple :
Les Calculated Insights calculent TotalClaimsPerPatient, AverageClaimAmount et HighRiskClaimScore sur les données harmonisées de réclamations pour les requêtes Agentforce.
Les agents Agentforce, Tableau, les plates-formes marketing et les SObjects Salesforce ont accès à des données harmonisées et résolues en fonction de l ’ identité. Le niveau cible est une décision architecturale pilotée par les exigences de latence, de gouvernance et de résidence des données.
Exemple :
A Clams Adjudication Agentforce Agent interroge les objets modèle de données et les indicateurs de performance Data 360 pour trouver les réclamations à haut risque à examiner en priorité. Tableau affiche le volume des réclamations et les tendances en matière d’anomalies. Les enregistrements de réclamation approuvés retournent dans le Claims SObject pour initier les workflows de paiement.
Dans les architectures Headless 360, l’activation achemine directement vers des systèmes externes via l’API Query, l’API Pub/Sub ou des cibles d’activation d’entrepôt de données Cloud. Ensuite, le serveur MCP recherche des données de document harmonisées et des Connaissances calculées en tant qu’outils appelables pour les agents IA externes.
Le pipeline de traitement transactionnel gère l’extraction de documents uniques à l’exécution sans UDMO ou UDLO préingéré, ce qui convient aux cas d’utilisation pilotés par l’événement (par exemple, un client chargeant un formulaire, un agent recevant un fichier PDF ou un système externe initiant l’extraction dans un workflow de traitement transactionnel). La gouvernance ETL s’applique de façon identique aux deux pipelines.
Scénario réel
Lors d’une demande de prêt, un client de la banque charge un fichier PDF de sa facture de services publics via l’application mobile de la banque. L’événement initie l’extraction en temps réel, ce qui signifie qu’aucun UDLO ou UDMO pré-ingéré n’est impliqué.
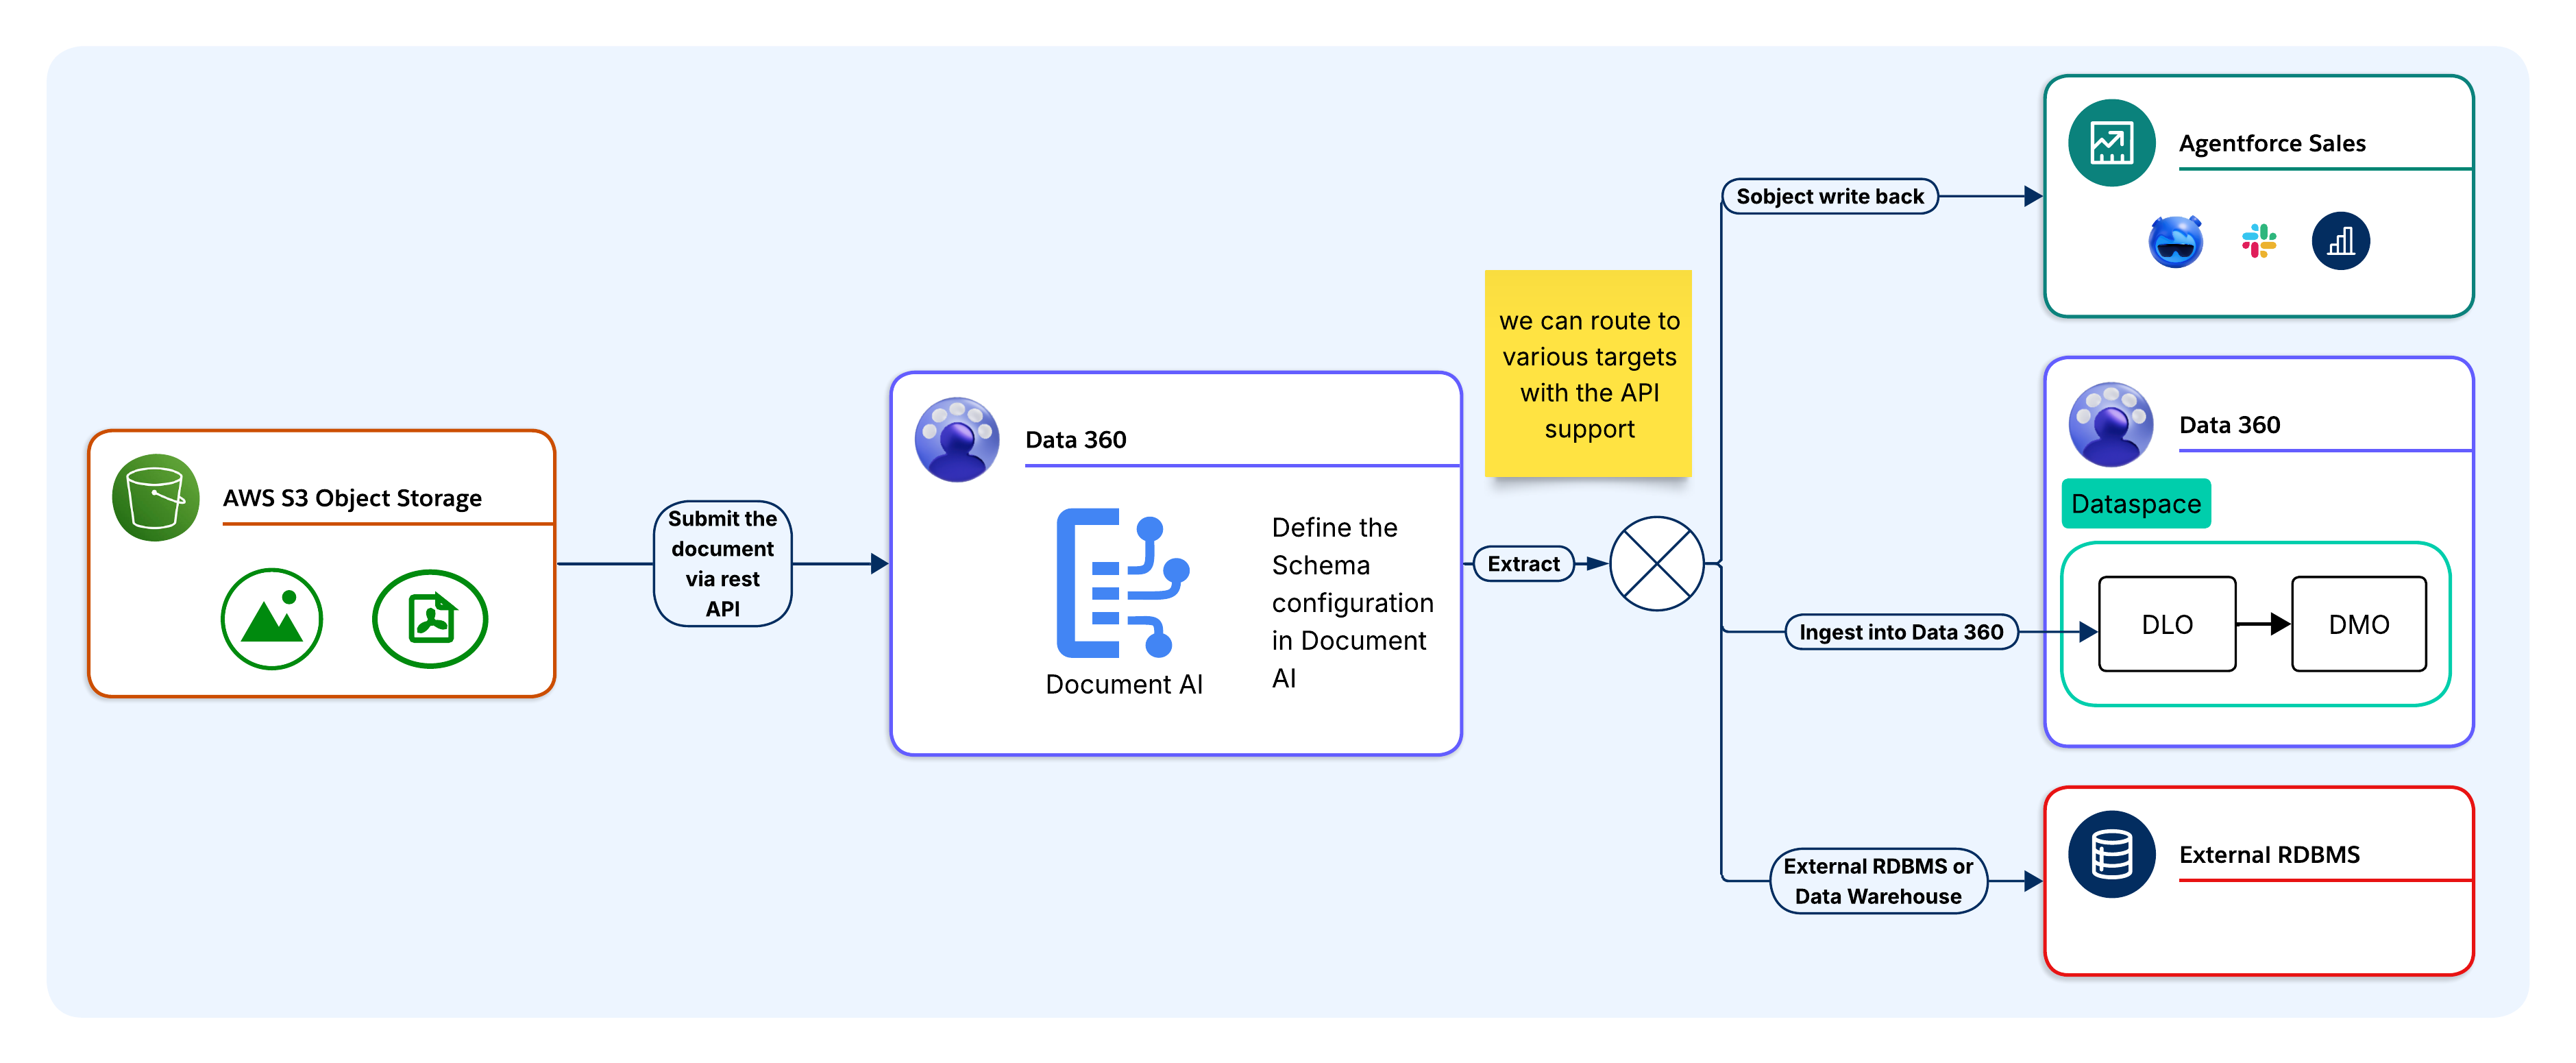
Avant d’invoquer l’API, les architectes doivent définir et stocker dans Data 360 un schéma qui spécifie les champs, les types de données et les instructions d’extraction sous le format Schéma JSON. Un ID de schéma unique est attribué à chaque schéma. À l’exécution, l’application appelante référence l’ID de schéma pour garder la logique d’extraction centralisée dans Data 360 au lieu de l’incorporer dans le code de l’application.
Exemple :
L’équipe de la banque a un schéma de ProofOfAddress prédéfini dans Data 360, qui spécifie des champs tels que CustomerName, AddressLine1, City, PostCode et DocumentDate. Ces informations sont stockées dans une configuration de version qui peut être référencée par un ID de schéma.
L’application appelante soumet le document et l’ID de schéma dans une requête d’API REST unique en tant que charge utile ou référence de fichier codée en base64. Aucune ingestion UDLO n’est requise. L’IA du document applique l’extraction du document et renvoie la sortie structurée basée sur le schéma fourni.
Exemple :
L’application mobile soumet la facture de service en tant que charge utile codée en base64 avec l’ID de schéma de ProofOfAddress dans un seul appel d’API REST. Ce processus ne nécessite pas d’étape d’ingestion UDLO.
Le LLM traite la sortie OCR par rapport au schéma et renvoie une charge utile JSON structurée de façon synchrone. Les champs introuvables dans le document sont renvoyés nuls. L’appelant est propriétaire de la réponse JSON complète et passe à l’acheminement.
Exemple :
Document AI applique OCR au fichier PDF et le LLM renvoie une charge de travail JSON structurée avec des champs d’adresse extraits. Les champs introuvables (par exemple, si le PostCode est manquant dans la facture) sont renvoyés null.
Une fois extraite, la charge utile JSON peut être acheminée vers un ou plusieurs niveaux cibles selon le cas d’utilisation :
- Salesforce SObject: Il correspond directement aux champs de SObject via Apex ou Flow pour les workflows CRM et les processus d’approbation.
- Data 360 DLO/DMO Pipeline : Achemine vers un Data Lake Object (DLO) pour harmonisation, résolution d’identité, Calculated Insights et ancrage Agentforce.
- RDBMS externe ou entrepôt de données : Achemine par MuleSoft, appel Apex, événements de plateforme ou ETL pour des systèmes extérieurs à Salesforce.
- Intégration personnalisée : Renvoie les charges utiles JSON structurées à l’application appelante pour stockage dans n’importe quel système externe ou magasin de données.
- Flux ou agent en aval : Transmet la sortie JSON structurée directement à un flux ou un agent en aval sans aucune persistance dans un SObject. Ce schéma est courant pour les clients qui utilisent l’IA de documents comme étape d’extraction en temps réel dans une automatisation plus large ou un workflow agent.
Notez qu’un schéma unique peut atteindre simultanément plusieurs niveaux, différents groupes de champs acheminant vers différentes cibles à partir du même point d’extraction.
Exemple :
Une charge de travail ProofOfAddress peut atteindre trois niveaux à la fois (par exemple, CustomerName et AddressLine1 écrivent dans le SObject Contact), ce qui initie un flux de vérification de l’adresse. Ensuite, la charge utile complète est acheminée vers un objet lac de données pour harmonisation et évaluation des risques, et une copie est acheminée vers le système KYC de la banque via MuleSoft pour consignation de la conformité réglementaire.
Une fois écrites, les données extraites sont immédiatement activées dans le système cible. Pour des cibles SObject, les déclencheurs, les flux et les processus d’approbation sont activés dans l’enregistrement mis à jour. Pour les cibles DLO/DMO, les données entrent dans le pipeline d’harmonisation et de résolution de l’identité et dans le contexte Agentforce. Pour des cibles SGBD externes, les données sont disponibles pour les requêtes en aval dès que l’écriture est terminée.
Exemple :
Le flux de vérification d’adresse est immédiatement activé dans l’enregistrement Contact mis à jour, ce qui fait passer la demande de prêt à l’étape suivante. L’agent de prêt Agentforce trouve l’adresse vérifiée dans Data 360, et le système KYC enregistre la soumission du document à des fins d’audit.
Document AI est plus adapté à des conditions architecturales spécifiques. Son application hors de ces conditions entraîne une complexité inutile et des coûts supplémentaires.
En tant qu’architectes, il est important d’évaluer ces critères avant de s’engager dans l’IA Document en tant que mécanisme d’extraction.
Utilisez Document AI lorsque :
- Les documents sont la principale source de données. Les informations requises existent uniquement sous forme de document et ne sont pas disponibles dans une API structurée ou une base de données (par exemple, contrats scannés, rapports de laboratoire, formulaires d’admission ou déclarations d’assurance).
- Les mises en page des documents varient selon les sources. Le même type de document provient de plusieurs fournisseurs, partenaires ou régions avec des positions et des formats de champ différents. L’extraction LLM pilotée par le schéma s’adapte sans maintenance par mise en page.
- Les données extraites doivent alimenter Data 360 ou Agentforce. L’extraction doit participer à la résolution de l’identité, Calculated Insights ou à l’ancrage Agentforce. Document AI est livré directement dans le pipeline DLO/DMO sans couche ETL séparée.
- Le volume justifie l’automatisation gouvernée. Le volume de documents dépasse ce que le traitement manuel peut traiter sans coût de main-d’œuvre mesurable ni risque de qualité des données.
- Les documents contiennent un contenu réglementé. Les données PHI, PII ou financières doivent transiter par une couche de rétention des données nulle et masquant les PII avant d’atteindre un grand livre. L’ETL le satisfait nativement. Les clients qui ne souhaitent pas que le contenu extrait soit conservé à tout moment doivent également prendre en compte le flux d’API transactionnelle, qui renvoie une sortie structurée directement à l’application appelante sans écrire dans un SObject ou un magasin de données.
- Le cas d’utilisation est piloté par l’événement. Un document arrive à l’exécution (par exemple, un chargement de client, une pièce jointe PDF d’agent ou un déclencheur système externe). Le pipeline de traitement transactionnel gère l’extraction synchrone de documents uniques sans configuration par lot.
N’utilisez pas Document AI lorsque :
- Les données sources sont déjà structurées. Si le système en amont expose une API REST, un tableau de base de données ou un fichier structuré (par exemple, CSV, JSON ou XML), utilisez un connecteur Data 360 standard. L’exécution de données structurées à travers un pipeline d’extraction LLM ajoute des coûts de latence et de crédit sans avantages supplémentaires.
- Les documents sont générés par machine avec un schéma fixe. Les fichiers PDF générés par le système à partir d’un système ERP connu ou d’une plate-forme de facturation avec une présentation stable conviennent mieux à un analyseur déterministe. L’extraction LLM est conçue pour la variabilité, et son application à des documents à schéma fixe entraîne des pertes de contexte et de crédits.
- Les exigences de précision dépassent les seuils de confiance en LLM. Document AI ne garantit pas une précision d’extraction de 100 %. Les cas d’utilisation où une valeur de champ manquée ou incorrecte comporte un risque financier, juridique ou clinique important nécessitent une étape de validation HITL. N’utilisez pas Document AI comme couche d’extraction unique pour les décisions à fort enjeu sans flux de validation.
- Les documents dépassent les contraintes de la plate-forme. La limite actuelle en taille de fichier de 10 Mo et les contraintes de longueur du contexte LLM rendent l’IA des documents inadaptée aux documents volumineux ou denses sans prétraitement pour les séparer et les réassembler hors de la plate-forme.
- Note : Chez Salesforce, nous améliorons activement ces garde-fous d’acceptation afin d’élargir les tailles de fichier, le nombre de pages et les extensions de fichier pris en charge. Les contraintes continueront d’évoluer à l’avenir.
Examinons de plus près plusieurs scénarios qui utilisent le pipeline de lots Document AI soutenu par un objet source UDMO. Dans ce cas, les données extraites transitent par le pipeline d ’ objets lac de données/objet modèle de données Data 360 pour harmonisation, résolution de l ’ identité, connaissances calculées et activation Agentforce. Chaque cas d’utilisation est plus adapté au traitement de documents planifiés ou pilotés par un événement, à haut volume.
Agentforce Sales : Intelligence des contrats et des factures
Les PDFs Contract sont ingérés depuis le stockage Cloud via le pipeline batch. Le schéma extrait ContractValue, RenewalDate, PaymentTerms et CounterpartyName, puis les mappe avec les objets modèle de données Compte et Contrat. Les Connaissances calculées dérivent des scores de risque de renouvellement. Agentforce alerte les chargés de compte avant la fermeture des fenêtres de renouvellement, ce qui élimine la révision manuelle des contrats et les renouvellements manqués.
Agentforce Service : Déviation de requête et ancrage des connaissances
Les fichiers PDF d’enquête et les pièces jointes aux cas sont ingérés via le pipeline batch. Le schéma extrait les indicateurs de sentiment, les catégories de problèmes et les notes de résolution, puis les mappe avec les objets modèle de données Case et Knowledge Article. Agentforce interroge la base de Knowledge harmonisée à l’ouverture de la requête et localise les étapes de dépannage appropriées, ce qui réduit les frais de recherche d’agents.
Agentforce Health : Traitement des documents cliniques
Les rapports de laboratoire, les fichiers PDF d’admission et les formulaires cliniques manuscrits sont ingérés via le pipeline batch. Le schéma extrait des champs, notamment PatientID, DiagnosisCode, MedicationName et TestResult, puis les mappe avec les objets modèle de données Health Cloud, qui prennent en charge la coordination des soins et les workflows de recherche clinique conformes à la norme HIPAA.
Services financiers : Automatisation des documents de prêt et d’impôt
Les demandes de prêt, les déclarations de revenus et les comptes de résultat sont ingérés via le pipeline par lot. Le schéma extrait des champs, notamment AnnualIncome, TaxYear et EmployerName, puis les mappe avec les objets modèle de données Compte financier. Les Connaissances calculées joignent les données de revenu dérivées de documents et les données CRM pour faciliter le score de risque de crédit automatisé. Agentforce repère les détails du prêt extraits directement au cours des interactions avec le service client. Ce modèle prend directement en charge le cas d’utilisation Agent de présélection de prêt, publié sur le centre des développeurs Salesforce Agentic Enterprise Solutions.
HR: Traitement des documents de la force de travail
Les documents d’intégration, les formulaires fiscaux et les fichiers PDF de certification sont ingérés via le pipeline par lot. Les champs extraits sont mappés avec les objets modèle de données Enregistrement employé, puis liés au profil Employé unifié. Des flux spécifiques initient des tâches d’intégration et des contrôles de conformité basés sur les données extraites. Ce modèle prend directement en charge le cas d’utilisation Agentic d’automatisation du traitement des CV. L’Document AI extrait les compétences, l’historique professionnel et les qualifications des CV au format PDF, qu’Agentforce utilise ensuite pour faire correspondre les candidats aux critères des postes ouverts et les acheminer vers des workflows de recrutement.
Services professionnels : Proposition et intelligence de la recherche
Les diaporamas de propositions et les rapports de recherche sont ingérés via le pipeline par lot. Les infrastructures, les points de repère et les résumés d’engagement extraits sont mappés avec des objets modèle de données personnalisés, puis indexés pour la recherche vectorielle. Agentforce récupère au moment de la requête des recommandations pertinentes au contexte, qui sont fondées sur le contenu extrait du document. Ce modèle étend le modèle Ground Agentforce on Website Content. Les documents sont indexés via l’IA Document et remplissent la même fonction d’ancrage pour les réponses des agents que les contenus de site Web indexés via des connecteurs Data 360.
Statut de conformité HIPAA :
Les schémas Health Cloud décrits dans le présent document appliquent des contrôles ETL (par exemple, zéro rétention des données et masquage PHI) pour les entrées de texte. Ces contrôles ne constituent pas à eux seuls une certification HIPAA. Les architectes qui conçoivent pour des environnements cliniques réglementés doivent confirmer le statut de certification HIPAA actuel auprès de l’équipe de conformité de Salesforce avant de s’engager dans une architecture basée sur l’intelligence artificielle des documents dans ces contextes.
Examinons de plus près plusieurs scénarios qui invoquent l’API REST Document AI avec un schéma qui n’est pas lié à un UDMO. Les charges utiles JSON extraites sont acheminées directement vers des systèmes externes de façon synchrone à l’exécution.
Chaîne d’approvisionnement : Traitement des factures fournisseurs vers ERP
Lorsqu’un fichier PDF de facture fournisseur arrive dans un compartiment de stockage surveillé ou une passerelle de messagerie, un déclencheur d’événement appelle l’API REST Document AI avec la facture et un ID de schéma prédéfini. Le schéma extrait VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount et DueDate. La charge de travail JSON est acheminée via MuleSoft vers le module Comptes fournisseurs ERP avec une validation de champ nulle et une logique de mise à jour/insertion idempotente, qui élimine la maintenance du modèle pour la variabilité du format fournisseur.
Opérations juridiques : Revue de contrat vers CLM
Lorsqu’un fichier PDF de contrat est chargé dans le portail légal, le back-end appelle l’API REST Document AI de façon synchrone. Le schéma extrait GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause et CounterpartySignatory. La charge de travail JSON est acheminée par appel Apex vers le système CLM (Contract Lifecycle Management). Tous les champs introuvables sont renvoyés null et le CLM applique les règles d’obligation par défaut aux valeurs manquantes.
Déclarations d’assurance : Premier avis de traitement de perte
Lorsqu’un assuré soumet un formulaire First Notice of Loss (FNOL), le portail back-end appelle l’API REST Document AI de façon synchrone. Le schéma extrait PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName et ContactPhone. La charge de travail JSON est acheminée vers la base de données de gestion des déclarations par appel Apex ou ETL, ce qui crée un enregistrement de déclaration prérempli que les experts peuvent examiner avant l ’ ouverture de la déclaration officielle.
Avant de passer en production, vous devez créer des conceptions pour ces scénarios d’échec.
- Traitement des champs nuls : Le LLM renvoie null pour les champs qu’il ne peut pas localiser ou extraire en toute confiance. Validez la logique de traitement des valeurs nulles lors de la conception du schéma et implémentez une valeur par défaut ou une logique de rejet dans la couche d’intégration avant d’écrire dans des cibles avec des contraintes NOT NULL ou des clés de correspondance requises.
- Dégradation de la qualité OCR : La précision OCR se dégrade en dessous de 150 DPI, sur écriture irrégulière ou sur scans bruyants. Les erreurs de lecture se propagent dans l’extraction LLM sous forme d’entrée corrompue sans signaux d’erreur. Appliquer une qualité d’analyse minimale lors de l’ingestion et implémenter des contrôles de seuil de confiance dans les champs numériques et de date.
- Inadéquation de version du schéma : La mise à jour d’une configuration de schéma après la planification d’une tâche par lot entraîne le traitement des documents en vol par rapport à la version précédente, ce qui produit des champs manquants ou renommés qui rompent le mappage en aval. Versionnez explicitement des schémas et coordonnez les mises à jour avec des planifications de tâches par lot.
- Limites de taille de fichier : Les documents qui dépassent 10 Mo sont rejetés. Les échecs de pipeline par lot sont silencieux sans surveillance configurée, et les appelants transactionnels reçoivent une erreur 4xx. Pré-validez la taille des fichiers lors de l’ingestion et implémentez un pré-traitement pour séparer ou compresser les documents qui approchent régulièrement de la limite.
- Dépassement du contexte LLM : Les documents denses ou multi-pages peuvent dépasser la fenêtre de contexte LLM dans la limite de 10 Mo. Le LLM abandonne silencieusement les contenus qui dépassent le contexte. Implémentez une stratégie de segmentation qui divise les documents par plage de pages et remonte les champs extraits avant de les transférer vers la cible.
- Masquage du Trust Layer affectant l’extraction : L’ETL fonctionne au niveau de l’invite, pas au niveau du document. Par conséquent, le masquage ne s’applique pas au contenu du document qui transite par l’IA du document. Les champs de schéma qui dépendent des valeurs PII du document ne sont pas affectés par les stratégies de masquage ETL.
- Idempotence en écriture du SGBDR externe : Le pipeline de traitement transactionnel n’a pas d’idempotence intégrée pour les cibles SGBDR externes. Les tentatives de couche d’intégration créent des lignes dupliquées, sauf si la logique d’écriture gère explicitement la déduplication. Implémentez des mises à jour/insertions idempotentes en utilisant une empreinte de document ou un ID externe dans tous les chemins d’écriture externes.
- Épuisement du crédit à mi-exécution : Les exécutions par lots importantes peuvent épuiser les crédits Digital Wallet avant le traitement de tous les documents, ce qui produit des ensembles de données DLO incomplets que les étapes en aval considèrent comme complets. Définissez des alertes de consommation sur 75 % et 90 % des crédits disponibles, et limitez la taille des lots pour respecter le budget de crédit de chaque cycle.
- Limite de champs du schéma — Contrainte architecturale : L’IA du document applique une limite de 50 champs pour les champs de niveau racine dans une configuration de schéma. Il s’agit d’une contrainte de conception, pas d’une erreur d’exécution, et les architectes doivent en tenir compte lors de la conception du modèle de données et du schéma.
- Pour les cas d’utilisation qui nécessitent une extraction plus large :
- Priorisez sans pitié. Affinez le schéma aux champs qui déterminent la valeur d’automatisation, pas à la couverture exhaustive des documents.
- Tirez parti des objets imbriqués (jusqu’à 3 niveaux ; mode par lot avec l’objet source uniquement) pour réduire le nombre de champs au niveau racine sans sacrifier la profondeur d’extraction.
- Décomposez des documents complexes à travers plusieurs configurations IA de documents qui ciblent des sections de documents distinctes, écrivez des résultats dans des objets lac de données séparés qui se joignent en aval dans Data 360.
- Pour les cas d’utilisation qui nécessitent une extraction plus large :
- Limites de taux d’API : L’IA du document impose une limite de 50 appels d’API d’extraction par minute et par locataire. Le plafond théorique est de 300 appels par minute, qui est régi par la passerelle Einstein LLM. Les intégrations transactionnelles à haut volume doivent être conçues avec une temporisation exponentielle, une mise en file d’attente des requêtes et une gestion du débit par locataire. Ne supposez pas que la capacité de rafale est disponible dans les environnements de production multilocataires.
- Profil de latence d’API : Les API d’extraction Document AI sont entièrement synchrones. Les temps de réponse typiques vont de 5 à 15 secondes, et varient selon la taille du fichier et la complexité du schéma.
- Cela a des implications directes pour l’architecture d’intégration :
- Définissez les délais d’attente pour les appels à un minimum de 30 secondes.
- N’invoquez pas Document AI dans les flux avec des exigences de SLA inférieures à une seconde.
- Tenez compte de la latence dans les calculs de débit par rapport au plafond de la limite tarifaire pour les pipelines de traitement par lot.
- Définissez les délais d’attente pour les appels à un minimum de 30 secondes.
- Cela a des implications directes pour l’architecture d’intégration :
- Documents cryptés et protégés par mot de passe : Document AI ne traite pas les fichiers protégés par mot de passe (les mots de passe utilisateur sont requis pour ouvrir les fichiers) ni les fichiers PDF cryptés avec un mot de passe propriétaire/autorisations, y compris les fichiers qui s’ouvrent normalement, mais qui limitent la copie, l’impression ou la modification au niveau de la couche d’autorisations PDF.
- Cette contrainte se situe à la limite d’ingestion :
- Concevez des pipelines de réception de documents pour détecter et acheminer les fichiers cryptés vers un chemin de refus ou de traitement manuel avant qu’ils n’atteignent l’IA Document.
- Ne vous appuyez pas sur le traitement des erreurs d’exécution en tant que porte principale.
- Cette contrainte se situe à la limite d’ingestion :
L’IA Data 360 Document s’aligne sur plusieurs piliers de l’infrastructure bien architecturée de Salesforce.
- Trust : L’ETL applique une rétention de données nulle avec les fournisseurs de LLM, masque les entrées PII avant qu’elles atteignent le modèle et analyse les sorties pour détecter les contenus confidentiels. Les architectes doivent étendre cette posture aux données extraites au repos. Le masquage au niveau des champs dans les DLO n’est pas appliqué par l’ETL et nécessite des politiques en aval pour le Espace de données et des Permission Sets.
- Fiabilité : Chaque mode d’échec de la section Considérations relatives à la conception (extraction de champ nul, lecture incorrecte de l’OCR, incohérence de version de schéma, violation de taille de fichier, dépassement du contexte du grand livre, interférence de masquage ETL, idempotence en écriture du SGBDR et épuisement du crédit) représente une classe d’échec distincte avec un signal de détection documenté et un chemin de résolution.
- Excellence opérationnelle (gestion du changement) : Le modèle d’extraction piloté par le schéma dissocie la logique d’extraction de la présentation du document. Lorsqu’un fournisseur change un format de facture ou qu’un formulaire réglementaire est mis à jour, les architectes doivent mettre à jour une seule configuration de schéma plutôt que de modifier le code d’intégration.
- Excellence opérationnelle (maintenabilité) : La centralisation des configurations de schéma dans Data 360 plutôt que l’incorporation d’une logique d’extraction dans un code d’application rend l’intention d’extraction explicite, contrôlée et auditable. Toutes les cibles en aval consomment le même contrat de schéma, quel que soit leur niveau cible.
- Excellence opérationnelle (réutilisation de l’intégration) : Document AI expose l’extraction à travers plusieurs surfaces d’intégration : API REST, Apex, Flow, MuleSoft, Agentforce Actions, et le serveur MCP. Une configuration de schéma unique s’étend simultanément à plusieurs niveaux cibles sans reconstruire la capacité d’extraction par consommateur.
- Optimisation des ressources et des coûts : Le guide de sélection du pipeline, la limite de taille de fichier de 10 Mo et les contraintes de longueur du contexte du grand livre avant l’assemblage représentent des décisions de conception sensibles aux performances. La section Quand utiliser formalise les conditions dans lesquelles l’IA du document n’est pas l’outil approprié (par exemple, exigences de latence inférieure à la seconde, données sources entièrement structurées et documents générés par machine à schéma fixe).
Il s’agit d’un point de départ structuré pour configurer Data 360 Document AI dans un environnement sandbox. Terminez toutes les phases dans l’environnement sandbox avant de passer en production.
Avant de commencer la configuration, vous devez confirmer :
- Taille du fichier : Vérifiez que la taille des documents représentatifs est inférieure à 10 Mo.
- Pipeline : Vérifiez si le cas d’utilisation nécessite le pipeline par lot (soutenu par UDMO, haut volume) ou le pipeline de traitement transactionnel (piloté par l’API, document unique). Ce choix conditionne toutes les configurations ultérieures.
- Niveau cible : Vérifiez l’emplacement d’arrivée des données extraites : SObject Salesforce, Objet lac de données/objet modèle de données Data 360, SGBDR externe ou une combinaison de ces éléments.
- Dépendance Agentforce : Avant de déployer un traitement de document piloté par Agentforce, vérifiez qu’un LLM pris en charge (par exemple, GPT-4o) est activé dans votre organisation via les paramètres ETL. Agentforce est un prérequis strict de la plateforme pour Document AI. Toute la surface de fonctionnalité IA du document, y compris toutes les API d’extraction, n’est pas disponible tant qu’Agentforce n’est pas actif dans l’organisation cible. Tenez compte de ces éléments dans les évaluations de la préparation de l’organisation et le séquençage du provisionnement. Prévoyez quelques minutes pour que la disponibilité de l’API se stabilise après l’activation.
- Impact de la désactivation d’Agentforce : Si Agentforce est désactivé après la configuration et le déploiement de Document AI, tous les traitements d’extraction (interface utilisateur et API) seront immédiatement bloqués. Il en va de même pour la désactivation du modèle. La désactivation du modèle sous-jacent a un effet équivalent sur la disponibilité de l’IA Document. Dans les deux cas, les configurations de schéma existantes sont conservées et resteront visibles - aucune configuration ni perte de données ne se produira - mais la capacité est totalement inexploitable tant qu’Agentforce et le modèle ne sont pas réactivés. Concevez des runbooks opérationnels pour considérer la disponibilité d’Agentforce et l’activation du modèle comme des dépendances essentielles au bon fonctionnement de Document AI.
- Consommation de crédits / tarification : Utilisez des crédits Data 360 ou des crédits Flex pour des estimations de TCO dérivées de documents échantillons représentatifs.
- Créez la configuration du schéma. Définissez des champs d’extraction, des types de données et des instructions sous le format Schéma JSON dans la configuration de Data 360 Document AI. Pour le pipeline par lot, liez-le à un UDMO. Pour le pipeline de traitement transactionnel, créez-le sans objet source. Enregistrez l’ID de schéma.
- Alignez les noms de champ sur le niveau cible. Mappez les noms de champ avec des définitions de colonne d’objet lac de données, des noms d’API SObject ou des noms de colonne SGBDR. Les noms mal alignés créent une surcharge de mappage dans la couche d’intégration.
- Configurez l’objet source UDMO (par lot uniquement). Définissez des documents dans l’étendue et configurez la connectivité de la source d’ingestion (par exemple, S3, Google Cloud Storage, Salesforce Files ou MuleSoft). Vérifiez que le compte de service d’ingestion a l’étendue d’identifiant IAM ou OAuth requise.
- Appliquez les politiques de masquage des informations personnelles identifiables (PII). Configurez des stratégies de masquage des données dans les paramètres ETL avant de traiter tout contenu réglementé. Définissez les types de champ (PHI, PII et identifiants financiers) masqués avant que les entrées atteignent le grand livre. Ne le remettez pas à plus tard.
- Attribuez l’étendue de l’Espace de données et les ensembles d’autorisations. Étendez le traitement à l’espace de données approprié et configurez des ensembles d’autorisations pour contrôler la création de schémas, l’exécution de tâches par lot, l’invocation d’API REST et l’activation en aval.
- Configurez l’authentification API (en pipeline de traitement transactionnel uniquement). Créez une application connectée avec les étendues OAuth cdp_ingest_api et api. Pour les appelants internes de l’organisation, utilisez un identifiant nommé qui pointe vers un identifiant externe. Pour des appelants externes, configurez des identifiants client OAuth 2.0 ou un flux porteur JWT. Testez et validez l’extraction avant de continuer.
- SObject write-back : Implémentez un élément Apex (@InvocableMethod) ou Flow qui mappe les champs de réponse JSON avec des champs SObject . Utilisez Database.upsert() avec un ID externe pour éviter les doublons. Appliquez la sécurité au niveau du champ sur les champs SObject cibles.
- Pipeline DLO/DMO Data 360 : Faites correspondre les champs DLO extraits aux DMO alignés sur le modèle de données Customer 360. Configurez des règles de résolution de l’identité pour lier des enregistrements de document à des Individus unifiés. Définissez des Insights calculés et ajoutez des DMO pour Agentforce. Pour le pipeline de traitement transactionnel, acheminez d’abord la charge de travail JSON vers un objet lac de données via l’API Ingestion.
- SGBDR externe ou entrepôt de données : Sélectionnez le modèle d’intégration : MuleSoft (tissu d’intégration existant), appel externe HTTP Apex (léger, natif de l’organisation), événements de plate-forme avec l’abonné Pub/Sub (piloté par l’événement) ou ETL (lot haut volume). Implémentez des mises à jour/insertions idempotentes en utilisant une empreinte de document ou un ID externe dans tous les chemins d’écriture externes.
- Parcours d’activation : Connectez des actions Agentforce à des configurations de schéma pour l’extraction interactive. Configurer des déclencheurs de flux ou Apex pour les workflows de traitement automatisés et établir les cibles d’activation pour chaque groupe de champs.
- Traitement des erreurs (oléoduc de traitement transactionnel uniquement). Configurez la surface de réponse HTTP complète : 200 (réussi, y compris des réponses null partielles), 400 (requête malformée ou ID de schéma introuvable), 413 (fichier dépassant 10 Mo), 5xx (erreur de service). Implémentez un backoff exponentiel pour les tentatives 5xx avec au maximum 3 tentatives. Consignez la réponse JSON brute et l’ID de schéma à chaque appel.
- Testez les schémas avec des exemples de documents. Soumettez des exemples représentatifs via l’interface IA du document ou l’API REST. Confirmez la précision de l’extraction, la couverture de champ et le traitement des valeurs nulles dans les variations de présentation.
- Validez le traitement des champs nuls. Vérifiez que toutes les cibles en aval peuvent gérer les valeurs nulles pour les champs introuvables dans un document. Notez que les contraintes NOT NULL échouent silencieusement sans traitement explicite des valeurs nulles.
- Prévérifiez les tailles de fichier. Vérifiez que les documents de production restent inférieurs à 10 Mo. Implémentez un prétraitement pour séparer ou compresser les documents qui approchent régulièrement de la limite.
- Validez l’extraction de bout en bout. Pour le pipeline par lot, initiez une exécution complète et vérifiez que les champs extraits atterrissent correctement dans chaque niveau cible. Pour le pipeline de traitement transactionnel, suivez la réponse JSON à travers la couche d’intégration jusqu’à la cible. Vérifiez l’exécution du déclencheur et du flux pour les cibles SObject, la liaison de résolution de l’identité pour les cibles DLO/DMO et l’idempotence pour les cibles RDBMS.
- Confirmez le comportement Trust Layer. L’ETL n’applique pas le masquage des PII au contenu du document. Par conséquent, le LLM renvoie les données PII en l’état dans les champs extraits. Vérifiez que vos champs de schéma, l’acheminement des données et le stockage en aval sont conçus pour gérer correctement la sortie contenant des informations d’identification personnelle, et vérifiez que toutes les exigences de conformité ou de rétention sont satisfaites hors de la plate-forme.
- Définissez les alertes du portefeuille numérique. Configurez des alertes de consommation à 75 % et 90 % des crédits disponibles. Établissez des limites en taille de lot et des estimations de taux ad hoc dans le budget de crédit de chaque cycle.
- Validez la surveillance des lots (pipeline par lots uniquement). Examinez les taux de réussite de l’extraction, les taux de champ nul et la réalisation des tâches dans la console de surveillance Data 360. Confirmez la propagation de la balise de l’UDLO à travers le DLO jusqu’au DMO dans le lignage des données.
- Valider le traitement des erreurs d’API (en pipeline de traitement transactionnel uniquement). Testez toutes les conditions d’erreur : 413 (documents de plus de 10 Mo), 400 (ID de schéma non valides), 200 (extractions valides avec des valeurs nulles partielles). Vérifiez que la logique de nouvelle tentative est activée dans les réponses 5xx simulées sans créer d’écritures dupliquées.
Ce document met en évidence les fondements architecturaux de Data 360 Document AI:
- Deux pipelines de traitement et quand les utiliser
- Le modèle de configuration du schéma
- Cadre de décision du niveau cible
- Contraintes technologiques fondamentales
- Modes d’échec
- Alignement sur le Well-Architected Framework
Le Guide de démarrage rapide pour architectes fournit la séquence de configuration d’une validation de concept sandbox.
La posture architecturale principale prend en charge les données dérivées de documents qui sont régies par la couche Schéma, traitées via un pipeline LLM appliqué par ETL et livrées au même cycle de vie des données Data 360 qui régit toutes nos autres données d’entreprise.
Les architectes qui appliquent ces principes (sélection du pipeline approprié, conception de schémas au niveau du type de document et conception pour des modes de défaillance avant la production) développent des capacités d’extraction qui évoluent et perdurent dans le cadre des exigences réglementaires de gouvernance de l’industrie.
Yugandhar Bora est architecte en génie logiciel chez Salesforce, spécialiste de l’architecture de données sur la plate-forme Data and Intelligence Platform. Il dirige les initiatives du Conseil d’examen de l’architecture d’entreprise (EARB) qui se concentrent sur la gouvernance des données et les modèles de données unifiés, tout en contribuant à des solutions de provisionnement de plate-forme automatisées.
Ananth Anto est directrice de la gestion des produits chez Salesforce Data 360 et dirige les initiatives d’IA de documents et Data Graph. Basé à Bangalore, il travaille avec des clients professionnels pour résoudre des défis réels de traitement de documents et d’intelligence des données. Il aime explorer les cas d’utilisation d’entreprise pour l’IA générative (IA générative).
Nishan Naseer est architecte en génie logiciel chez Salesforce. Il travaille sur le traitement non structuré des données, les pipelines RAG et l’intelligence documentaire. Il est passionné par l’exploitation de la puissance de l’IA pour relever des défis réels et trouver des solutions créatives aux problèmes complexes des clients.