Les architectures de données d’entreprise vivent rarement dans un seul système. Salesforce gère l’engagement des clients, le pipeline et les interactions de service. Les plates-formes analytiques telles que Snowflake hébergent des transactions historiques, des enregistrements financiers, des données d’utilisation et des métriques opérationnelles. Traditionnellement, pour relier ces deux mondes, il fallait construire et maintenir des pipelines ETL : tâches planifiées qui extraient des données de la source, les transforment et chargent des copies dans Salesforce. En raison de ces pipelines, les données arrivent en retard, les politiques de gouvernance se multiplient entre les systèmes et les pipelines requièrent une attention opérationnelle continue.
Salesforce Data Virtualization offre un modèle différent. Au lieu de déplacer les données dans Salesforce, il permet à Salesforce d’interroger les données directement à leur source, à l’exécution, sans réplication. Les utilisateurs affichent les données externes live via des interfaces Salesforce standard. Les données ne quittent jamais leur source d’autorité. Ce document explique le fonctionnement du modèle, quand l’utiliser et comment commencer, en utilisant Snowflake comme exemple concret.
Salesforce Data Virtualization est un modèle d’architecture d’intégration qui permet à Salesforce d’interroger des données directement à partir de systèmes externes à l’exécution, sans copier ni répliquer ces données dans le stockage Salesforce. Au lieu de déplacer les données, la plate-forme envoie la requête.
Par conséquent, les utilisateurs de Salesforce interagissent avec des données externes via des interfaces Salesforce familières (telles que des présentations de page, des listes associées, des rapports ou des flux) pendant que les données restent dans leur système source faisant autorité. La gouvernance, le contrôle d’accès et la localisation des données restent là où ils doivent être.
Ce schéma est construit sur un principe architectural unique : Les données restent à la source. Le calcul passe aux données.
La plupart des déploiements Salesforce d’entreprise s’intègrent à des plates-formes de données externes (notamment des entrepôts de données, des bases de données opérationnelles ou des magasins analytiques) via des pipelines de réplication. Les pipelines extraient, transforment et chargent des données dans Salesforce selon une planification. Cette approche fonctionne, mais la réplication introduit des compromis structurels :
- Les données répliquées sont toujours retardées. Les pipelines introduisent un décalage, et des données obsolètes conduisent à de mauvaises décisions.
- Chaque copie de données élargit la portée de conformité. Les données confidentielles (telles que les informations d’identification personnelle, les dossiers financiers ou les données de santé) dans plusieurs systèmes nécessitent de gérer plusieurs politiques de gouvernance.
- Les pipelines nécessitent un investissement opérationnel continu, une surveillance, un traitement des défaillances, une gestion des dérives de schéma et une logique de retraitement.
La virtualisation des données répond directement à ces compromis. Il retire entièrement le pipeline pour les cas d’utilisation intensifs, conserve les données à leur emplacement faisant autorité et offre aux utilisateurs Salesforce une vue en temps réel et régie des données externes sans la réplication.
Les objets externes sont le principal mécanisme par lequel la virtualisation des données expose des données externes dans Salesforce. Ils se comportent comme des objets Salesforce standard : interrogeable via SOQL, visible dans les présentations de page et les listes associées, et accessible via des API Salesforce standard. La principale différence est qu’aucune donnée n’est stockée dans Salesforce. L’objet externe est une projection de schéma : une définition de ce à quoi ressemblent les données externes, pas une copie des données elles-mêmes.
Lorsqu’un utilisateur charge une page ou exécute un rapport qui référence un Objet externe, Salesforce exécute une requête live sur le système externe et renvoie uniquement l’ensemble de résultats de cette interaction.
Lorsque Salesforce exécute une requête SOQL sur un Objet externe, il traduit les filtres (clauses WHERE), les ordres de tri (ORDER BY) et les limites (LIMIT) dans le SQL équivalent, puis les envoie au système externe. Le système externe exécute la requête sur son propre moteur de calcul et renvoie uniquement l’ensemble de résultats filtré. Le travail se produit là où les données résident, et seule la réponse est renvoyée à Salesforce.
La virtualisation des données applique simultanément deux couches de sécurité indépendantes. Le système externe applique ses propres contrôles d’accès lors de l’exécution de la requête, notamment la sécurité au niveau de la ligne, le masquage des colonnes et l’accès basé sur le rôle. Salesforce applique son propre modèle de sécurité en plus : profils, ensembles d’autorisations, sécurité au niveau du champ et règles de partage. Les deux couches sont actives dans chaque requête. Aucun ne remplace l’autre.
Les architectes décrivent souvent la virtualisation des données comme un modèle « zéro copie ». Zero-copy signifie pas de réplication persistante dans le stockage Salesforce. Il n’existe aucun enregistrement d’écriture de pipeline ETL dans des objets Salesforce. Aucune synchronisation planifiée ne crée une copie locale. L’objet externe ne contient aucune ligne.
Zéro copie ne signifie pas zéro transmission de données. Chaque fois qu’un utilisateur interroge un Objet externe, un ensemble de résultats passe du système externe à Salesforce sur le réseau. Pour des ensembles de résultats volumineux ou une fréquence de requête élevée, les coûts de sortie des données et la latence du réseau sont des facteurs réels pour les architectes. Ce n’est pas une limitation à masquer : c’est une contrainte de conception à prendre en compte.
Tenez compte des différences architecturales ci-dessous si votre cas d’utilisation nécessite des volumes importants, un accès fréquent ou une faible latence.
Snowflake est l’un des systèmes externes les plus fréquemment connectés à Salesforce via la virtualisation des données. Il sert d’exemple concret du fonctionnement du modèle de bout en bout.
Dans cette configuration, Salesforce se connecte à Snowflake en utilisant Salesforce Connect avec l’adaptateur SQL pour Snowflake. Les tableaux et les vues Snowflake sont exposés en tant qu’objets externes dans Salesforce. Lorsqu’un utilisateur interroge un Objet externe, Salesforce traduit le SOQL en SQL et le soumet à l’API Snowflake Statements via un appel externe HTTPS authentifié. Snowflake exécute la requête dans son entrepôt virtuel, applique sa propre sécurité au niveau de la ligne et le masquage des colonnes, et renvoie uniquement l’ensemble de résultats. Aucune donnée n’est écrite à aucun moment dans le stockage Salesforce.
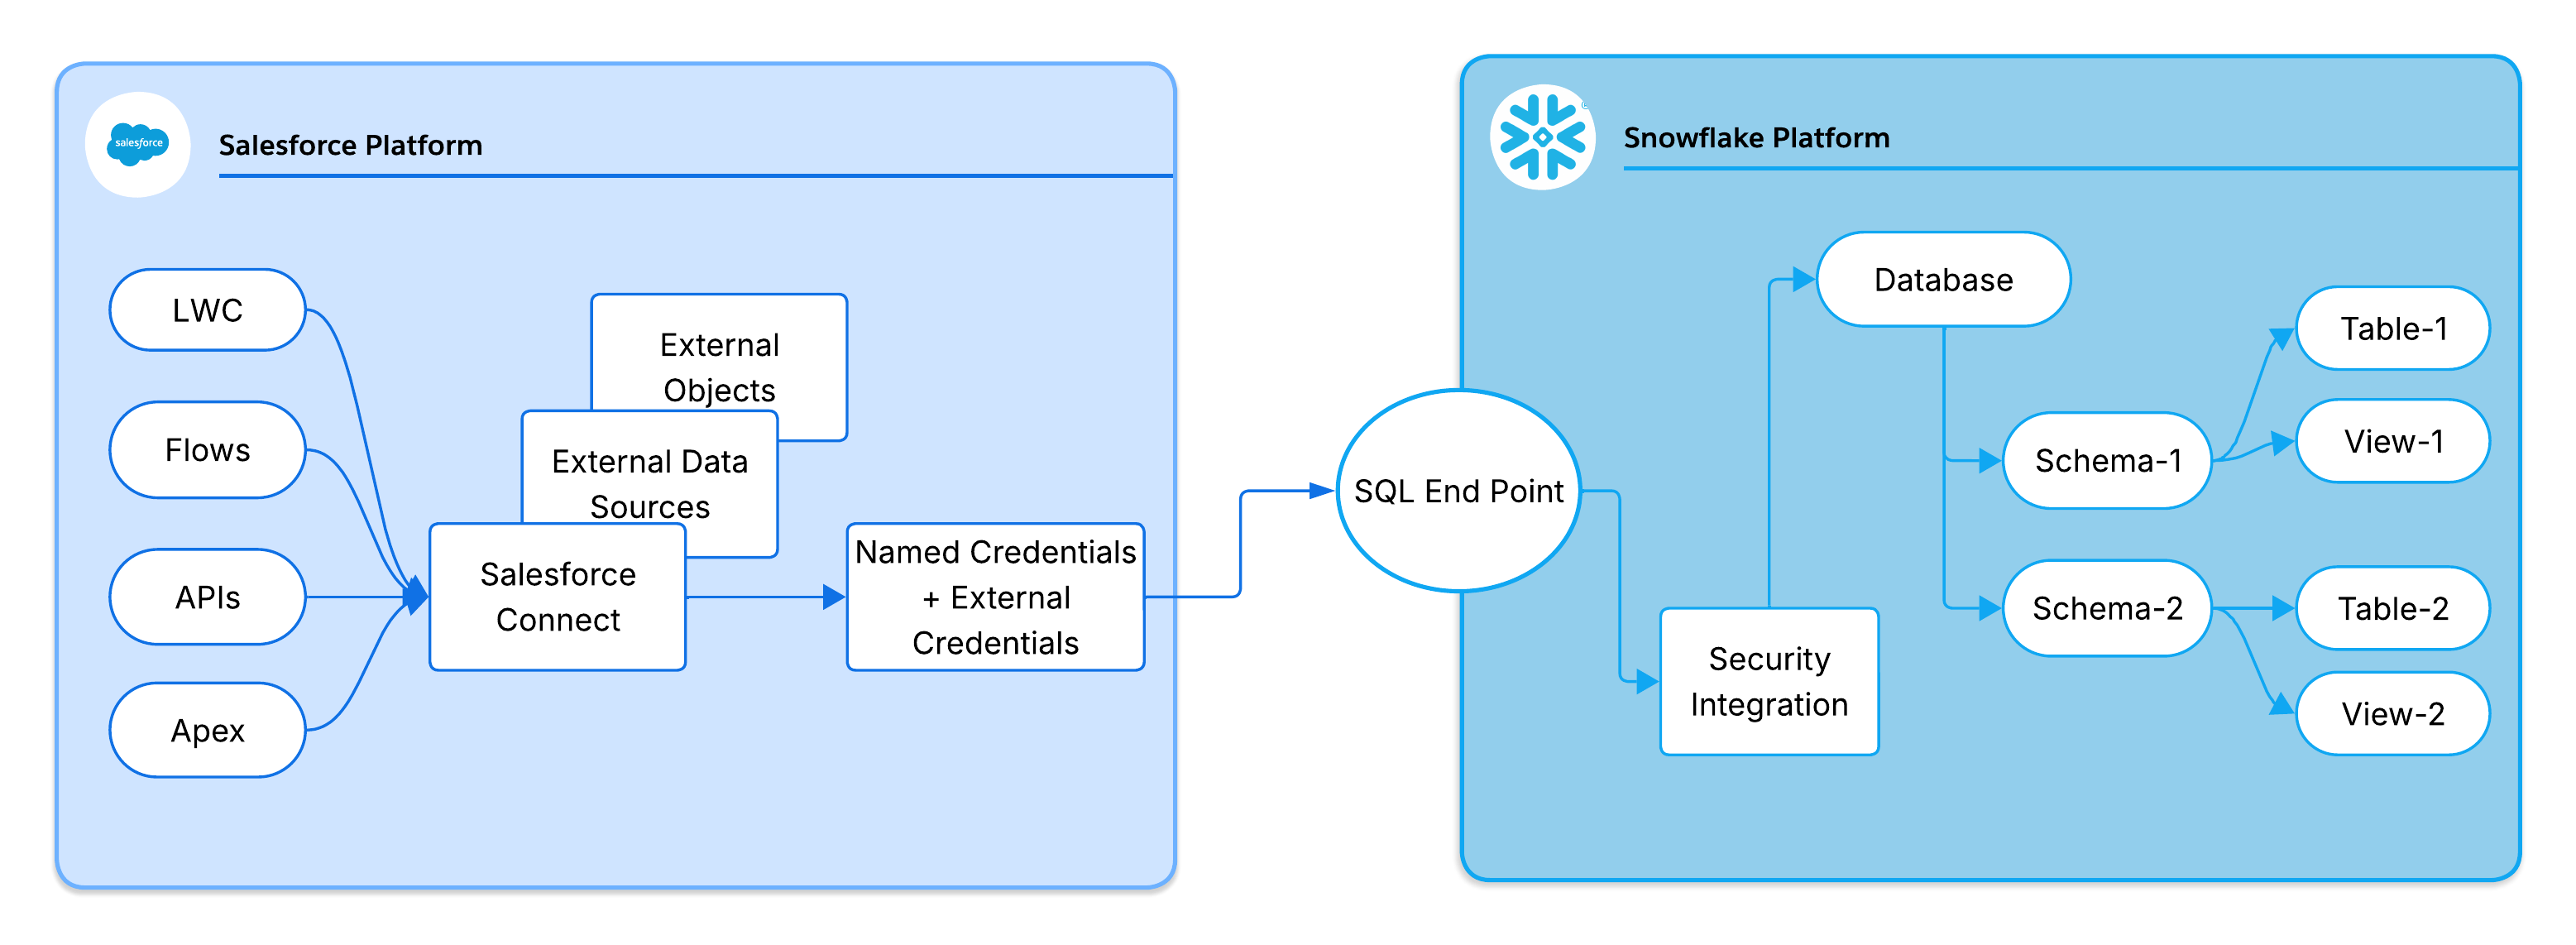
Salesforce Connect utilise un modèle OAuth 2.0 délégué pour s’authentifier à Snowflake. Les principaux composants sont les suivants :
- Fournisseur d’authentification : Gère la poignée de main OAuth avec Snowflake. Gère les demandes de jeton et mappe le jeton renvoyé avec l’identifiant Salesforce.
- Identifiant externe : Contient les jetons d’accès et d’actualisation OAuth en toute sécurité dans la boutique d’identifiants cryptés Salesforce et les injecte dans des appels externes sortants.
- Identifiant nommé : Définit l’URL du point de terminaison Snowflake et référence l’identifiant externe.
- Intégration de la sécurité Snowflake : Enregistre Salesforce en tant que client OAuth de confiance dans Snowflake. Définit l’URI de redirection autorisé, les flux OAuth et le TTL de jeton.
Les composants suivants forment une chaîne de dépendances : La Source de données externe référence l’identifiant nommé, qui référence l’identifiant externe, qui référence le fournisseur d’authentification. Comprendre cette chaîne est essentiel pour dépanner les pannes de connectivité ou d’accès.
Salesforce prend en charge deux modèles de délégation d’identité lors de l’authentification avec Snowflake :
- Principal nommé : Un compte de service partagé authentifie tous les utilisateurs Salesforce contre Snowflake. Elle est plus simple à configurer, mais n’a pas d’auditabilité par utilisateur ni de contrôle d’accès Snowflake précis.
- Principal par utilisateur : Chaque utilisateur Salesforce s’authentifie avec son propre jeton OAuth. Cela active la sécurité au niveau de la ligne Snowflake et des pistes d’audit par utilisateur complètes, avec un compromis entre une gestion des jetons plus élevée (flux OAuth par utilisateur, actualisation, révocation).
Guide décisionnel : Utilisez le Principal par utilisateur pour les données réglementées ou les Informations d’identification personnelle (PII). Utilisez Principal nommé lorsque les règles de partage Salesforce offrent un contrôle d’accès suffisant et que la priorité est la simplicité.
Ces limites du gouverneur Salesforce façonnent directement la conception de solutions lors de l’utilisation d’objets externes avec Snowflake :
- Limite d’appels externes : 100 par transaction Apex. Les pages ou les flux qui contiennent plusieurs requêtes Objet externe peuvent atteindre rapidement cette limite.
- Expiration de l’appel : 120 secondes maximum. Les longues requêtes Snowflake entraînent une exception à l’exécution.
- Limite de lignes SOQL : 50 000 lignes. Paginer les grands ensembles de résultats.
- Contraintes asynchrones : Apex par lot et la plupart des contextes asynchrones limitent les appels externes. Gardez l’accès Objet externe dans les limites des transactions synchrones. Pour des cas d’utilisation asynchrones qui interrogent des Objets externes, vous pouvez envisager des appels externes Continuation pour des interactions asynchrones initiées par l’utilisateur, ou concevoir le flux pour effectuer l’accès aux données externes dans une transaction synchrone et transmettre les résultats de façon asynchrone.
Guide de conception : N’interrogez pas Objets externes dans des boucles. Envoyez automatiquement des filtres de clause WHERE à Snowflake afin de réduire la taille des résultats et la fréquence des appels externes.
Chaque requête que Salesforce envoie à Snowflake est consignée dans Historique des requêtes Snowflake avec des métadonnées d’exécution complètes : latence, lignes scannées, entrepôt utilisé et identité d’exécution. Cet historique fournit une auditabilité de bout en bout depuis l’action de l’utilisateur Salesforce jusqu’à l’exécution de Snowflake, et est le principal outil de diagnostic pour l’ajustement des performances et la validation de l’accès.
La virtualisation des données est adaptée aux cas d’utilisation où l’accès en temps réel, la gouvernance et la réduction des frais de réplication dépassent les contraintes d’un modèle d’accès fédéré en temps de requête.
Utilisez-la quand :
- L’accès analytique intensif en lecture est la principale exigence. Si les utilisateurs doivent interroger et afficher des données externes dans des interfaces utilisateur, des rapports ou des flux Salesforce sans les réécrire, la virtualisation des données élimine les surcoûts du pipeline pour les scénarios en lecture seule.
- L’actualisation des données est essentielle. Lorsque des données répliquées périmées entraînent des risques métiers (tels que des soldes financiers périmés, des niveaux d’inventaire ou un statut de conformité), le modèle fédéré garantit que chaque requête reflète des données live.
- Les exigences de gouvernance et de résidence des données sont strictes. Lorsque des contraintes réglementaires ou contractuelles interdisent de copier des données confidentielles dans Salesforce, la virtualisation conserve les données à leur emplacement faisant autorité tout en les rendant accessibles dans Salesforce. Un seul système contient les données.
- Un contrôle d’accès à deux niveaux est requis. Lorsque les deux contrôles d’accès natifs du système externe et le modèle de sécurité Salesforce s’appliquent simultanément, le modèle fédéré s’applique sans duplication des données.
- Le système externe est déjà le système faisant autorité. Si les données sont déjà propres, régies et interrogeables dans le système source, leur virtualisation évite les transformations redondantes, les coûts de stockage et les risques de divergence.
À éviter quand :
- Des écritures à faible latence sont requises. Les objets externes sont en lecture seule. Les cas d’utilisation de réécriture nécessitent un modèle d’intégration différent.
- Des jointures multi-objets complexes sont nécessaires. SOQL dans plusieurs objets externes ne prend pas en charge les jointures. Prématérialisez les données jointes dans une vue unique du système source.
- Les fonctionnalités Salesforce AI ou Agentforce nécessitent des données natives. Actuellement, les fonctionnalités Einstein et Agentforce (notamment l’ancrage pour Einstein Copilot, le score prédictif et les actions Agentforce) fonctionnent sur des objets Salesforce natifs. Ces fonctionnalités ne prennent pas en charge les Objets externes en tant que source de données d’ancrage ou d’activation. Si l’activation de l’IA est incluse dans la portée de ces données, Salesforce Data 360 est la solution complémentaire recommandée.
- Modèles d’accès à haute fréquence et à haut volume. Les objets externes sont conçus pour l’accès à la demande. Les charges de travail qui déclenchent des centaines de requêtes par minute épuisent les limites du gouverneur et dégradent les performances.
Les cas d’utilisation ci-dessous illustrent l’application de Salesforce Data Virtualization dans des scénarios d’entreprise courants. Chaque exemple utilise Snowflake comme système externe, mais le schéma sous-jacent s’applique à n’importe quelle source de données compatible SQL prise en charge par Salesforce Connect.
Défi : Les équipes de support avaient besoin de rapports unifiés combinant les données des requêtes Salesforce avec le volume de tickets, le temps de résolution et les métriques d’escalade stockées dans Snowflake. L’élaboration et la gestion d’un pipeline de réplication pour ces données ont entraîné un décalage et des frais opérationnels supplémentaires pour un cas d’utilisation de rapports en lecture seule.
Solution : L’équipe a exposé des vues Snowflake contenant des métriques de ticket en tant qu’objets externes dans Salesforce. L’équipe a configuré Salesforce Reports pour joindre des objets Requête natifs aux données de ticket externe.
Résultat :
- Les rapports reflètent toujours les données live Snowflake. Aucun décalage du pipeline.
- La gouvernance des métriques de support confidentielles reste présente dans Snowflake.
- Aucun pipeline ETL à élaborer, surveiller ou gérer.
Défi : Une équipe financière a conservé des données faisant autorité sur la limite de crédit et le solde dans Snowflake. La réplication de ces valeurs dans Salesforce via ETL inverse a entraîné un délai de réplication, ce qui a amené les commerciaux à conclure des affaires sur la base d’informations de crédit périmées. L’équipe de conformité a également signalé le risque de stockage de données financières confidentielles dans le stockage Salesforce.
Solution : L’équipe a virtualisé la vue financière Snowflake en tant qu’objet externe et l’a exposée dans la présentation de page Compte. Les commerciaux voient désormais le statut de crédit en direct dans leur vue Compte standard dans Salesforce.
Résultat :
- Données de crédit en temps réel dans chaque page Compte. Pas de décalage.
- Le pipeline ETL inversé a été éliminé pour les données financières.
- Données financières confidentielles jamais copiées dans le stockage Salesforce. L’étendue de conformité reste dans Snowflake.
Défi : Lors d’une fusion, l’entreprise acquéreuse devait permettre aux utilisateurs de Salesforce de visualiser les données opérationnelles de 6 jeux de données Snowflake haut volume couvrant les transactions, la facturation et l’utilisation. La réplication de téraoctets de données dans Salesforce n’était pas viable dans le calendrier de fusion, et l’élaboration de pipelines ETL personnalisés pour chaque jeu de données aurait nécessité un investissement technique important.
Solution : L’équipe a configuré des Objets externes pour les 6 jeux de données Snowflake en utilisant Salesforce Connect avec un rôle d’intégration à moindre privilège. Aucun code personnalisé requis. Les requêtes sont exécutées directement dans Snowflake et toutes les activités sont consignées dans l’historique des requêtes Snowflake pour les rapports de conformité.
Résultat :
- Configuration entièrement déclarative. Aucun code personnalisé ni pipeline requis.
- La fraîcheur des données est garantie. Chaque requête reflète les données live Snowflake lors de l’exécution.
- Journal d’audit complet dans l’historique des requêtes Snowflake pour les rapports réglementaires et de conformité.
La virtualisation des données introduit un profil opérationnel distinct. Concevez les scénarios d’échec suivants :
- Expiration du jeton OAuth: Les jetons ont une durée de vie finie (TTL). Les jetons expirés entraînent des échecs d’appel externe. Surveillez les réponses non autorisées 401 et implémentez une logique d’actualisation.
- Démarrage à froid de l’entrepôt (spécifique à Snowflake): Les entrepôts automatiquement suspendus ajoutent de 5 à 30 secondes à la première requête. Pour les cas d’utilisation accessibles aux utilisateurs avec des exigences de latence, préchauffez avec une requête légère planifiée pendant les heures ouvrables.
- Inadéquation des rôles: Un rôle mal configuré dans le système externe peut renvoyer zéro ligne en silence plutôt qu’une erreur. Validez les privilèges rôle à objet dans le système externe indépendamment de Salesforce.
- Dépassement d’ensemble de résultats: Les charges utiles surdimensionnées dépassent les limites en API. Appliquez toujours des clauses LIMIT et exposez des vues filtrées plutôt que des tableaux bruts.
- Panne système externe: Aucun mécanisme de secours ni cache n’existe. Encapsulez les appels externes dans des états d’erreur try/catch et exposez-les dans l’interface utilisateur. Pour des données critiques, adoptez une approche par paliers: virtualiser pour un accès en temps réel, et maintenir une solution de repli répliquée légère pour les champs les plus critiques afin de garantir la disponibilité pendant les pannes du système source.
Salesforce Data Virtualization s’aligne sur les piliers suivants de l’infrastructure Salesforce Well-Architected.
- Trust : Le modèle OAuth 2.0 délégué et le guide des rôles à moindre privilège sont conformes à Trust. Le contrôle d’accès à deux niveaux (système source + Salesforce) permet d’appliquer la défense en profondeur.
- Fiabilité (tolérance aux défauts) : La section Modes d’échec traite directement de la fiabilité : L’expiration du jeton, le démarrage à froid, la configuration incorrecte du rôle, le dépassement d’ensemble de résultats et le traitement des pannes représentent chacun une classe d’échec distincte avec un chemin de résolution documenté.
- Fiabilité (évolutivité) : La réduction automatique des requêtes, le guide de dimensionnement de l’entrepôt et la sensibilisation aux limites en appels externes optimisent l’efficacité d’exécution dans les contraintes du gouverneur Salesforce, un problème de fiabilité pour les solutions qui fonctionnent à grande échelle.
- Excellence opérationnelle : L’historique des requêtes Snowflake en tant que principal outil d’observabilité soutient l’excellence opérationnelle : les architectes font le choix délibéré et traçable d’utiliser des outils natifs de la plate-forme pour l’auditabilité de bout en bout et les diagnostics de performance plutôt que de construire une infrastructure de consignation personnalisée.
Cette section offre aux architectes et aux concepteurs un point de départ structuré pour élaborer le modèle de virtualisation des données dans un environnement sandbox. Ce n’est pas un guide d’implémentation complet, traitez-le comme une séquence validée de décisions et d’étapes de configuration pour orienter votre première preuve de concept.
Vérifiez les points suivants avant de commencer un travail de configuration :
- Autorisation de licence : Salesforce Connect n’est pas inclus dans toutes les éditions Salesforce. L’adaptateur SQL pour Snowflake nécessite une licence complémentaire distincte au-delà de l’autorisation Salesforce Connect de base. Vérifiez les deux dans votre organisation avant de continuer.
- Sandbox d’abord : Effectuez toutes les phases dans un environnement sandbox avant de promouvoir votre configuration en production.
- Accès Snowflake : Vérifiez que vous êtes autorisé à créer une intégration de sécurité dans Snowflake et à accéder à la base de données, au schéma et aux objets cibles.
- Version de l’adaptateur : Vérifiez que l’adaptateur SQL pour Snowflake est disponible dans l’édition de votre organisation et que l’URL de votre compte Snowflake ne contient pas de traits de soulignement (remplacez-le par des tirets si c’est le cas). Il s’agit d’une contrainte de plate-forme Salesforce pour la résolution du nom d’hôte d’appel externe).
La configuration de la virtualisation des données avec un système SQL externe tel que Snowflake est un processus déclaratif, piloté par la configuration, sans code personnalisé requis. La configuration suit trois phases séquentielles : établissement d’identité et Trust, configuration de la surface de données et exposition des données aux utilisateurs finaux.
Cette phase établit une chaîne de confiance OAuth 2.0 sécurisée et déléguée entre Salesforce et le système externe. Effectuez cette phase avant de lancer une configuration de surface de données.
- Créez un fournisseur d’authentification dans Salesforce. Utilisez le type OpenID Connect. Utilisez des valeurs d’espace réservé à cette étape - revenez les compléter après avoir récupéré les valeurs du système externe. Après l’enregistrement, Salesforce génère une URL de rappel. Conservez cette valeur.
- Enregistrez Salesforce en tant que client OAuth dans le système externe. Dans Snowflake, cela signifie créer une intégration de sécurité (OAuth, type Client confidentiel). Saisissez l’URL de rappel Salesforce en tant qu’URI de redirection. Récupérez l’ID de client, le Secret client, l’URL d’autorisation et l’URL de jeton depuis l’intégration après la création.
- Complétez la configuration du fournisseur d’authentification. Revenez dans le fournisseur d’authentification Salesforce et remplissez-le avec les valeurs récupérées dans le système externe : Clé consommateur, Secret consommateur, URL d’autorisation et URL de jeton.
- Créez l’identifiant externe. Définissez le protocole sur OAuth 2.0, liez-le au fournisseur d’authentification, puis ajoutez un principal (nommé ou par utilisateur, selon la décision de votre modèle d’identité). Cet objet gère le cycle de vie du jeton OAuth.
- Créez l’identifiant nommé. Définissez le point de terminaison sur l’URL d’API du système externe (par exemple,
https://<account>.snowflakecomputing.com/api/v2/statements/) et liez-le à l’identifiant externe. - Octroyez l’accès du profil à l’identifiant externe. Sans cette étape, les utilisateurs ne peuvent pas invoquer des requêtes fédérées, même si toutes les autres configurations sont correctes.
- Initiez le flux OAuth pour terminer l’authentification. Déclenchez la poignée de main OAuth depuis Salesforce. La plate-forme redirige vers la connexion système externe, valide les identifiants et stocke les jetons générés en toute sécurité dans Identifiant externe. Cette étape lie le contexte de l’utilisateur à un jeton valide. Toutes les requêtes fédérées échouent jusqu’à ce que cette étape soit terminée.
Cette phase connecte Salesforce au schéma de données externe et crée les définitions d’objet externe que les utilisateurs et la plate-forme interrogent.
- Créez la source de données externe. Sélectionnez l’adaptateur approprié (par exemple, l’adaptateur SQL pour Snowflake), pointez-le vers la base de données et le schéma cibles, puis liez-le à l’identifiant nommé que vous avez créé à la phase 1.
- Validez la connexion. Utilisez la validation intégrée dans la Source de données externe. Un résultat positif confirme que la chaîne de Trust OAuth est complète et que le système externe est accessible.
- Synchronisez les métadonnées. Initiez une synchronisation des métadonnées depuis la Source de données externe. Salesforce inspecte le schéma cible et génère des définitions d’objet externe, en mappant des colonnes externes avec des types de champ Salesforce.
- Sélectionnez et exposez les tables ou les vues requises. Choisissez les tableaux ou les vues externes à exposer en tant qu’objets externes. La meilleure pratique consiste à exposer des vues organisées plutôt que des tableaux bruts. Les vues permettent un préfiltrage des colonnes, des restrictions au niveau de la ligne et un contrôle plus strict des éléments auxquels la couche Salesforce peut accéder.
Cette phase rend les Objets externes visibles et utilisables par les utilisateurs finaux au sein de Salesforce Lightning Experience.
- Créez des onglets pour les objets externes. Les onglets rendent les objets externes directement navigables dans les applications Lightning.
- Ajoutez des objets externes aux mises en page. Exposer des données externes pertinentes avec des enregistrements Salesforce natifs (par exemple, ajouter une vue financière Snowflake à la présentation de page Compte).
- Ajouter à des listes associées. Insérez des Objets externes dans des listes associées pour offrir aux utilisateurs une vue unifiée des données natives et externes en contexte.
- Validez la fédération de requêtes de bout en bout. Chargez une page ou exécutez une requête qui référence un Objet externe. Examinez ensuite l’historique des requêtes du système externe (par exemple, Historique des requêtes Snowflake) pour vérifier que la requête a été exécutée à la source. Vérifiez que le rôle, l’entrepôt et l’identité appropriés ont exécuté la requête.
Une fois les trois phases terminées, les utilisateurs de Salesforce peuvent interagir avec des données externes live via des interfaces Salesforce standard, sans savoir que les données proviennent de sources extérieures à Salesforce.
La virtualisation des données Salesforce remplace l’intégration basée sur la réplication par la fédération de temps de requête. Les données restent dans leur source faisant autorité. Les utilisateurs de Salesforce interagissent avec elles via des interfaces de plate-forme standard. Il n’y a pas de pipeline à construire, pas de copie à gouverner et pas de décalage à gérer.
Ce modèle est le bon choix lorsque l’accès en lecture seule, l’actualisation des données en temps réel, la gouvernance stricte et le contrôle d’accès à deux couches sont les principaux moteurs. C’est le mauvais choix lorsque des écritures sont requises, lorsque l’IA ou les fonctionnalités d’automatisation dépendent d’objets Salesforce natifs, ou lorsque les modèles d’accès sont trop fréquents pour que les limites du gouverneur puissent être respectées.
Snowflake illustre bien le schéma : une connexion fédérée régie, à temps de requête, établie par déclaration sans code personnalisé, observable de bout en bout dans l’historique des requêtes Snowflake et exécutoire à la fois via les contrôles d’accès natifs Snowflake et le modèle de sécurité complet de Salesforce.
Avant de vous engager dans cette architecture, validez l’autorisation de licence, évaluez l’exposition limite du gouverneur par rapport à vos modèles d’accès attendus et confirmez la préparation OAuth dans un environnement sandbox. Le modèle récompense une conception réfléchie en amont : Si le modèle d’identité, la chaîne d’authentification et la stratégie de visualisation sont correctement établis, l’empreinte opérationnelle demeure minimale.
Yugandhar Bora est architecte en génie logiciel chez Salesforce, spécialisé dans l’architecture de données au sein de la plate-forme Data & Intelligence Applications. Il dirige les initiatives du Comité d’examen de l’architecture d’entreprise (EARB) axées sur la gouvernance des données et les modèles de données unifiés, tout en contribuant à des solutions de provisionnement de plate-forme automatisées.