La plupart des pipelines d’intégration d’entreprise entre Salesforce et des plates-formes d’analyse externes s’appuient sur un code personnalisé. Ils fonctionnent jusqu’à ce qu’un problème survienne. La dérive du schéma, l’épuisement des API et les lacunes liées à la suppression définitive nécessitent une intervention constante de l’équipe d’ingénierie. À mesure que les entreprises s’orientent vers des architectures agiles et pilotées par les développeurs citoyens, ce modèle devient un goulot d’étranglement : Les équipes d’analyse attendent des sprints d’ingénierie pour ajouter un champ Salesforce à un schéma en aval, les échecs de chargement nocturne retardent les rapports du lundi matin et de simples changements de configuration nécessitent des révisions de code et des déploiements.
CRM Analytics, la plate-forme native d’analyse et d’intelligence économique de Salesforce, résout ce problème en permettant aux entreprises d’explorer les données, d’élaborer des tableaux de bord interactifs et de recueillir des connaissances pilotées par l’IA sans quitter l’écosystème Salesforce. Au cœur de cette capacité se trouve une fonctionnalité de synchronisation des données déclarative et à faible code intégrée nativement à la plate-forme : CRM Analytics SyncOut et CRM Analytics SyncIn.
CRM Analytics SyncOut déplace les enregistrements Salesforce vers des magasins de données externes selon une planification configurée, en utilisant la Capture des données de modification (CDC) pour les charges incrémentielles et le suivi de suppression définitive intégré pour marquer les enregistrements définitivement retirés. CRM Analytics SyncIn renvoie des données externes dans Salesforce, mappe des colonnes avec des champs d’objet et met à jour des enregistrements en utilisant l’API de transfert en masse 2.0. Les deux sont entièrement configurés dans la Configuration de Salesforce. Aucun pipeline, aucun script intermédiaire, aucune surveillance personnalisée. Les administrateurs configurent une tâche de synchronisation dans une session de configuration unique. La plate-forme gère automatiquement l’exécution, les nouvelles tentatives, la consignation des erreurs et le mappage de schémas.
Ce guide explique le schéma, quand l’utiliser, comment l’implémenter avec Snowflake comme exemple travaillé, et les considérations architecturales qui déterminent s’il répond à un problème d’intégration donné.
Note de licence : CRM Analytics SyncIn et SyncOut ne sont pas disponibles dans les éditions Salesforce de base sans complément de licence CRM Analytics. Vérifiez les autorisations de licence avant de concevoir une architecture de synchronisation qui dépend de ces capacités.
L’intégration de données est l’une des surfaces à friction les plus élevées de l’architecture d’entreprise. Un pipeline ETL personnalisé depuis Salesforce vers une plate-forme d’analyse nécessite généralement une application connectée pour l’authentification, une tâche planifiée pour l’extraction SOQL, une couche de transformation pour réconcilier les types de champ, une zone intermédiaire pour le chargement en masse et une couche de surveillance pour détecter les échecs. Chaque composant d’un code personnalisé représente un point d’échec.
Le coût de cette friction s’accumule au fil du temps. La dérive du schéma dans Salesforce (un champ renommé, une nouvelle valeur de liste de sélection, un nom d’API modifié) rompt le pipeline en silence. L’épuisement de l’API durant les pics d’utilisation interrompt l’extraction. Les enregistrements définitivement supprimés ne sont jamais affichés dans le tableau cible, ce qui laisse des données périmées que les analytiques en aval traitent en direct. L’équipe d’ingénieurs devient le goulot d’étranglement des opérations courantes sur les données.
CRM Analytics SyncIn et SyncOut changent le modèle de fonctionnement. La configuration remplace le code. La plate-forme assume la responsabilité de l’exécution, du traitement des erreurs, du mappage de schémas et de l’observabilité. Les administrateurs peuvent définir, modifier et surveiller les tâches de synchronisation sans générer de ticket de développement.
Le résultat de ce nouveau modèle d’exploitation est une réduction du temps entre la conception de l’intégration et la synchronisation opérationnelle, une réduction des frais d’ingénierie et un modèle d’intégration qui s’adapte aux contraintes de la plate-forme plutôt que de nécessiter une maintenance de code personnalisée.
SyncIn et SyncOut sont les deux modes directionnels de synchronisation des données CRM Analytics. SyncOut déplace les enregistrements Salesforce vers une plate-forme externe. SyncIn intègre des enregistrements externes dans Salesforce. Les deux fonctionnent sur un modèle de configuration déclaratif sans code personnalisé requis.
La configuration déclarative signifie que tous les comportements de synchronisation sont définis via l’interface utilisateur par pointer-cliquer dans la Configuration de Salesforce. L’objet source, le tableau cible, les mappages de champs, la planification de synchronisation, le mode de synchronisation et les filtres sont définis à travers les métadonnées de configuration. La plate-forme dérive le plan d’exécution à partir de ces métadonnées et le gère de bout en bout.
La synchronisation complète par rapport à la synchronisation incrémentielle contrôle les données déplacées à chaque exécution. Une synchronisation complète interroge tous les enregistrements qui correspondent aux critères de filtrage à chaque exécution. Une synchronisation incrémentielle utilise CDC pour interroger uniquement les enregistrements qui ont changé depuis la dernière exécution. La synchronisation incrémentielle est le mode recommandé pour les objets haut volume, car elle réduit considérablement la consommation d’API et la durée de synchronisation.
La Capture des données est une capacité de la plate-forme Salesforce qui enregistre les modifications apportées aux objets au niveau du champ sous forme de flux d ’ événements. SyncOut utilise CDC pour détecter les créations, les mises à jour et les suppressions sans effectuer d’analyses complètes des tableaux. CDC doit être activé par objet dans la Configuration de Salesforce pour pouvoir être référencé par une configuration de synchronisation.
Le suivi des suppressions définitives résout l’un des problèmes les plus persistants dans l’ETL entre Salesforce et des systèmes externes. Lorsqu’un enregistrement est définitivement supprimé dans Salesforce, il disparaît des requêtes SOQL standard. Sans suivi explicite, la plate-forme externe n’apprend jamais que l’enregistrement a été retiré. Le suivi de la suppression définitive de SyncOut, lorsqu’il est activé, marque les enregistrements supprimés dans le tableau cible avec DEL_FLAG = 'Y', ce qui fournit aux systèmes en aval un signal fiable pour filtrer les données périmées.
La fréquence de synchronisation est configurable de 15 minutes à une semaine. Le choix est un compromis entre l’actualisation des données, la consommation d’API et le coût de calcul de l’entrepôt Snowflake. Les synchronisations de 15 minutes approchent en temps quasi réel pour les tableaux de bord opérationnels. Les synchronisations quotidiennes sont appropriées pour les charges de travail de génération de rapports par lot.
Les limites du gouverneur limitent la conception des tâches de synchronisation : La limite en requêtes de l’API Salesforce (15 000 appels par 24 heures sur Unlimited Edition), la taille de lot de 10 000 enregistrements de l’API de transfert en masse 2.0 et la limite en lignes de requête SOQL de 50 000 par transaction informent tous sur la taille et la planification des tâches de synchronisation. La plate-forme gère automatiquement la segmentation et la pagination, mais les architectes doivent tenir compte de l’espace limité dans toutes les tâches de synchronisation exécutées dans l’organisation.
Snowflake est une cible principale et une source pour la synchronisation des données avec Salesforce CRM Analytics. Il sert d’exemple concret du fonctionnement du mouvement de données par lot et incrémentiel de bout en bout.
Cette section présente une vue d’ensemble de l’implémentation de CRM Analytics SyncOut et SyncIn en utilisant Snowflake comme plate-forme d’analyse externe. Il couvre chaque méthode, les modèles d’authentification partagés, les infrastructures de sécurité, les considérations relatives aux plates-formes clés et les pratiques d’observabilité.
Dans cette configuration SyncOut, Salesforce utilise CRM Analytics SyncOut pour envoyer automatiquement des enregistrements à Snowflake. La plate-forme extrait les données via SOQL, gère automatiquement les conversions de type et les charge dans des tableaux Snowflake selon une planification configurée (allant de 15 minutes à une semaine). Pour une sémantique de chargement spécifique, consultez la documentation actuelle de Salesforce et Snowflake.
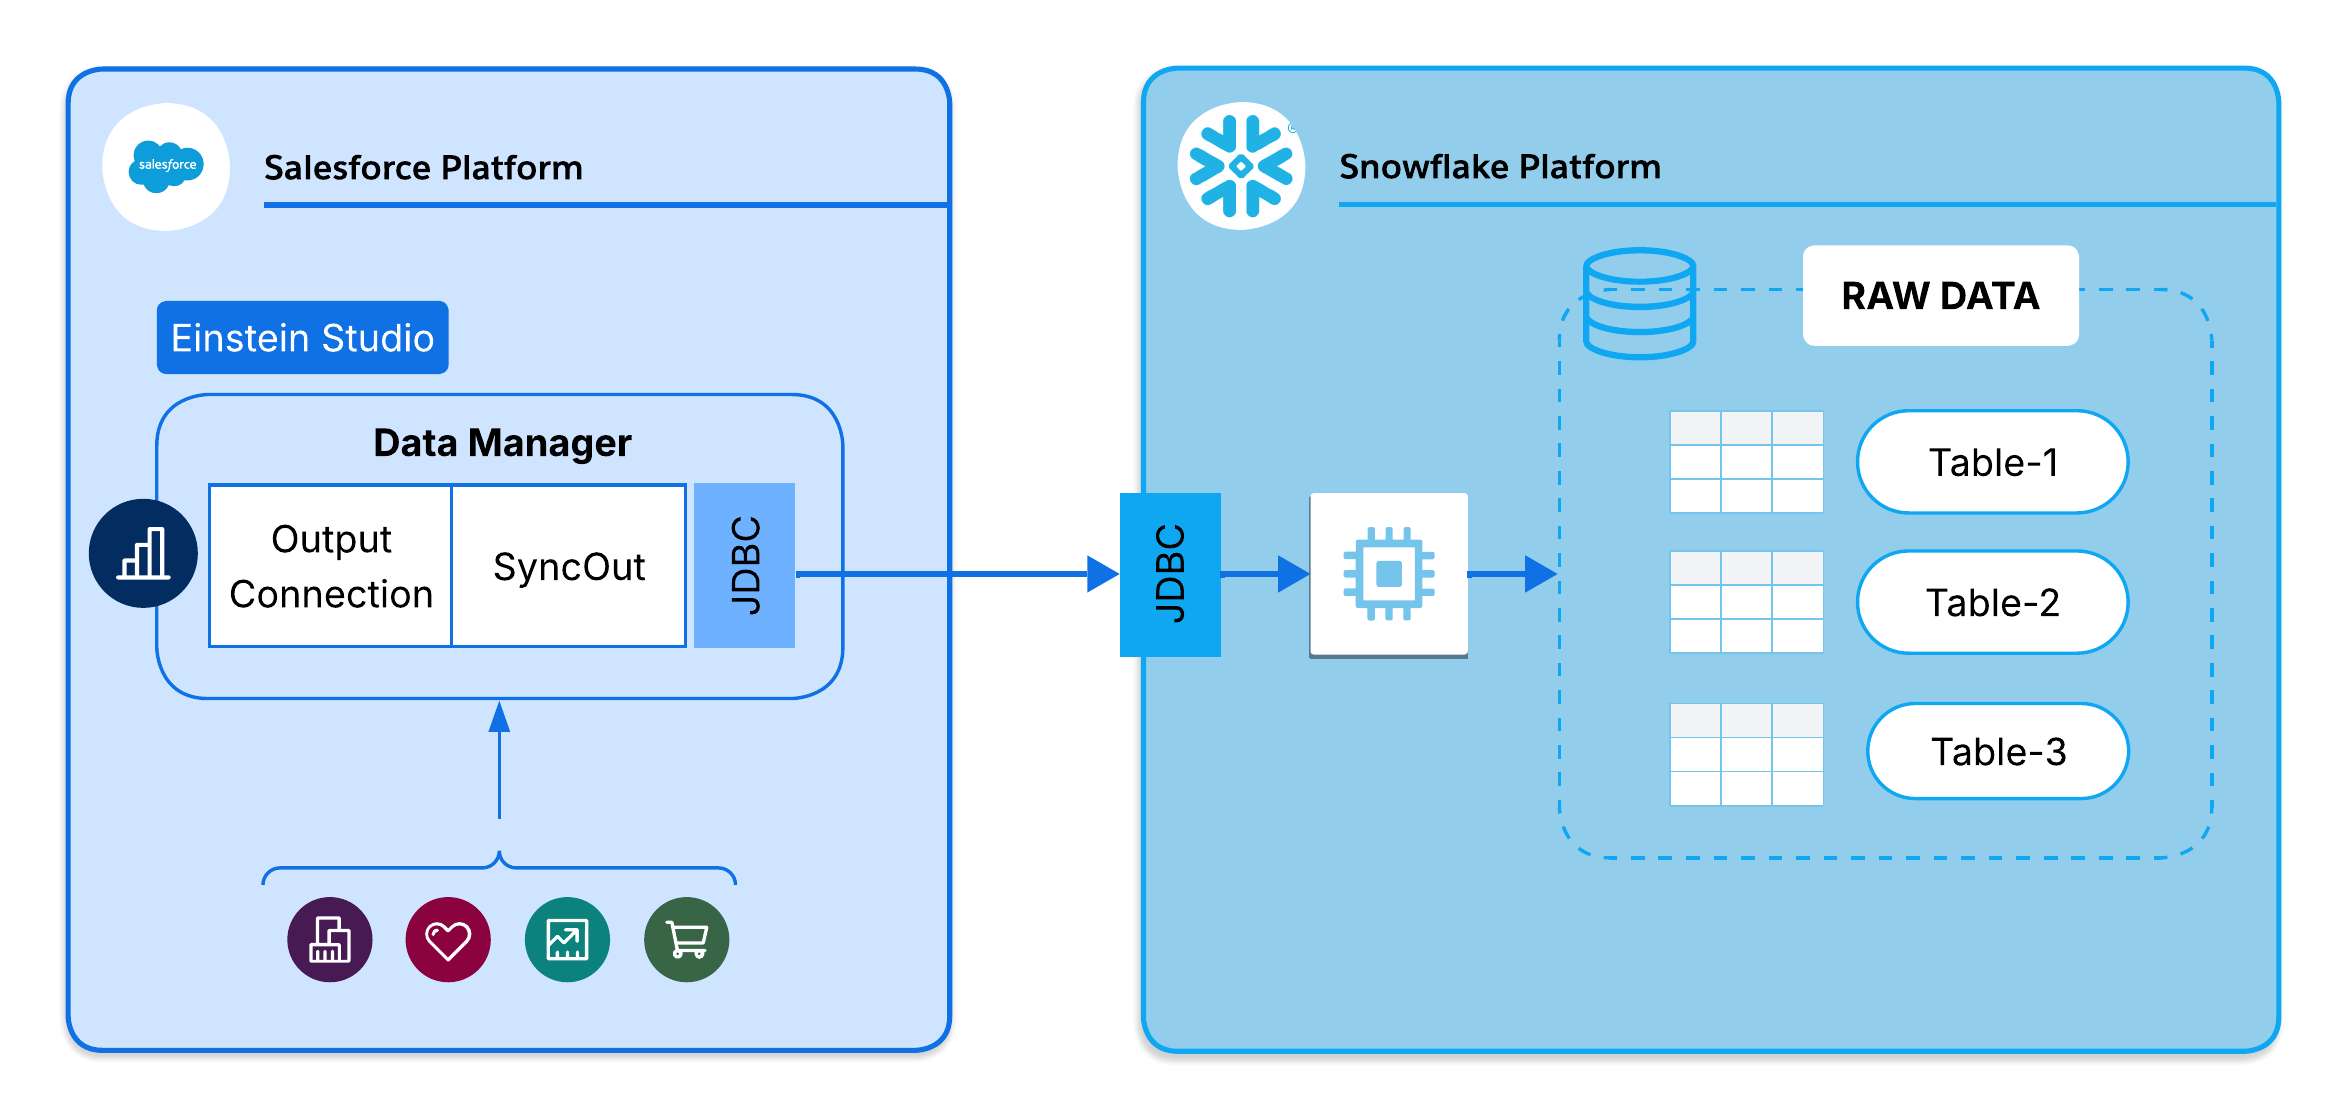
Dans cette configuration SyncIn, Salesforce utilise CRM Analytics SyncIn pour extraire des données dans Salesforce. La plate-forme interroge Snowflake via l’API Statements et met à jour/insère les résultats dans Salesforce en utilisant l’API de transfert en masse 2.0. Les grands ensembles de résultats sont automatiquement paginés pour respecter les limites de l’API. La synchronisation est exécutée selon une planification configurée, allant de 15 minutes à une fois par semaine.
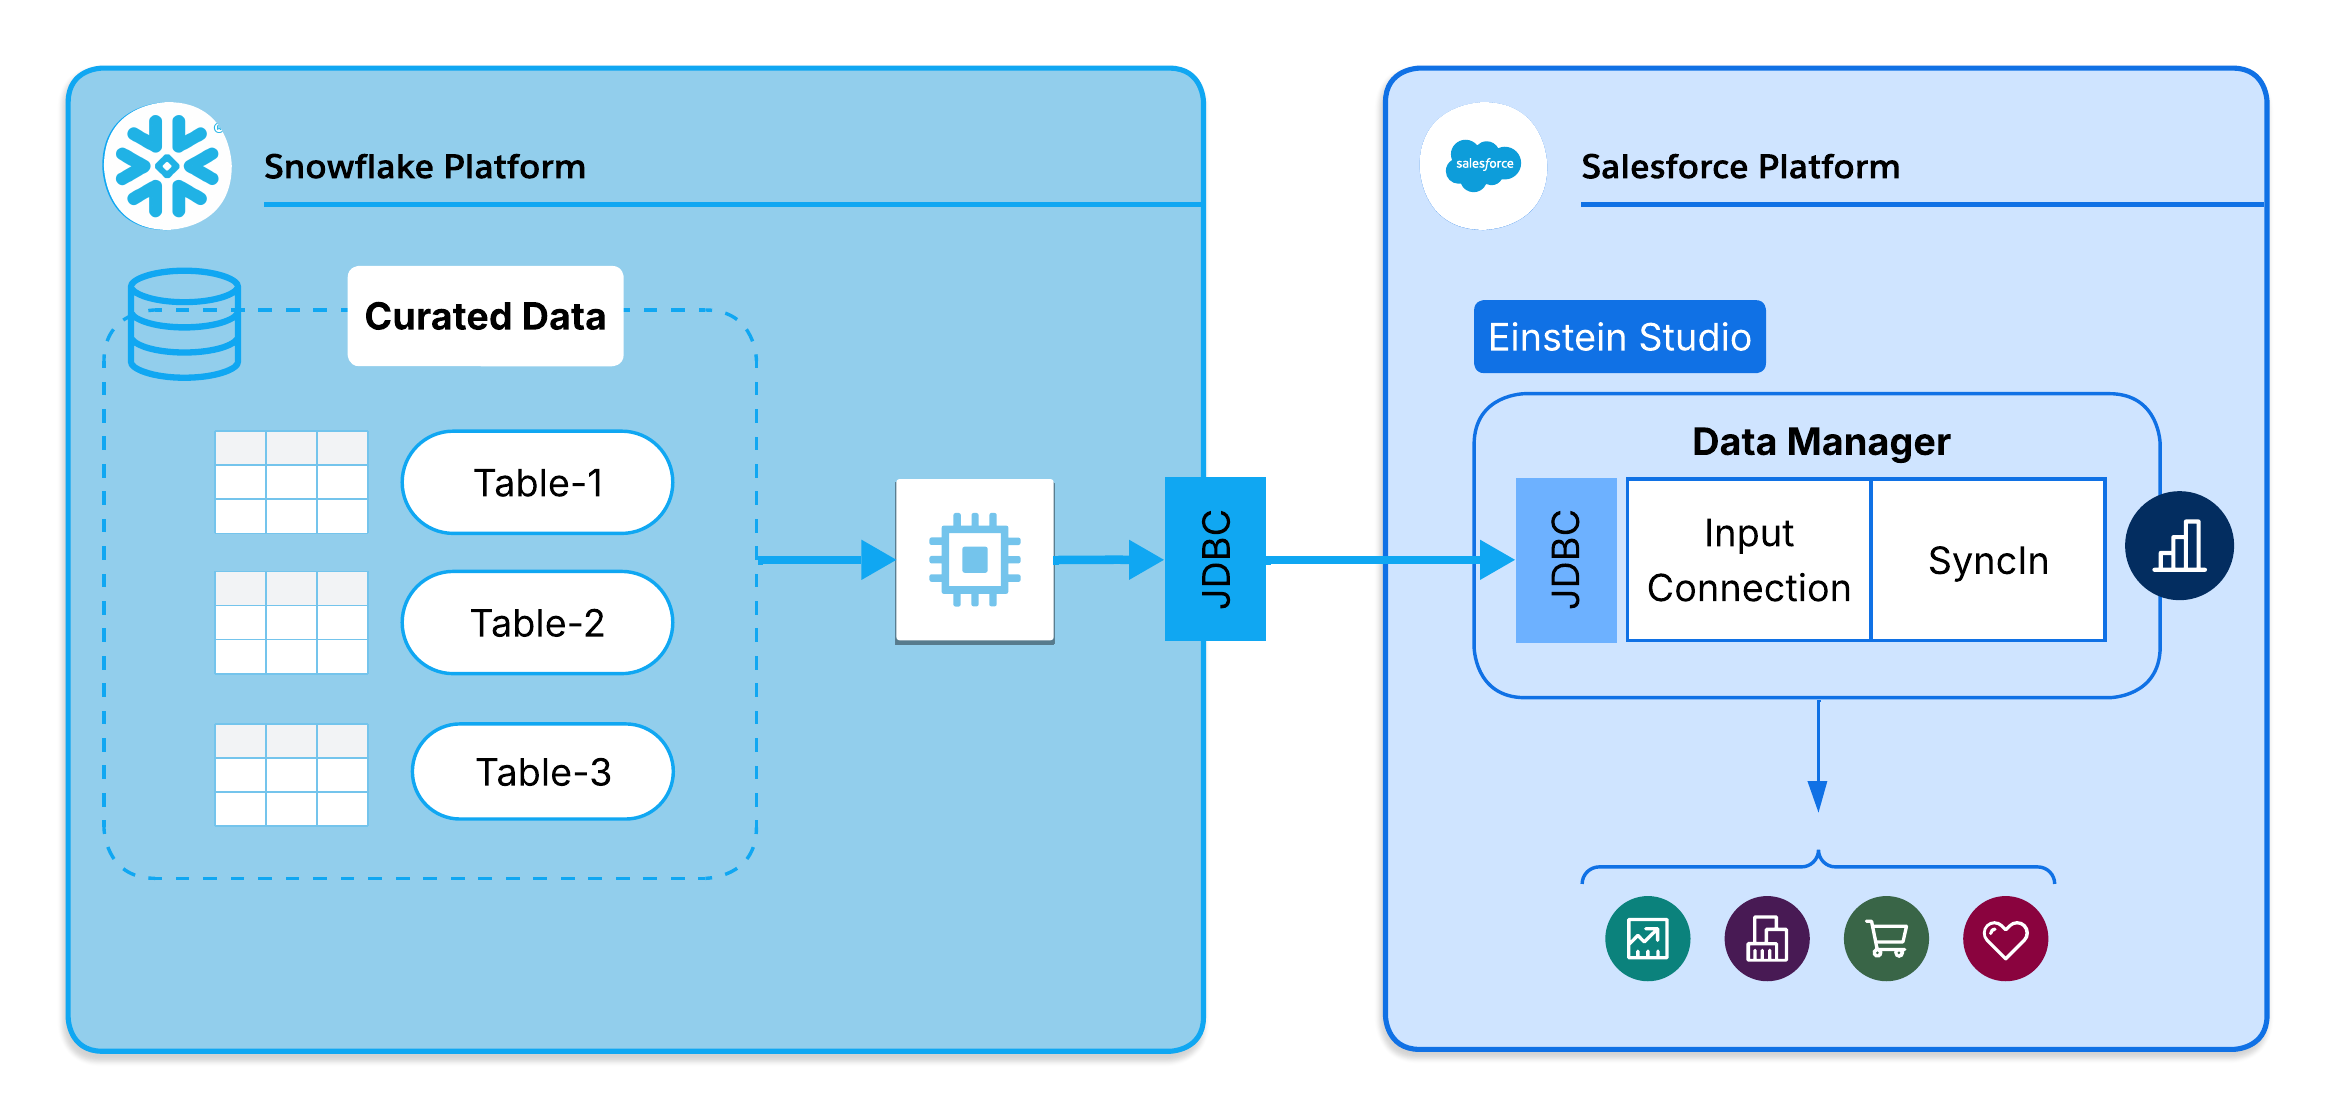
La synchronisation Salesforce prend en charge plusieurs méthodes d’authentification pour se connecter en toute sécurité à Snowflake. Les deux principales approches des intégrations d’entreprise sont Key-Pair (Private Key) et Delegate OAuth 2.0.
Méthode 1: Authentification par paire de clés (clé privée): L’authentification par paire de clés est l’approche recommandée pour le mouvement de données système à système automatisé, tel que CRM Analytics SyncIn et SyncOut. L’authentification s’appuie sur des jetons Web JSON (JWT) plutôt que sur des mots de passe ou des jetons actualisables, ce qui la rend adaptée aux tâches planifiées sans surveillance qui ne nécessitent pas d’actualisation de jeton.
- Certificat Salesforce : Générez une clé privée et stockez-la en toute sécurité dans Gestion des certificats et des clés Salesforce.
- Identifiant externe/nommé : Configuré pour utiliser un échange JWT. Salesforce utilise la clé privée stockée pour signer des requêtes de connexion sortantes.
- Clé publique de l’utilisateur Snowflake : La clé publique correspondante est attribuée directement au compte de service Snowflake dédié (p. ex. ALTER USER CRM_ANALYTICS_SYNC_USER SET RSA_PUBLIC_KEY = ’…’). Snowflake utilise ensuite cette clé pour vérifier la signature JWT entrante. Aucune intégration de sécurité n’est requise pour cette méthode.
Méthode 2 : Authentification OAuth 2.0 déléguée : Alternativement, Salesforce peut utiliser une poignée de main OAuth pour s’authentifier. Les principaux composants sont les suivants :
- Fournisseur d’authentification : Gère la poignée de main OAuth avec Snowflake, en utilisant les identifiants client récupérés dans l’intégration de sécurité Snowflake.
- Identifiant externe : Maintient les jetons OAuth en toute sécurité dans Salesforce et les injecte automatiquement dans les appels externes de synchronisation.
- Identifiant nommé : Définit l’URL du point de terminaison Snowflake (p. ex. https://<account>.snowflakecomputing.com) et référence l’identifiant externe.
- Intégration de la sécurité Snowflake : Enregistre Salesforce en tant que client OAuth de confiance dans Snowflake (OAUTH_CLIENT = CUSTOM). Définit l’URI de redirection autorisé et active les jetons d’actualisation.
Dépendance de configuration : Quelle que soit la méthode choisie, ces composants forment une chaîne de dépendance reliant la configuration de synchronisation au point de terminaison. Il est nécessaire d’accorder aux profils Salesforce appropriés l’accès à l’identifiant nommé. Sans cet accès, les tâches de synchronisation échouent en raison d’erreurs d’authentification, quelles que soient les autres configurations.
La synchronisation en arrière-plan repose sur une identité d’intégration unique.
- Compte de service dédié : Créez un compte de service Snowflake dédié avec un rôle de moindre privilège limité aux bases de données, schémas et tableaux requis pour la synchronisation.
- Autorisations granulaires : Pour SyncOut, ce rôle nécessite INSÉRER, METTRE À JOUR et SÉLECTIONNER dans les tableaux cibles. N’utilisez jamais des rôles à privilège élevé tels que ACCOUNTADMIN, SECURITYADMIN ou SYSADMIN.
- Limites du gouverneur et segmentation : Pendant l’extraction SyncOut, les grands ensembles de résultats sont automatiquement segmentés pour respecter les limites du gouverneur SOQL Salesforce. SyncIn récupère les grands ensembles de résultats de l’API Snowflake Statements via la pagination automatique pour gérer efficacement les volumes de données.
- Capture des données modifiées (CDC) : SyncOut incrémentiel s’appuie sur le flux d’événements Salesforce CDC pour identifier les enregistrements créés, mis à jour ou supprimés. Si le suivi de la suppression définitive est activé, les enregistrements Salesforce supprimés ne sont pas supprimés, mais marqués avec
DEL_FLAG = 'Y'dans Snowflake. - Contraintes d’upsert : SyncIn s’appuie sur Bulk API 2.0 pour charger les données dans Salesforce. Pour cela, un champ ID externe désigné doit être configuré dans l’objet Salesforce cible afin d’agir en tant que clé de mise à jour/insertion.
- Guide de conception : Synchronisez toujours à partir de vues Snowflake organisées plutôt que de tableaux bruts. Les vues permettent le préfiltrage des lignes, la sélection des colonnes et l’application d’une logique métier, réduisant ainsi le volume de données, la durée de synchronisation et les coûts de calcul de l’entrepôt Snowflake proportionnellement au préfiltrage appliqué.
Chaque exécution de synchronisation génère des pistes d’audit complètes pour valider le mouvement des données. Le tableau de bord Sync Task Monitor fournit le statut en temps réel, le nombre d’enregistrements traités, les durées d’exécution et des journaux d’erreur détaillés pour SyncIn et SyncOut. Du côté de Snowflake, chaque requête soumise par Salesforce est consignée dans Historique des requêtes Snowflake, ce qui offre une visibilité totale sur la latence d’exécution, les lignes scannées et l’utilisation des calculs d’entrepôt. De plus, les architectes définissent des tableaux d’audit Snowflake dédiés pour capturer les métadonnées d’exécution de synchronisation (horodatage, nombre d’enregistrements et erreurs), qui ne sont pas automatiquement générées par la plate-forme. Pour la validation de bout en bout, comparez le nombre d’enregistrements entre les deux plates-formes : vérifiez les enregistrements actifs dans Snowflake (WHERE DEL_FLAG = 'N') pour les exécutions SyncOut, et comparez le nombre d’objets cibles Salesforce directement à la vue source Snowflake d’origine pour les exécutions SyncIn.
Utilisez CRM Analytics SyncIn et SyncOut lorsque :
- La synchronisation bidirectionnelle est une exigence : Les données sont transmises dans Salesforce via SyncIn et vers une plate-forme externe via SyncOut.
- Le suivi de la suppression définitive est essentiel : Le marquage intégré de SyncOut résout un problème ETL historiquement complexe sans logique de réconciliation personnalisée.
- La synchronisation incrémentielle basée sur le CDC est viable : Pour les objets Salesforce à haut volume, CDC réduit considérablement la consommation d’API et la durée de synchronisation par rapport aux analyses complètes.
- La synchronisation par lot planifiée remplit les exigences de latence : La fréquence de synchronisation minimale est de 15 minutes, adaptée aux tableaux de bord opérationnels et aux rapports analytiques en temps quasi réel.
- Un faible coût opérationnel est une priorité : Les tableaux de bord intégrés offrent une visibilité totale de la synchronisation sans infrastructure de consignation personnalisée ou d’alerte, et l’interface utilisateur de configuration déclarative permet aux administrateurs de définir, de modifier et de surveiller les tâches de synchronisation sans générer de ticket de développement.
N’utilisez pas ce schéma si :
- Des transformations complexes sont requises : jointures de tableaux multiples, analyse JSON ou gestion d’une logique métier avancée dans les vues Snowflake ou une couche de transformation dédiée avant ou après la synchronisation.
- Une latence inférieure à 15 minutes est requise : Pour des cas d’utilisation en temps réel, utilisez les API Platform Events ou Streaming.
- Les charges de travail en streaming à très haut volume sont dans le périmètre : Les objets avec des millions de transactions par heure sont mieux servis par des pipelines dédiés au streaming (Kafka, Événements de plate-forme).
- Une logique personnalisée de traitement des erreurs est nécessaire : La plate-forme fournit une relance standard et une journalisation des erreurs. Les schémas de nouvelle tentative complexes ou les alertes personnalisées nécessitent Apex ou une orchestration externe.
- Synchronisation multi-organisations ou inter-clouds : CRM Analytics SyncIn et SyncOut fonctionnent dans une seule organisation Salesforce. MuleSoft ou une couche d’intégration personnalisée est requise pour les scénarios multi-organisations.
Une équipe a exécuté des pipelines ETL complexes pour charger des données analytiques Snowflake dans des jeux de données CRM Analytics. Les pipelines étaient lents, fragiles et nécessitaient un entretien technique constant.
CRM Analytics SyncIn a été configuré pour synchroniser des vues agrégées Snowflake organisées directement dans des objets personnalisés Salesforce. L’équipe a reconfiguré les tableaux de bord CRM Analytics pour lire à partir de ces objets au lieu de jeux de données CRM Analytics. Le résultat : deux pipelines ETL éliminés, une durée de synchronisation réduite de quatre heures à 30 minutes et des administrateurs capables de modifier les configurations de synchronisation sans générer de ticket d’ingénierie.
Une équipe de données devait suivre les enregistrements Salesforce définitivement supprimés dans leur magasin de données opérationnelles Snowflake. Les approches traditionnelles nécessitaient des tâches fractionnées et une logique complexe de réconciliation des ID, qui prenait des heures et était fragile dans les changements de schéma.
L’équipe a configuré CRM Analytics SyncOut avec CDC et le suivi de la suppression définitive activés. Les enregistrements supprimés sont désormais automatiquement marqués avec DEL_FLAG = ‘Y’ dans le tableau de consommation Snowflake. Les requêtes Analytics en aval s’appliquent WHERE DEL_FLAG = ‘N’ pour afficher uniquement les enregistrements actifs. La logique de réconciliation a été entièrement éliminée et la durée de synchronisation est passée de huit heures à des cycles incrémentiels de 15 minutes.
Lors d’une acquisition, l’entreprise acquéreuse a synchronisé six objets Salesforce haut volume dans Snowflake pour la génération de rapports inter-organisations et la conformité réglementaire dans un délai fixe.
L’équipe a configuré CRM Analytics SyncOut pour les six objets avec des synchronisations incrémentielles basées sur le CDC. Les tableaux de métadonnées d’audit ont suivi les changements de schéma et le nombre d’enregistrements pendant la période d’intégration. Ils n’ont écrit aucun code personnalisé. L’actualisation des données est passée de tous les jours à 15 minutes, et les tableaux de métadonnées d’audit ont fourni la traçabilité requise pour les rapports de conformité.
Les tâches de synchronisation partagent le budget d’API de l’organisation. Une organisation qui exécute de nombreuses tâches de synchronisation à haute fréquence contre des objets volumineux risque d’épuiser les 15 000 appels d’API par limite de 24 heures. Inventaire de toutes les tâches de synchronisation, estimation de la consommation d’API par exécution et planification échelonnée pour distribuer la charge. Pour les objets avec des taux de modification faibles à modérés, le mode incrémentiel basé sur le CDC peut réduire considérablement la consommation d’API par exécution par rapport à la synchronisation complète.
SyncIn et SyncOut exécutent des requêtes et des chargements de données dans un entrepôt Snowflake, consommant des crédits de calcul. Pour de simples requêtes SELECT, un entrepôt X-Small ou Small est généralement suffisant. Pour des chargements SyncOut importants, un entrepôt de taille Medium ou Large peut être requis. Configurez la suspension automatique (5 minutes d’inactivité) et la reprise automatique dans l’entrepôt. Utilisez un entrepôt dédié pour les tâches de synchronisation en production afin d’isoler les coûts et d’éviter les conflits avec les requêtes des utilisateurs.
Si un champ Salesforce est renommé, retiré ou change de nom d’API, le mappage de champ SyncOut correspondant échoue en silence ou consigne les erreurs. Établissez un processus de gestion des modifications qui inclut la révision des configurations de synchronisation actives dans le cadre de toute modification des métadonnées Salesforce. Les tableaux d’audit Snowflake fournissent un historique des modifications qui permet d’identifier les événements de dérive.
Le suivi de la suppression définitive dans SyncOut nécessite l’activation de CDC dans l’objet Salesforce. Si CDC n’est pas activé, l’option « Suivre les suppressions définitives » est sans effet. Valider l’activation du CDC dans le cadre de la liste de contrôle de configuration de la synchronisation, notamment lors de la configuration initiale ou après des migrations d’organisation.
La classe d’échec la plus courante est l’expiration des identifiants ou la perte d’autorisations. Les identifiants nommés doivent rester valides et le compte de service Snowflake doit conserver ses autorisations d’utilisation d’entrepôt et de tableau. Pour les configurations basées sur OAuth, les échecs d’actualisation de jeton peuvent bloquer en silence les tâches de synchronisation. Surveillez les modèles d’erreur d’authentification dans le tableau de bord Sync Job Monitor et configurez Chatter ou des notifications par e-mail en cas d’échec d’une tâche.
SyncIn utilise un champ ID externe Salesforce comme clé de mise à jour/insertion. Si la vue Snowflake source contient des valeurs dupliquées dans le champ de clé, la mise à jour/insertion échoue pour les enregistrements affectés. Forcez l’unicité dans le champ de clé de la couche de vue Snowflake avant qu’il atteigne la configuration de synchronisation.
Lorsque les tâches de synchronisation échouent, la plate-forme consigne des messages d’erreur détaillés par enregistrement dans la Surveillance des tâches de synchronisation. Scénarios d’échec courants et leurs résolutions :
- Échec de l’authentification : vérifiez le statut Identifiant nommé et l’expiration du compte Snowflake. Réauthentifiez OAuth si l’actualisation du jeton a échoué.
- Erreur de mappage de champs : vérifiez la compatibilité du type entre les colonnes Snowflake et les champs Salesforce. Vérifiez la sécurité au niveau du champ pour l’utilisateur actif.
- Limitation du gouverneur dépassée : réduire la fréquence de synchronisation ou passer en mode CDC incrémentiel pour répartir la consommation d’API.
- Entrepôt Snowflake suspendu : configurez la reprise automatique dans l’entrepôt ou déclenchez une reprise manuelle avant la prochaine synchronisation planifiée.
- Le suivi de la suppression définitive ne fonctionne pas ; : confirmer que CDC est activé dans l’objet et l’indicateur « Suivre les suppressions définitives » est défini dans la configuration de synchronisation.
La synchronisation des données CRM Analytics s’aligne sur plusieurs piliers de l’infrastructure Salesforce Well-Architected.
- Fiabilité (tolérance aux défauts) : La plate-forme gère automatiquement l’exécution, la logique de nouvel essai et le traitement des échecs partiels. Les enregistrements échoués sont consignés individuellement dans la Surveillance des tâches de synchronisation. Implémentez la réconciliation du nombre d’enregistrements en cas d’échec de la vérification de la cohérence, complétez-la avec des notifications d’échec et surveillez la Surveillance des tâches de synchronisation pour détecter les modèles d’erreur récurrents. La synchronisation incrémentielle basée sur le CDC réduit le rayon d’explosion d’une exécution échouée en limitant la fenêtre de données dans l’étendue.
- Trust : Le modèle d’identifiant (identifiants nommés, identifiants externes, fournisseur d’authentification) applique automatiquement le stockage crypté, l’actualisation automatique des jetons et la gestion centralisée. L’accès avec le moindre privilège côté Snowflake limite le rayon d’explosion d’un identifiant compromis. La sécurité au niveau du champ est appliquée pendant la synchronisation. Les utilisateurs ne peuvent pas synchroniser les champs auxquels ils ne sont pas autorisés à accéder.
- Optimisation des ressources et des coûts : Le mode CDC incrémentiel est le principal levier d’optimisation des performances. Il réduit la consommation d’API, la durée de synchronisation et le coût de calcul Snowflake par rapport à la synchronisation complète. Le préfiltrage des vues Snowflake réduit encore le volume de données en transit. La suspension automatique de l’entrepôt empêche les dépenses de calcul inactives.
- Excellence opérationnelle : Le modèle de configuration déclaratif signifie que les tâches de synchronisation sont définies dans des métadonnées, pas dans un code. Cela les rend auditables, reproductibles et gérables sans intervention technique. Les tableaux de bord de surveillance intégrés offrent une observabilité totale sans infrastructure de consignation personnalisée.
- Fiabilité (évolutivité) : La plateforme gère automatiquement la segmentation, la pagination et le traitement par lots via Bulk API. Pour des objets avec des volumes d’enregistrement très élevés, le mode CDC incrémentiel et la planification hors pointe sont les principaux leviers architecturaux pour maintenir le débit dans les limites des contraintes du gouverneur.
Cette liste de contrôle présente les étapes minimales de configuration et de validation d’une configuration de synchronisation.
Liste de contrôle de pré-configuration :
- Activez Capture des données de modification sur tous les objets Salesforce destinés au mode incrémentiel SyncOut (Configuration → Capture des données de modification).
- Créez un compte de service Snowflake dédié avec un rôle de moindre privilège ; accordez uniquement les autorisations de table et d’entrepôt requises.
- Créez une intégration de sécurité Snowflake si vous utilisez l’authentification OAuth.
- Identifiez le champ ID externe dans chaque objet Salesforce que SyncIn utilisera en tant que clé de mise à jour/insertion ; vérifiez l’unicité des données sources.
Connectivité :
- Créer un fournisseur d’authentification dans Salesforce (Configuration → Fournisseurs d’authentification).
- Créez un identifiant externe et un lien vers Fournisseur d’authentification (Configuration → Identifiants nommés → Identifiants externes).
- Créez un identifiant nommé et liez-le à l’identifiant externe (Configuration → Identifiants nommés).
- Accordez l’accès à l’identifiant nommé aux profils Salesforce appropriés.
Configuration SyncOut :
- Créer une connexion Snowflake (Configuration → Analytics Studio → Gestionnaire de données → Connexions → Connexions Snowflake).
- Créer une configuration SyncOut : objet source, tableau cible, mode de synchronisation, mappages de champs, CDC, suivi de suppression définitive, planification.
- Commencez par la synchronisation quotidienne. Vérifiez la qualité et les performances des données avant d’augmenter la fréquence.
Configuration SyncIn :
- Créer une source de données externe (Configuration → Analytics Studio → Gestionnaire de données → Connexions → Connexions Snowflake).
- Créer une configuration SyncIn : vue source, objet cible, champ ID externe, mappages de champs, planification.
- Synchronisez à partir de vues Snowflake, pas à partir de tableaux bruts.
Validation :
- Vérifiez la Surveillance des tâches de synchronisation après la première exécution (Configuration → Analytics Studio → Gestionnaire de données → Surveillance des tâches de synchronisation).
- Interrogez le tableau d’audit Snowflake pour confirmer l’écriture des métadonnées de synchronisation.
- Validez le marquage de suppression définitive en confirmant que la colonne DEL_FLAG est présente et remplie.
- Comparez le nombre d’enregistrements entre la source et la cible.
- Configurez des notifications d’échec via Chatter ou par e-mail.
Utilisez ce schéma lorsque la synchronisation par lot planifiée remplit les exigences de latence, lorsque le flux de données bidirectionnel est nécessaire et lorsque la réduction de la dépendance de l’ingénierie aux opérations d’intégration est une priorité.
L’exemple Snowflake utilisé dans ce guide illustre le cycle de vie complet : configuration de la connectivité, configuration, flux d’exécution et validation. Les mêmes principes s’appliquent à toutes les plates-formes de données externes prises en charge.
Lorsque la latence inférieure à 15 minutes, des transformations complexes ou des scénarios multi-organisations sont inclus, évaluez les événements de plate-forme, les API Streaming ou MuleSoft en tant qu’approches complémentaires ou alternatives.
Yugandhar Bora est architecte en génie logiciel chez Salesforce, spécialisé dans l’architecture de données au sein de la plate-forme Data & Intelligence Applications. Il dirige les initiatives du Comité d’examen de l’architecture d’entreprise (EARB) axées sur la gouvernance des données et les modèles de données unifiés, tout en contribuant à des solutions de provisionnement de plate-forme automatisées.