Les agents raisonnent sur les objectifs, déduisent les paramètres du contexte et sélectionnent dynamiquement des actions. Par conséquent, chaque intégration qu’un agent touche doit gérer l’ambiguïté, prendre en charge la répétition en toute sécurité et échouer de manière à ce que l’agent puisse récupérer de façon autonome.
Les systèmes agentsiques invalident plusieurs hypothèses que la conception traditionnelle de l’intégration tient pour acquises. Les entrées ne seront pas toujours bien formées. Une action utilisateur unique peut déclencher une chaîne d’agents à travers les frontières de l’organisation, chacun ayant besoin d’une délégation de pouvoir pour agir.
Ce document cartographie les changements architecturaux qui découlent de cette réalité : les nouveaux principes de conception, les modèles agentsiques et la manière dont la plate-forme Salesforce les fournit.
Chaque schéma de ce document suit la même structure :
Nom: L’identificateur du modèle qui indique le type d’intégration contenu dans le modèle.
Contexte: Le scénario d’intégration global que le schéma traite. Contexte fournit des informations sur ce que les utilisateurs tentent d’accomplir et comment l’application répond à leurs besoins.
Problème: Le défi (exprimé sous forme de question) que le schéma est conçu pour résoudre. En examinant les schémas, lisez cette section pour déterminer rapidement si le schéma s’applique à votre scénario d’intégration.
Forces: Les contraintes et les circonstances qui peuvent rendre le problème difficile à résoudre.
Application du modèle Salesforce: La méthode recommandée pour appliquer le schéma au scénario.
Croquis: Un diagramme de séquence UML (Unified Modeling Language) qui montre comment l’application du schéma traite le scénario.
Résultats: Comment le schéma résout les forces associées au scénario. Cette section présente également les nouveaux défis qui peuvent survenir suite à l’application du schéma.
Considérations relatives à la conception : Guide adapté à la plate-forme pour appliquer correctement la solution, suivi de notes d’implémentation spécifiques à Salesforce. Ces considérations couvrent les principes de conception d’actions et les exigences de configuration spécifiques à la plate-forme.
Traitement et récupération des erreurs : Guide de gestion des échecs pendant l’application du schéma. Ce point couvre quatre domaines :
- Comment les actions communiquent l’échec à l’agent à travers des réponses d’erreur structurées et actionnables qui fournissent un contexte suffisant pour la prise de décision en aval
- Comment l’agent détermine s’il doit réessayer, s’autocorriger ou arrêter l’exécution
- Comment les actions de compensation traitent les résultats partiels et l’état inter-plate-forme non concordant
- Exigences d’dempotence pour les opérations d’écriture retirées
Considérations relatives à la sécurité : Exigences de sécurité pour appliquer le schéma en toute sécurité. Ces considérations couvrent, entre autres, la gestion des identifiants, l’étendue des moindres privilèges des utilisateurs de l’intégration et des applications connectées, la consignation des audits des actions invoquées par l’agent et les exigences de validation des entrées pour les paramètres provenant de contenus fournis par l’utilisateur ou inférés par le LLM.
Exemple : Un scénario de bout en bout qui décrit l’utilisation du modèle de conception dans un scénario Salesforce réel. L’exemple explique les objectifs et comment appliquer le modèle pour atteindre ces objectifs.
Le tableau ci-dessous répertorie les modèles d’implémentation couverts.
Liste de modèles
| Modèle | Ce qu’il fait |
|---|---|
| Invocation d’actions séquentielles | Un agent invoque une série d’actions dont chaque étape dépend du résultat vérifié de la précédente. L’agent gère le contexte à travers la chaîne, notamment les identifiants, les codes de statut et les données intermédiaires, et l’utilise pour déterminer si l’étape suivante peut être poursuivie. |
| Invocation d’actions parallèles | Lorsqu’une série d’actions sont indépendantes les unes des autres, l’agent les invoque simultanément plutôt qu’en séquence. Le temps de workflow total est lié à l’appel le plus lent plutôt qu’à la somme de tous les appels. |
| Invocation d’actions asynchrones | Un agent répartit une opération vers un système en aval via un événement de plate-forme, une file d’attente de messages ou une tâche en arrière-plan sans attendre le résultat. L’obligation de l’agent prend fin lors de l’invocation confirmée ; le système en aval prend la responsabilité de l’exécution indépendamment de la session de l’agent. |
| Invocation de l’agent à la demande | Une application externe ou un orchestrateur IA appelle un agent par programmation, fournit le contexte et attend une réponse structurée. L’agent agit comme un service back-end intelligent que l’appelant initie, l’agent raisonne et agit, et le résultat est consommé par l’appelant. |
| Exécution autonome de l’agent pilotée par un événement | Une condition de données telle qu’un abandon de panier d’achat, un échec de paiement, une baisse d’utilisation déclenche automatiquement un agent sans qu’aucun humain n’initie l’interaction. Aucun appelant n’attend une réponse. L’agent reçoit la charge de travail de l’événement en tant que contexte d’ancrage et exécute un workflow de réponse entièrement seul. |
| Ancrage des connaissances à partir de contenus d’entreprise | Avant de générer une réponse, l’agent récupère les documents pertinents dans une boutique Knowledge entreprise et les injecte dans sa fenêtre contextuelle. Le LLM fournit le raisonnement; la couche de récupération fournit les faits. |
| Injection vérifiée du contexte client | Les attributs vérifiés et structurés d’un profil client unifié sont préremplis en tant qu’entrées d’action avant que l’agent n’invoque une action. L’agent reçoit des faits tels que le segment, le niveau, le risque d’attrition et la valeur de durée de vie au lieu de les déduire. |
| Intégration d’outils inter-systèmes | Un agent se connecte à des systèmes externes extérieurs à la plate-forme Salesforce via une interface d’outil uniforme basée sur la norme MCP (Model Context Protocol). Chaque système externe expose ses capacités en tant qu’outils décrits et appelables. L’agent les découvre et les invoque sans avoir besoin de connaître l’API native ou le schéma de chaque système. |
| Les capacités métiers en tant qu’outils appelables | Les capacités métiers de l’entreprise, telles que les entités commerciales, les processus et les connaissances, sont exposées en tant qu’outils MCP que tout agent externe de n’importe quelle infrastructure peut découvrir et invoquer. |
| Délégation inter-agents | Un agent appelant décompose une requête complexe et délègue des tâches secondaires spécifiques au domaine à des agents pairs spécialisés sur différentes plates-formes ou systèmes fournisseurs en utilisant le protocole A2A (Agent à agent). L’agent appelant gère le cycle de vie des tâches et agrège les résultats des agents distants. |
| Agents en tant que Services appelables | Un agent Agentforce interne publie ses capacités de domaine en tant que point de terminaison A2A gouverné et découvrable afin que des orchestrateurs externes ou des agents pairs puissent lui déléguer des tâches. L’agent gère le cycle de vie des tâches entrantes et renvoie des résultats structurés à l’appelant distant. |
Les modèles de ce document sont classés en trois catégories. Cette catégorisation aide les architectes à identifier rapidement les modèles pertinents pour le défi d’intégration qu’ils sont en train de résoudre, qu’ils conçoivent ce qu’un agent appelle, ce qui déclenche un agent ou comment un agent est ancré avec des connaissances avant qu’il n’agisse. Au lieu de lire chaque modèle, vous pouvez accéder directement à la catégorie qui correspond à votre conception.
Invocation d’action :
Ces modèles couvrent la façon dont un agent appelle des systèmes externes pour récupérer des données ou exécuter des opérations dans le cadre de son cycle de raisonnement. Il s’agit de modèles sortants dans lesquels l’agent est l’initiateur. Ils abordent le séquencement (lorsque les étapes dépendent les unes des autres), le parallélisme (lorsqu’elles ne le font pas), l’idempotence et le traitement des échecs partiels. Utilisez ces modèles lors de la conception des outils qu’un agent invoquera pour réaliser le travail.
Invocation de l’agent :
Ces modèles déterminent comment des systèmes ou des événements externes entraînent l’action d’un agent. Ce sont des modèles entrants dans lesquels des systèmes externes déclenchent ces agents. Le déclencheur peut être une application humaine qui passe un appel par programmation et attend une réponse, ou une condition de données autonome qui déclenche l’agent. Utilisez ces schémas pour définir comment et quand un agent est déclenché.
Ancrage avec les données d’entreprise :
Les modèles de cette catégorie couvrent comment les agents sont ancrés avec des connaissances précises, à jour et spécifiques à l’organisation avant qu’ils raisonnent ou agissent.
Choisir la bonne stratégie n’est pas chose facile. Chaque modèle cible une préoccupation spécifique : capacités système, volume de données, gestion des échecs et transactionnalité.
Les tableaux matriciels de sélection répertorient les modèles et leurs aspects clés pour vous aider à déterminer le modèle le plus adapté à vos exigences d’intégration. Les modèles sont classés en utilisant ces dimensions.
| Aspect | Description |
|---|---|
| Type | Spécifie la catégorie d’intégration : Invocation d’action, invocation d’agent ou Ancrage avec les données d’entreprise Invocation d’action : Ces intégrations sortantes vont de simples appels d’outils à une étape à des séquences complexes à plusieurs étapes et des sorties parallèles, et nécessitent une attention particulière aux contraintes d’ordre, à l’idempotence et au traitement des échecs partiels dans des back-ends hétérogènes. Invocation de l’agent : Les invocations d’agents sont les façons dont des systèmes ou des événements externes mettent un agent en action. Ces intégrations entrantes vont des appels programmatiques synchrones passés par des applications humaines qui attendent une réponse structurée aux exécutions entièrement autonomes pilotées par un événement où une condition de données déclenche l’agent sans qu’aucun humain n’initie ou n’attende l’interaction. Ancrage avec les données d’entreprise : Les intégrations d’ancrage sont les façons dont un agent reçoit des connaissances précises, à jour et spécifiques à l’organisation avant qu’il raisonne ou agisse. Ces intégrations vont de la récupération de documents non structurés dans des magasins de contenus d’entreprise à l’injection d’attributs structurés vérifiés à partir de profils clients unifiés, afin de garantir que l’agent fonctionne sur des faits plutôt que sur une inférence hallucinée. |
| Calendrier | Spécifie le style d’intégration en fonction du calendrier : Dans ce document, synchrone ou asynchrone synchrone ou asynchrone désigne le déclenchement de l’agent lui-même ou l’invocation des actions. Il ne couvre pas ce qui se passe en interne. Cependant, en général, un utilisateur attend pendant que l’agent invoque des actions et traite les résultats. L’agent n’adressera pas le message utilisateur suivant tant qu’il n’aura pas terminé le tour actuel. Synchrone: Le blocage et les requêtes en temps réel sont des opérations de requête/réponse. Le résultat est immédiatement renvoyé à l’appelant via cette opération. Asynchrone: Les requêtes non bloquantes, en file d’attente ou basées sur un message sont invoquées par une opération unidirectionnelle en temps quasi réel. Les résultats et tous les défauts sont renvoyés en invoquant d’autres opérations unidirectionnelles. L’appelant fait donc la demande et continue sans attendre une réponse. |
Le tableau ci-dessous répertorie les modèles et leurs principaux aspects pour vous aider à déterminer le modèle le plus adapté à vos besoins lorsque votre intégration se fait depuis Salesforce vers un autre système.
| Type | Calendrier | Modèle clé à prendre en compte |
|---|---|---|
| Invocation d’action | Synchrone | Invocation d’actions séquentielles Invocation d’actions parallèles Intégration d’outils inter-systèmes Délégation inter-agents |
| Invocation d’action | Asynchrone | Invocation d’actions asynchrones |
| Invocation d’un agent | Synchrone | Invocation de l’agent à la demande Agents en tant que Services appelables |
| Invocation d’un agent | Asynchrone | Exécution autonome de l’agent pilotée par un événement |
| Ancrage avec les données d’entreprise | Synchrone | Ancrage des connaissances à partir de contenus d’entreprise Injection vérifiée du contexte client |
Chaque section des modèles décrit comment les élaborer. Chaque schéma est une solution répétitive à un problème d’intégration spécifique dans des architectures agentiques. Il indique quand utiliser le schéma, quelles forces déterminent la décision et comment la plate-forme Salesforce la prend en charge.
Contexte
De nombreux workflows métiers sont intrinsèquement séquentiels. Chaque étape nécessite un résultat vérifié de la précédente pour pouvoir continuer. Par exemple, un remboursement ne peut pas être initié tant que l’éligibilité n’est pas confirmée, un compte de facturation ne peut pas être créé tant que l’enregistrement de la commande n’existe pas et un contrôle de conformité ne peut pas être consigné tant que le contrôle n’a pas réussi.
Dans l’automatisation traditionnelle, ces dépendances sont codées en tant que logique de flux codée en dur. Dans un système agentique, l’agent évalue le résultat de chaque action et détermine si les conditions préalables à l’étape suivante sont remplies.
Ce schéma décrit le modèle d’intégration sortant de base. Ici, un seul agent opère dans un domaine et invoque une séquence, où la sortie de chaque action déclenche l’invocation de l’action suivante dans la chaîne. L’agent orchestrateur maintient le contexte transactionnel à travers la chaîne, accumulant les identifiants, les codes de statut et les données renvoyés par chaque étape. Il utilise ce contexte pour prendre des décisions ultérieures.
Ce schéma est le pendant agentique de Remote Process Invocation – Request and Reply du guide Integration Patterns qui décrit un appel externe synchrone unique. Le schéma agentique étend le schéma à une chaîne d’appels dépendants pilotée par l’agent dans un cycle de raisonnement unique.
Problème
Lorsqu’un agent exécute un workflow à plusieurs étapes qui couvre le système hôte et un ou plusieurs systèmes distants, quatre défis doivent être relevés :
- Ordonnancement - Les actions doivent être invoquées dans l’ordre approprié, chaque étape étant fermée à la réussite de la précédente.
- Propagation des données : les données de réponse de chaque étape doivent être transmises en entrée à la suivante.
- Isolation des défaillances - Les défaillances à un point quelconque de la chaîne ne doivent pas produire un état partiel ou incohérent entre les systèmes.
- Vérification de réalisation - L’agent doit confirmer que toutes les étapes ont réussi avant de déclarer un résultat.
Forces
En appliquant ce schéma, répondez aux questions suivantes :
-
Chaque action de la chaîne dépend-elle des données renvoyées par l’action précédente, ou les dépendances dépendent-elles uniquement du statut de réussite ou d’échec ?
Les dépendances de données nécessitent que l’agent transmette des identifiants et des attributs à travers les étapes.
-
Tous les points de terminaison distants sont-ils capables de répondre pendant l’expiration du cycle de raisonnement de l’agent ?
Un système externe lent à n’importe quelle étape de la chaîne bloque toute la séquence.
-
La chaîne exige-t-elle une réussite complète de bout en bout ou un achèvement partiel est-il acceptable ?
-
Si une réussite complète est requise, définissez une stratégie de compensation pour les étapes qui doivent être annulées en cas d’échec en aval.
-
Peut-on réessayer en toute sécurité l’une des opérations d’écriture de la chaîne ?
Toutes les actions d’écriture doivent être idempotentes. La boucle de raisonnement de l’agent peut invoquer la même action plusieurs fois en raison de tentatives de Grand modèle de langage (LLM) ou de confirmations ambiguës.
-
La chaîne est-elle invoquée par une interaction utilisateur (conversationnelle, faible simultanéité) ou par un déclencheur automatisé (concurrence potentiellement élevée) ?
Cela détermine si le blocage synchrone est acceptable ou si un schéma asynchrone est requis.
Application de modèle Salesforce
| Solution | Ajustement | Commentaires |
|---|---|---|
| Actions Apex | Idéal pour les appels externes et la logique complexe | Une étape nécessite un appel externe HTTP à un système distant, une transformation de données personnalisée ou une logique de traitement des erreurs qui dépasse les capacités déclaratives de Flux. Les actions Apex exposent la plate-forme complète pour l’intégration tout en restant appelable par l’agent via l’annotation @InvocableMethod. |
| Actions de flux (lancées automatiquement) | Idéal pour les étapes de règle métier et les opérations CRM allégées | Une étape applique une logique métier déclarative, interroge ou met à jour des enregistrements CRM, ou orchestre un processus qui ne nécessite pas de code personnalisé. Les flux lancés automatiquement peuvent être appelés en natif à partir de sous-agents Agentforce et renvoient des variables de sortie typées que l’agent utilise pour déterminer l’étape suivante. |
| Services externes (importation OpenAPI) | Idéal pour l’intégration d’API externe typée et découvrable | Un système externe expose une spécification OpenAPI. Les Services externes génèrent des stubs Apex fortement typés qui peuvent être directement appelés en tant qu’actions d’agent, éliminant ainsi le mappage manuel des schémas et rendant les opérations de l’API externe visibles pour l’agent en tant que capacités nommées. Chaque opération dans la spécification importée devient une action appelée nommée. L’agent sélectionne les actions en fonction de leurs étiquettes sémantiques générées. Enregistrez les actions générées dans le Centre de rubriques Agentforce pour permettre à l’agent de les découvrir au moment du raisonnement. Note: si le service hébergé en externe est RESTful, mais que la spécification OpenAPI n’est pas disponible ou viable, utilisez Identifiants nommés dans Apex ou Flux pour passer directement l’appel externe HTTP. Un code Apex est nécessaire pour analyser les résultats. |
| Actions connectées MuleSoft | Idéal pour l’intégration complexe de fan-out middleware ou de système hérité | Utilisé lorsque le système distant nécessite une traduction de protocole, une transformation de données ou une orchestration entre plusieurs systèmes back-end avant de renvoyer une réponse. L’agent passe un seul appel externe à MuleSoft, qui gère la complexité en aval et renvoie une réponse unifiée. |
Croquis
Diagramme de séquence pour l’invocation d’actions séquentielles
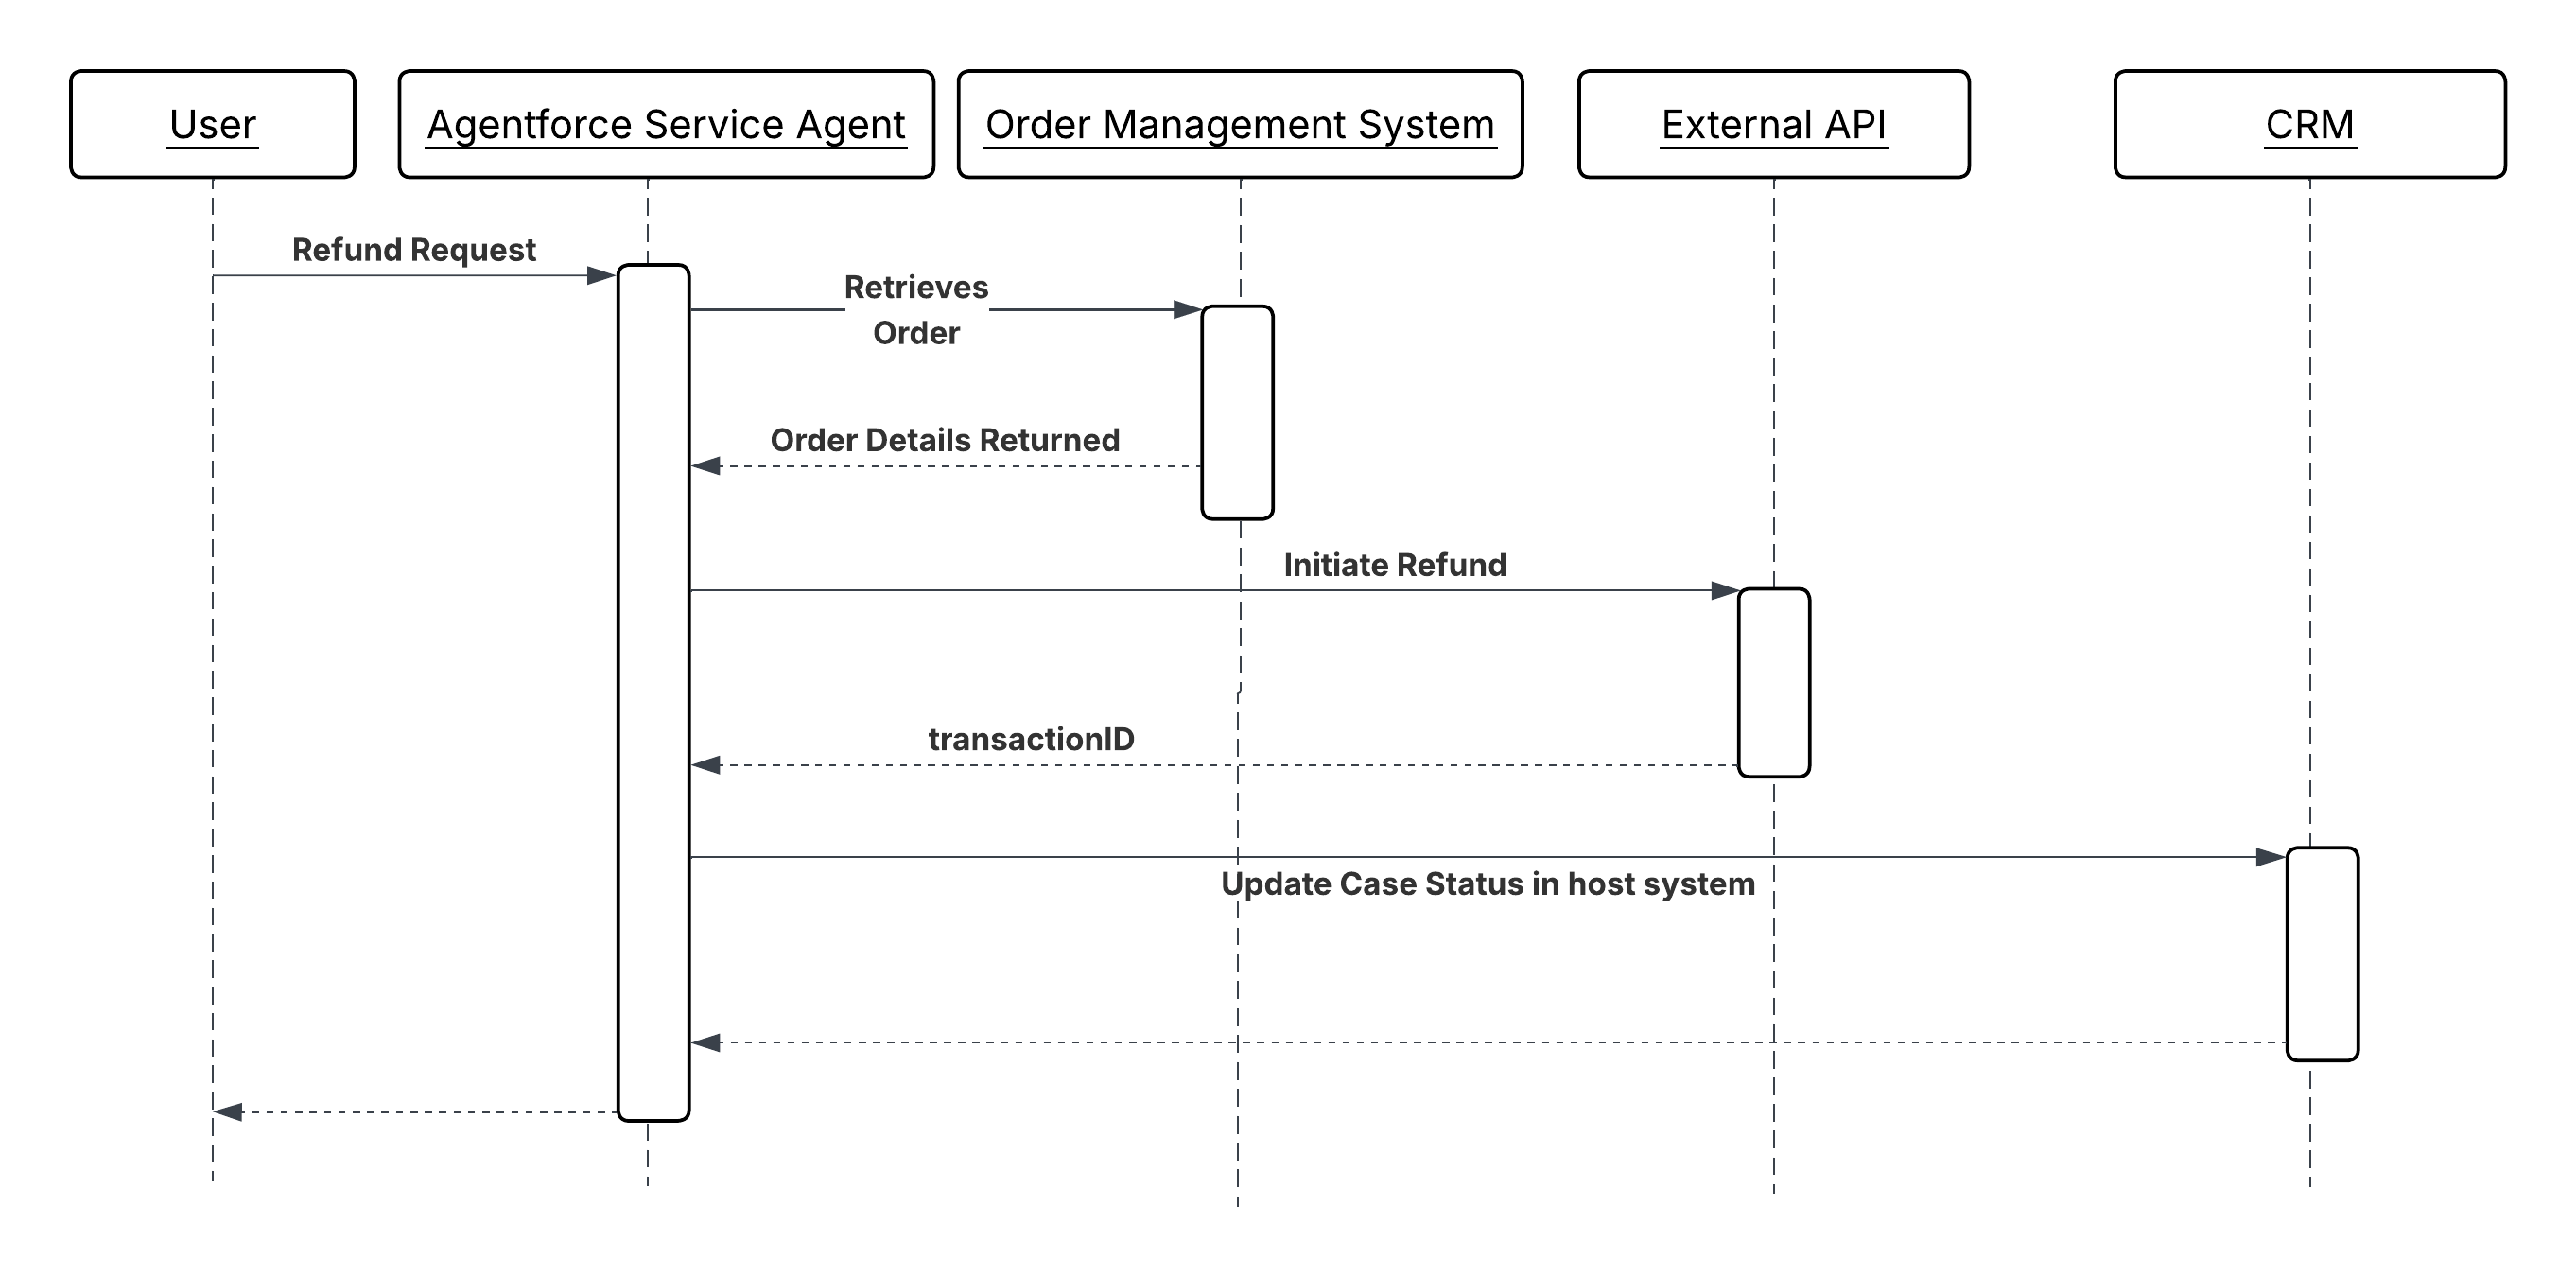
Résultats
L’agent exécute un workflow inter-systèmes en tant que séquence cohérente et supervisée, pas en tant que script « fire and forget ». Le résultat de chaque étape est évalué avant l’invocation de l’étape suivante. Par conséquent, l’agent détecte les échecs le plus tôt possible au lieu de découvrir une réalisation partielle après coup.
Le système hôte (Salesforce CRM) est mis à jour uniquement lorsque l’opération distante a confirmé le statut (réussite ou échec). Les identifiants et l’état renvoyés par des systèmes externes, tels que les numéros de compte de facturation, les ID de transaction et les codes de confirmation, sont propagés à travers la chaîne et conservés, créant un enregistrement complet et traçable du résultat du workflow.
L’agent est responsable du raisonnement sur les résultats et de l’ordonnancement des décisions. Chaque action est responsable uniquement de son propre fonctionnement et de renvoyer un résultat structuré. Aucune couche ne code la logique de l’autre.
Considérations relatives à la conception
Recommandations indépendantes de la plate-forme
- Assurez-vous que chaque action de la chaîne contient une description sémantique écrite dans un langage basé sur l’intention, pas en tant que signature de méthode technique. L’agent sélectionne les actions en fonction de ces descriptions. Une description indiquant « appelle l’API de facturation » est moins utile qu’une description indiquant « crée un compte de facturation dans le système de facturation et renvoie le nouvel identifiant de compte ».
- Rendez toutes les opérations d’écriture de la chaîne idempotentes. La boucle de raisonnement de l’agent peut réessayer une action si elle reçoit une réponse ambiguë. L’action doit produire le même résultat en cas d’invocation répétée.
- Validez tous les paramètres d’entrée déduits du LLM de manière défensive à la frontière de l’action. Ne supposez jamais que les paramètres transmis par l’agent sont bien formés, compris dans la plage ou du type attendu.
- Concevez chaque action pour une responsabilité unique. Une action qui crée un compte de facturation et envoie un e-mail de confirmation dans le même appel est plus difficile à réessayer, plus difficile à tester et plus difficile à raisonner pour l’agent que deux actions discrètes.
Notes d’implémentation Salesforce
- Pour Apex Actions, annotez avec @InvocableMethod(label=’…’ description = ’…’). La « description » est lue par l’agent pour déterminer quand invoquer l’action. Déclarez toutes les variables d’entrée et de sortie avec @InvocableVariable en utilisant des champs descriptifs « label » et « description ». Renvoyez des objets de résultat structurés avec des indicateurs explicites de réussite/échec et des messages d’erreur lisibles par l’utilisateur.
- Pour Actions de flux, utilisez exclusivement des flux lancés automatiquement. Les flux d’écran ne sont pas pris en charge dans les contextes d’agent autonome. Gardez chaque flux atomique ; une action, une responsabilité. Configurez des chemins de défaut dans chaque élément d’appel externe pour détecter les erreurs d’intégration et renvoyer des messages d’erreur actionnables à l’agent au lieu de laisser les exceptions non détectées terminer la session.
- Pour les Services externes, importez la spécification OpenAPI du système cible et enregistrez les actions générées dans la rubrique Agentforce. Encapsulez les stubs générés dans Named Credentials pour éviter de coder en dur les points de terminaison ou les identifiants dans la définition de l’action.
- Pour tous les appels externes, définissez des délais d’expiration explicites. Un appel externe suspendu sans expiration bloque le cycle de raisonnement de l’agent jusqu’à ce que la limite en sessions soit atteinte. Renvoyez un échec gracieux avec un message d’erreur explicite lorsque le délai d’expiration est dépassé. Tous les appels externes ont une expiration configurable allant jusqu’à 120 secondes. Ils sont également soumis aux limites du gouverneur des transactions synchrones Apex. Par conséquent, veillez à limiter le risque d’instanciation de plus de 50 transactions exécutées pendant plus de cinq secondes chacune.
Traitement et récupération des erreurs
- L’agent conditionne chaque étape par la réussite explicite de l’étape précédente. Les actions doivent renvoyer un résultat structuré qui inclut un indicateur de réussite ou d’échec clair. L’agent ne peut pas déduire de façon fiable l’échec d’une réponse manquante ou nulle seule.
- Lorsqu’une action échoue, l’agent utilise le message d’erreur renvoyé par l’action pour déterminer son prochain mouvement : Invitez l’utilisateur à corriger la saisie, tentez une auto-réparation avec des paramètres ajustés, ou arrêtez la chaîne et consignez l’échec pour examen humain. Par conséquent, les messages d’erreur doivent être spécifiques et actionnables : “Plage de dates non valide : « endDate ne peut pas précéder startDate » est acceptable ; un code d’état 400 seul ne l’est pas.
- Pour les chaînes dans lesquelles la réalisation partielle crée un état incohérent (par exemple, le compte de facturation a été créé, mais l’enregistrement CRM n’a pas été mis à jour), l’agent invoque une action de compensation pour annuler ou marquer l’état partiel avant de révéler l’échec. Concevez des parcours de compensation en tant qu’actions nommées parallèlement au parcours principal.
- Si une action d’écriture a potentiellement réussi, mais a renvoyé une réponse ambiguë (expiration réseau, pas d’acceptation), la nouvelle tentative doit utiliser la même clé d’idempotence ou ID de référence externe que l’appel d’origine. N’émettez jamais une nouvelle tentative non vérifiée sur une écriture non idempotente.
Considérations de sécurité
- Encapsulez tous les appels externes dans des identifiants nommés. Ne codez jamais en dur des points de terminaison ou des identifiants dans des configurations de code Apex ou de flux. Ils doivent être gérés via le magasin d’identifiants sécurisé de la plateforme et renouvelés sans changement de code.
- Appliquez le principe du moindre privilège à l’utilisateur de l’intégration ou à l’application connectée utilisée par chaque action. Une action qui lit uniquement les données d’une commande ne doit pas contenir d’autorisations d’écriture sur le système de facturation. Étendez les identifiants aux opérations minimales requises par l’action.
- Consignez l’invocation de chaque action de la chaîne avec son ID de session, ses paramètres d’entrée (assainis des valeurs confidentielles) et son résultat. Si le résultat est contesté, ce journal d’audit est le principal mécanisme de reconstitution des raisons pour lesquelles l’agent a exécuté une séquence d’actions donnée.
- Assainissez tous les paramètres d’entrée qui proviennent du texte fourni par l’utilisateur avant de les transmettre à des systèmes externes. L’entrée utilisateur transmise par l’agent dans un appel externe d’API est un vecteur d’injection potentiel. Validez le type, le format et la plage à la frontière de l’action avant l’appel externe.
Exemple
Un agent du service client qui traite une demande de remboursement exécute une chaîne séquentielle en quatre étapes:
GetOrderDetails(Action Apex) récupère l’enregistrement de la commande dans le Système de gestion des commandes en utilisant l’ID de commande fourni par l’utilisateur. Il renvoie le statut de la commande, les éléments de ligne, la date d’achat et le mode de paiement. L’agent détermine si la commande est dans un état remboursable avant de continuer.ValidateRefundEligibility(Flux lancé automatiquement) applique les règles métiers d’éligibilité au remboursement, notamment la fenêtre de retour, les restrictions de catégorie de produits et l’historique des remboursements antérieurs. Il renvoie une raison booléenne « éligible » et, si elle n’est pas éligible, une raison en langage clair que l’agent peut exposer à l’utilisateur.InitiateRefund(Action Apex) appelle l’API de la passerelle de paiement externe avec l’ID de commande et le montant de remboursement. Renvoie un « refundTransactionId » en cas de réussite. Cette action est idempotente. S’il est appelé une deuxième fois avec le même ID de commande, il renvoie l’ID de transaction existant au lieu de créer un remboursement dupliqué.UpdateCaseStatus(Flux lancé automatiquement) met à jour l’enregistrement de la requête CRM avec l’ID de transaction de remboursement, définit le statut de la requête sur « Remboursement résolu émis » et crée une tâche de suivi pour le propriétaire du compte. Cette étape est exécutée uniquement lorsque « InitiateRefund » a renvoyé un ID de transaction confirmé.
Si le InitiateRefund expire ou renvoie une erreur, l’agent arrête la chaîne, n’invoque pas de UpdateCaseStatus et expose un message actionnable à l’utilisateur. La requête reste ouverte et non résolue, préservant l’état exact dans le CRM.
Contexte
Les chaînes d’actions séquentielles sont efficaces lorsque les étapes d’exécution sont dépendantes les unes des autres. Une étape conditionne l’accès à la suivante. Cependant, de nombreux workflows contiennent une série d’étapes qui n’ont aucune interdépendance. Par exemple, les étapes qui comprennent la récupération de l’inventaire des produits, la récupération des autorisations client et la vérification d’une estimation d’expédition peuvent toutes se dérouler simultanément, car aucune entrée d’étape ne nécessite la sortie d’une autre. L’exécution séquentielle de ces étapes fait perdre un temps proportionnel au nombre d’étapes.
Dans un schéma d’invocation parallèle, l’agent identifie qu’un ensemble d’actions sont indépendantes et les invoque simultanément plutôt que dans l’ordre. Le temps de workflow global est lié à l’action individuelle la plus lente plutôt qu’à la somme de tous les temps d’action. Une fois tous les résultats renvoyés, l’agent les agrège dans une réponse cohérente unique ou les utilise ensemble comme entrées à l’étape suivante du raisonnement.
Le défi architectural clé n’est pas l’invocation parallèle elle-même. Il s’agit de gérer le fan-out dans les contraintes de concurrence de la plateforme et de s’assurer que l’étape d’agrégation gère avec souplesse les échecs partiels, sans écarter les résultats qui ont réussi.
Problème
Comment un agent orchestre-t-il efficacement l’exécution simultanée de capacités multiples et indépendantes et agrège-t-il les résultats individuels dans une réponse unique et cohérente pour l’utilisateur ou les étapes suivantes ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- Quelles sont les considérations relatives aux actions concernant la sécurité des threads et le partage de l’état mutable ?
- Comment la solution va-t-elle gérer et éviter d’atteindre les limites du gouverneur Salesforce pour les appels externes Apex parallèles dans une seule transaction ?
- Faut-il utiliser des schémas asynchrones (comme Apex Queueable ou Événements de plate-forme) pour éviter les limites du gouverneur ?
- Une agrégation synchrone des résultats est-elle requise avant que l’agent puisse continuer ?
Application du modèle Salesforce
| Solution | Ajustement | Commentaires |
|---|---|---|
| Approche middleware | Idéal pour un fan-out élevé (>5 points de terminaison) et l’agrégation multi-plateforme | Vous avez besoin d’une couche middleware. L’agent passe un appel au middleware. Ensuite, le middleware s’adonne à 10 systèmes en parallèle, agrège les données et renvoie une réponse unique à l’agent. Ceci est préférable lorsque l’agent doit appeler de nombreux systèmes externes hétérogènes. Le middleware absorbe la complexité du fan-out et renvoie une réponse agrégée unique. |
| Apex Queueable | Convient parfaitement au parallélisme interne Salesforce | Vous devez déclencher plusieurs tâches pouvant être mises en file d’attente. Salesforce gère la file d’attente, mais si vous avez suffisamment de « créneaux » dans votre limite en simultanéité, ils peuvent être exécutés en même temps. Utilisé lorsque des opérations parallèles sont effectuées dans l’organisation Salesforce et que des créneaux simultanés sont disponibles. Cela ne convient pas lorsqu’une réponse agrégée immédiate est requise. |
| Événements de plate-forme | Idéal pour l’envoi sans accusé de réception ou la cohérence éventuelle | Il n’est pas nécessaire d’agréger les résultats de façon synchrone. Chaque événement déclenche une transaction isolée, ce qui optimise le débit, mais nécessite un rapprochement en aval. Utilisez ce mécanisme lorsque la cohérence éventuelle est acceptable et que le débit est plus important que la latence de réponse. |
Croquis
Diagramme de séquence pour l’invocation d’actions parallèles
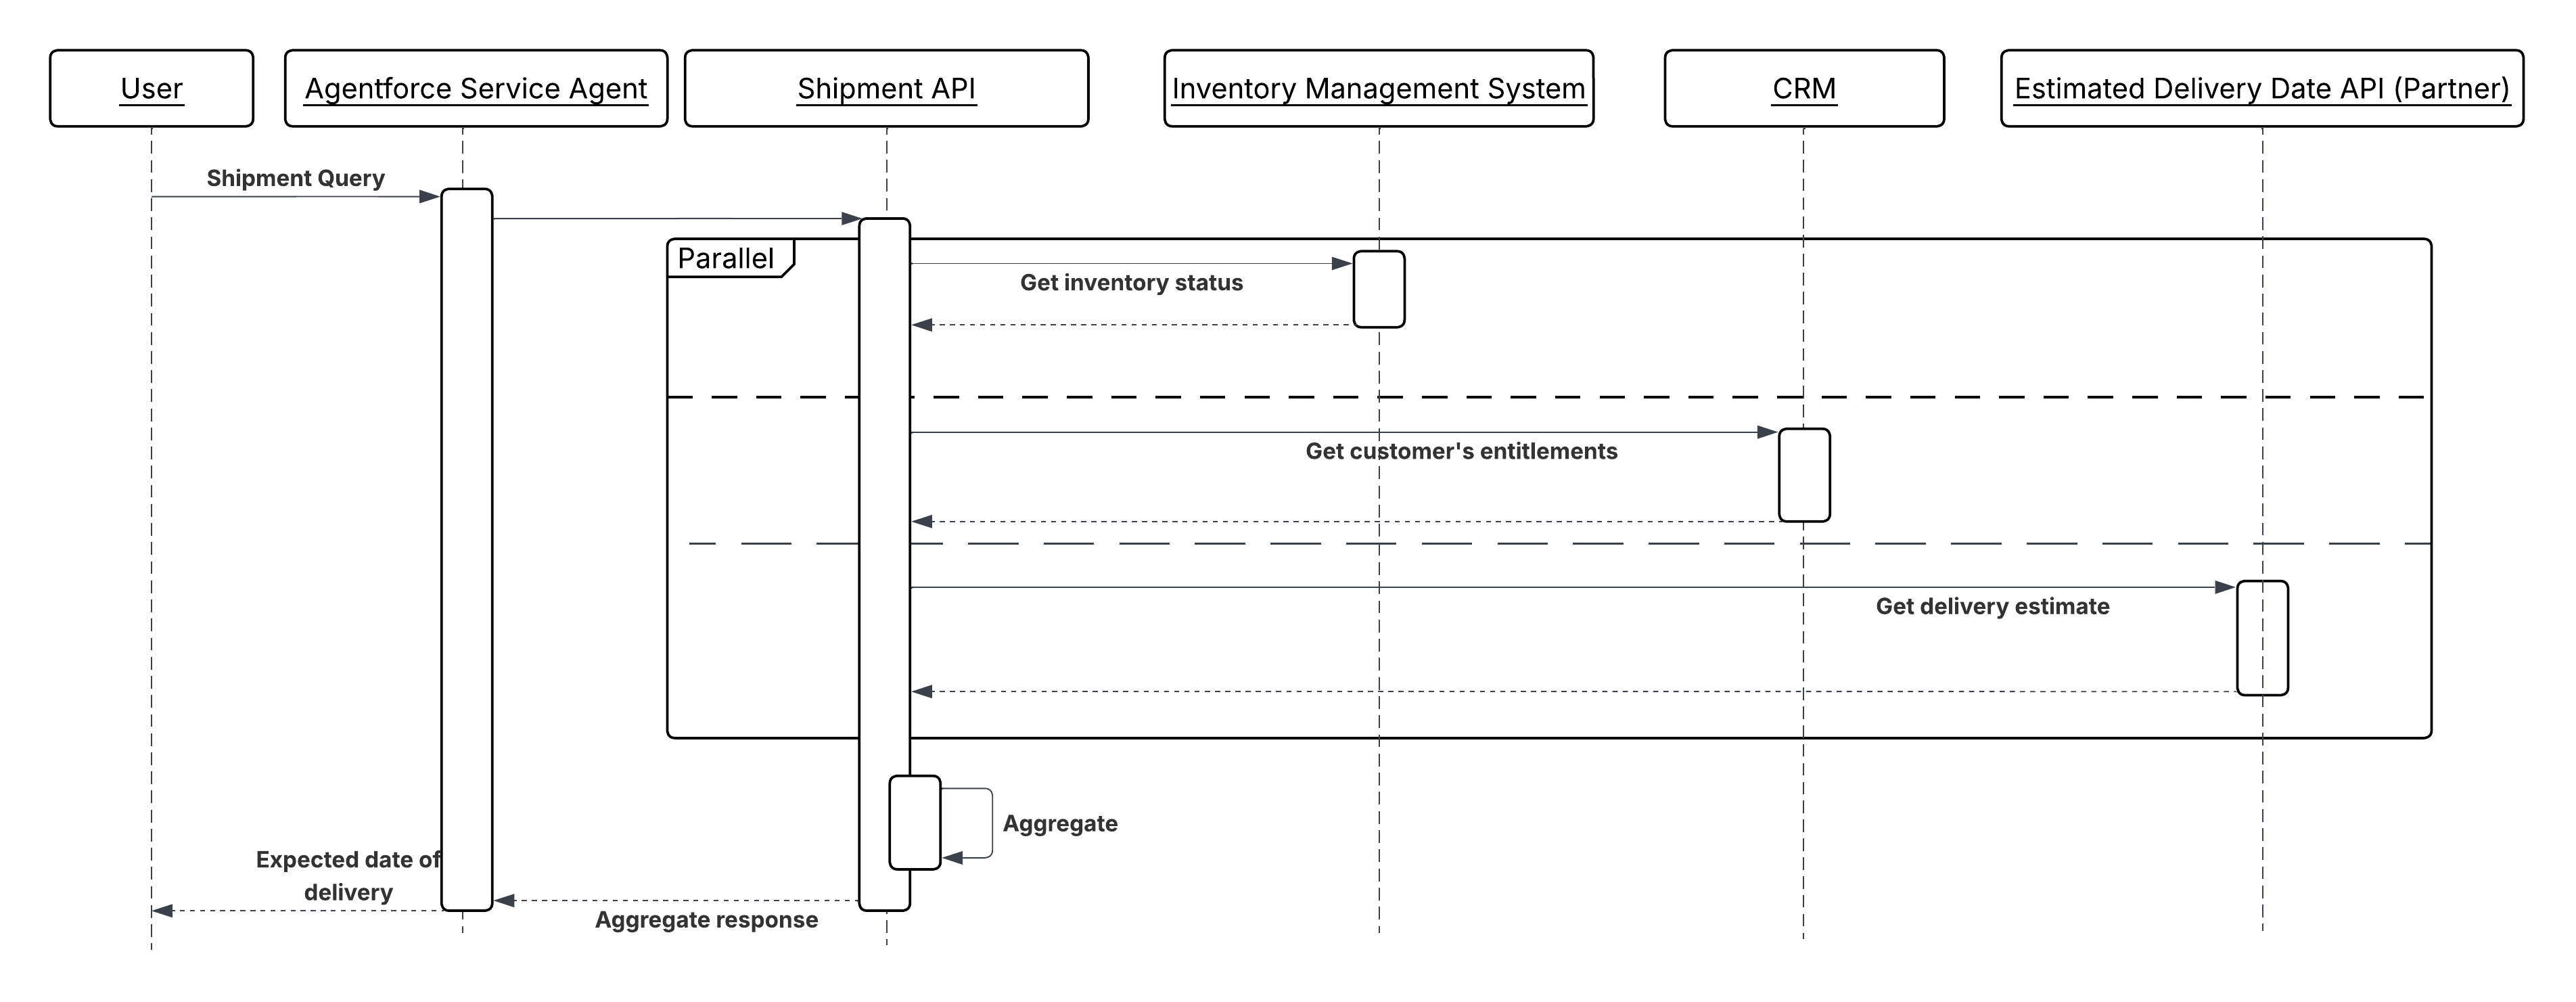
Résultats
Lorsque des actions indépendantes sont exécutées en parallèle, le temps de workflow de bout en bout est lié par l’action individuelle la plus lente plutôt que par la somme de toutes les actions. Pour un workflow avec trois appels externes indépendants d’une durée moyenne de 300 ms chacun, l’exécution parallèle prend environ 300 ms ; l’exécution séquentielle prend environ 900 ms. À l’échelle, cette différence s’aggrave dans chaque session d’agent exécutée simultanément.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Confirmez l’indépendance avant de paralléliser. Les actions peuvent être exécutées en parallèle en toute sécurité uniquement si aucune action ne lit l’état écrit par l’autre, et l’échec d’aucune action ne doit annuler l’autre. Si une dépendance existe, même molle, utilisez à la place l’enchaînement séquentiel.
- Concevez explicitement l’étape d’agrégation. Définissez à l’avance à quoi ressemble un ensemble de résultats complet, ce qu’un ensemble de résultats partiel signifie pour le raisonnement en aval, et si l’agent doit attendre tous les résultats ou procéder une fois qu’un seuil (par exemple, cinq appels sur sept au total) est revenu.
- Toutes les opérations d’écriture parallèle doivent être idempotentes. Chaque opération est exécutée de façon isolée sans frontière de transaction partagée. Par conséquent, réessayer une branche individuelle ne peut pas dupliquer les effets secondaires.
Notes d’implémentation Salesforce
- Pour Apex Queueable : Soumettez toutes les tâches dans une seule transaction afin d’optimiser les chances d’exécution simultanée. Notez que les créneaux horaires simultanés disponibles sont partagés dans l’ensemble de l’organisation. Concevez en partant du principe que les créneaux horaires ne sont pas toujours disponibles et élaborez une solution de secours à l’exécution séquentielle lorsqu’ils ne le sont pas.
- Pour les événements de plate-forme : Écrivez le résultat de chaque opération dans un enregistrement intermédiaire dédié (saisi par un ID de corrélation partagé) au lieu de mettre directement à jour l’enregistrement cible. Un déclencheur Flux ou Apex final d’agrégation lit tous les enregistrements intermédiaires une fois le décompte attendu atteint, puis applique atomiquement la mise à jour consolidée.
- Pour Middleware Fan-Out : Définissez un délai d’expiration explicite pour l’appel externe unique supérieur au délai de réponse attendu dans le pire des cas du back-end le plus lent, tout en respectant la limite d’expiration de l’appel Salesforce. Le middleware renvoie des résultats partiels avec une indication claire des back-ends échoués, au lieu d’expirer la réponse complète.
Traitement et récupération des erreurs
- Traitez la réussite partielle comme un résultat de première classe. Si trois ou quatre opérations parallèles réussissent, l’agent utilise les trois résultats réussis et gère l’échec en l’exposant explicitement à l’utilisateur, en le consignant pour une nouvelle tentative ou en invoquant une action compensatoire, au lieu d’abandonner tous les résultats ou de procéder comme si l’échec ne s’était pas produit.
- Pour les modèles Queueable et Platform Event, utilisez un ID de corrélation (généré au point de sortie) pour lier toutes les branches parallèles à la session de l’agent d’origine. Cet ID est requis pour reconstituer les résultats et retracer les échecs jusqu’à leur source dans les journaux.
- Si une branche parallèle échoue et que l’opération peut être ré-essayée en toute sécurité, mettez en file d’attente uniquement la branche échouée en utilisant l’ID de corrélation et la clé d’idempotence d’origine. Ne réinvoquez pas toutes les branches.
- Définissez un seuil d’expiration pour l’étape d’agrégation. Si tous les résultats n’atteignent pas le seuil, procédez avec les résultats disponibles et marquez l’ensemble incomplet au lieu d’attendre indéfiniment.
Considérations de sécurité
- Chaque contexte d’exécution parallèle, que ce soit une tâche qui peut être mise en file d’attente, un déclencheur d’événement de plate-forme ou un appel externe middleware, doit appliquer les mêmes contrôles d’accès qu’un appel externe séquentiel. Le parallélisme n’assouplit pas les règles d’accès aux données. Chaque branche doit fonctionner avec le même identifiant de moindre privilège que si elle était invoquée seule.
- Pour le fan-out middleware, la couche middleware ne met pas en cache ni ne consigne les charges utiles de réponse des back-ends individuels au-delà de la fenêtre d’agrégation. La réponse de chaque back-end peut contenir des données confidentielles qui ne doivent pas persister hors du périmètre de l’opération immédiate.
- Assurez-vous que les enregistrements intermédiaires utilisés pour l’agrégation des événements de plate-forme ne sont pas lisibles par l’utilisateur final de l’agent. Ces enregistrements peuvent contenir des données intermédiaires partiellement formées qui ne sont pas encore propres à la consommation.
Exemple
Un agent de service répond à une question de réalisation complexe : “Pouvez-vous m’expédier cette commande avant vendredi ?” La réponse nécessite des données de tous les systèmes indépendants simultanément, comme expliqué ci-dessous :
- L’agent identifie trois besoins en données indépendants : le niveau d’inventaire actuel, les autorisations actives du client et la période de livraison estimée du transporteur pour l’emplacement du client.
- Trois actions sont invoquées en parallèle :
GetInventoryStatus(du système d’inventaire externe via middleware),GetCustomerEntitlements(de Salesforce CRM) etGetDeliveryEstimate(de l’API du transporteur via middleware). - Chaque action renvoie sa réponse indépendamment. L’agent attend la réception des trois réponses (ou l’expiration de l’agrégation est atteinte).
- Avec les trois résultats disponibles, l’agent analyse les données combinées, en évaluant si l’inventaire est suffisant, si l’autorisation du client couvre l’expédition express et si le transporteur confirme que la livraison du vendredi est possible pour le code postal du client.
- L’agent renvoie à l’utilisateur une réponse unique et ancrée, tirée de trois systèmes, dans le délai nécessaire pour répondre au plus lent des trois appels.
Contexte
Certaines opérations initiées par l’agent ne produisent pas le résultat dont l’agent a besoin pour poursuivre son cycle de raisonnement actuel. L’envoi d’une notification, le déclenchement d’un processus par lot en aval, la publication d’un événement dans une file d’attente de messages ou la soumission d’une tâche de longue haleine sont autant d’opérations dans lesquelles l’obligation de l’agent se termine à la répartition ; le système en aval s’approprie et réalise le travail de façon indépendante.
Dans l’automatisation traditionnelle, ils sont modélisés en tant qu’appels externes ou publications d’événements de plate-forme. Dans un système agentique, l’agent décide pendant le raisonnement que l’opération n’est pas bloquante, l’expédie, enregistre la confirmation de l’expédition, et poursuit ou conclut le tour sans attendre le résultat en aval.
Ce schéma est la contrepartie agentique de Remote Process Invocation – Fire and Forget dans le guide Integration Patterns. Le schéma agentique l’étend en faisant de la décision de répartition une partie du raisonnement de l’agent, et en garantissant la traçabilité de la répartition même si aucune réponse n’est renvoyée à l’agent.
Problème
Lorsqu’un agent doit initier une opération en aval qui dépasse sa session ou son cycle de raisonnement, trois défis doivent être relevés :
- Invocation non bloquante : L’agent doit déclencher l’opération et confirmer la livraison sans laisser le cycle de raisonnement ouvert en attendant un résultat.
- Confirmation de livraison : L’agent doit faire la distinction entre une répartition réussie (le message a été accepté) et un résultat réussi (le processus en aval terminé). L’agent ne peut confirmer que le premier.
- Traçabilité : Comme l’agent ne reçoit aucun résultat, l’opération doit être observable via des journaux, des enregistrements d’événements ou la surveillance de la plate-forme indépendamment de la session de l’agent.
Forces
En appliquant ce schéma, répondez aux questions suivantes :
-
L’agent a-t-il besoin du résultat de cette opération pour terminer son tour actuel ? Si oui, ce n’est pas le bon schéma. Utilisez à la place Invocation d’actions séquentielles.
-
Le système en aval est-il capable de recevoir et de traiter de façon fiable le message ou l’événement réparti sans accusé de réception synchrone ? Le système cible doit être durable. Il ne doit pas perdre le message s’il est temporairement indisponible.
-
L’opération est-elle idempotente ou faut-il empêcher une répartition en double ? Les tentatives au niveau du réseau et les tentatives de raisonnement de l’agent peuvent entraîner plusieurs tentatives de la même répartition. Si l’opération en aval n’est pas idempotente, l’action doit porter une clé de déduplication.
-
L’utilisateur ou un processus en aval doit-il savoir quand l’opération est terminée ? L’agent peut seulement confirmer la répartition. Si le statut de réalisation est requis, concevez un mécanisme de notification ou de suivi séparé. Un Événement de plate-forme, une mise à jour de cas ou un rappel - hors de ce cycle de raisonnement.
Application Salesforce Pattern
| Solution | Ajustement | Commentaires |
|---|---|---|
| API Pub/Sub | Idéal pour la diffusion en continu d’événements externes ou à haut débit | L’agent invoque une action Apex qui publie un événement dans l’API Pub/Sub Salesforce sur gRPC. L’action renvoie un replayId PublishResult à l’agent en tant que confirmation de l’expédition. Utilisé lorsque les consommateurs en aval sont des systèmes externes qui s’abonnent via l’API Pub/Sub plutôt que des déclencheurs Flow ou Apex natifs de Salesforce, ou lorsque la diffusion d’événements à haut débit est requise. |
| Événements de plate-forme (action Apex) | Idéal pour la répartition asynchrone intra-Salesforce | L’agent invoque une action Apex qui publie un Événement de plate-forme. L’événement est livré à tous les abonnés de façon asynchrone. L’action renvoie une confirmation de publication à l’agent ; elle ne renvoie pas de résultat de traitement. Utilisé lorsque le consommateur en aval se trouve sur la plate-forme Salesforce. L’agent invoque une action Apex qui appelle EventBus.publish(). L’action renvoie un SaveResult confirmant l’acceptation. |
| File d’attente Apex / Lot (action Apex) | Idéal pour les traitements en arrière-plan de longue durée | L’agent invoque une action Apex qui met en file d’attente une tâche Queueable ou Batch. La tâche est exécutée hors de la transaction de l’agent. L’action renvoie un ID de tâche que l’agent peut exposer à l’utilisateur en tant que référence. Utilisé lorsque le travail en aval est un traitement de données d’opération Salesforce de longue durée, des mises à jour d’objets multiples ou des appels externes qui dépassent les limites synchrones. System.enqueueJob() renvoie un ID de tâche que l’agent enregistre en tant que référence. |
| Flux asynchrone MuleSoft | Idéal pour la répartition de la file d’attente de messages externes | L’agent invoque une action exposée à MuleSoft qui place un message dans une file d’attente externe (Kafka, JMS, SQS). MuleSoft gère la traduction du protocole et la confirmation de livraison. L’agent reçoit la confirmation que le message a été accepté par MuleSoft, pas qu’il a été traité en aval. |
| Point de terminaison REST externe (action Apex) | Idéal pour la soumission d’événements système externes | Le système cible expose un point de terminaison qui accepte une soumission et renvoie immédiatement un ID d’accusé de réception, en terminant le traitement de façon asynchrone. L’agent reçoit l’ID d’accusé de réception et l’enregistre. |
Croquis
Diagramme de séquence pour l’invocation d’actions asynchrones
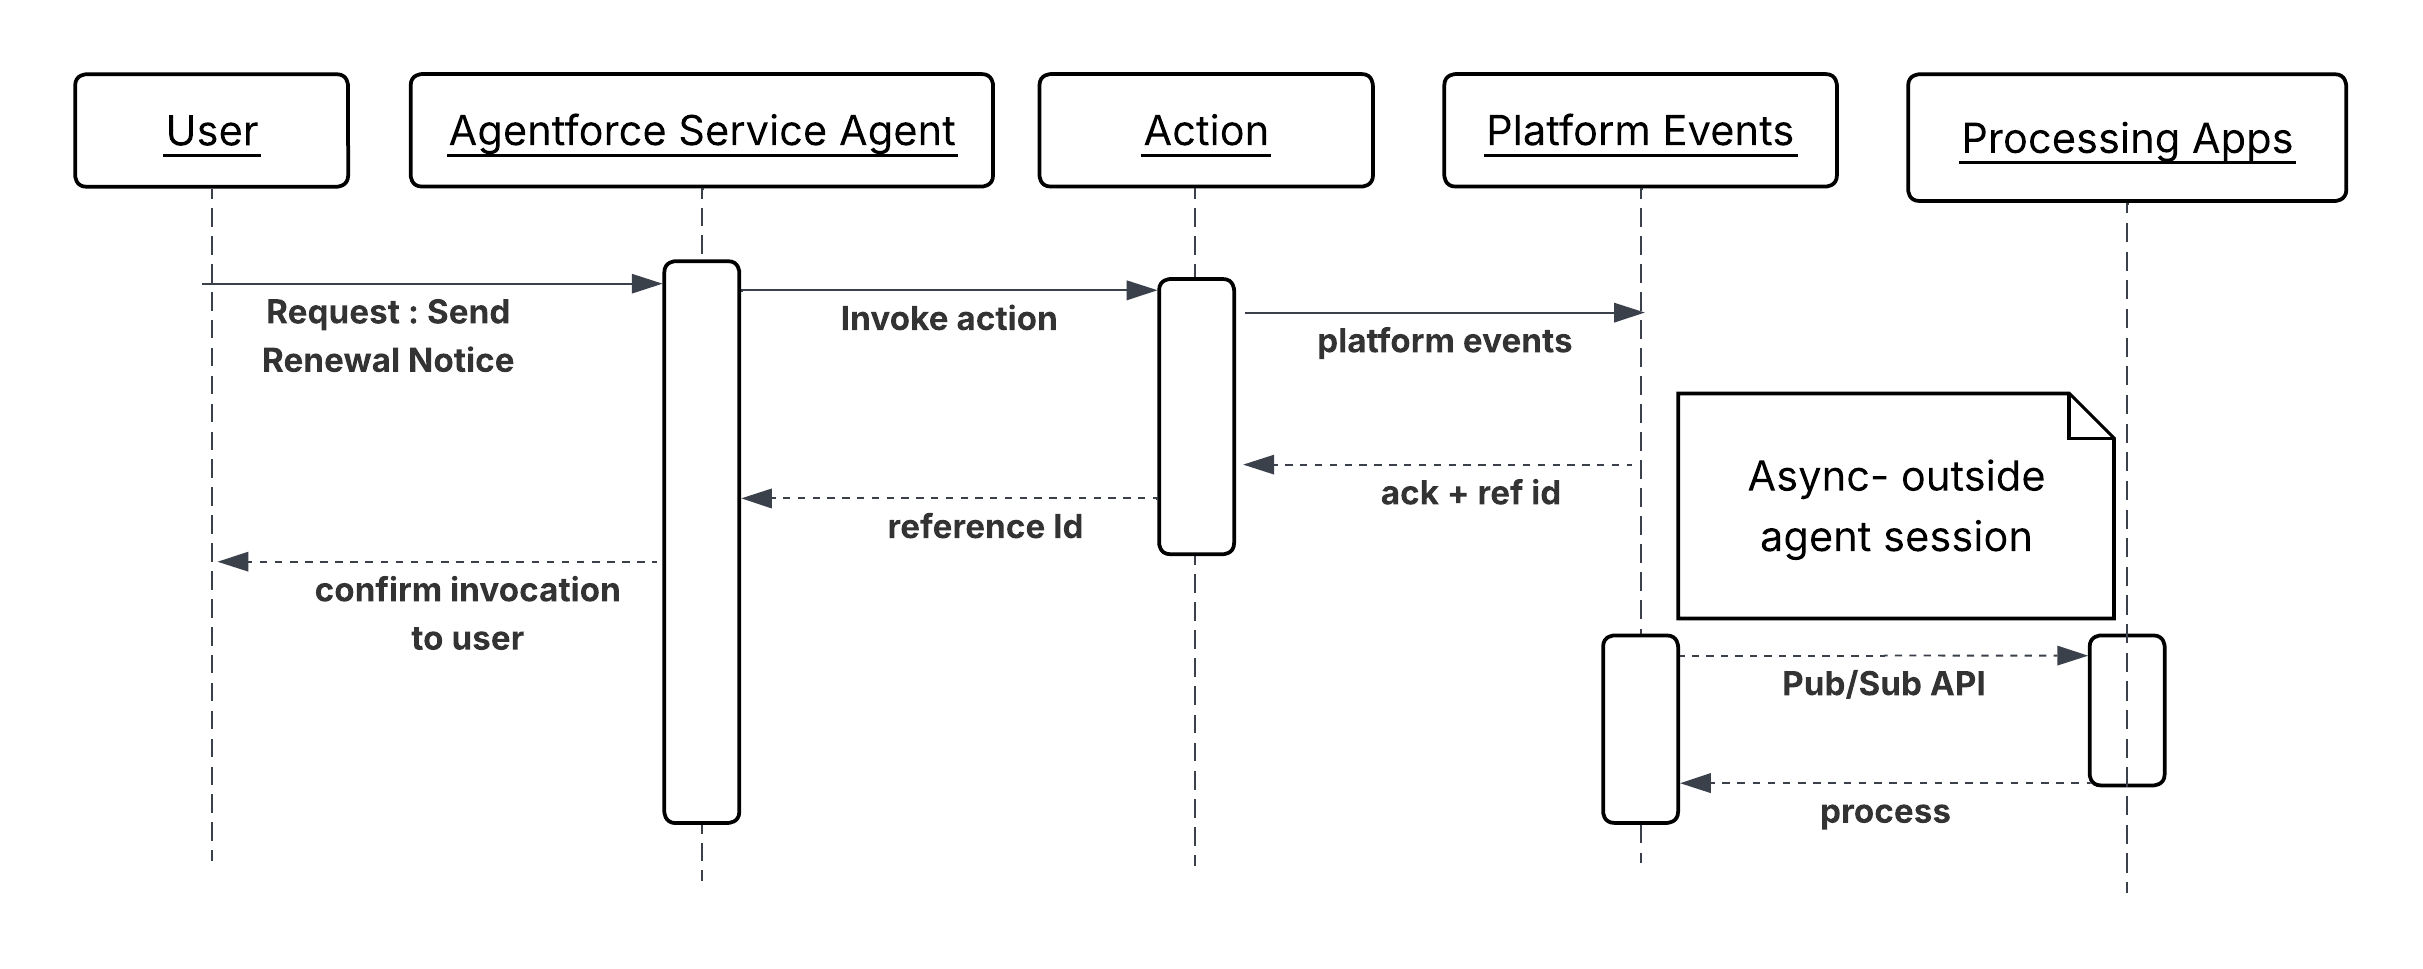
Résultats
L’agent invoque une opération en aval sans bloquer son cycle de raisonnement sur le résultat. Le tour se termine avec la confirmation que l’opération a été acceptée, pas qu’elle a été terminée. Le système en aval s’approprie entièrement l’exécution. L’opération répartie est traçable via des abonnés à un événement de plate-forme, des ID de tâche ou des ID de confirmation de file d’attente externes enregistrés dans le CRM au moment de la répartition. Si l’opération en aval échoue, cet échec est révélé par la surveillance du système en aval, pas par la session de l’agent qui l’a initiée.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Rédigez des descriptions d’action dans un langage basé sur l’intention. Par exemple, « Soumet une notification de renouvellement à la file d’attente de messagerie et renvoie un ID de référence de répartition » est plus utile à l’agent que « appelle le point de terminaison de notification ».
- Ne décrivez jamais une action de répartition comme « envoie et confirme la livraison de ». L’agent peut seulement confirmer l’acceptation. La livraison et le traitement en aval sont hors de portée de l’agent.
Notes d’implémentation Salesforce
- Renvoyez un ID de référence de chaque action d’invocation, par exemple un
ReplayIdd’événement de plate-forme, un ID de tâche Queueable, un replayId d’API Pub/SubPublishResultou un jeton de reconnaissance externe. Enregistrez-le dans un enregistrement CRM lors de l’invocation. C’est le seul journal d’audit que la session de l’agent produira. - Pour l’API Pub/Sub, l’agent invoque une action Apex qui passe un appel externe gRPC au point de terminaison ‘/Publish’ de l’API Pub/Sub. L’action doit gérer l’étape d’enregistrement du schéma - les événements doivent être numérotés sous le format Avro par rapport au schéma enregistré. Renvoyez le
PublishResult ‘replayId’à l’agent en tant que référence de répartition. - Pour les événements de plate-forme, appelez
EventBus.publish()dans l’action Apex et vérifiez si SaveResult contient des erreurs avant de renvoyer un indicateur de réussite à l’agent. Ne présumez pas de la réussite de la publication ; validez-la. - Pour Tâches Queueable, implémentez l’interface Queueable et appelez System.enqueueJob() depuis l’action. Renvoyez l’ID AsyncApexJob généré à l’agent.
- Pour des points de terminaison asynchrones externes, le point de terminaison cible doit renvoyer immédiatement un accusé de réception (HTTP 202 Accepté) avec un ID de référence. Si le point de terminaison bloque jusqu’à la fin du traitement, il est synchrone et ce schéma ne s’applique pas.
Traitement et récupération des erreurs
- Une action d’invocation doit distinguer l’échec de la répartition (le message n’a pas été accepté) et l’échec du traitement (le message a été accepté, mais l’opération en aval a échoué plus tard). L’agent ne peut gérer que le premier.
- Si l’invocation échoue, l’action doit renvoyer un échec structuré avec un motif clair. L’agent peut réessayer la répartition, escalader vers un humain ou consigner un enregistrement de répartition échoué, mais il ne peut pas récupérer un échec de traitement en aval pendant la même session.
- Pour les opérations où l’échec en aval doit éventuellement être révélé, concevez une boucle de rétroaction séparée, par exemple un Événement de plate-forme publié par le processus en aval, un flux planifié qui vérifie le statut de la tâche ou une requête de suivi extérieure à la session de l’agent.
Considérations de sécurité
- Encapsulez tous les appels externes asynchrones dans des identifiants nommés. L’action d’invocation n’incorpore pas d’URL de point de terminaison ni d’identifiants dans un code.
- Validez et désinfectez tous les paramètres transmis à l’action d’invocation avant qu’ils soient incorporés à la charge de travail de l’événement ou au corps du message. Le texte fourni par l’utilisateur transmis dans un message asynchrone est un vecteur d’injection potentiel dans le consommateur en aval.
- Consignez chaque envoi avec un ID de session, un ID de référence et une charge utile assainie au moment de l’envoi. Comme aucune réponse ne revient à l’agent, ce journal est le principal mécanisme de reconstruction de ce que l’agent a initié.
- Appliquez le moindre privilège à l’utilisateur de l’intégration ou à l’application connectée. Une action de répartition qui publie dans une file d’attente de notification ne doit pas contenir d’identifiants qui autorisent les lectures ou les écritures sur des systèmes non associés.
Exemple
Un agent de gestion du renouvellement qui gère un contrat approchant de l’expiration détermine que le client est éligible pour une notification de renouvellement automatique. L’agent n’a pas besoin de confirmer que l’e-mail a été remis avant de conclure le tour.
CheckRenewalEligibility(Flux lancé automatiquement) évalue les termes du contrat, le niveau client et le statut de désabonnement. Renvoie une valeur booléenne « éligible » et le canal de notification préféré.DispatchRenewalNotification(Action Apex) publie un Événement de plate-formeRenewalNotification\_\_econtenant l’ID de contrat, l’ID de client, le canal de notification et une clé d’idempotence générée. Renvoie un ReplayId confirmant l’acceptation de l’événement par la plate-forme.UpdateContractRecord(Flux lancé automatiquement) écrit l’horodatage deReplayIdet de l’envoi dans l’enregistrement Contrat, et définit un indicateur de statut « Notification envoyée ».
Contexte
Les applications externes, telles que les portails clients, les applications mobiles, les plates-formes SaaS tierces et les systèmes partenaires, doivent invoquer des agents par programmation pour gérer les demandes de service, initier des workflows ou exposer des réponses pilotées par l’IA dans leurs propres interfaces. L’agent agit en tant que service back-end intelligent. Le système externe fournit le contexte, l’agent raisonne et agit, et l’appelant consomme la réponse.
De plus en plus, l’appelant est lui-même un agent IA ou un orchestrateur plutôt qu’une application à visage humain. Dans ces schémas IA vers IA, un agent orchestrateur délègue une étape de raisonnement, une référence CRM ou une action à Agentforce en tant qu’appel d’outil discret. Nous devons exposer un serveur MCP (Model Context Protocol) pour prendre en charge ce schéma.
Problème
Lorsqu’un agent système externe ou IA doit exploiter à la demande les capacités d’un agent Agentforce, comment s’authentifie-t-il, crée-t-il une session d’agent, transmet-il les données conversationnelles et contextuelles nécessaires et reçoit-il de façon fiable la réponse structurée de l’agent pour piloter sa propre logique en aval ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- L’appelant externe attend-il une réponse synchrone et à faible latence ou un rappel asynchrone est-il acceptable ?
- Comment l’identité de l’appelant est-elle établie et propagée dans le contexte d’exécution de l’agent pour l’accès aux données et la personnalisation ?
- Quel est le volume attendu de sessions déclenchées par l’API en simultané, et comment cela interagit-il avec les limites de débit et de concurrence de l’API Salesforce ?
- Le système externe doit-il maintenir la continuité de la session sur plusieurs tours (conversation à plusieurs tours) ou chaque requête est-elle sans état ?
- Comment la réponse de l’agent doit-elle être structurée pour que le système d’appel puisse l’analyser et agir par programmation ?
- L’appelant est-il une application orientée vers l’humain nécessitant une intégration REST directe, ou un agent IA ou orchestrateur capable d’invoquer Agentforce comme outil via un protocole standard, tel que MCP ?
Modèle d’application Salesforce
| Solution | Ajustement | Commentaires |
|---|---|---|
| API Agentforce Agent – à tour unique (synchrone) | Idéal pour les intégrations sans état – requête-réponse | Le système d’appel nécessite une réponse immédiate et structurée, et le raisonnement de l’agent doit être terminé dans les limites de la tolérance d’expiration de l’appelant. Le système d’appel gère les phases complètes du cycle de vie de la session, à savoir la création, les tours et la fin. Le système externe s’authentifie, crée une session avec des variables de contexte, envoie un message unique, reçoit la réponse de l’agent et ferme la session. Cette API Agentforce est l’interface REST principale via laquelle les systèmes externes créent des sessions, échangent des messages et ferment des sessions par programmation. L’échange complet est effectué dans un cycle requête-réponse HTTP. Les réponses comprennent la sortie en langage naturel de l’agent et toutes les variables de sortie structurées produites par les actions que l’agent a invoquées pendant le raisonnement. |
| API Agentforce Agent – multi-tours (continuité de la session) | Idéal pour les intégrations conversationnelles nécessitant un état d’un tour à l’autre | L’interface externe est conversationnelle (par exemple, un widget de chat ou une interface vocale) et l’interaction nécessite plusieurs échanges pour parvenir à une résolution. Le système externe crée une session une fois et réutilise l’ID de session dans plusieurs échanges de messages. L’agent conserve le contexte conversationnel entre les tours, par exemple les questions préalables, les données récupérées, les décisions prises sans que l’appelant les réapprovisionne. |
| Asynchrone avec Polling ou Webhook Callback | Idéal pour les workflows de raisonnement à latence élevée ou les interfaces utilisateur sensibles au temps | Le temps de traitement de l’agent n’est pas négligeable et la tenue d’une connexion HTTP ouverte dégraderait l’expérience utilisateur de l’appelant ou déclencherait des expirations en amont. Le système externe soumet la requête et reçoit immédiatement un accusé de réception avec un ID de tâche ou de session. Il interroge ensuite un point de terminaison de statut ou enregistre un webhook pour recevoir la réponse de l’agent lorsque le raisonnement est terminé. Actuellement, ce schéma peut être implémenté avec une API wrapper hébergée sur un middleware tel que MuleSoft. Le consommateur externe invoque cette API Wrapper et enregistre le point de terminaison webhook. L’API Wrapper renvoie l’accusé de réception au système externe après avoir invoqué l’agent Agentforce. Cette API wrapper maintient également la session de l’agent Agentforce, et renvoie la réponse au système externe en utilisant le point de terminaison webhook enregistré une fois que l’agent a répondu. |
| Agentforce via MCP (Salesforce Headless 360) | Idéal pour l’invocation IA vers IA où l’appelant est un client compatible MCP | Le client MCP appelant invoque Agentforce comme un outil via le serveur MCP prêt à l’emploi fourni par Salesforce Headless 360. Le cycle de vie de la session est géré de façon transparente par le serveur MCP, et l’agent appelant interagit via un appel d’outil standard sans élaborer une intégration REST personnalisée. Utilisez cette solution lorsque l’appelant est un client MCP qui doit déléguer à Agentforce le raisonnement, la récupération du contexte CRM ou l’exécution d’actions en tant qu’étape discrète d’un workflow agentique plus large. |
Croquis
Diagramme de séquence pour l’invocation d’un agent à la demande
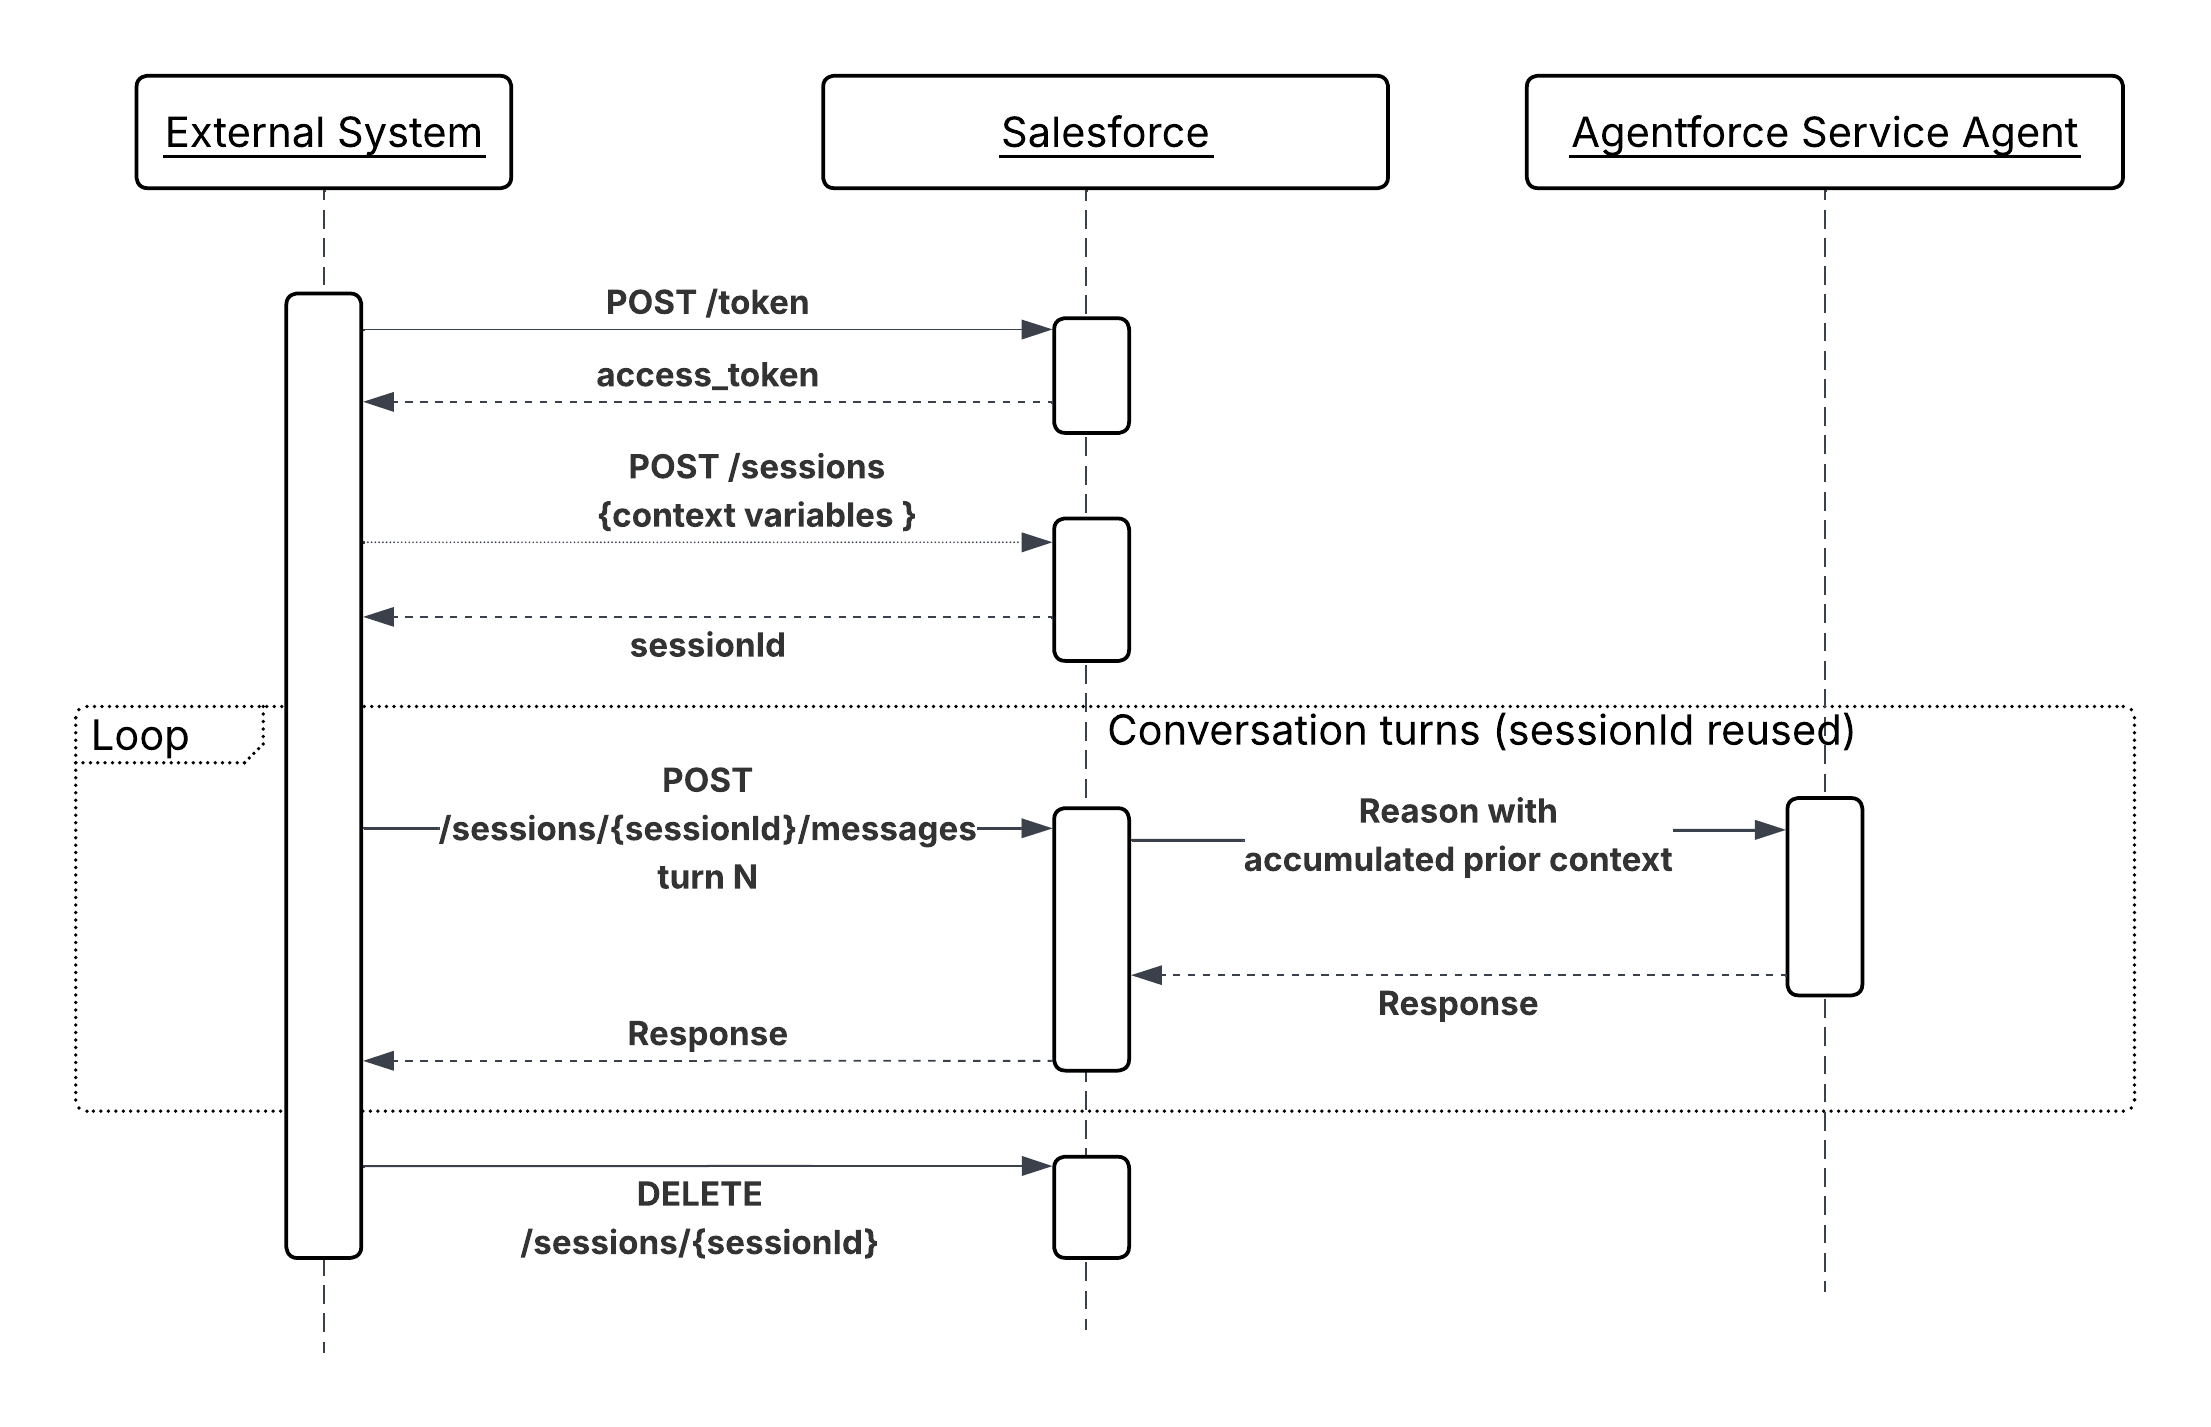
Résultats
Ce schéma expose Agentforce comme un service d’IA appelable. Les systèmes externes accèdent au raisonnement, aux outils et au contexte CRM de l’agent sans répliquer cette logique. L’appelant reste responsable de la gestion du cycle de vie de la session et de la restitution de la réponse. L’agent reste responsable de l’ensemble du raisonnement, de la sélection de l’outil et de la synthèse des réponses.
Lorsque l’appelant est un agent IA ou un orchestrateur, le mécanisme Agentforce via MCP (disponible prêt à l’emploi via Salesforce Headless 360) retire entièrement la nécessité d’une intégration REST personnalisée. Le serveur MCP gère le cycle de vie des sessions au nom de l’agent appelant, ce qui permet à Agentforce de participer en tant qu’outil de première classe à des workflows multi-agents sans plomberie supplémentaire.
Considérations relatives à la conception
Recommandations indépendantes de la plate-forme
- Évitez de rendre l’appel d’API externe synchrone et bloquant dans les flux d’interfaces utilisateur sensibles au temps. Adoptez un modèle de rappel par sondage ou webhook dans lequel les temps de réponse des agents ne sont pas triviaux, afin de dissocier l’expérience utilisateur du temps de traitement de l’agent.
- Sélectionnez le mécanisme d’appel en fonction de la nature de l’appelant, pas de sa disponibilité. Les applications accessibles à l’homme et les intégrations système doivent utiliser directement l’API Agent. Les outils qui prennent en charge les MCP doivent utiliser le serveur Agentforce MCP. Mélanger les mécanismes pour un même type d’appelant ajoute une complexité inutile sans avantage architectural.
Notes d’implémentation Salesforce
- Injectez le contexte de la session dans la requête POST de création de session, pas dans le premier message utilisateur. Lorsque le système externe crée la session, il peut transmettre des variables de contexte structurées (ID de compte, données d’autorisation, résumé des interactions précédentes) directement en tant que paramètres de session nommés. Ces variables sont disponibles pour l’agent avant qu’il ne traite un seul tour. Par conséquent, il commence à raisonner à partir d’un état ancré sans émettre d’appels de référence pour déterminer qui est le client ou ce à quoi il a droit. La transmission des mêmes données dans le corps du message force à la place l’agent à analyser un texte non structuré pour extraire les faits qu’il aurait pu recevoir sous forme de variables typées, ce qui augmente la latence, introduit des erreurs d’extraction et consomme des étapes de raisonnement qui n’ajoutent aucune valeur métier.
- Concevez des réponses d’agent structurées et analysables par machine. Utilisez des conventions de variables de sortie et des instructions d’invite qui guident l’agent à renvoyer des réponses compatibles JSON ou clairement délimitées lorsque l’appelant est un système au lieu d’un humain.
- Gérez explicitement le cycle de vie des sessions. Terminez rapidement les sessions après avoir utilisé
DELETE /einstein/ai-agent/v1/sessions/{sessionId}pour libérer les créneaux simultanés et éviter que le contexte périmé persiste dans les interactions non associées. - Tenez compte des limitations en sessions simultanées de Salesforce. Pour des scénarios à haut débit, implémentez un pool de sessions ou une couche de mise en file d’attente dans le système d’appel afin d’éviter le rejet des requêtes pendant les pics de charge.
- Lorsque vous invoquez Agentforce via MCP, transmettez le contexte en tant que paramètres d’entrée d’outil plutôt qu’en tant que variables de session. Le serveur MCP gère le cycle de vie de la session de façon transparente. Par conséquent, l’agent appelant ne peut pas définir des paramètres de session nommés directement lors de la création. Assurez-vous que tout le contexte requis (ID d’enregistrement, identité de l’utilisateur, données d’autorisation) est inclus dans la charge de travail de l’appel d’outil afin que l’agent commence à raisonner à partir d’un état ancré.
- Considérez la gestion transparente des sessions du serveur MCP comme pratique, pas comme un contournement simultané. Chaque invocation d’outil consomme toujours un créneau de session d’agent Salesforce. Les orchestrateurs à haute fréquence qui appellent Agentforce via MCP à l’échelle doivent tenir compte des mêmes limites en sessions simultanées que celles qui s’appliquent aux appelants directs de l’API Agent.
Traitement et récupération des erreurs
- L’API Agent renvoie des codes d’erreur HTTP standard. Le système d’appels doit gérer « 429 requêtes de trop » (limite en taux) avec un backoff exponentiel et « 503 Service non disponible » avec une logique de nouvelle tentative.
- Lorsque l’agent lui-même rencontre une défaillance d’outil irrémédiable, il renvoie une erreur de langage naturel gracieuse dans le corps de réponse. Le système d’appel détecte ces réponses sentinelles (par exemple, la vérification d’un champ de statut « erreur » dans la réponse) et achemine en conséquence en réessayant avec un contexte supplémentaire, en présentant une expérience de repli ou en acheminant vers un humain.
- Lors de l’invocation via MCP, les erreurs apparaissent sur deux couches distinctes : Erreurs de transport MCP (appels d’outils malformés, indisponibilité du serveur) et échecs de raisonnement Agentforce (erreurs d’exécution d’outils, actions irrésolvables). L’agent orchestrateur doit gérer les deux couches indépendamment. Les erreurs de transport MCP devraient déclencher des tentatives au niveau du protocole; les échecs de raisonnement Agentforce renvoyés dans la réponse de l’outil devraient être traités par la propre logique de repli ou d’escalade de l’orchestre.
Considérations de sécurité
- Utilisez les étendues OAuth les plus étroites possibles pour l’application cliente externe. Une intégration qui n’a besoin que d’invoquer un agent ne doit pas avoir d’étendues d’accès aux données supérieures à celles requises par l’agent lui-même.
- Validez et désinfectez toutes les entrées du système externe avant de les injecter en tant que variables de session. Les entrées externes sont une surface d’attaque pour l’injection rapide. Par exemple, un appelant malveillant peut créer un champ « customerQuery » conçu pour remplacer les instructions de l’agent.
- Appliquez la liste d’autorisations IP à l’application cliente externe afin de restreindre les systèmes externes qui peuvent s’authentifier et appeler l’API Agent.
- Consignez toutes les sessions déclenchées par l’API entrante avec l’identité de l’appelant, l’ID de session et les métadonnées de requête/réponse à des fins d’audit et de sécurité.
- Lorsque Agentforce est invoqué via MCP, le serveur MCP s’authentifie à Salesforce au nom de l’utilisateur appelant. Assurez-vous que les identifiants d’application connectée du serveur MCP sont limités aux autorisations minimales requises, et que l’identité de l’utilisateur (en utilisant des outils MCP tels que Claude) - identité est propagée explicitement dans le contexte de la session via des paramètres d’entrée d’outil.
Exemple
Un portail de services financiers déclenche un agent Agentforce pour gérer une demande de prêt immobilier.
- Le portail s’authentifie en utilisant le flux OAuth Identifiants client et obtient un jeton de porteur.
- Il appelle “POST /einstein/ai-agent/v1/sessions” avec des variables de session : ”{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }”.
- L’utilisateur soumet sa question : « De quels documents ai-je besoin pour compléter ma demande ? »
- Le portail appelle « POST /Einstein/ai-agent/v1/sessions/{sessionId}/messages » avec le texte de l’utilisateur.
- L’agent Agentforce invoque une action de flux « GetDocumentChecklist », récupère les exigences spécifiques au type de prêt et renvoie une liste structurée.
- Le portail restitue la réponse de l’agent en ligne et ferme la session à la sortie de l’utilisateur.
Contexte
Les workflows des agents ne proviennent pas tous d’une requête humaine. Des signaux critiques pour l’entreprise, tels qu’une chute soudaine des métriques d’utilisation de produits, un abandon de panier d’achat important ou un échec de paiement franchissant un seuil de risque, se produisent fréquemment dans les données opérationnelles. Lorsque ces signaux nécessitent des réponses intelligentes à plusieurs étapes, attendre qu’un humain remarque et agisse introduit une latence qui aggrave les coûts réels de l’entreprise.
Ce schéma décrit comment les événements en temps réel servent de points d’entrée autonomes pour les agents. L’agent est invoqué par une condition de données plutôt qu’un utilisateur, raisonne sur le contexte de l’événement et exécute un workflow de réponse, le tout sans initiation humaine.
Problème
Lorsqu’un événement commercial en temps réel se produit dans Data 360 ou la plate-forme Salesforce, comment cet événement peut-il instancier de façon autonome une session d’agent, fournir la charge de travail de l’événement en tant que contexte d’ancrage et conduire un workflow d’action non conversationnelle à son terme sans qu’un humain initie ou guide l’interaction ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- Une réponse est-elle requise immédiatement au moment du déclenchement de l’événement ou le traitement en temps quasi réel (secondes à minutes) est-il acceptable?
- La charge de travail de l’événement contient-elle un contexte suffisant pour ancrer l’agent, ou l’agent doit-il effectuer des recherches supplémentaires avant de raisonner efficacement ?
- Quel est le volume et la fréquence des événements attendus ? Les flux d’événements à haut débit nécessitent une gestion tarifaire afin d’éviter d’épuiser les limites en concurrences d’agents.
- Le même événement peut-il être déclenché plusieurs fois pour la même entité commerciale (au moins une fois la livraison) ? Si oui, les actions doivent être idempotentes.
- Existe-t-il un parcours d’escalade humaine si l’agent ne peut pas résoudre l’événement de façon autonome ?
- Comment le traitement des événements échoués doit-il être exposé ? Avec une file d’attente lettre morte, une alerte ou la création d’une requête ?
Application Salesforce Pattern
| Solution | Ajustement | Commentaires |
|---|---|---|
| Flux déclenchés par Data 360 | Idéal pour les signaux comportementaux et basés sur des métriques | Cela convient mieux lorsque la condition de déclenchement est définie comme un changement d’appartenance au segment Data 360 ou un seuil de métrique. Data 360 détecte la situation de l’entreprise (par exemple, abandon du panier d’achat, baisse de l’utilisation) et déclenche un flux déclenché. Le flux mappe les attributs de charge de travail d’événements avec des variables de session d’agent et crée la session Agentforce. |
| Événements de plate-forme + flux déclenché automatiquement ou Apex. | Idéal pour les événements internes à la plate-forme et inter-systèmes | Utilisez cette solution lorsque la source de l’événement se situe sur la plate-forme Salesforce ou lorsqu’une couche middleware publie l’événement après avoir détecté la condition dans un système externe. Un événement de plate-forme publié par n’importe quel processus Salesforce ou système externe déclenche un déclencheur Apex ou Flux lancé automatiquement, qui construit la session de l’agent avec la charge utile de l’événement en contexte. |
Croquis
Diagramme de séquence pour l’exécution d’agents pilotée par un événement
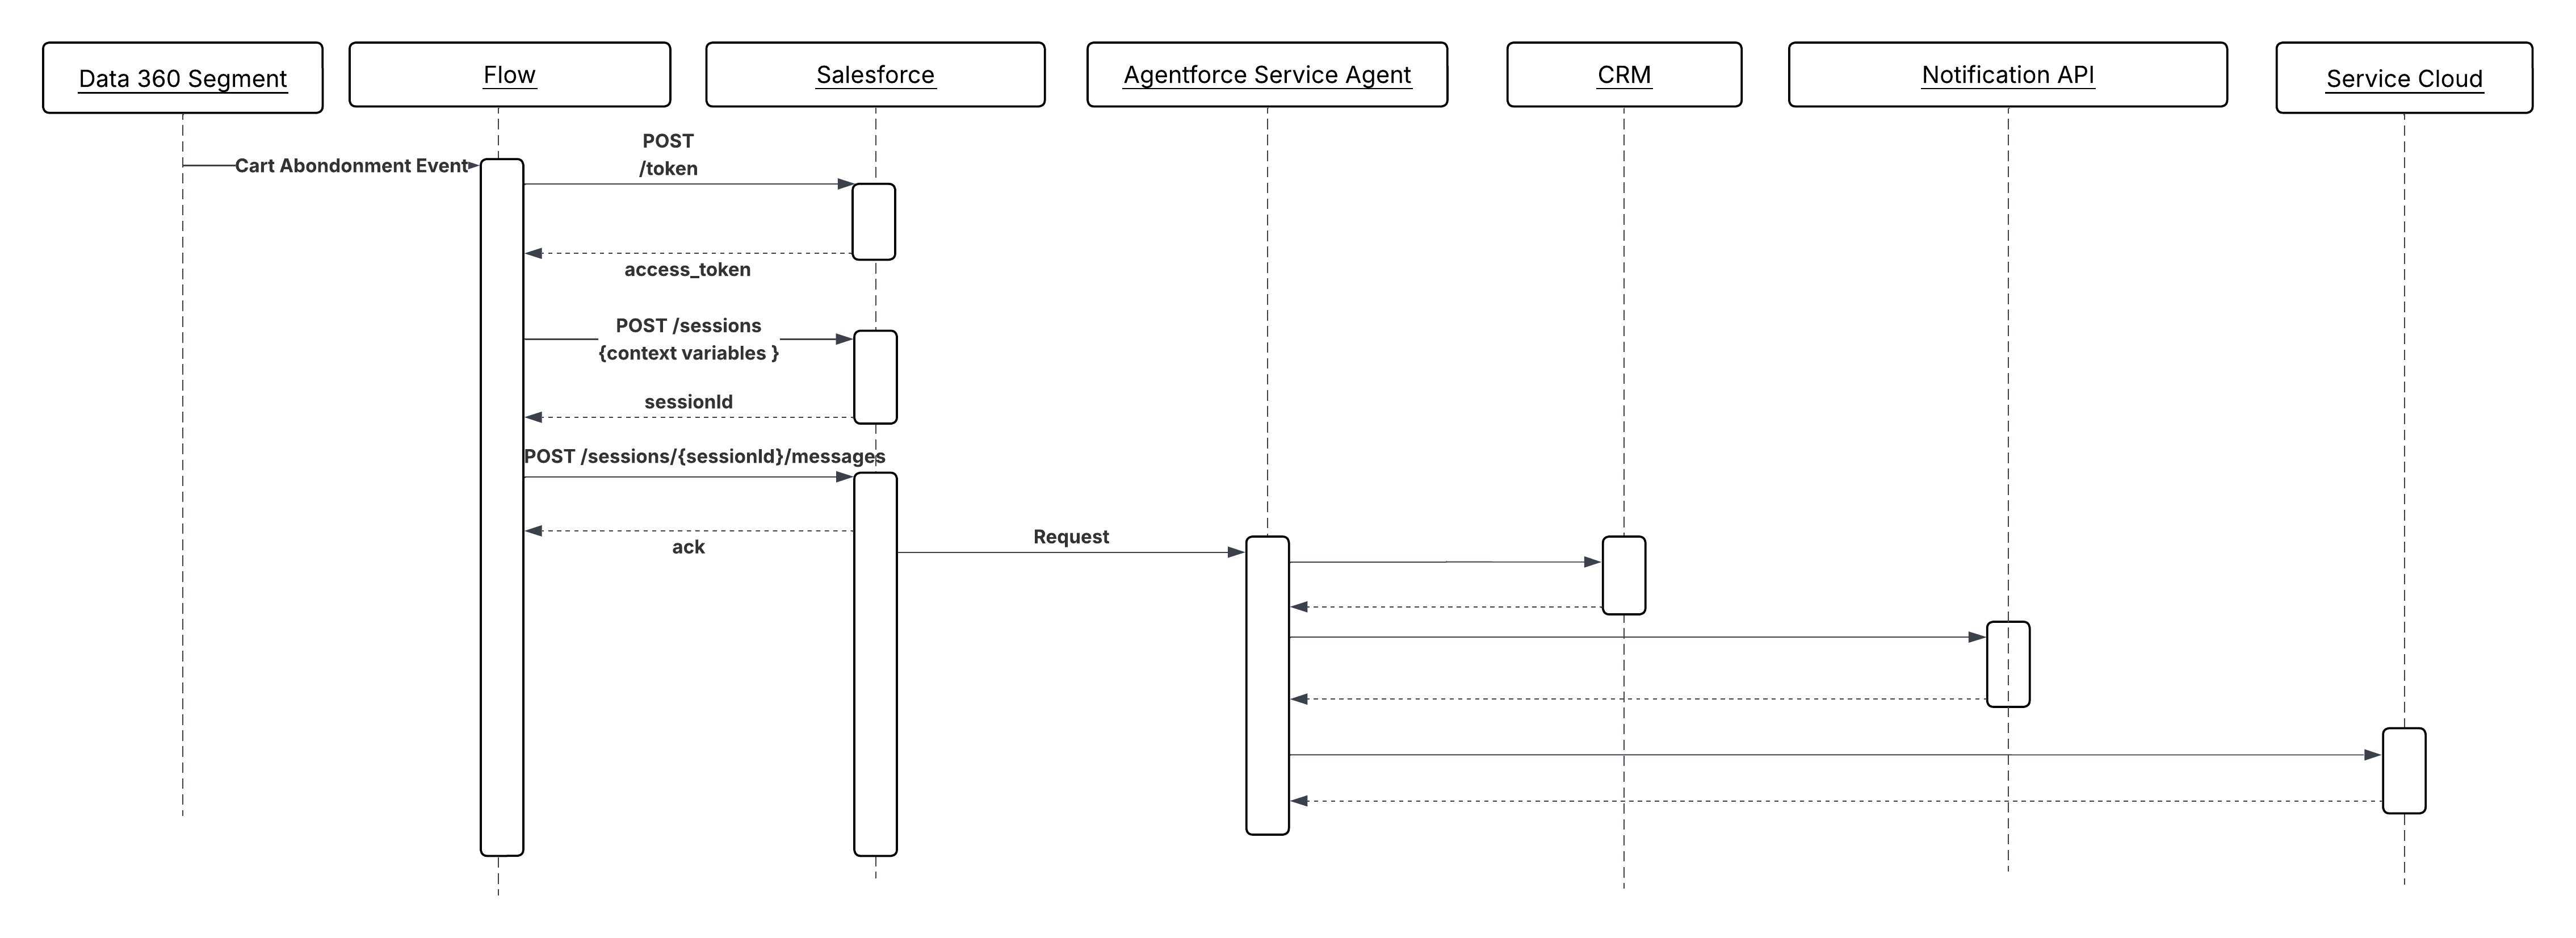
Résultats
Les agents deviennent des participants réactifs aux opérations commerciales en temps réel, pas des répondeurs passifs aux demandes humaines. Les agents déclenchés par un événement peuvent exécuter des workflows de récupération, de tri et d’escalade à la vitesse des données, pas à la vitesse de l’attention humaine.
Le système de déclenchement (Data 360 ou événements de plate-forme) reste responsable de la détection des événements et de la formation de la charge utile. L’agent reste responsable du raisonnement sur cette charge de travail et de la sélection de la chaîne d’actions correcte. Aucun tour conversationnel n’est requis, la charge de travail de l’événement est l’entrée complète.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Concevez toutes les actions pour l’invocation non conversationnelle. Il n’y a pas de tour utilisateur. L’agent doit parvenir à une résolution uniquement à partir du contexte d’ancrage initial. Les actions doivent renvoyer des résultats structurés et déterministes plutôt que de demander des éclaircissements.
- Assurez-vous que la charge de travail de l’événement contient un contexte d’ancrage suffisant avant la création de la session de l’agent. Une charge de travail allégée qui force l’agent à passer plusieurs appels de référence avant qu’il puisse raisonner augmente la latence et la consommation simultanée.
- Rendez idempotentes toutes les opérations d’écriture déclenchées par des agents pilotés par l’événement. Les systèmes de livraison d’événements offrent généralement des garanties d’au moins une fois. Le traitement des événements dupliqués ne peut pas produire d’effets secondaires dupliqués.
Notes d’implémentation Salesforce
- Dans Flux déclenchés par Data 360, mappez les attributs de charge utile d’événements (par exemple, « accountId », « eventType », «metricValue », « productIds ») directement avec des variables de session nommées lors de la création de la session. Cela motive l’agent à partir de la première étape de raisonnement sans nécessiter d’action de récupération.
- Pour des déclencheurs d’événement de plate-forme, utilisez un flux lancé automatiquement plutôt qu’un flux d’écran. Les flux d’écran ne sont pas pris en charge dans des contextes autonomes et non conversationnels.
- Définissez une expiration de session explicite dans les sessions déclenchées par un événement. Contrairement aux sessions conversationnelles, aucun utilisateur ne peut étendre l’interaction. Une session bloquée par une action échouée ne doit pas contenir indéfiniment un créneau simultané.
- Utilisez des chemins de défaut de flux pour gérer les échecs de création de sessions d’agent. Si la session ne peut pas être créée, le chemin de défaut doit publier un événement de compensation ou créer une requête pour un suivi humain plutôt que d’abandonner l’événement en silence.
Traitement et récupération des erreurs
- Les événements qui ne déclenchent pas une session d’agent avec succès en raison de limitations en simultanéité, d’erreurs de création de session ou d’échecs de validation de charge utile doivent être acheminés vers un chemin de défaut qui crée une requête, déclenche une alerte ou publie l’événement dans une file d’attente en lettres mortes pour retraitement.
- Les échecs de l’agent en cours d’exécution (par exemple, expiration d’une action requise) doivent être consignés avec l’ID d’événement d’origine. Puisque le déclenchement est asynchrone et qu’il n’y a aucun appelant en attente, la surface d’erreur est entièrement basée sur l’observabilité : journaux, tableaux de bord et seuils d’alerte.
- Implémentez un plafond de tentatives. Si un événement entraîne de façon fiable l’échec d’un agent, les tentatives illimitées épuisent les limites en simultanéité. Après un nombre maximal de tentatives configurable, acheminez l’événement vers une file d’attente d’examen humain avec le contexte complet joint.
- Suivez l’ID d’événement à travers le cycle de vie complet de la session de l’agent. Ce suivi active la corrélation entre le signal de données d’origine et toutes les actions en aval pour l’audit et le débogage.
Considérations de sécurité
- Validez et désinfectez tous les attributs de charge utile d’événements avant de les injecter en tant que variables de session d’agent. Les charges utiles d’événements de Data 360 ou d’éditeurs externes sont une surface d’attaque pour l’injection rapide. Par exemple, un champ de charge utile peut être conçu pour remplacer les instructions de l’agent.
- Exécutez des sessions d’agent déclenchées par un événement sous un utilisateur de l’intégration dédié et à moindre privilège plutôt que sous une identité d’administrateur à privilège élevé. L’agent détient uniquement les autorisations requises pour exécuter son ensemble d’actions défini.
- Consignez toutes les sessions déclenchées par un événement avec l’ID d’événement d’origine, le type d’événement et les variables de session injectées à la création. Ce journal d’audit est nécessaire pour reconstituer les raisons pour lesquelles l’agent a pris une mesure donnée si le résultat est contesté.
Exemple
Une entreprise de vente au détail utilise Data 360 pour suivre en temps réel le comportement du panier d’achat. Lorsqu’un panier d’achat avec une valeur supérieure à un seuil défini est abandonné :
- Data 360 détecte le signal d’abandon et déclenche un flux déclenché avec la charge utile de l’événement : « customerId », « cartValue », « productIds » et « abandonTimestamp ».
- Le flux mappe ces attributs avec des variables de session Agentforce et crée une nouvelle session d’agent. Aucune interaction utilisateur n’est requise.
- L’agent évalue l’historique des achats, les autorisations actuelles et la composition du panier d’achat du client en utilisant ses actions de récupération disponibles.
- L’agent invoque une action de
SelectRecoveryOffer, qui applique le niveau de remise approprié en fonction du segment de clients, et une action deSendProactiveNotificationpour livrer l’offre via le canal préféré du client. - L’agent invoque des
CreateFollowUpTaskpour consigner l’interaction dans le CRM afin d’assurer la visibilité du propriétaire du compte. - La session se ferme automatiquement une fois la chaîne d’actions terminée. L’ID d’événement d’origine est conservé dans le journal de session pour la traçabilité.
Contexte
Les LLM sont formés sur les données publiques. Ils n’ont aucune Knowledge des produits, des politiques, de l’historique des requêtes ou des contrats de votre organisation, sauf si ces informations sont explicitement fournies au moment du raisonnement. Sans fondement, un agent interrogé sur l’autorisation de service d’un client ou les termes d’un contrat spécifique hallucine une réponse ou admet qu’il ne sait pas. Aucun de ces résultats n’est acceptable dans un contexte d’entreprise.
Retrieval-Augmented Generation (RAG) résout ce problème en récupérant les documents pertinents d’un magasin Knowledge entreprise et en les injectant dans la fenêtre contextuelle de l’agent avant qu’elle ne génère une réponse. L’agent raisonne sur le contenu récupéré comme un article Knowledge, une résolution de requête passée, une spécification de produit comme si on lui avait donné directement ces informations. Le LLM fournit le raisonnement; la couche de récupération fournit les faits.
Par exemple, un agent de service traitant une réclamation de garantie complexe n’a pas besoin d’inclure les conditions de la politique de garantie dans ses instructions. À la place, lorsque le client décrit son problème, l’agent effectue une recherche sémantique ou une recherche hybride (recherche par mot-clé + recherche sémantique) par rapport à un index vectoriel de la documentation de garantie, récupère les termes applicables et les utilise pour déterminer l’éligibilité et les étapes suivantes. La réponse est fondée sur le document de politique actuel, qui fait autorité, et non sur les données d’entraînement du modèle.
Problème
Un agent doit répondre à une question ou prendre une décision qui dépend de Knowledge organisationnelles propriétaires telles que des politiques, des contrats, de la documentation produit ou des données de requête historiques qui ne faisaient pas partie des données de formation du grand livre. Comment l’agent récupère-t-il le contenu le plus pertinent au moment du raisonnement, s’assure-t-il que le contenu récupéré est à jour et fait autorité, et l’injecte-t-il dans le contexte avec suffisamment de précision pour éviter tout bruit ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- Le contenu Knowledge est-il statique et rarement mis à jour (par exemple, les manuels de produits) ou change-t-il continuellement (par exemple, les résolutions de requêtes, les descriptions d’inventaire)? La fréquence de mise à jour détermine la conception du pipeline d’ingestion.
- Quelle est la taille du contenu ? Une petite base de connaissances peut être récupérée de façon exhaustive ; une grande base nécessite un segmentage, une intégration et une indexation sémantique pour renvoyer uniquement les passages les plus pertinents.
- La requête bénéficie-t-elle d’une seule récupération ciblée ou la combinaison des résultats de plusieurs sources Knowledge (par exemple, documentation et requêtes passées simultanément) produira-t-elle une réponse mieux fondée ? Ce dernier nécessite une récupération d’ensemble.
- Est-il nécessaire de filtrer les contenus récupérés par métadonnées avant le classement sémantique, par exemple en limitant les résultats aux documents correspondant au niveau de produit ou à la zone géographique du client ?
- Quelle est la sensibilité du contenu de connaissances ? Le contenu récupéré est injecté dans la fenêtre de contexte du grand livre et influence la réponse de l’agent. Le contenu qui ne doit pas être exposé à certains utilisateurs doit être régi par la couche de récupération, pas supposé être filtré par le grand livre.
Application du modèle Salesforce
| Solution | Ajustement | Commentaires |
|---|---|---|
| Génération augmentée de récupération (RAG) avec Data 360 | Idéal pour les cas d’utilisation d’entreprise | L’agent effectue une recherche sémantique par rapport aux index vectoriels Data 360 avant de générer une réponse. Les contenus récupérés, tels que les articles Knowledge, les requêtes passées, la documentation produit, sont injectés dans le contexte LLM en tant qu’ancrage. Cela peut être appelé en utilisant des actions Retriever, Flux ou Apex personnalisé. Notez que Data 360 prend en charge un pipeline intégré allant du contenu brut au contexte prêt pour l’agent, pas seulement un magasin vectoriel :
Toutes ces fonctionnalités sont offertes clé en main avec une configuration complète. Nous avons deux types de récupérateur pour Data360 : Récupérateur individuel: Une action Salesforce Retriever configurée effectue une recherche sémantique par rapport à un seul Index de recherche défini et renvoie les segments de contenu les plus pertinents. Les résultats sont injectés directement dans le prompt du LLM en tant que contexte d’ancrage. Utilisez Individual Retriever Action lorsque la requête est mieux servie par une source de connaissances unique et ciblée. Ensemble Retriever : Une action Ensemble Retriever combine les résultats de plusieurs récupérateurs individuels, par exemple un index de documentation produit et un index de requêtes résolues. Les récupérateurs d’ensemble ne combinent pas les scores de pertinence des récupérateurs individuels, car ces scores ne sont pas comparables entre des index hétérogènes. À la place, tous les segments récupérés sont transmis via un modèle de reclassement à code croisé qui calcule indépendamment le score de chaque paire (requête, segment), produisant un classement unifié. Ceci est architecturalement significatif: Cela signifie que la qualité du classement inter-sources s’améliore avec le modèle de reclassement, et non grâce à un étalonnage manuel du score. Après les avoir reclassés, le résultat unifié est disponible dans le prompt du LLM en tant que contexte d’ancrage. Utilisez l’action Ensemble Retriever lorsqu’une réponse plus complète nécessite des preuves provenant de plusieurs domaines de connaissances. |
| RAG avec des bases de données vectorielles tierces | Convient lorsque vous travaillez dans les contraintes d’infrastructure existantes | Cette approche intègre des magasins vectoriels tiers qui pourraient déjà exister dans votre infrastructure pour indexer les incorporations de données propriétaires, en les exploitant pour la recherche sémantique et la récupération de contenus en temps réel. Cela peut être implémenté en utilisant Flow ou Apex personnalisé. |
Croquis
Diagramme de séquence pour l’ancrage des connaissances à partir du contenu d’entreprise
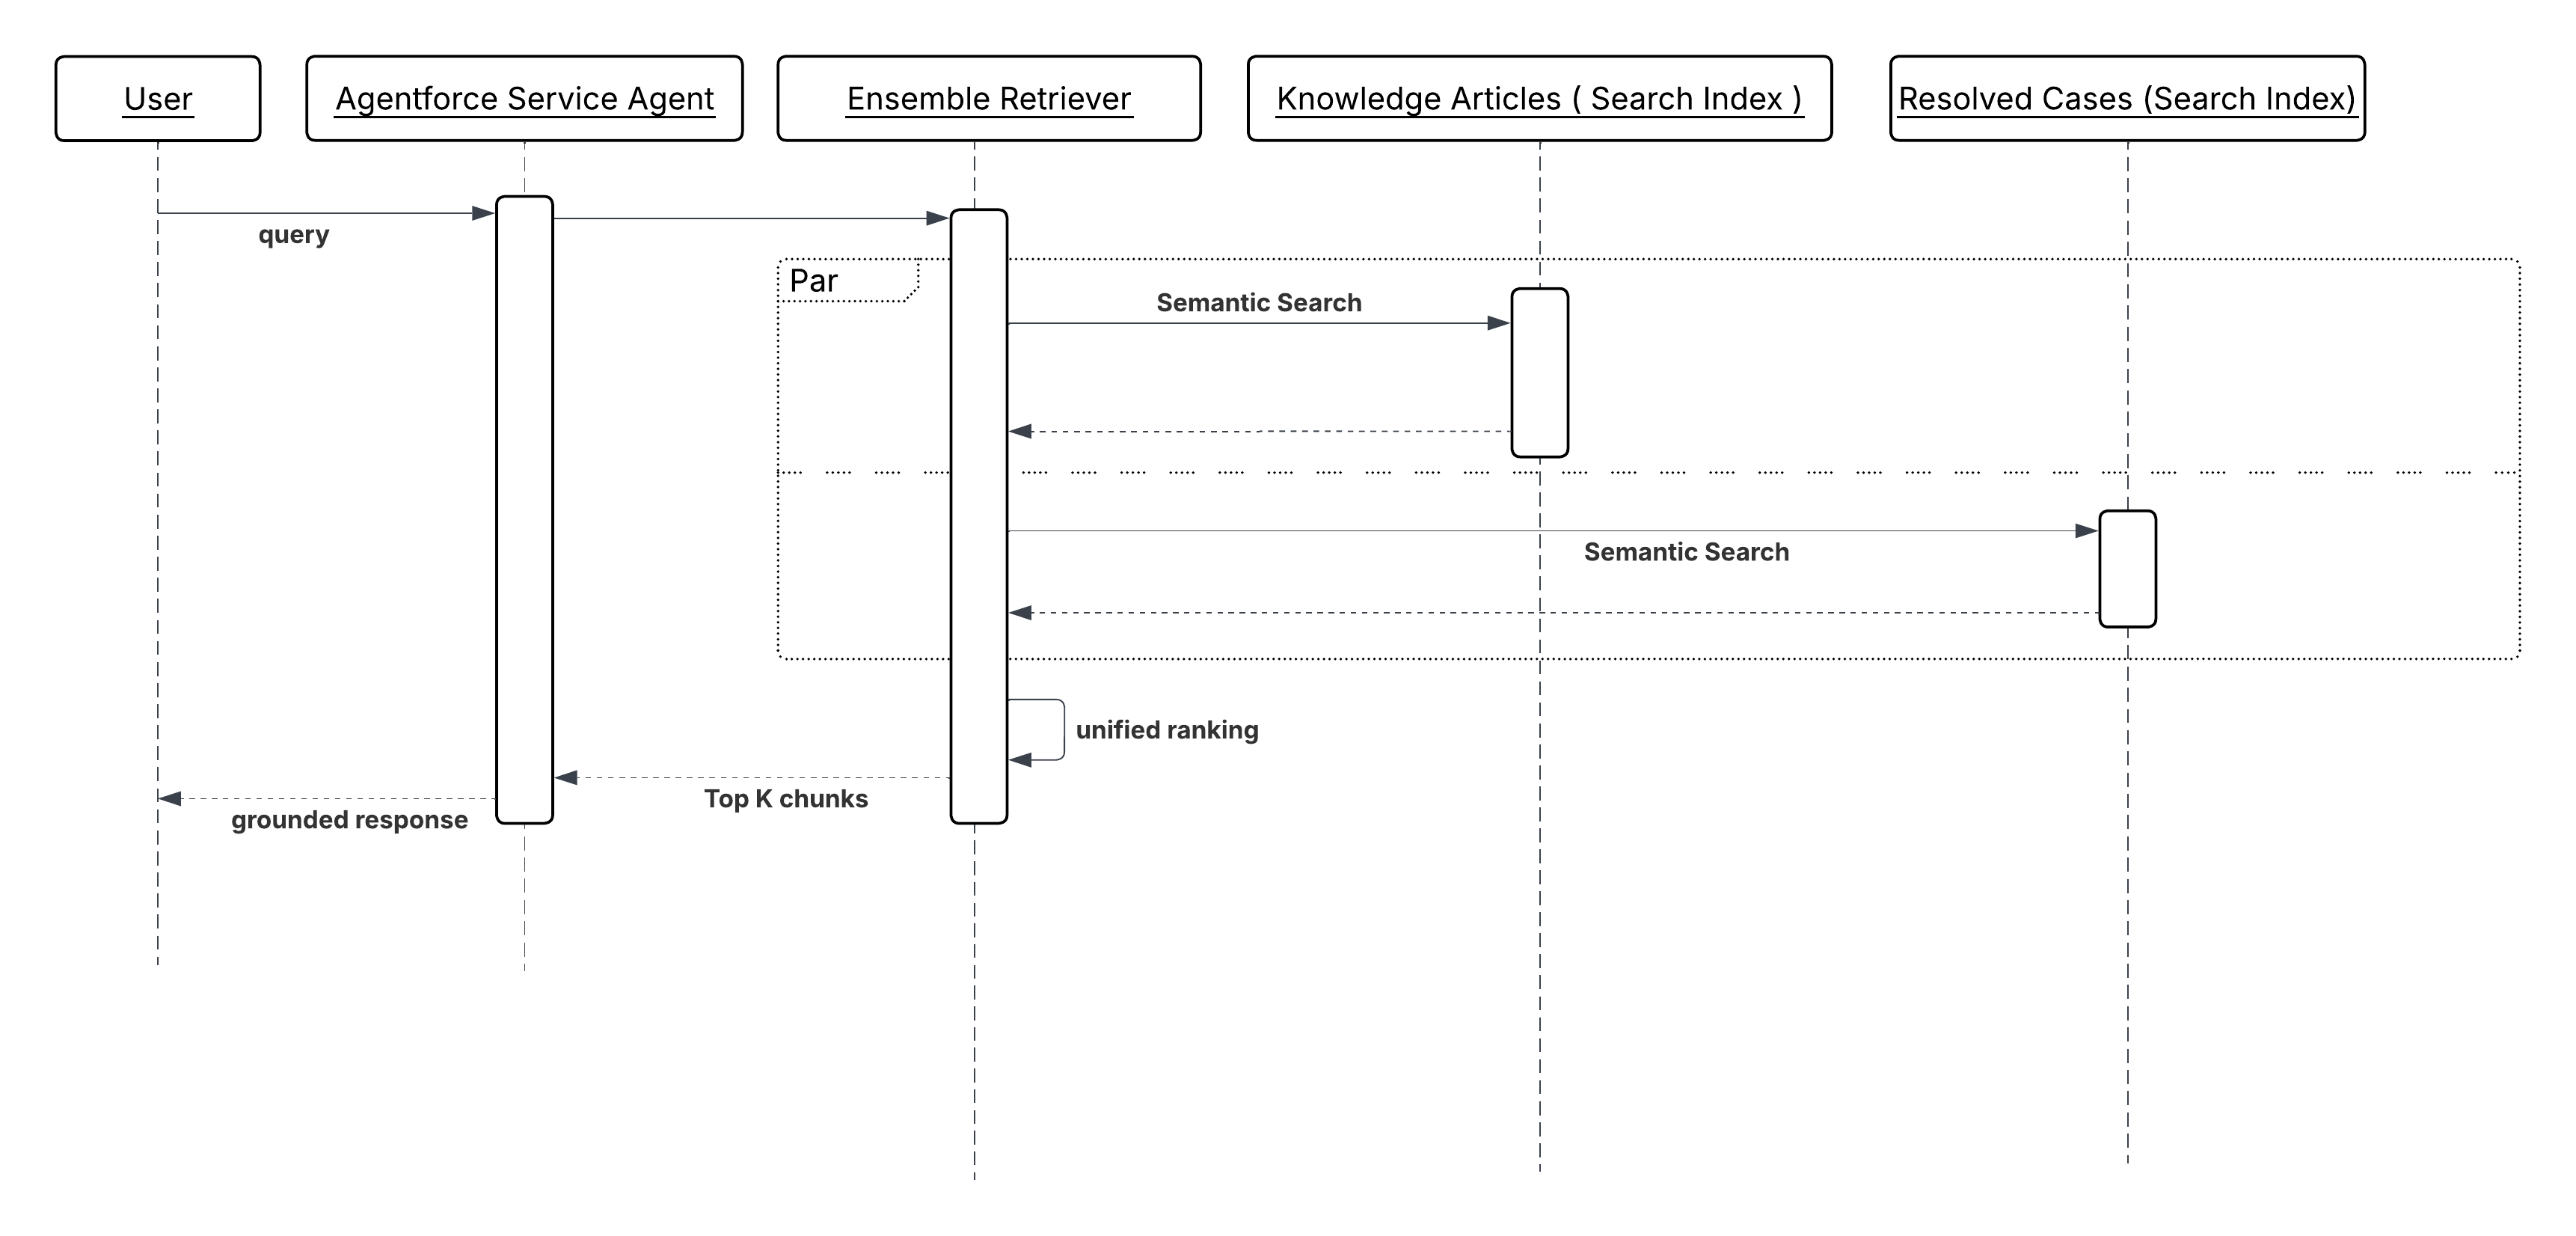
Résultats
Les réponses de l’agent sont ancrées aux connaissances actuelles de l’organisation, qui font autorité, plutôt qu’aux données de formation du LLM. Le risque d’hallucination sur des questions factuelles telles que les termes de la police, les spécifications du produit, les détails d’autorisation est réduit, car le modèle raisonne sur des preuves récupérées, pas sur une génération à partir de la mémoire.
Le contenu de connaissances reste indépendamment maintenable. La mise à jour d’un document de stratégie ou l’ajout d’une nouvelle résolution de requête à l’index prend effet immédiatement pour toutes les interactions ultérieures des agents, sans réentraînement ni redéploiement du modèle.
La récupération fournit également un journal d’audit implicite. La réponse de l’agent est dérivée de documents récupérés spécifiques. Par conséquent, le contenu source peut être consigné avec la réponse, ce qui permet de suivre les raisons pour lesquelles l’agent a donné une réponse particulière.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Divisez et intégrez le contenu de connaissances à la granularité appropriée. Les segments trop volumineux diluent la pertinence. Les segments trop petits perdent le contexte environnant dont le LLM a besoin pour raisonner correctement. Pour la plupart des types de document d’entreprise, la segmentation au niveau du paragraphe avec des fenêtres contextuelles superposées produit la meilleure qualité de récupération.
- Considérez la précision de la récupération comme une préoccupation de conception de premier ordre. L’injection de contenus de faible pertinence dans la fenêtre contextuelle de l’agent n’est pas neutre. Il introduit un bruit qui dégrade la qualité de réponse. Ajustez les seuils de récupération et les limites top-k afin d’équilibrer rappel et précision pour chaque domaine Knowledge.
- La latence d’ingestion est un accord de niveau de service opérationnel. Si un document de stratégie est mis à jour, mais que l’index vectoriel n’a pas été actualisé, l’agent récupère et agit en fonction des informations périmées. Définissez une tolérance acceptable à l’humidité pour chaque type de contenu et concevez des pipelines d’ingestion en conséquence.
Notes d’implémentation Salesforce
- Remplissez les index vectoriels Data 360 via le pipeline d’ingestion approprié pour la fréquence de mise à jour du contenu. Utilisez l’ingestion par lot pour les documents statiques, et le streaming ou la Capture des données de modification (CDC) pour les enregistrements qui changent en permanence.
- Pour Ensemble Retrievers, configurez les pondérations de classement de pertinence par source. Un index de requêtes résolues peut nécessiter un biais de récence ; un index de documentation de politique peut ne pas en avoir besoin. Ajustez les pondérations en fonction des types de requête que l’agent doit traiter.
- Utilisez des filtres de métadonnées dans Apex personnalisé ou des récupérateurs de flux pour récupérer l’étendue avant l’exécution de la recherche sémantique. Le filtrage par ligne de produit, région ou type de document avant le classement réduit le bruit et améliore la précision des éléments injectés dans le contexte.
- N’injectez pas le document récupéré complet dans le contexte LLM. Transmettez uniquement les segments ou les extraits appropriés. Les injections de contexte volumineuses consomment un budget de jeton, augmentent la latence et réduisent la proportion de la fenêtre de contexte disponible pour le raisonnement de l’agent.
Traitement et récupération des erreurs
- Si la récupération ne renvoie aucun résultat, renvoyez un statut explicite « Aucun résultat trouvé » au lieu de continuer sans fondement. L’agent peut ensuite élargir la requête, demander des éclaircissements à l’utilisateur ou escalader vers un humain.
- Chaque segment renvoyé par les retrievers contient un score de pertinence. Selon le cas d’utilisation, une certaine valeur de confiance/pertinence de seuil doit être configurée au-delà de laquelle l’agent doit traiter la récupération comme confiante, sinon elle doit revenir à une clarification ou à une escalade.
- Si l’index vectoriel ou le service de récupération est temporairement indisponible, l’action retriever ou l’appel externe Apex doit renvoyer une erreur structurée avec un motif descriptif. Consignez l’échec avec l’ID de session et la requête afin d’identifier les écarts de récupération et de surveiller la disponibilité de l’index ou du service.
- Pour les domaines Knowledge sensibles au temps, implémentez un contrôle de fraîcheur dans le cadre de la réponse de récupération. Si le document correspondant le plus récent a été mis à jour pour la dernière fois au-delà d’un seuil de périmé défini, signalez-le à l’agent pour qu’il puisse qualifier sa réponse ou demander une vérification.
Considérations de sécurité
- La récupération doit respecter les autorisations d’accès aux données de l’utilisateur au nom duquel l’agent agit. Une session d’agent exécutée dans le contexte d’une interaction avec un client ne doit pas récupérer des documents opérationnels internes, des notes de stratégie de tarification ou des enregistrements auxquels l’utilisateur n’aurait pas accès autrement. Appliquez la sécurité au niveau du champ et au niveau de l’enregistrement à la couche de récupération. Ne vous appuyez pas sur le grand livre pour retenir les contenus récupérés confidentiels.
- Le contenu récupéré est injecté dans la fenêtre de contexte LLM et peut influencer ou apparaître dans la réponse de l’agent. Traitez chaque document du contenu de récupération comme potentiellement visible pour l’utilisateur final et régissez l’appartenance au contenu en conséquence.
- Consignez toutes les requêtes de récupération et les identificateurs de document des segments récupérés avec l’ID de session. Ce journal d’audit permet de reconstituer les preuves utilisées par l’agent pour répondre, qui peuvent être requises pour des obligations de conformité, de résolution des litiges ou d’explicabilité.
Exemple
Un agent des services financiers traite la requête d’un client concernant les pénalités de remboursement anticipé sur un produit d’épargne à durée déterminée :
- Le client demande : « Quelle pénalité encourrais-je si je retirais mes fonds six mois plus tôt ? »
- L’agent invoque une action Individu récupérateur configurée par rapport à un index vectoriel de documents sur les conditions d’utilisation du produit.
- Le récupérateur effectue une recherche sémantique en utilisant le contexte de la requête, par exemple le type de produit et le compte client, et la question spécifique, et renvoie les trois segments de document les plus pertinents - la clause d’échange anticipé, le tableau de calcul des pénalités et les exceptions applicables aux cas de difficulté.
- Les segments récupérés sont injectés dans la fenêtre contextuelle de l’agent avec la question du client.
- L’agent motive les conditions récupérées, identifie le taux de pénalité applicable au niveau de produit et au calendrier d’échange du client, et renvoie une réponse précise, basée sur la politique, en citant la date effective des conditions qu’il a utilisées.
- Les identificateurs de document des segments récupérés sont consignés avec l’enregistrement de session pour l’auditabilité.
Contexte
Les LLM sont probabilistes par nature. Lorsqu’on leur demande de raisonner sur un client spécifique, ils déduisent, estiment ou hallucinent des faits qui ne leur ont pas été explicitement donnés. Un agent qui invoque une action de tarification sans savoir que le client est un compte professionnel à valeur élevée à un niveau préféré peut appliquer une logique de remise incorrecte. Un agent qui escalade un dossier de support sans connaître le score de risque d’attrition du client peut déprioriser un compte sur le point de se résilier.
L’injection de contexte client vérifiée répond à ce problème en préremplissant les paramètres d’entrée d’action avec des attributs vérifiés et structurés du profil unifié avant que l’agent invoque une action. L’agent ne déduit pas le segment du client, la valeur de durée de vie ou la tendance de satisfaction client (CSAT). Il reçoit ces faits comme des éléments de base et des motifs. Ce schéma réduit le risque d’hallucination dans les décisions spécifiques au client et élimine les appels de référence redondants pendant le cycle de raisonnement.
Par exemple, avant qu’un agent de tarification invoque une action « GenerateQuote », la configuration du sous-agent injecte automatiquement le segment, le niveau et la valeur de durée de vie du client depuis son profil unifié. L’action reçoit des faits vérifiés plutôt que des approximations déduites du LLM, et le devis est ancré à la relation commerciale réelle du client.
Ce n’est pas une alternative au schéma « Knowledge Grounding from Enterprise Content ». Un agent bien conçu peut utiliser à la fois : « Knowledge Grounding from Enterprise Content » fournit des connaissances basées sur des documents, tandis que « Verified Customer Context Injection » établit l’identité du client.
Problème
Comment s’assurer qu’un agent dispose de faits précis et spécifiques au client, tels que le segment, le niveau, la valeur à vie, le risque d’attrition ou d’autres attributs de profil, avant d’entreprendre une action, plutôt que de deviner ces faits lui-même ?
Forces
Lors de l’application de ce schéma, répondez aux questions suivantes :
- Quels paramètres d’entrée d’action représentent des faits spécifiques au client qui, s’ils étaient inférés plutôt qu’originaires, produiraient des résultats incorrects ou incohérents ?
- Les attributs de profil requis sont-ils disponibles en tant que champs de profil unifié Data 360 standard ou nécessitent-ils des connaissances calculées dérivées de données comportementales et transactionnelles brutes ?
- À quelle fréquence les attributs de profil appropriés changent-ils ? Des attributs tels que le score de risque d’attrition ou la tendance de satisfaction client nécessitent une garantie d’actualisation. Les données de profil périmées entraînent les mêmes résultats incorrects que les données hallucinées.
- Les attributs de profil doivent-ils être injectés lors de la création de la session (constante pendant la durée de la session) ou récupérés à l’état neuf au point d’invocation de l’action (pour refléter les changements d’état en milieu de session) ?
- L’agent doit-il raisonner directement sur les attributs de profil, ou sont-ils consommés uniquement par l’action et opaques pour la boucle de raisonnement de l’agent ?
Application de modèle Salesforce
| Solution | Ajustement | Commentaires |
|---|---|---|
| Configuration du sous-agent - Mappage des attributs de profil | Idéal pour l’ancrage statique au niveau de la session | Convient mieux lorsque les attributs du profil sont stables dans une seule interaction. Mappez les attributs de profil unifié Data 360 (par exemple, « customerSegment », «tier », « lifetimeValue ») directement avec des paramètres d’entrée d’action dans la configuration des sous-agents Agentforce. Les attributs sont résolus à la création de la session et maintenus constants pendant la durée de la session. |
| Flux connectés Data 360 | Idéal pour l’actualisation dynamique ou à mi-session | Utilisé lorsque les attributs de profil changent fréquemment ou lorsque l’action nécessite l’état le plus récent. Utilisez un flux connecté à Data 360 en tant qu’étape d’action pour exposer le dernier état du profil au point d’invocation.Le flux interroge le profil unifié, applique toutes les transformations nécessaires et renvoie les attributs en tant que variables de sortie consommées par l’action suivante de la chaîne. |
| Connaissances calculées en tant qu’entrées d’action : | Idéal pour les métriques dérivées complexes | Utilisé lorsque les agents doivent raisonner sur des métriques métiers calculées (score de risque de résiliation, tendances de satisfaction client, indice d’adoption de produits) plutôt que d’interpréter des données brutes. Définies dans Data 360 en tant que métriques dérivées calculées sur des données comportementales, transactionnelles et d’engagement. Les Connaissances calculées sont exposées en tant qu’attributs de profil interrogeables et peuvent être mappées avec des entrées d’action via une configuration de rubrique ou un flux connecté. |
Croquis
Diagramme de séquence pour l’injection vérifiée du contexte client
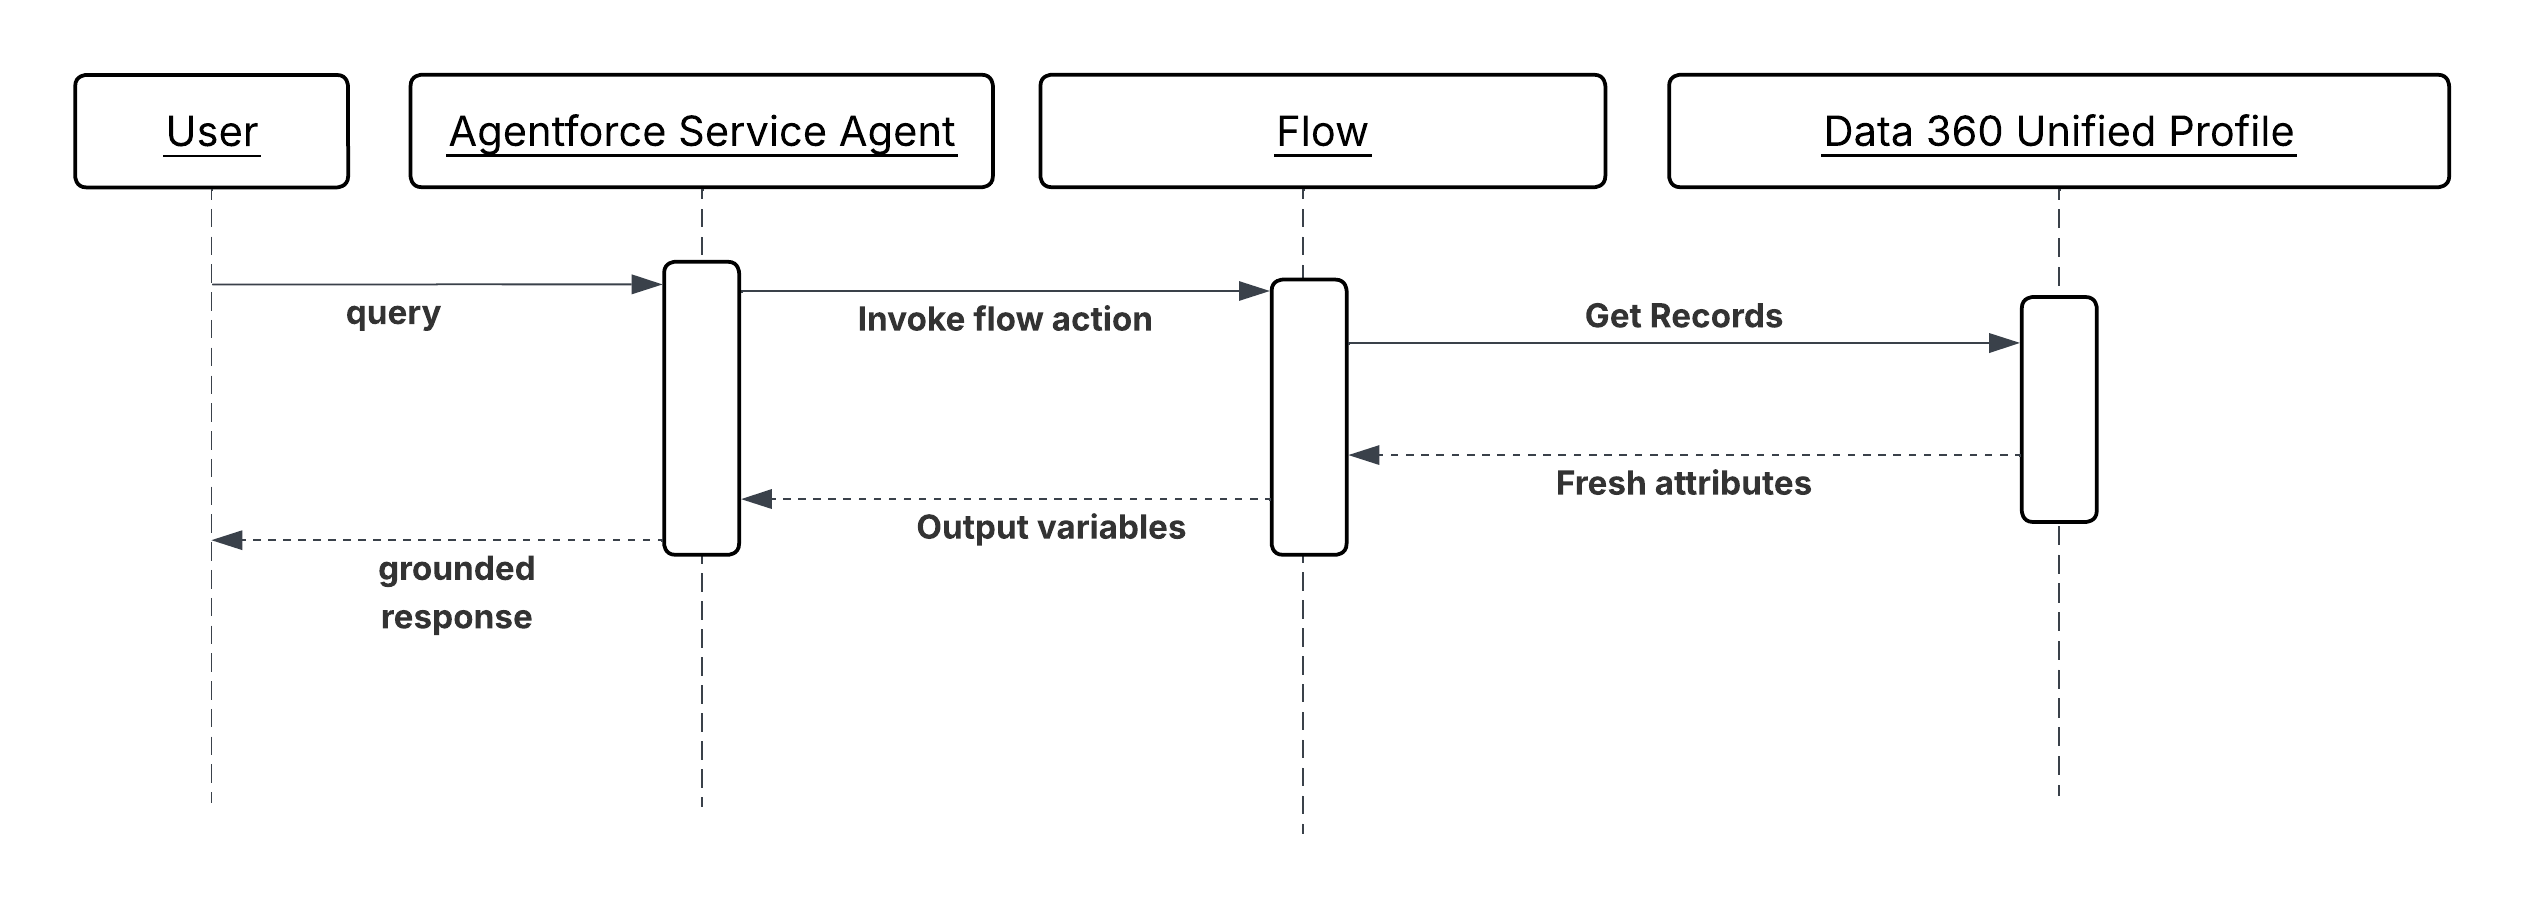
Résultats
Les actions reçoivent des faits clients vérifiés et structurés plutôt que des approximations déduites par un modèle de langage (LLM). Le raisonnement de l’agent est ancré à l’état actuel du profil du client, ce qui réduit le risque d’hallucination dans les décisions où la précision des faits détermine la qualité du résultat, notamment la tarification, les contrôles d’autorisation, l’acheminement d’escalade, les offres de rétention.
L’ancrage du profil réduit également la latence de raisonnement. Lorsque l’agent n’a pas besoin d’émettre des appels de référence pour établir le contexte client de base, le cycle de raisonnement est plus court et la concurrence est consommée pendant moins de temps.
Le profil unifié Data 360 reste la source autorisée des faits clients. La configuration du sous-agent ou le flux connecté est la couture d’intégration. L’agent est responsable du raisonnement sur ces faits et de la sélection des actions, pas de la source des faits eux-mêmes.
Considérations relatives à la conception
Recommandations indépendantes de la plateforme
- Identifiez toutes les entrées d’action qui comportent un risque d’hallucination, où l’inférence du LLM peut produire un résultat incorrect au lieu d’une valeur vérifiée. Les entrées avec risque d’hallucination sont candidates pour l’ancrage au profil. Les entrées ne nécessitent pas toutes un ancrage. La surinjection de données de profil ajoute du bruit à la fenêtre contextuelle de l’agent.
- Considérez la fraîcheur du profil comme une décision de conception, pas comme une réflexion a posteriori. Définissez la tolérance acceptable à l’obsolescence pour chaque attribut ancré et choisissez le mécanisme d’injection en conséquence : mappage au niveau de la session pour les attributs stables, actualisation basée sur le flux pour les attributs volatiles.
- Les Connaissances calculées doivent coder la logique métier, pas les métriques brutes. Un raisonnement d’agent sur un « churnRiskScore » de 0,87 est plus efficace qu’un raisonnement d’agent sur 14 signaux comportementaux bruts. Calculez l’interprétation dans Data 360 ; transmettez le résultat à l’agent.
Notes d’implémentation Salesforce
- L’ancrage du profil est aussi fiable que l’unification qui le sous-tend. Par exemple, la valeur du Profil unifié dépend entièrement de la qualité de la résolution de l’identité en amont. Si un client a des identités fragmentées entre des systèmes sources qui n’ont pas été unifiés, les attributs de profil que l’agent reçoit sont incomplets ou ne représentent qu’une vue partielle (par exemple, Valeur de durée de vie calculée avec les données d’un canal, mais pas d’un autre).
- Pour des flux connectés Data 360, utilisez l’élément Obtenir des enregistrements avec un filtre dans « recordId » ou « accountId » de la session actuelle pour récupérer uniquement l’enregistrement de profil correspondant. Renvoyez uniquement les attributs requis par l’action en aval. Ne renvoyez pas l’objet profil complet.
- Les Connaissances Calculées doivent être maintenues à jour via les pipelines d’ingestion Data 360. Configurez l’actualisation en continu ou en temps quasi réel des connaissances utilisées dans des décisions sensibles au temps (par exemple, risque d’attrition dans un workflow de rétention). Les connaissances actualisées par lot sont acceptables pour les attributs à évolution plus lente (par exemple, niveau de valeur de contrat annuel).
- Vérifiez que les attributs de profil mappés ne sont pas nuls avant l’invocation de l’action. Un « customerTier » nul transmis à une action de tarification est aussi nocif qu’une valeur hallucinée. Utilisez des éléments de décision de flux pour détecter les données de profil manquantes et acheminer vers une solution de secours qui récupère un paramètre par défaut ou invite à une clarification.
- Dans la configuration du sous-agent, mappez les attributs de profil avec des paramètres d’entrée d’action en utilisant des noms de variable explicites et sémantiquement clairs (par exemple, « customerTier », « lifetimeValueUSD », «churnRiskScore »). Le LLM lit ces noms lors de la sélection et de la composition d’actions ; les noms ambigus dégradent la précision de la sélection.
Traitement et récupération des erreurs
- Si un attribut de profil requis est nul ou non disponible au moment de l’invocation de l’action, l’agent ne doit pas procéder avec un défaut potentiellement incorrect. L’action doit renvoyer une erreur structurée indiquant l’attribut manquant, et l’agent doit inviter l’utilisateur à clarifier ou escalader vers un humain s’il fonctionne sans conversation.
- Si un flux connecté à Data 360 ne parvient pas à récupérer les données de profil (par exemple, en raison d’une interruption du service Data 360), le chemin de défaut du flux doit renvoyer une erreur structurée à l’agent avec le motif d’échec spécifique. L’agent peut ensuite décider de réessayer, de continuer avec une expérience dégradée ou de révéler l’échec à l’utilisateur.
- Consignez toutes les valeurs d’attribut de profil injectées lors de la création de la session ou de l’invocation de l’action avec l’ID de session. Cela permet de reconstituer toute décision contestée de l’agent avec les faits clients exacts que l’agent a reçus à l’époque.
Considérations de sécurité
- Les attributs de profil injectés dans le contexte de l’agent sont soumis aux mêmes contrôles d’accès aux données que n’importe quel enregistrement CRM. Assurez-vous que l’utilisateur de l’intégration ou l’application connectée utilisé pour résoudre les attributs de profil détient uniquement les autorisations au niveau du champ requises pour les attributs exposés, pas un accès en lecture au profil élargi.
- Les connaissances calculées qui codent des métriques dérivées confidentielles (par exemple, score de santé prédit, niveau de risque financier) doivent être traitées comme des champs confidentiels et régies par les mêmes contrôles d’accès que les données sous-jacentes. Faire apparaître un score de risque d’attrition élevé à un agent qui opère dans un contexte où il est exposé au client nécessite un examen attentif de ce que l’agent peut communiquer.
- N’exposez pas les attributs de profil qui ne sont pas requis par l’action. Chaque attribut supplémentaire dans la fenêtre contextuelle de l’agent est un élément de données supplémentaire qui peut être reproduit dans la réponse de l’agent. Appliquez un principe minimum nécessaire à l’ancrage du profil.
- Auditez toutes les sessions dans lesquelles des Connaissances calculées ou des attributs de profil sensibles ont été injectés en entrée. Ces sessions représentent des décisions prises sur la base d’Intelligence client dérivée et peuvent être soumises à des exigences d’explicabilité ou réglementaires dans certains secteurs d’activité.
Exemple
Une entreprise de télécommunications utilise Agentforce pour gérer les conversations de rétention avec les clients qui ont initié une demande d’annulation.
- Lorsqu’une requête d’annulation est ouverte, la session de l’agent est créée avec le contexte « accountId » du client.
- La configuration du sous-agent mappe trois attributs Profil unifié Data 360 avec des variables de session lors de la création : « customerTier » (Entreprise), « lifetimeValueUSD » (42 000) et « contractRenewalDate » (60 jours).
- Une connaissance calculée telle que « churnRiskScore » (0,91, calculée à partir de la baisse d’utilisation, de la fréquence de ticket de support et de la tendance NPS) est mappée en tant que variable de session supplémentaire via un flux connecté à Data 360 invoqué en tant que première étape d’action.
- L’agent, désormais fondé sur des faits clients vérifiés, invoque une action « SelectRetentionOffer ». Les entrées comprennent « customerTier = Enterprise », « lifetimeValueUSD = 42000 » et « ChurnRiskScore = 0.91 ». Par conséquent, l’action renvoie l’offre de rétention de niveau maximum au lieu d’une offre standard.
- L’agent invoque « PresentOffer » pour livrer l’offre dans la conversation et « LogRetentionAttempt » pour enregistrer l’interaction dans le CRM avec tous les attributs ancrés préservés pour l’auditabilité.
Contexte
Les données d’entreprise sont fragmentées. Un agent qui ne peut agir que sur ce qui vit sur Salesforce Platform est limité à une fraction des informations dont il a besoin pour raisonner efficacement. Pour répondre à une question de service, il peut être nécessaire de lire le ticket ouvert d’un client dans Service Cloud. La préparation d’une proposition peut nécessiter de récupérer un fichier depuis Google Drive. L’analyse de l’utilisation des produits peut nécessiter d’interroger un entrepôt de données. Chacun de ces systèmes a ses propres API, son propre modèle d’authentification et son propre schéma de données. Le coût d’écriture d’un code d’intégration adapté pour chacun d’eux est ce qui a historiquement rendu la connectivité agent à système coûteuse et fragile.
MCP est une norme ouverte qui s’adresse directement à ce problème. Il définit une interface uniforme à travers laquelle un agent peut découvrir et invoquer des outils exposés par n’importe quel serveur conforme MCP, quel que soit le système sous-jacent. Chaque serveur MCP agit comme un adaptateur : il enveloppe les interfaces natives d’un système cible dans une interface standardisée et centrée sur l’outil que l’agent peut interroger, invoquer et composer sans rien connaître des protocoles ou schémas spécifiques du système.
Du point de vue de l’agent, la connexion à Slack, à une base de données SQL (Structured Query Language) et à un système de gestion de documents semble identique, trois serveurs MCP, chacun exposant un ensemble d’outils décrits et appelables. L’agent les sélectionne et les séquence en fonction de leurs descriptions sémantiques et de l’objectif qu’il essaie d’atteindre.
Problème
Lorsqu’un agent doit récupérer des informations ou déclencher des actions à travers plusieurs systèmes externes, chacun avec des API, une authentification et des schémas différents, comment peut-il découvrir, invoquer et composer ses capacités sans code d’intégration adapté par système ou couplage étroit avec l’implémentation d’un système ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- L’agent a-t-il besoin d’atteindre des systèmes extérieurs à la plate-forme Salesforce comme des magasins de documents, des outils de collaboration, des bases de données, du SaaS tiers, dont les API ne sont pas représentées nativement en tant qu’actions Agentforce ?
- La découverte dynamique de l’outil est-elle requise, lorsque l’agent identifie le point de terminaison d’intégration approprié au moment du raisonnement basé sur la requête actuelle, plutôt que d’avoir des intégrations codées en dur dans sa configuration ?
- Le paysage de l’intégration change-t-il fréquemment ? De nouveaux systèmes ont-ils été ajoutés, des systèmes existants ont-ils été mis à jour et d’autres changements peuvent s’avérer nécessaires, de sorte qu’une approche adaptée au système entraînerait des frais de maintenance non durables ?
- Existe-t-il un besoin de dissocier la couche de raisonnement de l’agent des détails d’implémentation des systèmes en aval, afin qu’une modification de l’API d’un système cible ne nécessite pas de modifier les instructions ou la configuration des sous-agents de l’agent ?
- Les systèmes cibles appartiennent-ils à différentes équipes ou fournisseurs, chacun étant responsable d’exposer ses propres capacités, ce qui rend un modèle de serveur MCP côté fournisseur plus pratique qu’une intégration côté consommateur par agent ?
Application du pattern Salesforce
| Solution | Ajustement | Commentaires |
|---|---|---|
| Serveurs Salesforce MCP | Idéal pour les objectifs de l’écosystème Salesforce | Utilisé lorsque le système cible est dans l’écosystème Salesforce et qu’un serveur MCP tiers est disponible. Salesforce Headless 360 fournit des serveurs MCP pour ses propres capacités de plate-forme, exposant les données CRM, les flux et les actions de plate-forme en tant qu’outils conformes MCP. Réduit les efforts d’implémentation à la configuration plutôt qu’au développement. Note: Actuellement, les serveurs Salesforce MCP prennent en charge uniquement les identifiants utilisateur pour l’authentification et l’autorisation. |
| Serveurs MCP MuleSoft personnalisés | Mieux lorsque aucun serveur MCP tiers n’existe | L’utilisation pour des systèmes hérités, des applications internes propriétaires ou des plates-formes SaaS tierces est antérieure à la norme MCP. Lorsqu’un système cible ne fournit pas son propre serveur MCP, une couche d’intégration MuleSoft peut être encapsulée dans un serveur MCP personnalisé qui expose les capacités du système en tant qu’outils. Il peut également être utilisé avec des API Salesforce si des MCP sont requis pour que les agents soient consommés uniquement avec des identifiants utilisateur système. MuleSoft gère la traduction du protocole, l’authentification et la transformation des données. La couche MCP permet aux agents de découvrir le résultat. |
| Serveurs MCP tiers | Idéal pour les systèmes de produits de base avec des écosystèmes MCP actifs | Un serveur MCP géré par le fournisseur existe pour votre plate-forme (GitHub, Google Workspace) et répond aux exigences de sécurité et de maintenance. Un nombre croissant de plates-formes d’entreprise telles que GitHub, Google Workspace et d’autres publient leurs propres serveurs MCP. Lorsqu’un serveur prêt pour la production et géré par le fournisseur existe, préférez-le à l’élaboration d’un serveur personnalisé. Évaluez la posture de sécurité et l’engagement de maintenance avant de les adopter. |
Croquis
Diagramme de séquence pour l’injection vérifiée du contexte client
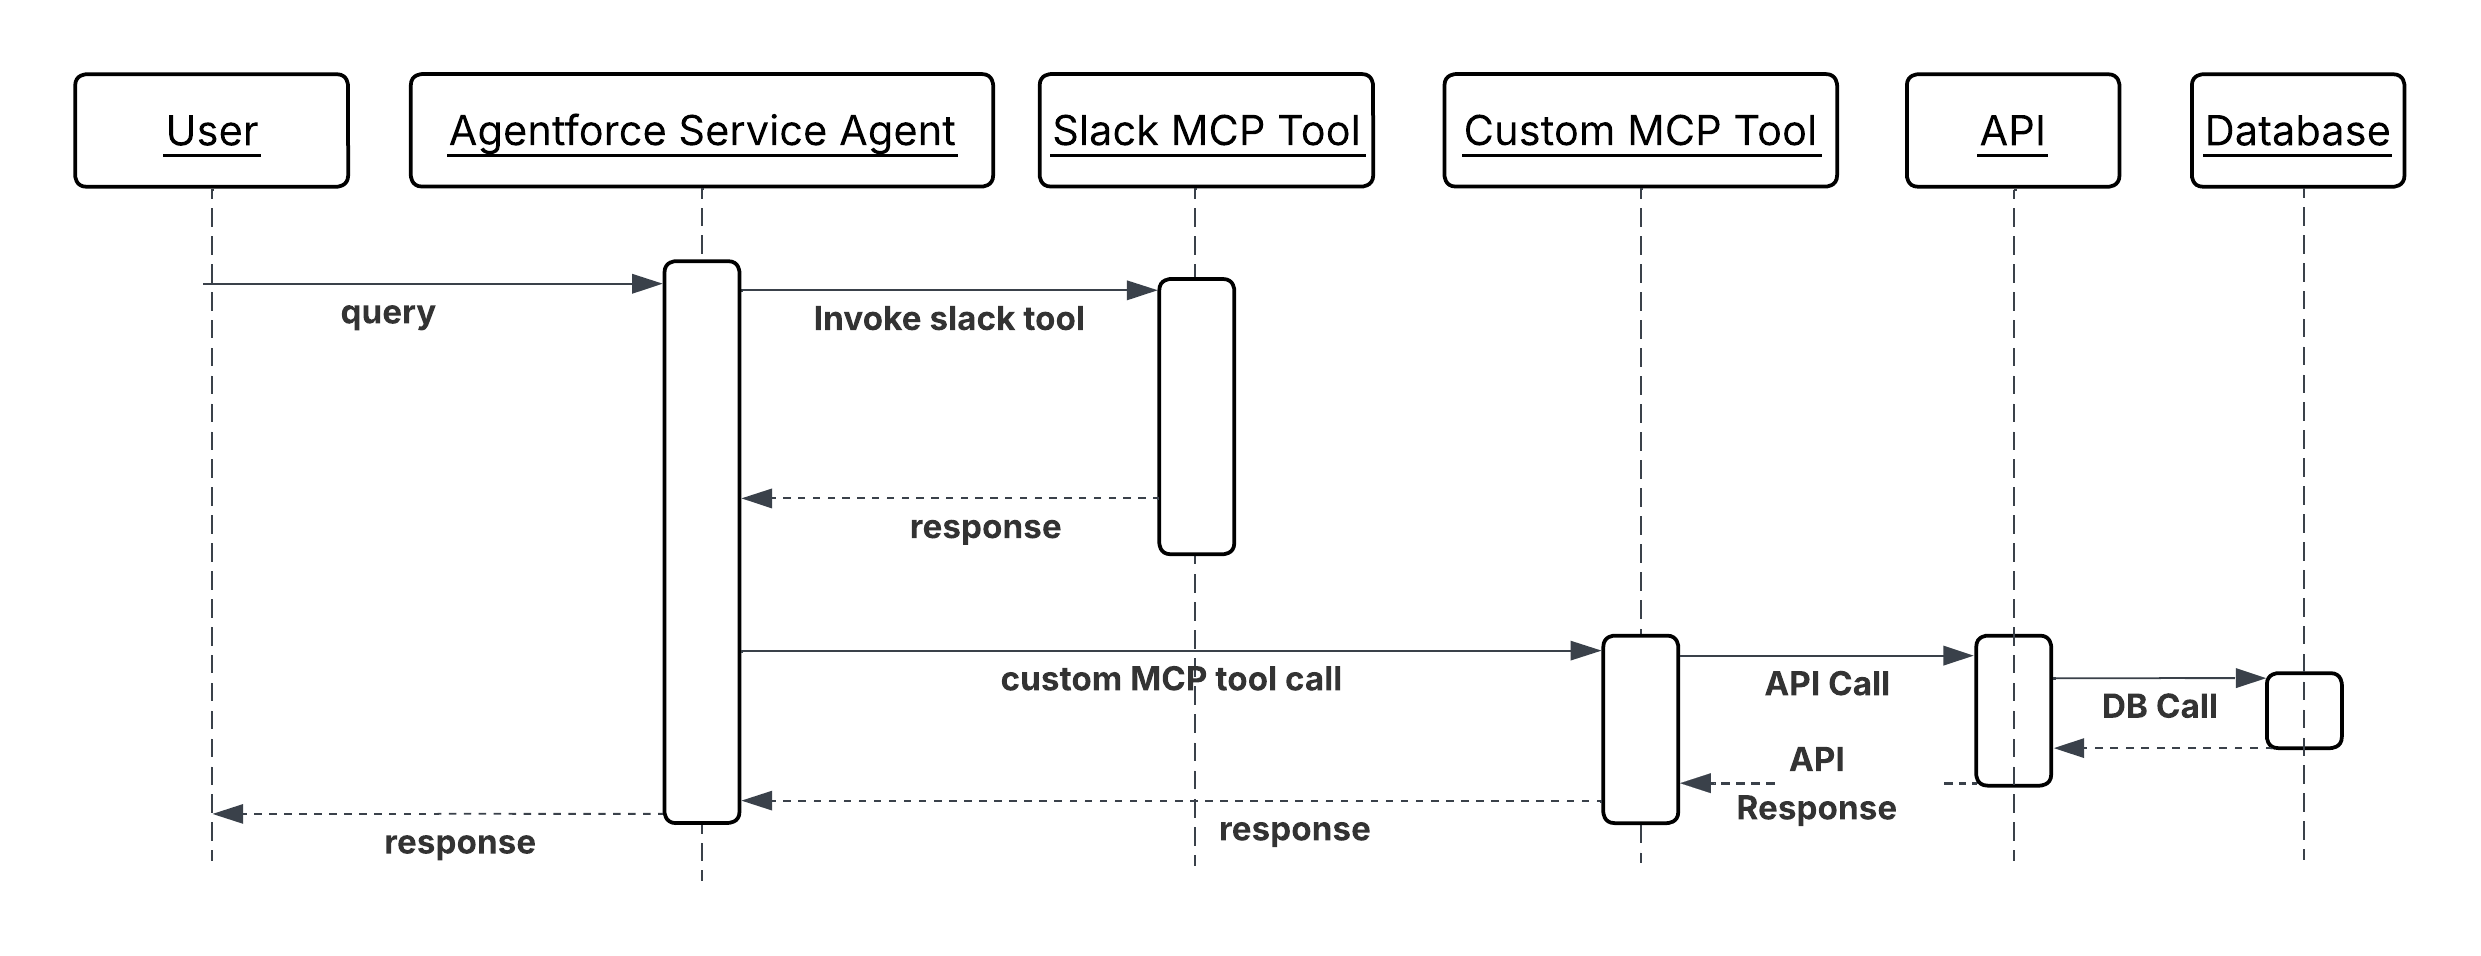
Résultats
La surface accessible de l’agent augmente sans augmenter sa complexité d’intégration. L’ajout d’un nouveau système externe implique de déployer ou de configurer un serveur MCP pour celui-ci et de ne pas écrire d’appels Apex ou d’intégrations de flux adaptés par agent. La couche de raisonnement de l’agent reste inchangée ; elle découvre et invoque les nouveaux outils en fonction de leurs seules descriptions sémantiques.
La norme MCP crée également une séparation nette de la propriété : l’équipe responsable d’un système expose ses capacités en tant que serveur MCP ; l’équipe de l’agent consomme ces capacités sans avoir besoin de comprendre les capacités internes du système. Cette limite réduit les frais de coordination à mesure que le nombre de systèmes intégrés augmente.
La composabilité de l’outil est une conséquence directe. Tous les outils partagent la même interface d’invocation. Par conséquent, l’agent peut enchaîner des outils à partir de différents systèmes, récupérer un fichier depuis Google Drive, en extraire des données et écrire le résultat dans un enregistrement CRM aussi naturellement que d’enchaîner des actions dans un seul système.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Les descriptions d’outil sont la seule base sur laquelle l’agent peut décider s’il invoque un outil et comment. Rédigez des descriptions dans un langage clair, basé sur l’intention, qui indique ce que l’outil fait, quand il s’applique et ce qu’il renvoie. Une description indiquant « interroge la base de données CRM » est moins utile que « récupère les requêtes ouvertes du compte, organisées par priorité, pour un ID de compte donné ».
- Limitez chaque outil MCP à une capacité atomique unique. Un outil qui récupère un document et rédige également un résumé dans le système source est plus difficile à raisonner pour l’agent, plus difficile à réessayer en cas d’échec et plus difficile à sécuriser que deux outils discrets. Un outil, une responsabilité.
- Concevez des outils pour que les sorties soient des entrées composables. Le résultat d’un outil de récupération doit être structuré de façon à être mappé naturellement avec les paramètres d’entrée des outils d’action qui le suivent généralement, réduisant ainsi le travail de transformation que l’agent doit effectuer entre les étapes.
- Serveurs MCP distants. Les installations binaires locales créent une complexité de déploiement et de gestion des versions qui augmente avec le nombre d’environnements d’agents. Un serveur hébergé à distance peut être mis à jour indépendamment des agents qui le consomment.
Notes d’implémentation Salesforce
- Si vous souhaitez une authentification MCP cohérente, une limite en taux, des validations de charge utile dans tous les appels MCP sortants, utilisez la passerelle IA telle que la passerelle Omni MuleSoft qui prend en charge les serveurs MCP et configurez-la avant d’exposer un serveur MCP aux agents.
- Utilisez les identifiants OAuth 2.0 pour tous les identifiants requis par les connexions au serveur MCP. Les identifiants ne doivent pas apparaître dans les paramètres de l’outil, les configurations d’action ou le code Apex.
- Certains outils de GCP peuvent avoir besoin d’identifiants utilisateur pour exécuter certaines actions selon le cas d’utilisation de l’entreprise (par exemple un transfert de fonds). Pour propager des jetons d’identité utilisateur, utilisez la stratégie OAuth 2.0 On Behalf Of Credentials Injection, qui est actuellement prise en charge avec la passerelle Omni MuleSoft.
- Pour des serveurs MCP MuleSoft personnalisés : définir le schéma d’outil MCP dans la spécification d’API de MuleSoft et enregistrer le point de terminaison du serveur dans le catalogue d’outils Agentforce. Testez les descriptions d’outils par rapport aux requêtes représentatives des agents afin de vérifier que l’agent sélectionne l’outil approprié pour la tâche appropriée avant de le déployer en production.
Traitement et récupération des erreurs
- Lorsqu’un appel à l’outil MCP renvoie une erreur, l’agent inspecte le code d’erreur lisible par ordinateur pour déterminer l’action de récupération appropriée : demander des paramètres manquants à l’utilisateur, réessayer avec une entrée correcte ou escalader vers un humain. Il ne consomme jamais silencieusement des erreurs ou continue à raisonner comme si l’appel à l’outil avait réussi.
- L’agent implémente directement une logique de nouvelle tentative pour les échecs transitoires.
- Consignez chaque invocation d’outil MCP côté client avec le nom de l’outil, les paramètres d’entrée assainis et le résultat. Cette trace côté client combinée aux journaux côté serveur est le principal mécanisme de diagnostic des raisons pour lesquelles un agent a suivi un parcours d’action particulier lorsqu’un workflow ne produit pas le résultat attendu.
Considérations de sécurité
- Toutes les connexions de serveur MCP sortantes transitent par la passerelle. La passerelle applique automatiquement la vérification de l’authentification, la limitation du taux afin d’éviter les abus d’outils et l’inspection de la charge utile afin de détecter les tentatives d’injection rapide dans les paramètres de l’outil. Les connexions directes et non médiatisées des agents aux serveurs MCP contournent ces contrôles et ne sont pas autorisées.
- Étendez les connexions du serveur MCP de chaque agent uniquement aux serveurs dont cet agent a réellement besoin des outils. Un agent configuré avec un accès à tous les serveurs MCP disponibles a une surface d’attaque plus grande qu’un agent connecté uniquement aux outils que ses tâches définies exigent.
- Validez et désinfectez les paramètres d’entrée de l’outil avant de les transmettre à l’outil, en particulier lorsque les valeurs des paramètres dérivent d’un texte fourni par l’utilisateur ou d’un contenu généré par LLM. Ne transmettez pas la sortie LLM non validée directement en tant que paramètres d’outil. Un assaillant qui peut influencer le raisonnement de l’agent peut utiliser ce chemin pour injecter des valeurs malveillantes dans des appels système en aval.
- Traitez la liste des serveurs MCP connectés de l’agent et leurs inventaires d’outils comme une configuration confidentielle. Un assaillant qui connaît les outils dont dispose un agent et les paramètres qu’il accepte dispose d’une carte pour élaborer des charges utiles d’injection rapide conçues pour abuser de ces outils.
Exemple
Un agent commercial prépare un briefing de compte complet avant un appel client important :
- L’agent reçoit la requête : « Préparez un briefing sur Acme Corp avant la discussion sur le renouvellement de demain. »
- L’agent interroge le catalogue d’outils MCP et identifie trois outils pertinents à travers deux serveurs MCP :
GetRecentEmails,GetOpenOpportunitiesetGetSupportTicketSummary. - L’agent invoque les trois outils en parallèle. Chaque serveur MCP traduit l’appel vers l’API native de son système cible, récupère les données pertinentes et renvoie un résultat structuré.
- L’agent reçoit les trois résultats. L’agent récupère les fils d’e-mails récents, l’opportunité de renouvellement ouverte avec la taille et l’étape de l’affaire, ainsi qu’un résumé des tickets de support ouverts par priorité, et les synthétise dans un briefing de compte structuré.
- L’agent invoque
CreateAccountNotepour enregistrer le briefing dans l’enregistrement du compte et renvoie un résumé à l’utilisateur demandeur. - Les quatre invocations d’outils MCP sont consignées par la passerelle avec les noms d’outils, les identités de serveur et les résultats de l’enregistrement d’audit de session.
Contexte
Le schéma MCP sortant décrit un agent Agentforce consommant des outils à partir de serveurs MCP externes. Le modèle entrant inverse ce schéma. Les capacités de la plate-forme Salesforce telles que les enregistrements CRM, les flux, la logique Apex et les connaissances Data 360 sont exposées en tant qu’outils MCP que les agents externes, exécutés sur n’importe quelle infrastructure LLM, peuvent découvrir et invoquer.
Ce schéma est important, car les déploiements d’IA d’entreprise sont rarement à fournisseur unique. L’agent d’un partenaire construit sur une infrastructure différente peut avoir besoin de référencer le statut du compte d’un client dans Salesforce. Une équipe de science des données interne qui exécute un agent basé sur Python peut avoir besoin de déclencher un flux Salesforce pour lancer un processus d’approbation. Sans mécanisme d’exposition standardisé, chaque consommateur externe nécessite une intégration sur mesure. L’exposition des capacités de Salesforce en tant que serveur MCP offre à chaque agent compatible MCP une interface unique et accessible aux outils de la plate-forme, quelle que soit la méthode d’élaboration de l’agent appelant.
Par exemple, l’agent d’acquisition d’un partenaire, qui s’appuie sur une infrastructure tierce, doit vérifier le statut du contrat d’un fournisseur dans Salesforce avant d’approuver un bon de commande. Au lieu d’élaborer une intégration REST directe, il invoque un outil de GetContractStatus sur le serveur Salesforce MCP. L’outil applique les mêmes contrôles d’accès que n’importe quelle opération Salesforce native. L’agent appelant affiche uniquement le résultat.
Problème
Lorsqu’un agent externe élaboré sur une infrastructure différente, appartenant à un partenaire ou exécuté hors de Salesforce Platform doit invoquer les capacités de Salesforce dans le cadre de son propre workflow, comment ces capacités peuvent-elles être exposées de façon standardisée, découvrable et régie en toute sécurité, qui ne nécessite pas une intégration personnalisée par consommateur externe ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- Les agents externes qui doivent consommer les capacités de Salesforce sont-ils construits sur des infrastructures qui prennent en charge la norme MCP ? Sinon, une API REST ou une approche webhook peut être plus appropriée que la MCP.
- Quelles capacités Salesforce doivent être exposées : récupération de données en lecture seule, opérations d’écriture, invocations de flux ou une combinaison ? L’étendue de l’exposition détermine directement la surface de sécurité qui doit être régie.
- Comment l’identité de l’agent appelant externe doit-elle être vérifiée et avec quelles autorisations Salesforce ses invocations doivent-elles être exécutées ? Les appels d’agent à plate-forme ne doivent pas hériter d’autorisations plus larges que celles requises par l’opération spécifique.
- Le serveur Salesforce MCP est-il destiné aux consommateurs internes (agents d’autres équipes au sein de la même organisation) ou externes (agents partenaires et clients) ? Le modèle Trust et les exigences d’authentification diffèrent sensiblement entre ces audiences.
- Comment l’ensemble d’outils exposés va-t-il évoluer au fil du temps ? Les nouvelles capacités de Salesforce ajoutées au serveur MCP peuvent être immédiatement découvertes par tous les agents connectés. L’exposition involontaire aux outils doit être régie par un processus de publication délibéré.
Application du modèle Salesforce Pattern
| Solution | Ajustement | Commentaires |
|---|---|---|
| Salesforce en tant que serveur MCP (natif) | Idéal pour exposer les capacités natives de Salesforce | Utilisé lorsque les outils à exposer sont mappés directement avec les opérations de plate-forme Salesforce existantes et les agents appelants sont compatibles MCP. La capacité native du serveur MCP de Salesforce Headless 360 permet de déclarer les opérations de plate-forme telles que les requêtes d’enregistrement, les invocations de flux et les actions Apex en tant qu’outils MCP et de les exposer à n’importe quel agent externe compatible MCP. L’accès est régi par le modèle d’autorisation Salesforce. Notez que ces serveurs MCP Headless 360 sont actuellement accessibles uniquement avec des identifiants utilisateur. |
| MuleSoft comme façade du serveur MCP | Idéal lorsque la transformation ou l’agrégation multisystème est requise | Utilisé lorsque l’agent appelant a besoin d’une capacité qui nécessite des données de plusieurs objets Salesforce, une transformation avant livraison ou une composition avec des données d’autres systèmes. L’interface MCP reste propre et simple, la complexité est absorbée par MuleSoft. Une couche MCP MuleSoft se trouve devant Salesforce et expose le résultat agrégé de plusieurs opérations de plate-forme dans un seul outil MCP. Cette solution peut également être utilisée par les agents lorsque l’identité de l’utilisateur ne peut pas être propagée pour l’authentification et l’autorisation Salesforce. Par exemple, si les agents Agentforce ont besoin de serveurs MCP avec des identifiants système, il faudra compter sur des serveurs MCP personnalisés comme celui élaboré avec et hébergé sur MuleSoft. |
Croquis
Diagramme de séquence des capacités métiers en tant qu’outil appelable
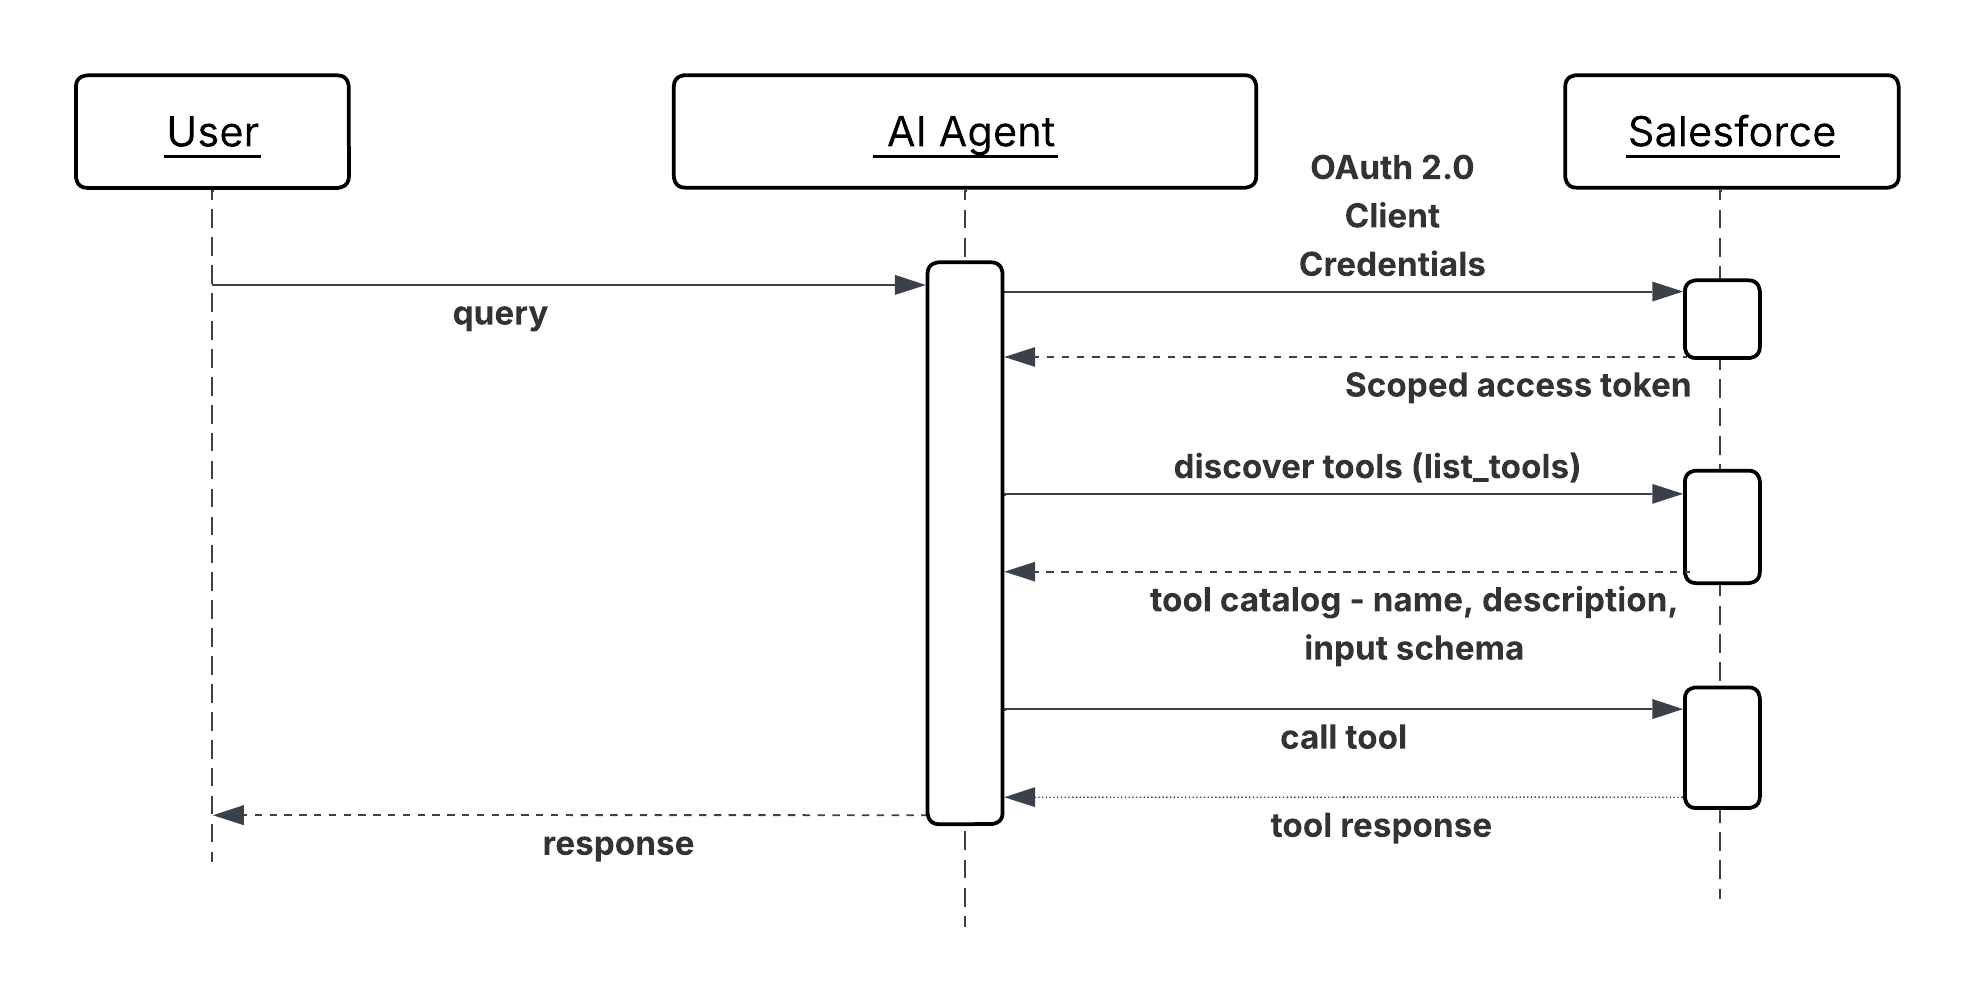
Résultats
Salesforce devient un participant de premier ordre dans les écosystèmes d’agents multifournisseurs. Les agents externes peuvent découvrir et consommer les capacités de la plate-forme sans avoir besoin d’une intégration REST personnalisée par consommateur ou par cas d’utilisation. Le nombre de consommateurs peut croître sans augmentation proportionnelle des frais généraux de maintenance de l’intégration.
Avec Headless 360, le modèle d’autorisation Salesforce régit chaque invocation d’outil entrant. Les clients MCP externes ne contournent pas les contrôles d’accès aux données existants, ils fonctionnent en leur sein. Cela signifie que le dispositif de sécurité d’exposition des capacités via MCP équivaut à les exposer via n’importe quelle autre surface d’API authentifiée.
La découverte des outils est un avantage combiné. À mesure que de nouvelles capacités Salesforce sont ajoutées au catalogue d’outils du serveur MCP, elles sont immédiatement disponibles pour tous les agents externes connectés, sans que ces agents soient contraints de mettre à jour leurs configurations.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Publiez uniquement ce dont les agents externes ont besoin. Chaque outil ajouté au catalogue du serveur MCP augmente la surface d’attaque et la charge de gouvernance. Auditez délibérément l’inventaire des outils. Définissez les capacités approuvées pour la consommation externe et traitez l’exposition non approuvée comme un écart de configuration, pas comme un écart par défaut.
- Rédigez des descriptions d’outils pour des consommateurs externes. L’opérateur d’un agent externe n’a aucune connaissance de votre modèle de données interne ou des conventions de nommage. Gardez les descriptions autonomes : ce que fait l’outil, ce que signifie chaque paramètre, ce que représente le résultat et toutes les contraintes ou prérequis que l’appelant doit satisfaire.
- Les outils de version explicitement lorsque leurs schémas d’entrée ou de sortie changent. Un agent externe qui dépend du schéma actuel d’un outil se rompt silencieusement si le schéma change sans préavis. Traitez les modifications d’interface d’un outil MCP avec la même discipline qu’une modification d’API REST publique.
Notes d’implémentation Salesforce
- Exécutez chaque invocation d’outil Salesforce prêt à l’emploi (OOTB) entrant MCP (Headless 360) sous un utilisateur dont les autorisations s’étendent uniquement aux opérations requises par les outils exposés. N’exécutez pas d’appels d’agent entrants sous une identité d’administrateur à privilèges élevés.
- Pour appliquer l’authentification, la limitation du taux, la validation du schéma et la détection des informations d’identification personnelle (PII) de façon cohérente dans tous les outils MCP, utilisez la passerelle IA telle que MuleSoft Omni Gateway.
- Pour MuleSoft MCP Facades, définissez le schéma d’outil MCP dans MuleSoft indépendamment du schéma d’API Salesforce sous-jacent. L’interface MCP doit refléter le besoin conceptuel de l’agent appelant, pas la forme de l’objet Salesforce qui le supporte. Ce découplage permet à l’implémentation Salesforce d’évoluer sans rompre le contrat d’outil externe.
Gestion des erreurs et reprise
- Les échecs d’invocation d’outils doivent renvoyer des réponses d’erreur MCP structurées avec un code lisible par ordinateur et une description en langage clair. L’agent externe appelant n’a aucune visibilité sur les éléments internes de la plate-forme Salesforce. Par exemple, les messages d’erreur doivent être autonomes et actionnables sans avoir à Knowledge les codes d’erreur ou les modèles d’objet spécifiques à Salesforce.
- Les erreurs de limite de taux et les échecs d’authentification doivent être renvoyés rapidement avec suffisamment d’informations pour permettre à l’opérateur de l’agent externe de diagnostiquer et de corriger la limite de taux atteinte ou l’identifiant rejeté sans exposer les détails de configuration interne.
- Consignez toutes les invocations d’outils MCP entrants à la passerelle Omni avec l’identité de l’agent appelant, l’outil invoqué, les paramètres d’entrée (assainis des valeurs confidentielles) et le résultat. Ce journal est la principale piste de preuve pour diagnostiquer les échecs signalés par des consommateurs externes et pour auditer les éléments auxquels les agents externes ont accédé.
Considérations de sécurité
- Chaque connexion MCP entrante doit s’authentifier avant qu’un outil soit accessible. N’autorisez pas la découverte non authentifiée du catalogue d’outils. La liste des capacités exposées est elle-même une information confidentielle.
- Appliquez l’autorisation au niveau de l’outil en plus de l’authentification au niveau de la connexion. Un agent externe enregistré ne devrait pouvoir invoquer que les outils spécifiques auxquels il a explicitement accès, pas le catalogue complet. Appliquez-le à la passerelle, pas à la couche application.
- Validez et désinfectez tous les paramètres de l’outil entrant avant de les transmettre aux opérations de Salesforce Platform. Les paramètres des agents externes sont une surface d’entrée non approuvée. Un paramètre malicieux peut tenter de remplacer les filtres de requête, d’injecter des fragments SOQL (Salesforce Object Query Language) ou d’influencer des variables de flux. Validez le type, le format et la plage à la limite du serveur MCP ou de la façade.
- Effectuer un examen périodique de l’accès des consommateurs externes inscrits. Révoquez les identifiants des agents qui ne sont plus actifs ou dont l’étendue d’accès a changé. Un identifiant dormant mais valide pour une intégration de partenaire décommissionné est un risque permanent inutile.
- Évitez d’enfreindre les limites de la plate-forme en limitant le taux de messages MCP entrants dans la passerelle. Réduisez le trafic des agents non critiques lorsqu’ils sont chargés en utilisant des stratégies de hiérarchisation basées sur un accord de niveau de service.
Exemple
Un agent d’acquisition exploité par un partenaire logistique doit vérifier le contrat et le statut de crédit d’un fournisseur avant d’approuver un bon de commande de grande valeur :
- L’agent du partenaire s’authentifie à la passerelle en utilisant ses identifiants clients OAuth 2.0 enregistrés et reçoit un jeton d’accès étendu.
- L’agent interroge le catalogue d’outils du serveur Salesforce MCP et identifie deux outils pertinents :
GetSupplierContractStatusetGetAccountCreditSummary. - L’agent invoque
GetSupplierContractStatusavec l’identifiant du fournisseur. Le serveur MCP le traduit en requête d’enregistrement Salesforce, applique la sécurité au niveau du champ de l’utilisateur de l’intégration, et renvoie le statut actuel du contrat, la date d’expiration et toutes les garanties de conformité marquées. - L’agent invoque
GetAccountCreditSummary, qui transite par la MCP Facade MuleSoft. La façade agrège le solde restant de la facture et l’historique de paiement du fournisseur à partir de deux objets Salesforce, et renvoie un résumé de crédit composé unique. - Avec les deux résultats, l’agent du partenaire détermine que le contrat est actif et que la position de crédit est dans les limites acceptables, et approuve le bon de commande dans son propre système.
- Les deux invocations d’outils sont consignées par la passerelle avec l’identité de l’agent partenaire, les outils invoqués et les résultats, ce qui crée un enregistrement vérifiable indiquant l’accès externe accordé et les données renvoyées.
Contexte
Les systèmes d’entreprise s’appuient désormais sur des essaims ou des réseaux d’agents collaboratifs, dans lesquels les requêtes complexes sont décomposées et déléguées à des agents spécialisés dans différents domaines ou plates-formes de fournisseurs. Ces agents, chacun ayant son propre rôle, ses propres capacités et ses propres outils, ont besoin d’une méthode de communication standardisée et sécurisée pour se coordonner en vue d’atteindre des objectifs communs sans nécessiter une intervention humaine à chaque étape.
Problème
Comment un agent IA appelant peut-il découvrir dynamiquement, interagir en toute sécurité et déléguer à un agent pair distant des tâches complexes ou spécifiques à un domaine, qui peuvent être élaborées sur une infrastructure différente ou exploitées par un autre fournisseur, et recevoir des résultats structurés pour réaliser un workflow d’entreprise plus large ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- Comment les agents, développés en utilisant diverses infrastructures ou opérant à travers des domaines d’application cloisonnés, interagissent-ils ?
- Comment les agents peuvent-ils collaborer et déléguer des tâches sans exposer leur logique interne, leur mémoire ou leurs outils propriétaires ?
- Comment les agents prennent-ils en charge les tâches complexes et longues tout en fournissant des mises à jour d’état en temps réel, des notifications en continu et push ?
- Comment les agents appliquent-ils la sécurité au niveau de l’entreprise (authentification, autorisation) et l’adhésion aux politiques pour la communication inter-agents ?
- Comment les agents gèrent-ils les workflows de tâches structurés (initiation, progression, réalisation) qui vont au-delà des simples appels d’API ?
Application du modèle Salesforce
Le protocole A2A est une norme ouverte qui permet aux agents de découvrir, de déléguer et de collaborer avec d’autres agents en tant que pairs. Il fournit un langage commun permettant aux agents d’échanger des informations en toute sécurité et de coordonner les actions entre différentes plates-formes et fournisseurs. A2A se concentre sur la communication pair-à-pair, en complément de MCP, qui se concentre sur la connexion des agents à des outils et des API.
| Solution | Ajustement | Commentaires |
|---|---|---|
| Orchestration multi-agents mono-organisation (SOMA) | Mieux lorsque tous les agents de domaine vivent dans une seule organisation et qu’aucun acheminement interfournisseurs n’est requis | Un superagent (orchestrateur) décompose les requêtes et achemine jusqu’à environ 7 sous-agents connectés en utilisant l’acheminement basé sur le LLM (le Moteur de Raisonnement Atlas lit les descriptions des sous-agents) ou l’acheminement déterministe (Script Agent). Ce modèle est recommandé par défaut avant d’opter pour A2A. Combinaisons prises en charge : Agentforce Service Agent → Agentforce Service Agent, Agentforce Employee Agent → Agentforce Employee Agent, Agentforce Employee Agent → Agentforce Service Agent Seul l’orchestrateur peut escalader vers un humain ; les sous-agents ne peuvent pas. |
| Délégation multi-agents dirigée par l’orchestrateur | Idéal pour les workflows complexes nécessitant plusieurs agents spécialisés | Utilisé lorsque le workflow couvre plusieurs domaines, par exemple l’approvisionnement, la vérification et l’approbation appartenant chacun à un agent différent. Un agent orchestrateur décompose la requête de niveau supérieur et délègue les sous-tâches à deux agents pairs ou plus de façon séquentielle ou parallèle. Chaque agent pair exécute sa fonction de domaine spécialisé et renvoie un artefact ; l’orchestrateur agrège les résultats et pilote l’étape suivante. |
Croquis
L’architecture implique qu’un agent appelant initie une communication, facilitée par un catalogue/registre d’agents pour la découverte :
Diagramme de séquence de la délégation inter-agents
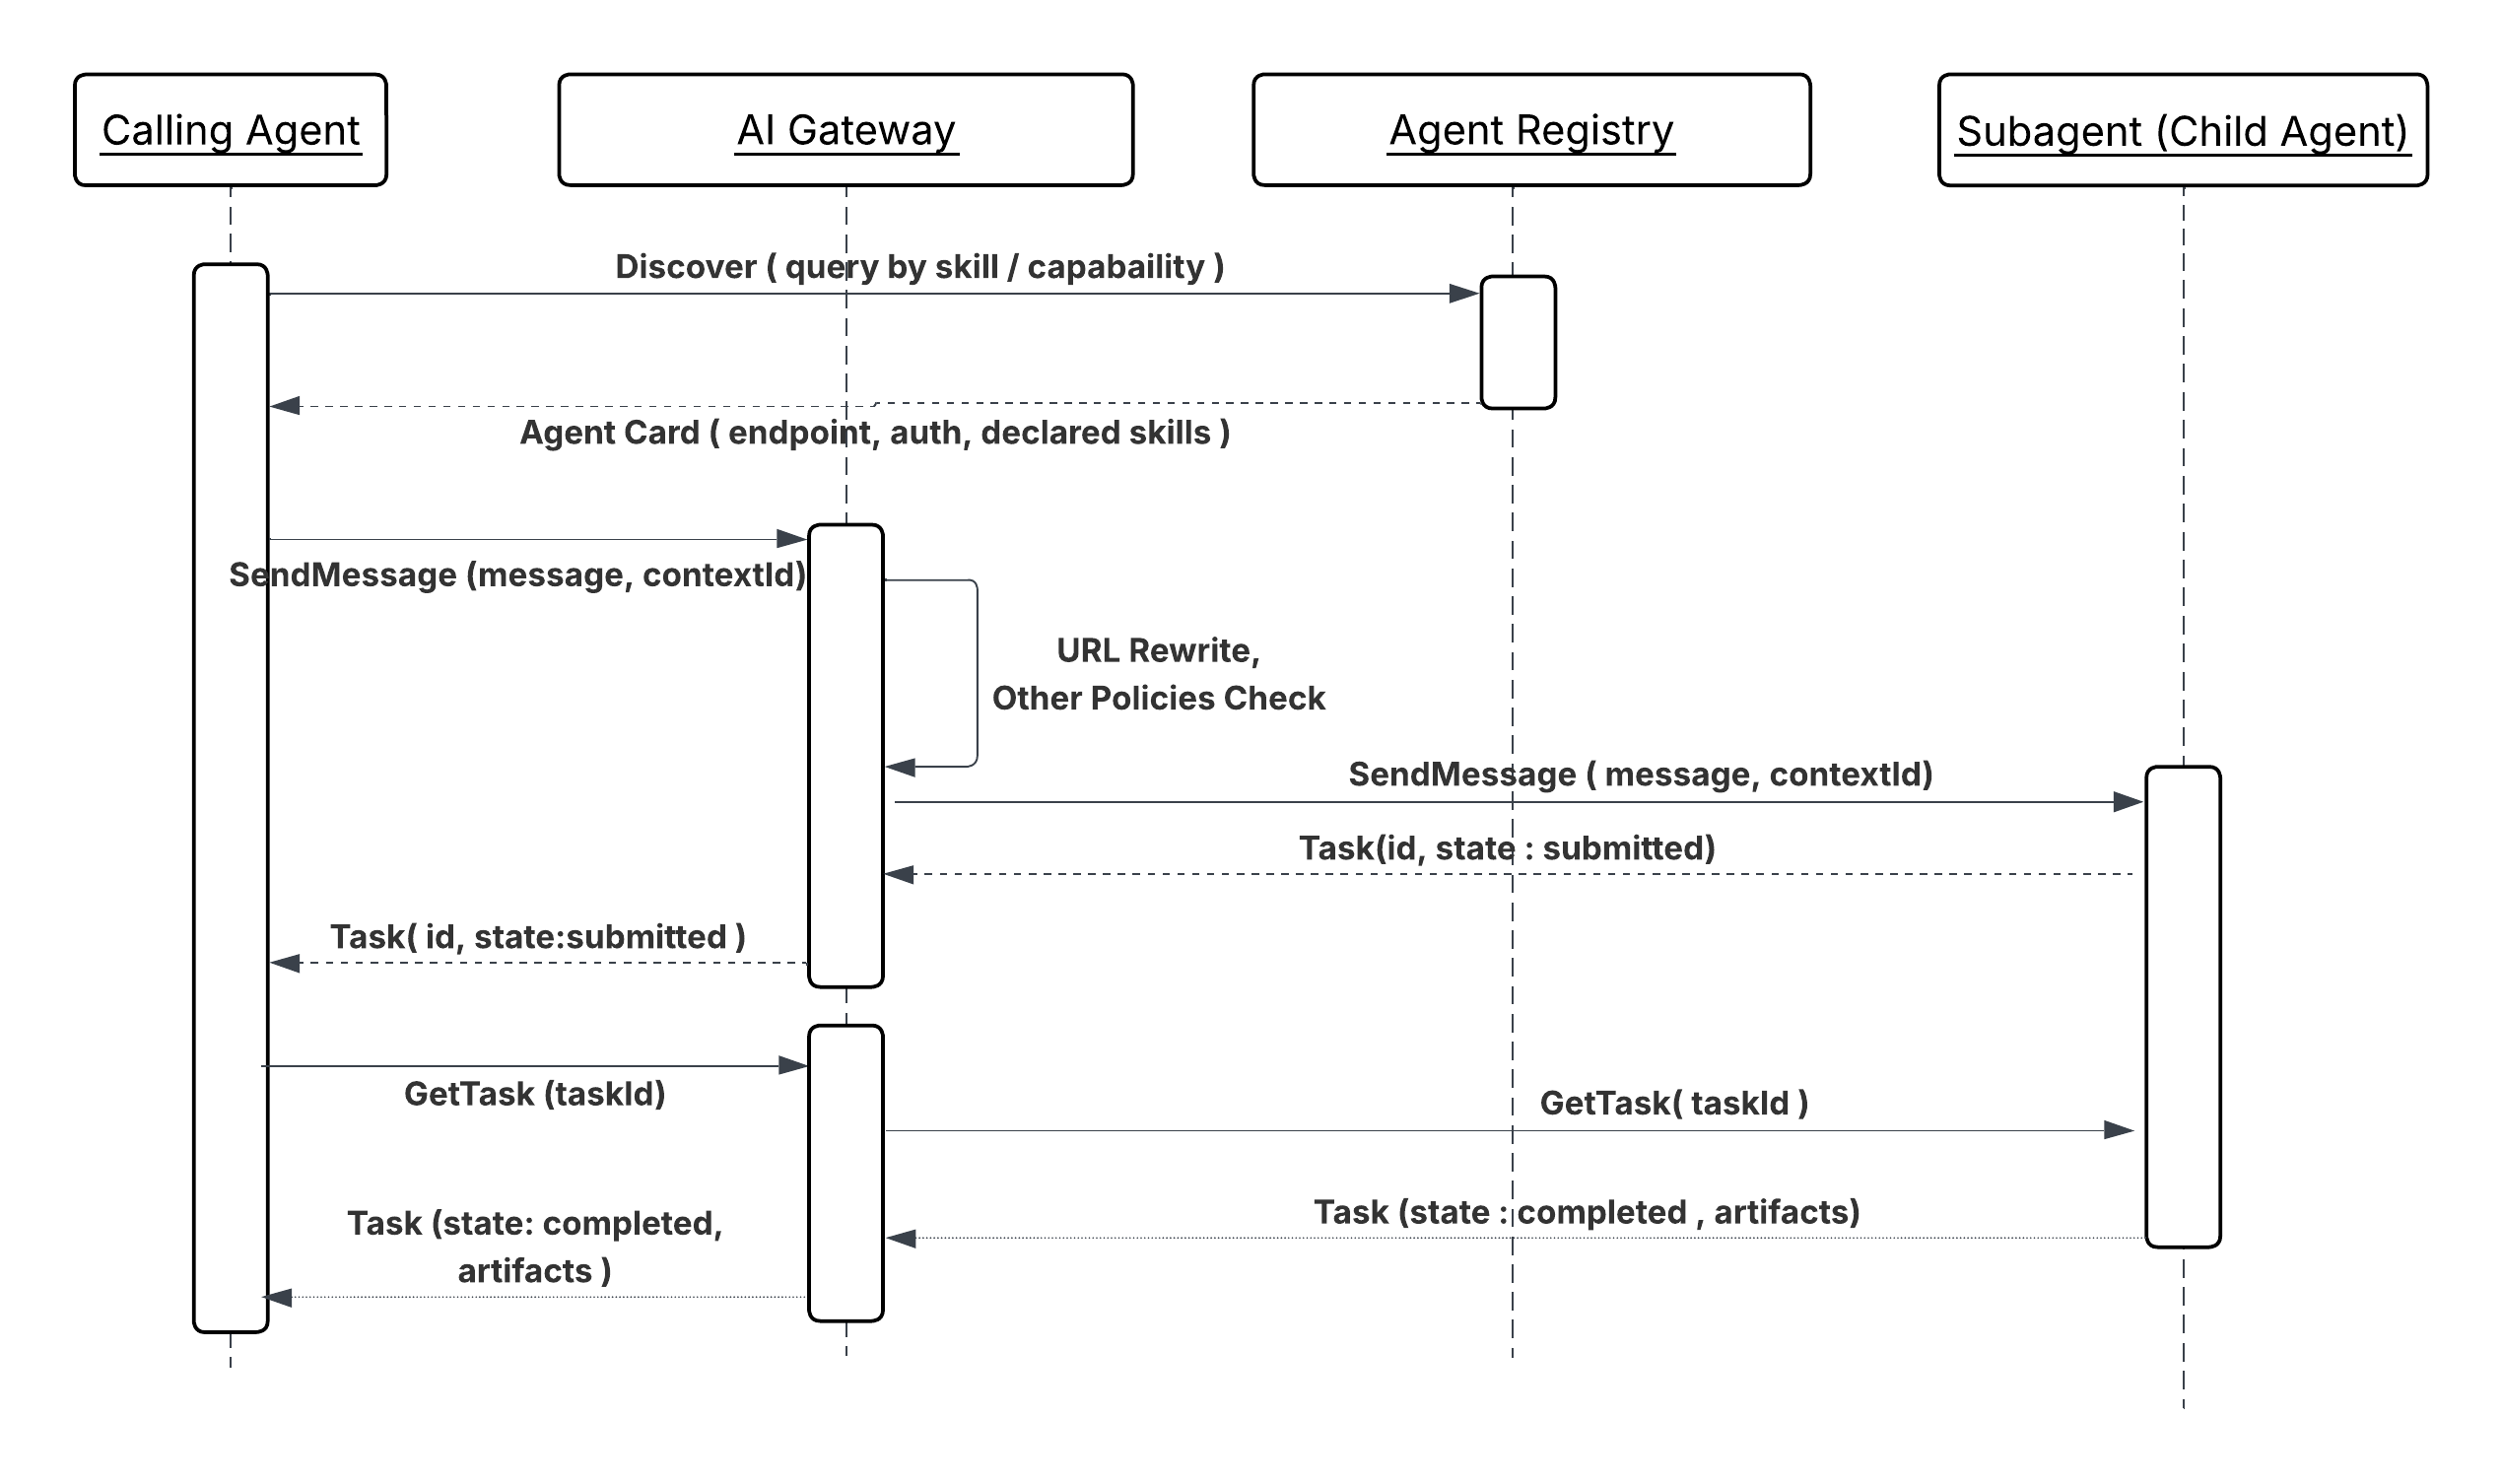
L’agent pair traite la requête en utilisant sa logique, sa mémoire et ses outils spécifiques au domaine, puis renvoie des résultats structurés à l’agent appelant.
Résultats
La délégation A2A sépare la propriété du domaine de l’orchestration du workflow. L’agent appelant n’a pas besoin de savoir comment l’agent pair est construit, sur quelle plate-forme il est exécuté ou quels outils il utilise en interne ; il délègue une tâche et reçoit un artefact structuré. Cette frontière signifie qu’un agent spécialisé (vérification des antécédents, score de risque financier, acheminement logistique) peut être développé, déployé et amélioré indépendamment des workflows qui l’invoquent.
Le modèle de cycle de vie des tâches du protocole (soumis, opérationnel, terminé, échoué) prend en charge
opérations à long terme nativement. L’agent appelant peut s’inscrire aux mises à jour d’état plutôt que
que de tenir une connexion bloquante, ce qui signifie que les tâches A2A peuvent s’étendre sur quelques minutes ou heures
sans demander à l’agent orchestrateur de rester actif pendant toute la durée.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Dans des scénarios complexes, un courtier agent peut agir en tant que service d’acheminement intelligent ou « standard intelligent » pour coordonner la délégation de tâches entre les agents spécialisés et gérer les processus à plusieurs étapes.
- Comme A2A prend en charge les tâches de longue durée, la communication doit être orientée vers la réalisation des tâches, la définition d’un cycle de vie pour l’objet tâche et la fourniture de mises à jour et de notifications en temps réel.
- Le protocole est conçu pour prendre en charge divers types de contenu, notamment le texte, les fichiers, les données structurées, le streaming audio et vidéo.
- Les relations et les dépendances entre les agents et leurs capacités sont définies par déclaration dans un fichier de configuration (par exemple, « agent-network.yaml ») et publiées dans le registre des agents.
Notes d’implémentation Salesforce
- Pour une orchestration SOMA efficace, gardez les sous-agents connectés en dessous de 7 afin de préserver la qualité de l’acheminement.
- Actuellement, seule la couche de délégation unique est prise en charge (superagent → sous-agent) ; des chaînes plus profondes poussent la latence à un « taux intenable ». Actuellement, les sous-agents ne peuvent pas déléguer à d’autres sous-agents connectés.
- Le transfert humain est pris en charge uniquement au niveau de l’orchestre ; les sous-agents ne peuvent pas escalader.
- Dans SOMA, utilisez le script Agent lorsque l’acheminement basé sur le langage LLM produit un acheminement incorrect sur des entrées ambiguës pour l’acheminement déterministe. Agent Script active le contexte partagé organisé entre les agents.
Traitement et récupération des erreurs
Le protocole A2A définit des codes d’erreur complets pour faciliter le débogage robuste et la gestion des erreurs.
- Logique de récupération : Les agents doivent incorporer des stratégies de nouvel essai (réessayer), une logique de basculement aux agents capables alternatifs et des expirations explicites.
- Suivi de l’état de la tâche : Le workflow de gestion des tâches permet aux agents de rester synchronisés avec le dernier statut d’une tâche, ce qui facilite la reprise en cas d’interruption.
- Observabilité : La consignation des détails des interactions, notamment la latence, les taux de réussite et les fréquences d’erreur, est essentielle pour surveiller la qualité et le dépannage.
Considérations de sécurité
- Authentification de niveau entreprise : A2A est conçu pour s’aligner sur les normes d’authentification et d’autorisation de niveau entreprise, telles que OAuth 2.0 et JWT, souvent gérées par des plates-formes externes telles que Okta.
- Passerelle pour protéger A2A : Une passerelle (par exemple, MuleSoft Omni Gateway) est essentielle pour appliquer des politiques à toutes les communications A2A, agissant à la fois comme une passerelle d’entrée et de sortie pour protéger les agents et contrôler le trafic sortant vers les agents et les services externes.
- Application des politiques : La réécriture de la carte de l’agent, la validation du schéma, le contrôle de pointe, le détecteur d’informations d’identification personnelle et d’autres stratégies doivent être appliqués pour la protection du serveur A2A et des données.
Exemple
Workflow de sourcing de candidats
Un responsable du recrutement charge son agent orchestrateur central de trouver des candidats correspondant à une liste de postes et à un ensemble de compétences.
- Découverte : L’agent orchestrateur interroge le registre de l’agent et découvre un agent de recrutement spécialisé et un agent de vérification des antécédents (tous deux des agents pairs).
- Délégation (A2A) : L’agent orchestrateur envoie une demande de tâche structurée (message A2A) à l’agent recruteur pour trouver des candidats.
- Traitement par les pairs : L’agent recruteur exécute son propre workflow (par exemple, appeler un outil LinkedIn externe via MCP).
- Retour d’artefact (A2A) : L’agent recruteur renvoie une liste de candidats suggérés (l’artefact).
- Délégation séquentielle : L’agent orchestrateur délègue ensuite une autre tâche (A2A) à l’agent de contrôle des antécédents du candidat le plus qualifié. Cet agent effectue la vérification et renvoie le résultat, réalisant ainsi la tâche globale.
Contexte
Les workflows d’entreprise complexes nécessitent souvent des agents spécialisés hébergés sur des plates-formes externes ou des systèmes partenaires pour initier des tâches, déléguer des requêtes ou fournir des mises à jour aux agents internes (par exemple, ceux de Salesforce Platform). Ce schéma indique comment un agent Agentforce interne reçoit et traite de façon sécurisée et fiable les requêtes d’un agent pair distant pour exécuter une capacité spécifique au domaine.
Problème
Comment un agent IA spécialisé interne (par exemple, un agent de vérification des antécédents sur Agentforce) peut-il exposer en toute sécurité sa fonctionnalité spécifique au domaine à des agents pairs externes, traiter une requête A2A structurée entrante et gérer le cycle de vie des tâches (y compris les mises à jour de statut en temps réel) pour renvoyer des artefacts structurés à l’agent appelant distant ?
Forces
En appliquant ce schéma, répondez aux questions suivantes :
- Comment exposer en toute sécurité les capacités des agents internes aux agents externes sans compromettre la logique ou les outils internes ?
- Comment appliquer des stratégies de sécurité de niveau entreprise pour vérifier l’identité et l’autorité déléguée de l’agent appelant avant de traiter les demandes ?
- Comment gérer les longues tâches entrantes tout en fournissant des mises à jour d’état structurées et asynchrones ?
- Comment garantir une interaction transparente avec les agents sur la base de diverses infrastructures externes ?
Application du modèle Salesforce
Le protocole A2A fournit la norme ouverte pour la délégation et la collaboration pair-à-pair sécurisées. L’agent interne agit en tant qu’agent pair, présentant ses capacités via un Catalogue d’agents/Registre et utilisant A2A sur des canaux sécurisés (HTTPS/SSE) pour recevoir et répondre à des requêtes structurées.
| Solution | Ajustement | Commentaires |
|---|---|---|
| Agentforce Connected Subagent (SOMA) | Mieux lorsque l’agent appelant est un autre agent Agentforce dans la même organisation | Utilisé lorsque les deux agents vivent dans la même organisation Salesforce et que l’appelant est un orchestrateur Agentforce. L’agent est connecté en tant que sous-agent via Agentforce Builder et exposé à l’orchestrateur via sa description et les actions déclarées. L’orchestre achemine les tâches en utilisant l’acheminement basé sur le LLM (moteur de raisonnement Atlas) ou l’acheminement déterministe (script Agent). Aucun protocole A2A, passerelle ou enregistrement externe n’est requis. Combinaisons prises en charge : Agentforce Agent de service→Agentforce Agent de service Agentforce Agent employé→ Agentforce Agent employé Agentforce Agent employé→Agent de service Agentforce Seul l’orchestrateur peut escalader vers un humain; les sous-agents ne peuvent pas. |
| Acheminement par courtier d’agents (entrant) | Mieux lorsque l ’ organisation héberge plusieurs agents Agentforce dotés de capacités complémentaires et que l ’ agent appelant ne peut pas ou ne doit pas sélectionner une cible spécifique | Utilisé lorsque l’agent appelant est externe à Salesforce ou à une autre organisation Salesforce et ne devrait pas avoir besoin de savoir quel agent interne spécifique (Agentforce ou d’autres agents fournisseurs) traite sa demande. Un courtier MuleSoft est assis entre la passerelle Omni MuleSoft et le pool d’agents Agentforce internes. Il reçoit la tâche A2A entrante, évalue les capacités déclarées des agents internes disponibles par rapport aux exigences de la tâche et achemine la requête vers l’agent le plus compétent. Le courtier gère également le basculement si l’agent cible principal n’est pas disponible ou renvoie un échec, le courtier redirige vers un agent équivalent sans exposer la nouvelle tentative à l’appelant externe ; l’appelant externe n’est jamais au courant des décisions ou tentatives d’acheminement internes. |
Croquis
Diagramme de séquence des agents en tant que services appelables
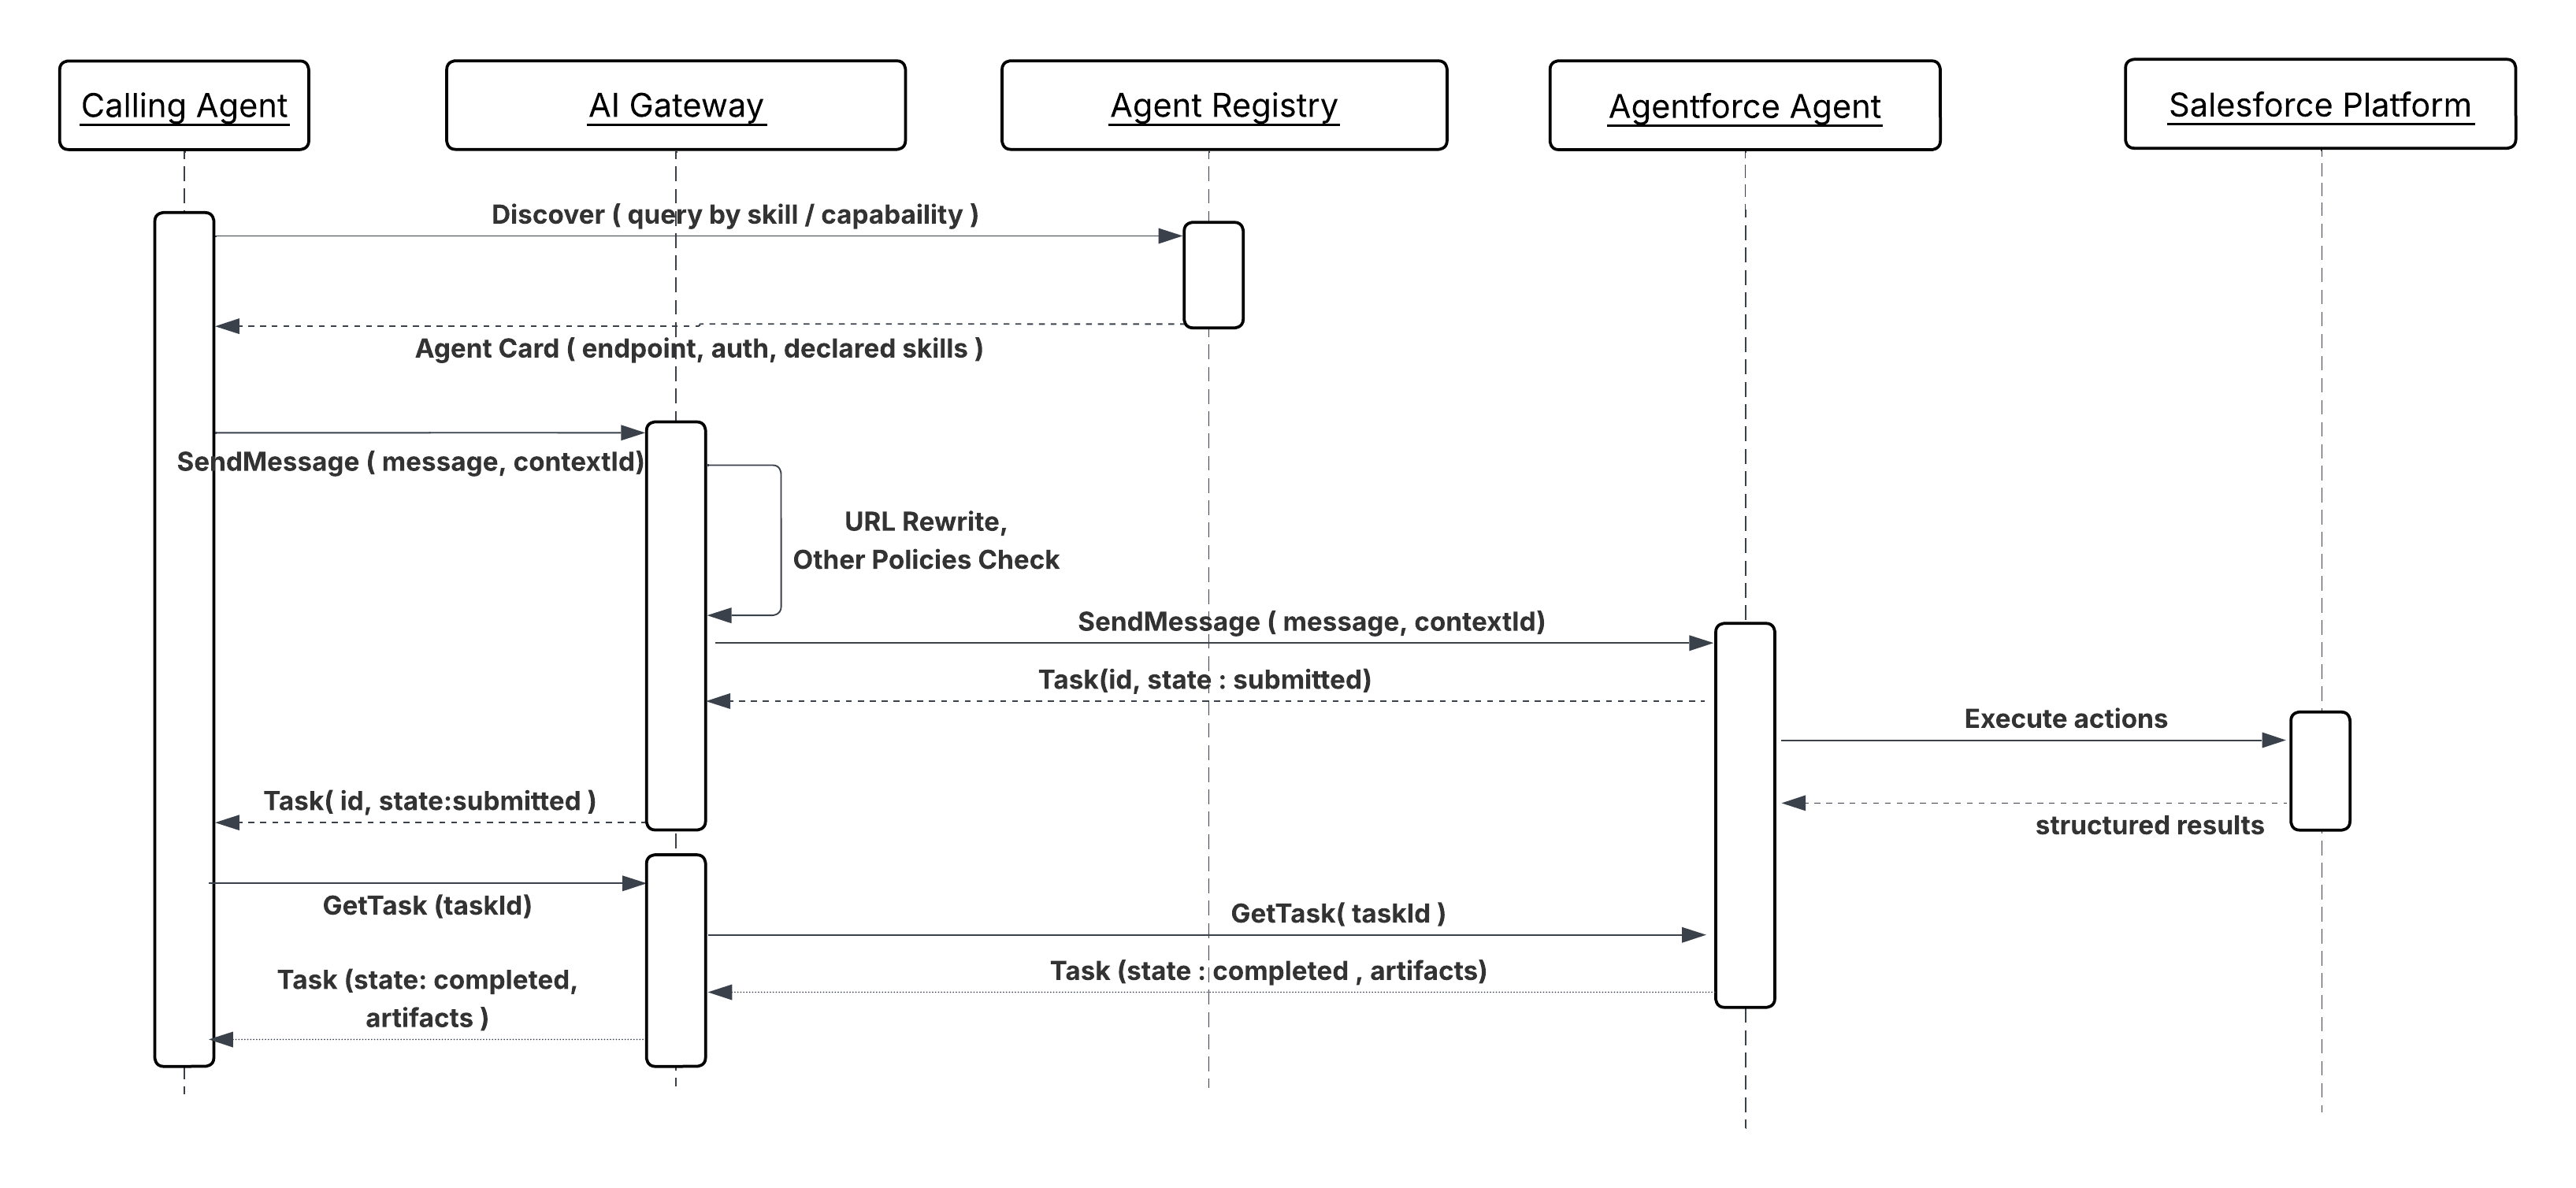
Résultats
Ce schéma expose les agents internes en tant que services spécialisés dans un réseau multi-agents. Les agents externes peuvent déléguer en toute sécurité des tâches à des capacités internes pendant que l’organisation garde le contrôle, l’auditabilité et l’application des politiques.
Considérations relatives à la conception
Guide agnostique de la plate-forme
- Une passerelle (par exemple, MuleSoft Omni Gateway) doit être positionnée en tant que point d’entrée pour appliquer des politiques, notamment la limitation du taux, l’authentification et la validation de la charge utile, à toutes les requêtes A2A entrantes.
- Les agents internes doivent gérer l’état de l’objet tâche depuis l’initiation externe jusqu’à la réalisation, en s’assurant que l’agent qui appelle à distance reçoit des mises à jour de statut vérifiables et cohérentes.
- Assurez-vous que les capacités publiées de l’agent dans la carte de l’agent sont claires, basées sur l’intention et incluent les étendues de sécurité nécessaires pour la délégation.
Traitement et récupération des erreurs
- Codes d’erreur structurés : En cas d’échec, l’agent interne doit renvoyer des messages d’erreur structurés conformes A2A à l’agent appelant pour activer la logique de nouvel essai à distance ou des mécanismes de basculement alternatifs.
- Idempotence : L’agent doit vérifier que tous les effets secondaires déclenchés par une nouvelle requête A2A d’un agent externe (en raison d’une interruption ou d’une reprise du réseau) sont idempotents.
Considérations de sécurité
- Application de politiques entrantes: La passerelle doit appliquer des stratégies de liste d’autorisations/de liste de blocage pour les agents externes et de validation des jetons JWT/OAuth 2.0 afin de vérifier l’identité et l’autorité déléguée de l’agent appelant.
- Assainissement des entrées : Validez et désinfectez toutes les charges de travail des requêtes entrantes afin de limiter les attaques potentielles par injection rapide ou par données malveillantes.
- Propagation de l’identité : Mappez en toute sécurité l’identité de l’agent externe et ses pouvoirs délégués avec des contextes de sécurité internes (par exemple, des profils utilisateur Salesforce) avant d’exécuter des actions contre des systèmes internes.
Exemple
Interrogation système externe
- Demande : Un Agent de recrutement sur un système partenaire envoie une demande de tâche A2A à un Agent de vérification des employés interne (pair agent) sur Agentforce pour confirmer le statut d’emploi d’un nouveau candidat.
- Traitement : L’agent de vérification des employés reçoit la demande via la passerelle, vérifie les identifiants de l’agent partenaire, exécute son workflow interne (par exemple, appeler un système RH interne) et met en forme la réponse.
- Réponse : L’agent pair renvoie un artefact A2A structuré (par exemple, la date de début de l’emploi et le titre du poste) à l’agent de recrutement distant, qui procède ensuite à son workflow externe.
-
Passerelle de protection des MCP, A2A et API
Une passerelle est requise en tant que point d’application unique pour tout le trafic agent à système et système à agent.
-
Connexions sécurisées: Une passerelle garantit que seuls les agents authentifiés et autorisés interagissent avec les points de terminaison MCP, A2A et API en limitant l’accès.
-
SLA appliqués : Une passerelle peut appliquer des limites de taux, ce qui aide les organisations à satisfaire aux exigences de performance et évite la surcharge du serveur MCP et A2A.
-
Gouvernance simplifiée : Une passerelle offre une visibilité et un contrôle centralisés sur toutes les interactions du serveur, ce qui simplifie la gestion et la surveillance des activités des agents.
-
Cohérence et protection des données : Les stratégies, telles que la validation de schéma, imposent la cohérence des données et la détection des informations d’identification personnelle peut protéger les informations confidentielles.
Passerelle Omni MuleSoft
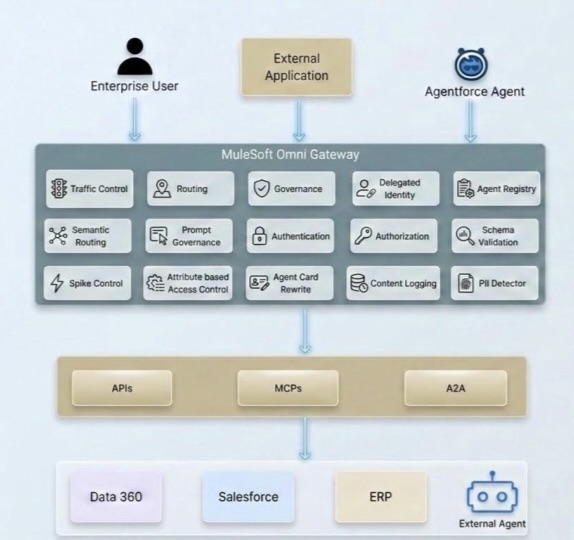
- Chaîne de propagation de l’identité
À mesure que les entreprises adoptent le paradigme agentique, un nouveau défi de sécurité apparaît : Comment l’identité de l’utilisateur final transite-t-elle à travers un réseau d’agents IA autonomes ? Dans les architectures d’API traditionnelles, un utilisateur s’authentifie une fois et l’application appelle des services back-end au nom de l’utilisateur. La chaîne d’identité est courte, bien comprise et généralement gérée dans un seul domaine Trust.
Les architectures Agentic contiennent cependant des chaînes beaucoup plus longues où une seule requête s’étend à travers divers agents, services et serveurs MCP, chacun pouvant franchir les frontières des services, des domaines Trust et même des frontières de l’organisation. Sans stratégie délibérée de propagation de l’identité, les entreprises doivent choisir entre la sécurité et la fonctionnalité, un dilemme qu’aucun architecte n’a à résoudre.
MuleSoft répond aux complexités de la propagation de l’identité avec sa fonctionnalité Identité de l’agent de confiance. Cette solution utilise une stratégie basée sur une stratégie, gérée par la passerelle, pour garantir le maintien de l’identité de l’utilisateur dans divers types d’interaction, notamment les protocoles A2A, les appels d’outils MCP et les requêtes d’API REST. En centralisant la gestion de l’identité au niveau de la couche Passerelle Omni via des politiques d’authentification sortantes, les entreprises peuvent sécuriser l’ensemble de leur réseau d’agents sans modifier les services ou les agents back-end. Pour plus d’informations, consultez Identité de l’agent de confiance pour l’entreprise agentique.
- Sécurité RAG dans Data 360
Data 360 prend en charge le contrôle d’accès basé sur l’attribut (ABAC) au niveau de l’objet, du champ et de la ligne via les paramètres de la Stratégie de gouvernance des données. C’est la méthode principale pour contrôler les données visibles par qui, y compris dans les index de recherche RAG. Pour des données structurées, les conditions d’accès utilisateur sont implémentées en utilisant des attributs utilisateur et des ensembles d’autorisations. Pour des données non structurées, le filtrage des métadonnées (préfiltres dans les index de recherche) peut restreindre les éléments récupérés.
La communication avec le LLM passe par la Couche Trust Einstein, qui masque les informations confidentielles/PII avant qu’elles n’atteignent le modèle protégeant la confidentialité des données non seulement pendant la recherche mais aussi avant la génération.
Pour vous protéger contre les empoisonnements RAG, assurez-vous que des règles strictes de gouvernance et de validation des données sont appliquées avant que les données soient disponibles pour la recherche vectorielle. La couche de confiance Einstein peut également imposer des contrôles de masquage et de toxicité des prompts. Vous pouvez appliquer des ensembles d’autorisations stricts au profil Utilisateur agent.
- Nouveau modèle d’identifiants nommés Salesforce a revu son architecture d’authentification en introduisant un modèle Identifiants nommés à deux niveaux qui sépare clairement les préoccupations entre connectivité et identité. Utilisez-le dès que vous passez des appels externes via Apex et évitez de créer votre propre protocole d’authentification. Ce modèle offre également une extensibilité et une sécurité renforcée. Les identifiants externes sont à la base de ce modèle. Ils stockent les détails d’authentification réels et prennent en charge un ensemble enrichi de protocoles, notamment les identifiants clients OAuth 2.0, le porteur JWT et AWS Signature V4, tout en définissant le mappage des principaux : soit en tant que principal nommé unique (partagé entre tous les utilisateurs), soit en tant que principaux par utilisateur (où chaque utilisateur s’authentifie avec sa propre identité). Les identifiants nommés agissent à leur tour comme couche de point de terminaison. Ils définissent l’URL de l’appel externe et référencent un identifiant externe pour gérer la poignée de main d’authentification, en gardant la configuration du point de terminaison nettement découplée de la gestion des identifiants. Pour activer les flux d’authentification par utilisateur, les administrateurs mappent les ensembles d’autorisations avec le principal Identifiants externes approprié, afin que seuls les utilisateurs attribués à l’ensemble d’autorisations approprié puissent invoquer des appels externes sous leur propre identité. Cette conception à deux niveaux simplifie non seulement la configuration sécurisée des appels externes, mais offre également aux architectes beaucoup plus de flexibilité et de contrôle de gouvernance sur la façon dont les intégrations s’authentifient à travers les systèmes connectés à Salesforce. Pour plus d’informations, consultez la documentation des Identifiants nommés.
Cette section mappe les modèles de traitement des données de l’architecture avec les obligations de conformité les plus fréquemment rencontrées dans les déploiements d’entreprise réglementés.
Contrôle d’accès : Le modèle utilisateur d’intégration à moindre privilège décrit dans les modèles d’intégration (identifiants nommés étendus, étendues OAuth 2.0 par agent, listes d’autorisations de passerelle) est mappé directement avec des contrôles d’accès logiques. Maintenir la preuve que la portée des identifiants de chaque agent est examinée et approuvée.
Journalisation des audits : Les exigences de consignation des audits par modèle (ID de session, invocations d’outils, paramètres d’entrée désinfectés des valeurs confidentielles, résultats) satisfont aux contrôles de surveillance et de consignation. Assurez-vous que les journaux sont inviolables, conservés pendant la période requise et accessibles à l’équipe de sécurité sans avoir accès aux systèmes de production.
Gestion des modifications : Les changements de schéma d’outil MCP et les mises à jour de carte d’agent A2A qui affectent les consommateurs constituent des changements d’interface et doivent être soumis à des contrôles de gestion des modifications. Versionnez explicitement les outils (mentionnés dans le schéma entrant MCP) et traitez les modifications de rupture comme des événements de configuration nécessitant une approbation.
Disponibilité : Les limites de simultanéité des agents, les plafonds de réessais sur les modèles déclenchés par un événement, et l’acheminement en lettre morte pour les événements échoués constituent des contrôles de disponibilité. Documentez l’enveloppe de débit attendue et le comportement d’échec de chaque schéma déployé dans le cadre du package de preuves de disponibilité.
Note: Cette liste ne représente pas un guide complet pour garantir la conformité de vos solutions agentiques. Toutes les exigences réglementaires applicables doivent être respectées.
- Premiers pas avec l’API Agent :
- Activation des agents de confiance avec Data 360 :
- Vue d’ensemble de la passerelle Omni MuleSoft :
- Politique d’injection d’identifiants OAuth 2.0 pour le compte de :
- Identité d’agent de confiance pour Agentic Enterprise :
Gulal Kumar est architecte en génie logiciel chez Salesforce avec plus de 20 ans d’expérience. Son expertise couvre l’IA, l’intégration, les API et l’architecture d’entreprise, avec un focus sur la conduite de la transformation métier à travers des solutions IA sécurisées, résilientes et innovantes. Connectez-vous avec lui sur LinkedIn.