Las compañías gestionan una amplia gama de tipos de documentos, incluyendo facturas, pedidos de compra, contratos legales y manuales técnicos. El procesamiento manual es lento, proclive a errores y consume un estimado del 15 al 25% del tiempo de los empleados. Los enfoques de automatización anteriores (por ejemplo, Automatización de procesos robóticos (RPA), Reconocimiento óptico de caracteres (OCR) y herramientas de flujo de trabajo) redujeron parte de la carga, pero produjeron oportunidades en curso rígidas, altos gastos generales de mantenimiento y adopción de silos entre equipos de negocio individuales.
Los documentos llevan contexto estructural enriquecido (por ejemplo, jerarquías de tablas, relaciones de campos espaciales y secciones de referencia cruzada) que el procesamiento de texto plano no puede conservar. Eliminar un documento en texto sin formato descarta el contexto de negocio que hace que la extracción sea precisa y útil, lo que degrada la calidad de análisis descendente, inferencia de _Inteligencia artificial (_IA) y automatización de procesos.
Para ser efectivos, los sistemas de Procesamiento inteligente de documentos deben clasificar documentos por tipo, extraer datos estructurados con precisión desde formatos de variable y entregar esos datos de forma gobernada y consultable a sistemas descendentes. Los IDP también deben gestionar la variabilidad de documentos a escala sin requerir configuración por plantilla para cada nuevo formato de documento, y deben estar centralizados y ser accesibles entre unidades de negocio. Este reto se ve agravado por el gran volumen del problema clave: Los datos no estructurados representan aproximadamente el 80% de todos los datos de la compañía, y la mayoría se acumulan en forma de documentos entre sistemas de archivos, almacenamiento en la nube y repositorios de contenido que están fuera del alcance de los sistemas de Gestión de relaciones con clientes (CRM), agentes de IA y plataformas de análisis.
La IA de documentos de Data 360 es la función de procesamiento de documentos de Salesforce en Data 360, que está diseñada para solucionar esta brecha. Extrae, clasifica y analiza contenido de documentos no estructurado y semiestructurado utilizando Modelos de lenguaje grande, Reconocimiento óptico de caracteres, Procesamiento de lenguaje natural y Aprendizaje automático. El resultado son datos estructurados, gobernados y consultables que se integran en las oportunidades en curso de Data 360 donde los agentes Agentforce, las herramientas de análisis y los flujos de trabajo de automatización pueden acceder a ellos a través de interfaces estándar sin requerir capas de extracción o transformación personalizadas.
Las plataformas de datos de compañía procesan datos tabulares estructurados. Sin embargo, la mayoría de los datos de la compañía llegan como documentos y permanecen inaccesibles para agentes de CRM, ERP, IA y oportunidades en curso de análisis hasta que alguien los extraiga manualmente. Esta es una brecha arquitectónica, no un problema de flujo de trabajo.
Los enfoques anteriores combinaban el cambio manual de claves, el OCR basado en reglas y las secuencias de comandos RPA. Estos métodos funcionaban a pequeña escala, pero no podían gestionar el volumen, la variedad y la velocidad de los tipos de documentos que generan las empresas modernas. Las herramientas basadas en reglas requieren plantillas explícitas por variante de formato. Cualquier cambio de formato interrumpe la extracción y requiere un desarrollador, una nueva plantilla y un ciclo de implementación.
A escala, esto produce soluciones de puntos frágiles sin gobernanza centralizada, esquema compartido y ruta a la preparación para la IA. Las oportunidades en curso de extracción incoherentes se propagan aguas abajo. En otras palabras, los análisis heredan incoherencias de datos, los modelos de IA producen resultados poco fiables y el contenido regulado como Información de salud personal e Información de identificación personal carece de gobernanza sistemática.
Los LLM extraen campos sin plantillas explícitas. Una configuración de esquema única rige la extracción entre variantes de formato, idiomas y formatos, que se adapta al documento en vez de requerir que el documento se ajuste a una estructura fija. Esto cambia el procesamiento de documentos de una operación de silo con gran carga de mantenimiento a una función centralizada y gobernada.
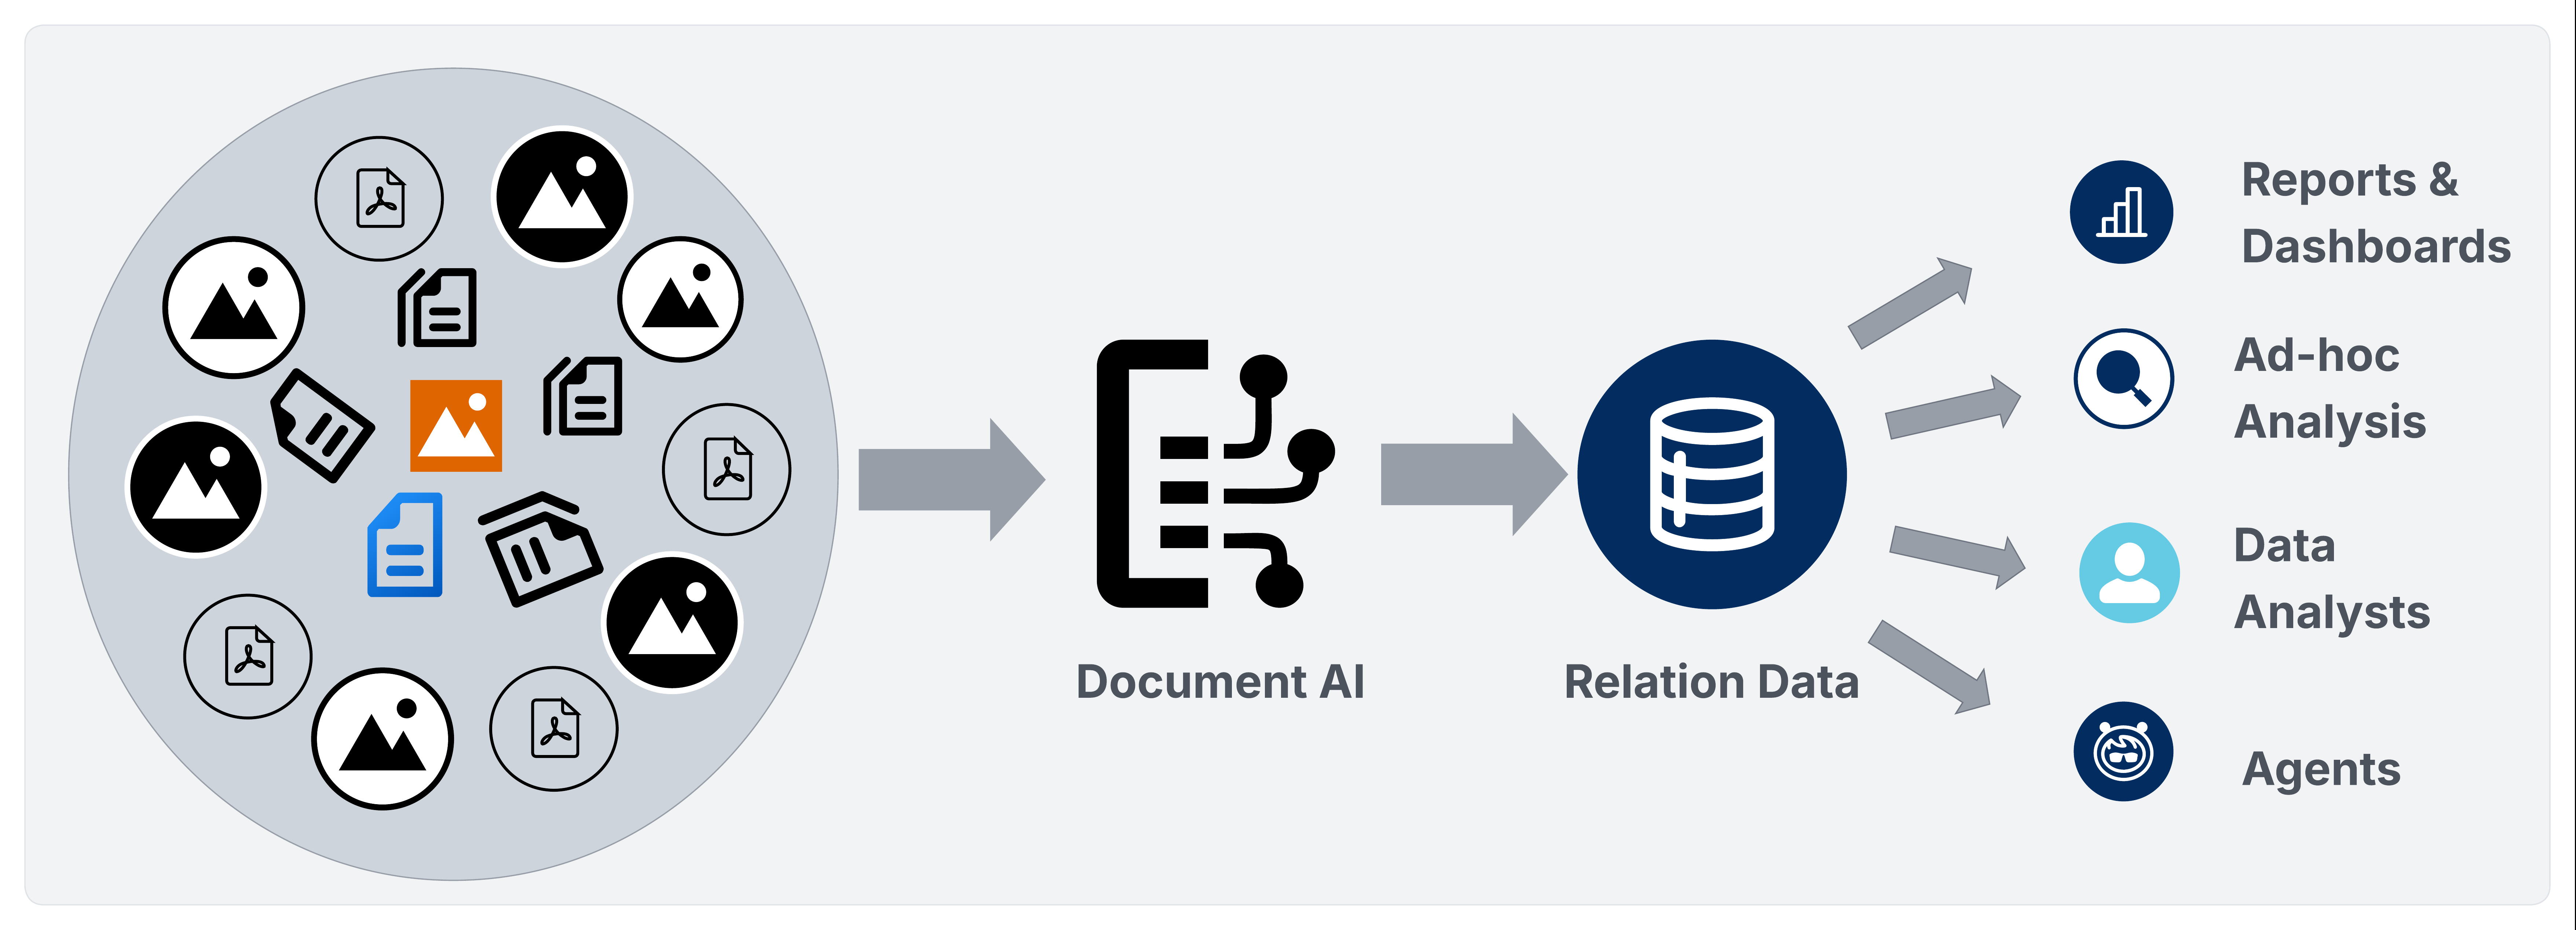
La IA de documentos de Data 360 pone en marcha el procesamiento de documentos en la plataforma Data 360 a través de dos oportunidades en curso.
- Las Oportunidades en curso por lotes enrutan datos extraídos a través de ingreso, resolución de identidad, perspectivas calculadas, activaciones, análisis y activación Agentforce.
- Las Oportunidades en curso de procesamiento de transacciones exponen una API de REST que devuelve JSON estructurado de forma síncrona, lo que permite a los arquitectos enrutar datos derivados de documentos a SObjects de Salesforce, las oportunidades en curso Objeto de lago de datos / Objeto de modelo de datos (DLO/DMO) o bases de datos externas y almacenes sin sobrecarga de configuración por lotes.
En ambos casos, los datos extraídos ingresan en un modelo gobernado dirigido por esquemas en vez de un conjunto fragmentado de herramientas de puntos.
La IA de documentos de Data 360 es la función nativa de Salesforce Procesamiento inteligente de documentos (IDP) en la plataforma Data 360. Convierte contenido de documento no estructurado y semiestructurado en datos gobernados y consultables que participan completamente durante todo el ciclo de vida de Data 360.
La IA de documentos de Data 360 es la función nativa de Salesforce Procesamiento inteligente de documentos (IDP) en Data 360. Ingresa documentos no estructurados y semiestructurados, extrae datos estructurados utilizando una configuración de esquema declarativo y entrega esos datos a las oportunidades en curso de Data 360 para Armonización, Resolución de identidad, Análisis y Activación Agentforce.
La IA de documentos de Data 360 admite dos modalidades de procesamiento:
- Procesamiento por lotes masivo: Procesa conjuntos de documentos de gran tamaño que se definen en Objetos de modelo de datos no estructurados (UDMO) en base a eventos.
- Procesamiento transaccional: Procesa un único documento a través de la API de REST y devuelve una carga JSON estructurada de forma síncrona. Los arquitectos pueden enrutar esa carga a las oportunidades en curso de DLO/DMO de Data 360, los objetos de Salesforce o las bases de datos y almacenes externos a través de MuleSoft, llamadas Apex o Einstein Trust Layer (ETL). El nivel de destino es una decisión arquitectónica dirigida por los requisitos de latencia, gobernanza y residencia de datos.
La IA de documentos admite actualmente archivos PDF, archivos de imagen (JPEG, PNG) y documentos manuscritos.
La IA de documentos de Data 360 reúne cuatro tecnologías de procesamiento en una única canalización gobernada. Cada componente gestiona una etapa distinta del ciclo de vida de documento a datos:
- Reconocimiento óptico de caracteres (OCR): Convierte imágenes escaneadas, contenido manuscrito y PDF basados en imágenes en texto legible por máquina antes del procesamiento LLM. Se recomienda un mínimo de 150 ppp para una extracción fiable.
- Modelos de lenguaje grande (LLM): Enrute la extracción a través de la pasarela Einstein LLM utilizando el modelo elegido por el usuario. El LLM recibe la salida de OCR junto con la configuración del esquema JSON y devuelve una carga de extracción estructurada. Se están planificando modelos de Géminis y modelos adicionales para su futura aplicación.
- Procesamiento del lenguaje natural (NLP): Realiza comprensión contextual, reconocimiento de entidades, análisis de fechas y extracción de campos semánticos directamente en el LLM a través de ingeniería de solicitudes estructurada: la solicitud definida por esquema y la salida de OCR sirven como las únicas entradas. Todas las interacciones LLM se enrutan a través del ETL, que aplica retención de datos cero con proveedores de modelo y enmascara el PII en entradas basadas en texto antes de que lleguen al modelo. No se emplea ningún motor NLP separado.
- Procesamiento multimodal: Procesa imágenes incrustadas en PDF como entradas de extracción separadas, lo que permite al LLM extraer datos de diagramas, tablas representadas por imágenes y páginas de contenido mixto que OCR por sí solo no puede analizar.
Además de las cuatro tecnologías de procesamiento, la IA de documentos también gestiona:
- Capa Einstein Trust: Enruta todas las interacciones de LLM a través del ETL, que aplica retención de datos cero con proveedores de modelos y enmascara PII antes de que las entradas lleguen al LLM con la excepción de datos multimodales (por ejemplo, documentos adjuntos que se procesan a través de IA de documentos) donde el enmascaramiento de PII no es compatible actualmente y los datos se envían tal cual a modelos externos. El ETL solo rige la ruta de interacción LLM. Los datos extraídos que se redactan en Objetos de lago de datos se almacenan tal cual; el enmascaramiento a nivel de campo en periodos de inactividad debe solucionarse a través de controles de regulación de datos descendentes.
- Límites de tamaño de archivo: La IA de documentos procesa archivos de hasta 10MB por solicitud. Los límites de longitud de contexto LLM pueden restringir aún más el procesamiento para documentos densos de varias páginas dentro de este límite.
Los arquitectos de compañía que están implementando la IA de documentos de Data 360 deben aplicar estos principios antes de comprometerse a un diseño de implementación.
- Seleccione la canalización antes de diseñar el esquema. Las oportunidades en curso de procesamiento por lotes y transaccionales difieren en modelo de ingreso, vinculación de esquemas, flexibilidad de destino y latencia. Es importante confirmar qué oportunidades en curso requiere cada caso de uso antes de definir el esquema como la actualización agrega una renovación evitable.
- Diseñe esquemas a nivel de tipo de documento. El uso de un esquema único y bien elaborado por tipo de documento es más mantenible que el uso de configuraciones por caso, y también es la palanca más grande para la calidad de extracción. Hacer esto correctamente requiere el uso de un conjunto diverso de documentos, incluyendo casos extremos, en vez de diseñar desde un único ejemplo. Utilice solicitudes de forma iterativa en los niveles de campo, tabla y esquema para encontrar brechas, y luego pruébelas y ajústelas con múltiples muestras de documentos antes de finalizar. Tenga en cuenta que un esquema que funciona bien en un documento puede quedarse corto en otros, por lo que la amplitud y la iteración son esenciales. La flexibilidad de esquema, incluyendo la eliminación de columnas que no se extraen de forma fiable entre tipos de documentos, es igualmente importante. Mantenerse en campos que introducen ruido o incoherencia socava la calidad general de la extracción, de modo que es importante tratar la eliminación de columnas como una decisión de diseño de primera clase.
- Seleccione el nivel de destino correcto por grupo de campos. Los campos que dirigen flujos de trabajo o aprobaciones de CRM se redactan en SObjects. Los campos que están enriqueciendo el perfil unificado o los análisis de noticias en tiempo real pertenecen a las oportunidades en curso de DLO/DMO. Los campos que sirven sistemas externos pertenecen al nivel RDBMS. Tenga en cuenta que un esquema único puede extenderse a múltiples niveles simultáneamente.
- Aplique la regulación antes de procesar contenido regulado. Los datos regulados necesitan protección en cada capa. Es por eso que es importante configurar el enmascaramiento de PII, las etiquetas de clasificación de datos y el Control de acceso basado en atributos (ABAC) después de almacenar los datos extraídos en los Objetos de lago de datos (DLO) de salida. Esto proporciona una aplicación más precisa y acceso consciente del contexto que se basa en la clasificación de datos, la función de usuario y el contexto organizativo. La gobernanza se divide en dos vías: el ELT rige la interacción LLM, mientras que los datos extraídos almacenados en los DLO deben gobernarse por separado (directamente a nivel de DLO y base de datos) a través de configuraciones de Espacio de datos, Conjuntos de permisos y políticas ABAC. Estos controles deben mantener la coherencia en el nivel de almacenamiento (no solo la capa de aplicación), de modo que las restricciones de acceso permanecen intactas independientemente de cómo se acceda a los datos después del ingreso. Tenga en cuenta que las brechas en cualquier capa pueden exponer datos regulados aguas abajo incluso cuando otros están configurados correctamente.
- Diseño para modos de fallo antes de la producción. Trate la gestión de campos nulos, los umbrales de calidad de OCR, la validación previa del tamaño de archivo, el desbordamiento del contexto LLM, la idempotencia de escritura RDBMS y los límites de presupuesto de crédito antes de la primera ejecución por lotes de producción. Estos no son casos extremos: son superficies de fallo predecibles que deben tratarse explícitamente en el diseño de oportunidades en curso, no descubrirse durante el tiempo de ejecución.
- Trate los puntuajes de confianza como una señal de enrutamiento de primera clase, no como una idea posterior al diagnóstico. Los resultados de extracción llevan valores de confianza a nivel de campo derivados de las probabilidades de registro (logprobs) del resultado del modelo subyacente. Para cada campo, tabla o columna extraídos, el puntuaje refleja la certeza a nivel de token del modelo del valor extraído. Esto hace que los puntuajes de confianza sean una señal fundamentada estadísticamente lo suficientemente fiable como para servir como la puerta principal para umbrales de distribución humana en bucle. Utilice puntuajes de confianza para identificar sistemáticamente extracciones de baja calidad e iniciar puntos de control HITL para valores de campo de baja confianza, coincidencias de esquemas ambiguas o fallos de oportunidades en curso repetidos en vez de basarse en heurística o comprobaciones puntuales manuales. Cuando la recuperación automatizada no es posible, el puntuaje de confianza respaldado por HITL garantiza que el juicio humano se aplica exactamente donde se necesita.
- Diseñe rutas de activación en paralelo con el diseño de esquemas. El valor de la IA de documentos proviene de la capacidad de activar datos extraídos en agentes y flujos de trabajo de Salesforce. Le permite diseñar Acciones, Flujos y Perspectivas calculadas de Agentforce junto con el diseño de esquemas de extracción, no después.
La IA de documentos funciona en dos oportunidades en curso:
- Una canalización por lotes para un procesamiento de gran volumen respaldado por UDMO
- Una canalización de procesamiento transaccional para la extracción en tiempo real dirigida por API
Ambas oportunidades en curso comparten el mismo contrato de configuración de esquema y la misma regulación de ETL, pero difieren en cómo entran los documentos en el sistema y dónde llegan los datos extraídos.
Echemos un vistazo más de cerca a cada canalización.
Las oportunidades en curso por lotes procesan conjuntos de documentos recurrentes definidos por un UDMO. Se adapta a casos de uso programados o dirigidos por eventos en los que los documentos se ingresan desde el almacenamiento de la compañía, luego pasan por la extracción de documentos y se entregan a las oportunidades en curso de DATA 360 DLO/DMO para Armonización, Resolución de identidad y Activación.
Escenario del mundo real
Cada día, un asegurador recibe miles de documentos de reclamaciones médicas de portales de proveedores que se cargan como PDF en Amazon S3. El UDMO define el conjunto de documentos dentro del ámbito y envía todos los PDF de reclamaciones al depósito de /claims/incoming/ en un plazo de 24 horas.
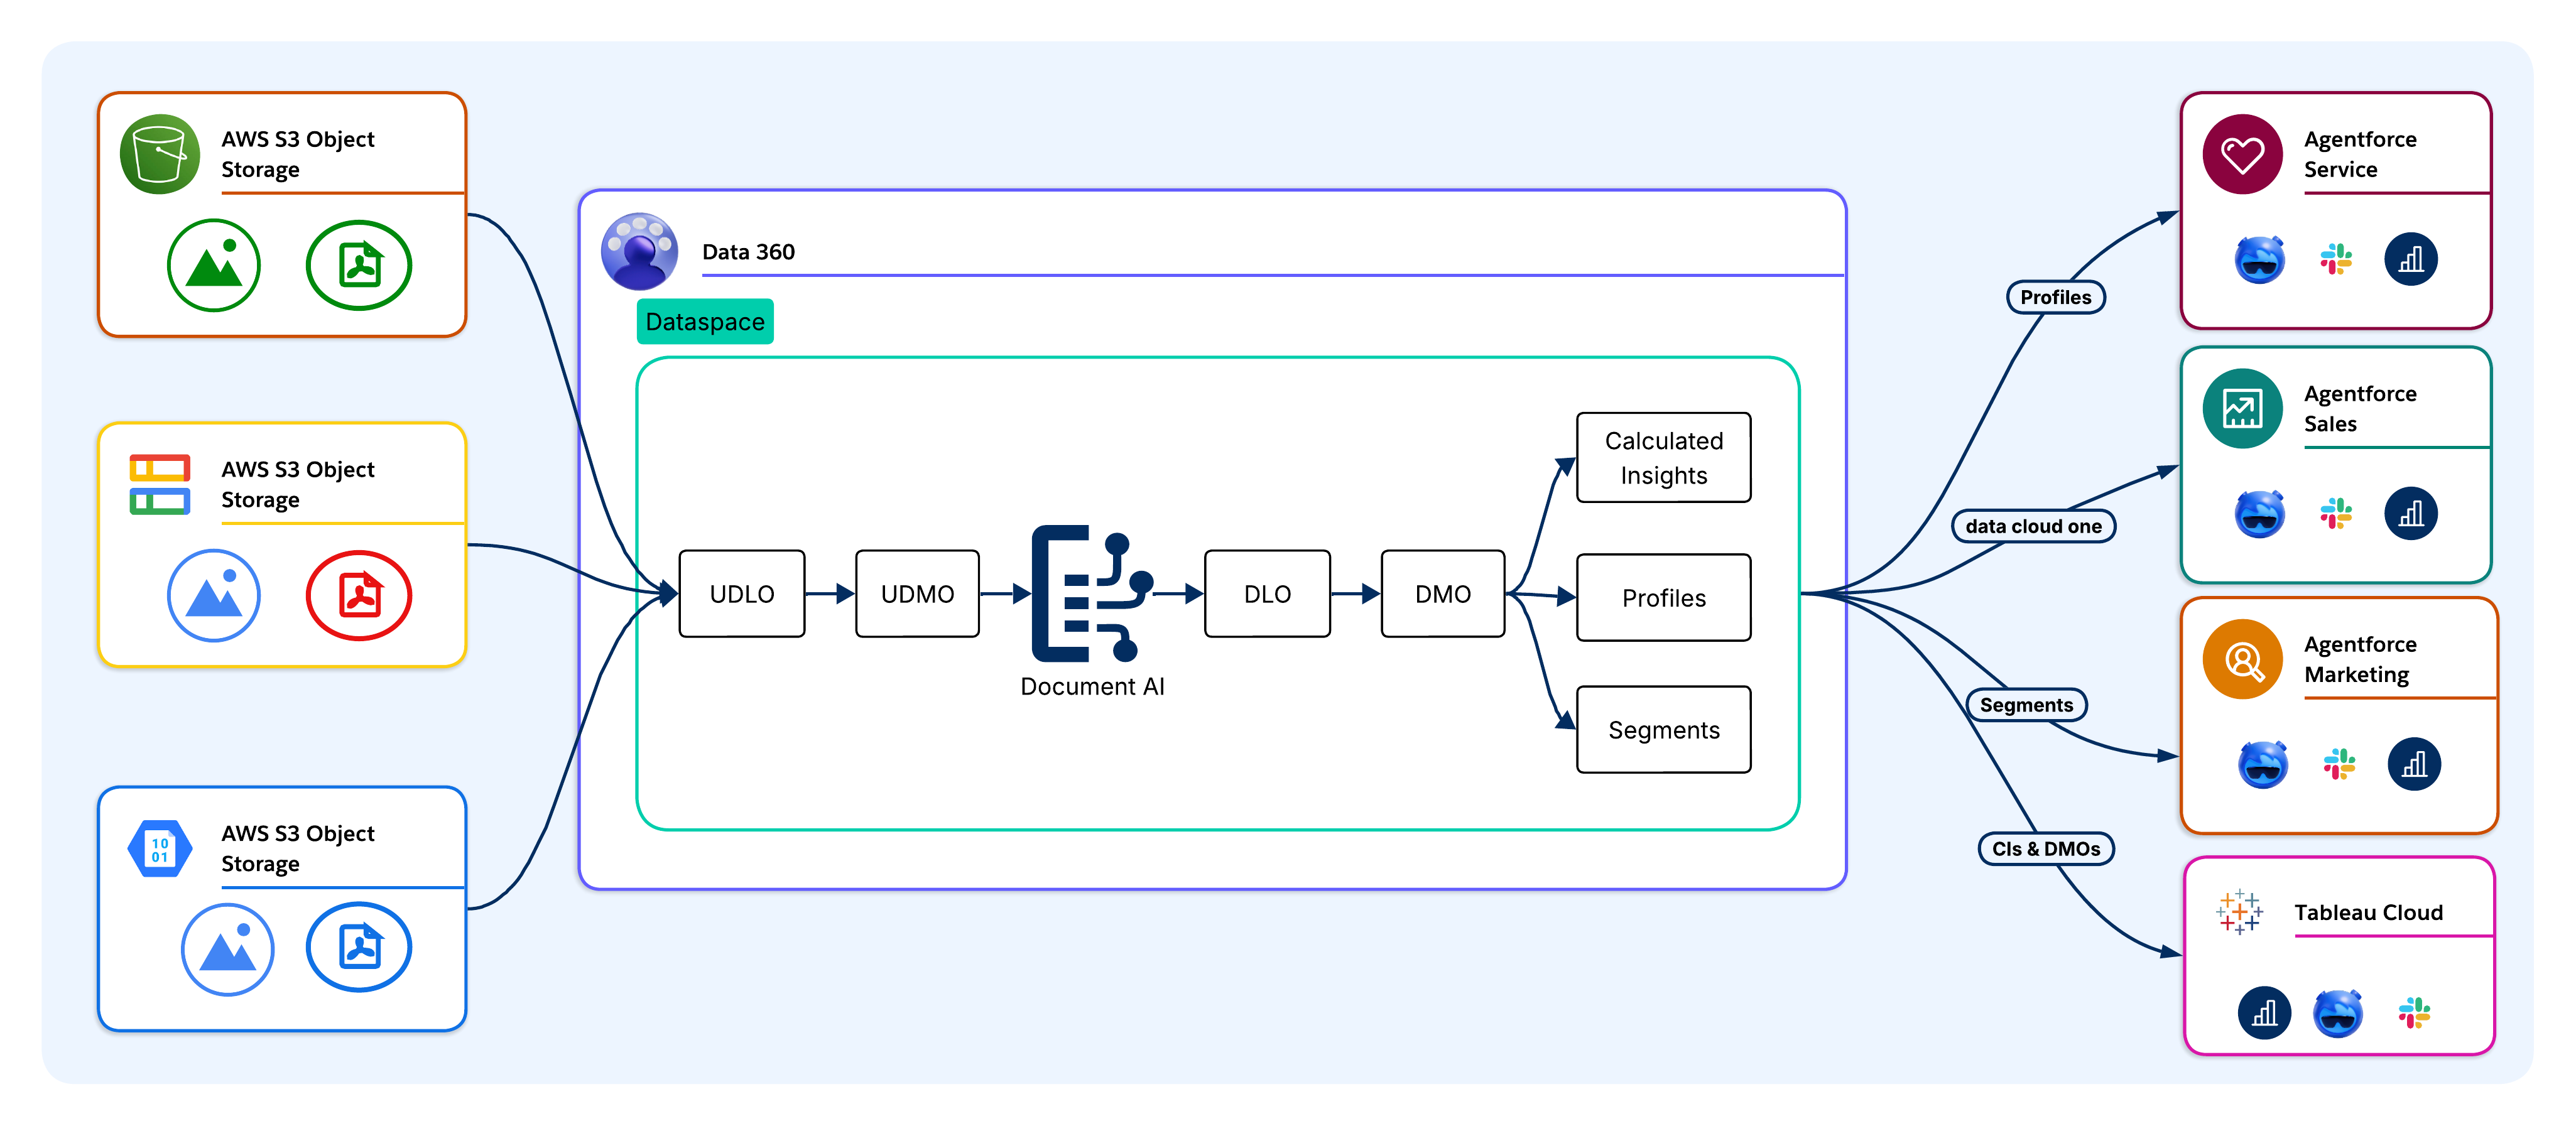
Los documentos se ingresan en Data 360 desde sistemas de origen de compañía sin duplicación física. Las fuentes compatibles incluyen Amazon S3, Google Cloud Storage, objetos de archivos de Salesforce CRM, oportunidades en curso orquestadas por MuleSoft y cargas de API directas. En implementaciones de Headless 360, los documentos se ingresan a través de conectores de almacenamiento en la nube o la API de ingreso, que omite la capa de CRM. El servidor Model Context Protocol (MCP) expone el ingreso como una herramienta llamable para agentes de IA externos y clientes LLM.
Al ingresar, los documentos sin procesar se almacenan como Objetos de lago de datos no estructurados (UDLO), que se asignan a la ubicación física y los metadatos de cada documento sin mover o transformar el archivo de origen.
Ejemplo:
Los archivos PDF de reclamaciones se ingresan desde S3 en Data 360 a través del conector de almacenamiento en la nube. Cada documento se almacena como un UDLO que apunta al objeto S3. No se produce ninguna duplicación física.
La IA de documentos procesa cada UDLO con una configuración de esquema que define qué campos extraer junto con sus tipos de datos de destino. El UDMO define qué documentos están en el ámbito. El LLM (GPT-4o, Géminis o Claude) lee cada documento y devuelve una carga de extracción estructurada.
Ejemplo:
La IA de documentos procesa cada UDLO con un esquema de reclamaciones que define campos como: ClaimID, PatientName, DiagnosisCode, BillingAmount y ServiceDate. Los LLM luego leen cada PDF y devuelven una carga de extracción estructurada.
Una vez extraídos los datos, persisten en los DLO, que son la capa de almacenamiento sin procesar de Data 360. Los DLO conservan los campos extraídos sin imponer lógica de negocio, lo que mantiene una representación física precisa para la trazabilidad y la transformación descendente. El UDLO mantiene una referencia al documento de origen para activar el linaje a nivel de campo en cualquier punto de las oportunidades en curso.
Ejemplo:
Todos los campos extraídos llegan a un DLO de reclamaciones, lo que mantiene una representación precisa y sin procesar de cada reclamación con un linaje completo que se puede rastrear hasta el PDF de origen.
Los campos de DLO se asignan a DMO que se alinean con el Modelo de datos Customer 360 estándar. Este es el límite donde los datos derivados de documentos pasan de campos sin procesar extraídos a entidades con sentido de negocio. El DLO de factura se asigna a un DMO de factura, y campos como CustomerID y BillingAmount se convierten en claves de unión y atributos de coincidencia en el modelo de datos unificado. Los datos de documentos armonizados participan en segmentación, Perspectivas calculadas y activación a través de las mismas interfaces utilizadas por CRM y datos de transacciones.
Ejemplo:
El DLO Reclamaciones se asigna a un DMO Reclamaciones. Los campos PatientID y PolicyNumber se convierten en claves de unión que vinculan registros de reclamaciones a perfiles de pacientes unificados.
Los datos de DMO armonizados participan en la resolución de identidad. Los campos extraídos (por ejemplo, nombres de clientes, direcciones de email o números de cuenta) sirven como claves de coincidencia para vincular registros de documentos a Personas unificadas (Registros dorados), lo que cierra la brecha de documento a perfil.
Ejemplo:
Los campos de extracción (por ejemplo, PatientName, DateOfBirth y PolicyNumber) sirven como claves de coincidencia para la resolución de identidad, lo que vincula registros de reclamación al particular unificado correcto. Esto se produce incluso si el mismo paciente aparece con una ortografía de nombre ligeramente diferente en los documentos.
Los arquitectos definen Perspectivas calculadas, que son mediciones agregadas que se calculan entre datos de documentos armonizados (por ejemplo, el gasto total de varias partidas de factura, puntuajes de riesgo de renovación de contratos e índices de gravedad de reclamaciones).
Ejemplo:
Perspectivas calculadas calcula TotalClaimsPerPatient, AverageClaimAmount y HighRiskClaimScore entre datos de reclamaciones armonizados para consultas Agentforce.
Los datos armonizados resueltos por identidad son accesibles para Agentforce Agents, Tableau, plataformas de marketing y SObjects de Salesforce. El nivel de destino es una decisión arquitectónica dirigida por los requisitos de latencia, gobernanza y residencia de datos.
Ejemplo:
Un Claims Adjudication Agentforce consulta los DMO e IC de Data 360 para encontrar reclamaciones de alto riesgo para revisión de prioridad. Los tableros de Tableau muestran el volumen de reclamaciones y las tendencias de anomalías. Los registros de reclamaciones aprobados vuelven al Objeto Reclamaciones para iniciar flujos de trabajo de pago.
En arquitecturas de Headless 360, la activación enruta directamente a sistemas externos a través de la API de consulta, la API Pub/Sub o los destinos de activación del almacén de datos de Cloud. A continuación, el servidor MCP encuentra datos de documentos armonizados y Perspectivas calculadas como herramientas llamables para agentes de IA externos.
Las oportunidades en curso de procesamiento transaccional gestionan la extracción de documentos únicos en tiempo de ejecución sin un UDMO o UDLO preintroducido, que se adapta a casos de uso dirigidos por eventos (por ejemplo, un cliente cargando un formulario, un agente recibiendo un PDF o un sistema externo iniciando la extracción dentro de un flujo de trabajo de procesamiento transaccional). La regulación de ETL se aplica a ambas oportunidades en curso de forma idéntica.
Escenario del mundo real
Mientras solicita un préstamo, un cliente de banco carga un PDF de su factura de servicios públicos a través de la aplicación móvil del banco. El evento inicia la extracción en tiempo real, lo que significa que no hay implicado ningún UDLO u UDMO ingresado previamente.
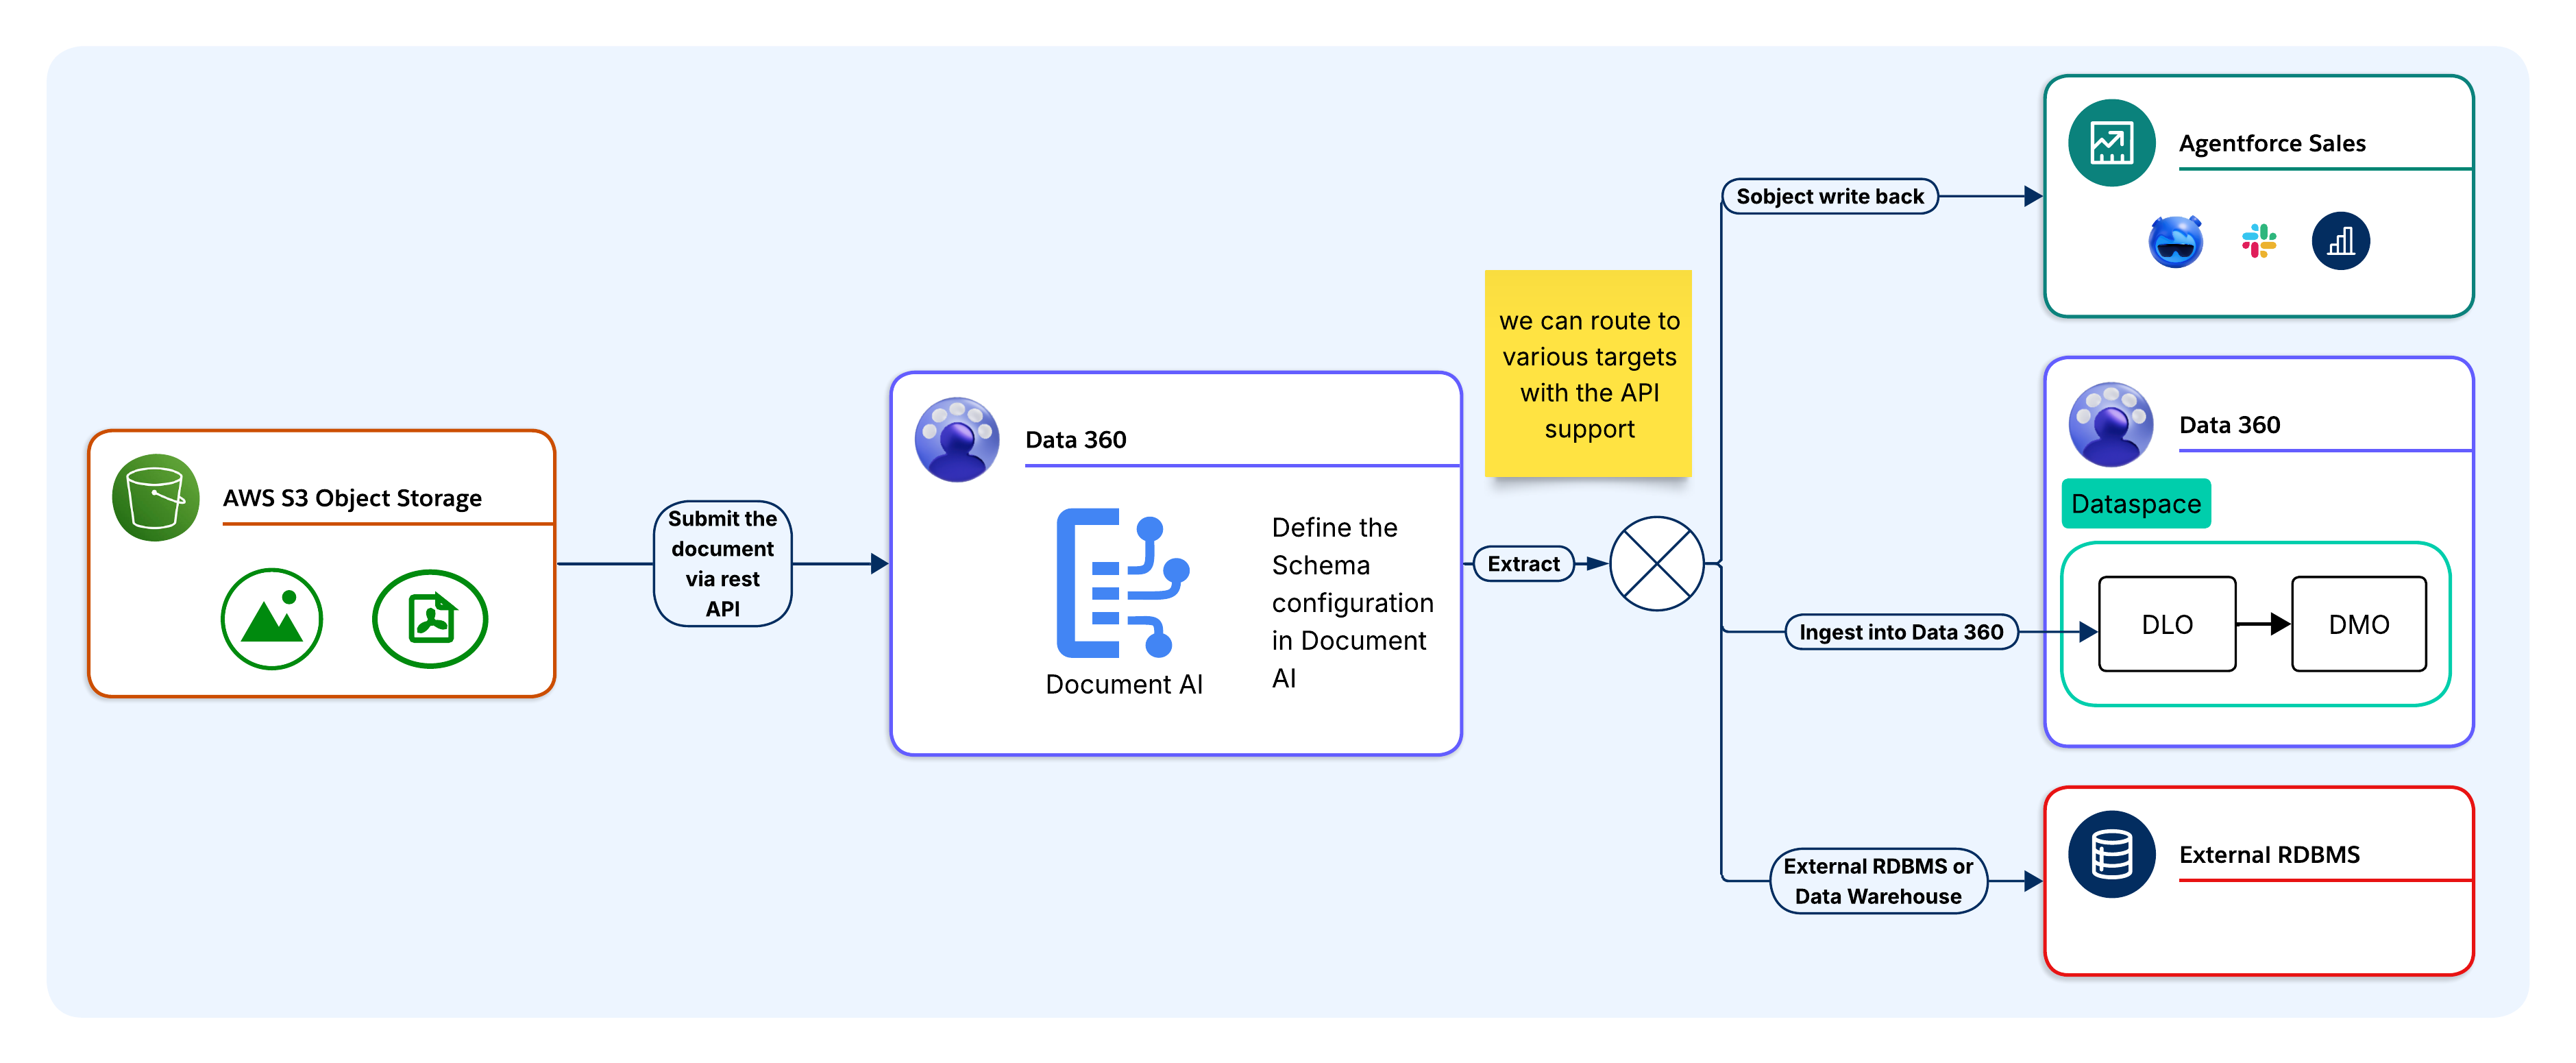
Antes de invocar la API, los arquitectos deben definir y almacenar un esquema en Data 360 que especifique los campos, los tipos de datos y las instrucciones de extracción en formato Esquema JSON. Cada esquema tiene asignado un Id. de esquema exclusivo. En tiempo de ejecución, la aplicación que llama hace referencia al Id. de esquema para mantener la lógica de extracción centralizada en Data 360 en vez de integrarla en el código de la aplicación.
Ejemplo:
El equipo del banco tiene un esquema de ProofOfAddress predefinido en Data 360, que especifica campos como CustomerName, AddressLine1, City, PostCode y DocumentDate. Esta información se almacena como una configuración versionada a la que se puede hacer referencia mediante un Id. de esquema.
La aplicación que llama envía el documento y el Id. de esquema en una única solicitud de API de REST como una referencia de archivo o carga codificada con base64. No se requiere ingreso de UDLO. La IA de documentos aplica la extracción de documentos y devuelve el resultado estructurado basándose en el esquema proporcionado.
Ejemplo:
La aplicación móvil envía la factura de servicios públicos como una carga codificada con base64 junto con el Id. de esquema de ProofOfAddress en una sola llamada de API de REST. Este proceso no requiere un paso de ingreso de UDLO.
El LLM procesa la salida de OCR con el esquema y devuelve una carga de JSON estructurada de forma síncrona. Los campos que no se encuentran en el documento se devuelven como nulos. La persona que llama es propietaria de la respuesta JSON completa y continúa con el enrutamiento.
Ejemplo:
La IA de documento aplica OCR al PDF y el LLM devuelve una carga de JSON estructurada con campos de dirección extraídos. Los campos que no se encuentran (por ejemplo, si falta el PostCode en la factura) se devuelven como nulos.
Una vez extraída, la carga JSON se puede enrutar a uno o más niveles de destino dependiendo del caso de uso:
- Objeto de Salesforce: Asigne directamente a campos de SObject mediante Apex o Flow para flujos de trabajo y aprobaciones de CRM.
- Oportunidades en curso de DLO/DMO de Data 360: Enruta a un DLO para Armonización, Resolución de identidad, Perspectivas calculadas y Fundamentación Agentforce.
- RDBMS externo o Almacén de datos: Enruta a través de MuleSoft, llamadas Apex, eventos de plataforma o ETL para sistemas que están fuera de Salesforce.
- Integración personalizada: Devuelve cargas de JSON estructuradas a la aplicación llamante para su almacenamiento en cualquier sistema externo o establecimiento de datos.
- Flujo descendente o Agente: Pasa la salida de JSON estructurada directamente a un flujo descendente o agente sin ninguna persistencia en un SObject. Este es un patrón común para clientes que utilizan la IA de documentos como un paso de extracción en tiempo real en una automatización más grande o un flujo de trabajo de agentes.
Tenga en cuenta que un esquema único puede extenderse a múltiples niveles simultáneamente, con diferentes grupos de campos enrutando a diferentes destinos desde el mismo punto de extracción.
Ejemplo:
Una carga de ProofOfAddress puede extenderse a tres niveles a la vez (por ejemplo, CustomerName y AddressLine1 escriben en el Objeto de contacto), que inicia un Flujo de verificación de dirección. A continuación, la carga completa enruta a un DLO para Armonización y Puntuaje de Riesgo, y una copia enruta al sistema KYC del banco a través de MuleSoft para el registro del cumplimiento normativo.
Una vez redactados, los datos extraídos se activan en el sistema de destino de inmediato. Para destinos de SObject, los desencadenadores, flujos y procesos de aprobación se activan en el registro alterado. En el caso de objetivos de DLO/DMO, los datos entran en las oportunidades en curso de Armonización y Resolución de identidad y en el contexto Agentforce. Para destinos de RDBMS externos, los datos están disponibles para consultas descendentes en cuanto se complete la escritura.
Ejemplo:
El Flujo de verificación de dirección se activa inmediatamente en el registro Contacto alterado, lo que hace avanzar la solicitud de préstamo a la siguiente etapa. El agente de préstamos Agentforce encuentra la dirección verificada de Data 360 y el sistema KYC registra el envío del documento para fines de auditoría.
La IA de documentos se adapta mejor a condiciones arquitectónicas específicas. Aplicarlo fuera de esas condiciones introduce complejidad innecesaria y costos adicionales.
Como arquitectos, es importante evaluar estos criterios antes de comprometerse con la IA de documentos como el mecanismo de extracción.
Utilice la IA de documentos cuando:
- Los documentos son el origen de datos principal. La información requerida solo existe en formato de documento y no está disponible desde una API estructurada o base de datos (por ejemplo, contratos escaneados, reportes de laboratorio, formularios de admisión o reclamaciones de seguros).
- Los formatos de documento varían entre orígenes. El mismo tipo de documento llega de múltiples proveedores, socios o regiones con diferentes formatos y posiciones de campo. La extracción LLM dirigida por esquemas se adapta sin mantenimiento por formato.
- Los datos extraídos deben alimentar Data 360 o Agentforce. La extracción debe participar en la resolución de identidad, Perspectivas calculadas o Fundamentación Agentforce. La IA de documentos se entrega directamente en las oportunidades en curso de DLO/DMO sin una capa ETL separada.
- El volumen justifica la automatización gobernada. El volumen de documentos supera lo que el procesamiento manual puede gestionar sin costos de mano de obra mensurables o riesgos de calidad de datos.
- Los documentos contienen contenido regulado. PHI, PII o datos financieros deben enrutarse a través de una capa de retención de datos cero y enmascaramiento de PII antes de alcanzar un LLM. El ETL satisface esto de forma nativa. Los clientes que no requieren que se mantenga ningún contenido extraído en ningún punto también deben tener en cuenta el flujo de API transaccional, que devuelve resultados estructurados directamente a la aplicación que llama sin escribir en ningún SObject o establecimiento de datos.
- El caso de uso está dirigido por eventos. Un documento llega en tiempo de ejecución (por ejemplo, una carga de cliente, un archivo adjunto PDF de agente o un desencadenador del sistema externo). Las oportunidades en curso de procesamiento transaccional gestionan la extracción síncrona de un solo documento sin configuración por lotes.
No utilice la IA de documentos cuando:
- Los datos de origen ya están estructurados. Si el sistema ascendente expone una API de REST, una tabla de base de datos o un archivo estructurado (por ejemplo, CSV, JSON o XML), utilice un conector Data 360 estándar. La ejecución de datos estructurados a través de una canalización de extracción LLM agrega latencia y costos de crédito sin beneficios adicionales.
- Los documentos se generan automáticamente con un esquema fijo. Los PDF generados por el sistema desde un sistema ERP conocido o una plataforma de facturación con un formato estable son más adecuados para un analizador determinista. La extracción LLM está diseñada para la variabilidad, y su aplicación a documentos de esquema fijo desperdicia contexto y créditos.
- Los requisitos de precisión superan los umbrales de confianza de LLM. La IA de documentos no garantiza una precisión de extracción del 100%. Los casos de uso donde un valor de campo perdido o incorrecto conlleva un riesgo financiero, legal o clínico significativo requieren un paso de validación HITL. No utilice la IA de documentos como la única capa de extracción para decisiones de alto riesgo sin un flujo de trabajo de validación.
- Los documentos superan las restricciones de la plataforma. El límite de tamaño de archivo de 10MB actual y las restricciones de longitud de contexto LLM hacen que la IA de documentos no sea adecuada para documentos grandes o densos sin procesamiento previo para dividirlos y volver a ensamblarlos fuera de la plataforma.
- Nota: En Salesforce, estamos mejorando activamente estas barandillas de aceptación para ampliar los tamaños de archivo, conteos de páginas y extensiones de archivo compatibles. Las restricciones seguirán evolucionando hacia adelante.
Echemos un vistazo con más detalle a varios escenarios que utilizan las oportunidades en curso por lotes de IA de documentos respaldadas por un objeto de origen UDMO. En estos casos, los datos extraídos se enrutan a través de las oportunidades en curso de DATA 360 DLO/DMO para Armonización, Resolución de identidad, Perspectivas calculadas y Activación Agentforce. Cada caso de uso es el más adecuado para el procesamiento de documentos de gran volumen programado o dirigido por eventos.
Agentforce Sales: Inteligencia de contratos y facturas
Los PDF de contratos se ingresan desde el almacenamiento de Cloud a través de las oportunidades en curso por lotes. El esquema extrae ContractValue, RenewalDate, PaymentTerms y CounterpartyName, y luego los asigna a los DMO de Cuenta y Contrato. Perspectivas calculadas deriva puntuajes de riesgo de renovación. Agentforce alerta a los ejecutivos de cuentas antes de que se cierren los plazos de renovación, lo que elimina la revisión manual de contratos y las renovaciones perdidas.
Servicio Agentforce: Desviación de casos y Fundamentación de Knowledge
Los PDF de encuestas y los archivos adjuntos de casos se ingresan a través de las oportunidades en curso por lotes. El esquema extrae indicadores de opinión, categorías de problemas y notas de resolución, y luego los asigna a los DMO de caso y artículo Knowledge. Agentforce consulta la base de Knowledge armonizada cuando se abre el caso y localiza pasos de solución de problemas relevantes, lo que reduce la carga de trabajo de búsqueda de agentes.
Agentforce Health: Procesamiento de documentos clínicos
Los reportes de laboratorio, los PDF de admisión y los formularios clínicos manuscritos se ingresan a través de las oportunidades en curso por lotes. El esquema extrae campos, incluyendo PatientID, DiagnosisCode, MedicationName y TestResult, y luego los asigna a los DMO de Health Cloud, que admiten flujos de trabajo de investigación clínica y coordinación de cuidados alineados con HIPAA.
Servicios financieros: Automatización de documentos de préstamos e impuestos
Las solicitudes de préstamos, las declaraciones de impuestos y las declaraciones de ingresos se ingresan a través de las oportunidades en curso por lotes. El esquema extrae campos, incluyendo AnnualIncome, TaxYear y EmployerName, y luego los asigna a los DMO de Cuenta financiera. Perspectivas calculadas une datos de ingresos derivados de documentos y datos de CRM para facilitar el puntuaje de riesgo de crédito automatizado. Agentforce localiza los detalles del préstamo extraído en línea durante las interacciones de servicio al cliente. Este patrón admite directamente el caso de uso Agente de precalificación de préstamos que se publicó en el centro de desarrollador de Soluciones de negocio de Salesforce.
RRHH: Procesamiento de documentos de plantilla de trabajo
Los documentos de incorporación, los formularios de impuestos y los PDF de certificación se ingresan a través de las oportunidades en curso por lotes. Los campos extraídos se asignan a los DMO de Registro de empleado y luego se vinculan al perfil Empleado unificado. Flujos específicos inician tareas de incorporación y comprobaciones de cumplimiento basándose en los datos extraídos. Este patrón admite directamente el caso de uso Agente de procesamiento de reanudación automático. La IA de documentos extrae habilidades, historial laboral y cualificaciones de los PDF de currículum, que Agentforce utiliza para comparar candidatos con criterios de funciones abiertas y enrutarlos a flujos de trabajo de contratación.
Servicios profesionales: Inteligencia de propuestas e investigaciones
Los conjuntos de propuestas y los reportes de investigación se ingresan a través de las oportunidades en curso por lotes. Los marcos de trabajo, los indicadores y los resúmenes de implicación extraídos se asignan a DMO personalizados y luego se indexan para la búsqueda de vectores. Agentforce recupera recomendaciones relevantes en contexto en el momento de la consulta, que se basan en contenido de documento extraído. Este patrón amplía el patrón Ground Agentforce en contenido de sitio web. Los documentos se indexan a través de la IA de documentos y cumplen la misma función de fundamentación para respuestas de agentes que el contenido del sitio web indexado a través de conectores de Data 360.
Estado de cumplimiento de HIPAA:
Las pautas Health Cloud descritas en este documento aplican controles de ETL (por ejemplo, retención cero de datos y enmascaramiento de PHI) para entradas de texto. Estos controles por sí solos no constituyen certificación HIPAA. Los arquitectos que están diseñando entornos clínicos regulados deben confirmar el estado de certificación HIPAA actual con el equipo de cumplimiento de Salesforce antes de comprometerse con una arquitectura basada en IA de documentos en esos contextos.
Echemos un vistazo con más detalle a varios escenarios que invocan la API de REST de IA de documentos con un esquema que no está vinculado a un UDMO. Las cargas JSON extraídas se enrutan directamente a sistemas externos de forma síncrona en tiempo de ejecución.
Cadena de suministro: Procesamiento de facturas de proveedor a ERP
Cuando un PDF de factura de proveedor llega a un depósito de almacenamiento monitoreado o pasarela de email, un desencadenador de evento llama a la API de REST de IA de documento con la factura y un Id. de esquema predefinido. El esquema extrae VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount y DueDate. La carga de JSON se enruta a través de MuleSoft al módulo Cuentas ERP a pagar con validación de campo nula y lógica de alteración idempotente, lo que elimina el mantenimiento de plantillas para la variabilidad de formato de proveedores.
Operaciones legales: Revisión de contratos en CLM
Cuando se carga un PDF de contrato en el portal legal, el backend llama a la API de REST de IA de documentos de forma síncrona. El esquema extrae GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause y CounterpartySignatory. La carga de JSON se enruta a través de una llamada Apex al sistema de gestión del ciclo de vida de contratos (CLM). Cualquier campo que no se encuentre se devuelve como nulo y el CLM aplica las reglas de obligación predeterminadas a los valores que faltan.
Reclamaciones de seguros: Primer aviso de procesamiento de pérdidas
Cuando un tomador de póliza envía un formulario de Primer aviso de pérdida (FNOL), el portal backend llama a la API de REST de IA de documentos de forma síncrona. El esquema extrae PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName y ContactPhone. La carga útil de JSON enruta a la base de datos de gestión de reclamaciones a través de una llamada Apex o ETL, que crea un registro de reclamación rellenado previamente para que los ajustadores lo revisen antes de abrir la reclamación formal.
Antes de pasar a producción, debe crear diseños para estos escenarios de fallo.
- Gestión de campos nulos: El LLM devuelve nulo para campos que no puede localizar o extraer con confianza. Valide la lógica de gestión de nulos en el diseño de esquemas e implemente la lógica de rechazo o valor predeterminado en la capa de integración antes de escribir en cualquier destino con restricciones NO NULAS o claves de coincidencia requeridas.
- Degradación de calidad de OCR: La precisión de OCR se degrada por debajo de 150 ppp, en escritura irregular o en exploraciones ruidosas. Los errores de lectura se propagan a la extracción LLM como entrada dañada sin señales de error. Aplique la calidad de exploración mínima en el ingreso e implemente comprobaciones de umbral de confianza en campos numéricos y de fecha.
- Desajuste de versión de esquema: La actualización de una configuración de esquema después de programar un trabajo por lotes provoca que los documentos en vuelo se procesen con la versión anterior, lo que produce campos que faltan o que cambian de nombre que interrumpen la asignación descendente. Verifique esquemas de forma explícita y coordine actualizaciones con programaciones de trabajos por lotes.
- Límites de tamaño de archivo: Los documentos que superen los 10MB se rechazan. Los fallos de oportunidades en curso por lotes guardan silencio sin la configuración de monitoreo y los llamantes de transacciones reciben un error 4xx. Valide previamente los tamaños de archivo en el momento de la admisión e implemente el procesamiento previo para dividir o comprimir documentos que se acercan regularmente al límite.
- Desbordamiento de contexto LLM: Los documentos densos o de varias páginas pueden superar el plazo de contexto LLM dentro del límite de 10MB. El LLM descarta silenciosamente contenido que supera el contexto. Implemente una estrategia de fragmentación que divide documentos por intervalo de página y vuelve a reunir los campos extraídos antes de transferirlos al destino.
- Enmascaramiento de capa de confianza que afecta a la extracción: El ETL funciona a nivel de solicitud (no a nivel de documento), de modo que el enmascaramiento no se aplica al contenido de documentos que pasa por la IA de documentos. Los campos de esquema que dependen de valores de PII en el documento no se ven afectados por políticas de enmascaramiento de ETL.
- Idempotencia de escritura RDBMS externa: Las oportunidades en curso de procesamiento transaccional no tienen ninguna idempotencia integrada para objetivos de RDBMS externos. Los reintentos de capa de integración crean filas duplicadas a menos que la lógica de escritura trate la desduplicación de forma explícita. Implemente alteraciones idempotentes utilizando una huella de documento o un Id. externo en todas las rutas de escritura externas.
- Agotamiento de crédito a mitad de ejecución: Las ejecuciones por lotes de gran tamaño pueden agotar los créditos Digital Wallet antes de que se procesen todos los documentos, lo que produce conjuntos de datos de DLO incompletos que los pasos posteriores ven como completos. Establezca alertas de consumo en 75% y 90% de créditos disponibles y limite el tamaño de los lotes para permanecer dentro del presupuesto de crédito para cada ciclo.
- Límite de campos de esquema: Restricción arquitectónica: La IA de documentos aplica un límite de 50 campos para campos de nivel raíz en una configuración de esquema. Esta es una restricción de tiempo de diseño, no un error de tiempo de ejecución, y los arquitectos deben tenerla en cuenta durante el diseño de esquemas y modelos de datos.
- Para casos de uso que requieren una extracción más amplia:
- Priorice despiadadamente. Restrinja el esquema a campos que dirigen el valor de automatización, no la cobertura de documentos exhaustiva.
- Aproveche los objetos anidados (hasta 3 niveles; modo por lotes solo con objeto de origen) para reducir el conteo de campos a nivel de raíz sin sacrificar la profundidad de extracción.
- Descomponga documentos complejos entre múltiples configuraciones de IA de documentos que se dirigen a secciones de documentos distintas, redacte resultados en DLO separados que se unen aguas abajo en Data 360.
- Para casos de uso que requieren una extracción más amplia:
- Límites de frecuencia de API: La IA de documentos aplica un límite de 50 llamadas de API de extracción por minuto por arrendatario. El límite máximo teórico es de 300 llamadas por minuto, que se rige por la Puerta Einstein LLM. Las integraciones de transacciones de gran volumen deben diseñarse con retroceso exponencial, colas de solicitudes y presupuestos de rendimiento a nivel de arrendatario. No asuma que la capacidad de ráfaga está disponible en entornos de producción de múltiples arrendatarios.
- Perfil de latencia de API: Las API de extracción de IA de documentos son completamente síncronas. Los tiempos de respuesta habituales oscilan entre 5 y 15 segundos y varían por tamaño de archivo y complejidad de esquema.
- Esto tiene implicaciones directas para la arquitectura de integración:
- Establezca los tiempos de espera de los llamantes en un mínimo de 30 segundos.
- No invoque la IA de documentos en flujos con requisitos de SLA de subsegundos.
- Tenga en cuenta la latencia en los cálculos de rendimiento frente al límite de frecuencia máximo para oportunidades en curso de procesamiento por lotes.
- Establezca los tiempos de espera de los llamantes en un mínimo de 30 segundos.
- Esto tiene implicaciones directas para la arquitectura de integración:
- Documentos cifrados y protegidos por contraseña: La IA de documentos no procesa archivos protegidos por contraseña (se requieren contraseñas de usuario para abrir archivos) o PDF cifrados con una contraseña de propietario/permisos, incluyendo archivos que se abren normalmente pero restringen la copia, impresión o modificación en la capa de permisos PDF.
- Esta restricción se encuentra en el límite de ingreso:
- Diseñe oportunidades en curso de admisión de documentos para detectar y enrutar archivos cifrados a una ruta de rechazo o procesamiento manual antes de que alcancen la IA de documentos.
- No se base en la gestión de errores en tiempo de ejecución como la puerta principal.
- Esta restricción se encuentra en el límite de ingreso:
La IA de documentos de Data 360 se alinea con varios pilares del Marco bien diseñado de Salesforce.
- Confianza: El ETL aplica retención de datos cero con proveedores LLM, enmascara entradas de PII antes de que lleguen al modelo y explora salidas para contenido confidencial. Los arquitectos deben ampliar esta postura a datos extraídos en periodos de inactividad. El ETL no aplica el enmascaramiento a nivel de campo en los DLO y requiere políticas de espacio de datos descendentes y conjuntos de permisos.
- Fiabilidad: Cada modo de fallo en la sección Consideraciones de diseño (extracción de campo nulo, lectura incorrecta de OCR, no coincidencia de versión de esquema, brecha de tamaño de archivo, desbordamiento de contexto LLM, interferencia de enmascaramiento ETL, idempotencia de escritura RDBMS y agotamiento de crédito) representa una clase de fallo distinta con una señal de detección documentada y una ruta de resolución.
- Excelencia operativa (gestión de cambios): El modelo de extracción dirigido por esquema desvincula la lógica de extracción del formato de documento. Cuando un proveedor cambia un formato de factura o se actualiza un formulario regulador, los arquitectos solo necesitan actualizar una configuración de esquema en vez de modificar el código de integración.
- Excelencia operativa (mantenibilidad): La centralización de configuraciones de esquemas en Data 360 en vez de integrar lógica de extracción en código de aplicación hace que la intención de extracción sea explícita, versionada y auditable. Todos los destinos descendentes consumen el mismo contrato de esquema independientemente de su nivel de destino.
- Excelencia operativa (reutilización de integración): La IA de documentos expone la extracción en múltiples superficies de integración: API de REST, Apex, Flow, MuleSoft, Agentforce Actions y el servidor MCP. Una configuración de esquema única se despliega a múltiples niveles de destino de forma simultánea sin volver a construir la capacidad de extracción por consumidor.
- Optimización de recursos y costos: Las directrices de selección de oportunidades en curso, el límite de tamaño de archivo de 10MB y las restricciones de longitud de contexto LLM previas al ensamblaje representan decisiones de diseño que tienen en cuenta el desempeño. La sección Cuándo utilizar formaliza las condiciones para cuando la IA de documentos no es la herramienta correcta (por ejemplo, requisitos de latencia por debajo del segundo, datos de origen completamente estructurados y documentos generados por máquina de esquema fijo).
Este es un punto de inicio estructurado para configurar la IA de documentos de Data 360 en un entorno sandbox. Complete todas las fases en el entorno sandbox antes de pasar a producción.
Antes de iniciar la configuración, debe confirmar:
- Tamaño de archivo: Valide que los tamaños de documentos representativos sean inferiores a 10MB.
- Oportunidades en curso: Confirme si el caso de uso requiere la canalización por lotes (con respaldo de UDMO, de gran volumen) o la canalización de procesamiento transaccional (dirigida por API, de un solo documento). Esto dirige toda la configuración posterior.
- Nivel de objetivo: Confirme dónde llegan los datos extraídos: SObject de Salesforce, DLO/DMO de Data 360, RDBMS externo o una combinación.
- Dependencia Agentforce: Antes de implementar cualquier procesamiento de documentos con tecnología Agentforce, confirme que un LLM compatible (por ejemplo, GPT-4o) está activado en su organización a través de la configuración de ETL. Agentforce es un requisito previo de plataforma sólida para la IA de documentos. Toda la superficie de la función de IA de documentos, incluyendo todas las API de extracción, no estará disponible hasta que Agentforce esté activo en la organización de destino. Tenga esto en cuenta en las evaluaciones de preparación de la organización y la secuenciación de aprovisionamiento. Espere unos minutos para que la disponibilidad de API se estabilice tras la activación.
- Repercusión de desactivación Agentforce: Si Agentforce se desactiva después de configurar e implementar la IA de documentos, todo el procesamiento de extracción (interfaz de usuario y API) se bloqueará inmediatamente. Lo mismo se aplica a la desactivación de modelos. La desactivación del modelo subyacente tiene un efecto equivalente en la disponibilidad de IA de documentos. En ambos casos, las configuraciones de esquemas existentes se mantienen y permanecerán visibles (no se producirá ninguna configuración o pérdida de datos), pero la capacidad es completamente inoperable hasta que Agentforce y el modelo se vuelvan a activar. Diseñe guías operativas para tratar la disponibilidad Agentforce y la activación de modelos como dependencias de salud de IA de documentos.
- Precio/consumo de crédito: Utilice créditos de Data 360 o Flex Credits para estimaciones de TCO derivadas de documentos de muestra representativos.
- Cree la configuración del esquema. Defina campos de extracción, tipos de datos e instrucciones en formato Esquema JSON en la configuración de la IA de documentos de Data 360. Para las oportunidades en curso por lotes, vincúlelas a un UDMO. Para las oportunidades en curso de procesamiento de transacciones, créelas sin un objeto de origen. Registre el Id. de esquema.
- Alinee los nombres de campo con el nivel de destino. Haga coincidir nombres de campo con definiciones de columna de DLO, nombres de API de SObject o nombres de columna de RDBMS. Los nombres desalineados crean gastos generales de asignación en la capa de integración.
- Configure el objeto de origen de UDMO (solo por lotes). Defina documentos en ámbito y configure la conectividad de origen de ingreso (por ejemplo, S3, Google Cloud Storage, Salesforce Files o MuleSoft). Confirme que la cuenta de servicio de admisión tiene el ámbito de credencial de OAuth o IAM requerido.
- Aplique políticas de enmascaramiento de PII. Configure políticas de Enmascaramiento de datos en la configuración de ETL antes de procesar cualquier contenido regulado. Defina qué tipos de campo (PHI, PII e identificadores financieros) están enmascarados antes de que las entradas lleguen al LLM. No aplace este paso.
- Asigne el ámbito Espacio de datos y los conjuntos de permisos. Procesamiento de ámbito en el Espacio de datos apropiado y configure Conjuntos de permisos para controlar la creación de esquemas, la ejecución de trabajos por lotes, la invocación de API de REST y la activación descendente.
- Configure la autenticación de API (solo oportunidades en curso de procesamiento de transacciones). Cree una aplicación conectada con ámbitos de OAuth cdp_ingest_api y api. Para llamantes internos de la organización, utilice una Credencial nombrada que vincula a una Credencial externa. Para llamantes externos, configure credenciales de cliente de OAuth 2.0 o un flujo de soporte JWT. Pruebe y valide la extracción antes de continuar.
- Escritura no simultánea de SObject: Implemente un elemento Apex (@InvocableMethod) o Flow que asigne campos de respuesta JSON a campos SObject. Utilice Database.upsert() con un Id. externo para evitar duplicados. Aplique Seguridad a nivel de campo en campos de SObject de destino.
- Oportunidades en curso de DLO/DMO de Data 360: Asigne campos de DLO extraídos a DMO que se alinean con el Customer 360 Data Model. Configure reglas de resolución de identidad para vincular registros de documentos a particulares unificados. Defina Perspectivas calculadas y agregue DMO para Agentforce. Para las oportunidades en curso de procesamiento de transacciones, enrute la carga útil de JSON a un DLO a través de la API de ingreso primero.
- RDBMS externo o almacén de datos: Seleccione el patrón de integración: MuleSoft (tejido de integración existente), llamada HTTP de Apex (ligera, nativa de la organización), eventos de plataforma con el suscriptor Pub/Sub (dirigido por eventos) o ETL (lote de gran volumen). Implemente alteraciones idempotentes utilizando una huella de documento o un Id. externo en todas las rutas de escritura externas.
- Rutas de activación: Conecte acciones Agentforce con configuraciones de esquemas para una extracción interactiva. Configure desencadenadores de Flujo o Apex para flujos de trabajo de procesamiento automatizado y establezca los destinos de activación para cada grupo de campos.
- Tratamiento de errores (solo oportunidades en curso de procesamiento de transacciones). Configure la superficie de respuesta HTTP completa: 200 (correcto, incluyendo respuestas nulas parciales), 400 (solicitud incorrecta o Id. de esquema no encontrado), 413 (archivo superior a 10MB), 5xx (error de servicio). Implemente una reducción exponencial para reintentos 5xx con un máximo de 3 intentos. Registre la respuesta JSON sin procesar y el Id. de esquema en cada llamada.
- Pruebe esquemas con documentos de muestra. Envíe muestras representativas a través de la interfaz de IA de documentos o la API de REST. Confirme la precisión de extracción, la cobertura de campo y la gestión nula entre variaciones de formato.
- Valide la gestión de campos nulos. Confirme que todos los destinos descendentes pueden gestionar valores nulos para campos no encontrados en un documento. Tenga en cuenta que las restricciones NO NULAS fallan silenciosamente sin una gestión nula explícita.
- Valide tamaños de archivo previamente. Confirme que los documentos de producción permanecen por debajo de 10MB. Implemente el procesamiento previo para dividir o comprimir documentos que se acercan regularmente al límite.
- Valide la extracción de extremo a extremo. Para las oportunidades en curso por lotes, inicie una ejecución completa y confirme que los campos extraídos llegan correctamente a cada nivel de destino. Para las oportunidades en curso de procesamiento de transacciones, siga la respuesta JSON a través de la capa de integración hasta el destino. Verifique el desencadenador y la ejecución del flujo para los objetivos de SObject, el vínculo de resolución de identidad para los objetivos de DLO/DMO y la idempotencia para los objetivos de DRBMS.
- Confirme el comportamiento de Trust Layer. El ETL no aplica el enmascaramiento de PII al contenido de documentos, de modo que el LLM devolverá datos de PII en campos extraídos tal cual. Confirme que sus campos de esquema, enrutamiento de datos y almacenamiento descendente están diseñados para gestionar resultados que llevan PII de forma apropiada, y asegúrese de que cualquier requisito de cumplimiento o retención se soluciona fuera de la plataforma.
- Establezca alertas Digital Wallet. Configure alertas de consumo al 75% y 90% de los créditos disponibles. Establezca límites de tamaño de lote y estimaciones de tipo ad hoc dentro del presupuesto de crédito para cada ciclo.
- Valide el monitoreo por lotes (solo oportunidades en curso por lotes). Revise índices de éxito de extracción, índices de campos nulos y finalización de trabajos en la consola de monitoreo de Data 360. Confirme la propagación de etiquetas desde el UDLO a través del DLO al DMO en el linaje de datos.
- Valide la gestión de errores de API (solo oportunidades en curso de procesamiento de transacciones). Pruebe todas las condiciones de error: 413 (documentos de más de 10MB), 400 (Id. de esquema no válidos), 200 (extracciones válidas con nulos parciales). Confirme que la lógica de reintento se activa en respuestas 5xx simuladas sin crear escrituras duplicadas.
Este documento destaca los fundamentos arquitectónicos de la IA de documentos Data 360:
- Dos oportunidades en curso de procesamiento y cuándo utilizarlas
- El modelo de configuración de esquemas
- El marco de decisiones de nivel de destino
- Restricciones tecnológicas principales
- Modos de fallo
- Alineación de Marco bien estructurado
La Guía de inicio rápido para arquitectos proporciona la secuencia de configuración para una prueba de concepto de sandbox.
La postura arquitectónica principal admite datos derivados de documentos que se rigen en la capa Esquema, se procesan a través de una canalización LLM aplicada por ETL y se entregan al mismo ciclo de vida de datos de Data 360 que rige todos nuestros otros datos de compañía.
Los arquitectos que aplican estos principios (seleccionar las oportunidades en curso correctas, diseñar esquemas a nivel de tipo de documento y diseñar modos de fallo antes de la producción) crean funciones de extracción que se amplían y perduran bajo requisitos de regulación de la industria regulados.
Yugandhar Bora es un Arquitecto de Ingeniería de Software en Salesforce que se especializa en arquitectura de datos dentro de la plataforma Aplicaciones de datos e inteligencia. Lidera iniciativas del Enterprise Architecture Review Board (EARB) que se centran en la gobernanza de datos y modelos de datos unificados, mientras que también contribuye a soluciones de aprovisionamiento de plataforma automatizadas.
Ananth Anto es una Directora de Gestión de productos de Salesforce Data 360 que lidera iniciativas de IA de documentos y gráficos de datos. Con sede en Bangalore, trabaja con clientes de negocio para resolver retos reales de procesamiento de documentos e inteligencia de datos. Le gusta explorar casos de uso de Enterprise para IA generativa (IA general).
Nishan Naseer es un Arquitecto de Ingeniería de Software de Salesforce que trabaja en Procesamiento de datos no estructurado, Canalizaciones de RAG e Inteligencia de documentos. Le apasiona aprovechar el poder de la IA para abordar retos reales y encontrar soluciones creativas a problemas complejos de los clientes.