Interoperabilidad de Data 360
Las compañías a menudo almacenan datos en Salesforce y otros lagos de datos externos (por ejemplo, Snowflake, Google BigQuery, Databricks, Redshift o almacenamiento de objetos como Amazon S3). El silo de datos entre múltiples sistemas crea un reto para las compañías que desean aprovechar el valor completo de sus datos para potenciar experiencias dirigidas por IA. Salesforce Data 360 es la capa de inteligencia fundamental que cada agente de IA Agentforce utiliza para acceder al contexto correcto en el momento correcto.
Los arquitectos que trabajan para reunir datos entre múltiples lagos de datos se enfrentan a decisiones arquitectónicas clave sobre cómo integrar mejor esos datos. Data 360 proporciona múltiples opciones para la integración de datos, cada una ofreciendo varios pros y contras.
Esta guía proporciona un marco de trabajo para evaluar qué patrón se ajusta mejor a sus requisitos de latencia, costo, capacidad de ampliación, gobernanza y complejidad al integrar datos, ayudándole a elegir cuándo utilizar el ingreso de datos, la federación de datos Cero copia o un enfoque híbrido. La guía también le ayudará a seleccionar entre diferentes métodos de ingreso de datos y federación de datos, cada uno de los cuales satisface una necesidad diferente.
La integración de casas de lago de datos externas con Data 360 requiere considerar cuidadosamente las ventajas entre la actualización de datos, la gobernanza y la eficiencia de las oportunidades en curso. Por ejemplo, el uso de consultas en vivo de federación de datos Cero copia maximiza la actualización de los datos pero puede reducir la eficiencia de las oportunidades en curso a medida que más datos se mueven por la red. Para la mayoría de las implementaciones del mundo real, la combinación del ingreso y la federación en un ecosistema de casas de lago de múltiples nubes es la ruta óptima. Este enfoque híbrido garantiza una arquitectura ampliable, gobernada e interoperable que admite cargas de trabajo operativas de baja latencia (por ejemplo, personalización en tiempo real y detección de fraudes) y cargas de trabajo analíticas (por ejemplo, creación de reportes regulatorios y análisis de tendencias históricas). Esta guía le ayuda a determinar cómo navegar por estas compensaciones utilizando una estrategia apropiada.
- El ingreso de datos copia datos en Salesforce Data 360 y crea modelos de datos canónicos gobernados. Esto es ideal para cuando necesita:
- Cree un Customer 360 integral. Esto le permite unificar y transformar orígenes dispares en un único perfil de confianza.
- Cumplir con el estricto cumplimiento normativo. Esto le permite crear una copia auditable y centralizada de modo que el acceso a los datos y el linaje puedan controlarse estrechamente.
- Federación de copia cero consulta fuentes externas en tiempo real sin duplicación, lo que permite la personalización en tiempo real, tableros en vivo e incorporación rápida de fuentes. Este enfoque proporciona dos opciones principales, pero hay ventajas que deben equilibrarse:
- Consulta en vivo: Utilice esto para análisis interactivos y tableros de datos en tiempo real que viven en plataformas de datos externas (por ejemplo, Snowflake, BigQuery, Redshift o Databricks). Esto ayuda a evitar la duplicación de datos lenta y costosa enviando el procesamiento de consultas al sistema de origen y devolviendo solo los resultados necesarios. Este enfoque está optimizado para consultas poco frecuentes o ad-hoc donde la actualización es crítica. Es adecuado para cargas de trabajo de baja consulta por segundo (QPS) (los costos de consulta pueden aumentar significativamente con un QPS alto).
- Almacenamiento en caché (Consulta acelerada): Utilice esto para consultas de datos frecuentes que no cambian a menudo. Las consultas aceleradas mantienen una caché local que se actualiza a intervalos configurables (15 minutos a 7 días), lo que reduce las coincidencias de origen repetidas. Este enfoque equilibra el desempeño y el costo del tablero, la segmentación y las cargas de trabajo de BI donde los resultados ligeramente obsoletos son aceptables. Esto no es adecuado para la toma de decisiones de subsegundos.
- Federación de archivos: Utilice esto para el procesamiento por lotes a gran escala y el entrenamiento de modelos de IA para datos en el lago de datos de su nube (por ejemplo, S3 o ADLS). Este enfoque evita el ingreso lento y costoso consultando directamente archivos en formatos de tabla abierta, lo que desbloquea conjuntos de datos ETL masivos y cargas de trabajo de ciencia de datos.
- Los modelos híbridos combinan el ingreso para Perfiles unificados con la federación para mayor frescura, lo que admite la implicación de OmniCanal, acciones dirigidas por Agentforce y entrenamiento de IA/ML.
- Emplear una arquitectura híbrida. La mezcla de ingreso y federación de datos es a menudo necesaria.
- Utilice Ingreso de datos en datos críticos para modelos de datos canónicos y gobernanza principal.
- Utilice Copia cero para el resto de la federación de datos para mantener la actualización y minimizar la carga operativa de la creación y el mantenimiento de oportunidades en curso de ingreso de datos.
- La frecuencia de ingreso de datos importa. Seleccione la frecuencia basándose en el valor de negocio, las necesidades de latencia y la complejidad operativa.
- Utilice tiempo real para flujos de trabajo urgentes (por ejemplo, personalización, tableros en vivo y acciones Agentforce).
- Utilice Casi en tiempo real para procesos de urgencia moderada (por ejemplo, campañas y reportes operativos).
- Utilice lotes para conjuntos de datos históricos o de baja velocidad.
- Haga coincidir patrones de federación con latencia y desempeño. Seleccione la opción que mejor se ajuste a sus patrones de acceso y requisitos de frescura, desempeño y costo.
- Utilice Live Query para tableros operativos y personalización en tiempo real donde la baja latencia es crítica.
- Utilice el almacenamiento en caché (Consulta acelerada) cuando las consultas sean frecuentes y los resultados ligeramente obsoletos sean aceptables, lo que ayuda a equilibrar el desempeño y el costo.
- Utilice Federación de archivos para análisis a gran escala y con gran rendimiento o cargas de trabajo por lotes, ideales para conjuntos de datos históricos o menos urgentes.
- Alinear la gobernanza con los requisitos de residencia de datos.
- Utilice la ingesta cuando la gobernanza centralizada sea crítica.
- Utilice la federación cuando la gobernanza descentralizada sea aceptable, mientras aplica una gobernanza estricta en el origen externo.
- Utilice Copia cero con respecto a políticas a nivel de origen (por ejemplo, seguridad a nivel de filas y enmascaramiento de datos).
- Priorice el ingreso para flujos de trabajo de alto valor. Aplique el ingreso de forma selectiva a procesos críticos (por ejemplo, resolución de identidad, creación de reportes regulatorios y activación operativa).
- El costo y la complejidad dirigen las decisiones. El ingreso en tiempo real puede ser costoso y complejo. Por eso es importante que los arquitectos sopesen el costo de incorporar, almacenar y transformar datos con el costo de consultarlos directamente a través de Copia cero.
La selección del patrón de integración correcto (Ingreso de datos, Copia cero o un enfoque híbrido) afecta directamente a la latencia, la gobernanza, la eficiencia operativa y el costo entre plataformas multinube. Esta decisión determina cómo se entregan perspectivas en tiempo real, activación dirigida por IA e implicación personalizada de forma fiable y a escala.
Esta tabla compara los patrones de ingesta de datos y copia cero en Salesforce Data 360, centrándose en funciones, compensaciones y beneficios, así como casos de uso y resultados de negocio. Utilice esto como referencia para diseñar plataformas de datos híbridas de múltiples nubes que equilibran desempeño, costo y cumplimiento.
| Tipo de patrón | Modo/herramienta | Beneficios | Consideraciones | Resultados |
|---|---|---|---|---|
| Ingreso de datos |
En tiempo real:
|
|
|
Agentforce:
|
Transmisión:
|
|
|
Agentforce:
|
|
Lote:
|
|
|
Agentforce:
|
|
| Zero Copy |
Consulta en vivo:
|
|
|
Agentforce:
|
Consulta acelerada (almacenamiento en caché):
|
|
|
Agentforce:
|
|
Federación de archivos:
|
|
|
Agentforce:
|
Existen tres patrones de integración principales para Data 360: ingreso de datos, federación de datos sin copia y un enfoque híbrido.
Con Ingreso de datos, los datos se copian físicamente en Data 360 y se rigen completamente, a diferencia de Copia cero donde los datos permanecen en el origen. En otras palabras, la computación para transformaciones se produce en Data 360, que proporciona una gobernanza y auditoría centralizadas.
Utilice Ingreso de datos para almacenar conjuntos de datos gobernados canónicos en Salesforce Data 360 para el cumplimiento y el control operativo. Utilice el ingreso cuando se requiera control completo, auditoría y trazabilidad. El ingreso de datos es ideal para flujos de trabajo regulados o de alto valor donde la computación centralizada y la gobernanza son fundamentales.
El ingreso es adecuado para crear una base de confianza para la resolución de identidad, la creación de reportes regulatorios, flujos de trabajo dirigidos por IA de misión crítica y la implicación de clientes.

Los métodos de ingesta de datos pueden variar, dependiendo del conector que utilice para ingresar sus datos. Algunos conectores ofrecen una variedad de métodos de ingreso, mientras que otros solo funcionan en modo por lotes o transmisión. Para obtener una lista completa de conectores de Data 360 y métodos disponibles, consulte Data 360: Integraciones y conectores.
- En tiempo real:
- Proporciona un ingreso de subsegundos utilizando Captura de datos (CDC)
- Adecuado para flujos de trabajo urgentes (por ejemplo, detección de fraude, personalización y tableros operativos)
- Cuenta con transformaciones distribuidas y agregaciones en Data 360, lo que ayuda a reducir las E/S descendentes y optimizar el uso de computación
- Admite el uso de CDC incrementales para minimizar la reorganización de datos
- Transmisión:
- Proporciona ingesta cada 1-3 minutos en pequeños incrementos
- Equilibra la frescura y el costo
- Adecuado para orquestación de campañas, implicación casi en vivo y creación de reportes operativos
- Admite el uso de microlotes para controlar picos de E/S
- Agrega datos en el origen (si es posible) para reducir volúmenes de transferencia y optimizar el almacenamiento
- Lote (Cargas programadas):
- Proporciona el ingreso periódico de grandes conjuntos de datos (por ejemplo, cada hora, cada día y cada semana)
- Proporciona rentabilidad y fiabilidad para conjuntos de datos históricos, creación de reportes reguladores y casos de uso de cumplimiento
- Garantiza que la localidad de cálculo está en la misma región que el almacenamiento de origen para mejorar el desempeño y optimizar los costos
- Casos de uso de ingreso de datos:
- Generar perfiles unificados Customer 360. Cree una única fuente de verdad para atributos e identidades de clientes.
- Mantenga conjuntos de datos de cumplimiento normativo. Aplique la gobernanza, el linaje y la capacidad de auditoría para datos confidenciales.
- Centralice la orquestación de campañas. Asegúrese de que marketing, ventas y servicio funcionan desde conjuntos de datos coherentes y de confianza.
- Prácticas de diseño:
- Acomode el ingreso por lotes para necesidades históricas o tolerantes a baja latencia (por ejemplo, creación de reportes de archivo o instantáneas periódicas).
- Utilice las API de transmisión o CDC para mantener la actualización para flujos de trabajo operativos y de personalización para garantizar actualizaciones casi en tiempo real.
- Controle el almacenamiento y calcule el crecimiento aplicando cargas incrementales para optimizar el costo y la eficiencia (en vez de volver a cargar conjuntos de datos completos).
- Alinee las oportunidades en curso de ingreso con la localidad de cálculo y el procesamiento incremental para reducir la E/S de red.
- Aplique transformaciones dentro de Data 360 para evitar mover datos sin procesar innecesariamente.
- Consideraciones de costos:
- Ingreso en tiempo real tiene los costos de computación y oportunidades en curso más altos, que pueden justificarse para flujos de trabajo de alto valor y urgentes (por ejemplo, personalización, tableros operativos o acciones dirigidas por Agentforce).
- Ingreso de transmisión tiene costos de computación y almacenamiento moderados, que pueden ser adecuados para actualizaciones frecuentes que pueden tolerar ligeros retrasos (por ejemplo, orquestación de campañas o creación de reportes operativos).
- Ingreso por lotes tiene costos de computación más bajos y almacenamiento predecible, lo que es adecuado para conjuntos de datos históricos o actualizaciones de baja frecuencia. El ingreso de datos por lotes desde organizaciones de Salesforce utilizando ciertos conectores es gratuito.
- Modo de actualización Le permite seleccionar el modo de actualización incremental, que reduce el ingreso total y calcula los costos. En Salesforce, recomendamos utilizar actualización incremental siempre que sea posible para optimizar la eficiencia entre todos los tipos de ingreso.
- El costo también se ve afectado por el volumen de E/S desde el origen a Data 360. La optimización de tamaños de lote, particiones y alineación regional reduce los costos de transferencia y mejora el desempeño.
- Escenarios de industria:
- Finanzas: Los conjuntos de datos de ingreso son obligatorios para conocer a su cliente (KYC), antiblanqueo de dinero y detección de fraude donde la capacidad de auditoría y el cumplimiento no son negociables.
- Cuidados sanitarios: Utilice el ingreso para la resolución de identidad de pacientes y registros compatibles con HIPAA, lo que permite vistas seguras y unificadas.
- Retail: Consolide datos de puntos de venta, comercio electrónico y programas de fidelidad en perfiles unificados para segmentación y personalización.
- Telecom: Apoye la prevención de abandonos y los análisis de uso con datos de suscriptor gobernados canónicos.
| Función | Ingreso en tiempo real | Ingreso de transmisión | Ingestión por lotes |
|---|---|---|---|
| Latencia y frescura | Cuenta con ingreso de latencia de subsegundos a través de las API de ingreso con compatibilidad de Captura de datos. Proporciona oportunidades en curso de transmisión continua. Adecuado para casos de uso operativos de baja latencia. | Incluye el ingreso de microlotes cada 1 a 3 minutos a través de conectores nativos. Admite actualizaciones incrementales. Se espera una ligera latencia. | Se espera latencia de datos. Permite cargas de gran volumen programadas. Cuenta con ingesta periódica (por hora, diariamente y semanalmente). No es adecuado para operaciones urgentes. |
| Casos de uso principales | Ideal para casos de uso operativos y de personalización de baja latencia. Utilizar para flujos de trabajo urgentes. Admite flujos de trabajo dirigidos por eventos. Utilice alertas de fraude en tiempo real y alertas operativas. | Adecuado para procesos de urgencia moderada. Utilizar para orquestación de campañas, implicación casi en vivo y creación de reportes operativos. Utilizar para desencadenadores de campaña oportunos. | Rentable para conjuntos de datos masivos. Fiable para análisis históricos. Utilizar para flujos de trabajo de agregación histórica o creación de reportes regulados. Adecuado para conjuntos de datos históricos o de baja velocidad. |
| Complejidad arquitectónica y E/S | Incluye arquitectura compleja y de alto costo. Requiere sistemas de origen de baja latencia. E/S intensiva. Los orígenes de gran volumen pueden causar oportunidades en curso saturadas. | Cuenta con una arquitectura más sencilla que en tiempo real. E/S es moderada. Adecuado para patrones de actualización repetidos predecibles. El tamaño de lote afecta a la memoria y el cálculo. | Fácil de implementar. intensivo de E/S durante los plazos de carga. El rendimiento de red puede convertirse en un cuello de botella para lotes grandes. |
| Consideraciones de costos | Incluye los costos de computación y oportunidades en curso más altos. Justificable solo para flujos de trabajo de alto valor y urgentes. | Incluye costos de computación y almacenamiento moderados. Proporciona un enfoque de costo frente a frescura equilibrado. Adecuado para actualizaciones frecuentes que pueden tolerar ligeros retrasos. | Las funciones reducen los costos de computación y el almacenamiento predecible. Recomendado para conjuntos de datos históricos o actualizaciones de baja frecuencia. El ingreso a través de oportunidades en curso internas de Salesforce es gratuito. |
| Prácticas de diseño | Utilice CDC incrementales para minimizar la reorganización de datos. Filtre y utilice campos selectivos para reducir los gastos generales. | Utilice microlotes para controlar picos de E/S. Considere la agregación con ventanas para reducir la carga de procesamiento. | Utilizar para creación de reportes de archivo o instantáneas periódicas. Asegúrese de que la localidad de cálculo está en la misma región que el almacenamiento de origen para la optimización de costos. |
Utilice Copia cero para la consulta en tiempo real de sistemas externos sin duplicación de datos para permitir la agilidad, la actualización y el acceso ampliable a conjuntos de datos grandes o transitorios. Es adecuado para tableros en vivo, análisis exploratorios, entrenamiento de modelos de IA/ML e implicación de clientes en tiempo real directamente a través de Salesforce Data 360.
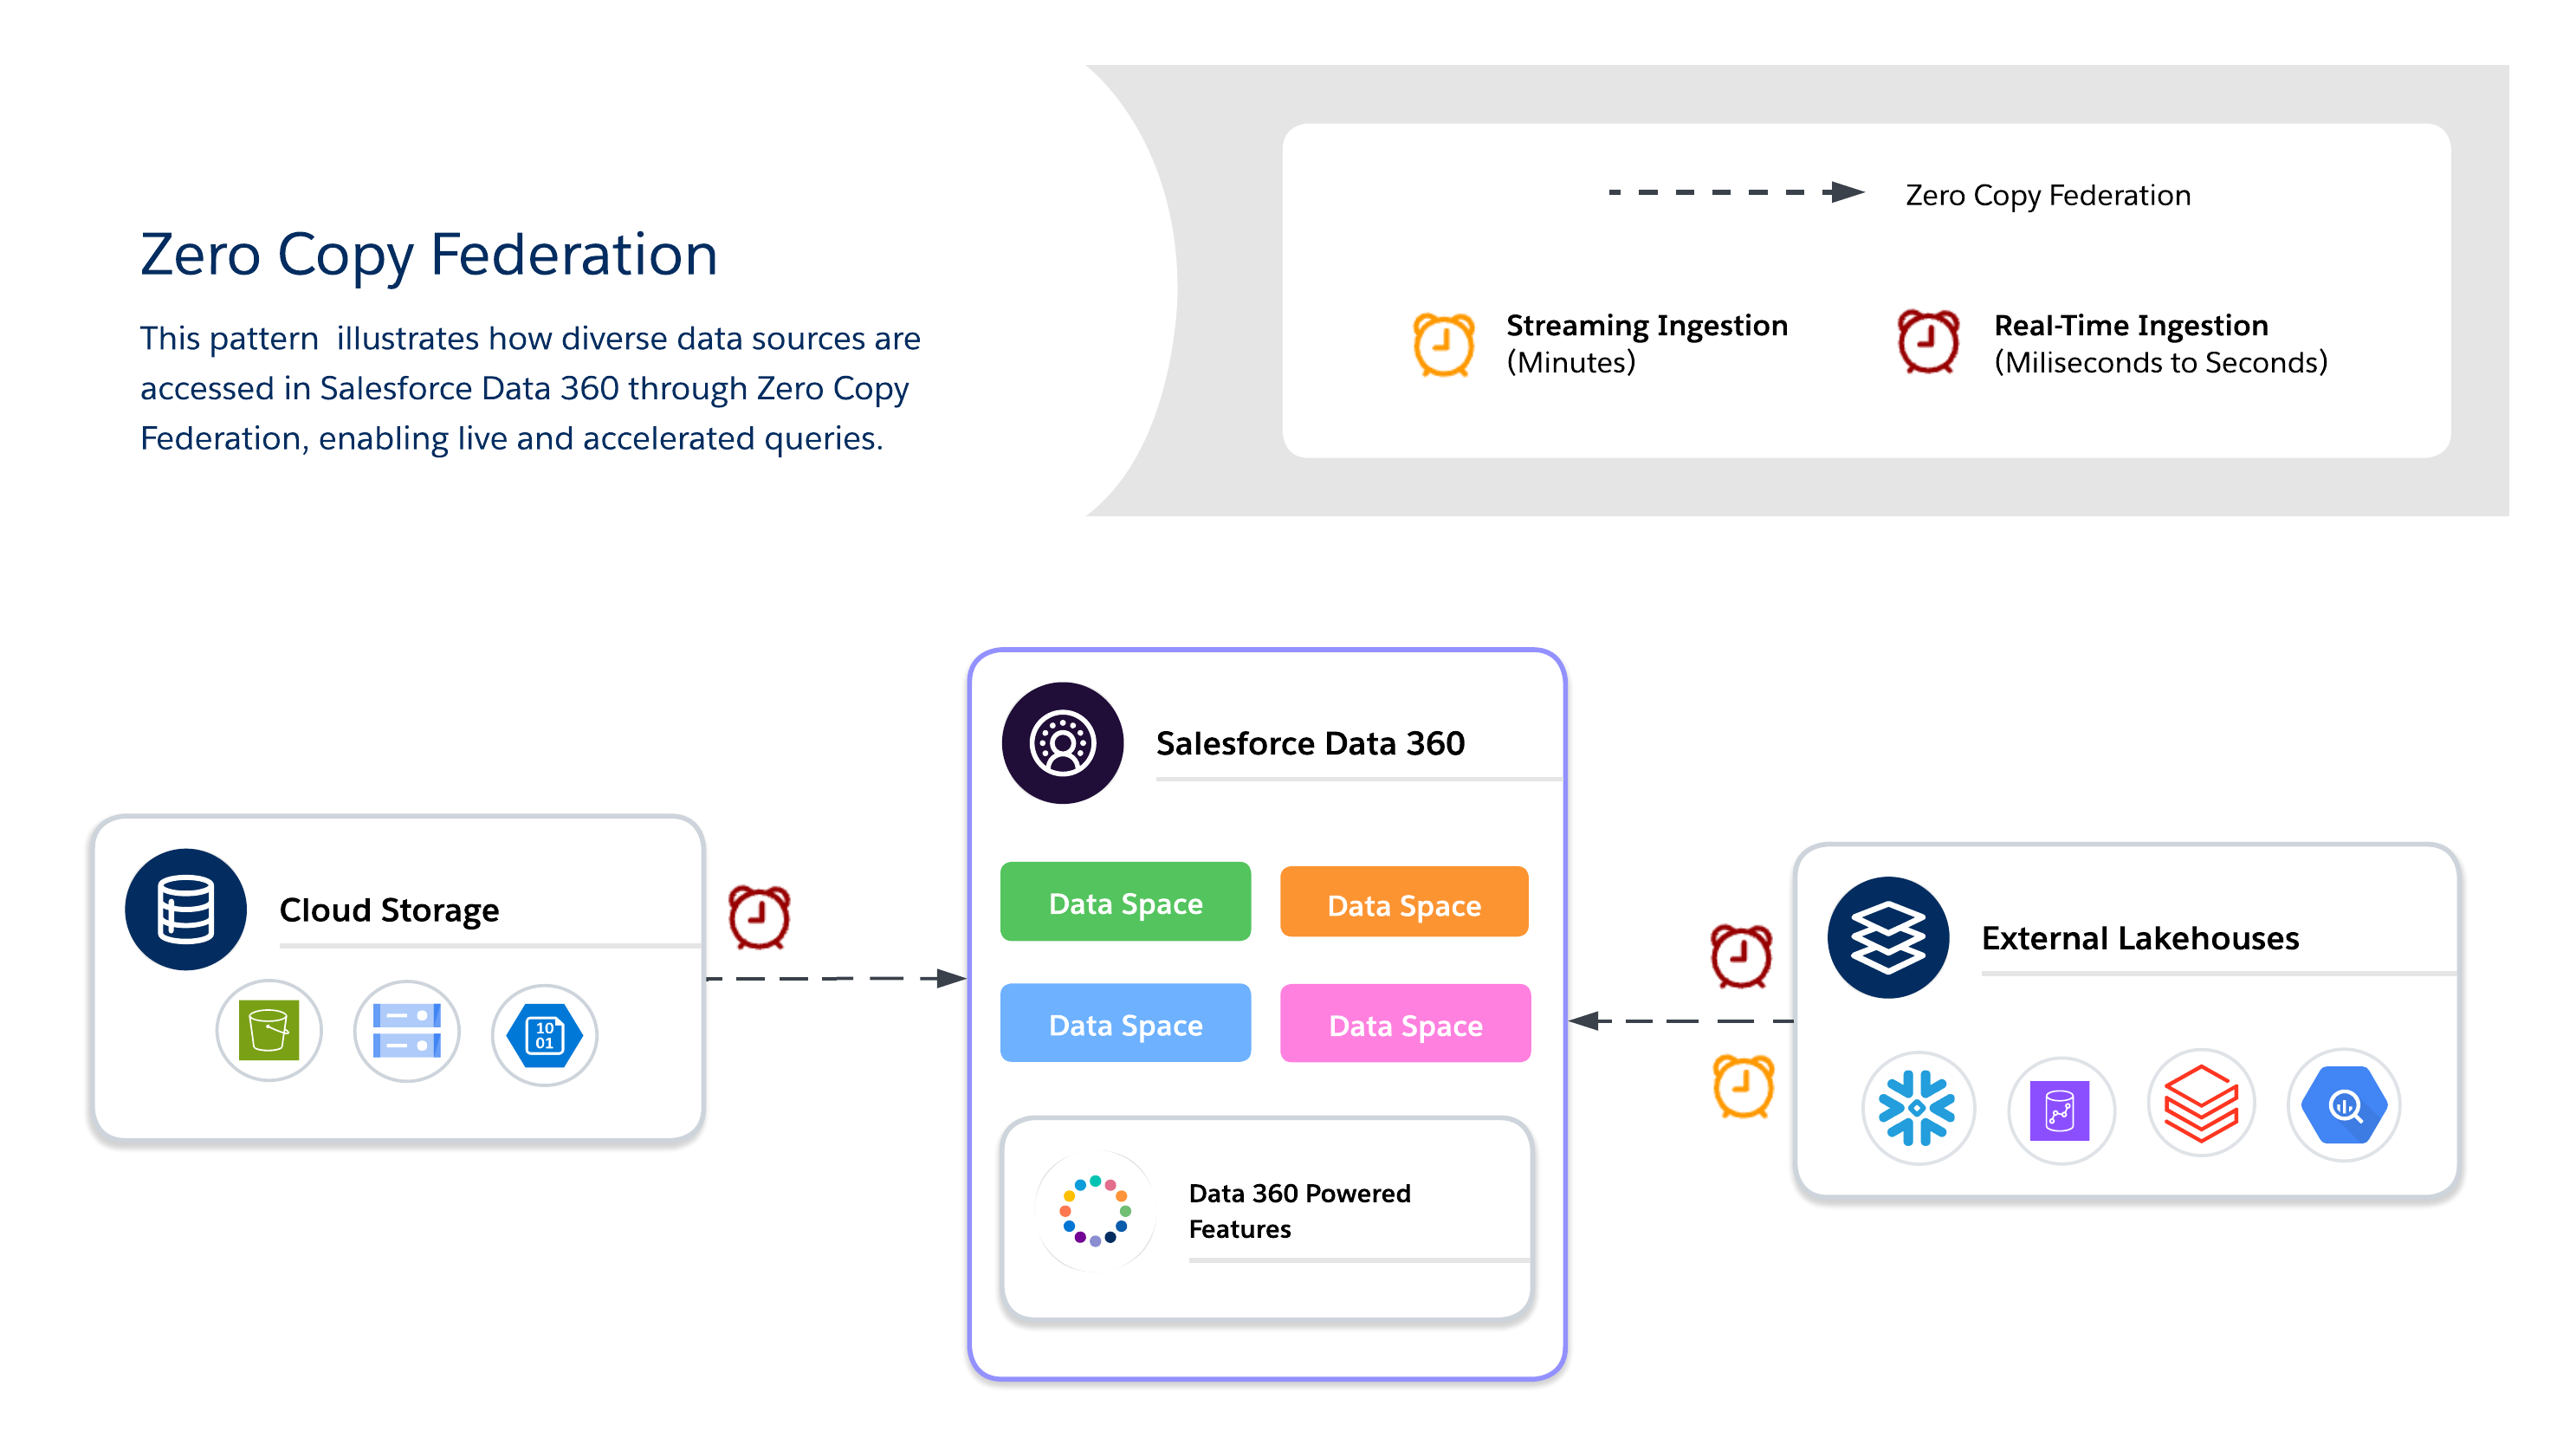
Al utilizar Copia cero, los arquitectos deben elegir entre tres métodos de federación de datos disponibles, cada uno de los cuales ofrece sus propias ventajas entre frescura, desempeño y costo.
- Consulta en vivo
- Ejecuta consultas directamente en sistemas externos (por ejemplo, Snowflake, Google BigQuery, Redshift, Databricks, etc.) sin duplicación de datos.
- Minimiza el movimiento de datos en la red y reduce la E/S en el cálculo de Salesforce Data 360, que es óptimo cuando se pueden empujar predicados y agregaciones hacia abajo.
- Adecuado para perspectivas en tiempo real y tableros operativos de baja latencia.
- Dependiendo del desempeño del sistema externo.
- Almacenamiento en caché (Consulta acelerada)
- Almacena temporalmente copias en caché de datos federados en Salesforce Data 360.
- Reduce los costos y la latencia de consultas repetidas para conjuntos de datos a los que se accede con frecuencia con duración configurable (minutos a días).
- Los datos no se copian de forma permanente ni se rigen completamente, de modo que la actualización se gestiona a través de actualizaciones programadas desde el origen.
- La actualización incremental solo admite alteraciones. Los registros eliminados no se eliminan de la caché.
- Realice una actualización completa periódicamente para asegurarse de que la caché permanece sincronizada con el origen.
- Nota: El conector de Snowflake admite la función Descargar, que mejora los índices de aceleración utilizando un depósito de preparación iniciado por Snowflake. Esto está activado de forma predeterminada, pero se puede desactivar modificando la conexión.
- Federación de archivos
- Proporciona acceso directo de solo lectura a conjuntos de datos a gran escala en establecimientos de objetos (por ejemplo, S3 y GCS con Iceberg).
- Adecuado para cargas de trabajo de IA/ML, análisis históricos y creación de reportes a escala de petabytes sin mover datos.
- El desempeño de las consultas depende en gran medida del formato del objeto, la partición y la E/S de red. Las exploraciones de gran tamaño pueden generar E/S sustanciales si no están optimizadas.
- Casos de uso
- La personalización en tiempo real y flujos de trabajo adaptativos entregan ofertas dinámicas, recomendaciones y siguientes mejores acciones a medida que cambian los comportamientos de los clientes.
- Los tableros en vivo y los análisis operativos potencian los tableros clave de negocio y los indicadores clave de desempeño directamente desde almacenes externos.
- El entrenamiento de modelos de IA/ML con grandes conjuntos de datos externos aprovecha los datos a escala de petabytes de lagos de datos y almacenes sin moverlos a través de Federación de archivos.
- Escenarios industriales
- Retail/Media: Active recomendaciones personalizadas e implicación de clientes en tiempo real federando datos de interacciones de contenido o transmisiones de clics.
- Finanzas: Ejecute la detección de fraudes y el puntuaje de riesgos casi en tiempo real consultando almacenes externos sin duplicar datos confidenciales.
- Tech/Enterprise: Admita la creación de reportes entre nubes, tableros de servicio de TI y análisis operativos cuando los conjuntos de datos residen en múltiples sistemas.
- Prácticas de diseño
- Consulta en vivo
- Utilizar para consultas de alta QPS y baja latencia cuando la actualización es crítica.
- Envíe predicados y agregaciones al sistema externo para reducir la reorganización de datos en la red.
- Evite consultas que exploran innecesariamente volúmenes de datos masivos.
- Considere la poda de particiones y filtros en su lugar.
- Federación de archivos
- Acceda a conjuntos de datos a escala de petabytes en establecimientos de objetos sin ingreso.
- Minimice la latencia y los costos de salida manteniendo el almacenamiento de objetos en la misma región de Cloud que el cálculo de Salesforce.
- Utilice formatos particionados y columnares (Parquet/ORC) y filtros de distribución para reducir la transferencia de E/S y red.
- Aproveche la distribución de consultas y predicados para filtrar y agregar datos en el origen, lo que reduce el movimiento de datos.
- Evite el acceso a datos entre regiones, a menos que sea absolutamente necesario, porque aumenta la E/S, la latencia y los costos.
- Almacenamiento en caché (Consulta acelerada)
- Almacenar en caché conjuntos de datos a los que se accede frecuentemente para equilibrar el costo y el desempeño.
- Configure intervalos de actualización para equilibrar la actualización frente al costo de consulta.
- Cumplimiento: Aplique la regulación en el origen aprovechando la seguridad a nivel de filas y enmascarando políticas directamente en sistemas federados.
- Estas son algunas mejores prácticas para el enmascaramiento y el RLS uniforme entre plataformas:
- Utilice un Id. de compañía centralizado. Asigne usuarios y entidades en Salesforce Data 360 a un identificador de compañía único y centralizado que se corresponda con identidades en sistemas externos.
- Alinee Políticas de seguridad. Asegúrese de que las políticas de RLS y enmascaramiento en sistemas federados se aplican basándose en la identidad asignada. Esto mantiene el cumplimiento al consultar datos externos.
- Estandarizar esquemas de identidad. Mantenga atributos de identidad coherentes (email, Id. de usuario, Id. de cliente, etc.) entre todos los orígenes de datos para evitar desajustes e infracciones de acceso.
- Estas son algunas mejores prácticas para el enmascaramiento y el RLS uniforme entre plataformas:
- Consulta en vivo
- Consideraciones de costos
- Consulta en vivo: En el modelo de pago por consulta, los costos se acumulan en el cálculo de casas de lago externas, lo que puede provocar picos con un alto QPS. Esto es adecuado para casos de uso críticos de frescura donde el valor es superior a la variabilidad de costos.
- Consulta acelerada (almacenamiento en caché): Este método reduce el costo de la consulta (en comparación con Consulta en vivo) reduciendo las visitas al sistema de origen; sin embargo, se suma a los costos de ingreso de datos por lotes para rellenar y actualizar la caché. Esto es adecuado para conjuntos de datos de acceso frecuente.
- Federación de archivos: Esta es la opción de almacenamiento más económica como datos en Almacén de objetos; sin embargo, los costos de consulta dependen del tamaño del archivo, la partición y la poda. Esto es adecuado para datos históricos o masivos a escala de petabytes.
| Punto de decisión | Consulta en vivo | Almacenamiento en caché (Consulta acelerada) | Federación de archivos |
|---|---|---|---|
| Ubicación de origen de datos | Casas de lago de datos externas (por ejemplo, Snowflake, Google BigQuery, Redshift y Databricks) | Casas de lago de datos externas (por ejemplo, Snowflake, Google BigQuery, Redshift y Databricks) | Establecimientos de objetos o lagos de datos de nube (por ejemplo, S3, ADLS y GCS), que a menudo utilizan formatos de tabla abierta como Iceberg. |
| Propósito/Caso de uso | Adecuado para análisis interactivo y tableros en tiempo real. Adecuado para la personalización en tiempo real y flujos de trabajo dinámicos. | Adecuado para cuando las consultas son frecuentes, pero los resultados ligeramente obsoletos son aceptables. Adecuado para tableros de BI y segmentación. | Adecuado para el procesamiento por lotes a gran escala y el entrenamiento de modelos de IA/ML. Adecuado para análisis históricos y creación de reportes a escala de petabytes. |
| Frescura/Latencia | Proporciona la máxima frescura Ejecuta consultas directamente en tiempo real. Admite decisiones por subsegundos cuando el sistema de origen está optimizado para consultas de baja latencia con distribución de predicados efectiva. | Utilizar cuando los resultados ligeramente obsoletos son aceptables. La actualización depende del intervalo de caché, que es configurable de 15 minutos a 7 días. | Adecuado para trabajos intensivos de rendimiento y por lotes. No es adecuado para tableros en tiempo real. |
| Patrón de acceso | Adecuado para consultas infrecuentes o ad-hoc donde la actualización es crítica y el volumen de consultas es bajo. Los costos se disparan significativamente a un QPS alto, de modo que es importante evaluar el almacenamiento en caché (Consulta acelerada) cuando la frecuencia de consulta es alta. | Adecuado para escenarios de lectura de alta frecuencia. Mejora el desempeño para patrones de acceso frecuentes. | Proporciona acceso de solo lectura. Adecuado para conjuntos de datos a escala de petabytes sin ingreso. |
| Controladores de desempeño | Muy dependiente del desempeño del sistema de origen externo. Adecuado para cuando los predicados y las agregaciones se pueden enviar al origen. | Reduce la latencia en comparación con consultas en vivo repetidas. El desempeño depende de la gestión de caché y los intervalos. | El desempeño depende en gran medida del formato del objeto, la partición y el rendimiento del sistema externo. Utilice formatos particionados y de columnas (Parquet/ORC). |
| Consecuencias de costos | Este es un modelo de pago por consulta, de modo que los costos se acumulan en cálculos de casas de lago externas. Es rentable para consultas poco frecuentes, pero los gastos pueden aumentar con un alto volumen de QPS. | El costo es inferior a las consultas en vivo repetidas. Reduce la necesidad de consultar repetidamente el origen externo, pero agrega almacenamiento en caché y sobrecarga de actualización. | Esta es la opción de almacenamiento más económica. Para configuraciones de AWS de la misma región y la misma nube (por ejemplo, S3 en EE.UU.-Este-1 con un arrendatario de Data Cloud que también está en EE.UU.-Este-1), los créditos no se consumen para las filas a las que se accede. Las configuraciones entre regiones o entre nubes (por ejemplo, Azure, GCS o diferentes regiones de AWS) generan consumo de crédito para las filas a las que se accede. Los costos de consulta también dependen del tamaño del archivo, la partición y la optimización de distribución de predicados. |
| Consideración clave | Evite consultas sin filtrar que exploran volúmenes de datos masivos innecesariamente. | Este enfoque requiere gestión de caché. No es adecuado para la decisión de subsegundos. | El desempeño de las consultas se basa en gran medida en la optimización a través de particiones y distribución de predicados. |
Las arquitecturas híbridas permiten a los arquitectos anclar conjuntos de datos críticos en Data 360 para una gobernanza centralizada al tiempo que aprovechan las consultas federadas para mayor frescura, menor duplicación y acceso ampliable a conjuntos de datos externos de gran tamaño. Este enfoque equilibra las E/S, calcula la localidad, el costo y los requisitos de cumplimiento.
Utilice un enfoque híbrido para una gobernanza equilibrada, frescura y eficiencia operativa combinando el ingreso de datos y la copia cero para entregar perspectivas con capacidad de acción en tiempo real. Utilice el ingreso para conjuntos de datos regulados de alto valor donde se requiere trazabilidad, RLS y enmascaramiento, y la federación para conjuntos de datos efímeros o de gran volumen donde la actualización y el desempeño son clave.
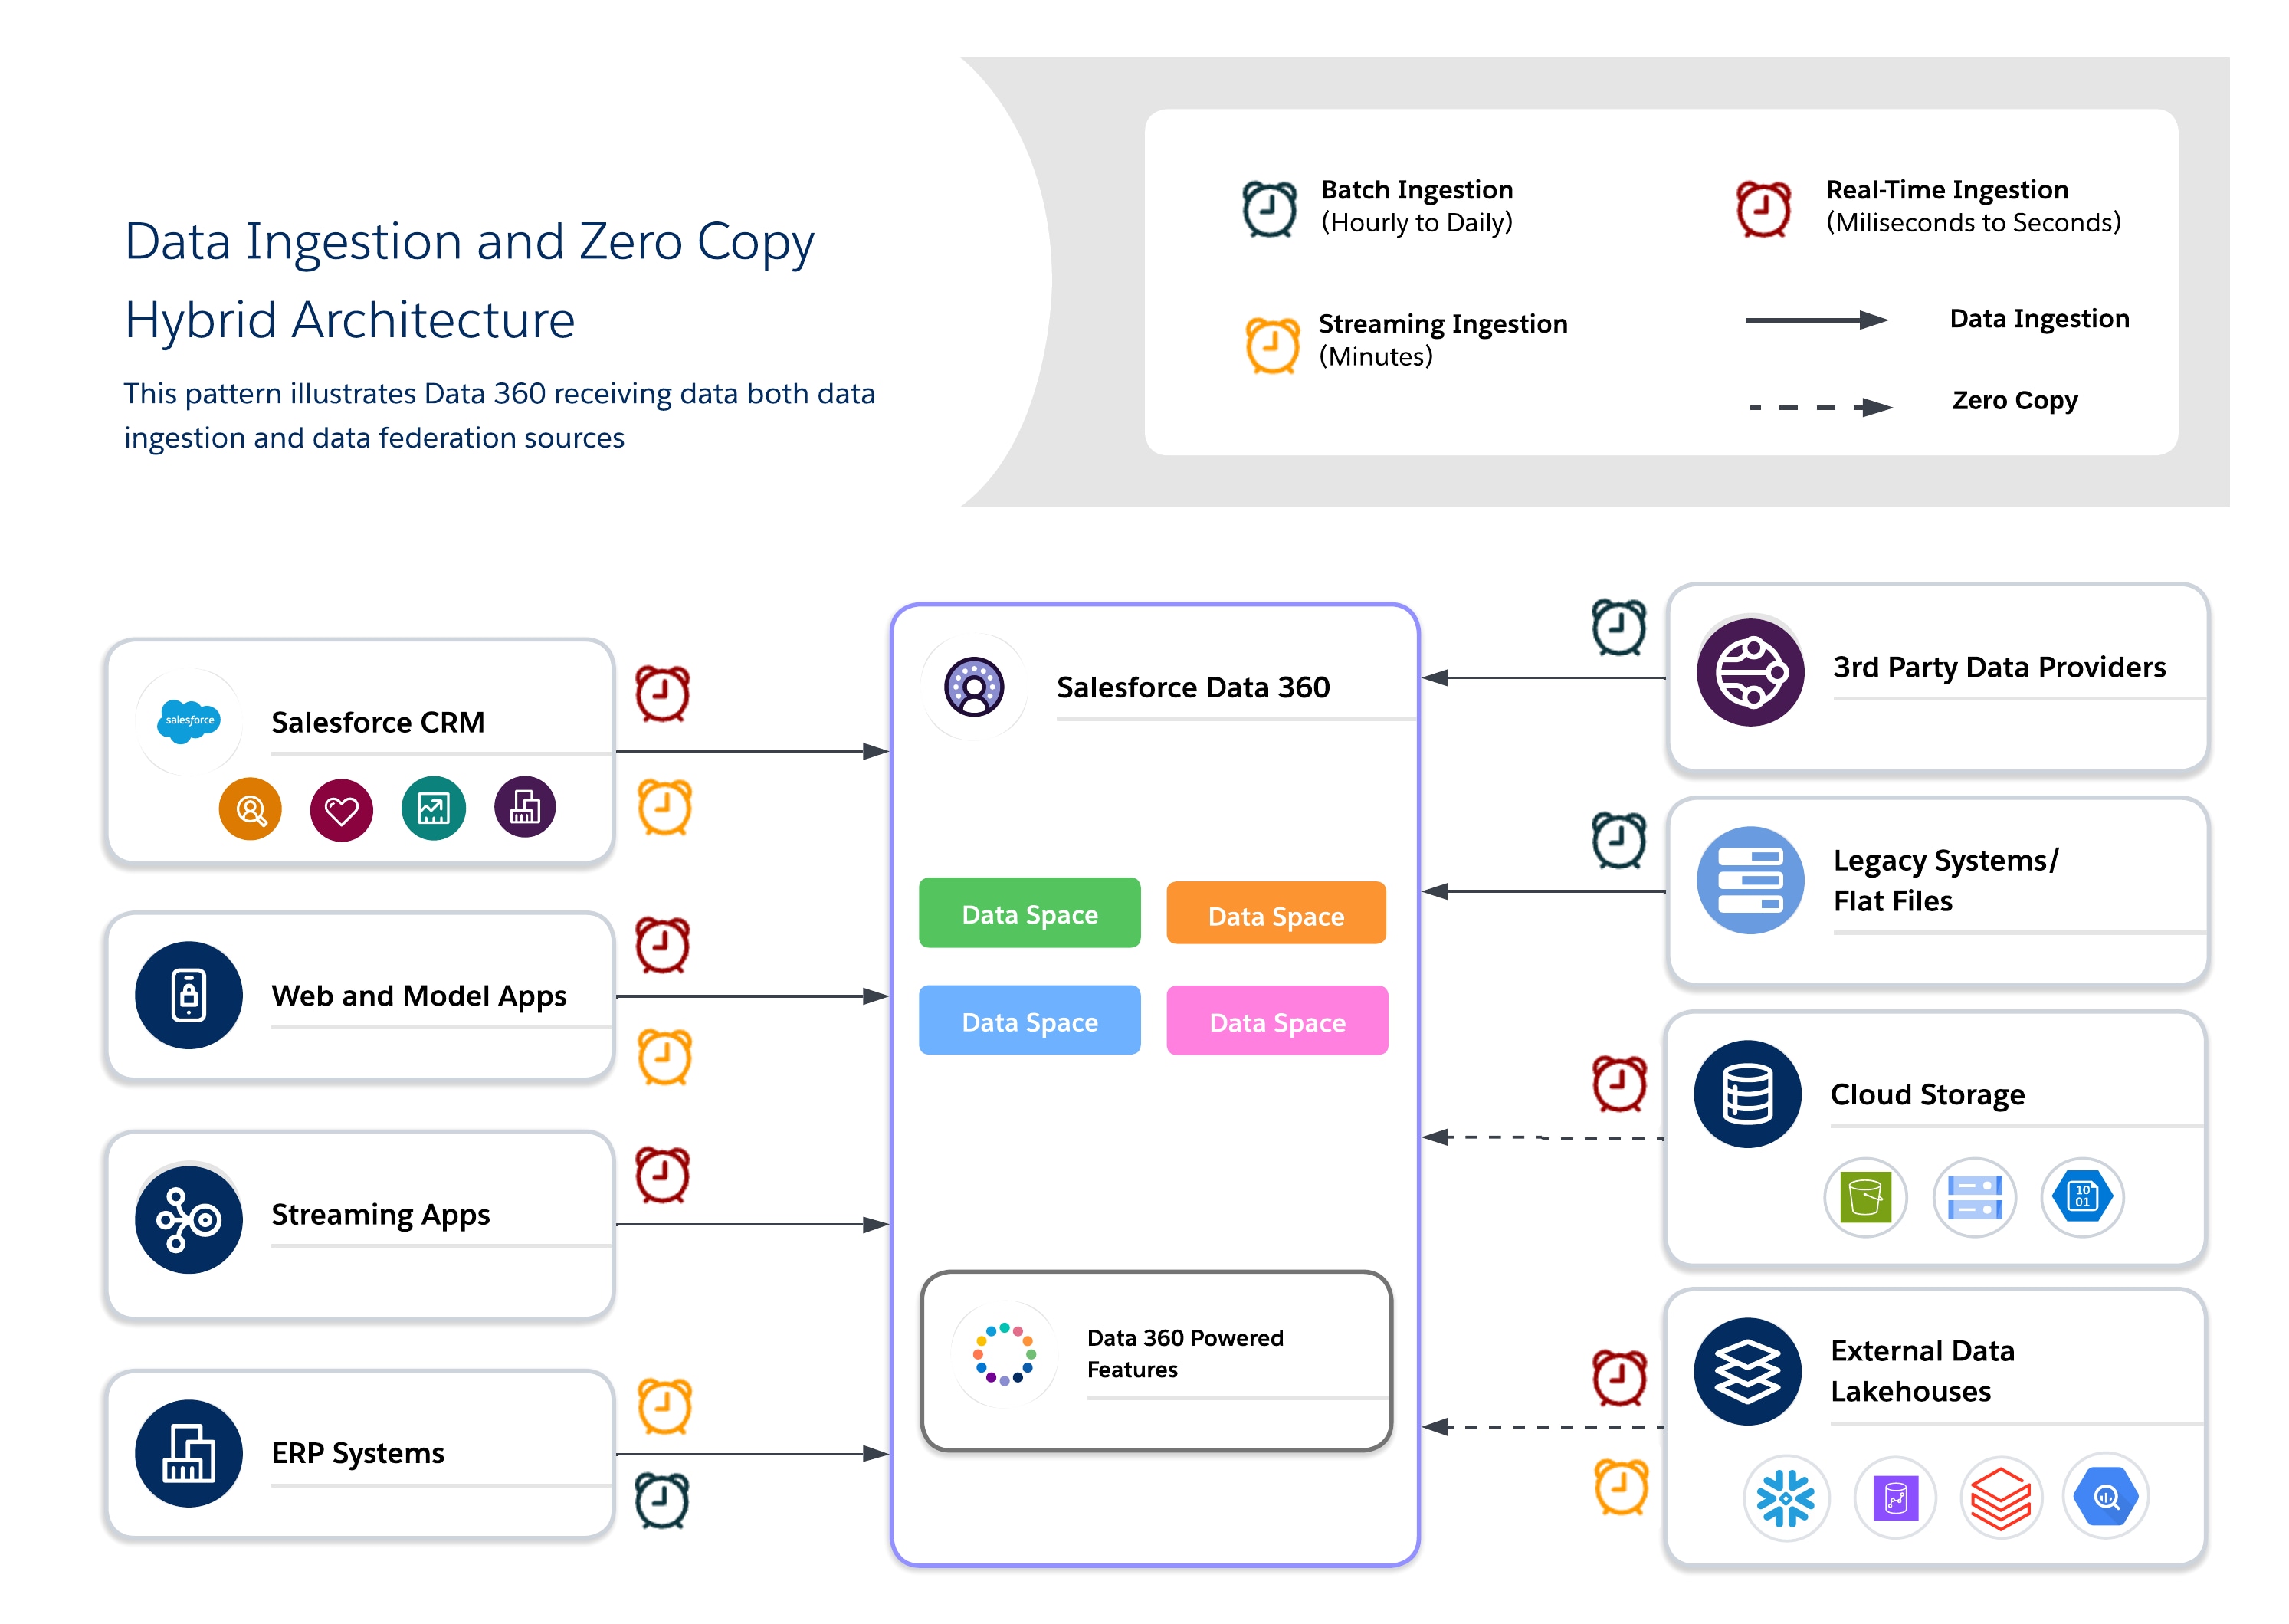
- Casos de uso
- Participación de OmniCanal: Combine datos históricos de clientes con comportamiento en tiempo real para entregar experiencias coherentes y contextuales.
- Oportunidades en curso de IA/ML: Entrene modelos en conjuntos de datos canónicos depurados mientras los enriquece con señales sin procesar o en tiempo real procedentes de fuentes externas.
- Necesita cumplimiento y agilidad mixtos: Aplique una regulación estricta para datos confidenciales y una federación para la agilidad operativa.
- Escenarios industriales
- Retail: Utilice el ingreso para la resolución de identidad y la unificación de perfiles, así como la federación para ofertas y personalización en tiempo real.
- Cuidados sanitarios: Mantenga registros de pacientes dorados a través del ingreso mientras utiliza la federación en transmisiones de dispositivos IoT y datos de sensores para contexto inmediato.
- Servicios financieros: Ingrese datos regulados en un lago regulado por el cumplimiento mientras utiliza la federación para consultas de detección de fraude externo y monitoreo de riesgos.
- Prácticas de diseño
- Ancle la gobernanza con el ingreso: Ingrese datos de alto valor o regulados en modelos canónicos para garantizar Trust y cumplimiento.
- Utilizar Federation for Freshness: Permite a las casas de lago externas proporcionar acceso a datos en tiempo real o a gran escala sin duplicación.
- Equilibrar costo frente a desempeño: Perfil de cargas de trabajo para determinar cuándo utilizar la ingesta frente a la federación, lo que minimiza los costos de almacenamiento y consulta innecesarios.
- Aplicar gobernanza por capas: Aplique la regulación centralizada para datos ingresados mientras aprovecha los controles de seguridad de sistemas federados (por ejemplo, RLS y enmascaramiento).
- Nota: Cuando está diseñando oportunidades en curso híbridas, es importante garantizar el ingreso incremental para conjuntos de datos históricos y distribuir agregaciones o filtros a orígenes federados para optimizar la E/S y calcular el uso.
- Consideraciones de costos
- Sopese el costo total frente al desempeño combinando el ingreso de datos críticos o de cumplimiento con la federación cuando se necesita actualización.
- Tenga en cuenta las E/S y calcule la distribución al mezclar el ingreso y la federación. Para reducir el costo de computar consultas repetidas en sistemas de origen, utilice el almacenamiento en caché (Consulta acelerada) para conjuntos de datos federados de alta lectura y acceso frecuente.
- Utilice esta regla para guiar la decisión de ingreso frente a federación: cuando se accede a los datos con frecuencia pero cambia con poca frecuencia, Consulta acelerada suele ser más rentable. Sin embargo, cuando los datos cambian con frecuencia (en relación con la frecuencia de acceso), Live Query o el ingreso es más apropiado. Estos son algunos ejemplos de costos:
- La aceleración gana: Un tablero creado a partir de 1 millón de registros y actualizado diariamente con ~10.000 cambios se visualiza 20 veces al día. Los costos de aceleración equivalen a aproximadamente ~600 créditos/mes frente a ~4.200 créditos/mes para Consultas en vivo.
- Live Query gana: Segmentos que se publican 20 veces al día utilizando datos que cambian cada 30 minutos. Las Consultas en vivo cuestan aproximadamente ~4.200 créditos/mes frente a ~28.800 créditos/mes para la aceleración con esta frecuencia de actualización.
Echemos un vistazo con más detalle a algunos arquetipos comunes que ilustran cómo aplicar esta lógica.
- El arquetipo “Fuente única de la verdad”: Centralizar y gobernar
- Escenario: Necesita crear perfiles de Customer 360 unificados que cumplan los requisitos para toda su compañía global. Los datos provienen de una docena de sistemas diferentes, deben cumplir con las estrictas leyes de RGPD y CCPA, y servirán como la fuente de la verdad para todas las interacciones de marketing y servicio.
- Patrón recomendado: Ingreso de datos. La prioridad aquí es la gobernanza, Trust y Control. Ingresar los datos en Data 360 es la única forma de crear un perfil canónico completamente auditable que esté aislado de los sistemas de origen.
- El arquetipo “Perspectivas en tiempo real”: Analizar sin moverse
- Escenario: Su equipo de ciencias de datos necesita ejecutar consultas exploratorias en una tabla de transacciones masiva y en constante actualización en Snowflake. Al mismo tiempo, su equipo ejecutivo desea un tablero de BI en vivo que funcione con esos mismos datos. Mover petabytes de datos diariamente es lento y costoso.
- Patrón recomendado: Zero Copy Federation. La prioridad aquí es la velocidad, la agilidad y la rentabilidad a escala. Copia cero le permite aprovechar la potencia de su almacén de datos existente para consultas en tiempo real sin la carga y la latencia de la duplicación de datos.
- El arquetipo “Inteligencia híbrida”: Gobernar el núcleo, federar el borde
- Escenario: Desea enriquecer sus perfiles de clientes gobernados e ingresados con señales de comportamiento en tiempo real (por ejemplo, clics de sitios web) desde un lago de datos. Necesita la estabilidad del perfil principal pero la inmediatez de los datos en vivo para potenciar la personalización en el momento.
- Patrón recomendado: Un enfoque híbrido. Utilice Ingreso de datos para crear un núcleo estable y regulado para sus datos de clientes. Utilice Copia cero para federar los datos volátiles de “borde” en tiempo real, y luego unirlos entre sí en el momento de la consulta para una vista completa al segundo.
La estrategia de datos de compañía ya no se centra en la elección de un patrón de integración único: se trata de diseñar flexibilidad controlada dentro de un ecosistema de datos interoperable. El enfoque correcto asigna cada sistema de origen al patrón que mejor se ajuste a sus requisitos de frescura, gobernanza, costo y acceso:
- Ingrese conjuntos de datos regulados de misión crítica en Salesforce Data Cloud para el cumplimiento, la resolución de identidad y los flujos de trabajo operativos.
- Genere datos a través de Copia cero para análisis en vivo, exploratorios y dirigidos por IA sin duplicar el almacenamiento.
- Aplicar almacenamiento en caché (Consulta acelerada) para reducir la carga del sistema de origen y el consumo de crédito cuando la frecuencia de consulta es alta y la frecuencia de cambio de datos es baja
Salesforce Data 360 en Hyperforce ofrece capacidad de ampliación y resistencia de múltiples regiones. Su casa de lago abierto con tablas de Iceberg permite la separación de cálculos y la interoperabilidad con plataformas como Snowflake, Databricks y S3 Iceberg, que forma la columna vertebral de un ecosistema de datos multinube verdaderamente interoperable.
A medida que evolucionan los ecosistemas de datos, debemos equilibrar continuamente la frescura, el costo, el desempeño y el cumplimiento para mantener la agilidad arquitectónica. Por eso es importante preparar su plataforma para el futuro unificando datos ingresados y gobernados con acceso federado. Esto permite la inteligencia en tiempo real, la activación de IA y la personalización a escala de compañía entre nubes, regiones y dominios de negocio.
Tenga en cuenta que las soluciones únicas no se adaptan a la mayoría de los negocios. La estrategia óptima asigna el patrón correcto al controlador de negocio correcto.
Yugandhar Bora es un Arquitecto de Ingeniería de Software en Salesforce que se especializa en arquitectura de datos dentro de la plataforma Aplicaciones de datos e inteligencia. Lidera iniciativas de la Junta de Revisión de la Arquitectura Empresarial (EARB) que se centran en la gobernanza de datos y modelos de datos unificados, mientras que también contribuye a soluciones de aprovisionamiento de plataforma automatizadas.
Jan Fernando es Arquitecto Principal de la Oficina del Arquitecto Jefe (OCA) de Salesforce, que se incorporó a Salesforce en 2012. Aporta una gran experiencia de su época en el ecosistema de startups. Antes de unirse a la OCA, pasó más de una década en la organización Plataforma, donde lideró varias transformaciones tecnológicas clave.