Introducción
Nota: Los “temas” se han cambiado a “subagentes” en este artículo, según nuestras últimas convenciones de nomenclatura de productos.
Puede crear un agente que tenga un buen rendimiento en un entorno de prueba, solo para que siga rutas completamente diferentes al procesar el mismo flujo de trabajo dos veces. Esta limitación fundamental muestra cómo gestionaba la ejecución el modelo Agentforce anterior: cada decisión, desde la interpretación de la intención hasta la selección de la acción, fue tomada en tiempo real por el LLM, sin ninguna ruta garantizada a través del flujo de trabajo.
Los LLM pueden producir resultados incoherentes en respuesta a entradas idénticas. Variaciones sutiles en contexto, solicitudes del sistema o generación de tokens son suficientes para enviar un agente por una ruta diferente. Para muchas interacciones, esta variabilidad es aceptable. Sin embargo, para flujos de trabajo de múltiples etapas que requieren capacidad de auditoría, reproducibilidad y trazabilidad, no lo es. Una aprobación de préstamo, una transferencia de inventario o un proceso de triaje de pacientes no puede depender de un agente que razona su camino a través de los pasos de forma diferente cada vez.
El nuevo Agentforce Builder y la secuencia de comandos de agente solucionan este problema separando la ejecución determinista del razonamiento LLM. El modelo híbrido de Agentforce garantiza que el agente siga una estructura definida con precisión para cada ejecución de flujo de trabajo, mientras sigue utilizando el razonamiento LLM donde el juicio, la comprensión del lenguaje natural o la interpretación contextual son genuinamente necesarios.
En la versión anterior de Agentforce, un agente operaba como un bucle reactivo simple. Cada decisión, desde la interpretación de la intención hasta la selección de la siguiente acción, se tomó en tiempo real por el LLM basándose únicamente en la entrada más reciente del usuario. No había ninguna ruta de ejecución garantizada, ningún estado persistente y ningún mecanismo para aplicar una secuencia de pasos.
No se pudieron garantizar las rutas de ejecución
Como cada decisión dependía del razonamiento en tiempo real del LLM, variaciones menores en la entrada, la solicitud del sistema o la versión del modelo produjeron diferentes selecciones de acción en solicitudes idénticas. Esto hizo que el modelo anterior fuera difícil de probar rigurosamente: un flujo de trabajo que pasó por etapas podía comportarse de forma diferente en producción, y no existía ninguna forma fiable de reproducir una ruta de ejecución específica para fines de depuración o auditoría.
Cada interacción pagó el coste LLM completo
Incluso escenarios de conversación sencillos requerían un mínimo de tres ciclos LLM: selección de subordinados, selección de acciones y generación de respuestas finales. Tareas de múltiples pasos ampliadas a cinco o más ciclos. Para los arquitectos que diseñan flujos de trabajo de gran volumen o sensibles a la latencia, esto no era solo un problema de rendimiento. Significaba que no podía cortocircuitar el bucle de razonamiento para pasos que no requerían juicio, porque la arquitectura no tenía ningún mecanismo para distinguir entre los dos.
La ejecución no determinista creó una brecha de auditoría
En las industrias reguladas, auditabilidad significa poder demostrar que se siguió un proceso específico de una forma específica para una transacción específica. Un modelo puramente no determinista no puede proporcionar esa garantía. Si la ruta de ejecución varía entre ejecuciones, el seguimiento de auditoría también varía y “el agente decidió” no es una respuesta defendible en una revisión de cumplimiento.
El Estado no sobrevivió a la conversación
Basarse en el procesamiento de un solo turno significaba que el agente no tenía memoria persistente de pasos anteriores. Si la conversación se desvió incluso ligeramente, el agente podría descartar el contexto capturado anteriormente y obligar al usuario a reiniciar. Para flujos de trabajo transaccionales de múltiples pasos, esto creó un límite de fiabilidad: Cuantos más pasos en el proceso, mayor será la probabilidad de pérdida de contexto antes de su finalización.
Los pasos completados no se recordaron
Sin la gestión de estado, los agentes no tenían registro de qué pasos obligatorios ya había completado un usuario. Esto produjo un bucle impredecible, donde un agente volvería a un paso que el usuario ya había finalizado. Más allá del impacto de la experiencia de usuario, esto creó un problema arquitectónico más profundo: diseñar un flujo de trabajo secuencial fiable era imposible porque el agente no podía aplicar la secuencia.
El nuevo Agentforce, GA desde febrero de 2026, cambia del razonamiento LLM puramente probabilista a un modelo híbrido. En vez de enrutar cada decisión a través de LLM, separa la ejecución determinista del razonamiento LLM y permite a cada uno gestionar solo lo que es adecuado para él. Para dar cobertura a esto, Agentforce presentó dos herramientas de redacción: Agent Script para desarrollo basado en código, y Agentforce Studio, un entorno de edificio sin código.
Agenteforce Builder
Agentforce Builder es el entorno recomendado para desarrollar nuevos agentes. Está alojado en Agentforce Studio y sustituye a la experiencia de configuración heredada, que permanece disponible pero ya no es la ruta de creación principal. En el Generador, trabaja en una vista de lienzo visual o directamente en una vista de secuencia de comandos, modificando la secuencia de comandos de agente que define el comportamiento de su agente.
Script de agente
Agent Script es un lenguaje declarativo específico del dominio (DSL) que define todo acerca de cómo se comporta un agente: su configuración, lógica comercial y solicitudes. Está estructurado como pares clave-valor que pueden abarcar múltiples líneas o incluir subpropiedades anidadas, y está diseñado para ser legible por humanos sin requerir Knowledge de la arquitectura de gráficos subyacente.
Agent Script le permite expresar dos tipos de instrucciones fundamentalmente diferentes en el mismo agente: instrucciones de lógica determinista e instrucciones de solicitud. Las instrucciones de lógica determinista definen condiciones y secuencias de acción que se ejecutan como código sin implicación de LLM. Las instrucciones de solicitud definen directrices de lenguaje natural que el LLM interpreta en tiempo de ejecución. El límite entre ambos es explícito y deliberado, y comprender dónde colocar ese límite es una de las decisiones de diseño principales que tomará al crear con el nuevo Agentforce.
Lógica determinista en la práctica
Cuando las instrucciones son deterministas, el agente sigue una ruta de ejecución definida independientemente de cómo el usuario formule su entrada. El siguiente ejemplo muestra un subagente que carga un panel Inteligencia de clientes. Comprueba un Id. de cliente, obtiene datos de perfil, historial de pedidos y tickets de asistencia, luego calcula el valor de toda la vida del cliente y el riesgo de abandono. Ninguno de estos pasos requiere razonamiento LLM.
Esta lógica llama a acciones en una secuencia fija cada vez que se cumplen ciertas condiciones.
Instrucciones de solicitud y traspaso deliberado de LLM
Donde la lógica determinista gestiona condiciones y secuencias que se pueden expresar como código, las instrucciones de solicitud gestionan todo lo que requiere juicio, interpretación o generación de lenguaje natural. Cuando el Motor de razonamiento de Atlas encuentra un nodo con instrucciones de solicitud, desencadena una llamada LLM. Cuando no lo hace, se ejecuta de forma determinista.
El siguiente ejemplo muestra un subagente para productos y servicios. Las instrucciones son una solicitud de varias líneas que indica al LLM cómo responder, cuándo buscar información y cómo gestionar la ambigüedad. Este es el patrón correcto cuando el intervalo de posibles entradas de usuario es demasiado amplio para anticipar con lógica condicional, o cuando la calidad de la respuesta depende de la capacidad del LLM para interpretar el contexto y generar una respuesta natural.
Las instrucciones de solicitud en un nodo desencadenan la llamada LLM. Eso no es incidental: es el mecanismo por el que la secuencia de comandos de agente hace que el límite de LLM sea explícito y aplicable, en vez de dejarlo a la inferencia en tiempo de ejecución.
Este subagente muestra lógica determinista y traspaso de LLM en acción.
La canalización de ejecución de tres etapas
Agentforce Builder y Script de agente son la capa de creación, pero Gráfico de agente y el Motor de razonamiento de Atlas ejecutan su agente. Por diseño, ninguno de estos componentes es directamente accesible para usted. La separación de la creación y la ejecución permite a la plataforma aplicar un comportamiento determinista independientemente de cómo se escribió la secuencia de comandos.
Las oportunidades en curso pasan por tres etapas.
- La redacción es donde trabaja. La secuencia de comandos de agente es legible por humanos y se puede modificar en vista de lienzo o vista de secuencia de comandos en Agentforce Builder. Esta es la única capa con la que interactúa directamente.
- La compilación es donde el compilador de Salesforce transforma su secuencia de comandos de agente en un gráfico de agente, un plan de ejecución serializado optimizado para la ejecución automática en vez de la capacidad de lectura humana. No depura en esta capa. La compilación produce una representación que el tiempo de ejecución puede atravesar de forma eficiente.
- La ejecución en tiempo de ejecución es donde el Motor de razonamiento Atlas asume el mando. Lee el Gráfico de agente, lo atraviesa basándose en el estado de sesión actual y decide en cada nodo si ejecutar de forma determinista o invocar el LLM. El motor aplica explícitamente cláusulas de protección y enrutamiento condicional aquí, en vez de inferir.
Gráfico de agente
Gráfico de agente es la representación intermedia que se encuentra entre su secuencia de comandos legible por humanos y la ejecución en tiempo de ejecución real. Su estructura está optimizada para el equipo de estado que la consume, no para el arquitecto que creó la secuencia de comandos. Comprender que existe y lo que representa importa porque es el artefacto que utiliza el Motor de razonamiento para aplicar el plan de ejecución que define su secuencia de comandos.
Motor de razonamiento del atlas
El Motor de razonamiento Atlas es un ejecutor de máquina de estado. En cada turno, atraviesa el Gráfico de agente basándose en el estado de sesión, ejecuta nodos deterministas como código y desencadena llamadas LLM solo donde hay instrucciones de solicitud presentes. También aplica cláusulas de protección y gestiona el enrutamiento condicional. El Motor de razonamiento es donde se implementa el modelo de razonamiento híbrido; la secuencia de comandos define el límite y el motor lo respeta.
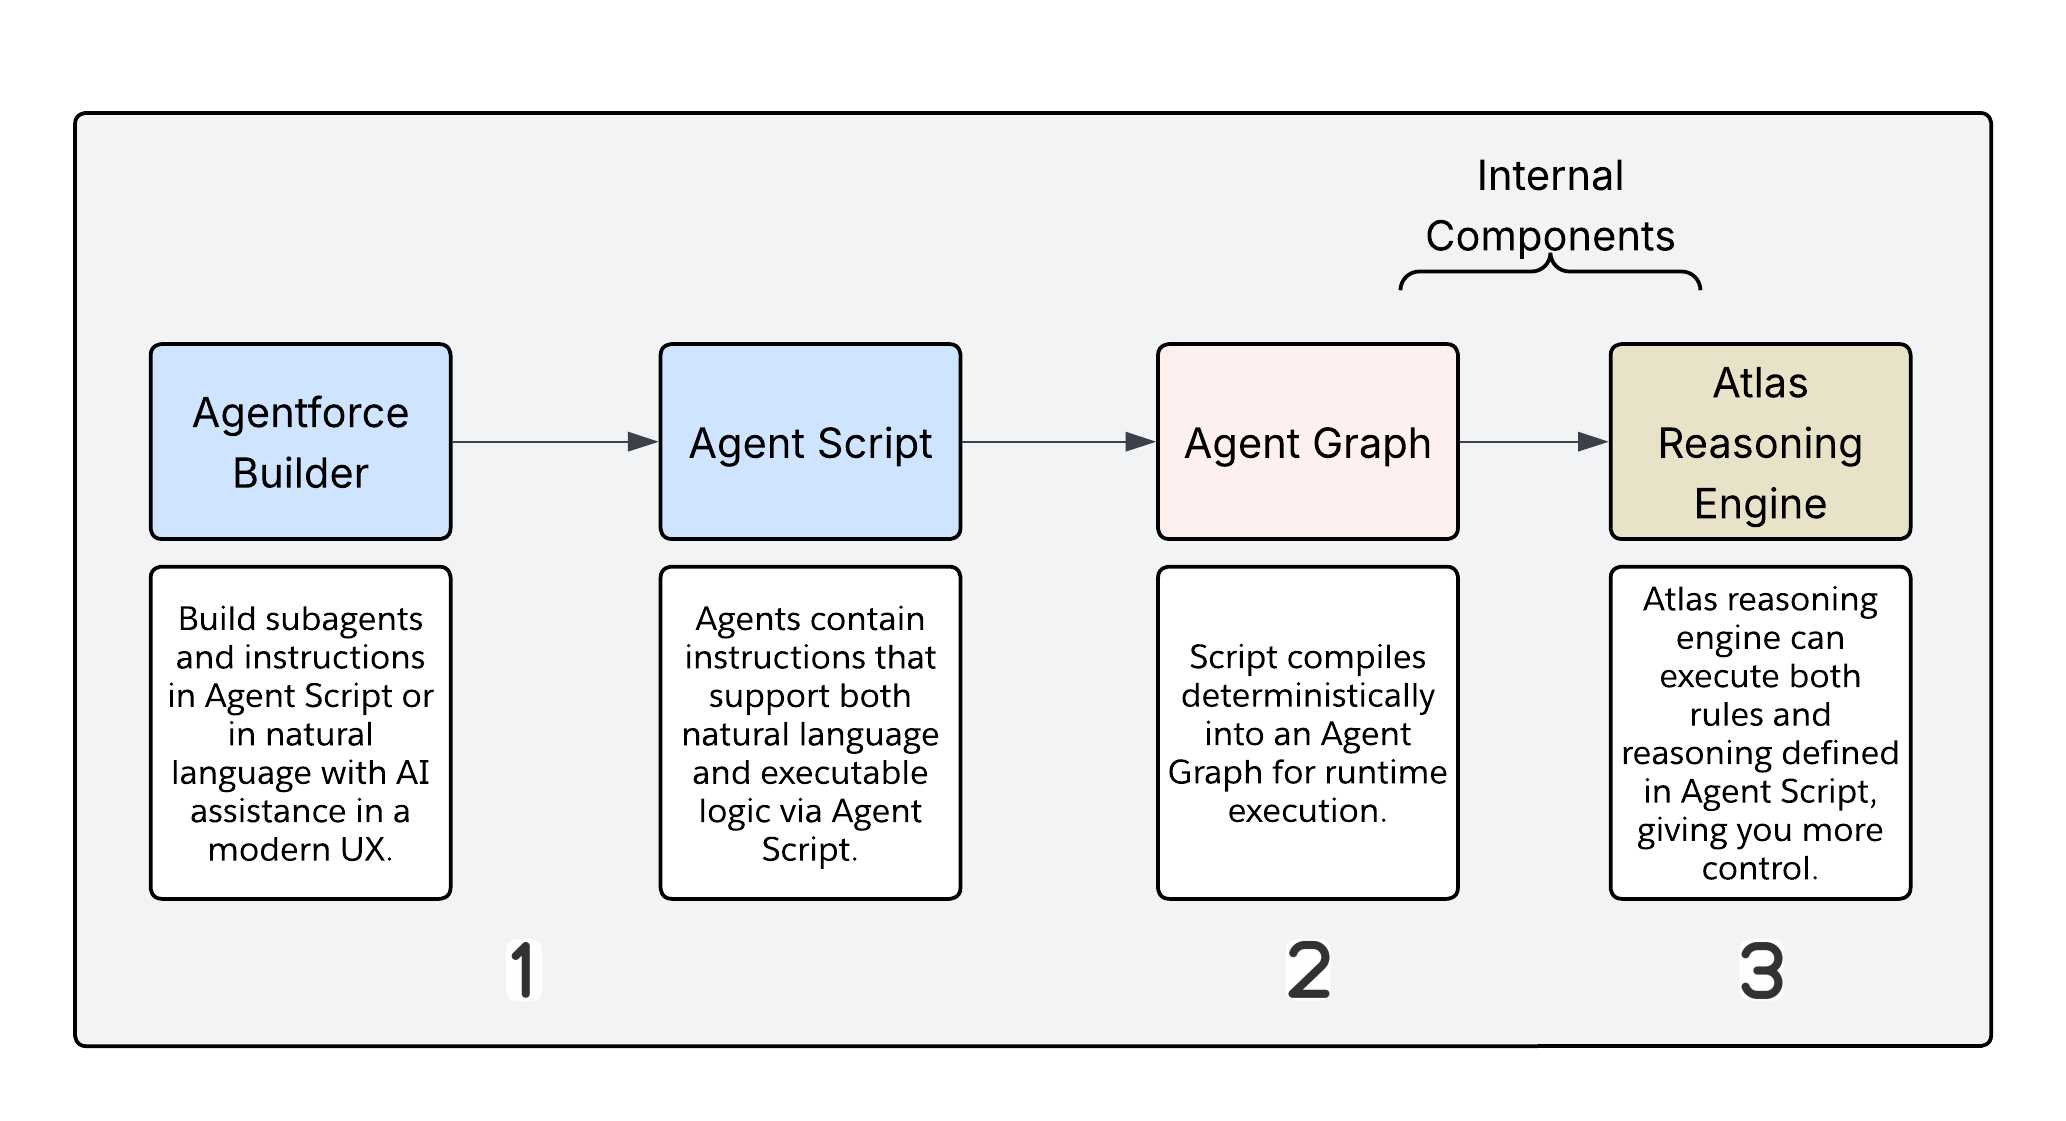
Gráfico de agente no es un contenedor LLM. Es un motor de razonamiento híbrido que separa la ejecución determinista del razonamiento probabilista. La regla de regulación es sencilla: si puede expresar una decisión como código, debe escribirse como lógica. Si la decisión requiere juicio, interpretación o generación de lenguaje natural, el LLM debe gestionarla. Esta decisión de diseño es la opción arquitectónica más importante en el nuevo modelo Agentforce. El lugar donde recae el límite LLM afecta directamente al coste, la latencia, la capacidad de auditoría y la fiabilidad de su solución.
El Motor de razonamiento de Atlas evalúa cada turno de usuario entrante y lo enruta por una de dos rutas.
Ruta A: ejecución determinista
Esta ruta no tiene exposición LLM. Se comporta como código compilado en tiempo de ejecución. El Motor de razonamiento clasifica la intención del usuario y determina que una instrucción de lógica coincide, omitiendo el LLM completamente. La secuencia de comandos de agente compilada se ejecuta de arriba a abajo, con reglas if-else ejecutando incondicionalmente en cada turno. Las acciones de Flujo, Apex o API se llaman con parámetros deterministas, sin ensamblaje de solicitudes o llamada de modelo implicada. El resultado vuelve a pasar por Trust layer con un registro de auditoría completo.
Ruta B: Razonamiento LLM
El Motor de razonamiento toma esta ruta cuando no puede resolver la intención utilizando instrucciones de lógica por separado. Atraviesa el gráfico de agente y evalúa cada nodo. Los nodos con instrucciones de solicitud desencadenan una llamada LLM. Los nodos sin ellos se ejecutan de forma determinista. La presencia de una instrucción prompt es el desencadenador y está explícita en la secuencia de comandos en vez de inferirse en tiempo de ejecución.
Qué desencadena una llamada LLM
Hay ocho puntos en el ciclo de vida de ejecución donde se invoca el LLM. La clasificación de subagente, o decidir qué subagente coincide con la solicitud del usuario, es uno, aunque una ruta de cortocircuito puede omitir la llamada LLM completa cuando la clasificación es inequívoca. El razonamiento de agentes, donde el agente decide qué acción realizar a continuación, siempre pasa por el LLM. También lo hace la generación de respuestas, donde la respuesta final se reúne desde una solicitud hidratada.
Los desencadenadores restantes son más operativos: La validación de fundamentación confirma que el resultado se basa en datos recuperados; la simulación de acción emula respuestas en el entorno Vista previa y Simular en vez de ejecutarse en vivo; la generación de resultados estructurados gestiona casos donde la respuesta necesita ajustarse a un esquema definido; y la generación de indicadores de localización y progreso gestiona el formato y la mensajería transitoria donde no existe ningún valor predeterminado de autoría previa.
Lo que sigue siendo determinista
El desplazamiento de gráficos y las transiciones de estado nunca implican el LLM. Los bloques de ciclo de vida de before_reasoning y after_reasoning se ejecutan de forma determinista siempre que contengan solo nodos de acción sin instrucciones de solicitud. Las matemáticas, la obtención de datos, la validación y la lógica condicional pertenecen al código. Cualquier acción que ejecute Flow, Apex o una API de REST permanece directamente en la ruta determinista. Cualquier nodo sin instrucciones de solicitud se ejecuta sin una llamada LLM.
Ser explícito sobre este límite con su equipo importa. Cada llamada LLM innecesaria agrega latencia, coste y variabilidad. Los arquitectos deben distribuir lógica determinista de forma predeterminada, reservando el LLM para casos donde la tarea requiere realmente su capacidad de razonamiento.
Directrices de diseño: lógica de envío a código de forma predeterminada
Utilice instrucciones de lógica de secuencia de comandos de agente al redactar instrucciones de solicitud que podrían expresarse como una condición, una asignación de variable o un filtro de acción. Cada llamada LLM innecesaria agrega latencia, coste y variabilidad.
La posición predeterminada debe ser determinista. Aísle cada comportamiento de agente que se pueda codificar como regla y muévalo a la secuencia de comandos de agente. Las tareas restantes que requieren síntesis de lenguaje natural, juicio contextual o interpretación compleja pertenecen a nodos que llevan solicitudes. Eso no es una limitación; es el límite funcionando según lo previsto. El LLM gestiona lo que es más adecuado y todo lo demás se ejecuta como código.
La unidad de ejecución principal en Script de agente no es el turno de usuario. Es el análisis: un único ciclo completo a través de los tres bloques de ciclo de vida de un subagente. El Motor de razonamiento de Atlas inicia un análisis cada vez que un subagente necesita procesar algo, lo que sucede en tres situaciones: en la primera entrada en el subagente, después de cada llamada de herramienta cuando una acción completa y devuelve un resultado, y en cada nuevo turno de usuario dentro del mismo subagente.
Comprender el límite del análisis es importante porque determina cuántas veces se ejecuta cada bloque y, por lo tanto, dónde puede y no puede confiar en que una pieza de lógica determinada se ejecute exactamente una vez.
Cada subgente define tres zonas de ejecución:
| Bloquear | Cuando se ejecuta | Participación de LLM |
|---|---|---|
before_reasoning | Al inicio de cada análisis, antes de que el LLM vea nada | Ninguno |
reasoning | Durante la resolución determinista, antes de cualquier llamada LLM | Mixto |
after_reasoning | Después de que se complete el razonamiento y el LLM haya respondido | Ninguna (con una advertencia crítica) |
Tanto before_reasoning como after_reasoning son totalmente deterministas. Ejecutan acciones, establecen variables y aplican lógica condicional sin implicar el LLM. Esto los convierte en los bloques fiables y de bajo coste en la secuencia de comandos.
Cuándo utilizar before_reasoning
La before_reasoning se ejecuta al inicio de cada análisis sin excepción. Se ejecuta en la primera entrada en el subagente y de nuevo después de cada llamada de herramienta o nuevo cambio de usuario dentro de ese subagente. Un run @actions.X en before_reasoning es código. A diferencia de una instrucción dentro de un bloque de solicitudes, que el LLM puede seguir o no, before_reasoning se ejecuta incondicionalmente.
Utilice este bloque para la inicialización de sesiones: obtención de registros de contexto, establecimiento de variables de sesión desde Apex o Flow. También es donde pertenecen las comprobaciones de autenticación y asignación, porque desea que se verifiquen antes de que el LLM vea cualquier herramienta. La hidratación de contexto también encaja aquí: llamar a una acción de recuperación de datos de modo que el LLM reciba variables rellenadas previamente en vez de necesitar solicitarlas. Cualquier variable de contador o auditoría que se deba incrementar en cada análisis debe establecerse aquí, porque la directiva de set en before_reasoning está garantizada de una forma que no lo está una instrucción de canalización.
Lo que no pertenece aquí es la lógica que solo debe ejecutarse una vez por sesión, ya que la before_reasoning se ejecuta en cada análisis, no solo en la primera entrada. Cualquier cosa que dependa de la entrada del usuario desde el turno actual tampoco pertenece aquí, porque esa entrada no se procesó aún. Y las transiciones nunca deben estar en before_reasoning: una instrucción transition to aquí disparará incondicionalmente en cada análisis y creará bucles.
Si necesita inicialización una vez por sesión, guárdela explícitamente:
Un turno de usuario puede desencadenar múltiples análisis: vez en la entrada, luego de nuevo después de cada llamada de herramienta. Esa función tiene tres consecuencias prácticas: Las acciones de inicialización en before_reasoning se ejecutarán más de una vez por turno de usuario en flujos de múltiples acciones, las variables de contador incrementadas aquí reflejarán el recuento de análisis, no el recuento de turnos, y las acciones con efectos secundarios, llamadas de API externas o escrituras de registros, no deben vivir en before_reasoning a menos que la nueva ejecución en cada análisis sea explícitamente aceptable.
before_reasoning no es un constructor. Es una comprobación previa al vuelo que se ejecuta con cada análisis. Diseñarla en consecuencia.
Cuándo utilizar after_reasoning
La after_reasoning se ejecuta una vez finalizado el bucle de razonamiento, después de que el LLM haya respondido y se hayan capturado los resultados de la acción. Aquí es donde pertenecen las comprobaciones deterministas posteriores a la acción: evaluación de resultados de acciones y bifurcación basándose en resultados. Las transiciones deterministas, o pasar al siguiente subagente basándose en estado variable en vez de juicio LLM, se encuentran aquí. También lo hace la limpieza de variables antes del siguiente turno y la secuenciación de orquestación cuando necesita encadenar subagentes en un orden predecible sin una decisión de enrutamiento LLM.
Tratar a after_reasoning como la capa de la barandilla. Es donde aplica reglas comerciales y gestión de estado después de que el LLM haya realizado su trabajo, garantizando que los flujos de procesos críticos permanecen predecibles independientemente de lo que generó el LLM.
Utilizar is_displayable: True sabiamente
Cada arquitecto que diseña flujos de orquestación necesita comprender este comportamiento de plataforma. Cuando se establece el is_displayable: True en una acción, la plataforma sale del bucle de razonamiento en cuanto el LLM decide aflorar ese resultado. Esa salida se produce de inmediato, lo que significa que after_reasoning nunca se ejecuta.
Este es un comportamiento de plataforma conocido, pero tiene una consecuencia directa para la orquestación: cualquier lógica que haya colocado en after_reasoning se omitirá cuando una acción visible forme parte del flujo.
La respuesta es directa. Mueva la lógica que debe ejecutarse de forma fiable en el bloque de before_reasoning del subagente posterior en vez del bloque de after_reasoning del actual.
Directrices de diseño: dónde colocar la lógica de inicialización
Decidir dónde colocar la lógica es consecuencia al diseñar un subagente. Este marco de trabajo cubre los escenarios más comunes:
| Escenario | Dónde ponerlo |
|---|---|
| Debe ejecutarse antes de que el LLM vea cualquier contexto | before_reasoning |
| Ejecuta cada análisis, incluyendo la reentrada en nuevos turnos de usuario | before_reasoning |
| Depende de la salida de acción de este turno | Bloque de if condicional en reasoning |
| Requiere una transición de subagente determinista basada en el resultado | after_reasoning (pero ver advertencia de is_displayable abajo) |
Requiere lógica de orquestación cuando la acción descendente utiliza is_displayable: True | before_reasoning del siguiente subagente |
| Utiliza lógica que requiere juicio o contexto de usuario | reasoning con instrucciones de solicitud |
El principio subyacente es sencillo. Cuando escribe una instrucción de solicitud indicando al LLM que “ejecute siempre” una acción, esa es una sugerencia. El LLM puede seguirlo o no dependiendo del contexto. Cuando coloca una directiva de run en before_reasoning, eso es código. Se ejecuta en cada análisis sin excepción.
La disponibilidad de acción condicional es el mecanismo por el que la secuencia de comandos de agente expone u oculta acciones del LLM basándose en el estado de la variable de tiempo de ejecución. Cuando la condición de available when se evalúa como false, la acción se elimina de la lista de herramientas presentada al LLM completamente. Cualquier valor falso, incluyendo None, False, 0 o una cadena vacía, suprime la acción.
Esta no es una instrucción de solicitud que indica al LLM “no llame a esto aún”, es una puerta a nivel de plataforma dura. El LLM no puede llamar a una acción a la que no puede acceder.
En este ejemplo, la execute_transfer es invisible para el LLM hasta que validation_passed evalúe la true. La plataforma aplica la puerta, no mediante instrucciones.
Directrices de diseño: nunca permitir que el LLM establezca la variable de puerta
Proporcione a cada variable de una cláusula de available when una ruta de código determinista que establezca la variable antes de que se ejecute la acción asociada. Utilice before_reasoning o un bloque de run y set determinista en reasoning para mantener la variable en un estado conocido. Si confía en el LLM para establecer la variable de puerta, ha vuelto a introducir la variabilidad para la que se diseñó la puerta. Dependiendo de la conversación, el LLM puede establecerla o no, lo que significa que la puerta puede abrirse o no.
Problema del bucle de acción
Un bucle de acción se produce cuando el LLM llama a la misma acción repetidamente sin alcanzar nunca un estado terminal. Ocurre cuando dos condiciones son verdaderas simultáneamente: la condición de available when permanece satisfecha después de que se ejecute la acción y las instrucciones de razonamiento no indican explícitamente al LLM que deje de llamarlo.
La plataforma no suprime automáticamente una acción después de llamarla. Si la puerta permanece abierta y las instrucciones de razonamiento son ambiguas, el LLM llama a la misma acción en cada análisis indefinidamente.
Considere available when @variables.interest != "" como un ejemplo. Si la acción se ejecuta pero la variable de interés no está vacía, la puerta permanece abierta en el siguiente análisis. El LLM ve la acción como disponible, no tiene instrucciones que le indiquen detenerse y la llama de nuevo.
Existen dos formas fiables de romper el bucle. La primera es establecer la variable de puerta en un estado cerrado como parte de la lógica posterior a la ejecución de la acción, de modo que available when evalúe false en el siguiente análisis. El segundo es utilizar un has_run booleano separado que cierra la puerta después de la primera ejecución. Ambos enfoques proporcionan a la puerta un estado cerrado determinista, que es la condición que necesita la plataforma para suprimir la acción.
Una transferencia bancaria es una lente útil para comprender cómo funcionan estos patrones juntos en la práctica. El flujo de trabajo tiene un aspecto sencillo desde fuera: mover dinero de una cuenta a otra. La implementación requiere múltiples pasos complejos. Antes de que se ejecute la transferencia, el agente debe recopilar detalles de cuenta, validar el importe, comprobar los límites de transferencia, confirmar el saldo disponible y solo a continuación exponer la acción de transferencia. Cada paso depende de los pasos anteriores. Ninguno de ellos debe dejarse a juicio de LLM.
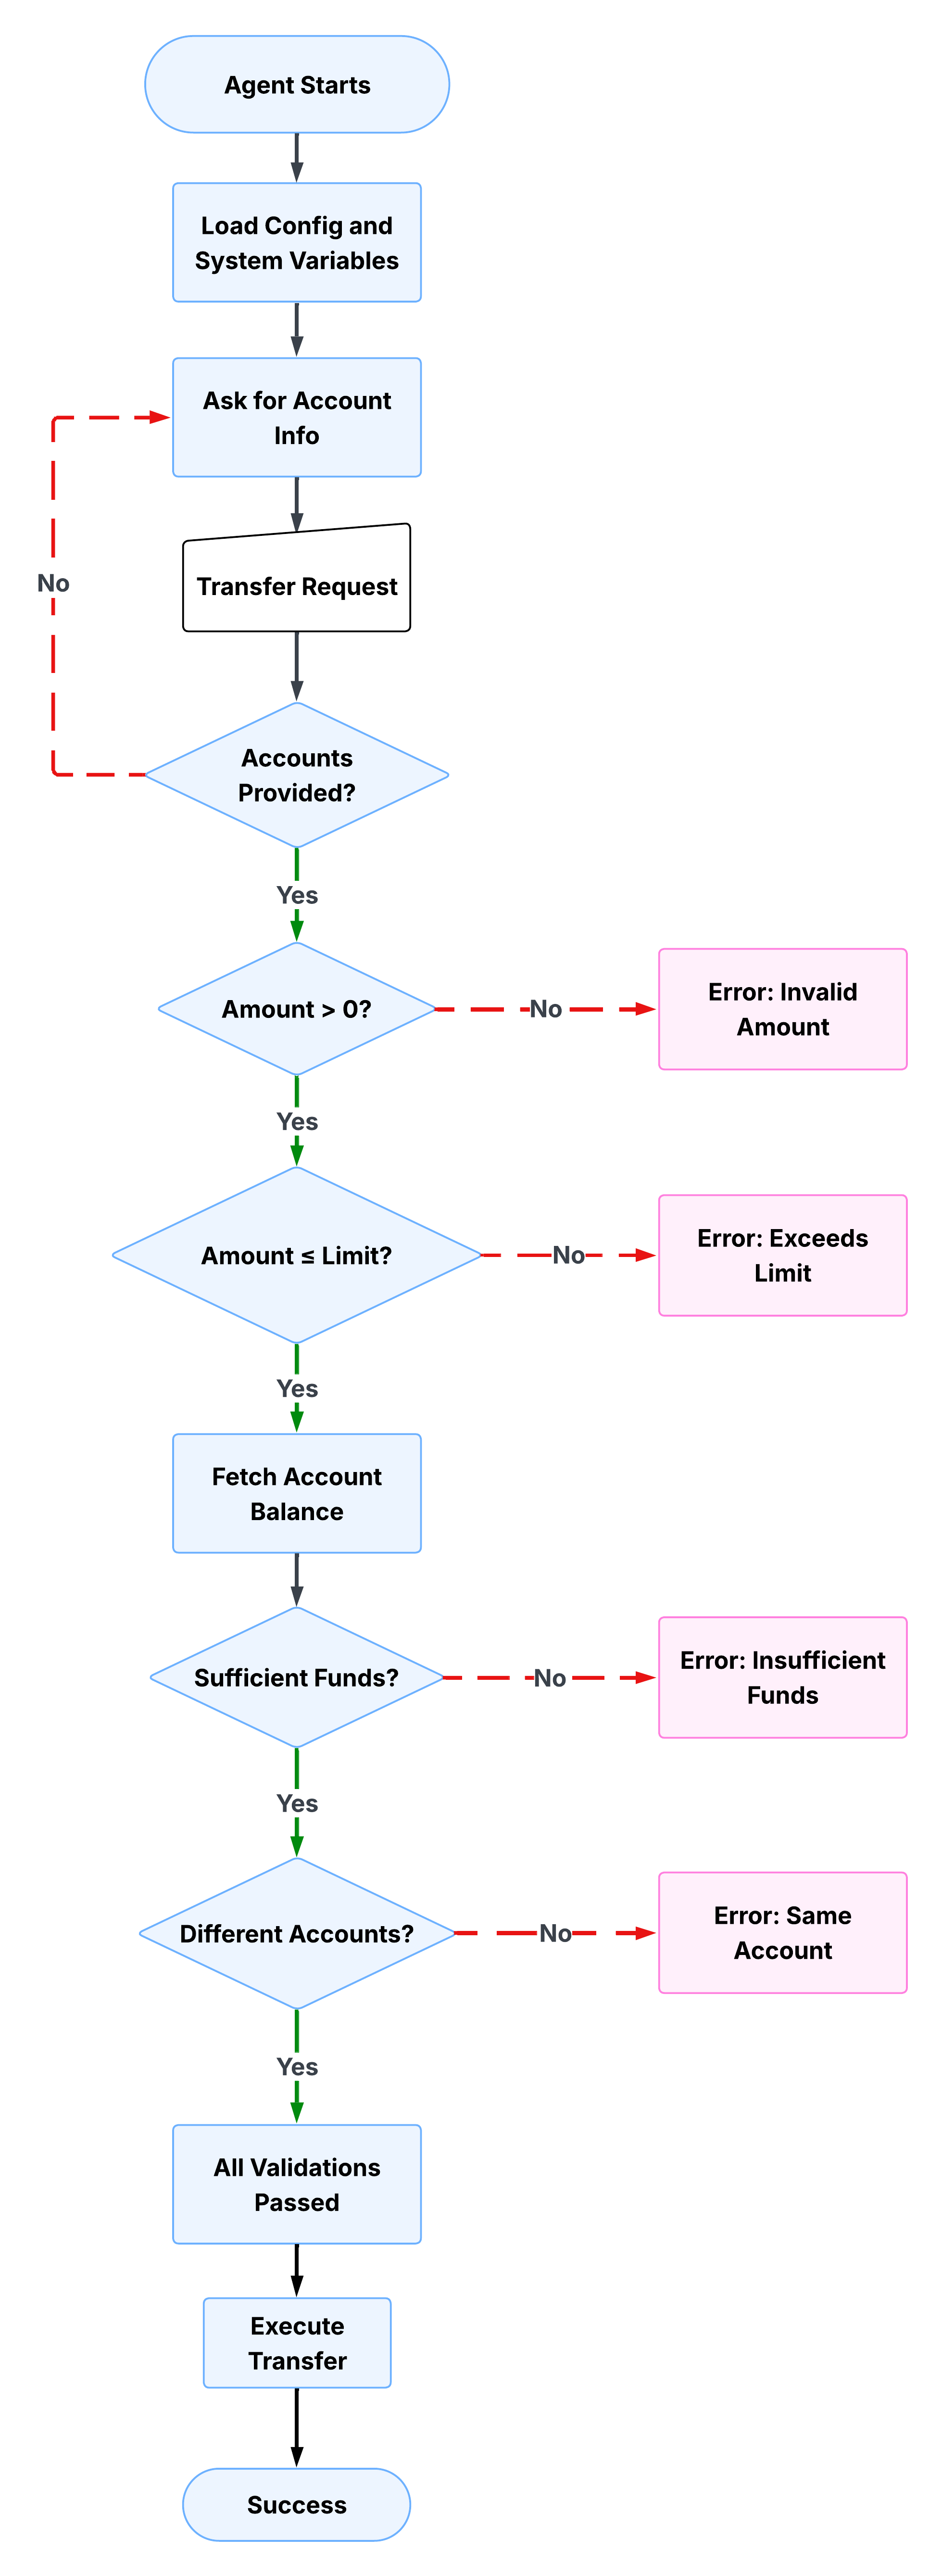
Recopilar y validar entradas
El primer subagente recopila la cuenta de origen, la cuenta de destino y el importe de transferencia del usuario. No continuará hasta que los tres estén presentes y sean válidos. La secuencia de comandos de agente comprueba cada campo en secuencia: si falta la cuenta de origen, pregunta. Si falta el destino, se pregunta. Si el importe es cero o negativo, se pregunta. La variable validation_passed solo se establece en true después de que se hayan borrado todas las comprobaciones.
La secuencia de comandos siguiente muestra esto en la práctica. Observe que validation_passed está establecido explícitamente como false en cada punto de fallo y se indica al LLM que no continúe. Las comprobaciones deterministas se ejecutan incondicionalmente, mientras que las instrucciones de solicitud gestionan la respuesta de cara al usuario.
Aplicar reglas comerciales
Después de que el agente valide entradas, comprueba si el importe de transferencia supera el límite de transferencia configurado. Aquí es donde las reglas comerciales se convierten en código en vez de instrucciones. El límite no es algo sobre lo que el LLM razona; es un umbral duro definido en la secuencia de comandos y comprobado de forma determinista en cada análisis.
Si el importe supera el límite, el validation_passed se vuelve a establecer en false y el LLM presenta al usuario tres opciones: transferir el importe máximo permitido, dividirlo en múltiples transferencias o ponerse en contacto con el servicio de asistencia para límites más altos. El agente no puede continuar hasta que el usuario resuelva la excepción. Observe cómo la instrucción prompt aquí está haciendo exactamente lo que el razonamiento LLM es adecuado para: presentando opciones conversacionalmente y gestionando la respuesta del usuario. La regla comercial en sí es determinista, pero la conversación en torno a ella no.
La siguiente secuencia de comandos muestra cómo funciona la comprobación de límite. La condición determinista evalúa el importe de transferencia frente a la variable límite, establece validation_passed en false si se supera el umbral y delega en una instrucción prompt para gestionar la respuesta de cara al usuario.
Aplicar cláusulas de protección
Con las comprobaciones de importe y límite completadas, el agente obtiene el saldo de cuenta de origen y confirma que hay fondos suficientes disponibles. Las cláusulas de protección evitan que el agente intente operaciones cuando no se cumplen las condiciones previas. A diferencia de una instrucción prompt que indica al LLM que compruebe el saldo, una cláusula de protección en la secuencia de comandos de agente hace que la comprobación sea incondicional. El LLM no decide si ejecutarlo.
Si el saldo es insuficiente, el agente calcula la carencia y presenta al usuario una alternativa concreta. El validation_passed se establece en false hasta que pase esta comprobación, lo que significa que la acción de transferencia permanece activa.
La siguiente secuencia de comandos muestra una llamada de acción determinista que obtiene el equilibrio, seguida de una comprobación condicional que lo evalúa. La obtención solo se ejecuta si el saldo no se recuperó aún, evitando llamadas de API redundantes en análisis posteriores.
Errores superficiales claramente
Las cláusulas Guard establecen el estado. Los mensajes de error lo comunican. Cuando validation_passed es false, el agente necesita proporcionar al usuario suficiente información para resolver el problema sin reiniciar. Los mensajes de error vagos crean fricción; los estructurados cierran el bucle con mayor rapidez.
La secuencia de comandos siguiente muestra el mensaje de error de fondos insuficientes en la práctica. No solo indica al usuario que falló la transferencia. Muestra el saldo disponible, el importe solicitado, la carencia calculada y ofrece un siguiente paso concreto, todo reunido a partir de variables de sesión en vez de generado por el LLM.
El cálculo de carencias se produce en la secuencia de comandos, no en el LLM. La alternativa sugerida, transferir el saldo disponible, se deriva de forma determinista del estado de la sesión. La función del LLM aquí es puramente presentacional: entrega un mensaje que la secuencia de comandos ya ha estructurado.
Acceso a la acción de transferencia
Cada comprobación de validación en los pasos anteriores establece o borra la misma variable: validation_passed. Esa variable está ahora haciendo su trabajo más importante. La acción execute_transfer está disponible condicionalmente, lo que significa que solo aparece en la lista de herramientas del LLM cuando validation_passed es true. Hasta que cada comprobación anterior haya pasado y establecido esa variable, la acción no existe desde la perspectiva del LLM.
Este es el patrón de la sección de puerta anterior aplicada a un flujo de trabajo de producción. La acción de transferencia no está oculta por una instrucción prompt. Está oculto por la plataforma. Ninguna cantidad de presión de conversación o frase ambigua puede hacer que el LLM la invoque antes de que se cumplan las condiciones previas.
La siguiente secuencia de comandos muestra cómo se configura la puerta. La cláusula available when hace referencia a validation_passed directamente, y los parámetros de acción están vinculados a las variables de sesión recopiladas y validadas en los pasos anteriores.
Los tres parámetros, from_account, to_account y amount, se pasan de forma determinista desde variables de sesión. Cuando esta acción esté disponible, se habrá validado cada valor. El LLM no está reuniendo los parámetros desde el contexto de la conversación; los está leyendo desde el estado.
Seguimiento del estado durante el flujo de trabajo
Los patrones de las secciones anteriores solo funcionan porque el estado de la sesión persiste en todo el flujo de trabajo. Los números de cuenta capturados en el primer paso están disponibles en el cuarto. Los resultados de validación se establecen en una acción de puerta de comprobación en otra. La conversación puede desviarse, el usuario puede formular preguntas de seguimiento y el agente aún sabrá exactamente dónde está en el proceso.
El bloque de variables a continuación muestra el estado de sesión completo para este flujo de trabajo. Cada variable tiene un tipo definido, un valor predeterminado y una descripción. Dos variables gestionan la mayor parte del trabajo de orquestación: validation_passed controla la disponibilidad de acciones en cada puerta, y validation_information lleva contexto legible por las personas acerca de por qué falló una comprobación, que el LLM puede aflorar al usuario sin necesidad de razonar acerca del estado subyacente.
Cada variable comienza en un estado predeterminado conocido. Las cadenas toman como valor predeterminado vacío, los números cero y el validation_passed booleano false. Esto significa que la puerta está cerrada de forma predeterminada. El flujo de trabajo tiene que ganarse activamente el derecho de continuar en cada paso, en vez de comenzar con la puerta abierta y depender de comprobaciones para cerrarla.
El ejemplo de transferencia bancaria ilustra dónde la lógica determinista es la herramienta correcta, pero no siempre es la mejor opción. Comprender el límite es tan importante como comprender los patrones.
La lógica determinista es la opción correcta cuando el flujo de trabajo requiere una secuencia de ejecución garantizada, cuando los errores tienen consecuencias significativas, cuando el proceso necesita producir un seguimiento de auditoría reproducible o cuando las reglas comerciales están suficientemente bien definidas para expresarse como condiciones y umbrales. Los flujos de trabajo de finanzas, cuidados sanitarios y seguros generalmente se incluyen en esta categoría.
El razonamiento LLM puro sin restricciones deterministas estrictas tiene más sentido cuando el valor de la interacción reside en la flexibilidad en vez de la precisión. El servicio de atención al cliente abierto, los productos en la etapa inicial donde los procesos comerciales aún están evolucionando y las consultas informativas de bajo riesgo son todos casos donde la variabilidad del razonamiento LLM es una función, no un problema.
En la práctica, la mayoría de los agentes de producción necesitan ambos. La decisión de dónde recae el límite no es una opción binaria entre determinista y probabilista; es una decisión de diseño que toma en el nivel del nodo para cada parte del flujo de trabajo de su agente.
| Utilizar lógica determinista para | Utilizar razonamiento LLM para |
|---|---|
| Validación y desinfección de entrada | Comprensión del lenguaje natural y detección de intenciones |
| Aplicación de reglas comerciales | Generación de respuestas conversacionales y empáticas |
| Orquestación de procesos secuenciales | Gestión de entradas ambiguas o inesperadas |
| Gestión de estado y conservación de contexto | Proporcionar explicaciones y aclaraciones |
| Cláusulas de protección que evitan operaciones no válidas | Adaptación del tono y la mensajería al contexto de usuario |
El límite es la decisión de diseño
El ejemplo de transferencia bancaria es una ilustración de una filosofía de diseño: que el límite entre la ejecución determinista y el razonamiento LLM es la decisión arquitectónica más consecuente que toma al crear un agente de producción.
Coloque un límite demasiado rígido y terminará con un agente rígido, caro de mantener e incapaz de gestionar la variación natural de conversaciones reales. Hacer mal el límite en la otra dirección crea un agente que es flexible pero impredecible, tiene un buen rendimiento en las pruebas pero se comporta de forma diferente en producción y no puede producir un seguimiento de auditoría fiable o confiar en una transacción de alto riesgo.
El nuevo modelo Agentforce le proporciona las herramientas para colocar ese límite deliberadamente. Agent Script le permite expresar instrucciones de solicitud y lógica determinista en el mismo archivo, con una sintaxis explícita para hacer visible el límite. El Motor de razonamiento Atlas aplica la lógica y solicita en tiempo de ejecución. Los bloques before_reasoning y after_reasoning le proporcionan zonas de ejecución garantizadas en cualquier lado de la llamada LLM. La disponibilidad de acciones condicionales garantiza que el LLM solo pueda actuar cuando se cumplan las condiciones previas.
Ninguna de estas funciones está aislada. Trabajan conjuntamente para crear una arquitectura coherente para agentes de creación en la que las empresas puedan Trust con flujos de trabajo de misión crítica. El modelo de razonamiento híbrido reconoce que el determinismo y la flexibilidad tienen funciones en su arquitectura; es el trabajo del arquitecto decidir con precisión dónde se aplica cada uno.
Recetas de secuencias de comandos de agentes
Guía del desarrollador Agentforce
Gráfico de agente de Agentforce: Hacia el determinismo guiado con razonamiento híbrido
Gulal Kumar es Arquitecto de Ingeniería de Software en Salesforce con más de 20 años de experiencia. Su experiencia abarca la IA, la integración, las API y la arquitectura empresarial, con un enfoque en impulsar la transformación comercial a través de soluciones de IA seguras, resistentes e innovadoras. Conecta con él en LinkedIn.
Miriam McCabe es Directora Senior y líder del equipo de Evangelismo de Arquitectos. Su trabajo se centra en permitir a la comunidad de arquitectos de Salesforce global liderar en la era de los agentes a través de contenido profundamente técnico, programación en vivo e implicación de la comunidad. Síguela en LinkedIn.