Las arquitecturas de datos empresariales rara vez viven en un sistema. Salesforce gestiona la implicación de los clientes, las oportunidades en curso y las interacciones de servicio. Las plataformas de análisis como Snowflake alojan transacciones históricas, registros financieros, datos de uso y mediciones operativas. Tradicionalmente, unir estos dos mundos significaba construir y mantener oportunidades en curso de ETL: trabajos programados que extraen datos del origen, los transforman y cargan copias en Salesforce. Como resultado de estas oportunidades en curso, los datos llegan con retraso, las políticas de gobernanza se multiplican entre sistemas y las oportunidades en curso demandan cuidados operativos continuos.
La virtualización de datos de Salesforce ofrece un modelo diferente. En vez de mover datos a Salesforce, permite a Salesforce consultar datos directamente en su origen, en tiempo de ejecución, sin replicación. Los usuarios ven datos externos en vivo a través de interfaces estándar de Salesforce. Los datos nunca salen de su página de inicio autorizada. Este documento explica cómo funciona el patrón, cuándo utilizarlo y cómo empezar a trabajar, utilizando Snowflake como un ejemplo trabajado concreto.
Virtualización de datos de Salesforce es un patrón de arquitectura de integración que permite a Salesforce consultar datos directamente desde sistemas externos en tiempo de ejecución, sin copiar o replicar esos datos en el almacenamiento de Salesforce. En vez de mover datos, la plataforma envía la consulta.
Como resultado, los usuarios de Salesforce interactúan con datos externos a través de interfaces de Salesforce familiares (como formatos de página, listas relacionadas, informes o flujos) mientras los datos permanecen en su sistema de origen autorizado. La gobernanza, el control de acceso y la residencia de datos permanecen donde pertenecen.
Este patrón está construido sobre un único principio arquitectónico: los datos permanecen en el origen. El cálculo se traslada a los datos.
La mayoría de las implementaciones empresariales de Salesforce se integran con plataformas de datos externas (como almacenes de datos, bases de datos operativas o establecimientos analíticos) a través de oportunidades en curso de replicación. Las oportunidades en curso extraen, transforman y cargan datos en Salesforce en una programación. Este enfoque funciona, pero la replicación presenta desventajas estructurales:
- Los datos replicados siempre se retrasan. Las oportunidades en curso introducen retardo y los datos obsoletos conducen a malas decisiones.
- Cada copia de datos amplía el ámbito de cumplimiento. Los datos confidenciales (como información de identificación personal, registros financieros o datos de salud) en múltiples sistemas requieren mantener múltiples políticas de gobernanza.
- Las oportunidades en curso requieren inversión operativa continua, supervisión, gestión de fallos, gestión de deriva de esquemas y lógica de reprocesamiento.
La virtualización de datos soluciona estas compensaciones directamente. Elimina completamente las oportunidades en curso para casos de uso con gran volumen de lectura, mantiene los datos en su ubicación autorizada y proporciona a los usuarios de Salesforce una vista gobernada en tiempo real de datos externos sin el gasto de replicación.
Los objetos externos son el mecanismo principal a través del cual la virtualización de datos aflora datos externos dentro de Salesforce. Se comportan como objetos estándar de Salesforce: consultable a través de SOQL, visible en formatos de página y listas relacionadas y accesible a través de API estándar de Salesforce. La diferencia clave es que no se almacenan datos en Salesforce. El Objeto externo es una proyección de esquema: una definición del aspecto de los datos externos, no una copia de los datos en sí.
Cuando un usuario carga una página o ejecuta un informe que hace referencia a un Objeto externo, Salesforce ejecuta una consulta en vivo en el sistema externo y solo devuelve el conjunto de resultados para esa interacción.
Cuando Salesforce ejecuta una consulta SOQL en un objeto externo, traduce filtros (cláusulas WHERE), órdenes de clasificación (ORDER BY) y límites (LIMIT) en el SQL equivalente y los envía al sistema externo. El sistema externo ejecuta la consulta en su propio motor de computación y solo devuelve el conjunto de resultados filtrado. El trabajo se produce donde residen los datos y solo la respuesta vuelve a Salesforce.
La virtualización de datos aplica dos capas de seguridad independientes de forma simultánea. El sistema externo aplica sus propios controles de acceso en tiempo de ejecución de consultas, incluyendo seguridad a nivel de filas, enmascaramiento de columnas y acceso basado en funciones. Salesforce aplica su propio modelo de seguridad: perfiles, conjuntos de permisos, seguridad a nivel de campo y reglas de colaboración. Ambas capas están activas en cada consulta. Ninguno sustituye al otro.
Los arquitectos describen frecuentemente la virtualización de datos como un patrón de “copia cero”. Cero copia significa que no hay replicación persistente en el almacenamiento de Salesforce. No hay oportunidades en curso de ETL escribiendo registros en objetos de Salesforce. No hay sincronización programada creando una copia local. El Objeto externo no alberga filas.
Cero copia no significa cero transmisión de datos. Cada vez que un usuario consulta un Objeto externo, un conjunto de resultados se desplaza desde el sistema externo a Salesforce a través de la red. Para grandes conjuntos de resultados o alta frecuencia de consulta, los costes de salida de datos y la latencia de red son factores reales para los que los arquitectos deben diseñar. Esto no es una limitación para ocultar: es una restricción de diseño a tener en cuenta.
Tenga en cuenta estas diferencias arquitectónicas si su caso de uso requiere grandes volúmenes, acceso frecuente o baja latencia.
Snowflake es uno de los sistemas externos más comunes conectados a Salesforce a través de la virtualización de datos. Sirve como ejemplo concreto de cómo funciona el patrón de extremo a extremo.
En esta configuración, Salesforce se conecta a Snowflake utilizando Salesforce Connect con el Adaptador SQL para Snowflake. Las tablas y vistas de Snowflake aparecen como Objetos externos en Salesforce. Cuando un usuario consulta un Objeto externo, Salesforce traduce SOQL a SQL y lo envía a la API de declaraciones de Snowflake a través de una llamada HTTPS autenticada. Snowflake ejecuta la consulta en su almacén virtual, aplica su propia seguridad a nivel de filas y enmascaramiento de columnas y devuelve solo el conjunto de resultados. No se escriben datos en el almacenamiento de Salesforce en ningún momento.
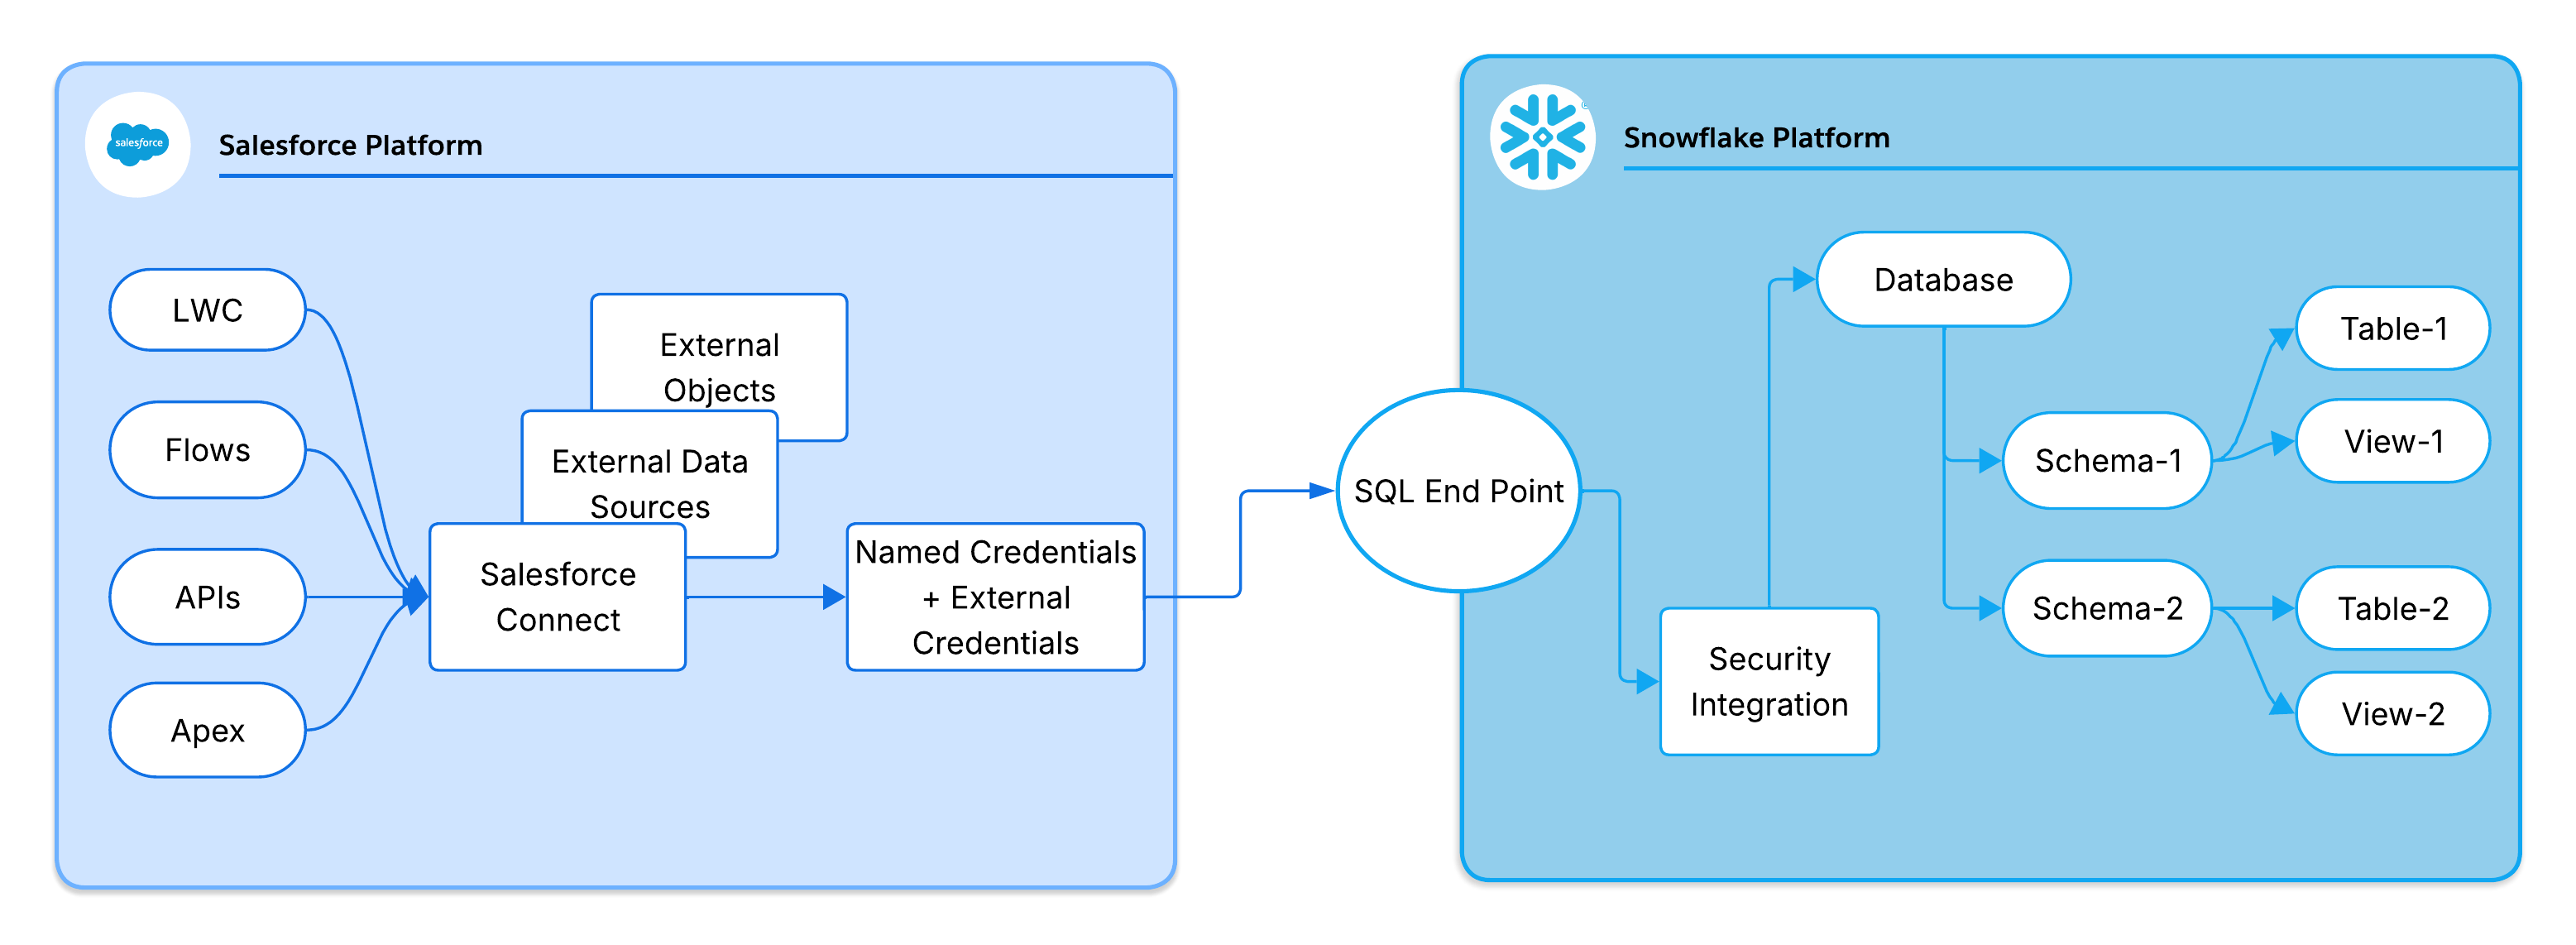
Salesforce Connect utiliza un modelo de OAuth 2.0 delegado para autenticarse con Snowflake. Los componentes clave son:
- Proveedor de autenticación: Gestiona el apretón de manos de OAuth con Snowflake. Gestiona solicitudes de token y asigna el token devuelto a la credencial de Salesforce.
- Credencial externa: Mantiene los tokens de acceso y actualización de OAuth de forma segura en el establecimiento de credenciales cifradas de Salesforce y los inyecta en llamadas salientes.
- Credencial nombrada: Define la URL del extremo de Snowflake y hace referencia a la credencial externa.
- Integración de seguridad de Snowflake: Registra Salesforce como cliente de confianza de OAuth en Snowflake. Define el URI de redireccionamiento permitido, los flujos de OAuth y el TTL de token.
Estos componentes forman una cadena de dependencia: Origen de datos externo hace referencia a la credencial nombrada, que hace referencia a la credencial externa, que hace referencia al proveedor de autenticación. Comprender esta cadena es esencial al solucionar problemas de conectividad o fallos de acceso.
Salesforce admite dos modelos de delegación de identidad al autenticarse con Snowflake:
- Principal nombrado: Una cuenta de servicio compartida autentica todos los usuarios de Salesforce en Snowflake. Esto es más sencillo de configurar, pero no tiene capacidad de auditoría por usuario o control de acceso de Snowflake preciso.
- Principal por usuario: Cada usuario de Salesforce se autentica con su propio token de OAuth. Esto permite la seguridad a nivel de filas de Snowflake y los seguimientos de auditoría por usuario completos, con una ventaja de un mayor gasto de gestión de tokens (flujos de OAuth por usuario, actualización, revocación).
Orientación de decisión: Utilice Principal por usuario para datos regulados o Información de identificación personal (PII). Utilice Principal nombrado cuando las reglas de colaboración de Salesforce proporcionan suficiente control de acceso y la sencillez es la prioridad.
Estos límites reguladores de Salesforce dan forma directamente al diseño de soluciones cuando se utilizan Objetos externos con Snowflake:
- Límite de llamadas: 100 por transacción Apex. Las páginas o flujos con múltiples consultas de Objetos externos pueden alcanzar este límite rápidamente.
- Tiempo de espera de llamada: 120 segundos máximo. Las consultas de Snowflake de larga ejecución causan una excepción de tiempo de ejecución.
- Límite de filas SOQL: 50.000 filas. Paginar conjuntos de resultados de gran tamaño.
- Restricciones asíncronas: Apex por lotes y la mayoría de los contextos asíncronos restringen las llamadas. Mantenga el acceso a Objetos externos dentro de los límites de transacciones síncronas. Para casos de uso asíncronos que consultan Objetos externos, considere Llamadas de continuación para interacciones asíncronas iniciadas por el usuario o diseñe el flujo para realizar acceso a datos externos en una transacción síncrona y transferir resultados de forma asíncrona.
Orientación de diseño: No consulte Objetos externos dentro de bucles. Envíe filtros de cláusula WHERE a Snowflake para reducir el tamaño del resultado y la frecuencia de las llamadas.
Cada consulta que Salesforce envía a Snowflake se registra en Historial de consultas de Snowflake con metadatos de ejecución completos: latencia, filas exploradas, almacén utilizado e identidad de ejecución. Este historial proporciona capacidad de auditoría integral desde la acción de usuario de Salesforce hasta la ejecución de Snowflake y es la herramienta de diagnóstico principal para el ajuste del rendimiento y la validación de acceso.
La virtualización de datos es adecuada para casos de uso donde el acceso en tiempo real, la regulación y la reducción de la carga de trabajo de replicación superan las restricciones de un modelo de acceso en tiempo de consulta federado.
Úselo cuando:
- El acceso analítico de lectura intensiva es el requisito principal. Si los usuarios necesitan consultar y mostrar datos externos en interfaces de usuario, informes o flujos de Salesforce sin volver a escribir, Virtualización de datos elimina los gastos generales de oportunidades en curso para escenarios de solo lectura.
- La actualización de datos es fundamental. Donde los datos replicados obsoletos crean riesgo comercial (como saldos financieros desfasados, niveles de inventario o estado de cumplimiento), el modelo federado garantiza que cada consulta refleja datos en vivo.
- Los requisitos de gobernanza y residencia de datos son estrictos. Cuando las restricciones reglamentarias o contractuales prohíben copiar datos confidenciales en Salesforce, la virtualización mantiene los datos en su ubicación autorizada mientras los hace accesibles dentro de Salesforce. Solo un sistema alberga los datos.
- Se requiere control de acceso de doble capa. Cuando tanto los controles de acceso nativos del sistema externo como el modelo de seguridad de Salesforce se aplican simultáneamente, el modelo federado aplica ambos sin duplicación de datos.
- El sistema externo ya es el sistema autorizado de registro. Si los datos ya están limpios, gobernados y consultables en el sistema de origen, virtualizarlos evita la transformación redundante, el coste de almacenamiento y el riesgo de divergencia.
Evítelo cuando:
- Se requieren escrituras de baja latencia. Los objetos externos son de solo lectura. Los casos de uso de escritura no simultánea requieren un patrón de integración diferente.
- Se necesitan uniones de múltiples objetos complejas. SOQL entre múltiples objetos externos no admite uniones. Materialice previamente datos unidos como una única vista en el sistema de origen.
- Las funciones de IA de Salesforce o Agentforce requieren datos nativos. Actualmente, las funciones Einstein y Agentforce (incluyendo la fundamentación para Einstein Copilot, puntuación predictiva y acciones Agentforce) operan en objetos nativos de Salesforce. Estas funciones no admiten Objetos externos como una fuente de datos de fundamentación o activación. Si la activación de IA está en el ámbito de estos datos, Salesforce Data 360 es la solución complementaria recomendada.
- Patrones de acceso de alta frecuencia y gran volumen. Los objetos externos están diseñados para el acceso on-demand. Las cargas de trabajo que desencadenan cientos de consultas por minuto agotan los límites reguladores y merman el rendimiento.
Los siguientes casos de uso ilustran cómo se aplica la virtualización de datos de Salesforce en escenarios empresariales comunes. Cada ejemplo utiliza Snowflake como sistema externo, pero el patrón subyacente se aplica a cualquier origen de datos compatible con SQL compatible con Salesforce Connect.
Desafío: Los equipos de asistencia necesitaban informes unificados que combinaran datos de casos de Salesforce con el volumen de tickets, el tiempo de resolución y las mediciones de distribución almacenadas en Snowflake. La creación y el mantenimiento de una canalización de replicación para estos datos introdujo retraso y agregó gastos operativos para un caso de uso de creación de informes de solo lectura.
Solución: El equipo expuso vistas de Snowflake que contenían mediciones de ticket como Objetos externos en Salesforce. El equipo configuró Salesforce Reports para unir objetos Caso nativos con los datos de ticket externos.
Resultado:
- Los informes siempre reflejan datos de Snowflake en vivo. Sin retardo de oportunidades en curso.
- La gobernanza de mediciones de asistencia confidenciales permanece en Snowflake.
- Sin oportunidades en curso de ETL para crear, supervisar o mantener.
Desafío: Un equipo financiero mantuvo datos de saldo y límite de crédito autorizados en Snowflake. La replicación de estos valores en Salesforce a través de ETL inverso introdujo el retardo de replicación, lo que provocó que los representantes de ventas se comprometieran a negociaciones basándose en información de crédito obsoleta. El equipo de cumplimiento también marcó el riesgo de almacenar datos financieros confidenciales en Salesforce Storage.
Solución: El equipo virtualizó la vista de finanzas de Snowflake como un Objeto externo y la afloró en el formato de página Cuenta. Los representantes de ventas ahora ven el estado de crédito en vivo como parte de su vista Cuenta estándar en Salesforce.
Resultado:
- Datos de crédito en tiempo real en cada página Cuenta. Sin demora.
- Oportunidades en curso de ETL inversas eliminadas para datos financieros.
- Datos financieros confidenciales nunca copiados en el almacenamiento de Salesforce. El ámbito de cumplimiento permanece en Snowflake.
Desafío: Durante una fusión, la empresa adquirente necesitaba proporcionar a los usuarios de Salesforce visibilidad sobre datos operativos de 6 conjuntos de datos de Snowflake de gran volumen que cubren transacciones, facturación y uso. La replicación de terabytes de datos en Salesforce no era viable en la cronología de fusión, y la creación de oportunidades en curso de ETL personalizadas para cada conjunto de datos habría requerido una inversión de ingeniería significativa.
Solución: El equipo configuró Objetos externos para los 6 conjuntos de datos de Snowflake utilizando Salesforce Connect con una función de integración de privilegios mínimos. No se requiere código personalizado. Las consultas se ejecutan directamente en Snowflake y toda la actividad se registra en Historial de consultas de Snowflake para la creación de informes de cumplimiento.
Resultado:
- Configuración completamente declarativa. No se requiere código personalizado ni oportunidades en curso.
- Actualización de datos garantizada. Cada consulta refleja datos de Snowflake en vivo en el tiempo de ejecución.
- Seguimiento de auditoría completo en Historial de consultas de Snowflake para la creación de informes normativos y de cumplimiento.
Virtualización de datos presenta un perfil operativo distinto. Diseño para estos escenarios de fallo:
- Caducidad del token de OAuth: Los tokens tienen un tiempo de vida finito (TTL). Los tokens caducados causan fallos de llamada. Supervise 401 respuestas no autorizadas e implemente lógica de actualización.
- Inicio en frío de almacén (específico de Snowflake): Los almacenes suspendidos automáticamente agregan de 5 a 30 segundos en la primera consulta. Para casos de uso de cara al usuario con requisitos de latencia, realice un calentamiento previo con una consulta programada ligera durante el horario de oficina.
- Desajuste de función: Una función mal configurada en el sistema externo puede devolver cero filas de forma silenciosa en vez de un error. Valide privilegios de función a objeto en el sistema externo independientemente de Salesforce.
- Desbordamiento de conjunto de resultados: Las cargas sobredimensionadas superan los límites de API. Aplique siempre cláusulas LIMIT y exponga vistas filtradas en vez de tablas sin procesar.
- Apagones del sistema externo: No existe ninguna reserva o caché. Aplique las llamadas en intentos/capturas y aflore estados de error informativo en la interfaz de usuario. Para datos críticos para la misión, considere un enfoque por niveles: virtualice para el acceso en tiempo real, y mantenga una reserva replicada ligera para los campos más críticos para garantizar la disponibilidad durante las interrupciones del sistema de origen.
La virtualización de datos de Salesforce se alinea con los siguientes pilares del marco de trabajo bien arquitectado de Salesforce.
- Confianza: El modelo delegado de OAuth 2.0 y las directrices de funciones con menos privilegios se alinean con Trust. El control de acceso de doble capa (sistema de origen + Salesforce) aplica la defensa en profundidad.
- Fiabilidad (tolerancia a fallos): La sección de modos de fallo aborda la fiabilidad directamente: caducidad de token, inicio en frío, configuración incorrecta de funciones, desbordamiento de conjunto de resultados y gestión de fallos representan una clase de fallo distinta con una ruta de resolución documentada.
- Fiabilidad (escalabilidad): La distribución de consultas, las directrices de tamaño de almacén y el conocimiento del límite de llamadas optimizan la eficiencia de ejecución dentro de las restricciones reguladoras de Salesforce, un problema de fiabilidad para soluciones que operan a escala.
- Excelencia operativa: Historial de consultas de Snowflake como herramienta de observabilidad principal admite la excelencia operativa: Los arquitectos toman la decisión deliberada y trazable de utilizar herramientas nativas de plataforma para la auditoría integral y el diagnóstico de rendimiento en vez de crear infraestructura de registro personalizada.
Esta sección proporciona a arquitectos y diseñadores un punto de inicio estructurado para crear el patrón Virtualización de datos en un entorno sandbox. No es una guía de implementación completa: trátela como una secuencia validada de decisiones y pasos de configuración para orientar su primera prueba de concepto.
Confirme lo siguiente antes de iniciar cualquier trabajo de configuración:
- Asignación de licencia: Salesforce Connect no se incluye en todas las ediciones de Salesforce. El Adaptador de SQL para Snowflake requiere una licencia complementaria separada más allá de la asignación Salesforce Connect base. Verifique ambos en su organización antes de continuar.
- Sandbox primero: Complete todas las fases en un entorno sandbox antes de promocionar su configuración a producción.
- Acceso a Snowflake: Confirme que tiene permiso para crear una Integración de seguridad en Snowflake y acceso a la base de datos, el esquema y los objetos de destino.
- Versión del adaptador: Confirme que el Adaptador de SQL para Snowflake está disponible en su edición de organización y que la URL de su cuenta de Snowflake no contiene guiones bajos (sustituya con guiones si los contiene. Esta es una restricción de la plataforma Salesforce para la resolución de nombres de host de llamadas).
La configuración de Virtualización de datos con un sistema SQL externo como Snowflake es un proceso declarativo dirigido por la configuración; no se requiere código personalizado. La configuración sigue tres fases secuenciales: establecimiento de identidad y Trust, configuración de la superficie de datos y exposición de datos a usuarios finales.
Esta fase establece una cadena de Trust OAuth 2.0 delegada y segura entre Salesforce y el sistema externo. Complete esta fase antes de iniciar cualquier configuración de superficie de datos.
- Cree un proveedor de autenticación en Salesforce. Utilice el tipo OpenID Connect. Utilice valores de marcador de posición en esta etapa: vuelva a completarlo después de recuperar valores del sistema externo. Después de guardar, Salesforce genera una URL de devolución de llamada. Mantenga este valor.
- Registre Salesforce como cliente de OAuth en el sistema externo. En Snowflake, esto significa crear una Integración de seguridad (OAuth, tipo Cliente confidencial). Proporcione la URL de devolución de llamada de Salesforce como el URI de redireccionamiento. Recupere el Id. de cliente, el Secreto de cliente, la URL de autorización y la URL de token de la integración después de la creación.
- Complete la configuración del proveedor de autenticación. Vuelva al proveedor de autenticación de Salesforce y rellénelo con los valores recuperados del sistema externo: Clave de consumidor, Secreto de consumidor, URL de autorización y URL de token.
- Cree la credencial externa. Establezca Protocolo en OAuth 2.0, vincúlelo al Proveedor de autenticación y agregue un Principal (Nombrado o Por usuario, basándose en su decisión de modelo de identidad). Este objeto gestiona el ciclo de vida del token de OAuth.
- Cree la credencial nombrada. Establezca el extremo en la URL de API del sistema externo (por ejemplo,
https://<account>.snowflakecomputing.com/api/v2/statements/) y vincúlelo a la Credencial externa. - Otorgue acceso de perfil a la credencial externa. Sin este paso, los usuarios no pueden invocar consultas federadas incluso si la configuración es correcta.
- Inicie el flujo de OAuth para completar la autenticación. Desencadene el apretón de manos de OAuth desde Salesforce. La plataforma redirige al inicio de sesión del sistema externo, valida credenciales y almacena los tokens resultantes de forma segura en la Credencial externa. Este paso vincula el contexto de usuario a un token válido. Todas las consultas federadas fallan hasta que se complete este paso.
Esta fase conecta Salesforce con el esquema de datos externo y crea las definiciones de Objeto externo que consultan los usuarios y la plataforma.
- Cree la fuente de datos externa. Seleccione el adaptador apropiado (por ejemplo, Adaptador de SQL para Snowflake), apunte a la base de datos y el esquema de destino y vincúlelo a la credencial nombrada que creó en la Fase 1.
- Valide la conexión. Utilice la validación integrada en la Fuente de datos externa. Un resultado satisfactorio confirma que la cadena de confianza de OAuth Trust está completa y que el sistema externo es accesible.
- Sincronizar metadatos. Inicie una sincronización de metadatos desde la fuente de datos externa. Salesforce realiza una introspección del esquema de destino y genera definiciones de Objeto externo, asignando columnas externas a tipos de campo de Salesforce.
- Seleccione y exponga las tablas o vistas requeridas. Seleccione qué tablas o vistas externas aflorar como Objetos externos. Como práctica recomendada, exponga vistas depuradas en vez de tablas sin procesar. Las vistas permiten el filtrado previo de columnas, restricciones a nivel de filas y un control más estricto sobre a lo que puede acceder la capa de Salesforce.
Esta fase hace que los objetos externos sean visibles y utilizables para usuarios finales en Salesforce Lightning Experience.
- Cree fichas para Objetos externos. Las fichas hacen que los objetos externos sean directamente navegables en aplicaciones Lightning.
- Agregue Objetos externos a formatos de página. Aflore datos externos relevantes junto con registros nativos de Salesforce (por ejemplo, agregue una vista de finanzas de Snowflake al formato de página Cuenta).
- Agregar a listas relacionadas. Incluya Objetos externos en listas relacionadas para proporcionar a los usuarios una vista unificada de datos nativos y externos en contexto.
- Valide la federación de consultas de extremo a extremo. Cargue una página o ejecute una consulta que haga referencia a un objeto externo. A continuación inspeccione el historial de consultas del sistema externo (por ejemplo, Historial de consultas de Snowflake) para confirmar que la consulta se ejecutó en el origen. Verifique que la función, el almacén y la identidad correctos ejecutaron la consulta.
Tras completar las tres fases, los usuarios de Salesforce pueden interactuar con datos externos en vivo a través de interfaces estándar de Salesforce, sin tener en cuenta que los datos se originan fuera de Salesforce.
La virtualización de datos de Salesforce sustituye la integración basada en replicación por federación de tiempo de consulta. Los datos permanecen en su origen autorizado; los usuarios de Salesforce interactúan con ellos a través de interfaces de plataforma estándar. No hay oportunidades en curso que crear, no hay copia que gobernar y no hay retardo que gestionar.
Este patrón es la opción correcta cuando el acceso de gran volumen de lectura, la actualización de datos en tiempo real, la regulación estricta y el control de acceso de doble capa son los controladores principales. Es la opción incorrecta cuando se requieren escrituras, cuando la IA o las funciones de automatización dependen de objetos nativos de Salesforce o cuando los patrones de acceso son demasiado altos para que los límites reguladores los acomoden.
Snowflake ilustra bien el patrón: una conexión federada gobernada en tiempo de consulta establecida declarativamente sin código personalizado, observable de extremo a extremo a través del Historial de consultas de Snowflake y aplicable a través de los controles de acceso nativos de Snowflake y el modelo de seguridad completo de Salesforce.
Antes de confirmar esta arquitectura, valide la asignación de licencias, evalúe la exposición del límite regulador frente a sus patrones de acceso esperados y confirme la preparación para OAuth en un entorno sandbox. El patrón premia el diseño inicial cuidadoso: obtener el modelo de identidad, la cadena de credenciales y la estrategia de vista correctos, y la huella operativa es mínima.
Yugandhar Bora es Arquitecto de Ingeniería de Software en Salesforce, especializado en arquitectura de datos dentro de la plataforma Aplicaciones de datos e inteligencia. Lidera iniciativas de Enterprise Architecture Review Board (EARB) centradas en la gobernanza de datos y modelos de datos unificados, mientras contribuye a soluciones de aprovisionamiento de plataforma automatizadas.