Los agentes razonan sobre objetivos, deducen parámetros del contexto y seleccionan acciones de forma dinámica. Como resultado, cada integración que toca un agente debe gestionar la ambigüedad, admitir repeticiones seguras y fallar en formas en que el agente puede recuperarse de forma autónoma.
Los sistemas agentes invalidan varios supuestos que el diseño de integración tradicional da por sentado. Las entradas no siempre estarán bien formadas. Una acción de usuario único puede generar una cadena de agentes a través de los límites organizativos, cada uno de los cuales necesita autoridad delegada para actuar.
Este documento asigna los turnos arquitectónicos que se desprenden de esa realidad: los nuevos principios de diseño, los patrones de agentes y cómo los entrega Salesforce Platform.
Cada patrón de este documento sigue la misma estructura:
Nombre: El identificador de patrón que indica el tipo de integración contenido en el patrón.
Contexto: Escenario de integración general que aborda el patrón. Contexto proporciona información acerca de lo que los usuarios están intentando lograr y cómo se comporta la aplicación según sus necesidades.
Problema: El reto (expresado como una pregunta) que el patrón está diseñado para resolver. Cuando revise los patrones, lea esta sección para comprender rápidamente si el patrón se aplica a su escenario de integración.
Fuerzas: Las restricciones y circunstancias que pueden dificultar la solución del problema.
Aplicación Salesforce Pattern: La forma recomendada de aplicar el patrón al escenario.
Boceto: Un diagrama de secuencia de Lenguaje de modelado unificado (UML) que muestra cómo la aplicación de patrón aborda el escenario.
Resultados: Cómo resuelve el patrón las fuerzas asociadas con el escenario. Esta sección también contiene nuevos retos que pueden surgir como resultado de la aplicación del patrón.
Consideraciones de diseño: Directrices específicas de la plataforma para aplicar la solución correctamente, seguidas de notas de implementación específicas de Salesforce. Estas consideraciones cubren principios de diseño de acciones y requisitos de configuración específicos de plataforma.
Gestión y recuperación de errores: Directrices para la gestión de fallos durante la aplicación de patrones. Este parámetro cubre cuatro áreas:
- Cómo comunican las acciones el fallo al agente a través de respuestas de error estructuradas y con capacidad de acción que proporcionan contexto suficiente para la toma de decisiones descendente
- Cómo determina el agente si reintentar, autocorregir o detener la ejecución
- Cómo las acciones de compensación solucionan resultados parciales y estado multiplataforma no coincidente
- Requisitos de ideopotencia para operaciones de escritura retiradas
Consideraciones de seguridad: Requisitos de seguridad para aplicar el patrón de forma segura. Estas consideraciones cubren la gestión de credenciales, el ámbito de menor privilegio de usuarios de integración y aplicaciones conectadas, el registro de auditoría de acciones invocadas por agentes y los requisitos de validación de entrada para parámetros que se originan desde contenido proporcionado por el usuario o inferido por LLM, entre otros.
Ejemplo: Un escenario de extremo a extremo que describe cómo se utiliza el patrón de diseño en un escenario real de Salesforce. El ejemplo explica los objetivos y cómo aplicar el patrón para alcanzar esos objetivos.
La siguiente tabla enumera los patrones de implementación cubiertos.
Lista de patrones
| Patrón | Lo que hace |
|---|---|
| Invocación de acción secuencial | Un agente invoca una serie de acciones donde cada paso depende del resultado verificado del anterior. El agente mantiene el contexto en toda la cadena como identificadores, códigos de estado, datos intermedios y lo utiliza para decidir si el siguiente paso puede continuar. |
| Invocación de acción paralela | Cuando un conjunto de acciones son independientes entre sí, el agente las invoca de forma simultánea en vez de secuencial. El tiempo total de flujo de trabajo está limitado por la llamada más lenta en vez de la suma de todas las llamadas. |
| Invocación de acción asíncrona | Un agente despacha una operación a un sistema descendente a través de un evento de plataforma, cola de mensajes o trabajo en segundo plano sin esperar el resultado. La obligación del agente finaliza en la invocación confirmada; el sistema descendente toma la propiedad de la ejecución independientemente de la sesión del agente. |
| Invocación de agente On-Demand | Una aplicación externa o un orquestador de IA llama a un agente de forma programática, proporciona contexto y espera una respuesta estructurada. El agente actúa como un servicio backend inteligente que inicia el llamante, el agente razona y actúa y el resultado lo consume el llamante. |
| Ejecución de agentes dirigida por eventos autónoma | Una condición de datos como abandono de carrito, fallo de pago, caída de uso despide automáticamente a un agente sin que ningún humano inicie la interacción. No hay llamante esperando una respuesta; el agente recibe la carga del evento como contexto de fundamentación y ejecuta un flujo de trabajo de respuesta completamente por sí mismo. |
| Fundamentación de conocimiento desde contenido de empresa | Antes de generar una respuesta, el agente recupera documentos relevantes de un establecimiento de Enterprise Knowledge y los inyecta en su ventana de contexto. El LLM proporciona el razonamiento; la capa de recuperación proporciona los hechos. |
| Inyección de contexto de cliente verificada | Los atributos estructurados verificados de un perfil de cliente unificado se rellenan previamente como entradas de acción antes de que el agente invoque una acción. El agente recibe hechos como segmento, nivel, riesgo de abandono y valor de toda la vida en vez de inferirlos. |
| Integración de herramientas entre sistemas | Un agente se conecta a sistemas externos fuera de la plataforma Salesforce a través de una interfaz de herramienta uniforme basada en el estándar Protocolo de contexto de modelo (MCP). Cada sistema externo expone sus funciones como herramientas llamables descritas; el agente las descubre e invoca sin necesidad de conocer la API o el esquema nativo de cada sistema. |
| Capacidades comerciales como herramientas llamables | Las funciones comerciales de empresa como entidades comerciales, procesos y perspectivas se exponen como herramientas de MCP que cualquier agente externo en cualquier marco de trabajo puede descubrir e invocar. |
| Delegación entre agentes | Un agente llamante descompone una solicitud compleja y delega subtareas específicas del dominio a agentes homólogos especializados en diferentes plataformas o sistemas de proveedores utilizando el protocolo Agente a Agente (A2A). El agente que llama gestiona el ciclo de vida de la tarea y agrega resultados desde los agentes remotos. |
| Agentes como servicios llamables | Un agente Agentforce interno publica sus funciones de dominio como un extremo A2A gobernado y detectable de modo que los orquestadores externos o agentes iguales puedan delegarle tareas. El agente gestiona el ciclo de vida de la tarea entrante y devuelve resultados estructurados al llamante remoto. |
Los patrones de este documento se clasifican en tres categorías. Esta categorización ayuda a los arquitectos a identificar rápidamente qué patrones son relevantes para el reto de integración que están resolviendo, ya sea que estén diseñando lo que un agente llama, lo que desencadena un agente o cómo un agente se fundamenta con Knowledge antes de que actúe. En vez de leer cada patrón, puede navegar directamente a la categoría que coincida con su problema de diseño.
Invocación de acción:
Estos patrones cubren cómo un agente llama a sistemas externos para recuperar datos o ejecutar operaciones como parte de su ciclo de razonamiento. Estos son patrones salientes donde el agente es el iniciador. Tratan la secuenciación (cuando los pasos dependen entre sí), el paralelismo (cuando no), la idempotencia y la gestión de fallos parciales. Utilice estos patrones al diseñar las herramientas que invocará un agente para realizar el trabajo.
Invocación de agente:
Estos patrones abordan cómo los sistemas o eventos externos llevan a un agente a la acción. Estos son patrones entrantes donde los sistemas externos desencadenan estos agentes. El desencadenador puede ser una aplicación de cara al público que realiza una llamada programática y espera una respuesta, o una condición de datos autónoma que desencadena el agente. Utilice estos patrones al diseñar cómo y cuándo se desencadena un agente.
Fundamentación con datos de empresa:
Los patrones en esta categoría cubren cómo se fundamentan los agentes con Knowledge preciso, actual y específico de la organización antes de razonar o actuar.
Seleccionar la estrategia correcta no es trivial. Cada patrón se dirige a un problema específico: funciones del sistema, volumen de datos, gestión de fallos y transaccionalidad.
Las tablas matriciales de selección enumeran los patrones y sus aspectos clave para ayudarle a determinar qué patrón se ajusta mejor a sus requisitos de integración. Los patrones se categorizan utilizando estas dimensiones.
| Aspecto | Descripción |
|---|---|
| Tipo | Especifica la categoría de integración: Invocación de acción, Invocación de agente o Fundamentación con Enterprise Data Action Invocation: Estas integraciones salientes van desde simples llamadas de herramienta de un solo paso a complejas secuencias de múltiples pasos y salidas paralelas, y requieren una cuidadosa consideración de las restricciones de pedido, la idempotencia y la gestión de fallos parciales entre backends heterogéneos. Invocación de agente: Las invocaciones de agentes son las formas en que los sistemas o eventos externos llevan a un agente a la acción. Estas integraciones entrantes abarcan desde llamadas programáticas síncronas realizadas por aplicaciones de cara al público que esperan una respuesta estructurada hasta ejecuciones dirigidas por eventos completamente autónomas donde una condición de datos desencadena al agente sin que ningún humano inicie o espere la interacción. Fundamentación con datos de empresa: Las integraciones de fundamentación son las formas en que se proporciona a un agente Knowledge preciso, actual y específico de la organización antes de razonar o actuar. Estas integraciones van desde la recuperación de documentos no estructurados desde establecimientos de contenido comercial hasta la inyección de atributos estructurados verificados desde perfiles de clientes unificados, garantizando que el agente opera en hechos en vez de inferencias alucinadas. |
| Cronología | Especifica el estilo de integración en función del tiempo: Síncrono o Asíncrono Síncrono frente a Asíncrono en este documento hace referencia a cómo se desencadena el agente en sí o cómo invoca las acciones. No cubre lo que sucede internamente. Pero en general, un usuario espera durante el tiempo que el agente está invocando acciones y procesando resultados. El agente no dirigirá el siguiente mensaje de usuario hasta que finalice el turno actual. Síncrono: Las solicitudes de bloqueo y en tiempo real son operaciones de solicitud/respuesta. El resultado se devuelve a la persona que llama inmediatamente a través de esta operación. Asíncrono: Las solicitudes no bloqueadas, en cola o basadas en mensajes se invocan por una operación unidireccional que es casi en tiempo real. Los resultados y cualquier fallo se devuelven invocando otras operaciones unidireccionales. Por lo tanto, el llamante realiza la solicitud y continúa sin esperar una respuesta. |
Esta tabla enumera los patrones y sus aspectos clave para ayudarle a determinar qué patrón se ajusta mejor a sus requisitos cuando su integración es desde Salesforce a otro sistema.
| Tipo | Cronología | Patrón clave a tener en cuenta |
|---|---|---|
| Invocación de acción | Síncrono | Invocación de acción secuencial Invocación de acción paralela Integración de herramientas entre sistemas Delegación entre agentes |
| Invocación de acción | Asíncrono | Invocación de acción asíncrona |
| Invocación de agente | Síncrono | Invocación de agente On-Demand Agentes como servicios llamables |
| Invocación de agente | Asíncrono | Ejecución de agentes dirigida por eventos autónoma |
| Fundamentación con datos de empresa | Síncrono | Fundamentación de conocimiento desde contenido de empresa Inyección de contexto de cliente verificada |
Cada sección de patrones describe cómo crearlos. Cada patrón es una solución repetible a un problema de integración específico en arquitecturas de agentes. Cubre cuándo utilizar el patrón, qué fuerzas dan forma a la decisión y cómo la plataforma Salesforce la entrega.
Contexto
Muchos flujos de trabajo comerciales son inherentemente secuenciales: cada paso requiere un resultado verificado del anterior antes de que pueda continuar. Por ejemplo, no se puede iniciar un reembolso hasta que se confirme la aptitud, no se puede crear una cuenta de facturación hasta que exista el registro del pedido y no se puede registrar una comprobación de cumplimiento hasta que se haya superado la comprobación.
En la automatización tradicional, estas dependencias se codifican como lógica de flujo codificada. En un sistema agente, el agente evalúa el resultado de cada acción y determina si se cumplen las condiciones previas para el siguiente paso.
Este patrón describe el modelo de integración saliente fundacional. Aquí, un único agente opera dentro de un dominio e invoca una secuencia, donde la salida de cada acción controla la invocación de la siguiente acción en la cadena. El agente orquestador mantiene el contexto transaccional en toda la cadena, acumulando identificadores, códigos de estado y datos devueltos por cada paso. Utiliza este contexto para dirigir decisiones posteriores.
Este patrón es la contrapartida agente de Invocación de procesos remotos - Solicitud y respuesta desde la guía Patrones de integración que describe una única llamada síncrona. El patrón agente amplía el patrón a una cadena dirigida por agente de llamadas dependientes en un único ciclo de razonamiento.
Problema
Cuando un agente ejecuta un flujo de trabajo de múltiples pasos que abarca el sistema host y uno o más sistemas remotos, se deben solucionar cuatro retos:
- Secuenciación - Las acciones deben invocarse en el orden correcto, con cada paso en la finalización correcta del anterior.
- Propagación de datos: Los datos de respuesta de cada paso deben pasarse como entrada al siguiente.
- Aislamiento de fallos - Los fallos en cualquier punto de la cadena no deben producir un estado parcial o incoherente entre sistemas.
- Verificación de finalización - El agente debe confirmar que todos los pasos se completaron correctamente antes de reportar un resultado.
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
-
¿Cada acción de la cadena depende de los datos devueltos por la acción anterior, o las dependencias solo están en estado de operación correcta o fallo?
Las dependencias de datos requieren que el agente lleve identificadores y atributos entre pasos.
-
¿Son todos los extremos remotos capaces de responder dentro del tiempo de espera del ciclo de razonamiento del agente?
Un sistema externo lento en cualquier paso de la cadena bloquea la secuencia completa.
-
¿Requiere la cadena un éxito completo de extremo a extremo o es aceptable la finalización parcial?
-
Si se requiere un éxito completo de extremo a extremo, defina una estrategia de compensación para los pasos que se deben revertir cuando se produce un fallo descendente.
-
¿Se puede reintentar alguna de las operaciones de escritura en la cadena de forma segura?
Todas las acciones de escritura deben ser idempotentes; el bucle de razonamiento del agente puede invocar la misma acción más de una vez debido a reintentos de Modelo de gran lenguaje (LLM) o confirmaciones ambiguas.
-
¿Se invoca la cadena por una interacción de usuario (conversación, baja concurrencia) o por un desencadenador automatizado (potencialmente alta concurrencia)?
Esto determina si el bloqueo síncrono es aceptable o si se requiere un patrón asíncrono.
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| Acciones Apex | Ideal para llamadas externas y lógica compleja | Un paso requiere una llamada HTTP a un sistema remoto, una transformación de datos personalizada o una lógica de gestión de errores que supere las funciones declarativas de Flujo. Las acciones Apex exponen la plataforma completa para la integración mientras permanecen llamables por el agente a través de la anotación @InvocableMethod. |
| Acciones de flujo (iniciado automáticamente) | Lo mejor para pasos de reglas comerciales y operaciones de CRM ligeras | Un paso aplica lógica comercial declarativa, consulta o actualiza registros de CRM u orquesta un proceso que no requiere código personalizado. Los flujos iniciados automáticamente son invocables de forma nativa desde subagentes Agentforce y devuelven variables de salida escritas que el agente utiliza para determinar el siguiente paso. |
| Servicios externos (Importación de OpenAPI) | Lo mejor para la integración de API externa tecleada y detectable | Un sistema externo expone una especificación de OpenAPI. Servicios externos genera adaptadores Apex tipificados con fuerza que se pueden llamar directamente como acciones de agentes, eliminando la asignación de esquemas manual y haciendo que las operaciones de la API externa sean visibles para el agente como funciones nombradas. Cada operación en la especificación importada se convierte en una acción nombrada y llamable. El agente selecciona acciones basándose en sus etiquetas semánticas generadas. Registre acciones generadas en el Centro de temas de Agentforce para que el agente pueda descubrirlas en el momento del razonamiento. Nota: si el servicio alojado de forma externa es RESTful, pero la especificación de OpenAPI no está disponible o no es viable, utilice Credenciales nombradas en Apex o Flujos para realizar la llamada HTTP directamente. Se necesita código Apex para analizar los resultados. |
| Acciones conectadas de MuleSoft | Lo mejor para un ventilador de middleware complejo o una integración de sistema heredada | Se utiliza cuando el sistema remoto requiere traducción de protocolo, transformación de datos u orquestación entre múltiples sistemas backend antes de devolver una respuesta. El agente realiza una única llamada a MuleSoft y MuleSoft gestiona la complejidad descendente y devuelve una respuesta unificada. |
Boceto
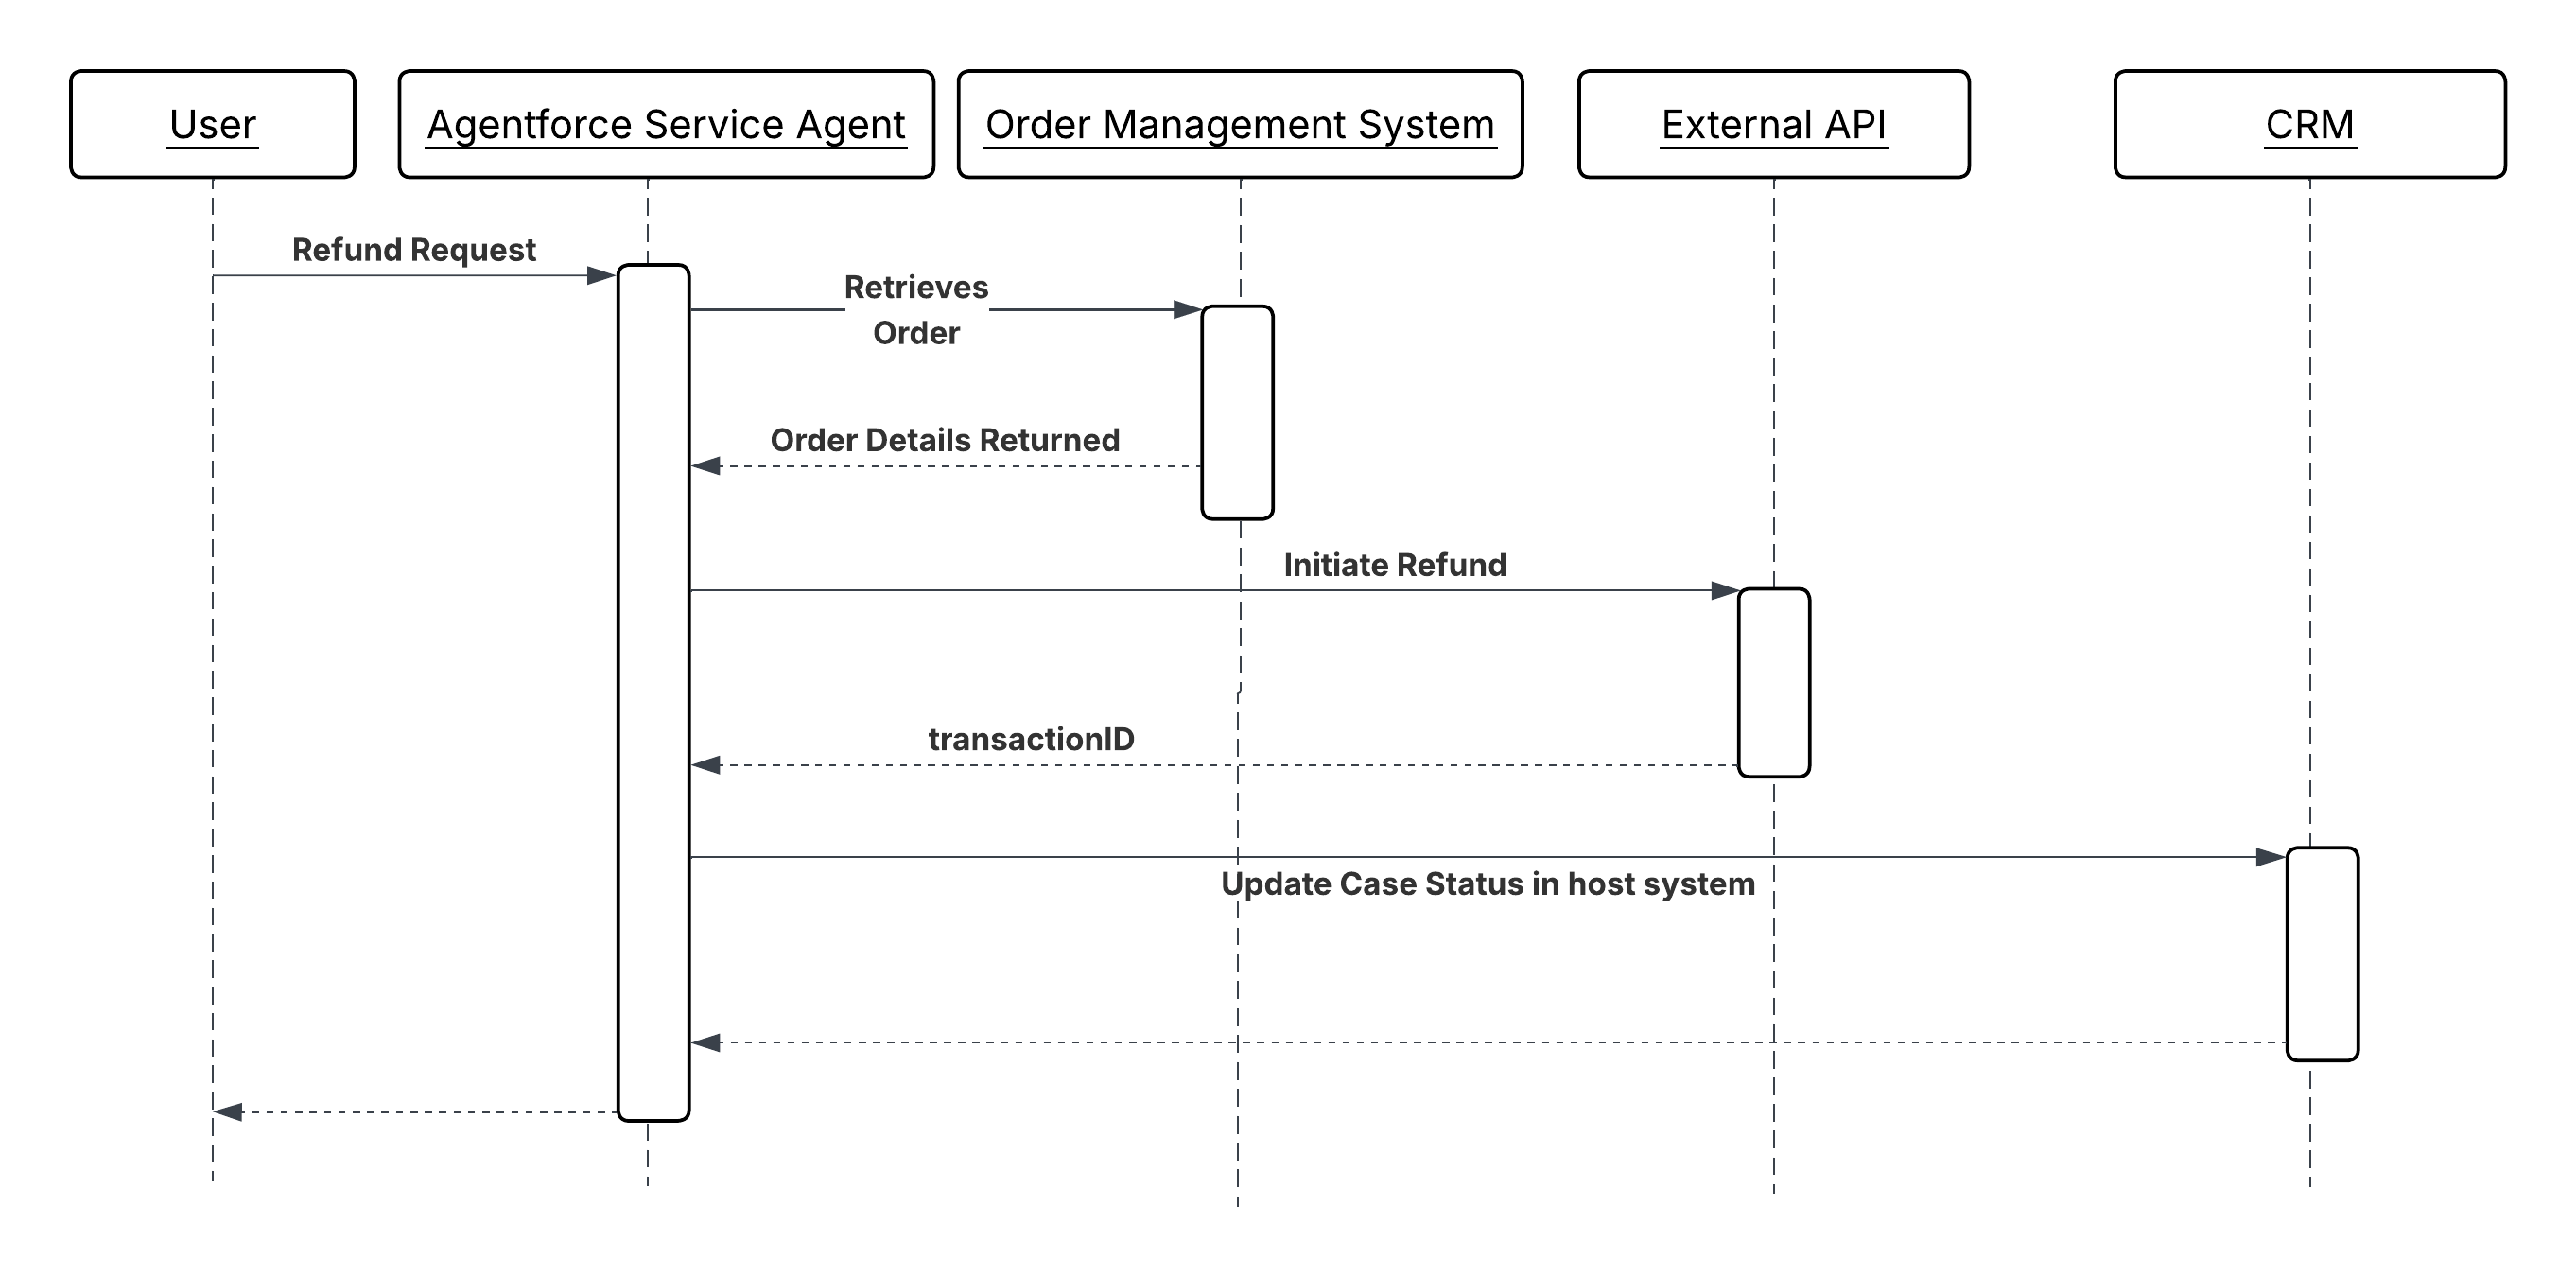
Diagrama de secuencia para invocación de acción secuencial
Resultados
El agente ejecuta un flujo de trabajo entre sistemas como una secuencia coherente supervisada y no una secuencia de comandos de activación y olvido. El resultado de cada paso se evalúa antes de invocar el siguiente paso, de modo que el agente detecta fallos en el punto más temprano posible en vez de descubrir una finalización parcial después del hecho.
El sistema host (Salesforce CRM) se actualiza solo después de que la operación remota confirme el estado (correcto o fallido). Los identificadores y el estado devueltos por sistemas externos, como números de cuenta de facturación, Id. de transacción, códigos de confirmación se propagan por la cadena y persisten, creando un registro completo y rastreable del resultado del flujo de trabajo.
El agente es responsable de razonar sobre los resultados y las decisiones de secuenciación. Cada acción es responsable únicamente de su propia operación y de devolver un resultado estructurado. Ninguna capa codifica la lógica de la otra.
Consideraciones de diseño
Orientación específica de plataforma
- Asegúrese de que cada acción en la cadena lleva una descripción semántica escrita en un lenguaje basado en intención y no como una firma de método técnico. El agente selecciona acciones basándose en estas descripciones. Una descripción que diga “llama a la API de facturación” es menos útil que una que diga “crea una cuenta de facturación en el sistema de facturación y devuelve el nuevo identificador de cuenta”.
- Haga que todas las operaciones de escritura en la cadena sean idempotentes. El bucle de razonamiento del agente puede reintentar una acción si recibe una respuesta ambigua. La acción debe producir el mismo resultado en la invocación repetida.
- Valide todos los parámetros de entrada inferidos de LLM defensivamente en el límite de acción. Nunca asuma que los parámetros pasados por el agente están bien formados, dentro del intervalo o del tipo esperado.
- Diseñe cada acción para una única responsabilidad. Una acción que crea una cuenta de facturación y envía un correo electrónico de confirmación en la misma llamada es más difícil de reintentar, más difícil de probar y más difícil de razonar para el agente que dos acciones discretas.
Notas de implementación de Salesforce
- Para Acciones Apex, anote con @InvocableMethod(label=’…’ description=’…’). El agente lee la “descripción” para determinar cuándo invocar la acción. Declare todas las variables de entrada y salida con @InvocableVariable utilizando campos descriptivos “etiqueta” y “descripción”. Devuelva objetos de resultados estructurados con indicadores de éxito/fracaso explícitos y mensajes de error legibles por las personas.
- Para Acciones de flujo, utilice Flujos iniciados automáticamente exclusivamente; los flujos de pantalla no son compatibles en contextos de agentes autónomos. Mantenga cada flujo atómico; una acción, una responsabilidad. Configure rutas de fallo en cada elemento de llamada externa para capturar errores de integración y devolver mensajes de error con capacidad de acción al agente en vez de permitir que las excepciones no detectadas finalicen la sesión.
- Para Servicios externos, importe la especificación OpenAPI del sistema de destino y registre las acciones generadas en el Tema Agentforce. Envuelva los stubs generados en Credenciales nombradas para evitar extremos de codificación o credenciales en la definición de acción.
- Para todas las llamadas externas, establezca tiempos de espera de llamadas explícitas. Una llamada que se cuelga sin tiempo de espera bloqueará el ciclo de razonamiento del agente hasta que se alcance el límite de sesiones. Devuelva un fallo elegante con un mensaje de error descriptivo cuando se supere el tiempo de espera. Todas las llamadas externas tienen un tiempo de espera configurable de hasta 120 segundos. También están sujetas a límites reguladores de transacciones síncronas Apex, por lo que asegúrese de mitigar el riesgo de crear instancias de más de 50 transacciones que se ejecutan durante más de cinco segundos cada una.
Gestión y recuperación de errores
- El agente controla cada paso en el éxito explícito del predecesor del paso. Las acciones deben devolver un resultado estructurado que incluya un indicador de éxito o fracaso claro. El agente no puede inferir de forma fiable el fallo a partir de una respuesta que falta o nula por sí sola.
- Cuando una acción falla, el agente utiliza el mensaje de error devuelto por la acción para determinar su siguiente movimiento: solicitar al usuario una entrada corregida, intentar un reintento de autocuración con parámetros ajustados o detener la cadena y registrar el fallo para revisión humana. Por lo tanto, los mensajes de error deben ser específicos y con capacidad de acción: “Intervalo de fechas no válido: endDate no puede preceder a startDate” es utilizable; el código de estado 400 por sí solo no.
- Para cadenas donde la finalización parcial crea un estado incoherente (por ejemplo, la cuenta de facturación se creó pero el registro CRM no se actualizó), el agente invoca una acción de compensación para revertir o marcar el estado parcial antes de aflorar el fallo. Diseñe rutas de compensación como acciones nombradas junto a la ruta de avance.
- Si una acción de escritura se realizó con éxito, pero devolvió una respuesta ambigua (tiempo de espera de red, sin acuse de recibo), el reintento debe utilizar la misma clave de idempotencia o Id. de referencia externa que la llamada original. Nunca emita un reintento no seleccionado en una escritura no idempotente.
Consideraciones de seguridad
- Envuelva todas las llamadas externas en credenciales nombradas. Nunca codifique extremos o credenciales en configuraciones de código Apex o Flujo. Estos deben gestionarse a través del establecimiento de credenciales seguro de la plataforma y rotarse sin cambios de código.
- Aplique el principio de privilegios mínimos al usuario de integración o la aplicación conectada utilizada por cada acción. Una acción que solo lee datos de pedidos no debe albergar permisos de escritura en el sistema de facturación. Credenciales de ámbito al mínimo de operaciones que requiere la acción.
- Registre la invocación de cada acción en la cadena con su Id. de sesión, parámetros de entrada (desinfectados de valores confidenciales) y resultado. Si se disputa el resultado, este seguimiento de auditoría es el mecanismo principal para reconstruir por qué el agente ejecutó una secuencia determinada de acciones.
- Desinfectar todos los parámetros de entrada que se originan desde texto proporcionado por el usuario antes de pasarlos a sistemas externos. La entrada de usuario que se pasó a través del agente a una llamada de API externa es un posible vector de inyección. Valide el tipo, el formato y el intervalo en el límite de acción antes de realizar la llamada.
Ejemplo
Un Agente de servicio al cliente que gestiona una solicitud de reembolso ejecuta una cadena secuencial de cuatro pasos:
GetOrderDetails(Apex Action) recupera el registro de pedido desde el Sistema de gestión de pedidos utilizando el Id. de pedido proporcionado por el usuario. Devuelve el estado del pedido, las partidas, la fecha de compra y el método de pago. El agente evalúa si el pedido está en un estado reembolsable antes de continuar.ValidateRefundEligibility(Flujo iniciado automáticamente) aplica las reglas comerciales para la elegibilidad de reembolsos, incluyendo plazo de devolución, restricciones de categoría de productos e historial de reembolsos anterior. Devuelve un booleano “elegible” y, si no es elegible, un motivo de lenguaje sin formato por el que el agente puede aflorar al usuario.InitiateRefund(Apex Action) llama a la API de la pasarela de pago externa con el Id. del pedido y el importe del reembolso. Devuelve un “refundTransactionId” en caso de éxito. Esta acción es idempotente. Si se llama por segunda vez con el mismo Id. de pedido, devuelve el Id. de transacción existente en vez de crear un reembolso duplicado.UpdateCaseStatus(Flujo iniciado automáticamente) actualiza el registro de caso de CRM con el Id. de transacción de reembolso, establece el estado del caso como “Reembolso resuelto emitido” y crea una tarea de seguimiento para el propietario de la cuenta. Este paso se ejecuta solo después de que “InitiateRefund” haya devuelto un Id. de transacción confirmado.
Si el InitiateRefund agota el tiempo de espera o devuelve un error, el agente detiene la cadena, no invoca UpdateCaseStatus y aflora un mensaje con capacidad de acción al usuario. El caso permanece abierto y sin resolver, conservando el estado preciso en CRM.
Contexto
Las cadenas de acciones secuenciales son eficientes cuando los pasos de ejecución dependen entre sí. Un paso da paso al siguiente. Pero muchos flujos de trabajo contienen un conjunto de pasos que no tienen interdependencias. Por ejemplo, los pasos que incluyen la recuperación de inventario de productos, la obtención de asignaciones de clientes y la comprobación de una estimación de envío pueden producirse simultáneamente, ya que ninguna entrada de paso requiere la salida de otra. La ejecución de estos pasos desperdicia secuencialmente tiempo proporcional al número de pasos.
En un patrón de invocación paralelo, el agente identifica que un conjunto de acciones son independientes y las invoca de forma simultánea en vez de secuencial. El tiempo de flujo de trabajo general está vinculado por la acción individual más lenta en vez de la suma de todos los tiempos de acción. Una vez devueltos todos los resultados, el agente los agrega en una única respuesta coherente o los utiliza conjuntamente como entradas en la siguiente etapa de razonamiento.
El reto arquitectónico clave no es la invocación paralela en sí. Está gestionando el desglose dentro de las restricciones de concurrencia de plataforma y garantizando que el paso de agregación gestiona fallos parciales con gracia, sin descartar los resultados que se realizaron con éxito.
Problema
¿Cómo orquesta un agente de forma eficiente la ejecución simultánea de múltiples funciones independientes y agrega los resultados individuales en una respuesta única y coherente para el usuario o pasos posteriores?
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
- ¿Cuáles son las consideraciones para las acciones relacionadas con la seguridad de hilos y la colaboración de estado mutable?
- ¿Cómo gestionará la solución y evitará alcanzar los límites reguladores de Salesforce para llamadas Apex paralelas en una sola transacción?
- ¿Existe la necesidad de utilizar patrones asíncronos (como Apex en cola o Eventos de plataforma) para evitar límites reguladores?
- ¿Se requiere la agregación síncrona de los resultados antes de que el agente pueda continuar?
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| Enfoque de middleware | Lo mejor para salidas de ventilador altas (>5 extremos) y agregación entre plataformas | Necesita una capa de middleware. El agente realiza una llamada al middleware. A continuación, el middleware hace que se agreguen los datos a 10 sistemas en paralelo y envía una única respuesta de vuelta al agente. Esto se prefiere cuando el agente debe llamar a muchos sistemas externos heterogéneos. El middleware absorbe la complejidad del abanico y devuelve una única respuesta agregada. |
| Apex en cola | Lo mejor para el paralelismo interno de Salesforce | Necesita activar múltiples trabajos en cola. Mientras Salesforce gestiona la cola, si tiene suficientes “ranuras” en su límite de concurrencia, estas se pueden ejecutar al mismo tiempo. Se utiliza cuando las operaciones paralelas están dentro de la organización de Salesforce y hay divisiones de concurrencia disponibles. Esto no es adecuado cuando se requiere una respuesta agregada inmediata. |
| Eventos de plataforma | Lo mejor para olvidar el fuego o la coherencia eventual | Los resultados no necesitan agregarse de forma síncrona. Cada evento desencadena una transacción aislada, maximizando el rendimiento pero requiriendo reconciliación descendente. Utilice este mecanismo cuando la coherencia eventual sea aceptable y el rendimiento sea más importante que la latencia de respuesta. |
Boceto
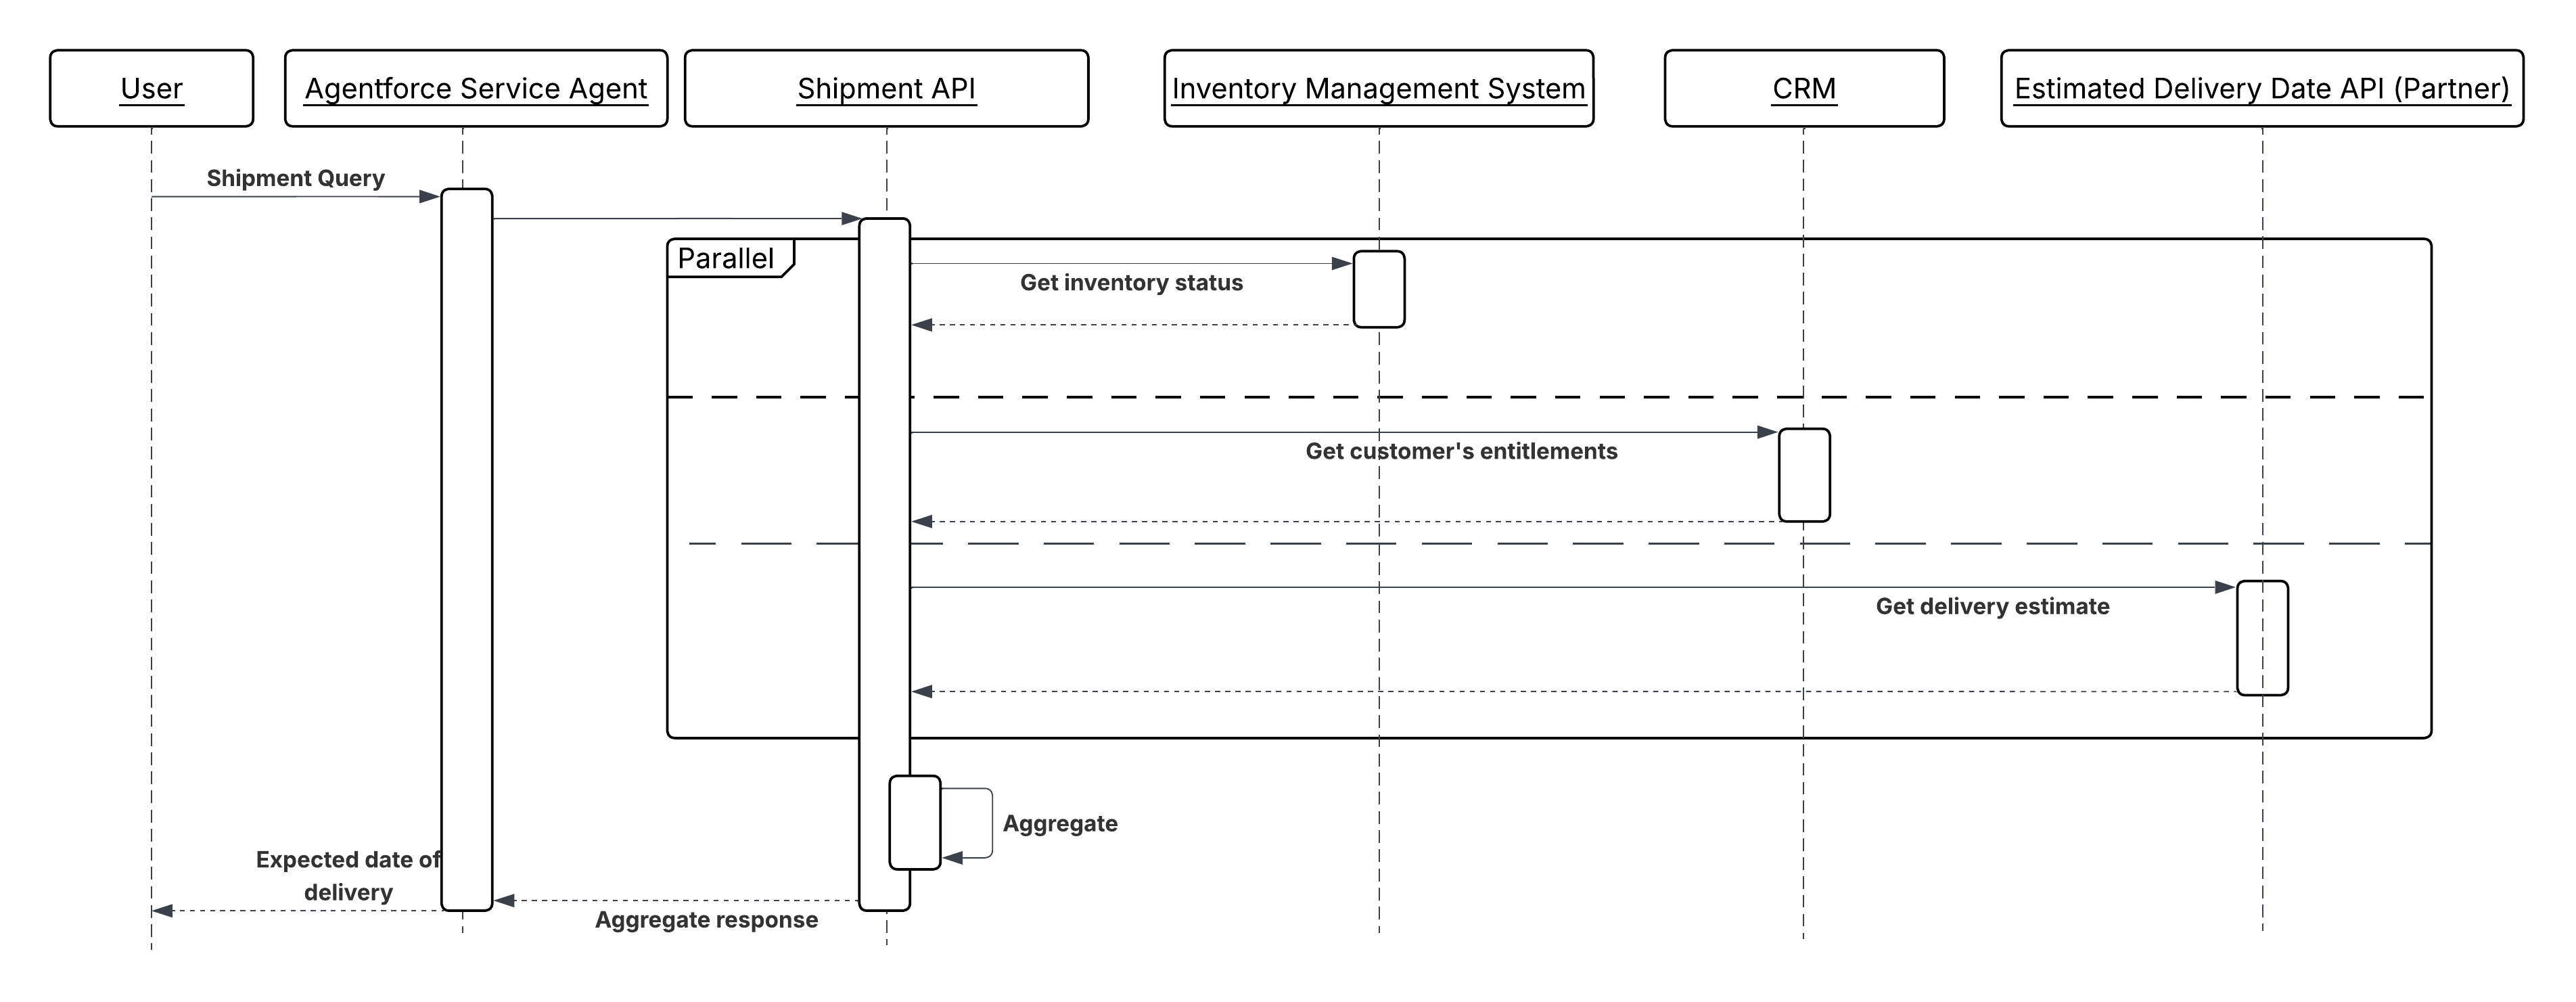
Diagrama de secuencia para la invocación de acciones paralelas
Resultados
Cuando las acciones independientes se ejecutan en paralelo, el tiempo de flujo de trabajo de extremo a extremo está limitado por la acción individual más lenta en vez de la suma de todas las acciones. Para un flujo de trabajo con tres llamadas independientes con un promedio de 300 ms cada una, la ejecución paralela se completa en ~300 ms; la ejecución secuencial tarda ~900 ms. A escala, esta diferencia se compone en cada sesión de agente que se ejecuta al mismo tiempo.
Consideraciones de diseño
Orientación específica de plataforma
- Confirme la independencia antes de paralelizar. Las acciones son seguras para ejecutarse en paralelo solo si ninguna acción lee el estado escrito por la otra y el fallo de ninguna acción debe cancelar la otra. Si existe una dependencia, incluso una dependencia suave, utilice el encadenamiento secuencial en su lugar.
- Diseñe el paso de agregación de forma explícita. Defina con antelación el aspecto de un conjunto de resultados completo, lo que significa un conjunto de resultados parcial para el razonamiento descendente y si el agente debe esperar todos los resultados o continuar una vez devuelto un umbral (por ejemplo, cinco de siete llamadas en total).
- Todas las operaciones de escritura paralelas deben ser idempotentes. Cada operación se ejecuta de forma aislada sin un límite de transacción compartido, de modo que reintentar cualquier sucursal individual no puede duplicar efectos secundarios.
Notas de implementación de Salesforce
- Para Apex en cola: Envíe todos los trabajos en una sola transacción para maximizar la posibilidad de ejecución simultánea. Tenga en cuenta que las divisiones de concurrencia disponibles se comparten en toda la organización; diseñe con el supuesto de que las divisiones no siempre están disponibles y cree una reserva para la ejecución secuencial cuando no lo están.
- Para eventos de plataforma: Redacte el resultado de cada operación en un registro de organización exclusivo (introducido por un Id. de correlación compartido) en vez de actualizar el registro de destino directamente. Un desencadenador de flujo de agregación final o Apex lee todos los registros de etapas una vez alcanzado el recuento esperado, luego aplica la actualización consolidada de forma atómica.
- Para Middleware Fan-Out: Establezca un tiempo de espera explícito en la llamada única que sea más largo que el tiempo de respuesta en el peor de los casos esperado del backend más lento, pero que aún esté dentro del límite de tiempo de espera de llamadas de Salesforce. El middleware devuelve resultados parciales con una indicación clara de qué backends fallaron, en vez de agotar el tiempo de espera de toda la respuesta.
Gestión y recuperación de errores
- Trate el éxito parcial como un resultado de primera clase. Si tres o cuatro operaciones paralelas tienen éxito, el agente utiliza los tres resultados correctos y gestiona el fallo aflorándolo explícitamente al usuario, registrándolo para reintentarlo o invocando una acción de compensación en vez de descartar todos los resultados o continuar como si no se hubiera producido el fallo.
- Para patrones de eventos de plataforma y cola, utilice un Id. de correlación (generado en el punto de retirada de abanico) para vincular todas las bifurcaciones paralelas de vuelta a la sesión de agente de origen. Este Id. es obligatorio para volver a reunir resultados y rastrear fallos desde su origen en registros.
- Si una bifurcación paralela falla y la operación es segura para volver a intentarlo, vuelva a poner en cola únicamente la bifurcación con fallos utilizando el Id. de correlación original y la clave de idempotencia. No vuelva a invocar todas las sucursales.
- Defina un umbral de tiempo de espera para el paso de agregación. Si no todos los resultados llegan dentro del umbral, continúe con los resultados disponibles y marque el conjunto incompleto en vez de esperar indefinidamente.
Consideraciones de seguridad
- Cada contexto de ejecución paralelo, ya sea un trabajo en cola, un desencadenador de eventos de plataforma o una llamada de middleware, debe aplicar los mismos controles de acceso que una llamada secuencial. El paralelismo no relaja las reglas de acceso a los datos. Cada sucursal debe operar bajo la misma credencial de menor privilegio que lo haría si se invoca por separado.
- Para el desglose de middleware, la capa de middleware no almacena en caché o registra cargas de respuesta de backends individuales más allá de la ventana de agregación. La respuesta de cada backend puede contener datos confidenciales que no deben persistir fuera del ámbito de la operación inmediata.
- Asegúrese de que los registros de organización utilizados para la agregación de eventos de plataforma no son legibles por el usuario final del agente. Estos registros pueden contener datos intermedios parcialmente formados que aún no están aptos para el consumo.
Ejemplo
Un Agente de servicio responde a una pregunta de realización compleja: “¿Puede enviarme este pedido para el viernes?” La respuesta requiere datos de todos los sistemas independientes de forma simultánea, como se explica a continuación:
- El agente identifica tres necesidades de datos independientes: el nivel de inventario actual, las asignaciones activas del cliente y el plazo de entrega estimado del transportista para la ubicación del cliente.
- Se invocan tres acciones en paralelo:
GetInventoryStatus(desde el sistema de inventario externo a través de middleware),GetCustomerEntitlements(desde Salesforce CRM) yGetDeliveryEstimate(desde la API del operador a través de middleware). - Cada acción se devuelve de forma independiente. El agente espera hasta que se reciban las tres respuestas (o se alcance el tiempo de espera de agregación).
- Con los tres resultados disponibles, el agente razona sobre los datos combinados, evaluando si el inventario es suficiente, la asignación del cliente cubre el envío exprés y el transportista confirma que la entrega del viernes es factible para el código postal del cliente.
- El agente devuelve una única respuesta fundamentada al usuario, extraída de tres sistemas, en el tiempo que tardó en responder la más lenta de las tres llamadas.
Contexto
Algunas operaciones iniciadas por agentes no producen un resultado que el agente necesite para continuar su ciclo de razonamiento actual. El envío de una notificación, el desencadenamiento de un proceso por lotes descendente, la publicación de un evento en una cola de mensajes o el envío de un trabajo de larga duración son operaciones donde la obligación del agente finaliza en el despacho; el sistema descendente toma la propiedad y completa el trabajo de forma independiente.
En la automatización tradicional, se modelan como llamadas de activación y olvido o publicaciones de eventos de plataforma. En un sistema agente, el agente decide durante el razonamiento que la operación no es de bloqueo, la despacha, registra la confirmación de despacho y continúa o concluye el turno sin esperar el resultado descendente.
Este patrón es la contrapartida agente de Invocación de procesos remotos: Disparar y olvidar desde la guía Patrones de integración. El patrón de agente lo amplía haciendo que la decisión de despacho forme parte del razonamiento del agente y garantizando que el despacho sea rastreable incluso si no se devuelve ninguna respuesta al agente.
Problema
Cuando un agente necesita iniciar una operación descendente que se ejecuta más allá de la sesión o el ciclo de razonamiento del agente, se deben solucionar tres retos:
- Invocación no bloqueante: El agente debe iniciar la operación y confirmar la entrega sin mantener el ciclo de razonamiento abierto esperando un resultado.
- Confirmación de entrega: El agente debe distinguir entre un despacho correcto (se aceptó el mensaje) y un resultado correcto (se completó el proceso descendente). Solo puede afirmar lo primero.
- Trazabilidad: Como el agente no recibe ningún resultado, la operación debe ser observable a través de registros, registros de eventos o supervisión de plataforma independientemente de la sesión del agente.
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
-
¿Necesita el agente el resultado de esta operación para completar su turno actual? En caso afirmativo, este no es el patrón correcto. Utilice Invocación de acción secuencial en su lugar.
-
¿Puede el sistema descendente recibir y procesar de forma fiable el mensaje o evento despachado sin una confirmación síncrona? El sistema de destino debe ser duradero. No debe perder el mensaje si no está disponible temporalmente.
-
¿Es la operación idempotente o es necesario proteger el despacho duplicado? Los reintentos a nivel de red y los reintentos de razonamiento de agentes pueden provocar que se intente el mismo despacho más de una vez. Si la operación descendente no es idempotente, la acción debe llevar una clave de deduplicación.
-
¿Necesita el usuario o un proceso descendente saber cuándo se completa la operación? El agente solo puede confirmar el despacho. Si se requiere el estado de finalización, diseñe un mecanismo de notificación o seguimiento separado. Un evento de plataforma, una actualización de caso o una devolución de llamada, que está fuera de este ciclo de razonamiento.
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| API Pub/Sub | Mejor para transmisión de eventos externos o de alto rendimiento | El agente invoca una acción Apex que publica un evento en la API Pub/Sub de Salesforce a través de gRPC. La acción devuelve un PublishResult replayId al agente como confirmación de envío. Se utiliza cuando los consumidores descendentes son sistemas externos que se suscriben a través de la API Pub/Sub en vez de desencadenadores de flujo o Apex nativos de Salesforce, o cuando se requiere transmisión de eventos de alto rendimiento. |
| Eventos de plataforma (Acción Apex) | Lo mejor para el despacho asíncrono dentro de Salesforce | El agente invoca una acción Apex que publica un Evento de plataforma. El evento se entrega a todos los suscriptores de forma asíncrona. La acción devuelve una confirmación de publicación al agente; no devuelve un resultado de procesamiento. Se utiliza cuando el consumidor descendente está dentro de la plataforma Salesforce. El agente invoca una acción Apex que llama a EventBus.publish(). La acción devuelve un SaveResult confirmando la aceptación. |
| Cola / Lote de Apex (Acción de Apex) | Lo mejor para un procesamiento en segundo plano de larga ejecución | El agente invoca una acción Apex que pone en cola un trabajo en cola o por lotes. El trabajo se ejecuta fuera de la transacción del agente. La acción devuelve un Id. de trabajo que el agente puede aflorar al usuario como referencia. Se utiliza cuando el trabajo descendente es un procesamiento de datos de operaciones de Salesforce de larga ejecución, actualizaciones de múltiples objetos o llamadas externas que superan los límites síncronos. System.enqueueJob() devuelve un Id. de trabajo que el agente registra como referencia. |
| Flujo asíncrono de MuleSoft | Lo mejor para el despacho de colas de mensajes externos | El agente invoca una acción expuesta de MuleSoft que coloca un mensaje en una cola externa (Kafka, JMS, SQS). MuleSoft gestiona la traducción de protocolos y la confirmación de entrega. El agente recibe confirmación de que el mensaje fue aceptado por MuleSoft, no de que se procesara en el flujo descendente. |
| Extremo REST externo (Acción Apex) | Lo mejor para el envío de eventos del sistema externo | El sistema de destino expone un extremo que acepta un envío y devuelve un Id. de confirmación de inmediato, completando el procesamiento de forma asíncrona. El agente recibe el Id. de confirmación y lo registra. |
Boceto
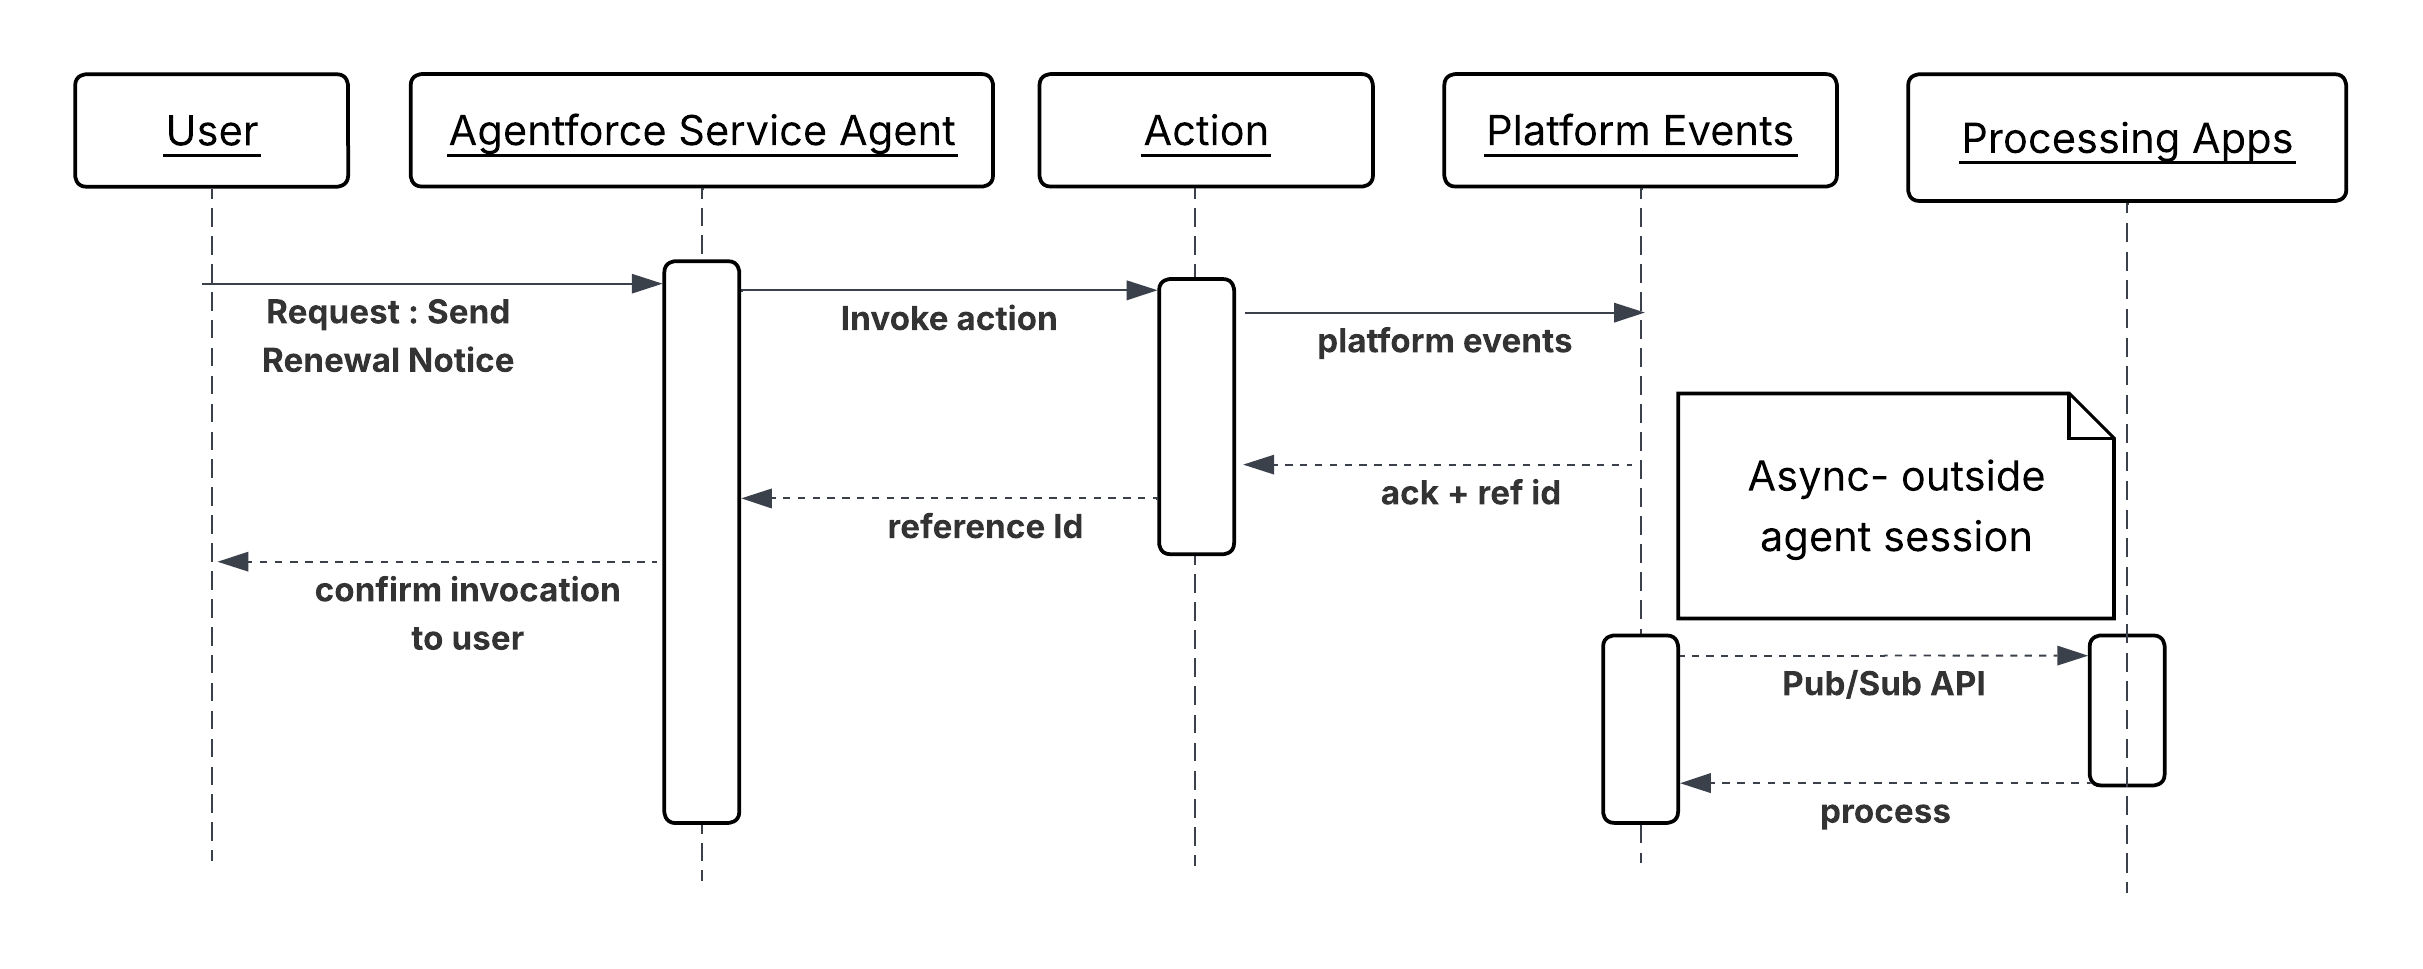
Diagrama de secuencia para invocación de acción asíncrona
Resultados
El agente invoca una operación descendente sin bloquear su ciclo de razonamiento en el resultado. El turno se completa con la confirmación de que se aceptó la operación, no que se completó. El sistema descendente toma la propiedad completa de la ejecución. La operación despachada es rastreable a través de suscriptores de eventos de plataforma, Id. de trabajo o Id. de reconocimiento de cola externa que se registran en CRM en el momento del despacho. Si la operación descendente falla, ese fallo aparece a través de la supervisión propia del sistema descendente, no a través de la sesión de agente que la inició.
Consideraciones de diseño
Orientación específica de plataforma
- Redacte descripciones de acciones en un lenguaje basado en intención. Por ejemplo, “Envía una notificación de renovación a la cola de mensajería y devuelve un Id. de referencia de despacho” es más útil para el agente que “llama al extremo de notificación”.
- Nunca describa una acción de despacho como “envía y confirma entrega de”. El agente solo puede confirmar la aceptación. La entrega y el procesamiento descendentes están fuera de la observabilidad del agente.
Notas de implementación de Salesforce
- Devuelve un Id. de referencia de cada acción de invocación, por ejemplo, un
ReplayIdde evento de plataforma, un Id. de trabajo en cola, unPublishResultde API Pub/Sub replayId o un token de reconocimiento externo. Regístrelo en un registro de CRM en el momento de la invocación. Este es el único seguimiento de auditoría que producirá la sesión de agente. - Para la API Pub/Sub, el agente invoca una acción Apex que realiza una llamada gRPC al extremo de la API Pub/Sub ‘/Publish’. La acción debe gestionar el paso de registro de esquema: los eventos deben tener un número de serie en formato Avro en el esquema registrado. Devuelva el
PublishResult ‘replayId’al agente como referencia de despacho. - Para Eventos de plataforma, llame a
EventBus.publish()dentro de la acción Apex y compruebe si SaveResult tiene errores antes de devolver un indicador de éxito al agente. No asuma el éxito de la publicación; valídelo. - Para Trabajos en cola, implemente la interfaz En cola y llame a System.enqueueJob() desde la acción. Devuelva el Id. de AsyncApexJob resultante al agente.
- Para extremos asíncronos externos, el extremo de destino debe devolver un acuse de recibo inmediatamente (HTTP 202 aceptado) con un Id. de referencia. Si el extremo bloquea hasta que se complete el procesamiento, es síncrono y este patrón no se aplica.
Gestión y recuperación de errores
- Una acción de invocación debe distinguir entre fallo de despacho (el mensaje no se aceptó) y fallo de procesamiento (el mensaje se aceptó pero la operación descendente falló más tarde). El agente solo puede gestionar lo primero.
- Si la invocación falla, la acción debe devolver un fallo estructurado con un motivo claro. El agente puede reintentar el despacho, distribuir a un humano o registrar un registro de despacho fallido, pero no puede recuperar un fallo de procesamiento descendente en la misma sesión.
- Para operaciones donde el fallo descendente debe aflorar eventualmente, diseñe un bucle de comentarios separado como un Evento de plataforma publicado por el proceso descendente, un flujo programado que comprueba el estado del trabajo o un caso de seguimiento que están fuera de la sesión de agente.
Consideraciones de seguridad
- Envuelva todas las llamadas asíncronas externas en credenciales nombradas. La acción de invocación no incrusta direcciones URL de extremo o credenciales en código.
- Valide y desinfecte todos los parámetros pasados a la acción de invocación antes de que se incrusten en la carga útil del evento o el cuerpo del mensaje. El texto proporcionado por el usuario pasado a un mensaje asíncrono es un posible vector de inyección en el consumidor descendente.
- Registre cada despacho con Id. de sesión, Id. de referencia y carga depurada en el momento del despacho. Como no se devuelve ninguna respuesta al agente, este registro es el mecanismo principal para reconstruir lo que inició el agente.
- Aplique menos privilegios al usuario de integración o la aplicación conectada. Una acción de despacho que se publica en una cola de notificaciones no debe contener credenciales que permitan lecturas o escrituras en sistemas no relacionados.
Ejemplo
Un agente de gestión de renovación que gestiona un contrato próximo al vencimiento determina que el cliente es apto para una notificación de renovación automática. El agente no necesita confirmación de que se entregó el correo electrónico antes de concluir el turno.
CheckRenewalEligibility(Flujo iniciado automáticamente) evalúa las condiciones del contrato, el nivel del cliente y el estado de anulación de suscripción. Devuelve un booleano “elegible” y el canal de notificación preferido.DispatchRenewalNotification(Apex Action) publica un Evento de plataforma deRenewalNotification\_\_eque contiene el Id. de contrato, el Id. de cliente, el canal de notificación y una clave de idempotencia generada. Devuelve un ReplayId confirmando que el evento fue aceptado por la plataforma.UpdateContractRecord(Flujo iniciado automáticamente) escribe la marca de tiempo deReplayIdy despacho en el registro Contrato y establece un indicador de estado “Notificación despachada”.
Contexto
Las aplicaciones externas como portales de clientes, aplicaciones móviles, plataformas SaaS externas y sistemas de socios necesitan invocar agentes de forma programática para gestionar solicitudes de servicio, iniciar flujos de trabajo o aflorar respuestas dirigidas por IA en sus propias interfaces. El agente actúa como un servicio backend inteligente. El sistema externo proporciona contexto, los motivos y acciones del agente y el llamante consume la respuesta.
Cada vez más, el llamante es en sí mismo un agente de IA u orquestador en vez de una aplicación de cara al ser humano. En estos patrones de IA a IA, un agente de orquestación delega un paso de razonamiento, una búsqueda de CRM o una acción a Agentforce como una llamada de herramienta discreta. Necesitamos exponer un servidor de Protocolo de contexto de modelo (MCP) para admitir este patrón.
Problema
Cuando un sistema externo o agente de IA necesita aprovechar las funciones de un agente Agentforce on demand, ¿cómo se autentica, crea una sesión de agente, pasa los datos contextuales y de conversación necesarios y recibe de forma fiable la respuesta estructurada del agente para dirigir su propia lógica descendente?
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
- ¿Espera la persona que llama externa una respuesta síncrona de baja latencia o es aceptable una devolución de llamada asíncrona?
- ¿Cómo se establece y se propaga la identidad del llamante en el contexto de ejecución del agente para el acceso y la personalización de datos?
- ¿Cuál es el volumen esperado de sesiones desencadenadas por API simultáneas y cómo interactúa con los límites de frecuencia y concurrencia de API de Salesforce?
- ¿Necesita el sistema externo mantener la continuidad de la sesión en múltiples turnos (conversación de múltiples turnos) o cada solicitud es apátrida?
- ¿Cómo debe estructurarse la respuesta del agente de modo que el sistema llamante pueda analizarla y actuar sobre ella de forma programática?
- ¿Es la persona que llama una aplicación de cara al público que requiere integración de REST directa, o un agente de IA u orquestador que puede invocar Agentforce como una herramienta a través de un protocolo estándar, como MCP?
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| API de agente Agentforce - Turno único (Síncrono) | Lo mejor para integraciones sin estado y solicitud-respuesta | El sistema de llamadas requiere una respuesta estructurada e inmediata y se espera que el razonamiento del agente se complete dentro de la tolerancia de tiempo de espera del llamante. El sistema de llamadas gestiona las fases del ciclo de vida de la sesión completa: creación, turnos y finalización. El sistema externo se autentica, crea una sesión con variables de contexto, envía un único mensaje, recibe la respuesta del agente y cierra la sesión. Esta API Agentforce es la interfaz de REST principal a través de la cual los sistemas externos crean sesiones, intercambian mensajes y cierran sesiones de forma programática. El intercambio completo se completa en un ciclo de solicitud-respuesta HTTP. Las respuestas incluyen la salida del lenguaje natural del agente y cualquier variable de salida estructurada producida por acciones que el agente invocó durante el razonamiento. |
| API de agente Agentforce - Varios turnos (Continuidad de sesión) | Lo mejor para integraciones de conversación que requieren estado entre turnos | La interfaz externa es conversacional (por ejemplo, un widget de chat o una interfaz de voz) y la interacción requiere múltiples intercambios para alcanzar una resolución. El sistema externo crea una sesión una vez y reutiliza el Id. de sesión entre múltiples intercambios de mensajes. El agente mantiene el contexto de conversación entre turnos como preguntas anteriores, datos recuperados, decisiones tomadas sin que la persona que llama lo vuelva a proporcionar. |
| Asíncrono con sondeo o devolución de llamada de Webhook | Lo mejor para flujos de trabajo de razonamiento de alta latencia o interfaces de usuario sensibles al tiempo | El tiempo de procesamiento del agente no es trivial y mantener una conexión HTTP abierta podría degradar la experiencia de usuario del llamante o desencadenar tiempos de espera ascendentes. El sistema externo envía la solicitud y recibe inmediatamente una confirmación con un Id. de trabajo o sesión. A continuación sondea un extremo de estado o registra un gancho web para recibir la respuesta del agente cuando se completa el razonamiento. Actualmente, este patrón se puede implementar con una API de contenedor alojada en un middleware como MuleSoft. El consumidor externo invoca esta API de Wrapper y registra el extremo de webhook. La API envolvente devuelve el acuse de recibo al sistema externo tras invocar al agente Agentforce. Esta API envolvente también mantiene la sesión de agente Agentforce y devuelve la respuesta al sistema externo utilizando el extremo de webhook registrado una vez que el agente responde. |
| Agentforce mediante MCP (Salesforce Headless 360) | Lo mejor para la invocación de IA a IA donde el llamante es un cliente compatible con MCP | El cliente MCP que llama invoca Agentforce como una herramienta a través del servidor MCP listo para su uso proporcionado por Salesforce Headless 360. El ciclo de vida de la sesión se gestiona de forma transparente por el servidor MCP, y el agente que llama interactúa a través de llamadas de herramientas estándar sin crear una integración de REST personalizada. Utilice esta solución cuando el llamante es un cliente de MCP que necesita delegar el razonamiento, la recuperación de contexto de CRM o la ejecución de acciones en Agentforce como un paso discreto en un flujo de trabajo de agente más amplio. |
Boceto
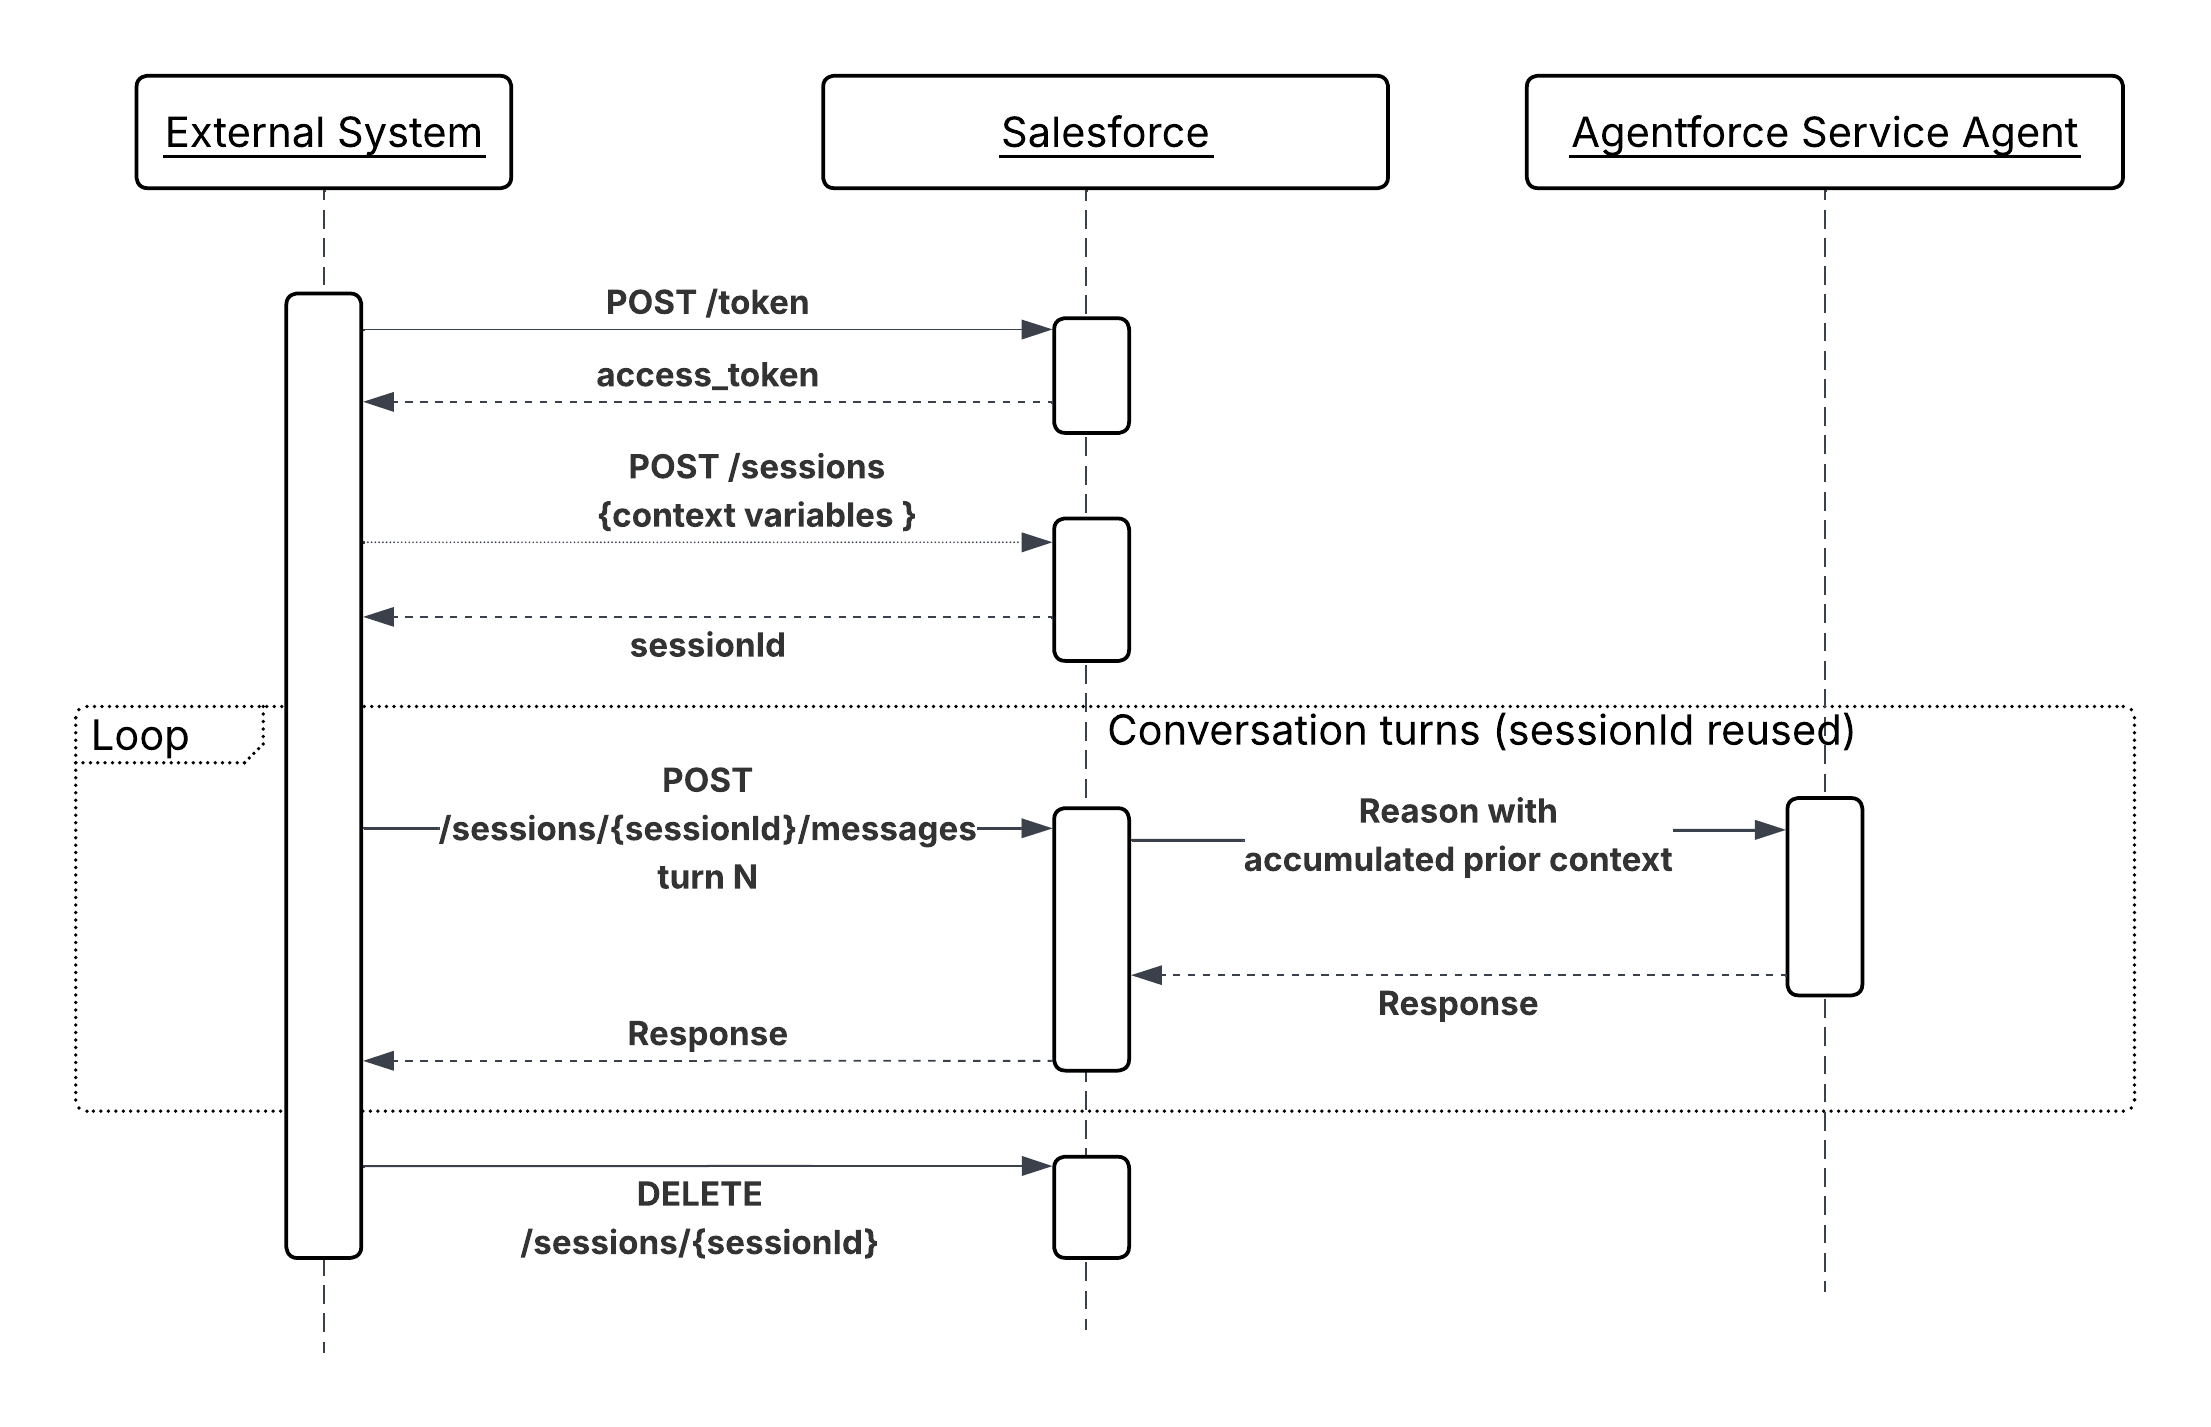
Diagrama de secuencia para la invocación de agentes On-Demand
Resultados
Este patrón expone Agentforce como un servicio de IA llamable. Los sistemas externos obtienen acceso al razonamiento, las herramientas y el contexto de CRM del agente sin replicar esa lógica. La persona que llama sigue siendo responsable de la gestión del ciclo de vida de la sesión y la presentación de la respuesta. El agente sigue siendo responsable de todo el razonamiento, la selección de herramientas y la síntesis de respuestas.
Cuando el llamante es un agente de IA u orquestador, Agentforce mediante el mecanismo MCP (disponible de forma inmediata a través de Salesforce Headless 360) elimina la necesidad de una integración de REST personalizada por completo. El servidor MCP gestiona el ciclo de vida de la sesión en nombre del agente que llama, permitiendo a Agentforce participar como una herramienta de primera clase en flujos de trabajo de múltiples agentes sin fontanería adicional.
Consideraciones de diseño
Orientación específica de plataforma
- Evite hacer que la llamada de API externa sea síncrona y bloquear flujos de la interfaz de usuario sensibles al tiempo. Adopte un patrón de sondeo o devolución de llamada de webhook donde los tiempos de respuesta de los agentes no son triviales, para desvincular la experiencia del usuario del tiempo de procesamiento del agente.
- Seleccione el mecanismo de llamada basándose en la naturaleza de la persona que llama, no en la disponibilidad. Las aplicaciones de cara al público y las integraciones de sistemas deben utilizar la API de agente directamente. Las herramientas que admiten MCP deben utilizar el servidor Agentforce MCP. Los mecanismos de mezcla para el mismo tipo de llamante agregan complejidad innecesaria sin beneficio arquitectónico.
Notas de implementación de Salesforce
- Inyecte contexto de sesión en la solicitud POST de creación de sesión, no en el primer mensaje de usuario. Cuando el sistema externo crea la sesión, tiene la oportunidad de pasar variables de contexto estructuradas (Id. de cuenta, datos de asignación, resumen de interacción anterior) directamente como parámetros de sesión nombrados. Estas variables están disponibles para el agente antes de que procese un único turno, de modo que comienza a razonar desde un estado fundamentado sin emitir llamadas de búsqueda para establecer quién es el cliente o a qué tiene derecho. Pasar los mismos datos dentro del cuerpo del mensaje en su lugar obliga al agente a analizar texto no estructurado para extraer hechos que podría haber recibido como variables escritas, aumentando la latencia, introduciendo errores de extracción y consumiendo pasos de razonamiento que no agregan valor comercial.
- Diseñe respuestas de agentes para que sean estructuradas y analizables automáticamente. Utilice convenciones de variables de salida e instrucciones de solicitud que guían al agente para devolver respuestas pensadas para JSON o claramente delimitadas cuando el llamante es un sistema en vez de un humano.
- Gestione el ciclo de vida de la sesión de forma explícita. Finalice sesiones rápidamente después de utilizar
DELETE /einstein/ai-agent/v1/sessions/{sessionId}para liberar divisiones de concurrencia y evitar que el contexto obsoleto persista entre interacciones no relacionadas. - Tenga en cuenta los límites de sesiones simultáneas de Salesforce. Para escenarios de alto rendimiento, implemente un grupo de sesiones o una capa de cola en el sistema de llamadas para evitar el rechazo de solicitudes durante el pico de carga.
- Al invocar Agentforce mediante MCP, pase el contexto como parámetros de entrada de herramienta en vez de como variables de sesión. El servidor MCP gestiona el ciclo de vida de la sesión de forma transparente, de modo que el agente que llama no puede establecer parámetros de sesión nombrados directamente en el momento de la creación. Asegúrese de que todo el contexto requerido (Id. de registro, identidad de usuario, datos de asignación) está incluido en la carga de llamada de herramienta de modo que el agente comience a razonar desde un estado fundamentado.
- Trate la gestión de sesiones transparente del servidor MCP como una comodidad, no como un omisión de concurrencia. Cada invocación de herramienta aún consume un puesto de sesión de agente de Salesforce. Los orquestadores de alta frecuencia que llaman Agentforce a escala a través de MCP deben tener en cuenta los mismos límites de sesiones simultáneas que se aplican a los llamantes directos de API de agente.
Gestión y recuperación de errores
- La API de agente devuelve códigos de error HTTP estándar. El sistema de llamadas debe gestionar “429 Demasiadas solicitudes” (límite de frecuencia) con retroceso exponencial y “503 Servicio no disponible” con lógica de reintento.
- Cuando el propio agente encuentra un fallo de herramienta irresoluble, devuelve un error de lenguaje natural elegante en el cuerpo de respuesta. El sistema de llamada detecta estas respuestas centinela (por ejemplo, comprobando un campo de estado “error” en la respuesta) y enruta en consecuencia reintentando con contexto adicional, presentando una experiencia de reserva o distribuyendo a un humano.
- Al invocar a través de MCP, los errores afloran en dos capas diferentes: Errores de transporte de MCP (llamadas de herramientas mal formadas, no disponibilidad del servidor) y fallos de razonamiento Agentforce (errores de ejecución de herramientas, acciones irresolubles). El agente orquestador debe gestionar ambas capas de forma independiente. Los errores de transporte de MCP deben desencadenar reintentos a nivel de protocolo; los fallos de razonamiento Agentforce devueltos en la respuesta de la herramienta deben ser gestionados por la propia lógica de reserva o distribución del orquestador.
Consideraciones de seguridad
- Utilice los ámbitos de OAuth más restringidos posibles para la aplicación cliente externa. Una integración que solo necesita invocar a un agente no debe albergar ámbitos para el acceso a datos más allá de lo que requiere el agente en sí.
- Valide y desinfecte todas las entradas del sistema externo antes de inyectarlas como variables de sesión. Las entradas externas son una superficie de ataque para la inyección rápida. Por ejemplo, un llamante malintencionado puede crear un campo “customerQuery” diseñado para sustituir instrucciones de agentes.
- Aplique la lista de admisión de direcciones IP en la aplicación cliente externa para restringir qué sistemas externos pueden autenticarse y llamar a la API de agente.
- Registre todas las sesiones desencadenadas por API entrantes con identidad de llamante, Id. de sesión y metadatos de solicitud/respuesta para fines de auditoría y seguridad.
- Cuando se invoca Agentforce mediante MCP, el servidor MCP se autentica en Salesforce en nombre del usuario que llama. Asegúrese de que las credenciales de la aplicación conectada del servidor MCP tienen el ámbito de los permisos mínimos requeridos y que la identidad del usuario final (utilizando herramientas de MCP como Claude) - identidad se propaga en el contexto de sesión de forma explícita a través de parámetros de entrada de herramienta.
Ejemplo
Un portal de servicios financieros desencadena un agente Agentforce para gestionar una consulta hipotecaria.
- El portal se autentica utilizando el flujo de OAuth Credenciales de cliente y obtiene un token de soporte.
- Llama “POST /Einstein /ai-agent/v1/sessions” con variables de sesión: “{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }”.
- El usuario envía su pregunta: “¿Qué documentos necesito para completar mi solicitud?”
- El portal llama “POST /Einstein/ai-agent/v1/sessions/{sessionId}/messages” con el texto del usuario.
- El agente Agentforce invoca una acción de flujo “GetDocumentChecklist”, recupera los requisitos específicos del tipo de préstamo y devuelve una lista estructurada.
- El portal representa la respuesta del agente en línea y cierra la sesión al salir el usuario.
Contexto
No todos los flujos de trabajo agentes se originan desde una solicitud humana. Señales críticas comerciales como una caída repentina en mediciones de uso de productos, un abandono de carrito de alto valor o un fallo de pago que supera un umbral de riesgo, se producen con frecuencia en datos operativos. Cuando estas señales requieren respuestas inteligentes de múltiples pasos, esperar que un humano se dé cuenta y actúe introduce la latencia que se compone en el coste comercial real.
Este patrón describe cómo los eventos en tiempo real sirven como puntos de entrada autónomos para agentes. El agente es invocado por una condición de datos en vez de por un usuario, razona sobre el contexto del evento y ejecuta un flujo de trabajo de respuesta, todo sin la iniciación humana.
Problema
Cuando se produce un evento comercial en tiempo real en Data 360 o Salesforce Platform, ¿cómo puede ese evento instanciar de forma autónoma una sesión de agente, proporcionar la carga de evento como contexto de fundamentación e impulsar un flujo de trabajo de acción no conversacional hasta su finalización sin que un humano inicie o guíe la interacción?
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
- ¿Se requiere una respuesta inmediatamente en el momento en que se desencadena el evento o es aceptable el procesamiento casi en tiempo real (segundos a minutos)?
- ¿Contiene la carga de evento suficiente contexto para fundamentar al agente o necesita el agente realizar búsquedas adicionales antes de que pueda razonar de forma efectiva?
- ¿Cuál es el volumen y la frecuencia de eventos esperados? Las transmisiones de eventos de alto rendimiento requieren gestión de frecuencia para evitar agotar los límites de concurrencia de agentes.
- ¿Puede el mismo evento desencadenarse más de una vez para la misma entidad comercial (entrega al menos una vez)? Si es así, las acciones deben ser idempotentes.
- ¿Existe una ruta de distribución humana si el agente no puede resolver el evento de forma autónoma?
- ¿Cómo debe aflorar el procesamiento de eventos fallidos? ¿Con una cola de letra muerta, una alerta o la creación de casos?
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
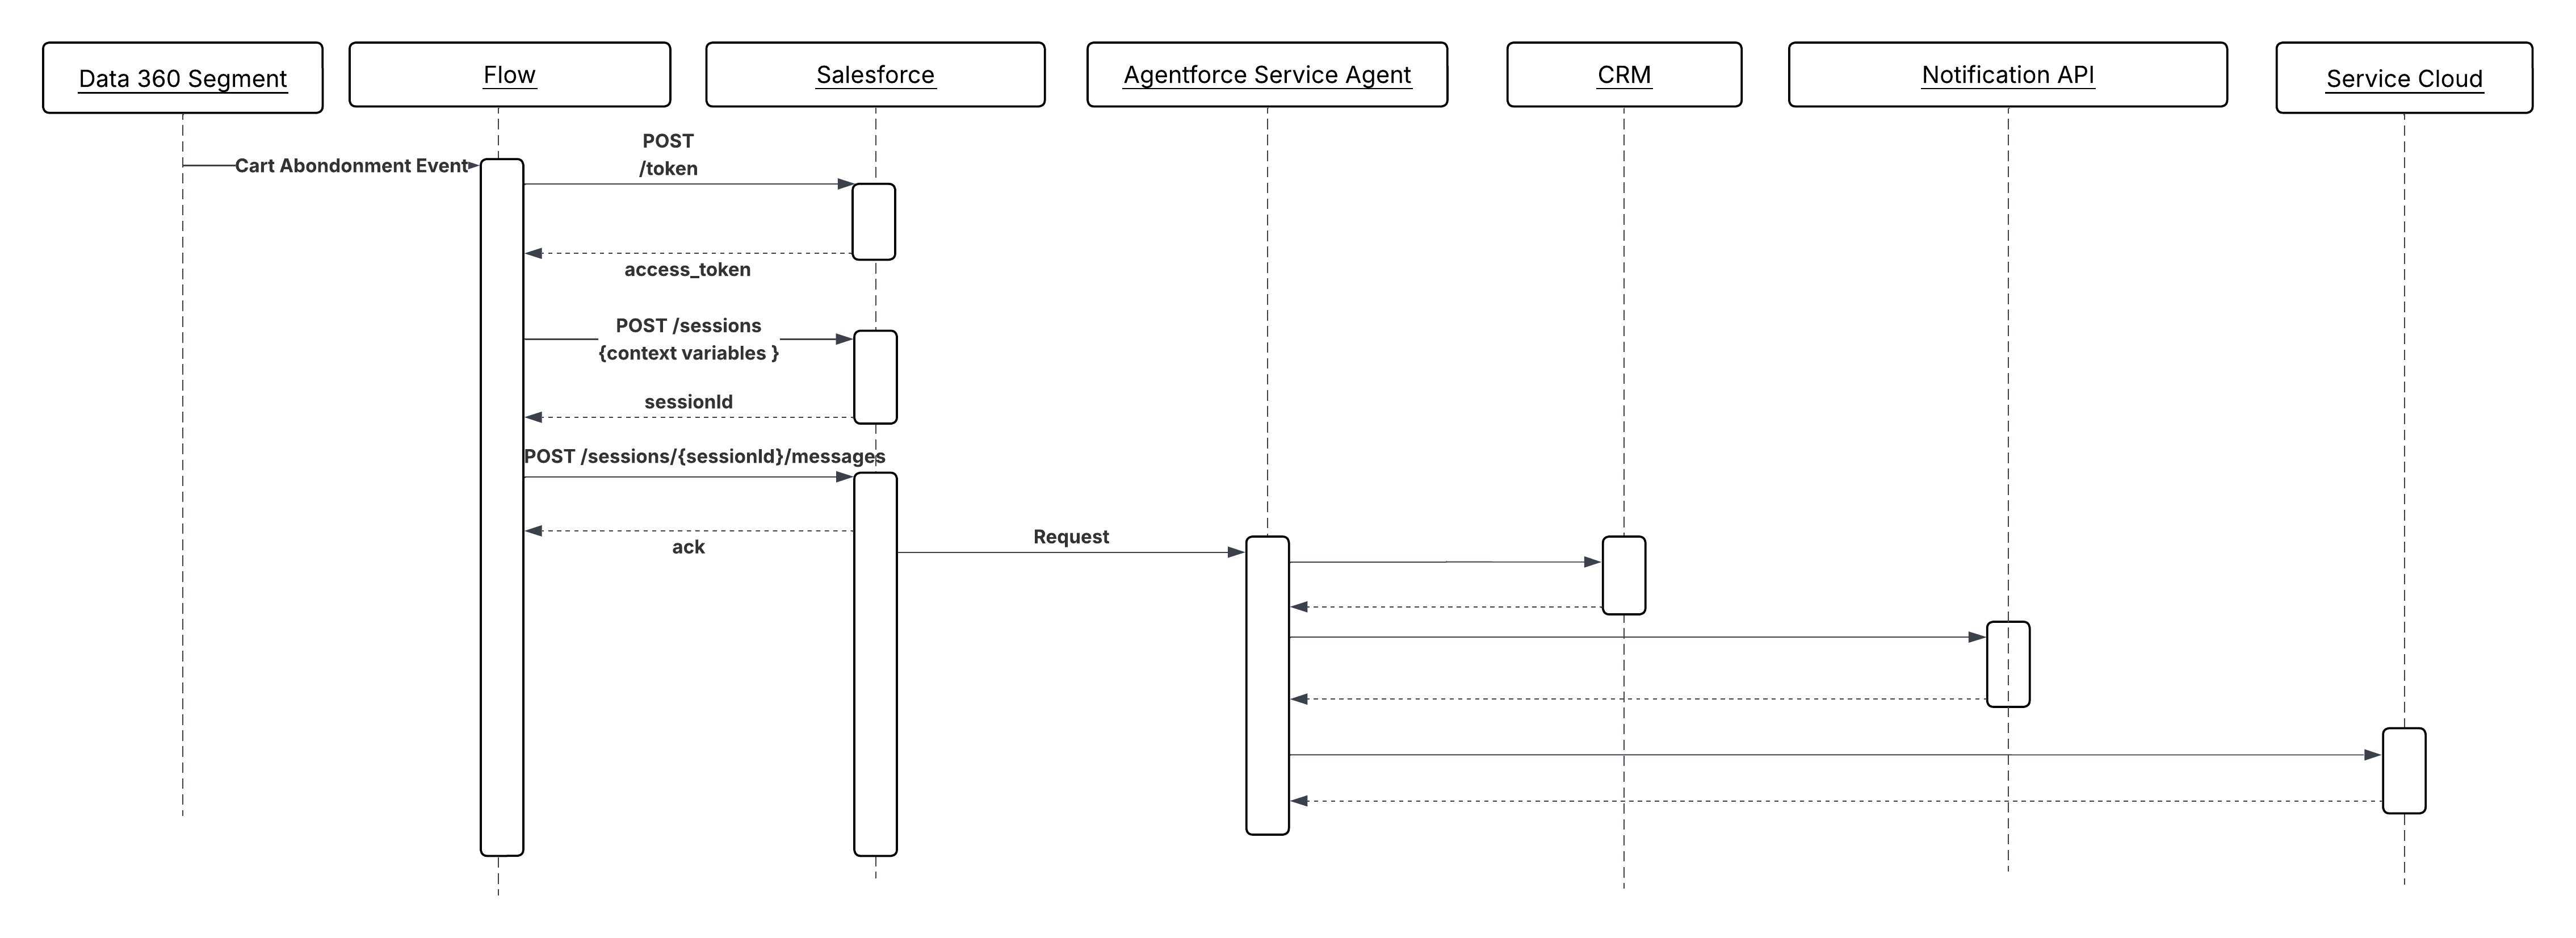
| Flujos desencadenados por Data 360 | Lo mejor para señales basadas en mediciones y comportamiento | Esto se ajusta mejor cuando la condición de desencadenador se define como un cambio de pertenencia a segmento de Data 360 o umbral de medición. Data 360 detecta la condición comercial (por ejemplo, abandono de carrito, caída de uso) e inicia un flujo desencadenado. El flujo asigna atributos de carga de evento a variables de sesión de agente y crea la sesión Agentforce. |
| Eventos de plataforma + Flujo iniciado automáticamente o Apex | Ideal para eventos internos de plataforma y entre sistemas | Utilice esta solución cuando el origen del evento esté en la plataforma Salesforce o cuando una capa de middleware publique el evento después de detectar la condición en un sistema externo. Un evento de plataforma publicado por cualquier proceso de Salesforce o sistema externo desencadena un desencadenador Apex o Flujo iniciado automáticamente, que construye la sesión de agente con la carga de evento como contexto. |
Boceto
Diagrama de secuencia para la ejecución de agentes dirigida por eventos
Resultados
Los agentes se convierten en participantes reactivos en operaciones comerciales en tiempo real, no respondedores pasivos a solicitudes humanas. Los agentes desencadenados por eventos pueden ejecutar flujos de trabajo de recuperación, triaje y distribución a la velocidad de los datos en vez de a la velocidad de la atención humana.
El sistema desencadenante (Data 360 o eventos de plataforma) sigue siendo responsable de la detección de eventos y la formación de cargas. El agente sigue siendo responsable de razonar sobre esa carga y seleccionar la cadena de acción correcta. No se requiere turno de conversación; la carga del evento es la entrada completa.
Consideraciones de diseño
Orientación específica de plataforma
- Diseñe todas las acciones para invocación no conversacional. No hay turno de usuario; el agente debe alcanzar una resolución solo desde el contexto de fundamentación inicial. Las acciones deben devolver resultados estructurados y deterministas en vez de solicitar aclaraciones.
- Asegúrese de que la carga de evento lleva suficiente contexto de fundamentación antes de crear la sesión de agente. Una carga pobre que fuerza al agente a realizar múltiples llamadas de búsqueda antes de que pueda razonar aumenta la latencia y el consumo de concurrencia.
- Haga que todas las operaciones de escritura desencadenadas por agentes dirigidos por eventos sean ideopotentes. Los sistemas de entrega de eventos normalmente proporcionan garantías al menos una vez. El procesamiento de eventos duplicados no puede producir efectos secundarios duplicados.
Notas de implementación de Salesforce
- En Flujos desencadenados por Data 360, asigne atributos de carga de eventos (por ejemplo, “accountId”, “eventType”, “metricValue”, “productIds”) directamente a variables de sesión nombradas en el momento de la creación de la sesión. Esto fundamenta al agente desde el primer paso de razonamiento sin requerir una acción de recuperación.
- Para desencadenadores de eventos de plataforma, utilice un Flujo iniciado automáticamente en vez de un flujo de pantalla. Los flujos de pantalla no se admiten en contextos autónomos no conversacionales.
- Establezca un tiempo de espera de sesión explícito en sesiones desencadenadas por eventos. A diferencia de las sesiones de conversación, no hay ningún usuario para ampliar la interacción; una sesión que se estanca en una acción fallida no debe albergar un puesto de hora de concurrencia indefinidamente.
- Utilice rutas de fallo de flujo para gestionar fallos de creación de sesiones de agentes. Si no se puede crear la sesión, la ruta de fallo debe publicar un evento de compensación o crear un caso para el seguimiento humano en vez de descartar silenciosamente el evento.
Gestión y recuperación de errores
- Los eventos que no desencadenan una sesión de agente correctamente debido a límites de concurrencia, errores de creación de sesión o fallos de validación de carga deben enrutarse a una ruta de fallo que crea un caso, desencadena una alerta o publica el evento en una cola de letra muerta para su reprocesamiento.
- Los fallos de agentes a mitad de la ejecución (por ejemplo, el tiempo de espera de una acción requerida) deben registrarse con el Id. de evento de origen. Como el desencadenamiento es asíncrono y no hay llamante en espera, la superficie de error se basa completamente en la observabilidad: registros, paneles y umbrales de alerta.
- Implemente un techo de reintento. Si un evento causa un fallo de agente de forma fiable, los reintentos sin límites agotarán los límites de concurrencia. Después de un número máximo configurable de intentos, enrute el evento a una cola de revisión humana con contexto completo adjunto.
- Realice un seguimiento del Id. de evento durante el ciclo de vida completo de la sesión de agente. Este seguimiento permite la correlación entre la señal de datos de origen y todas las acciones descendentes para auditoría y depuración.
Consideraciones de seguridad
- Valide y desinfecte todos los atributos de carga de eventos antes de inyectarlos como variables de sesión de agente. Las cargas de eventos de Data 360 o publicadores externos son una superficie de ataque para la inyección rápida. Por ejemplo, un campo de carga creado puede diseñarse para sustituir instrucciones de agentes.
- Ejecute sesiones de agentes desencadenadas por eventos bajo un usuario de integración de privilegios mínimos exclusivo en vez de una identidad de administrador de privilegios altos. El agente solo tiene los permisos requeridos para ejecutar su conjunto de acciones definido.
- Registre todas las sesiones desencadenadas por eventos con el Id. de evento de origen, el tipo de evento y las variables de sesión inyectadas en la creación. Este seguimiento de auditoría es obligatorio para reconstruir por qué el agente realizó una acción concreta si se disputa el resultado.
Ejemplo
Una empresa minorista utiliza Data 360 para realizar un seguimiento del comportamiento del carrito en tiempo real. Cuando se abandona un carrito con un valor superior a un umbral definido:
- Data 360 detecta la señal de abandono y activa un flujo desencadenado con la carga de evento: “customerId”, “cartValue”, “productIds” y “abandonmentTimestamp”.
- El flujo asigna estos atributos a variables de sesión Agentforce y crea una nueva sesión de agente. No se requiere interacción de usuario.
- El agente evalúa el historial de compras del cliente, las asignaciones actuales y la composición del carrito utilizando sus acciones de recuperación disponibles.
- El agente invoca una acción de
SelectRecoveryOffer, que aplica el nivel de descuento apropiado basándose en el segmento de cliente, y una acción deSendProactiveNotificationpara entregar la oferta a través del canal preferido del cliente. - El agente invoca
CreateFollowUpTaskpara registrar la interacción en CRM para la visibilidad del propietario de la cuenta. - La sesión se cierra automáticamente después de completar la cadena de acción. El Id. del evento de origen se mantiene en el registro de sesión para la trazabilidad.
Contexto
Los LLM están capacitados en datos públicos. No tienen Knowledge de los productos, políticas, historial de casos o contratos de su organización a menos que esa información se proporcione explícitamente en el momento del razonamiento. Sin fundamentación, un agente preguntado acerca de la asignación de servicio de un cliente o las condiciones de un contrato específico alucinará con una respuesta o admitirá que no lo sabe. Ninguno de los resultados es aceptable en un contexto empresarial.
La generación aumentada de recuperación (RAG) resuelve esto recuperando documentos relevantes desde un establecimiento de Knowledge empresarial e inyectándolos en la ventana de contexto del agente antes de que genere una respuesta. El agente razona sobre contenido recuperado como un artículo Knowledge, una resolución de caso pasado, una especificación de producto como si se le hubiera proporcionado esa información directamente. El LLM proporciona el razonamiento; la capa de recuperación proporciona los hechos.
Por ejemplo, un Agente de servicio gestionando una reclamación de garantía compleja no necesita tener términos de póliza de garantía incrustados en sus instrucciones. En su lugar, cuando el cliente describe su problema, el agente realiza una búsqueda semántica o búsqueda híbrida (búsqueda de palabras clave + búsqueda semántica) con un índice vectorial de documentación de garantía, recupera los términos aplicables y los utiliza para determinar la aptitud y los siguientes pasos. La respuesta se basa en el documento de política actual y autorizado, no en los datos de entrenamiento del modelo.
Problema
Un agente necesita responder a una pregunta o tomar una decisión que dependa de Knowledge organizativo propio como políticas, contratos, documentación de productos o datos de casos históricos que no formaban parte de los datos de formación de LLM. ¿Cómo recupera el agente el contenido más relevante en el momento del razonamiento, garantiza que el contenido recuperado es actual y autorizado y lo inyecta en contexto con suficiente precisión para evitar ruidos?
Fuerzas
Al aplicar este patrón, responda a las siguientes preguntas:
- ¿El contenido de Knowledge es estático y se actualiza con poca frecuencia (por ejemplo, manuales de productos) o cambia continuamente (por ejemplo, resoluciones de casos, descripciones de inventario)? La frecuencia de actualización determina el diseño de las oportunidades en curso de introducción.
- ¿Qué tamaño tiene el contenido? Una base de Knowledge pequeña se puede recuperar de forma exhaustiva; una grande requiere segmentación, incrustación e indexado semántico para devolver solo los pasajes más relevantes.
- ¿Se beneficia la consulta de una única recuperación centrada, o la combinación de resultados de múltiples fuentes Knowledge (por ejemplo, documentación y casos pasados simultáneamente) produciría una respuesta mejor fundamentada? Este último requiere recuperación de conjunto.
- ¿Es necesario filtrar el contenido recuperado por metadatos antes de la clasificación semántica, por ejemplo, restringir los resultados a documentos relevantes para el nivel de producto o la geografía del cliente?
- ¿Qué grado de sensibilidad tiene el contenido de Knowledge? El contenido recuperado se inyecta en la ventana de contexto de LLM e influye en la respuesta del agente; el contenido que no debe aflorar a ciertos usuarios debe regirse en la capa de recuperación, no asumirse filtrado por LLM.
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| Generación aumentada de recuperación (RAG) con Data 360 | Lo mejor para casos de uso de empresa | El agente realiza una búsqueda semántica en índices vectoriales de Data 360 antes de generar una respuesta. El contenido recuperado como artículos Knowledge, casos pasados, documentación de productos se inyecta en el contexto LLM como fundamento. Esto se puede llamar utilizando acciones de Recuperador, Flujo o Apex personalizado. Tenga en cuenta que Data 360 admite una canalización integrada desde contenido sin procesar a contexto listo para agentes, no solo un almacenamiento vectorial:
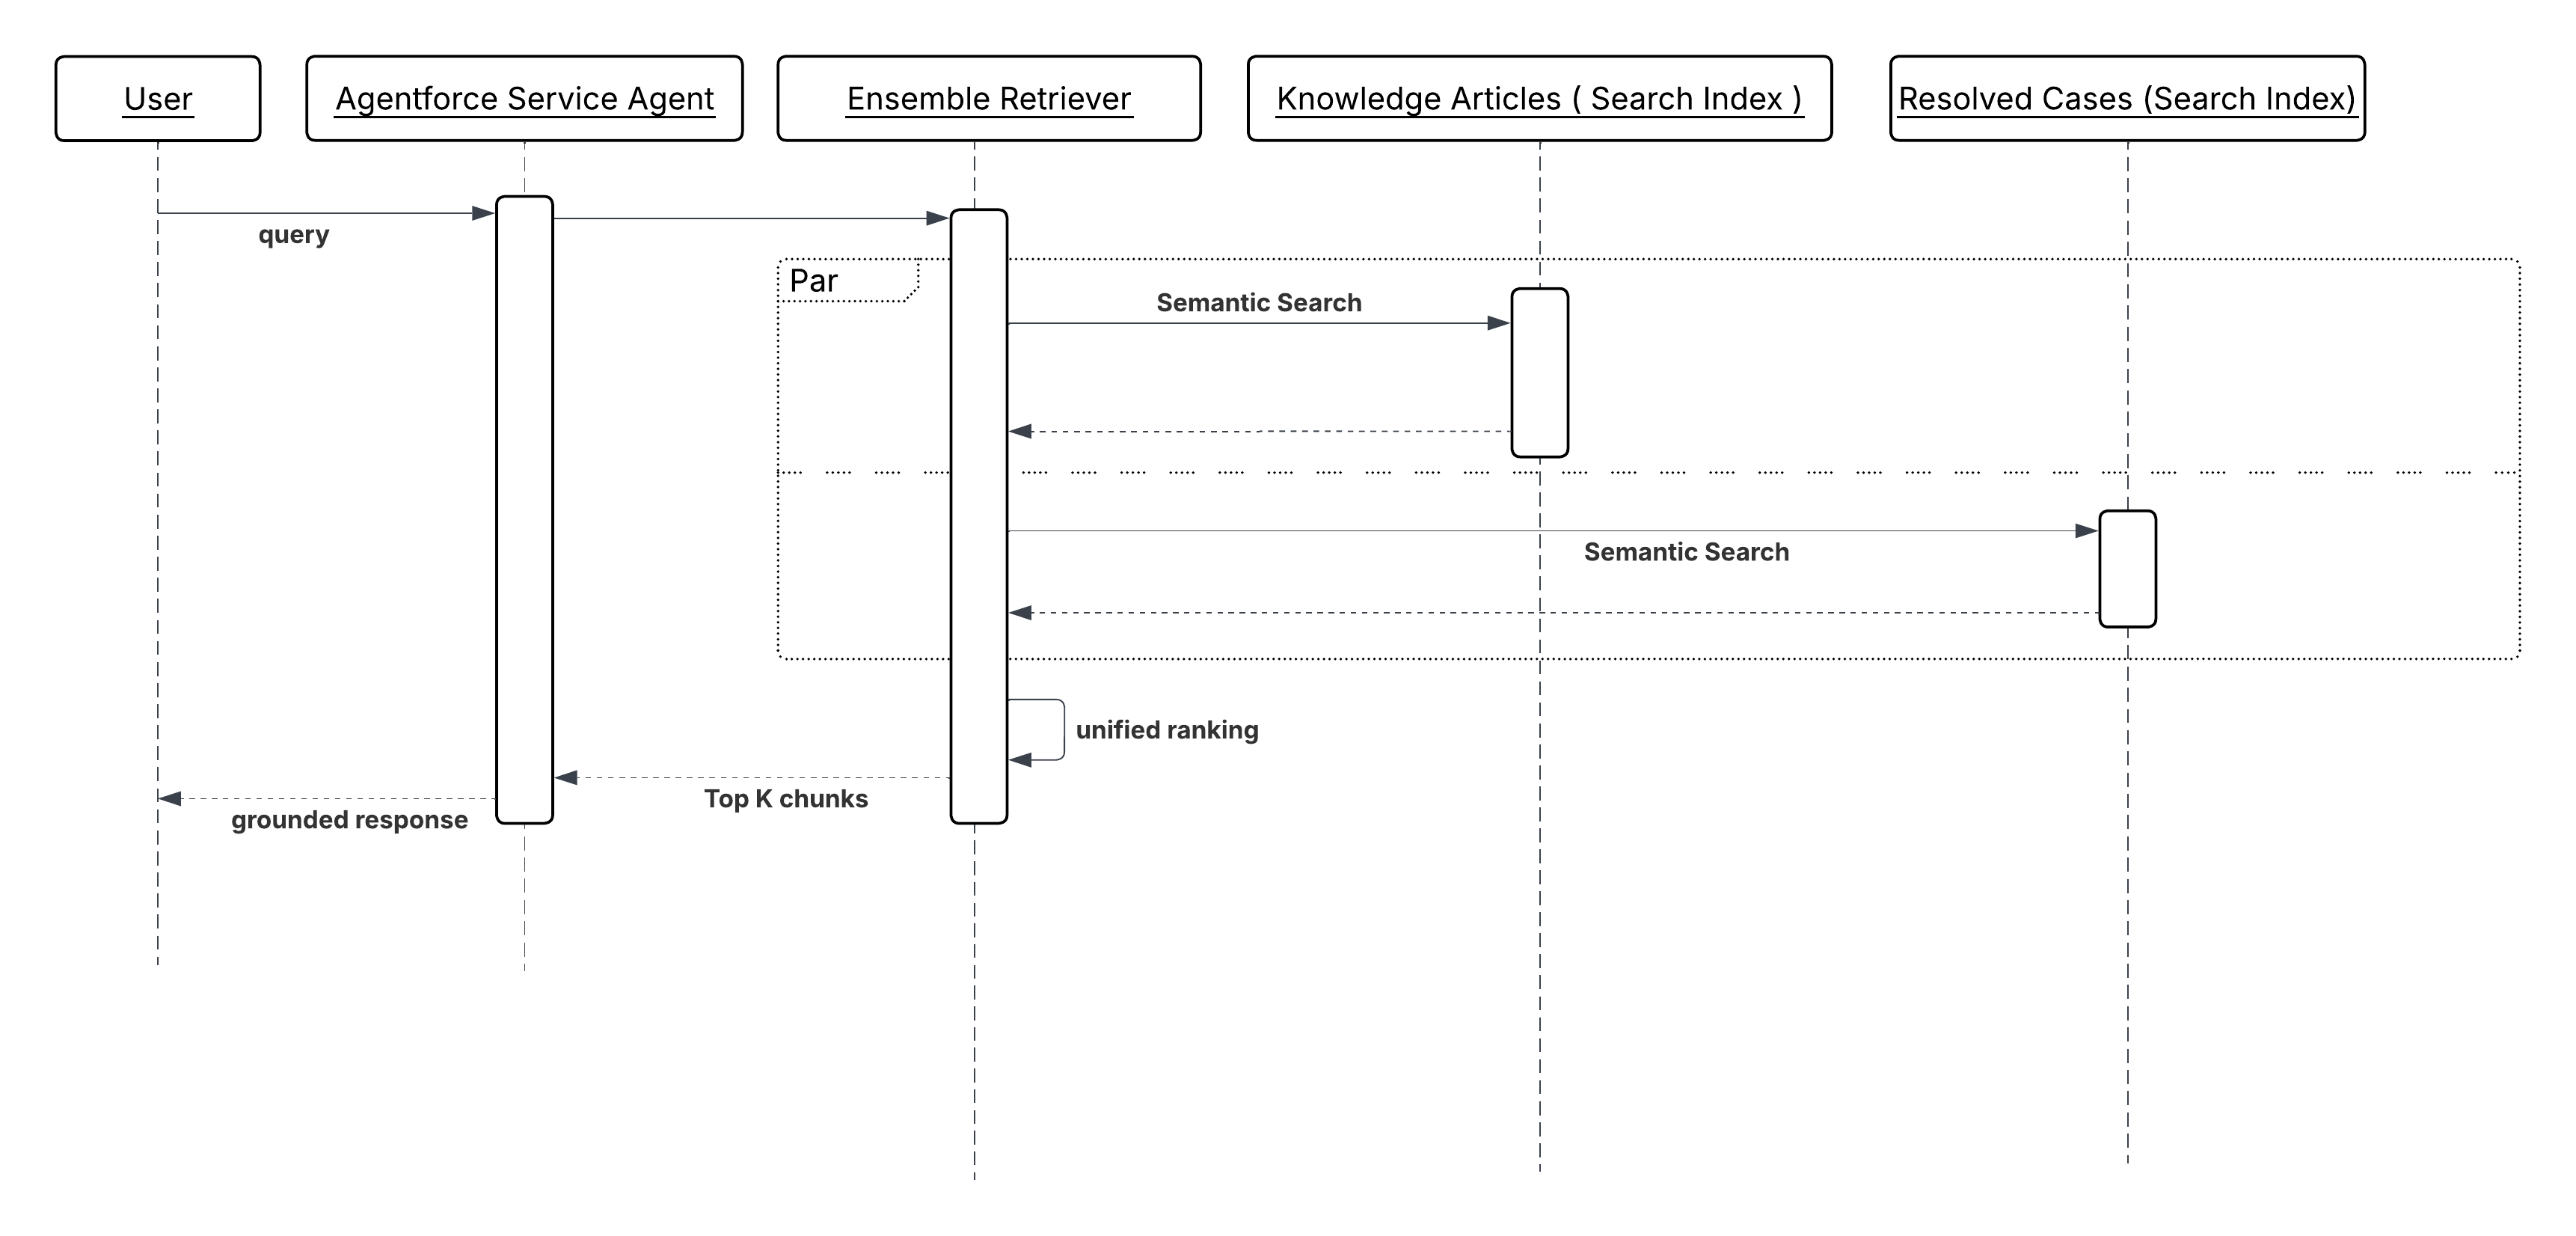
Todas estas funciones se ofrecen de forma llave en mano con capacidad de configuración completa. Tenemos dos tipos de recuperadores para Data360: Recuperador individual: Una acción de recuperación de Salesforce configurada realiza una búsqueda semántica en un único índice de búsqueda definido y devuelve los fragmentos de contenido más relevantes. Los resultados se inyectan directamente en la solicitud LLM como contexto de fundamentación. Utilice Acción de recuperador individual cuando la consulta se sirve mejor por un único origen de Knowledge centrado. Ensamble Retriever: Una Acción de recuperación de conjuntos combina los resultados de múltiples recuperadores individuales, por ejemplo, un índice de documentación de productos y un índice de casos resueltos. Los recuperadores de conjuntos no combinan puntuaciones de relevancia de recuperadores individuales ya que esas puntuaciones no son comparables entre índices heterogéneos. En su lugar, todos los fragmentos recuperados se pasan a través de un modelo de reordenador de codificador cruzado que puntúa independientemente cada par (consulta, fragmento), produciendo una clasificación unificada. Esto es arquitectónicamente significativo: significa que la calidad de la clasificación de orígenes cruzados mejora con el modelo de reordenación, no con la calibración de puntuaciones manual. Tras volver a clasificarlos, hace que el resultado unificado esté disponible para solicitudes LLM como contexto de fundamentación. Utilice Acción de recuperación de conjuntos cuando una respuesta más completa requiera pruebas de más de un dominio Knowledge. |
| RAG con bases de datos vectoriales externas | Adecuado cuando se trabaja con restricciones de infraestructura existentes | Este enfoque integra establecimientos vectoriales externos que ya podrían existir en su infraestructura para indexar incrustaciones de datos propias, aprovechándolas para la búsqueda semántica en tiempo real y la recuperación de contenido. Esto se puede implementar utilizando Flow o Apex personalizado. |
Boceto
Diagrama de secuencia para Knowledge Grounding desde Enterprise Content
Resultados
Las respuestas del agente están ancladas en el Knowledge actual y autorizado de la organización en vez de los datos de formación del LLM. El riesgo de alucinaciones en preguntas fácticas como términos de póliza, especificaciones de productos, detalles de asignación se reduce porque el modelo está razonando sobre pruebas recuperadas, no generando desde la memoria.
El contenido de Knowledge permanece independientemente mantenible. La actualización de un documento de política o la incorporación de una nueva resolución de caso al índice entra en vigor inmediatamente para todas las interacciones de agentes posteriores, sin volver a entrenar o implementar el modelo.
La recuperación también proporciona un seguimiento de auditoría implícito. Debido a que la respuesta del agente se deriva de documentos recuperados específicos, el contenido de origen puede registrarse junto con la respuesta, lo que permite rastrear por qué el agente dio una respuesta concreta.
Consideraciones de diseño
Orientación específica de plataforma
- Desglosar e integrar contenido Knowledge con la granularidad correcta. Los fragmentos que son demasiado grandes diluyen la relevancia. Los fragmentos que son demasiado pequeños pierden el contexto circundante que el LLM necesita razonar correctamente. Para la mayoría de los tipos de documentos comerciales, el corte a nivel de párrafo con ventanas de contexto superpuestas produce la mejor calidad de recuperación.
- Trate la precisión de la recuperación como un problema de diseño de primera clase. La inyección de contenido de baja relevancia en la ventana de contexto del agente no es neutra. Introduce ruido que degrada la calidad de la respuesta. Ajuste los umbrales de recuperación y los límites máximos para equilibrar la recuperación con la precisión para cada dominio Knowledge.
- La latencia de introducción es un SLA operativo. Si se actualiza un documento de política pero no se actualiza el índice vectorial, el agente recupera y actúa sobre información obsoleta. Defina una tolerancia aceptable a la obsolescencia para cada tipo de contenido y diseñe oportunidades en curso de introducción en consecuencia.
Notas de implementación de Salesforce
- Rellene índices vectoriales de Data 360 a través de las oportunidades en curso de introducción apropiadas para la frecuencia de actualización de contenido. Utilice la introducción por lotes para documentos estáticos y la transmisión o Captura de datos de cambios (CDC) para registros que cambian continuamente.
- Para Recuperadores de conjuntos, configure las ponderaciones de clasificación de relevancia por origen. Un índice de casos resueltos puede necesitar un sesgo de recencia; un índice de documentación de políticas puede no necesitarlo. Ajuste las ponderaciones basándose en los tipos de consulta que se espera que el agente gestione.
- Utilice filtros de metadatos en Apex personalizado o recuperadores de flujo para delimitar la recuperación antes de que se ejecute la búsqueda semántica. El filtrado por línea de producto, región o tipo de documento antes de la clasificación reduce el ruido y mejora la precisión de lo que se inyecta en contexto.
- No inyecte el documento recuperado completo en el contexto LLM. Pase solo los fragmentos o resúmenes relevantes. Las inyecciones de contexto de gran tamaño consumen presupuesto de token, aumentan la latencia y reducen la proporción del plazo de contexto disponible para el razonamiento del agente.
Gestión y recuperación de errores
- Si la recuperación no devuelve ningún resultado, devuelva un estado explícito “no se encontraron resultados” en vez de continuar sin fundamento. A continuación, el agente puede ampliar la consulta, solicitar al usuario aclaraciones o distribuir a un humano.
- Cada fragmento devuelto desde los recuperadores contiene una puntuación de relevancia. Dependiendo del caso de uso, debe configurarse un valor de confianza/relevancia de umbral determinado por encima del cual el agente debe tratar la recuperación como segura, de lo contrario debe volver a la aclaración o distribución.
- Si el índice vectorial o el servicio de recuperación no están disponibles temporalmente, la acción retriever o la llamada Apex debe devolver un error estructurado con una razón descriptiva. Registre el fallo con el Id. de sesión y consulte de modo que se puedan identificar brechas de recuperación y se pueda supervisar la disponibilidad del índice o servicio.
- Para dominios de Knowledge sensibles al tiempo, implemente una comprobación de actualización como parte de la respuesta de recuperación. Si el documento coincidente más reciente se actualizó por última vez más allá de un umbral de obsolescencia definido, marque esto al agente de modo que pueda cualificar su respuesta o solicitud de verificación.
Consideraciones de seguridad
- La recuperación debe respetar los permisos de acceso a los datos del usuario en cuyo nombre actúa el agente. Una sesión de agente que se ejecuta en el contexto de una interacción de cara al cliente no debe recuperar documentos operativos internos, notas de estrategia de precios o registros a los que el usuario final no tendría acceso de otro modo. Aplique seguridad a nivel de campo y a nivel de registro en la capa de recuperación. No dependa del LLM para retener contenido recuperado confidencial.
- El contenido recuperado se inyecta en la ventana de contexto LLM y puede influir o aparecer en la respuesta del agente. Trate cada documento en el contenido de recuperación como potencialmente visible para el usuario final y rija la pertenencia al contenido en consecuencia.
- Registre todas las consultas de recuperación y los identificadores de documento de fragmentos recuperados junto con el Id. de sesión. Este seguimiento de auditoría permite la reconstrucción de la evidencia que el agente utilizó al responder, que puede ser necesaria para el cumplimiento, la resolución de conflictos o las obligaciones de explicabilidad.
Ejemplo
Un agente de servicios financieros gestiona una consulta de cliente sobre penalizaciones de canje anticipado en un producto de ahorro a plazo fijo:
- El cliente solicita: “¿Qué penalización sufriría si retiro mis fondos seis meses antes?”
- El agente invoca una Acción de recuperador individual configurada en un índice vectorial de documentos de condiciones de productos.
- El recuperador realiza una búsqueda semántica utilizando el contexto de consulta, como el tipo de producto y la cuenta de cliente, y la pregunta específica y devuelve los tres fragmentos de documento más relevantes: la cláusula de canje anticipado, la tabla de cálculo de penalizaciones y las excepciones aplicables a casos difíciles.
- Los fragmentos recuperados se inyectan en la ventana de contexto del agente junto con la pregunta del cliente.
- El agente razona sobre las condiciones recuperadas, identifica el índice de penalización aplicable para el nivel de producto y la cronología de canje del cliente y devuelve una respuesta precisa y basada en pólizas, citando la fecha efectiva de las condiciones que utilizó.
- Los identificadores de documento de los fragmentos recuperados se registran con el registro de sesión para la capacidad de auditoría.
Contexto
Las LLM son probabilistas por naturaleza. Cuando se les solicita razonar sobre un cliente específico, infieren, estiman o alucinan hechos que no se les proporcionaron explícitamente. Un agente que invoca una acción de precios sin saber que el cliente es una cuenta comercial de alto valor en un nivel preferido puede aplicar la lógica de descuento incorrecta. Un agente que distribuye un caso de asistencia sin saber la puntuación de riesgo de abandono del cliente puede despriorizar una cuenta que está a días de abandonar.
Inyección de contexto de cliente verificada soluciona esto rellenando previamente parámetros de entrada de acción con atributos estructurados verificados desde el perfil unificado antes de que el agente invoque una acción. El agente no deduce el segmento del cliente, el valor de toda la vida o la tendencia de satisfacción del cliente (CSAT). Recibe esos hechos como entradas de fundamentación y razones sobre ellos. Este patrón reduce el riesgo de alucinaciones en decisiones específicas del cliente y elimina llamadas de búsqueda redundantes durante el ciclo de razonamiento.
Por ejemplo, antes de que un agente de precios invoque una acción “GenerateQuote”, la configuración del subagente inyecta automáticamente el segmento, el nivel y el valor de vida útil del cliente desde su perfil unificado. La acción recibe hechos verificados en vez de aproximaciones inferidas de LLM, y el presupuesto está anclado en la relación comercial real del cliente.
Esta no es una alternativa al patrón “Knowledge Grounding from Enterprise Content”. Un agente bien diseñado puede utilizar ambos: “Knowledge Grounding from Enterprise Content” proporciona Knowledge basado en documentos, mientras que “Verified Customer Context Injection” establece la identidad del cliente.
Problema
¿Cómo asegurarse de que un agente tiene hechos precisos específicos del cliente como segmento, nivel, valor de vida útil, riesgo de abandono u otros atributos de perfil antes de realizar una acción, en vez de adivinar esos hechos por sí mismo?
Fuerzas
Al aplicar este patrón, responda a las siguientes preguntas:
- ¿Qué parámetros de entrada de acción representan hechos específicos del cliente que, si se deducen en vez de originados, producirían resultados incorrectos o incoherentes?
- ¿Están los atributos de perfil obligatorios disponibles como campos de perfil unificados de Data 360 estándar, o requieren perspectivas calculadas derivadas de datos de comportamiento y transacciones sin procesar?
- ¿Con qué frecuencia cambian los atributos de perfil relevantes? Los atributos como puntuación de riesgo de abandono o tendencia de CSAT requieren una garantía de actualización; los datos de perfil obsoletos conducen a los mismos resultados incorrectos que los datos alucinados.
- ¿Deberían inyectarse atributos de perfil en el momento de la creación de la sesión (constante para la duración de la sesión) o recuperarse de nuevo en el punto de invocación de acción (para reflejar cambios de estado a mitad de la sesión)?
- ¿Necesita el agente razonar sobre los atributos de perfil directamente o solo los consume la acción y son opacos al bucle de razonamiento del agente?
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| Configuración de subagente: asignación de atributos de perfil | Lo mejor para la fundamentación a nivel de sesión estática | Mejor ajuste cuando los atributos de perfil son estables en una sola interacción. Asigne atributos de perfil unificado de Data 360 (por ejemplo, “customerSegment”, “tier”, “lifetimeValue”) directamente a parámetros de entrada de acción en la configuración de subagentes Agentforce. Los atributos se resuelven en la creación de la sesión y se mantienen constantes durante la duración de la sesión. |
| Flujos conectados de Data 360 | Mejor para actualización dinámica o a mitad de sesión | Se utiliza cuando los atributos de perfil cambian con frecuencia o cuando la acción requiere el estado más actual. Utilice un flujo conectado a Data 360 como un paso de acción para aflorar el estado de perfil más reciente en el punto de invocación.El flujo consulta el perfil unificado, aplica cualquier transformación necesaria y devuelve los atributos como variables de salida consumidas por la siguiente acción en la cadena. |
| Perspectivas calculadas como entradas de acción | Lo mejor para mediciones derivadas complejas | Se utiliza cuando los agentes necesitan razonar sobre mediciones comerciales calculadas (puntuación de riesgo de abandono, tendencias de CSAT, índice de adopción de productos) en vez de interpretar datos sin procesar. Definido en Data 360 como mediciones derivadas calculadas sobre datos de comportamiento, transaccionales y de implicación. Las Perspectivas calculadas se afloran como atributos de perfil consultables y se pueden asignar a entradas de acción a través de configuración de tema o un flujo conectado. |
Boceto
Diagrama de secuencia para inyección de contexto de cliente verificado
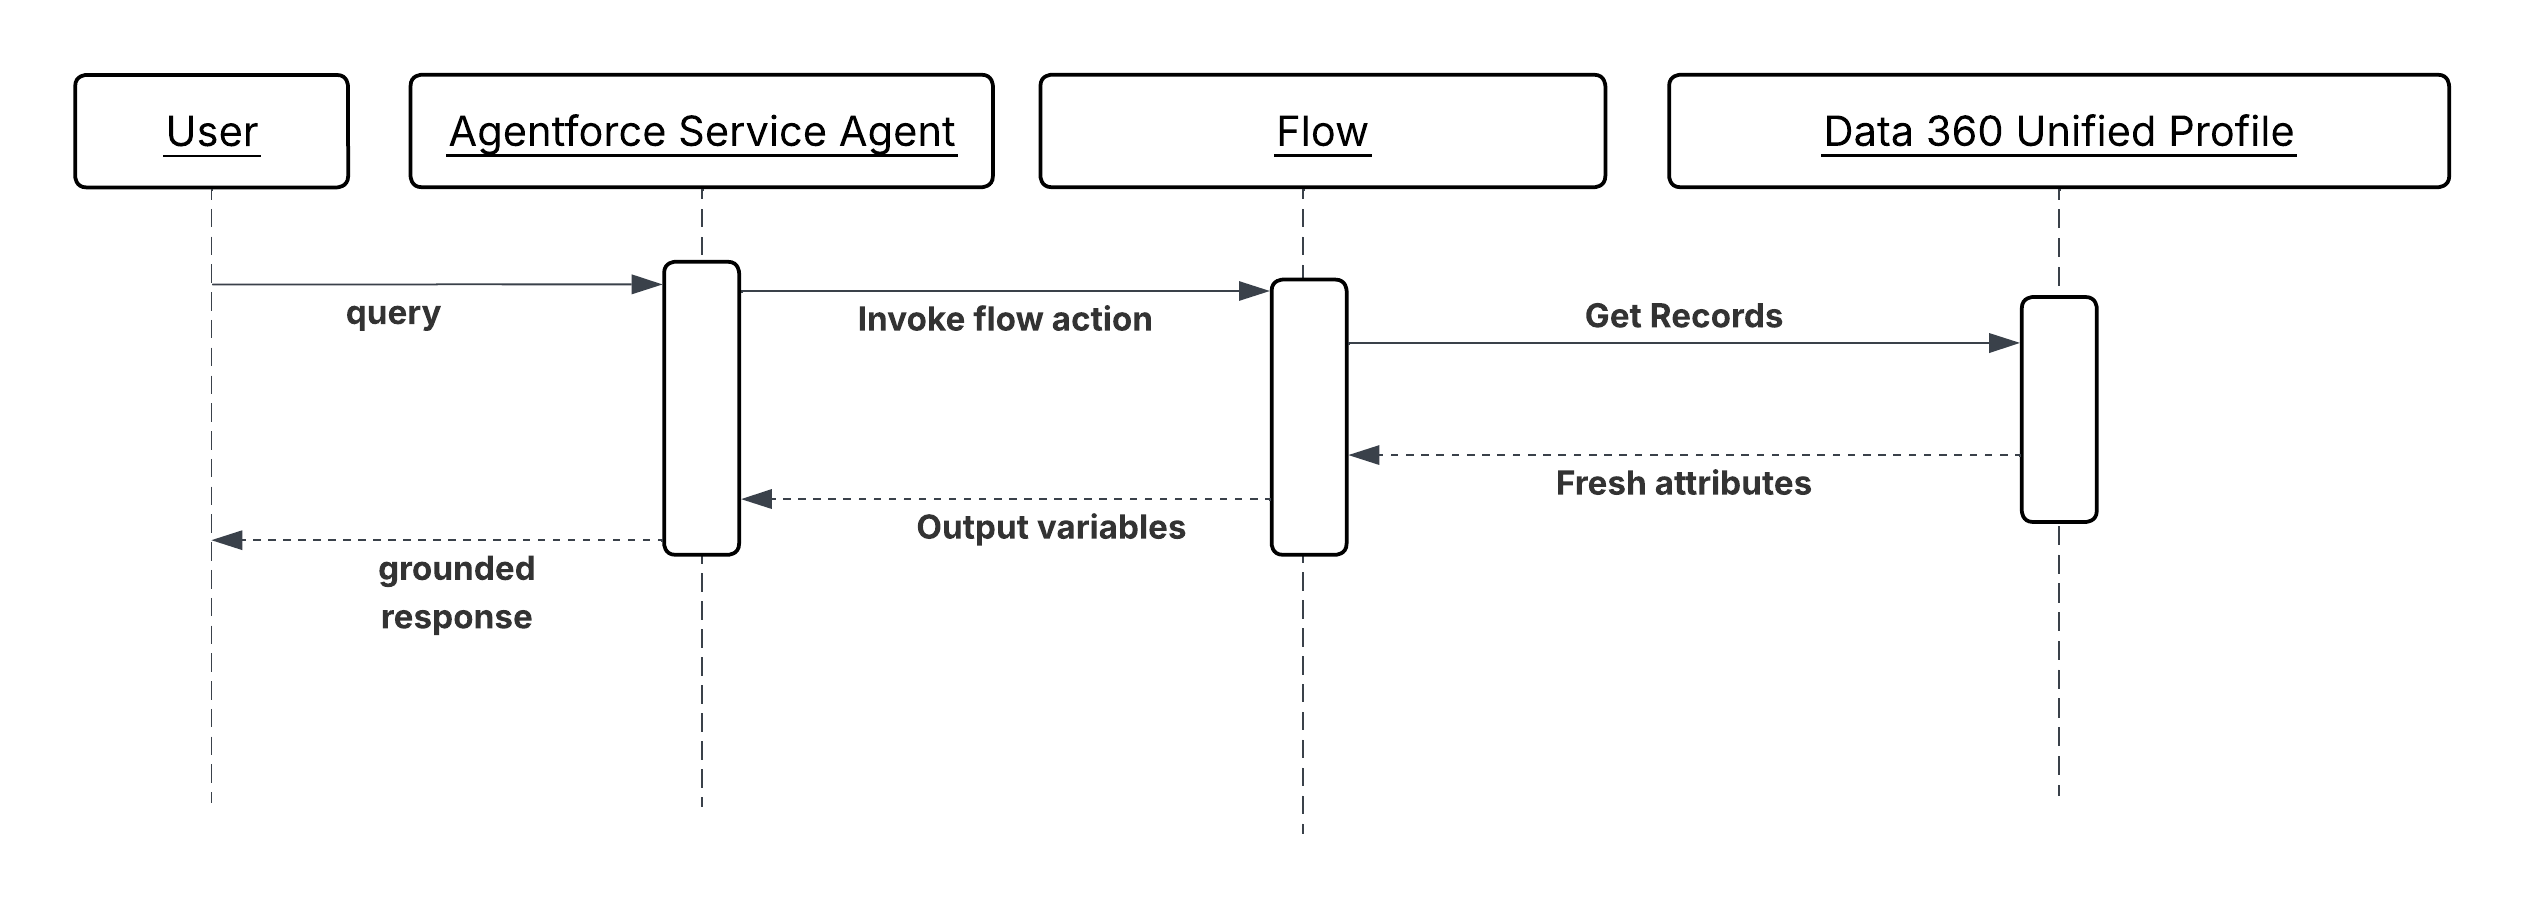
Resultados
Las acciones reciben hechos de clientes verificados y estructurados en vez de aproximaciones inferidas de LLM. El razonamiento del agente se basa en el estado de perfil real del cliente, reduciendo el riesgo de alucinaciones en decisiones donde la precisión de los hechos determina la calidad de los resultados como precios, comprobaciones de asignaciones, enrutamiento de distribución, ofertas de retención.
La fundamentación de perfiles también reduce la latencia de razonamiento. Cuando el agente no necesita emitir llamadas de búsqueda para establecer el contexto básico del cliente, el ciclo de razonamiento es más corto y la concurrencia se consume durante menos turnos.
El perfil unificado de Data 360 sigue siendo el origen autorizado de hechos de clientes. La configuración de subagente o flujo conectado es la costura de integración. El agente es responsable de razonar sobre esos hechos y seleccionar acciones, no de obtener los hechos en sí.
Consideraciones de diseño
Orientación específica de plataforma
- Identifique todas las entradas de acción que conllevan riesgo de alucinaciones, donde la inferencia LLM podría producir un resultado erróneo en vez de un valor verificado. Las entradas con riesgo de alucinaciones son candidatas para la fundamentación de perfiles. No todas las entradas requieren fundamentación; la sobreinyección de datos de perfil agrega ruido a la ventana de contexto del agente.
- Trate la actualización del perfil como una decisión de diseño, no como una idea posterior. Defina la tolerancia de obsolescencia aceptable para cada atributo fundamentado y seleccione el mecanismo de inyección en consecuencia: asignación a nivel de sesión para atributos estables, actualización basada en flujo para los volátiles.
- Perspectivas calculadas debe codificar la lógica comercial, no mediciones sin procesar. Un razonamiento de agente sobre un “churnRiskScore” de 0,87 es más efectivo que un razonamiento de agente sobre 14 señales de comportamiento sin procesar. Compute la interpretación en Data 360; pase el resultado al agente.
Notas de implementación de Salesforce
- La fundamentación de perfiles solo es tan fiable como la unificación detrás. Por ejemplo, el valor del perfil unificado depende completamente de la calidad de la resolución de identidad ascendente. Si un cliente tiene identidades fragmentadas entre sistemas de origen que no se han unificado, los atributos de perfil que recibe el agente estarán incompletos o representarán solo una vista parcial (por ejemplo, Valor de vida útil calculado con datos de un canal pero no de otro).
- Para flujos conectados de Data 360, utilice el elemento Obtener registros con un filtro en el “recordId” o “accountId” de la sesión actual para recuperar solo el registro de perfil relevante. Devuelva solo los atributos requeridos por la acción descendente; no devuelva el objeto de perfil completo.
- Perspectivas calculadas debe mantenerse actualizada a través de oportunidades en curso de introducción de Data 360. Configure la transmisión o la actualización casi en tiempo real para perspectivas utilizadas en decisiones urgentes (por ejemplo, riesgo de abandono en un flujo de trabajo de retención). Las perspectivas actualizadas por lotes son aceptables para atributos de movimiento más lento (por ejemplo, nivel de valor de contrato anual).
- Valide que los atributos de perfil asignados no sean nulos antes de la invocación de acción. Un “customerTier” nulo pasado a una acción de precios es tan perjudicial como un valor alucinado. Utilice elementos de decisión de flujo para detectar datos de perfil que faltan y enrutar a una reserva que recupera un valor predeterminado o solicita aclaraciones.
- En la configuración de subagente, asigne atributos de perfil a parámetros de entrada de acción utilizando nombres de variable descriptivos y semánticamente claros (por ejemplo, “customerTier”, “lifetimeValueUSD”, “churnRiskScore”). El LLM lee estos nombres al seleccionar y redactar acciones; los nombres ambiguos degradan la precisión de la selección.
Gestión y recuperación de errores
- Si un atributo de perfil obligatorio es nulo o no está disponible en el momento de la invocación de la acción, el agente no debe continuar con un valor predeterminado potencialmente incorrecto. La acción debe devolver un error estructurado indicando el atributo que falta, y el agente debe solicitar al usuario aclaraciones o distribuir a un humano si opera de forma no conversacional.
- Si un flujo conectado a Data 360 no recupera datos de perfil (por ejemplo, debido a una interrupción del servicio de Data 360), la ruta de fallo del flujo debería devolver un error estructurado al agente con el motivo de fallo específico. A continuación, el agente puede decidir si reintentarlo, continuar con una experiencia degradada o aflorar el fallo al usuario.
- Registre todos los valores de atributos de perfil inyectados en la creación de sesión o la invocación de acción junto con el Id. de sesión. Esto garantiza que cualquier decisión de agente en disputa se pueda reconstruir con los hechos de cliente exactos que se proporcionaron al agente en ese momento.
Consideraciones de seguridad
- Los atributos de perfil inyectados en contexto de agente están sujetos a los mismos controles de acceso a datos que cualquier registro de CRM. Asegúrese de que el usuario de integración o la aplicación conectada utilizada para resolver atributos de perfil solo tiene los permisos a nivel de campo requeridos para los atributos que se están aflorando y no un acceso de lectura de perfil más amplio.
- Las Perspectivas calculadas que codifican mediciones derivadas confidenciales (por ejemplo, puntuación de salud predicha, nivel de riesgo financiero) deben tratarse como campos confidenciales y regirse por los mismos controles de acceso que los datos subyacentes. Hacer aflorar una puntuación de riesgo de abandono alto a un agente que opera en un contexto de cara al cliente requiere una consideración cuidadosa de lo que el agente puede comunicar.
- No aflore atributos de perfil que no son requeridos por la acción. Cada atributo adicional en la ventana de contexto del agente es un elemento de datos adicional que podría reproducirse en la respuesta del agente. Aplique un principio mínimo necesario a la fundamentación de perfiles.
- Realice una auditoría de todas las sesiones en las que Perspectivas calculadas o atributos de perfil confidencial se inyectaron como entradas. Estas sesiones representan decisiones tomadas en base a Inteligencia de clientes derivada y pueden estar sujetas a requisitos de explicabilidad o regulación en ciertos sectores.
Ejemplo
Una empresa de telecomunicaciones utiliza Agentforce para gestionar conversaciones de retención con clientes que iniciaron una solicitud de cancelación.
- Cuando se abre un caso de cancelación, la sesión de agente se crea con el “accountId” del cliente como contexto.
- La configuración del subsubgente asigna tres atributos Perfil unificado de Data 360 a variables de sesión en el momento de la creación: “customerTier” (Empresa), “lifetimeValueUSD” (42.000) y “contractRenewalDate” (60 días).
- Una Perspectiva calculada como “churnRiskScore” (0,91, calculada a partir de la disminución de uso, la frecuencia de tickets de asistencia y la tendencia de NPS) se asigna como una variable de sesión adicional a través de un flujo conectado a Data 360 invocado como el primer paso de acción.
- El agente, ahora basado en hechos verificados del cliente, invoca una acción “SelectRetentionOffer”. Como las entradas incluyen “customerTier = Enterprise”, “lifetimeValueUSD = 42000” y “churnRiskScore = 0,91”, la acción devuelve la oferta de retención de nivel máximo en vez de una estándar.
- El agente invoca “PresentOffer” para entregar la oferta en la conversación y “LogRetentionAttempt” para registrar la interacción en CRM con todos los atributos fundamentados conservados para la capacidad de auditoría.
Contexto
Los datos de empresa están fragmentados. Un agente que solo puede actuar sobre lo que vive dentro de Salesforce Platform está limitado a una fracción de la información que necesita para razonar de forma efectiva. Responder a una pregunta de servicio puede requerir leer el ticket abierto de un cliente en Service Cloud. La preparación de una propuesta puede requerir la recuperación de un archivo de Google Drive. El análisis del uso de productos puede requerir consultar un almacén de datos. Cada uno de estos sistemas tiene sus propias API, su propio modelo de autenticación y su propio esquema de datos, y el coste de escribir código de integración personalizado para cada uno es lo que históricamente ha hecho que la conectividad de agente a sistema sea cara y frágil.
MCP es un estándar abierto que trata esto directamente. Define una interfaz uniforme a través de la cual un agente puede descubrir e invocar herramientas expuestas por cualquier servidor compatible con MCP, independientemente del sistema subyacente. Cada servidor MCP actúa como un adaptador: Encierra las interfaces nativas de un sistema de destino en una interfaz estandarizada centrada en herramientas que el agente puede consultar, invocar y redactar sin saber nada sobre los protocolos o esquemas específicos del sistema.
Desde la perspectiva del agente, la conexión con Slack, una base de datos de Structured Query Language (SQL) y un sistema de gestión de documentos tienen el mismo aspecto, tres servidores MCP, cada uno exponiendo un conjunto de herramientas llamadas descritas. El agente los selecciona y los secuencia basándose en sus descripciones semánticas y el objetivo que está intentando alcanzar.
Problema
Cuando un agente necesita recuperar información o desencadenar acciones entre múltiples sistemas externos, cada uno con API, autenticación y esquemas diferentes, ¿cómo puede descubrir, invocar y componer sus funciones sin código de integración personalizado por sistema o acoplamiento estrecho a la implementación de cualquier sistema?
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
- ¿Necesita el agente llegar a sistemas fuera de la plataforma Salesforce como almacenes de documentos, herramientas de colaboración, bases de datos, SaaS externo, cuyas API no están representadas de forma nativa como acciones Agentforce?
- ¿Se requiere la detección de herramientas dinámicas, donde el agente identifica el extremo de integración correcto en el momento del razonamiento basándose en la solicitud actual, en vez de tener integraciones codificadas en su configuración?
- ¿Cambia frecuentemente el panorama de la integración; se agregan nuevos sistemas, se actualizan los existentes y otros cambios pueden requerir un enfoque adaptado por sistema que cree gastos generales de mantenimiento insostenibles?
- ¿Existe la necesidad de desvincular la capa de razonamiento del agente de los detalles de implementación de sistemas descendentes, de modo que un cambio en la API de un sistema de destino no requiera cambios en las instrucciones del agente o la configuración del subagente?
- ¿Son los sistemas de destino propiedad de diferentes equipos o proveedores, cada uno responsable de exponer sus propias funciones, haciendo que un modelo de servidor MCP del lado del proveedor sea más práctico que una integración del lado del consumidor por agente?
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| Servidores MCP de Salesforce | Ideal para objetivos de ecosistemas de Salesforce | Se utiliza cuando el sistema de destino está dentro del ecosistema de Salesforce y un servidor MCP propio está disponible. Salesforce Headless 360 proporciona servidores MCP para sus propias funciones de plataforma, exponiendo datos de CRM, flujos y acciones de plataforma como herramientas compatibles con MCP. Reduce el esfuerzo de implementación a configuración en vez de desarrollo. Nota: Actualmente, los servidores de Salesforce MCP solo admiten credenciales de usuario final para autenticación y autorización. |
| Servidores MCP de MuleSoft personalizados | Mejor cuando no existe ningún servidor MCP propio | El uso para sistemas heredados, aplicaciones internas propias o plataformas SaaS externas es anterior al estándar MCP. Cuando un sistema de destino no proporciona su propio servidor MCP, una capa de integración de MuleSoft se puede incluir en un servidor MCP personalizado que expone las funciones del sistema como herramientas. También se puede utilizar con API de Salesforce si se requieren MCP para que los agentes se consuman solo con credenciales de usuario del sistema. MuleSoft gestiona la traducción de protocolos, la autenticación y la transformación de datos; la capa MCP hace que el resultado sea detectable por los agentes. |
| Servidores MCP externos | Ideal para sistemas de materias primas con ecosistemas MCP activos | Existe un servidor MCP mantenido por el proveedor para su plataforma (GitHub, Google Workspace) y cumple los requisitos de seguridad y mantenimiento. Un número creciente de plataformas empresariales como GitHub, Google Workspace y otras publican sus propios servidores MCP. Donde existe un servidor listo para producción y mantenido por el proveedor, prefiera que se cree uno personalizado. Evalúe la postura de seguridad y el compromiso de mantenimiento antes de adoptar. |
Boceto
Diagrama de secuencia para inyección de contexto de cliente verificado
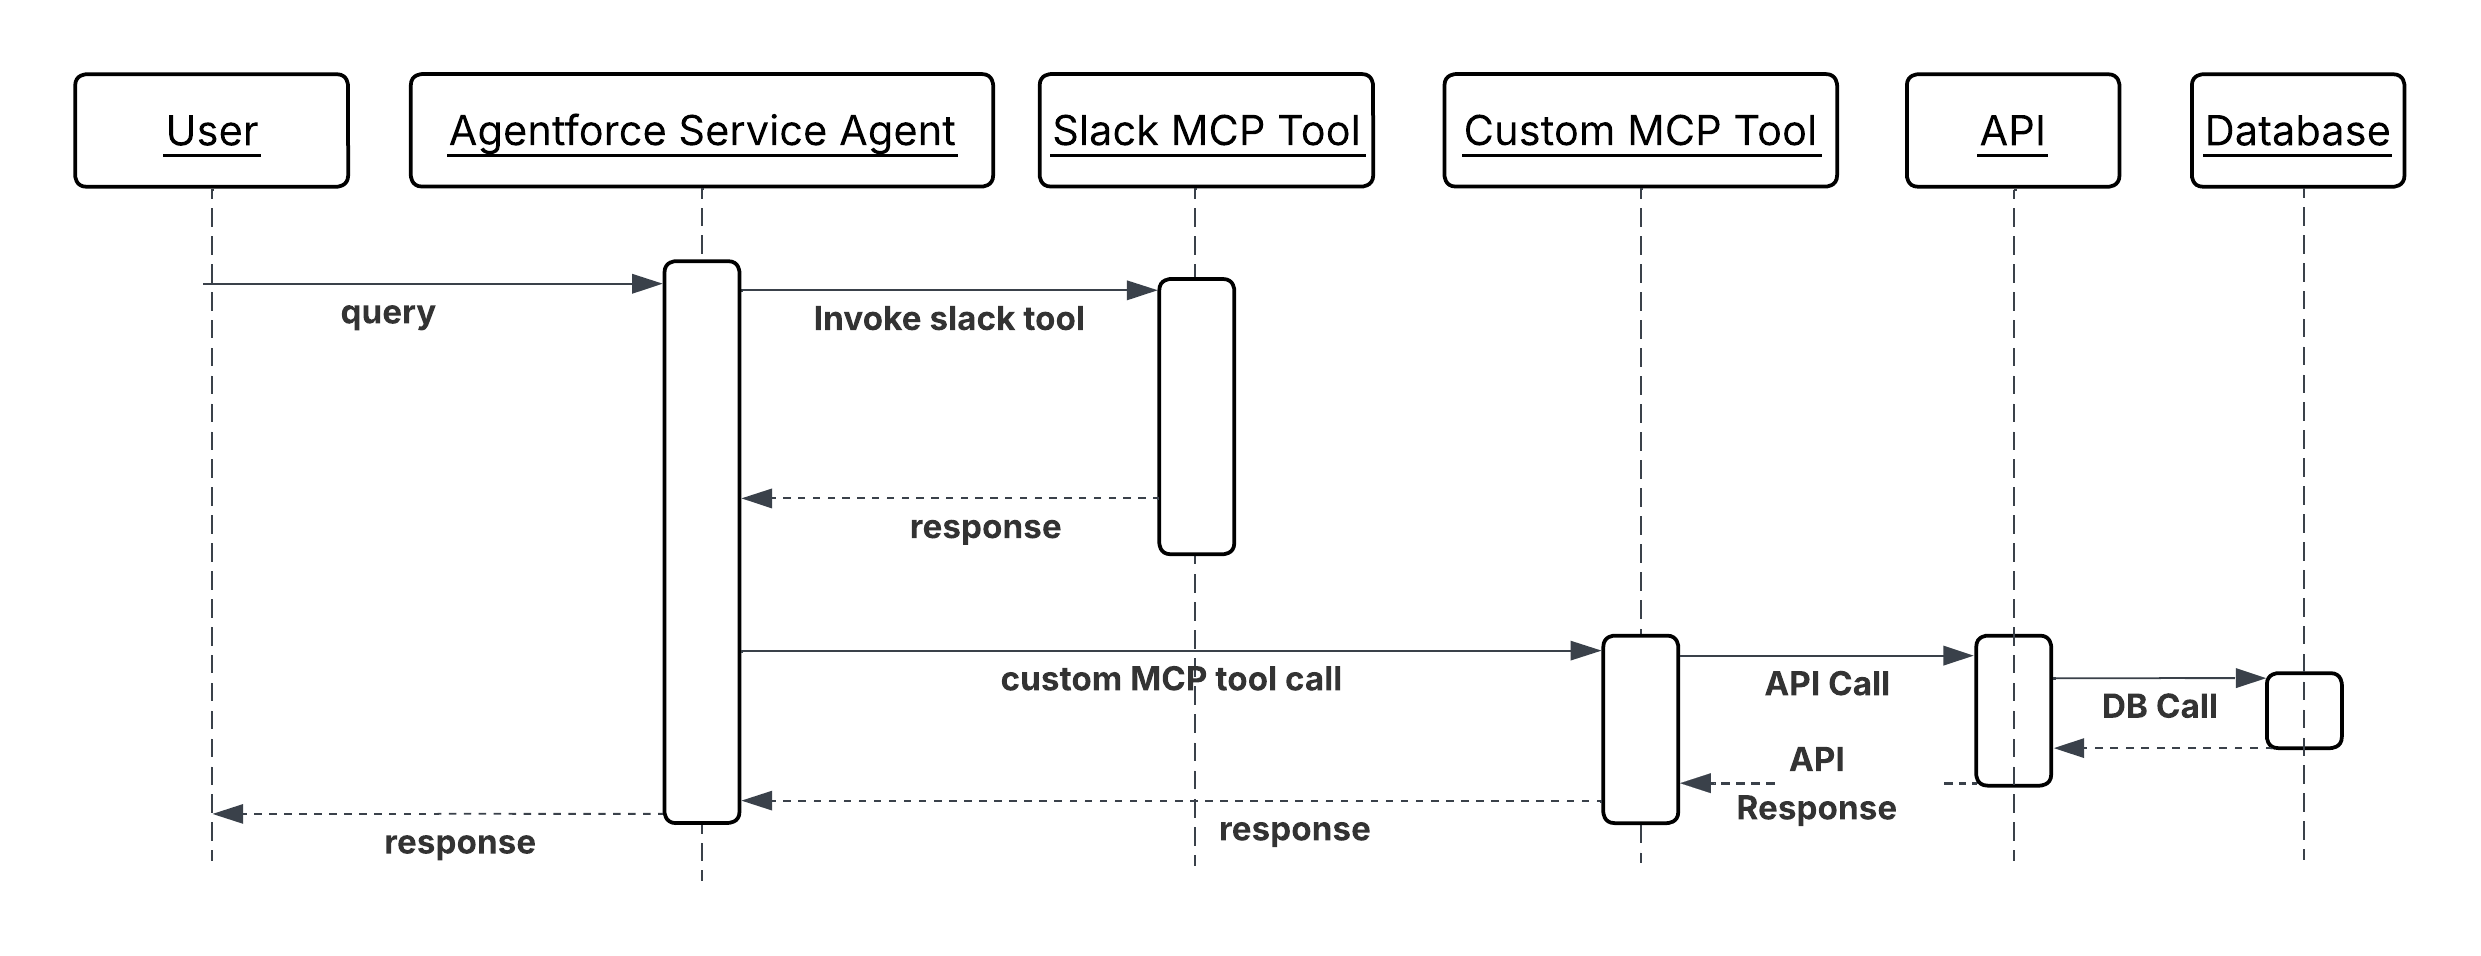
Resultados
El área superficial alcanzable del agente se amplía sin aumentar su complejidad de integración. Agregar un nuevo sistema externo significa implementar o configurar un servidor MCP para él y no redactar llamadas Apex personalizadas o integraciones de flujo por agente. La capa de razonamiento del agente permanece sin cambios; descubre e invoca las nuevas herramientas basándose solo en sus descripciones semánticas.
El estándar MCP también crea una separación de propiedad limpia: el equipo responsable de un sistema expone sus funciones como un servidor MCP; el equipo de agentes consume esas funciones sin necesidad de comprender los elementos internos del sistema. Este límite reduce los gastos generales de coordinación a medida que crece el número de sistemas integrados.
La capacidad de creación de herramientas es un resultado directo. Como todas las herramientas comparten la misma interfaz de invocación, el agente puede encadenar herramientas de diferentes sistemas, recuperar un archivo de Google Drive, extraer datos de él y redactar el resultado en un registro de CRM de forma tan natural como las acciones encadenadas en un sistema.
Consideraciones de diseño
Orientación específica de plataforma
- Las descripciones de herramientas son la única base del agente para decidir si invocar una herramienta y cómo hacerlo. Redacte descripciones en un lenguaje claro basado en la intención que indique qué hace la herramienta, cuándo se aplica y qué devuelve. Una descripción que dice “consulta la base de datos de CRM” es menos útil que “recupera los casos abiertos de la cuenta, ordenados por prioridad, para un Id. de cuenta concreto”. Las descripciones deficientes producen una mala selección de herramientas.
- Alcance cada herramienta MCP a una única capacidad atómica. Una herramienta que recupera un documento y también escribe un resumen de vuelta al sistema de origen es más difícil de razonar para el agente, más difícil de reintentar en caso de fallo y más difícil de proteger que dos herramientas discretas. Una herramienta, una responsabilidad.
- Diseñe herramientas de modo que los resultados sean entradas que se puedan componer. El resultado de una herramienta de recuperación debe estructurarse de una forma que se asigne de forma natural a los parámetros de entrada de las herramientas de acción que normalmente la siguen, reduciendo el trabajo de transformación que el agente debe realizar entre pasos.
- Servidores MCP de host remoto. Las instalaciones binarias locales crean complejidad de implementación y versión que crece con el número de entornos de agentes. Un servidor alojado de forma remota se puede actualizar independientemente de los agentes que lo consumen.
Notas de implementación de Salesforce
- Si desea una autenticación MCP coherente, límite de frecuencia, validaciones de carga en todas las llamadas MCP salientes, utilice Pasarela de IA como Pasarela de OmniCanal de MuleSoft compatible con servidores MCP y configúrela antes de exponer cualquier servidor MCP a agentes.
- Utilice credenciales de OAuth 2.0 para todas las credenciales requeridas por conexiones de servidor MCP. Las credenciales no deben aparecer en parámetros de herramientas, configuraciones de acciones o código Apex.
- Algunas herramientas de MCP podrían necesitar credenciales de usuario final para realizar algunas acciones dependiendo del caso de uso comercial (como transferencia de fondos). Para propagar tokens de identidad de usuario final, utilice la política de inyección de OAuth 2.0 en nombre de credenciales que actualmente es compatible con MuleSoft OmniGateway.
- Para servidores MCP de MuleSoft personalizados: defina el esquema de herramientas de MCP en la especificación de API de MuleSoft y registre el extremo del servidor en el catálogo de herramientas Agentforce. Pruebe descripciones de herramientas con consultas de agentes representativos para verificar que el agente selecciona la herramienta correcta para la tarea correcta antes de implementar en producción.
Gestión y recuperación de errores
- Cuando una llamada de herramienta MCP devuelve un error, el agente inspecciona el código de error legible por máquina para determinar la acción de recuperación apropiada: solicitando parámetros que faltan al usuario, reintentando con entrada corregida o distribuyendo a un humano. Nunca consume de forma silenciosa errores o continúa razonando como si la llamada de herramienta se realizara correctamente.
- El agente implementa lógica de reintento para fallos transitorios directamente.
- Registre cada invocación de herramienta MCP desde el lado del cliente con el nombre de la herramienta, los parámetros de entrada desinfectados y el resultado. Este rastreo del lado del cliente combinado con registros del lado del servidor es el mecanismo principal para diagnosticar por qué un agente realizó una ruta de acción concreta cuando un flujo de trabajo no produce el resultado esperado.
Consideraciones de seguridad
- Todas las conexiones de servidor MCP salientes pasan por la pasarela. La pasarela aplica la verificación de autenticación, la limitación de velocidad para evitar el abuso de herramientas y la inspección de carga para detectar intentos de inyección de solicitudes en parámetros de herramientas. Las conexiones directas no mediadas desde agentes a servidores MCP omiten estos controles y no están permitidas.
- Conexiones de servidor MCP de cada agente solo a los servidores cuyas herramientas requiere ese agente en realidad. Un agente configurado con acceso a todos los servidores MCP disponibles tiene una superficie de ataque mayor que una conectada solo a las herramientas que demandan sus tareas definidas.
- Valide y desinfecte los parámetros de entrada de la herramienta antes de pasarlos a la herramienta, especialmente cuando los valores de parámetros se derivan de texto proporcionado por el usuario o contenido generado por LLM. No pase el resultado LLM no validado directamente como parámetros de herramienta; un atacante que puede influir en el razonamiento del agente puede utilizar esa ruta para inyectar valores maliciosos en llamadas del sistema descendentes.
- Trate la lista del agente de servidores MCP conectados y sus inventarios de herramientas como configuración confidencial. Un atacante que sabe qué herramientas tiene disponibles un agente y qué parámetros acepta tiene un mapa para crear cargas de inyección de solicitudes diseñadas para abusar de esas herramientas.
Ejemplo
Un agente de ventas prepara un informe de cuenta completo antes de una llamada de cliente de alto valor:
- El agente recibe la solicitud: “Preparar una sesión informativa sobre Acme Corp antes del debate de renovación de mañana”.
- El agente consulta el catálogo de herramientas de MCP e identifica tres herramientas relevantes entre dos servidores de MCP:
GetRecentEmails,GetOpenOpportunitiesyGetSupportTicketSummary. - El agente invoca las tres herramientas en paralelo. Cada servidor MCP traduce la llamada a la API nativa de su sistema de destino, recupera los datos relevantes y devuelve un resultado estructurado.
- El agente recibe los tres resultados. Hilos de correo electrónico recientes, la oportunidad de renovación abierta con el tamaño y la etapa de la negociación y un resumen de tickets de asistencia abiertos por prioridad, y los sintetiza en una sesión informativa de cuenta estructurada.
- El agente invoca
CreateAccountNotepara guardar la información en el registro de cuenta y devuelve un resumen al usuario solicitante. - Las cuatro invocaciones de herramientas de MCP se registran por la pasarela con nombres de herramientas, identidades de servidor y resultados para el registro de auditoría de sesión.
Contexto
El patrón de MCP saliente describe un agente Agentforce consumiendo herramientas desde servidores MCP externos. El patrón entrante invierte esto. Las funciones de la plataforma Salesforce como registros de CRM, flujos, lógica Apex y perspectivas de Data 360 se exponen como herramientas de MCP que los agentes externos, que se ejecutan en cualquier marco de trabajo LLM, pueden descubrir e invocar.
Este patrón importa porque las implementaciones de IA empresarial rara vez son de un solo proveedor. Es posible que el agente de un socio creado en un marco de trabajo diferente necesite buscar el estado de cuenta de un cliente en Salesforce. Un equipo de ciencia de datos interno que ejecuta un agente basado en Python podría necesitar desencadenar un flujo de Salesforce para iniciar un proceso de aprobación. Sin un mecanismo de exposición estandarizado, cada consumidor externo requiere una integración personalizada. La exposición de las funciones de Salesforce como un servidor MCP proporciona a cada agente compatible con MCP una interfaz uniforme y detectable con las herramientas de la plataforma independientemente de cómo esté construido el agente que llama.
Por ejemplo, el agente de adquisiciones de un socio, creado en un marco de trabajo externo, necesita verificar el estado del contrato de un proveedor en Salesforce antes de aprobar un pedido de compra. En vez de crear una integración de REST directa, invoca una herramienta de GetContractStatus en el servidor MCP de Salesforce. La herramienta aplica los mismos controles de acceso que cualquier operación nativa de Salesforce; el agente que llama solo ve el resultado.
Problema
Cuando un agente externo creado en un marco de trabajo diferente, propiedad de un socio o que se ejecuta fuera de la plataforma Salesforce necesita invocar funciones de Salesforce como parte de su propio flujo de trabajo, ¿cómo se pueden exponer esas funciones de una forma estandarizada, detectable y gobernada de forma segura que no requiere una integración personalizada por consumidor externo?
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
- ¿Están los agentes externos que necesitan consumir funciones de Salesforce creados en marcos de trabajo que admiten el estándar MCP? De lo contrario, una API de REST o un enfoque de webhook puede ser más apropiado que MCP.
- ¿Qué funciones de Salesforce necesitan exponerse: recuperación de datos de solo lectura, operaciones de escritura, invocaciones de flujos o una combinación? El ámbito de exposición determina directamente el área de superficie de seguridad que se debe regular.
- ¿Cómo se debe verificar la identidad del agente llamante externo y bajo qué permisos de Salesforce se deben ejecutar sus invocaciones? Las llamadas de agente a plataforma no deben heredar permisos más amplios de los que requiere la operación específica.
- ¿Está pensado el servidor Salesforce MCP para consumidores internos (agentes de otros equipos en la misma organización) o consumidores externos (agentes socios y clientes)? El modelo Trust y los requisitos de autenticación varían significativamente entre estas audiencias.
- ¿Cómo evolucionará el conjunto de herramientas expuestas con el tiempo? Las nuevas funciones de Salesforce agregadas al servidor MCP se vuelven detectables de inmediato por todos los agentes conectados; la exposición no intencionada de herramientas debe regirse por un proceso de publicación deliberado.
Aplicación de patrón de Salesforce
| Solución | Ajuste | Comentarios |
|---|---|---|
| Salesforce como servidor MCP (Nativo) | Lo mejor para exponer funciones de Salesforce propias | Se utiliza cuando las herramientas que se van a exponer se asignan directamente a operaciones de plataforma de Salesforce existentes y los agentes que llaman son compatibles con MCP. La función de servidor MCP nativo de Salesforce Headless 360 permite que las operaciones de plataforma como consultas de registros, invocaciones de flujos y acciones Apex se declaren como herramientas MCP y se expongan a cualquier agente externo compatible con MCP. El acceso se rige por el modelo de permisos de Salesforce. Tenga en cuenta que estos servidores MCP de Headless 360 solo se pueden acceder con credenciales de usuario final actualmente. |
| MuleSoft como fachada de servidor MCP | Mejor cuando se requiere transformación o agregación de múltiples sistemas | Se utiliza cuando el agente llamante necesita una función que requiere datos de más de un objeto de Salesforce, transformación antes de la entrega o composición con datos de otros sistemas. La interfaz MCP permanece limpia y sencilla; la complejidad es absorbida por MuleSoft. Una capa de MuleSoft MCP se encuentra frente a Salesforce y expone el resultado agregado de múltiples operaciones de plataforma como una única herramienta de MCP. Esta solución también puede ser utilizada por agentes donde la identidad del usuario final no se puede propagar para la autenticación y autorización de Salesforce. Por ejemplo, si Agentforce Agents necesita servidores MCP con credenciales del sistema, tendremos que depender de servidores MCP personalizados como uno creado con y alojado en MuleSoft. |
Boceto
Diagrama de secuencia para funciones comerciales como herramienta llamable
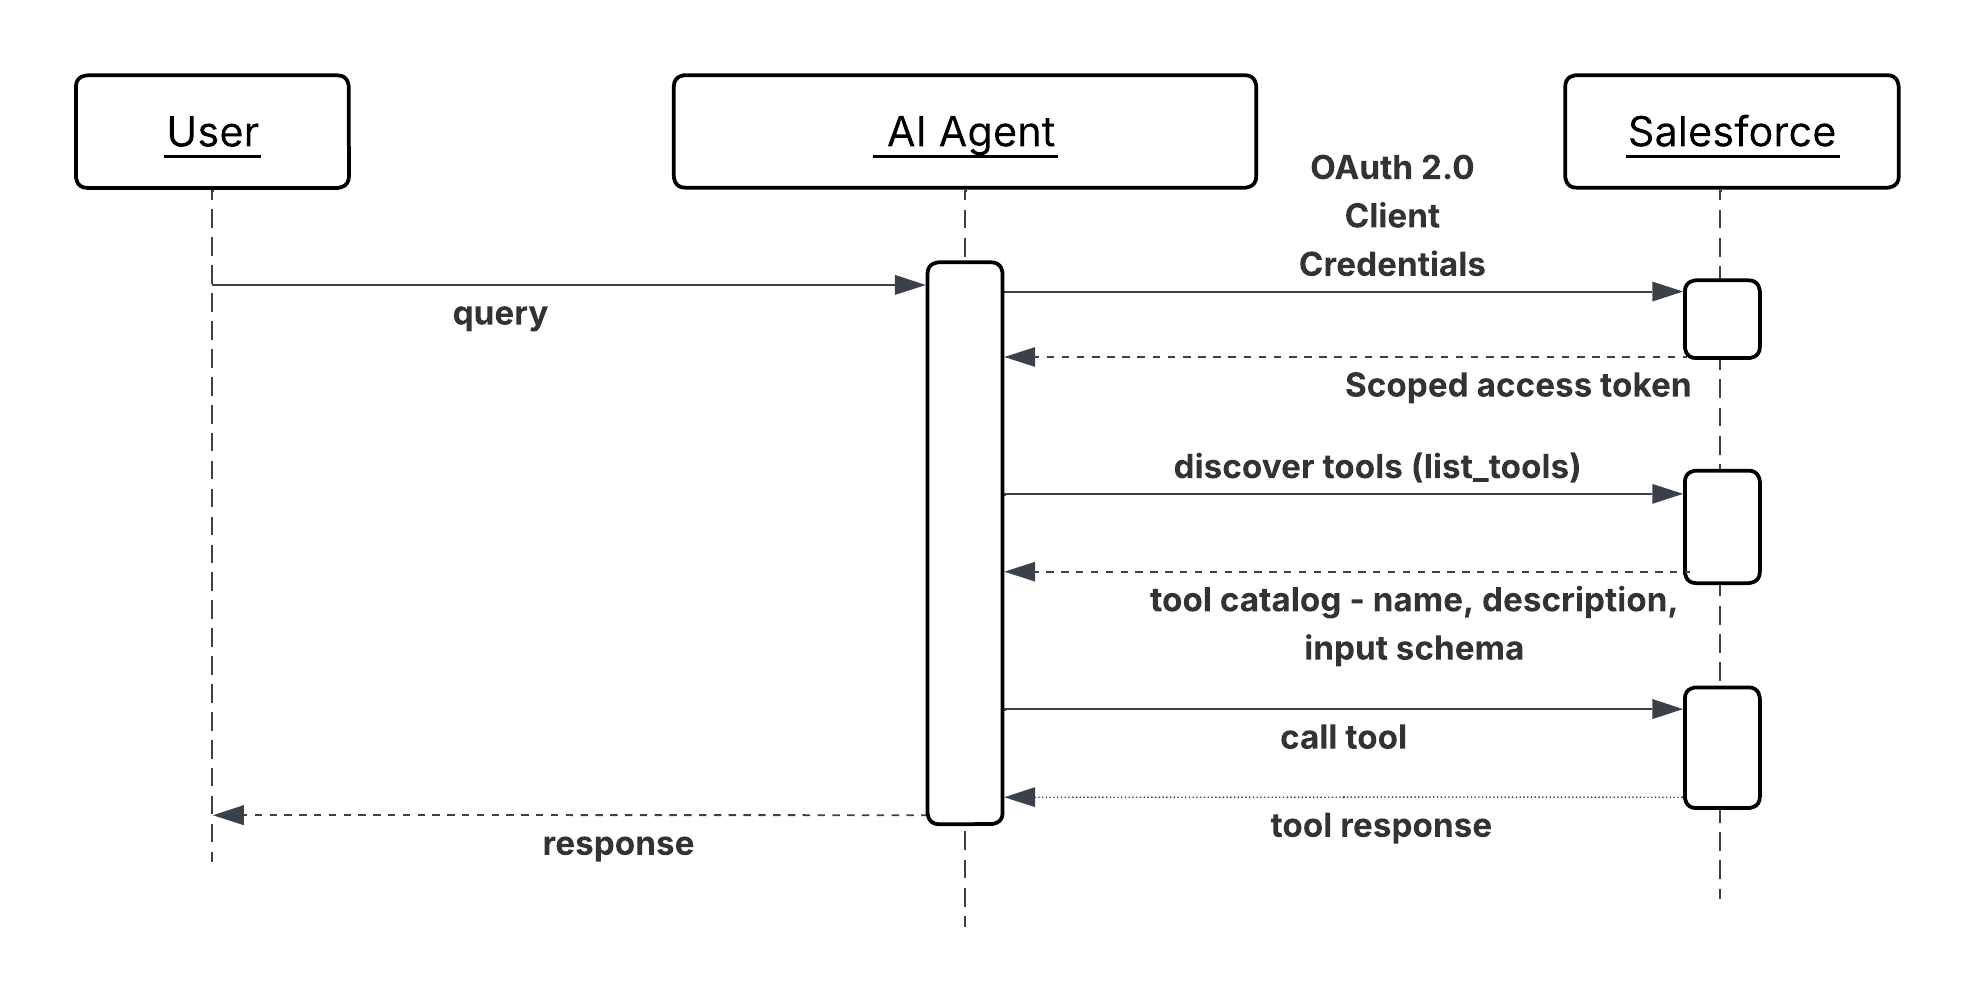
Resultados
Salesforce se convierte en un participante de primera clase en ecosistemas de múltiples proveedores. Los agentes externos pueden descubrir y consumir funciones de plataforma sin requerir una integración de REST personalizada por consumidor o caso de uso. El número de consumidores puede crecer sin un crecimiento proporcional en los gastos generales de mantenimiento de la integración.
Con Headless 360, el modelo de permisos de Salesforce rige cada invocación de herramienta entrante. Los clientes MCP externos no omiten los controles de acceso a datos existentes; operan dentro de ellos. Esto significa que la postura de seguridad de exponer funciones a través de MCP es equivalente a exponerlas a través de cualquier otra superficie de API autenticada.
La capacidad de detección de herramientas es un beneficio compuesto. A medida que se agregan nuevas funciones de Salesforce al catálogo de herramientas del servidor MCP, quedan disponibles de inmediato para todos los agentes externos conectados sin requerir que esos agentes actualicen sus configuraciones.
Consideraciones de diseño
Orientación específica de plataforma
- Publique solo lo que necesitan los agentes externos. Cada herramienta agregada al catálogo del servidor MCP amplía la superficie de ataque y la carga de regulación. Audite el inventario de herramientas deliberadamente. Defina qué funciones están aprobadas para consumo externo y trate la exposición no aprobada como un déficit de configuración, no como un valor predeterminado.
- Redacte descripciones de herramientas para consumidores externos. El operador de un agente externo no tiene Knowledge de su modelo de datos interno o convenciones de nomenclatura. Mantenga las descripciones independientes: lo que hace la herramienta, lo que significa cada parámetro, lo que representa el resultado y cualquier restricción o requisito previo que el llamante debe satisfacer.
- Herramientas de versión explícitamente cuando cambian sus esquemas de entrada o salida. Un agente externo que depende del esquema actual de una herramienta se interrumpirá silenciosamente si el esquema cambia sin previo aviso. Trate los cambios de ruptura en la interfaz de una herramienta MCP con la misma disciplina que un cambio de ruptura en una API de REST pública.
Notas de implementación de Salesforce
- Ejecute cada invocación de herramienta MCP (Headless 360) lista para su uso entrante de Salesforce (OOTB) bajo un usuario final cuyos permisos se aplican únicamente a las operaciones que requieren las herramientas expuestas. No ejecute llamadas de agentes entrantes bajo una identidad de administrador de privilegios altos.
- Para aplicar autenticación, limitación de velocidad, validación de esquemas y detección de información de identificación personal (PII) de forma coherente en todas las herramientas de MCP, utilice Pasarela de IA como Pasarela de OmniSoft de Mule.
- Para Fachadas de MCP de MuleSoft, defina el esquema de herramienta de MCP en MuleSoft independientemente del esquema de API de Salesforce subyacente. La interfaz MCP debe reflejar la necesidad conceptual del agente que llama y no la forma del objeto de Salesforce que lo respalda. Este desacoplamiento permite que la implementación de Salesforce evolucione sin romper el contrato de la herramienta externa.
Gestión y recuperación de errores
- Los fallos de invocación de herramientas deben devolver respuestas de error de MCP estructuradas con un código legible por máquina y una descripción en lenguaje normal. El agente externo que llama no tiene visibilidad en los internos de la plataforma Salesforce, como los mensajes de error, debe ser autónomo y con capacidad de acción sin requerir Knowledge de códigos de error o modelos de objetos específicos de Salesforce.
- Los errores de límite de frecuencia y los fallos de autenticación deben devolverse rápidamente con suficiente información para que el operador del agente externo diagnostique y solucione qué límite de frecuencia se alcanzó o qué credencial se rechazó sin exponer detalles de configuración interna.
- Registre todas las invocaciones de herramientas MCP entrantes en la Pasarela de OmniCanal con la identidad del agente que llama, la herramienta invocada, los parámetros de entrada (desinfectados de valores confidenciales) y el resultado. Este registro es el seguimiento de evidencia principal para diagnosticar fallos reportados por consumidores externos y para auditar a qué accedieron los agentes externos.
Consideraciones de seguridad
- Cada conexión MCP entrante debe autenticarse antes de que cualquier herramienta sea accesible. No permita el descubrimiento no autenticado del catálogo de herramientas; la lista de funciones expuestas es en sí misma información confidencial.
- Aplique la autorización a nivel de herramienta además de la autenticación a nivel de conexión. Un agente externo registrado solo debe poder invocar las herramientas específicas a las que se le otorgó acceso de forma explícita, no el catálogo completo. Aplique esto en la pasarela, no en la capa de aplicación.
- Valide y desinfecte todos los parámetros de herramientas entrantes antes de pasarlos a operaciones de plataforma de Salesforce. Los parámetros de agentes externos son una superficie de entrada no fiable: un parámetro creado con fines malintencionados podría intentar sustituir filtros de consulta, inyectar fragmentos de Salesforce Object Query Language (SOQL) o influir en variables de flujo. Valide el tipo, el formato y el intervalo en el límite de MCP Server o fachada.
- Realice una revisión de acceso periódica de consumidores externos registrados. Revoque credenciales para agentes que ya no están activos o cuyo ámbito de acceso cambió. Una credencial latente pero válida para una integración de socio desmantelada es un riesgo permanente innecesario.
- Protéjase de infringir los límites de plataforma limitando la velocidad de los mensajes MCP entrantes en la pasarela. Restrinja el tráfico de agentes no críticos cuando están bajo carga utilizando políticas de niveles basadas en SLA.
Ejemplo
Un agente de compras operado por un socio logístico necesita verificar el contrato y el estado de crédito de un proveedor antes de aprobar un pedido de compra de alto valor:
- El agente del socio se autentica en la pasarela utilizando sus credenciales de cliente de OAuth 2.0 registradas y recibe un token de acceso con ámbito.
- El agente consulta el catálogo de herramientas de Salesforce MCP Server e identifica dos herramientas relevantes:
GetSupplierContractStatusyGetAccountCreditSummary. - El agente invoca
GetSupplierContractStatuscon el identificador del proveedor. El servidor MCP traduce esto a una consulta de registro de Salesforce, aplica la seguridad a nivel de campo del usuario de integración y devuelve el estado actual del contrato, la fecha de caducidad y cualquier retención de cumplimiento marcada. - El agente invoca
GetAccountCreditSummary, que enruta a través de la Fachada de MuleSoft MCP. La fachada agrega el saldo de facturas pendiente del proveedor y el historial de pagos desde dos objetos de Salesforce y devuelve un único resumen de crédito compuesto. - Con ambos resultados, el agente del socio determina que el contrato está activo y la posición de crédito está dentro de los límites aceptables, y aprueba el pedido de compra en su propio sistema.
- Ambas invocaciones de herramientas se registran por la pasarela con la identidad del agente de socio, las herramientas invocadas y los resultados que crean un registro auditable de qué acceso externo se otorgó y qué datos se devolvieron.
Contexto
Los sistemas empresariales ahora se basan en enjambres o redes de agentes de colaboración, donde las solicitudes complejas se descomponen y delegan en agentes especializados entre diferentes dominios o plataformas de proveedores. Estos agentes, cada uno con su propia función, funciones y herramientas, necesitan un método de comunicación estandarizado y seguro para coordinarse hacia objetivos compartidos sin requerir intervención humana en cada paso.
Problema
¿Cómo puede un agente de IA llamante descubrir dinámicamente, interactuar de forma segura y delegar tareas complejas o específicas de dominio a un agente de pares remoto que puede crearse en un marco de trabajo diferente u operarse por un proveedor diferente y recibir resultados estructurados para completar un flujo de trabajo empresarial más grande?
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
- ¿Cómo interoperan los agentes, desarrollados utilizando marcos de trabajo diversos u operando entre estados de aplicación aislados?
- ¿Cómo pueden los agentes colaborar y delegar tareas sin exponer su lógica interna, memoria o herramientas propias?
- ¿Cómo admiten los agentes tareas complejas y de larga ejecución mientras proporcionan actualizaciones de estado en tiempo real, transmisiones y notificaciones distribuidas?
- ¿Cómo aplican los agentes la seguridad de nivel empresarial (autenticación, autorización) y la adhesión a políticas para la comunicación entre agentes?
- ¿Cómo gestionan los agentes flujos de trabajo de tareas estructuradas (iniciación, progresión, finalización) que van más allá de las simples llamadas de API?
Aplicación de patrón de Salesforce
El Protocolo A2A es un estándar abierto que permite a los agentes descubrir, delegar y colaborar con otros agentes como compañeros. Proporciona un lenguaje común para que los agentes intercambien información de forma segura y coordinen acciones entre diferentes plataformas y proveedores. A2A se centra en la comunicación punto a punto, complementando MCP, que se centra en conectar agentes con herramientas y API.
| Solución | Ajuste | Comentarios |
|---|---|---|
| Orquestación de múltiples agentes de una sola organización (SOMA) | Mejor cuando todos los agentes de dominio viven en una organización y no se requiere enrutamiento entre proveedores | Un superagente (orquestador) descompone solicitudes y enruta hasta ~7 subagentes conectados utilizando enrutamiento basado en LLM (el Motor de razonamiento del atlas lee descripciones de subagente) o enrutamiento determinista (Script de agente). Este es el patrón recomendado predeterminado antes de alcanzar A2A. Combinaciones compatibles: Agentforce Agente de servicio→Agenteforce Agente de servicio Agentforce Agente de empleados→ Agentforce Agente de empleados Agentforce Agente de empleados→Agenteforce Agente de servicios Solo el orquestador puede escalar a un humano; los subagentes no. |
| Delegación de múltiples agentes dirigida por orquestador | Ideal para flujos de trabajo complejos que requieren múltiples agentes especializados | Se utiliza cuando el flujo de trabajo abarca múltiples dominios, como, por ejemplo, el origen, la verificación y la aprobación, cada uno propiedad de un agente diferente. Un agente orquestador descompone la solicitud de nivel superior y delega subtareas a dos o más agentes iguales en secuencia o en paralelo. Cada agente homólogo ejecuta su función de dominio especializada y devuelve un artefacto; el orquestador agrega resultados y dirige el siguiente paso. |
Boceto
La arquitectura implica un agente que llama iniciando la comunicación, facilitado por un catálogo/registro de agentes para descubrimiento:
Gráfico de secuencia para la delegación de agentes cruzados
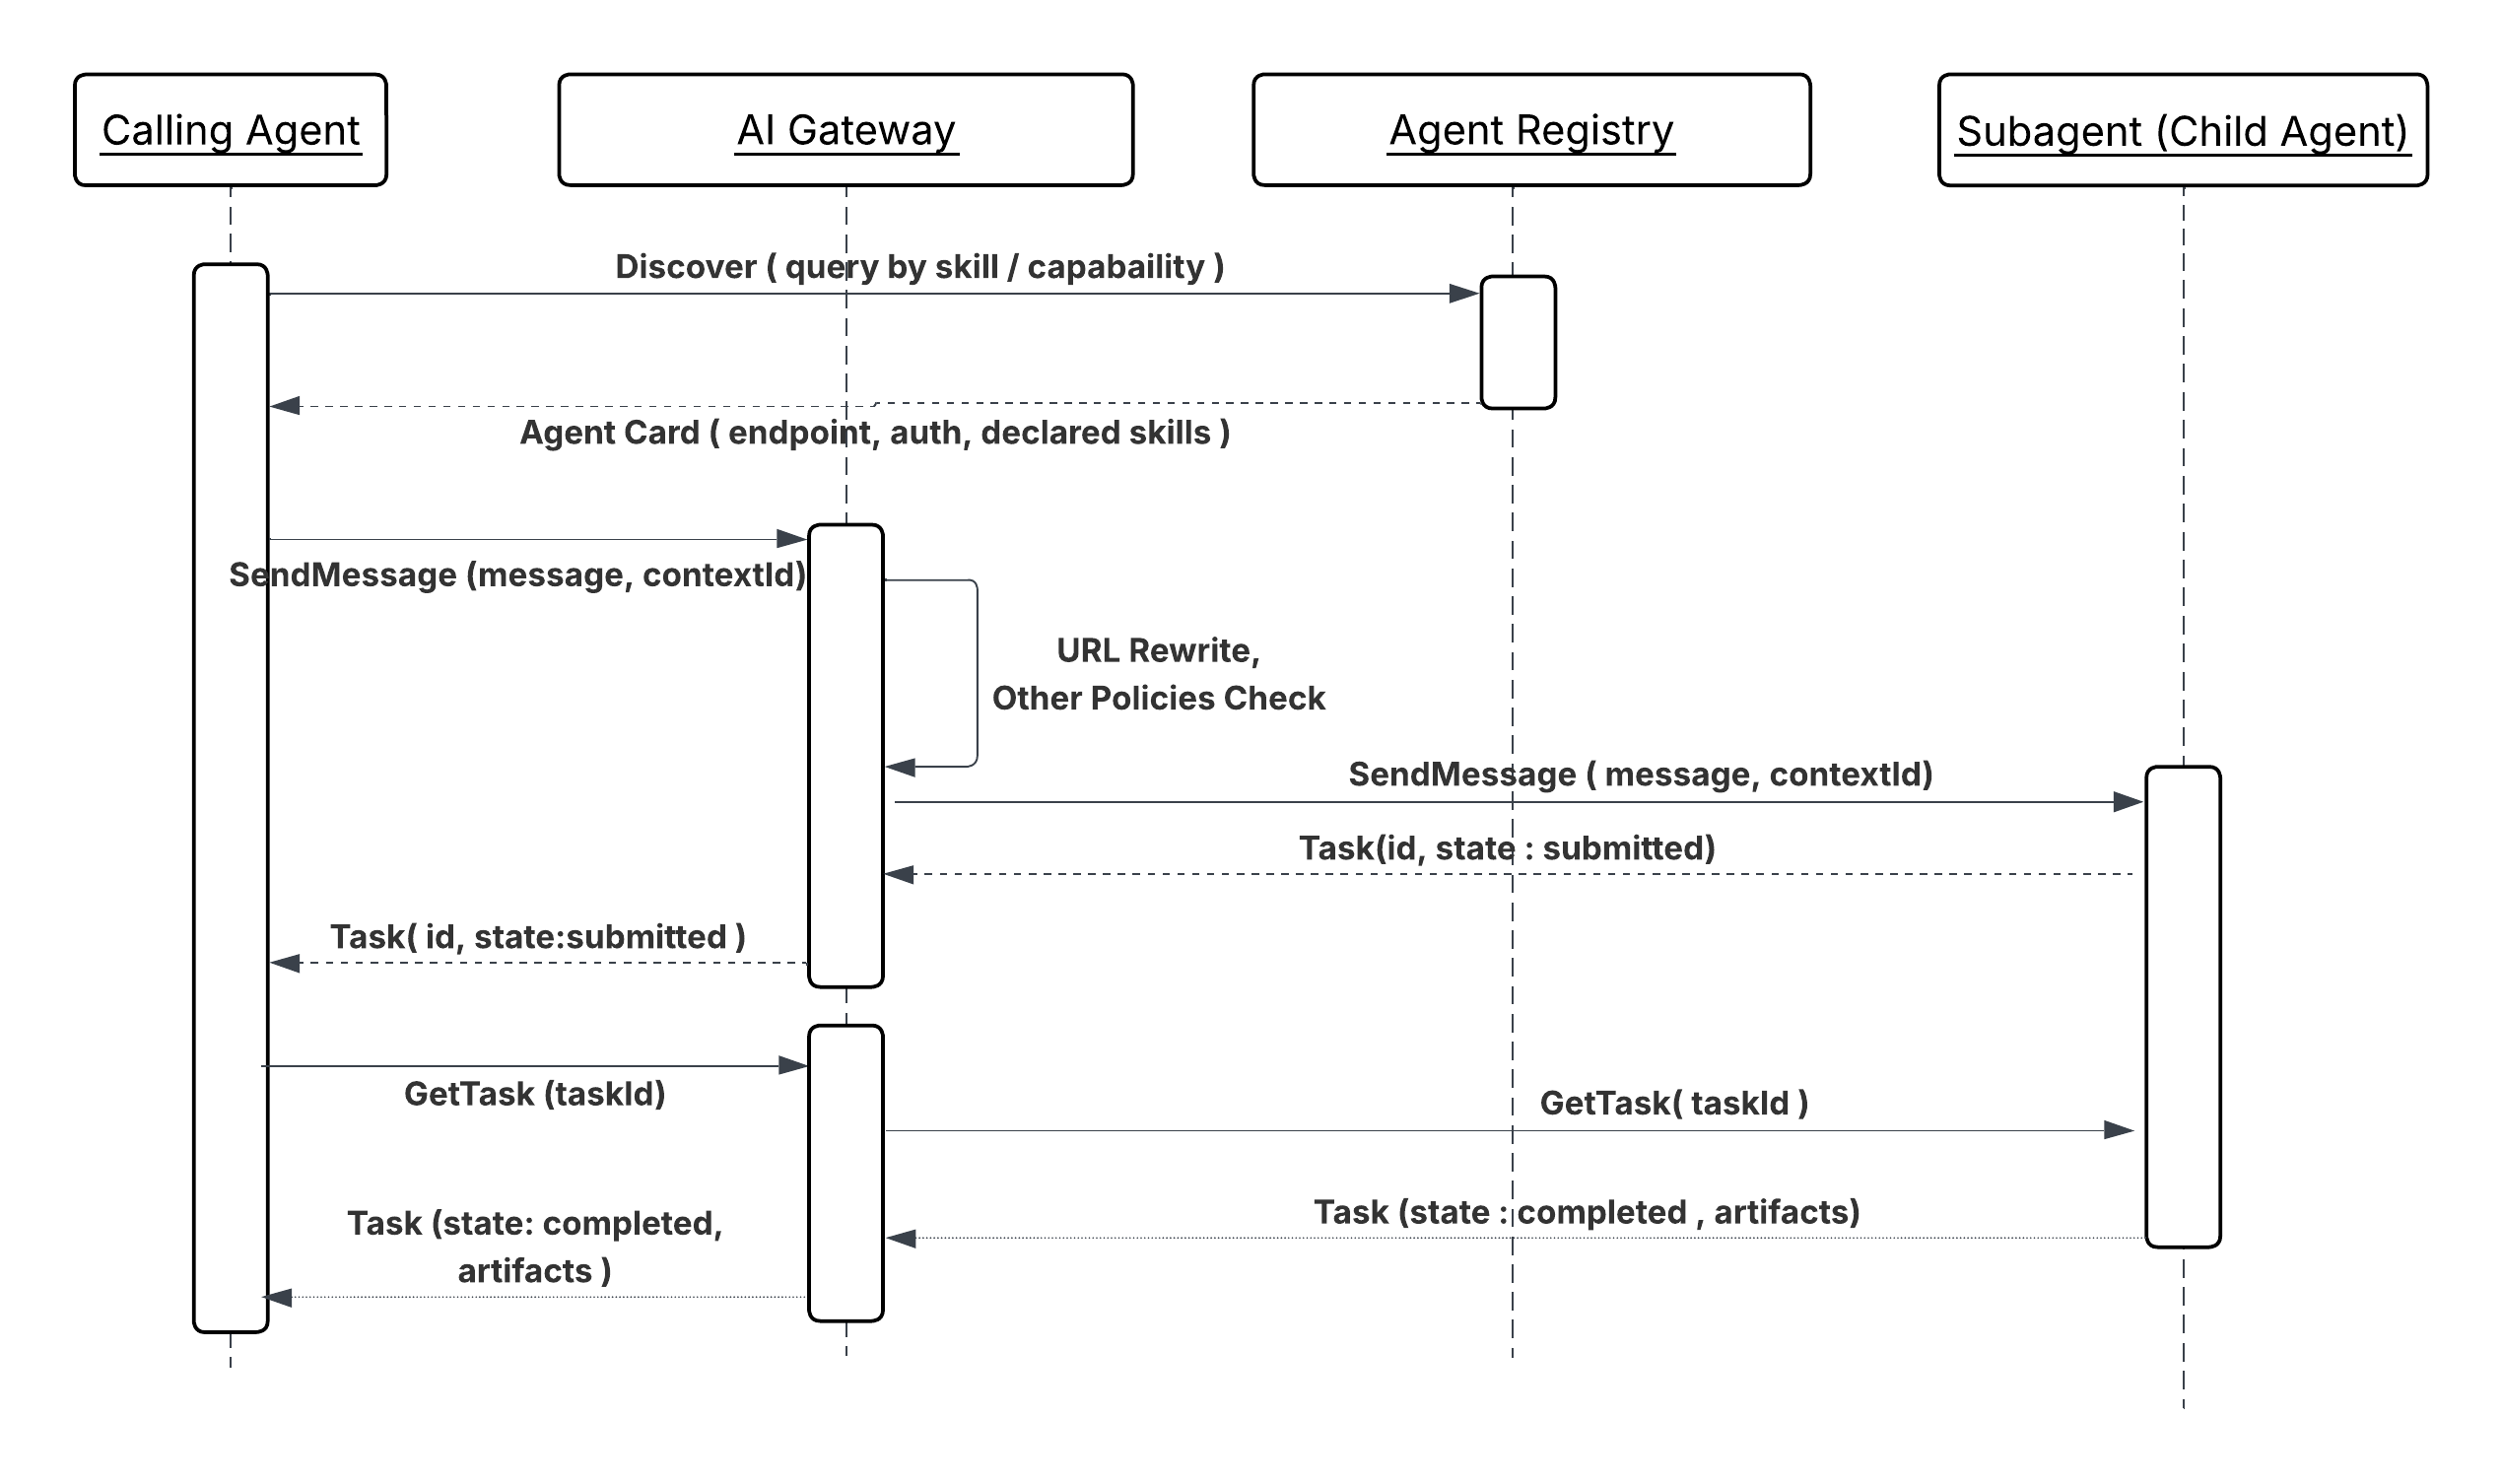
El agente homólogo procesa la solicitud utilizando su lógica específica de dominio, memoria y herramientas, luego devuelve resultados estructurados al agente que llama.
Resultados
La delegación de A2A separa la propiedad del dominio de la orquestación de flujos de trabajo. El agente que llama no necesita saber cómo está construido el agente de compañeros, en qué plataforma se ejecuta o qué herramientas utiliza de forma interna; delega una tarea y recibe un artefacto estructurado. Este límite significa que un agente especializado (verificación en segundo plano, puntuación de riesgo financiero, enrutamiento logístico) puede desarrollarse, implementarse y mejorarse independientemente de los flujos de trabajo que lo invocan.
El modelo de ciclo de vida de tareas del protocolo (enviado, trabajando, completado, fallido) admite
operaciones de larga ejecución de forma nativa. El agente que llama puede registrarse para actualizaciones de estado en lugar de
que mantener una conexión de bloqueo, lo que significa que las tareas A2A pueden abarcar minutos u horas
sin requerir que el agente orquestador permanezca activo durante todo el proceso.
Consideraciones de diseño
Orientación específica de plataforma
- En escenarios complejos, un corredor de agentes puede actuar como un servicio de enrutamiento inteligente o “conmutador inteligente” para coordinar la delegación de tareas entre agentes especializados y gestionar procesos de múltiples pasos.
- Dado que A2A admite tareas de larga ejecución, la comunicación debe estar orientada a la finalización de tareas, definiendo un ciclo de vida para el objeto de tarea y proporcionando notificaciones y actualizaciones de estado en tiempo real.
- El protocolo está diseñado para admitir varios tipos de contenido, incluyendo texto, archivos, datos estructurados, transmisión de audio y vídeo.
- Las relaciones y dependencias entre agentes y sus funciones se definen declarativamente en un archivo de configuración (por ejemplo, “agent-network.yaml”) y se publican en el registro de agentes.
Notas de implementación de Salesforce
- Para una orquestación de SOMA efectiva, mantenga los subagentes conectados por debajo de 7 para preservar la calidad del enrutamiento.
- Actualmente, solo se admite la capa de delegación única (superagente → subagente); las cadenas más profundas empujan la latencia a un “índice insostenible”. Actualmente, los subagentes no pueden delegar en otros subagentes conectados.
- La transferencia humana solo se admite a nivel de orquestador; los subagentes no pueden distribuirse.
- Dentro de SOMA, utilice la secuencia de comandos de agente cuando el enrutamiento basado en LLM produzca errores de enrutamiento en entradas ambiguas para el enrutamiento determinista. Agent Script activa el contexto compartido depurado entre agentes.
Gestión y recuperación de errores
El protocolo A2A define códigos de error completos para facilitar la depuración y la gestión de errores sólidas.
- Lógica de recuperación: Los agentes deben incorporar políticas de reintento (reintentos), lógica de conmutación por error a agentes capaces alternativos y tiempos de espera explícitos.
- Seguimiento de estado de tarea: El flujo de trabajo de gestión de tareas garantiza que los agentes puedan permanecer sincronizados con el estado más reciente de una tarea, facilitando la recuperación en caso de interrupción.
- Observabilidad: El registro de detalles de interacción, como latencia, índices de éxito y frecuencias de error, es fundamental para supervisar la calidad y la solución de problemas.
Consideraciones de seguridad
- Autenticación de nivel empresarial: A2A está diseñado para alinearse con estándares de autenticación y autorización de nivel empresarial, como OAuth 2.0 y JWT, a menudo gestionados por plataformas externas como Okta.
- Puerta de enlace para proteger A2A: Una pasarela (por ejemplo, MuleSoft OmniGateway) es esencial para aplicar políticas en todas las comunicaciones A2A, actuando como una pasarela de entrada y salida para proteger agentes y controlar el tráfico saliente a agentes y servicios externos.
- Aplicación de políticas: Se deben aplicar políticas de Reescritura de tarjeta de agente, Validación de esquema, Control de pico, Detector de PII y otras para el servidor A2A y la protección de datos.
Ejemplo
Flujo de trabajo Abastecimiento de candidatos
Un gerente de contratación asigna tareas a su agente orquestador central para encontrar candidatos que coincidan con un listado de trabajos y un conjunto de habilidades.
- Descubrimiento: El agente orquestador consulta el registro de agentes y descubre un agente de contratación especializado y un agente de comprobación de antecedentes (ambos agentes iguales).
- Delegación (A2A): El agente orquestador envía una solicitud de tarea estructurada (mensaje A2A) al agente de contratación para obtener candidatos.
- Procesamiento por compañeros: El agente de contratación ejecuta su propio flujo de trabajo (por ejemplo, llamando a una herramienta de LinkedIn externa a través de MCP).
- Devolución de artefacto (A2A): El agente de contratación devuelve una lista de candidatos sugeridos (el artefacto).
- Delegación secuencial: A continuación, el agente orquestador delega otra tarea (A2A) al agente de comprobación de antecedentes para el candidato principal. Este agente realiza la comprobación y devuelve el resultado, completando la tarea general.
Contexto
Los flujos de trabajo empresariales complejos a menudo requieren agentes especializados alojados en plataformas externas o sistemas de socios para iniciar tareas, delegar consultas o proporcionar actualizaciones a agentes internos (por ejemplo, aquellos en Salesforce Platform). Este patrón dirige el modo en que un agente Agentforce interno recibe y procesa de forma segura y fiable solicitudes procedentes de un agente de pares remoto para ejecutar una función específica de dominio.
Problema
¿Cómo puede un agente de IA especializado interno (por ejemplo, un agente de comprobación en segundo plano en Agentforce) exponer de forma segura su funcionalidad específica de dominio a agentes homólogos externos, procesar una solicitud A2A estructurada entrante y gestionar el ciclo de vida de tareas (incluyendo actualizaciones de estado en tiempo real) para devolver artefactos estructurados al agente de llamadas remoto?
Fuerzas
Cuando aplique este patrón, responda a las siguientes preguntas:
- ¿Cómo expone de forma segura las funciones de agentes internos a agentes externos sin comprometer la lógica o las herramientas internas?
- ¿Cómo aplica políticas de seguridad de nivel empresarial para verificar la identidad del agente que llama y la autoridad delegada antes de procesar solicitudes?
- ¿Cómo gestiona tareas entrantes de larga ejecución mientras proporciona actualizaciones de estado estructuradas y asíncronas?
- ¿Cómo garantiza una interacción sencilla con agentes creados sobre marcos de trabajo externos diversos?
Aplicación de patrón de Salesforce
El Protocolo A2A proporciona el estándar abierto para la delegación y colaboración seguras de punto a punto. El agente interno actúa como el agente homólogo, anunciando sus funciones a través de un Catálogo/Registro de agente y utilizando A2A a través de canales seguros (HTTPS/SSE) para recibir y responder a solicitudes estructuradas.
| Solución | Ajuste | Comentarios |
|---|---|---|
| Subagente conectado de Agentforce (SOMA) | Mejor cuando el agente que llama es otro agente Agentforce en la misma organización | Se utiliza cuando ambos agentes viven en la misma organización de Salesforce y el llamante es un orquestador Agentforce. El agente está conectado como un subagente a través de Agentforce Builder y expuesto al orquestador a través de su descripción y acciones declaradas. El orquestador enruta tareas utilizando enrutamiento basado en LLM (Motor de razonamiento del atlas) o enrutamiento determinista (Script de agente). No se requiere ningún protocolo A2A, pasarela o registro externo. Combinaciones compatibles: Agentforce Agente de servicio→Agenteforce Agente de servicio Agentforce Agente de empleados→ Agentforce Agente de empleados Agentforce Agente de empleados→Agenteforce Agente de servicio Solo el orquestador puede escalar a un humano; los subagentes no. |
| Enrutamiento de corredor de agentes (Entrante) | Mejor cuando la organización aloja múltiples agentes Agentforce con funciones complementarias y el agente que llama no puede o no debe seleccionar un destino específico | Se utiliza cuando el agente que llama es externo a Salesforce u otra organización de Salesforce y no necesita saber qué agente interno específico (Agentforce u otros agentes proveedores) gestiona su solicitud. Un corredor de agentes de MuleSoft se encuentra entre la Pasarela de OmniCanal de MuleSoft y el grupo de agentes Agentforce internos. Recibe la tarea A2A entrante, evalúa las funciones declaradas de los agentes internos disponibles con respecto a los requisitos de la tarea y enruta la solicitud al agente más adecuado. El corredor también gestiona la conmutación por error si el agente de destino principal no está disponible o devuelve un fallo, el corredor redirige a un agente equivalente sin aflorar el reintento al llamante externo; el llamante externo nunca es consciente de decisiones de enrutamiento interno o reintentos. |
Boceto
Diagrama de secuencia para agentes como servicios llamables
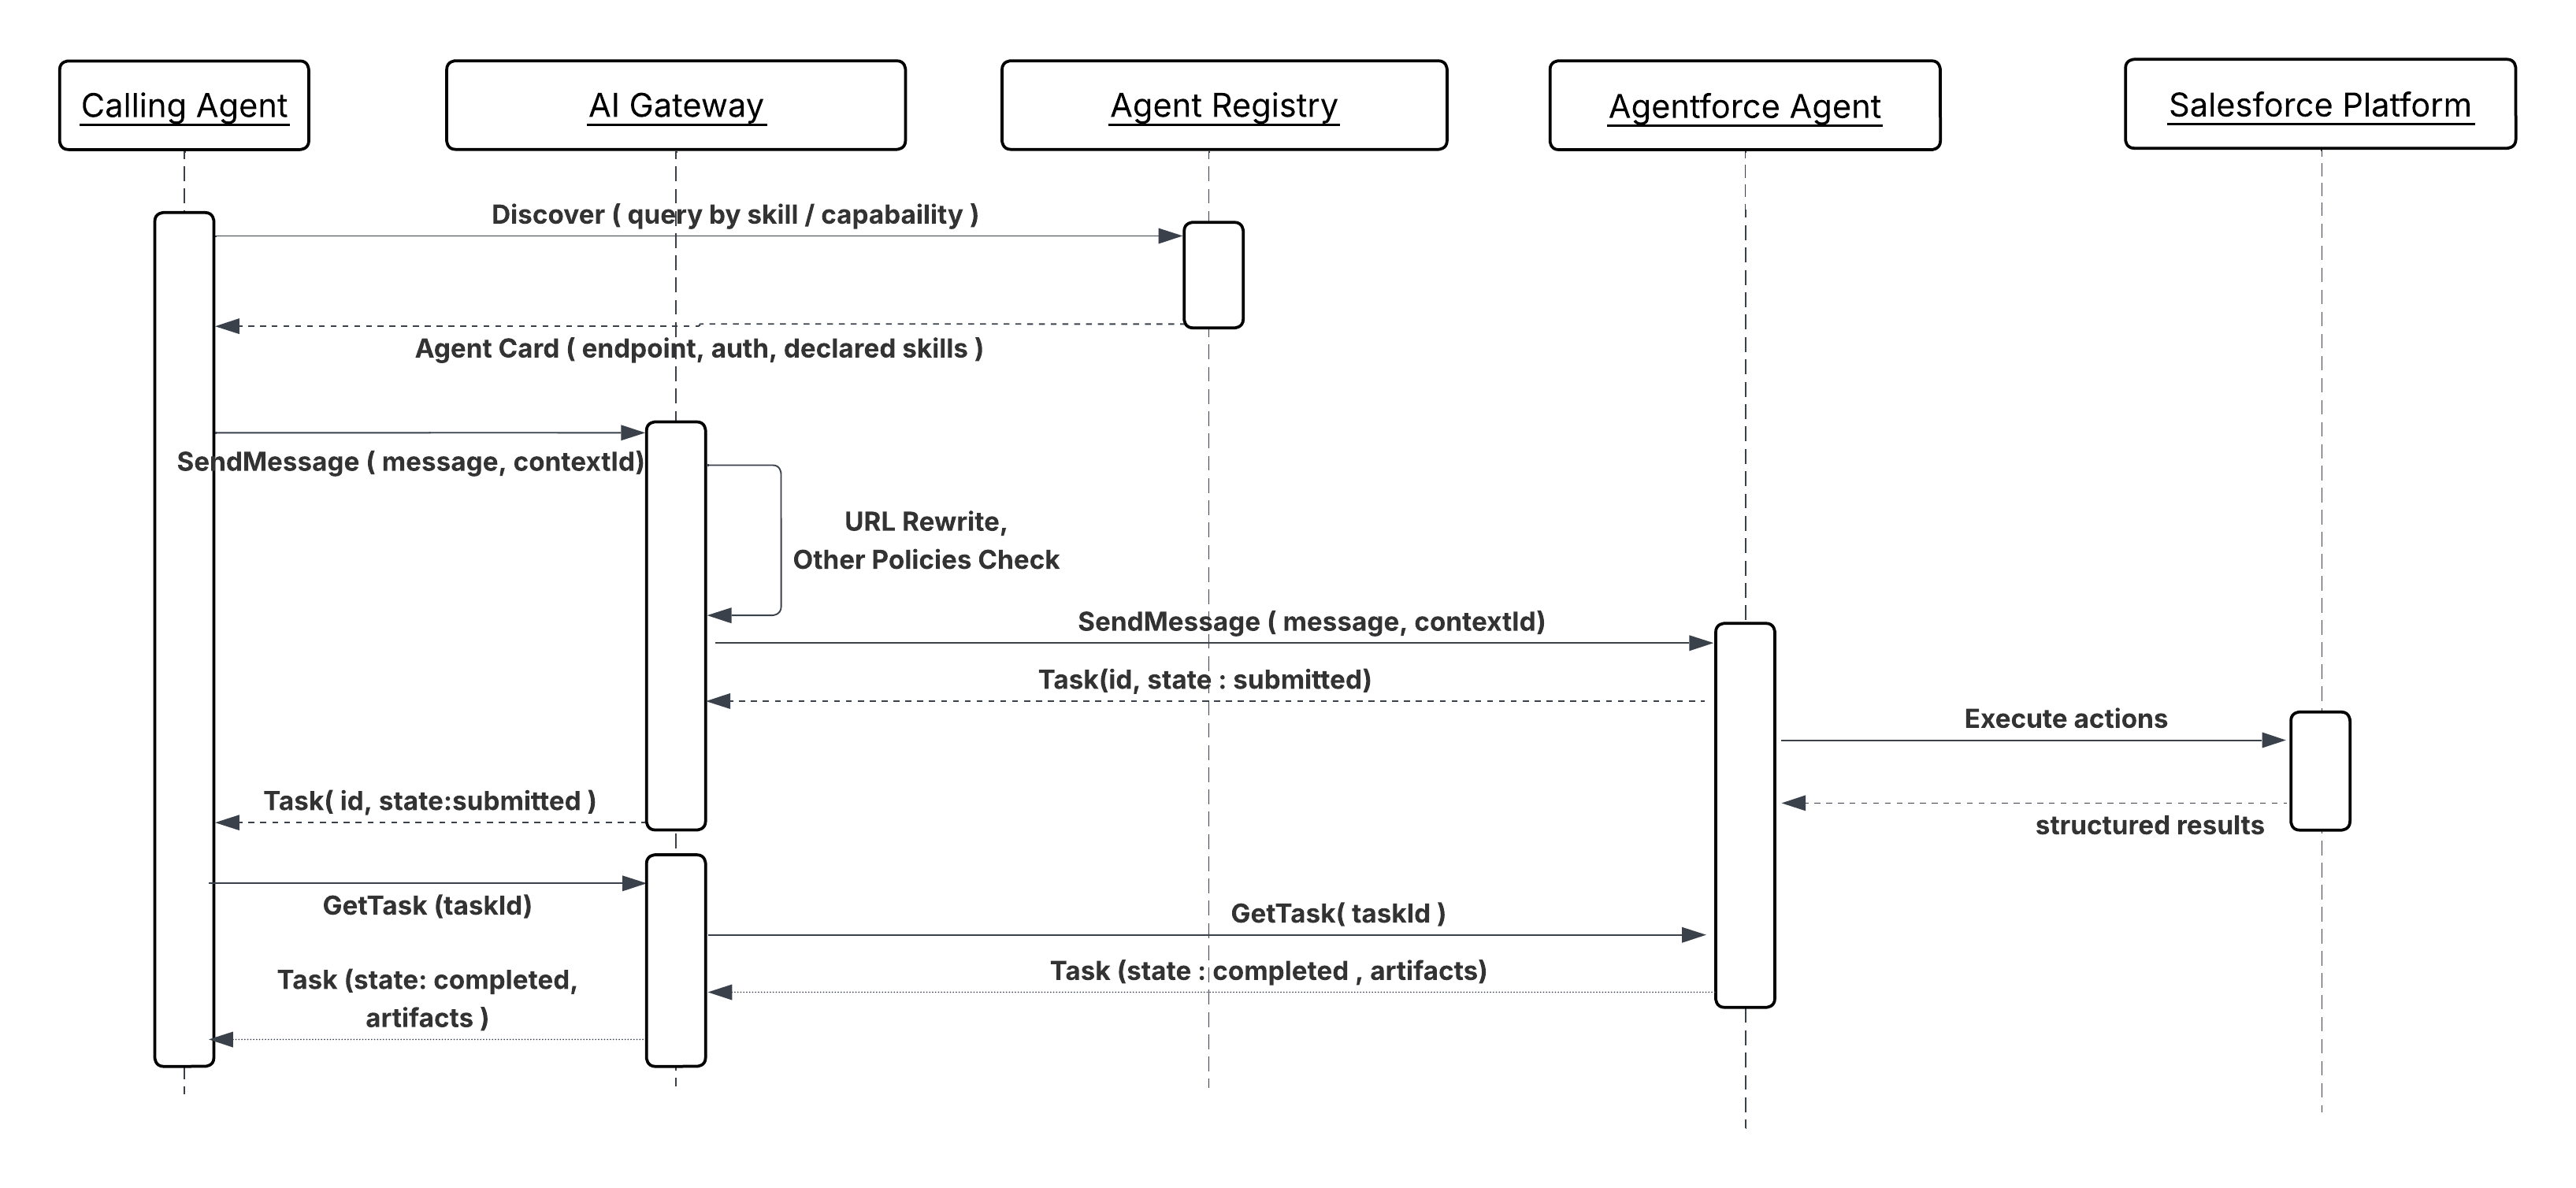
Resultados
Este patrón expone agentes internos como servicios especializados en una red de múltiples agentes. Los agentes externos pueden delegar tareas de forma segura en funciones internas mientras la organización mantiene el control, la capacidad de auditoría y la aplicación de políticas.
Consideraciones de diseño
Orientación específica de plataforma
- Una pasarela (por ejemplo, MuleSoft OmniGateway) debe colocarse como un punto de entrada para aplicar políticas, incluyendo limitación de velocidad, autenticación y validación de carga, en todas las solicitudes A2A entrantes.
- Los agentes internos deben gestionar el estado del objeto de tarea desde la iniciación externa hasta la finalización, garantizando que el agente de llamadas remoto recibe actualizaciones de estado coherentes y verificables.
- Asegúrese de que las funciones publicadas del agente en la tarjeta de agente son claras, basadas en la intención e incluyen ámbitos de seguridad necesarios para la delegación.
Gestión y recuperación de errores
- Códigos de error estructurados: En caso de fallo, el agente interno debe devolver mensajes de error estructurados compatibles con A2A al agente llamante para activar la lógica de reintento remoto o mecanismos de conmutación por error alternativos.
- Impotencia: El agente debe verificar que cualquier efecto secundario desencadenado por una solicitud A2A reintentada de un agente externo (debido a la interrupción o recuperación de la red) es idempotente.
Consideraciones de seguridad
- Aplicación de políticas entrante: La pasarela debe aplicar políticas para incluir en la lista de admisión/lista de bloqueo agentes externos y validar tokens de JWT/OAuth 2.0 para verificar la identidad y la autoridad delegada del agente llamante.
- Desinfección de entrada: Valide y desinfecte todas las cargas de solicitudes entrantes para mitigar la posible inyección de solicitudes o ataques de datos maliciosos.
- Propagación de identidad: Asigne de forma segura la identidad del agente externo y su autoridad delegada a contextos de seguridad internos (por ejemplo, perfiles de usuario de Salesforce) antes de ejecutar acciones contra sistemas internos.
Ejemplo
Consulta externa del sistema
- Solicitud: Un agente de contratación en un sistema de socios envía una solicitud de tarea A2A a un agente de verificación de empleados interno (agente de compañeros) en Agentforce para confirmar el estado de empleo de un nuevo candidato.
- Procesamiento: El Agente de verificación de empleados recibe la solicitud a través de la pasarela, verifica las credenciales del agente de socio, ejecuta su flujo de trabajo interno (por ejemplo, llamando a un sistema de recursos humanos interno) y da formato a la respuesta.
- Respuesta: El Agente de compañeros devuelve un artefacto A2A estructurado (por ejemplo, fecha de inicio de empleo y cargo) al Agente de contratación remoto, que luego continúa con su flujo de trabajo externo.
-
Puerta de enlace para la protección de MCP, A2A y API
Se requiere una pasarela como punto de aplicación único para todo el tráfico de agente a sistema y de sistema a agente.
-
Conexiones seguras: Una pasarela garantiza que solo los agentes autenticados y autorizados interactúen con extremos de MCP, A2A y API restringiendo el acceso.
-
SLA aplicados: Una pasarela puede aplicar límites de frecuencia, ayudando las organizaciones a cumplir los requisitos de rendimiento y evitando la sobrecarga de servidores MCP y A2A.
-
Gobernanza simplificada: Una pasarela ofrece visibilidad y control centralizados sobre todas las interacciones del servidor, simplificando la gestión y supervisión de la actividad de los agentes.
-
Coherencia y protección de datos: Las políticas, como la validación de esquemas, aplican la coherencia de datos y la detección de PII pueden proteger información confidencial.
Pasarela de OmniSoft de Muele
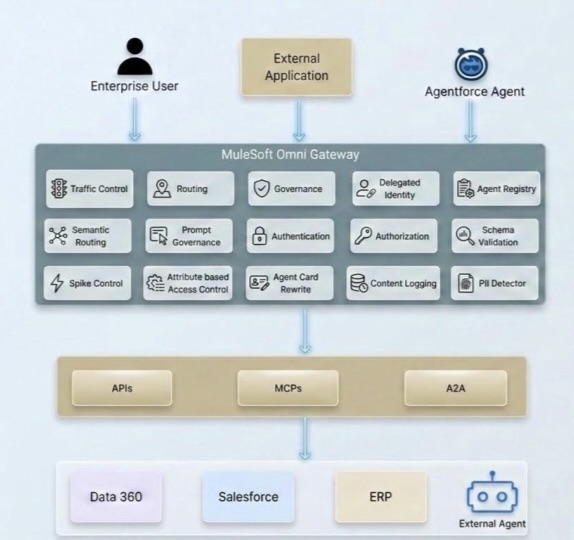
- Cadena de propagación de identidad
A medida que las empresas adoptan el paradigma de los agentes, surge un nuevo desafío de seguridad: ¿Cómo fluye la identidad del usuario final a través de una red de agentes de IA autónomos? En arquitecturas de API tradicionales, un usuario se autentica una vez y la aplicación llama a servicios backend en nombre del usuario. La cadena de identidad es corta, bien comprendida y normalmente se gestiona en un único dominio Trust.
Sin embargo, las arquitecturas de agentes presentan cadenas mucho más largas donde una única solicitud se despliega entre varios agentes, servicios y servidores MCP, cada uno cruzando potencialmente los límites de servicio, Trust Domains e incluso fronteras organizativas. Sin una estrategia deliberada para la propagación de identidad, las empresas se enfrentan a una opción entre seguridad y funcionalidad, un dilema que ningún arquitecto necesita abordar.
MuleSoft soluciona las complejidades de la propagación de identidad con su función Identidad de agente de confianza. Esta solución utiliza una estrategia basada en políticas y gestionada por pasarela para garantizar que la identidad del usuario final se mantiene entre varios tipos de interacción, incluyendo protocolos A2A, llamadas de herramientas MCP y solicitudes de API de REST. Al centralizar la gestión de identidad en la capa Pasarela de OmniCanal a través de políticas de autenticación salientes, las empresas pueden proteger toda su red de agentes sin modificar agentes o servicios backend. Para obtener más detalles, consulte Identidad de agente de confianza para Agentic Enterprise.
- Seguridad RAG en Data 360
Data 360 admite el control de acceso basado en atributos (ABAC) en los niveles de objeto, campo y fila a través de la configuración de Política de gobernanza de datos. Esta es la forma principal de controlar qué datos son visibles para quién, incluyendo dentro de índices de búsqueda RAG. Para datos estructurados, las condiciones de acceso de usuario se implementan utilizando atributos de usuario y conjuntos de permisos. Para datos no estructurados, el filtrado de metadatos (prefiltros en índices de búsqueda) puede restringir lo que se recupera.
La comunicación con el LLM pasa por la Einstein Trust Layer, que enmascara la información confidencial/PII antes de que llegue al modelo protegiendo la privacidad de los datos no solo durante la búsqueda sino también antes de la generación.
Para protegerse contra el envenenamiento por RAG, asegúrese de que se aplican reglas de validación y regulación de datos estrictas antes de que los datos estén disponibles para la búsqueda de vectores. La Capa Einstein Trust también puede aplicar comprobaciones de toxicidad/enmascaramiento rápido. Puede aplicar conjuntos de permisos estrictos en el perfil Usuario de agente.
- Nuevo modelo de credencial nombrada Salesforce ha renovado su arquitectura de autenticación introduciendo un modelo de credenciales nombradas de dos niveles que separa limpiamente las preocupaciones entre conectividad e identidad. Utilice esto siempre que realice llamadas a través de Apex y evite crear su propio protocolo de autenticación. Este modelo también proporciona extensibilidad y seguridad mejorada. Las credenciales externas se encuentran en la base de este modelo. Almacenan los detalles de autenticación reales y admiten un conjunto enriquecido de protocolos incluyendo Credenciales de cliente de OAuth 2.0, Portador de JWT y AWS Signature V4, mientras que también definen cómo se asignan los principales: como un único Principal nombrado (compartido entre todos los usuarios) o como Principales por usuario (donde cada usuario se autentica con su propia identidad). Las credenciales nombradas, a su vez, actúan como la capa de extremo. Definen la URL de llamada y hacen referencia a una credencial externa para gestionar el apretón de manos de autenticación, manteniendo la configuración de extremo limpiamente desvinculada de la gestión de credenciales. Para activar flujos de autenticación por usuario, los administradores asignan Conjuntos de permisos al principal de credencial externa apropiado, de modo que solo los usuarios con la asignación de Conjunto de permisos correcta pueden invocar llamadas bajo su propia identidad. Este diseño de dos niveles no solo simplifica la configuración de llamadas seguras, sino que también proporciona a los arquitectos mucha mayor flexibilidad y control de gobernanza sobre cómo se autentican las integraciones entre sistemas conectados a Salesforce. Para obtener más detalles, consulte la documentación Credenciales nombradas.
Esta sección asigna los patrones de gestión de datos de la arquitectura a las obligaciones de cumplimiento que se encuentran con mayor frecuencia en implementaciones empresariales reguladas.
Control de acceso: El modelo de usuario de integración con menos privilegios descrito en los patrones de integración (Credenciales nombradas con ámbito, ámbitos de OAuth 2.0 por agente, listas de admisión de pasarelas) se asigna directamente a controles de acceso lógico. Mantenga pruebas de que el ámbito de credencial de cada agente está revisado y aprobado.
Registro de auditoría: Los requisitos de registro de auditoría por patrón (Id. de sesión, invocaciones de herramientas, parámetros de entrada desinfectados de valores confidenciales, resultados) satisfacen los controles de supervisión y registro. Asegúrese de que los registros son a prueba de manipulaciones, se mantienen durante el periodo requerido y son accesibles para el equipo de seguridad sin requerir acceso a sistemas de producción.
Gestión de cambios: Los cambios de esquema de la herramienta MCP y las actualizaciones de tarjeta de agente A2A que afectan a los consumidores constituyen cambios de interfaz y deben estar sujetos a controles de gestión de cambios. Herramientas de versión explícitamente (mencionadas en patrón entrante de MCP) y tratan los cambios de ruptura como eventos de configuración que requieren aprobación.
Disponibilidad: Los límites de concurrencia de agentes, los límites de reintento en patrones desencadenados por eventos y el enrutamiento de letra muerta para eventos fallidos constituyen controles de disponibilidad. Documente la envolvente de rendimiento prevista y el comportamiento de fallo para cada patrón implementado como parte del paquete de pruebas de disponibilidad.
Nota: Esta lista no representa una guía completa para garantizar el cumplimiento de sus soluciones de agente. Se deben cumplir todos los requisitos reglamentarios aplicables.
- Primeros pasos con API de agente
- Activar agentes de confianza con Data 360
- Descripción general de la pasarela de OmniSoft
- Política de inyección de credenciales en nombre de OAuth 2.0
- Identidad de agente de confianza para la empresa agente
Gulal Kumar es Arquitecto de Ingeniería de Software en Salesforce con más de 20 años de experiencia. Su experiencia abarca la IA, la integración, las API y la arquitectura empresarial, con un enfoque en impulsar la transformación comercial a través de soluciones de IA seguras, resistentes e innovadoras. Conecta con él en LinkedIn.