Einführung
Hinweis: “Themen” wurden in diesem Artikel gemäß unseren neuesten Produktbenennungskonventionen in “Nachhaltige” umbenannt.
Sie können einen Agenten erstellen, der in einer Testumgebung gut funktioniert, nur damit er beim zweimaligen Verarbeiten desselben Workflows völlig unterschiedliche Routen beschreitet. Diese grundlegende Einschränkung zeigt, wie das vorherige Agentforce Modell die Ausführung verarbeitet hat: Jede Entscheidung – von der Intent-Interpretation bis zur Aktionsauswahl – wurde vom LLM in Echtzeit getroffen, ohne dass ein garantierter Pfad durch den Workflow vorhanden war.
LLMs können als Reaktion auf identische Eingaben zu inkonsistenten Ergebnissen führen. Subtile Variationen des Kontexts, der Systemaufforderungen oder der Tokengenerierung reichen aus, um einen Agenten auf eine andere Route zu schicken. Für viele Interaktionen ist diese Variabilität akzeptabel. Bei mehrstufigen Workflows, die Überprüfbarkeit, Reproduzierbarkeit und Rückverfolgbarkeit erfordern, ist dies jedoch nicht der Fall. Eine Darlehensgenehmigung, eine Inventarübertragung oder ein Patientenprobeprozess kann nicht von einem Agenten abhängen, der sich jedes Mal anders durch die Schritte schleicht.
Der neue Agentforce Builder und das Agentenskript lösen dieses Problem, indem sie die deterministische Ausführung von der LLM-Überlegung trennen. Das Hybridmodell von Agentforce stellt sicher, dass der Agent bei jeder Workflow-Ausführung einer genau definierten Struktur folgt, während er dennoch LLM-Überlegungen verwendet, bei denen Urteilsvermögen, natürliches Sprachverständnis oder Kontextinterpretation wirklich erforderlich sind.
In der vorherigen Version von Agentforce funktionierte ein Agent als einfache reaktive Schleife. Jede Entscheidung – von der Interpretation des Intents bis zur Auswahl der nächsten Aktion – wurde in Echtzeit von der LLM ausschließlich anhand der neuesten Eingaben des Benutzers getroffen. Es gab keinen garantierten Ausführungspfad, keinen persistenten Status und keinen Mechanismus zum Erzwingen einer Sequenz von Schritten.
Ausführungspfade konnten nicht garantiert werden
Da jede Entscheidung von der Echtzeitüberlegungen des LLM abhing, führten geringfügige Variationen in der Eingabe, der Systemaufforderung oder der Modellversion zu unterschiedlichen Aktionsauswahlen für identische Anforderungen. Dadurch war das Vorgängermodell schwer zu testen: Ein in der Staging-Phase übergebener Workflow konnte sich in der Produktion anders verhalten und es gab keine zuverlässige Möglichkeit, einen bestimmten Ausführungspfad zu Debugging- oder Überwachungszwecken zu reproduzieren.
Jede Interaktion hat die vollen LLM-Kosten bezahlt
Selbst für einfache Unterhaltungsszenarien waren mindestens drei LLM-Zyklen erforderlich: Auswahl des Unteragenten, Aktionsauswahl und Generierung der endgültigen Antwort. Aufgaben mit mehreren Schritten, die auf fünf oder mehr Zyklen erweitert wurden. Für Architekten, die Workflows mit hohem Volumen oder Latenzempfindlichkeit entwerfen, war dies nicht nur ein Leistungsproblem. Das bedeutete, dass Sie die Argumentationsschleife für Schritte, die kein Urteil erfordern, nicht kurzschließen konnten, da die Architektur keinen Mechanismus zum Unterscheiden zwischen beiden hatte.
Nicht deterministische Ausführung führte zu einer Überprüfungslücke
In regulierten Branchen bedeutet Überprüfbarkeit, nachweisen zu können, dass ein bestimmter Prozess für eine bestimmte Transaktion auf eine bestimmte Weise befolgt wurde. Ein rein nichtdeterministisches Modell kann diese Garantie nicht bieten. Wenn der Ausführungspfad zwischen Ausführungen variiert, variiert auch der Überprüfungspfad und “der Agent hat entschieden” ist keine vertretbare Antwort in einer Konformitätsüberprüfung.
Das Bundesland hat die Unterhaltung nicht überlebt
Wenn der Agent sich auf die Single-Turn-Verarbeitung verließ, hatte er keine persistente Erinnerung an frühere Schritte. Wenn die Unterhaltung auch nur geringfügig abweicht, kann der Agent zuvor erfassten Kontext verwerfen und den Benutzer zwingen, neu zu starten. Bei mehrstufigen Transaktions-Workflows wurde dadurch eine Zuverlässigkeitsobergrenze festgelegt: Je mehr Schritte im Prozess, desto höher ist die Wahrscheinlichkeit eines Kontextverlusts vor Abschluss.
Abgeschlossene Schritte wurden nicht gespeichert
Ohne die Staatsverwaltung hatten Agenten keine Aufzeichnungen darüber, welche obligatorischen Schritte ein Benutzer bereits abgeschlossen hatte. Dies führte zu einer unvorhersehbaren Schleife, bei der ein Agent zu einem Schritt zurückkehrte, den der Benutzer bereits abgeschlossen hatte. Neben den Auswirkungen auf die Benutzererfahrung führte dies zu einem tieferen architektonischen Problem: Das Entwerfen eines zuverlässigen sequenziellen Workflows war unmöglich, da der Agent die Sequenz nicht erzwingen konnte.
Die neue Agentforce, die seit Februar 2026 allgemein verfügbar ist, wechselt von rein probabilistischen LLM-Überlegungen zu einem Hybridmodell. Statt jede Entscheidung durch das LLM weiterzuleiten, wird die deterministische Ausführung von der LLM-Überlegung getrennt und jeder kann nur das verarbeiten, wofür er geeignet ist. Zur Unterstützung hat Agentforce zwei Erstellungstools eingeführt: Agentenskript für die codebasierte Entwicklung und Agentforce Studio, eine Umgebung ohne Code.
Agentforce Builder
Agentforce Builder ist die empfohlene Umgebung für die Entwicklung neuer Agenten. Sie wird in Agentforce Studio gehostet und ersetzt die alte Setup-Erfahrung, die weiterhin verfügbar ist, aber nicht mehr der primäre Erstellungspfad ist. Im Generator arbeiten Sie entweder in einer visuellen Zeichenbereichsansicht oder direkt in der Skriptansicht und bearbeiten das Agentenskript, das das Verhalten Ihres Agenten definiert.
Agentenskript
Agentenskript ist eine deklarative, domänenspezifische Sprache (DSL), die alles über das Verhalten eines Agenten definiert: Konfiguration, Geschäftslogik und Aufforderung. Sie ist als Schlüssel-Wert-Paare strukturiert, die sich über mehrere Zeilen erstrecken oder verschachtelte Untereigenschaften enthalten können, und ist so konzipiert, dass sie für Menschen lesbar ist, ohne Knowledge über die zugrunde liegende Diagrammarchitektur zu benötigen.
Mit Agentenskript können Sie zwei grundlegend unterschiedliche Arten von Anweisungen im selben Agenten ausdrücken: Anweisungen zur deterministischen Logik und Aufforderungsanweisungen. Deterministische Logikanweisungen definieren Bedingungen und Aktionssequenzen, die als Code ohne LLM-Beteiligung ausgeführt werden. Eingabeaufforderungsanweisungen definieren die Hilfestellung für natürliche Sprachen, die von der LLM zur Laufzeit interpretiert wird. Die Grenze zwischen beiden ist explizit und bewusst. Wenn Sie wissen, wo diese Grenze platziert werden soll, ist dies eine der wichtigsten Designentscheidungen, die Sie beim Erstellen mit der neuen Agentforce treffen werden.
Deterministische Logik in der Praxis
Wenn Anweisungen deterministisch sind, folgt der Agent einem definierten Ausführungspfad, unabhängig davon, wie der Benutzer seine Eingabe formuliert. Im folgenden Beispiel wird ein Unteragent gezeigt, der ein Dashboard für Kundenintelligenzen lädt. Sie sucht nach einer Kunden-ID, ruft Profildaten, den Auftragsverlauf und Support-Tickets ab und berechnet dann den Kundenlebenszeitwert und das Abwanderungsrisiko. Für keinen dieser Schritte ist eine LLM-Überlegung erforderlich.
Diese Logik ruft Aktionen in einer festen Reihenfolge auf, sobald bestimmte Bedingungen erfüllt sind.
Aufforderungsanweisungen und bewusste LLM-Übergabe
Wenn deterministische Logik Bedingungen und Sequenzen verarbeitet, die als Code ausgedrückt werden können, verarbeiten Aufforderungsanweisungen alles, was Urteilsvermögen, Interpretation oder die Generierung natürlicher Sprache erfordert. Wenn das Atlas Reasoning Engine auf einen Knoten mit Aufforderungsanweisungen stößt, wird ein LLM-Aufruf ausgelöst. Andernfalls wird er deterministisch ausgeführt.
Das folgende Beispiel zeigt einen Unteragenten für Produkte und Services. Bei den Anweisungen handelt es sich um eine mehrzeilige Eingabeaufforderung, mit der die LLM informiert wird, wie sie antworten, wann sie Informationen nachschlagen und wie sie mit Mehrdeutigkeiten umgehen soll. Dies ist das richtige Muster, wenn der Bereich der möglichen Benutzereingaben zu breit ist, um sie mit bedingter Logik zu antizipieren, oder wenn die Qualität der Antwort von der Fähigkeit des LLM abhängt, den Kontext zu interpretieren und eine natürliche Antwort zu generieren.
Die Aufforderungsanweisungen für einen Knoten lösen den LLM-Aufruf aus. Das ist kein Zufall – es ist der Mechanismus, mit dem das Agentenskript die LLM-Grenze explizit und erzwingbar macht, statt sie der Laufzeitableitung zu überlassen.
Dieser Unteragent zeigt deterministische Logik und LLM-Übergabe in Aktion.
Die dreistufige Ausführungs-Pipeline
Der Agentforce Builder und das Agentenskript sind die Erstellungsebene, das Agentendiagramm und das Atlas Reasoning Engine führen Ihren Agenten jedoch tatsächlich aus. Designbedingt ist keine dieser Komponenten für Sie direkt zugänglich. Durch die Trennung von Erstellung und Ausführung kann die Plattform deterministisches Verhalten unabhängig davon erzwingen, wie das Skript geschrieben wurde.
Die Pipeline durchläuft drei Phasen.
- Beim Autorisieren arbeiten Sie. Das Agentenskript ist für Menschen lesbar und kann in der Zeichenbereichsansicht oder in der Skriptansicht im Agentforce Builder bearbeitet werden. Dies ist die einzige Ebene, mit der Sie direkt interagieren.
- Bei der Kompilierung wandelt der Salesforce-Compiler Ihr Agentenskript in ein Agentendiagramm um, einen serialisierten Ausführungsplan, der für die maschinelle Ausführung optimiert ist und nicht für die menschliche Lesbarkeit. Sie debuggen nicht auf dieser Ebene. Durch die Kompilierung wird eine Darstellung erstellt, die die Laufzeit effizient durchlaufen kann.
- Bei der Laufzeitausführung übernimmt das Atlas Reasoning Engine. Er liest das Agentendiagramm, traversiert es anhand des aktuellen Sitzungsstatus und entscheidet bei jedem Knoten, ob er deterministisch ausgeführt werden soll oder ob er das LLM aufruft. Das Modul erzwingt hier explizit Guard-Klauseln und die bedingte Weiterleitung, statt daraus zu schließen.
Agentendiagramm
Das Agentendiagramm ist die Zwischendarstellung zwischen Ihrem für Menschen lesbaren Skript und der tatsächlichen Laufzeitausführung. Seine Struktur ist für die State Machine optimiert, die es verwendet, nicht für den Architekten, der das Skript erstellt hat. Das Verständnis, dass es vorhanden ist und was es darstellt, ist wichtig, da es das Artefakt ist, das das Argumentationsmodul zum Erzwingen des Ausführungsplans verwendet, den Ihr Skript definiert.
Atlas-Urteilsmodul
Das Atlas Reasoning Engine ist ein State Machine Executor. In jedem Zug wird das Agentendiagramm anhand des Sitzungsstatus traversiert, deterministische Knoten werden als Code ausgeführt und LLM-Aufrufe werden nur ausgelöst, wenn Aufforderungsanweisungen vorhanden sind. Außerdem werden Schutzklauseln erzwungen und die bedingte Weiterleitung verarbeitet. Das Argumentationsmodul ist der Ort, an dem das hybride Argumentationsmodell tatsächlich implementiert ist. Das Skript definiert die Grenze und das Modul berücksichtigt sie.
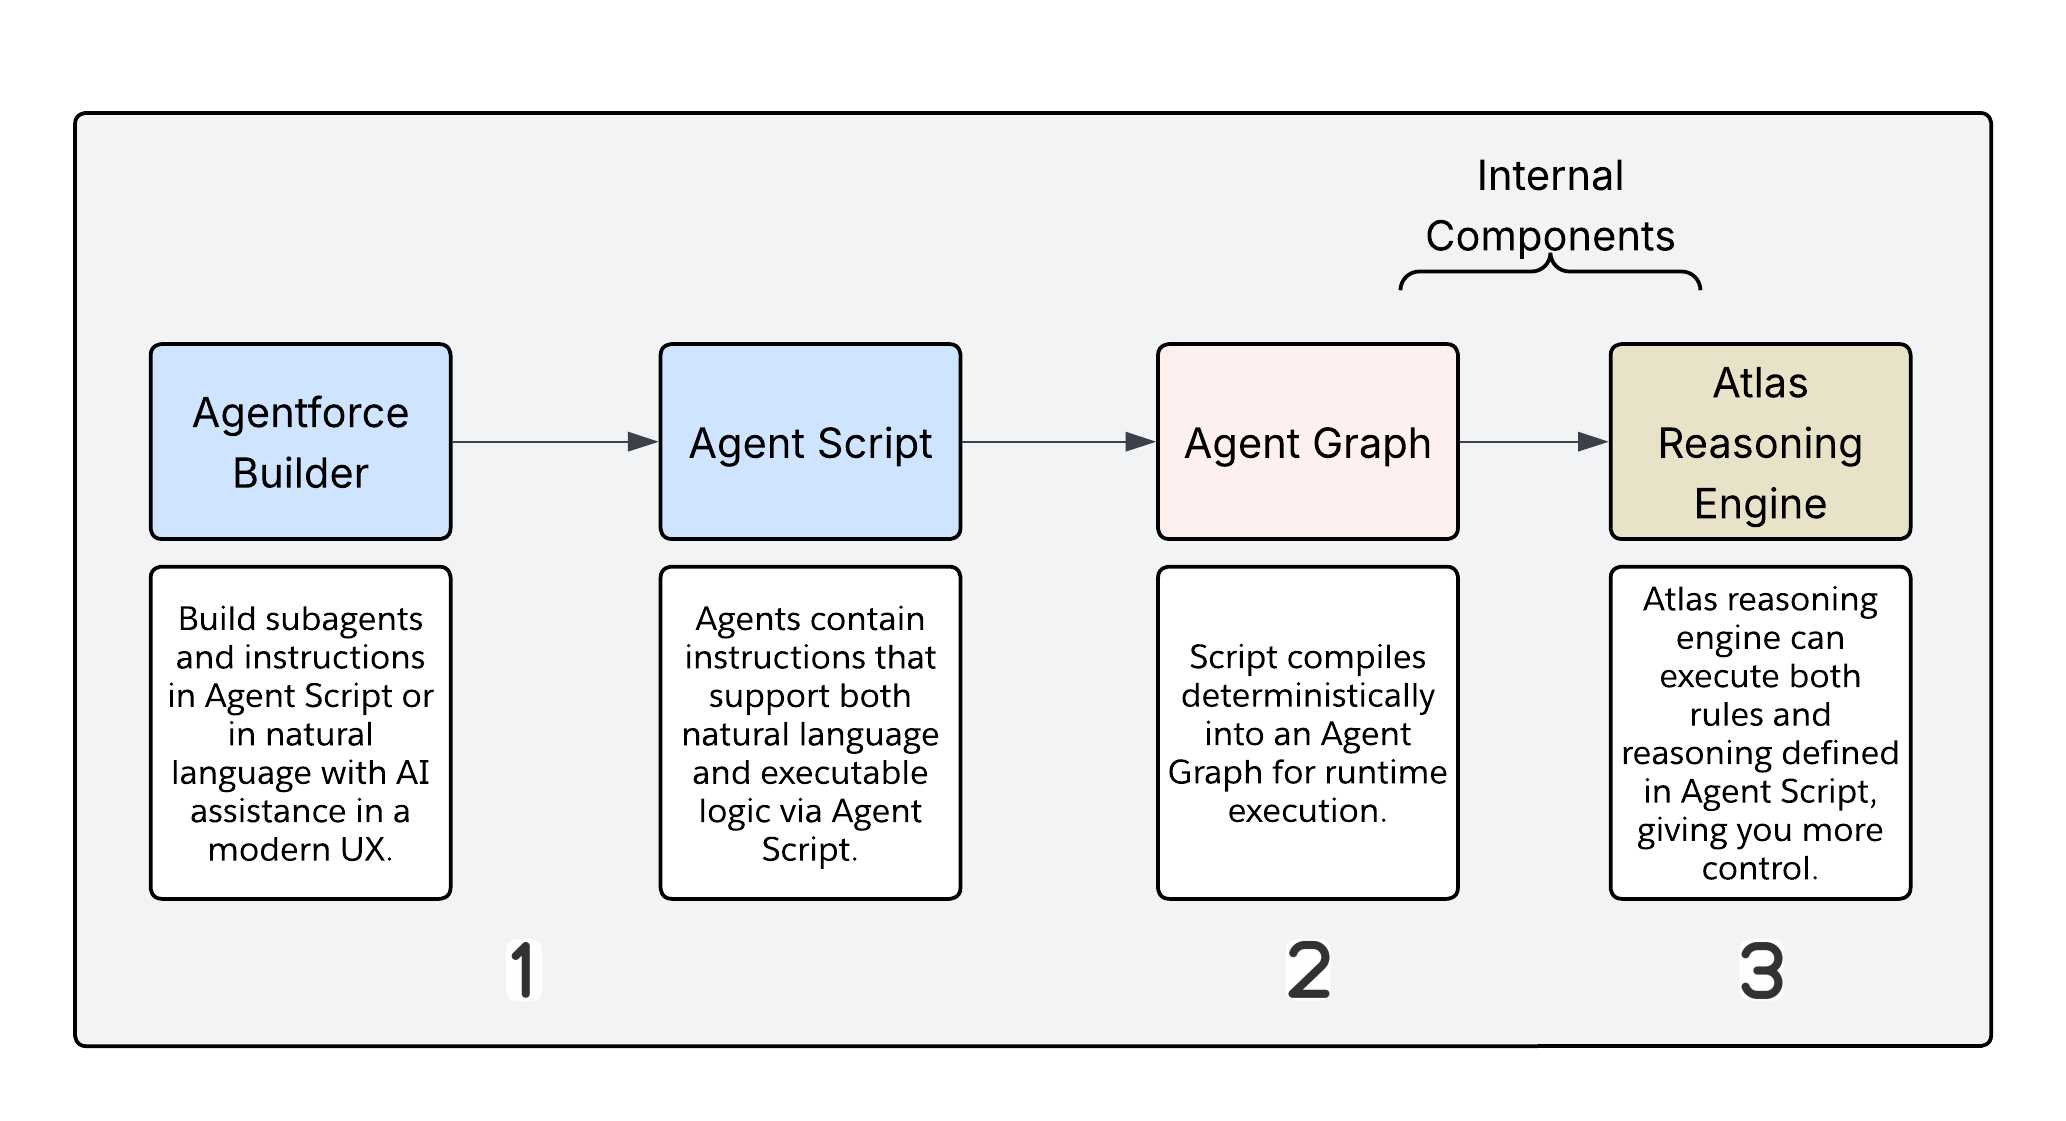
Das Agentendiagramm ist kein LLM-Wrapper. Es ist ein hybrides Argumentationsmodul, das die deterministische Ausführung von der probabilistischen Argumentation trennt. Die Regel ist einfach: Wenn Sie eine Entscheidung als Code ausdrücken können, sollte sie als Logik geschrieben werden. Wenn für die Entscheidung Urteile, Interpretationen oder die Generierung natürlicher Sprache erforderlich sind, sollte das LLM dies übernehmen. Diese Entwurfsentscheidung ist die wichtigste architektonische Entscheidung im neuen Agentforce Modell. Wo die LLM-Grenze fällt, wirkt sich direkt auf die Kosten, die Latenz, die Überprüfbarkeit und die Zuverlässigkeit Ihrer Lösung aus.
Das Atlas Reasoning Engine wertet jeden eingehenden Benutzerzug aus und leitet ihn über einen von zwei Pfaden weiter.
Pfad A: Deterministische Ausführung
Dieser Pfad weist keine LLM-Belastung auf. Er verhält sich wie kompilierter Code zur Laufzeit. Das Argumentationsmodul klassifiziert den Intent des Benutzers und bestimmt, ob eine Logikanweisung übereinstimmt, wobei das LLM vollständig umgangen wird. Das kompilierte Agentenskript wird von oben nach unten ausgeführt, wobei If-else-Regeln bei jedem Zug bedingungslos ausgeführt werden. Flow-, Apex- oder API-Aktionen werden mit deterministischen Parametern aufgerufen, ohne dass eine Aufforderungszusammenstellung oder ein Modellaufruf erforderlich ist. Das Ergebnis wird mit vollständiger Überprüfungsprotokollierung durch die Trust Layer zurückgegeben.
Pfad B: LLM-Überlegungen
Das Argumentationsmodul geht diesen Weg, wenn es Intent nicht allein mit Logikanweisungen auflösen kann. Sie durchläuft das Agentendiagramm und wertet jeden Knoten aus. Knoten mit Aufforderungsanweisungen lösen einen LLM-Aufruf aus. Knoten ohne sie werden deterministisch ausgeführt. Das Vorhandensein einer Aufforderungsanweisung ist der Auslöser und wird im Skript explizit angegeben und nicht zur Laufzeit abgeleitet.
Was einen LLM-Aufruf auslöst
Es gibt acht Punkte im Ausführungslebenszyklus, an denen die LLM aufgerufen wird. Die Subagent-Klassifizierung oder die Entscheidung, welcher Subagent mit der Anforderung des Benutzers übereinstimmt, ist eine, obwohl ein Kurzschlusspfad den vollständigen LLM-Aufruf umgehen kann, wenn die Klassifizierung eindeutig ist. Die Agentenüberlegungen, bei denen der Agent entscheidet, welche Aktion als Nächstes ausgeführt werden soll, werden immer durch die LLM geleitet. Ebenso die Generierung von Antworten, bei denen die endgültige Antwort aus einer Eingabeaufforderung mit Hydratisierung zusammengesetzt wird.
Die restlichen Auslöser sind funktionsfähiger: Die Integritätsvalidierung bestätigt, dass die Ausgabe auf abgerufenen Daten basiert. Die Aktionssimulation emuliert Antworten in der Umgebung “Vorschau” und “Simulieren”, statt sie live auszuführen. Die strukturierte Ausgabegenerierung verarbeitet Fälle, in denen die Antwort einem definierten Schema entsprechen muss.
Was bleibt deterministisch
Die Diagrammtraversierung und Statusumstellungen beinhalten niemals die LLM. Die Lebenszyklusblöcke before_reasoning und after_reasoning werden deterministisch ausgeführt, solange sie nur Aktionsknoten ohne Aufforderungsanweisungen enthalten. Mathematik, Datenabruf, Validierung und bedingte Logik gehören alle in Code. Alle Aktionen, die Flow, Apex oder eine REST-API ausführen, bleiben direkt auf dem deterministischen Pfad. Alle Knoten ohne Aufforderungsanweisungen werden ohne LLM-Aufruf ausgeführt.
Es ist wichtig, dass Sie diese Grenze zu Ihrem Team explizit festlegen. Jeder unnötige LLM-Aufruf erhöht Latenz, Kosten und Variabilität. Architekten sollten standardmäßig deterministische Logik übertragen und die LLM für Kundenvorgänge reservieren, bei denen die Aufgabe tatsächlich ihre Argumentationsfunktion erfordert.
Gestaltungsanleitung: Push-Logik standardmäßig auf Code
Verwenden Sie Anweisungen zur Logik des Agentenskripts, wenn Sie Aufforderungsanweisungen schreiben, die als Bedingung, Variablenzuweisung oder Aktionsfilter ausgedrückt werden könnten. Jeder unnötige LLM-Aufruf erhöht Latenz, Kosten und Variabilität.
Die Standardposition sollte deterministisch sein. Isolieren Sie jedes Agentenverhalten, das in der Regel kodiert werden kann, und verschieben Sie es in das Agentenskript. Die verbleibenden Aufgaben, die eine Synthese natürlicher Sprache, kontextbezogene Beurteilung oder komplexe Interpretation erfordern, gehören zu Knoten mit Eingabeaufforderungen. Das ist keine Einschränkung, sondern die Grenze funktioniert wie vorgesehen. Der LLM verarbeitet, wofür er am besten geeignet ist, und alles andere wird als Code ausgeführt.
Die primäre Ausführungseinheit im Agentenskript ist nicht der Benutzerzug. Es ist die Parse: einen einzelnen vollständigen Zyklus durch die drei Lebenszyklusblöcke eines Unteragenten. Das Atlas Reasoning Engine initiiert jedes Mal eine Analyse, wenn ein Unteragent etwas verarbeiten muss. Dies geschieht in drei Situationen: bei der ersten Eingabe im Unteragenten, nach jedem Tool-Aufruf, wenn eine Aktion abgeschlossen ist und ein Ergebnis zurückgibt, und bei jedem neuen Benutzer innerhalb desselben Unteragenten.
Das Verständnis der Parse-Grenze ist wichtig, da sie bestimmt, wie oft jeder Block ausgeführt wird und wo Sie sich daher darauf verlassen können, dass ein bestimmter Teil der Logik genau einmal ausgeführt wird.
Jeder Unteragent definiert drei Ausführungszonen:
| Blockieren | Wenn sie ausgeführt wird | LLM-Beteiligung |
|---|---|---|
before_reasoning | Zu Beginn jeder Analyse, bevor die LLM etwas sieht | Keine |
reasoning | Während der deterministischen Auflösung vor LLM-Aufrufen | Gemischt |
after_reasoning | Nach Abschluss der Argumentation und Antwort des LLM | Keine (mit kritischen Einschränkungen) |
before_reasoning und after_reasoning sind vollständig deterministisch. Sie führen Aktionen aus, legen Variablen fest und wenden bedingte Logik an, ohne die LLM einzubeziehen. Dadurch sind sie die zuverlässigen, kostengünstigen Blöcke im Skript.
Anwendungszeitpunkt before_reasoning
before_reasoning wird ausnahmslos am Anfang jeder Analyse ausgeführt. Sie wird beim ersten Eingeben in den Unteragenten und erneut ausgeführt, nachdem sich jeder Tool-Aufruf oder jeder neue Benutzer innerhalb dieses Unteragenten gedreht hat. Ein run @actions.X in before_reasoning ist code. Im Gegensatz zu einer Anweisung innerhalb eines Aufforderungsblocks, der der LLM folgen kann, wird before_reasoning bedingungslos ausgeführt.
Verwenden Sie diesen Block für die Sitzungsinitialisierung: Abrufen von Kontextdatensätzen und Festlegen von Sitzungsvariablen aus Apex oder Flow. Hier gehören auch Authentifizierung und Anspruchsprüfungen hin, da Sie diese überprüfen möchten, bevor die LLM Tools sieht. Die Kontexthydrierung passt auch hier: Aufrufen einer Datenabrufaktion, damit der LLM vorab ausgefüllte Variablen empfängt, statt sie anfordern zu müssen. Alle Zähler- oder Überwachungsvariablen, die bei jeder Parse inkrementiert werden müssen, sollten hier festgelegt werden, da die before_reasoning set-Direktive so gewährleistet ist, dass dies bei einer Pipeline-Anweisung nicht der Fall ist.
Was hier nicht hingehört, ist Logik, die nur einmal pro Sitzung ausgeführt werden sollte, da before_reasoning bei jeder Parse und nicht nur beim ersten Eintrag ausgeführt wird. Alles, was von der Benutzereingabe aus dem aktuellen Zug abhängt, gehört ebenfalls nicht hierher, da diese Eingabe noch nicht verarbeitet wurde. Und Umstellungen sollten nie before_reasoning: sein Eine transition to-Anweisung löst hier bei jeder Parse bedingungslos aus und erstellt Schleifen.
Wenn Sie die Initialisierung einmal pro Sitzung benötigen, sollten Sie sie explizit schützen:
Ein Benutzerzug kann mehrere Parses auslösen: einmal bei der Eingabe, dann erneut nach jedem Tool-Aufruf. Diese Funktion hat drei praktische Konsequenzen: Initialisierungsaktionen in before_reasoning werden in Flows mit mehreren Aktionen mehrmals pro Benutzerzug ausgeführt, die hier inkrementierten Zählervariablen geben die Anzahl der Parses wieder, nicht die Anzahl der Parses, und Aktionen mit Nebenwirkungen, externen API-Aufrufen oder Datensatzschreibvorgängen sollten nicht in before_reasoning bleiben, es sei denn, die erneute Ausführung für jede Parses ist explizit zulässig.
before_reasoning ist kein Konstruktor. Es handelt sich um eine Vorabprüfung, die bei jeder Analyse ausgeführt wird. Gestalten Sie sie entsprechend.
Anwendungszeitpunkt after_reasoning
Die after_reasoning wird ausgeführt, sobald die Argumentationsschleife abgeschlossen ist, nachdem der LLM geantwortet hat und Aktionsausgaben erfasst wurden. Hier gehören deterministische Prüfungen nach der Aktion: Auswerten von Aktionsausgaben und Verzweigen anhand von Ergebnissen. Deterministische Übergänge oder das Wechseln zum nächsten Unteragenten auf der Grundlage des Variablenstatus statt des LLM-Urteils finden Sie hier. Ebenso die Variablenbereinigung vor dem nächsten Zug und die Orchestrierungssequenzierung, wenn Sie Unteragenten in einer vorhersehbaren Reihenfolge ohne LLM-Weiterleitungsentscheidung verketten müssen.
Behandeln Sie after_reasoning als Leitplankenebene. Hier erzwingen Sie Geschäftsregeln und die Verwaltung von Bundesstaaten, nachdem die LLM ihre Arbeit erledigt hat, und stellen sicher, dass wichtige Prozess-Flows vorhersehbar bleiben, unabhängig davon, was die LLM generiert hat.
is_displayable: True mit Bedacht verwenden
Jeder Architekt, der Orchestrierungs-Flows entwirft, muss dieses Plattformverhalten verstehen. Wenn is_displayable: True für eine Aktion festgelegt ist, verlässt die Plattform die Argumentationsschleife, sobald die LLM diese Ausgabe anzeigt. Diese Beendigung erfolgt sofort, d. h., after_reasoning wird nie ausgeführt.
Dies ist ein bekanntes Plattformverhalten, hat jedoch eine direkte Konsequenz für die Orchestrierung: Alle Logiken, die Sie in after_reasoning platziert haben, werden übersprungen, wenn eine anzeigbare Aktion Teil des Flows ist.
Die Antwort ist einfach. Verschieben Sie die Logik, die zuverlässig ausgeführt werden muss, in den before_reasoning des nachfolgenden Unteragenten und nicht in den after_reasoning des aktuellen.
Gestaltungsanleitung: Ort der Platzierung der Initialisierungslogik
Die Entscheidung, wo Logik platziert werden soll, ist beim Entwerfen eines Unteragenten von entscheidender Bedeutung. Dieses Framework deckt die häufigsten Szenarien ab:
| Szenario | Wohin damit? |
|---|---|
| Muss ausgeführt werden, bevor der LLM Kontext angezeigt wird | before_reasoning |
| Führt jede Parse aus, einschließlich der erneuten Eingabe bei neuen Benutzern | before_reasoning |
| Hängt von der Aktionsausgabe in diesem Zug ab | Bedingter if in reasoning |
| Erfordert deterministische Umstellung auf Subagenten basierend auf dem Ergebnis | after_reasoning (siehe is_displayable unten) |
Erfordert Orchestrierungslogik, wenn die nachgelagerte Aktion is_displayable: True verwendet | before_reasoning des nächsten Unteragenten |
| Verwendet Logik, die Urteils- oder Benutzerkontext erfordert | reasoning mit Aufforderungsanweisungen |
Das zugrunde liegende Prinzip ist einfach. Wenn Sie eine Aufforderungsanweisung schreiben, in der die LLM angewiesen wird, eine Aktion “immer auszuführen”, ist dies ein Vorschlag. Die LLM kann ihr je nach Kontext folgen, aber nicht. Wenn Sie eine run-Direktive in before_reasoning platzieren, ist dies Code. Sie wird ausnahmslos bei jeder Parse ausgeführt.
Bei der Verfügbarkeit von bedingten Aktionen handelt es sich um den Mechanismus, mit dem das Agentenskript Aktionen basierend auf dem Status der Laufzeitvariablen im LLM ein- oder ausblendet. Wenn die available when als false ausgewertet wird, wird die Aktion vollständig aus der Toolliste entfernt, die dem LLM angezeigt wird. Falsche Werte, einschließlich None, False, 0 oder einer leeren Zeichenfolge, unterdrücken die Aktion.
Dies ist keine Aufforderungsanweisung, die dem LLM sagt “Noch nicht aufrufen”, es ist ein hartes Gate auf Plattformebene. Der LLM kann keine Aktion aufrufen, auf die er nicht zugreifen kann.
In diesem Beispiel ist die execute_transfer für die LLM unsichtbar, bis die validation_passed als true ausgewertet wird. Das Gate wird von der Plattform erzwungen, nicht per Anweisung.
Gestaltungsanleitung: Legen Sie die Gate-Variable niemals über das LLM fest
Geben Sie jeder Variablen in einer available when einen deterministischen Codepfad an, der die Variable vor der Ausführung der zugeordneten Aktion festlegt. Verwenden Sie before_reasoning oder einen deterministischen run- und set, reasoning die Variable in einem bekannten Zustand zu halten. Wenn Sie sich beim Festlegen der Gate-Variablen auf die LLM verlassen, haben Sie die Variabilität, die das Gate verhindern soll, wieder eingeführt. Abhängig von der Unterhaltung kann die LLM sie festlegen, aber nicht, d. h., das Gate kann geöffnet werden oder nicht.
Das Problem der Aktionsschleife
Eine Aktionsschleife tritt auf, wenn der LLM dieselbe Aktion wiederholt aufruft, ohne jemals einen Endstatus zu erreichen. Dies geschieht, wenn zwei Bedingungen gleichzeitig wahr sind: die available when-Bedingung nach der Ausführung der Aktion weiterhin erfüllt ist und die Argumentationsanweisungen den LLM nicht explizit auffordern, den Aufruf einzustellen.
Die Plattform unterdrückt eine Aktion nicht automatisch, nachdem sie aufgerufen wurde. Wenn das Gate geöffnet bleibt und die Argumentationsanweisungen mehrdeutig sind, ruft das LLM unbegrenzt dieselbe Aktion für jede Parse auf.
Sehen Sie sich available when @variables.interest != "" als Beispiel an. Wenn die Aktion ausgeführt wird, die Interessenvariable jedoch nicht leer ist, bleibt das Gate bei der nächsten Analyse geöffnet. Der LLM sieht die Aktion als verfügbar an, hat keine Anweisung zum Anhalten und ruft sie erneut auf.
Es gibt zwei zuverlässige Möglichkeiten, die Schleife zu durchbrechen. Die erste besteht darin, die Gate-Variable als Teil der Logik nach der Ausführung der Aktion auf einen geschlossenen Zustand zu setzen, damit available when bei der nächsten Analyse als false ausgewertet wird. Die zweite besteht darin, einen separaten booleschen has_run zu verwenden, der das Gate nach der ersten Ausführung schließt. Beide Ansätze verleihen dem Gate einen deterministischen geschlossenen Zustand, d. h. die Bedingung, die die Plattform benötigt, um die Aktion zu unterdrücken.
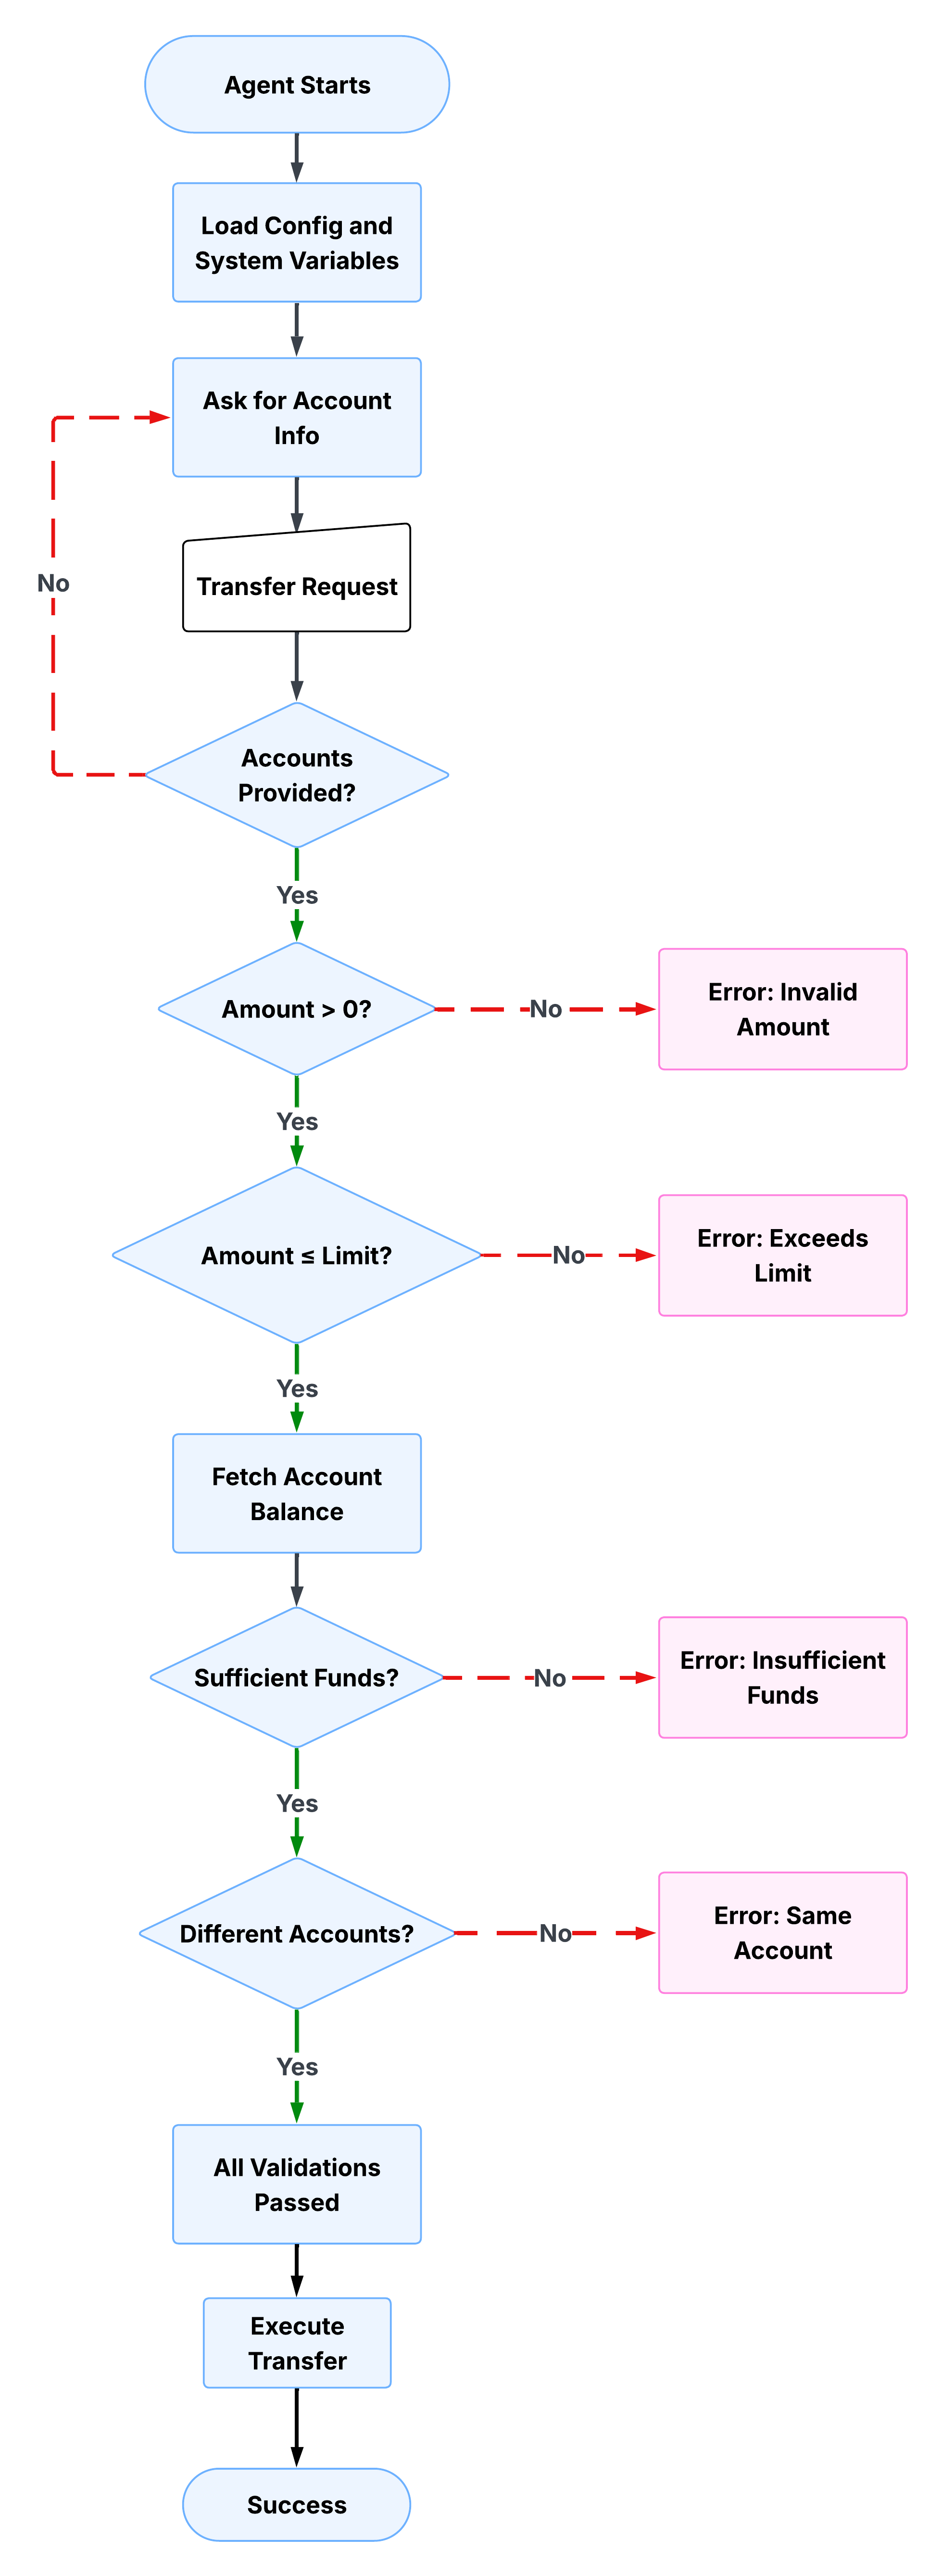
Eine Banküberweisung ist eine nützliche Linse, um zu verstehen, wie diese Muster in der Praxis funktionieren. Der Workflow sieht von außen einfach aus: Geld von einem Konto auf ein anderes verschieben. Die Implementierung erfordert mehrere komplexe Schritte. Bevor die Übertragung ausgeführt wird, muss der Agent Accountdetails erfassen, den Betrag validieren, Übertragungsobergrenzen überprüfen, den verfügbaren Saldo bestätigen und erst dann die Übertragungsaktion offenlegen. Jeder Schritt hängt von den vorherigen Schritten ab. Keiner von ihnen sollte dem LLM-Urteil überlassen werden.
Erfassen und Validieren von Eingaben
Der erste Unteragent erfasst den Quellaccount, den Zielaccount und den Übertragungsbetrag vom Benutzer. Sie wird erst fortgesetzt, wenn alle drei vorhanden und gültig sind. Das Agentenskript überprüft jedes Feld in der Reihenfolge: Wenn der Quellaccount fehlt, wird gefragt. Wenn das Ziel fehlt, wird danach gefragt. Wenn der Betrag null oder negativ ist, wird gefragt. Die Variable validation_passed wird erst dann auf true festgelegt, wenn alle Prüfungen eindeutig sind.
Das folgende Skript zeigt dies in der Praxis. Beachten Sie, dass “validation_passed” an jedem Fehlerpunkt explizit auf “false” festgelegt ist und die LLM angewiesen wird, nicht fortzufahren. Die deterministischen Überprüfungen werden bedingungslos ausgeführt, während die Aufforderungsanweisungen die benutzerseitige Antwort verarbeiten.
Geschäftsregeln erzwingen
Nachdem der Agent Eingaben validiert hat, wird überprüft, ob der Übertragungsbetrag die konfigurierte Übertragungsobergrenze überschreitet. Hier werden Geschäftsregeln zu Code und nicht zu Anweisungen. Die Obergrenze ist nicht etwas, was die LLM begründet. Sie ist ein harter Schwellenwert, der im Skript definiert und bei jeder Analyse deterministisch überprüft wird.
Wenn der Betrag die Obergrenze überschreitet, wird validation_passed wieder auf false zurückgesetzt und der Benutzer hat drei Optionen: Übertragen Sie den maximal zulässigen Betrag, teilen Sie ihn in mehrere Übertragungen auf oder wenden Sie sich an den Support, um höhere Obergrenzen zu erhalten. Der Agent kann erst fortfahren, nachdem der Benutzer die Ausnahme behoben hat. Beachten Sie, dass die Aufforderungsanweisung hier genau das tut, wofür sich die LLM-Überlegungen eignen: Anzeigen von Optionen in einer Unterhaltung und Verarbeiten der Antwort des Benutzers. Die Geschäftsregel selbst ist deterministisch, die Unterhaltung darum jedoch nicht.
Das folgende Skript zeigt, wie die Obergrenzenüberprüfung funktioniert. Die deterministische Bedingung wertet den Übertragungsbetrag anhand der Obergrenzenvariablen aus, legt die validation_passed auf false fest, wenn der Schwellenwert überschritten wird, und delegiert sie an eine Aufforderung, die benutzerseitige Antwort zu verarbeiten.
Anwenden von Schutzklauseln
Nach Abschluss der Betrags- und Obergrenzenüberprüfungen ruft der Agent den Quellaccountsaldo ab und bestätigt, dass genügend Mittel verfügbar sind. Schutzklauseln verhindern, dass der Agent Vorgänge ausführt, wenn die Voraussetzungen nicht erfüllt sind. Im Gegensatz zu einer Aufforderungsanweisung, die die LLM anweist, den Saldo zu überprüfen, wird die Prüfung durch eine Guard-Klausel im Agentenskript bedingungslos. Der LLM entscheidet nicht, ob er ausgeführt werden soll.
Wenn der Saldo nicht ausreicht, berechnet der Agent den Engpass und stellt dem Benutzer eine konkrete Alternative bereit. “validation_passed” ist auf “false” festgelegt, bis diese Überprüfung bestanden ist, d. h., die Übertragungsaktion bleibt gegatet.
Das folgende Skript zeigt einen Aufruf der deterministischen Aktion, der den Saldo abruft, gefolgt von einer bedingten Überprüfung, die ihn auswertet. Der Abruf wird nur ausgeführt, wenn der Saldo noch nicht abgerufen wurde, wodurch redundante API-Aufrufe bei nachfolgenden Parsen vermieden werden.
Oberflächenfehler deutlich
Schutzklauseln legen den Status fest. Fehlermeldungen kommunizieren dies. Wenn es sich bei validation_passed um false handelt, muss der Agent dem Benutzer genügend Informationen bereitstellen, um das Problem ohne Neustart zu beheben. Vage Fehlermeldungen verursachen Reibung, strukturierte schließen die Schleife schneller.
Im folgenden Skript wird die Fehlermeldung “Nicht ausreichende Mittel” in der Praxis angezeigt. Dadurch wird dem Benutzer nicht nur mitgeteilt, dass die Übertragung fehlgeschlagen ist. Sie zeigt den verfügbaren Saldo, den angeforderten Betrag und den berechneten Fehlbetrag an und bietet einen konkreten nächsten Schritt, der alle aus Sitzungsvariablen zusammengesetzt und nicht durch die LLM generiert wird.
Die Berechnung des Engpasses erfolgt im Skript, nicht im LLM. Die vorgeschlagene Alternative, die Übertragung des verfügbaren Saldos, wird deterministisch aus dem Sitzungsstatus abgeleitet. Die Rolle des LLM ist hier rein präsentativ: es stellt eine Nachricht bereit, die das Skript bereits strukturiert hat.
Gate der Übertragungsaktion
Bei jeder Validierungsprüfung in den vorhergehenden Schritten wird dieselbe Variable festgelegt oder gelöscht: validation_passed. Diese Variable erledigt nun ihre wichtigste Aufgabe. Die execute_transfer ist bedingt verfügbar, d. h., sie wird nur in der Toolliste des LLM angezeigt, wenn validation_passed true ist. Die Aktion ist aus der Perspektive des LLM erst vorhanden, nachdem jede vorherige Prüfung bestanden und diese Variable festgelegt wurde.
Dies ist das Muster aus dem früheren Gate-Abschnitt, das auf einen Produktions-Workflow angewendet wurde. Die Übertragungsaktion wird nicht durch eine Aufforderungsanweisung ausgeblendet. Sie wird von der Plattform ausgeblendet. Kein großer Unterhaltungsdruck oder eine mehrdeutige Formulierung kann dazu führen, dass der LLM ihn aufruft, bevor die Voraussetzungen erfüllt sind.
Das folgende Skript zeigt, wie das Gate konfiguriert ist. Die available when-Klausel verweist direkt auf validation_passed und die Aktionsparameter sind an die in den vorherigen Schritten erfassten und validierten Sitzungsvariablen gebunden.
Alle drei Parameter from_account, to_account und amount werden deterministisch aus Sitzungsvariablen übergeben. Wenn diese Aktion verfügbar ist, wurde jeder Wert validiert. Der LLM stellt die Parameter nicht aus dem Unterhaltungskontext zusammen, sondern liest sie aus dem Status.
Verfolgen des Status im gesamten Workflow
Die Muster in den vorherigen Abschnitten funktionieren nur, da der Sitzungsstatus über den gesamten Workflow hinweg beibehalten wird. Die im ersten Schritt erfassten Accountnummern sind im vierten Schritt verfügbar. Validierungsergebnisse, die in einer Check-Gate-Aktion in einer anderen festgelegt sind. Die Unterhaltung kann abweichen, der Benutzer kann Folgefragen stellen und der Agent weiß weiterhin genau, wo er sich im Prozess befindet.
Der Variablenblock unten zeigt den vollständigen Sitzungsstatus für diesen Workflow an. Jede Variable verfügt über einen definierten Typ, einen Standardwert und eine Beschreibung. Zwei Variablen übernehmen den Großteil der Orchestrierungsarbeit: validation_passed steuert die Aktionsverfügbarkeit bei jedem Gate und validation_information enthält einen für Menschen lesbaren Kontext darüber, warum eine Überprüfung fehlgeschlagen ist. Dieser kann dem Benutzer angezeigt werden, ohne dass er sich über den zugrunde liegenden Zustand Gedanken machen muss.
Jede Variable beginnt in einem bekannten Standardstatus. Zeichenfolgen sind standardmäßig leer, Zahlen auf null und validation_passed boolesch auf false. Das bedeutet, dass das Gate standardmäßig geschlossen ist. Der Workflow muss sich das Recht verdienen, bei jedem Schritt aktiv fortzufahren, statt das Tor zu öffnen und sich auf Prüfungen zum Schließen zu verlassen.
Das Beispiel für eine Banküberweisung zeigt, wo deterministische Logik das richtige Tool ist, aber nicht immer die beste Wahl. Das Verständnis der Grenze ist ebenso wichtig wie das Verständnis der Muster.
Deterministische Logik ist die richtige Wahl, wenn für den Workflow eine garantierte Ausführungsreihenfolge erforderlich ist, wenn Fehler erhebliche Folgen haben, wenn der Prozess einen reproduzierbaren Überprüfungsprotokoll erstellen muss oder wenn Geschäftsregeln gut genug definiert sind, um als Bedingungen und Schwellenwerte ausgedrückt zu werden. Finanz-, Gesundheits- und Versicherungs-Workflows fallen im Allgemeinen in diese Kategorie.
Reine LLM-Überlegungen ohne strenge deterministische Einschränkungen sind sinnvoller, wenn der Wert der Interaktion in Flexibilität und nicht in Präzision liegt. Offener Kundensupport, Produkte in der Anfangsphase, bei denen sich Geschäftsprozesse noch weiterentwickeln, und Informationsabfragen mit geringer Beteiligung sind allesamt Fälle, in denen die Variabilität der LLM-Überlegungen ein Merkmal und kein Problem ist.
In der Praxis benötigen die meisten Produktionsagenten beides. Die Entscheidung, wo die Grenze liegt, ist keine binäre Entscheidung zwischen deterministisch und probabilistisch, sondern eine Designentscheidung, die Sie auf Knotenebene für jeden Teil des Workflows Ihres Agenten treffen.
| Deterministische Logik verwenden für | Verwenden von LLM-Überlegungen für |
|---|---|
| Eingabevalidierung und -bereinigung | Natürliches Sprachverständnis und Intent-Erkennung |
| Durchsetzung von Geschäftsregeln | Generieren von gesprächigen, einfühlsamen Antworten |
| Sequenzielle Prozessorchestrierung | Umgang mit mehrdeutigen oder unerwarteten Eingaben |
| Bundesstaatsverwaltung und Kontexterhaltung | Bereitstellen von Erläuterungen und Klarstellungen |
| Schutzklauseln, die ungültige Vorgänge verhindern | Anpassen von Ton und Messaging an den Benutzerkontext |
Die Grenze ist die Designentscheidung
Das Beispiel für eine Banküberweisung veranschaulicht eine Designphilosophie: dass die Grenze zwischen deterministischer Ausführung und LLM-Überlegungen die folgenreichste architektonische Entscheidung ist, die Sie beim Erstellen eines Produktionsagenten treffen.
Platzieren Sie eine Grenze, die zu starr ist, und Sie erhalten einen Agenten, der starr, teuer in der Wartung und nicht in der Lage ist, die natürliche Variation realer Unterhaltungen zu verarbeiten. Wenn Sie die Grenze in die andere Richtung verfehlen, entsteht ein Agent, der flexibel, aber unvorhersehbar ist, bei Tests gut abschneidet, sich in der Produktion jedoch anders verhält und keinen zuverlässigen Prüfpfad erstellen kann oder bei einer Transaktion mit hohem Einsatz vertrauen kann.
Das neue Agentforce Modell bietet Ihnen die Tools, um diese Grenze bewusst zu platzieren. Mit Agentenskript können Sie deterministische Logik und Aufforderungsanweisungen in derselben Datei ausdrücken, mit einer expliziten Syntax, um die Grenze sichtbar zu machen. Das Atlas Reasoning Engine erzwingt Logik und Aufforderungen zur Laufzeit. Die Blöcke before_reasoning und after_reasoning bieten Ihnen garantierte Ausführungszonen auf beiden Seiten des LLM-Aufrufs. Die Verfügbarkeit von bedingten Aktionen stellt sicher, dass die LLM nur dann handeln kann, wenn die Voraussetzungen erfüllt sind.
Keine dieser Funktionen ist isoliert. Gemeinsam entwickeln sie eine kohärente Architektur für die Erstellung von Agenten, denen Unternehmen bei geschäftskritischen Workflows Trust schenken können. Das hybride Argumentationsmodell erkennt, dass Determinismus und Flexibilität in Ihrer Architektur eine Rolle spielen. Es ist die Aufgabe des Architekten, genau zu entscheiden, wo die einzelnen Elemente gelten.
Agentendiagramm von Agentforce: Hin zu geführtem Determinismus mit hybrider Argumentation
Gulal Kumar ist Software-Entwickler bei Salesforce und verfügt über mehr als 20 Jahre Erfahrung. Seine Expertise erstreckt sich auf AI, Integration, APIs und Unternehmensarchitektur, wobei er sich darauf konzentriert, die Geschäftstransformation durch sichere, belastbare und innovative AI-Lösungen voranzutreiben. Verbinden Sie sich mit ihm über LinkedIn.
Miriam McCabe ist Senior Director und Leiter des Teams “Architekt Evangelisation”. Ihre Arbeit konzentriert sich darauf, die globale Salesforce-Architekten-Community durch fundierte technische Inhalte, Live-Programmierung und Community-Engagement in die Lage zu versetzen, im Zeitalter der Agenten führend zu sein. Folgen Sie ihr auf LinkedIn.